> ## Content Index
> Fetch the complete content index at: https://arabroot.io/llms.txt
> Use this file to discover other available public pages before exploring further.
# أنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwright
- URL: https://arabroot.io/articles/انواع-الاختبارات-للمبتدئين-unit-و-integration-و-e2e/
- Published: 2026-10-05T19:30:00.000Z
- Updated: 2026-10-09T09:42:50.000Z
- Description: ما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
- Author: فريق عرب رووت
- Tags: الأدلة التقنية, DevOps والتشغيل, DevOps وCI/CD, الاستضافة الذاتية
لنفرض أنك أصلحت خطأ في صفحة الطلبات الأسبوع الماضي، ثم جاء زميلك اليوم وعدل دالة صغيرة في مكان آخر من الكود، فعاد الخطأ نفسه إلى الإنتاج Production دون أن يلاحظه أحد، لأن أحداً لم يفتح صفحة الطلبات بعد هذا التعديل. ومع تكرار هذا الموقف يبدأ الفريق في الخوف من الكود نفسه، فلا أحد يريد أن يلمس الدالة القديمة التي تعمل «بطريقة ما»، وكل تعديل بسيط يحتاج يوماً كاملاً من النقر في الصفحات قبل النشر. والحل الذي تستخدمه الفرق لهذه المشكلة هو **الاختبارات الآلية Automated Tests**، أي كود يتحقق من كودك في كل مرة يتغير فيها، وفي الأمر تفاصيل كثيرة، فهناك أنواع كثيرة من الاختبارات ولكل منها ما يكشفه وما يفوته، وهناك أدوات مفتوحة المصدر لكل نوع منها.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي أن تفتح التطبيق وتنقر فيه قبل كل نشر، وما الذي يضيفه الاختبار الآلي في خط CI.
- أنواع الاختبارات واحداً واحداً: الوحدة Unit والتكامل Integration والعقد Contract وال API والنهاية إلى النهاية E2E والدخان Smoke والانحدار Regression والقبول Acceptance والاختبار المرئي Visual والأداء والأمان والاختبار الاستكشافي، مع ما يكشفه كل نوع وما يفوته وسرعته وتكلفته.
- البدائل Test Doubles مثل Mock وStub وFake، والاختبارات المتقلبة Flaky Tests ولماذا تحدث.
- هرم الاختبارات وكأس الاختبارات، وكيف يختار فريق صغير مزيجاً معقولاً منها، وماذا تعني نسبة تغطية الكود Code Coverage.
- الأدوات مفتوحة المصدر لكل طبقة بتراخيصها، ثم Playwright بالتفصيل ومقارنته مع Cypress وSelenium.
- أين يعمل كل نوع في خط CI، ثم تجربة عملية على تطبيق صغير فيه اختبارات وحدة وتكامل وAPI وE2E، نكسر فيها الكود ثلاث مرات ونرى أي طبقة تكشف كل خطأ، ثم اختبار متقلب وإصلاحه.
## لماذا نكتب الاختبارات أصلاً؟
### النقر اليدوي قبل كل نشر
الطريقة الأولى التي يبدأ بها كل فريق هي أن يفتح أحدهم التطبيق قبل النشر، فيسجل الدخول ويضيف عنصراً ويحذف آخر، ثم يقول «يعمل». وهذه الطريقة مفيدة في البداية لكنها تفشل لأسباب واضحة، فهي بطيئة وتأخذ وقتاً يزيد مع كل ميزة جديدة، وهي غير مكتملة لأن الإنسان يختبر ما يتذكره فقط ويختبر عادة الطريق السعيد Happy Path الذي يعرف أنه يعمل، وهي غير قابلة للتكرار لأن ما فعله اليوم ليس بالضرورة ما يفعله غداً، والأهم أنها تحدث في نهاية العمل، أي بعد أن أصبح الخطأ مدفوناً تحت تغييرات كثيرة لا تعرف أيها السبب.
والحل الأول الذي يخطر على البال هو أن يكتب الفريق قائمة خطوات مكتوبة Test Plan يتبعها من يختبر قبل كل إصدار، وهذا أفضل لأنه يجعل الاختبار متكرراً، لكنه ما زال بطيئاً ويعتمد على صبر من ينفذه، ومع خمسين خطوة وإصدار كل يوم فسوف تجد أن الخطوات تختصر شيئاً فشيئاً حتى تختفي.
### الاختبار الآلي في خط CI
الحل الأنسب هو أن تتحول هذه الخطوات إلى كود يعمل آلياً على كل تغيير، فعندما يفتح المطور طلب دمج Pull Request يشغل خط CI الاختبارات كلها خلال دقائق، فإذا فشل اختبار عرف المطور الخطأ وهو ما زال يتذكر ما كتبه، ولا يدمج الكود حتى ينجح. وقد ذكرنا في [CI سريع على كل commit وكل طلب دمج](https://arabroot.io/articles/%D8%A7%D9%84%D8%AA%D8%B7%D9%88%D9%8A%D8%B1-%D8%B9%D9%84%D9%89-%D8%A7%D9%84%D9%81%D8%B1%D8%B9-%D8%A7%D9%84%D8%B1%D8%A6%D9%8A%D8%B3%D9%8A-trunk-based/#fast-ci) أن الدمج اليومي في main لا يكون آمناً إلا بهذه الاختبارات، وتوصي [صفحة DORA عن أتمتة الاختبارات](https://dora.dev/capabilities/test-automation/?ref=arabroot.io) بأن يحصل المطور على نتيجة الاختبارات الآلية في أقل من عشر دقائق على جهازه وفي خط CI، وبألا يتسامح الفريق مع الاختبارات المتقلبة، والسبب أن الاختبار الذي لا تثق في نتيجته لا يحميك من شيء.
وقد يتساءل البعض: هل يعني هذا أن الاختبار اليدوي انتهى؟ والإجابة لا، فالآلة جيدة في تكرار ما تعرفه، أما الإنسان فهو الأفضل في اكتشاف ما لم يخطر على بال أحد، لذلك يبقى الاختبار الاستكشافي Exploratory Testing الذي نشرحه بعد قليل، أما الخطوات المتكررة نفسها فمكانها الكود.
## أنواع الاختبارات واحداً واحداً
أسماء أنواع الاختبارات ليست موحدة بين الفرق، فما يسميه فريق «اختبار تكامل» قد يسميه فريق آخر «اختبار خدمة»، ويعترف بذلك [مقال The Practical Test Pyramid](https://martinfowler.com/articles/practical-test-pyramid.html?ref=arabroot.io) الذي كتبه Ham Vocke على موقع Martin Fowler، لذلك لا تتوقف عند الاسم كثيراً، وانظر إلى ما يشغله الاختبار فعلاً من تطبيقك. والصورة التالية تبين تطبيقاً صغيراً من متصفح و API ودالة منطق ومستودع بيانات Repository وقاعدة بيانات، والجزء الذي يلمسه كل نوع منه:
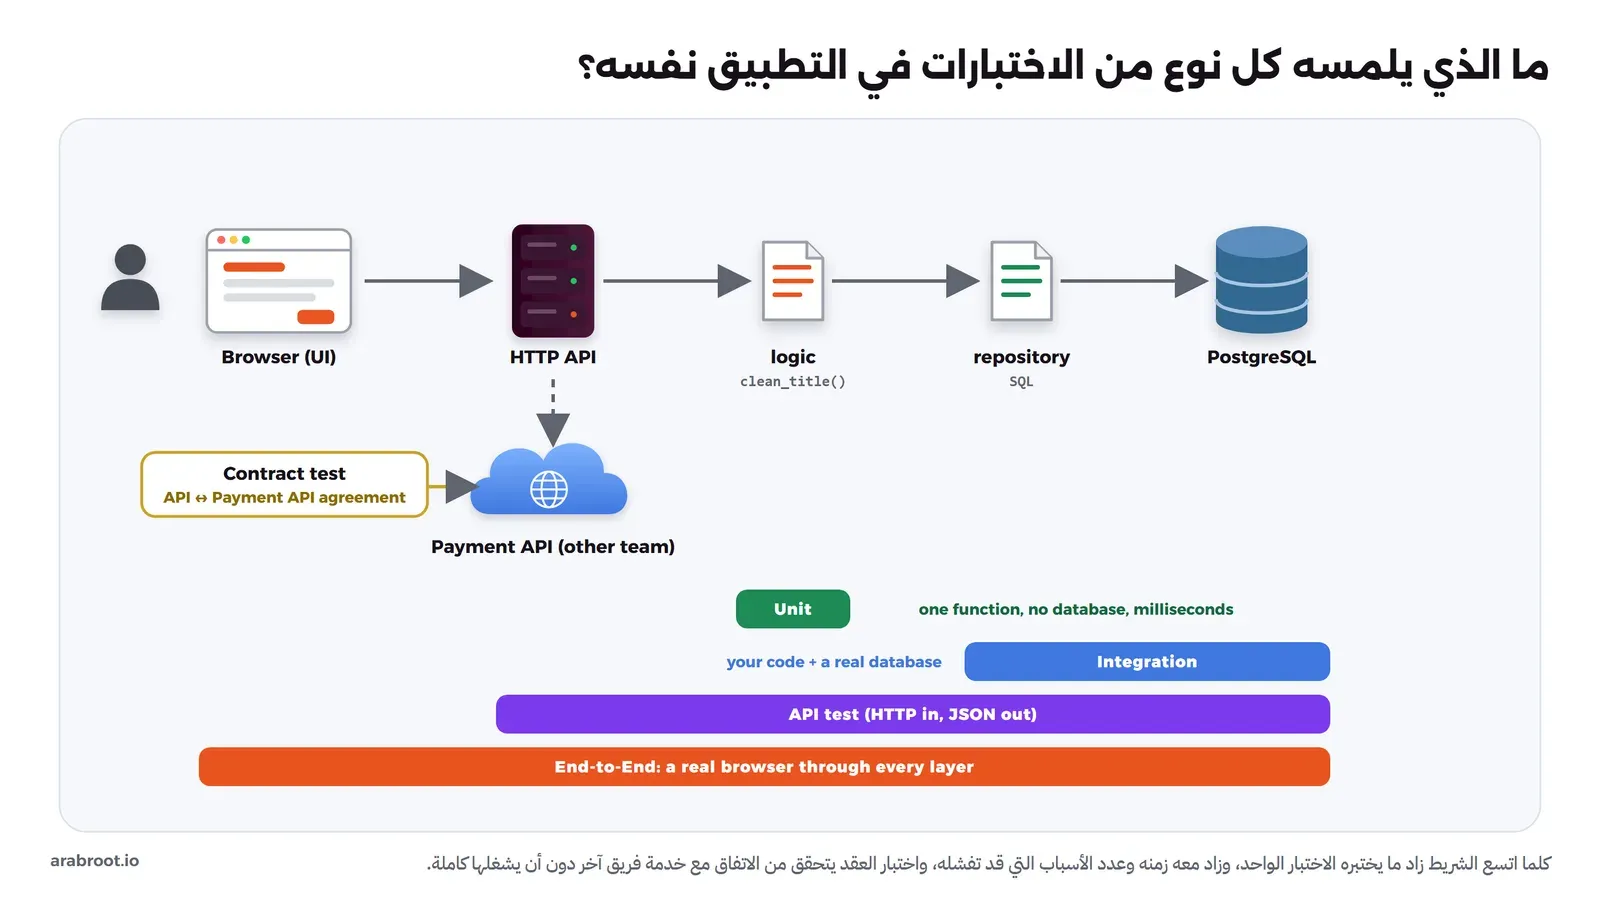
كلما اتسع الاختبار غطى طبقات أكثر، وزاد زمنه وعدد الأسباب التي قد تفشله
### اختبار الوحدة Unit Test
اختبار الوحدة يشغل جزءاً صغيراً من الكود، دالة أو كلاس، بمعزل عن قاعدة البيانات والشبكة والملفات، ويتحقق من النتيجة. فإذا كانت لديك دالة تنظف عنوان المهمة من المسافات وترفض العنوان الفارغ أو الطويل، فاختبار الوحدة يستدعيها بعشرة مدخلات مختلفة ويتحقق من كل نتيجة في أجزاء من الثانية.
- **ما يكشفه:** أخطاء المنطق والحالات الحدية Edge Cases، مثل الحد الأقصى بالضبط، والقيمة الفارغة، والنص العربي، والأرقام السالبة.
- **ما يفوته:** كل ما يحدث بين الأجزاء، مثل استعلام SQL خطأ، أو اسم حقل لا يطابق ما يرسله المتصفح، أو إعداد ناقص في البيئة.
- **السرعة والتكلفة:** الأسرع والأرخص، ويمكن أن تشغل آلافاً منها في ثوان، وعندما يفشل أحدها يشير إلى السطر نفسه تقريباً.
### اختبار التكامل Integration Test
اختبار التكامل يشغل كودك مع اعتماد حقيقي واحد على الأقل، والأشهر أن يكون قاعدة بيانات حقيقية من النوع نفسه الذي في الإنتاج، فيتحقق من أن الاستعلام يعمل فعلاً وأن الجدول بالشكل المتوقع وأن الترميز يحفظ النص العربي كما هو. ولا تقم بتشغيل اختبارات التكامل على قاعدة بيانات مختلفة عن الإنتاج، مثل SQLite بدل PostgreSQL، والسبب أن الفرق بينهما في الأنواع والدوال والأقفال هو بالضبط ما تريد أن يكشفه هذا الاختبار. والطريقة المعتادة اليوم أن تشغل قاعدة البيانات في Container أثناء الاختبار، إما كخدمة في ملف Compose كما سنفعل في التجربة، أو من داخل الكود نفسه بمكتبة [Testcontainers](https://testcontainers.com/?ref=arabroot.io) التي تنشئ ال Container قبل الاختبار وتحذفه بعده.
- **ما يكشفه:** أخطاء SQL، والترحيل Migration الناقص، وتعارض الأنواع، وأخطاء الحدود بين كودك والمكتبة أو الخدمة.
- **ما يفوته:** الواجهة والمتصفح، والتكامل مع الخدمات التي لم تشغلها في الاختبار.
- **السرعة والتكلفة:** ثوان، وتحتاج Docker في جهاز المطور وفي خط CI.
### اختبار العقد Contract Test
عندما يعتمد تطبيقك على API يملكه فريق آخر، فأنت أمام خيارين سيئين، إما أن تشغل خدمتهم كاملة في كل اختبار وهذا بطيء ومعقد، أو أن تستبدلها ببديل وهمي قد يختلف عن الحقيقة يوماً ما دون أن تعرف. واختبار العقد يحل ذلك بأن يسجل ما يتوقعه المستهلك Consumer من الخدمة، أي الطلبات التي يرسلها وشكل الردود التي يحتاجها، في ملف يسمى العقد Contract، ثم يتحقق المزود Provider في اختباراته أنه ما زال يلتزم بهذا العقد. والأداة الأشهر لهذا النوع [Pact](https://docs.pact.io/?ref=arabroot.io)، وتصف وثائقها أسلوبها بأنه Consumer-Driven Contracts، أي أن العقد يتولد من اختبارات المستهلك نفسها، فلا يختبر إلا ما يستخدمه المستهلك فعلاً.
- **ما يكشفه:** تغيير في API فريق آخر يكسر تطبيقك، مثل حذف حقل أو تغيير نوعه، قبل أن ينشر هذا التغيير.
- **ما يفوته:** منطق الخدمة الأخرى نفسه، فالعقد يتحقق من الشكل وليس من صحة الحسابات.
- **السرعة والتكلفة:** سريع في التشغيل، لكنه يحتاج تنسيقاً بين الفريقين ومكاناً مشتركاً للعقود، وهو مفيد عندما تكون الخدمات كثيرة والفرق منفصلة، أما في تطبيق واحد يملكه فريق واحد فاختبار التكامل يكفيك غالباً.
### اختبار ال API
اختبار ال API يرسل طلبات HTTP حقيقية إلى تطبيقك وهو يعمل، ويتحقق من رمز الحالة Status Code ومن محتوى الرد، دون متصفح. وهو يشبه ما تفعله أنت بأمر curl، لكنه مكتوب ومتكرر، ويختبر التطبيق من الخارج كما يراه الكلاينت، بما في ذلك التوجيه Routing والتحقق Validation والصلاحيات وقاعدة البيانات خلفها. وقد شرحنا رموز الحالة وما تعنيه في [HTTP وHTTPS للمبتدئين](https://arabroot.io/articles/http-%D9%88-https-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/).
- **ما يكشفه:** رد بشكل خطأ، أو رمز حالة خطأ، أو طلب يقبل بدون تسجيل دخول، أو تحقق ناقص من المدخلات.
- **ما يفوته:** الواجهة، فإذا كانت الصفحة ترسل اسم حقل خطأ فاختبار ال API لا يعرف ذلك لأنه يرسل الطلب الصحيح بنفسه.
- **السرعة والتكلفة:** أسرع بكثير من المتصفح، ومناسب لأغلب سيناريوهات «من الطرف إلى الطرف» في الخلفية Backend.
### اختبار النهاية إلى النهاية End-to-End
اختبار E2E يفتح متصفحاً حقيقياً ويتصرف كمستخدم، فيكتب في الحقول وينقر الأزرار وينتظر النتيجة على الشاشة، والطلب يمر بكل الطبقات حتى قاعدة البيانات ثم يعود. وهو الاختبار الأقرب لما يراه المستخدم، لذلك يعطيك أكبر ثقة بأن «تسجيل الدخول ثم إضافة مهمة» يعمل فعلاً.
- **ما يكشفه:** أخطاء الواجهة وJavaScript، والحقول التي لا تطابق ال API، والأزرار المخفية أو المعطلة، والمشكلات التي تظهر في متصفح دون آخر.
- **ما يفوته:** أغلب الحالات الحدية، لأنك لن تكتب اختبار متصفح لكل قيمة ممكنة، وعندما يفشل لا يخبرك بمكان الخطأ في الكود مباشرة.
- **السرعة والتكلفة:** ثوان لكل اختبار بدل أجزاء من الثانية، وأكثر عرضة للتقلب، وأصعب في الصيانة لأن تغيير الواجهة قد يكسره. ويصف Martin Fowler في [مقاله عن هرم الاختبارات](https://martinfowler.com/bliki/TestPyramid.html?ref=arabroot.io) الاختبارات التي تمر عبر الواجهة بأنها هشة Brittle ومكلفة في الكتابة وبطيئة في التشغيل، لذلك اجعلها قليلة ومخصصة للمسارات المهمة.
### اختبار الدخان Smoke Test
اختبار الدخان مجموعة صغيرة جداً من الفحوص السريعة تتأكد أن الأساسيات تعمل، مثل أن الصفحة الرئيسية ترد ب 200 وأن تسجيل الدخول ممكن وأن ال API يتصل بقاعدة البيانات، والاسم قادم من اختبار الأجهزة الكهربائية، فإذا شغلت الجهاز ولم يخرج منه دخان فهذا يكفي لتكمل الفحص. ومكانه الطبيعي بعد كل نشر مباشرة، وقبل الاختبارات الطويلة، فإذا فشل فلا داعي لتشغيل الباقي. وهو قريب من فحوص الصحة Health Checks التي شرحناها في [قائمة تحقق المطور](https://arabroot.io/articles/%D9%82%D8%A7%D8%A6%D9%85%D8%A9-%D8%AA%D8%AD%D9%82%D9%82-%D8%A7%D9%84%D9%85%D8%B7%D9%88%D8%B1-%D9%82%D8%A8%D9%84-%D9%86%D8%B4%D8%B1-%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%87/#health-checks)، لكنه يختبر سيناريو من وجهة نظر المستخدم وليس حالة العملية فقط.
- **ما يكشفه:** نشر مكسور تماماً، مثل متغير بيئة ناقص أو قاعدة بيانات لا يصل إليها التطبيق.
- **ما يفوته:** كل ما هو أعمق من الأساسيات.
- **السرعة والتكلفة:** دقيقة أو أقل، ويستحق أن يعمل على الإنتاج بعد كل نشر.
### اختبار الانحدار Regression Test
اختبار الانحدار ليس طبقة جديدة، وإنما هو هدف، أي التأكد من أن ما كان يعمل ما زال يعمل بعد التغيير، والاسم يأتي من أن البرنامج «ينحدر» إلى حالة أسوأ. وكل مجموعة الاختبارات الآلية هي في الواقع اختبار انحدار عندما تشغلها على تغيير جديد. والعادة الأهم هنا: **كل خطأ يصل إلى الإنتاج يحصل على اختبار يعيد إنتاجه قبل إصلاحه**، فتكتب الاختبار وتراه يفشل، ثم تصلح الكود وتراه ينجح، وبهذا لا يعود الخطأ نفسه أبداً دون أن يلاحظه أحد، وهذه هي المشكلة التي بدأنا بها المقال. وإذا لم تعرف أي commit أدخل الخطأ فالأمر [git bisect](https://arabroot.io/articles/git-merge-%D9%88-rebase-%D9%88-cherry-pick/#bisect) مع هذا الاختبار يجده لك آلياً.
### اختبار القبول Acceptance Test وUAT
اختبار القبول يتحقق من أن الميزة تفعل ما طلبه صاحب العمل، بلغة المتطلبات وليس بلغة الكود، مثل «عندما يضيف المستخدم مهمة فارغة تظهر له رسالة خطأ». وقد يكون آلياً، وغالباً يكتب كاختبار E2E أو API بأسماء مأخوذة من المتطلبات، وقد يكون يدوياً وهنا يسمى اختبار قبول المستخدم User Acceptance Testing واختصاراً UAT، حيث يجرب صاحب المنتج أو العميل الميزة بنفسه قبل إطلاقها. ومكان UAT الطبيعي بيئة معاينة Preview Environment لطلب الدمج نفسه، كما شرحنا في [بيئة معاينة لكل طلب دمج](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%8A%D8%A6%D8%A7%D8%AA-%D9%88%D9%85%D8%B9%D8%A7%D9%8A%D9%86%D8%A9-%D8%A7%D9%84%D9%85%D9%8A%D8%B2%D8%A7%D8%AA-%D9%88-gitops-%D9%84%D9%84%D9%81%D8%B1%D9%82/#preview-environments)، فيرى مدير المنتج الميزة وحدها قبل أن تختلط بغيرها.
### الاختبار المرئي Visual Regression واللقطات Snapshot
الاختبار المرئي يأخذ صورة للصفحة أو لجزء منها ويقارنها بصورة مرجعية محفوظة، فإذا اختلف عدد من البكسلات أكبر من حد تحدده فشل الاختبار، وهذا يكشف ما لا تكشفه الاختبارات الأخرى، مثل زر انزاح فوق نص أو اتجاه RTL انكسر بعد تحديث مكتبة CSS، لأن هذه الصفحة «تعمل» وظيفياً لكنها تبدو خطأ. وفي Playwright تفعل ذلك بالتحقق [toHaveScreenshot()](https://playwright.dev/docs/test-snapshots?ref=arabroot.io)، وهناك أدوات مخصصة مثل BackstopJS. أما اختبار اللقطة Snapshot Test بمعناه في Jest وVitest فهو يحفظ مخرجاً نصياً، مثل HTML أو JSON، ويقارنه في المرة التالية. والمشكلة في النوعين واحدة، فالصور تختلف بين أنظمة التشغيل والخطوط والمتصفحات، لذلك ولد الصور المرجعية وقارنها داخل Docker Image واحدة، وراجع كل تحديث للصور المرجعية كما تراجع الكود، ولا تقم بقبول كل الاختلافات دفعة واحدة، والسبب أنك بذلك تحفظ الخطأ نفسه كمرجع جديد.
### اختبار الأداء والأحمال Load Testing
اختبارات الأداء تجيب عن أسئلة مختلفة تماماً: كم طلباً في الثانية يتحمل التطبيق، وكيف يتغير زمن الرد p95 مع زيادة المستخدمين، ومتى ينهار. وأدواتها مفتوحة المصدر مثل k6 وLocust ترسل آلاف الطلبات من مستخدمين افتراضيين وتقيس النتائج، وهي تعمل عادة ليلاً أو قبل الإصدارات الكبيرة على بيئة تشبه الإنتاج، وليس على كل طلب دمج. وقد خصصنا لها مقالاً مخططاً في مرحلة [الأداء والموثوقية SRE](https://arabroot.io/start/#stage-sre) من خارطة الطريق، ومعه قياس سرعة الصفحات بأداة Lighthouse، وإذا كان التطبيق بطيئاً الآن فابدأ من [تتبع الطلب البطيء](https://arabroot.io/articles/%D8%AA%D8%AA%D8%A8%D8%B9-%D8%A7%D9%84%D8%B7%D9%84%D8%A8-%D8%A7%D9%84%D8%A8%D8%B7%D9%8A%D8%A1-%D9%85%D9%86-%D8%A7%D9%84%D9%85%D8%AA%D8%B5%D9%81%D8%AD-%D8%A7%D9%84%D9%89-%D9%82%D8%A7%D8%B9%D8%AF%D8%A9-%D8%A7%D9%84%D8%A8%D9%8A%D8%A7%D9%86%D8%A7%D8%AA/).
### اختبارات الأمان
الأمان له اختباراته الآلية أيضاً، أشهرها الفحص الثابت للكود SAST الذي يقرأ الكود دون تشغيله ويبحث عن أنماط خطرة، والفحص الديناميكي DAST الذي يهاجم التطبيق وهو يعمل كما يفعل المخترق، وفحص المكتبات التي تعتمد عليها SCA بحثاً عن ثغرات معروفة، ومعها فحص الأسرار المسربة في الكود. وهذه كلها مشروحة في مقالات مخططة في مرحلة [DevOps وCI/CD](https://arabroot.io/start/#stage-devops) من خارطة الطريق. وما يعنينا هنا أن اختباراتك العادية تستطيع أن تغطي جزءاً مهماً من الأمان بنفسها، مثل اختبار API يتأكد أن الطلب بدون تسجيل دخول يرد ب 401 وأن مستخدماً لا يرى بيانات غيره، وسوف ترى في التجربة أن هذا الخطأ الأخير بالذات لا يكشفه إلا الاختبار الذي يبحث عنه صراحة.
### الاختبار الاستكشافي Exploratory Testing
الاختبار الاستكشافي يدوي ومقصود، فيجلس إنسان يعرف المنتج أمام الميزة الجديدة ويحاول أن يكسرها بكل الطرق التي تخطر بباله، بلا خطوات مكتوبة مسبقاً، فيضع نصاً عربياً طويلاً مع رموز تعبيرية، وينقر الزر مرتين بسرعة، ويفتح الصفحة في تبويبين، ويقطع الإنترنت في منتصف الحفظ. وهو لا يعوض الاختبارات الآلية، لكنه يكشف ما لم يتوقعه أحد، وكل ما يكتشفه بهذه الطريقة يتحول إلى اختبار آلي حتى لا تحتاج أن تكتشفه مرة ثانية.
### الأنواع في جدول واحد
| النوع | ما يشغله | يكشف | يفوته | الزمن التقريبي |
| ----------- | ------------------------------------ | ------------------------- | ------------------- | ---------------- |
| Unit | دالة أو كلاس بمعزل عن غيره | المنطق والحالات الحدية | ما بين الأجزاء | أجزاء من الثانية |
| Integration | الكود مع قاعدة بيانات أو خدمة حقيقية | SQL والترحيل والأنواع | الواجهة | ثوان |
| Contract | الاتفاق بين مستهلك ومزود | تغيير API فريق آخر | منطق المزود | ثوان |
| API | التطبيق كاملاً عبر HTTP | الردود والصلاحيات والتحقق | الواجهة | ثوان |
| E2E | متصفح حقيقي عبر كل الطبقات | الواجهة والتكامل الكامل | أغلب الحالات الحدية | ثوان لكل اختبار |
| Smoke | فحوص قليلة بعد النشر | نشر مكسور | كل ما هو أعمق | دقيقة |
| Visual | صور الصفحات | تغير الشكل والتنسيق | الوظيفة | ثوان |
| Load | آلاف الطلبات المتزامنة | حدود الأداء | صحة النتائج | دقائق إلى ساعات |
| Exploratory | إنسان يحاول كسر الميزة | ما لم يتوقعه أحد | التكرار | ساعة أو أكثر |
## البدائل Test Doubles: Mock وStub وFake
عندما تكتب اختبار وحدة لدالة تحفظ في قاعدة البيانات أو ترسل بريداً، فأنت لا تريد قاعدة بيانات حقيقية ولا بريداً حقيقياً، لذلك تعطي الدالة بديلاً يتصرف كالاعتماد الحقيقي، وهذا البديل يسمى Test Double، والاسم مأخوذ من الممثل البديل Stunt Double في الأفلام. وقد شرح Martin Fowler في مقاله المعروف [Mocks Aren't Stubs](https://martinfowler.com/articles/mocksArentStubs.html?ref=arabroot.io) الأنواع الخمسة كما سماها Gerard Meszaros، وهي كما يلي:
- **Dummy:** كائن يمرر فقط ليملأ قائمة المعاملات Parameters ولا يستخدم أبداً.
- **Fake:** تطبيق حقيقي يعمل لكنه يختصر الطريق بشكل لا يناسب الإنتاج، والمثال الأشهر قاعدة بيانات في الذاكرة In-memory.
- **Stub:** يرد بإجابات جاهزة على الاستدعاءات التي يحتاجها الاختبار، ولا يرد على غيرها.
- **Spy:** Stub يسجل أيضاً كيف استدعي، مثل خدمة بريد تعد الرسائل التي طلب منها إرسالها.
- **Mock:** كائن مبرمج مسبقاً بتوقعات Expectations عن الاستدعاءات التي يجب أن تصله، ثم يتحقق منها.
والصورة التالية تبين الأنواع الخمسة والفرق بين طريقتي التحقق:
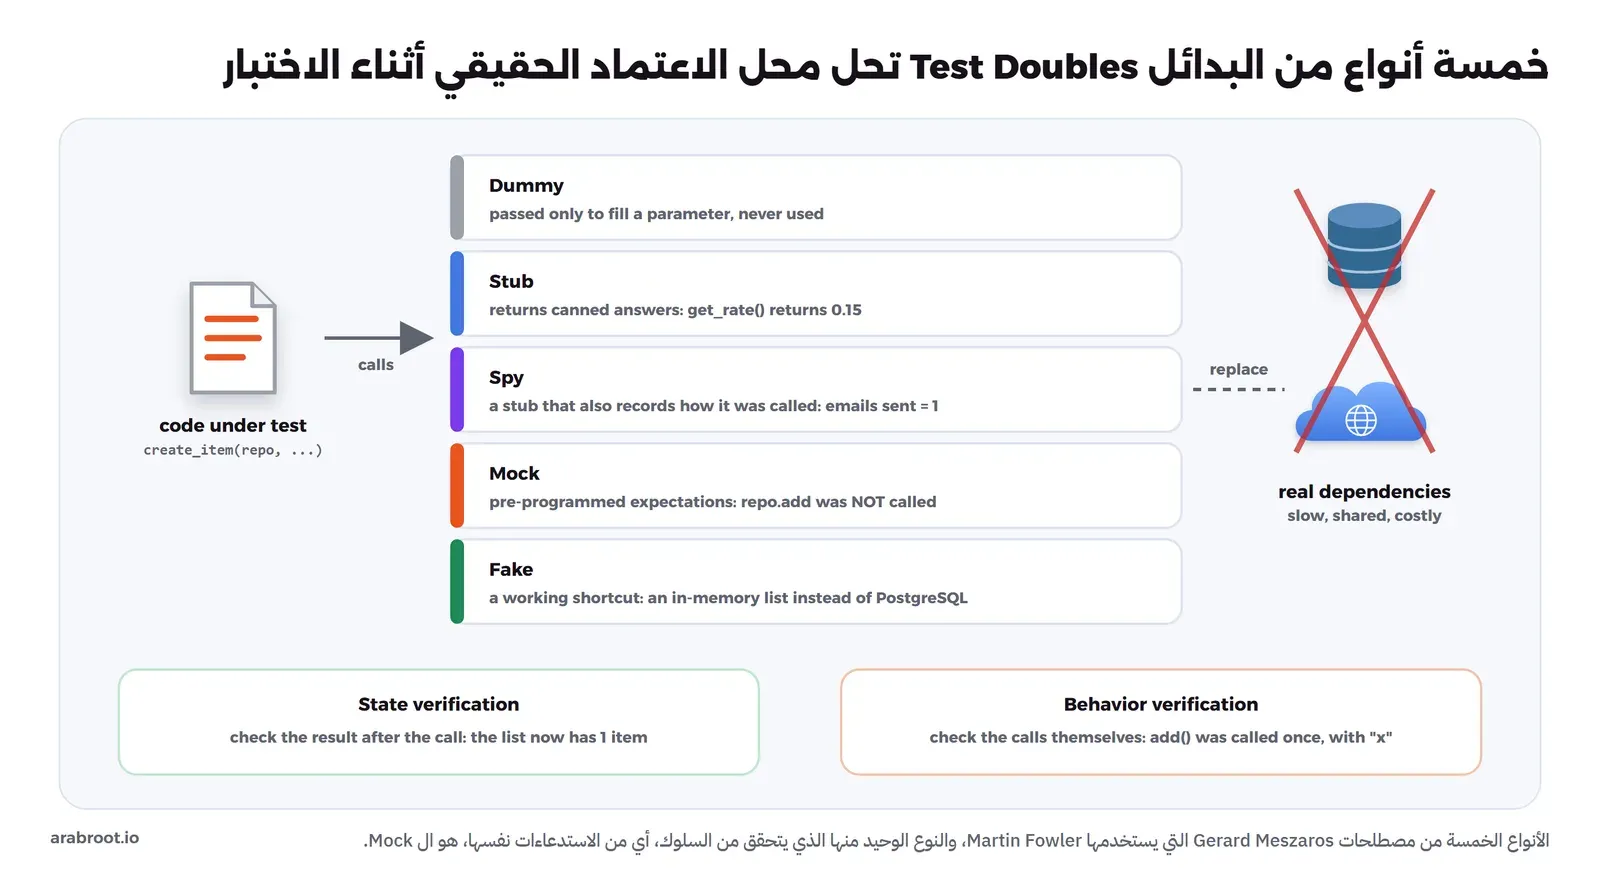
البديل يحل محل الاعتماد البطيء أو المشترك، والفرق المهم هو ما الذي تتحقق منه بعد الاستدعاء
والفرق الأهم الذي يركز عليه المقال هو بين **التحقق من الحالة State Verification**، أي أن تنظر إلى النتيجة بعد الاستدعاء كأن تجد عنصراً واحداً في القائمة، و**التحقق من السلوك Behavior Verification**، أي أن تتحقق من الاستدعاءات نفسها كأن الدالة `add` استدعيت مرة واحدة، ويذكر Fowler أن ال Mock وحده من بين هذه الأنواع يصر على التحقق من السلوك. وفي التجربة العملية سوف ترى النوعين: Fake يحفظ في قائمة، وMock من مكتبة `unittest.mock` في Python يتحقق أن العنوان الفارغ لا يصل إلى قاعدة البيانات أصلاً.
وهل نستخدم ال Mock في كل مكان؟ لا، والسبب أن كل Mock يربط الاختبار بطريقة كتابة الكود من الداخل، فإذا أعدت ترتيب الكود دون أن تغير سلوكه فسوف تفشل الاختبارات وهي لا تحمي شيئاً، والأسوأ أن البديل قد يختلف عن الاعتماد الحقيقي فينجح الاختبار والكود مكسور، وسوف ترى هذا بعينك في التجربة عندما ينجح اختبار الوحدة مع Fake بينما الاستعلام الحقيقي يسرب بيانات مستخدم لآخر. لذلك استخدم البدائل للحدود البطيئة أو غير المتوقعة، مثل خدمة دفع خارجية أو الوقت الحالي، واستخدم الشيء الحقيقي حيث يكون رخيصاً، مثل قاعدة بيانات في Container.
## الاختبارات المتقلبة Flaky Tests
الاختبار المتقلب هو الاختبار الذي ينجح مرة ويفشل مرة على الكود نفسه دون أي تغيير، وهو أخطر مما يبدو، لأن الفريق يتعلم بسرعة أن «الأحمر» لا يعني شيئاً فيعيد التشغيل حتى يصبح أخضر، ثم يأتي يوم يكون فيه الفشل حقيقياً فيتجاهله الجميع. وقد نشرت Google في [مقال عن الاختبارات المتقلبة عندها](https://testing.googleblog.com/2016/05/flaky-tests-at-google-and-how-we.html?ref=arabroot.io) سنة 2016 أن قرابة 1.5% من كل تشغيلات الاختبارات عندها تعطي نتيجة متقلبة، وأن قرابة 16% من اختباراتها فيها درجة من التقلب، وذكرت أن من أسبابه التزامن Concurrency والاعتماد على سلوك غير محدد وكود الأطراف الأخرى ومشكلات البنية التحتية. والصورة التالية تبين أشهر سبب في اختبارات المتصفح، وهو الانتظار الثابت، وهو بالضبط ما سنعيد إنتاجه في التجربة:
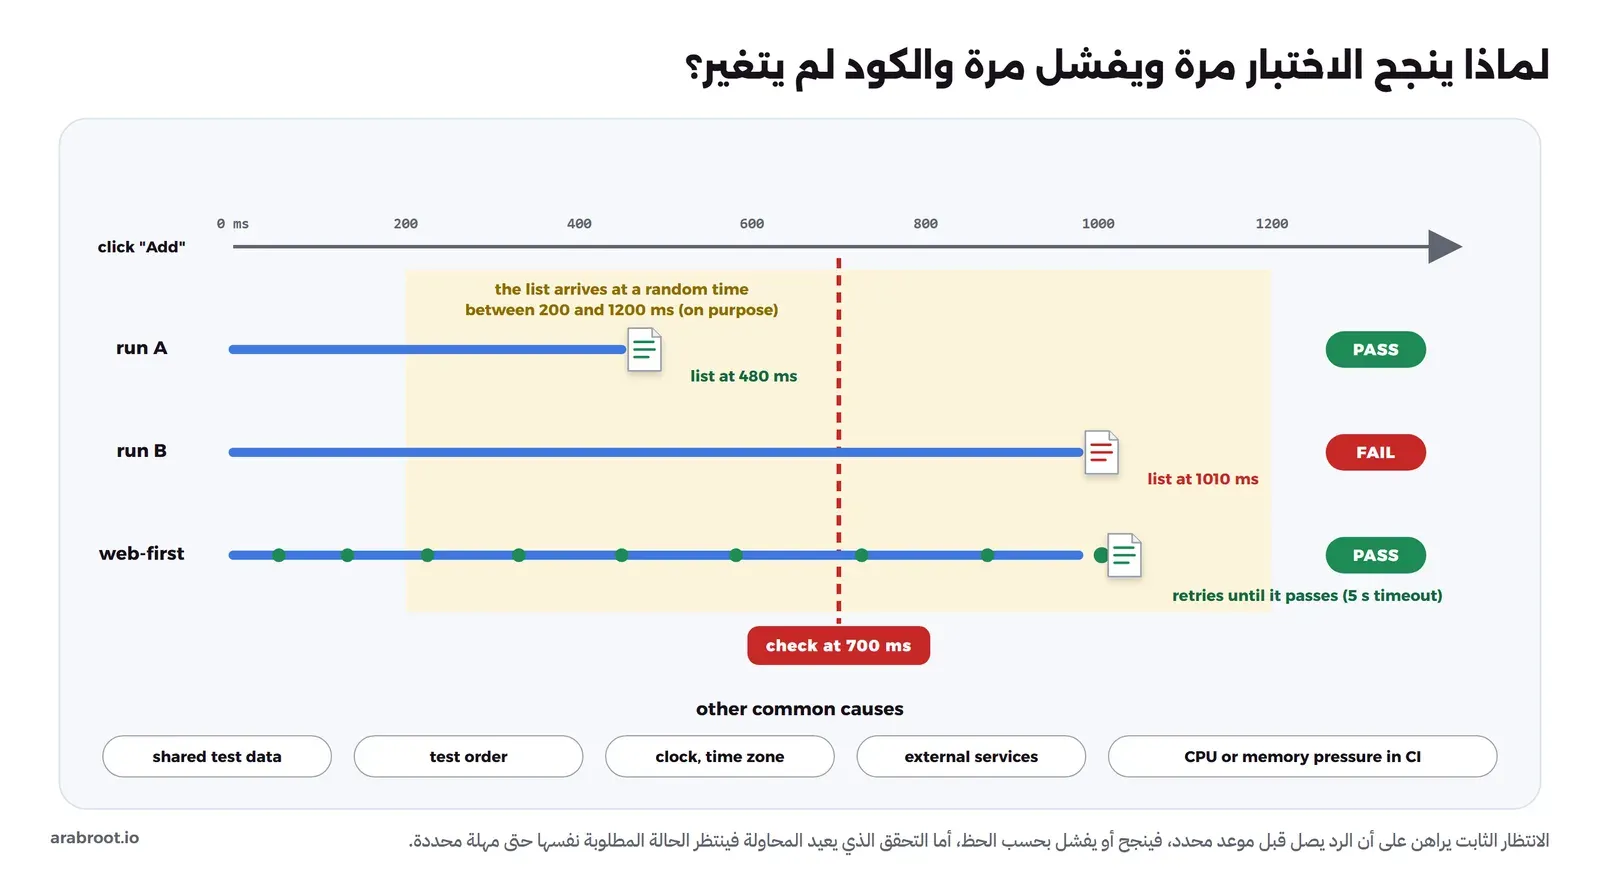
الانتظار الثابت يراهن على التوقيت، والتحقق الذي يعيد المحاولة ينتظر الحالة نفسها
وأشهر أسباب التقلب كما يلي:
- **التوقيت:** الاختبار يفترض أن شيئاً سيحدث خلال مدة ثابتة، مثل `sleep(1)`، وفي خط CI المشغول يتأخر قليلاً فيفشل.
- **البيانات المشتركة:** اختباران يكتبان في الجدول نفسه أو يستخدمان الاسم نفسه، فتعتمد النتيجة على من سبق، وسوف ترى هذا أيضاً في التجربة.
- **ترتيب الاختبارات:** اختبار يعتمد على أثر اختبار قبله، فينجح عند تشغيلها معاً ويفشل وحده أو عند التشغيل المتوازي.
- **الوقت والمنطقة الزمنية:** اختبار يعمل في كل الأيام إلا آخر يوم في الشهر، أو يعمل على جهازك ويفشل على سيرفر CI بتوقيت UTC.
- **الخدمات الخارجية والشبكة:** API حقيقي لطرف آخر يتأخر أو يحد معدل الطلبات.
وما الحل؟ أولاً أصلح السبب ولا تقم بإخفائه بإعادة المحاولة التلقائية لكل شيء، والسبب أن إعادة المحاولة تخفي أيضاً الأخطاء الحقيقية التي تظهر أحياناً، مثل حالة تسابق Race Condition في كودك نفسه. وإذا لم تستطع إصلاحه فوراً فاعزله Quarantine، أي انقله إلى مجموعة لا تمنع الدمج وتعمل ليلاً، وافتح له مهمة بصاحب وموعد، فإن بقي في العزل أسابيع فاحذفه أو أعد كتابته، لأن الاختبار المعزول إلى الأبد لا يحمي شيئاً. أما إعادة المحاولة في خط CI فاستخدمها لكشف التقلب وليس لإخفائه، فإن Playwright مثلاً يصنف الاختبار الذي فشل ثم نجح عند إعادة المحاولة بأنه flaky في التقرير، كما تذكر [وثائق إعادة المحاولة Retries](https://playwright.dev/docs/test-retries?ref=arabroot.io)، فتعرف أين تبحث.
## كم اختباراً من كل نوع؟ الهرم والكأس
بعد أن عرفنا الأنواع يأتي السؤال العملي: كيف أوزع وقتي بينها؟ وهناك شكلان مشهوران للإجابة، والصورة التالية تضعهما جنباً إلى جنب:
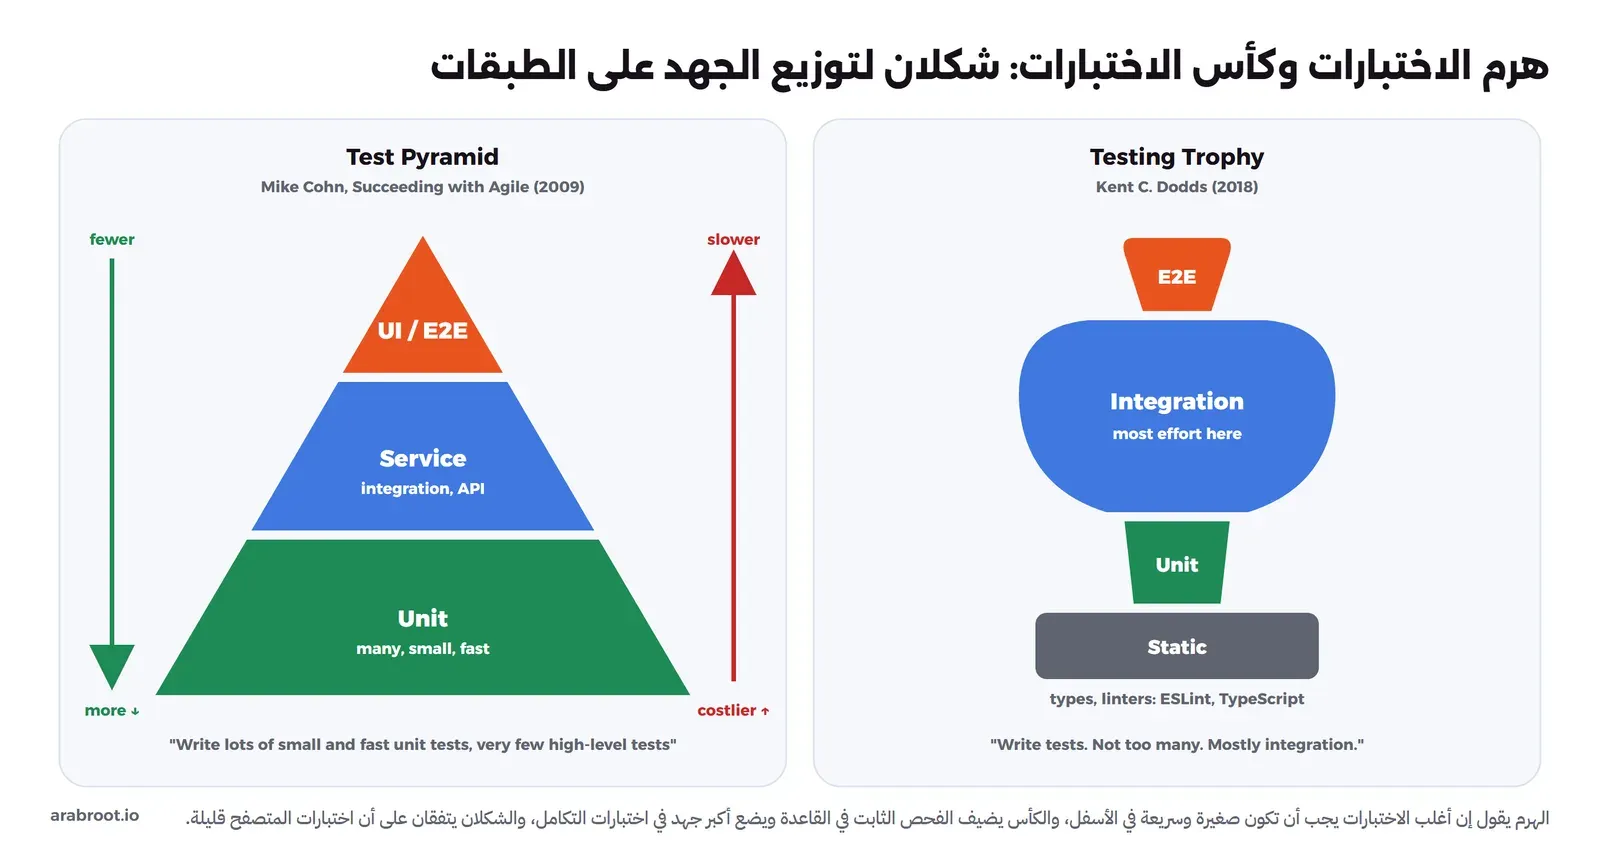
الهرم يضع أكبر عدد في اختبارات الوحدة، والكأس يضع أكبر جهد في اختبارات التكامل، والاثنان يجعلان اختبارات المتصفح قليلة
### هرم الاختبارات Test Pyramid
الهرم فكرة Mike Cohn في كتابه Succeeding with Agile سنة 2009، كما يذكر Martin Fowler في [مقاله عن الهرم](https://martinfowler.com/bliki/TestPyramid.html?ref=arabroot.io)، وكان اسمه في الكتاب «هرم أتمتة الاختبارات» Test Automation Pyramid، وطبقاته من الأسفل إلى الأعلى: اختبارات الوحدة ثم اختبارات الخدمة Service ثم اختبارات الواجهة UI. والفكرة أن الاختبار كلما ارتفع في الهرم أصبح أبطأ وأغلى وأكثر هشاشة، لذلك يقل عدده. ويلخص Ham Vocke في [The Practical Test Pyramid](https://martinfowler.com/articles/practical-test-pyramid.html?ref=arabroot.io) ما يبقى من الهرم في أمرين: اكتب اختبارات بدرجات تفصيل مختلفة، وكلما ارتفع المستوى قل عدد الاختبارات، ويحذر من الشكل المقلوب الذي يسميه مخروط الآيس كريم Ice-cream Cone، أي كثير من اختبارات الواجهة اليدوية والآلية وقليل من اختبارات الوحدة، وهو الشكل الذي تصل إليه الفرق التي بدأت بالنقر اليدوي ثم سجلته كما هو. ويعترف المقال نفسه بأن الهرم بشكله الحرفي مبسط أكثر من اللازم، وأن قيمته في هذه القاعدة العامة.
### كأس الاختبارات Testing Trophy
الكأس رسمه Kent C. Dodds سنة 2018، وجاءت الفكرة بعد مقاله [Write tests. Not too many. Mostly integration.](https://kentcdodds.com/blog/write-tests?ref=arabroot.io) الذي يشرح فيه عبارة كتبها Guillermo Rauch. ويضيف الكأس في قاعدته الفحص الثابت Static Analysis، أي أنظمة الأنواع مثل TypeScript وأدوات الفحص مثل ESLint، ثم اختبارات وحدة أقل، ثم أكبر جزء لاختبارات التكامل، ثم اختبارات E2E قليلة في الأعلى. ويوضح Dodds في [مقاله عن الكأس](https://kentcdodds.com/blog/the-testing-trophy-and-testing-classifications?ref=arabroot.io) أنه فكر فيه من خلال تطبيقات JavaScript التي تعمل في المتصفح، وأنه أضاف الفحص الثابت لأنه ليس أمراً مضموناً في JavaScript كما هو في اللغات التي سادت عندما ظهر الهرم، وأنه لم يفكر في انطباقه على الخدمات الخلفية. وهذه نقطة مهمة، فالشكلان لا يتعارضان كما يبدو، والخلاف بينهما في الغالب خلاف في تعريف «الوحدة»، كما يذكر Fowler في مقاله عن الهرم.
### مزيج معقول لفريق صغير
إذا كنت في فريق صغير يبني تطبيق ويب عادياً بقاعدة بيانات، فالمزيج التالي نقطة بداية جيدة، وهو رأينا وليس قاعدة من مصدر:
1. **الفحص الثابت أولاً:** Linter وأنواع Types إن كانت لغتك تدعمها، لأنه مجاني تقريباً ويعمل على كل حفظ.
2. **اختبارات وحدة للمنطق الذي يستحق:** الحسابات والتحويلات والتحقق والقواعد التجارية، وليس كل دالة تنقل بيانات من مكان إلى آخر.
3. **اختبارات تكامل وAPI لكل مسار في ال API:** على قاعدة بيانات حقيقية في Container، وهذه في أغلب تطبيقات الويب هي التي تعطيك أكبر ثقة مقابل وقتها، وفيها الحالات المهمة للصلاحيات مثل «المستخدم لا يرى بيانات غيره».
4. **عدد قليل من اختبارات E2E للمسارات التي إذا انكسرت توقف العمل:** التسجيل وتسجيل الدخول والشراء أو الحفظ الأساسي، على متصفح واحد في كل طلب دمج، وعلى المتصفحات الثلاثة بعد الدمج.
5. **اختبار انحدار لكل خطأ وصل إلى الإنتاج**، في الطبقة الأدنى التي تستطيع إعادة إنتاجه.
والقاعدة التي تجمع كل ذلك: اختبر كل سلوك في أدنى طبقة تستطيع كشفه، ولا تقم بتكرار الاختبار نفسه في كل الطبقات، والسبب أن التكرار يضاعف وقت التشغيل والصيانة ولا يضيف ثقة.
## تغطية الكود Code Coverage: ماذا تقيس، ولماذا 100% ليست الهدف
تغطية الكود هي نسبة أسطر الكود، أو الفروع Branches، التي نفذت أثناء تشغيل الاختبارات، وتحسبها أدوات مثل coverage.py في Python وأدوات مدمجة في Jest وVitest وGo. ولاحظ الكلمة المهمة هنا: **نفذت**، وليس «اختبرت»، فالسطر الذي نفذ دون أن يتحقق أي اختبار من نتيجته يحسب مغطى. وقد كتب ثلاثة من مهندسي Google في [Code Coverage Best Practices](https://testing.googleblog.com/2020/08/code-coverage-best-practices.html?ref=arabroot.io) سنة 2020 أن نسبة التغطية العالية لا تضمن جودة الاختبارات، وأن التركيز على الوصول إلى 100% يعطي شعوراً زائفاً بالأمان وقد يكون هدراً يصنع اختبارات قليلة القيمة يجب صيانتها، وأن قيمة التغطية الأكبر في أنها تكشف ما لم يغط وليس ما غطي. وذكروا أنهم في Google يعطون إرشاداً عاماً بأن 60% «مقبولة» و75% «جيدة» و90% «ممتازة»، مع تفضيلهم أن يختار كل فريق ما يناسبه بدل فرض رقم من الأعلى، وأن الانتقال من 90% إلى 95% لا يستحق الهوس. والطريقة الأدق لقياس ما إذا كانت اختباراتك تتحقق فعلاً من الأسطر التي تغطيها، بحسب المقال نفسه، هي اختبار الطفرات Mutation Testing، حيث تغير الأداة الكود عمداً، مثل تحويل `>` إلى `>=`، وتنظر هل فشل أي اختبار.
وسوف ترى في التجربة مثالاً عملياً على ذلك، فملف المنطق مغطى 100% وفيه خطأ حقيقي، ولا يكشفه إلا اختبار واحد يتحقق من الحد بالضبط. لذلك استخدم التغطية في مراجعة الكود لتسأل «لماذا هذا الفرع غير مختبر؟»، ولا تقم بجعلها شرطاً رقمياً يكتب له المطورون اختبارات بلا تحقق، والسبب أن الرقم سوف يرتفع والثقة لن ترتفع معه.
## الأدوات مفتوحة المصدر لكل طبقة
الجدول التالي يجمع الأدوات الأشهر لكل طبقة، والتراخيص منقولة من ملف LICENSE في مستودع كل أداة كما وجدناه في أكتوبر 2026، وكلها مفتوحة المصدر إلا ما ذكرناه صراحة:
| الطبقة | الأداة | اللغة | الترخيص | ملاحظة |
| ----------- | -------------------------------------------------------------------------------------------------------------------- | ------------------------------------------ | ------------------------------------------------------------ | -------------------------------------------------------------------------------------------------------------------------------------------------------- |
| Unit | [pytest](https://github.com/pytest-dev/pytest?ref=arabroot.io) | Python | MIT | الأشهر في Python، وتوسعه إضافات مثل pytest-cov |
| Unit | [JUnit](https://github.com/junit-team/junit-framework?ref=arabroot.io) | Java وKotlin | EPL-2.0 | المستودع يضم JUnit 5 و6 بواجهة Jupiter |
| Unit | [Jest](https://github.com/jestjs/jest?ref=arabroot.io) | JavaScript وTypeScript | MIT | شائع في مشروعات React وNode |
| Unit | [Vitest](https://github.com/vitest-dev/vitest?ref=arabroot.io) | JavaScript وTypeScript | MIT | مبني على Vite، وواجهته قريبة من Jest |
| Unit | [الحزمة testing](https://pkg.go.dev/testing?ref=arabroot.io) | Go | BSD-3-Clause | جزء من Go نفسها، وتعمل بالأمر go test |
| Unit | [xUnit.net](https://github.com/xunit/xunit?ref=arabroot.io) و[NUnit](https://github.com/nunit/nunit?ref=arabroot.io) | C# و.NET | Apache-2.0 وMIT | الإطاران الأشهر في .NET |
| Integration | [Testcontainers](https://testcontainers.com/?ref=arabroot.io) | Java وGo و.NET وNode.js وPython وغيرها | MIT، ونسخة Python بترخيص Apache-2.0 | تشغل قاعدة البيانات أو أي خدمة في Container من داخل الاختبار |
| Contract | [Pact](https://docs.pact.io/?ref=arabroot.io) | عدة لغات | pact-js وpact-python بترخيص MIT، وpact-jvm بترخيص Apache-2.0 | ومعها [Pact Broker](https://github.com/pact-foundation/pact%5Fbroker?ref=arabroot.io) المفتوح بترخيص MIT لمشاركة العقود |
| API | [Hurl](https://hurl.dev/?ref=arabroot.io) | ملفات نصية | Apache-2.0 | طلبات HTTP وتحققات في ملف نصي، وتعمل من سطر الأوامر وفي CI |
| API | [Bruno](https://github.com/usebruno/bruno?ref=arabroot.io) | واجهة رسومية وCLI | MIT | يحفظ الطلبات كملفات نصية في المستودع، وأغلب الميزات مفتوحة مع نسخ تجارية |
| API | Postman | واجهة رسومية | تجاري مغلق المصدر | التطبيق نفسه ليس مفتوح المصدر، أما أداة تشغيل مجموعاته من سطر الأوامر [Newman](https://github.com/postmanlabs/newman?ref=arabroot.io) فبترخيص Apache-2.0 |
| E2E | [Playwright](https://github.com/microsoft/playwright?ref=arabroot.io) | TypeScript وJavaScript وPython وJava و.NET | Apache-2.0 | من Microsoft، ونشرحه بالتفصيل بعد قليل |
| E2E | [Cypress](https://github.com/cypress-io/cypress?ref=arabroot.io) | JavaScript وTypeScript | MIT | الأداة نفسها مفتوحة، أما خدمة [Cypress Cloud](https://www.cypress.io/pricing?ref=arabroot.io) للتوازي والتقارير فمدفوعة بعد حد مجاني |
| E2E | [Selenium](https://github.com/SeleniumHQ/selenium?ref=arabroot.io) | Java وPython وC# وRuby وJavaScript | Apache-2.0 | مبني على بروتوكول [WebDriver](https://www.w3.org/TR/webdriver1/?ref=arabroot.io) الذي أصبح توصية W3C سنة 2018 |
| E2E | [WebdriverIO](https://github.com/webdriverio/webdriverio?ref=arabroot.io) | JavaScript وTypeScript | MIT | يعمل فوق WebDriver، ويدعم المتصفح والجوال |
| Mobile | [Appium](https://github.com/appium/appium?ref=arabroot.io) | عدة لغات | Apache-2.0 | أتمتة تطبيقات Android وiOS ببروتوكول WebDriver |
| Visual | Playwright و[BackstopJS](https://github.com/garris/BackstopJS?ref=arabroot.io) | JavaScript | Apache-2.0 وMIT | مقارنة الصور بصور مرجعية |
| Load | [k6](https://github.com/grafana/k6?ref=arabroot.io) و[Locust](https://github.com/locustio/locust?ref=arabroot.io) | JavaScript وPython | AGPL-3.0 وMIT | لها مقال مخطط في مرحلة [SRE](https://arabroot.io/start/#stage-sre) |
وقد يتساءل البعض: هل يهمني الترخيص في أداة اختبار لا تصل إلى الإنتاج؟ والإجابة أنه يهمك أقل مما يهمك في المكتبات التي تدمجها في تطبيقك، لكنه يهمك في حالتين، الأولى عندما تعدل الأداة نفسها وتقدمها لغيرك كخدمة، مثل AGPL في k6، والثانية عندما تكون الأداة مفتوحة لكن الميزات التي يحتاجها فريقك في خدمة سحابية مدفوعة، فاقرأ ما الذي يعمل محلياً قبل أن تبني خطك عليها. وقد شرحنا الفرق بين التراخيص في [البرمجيات مفتوحة المصدر وتراخيصها](https://arabroot.io/articles/%D9%85%D8%A7-%D9%87%D9%8A-%D8%A7%D9%84%D8%A8%D8%B1%D9%85%D8%AC%D9%8A%D8%A7%D8%AA-%D9%85%D9%81%D8%AA%D9%88%D8%AD%D8%A9-%D8%A7%D9%84%D9%85%D8%B5%D8%AF%D8%B1-%D9%88%D8%AA%D8%B1%D8%A7%D8%AE%D9%8A%D8%B5%D9%87%D8%A7/).
## Playwright بالتفصيل
[Playwright](https://playwright.dev/?ref=arabroot.io) مكتبة مفتوحة المصدر من Microsoft بترخيص Apache-2.0 لأتمتة المتصفحات، ومعها مشغل اختبارات Playwright Test في نسخة Node.js، وتدعم [لغات](https://playwright.dev/docs/languages?ref=arabroot.io) TypeScript وJavaScript وPython وJava و.NET، وتشغل ثلاثة محركات متصفح: Chromium الذي تبنى عليه Chrome وEdge، وFirefox، وWebKit الذي يبنى عليه Safari. والصورة التالية تبين كيف تتوزع الاختبارات على المتصفحات، وماذا يحدث قبل كل نقرة:
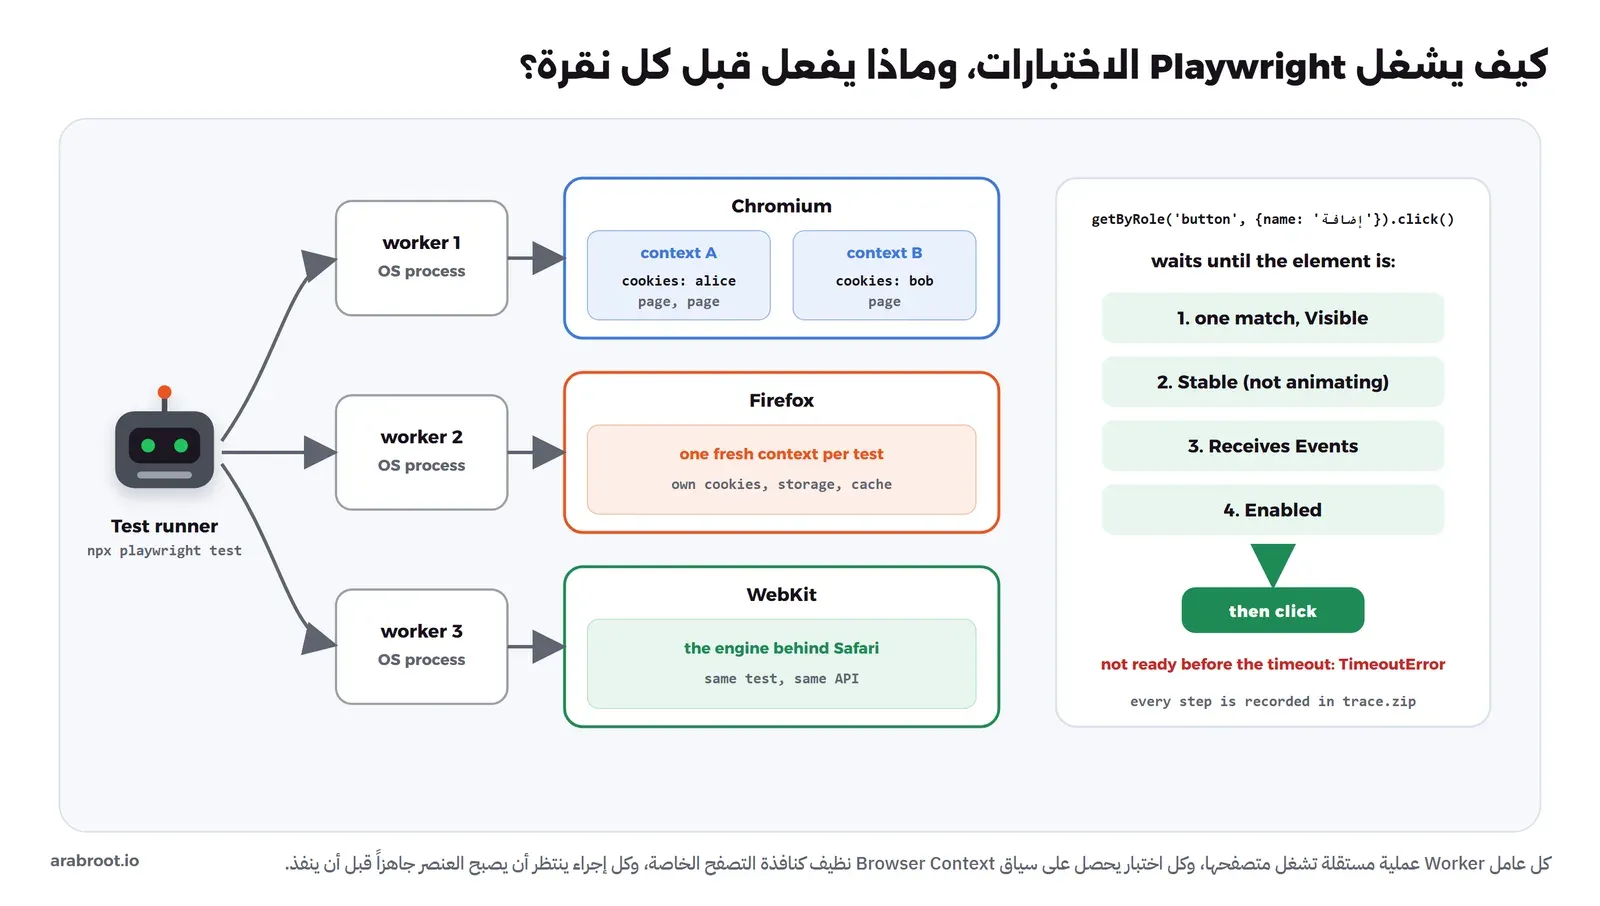
كل اختبار يحصل على سياق متصفح نظيف، وكل إجراء ينتظر أن يصبح العنصر جاهزاً
### الانتظار التلقائي Auto-waiting
أكبر مصدر للتقلب في اختبارات المتصفح القديمة أن الاختبار ينقر زراً لم يظهر بعد، أو ظهر لكنه ما زال يتحرك، فيضيف المطور `sleep` ويأمل خيراً. وPlaywright يحل ذلك بأن كل إجراء ينتظر قبل التنفيذ مجموعة فحوص تسميها الوثائق [Actionability Checks](https://playwright.dev/docs/actionability?ref=arabroot.io)، فقبل `click()` مثلاً ينتظر أن يشير المحدد إلى عنصر واحد بالضبط، وأن يكون العنصر ظاهراً Visible، وثابتاً Stable أي لا يتحرك، ويستقبل الأحداث Receives Events أي لا يغطيه عنصر آخر، ومفعلاً Enabled، فإذا لم تتحقق خلال المهلة فشل الإجراء بخطأ TimeoutError. والأمر نفسه في التحققات، فالتحقق مثل `await expect(locator).toBeVisible()` يعيد الفحص مرة بعد مرة حتى يتحقق الشرط أو تنتهي المهلة، وهي 5 ثوان افتراضياً كما تذكر [وثائق التحققات Assertions](https://playwright.dev/docs/test-assertions?ref=arabroot.io)، وهذه تسمى التحققات التي تعيد المحاولة Auto-retrying Assertions، وسوف ترى في التجربة الفرق بينها وبين قراءة القيمة مرة واحدة.
### المحددات Locators حسب الدور
المحدد هو الطريقة التي تشير بها إلى العنصر، والطريقة القديمة هي محددات CSS مثل `#btn-2 > span`، وهي تنكسر مع أي تغيير في التصميم. ويوصي Playwright في [وثائق المحددات](https://playwright.dev/docs/locators?ref=arabroot.io) بأن تبحث عن العنصر كما يراه المستخدم أو قارئ الشاشة، مثل `page.getByRole('button', { name: 'إضافة' })` و`page.getByLabel('كلمة المرور')`، وفائدة ذلك مزدوجة، فالاختبار لا ينكسر عندما يتغير ال CSS، وإذا لم يجد الاختبار الزر بدوره واسمه فهذا غالباً يعني أن الزر غير واضح لقارئ الشاشة أيضاً، أي أن الاختبار يكشف مشكلة في سهولة الوصول Accessibility.
### المتصفحات والسياقات Browser Contexts
بدل أن يفتح Playwright متصفحاً جديداً لكل اختبار، وهذا بطيء، فإنه يفتح لكل اختبار سياقاً Browser Context جديداً داخل المتصفح نفسه، والسياق يشبه نافذة التصفح الخاصة، فله Cookies وتخزين محلي Local Storage خاص به ولا يرى ما في غيره، وتصفه [وثائق العزل Isolation](https://playwright.dev/docs/browser-contexts?ref=arabroot.io) بأنه سريع ورخيص في الإنشاء ومعزول تماماً. وبهذا لا يرث اختبار تسجيل دخول من اختبار قبله، ويمكنك في الاختبار الواحد أن تفتح سياقين لمستخدمين مختلفين، مثل محادثة بين أليس وبوب.
### التشغيل المتوازي
يشغل Playwright Test الاختبارات في عمليات Workers مستقلة من نظام التشغيل، لكل منها متصفحها، وبشكل افتراضي تعمل الملفات المختلفة بالتوازي، والاختبارات داخل الملف الواحد بالترتيب، إلا إذا فعلت `fullyParallel` كما تشرح [وثائق التوازي](https://playwright.dev/docs/test-parallel?ref=arabroot.io). وهذا يجعل مجموعة كبيرة من الاختبارات تنتهي في دقائق، بشرط أن تكون الاختبارات مستقلة فعلاً عن بعضها، فلا تتشارك في مستخدم واحد أو سجل واحد في قاعدة البيانات.
### عارض التتبع Trace Viewer
عندما يفشل اختبار متصفح في خط CI فأصعب ما في الأمر أن تعرف ماذا رأى المتصفح لحظة الفشل. و[عارض التتبع Trace Viewer](https://playwright.dev/docs/trace-viewer?ref=arabroot.io) يحل ذلك، فعند تفعيل الخيار `trace` يسجل Playwright ملف `trace.zip` فيه كل إجراء مع لقطة من الصفحة قبله وبعده، وطلبات الشبكة، ورسائل ال Console، ثم تفتحه بالأمر `npx playwright show-trace` وتتنقل فيه خطوة خطوة كأنك تعيد تشغيل الاختبار، وسوف نفتح في التجربة ملف تتبع حقيقياً لاختبار فشل.
### توليد الاختبار بالتسجيل Codegen
الأمر `npx playwright codegen` يفتح متصفحاً ويسجل ما تفعله فيه ككود اختبار، ويختار المحددات المناسبة حسب الدور والنص كما تشرح [وثائق Codegen](https://playwright.dev/docs/codegen?ref=arabroot.io). وهو مفيد لتبدأ منه أو لتعرف المحدد الصحيح لعنصر صعب، لكن لا تقم بحفظ التسجيل كما هو اختباراً نهائياً، والسبب أن التسجيل يسجل كل ما فعلته بلا تحقق من النتيجة، ويصف Fowler أدوات التسجيل والإعادة Record-Playback بأنها فكرة سيئة غالباً لأنها تقاوم التغيير، وأنها مفيدة فقط لتوليد أجزاء تعدلها بعد ذلك. أما توليد الاختبارات بالذكاء الاصطناعي ووكلاء Playwright وخادم Playwright MCP والاختبارات التي تصلح نفسها Self-healing فلها مقال خاص هو [أتمتة الاختبارات بالذكاء الاصطناعي](https://arabroot.io/articles/%D8%A7%D8%AA%D9%85%D8%AA%D8%A9-%D8%A7%D9%84%D8%A7%D8%AE%D8%AA%D8%A8%D8%A7%D8%B1%D8%A7%D8%AA-%D8%A8%D8%A7%D9%84%D8%B0%D9%83%D8%A7%D8%A1-%D8%A7%D9%84%D8%A7%D8%B5%D8%B7%D9%86%D8%A7%D8%B9%D9%8A/).
### التشغيل في Docker وفي CI
تنشر Microsoft Docker Image رسمية فيها المتصفحات الثلاثة وكل ما تحتاجه من مكتبات النظام، باسم `mcr.microsoft.com/playwright:v1.63.0-noble` وقت كتابة المقال، والجزء `noble` يعني Ubuntu 24.04، ويجب أن يطابق رقم الإصدار في اسم ال Image رقم إصدار `@playwright/test` في مشروعك، والسبب أن كل إصدار من Playwright يحتاج نسخاً محددة من المتصفحات. وتوصي [وثائق Docker](https://playwright.dev/docs/docker?ref=arabroot.io) بالخيار `--ipc=host` مع Chromium لأنه قد تنفد ذاكرته ويتوقف بدونه، وبالخيار `--init` لتجنب العمليات المعلقة Zombie Processes، وتذكر أن ال Image تشغل المتصفحات بالمستخدم root فيتعطل صندوق الحماية Sandbox في Chromium، وأن هذا مقبول لاختبارات موقعك الموثوق، أما زيارة مواقع غير موثوقة مثل جمع البيانات Scraping فتحتاج مستخدماً منفصلاً وملف seccomp كما تشرح الصفحة نفسها. وهناك صفحة [إعداد CI](https://playwright.dev/docs/ci?ref=arabroot.io) بأمثلة لأشهر الأنظمة.
### Playwright أم Cypress أم Selenium؟
المشكلة التي تحلها الأدوات الثلاث واحدة، وهي أن تتحكم في متصفح حقيقي من كود الاختبار، والفرق في الطريقة التي تتحكم بها وما تدعمه حولها. وليس لدينا بعد دليل تثبيت منفصل لكل منها على الموقع، لذلك نكتفي هنا بنقاط القوة والضعف بحسب وثائق كل أداة، ثم الجدول.
**Playwright**
- **نقاط القوة:** الانتظار التلقائي والتحققات التي تعيد المحاولة، والمحركات الثلاثة بما فيها WebKit من واجهة واحدة، وسياقات معزولة سريعة، وعارض التتبع، والتوازي ومشغل الاختبارات مدمجان دون خدمة مدفوعة، وخمس لغات.
- **نقاط الضعف:** يشغل افتراضياً نسخاً من المتصفحات ينزلها مع كل إصدار منه، وليست بالضرورة النسخة التي ثبتها المستخدم، وإن كان يستطيع تشغيل Chrome وEdge المثبتين بالخيار `channel` كما تذكر [وثائق المتصفحات](https://playwright.dev/docs/browsers?ref=arabroot.io)، ومشغل الاختبارات الكامل بميزاته في نسخة Node.js، أما في اللغات الأخرى فتستخدم مكتبة Playwright مع مشغل اللغة مثل pytest.
**Cypress**
- **نقاط القوة:** تجربة تطوير مريحة داخل المتصفح نفسه مع إعادة عرض كل خطوة، ويدعم اختبار المكونات Component Testing، ويدعم بحسب [وثائقه](https://docs.cypress.io/app/references/launching-browsers?ref=arabroot.io) متصفحات عائلة Chrome وFirefox، ومعها WebKit بشكل تجريبي.
- **نقاط الضعف:** لغته JavaScript وTypeScript فقط، ويذكر في [صفحة القيود](https://docs.cypress.io/app/references/trade-offs?ref=arabroot.io) أنه لا يتحكم في أكثر من متصفح واحد في الوقت نفسه، وأن كل اختبار مرتبط بنطاق رئيسي واحد إلا عبر الأمر `cy.origin`، وأن تعدد التبويبات يحتاج إضافة، والتوازي والتقارير المتقدمة في خدمة Cypress Cloud المدفوعة بعد الحد المجاني.
**Selenium**
- **نقاط القوة:** الأقدم والأوسع انتشاراً، ومبني على معيار [WebDriver](https://www.w3.org/TR/webdriver1/?ref=arabroot.io) من W3C فيعمل مع المتصفحات الحقيقية التي يثبتها المستخدم عبر برامج التشغيل Drivers التي يصدرها أصحاب المتصفحات، وله مكتبات رسمية لخمس لغات، وSelenium Grid لتوزيع الاختبارات على أجهزة كثيرة.
- **نقاط الضعف:** مكتبة أتمتة وليست إطار اختبار كاملاً، فتحتاج أن تختار مشغل الاختبارات والتقارير وطريقة الانتظار بنفسك، والانتظار فيه صريح بأوامر Wait تكتبها أنت، وهذا مصدر شائع للتقلب إذا كتب بشكل خطأ.
| | Playwright | Cypress | Selenium |
| ----------- | ---------------------------------- | ------------------------------------- | -------------------------------------------------------------- |
| الترخيص | Apache-2.0 | MIT، والخدمة السحابية مدفوعة | Apache-2.0 |
| اللغات | TS/JS وPython وJava و.NET | JS/TS | Java وPython وC# وRuby وJS |
| المتصفحات | Chromium وFirefox وWebKit | عائلة Chrome وFirefox، وWebKit تجريبي | كل متصفح له WebDriver |
| الانتظار | تلقائي قبل كل إجراء وتحقق | تلقائي في أوامره | صريح تكتبه أنت |
| التوازي | مدمج ومجاني | عبر Cypress Cloud أو أدوات خارجية | عبر مشغل الاختبارات أو Selenium Grid |
| تشخيص الفشل | Trace Viewer ولقطات وفيديو | إعادة عرض الخطوات ولقطات وفيديو | بحسب ما تضيفه |
| يناسب | فريق يبدأ اليوم ويريد أداة متكاملة | فريق Frontend بلغة JavaScript | فريق لديه اختبارات Selenium أو يحتاج متصفحات المستخدم الحقيقية |
وإذا كنت تبدأ من الصفر اليوم فالأنسب في رأينا Playwright، لأنه يعطيك ما تحتاجه دون خدمة مدفوعة، أما إذا كان لدى فريقك مئات الاختبارات التي تعمل جيداً بأداة أخرى فلا تقم بإعادة كتابتها لمجرد التغيير، وانقل الاختبارات المتقلبة أولاً إن احتجت.
## أين يعمل كل اختبار في خط CI؟
ليس كل اختبار يعمل في كل مكان، والقاعدة أن الاختبار الأسرع يعمل أبكر وأكثر، والأبطأ يعمل لاحقاً وأقل، والصورة التالية تبين ذلك:
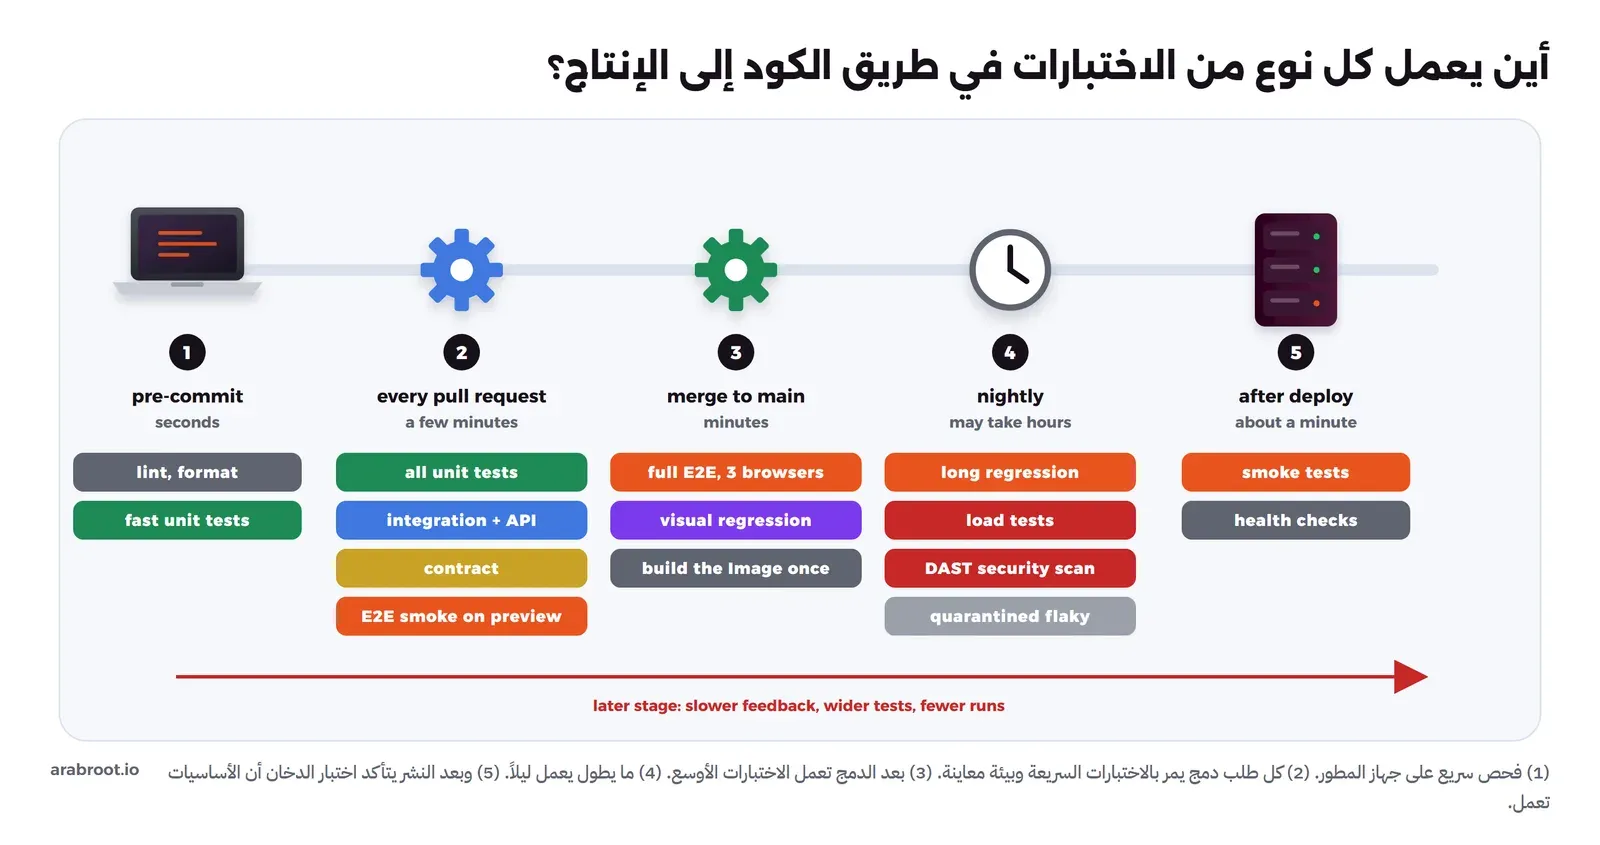
كلما تأخرت المرحلة أصبحت الاختبارات أوسع وأبطأ وأقل تكراراً
1. **قبل ال commit على جهاز المطور:** الفحص والتنسيق واختبارات الوحدة السريعة، عبر Git Hook أو محرر الكود، وهدفها ثوان، فإن طالت فسوف يتجاوزها المطورون.
2. **على كل طلب دمج:** كل اختبارات الوحدة والتكامل وال API والعقود، واختبار دخان E2E لمسار أو اثنين على متصفح واحد، ويفضل أن يعمل على [بيئة المعاينة](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%8A%D8%A6%D8%A7%D8%AA-%D9%88%D9%85%D8%B9%D8%A7%D9%8A%D9%86%D8%A9-%D8%A7%D9%84%D9%85%D9%8A%D8%B2%D8%A7%D8%AA-%D9%88-gitops-%D9%84%D9%84%D9%81%D8%B1%D9%82/#preview-environments) الخاصة بالطلب، وهذا هو الحاجز الذي يمنع الدمج إذا فشل.
3. **بعد الدمج في main:** اختبارات E2E كاملة على المتصفحات الثلاثة، والاختبار المرئي، ثم تبنى ال Docker Image مرة واحدة وتنتقل كما هي بين البيئات.
4. **ليلاً:** ما يطول، مثل الانحدار الواسع واختبارات الأحمال وفحص DAST، والاختبارات المعزولة لتعرف هل ما زالت متقلبة.
5. **بعد كل نشر:** اختبار الدخان على البيئة التي نشرت إليها، فإن فشل فتراجع فوراً.
ولكي يبقى خط CI سريعاً، وهدف DORA الذي ذكرناه أقل من عشر دقائق، فإليك ما يفيد عملياً:
- شغل المراحل السريعة أولاً واجعل الفشل يوقف ما بعدها، فلا معنى لتشغيل E2E لعشر دقائق وهناك اختبار وحدة فشل في الثانية الأولى.
- قسم الاختبارات الطويلة على أكثر من جهاز، ويسمي Playwright ذلك Sharding بالخيار `--shard=1/4`.
- احفظ ال Cache للمكتبات وال Docker Images بين التشغيلات.
- احذف اختبار E2E الذي يكرر ما يغطيه اختبار API، فالمتصفح أغلى طبقة.
- احفظ ملفات `test-results` والتقرير كملف مرفق Artifact عند الفشل، حتى يفتح المطور التتبع دون أن يعيد التشغيل.
وقد شرحنا تشغيل خط CI على سيرفرك في دليل [Gitea Actions لتشغيل CI/CD على السيرفر](https://arabroot.io/articles/gitea-actions-%D8%AA%D8%B4%D8%BA%D9%8A%D9%84-ci-cd-%D8%B9%D9%84%D9%89-%D8%AE%D8%A7%D8%AF%D9%85%D9%83/)، والأوامر في التجربة التالية هي نفسها التي تضعها في خطوات ذلك الخط.
## تجربة عملية: أربع طبقات من الاختبارات وثلاثة أخطاء متعمدة
سوف نبني تطبيق مهام صغيراً بلغة Python وإطار FastAPI، فيه تسجيل دخول وقائمة مهام لكل مستخدم في PostgreSQL، ثم نكتب له اختبارات وحدة ب pytest، واختبارات تكامل على PostgreSQL حقيقية، واختبار API بأداة Hurl، واختبارات E2E ب Playwright داخل ال Docker Image الرسمية. بعد ذلك نكسر الكود ثلاث مرات، في كل مرة في طبقة مختلفة، ونرى أي اختبار يكشف الخطأ وأي اختبار يفوته، ثم نصنع اختباراً متقلباً ونصلحه. وكل ال Containers تبدأ بالاسم `lab-test-`، والتطبيق ينشر على المنفذ `127.0.0.1:19280` فقط.
### ملفات التجربة
شكل المجلد كما يلي:
```text
lab-test/
├── compose.yaml
├── Dockerfile
├── requirements.txt
├── pytest.ini
├── app/
│ ├── __init__.py
│ ├── logic.py
│ ├── repo.py
│ └── main.py
├── tests/
│ ├── unit/test_logic.py
│ └── integration/test_repo.py
├── api/items.hurl
└── e2e/
├── package.json
├── playwright.config.ts
└── tests/
├── items.spec.ts
└── flaky.spec.ts
```
ملف `compose.yaml` يشغل قاعدة البيانات والتطبيق على شبكة باسم `lab-test-net`، ولاحظ المتغير `SLOW_LIST` الذي يجعل قائمة المهام تتأخر وقتاً عشوائياً، وسوف نحتاجه في قسم الاختبار المتقلب:
```yaml
name: lab-test
services:
db:
image: postgres:18-alpine
container_name: lab-test-db
environment:
POSTGRES_USER: app
POSTGRES_PASSWORD: app-pass
POSTGRES_DB: app
healthcheck:
test: ["CMD-SHELL", "pg_isready -U app"]
interval: 2s
retries: 20
app:
build: .
image: lab-test-app:1
container_name: lab-test-app
environment:
DATABASE_URL: postgresql://app:app-pass@lab-test-db:5432/app
SLOW_LIST: "1"
ports:
- "127.0.0.1:19280:8000"
depends_on:
db:
condition: service_healthy
networks:
default:
name: lab-test-net
```
وملف `Dockerfile` وملف المكتبات بإصداراتها، وملف `pytest.ini` الذي يجعل pytest يجد الحزمة `app`:
```dockerfile
FROM python:3.13-slim
WORKDIR /src
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app ./app
COPY tests ./tests
COPY pytest.ini .
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000"]
```
```text
fastapi==0.142.2
uvicorn==0.54.0
psycopg[binary]==3.3.6
python-multipart
pytest==9.1.1
pytest-cov==7.1.0
```
```ini
[pytest]
pythonpath = .
testpaths = tests
```
المنطق في ملف `app/logic.py`، وهو دالة تنظف عنوان المهمة وترفض الفارغ وما زاد على 80 حرفاً، ودالة تنشئ المهمة عبر مستودع البيانات الذي تعطيه لها، وهذا الفصل هو ما يسمح لنا باختبارها ببديل:
```python
MAX_TITLE = 80
def clean_title(raw: str) -> str:
"""Trim the title, collapse inner spaces and enforce the length limit."""
title = " ".join((raw or "").split())
if not title:
raise ValueError("title is empty")
if len(title) > MAX_TITLE:
raise ValueError(f"title is longer than {MAX_TITLE} characters")
return title
def create_item(repo, owner: str, raw_title: str) -> dict:
"""Validate the title, then ask the repository to store it."""
title = clean_title(raw_title)
return repo.add(owner, title)
```
ومستودع البيانات في `app/repo.py` هو المكان الوحيد الذي يكتب SQL:
```python
SCHEMA = """
CREATE TABLE IF NOT EXISTS items (
id serial PRIMARY KEY,
owner text NOT NULL,
title text NOT NULL,
created_at timestamptz NOT NULL DEFAULT now()
)
"""
class PgRepo:
def __init__(self, conn):
self.conn = conn
def init(self):
with self.conn.cursor() as cur:
cur.execute(SCHEMA)
def add(self, owner, title):
with self.conn.cursor() as cur:
cur.execute(
"INSERT INTO items (owner, title) VALUES (%s, %s) RETURNING id, title",
(owner, title),
)
row = cur.fetchone()
return {"id": row[0], "title": row[1]}
def list(self, owner):
with self.conn.cursor() as cur:
cur.execute(
"SELECT id, title FROM items WHERE owner = %s ORDER BY id DESC",
(owner,),
)
return [{"id": r[0], "title": r[1]} for r in cur.fetchall()]
```
والتطبيق في `app/main.py`، وفيه صفحة تسجيل دخول وصفحة مهام تحمل القائمة ب JavaScript من `/api/items` وترسل المهمة الجديدة بطلب POST، وهو تطبيق تجربة فقط، فالجلسات في الذاكرة وكلمات المرور مكتوبة في الكود، ولا تقم بنقل هذا الشكل إلى تطبيق حقيقي:
```python
import os, random, secrets, time
from contextlib import asynccontextmanager
import psycopg
from fastapi import FastAPI, Form, Request
from fastapi.responses import HTMLResponse, JSONResponse, RedirectResponse
from pydantic import BaseModel
from app.logic import create_item
from app.repo import PgRepo
DB = os.environ["DATABASE_URL"]
USERS = {"alice": "alice-pass", "bob": "bob-pass"}
SESSIONS = {} # token -> username (in memory: enough for a lab)
SLOW_LIST = os.environ.get("SLOW_LIST") == "1"
def repo():
return PgRepo(psycopg.connect(DB, autocommit=True))
@asynccontextmanager
async def lifespan(app):
repo().init() # create the table on start
yield
app = FastAPI(lifespan=lifespan)
def current_user(request: Request):
return SESSIONS.get(request.cookies.get("session", ""))
@app.get("/health")
def health():
return {"status": "ok"}
@app.post("/login")
def login(username: str = Form(...), password: str = Form(...)):
if USERS.get(username) != password:
return HTMLResponse(LOGIN_PAGE.replace("", 'بيانات الدخول غير صحيحة
'), status_code=401)
token = secrets.token_hex(16)
SESSIONS[token] = username
resp = RedirectResponse("/", status_code=303)
resp.set_cookie("session", token, httponly=True, samesite="lax")
return resp
class NewItem(BaseModel):
title: str
@app.get("/api/items")
def list_items(request: Request):
user = current_user(request)
if not user:
return JSONResponse({"error": "login required"}, status_code=401)
if SLOW_LIST:
time.sleep(random.uniform(0.2, 1.2)) # a slow database or network, on purpose
return repo().list(user)
@app.post("/api/items", status_code=201)
def add_item(item: NewItem, request: Request):
user = current_user(request)
if not user:
return JSONResponse({"error": "login required"}, status_code=401)
try:
return create_item(repo(), user, item.title)
except ValueError as e:
return JSONResponse({"error": str(e)}, status_code=422)
@app.get("/", response_class=HTMLResponse)
def home(request: Request):
user = current_user(request)
if not user:
return LOGIN_PAGE
return ITEMS_PAGE.replace("{{user}}", user)
LOGIN_PAGE = """تسجيل الدخول
تسجيل الدخول
"""
ITEMS_PAGE = """مهامي
مهام {{user}}
"""
```
### اختبارات الوحدة
اختبارات الوحدة في `tests/unit/test_logic.py` لا تحتاج قاعدة بيانات، ولاحظ فيها الاختبارين اللذين يتحققان من الحد بالضبط، 80 حرفاً مقبولة و81 مرفوضة، والبديلين: `FakeRepo` يحفظ في قائمة، و`Mock` يتحقق أن `add` لم تستدع:
```python
from unittest.mock import Mock
import pytest
from app.logic import MAX_TITLE, clean_title, create_item
def test_trims_and_collapses_spaces():
assert clean_title(" شراء خبز ") == "شراء خبز"
def test_empty_title_is_rejected():
with pytest.raises(ValueError, match="empty"):
clean_title(" ")
def test_title_at_the_limit_is_accepted():
assert len(clean_title("a" * MAX_TITLE)) == MAX_TITLE
def test_title_over_the_limit_is_rejected():
with pytest.raises(ValueError, match="longer"):
clean_title("a" * (MAX_TITLE + 1))
class FakeRepo:
"""A fake: a real, working repository that keeps items in a list."""
def __init__(self):
self.rows = []
def add(self, owner, title):
self.rows.append((owner, title))
return {"id": len(self.rows), "title": title}
def list(self, owner):
return [{"id": i + 1, "title": t} for i, (o, t) in enumerate(self.rows) if o == owner]
def test_create_item_stores_the_clean_title():
repo = FakeRepo()
create_item(repo, "alice", " مهمة أولى ")
assert repo.list("alice") == [{"id": 1, "title": "مهمة أولى"}]
def test_invalid_title_never_reaches_the_repository():
repo = Mock() # a mock: we check how it was called
with pytest.raises(ValueError):
create_item(repo, "alice", "")
repo.add.assert_not_called()
```
### اختبارات التكامل على PostgreSQL حقيقية
اختبارات التكامل في `tests/integration/test_repo.py` تتصل بقاعدة البيانات الحقيقية، وكل اختبار يعمل داخل Transaction يلغى في النهاية بالأمر `rollback`، فلا يترك أثراً لغيره، ولاحظ الاختبار الثاني الذي يتحقق صراحة أن أليس لا ترى مهمة بوب:
```python
import os
import psycopg
import pytest
from app.repo import PgRepo
@pytest.fixture
def repo():
# A real PostgreSQL; every test runs inside a transaction that is rolled back at the end
conn = psycopg.connect(os.environ["DATABASE_URL"])
r = PgRepo(conn)
r.init()
yield r
conn.rollback()
conn.close()
def test_add_then_list_newest_first(repo):
repo.add("alice", "الأولى")
repo.add("alice", "الثانية")
titles = [i["title"] for i in repo.list("alice")]
assert titles[:2] == ["الثانية", "الأولى"]
def test_users_do_not_see_each_other_items(repo):
repo.add("alice", "مهمة أليس")
repo.add("bob", "مهمة بوب")
titles = [i["title"] for i in repo.list("alice")]
assert "مهمة أليس" in titles
assert "مهمة بوب" not in titles
def test_long_unicode_title_round_trips(repo):
title = "مهمة " * 15
saved = repo.add("alice", title.strip())
assert repo.list("alice")[0]["title"] == saved["title"]
```
### اختبار ال API بأداة Hurl
اختبار ال API في ملف نصي واحد بصيغة [Hurl](https://hurl.dev/?ref=arabroot.io)، وكل طلب فيه يتبعه رمز الحالة المتوقع والتحققات، وHurl يحفظ ال Cookie بين الطلبات في الملف نفسه:
```text
# 1. Without logging in, the API refuses
GET http://lab-test-app:8000/api/items
HTTP 401
# 2. Log in: Hurl keeps the session cookie for the next requests
POST http://lab-test-app:8000/login
[Form]
username: alice
password: alice-pass
HTTP 303
# 3. Add an item
POST http://lab-test-app:8000/api/items
{"title": " مهمة من Hurl "}
HTTP 201
[Asserts]
jsonpath "$.title" == "مهمة من Hurl"
jsonpath "$.id" isInteger
# 4. The new item is in the list
GET http://lab-test-app:8000/api/items
HTTP 200
[Asserts]
jsonpath "$[0].title" == "مهمة من Hurl"
# 5. An empty title is rejected with a clear error
POST http://lab-test-app:8000/api/items
{"title": " "}
HTTP 422
[Asserts]
jsonpath "$.error" == "title is empty"
```
### اختبار E2E ب Playwright
ملف الإعداد يحدد عنوان التطبيق داخل شبكة Docker، والمتصفحات الثلاثة، ويحفظ التتبع واللقطة عند الفشل فقط:
```json
{
"name": "lab-test-e2e",
"private": true,
"devDependencies": {
"@playwright/test": "1.63.0"
}
}
```
```typescript
import { defineConfig, devices } from '@playwright/test';
export default defineConfig({
testDir: './tests',
fullyParallel: true,
retries: process.env.CI ? 2 : 0,
reporter: [['list'], ['html', { open: 'never' }]],
use: {
baseURL: process.env.BASE_URL || 'http://lab-test-app:8000',
trace: 'retain-on-failure',
screenshot: 'only-on-failure',
},
projects: [
{ name: 'chromium', use: { ...devices['Desktop Chrome'] } },
{ name: 'firefox', use: { ...devices['Desktop Firefox'] } },
{ name: 'webkit', use: { ...devices['Desktop Safari'] } },
],
});
```
والاختبار نفسه يسجل الدخول ويضيف مهمة باسم فريد ويتحقق من رسالة النجاح ومن ظهور المهمة في القائمة، ولاحظ أن كل المحددات بالدور أو بالنص الظاهر للمستخدم:
```typescript
import { test, expect } from '@playwright/test';
test('user logs in and adds an item', async ({ page }) => {
const title = `اشتر حليباً ${Date.now()}`;
await page.goto('/');
await page.getByLabel('اسم المستخدم').fill('alice');
await page.getByLabel('كلمة المرور').fill('alice-pass');
await page.getByRole('button', { name: 'دخول' }).click();
await expect(page.getByRole('heading', { name: 'مهام alice' })).toBeVisible();
await page.getByLabel('عنوان المهمة').fill(title);
await page.getByRole('button', { name: 'إضافة' }).click();
await expect(page.getByRole('status')).toHaveText('تمت الإضافة');
await expect(page.getByRole('listitem').filter({ hasText: title })).toBeVisible();
});
```
### التشغيل: كل الطبقات خضراء
الآن نشغل قاعدة البيانات والتطبيق:
```bash
cd lab-test
docker compose up -d --build
curl -s http://127.0.0.1:19280/health
```
والمخرج سوف يكون كما يلي:
```text
{"status":"ok"}
```
ثم اختبارات الوحدة مع قياس التغطية لملف المنطق:
```bash
docker run --rm --name lab-test-unit lab-test-app:1 \
pytest tests/unit -v --cov=app.logic --cov-report=term-missing
```
والمخرج سوف يكون كما يلي:
```text
============================= test session starts ==============================
platform linux -- Python 3.13.16, pytest-9.1.1, pluggy-1.6.0 -- /usr/local/bin/python3.13
cachedir: .pytest_cache
rootdir: /src
configfile: pytest.ini
plugins: cov-7.1.0, anyio-4.15.1
collecting ... collected 6 items
tests/unit/test_logic.py::test_trims_and_collapses_spaces PASSED [ 16%]
tests/unit/test_logic.py::test_empty_title_is_rejected PASSED [ 33%]
tests/unit/test_logic.py::test_title_at_the_limit_is_accepted PASSED [ 50%]
tests/unit/test_logic.py::test_title_over_the_limit_is_rejected PASSED [ 66%]
tests/unit/test_logic.py::test_create_item_stores_the_clean_title PASSED [ 83%]
tests/unit/test_logic.py::test_invalid_title_never_reaches_the_repository PASSED [100%]
================================ tests coverage ================================
_______________ coverage: platform linux, python 3.13.16-final-0 _______________
Name Stmts Miss Cover Missing
--------------------------------------------
app/logic.py 11 0 100%
--------------------------------------------
TOTAL 11 0 100%
============================== 6 passed in 0.18s ===============================
```
ثم اختبارات التكامل على الشبكة نفسها مع قاعدة البيانات:
```bash
docker run --rm --name lab-test-integration --network lab-test-net \
-e DATABASE_URL=postgresql://app:app-pass@lab-test-db:5432/app \
lab-test-app:1 pytest tests/integration -v
```
```text
============================= test session starts ==============================
platform linux -- Python 3.13.16, pytest-9.1.1, pluggy-1.6.0 -- /usr/local/bin/python3.13
cachedir: .pytest_cache
rootdir: /src
configfile: pytest.ini
plugins: cov-7.1.0, anyio-4.15.1
collecting ... collected 3 items
tests/integration/test_repo.py::test_add_then_list_newest_first PASSED [ 33%]
tests/integration/test_repo.py::test_users_do_not_see_each_other_items PASSED [ 66%]
tests/integration/test_repo.py::test_long_unicode_title_round_trips PASSED [100%]
============================== 3 passed in 0.23s ===============================
```
ثم اختبار ال API ب Hurl من ال Docker Image الرسمية:
```bash
docker run --rm --name lab-test-api --network lab-test-net \
-v "$PWD/api:/api" ghcr.io/orange-opensource/hurl:8.0.0 --test /api/items.hurl
```
```text
Success /api/items.hurl (5 request(s) in 673 ms)
--------------------------------------------------------------------------------
Executed files: 1
Executed requests: 5 (7.4/s)
Succeeded files: 1 (100.0%)
Failed files: 0 (0.0%)
Duration: 677 ms (0h:0m:0s:677ms)
```
وأخيراً اختبار E2E في ال Docker Image الرسمية ل Playwright على المتصفحات الثلاثة:
```bash
docker run --rm --name lab-test-e2e --init --ipc=host --network lab-test-net \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
sh -c "npm install --no-audit --no-fund >/dev/null 2>&1; npx playwright --version; npx playwright test tests/items.spec.ts"
```
```text
Version 1.63.0
Running 3 tests using 3 workers
✓ 2 [chromium] › tests/items.spec.ts:3:5 › user logs in and adds an item (1.9s)
✓ 3 [webkit] › tests/items.spec.ts:3:5 › user logs in and adds an item (2.8s)
✓ 1 [firefox] › tests/items.spec.ts:3:5 › user logs in and adds an item (6.0s)
3 passed (10.2s)
```
في المخرجات أعلاه لاحظ التالي:
- اختبارات الوحدة الستة انتهت في 0.18 ثانية، والتكامل الثلاثة في 0.23 ثانية مع قاعدة بيانات حقيقية، وطلبات Hurl الخمسة في أقل من ثانية، أما اختبار المتصفح الواحد فأخذ بين ثانيتين وست ثوان لكل متصفح، وعشر ثوان للمجموعة، وهذا هو الهرم بالأرقام على جهازنا، والأرقام للتوضيح فقط وتختلف من جهاز لآخر.
- الاختبار نفسه عمل على Chromium وFirefox وWebKit بالتوازي في ثلاثة Workers دون أي تغيير في الكود.
- تغطية `app/logic.py` هي 100%، فلا يوجد سطر لم ينفذ، وسوف نرى بعد قليل ماذا يساوي هذا الرقم فعلاً.
### الخطأ الأول: الحد الأقصى، تكشفه اختبارات الوحدة ويفوته المتصفح
لنفرض أن أحد المطورين غير شرط الطول في `app/logic.py` من `>` إلى `>=`، وهو خطأ من نوع «أقل بواحد» Off-by-one، فأصبح العنوان الذي طوله 80 حرفاً بالضبط مرفوضاً:
```python
if len(title) >= MAX_TITLE:
```
بعد إعادة البناء بالأمر `docker compose up -d --build` نشغل اختبارات الوحدة:
```bash
docker run --rm --name lab-test-unit lab-test-app:1 pytest tests/unit
```
```text
============================= test session starts ==============================
platform linux -- Python 3.13.16, pytest-9.1.1, pluggy-1.6.0
rootdir: /src
configfile: pytest.ini
plugins: cov-7.1.0, anyio-4.15.1
collected 6 items
tests/unit/test_logic.py ..F... [100%]
=================================== FAILURES ===================================
_____________________ test_title_at_the_limit_is_accepted ______________________
def test_title_at_the_limit_is_accepted():
> assert len(clean_title("a" * MAX_TITLE)) == MAX_TITLE
^^^^^^^^^^^^^^^^^^^^^^^^^^^^
tests/unit/test_logic.py:18:
_ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _ _
raw = 'aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa'
def clean_title(raw: str) -> str:
"""Trim the title, collapse inner spaces and enforce the length limit."""
title = " ".join((raw or "").split())
if not title:
raise ValueError("title is empty")
if len(title) >= MAX_TITLE:
> raise ValueError(f"title is longer than {MAX_TITLE} characters")
E ValueError: title is longer than 80 characters
app/logic.py:10: ValueError
=========================== short test summary info ============================
FAILED tests/unit/test_logic.py::test_title_at_the_limit_is_accepted - ValueE...
========================= 1 failed, 5 passed in 0.10s ==========================
```
اختبار الحد بالضبط فشل وأشار إلى السطر نفسه في `app/logic.py:10`، أما اختبار المتصفح فنجح، لأنه يضيف عنواناً قصيراً لا يقترب من الحد:
```bash
docker run --rm --name lab-test-e2e --init --ipc=host --network lab-test-net \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
npx playwright test tests/items.spec.ts --project=chromium
```
```text
Running 1 test using 1 worker
✓ 1 [chromium] › tests/items.spec.ts:3:5 › user logs in and adds an item (17.3s)
1 passed (31.0s)
```
والآن السؤال المهم: ماذا لو لم يكتب أحد اختبار الحد بالضبط؟ نشغل الاختبارات نفسها على الكود المكسور مع استبعاد هذا الاختبار وحده، ونقيس التغطية:
```bash
docker run --rm --name lab-test-unit lab-test-app:1 pytest tests/unit -q --cov=app.logic \
--deselect tests/unit/test_logic.py::test_title_at_the_limit_is_accepted
```
```text
..... [100%]
================================ tests coverage ================================
_______________ coverage: platform linux, python 3.13.16-final-0 _______________
Name Stmts Miss Cover
----------------------------------
app/logic.py 11 0 100%
----------------------------------
TOTAL 11 0 100%
5 passed, 1 deselected in 0.14s
```
كل الاختبارات نجحت والتغطية 100% والكود فيه خطأ، لأن اختبار 81 حرفاً ينفذ سطر الرفض نفسه فيحسب السطر مغطى، لكن لا يوجد اختبار يتحقق من أن 80 مقبولة. وهذا بالضبط ما قصده مقال Google بأن التغطية تقول ما نفذ وليس ما اختبر، وهو أيضاً بالضبط نوع التغيير الذي يصنعه اختبار الطفرات ليكشف هذه الفجوة.
### الخطأ الثاني: تسرب البيانات، يكشفه التكامل ويفوته ال API
نعيد الشرط كما كان، ثم نفرض أن مطوراً نسخ استعلاماً من صفحة الإدارة إلى `list` في `app/repo.py` ونسي شرط المالك، فأصبح كل مستخدم يرى مهام الجميع:
```python
def list(self, owner):
with self.conn.cursor() as cur:
cur.execute("SELECT id, title FROM items ORDER BY id DESC")
return [{"id": r[0], "title": r[1]} for r in cur.fetchall()]
```
اختبارات الوحدة تنجح كلها، لأن `FakeRepo` يفلتر بالمالك بشكل صحيح ولا يعرف شيئاً عن SQL:
```bash
docker run --rm --name lab-test-unit lab-test-app:1 pytest tests/unit -q
```
```text
...... [100%]
6 passed in 0.09s
```
أما اختبارات التكامل فتكشفه فوراً:
```bash
docker run --rm --name lab-test-integration --network lab-test-net \
-e DATABASE_URL=postgresql://app:app-pass@lab-test-db:5432/app \
lab-test-app:1 pytest tests/integration
```
```text
============================= test session starts ==============================
platform linux -- Python 3.13.16, pytest-9.1.1, pluggy-1.6.0
rootdir: /src
configfile: pytest.ini
plugins: cov-7.1.0, anyio-4.15.1
collected 3 items
tests/integration/test_repo.py .F. [100%]
=================================== FAILURES ===================================
____________________ test_users_do_not_see_each_other_items ____________________
repo =
def test_users_do_not_see_each_other_items(repo):
repo.add("alice", "مهمة أليس")
repo.add("bob", "مهمة بوب")
titles = [i["title"] for i in repo.list("alice")]
assert "مهمة أليس" in titles
> assert "مهمة بوب" not in titles
E AssertionError: assert 'مهمة بوب' not in ['مهمة بوب', 'مهمة أليس', 'مهمة من Hurl', 'اشتر حليباً 1791265788834', 'اشتر حليباً 1791265702834', 'اشتر حليباً 1791265701929', ...]
tests/integration/test_repo.py:32: AssertionError
=========================== short test summary info ============================
FAILED tests/integration/test_repo.py::test_users_do_not_see_each_other_items
========================= 1 failed, 2 passed in 0.47s ==========================
```
واختبار ال API ينجح رغم أن الخطأ في الطريق الذي يختبره:
```bash
docker run --rm --name lab-test-api --network lab-test-net \
-v "$PWD/api:/api" ghcr.io/orange-opensource/hurl:8.0.0 --test /api/items.hurl
```
```text
Success /api/items.hurl (5 request(s) in 569 ms)
--------------------------------------------------------------------------------
Executed files: 1
Executed requests: 5 (8.4/s)
Succeeded files: 1 (100.0%)
Failed files: 0 (0.0%)
Duration: 598 ms (0h:0m:0s:598ms)
```
في المخرجات أعلاه لاحظ التالي:
- اختبار التكامل الذي فشل هو الذي يبحث عن هذا الخطأ تحديداً، أما الاختباران الآخران على الكود نفسه فنجحا، فالتغطية وحدها لم تكن لتكشفه.
- القائمة في رسالة الفشل فيها مهام من تشغيلات سابقة ومن مستخدمين آخرين، وهذا بالضبط ما يراه المستخدم في الإنتاج: بيانات غيره.
- اختبار ال API سجل الدخول بمستخدم واحد فقط، ورأى مهمته في أول القائمة، فنجح. فالاختبار لا يكشف إلا ما يبحث عنه، ولو أضفنا إلى ملف Hurl تسجيل دخول ثانياً لبوب والتحقق من أنه لا يرى مهمة أليس لكشفه، وهذا هو المكان الصحيح لاختبارات الصلاحيات في كل API.
- الخطأ نفسه خطير أمنياً، فهو من نوع التحكم في الوصول المكسور Broken Access Control، وهذا مثال على أن اختباراتك العادية جزء من الأمان.
### الخطأ الثالث: اسم حقل في الواجهة، يكشفه المتصفح وحده
نعيد الاستعلام كما كان، ثم نغير سطراً واحداً في JavaScript داخل `app/main.py`، فترسل الصفحة الحقل باسم `name` بدل `title`، كأن مطور الواجهة اتبع اسماً قديماً في وثيقة:
```javascript
body: JSON.stringify({name: title})});
```
الطبقات الثلاث الأولى خضراء كلها، لأن أياً منها لا يشغل JavaScript الصفحة:
```bash
docker run --rm --name lab-test-unit lab-test-app:1 pytest tests/unit -q | tail -1
docker run --rm --name lab-test-integration --network lab-test-net \
-e DATABASE_URL=postgresql://app:app-pass@lab-test-db:5432/app \
lab-test-app:1 pytest tests/integration -q | tail -1
docker run --rm --name lab-test-api --network lab-test-net \
-v "$PWD/api:/api" ghcr.io/orange-opensource/hurl:8.0.0 --test /api/items.hurl 2>&1 | head -1
```
```text
6 passed in 0.07s
3 passed in 0.28s
Success /api/items.hurl (5 request(s) in 539 ms)
```
أما اختبار المتصفح ففشل:
```bash
docker run --rm --name lab-test-e2e --init --ipc=host --network lab-test-net \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
npx playwright test tests/items.spec.ts --project=chromium
```
```text
Running 1 test using 1 worker
✘ 1 [chromium] › tests/items.spec.ts:3:5 › user logs in and adds an item (6.1s)
1) [chromium] › tests/items.spec.ts:3:5 › user logs in and adds an item ──────────────────────────
Error: expect(locator).toHaveText(expected) failed
Locator: getByRole('status')
Expected: "تمت الإضافة"
Received: "خطأ: undefined"
Timeout: 5000ms
Call log:
- Expect "toHaveText" getByRole('status') with timeout 5000ms
- waiting for getByRole('status')
14 × locator resolved to خطأ: undefined
- unexpected value "خطأ: undefined"
13 | await page.getByRole('button', { name: 'إضافة' }).click();
14 |
> 15 | await expect(page.getByRole('status')).toHaveText('تمت الإضافة');
| ^
16 | await expect(page.getByRole('listitem').filter({ hasText: title })).toBeVisible();
17 | });
18 |
at /e2e/tests/items.spec.ts:15:42
attachment #1: screenshot (image/png) ──────────────────────────────────────────────────────────
test-results/items-user-logs-in-and-adds-an-item-chromium/test-failed-1.png
────────────────────────────────────────────────────────────────────────────────────────────────
Error Context: test-results/items-user-logs-in-and-adds-an-item-chromium/error-context.md
attachment #3: trace (application/zip) ─────────────────────────────────────────────────────────
test-results/items-user-logs-in-and-adds-an-item-chromium/trace.zip
Usage:
npx playwright show-trace test-results/items-user-logs-in-and-adds-an-item-chromium/trace.zip
────────────────────────────────────────────────────────────────────────────────────────────────
1 failed
[chromium] › tests/items.spec.ts:3:5 › user logs in and adds an item ───────────────────────────
```
في المخرج أعلاه لاحظ التالي:
- التحقق `toHaveText` أعاد الفحص 14 مرة خلال المهلة، 5 ثوان، قبل أن يقرر الفشل، فهذا ليس تقلباً في التوقيت وإنما نتيجة ثابتة.
- Playwright حفظ ثلاثة ملفات في `test-results`: لقطة الشاشة لحظة الفشل، وملف `error-context.md`، وملف التتبع `trace.zip`، لأننا طلبنا ذلك في الإعداد عند الفشل فقط.
- الرسالة `خطأ: undefined` تقول إن ال API رد بخطأ لكن الصفحة لم تجد فيه حقل `error`، وهذا يكفي لتشك في الطلب نفسه.
والصورة التالية هي لقطة الشاشة التي حفظها Playwright لحظة الفشل، كما هي:
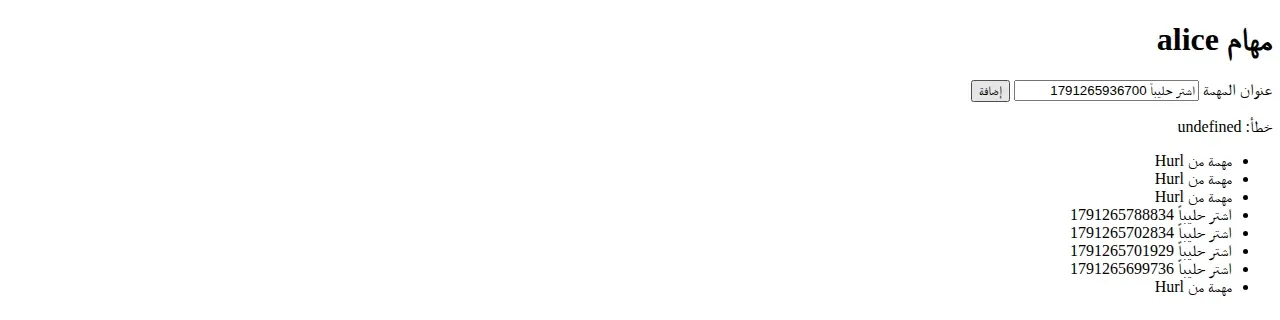
اللقطة التي حفظها Playwright لحظة الفشل، والرسالة الظاهرة هي رسالة الخطأ التي ظهرت للمستخدم
ولنعرف السبب نفتح ملف التتبع بعارض التتبع، وقد شغلناه داخل ال Docker Image نفسها ونشرناه على منفذ محلي:
```bash
docker run -d --name lab-test-trace -p 127.0.0.1:19281:9323 \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
npx playwright show-trace --host 0.0.0.0 --port 9323 \
test-results/items-user-logs-in-and-adds-an-item-chromium/trace.zip
```
ثم فتحنا `http://127.0.0.1:19281/` في المتصفح، واخترنا تبويب Network، والصورة التالية تبين ما ظهر:
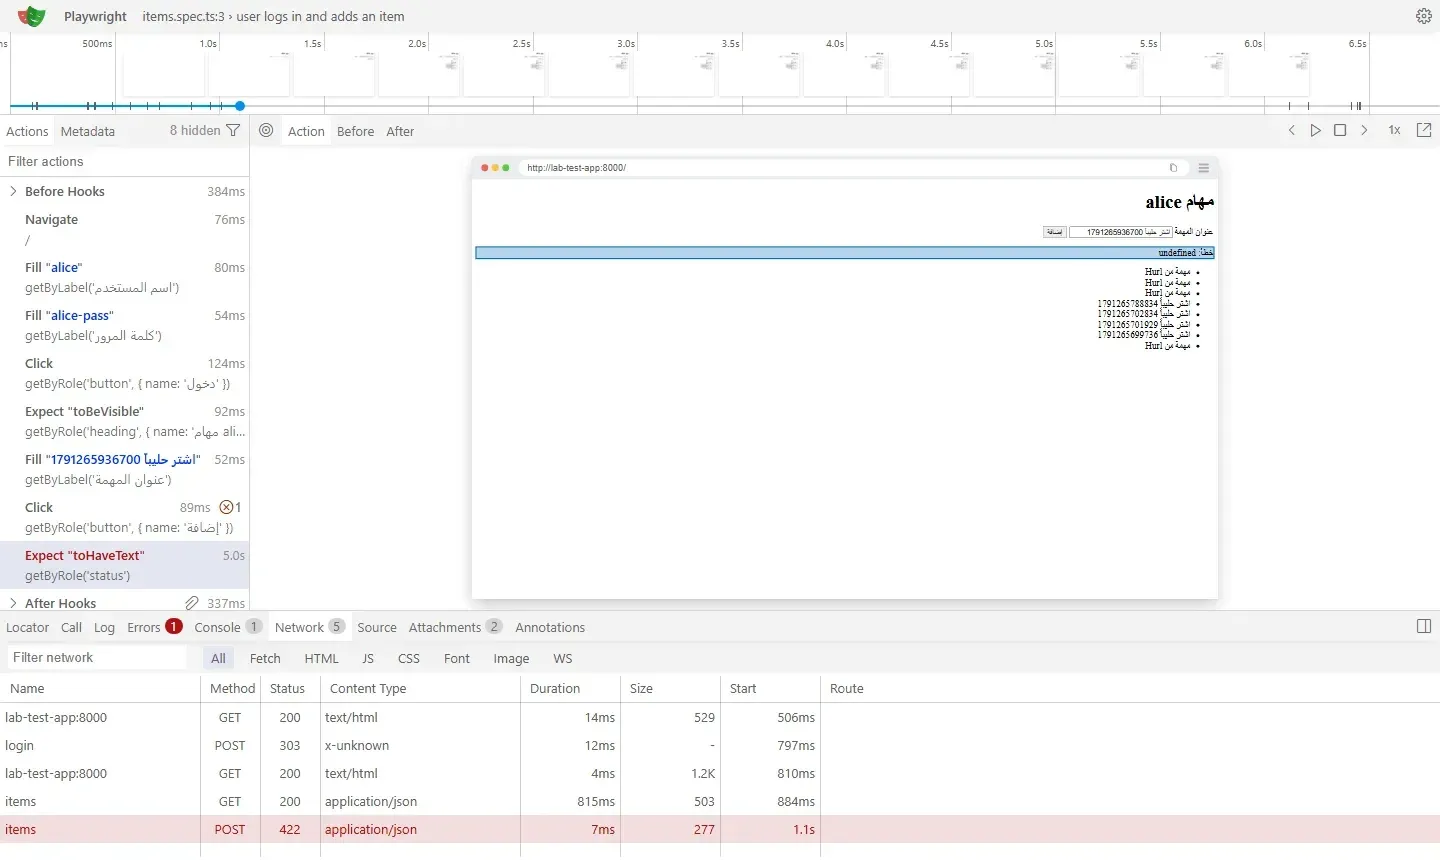
عارض التتبع يكشف السبب: طلب POST إلى ال API رد ب 422، أي أن ما أرسلته الصفحة لم يطابق ما يتوقعه ال API
لاحظ أن كل خطوة في القائمة على اليسار لها زمنها، وأن النقر على زر الإضافة عليه علامة خطأ، وأن طلب `POST items` رد ب 422، أي أن ال API رفض شكل الطلب، فتعرف خلال دقيقة أن المشكلة في جسم الطلب الذي ترسله الصفحة وليست في ال API، دون أن تعيد تشغيل الاختبار أو تضيف سطر طباعة واحداً. وبعد ذلك أوقفنا عارض التتبع بالأمر `docker rm -f lab-test-trace`.
والخلاصة من الأخطاء الثلاثة في جدول:
| الخطأ | Unit | Integration | API | E2E |
| ---------------------- | ---- | ----------- | -------- | -------- |
| الحد الأقصى \>= | كشفه | لم نشغله | لم نشغله | فاته |
| تسرب بيانات المستخدمين | فاته | كشفه | فاته | لم نشغله |
| اسم الحقل في الواجهة | فاته | فاته | فاته | كشفه |
وهذا هو السبب الحقيقي لوجود أكثر من نوع، فكل طبقة ترى جزءاً من التطبيق ولا ترى غيره.
### اختبار متقلب: انتظار ثابت مقابل الانتظار التلقائي
بعد إعادة السطر كما كان نضيف ملف `e2e/tests/flaky.spec.ts` فيه اختباران يفعلان الشيء نفسه، يسجلان الدخول ببوب ويضيفان مهمة، والفرق في طريقة التحقق فقط، فالأول ينتظر 700 مللي ثانية ثابتة ثم يقرأ عناصر القائمة مرة واحدة، والثاني يستخدم تحققاً يعيد المحاولة. وتذكر أن القائمة في تطبيقنا تتأخر وقتاً عشوائياً بين 200 و1200 مللي ثانية بسبب `SLOW_LIST=1`، وهذا يشبه API بطيئاً في الواقع:
```typescript
import { test, expect } from '@playwright/test';
// The list is loaded by JavaScript after a random delay (SLOW_LIST=1), like a slow API
async function loginAsBobAndAdd(page, title: string) {
await page.goto('/');
await page.getByLabel('اسم المستخدم').fill('bob');
await page.getByLabel('كلمة المرور').fill('bob-pass');
await page.getByRole('button', { name: 'دخول' }).click();
await page.getByLabel('عنوان المهمة').fill(title);
await page.getByRole('button', { name: 'إضافة' }).click();
}
test('naive: fixed sleep, then count once', async ({ page }) => {
const title = `naive ${crypto.randomUUID().slice(0, 8)}`;
await loginAsBobAndAdd(page, title);
await page.waitForTimeout(700); // "should be enough"
const texts = await page.getByRole('listitem').allTextContents();
expect(texts).toContain(title); // checked once, no retry
});
test('web-first: let Playwright wait', async ({ page }) => {
const title = `web-first ${crypto.randomUUID().slice(0, 8)}`;
await loginAsBobAndAdd(page, title);
await expect(page.getByRole('listitem').filter({ hasText: title })).toBeVisible();
});
```
والخيار `--repeat-each=20` يشغل كل اختبار عشرين مرة، وهو الطريقة الأسرع لكشف التقلب قبل أن يكشفه خط CI:
```bash
docker run --rm --name lab-test-e2e --init --ipc=host --network lab-test-net \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
npx playwright test tests/flaky.spec.ts --project=chromium --repeat-each=20 --reporter=dot
```
والمخرج كان كما يلي، وقد اختصرنا تفاصيل الفشل المتكررة إلى أولها:
```text
Running 40 tests using 4 workers
·F·F·················FF··············F··
1) [chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ───────────────────
Error: expect(received).toContain(expected) // indexOf
Expected value: "naive 4df4186e"
Received array: ["web-first 19", "naive 19", "web-first 18", "naive 18", "web-first 17", "naive 17", "web-first 16", "naive 16", "naive 15", "web-first 15", …]
17 | await page.waitForTimeout(700); // "should be enough"
18 | const texts = await page.getByRole('listitem').allTextContents();
> 19 | expect(texts).toContain(title); // checked once, no retry
| ^
20 | });
21 |
22 | test('web-first: let Playwright wait', async ({ page }) => {
at /e2e/tests/flaky.spec.ts:19:17
…
5 failed
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
35 passed (55.1s)
```
في المخرج أعلاه لاحظ التالي:
- كل نقطة اختبار نجح وكل F اختبار فشل، والفشل الخمسة كلها في الاختبار الأول، أي 5 من 20 تشغيلاً، أما الاختبار الثاني فنجح عشرين مرة من عشرين على الكود نفسه والتطبيق نفسه.
- القائمة في رسالة الفشل الأولى فيها مهام كثيرة لكن ليس فيها المهمة الجديدة، لأن ما قرأه الاختبار هو القائمة القديمة قبل أن يعود طلب التحديث، وفي فشل آخر كانت القائمة فارغة تماماً لأن التحميل الأول نفسه لم يكن قد انتهى.
- لو كان هذا الاختبار في خط CI لنجح غالباً، وفشل مرة كل بضعة تشغيلات بلا سبب واضح، وهذا بالضبط ما يعلم الفريق أن يتجاهل اللون الأحمر.
وماذا يحدث إذا فعلنا إعادة المحاولة بالخيار `--retries=2` على الاختبار الأول وحده؟
```bash
docker run --rm --name lab-test-e2e --init --ipc=host --network lab-test-net \
-v "$PWD/e2e:/e2e" -w /e2e mcr.microsoft.com/playwright:v1.63.0-noble \
npx playwright test tests/flaky.spec.ts --project=chromium -g naive --repeat-each=10 --retries=2 --reporter=dot
```
```text
Running 10 tests using 4 workers
···×···±··×±
…
2 flaky
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
[chromium] › tests/flaky.spec.ts:14:5 › naive: fixed sleep, then count once ────────────────────
8 passed (20.9s)
```
العلامة × تعني محاولة فشلت، و± تعني أن الاختبار نجح في إعادة المحاولة، فلم يفشل التشغيل، لكن Playwright صنف الاختبارين بأنهما flaky في التقرير، وهذا هو الاستخدام الصحيح لإعادة المحاولة: أن تعرف الاختبار المتقلب فتصلحه بالطريقة الثانية، وليس أن يمر الخط باللون الأخضر وتنسى الأمر.
⚠️
في نسختنا الأولى من هذا الملف كان عنوان المهمة `naive` أو `web-first` مع رقم التكرار فقط، فتكررت العناوين نفسها بين التشغيلات لأن قاعدة البيانات تبقى، وفشل حتى الاختبار الثاني بخطأ `strict mode violation: ... resolved to 2 elements`، لأن المحدد وجد مهمتين بالاسم نفسه. وهذا سبب آخر للتقلب هو البيانات المشتركة بين الاختبارات، والحل الذي استخدمناه هو اسم فريد لكل تشغيل عبر `crypto.randomUUID()`.
### إزالة التجربة
نحذف ال Containers وال Volume والشبكة التي أنشأها ملف Compose، ثم ال Docker Image التي بنيناها، بالأسماء فقط:
```bash
docker compose -p lab-test down -v
docker rmi lab-test-app:1
```
وال Containers الأخرى في التجربة كلها شغلناها بالخيار `--rm` فحذفت عند انتهائها، أما ال Images الرسمية ل PostgreSQL وPlaywright وHurl فاحذفها بالأمر `docker rmi` باسمها إن لم تعد تحتاجها.
## أخطاء شائعة
- **البدء باختبارات المتصفح:** الفريق الذي يبدأ ب E2E لكل شيء ينتهي بمخروط الآيس كريم، مجموعة بطيئة ومتقلبة لا يثق بها أحد، فابدأ بالطبقات الأدنى واجعل المتصفح للمسارات الحرجة.
- **Mock لكل شيء:** اختبارات تمر لأن البدائل تتصرف كما تتوقع أنت، بينما الاعتماد الحقيقي يتصرف بشكل آخر، كما رأيت في خطأ التسرب.
- **اختبارات التكامل على قاعدة بيانات مختلفة عن الإنتاج:** SQLite بدل PostgreSQL يخفي الفروق التي تريد كشفها.
- **sleep في الاختبارات:** انتظار ثابت يجعل الاختبار بطيئاً ومتقلباً في الوقت نفسه، فانتظر الحالة نفسها بتحقق يعيد المحاولة.
- **إعادة التشغيل حتى يصبح أخضر:** إعادة المحاولة التلقائية بلا متابعة تخفي التقلب وتخفي معه أخطاء حقيقية تظهر أحياناً.
- **اختبارات تعتمد على بعضها:** اختبار يعتمد على مستخدم أنشأه اختبار قبله ينكسر عند التشغيل المتوازي أو بترتيب آخر.
- **التغطية كهدف رقمي:** اختبارات تنفذ الأسطر دون أن تتحقق من شيء ترفع الرقم ولا ترفع الثقة.
- **محددات CSS هشة:** `div:nth-child(3) > span` ينكسر مع أي تعديل في التصميم، فاستخدم الدور والنص الظاهر.
- **إصلاح الخطأ دون اختبار:** كل خطأ وصل إلى الإنتاج دون اختبار يعيد إنتاجه مرشح للعودة.
- **خط CI يأخذ نصف ساعة:** سوف يجمع المطورون تغييرات أكبر ليقللوا الانتظار، فتعود مشكلة الفروع الطويلة.
## قائمة تحقق
- كل طلب دمج يشغل الاختبارات آلياً، ولا يدمج شيء في main إذا فشلت.
- الخط كاملاً حتى نتيجة الطلب في أقل من عشر دقائق تقريباً، والمراحل السريعة أولاً.
- المنطق المهم له اختبارات وحدة تشمل الحدود والقيم الفارغة والنص العربي.
- كل مسار في ال API له اختبار تكامل أو API على قاعدة بيانات حقيقية في Container، ومعه اختبار صلاحيات «مستخدم لا يرى بيانات غيره».
- اختبارات E2E قليلة للمسارات الحرجة، بمحددات حسب الدور، وبلا sleep.
- كل اختبار مستقل ببياناته، ويعمل بالتوازي وبأي ترتيب.
- التتبع واللقطات تحفظ عند الفشل كملف مرفق في خط CI.
- الاختبارات المتقلبة تعزل وتحصل على مهمة بصاحب، ولا تبقى معزولة إلى الأبد.
- كل خطأ من الإنتاج يحصل على اختبار انحدار قبل إصلاحه.
- اختبار دخان يعمل بعد كل نشر.
## الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الاختبار الآلي في خط CI هو ما يجعلك تغير الكود دون خوف، والنقر اليدوي يبقى للاستكشاف وليس للتكرار.
- كل نوع يرى جزءاً من التطبيق: الوحدة ترى المنطق، والتكامل يرى الحدود مع قاعدة البيانات، وال API يرى التطبيق من الخارج، والمتصفح يرى ما يراه المستخدم، وقد رأيت في التجربة ثلاثة أخطاء لم تكشف كل منها إلا طبقة واحدة.
- الهرم والكأس يتفقان على أن اختبارات المتصفح قليلة، ولفريق صغير يبني تطبيق ويب فاختبارات التكامل وال API على قاعدة بيانات حقيقية تعطي أكبر ثقة مقابل وقتها.
- البدائل مفيدة للحدود البطيئة أو الخارجية، والإكثار منها يجعل الاختبارات تختبر البدائل نفسها.
- تغطية 100% لا تعني أن الكود مختبر، فاستخدمها لتجد ما لم يغط.
- الاختبار المتقلب أخطر من غيابه، فأصلح سببه، وفي المتصفح انتظر الحالة بتحقق يعيد المحاولة بدل الانتظار الثابت.
- Playwright خيار مفتوح المصدر متكامل لاختبارات المتصفح، بانتظار تلقائي ومتصفحات ثلاثة وعارض تتبع وDocker Image رسمية.
وفي مقالات قادمة بإذن الله سوف نتحدث عن اختبار الأحمال ب k6 وLocust، وعن فحوص الأمان في خط CI.
[دليلTrunk-Based Development: فروع قصيرة ودمج يوميلماذا تنفجر الفروع الطويلة يوم الإصدار، وكيف يدمج الفريق عمله في main كل يوم بأمان مع CI وFeature Flags.](https://arabroot.io/articles/%D8%A7%D9%84%D8%AA%D8%B7%D9%88%D9%8A%D8%B1-%D8%B9%D9%84%D9%89-%D8%A7%D9%84%D9%81%D8%B1%D8%B9-%D8%A7%D9%84%D8%B1%D8%A6%D9%8A%D8%B3%D9%8A-trunk-based/)[دليلمن الفرع إلى الإنتاج: البيئات وGitOps للفرقكيف يختبر فريقك كل ميزة وحدها ويعرضها على العميل دون أن تصل ميزة غير جاهزة إلى الإنتاج.](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%8A%D8%A6%D8%A7%D8%AA-%D9%88%D9%85%D8%B9%D8%A7%D9%8A%D9%86%D8%A9-%D8%A7%D9%84%D9%85%D9%8A%D8%B2%D8%A7%D8%AA-%D9%88-gitops-%D9%84%D9%84%D9%81%D8%B1%D9%82/)[دليلGit في العمل اليومي: الدمج والتراجع دون أن تخسر عملكمتى تستخدم Merge ومتى تستخدم Rebase، وكيف تنقل إصلاحاً إلى فرع الإصدار أو تسترجع عملاً ظننت أنه ضاع.](https://arabroot.io/articles/git-merge-%D9%88-rebase-%D9%88-cherry-pick/)[دليلGitea Actions: تشغيل CI/CD وبناء Docker Images على سيرفركاجعل سيرفرك يختبر الكود ويبني Docker Images تلقائياً مع كل push، دون أن يخرج كودك أو أسرارك إلى خدمة CI خارجية.](https://arabroot.io/articles/gitea-actions-%D8%AA%D8%B4%D8%BA%D9%8A%D9%84-ci-cd-%D8%B9%D9%84%D9%89-%D8%AE%D8%A7%D8%AF%D9%85%D9%83/)[دليلقبل أن تنشر تطبيقك على خادمك: قائمة تحقق للمطورالأخطاء التي لا تظهر إلا بعد نشر تطبيقك في Docker خلف Reverse Proxy، وكيف تعالج كل واحد منها قبل أن يصل إلى المستخدمين.](https://arabroot.io/articles/%D9%82%D8%A7%D8%A6%D9%85%D8%A9-%D8%AA%D8%AD%D9%82%D9%82-%D8%A7%D9%84%D9%85%D8%B7%D9%88%D8%B1-%D9%82%D8%A8%D9%84-%D9%86%D8%B4%D8%B1-%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%87/)[دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.](https://arabroot.io/articles/%D8%A7%D8%AA%D9%85%D8%AA%D8%A9-%D8%A7%D9%84%D8%A7%D8%AE%D8%AA%D8%A8%D8%A7%D8%B1%D8%A7%D8%AA-%D8%A8%D8%A7%D9%84%D8%B0%D9%83%D8%A7%D8%A1-%D8%A7%D9%84%D8%A7%D8%B5%D8%B7%D9%86%D8%A7%D8%B9%D9%8A/)
## سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة بتطبيق FastAPI 0.142 على Python 3.13 وPostgreSQL 18، واختبارات pytest 9.1 وHurl 8.0 وPlaywright 1.63 في Docker، والتحقق من تراخيص الأدوات من مستودعاتها.