عندما تكتب لمساعد البرمجة جملة مثل «اختباران يفشلان في هذا المشروع، أصلحهما»، فإنه يفتح الملفات ويقرأها، ثم يشغل الاختبارات ويقرأ الأخطاء، ثم يعدل سطراً في الكود ويشغل الاختبارات مرة أخرى، وفي النهاية يكتب لك «تم الإصلاح». وقد يبدو هذا كأن برنامجاً ذكياً يجلس على جهازك ويعمل مثل المبرمج، ولكن ما يحدث في الداخل مختلف عن ذلك، فالنموذج الذي يقف خلف المساعد لا يفتح ملفاً ولا يشغل أمراً، ولا يرى جهازك أصلاً، وكل ما يفعله أنه يقرأ نصاً ويكتب نصاً، ثم يأتي برنامج آخر يقرأ هذا النص وينفذ ما فيه. وفهم هذا الفرق هو ما يجعلك تعرف لماذا يخطئ المساعد أحياناً في أشياء بسيطة، ولماذا يكلف السؤال بالعربية أكثر من الإنجليزية، ولماذا تختلف الإجابة على السؤال نفسه من مرة إلى مرة، ولماذا يجب ألا تصدق رسالة «تم الإصلاح» قبل أن ترى الاختبارات تنجح بنفسك.
وفي هذا المقال سوف نفتح المساعد من الداخل خطوة خطوة، ولن نعتمد على شرح نظري، وإنما سوف نشغل نموذجاً مفتوح المصدر على معالج عادي دون بطاقة رسومية ودون اشتراك في أي خدمة، ونرى بأعيننا التوكنات التي يقرأها، والاحتمالات التي يختار منها كل كلمة، والنص الذي يكتبه عندما يطلب أداة، ثم نبني بأيدينا أصغر وكيل برمجة ممكن، ونتركه يصلح خطأً حقيقياً في مشروع صغير. وفي هذا المقال سوف نتناول:
- الأجزاء الثلاثة لأي مساعد برمجة: النموذج، وبيئة التشغيل Harness، والأدوات.
- التوكنات Tokens: ما الذي يقرأه النموذج فعلاً، ولماذا تكلف العربية أكثر.
- نافذة السياق Context Window: كل ما يعرفه النموذج في لحظة الإجابة.
- كيف يكتب النموذج توكناً بعد توكن، وما الذي تفعله الحرارة Temperature.
- تعليمات النظام System Prompt، واستدعاء الأدوات Tool Calling كما يحدث على السلك.
- الحلقة التي تحول النموذج إلى وكيل Agent، وما الذي يحدث عندما ينقصها السياق.
ثلاثة أجزاء: النموذج Model وبيئة التشغيل Harness والأدوات Tools
كل أدوات البرمجة بالذكاء الاصطناعي التي تسمع عنها، سواءً كانت تعمل في سطر الأوامر أو داخل محرر الكود أو في المتصفح، ومهما كانت الشركة التي تقف خلفها، مبنية من ثلاثة أجزاء، والشكل التالي يبينها:
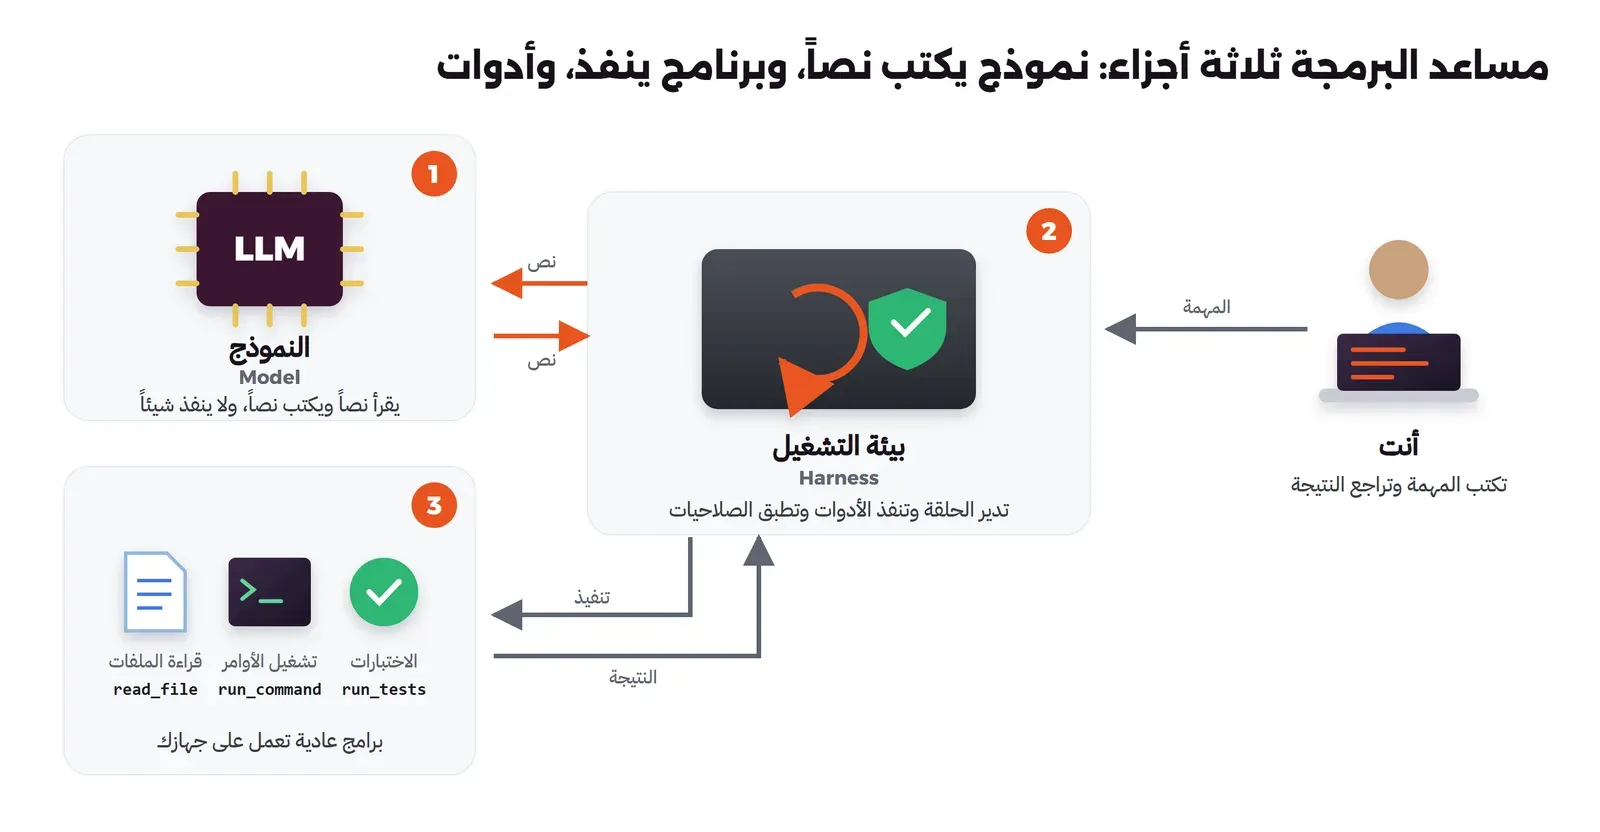
- النموذج اللغوي الكبير Large Language Model، واختصاراً LLM: شبكة عصبية مدربة على كميات ضخمة من النصوص والكود، تأخذ نصاً وتعطي احتمالاً لكل قطعة نص يمكن أن تأتي بعده، ولا يوجد فيها أي شيء ينفذ أمراً أو يفتح ملفاً.
- بيئة التشغيل Harness: البرنامج العادي الذي تثبته على جهازك أو يعمل في السحابة، وهو الذي يجمع ما يرسله إلى النموذج، ويقرأ ما يكتبه النموذج، ويقرر هل ينفذه أم لا، وينفذه فعلاً، ثم يعيد النتيجة إلى النموذج، ويطبق الصلاحيات التي حددتها أنت.
- الأدوات Tools: دوال عادية في بيئة التشغيل، مثل قراءة ملف أو كتابته أو تشغيل أمر في الطرفية أو البحث في الكود، ولكل أداة اسم ووصف وقائمة معاملات يراها النموذج على شكل نص.
وهذا التقسيم ليس تبسيطاً للشرح، وإنما هو ما تجده في توثيق كل الشركات، فتوثيق OpenAI عن استدعاء الدوال وتوثيق Anthropic عن استخدام الأدوات وتوثيق Google عن Gemini يشرح الشيء نفسه بكلمات مختلفة: أنت تعرف الأدوات في الطلب، والنموذج يرد بطلب لاستدعاء أداة، وبرنامجك هو الذي ينفذها ويرسل النتيجة. لذلك عندما تقارن بين أداتين من أدوات البرمجة فأنت في الحقيقة تقارن بين ثلاثة أشياء منفصلة: أي نموذج تستخدم، وكيف بنيت بيئة التشغيل، وأي أدوات تعطيها للنموذج، وقد تجد أداتين تستخدمان النموذج نفسه وتعطيان نتائج مختلفة تماماً بسبب الجزأين الآخرين.
المختبر: نموذج مفتوح المصدر على معالج عادي CPU
حتى نرى هذه الأجزاء بوضوح نحتاج نموذجاً نستطيع أن نسأله عن تفاصيله الداخلية، مثل الاحتمالات التي يحسبها والقاموس الذي يقطع به النص، وهذا لا تعطيه أغلب الخدمات المدفوعة بالكامل. لذلك سوف نستخدم Ollama، وهو خادم مفتوح المصدر يشغل النماذج على جهازك ويعطيك واجهة HTTP بسيطة، ومعه نموذجان صغيران من عائلة Qwen2.5-Coder المفتوحة المخصصة للكود: qwen2.5-coder:1.5b بحجم 1.5 مليار معامل Parameter، وqwen2.5-coder:3b بحجم 3 مليارات، والنموذجان يشتركان في القاموس نفسه. والتوكنات والاحتمالات في هذا المقال من النموذج الأول، واستدعاء الأدوات والوكيل من النموذج الثاني، ومع كل مخرج نذكر النموذج الذي أخرجه. واخترنا نماذج صغيرة عمداً، لأنها تعمل على أي جهاز، ولأن أخطاءها أوضح من أخطاء النماذج الكبيرة، وسوف نرى أن كل خطأ منها يكشف جزءاً من طريقة العمل. والسكربت التالي يشغل المختبر كله على جهاز فيه Docker وNode.js 22، ولا يحتاج أي مفتاح API:
#!/bin/bash
# The whole lab on one machine, CPU only, no API key:  bash run.sh
# Needs Docker and Node.js 22. Ollama runs in a Container; the scripts talk to it on localhost:11434.
set -eo pipefail
C=${OLLAMA_CONTAINER:-ollama}
if ! docker ps --format '{{.Names}}' | grep -qx "$C"; then
  docker run -d --name "$C" -p 127.0.0.1:11434:11434 -v ollama:/root/.ollama ollama/ollama:0.40.13 > /dev/null
  sleep 5
fi
docker exec "$C" ollama pull qwen2.5-coder:1.5b > /dev/null
docker exec "$C" ollama pull qwen2.5-coder:3b > /dev/null
# the tokenizer lives at the start of the model file: copy the first 12 MB (the weights are not needed)
mkdir -p data
digest=$(docker exec "$C" cat /root/.ollama/models/manifests/registry.ollama.ai/library/qwen2.5-coder/1.5b \
  | grep -o '"application/vnd.ollama.image.model","digest":"sha256:[0-9a-f]*' | grep -o '[0-9a-f]\{64\}')
docker exec "$C" head -c 12000000 "/root/.ollama/models/blobs/sha256-$digest" > data/model-head.gguf
node 01-tokens.mjs data/model-head.gguf | tee out-01-tokens.txt
node 02-next-token.mjs | tee out-02-next-token.txt
node 03-tool-call.mjs | tee out-03-tool-call.txt
node agent.mjs qwen2.5-coder:3b 12 tree | tee out-04-agent.txt
node agent.mjs qwen2.5-coder:1.5b 12 tree | tee out-05-agent-small.txt
node agent.mjs qwen2.5-coder:3b 6 bare | tee out-06-agent-bare.txt
في السكربت أعلاه لاحظ التالي:
- Ollama يعمل داخل Container بالإصدار 0.40.13، ويستمع على
127.0.0.1فقط حتى لا يصبح متاحاً لكل من في شبكتك. - نسخ أول 12 ميجابايت من ملف النموذج ليس خطأً، فالقاموس الذي يقطع به النموذج النص محفوظ في بداية الملف، والأوزان بعده، وسوف نقرأ هذا القاموس بأنفسنا في القسم التالي.
- كل ملف من ملفات المختبر يكتب مخرجه في ملف
out-*.txt، وكل رقم في هذا المقال منقول من هذه الملفات كما هو.
وكل السكربتات تتكلم مع Ollama عبر دالة صغيرة واحدة، والسبب في أننا لم نستخدم fetch أن النموذج على معالج بطيء قد يأخذ أكثر من خمس دقائق قبل أن يبدأ الرد، وfetch في Node.js يتوقف بعد 300 ثانية من انتظار رأس الرد Headers، فإذا استخدمته مع نموذج بطيء فسوف يظهر لك الخطأ HeadersTimeoutError قبل أن يصل الرد:
// POST JSON to the local Ollama server with node:http and no timeout: on a slow CPU one answer can take minutes,
// longer than the 300 s that fetch() waits for the response headers.
import { request } from 'node:http';
export const OLLAMA = process.env.OLLAMA_HOST || 'http://localhost:11434';
export function post(path, body) {
  return new Promise((resolve, reject) => {
    const req = request(OLLAMA + path, { method: 'POST', headers: { 'content-type': 'application/json' } }, (res) => {
      let data = ''; res.setEncoding('utf8'); res.on('data', (c) => { data += c; });
      res.on('end', () => { try { resolve(JSON.parse(data)); } catch (e) { reject(new Error(`bad reply ${res.statusCode}: ${data.slice(0, 200)}`)); } });
    });
    req.on('error', reject); req.end(JSON.stringify(body));
  });
}ماذا يقرأ النموذج؟ التوكنات Tokens
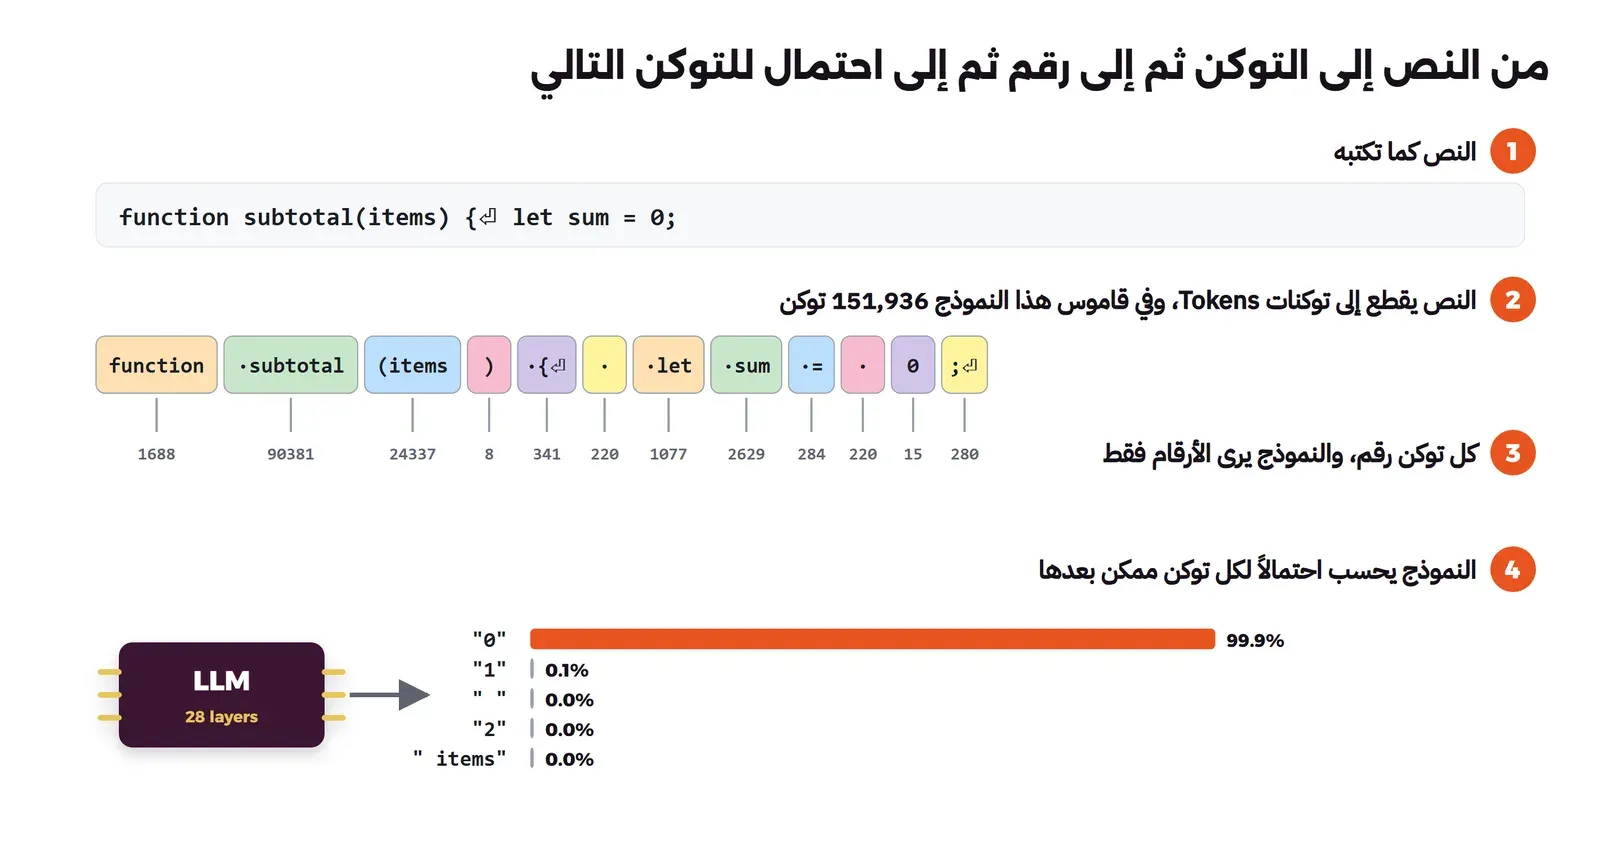
النموذج لا يقرأ حروفاً ولا كلمات، وإنما يقرأ قطعاً من النص اسمها التوكنات Tokens، والتوكن قد يكون كلمة كاملة مثل function، أو جزءاً من كلمة، أو مسافة، أو رمزاً مثل القوس. وقبل أن يصل نصك إلى النموذج يمر على برنامج صغير اسمه المقسم Tokenizer، يقطع النص إلى توكنات من قاموس ثابت، ثم يستبدل كل توكن برقمه في هذا القاموس، والنموذج لا يرى إلا هذه الأرقام. والطريقة التي تستخدمها أغلب النماذج اليوم لبناء هذا القاموس اسمها ترميز أزواج البايتات Byte Pair Encoding، واختصاراً BPE، وقد اقترحها Sennrich وزملاؤه عام 2015 للترجمة الآلية، ثم طبقتها ورقة GPT-2 على مستوى البايتات حتى يستطيع النموذج أن يكتب أي نص بأي لغة دون أن يقابل حرفاً لا يعرفه. والفكرة بسيطة: تبدأ من البايتات المفردة، ثم تدمج الزوج الذي يتكرر أكثر من غيره في نصوص التدريب في توكن واحد، وتكرر الدمج عشرات الآلاف من المرات، فتصبح الكلمات الشائعة توكناً واحداً، وتبقى الكلمات النادرة مقطعة.
وحتى لا نكتفي بالكلام، فإن ملف النموذج بصيغة GGUF التي يستخدمها Ollama يحفظ القاموس وقواعد الدمج في بدايته، والملف التالي يقرأها ويقطع بها النص بالطريقة نفسها التي يقطع بها النموذج:
// A small reader for the tokenizer stored inside a GGUF model file (the format Ollama keeps its models in),
// and the byte-level BPE that Qwen2 models use. No packages; only the start of the file is needed.
import { readFileSync } from 'node:fs';

export function readGguf(path) {
  const b = readFileSync(path); let o = 0;
  const u32 = () => { const v = b.readUInt32LE(o); o += 4; return v; };
  const u64 = () => { const v = Number(b.readBigUInt64LE(o)); o += 8; return v; };
  const str = () => { const n = u64(); const s = b.toString('utf8', o, o + n); o += n; return s; };
  const val = (t) => {
    switch (t) {
      case 0: return b.readUInt8(o++); case 1: return b.readInt8(o++);
      case 2: { const v = b.readUInt16LE(o); o += 2; return v; } case 3: { const v = b.readInt16LE(o); o += 2; return v; }
      case 4: return u32(); case 5: { const v = b.readInt32LE(o); o += 4; return v; }
      case 6: { const v = b.readFloatLE(o); o += 4; return v; } case 7: return b.readUInt8(o++) !== 0;
      case 8: return str();
      case 9: { const it = u32(); const n = u64(); const a = new Array(n); for (let i = 0; i < n; i++) a[i] = val(it); return a; }
      case 10: return u64(); case 11: { const v = Number(b.readBigInt64LE(o)); o += 8; return v; }
      case 12: { const v = b.readDoubleLE(o); o += 8; return v; }
      default: throw new Error('unknown GGUF type ' + t);
    }
  };
  if (b.toString('ascii', 0, 4) !== 'GGUF') throw new Error('not a GGUF file'); o = 4;
  const version = u32(); u64(); const kvs = u64(); const meta = { version };
  for (let i = 0; i < kvs; i++) { const k = str(); meta[k] = val(u32()); }
  return meta;
}

// GPT-2 byte-level mapping: every byte becomes a printable character, so a space is shown as «Ġ» and a newline as «Ċ».
const BYTE2CHAR = (() => {
  const bs = []; for (let i = 33; i <= 126; i++) bs.push(i); for (let i = 161; i <= 172; i++) bs.push(i); for (let i = 174; i <= 255; i++) bs.push(i);
  const cs = [...bs]; let n = 0; for (let i = 0; i < 256; i++) if (!bs.includes(i)) { bs.push(i); cs.push(256 + n++); }
  const m = new Array(256); bs.forEach((x, i) => { m[x] = String.fromCodePoint(cs[i]); }); return m;
})();
const CHAR2BYTE = Object.fromEntries(BYTE2CHAR.map((c, i) => [c, i]));

// Qwen2's pre-tokenizer pattern (tokenizer.json of the Qwen2 family), with the case-insensitive group written out for JavaScript
const PRE = /'(?:[sS]|[tT]|[rR][eE]|[vV][eE]|[mM]|[lL][lL]|[dD])|[^\r\n\p{L}\p{N}]?\p{L}+|\p{N}| ?[^\s\p{L}\p{N}]+[\r\n]*|\s*[\r\n]+|\s+(?!\S)|\s+/gu;

export function makeTokenizer(meta) {
  const tokens = meta['tokenizer.ggml.tokens']; const types = meta['tokenizer.ggml.token_type'] || [];
  const id = new Map(tokens.map((t, i) => [t, i]));
  const rank = new Map(meta['tokenizer.ggml.merges'].map((m, i) => [m, i]));
  const special = tokens.filter((t, i) => types[i] === 3 || types[i] === 4).sort((a, b) => b.length - a.length);
  const bpe = (word) => {
    let parts = [...word];
    for (;;) {
      let best = -1, bestRank = Infinity;
      for (let i = 0; i < parts.length - 1; i++) { const r = rank.get(parts[i] + ' ' + parts[i + 1]); if (r !== undefined && r < bestRank) { bestRank = r; best = i; } }
      if (best < 0) return parts;
      parts = [...parts.slice(0, best), parts[best] + parts[best + 1], ...parts.slice(best + 2)];
    }
  };
  const encode = (text) => {
    const out = [];
    const re = special.length ? new RegExp(special.map(s => s.replace(/[|[\]\\^$.*+?(){}]/g, '\\$&')).join('|'), 'g') : null;
    let last = 0; const chunks = [];
    if (re) for (const m of text.matchAll(re)) { chunks.push([text.slice(last, m.index), false], [m[0], true]); last = m.index + m[0].length; }
    chunks.push([text.slice(last), false]);
    for (const [chunk, isSpecial] of chunks) {
      if (!chunk) continue;
      if (isSpecial) { out.push(id.get(chunk)); continue; }
      for (const m of chunk.match(PRE) || []) {
        const mapped = [...Buffer.from(m, 'utf8')].map(x => BYTE2CHAR[x]).join('');
        for (const p of bpe(mapped)) { const t = id.get(p); if (t === undefined) throw new Error('no token for ' + p); out.push(t); }
      }
    }
    return out;
  };
  // the readable text of one token (bytes back to UTF-8; a token can hold half of an Arabic letter)
  const piece = (t) => Buffer.from([...tokens[t]].map(c => CHAR2BYTE[c] ?? 63)).toString('utf8');
  return { encode, piece, vocab: tokens.length, raw: (t) => tokens[t] };
}
والملف 01-tokens.mjs يستخدم هذا المقسم على أمثلة، ويقارن كل عدد بالعدد الذي يعيده خادم Ollama نفسه في الحقل prompt_eval_count، وأول ما يطبعه هو ما يقوله ملف النموذج عن نفسه، والمخرج سوف يكون كما يلي:
name            Qwen2.5 Coder 1.5B Instruct
context window  32768 tokens
vocabulary      151936 tokens
layers          28, each token is a vector of 1536 numbers
لاحظ أن القاموس فيه 151,936 توكن، وأن كل توكن يتحول داخل النموذج إلى متجه Vector من 1,536 رقماً يمر على 28 طبقة Layer، وأن نافذة السياق 32,768 توكن، وسوف نعود إلى هذا الرقم الأخير بعد قليل. والقسم الثاني يقطع ثلاثة أسطر من الكود، والخط العمودي يفصل بين التوكنات، والرمز ⏎ هو نهاية السطر:
function| subtotal|(items|)| {⏎| | let| sum| =| |0|;⏎| | for| (|const| item| of| items|)| sum| +=| item|.price| *| item|.qty|;
99 characters -> 28 tokens
token ids: 1688 90381 24337 8 341 220 1077 2629 284 220 15 280 ...
في المخرج أعلاه لاحظ التالي:
- 99 حرفاً أصبحت 28 توكن، أي أن التوكن في الكود الإنجليزي حوالي 3.5 حروف.
- المسافة جزء من التوكن، فالتوكن
" subtotal"يبدأ بمسافة، وهو توكن مختلف تماماً عنsubtotalدون مسافة، والنموذج تعلم أن الكلمة بعد مسافة غير الكلمة في بداية السطر. - المسافتان في بداية السطر الثاني أصبحتا توكنين، مسافة وحدها ثم
" let"، وهذا ما يجعل المسافات البادئة Indentation في الكود تستهلك جزءاً من نافذة السياق. - الرقم
0توكن وحده، فهذا المقسم يقطع الأرقام رقماً رقماً، ولذلك يرى النموذج الرقم 2026 أربعة توكنات، وهذا أحد أسباب أخطاء النماذج في الحساب.
والشكل التالي يلخص الطريق من النص إلى الأرقام ثم إلى التوكن التالي:
لماذا تكلف العربية أكثر؟
القاموس يبنى من نصوص التدريب، فاللغة التي تكثر في هذه النصوص تحصل على توكنات أطول، والتي تقل فيها تبقى مقطعة. والقسم الثالث من المختبر يقطع التعليق نفسه مكتوباً بالإنجليزية ثم بالعربية:
 10 tokens, 9 words: //| add| the| prices| of| all| items| in| the| cart
 12 tokens, 6 words: //| ا|جمع| أس|عار| كل| المنت|ج|ات| في| السل|ة
 11 tokens, 10 words: //| return| an| error| if| the| user| is| not| logged| in
 15 tokens, 7 words: //| أ|رجع| خط|أ| إذا| لم| ي|سجل| المست|خدم| د|خ|ول|ه
التعليق الإنجليزي الأول من 9 كلمات أصبح 10 توكنات، أي توكن تقريباً لكل كلمة، والعربي من 6 كلمات أصبح 12 توكن، أي توكنين لكل كلمة، وكلمة «المستخدم» وحدها أصبحت قطعتين، و«دخوله» أربع قطع. وهذا يعني ثلاثة أشياء عملية: الخدمات المدفوعة تحاسبك بالتوكن، فالطلب نفسه بالعربية يكلف أكثر، ونافذة السياق تمتلئ أسرع بالنص العربي، والنموذج يتعامل مع الكلمة العربية المقطعة بصعوبة أكبر من الكلمة التي يراها توكناً واحداً. وهذه الأرقام خاصة بقاموس هذا النموذج، فلكل شركة قاموسها، وبعض النماذج الحديثة أضافت توكنات عربية أكثر، لذلك لا تنقل النسبة من نموذج إلى آخر، وإنما قسها على النموذج الذي تستخدمه. والنصيحة العملية أن تكتب التعليمات الطويلة الثابتة، مثل ملف تعليمات المشروع، بالإنجليزية إذا كان فريقك يقرؤها، وأن تكتب سؤالك بالعربية إذا كان هذا أوضح لك، فالوضوح أهم من التوكنات القليلة.
وقد يتساءل البعض: هل المقسم الذي كتبناه يقطع النص فعلاً كما يقطعه النموذج، أم أنه تقريب؟ والإجابة في القسم الرابع، الذي يرسل كل نص إلى الخادم ويقارن العددين:
ours   28  server   28  same  "function subtotal(items) {\n  l"...
ours   10  server   10  same  "// add the prices of all items"...
ours   12  server   12  same  "// اجمع أسعار كل المنتجات في ا"...
ours  147  server  147  same  "// Shopping cart helpers for a"...
الأعداد متطابقة في الحالات الأربع، بما فيها ملف cart.js كاملاً بـ 147 توكن، وهذا يؤكد أن القاموس وقواعد الدمج داخل ملف النموذج هما كل ما يحتاجه المقسم، وأن 73 سطراً من JavaScript دون أي مكتبة تكفي لتعيد ما يفعله.
نافذة السياق Context Window: كل ما يعرفه النموذج في هذه اللحظة
نافذة السياق Context Window هي أكبر عدد من التوكنات يستطيع النموذج أن يقرأه في الطلب الواحد، ويدخل فيها كل شيء: تعليمات النظام، ووصف الأدوات، والمحادثة كلها من أولها، والملفات التي قرأها، ومخرجات الأوامر التي شغلها، والإجابة التي يكتبها الآن. والنقطة التي يغفل عنها كثير من المطورين أن النموذج لا يتذكر شيئاً بين طلب وآخر، فهو دالة تأخذ نصاً وتعطي نصاً، والمحادثة الطويلة التي تراها في المساعد موجودة في بيئة التشغيل لا في النموذج، وفي كل مرة يرسل البرنامج المحادثة كاملة من أولها. والقسم الخامس من المختبر الأول يبين ذلك على سؤال من ست كلمات:
the question alone:                6 tokens
after the chat template and the default system prompt: 35 tokens
our count of the same wrapped text: 35 tokens
<|im_start|>system⏎
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>⏎
<|im_start|>user⏎
Why do two tests fail?<|im_end|>⏎
<|im_start|>assistant⏎
السؤال وحده 6 توكنات، ولكن ما وصل إلى النموذج 35 توكن، والسبب أن الخادم وضع السؤال داخل قالب المحادثة Chat Template الخاص بهذا النموذج: علامات <|im_start|> و<|im_end|> التي تفصل بين الأدوار، وتعليمات نظام افتراضية لم نكتبها نحن، وفي آخره بداية دور المساعد، أي أن النموذج يكمل نصاً يبدأ بـ «المساعد:». وهذه هي كل حقيقة «المحادثة» مع النموذج: نص واحد طويل فيه أدوار، والنموذج يكمل ما بعد آخر دور.
ونافذة 32,768 توكن تبدو كبيرة، ولكن لها حدود عملية يجب أن تعرفها:
- ما يتسع له النموذج ليس بالضرورة ما يرسله الخادم، فتوثيق Ollama يذكر في الأسئلة الشائعة أنه يستخدم نافذة من 4,096 توكن افتراضياً ما لم تغيرها بالمعامل
num_ctxأو بالمتغيرOLLAMA_CONTEXT_LENGTH، أي ثمن ما يتسع له هذا النموذج. ولذلك كتبناnum_ctx: 4096صراحة في الوكيل، حتى يكون الحد ظاهراً في الكود لا مخفياً في إعداد الخادم، فإذا طالت المحادثة أكثر منه فإن النموذج لن يرى كل ما أرسلته، فاعرف الحد الذي يعمل به الخادم قبل أن تثق في جلسة طويلة. - النموذج لا يستخدم كل النافذة بالجودة نفسها، فقد وجدت دراسة Lost in the Middle عام 2023 أن النماذج تجد المعلومة بشكل أفضل عندما تكون في بداية السياق أو نهايته، وأن الأداء يقل بشكل واضح عندما تكون المعلومة في وسط سياق طويل.
- كل ملف يقرؤه الوكيل وكل مخرج أمر يشغله يبقى في السياق إلى آخر المحادثة، ويرسل مع كل طلب بعده، وهذا ما سوف نراه بالأرقام في الوكيل الذي سوف نبنيه.
لذلك فإن جزءاً كبيراً من عمل بيئة التشغيل في الأدوات الحقيقية هو إدارة هذه النافذة: ماذا تضع فيها، وماذا تختصر، ومتى تلخص المحادثة القديمة، وهذا ما يسمى هندسة السياق Context Engineering، وله مقال خاص في هذا المسار.
النموذج لا يكتب إجابة، وإنما يتوقع التوكن التالي Next Token
بعد أن يقرأ النموذج التوكنات يحسب لكل توكن في القاموس، أي لكل واحد من 151,936 توكن، احتمالاً أن يكون هو التوكن التالي، وهذا كل ما يفعله النموذج في الخطوة الواحدة. والمعمارية التي تقوم عليها هذه النماذج اسمها Transformer، ونشرتها ورقة Attention Is All You Need عام 2017، وتفاصيلها خارج موضوع هذا المقال، والذي يهمنا هنا هو المخرج: قائمة احتمالات. وخادم Ollama يستطيع أن يعيد هذه الاحتمالات في حقل logprobs كما يذكر توثيق الواجهة، والملف التالي يطلبها:
// 02: the model predicts one token at a time. Reads the probabilities the server returns (logprobs),
// then shows what the temperature does to the choice.
//   node 02-next-token.mjs
import { post } from './ollama.mjs';
const MODEL = 'qwen2.5-coder:1.5b';
const gen = (prompt, options, extra = {}) => post('/api/generate', { model: MODEL, prompt, raw: true, stream: false, options, ...extra });
const pct = (lp) => (Math.exp(lp) * 100).toFixed(1).padStart(5) + '%';
const vis = (s) => JSON.stringify(s);

const prefix = 'function subtotal(items) {\n  let sum = ';
console.log('### 1. Candidates for the next token after: ' + vis(prefix));
const r1 = await gen(prefix, { num_predict: 1, temperature: 0 }, { logprobs: true, top_logprobs: 5 });
for (const c of r1.logprobs[0].top_logprobs) console.log(`${pct(c.logprob)}  ${vis(c.token)}`);

console.log('\n### 2. One token at a time, the most likely each time (temperature 0)');
const r2 = await gen(prefix, { num_predict: 14, temperature: 0 }, { logprobs: true, top_logprobs: 2 });
for (const s of r2.logprobs) {
  const second = s.top_logprobs.find(c => c.token !== s.token);
  console.log(`${pct(s.logprob)}  ${vis(s.token).padEnd(14)} second choice ${second ? vis(second.token) + ' ' + pct(second.logprob).trim() : '-'}`);
}
console.log('text: ' + vis(r2.response));

const open = '// the variable that holds how many seconds to wait before retrying\nconst';
console.log('\n### 3. A place with no single right answer: ' + vis(open));
const r3 = await gen(open, { num_predict: 1, temperature: 0 }, { logprobs: true, top_logprobs: 5 });
const top = r3.logprobs[0].top_logprobs;
for (const c of top) console.log(`${pct(c.logprob)}  ${vis(c.token)}`);
console.log('\nthe same five candidates after dividing by the temperature (shares among these five only):');
for (const T of [0.2, 1, 1.5]) {
  const w = top.map(c => Math.exp(c.logprob / T)); const z = w.reduce((a, b) => a + b, 0);
  console.log(`T=${String(T).padEnd(4)} ` + top.map((c, i) => `${c.token} ${(w[i] / z * 100).toFixed(0)}%`).join('  '));
}

console.log('\n### 4. Five runs at temperature 0, then five at temperature 1.2 (different seed each run)');
for (const T of [0, 1.2]) {
  const outs = [];
  for (let seed = 1; seed <= 5; seed++) { const r = await gen(open, { num_predict: 8, temperature: T, seed }); outs.push(r.response.split('\n')[0].trim()); }
  console.log(`T=${T}`); outs.forEach((o, i) => console.log(`  run ${i + 1}: const ${o}`));
}
القسم الأول يعطي النموذج بداية دالة تجمع أسعار السلة، ويطلب أعلى خمسة توكنات احتمالاً بعد let sum = ، والمخرج سوف يكون كما يلي:
 99.9%  "0"
  0.1%  "1"
  0.0%  " "
  0.0%  "2"
  0.0%  " items"
النموذج متأكد بنسبة 99.9% أن التوكن التالي هو الرقم صفر، وهذا منطقي لأن كل مجموع يبدأ من الصفر في ملايين الملفات التي تدرب عليها. والقسم الثاني يترك النموذج يكمل 14 توكن، ويختار في كل خطوة التوكن الأعلى احتمالاً، ويطبع معه البديل الثاني:
 99.9%  "0"            second choice "1" 0.0%
 79.0%  ";\n"          second choice ";\n\n" 13.5%
 96.7%  " "            second choice "  \n" 2.8%
 67.0%  " for"         second choice " items" 29.4%
 75.7%  " ("           second choice "(let" 22.7%
 89.7%  "let"          second choice "const" 7.6%
 69.0%  " i"           second choice " item" 29.6%
 96.2%  " ="           second choice " of" 1.5%
 99.7%  " "            second choice " items" 0.2%
 99.7%  "0"            second choice "1" 0.3%
 99.5%  ";"            second choice "," 0.4%
 99.9%  " i"           second choice " items" 0.0%
 99.8%  " <"           second choice " <=" 0.1%
 99.9%  " items"       second choice "items" 0.0%
text: "0;\n  for (let i = 0; i < items"
في المخرج أعلاه لاحظ التالي:
- النموذج يكتب توكناً واحداً في كل خطوة، ثم يضيفه إلى النص ويحسب الاحتمالات من جديد، وهذه هي الكتابة كلها، فلا توجد خطة للدالة كاملة في مكان ما، وإنما خطوة بعد خطوة.
- بعض الخطوات محسومة مثل
" ="بنسبة 96.2%، وبعضها قريب من التعادل، فبعد السطر الأول اختار" for"بنسبة 67% والبديل" items"بنسبة 29.4%، أي أن النموذج كان قريباً من أن يكتبitems.forEachأوitems.reduceبدل الحلقة. - بعد
for (اختارletبنسبة 89.7% ثمi = 0، أي الحلقة بالفهرس التي تبدأ من الصفر، وهي بالضبط الحلقة التي سوف نجد فيها الخطأ في المشروع الذي سوف يصلحه الوكيل، فهناك يبدأ الفهرس من 1 بدل 0.
الحرارة Temperature: لماذا تختلف الإجابة من مرة إلى مرة؟
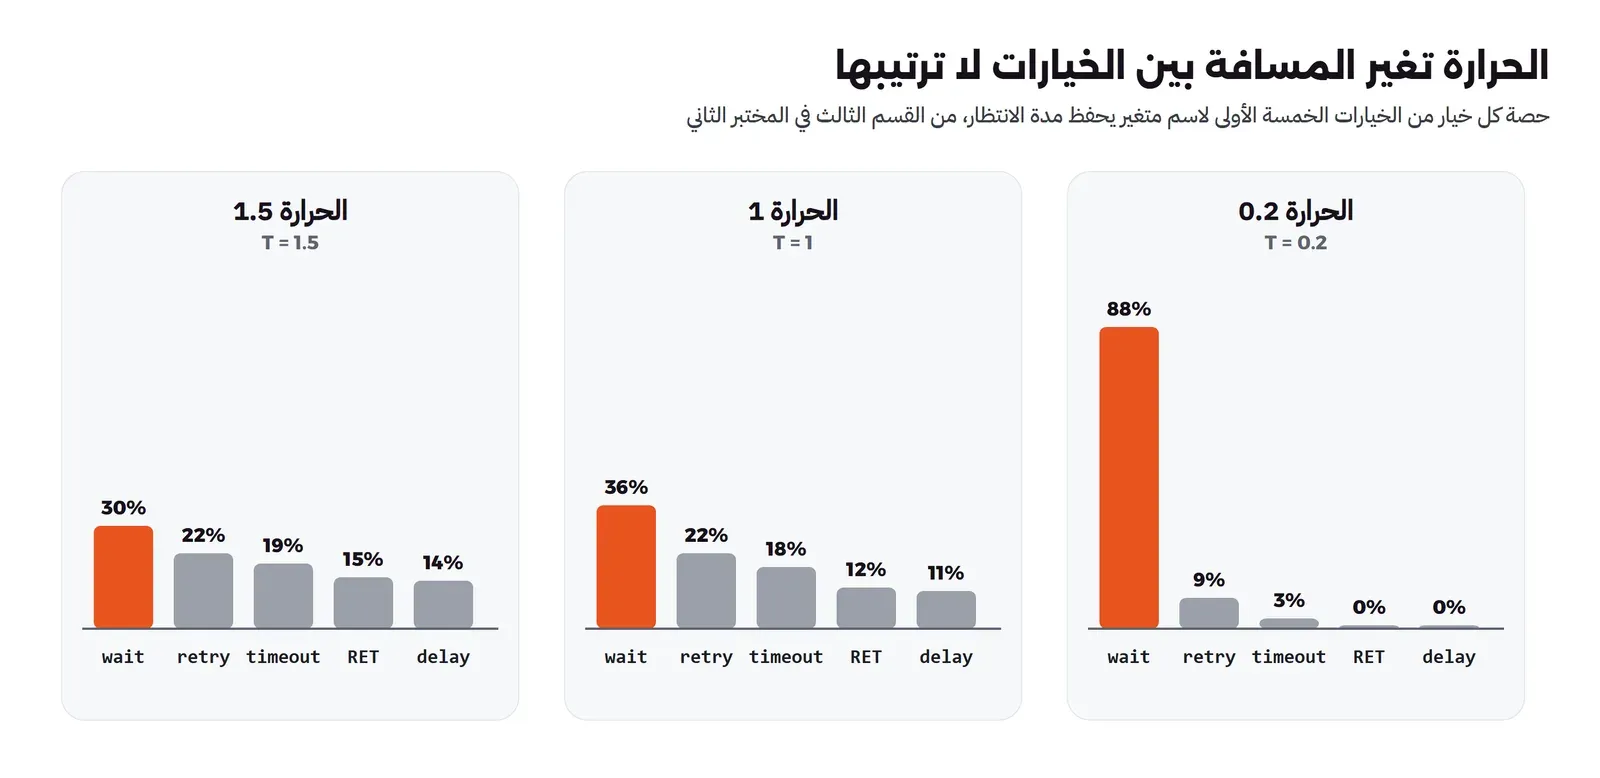
إذا اختار النموذج دائماً التوكن الأعلى احتمالاً فإنه يعطي الإجابة نفسها في كل مرة، وهذا ما يسمى الاختيار الجشع Greedy Decoding. ولكن أغلب الخدمات لا تعمل بهذه الطريقة افتراضياً، وإنما تسحب التوكن عشوائياً بحسب الاحتمالات، وتتحكم في هذا السحب بمعامل اسمه الحرارة Temperature، حيث تقسم الاحتمالات على الحرارة قبل السحب: الحرارة المنخفضة تكبر الفرق بين الاحتمال الأعلى والباقي، والحرارة العالية تقرب بينها. والقسم الثالث يأخذ مكاناً في الكود لا توجد فيه إجابة واحدة صحيحة، وهو اسم متغير يحفظ مدة الانتظار قبل إعادة المحاولة:
 20.5%  " wait"
 12.8%  " retry"
 10.6%  " timeout"
  6.9%  " RET"
  6.4%  " delay"

the same five candidates after dividing by the temperature (shares among these five only):
T=0.2   wait 88%   retry 9%   timeout 3%   RET 0%   delay 0%
T=1     wait 36%   retry 22%   timeout 18%   RET 12%   delay 11%
T=1.5   wait 30%   retry 22%   timeout 19%   RET 15%   delay 14%
الاحتمالات هنا موزعة، فأعلى خيار " wait" بنسبة 20.5% فقط، وعند الحرارة 0.2 يأخذ هذا الخيار 88% من الحصة بين الخمسة، وعند الحرارة 1.5 تصبح الخيارات متقاربة. لاحظ أن هذه الحصص محسوبة على الخيارات الخمسة الأولى فقط، فالنموذج الحقيقي يوزع الاحتمال على القاموس كله، ولكن الاتجاه هو نفسه. والشكل التالي يبين ذلك:
والقسم الرابع يشغل الطلب نفسه خمس مرات بالحرارة صفر، ثم خمس مرات بالحرارة 1.2، وفي كل مرة بذرة Seed مختلفة للمولد العشوائي:
T=0
  run 1: const waitTime = 5000
  run 2: const waitTime = 5000
  run 3: const waitTime = 5000
  run 4: const waitTime = 5000
  run 5: const waitTime = 5000
T=1.2
  run 1: const waitingPeriod = 5000
  run 2: const waitSeconds = 5;
  run 3: const waitSeconds = 10;
  run 4: const interval = 5;
  run 5: const waitSeconds = 5;
بالحرارة صفر خرجت الإجابة نفسها خمس مرات، وبالحرارة 1.2 خرجت خمس إجابات مختلفة، وكلها كود صحيح، ولكن بأسماء وقيم مختلفة. والقيمة الافتراضية في Ollama هي 0.8 كما في توثيق المعاملات، ولكل خدمة قيمتها الافتراضية، وبعض أدوات البرمجة لا تعطيك التحكم فيها أصلاً. والدرس العملي أن اختلاف الإجابة على السؤال نفسه ليس عطلاً، وإنما هو جزء من طريقة عمل النموذج، ولذلك لا تقم بالحكم على أداة من تجربة واحدة، وإذا كنت تبني أداة فاستخدم حرارة منخفضة وبذرة ثابتة في المهام التي تريد فيها نتيجة يمكن تكرارها، مثل الوكيل الذي سوف نبنيه، فقد شغلناه بالحرارة صفر.
تعليمات النظام System Prompt: نص يضاف قبل كلامك
رأينا في قسم السياق أن الخادم أضاف قبل سؤالنا جملة «You are Qwen, created by Alibaba Cloud. You are a helpful assistant.»، وهذه هي تعليمات النظام System Prompt الافتراضية لهذا النموذج، وهي نص عادي يوضع في أول المحادثة بدور خاص اسمه system، والنموذج تدرب على أن يعطي ما في هذا الدور وزناً أكبر مما يأتي بعده. وكل أداة برمجة تكتب تعليمات نظام خاصة بها، وغالباً تكون طويلة: من أنت، وما الأدوات المتاحة، ومتى تستخدم كل أداة، وماذا تفعل قبل أن تعدل ملفاً، وكيف تكتب رسالة الـ Commit، وعندما تضيف ملف تعليمات المشروع مثل AGENTS.md أو CLAUDE.md فإن بيئة التشغيل تضعه في السياق بجانب هذه التعليمات.
وهناك نقطتان يجب أن تتذكرهما عن تعليمات النظام:
- تعليمات النظام توجيه لا قيد، فهي نص يقرؤه النموذج، ولا يوجد شيء في النموذج يمنعه من مخالفتها، وفي الوكيل الذي سوف نبنيه كتبنا «Fix the code, not the tests»، ومع ذلك وضعنا في بيئة التشغيل منعاً حقيقياً لتعديل ملفات الاختبار، لأن الجملة وحدها لا تضمن شيئاً.
- أي نص يدخل السياق يقرؤه النموذج بالطريقة نفسها، سواءً كتبته أنت أو جاء من ملف أو صفحة ويب أو مخرج أمر، ولذلك فإن تعليمات مكتوبة داخل ملف في المشروع قد تؤثر في الوكيل كأنها منك، وهذا ما يسمى حقن التعليمات Prompt Injection، وله مقال خاص في مرحلة الأمان من هذا المسار.
استدعاء الأدوات Tool Calling: النموذج يطلب والبرنامج ينفذ
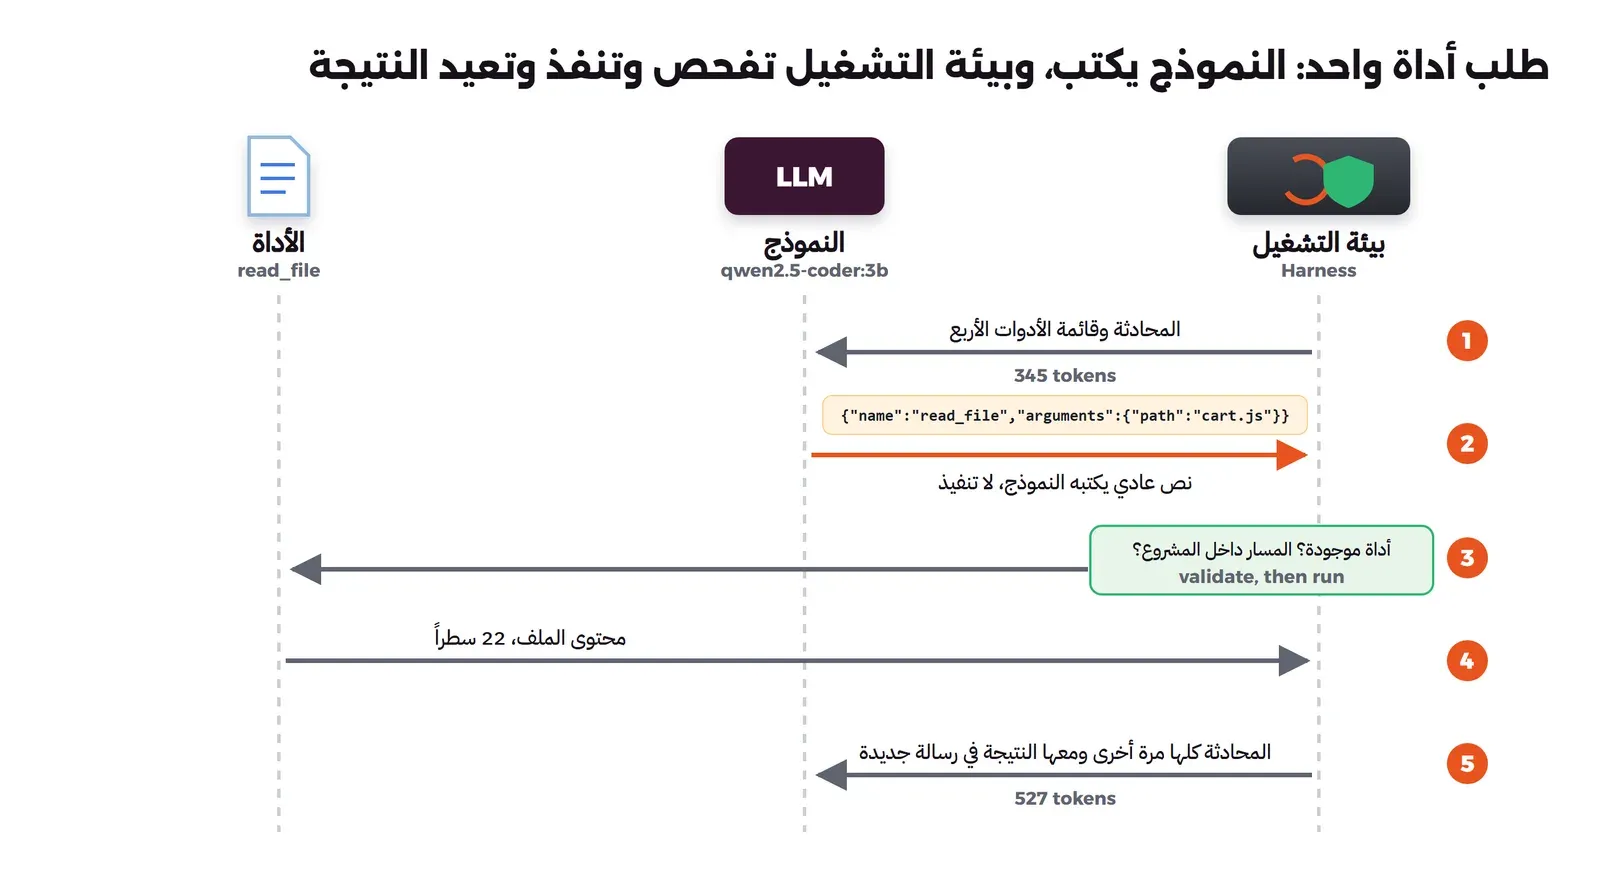
الآن نصل إلى الجزء الذي يحول النموذج من آلة تكتب نصاً إلى شيء يعمل على جهازك. والفكرة أن البرنامج يرسل مع المحادثة قائمة بالأدوات المتاحة، لكل أداة اسم ووصف ومعاملات بصيغة JSON Schema، فإذا قرر النموذج أنه يحتاج أداة فإنه لا يكتب إجابة للمستخدم، وإنما يكتب طلباً منظماً فيه اسم الأداة وقيم معاملاتها، وبيئة التشغيل هي التي تنفذ. وفكرة تدريب النموذج على استدعاء الأدوات بنفسه قديمة نسبياً، ومن أشهر أوراقها Toolformer عام 2023. والملف التالي يرسل طلباً فيه أداة واحدة لقراءة الملفات، ثم يعرض كل ما يحدث على السلك:
// 03: a tool call, raw. What the program sends, what the model returns, how the harness checks it,
// what the tool list costs, and the template that turns the tool list into text the model can read.
//   node 03-tool-call.mjs
import { post } from './ollama.mjs';
const MODEL = 'qwen2.5-coder:3b';
const SMALL = 'qwen2.5-coder:1.5b';
const OPTIONS = { temperature: 0, seed: 3, num_ctx: 4096, num_predict: 200 };
const tools = [{ type: 'function', function: { name: 'read_file', description: 'Read one file of the project',
  parameters: { type: 'object', properties: { path: { type: 'string', description: 'Path relative to the project root' } }, required: ['path'] } } }];
const system = { role: 'system', content: 'You are a coding agent. Use the tools to look at the code before answering.' };
const messages = [system, { role: 'user', content: 'Read cart.js and tell me what the function total returns.' }];
const chat = (body, model = MODEL) => post('/api/chat', { model, stream: false, ...body, options: { ...OPTIONS, ...(body.options || {}) } });
// the call may come in the structured tool_calls field, or as JSON text (with or without tags or a code fence)
const parseCall = (m) => { const f = m.tool_calls?.[0]?.function; if (f) return f;
  try { const j = JSON.parse(m.content.replace(/<\/?tool_call>/g, '').replace(/```(json)?/g, '').trim()); return j.name ? j : null; } catch { return null; } };
// what a harness does before running anything: is it a real tool, and are the arguments the right type?
const check = (call) => {
  if (!call) return 'no tool call, a normal answer';
  if (call.name !== 'read_file') return `error: there is no tool named ${call.name}, the only tool is read_file`;
  const args = typeof call.arguments === 'string' ? JSON.parse(call.arguments) : call.arguments;
  if (typeof args?.path !== 'string') return `error: "path" must be a string such as "cart.js", got ${JSON.stringify(args?.path)}`;
  return 'ok';
};

console.log('### 1. The request: the conversation plus the list of tools');
console.log(JSON.stringify({ model: MODEL, messages, tools }, null, 1));

console.log(`\n### 2. The reply as it came back (${MODEL})`);
const r = await chat({ messages, tools });
console.log(JSON.stringify(r.message, null, 1));
console.log(`harness check: ${check(parseCall(r.message))}`);

console.log(`\n### 3. The same request to the smaller model (${SMALL})`);
const rs = await chat({ messages, tools }, SMALL);
console.log(JSON.stringify(rs.message, null, 1));
console.log(`harness check: ${check(parseCall(rs.message))}`);

console.log(`\n### 4. The smaller model, a vaguer question: "What does the function total in cart.js return?"`);
const rv = await chat({ messages: [system, { role: 'user', content: 'What does the function total in cart.js return?' }], tools }, SMALL);
console.log(JSON.stringify(rv.message, null, 1));
console.log(`harness check: ${check(parseCall(rv.message))}`);

console.log('\n### 5. What the tool list costs on every request');
const without = await chat({ messages, options: { num_predict: 1 } });
console.log(`same messages without tools: ${without.prompt_eval_count} tokens`);
console.log(`same messages with one tool:  ${r.prompt_eval_count} tokens`);

console.log('\n### 6. Where the tools go: the model template on the server');
const show = await post('/api/show', { model: MODEL });
const lines = show.template.split('\n'); const a = lines.findIndex(l => l.includes('# Tools')); const b = lines.findIndex((l, i) => i > a && l.trim().startsWith('</tool_call>'));
console.log(lines.slice(a, b + 1).join('\n'));
القسم الأول هو الطلب كما يرسله البرنامج إلى واجهة استدعاء الأدوات في Ollama، وهو بالشكل نفسه تقريباً في كل الخدمات:
{
 "model": "qwen2.5-coder:3b",
 "messages": [
  {
   "role": "system",
   "content": "You are a coding agent. Use the tools to look at the code before answering."
  },
  {
   "role": "user",
   "content": "Read cart.js and tell me what the function total returns."
  }
 ],
 "tools": [
  {
   "type": "function",
   "function": {
    "name": "read_file",
    "description": "Read one file of the project",
    "parameters": {
     "type": "object",
     "properties": {
      "path": {
       "type": "string",
       "description": "Path relative to the project root"
      }
     },
     "required": [
      "path"
     ]
    }
   }
  }
 ]
}
والقسم الثاني هو رد النموذج qwen2.5-coder:3b كما وصل، ومعه نتيجة الفحص الذي تجريه الدالة check قبل أن تنفذ أي شيء:
{
 "role": "assistant",
 "content": "{\"name\": \"read_file\", \"arguments\": {\"path\": {\"type\": \"string\", \"description\": \"Path relative to the project root\", \"value\": \"cart.js\"}}}"
}
harness check: error: "path" must be a string such as "cart.js", got {"type":"string","description":"Path relative to the project root","value":"cart.js"}
في المخرج أعلاه لاحظ التالي:
- الرد ليس في الحقل المنظم
tool_calls، وإنما فيcontentنصاً عادياً، لأن النموذج لم يكتب العلامات التي ينتظرها الخادم، وسوف نرى هذه العلامات في القسم السادس. - النموذج اختار الأداة الصحيحة
read_file، وعرف أن الملف المطلوب هوcart.js، ولكنه بدل أن يكتب"path": "cart.js"نسخ تعريف المعامل من القائمة، بنوعه ووصفه، ووضع القيمة داخله في حقل اسمهvalueلم يطلبه أحد. - الفحص رفض الطلب لأن المسار ليس نصاً، ولو لم يكن هناك فحص لوصل كائن JSON إلى دالة تتوقع مساراً، والنتيجة خطأ غير مفهوم في أفضل الأحوال.
والقسم الثالث يرسل الطلب نفسه إلى النموذج الأصغر qwen2.5-coder:1.5b:
{
 "role": "assistant",
 "content": "```json\n{\n  \"name\": \"read_file\",\n  \"arguments\": {\n    \"path\": {\n      \"type\": \"string\",\n      \"description\": \"Path relative to the project root\"\n    }\n  }\n}\n```"
}
harness check: error: "path" must be a string such as "cart.js", got {"type":"string","description":"Path relative to the project root"}
النموذج الأصغر وقع في الخطأ نفسه، ونسي القيمة كلها، ووضع الطلب داخل علامات الكود ```json، مع أن القالب الذي سوف نراه بعد قليل يطلب منه صراحة ألا يفعل ذلك. والقسم الرابع يرسل إلى النموذج الأصغر سؤالاً أقل وضوحاً، لا يذكر القراءة:
{
 "role": "assistant",
 "content": "{\"name\": \"total\", \"arguments\": {\"cart\": {\"type\": \"object\", \"description\": \"Cart object containing items and quantities\"}}}"
}
harness check: error: there is no tool named total, the only tool is read_file
هنا اخترع النموذج أداة اسمها total، وهو اسم الدالة التي سألناه عنها، لأن السؤال يذكر total والقائمة فيها أداة واحدة بنية مشابهة، فكتب طلباً بالشكل الصحيح لأداة غير موجودة. وهذه الأخطاء الثلاثة، أي نسخ تعريف المعامل، وتغليف الطلب بعلامات الكود، واختراع أداة، هي بالضبط ما تحمي منه بيئة التشغيل نفسها: تتأكد أن الأداة موجودة، وأن المعاملات من النوع الصحيح، وأن المسار داخل المشروع، ثم تعيد للنموذج رسالة خطأ واضحة يستطيع أن يصحح بها طلبه. والنماذج الكبيرة تخطئ في هذا أقل بكثير، ولكنها تخطئ، ولذلك لا تجد بيئة تشغيل جادة تنفذ الطلب كما وصل.
والقسم الخامس يقيس ما تكلفه قائمة الأدوات:
same messages without tools: 42 tokens
same messages with one tool:  176 tokens
أداة واحدة بوصف قصير أضافت 134 توكن إلى طلب من 42 توكن، أي أن قائمة الأدوات هنا أكبر من المحادثة نفسها ثلاث مرات، وهذه التوكنات ترسل مع كل طلب في المحادثة لا مرة واحدة. والأدوات الحقيقية تعطي النموذج عشرات الأدوات بأوصاف طويلة، ولذلك تجد أن أول طلب في أي أداة برمجة يحمل آلاف التوكنات قبل أن تكتب أنت حرفاً، وهذا جزء من تكلفة كل طلب ومن مساحة نافذة السياق.
وقد يتساءل البعض: كيف يفهم النموذج قائمة الأدوات وهي JSON، وهو لا يقرأ إلا توكنات؟ والإجابة في القسم السادس، الذي يطبع جزءاً من قالب المحادثة المحفوظ مع النموذج على الخادم:
# Tools

You may call one or more functions to assist with the user query.

You are provided with function signatures within <tools></tools>:
<tools>
{{- range .Tools }}
{"type": "function", "function": {{ .Function }}}
{{- end }}
</tools>

For each function call, return a json object with function name and arguments within <tool_call></tool_call> with NO other text. Do not include any backticks or ```json.
<tool_call>
{"name": <function-name>, "arguments": <args-json-object>}
</tool_call>
هذا هو السر كله: القالب يحول قائمة الأدوات إلى نص إنجليزي يضاف إلى تعليمات النظام، يقول للنموذج إن لديه دوالاً ويضع تعريفاتها بين <tools> و</tools>، ويطلب منه إذا أراد دالة أن يكتب JSON بين <tool_call> و</tool_call>، ثم يقرأ الخادم ما يكتبه النموذج ويبحث عن هذه العلامات، فإذا وجدها حوله إلى الحقل المنظم tool_calls. أي أن استدعاء الأدوات اتفاق على شكل نص، تدرب عليه النموذج، وتطبقه بيئة التشغيل، والشكل التالي يلخص الدورة:
حلقة الوكيل Agent Loop: من استدعاء واحد إلى وكيل
استدعاء أداة واحدة يجيب عن سؤال واحد، أما مهمة مثل «أصلح الاختبارات» فتحتاج سلسلة: اقرأ، ثم شغل، ثم عدل، ثم شغل مرة أخرى. والوكيل Agent في أبسط تعريف هو حلقة حول استدعاء الأدوات: ترسل المحادثة، فإذا طلب النموذج أداة نفذتها وأضفت نتيجتها إلى المحادثة وأرسلتها من جديد، وتستمر حتى يرد النموذج بإجابة دون طلب أداة. وهذا النمط الذي يتبادل فيه النموذج التفكير والفعل والملاحظة وصفته ورقة ReAct عام 2022، وكل أدوات البرمجة الوكيلة اليوم مبنية على صورة منه، مع فروق كبيرة في التفاصيل.
والمشروع الذي سوف يصلحه الوكيل ملف واحد لحساب سلة متجر، والمبالغ فيه بالهللة كأرقام صحيحة حتى لا ندخل في أخطاء الكسور العشرية:
// Shopping cart helpers for a small online store.

// Sum of price * qty for every item, in halalas (integers, no floating point money).
function subtotal(items) {
  let sum = 0;
  for (let i = 1; i < items.length; i++) {
    sum += items[i].price * items[i].qty;
  }
  return sum;
}

// VAT in Saudi Arabia is 15%. Rounded to the nearest halala.
function vat(amount) {
  return Math.round(amount * 0.15);
}

function total(items) {
  const s = subtotal(items);
  return s + vat(s);
}

module.exports = { subtotal, vat, total };
والاختبارات التي تفشل:
const test = require('node:test');
const assert = require('node:assert');
const { subtotal, vat, total } = require('./cart.js');

const items = [
  { name: 'keyboard', price: 15000, qty: 1 },
  { name: 'cable', price: 2500, qty: 2 },
];

test('subtotal adds every item', () => {
  assert.strictEqual(subtotal(items), 20000);
});

test('vat is 15 percent', () => {
  assert.strictEqual(vat(20000), 3000);
});

test('total is subtotal plus vat', () => {
  assert.strictEqual(total(items), 23000);
});

test('empty cart costs nothing', () => {
  assert.strictEqual(total([]), 0);
});
والخطأ في الحلقة داخل subtotal، فهي تبدأ من الفهرس 1 بدل 0، فتتجاوز المنتج الأول، ولذلك يفشل اختبار المجموع واختبار الإجمالي، وينجح اختبار الضريبة واختبار السلة الفارغة. والملف التالي هو الوكيل كاملاً، في حوالي 100 سطر ودون أي مكتبة:
// 04: the smallest coding agent: a loop that sends the conversation to the model, runs the tool it asks for,
// adds the result to the conversation, and repeats until the model answers without a tool call.
//   node agent.mjs [model] [max steps] [bare|tree]      (Ollama on http://localhost:11434, no packages)
//   bare: the model gets only the task;  tree: the harness also puts the list of project files in the system prompt
import { cpSync, rmSync, readFileSync, writeFileSync, readdirSync } from 'node:fs';
import { resolve, relative, dirname } from 'node:path';
import { fileURLToPath } from 'node:url';
import { execFileSync } from 'node:child_process';
import { post } from './ollama.mjs';

const HERE = dirname(fileURLToPath(import.meta.url));
const MODEL = process.argv[2] || 'qwen2.5-coder:1.5b';
const MAX_STEPS = +(process.argv[3] || 10);
const MODE = process.argv[4] || 'tree';
const REPO = resolve(HERE, 'work', 'repo');
rmSync(resolve(HERE, 'work'), { recursive: true, force: true });
cpSync(resolve(HERE, 'repo-start'), REPO, { recursive: true });   // a fresh copy of the buggy project every run

// The tools: what the model may ask for, described in JSON Schema. The model never runs anything itself.
const TOOLS = [
  { type: 'function', function: { name: 'list_files', description: 'List the files of the project', parameters: { type: 'object', properties: {} } } },
  { type: 'function', function: { name: 'read_file', description: 'Read one file of the project', parameters: { type: 'object', properties: { path: { type: 'string', description: 'Path relative to the project root' } }, required: ['path'] } } },
  { type: 'function', function: { name: 'write_file', description: 'Replace the whole content of one file of the project', parameters: { type: 'object', properties: { path: { type: 'string' }, content: { type: 'string', description: 'The complete new file content' } }, required: ['path', 'content'] } } },
  { type: 'function', function: { name: 'run_tests', description: 'Run the project tests with node --test and return the summary', parameters: { type: 'object', properties: {} } } },
];

// The harness decides what is allowed, not the model: paths stay inside the project, and test files are read-only.
function inside(p) {
  if (typeof p !== 'string') throw new Error(`refused: "path" must be a string such as "cart.js", got ${JSON.stringify(p)}`);
  const full = resolve(REPO, p); const rel = relative(REPO, full); if (rel.startsWith('..') || rel === '') throw new Error(`refused: ${p} is outside the project`); return full; }
function runTool(name, args) {
  switch (name) {
    case 'list_files': return readdirSync(REPO).join('\n');
    case 'read_file': return readFileSync(inside(args.path), 'utf8');
    case 'write_file': {
      if (typeof args.content !== 'string') return `refused: "content" must be the complete file as a string`;
      if (/\.test\.js$/.test(String(args.path))) return `refused: ${args.path} is a test file, tests are not changed to make them pass`;
      writeFileSync(inside(args.path), String(args.content)); return `wrote ${args.path} (${String(args.content).split('\n').length} lines)`;
    }
    case 'run_tests': {
      let out; try { out = execFileSync(process.execPath, ['--test'], { cwd: REPO, encoding: 'utf8', stdio: ['ignore', 'pipe', 'pipe'] }); } catch (e) { out = (e.stdout || '') + (e.stderr || ''); }
      // keep what a developer would read: the failing tests with expected/actual, and the counts
      const keep = out.split('\n').filter(l => /^not ok|^ok|^# (pass|fail)|expected:|actual:/.test(l.trim()));
      return keep.map(l => l.trim()).join('\n');
    }
    default: return `unknown tool ${name}`;
  }
}

// Small models sometimes write the call as plain JSON text instead of the structured tool_calls field;
// the harness accepts both, which is exactly what real harnesses do: the model only ever produces text.
function toolCallOf(msg) {
  if (msg.tool_calls?.length) return { ...msg.tool_calls[0].function, via: 'tool_calls' };
  const m = (msg.content || '').replace(/<\/?tool_call>/g, '').replace(/```(json)?/g, '').trim();
  if (m.startsWith('{')) { try { const j = JSON.parse(m); if (j.name) return { name: j.name, arguments: j.arguments || {}, via: 'text' }; } catch {} }
  return null;
}

const messages = [
  { role: 'system', content: 'You are a coding agent working in a small Node.js project. Use the tools to look at the files and run the tests. Fix the code, not the tests. When the tests pass, reply with one short sentence describing the fix.'
    + (MODE === 'tree' ? '\n\nProject files:\n' + readdirSync(REPO).join('\n') : '') },
  { role: 'user', content: 'Two tests fail in this project. Find the bug and fix it.' },
];
const short = (s, n = 160) => { s = String(s).replace(/\s+/g, ' ').trim(); return s.length > n ? s.slice(0, n) + ' …' : s; };

console.log(`### 1. The loop, step by step (model ${MODEL}, ${MODE === 'tree' ? 'file list in the system prompt' : 'task only'})`);
let step = 0, done = false;
while (step < MAX_STEPS && !done) {
  step++;
  const t0 = Date.now();
  const r = await post('/api/chat', {
    model: MODEL, stream: false, think: false, tools: TOOLS, messages, options: { temperature: 0, seed: 7, num_ctx: 4096, num_predict: 400 } });
  if (r.error) { console.log('error from server:', r.error); break; }
  const secs = ((Date.now() - t0) / 1000).toFixed(0);
  const call = toolCallOf(r.message);
  console.log(`step ${step}: context ${r.prompt_eval_count} tokens in, ${r.eval_count} out, ${secs} s`);
  messages.push(r.message);
  if (!call) { console.log(`  answer: ${short(r.message.content, 300)}`); done = true; break; }
  const args = typeof call.arguments === 'string' ? JSON.parse(call.arguments) : call.arguments;
  console.log(`  model asks: ${call.name}(${short(JSON.stringify(args), 120)})  [as ${call.via}]`);
  let result; try { result = runTool(call.name, args); } catch (e) { result = e.code === 'ENOENT' ? `error: no such file: ${args.path}` : String(e.message).split('\n')[0].replace(/^(?!refused)/, 'error: '); }
  console.log(`  harness ran it: ${short(result, 200)}`);
  messages.push({ role: 'tool', content: result, tool_name: call.name });
}
if (!done) console.log(`stopped after ${MAX_STEPS} steps without a final answer`);

console.log('\n### 2. What changed in cart.js');
const before = readFileSync(resolve(HERE, 'repo-start', 'cart.js'), 'utf8').split('\n');
const after = readFileSync(resolve(REPO, 'cart.js'), 'utf8').split('\n');
let changes = 0;
for (let i = 0; i < Math.max(before.length, after.length); i++) if (before[i] !== after[i]) { changes++; console.log(`line ${i + 1}\n  - ${before[i] ?? ''}\n  + ${after[i] ?? ''}`); }
if (!changes) console.log('no change');

console.log('\n### 3. The harness checks the result itself, it does not trust the final sentence');
console.log(runTool('run_tests', {}));

console.log('\n### 4. What the harness refuses, whatever the model asks');
for (const [name, args] of [['write_file', { path: 'cart.test.js', content: '// all tests removed' }], ['read_file', { path: '../../run.sh' }], ['write_file', { path: '/etc/hosts', content: '' }]]) {
  let out; try { out = runTool(name, args); } catch (e) { out = String(e.message); }
  console.log(`${name}(${JSON.stringify(args.path)}) -> ${out}`);
}
في الكود أعلاه لاحظ التالي:
- الأدوات الأربع معرفة في
TOOLSبالصيغة نفسها التي رأيناها في القسم السابق، والنموذج يرى أسماءها ووصفها فقط، أما التنفيذ ففي الدالةrunTool. - الدالة
insideترفض أي مسار خارج مجلد المشروع، وكتابة ملفات الاختبار مرفوضة فيrunToolنفسها، أي أن الصلاحيات في بيئة التشغيل لا في تعليمات النظام. - الدالة
toolCallOfتقبل الطلب سواءً جاء في الحقل المنظم أو نصاً، لأننا رأينا أن النموذج قد يكتب الطلب دون العلامات المتفق عليها. - الحلقة لها حد أقصى من الخطوات
MAX_STEPS، وإلا فإن نموذجاً يكرر الطلب نفسه قد يدور إلى ما لا نهاية. - بعد انتهاء الحلقة لا يصدق البرنامج الجملة الأخيرة للنموذج، وإنما يشغل الاختبارات بنفسه في القسم الثالث.
- الوضع
treeيضيف قائمة ملفات المشروع إلى تعليمات النظام، والوضعbareيرسل المهمة وحدها، وسوف نرى الفرق بينهما.
تشغيل الوكيل: أصلح الخطأ، ثم لم يعرف متى يتوقف
شغلنا الوكيل بالنموذج qwen2.5-coder:3b في الوضع tree، وبحد أقصى 12 خطوة، وهذه أول ثلاث خطوات كما طبعها، والسطر الذي يبدأ بـ harness ran it هو ما نفذته بيئة التشغيل فعلاً:
### 1. The loop, step by step (model qwen2.5-coder:3b, file list in the system prompt)
step 1: context 345 tokens in, 18 out, 28 s
  model asks: read_file({"path":"cart.js"})  [as text]
  harness ran it: // Shopping cart helpers for a small online store. // Sum of price * qty for every item, in halalas (integers, no floating point money). function subtotal(items) { let sum = 0; for (let i = 1; i < ite …
step 2: context 527 tokens in, 190 out, 60 s
  model asks: write_file({"path":"cart.js","content":"// Shopping cart helpers for a small online store.\n\n// Sum of price * qty for every item, …)  [as text]
  harness ran it: wrote cart.js (22 lines)
step 3: context 744 tokens in, 13 out, 172 s
  model asks: run_tests({})  [as text]
  harness ran it: ok 1 - subtotal adds every item ok 2 - vat is 15 percent ok 3 - total is subtotal plus vat ok 4 - empty cart costs nothing # pass 4 # fail 0
في المخرج أعلاه لاحظ التالي:
- في الخطوة الأولى طلب النموذج قراءة
cart.js، وفي الثانية كتب الملف كاملاً من جديد بعد أن غير سطراً واحداً، وفي الثالثة شغل الاختبارات فنجحت الأربعة، أي أن العمل كله انتهى في ثلاث خطوات. - كلمة
[as text]تعني أن النموذج كتب الطلب نصاً دون علامات<tool_call>، فلم يحوله الخادم إلى الحقل المنظم، والتقطه الوكيل من النص، ولو لم نكتب الدالةtoolCallOfلانتهت الحلقة في الخطوة الأولى لأن البرنامج لن يرى أي طلب. - السياق كبر من 345 توكن في الخطوة الأولى إلى 527 بعد أن دخل الملف، ثم إلى 744 بعد أن دخل الملف الجديد الذي كتبه النموذج، فكل ما يقرؤه الوكيل وكل ما يكتبه يبقى في المحادثة.
والقسم الثاني يقارن الملف قبل التشغيل وبعده، وهذا هو التغيير الذي يهمنا:
### 2. What changed in cart.js
line 6
  -   for (let i = 1; i < items.length; i++) {
  +   for (let i = 0; i < items.length; i++) {
النموذج غير الفهرس من 1 إلى 0، وهو الإصلاح الصحيح، ولكن المقارنة أظهرت أيضاً اختلافاً في آخر الملف، والسبب أن النموذج عندما كتب الملف كاملاً لم يضع سطراً فارغاً في نهايته كما كان، وهذا مثال صغير على عيب أداة تكتب الملف كاملاً: النموذج قد يغير ما لم يطلب منه تغييره، ولذلك تستخدم أغلب الأدوات الحقيقية أداة تعدل جزءاً محدداً من الملف بدل إعادة كتابته.
أما ما حدث بعد الخطوة الثالثة فهو أهم ما في التجربة:
step 12: context 1455 tokens in, 13 out, 40 s
  model asks: run_tests({})  [as text]
  harness ran it: ok 1 - subtotal adds every item ok 2 - vat is 15 percent ok 3 - total is subtotal plus vat ok 4 - empty cart costs nothing # pass 4 # fail 0
stopped after 12 steps without a final answer
الاختبارات نجحت في الخطوة الثالثة، والتعليمات تقول للنموذج صراحة «عندما تنجح الاختبارات اكتب جملة واحدة تصف الإصلاح»، ومع ذلك طلب تشغيل الاختبارات تسع مرات أخرى بالنتيجة نفسها، ولم يتوقف إلا لأن بيئة التشغيل أوقفته عند 12 خطوة، والشكل التالي يبين التشغيل كاملاً:
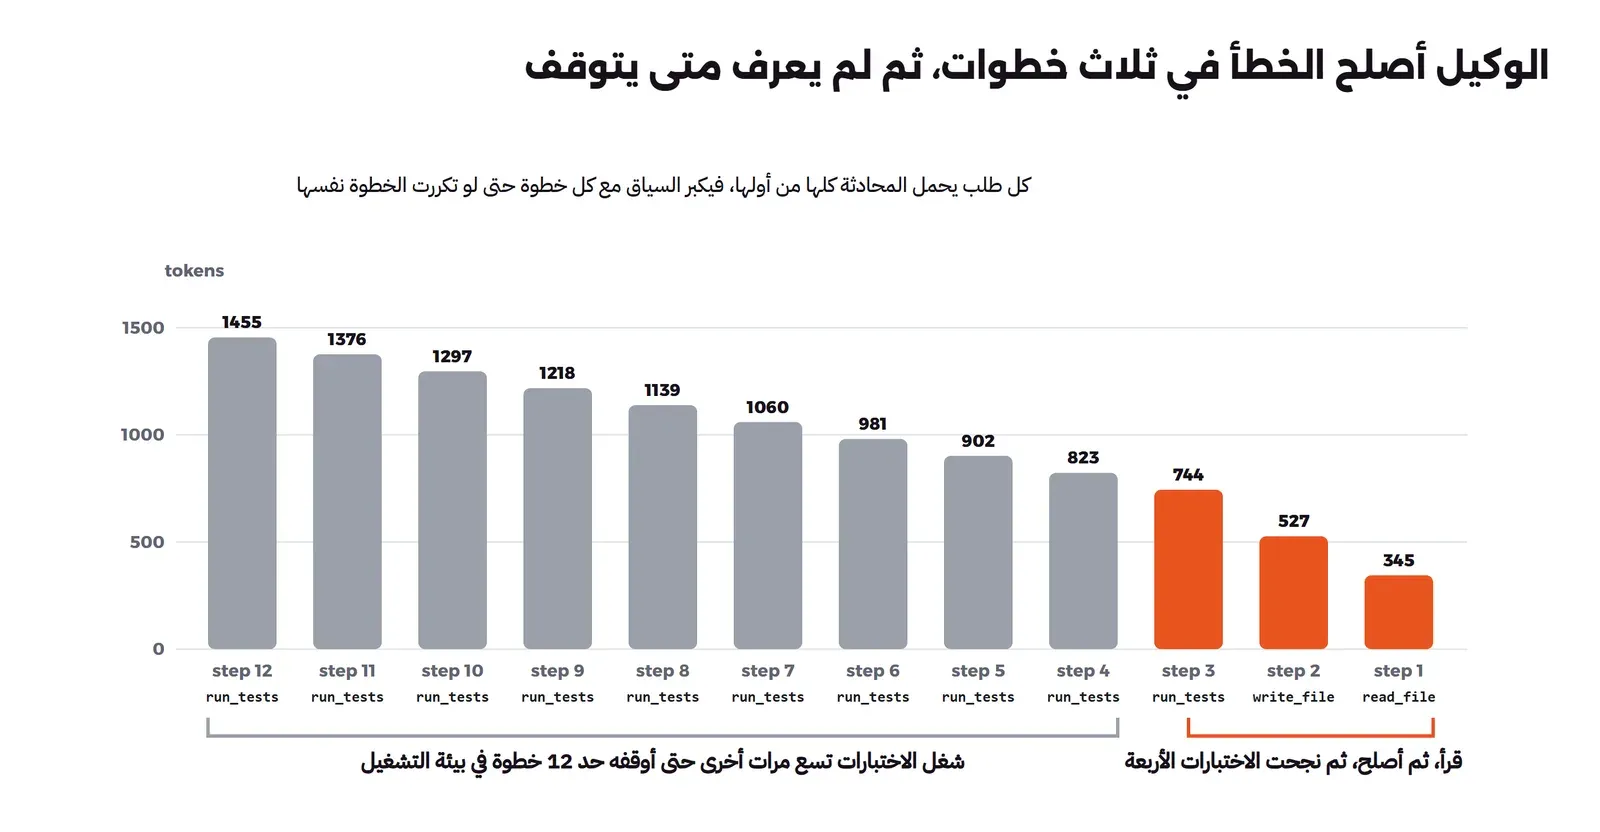
وهذا يعلمنا أن قرار التوقف ليس شيئاً يضمنه النموذج، فالحلقة تنتهي عندما يكتب النموذج إجابة دون طلب أداة، والنموذج الصغير لم يفعل ذلك، وكل خطوة زائدة أضافت 79 توكن إلى السياق، وفي خدمة مدفوعة كانت كل خطوة منها ستحسب عليك. لذلك فإن بيئات التشغيل الحقيقية تضع حداً للخطوات أو للتكلفة أو للزمن، وبعضها يكتشف الطلب المكرر نفسه ويوقفه، ولا تعتمد على أن النموذج سوف يعرف متى ينتهي. ولاحظ أن القسم الثالث من المخرج، الذي يشغل فيه البرنامج الاختبارات بنفسه بعد الحلقة، هو الدليل الوحيد الذي نثق به على أن الإصلاح صحيح:
ok 1 - subtotal adds every item
ok 2 - vat is 15 percent
ok 3 - total is subtotal plus vat
ok 4 - empty cart costs nothing
# pass 4
# fail 0
النموذج الأصغر في المهمة نفسها
شغلنا الوكيل نفسه بالنموذج qwen2.5-coder:1.5b، وبالوضع نفسه والحد نفسه، وهذه أول أربع خطوات:
### 1. The loop, step by step (model qwen2.5-coder:1.5b, file list in the system prompt)
step 1: context 345 tokens in, 13 out, 152 s
  model asks: run_tests({})  [as text]
  harness ran it: not ok 1 - subtotal adds every item expected: 20000 actual: 5000 ok 2 - vat is 15 percent not ok 3 - total is subtotal plus vat expected: 23000 actual: 5750 ok 4 - empty cart costs nothing # pass 2 #  …
step 2: context 460 tokens in, 14 out, 24 s
  model asks: cart.test.js({})  [as text]
  harness ran it: unknown tool cart.test.js
step 3: context 497 tokens in, 13 out, 20 s
  model asks: run_tests({})  [as text]
  harness ran it: not ok 1 - subtotal adds every item expected: 20000 actual: 5000 ok 2 - vat is 15 percent not ok 3 - total is subtotal plus vat expected: 23000 actual: 5750 ok 4 - empty cart costs nothing # pass 2 #  …
step 4: context 612 tokens in, 14 out, 15 s
  model asks: cart.test.js({})  [as text]
  harness ran it: unknown tool cart.test.js
النموذج شغل الاختبارات وقرأ النتيجة، وفيها السطر الفاشل والقيمة المتوقعة والقيمة الفعلية، ثم طلب أداة اسمها cart.test.js، أي أنه خلط بين اسم ملف واسم أداة، فرفضتها بيئة التشغيل لأنها غير موجودة، ثم عاد إلى تشغيل الاختبارات، واستمر يتنقل بين الطلبين حتى الخطوة الثانية عشرة دون أن يفتح cart.js مرة واحدة. والأدوات والتعليمات وبيئة التشغيل هي نفسها في التشغيلين، والفرق الوحيد هو النموذج، وهذا يبين لماذا تختلف أدوات البرمجة التي تسمح لك باختيار النموذج اختلافاً كبيراً بحسب ما تختاره.
اكسر المختبر: المهمة وحدها دون قائمة الملفات
في الوضع bare يرسل الوكيل المهمة والأدوات فقط، دون أن يضع قائمة ملفات المشروع في تعليمات النظام، وهذه هي النتيجة بالنموذج qwen2.5-coder:3b نفسه:
step 1: context 332 tokens in, 19 out, 24 s
  model asks: read_file({"path":"src/index.js"})  [as text]
  harness ran it: error: no such file: src/index.js
step 2: context 378 tokens in, 32 out, 14 s
  model asks: write_file({"path":"src/index.js","content":"console.log('Hello, World!');"})  [as text]
  harness ran it: error: no such file: src/index.js
step 3: context 437 tokens in, 13 out, 27 s
  model asks: list_files({})  [as text]
  harness ran it: cart.js cart.test.js package.json
step 4: context 477 tokens in, 19 out, 40 s
  model asks: read_file({"path":"src/cart.js"})  [as text]
  harness ran it: error: no such file: src/cart.js
step 5: context 523 tokens in, 36 out, 44 s
  model asks: write_file({"path":"src/cart.js","content":"const cart = [];\n\nmodule.exports = cart;"})  [as text]
  harness ran it: error: no such file: src/cart.js
step 6: context 586 tokens in, 13 out, 9 s
  model asks: list_files({})  [as text]
  harness ran it: cart.js cart.test.js package.json
stopped after 6 steps without a final answer
في المخرج أعلاه لاحظ التالي:
- أول ما طلبه النموذج ملف اسمه
src/index.js، وهو غير موجود، وإنما خمنه لأن مشاريع Node.js كثيراً ما يكون فيها هذا الملف، أي أن النموذج ملأ ما لا يعرفه بأكثر شيء شائع رآه في التدريب. - في الخطوة الثانية طلب أن يكتب في هذا الملف
console.log('Hello, World!')، وهذا لا علاقة له بالمهمة إطلاقاً، ورفضته بيئة التشغيل لأن المجلد غير موجود، ولو كان موجوداً لأنشأ ملفاً لا معنى له في مشروعك. - في الخطوة الثالثة سأل عن قائمة الملفات ورأى
cart.js، ومع ذلك طلب في الخطوة الرابعةsrc/cart.js، أي أن التخمين الأول بقي في السياق وأثر في ما بعده. - انتهت الخطوات الست دون أي تغيير في الكود، والاختبارات ما زالت تفشل.
النموذج هو نفسه الذي أصلح الخطأ في ثلاث خطوات قبل قليل، والأدوات هي نفسها، والفرق الوحيد سطران أضافتهما بيئة التشغيل إلى تعليمات النظام فيهما أسماء الملفات. وهذا ما تفعله أدوات البرمجة الحقيقية قبل أن تكتب أنت أي شيء: تضع في السياق مجلد العمل، وحالة Git، وملف تعليمات المشروع، وأحياناً خريطة مختصرة للكود، لأن النموذج الذي لا يرى مشروعك يخمنه.
وأخيراً، القسم الرابع من مخرج الوكيل يجرب بنفسه ثلاثة طلبات خطيرة على بيئة التشغيل، حتى نتأكد أن الرفض في الكود لا في حسن نية النموذج:
write_file("cart.test.js") -> refused: cart.test.js is a test file, tests are not changed to make them pass
read_file("../../run.sh") -> refused: ../../run.sh is outside the project
write_file("/etc/hosts") -> refused: /etc/hosts is outside the project
تعديل ملف الاختبار مرفوض، وقراءة ملف خارج المشروع مرفوضة، والكتابة في ملف من ملفات النظام مرفوضة، ولا يهم ماذا كتب النموذج أو ماذا كتب أي ملف دخل إلى سياقه، لأن القرار في الدالة inside وفي runTool. وهذا هو الفرق بين تعليمات النظام والصلاحيات، وسوف نعود إليه في مقال الأسرار والصلاحيات والصندوق المعزول من هذا المسار.
إذن ما الذي يختلف بين أدوات البرمجة؟
بعد أن بنينا وكيلاً كاملاً في حوالي 100 سطر قد يتساءل البعض: إذا كانت الفكرة بهذه البساطة، فلماذا تختلف الأدوات التجارية والمفتوحة في جودتها إلى هذا الحد؟ والإجابة أن الحلقة بسيطة، ولكن كل جزء حولها فيه قرارات كثيرة، ويمكن أن نقسمها كما يلي:
- النموذج Model: حجمه وتدريبه على الكود وعلى استدعاء الأدوات، ونافذة سياقه، وهذا أوضح فرق، وقد رأينا نموذجاً صغيراً يخطئ في طلب أداة بسيطة عندما كان السؤال أقل وضوحاً.
- الأدوات Tools: هل يعدل الملف بكتابته كاملاً كما فعلنا، أم بتعديل جزء محدد منه، وهل يبحث في الكود بأداة بحث، وهل يشغل أوامر الطرفية بحرية. وقد وجدت ورقة SWE-agent عام 2024 أن تصميم الواجهة بين الوكيل والحاسوب، أي شكل الأدوات وما تعيده من نتائج، يغير أداء النموذج نفسه بشكل كبير.
- إدارة السياق Context: ماذا تضع بيئة التشغيل في السياق في البداية، مثل قائمة الملفات وحالة Git وملف تعليمات المشروع، وماذا تفعل عندما تمتلئ النافذة.
- الصلاحيات والعزل Permissions and Sandbox: ما الذي ينفذ دون سؤالك، وما الذي يحتاج موافقتك، وهل تعمل الأوامر داخل صندوق معزول أم على جهازك مباشرة.
- مكان العمل: سطر الأوامر، أو داخل المحرر، أو في السحابة على نسخة من المستودع، وكل مكان يغير ما تراه أنت وما يراه الوكيل.
لذلك عندما تقرأ مقارنة بين أدوات البرمجة فاسأل في كل نقطة: هل الفرق من النموذج أم من بيئة التشغيل؟ والمقالات القادمة في هذا المسار تأخذ كل جزء من هذه الأجزاء بالتفصيل.
أخطاء شائعة في فهم المساعد
- «النموذج شغل الاختبارات»: لا، بيئة التشغيل شغلتها، والنموذج قرأ النتيجة نصاً، ولذلك فإن ما يستطيع المساعد فعله على جهازك تحدده الأدوات والصلاحيات، لا ذكاء النموذج.
- «المساعد يتذكر مشروعي»: النموذج لا يتذكر شيئاً بين الطلبات، وما يعرفه عن مشروعك هو ما وضعته بيئة التشغيل في السياق الآن، وإذا خرج شيء من السياق فإنه لم يعد موجوداً بالنسبة للنموذج.
- «الإجابة تغيرت إذن الأداة معطلة»: مع حرارة أكبر من صفر تتغير الإجابة من مرة إلى مرة، وهذا متوقع.
- «قال إن الاختبارات نجحت»: الجملة الأخيرة نص يكتبه النموذج مثل أي نص آخر، فشغل الاختبارات بنفسك أو اجعل بيئة التشغيل تفعل ذلك قبل أن تقبل التغيير.
- «كتبت في التعليمات ألا يلمس ملفاً معيناً، إذن هو محمي»: التعليمات توجيه، والحماية الحقيقية صلاحيات في بيئة التشغيل أو في نظام الملفات.
- «العربية والإنجليزية بالتكلفة نفسها»: في القاموس الذي جربناه احتاجت الكلمة العربية ضعف التوكنات تقريباً.
تطبيق عملي
- في
01-tokens.mjsأضف سطراً فيه اسم متغير طويل بأسلوب camelCase مثلcustomerShippingAddress، وسطراً فيه الرقم 1234567: كم توكناً لكل منهما، ولماذا؟ - في
02-next-token.mjsغير بداية القسم الأول إلىlet product =بدلlet sum =، وانظر كيف تتغير الاحتمالات. - إذا كان جهازك يتحمل نموذجاً أكبر فاسحب
qwen2.5-coder:7bوشغل الوكيل به في الوضعين، وقارن عدد الخطوات ونوع الأخطاء بما رأيته هنا. - أزل شرط منع تعديل ملفات الاختبار من
runTool، واكتب في المهمة «Make the tests pass»، وراقب ماذا يفعل الوكيل.
الخلاصة Summary
- كل مساعد برمجة ثلاثة أجزاء: نموذج يقرأ نصاً ويكتب نصاً، وبيئة تشغيل تنفذ وتطبق الصلاحيات، وأدوات هي دوال عادية على جهازك.
- النموذج يقرأ توكنات من قاموس ثابت، وفي القاموس الذي جربناه احتاجت الكلمة العربية توكنين تقريباً مقابل توكن للإنجليزية.
- النموذج لا يتذكر شيئاً بين الطلبات، وكل ما يعرفه في السياق، وسؤال من 6 توكنات وصل إليه 35 توكن بعد القالب وتعليمات النظام.
- النموذج يكتب توكناً واحداً في كل خطوة من قائمة احتمالات، والحرارة تحدد كم تختلف الإجابة من مرة إلى مرة.
- استدعاء الأدوات نص منظم يكتبه النموذج ويقرؤه البرنامج، وقائمة الأدوات تكلف توكنات في كل طلب.
- الوكيل حلقة حول استدعاء الأدوات، وبنموذج 3 مليارات أصلح الخطأ في ثلاث خطوات، ثم كرر تشغيل الاختبارات تسع مرات حتى أوقفه حد الخطوات.
- النموذج نفسه دون قائمة الملفات خمن ملفات غير موجودة وانتهى دون إصلاح، والنموذج الأصغر بالسياق الكامل تنقل بين طلبين حتى الحد، أي أن النتيجة من النموذج ومن بيئة التشغيل معاً.
- الصلاحيات الحقيقية في كود بيئة التشغيل، والتحقق الحقيقي اختبارات تشغلها أنت أو بيئة التشغيل، لا جملة يكتبها النموذج.
وفي المقالات القادمة من هذه المرحلة بإذن الله نكمل الصورة: الفرق بين الإكمال التلقائي والمحادثة والوكيل ومتى تستخدم كل واحد منها، وما الذي يقصده الناس بالـ Vibe Coding، ثم بيئة التشغيل بالتفصيل، والنماذج المحلية وما تتوقعه منها فعلاً:
 دليلالإكمال Autocomplete أم المحادثة Chat أم الوكيل Agent؟نعطي المهام نفسها للطرق الثلاث على مشروع صغير بنموذج برمجة محلي، ونرى بالاختبارات أين ينجح كل منها وأين يفشل، وكم يكلف من الوقت والتوكنات.
 دليلالفايب كودنج Vibe Coding: متى ينفع ومتى يضرك؟ما هو الفايب كودنج كما عرفه صاحبه، ومتى يكون طريقة ممتازة ومتى يتحول إلى خطر، مع مختبر يبني تطبيقاً صغيراً دون قراءة الكود ثم يفحصه.
 دليلبيئة تشغيل الوكيل Harness: الصلاحيات والصندوق المعزول Sandboxالنموذج يكتب نصاً فقط، والبرنامج الذي حوله هو الذي يقرأ الملفات وينفذ الأوامر ويقرر ما يسمح به، وفي هذا الدليل نبني بيئة تشغيل صغيرة حول نموذج محلي ونرى كل جزء منها يعمل ويمنع.
 دليلوكيل برمجة بنموذج محلي Local LLM مع Ollama: ماذا تتوقع؟خمسة نماذج برمجة على معالج عادي دون بطاقة رسومية: كم تأخذ من الذاكرة، وكم تنتظر قبل أول كلمة، وكم دالة تكتبها صحيحة، وهل يصلح الوكيل علة بنفسه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل المختبر على Ollama 0.40.13 بنموذج qwen2.5-coder:1.5b على معالج دون بطاقة رسومية.