Prices without VAT
" > site/index.html echo v1.0 > site/version.txt git add . && git commit -qm "Shop page v1.0" && git tag v1.0 echo "Prices include 15% VAT
" > site/index.html echo v1.1 > site/version.txt git commit -qam "Show prices with VAT" && git tag v1.1 git remote add origin http://dvb-gitea:3000/ops/shop-web.git git push -q -u origin main --tags git log --oneline --decorate ``` والمخرج سوف يكون كما يلي: ```text 5d1eb9e (HEAD -> main, tag: v1.1, origin/main) Show prices with VAT aa32ee4 (tag: v1.0) Shop page v1.0 ``` لاحظ أن كل إصدار له اسم ثابت هو الوسم، وأن كل وسم يشير إلى Commit محدد بالهاش، وأن الملف `version.txt` داخل الموقع يحمل اسم الإصدار نفسه، وهذا الملف الصغير هو ما سوف يجعلنا نعرف لاحقاً ماذا يعمل على كل سيرفر. وإذا كانت مفاهيم Commit والوسم والدفع جديدة عليك فقد شرحناها من البداية في [إدارة النسخ وGit للمبتدئين](https://arabroot.io/articles/%D8%A7%D8%AF%D8%A7%D8%B1%D8%A9-%D8%A7%D9%84%D9%86%D8%B3%D8%AE-%D9%88-git-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/). ### النشر اليدوي Manual Deploy: سيرفر منسي نفرض الآن أن الإصدار v1.0 يعمل على السيرفرات الثلاثة، وجاء وقت نشر v1.1 الذي يعرض الأسعار مع الضريبة، والشخص المسؤول ينشر كما ينشر كثير من الفرق: يحضر الملفات على جهازه، ثم ينسخها إلى كل سيرفر بأمر منفصل. ولأن المختبر يجب أن يبين ما يحدث عندما تنسى خطوة، فقد نسخنا عمداً إلى السيرفرين الأول والثاني فقط، تماماً كما نسي فني Knight السيرفر الثامن: ```bash cd /src/shop-web && git checkout -q v1.1 docker cp site/. dvb-web1:/usr/share/nginx/html/ docker cp site/. dvb-web2:/usr/share/nginx/html/ ``` الأمران نجحا دون أي رسالة، ومن وجهة نظر من نفذهما فقد انتهى النشر. الآن نسأل كل سيرفر عن الإصدار الذي يعمل عليه بالسكربت الصغير `check.sh`: ```bash #!/bin/sh # Which version does each server answer with? for s in $(cat servers.txt); do printf '%s ' "$s"; wget -qO- "http://$s/version.txt" 2>/dev/null || echo "unreachable" done ``` والملف `servers.txt` فيه أسماء السيرفرات الثلاثة، سطر لكل سيرفر. وعند تشغيل السكربت سوف تجد ما يلي: ```text dvb-web1 v1.1 dvb-web2 v1.1 dvb-web3 v1.0 ``` هذا الانحراف Drift بين السيرفرات هو ما لم يكن أحد يراه في Knight، ولكن ماذا يرى العملاء؟ لنرسل 30 طلباً إلى موزع الطلبات ونعد الإصدارات التي تصل إليها: ```bash for i in $(seq 30); do wget -qO- http://dvb-lb/version.txt; done | sort | uniq -c ``` والمخرج سوف يكون كما يلي: ```text 10 v1.0 20 v1.1 ``` في المخرج أعلاه لاحظ التالي: - ثلث الطلبات وصلت إلى الإصدار القديم، أي أن عميلاً من كل ثلاثة يرى أسعاراً دون ضريبة، وإذا حدث الصفحة فقد يرى السعر الآخر، وهذا أسوأ من أن يكون الموقع كله على الإصدار القديم، لأن العميل الذي يرى سعرين مختلفين للمنتج نفسه يفقد الثقة في المتجر، وفريق الدعم يتلقى شكاوى لا يستطيع إعادة إنتاجها لأن الموقع «يعمل عنده». - في أول تجربة أرسلنا 6 طلبات فقط فوصل واحد منها إلى الإصدار القديم، وليس اثنان كما يتوقع من التوزيع بالتناوب Round Robin، والسبب أن nginx يعمل بعدة عمليات Worker Processes، وكل عملية تحفظ دور التوزيع الخاص بها، فلا تصل الطلبات إلى السيرفرات بالتساوي في عينة صغيرة. والدرس أن فحصاً سريعاً بطلبين أو ثلاثة من المتصفح قد لا يكشف المشكلة أصلاً. - لم يفشل أي أمر ولم يظهر أي خطأ، فالمشكلة لا تكتشف إلا إذا سأل أحد السؤال الصحيح: ما الإصدار الذي يعمل على كل سيرفر الآن؟ ### نشر من وسم Git Tag بسكربت يتحقق الحل البسيط الأول الذي يخطر على البال هو قائمة خطوات مكتوبة في ملف، وهي أفضل من الذاكرة، ولكنها ما زالت تعتمد على أن ينفذ الإنسان كل سطر فيها بالترتيب دون أن يقاطعه أحد في منتصف الليل. والخطوة التالية أن تحول القائمة نفسها إلى سكربت، فالسكربت لا ينسى سيرفراً ولا يتعب، والأهم أنه يستطيع أن يتحقق من النتيجة بعد كل نشر. وهذا هو السكربت `deploy.sh`: ```bash #!/bin/sh # Deploy one Git tag of shop-web to every server in servers.txt, then check each one. # ./deploy.sh v1.1 set -eu TAG="$1" REPO="http://dvb-gitea:3000/ops/shop-web.git" WORK="/tmp/release-$TAG" rm -rf "$WORK" git -c advice.detachedHead=false clone --quiet --depth 1 --branch "$TAG" "$REPO" "$WORK" echo "release $TAG = commit $(git -C "$WORK" rev-parse --short HEAD)" for s in $(cat servers.txt); do docker cp "$WORK/site/." "$s:/usr/share/nginx/html/" echo "copied to $s" done fail=0 for s in $(cat servers.txt); do got=$(docker exec "$s" cat /usr/share/nginx/html/version.txt 2>/dev/null || echo "unreachable") if [ "$got" = "$TAG" ]; then echo "ok $s $got"; else echo "FAIL $s $got"; fail=1; fi done echo "$(date -u +%FT%TZ) $TAG $(git -C "$WORK" rev-parse --short HEAD) fail=$fail" >> deploy.log exit $fail ``` في السكربت أعلاه لاحظ التالي: - السكربت لا يأخذ الملفات من جهاز من ينشر، وإنما يستنسخ الوسم المطلوب من Gitea، وبالتالي فما ينشر هو بالضبط ما في المستودع تحت هذا الاسم، وليس نسخة على جهاز شخص فيها تعديل صغير لم يدفعه. - قائمة السيرفرات في ملف واحد `servers.txt`، فإذا أضفت سيرفراً رابعاً أضفته في مكان واحد، ولا يمكن أن تنساه في خطوة وتتذكره في أخرى. - الحلقة الثانية تتحقق من كل سيرفر بعد النسخ، والسكربت ينتهي برمز خروج Exit Code غير الصفر إذا اختلف أي سيرفر، وهذا الرمز هو ما سوف يجعل خط CI/CD لاحقاً يعرف أن النشر فشل. - كل نشر يكتب سطراً في `deploy.log` فيه الوقت والوسم والـ Commit والنتيجة، فإذا سألك أحد «ماذا نشرنا أمس؟» فعندك الإجابة. وعند أول تشغيل للسكربت ظهرت مشكلة حقيقية، فقد كان سطر الاستنساخ في البداية `git clone --quiet --depth 1 --branch "$TAG"` دون الخيار `advice.detachedHead`، فطبع Git فوق مخرج السكربت فقرة طويلة من خمسة عشر سطراً تبدأ هكذا: ```text Note: switching to 'aa32ee4ed7db0a39820441ba7b7156660025eddb'. You are in 'detached HEAD' state. You can look around, make experimental changes and commit them, and you can discard any commits you make in this state without impacting any branches by switching back to a branch. ``` والسبب أن الاستنساخ على وسم وليس على فرع يجعل المستودع في حالة HEAD منفصل Detached HEAD، وGit ينبه المستخدم إلى ذلك حتى مع `--quiet` لأن التنبيه نصيحة Advice وليس رسالة تقدم. والرسالة لا تضر في هذه الحالة لأننا لن نكتب أي Commit في مجلد النشر، ولكن المشكلة الحقيقية أن مخرج النشر الذي يمتلئ بنصوص لا معنى لها يجعل من يقرؤه يتعود على تجاهله، فإذا ظهر فيه يوماً سطر خطأ مهم ضاع بين النصوص كما ضاعت رسائل Knight السبع والتسعون. لذلك أضفنا الخيار `-c advice.detachedHead=false` الذي يطفئ هذه النصيحة لهذا الأمر فقط، فأصبح المخرج قصيراً يقرأ في ثانية. الآن ننشر v1.1 بالسكربت على السيرفرات الثلاثة، ثم نرسل 30 طلباً كما فعلنا قبل قليل: ```bash ./deploy.sh v1.1; echo "exit=$?" for i in $(seq 30); do wget -qO- http://dvb-lb/version.txt; done | sort | uniq -c ``` والمخرج سوف يكون كما يلي: ```text release v1.1 = commit 5d1eb9e copied to dvb-web1 copied to dvb-web2 copied to dvb-web3 ok dvb-web1 v1.1 ok dvb-web2 v1.1 ok dvb-web3 v1.1 exit=0 30 v1.1 ``` السطر الأول يربط اسم الإصدار بالـ Commit الذي نشر فعلاً، ثم ثلاثة أسطر للنسخ، ثم ثلاثة أسطر للتحقق، ورمز الخروج صفر، والطلبات الثلاثون كلها وصلت إلى v1.1، فالعملاء يرون سعراً واحداً. وفي Gitea تجد الوسوم في تبويب Releases ثم Tags، وكل وسم مع الهاش المختصر للـ Commit الخاص به، وهذا السجل هو المرجع الذي يقول ما الذي يمكن نشره وما الذي نشر: 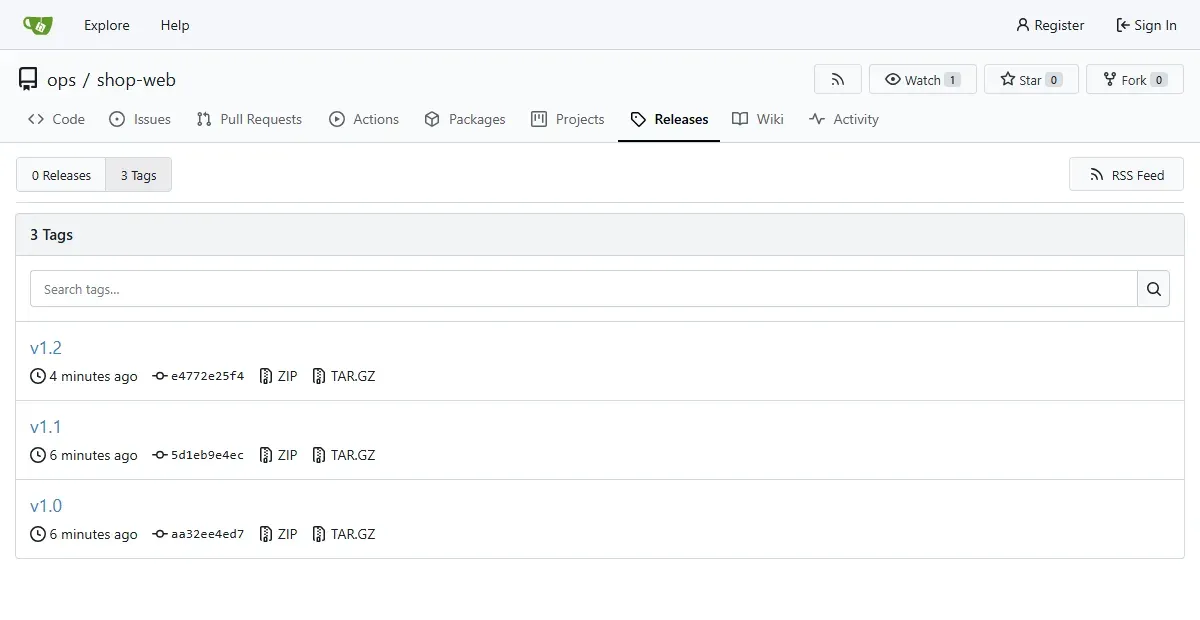 كل إصدار وسم ثابت في Gitea يشير إلى Commit محدد، والسكربت ينشر من هذا الاسم فقط ### ماذا يحدث إذا توقف سيرفر أثناء النشر؟ What If السكربت السابق يعمل عندما يكون كل شيء سليماً، ولكن السؤال المهم في أي طريقة نشر هو ماذا يحدث عندما لا يكون كل شيء سليماً. لذلك أضفنا إصداراً ثالثاً v1.2 فيه شريط «توصيل مجاني» ودفعناه مع وسمه، ثم أوقفنا السيرفر الثاني كأنه تعطل، ثم نشرنا: ```bash docker stop dvb-web2 ./deploy.sh v1.2; echo "exit=$?" for i in $(seq 30); do wget -qO- -T 3 http://dvb-lb/version.txt; done | sort | uniq -c ``` والمخرج سوف يكون كما يلي: ```text release v1.2 = commit e4772e2 copied to dvb-web1 copied to dvb-web2 copied to dvb-web3 ok dvb-web1 v1.2 FAIL dvb-web2 unreachable ok dvb-web3 v1.2 exit=1 wget: download timed out wget: download timed out ... 19 v1.2 ``` وهذه النتيجة فيها ثلاث ملاحظات مهمة: - **النسخ «نجح» إلى سيرفر متوقف:** السطر `copied to dvb-web2` ظهر مع أن السيرفر متوقف، والسبب أن `docker cp` يكتب في ملفات الـ Container حتى وهو متوقف، فالأمر لم يفشل. ومثل هذا يحدث في الواقع كثيراً، فأمر النسخ قد ينجح إلى سيرفر خدمته متوقفة أو إلى مجلد لا يقرأ منه التطبيق، ولذلك فنجاح خطوة النشر لا يثبت أن النشر نجح، وما يثبته هو سؤال الخدمة نفسها بعد النشر، وهذا ما فعلته الحلقة الثانية فأظهرت `FAIL` وأنهت السكربت بالرمز 1. - **العملاء رأوا انتظاراً وليس إصداراً قديماً:** من 30 طلباً وصل 19 إلى v1.2، وانتهى 11 بانتهاء المهلة Timeout بعد 3 ثوان، والسبب أن موزع الطلبات ما زال يرسل جزءاً من الطلبات إلى عنوان السيرفر المتوقف، وينتظر الاتصال حتى تنتهي مهلة العميل. وهذا يعني أن موزع الطلبات يحتاج إلى فحص صحة Health Check يخرج السيرفر المعطل من التوزيع، وهو موضوع [مفاهيم التوفر العالي](https://arabroot.io/articles/%D9%85%D9%81%D8%A7%D9%87%D9%8A%D9%85-%D8%A7%D9%84%D8%AA%D9%88%D9%81%D8%B1-%D8%A7%D9%84%D8%B9%D8%A7%D9%84%D9%8A-high-availability-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/). - **السجل يحفظ الفشل:** الملف `deploy.log` أصبح فيه ثلاثة أسطر، والثالث يقول `fail=1`، فمن يأتي في الصباح يعرف أن آخر نشر لم يكتمل دون أن يسأل أحداً. ```text 2026-11-03T09:33:39Z v1.0 aa32ee4 fail=0 2026-11-03T09:34:50Z v1.1 5d1eb9e fail=0 2026-11-03T09:35:07Z v1.2 e4772e2 fail=1 ``` وبعد إعادة تشغيل السيرفر الثاني بالأمر `docker start dvb-web2` أعدنا تشغيل السكربت نفسه بالوسم نفسه، فظهرت الأسطر الثلاثة `ok` ورمز الخروج صفر، ووصلت الطلبات الثلاثون كلها إلى v1.2\. وهذه خاصية مهمة اسمها التكرار الآمن Idempotency، أي أن تشغيل النشر نفسه مرتين يعطي النتيجة نفسها، فإذا فشل النشر في منتصفه لا تحتاج إلى خطوات خاصة لإصلاحه، وإنما تصلح السبب وتعيد التشغيل. ### ما الذي تعلمناه من المختبر؟ Lessons هذا السكربت ليس خط CI/CD، وما زال ينقصه الكثير: لا يبني ولا يختبر، ويعمل من جهاز شخص، ويتطلب أن يتذكر أحد تشغيله. ولكنه يبين في أربعين سطراً فكرة DevOps الأساسية في النشر: - مصدر الحقيقة Source of Truth هو المستودع، والإصدار اسم ثابت فيه، وليس مجلداً على جهاز أحد. - كل خطوة تتكرر تكتب مرة واحدة وتنفذ بالطريقة نفسها في كل مرة، فلا تعتمد على ذاكرة شخص. - النشر لا ينتهي بالنسخ، وإنما بالتحقق من أن كل سيرفر يعمل بما هو مطلوب، وبرمز خروج واضح عند الفشل. - كل نشر يترك أثراً يقرؤه الآخرون، ومخرجه قصير وواضح حتى لا يتعود أحد على تجاهله. وفي مقال [CI/CD للمبتدئين](https://arabroot.io/start/#stage-devops) من هذه المرحلة سوف ننقل الفكرة نفسها إلى خط آلي في Gitea Actions يبني ويختبر وينشر مع كل دفعة Push، دون أن يحتاج أحد إلى تشغيل سكربت من جهازه، أما تاريخ طرق النشر كلها من FTP إلى GitOps فقد شرحناه في [طرق نشر التطبيقات](https://arabroot.io/articles/%D8%B7%D8%B1%D9%82-%D9%86%D8%B4%D8%B1-%D8%A7%D9%84%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D8%A7%D8%AA-%D9%85%D9%86-ftp-%D8%A7%D9%84%D9%89-gitops/). ### التنظيف Cleanup عند الانتهاء احذف كل ما أنشأته التجربة، والـ Volume الخاص بـ Gitea معها: ```bash docker rm -f dvb-gitea dvb-web1 dvb-web2 dvb-web3 dvb-lb dvb-ops docker volume rm dvb-gitea-data docker network rm dvb-net ``` ## الممارسات الأساسية Core Practices بعد أن رأيت المشكلة على جهازك نرجع إلى الصورة الكاملة، فممارسات DevOps كثيرة، ولكن الفريق الصغير لا يحتاجها كلها في يوم واحد، والصورة التالية تبينها بالترتيب الذي نقترحه، حيث تعتمد كل ممارسة على ما قبلها:  كل ممارسة تبنى على ما قبلها، فلا معنى لخط CI إذا لم يكن الكود كله في Git - **إدارة النسخ Version Control:** الكود والإعدادات وسكربتات النشر وملفات البنية كلها في Git، وليس الكود فقط، فلا يوجد شيء في الإنتاج لا تعرف من أين جاء، وهذه من الممارسات التي تربطها DORA مباشرة بالأداء كما في صفحة [Version Control](https://dora.dev/capabilities/version-control/?ref=arabroot.io). وإذا كنت تبدأ من الصفر فابدأ بمقال [أول مستودع لك](https://arabroot.io/start/#stage-git) في مرحلة Git. - **مراجعة الكود Code Review:** لا يدخل تغيير إلى الفرع الرئيسي قبل أن يقرأه شخص آخر، وهذا يحقق ما غاب في Knight، أي شخص ثان يرى التغيير قبل الإنتاج، ومعه تنتقل المعرفة بين أعضاء الفريق. - **التكامل المستمر Continuous Integration:** كل دفعة إلى المستودع تبنى وتختبر آلياً خلال دقائق، فيعرف المطور أن تغييره أفشل شيئاً وهو ما زال يتذكر ما كتب، والتطبيق العملي على سيرفرك في [Gitea Actions](https://arabroot.io/articles/gitea-actions-%D8%AA%D8%B4%D8%BA%D9%8A%D9%84-ci-cd-%D8%B9%D9%84%D9%89-%D8%AE%D8%A7%D8%AF%D9%85%D9%83/). - **النشر المستمر Continuous Delivery:** كل نسخة نجحت في الاختبارات جاهزة للنشر بأمر واحد أو تنشر تلقائياً، كما في [أتمتة النشر Deployment Automation](https://dora.dev/capabilities/deployment-automation/?ref=arabroot.io)، ومع البيئات المختلفة مثل staging والإنتاج كما في [البيئات وGitOps](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%8A%D8%A6%D8%A7%D8%AA-%D9%88%D9%85%D8%B9%D8%A7%D9%8A%D9%86%D8%A9-%D8%A7%D9%84%D9%85%D9%8A%D8%B2%D8%A7%D8%AA-%D9%88-gitops-%D9%84%D9%84%D9%81%D8%B1%D9%82/). - **المراقبة Monitoring:** تعرف بأن الخدمة تعطلت قبل أن يتصل بك العميل، وتعرف بعد كل نشر هل تغير شيء في الأخطاء أو في سرعة الاستجابة، والمرجع الكامل في [دليل المراقبة](https://arabroot.io/articles/%D8%AF%D9%84%D9%8A%D9%84-%D8%A7%D9%84%D9%85%D8%B1%D8%A7%D9%82%D8%A8%D8%A9-monitoring-%D9%85%D8%A7%D8%B0%D8%A7-%D8%AA%D8%B1%D8%A7%D9%82%D8%A8-%D9%81%D9%8A-%D8%B3%D9%8A%D8%B1%D9%81%D8%B1%D8%A7%D8%AA%D9%83-%D9%88%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D8%A7%D8%AA%D9%83/). - **مراجعة الحوادث Postmortem:** بعد كل عطل مهم يكتب الفريق ما حدث وما الذي سمح به وما الذي سوف يتغير، دون البحث عن شخص يلام. - **البنية كشيفرة Infrastructure as Code:** السيرفرات وإعداداتها تكتب في ملفات داخل Git، فيصبح السيرفر الجديد نسخة مطابقة في دقائق، ولا يحدث انحراف كالذي رأيناه في المختبر، والمفاهيم في [البنية كشيفرة IaC للمبتدئين](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%86%D9%8A%D8%A9-%D9%83%D8%B4%D9%8A%D9%81%D8%B1%D8%A9-iac-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/). وقد يتساءل البعض: لماذا وضعنا البنية كشيفرة في آخر القائمة وهي من أشهر ما يقال عن DevOps؟ والإجابة أن الفريق الذي يملك سيرفرين ولا يملك اختبارات آلية ولا مراقبة سوف يستفيد من الاختبارات والمراقبة أكثر بكثير من Terraform، وأن كتابة البنية في ملفات تفيد أكثر عندما يكون عندك ما يكفي من السيرفرات والبيئات لكي يظهر الانحراف بينها. ## الثقافة Culture: ما الذي يتغير في سلوك الفريق؟ إذا طبقت كل الممارسات السابقة وبقيت الثقافة كما هي فسوف تعود المشكلة بأدوات أحدث، فخط CI الذي يفشل كل يوم ويتجاهله الجميع لا يفيد، والمراقبة التي لا ينظر إليها أحد لا تفيد، ومراجعة الكود التي يوافق فيها المراجع دون أن يقرأ لا تفيد. ولذلك فالسؤال الحقيقي هو كيف يتصرف الناس، وفيما يلي أهم ما يتغير: - **المسؤولية المشتركة Shared Ownership:** المطور يهتم بما يحدث لكوده بعد النشر، فيرى المقاييس والسجلات ويشارك في المناوبة On-call على الأقل لخدمته، وفريق التشغيل يشارك في التصميم مبكراً ويقول رأيه في ما يصعب تشغيله قبل أن يكتب، وقد ناقشنا من يتحمل المسؤولية عند العطل في [من يتحمل المسؤولية عندما يتعطل الإنتاج؟](https://arabroot.io/articles/%D9%85%D9%86-%D9%8A%D8%AA%D8%AD%D9%85%D9%84-%D8%A7%D9%84%D9%85%D8%B3%D8%A4%D9%88%D9%84%D9%8A%D8%A9-%D8%B9%D9%86%D8%AF%D9%85%D8%A7-%D9%8A%D8%AA%D8%B9%D8%B7%D9%84-%D8%A7%D9%84%D8%A7%D9%86%D8%AA%D8%A7%D8%AC/). - **اللوم يغلق باب التعلم:** عندما يعاقب من يعترف بالخطأ يتعلم الجميع أن يخفوا الأخطاء، وأبحاث DORA تربط الثقافة التي يسميها Ron Westrum «الثقافة المولدة Generative Culture»، حيث تتدفق المعلومات بحرية ويتعلم الفريق من الفشل، بأداء أفضل في التسليم وفي رضا الفريق، كما في صفحة [Generative Organizational Culture](https://dora.dev/capabilities/generative-organizational-culture/?ref=arabroot.io). - **الشفافية Transparency:** لوحات المراقبة وحالة خط CI وسجل النشر يراها الجميع، وليس فريقاً واحداً، فلا يحتاج أحد إلى أن يسأل «هل نشرتم شيئاً اليوم؟». - **إزالة العمل اليدوي المتكرر Toil:** كل مهمة يدوية تتكرر كل أسبوع هي فرصة للأتمتة، والفريق يخصص لها وقتاً من عمله وليس في وقت فراغ لا يأتي. وهل هذا يعني أن الثقافة تتغير بقرار من المدير؟ لا، والتفصيل أن الثقافة تتغير بالممارسة نفسها أكثر مما تتغير بالكلام، فالفريق الذي يكتب أول مراجعة حادثة بلا لوم ويرى أن الشخص الذي أخطأ لم يعاقب، وإنما تغير النظام بسبب ما كتبه، سوف يكتب المراجعة التالية بصدق أكبر. وقد ناقشنا الجانب الشخصي من ذلك في [حين يلومك الفريق على عطل لم تسببه](https://arabroot.io/articles/%D8%AD%D9%8A%D9%86-%D9%8A%D9%84%D9%88%D9%85%D9%83-%D8%A7%D9%84%D9%81%D8%B1%D9%8A%D9%82-%D8%B9%D9%84%D9%89-%D8%B9%D8%B7%D9%84-%D9%84%D9%85-%D8%AA%D8%B3%D8%A8%D8%A8%D9%87/). ## كيف تعرف أنك تتحسن؟ مقاييس DORA Metrics بدلاً من أن تسأل «هل نحن DevOps؟» وهو سؤال لا جواب له، اسأل أسئلة لها أرقام. وأشهر هذه الأسئلة [مقاييس DORA](https://dora.dev/guides/dora-metrics-four-keys/?ref=arabroot.io)، وهي اليوم خمسة، ثلاثة منها تقيس السرعة Throughput واثنان تقيس الثبات Instability: | المقياس | ماذا يقيس | من أين تأخذه في فريق صغير | | ------------------------------------------------------- | ----------------------------------------------------------- | ---------------------------------------- | | زمن التغيير Change Lead Time | الوقت من دخول التغيير إلى Git حتى وصوله إلى الإنتاج | وقت ال Commit ووقت النشر في سجل النشر | | تكرار النشر Deployment Frequency | عدد مرات النشر في فترة معينة | عدد أسطر سجل النشر في الأسبوع | | زمن التعافي من نشر فاشل Failed Deployment Recovery Time | الوقت حتى تعود الخدمة بعد نشر يحتاج تدخلاً فورياً | من وقت النشر الفاشل حتى النشر الذي أصلحه | | نسبة فشل التغييرات Change Fail Rate | نسبة النشرات التي احتاجت تدخلاً فورياً بعدها | النشرات التي تبعها تراجع أو إصلاح عاجل | | نسبة إعادة النشر Deployment Rework Rate | نسبة النشرات غير المخطط لها التي جاءت بسبب حادثة في الإنتاج | النشرات التي سببها عطل وليس خطة | لاحظ أن الملف `deploy.log` في المختبر، رغم بساطته، يكفي لحساب أول مقياسين تقريباً، فكل سطر فيه وقت ووسم ونتيجة، ومن وقت ال Commit في Git تعرف كم انتظر التغيير قبل أن ينشر. ولا تقم بتحويل هذه المقاييس إلى أهداف يقيم بها الأفراد، والسبب أن الناس سوف يحسنون الرقم بدلاً من العمل، فالفريق الذي يقاس بعدد النشرات سوف ينشر تغييرات فارغة، والمقاييس وجدت لكي يرى الفريق أين يتعطل طريقه، وقد شرحناها بتفصيل أكبر في [مقاييس DORA](https://arabroot.io/articles/%D8%A7%D9%84%D9%81%D8%B1%D9%82-%D8%A8%D9%8A%D9%86-devops-%D9%88-sre-%D9%88-platform-engineering/#dora). ## من أين يبدأ فريق صغير؟ First Steps إذا كان فريقك اليوم يشبه المشهد في أول المقال فلا تبدأ بمشروع كبير اسمه «التحول إلى DevOps»، وإنما بخطوات صغيرة كل واحدة منها تزيل ألماً تعرفه، وهذا ترتيب نقترحه لفريق من ثلاثة إلى عشرة أشخاص: 1. **الأسبوع الأول:** ضع كل الكود وملفات الإعداد بدون أسرار وسكربتات النشر في Git، على سيرفر [Gitea](https://arabroot.io/articles/%D8%AA%D8%AB%D8%A8%D9%8A%D8%AA-gitea-%D9%85%D8%B9-docker-compose/) خاص بالفريق أو على منصة مستضافة، وتأكد أن ما يعمل في الإنتاج له وسم في المستودع. 2. **الأسبوع الثاني:** اكتب خطوات النشر الحالية كما هي في ملف، ثم حولها إلى سكربت واحد مثل الذي في المختبر، مع التحقق في آخره، حتى لو بقي تشغيله يدوياً. 3. **الأسبوع الثالث:** اتفق مع الفريق أن لا يدخل شيء إلى الفرع الرئيسي دون طلب دمج يراجعه شخص آخر، واجعل الطلبات صغيرة. 4. **الشهر الثاني:** شغل الاختبارات الموجودة، حتى لو كانت قليلة، آلياً مع كل دفعة Push، ثم اجعل السكربت ينشر من الخط نفسه إلى بيئة staging. 5. **الشهر الثالث:** أضف فحصاً من الخارج يتأكد أن الموقع يعمل، وتنبيهاً يصل إلى شخص مناوب، واكتب أول مراجعة حادثة بلا لوم عند أول عطل. وبعد كل خطوة انظر إلى سجل النشر، فإذا أصبح الفريق ينشر أكثر وبخوف أقل فأنت على الطريق الصحيح، وإذا أصبح عندك أدوات أكثر والنشر ما زال مرة في الشهر فارجع إلى الخطوة التي يتعطل عندها الطريق. ## أخطاء شائعة Common Mistakes - **شراء الأداة قبل فهم المشكلة:** فريق يبدأ بتثبيت Kubernetes لأن الجميع يتحدث عنه، وهو لا يملك اختبارات آلية ولا يعرف كم يأخذ النشر الآن، والنتيجة نظام أعقد ينشر بنفس البطء، فابدأ بقياس الطريق الحالي ثم اختر الأداة التي تزيل أبطأ نقطة فيه. - **تعيين «شخص DevOps» واحد:** يصبح هذا الشخص هو الجدار الجديد، فكل نشر ينتظره، وكل معرفة في رأسه، وإذا أخذ إجازة توقف كل شيء، والأفضل أن يبني هذا الشخص أدوات يستخدمها الفريق بنفسه، وأن يعرف شخصان على الأقل كل جزء. - **الأتمتة دون تحقق:** سكربت ينسخ ولا يتحقق أخطر أحياناً من اليدوي، لأنه يعطيك ثقة لا يستحقها، كما رأيت في المختبر عندما «نجح» النسخ إلى سيرفر متوقف. - **تجاهل الخط الأحمر:** عندما يفشل خط CI كل يوم لأسباب غير مهمة يتعلم الفريق أن اللون الأحمر طبيعي، فإذا جاء فشل حقيقي لم ينتبه له أحد، فأصلح الاختبارات المتقلبة أو احذفها بدلاً من التعود عليها. - **نسخ ممارسات الشركات الكبيرة كما هي:** ما تفعله Google بآلاف المهندسين لا يناسب فريقاً من خمسة، فخذ الفكرة واترك الحجم. - **ترك الكود الميت في الإنتاج:** الميزة التي توقف استخدامها ما زالت كوداً يمكن أن يعمل بالخطأ، كما حدث مع Power Peg في Knight بعد تسع سنوات من توقفه، فاحذف ما لا تستخدمه، وأزل مفاتيح Feature Flags القديمة بعد انتهاء الحاجة إليها. ## قائمة تحقق Checklist استخدم الأسئلة التالية لتعرف أين يقف فريقك الآن، وكل إجابة «لا» هي خطوتك التالية: | السؤال | إذا كانت الإجابة لا | | ----------------------------------------------------- | -------------------------------------- | | هل كل ما يعمل في الإنتاج موجود في Git مع وسم للإصدار؟ | ابدأ من إدارة النسخ ووسوم الإصدارات | | هل يستطيع شخصان على الأقل في الفريق أن ينشرا إصداراً؟ | اكتب النشر في سكربت يعمل لأي شخص | | هل يتحقق النشر من كل سيرفر بعد أن ينتهي؟ | أضف خطوة تحقق ورمز خروج كما في المختبر | | هل يراجع شخص آخر كل تغيير قبل أن يدمج؟ | اتفق على طلبات الدمج ومراجعة الكود | | هل تعمل الاختبارات آلياً مع كل دفعة Push؟ | شغل خط CI ولو باختبار واحد | | هل تعرف بالعطل قبل أن يخبرك العميل؟ | أضف فحصاً من الخارج وتنبيهاً | | هل تستطيع أن تقول متى نشرت آخر مرة وماذا نشرت؟ | احفظ سجلاً لكل نشر | | هل تكتب مراجعة لكل عطل مهم دون البحث عن شخص يلام؟ | اكتب أول مراجعة عند أول عطل قادم | ## ماذا تقرأ بعد ذلك؟ Next Steps هذا المقال هو بداية المرحلة، والمقالات التالية تأخذ كل ممارسة وحدها بتجربة عملية، وأقرب ما يفيدك الآن: [دليلإدارة النسخ وGit للمبتدئين: لماذا نحتاجها وكيف تعمللماذا تضيع الملفات بأسماء final\_v2 ويمسح الزملاء عمل بعضهم، وكيف يحل Git ذلك على مشروع حقيقي من أول commit.](https://arabroot.io/articles/%D8%A7%D8%AF%D8%A7%D8%B1%D8%A9-%D8%A7%D9%84%D9%86%D8%B3%D8%AE-%D9%88-git-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/)[دليلGitea: خادم Git خاص لفريقك على سيرفرككيف تثبت Gitea على سيرفرك حتى يبقى كود فريقك عندك بتجربة تشبه GitHub، مع النسخ الاحتياطي والتحديث.](https://arabroot.io/articles/%D8%AA%D8%AB%D8%A8%D9%8A%D8%AA-gitea-%D9%85%D8%B9-docker-compose/)[دليلGitea Actions: تشغيل CI/CD وبناء Docker Images على سيرفركاجعل سيرفرك يختبر الكود ويبني Docker Images تلقائياً مع كل push، دون أن يخرج كودك أو أسرارك إلى خدمة CI خارجية.](https://arabroot.io/articles/gitea-actions-%D8%AA%D8%B4%D8%BA%D9%8A%D9%84-ci-cd-%D8%B9%D9%84%D9%89-%D8%AE%D8%A7%D8%AF%D9%85%D9%83/)[دليلطرق نشر التطبيقات من FTP إلى GitOps، وأين تقف أنتكيف تطور نشر التطبيقات عبر السنين، وما الذي يتعطل في كل طريقة، وكيف تعرف أين تقف وما خطوتك التالية.](https://arabroot.io/articles/%D8%B7%D8%B1%D9%82-%D9%86%D8%B4%D8%B1-%D8%A7%D9%84%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D8%A7%D8%AA-%D9%85%D9%86-ftp-%D8%A7%D9%84%D9%89-gitops/)[دليلمن الفرع إلى الإنتاج: البيئات وGitOps للفرقكيف يختبر فريقك كل ميزة وحدها ويعرضها على العميل دون أن تصل ميزة غير جاهزة إلى الإنتاج.](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D9%8A%D8%A6%D8%A7%D8%AA-%D9%88%D9%85%D8%B9%D8%A7%D9%8A%D9%86%D8%A9-%D8%A7%D9%84%D9%85%D9%8A%D8%B2%D8%A7%D8%AA-%D9%88-gitops-%D9%84%D9%84%D9%81%D8%B1%D9%82/)[دليلDevOps وSRE وهندسة المنصات: أين يلتقي كل منها؟ما الذي يعنيه كل مصطلح فعلاً، وكيف تحسب ميزانية الأخطاء، وما شكل الفريق المناسب لحجم شركتك.](https://arabroot.io/articles/%D8%A7%D9%84%D9%81%D8%B1%D9%82-%D8%A8%D9%8A%D9%86-devops-%D9%88-sre-%D9%88-platform-engineering/) ابدأ بـ [إدارة النسخ وGit للمبتدئين](https://arabroot.io/articles/%D8%A7%D8%AF%D8%A7%D8%B1%D8%A9-%D8%A7%D9%84%D9%86%D8%B3%D8%AE-%D9%88-git-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/) إذا كان Git جديداً عليك، ثم [تثبيت Gitea](https://arabroot.io/articles/%D8%AA%D8%AB%D8%A8%D9%8A%D8%AA-gitea-%D9%85%D8%B9-docker-compose/) ليكون للفريق سيرفر Git خاص، ثم [Gitea Actions](https://arabroot.io/articles/gitea-actions-%D8%AA%D8%B4%D8%BA%D9%8A%D9%84-ci-cd-%D8%B9%D9%84%D9%89-%D8%AE%D8%A7%D8%AF%D9%85%D9%83/) لتشغيل أول خط CI/CD، وإذا أردت أن ترى الطريق كله بمراحله فافتح [مرحلة DevOps والنشر المستمر في خارطة الطريق](https://arabroot.io/start/#stage-devops). ## الخلاصة Summary - ظهر DevOps لأن فريق التطوير وفريق التشغيل كانا يعملان بهدفين متعاكسين، فأصبح النشر نادراً وكبيراً ومؤلماً، وأصبح كل عطل نقاشاً عن المسؤول. - DevOps طريقة عمل تجعل من يبني ومن يشغل فريقاً واحداً، وتلخصها المبادئ الثلاثة: التدفق، والتغذية الراجعة، والتعلم المستمر، والأدوات وسيلة لتطبيقها وليست هي. - حادثة Knight Capital تبين أن الخطأ البشري سوف يحدث، وأن السؤال هو هل في النظام ما يمسكه: نشر آلي، وتحقق بعد النشر، وتنبيهات يراها أحد، ومراجعة ثانية. - في المختبر وصل ثلث الطلبات إلى الإصدار القديم بعد نشر يدوي نسي سيرفراً، وأصلح ذلك سكربت ينشر من وسم Git ويتحقق من كل سيرفر، وكشف السكربت نفسه أن النسخ قد «ينجح» إلى سيرفر متوقف. - ابدأ بخطوات صغيرة بالترتيب: Git، ثم سكربت نشر يتحقق، ثم مراجعة الكود، ثم CI، ثم المراقبة ومراجعة الحوادث، وقس تقدمك بمقاييس DORA دون أن تحولها إلى أداة لتقييم الأفراد. ## سجل التحديثات Changelog - نوفمبر 2026: كتابة المقال واختبار التجربة على Gitea 28.3.0 وnginx 1.29.8 وAlpine 3.24.3 مع git 2.54.0.