> ## Content Index
> Fetch the complete content index at: https://arabroot.io/llms.txt
> Use this file to discover other available public pages before exploring further.
# معيار MARC21 للمبتدئين: بطاقة الفهرسة في الحاسب
- URL: https://arabroot.io/articles/معيار-marc21-للمبتدئين-كيف-يقرا-الحاسب-بطاقة-الفهرسة/
- Published: 2026-11-17T00:32:55.000Z
- Updated: 2026-11-17T01:32:59.000Z
- Description: نقرأ تسجيلتين حقيقيتين من فهرس مكتبة الكونغرس حقلاً حقلاً، ونرى أين يذهب العنوان العربي، ولماذا ضاعت همزة عند التحويل إلى MARC-8.
- Author: فريق عرب رووت
- Tags: الأدلة التقنية, المكتبات ونظم المعلومات, تطبيقات لفريقك, الاستضافة الذاتية
إذا عملت في مكتبة جامعية أو في قسم تقنية المعلومات الذي يخدمها، فقد رأيت هذه الأرقام: 245 و100 و650، وسمعت المفهرس يقول «العنوان ناقص في الحقل 245» أو «الحرف العربي في 880»، ورأيت ملفاً بامتداد `.mrc` إذا فتحته في محرر نصوص ظهرت لك سطور من الأرقام والحروف لا تفهم منها شيئاً. وقد يطلب منك يوماً أن تنقل عشرين ألف تسجيلة من نظام قديم إلى Koha، أو أن تعرف لماذا يظهر عنوان كتاب عربي في الفهرس بحروف مقطعة، أو لماذا لا يجد الطالب كتاباً موجوداً على الرف. وكل هذه الأسئلة لها جواب واحد يبدأ من فهم معيار MARC21 نفسه، وهو المعيار الذي تتبادل به أغلب مكتبات العالم وصف الكتب منذ عقود، وفي هذا المقال سوف نتناول:
- لماذا احتاجت المكتبات معياراً يقرؤه الحاسب، وكيف تحولت بطاقة الفهرس الورقية إلى حقول مرقمة.
- كيف يبنى ملف MARC من الداخل: الرأس Leader والدليل Directory والحقول، والمؤشرات Indicators والحقول الفرعية Subfields.
- مختبر يجلب تسجيلتين حقيقيتين من فهرس مكتبة الكونغرس، رواية «أولاد حارتنا» بالعربية وترجمتها الإنجليزية، ثم نقرؤهما حقلاً حقلاً: الرأس و008 و020 و100 و245 و260/264 و300 والموضوعات.
- الحرف العربي في التسجيلة: الحقل 880 المرتبط، والفرق بين الترميزين MARC-8 وUTF-8، وهمزة ضاعت في التحويل أمامنا.
- تحويل التسجيلة إلى MARCXML، وماذا يحدث إذا عدلت ملف MARC بيدك، ثم قائمة تحقق قبل استيراد أي ملف.
وإذا كنت لم تقرأ بعد عن أنظمة المكتبة نفسها، فقد شرحنا في دليل [نظام المكتبة Koha](https://arabroot.io/articles/%D8%AA%D8%AB%D8%A8%D9%8A%D8%AA-%D9%86%D8%B8%D8%A7%D9%85-%D8%A7%D9%84%D9%85%D9%83%D8%AA%D8%A8%D8%A9-koha-%D9%84%D8%A7%D8%AF%D8%A7%D8%B1%D8%A9-%D8%A7%D9%84%D9%83%D8%AA%D8%A8-%D9%88%D8%A7%D9%84%D8%A7%D8%B9%D8%A7%D8%B1%D8%A9/) كيف تستورد تسجيلات MARCXML وكيف تحمل كل نسخة على الرف حقلاً خاصاً بها، وهنا نذهب خطوة إلى الداخل لنفهم التسجيلة نفسها، والمقالات التالية في هذه المرحلة تبني عليه:
[دليلخريطة أنظمة المكتبة: ILS والمستودع وبوابة البحثما الأنظمة التي تتكون منها المكتبة الحديثة وكيف تتكلم مع بعضها، مع مختبر ينسخ تسجيلة كتاب من مكتبة الكونغرس عبر Z39.50 ويحصد مستودعاً عبر OAI-PMH.](https://arabroot.io/articles/%D8%AE%D8%B1%D9%8A%D8%B7%D8%A9-%D8%A7%D9%86%D8%B8%D9%85%D8%A9-%D8%A7%D9%84%D9%85%D9%83%D8%AA%D8%A8%D8%A9-ils-%D9%88%D8%A7%D9%84%D9%85%D8%B3%D8%AA%D9%88%D8%AF%D8%B9-%D9%88%D8%A8%D9%88%D8%A7%D8%A8%D8%A9-%D8%A7%D9%84%D8%A8%D8%AD%D8%AB/)[دليلقواعد RDA للكتاب العربي وأسماء المؤلفيننقرأ قواعد RDA من ست تسجيلات حقيقية في فهرس مكتبة الكونغرس، ونرى كيف يدخل اسم المؤلف العربي وكيف تكتب السنة الهجرية والرومنة.](https://arabroot.io/articles/%D8%A7%D9%84%D9%81%D9%87%D8%B1%D8%B3%D8%A9-%D8%A8%D9%82%D9%88%D8%A7%D8%B9%D8%AF-rda-%D9%84%D9%84%D9%83%D8%AA%D8%A8-%D8%A7%D9%84%D8%B9%D8%B1%D8%A8%D9%8A%D8%A9-%D9%88%D8%A7%D8%B3%D9%85%D8%A7%D8%A1-%D8%A7%D9%84%D9%85%D8%A4%D9%84%D9%81%D9%8A%D9%86/)[دليلDublin Core وBIBFRAME: البيانات الوصفية بعد MARCنحول تسجيلتين حقيقيتين من مكتبة الكونغرس إلى Dublin Core وإلى BIBFRAME بالأدوات الرسمية، ونرى ما يبقى وما يضيع من الوصف العربي.](https://arabroot.io/articles/dublin-core-%D9%88-bibframe-%D8%A7%D9%84%D8%A8%D9%8A%D8%A7%D9%86%D8%A7%D8%AA-%D8%A7%D9%84%D9%88%D8%B5%D9%81%D9%8A%D8%A9-%D8%A8%D8%B9%D8%AF-marc/)[دليلملفات الإسناد Authority Files وأسماء المؤلفين العربنبحث في ملف أسماء مكتبة الكونغرس عن مؤلفين عرب، ونقيس كم اسماً حقيقياً في فهرس مفتوح يجد صاحبه بالشكل المعتمد والإحالات والتوحيد.](https://arabroot.io/articles/%D9%85%D9%84%D9%81%D8%A7%D8%AA-%D8%A7%D9%84%D8%A7%D8%B3%D9%86%D8%A7%D8%AF-authority-records-%D9%88%D8%AA%D9%88%D8%AD%D9%8A%D8%AF-%D8%A7%D8%B3%D9%85%D8%A7%D8%A1-%D8%A7%D9%84%D9%85%D8%A4%D9%84%D9%81%D9%8A%D9%86-%D8%A7%D9%84%D8%B9%D8%B1%D8%A8/)
## لماذا احتاجت المكتبات معياراً يقرؤه الحاسب؟
قبل الحاسب كان الفهرس خزانة فيها أدراج، وفي كل درج بطاقات بحجم واحد، وعلى كل بطاقة وصف كتاب بترتيب ثابت: رقم التصنيف في الزاوية، ثم اسم المؤلف، ثم العنوان ومن شارك فيه، ثم الطبعة ومكان النشر والناشر والسنة، ثم عدد الصفحات والطول، ثم الموضوعات مرقمة في الأسفل. والمفهرس الخبير يقرأ هذه البطاقة في ثانية، لأنه يعرف أن السطر الأول بالخط العريض هو المؤلف، وأن ما بعد الشرطة المائلة هو بيان المسؤولية، وأن الرقم قبل «p.» هو عدد الصفحات، أي أن المعنى عنده يأتي من مكان الكلمة وشكلها.
والمشكلة أن الحاسب لا يرى الخط العريض ولا يعرف أن هذا السطر جاء أولاً لأنه المؤلف، فإذا أعطيته نص البطاقة كما هو فلن يعرف أين ينتهي العنوان ويبدأ الناشر، ولن يستطيع أن يرتب الكتب بالمؤلف أو أن يبحث بالموضوع. لذلك بدأت مكتبة الكونغرس في الستينيات مشروعاً لتحويل البطاقة إلى صيغة يقرؤها الحاسب، وسمته MAchine-Readable Cataloging، واختصاراً MARC، والفكرة كانت بسيطة: كل معلومة في البطاقة تأخذ رقماً ثابتاً يدل على معناها، فالحاسب لا يحتاج أن يفهم النص، وإنما يقرأ الرقم. وتطور المعيار عبر السنين، وفي نهاية التسعينيات دمجت النسخة الأمريكية USMARC والنسخة الكندية CAN/MARC في معيار واحد سمي MARC21، وهو الذي تديره اليوم مكتبة الكونغرس وتنشر توثيقه كاملاً في صفحة [MARC 21 Format for Bibliographic Data](https://www.loc.gov/marc/bibliographic/?ref=arabroot.io).
والصورة التالية تبين الفكرة بتسجيلة حقيقية من فهرس مكتبة الكونغرس، الترجمة الإنجليزية لرواية «أولاد حارتنا» لنجيب محفوظ، كما كانت ستبدو على بطاقة، وكما هي في MARC21:
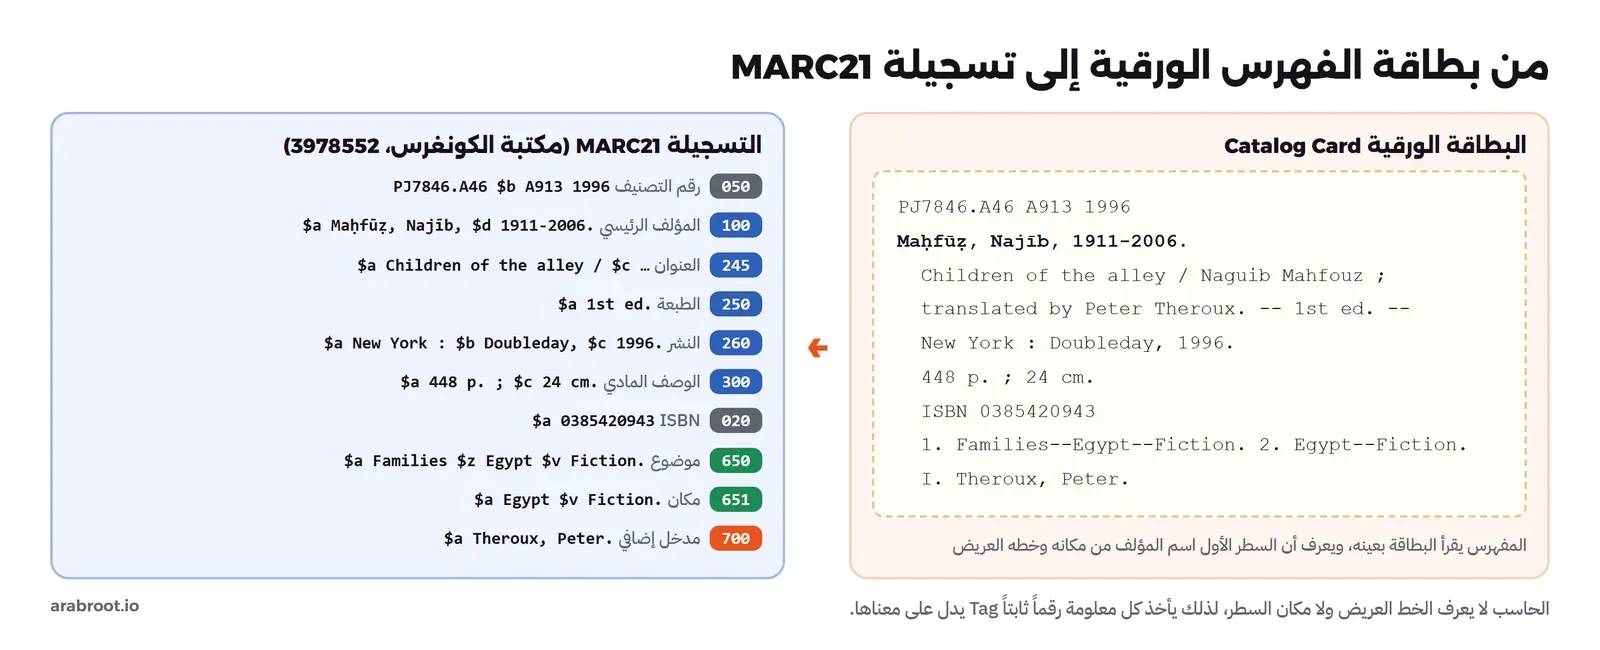
السطر في البطاقة يعرف بمكانه وشكله، وفي MARC21 يعرف برقم الحقل
في الصورة أعلاه لاحظ التالي:
- كل معلومة في البطاقة أصبحت حقلاً Field برقم من ثلاث خانات يسمى Tag، والمؤلف دائماً في 100 والعنوان دائماً في 245، في أي مكتبة في العالم تستخدم المعيار.
- داخل الحقل الواحد أجزاء، فالنشر في 260 فيه المكان والناشر والسنة، وكل جزء حقل فرعي Subfield يبدأ برمز مثل `$a` و`$b` و`$c`، وبالتالي يعرف البرنامج أن «Doubleday» هو الناشر لأنه في `$b`.
- الترقيم الذي تراه داخل الحقول مثل « : » و« / » و« ; » بقي كما كان على البطاقة، وهو ترقيم الوصف الدولي ISBD، وسوف نعود إليه.
وقد يتساءل البعض: إذا كانت قواعد البيانات اليوم تخزن أي شيء، فلماذا ما زالت المكتبات تستخدم صيغة من الستينيات؟ والإجابة على ذلك أن قيمة MARC ليست في الصيغة نفسها، وإنما في أن ملايين التسجيلات مكتوبة بها، وأن كل نظام مكتبة مثل Koha وFOLIO وEvergreen يقرؤها ويكتبها، وأن المكتبة التي تشتري كتاباً جديداً لا تفهرسه من الصفر وإنما تنسخ تسجيلته من مكتبة أخرى عبر Z39.50 أو SRU، وهذا النسخ لا يعمل إلا لأن الجميع يتكلم اللغة نفسها. لذلك حتى المعايير الأحدث مثل BIBFRAME، التي سوف نشرحها في مقال قادم، تبدأ اليوم من تحويل تسجيلات MARC الموجودة.
## كيف يبنى ملف MARC من الداخل؟
الملف الذي يصلك بامتداد `.mrc` مكتوب بصيغة تبادل اسمها [MARC 21 Record Structure](https://www.loc.gov/marc/specifications/specrecstruc.html?ref=arabroot.io)، وهي مبنية على المعيار الدولي ISO 2709، والتسجيلة الواحدة فيه سلسلة واحدة من البايتات لها ثلاثة أجزاء، والصورة التالية تبينها بالأرقام الحقيقية لتسجيلة «أولاد حارتنا» التي سوف نجلبها بعد قليل:
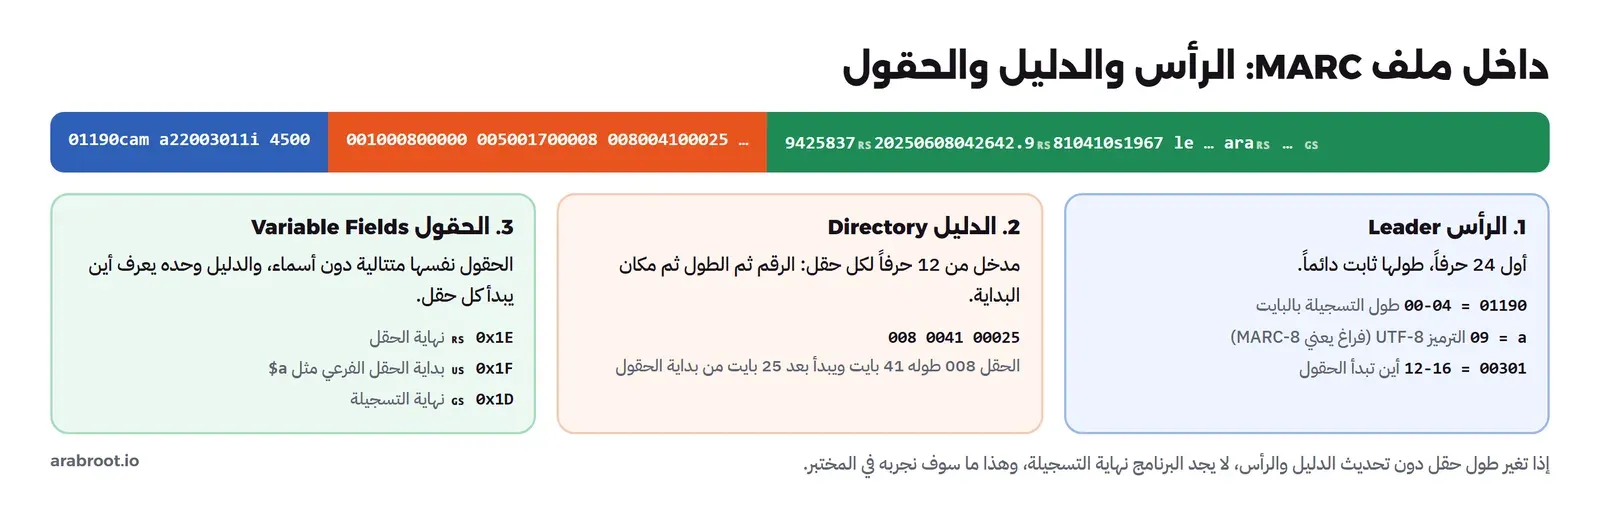
تسجيلة MARC: رأس ثابت الطول، ثم دليل يقول أين يبدأ كل حقل، ثم الحقول دون أسماء
والأجزاء الثلاثة كما يلي:
1. **الرأس Leader:** أول 24 حرفاً من التسجيلة، وطوله ثابت دائماً، وفيه معلومات عن التسجيلة نفسها وليس عن الكتاب: طولها بالبايت، ونوع المادة (نص أو خريطة أو تسجيل صوتي)، والترميز المستخدم، وأين تبدأ الحقول. وتوثيقه كاملاً في صفحة [Leader](https://www.loc.gov/marc/bibliographic/bdleader.html?ref=arabroot.io).
2. **الدليل Directory:** بعد الرأس مباشرة، وهو قائمة فيها مدخل من 12 حرفاً لكل حقل: ثلاثة للرقم، وأربعة للطول، وخمسة لمكان البداية. والدليل هو الذي يجعل البرنامج يقفز إلى الحقل 245 مباشرة دون أن يقرأ ما قبله.
3. **الحقول Variable Fields:** البيانات نفسها متتالية، وكل حقل ينتهي بالرمز `0x1E`، وكل حقل فرعي يبدأ بالرمز `0x1F` ثم حرف الحقل الفرعي، والتسجيلة كلها تنتهي بالرمز `0x1D`. ولاحظ أن الحقول لا تحمل أرقامها، فالرقم موجود في الدليل فقط.
وهذا التصميم منطقي إذا تذكرت أن المعيار ولد في زمن الأشرطة الممغنطة، فالبرنامج يقرأ الرأس فيعرف طول التسجيلة، فيقرأ هذا العدد من البايتات بالضبط، ثم يقرأ الدليل ليعرف أماكن الحقول. ولكن هذا التصميم نفسه يجعل الملف حساساً جداً، فلو زاد حرف واحد في حقل دون تحديث الطول في الدليل والرأس، لن يجد البرنامج نهاية التسجيلة، وسوف نجرب ذلك بأيدينا.
### المؤشرات Indicators والحقول الفرعية Subfields
الحقول في MARC نوعان. الأول حقول التحكم Control Fields من 001 إلى 009، وليس فيها مؤشرات ولا حقول فرعية، وإنما قيمة واحدة مثل رقم التسجيلة في 001، أو سلسلة ثابتة الطول تعرف معانيها بالمواقع كما في 008\. والثاني حقول البيانات Data Fields من 010 إلى 999، ولكل واحد منها مؤشران Indicators، وهما خانتان بعد الرقم مباشرة، ثم الحقول الفرعية. والمؤشر يغير طريقة التعامل مع الحقل دون أن يكون جزءاً من النص، وأشهر مثال عليه الحقل 245:
```text
245 10 $a Children of the alley / $c Naguib Mahfouz ; translated by Peter Theroux.
245 13 $6 880-02 $a al-Intāj al-fikrī al-Maghribī : $b fī maktabat al-malik Fahd al-waṭanīyah
```
في المثالين أعلاه لاحظ التالي:
- المؤشر الأول `1` يعني أن هناك مدخلاً للعنوان، أي أن العنوان يظهر في فهرس العناوين.
- المؤشر الثاني هو عدد الحروف التي يتجاهلها البرنامج عند الفرز، وهو `0` في الأول، و`3` في الثاني لأن العنوان يبدأ بـ «al-» وهي ثلاثة حروف، وبالتالي يرتب الكتاب تحت «Intāj» وليس تحت حرف A، وهذا المؤشر مهم جداً للكتب العربية المرومنة التي تبدأ بأداة التعريف، وأغلب الأخطاء في ترتيب الفهارس العربية تأتي منه.
- الحقول الفرعية داخل 245: `$a` العنوان الأصلي، و`$b` بقية العنوان، و`$c` بيان المسؤولية كما هو مكتوب في صفحة العنوان، و`$6` رقم الربط بالحقل 880، وتوثيق كل حرف في صفحة [245 Title Statement](https://www.loc.gov/marc/bibliographic/bd245.html?ref=arabroot.io).
والصورة التالية تجمع عائلات الحقول، لأن المئات في MARC لها معنى، فإذا عرفت أن 6XX للموضوعات و7XX للمداخل الإضافية فلن تحتاج حفظ كل رقم:
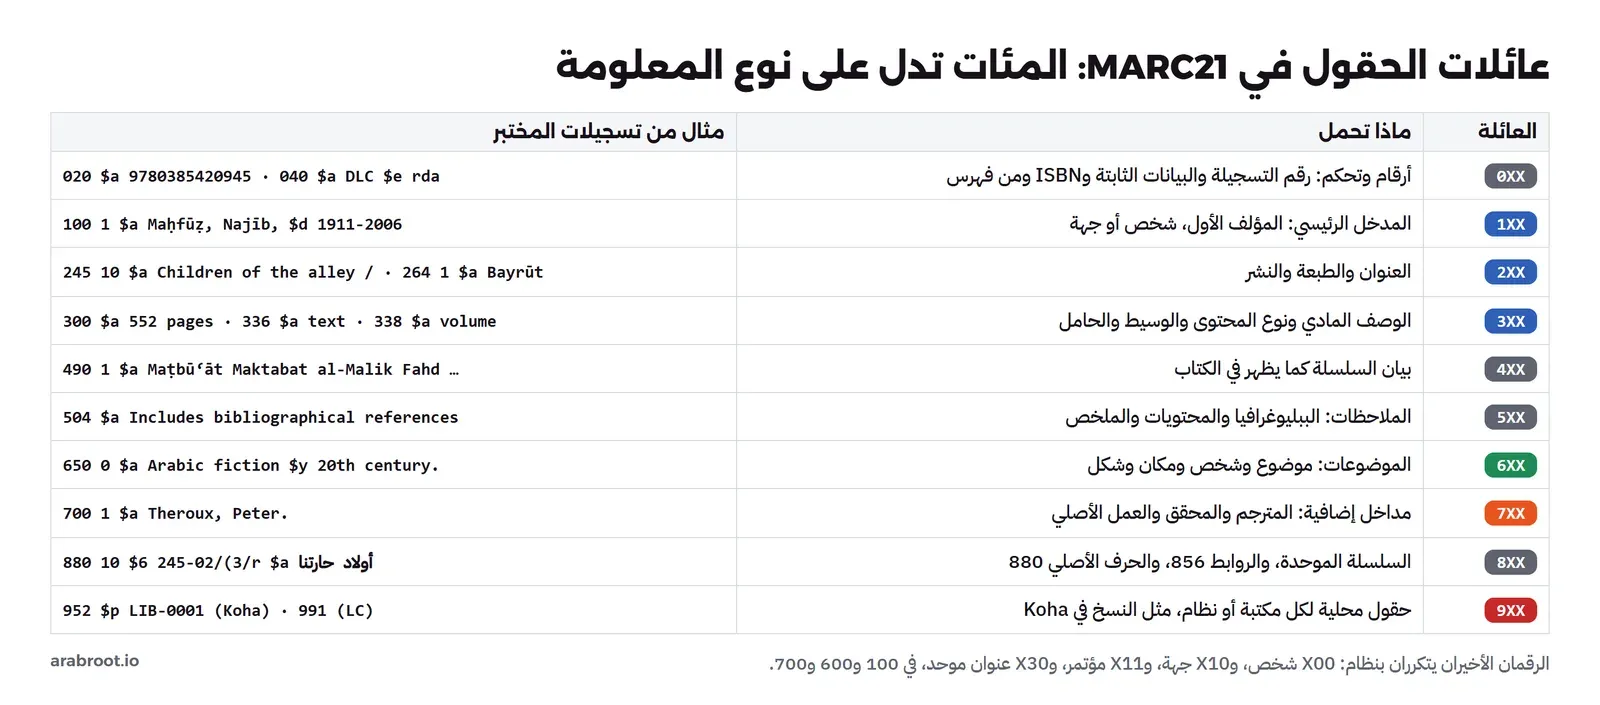
عائلات الحقول: رقم المئات يقول نوع المعلومة، والرقمان الأخيران يتكرران بنظام بين العائلات
## المختبر: نجلب تسجيلتين حقيقيتين من مكتبة الكونغرس
الآن سوف نقوم بالعمل الفعلي، والفكرة أن نقرأ تسجيلات حقيقية كما يستلمها نظام مكتبتك، وليس أمثلة مكتوبة باليد. واخترنا كتابين لهما علاقة ببعضهما: رواية «أولاد حارتنا» لنجيب محفوظ بطبعة دار الآداب في بيروت، وهي تسجيلة عربية فيها حرف لاتيني وحرف عربي، وترجمتها الإنجليزية «Children of the alley» التي نشرتها Doubleday في 1996، وهي تسجيلة إنجليزية فيها ISBN وموضوعات ومترجم.
وسوف نستخدم أداتين مفتوحتي المصدر: [yaz-client](https://software.indexdata.com/yaz/doc/yaz-client.html?ref=arabroot.io) من حزمة YAZ، وهي عميل Z39.50 يتصل بفهرس أي مكتبة، ومعها [yaz-marcdump](https://software.indexdata.com/yaz/doc/yaz-marcdump.html?ref=arabroot.io) الذي يعرض ملفات MARC ويحولها، ثم مكتبة [pymarc](https://pypi.org/project/pymarc/?ref=arabroot.io) في Python لنقرأ المواقع بأنفسنا. ولا تحتاج أن تكون مبرمجاً لتتبع الخطوات، فالأوامر تنسخ كما هي، والمهم هو قراءة المخرج.
### تجهيز Container للمختبر
نضع الأدوات كلها في Container واحد من Debian 13، فلا تثبت شيئاً على جهازك، والملف التالي هو `lab/Dockerfile` في حزمة المقال:
```dockerfile
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends yaz python3 python3-pip xsltproc libxml2-utils curl jq ca-certificates git locales \
&& sed -i 's/# en_US.UTF-8/en_US.UTF-8/' /etc/locale.gen && locale-gen && rm -rf /var/lib/apt/lists/* \
&& pip3 install --no-cache-dir --break-system-packages pymarc
ENV LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 PYTHONIOENCODING=utf-8
WORKDIR /lab
```
```bash
docker build -t marc-lab lab/
docker run --rm marc-lab sh -c 'yaz-client -V | head -1; pip3 show pymarc | grep Version'
```
```text
YAZ version: 5.34.4 b42e25e840666ea3422c3bd5cb566b07f78a99cd
Version: 5.4.1
```
ولاحظ أننا ثبتنا pymarc من PyPI، والسبب أن Debian 13 لا يحتوي حزمة `python3-pymarc`، فأول محاولة لبناء الـ Image فشلت بالرمز 100 من `apt-get`، ولذلك أضفنا `pip3` مع الخيار `--break-system-packages`، وهو مقبول هنا لأن الـ Container مخصص للمختبر فقط.
### البحث في فهرس مكتبة الكونغرس عبر Z39.50
مكتبة الكونغرس تتيح فهرسها للعامة عبر بروتوكولي Z39.50 وSRU على العنوان `lx2.loc.gov:210/LCDB`، كما في صفحة [Z39.50 Gateway](https://www.loc.gov/z3950/?ref=arabroot.io). وملف الأوامر التالي `lab/fetch.yaz` يتصل بالفهرس، ويطلب التسجيلات بصيغة MARC، ويحفظ ما يصل كما هو في الملف `records.mrc`:
```text
open lx2.loc.gov:210/LCDB
format usmarc
elements F
set_marcdump records.mrc
find @attr 1=12 "9425837"
show 1
find @attr 1=7 "9780385420945"
show 1
close
quit
```
في الأوامر أعلاه لاحظ التالي:
- `format usmarc` يطلب التسجيلة بصيغة MARC، و`elements F` يطلب التسجيلة كاملة Full وليس المختصرة.
- `@attr 1=7` بحث بالرقم الدولي ISBN، و`@attr 1=12` بحث برقم التسجيلة المحلي في الحقل 001، وهذه أرقام خصائص Bib-1 التي يفهمها كل خادم Z39.50.
- بحثنا عن «أولاد حارتنا» برقم التسجيلة وليس بالرقم الدولي، لأن الطبعة من سنة 1967 ولا يوجد لها ISBN أصلاً، فالأرقام الدولية بدأت في السبعينيات.
```bash
docker run --rm -v "$PWD/lab:/lab" marc-lab yaz-client -f fetch.yaz
```
```text
Connecting...OK.
Sent initrequest.
Connection accepted by v3 target.
ID : 81
Name : Metaproxy/YAZ
Version: 1.22.4/5.37.3 f4d264b12afc861e48cfd7f7e98ebd95fc7679dc
Options: search present scan namedResultSets
Elapsed: 0.391110
Sent searchRequest.
Received SearchResponse.
Search was a success.
Number of hits: 1, setno 1
```
والمخرج يقول إن الخادم قبل الاتصال بالإصدار الثالث من البروتوكول، وإنه يعمل ببرنامج Metaproxy، وإن البحث أعاد تسجيلة واحدة، وتكرر الشيء نفسه للبحث الثاني، فأصبح عندنا ملف `records.mrc` فيه تسجيلتان.
⚠️
في محاولة سابقة بحثنا عن الرواية برقم مكتبة الكونغرس LCCN وهو `ne68001830` بالخاصية `@attr 1=9`، فأعاد الخادم مرة الكتاب الصحيح، ومرة أخرى بالأمر نفسه كتاباً ألمانياً عن الفيلسوف Fichte لا علاقة له به. لذلك لا تثق بنتيجة البحث بالأرقام ذات البادئة قبل أن تقرأ الحقل 245، وابحث برقم 001 أو بالرقم الدولي عندما يكون متاحاً.
وإذا كنت تفضل أداة الويب العادية على Z39.50، فالخادم نفسه يجيب عن طلب SRU، وهو عنوان URL تفتحه حتى من المتصفح، والأمر التالي في الملف `lab/sru.sh` يطلب التسجيلة الإنجليزية بصيغة MARCXML ويطبع عنوانها:
```bash
curl -s "http://lx2.loc.gov:210/LCDB?operation=searchRetrieve&version=1.1&query=bath.isbn=9780385420945&recordSchema=marcxml&maximumRecords=1" -o sru.xml
grep -o '[0-9]*' sru.xml
xmllint --xpath '//*[local-name()="datafield"][@tag="245"]/*[local-name()="subfield"]/text()' sru.xml; echo
```
```text
1
Children of the alley /
Naguib Mahfouz ; translated by Peter Theroux.
```
والفرق بين الطريقتين أن Z39.50 بروتوكول خاص بالمكتبات يحتاج عميلاً مثل yaz-client أو وحدة Z39.50 في Koha، وأن SRU هو الفكرة نفسها فوق HTTP، فتستطيع أي أداة ويب أن تستخدمه، وقد شرحنا البروتوكولين ومكانهما بين أنظمة المكتبة في مقال خريطة أنظمة المكتبة.
## قراءة الرأس والحقل 008 موقعاً موقعاً
الآن نقرأ ما وصلنا، وسوف نبدأ بالأجزاء التي لا تحمل أسماء أصلاً، الرأس والحقل 008، لأنها أكثر ما يحير من يرى MARC أول مرة. والسكربت `lab/read.py` يفتح الملف بمكتبة pymarc، ويقطع الرأس و008 إلى مواقعهما، ثم يطبع الحقول التي نريدها:
```python
import sys, unicodedata
from pymarc import MARCReader
with open(sys.argv[1], "rb") as fh:
for rec in MARCReader(fh):
L = rec.leader
print("=" * 60)
print("Leader :", L)
print(" 05 status :", L[5])
print(" 06 type :", L[6])
print(" 07 bib level :", L[7])
print(" 09 encoding :", repr(L[9]))
print(" 17 encoding level:", repr(L[17]))
print(" 18 cataloging :", repr(L[18]))
f008 = rec["008"].data
print("008 :", f008)
print(" 00-05 entered :", f008[0:6])
print(" 06 date type :", f008[6])
print(" 07-10 date1 :", f008[7:11])
print(" 15-17 place :", repr(f008[15:18]))
print(" 33 lit. form :", f008[33])
print(" 35-37 language :", f008[35:38])
for tag in ("020", "040", "100", "245", "250", "260", "264", "300", "650", "651"):
for f in rec.get_fields(tag):
print(tag, f.indicators, f.subfields_as_dict() if hasattr(f, "subfields_as_dict") else f)
for f in rec.get_fields("880"):
link = f["6"]
print("880 ->", link, "|", f.value())
```
```bash
docker run --rm -v "$PWD/lab:/lab" marc-lab python3 read.py records.mrc
```
والمخرج سوف يكون كما يلي، وهذا الجزء الخاص بالرواية العربية:
```text
============================================================
Leader : 01190cam a22003011i 4500
05 status : c
06 type : a
07 bib level : m
09 encoding : 'a'
17 encoding level: '1'
18 cataloging : 'i'
008 : 810410s1967 le 000 0 ara
00-05 entered : 810410
06 date type : s
07-10 date1 : 1967
15-17 place : 'le '
33 lit. form : 0
35-37 language : ara
```
والصورة التالية تضع كل حرف في موقعه مع معناه:
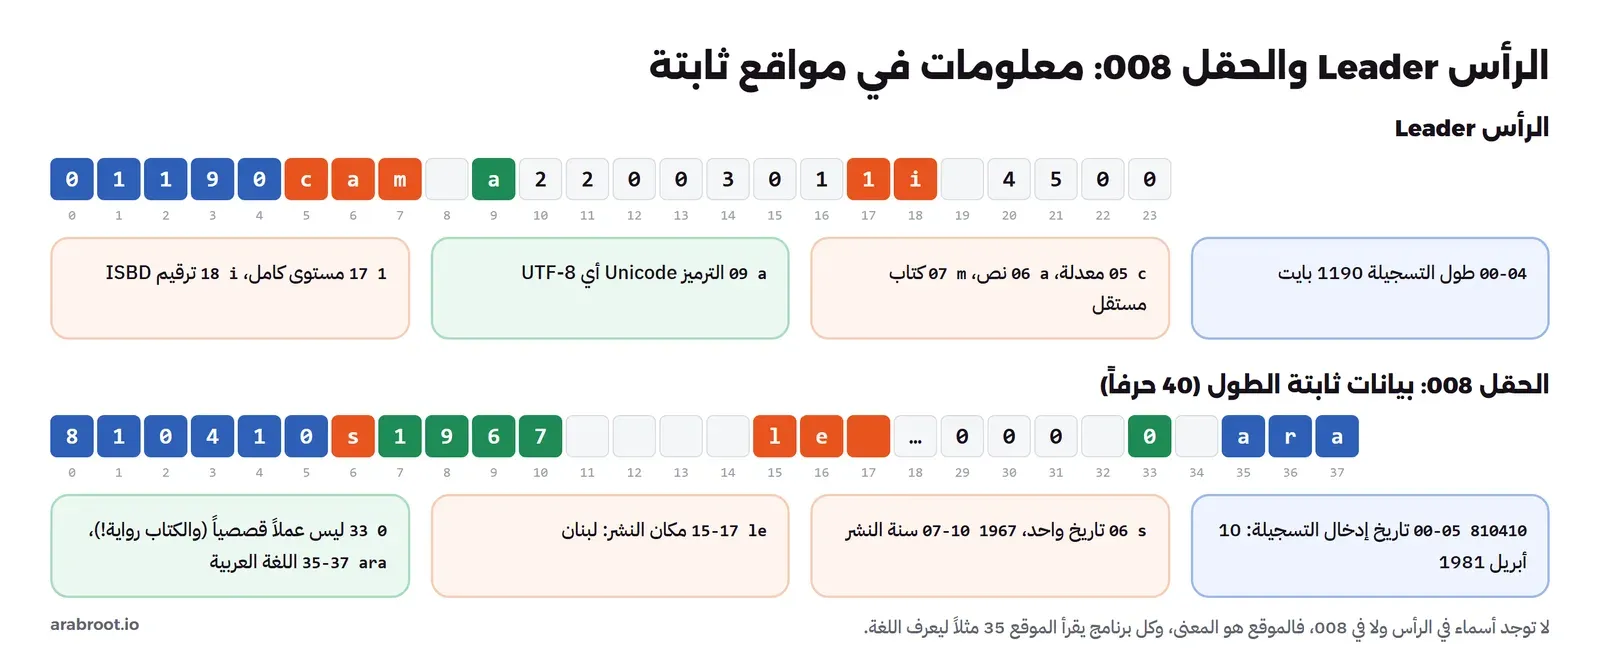
الرأس و008: الموقع هو المعنى، ولا توجد أسماء
في المخرج أعلاه لاحظ التالي:
- **الموقع 09 في الرأس قيمته `a`**، أي أن التسجيلة مرمزة بـ Unicode UTF-8، ولو كان فراغاً لكانت بالترميز القديم MARC-8، وهذا أهم حرف في الرأس لمن يستورد تسجيلات عربية، لأن البرنامج الذي يقرأ الترميز خطأ يحول العربية إلى رموز لا معنى لها، كما سوف نرى.
- **الموقعان 06 و07** يقولان إن المادة نص `a` وإنها كتاب مستقل `m` Monograph، وهذا يحدد أي جدول من جداول 008 ينطبق، فللكتب جدول وللدوريات جدول وللخرائط جدول، كما في صفحة [008 Fixed-Length Data Elements](https://www.loc.gov/marc/bibliographic/bd008.html?ref=arabroot.io).
- **الموقع 18 قيمته `i`**، أي أن الترقيم داخل الحقول يتبع ISBD، وهذا هو السبب في « : » و« / » التي رأيناها في 245 و264.
- **في 008 تاريخ الإدخال 810410**، أي أن مكتبة الكونغرس أدخلت هذه التسجيلة في 10 أبريل 1981، ورمز المكان `le` للبنان من قائمة رموز الدول في MARC، واللغة `ara` من قائمة رموز اللغات، ومنها يأخذ Koha وأي فهرس آخر فلتر اللغة.
- **الموقع 33 قيمته `0`**، أي «ليس عملاً قصصياً» Not fiction، والكتاب رواية! وفي التسجيلة الإنجليزية للترجمة نفسها كانت القيمة `1` Fiction. وهذا ليس خطأ في الأداة وإنما في التسجيلة، وهو تذكير بأن التسجيلات المنسوخة حتى من أكبر مكتبة في العالم تحمل أخطاء، فإذا بنيت فلتراً «روايات» على الموقع 33 فلن تظهر فيه هذه الرواية.
## قراءة الحقول: المؤلف والعنوان والنشر والوصف
بعد الرأس طبع السكربت الحقول نفسها، وهذا مخرج التسجيلتين، الرواية العربية أولاً ثم الترجمة الإنجليزية:
```text
040 Indicators(first=' ', second=' ') {'a': ['DLC'], 'b': ['eng'], 'e': ['rda'], 'c': ['CarP'], 'd': ['DLC']}
100 Indicators(first='1', second=' ') {'6': ['880-01'], 'a': ['Maḥfūẓ, Najīb,'], 'd': ['1911-2006,'], 'e': ['author.']}
245 Indicators(first='1', second='0') {'6': ['880-02'], 'a': ['Awlād ḥāratinā :'], 'b': ['riwāyah /'], 'c': ['Najīb Maḥfūẓ.']}
264 Indicators(first=' ', second='1') {'6': ['880-03'], 'a': ['Bayrūt :'], 'b': ['Dār al-Ādāb,'], 'c': ['[1967]']}
300 Indicators(first=' ', second=' ') {'a': ['552 pages ;'], 'c': ['25 cm']}
650 Indicators(first=' ', second='0') {'a': ['Arabic fiction'], 'y': ['20th century.']}
880 -> 100-01/(3/r | 100-01/(3/r محفوظ، نجيب، 1911-2006, author.
880 -> 245-02/(3/r | 245-02/(3/r أولاد حارتنا : رواية / نجيب محفوظ.
880 -> 264-03/(3/r | 264-03/(3/r بيروت : دار الآداب، [1967]
```
```text
020 Indicators(first=' ', second=' ') {'a': ['0385420943']}
020 Indicators(first=' ', second=' ') {'a': ['9780385420945']}
040 Indicators(first=' ', second=' ') {'a': ['DLC'], 'c': ['DLC'], 'd': ['OCoLC', 'DLC']}
100 Indicators(first='1', second=' ') {'a': ['Maḥfūẓ, Najīb,'], 'd': ['1911-2006.']}
245 Indicators(first='1', second='0') {'a': ['Children of the alley /'], 'c': ['Naguib Mahfouz ; translated by Peter Theroux.']}
250 Indicators(first=' ', second=' ') {'a': ['1st ed.']}
260 Indicators(first=' ', second=' ') {'a': ['New York :'], 'b': ['Doubleday,'], 'c': ['1996.']}
300 Indicators(first=' ', second=' ') {'a': ['448 p. ;'], 'c': ['24 cm.']}
650 Indicators(first=' ', second='0') {'a': ['Families'], 'z': ['Egypt'], 'v': ['Fiction.']}
651 Indicators(first=' ', second='0') {'a': ['Egypt'], 'v': ['Fiction.']}
```
وسوف نمر على الحقول واحداً واحداً، لأن كل حقل منها فيه درس:
### الحقل 020: الرقم الدولي ISBN
الترجمة الإنجليزية فيها حقلان 020، الأول بالرقم القديم من عشر خانات `0385420943`، والثاني بالرقم من ثلاث عشرة خانة `9780385420945`، وهما للكتاب نفسه، لأن الأرقام الدولية تحولت إلى 13 خانة في 2007، والتسجيلات القديمة تحفظ الشكلين حتى يجدها من يبحث بأي منهما. أما الرواية العربية فلا يوجد فيها 020 أصلاً، والسبب كما ذكرنا أن الطبعة من سنة 1967\. وهذا مهم عند ترحيل البيانات، فلا تجعل البرنامج يرفض تسجيلة لأن الحقل 020 فارغ، ولا تستخدم الرقم الدولي وحده لاكتشاف التكرار، لأن الكتب العربية القديمة وكثيراً من مطبوعات الجهات الحكومية والجامعات ليس لها رقم دولي. ومواصفات الحقل في صفحة [020 ISBN](https://www.loc.gov/marc/bibliographic/bd020.html?ref=arabroot.io).
### الحقل 040: من فهرس التسجيلة وبأي قواعد
الحقل 040 يشبه توقيع المفهرس، ففي الرواية العربية `$a DLC` أي أن مكتبة الكونغرس أنشأتها، و`$b eng` أي أن لغة الفهرسة (الملاحظات والوصف) إنجليزية، و`$e rda` أي أن الوصف تم بقواعد RDA، و`$d` لكل مكتبة عدلتها بعد ذلك. أما الترجمة الإنجليزية فلا يوجد فيها `$e rda`، لأنها فهرست في 1995 بالقواعد الأقدم AACR2، وفيها `$d OCoLC` أي أن OCLC عدلتها في الطريق. وهذا الحقل هو أول ما يقرؤه المفهرس الخبير، لأنه يعرف منه هل يثق بالتسجيلة كما هي، وهل يتوقع «448 p.» أم «552 pages»، وهو الفرق الذي سوف نشرحه في مقال الفهرسة بقواعد RDA.
### الحقل 100: المؤلف الرئيسي
المؤلف في التسجيلتين مكتوب بالشكل نفسه تماماً: `Maḥfūẓ, Najīb, 1911-2006`، مع أن صفحة العنوان في الترجمة تقول «Naguib Mahfouz». والسبب أن الحقل 100 لا ينقل الاسم كما هو مطبوع، وإنما يكتب الشكل المعتمد Authorized Form من ملف الإسناد، أي الشكل الذي اتفقت عليه المكتبات لهذا الشخص، والتاريخان `$d` يميزانه عن شخص آخر بالاسم نفسه. وبالفعل يوجد في ملف الإسناد في مكتبة الكونغرس شخص ثان اسمه نجيب محفوظ، طبيب مصري ولد في 1882، وهذا موضوع مقال ملفات الإسناد في هذه المرحلة. ولاحظ أيضاً المؤشر الأول `1`، ومعناه أن الاسم مقلوب: اسم العائلة ثم فاصلة ثم الاسم الأول، وفي الرواية العربية `$e author.` وهو مصطلح الدور Relator Term الذي أضافته RDA، ولا يوجد في التسجيلة الأقدم.
### الحقل 245: العنوان كما هو في الكتاب
بعكس الحقل 100، الحقل 245 ينقل العنوان كما هو في صفحة العنوان، وبيان المسؤولية `$c` ينقل الأسماء كما طبعت: «Naguib Mahfouz ; translated by Peter Theroux». لذلك تجد في التسجيلة نفسها الاسم بشكلين: الشكل المطبوع في 245، والشكل الموحد في 100، والأول يخبر القارئ بما سوف يراه على الغلاف، والثاني يجمع كل كتب الشخص تحت اسم واحد. وفي الرواية العربية العنوان مرومن Romanized أي مكتوب بالحرف اللاتيني بجدول ALA-LC: `Awlād ḥāratinā`، والعنوان بالحرف العربي ليس هنا وإنما في الحقل 880، وهذا يحتاج قسماً خاصاً.
### الحقلان 260 و264: النشر
الترجمة الإنجليزية تستخدم الحقل 260 «Publication, Distribution, etc.»، والرواية العربية تستخدم 264 «Production, Publication, Distribution, Manufacture, and Copyright Notice»، والحقل 264 جاء مع RDA، ومؤشره الثاني يحدد نوع البيان: `1` نشر، و`4` حقوق النشر، وغيرها، كما في صفحة [264](https://www.loc.gov/marc/bibliographic/bd264.html?ref=arabroot.io). والفرق العملي أن RDA تفرق بين سنة النشر وسنة حقوق الطبع، فلا تكتب «c1981» داخل حقل النشر كما كانت القواعد القديمة تفعل. ولاحظ السنة `[1967]` بين قوسين مربعين، ومعناها أن السنة غير مطبوعة في الكتاب وأن المفهرس استنتجها من مصدر آخر، وهذه الأقواس مهمة للمفهرس، ولكن البرنامج الذي يرتب بالسنة يجب أن يأخذ السنة من 008 وليس من هذا النص.
### الحقل 300: الوصف المادي
«448 p. ; 24 cm.» في الترجمة، و«552 pages ; 25 cm» في الرواية العربية. الفرق في الاختصار هو الفرق بين AACR2 وRDA، فالقواعد الجديدة تكتب الكلمة كاملة ولا تختصر. والمقاس بالسنتيمتر هو طول الكتاب وليس عرضه، والسبب تاريخي: كانت المكتبات تحتاج أن تعرف على أي رف يقف الكتاب. وقد يبدو هذا الحقل غير مهم للبحث، ولكنه أول ما ينظر إليه موظف الإعارة عندما يختلف كتاب في يده مع الوصف في النظام.
### حقول 6XX: الموضوعات
الرواية العربية لها موضوع واحد `650 0 $a Arabic fiction $y 20th century.`، والترجمة لها موضوع `650 0 $a Families $z Egypt $v Fiction.` ومكان `651 0 $a Egypt $v Fiction.`. والمؤشر الثاني `0` يعني أن الموضوع من قائمة رؤوس موضوعات مكتبة الكونغرس LCSH، والحروف الفرعية تقسم الموضوع: `$y` تقسيم زمني، و`$z` جغرافي، و`$v` شكل، ومواصفاتها في صفحة [650 Subject Added Entry](https://www.loc.gov/marc/bibliographic/bd650.html?ref=arabroot.io). ولاحظ أن الموضوعات بالإنجليزية حتى في الكتاب العربي، لأن لغة الفهرسة في مكتبة الكونغرس إنجليزية، والمكتبة العربية التي تنسخ هذه التسجيلة إما أن تترك الموضوع كما هو، أو تضيف موضوعاً عربياً من قائمة رؤوس موضوعات عربية معتمدة وتكتب مصدرها في `$2` مع المؤشر الثاني `7`، ولا تقم بترجمة LCSH بنفسك في الحقل نفسه مع المؤشر `0`، والسبب أن المؤشر يقول للنظام إن هذا رأس من LCSH وهو ليس كذلك.
## الحرف العربي: الحقل 880 والحقول المرتبطة
الآن نصل إلى أكثر ما يهم المكتبات العربية. التسجيلة العربية فيها كل معلومة مرتين: مرة بالحرف اللاتيني في الحقل الأصلي، ومرة بالحرف العربي في حقل 880 يسمى الحقل المرتبط بالتمثيل البديل Alternate Graphic Representation، والربط بينهما بالحقل الفرعي `$6`، كما في الصورة التالية:
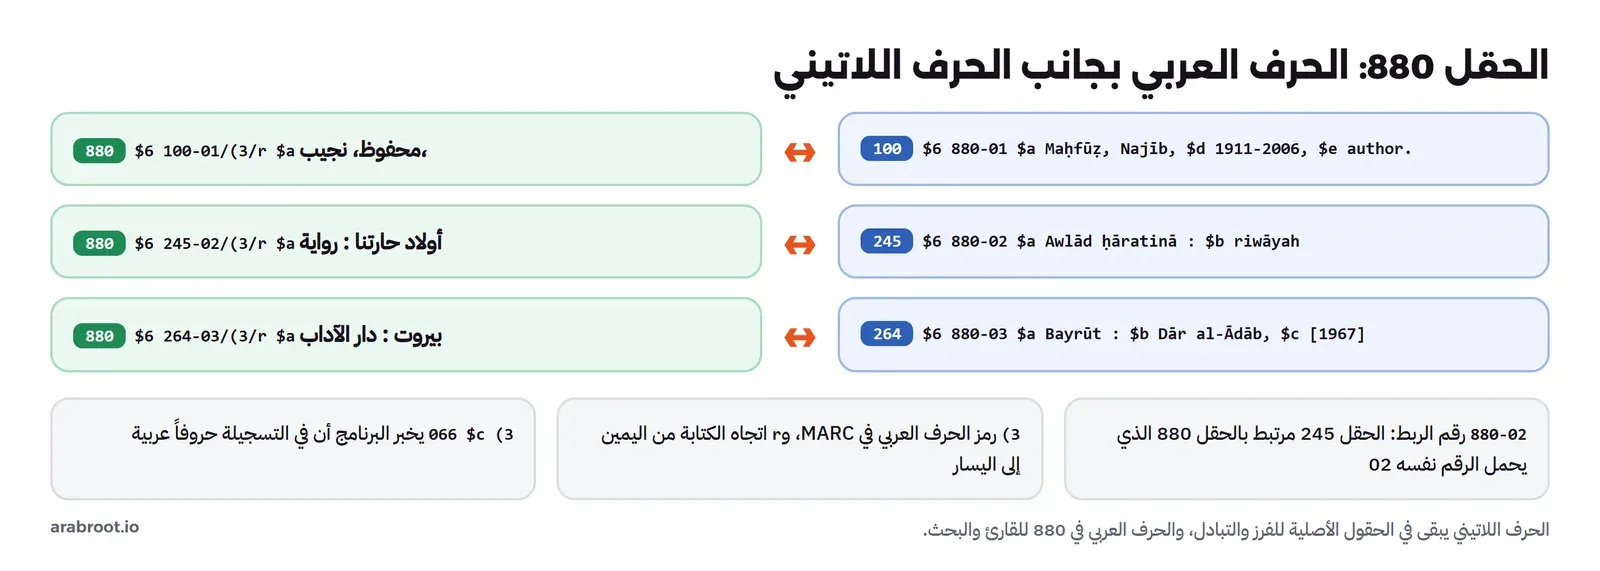
الحقل الأصلي يشير إلى 880 بالرقم نفسه، و880 يحمل رقم الحقل الأصلي ورمز الحرف واتجاهه
في الصورة أعلاه لاحظ التالي:
- في الحقل 245 القيمة `$6 880-02`، أي «النص البديل لهذا الحقل في الحقل 880 رقم 02»، وفي الحقل 880 المقابل القيمة `$6 245-02/(3/r`، أي «هذا الحقل هو النص البديل للحقل 245 رقم 02، بالحرف `(3` العربي، واتجاهه `r` من اليمين إلى اليسار». ومواصفاته في صفحة [880 Alternate Graphic Representation](https://www.loc.gov/marc/bibliographic/bd880.html?ref=arabroot.io).
- الرقم `02` مجرد رقم ربط وليس ترتيباً، فالمهم أن يكون متطابقاً بين الحقلين، ولذلك إذا حذفت حقلاً 880 بيدك ولم تحذف `$6` من الحقل الأصلي بقي رابط يشير إلى لا شيء، وبعض البرامج ترفض التسجيلة عندها.
- في التسجيلة حقل `066 $c (3`، وهو يخبر البرنامج قبل أن يقرأ الحقول أن فيها الحرف العربي من مجموعة MARC-8 العربية، وهذا من بقايا زمن MARC-8، فالتسجيلة اليوم بـ UTF-8 كما رأينا في الرأس.
وقد يتساءل البعض: لماذا لا تكتب المكتبة العنوان بالعربية في 245 مباشرة؟ والإجابة على ذلك أن هذا ممكن، وكثير من المكتبات العربية تفعله، فتضع العربية في الحقول الأصلية ولا تستخدم 880، وهو ما يسمى نموذج الحرف الأصلي. ولكن مكتبة الكونغرس وأغلب المكتبات الغربية تحتاج الحرف اللاتيني في الحقول الأصلية، لأن موظفيها وقراءها وأنظمة الفرز عندها مبنية عليه، ولذلك جاء الحقل 880 ليحمل الحرف الأصلي بجانب الحرف اللاتيني. والنتيجة العملية لك: إذا نسخت تسجيلة من مكتبة الكونغرس إلى مكتبتك العربية، فالعنوان العربي في 880 وليس في 245، والفهرس الذي لا يعرض 880 ولا يفهرسه للبحث سوف يعرض للقارئ «Awlād ḥāratinā» فقط، ولن يجد القارئ الكتاب إذا كتب «أولاد حارتنا». وهذا بالضبط ما عالجناه في مقال واجهة البحث مع VuFind، حيث جعلنا البحث يقرأ الحقل 880.
والصورة التالية من فهرس مكتبة الكونغرس نفسه للتسجيلة نفسها، وفيها ترى الحقلين معاً: العنوان المرومن ثم العنوان العربي تحته:
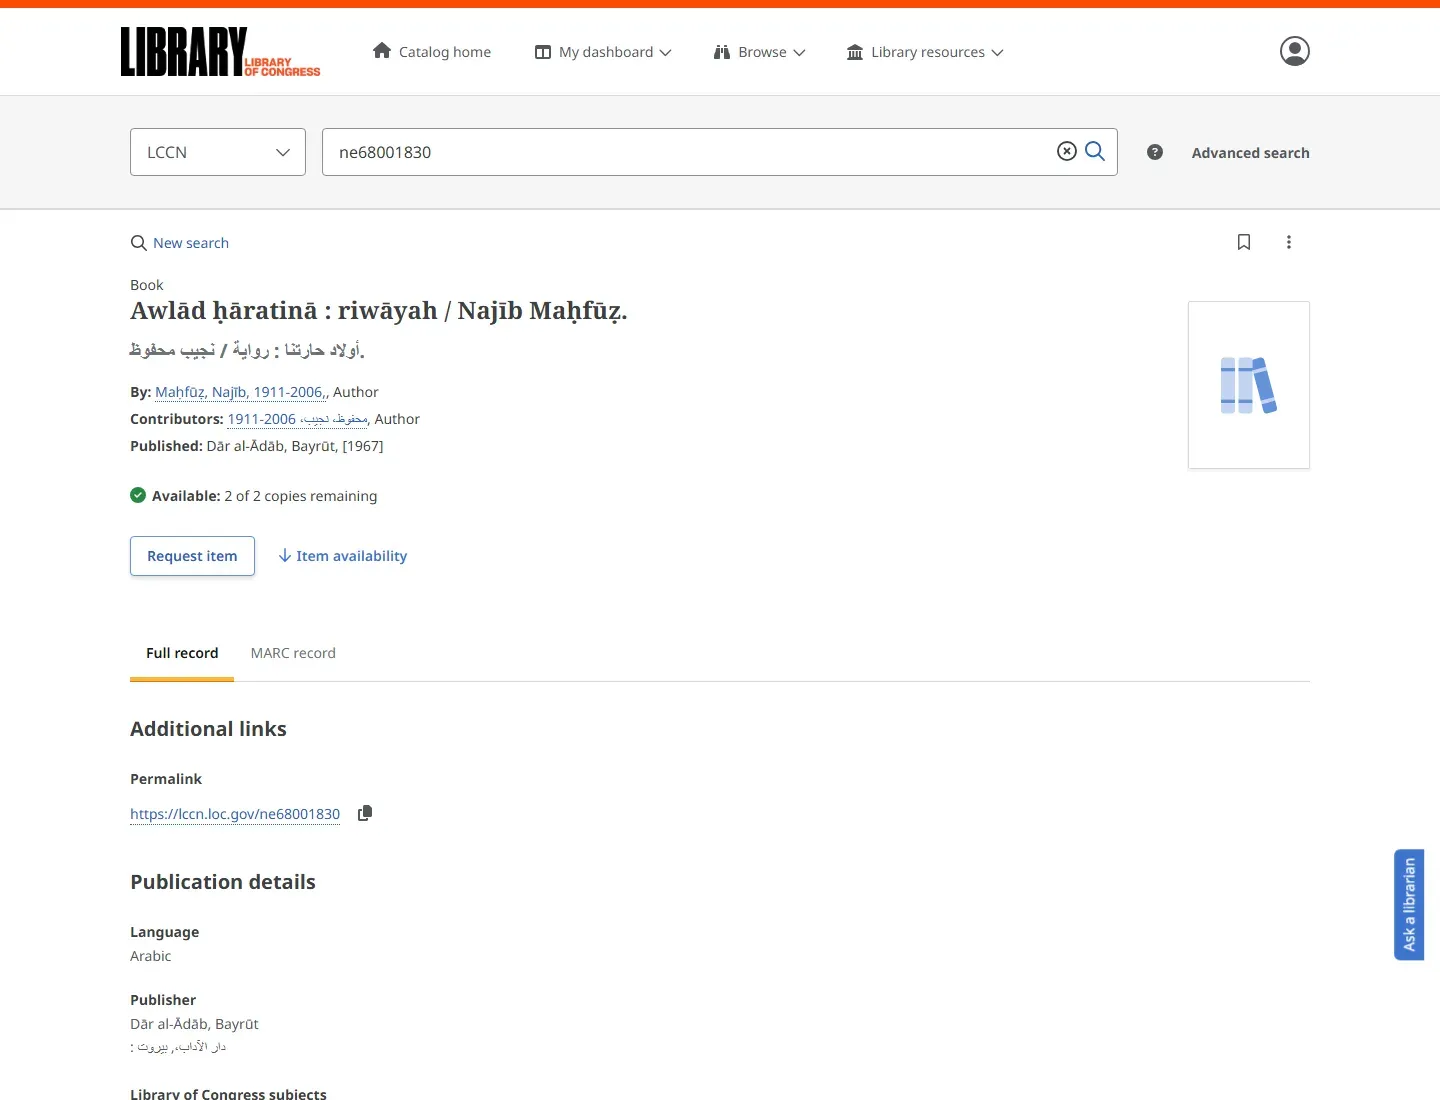
فهرس مكتبة الكونغرس يعرض 245 و880 معاً، ولاحظ الاسم العربي في سطر المساهمين وقد انقلب ترتيبه مع التاريخ
ولاحظ في الصورة سطر «Contributors» حيث ظهر الاسم العربي مع التاريخ بترتيب مقلوب، والسبب أن الواجهة تضع نصاً عربياً وأرقاماً في سطر إنجليزي دون عزل الاتجاه Bidi Isolation، وهي مشكلة عرض وليست مشكلة بيانات، وقد شرحنا أسبابها وحلولها في مقال [التعريب والنص ثنائي الاتجاه](https://arabroot.io/articles/%D8%A7%D9%84%D8%AA%D8%B9%D8%B1%D9%8A%D8%A8-i18n-%D9%88%D8%A7%D9%84%D9%86%D8%B5-%D8%AB%D9%86%D8%A7%D8%A6%D9%8A-%D8%A7%D9%84%D8%A7%D8%AA%D8%AC%D8%A7%D9%87-bidi-%D9%84%D9%84%D9%85%D8%B7%D9%88%D8%B1%D9%8A%D9%86/).
## الترميز: MARC-8 أم UTF-8؟
قبل Unicode كانت لكل لغة جداول ترميز خاصة بها، فوضعت مكتبة الكونغرس ترميزاً خاصاً بالمكتبات اسمه MARC-8، فيه جدول للاتينية وجداول للعربية والعبرية والسيريلية والصينية واليابانية والكورية، والتنقل بين الجداول داخل النص يكون بتسلسلات هروب Escape Sequences، فالبايت `ESC` ثم `(3` يعني «من هنا الحروف من الجدول العربي الأساسي»، و`ESC (B` يعني «عد إلى اللاتيني»، كما في صفحة [MARC-8 Encoding Environment](https://www.loc.gov/marc/specifications/speccharmarc8.html?ref=arabroot.io) وجدول [Basic Arabic](https://www.loc.gov/marc/specifications/codetables/BasicArabic.html?ref=arabroot.io). ثم سمح المعيار بـ UTF-8، وهو اليوم ما تستخدمه أغلب المكتبات، والموقع 09 في الرأس يقول أيهما في التسجيلة. وإذا أردت فهم Unicode وUTF-8 نفسيهما من البداية فقد شرحناهما في مقال [ترميز النصوص ASCII وUnicode وUTF-8](https://arabroot.io/articles/%D8%AA%D8%B1%D9%85%D9%8A%D8%B2-%D8%A7%D9%84%D9%86%D8%B5%D9%88%D8%B5-ascii-%D9%88-unicode-%D9%88-utf-8-%D9%88%D8%A7%D9%84%D8%AD%D8%B1%D9%88%D9%81-%D8%A7%D9%84%D9%85%D8%B4%D9%88%D9%87%D8%A9/).
ومع أن MARC-8 أصبح من الماضي، فما زلت تقابله في ثلاث حالات: تسجيلات قديمة صدرت من أنظمة قديمة، وخوادم Z39.50 ترسل MARC-8 افتراضياً، وأنظمة قديمة لا تقبل إلا MARC-8\. لذلك جربنا التحويل بأنفسنا، فحولنا تسجيلاتنا من UTF-8 إلى MARC-8 بالأداة yaz-marcdump:
```bash
yaz-marcdump -i marc -o marc -f UTF-8 -t MARC-8 -l 9=32 records.mrc > records-marc8.mrc
```
والخيار `-l 9=32` يضع فراغاً (الرمز 32) في الموقع 09 من الرأس، حتى يقول الرأس الحقيقة عن الترميز الجديد. ثم قرأنا الملف الجديد بثلاث طرق في السكربت `lab/enc.py`:
```python
import sys, unicodedata
from pymarc import MARCReader
def first(path, **kw):
with open(path, "rb") as fh:
return next(iter(MARCReader(fh, **kw)))
raw = open("records-marc8.mrc", "rb").read()
i = raw.find(b"245-02")
print("MARC-8 bytes :", raw[i:i+40])
r = first("records-marc8.mrc")
print("leader/09 :", repr(r.leader[9]))
print("default read :", r.get_fields("880")[1]["a"])
r = first("records-marc8.mrc", force_utf8=True, utf8_handling="replace")
print("force_utf8 :", r.get_fields("880")[1]["a"])
```
```text
MARC-8 bytes : b'245-02/(3/r\x1fa\x1b(3GhdGO\x1b(B \x1b(3MGQJfG\x1b(B :\x1f'
leader/09 : ' '
default read : اولاد حارتنا :
force_utf8 : (3GhdGO(B (3MGQJfG(B :
```
في المخرج أعلاه لاحظ التالي:
- البايتات تبين MARC-8 كما هو: `\x1b(3` للدخول إلى الجدول العربي، ثم حروف لاتينية عادية `GhdGO` تعني في هذا الجدول «اولاد»، ثم `\x1b(B` للخروج. فالعربية في MARC-8 مكتوبة بحروف لاتينية لها معنى آخر داخل الجدول.
- القراءة الافتراضية في pymarc رأت فراغاً في الموقع 09، فحولت MARC-8 إلى Unicode، وظهر العنوان عربياً.
- عندما أجبرنا pymarc على قراءة الملف على أنه UTF-8 بالخيار `force_utf8`، ظهرت الحروف اللاتينية كما هي «(3GhdGO(B»، وهذا هو العرض الذي تراه عندما يستورد نظام ما تسجيلات MARC-8 وهو يظنها UTF-8، أو عندما يكون الموقع 09 خطأ.
### همزة ضاعت أمامنا
ولكن انظر جيداً إلى «اولاد» في القراءة الافتراضية: الهمزة غير موجودة، والعنوان الأصلي «أولاد». فهل أخطأت pymarc في القراءة؟ قارنا كل حقول 880 قبل التحويل وبعده بالسكربت `lab/roundtrip.py`، بعد توحيد الشكل وحذف علامات الاتجاه من الطرفين حتى تكون المقارنة عادلة:
```text
same | 100-01/(3/r محفوظ، نجيب، 1911-2006, author. | 100-01/(3/r محفوظ، نجيب، 1911-2006, author.
DIFF | 245-02/(3/r أولاد حارتنا : رواية / نجيب محفوظ. | 245-02/(3/r اولاد حارتنا : رواية / نجيب محفوظ.
DIFF | 264-03/(3/r بيروت : دار الآداب، [1967] | 264-03/(3/r بيروت : دار الاداب، [1967]
```
الهمزة في «أولاد» والمدة في «الآداب» ضاعتا في التحويل، والأداة لم تطبع أي رسالة خطأ. ولكي نعرف السبب طبعنا رموز Unicode للعنوان كما وصل من مكتبة الكونغرس، بالسكربت `lab/nfd.py`، وقارناها بالكلمة نفسها كما يكتبها أي شخص من لوحة المفاتيح:
```text
stored : ['0x200f', '0x627', '0x654', '0x648', '0x644', '0x627']
typed : ['0x623', '0x648', '0x644', '0x627', '0x62f']
plain match : False
NFC match : True
NFC form : أولاد حارتنا :
```
وهنا السبب كله:
- مكتبة الكونغرس تخزن «أ» حرفين: الألف `U+0627` ثم الهمزة المركبة `U+0654` Combining Hamza Above، وهذا هو الشكل المفكك NFD. أما لوحة المفاتيح فتكتب «أ» حرفاً واحداً `U+0623`، وهو الشكل المركب NFC. والشكلان يظهران على الشاشة متطابقين تماماً، ولكنهما للحاسب نصان مختلفان.
- قبل العنوان رمز `U+200F` وهو علامة الاتجاه من اليمين إلى اليسار Right-to-Left Mark، وهو غير مرئي، ويوجد في بداية كل حقل عربي ونهايته في هذه التسجيلة.
- البحث البسيط عن «أولاد» داخل العنوان فشل `plain match : False`، وبعد توحيد العنوان إلى NFC نجح. وهذا يعني أن فهرساً يبحث في هذه التسجيلات دون توحيد لن يجد الكتاب إذا كتب القارئ «أولاد» بالهمزة، وهو من الأسباب التي جعلت بحث Koha العربي يحتاج سلسلة ICU التي شرحناها في دليله.
والصورة التالية تبين ما حدث، ثم الحل الذي جربناه:
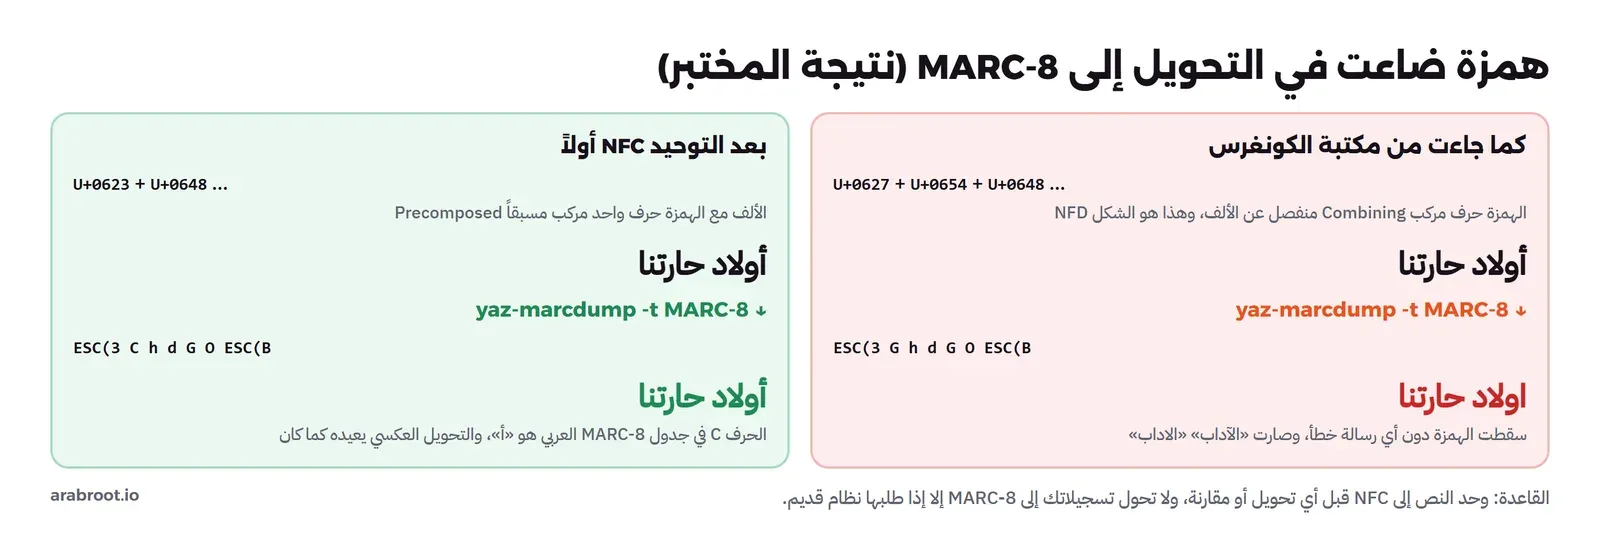
الهمزة المفككة لا مقابل لها في تحويل yaz إلى MARC-8 فتسقط، والهمزة المركبة تتحول إلى حرف من الجدول العربي
والحل الذي جربناه أن نوحد كل الحقول إلى NFC قبل التحويل، بالسكربت `lab/nfc-write.py` الذي يقرأ التسجيلات ويكتبها من جديد بعد التوحيد:
```python
import unicodedata as u
from pymarc import MARCReader, Subfield
out = open("records-nfc.mrc", "wb")
for rec in MARCReader(open("records.mrc", "rb")):
for f in rec.get_fields():
if not f.is_control_field():
f.subfields = [Subfield(s.code, u.normalize("NFC", s.value)) for s in f.subfields]
out.write(rec.as_marc())
out.close()
```
```bash
python3 nfc-write.py
yaz-marcdump -i marc -o marc -f UTF-8 -t MARC-8 -l 9=32 records-nfc.mrc > nfc-marc8.mrc
yaz-marcdump -f MARC-8 -t UTF-8 nfc-marc8.mrc | grep "^880 10"
```
```text
880 10 $6 245-02/(3/r $a أولاد حارتنا : $b رواية / $c نجيب محفوظ.
```
وبعد التوحيد أصبح بايت «أ» في MARC-8 هو `C` بدلاً من `G` الذي يعني الألف وحدها، فعاد العنوان كاملاً بعد التحويل في الاتجاهين. والدرس هنا أوسع من MARC-8، فهو قاعدة لكل من يتعامل مع بيانات عربية من مصادر مختلفة: وحد النص إلى NFC قبل أي تحويل أو مقارنة أو اكتشاف تكرار، والسبب أن الشكلين المتطابقين على الشاشة مختلفان في البايتات، والتوحيد موثق في معيار [Unicode Normalization Forms](https://unicode.org/reports/tr15/?ref=arabroot.io). ولا تقم بتحويل تسجيلاتك إلى MARC-8 إلا إذا طلبها نظام قديم لا يقبل غيرها، وعندها اختبر عينة عربية قبل وبعد كما فعلنا هنا.
## التحويل إلى MARCXML
الصيغة الثنائية ISO 2709 مناسبة للأنظمة، ولكنها صعبة على الإنسان وعلى أدوات الويب، لذلك وضعت مكتبة الكونغرس صيغة [MARCXML](https://www.loc.gov/standards/marcxml/?ref=arabroot.io)، وهي التسجيلة نفسها بالحقول والمؤشرات والحقول الفرعية نفسها، ولكن في XML. وهي الصيغة التي استوردناها في Koha، والتي ترسلها خوادم SRU، والتي تبدأ منها أدوات التحويل إلى المعايير الأحدث. والتحويل بأمر واحد:
```bash
yaz-marcdump -i marc -o marcxml records.mrc > records.xml
xmllint --noout records.xml && echo xml-ok
```
```text
xml-ok
```
وهذه بداية التسجيلة العربية في الملف الناتج:
```xml
01190cam a22003011i 4500
9425837
20250608042642.9
810410s1967 le 000 0 ara
...
245-02/(3/r
أولاد حارتنا :
رواية /
```
في الملف أعلاه لاحظ التالي:
- الرأس موجود كما هو، ولكن الدليل Directory غير موجود، والسبب أن XML نفسه يحدد بداية كل عنصر ونهايته، فلا حاجة للأطوال والمواقع، وبالتالي تستطيع أن تعدل ملف MARCXML في أي محرر دون أن تفسده، بعكس الملف الثنائي.
- كل حقل عنصر `datafield` فيه الرقم والمؤشران كخصائص، وكل حقل فرعي عنصر `subfield`، فإذا أردت أن تستخرج كل العناوين من عشرين ألف تسجيلة فأداة XPath عادية تكفي، كما فعلنا مع `xmllint` في طلب SRU.
- عناوين الحقول المكتوبة في الطول 1190 لم تعد تعني شيئاً هنا، فالبرنامج الذي يحول MARCXML إلى ISO 2709 يحسب الرأس والدليل من جديد.
## MARC21 أم UNIMARC؟
عندما تثبت Koha يسألك معالج التثبيت: MARC21 أم UNIMARC؟ والسؤال يحير من لا يعرف أن هناك عائلتين من MARC. فإلى جانب MARC21 الذي تديره مكتبة الكونغرس، يوجد UNIMARC الذي يديره الاتحاد الدولي لجمعيات المكتبات IFLA، وقد صمم في السبعينيات ليكون صيغة تبادل دولية بين الصيغ الوطنية، وتستخدمه مكتبات في أوروبا خاصة. والمعياران يتشابهان في البناء نفسه، فكلاهما ISO 2709 برأس ودليل وحقول ومؤشرات وحقول فرعية، ولكن الأرقام مختلفة: العنوان في UNIMARC في الحقل 200 وليس 245، والمؤلف الشخص في 700 وليس 100، والموضوع في 606 وليس 650\. وبالتالي برنامج يقرأ تسجيلة UNIMARC على أنها MARC21 يضع العنوان في مكان غير معروف ويعرض المؤلف على أنه مدخل إضافي.
وقد رأينا هذا عملياً في مقال خريطة أنظمة المكتبة، عندما أعاد خادم Z39.50 تسجيلات UNIMARC إلى Koha مثبت على MARC21 فظهرت النتائج أعمدة من التواريخ والرموز. والقاعدة بسيطة: اختر المعيار الذي تستخدمه المكتبات التي سوف تنسخ منها التسجيلات أكثر، وفي أغلب المكتبات الجامعية العربية التي تنسخ من مكتبة الكونغرس وOCLC فهو MARC21، ولا تقم بتغيير اختيارك بعد بدء الفهرسة، والسبب أن كل حقل في كل تسجيلة مبني عليه، والتحويل بين المعيارين ممكن بأدوات، ولكنه يفقد التفاصيل التي ليس لها مقابل مباشر.
## ما الذي لا يحسنه MARC؟
بعد كل ما سبق قد يبدو MARC معياراً كاملاً، ولكن له حدوداً تعرفها المكتبات جيداً، وهي التي دفعت مكتبة الكونغرس إلى العمل على بديل. أولها أن التسجيلة تصف الكتاب في مكان واحد، فاسم المؤلف نص مكرر في كل تسجيلة لكل كتبه، وإذا تغير الشكل المعتمد للاسم وجب تعديل آلاف التسجيلات، بدلاً من أن تشير كل تسجيلة إلى سجل واحد للشخص. وثانيها أن العلاقة بين العمل وترجماته وطبعاته غير واضحة، فتسجيلتا «أولاد حارتنا» وترجمتها الإنجليزية مستقلتان، والربط بينهما نص في الحقل 240 «Awlād al-ḥāratinā. English» يفهمه الإنسان، ويحتاج البرنامج قواعد خاصة ليفهمه. وثالثها أن الويب لا يتكلم MARC، فمحركات البحث والبيانات المترابطة Linked Data تتعامل مع روابط URI وليس مع الحقل 650 والمؤشر الثاني.
ولهذا تحاول المكتبات منذ سنوات أن تضيف إلى MARC روابط، وقد رأيت في تسجيلة سعودية حديثة من مكتبة الكونغرس الحقل الفرعي `$0` وفيه رابط سجل المؤلف في id.loc.gov، و`$1` وفيه رابط الشخص نفسه، وهذه خطوة نحو BIBFRAME الذي يصف الكتاب كروابط بين كيانات بدلاً من تسجيلة مسطحة، وسوف نحول التسجيلتين نفسيهما إلى BIBFRAME وإلى Dublin Core في مقال قادم، ونرى ما الذي يبقى وما الذي يضيع.
## ماذا يحدث إذا عدلت ملف MARC بيدك؟
من الأخطاء الشائعة أن يفتح الموظف ملف `.mrc` في محرر نصوص ليصحح كلمة، أو أن يكتب سكربت يستبدل نصاً في الملف كله، مثلاً لتصحيح اسم مدينة. ولكي نرى النتيجة كتبنا السكربت `lab/dir.py`، وهو يقرأ الرأس والدليل أولاً، ثم يغير «Bayr» إلى «Bayyr» في التسجيلة العربية، أي يزيد حرفاً واحداً، ثم يحاول قراءتها:
```python
from pymarc import MARCReader
d = open("records.mrc", "rb").read()
rec1 = d[: int(d[:5])]
base = int(rec1[12:17])
print("record length :", int(rec1[:5]), "base address:", base)
directory = rec1[24:base - 1]
for i in range(0, 60, 12):
e = directory[i:i+12].decode()
print("dir entry", e, "-> tag", e[:3], "length", int(e[3:7]), "start", int(e[7:]))
bad = rec1.replace(b"Bayr", b"Bayyr")
print("bytes before/after edit:", len(rec1), len(bad))
open("bad.mrc", "wb").write(bad)
reader = MARCReader(open("bad.mrc", "rb"))
for r in reader:
print("record:", None if r is None else r["245"]["a"], "| error:", repr(reader.current_exception))
```
```text
record length : 1190 base address: 301
dir entry 001000800000 -> tag 001 length 8 start 0
dir entry 005001700008 -> tag 005 length 17 start 8
dir entry 008004100025 -> tag 008 length 41 start 25
dir entry 035001200066 -> tag 035 length 12 start 66
dir entry 906004500078 -> tag 906 length 45 start 78
bytes before/after edit: 1190 1191
record: None | error: EndOfRecordNotFound()
```
في المخرج أعلاه لاحظ التالي:
- الدليل يعمل كما شرحنا: الحقل 001 طوله 8 بايتات ويبدأ من 0، أي «9425837» ومعه رمز نهاية الحقل، والحقل 005 يبدأ من 8، والحقل 008 طوله 41 ويبدأ من 25، أي 40 حرفاً ورمز النهاية.
- بعد التعديل أصبح طول التسجيلة 1191 بايت والرأس ما زال يقول 1190، فقرأت pymarc 1190 بايت ولم تجد رمز نهاية التسجيلة في مكانه، فرفضتها كلها بالخطأ `EndOfRecordNotFound`. أي أن حرفاً واحداً أضاع التسجيلة كاملة.
أما yaz-marcdump فهو أكثر تسامحاً، فحاول قراءة التسجيلة، ولكن كل حقل بعد الحقل المعدل انزاح بايتاً:
```text
264 1 $6 880-03 $a Bayyrūt : $b Dār al-Ādāb, $c [1967
(No separator at end of field length=51)
(No separator at end of field length=87)
300 $a 552 pages ; $c 25 c
(No separator at end of field length=23)
```
لاحظ «\[1967» دون القوس الأخير، و«25 c» بدلاً من «25 cm»، فكل حقل بعد التعديل خسر حرفه الأخير، وهذا أخطر من الرفض، لأن النظام الذي يستورد بهذه الطريقة يقبل تسجيلات تالفة دون أن تنتبه. لذلك لا تقم بتعديل ملف ISO 2709 بمحرر نصوص أو بأمر `sed` إطلاقاً، وإنما حوله إلى MARCXML أو إلى الصيغة النصية التي تفهمها أداة مثل MarcEdit، ثم عدل، ثم أعد التحويل، أو عدل بمكتبة مثل pymarc تعيد حساب الرأس والدليل عند الكتابة كما فعل السكربت `nfc-write.py`.
## أخطاء شائعة عند استيراد تسجيلات MARC
جمعنا في الجدول التالي ما رأيناه في المختبر، وما يحدث عادة عند ترحيل مكتبة من نظام إلى آخر:
| العرض | السبب | الحل |
| ------------------------------------------- | ------------------------------------------------------------- | ------------------------------------------------------------------------------------- |
| العربية تظهر حروفاً لاتينية مثل «(3GhdGO(B» | تسجيلات MARC-8 قرئت على أنها UTF-8، أو الموقع 09 في الرأس خطأ | افحص الموقع 09 في عينة، وحول بـ yaz-marcdump -f MARC-8 -t UTF-8 -l 9=97 قبل الاستيراد |
| الهمزات والمدات تختفي بعد التحويل | نص مفكك NFD حول إلى MARC-8 | وحد إلى NFC قبل التحويل، واختبر عينة عربية قبل وبعد |
| القارئ لا يجد الكتاب بكلمة «أولاد» | النص مخزن NFD، أو الفهرس لا يقرأ الحقل 880 | توحيد في محرك البحث، وفهرسة 880 مع 245 |
| تسجيلة كاملة ترفض بعد تعديل بسيط | تعديل الملف الثنائي دون تحديث الرأس والدليل | عدل MARCXML أو بمكتبة تعيد الحساب |
| الكتب العربية ترتب كلها تحت حرف A | المؤشر الثاني في 245 صفر مع عنوان يبدأ بـ «al-» | المؤشر الثاني 3 لـ «al-»، أو حرف الأصل في نموذج الحرف الأصلي |
| فلتر «روايات» يخفي روايات | الموقع 33 في 008 خطأ في التسجيلة المنسوخة | لا تعتمد على موقع واحد، واجمع 008 مع 655 و650 |
| البحث بالرقم يعيد كتاباً آخر | فهرسة الأرقام ذات البادئة في الخادم البعيد | تأكد من 245 قبل الحفظ، وابحث بـ 001 أو ISBN |
## قائمة تحقق قبل استيراد أي ملف MARC
1. اعرض أول عشر تسجيلات بالأمر `yaz-marcdump file.mrc | head -100`، وتأكد أن الأداة تقرؤها دون رسائل «No separator».
2. افحص الموقع 09 في الرأس: `a` أي UTF-8، وفراغ أي MARC-8، ولا تبدأ قبل أن تعرف أيهما.
3. عد التسجيلات قبل الاستيراد وبعده، فالفرق يعني تسجيلات رفضت بصمت.
4. اختر خمس تسجيلات عربية واعرض الحقلين 245 و880 في الفهرس بعد الاستيراد، وابحث بكلمة فيها همزة وكلمة فيها تاء مربوطة.
5. تأكد أن الحقل 040 يحمل رمز مكتبتك في `$d` إذا عدلت التسجيلات، حتى يعرف من بعدك من غير ماذا.
6. لا تحذف الحقول التي لا تفهمها، مثل 066 و880 والحقول المحلية، قبل أن تعرف من يستخدمها.
7. احتفظ بالملف الأصلي كما وصل، وحول دائماً إلى ملف جديد.
## تدريب عملي
- عدل الملف `fetch.yaz` ليبحث بالرقم الدولي لكتاب عربي في مكتبتك، ثم اقرأ الرأس و008 والحقل 040: هل فهرس بـ RDA أم بالقواعد الأقدم؟ وهل فيه 880؟
- غير المؤشر الثاني في الحقل 245 لعنوان يبدأ بـ «al-» إلى 0 ثم إلى 3 في نسخة MARCXML، واستوردها في Koha تجريبي، وقارن ترتيب النتائج.
## الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- MARC21 حول بطاقة الفهرس إلى حقول مرقمة يفهمها الحاسب، وقيمته اليوم في ملايين التسجيلات وفي أن كل نظام مكتبة يقرؤه، وليس في الصيغة نفسها.
- الملف الثنائي رأس من 24 حرفاً ودليل بالأطوال والمواقع ثم الحقول، وأي تعديل يدوي يغير الطول يفسد التسجيلة أو يقطع حقولها بصمت.
- الرأس و008 بلا أسماء، والموقع هو المعنى: 09 للترميز، و35 إلى 37 للغة، والتسجيلات المنسوخة تحمل أخطاء حتى من مكتبة الكونغرس.
- الحقل 100 يحمل الشكل الموحد للاسم و245 يحمل ما هو مطبوع، والعربية في تسجيلات مكتبة الكونغرس في 880 مرتبطة بالحقل الأصلي عبر `$6`.
- تسجيلات مكتبة الكونغرس تخزن الهمزة مفككة NFD، والتحويل إلى MARC-8 أسقطها دون خطأ، والتوحيد إلى NFC قبل أي تحويل أو مقارنة هو الحل.
- MARCXML هو الصيغة الآمنة للتعديل والتحويل، ومنها تبدأ أدوات المعايير الأحدث مثل Dublin Core وBIBFRAME.
وفي المقال التالي من هذه المرحلة بإذن الله سوف نتحدث عن قواعد الوصف RDA نفسها، أي ماذا يكتب المفهرس داخل هذه الحقول للكتاب العربي: أسماء المؤلفين بالكنية والنسب، والتاريخ الهجري، والحقول 336 و337 و338.
## سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتجربة المختبر على YAZ 5.34.4 وpymarc 5.4.1 في Debian 13 مع تسجيلات حقيقية من فهرس مكتبة الكونغرس.