

في مقال Agile بلا شعارات شرحنا Scrum وKanban كما تصفها أدلتها الرسمية، وانتهينا إلى أن الفكرة التي تجمع كل هذه الأساليب أن تسلم برنامجاً يعمل على دفعات صغيرة ثم تتعلم مما يحدث. فماذا يحدث لهذه الفكرة عندما يصبح عند كل مطور في الفريق مساعد ذكاء اصطناعي AI Assistant يكتب في دقائق ما كان يأخذ منه يوماً؟ هل تصبح السبرنتات أقصر، وهل يختفي التقدير، وهل نحتاج إلى أدوار جديدة؟ ستجد على الإنترنت إجابات كثيرة واثقة جداً، من «إنتاجية عشرة أضعاف» إلى «Scrum ماتت»، وأغلبها لا يستند إلى قياس.
لذلك سوف نلتزم في هذا المقال بقاعدة واحدة: ما تقوله الأبحاث المنشورة نذكره مع مصدره وحدوده ومن مولها، وما هو رأي أو توقع نكتب أنه رأي ونذكر من قاله، وسوف نناقش فيه ما يلي:
- ما الذي قاسته أبحاث DORA في 2024 و2025، وتجربة METR العشوائية، ودراسات GitHub وMicrosoft، واستبيان Stack Overflow، وما الذي لا تقوله.
- ما الذي يتغير في الفريق: قصص أصغر، ومراجعة تصبح هي عنق الزجاجة Bottleneck، ومعايير قبول واختبارات أهم من قبل، وذكاء اصطناعي يكتب مسودة القصة والإنسان يملكها.
- المخاطر: حمل المراجعة Review Load، والجودة والاستقرار Stability، وضعف المهارات Deskilling، والأمن.
- قالب سياسة Policy جاهز لاستخدام الذكاء الاصطناعي داخل Scrum أو Kanban، وما الذي لا يتغير مهما تغيرت الأدوات.
ماذا تقول الأبحاث حتى الآن؟
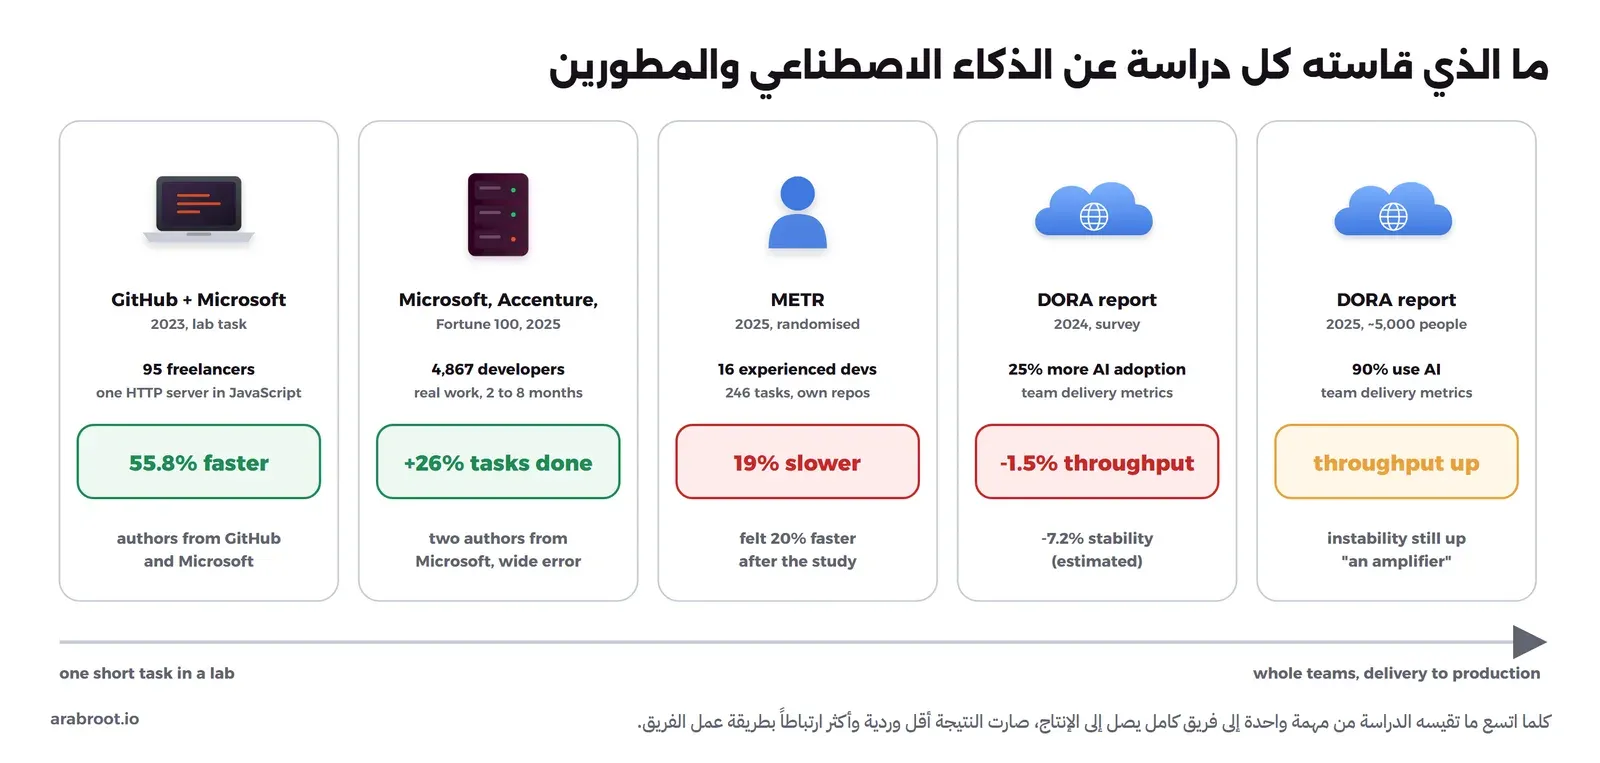
قبل الأرقام لاحظ أن كل دراسة قاست شيئاً مختلفاً، فبعضها قاس مهمة واحدة صغيرة في مختبر، وبعضها قاس عدد المهام المنجزة في شركات، وبعضها سأل آلاف الفرق عن مقاييس التسليم كلها، والصورة التالية تضعها بجانب بعضها:
تقرير DORA 2024: الأفراد أسرع، والتسليم Delivery أقل استقراراً
أبحاث DORA تديرها Google Cloud منذ سنوات، وتعتمد على استبيان كبير يربط ممارسات الفرق بمقاييس التسليم. وفي ملخص تقرير 2024 الذي كتبه Nathen Harvey وDerek DeBellis قال 75% من المشاركين إنهم يعتمدون على الذكاء الاصطناعي في مهمة يومية واحدة على الأقل، وأكثر من الثلث شعروا بزيادة متوسطة أو كبيرة في إنتاجيتهم. وقدر التقرير أن زيادة الاستخدام بنسبة 25% ترتبط بتحسن جودة التوثيق بنسبة 7.5%، وجودة الكود بنسبة 3.4%، وسرعة مراجعة الكود Code Review بنسبة 3.1%، ولكنها ترتبط أيضاً بانخفاض إنتاجية التسليم Delivery Throughput بنسبة 1.5% تقريباً، وانخفاض استقرار التسليم Delivery Stability بنسبة 7.2% تقريباً، وقال 39% إنهم يثقون قليلاً أو لا يثقون إطلاقاً في الكود الذي يكتبه الذكاء الاصطناعي. والتفسير الذي يقترحه التقرير أن تحسين الكتابة وحده لا يحسن التسليم إذا لم يلتزم الفريق بالأساسيات، مثل الدفعات الصغيرة Small Batches والاختبارات القوية.
تقرير DORA 2025: الذكاء الاصطناعي يضخم ما هو موجود
في سنة 2025 خصصت DORA تقريرها كله للموضوع باسم State of AI-assisted Software Development، وكما في ملخص التقرير شارك فيه قرابة خمسة آلاف شخص مع أكثر من مئة ساعة من المقابلات، وقال 90% إنهم يستخدمون الذكاء الاصطناعي في العمل، وأكثر من 80% إنه رفع إنتاجيتهم، و30% إنهم يثقون قليلاً أو لا يثقون في الكود الذي يكتبه. والتغير المهم عن 2024 أن الاستخدام صار مرتبطاً بإنتاجية تسليم أعلى وأداء منتج أفضل، ولكنه ما زال مرتبطاً بانخفاض الاستقرار. والجملة التي لخص بها التقرير النتيجة أن دور الذكاء الاصطناعي الأساسي أنه مضخم Amplifier، يكبر نقاط القوة الموجودة في المؤسسة ونقاط ضعفها، فالفريق الذي عنده اختبارات وفروع قصيرة ونشر آلي يستفيد، والفريق الذي ليس عنده هذا يصل إلى مشاكله أسرع.
ومع التقرير نشرت DORA نموذج قدرات الذكاء الاصطناعي AI Capabilities Model، وهو سبع قدرات تجدها موسومة بكلمة AI في قائمة قدرات DORA: موقف واضح ومعلن من الذكاء الاصطناعي Clear and Communicated AI Stance، وبيانات داخلية سليمة Healthy Data Ecosystems، وبيانات داخلية يصل إليها الذكاء الاصطناعي AI-accessible Internal Data، وإدارة النسخ Version Control، والعمل على دفعات صغيرة Working in Small Batches، والتركيز على المستخدم User-centric Focus، وهندسة المنصات Platform Engineering. ولاحظ أن ثلاثاً منها على الأقل ممارسات Agile وDevOps قديمة، وهذا يقول لك شيئاً عن أين تستثمر.
تجربة METR العشوائية Randomized Trial: الشعور بالسرعة ليس قياساً
في تجربة عشوائية Randomized نشرتها مؤسسة METR في يوليو 2025 بعنوان Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity، عمل 16 مطوراً خبيراً على 246 مهمة في مشاريع مفتوحة المصدر يعرفونها جيداً، فأخذت المهام التي سمح فيها بالذكاء الاصطناعي وقتاً أطول بنسبة 19%، بينما قدر المطورون بعد الانتهاء أنه اختصر وقتهم بنسبة 20%. وقد شرحنا هذه التجربة وحدودها، ومعها تحديث METR في فبراير 2026، في مقال تمارين Kata، والخلاصة التي تهمنا هنا أمران: أن التحديث أظهر أرقاماً تشير إلى تسريع مع أدوات أحدث، ولكن METR نفسها وصفت بياناتها الجديدة بأنها دليل ضعيف جداً لأن كثيراً من المطورين رفضوا أن يعملوا دون ذكاء اصطناعي، وأن شعور الفريق بأنه أسرع لا يكفي لتعدل خطتك عليه، فقس قبل أن تغير.
دراسات GitHub وMicrosoft، ومن أجراها
أشهر رقم تسمعه هو 55.8%، وهو من تجربة Peng وزملائه المنشورة سنة 2023، حيث طلب من 95 مبرمجاً مستقلاً جاؤوا من منصة Upwork أن يكتبوا HTTP server بلغة JavaScript بأسرع ما يمكن، فأنهت المجموعة التي معها GitHub Copilot المهمة أسرع بنسبة 55.8%، بمجال ثقة Confidence Interval من 21% إلى 89%. ولاحظ أمرين: أن المهمة واحدة وصغيرة وتبدأ من الصفر، وهذا أسهل ما يمكن للأداة، وأن ثلاثة من الكتاب الأربعة من Microsoft Research وGitHub، وهي الشركة التي تبيع الأداة.
والدراسة الأوسع هي ثلاث تجارب ميدانية نشرها Kevin Zheyuan Cui وزملاؤه في فبراير 2025، أجريت داخل Microsoft وAccenture وشركة من قائمة Fortune 100 على 4,867 مطوراً في عملهم الحقيقي، ووجدت زيادة 26.08% في عدد المهام المنجزة أسبوعياً مع خطأ معياري Standard Error 10.3%، وأن المطورين الأقل خبرة استخدموا الأداة أكثر واستفادوا أكثر. وهي أقوى من تجربة المختبر لأنها في عمل حقيقي، ولكن اثنين من الكتاب يعملان في Microsoft، والمقياس هو عدد المهام وليس جودتها أو أثرها في الإنتاج، والكتاب أنفسهم يقولون إن كل تجربة وحدها كانت مشوشة Noisy.
استبيان Stack Overflow Survey: الاستخدام يرتفع والثقة مشروطة
في استبيان المطورين 2025 قال 84% إنهم يستخدمون أدوات الذكاء الاصطناعي أو يخططون لذلك، و51% من المطورين المحترفين يستخدمونها يومياً، ولكن من لا يثقون في دقة مخرجاتها كانوا 46% مقابل 33% يثقون، و3% فقط يثقون بها ثقة عالية. وأكبر مشكلة ذكرها 66% هي الحلول «almost right, but not quite»، أي الصحيحة تقريباً، وقال 45% إن تصحيح أخطاء الكود الذي يكتبه الذكاء الاصطناعي يأخذ وقتاً أطول. وفي استبيان 2026 قال 73% إنهم يستخدمون مساعدات البرمجة والوكلاء Agents يومياً، و31% من هؤلاء يستخدمونها أكثر من أربع ساعات في اليوم، ولكن 48% قالوا إنهم يثقون بالذكاء الاصطناعي عندما يستطيعون التحقق من إجابته بسهولة، و16% فقط يثقون به في أغلب المهام غير المهمة. وتذكر أن هذا استبيان يجيب عليه من يختار أن يجيب، فهو يقيس ما يقوله المطورون لا ما يحدث في الإنتاج.
ما الذي تثبته الأدلة Evidence، وما الذي لا تثبته؟
| ما تقوله الأدلة بثقة معقولة | ما لا تثبته حتى الآن |
|---|---|
| الاستخدام أصبح شبه عام في الفرق (DORA 2025 وStack Overflow 2026) | أن كل فريق يستخدمه أصبح أسرع في التسليم إلى المستخدم |
| المهام الصغيرة المعزولة تنجز أسرع مع الأداة (Peng 2023 وCui 2025) | أن السرعة في المهمة تعني سرعة في المنتج كله أو جودة أعلى |
| الاستقرار في التسليم ينخفض مع زيادة الاستخدام في بيانات DORA للسنتين | أن الأداة هي السبب المباشر، فبيانات DORA ارتباطات من استبيان |
| شعور المطور بسرعته قد يختلف عن القياس (METR 2025) | أن الأداة تبطئ الخبراء دائماً، فالأدوات تتغير والتحديث الأخير يشير إلى عكس ذلك بدليل ضعيف |
| الثقة مشروطة بقدرة الإنسان على التحقق (Stack Overflow 2025 و2026) | حجم الأثر على المهارات وجودة الأنظمة بعد سنوات، فلا توجد دراسة طويلة بعد |
ما الذي يتغير في الفريق؟
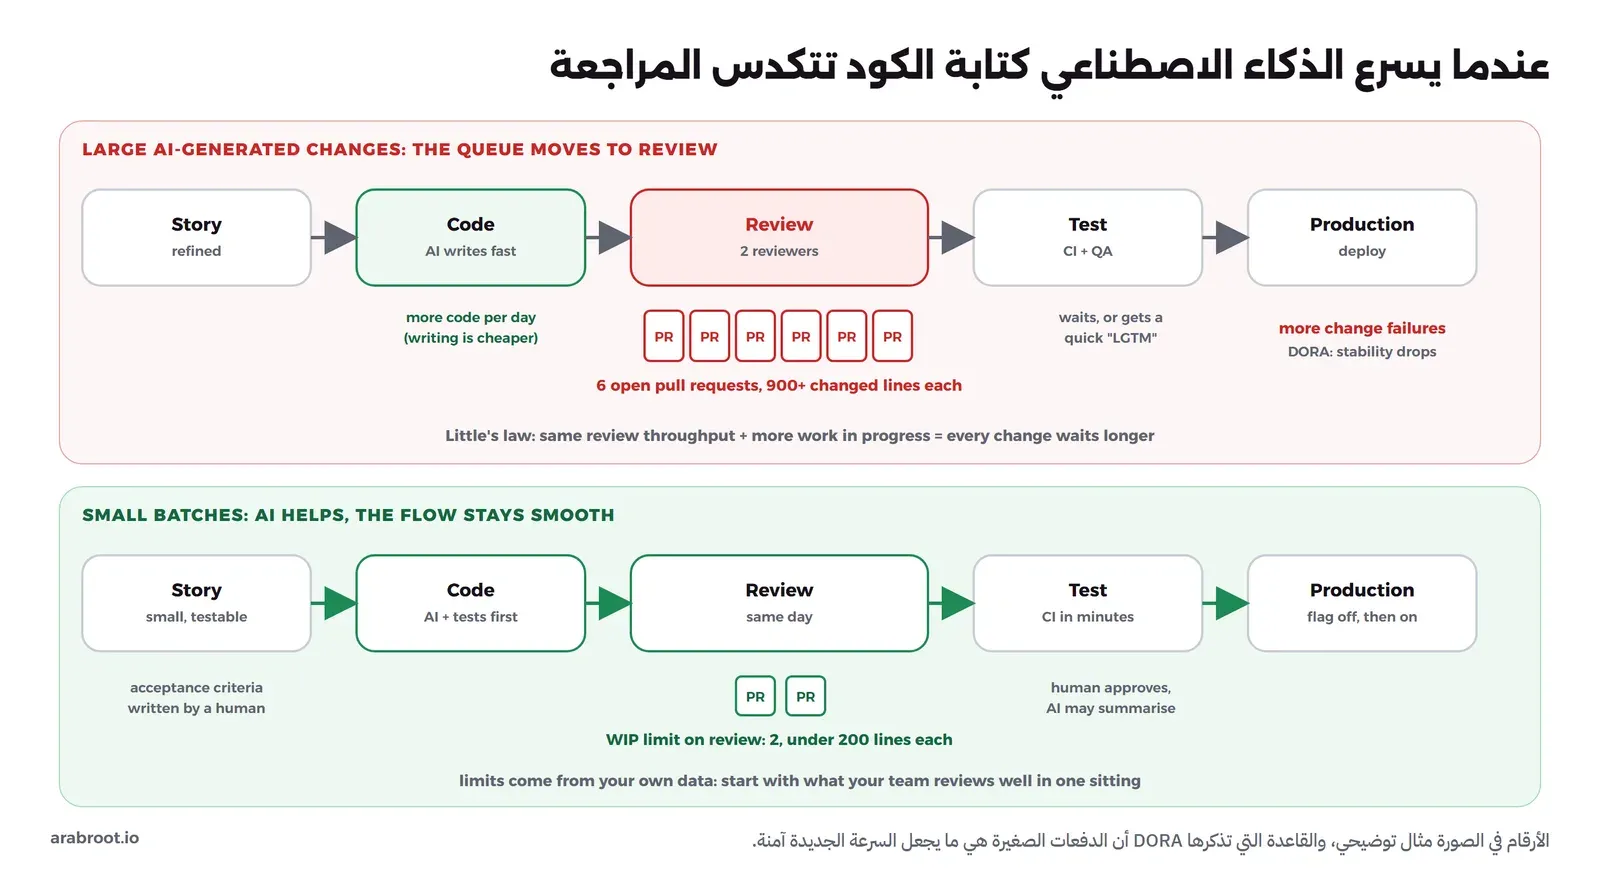
ما في هذا القسم آراء نبنيها على الأدلة أعلاه وعلى قدرات DORA، وليست نتائج دراسات، فاقرأها على أنها فرضيات Hypotheses يختبرها فريقك في الاستعادة Retrospective. والفكرة الأساسية تبينها الصورة التالية: عندما يصبح كتابة الكود أرخص، لا يختفي العمل، وإنما ينتقل إلى المرحلة التالية:
قصص User Stories أصغر، لا قصص أكبر
الحل البسيط الذي يخطر على البال أن الفريق صار أسرع، فليأخذ قصصاً أكبر في كل سبرنت، أو يطلب من الأداة أن تكتب الميزة كلها في طلب دمج Pull Request واحد. وهذا يفشل لأن التغيير الكبير صعب المراجعة والاختبار والدمج، وهذا بالضبط ما تقوله صفحة DORA عن الدفعات الصغيرة: الذكاء الاصطناعي يكتب كتلاً كبيرة من الكود بسرعة، ولكن التغييرات الكبيرة صعب أن تراجع وتختبر وتدمج بأمان، والدفعات الصغيرة هي العلاج الذي يقابل انخفاض الاستقرار. والطريقة الأنسب أن تستخدم الوقت الذي وفرته الأداة لتقسم العمل أكثر، فكل قصة يمكن أن تصل إلى الإنتاج وحدها خلف Feature Flag، وكل طلب دمج يمكن أن يقرأه زميلك في جلسة واحدة.
المراجعة Code Review تصبح عنق الزجاجة Bottleneck
إذا كان الفريق يكتب ضعف الكود ويراجع بنفس السرعة، فبحسب قانون Little سوف يتضاعف الانتظار أمام المراجعة، وعندها يحدث أحد أمرين: إما أن تنتظر طلبات الدمج أياماً، أو أن يوافق المراجع بسرعة دون أن يقرأ، وكلاهما سيئ. والعلاج من أدوات Kanban نفسها: حد للعمل الجاري WIP Limit على عمود المراجعة، وحد لحجم طلب الدمج، وقاعدة أن من ينتهي من كتابة الكود ويجد المراجعة ممتلئة يراجع قبل أن يبدأ شيئاً جديداً، وقد شرحنا شكل طلبات الدمج الصغيرة في التطوير على الفرع الرئيسي. ويمكن أن يساعد الذكاء الاصطناعي في المراجعة نفسها بأن يلخص التغيير ويشير إلى الأسطر الخطرة، ولكن الموافقة تبقى لإنسان يفهم الكود.
معايير القبول Acceptance Criteria والاختبارات Tests أهم من قبل
عندما يكتب الكود شخص، فإنه يفهم عادة ما يجب أن يحدث، وعندما تكتبه أداة فإنها تكتب كوداً يبدو صحيحاً، وفي استبيان Stack Overflow كانت أكبر شكوى أن الحلول صحيحة تقريباً. لذلك تصبح معايير القبول Acceptance Criteria المكتوبة قبل الكود هي المرجع الذي يحكم به على ما كتبته الأداة، ويصبح من الضروري أن يقرر إنسان ما هو الصحيح في الاختبارات، وهي مشكلة المرجع Test Oracle التي شرحناها في أتمتة الاختبارات بالذكاء الاصطناعي. وعملياً أضف إلى تعريف الإنجاز Definition of Done سطرين: أن معايير القبول تحقق منها شخص غير كاتب الكود، وأن الاختبارات التي كتبتها الأداة راجعها إنسان وتأكد أنها تفشل عندما يكون الكود خاطئاً.
الأداة تكتب مسودة القصة User Story، ومالك المنتج Product Owner يملكها
من أكثر الاستخدامات فائدة أن تعطي الأداة ملاحظات اجتماع أو مجموعة تذاكر دعم، فتقترح قصص مستخدمين User Stories ومعايير قبول وحالات حدية Edge Cases لم يفكر فيها أحد. ولكن هناك مشكلة رئيسية في هذا الاستخدام، وهي أن القصة التي تكتبها الأداة مقنعة الشكل حتى لو كانت تحل المشكلة الخطأ، ودليل Scrum يقول إن مالك المنتج هو المسؤول عن إنشاء عناصر القائمة Product Backlog وشرحها وترتيبها، وهذه مسؤولية لا تنتقل إلى أداة. والقاعدة التي نقترحها أن كل قصة كتبت مسودتها أداة يقرؤها مالك المنتج ويعدلها ويقبلها باسمه قبل أن تدخل التخطيط، وكيف تكتب المتطلبات الجيدة أصلاً موضوع مقالين مستقلين:
 دليلهندسة المتطلبات Requirements Engineering من الطلب إلى ما يبنىما هو المتطلب Requirement، وكيف تجمعه وتكتبه وتراجعه وتدير تغييره، ولماذا تفشل مشاريع كبيرة عندما تهمل هذه الخطوة.
 دليلمن فكرة غامضة إلى متطلبات Requirements واضحة: مثال عملي مع القوالبكيف تحول جملة «نبغى نظام حجز مواعيد لعيادة» إلى متطلبات Requirements واضحة يمكن بناؤها واختبارها، مع قوالب جاهزة للنسخ.
نماذج أولية Prototypes أسرع في مراجعة السبرنت Sprint Review
صار من السهل أن يبني الفريق نموذجاً أولياً Prototype يعمل في يوم بدل أسبوع، وهذا يعيدنا إلى نصيحة Royce القديمة بأن تبني نسخة تجريبية قبل النسخة الحقيقية. فاستخدمه في مراجعة السبرنت لتعرض على المستخدمين فكرتين أو ثلاثاً قبل أن تلتزم بواحدة، ولكن لا تقم بنقل النموذج إلى الإنتاج كما هو، والسبب أنه كتب ليجيب عن سؤال لا ليعيش سنوات، فلم يمر بتعريف الإنجاز ولا بالمراجعة الأمنية.
هل تتغير الأدوار؟
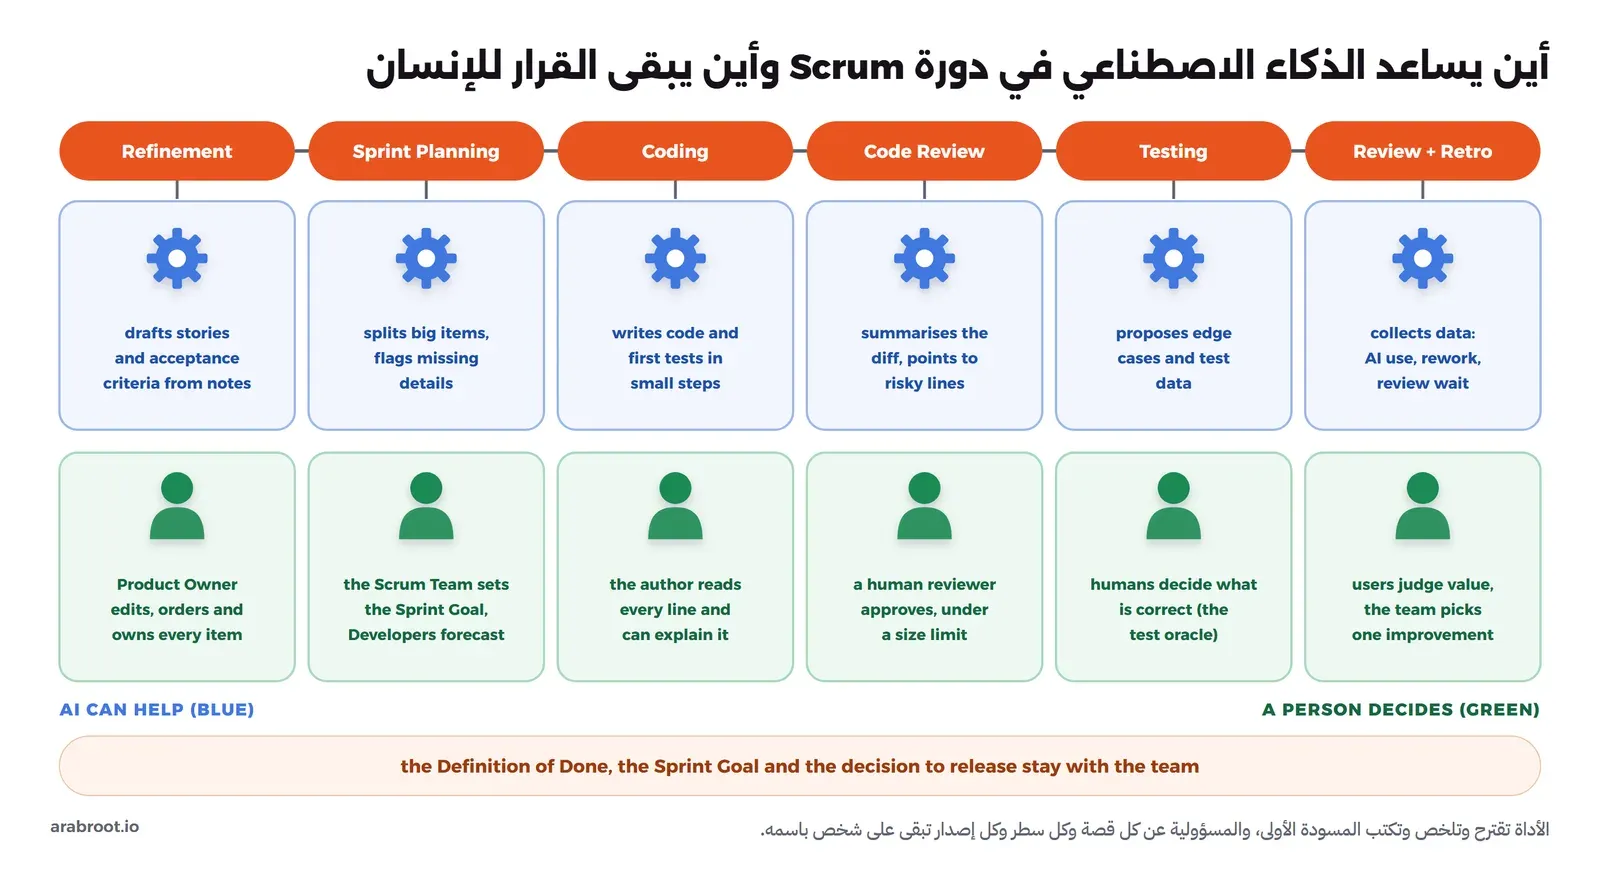
رأينا أن المسؤوليات الثلاث في دليل Scrum تبقى كما هي، والسبب أن الدليل يعرفها بالمسؤولية Accountability لا بالعمل اليدوي، ووكيل الذكاء الاصطناعي AI Agent لا يمكن أن يكون مسؤولاً عن شيء، فالمطورون ما زالوا مسؤولين عن الجودة والالتزام بتعريف الإنجاز حتى لو كتب الوكيل نصف الكود، ومالك المنتج مسؤول عن القيمة، وScrum Master مسؤول عن فعالية الفريق، ومن ذلك أن يلاحظ أن المراجعة صارت العائق. والذي نتوقعه، وهو رأي لا نتيجة بحث، أن وقت المطور سوف ينتقل أكثر من كتابة الكود إلى تحديد المطلوب بدقة والتحقق منه، والصورة التالية تبين أين يمكن أن تساعد الأداة في كل خطوة من الدورة، وأين يبقى القرار لشخص:
المخاطر وكيف تتعامل معها
حمل المراجعة Review Load والموافقة السريعة Rubber Stamping
عندما يرى المراجع عشرة طلبات دمج كبيرة في اليوم فإنه يتعب، والتعب يعني موافقة سريعة بكلمة LGTM دون قراءة، وعندها يدخل الكود «الصحيح تقريباً» إلى الفرع الرئيسي. والعلاج حدود للحجم والعدد كما ذكرنا، وقاعدة أن كاتب طلب الدمج يستطيع أن يشرح كل سطر فيه دون أن يرجع إلى الأداة، فإذا لم يستطع فالطلب غير جاهز للمراجعة.
الجودة Quality والاستقرار Stability
انخفاض الاستقرار في بيانات DORA للسنتين هو الإشارة الأوضح حتى الآن، ولذلك قس ما يحدث بعد النشر لا قبله: نسبة التغييرات التي تحتاج إلى إصلاح عاجل Change Failure Rate، وزمن التعافي Recovery Time، وكم من العمل المنجز عاد كأخطاء. وقد شرحنا مقاييس DORA وكيف تستخدمها للفريق في خارطة CTO لشركة SaaS ناشئة، ولا تقم بقياس عدد الأسطر أو نسبة الكود الذي كتبته الأداة كمؤشر نجاح، والسبب أن هذه أرقام ترتفع بسهولة ولا تقول شيئاً عن المستخدم.
ضعف المهارات Deskilling
المهارة التي لا تستخدمها تضعف، وهذا ليس رأياً جديداً، فقد جمعنا الأبحاث عن تسليم التفكير للأدوات Cognitive Offloading وما تقوله دراسات الذكاء الاصطناعي عن التعلم في مقال تمارين Kata، ومعها جلسة أسبوعية مع الفريق يمكن أن تضعها في السبرنت كما تضع أي عمل آخر. وهذا مهم بشكل خاص للمطورين الجدد، فالدراسة الميدانية لMicrosoft وAccenture وجدت أن الأقل خبرة هم الأكثر استخداماً للأداة، وهم أيضاً الذين يحتاجون إلى أن يتعلموا ما تكتبه.
الأمن Security
كل وكيل يقرأ تذاكر أو صفحات ويب أو رسائل يمكن أن تصله تعليمات مخفية فيها، وكل وكيل له صلاحية كتابة يمكن أن يفعل أكثر مما تريد، والنماذج قد تقترح حزماً بأسماء غير موجودة يسجلها المهاجم لاحقاً، وقد شرحنا كل ذلك في حقن التعليمات Prompt Injection والصلاحيات الزائدة Excessive Agency وسلسلة التوريد من قائمة OWASP لتطبيقات نماذج اللغة، وكيف تحمي الاعتماديات في أمن سلسلة التوريد البرمجية، وكيف تكتشف الأسرار التي تسربت إلى الكود في اكتشاف الأسرار المسربة. والقاعدة على مستوى الفريق بسيطة: الوكيل يعمل في بيئة معزولة Sandbox على فرع، دون مفاتيح الإنتاج، وكل اعتمادية جديدة يقترحها يتحقق منها إنسان.
قالب سياسة فريق لاستخدام الذكاء الاصطناعي داخل Scrum وKanban
توصي صفحة DORA عن الموقف الواضح من الذكاء الاصطناعي بأن تكون السياسة في ثلاث خانات بدل «مسموح أو ممنوع»: ممنوع، ومسموح بضوابط، ومسموح، وأن تكون وثيقة حية يسهل الوصول إليها وتتطور مع الأسئلة، والسبب أن الغموض نفسه خطر، فالمطور الذي لا يعرف ما المسموح إما أن يتجنب الأداة كلها أو يستخدمها في الخفاء. والصورة التالية تبين الخانات الثلاث بأمثلة:
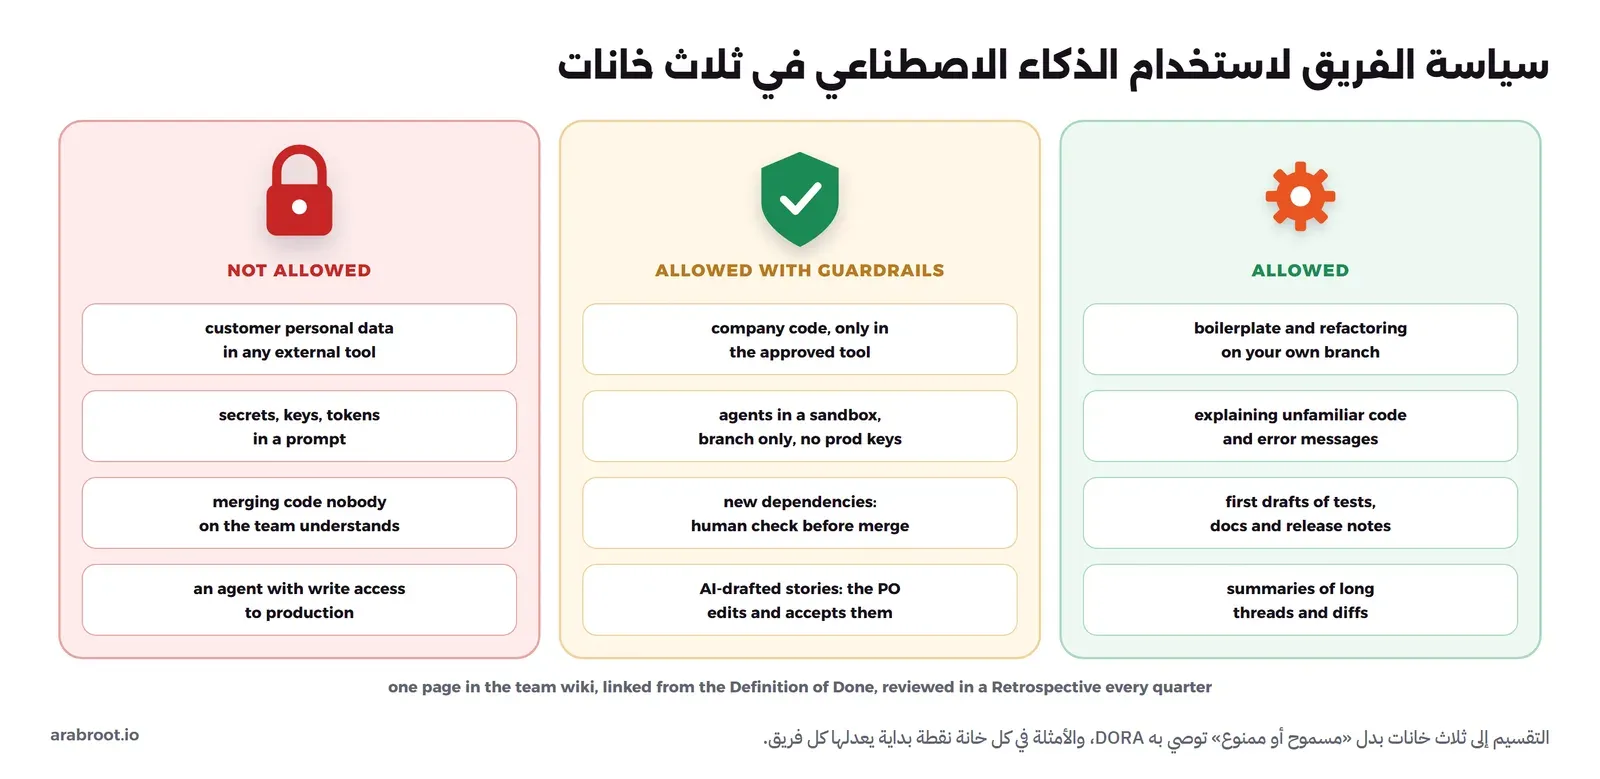
والقالب التالي صفحة واحدة تضعها في Wiki الفريق أو في المستودع، وكتبناه بالإنجليزية لأن أغلب الفرق تحفظ هذه الوثائق بجانب الكود، فعدله بما يناسبك:
# Team AI Working Agreement (v1, owner: Scrum Master, review: every quarter)

## Approved tools
- Coding assistant: <tool>, company account only
- Chat model for docs and stories: <tool> or the self-hosted model

## Not allowed
- Customer personal data, production logs or secrets in any prompt
- Merging code that the author cannot explain line by line
- Agents with write access to production or to main

## Allowed with guardrails
- Company code only in the approved tools
- Agents run in a sandbox, on a branch, without production credentials
- New dependencies suggested by AI: a human checks name, source and licence
- AI-drafted stories and acceptance criteria: the Product Owner edits and accepts them

## Allowed
- Boilerplate, refactoring and explanations on your own branch
- First drafts of tests, docs and release notes (a human reviews them)

## Flow rules (Scrum or Kanban)
- Pull requests under ~200 changed lines; split larger work
- WIP limit on the Review column: 2 per reviewer
- Review within the same working day
- The author answers review questions without asking the tool

## Definition of Done additions
- Acceptance criteria checked by someone other than the author
- AI-written tests reviewed and seen failing on wrong code
- No new secrets, no unchecked dependencies

## What we measure (team level, never per person)
- DORA metrics, cycle time, review wait time, rework after release
في الإعداد أعلاه لاحظ التالي:
- الأرقام، مثل 200 سطر وحد 2 للمراجعة، نقطة بداية لا قاعدة علمية، فابدأ بها ثم عدلها من بيانات لوحتك بعد سبرنتين أو ثلاثة.
- السياسة لها مالك وموعد مراجعة، والسبب أن الأدوات تتغير كل بضعة أشهر، والوثيقة التي لا يملكها أحد تصبح قديمة بسرعة.
- المقاييس على مستوى الفريق فقط، فقياس الأفراد بعدد طلبات الدمج أو بنسبة الكود الذي كتبته الأداة يدفع الناس إلى تضخيم الأرقام كما حدث مع النقاط.
- إذا كانت بيانات مؤسستك لا يجوز أن تخرج إليها، فالنموذج المحلي خيار يستحق النظر، وطريقة تشغيله واختبار ما يكتبه في أتمتة الاختبارات بالذكاء الاصطناعي.
ما الذي لا يتغير في Agile؟
إذا رجعت إلى المبادئ الاثني عشر في بيان Agile فلن تجد مبدأً واحداً تلغيه الأداة: البرنامج الذي يعمل ما زال هو المقياس الأول للتقدم، والتسليم المتكرر ما زال أفضل من التسليم الكبير، والأشخاص من جهة العمل والمطورون ما زالوا يحتاجون إلى أن يعملوا معاً كل يوم، والوتيرة التي يمكن الاستمرار عليها ما زالت مهمة، بل ربما أهم عندما يستطيع كل شخص أن يبدأ عشرة أعمال في صباح واحد. والذي يبقى كذلك:
- الأشخاص والمسؤولية Accountability: كل قصة وكل سطر وكل إصدار له شخص يملكه ويستطيع أن يشرحه.
- حلقات التغذية الراجعة Feedback Loops: مراجعة مع المستخدمين، واختبارات آلية سريعة، ومراقبة بعد النشر، فالأداة تسرع الكتابة ولا تسرع معرفة ما إذا كان ما كتبته مفيداً.
- الدفعات الصغيرة Small Batches: وهي في بيانات DORA ما يحول السرعة الجديدة إلى قيمة بدل أن يحولها إلى عدم استقرار.
توقعات للسنوات القادمة، بوصفها آراء
ما يلي توقعات لا نتائج، ولكل منها من قاله:
- الأثر يعتمد على الفريق أكثر من الأداة: وهذا رأي تقرير DORA 2025 الذي وصف الذكاء الاصطناعي بأنه مضخم لما هو موجود، فالتوقع أن تتسع الفجوة بين الفرق التي عندها الأساسيات والفرق التي ليس عندها.
- السرعة الفردية ترتفع مع الأدوات الأحدث: وهذا ما تعتقده METR في تحديث فبراير 2026 بناءً على حديثها مع المشاركين، مع تأكيدها أن بياناتها لا تكفي لتقدير الحجم.
- أطر العمل Frameworks التجارية تعيد تسويق نفسها حول الذكاء الاصطناعي: فقد أضافت SAFe نسخة باسم AI-Native SAFe، وتذكر هنا نقد Schwaber وFowler لأطر التوسع الذي شرحناه في المقال السابق، فاسم جديد للإطار لا يغير المشكلة.
- رأينا نحن: أن قيد التخطيط في السبرنت سوف يكون أقل في كتابة الكود وأكثر في المراجعة والاختبار وفهم المطلوب، ولذلك نتوقع أن تهتم الفرق الناجحة بحدود العمل الجاري على المراجعة وبجودة معايير القبول أكثر من اهتمامها بعدد النقاط.
قائمة تحقق قبل أن يعتمد فريقك على الذكاء الاصطناعي
- هل عند الفريق سياسة مكتوبة بثلاث خانات، ولها مالك وموعد مراجعة؟
- هل على عمود المراجعة حد للعمل الجاري WIP Limit، ولطلب الدمج Pull Request حد للحجم؟
- هل يشمل تعريف الإنجاز التحقق من معايير القبول ومراجعة الاختبارات التي كتبتها الأداة؟
- هل كل قصة كتبت الأداة مسودتها قبلها مالك المنتج باسمه؟
- هل تعمل الوكلاء في بيئة معزولة دون مفاتيح الإنتاج، وتفحص اعتمادياتها الجديدة؟
- هل تقيسون التسليم والاستقرار بعد النشر، لا عدد الأسطر أو نسبة الكود المولد؟
- هل في السبرنت وقت لتمرين المهارات، خاصة للمطورين الجدد؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الاستخدام صار شبه عام، ولكن النتائج تختلف بحسب ما تقيسه: المهمة الصغيرة أسرع، والتسليم في بيانات DORA أقل استقراراً، وشعور المطور بسرعته قد يخالف القياس.
- دراسات GitHub وMicrosoft مفيدة، ولكن أجرتها جهات تبيع الأداة، وتقيس السرعة أو عدد المهام لا الجودة في الإنتاج.
- الذكاء الاصطناعي ينقل الضغط من كتابة الكود إلى المراجعة والاختبار، فضع حداً للعمل الجاري على المراجعة وحداً لحجم طلب الدمج.
- القصص أصغر لا أكبر، ومعايير القبول والاختبارات المكتوبة بيد إنسان أهم من قبل، والأداة تكتب مسودة القصة ومالك المنتج يملكها.
- المسؤوليات الثلاث في Scrum لا تتغير، لأن الأداة لا يمكن أن تكون مسؤولة، والسياسة الواضحة في ثلاث خانات تقلل الخطر وتشجع الاستخدام الصحيح.
- ما لا يتغير هو الأهم: الأشخاص، وحلقات التغذية الراجعة، والدفعات الصغيرة.
 دليلAgile بلا شعارات: Scrum وKanban كما يطبقان فعلاًمن أين جاءت Agile، وكيف تعمل Scrum وKanban كما تصفها أدلتها الرسمية، وما الأخطاء التي تحولها إلى اجتماعات بلا فائدة.
 دليللماذا تتمرن دون ذكاء اصطناعي؟ تمارين Kata لك ولفريقكما الذي تقوله الأبحاث عن تسليم التفكير للأدوات، وكيف يحفظ روتين صغير من التمارين تحلها بيدك مهارتك وحدك ومع فريقك.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلOWASP Top 10 لتطبيقات LLM: المخاطر وكيف تحمي تطبيقكأخطر عشر مشكلات في التطبيقات المبنية على نماذج اللغة، من حقن التعليمات Prompt Injection إلى تسرب البيانات، وكيف تمنع كلاً منها.
 دليلأمن سلسلة التوريد البرمجية Software Supply Chain للمبتدئينكل ما بين كود غيرك وسيرفرك قد يحمل كود المهاجم، وهنا تعرف التهديدات الحقيقية بحوادث موثقة والدفاع المناسب لكل حلقة.
 دليلTrunk-Based Development: فروع قصيرة ودمج يوميلماذا تنفجر الفروع الطويلة يوم الإصدار، وكيف يدمج الفريق عمله في main كل يوم بأمان مع CI وFeature Flags.
سجل التحديثات
- أكتوبر 2026: كتابة المقال من تقارير DORA 2024 و2025، وتجربة METR 2025 وتحديثها في فبراير 2026، ودراستي Peng 2023 وCui 2025، واستبياني Stack Overflow 2025 و2026، مع رسومات للأدلة وعنق الزجاجة في المراجعة ودورة Scrum وقالب السياسة.


