> ## Content Index
> Fetch the complete content index at: https://arabroot.io/llms.txt
> Use this file to discover other available public pages before exploring further.
# Dublin Core وBIBFRAME: البيانات الوصفية بعد MARC
- URL: https://arabroot.io/articles/dublin-core-و-bibframe-البيانات-الوصفية-بعد-marc/
- Published: 2026-11-17T00:34:55.000Z
- Updated: 2026-11-17T01:33:03.000Z
- Description: نحول تسجيلتين حقيقيتين من مكتبة الكونغرس إلى Dublin Core وإلى BIBFRAME بالأدوات الرسمية، ونرى ما يبقى وما يضيع من الوصف العربي.
- Author: فريق عرب رووت
- Tags: الأدلة التقنية, المكتبات ونظم المعلومات, تطبيقات لفريقك, الاستضافة الذاتية
إذا كانت مكتبتك الجامعية تشغل نظاماً للمكتبة مثل Koha ومستودعاً رقمياً للرسائل مثل DSpace، فأنت تعيش مع معيارين للوصف دون أن تنتبه: الكتب في نظام المكتبة موصوفة بـ MARC21، والرسائل في المستودع موصوفة بـ Dublin Core. ثم يأتي يوم تطلب فيه الإدارة بوابة بحث واحدة تجمع الاثنين، أو يطلب منك مشروع وطني أن تصدر تسجيلاتك بصيغة يفهمها، أو تقرأ أن مكتبة الكونغرس انتقلت إلى شيء اسمه BIBFRAME وتتساءل هل عليك أن تنتقل أنت أيضاً. وكل هذه الأسئلة تحتاج أن تعرف ماذا يحفظ كل معيار، وماذا يضيع عندما تنقل التسجيلة من واحد إلى آخر، والطريقة الوحيدة لتعرف ذلك بثقة أن تحول تسجيلات حقيقية بنفسك وتقرأ الناتج سطراً سطراً، بدلاً من أن تعتمد على جداول المقارنة العامة، وفي هذا المقال سوف نتناول:
- Dublin Core: العناصر الخمسة عشر، ومصطلحات DCMI الأدق، ولماذا تستخدمه المستودعات وبروتوكول OAI-PMH.
- BIBFRAME 2.0 من مكتبة الكونغرس: العمل والنسخة المنشورة والمادة، والروابط بدلاً من النصوص، والثلاثيات Triples.
- مختبر يحول تسجيلتي «أولاد حارتنا» الحقيقيتين من مكتبة الكونغرس إلى Dublin Core بملفات XSLT الرسمية، وإلى BIBFRAME بأداة marc2bibframe2، ويعرض ما بقي وما ضاع.
- مقارنة تحويلنا بـ BIBFRAME الذي تنشره مكتبة الكونغرس نفسها لكتاب سعودي من 2024.
- من يستخدم ماذا اليوم، ومتى تحتاج كل معيار في مكتبتك.
وهذا المقال يبني على مقال MARC21 للمبتدئين، فالتسجيلتان اللتان نحولهما هنا هما اللتان قرأناهما هناك حقلاً حقلاً، وعلى دليل [المستودع العلمي للجامعة مع DSpace](https://arabroot.io/articles/%D8%AA%D8%AB%D8%A8%D9%8A%D8%AA-%D8%A7%D9%84%D9%85%D8%B3%D8%AA%D9%88%D8%AF%D8%B9-%D8%A7%D9%84%D8%B9%D9%84%D9%85%D9%8A-%D9%84%D9%84%D8%AC%D8%A7%D9%85%D8%B9%D8%A9-%D9%85%D8%B9-dspace/) الذي رأينا فيه Dublin Core داخل المستودع وحصاده عبر OAI-PMH، فلن نعيد هنا تثبيت المستودع ولا شرح البروتوكول:
[دليلمعيار MARC21 للمبتدئين: بطاقة الفهرسة في الحاسبنقرأ تسجيلتين حقيقيتين من فهرس مكتبة الكونغرس حقلاً حقلاً، ونرى أين يذهب العنوان العربي، ولماذا ضاعت همزة عند التحويل إلى MARC-8.](https://arabroot.io/articles/%D9%85%D8%B9%D9%8A%D8%A7%D8%B1-marc21-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86-%D9%83%D9%8A%D9%81-%D9%8A%D9%82%D8%B1%D8%A7-%D8%A7%D9%84%D8%AD%D8%A7%D8%B3%D8%A8-%D8%A8%D8%B7%D8%A7%D9%82%D8%A9-%D8%A7%D9%84%D9%81%D9%87%D8%B1%D8%B3%D8%A9/)[دليلقواعد RDA للكتاب العربي وأسماء المؤلفيننقرأ قواعد RDA من ست تسجيلات حقيقية في فهرس مكتبة الكونغرس، ونرى كيف يدخل اسم المؤلف العربي وكيف تكتب السنة الهجرية والرومنة.](https://arabroot.io/articles/%D8%A7%D9%84%D9%81%D9%87%D8%B1%D8%B3%D8%A9-%D8%A8%D9%82%D9%88%D8%A7%D8%B9%D8%AF-rda-%D9%84%D9%84%D9%83%D8%AA%D8%A8-%D8%A7%D9%84%D8%B9%D8%B1%D8%A8%D9%8A%D8%A9-%D9%88%D8%A7%D8%B3%D9%85%D8%A7%D8%A1-%D8%A7%D9%84%D9%85%D8%A4%D9%84%D9%81%D9%8A%D9%86/)[دليلملفات الإسناد Authority Files وأسماء المؤلفين العربنبحث في ملف أسماء مكتبة الكونغرس عن مؤلفين عرب، ونقيس كم اسماً حقيقياً في فهرس مفتوح يجد صاحبه بالشكل المعتمد والإحالات والتوحيد.](https://arabroot.io/articles/%D9%85%D9%84%D9%81%D8%A7%D8%AA-%D8%A7%D9%84%D8%A7%D8%B3%D9%86%D8%A7%D8%AF-authority-records-%D9%88%D8%AA%D9%88%D8%AD%D9%8A%D8%AF-%D8%A7%D8%B3%D9%85%D8%A7%D8%A1-%D8%A7%D9%84%D9%85%D8%A4%D9%84%D9%81%D9%8A%D9%86-%D8%A7%D9%84%D8%B9%D8%B1%D8%A8/)[دليلخريطة أنظمة المكتبة: ILS والمستودع وبوابة البحثما الأنظمة التي تتكون منها المكتبة الحديثة وكيف تتكلم مع بعضها، مع مختبر ينسخ تسجيلة كتاب من مكتبة الكونغرس عبر Z39.50 ويحصد مستودعاً عبر OAI-PMH.](https://arabroot.io/articles/%D8%AE%D8%B1%D9%8A%D8%B7%D8%A9-%D8%A7%D9%86%D8%B8%D9%85%D8%A9-%D8%A7%D9%84%D9%85%D9%83%D8%AA%D8%A8%D8%A9-ils-%D9%88%D8%A7%D9%84%D9%85%D8%B3%D8%AA%D9%88%D8%AF%D8%B9-%D9%88%D8%A8%D9%88%D8%A7%D8%A8%D8%A9-%D8%A7%D9%84%D8%A8%D8%AD%D8%AB/)
## ما هي البيانات الوصفية Metadata، ولماذا لها معايير؟
البيانات الوصفية Metadata هي بيانات عن شيء آخر: عنوان الكتاب ومؤلفه وسنته بيانات وصفية عن الكتاب، وتاريخ التقاط الصورة واسم الكاميرا بيانات وصفية عن الصورة، واسم الملف وحجمه بيانات وصفية عن الملف. والمكتبة في أهم ما تقدمه صانعة بيانات وصفية، لأن الكتاب على الرف لا يجده أحد إذا لم يكن موصوفاً في فهرس. والسؤال الذي تجيب عنه المعايير ليس «ماذا نصف»، فكل المكتبات تصف العنوان والمؤلف، وإنما «بأي شكل نكتب الوصف حتى يفهمه غيرنا». فالمكتبة التي تصف كتبها بطريقتها الخاصة لا تستطيع أن تنسخ تسجيلات من غيرها، ولا أن يحصد أحد فهرسها، ولا أن تنتقل إلى نظام جديد دون أن تعيد كتابة كل شيء.
ولهذا لا يوجد معيار واحد يناسب كل شيء، فكل معيار يوازن بين أمرين: الدقة، أي أن يحفظ كل تفصيل يحتاجه المتخصص، والبساطة، أي أن يكتبه ويقرؤه غير المتخصص وأي برنامج. وMARC اختار الدقة، وDublin Core اختار البساطة، وBIBFRAME يحاول أن يأخذ الدقة ويضيف إليها لغة الويب. وأنت في مكتبتك لا تختار معياراً واحداً، وإنما تختار لكل نظام المعيار الذي يناسب من يكتب فيه ومن يقرأ منه، ثم تعرف كيف تنقل البيانات بينها دون أن تفقد ما يهمك، وهذا ما يدور حوله بقية المقال.
## ثلاث طرق لوصف الكتاب نفسه
قبل الدخول في التفاصيل، الصورة التالية تضع الرواية نفسها في النماذج الثلاثة جنباً إلى جنب، لأن الفرق بينها ليس في أسماء الحقول فقط، وإنما في طريقة التفكير في الوصف:
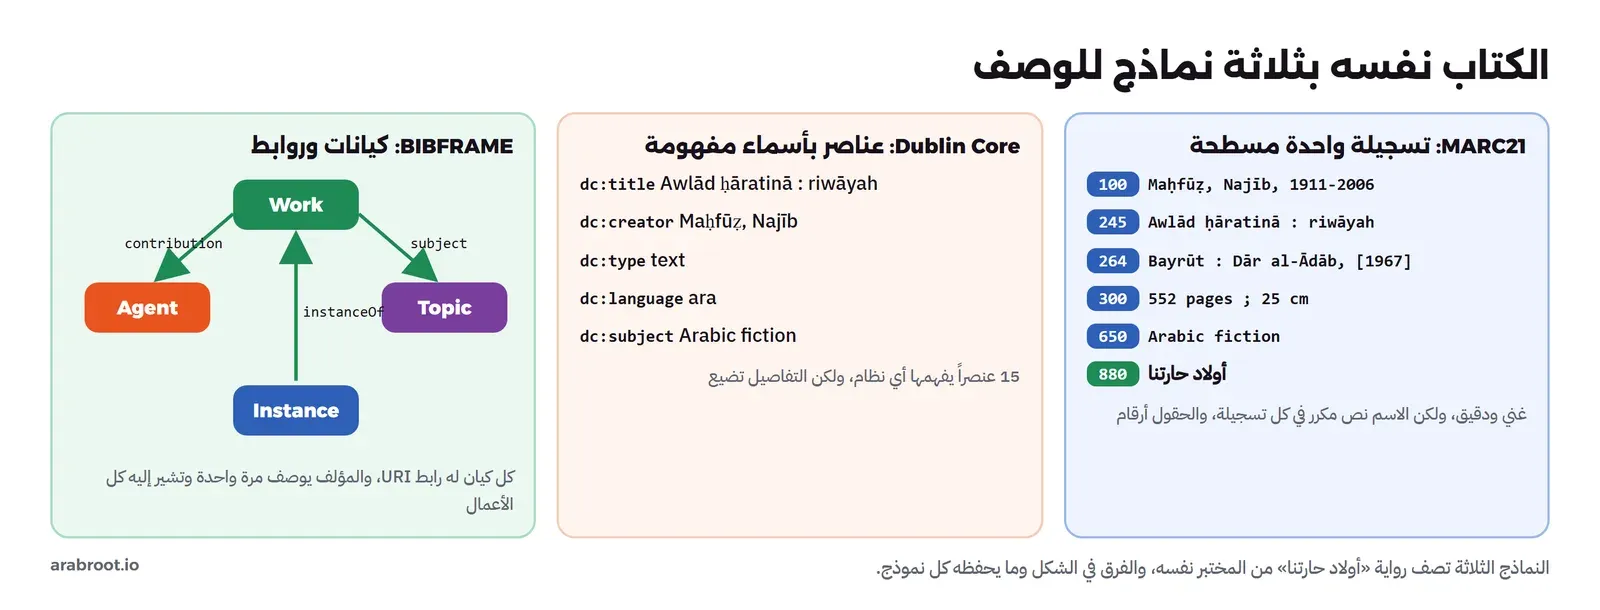
MARC تسجيلة واحدة، وDublin Core قائمة عناصر، وBIBFRAME شبكة كيانات وروابط
في الصورة أعلاه لاحظ التالي:
- **MARC21** يضع كل شيء في تسجيلة واحدة مسطحة: المؤلف نص في الحقل 100، والموضوع نص في 650، والعربية في 880\. وهو الأغنى بالتفاصيل، ولكنه مكتوب للمفهرسين وأنظمة المكتبات.
- **Dublin Core** قائمة عناصر بأسماء يفهمها أي شخص: العنوان والمنشئ والموضوع والتاريخ، وهو مسطح أيضاً، ولكنه أبسط بكثير، وكلما بسطت الوصف ضاعت تفاصيل.
- **BIBFRAME** لا يصف «تسجيلة»، وإنما أشياء مرتبطة: عمل، ونسخة منشورة منه، وشخص ساهم فيه، وموضوع يتناوله، وكل شيء منها له رابط URI، والعلاقة بينها لها اسم. وبالتالي يوصف المؤلف مرة واحدة، وتشير إليه كل أعماله.
## Dublin Core: خمسة عشر عنصراً يفهمها الجميع
ولد Dublin Core في ورشة عمل عقدت في 1995 في مدينة دبلن بولاية أوهايو الأمريكية، ومن هنا اسمه، وكان السؤال الذي تحاول الإجابة عنه: ما أقل مجموعة من العناصر تكفي لوصف أي مورد على الويب، بحيث يستطيع صاحب الموقع أن يكتبها بنفسه دون أن يكون مفهرساً؟ والإجابة كانت خمسة عشر عنصراً، تعرف اليوم باسم [Dublin Core Metadata Element Set](https://www.dublincore.org/specifications/dublin-core/dces/?ref=arabroot.io)، وأصبحت معياراً دولياً هو [ISO 15836](https://www.iso.org/standard/71339.html?ref=arabroot.io)، وتديرها مبادرة Dublin Core للبيانات الوصفية DCMI. والصورة التالية تبين العناصر بمجموعاتها:
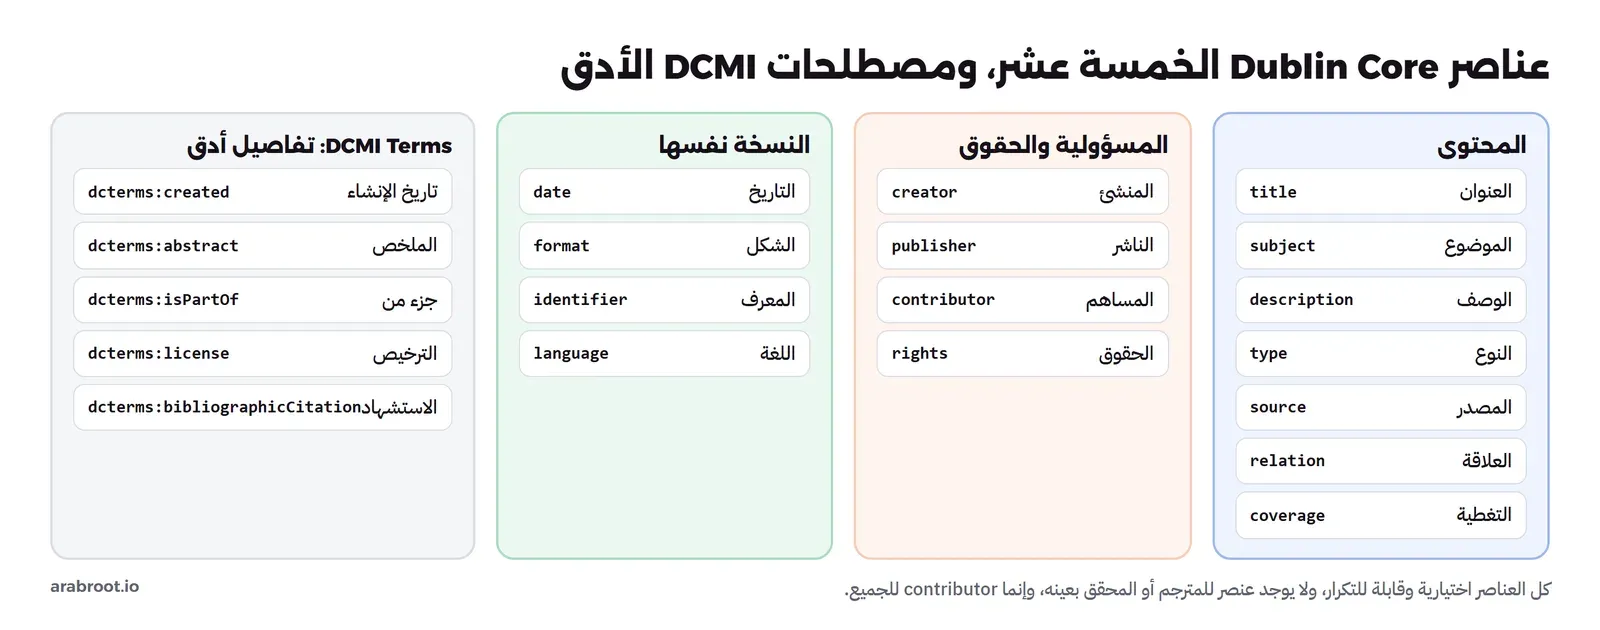
العناصر الخمسة عشر كلها اختيارية وقابلة للتكرار، ومصطلحات DCMI تضيف دقة لمن يحتاجها
وثلاث خصائص في Dublin Core تفسر نجاحه وحدوده معاً:
- **كل عنصر اختياري وقابل للتكرار:** لا يوجد عنصر إلزامي، والكتاب الذي له ثلاثة مؤلفين يكتب `dc:creator` ثلاث مرات. وهذا يجعل أي وصف مقبولاً، حتى الناقص.
- **لا يوجد ترتيب ولا أدوار:** لا يوجد «المؤلف الأول»، ولا يوجد عنصر للمترجم أو المحقق أو المشرف، وإنما `dc:contributor` لكل من شارك، دون أن تعرف دوره. وفي الكتاب العربي المحقق هذا يعني أن المحقق والشارح وصاحب المقدمة يصبحون شيئاً واحداً.
- **القيم نصوص حرة:** `dc:date` قد يكون «1996.» أو «1433 هـ» أو «2012-05»، و`dc:subject` قد يكون من قائمة معتمدة أو كلمة كتبها الطالب، والمعيار نفسه لا يمنع شيئاً.
ولذلك أضافت DCMI لاحقاً [DCMI Metadata Terms](https://www.dublincore.org/specifications/dublin-core/dcmi-terms/?ref=arabroot.io)، وهي مصطلحات أدق في نطاق `dcterms:`، مثل `dcterms:created` لتاريخ الإنشاء و`dcterms:issued` لتاريخ الإصدار و`dcterms:abstract` للملخص و`dcterms:isPartOf` للجزء من سلسلة أو مجلة، وتستخدمها المستودعات بأسماء مؤهلة Qualified، فترى في DSpace حقولاً مثل `dc.contributor.author` و`dc.contributor.advisor` للمشرف و`dc.date.issued`، وهذه الإضافات هي ما يجعل وصف الرسالة الجامعية معقولاً في المستودع.
### لماذا تستخدمه المستودعات إذا كان فقيراً؟
قد يتساءل البعض: إذا كان Dublin Core يضيع الأدوار والتفاصيل، فلماذا تستخدمه المستودعات الرقمية؟ والإجابة على ذلك في سببين. الأول أن من يودع الرسالة في المستودع غالباً هو الطالب نفسه أو موظف القسم، وليس مفهرساً يعرف MARC، ونموذج إيداع فيه «العنوان» و«المؤلف» و«المشرف» و«الملخص» و«الكلمات المفتاحية» يملؤه أي شخص. والثاني أن بروتوكول الحصاد OAI-PMH، الذي تجمع به البوابات الوطنية والدولية سجلات المستودعات، يجعل Dublin Core البسيط بصيغة `oai_dc` صيغة إلزامية في كل مستودع، كما في [مواصفة البروتوكول](https://www.openarchives.org/OAI/openarchivesprotocol.html?ref=arabroot.io)، وبالتالي يستطيع أي حاصد في العالم أن يقرأ أي مستودع، حتى لو لم يعرف شيئاً عن صيغه الأخرى. فالبساطة هنا هي الهدف، والثمن هو التفاصيل.
وفي المكتبات العربية مشكلة إضافية في الحصاد، فالبوابة التي تحصد مستودعات عدة جامعات تجمع سجلات كتبها أشخاص مختلفون، فتجد اسم الباحث الواحد بالعربية في مستودع، وبالحرف اللاتيني في آخر، وبترتيب مختلف في ثالث، والتاريخ هجرياً في مستودع وميلادياً في آخر. وDublin Core البسيط لا يملك وسيلة لتوحيد ذلك، لأنه لا يعرف ملفات الإسناد ولا صيغ التواريخ، لذلك تحتاج البوابة إلى خطوة تنظيف وتوحيد بعد الحصاد، وكلما اتفقت المستودعات على شكل واحد للاسم والتاريخ قبل الحصاد قل هذا العمل.
### وصف رسالة جامعية عربية بـ Dublin Core المؤهل
لكي ترى كيف يعمل Dublin Core المؤهل في مكان يناسبه، لنفرض أن طالبة ماجستير تودع رسالتها في مستودع الجامعة، والرسالة بالعربية ولها ملخص بالعربية وآخر بالإنجليزية. القرارات التي يحتاجها الوصف تختلف عن قرارات المفهرس في MARC، وهي كما يلي:
- **العنوان بلغتين:** العنوان العربي في `dc.title`، والعنوان الإنجليزي من صفحة الملخص في `dc.title.alternative`، ولكل قيمة وسم لغتها `ar` أو `en`، لأن البوابة التي تحصد المستودع تعرض للقارئ القيمة بلغته إذا كانت موسومة.
- **اسم الباحثة:** في `dc.contributor.author` بشكل واحد تختاره الجامعة وتطبقه على كل الرسائل، مثل «اسم العائلة، الاسم الأول»، لأن Dublin Core لا يعرف ملفات الإسناد، فالاتساق كله مسؤولية من يدخل البيانات. وإذا كان للباحثة معرف ORCID فهو أفضل ما يربط اسمها بأعمالها، كما شرحنا في مقال [معرف ORCID وDOI](https://arabroot.io/articles/%D9%85%D8%B9%D8%B1%D9%81-orcid-%D9%88-doi-%D9%83%D9%8A%D9%81-%D8%AA%D8%B1%D8%A8%D8%B7-%D8%A7%D8%B3%D9%85%D9%83-%D8%A8%D8%A7%D8%A8%D8%AD%D8%A7%D8%AB%D9%83/).
- **المشرف:** في `dc.contributor.advisor`، وهذا مثال واضح على ما يضيفه التأهيل، لأن Dublin Core البسيط سوف يضع المشرف في `dc:contributor` بلا دور.
- **التواريخ:** `dc.date.issued` سنة المناقشة أو الإجازة، وهو التاريخ الذي يراه القارئ، بينما يكتب المستودع آلياً `dc.date.accessioned` لتاريخ الإيداع، ولا تخلط بينهما، لأن رسالة نوقشت في 2019 وأودعت في 2026 هي رسالة من 2019.
- **الموضوعات:** الكلمات المفتاحية التي يكتبها الطالب في `dc.subject`، والموضوع من قائمة معتمدة، إذا كانت المكتبة تضيفه، في حقل مؤهل منفصل يذكر القائمة، حتى لا تختلط الكلمات الحرة بالرؤوس المعتمدة.
- **الملخصان:** كل ملخص في `dc.description.abstract` بوسم لغته، وهذا يجعل الرسالة العربية قابلة للاكتشاف من قارئ لا يقرأ العربية.
ولاحظ أن كل هذه القرارات اتفاقات داخل المستودع، فالمعيار نفسه لا يفرضها، وعند الحصاد عبر `oai_dc` تتحول كل الحقول المؤهلة إلى العناصر الخمسة عشر البسيطة، فيصبح المشرف `dc:contributor` مثل أي مساهم، ويصبح العنوان الإنجليزي عنواناً ثانياً. وإذا أردت أن تحفظ التأهيل عند الحصاد فقدم صيغة أغنى بجانب `oai_dc`، مثل MODS أو صيغة المستودع الكاملة، كما يفعل DSpace في قائمة صيغه.
## BIBFRAME: الكتاب كروابط بين كيانات
في 2011 أعلنت مكتبة الكونغرس مبادرة لإيجاد بديل لـ MARC، وسمتها إطار الوصف الببليوغرافي Bibliographic Framework، واختصاراً BIBFRAME، ثم صدر الإصدار 2.0 من النموذج في 2016، ووثائقه في صفحة [BIBFRAME](https://www.loc.gov/bibframe/?ref=arabroot.io) و[نظرة على نموذج BIBFRAME 2.0](https://www.loc.gov/bibframe/docs/bibframe2-model.html?ref=arabroot.io). والفكرة أن الوصف لا يكون تسجيلة نصية، وإنما بيانات مترابطة Linked Data بلغة الويب نفسها RDF، كل شيء فيها له رابط، والعلاقات بين الأشياء لها أسماء ومعان يفهمها البرنامج. والصورة التالية تبين الكيانات الأساسية بقيم حقيقية من تحويلنا في المختبر:
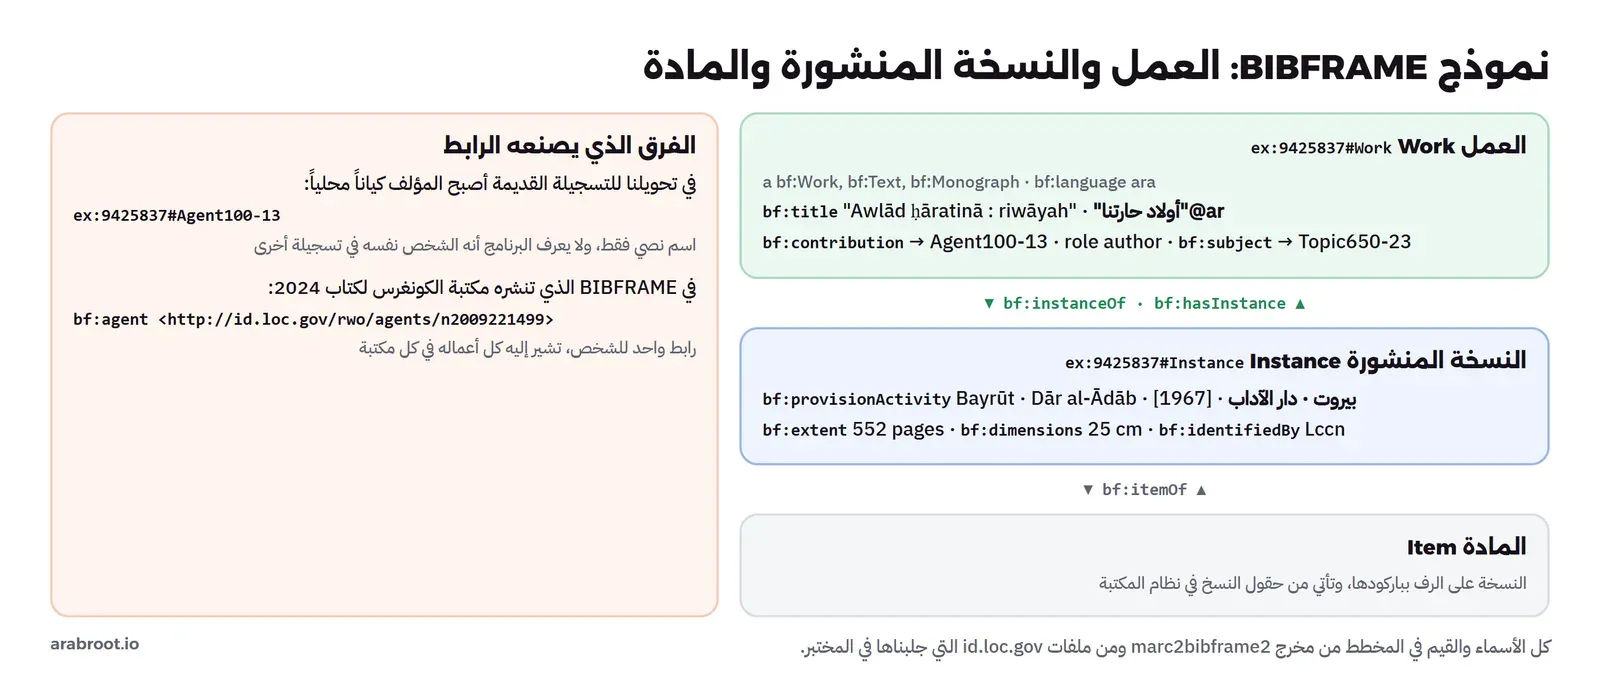
العمل والنسخة المنشورة والمادة، والفرق الكبير بين مؤلف هو نص محلي ومؤلف هو رابط عام
والكيانات الأساسية ثلاثة:
- **العمل Work:** المحتوى الفكري، أي الرواية نفسها، ومعه لغتها وموضوعها ومن أنشأها. وفي BIBFRAME يجمع العمل ما يسميه نموذج RDA العمل والتعبير معاً في أغلب الحالات، فالترجمة الإنجليزية عمل مستقل يرتبط بالأصل بعلاقة.
- **النسخة المنشورة Instance:** طبعة محددة بناشرها وسنتها وعدد صفحاتها ورقمها الدولي، وترتبط بالعمل بعلاقة `bf:instanceOf`.
- **المادة Item:** النسخة على الرف ببارکودها ومكانها، وترتبط بالنسخة المنشورة بعلاقة `bf:itemOf`.
وحول هذه الثلاثة كيانات أخرى: الشخص أو الجهة Agent، والموضوع Topic، والمكان، وكلها يفضل أن تكون روابط إلى ملفات معتمدة مثل id.loc.gov بدلاً من نصوص، وهذا هو الفرق الحقيقي، وليس الصيغة. وقد يتساءل البعض: ما الفائدة العملية من الرابط إذا كان الاسم مكتوباً في النص على أي حال؟ والإجابة على ذلك أن الرابط لا يتغير عندما يتغير الشكل المعتمد للاسم، وأن البرنامج يستطيع أن يتبعه ليعرف عن الشخص أكثر: تاريخ ميلاده، وأسماءه الأخرى، ومعرفاته في VIAF وWikidata، وأن مكتبتين تستخدمان الرابط نفسه تعرفان آلياً أنهما تتحدثان عن الشخص نفسه، دون مطابقة أسماء.
### البيانات المترابطة Linked Data في أربع قواعد
BIBFRAME تطبيق في المكتبات لفكرة أوسع اسمها البيانات المترابطة، وقد لخصها Tim Berners-Lee في 2006 في [أربع قواعد](https://www.w3.org/DesignIssues/LinkedData.html?ref=arabroot.io) بسيطة تفهم دون برمجة:
1. استخدم روابط URI أسماء للأشياء، فالشخص والعمل والموضوع لكل منها رابط، وليس نصاً فقط.
2. اجعل هذه الروابط من نوع HTTP، حتى يستطيع أي شخص أو برنامج أن يفتحها.
3. عندما يفتح أحد الرابط، أعطه معلومات مفيدة بصيغ قياسية مثل RDF، وهذا ما رأيناه عندما جلبنا `.nt` من id.loc.gov.
4. ضع في هذه المعلومات روابط إلى أشياء أخرى، حتى يستطيع البرنامج أن ينتقل منها ويكتشف المزيد، كما يرتبط سجل المؤلف في مكتبة الكونغرس بمعرفاته في VIAF وWikidata.
وبهذا الشكل يصبح فهرس المكتبة جزءاً من الويب نفسه، وليس جزيرة مستقلة لا يقرؤها إلا نظامها. وللمكتبة العربية معنى خاص هنا، لأن المشكلة الكبرى في الفهارس العربية هي تعدد أشكال الأسماء، والرابط هو الحل الطبيعي لها: «نجيب محفوظ» و«Naguib Mahfouz» و«Maḥfūẓ, Najīb» نصوص مختلفة، ولكنها كلها تشير إلى رابط واحد، فلا يحتاج البرنامج أن يخمن أنها الشخص نفسه.
### BIBFRAME ونموذج RDA: أين يلتقيان وأين يختلفان؟
إذا قرأت مقال قواعد RDA فقد تلاحظ أن BIBFRAME يشبه نموذج العمل والتعبير والتجسيد والمادة، ولكنه ليس نسخة منه. ففي نموذج RDA أربعة مستويات، وفي BIBFRAME ثلاثة، والسبب أن مكتبة الكونغرس اختارت أن تجمع العمل والتعبير في كيان واحد هو Work، فترجمة «أولاد حارتنا» إلى الإنجليزية عمل مستقل في BIBFRAME، يرتبط بالعمل الأصلي بعلاقة، وليس تعبيراً تحت العمل نفسه. وهذا الاختيار أبسط في التطبيق، لأن أغلب الأعمال لها تعبير واحد فقط، ولكنه يعني أن جمع الترجمات تحت الأصل يعتمد على العلاقات، وهذا ما رأيناه في الـ Hub الذي صنعته الأداة من الحقل 240.
والفرق الآخر أن RDA قواعد وصف، أي ماذا تكتب، وBIBFRAME نموذج بيانات، أي أين تكتب وكيف ترتبط الأشياء، فهو بالنسبة لـ RDA مثل MARC: وعاء تضع فيه وصفاً مكتوباً بالقواعد. لذلك ترى في البيانات الإدارية للعمل الذي حولناه `bf:descriptionConventions` برابط `rda` و`isbd`، أي «هذا الوصف كتب بقواعد RDA وترقيم ISBD»، وهي ترجمة الحقل 040 والموقع 18 في الرأس. وبالتالي الانتقال إلى BIBFRAME لا يغير قواعد الفهرسة التي تعلمها المفهرسون، وإنما يغير الوعاء.
### الثلاثية Triple: وحدة البناء في BIBFRAME
كل ما في BIBFRAME مكتوب بجمل صغيرة من ثلاثة أجزاء تسمى الثلاثيات Triples، كما في نموذج [RDF](https://www.w3.org/TR/rdf11-concepts/?ref=arabroot.io) من W3C: الموضوع Subject وهو الشيء الذي نصفه، والخاصية Predicate وهي نوع العلاقة، والقيمة Object وهي إما رابط لشيء آخر أو نص. والصورة التالية تبين ثلاث ثلاثيات حقيقية من ملف المختبر:
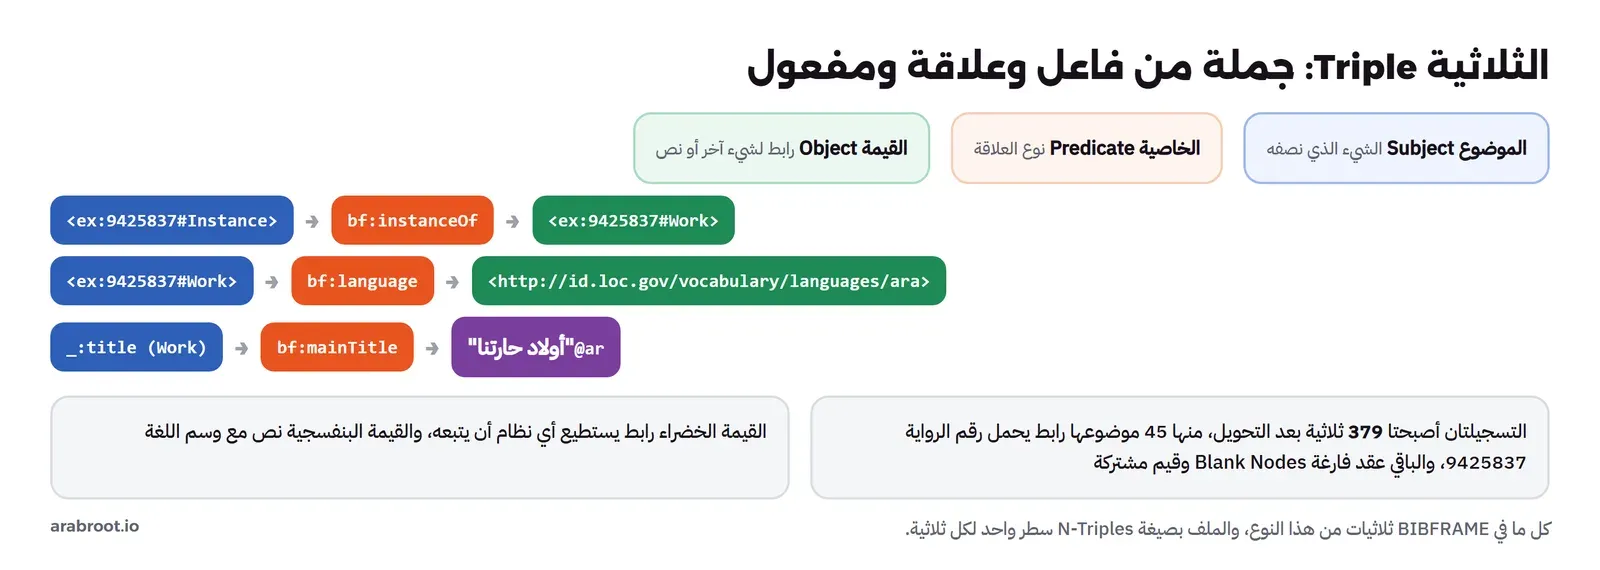
الثلاثية جملة: هذه النسخة المنشورة هي نسخة من هذا العمل
## المختبر: نحول تسجيلتين حقيقيتين
الآن سوف نقوم بالتحويل الفعلي. ونبدأ من ملف `records.xml` الذي صنعناه في مقال MARC21، وفيه تسجيلتا «أولاد حارتنا» وترجمتها الإنجليزية «Children of the alley» بصيغة MARCXML كما جاءتا من مكتبة الكونغرس. ونستخدم الـ Container نفسه من Debian 13، وأضفنا إليه حزمة `raptor2-utils` التي فيها الأداة [rapper](https://librdf.org/raptor/rapper.html?ref=arabroot.io) لقراءة RDF وتحويله بين صيغه:
```dockerfile
FROM marc-lab
RUN apt-get update && apt-get install -y --no-install-recommends raptor2-utils && rm -rf /var/lib/apt/lists/*
```
```bash
docker build -t marc-lab-rdf -f lab/Dockerfile.rdf lab/
docker run --rm marc-lab-rdf sh -c 'rapper --version; xsltproc --version | head -1'
```
```text
2.0.16
Using libxml 20914, libxslt 10135 and libexslt 820
```
ثم نجلب أدوات التحويل الرسمية من مكتبة الكونغرس بالملف `lab/setup.sh`: مستودع [marc2bibframe2](https://github.com/lcnetdev/marc2bibframe2?ref=arabroot.io) بالإصدار v3.1.0، وملفا XSLT للتحويل من MARC إلى Dublin Core:
```bash
set -e
mkdir -p dl
git clone -q --depth 1 --branch v3.1.0 https://github.com/lcnetdev/marc2bibframe2.git dl/marc2bibframe2
git -C dl/marc2bibframe2 log -1 --format='%h %cs'
for f in MARC21slim2OAIDC.xsl MARC21slimUtils.xsl; do curl -s -o dl/$f https://www.loc.gov/standards/marcxml/xslt/$f; done
sed 's#http://www.loc.gov/standards/marcxml/xslt/MARC21slimUtils.xsl#MARC21slimUtils.xsl#' dl/MARC21slim2OAIDC.xsl > dl/oaidc-local.xsl
```
```text
ed9abb0 2026-04-16
```
ولاحظ السطر الأخير مع `sed`، فهو لم يكن في المحاولة الأولى. ملف `MARC21slim2OAIDC.xsl` يستورد ملفاً مساعداً من عنوان `http://` على موقع مكتبة الكونغرس، وعندما شغلناه كما هو كانت النتيجة كما يلي:
```text
error : Unknown IO error
warning: failed to load external entity "http://www.loc.gov/standards/marcxml/xslt/MARC21slimUtils.xsl"
compilation error: file dl/MARC21slim2OAIDC.xsl line 3 element import
xsl:import : unable to load http://www.loc.gov/standards/marcxml/xslt/MARC21slimUtils.xsl
```
والسبب أن الموقع يحول طلبات `http` إلى `https`، وأن xsltproc لا يجلب الملفات عبر `https` عند الاستيراد، فيفشل التحويل كله بسطر واحد. والحل الذي جربناه أن ننزل الملف المساعد بأنفسنا ونجعل الاستيراد يشير إلى النسخة المحلية، وهذا أفضل على أي حال، لأن التحويل لا يجب أن يعتمد على موقع خارجي كلما شغلته.
## التحويل إلى Dublin Core
ملف التحويل الرسمي يقرأ MARCXML ويخرج `oai_dc`، أي الصيغة التي يرسلها المستودع لأي حاصد:
```bash
xsltproc dl/oaidc-local.xsl records.xml > dc.xml
```
والمخرج سوف يكون كما يلي، بعد حذف تكرار تعريف النطاق `xmlns:dc` من كل سطر للاختصار:
```xml
Awlād ḥāratinā : riwāyah /
880-01
Maḥfūẓ, Najīb,
1911-2006,
author.
text
ara
Arabic fiction
Children of the alley /
Maḥfūẓ, Najīb,
1911-2006.
Theroux, Peter.
text
...
New York : Doubleday,
1996.
eng
Families
URN:ISBN:0385420943
URN:ISBN:9780385420945
```
وقبل أن تقرأ الملاحظات، قارن الوصفين: الرواية العربية، وهي التسجيلة الأحدث والمفهرسة بقواعد RDA، خرجت بخمسة عناصر فقط، والترجمة الإنجليزية الأقدم خرجت بوصف أكمل. والصورة التالية تجمع ما بقي وما ضاع:
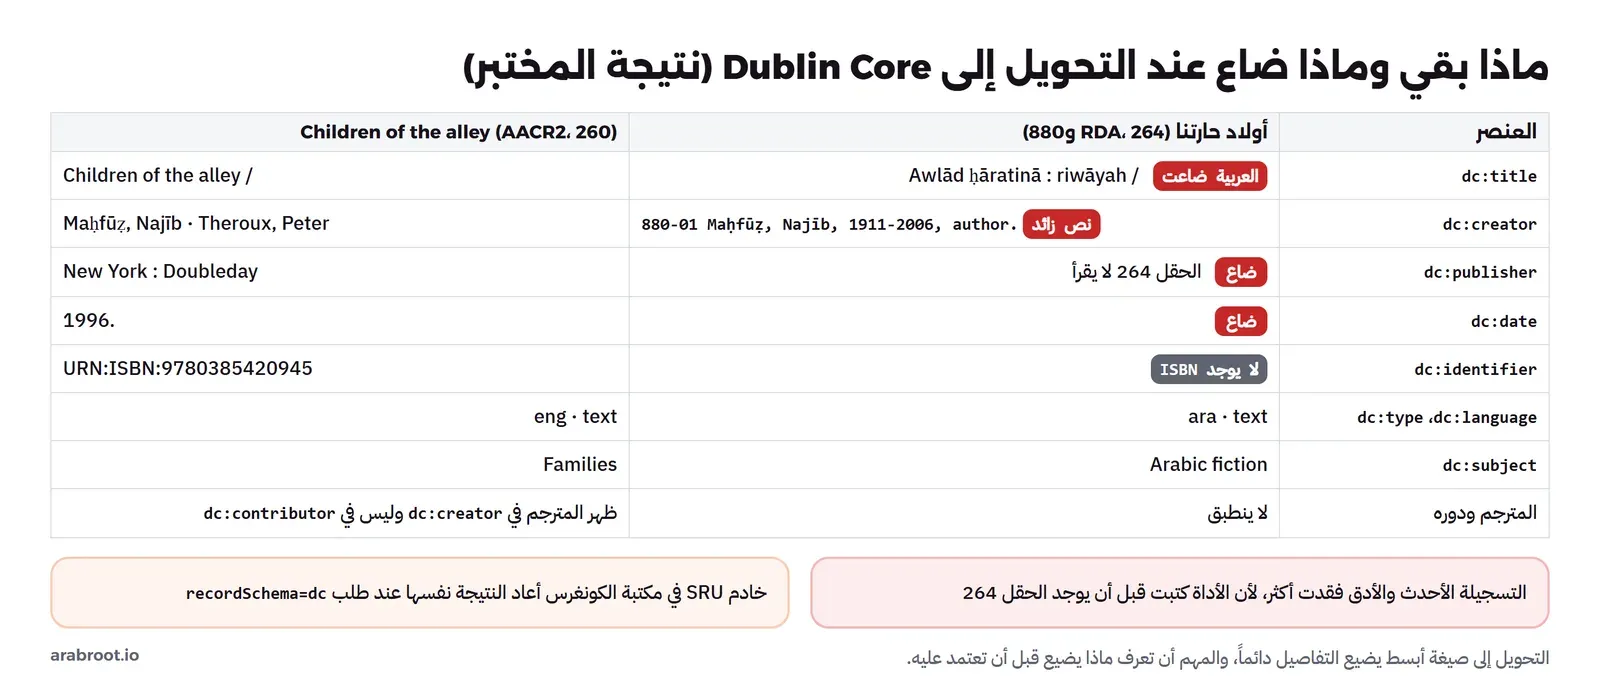
الوصف الأدق فقد أكثر، لأن أداة التحويل أقدم من الحقل الذي يحمل النشر في RDA
في المخرج والصورة لاحظ التالي:
- **الناشر والتاريخ ضاعا من التسجيلة العربية**، والسبب أن ملف التحويل يقرأ الحقل 260 فقط، وتسجيلات RDA تضع النشر في 264\. وتاريخ آخر تعديل مكتوب في رأس الملف نفسه هو 2010، أي قبل أن يضاف الحقل 264 إلى MARC21\. وهذا يعني أن مستودعاً يصدر تسجيلاته الحديثة بهذه الأداة كما هي يرسل للحاصدين أوصافاً بلا ناشر ولا تاريخ، والقارئ في البوابة لن يعرف سنة الكتاب.
- **العربية ضاعت كلها**، فالأداة لا تقرأ الحقل 880، فالعنوان في Dublin Core «Awlād ḥāratinā» فقط، والقارئ العربي الذي يبحث في بوابة تحصد هذه السجلات بكلمة «حارتنا» لن يجدها.
- **المنشئ فيه «880-01»**، لأن الأداة تجمع كل الحقول الفرعية في 100 بما فيها `$6` الذي يربط بالحقل 880، وهو رقم داخلي لا معنى له خارج MARC، ومعه «author.» وهي كلمة الدور من `$e`، فالمنشئ أصبح نصاً فيه رقم ودور واسم وتاريخ.
- **المترجم أصبح منشئاً**، فبيتر ثيرو ظهر في `dc:creator` مثل نجيب محفوظ، لأن الأداة تضع كل الحقول 100 و700 في المنشئ، ولا يوجد في Dublin Core البسيط مكان للدور أصلاً.
وللتأكد أن هذه ليست مشكلة في نسختنا من الأداة، طلبنا التسجيلة العربية نفسها من خادم SRU في مكتبة الكونغرس بصيغة Dublin Core مباشرة، بالملف `lab/run2.sh`:
```bash
curl -s "http://lx2.loc.gov:210/LCDB?operation=searchRetrieve&version=1.1&maximumRecords=1&query=bath.lccn=ne68001830&recordSchema=dc"
```
```xml
Awlād ḥāratinā : riwāyah /
880-01 Maḥfūẓ, Najīb, 1911-2006, author.
text
ara
Arabic fiction--20th century.
```
النتيجة نفسها تقريباً من خادم مكتبة الكونغرس: «880-01» في المنشئ، ولا ناشر ولا تاريخ ولا عربية، والفرق الوحيد أن الموضوع جاء بتقسيمه الزمني. ولاحظ أيضاً أن الحروف اللاتينية الموسومة مرسلة مفككة، أي الحرف ثم العلامة المركبة `̄`، وهي المشكلة نفسها التي رأيناها مع الهمزة العربية في مقال MARC21\. والدرس أن التحويل إلى Dublin Core ليس عملية آمنة تثق بها، وإنما خطوة تختبرها بتسجيلاتك أنت قبل أن تعتمد عليها، وإذا كان مستودعك أو نظامك يصدر `oai_dc` من تسجيلات MARC، فافتح عينة عربية حديثة من المخرج، وابحث عن الناشر والتاريخ والعنوان العربي.
💡
إذا احتجت تحويلاً أدق، فعدل نسختك المحلية من ملف XSLT لتقرأ 264 مع 260، و880 لتضيف العنوان العربي كعنصر `dc:title` ثان، وتحذف `$6` و`$e` من المنشئ. وهذا تعديل صغير على ملف XSLT، وهو أحد أسباب أن تبقي الملف محلياً كما فعلنا.
## MODS: الطريق الوسط بين MARC وDublin Core
بين MARC الغني الصعب وDublin Core البسيط الفقير يوجد معيار ثالث من مكتبة الكونغرس اسمه [MODS](https://www.loc.gov/standards/mods/?ref=arabroot.io)، أي مخطط وصف البيانات الوصفية للأشياء Metadata Object Description Schema، وهو XML بأسماء عناصر مفهومة مثل `titleInfo` و`name` و`originInfo`، ولكنه يحفظ أغلب ما في MARC. والملف `lab/run2.sh` طلب التسجيلة العربية نفسها من خادم SRU بصيغة MODS، وهذا جزء مما وصل:
```xml
Awlād ḥāratinā
riwāyah
أولاد حارتنا :
...
Bayrūt :
Dār al-Ādāb,
publisher
[1967]
```
في الجزء أعلاه لاحظ التالي:
- **العربية موجودة** في `titleInfo` ثان عليه `script="Arab"`، ومربوط بالعنوان اللاتيني بالقيمة نفسها `altRepGroup="02"`، وهي الترجمة المباشرة لرقم الربط في `$6 880-02`. والرموز `أ` في بداية العنوان هي الألف ثم الهمزة المركبة، أي «أ» المفككة التي رأيناها في مقال MARC21.
- **الناشر والتاريخ موجودان** في `originInfo` مع دور الناشر، وبالحرفين، أي أن MODS قرأ الحقل 264 وحقله 880، بعكس Dublin Core من الخادم نفسه.
- والأسماء في MODS لها أدوار `roleTerm`، والمواضيع لها مصدرها `authority="lcsh"` وتقسيمها الزمني في عنصر مستقل.
لذلك إذا احتاج مستودعك أو بوابتك صيغة XML مفهومة تحفظ العربية والأدوار، ولم تكن مستعداً لـ BIBFRAME، فـ MODS خيار عملي، وكثير من المستودعات تقدمه عبر OAI-PMH بجانب `oai_dc`.
## التحويل إلى BIBFRAME بأداة marc2bibframe2
أداة marc2bibframe2 هي التحويل الرسمي الذي تستخدمه مكتبة الكونغرس، وهي مجموعة ملفات XSLT 1.0 تعمل بأي معالج XSLT مثل xsltproc، ومواصفاتها منشورة في صفحة [MARC to BIBFRAME Conversion](https://www.loc.gov/bibframe/mtbf/?ref=arabroot.io). ويوصي دليلها بخطوة معالجة أولية Preprocessing تقسم التسجيلة الواحدة إلى عدة تسجيلات إذا كانت تصف أكثر من نسخة منشورة، ثم التحويل نفسه، ثم نحول الناتج إلى N-Triples لنعد الثلاثيات، وهذا هو الملف `lab/run.sh`:
```bash
set -e
S=$(date +%s%N)
M=dl/marc2bibframe2/xsl
xsltproc $M/ConvSpec-Preprocess0-Splitting.xsl records.xml > pre.xml
grep -c " bf.rdf
echo "convert ms: $(( ($(date +%s%N)-S)/1000000 ))"
rapper -q -i rdfxml -o ntriples bf.rdf > bf.nt
wc -l < bf.nt
xsltproc dl/oaidc-local.xsl records.xml > dc.xml
```
```text
2
No 'idsource' runtime value provided. No agent identified as the actor converting the record.
No 'idsource' runtime value provided. No agent identified as the actor converting the record.
convert ms: 1426
379
```
في المخرج أعلاه لاحظ التالي:
- المعالجة الأولية أبقت التسجيلتين اثنتين، لأن كل واحدة تصف طبعة واحدة.
- الرسالة «No 'idsource' runtime value provided» تحذير وليست خطأ، ومعناها أننا لم نخبر الأداة بمصدر رقم التسجيلة المحلي في الحقل 001، فلن تكتب في البيانات الإدارية من أعطى هذا الرقم. وفي مكتبتك مرر رابط مكتبتك بالخيار `--stringparam idsource`، كما في مثال دليل الأداة الذي يمرر رابط مكتبة الكونغرس في قائمة المنظمات، حتى يعرف من يقرأ البيانات بعد سنوات من أين جاء الرقم.
- `baseuri` هو بداية الروابط التي تصنعها الأداة للكيانات الجديدة، وجعلناه `http://library.example.org/`، وفي الإنتاج يكون نطاقاً تملكه مكتبتك، لأن هذه الروابط يجب أن تبقى ثابتة.
- التحويل كله استغرق حوالي ثانية ونصف لتسجيلتين، وفي محاولة أولى في اليوم نفسه استغرق 2.4 ثانية، وأغلب الوقت تحميل ملفات XSLT نفسها، فالتحويل الدفعي لآلاف التسجيلات في ملف واحد أسرع بكثير من تسجيلة في كل مرة.
- التسجيلتان أصبحتا 379 ثلاثية، أي حوالي 190 ثلاثية لكل كتاب، مقابل حوالي ثلاثين حقلاً في تسجيلة MARC. والسبب أن كل شيء أصبح كياناً بعلاقات: العنوان كيان له نوع، والمساهمة كيان له دور، والبيانات الإدارية كيانات.
### قراءة الناتج بصيغة Turtle
صيغة N-Triples مناسبة للبرامج، ولكنها صعبة القراءة، لذلك حولنا الناتج إلى صيغة Turtle التي تجمع ثلاثيات الشيء الواحد معاً، بالملف `lab/turtle.sh`، ثم فككنا رموز Unicode التي يكتبها rapper بالشكل `\uXXXX` حتى تظهر العربية، وهذا جزء النسخة المنشورة من الرواية العربية:
```text
bf:carrier ;
bf:dimensions "25 cm" ;
bf:extent [
a bf:Extent ;
rdfs:label "552 pages"
] ;
bf:identifiedBy [
a bf:Local ;
rdf:value "9425837"
], [
a bf:Lccn ;
rdf:value "ne 68001830 "
] ;
bf:instanceOf ;
bf:issuance ;
bf:media ;
bf:provisionActivity [
bflc:simpleAgent "Dār al-Ādāb", "دار الآداب،"@ar ;
bflc:simpleDate "[1967]", "[1967]"@ar ;
bflc:simplePlace "Bayrūt", "بيروت :"@ar ;
a bf:ProvisionActivity, bf:Publication
], [
bflc:simpleAgent "Dār al-Ādāb", "دار الآداب،"@ar ;
bflc:simpleDate "[1967]", "[1967]"@ar ;
bflc:simplePlace "Bayrūt", "بيروت :"@ar ;
bf:date "1967"^^ ;
bf:place ;
a bf:ProvisionActivity, bf:Publication
] ;
bf:responsibilityStatement "Najīb Maḥfūẓ", "نجيب محفوظ"@ar ;
bf:title [
bf:mainTitle "Awlād ḥāratinā", "أولاد حارتنا :"@ar ;
bf:subtitle "riwāyah", "رواية /"@ar ;
a bf:Title
] ;
a bf:Instance .
```
في الناتج أعلاه لاحظ التالي:
- **العربية بقيت هنا**، بعكس Dublin Core، فكل قيمة لها نسختان: لاتينية دون وسم، وعربية بالوسم `@ar`، والأداة قرأت الحقول 880 وربطتها بحقولها الأصلية. وهذا وحده سبب كاف لتفضيل BIBFRAME على Dublin Core إذا كانت بياناتك عربية.
- **الحرف اللاتيني نظف من ترقيم ISBD والعربي لم ينظف**: «Awlād ḥāratinā» دون « :»، و«أولاد حارتنا :» مع النقطتين، و«دار الآداب،» مع الفاصلة. والسبب على الأرجح علامات الاتجاه `U+200F` غير المرئية في نهاية النص العربي، فالأداة تبحث عن الترقيم في آخر النص فتجد علامة الاتجاه بدلاً منه. وهذه النتيجة تظهر للقارئ إذا عرضت البوابة القيمة العربية كما هي.
- **بيان النشر تكرر مرتين**، مرة من 264 ومرة بإضافة التاريخ ورمز البلد `le` من 008، وهذا من طبيعة التحويل الآلي، والبرنامج الذي يعرض البيانات يحتاج أن يختار واحدة.
- **الأشياء المعروفة أصبحت روابط**: نوع الحامل `carriers/nc`، ونوع الوسيط، وبلد النشر، واللغة، كلها روابط إلى مفردات مكتبة الكونغرس في id.loc.gov، لأن التسجيلة كانت تحمل رموزها في 008 و336 إلى 338.
وقد تسأل لماذا لا تنظف الأداة الترقيم العربي كما تنظف اللاتيني؟ والأرجح أن من كتبها اختبرها على نصوص لاتينية في أغلبها، وهذا تذكير بأن أدوات المكتبات الدولية تحتاج من يختبرها بالعربية ويبلغ مطوريها بما يجده، فالمستودع مفتوح على GitHub ويقبل البلاغات.
ووسم اللغة له فائدة عملية تتجاوز الشكل، فواجهة البحث التي تقرأ هذه البيانات تستطيع أن تعرض للقارئ الذي اختار العربية القيمة الموسومة `@ar`، وللقارئ الإنجليزي القيمة اللاتينية، وتستطيع أن تفهرس كل قيمة بمحلل لغتها، فتطبق على العربية التوحيد وإزالة «ال» وتطبق على اللاتينية إزالة العلامات، بدلاً من أن تخلط القيم في حقل واحد كما يحدث مع 245 و880 في كثير من الفهارس. وهذا ما يجعل البحث العربي ممكناً دون أن يحتاج المبرمج أن يعرف أرقام MARC، وقد شرحنا تحليل النص العربي في محركات البحث في مقال [البحث في النصوص العربية](https://arabroot.io/articles/%D8%A7%D9%84%D8%A8%D8%AD%D8%AB-%D9%81%D9%8A-%D8%A7%D9%84%D9%86%D8%B5%D9%88%D8%B5-%D8%A7%D9%84%D8%B9%D8%B1%D8%A8%D9%8A%D8%A9-%D9%85%D8%B9-opensearch-%D9%88-meilisearch/).
أما المؤلف فالقصة مختلفة، فهذا هو الكيان الذي صنعته الأداة له:
```text
bflc:marcKey "1001 $6880-01$aMaḥfūẓ, Najīb,$d1911-2006,$eauthor.", "8801 $6100-01/(3/r$aمحفوظ، نجيب،$d1911-2006,$eauthor."@ar ;
a bf:Agent, bf:Person ;
rdfs:label "Maḥfūẓ, Najīb, 1911-2006", "محفوظ، نجيب، 1911-2006"@ar .
```
المؤلف أصبح كياناً برابط محلي `#Agent100-13`، أي «الشخص في الحقل 100 من هذه التسجيلة»، واسمه نص، ولا يوجد فيه رابط إلى ملف الإسناد. وفي تسجيلة الترجمة الإنجليزية صنعت الأداة كياناً آخر `3978552#Agent100-18` للشخص نفسه، فأصبح نجيب محفوظ كيانين لا يعرف البرنامج أنهما واحد. والسبب أن التسجيلتين القديمتين لا تحملان في 100 الحقل الفرعي `$0` أو `$1` برابط الشخص، والأداة لا تخترع الرابط، وإنما تنقل ما في التسجيلة. ولاحظ أيضاً في الترجمة أن بيتر ثيرو أخذ الدور `relators/ctb` أي «مساهم»، وليس «مترجم»، لأن تسجيلة AACR2 لا تكتب الدور في 700، فلم تجد الأداة غير الدور العام.
وفي الترجمة شيء جميل أيضاً: الحقل 240 الذي يشير إلى العمل الأصلي أصبح كياناً من نوع `bf:Hub`، والعمل الإنجليزي يرتبط به بعلاقة `bf:expressionOf`:
```text
bflc:marcKey "1001 $aMaḥfūẓ, Najīb,$d1911-2006.$tAwlād al-ḥāratinā.$lEnglish" ;
...
bf:title [
bf:mainTitle "Awlād al-ḥāratinā. English" ;
a bf:Title
] ;
a bf:Hub .
```
وهذا بالضبط ما كان MARC يكتبه نصاً يفهمه الإنسان، وأصبح علاقة يفهمها البرنامج: هذا العمل الإنجليزي تعبير عن «أولاد حارتنا». ولكن لاحظ أن الـ Hub هنا محلي أيضاً، فلا يعرف البرنامج أنه الرواية العربية في التسجيلة الأخرى إلا إذا طابق النصوص.
## ماذا يحدث إذا كانت التسجيلة تحمل روابط؟
لكي نختبر الفرض الذي ذكرناه، حولنا تسجيلة حديثة تحمل الروابط، كتاب «المخطوطات في السعودية» من 2024، وفي الحقل 100 منها `$0` و`$1` برابط المؤلف كما رأينا في مقال قواعد RDA. وجلبناها من خادم SRU بصيغة MARCXML، واستخرجنا التسجيلة من غلاف الاستجابة بأداة `xmllint`، لأن marc2bibframe2 أعاد صفر ثلاثيات في المحاولة الأولى عندما أعطيناه الاستجابة كما هي بغلاف SRU، ثم حولناها:
```bash
B="http://lx2.loc.gov:210/LCDB?operation=searchRetrieve&version=1.1&maximumRecords=1"
curl -s "$B&query=bath.isbn=9786030525560&recordSchema=marcxml" > saudi-sru.xml
xmllint --xpath '//*[local-name()="record" and namespace-uri()="http://www.loc.gov/MARC21/slim"]' saudi-sru.xml > saudi.xml
xsltproc dl/marc2bibframe2/xsl/marc2bibframe2.xsl saudi.xml > saudi.rdf 2>/dev/null
rapper -q -i rdfxml -o ntriples saudi.rdf > saudi.nt
wc -l < saudi.nt
grep -E 'bibframe/agent>' saudi.nt
```
```text
198
_:genid1 .
_:genid3 .
_:genid9 .
```
هذه المرة المؤلف ليس كياناً محلياً، وإنما الرابط العام `http://id.loc.gov/rwo/agents/n2009221499`، أي الشخص نفسه كما تعرفه مكتبة الكونغرس، وأي مكتبة في العالم تحول تسجيلة لكتاب آخر له وفيها الرابط نفسه، يعرف برنامجها آلياً أنه الشخص نفسه. والدرس هنا مهم لمن يخطط للانتقال: جودة BIBFRAME الذي تحصل عليه تعتمد على جودة MARC الذي تبدأ منه، وأهم ما تفعله اليوم في فهرسك، حتى لو لم تنتقل أبداً، أن تضيف روابط الإسناد `$0` إلى حقول المؤلفين والموضوعات، وهذا موضوع مقال ملفات الإسناد.
وقد يتساءل البعض: فهرسي فيه عشرون ألف تسجيلة بلا روابط، فهل أضيفها يدوياً؟ والإجابة أن لا، فإضافة الروابط عمل دفعي: يطابق برنامج أسماء المؤلفين في الحقل 100 بملف الإسناد، فإذا وجد تطابقاً واحداً مؤكداً أضاف `$0`، وإذا وجد أكثر من تطابق أو لم يجد شيئاً وضع التسجيلة في قائمة يراجعها المفهرس. وهذه المطابقة نفسها ليست سهلة مع الأسماء العربية، لأن الاسم الواحد له عشرات الأشكال، وقد قسنا في مقال ملفات الإسناد كم اسماً يطابق إذا استخدمت الشكل المعتمد وحده، وكم يطابق إذا أضفت الإحالات والتوحيد، والفرق كبير.
## ماذا تنشر مكتبة الكونغرس نفسها؟
في مقال قواعد RDA رأينا في تسجيلة الكتاب نفسه الحقل `884 $a DLC bibframe2marc v3.2-dev`، أي أن مكتبة الكونغرس أنشأت الوصف أصلاً في BIBFRAME، ثم حولته إلى MARC بأداة [bibframe2marc](https://github.com/lcnetdev/bibframe2marc?ref=arabroot.io) حتى تستطيع المكتبات الأخرى نسخه. والمكتبة تنشر الأصل في id.loc.gov، فجلبنا العمل والنسخة المنشورة بصيغة N-Triples بالملف `lab/lc-bf.sh`:
```bash
UA='arabroot-lab/1.0 (hello@arabroot.io)'
curl -s -A "$UA" -o lc-work.nt https://id.loc.gov/resources/works/in00024491626.nt
curl -s -A "$UA" -o lc-instance.nt https://id.loc.gov/resources/instances/in00024491626.nt
wc -l lc-work.nt lc-instance.nt
grep -h -E 'bibframe/(agent|role)> .
_:b50httpc0liddOtlocdOtgovresourcesworksin00024491626 .
"al-Makhṭūṭāt fī al-Saʻūdīyah" .
"المخطوطات في السعودية"@ar-arab .
"al-Makhṭūṭāt fī al-Saʻūdīyah" .
"المخطوطات في السعودية"@ar-arab .
```
في المخرج أعلاه لاحظ التالي:
- العمل والنسخة المنشورة ملفان منفصلان برابطين، `resources/works/` و`resources/instances/`، وفيهما معاً 424 ثلاثية، بينما صنع تحويلنا من MARC للكتاب نفسه 198 ثلاثية فقط، فالوصف الأصلي أغنى من الوصف المحول.
- المؤلف رابط عام بالدور `relators/aut` كرابط أيضاً، وليس كلمة «author».
- العنوان العربي موسوم `@ar-arab`، أي العربية بالحرف العربي، بينما وسمه تحويلنا `@ar` فقط، والوسم الأدق يفرق بين العربية بحرفها والعربية المرومنة، وهو فرق مهم لمحرك بحث يريد أن يعرف أي القيمتين يعرض للقارئ العربي.
- العنوان العربي في بيانات مكتبة الكونغرس دون ترقيم ISBD ودون علامات اتجاه، بعكس تحويلنا، لأنه كتب في BIBFRAME أصلاً ولم يمر بتحويل من 880.
وقد حاولنا أن نأخذ صورة لصفحة هذا العمل في id.loc.gov من المتصفح، فظهرت صفحة تحقق من Cloudflare، والملفات بصيغة `.nt` و`.marcxml.xml` وصلت دون مشكلة بطلبات قليلة باسم مستخدم واضح، فإذا بنيت أداة تجلب من id.loc.gov فاستخدم هذه الصيغ مباشرة، وأبطئ الطلبات.
## من يستخدم ماذا اليوم؟
بعد كل ما سبق قد يبدو أن BIBFRAME هو المستقبل وأن عليك أن تنتقل غداً، ولكن الصورة الحقيقية أكثر هدوءاً، والصورة التالية تضع كل معيار في مكانه في مكتبة جامعية:
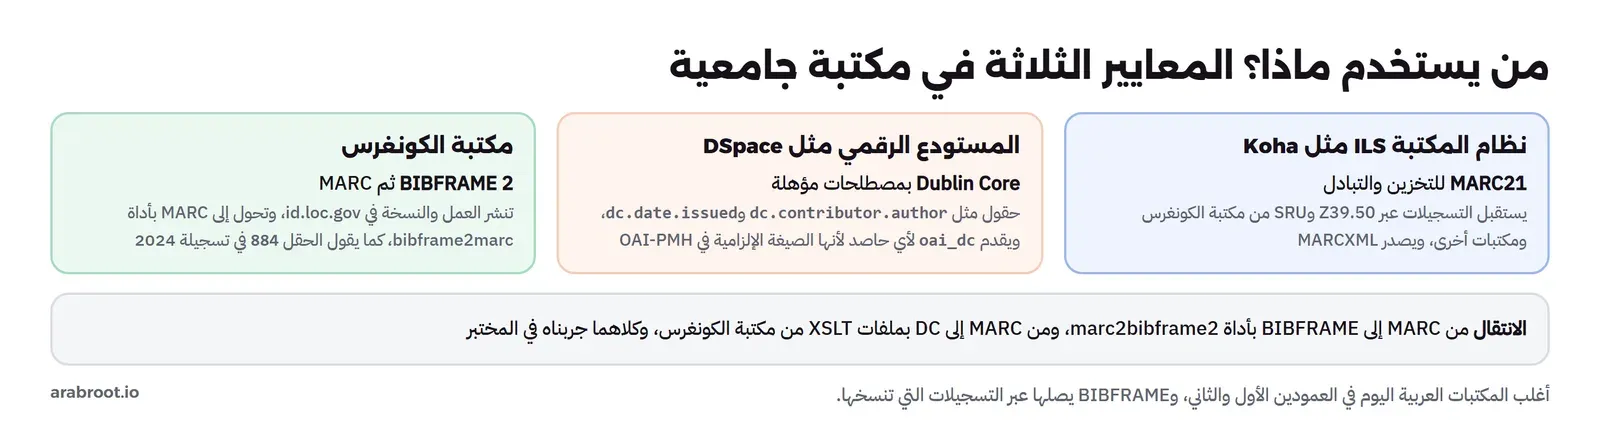
كل معيار في المكان الذي يناسبه، والتحويل بينها أدوات وليست قرارات
- **نظام المكتبة يبقى على MARC21:** Koha وأنظمة المكتبات الأخرى تخزن MARC وتتبادله، والتسجيلات التي تنسخها من مكتبة الكونغرس تصلك MARC حتى لو أنشئت في BIBFRAME، لأن مكتبة الكونغرس نفسها تحولها لكم.
- **المستودع يبقى على Dublin Core:** DSpace يصف الرسائل والأبحاث بـ Dublin Core المؤهل، ويقدم `oai_dc` لكل حاصد، وهذا مناسب لطبيعة الإيداع الذاتي، وقد شرحنا سجلاته وحصاده في دليل DSpace.
- **BIBFRAME للمكتبات الكبرى ومشاريع البيانات المترابطة:** مكتبة الكونغرس تفهرس به وتنشره، وأدوات التحويل مفتوحة، والمكتبة العربية التي تريد أن تنشر فهرسها كبيانات مترابطة، أو تشارك في مشروع وطني لذلك، تستطيع أن تبدأ بتحويل MARC الموجود كما فعلنا هنا.
ولاحظ أن هذه الأعمدة ليست منفصلة في الواقع، فالبوابة التي تجمعها تقرأ MARC من النظام وDublin Core من المستودع في وقت واحد، وتحتاج أن تفهم الاثنين وتعرض النتيجة للقارئ بشكل واحد، ولهذا تحتاج كل مكتبة شخصاً واحداً على الأقل يفهم المعايير الثلاثة ويعرف ماذا يضيع بينها، حتى لو لم تستخدم BIBFRAME في أي نظام عندها.
والقرار العملي لأغلب المكتبات العربية اليوم ليس «MARC أم BIBFRAME»، وإنما تحسين MARC الحالي حتى يكون جاهزاً لأي تحويل: روابط `$0` للأسماء والموضوعات، وحقول 264 و336 إلى 338 كما تطلب RDA، والعربية موحدة NFC، وأدوار صريحة في `$e`. فهذه هي الأشياء التي رأينا في المختبر أنها تحدد جودة ما يخرج من التحويل، إلى Dublin Core أو إلى BIBFRAME.
## هل تحتاج مكتبتك أن تنتقل إلى BIBFRAME؟
السؤال الذي يصل في النهاية إلى مدير المكتبة أو مسؤول تقنية المعلومات: هل نبدأ مشروع انتقال؟ والإجابة الصادقة لأغلب المكتبات العربية اليوم: ليس بعد، ولكن جهز بياناتك، والسبب أن الانتقال الكامل يحتاج ثلاثة أشياء غير متوفرة في أغلب المكتبات. الأول نظام مكتبة يخزن BIBFRAME ويعمل به في الفهرسة والإعارة والبحث، وأنظمة المكتبات المفتوحة المصدر الشائعة ما زالت مبنية على MARC. والثاني محرر فهرسة يعمل بالكيانات والروابط، والمفهرسون مدربون عليه. والثالث مصدر للروابط، أي ملف إسناد للأسماء والموضوعات يعطي كل مؤلف عربي رابطاً ثابتاً، وأغلب الأسماء العربية المحلية ليس لها سجل في ملف دولي.
ولكن هناك حالات يكون فيها BIBFRAME أو البيانات المترابطة عموماً مفيدة الآن، دون انتقال كامل:
- **نشر الفهرس كبيانات مفتوحة:** مكتبة وطنية أو جامعية تريد أن يجد الباحثون وأدوات الويب مقتنياتها العربية، تستطيع أن تحول تصديراً دورياً من MARC إلى BIBFRAME وتنشره، بينما يبقى العمل اليومي في النظام الحالي.
- **بوابة تجمع مصادر مختلفة:** بوابة تجمع كتب المكتبة ورسائل المستودع ووثائق الأرشيف، تستفيد من نموذج يربط الأشخاص بروابط بدلاً من مطابقة النصوص، وهذا ما شرحناه في مقال واجهة البحث Discovery.
- **مشروع وطني للأسماء:** إذا بدأت مكتبات بلد عربي ملف إسناد مشتركاً للأسماء، فكل رابط يضاف إلى تسجيلاتها اليوم يجعل أي تحويل في المستقبل أفضل، كما رأينا في الفرق بين تسجيلة 1967 وتسجيلة 2024.
وأي مشروع من هذه يبدأ بالخطوة نفسها التي فعلناها في هذا المقال: حول عينة صغيرة، وافتح الناتج بعينك، واكتب ما ضاع وما تكرر وما بقي نصاً بدلاً من أن يكون رابطاً، ثم قرر.
## أخطاء شائعة عند التحويل بين المعايير
| الخطأ | ما رأيناه في المختبر | الحل |
| ------------------------------------------ | ---------------------------------------------------- | ------------------------------------------------------ |
| الثقة بملف XSLT قديم للتحويل إلى DC | تسجيلة RDA دون ناشر ولا تاريخ | اختبر عينة حديثة، وعدل نسختك المحلية لتقرأ 264 |
| تجاهل الحقل 880 في التحويل | العنوان العربي غير موجود في DC | أضف 880 كعناصر إضافية بوسم اللغة، أو استخدم صيغة تحفظه |
| استيراد XSLT من عنوان http خارجي | unable to load ... MARC21slimUtils.xsl | نزل الملفات المساعدة واستوردها محلياً |
| تمرير استجابة SRU كاملة إلى marc2bibframe2 | صفر ثلاثيات دون رسالة خطأ | استخرج عنصر record بأداة XPath أولاً |
| تحويل تسجيلات دون روابط إسناد | نجيب محفوظ كيانان محليان لا يعرف البرنامج أنهما واحد | أضف $0 في MARC قبل التحويل |
| baseuri مؤقت في الإنتاج | روابط library.example.org في البيانات | نطاق تملكه المكتبة ولا يتغير |
## قائمة تحقق قبل أن تصدر بياناتك بصيغة جديدة
1. اختر عشر تسجيلات تمثل فهرسك: عربية وإنجليزية، قديمة بـ AACR2 وحديثة بـ RDA، ومترجمة ومحققة.
2. حولها وافتح المخرج بعينك، وابحث فيه عن الناشر والتاريخ والعنوان العربي والمترجم.
3. عد العناصر أو الثلاثيات قبل وبعد، فالتسجيلة التي تخرج بخمسة عناصر فقدت شيئاً.
4. ابحث عن الأرقام الداخلية مثل «880-01» في النصوص، فهي علامة على أداة تنقل حقولاً فرعية لا معنى لها خارج MARC.
5. ابحث عن ترقيم ISBD في نهايات القيم، وخاصة العربية.
6. تأكد أن الروابط التي تصنعها الأداة تبدأ بنطاق مكتبتك، وأن روابط الأشخاص والموضوعات تشير إلى ملفات معتمدة حيث يوجد `$0`.
## تدريب عملي
- عدل نسختك من `oaidc-local.xsl` لتقرأ الحقل 264 مع 260، وأعد تحويل التسجيلة العربية، وتأكد أن الناشر والتاريخ ظهرا.
- أضف إلى الحقل 100 في التسجيلة العربية الحقل الفرعي `$1 http://id.loc.gov/rwo/agents/n82091918` في نسخة من MARCXML، وأعد التحويل إلى BIBFRAME، ثم ابحث عن `bibframe/agent` في الناتج.
## الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Dublin Core خمسة عشر عنصراً اختيارياً يفهمها أي نظام، وهو صيغة الحصاد الإلزامية في OAI-PMH، ولكنه لا يعرف الأدوار ولا الترتيب، ومصطلحات DCMI تضيف دقة يحتاجها المستودع.
- التحويل الرسمي من MARC إلى Dublin Core أضاع من تسجيلة RDA العربية الناشر والتاريخ والعربية كلها، وأضاف «880-01» إلى المنشئ، وخادم مكتبة الكونغرس أعطى النتيجة نفسها.
- BIBFRAME يصف العمل والنسخة المنشورة والمادة ككيانات مرتبطة بثلاثيات RDF، وحفظ العربية بوسم اللغة، ولكن المؤلف بقي نصاً محلياً لأن التسجيلات القديمة لا تحمل روابط.
- التسجيلة التي تحمل `$0` و`$1` تحولت إلى رابط عام للشخص، فجودة BIBFRAME تعتمد على جودة MARC الذي تبدأ منه.
- مكتبة الكونغرس تفهرس في BIBFRAME وتحول إلى MARC، ووصفها الأصلي أغنى من أي تحويل، وأغلب المكتبات العربية تبقى على MARC في النظام وDublin Core في المستودع، وتجهز بياناتها للتحويل بالروابط والتوحيد.
وفي المقال التالي من هذه المرحلة بإذن الله سوف نتحدث عن ملفات الإسناد نفسها، أي الروابط التي رأينا أنها تصنع الفرق كله: كيف تبحث فيها، وكيف تطابق أسماء المؤلفين العرب في فهرسك بها.
## سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتجربة التحويل بأداة marc2bibframe2 v3.1.0 وملفات XSLT من مكتبة الكونغرس مع xsltproc (libxslt 1.1.35) وrapper 2.0.16 على تسجيلات حقيقية.