> ## Content Index
> Fetch the complete content index at: https://arabroot.io/llms.txt
> Use this file to discover other available public pages before exploring further.
# HTTP وHTTPS ببساطة: ماذا يحدث بين الرابط والصفحة
- URL: https://arabroot.io/articles/http-و-https-للمبتدئين/
- Published: 2026-10-05T17:30:00.000Z
- Updated: 2026-10-09T09:42:41.000Z
- Description: ماذا يحدث بين كتابة الرابط وظهور الصفحة، وكيف تقرأ الطلب والرد ورموز مثل 502 و504، ولماذا يكلف الاتصال الجديد أكثر.
- Author: فريق عرب رووت
- Tags: الأدلة التقنية, الشبكات والبنية التحتية, الشبكات والوصول, الاستضافة الذاتية
كل ما تفعله في المتصفح يمر عبر بروتوكول واحد، فعندما تفتح صفحة أو ترسل نموذجاً أو يطلب تطبيق الجوال بياناتك من السيرفر، فإن الذي يحدث في الخلفية هو طلب HTTP يخرج من جهازك ورد HTTP يعود إليه، وقد تحمل الصفحة الواحدة عشرات الطلبات من هذا النوع. ومع ذلك فإن كثيراً من المطورين ومديري السيرفرات يتعاملون مع HTTP كصندوق مغلق إلى أن يظهر لهم خطأ 502 بعد تحديث التطبيق، أو يشتكي مستخدم من بطء صفحة سريعة على أجهزتهم، أو يكتشفون أن تطبيقهم يفتح آلاف الاتصالات إلى API خارجي دون سبب واضح. وفي كل هذه الحالات فإن الحل يبدأ من فهم ما يحمله الطلب والرد، وكيف يفتح الاتصال وكيف يعاد استخدامه.
وهذا المقال هو الأساس الذي تبني عليه بقية مقالات الويب في الموقع، فهو يشرح البروتوكول نفسه، ثم يرسل القارئ إلى المقال المتخصص عند كل موضوع له مقال مستقل، مثل التخزين المؤقت والشهادات وCORS وترويسات الأمان، وسوف نناقش في هذا المقال ما يلي:
- ماذا يحدث بين كتابة الرابط وظهور الصفحة: أجزاء الرابط URL، ثم DNS وTCP وTLS والطلب والرد.
- شكل الطلب Request والرد Response، والطرق Methods ومعنى الطريقة الآمنة Safe والطريقة المتكررة Idempotent.
- رموز الحالة Status Codes الأكثر استخداماً وما تعنيه عملياً، ومن أين يأتي 502 و504 خلف ال Reverse Proxy.
- الترويسات Headers المهمة باختصار، مع رابط المقال الذي يشرح كل واحدة منها بالتفصيل.
- HTTPS: ما الذي تضيفه طبقة TLS، وما الذي لا تخفيه.
- إعادة استخدام الاتصال Connection Reuse: ثمن الاتصال الجديد، وKeep-Alive في HTTP/1.1، وحد الاتصالات الست في المتصفح، وتعدد التدفقات Multiplexing في HTTP/2، وHTTP/3 فوق QUIC، والتفاوض عبر ALPN، ومجمع الاتصالات Connection Pool داخل كود تطبيقك.
- تجربة عملية ب Nginx وcurl وPython نرى فيها كل ما سبق بمخرجات حقيقية، ثم الأدوات والأخطاء الشائعة وقائمة تحقق.
## ماذا يحدث عندما تفتح رابطاً؟
قبل أن نتحدث عن البروتوكول نفسه لنأخذ مثالاً بسيطاً: تكتب في المتصفح رابطاً مثل `https://arabroot.io/articles/http?page=2#summary` وتضغط Enter، فتظهر الصفحة بعد جزء من الثانية. وفي هذا الجزء من الثانية يقوم المتصفح بعدة خطوات منفصلة، وكل خطوة منها لها أخطاؤها ومشكلاتها الخاصة، لذلك فإن معرفة الترتيب هي أول ما تحتاجه عندما يتعطل شيء.
### أجزاء الرابط URL
الرابط URL، أي Uniform Resource Locator، هو العنوان الكامل للمورد الذي تطلبه، ويتكون من الأجزاء التالية كما يشرحها [توثيق MDN](https://developer.mozilla.org/en-US/docs/Learn%5Fweb%5Fdevelopment/Howto/Web%5Fmechanics/What%5Fis%5Fa%5FURL?ref=arabroot.io) ومعيار [RFC 3986](https://www.rfc-editor.org/rfc/rfc3986.html?ref=arabroot.io):
- **البروتوكول Scheme:** `https` أو `http`، ويحدد هل يكون الاتصال مشفراً أم لا.
- **اسم المضيف Host:** `arabroot.io`، وهو الاسم الذي يسأل عنه المتصفح في DNS ليعرف عنوان السيرفر، ثم يرسله داخل الطلب نفسه حتى يعرف السيرفر أي موقع تريد إذا كان يستضيف أكثر من موقع.
- **المنفذ Port:** لا يكتب عادة لأن المتصفح يستخدم المنفذ الافتراضي، وهو 80 ل HTTP و443 ل HTTPS، فإذا كان الموقع على منفذ آخر وجب أن تكتبه مثل `:8443`.
- **المسار Path:** `/articles/http`، وهو المورد المطلوب داخل الموقع.
- **سلسلة الاستعلام Query String:** `?page=2`، وهي معاملات إضافية يقرؤها التطبيق.
- **المقطع Fragment:** `#summary`، وهو مكان داخل الصفحة نفسها، ولاحظ أنه لا يرسل إلى السيرفر أبداً، فالمتصفح يحتفظ به ويستخدمه بعد أن تصل الصفحة، لذلك لا تضع فيه شيئاً تتوقع أن يقرأه السيرفر.
### من DNS إلى الرد
بعد أن يفصل المتصفح أجزاء الرابط تبدأ الخطوات التالية بالترتيب:
1. **البحث في DNS:** يسأل المتصفح عن عنوان IP الخاص ب `arabroot.io`، وقد شرحنا ما يحدث في هذه الخطوة سجلاً سجلاً في [ماذا يحدث عندما تكتب اسم موقع في المتصفح؟](https://arabroot.io/articles/%D8%B4%D8%B1%D8%AD-dns-%D9%88%D8%B3%D8%AC%D9%84%D8%A7%D8%AA%D9%87-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#how-lookup).
2. **فتح اتصال TCP:** يرسل جهازك إلى السيرفر على المنفذ 443 ما يسمى المصافحة الثلاثية Three-Way Handshake، أي SYN ثم SYN-ACK ثم ACK، وهي ذهاب وعودة كاملة عبر الشبكة قبل أن يرسل أي بايت من الطلب.
3. **مصافحة TLS:** يتفق الطرفان على مفاتيح التشفير، ويرسل السيرفر شهادته فيتحقق منها المتصفح، ويتفقان أيضاً على إصدار HTTP الذي سيستخدمانه، وتحتاج هذه الخطوة في TLS 1.3 إلى ذهاب وعودة واحدة.
4. **الطلب:** يرسل المتصفح طلب HTTP، مثل `GET /articles/http?page=2`.
5. **الرد:** يرسل السيرفر رمز الحالة والترويسات ثم محتوى الصفحة.
6. **بقية ملفات الصفحة:** يقرأ المتصفح صفحة HTML فيجد فيها ملفات CSS وJavaScript وصوراً وخطوطاً، فيطلبها واحداً واحداً، والأصل أن يستخدم الاتصال نفسه الذي فتحه في الخطوة الثانية بدل أن يفتح اتصالاً جديداً لكل ملف، وهذا هو موضوع النصف الثاني من المقال.
والصورة التالية تبين أجزاء الرابط، ثم الخطوات الست بالترتيب:
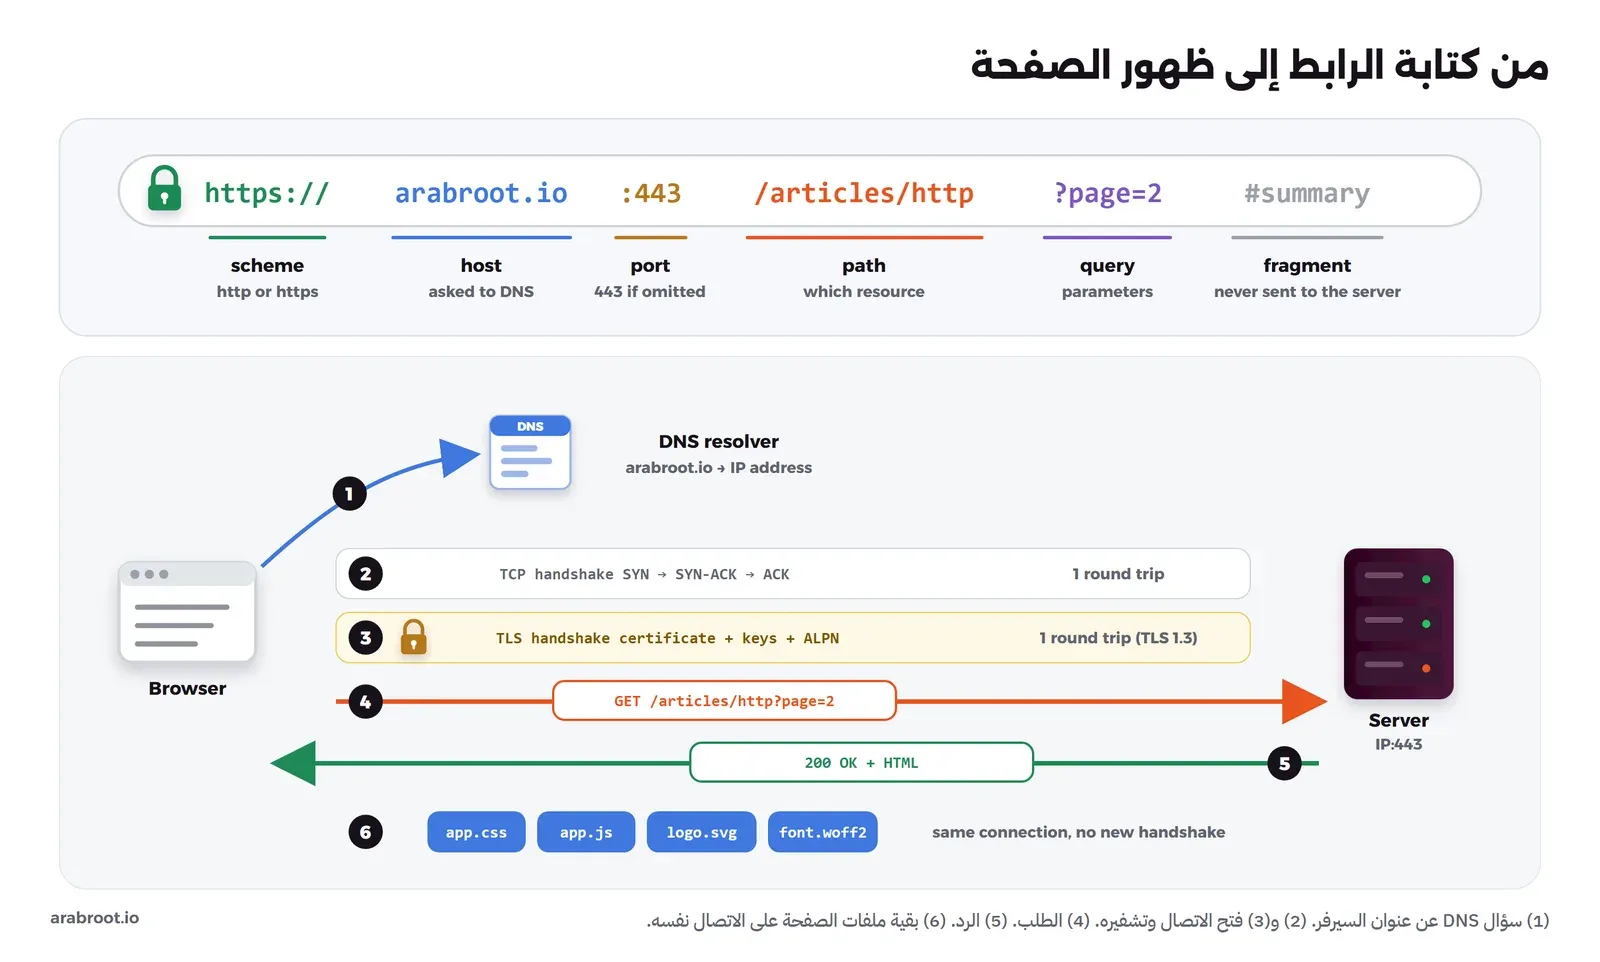
ثلاث مرات ذهاب وعودة على الأقل قبل أول بايت من الصفحة، ثم يعيد المتصفح استخدام الاتصال لبقية الملفات
ولاحظ أن الخطوات 2 و3 لا علاقة لها بمحتوى الصفحة إطلاقاً، فهي ثمن فتح الاتصال فقط، وكل ذهاب وعودة فيها يأخذ وقتاً يعتمد على المسافة بينك وبين السيرفر كما شرحنا في [لماذا يتأخر الرد؟](https://arabroot.io/articles/%D9%83%D9%8A%D9%81-%D9%8A%D8%B5%D9%84-%D8%A7%D9%84%D8%A5%D9%86%D8%AA%D8%B1%D9%86%D8%AA-%D8%A5%D9%84%D9%89-%D8%A8%D9%8A%D8%AA%D9%83/#latency)، وهذا ما يجعل إعادة استخدام الاتصال مهمة إلى هذه الدرجة.
## الطلب والرد: رسالتان نصيتان
HTTP، أي Hypertext Transfer Protocol، هو بروتوكول طلب ورد Request/Response: الكلاينت يرسل طلباً، والسيرفر يرد عليه، ولا يرسل السيرفر شيئاً من تلقاء نفسه. والجميل في HTTP/1.1 أن الرسالتين نص عادي تستطيع أن تكتبه بيدك، فالأمر التالي من التجربة العملية في آخر المقال يرسل طلباً كاملاً إلى Nginx باستخدام `nc` دون أي متصفح أو مكتبة:
```bash
docker run --rm --network lab-http-net alpine:3.24 sh -c \
"printf 'GET / HTTP/1.1\r\nHost: localhost\r\nConnection: close\r\n\r\n' | nc lab-http-nginx 80"
```
والمخرج سوف يكون كما يلي:
```text
HTTP/1.1 200 OK
Server: nginx/1.31.6
Date: Tue, 06 Oct 2026 05:00:11 GMT
Content-Type: text/html
Content-Length: 55
Last-Modified: Tue, 06 Oct 2026 04:29:04 GMT
Connection: close
ETag: "6ac47910-37"
Alt-Svc: h3=":443"; ma=86400
Accept-Ranges: bytes
lab
Hello HTTP
```
في الطلب والمخرج أعلاه لاحظ التالي:
- الطلب ثلاثة أسطر وسطر فارغ: سطر الطلب `GET / HTTP/1.1`، ثم ترويستان، ثم سطر فارغ يعني أن الترويسات انتهت، وكل سطر ينتهي ب `\r\n` الذي يسمى CRLF.
- الترويسة `Host` إلزامية في كل طلب HTTP/1.1 بحسب [RFC 9112](https://www.rfc-editor.org/rfc/rfc9112.html?ref=arabroot.io#name-request-target)، والسبب أن السيرفر الواحد يستضيف عادة عدة مواقع على العنوان نفسه، فلا يعرف أيها تريد إلا من هذه الترويسة.
- الرد يبدأ بسطر الحالة `HTTP/1.1 200 OK`، ثم الترويسات، ثم سطر فارغ، ثم المحتوى، وطوله بالضبط 55 بايت كما تقول `Content-Length`، وهكذا يعرف الكلاينت أين ينتهي الرد.
### مم يتكون الطلب والرد؟
الرسالتان لهما الشكل نفسه، والفرق في السطر الأول فقط، والصورة التالية تبين ذلك على طلب ينشئ ملاحظة جديدة:
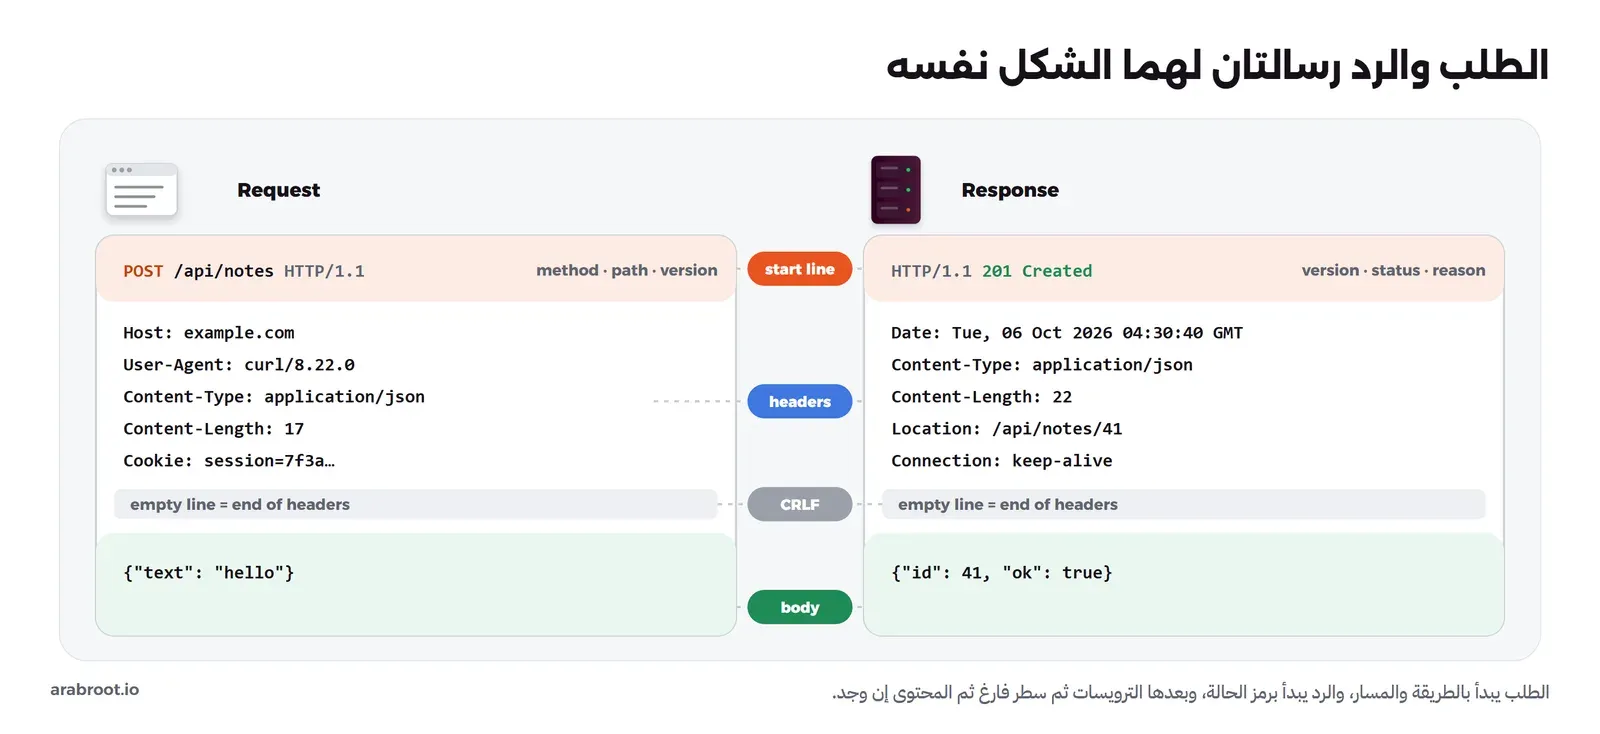
سطر البداية ثم الترويسات ثم سطر فارغ ثم المحتوى، في الطلب والرد على حد سواء
- **سطر الطلب Request Line:** الطريقة Method ثم المسار ثم إصدار البروتوكول.
- **سطر الحالة Status Line:** الإصدار ثم رمز الحالة ثم عبارة قصيرة مثل `OK` أو `Not Found` يقرؤها الإنسان، أما البرامج فتعتمد على الرقم فقط.
- **الترويسات Headers:** أسطر بالشكل `Name: value` تحمل معلومات عن الرسالة، وأسماؤها لا تفرق بين الحروف الكبيرة والصغيرة بحسب [RFC 9110](https://www.rfc-editor.org/rfc/rfc9110.html?ref=arabroot.io#name-field-names)، لذلك سوف تراها في HTTP/2 بحروف صغيرة دائماً كما في التجربة.
- **المحتوى Body:** اختياري، فطلب GET لا يحمل محتوى عادة، والرد على HEAD لا يحمل محتوى أبداً، أما POST وPUT فيحملان البيانات التي ترسلها.
وفي HTTP/2 وHTTP/3 تبقى هذه المعاني نفسها، لكن الرسالة لا تعود نصاً تقرؤه، وإنما إطارات ثنائية Binary Frames، وسطر الطلب يتحول إلى ترويسات خاصة تبدأ بنقطتين مثل `:method` و`:path` و`:authority` بدل Host، وسوف ترى ذلك في مخرج curl في التجربة.
### HTTP لا يتذكرك
كل طلب في HTTP مستقل عن الطلب الذي قبله، فالسيرفر لا يعرف من البروتوكول نفسه أن الطلب الثاني جاء من الشخص نفسه الذي سجل الدخول في الطلب الأول، وهذا ما يسمى Stateless. والطريقة التي تحل بها المواقع هذه المشكلة هي ملفات تعريف الارتباط Cookies والجلسات والتوكنات، وقد شرحناها بالتفصيل في [HTTP لا يتذكرك: كل طلب يصل غريباً](https://arabroot.io/articles/%D8%A7%D9%84%D8%AC%D9%84%D8%B3%D8%A7%D8%AA-%D9%88%D9%85%D9%84%D9%81%D8%A7%D8%AA-%D8%AA%D8%B9%D8%B1%D9%8A%D9%81-%D8%A7%D9%84%D8%A7%D8%B1%D8%AA%D8%A8%D8%A7%D8%B7-%D9%88-jwt-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#the-problem). ولاحظ أن إعادة استخدام الاتصال التي سنشرحها لاحقاً لا تغير هذه الحقيقة، فطلبان على الاتصال نفسه قد يكونان لمستخدمين مختلفين خلف ال Reverse Proxy نفسه.
## الطرق Methods: ماذا تريد من السيرفر؟
الطريقة Method هي الكلمة الأولى في الطلب، وهي تقول للسيرفر ماذا تريد أن تفعل بالمورد الذي في المسار، والطرق التي سوف تستخدمها في عملك اليومي هي:
| الطريقة | ماذا تفعل | آمنة Safe | متكررة Idempotent |
| ------- | ---------------------------------------------------------------------------- | --------- | ----------------- |
| GET | تطلب المورد، مثل صفحة أو ملف أو بيانات JSON | نعم | نعم |
| HEAD | مثل GET لكن الرد يحمل الترويسات فقط دون المحتوى | نعم | نعم |
| OPTIONS | تسأل عن الإمكانات المتاحة للمورد، ويستخدمها المتصفح في الطلب التمهيدي ل CORS | نعم | نعم |
| POST | ترسل بيانات ليعالجها السيرفر، مثل إنشاء طلب شراء أو إرسال نموذج | لا | لا |
| PUT | تستبدل المورد كاملاً بما ترسله، أو تنشئه إذا لم يكن موجوداً | لا | نعم |
| PATCH | تعدل جزءاً من المورد | لا | لا |
| DELETE | تحذف المورد | لا | نعم |
والكلمتان في العمودين الأخيرين هما أهم ما في هذا الجدول:
- **الطريقة الآمنة Safe:** بحسب [RFC 9110](https://www.rfc-editor.org/rfc/rfc9110.html?ref=arabroot.io#name-safe-methods) هي الطريقة التي لا يطلب بها الكلاينت تغيير أي شيء على السيرفر، وهي GET وHEAD وOPTIONS وTRACE. والسبب في هذا التصنيف أن برامج الزحف Crawlers والمتصفحات التي تحمل الصفحات مسبقاً Prefetch تطلب أي رابط GET تجده دون أن تسأل أحداً، لذلك لا تقم أبداً بوضع عملية حذف أو تعديل خلف رابط GET مثل `/delete?id=5`، فقد يحذف محرك بحث أو إضافة في المتصفح بياناتك دون أن يضغط أحد أي زر.
- **الطريقة المتكررة Idempotent:** هي الطريقة التي يكون أثر تكرارها عشر مرات مثل أثر تنفيذها مرة واحدة، وهي PUT وDELETE والطرق الآمنة، فحذف المورد نفسه مرتين ينتهي بالنتيجة نفسها. وتقول المواصفة إن الفائدة العملية من ذلك أن الكلاينت يستطيع أن يعيد الطلب تلقائياً إذا انقطع الاتصال قبل أن يصله الرد، أما POST فليس متكرراً، فإذا أعاده الكلاينت تلقائياً فقد ينشئ طلب شراء ثانياً، لذلك لا تعيد المكتبات المحترمة طلبات POST تلقائياً.
أما PATCH فقد عرفها معيار منفصل هو [RFC 5789](https://www.rfc-editor.org/rfc/rfc5789.html?ref=arabroot.io)، وينص على أنها ليست آمنة وليست متكررة بالضرورة، والسبب أن تعديلاً مثل «زد الرصيد 10» يعطي نتيجة مختلفة في كل مرة. وتفاصيل كل طريقة في [توثيق MDN للطرق](https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Methods?ref=arabroot.io)، وطلب OPTIONS الذي يرسله المتصفح قبل طلبات CORS شرحناه في [الطلب التمهيدي Preflight](https://arabroot.io/articles/%D8%B4%D8%B1%D8%AD-cors-%D9%88%D8%B3%D9%8A%D8%A7%D8%B3%D8%A9-%D8%A7%D9%84%D9%85%D8%B5%D8%AF%D8%B1-%D8%A7%D9%84%D9%88%D8%A7%D8%AD%D8%AF/#preflight).
## رموز الحالة Status Codes: ماذا يقول لك الرد؟
رمز الحالة رقم من ثلاث خانات، والخانة الأولى وحدها تحدد نوع الرد بحسب [RFC 9110](https://www.rfc-editor.org/rfc/rfc9110.html?ref=arabroot.io#name-status-codes)، أما الخانتان الأخيرتان فلا تحملان أي تصنيف، وهذا يعني أنك عندما ترى رقماً لا تعرفه فإن الخانة الأولى تكفي لتعرف من المسؤول عن المشكلة:
- **1xx معلوماتي Informational:** رد مؤقت، مثل `101 Switching Protocols` الذي يرد به السيرفر عند فتح WebSocket.
- **2xx نجاح Success:** `200 OK` للطلب العادي، و`201 Created` عند إنشاء مورد جديد، و`204 No Content` عندما ينجح الطلب ولا يوجد ما يرسل.
- **3xx إعادة توجيه Redirection:** المورد في مكان آخر، أو لم يتغير منذ آخر مرة.
- **4xx خطأ من الكلاينت Client Error:** الطلب نفسه فيه مشكلة، فلا فائدة من إعادته كما هو.
- **5xx خطأ من السيرفر Server Error:** الطلب سليم لكن السيرفر أو شيء خلفه فشل في تنفيذه.
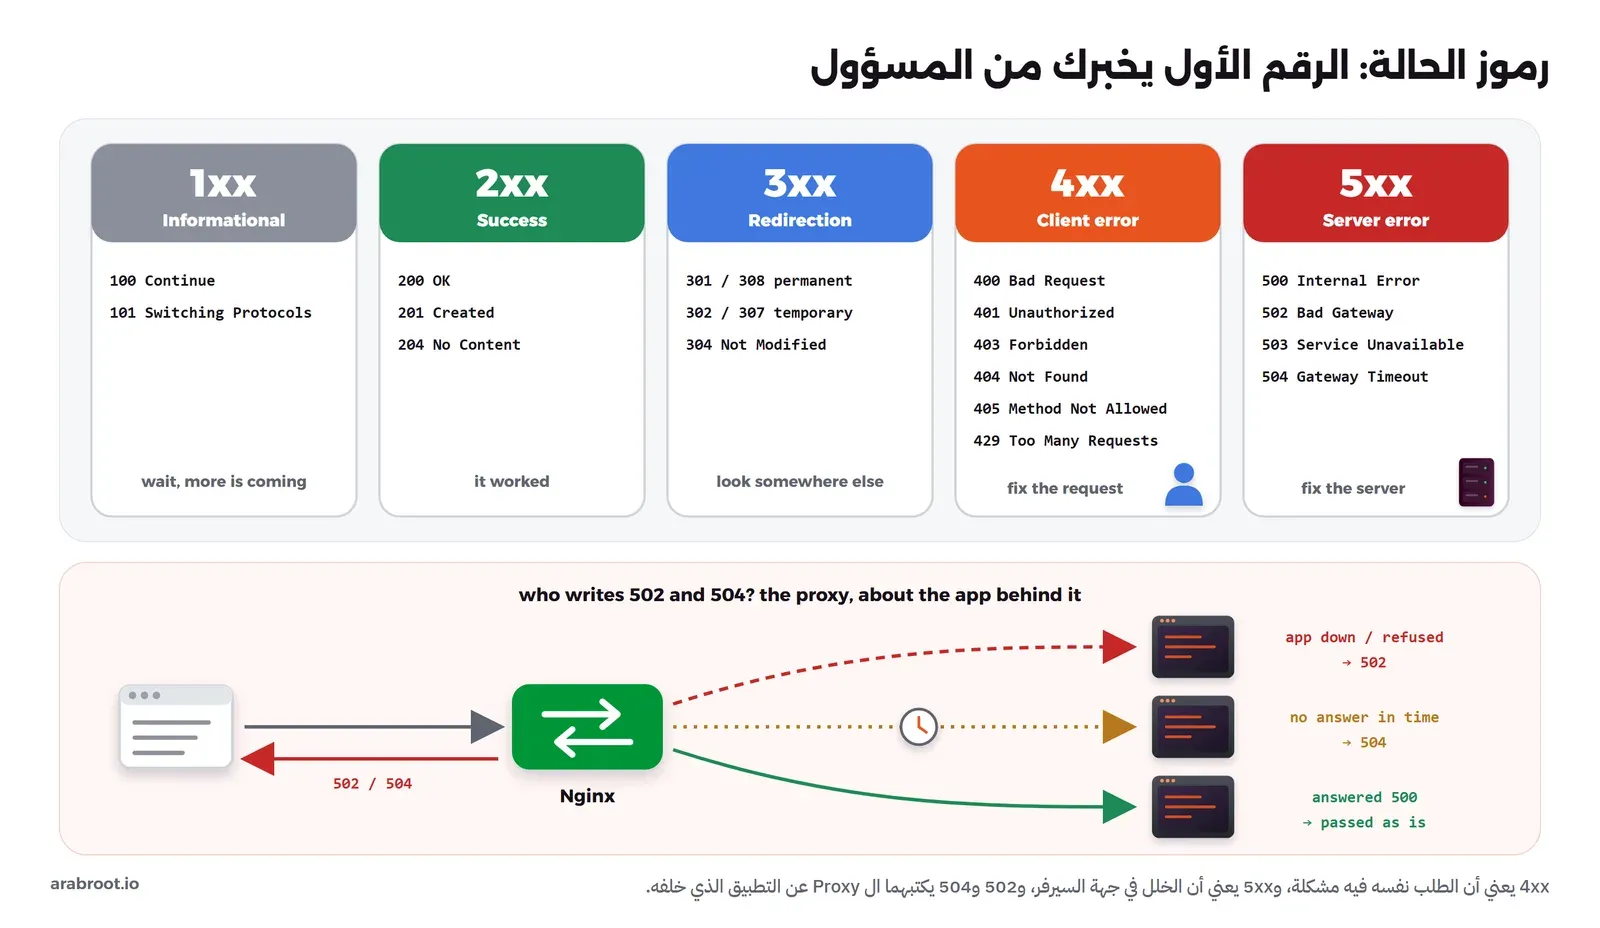
الخانة الأولى تحدد المسؤول، و502 و504 يكتبهما ال Proxy عن التطبيق الذي خلفه
### إعادة التوجيه: 301 و302 و307 و308 و304
الرد 301 و308 يعنيان أن المورد انتقل نهائياً إلى العنوان الموجود في ترويسة `Location`، و302 و307 يعنيان أن الانتقال مؤقت. والفرق بين كل زوج منهما أن المواصفة تسمح للمتصفح لأسباب تاريخية بأن يحول طلب POST إلى GET عند 301 و302، أما 307 و308 فيشترطان إعادة الطلب بالطريقة نفسها والمحتوى نفسه، لذلك إذا كنت تنقل API يستقبل POST فاستخدم 308 وليس 301\. والمثال الأقرب هو التحويل من HTTP إلى HTTPS على موقعنا:
```bash
curl -sI http://arabroot.io/ | grep -i -E "^HTTP|^location"
```
والمخرج سوف يكون كما يلي:
```text
HTTP/1.1 308 Permanent Redirect
Location: https://arabroot.io/
```
أما `304 Not Modified` فليس انتقالاً، وإنما جواب على طلب مشروط يقول فيه الكلاينت «عندي نسخة بهذا ال ETag، هل تغيرت؟»، فيرد السيرفر دون أي محتوى إذا لم تتغير، وقد شرحنا هذه الآلية مع ال Cache في [ETag وLast-Modified والرد 304](https://arabroot.io/articles/%D8%B4%D8%A8%D9%83%D8%A9-%D8%AA%D9%88%D8%B5%D9%8A%D9%84-%D8%A7%D9%84%D9%85%D8%AD%D8%AA%D9%88%D9%89-cdn-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#revalidation).
### أخطاء الكلاينت: 400 و401 و403 و404 و405 و429
- **400 Bad Request:** الطلب نفسه غير صالح، مثل JSON مكسور أو ترويسة مكتوبة بشكل خاطئ.
- **401 Unauthorized:** اسمه مضلل، فهو يعني في الحقيقة «لم تثبت من أنت»، أي أن الطلب لا يحمل بيانات دخول صالحة، وتشترط المواصفة أن يحمل الرد ترويسة `WWW-Authenticate` تخبر الكلاينت كيف يثبت هويته.
- **403 Forbidden:** السيرفر فهم الطلب ويرفض تنفيذه، فإذا كان المستخدم قد سجل دخوله فهذا يعني أنه معروف لكن لا يملك الصلاحية، وإعادة تسجيل الدخول بالحساب نفسه لن تغير شيئاً.
- **404 Not Found:** لا يوجد مورد بهذا المسار، أو أن السيرفر لا يريد أن يكشف وجوده، لذلك تستخدم بعض التطبيقات 404 بدل 403 حتى لا يعرف المهاجم أن المسار موجود.
- **405 Method Not Allowed:** المسار موجود لكنه لا يقبل هذه الطريقة، مثل POST على ملف ثابت كما سنرى في التجربة.
- **429 Too Many Requests:** أرسلت طلبات كثيرة في وقت قصير، وقد يحمل الرد ترويسة `Retry-After` تقول لك متى تحاول مرة أخرى، وهو من معيار [RFC 6585](https://www.rfc-editor.org/rfc/rfc6585.html?ref=arabroot.io)، وقد شرحنا كيف تضع هذا الحد على تطبيقاتك في [الحد من معدل الطلبات Rate Limiting](https://arabroot.io/articles/%D8%AD%D9%85%D8%A7%D9%8A%D8%A9-%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D8%A7%D8%AA-%D8%A7%D9%84%D9%88%D9%8A%D8%A8-%D8%B9%D9%84%D9%89-%D9%85%D8%B3%D8%AA%D9%88%D9%89-http/#rate-limiting).
ومن هذه العائلة أيضاً `413 Content Too Large` الذي تراه عند رفع ملف أكبر من الحد المسموح، وله مقال كامل هو [اقرأ الرد قبل أن تغير أي إعداد](https://arabroot.io/articles/%D8%AD%D8%AF%D9%88%D8%AF-%D8%AD%D8%AC%D9%85-%D8%B1%D9%81%D8%B9-%D8%A7%D9%84%D9%85%D9%84%D9%81%D8%A7%D8%AA/#read-the-413).
### أخطاء السيرفر: من أين يأتي 502 و503 و504؟
عندما يقف أمام تطبيقك Reverse Proxy مثل Nginx، وهذا هو الشائع في كل استضافة ذاتية، فإن الرد الذي يصل إلى المتصفح قد يكتبه التطبيق وقد يكتبه ال Proxy نفسه، والتفريق بينهما يوفر عليك ساعات من البحث في المكان الخطأ:
- **500 Internal Server Error:** يكتبه التطبيق عادة عندما يحدث استثناء Exception في الكود، ويمرره ال Proxy كما هو، فابحث عنه في سجلات التطبيق.
- **502 Bad Gateway:** بحسب المواصفة يعني أن السيرفر الذي يعمل كوسيط Gateway أو Proxy تلقى رداً غير صالح من السيرفر الذي خلفه، وعملياً فإن أشهر أسبابه أن التطبيق متوقف أو يعمل على منفذ آخر أو أن ال Container أعيد تشغيله وتغير عنوانه، فلا يستطيع Nginx الاتصال به أصلاً.
- **503 Service Unavailable:** السيرفر غير قادر على خدمة الطلب مؤقتاً بسبب الضغط أو الصيانة، وقد يحمل `Retry-After`.
- **504 Gateway Timeout:** ال Proxy اتصل بالتطبيق لكن التطبيق لم يرد خلال المهلة المحددة، وفي Nginx هذه المهلة هي `proxy_read_timeout` وقيمتها الافتراضية 60 ثانية، وقد شرحنا متى ترفعها ومتى تصلح البطء نفسه في [الطلبات البطيئة وخطأ 504](https://arabroot.io/articles/%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%83-%D8%AE%D9%84%D9%81-reverse-proxy/#timeouts).
وقد يتساءل البعض: كيف أعرف هل 502 من التطبيق أم من ال Proxy؟ والإجابة في سجل أخطاء ال Proxy، فعندما يكتب Nginx الرد 502 أو 504 بنفسه فإنه يسجل السبب بوضوح، مثل `connect() failed (111: Connection refused)` أو `upstream timed out`، كما سترى في التجربة العملية.
## الترويسات Headers: نظرة سريعة وأين تجد تفاصيلها
الترويسات هي المكان الذي يحمل فيه HTTP كل شيء ما عدا المحتوى نفسه، وهي كثيرة جداً، وأغلب الترويسات المهمة لها مقال مستقل في الموقع يشرحها بالتفصيل، لذلك سوف نكتفي هنا بوظيفة كل منها ونرسلك إلى المقال الذي يملكها:
- **Host:** اسم الموقع المطلوب، وهو الذي يجعل سيرفراً واحداً يستضيف عشرات المواقع، وإذا كان تطبيقك خلف Proxy فراجع [اسم المضيف Host](https://arabroot.io/articles/%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%83-%D8%AE%D9%84%D9%81-reverse-proxy/#public-url) حتى لا يكتب التطبيق روابط خاطئة.
- **Content-Type:** نوع المحتوى، مثل `text/html` أو `application/json`، والمتصفح يعتمد عليه في طريقة عرض الملف، والترويسة `X-Content-Type-Options: nosniff` تمنعه من التخمين كما في [لا تخمن نوع الملف](https://arabroot.io/articles/%D8%AA%D8%B1%D9%88%D9%8A%D8%B3%D8%A7%D8%AA-%D8%A7%D9%84%D8%A3%D9%85%D8%A7%D9%86-hsts-%D9%88-csp/#nosniff).
- **Content-Length:** طول المحتوى بالبايت، وبه يعرف الطرف الآخر أين تنتهي الرسالة دون أن يغلق الاتصال، وهذا ما يسمح بإعادة استخدامه كما سيأتي.
- **User-Agent:** اسم البرنامج الذي أرسل الطلب وإصداره، مثل `curl/8.22.0`، ويكتبه الكلاينت كما يريد، لذلك لا تعتمد عليه في أي قرار أمني.
- **Accept وAccept-Encoding:** الأنواع وطرق الضغط التي يقبلها الكلاينت، مثل gzip وBrotli، فيختار السيرفر ما يناسبه منها.
- **Cookie وSet-Cookie:** السيرفر يرسل Set-Cookie، والمتصفح يعيدها في Cookie مع كل طلب بعد ذلك، وقد شرحناهما مع خصائص Secure وHttpOnly وSameSite في [Set-Cookie وCookie في طلب حقيقي](https://arabroot.io/articles/%D8%A7%D9%84%D8%AC%D9%84%D8%B3%D8%A7%D8%AA-%D9%88%D9%85%D9%84%D9%81%D8%A7%D8%AA-%D8%AA%D8%B9%D8%B1%D9%8A%D9%81-%D8%A7%D9%84%D8%A7%D8%B1%D8%AA%D8%A8%D8%A7%D8%B7-%D9%88-jwt-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#cookie-headers).
- **Cache-Control وETag:** تحددان من يحفظ الرد ومدة صلاحيته، وهي موضوع مقال [Cache-Control: الترويسة التي تقرر كل شيء](https://arabroot.io/articles/%D8%B4%D8%A8%D9%83%D8%A9-%D8%AA%D9%88%D8%B5%D9%8A%D9%84-%D8%A7%D9%84%D9%85%D8%AD%D8%AA%D9%88%D9%89-cdn-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#cache-control).
- **ترويسات الأمان:** HSTS وContent-Security-Policy وأخواتها، وهي تعليمات يرسلها السيرفر إلى المتصفح، وقد شرحناها في [ترويسات الأمان HSTS وCSP](https://arabroot.io/articles/%D8%AA%D8%B1%D9%88%D9%8A%D8%B3%D8%A7%D8%AA-%D8%A7%D9%84%D8%A3%D9%85%D8%A7%D9%86-hsts-%D9%88-csp/).
- **Origin وترويسات Access-Control:** تحدد هل يسمح المتصفح لصفحة من موقع آخر بقراءة الرد، وهي موضوع [شرح CORS وسياسة المصدر الواحد](https://arabroot.io/articles/%D8%B4%D8%B1%D8%AD-cors-%D9%88%D8%B3%D9%8A%D8%A7%D8%B3%D8%A9-%D8%A7%D9%84%D9%85%D8%B5%D8%AF%D8%B1-%D8%A7%D9%84%D9%88%D8%A7%D8%AD%D8%AF/).
- **X-Forwarded-For وX-Forwarded-Proto:** يضيفها ال Reverse Proxy ليعرف التطبيق عنوان الزائر الحقيقي وهل جاء عبر HTTPS، والتفاصيل في [الترويسات التي تحمل معلومات الزائر](https://arabroot.io/articles/%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%83-%D8%AE%D9%84%D9%81-reverse-proxy/#headers).
- **Connection وKeep-Alive:** تتحكمان في بقاء الاتصال مفتوحاً في HTTP/1.x، وهما موضوع هذا المقال، ونشرحهما في قسم إعادة استخدام الاتصال.
## HTTPS: نفس HTTP داخل نفق TLS
HTTPS ليس بروتوكولاً مختلفاً، وإنما هو HTTP نفسه بنفس الطرق والترويسات ورموز الحالة، لكنه يمر داخل اتصال TLS بدل أن يمر نصاً مكشوفاً على الشبكة، ويستخدم المنفذ 443 افتراضياً بدل 80\. وما تضيفه طبقة TLS ثلاثة أشياء:
- **السرية Confidentiality:** من يقف في الطريق، مثل شبكة Wi-Fi في مقهى أو أي جهاز بينك وبين السيرفر، لا يستطيع قراءة المسار ولا الترويسات ولا Cookies ولا المحتوى.
- **سلامة البيانات Integrity:** لا يستطيع أحد أن يعدل الرد في الطريق، مثل أن يحقن إعلاناً أو سكربتاً، دون أن يكتشف ذلك الطرفان.
- **التحقق من هوية السيرفر Authentication:** السيرفر يثبت بشهادته أنه صاحب النطاق فعلاً، وهذا هو الجزء الذي يمنع المهاجم من أن ينتحل شخصية الموقع، وقد شرحنا الشهادات وسلسلة الثقة ومكان فحص الشهادة في المصافحة في [أين تفحص الشهادة في مصافحة TLS 1.3؟](https://arabroot.io/articles/%D8%A7%D9%84%D8%B4%D9%87%D8%A7%D8%AF%D8%A7%D8%AA-%D8%A7%D9%84%D8%B1%D9%82%D9%85%D9%8A%D8%A9-tls-%D9%88-x509-%D9%88%D8%B5%D9%8A%D8%BA-pem-%D9%88-der/#tls-handshake).
هل يعني ذلك أن HTTPS يخفي كل شيء؟ لا، فمن يراقب الشبكة ما زال يرى عنوان IP الخاص بالسيرفر، ويرى عادة اسم النطاق نفسه لأن المتصفح يرسله في بداية المصافحة ضمن ما يسمى SNI حتى يعرف السيرفر أي شهادة يرسل، ويرى أحجام الرسائل وتوقيتها. أما المسار وسلسلة الاستعلام والترويسات والمحتوى فكلها مشفرة. ولاحظ أيضاً أن HTTP/3 لا يوجد أصلاً دون تشفير، لأن QUIC الذي يعمل فوقه يدمج TLS 1.3 في مصافحته كما سيأتي.
ولاحظ أن مصافحة TLS هي أيضاً المكان الذي يتفق فيه الطرفان على إصدار HTTP، وهذا ما سنراه في قسم ALPN، وأما إجبار المتصفح على عدم فتح موقعك عبر HTTP مرة أخرى بعد أول زيارة فهو وظيفة ترويسة HSTS في [HSTS: لا تفتح هذا النطاق عبر HTTP مرة أخرى](https://arabroot.io/articles/%D8%AA%D8%B1%D9%88%D9%8A%D8%B3%D8%A7%D8%AA-%D8%A7%D9%84%D8%A3%D9%85%D8%A7%D9%86-hsts-%D9%88-csp/#hsts).
## إعادة استخدام الاتصال Connection Reuse
وصلنا إلى الجزء الذي يغفل عنه أغلب المطورين، رغم أنه يؤثر على سرعة كل صفحة وكل API، فقد رأينا في أول المقال أن الطلب يحتاج قبله إلى اتصال TCP ثم مصافحة TLS، والسؤال الآن: هل يدفع كل طلب هذا الثمن من جديد؟ والإجابة تعتمد على إصدار HTTP وعلى طريقة كتابة الكلاينت، وسوف نمشي مع هذا السؤال من HTTP/1.0 إلى HTTP/3 ثم إلى الكود الذي تكتبه بنفسك.
### كم يكلف الاتصال الجديد؟
الاتصال الجديد عبر HTTPS يحتاج إلى ذهاب وعودة Round Trip، واختصاراً RTT، لمصافحة TCP، ثم ذهاب وعودة لمصافحة TLS 1.3، ثم ذهاب وعودة للطلب نفسه، أي ثلاث مرات ذهاب وعودة قبل أول بايت من الرد، بينما الطلب على اتصال مفتوح مسبقاً يحتاج إلى ذهاب وعودة واحدة فقط. والأمر التالي من التجربة العملية يطلب الملف نفسه من موقعنا مرتين في أمر curl واحد، ويطبع توقيت كل مرحلة:
```bash
for i in 1 2 3; do
docker run --rm curlimages/curl:8.22.0 -s -o /dev/null -o /dev/null \
https://arabroot.io/robots.txt https://arabroot.io/robots.txt \
-w 'new=%{num_connects} dns=%{time_namelookup} tcp=%{time_connect} tls=%{time_appconnect} first_byte=%{time_starttransfer} total=%{time_total}\n'
echo
done
```
والمخرج سوف يكون كما يلي:
```text
new=1 dns=0.010066 tcp=0.116192 tls=0.242095 first_byte=0.368110 total=0.368245
new=0 dns=0.000000 tcp=0.000000 tls=0.000000 first_byte=0.159165 total=0.159305
new=1 dns=0.006662 tcp=0.115982 tls=0.225638 first_byte=0.347382 total=0.347478
new=0 dns=0.000000 tcp=0.000000 tls=0.000000 first_byte=0.092410 total=0.092508
new=1 dns=0.008325 tcp=0.114899 tls=0.249112 first_byte=0.359295 total=0.359414
new=0 dns=0.000000 tcp=0.000000 tls=0.000000 first_byte=0.119869 total=0.119984
```
في المخرج أعلاه لاحظ التالي:
- القيم في [توثيق curl](https://curl.se/docs/manpage.html?ref=arabroot.io) تراكمية من بداية الطلب: `time_connect` هو وقت انتهاء اتصال TCP، و`time_appconnect` وقت انتهاء مصافحة TLS، و`time_starttransfer` وقت وصول أول بايت من الرد، و`num_connects` عدد الاتصالات الجديدة التي فتحها هذا الطلب.
- في الطلب الأول من كل تشغيل أخذ اتصال TCP قرابة 0.11 ثانية، ثم أخذت مصافحة TLS قرابة 0.12 ثانية أخرى، فلم يرسل الطلب نفسه إلا بعد ثلثي الوقت تقريباً.
- الطلب الثاني يحمل `new=0` وأصفاراً في مراحل الاتصال، أي أن curl أعاد استخدام الاتصال نفسه، فوصل أول بايت في 0.09 إلى 0.16 ثانية بدل 0.35 تقريباً.
- هذه أرقام من جهازنا إلى موقعنا ولها غرض التوضيح فقط، والنسبة تكبر كلما بعد السيرفر عنك، فكل ذهاب وعودة إضافية تتأثر بالمسافة.
والصورة التالية تبين الفرق نفسه على مخطط زمني:
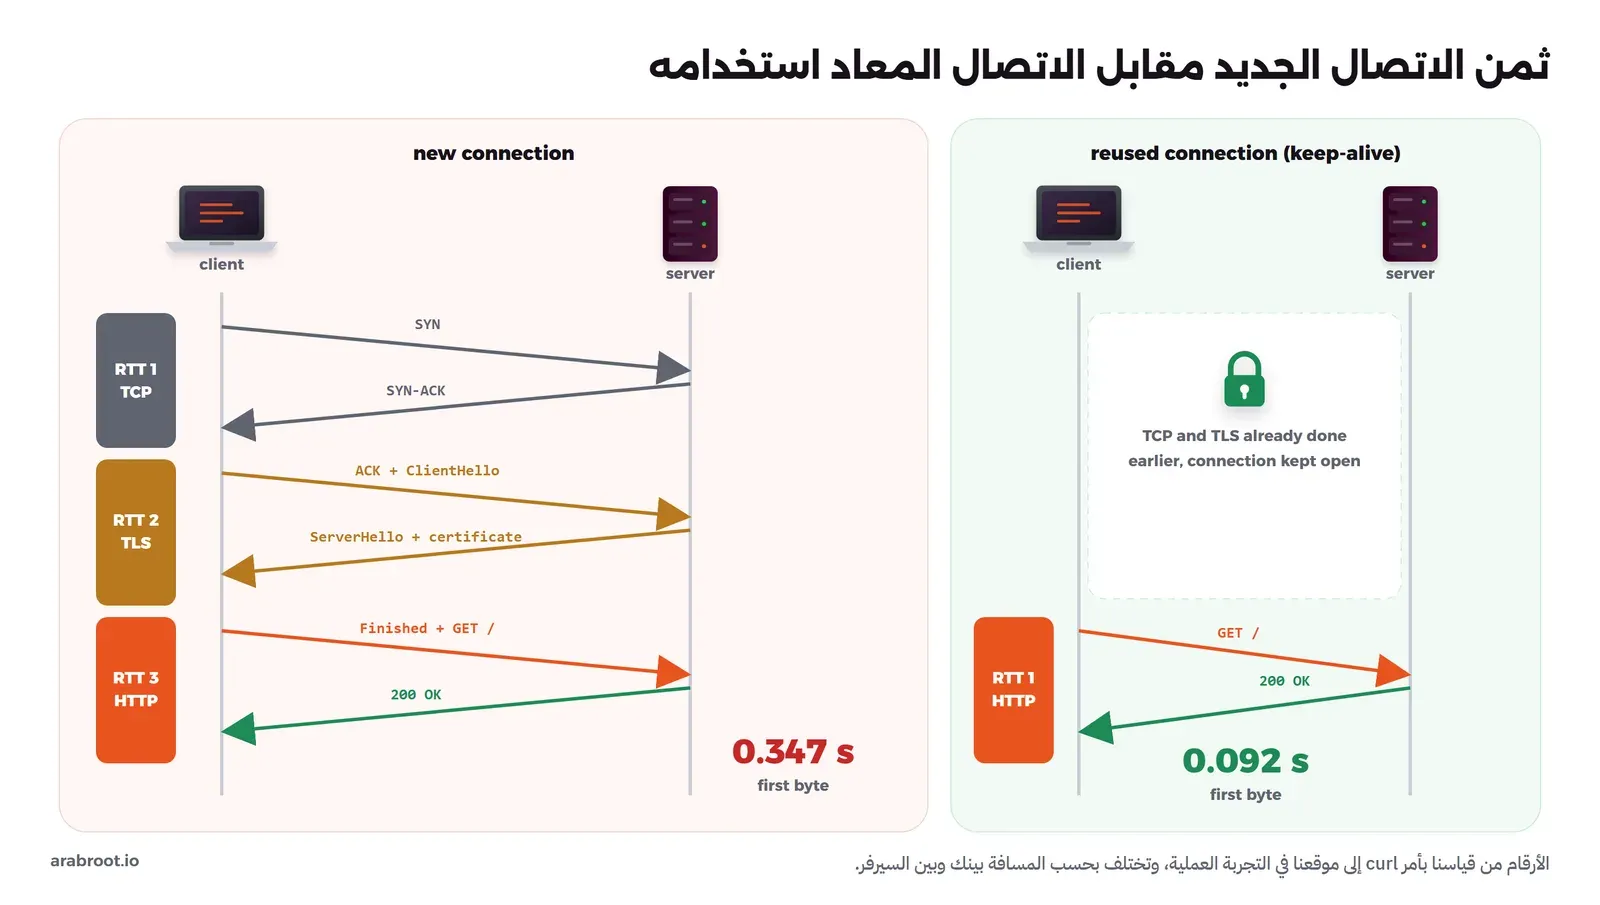
الاتصال الجديد يدفع ثلاث مرات ذهاب وعودة قبل أول بايت، والاتصال المعاد استخدامه يدفع مرة واحدة
وبالإضافة إلى الوقت فإن مصافحة TLS تستهلك معالجاً على الطرفين لأنها تتضمن عمليات المفتاح العام، وكل اتصال مفتوح يحجز ذاكرة على السيرفر، وكل اتصال مغلق يبقى فترة في حالة TIME\_WAIT على الطرف الذي أغلقه، فإذا فتح تطبيقك آلاف الاتصالات القصيرة في الدقيقة فقد تنفد المنافذ المحلية Ephemeral Ports قبل أن ينفد أي شيء آخر.
### HTTP/1.0: اتصال لكل طلب
في HTTP/1.0 كان السلوك الافتراضي أن يغلق السيرفر الاتصال بعد كل رد، فصفحة فيها عشرون ملفاً تعني عشرين اتصالاً ومصافحة جديدة، وهذا هو الحل البسيط الذي يبدو منطقياً في البداية لأنه بسيط ولا يحتاج إلى أن يعرف أحد أين تنتهي الرسالة، فنهاية الاتصال هي نهاية الرد. وجاءت بعد ذلك إضافة غير رسمية هي الترويسة `Connection: keep-alive` التي يطلب بها الكلاينت إبقاء الاتصال مفتوحاً، ولكنها لم تكن مضمونة، فبعض ال Proxies القديمة كانت تمررها دون أن تفهمها فتتعطل الاتصالات، كما يشرح [ملحق RFC 9112](https://www.rfc-editor.org/rfc/rfc9112.html?ref=arabroot.io#name-keep-alive-connections).
### HTTP/1.1: الاتصال الدائم Persistent Connection وKeep-Alive
في HTTP/1.1 انعكس الأصل، فتنص [المواصفة](https://www.rfc-editor.org/rfc/rfc9112.html?ref=arabroot.io#name-persistence) على أن الاتصالات الدائمة Persistent Connections هي السلوك الافتراضي، أي أن الاتصال يحمل عدة طلبات وردود واحداً بعد الآخر، ولا يغلق إلا إذا أرسل أحد الطرفين `Connection: close`، أو انتهت مهلة بقائه خاملاً. وهذا ما يسميه الناس Keep-Alive حتى في HTTP/1.1، رغم أن الترويسة لم تعد ضرورية فيه. وشرط إعادة الاستخدام أن يعرف كل طرف أين تنتهي الرسالة دون إغلاق الاتصال، لذلك يحمل كل رد إما `Content-Length` أو ترميز التقسيم `Transfer-Encoding: chunked`.
والسيرفر هو الذي يقرر متى يغلق الاتصال الخامل، ففي Nginx مثلاً يبقى اتصال الكلاينت الخامل مفتوحاً 75 ثانية بحسب القيمة الافتراضية ل [keepalive\_timeout](https://nginx.org/en/docs/http/ngx%5Fhttp%5Fcore%5Fmodule.html?ref=arabroot.io#keepalive%5Ftimeout)، ويخدم الاتصال الواحد حتى 1000 طلب بحسب [keepalive\_requests](https://nginx.org/en/docs/http/ngx%5Fhttp%5Fcore%5Fmodule.html?ref=arabroot.io#keepalive%5Frequests) ثم يغلقه حتى يحرر الذاكرة المرتبطة به. وقد يتساءل البعض: لماذا لا يبقى الاتصال مفتوحاً إلى الأبد؟ والإجابة أن كل اتصال خامل يحجز ذاكرة وواصف ملف File Descriptor على السيرفر، وسيرفر يخدم مئة ألف زائر لا يستطيع أن يحتفظ باتصال كل واحد منهم بعد أن يغادر.
ولاحظ أن الكلاينت يجب أن يتوقع أن يغلق السيرفر الاتصال الخامل في أي لحظة، فإذا أرسل طلباً على اتصال أغلقه السيرفر للتو فسوف يفشل الطلب، وهنا تأتي فائدة الطرق المتكررة Idempotent التي شرحناها، فالمكتبة تستطيع أن تعيد GET على اتصال جديد بأمان، ولا تستطيع ذلك مع POST.
### طلب واحد في كل مرة، وحد الاتصالات الست
حل HTTP/1.1 مشكلة ثمن الاتصال، لكن بقيت مشكلة أخرى: الاتصال الواحد يحمل طلباً واحداً في كل لحظة، فلا يرسل الطلب الثاني إلا بعد أن يكتمل الرد الأول، فإذا كان الرد الأول بطيئاً، مثل تقرير يحتاج ثانيتين، فكل ما خلفه على الاتصال نفسه ينتظر، وهذا ما يسمى حجب رأس الطابور Head-of-Line Blocking. وقد حاولت المواصفة حل ذلك بما يسمى Pipelining، أي إرسال عدة طلبات دون انتظار الردود، لكنها اشترطت أن تعود الردود بالترتيب نفسه، فبقي الرد البطيء يحجب ما خلفه، ويذكر [توثيق MDN](https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Connection%5Fmanagement%5Fin%5FHTTP%5F1.x?ref=arabroot.io) أن المتصفحات لا تفعله وأن HTTP/2 حل محله.
والحل العملي الذي اعتمدته المتصفحات هو فتح عدة اتصالات متوازية إلى الموقع نفسه، والحد الشائع اليوم ستة اتصالات لكل مصدر Origin كما يذكر MDN، ويقول [توثيق أدوات المطور في Chrome](https://developer.chrome.com/docs/devtools/network/reference?ref=arabroot.io) صراحة إن الطلب ينتظر في الطابور Queueing إذا كانت هناك ستة اتصالات TCP مفتوحة لهذا المصدر، وإن هذا الحد يخص HTTP/1.0 وHTTP/1.1 فقط. لذلك ظهرت حيلة توزيع الملفات على عدة نطاقات فرعية Domain Sharding مثل `static1` و`static2` لتحصل الصفحة على ستة اتصالات لكل نطاق، ويقول [MDN](https://developer.mozilla.org/en-US/docs/Glossary/Domain%5Fsharding?ref=arabroot.io) إن هذه الحيلة لم تعد مطلوبة مع HTTP/2، بل تضر لأنها تضيف بحث DNS ومصافحة لكل نطاق.
### HTTP/2: عدة طلبات على اتصال واحد
جاء HTTP/2 الذي وحدت مواصفته في [RFC 9113](https://www.rfc-editor.org/rfc/rfc9113.html?ref=arabroot.io) بحل مختلف: بدل ستة اتصالات كل منها يحمل طلباً واحداً، اتصال واحد يحمل عدداً كبيراً من الطلبات في الوقت نفسه. ويقوم ذلك على فكرتين:
- **التدفقات Streams والإطارات Frames:** كل طلب ورده يسير في تدفق له رقم، والرسالة تقسم إلى إطارات ثنائية صغيرة، فيرسل الطرفان إطارات من تدفقات مختلفة متداخلة على الاتصال نفسه، وهذا ما يسمى تعدد التدفقات Multiplexing، فلا ينتظر ملف CSS انتهاء صورة كبيرة.
- **ضغط الترويسات HPACK:** الطلبات المتتالية إلى الموقع نفسه تكرر ترويسات طويلة مثل User-Agent وCookie، فيستخدم HTTP/2 طريقة ضغط خاصة هي [HPACK](https://www.rfc-editor.org/rfc/rfc7541.html?ref=arabroot.io) تعتمد على جدول ثابت للترويسات الشائعة وجدول متغير يتذكر ما أرسل على الاتصال، فترسل الترويسة المكررة كرقم صغير بدل نصها كاملاً.
وتقول المواصفة في مقدمتها إن ذلك يسمح باستخدام اتصالات TCP أقل من HTTP/1.x، وإن الاتصالات الأقل والأطول عمراً تستفيد من سعة الشبكة بشكل أفضل، ثم تقول بصراحة إن حجب رأس الطابور على مستوى TCP لم يحل في هذا البروتوكول. والسبب أن TCP يسلم البايتات بالترتيب، فإذا ضاعت حزمة واحدة توقف تسليم كل ما بعدها حتى يعاد إرسالها، حتى لو كانت البايتات المتوقفة تخص تدفقات أخرى لا علاقة لها بالحزمة الضائعة، وهذه المشكلة تظهر على الشبكات التي تفقد حزماً كثيرة مثل شبكات الجوال الضعيفة.
### HTTP/3: فوق QUIC بدل TCP
لحل هذه المشكلة الأخيرة كان لا بد من تغيير طبقة النقل نفسها، فجاء [HTTP/3](https://www.rfc-editor.org/rfc/rfc9114.html?ref=arabroot.io) في يونيو 2022 يعمل فوق بروتوكول [QUIC](https://www.rfc-editor.org/rfc/rfc9000.html?ref=arabroot.io) الذي يعمل بدوره فوق UDP، والمعاني نفسها لم تتغير: الطرق ورموز الحالة والترويسات هي نفسها. وما يضيفه QUIC هو:
- **تدفقات مستقلة:** QUIC يعرف التدفقات بنفسه ويعيد إرسال الحزمة الضائعة لتدفقها فقط، فيتوقف التدفق المتأثر وحده وتكمل بقية التدفقات، وهذه هي الفقرة التي تذكرها مقدمة RFC 9114 حين تشرح لماذا لم يكف HTTP/2.
- **TLS 1.3 مدمج في المصافحة:** مصافحة QUIC تجمع إعدادات النقل والتشفير معاً، فيحتاج الاتصال الجديد إلى ذهاب وعودة واحدة بدل مرتين ل TCP ثم TLS، ويسمح أيضاً بوضع 0-RTT الذي يرسل فيه الكلاينت بيانات مع أول رسالة إذا كان قد اتصل بالسيرفر نفسه من قبل. ولكن تنبه إلى أن بيانات 0-RTT لا تحميها المواصفة من إعادة الإرسال Replay بحسب [RFC 9001](https://www.rfc-editor.org/rfc/rfc9001.html?ref=arabroot.io#name-replay-attacks-with-0-rtt)، لذلك لا يجوز أن تحمل إلا طلبات آمنة مثل GET.
- **ضغط ترويسات جديد QPACK:** لأن HPACK يفترض وصول الإطارات بالترتيب، وهذا ما لم يعد مضموناً بين التدفقات، فاستبدل ب [QPACK](https://www.rfc-editor.org/rfc/rfc9204.html?ref=arabroot.io).
وكيف يعرف المتصفح أن الموقع يدعم HTTP/3 رغم أنه يتصل أول مرة عبر TCP؟ والإجابة في الترويسة `Alt-Svc` التي يرسلها السيرفر في رد HTTP/1.1 أو HTTP/2، مثل `Alt-Svc: h3=":443"; ma=86400`، أي أن HTTP/3 متاح على منفذ UDP رقم 443، وأن هذه المعلومة صالحة 86400 ثانية، وهي الآلية التي يذكرها [RFC 9114](https://www.rfc-editor.org/rfc/rfc9114.html?ref=arabroot.io#name-http-alternative-services)، فيجرب المتصفح QUIC في الطلبات التالية. ولهذا فإن تفعيل HTTP/3 على سيرفرك يحتاج إلى فتح منفذ UDP 443 في جدار الحماية Firewall إلى جانب TCP 443، وهذا ما ينساه كثيرون فيبقى الموقع على HTTP/2 دون أي رسالة خطأ. ويدعم Nginx بروتوكول HTTP/3 منذ الإصدار 1.25.0، ويصف [توثيق الوحدة](https://nginx.org/en/docs/http/ngx%5Fhttp%5Fv3%5Fmodule.html?ref=arabroot.io) هذا الدعم بأنه تجريبي حتى الآن.
والصورة التالية تجمع الإصدارات الثلاثة:
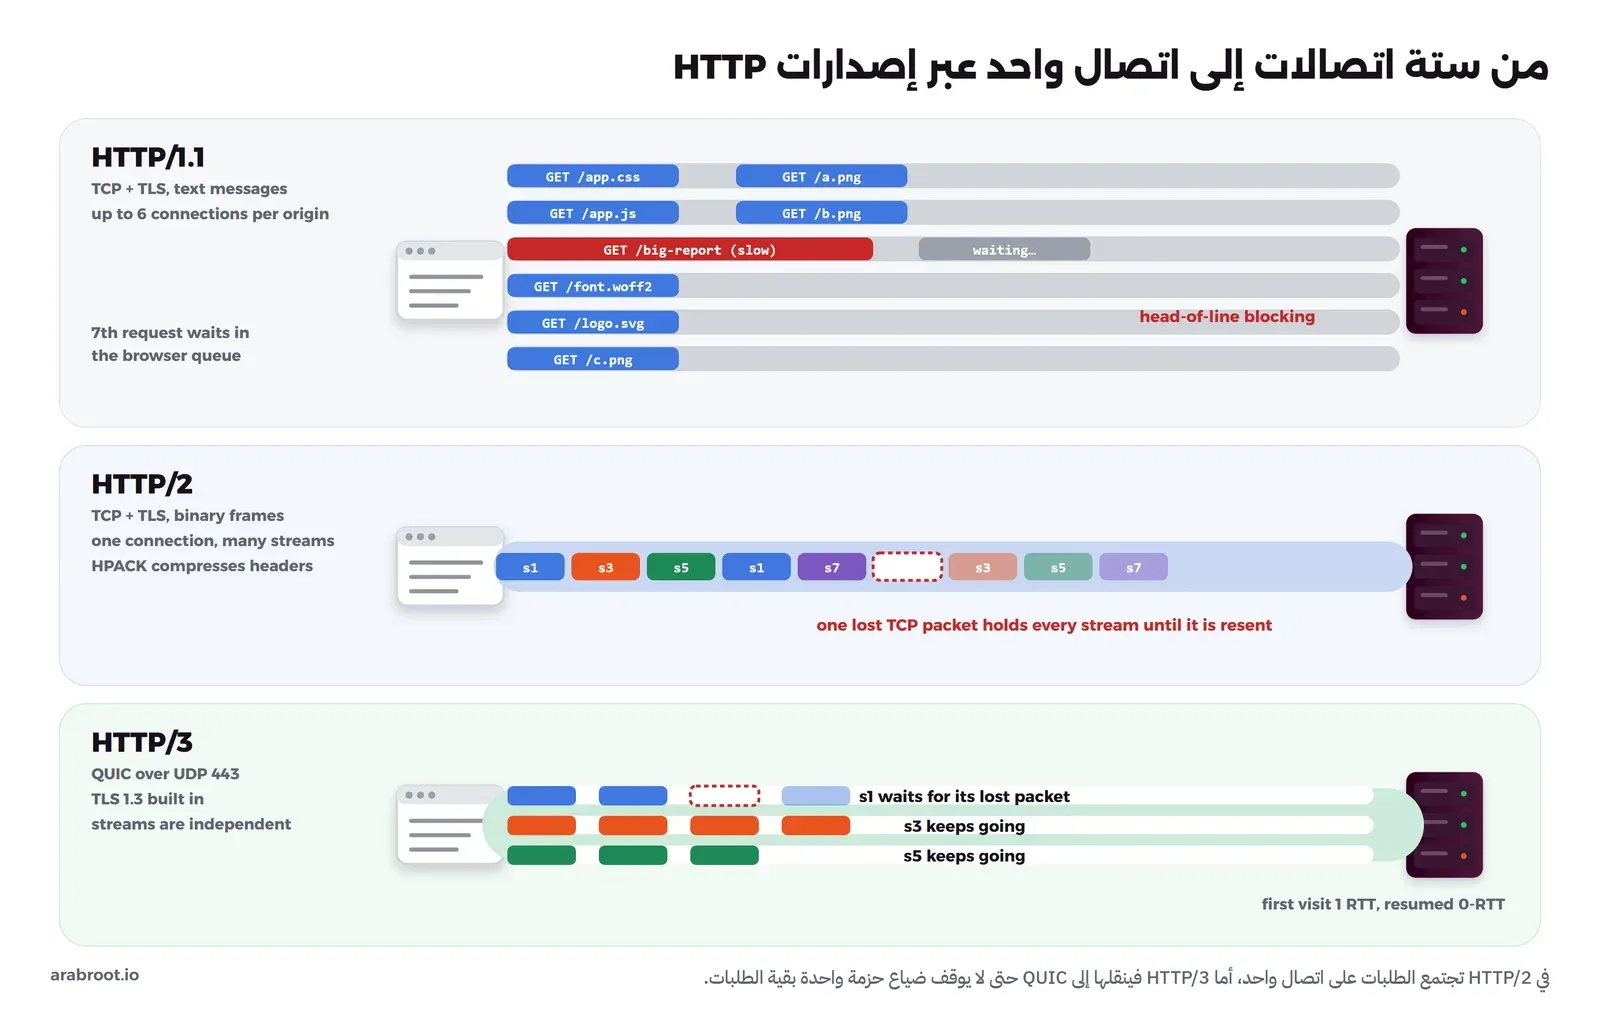
HTTP/1.1 يوزع الطلبات على ستة اتصالات، وHTTP/2 يجمعها على اتصال واحد، وHTTP/3 يفصل التدفقات حتى لا توقفها حزمة ضائعة
### من يقرر الإصدار؟ التفاوض عبر ALPN
المتصفح لا يعرف مسبقاً هل يدعم السيرفر HTTP/2، ولا يريد أن يدفع ذهاباً وعودة إضافية ليسأل، لذلك يتم الاتفاق داخل مصافحة TLS نفسها عبر امتداد اسمه ALPN، أي Application-Layer Protocol Negotiation، المعرف في [RFC 7301](https://www.rfc-editor.org/rfc/rfc7301.html?ref=arabroot.io): يرسل الكلاينت في رسالة ClientHello قائمة البروتوكولات التي يعرفها، مثل `h2` و`http/1.1`، ويختار السيرفر واحداً منها في رده. والاسم `h2` هو معرف HTTP/2 فوق TLS بحسب RFC 9113، و`h3` هو معرف HTTP/3\. وسوف ترى في التجربة سطرين من curl يقولان ذلك حرفياً: `ALPN: curl offers h2,http/1.1` ثم `ALPN: server accepted h2`. ولاحظ أن هذا التفاوض يحدث داخل مصافحة TLS، فعلى اتصال HTTP غير مشفر لا يوجد ALPN، وهذا من أسباب ارتباط HTTP/2 عملياً ب HTTPS.
### مجمع الاتصالات Connection Pool داخل كود تطبيقك
كل ما سبق يحدث تلقائياً في المتصفح، أما عندما يتصل تطبيقك ب API آخر، مثل بوابة دفع أو خدمة بريد أو خدمة داخلية، فإن إعادة استخدام الاتصال مسؤوليتك أنت، والذي يحققها هو مجمع الاتصالات Connection Pool داخل مكتبة HTTP: كائن واحد يحتفظ بالاتصالات المفتوحة الخاملة لكل سيرفر، فإذا جاء طلب جديد إلى السيرفر نفسه أعطاه اتصالاً جاهزاً بدل أن يفتح اتصالاً جديداً. والفكرة نفسها شرحناها مع قواعد البيانات في [مقال تجميع الاتصالات Connection Pooling](https://arabroot.io/articles/%D8%AA%D8%AC%D9%85%D9%8A%D8%B9-%D8%A7%D9%84%D8%A7%D8%AA%D8%B5%D8%A7%D9%84%D8%A7%D8%AA-connection-pooling-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/).
والخطأ الشائع أن ينشئ الكود كلاينت HTTP جديداً داخل الدالة التي تستدعى مع كل طلب، فيرمي الكلاينت ومجمعه مع انتهاء الدالة، ويدفع كل استدعاء مصافحة TCP وTLS كاملة. وفي Python مثلاً فإن الدالة `requests.get` تنشئ Session مؤقتة وتغلقها بعد كل استدعاء كما ترى في [كود المكتبة نفسه](https://github.com/psf/requests/blob/main/src/requests/api.py?ref=arabroot.io)، بينما يقول [توثيق requests](https://requests.readthedocs.io/en/latest/user/advanced/?ref=arabroot.io) إن الكائن `Session` يستخدم مجمع اتصالات urllib3، فتعاد الاتصالات إلى السيرفر نفسه. والصورة التالية تبين الفرق:
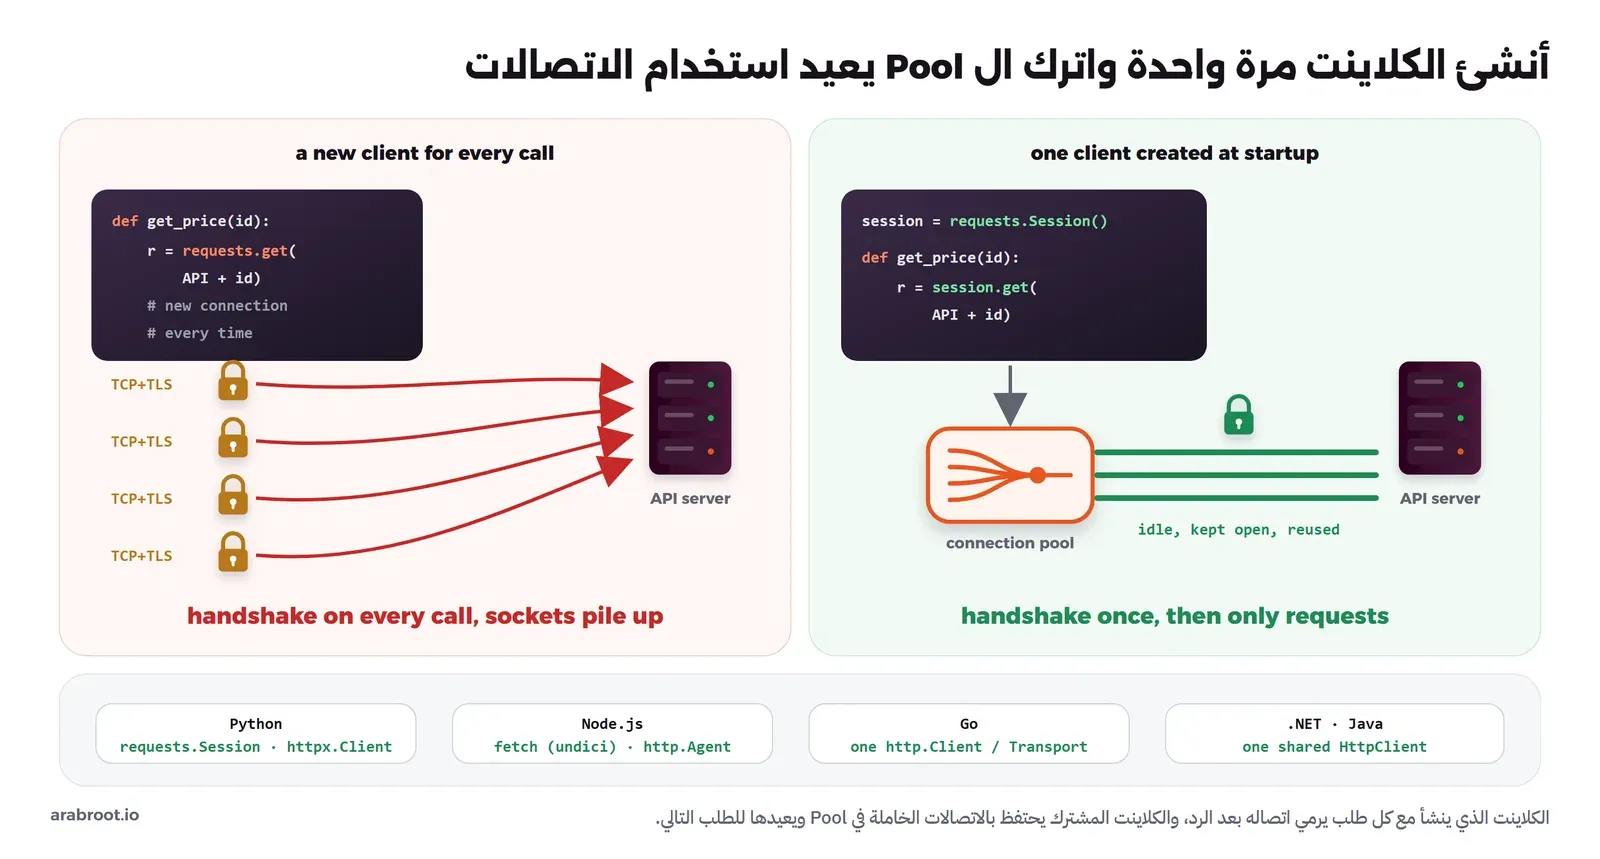
الكلاينت الذي ينشأ مع كل طلب يرمي اتصاله، والكلاينت المشترك يعيد استخدامه
والقاعدة واحدة في كل اللغات: أنشئ الكلاينت مرة واحدة عند تشغيل التطبيق، واستخدمه في كل الطلبات، وأغلقه عند إيقاف التطبيق، وفيما يلي ما يقابل ذلك في اللغات الشائعة:
- **Python مع requests:** كائن `requests.Session()` واحد على مستوى التطبيق، ولاحظ ما يقوله التوثيق نفسه: الاتصال لا يعود إلى المجمع إلا بعد قراءة محتوى الرد كاملاً، فإذا استخدمت `stream=True` ولم تقرأ المحتوى بقي الاتصال محجوزاً.
- **Python مع httpx:** كائن `httpx.Client()` أو `httpx.AsyncClient()`، ويقول [توثيق httpx](https://www.python-httpx.org/advanced/clients/?ref=arabroot.io) إن الدوال العامة مثل `httpx.get` تفتح اتصالاً جديداً لكل طلب، وإن الكائن Client هو الذي يستخدم مجمع الاتصالات.
- **Node.js:** الدالة `fetch` المدمجة مبنية على مكتبة undici كما في [توثيق Node.js](https://nodejs.org/api/globals.html?ref=arabroot.io)، ويقول [توثيق undici](https://github.com/nodejs/undici/blob/main/docs/docs/api/Agent.md?ref=arabroot.io) إن الكائن Agent الذي تستخدمه fetch افتراضياً ينشئ Pool لكل Origin ويعيد استخدامه، فلا تحتاج إلى شيء لتستفيد منه. أما الوحدة `http` فإن الكائن العام `http.globalAgent` يعمل بإعادة الاستخدام مفعلة، بينما أي `new http.Agent()` تنشئه بنفسك يأتي بالخيار `keepAlive` معطلاً افتراضياً بحسب [توثيق http](https://nodejs.org/api/http.html?ref=arabroot.io)، فلا تنشئ Agent جديداً لكل طلب، وإذا أنشأته فمرر `keepAlive: true`.
- **Go:** يقول [توثيق net/http](https://pkg.go.dev/net/http?ref=arabroot.io) إن الكائنين Client وTransport يجب أن ينشآ مرة واحدة ويعاد استخدامهما، وإن الاتصال لا يعاد استخدامه إلا إذا قرأت محتوى الرد حتى نهايته وأغلقته، ولاحظ أن القيمة الافتراضية للإعداد `MaxIdleConnsPerHost` هي 2 فقط، فإذا كان تطبيقك يرسل مئات الطلبات المتوازية إلى السيرفر نفسه فسوف يغلق أغلب الاتصالات بعد استخدامها ويفتح غيرها، والحل أن ترفع هذه القيمة في Transport خاص بك.
- **.NET وJava:** توصي [إرشادات Microsoft](https://learn.microsoft.com/en-us/dotnet/fundamentals/networking/http/httpclient-guidelines?ref=arabroot.io) بكائن `HttpClient` طويل العمر أو باستخدام `IHttpClientFactory`، وتذكر أن هذا يتجنب استنزاف المنافذ Socket Exhaustion، ويقول [توثيق Java](https://docs.oracle.com/en/java/javase/21/docs/api/java.net.http/java/net/http/HttpClient.html?ref=arabroot.io) إن كل `HttpClient` يدير مجمع اتصالاته الخاص الذي لا يشارك بين الكائنات المختلفة.
### وماذا عن الاتصال بين Nginx وتطبيقك؟
هناك اتصال ثالث غير الاتصال من المتصفح والاتصال من كود تطبيقك، وهو الاتصال من ال Reverse Proxy إلى التطبيق خلفه، فقد كان Nginx لفترة طويلة يفتح اتصالاً جديداً إلى التطبيق مع كل طلب إلا إذا ضبطت ذلك بنفسك، وقد تغيرت القيم الافتراضية في الإصدارات الحديثة، وشرحنا الإعداد والإصدار الذي تغير فيه في [إعادة استخدام اتصالات HTTP](https://arabroot.io/articles/%D8%AA%D8%AC%D9%85%D9%8A%D8%B9-%D8%A7%D9%84%D8%A7%D8%AA%D8%B5%D8%A7%D9%84%D8%A7%D8%AA-connection-pooling-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/#http-reuse).
## تجربة عملية: نرى الطلب والرد وإعادة استخدام الاتصال
الآن سوف نقوم ببناء بيئة صغيرة على جهازك: Nginx يقدم ملفات ثابتة عبر HTTP وHTTPS مع HTTP/2، ويقف أمام تطبيق Python صغير فيه مسار سريع ومسار بطيء، وسجل Nginx مضبوط بحيث يطبع رقم الاتصال الذي حمل كل طلب، فنرى بأعيننا متى يعاد استخدام الاتصال ومتى يفتح اتصال جديد. والتجربة تحتاج Docker فقط، وكل المنافذ على `127.0.0.1` فلا يصل إليها أحد من خارج جهازك، ونستخدم curl من داخل شبكة Docker نفسها حتى تكون المخرجات واحدة على أي نظام.
### تجهيز Nginx والتطبيق
قم بإنشاء مجلد للتجربة:
```bash
mkdir -p ~/http-lab/certs ~/http-lab/html && cd ~/http-lab
```
ثم أنشئ فيه الملف `default.conf` التالي:
```nginx
# One line per request: which connection carried it, and how many requests that connection has served so far
log_format conn 'conn=$connection req=$connection_requests $server_protocol "$request" $status';
server {
listen 80;
listen 443 ssl;
listen 443 quic reuseport;
http2 on;
http3 on;
server_name localhost;
ssl_certificate /etc/nginx/certs/localhost.crt;
ssl_certificate_key /etc/nginx/certs/localhost.key;
add_header Alt-Svc 'h3=":443"; ma=86400' always; # tells clients HTTP/3 is available on UDP 443
access_log /var/log/nginx/access.log conn;
root /usr/share/nginx/html;
location = /old-page { return 301 /; } # moved permanently
location /api/ { proxy_pass http://lab-http-app:8000; proxy_read_timeout 2s; }
location /down/ { proxy_pass http://lab-http-app:9999; } # nothing listens on 9999
}
```
في الإعداد أعلاه لاحظ التالي:
- المتغير `$connection` هو الرقم التسلسلي للاتصال، و`$connection_requests` عدد الطلبات التي حملها هذا الاتصال حتى الآن بحسب [توثيق Nginx](https://nginx.org/en/docs/http/ngx%5Fhttp%5Fcore%5Fmodule.html?ref=arabroot.io#var%5Fconnection)، فإذا رأيت الرقم نفسه في سطرين فهما على الاتصال نفسه.
- `http2 on` يفعل HTTP/2 على منفذ TLS، و`listen 443 quic` مع `http3 on` يفعلان HTTP/3 على UDP بحسب [توثيق QUIC في Nginx](https://nginx.org/en/docs/quic.html?ref=arabroot.io).
- جعلنا مهلة انتظار التطبيق في `/api/` ثانيتين فقط حتى نرى 504 بسرعة، وجعلنا `/down/` يشير إلى منفذ لا يعمل عليه شيء حتى نرى 502.
ثم أنشئ الملف `app.py`، وهو تطبيق صغير يرد ب JSON، ويتأخر خمس ثوان في المسار `/api/slow`:
```python
# A tiny app behind Nginx: one fast endpoint and one slow endpoint
import json, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
class App(BaseHTTPRequestHandler):
def do_GET(self):
if self.path == "/api/slow":
time.sleep(5) # slower than Nginx is willing to wait
body = json.dumps({"path": self.path, "ok": True}).encode()
self.send_response(200)
self.send_header("Content-Type", "application/json")
self.send_header("Content-Length", str(len(body)))
self.end_headers()
self.wfile.write(body)
ThreadingHTTPServer(("0.0.0.0", 8000), App).serve_forever()
```
ثم الملفات الثابتة وشهادة موقعة ذاتياً Self-Signed للاسم `localhost` واسم ال Container، وقد شرحنا معنى هذه الأوامر في [تجربة الشهادات](https://arabroot.io/articles/%D8%A7%D9%84%D8%B4%D9%87%D8%A7%D8%AF%D8%A7%D8%AA-%D8%A7%D9%84%D8%B1%D9%82%D9%85%D9%8A%D8%A9-tls-%D9%88-x509-%D9%88%D8%B5%D9%8A%D8%BA-pem-%D9%88-der/#lab):
```bash
printf '\nlab\nHello HTTP
\n' > html/index.html
printf 'body{font-family:sans-serif}\n' > html/style.css
printf 'console.log("app");\n' > html/app.js
docker run --rm -v "$PWD/certs:/certs" alpine/openssl req -x509 -newkey ec \
-pkeyopt ec_paramgen_curve:prime256v1 -nodes -days 30 -subj "/CN=localhost" \
-addext "subjectAltName=DNS:localhost,DNS:lab-http-nginx" \
-keyout /certs/localhost.key -out /certs/localhost.crt
```
الآن نقوم بإنشاء شبكة وتشغيل التطبيق وNginx:
```bash
docker network create lab-http-net
docker run -d --name lab-http-app --network lab-http-net \
-v "$PWD/app.py:/app.py:ro" python:3.13-alpine python -u /app.py
docker run -d --name lab-http-nginx --network lab-http-net \
-p 127.0.0.1:18580:80 -p 127.0.0.1:18581:443 -p 127.0.0.1:18581:443/udp \
-v "$PWD/default.conf:/etc/nginx/conf.d/default.conf:ro" \
-v "$PWD/certs:/etc/nginx/certs:ro" \
-v "$PWD/html:/usr/share/nginx/html:ro" nginx:1.31-alpine
docker ps --filter name=lab-http --format 'table {{.Names}}\t{{.Status}}\t{{.Ports}}'
```
والمخرج سوف يكون كما يلي:
```text
NAMES STATUS PORTS
lab-http-nginx Up 2 seconds 127.0.0.1:18580->80/tcp, 127.0.0.1:18581->443/tcp, 127.0.0.1:18581->443/udp
lab-http-app Up 3 seconds
```
وحتى لا نكرر أمر Docker الطويل في كل خطوة نعرف دالة صغيرة في الطرفية اسمها `labcurl` تشغل curl داخل شبكة التجربة وتثق بالشهادة التي أنشأناها:
```bash
labcurl() { docker run --rm --network lab-http-net -v "$PWD/certs:/certs:ro" curlimages/curl:8.22.0 --cacert /certs/localhost.crt "$@"; }
```
### الخطوة 1: طلب مكتوب باليد عبر HTTP وHTTPS
الطلب عبر HTTP بالأمر `nc` رأيناه في [قسم الطلب والرد](#messages)، والآن نرسل الطلب نفسه مكتوباً باليد لكن عبر TLS، باستخدام `openssl s_client` الذي يفتح الاتصال المشفر ثم يمرر ما نكتبه كما هو، ونطلب HEAD حتى يأتي الرد دون محتوى:
```bash
docker run --rm --network lab-http-net -v "$PWD/certs:/certs:ro" --entrypoint sh alpine/openssl -c \
"printf 'HEAD / HTTP/1.1\r\nHost: localhost\r\nConnection: close\r\n\r\n' | openssl s_client -connect lab-http-nginx:443 -servername localhost -CAfile /certs/localhost.crt -alpn http/1.1 -quiet"
```
والمخرج سوف يكون كما يلي:
```text
Connecting to 192.168.48.3
depth=0 CN=localhost
verify return:1
HTTP/1.1 200 OK
Server: nginx/1.31.6
Date: Tue, 06 Oct 2026 05:00:26 GMT
Content-Type: text/html
Content-Length: 55
Last-Modified: Tue, 06 Oct 2026 04:29:04 GMT
Connection: close
ETag: "6ac47910-37"
Alt-Svc: h3=":443"; ma=86400
Accept-Ranges: bytes
```
لاحظ أن الطلب والرد هما النص نفسه حرفاً بحرف، والفرق الوحيد أنهما سارا داخل نفق TLS بعد أن تحقق openssl من الشهادة في السطر `verify return:1`، وهذا هو المعنى العملي لعبارة «HTTPS هو HTTP داخل TLS». ولاحظ أيضاً أننا طلبنا `-alpn http/1.1`، والسبب أن Nginx كان سيختار `h2` لو عرضناه عليه، ولا نستطيع أن نكتب إطارات HTTP/2 الثنائية بأيدينا.
### الخطوة 2: طلبان على اتصال واحد
عندما تعطي curl أكثر من رابط إلى الموقع نفسه في أمر واحد فإنه يعيد استخدام الاتصال، والخيار `-v` يطبع ما يحدث، والأسطر التي تبدأ ب `>` هي الطلب، والتي تبدأ ب `<` هي الرد، والتي تبدأ ب `*` هي ملاحظات curl:
```bash
labcurl -sv -o /dev/null -o /dev/null http://lab-http-nginx/ http://lab-http-nginx/style.css
docker logs --tail 2 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
* Host lab-http-nginx:80 was resolved.
* IPv6: (none)
* IPv4: 192.168.48.3
* Trying 192.168.48.3:80...
* Established connection to lab-http-nginx (192.168.48.3 port 80) from 192.168.48.4 port 57434
* using HTTP/1.x
> GET / HTTP/1.1
> Host: lab-http-nginx
> User-Agent: curl/8.22.0
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< Server: nginx/1.31.6
< Date: Tue, 06 Oct 2026 05:00:13 GMT
< Content-Type: text/html
< Content-Length: 55
< Last-Modified: Tue, 06 Oct 2026 04:29:04 GMT
< Connection: keep-alive
< ETag: "6ac47910-37"
< Alt-Svc: h3=":443"; ma=86400
< Accept-Ranges: bytes
<
{ [55 bytes data]
* Connection #0 to host lab-http-nginx:80 left intact
* Reusing existing http: connection with host lab-http-nginx
> GET /style.css HTTP/1.1
> Host: lab-http-nginx
> User-Agent: curl/8.22.0
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< Server: nginx/1.31.6
< Date: Tue, 06 Oct 2026 05:00:13 GMT
< Content-Type: text/css
< Content-Length: 29
< Last-Modified: Tue, 06 Oct 2026 04:29:04 GMT
< Connection: keep-alive
< ETag: "6ac47910-1d"
< Alt-Svc: h3=":443"; ma=86400
< Accept-Ranges: bytes
<
{ [29 bytes data]
* Connection #0 to host lab-http-nginx:80 left intact
conn=4 req=1 HTTP/1.1 "GET / HTTP/1.1" 200
conn=4 req=2 HTTP/1.1 "GET /style.css HTTP/1.1" 200
```
في المخرج أعلاه لاحظ التالي:
- السطر `Established connection` ظهر مرة واحدة فقط، وبعد الرد الأول قال curl إن الاتصال `left intact`، أي بقي مفتوحاً، ثم قال `Reusing existing http: connection` قبل الطلب الثاني.
- الرد يحمل `Connection: keep-alive`، أي أن Nginx يقول إنه سيبقي الاتصال مفتوحاً بعد هذا الرد.
- سجل Nginx يؤكد ذلك من جهة السيرفر: الطلبان على الاتصال رقم 4، والثاني هو الطلب رقم 2 على هذا الاتصال.
### الخطوة 3: نكسر إعادة الاستخدام عن قصد
الآن نرسل الطلبين نفسيهما مرة مع `Connection: close`، ومرة ب HTTP/1.0 الذي يغلق الاتصال بعد كل رد افتراضياً، ونطلب من curl أن يطبع عدد الاتصالات الجديدة لكل طلب:
```bash
labcurl -s -o /dev/null -o /dev/null -H "Connection: close" -w '%{num_connects} new connection(s) for %{url}\n' http://lab-http-nginx/ http://lab-http-nginx/style.css
labcurl -s -o /dev/null -o /dev/null --http1.0 -w '%{num_connects} new connection(s) for %{url}\n' http://lab-http-nginx/ http://lab-http-nginx/style.css
docker logs --tail 4 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
1 new connection(s) for http://lab-http-nginx/
1 new connection(s) for http://lab-http-nginx/style.css
1 new connection(s) for http://lab-http-nginx/
1 new connection(s) for http://lab-http-nginx/style.css
conn=6 req=1 HTTP/1.1 "GET / HTTP/1.1" 200
conn=7 req=1 HTTP/1.1 "GET /style.css HTTP/1.1" 200
conn=8 req=1 HTTP/1.0 "GET / HTTP/1.0" 200
conn=9 req=1 HTTP/1.0 "GET /style.css HTTP/1.0" 200
```
كل طلب الآن فتح اتصالاً جديداً، وكل اتصال في السجل حمل طلباً واحداً فقط، وهذا بالضبط ما يحدث في تطبيقك إذا كان شيء في الطريق يضيف `Connection: close`، أو إذا كان الكلاينت يتحدث HTTP/1.0، وهو ما يحدث مثلاً مع بعض أدوات اختبار الحمل القديمة فتعطيك أرقاماً أسوأ من الواقع.
### الخطوة 4: HTTP/1.1 أم HTTP/2؟ التفاوض ثم ستة طلبات متوازية
أولاً نرى التفاوض عبر ALPN، فنطلب الصفحة مرة ونحن نعرض HTTP/1.1 فقط، ومرة ونحن نعرض HTTP/2 أيضاً:
```bash
for v in --http1.1 --http2; do labcurl -sv -o /dev/null $v https://lab-http-nginx/ 2>&1 | grep -E "ALPN|^> GET|^< HTTP"; done
```
والمخرج سوف يكون كما يلي:
```text
* ALPN: curl offers http/1.1
* ALPN: server accepted http/1.1
> GET / HTTP/1.1
< HTTP/1.1 200 OK
* ALPN: curl offers h2,http/1.1
* ALPN: server accepted h2
> GET / HTTP/2
< HTTP/2 200
```
ثم نرسل ستة طلبات في الوقت نفسه بالخيار `-Z`، أي `--parallel`، مرة ب HTTP/1.1 ومرة ب HTTP/2، والصيغة `[1-6]` في الرابط يفهمها curl كستة روابط:
```bash
labcurl -s --http1.1 -Z -o /dev/null -o /dev/null -o /dev/null -o /dev/null -o /dev/null -o /dev/null \
-w '%{url} new=%{num_connects}\n' "https://lab-http-nginx/api/[1-6]"
docker logs --tail 6 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
https://lab-http-nginx/api/1 new=1
https://lab-http-nginx/api/2 new=1
https://lab-http-nginx/api/3 new=1
https://lab-http-nginx/api/4 new=1
https://lab-http-nginx/api/6 new=1
https://lab-http-nginx/api/5 new=1
conn=12 req=1 HTTP/1.1 "GET /api/1 HTTP/1.1" 200
conn=13 req=1 HTTP/1.1 "GET /api/2 HTTP/1.1" 200
conn=14 req=1 HTTP/1.1 "GET /api/3 HTTP/1.1" 200
conn=15 req=1 HTTP/1.1 "GET /api/4 HTTP/1.1" 200
conn=17 req=1 HTTP/1.1 "GET /api/6 HTTP/1.1" 200
conn=16 req=1 HTTP/1.1 "GET /api/5 HTTP/1.1" 200
```
والآن الأمر نفسه مع `--http2`:
```bash
labcurl -s --http2 -Z -o /dev/null -o /dev/null -o /dev/null -o /dev/null -o /dev/null -o /dev/null \
-w '%{url} new=%{num_connects}\n' "https://lab-http-nginx/api/[1-6]"
docker logs --tail 6 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
https://lab-http-nginx/api/1 new=1
https://lab-http-nginx/api/2 new=0
https://lab-http-nginx/api/3 new=0
https://lab-http-nginx/api/4 new=0
https://lab-http-nginx/api/5 new=0
https://lab-http-nginx/api/6 new=0
conn=24 req=1 HTTP/2.0 "GET /api/1 HTTP/2.0" 200
conn=24 req=2 HTTP/2.0 "GET /api/2 HTTP/2.0" 200
conn=24 req=3 HTTP/2.0 "GET /api/3 HTTP/2.0" 200
conn=24 req=4 HTTP/2.0 "GET /api/4 HTTP/2.0" 200
conn=24 req=5 HTTP/2.0 "GET /api/5 HTTP/2.0" 200
conn=24 req=6 HTTP/2.0 "GET /api/6 HTTP/2.0" 200
```
في المخرجين أعلاه لاحظ التالي:
- مع HTTP/1.1 احتاج curl إلى ستة اتصالات، من 12 إلى 17، لأن الاتصال الواحد لا يحمل إلا طلباً واحداً في كل لحظة، وهذا ما تفعله المتصفحات بالضبط حتى حد الستة.
- مع HTTP/2 فتح curl اتصالاً واحداً فقط، رقم 24، وحمل عليه الطلبات الستة في الوقت نفسه كتدفقات منفصلة، ولاحظ أن Nginx يعد كل تدفق طلباً في `req`.
- ترتيب الأسطر في HTTP/1.1 ليس بالضرورة ترتيب الروابط، فالطلبات متوازية وينتهي كل منها في وقته.
### الخطوة 5: رموز الحالة من مصدرها
الآن نطلب ستة مسارات صممناها لتعطي رموزاً مختلفة، ونطبع رمز الحالة فقط:
```bash
B=https://lab-http-nginx
labcurl -s -o /dev/null -w '%{http_code} %{redirect_url}\n' $B/old-page
labcurl -s -o /dev/null -w '%{http_code}\n' -H 'If-None-Match: "6ac47910-37"' $B/
labcurl -s -o /dev/null -w '%{http_code}\n' $B/missing
labcurl -s -o /dev/null -w '%{http_code}\n' -X POST $B/index.html
labcurl -s -o /dev/null -w '%{http_code}\n' $B/down/
labcurl -s -o /dev/null -w '%{http_code} after %{time_total}s\n' $B/api/slow
docker logs --tail 9 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
301 https://lab-http-nginx/
304
404
405
502
504 after 2.017299s
conn=31 req=1 HTTP/2.0 "GET /old-page HTTP/2.0" 301
conn=32 req=1 HTTP/2.0 "GET / HTTP/2.0" 304
2026/10/06 05:01:06 [error] 21#21: *33 open() "/usr/share/nginx/html/missing" failed (2: No such file or directory), client: 192.168.48.4, server: localhost, request: "GET /missing HTTP/2.0", host: "lab-http-nginx"
conn=33 req=1 HTTP/2.0 "GET /missing HTTP/2.0" 404
conn=34 req=1 HTTP/2.0 "POST /index.html HTTP/2.0" 405
2026/10/06 05:01:08 [error] 21#21: *35 connect() failed (111: Connection refused) while connecting to upstream, client: 192.168.48.4, server: localhost, request: "GET /down/ HTTP/2.0", upstream: "http://192.168.48.2:9999/down/", host: "lab-http-nginx"
conn=35 req=1 HTTP/2.0 "GET /down/ HTTP/2.0" 502
2026/10/06 05:01:11 [error] 21#21: *37 upstream timed out (110: Operation timed out) while reading response header from upstream, client: 192.168.48.4, server: localhost, request: "GET /api/slow HTTP/2.0", upstream: "http://192.168.48.2:8000/api/slow", host: "lab-http-nginx"
conn=37 req=1 HTTP/2.0 "GET /api/slow HTTP/2.0" 504
```
في المخرج أعلاه لاحظ التالي:
- الطلب الثاني أرسل ال ETag الذي رأيناه في الخطوة الأولى، فرد Nginx ب 304 دون محتوى لأن الملف لم يتغير.
- الرد 405 جاء لأن Nginx لا يقبل POST على ملف ثابت، فالمسار موجود والطريقة هي المرفوضة.
- الرد 502 كتبه Nginx بنفسه، والسبب في سجل الأخطاء `connect() failed (111: Connection refused)`، أي أنه لم يجد أحداً على المنفذ 9999، وهذا ما تراه عندما يكون التطبيق متوقفاً.
- الرد 504 جاء بعد ثانيتين بالضبط، وهي مهلة `proxy_read_timeout` التي ضبطناها، والسبب في السجل `upstream timed out`، بينما التطبيق نفسه كان سيرد بعد خمس ثوان ب 200، فالمشكلة هنا في البطء وليست في خطأ داخل التطبيق.
### الخطوة 6: Session في Python مقابل requests.get
الآن نرى الفرق نفسه من داخل كود تطبيق، فأنشئ الملف `pool_log.py` الذي يرسل ثلاثة طلبات دون Session ثم ثلاثة طلبات عبر Session واحدة إلى Nginx الخاص بالتجربة:
```python
# Three requests without a Session, then three with one, against our Nginx
import requests
URL = "https://lab-http-nginx/api/"
CA = "/certs/localhost.crt"
for i in range(3):
requests.get(f"{URL}no-session-{i}", verify=CA)
with requests.Session() as s:
for i in range(3):
s.get(f"{URL}session-{i}", verify=CA)
```
ثم شغله ب Python 3.13 مع requests 2.34.2، واقرأ سجل Nginx بعده:
```bash
docker run --rm --network lab-http-net -v "$PWD/pool_log.py:/pool_log.py:ro" -v "$PWD/certs:/certs:ro" \
python:3.13-alpine sh -c "pip install -q --root-user-action=ignore --disable-pip-version-check requests==2.34.2 && python /pool_log.py"
docker logs --tail 6 lab-http-nginx
```
والمخرج سوف يكون كما يلي:
```text
conn=65 req=1 HTTP/1.1 "GET /api/no-session-0 HTTP/1.1" 200
conn=67 req=1 HTTP/1.1 "GET /api/no-session-1 HTTP/1.1" 200
conn=69 req=1 HTTP/1.1 "GET /api/no-session-2 HTTP/1.1" 200
conn=71 req=1 HTTP/1.1 "GET /api/session-0 HTTP/1.1" 200
conn=71 req=2 HTTP/1.1 "GET /api/session-1 HTTP/1.1" 200
conn=71 req=3 HTTP/1.1 "GET /api/session-2 HTTP/1.1" 200
```
كل استدعاء ل `requests.get` فتح اتصالاً جديداً بمصافحة TLS كاملة، والطلبات الثلاثة عبر Session سارت على الاتصال رقم 71 نفسه. ولكي نرى أثر ذلك بالوقت على سيرفر بعيد أنشئ الملف `pool.py` الذي يطلب ملفاً صغيراً من موقعنا عشر مرات بكل طريقة:
```python
# The same 10 requests: a new connection each time, then one Session that keeps its connections
import time, requests
URL = "https://arabroot.io/robots.txt"
N = 10
start = time.perf_counter()
for _ in range(N):
requests.get(URL, timeout=10) # each call builds and throws away its own connection
no_pool = time.perf_counter() - start
with requests.Session() as session: # one Session = one connection pool, reused
start = time.perf_counter()
for _ in range(N):
session.get(URL, timeout=10)
pooled = time.perf_counter() - start
print(f"requests.get x{N}: {no_pool:.2f}s ({no_pool / N * 1000:.0f} ms per request)")
print(f"Session().get x{N}: {pooled:.2f}s ({pooled / N * 1000:.0f} ms per request)")
```
ثم شغله ثلاث مرات:
```bash
docker run --rm -v "$PWD/pool.py:/pool.py:ro" python:3.13-alpine sh -c \
"pip install -q --root-user-action=ignore --disable-pip-version-check requests==2.34.2 && python /pool.py && python /pool.py && python /pool.py"
```
والمخرج سوف يكون كما يلي:
```text
requests.get x10: 4.95s (495 ms per request)
Session().get x10: 1.87s (187 ms per request)
requests.get x10: 4.55s (455 ms per request)
Session().get x10: 2.58s (258 ms per request)
requests.get x10: 5.73s (573 ms per request)
Session().get x10: 2.55s (255 ms per request)
```
الأرقام تتغير بين تشغيل وآخر لأنها تمر عبر الإنترنت، وهي للتوضيح فقط، لكن النتيجة ثابتة في المرات الثلاث: الطلبات نفسها إلى السيرفر نفسه أخذت قرابة ضعف الوقت أو أكثر عندما فتح كل طلب اتصاله الخاص. وتخيل الآن أن هذا الكود يعمل داخل API يستقبل مئة طلب في الثانية، وكل طلب منها يستدعي بوابة الدفع.
### ماذا عن HTTP/3؟
Nginx في التجربة يقدم HTTP/3 فعلاً على منفذ UDP، ويعلن عن ذلك في الترويسة `Alt-Svc`، لكننا لم نستطع اختباره بأداة رسمية، والسبب أن Docker Image الرسمية ل curl ليست مبنية بدعم HTTP/3:
```bash
labcurl -sI https://lab-http-nginx/ | grep -i alt-svc
labcurl --http3 -sI https://lab-http-nginx/
```
والمخرج سوف يكون كما يلي:
```text
alt-svc: h3=":443"; ma=86400
curl: option --http3: the installed libcurl version does not support this
curl: try 'curl --help' or 'curl --manual' for more information
```
والطريقة الأسهل لترى HTTP/3 هي المتصفح نفسه على موقع حقيقي يدعمه، فموقعنا مثلاً يرسل `alt-svc: h3=":443"; ma=86400` عبر Cloudflare، وإذا فتحته مرتين ثم نظرت إلى عمود Protocol في أدوات المطور كما في القسم التالي فقد ترى `h3` بجانب الطلبات، بشرط أن تسمح شبكتك بمرور UDP على المنفذ 443، وإلا بقي المتصفح على `h2`.
### إزالة التجربة
الأوامر التالية تزيل ما أنشأته التجربة فقط:
```bash
docker rm -f lab-http-nginx lab-http-app
docker network rm lab-http-net
```
## أدوات تريك ما يحدث فعلاً
أهم أداة في هذا الموضوع هي curl، وهذه الخيارات التي استخدمناها في المقال ويجدر أن تحفظها:
| الخيار | ماذا يفعل |
| ------------------------------ | --------------------------------------------------------------------------------------------------------------- |
| \-v | يطبع الاتصال والمصافحة والطلب والرد كاملين، وهو أول ما تجربه عند أي مشكلة |
| \-I | يرسل HEAD ويطبع الترويسات فقط |
| \-H 'Name: value' | يضيف ترويسة إلى الطلب |
| \-X POST و\-d | يحدد الطريقة، ويرسل محتوى |
| \-L | يتبع إعادة التوجيه 3xx |
| \--http1.1 و\--http2 و\--http3 | يحدد الإصدار، والأخير يحتاج نسخة curl مبنية بدعم HTTP/3 |
| \-w '…' | يطبع متغيرات مثل %{http\_code} و%{time\_connect} و%{time\_appconnect} و%{time\_starttransfer} و%{num\_connects} |
| \-Z | يرسل الروابط بالتوازي بدل التتابع |
أما في المتصفح فافتح أدوات المطور بالمفتاح F12 ثم تبويب Network وأعد تحميل الصفحة، وفيه ما يلي بحسب [مرجع أدوات المطور في Chrome](https://developer.chrome.com/docs/devtools/network/reference?ref=arabroot.io):
- **رمز الحالة والطريقة والحجم والوقت** لكل طلب، وعند الضغط على الطلب ترى ترويساته وترويسات الرد في تبويب Headers.
- **عمود Protocol** الذي يظهر بالضغط بالزر الأيمن على عناوين الأعمدة، ويقول لك هل الطلب `http/1.1` أو `h2` أو `h3`، وعمود **Connection ID** الذي يكشف أي الطلبات سارت على الاتصال نفسه.
- **تبويب Timing** لكل طلب، ويقسم وقته إلى مراحل منها Queueing وDNS Lookup وInitial connection ثم انتظار الرد وتنزيله، فإذا رأيت Initial connection، وهي بحسب التوثيق تشمل مصافحة TCP والتفاوض على TLS، في أغلب الطلبات إلى الموقع نفسه فهذا يعني أن الاتصالات لا يعاد استخدامها، وإذا رأيت Queueing طويلاً مع HTTP/1.1 فأنت على الأرجح تصطدم بحد الاتصالات الست.
وإذا كنت تفضل أداة أسهل في القراءة من curl فهناك [HTTPie](https://httpie.io/docs/cli?ref=arabroot.io) التي تلون الترويسات وتنسق JSON، مثل `http -v GET example.com`، وهي مناسبة لتجربة ال APIs يدوياً.
## أخطاء شائعة
- **عملية تغيير خلف GET:** روابط مثل `/logout` أو `/delete?id=5` بطريقة GET يستدعيها أي برنامج يحمل الصفحات مسبقاً أو يزحف عليها، فاجعل كل تغيير POST أو PUT أو DELETE.
- **إعادة POST تلقائياً:** تفعيل إعادة المحاولة Retry في الكلاينت لكل الطرق قد يكرر عمليات الدفع والإنشاء، فاقصره على الطرق المتكررة، أو استخدم مفتاحاً يمنع التكرار في ال API نفسه إذا كان يدعمه.
- **الخلط بين 401 و403:** 401 يعني أن المستخدم لم يثبت من هو، و403 يعني أنه معروف لكنه لا يملك الصلاحية، والخلط بينهما يجعل الواجهة تطلب تسجيل الدخول من شخص مسجل أصلاً.
- **البحث عن 502 في كود التطبيق:** 502 و504 يكتبهما ال Proxy، فابدأ بسجل أخطائه، ثم تحقق هل التطبيق يعمل وعلى أي منفذ.
- **رفع المهلة لإخفاء البطء:** رفع `proxy_read_timeout` إلى عشر دقائق يحول 504 إلى صفحة معلقة، والأصح أن تعرف لماذا يتأخر التطبيق، أو تنقل العمل الطويل إلى مهمة في الخلفية.
- **كلاينت HTTP جديد مع كل طلب:** `requests.get` داخل حلقة، أو `new HttpClient()` في كل استدعاء، أو Transport جديد في Go لكل طلب، وكلها تدفع مصافحة كاملة في كل مرة وتترك منافذ كثيرة في TIME\_WAIT.
- **عدم قراءة الرد أو إغلاقه:** في Go وفي requests مع `stream=True` لا يعود الاتصال إلى المجمع إلا بعد قراءة المحتوى وإغلاقه، فيفتح الكلاينت اتصالات جديدة رغم أنك تستخدم Pool.
- **تفعيل HTTP/3 دون فتح UDP 443:** يرسل السيرفر Alt-Svc، ثم يفشل QUIC بصمت ويبقى المتصفح على HTTP/2، فلا تستفيد شيئاً ولا ترى أي خطأ.
- **Domain Sharding مع HTTP/2:** توزيع الملفات على عدة نطاقات فرعية كان حلاً ل HTTP/1.1، ومع HTTP/2 يضيف بحث DNS ومصافحة لكل نطاق ويمنع جمع الطلبات على اتصال واحد.
- **وضع بيانات سرية في Query String:** HTTPS يشفرها في الطريق، لكنها تبقى في سجلات السيرفر وال Proxy وسجل المتصفح، فضع التوكنات وكلمات المرور في الترويسات أو المحتوى.
## قائمة تحقق
- كل عملية تغير بيانات تستخدم POST أو PUT أو PATCH أو DELETE، وGET لا يغير شيئاً.
- ال API يرد بالرمز الصحيح: 201 عند الإنشاء، و401 و403 كل في مكانه، و404 للمسارات غير الموجودة بدل 200 مع رسالة خطأ.
- تعرف أين تقرأ سبب 502 و504 في سجل ال Proxy، وما هي المهلة المضبوطة عندك.
- الموقع يعمل عبر HTTPS فقط، وطلبات HTTP تتحول إليه ب 301 أو 308، ومعه HSTS بعد أن تتأكد أن كل النطاقات الفرعية تعمل عبر HTTPS.
- HTTP/2 مفعل على ال Reverse Proxy، وإذا فعلت HTTP/3 فمنفذ UDP 443 مفتوح في جدار الحماية وعند مزود السيرفر.
- في كود التطبيق كلاينت HTTP واحد مشترك لكل خدمة خارجية، ينشأ عند التشغيل ويغلق عند الإيقاف.
- محتوى كل رد يقرأ كاملاً ويغلق، وحجم المجمع مناسب لعدد الطلبات المتوازية، مثل `MaxIdleConnsPerHost` في Go.
- إعادة المحاولة التلقائية مقصورة على الطرق المتكررة.
- افتح أدوات المطور على صفحتك الرئيسية مرة واحدة وتأكد من عمود Protocol، ومن أن Initial connection لا يتكرر لكل طلب.
## الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- فتح الرابط يمر بخطوات منفصلة: DNS ثم TCP ثم TLS ثم الطلب ثم الرد، والمقطع بعد `#` لا يصل إلى السيرفر أبداً.
- الطلب والرد لهما الشكل نفسه: سطر بداية ثم ترويسات ثم سطر فارغ ثم محتوى، وفي HTTP/2 وHTTP/3 تبقى المعاني نفسها بإطارات ثنائية.
- GET وHEAD وOPTIONS آمنة لا تغير شيئاً، وPUT وDELETE متكررة يجوز إعادتها، وPOST لا هذه ولا تلك فلا تعاد تلقائياً.
- الخانة الأولى في رمز الحالة تقول من المسؤول، و502 و504 يكتبهما ال Proxy عندما يكون التطبيق متوقفاً أو بطيئاً.
- HTTPS هو HTTP نفسه داخل TLS، يخفي المسار والترويسات والمحتوى، ولا يخفي عنوان السيرفر واسم النطاق.
- الاتصال الجديد يكلف مرات ذهاب وعودة إضافية لمصافحة TCP وTLS قبل الطلب، وفي قياسنا كان أول بايت على اتصال جديد بعد 0.35 ثانية تقريباً وعلى الاتصال المعاد استخدامه بعد 0.1 ثانية تقريباً.
- HTTP/1.1 يعيد استخدام الاتصال لكنه يحمل طلباً واحداً في كل لحظة فتفتح المتصفحات حتى ستة اتصالات، وHTTP/2 يحمل الطلبات كلها على اتصال واحد، وHTTP/3 ينقلها إلى QUIC حتى لا توقفها حزمة ضائعة، والاختيار بينها يتم عبر ALPN وAlt-Svc.
- في كودك أنشئ كلاينت HTTP واحداً واستخدمه في كل الطلبات واقرأ كل رد حتى نهايته، والاتصال بين Nginx والتطبيق له إعداده الخاص في مقال تجميع الاتصالات.
[دليلشرح DNS وسجلاته للمبتدئين بمثال حقيقيكيف يتحول اسم نطاقك إلى عنوان سيرفرك، وما وظيفة كل سجل تضيفه في لوحة النطاق، والأخطاء التي تضيع فيها الساعات عادة.](https://arabroot.io/articles/%D8%B4%D8%B1%D8%AD-dns-%D9%88%D8%B3%D8%AC%D9%84%D8%A7%D8%AA%D9%87-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/)[دليلالشهادات الرقمية TLS للمبتدئين وصيغ ملفاتهاكيف يعرف المتصفح أنه يتحدث مع الموقع الحقيقي، وماذا يوجد داخل الشهادة، ولماذا تأتي ملفاتها بأكثر من صيغة.](https://arabroot.io/articles/%D8%A7%D9%84%D8%B4%D9%87%D8%A7%D8%AF%D8%A7%D8%AA-%D8%A7%D9%84%D8%B1%D9%82%D9%85%D9%8A%D8%A9-tls-%D9%88-x509-%D9%88%D8%B5%D9%8A%D8%BA-pem-%D9%88-der/)[دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.](https://arabroot.io/articles/%D8%B4%D8%A8%D9%83%D8%A9-%D8%AA%D9%88%D8%B5%D9%8A%D9%84-%D8%A7%D9%84%D9%85%D8%AD%D8%AA%D9%88%D9%89-cdn-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/)[دليلHSTS وCSP: ترويسات الأمان التي يحتاجها كل تطبيقما الذي تطلبه كل ترويسة أمان من المتصفح، ولماذا يصعب التراجع عن HSTS، وكيف تبني سياسة CSP لا تكسر تطبيقك.](https://arabroot.io/articles/%D8%AA%D8%B1%D9%88%D9%8A%D8%B3%D8%A7%D8%AA-%D8%A7%D9%84%D8%A3%D9%85%D8%A7%D9%86-hsts-%D9%88-csp/)[دليلكيف يرى تطبيقك عنوان الزائر الحقيقي خلف ال Reverse Proxyإذا كان تطبيقك يرى عنوان ال Proxy بدلاً من الزائر أو يولد روابط http، فهذا هو السبب والإعداد الصحيح لإطار عملك.](https://arabroot.io/articles/%D8%AA%D8%B7%D8%A8%D9%8A%D9%82%D9%83-%D8%AE%D9%84%D9%81-reverse-proxy/)[دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.](https://arabroot.io/articles/%D8%AA%D8%AC%D9%85%D9%8A%D8%B9-%D8%A7%D9%84%D8%A7%D8%AA%D8%B5%D8%A7%D9%84%D8%A7%D8%AA-connection-pooling-%D9%84%D9%84%D9%85%D8%A8%D8%AA%D8%AF%D8%A6%D9%8A%D9%86/)
## سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة Nginx 1.31.6 مع HTTP/2 أمام تطبيق Python 3.13 في Docker، باستخدام curl 8.22.0 وrequests 2.34.2، وقياس توقيت الاتصال الجديد والمعاد استخدامه إلى موقعنا، أما HTTP/3 فقد فعلناه في Nginx دون اختباره لأن Docker Image الرسمية ل curl لا تدعمه.