اكتب في فهرس أي مكتبة جامعية عربية «نجيب محفوظ»، ثم اكتب «Naguib Mahfouz»، ثم «محفوظ، نجيب»، وقارن النتائج. في كثير من الفهارس سوف تجد ثلاث قوائم مختلفة، كل واحدة فيها بعض كتبه، لأن كل مفهرس كتب الاسم بالشكل الذي رآه على الغلاف أو بالشكل الذي اعتاده. والطالب الذي يبحث مرة واحدة يظن أن المكتبة ليس فيها إلا ثلاثة كتب لمحفوظ، والمكتبة فيها ثلاثون. وهذه ليست مشكلة في محرك البحث، وإنما في البيانات نفسها، وحلها القديم الذي تستخدمه المكتبات منذ عقود اسمه ضبط الإسناد Authority Control، أي أن يكون لكل شخص شكل واحد معتمد لاسمه، وأن تكون كل الأشكال الأخرى إحالات إليه. وفي هذا المقال سوف نتناول:
- ما هو سجل الإسناد Authority Record، وما فيه: الشكل المعتمد والإحالات والمصادر، وكيف يبنى في MARC21.
- ملف أسماء مكتبة الكونغرس LC NAF، وكيف ترتبط به ملفات أخرى مثل VIAF وISNI وWikidata.
- مختبر يبحث آلياً في id.loc.gov عن اثني عشر مؤلفاً عربياً، ويعد أشكال أسمائهم، ويصل إلى معرفاتهم في VIAF وISNI عبر Wikidata.
- تجربة مطابقة حقيقية: 57 اسماً لمؤلفين عرب كما هي في فهرس Open Library، ونسبة ما يجد صاحبه في كل مستوى من مستويات المطابقة.
- كيف تبني ضبط الإسناد في مكتبتك، وأخطاء شائعة، وقائمة تحقق.
وقد ذكرنا في مقال قواعد RDA كيف يقرر المفهرس الشكل المعتمد لاسم المؤلف العربي، وفي مقال Dublin Core وBIBFRAME كيف يصنع الرابط إلى سجل الإسناد كل الفرق عند التحويل، وهنا نتعامل مع سجلات الإسناد نفسها:
 دليلمعيار MARC21 للمبتدئين: بطاقة الفهرسة في الحاسبنقرأ تسجيلتين حقيقيتين من فهرس مكتبة الكونغرس حقلاً حقلاً، ونرى أين يذهب العنوان العربي، ولماذا ضاعت همزة عند التحويل إلى MARC-8.
 دليلقواعد RDA للكتاب العربي وأسماء المؤلفيننقرأ قواعد RDA من ست تسجيلات حقيقية في فهرس مكتبة الكونغرس، ونرى كيف يدخل اسم المؤلف العربي وكيف تكتب السنة الهجرية والرومنة.
 دليلDublin Core وBIBFRAME: البيانات الوصفية بعد MARCنحول تسجيلتين حقيقيتين من مكتبة الكونغرس إلى Dublin Core وإلى BIBFRAME بالأدوات الرسمية، ونرى ما يبقى وما يضيع من الوصف العربي.
لماذا يحتاج المؤلف العربي ضبط إسناد أكثر من غيره؟
كل المكتبات في العالم تحتاج ضبط الإسناد، ولكن المؤلف العربي يحتاجه أكثر لثلاثة أسباب. الأول الحرف، فاسم المؤلف العربي يظهر بالحرف العربي في كتبه العربية، وبعدة رومنات في الكتب والمراجع الأجنبية: «Mahfouz» في الترجمات الإنجليزية، و«Machfus» في الألمانية، و«Mahfoez» في الهولندية، و«Maḥfūẓ» في الرومنة المكتبية. والثاني بنية الاسم، فالاسم التراثي له كنية واسم ونسب ولقب ونسبة، والمؤلف قد يعرف بأي منها، كما شرحنا في مقال قواعد RDA. والثالث الإملاء، فالاسم العربي نفسه يكتب بالهمزة ودونها، وبالتاء المربوطة والهاء، و«عبد الرحمن» و«عبدالرحمن»، و«ابن» و«بن».
والصورة التالية من سجل واحد حقيقي في ملف أسماء مكتبة الكونغرس، سجل نجيب محفوظ، وفيه 21 شكلاً لاسمه غير الشكل المعتمد:
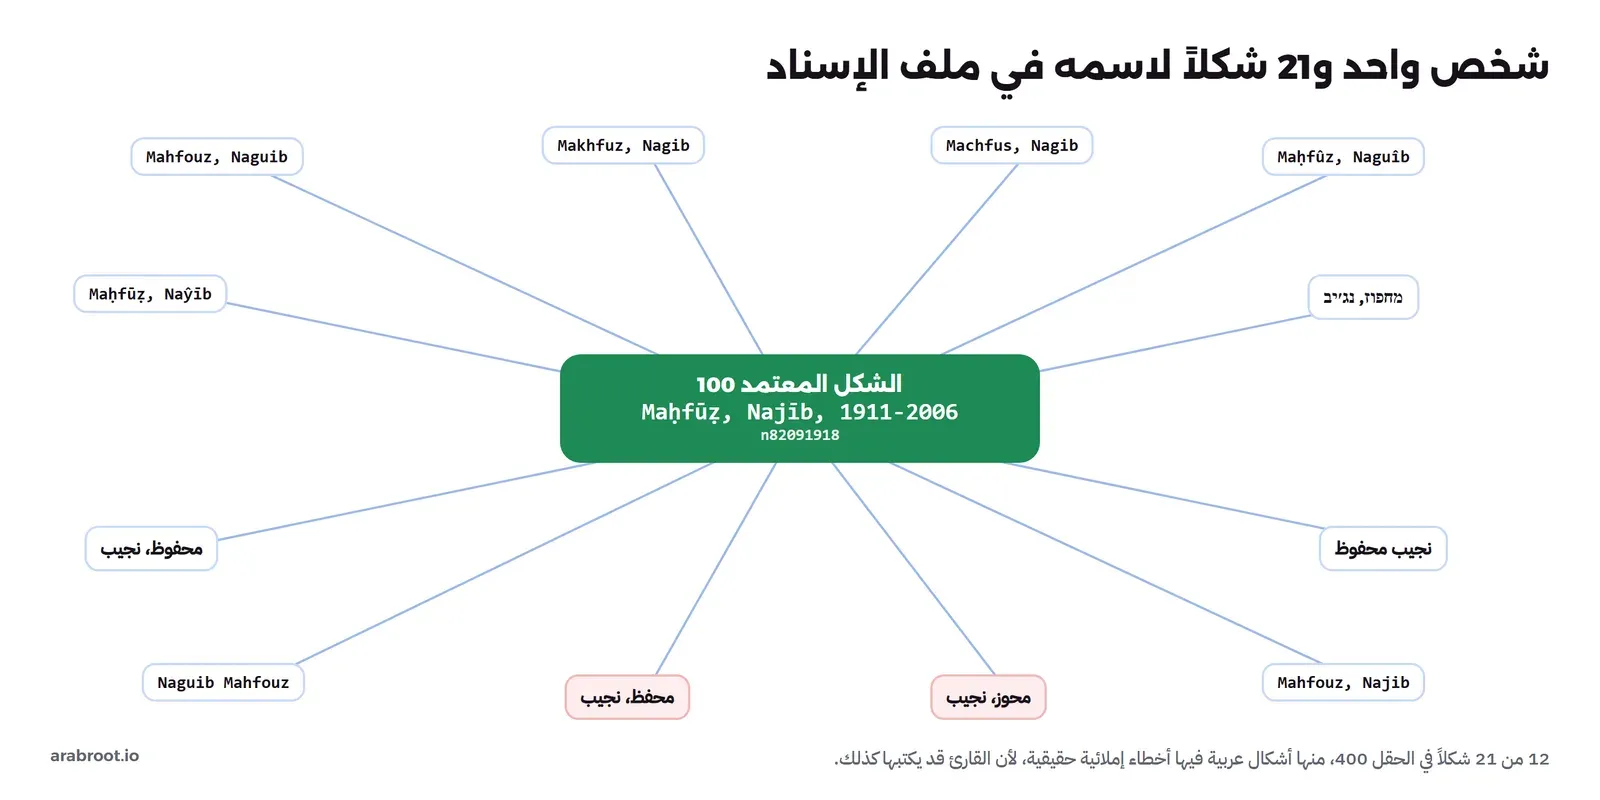
ولاحظ في الصورة شكلين عربيين فيهما أخطاء: «محفظ» و«محوز». وقد يبدو غريباً أن يحفظ ملف إسناد رسمي أشكالاً خاطئة، ولكن هذا مقصود، فالإحالة ليست شكلاً «صحيحاً»، وإنما شكل قد يكتبه شخص ما، وظهر فعلاً في مصدر ما، فإذا بحث به أحد وصل إلى المؤلف الصحيح.
فكرة قديمة قدم الفهارس
ضبط الإسناد ليس فكرة حاسوبية، فقد كتب Charles Cutter في قواعده للفهرس القاموسي في 1876 أن من أهداف الفهرس أن يري القارئ ما تملكه المكتبة لمؤلف معين، وهذا الهدف لا يتحقق إلا إذا جمعت كتب المؤلف تحت اسم واحد مهما اختلف شكله على الأغلفة. وفي زمن البطاقات كانت المكتبات تحتفظ بدرج خاص لبطاقات الإسناد، في كل بطاقة الشكل المعتمد والإحالات، وفي الفهرس العام بطاقات «انظر» تقول للقارئ: «Mahfouz, Naguib انظر Maḥfūẓ, Najīb». والحاسب لم يغير الفكرة، وإنما جعل الإحالة تعمل تلقائياً، فالقارئ يكتب أي شكل والنظام يوصله إلى كل الكتب، وجعل تغيير الشكل المعتمد عملية واحدة بدلاً من إعادة كتابة مئات البطاقات.
والإسناد لا يخص الأشخاص وحدهم، فهناك سجلات إسناد للجهات مثل الجامعات والوزارات التي تتغير أسماؤها، وللأعمال مثل «ألف ليلة وليلة» التي ليس لها مؤلف معروف ولها مئات الطبعات بعناوين مختلفة، وللموضوعات في قوائم رؤوس الموضوعات مثل LCSH وقوائم رؤوس الموضوعات العربية، والمنطق واحد في كلها: شكل معتمد، وإحالات، ومصادر. وفي هذا المقال نركز على الأسماء الشخصية، لأنها أكثر ما يربك الفهارس العربية.
والضرر لا يقف عند البحث، فكل ما تبنيه المكتبة فوق أسماء المؤلفين يتأثر: تقرير «أكثر المؤلفين إعارة» يوزع محفوظ على ثلاثة أسماء فلا يظهر في القائمة، وقرار شراء طبعة جديدة يبنى على عدد ما تملكه المكتبة له فيبدو أقل من الحقيقة، وتصدير الفهرس إلى بوابة وطنية ينقل الفوضى نفسها إلى كل من يحصدها. لذلك ضبط الإسناد ليس رفاهية للمفهرسين، وإنما شرط لصحة كل رقم يخرج من الفهرس.
ما هو سجل الإسناد Authority Record؟
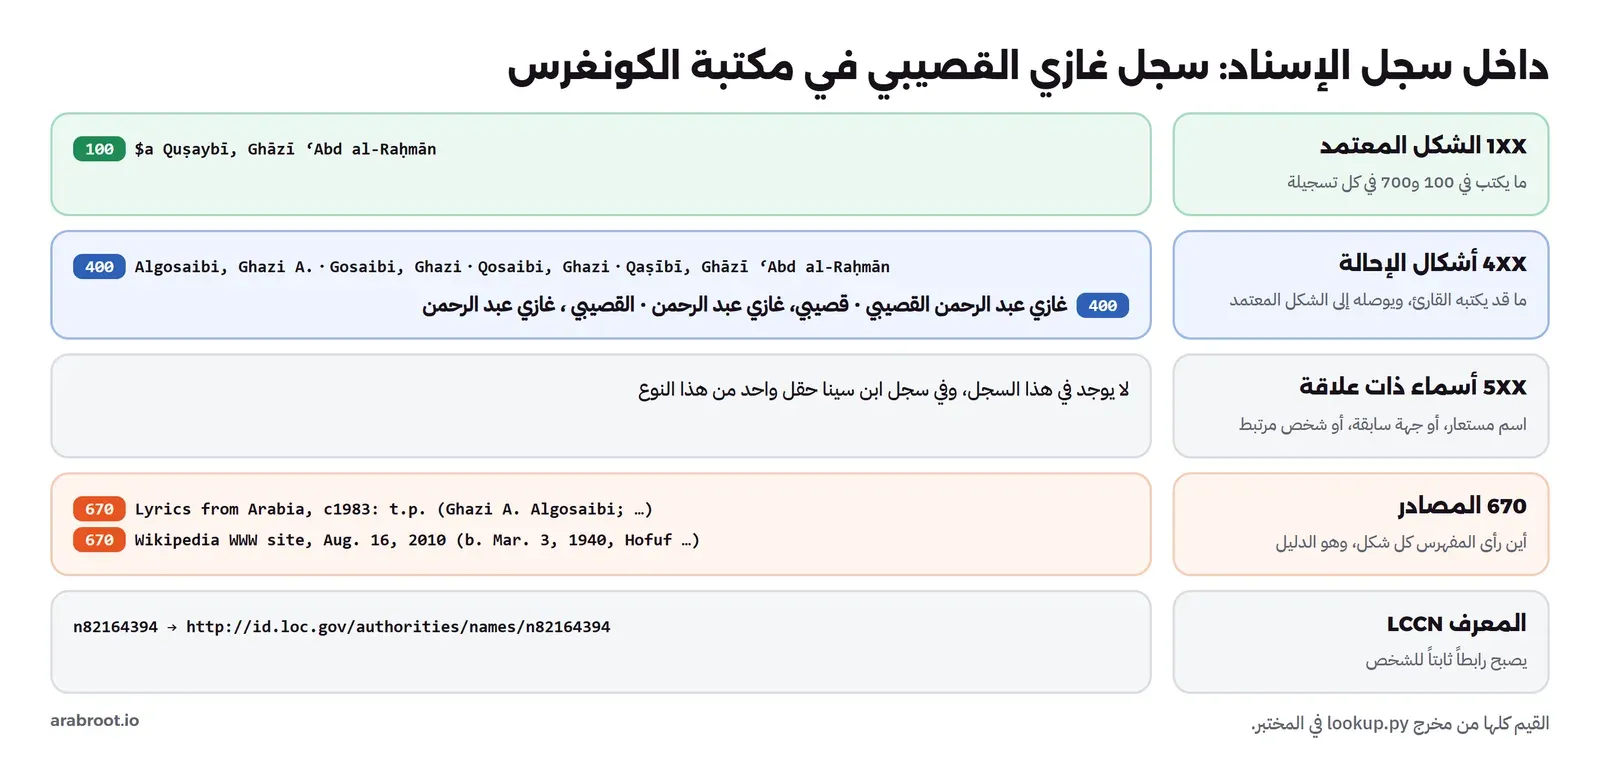
سجل الإسناد تسجيلة MARC21، ولكن ليس لكتاب، وإنما لشخص أو جهة أو عمل أو موضوع، ومعيارها MARC 21 Format for Authority Data. والفكرة أن الكتاب يوصف في تسجيلة ببليوغرافية، والمؤلف يوصف مرة واحدة في سجل إسناد، والتسجيلات الببليوغرافية كلها تستخدم الشكل الذي في سجل الإسناد. والصورة التالية تبين أجزاء السجل بسجل حقيقي، سجل غازي القصيبي:
والحقول الأساسية كما يلي:
- 1XX الشكل المعتمد Authorized Access Point: في الحقل 100 للشخص، و110 للجهة، و130 للعنوان الموحد، و150 للموضوع، وهو الشكل الذي يكتبه المفهرس في 100 أو 700 في التسجيلة الببليوغرافية. ومواصفاته في صفحة 100 Heading, Personal Name.
- 4XX أشكال الإحالة See From: كل شكل آخر للاسم، وهي التي تجعل البحث بـ «Algosaibi» يوصل إلى «Quṣaybī»، كما في صفحة 400 See From Tracing.
- 5XX انظر أيضاً See Also: علاقة باسم معتمد آخر، مثل الاسم المستعار والاسم الحقيقي لكاتب واحد، أو جهة تغير اسمها، وهو قليل في الأسماء الشخصية، كما في صفحة 500 See Also From Tracing.
- 670 المصدر: أين رأى المفهرس الاسم وبأي شكل، وما عرفه عن الشخص من المصدر، وهو الدليل الذي يعود إليه من يراجع السجل، ومواصفاته في صفحة 670 Source Data Found.
وأكبر ملف إسناد للأسماء في العالم هو ملف أسماء مكتبة الكونغرس LC Name Authority File، واختصاراً LC NAF، ولا تبنيه مكتبة الكونغرس وحدها، وإنما مئات المكتبات المشاركة في برنامج NACO التابع لبرنامج الفهرسة التعاونية PCC، وكل مكتبة عضو تضيف سجلات للمؤلفين الذين تفهرس كتبهم، وتتبع في ذلك دليل DCM Z1 لسجلات الأسماء. والملف كله متاح للعامة دون اشتراك في خدمة البيانات المترابطة id.loc.gov، وهي التي سوف نستخدمها في المختبر.
المختبر: البحث في ملف الإسناد آلياً
الآن سوف نقوم بالبحث الفعلي. نستخدم الـ Container نفسه من مقال MARC21، وفيه Python، وكتبنا سكربتاً صغيراً lab/lookup.py يفعل ثلاثة أشياء: يقترح سجلات لاسم مكتوب، ويجلب سجل الإسناد كاملاً بصيغة MARCXML ويطبع حقوله الأساسية، ويسأل Wikidata عن معرفات الشخص في الملفات الأخرى:
"""Look up Arab authors in LC NAF (id.loc.gov), then Wikidata for VIAF/ISNI ids.
Low volume: one request per step, a pause between requests, a plain User-Agent."""
import json, sys, time, urllib.parse, urllib.request
import xml.etree.ElementTree as ET

UA = {"User-Agent": "arabroot-lab/1.0 ([email protected])"}
M = "{http://www.loc.gov/MARC21/slim}"

def get(url):
    time.sleep(1.0)
    with urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=40) as r:
        return r.read()

AUTHORS = {  # LCCN of the authority record, found once with suggest2
    "nagib-mahfouz": "n82091918",
}

def suggest(q):
    url = "https://id.loc.gov/authorities/names/suggest2/?" + urllib.parse.urlencode({"q": q, "count": 5})
    return json.loads(get(url))["hits"]

def authority(lccn):
    root = ET.fromstring(get(f"https://id.loc.gov/authorities/names/{lccn}.marcxml.xml"))
    rec = root if root.tag == M + "record" else root.find(f".//{M}record")
    out = []
    for df in rec.findall(f"{M}datafield"):
        tag = df.get("tag")
        if tag[0] in "145" and tag[1:] in ("00", "10", "11", "30") or tag == "670":
            subs = " ".join(f"${s.get('code')} {s.text}" for s in df.findall(f"{M}subfield"))
            out.append((tag, subs))
    return out

def wikidata(lccn):
    q = f'SELECT ?p ?pLabel ?viaf ?isni WHERE {{ ?p wdt:P244 "{lccn}" . OPTIONAL{{?p wdt:P214 ?viaf}} OPTIONAL{{?p wdt:P213 ?isni}} SERVICE wikibase:label {{ bd:serviceParam wikibase:language "ar,en". }} }}'
    j = json.loads(get("https://query.wikidata.org/sparql?" + urllib.parse.urlencode({"format": "json", "query": q})))
    return [{k: v["value"] for k, v in b.items()} for b in j["results"]["bindings"]]

if __name__ == "__main__":
    mode = sys.argv[1]
    if mode == "suggest":
        for h in suggest(sys.argv[2]):
            print(h["token"], "|", h["aLabel"], "| variants:", len(h["more"].get("variantLabels", [])))
    elif mode == "auth":
        for tag, subs in authority(sys.argv[2]):
            print(tag, subs)
    elif mode == "wd":
        for b in wikidata(sys.argv[2]):
            print(b)
في السكربت أعلاه لاحظ التالي:
- كل طلب ينتظر ثانية قبل أن يرسل، ويحمل اسم مستخدم User-Agent واضحاً فيه بريد للتواصل، وهذا أدب التعامل مع خدمة عامة مجانية، فلا تقم بإرسال آلاف الطلبات في دقيقة، والسبب أن الخدمة قد تحظر عنوانك، ولأنها تخدم مكتبات العالم كله.
suggest2خدمة اقتراح في id.loc.gov، تأخذ بداية الاسم وتعيد السجلات التي تبدأ به مع أشكالها، وهي أسرع طريقة لتعرف رقم سجل الشخص.- الصيغة
.marcxml.xmlتعيد سجل الإسناد كاملاً بحقوله، وهي أنسب للمكتبات من صيغ RDF، لأنك تقرأ فيها الحقول التي تعرفها. - القاموس
AUTHORSمجرد ملاحظة بالرقم الذي وجدناه أول مرة، والسكربت لا يستخدمه.
وقد اخترنا Python لأن مكتباته القياسية تكفي، فلا يحتاج السكربت أي حزمة إضافية، ولكن الطلبات نفسها عناوين ويب عادية، فتستطيع أن تفتح رابط suggest2 في المتصفح وترى النتيجة بصيغة JSON، وأن تحفظ سجل الإسناد بصيغة MARCXML من الرابط نفسه بأداة curl، دون أي برمجة. وأي نظام مكتبة يستطيع أن يستخدم هذه الروابط نفسها في إضافة برمجية بسيطة تقترح على المفهرس الشكل المعتمد وهو يكتب الاسم.
ونبدأ بالبحث عن نجيب محفوظ بشكله المرومن:
docker run --rm -v "$PWD/lab:/lab" marc-lab python3 -I /lab/lookup.py suggest "Maḥfūẓ, Najīb"n88159292 | Maḥfūẓ, Najīb, 1882-1974 | variants: 3
n82091918 | Maḥfūẓ, Najīb, 1911-2006 | variants: 21
no2014020457 | Maḥfūẓ, Najīb, 1911-2006. Short stories. Selections. English (Stock). 1996 | variants: 2
no2004051053 | Maḥfūẓ, Najīb, 1911-2006. ʻAbath al-aqdār. English | variants: 1
no00074748 | Maḥfūẓ, Najīb, 1911-2006. ʻAbath al-aqdār. French | variants: 1في المخرج أعلاه لاحظ التالي:
- النتيجة الأولى ليست الروائي، وإنما شخص آخر بالاسم نفسه تماماً، ولد في 1882 وتوفي في 1974، والروائي هو الثاني، والفرق بينهما في التاريخ وحده. وسوف نعود إلى هذا بعد قليل لأنه أهم درس في المقال.
- النتائج الثلاث الأخيرة ليست أشخاصاً، وإنما أعمال: «مختارات من القصص القصيرة بالإنجليزية» و«عبث الأقدار» بالإنجليزية والفرنسية، لأن ملف الأسماء فيه أيضاً سجلات الأعمال بالشكل «المؤلف. العنوان. اللغة»، وهي التي تجمع ترجمات العمل الواحد كما شرحنا في مقال قواعد RDA.
- الرقم في البداية مثل
n82091918هو رقم الضبط LCCN للسجل، وهو الذي يصبح جزءاً من الرابط الدائم للشخص.
قراءة سجل الإسناد كاملاً
docker run --rm -v "$PWD/lab:/lab" marc-lab python3 -I /lab/lookup.py auth n82091918100 $a Maḥfūẓ, Najīb, $d 1911-2006
400 $a Makhfuz, Nagib, $d 1911-2006
400 $a Najīb Maḥfūẓ, $d 1911-2006
400 $a Mahfouz, Najib, $d 1911-2006
400 $a Naguib Mahfouz, $d 1911-2006
400 $a Mahfouz, Naguib, $d 1911-2006
400 $a Nagib Makhfuz, $d 1911-2006
400 $a Najib Mahfouz, $d 1911-2006
400 $a Maḥfûz, Naguîb, $d 1911-2006
400 $a Machfus, Nagib, $d 1911-2006
400 $a Naguîb Maḥfûz, $d 1911-2006
400 $a Nagib Machfus, $d 1911-2006
400 $a Maḥfūẓ, Naŷīb, $d 1911-2006
400 $a Maḥfuṭ, Nag'ib, $d 1911-2006
400 $a מחפוז, נג׳יב, $d 1911-2006 $7 (bcp47)he
400 $a محفوظ، نجيب، $d 1911-2006 $7 (bcp47)ar
400 $a محفظ، نجيب، $d 1911-2006
400 $a محفوز، نجيب، $d 1911-2006
400 $a محفوظ، نجب، $d 1911-2006
400 $a محفوظ، نحيب $7 (bcp47)ar
400 $a محوز، نجيب
400 $a نجيب محفوظ
670 $a His al-Sarāb, 1961.
670 $a His Ḥawla al-dīn wa-al-dīmuqrāṭīyah, 1990: $b t.p. (Najīb Maḥfūẓ) p. 223, etc. (Najīb Maḥfūẓ ʻAbd al-ʻAzīz Ibrāhīm Aḥmad al-Bāshā, his first name is Najīb Maḥfūẓ, named after the famous obstetrician, b. Dec. 11, 1911; author's works listed)
670 $a His Der Dieb und die Hunde, c1980: $b t.p. (Nagib Machfus)
670 $a Wikipedia WWW site, Aug. 30, 2006 $b (Naguib Mahfouz; b. Dec. 11, 1911, Cairo; d. Aug. 30, 2006; Nobel Prize-winning Egyptian novelist [1988])
670 $a Nobel Foundation, WWW, viewed on March 13, 2019: $b Nobel Prize in Literature 1988 (...)واختصرنا بعض أسطر 670 هنا، والمخرج كاملاً في الملف lab/out-auth-mahfouz.txt. وفي المخرج أعلاه لاحظ التالي:
- الإحالات بالترتيب المقلوب والمباشر: «Mahfouz, Naguib» و«Naguib Mahfouz» كلاهما موجود، لأن القارئ قد يكتب الاسم بأي ترتيب، والفهرس الذي يطابق حرفياً يحتاج الشكلين.
- إحالات بلغات أخرى: الألمانية «Machfus» من ترجمة «اللص والكلاب» إلى الألمانية، كما يقول الحقل 670، والإسبانية «Naŷīb»، والعبرية مع وسم اللغة
$7 (bcp47)he. - سبعة أشكال بالحرف العربي، منها «محفوظ، نجيب» الصحيح، ومنها أخطاء مثل «نحيب» و«نجب» و«محوز»، والأرجح أنها جاءت من تسجيلات حقيقية في فهارس مكتبات كتبها أحدهم بهذا الشكل.
- الحقل 670 يحمل قصة: من كتابه «حول الدين والديمقراطية» نعرف أن اسمه الكامل «نجيب محفوظ عبد العزيز إبراهيم أحمد الباشا»، وأن «نجيب محفوظ» اسمه الأول المركب، وأنه سمي على اسم طبيب الولادة الشهير. وهذا الطبيب هو بالضبط صاحب السجل الأول في نتيجة البحث.
وهذا هو السبب في أن المفهرس الخبير يقرأ الحقل 670 قبل أن يستخدم أي سجل، وليس الحقل 100 وحده، فالشكل المعتمد يقول كيف يكتب الاسم، أما المصادر فتقول من هو صاحبه: متى ولد، وماذا كتب، وأين عمل. وإذا كان الكتاب الذي بين يديك رواية صدرت في الستينيات، والسجل يقول إن صاحبه طبيب نساء وولادة ولد في 1882، فهذا ليس مؤلفك مهما تطابق الاسم. والقراءة تأخذ دقيقة، والخطأ الذي تمنعه يأخذ ساعات لاكتشافه وتصحيحه بعد أن تختلط الكتب في الفهرس، وقد تمر عليه سنوات دون أن ينتبه إليه أحد.
اسم واحد وشخصان: الدرس الأهم
سجل الطبيب في ملف الإسناد قصير، وهذا هو كاملاً من المختبر:
100 $a Maḥfūẓ, Najīb, $d 1882-1974
400 $a Mahfouz, Nagib, $d 1882-1974
400 $a محفوظ، نجيب
400 $a محفوظ، نجيب.، $d 1882-1974
670 $a Jawādī, M.M. al-Duktūr Najīb Maḥfūẓ, 1986: $b added t.p., etc. (Dr. Nagib Mahfouz, 1882-1974; Egyptian obstetrician and gynecologist)
670 $a LC manual cat., 11-10-88 $b (hdg.: Maḥfūẓ, Najīb, 1882- )
والصورة التالية تضع الشخصين جنباً إلى جنب:
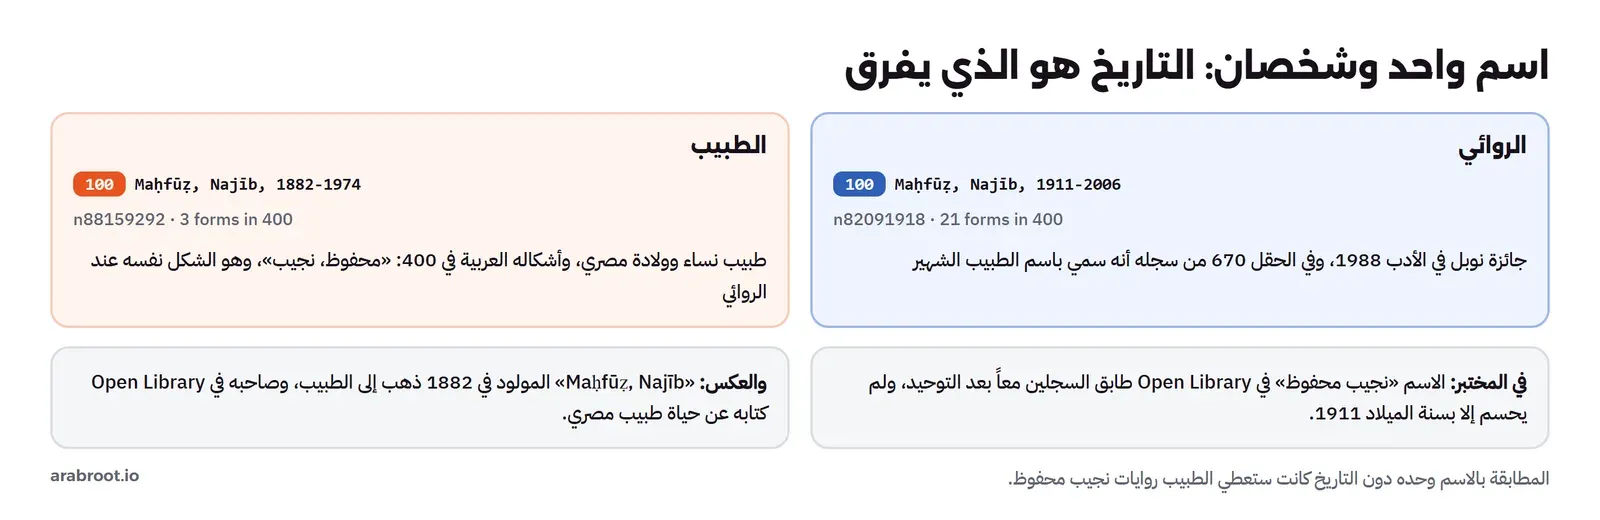
لاحظ أن الشكل العربي «محفوظ، نجيب» موجود في سجل الطبيب وفي سجل الروائي، وأن الشكل المعتمد في السجلين واحد حتى الفاصلة، والفرق في الحقل الفرعي $d وحده. وهذا يعني أن أي برنامج يطابق أسماء المؤلفين في فهرسك بالاسم دون التاريخ قد يعطي الطبيب روايات نجيب محفوظ، أو يعطي الروائي كتب الطبيب، وهذا خطأ يصعب اكتشافه، لأن النتيجة تبدو صحيحة لمن لا يعرف القصة. والقاعدة التي تخرج بها: لا تقم بإضافة رابط إسناد لاسم يطابق أكثر من سجل، والسبب أن الرابط الخطأ أسوأ من غيابه، فهو يخبر كل نظام يقرأ بياناتك بمعلومة خاطئة بثقة كاملة.
والمشكلة أكبر في الأسماء العربية الشائعة، فاسم مثل «محمد عبد الله» أو «أحمد علي» قد يكون لعشرات المؤلفين في فهرس جامعة واحدة، أغلبهم ليس له تاريخ ميلاد معروف للمفهرس، ولا سجل في أي ملف دولي. وهنا لا يكفي التاريخ، وإنما يحتاج المفهرس إلى ما يميز الشخص في 670: التخصص، أو الجهة، أو اسم الأب والجد كاملاً، وتسجيل ذلك في سجل الإسناد من أول كتاب، لأن التمييز بعد أن تختلط الكتب أصعب بكثير من التمييز عند الفهرسة.
اثنا عشر مؤلفاً عربياً في ملف الإسناد
لكي نرى الصورة أوسع من مؤلف واحد، اخترنا اثني عشر سجلاً لمؤلفين عرب من عصور مختلفة: الجاحظ وابن سينا والغزالي وابن خلدون من التراث، وطه حسين ونجيب محفوظ ومحمود درويش ونزار قباني من القرن العشرين، وغازي القصيبي وعبد الرحمن منيف من الكتاب السعوديين، ومعهم شخصان يشبهان اثنين منهم في الاسم: نجيب محفوظ الطبيب، ومحمد الغزالي الداعية المصري المولود في 1917. وهذا السطر الأول من مخرج سكربت المطابقة، وهو يعد أشكال كل سجل:
n50014331   1XX=Ḥusayn, Ṭāhā, 1889-1973 | 4XX=14 (Arabic script 7) | 5XX=0
n50037926   1XX=Darwīsh, Maḥmūd  | 4XX=12 (Arabic script 2) | 5XX=0
n50052785   1XX=Ibn Khaldūn, 1332-1406 | 4XX=22 (Arabic script 8) | 5XX=0
n79039822   1XX=Qabbānī, Nizār  | 4XX=6 (Arabic script 1) | 5XX=0
n79115518   1XX=Jāḥiẓ, -868 or 869 | 4XX=30 (Arabic script 16) | 5XX=0
n80002386   1XX=Avicenna, 980-1037 | 4XX=64 (Arabic script 15) | 5XX=1
n82091918   1XX=Maḥfūẓ, Najīb, 1911-2006 | 4XX=21 (Arabic script 7) | 5XX=0
n82097778   1XX=Ghazzālī, 1058-1111 | 4XX=57 (Arabic script 12) | 5XX=0
n82162484   1XX=Ghazālī, Muḥammad, 1917-1996 | 4XX=12 (Arabic script 4) | 5XX=0
n82164394   1XX=Quṣaybī, Ghāzī ʻAbd al-Raḥmān  | 4XX=11 (Arabic script 7) | 5XX=0
n85157058   1XX=Munīf, ʻAbd al-Raḥmān  | 4XX=7 (Arabic script 4) | 5XX=0
n88159292   1XX=Maḥfūẓ, Najīb, 1882-1974 | 4XX=3 (Arabic script 2) | 5XX=0
في المخرج أعلاه لاحظ التالي:
- ابن سينا له 64 شكلاً، والغزالي 57، والجاحظ 30، أي أن الأسماء التراثية التي ترجمت أعمالها إلى لغات كثيرة عبر قرون لها أشكال أكثر بكثير من المعاصرين، وابن سينا مدخله المعتمد «Avicenna»، الشكل اللاتيني الذي عرف به في أوروبا منذ العصور الوسطى، وليس «Ibn Sīnā»، لأن RDA تختار الشكل الأشهر في المصادر.
- نزار قباني له ستة أشكال فقط، منها شكل واحد بالعربية، ومحمود درويش له شكلان عربيان من اثني عشر، وهذا يعني أن البحث بالعربية في ملف الإسناد عن شاعر عربي كبير يعتمد على شكل أو شكلين، وأن المكتبة العربية لا تستطيع أن تعتمد على ملف مكتبة الكونغرس وحده لأشكالها العربية.
- بعض المعاصرين بلا تواريخ: «Darwīsh, Maḥmūd» و«Qabbānī, Nizār» و«Quṣaybī» و«Munīf» دون سنة ميلاد ولا وفاة، مع أنهم توفوا جميعاً. فالتاريخ في ملف الإسناد يضاف عندما يحتاج الاسم إلى تمييز، ولكن هذا يعني أن البرنامج الذي يستخدم التاريخ ليحسم المطابقة لن يجده دائماً.
- ابن سينا وحده له 5XX، وهو حقل علاقة بشكل معتمد آخر، فالأسماء الشخصية نادراً ما تحتاجه.
والملاحظة الأهم للمكتبات العربية أن الأشكال العربية في هذا الملف قليلة نسبياً، ومتفاوتة الجودة، فبعضها كتبه مفهرسون يعرفون العربية، وبعضها أضيف آلياً، وبعضها نقل من تسجيلات فيها أخطاء إملائية. وهذا ليس عيباً في الملف بقدر ما هو انعكاس لمن يساهم فيه، فالمكتبات التي تفهرس الكتب العربية في الملف الدولي قليلة، والمكتبة العربية التي تعتمد عليه تحتاج أن تكمل الأشكال العربية في ملفها المحلي، وتراجع ما تنسخه.
VIAF وISNI وWikidata: الإسناد خارج مكتبة واحدة
ملف مكتبة الكونغرس ملف واحد، ولكل مكتبة وطنية ملفها: المكتبة الوطنية الفرنسية، والألمانية، والإسبانية، ومكتبة الإسكندرية، وغيرها، وكل ملف فيه نجيب محفوظ بشكله المعتمد في تلك المكتبة. والسؤال: كيف يعرف البرنامج أن سجلات هذه الملفات كلها للشخص نفسه؟ وهنا يأتي دور ثلاثة مشاريع، والصورة التالية تبين كيف ترتبط بنجيب محفوظ نفسه:
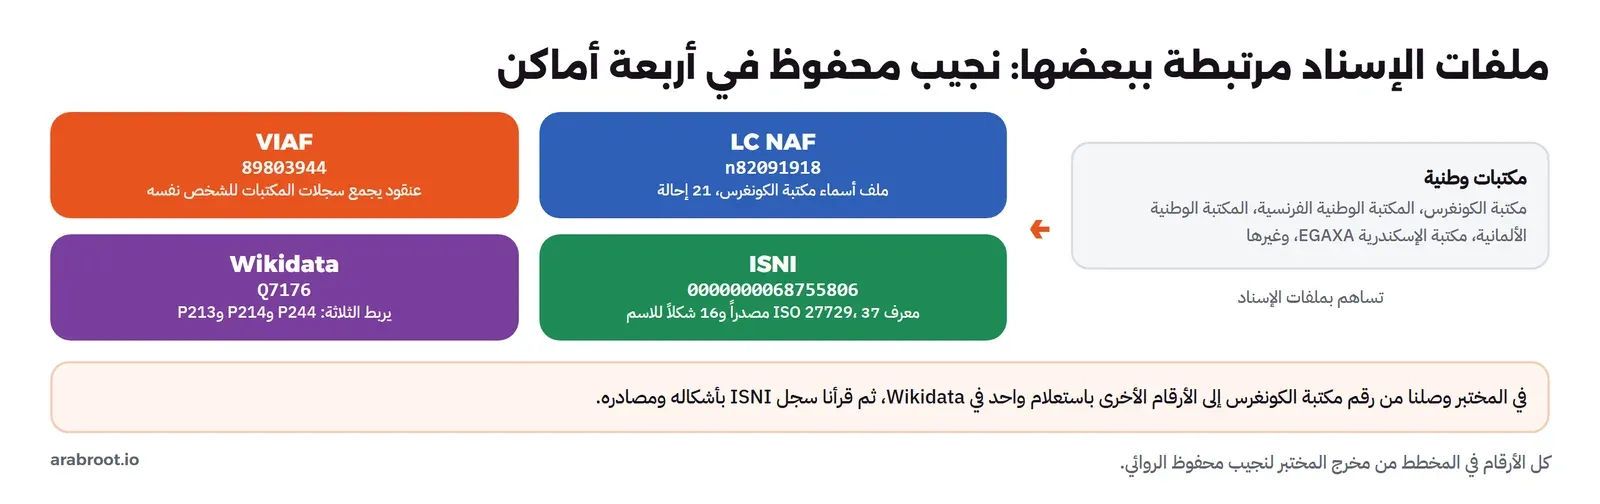
- VIAF، أي الملف الدولي الافتراضي للإسناد Virtual International Authority File، وتديره OCLC مع المكتبات الوطنية، يجمع سجلات الشخص نفسه من الملفات الوطنية في عنقود Cluster واحد برقم واحد، فلا يحل محل الملفات الوطنية، وإنما يربطها.
- ISNI، أي المعرف الدولي القياسي للأسماء International Standard Name Identifier، وهو معيار ISO يعطي كل منشئ رقماً من 16 خانة، ليس فقط للمؤلفين في المكتبات، وإنما للفنانين والناشرين والباحثين أيضاً.
- Wikidata، قاعدة المعرفة المفتوحة، وفيها لكل شخص عنصر برقم مثل Q7176، وفيه خصائص لمعرفاته في الملفات الأخرى: P244 لرقم مكتبة الكونغرس، وP214 لرقم VIAF، وP213 لرقم ISNI.
وفي المختبر استخدمنا Wikidata جسراً، لأن استعلاماً واحداً بلغة SPARQL في خدمة الاستعلام يأخذ رقم مكتبة الكونغرس ويعيد الأرقام الأخرى، وهو الوضع wd في السكربت:
for n in n82091918 n88159292 n82164394 n50052785 n80002386; do
  echo "## $n"; docker run --rm -v "$PWD/lab:/lab" marc-lab python3 -I /lab/lookup.py wd $n
done
## n82091918
{'p': 'http://www.wikidata.org/entity/Q7176', 'viaf': '89803944', 'isni': '0000000068755806', 'pLabel': 'نجيب محفوظ'}
## n88159292
{'p': 'http://www.wikidata.org/entity/Q4166439', 'viaf': '97027118', 'isni': '0000000107865099', 'pLabel': 'نجيب باشا محفوظ'}
## n82164394
{'p': 'http://www.wikidata.org/entity/Q471044', 'viaf': '59197341', 'isni': '0000000083861463', 'pLabel': 'غازي القصيبي'}
## n50052785
{'p': 'http://www.wikidata.org/entity/Q9294', 'viaf': '41841661', 'isni': '0000000121296275', 'pLabel': 'ابن خلدون'}
## n80002386
{'p': 'http://www.wikidata.org/entity/Q8011', 'viaf': '89770781', 'isni': '0000000121430876', 'pLabel': 'ابن سينا'}
{'p': 'http://www.wikidata.org/entity/Q8011', 'viaf': '6428151248003244270004', 'isni': '0000000121430876', 'pLabel': 'ابن سينا'}في المخرج أعلاه لاحظ التالي:
- طلبنا الاسم بالعربية أولاً
"ar,en"، فعادت كل الأسماء بالعربية من Wikidata، وهذه طريقة سهلة لتحصل على شكل عربي معروف لمؤلف تعرف رقمه في مكتبة الكونغرس، وهو شكل كتبه محررو Wikidata وليس مفهرسين، فاستخدمه للعرض وليس كشكل معتمد. - الطبيب له عنصر مستقل في Wikidata بالاسم «نجيب باشا محفوظ»، وله أرقام مستقلة في VIAF وISNI، فالفصل بين الشخصين متسق في الملفات الأربعة.
- ابن سينا عاد بسطرين، لأن عنصره في Wikidata يحمل رقمين في VIAF، والثاني رقم طويل غير معتاد. ومعنى ذلك غالباً أن VIAF نفسه جمع سجلات ابن سينا في عنقودين في وقت ما، وأن محرري Wikidata سجلوا الاثنين. وهذا يذكرك بأن العناقيد الآلية في VIAF تخطئ أحياناً، فتفصل شخصاً واحداً أو تجمع شخصين.
ثم قرأنا سجل نجيب محفوظ في ISNI مباشرة عبر خدمة SRU العامة، بالسكربت lab/isni.py:
import sys, time, urllib.parse, urllib.request, re
import xml.etree.ElementTree as ET
UA = {"User-Agent": "arabroot-lab/1.0 ([email protected])"}
isni = sys.argv[1]
url = "https://isni.oclc.org/sru/?" + urllib.parse.urlencode({"query": f'pica.isn = "{isni}"', "operation": "searchRetrieve", "recordSchema": "isni-b", "maximumRecords": 1})
x = urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=40).read()
root = ET.fromstring(x)
names = set()
for pn in root.iter("personalName"):
    f, s = pn.findtext("forename") or "", pn.findtext("surname") or ""
    names.add((s + ", " + f).strip(", "))
srcs = sorted({e.text for e in root.iter("source")})
print("ISNI", isni, "| name forms:", len(names), "| sources:", len(srcs))
print("sources:", ", ".join(srcs))
for n in sorted(names)[:40]:
    print("  ", n)
ISNI 0000000068755806 | name forms: 16 | sources: 37
sources: ALCS, B2Q, BAnQ, BNC, BNE, BNF, CEDA, DBC, EGAXA, ICCU, ISNI, KBR, LAC, LCNACO, LNB, LNL, MUBZ, MVB, NDL, NKC, NLFIN, NLI, NLN, NLP, NLR, NLS, NSK, NTA, NUKAT, OCLCT, PTBNP, RERO, SUDOC, SWNL, VIAF, VLACC, WKP
Mahfoez, Nagieb
Mahfouz, Naguib
Mahfouz, Najib
Mahfuz, Nagib
Mahfuz, Naguib
Mahfuz, Najib
Mahfúz, Nagíb
Mahfūz, Najīb
Mahfūz, Najı̄b
Maḥfūẓ, Najîb
Maḥfūẓ, Najīb
Maḥfūẓ, Naǧīb
Махфуз, Н
מחפוז, נגיב
محفوظ، نجيب،
نجيب محفوظفي المخرج أعلاه لاحظ التالي:
- 37 مصدراً تعرف هذا الشخص، منها مكتبة الكونغرس
LCNACO، والمكتبة الوطنية الفرنسيةBNF، والإسبانيةBNE، والإيطاليةICCU، واليابانيةNDL، ومكتبة الإسكندريةEGAXA، وهي المصدر العربي الوحيد في القائمة، وهذا وحده يقول الكثير عن حضور المكتبات العربية في ملفات الإسناد الدولية. - 16 شكلاً للاسم من هذه المصادر، فيها أشكال لم تكن في سجل مكتبة الكونغرس، مثل «Mahfoez, Nagieb» الهولندية و«Махфуз» الروسية و«Naǧīb» بالرومنة الألمانية، فالمصادر المختلفة تكمل بعضها.
- الشكلان «Mahfūz, Najīb» و«Mahfūz, Najı̄b» يبدوان متطابقين على الشاشة، ولكن الثاني مكتوب بحرف «ı» دون نقطة مع علامة مركبة فوقه، فهما نصان مختلفان للحاسب، وهي مشكلة التوحيد نفسها التي رأيناها مع الهمزة في مقال MARC21.
ووجود مكتبة الإسكندرية بين المصادر يعني أن سجلها لنجيب محفوظ داخل في عنقوده في VIAF، فالمكتبة العربية التي تساهم بملف إسنادها تجعل أشكالها العربية متاحة لكل من يفتح العنقود، وهذا طريق ثان غير NACO لتحسين حضور الأسماء العربية في الملفات الدولية.
وأما VIAF نفسه، فقد أخذنا أرقام عناقيده من Wikidata ومن قائمة مصادر ISNI، لأن موقعه الحالي تطبيق ويب يحمل بياناته من واجهته البرمجية، ولكل خدمة من هذه شروط استخدام يجب أن تقرأها قبل أن تبني عليها أداة دائمة.
وماذا عن ORCID؟
إذا كنت تعمل في مكتبة جامعية فأنت تعرف معرف ORCID الذي يطلبه الناشرون من الباحثين، وقد شرحناه في مقال معرف ORCID وDOI. والفرق بينه وبين سجل الإسناد مهم: ORCID يسجله الباحث بنفسه ويديره بنفسه، فهو يقول «هذا أنا وهذه أبحاثي»، أما سجل الإسناد فيكتبه مفهرس من مصادر يوثقها في 670، فهو يقول «هذا الشخص كما تعرفه المكتبات». ولكل منهما مكانه: ORCID ممتاز للباحثين المعاصرين الذين ينشرون مقالات، لأنه يصل إلى قواعد البيانات العلمية مباشرة، وسجل الإسناد ضروري لكل مؤلف في الفهرس، بما في ذلك الأموات والمؤلفون الذين لا يعرفون شيئاً عن ORCID. والمستودع الجامعي الجيد يحفظ الاثنين للباحث الواحد: معرف ORCID من الباحث، ورابط سجل الإسناد من المكتبة، وVIAF وISNI يحفظان ORCID أحياناً في سجلاتهما أيضاً.
كيف تستفيد مكتبتك من هذه الملفات؟
لا تحتاج المكتبة الصغيرة أن تبني تكاملاً برمجياً مع VIAF وISNI حتى تستفيد منها، فالاستخدام الأهم يدوي: عندما يتردد المفهرس في شخص، يفتح عنقوده في VIAF أو عنصره في Wikidata فيرى كيف وصفته المكتبات الوطنية الأخرى، وما تواريخه، وما أعماله، وهذا يحسم أغلب حالات الشك في دقائق. والاستخدام الثاني في سجل الإسناد المحلي نفسه، فحفظ رقم VIAF أو رابط مكتبة الكونغرس في السجل المحلي، في حقل المعرفات 024 مثلاً، يجعل الربط مع أي نظام في المستقبل عملية آلية بدلاً من مطابقة أسماء. والاستخدام الثالث للبوابات والمستودعات الأكبر، فهي تستطيع أن تجلب الأشكال العربية من Wikidata للعرض، وأن تعرض للقارئ صورة المؤلف ونبذة عنه، مع رابط واضح إلى المصدر.
المطابقة Matching: كم اسماً في فهرس حقيقي يجد مؤلفه؟
الآن نصل إلى السؤال الذي يهم أي مكتبة عندها آلاف التسجيلات بلا روابط إسناد: إذا أخذنا أسماء المؤلفين كما هي في فهرس حقيقي، وطابقناها آلياً بملف الإسناد، فكم منها يجد صاحبه؟ ولكي نجيب احتجنا أسماء حقيقية كتبها مفهرسون مختلفون، فاخترنا فهرس Open Library، وهو فهرس مفتوح يجمع تسجيلات من مكتبات وناشرين ومتطوعين، وله واجهة بحث عن المؤلفين، والسكربت lab/ol.py يبحث فيه:
docker run --rm -v "$PWD/lab:/lab" marc-lab python3 -I /lab/ol.py "نجيب محفوظ" "نزار قباني" "najib mahfuz"## نجيب محفوظ 2
OL173760A | نجيب محفوظ | 1911 | زقاق المدق | 314
OL16166295A | محفوظ، نجيب، | 1911 | Khān al-Khalīlī | 4
## نزار قباني 2
OL16012154A | قبانی، نزار | | Ashʻār majnūnah | 14
OL14380039A | قبانی/ هاشمی,نزار/ انسیه سادات | | گنجشک ها ویزا نمی خواهند | 1
## najib mahfuz 3
OL129666A | Maḥfūẓ, Najīb | 1882 | The life of an Egyptian doctor | 10
OL173760A | نجيب محفوظ | 1911 | زقاق المدق | 314
OL9072739A | Najīb ibn Maḥfūẓ Zubaydī | | al-Juhūd al-naḥwīyah lil-Shaykh al-ʻUtha | 1وهذا المخرج وحده درس في ضبط الإسناد، فلاحظ التالي:
- نجيب محفوظ له أكثر من سجل مؤلف في Open Library، الأول بالعربية فيه 314 عملاً، والثاني «محفوظ، نجيب،» بالشكل المقلوب فيه 4 أعمال، وفي بحث آخر بالإنجليزية وجدنا «Naguib Mahfouz» في ثلاثة سجلات أخرى منفصلة. أي أن القارئ الذي يفتح أحدها يرى جزءاً من أعماله فقط، وهي بالضبط المشكلة التي بدأنا بها المقال.
- نزار قباني بالياء الفارسية: «قبانی» وليس «قباني»، وهما حرفان مختلفان في Unicode رغم تشابههما، لأن التسجيلة جاءت من مصدر فارسي على الأرجح، والبحث العربي العادي بالياء العربية لا يجدها دون توحيد.
- الطبيب موجود هنا أيضاً: «Maḥfūẓ, Najīb» المولود في 1882، وأشهر أعماله «حياة طبيب مصري»، فالشخصان في هذا الفهرس أيضاً، وأي مطابقة دون تاريخ تخلطهما.
ثم جمعنا من نتائج البحث بأسماء مختلفة، بالعربية واللاتينية، 57 اسماً لسجلات مؤلفين في Open Library تخص الاثني عشر، وحددنا صاحب كل اسم يدوياً من أشهر أعماله وسنة ميلاده، فكان لابن خلدون وحده عشرة سجلات، ولنزار قباني تسعة، ولابن سينا ثمانية، ولنجيب محفوظ خمسة. ووضعناها في الملف lab/headings.tsv، وكل سطر فيه رقم سجل الإسناد الصحيح، ورقم السجل في Open Library، والاسم كما هو، وسنة الميلاد إذا كانت مكتوبة.
وقد يتساءل البعض: لماذا Open Library وليس فهرس مكتبة عربية؟ والإجابة أننا احتجنا فهرساً مفتوحاً للعامة، يمكن البحث فيه آلياً بواجهة موثقة، وفيه أسماء كتبها أشخاص مختلفون من مصادر مختلفة دون ضبط إسناد صارم، وهذا هو بالضبط وضع الفهرس الذي تحاول أي مكتبة أن تنظفه. وفهارس المكتبات الكبرى نفسها لا تصلح لهذا الاختبار، لأن أسماءها مضبوطة أصلاً بملف الإسناد، فالمطابقة فيها تعطي نسبة قريبة من الكمال لا تعلمك شيئاً. ولاحظ أننا لم نستخدم كل نتائج البحث، وإنما الأسماء التي عرفنا صاحبها يقيناً، لأن قياس المطابقة يحتاج إجابة صحيحة معروفة لكل اسم.
سكربت المطابقة بأربعة مستويات
والسكربت lab/match.py يجلب سجلات الإسناد الاثني عشر من id.loc.gov ويحفظها في المجلد auth/ حتى لا يطلبها مرة أخرى، ثم يطابق كل اسم بأربعة مستويات، كل مستوى يضيف خطوة إلى ما قبله:
"""Match real catalog headings (Open Library author names) to LC NAF authority records.
Level 1: exact match on the authorized 1XX form.
Level 2: exact match on 1XX or any 4XX variant.
Level 3: level 2 after normalization (diacritics, hamza, ta marbuta, Persian letters, word order, al-).
Level 4: level 3, then a birth year in the heading must equal the authority's first date (plus or minus one)."""
import os, re, sys, time, unicodedata, urllib.request
import xml.etree.ElementTree as ET
UA = {"User-Agent": "arabroot-lab/1.0 ([email protected])"}
M = "{http://www.loc.gov/MARC21/slim}"
os.makedirs("auth", exist_ok=True)
def record(lccn):
path = f"auth/{lccn}.xml"
if not os.path.exists(path):
time.sleep(1.0)
url = f"https://id.loc.gov/authorities/names/{lccn}.marcxml.xml"
open(path, "wb").write(urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=40).read())
root = ET.parse(path).getroot()
return root if root.tag == M + "record" else root.find(f".//{M}record")
def sub(df, code):
s = df.find(f"{M}subfield[@code='{code}']")
return s.text if s is not None else ""
def forms(rec):
main, variants, dates, see_also = None, [], "", 0
for df in rec.findall(f"{M}datafield"):
t = df.get("tag")
if t == "100":
main, dates = sub(df, "a"), sub(df, "d")
elif t == "400":
variants.append(sub(df, "a"))
elif t[0] == "5" and t[1:] == "00":
see_also += 1
return main, variants, dates, see_also
def clean(s):
return s.strip().rstrip(",.، ").strip()
AR = str.maketrans({"أ": "ا", "إ": "ا", "آ": "ا", "ٱ": "ا", "ة": "ه", "ى": "ي", "ی": "ي", "ک": "ك", "،": " ", "ـ": ""})
def norm(s):
s = unicodedata.normalize("NFKD", s.translate(AR))
s = "".join(c for c in s if not unicodedata.combining(c))
s = re.sub(r"[ʻʼ'`’‘]", "", s).lower()
s = re.sub(r"[0-9]+|[^\w\s-]", " ", s)
toks = []
for w in re.split(r"[\s,]+", s):
w = re.sub(r"^(al-|el-)", "", w)
w = re.sub(r"^ال(?=..)", "", w)
w = w.replace("-", "")
if w and w not in ("al", "ibn", "bin", "ابن", "بن"):
toks.append(w)
return frozenset(toks)
def years(d):
return [int(y) for y in re.findall(r"\d{3,4}", d)]
lccns = sorted({l.split("\t")[0] for l in open("headings.tsv", encoding="utf-8") if l.strip()})
AUTH = {}
for n in lccns:
main, var, d, sa = forms(record(n))
AUTH[n] = {"main": clean(main), "var": [clean(v) for v in var], "dates": d, "see": sa}
arabic = sum(1 for v in var if re.search(r"[-ۿ]", v))
print(f"{n:11} 1XX={main} {d} | 4XX={len(var)} (Arabic script {arabic}) | 5XX={sa}")
def level(name, by, lvl):
name = clean(name)
hits = []
for n, a in AUTH.items():
allf = [a["main"]] + a["var"]
if lvl == 1: ok = name == a["main"]
elif lvl == 2: ok = name in allf
else: ok = norm(name) in {norm(f) for f in allf}
if ok: hits.append(n)
if lvl == 4 and by and len(hits) > 1:
hits = [n for n in hits if (lambda ys: ys and abs(min(ys) - int(by)) <= 1)(years(AUTH[n]["dates"]))]
return hits
rows = [(l.rstrip("\r\n").split("\t") + [""])[:4] for l in open("headings.tsv", encoding="utf-8") if l.strip()]
print()
print("headings:", len(rows), "| authorities:", len(AUTH))
for lvl in (1, 2, 3, 4):
right = wrong = amb = none = 0
for n, key, name, by in rows:
h = level(name, by, lvl)
if not h: none += 1
elif len(h) > 1: amb += 1
elif h[0] == n: right += 1
else: wrong += 1
print(f"level {lvl}: correct {right}/{len(rows)} = {100*right/len(rows):.0f}% | ambiguous {amb} | wrong {wrong} | no match {none}")
print()
print("still unmatched at level 4:")
for n, key, name, by in rows:
h = level(name, by, 4)
if len(h) != 1 or h[0] != n:
print(" ", key, repr(name), "expected", n, "got", h)
print()
print("ambiguous at level 3 (resolved by the birth year at level 4?):")
for n, key, name, by in rows:
h = level(name, by, 3)
if len(h) > 1:
print(" ", key, repr(name), "born", by or "?", "->", h, "-> level 4:", level(name, by, 4))والمستويات الأربعة كما يلي:
- الشكل المعتمد كما هو: الاسم يطابق الحقل 100 حرفاً حرفاً، دون التاريخ وعلامات الترقيم في آخره. وهذا ما يفعله نظام يقارن الاسم بالشكل المعتمد فقط.
- المعتمد مع الإحالات: الاسم يطابق 100 أو أي 400 حرفاً حرفاً. وهذا ما تفعله أنظمة المكتبات التي تستخدم ملف الإسناد كاملاً.
- بعد التوحيد: قبل المقارنة يوحد السكربت الاسم وكل الأشكال: الهمزات إلى ألف، والتاء المربوطة إلى هاء، والياء والكاف الفارسيتان إلى العربيتين، وتحذف العلامات فوق الحروف اللاتينية والعين والهمزة المرومنتان، وتحذف «ال» و«al-» و«ibn» و«بن»، ثم يقارن الكلمات كمجموعة دون ترتيب، فيصبح «Mahfouz, Naguib» و«Naguib Mahfouz» شيئاً واحداً.
- التوحيد مع سنة الميلاد: إذا طابق الاسم أكثر من سجل، وكانت سنة الميلاد مكتوبة في Open Library، يبقى السجل الذي يبدأ تاريخه بهذه السنة.
النتائج
docker run --rm -w /lab -v "$PWD/lab:/lab" marc-lab python3 -I /lab/match.pyheadings: 57 | authorities: 12
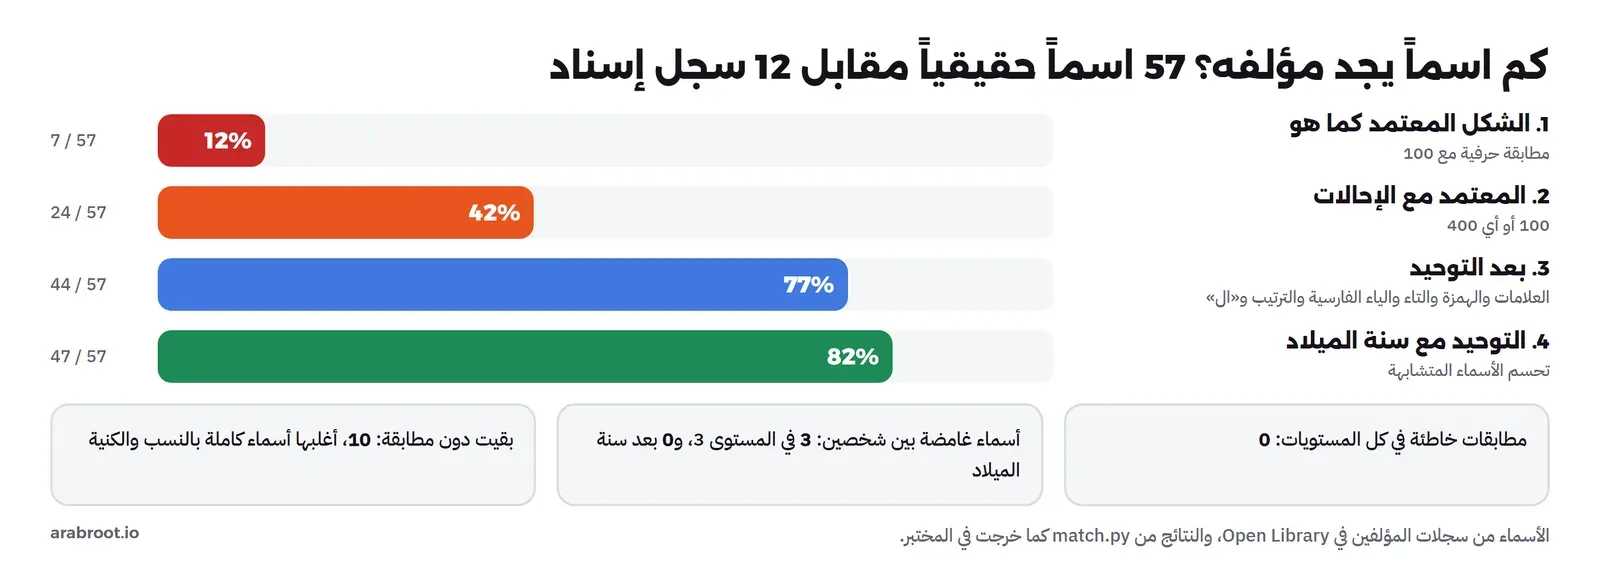
level 1: correct 7/57 = 12% | ambiguous 1 | wrong 0 | no match 49
level 2: correct 24/57 = 42% | ambiguous 2 | wrong 0 | no match 31
level 3: correct 44/57 = 77% | ambiguous 3 | wrong 0 | no match 10
level 4: correct 47/57 = 82% | ambiguous 0 | wrong 0 | no match 10
still unmatched at level 4:
OL5025284A "'Abd al-Rahmân ibn Muhammad Ibn Khaldûn" expected n50052785 got []
OL8013794A 'عبد الرحمن ابن خلدون Abdel Rahman Ibn Khaldun' expected n50052785 got []
OL9146135A 'طه حسين Taha Hussein' expected n50014331 got []
OL9107766A "Abu Uthman 'Amr Ibn Bahr al-Jahiz al-Basri" expected n79115518 got []
OL4113339A 'Abu Hamid Al-Ghazali' expected n82097778 got []
OL9461632A 'Mahmud Darwich محمود درويش' expected n50037926 got []
OL2775567A 'Ghazi Algosaibi' expected n82164394 got []
OL14204842A 'Ghazi Abdulrahman Algosaibi' expected n82164394 got []
OL4910733A 'Abdul Rahman Munif' expected n85157058 got []
OL13172406A 'Ibn Sina Avicenna' expected n80002386 got []
ambiguous at level 3 (resolved by the birth year at level 4?):
OL173760A 'نجيب محفوظ' born 1911 -> ['n82091918', 'n88159292'] -> level 4: ['n82091918']
OL16166295A 'محفوظ، نجيب،' born 1911 -> ['n82091918', 'n88159292'] -> level 4: ['n82091918']
OL129666A 'Maḥfūẓ, Najīb' born 1882 -> ['n82091918', 'n88159292'] -> level 4: ['n88159292']والصورة التالية تضع النسب الأربع جنباً إلى جنب:
وفي النتائج أربعة دروس:
- الشكل المعتمد وحده لا يكفي إطلاقاً: 7 أسماء من 57، أي 12 بالمئة، والسبب أن الشكل المعتمد المرومن بعلاماته مثل «Qabbānī, Nizār» لا يكتبه أحد خارج المكتبات بهذا الشكل. ومع الإحالات ارتفعت النسبة إلى 42 بالمئة، فالإحالات التي يجمعها المفهرسون عبر السنين هي نصف قيمة ملف الإسناد.
- التوحيد هو أكبر زيادة في النسبة: من 42 إلى 77 بالمئة، لأن أغلب الفروق بين الأسماء فروق في العلامات والهمزات والياء الفارسية والترتيب و«ال»، وليست فروقاً حقيقية. ولكن التوحيد له ثمن، فقد جعل ثلاثة أسماء غامضة بين الروائي والطبيب، لأن الاسم بعد التوحيد «نجيب محفوظ» وحسب.
- سنة الميلاد حسمت الغموض كله: الأسماء الثلاثة كان لها سنة ميلاد في Open Library، فذهب الاسمان المولودان في 1911 إلى الروائي، و«Maḥfūẓ, Najīb» المولود في 1882 إلى الطبيب. ولاحظ أن المطابقة الخاطئة بقيت صفراً في كل المستويات، لأن السكربت لا يختار عندما يجد أكثر من سجل، وإنما يعد الاسم غامضاً.
- العشرة الباقية أسماء كاملة أو مختلطة: «Abu Uthman 'Amr Ibn Bahr al-Jahiz al-Basri» فيه الكنية والاسم والنسب واللقب والنسبة معاً، ولا يوجد في الإحالات بهذا الطول، و«طه حسين Taha Hussein» فيه الحرفان معاً في اسم واحد، و«Ghazi Algosaibi» دون الحرف «A.» الموجود في الإحالة «Algosaibi, Ghazi A.»، و«Abdul Rahman Munif» بالشكل الشائع في الإنجليزية الذي لم يدخل الإحالات. وهذه تحتاج مطابقة جزئية، أي أن تكفي أغلب الكلمات، أو تحتاج مفهرساً، أو تحتاج إضافة الشكل إلى الإحالات.
وماذا عن الأسماء العشرة الباقية؟ الحل البسيط أن تقبل المطابقة إذا اشتركت أغلب كلمات الاسم مع أحد الأشكال، فيطابق «Ghazi Abdulrahman Algosaibi» الإحالة «Algosaibi, Ghazi A.» لأن كلمتين من ثلاث مشتركتان. ولكن هذه القاعدة خطيرة مع الأسماء العربية، لأن «عبد الرحمن» و«محمد» و«بن» كلمات تتكرر في آلاف الأسماء، فاسمان لشخصين مختلفين قد يشتركان في أغلب كلماتهما. لذلك إذا استخدمت المطابقة الجزئية فاجعلها تقترح ولا تقرر، أي أن تضع الاسم في قائمة المراجعة مع السجل المقترح، والمفهرس يقبل أو يرفض في ثوان، وكل قبول يضيف الشكل الجديد إلى الإحالات، فتزيد نسبة المطابقة الآلية في المرة القادمة.
ماذا يحدث لو أخطأنا في قاعدة السنة؟
في أول نسخة من السكربت كانت قاعدة المستوى الرابع تقبل السجل إذا وقعت سنة الميلاد بين أول تاريخ وآخر تاريخ في سجل الإسناد. وبدت القاعدة منطقية، ولكن النتيجة كانت أن «نجيب محفوظ» المولود في 1911 بقي غامضاً بين الشخصين، لأن 1911 تقع بين 1882 و1974، أي أن الروائي ولد في حياة الطبيب، والقاعدة لم تفرق بينهما. فغيرنا القاعدة لتقارن سنة الميلاد بأول تاريخ في سجل الإسناد فقط، مع فرق سنة واحدة، فحسمت الحالات الثلاث. وكان في النسخة الأولى خطأ آخر، فالتوحيد كان يحذف الأرقام ويترك الشرطة في «980-1037 Avicenna» كلمة فارغة، فلم يطابق الاسم «Avicenna» البسيط، وبعد تصحيحه ارتفع المستوى الثالث من 75 إلى 77 بالمئة. والدرس أن قواعد المطابقة تحتاج اختباراً بأسماء حقيقية تعرف أصحابها، كما فعلنا هنا، قبل أن تطبقها على فهرسك كله، والسبب أن خطأ صغيراً في قاعدة يمر على آلاف التسجيلات بصمت.
قواعد التوحيد Normalization للأسماء العربية
إذا أردت أن تبني مطابقة في مكتبتك، فهذه هي القواعد التي رفعت النسبة في المختبر، مع ما ينتبه له كل منها:
| القاعدة | مثال من المختبر | انتبه |
|---|---|---|
| الهمزات إلى ألف | «إبن سينا» تطابق «ابن سينا» | وحد NFC أولاً، فالهمزة المفككة في تسجيلات مكتبة الكونغرس حرفان |
| الياء والكاف الفارسيتان إلى العربيتين | «قبانی» تطابق «قباني» | شائع في تسجيلات من مصادر فارسية وأردية |
| حذف العلامات من الرومنة | «Qabbanī» تطابق «Qabbānī» | تحذف الفرق بين الحاء والهاء أيضاً، فلا تستخدمها في العرض |
| حذف «ال» و«al-» | «Al-Jāḥiẓ» تطابق «Jāḥiẓ» | لا تحذفها من كلمة طولها حرفان بعد «ال» |
| ترتيب الكلمات كمجموعة | «Naguib Mahfouz» تطابق «Mahfouz, Naguib» | يزيد الغموض بين الأسماء المتشابهة |
| سنة الميلاد | 1911 للروائي و1882 للطبيب | قارن بأول تاريخ في السجل، وكثير من السجلات بلا تاريخ |
وهناك قاعدة لم نضفها في المختبر، وتحتاجها أغلب الفهارس العربية: الأسماء المركبة بـ «عبد» مثل «عبد الرحمن» و«عبد الله»، تكتب مرة بمسافة ومرة دونها، ومرة «عبدالله» ومرة «عبد الله»، وفي الرومنة «ʻAbd al-Raḥmān» و«Abdulrahman» و«Abdul Rahman» و«Abdel Rahman». والتوحيد هنا أن تلصق «عبد» بما بعدها في الحرفين قبل المقارنة، وهو ما يقترحه التدريب العملي في آخر المقال، ولكن اختبر أثره، لأن كل قاعدة تقرب الأسماء تزيد احتمال الغموض بين شخصين.
ولا تقم بتطبيق هذه القواعد على البيانات نفسها، فالتوحيد يستخدم للمطابقة فقط، والسبب أنه يحذف فروقاً حقيقية: «حسن» و«حسين» لا يتأثران، ولكن «ḥ» و«h» يصبحان حرفاً واحداً، والاسم المعروض للقارئ يجب أن يبقى كما في السجل.
سجل إسناد لمؤلف محلي
أغلب مؤلفي مكتبتك ليس لهم سجل في ملف مكتبة الكونغرس: أعضاء هيئة التدريس الذين نشروا كتاباً واحداً، وأصحاب الرسائل الجامعية، والكتاب المحليون. وهؤلاء يحتاجون سجلات إسناد في ملفك المحلي، والمثال التالي يبين شكل هذا السجل باسم افتراضي «فلانة الفلاني»، وهو مثال مكتوب للشرح وليس سجلاً حقيقياً من أي ملف:
100 1  $a الفلاني، فلانة بنت محمد، $d 1985-
400 1  $a الفلاني، فلانة محمد
400 1  $a Fulānī, Fulānah bint Muḥammad, $d 1985-
400 1  $a Alfulani, F. M.
670    $a إدارة المستودعات الرقمية، 2024: $b صفحة العنوان (فلانة بنت محمد الفلاني) ظهر الغلاف (أستاذ مساعد، قسم علم المعلومات)
670    $a رسالة الدكتوراه، 2019: $b صفحة العنوان (F. M. Alfulani)
في السجل أعلاه لاحظ التالي:
- الشكل المعتمد بالعربية لأن المكتبة تفهرس بالحرف العربي، ومعه سنة الميلاد مفتوحة
1985-لأن الاسم شائع وقد يتكرر لشخص آخر. - الإحالات تشمل الشكل المرومن بجدول ALA-LC، والشكل الذي تكتبه صاحبته في أبحاثها الإنجليزية، لأن هذا هو الشكل الذي سوف يبحث به من قرأ أبحاثها.
- كل شكل له مصدر في 670، ومعه المعلومة التي تميز الشخص: الوظيفة والقسم، وهي التي يحتاجها المفهرس بعد سنوات إذا ظهر كتاب لشخص آخر بالاسم نفسه.
وهذا العمل يبدو كثيراً لكل مؤلف، ولكنه يكتب مرة واحدة، ثم يوفر على كل مفهرس بعده البحث والتخمين، ويجعل كل كتب المؤلف في مكان واحد للقارئ.
ضبط الإسناد Authority Control في مكتبتك خطوة خطوة
بعد المختبر، الصورة التالية تجمع ما يفعله المفهرس يومياً، وما تفعله المكتبة مع تسجيلاتها القديمة:
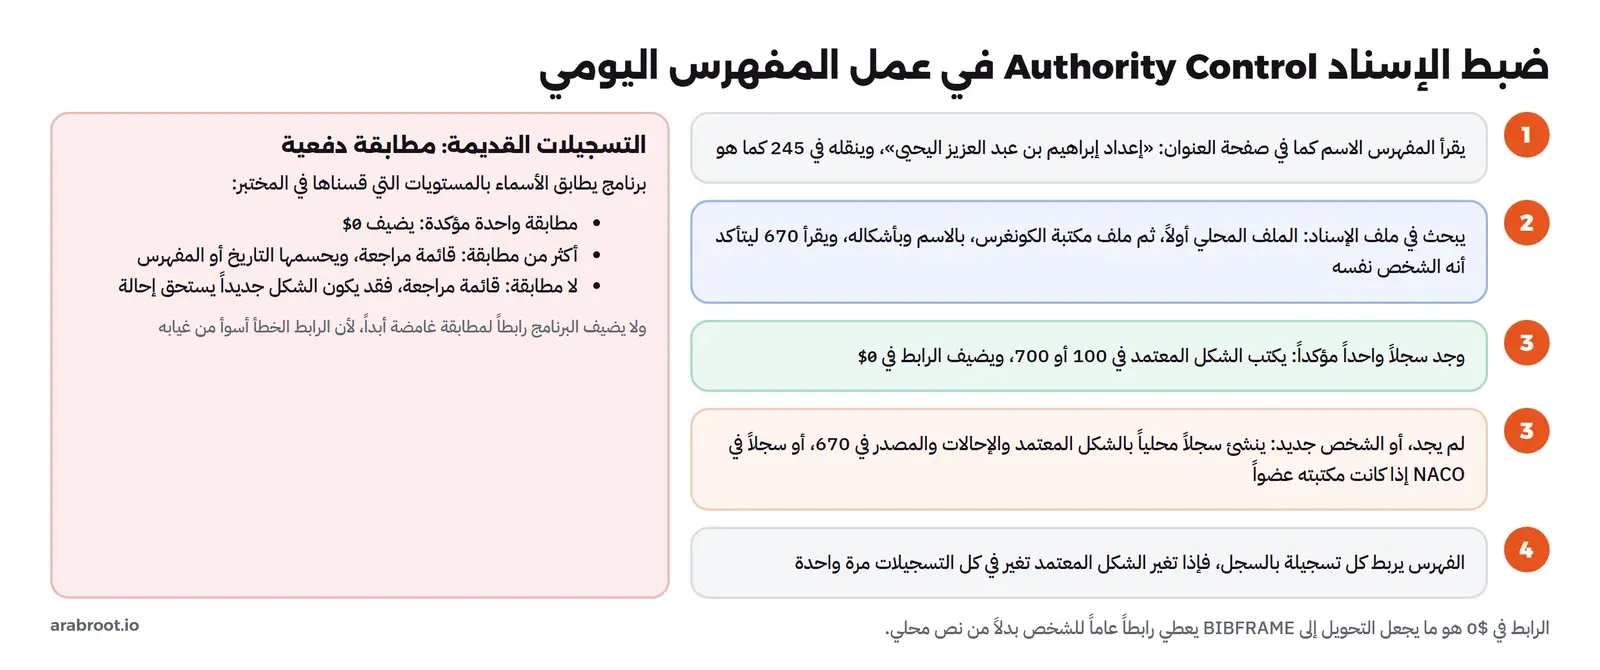
- ابدأ بملف إسناد محلي: أنظمة المكتبات مثل Koha فيها وحدة للإسناد Authorities تحفظ سجلات الأشخاص والموضوعات بصيغة MARC، وتربط بها حقول 100 و700 في التسجيلات. فإذا لم تكن مكتبتك تستخدمها فهذه أول خطوة، وقد شرحنا النظام في دليل نظام المكتبة Koha.
- انسخ قبل أن تنشئ: قبل أن تنشئ سجلاً لمؤلف، ابحث عنه في ملف مكتبة الكونغرس، فإذا وجدته فانسخ شكله المعتمد وإحالاته، وأضف إليها الأشكال العربية التي تعرفها مكتبتك ولا يحملها السجل.
- أنشئ للمحلي بعناية: المؤلف المحلي الذي ليس له سجل، وهو أغلب مؤلفي الرسائل الجامعية والكتب المحلية، ينشأ له سجل بالشكل المعتمد بقواعد مكتبتك، وبالإحالات التي ظهرت فعلاً، وبمصدر في 670 لكل شكل.
- اربط القديم دفعياً: طابق أسماء التسجيلات القديمة بالمستويات التي جربناها، وأضف الرابط للمطابقة الواحدة المؤكدة فقط، وضع الباقي في قائمة مراجعة يراجعها المفهرسون على مراحل.
- أضف المعرفات الدولية: عندما يكون للشخص سجل في ملف مكتبة الكونغرس، فرابطه في
$0، ورقمه في VIAF وISNI يمكن أن يحفظ في سجل الإسناد المحلي، وهذا ما يجعل بياناتك جاهزة لأي تحويل إلى BIBFRAME.
وقد يتساءل البعض: هل تستطيع مكتبة عربية أن تضيف مؤلفيها إلى ملف مكتبة الكونغرس نفسه؟ والإجابة نعم، عبر عضوية برنامج NACO، وهو برنامج تعاوني تنضم إليه المكتبات بعد تدريب ومراجعة، وكلما زادت المكتبات العربية المشاركة زادت الأشكال العربية الصحيحة في الملف الذي تعتمد عليه مكتبات العالم، بدلاً من الأشكال الآلية التي رأينا بعضها في سجل الجاحظ في مقال قواعد RDA.
أخطاء شائعة في ضبط الإسناد
| الخطأ | النتيجة | الصواب |
|---|---|---|
| المطابقة بالاسم دون التاريخ | روايات نجيب محفوظ في سجل الطبيب | التاريخ في المطابقة، وقائمة مراجعة لكل غموض |
| إضافة رابط لمطابقة غامضة | معلومة خاطئة بثقة كاملة في كل نظام يقرأ بياناتك | رابط للمطابقة الواحدة المؤكدة فقط |
| الاعتماد على الشكل المعتمد وحده | 12 بالمئة من الأسماء في المختبر | الإحالات مع التوحيد |
| تطبيق التوحيد على البيانات المعروضة | «Ḥusayn» تعرض «husayn» | التوحيد في المطابقة والبحث فقط |
| نسخ الأشكال العربية الآلية دون مراجعة | إحالات خاطئة مثل «غازي» في سجل الجاحظ | راجع كل شكل عربي قبل نسخه |
| سجل جديد لكل شكل للاسم | المؤلف موزع على عدة سجلات كما في Open Library | سجل واحد بالإحالات، وابحث قبل أن تنشئ |
| طلبات كثيرة سريعة إلى id.loc.gov | حظر العنوان، وضغط على خدمة عامة | انتظر بين الطلبات، واحفظ السجلات محلياً كما في auth/ |
قائمة تحقق لمشروع ضبط الإسناد
- وحدة الإسناد مفعلة في نظام المكتبة، والحقول 100 و700 مربوطة بها.
- دليل محلي يحدد الشكل المعتمد للأسماء العربية: الحرف، و«ال»، والترتيب، ومتى يضاف التاريخ.
- المفهرس يبحث في الملف المحلي ثم ملف مكتبة الكونغرس قبل أن ينشئ أي سجل.
- كل سجل جديد فيه 670 بالمصدر لكل شكل.
- المطابقة الدفعية مختبرة بعينة من الأسماء تعرف أصحابها، ونسبة المطابقة الخاطئة فيها صفر.
- الغموض وعدم المطابقة يذهبان إلى قائمة مراجعة، ولا يضاف رابط إلا لمطابقة مؤكدة.
- الطلبات إلى الخدمات العامة بطيئة، باسم مستخدم واضح، والسجلات محفوظة محلياً.
تدريب عملي
- أضف إلى
headings.tsvعشرة أسماء لمؤلف عربي من فهرس مكتبتك، بالأشكال المختلفة التي تجدها فيه، وشغلmatch.py: في أي مستوى يجد كل اسم صاحبه؟ - أضف إلى دالة التوحيد قاعدة تجعل «عبدالرحمن» و«عبد الرحمن» شيئاً واحداً، وقس هل تغيرت النسبة، وهل ظهر غموض جديد.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ضبط الإسناد يعطي كل شخص شكلاً معتمداً واحداً وإحالات من كل الأشكال الأخرى، وسجل الإسناد فيه 1XX و4XX و5XX و670 بصيغة MARC21.
- نجيب محفوظ له 21 إحالة في ملف مكتبة الكونغرس، وابن سينا 64، والغزالي 57، بينما لنزار قباني شكل عربي واحد، فالأشكال العربية في الملف الدولي تحتاج إكمالاً من المكتبات العربية.
- اسم واحد قد يكون لشخصين، كالروائي والطبيب، والتاريخ وحده يفرق بينهما، ولا يضاف رابط إسناد لمطابقة غامضة.
- VIAF يجمع الملفات الوطنية، وISNI يعطي معرفاً دولياً، وWikidata يربطها كلها، ووصلنا عبره من رقم مكتبة الكونغرس إلى بقية المعرفات باستعلام واحد.
- من 57 اسماً حقيقياً طابق الشكل المعتمد وحده 12 بالمئة، والإحالات 42، والتوحيد 77، والتوحيد مع سنة الميلاد 82 بالمئة دون مطابقة خاطئة واحدة.
والخطوة العملية التي تبدأ بها غداً بسيطة: اختر أكثر عشرين مؤلفاً إعارة في مكتبتك، وابحث عن كل واحد منهم في فهرسك بثلاثة أشكال، وإذا ظهرت لك قوائم مختلفة فقد عرفت من أين يبدأ مشروع ضبط الإسناد.
وبهذا نكون قد أكملنا مرحلة الفهرسة والبيانات الوصفية، وفي المرحلة التالية بإذن الله سوف نتحدث عن المستودعات والأرشيف الرقمي، حيث يتحول الوصف من الكتاب إلى الرسالة والوثيقة والمخطوطة.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتجربة البحث والمطابقة على ملف أسماء مكتبة الكونغرس عبر id.loc.gov، مع Wikidata وISNI وOpen Library، باستخدام Python 3.13.5 في Debian 13.