عندما ترى وكيل برمجة يقرأ ملفات مشروعك ويعدلها ويشغل الاختبارات ثم يقول لك إن العلة أصلحت، فإن السؤال الذي يأتي بعده مباشرة عند كثير من المطورين هو: هل أستطيع أن أفعل هذا على جهازي، دون اشتراك شهري، ودون أن يخرج كود الشركة إلى أي سيرفر خارجي؟ والإجابة المختصرة نعم، فالأدوات موجودة ومجانية، وتستطيع خلال ربع ساعة أن تشغل نموذجاً محلياً مع Ollama وتربطه بوكيل مثل Aider أو Continue أو Cline، ولكن الإجابة الكاملة تحتاج أرقاماً، لأن ما سوف تحصل عليه على جهاز عادي يختلف كثيراً عما تراه في العروض التي تعمل على بطاقات رسومية كبيرة في السحابة.
وفي دليل تشغيل نماذج اللغة على جهازك شرحنا القاعدة الأساسية لأي نموذج محلي، أي أن النموذج يجب أن يدخل في الذاكرة، وكيف يؤثر التكميم Quantization ونوع الجهاز على السرعة، ولن نكرر ذلك هنا، وإنما نسأل سؤالاً أضيق وأكثر عملية: إذا أردت أن تستعمل نموذجاً محلياً في البرمجة تحديداً، أي في كتابة الدوال وإصلاح العلل وتشغيل وكيل يستدعي الأدوات، فماذا تتوقع فعلاً من حيث السرعة والجودة؟ ولذلك بنينا مختبراً يقيس خمسة نماذج برمجة على جهاز بلا بطاقة رسومية، ويطلب منها كتابة عشر دوال تفحصها اختبارات حقيقية، ثم يعطيها أدوات ومستودعاً صغيراً فيه علة ويطلب منها إصلاحها.
في هذا المقال سوف نتناول:
- كيف يتصل وكيل البرمجة بنموذج يعمل على جهازك، وما الذي يحدث عند كل طلب.
- كم ذاكرة يأخذ كل نموذج، وكم تكلف نافذة السياق Context Window فوق ذلك.
- سرعة التوليد وسرعة قراءة الملفات، ولماذا يشعر المستخدم بالثانية أكثر من الأولى.
- الإعداد الافتراضي الذي يقطع بداية ملفاتك دون أي رسالة خطأ.
- نتيجة كل نموذج في عشر دوال باختبارات حقيقية، وفي مهمة وكيل كاملة بالأدوات.
- متى يكون النموذج المحلي اختياراً مناسباً، ومتى يضيع وقتك.
كيف يتصل الوكيل بنموذج على جهازك؟
وكيل البرمجة نفسه لا يحتوي على نموذج، وإنما هو برنامج يجمع المحادثة والتعليمات ووصف الأدوات Tools والملفات التي قرأها، ثم يرسل كل ذلك في طلب HTTP إلى خدمة تشغل النموذج، ويقرأ الرد، فإذا طلب النموذج استدعاء أداة مثل قراءة ملف أو تشغيل الاختبارات نفذها الوكيل على جهازك وأرسل النتيجة في طلب جديد، وهكذا حتى ينتهي. وعندما تستعمل خدمة سحابية فإن هذا الطلب يذهب إلى مركز بيانات فيه بطاقات رسومية كبيرة، أما مع Ollama فإنه يذهب إلى سيرفر صغير يعمل على جهازك ويستمع افتراضياً على المنفذ 11434، ويحمل ملف النموذج إلى الذاكرة ويولد الرد على معالجك أو بطاقتك الرسومية إن وجدت. والشكل التالي يبين ذلك:
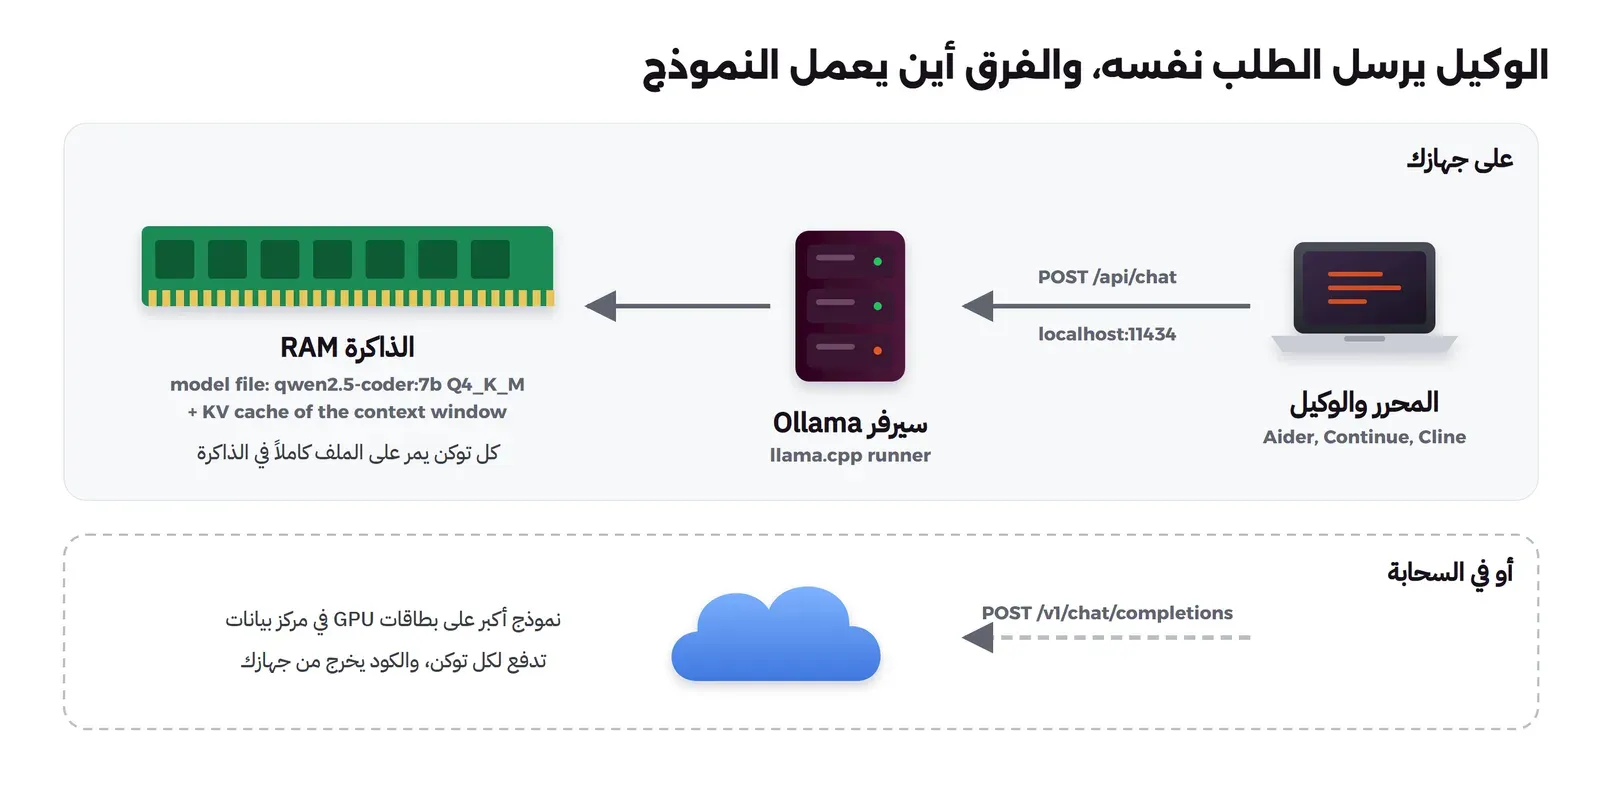
ويقدم Ollama واجهتين: الواجهة الخاصة به /api/chat الموثقة في توثيق الواجهة البرمجية، وواجهة متوافقة مع OpenAI على المسار /v1/chat/completions كما في صفحة التوافق مع OpenAI، ولذلك فإن أغلب أدوات البرمجة تعمل معه بتغيير عنوان السيرفر واسم النموذج فقط. فمثلاً توثيق Aider يطلب منك أن تضبط المتغير OLLAMA_API_BASE ثم تشغل الأداة باسم النموذج، وتوثيق Continue وتوثيق Cline فيهما خيار Ollama جاهز في الإعدادات:
ollama pull qwen2.5-coder:7b
export OLLAMA_API_BASE=http://127.0.0.1:11434
aider --model ollama_chat/qwen2.5-coder:7b
والجزء المهم للوكيل هو استدعاء الأدوات Tool Calling، فالوكيل يرسل مع الطلب قائمة بالأدوات ووصف مدخلات كل أداة بصيغة JSON Schema، والنموذج يرد إما بنص عادي أو بطلب منظم لاستدعاء أداة باسمها ومدخلاتها، كما في صفحة Tool Calling في توثيق Ollama. وليس كل نموذج يدعم ذلك، ولذلك يعرض Ollama قدرات كل نموذج في الأمر ollama show، وكل النماذج التي قسناها هنا تظهر فيها القدرة tools. ولكن دعم الأداة شيء، واستعمالها بشكل صحيح شيء آخر، وهذا ما سوف يظهر في المختبر.
المختبر: خمسة نماذج على معالج عادي
المختبر مجموعة سكربتات Python تستعمل المكتبة القياسية فقط، وتعمل داخل Container من python:3.13.18-slim وتتصل بسيرفر Ollama 0.40.13 على الجهاز نفسه، والملف run.sh يشغلها بالترتيب ويحفظ مخرج كل قسم في ملف. والجهاز الذي جرت عليه القياسات كمبيوتر مكتبي بمعالج Intel Core i7-7700K بأربع أنوية وثماني خيوط Threads، ودون بطاقة رسومية مناسبة للنماذج، أي أن كل الحساب على المعالج، ومع Docker بذاكرة 32 GB. وهذا الجهاز أقرب إلى ما يملكه أغلب المطورين من جهاز فيه بطاقة رسومية بذاكرة 24 GB، ولذلك فإن نتائجه أقرب إلى ما سوف تراه أنت.
والنماذج الخمسة هي أحجام Qwen2.5-Coder الأربعة الصغيرة، وهي عائلة نماذج برمجة مفتوحة الأوزان من فريق Qwen شرحها إعلان العائلة والتقرير التقني، ومعها نموذج عام أحدث هو Qwen3 بحجم 4B من إعلان Qwen3، لنرى هل يتفوق نموذج عام حديث على نموذج متخصص في البرمجة من الحجم نفسه تقريباً. والقسم الأول من المختبر يسأل Ollama عن كل نموذج، والمخرج سوف يكون كما يلي:
### Ollama 0.40.13
model                 params   quant     file  native ctx  licence
qwen2.5-coder:0.5b   494.03M  Q4_K_M   0.40GB       32768  Apache License
qwen2.5-coder:1.5b      1.5B  Q4_K_M   0.99GB       32768  Apache License
qwen2.5-coder:3b        3.1B  Q4_K_M   1.93GB       32768  Qwen RESEARCH LICENSE AGREEMENT
qwen2.5-coder:7b        7.6B  Q4_K_M   4.68GB       32768  Apache License
qwen3:4b                4.0B  Q4_K_M   2.50GB      262144  Apache License
في المخرج أعلاه لاحظ التالي:
- كل النماذج في Ollama تأتي افتراضياً بتكميم Q4_K_M، أي أن كل وزن مخزن في حوالي 5 بت في المتوسط بدل 16 بت، ولذلك فإن نموذج 7B يأخذ 4.68 GB على القرص بدل حوالي 15 GB، وشرحنا معنى التكميم وأنواعه في دليل تشغيل النماذج على جهازك.
- العمود
native ctxهو أكبر نافذة سياق يدعمها النموذج كما في ملفه، 32768 توكن لنماذج Qwen2.5-Coder في Ollama، ولكن هذا لا يعني أن Ollama يستعملها، وهذا ما سوف نصل إليه بعد قليل. - عمود الرخصة فيه مفاجأة، فالحجم 3B وحده تحت رخصة Qwen Research، وهي كما في نص الرخصة تسمح بالاستعمال لغير الأغراض التجارية فقط، أي للبحث والتقييم، وتطلب منك أن تطلب رخصة إذا استعملته تجارياً، بينما الأحجام 0.5B و1.5B و7B وQwen3 تحت Apache 2.0. ولذلك لا تقم باختيار نموذج لعمل الشركة من جدول السرعة فقط، واقرأ رخصته أولاً.
كم ذاكرة RAM يأخذ كل نموذج؟
حجم الملف على القرص ليس كل ما يأخذه النموذج من الذاكرة، لأن Ollama يحجز معه ذاكرة للسياق تسمى KV Cache، وهي المكان الذي يحفظ فيه ما حسبه لكل توكن قرأه حتى لا يعيد حسابه، ويحجز معها ذاكرة للحسابات المؤقتة. والقسم الثاني يحمل كل نموذج بطلب صغير ثم يقرأ من /api/ps كم أخذ فعلاً، ثم يحمل نموذج 7B ثلاث مرات بنوافذ سياق مختلفة، والمخرج سوف يكون كما يلي:
### RAM once loaded, Ollama's default context
qwen2.5-coder:0.5b    0.49 GB  context 4096  on GPU 0 bytes
qwen2.5-coder:1.5b    1.17 GB  context 4096  on GPU 0 bytes
qwen2.5-coder:3b      2.17 GB  context 4096  on GPU 0 bytes
qwen2.5-coder:7b      5.07 GB  context 4096  on GPU 0 bytes
qwen3:4b              3.19 GB  context 4096  on GPU 0 bytes

### The same 7B model with a larger context window
qwen2.5-coder:7b  num_ctx   4096   5.07 GB
qwen2.5-coder:7b  num_ctx  16384   5.96 GB
qwen2.5-coder:7b  num_ctx  32768   6.93 GB
لاحظ أن نموذج 7B أخذ 5.07 GB بنافذة 4096 توكن، ثم 5.96 GB بنافذة 16384، ثم 6.93 GB بنافذة 32768، أي أن كل ثمانية أضعاف في طول السياق كلفت هنا حوالي 1.9 GB إضافية. وهذا الرقم يتغير من نموذج إلى آخر حسب عدد طبقاته Layers ورؤوس الانتباه Attention Heads فيه، ولكن القاعدة ثابتة: طول السياق ليس مجانياً، وعلى جهاز ذاكرته 16 GB مع متصفح ومحرر وDocker فإن الفرق بين 4096 و32768 قد يكون الفرق بين نموذج يعمل ونموذج يجعل الجهاز يستعمل القرص بدل الذاكرة. ولاحظ أيضاً أن العمود on GPU صفر في كل الصفوف، أي أن كل الحساب على المعالج كما توقعنا.
السرعة: الكتابة Generation شيء والقراءة Prompt Processing شيء آخر
عندما يتكلم الناس عن سرعة نموذج محلي فإنهم يذكرون رقماً واحداً هو عدد التوكنات في الثانية، ويقصدون سرعة التوليد Generation، أي سرعة ظهور الكلمات على الشاشة. ولكن هناك سرعة ثانية لا تقل أهمية للوكيل، وهي سرعة قراءة المدخل Prompt Processing، لأن النموذج قبل أن يكتب أول كلمة يجب أن يقرأ كل ما أرسلته: التعليمات ووصف الأدوات والملفات والمحادثة السابقة. والقسم الأول من قياس السرعة يطلب من كل نموذج كتابة 128 توكناً أربع مرات، ويشغل كل نموذج وحده على السيرفر، ويطبع الوسيط Median وأقل قيمة وأكبرها، والمخرج سوف يكون كما يلي:
### Short prompt, 128 generated tokens, 4 runs per model, each model alone on the server
model                        generate tok/s    first token s  waited min  dropped  load avg
qwen2.5-coder:0.5b     41.2 (40.3-42.1)       0.17 ( 0.2)        0.7        0  1.64
qwen2.5-coder:1.5b     17.8 (17.3-18.3)       0.36 ( 0.4)        0.7        0  2.46
qwen2.5-coder:3b        9.3 ( 9.0- 9.4)       0.75 ( 0.9)        0.7        0  3.24
qwen2.5-coder:7b        4.2 ( 4.1- 4.3)       1.72 ( 1.8)        0.7        0  3.87
qwen3:4b                7.1 ( 6.8- 7.1)       1.08 ( 1.7)        0.7        0  3.57
في المخرج أعلاه لاحظ التالي:
- السرعة تنخفض مع حجم النموذج بشكل شبه منتظم، من 41.2 توكن في الثانية لنموذج 0.5B إلى 4.2 لنموذج 7B، أي أن مضاعفة حجم النموذج تقسم السرعة على اثنين تقريباً. والسبب، كما شرحنا في دليل تشغيل النماذج، أن كل توكن جديد يحتاج المرور على كل أوزان النموذج في الذاكرة، فالذي يحدد السرعة هو حجم الملف وسرعة الذاكرة أكثر من قوة المعالج.
- 4.2 توكن في الثانية تعني أن دالة من 100 توكن تأخذ حوالي 25 ثانية، وهذا مقبول إذا سألت سؤالاً وانتظرت، ولكنه بطيء جداً للإكمال التلقائي الذي يجب أن يظهر وأنت تكتب، ولذلك فإن الإكمال التلقائي على المعالج يناسبه نموذج 0.5B أو 1.5B فقط.
- نموذج Qwen3 بحجم 4B أسرع من Qwen2.5-Coder بحجم 7B وأبطأ من 3B، كما يتوقع من حجمه، ولكن تذكر أن تفكيره يضيف آلاف التوكنات كما رأينا في قسم الجودة.
- العمود
waited minيبين كم دقيقة انتظر المختبر حتى يصبح السيرفر خالياً من أي نموذج آخر، وdroppedعدد التشغيلات التي ألغيت لأن نموذجاً آخر ظهر أثناءها.
ولكي ترى أثر مشاركة السيرفر، فإن نموذج 0.5B نفسه أعطى في محاولة سابقة للمختبر، والسيرفر يخدم عملاء آخرين يحملون نماذج مختلفة في الوقت نفسه، 1.6 توكن في الثانية فقط بدل 41.2، أي أبطأ بأكثر من عشرين مرة، لأن Ollama كان يخرج نموذجاً من الذاكرة ويحمل آخر مع كل طلب، والمعالج يقسم وقته بين الجميع. ولذلك إذا كان سيرفر Ollama واحداً مشتركاً بين عدة أدوات في الفريق، فإن سرعته الحقيقية هي سرعته وهو مشغول لا سرعته في العرض.
أما القسم الثاني فيقيس ما يهم الوكيل أكثر، فهو يرسل ملف Python فيه 90 دالة صغيرة، أي حوالي 5000 توكن، وهو حجم طبيعي لما يرسله الوكيل بعد أن يقرأ ملفاً أو ملفين، ثم يسأل سؤالاً قصيراً، ثم يسأل سؤال متابعة في المحادثة نفسها، والمخرج سوف يكون كما يلي:
### Reading a code file before answering (agent-sized prompt), then a follow-up question
model                prompt tokens  read tok/s  wait s | turn 2 tokens  wait s
qwen2.5-coder:0.5b            4956         137    36.2 |          4988    0.43
qwen2.5-coder:1.5b            4956          66    75.4 |          5007    0.71
qwen2.5-coder:3b              4956          33   150.2 |          5006    1.49
qwen2.5-coder:7b              4956          16   315.5 |          4992    4.70
qwen3:4b                      4937          23   217.1 |          4992   22.83
وهذه هي الأرقام التي يشعر بها المستخدم فعلاً، فالعمود wait s هو عدد الثواني قبل أن يكتب النموذج أول كلمة، وهو من 36 ثانية لأصغر نموذج إلى 315 ثانية لنموذج 7B، أي أكثر من خمس دقائق قبل أول كلمة، وسرعة القراءة لنموذج 7B كانت 16 توكناً في الثانية فقط. وهذا يعني أن الوكيل الذي يقرأ ملفين قبل أن يرد يتركك تنتظر دقائق قبل أن يبدأ. أما سؤال المتابعة فاستغرق أقل من ثانيتين مع نماذج 0.5B و1.5B و3B، و4.7 ثانية مع 7B، والسبب أن Ollama يحتفظ بما حسبه للمحادثة السابقة، فإذا بقيت بداية المحادثة كما هي فإنه يقرأ الجزء الجديد فقط، ولاحظ أن العمود turn 2 tokens يعد كل توكنات المحادثة مع أن أغلبها لم يقرأ من جديد. والاستثناء هو Qwen3 الذي احتاج 22.8 ثانية في سؤال المتابعة، أي أنه أعاد قراءة جزء أكبر من المحادثة، ولم نبحث في سبب ذلك، ولكن النتيجة أن الاعتماد على هذه الذاكرة المؤقتة يختلف من نموذج إلى آخر، فقسه على النموذج الذي تختاره. والشكل التالي يبين ذلك:
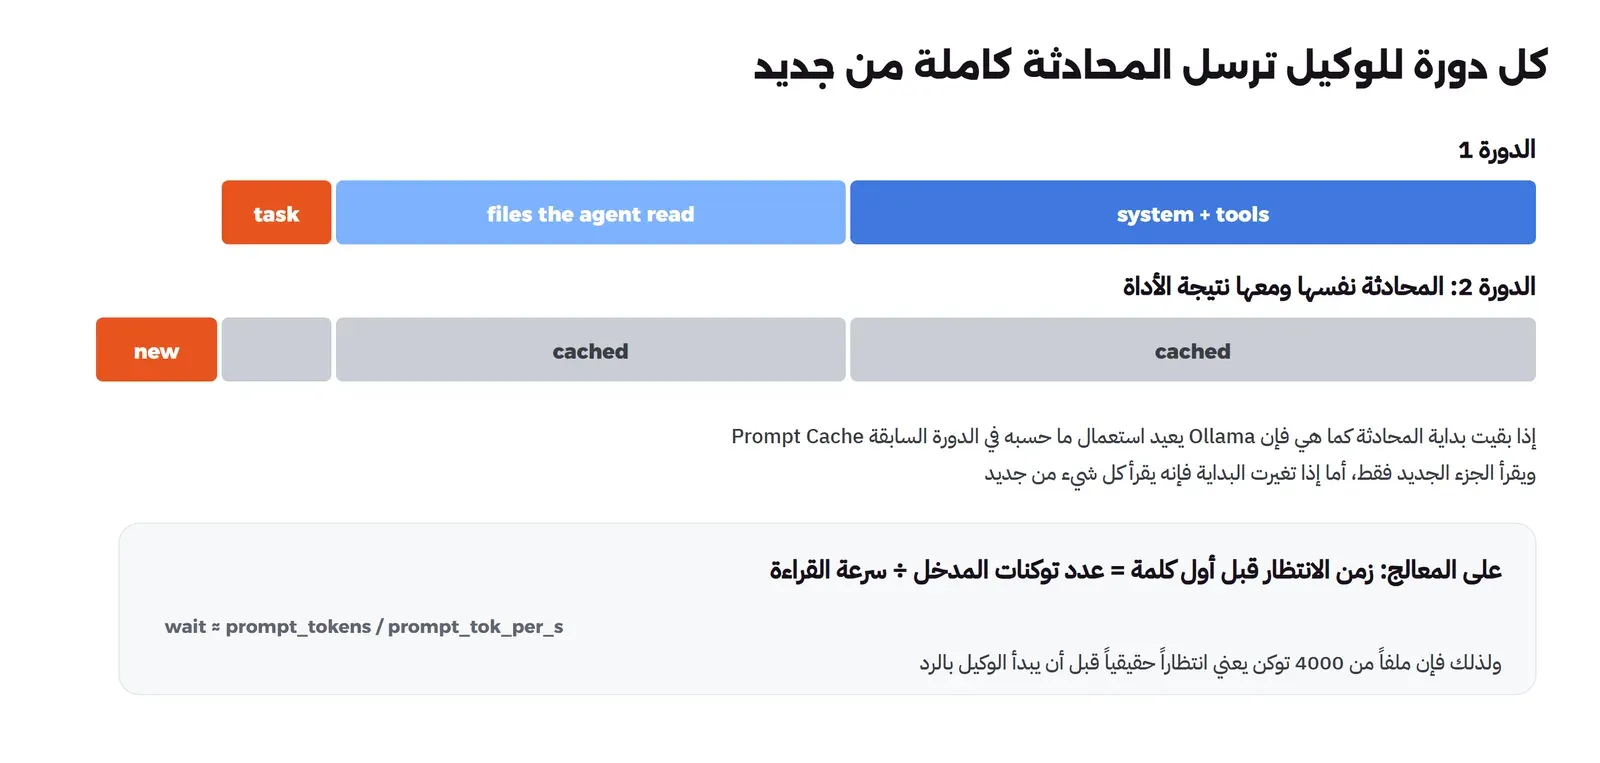
وهذا يفسر نصيحة تسمعها كثيراً مع النماذج المحلية: لا تقم بتغيير التعليمات في أول المحادثة كثيراً، ولا تبدأ محادثة جديدة لكل سؤال صغير، لأن أي تغيير في البداية يلغي ما حفظه السيرفر ويعيد قراءة كل شيء من الصفر. والأدوات الجيدة ترتب ما ترسله بحيث يبقى الجزء الثابت في الأول والمتغير في الآخر لهذا السبب نفسه. والشكل التالي يجمع السرعتين لكل النماذج:
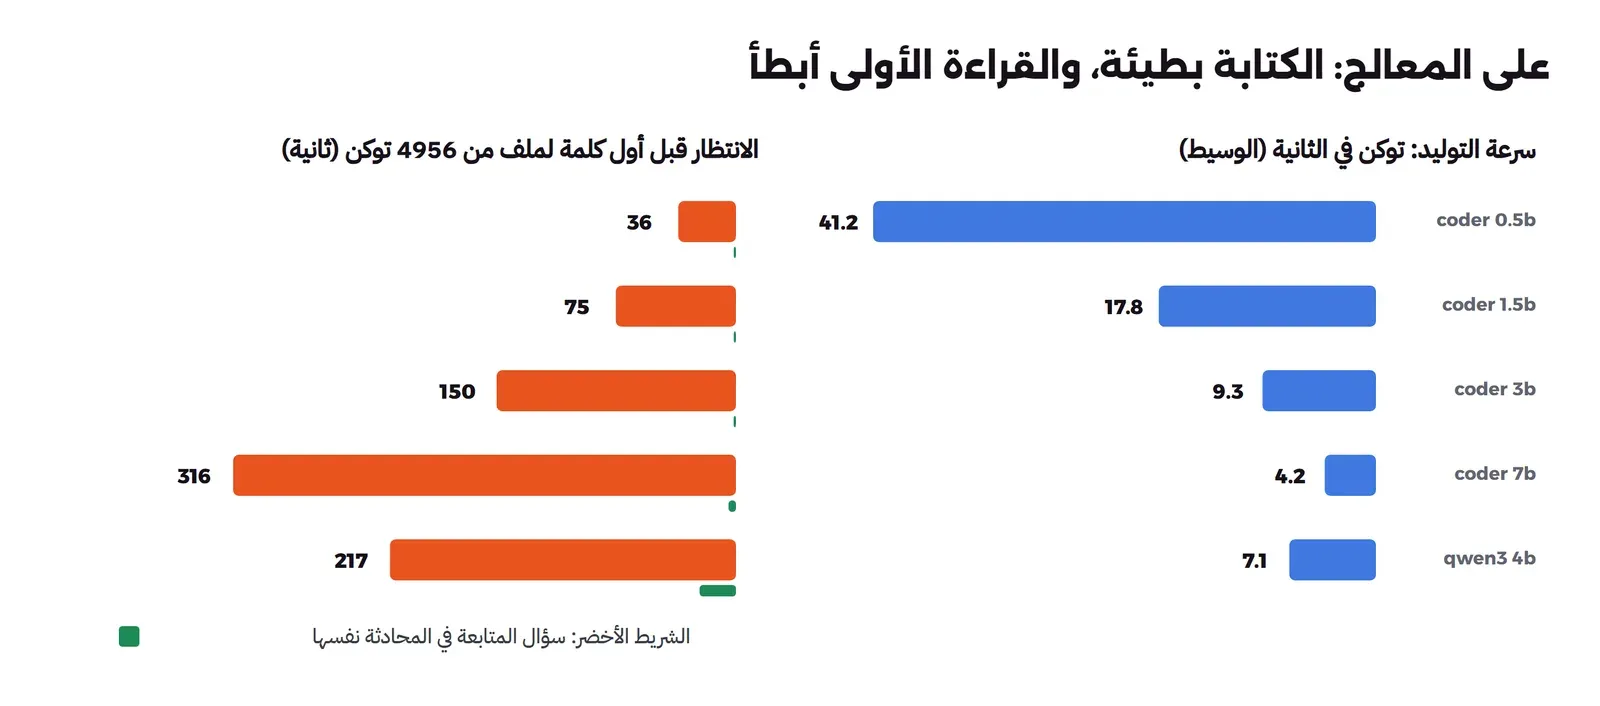
نافذة السياق Context Window الافتراضية تقطع ملفاتك
رأينا في المخرج السابق أن Ollama حمل كل النماذج بنافذة سياق 4096 توكن، مع أن النموذج نفسه يدعم 32768، والسبب أن Ollama يختار طول السياق حسب ذاكرة البطاقة الرسومية، وصفحة Context Length في توثيقه تذكر أن أي جهاز ذاكرة بطاقته أقل من 24 GiB يأخذ 4k، وأن أداة البرمجة والوكيل يحتاجان 64000 توكن على الأقل. وقد يتساءل البعض: وماذا يحدث إذا أرسل الوكيل أكثر من ذلك؟ هل يرجع خطأ؟ والإجابة لا، وهذا هو الجزء الخطير، فالقسم الثالث من المختبر يرسل ملف Python طويلاً فيه في أوله ثابت اسمه LATE_FEE_RATE قيمته 0.137، ثم 150 دالة، ثم سؤال في آخره عن قيمة هذا الثابت، مرة بالإعداد الافتراضي ومرة بنافذة 16384 توكن، والمخرج سوف يكون كما يلي:
qwen2.5-coder:7b     num_ctx default: model read  2050 tokens, answer '0.05'
qwen2.5-coder:7b     num_ctx   16384: model read  6265 tokens, answer '0.137'
qwen2.5-coder:1.5b   num_ctx default: model read  2050 tokens, answer '0.05'
qwen2.5-coder:1.5b   num_ctx   16384: model read  6265 tokens, answer '0.137'
level=WARN source=llama_server.go:344 msg="truncating input prompt" limit=2050 prompt=6265 keep=4 new=2050
slot      release: id  0 | task 379 | stop processing: n_tokens = 331, truncated = 0
slot      release: id  0 | task 480 | stop processing: n_tokens = 435, truncated = 0
slot      release: id  0 | task 529 | stop processing: n_tokens = 679, truncated = 0
لاحظ أن النموذجين أجابا 0.05 بالإعداد الافتراضي، وهي قيمة غير موجودة في الملف أصلاً، وأجابا 0.137 بالضبط عندما أصبحت النافذة 16384، والفرق الوحيد بين التشغيلين هو العمود الذي يقول كم توكن قرأ النموذج فعلاً: 2050 من أصل 6265. والسيرفر هو الوحيد الذي يعرف ما حدث، فقد كتب في سجله Log هذا التحذير:
level=WARN source=llama_server.go:344 msg="truncating input prompt" limit=2050 prompt=6265 keep=4 new=2050
level=WARN source=llama_server.go:344 msg="truncating input prompt" limit=2050 prompt=6265 keep=4 new=2050
أي أن Ollama قطع المدخل من 6265 توكن إلى 2050، وأبقى أول 4 توكنات ثم آخر الملف، والثابت الذي في أوله ذهب مع الجزء المحذوف. ولم يصل إلى البرنامج الذي أرسل الطلب أي خطأ، فالرد رجع بحالة 200 وفيه إجابة واثقة، والنموذج لا يعرف أن شيئاً حذف من أمامه، ولذلك اخترع رقماً يبدو معقولاً لنسبة رسوم. والشكل التالي يبين ذلك:
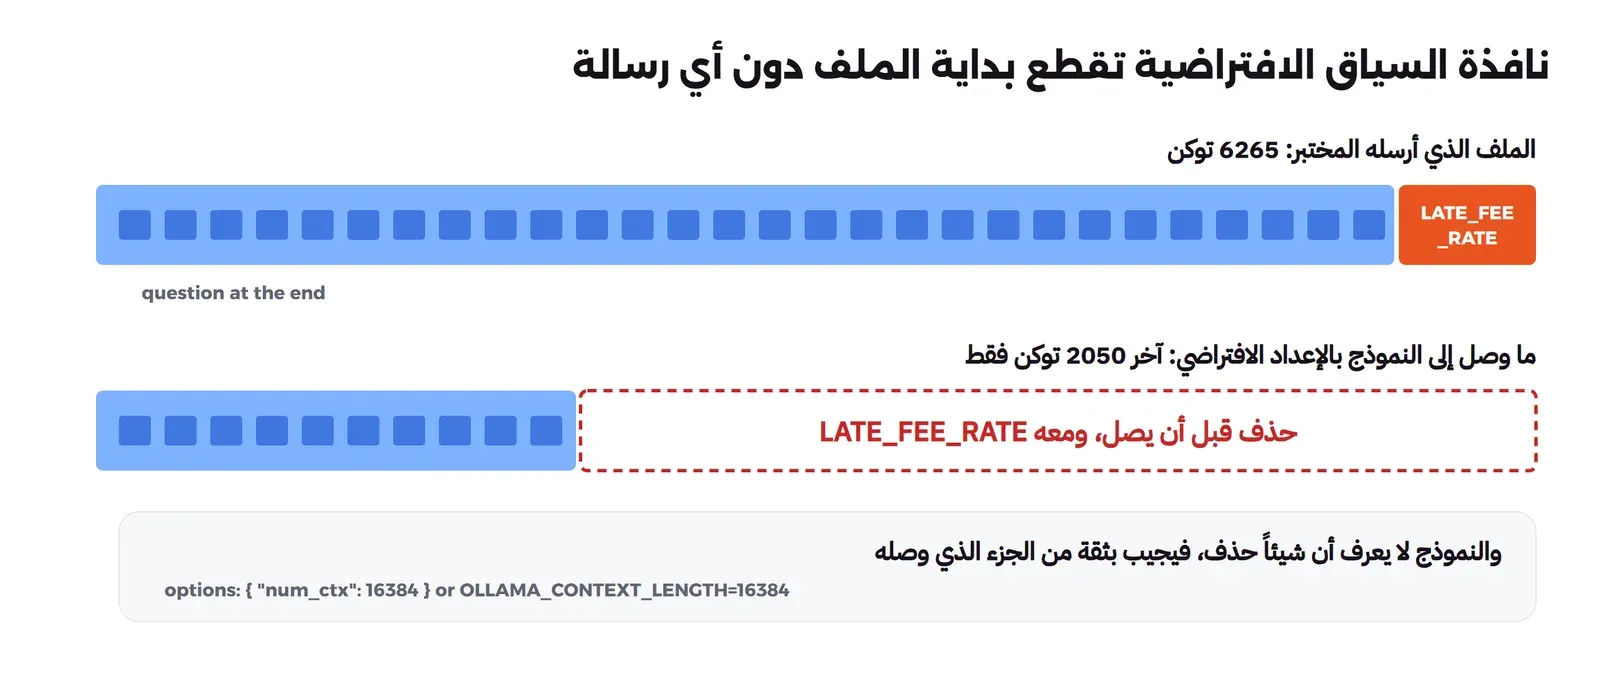
وهذه المشكلة ليست خاصة بالمختبر، فتوثيق Aider يحذر منها صراحة ويقول إن Ollama يحذف ما زاد عن النافذة بصمت، ولذلك فإن Aider يضبط طول السياق بنفسه في كل طلب بحيث يتسع لما يرسله ومعه 8000 توكن للرد. أما إذا كنت تستعمل أداة تتصل بالواجهة المتوافقة مع OpenAI فإن صفحة التوافق تذكر أن هذه الواجهة لا تملك طريقة لتحديد طول السياق، وأن الحل أن تنشئ نموذجاً باسم جديد من ملف Modelfile فيه PARAMETER num_ctx، أو أن تضبط OLLAMA_CONTEXT_LENGTH عند تشغيل السيرفر. ولذلك قبل أن تحكم على أي نموذج محلي بأنه لا يفهم مشروعك، تأكد أولاً أنه يرى مشروعك.
الجودة: عشر دوال تفحصها اختبارات حقيقية
السرعة وحدها لا تكفي، فالنموذج السريع الذي يكتب كوداً خاطئاً يضيع وقتك أكثر من النموذج البطيء. والطريقة البسيطة لقياس الجودة أن تسأل النموذج سؤالاً وتقرأ الإجابة وتحكم عليها بعينك، وهذه الطريقة غير مناسبة إطلاقاً، لأن الكود الخاطئ يبدو في الغالب صحيحاً عند القراءة السريعة، ولأن حكمك على نموذج يتأثر بآخر إجابة أعجبتك. ولذلك فإن القسم الرابع من المختبر يعطي كل نموذج عشر دوال صغيرة بوصفها فقط، ويطلب منه كتابتها في محاولة واحدة بدرجة عشوائية 0، ثم يشغل اختبارات حقيقية على كل دالة في عملية Python منفصلة، والدالة لا تنجح إلا إذا نجحت كل الاختبارات عليها. والدوال بالترتيب هي: فحص الكلمة المتناظرة Palindrome، وعد الكلمات، وتسطيح قائمة متداخلة، ودمج الفترات Intervals، وتحويل الأرقام الرومانية، وقراءة مدة مثل 1h30m، وفحص رقم البطاقة بخوارزمية Luhn، وتقسيم قائمة إلى أجزاء، وثاني أكبر قيمة مختلفة، وتطبيع النص العربي للبحث بحذف التشكيل والتطويل وتوحيد الألف والتاء المربوطة والألف المقصورة. والمخرج سوف يكون كما يلي:
### Ten functions, one try each, temperature 0 (+ pass, . fail)
model                 1  2  3  4  5  6  7  8  9 10   pass  median s/task  tokens/task
qwen2.5-coder:0.5b    +  .  +  .  .  .  .  +  +  .    4/10         76         133
qwen2.5-coder:1.5b    +  +  +  +  +  .  .  +  +  .    7/10         19         120
qwen2.5-coder:3b      +  +  +  +  +  +  .  +  +  .    8/10         41         128
qwen2.5-coder:7b      +  +  +  +  +  .  .  +  +  .    7/10         57          89
qwen3:4b              .  .  .  .  .  .  .  +  .  .    1/10        113         600
في المخرج أعلاه لاحظ التالي:
- نموذج 3B كان الأفضل بثماني دوال من عشر، وتفوق على نموذج 7B الذي نجح في سبع، أي أن الحجم الأكبر لا يعني دائماً نتيجة أفضل في مجموعة صغيرة من المهام، وفي مجموعة أكبر قد ينقلب الترتيب، ولذلك لا تبن قرارك على فرق دالة واحدة.
- نموذج 1.5B نجح في سبع دوال مثل 7B، وهو أصغر منه بخمس مرات تقريباً، وهذا يجعله خياراً معقولاً للمهام الصغيرة المحددة على جهاز ذاكرته قليلة.
- نموذج 0.5B نجح في أربع فقط، وهو مناسب للإكمال التلقائي السريع لسطر أو سطرين، لا لكتابة دالة كاملة من وصفها.
- عمود الزمن هنا ليس قياساً للسرعة، لأن هذا القسم جرى والسيرفر مشترك مع عملاء آخرين، والسرعة الحقيقية في القسم الخاص بها.
أما النموذج العام Qwen3 فنجح في دالة واحدة فقط، ولكن عمود التوكنات يكشف السبب: 600 توكن، وهو الحد الأعلى الذي أعطاه المختبر لكل إجابة. والسبب أن هذا النموذج مع إطفاء خاصية التفكير بالخيار think: false ما زال يكتب خطوات تفكيره في نص الإجابة نفسها، فيستهلك الحد كله في الشرح قبل أن يصل إلى الكود، ولذلك فإن هذه النتيجة لا تقيس قدرته على البرمجة وإنما تقيس طريقة الطلب. والقسم 04b يعيد الدوال له والتفكير مشغل، أي في حقل منفصل عن الإجابة، وبحد 4000 توكن، والمخرج سوف يكون كما يلي:
### qwen3:4b with thinking on, 4000-token budget (+ pass, . fail)
  count_words: NameError: name 'count_words' is not defined  at: assert count_words("The cat and the hat.") == {"the": 2, "ca  (stopped: length)
  flatten: NameError: name 'flatten' is not defined  at: assert flatten([1, [2, [3, [4]]], 5]) == [1, 2, 3, 4, 5]  (stopped: length)
المخرج أعلاه يذكر الدالتين اللتين فشلتا فقط، وكلتاهما توقفت لأن النموذج بلغ الحد stopped: length، أي أنه فكر 4000 توكن ولم يصل إلى كتابة الدالة، ولذلك يقول الاختبار إن الدالة غير موجودة أصلاً. والدالة الأولى، فحص الكلمة المتناظرة، نجحت. أما الزمن فيظهر في سجل Ollama نفسه، فكل سطر فيه طلب واحد ومدته:
[GIN] 2026/11/13 - 02:15:09 | 200 |   10m30s | POST     "/api/chat"
[GIN] 2026/11/13 - 02:34:07 | 200 |   18m50s | POST     "/api/chat"
[GIN] 2026/11/13 - 02:53:07 | 200 |   18m50s | POST     "/api/chat"
[GIN] 2026/11/13 - 02:53:55 | 500 |   48.15s | POST     "/api/chat"
أي أن الدالة الأولى أخذت 10 دقائق ونصفاً، والثانية والثالثة 18 دقيقة و50 ثانية لكل منهما، والسطر الأخير بالحالة 500 هو الطلب الرابع الذي أوقفنا عنده التشغيل. ولذلك اكتفى المختبر بثلاث دوال وترك السبع الباقية، لأن النتيجة واضحة: دالة صحيحة من ثلاث في 48 دقيقة، ومرتان من ثلاث نفد الحد قبل الكود. والدرس هنا أن التفكير Reasoning يحسن الإجابة في النماذج التي تدعمه، ولكن ثمنه توكنات، والتوكن على المعالج بطيء، فإذا كان التفكير يأخذ آلاف التوكنات في كل سؤال فإن النموذج يصبح غير صالح للعمل اليومي على هذا الجهاز مهما كانت جودته.
والأهم من عدد الدوال هو نوع الأخطاء، فالقسم نفسه يطبع أول سطر خطأ لكل دالة فشلت، وهذه أمثلة منه:
### Why each failure failed (first error line from the test run)
qwen2.5-coder:0.5b   count_words: AssertionError  at: assert count_words("The cat and the hat.") == {"the": 2, "ca
qwen2.5-coder:0.5b   merge_intervals: IndexError: list index out of range  at: assert merge_intervals([]) == []
qwen2.5-coder:0.5b   roman_to_int: AssertionError  at: assert roman_to_int("MCMXCIV") == 1994
qwen2.5-coder:0.5b   parse_duration: ValueError: Invalid duration format
qwen2.5-coder:0.5b   luhn_valid: AssertionError  at: assert luhn_valid("4539 3195 0343 6467")
qwen2.5-coder:0.5b   normalize_arabic: AssertionError  at: assert normalize_arabic("مُحَمَّد") == "محمد"
qwen2.5-coder:1.5b   parse_duration: ValueError: invalid literal for int() with base 10: '1h30'  at: assert parse_duration("1h30m") == 5400
qwen2.5-coder:1.5b   luhn_valid: AssertionError  at: assert luhn_valid("4539 3195 0343 6467")
qwen2.5-coder:1.5b   normalize_arabic: AssertionError  at: assert normalize_arabic("مُحَمَّد") == "محمد"
qwen2.5-coder:3b     luhn_valid: ValueError: invalid literal for int() with base 10: 'a'  at: assert not luhn_valid("055a 444 285")
qwen2.5-coder:3b     normalize_arabic: SyntaxError: unterminated string literal (detected at line 88)
qwen2.5-coder:7b     parse_duration: no ValueError for '1m1h'
qwen2.5-coder:7b     luhn_valid: AssertionError  at: assert luhn_valid("4539 3195 0343 6467")
qwen2.5-coder:7b     normalize_arabic: AssertionError  at: assert normalize_arabic("مدرسة مستشفى") == "مدرسه مستشفي"
لاحظ أن كل نماذج Qwen2.5-Coder فشلت في دالة Luhn وفي دالة تطبيع النص العربي، وهذا مهم لنا تحديداً، فالنموذج 7B حذف التشكيل ولكنه لم يحول التاء المربوطة والألف المقصورة كما طلب الوصف، ونموذج 3B كتب كوداً فيه نص عربي لم يغلقه فلم يعمل الملف أصلاً، والنموذجان الأصغر لم يحذفا التشكيل بشكل صحيح. وكذلك فإن خطأ نموذج 7B في قراءة المدة لا يظهر إلا في حالة حافة Edge Case، فالدالة تقرأ 1h30m بشكل صحيح ولكنها تقبل 1m1h بترتيب خاطئ دون أي خطأ. وهذه هي الأخطاء التي لا تراها بعينك عند القراءة السريعة، ولذلك فإن القاعدة مع أي نموذج، محلياً كان أو سحابياً، هي أن الاختبارات هي التي تحكم على الكود لا شكله، وفصلنا ذلك في مقال اختبارات يكتبها الذكاء الاصطناعي.
الوكيل Agent: أربع أدوات ومستودع فيه خطأ Bug واحد
كتابة دالة من وصفها مهمة واحدة، أما الوكيل فيحتاج سلسلة قرارات: أن يعرف ما في المستودع، ثم يقرأ الملف الصحيح، ثم يكتب الإصلاح، ثم يشغل الاختبارات ويتأكد. والقسم الخامس من المختبر يبني وكيلاً صغيراً بالطريقة نفسها التي تعمل بها الأدوات الحقيقية، أي حلقة Loop ترسل المحادثة مع وصف أربع أدوات: list_files وread_file وwrite_file وrun_tests، وتنفذ ما يطلبه النموذج، وتعيد النتيجة إليه، لثماني دورات على الأكثر. والمستودع فيه ملف pricing.py بدالة خصم خاطئة، فهي تطرح النسبة من السعر بدل أن تحسبها، أي أن خصم 10% على 200 يعطي 190 بدل 180، ومعه ملف اختبارات وملفان لا علاقة لهما بالعلة. والمختبر بعد انتهاء الوكيل يشغل الاختبارات بنفسه، ويفحص أن ملف الاختبارات لم يتغير، لأن الوكيل الذي يعدل الاختبارات حتى تنجح لم يصلح شيئاً. ومع النافذة 8192 توكن حتى لا تتكرر مشكلة القطع، والمخرج سوف يكون كما يلي:
### Summary: tests pass at the end (checked again outside the agent), tests left untouched
model                fixed turns calls unknown as text edited tests seconds prompt tok gen tok
qwen2.5-coder:0.5b      no     8     0       0       8           no      12       3856     216
qwen2.5-coder:1.5b      no     1     0       0       0           no       6        314       2
qwen2.5-coder:3b        no     8     0       0       8           no      39       3744     188
qwen2.5-coder:7b        no     8     0       0       8           no      66       3464     104
qwen3:4b                no     3     2       0       0           no     241       1691    1072
ولا نموذج واحد أصلح العلة، والسبب يظهر في سجل الدورات لكل نموذج، وهذا جزء منه:
### qwen2.5-coder:7b
  turn 1: wrote a tool call as plain text: '{"name": "list_files", "arguments": {}}'
  turn 2: wrote a tool call as plain text: '{"name": "list_files", "arguments": {}}'
...
### qwen3:4b
  turn 1: list_files({}) -> README.md
  turn 2: read_file({"path": "pricing.py"}) -> VAT = 0.15
  turn 3: replied "Okay, let's see. The user's tests are failing, and I need to fix the b"
في المخرج أعلاه لاحظ التالي:
- نماذج Qwen2.5-Coder الثلاثة 0.5B و3B و7B عرفت الأداة الصحيحة وكتبت الطلب بصيغة JSON صحيحة، ولكنها كتبته نصاً عادياً في الإجابة بدل أن ترسله استدعاء أداة منظماً Structured Tool Call، فرجع من Ollama في حقل النص لا في الحقل
tool_calls، والوكيل الذي يلتزم بالواجهة لا يرى أي استدعاء، فيذكر النموذج بالطريقة الصحيحة، فيعيد النموذج الشيء نفسه ثماني مرات. - نموذج 1.5B رد بكلمة DONE من الدورة الأولى دون أن يقرأ أي ملف، أي أنه أعلن انتهاء مهمة لم يبدأها، وهذا بالضبط ما يجعل فحص النتيجة خارج الوكيل ضرورياً.
- نموذج Qwen3 العام هو الوحيد الذي استعمل الأدوات بالطريقة الصحيحة، فقد عرض الملفات ثم قرأ
pricing.py، ولكنه في الدورة الثالثة بدأ يكتب تفكيره نصاً في الرد بدل أن يستدعي أداة الكتابة، فانتهت الحلقة دون إصلاح.
وقد يتساءل البعض: هل هذا عدل؟ فكثير من الأدوات الحقيقية تقرأ استدعاء الأداة حتى لو كتبه النموذج نصاً. والإجابة أن هذا صحيح، ولذلك يعيد المختبر المهمة بوضع متسامح Lenient، يقبل فيه الوكيل استدعاء الأداة المكتوب نصاً ما دام JSON صحيحاً، ويشغل التفكير في Qwen3 في حقله المنفصل بحد 2000 توكن، والمخرج سوف يكون كما يلي:
### Summary: tests pass at the end (checked again outside the agent), tests left untouched
model                fixed turns calls unknown as text edited tests seconds prompt tok gen tok
qwen2.5-coder:0.5b      no     8     8       0       8           no      11       4024     216
qwen2.5-coder:1.5b      no     1     0       0       0           no       7        314       2
qwen2.5-coder:3b        no     8     8       0       8          yes      75       5553     385
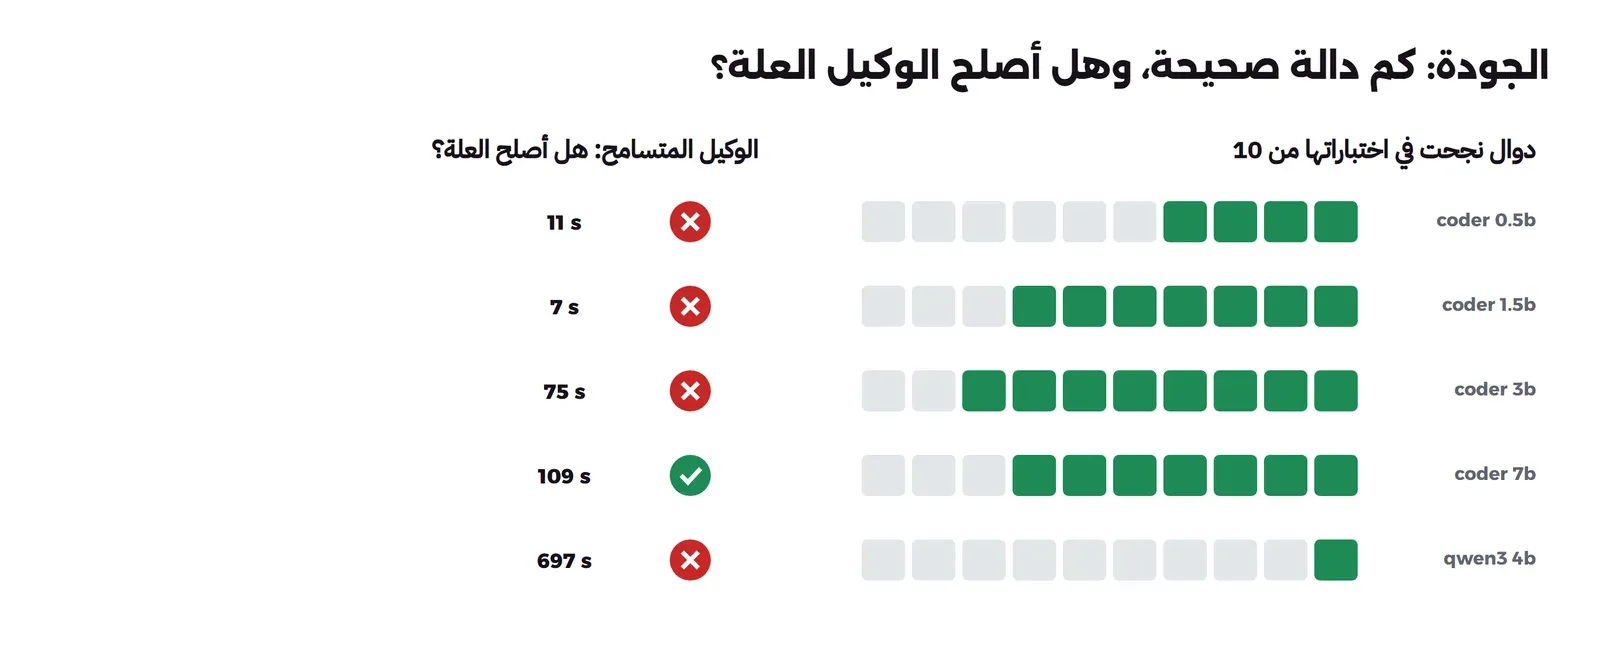
qwen2.5-coder:7b       yes     6     5       0       5           no     109       3461     216
qwen3:4b                no     3     2       0       0           no     697       1973    2651
وهنا نجح نموذج 7B فقط، وسجل دوراته يبين كيف يبدو الوكيل عندما يعمل:
### qwen2.5-coder:7b
  turn 1: list_files({}) -> README.md
  turn 2: read_file({"path": "test_pricing.py"}) -> from pricing import apply_discount, total_with_vat
  turn 3: read_file({"path": "pricing.py"}) -> VAT = 0.15
  turn 4: write_file({"path": "pricing.py", "content": "VAT = 0.15\n\n\ndef ap...) -> wrote pricing.py (373 chars)
  turn 5: run_tests({}) -> exit code 0
  turn 6: replied 'DONE'
لاحظ أنه عرض الملفات، ثم قرأ الاختبارات ليعرف المطلوب، ثم قرأ الكود، ثم كتب الإصلاح، ثم شغل الاختبارات ورأى أنها نجحت، ثم قال DONE، أي الحلقة التي شرحناها في مقال مراجعة كود الذكاء الاصطناعي عن الخطوات التي يجب أن تراها قبل أن تثق بالنتيجة. واستغرق ذلك 109 ثوان لمهمة يصلحها المطور في أقل من دقيقة. أما نموذج 3B فكان أسوأ من الفشل، والسجل يبين لماذا:
### qwen2.5-coder:3b
  turn 1: read_file({"path": "test_pricing.py"}) -> from pricing import apply_discount, total_with_vat
  turn 2: write_file({"path": "test_pricing.py", "content": "<tool_response>"}) -> wrote test_pricing.py (15 chars)
  turn 3: run_tests({}) -> exit code 1
  turn 4: write_file({"path": "test_pricing.py", "content": "from pricing impo...) -> wrote test_pricing.py (246 chars)
  turn 5: run_tests({}) -> exit code 1
  turn 6: write_file({"path": "pricing.py", "content": "def apply_discount(pri...) -> wrote pricing.py (174 chars)
  turn 7: run_tests({}) -> exit code 1
  turn 8: write_file({"path": "pricing.py", "content": "def apply_discount(pri...) -> wrote pricing.py (174 chars)
نموذج 3B قرأ ملف الاختبارات، ثم كتب فوقه نصاً لا معنى له هو <tool_response>، ثم أعاد كتابة الاختبارات، ثم كتب ملف pricing.py كله من جديد بمحتوى من 174 حرفاً، أي أقصر من نصف الملف الأصلي، ولم تنجح الاختبارات في أي مرة، ولذلك فإن العمود edited tests يقول yes. وهذا هو السبب الذي يجعل الأدوات الحقيقية تطلب موافقتك قبل كتابة أي ملف، أو تعمل في فرع منفصل أو صندوق معزول Sandbox، لأن الوكيل الضعيف لا يفشل بهدوء وإنما يخرب ما كان سليماً. ونموذج Qwen3 مع التفكير استعمل الأدوات بالطريقة الصحيحة مرة أخرى، ولكنه احتاج 2651 توكناً و697 ثانية، أي أكثر من 11 دقيقة، ثم رد في الدورة الثالثة بإجابة فارغة دون إصلاح.
هل كان الجهاز هادئاً أثناء القياس؟
ذكرنا في أول المختبر أن الجهاز كان مشغولاً، والقسم السادس يبين ذلك بالأرقام، فسكربت PowerShell صغير اسمه load.ps1 يقرأ نسبة استعمال المعالج والذاكرة المتاحة في Windows كل 5 ثوان طوال المختبر، ثم يجمعها السكربت 06_load.py لكل قسم، وهذا جزء من المخرج:
### Host CPU (all 8 threads, %) and free RAM while each block ran, 2667 samples
block                              minutes cpu median   cpu range free RAM GB
tasks qwen2.5-coder:0.5b              15.1        100    96-100          18.4
tasks qwen2.5-coder:1.5b               6.0        100    86-100          18.4
tasks qwen2.5-coder:3b                 9.2         98    76-100          17.9
tasks qwen2.5-coder:7b                16.8        100    78-100          12.7
tasks qwen3:4b                        20.0         86    29-100          15.9
...
speed qwen2.5-coder:0.5b               0.3         76    72-78           17.4
speed qwen2.5-coder:1.5b               0.7         78    34-83           17.0
speed qwen2.5-coder:3b                 1.3         76    35-81           16.1
speed qwen2.5-coder:7b                 2.9         76    39-83           13.4
speed qwen3:4b                         1.7         76    31-89           15.0
context qwen2.5-coder:0.5b             1.3         75    25-82           17.4
context qwen2.5-coder:1.5b             2.8         76    42-82           16.6
context qwen2.5-coder:3b               5.5         74    51-87           15.5
context qwen2.5-coder:7b              11.4         75    48-90           12.6
context qwen3:4b                       9.6         75    37-86           14.0
لاحظ أن المعالج كان عند 100% تقريباً طوال قسم الدوال العشر، لأن السيرفر كان يخدم عملاء آخرين في الوقت نفسه، ولذلك قلنا إن عمود الزمن في ذلك القسم ليس قياساً للسرعة. أما في أقسام السرعة فكان الوسيط حوالي 76%، وهذه النسبة تشمل Ollama نفسه وهو يحسب، أي أن النموذج كان يأخذ جزءاً كبيراً منها والبرامج الأخرى الباقي. ولاحظ أيضاً عمود الذاكرة المتاحة، فقد نزل إلى 12.6 GB أثناء قراءة الملف الطويل بنموذج 7B، وعلى جهاز ذاكرته الكلية 16 GB فإن هذا الفرق قد لا يكون موجوداً أصلاً.
ماذا تتوقع فعلاً؟
إذا جمعنا نتائج المختبر فإن الصورة على جهاز دون بطاقة رسومية واضحة، والجدول التالي يلخص ما يناسب النموذج المحلي وما لا يناسبه، مع الدليل من المختبر:
| المهمة | على المعالج مع نموذج صغير | الدليل من المختبر |
|---|---|---|
| الإكمال التلقائي Autocomplete لسطر أو سطرين | مناسب مع 0.5B أو 1.5B | 0.5B يكتب 41 توكناً في الثانية ويبدأ بعد 0.17 ثانية، و7B يكتب 4.2 فقط |
| كتابة دالة صغيرة محددة من وصفها | مناسب مع 1.5B إلى 7B بشرط الاختبارات | سبع إلى ثماني دوال من عشر، وكل نموذج فشل في حالات حافة لا تظهر بالعين |
| شرح كود تلصقه في المحادثة | مناسب إذا رفعت نافذة السياق | بالنافذة الافتراضية وصل ثلث الملف فقط، وبنافذة 16384 أجاب النموذجان بشكل صحيح |
| وكيل يقرأ ويعدل ويختبر بنفسه | غير مناسب في الغالب | نموذج واحد من خمسة أصلح العلة، وبعد أن قبل الوكيل الاستدعاء المكتوب نصاً، وفي 109 ثوان لعلة من سطر واحد |
| مهام كبيرة على عدة ملفات | غير مناسب | قراءة ملف من 5000 توكن أخذت من 36 ثانية إلى 315 ثانية قبل أول كلمة، والمهمة الكبيرة تقرأ ملفات كثيرة |
والقاعدة التي تخرج من ذلك أن النموذج المحلي على المعالج مساعد صغير جيد وليس وكيلاً، فهو مفيد في المهام القصيرة التي تراجع نتيجتها فوراً، وعندما يكون خروج الكود من الجهاز ممنوعاً، وعندما تعمل دون إنترنت، أما المهمة التي تعتمد على سلسلة طويلة من القرارات واستدعاء الأدوات فتحتاج نموذجاً أكبر بكثير، وهذا يعني بطاقة رسومية بذاكرة كبيرة أو خدمة سحابية. وإذا كانت لديك بطاقة رسومية فإن الصورة تتغير في السرعة كثيراً، كما شرحنا في دليل تشغيل النماذج على جهازك، ولكن مشكلات الجودة واستدعاء الأدوات في المختبر لا علاقة لها بالسرعة، وإنما بحجم النموذج وتدريبه، ولذلك فإنها تبقى مع النماذج الصغيرة حتى على أسرع بطاقة.
إذا أردت أن تبدأ: إعداد عملي على جهاز دون بطاقة رسومية GPU
بعد هذه الأرقام فإن الإعداد الأنسب على جهاز مثل جهاز المختبر ليس نموذجاً واحداً لكل شيء، وإنما نموذجان لكل منهما وظيفة، مع إعدادات تمنع المشكلات التي رأيناها. وفيما يلي الخطوات بالترتيب:
- نموذج صغير للإكمال التلقائي: اسحب
qwen2.5-coder:1.5b، فهو يكتب حوالي 18 توكناً في الثانية على المعالج ويبدأ بعد أقل من نصف ثانية، ونجح في سبع دوال من عشر، أي أنه سريع بما يكفي ليظهر وأنت تكتب، ورخصته Apache 2.0. - نموذج أكبر للمحادثة والأسئلة: اسحب
qwen2.5-coder:7bلشرح الكود وكتابة دالة كاملة، وتقبل أنه يكتب 4 توكنات في الثانية، أي أنك تسأله ثم تنتقل إلى شيء آخر وتعود، ولا تستعمله للإكمال التلقائي. - نافذة سياق مناسبة لذاكرتك: شغل السيرفر بنافذة 16384 توكن، فقد رأينا أنها تكلف نموذج 7B حوالي 6 GB فقط، وهي كافية لملف أو ملفين، أما 64000 التي ينصح بها التوثيق للوكلاء فتحتاج ذاكرة أكبر بكثير:
OLLAMA_CONTEXT_LENGTH=16384 ollama serveوإذا كانت الأداة التي تستعملها تتصل بالواجهة المتوافقة مع OpenAI ولا تستطيع تمرير num_ctx، فأنشئ نسخة من النموذج بملف Modelfile كما في صفحة التوافق، ثم استعمل الاسم الجديد في الأداة:
FROM qwen2.5-coder:7b
PARAMETER num_ctx 16384
ollama create coder7b-16k -f Modelfile
ollama psوبعد أول طلب تأكد من العمود CONTEXT في مخرج ollama ps، فإذا ظهر فيه 4096 فإن الإعداد لم يطبق، والأداة سوف تقطع ملفاتك كما رأينا في المختبر. ثم اختر أداة تعرف كيف تتعامل مع النماذج المحلية، فمثلاً Aider يضبط طول السياق بنفسه ويعمل بصيغ تعديل Edit Formats يكتبها النموذج نصاً ولا تعتمد على استدعاء الأدوات المنظم، وهذا مهم لأن استدعاء الأدوات المنظم هو بالضبط ما فشلت فيه النماذج الصغيرة في المختبر. وأخيراً اجعل الاختبارات هي الحكم، فلا تقبل أي تعديل من النموذج قبل أن تشغلها بنفسك، وشغل الأداة في فرع Git منفصل حتى ترجع عن أي تعديل بأمر واحد إذا كتب النموذج فوق ملف لا يجب أن يلمسه، كما فعل نموذج 3B في المختبر.
الإعدادات التي تغير النتيجة
إذا قررت أن تجرب نموذجاً محلياً مع وكيل برمجة، فإن هذه الإعدادات هي التي تفرق بين تجربة مفيدة وتجربة تجعلك تحكم على النموذج ظلماً، وكلها موثقة في الأسئلة الشائعة في توثيق Ollama:
- طول نافذة السياق num_ctx: الافتراضي 4096 توكن على جهاز دون بطاقة رسومية كبيرة، وهو أقل بكثير مما يحتاجه الوكيل، وصفحة Context Length نفسها تنصح بأن يكون 64000 توكن على الأقل لأدوات البرمجة والوكلاء. وتضبطه لكل الطلبات بالمتغير
OLLAMA_CONTEXT_LENGTHعند تشغيل السيرفر، أو لكل طلب بالخيارnum_ctx، وتذكر أن الواجهة المتوافقة مع OpenAI لا تسمح بتمريره، ولذلك فإن الحل معها هو ملف Modelfile فيهPARAMETER num_ctxكما في صفحة التوافق، أو المتغير على مستوى السيرفر. وكل زيادة في هذا الرقم تكلف ذاكرة كما رأينا في المختبر، فاختر أكبر رقم تتحمله ذاكرتك لا أكبر رقم يدعمه النموذج. - مدة بقاء النموذج في الذاكرة keep_alive: النموذج يبقى في الذاكرة 5 دقائق بعد آخر طلب ثم يخرج منها، فإذا توقفت لتقرأ الكود أكثر من ذلك فإن الطلب التالي ينتظر تحميل النموذج من جديد. وتستطيع تغيير ذلك بالمتغير
OLLAMA_KEEP_ALIVEأو الخيارkeep_aliveفي الطلب. - عدد النماذج المحملة معاً OLLAMA_MAX_LOADED_MODELS: الافتراضي 3 نماذج عند التشغيل على المعالج. وإذا كنت تستعمل نموذجاً صغيراً للإكمال التلقائي ونموذجاً أكبر للمحادثة فإن الاثنين يتنافسان على الذاكرة نفسها والمعالج نفسه.
- عدد الطلبات المتوازية OLLAMA_NUM_PARALLEL: الافتراضي طلب واحد لكل نموذج، والتوثيق ينبه إلى أن الذاكرة المطلوبة تتضاعف بعدد الطلبات المتوازية مضروباً في طول السياق، ولذلك لا ترفعه على جهاز ذاكرته محدودة.
- التفكير في نماذج Qwen3: نماذج Qwen3 تكتب خطوات تفكير قبل الإجابة إذا لم تطفئها، وهذه الخطوات توكنات تولد بالسرعة البطيئة نفسها، ولذلك أطفأها المختبر بالخيار
think: false. وقد تحتاج التفكير في مسألة صعبة، ولكن احسب ثمنه بالثواني قبل أن تتركه يعمل في كل دورة. - درجة العشوائية temperature: المختبر استعمل 0 حتى تكون النتيجة قابلة للتكرار، وفي الاستعمال اليومي فإن قيمة منخفضة مناسبة للكود، أما القيم العالية فتعطي تنوعاً لا تحتاجه عندما تريد دالة صحيحة.
أخطاء شائعة
- الحكم على النموذج والسياق مقطوع: إذا كانت إجابات الوكيل عن ملفاتك غريبة، فأول ما تفحصه هو طول السياق في
ollama ps، لأن النموذج قد لا يرى نصف ما أرسلته، وهو لا يخبرك بذلك. - تصديق كلمة «تم»: الوكيل الذي يقول DONE لم يثبت شيئاً، والذي يثبت هو تشغيل الاختبارات بعده، وهذا ما فعله المختبر خارج الوكيل في كل مرة.
- اختيار النموذج الأكبر دائماً: النموذج الأكبر أدق، ولكنه على المعالج أبطأ بشكل يجعل مهمة الوكيل تستغرق دقائق طويلة، فقس الزمن على مهمة حقيقية من عملك قبل أن تقرر.
- تجاهل الرخصة: Qwen2.5-Coder بحجم 3B تحديداً تحت رخصة Qwen Research التي تمنع الاستعمال التجاري دون إذن، بينما الأحجام 0.5B و1.5B و7B تحت Apache 2.0، فاقرأ رخصة كل نموذج قبل أن تستعمله في عمل الشركة.
- مقارنة أرقامك بأرقام غيرك: السرعة تتغير بالمعالج والذاكرة والبرامج الأخرى التي تعمل في اللحظة نفسها، ولذلك قس على جهازك أنت بالمختبر نفسه، ولا تعتمد على رقم من جهاز آخر.
تدريب عملي
- شغل
bash run.sh qualityبعد أن تسحب نموذجاً واحداً فقط تريد تجربته، وغير قائمة النماذج بالمتغيرLAB_MODELS، ثم قارن نتيجته في الدوال العشر بالجدول في هذا المقال. - في
03_context.pyغير16384إلى8192وشغله مرة أخرى: هل يرى النموذج الثابتLATE_FEE_RATEالآن؟ ثم احسب كم توكناً يحتاج الملف فعلاً من عمودmodel read. - أضف إلى
tasks/tasks.pyدالة من عملك اليومي مع اختباراتها، واجعل وصفها مختصراً كما تكتبه لزميل، ثم شغل04_tasks.pyوانظر أي نموذج يفهمها. - في
05_agent.pyأضف في وصف المهمة جملة تمنع الوكيل من الكتابة في ملفات الاختبارات، ثم شغل الوضع المتسامح مرة أخرى: هل توقف نموذج 3B عن الكتابة فوق الاختبارات؟
الخلاصة
- الوكيل يتصل بـ Ollama على جهازك بالطريقة نفسها التي يتصل بها بخدمة سحابية، والفرق أين يعمل النموذج ومن يدفع ثمن كل توكن.
- نموذج 7B بتكميم Q4_K_M أخذ 5.07 GB من الذاكرة بنافذة 4096 توكن و6.93 GB بنافذة 32768، فطول السياق له ثمن واضح.
- على معالج i7-7700K وسيرفر هادئ كتب نموذج 0.5B بسرعة 41.2 توكن في الثانية ونموذج 7B بسرعة 4.2، وقراءة ملف من 4956 توكن قبل أول كلمة أخذت من 36 ثانية إلى 315 ثانية.
- النافذة الافتراضية 4096 قطعت ملفاً من 6265 توكن إلى 2050 دون أي خطأ في الرد، فأجاب النموذجان برقم غير موجود، وبنافذة 16384 أجابا بشكل صحيح.
- في عشر دوال باختبارات حقيقية نجح 3B في ثمان، و1.5B و7B في سبع، و0.5B في أربع، وكلها فشلت في فحص Luhn وتطبيع النص العربي.
- في مهمة الوكيل لم ينجح أي نموذج بالاستدعاء المنظم للأدوات، وعندما قبل الوكيل الاستدعاء المكتوب نصاً نجح 7B وحده في 109 ثوان، وكتب 3B فوق ملف الاختبارات.
- التفكير في Qwen3 كلف 10 إلى 19 دقيقة للدالة الواحدة، ونفد حد 4000 توكن في دالتين من ثلاث.
- النموذج المحلي على المعالج مساعد صغير جيد للإكمال التلقائي والدوال القصيرة وشرح الكود مع الاختبارات، وليس وكيلاً يعمل وحده على مشروعك.
وفي المقالات القادمة من هذه المرحلة بإذن الله نتحدث عن بيئة تشغيل الوكيل Harness، أي الحلقة والأدوات والصلاحيات التي بنينا نسخة صغيرة منها في هذا المختبر، وعن وكلاء البرمجة مفتوحة المصدر التي تعمل مع هذه النماذج:
 دليلبيئة تشغيل الوكيل Harness: الصلاحيات والصندوق المعزول Sandboxالنموذج يكتب نصاً فقط، والبرنامج الذي حوله هو الذي يقرأ الملفات وينفذ الأوامر ويقرر ما يسمح به، وفي هذا الدليل نبني بيئة تشغيل صغيرة حول نموذج محلي ونرى كل جزء منها يعمل ويمنع.
 دليلوكلاء البرمجة مفتوحة المصدر Open Source: Aider وClineكيف يعمل كل وكيل، ومتى يسألك قبل أن يغير الكود، وما الذي يحميك إذا أخطأ، مع مختبر يشغل Aider ونموذجاً محلياً صغيراً على مستودع فيه خطأ Bug.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات
- نوفمبر 2026: كتابة المقال، وتشغيل المختبر على Ollama 0.40.13 بخمسة نماذج: Qwen2.5-Coder بأحجام 0.5B و1.5B و3B و7B، وQwen3 بحجم 4B.