

لنفرض أن فريقك يختلف على عنوان صفحة الأسعار: عنوان عام «نسخ احتياطي آلي لسيرفراتك»، أو عنوان يذكر فائدة محددة «استرجع أي ملف في دقيقتين، ولو حذف قبل شهر». والطريقة المعتادة أن يقرر صاحب الصوت الأعلى، أو أن تغير العنوان وتقارن تسجيلات هذا الأسبوع بالأسبوع الماضي، والمشكلة أن الأسبوعين مختلفان في كل شيء آخر: حملة، أو موسم، أو عطلة. واختبار A/B يحل هذا بأن يعرض النسختين في نفس الوقت على مجموعتين عشوائيتين من الزوار، ثم يحسب هل الفرق بينهما حقيقي أم صدفة. وفي هذا المقال سوف نشغل GrowthBook على سيرفرنا ونجري تجربة على صفحة تجريبية، والهدف الأهم أن تتعلم قراءة النتيجة، لأن أغلب أخطاء الاختبارات تحدث عند القراءة لا عند الإعداد.
وقد شرحنا في دليل Feature Flags أن التجربة نوع من الأعلام Experiment Flags، وفي مقال قياس التسويق كيف تعرف التحويل Conversion الذي تقيسه:
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
 دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تعرفه أنت، ونموذج إسناد تفهم ما يحسبه.
وفي هذا المقال سوف نتناول:
- مكونات التجربة: الفرضية والمقياس والتقسيم والعدد الكافي من المستخدمين.
- الأدوات: GrowthBook ومن يقابله من الخدمات التجارية.
- تشغيل GrowthBook مع مستودع بيانات PostgreSQL، وصفحة تختار العنوان بـ SDK.
- تجربة بحركة زوار مصطنعة نعرف فيها الفرق الحقيقي مسبقاً، ثم نقرأ ما يقوله GrowthBook مع 4,000 و12,000 مستخدم، ومع تجربة دون أي فرق.
- أخطاء القراءة الشائعة، والتوقف المبكر Peeking.
مكونات التجربة قبل أي أداة
- الفرضية Hypothesis: جملة واحدة تقول ماذا تغير ولماذا تتوقع أثراً، مثل «العنوان الذي يذكر الاسترجاع في دقيقتين يزيد التسجيل في التجربة المجانية، لأن الاسترجاع هو ما يقلق مدير السيرفر». والسبب أن الفرضية تمنعك من البحث بعد التجربة عن أي مقياس تحسن ثم ادعاء النجاح.
- المقياس الرئيسي Goal Metric: مقياس واحد تقرر به، وهنا نسبة من سجل في التجربة المجانية، ومعه مقاييس حماية Guardrail Metrics تتأكد أنك لم تفسد شيئاً آخر، مثل نسبة إلغاء الاشتراك.
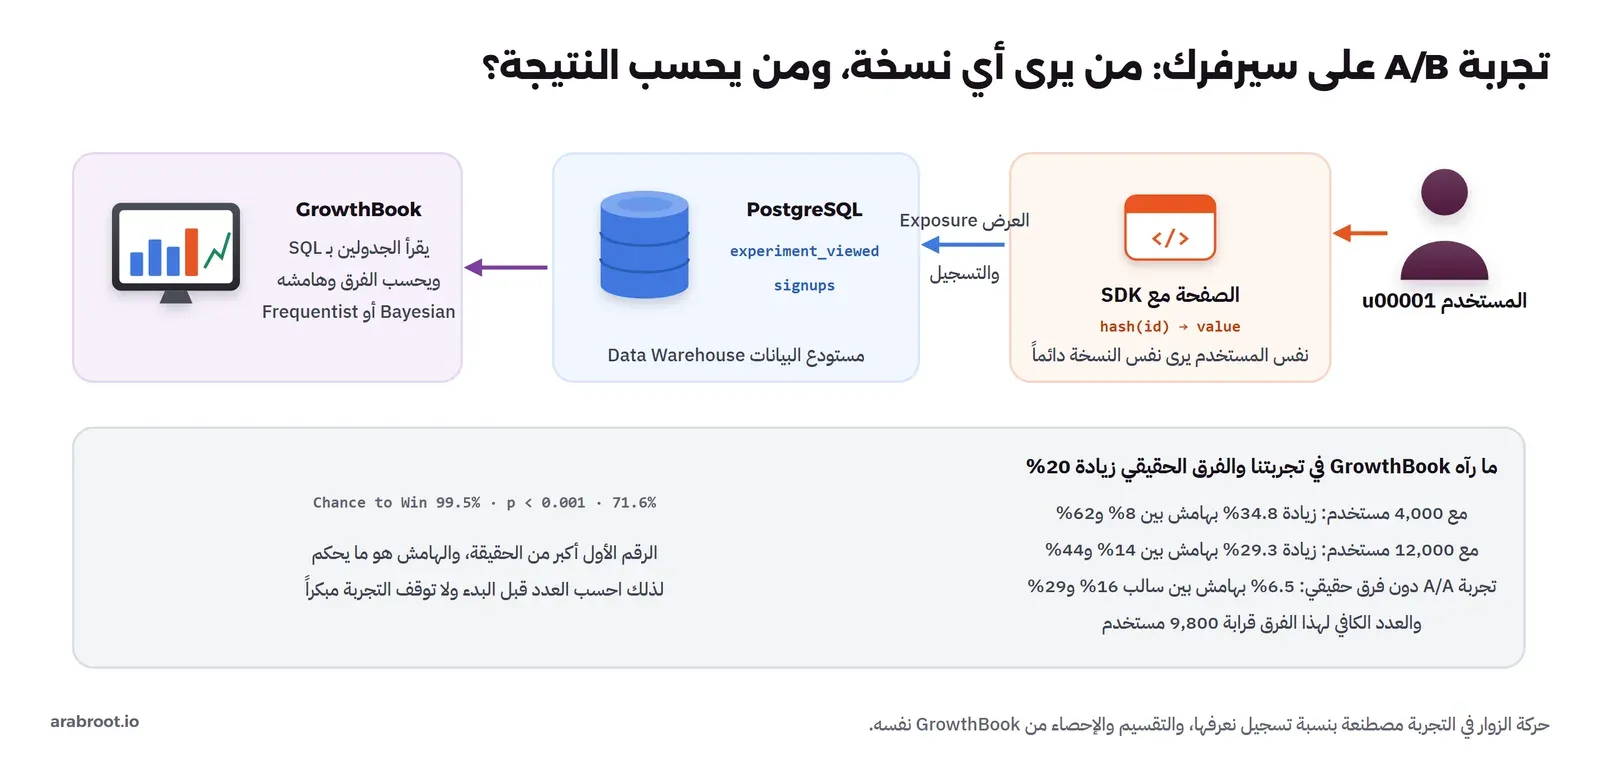
- التقسيم Randomization: كل مستخدم يدخل مجموعة بشكل عشوائي، ويبقى فيها في كل زياراته. والـ SDK في GrowthBook يفعل هذا بحساب هاش Hash من معرف المستخدم واسم التجربة، فيعطي رقماً بين 0 و1 يحدد النسخة، دون أن يخزن شيئاً أو يسأل سيرفراً.
- العرض Exposure: لحظة رأى المستخدم النسخة فعلاً، وتسجلها أنت في جدول، لأن من لم ير الصفحة لا يدخل في الحساب.
- العدد الكافي Sample Size: كم مستخدماً تحتاج حتى تكتشف الفرق الذي يهمك، ونحسبه في قسم مستقل لأنه أهم خطوة يتجاهلها الجميع.
والصورة التالية تبين كيف تعمل هذه المكونات في التجربة التي سوف نبنيها، ومعها ملخص النتائج التي سوف نصل إليها:
الأدوات: GrowthBook والخدمات التجارية
كانت Google Optimize الأداة المجانية التي يبدأ بها أغلب الناس، وقد أوقفتها Google في 30 سبتمبر 2023، فانقسم السوق بين خدمات تجارية مثل Optimizely وVWO، وأدوات منتجات تضم التجارب مع التحليلات مثل PostHog، وأدوات مفتوحة المصدر مخصصة للتجارب أشهرها GrowthBook.
GrowthBook منصة لأعلام الميزات Feature Flags والتجارب، وصدر الإصدار 5.1.0 في 22 سبتمبر 2026. والترخيص بحسب ملف الترخيص هو MIT لأغلب الكود، وترخيص Enterprise منفصل لمجلدات enterprise التي فيها ميزات الخطط المدفوعة. وما يميزه عن غيره أنه لا يجمع الأحداث بنفسه افتراضياً، وإنما يقرأ بياناتك من مستودع بيانات Data Warehouse تملكه، مثل PostgreSQL أو BigQuery أو ClickHouse، وهذا يعني أن نتائج التجربة تحسب من نفس الجداول التي تحسب منها الإيرادات. وأسعاره السحابية كما ظهرت في صفحة الأسعار في 25 أكتوبر 2026: Starter مجانية حتى 3 مستخدمين ومشروع واحد، وPro بسعر 40 دولاراً لكل مستخدم شهرياً حتى 30 مستخدماً، وEnterprise بعرض سعر.
- نقاط القوة: يقرأ من قاعدة بياناتك فلا تنسخ الأحداث إلى خدمة أخرى، ومحرك إحصاء بطريقتين Bayesian وFrequentist مع الاختبار المتتابع Sequential Testing، وSDK لأغلب اللغات يقسم المستخدمين محلياً دون طلب شبكة، ومشاريع غير محدودة التجارب في النسخة المجانية.
- نقاط الضعف: يحتاج من يكتب SQL للمقاييس واستعلام العرض، والـ Docker Image كبيرة (2.67 GB)، وبعض الميزات مثل المحرر المرئي بالذكاء الاصطناعي والـ Bandits في الخطط المدفوعة، والواجهة بالإنجليزية فقط.
تجربة عملية: GrowthBook مع PostgreSQL
التجربة أربع Containers: GrowthBook، وMongoDB يحفظ إعداداته وتجاربه، وPostgreSQL كمستودع بيانات فيه جدولا العرض والتسجيل، وتطبيق Node.js صغير يعرض صفحة الأسعار ويختار العنوان بالـ SDK. وهذا ملف Compose الذي شغلناه، دون قسم الشبكة الذي احتجناه على جهاز الاختبار فقط:
name: mkd-ab

services:
  mongo:
    image: mongo:8.0.32
    environment:
      MONGO_INITDB_ROOT_USERNAME: root
      MONGO_INITDB_ROOT_PASSWORD: ${MONGO_PASSWORD}
    volumes: ["mongo:/data/db"]

  growthbook:
    image: growthbook/growthbook:5.1.0
    ports:
      - "127.0.0.1:18782:3000"   # web app
      - "127.0.0.1:18783:3100"   # API
    environment:
      MONGODB_URI: mongodb://root:${MONGO_PASSWORD}@mongo:27017/growthbook?authSource=admin
      APP_ORIGIN: http://localhost:18782
      API_HOST: http://localhost:18783
      JWT_SECRET: ${JWT_SECRET}
      ENCRYPTION_KEY: ${ENCRYPTION_KEY}
      NODE_ENV: production
    volumes: ["uploads:/usr/local/src/app/packages/back-end/uploads"]
    depends_on: [mongo]

  warehouse:
    image: postgres:18.6
    environment:
      POSTGRES_DB: shop
      POSTGRES_USER: shop
      POSTGRES_PASSWORD: ${WAREHOUSE_PASSWORD}
    volumes:
      - warehouse:/var/lib/postgresql
      - ./warehouse.sql:/docker-entrypoint-initdb.d/01-warehouse.sql:ro

  app:
    image: node:24.22.1-bookworm
    working_dir: /app
    command: sh -c "npm install --no-audit --no-fund && node server.mjs"
    ports: ["127.0.0.1:18784:8080"]
    environment:
      DATABASE_URL: postgres://shop:${WAREHOUSE_PASSWORD}@warehouse:5432/shop
    volumes: ["./app:/app"]

volumes:
  mongo:
  uploads:
  warehouse:
في الإعداد أعلاه لاحظ التالي:
ENCRYPTION_KEYيشفر كلمات مرور مصادر البيانات داخل MongoDB، وإذا ضاع فلن يستطيع GrowthBook الاتصال بقاعدتك، لذلك احفظه مع النسخة الاحتياطية، وكل الأسرار ولدناها بـopenssl rand -hex 32.APP_ORIGINوAPI_HOSTهما العنوانان كما يراهما المتصفح، وفي الإنتاج يكونان نطاقين خلف Reverse Proxy بشهادة TLS كما في دليل الاستضافة الذاتية.- GrowthBook يتصل بالمستودع بمستخدم قراءة فقط اسمه
growthbook، والسبب أنه ينفذ استعلامات SQL تكتبها أنت في الواجهة، فلا تعطه صلاحية كتابة.
والجدولان في المستودع كما يلي، وهما أبسط شكل لما يسجله أي منتج:
CREATE TABLE experiment_viewed (
  user_id        text        NOT NULL,
  experiment_id  text        NOT NULL,
  variation_id   text        NOT NULL,
  ts             timestamptz NOT NULL
);
CREATE TABLE signups (
  user_id text        NOT NULL,
  ts      timestamptz NOT NULL
);
الصفحة: من يرى أي عنوان؟
التطبيق يستخدم مكتبة @growthbook/growthbook الإصدار 1.8.0، والتجربة معرفة بنفس المفتاح والنسخ ونسب التقسيم التي سجلناها في GrowthBook:
export const experiment = {
  key: 'pricing-headline',
  variations: [
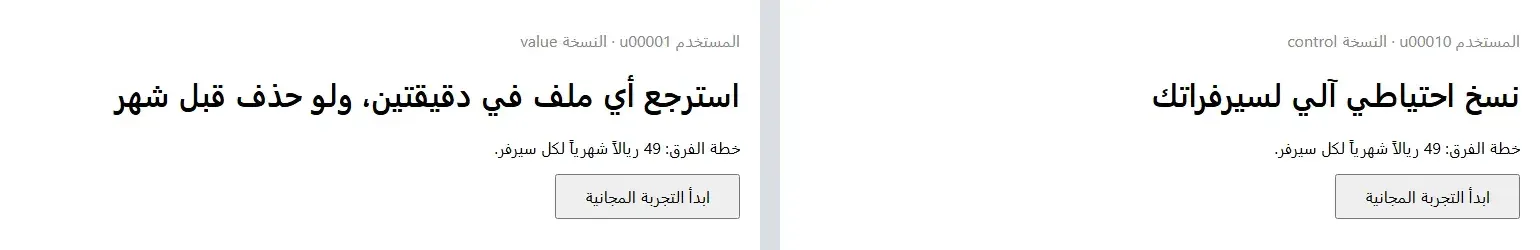
    { id: 'control', headline: 'نسخ احتياطي آلي لسيرفراتك' },
    { id: 'value', headline: 'استرجع أي ملف في دقيقتين، ولو حذف قبل شهر' },
  ],
  weights: [0.5, 0.5],
  hashAttribute: 'id',
  hashVersion: 2,      // the same hashing GrowthBook stores for new experiments
};
وعند كل طلب ينشئ السيرفر كائن GrowthBook بمعرف المستخدم، ويستدعي gb.run(experiment)، فيرجع النسخة ويستدعي trackingCallback الذي يكتب العرض. وهذه الصفحة لمستخدمين مختلفين:
حركة زوار نعرف نتيجتها مسبقاً
هنا نقطة مهمة في التجربة: لا يوجد عندنا زوار حقيقيون، ولو أرسلنا زيارات عشوائية لما عرفنا هل GrowthBook محق أم لا. لذلك كتبنا سكربت simulate.mjs يمر على عدد من المستخدمين، فيقسمهم الـ SDK الحقيقي ويكتب العرض كما تفعل الصفحة، ثم يقرر التسجيل برقم عشوائي بنسبة نعرفها: 8.0% لنسخة control و9.6% لنسخة value، أي أن الفرق الحقيقي زيادة 20% بالضبط. وبهذا نعرف الإجابة الصحيحة، ونرى ماذا يقول GrowthBook عنها:
docker compose exec -w /app app node simulate.mjs 4000 0.2والمخرج سوف يكون كما يلي:
value    users 1968 signups 205 rate 10.42%
control  users 2032 signups 157 rate 7.73%
ولاحظ أن النسبتين المحققتين ليستا 9.6% و8.0%، فالعشوائية وحدها أعطت النسخة الجديدة 10.42% والقديمة 7.73%، أي فرقاً ظاهراً أكبر من الحقيقي. وهذا ما يحدث مع زوارك الحقيقيين أيضاً، والفرق أنك هناك لا تعرف الرقم الحقيقي.
بعد ذلك عرفنا في GrowthBook ثلاثة أشياء من قائمة Metrics and Data، ويمكنك أن تفعلها من الواجهة أو من الـ API:
- مصدر البيانات Data Source من نوع PostgreSQL، ومعه استعلام العرض Exposure Query:
SELECT user_id, ts AS timestamp, experiment_id, variation_id FROM experiment_viewed. - المقياس Metric باسم Signup من نوع Binomial، أي نسبة من فعل الشيء مرة على الأقل:
SELECT user_id, ts AS timestamp FROM signups. - التجربة Experiment بالمفتاح
pricing-headlineوالنسختينcontrolوvalueوالمقياس Signup هدفاً، ثم زر Update في تبويب Results.
قراءة النتيجة: 4,000 مستخدم
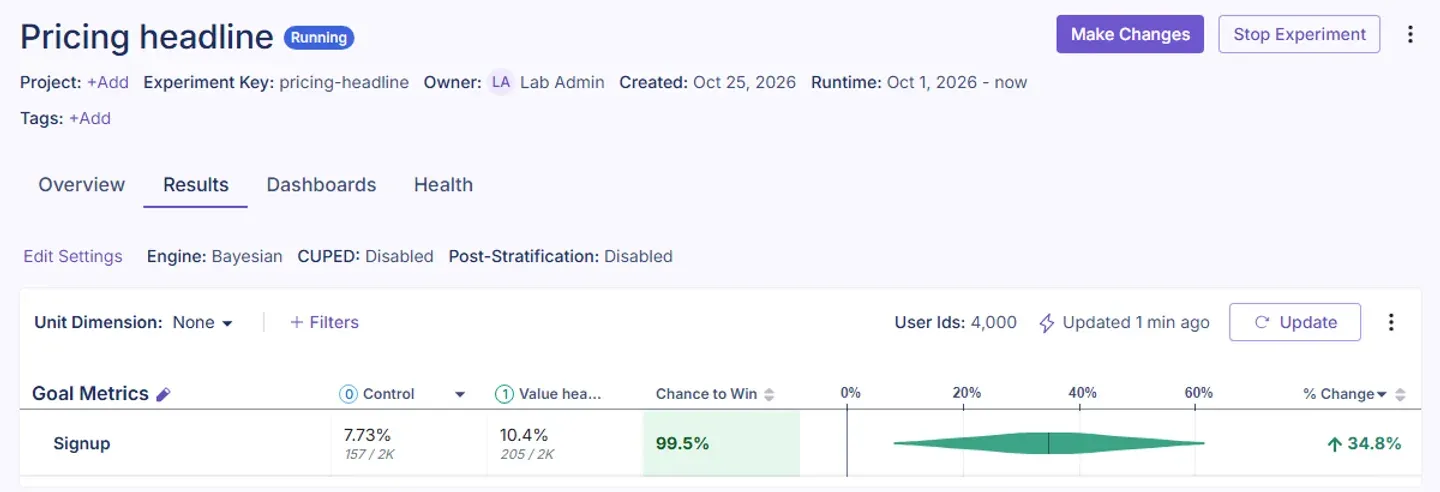
المحرك الافتراضي Bayesian، وهو يعطيك ثلاثة أرقام، وهذه هي كما قرأناها من الـ API:
bayesian    diff=relative  control 157/2032 (7.73%)  value 205/1968 (10.42%)  change 34.8  ci [8.1, 61.6]  chanceToWin 99.5%
bayesian diff=absolute control 157/2032 (7.73%) value 205/1968 (10.42%) change 2.7 ci [0.9, 4.5] chanceToWin 99.8%- التغير % Change: أفضل تقدير للفرق النسبي، وهو هنا 34.8%. وهذا الرقم الذي سوف يكتبه الجميع في الرسائل، وهو أكبر من الحقيقة بقرابة الضعف.
- الهامش Credible Interval: المدى الذي يقع فيه الفرق الحقيقي باحتمال 95%، وهو هنا من 8.1% إلى 61.6%. وهذا هو الرقم الذي يحكم: الفرق الحقيقي 20% داخله، ولكن 9% داخله أيضاً و55% كذلك، أي أننا نعرف أن العنوان الجديد أفضل غالباً، ولا نعرف بكم.
- فرصة الفوز Chance to Win: احتمال أن النسخة الجديدة أفضل من القديمة، وهو 99.5%، وتوثيق GrowthBook ينصح بأن تنتظر حتى يصل إلى 95% (أو ينزل إلى 5% إذا كانت النسخة أسوأ). ولاحظ أنه يجيب عن «هل هي أفضل؟» لا عن «بكم؟».
لذلك فالقراءة الأمينة لهذه النتيجة: العنوان الجديد أفضل على الأرجح، والزيادة في مكان ما بين 8% و62%، فلا تبن خطة الإيرادات على 35%. وقد شرح فريق GrowthBook الفرق بين الطريقتين وما يمكن قوله بكل منهما في توثيق الإحصاء.
12,000 مستخدم وطريقة Frequentist
ثم أعدنا السكربت بـ 12,000 مستخدم وبنفس الفرق الحقيقي، وغيرنا محرك الإحصاء في إعدادات التجربة إلى Frequentist لنرى قيمة p:
value    users 5920 signups 583 rate 9.85%
control  users 6080 signups 463 rate 7.62%
frequentist diff=relative  control 463/6080 (7.62%)  value 583/5920 (9.85%)  change 29.3  ci [14.2, 44.4]  p-value 0.0001
bayesian    diff=relative  control 463/6080 (7.62%)  value 583/5920 (9.85%)  change 29.3  ci [14.2, 44.4]  chanceToWin 100.0%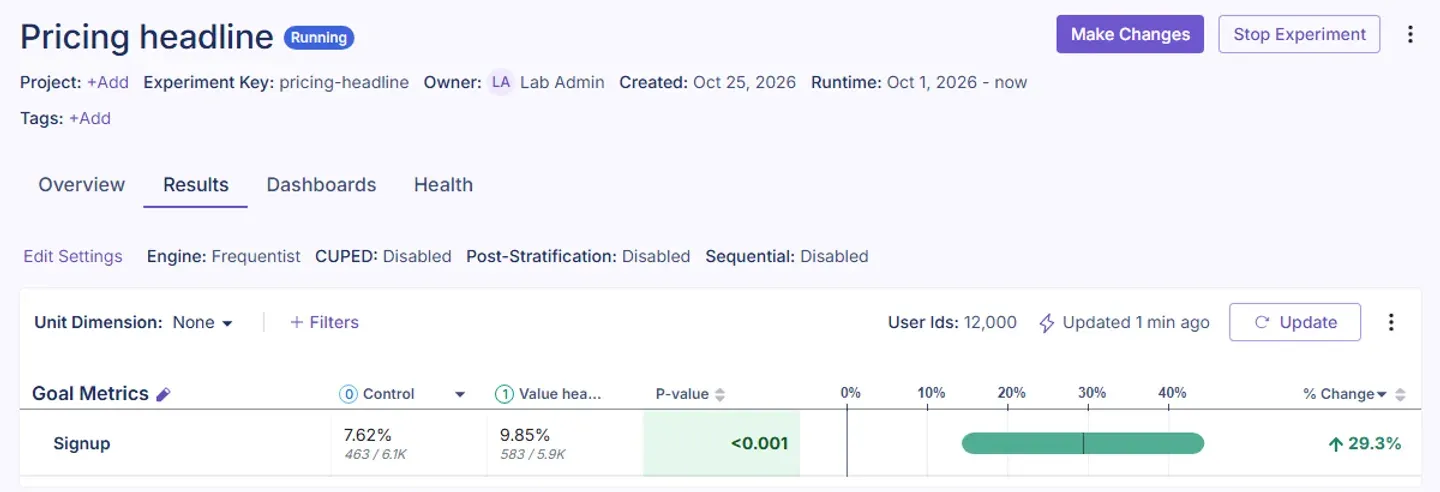
في المخرج أعلاه لاحظ التالي:
- الهامش ضاق من 8 إلى 62 إلى 14 إلى 44، وهذا هو ما يشتريه العدد الأكبر: دقة في معرفة «بكم».
- التقدير 29.3% ما زال أكبر من الحقيقي 20%، وهذا طبيعي في عينة واحدة، والحقيقي داخل الهامش.
- الطريقتان أعطتا نفس التغير ونفس الهامش هنا، والفرق في السؤال: قيمة p تقول ما احتمال أن ترى فرقاً بهذا الحجم لو لم يكن هناك فرق أصلاً، وفرصة الفوز تقول ما احتمال أن النسخة الجديدة أفضل. وقيمة p ليست احتمال أن تكون مخطئاً، وهذا أشهر خطأ في قراءتها.
تجربة دون أي فرق: A/A
قد يتساءل البعض: هل يمكن أن يظهر فرق حيث لا يوجد فرق؟ والإجابة نعم، ولذلك أعدنا السكربت بـ 4,000 مستخدم والفرق الحقيقي صفر، أي أن النسختين لهما نفس نسبة التسجيل 8%:
value    users 1968 signups 162 rate 8.23%
control  users 2032 signups 157 rate 7.73%
frequentist diff=relative  control 157/2032 (7.73%)  value 162/1968 (8.23%)  change 6.5  ci [-15.9, 29.0]  p-value 0.5678
bayesian    diff=relative  control 157/2032 (7.73%)  value 162/1968 (8.23%)  change 6.5  ci [-15.9, 29.0]  chanceToWin 71.6%
النسخة value «تفوقت» بـ 6.5% وفرصة فوز 71.6%، ولو كان هذا عنواناً جديداً لقال أحدهم إن الفرصة جيدة وطلب اعتماده. ولكن الهامش من سالب 15.9% إلى 29% يشمل الصفر بوضوح، وقيمة p هي 0.57، أي أن النتيجة لا تقول شيئاً. وتجربة A/A مفيدة فعلاً في الإنتاج قبل أول تجربة حقيقية، والسبب أنها تختبر الإعداد نفسه: إذا ظهر فيها فرق كبير ثابت، فالمشكلة في التقسيم أو في تسجيل العرض لا في المنتج.
كم مستخدماً تحتاج؟
حتى تكتشف فرقاً معيناً باحتمال معقول، تحتاج عدداً تحسبه قبل أن تبدأ، وليس بعد أن ترى النتيجة. وكتبنا سكربتاً صغيراً بالمعادلة المعروفة لاختبار نسبتين، بمستوى دلالة 5% وقوة اختبار Power تساوي 80%:
baseline 8.0% -> 9.6%  per variation 4918  total 9836
baseline 8.0% -> 8.8%  per variation 18869  total 37738
baseline 8.0% -> 10.8%  per variation 1702  total 3404
baseline 2.0% -> 2.4% per variation 21106 total 42212- لزيادة 20% من 8%، وهي تجربتنا، تحتاج قرابة 9,800 مستخدم. أي أن تجربة 4,000 كانت أصغر من اللازم، ونجحت لأن العشوائية أعطتها فرقاً أكبر من الحقيقي، وهذا بالضبط سبب تضخم الرقم 34.8%.
- لزيادة 10% تحتاج قرابة أربعة أضعاف العدد، والسبب أن العدد يتناسب مع مربع الفرق الذي تريد اكتشافه.
- إذا كانت نسبتك الأساسية 2% فقط، كما في كثير من صفحات الهبوط، فزيادة 20% تحتاج أكثر من 42 ألف مستخدم.
وهذا يعني لشركة ناشئة بألف زائر شهرياً لصفحة الأسعار: لا تختبر تغييرات صغيرة، واختبر تغييرات كبيرة يتوقع أن تعطي فرقاً كبيراً، أو اختبر في مكان أعلى في القمع فيه زوار أكثر. وفي GrowthBook حاسبة قوة Power Calculator تفعل نفس الحساب كما في توثيقها.
أخطاء القراءة الشائعة
- التوقف المبكر Peeking: أن تفتح النتائج كل يوم وتوقف التجربة عند أول لون أخضر. والسبب في خطورته أن النتيجة تتأرجح في الأيام الأولى، ومن ينظر عشرين مرة سوف يرى الأخضر صدفة. والحل أن تحدد العدد مسبقاً ولا تقرر قبله، أو أن تفعل الاختبار المتتابع Sequential Testing في GrowthBook الذي يصحح الهامش لمن ينظر باستمرار، مقابل هامش أعرض.
- تصديق الرقم الأوسط: الـ 34.8% ليست النتيجة، والهامش هو النتيجة.
- مقاييس كثيرة دون فرضية: إذا قست عشرين مقياساً فسوف يتحسن واحد منها غالباً صدفة، لذلك قرر المقياس الرئيسي قبل البدء.
- أسبوع واحد فقط: سلوك الزوار يختلف بين أيام الأسبوع، فشغل التجربة أسبوعاً كاملاً على الأقل أو أسبوعين حتى لو وصلت إلى العدد قبلها.
- تقسيم معطوب: إذا كانت نسبة المستخدمين بين النسختين بعيدة عن 50/50 بفرق كبير، فهناك خطأ في التسجيل يسمى عدم تطابق النسب Sample Ratio Mismatch، وGrowthBook ينبه له كما في صفحة حل مشكلات التجارب. وفي تجربتنا كانت النسبة 2,032 إلى 1,968، وهذا فرق طبيعي.
الموارد ونقاط التشغيل
بعد التجارب كان GrowthBook يستهلك 1.08 GiB من الذاكرة، وMongoDB قرابة 290 MiB، والمستودع 40 MiB، وكانت الـ Docker Image الخاصة بـ GrowthBook 2.67 GB. وقبل الإنتاج تذكر:
- انسخ MongoDB احتياطياً بـ
mongodump، ففيها التجارب ونتائجها وتعريف المقاييس، أما الأحداث نفسها ففي مستودعك. - ثبت رقم الإصدار، واقرأ ملاحظات الإصدار قبل الترقية لأن GrowthBook يشغل ترحيلات Migrations على MongoDB.
- أغلق التسجيل بعد إنشاء أول حساب، وضع الواجهة خلف الدخول الموحد SSO إن وجد.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- اختبار A/B يحتاج فرضية ومقياساً رئيسياً وتقسيماً ثابتاً لكل مستخدم وتسجيلاً للعرض، والأداة تأتي بعد ذلك.
- GrowthBook يقرأ من قاعدة بياناتك بـ SQL، والـ SDK يقسم المستخدمين بالهاش دون طلب شبكة.
- في تجربتنا كان الفرق الحقيقي 20%، فقال GrowthBook 34.8% مع 4,000 مستخدم و29.3% مع 12,000، والحقيقي داخل الهامش في المرتين، فاقرأ الهامش لا الرقم الأوسط.
- تجربة دون فرق أعطت فرصة فوز 71.6%، وهذا ليس فوزاً، والتوثيق ينصح بانتظار 95%.
- احسب العدد قبل البدء، فزيادة 20% من 8% تحتاج قرابة 9,800 مستخدم، ولا توقف التجربة عند أول لون أخضر.
وأقرب المقالات إلى هذا الموضوع:
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تعرفه أنت، ونموذج إسناد تفهم ما يحسبه.
 دليلتحليلات المنتج Product Analytics مع PostHog على سيرفركنشغل PostHog على سيرفرنا ونتتبع المستخدم من أول زيارة إلى أول فاتورة، ونقيس ما يحتاجه من ذاكرة ووقت إقلاع.
 دليلمقاييس المنتج Product Metrics وكيف تعرف أن الميزة نجحتكيف تختار مقياساً رئيسياً North Star لمنتجك، وتبني قمع التحويل Funnel وجدول العودة Retention من أحداث تطبيقك بأدوات تستضيفها على سيرفرك.
سجل التحديثات
- أكتوبر 2026: كتابة الدليل واختباره على GrowthBook 5.1.0 مع MongoDB 8.0.32 وPostgreSQL 18.6 ومكتبة @growthbook/growthbook 1.8.0 في Docker Engine 29.8.0، بحركة زوار مصطنعة بفرق حقيقي معروف.


