

افتح لوحة التحليلات Analytics Dashboard في أغلب الشركات وسوف تجد عشرات الأرقام: الزوار، والصفحات، ومدة الزيارة، وعدد المسجلين منذ البداية، وكلها ترتفع، ولا يعرف أحد ماذا يفعل بها. والسبب أن هذه الأرقام جمعت لأن الأداة تجمعها، لا لأن أحداً سأل سؤالاً يحتاج إليها. وفي مقالات هذه المرحلة، من إدارة المنتج إلى مهندس المنتج، تكرر طلب واحد: اكتب المقياس وقيمته الحالية قبل أن تبني، واقرأه بعد الإطلاق. وفي هذا المقال نجيب عن سؤالين: أي مقاييس تختار، وكيف تحسبها على سيرفرك.
وسوف نناقش في هذا المقال ما يلي:
- مقياس النجم الشمالي North Star Metric ومدخلاته، كما يشرحه دليل Amplitude.
- مقاييس القراصنة AARRR، والتفعيل Activation، والعودة Retention، وقمع التحويل Funnel، وجداول المجموعات Cohorts.
- المقاييس التي تبدو جيدة ولا تساعدك على أي قرار Vanity Metrics، والخصوصية ونظام حماية البيانات الشخصية.
- لماذا لم نختر PostHog للتجربة رغم أنه مفتوح المصدر، وماذا اخترنا بدلاً منه.
- تجربة عملية كاملة: Umami مع جدول أحداث خاص بك في PostgreSQL، وبيانات تجريبية لنظام العيادات، ثم قمع تحويل وجدول عودة بالأداة وبال SQL، ونكسر الجدول عمداً لنرى خطأً شائعاً.
مقياس النجم الشمالي North Star Metric
يعرف دليل North Star Playbook من شركة Amplitude، وأحد مؤلفيه John Cutler، مقياس النجم الشمالي بأنه معدل أو عدد أو نسبة واحدة تمثل استراتيجية المنتج Product Strategy، ويحدد له ثلاث صفات: أنه يمثل القيمة التي يحصل عليها المستخدمون من المنتج، وأنه داخل نطاق تأثير فرق المنتج والتسويق، وأنه مؤشر يسبق الإيرادات Leading Indicator، أي أنه يتحرك قبلها. ومثاله في الدليل أن فريق Netflix سنة 2005، عندما كانت ترسل أقراص DVD بالبريد، اختار مقياس نسبة العملاء الذين يضيفون ثلاثة أقراص أو أكثر إلى قائمتهم في أول جلسة.
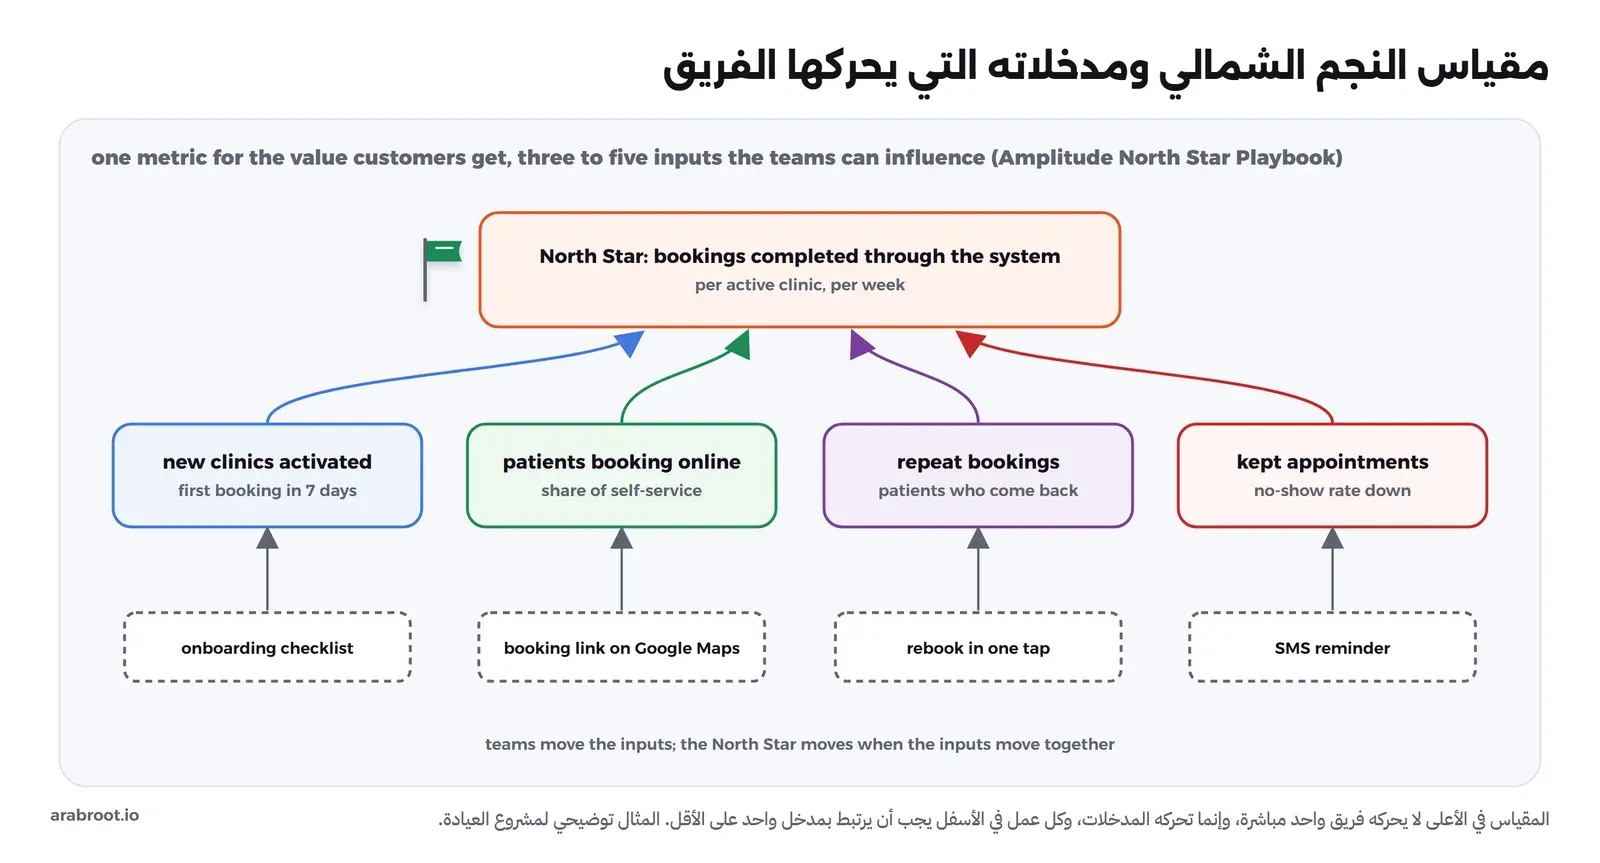
ومع المقياس من ثلاثة إلى خمسة مدخلات Inputs، وهي العوامل التي يعتقد الفريق أنها تحرك المقياس ويستطيع أن يؤثر عليها في عمله اليومي. ويقول الدليل إن المقياس نتيجة لهذه المدخلات، وإنك إذا استطعت أن تحرك المقياس مباشرة فهو على الأرجح ليس مقياساً جيداً. والصورة التالية تبين مثالاً لنظام العيادات:
في الصورة أعلاه لاحظ التالي:
- المقياس «حجوزات مكتملة لكل عيادة نشطة في الأسبوع» وليس «عدد العيادات المسجلة»، والسبب أن العيادة المسجلة التي لا تحجز شيئاً لم تحصل على أي قيمة، والمقياس يجب أن يمثل القيمة لا العدد.
- «مكتملة» تعني أن المريض حضر، فالمقياس يتحسن عندما تنخفض المواعيد الضائعة، وهو هدف المنتج الذي كتبناه في مقال إدارة المنتج.
- كل فريق يعمل على مدخل، ولا يعمل أحد على المقياس مباشرة، وهذا ما يجعل الأعمال الكثيرة تتجه في اتجاه واحد.
مقاييس القراصنة AARRR
في سبتمبر 2007 نشر Dave McClure عرض Startup Metrics for Pirates، وقسم فيه مسار العميل Customer Journey إلى خمس مراحل تختصر حروفها الأولى بAARRR، وهي صوت القرصان في الأفلام، ومن هنا جاء الاسم: الاكتساب Acquisition عندما يصل المستخدم إلى الموقع، والتفعيل Activation عندما تكون زيارته الأولى ناجحة، والعودة Retention عندما يرجع ويستخدم الموقع أكثر من مرة، والإحالة Referral عندما يعجبه المنتج فيدعو غيره، والإيرادات Revenue عندما يدفع. والصورة التالية تطبقها على نظام العيادات:
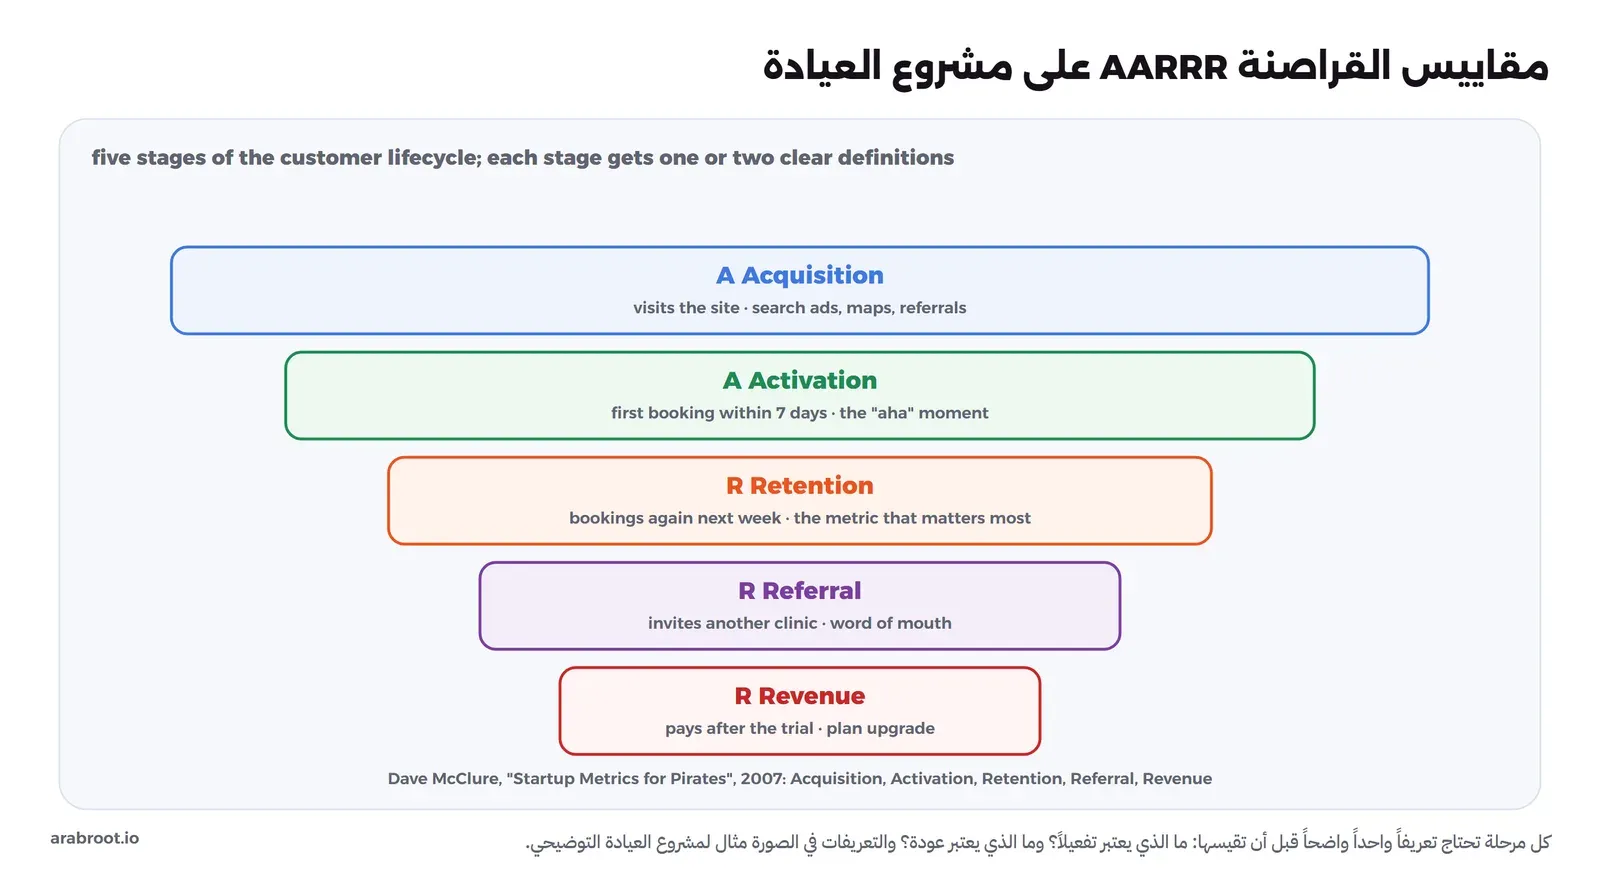
وأهم ما في هذا الإطار أنه يجبرك على تعريف كل مرحلة بحدث محدد، وأصعب تعريفين هما التفعيل والعودة:
- التفعيل Activation: اللحظة التي يحصل فيها المستخدم على القيمة الأولى، وليس التسجيل. ففي نظام العيادات، العيادة التي سجلت ولم تحجز شيئاً لم تتفعل، ولذلك عرفناه بأول حجز خلال 7 أيام من إنشاء العيادة. والمدة جزء من التعريف، لأن العيادة التي تحجز أول موعد بعد شهرين على الأرجح كانت ستغادر لولا شيء آخر.
- العودة Retention: نسبة من يعودون للقيام بالفعل المهم بعد فترة، وليس من يفتحون الموقع، ففي مثالنا نعدها بحدث
booking_createdفي الأسابيع التالية للتسجيل، لا بزيارة الصفحة الرئيسية. وهذا هو المقياس الذي يقول هل لديك منتج يحتاجه الناس، لأن أي حملة تسويق تستطيع أن ترفع الاكتساب أسبوعاً.
قمع التحويل Funnel وجدول المجموعات Cohort
قمع التحويل Funnel يجيب عن سؤال: من بين من بدأ الخطوة الأولى، كم وصل إلى كل خطوة بعدها وبنفس الترتيب؟ وجدول المجموعات Cohort Table يجيب عن سؤال آخر: من بين من سجل في أسبوع معين، كم عاد بعد أسبوع، وبعد أسبوعين، وبعد ثلاثة؟ والصورة التالية تبين الاثنين بأرقام المختبر الذي سنبنيه بعد قليل:
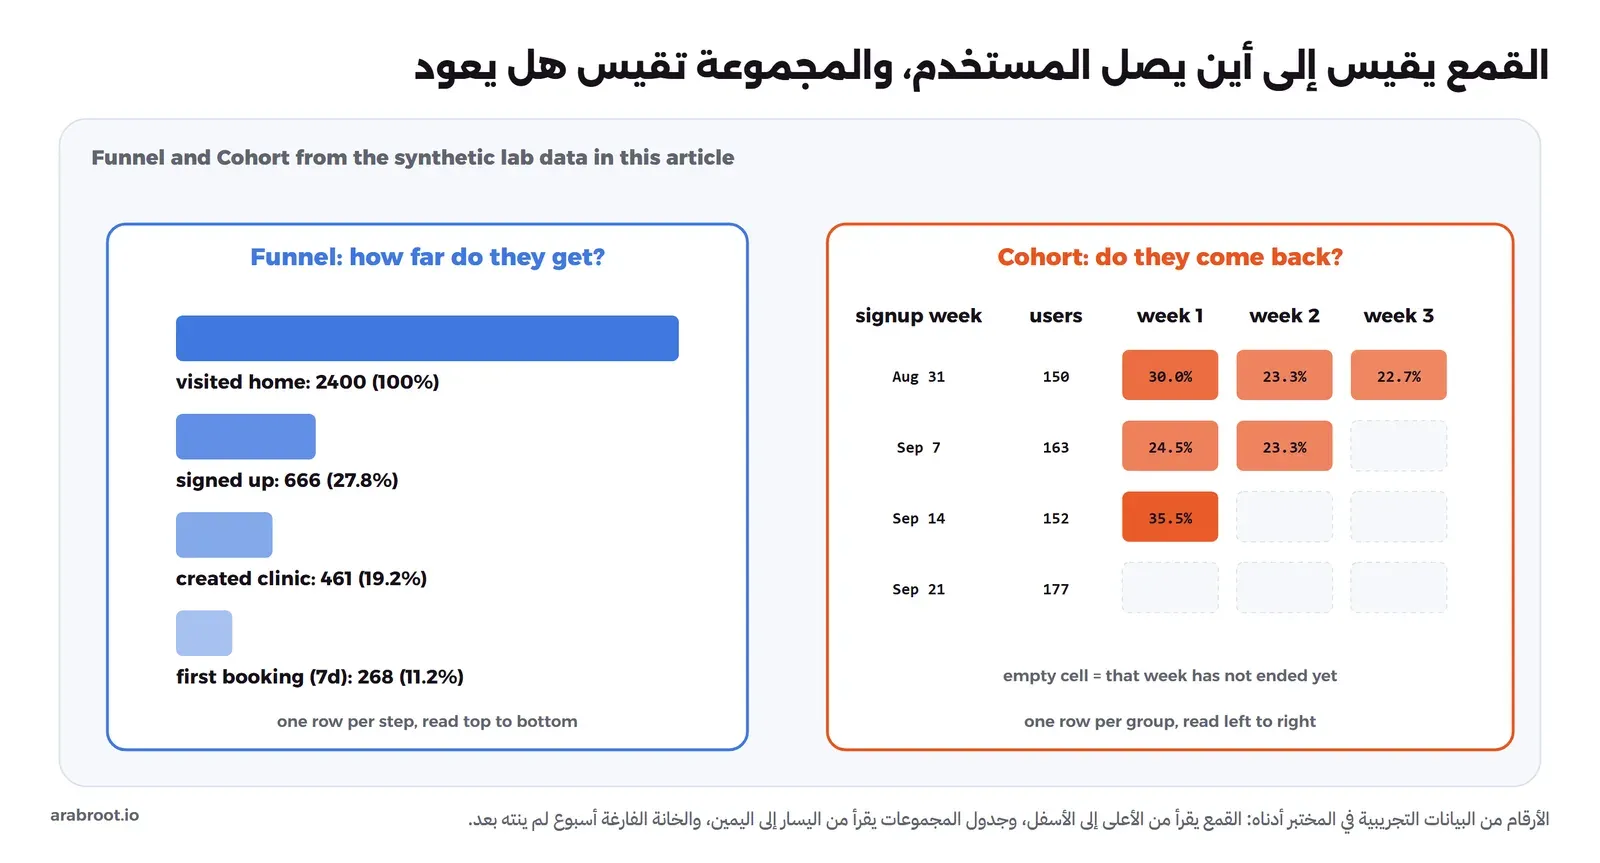
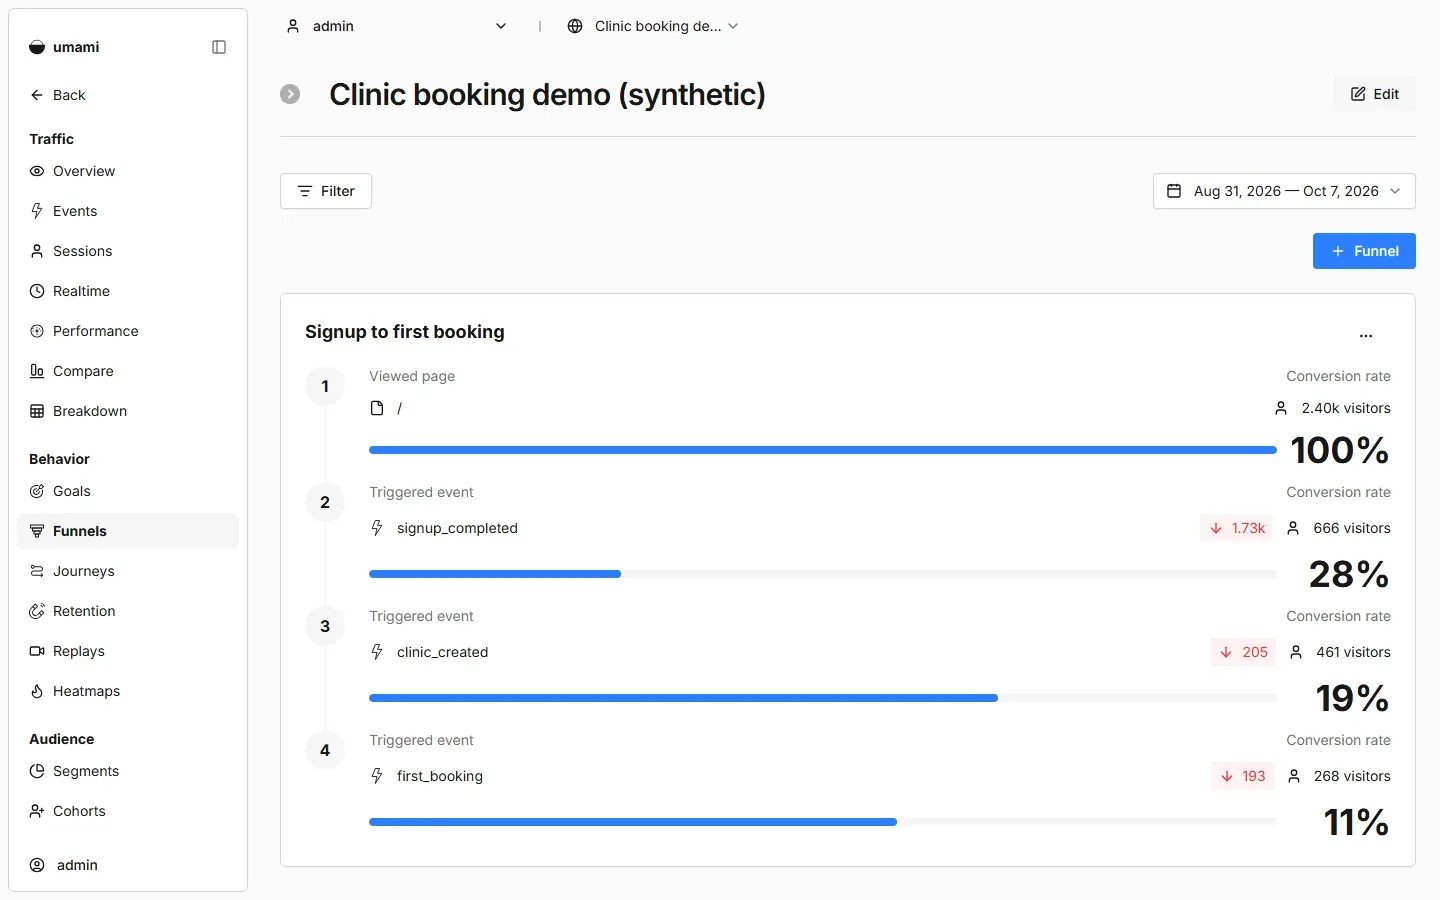
ولاحظ أن القمع يساعدك على أن تعرف أين تضيع أكبر نسبة، ففي المثال 72% من الزوار لا يسجلون، و42% من العيادات المنشأة لا تحجز خلال أسبوع، وكل منهما سؤال اكتشاف Discovery مختلف، أما جدول المجموعات فيساعدك على أن تعرف هل تتحسن العودة مع الوقت، أي هل المجموعات الجديدة أفضل من القديمة بعد التغييرات التي أطلقتها.
المقاييس التي تبدو جيدة Vanity Metrics ولا تساعدك على القرار
تسمى هذه المقاييس في مجتمع المنتجات Vanity Metrics، وعلامتها أنها ترتفع دائماً أو ترتفع لأسباب لا علاقة لها بالقيمة، ولا يتغير أي قرار إذا عرفتها. وأشهرها:
- العدد التراكمي للمسجلين Cumulative Signups منذ البداية: لا ينخفض أبداً حتى لو غادر كل المستخدمين، والبديل عدد المستخدمين النشطين في الأسبوع Weekly Active Users ونسبة العودة Retention.
- عدد الصفحات المشاهدة Page Views: قد يرتفع لأن المستخدم ضاع في الموقع ولم يجد ما يريد، والبديل نسبة من أكمل المهمة Task Completion.
- عدد الميزات المسلمة: مقياس مخرجات Outputs لا نتائج Outcomes، كما شرحنا في مقال إدارة المنتج.
- متوسط مدة الجلسة Session Duration: في منتج إنتاجية مثل نظام الحجز، الجلسة الأطول قد تعني أن الحجز أصعب، لا أن المستخدم أسعد، وهذا ما يسميه دليل Amplitude نوع «اللعبة» التي يلعبها منتجك: في لعبة الانتباه Attention Game الوقت قيمة، وفي لعبة الإنتاجية Productivity Game الوقت تكلفة.
والاختبار البسيط لأي رقم في لوحتك: لو ارتفع هذا الرقم 20% الأسبوع القادم، ماذا سنفعل بشكل مختلف؟ وإذا كانت الإجابة «لا شيء» فاحذفه من اللوحة.
الخصوصية Privacy: اجمع ما تحتاجه فقط
تحليلات المنتج Product Analytics تعني أنك تسجل ما يفعله أشخاص في منتجك، وفي المملكة يحكم ذلك نظام حماية البيانات الشخصية PDPL الذي تنشر نصه ولوائحه منصة حماية البيانات الشخصية، ومسؤول الالتزام Compliance في شركتك هو من يراجع ما تجمعه، ولكن هناك قواعد هندسية بسيطة تقلل المشكلة من أولها:
- استخدم معرفاً داخلياً مستعاراً Pseudonymous ID مثل
u-0412في أداة التحليلات، ولا ترسل البريد أو رقم الجوال أو الاسم في الأحداث ولا في خصائصها، والسبب أن الأداة تحتاج أن تعد لا أن تعرف من هو. وتذكر أن المعرف الذي تستطيع أن تربطه بشخص من قاعدة بياناتك ما زال يشير إلى شخص، فتعامل معه بنفس الحذر. - لا تضع بيانات حساسة Sensitive Data في الأحداث، ففي نظام عيادات لا يدخل نوع العلاج أو التشخيص في أي حدث تحليلات، والسبب أن البيانات الصحية من البيانات الحساسة التي ذكرناها في المثال العملي للمتطلبات.
- حدد مدة الاحتفاظ بالأحداث Data Retention، واحذف القديم بمهمة مجدولة Cron Job، فأغلب أسئلة المنتج تحتاج أشهراً لا سنوات.
- استضافة الأداة على سيرفرك تبقي البيانات لديك ولا ترسلها إلى طرف ثالث Third Party خارج المملكة، وهذا من أسباب اختيار أداة تستضيفها بنفسك أصلاً.
وتقول صفحة الأسئلة الشائعة في Umami إن كود التتبع لا يستخدم ملفات تعريف الارتباط Cookies، وإن الأداة لا تجمع بيانات تعرف الشخص، وهذا صحيح للزائر المجهول، ولكن لاحظ أنك عندما ترسل معرف مستخدم كما سنفعل في التجربة، فأنت من أضاف معرفاً للشخص، والمسؤولية عليك.
أي أداة؟ PostHog وUmami وPlausible وجدولك الخاص
المرشح الطبيعي لهذا المقال كان PostHog، فهو أداة تحليلات منتجات كاملة فيها القمع والمجموعات وتسجيل الجلسات Session Replay وال Feature Flags والتجارب Experiments، وملف LICENSE في مستودعه يقول إن الكود بترخيص MIT ما عدا مجلد ee الذي له ترخيص منفصل. ولكن عندما قرأنا صفحة الاستضافة الذاتية في أكتوبر 2026 وجدنا ما يلي:
- تقول الصفحة صراحة إن الاستضافة الذاتية Self-hosting غير مدعومة رسمياً، وإن الشركة لا تقدم أي ضمانات ولا دعماً لها، وإن المسار الوحيد هو تثبيت يسمى hobby على سيرفر واحد، وتوصي بسيرفر في حدود 4 vCPU و16GB من الذاكرة وأكثر من 30GB من التخزين، وتسأل في دليل الاختيار هل تتوقع أكثر من 300 ألف حدث.
- تقول نفس الصفحة إن الشركة لا تصدر إصدارات مرقمة للاستضافة الذاتية، وتوصي بأن تعمل دائماً على آخر Docker Image، وملف
docker-compose.hobby.ymlفي المستودع فيه 37 خدمة، منها ClickHouse وKafka متوافق (Redpanda) وTemporal وSeaweedFS، وأغلب Images فيه بوسمlatestأوmaster.
وهذا يتعارض مع قاعدتين نلتزم بهما في كل أدلة الموقع: أن تثبت إصدار كل Docker Image حتى تعرف ما الذي يعمل وتستطيع الرجوع إليه، وأن تختار للإنتاج ما يمكن دعمه. لذلك إذا أردت PostHog فالأنسب أن تستخدم خدمته السحابية بعد أن تراجع أين تخزن البيانات، أو أن تقبل أنك تشغل نسخة غير مدعومة. أما للاستضافة الذاتية فلدينا خياران أخف بكثير:
- Umami بترخيص MIT: تطبيق واحد مع PostgreSQL، وفي الإصدار 3.4.0 الذي استخدمناه تقارير للقمع Funnels والعودة Retention والأهداف Goals ومسارات المستخدم Journeys، ويقبل الأحداث من كود التتبع في الصفحة أو من سيرفرك عبر ال API.
- Plausible بترخيص AGPL-3.0، ونسخته للاستضافة الذاتية اسمها Community Edition، وهي تحليلات مواقع أكثر منها تحليلات منتج.
ومعهما، أو بدلاً منهما، جدول أحداث خاص بك في PostgreSQL، والسبب أن أسئلة المنتج المهمة تحتاج غالباً إلى ربط الأحداث ببيانات عملك، مثل خطة العيادة أو عدد أطبائها، وهذا سهل في SQL على قاعدة بياناتك، وقد ناقشنا متى تكفيك قاعدة واحدة لكل شيء في PostgreSQL لكل شيء. ولذلك جمعنا الاثنين في التجربة: Umami للوحات الجاهزة، والجدول لما تحتاج أن تحسبه بنفسك.
تجربة عملية: Umami وجدول أحداث Events Table في PostgreSQL
سوف نشغل ثلاث Containers على سيرفر أو جهاز فيه Docker، والصورة التالية تبين المكونات ومسار البيانات:
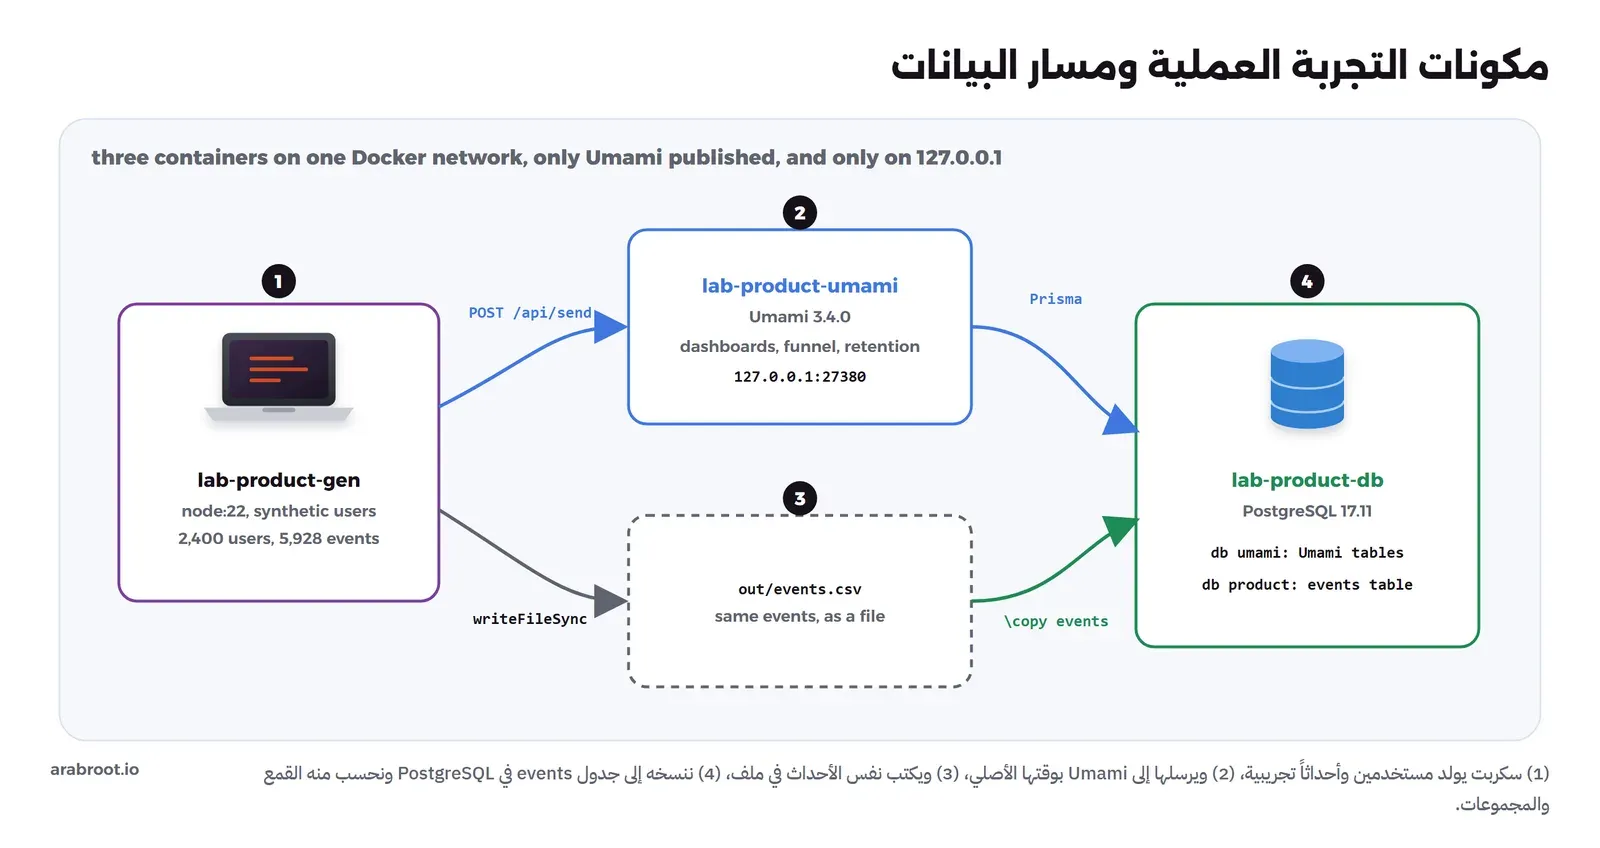
تشغيل Umami وPostgreSQL
نبدأ بمجلد التجربة وملف .env بأسرار مولدة:
mkdir -p lab-product/{init,gen,out} && cd lab-product
cat > .env <<EOF
POSTGRES_PASSWORD=$(openssl rand -hex 16)
APP_SECRET=$(openssl rand -hex 32)
TWO_FACTOR_ENCRYPTION_KEY=$(openssl rand -hex 32)
EOF
ثم ملف docker-compose.yml:
name: lab-product

services:
  db:
    image: postgres:17.11
    container_name: lab-product-db
    environment:
      POSTGRES_USER: umami
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
      POSTGRES_DB: umami
    volumes:
      - lab-product-db:/var/lib/postgresql/data
      - ./init:/docker-entrypoint-initdb.d:ro
      - ./out:/out
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U umami -d umami"]
      interval: 5s
      timeout: 5s
      retries: 10
    restart: unless-stopped

  umami:
    image: ghcr.io/umami-software/umami:3.4.0
    container_name: lab-product-umami
    environment:
      DATABASE_URL: postgresql://umami:${POSTGRES_PASSWORD}@db:5432/umami
      APP_SECRET: ${APP_SECRET}
      TWO_FACTOR_ENCRYPTION_KEY: ${TWO_FACTOR_ENCRYPTION_KEY}
    ports:
      - "127.0.0.1:27380:3000"
    depends_on:
      db:
        condition: service_healthy
    init: true
    healthcheck:
      test: ["CMD-SHELL", "curl -fs http://localhost:3000/api/heartbeat || exit 1"]
      interval: 5s
      timeout: 5s
      retries: 20
    restart: unless-stopped

  gen:
    image: node:22.23.3-bookworm-slim
    container_name: lab-product-gen
    profiles: ["tools"]
    working_dir: /gen
    volumes:
      - ./gen:/gen:ro
      - ./out:/out
    environment:
      UMAMI_URL: http://umami:3000
      UMAMI_PASSWORD: ${UMAMI_PASSWORD}
    command: ["node", "generate.mjs"]

volumes:
  lab-product-db:
    name: lab-product-db
في الإعداد أعلاه لاحظ التالي:
- كل Image بإصدار محدد:
postgres:17.11وghcr.io/umami-software/umami:3.4.0وnode:22.23.3-bookworm-slim، أما ملف Compose في مستودع Umami فيستخدمlatest، ولا ننصح به لأن التحديث يشغل ترحيلات Migrations على قاعدة البيانات دون أن تقرر أنت. - Umami وحده منشور، وعلى
127.0.0.1فقط، وقاعدة البيانات لا تنشر أي منفذ، ويصل إليها Umami والسكربت عبر شبكة Compose. - خدمة
genفي Profile اسمهtools، فلا تعمل معdocker compose up، وإنما نشغلها عند الحاجة. - مجلد
initيحتوي سكربت يعمل مرة واحدة عند إنشاء قاعدة البيانات، وينشئ قاعدة ثانية اسمهاproductلجدولنا، حتى لا نخلط جداولنا بجداول Umami التي تديرها ترحيلاته.
وهذا ملف init/10-product.sql:
-- a second database for our own events table, next to Umami's database
CREATE DATABASE product OWNER umami;
\connect product
CREATE TABLE events (
    id          bigserial   PRIMARY KEY,
    user_id     text        NOT NULL,
    event       text        NOT NULL,
    occurred_at timestamptz NOT NULL,
    props       jsonb       NOT NULL DEFAULT '{}'
);
CREATE INDEX events_event_time ON events (event, occurred_at);
CREATE INDEX events_user_time  ON events (user_id, occurred_at);
ALTER TABLE events OWNER TO umami;
والجدول بسيط عن قصد: من، وماذا، ومتى، وخصائص بصيغة jsonb، مع فهرسين لأكثر سؤالين نسألهما: كل أحداث نوع معين في فترة، وكل أحداث مستخدم معين بالترتيب. ثم نشغل الخدمتين:
docker compose up -d
docker compose ps --format 'table {{.Name}}\t{{.Image}}\t{{.Status}}\t{{.Ports}}'
والمخرج سوف يكون كما يلي:
NAME                IMAGE                                STATUS                 PORTS
lab-product-db      postgres:17.11                       Up 7 hours (healthy)   5432/tcp
lab-product-umami   ghcr.io/umami-software/umami:3.4.0   Up 7 hours (healthy)   127.0.0.1:27380->3000/tcp
تغيير كلمة مرور المدير Admin Password قبل أي شيء
بحسب توثيق Umami ينشئ التثبيت حساب مدير اسمه admin بكلمة المرور umami، وأول ما يجب أن تفعله أن تغيرها، ويمكن ذلك من الواجهة أو من ال API كما يلي:
NEWPW=$(openssl rand -hex 12); echo "UMAMI_PASSWORD=$NEWPW" >> .env
TOKEN=$(curl -s -X POST http://127.0.0.1:27380/api/auth/login -H 'Content-Type: application/json' \
  -d '{"username":"admin","password":"umami"}' | python3 -c "import sys,json;print(json.load(sys.stdin)['token'])")
curl -s -X POST http://127.0.0.1:27380/api/me/password -H "Authorization: Bearer $TOKEN" \
  -H 'Content-Type: application/json' -d "{\"currentPassword\":\"umami\",\"newPassword\":\"$NEWPW\"}"
curl -s -o /dev/null -w '%{http_code}\n' -X POST http://127.0.0.1:27380/api/auth/login \
  -H 'Content-Type: application/json' -d '{"username":"admin","password":"umami"}'
والمخرج سوف يكون كما يلي، والسطر الأخير يؤكد أن كلمة المرور القديمة لم تعد تعمل:
{"id":"41e2b680-648e-4b09-bcd7-3e2b10c06264","username":"admin","role":"admin","createdAt":"2026-10-09T01:36:23.196Z"}
401
توليد مستخدمين وأحداث تجريبية Synthetic Data
السكربت التالي يمثل نظام العيادات: كل أسبوع لمدة أربعة أسابيع من 1 سبتمبر 2026 يزور الموقع 600 شخص، ويسجل جزء منهم، وينشئ جزء من المسجلين عيادة، ويحجز جزء منها أول موعد، ثم يعود بعضهم أسبوعياً. ومن 15 سبتمبر نرفع احتمال أول حجز لنمثل إطلاق قائمة خطوات البداية. ويرسل السكربت كل حدث إلى Umami بوقته الأصلي، ويكتب نفس الأحداث في ملف CSV:
// Synthetic users for a demo clinic-booking SaaS. Every user, event and number here is generated, not real.
// It sends each event to Umami (/api/send, with its own timestamp) and writes the same events to /out/events.csv
// for our own PostgreSQL table.
import { writeFileSync } from 'node:fs';

const UMAMI = process.env.UMAMI_URL;
const HOST = 'demo.example.com';
const START = Date.UTC(2026, 8, 1);            // 1 September 2026
const END = Date.UTC(2026, 9, 6);              // nothing after 6 October 2026
const DAY = 86400e3, WEEK = 7 * DAY, MIN = 60e3;
const VISITORS_PER_WEEK = 600;

// a small seeded random generator, so every run produces the same data
let seed = 20261009;
const rnd = () => { seed |= 0; seed = (seed + 0x6D2B79F5) | 0; let t = Math.imul(seed ^ (seed >>> 15), 1 | seed); t = (t + Math.imul(t ^ (t >>> 7), 61 | t)) ^ t; return ((t ^ (t >>> 14)) >>> 0) / 4294967296; };
const chance = (p) => rnd() < p;
const between = (a, b) => a + rnd() * (b - a);

const UAS = [
    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/141.0.0.0 Safari/537.36',
    'Mozilla/5.0 (iPhone; CPU iPhone OS 18_6 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/18.6 Mobile/15E148 Safari/604.1',
    'Mozilla/5.0 (Linux; Android 15; Pixel 9) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/141.0.0.0 Mobile Safari/537.36',
    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/18.6 Safari/605.1.15',
];

// 1. log in and create the website
const login = await (await fetch(`${UMAMI}/api/auth/login`, { method: 'POST', headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ username: 'admin', password: process.env.UMAMI_PASSWORD || 'umami' }) })).json();
const auth = { 'Content-Type': 'application/json', Authorization: `Bearer ${login.token}` };
const site = await (await fetch(`${UMAMI}/api/websites`, { method: 'POST', headers: auth,
    body: JSON.stringify({ name: 'Clinic booking demo (synthetic)', domain: HOST }) })).json();
console.log('website', site.id);

// 2. build the users and their events
const users = [];
for (let w = 0; w < 4; w++) {
    for (let i = 0; i < VISITORS_PER_WEEK; i++) {
        const n = users.length + 1;
        const id = `u-${String(n).padStart(4, '0')}`;
        const ip = `${n % 2 ? '198.51.100' : '203.0.113'}.${(n % 250) + 1}`;
        const ua = UAS[n % UAS.length];
        const ev = [];
        const add = (t, name, path, data) => { if (t < END) ev.push({ t, name, path, data }); };
        // arrival: a random moment in the week, between 08:00 and 22:00 (UTC+3)
        const day = START + w * WEEK + Math.floor(between(0, 7)) * DAY;
        let t = day + between(5, 19) * 3600e3;
        add(t, null, '/');
        if (chance(0.45)) {
            t += between(1, 3) * MIN; add(t, null, '/signup');
            if (chance(0.6)) {
                t += between(2, 6) * MIN; add(t, 'signup_completed', '/signup', { plan: 'trial' });
                const signup = t;
                let activated = false;
                if (chance(0.7)) {
                    t += between(5, 60) * MIN; add(t, 'clinic_created', '/setup', { doctors: 1 + Math.floor(between(0, 4)) });
                    // from 15 September the new onboarding checklist is on (the change we want to measure)
                    const checklist = t >= Date.UTC(2026, 8, 15);
                    if (chance(checklist ? 0.65 : 0.5)) {
                        t += between(0.1, 48) * 3600e3; add(t, 'first_booking', '/calendar', { onboarding: checklist ? 'checklist' : 'old' });
                        activated = true;
                    }
                }
                // weekly return visits after the signup week
                const back = activated ? [0.7, 0.6, 0.55, 0.5] : [0.2, 0.1, 0.07, 0.05];
                back.forEach((p, k) => {
                    if (!chance(p)) return;
                    const r = signup + (k + 1) * WEEK + between(-2, 2) * DAY;
                    add(r, null, '/dashboard');
                    add(r + between(1, 10) * MIN, 'booking_created', '/calendar', { source: 'staff' });
                });
            }
        }
        users.push({ id, ip, ua, ev });
    }
}

// 3. send to Umami, one user at a time per worker so each session is created once
const send = async (u, e) => {
    const payload = { website: site.id, hostname: HOST, url: e.path, language: 'ar-SA', screen: '1440x900', title: 'Clinic booking demo',
        timestamp: Math.floor(e.t / 1000), id: u.id, ip: u.ip, userAgent: u.ua, ...(e.name ? { name: e.name, data: e.data } : {}) };
    const r = await fetch(`${UMAMI}/api/send`, { method: 'POST', headers: { 'Content-Type': 'application/json', 'User-Agent': u.ua },
        body: JSON.stringify({ type: 'event', payload }) });
    if (!r.ok) throw new Error(`${r.status} ${await r.text()}`);
};
const queue = [...users];
let sent = 0;
await Promise.all(Array.from({ length: 8 }, async () => {
    for (let u; (u = queue.shift());) for (const e of u.ev.sort((a, b) => a.t - b.t)) { await send(u, e); sent++; }
}));

// 4. the same events as CSV for our own table
const rows = ['user_id,event,occurred_at,props'];
for (const u of users) for (const e of u.ev) rows.push([u.id, e.name || 'page_view', new Date(e.t).toISOString(),
    `"${JSON.stringify(e.name ? e.data : { path: e.path }).replace(/"/g, '""')}"`].join(','));
writeFileSync('/out/events.csv', rows.join('\n') + '\n');
writeFileSync('/out/website-id.txt', site.id);
console.log(`users ${users.length}, events sent ${sent}, csv rows ${rows.length - 1}`);
في السكربت أعلاه لاحظ التالي:
- نقطة الإرسال
/api/sendهي نفسها التي يستخدمها كود التتبع في المتصفح، وتقبل بحسب كودها في الإصدار 3.4.0 وقتاً للحدثtimestamp، ومعرفاً للمستخدمid، وعنوان IP ونوع المتصفح في جسم الطلب، وهذا ما سمح لنا بملء خمسة أسابيع من البيانات في دقائق. وفي الإنتاج يرسل كود التتبع الأحداث من المتصفح، أو يرسلها سيرفرك عندما يحدث الفعل فعلاً كما شرحنا في مقال مهندس المنتج. - عناوين IP من النطاقات المخصصة للتوثيق
198.51.100.0/24و203.0.113.0/24، فلا تخص أي جهاز حقيقي. - المولد العشوائي له بذرة Seed ثابتة، فكل تشغيل ينتج نفس البيانات بالضبط، وهذا يسمح لك بالحصول على نفس الأرقام التي في المقال.
- الأحداث المهمة لها أسماء بصيغة الشيء ثم الفعل، ومعها خصائص قليلة، ولا يوجد فيها أي بيان شخصي.
ونشغله من خدمة gen:
docker compose --profile tools run --rm --name lab-product-gen genوالمخرج سوف يكون كما يلي بعد قرابة أربع دقائق:
website 2686bbcd-44ca-424f-8eb8-8c4f266f6e49
users 2400, events sent 5928, csv rows 5928
القمع Funnel والعودة Retention في Umami
نفتح Umami على http://127.0.0.1:27380، ونختار الموقع ثم الفترة من 31 أغسطس إلى 7 أكتوبر، وفي صفحة الأحداث Events نرى الأحداث الأربعة التي أرسلناها:
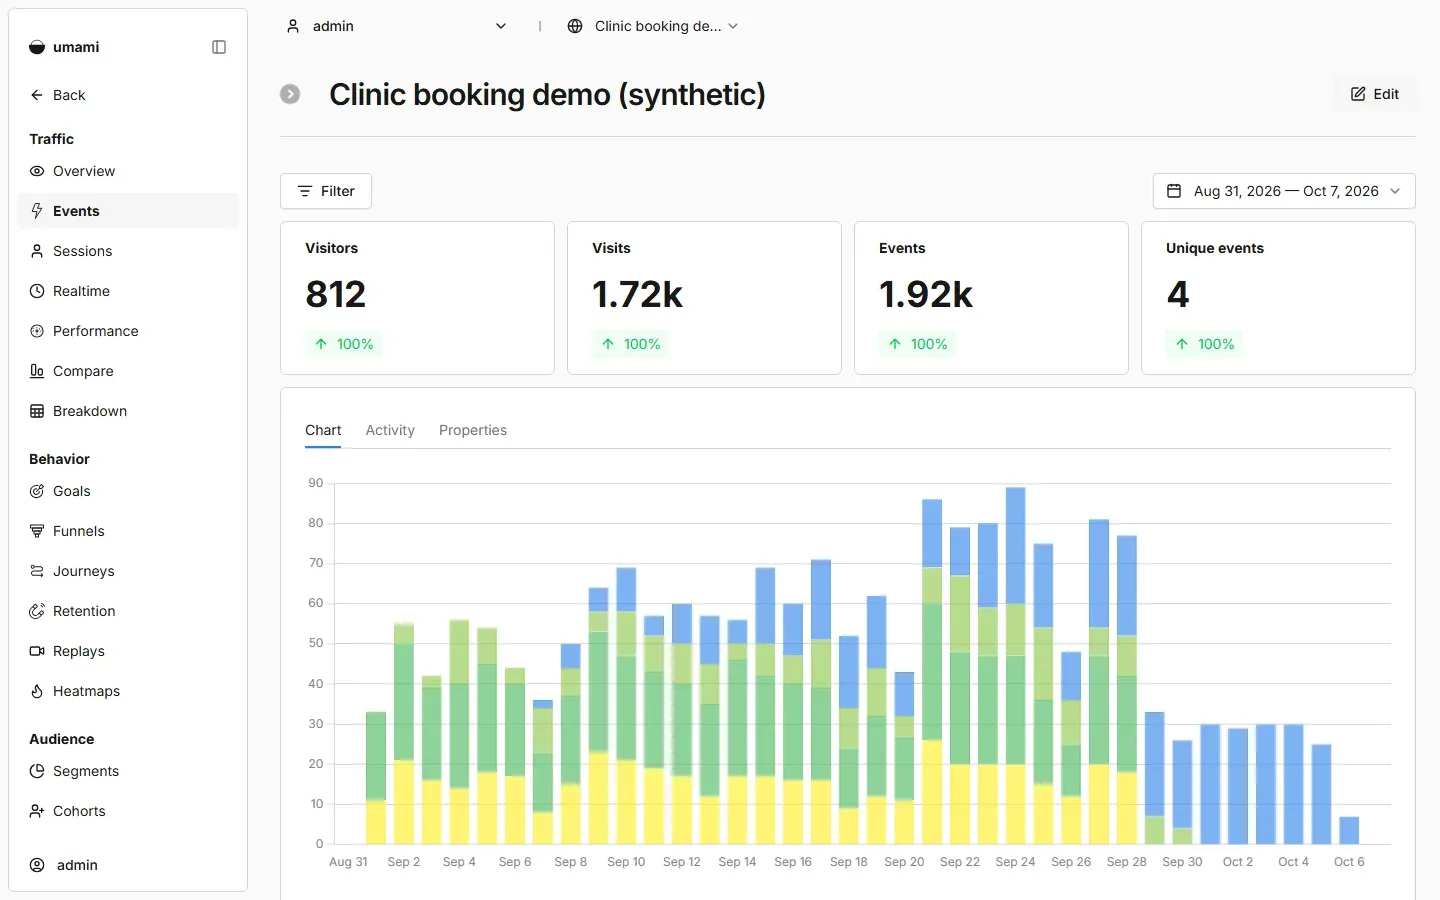
ثم ننشئ القمع، ويمكن ذلك من صفحة Funnels في الواجهة، وأنشأناه هنا من ال API حتى يكون التعريف مكتوباً:
W=$(cat out/website-id.txt)
curl -s -X POST "http://127.0.0.1:27380/api/websites/$W/funnels" -H "Authorization: Bearer $TOKEN" \
  -H 'Content-Type: application/json' -d '{"name":"Signup to first booking","parameters":{"window":10080,
  "steps":[{"type":"path","value":"/"},{"type":"event","value":"signup_completed"},
           {"type":"event","value":"clinic_created"},{"type":"event","value":"first_booking"}]}}'
والقيمة window بالدقائق كما في كود الاستعلام، و10080 دقيقة تساوي 7 أيام، أي أن كل خطوة يجب أن تحدث خلال أسبوع من التي قبلها. والصورة التالية تبين القمع:
أما صفحة Retention في Umami فتعرض شيئاً مختلفاً عما نريده، كما في الصورة التالية لشهر سبتمبر:
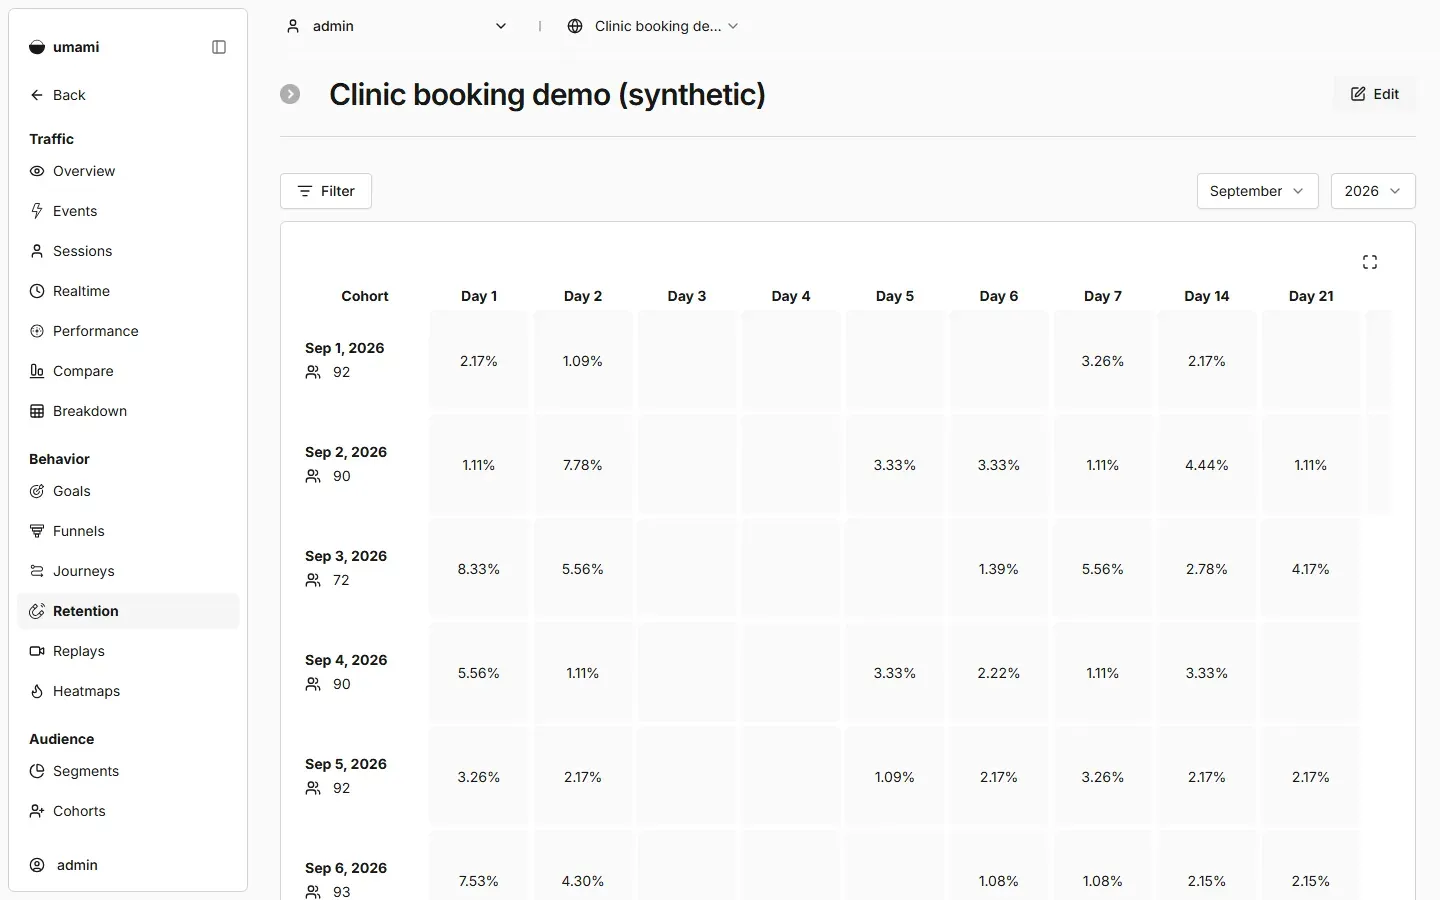
ولاحظ أن نسب العودة هنا صغيرة جداً، والسبب أن Umami يبني المجموعة من كل من زار الموقع في ذلك اليوم، و72% منهم لم يسجلوا أصلاً، ويعد أي زيارة لاحقة عودة. وهذا مفيد لموقع محتوى، ولكنه ليس سؤال المنتج، فسؤالنا: من بين العيادات التي سجلت، كم عادت لتحجز؟ وهذا ما سنحسبه بأنفسنا في الخطوة التالية.
وهناك ملاحظة ثانية في لوحة Umami: عدد الزوار Visitors للفترة كلها 2,546، بينما المستخدمون في بياناتنا 2,400 بالضبط. والسبب أن Umami يحسب معرف الجلسة Session ID من عنوان IP ونوع المتصفح وملح Salt يتغير كل شهر بحسب المتغير SALT_ROTATION الذي قيمته الافتراضية month كما في صفحة متغيرات البيئة، وهذا جزء من تصميمه لحماية الخصوصية، فالمستخدم الذي له أحداث في سبتمبر وأكتوبر يعد مرتين، وعندما عددنا هؤلاء في جدولنا وجدناهم 146 مستخدماً، أي 2,400 + 146 = 2,546. والدرس العملي أن «الزوار» في أدوات تحليلات المواقع تقدير، فلا تقارنه برقم من قاعدة بياناتك وتتوقع أن يتطابق.
القمع والعودة بال SQL من جدولك
ننسخ ملف CSV إلى جدول events بالأمر \copy، ثم نعد الأحداث:
docker exec lab-product-db psql -U umami -d product \
  -c "\copy events (user_id, event, occurred_at, props) FROM '/out/events.csv' WITH (FORMAT csv, HEADER true)"
docker exec lab-product-db psql -U umami -d product \
  -c "SELECT event, count(*) AS events, count(DISTINCT user_id) AS users FROM events GROUP BY event ORDER BY users DESC;"
والمخرج سوف يكون كما يلي:
COPY 5928
      event       | events | users
------------------+--------+-------
 page_view        |   4013 |  2400
 signup_completed |    666 |   666
 clinic_created   |    461 |   461
 booking_created  |    520 |   351
 first_booking    |    268 |   268
(5 rows)
ثم القمع، والشرط المهم فيه أن كل خطوة يجب أن تحدث بعد التي قبلها لنفس المستخدم، والخطوة الأخيرة خلال 7 أيام من إنشاء العيادة:
-- ordered funnel: each step must happen after the previous one, for the same user
WITH visit AS (
    SELECT user_id, min(occurred_at) AS t FROM events
    WHERE event = 'page_view' AND props->>'path' = '/' GROUP BY user_id
), signup AS (
    SELECT e.user_id, min(e.occurred_at) AS t FROM events e JOIN visit v USING (user_id)
    WHERE e.event = 'signup_completed' AND e.occurred_at >= v.t GROUP BY e.user_id
), clinic AS (
    SELECT e.user_id, min(e.occurred_at) AS t FROM events e JOIN signup s USING (user_id)
    WHERE e.event = 'clinic_created' AND e.occurred_at >= s.t GROUP BY e.user_id
), booking AS (
    SELECT e.user_id, min(e.occurred_at) AS t FROM events e JOIN clinic c USING (user_id)
    WHERE e.event = 'first_booking' AND e.occurred_at >= c.t
      AND e.occurred_at < c.t + interval '7 days' GROUP BY e.user_id
), steps AS (
    SELECT 1 AS step, 'visited home' AS name, count(*) AS users FROM visit
    UNION ALL SELECT 2, 'signed up',        count(*) FROM signup
    UNION ALL SELECT 3, 'created clinic',   count(*) FROM clinic
    UNION ALL SELECT 4, 'first booking (7d)', count(*) FROM booking
)
SELECT step, name, users,
       round(100.0 * users / first_value(users) OVER (ORDER BY step), 1) AS pct_of_start,
       round(100.0 * users / lag(users) OVER (ORDER BY step), 1)         AS pct_of_previous
FROM steps ORDER BY step;
docker exec lab-product-db psql -U umami -d product -f /out/funnel.sqlوالمخرج سوف يكون كما يلي:
 step |        name        | users | pct_of_start | pct_of_previous
------+--------------------+-------+--------------+-----------------
    1 | visited home       |  2400 |        100.0 |
    2 | signed up          |   666 |         27.8 |            27.8
    3 | created clinic     |   461 |         19.2 |            69.2
    4 | first booking (7d) |   268 |         11.2 |            58.1
(4 rows)
ولاحظ أن الأرقام 2400 و666 و461 و268 مطابقة تماماً لما عرضه Umami، وهذا ما نريده من تجربة كهذه: أن تثق بالأداة لأنك تستطيع أن تحسب نفس الرقم بنفسك. والعمود الأخير يضيف شيئاً لا يظهر بوضوح في اللوحة: نسبة كل خطوة من التي قبلها، فإنشاء العيادة 69.2% من المسجلين، وأول حجز 58.1% من العيادات.
نكسرها: جدول العودة Retention Table الذي يكذب
أول نسخة كتبناها لجدول العودة كانت كما يلي، وتحسب لكل مجموعة تسجيل أسبوعية Weekly Signup Cohort نسبة من أنشأ حجزاً في الأسبوع الأول والثاني والثالث بعد التسجيل:
-- first try: weekly retention by signup cohort (wrong for recent cohorts, see the text)
WITH signups AS (
    SELECT user_id, min(occurred_at) AS signed_up,
           date_trunc('week', min(occurred_at))::date AS cohort
    FROM events WHERE event = 'signup_completed' GROUP BY user_id
), activity AS (
    SELECT DISTINCT s.user_id, s.cohort,
           floor(extract(epoch FROM e.occurred_at - s.signed_up) / 604800)::int AS week_n
    FROM signups s JOIN events e USING (user_id)
    WHERE e.event = 'booking_created' AND e.occurred_at > s.signed_up
)
SELECT s.cohort, count(DISTINCT s.user_id) AS users,
       round(100.0 * count(DISTINCT a.user_id) FILTER (WHERE a.week_n = 1) / count(DISTINCT s.user_id), 1) AS week_1,
       round(100.0 * count(DISTINCT a.user_id) FILTER (WHERE a.week_n = 2) / count(DISTINCT s.user_id), 1) AS week_2,
       round(100.0 * count(DISTINCT a.user_id) FILTER (WHERE a.week_n = 3) / count(DISTINCT s.user_id), 1) AS week_3
FROM signups s LEFT JOIN activity a USING (user_id)
GROUP BY s.cohort ORDER BY s.cohort;
والمخرج كان كما يلي:
   cohort   | users | week_1 | week_2 | week_3
------------+-------+--------+--------+--------
 2026-08-31 |   150 |   30.0 |   23.3 |   22.7
 2026-09-07 |   163 |   24.5 |   23.3 |   12.9
 2026-09-14 |   152 |   35.5 |   15.1 |    0.0
 2026-09-21 |   177 |   26.0 |    0.6 |    0.0
 2026-09-28 |    24 |    4.2 |    0.0 |    0.0
(5 rows)
اقرأ الجدول كما يقرؤه مدير مستعجل: العودة في الأسبوع الثاني انهارت من 23% إلى أقل من 1% في مجموعة 21 سبتمبر، والأسبوع الثالث صفر لآخر ثلاث مجموعات، فهل هناك مشكلة كبيرة في المنتج؟ والإجابة لا، فآخر حدث في البيانات يوم 5 أكتوبر، والمستخدم الذي سجل يوم 24 سبتمبر لم يكمل أسبوعه الثاني بعد، والاستعلام يحسب الأسبوع الذي لم يحدث كأنه أسبوع لم يعد فيه أحد. وهذا خطأ شائع جداً في لوحات العودة، وأسوأ ما فيه أنه يظهر في المجموعات الأحدث، أي في المجموعات التي تريد أن تعرف هل تحسنت بعد آخر تغيير.
والحل أن يترك الاستعلام الخانة فارغة إذا لم ينته ذلك الأسبوع لكل مستخدم في المجموعة:
-- weekly retention by signup cohort: the share of each cohort that created a booking in week N after signing up.
-- A cell stays empty (NULL) when that week has not ended yet for every user in the cohort.
WITH data_end AS (
    SELECT max(occurred_at) AS t FROM events
), signups AS (
    SELECT user_id, min(occurred_at) AS signed_up,
           date_trunc('week', min(occurred_at))::date AS cohort
    FROM events WHERE event = 'signup_completed' GROUP BY user_id
), activity AS (
    SELECT DISTINCT s.user_id,
           floor(extract(epoch FROM e.occurred_at - s.signed_up) / 604800)::int AS week_n
    FROM signups s JOIN events e USING (user_id)
    WHERE e.event = 'booking_created' AND e.occurred_at > s.signed_up
), cell AS (
    SELECT s.cohort, n.week_n,
           count(DISTINCT s.user_id) AS users,
           count(DISTINCT a.user_id) AS returned,
           bool_and(s.signed_up + (n.week_n + 1) * interval '7 days' <= d.t) AS complete
    FROM signups s CROSS JOIN generate_series(1, 3) AS n(week_n) CROSS JOIN data_end d
    LEFT JOIN activity a ON a.user_id = s.user_id AND a.week_n = n.week_n
    GROUP BY s.cohort, n.week_n
)
SELECT cohort, max(users) AS users,
       max(CASE WHEN week_n = 1 AND complete THEN round(100.0 * returned / users, 1) END) AS week_1,
       max(CASE WHEN week_n = 2 AND complete THEN round(100.0 * returned / users, 1) END) AS week_2,
       max(CASE WHEN week_n = 3 AND complete THEN round(100.0 * returned / users, 1) END) AS week_3
FROM cell GROUP BY cohort ORDER BY cohort;
والمخرج سوف يكون كما يلي:
   cohort   | users | week_1 | week_2 | week_3
------------+-------+--------+--------+--------
 2026-08-31 |   150 |   30.0 |   23.3 |   22.7
 2026-09-07 |   163 |   24.5 |   23.3 |
 2026-09-14 |   152 |   35.5 |        |
 2026-09-21 |   177 |        |        |
 2026-09-28 |    24 |        |        |
(5 rows)
في المخرج أعلاه لاحظ التالي:
- الخانات الفارغة أسابيع لم تنته، وليست صفراً، والأرقام الموجودة كلها لأسابيع اكتملت.
- مجموعة 14 سبتمبر عادت في الأسبوع الأول بنسبة 35.5% مقابل 30% و24.5% قبلها، وهي أول مجموعة كاملة بعد قائمة خطوات البداية، ولكنها خانة واحدة من 152 عيادة، فلا تبن عليها قراراً، والطريقة الأنسب للمقارنة شرحناها في قراءة البيانات قبل وبعد.
- مجموعة 28 سبتمبر فيها 24 عيادة فقط، لأن البيانات التجريبية توقفت عن إضافة زوار جدد بعد أربعة أسابيع، والمجموعات الصغيرة تتقلب نسبها كثيراً، فاعرض عدد المستخدمين دائماً بجانب النسبة كما في العمود الثاني.
وإذا أردت هذه الجداول في لوحة يراها الفريق كل أسبوع، فالاستعلامات نفسها تعمل في Metabase أو Superset متصلة بقاعدة product.
التنظيف Cleanup
نحذف Containers التجربة وال Volume الخاص بها بالأمر التالي، ثم Images التي نزلناها لها فقط:
docker compose --profile tools down -v
docker rmi ghcr.io/umami-software/umami:3.4.0 node:22.23.3-bookworm-slim
والمخرج سوف يكون كما يلي:
 Container lab-product-umami Stopping
 Container lab-product-umami Stopped
 Container lab-product-umami Removing
 Container lab-product-umami Removed
 Container lab-product-db Stopping
 Container lab-product-db Stopped
 Container lab-product-db Removing
 Container lab-product-db Removed
 Network lab-product_default Removing
 Volume lab-product-db Removing
 Volume lab-product-db Removed
 Network lab-product_default Removed
Untagged: ghcr.io/umami-software/umami:3.4.0
Deleted: sha256:85909afc45bdcda1917394594a087421fdbb05610fded0fa9f6fb861abb2f367
Untagged: node:22.23.3-bookworm-slim
Deleted: sha256:c3de60bf2f9dd0ac6370e6117950ff62d6e339527e7472301c9c78a017978392
أخطاء شائعة في مقاييس المنتج Product Metrics
- لوحة فيها كل شيء: عشرات الأرقام لا يقرر أحد شيئاً بسببها، والعلاج مقياس رئيسي واحد North Star Metric ومدخلاته، وكل رقم آخر يجيب عن سؤال مكتوب.
- التفعيل Activation يساوي التسجيل Signup: المستخدم الذي سجل ولم يحصل على أي قيمة لم يتفعل، والعلاج تعريف التفعيل بفعل القيمة الأولى ومعه مدة.
- العودة بزيارة أي صفحة: كما رأينا في Umami، فعرف العودة بالفعل المهم.
- الأسابيع التي لم تنته تحسب صفراً: الخطأ الذي كسرنا به الجدول أعلاه.
- بيانات شخصية في الأحداث: البريد ورقم الجوال والتشخيص لا مكان لها في أداة التحليلات.
- مقارنة أرقام أداتين: «الزوار» في Umami و«المستخدمون» في قاعدتك يحسبان بطريقتين مختلفتين، فلا تتوقع أن يتطابقا.
- Images بوسم
latestفي أداة تحليلات: التحديث التلقائي يشغل ترحيلات على بياناتك، والعلاج إصدار ثابت ونسخة احتياطية Backup قبل كل تحديث.
قائمة تحقق Checklist قبل أن تبني لوحة مقاييس Dashboard
- هل اخترت مقياساً رئيسياً واحداً يمثل القيمة التي يحصل عليها المستخدم، ومعه من ثلاثة إلى خمسة مدخلات؟
- هل التفعيل والعودة معرفان بأحداث محددة ومدد محددة، ومكتوبان في مكان يراه الفريق؟
- هل أسماء الأحداث وخصائصها متفق عليها، ولا يوجد فيها بيان شخصي أو حساس؟
- هل تعرف القيمة الحالية لكل مقياس قبل أي تغيير تريد قياسه؟
- هل جدول العودة يترك الأسابيع التي لم تنته فارغة، ويعرض عدد المستخدمين بجانب كل نسبة؟
- هل تستطيع أن تحسب رقماً واحداً على الأقل من اللوحة بنفسك بال SQL وتجده مطابقاً؟
- هل الأداة على سيرفرك بإصدار ثابت، ولها نسخة احتياطية ومدة احتفاظ للبيانات؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- مقياس النجم الشمالي رقم واحد يمثل القيمة التي يحصل عليها المستخدم ويسبق الإيرادات، ويتحرك من خلال مدخلات يعمل عليها الفريق.
- AARRR تقسم مسار العميل إلى خمس مراحل، وأهم ما فيها أن تعرف التفعيل والعودة بأحداث القيمة لا بالتسجيل والزيارة.
- القمع يقول أين يضيع المستخدمون، وجدول المجموعات يقول هل يعودون، والأسبوع الذي لم ينته يجب أن يظهر فارغاً لا صفراً.
- PostHog مفتوح المصدر بترخيص MIT ما عدا مجلد ee، ولكن استضافته الذاتية غير مدعومة رسمياً وبلا إصدارات مرقمة، وUmami مع جدول أحداث في PostgreSQL أخف بكثير ويكفي أغلب الأسئلة.
- في التجربة طابقت أرقام القمع في Umami ما حسبناه بال SQL تماماً، واختلف عدد الزوار عن عدد المستخدمين بسبب تغير الملح كل شهر، وهذا متوقع في أدوات تحمي الخصوصية.
- اجمع ما تحتاجه فقط، بمعرف مستعار ودون بيانات شخصية أو حساسة، ومع مدة احتفاظ محددة.
 دليلإدارة المنتج: ماذا يفعل مدير المنتج Product Manager؟الفرق بين مدير المنتج ومدير المشروع ومالك المنتج Product Owner، وكيف يختار مدير المنتج ما يبنى ويرتب أولوياته ويقيس نتيجته.
 دليلماذا تبني قبل أن تبنيه؟ اكتشاف المنتج Product Discoveryكيف تتحقق من المشكلة والحل بمقابلات ونماذج أولية Prototypes وتجارب رخيصة قبل أن يكتب فريقك سطراً واحداً من الكود.
 دليلمهندس المنتج Product Engineer يملك النتيجة لا المهمةماذا تعني هندسة المنتج Product Engineering كما تصفها الشركات التي تعمل بها، وكيف ينتقل المطور من تنفيذ المهام إلى امتلاك نتيجتها.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختبار التجربة على Umami 3.4.0 وPostgreSQL 17.11 وNode.js 22.23.3 ببيانات تجريبية لنظام عيادات، مع مراجعة ترخيص PostHog وحالة استضافته الذاتية، ودليل North Star Playbook من Amplitude، وعرض Startup Metrics for Pirates لDave McClure سنة 2007.


