

لنفرض أنك تبني منتجاً جديداً مع فريق من ثلاثة مطورين، وبعد ستة أشهر نظرت إلى ملف docker-compose.yml فوجدت PostgreSQL للبيانات، وRedis للتخزين المؤقت Cache، وRabbitMQ لطابور المهام Job Queue، وElasticsearch للبحث، وMongoDB لأن أحدهم احتاج "مستندات مرنة"، وقاعدة متجهات Vector Database لميزة البحث بالذكاء الاصطناعي، وسيرفر cron صغير للمهام المجدولة، وكل نظام من هذه له نسخته الاحتياطية Backup وترقياته وكلمات مروره ومراقبته وأخطاؤه الخاصة، والفريق ما زال ثلاثة مطورين. وفي المقابل انتشرت بين الشركات الناشئة فكرة معاكسة تماماً اسمها "Just use Postgres": استخدم قاعدة PostgreSQL واحدة لكل هذه الأعمال حتى يثبت لك قياس حقيقي أنك تحتاج غيرها. وقد يتساءل البعض: هل هذا كلام جاد أم مبالغة من محبي PostgreSQL؟ والإجابة أن الفكرة صحيحة إلى حد بعيد ولكن لها حدود واضحة يمكن قياسها، وهذا ما سوف نفعله في هذا المقال على Container واحد.
وهذا المقال لا يكرر الأساسيات، فقد شرحنا لغة SQL في سلسلة تعلم SQL من ثلاثة أجزاء، وتصميم الجداول في تصميم قواعد البيانات، والجداول الضخمة والتقسيم Partitioning وال VACUUM في PostgreSQL للجداول الضخمة، أما هنا فسوف نأخذ كل عمل يذهب عادة إلى نظام متخصص ونرى كيف يقوم به PostgreSQL 18، ونشغل مثالاً حقيقياً، ثم نحدد أين يتوقف وما الإشارة التي تقول لك إن وقت الفصل قد جاء، وسوف نناقش في هذا المقال ما يلي:
- من أين جاءت فكرة "Just use Postgres"، ولماذا تنجح مع الشركات الناشئة.
- طابور المهام Job Queue مع
FOR UPDATE SKIP LOCKEDمع اثنين من برامج المعالجة Workers، والأدوات الجاهزة المبنية عليه، ثم الإشعاراتLISTEN/NOTIFYوحدودها. - التخزين المؤقت Cache في جدول
UNLOGGEDوفي العروض المحفوظة Materialized Views، مع قياس صريح لزمن الاستجابة Latency. - البحث النصي الكامل Full-Text Search بالعربية، والمستندات JSONB، والبيانات الجغرافية مع PostGIS، والمتجهات Embeddings مع pgvector.
- السلاسل الزمنية Time Series بالتقسيم وفهرس BRIN، والمهام المجدولة مع pg_cron، ونمط Outbox وسجل الأحداث.
- الواجهة البرمجية API من قاعدة البيانات مباشرة مع PostgREST وSupabase، والتحليلات Analytics داخل PostgreSQL.
- الثمن الحقيقي لقاعدة واحدة، وجدول قرار، وقائمة إشارات قابلة للقياس تقول لك متى تفصل.
من أين جاءت فكرة "Just use Postgres"؟
الفكرة أقدم من الشعار، ففي مارس 2015 كتب Dan McKinley مقاله المعروف Choose Boring Technology، وخلاصته أن كل شركة تملك عدداً قليلاً من "رموز الابتكار" Innovation Tokens، وكل تقنية جديدة تضيفها تستهلك واحداً منها لأنك سوف تتعلم أعطالها في الإنتاج Production بنفسك، لذلك فالأفضل أن تصرف هذه الرموز على ما يميز منتجك لا على البنية التحتية، وقد جمع لاحقاً أفكاره في موقع boringtechnology.club. ثم جاء من طبق الفكرة على PostgreSQL تحديداً، مثل مقال Stephan Schmidt Just Use Postgres for Everything الذي يعدد الأنظمة التي يمكن أن يحل محلها PostgreSQL، وقائمة Postgres is Enough التي تجمع الإضافات والأدوات لكل عمل، وكتاب Denis Magda Just Use Postgres! من Manning.
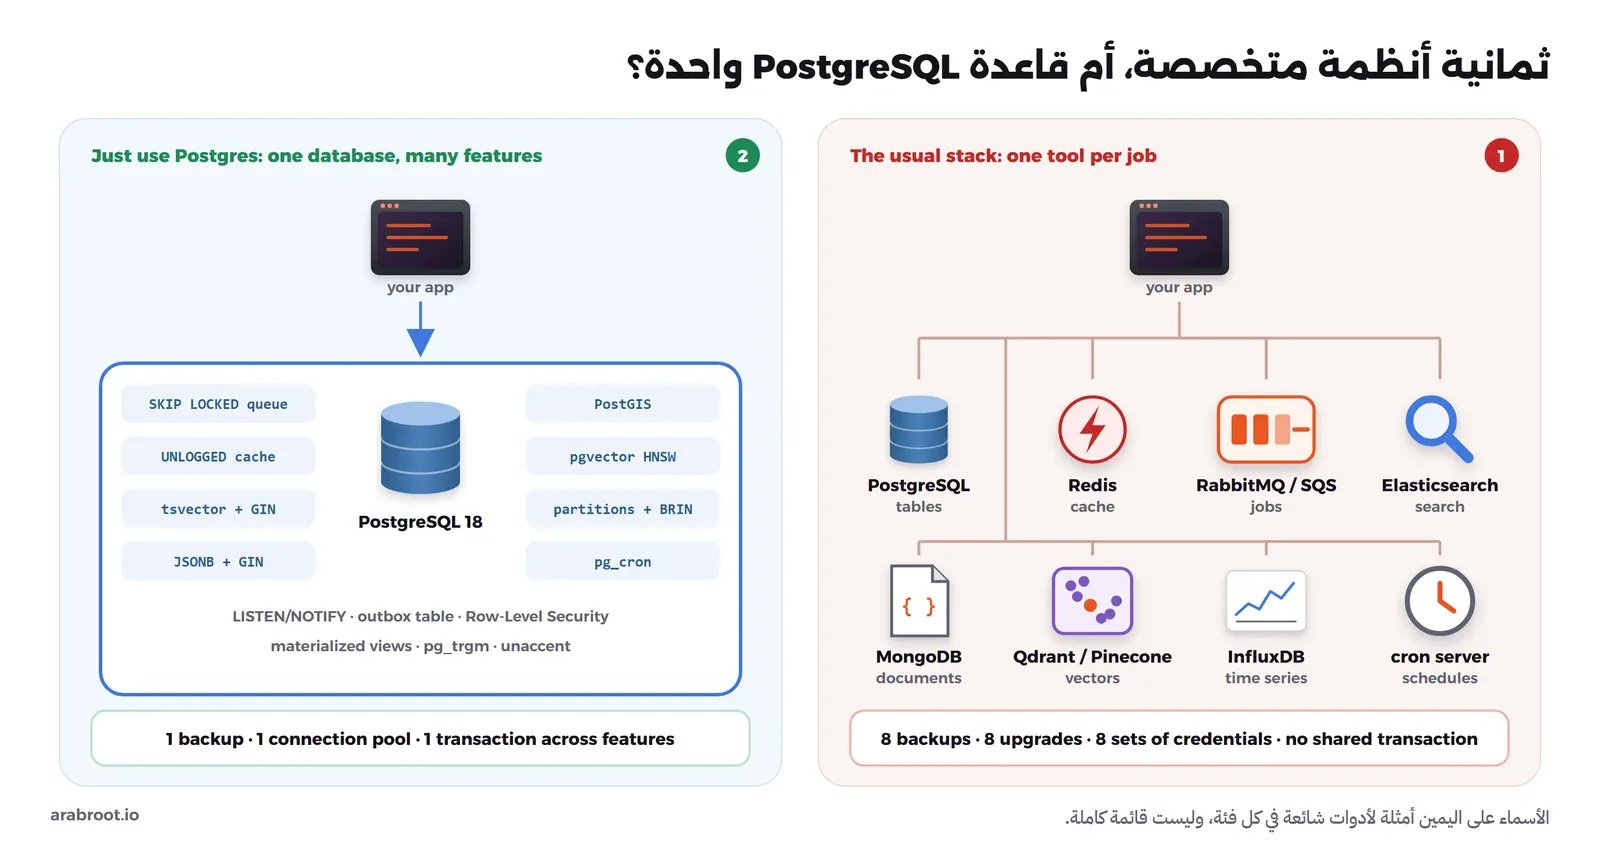
ولم تبق الفكرة عند PostgreSQL، ففي إعلان Rails 8 في نوفمبر 2024 أصبح الطابور والتخزين المؤقت وWebSockets تعمل من قاعدة البيانات نفسها عبر Solid Queue وSolid Cache وSolid Cable، والسبب الذي ذكره الإعلان أن الأقراص أصبحت سريعة بما يكفي لأعمال كانت تحتاج الذاكرة RAM في الماضي. والصورة التالية تبين الفرق بين الطريقتين:
لماذا تنجح الفكرة في الشركات الناشئة؟
الشركة الناشئة لا تموت عادة لأن قاعدة بياناتها بطيئة، وإنما لأن فريقها الصغير يصرف وقته على تشغيل الأنظمة بدل بناء المنتج، وفي خارطة CTO لشركة SaaS ناشئة ذكرنا أن أول قاعدة هي أن تؤجل كل ما لا تحتاجه الآن، وقاعدة واحدة تعطيك ما يلي:
- نسخة احتياطية Backup واحدة واستعادة واحدة: عندما تستعيد قاعدة البيانات إلى الساعة العاشرة صباحاً تعود الطلبات والطابور والكاش والمتجهات إلى اللحظة نفسها، أما مع خمسة أنظمة فكل واحد يعود إلى لحظة مختلفة، وعليك أن تصلح الفرق بيدك.
- معاملة Transaction واحدة عبر الميزات: إضافة الطلب وإضافة مهمة إرسال البريد في معاملة واحدة، فإما أن يحدثا معاً أو لا يحدث أي منهما، وهذا مستحيل بين PostgreSQL وRabbitMQ دون أنماط إضافية كما سيأتي في قسم Outbox.
- مجمع اتصالات Connection Pool واحد، ومراقبة واحدة، وصلاحيات واحدة: نفس
pg_stat_statementsيخبرك بأبطأ استعلام سواء كان بحثاً أو طابوراً، ونفس سياسات الصلاحيات تحمي الجميع. - مهارة واحدة في الفريق: كل مطور يعرف SQL، وليس كل مطور يعرف إعدادات Elasticsearch أو سلوك RabbitMQ عند امتلاء القرص.
- تكلفة أقل: سيرفر واحد أكبر قليلاً بدل عدة سيرفرات صغيرة أو عدة خدمات مدارة Managed Services لكل منها فاتورة.
ولكن لاحظ أن كل نقطة من هذه لها وجه آخر، فالقاعدة الواحدة نقطة فشل واحدة Single Point of Failure، والأحمال كلها تتقاسم المعالج والقرص، وسوف نعود إلى هذا الثمن بالتفصيل في قسم الثمن بعد أن نرى كل حالة على حدة.
تجهيز المختبر: PostgreSQL 18 مع الإضافات
سوف نشغل PostgreSQL 18 في Container واحد على المنفذ 55490 المربوط على العنوان المحلي فقط، ثم نثبت داخله ثلاث إضافات من مستودع PostgreSQL الرسمي apt.postgresql.org الموجود أصلاً في ال Image الرسمية، وهي PostGIS للبيانات الجغرافية وpgvector للمتجهات وpg_cron للمهام المجدولة، وإذا لم يكن Docker مثبتاً لديك فابدأ بدليل تثبيت Docker على Ubuntu:
docker run -d --name lab-pgall-pg -p 127.0.0.1:55490:5432 \
  -e POSTGRES_PASSWORD="$(openssl rand -hex 16)" --shm-size=512m \
  postgres:18.6

docker exec lab-pgall-pg bash -c "apt-get update -qq && \
  apt-get install -y -qq postgresql-18-postgis-3 postgresql-18-pgvector postgresql-18-cron"

docker exec lab-pgall-pg psql -U postgres \
  -c "ALTER SYSTEM SET shared_preload_libraries = 'pg_cron';" \
  -c "ALTER SYSTEM SET cron.database_name = 'postgres';"
docker restart lab-pgall-pg

docker exec lab-pgall-pg psql -U postgres \
  -c "CREATE EXTENSION pg_cron; CREATE EXTENSION postgis; CREATE EXTENSION vector;
      CREATE EXTENSION pg_trgm; CREATE EXTENSION unaccent;" \
  -c "SELECT extname, extversion FROM pg_extension ORDER BY 1;"
والمخرج سوف يكون كما يلي:
 extname  | extversion
----------+------------
 pg_cron  | 1.6
 pg_trgm  | 1.6
 plpgsql  | 1.0
 postgis  | 3.6.4
 unaccent | 1.1
 vector   | 0.8.7
(6 rows)
في الإعداد أعلاه لاحظ التالي:
- الإضافة pg_cron تعمل كعملية خلفية Background Worker داخل السيرفر، لذلك يجب أن تحمل من
shared_preload_librariesثم يعاد تشغيل السيرفر، وهي تنشئ جداولها في قاعدة بيانات واحدة تحددهاcron.database_nameكما يشرح ملف README الخاص بها. - الإضافتان
pg_trgmوunaccentموجودتان مع PostgreSQL نفسه ولا تحتاجان أي تثبيت. - تثبيت الحزم داخل Container يعمل يضيع إذا حذفته وأنشأته من جديد، لذلك في الإنتاج ابن Image خاصة بك بملف Dockerfile يبدأ من
postgres:18.6ويثبت نفس الحزم بإصدارات محددة، أو استخدم خدمة مدارة تدعم هذه الإضافات، وسوف نتحدث عن الخدمات المدارة في قسم الثمن.
طابور المهام Job Queue مع SKIP LOCKED
طابور المهام هو المكان الذي يضع فيه التطبيق عملاً يحتاج وقتاً، مثل إرسال بريد أو إنشاء ملف PDF أو استدعاء خدمة خارجية، ثم يعود للمستخدم فوراً، ويأتي برنامج معالجة يعمل في الخلفية Worker يأخذ المهمة وينفذها، وقد شرحنا لماذا تحتاجه في البريد التفاعلي Transactional Email. والأداة المعتادة لهذا العمل وسيط رسائل Message Broker مثل RabbitMQ أو خدمة مثل Amazon SQS، والسؤال هنا: هل يكفي جدول في PostgreSQL؟
لنبدأ بالجدول والدالة التي يستدعيها ال Worker، احفظ الملف التالي باسم queue.sql ثم نفذه بالأمر docker exec -i lab-pgall-pg psql -U postgres < queue.sql:
CREATE TABLE jobs (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    kind        text        NOT NULL,
    payload     jsonb       NOT NULL,
    status      text        NOT NULL DEFAULT 'queued',
    run_at      timestamptz NOT NULL DEFAULT now(),
    attempts    int         NOT NULL DEFAULT 0,
    done_by     text,
    done_at     timestamptz
);
CREATE INDEX jobs_queued_idx ON jobs (run_at, id) WHERE status = 'queued';

INSERT INTO jobs (kind, payload)
SELECT 'send_email', jsonb_build_object('order_id', g, 'to', 'customer' || g || '@example.com')
FROM generate_series(1, 20000) AS g;

CREATE PROCEDURE work(worker text, batch int DEFAULT 10)
LANGUAGE plpgsql AS $$
DECLARE n int;
BEGIN
  LOOP
    WITH next AS (
      SELECT id FROM jobs
      WHERE status = 'queued' AND run_at <= now()
      ORDER BY run_at, id
      LIMIT batch
      FOR UPDATE SKIP LOCKED
    )
    UPDATE jobs j
       SET status = 'done', done_by = worker, done_at = clock_timestamp(), attempts = attempts + 1
      FROM next WHERE j.id = next.id;
    GET DIAGNOSTICS n = ROW_COUNT;
    EXIT WHEN n = 0;
    PERFORM pg_sleep(0.001);   -- the "work": 1 ms per batch
    COMMIT;
  END LOOP;
END $$;
في الإعداد أعلاه لاحظ التالي:
- الفهرس الجزئي Partial Index على
(run_at, id)للمهام المنتظرة فقط يبقى صغيراً مهما كبر الجدول، لأن المهام المنتهية تخرج منه. - العمود
run_atيسمح بتأجيل مهمة أو إعادة محاولتها بعد دقائق، وهو ما تفعله الأدوات الجاهزة عند الفشل. - الإجراء
workيأخذ عشر مهام في كل دورة ثم يقوم بCOMMIT، والسطرpg_sleep(0.001)يمثل العمل الحقيقي فقط.
الحل البسيط: FOR UPDATE وحده
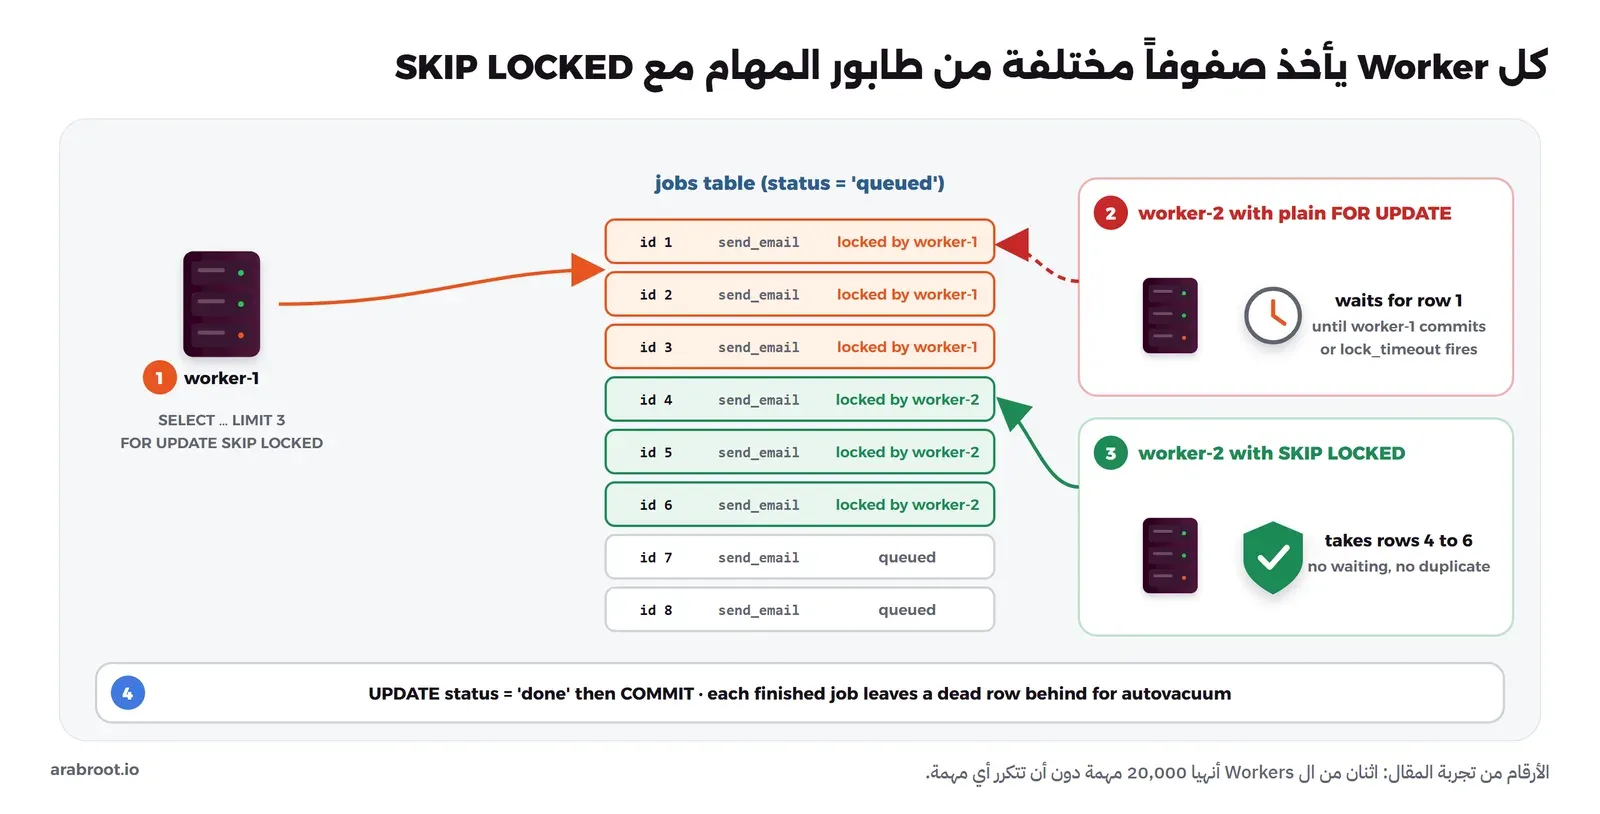
أول ما يخطر على البال أن يقرأ ال Worker أول مهمة منتظرة ويقفلها بـ FOR UPDATE حتى لا يأخذها غيره، والمشكلة أن ال Worker الثاني سوف يحاول قفل الصف نفسه فينتظر، ولنجرب ذلك بجلستين، في الجلسة الأولى يأخذ ال Worker الأول ثلاث مهام ويبقى في المعاملة ست ثوان:
docker exec lab-pgall-pg psql -U postgres -c "BEGIN; SELECT id FROM jobs WHERE status='queued' ORDER BY run_at,id LIMIT 3 FOR UPDATE; SELECT pg_sleep(6); COMMIT;"وفي جلسة ثانية خلال هذه الثواني نجرب ال Worker الثاني بالطريقتين:
docker exec lab-pgall-pg psql -U postgres -c "SET lock_timeout='2s';" \
  -c "SELECT id FROM jobs WHERE status='queued' ORDER BY run_at,id LIMIT 3 FOR UPDATE;"
docker exec lab-pgall-pg psql -U postgres \
  -c "SELECT id FROM jobs WHERE status='queued' ORDER BY run_at,id LIMIT 3 FOR UPDATE SKIP LOCKED;"
والمخرج سوف يكون كما يلي:
SET
ERROR:  canceling statement due to lock timeout
CONTEXT:  while locking tuple (0,1) in relation "jobs"
 id
----
  4
  5
  6
(3 rows)
الطريقة الأولى انتظرت الصف الأول حتى انتهت المهلة، ودون lock_timeout كانت سوف تنتظر حتى ينتهي ال Worker الأول، أي أن كل ال Workers يصطفون خلف Worker واحد، أما SKIP LOCKED فقد تجاوز الصفوف المقفلة وأخذ الصفوف 4 إلى 6 فوراً، وهذا بالضبط ما تقوله وثائق SELECT: تجاوز الصفوف المقفلة يعطي رؤية غير متسقة للبيانات فلا يصلح للاستعلامات العامة، ولكنه يصلح لعدة مستهلكين يقرؤون من جدول يعمل كطابور. والصورة التالية تبين ما حدث:
اثنان من ال Workers على عشرين ألف مهمة
الآن نشغل اثنين من ال Workers في الوقت نفسه على كل المهام:
docker exec lab-pgall-pg psql -U postgres -c "CALL work('worker-1');" &
docker exec lab-pgall-pg psql -U postgres -c "CALL work('worker-2');" &
wait
docker exec lab-pgall-pg psql -U postgres \
  -c "SELECT done_by, count(*) AS jobs, max(attempts) AS max_attempts,
             round(extract(epoch FROM max(done_at)-min(done_at))::numeric,2) AS seconds
      FROM jobs GROUP BY done_by ORDER BY 1;" \
  -c "SELECT count(*) FILTER (WHERE status='queued') AS still_queued,
             count(*) FILTER (WHERE attempts > 1) AS done_twice FROM jobs;"
والمخرج سوف يكون كما يلي:
 done_by  | jobs  | max_attempts | seconds
----------+-------+--------------+---------
 worker-1 |  9980 |            1 |    5.96
 worker-2 | 10020 |            1 |    5.96
(2 rows)

 still_queued | done_twice
--------------+------------
            0 |          0
(1 row)
تقاسم ال Workers الاثنان العمل تقريباً بالنصف، ولم تبق أي مهمة، ولم تنفذ أي مهمة مرتين، ولكن انظر الآن إلى ما تركه الطابور خلفه:
docker exec lab-pgall-pg psql -U postgres -c "SELECT pg_stat_force_next_flush();" \
  -c "SELECT relname, n_live_tup, n_dead_tup, n_tup_upd,
             pg_size_pretty(pg_total_relation_size('jobs')) AS size
      FROM pg_stat_user_tables WHERE relname='jobs';"
relname | n_live_tup | n_dead_tup | n_tup_upd | size
---------+------------+------------+-----------+---------
jobs | 20000 | 20000 | 20000 | 5688 kB
(1 row)كل تحديث في PostgreSQL يكتب نسخة جديدة من الصف ويترك القديمة صفاً ميتاً Dead Tuple حتى ينظفه autovacuum، وقد شرحنا السبب في قسم VACUUM من مقال الجداول الضخمة، والطابور هو أسوأ حالة لهذا السلوك لأن كل مهمة تكتب مرتين على الأقل، لذلك احذف المهام المنتهية أو انقلها إلى جدول أرشيف على دفعات، واضبط autovacuum لجدول الطابور بنسبة صغيرة، وإذا كان الطابور كبيراً جداً فقسمه حسب اليوم واحذف الأيام القديمة كاملة.
لا تكتب الطابور بنفسك: الأدوات الجاهزة
المثال أعلاه يشرح الفكرة، أما في الإنتاج فهناك أشياء كثيرة لم نكتبها: إعادة المحاولة مع تأخير متزايد، والمهام العالقة عندما يتوقف ال Worker فجأة في منتصف العمل، والأولويات، والمهام الفريدة، ولوحة المتابعة، لذلك استخدم أداة مبنية على هذه الفكرة بلغتك:
| الأداة | اللغة | الرخصة | ما يميزها |
|---|---|---|---|
| pgmq | SQL فقط، مع مكتبات لعدة لغات | PostgreSQL License | إضافة لا تحتاج Background Worker، واجهتها تشبه Amazon SQS مع مهلة الإخفاء Visibility Timeout، وتدعم PostgreSQL من 14 إلى 18 |
| River | Go | MPL-2.0 | إضافة المهمة داخل معاملة التطبيق نفسها Transactional Enqueueing، وبعض الميزات مثل Workflows في نسخة مدفوعة اسمها River Pro |
| Graphile Worker | Node.js | MIT | يستخدم LISTEN/NOTIFY لتبدأ المهمة خلال أجزاء من الثانية |
| pg-boss | Node.js | MIT | مبني على SKIP LOCKED، ويضيف المهمة داخل معاملة قائمة مع محولات لعدة ORM |
| Oban | Elixir | Apache-2.0 | يعمل على PostgreSQL وSQLite3 وMySQL، مع تحكم كامل بالمعاملة |
| Solid Queue | Ruby on Rails | MIT | جاء مع Rails 8 بديلاً عن Redis وSidekiq لأغلب التطبيقات، ويعمل على قاعدة بيانات التطبيق |
n_dead_tup يزيد يوماً بعد يوم رغم الضبط، أو أن استعلام أخذ المهام أصبح من أعلى الاستعلامات وقتاً في pg_stat_statements.الإشعارات LISTEN/NOTIFY: جرس وليس صندوق بريد
ال Worker في المثال السابق يسأل الجدول كل فترة: هل هناك مهام جديدة؟ وهذا يسمى الاستطلاع Polling، والبديل أن يخبره PostgreSQL فور وصول مهمة، وهذا ما يفعله الأمران LISTEN وNOTIFY، وهما نوع بسيط من النشر والاشتراك Pub/Sub داخل قاعدة البيانات. لنضف Trigger يرسل إشعاراً عند كل مهمة جديدة:
CREATE FUNCTION jobs_notify() RETURNS trigger
LANGUAGE plpgsql AS $$
BEGIN
  PERFORM pg_notify('new_job', json_build_object('id', NEW.id, 'kind', NEW.kind)::text);
  RETURN NEW;
END $$;
CREATE TRIGGER jobs_notify AFTER INSERT ON jobs
FOR EACH ROW EXECUTE FUNCTION jobs_notify();
ثم نفتح جلسة تستمع أربع ثوان، وفي جلسة أخرى نضيف مهمتين داخل معاملة واحدة بينهما ثانية:
docker exec lab-pgall-pg psql -U postgres -c "LISTEN new_job;" -c "SELECT pg_sleep(4);" &
sleep 1.5
docker exec lab-pgall-pg psql -U postgres -c "BEGIN;" \
  -c "INSERT INTO jobs (kind, payload) VALUES ('send_sms', '{\"order_id\": 20001}');" \
  -c "SELECT pg_sleep(1);" \
  -c "INSERT INTO jobs (kind, payload) VALUES ('send_email', '{\"order_id\": 20002}');" \
  -c "COMMIT;"
wait
والمخرج من جلسة الاستماع سوف يكون كما يلي:
LISTEN
 pg_sleep
----------

(1 row)

Asynchronous notification "new_job" with payload "{"id" : 20001, "kind" : "send_sms"}" received from server process with PID 129.
Asynchronous notification "new_job" with payload "{"id" : 20002, "kind" : "send_email"}" received from server process with PID 129.
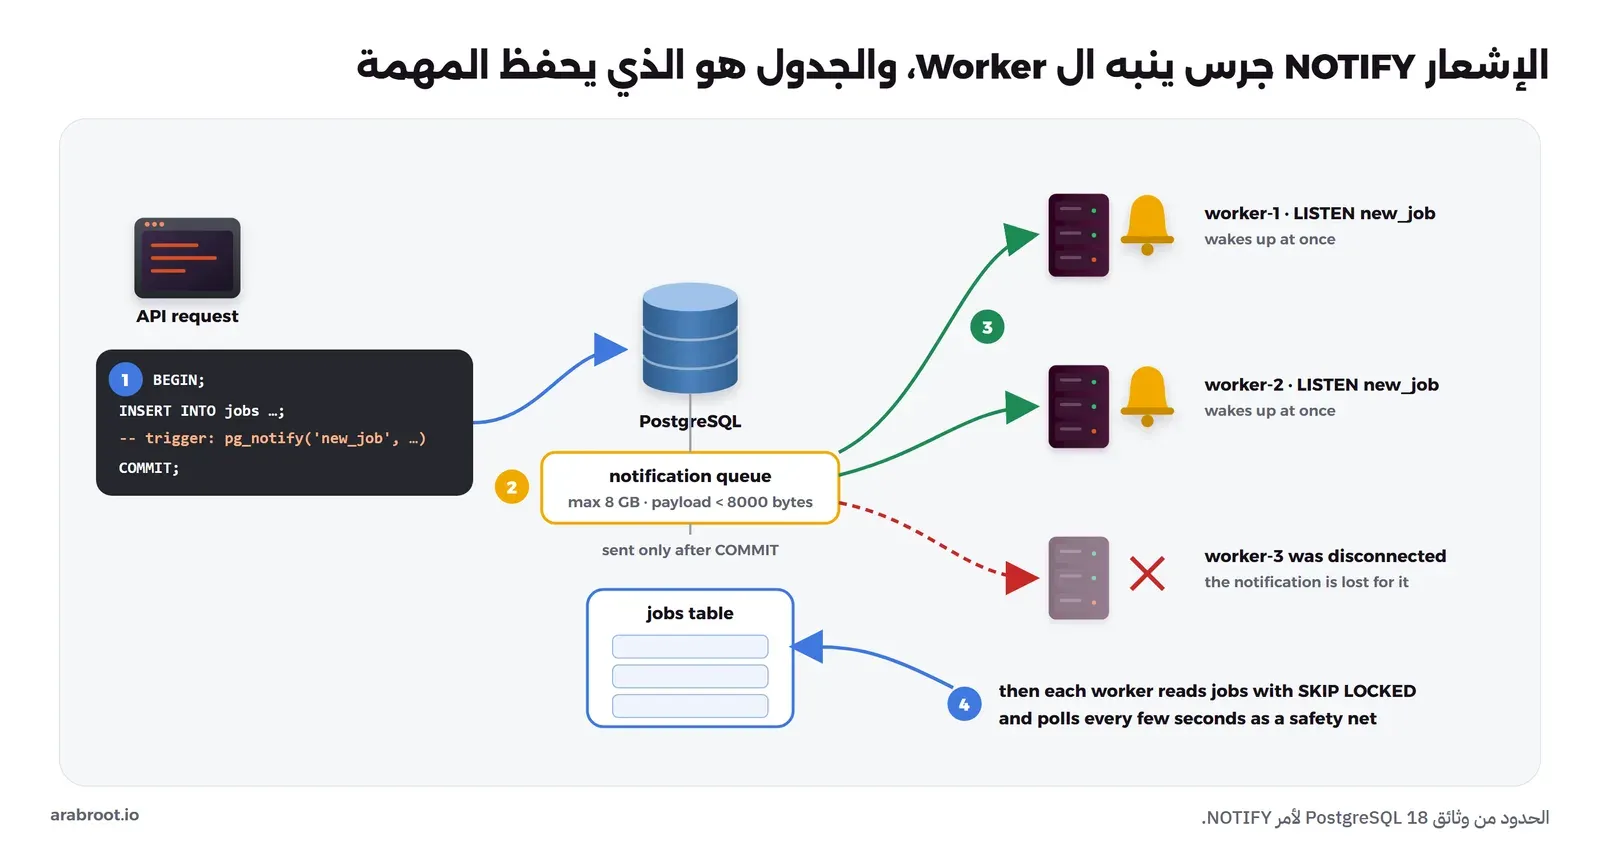
الإشعاران وصلا معاً بعد COMMIT وليس عند كل INSERT، وهذا مقصود، فلو ألغيت المعاملة لما وصل أي إشعار عن مهمة لم تحفظ، والآن لنكسر شيئاً، فالحمولة Payload لها حد أقصى:
docker exec lab-pgall-pg psql -U postgres -c "SELECT pg_notify('new_job', repeat('x', 8000));"ERROR: payload string too longوالصورة التالية تبين الطريقة الصحيحة لاستخدام الإشعارات مع الطابور:
وفيما يلي حدود الإشعارات كما تذكرها وثائق NOTIFY، ومنها تفهم لماذا لا تصلح لتكون الطابور نفسه:
- الإشعار لا يحفظ في أي مكان، فإذا كان ال Worker منقطعاً لحظة الإرسال فقد ضاع عليه، لذلك ضع المهمة في جدول دائماً، واجعل الإشعار مجرد تنبيه، واجعل ال Worker يستطلع الجدول كل بضع ثوان احتياطاً.
- الحمولة أقل من 8000 بايت في الإعداد الافتراضي، والوثائق نفسها تنصح بأن تضع البيانات في جدول وترسل المفتاح فقط.
- الإشعارات المرسلة تنتظر في طابور حجمه 8 جيجابايت في الإعداد القياسي، وإذا امتلأ فشلت كل معاملة ترسل إشعاراً عند COMMIT، وجلسة تستمع ثم تبقى في معاملة مفتوحة طويلاً تمنع تنظيف هذا الطابور، ويمكنك مراقبته بالدالة
pg_notification_queue_usage(). - الجلسة التي تستمع تحتاج اتصالاً ثابتاً بالسيرفر، فلا تعمل خلف PgBouncer في وضع Transaction Pooling كما يبين جدول ميزات PgBouncer، وقد شرحنا هذه الأوضاع في تجميع الاتصالات Connection Pooling.
التخزين المؤقت Cache: جدول UNLOGGED والعروض المحفوظة
الأداة المعتادة للتخزين المؤقت Redis أو Valkey، وهي تحفظ البيانات في الذاكرة RAM وتعطيك قيمة مفتاح Key-Value مع مدة صلاحية TTL وطرد تلقائي للقديم Eviction عند امتلاء الذاكرة، أما في PostgreSQL فلديك طريقتان، والصورة التالية تبينهما:
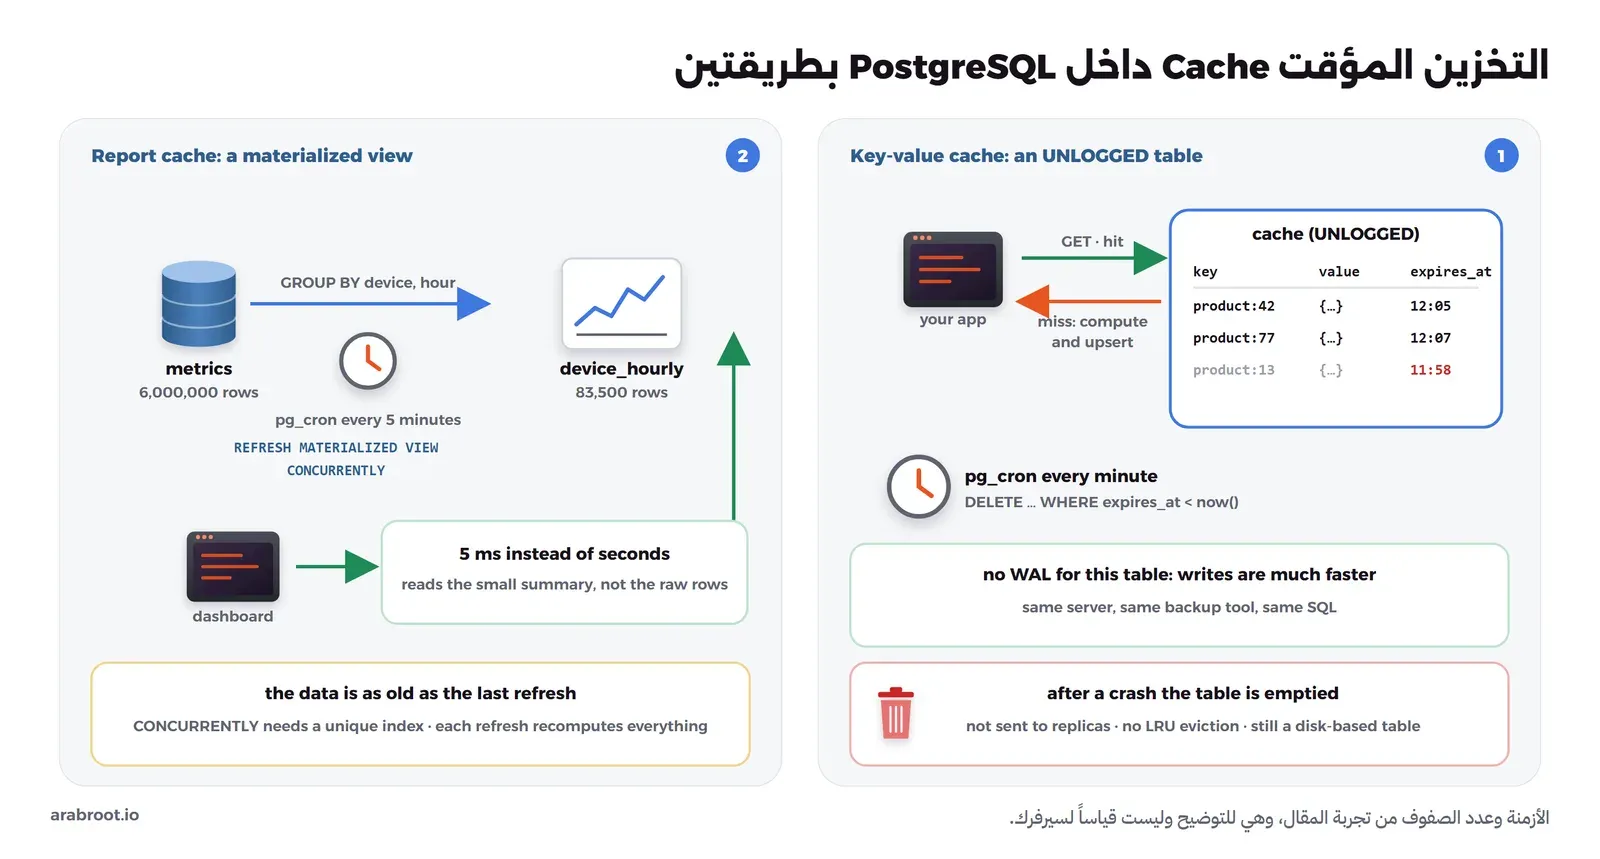
جدول UNLOGGED للمفاتيح والقيم
الجدول من نوع UNLOGGED لا يكتب في سجل WAL، لذلك تكون الكتابة فيه أسرع بكثير، ولنقس ذلك بأداة pgbench الموجودة في ال Image نفسها، أولاً الجدولان:
CREATE UNLOGGED TABLE cache (
    key        text PRIMARY KEY,
    value      jsonb       NOT NULL,
    expires_at timestamptz NOT NULL
);
CREATE INDEX cache_expires_idx ON cache (expires_at);
CREATE TABLE cache_logged (LIKE cache INCLUDING ALL);
ثم ملف الكتابة set_unlogged.pgb الذي يكتب منتجاً عشوائياً من مئة ألف بصلاحية خمس دقائق، وملف القراءة get_unlogged.pgb، ونسخة من ملف الكتابة على الجدول العادي باسم set_logged.pgb:
-- set_unlogged.pgb
\set k random(1, 100000)
INSERT INTO cache (key, value, expires_at)
VALUES ('product:' || :k, jsonb_build_object('id', :k, 'price', :k % 500), now() + interval '5 minutes')
ON CONFLICT (key) DO UPDATE SET value = EXCLUDED.value, expires_at = EXCLUDED.expires_at;

-- get_unlogged.pgb
\set k random(1, 100000)
SELECT value FROM cache WHERE key = 'product:' || :k AND expires_at > now();
الآن ننسخ الملفات إلى ال Container ونشغل كل ملف 15 ثانية بثمانية عملاء على جهاز بثماني أنوية:
for f in set_logged set_unlogged get_unlogged; do
  docker cp $f.pgb lab-pgall-pg:/tmp/
  echo "== $f"
  docker exec lab-pgall-pg pgbench -U postgres -n -c 8 -j 4 -T 15 -f /tmp/$f.pgb postgres \
    | grep -E 'latency average|tps ='
done
والمخرج سوف يكون كما يلي:
== set_logged
latency average = 4.408 ms
tps = 1814.707698 (without initial connection time)
== set_unlogged
latency average = 0.431 ms
tps = 18567.406312 (without initial connection time)
== get_unlogged
latency average = 0.425 ms
tps = 18826.758464 (without initial connection time)
في المخرج أعلاه لاحظ التالي:
- الكتابة في الجدول العادي أخذت 4.4 مللي ثانية لأن كل COMMIT ينتظر أن يصل WAL إلى القرص، وهذا الرقم كبير هنا لأن انتظار القرص
fsyncبطيء في بيئة المختبر، وعلى سيرفر بقرص NVMe سوف يكون الفرق أصغر، ولكن الجدول UNLOGGED تجاوز هذا الانتظار تماماً فأصبحت الكتابة 0.43 مللي ثانية. - القراءة 0.43 مللي ثانية في المتوسط بما فيها الشبكة والتحليل والتخطيط، وهذا رقم ممتاز لصفحة ويب، ولكن كن صريحاً مع نفسك: Redis يحفظ القيم في الذاكرة ويرد بأوامر بسيطة دون محلل SQL أو مخطط استعلامات أو نظام معاملات، لذلك فهو أسرع وأخف على المعالج لكل طلب، ولم نقسه هنا على الجهاز نفسه فلن نضع له رقماً.
- القراءات من الكاش تأخذ اتصالات ومعالجاً من نفس السيرفر الذي يخدم الطلبات، وهذا هو الثمن الحقيقي، وسوف نعود إليه في قسم الثمن.
أما عيب UNLOGGED فلنره بأعيننا، نوقف ال Container فجأة كأن السيرفر انقطعت عنه الكهرباء، ثم نعد الصفوف:
docker exec lab-pgall-pg psql -U postgres -c "CHECKPOINT;" \
  -c "SELECT (SELECT count(*) FROM cache) AS cache_rows, (SELECT count(*) FROM cache_logged) AS logged_rows;"
docker kill lab-pgall-pg && docker start lab-pgall-pg
docker exec lab-pgall-pg psql -U postgres \
  -c "SELECT (SELECT count(*) FROM cache) AS cache_rows, (SELECT count(*) FROM cache_logged) AS logged_rows;"
cache_rows | logged_rows
------------+-------------
93850 | 23860
(1 row)
cache_rows | logged_rows
------------+-------------
0 | 23860
(1 row)الجدول UNLOGGED أصبح فارغاً بعد الاستعادة من التوقف المفاجئ، وهذا سلوك موثق: الجدول لا يحمي بياناته من التوقف ويفرغ تلقائياً، ولا ينسخ إلى نسخ القراءة Standby، وهذا مقبول تماماً للكاش لأنه يعاد بناؤه من البيانات الأصلية، ولكنه غير مقبول لأي شيء آخر، فلا تضع فيه الجلسات Sessions إلا إذا كان خروج المستخدمين بعد كل توقف مقبولاً لديك. ولاحظ أيضاً أن الجدول لا يطرد القيم القديمة وحده، لذلك نحتاج مهمة تحذف المنتهي منها، وسوف نجدولها مع pg_cron في قسم المهام المجدولة.
العروض المحفوظة Materialized Views للتقارير
النوع الثاني من الكاش هو نتيجة استعلام ثقيل تحتاجه لوحة التحكم مرات كثيرة، فبدلاً من أن تحفظ النتيجة في Redis من كود التطبيق تحفظها قاعدة البيانات نفسها في عرض محفوظ Materialized View، وعلى جدول القراءات metrics الذي سوف ننشئه في قسم السلاسل الزمنية بستة ملايين صف:
CREATE MATERIALIZED VIEW device_hourly AS
SELECT device_id, date_trunc('hour', ts) AS hour, avg(temp_c) AS avg_temp, count(*) AS readings
FROM metrics GROUP BY 1, 2;
CREATE UNIQUE INDEX ON device_hourly (device_id, hour);   -- required for REFRESH ... CONCURRENTLY
والقراءة من العرض تأخذ أقل من مللي ثانية لأنها تقرأ ملخصاً جاهزاً من 83,500 صف:
docker exec lab-pgall-pg psql -U postgres -c "\timing on" \
  -c "SELECT device_id, hour, round(avg_temp::numeric, 2) AS avg_temp, readings FROM device_hourly
      WHERE device_id = 7 AND hour >= '2026-10-05 10:00+00' ORDER BY hour LIMIT 3;"
device_id | hour | avg_temp | readings
-----------+------------------------+----------+----------
7 | 2026-10-05 10:00:00+00 | 25.70 | 72
7 | 2026-10-05 11:00:00+00 | 25.70 | 72
7 | 2026-10-05 12:00:00+00 | 25.70 | 72
(3 rows)
Time: 0.817 msوالثمن أن البيانات عمرها عمر آخر تحديث، وأن كل تحديث يعيد حساب العرض كله، وقد أخذ التحديث في المختبر بين 6 و8 ثوان كما سوف نرى في سجل pg_cron، والخيار CONCURRENTLY يسمح بالقراءة أثناء التحديث بشرط وجود فهرس فريد على العرض.
pg_stat_statements على حساب الطلبات الحقيقية، أو عندما تحتاج طرداً تلقائياً للقيم القديمة عند امتلاء الذاكرة، أو عدادات تتغير آلاف المرات في الثانية مثل تحديد معدل الطلبات Rate Limiting، أو هياكل جاهزة مثل القوائم المرتبة Sorted Sets، أو عندما يكون زمن الاستجابة المطلوب أقل من مللي ثانية بثبات تحت الضغط.البحث النصي الكامل Full-Text Search بالعربية
الأداة المعتادة للبحث Elasticsearch أو OpenSearch أو Meilisearch، أما PostgreSQL ففيه بحث نصي كامل منذ سنوات: النص يتحول إلى tsvector أي قائمة كلمات بعد إرجاع كل كلمة إلى أصلها Stemming، والسؤال يتحول إلى tsquery، ويجمعهما فهرس GIN كما تشرح وثائق البحث النصي. وقد يتساءل البعض: وهل يدعم العربية؟ والإجابة نعم، وهذا مما يجهله كثيرون، فقد أضاف إصدار PostgreSQL 12 إرجاع الكلمات العربية إلى أصلها من مكتبة Snowball، ولنتأكد على PostgreSQL 18:
docker exec lab-pgall-pg psql -U postgres -c "\dF arabic" \
  -c "SELECT to_tsvector('simple', 'المستشفيات الحكومية في الرياض') AS simple,
             to_tsvector('arabic', 'المستشفيات الحكومية في الرياض') AS arabic;" \
  -c "SELECT unaccent('مُسْتَشْفَى') AS unaccent_ar, unaccent('café') AS unaccent_fr;"
List of text search configurations
Schema | Name | Description
------------+--------+-----------------------------------
pg_catalog | arabic | configuration for arabic language
(1 row)
simple | arabic
-----------------------------------------------+------------------------------------
'الحكومية':2 'الرياض':4 'المستشفيات':1 'في':3 | 'حكوم':2 'رياض':4 'في':3 'مستشف':1
(1 row)
unaccent_ar | unaccent_fr
-------------+-------------
مُسْتَشْفَى | cafe
(1 row)في المخرج أعلاه لاحظ التالي:
- الإعداد
simpleيحفظ الكلمة كما هي، فالبحث عن "مستشفى" لن يجد "المستشفيات"، أما الإعدادarabicفقد حذف "ال" وأرجع الكلمات إلى أصل تقريبي. - كلمة "في" بقيت في الإعداد العربي، لأنه لا يأتي بقائمة كلمات شائعة Stop Words عربية، وهذا يضخم الفهرس قليلاً ولا يضر النتائج كثيراً.
- الإضافة unaccent حذفت العلامة من الحرف الفرنسي ولم تحذف الحركات العربية، لأن قواعدها الافتراضية مكتوبة للحروف اللاتينية، لذلك لا تعتمد عليها في العربية واكتب دالة توحيد خاصة.
والعربية تكتب الكلمة نفسها بأكثر من شكل: الألف بهمزة ودونها، والياء والألف المقصورة، والتاء المربوطة والهاء، والحركات والتطويل، وقد شرحنا هذه المشكلة مع البحث الدلالي في قسم النص العربي من مقال RAG، والحل البسيط أن نوحد النص قبل الإعداد العربي في الكتابة وفي السؤال معاً:
CREATE FUNCTION ar_normalize(t text) RETURNS text
LANGUAGE sql IMMUTABLE PARALLEL SAFE AS $$
  SELECT translate(
           regexp_replace(t, '[ً-ْـ]', '', 'g'),  -- remove harakat and tatweel
           'أإآٱىة',                                               -- unify alef forms, alef maqsura, ta marbuta
           'اااايه')
$$;

CREATE TABLE posts (
    id     bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    title  text NOT NULL,
    body   text NOT NULL,
    search tsvector GENERATED ALWAYS AS (
             setweight(to_tsvector('arabic', ar_normalize(title)), 'A') ||
             setweight(to_tsvector('arabic', ar_normalize(body)),  'B')) STORED
);

INSERT INTO posts (title, body)
SELECT
  (ARRAY['افتتاح','توسعة','تقييم','مواعيد','أسعار','دليل'])[1 + g % 6] || ' ' ||
  (ARRAY['مستشفى','مدرسة','مطعم','صيدلية','مكتبة','حديقة','مَسْجِد'])[1 + (g / 6) % 7] || ' ' ||
  (ARRAY['الرياض','جدة','الدمام','مكة','المدينة','أبها','تبوك','الطائف'])[1 + (g / 42) % 8],
  'خبر رقم ' || g || ' عن ' ||
  (ARRAY['الخدمات الصحية','التعليم','المطاعم الشعبية','الإجازة الصيفية','المواصلات','الفعاليات'])[1 + (g / 7) % 6] ||
  ' مع تفاصيل الأسعار والمواقع وساعات العمل.'
FROM generate_series(1, 300000) AS g;
ANALYZE posts;
في الإعداد أعلاه لاحظ التالي:
- الدالة
IMMUTABLEلأنها تعطي النتيجة نفسها للنص نفسه دائماً، وهذا شرط لاستخدامها في عمود محسوب Generated Column أو في فهرس. - العمود
searchيحسب تلقائياً عند كل إضافة أو تعديل، والدالةsetweightتعطي العنوان وزنAوالنص وزنBحتى يتقدم في الترتيب ما وجدت الكلمة في عنوانه.
الآن نبحث عن "مستشفي الرياض" مكتوبة بالياء كما يكتبها كثير من الناس، مرة دون توحيد ومرة معه:
docker exec lab-pgall-pg psql -U postgres -c "SELECT
  (SELECT count(*) FROM posts WHERE to_tsvector('arabic', title) @@ websearch_to_tsquery('arabic', 'مستشفي الرياض')) AS without_normalize,
  (SELECT count(*) FROM posts WHERE search @@ websearch_to_tsquery('arabic', ar_normalize('مستشفي الرياض'))) AS with_normalize;"
without_normalize | with_normalize
-------------------+----------------
0 | 5357
(1 row)دون توحيد لم يجد البحث أي نتيجة، والسبب أن "مستشفى" بالألف المقصورة أصبحت في الفهرس 'مستشفي' بينما أصبحت "مستشفي" في السؤال 'مستشف'، فالمكتبة نفسها ترجع الشكلين إلى أصلين مختلفين، أما مع التوحيد فقد أصبح الشكلان نصاً واحداً قبل أن يصلا إليها. الآن نضيف فهرس GIN ونقارن الوقت:
docker exec lab-pgall-pg psql -U postgres -c "CREATE INDEX posts_search_idx ON posts USING gin (search);" \
  -c "SELECT pg_size_pretty(pg_relation_size('posts_search_idx')) AS gin_size, pg_size_pretty(pg_relation_size('posts')) AS table_size;" \
  -c "\timing on" \
  -c "SELECT id, title, round(ts_rank(search, q)::numeric, 3) AS rank
      FROM posts, websearch_to_tsquery('arabic', ar_normalize('مستشفي الرياض -توسعة')) AS q
      WHERE search @@ q ORDER BY rank DESC, id LIMIT 3;"
gin_size | table_size
----------+------------
21 MB | 130 MB
(1 row)
Timing is on.
id | title | rank
----+----------------------+-------
2 | تقييم مستشفى الرياض | 0.991
3 | مواعيد مستشفى الرياض | 0.991
4 | أسعار مستشفى الرياض | 0.991
(3 rows)
Time: 13.161 msوالدالة websearch_to_tsquery تفهم صيغة محركات البحث، فالعلامة -توسعة استبعدت أخبار التوسعة. وفي خطة التنفيذ نرى أن البحث عن 5,357 صفاً أخذ 6.3 مللي ثانية بالفهرس، مقابل 43 مللي ثانية بقراءة الجدول كله على ثلاثة معالجات بالتوازي عندما عطلنا الفهرس بالأمر SET enable_bitmapscan = off:
 Bitmap Heap Scan on posts (actual time=3.169..5.834 rows=5357.00 loops=1)
   Recheck Cond: (search @@ '''مستشف'' & ''رياض'''::tsquery)
   ->  Bitmap Index Scan on posts_search_idx (actual time=3.026..3.027 rows=5357.00 loops=1)
 Execution Time: 6.266 ms
والصورة التالية تبين مسار النص والسؤال حتى يلتقيا في الفهرس:
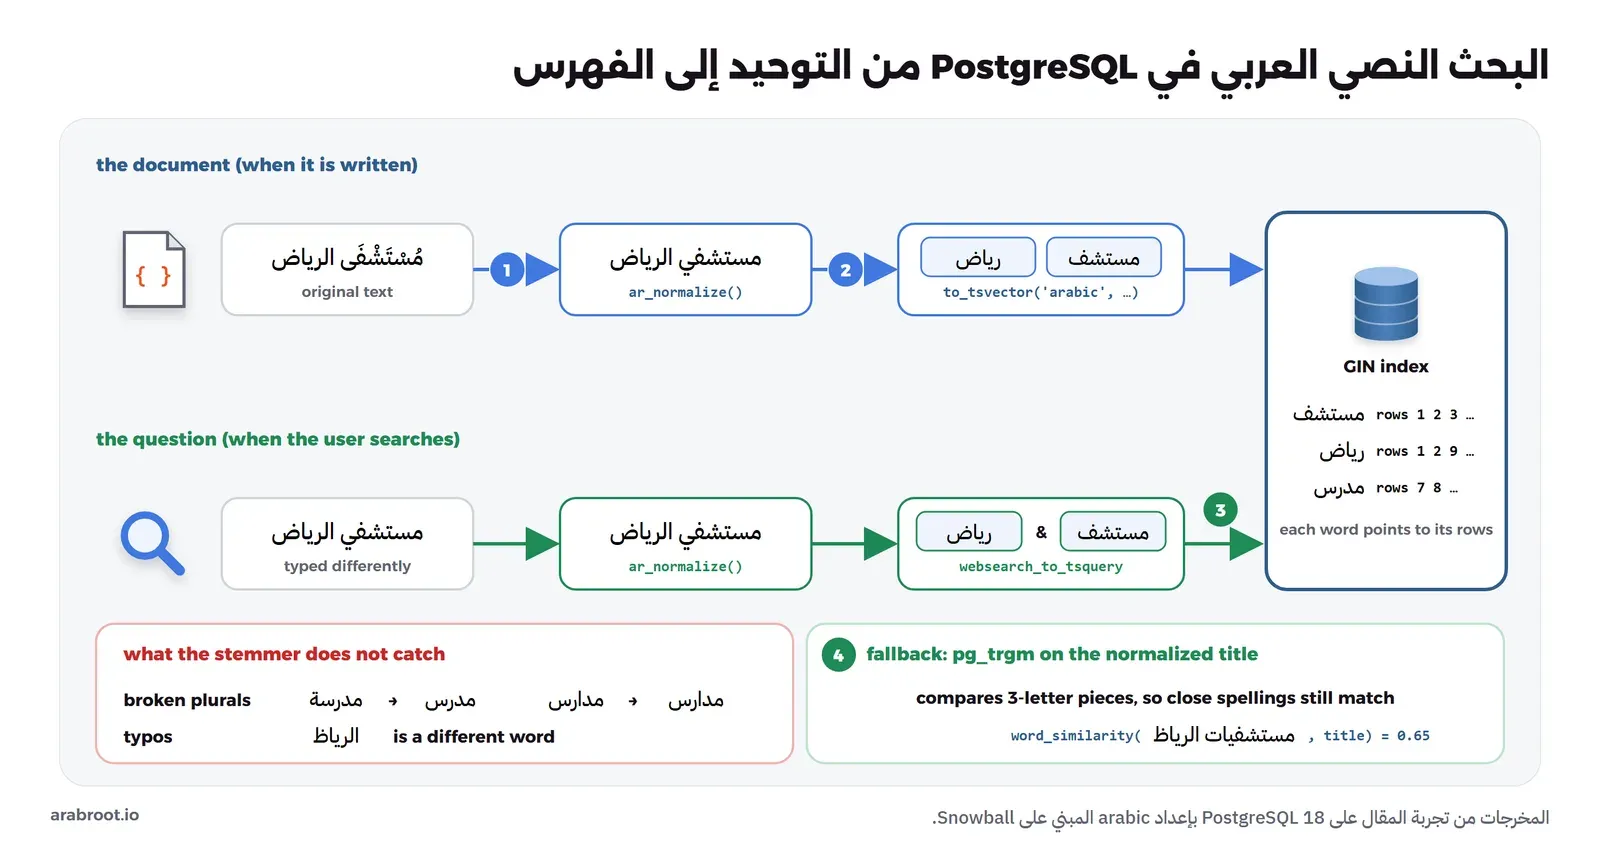
ولكن الإعداد العربي له حدود واضحة، فجموع التكسير لا ترجع إلى المفرد، فكلمة "مدرسة" تصبح 'مدرس' وكلمة "المدارس" تبقى 'مدارس'، وبعض الجموع السالمة تتصرف بشكل غير متوقع، فكلمة "المستشفيات" أصبحت 'مستشف' أما "مستشفيات" دون "ال" فأصبحت 'مستشفيا'، والأخطاء الإملائية مثل "الرياظ" كلمة أخرى تماماً، ولهذه الحالات أضف إضافة pg_trgm التي تقارن النصوص بقطع من ثلاثة أحرف Trigrams:
docker exec lab-pgall-pg psql -U postgres \
  -c "CREATE INDEX posts_title_trgm ON posts USING gin (ar_normalize(title) gin_trgm_ops);" \
  -c "SELECT DISTINCT title, round(word_similarity(ar_normalize('مستشفيات الرياظ'), ar_normalize(title))::numeric, 2) AS sim
      FROM posts WHERE ar_normalize('مستشفيات الرياظ') <% ar_normalize(title)
      ORDER BY sim DESC, title LIMIT 3;"
title | sim
----------------------+------
أسعار مستشفى الرياض | 0.65
افتتاح مستشفى الرياض | 0.65
تقييم مستشفى الرياض | 0.65
(3 rows)البحث بالجمع وبخطأ إملائي وجد العناوين الصحيحة، والطريقة المعتادة أن تبحث بالنص الكامل أولاً، فإذا قلت النتائج جربت التشابه، ولاحظ أن الدالة ts_rank ترتب حسب تكرار الكلمات وليست ترتيب BM25 الذي تستخدمه محركات البحث، فإذا احتجت BM25 داخل PostgreSQL فهناك إضافة pg_textsearch برخصة PostgreSQL، ومشروع ParadeDB برخصة AGPL-3.0، وقد قارنا البحث بالكلمات والبحث الدلالي في قسم البحث الهجين من مقال RAG.
المستندات JSONB بدل MongoDB
السبب المعتاد لإضافة MongoDB هو أن بعض البيانات لا تتبع شكلاً ثابتاً، مثل مواصفات المنتجات حيث للحاسوب ذاكرة ومنافذ وللهاتف سعة وألوان وللكتاب لغة وعدد صفحات، والنوع JSONB في PostgreSQL يحفظ هذه المستندات بصيغة ثنائية ويفهرسها، والمثال التالي يبين ذلك بثلاثمئة ألف منتج:
CREATE TABLE products (
    id     bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name   text  NOT NULL,
    price  numeric(10,2) NOT NULL,
    attrs  jsonb NOT NULL
);
INSERT INTO products (name, price, attrs)
SELECT 'product ' || g, (g % 900) + 10,
  CASE g % 3
    WHEN 0 THEN jsonb_build_object('type','laptop','brand',(ARRAY['lenovo','dell','hp','apple'])[1 + g % 4],
                                   'ram_gb',(ARRAY[8,16,32,64])[1 + (g/12) % 4],'ports',jsonb_build_array('usb-c','hdmi'))
    WHEN 1 THEN jsonb_build_object('type','phone','brand',(ARRAY['samsung','apple','xiaomi'])[1 + g % 3],
                                   'storage_gb',(ARRAY[128,256,512])[1 + (g/9) % 3],'colors',jsonb_build_array('black','white'))
    ELSE        jsonb_build_object('type','book','lang',(ARRAY['ar','en'])[1 + g % 2],'pages',100 + g % 400)
  END
FROM generate_series(1, 300000) AS g;
ANALYZE products;
نبحث عن حواسيب Lenovo بذاكرة 32 جيجابايت بالمعامل Operator @> الذي يعني "يحتوي"، قبل الفهرس وبعده:
docker exec lab-pgall-pg psql -U postgres \
  -c "SELECT id, attrs FROM products WHERE attrs @> '{\"type\":\"laptop\",\"brand\":\"lenovo\",\"ram_gb\":32}' ORDER BY id LIMIT 2;" \
  -c "EXPLAIN (ANALYZE, COSTS OFF) SELECT count(*) FROM products WHERE attrs @> '{\"type\":\"laptop\",\"brand\":\"lenovo\",\"ram_gb\":32}';" \
  -c "CREATE INDEX products_attrs_idx ON products USING gin (attrs jsonb_path_ops);" \
  -c "EXPLAIN (ANALYZE, COSTS OFF) SELECT count(*) FROM products WHERE attrs @> '{\"type\":\"laptop\",\"brand\":\"lenovo\",\"ram_gb\":32}';" \
  -c "SELECT pg_size_pretty(pg_relation_size('products_attrs_idx')) AS gin_size;"
والمخرج سوف يكون كما يلي بعد اختصار الخطط إلى الأسطر المهمة:
 id |                                      attrs
----+---------------------------------------------------------------------------------
 24 | {"type": "laptop", "brand": "lenovo", "ports": ["usb-c", "hdmi"], "ram_gb": 32}
 72 | {"type": "laptop", "brand": "lenovo", "ports": ["usb-c", "hdmi"], "ram_gb": 32}
(2 rows)

               ->  Parallel Seq Scan on products (actual time=0.018..35.047 rows=2083.33 loops=3)
                     Filter: (attrs @> '{"type": "laptop", "brand": "lenovo", "ram_gb": 32}'::jsonb)
                     Rows Removed by Filter: 97917
 Execution Time: 40.668 ms

CREATE INDEX
   ->  Bitmap Heap Scan on products (actual time=3.306..10.094 rows=6250.00 loops=1)
         ->  Bitmap Index Scan on products_attrs_idx (actual time=2.774..2.775 rows=6250.00 loops=1)
               Index Cond: (attrs @> '{"type": "laptop", "brand": "lenovo", "ram_gb": 32}'::jsonb)
 Execution Time: 10.550 ms

 gin_size
----------
 2096 kB
في المخرج أعلاه لاحظ التالي:
- دون فهرس قرأ PostgreSQL المنتجات كلها واستبعد 97,917 صفاً في كل واحد من ال Parallel Workers الثلاثة، ومع فهرس GIN ذهب مباشرة إلى 6,250 منتجاً مطابقاً.
- اخترنا
jsonb_path_opsبدل الفئة الافتراضية لأن الوثائق تذكر أنه أصغر وأسرع، ولكنه يدعم عوامل الاحتواء@>والمسارات فقط، ولا يدعم السؤال عن وجود مفتاح?.
والآن لنكسر شيئاً، نسأل عن حواسيب بذاكرة 32 جيجابايت أو أكثر، أي مقارنة وليست احتواء:
docker exec lab-pgall-pg psql -U postgres \
  -c "EXPLAIN (COSTS OFF) SELECT count(*) FROM products WHERE (attrs->>'ram_gb')::int >= 32;"
-> Parallel Seq Scan on products
Filter: (((attrs ->> 'ram_gb'::text))::integer >= 32)فهرس GIN لم يستخدم لأنه لا يفهم المقارنة بالأرقام، والحل فهرس عادي B-tree على التعبير نفسه، ويفضل أن يكون جزئياً على نوع المنتج:
docker exec lab-pgall-pg psql -U postgres \
  -c "CREATE INDEX products_ram_idx ON products (((attrs->>'ram_gb')::int)) WHERE attrs->>'type' = 'laptop';" \
  -c "EXPLAIN (ANALYZE, COSTS OFF) SELECT count(*) FROM products WHERE attrs->>'type' = 'laptop' AND (attrs->>'ram_gb')::int >= 32;"
-> Bitmap Heap Scan on products (actual time=2.304..17.398 rows=50000.00 loops=1)
-> Bitmap Index Scan on products_ram_idx (actual time=1.703..1.703 rows=50000.00 loops=1)
Index Cond: (((attrs ->> 'ram_gb'::text))::integer >= 32)
Execution Time: 22.305 msوالقاعدة العملية هنا أن تبقي في الأعمدة العادية كل ما تبحث به كثيراً أو تربط به جداول أو تضع عليه قيوداً Constraints، مثل السعر والنوع والمالك، وأن تضع في JSONB ما يختلف من منتج إلى آخر، والسبب أن الأعمدة لها أنواع وقيود وإحصاءات دقيقة يستخدمها المخطط، أما الحقول داخل JSONB فلا يعرف المخطط عنها إلا القليل، وقد شرحنا متى تكسر التطبيع عن قصد في تصميم قواعد البيانات.
البيانات الجغرافية Geospatial مع PostGIS
هنا لا يوجد صراع حقيقي، فإضافة PostGIS برخصة GPL-2.0 هي نفسها المعيار الذي تبنى عليه أنظمة كثيرة للخرائط، وهي تضيف أنواعاً للنقاط والخطوط والمضلعات ودوال للمسافة والتقاطع وفهرس GiST مكاني، والمثال التالي يضع مئتي ألف مكان عشوائي داخل مستطيل يغطي مدينة الرياض، صيدليات ومقاهي ومساجد ومدارس ومحطات وقود:
CREATE TABLE places (
    id    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    kind  text NOT NULL,
    geom  geography(Point, 4326) NOT NULL
);
SELECT setseed(0.42);
INSERT INTO places (kind, geom)
SELECT (ARRAY['pharmacy','cafe','mosque','school','fuel'])[1 + g % 5],
       ST_SetSRID(ST_MakePoint(46.55 + random() * 0.35, 24.55 + random() * 0.40), 4326)::geography
FROM generate_series(1, 200000) AS g;
ANALYZE places;
CREATE INDEX places_geom_idx ON places USING gist (geom);
ثم نسأل سؤالين معتادين في أي تطبيق توصيل أو خرائط: أقرب خمس صيدليات إلى نقطة في الرياض، وكم صيدلية في دائرة نصف قطرها كيلومتر واحد:
SELECT p.id, p.kind, round(ST_Distance(p.geom, me.g)::numeric) AS meters
FROM places p, (SELECT ST_SetSRID(ST_MakePoint(46.6744, 24.7114), 4326)::geography AS g) AS me
WHERE p.kind = 'pharmacy'
ORDER BY p.geom <-> me.g
LIMIT 5;

SELECT count(*) FROM places
WHERE kind = 'pharmacy'
  AND ST_DWithin(geom, ST_SetSRID(ST_MakePoint(46.6744, 24.7114), 4326)::geography, 1000);
id | kind | meters
--------+----------+--------
198000 | pharmacy | 106
171690 | pharmacy | 115
119175 | pharmacy | 173
20040 | pharmacy | 197
32795 | pharmacy | 229
(5 rows)
Time: 0.543 ms
count
-------
94
(1 row)
Time: 3.254 msفي الإعداد أعلاه لاحظ التالي:
- النوع
geographyيحسب المسافة بالمتر على سطح الأرض مباشرة، فلا تحتاج إلى تحويل الدرجات إلى أمتار بنفسك، وترتيب الإحداثيات فيST_MakePointهو خط الطول ثم خط العرض، وهذا أكثر خطأ نراه في هذه الاستعلامات. - المعامل Operator
<->فيORDER BYيجعل فهرس GiST يرجع الأقرب فالأقرب دون حساب المسافة لكل الصفوف، فأخذ الاستعلام 0.54 مللي ثانية مقابل 44 مللي ثانية دون الفهرس، والدائرة أخذت 3.3 مللي ثانية مقابل 1,331 مللي ثانية دونه، وحجم الفهرس 14 ميجابايت.
المتجهات Embeddings مع pgvector
البحث الدلالي Semantic Search يحول كل نص إلى متجه Vector من مئات الأرقام، ثم يبحث عن أقرب المتجهات إلى متجه السؤال، وقد شرحنا الفكرة كاملة مع نموذج حقيقي في البحث في مستنداتك مع RAG، والأدوات المتخصصة لهذا العمل قواعد متجهات مثل Qdrant وPinecone، أما في PostgreSQL فالإضافة pgvector برخصة PostgreSQL تضيف النوع vector وفهرس HNSW. ولن نعيد هنا ما شرحناه في مقال RAG، وإنما نقيس السرعة والحدود على مئة ألف متجه بطول 384 موزعة على ألف موضوع، أي مركز لكل موضوع مع ضجيج حوله حتى تشبه المتجهات الحقيقية، فالمتجهات العشوائية تماماً لا تشبه أي بيانات حقيقية وتعطي أسوأ نتيجة ممكنة للفهرس:
CREATE TABLE chunks (
    id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    topic      int  NOT NULL,
    embedding  vector(384) NOT NULL
);
SELECT setseed(0.7);
CREATE TEMP TABLE centres AS
SELECT t AS topic, (SELECT array_agg(random() - 0.5) FROM generate_series(1, 384) WHERE t >= 0) AS c
FROM generate_series(0, 999) AS t;
INSERT INTO chunks (topic, embedding)
SELECT g % 1000,
       (SELECT array_agg(c[i] + (random() - 0.5) * 0.6) FROM generate_series(1, 384) AS i WHERE g > 0)::vector
FROM generate_series(1, 100000) AS g JOIN centres ON centres.topic = g % 1000;
-- the question: a new vector near topic 42
CREATE TABLE probe AS
SELECT (SELECT array_agg(c[i] + (random() - 0.5) * 0.6) FROM generate_series(1, 384) AS i)::vector(384) AS q
FROM centres WHERE topic = 42;
ANALYZE chunks;

CREATE TABLE exact10 AS SELECT id FROM chunks ORDER BY embedding <=> (SELECT q FROM probe) LIMIT 10;
SET maintenance_work_mem = '512MB';
CREATE INDEX chunks_hnsw ON chunks USING hnsw (embedding vector_cosine_ops);
الجدول exact10 يحفظ أقرب عشرة متجهات بالبحث الكامل قبل الفهرس، حتى نقارن به نتيجة الفهرس، وقد أخذ بناء فهرس HNSW نحو 19 ثانية وحجمه 195 ميجابايت مقابل 156 ميجابايت للجدول نفسه. الآن نبحث مرة دون الفهرس ومرة به، ثم نعد كم من العشرة الصحيحة وجدها الفهرس، وذلك بملف knn.sql ننفذه بالأمر docker exec -i lab-pgall-pg psql -U postgres < knn.sql:
SELECT q::text AS q FROM probe \gset
SET enable_indexscan = off;
\timing on
SELECT id, topic, round((embedding <=> :'q')::numeric, 4) AS cosine_distance
FROM chunks ORDER BY embedding <=> :'q' LIMIT 5;
\timing off
RESET enable_indexscan;
\timing on
SELECT id, topic, round((embedding <=> :'q')::numeric, 4) AS cosine_distance
FROM chunks ORDER BY embedding <=> :'q' LIMIT 5;
SELECT id, topic, round((embedding <=> :'q')::numeric, 4) AS cosine_distance
FROM chunks ORDER BY embedding <=> :'q' LIMIT 5;
\timing off
SELECT count(*) AS found_of_10 FROM (SELECT id FROM chunks ORDER BY embedding <=> :'q' LIMIT 10) a JOIN exact10 USING (id);
id | topic | cosine_distance
------+-------+-----------------
4230 | 42 | 0.2284
4225 | 42 | 0.2294
4217 | 42 | 0.2311
4271 | 42 | 0.2336
4205 | 42 | 0.2352
(5 rows)
Time: 82.901 ms
id | topic | cosine_distance
------+-------+-----------------
4230 | 42 | 0.2284
4225 | 42 | 0.2294
4217 | 42 | 0.2311
4271 | 42 | 0.2336
4205 | 42 | 0.2352
(5 rows)
Time: 2.834 ms
id | topic | cosine_distance
------+-------+-----------------
4230 | 42 | 0.2284
4225 | 42 | 0.2294
4217 | 42 | 0.2311
4271 | 42 | 0.2336
4205 | 42 | 0.2352
(5 rows)
Time: 1.180 ms
found_of_10
-------------
10
(1 row)الفهرس أعطى النتائج نفسها في 2.8 مللي ثانية في المرة الأولى و1.2 مللي ثانية في الثانية بعد أن أصبحت صفحاته في الذاكرة، مقابل 83 مللي ثانية للبحث الكامل، ووجد العشرة الصحيحة كلها، أي أن نسبة الاسترجاع Recall هنا 10 من 10، ولكن تذكر أن HNSW فهرس تقريبي، فقد يفوته بعض الجيران الحقيقيين، والإعداد hnsw.ef_search يرفع الدقة على حساب السرعة.
ولاحظ أننا مررنا متجه السؤال كقيمة ثابتة عبر متغير psql، والسبب أننا عندما كتبنا الاستعلام في البداية بربط الجدول probe مع chunks لم يستخدم المخطط الفهرس أبداً وقرأ الجدول كله، فالفهرس يعمل عندما يكون متجه السؤال قيمة معروفة لحظة التنفيذ، وهو ما يحدث طبيعياً عندما يرسل التطبيق المتجه كمعامل Parameter.
الشرط WHERE مع فهرس المتجهات
والآن الحالة التي تفاجئ أغلب من يستخدم pgvector لأول مرة، نبحث عن أقرب خمسة متجهات إلى السؤال نفسه ولكن داخل الموضوع رقم 7 فقط، كأن تبحث في مستندات مستأجر Tenant واحد:
SELECT q::text AS q FROM probe \gset
SELECT count(*) AS rows_returned FROM (
  SELECT id FROM chunks WHERE topic = 7 ORDER BY embedding <=> :'q' LIMIT 5) t;
SET hnsw.iterative_scan = relaxed_order;
\timing on
SELECT id, topic, round((embedding <=> :'q')::numeric, 4) AS cosine_distance
FROM chunks WHERE topic = 7 ORDER BY embedding <=> :'q' LIMIT 5;
rows_returned
---------------
0
(1 row)
SET
Timing is on.
id | topic | cosine_distance
-----+-------+-----------------
745 | 7 | 0.9507
795 | 7 | 0.9625
774 | 7 | 0.9646
718 | 7 | 0.9724
743 | 7 | 0.9789
(5 rows)
Time: 182.542 msطلبنا خمس نتائج فرجع الاستعلام صفراً، والسبب كما يشرح قسم Filtering في pgvector أن الشرط يطبق بعد أن يرجع الفهرس مرشحيه، والفهرس يرجع 40 مرشحاً في الإعداد الافتراضي hnsw.ef_search = 40، وكلها قريبة من الموضوع 42 فلم يبق منها شيء للموضوع 7، ومنذ الإصدار 0.8.0 يمكنك تفعيل البحث المتكرر Iterative Scan فيستمر الفهرس في البحث حتى يجد العدد المطلوب، وقد أعطى النتائج الخمس في 182 مللي ثانية، وهذا أبطأ بكثير ولكنه صحيح. والصورة التالية تبين الحالتين:
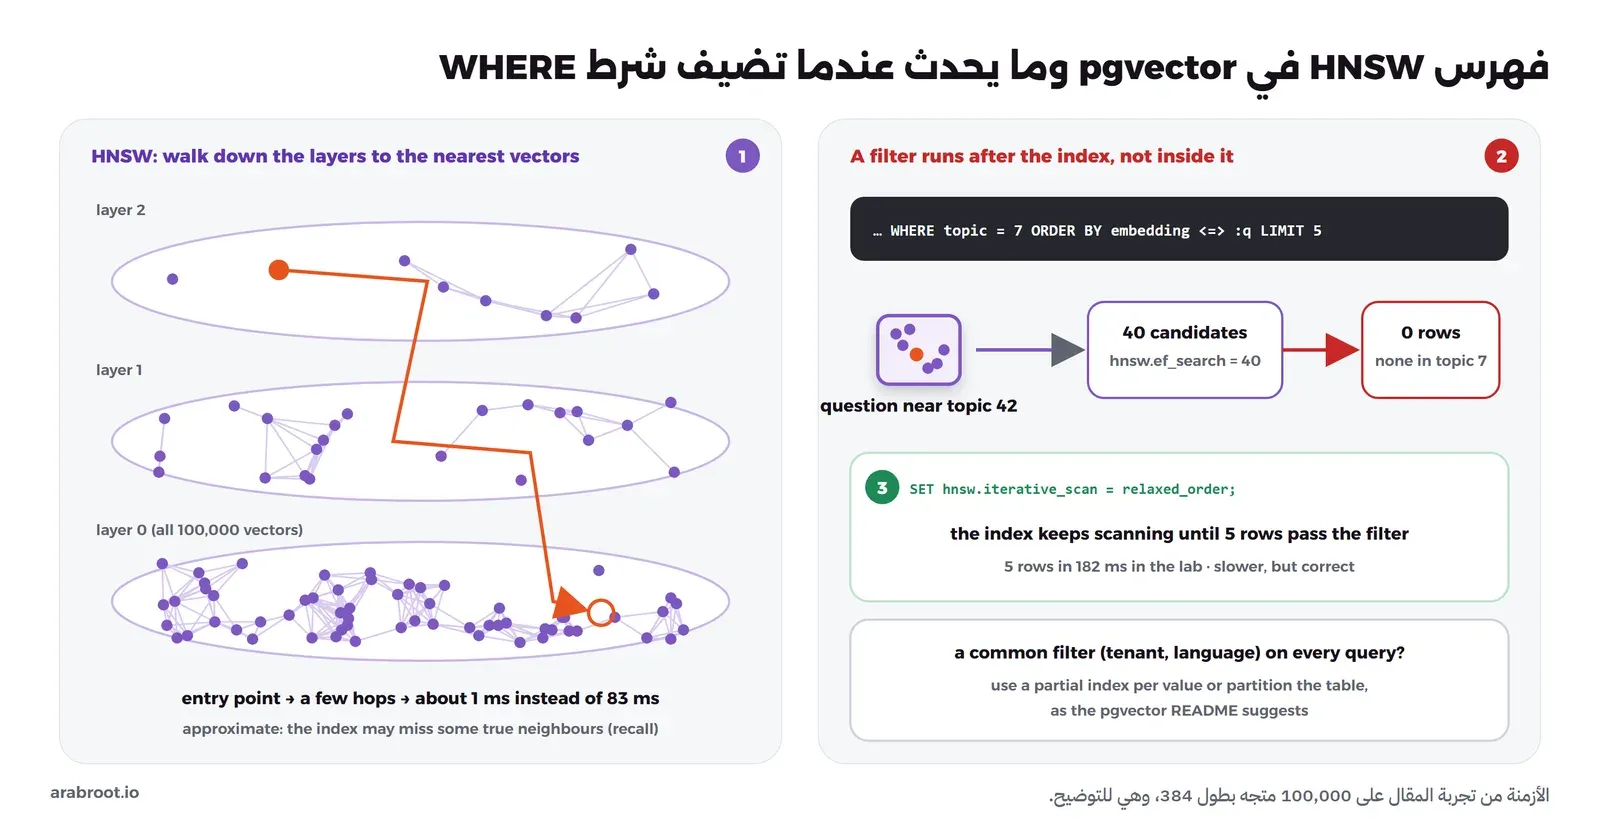
فإذا كان الشرط ثابتاً في أغلب الاستعلامات، مثل اللغة أو نوع المستند، فالأفضل فهرس جزئي لكل قيمة، وإذا كان الشرط بقيم كثيرة مثل المستأجر فالأفضل تقسيم الجدول، وهذا ما ينصح به README نفسه، وقد شرحنا عزل المستأجرين في بناء تطبيق SaaS متعدد المستأجرين.
vector في pgvector ويمكن رفعه إلى 4,000 بالنوع halfvec، أو عندما تحتاج بحثاً مع شروط كثيرة متغيرة على مئات الملايين من المتجهات بزمن ثابت. والإشارة العملية أن تقيس نسبة الاسترجاع وزمن الاستجابة معاً على أسئلة حقيقية، فإذا لم تصل إلى الدقة المطلوبة إلا بزمن لا تقبله فقد حان وقت الفصل.السلاسل الزمنية Time Series: التقسيم وBRIN
قراءات الحساسات وسجلات الأحداث والمقاييس Metrics كلها بيانات تصل بترتيب الوقت، وتقرأ غالباً بنطاق زمني، وتحذف بعد مدة، والأدوات المتخصصة لها مثل InfluxDB، أما في PostgreSQL فثلاث أدوات تكفي أغلب الحالات: التقسيم حسب اليوم، وفهرس BRIN الصغير جداً، وpg_cron لإنشاء الأقسام وحذفها، وقد شرحنا التقسيم بالتفصيل في قسم التقسيم من مقال الجداول الضخمة، لذلك نركز هنا على الأتمتة:
CREATE TABLE metrics (
    device_id  int         NOT NULL,
    ts         timestamptz NOT NULL,
    temp_c     real        NOT NULL
) PARTITION BY RANGE (ts);

CREATE FUNCTION metrics_add_day(d date) RETURNS void
LANGUAGE plpgsql AS $$
BEGIN
  EXECUTE format('CREATE TABLE IF NOT EXISTS %I PARTITION OF metrics FOR VALUES FROM (%L) TO (%L)',
                 'metrics_' || to_char(d, 'YYYYMMDD'), d, d + 1);
END $$;

SELECT metrics_add_day(d::date)
FROM generate_series(date '2026-10-01', date '2026-10-08', interval '1 day') AS d;

INSERT INTO metrics (device_id, ts, temp_c)
SELECT g % 500, timestamptz '2026-10-01 00:00+00' + (g * interval '100 milliseconds'), 20 + (g % 150) / 10.0
FROM generate_series(1, 6000000) AS g;   -- one week, about 10 readings per second

CREATE INDEX metrics_ts_brin ON metrics USING brin (ts);
ANALYZE metrics;

CREATE FUNCTION metrics_drop_older_than(keep interval) RETURNS int
LANGUAGE plpgsql AS $$
DECLARE r record; n int := 0;
BEGIN
  FOR r IN SELECT c.relname FROM pg_inherits i JOIN pg_class c ON c.oid = i.inhrelid
           WHERE i.inhparent = 'metrics'::regclass
             AND to_date(right(c.relname, 8), 'YYYYMMDD') < current_date - keep
  LOOP
    EXECUTE format('DROP TABLE %I', r.relname);   -- the whole day's file goes, no DELETE and no dead rows
    n := n + 1;
  END LOOP;
  RETURN n;
END $$;
ثم نسأل عن متوسط الحرارة في ثلاث ساعات من يوم 5 أكتوبر، وننظر إلى الخطة:
docker exec lab-pgall-pg psql -U postgres \
  -c "EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF) SELECT count(*) FROM metrics
      WHERE ts >= '2026-10-05 10:00+00' AND ts < '2026-10-05 13:00+00';" \
  -c "\di+ metrics_20261005*" -c "SELECT pg_size_pretty(pg_relation_size('metrics_20261005'));"
والمخرج سوف يكون كما يلي بعد اختصار الخطة إلى الأسطر المهمة:
               ->  Parallel Bitmap Heap Scan on metrics_20261005 metrics (actual rows=36000.00 loops=3)
                     Recheck Cond: ((ts >= '2026-10-05 10:00:00+00'::timestamp with time zone) AND (ts < '2026-10-05 13:00:00+00'::timestamp with time zone))
                     Rows Removed by Index Recheck: 10891
                     Heap Blocks: lossy=393
                     ->  Bitmap Index Scan on metrics_20261005_ts_idx (actual rows=8960.00 loops=1)
 Execution Time: 19.476 ms

 Schema |          Name           | Type  |  Owner   |      Table       | Persistence | Access method | Size  | Description
--------+-------------------------+-------+----------+------------------+-------------+---------------+-------+-------------
 public | metrics_20261005_ts_idx | index | postgres | metrics_20261005 | permanent   | brin          | 48 kB |

 pg_size_pretty
----------------
 43 MB
في المخرج أعلاه لاحظ التالي:
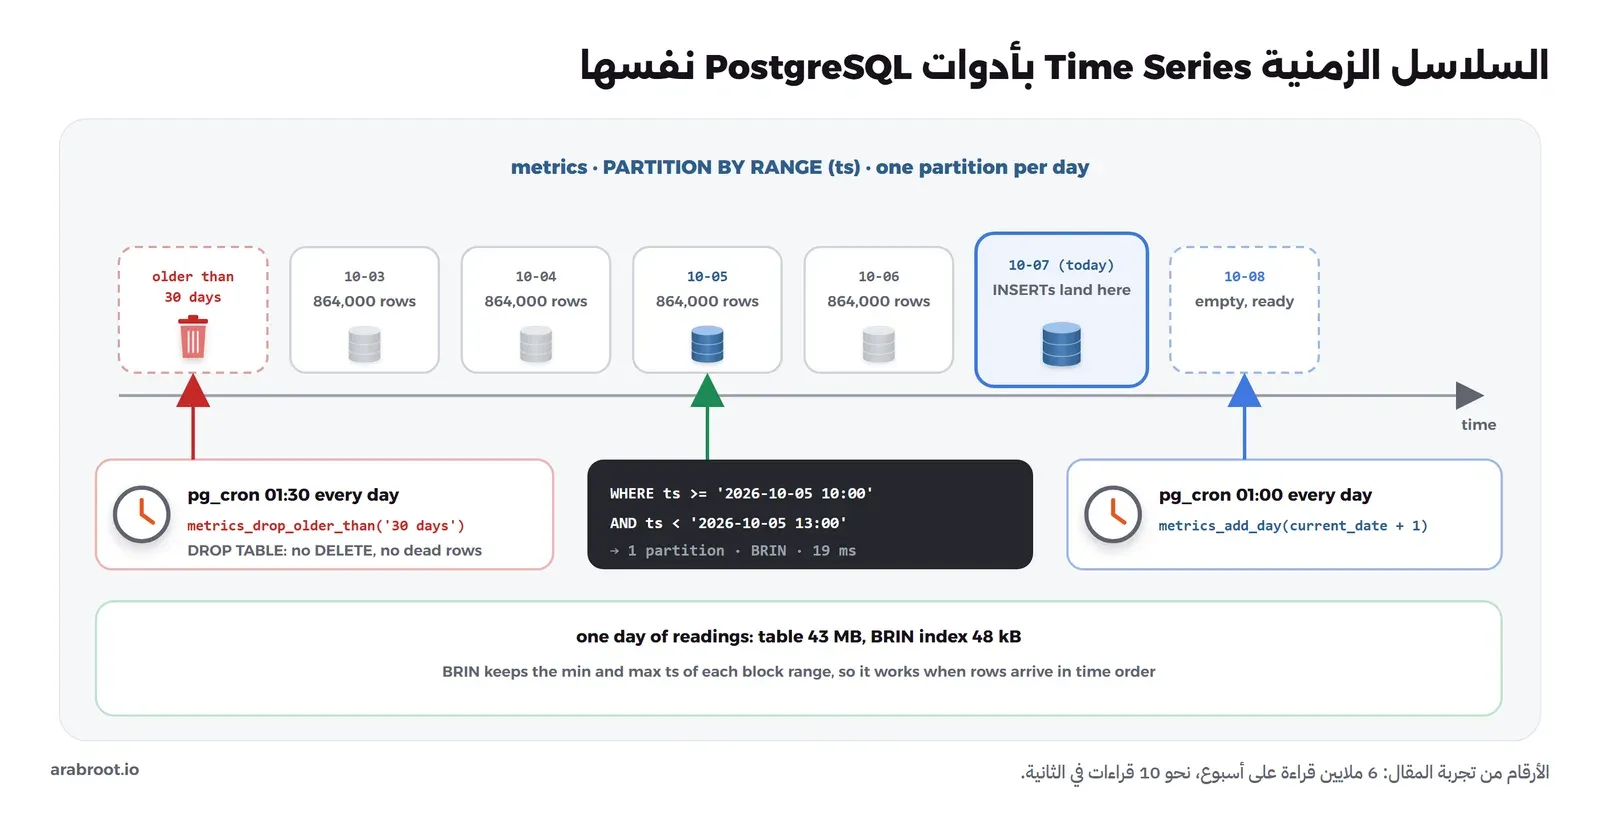
- من بين سبعة أقسام بستة ملايين صف قرأ PostgreSQL قسماً واحداً فقط هو يوم 5 أكتوبر، وهذا ما يسمى تقليم الأقسام Partition Pruning.
- فهرس BRIN لليوم الواحد حجمه 48 كيلوبايت مقابل 43 ميجابايت للبيانات، لأنه لا يحفظ كل قيمة وإنما أصغر وأكبر وقت في كل مجموعة من الصفحات، وهذا يعمل فقط لأن القراءات تصل بترتيب الوقت، والصفوف التي استبعدها بعد القراءة
Rows Removed by Index Recheckهي ثمن هذا الحجم الصغير.
والصورة التالية تبين دورة حياة الأقسام:
وقد يتساءل البعض: ولماذا لا نستخدم TimescaleDB وهي إضافة لـ PostgreSQL مخصصة لهذا العمل؟ والإجابة أنها خيار ممتاز ولكن انتبه لرخصتها، فالمستودع فيه كود برخصة Apache 2.0 وكود في مجلد tsl برخصة Timescale License التي تسمى اليوم Tiger Data License كما يبين ملف الرخصة، وصفحة النسخ تبين أن الضغط والتخزين العمودي Columnstore والملخصات المستمرة Continuous Aggregates وسياسات الحذف add_retention_policy كلها في نسخة Community بالرخصة الخاصة وليست في نسخة Apache 2. والرخصة الخاصة تسمح لك بتشغيلها مجاناً على سيرفرك، ولكنها لا تسمح لك ببيعها كخدمة قاعدة بيانات، ولاحظ أن الحزمة postgresql-18-timescaledb في مستودع apt.postgresql.org لا تحتوي إلا ملفات Apache، فقد فحصنا محتواها فوجدنا timescaledb-2.30.2.so دون ملف -tsl، أي أن هذه الميزات غير موجودة فيها، وقد شرحنا أنواع الرخص في البرمجيات مفتوحة المصدر وتراخيصها.
المهام المجدولة Scheduled Jobs مع pg_cron
كل ما سبق يحتاج مهاماً دورية: حذف الكاش المنتهي، وتحديث العرض المحفوظ، وإنشاء قسم الغد، وحذف الأقسام القديمة، والمعتاد أن تكتب لها سكربتات على سيرفر cron منفصل أو في أداة مثل Airflow، أما pg_cron برخصة PostgreSQL فيقرأ صيغة cron المعروفة ويشغل أوامر SQL من داخل قاعدة البيانات:
SELECT cron.schedule('purge-cache',    '* * * * *',   $$DELETE FROM cache WHERE expires_at < now()$$);
SELECT cron.schedule('refresh-hourly', '*/5 * * * *', $$REFRESH MATERIALIZED VIEW CONCURRENTLY device_hourly$$);
SELECT cron.schedule('next-partition', '0 1 * * *',   $$SELECT metrics_add_day(current_date + 1)$$);
SELECT cron.schedule('drop-old-days',  '30 1 * * *',  $$SELECT metrics_drop_older_than('30 days')$$);
ولنتأكد أن حذف الكاش يعمل نضيف خمسة آلاف قيمة منتهية، وبعد دقيقتين نقرأ سجل التنفيذ:
docker exec lab-pgall-pg psql -U postgres \
  -c "INSERT INTO cache (key, value, expires_at) SELECT 'k' || g, '{}', now() - interval '1 minute' FROM generate_series(1, 5000) g;"
docker exec lab-pgall-pg psql -U postgres \
  -c "SELECT j.jobname, d.status, d.return_message, to_char(d.start_time, 'HH24:MI:SS') AS started,
             round(extract(epoch FROM d.end_time - d.start_time)::numeric * 1000) AS ms
      FROM cron.job_run_details d JOIN cron.job j USING (jobid)
      ORDER BY d.start_time DESC LIMIT 6;"
jobname | status | return_message | started | ms
----------------+-----------+---------------------------+----------+------
purge-cache | succeeded | DELETE 0 | 14:03:00 | 18
purge-cache | succeeded | DELETE 0 | 14:02:00 | 1
purge-cache | succeeded | DELETE 0 | 14:01:00 | 2
purge-cache | succeeded | DELETE 0 | 14:00:00 | 2
refresh-hourly | succeeded | REFRESH MATERIALIZED VIEW | 14:00:00 | 6459
purge-cache | succeeded | DELETE 0 | 13:59:00 | 1
(6 rows)وقبل هذه الأسطر كان التنفيذ الأول في الساعة 13:58 قد أرجع DELETE 5000 في 4 مللي ثانية، ثم أصبحت الحذوفات التالية صفراً لأنه لم تنته قيم جديدة، والعرض المحفوظ أخذ تحديثه 6.5 ثانية من عمل السيرفر كل خمس دقائق، وهذا رقم يجب أن تراقبه لأنه يتقاسم المعالج مع الطلبات. وفي الإعداد أعلاه لاحظ التالي:
- الجدول
cron.job_run_detailsيكبر مع كل تنفيذ، فمهمة كل دقيقة تضيف أكثر من 1,400 صف في اليوم، لذلك أضف مهمة تحذف السجل الأقدم من أسبوع. - الأوقات بتوقيت GMT في الإعداد الافتراضي، ويمكنك تغييرها بالإعداد
cron.timezoneكما يذكر README. - pg_cron لا يشغل أي مهمة على سيرفر في وضع Hot Standby، أي أن المهام تعمل على السيرفر الرئيسي فقط، ويبدأ العمل تلقائياً على النسخة التي تصبح رئيسية بعد الانتقال Failover كما يذكر README.
سجل الأحداث Event Log ونمط Outbox
في مقال الأنظمة الموزعة شرحنا نمط Outbox نظرياً: التطبيق يحفظ الطلب ثم يرسل حدثاً إلى وسيط الرسائل، وإذا توقف بين الخطوتين ضاع الحدث، والحل أن يكتب الحدث في جدول داخل المعاملة نفسها، ثم يأتي Worker يرسله لاحقاً، وهنا نطبقه على PostgreSQL ونكسره عن قصد:
CREATE TABLE orders (
    id       bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer text          NOT NULL,
    total    numeric(10,2) NOT NULL CHECK (total > 0)
);
CREATE TABLE outbox (
    id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    topic        text        NOT NULL,
    payload      jsonb       NOT NULL,
    created_at   timestamptz NOT NULL DEFAULT now(),
    published_at timestamptz
);
CREATE INDEX outbox_pending_idx ON outbox (id) WHERE published_at IS NULL;
ثم ملف 14-outbox-run.sql فيه طلب صحيح وطلب بقيمة سالبة يخالف القيد، ثم ال Worker الذي يرسل الأحداث المنتظرة، ونشغله بالأمرين docker cp 14-outbox-run.sql lab-pgall-pg:/tmp/ وdocker exec lab-pgall-pg psql -U postgres -f /tmp/14-outbox-run.sql:
BEGIN;
WITH o AS (INSERT INTO orders (customer, total) VALUES ('c-1001', 250.00) RETURNING id, customer, total)
INSERT INTO outbox (topic, payload)
SELECT 'order.created', jsonb_build_object('order_id', id, 'customer', customer, 'total', total) FROM o;
COMMIT;

BEGIN;
WITH o AS (INSERT INTO orders (customer, total) VALUES ('c-1002', -5) RETURNING id, customer, total)
INSERT INTO outbox (topic, payload)
SELECT 'order.created', jsonb_build_object('order_id', id) FROM o;
COMMIT;

SELECT (SELECT count(*) FROM orders) AS orders, (SELECT count(*) FROM outbox) AS outbox_rows;

-- the relay: take pending events, publish them to the broker, mark them
WITH batch AS (
  SELECT id FROM outbox WHERE published_at IS NULL ORDER BY id LIMIT 100 FOR UPDATE SKIP LOCKED
)
UPDATE outbox SET published_at = now() FROM batch WHERE outbox.id = batch.id
RETURNING outbox.id, outbox.topic, outbox.payload;
BEGIN
INSERT 0 1
COMMIT
BEGIN
psql:/tmp/14-outbox-run.sql:10: ERROR: new row for relation "orders" violates check constraint "orders_total_check"
DETAIL: Failing row contains (2, c-1002, -5.00).
ROLLBACK
orders | outbox_rows
--------+-------------
1 | 1
(1 row)
id | topic | payload
----+---------------+--------------------------------------------------------
1 | order.created | {"total": 250.00, "customer": "c-1001", "order_id": 1}
(1 row)
UPDATE 1الطلب الخاطئ رفضه القيد، فألغيت المعاملة كلها ولم يبق له حدث في Outbox، وهذا هو المقصود: الطلب والحدث يحفظان معاً أو لا يحفظ أي منهما، وال Worker أخذ الحدث الوحيد بـ SKIP LOCKED حتى يعمل أكثر من Worker دون تكرار، ثم يرسله إلى الوسيط أو البريد أو Webhook. والصورة التالية تبين الطريقتين:
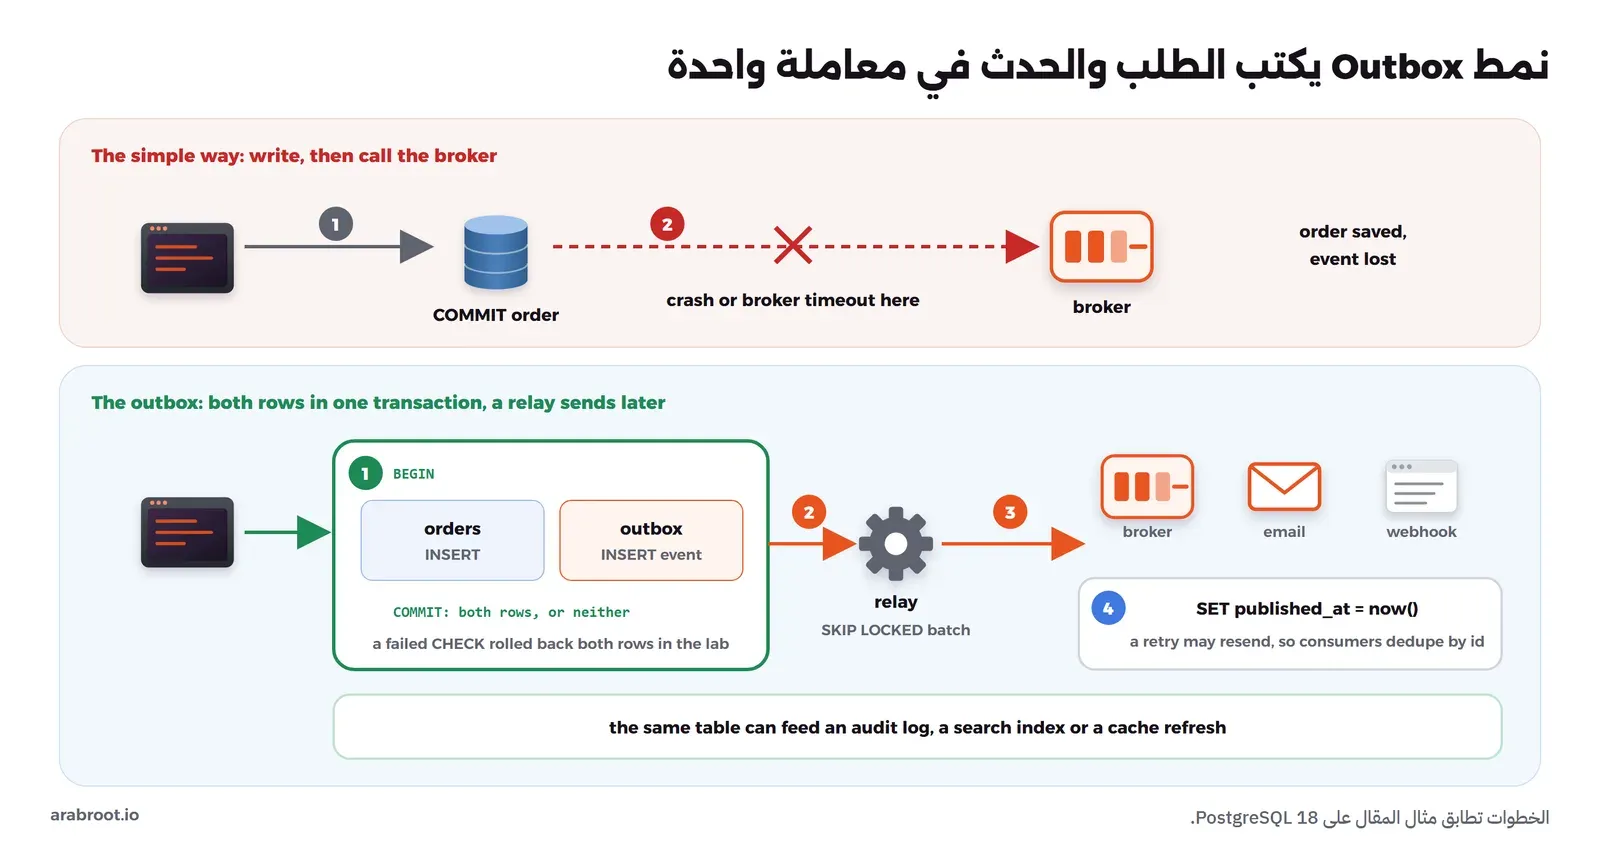
ولاحظ أن ال Worker قد يرسل الحدث ثم يتوقف قبل أن يضع published_at، فيرسله مرة أخرى بعد عودته، لذلك فالتسليم هنا "مرة واحدة على الأقل"، ويجب أن يتجاهل المستهلك الحدث المكرر بمعرفه، وهذا ما شرحناه باسم Idempotency في مقال الأنظمة الموزعة. والجدول نفسه يصلح سجلاً للأحداث Event Log تغذي منه فهرس البحث أو تحديث الكاش أو سجل التدقيق، أما سجل التدقيق Audit Trail الذي لا يقبل التعديل فقد خصصنا له مقالاً كاملاً هو سجل التدقيق Audit Trail مع جدول Append-only وسلسلة هاش في PostgreSQL 18.
الواجهة البرمجية API من قاعدة البيانات: PostgREST وSupabase
الخطوة الأبعد في هذه الفكرة أن تصبح قاعدة البيانات نفسها هي الواجهة البرمجية، فأداة PostgREST برخصة MIT تقرأ الجداول والعروض والدوال وتعطيك REST API كاملة لها، والصلاحيات لا تكتب في كود التطبيق وإنما في قاعدة البيانات نفسها بأدوار PostgreSQL وسياسات الصفوف Row-Level Security، فكل طلب يحمل توكن JWT يحدد الدور، وكل سياسة تحدد الصفوف التي يراها هذا الدور، ومنصة Supabase تبني واجهتها البرمجية على PostgREST كما تذكر وثائقها وتعتمد على RLS لحماية البيانات.
وهذا الأسلوب يناسب لوحات الإدارة والتطبيقات التي أغلبها قراءة وكتابة مباشرة، ولكنه ينقل منطق العمل إلى SQL، فإذا كان فريقك لا يكتب SQL جيداً أو كان منطق العمل معقداً يستدعي خدمات خارجية فالأفضل أن تبقى الواجهة في كود التطبيق، أما سياسات RLS نفسها فهي مفيدة في الحالتين، وقد طبقناها خطوة بخطوة مع الاختبارات في سياسات الصفوف Row-Level Security، فلن نكررها هنا.
التحليلات Analytics داخل PostgreSQL
PostgreSQL قاعدة صفوف Row Store، أي أن كل صف محفوظ كاملاً في مكان واحد، وهذا ممتاز لطلب واحد يقرأ صفاً واحداً، أما التقرير الذي يجمع عموداً واحداً من ملايين الصفوف فيقرأ كل الصفوف بكل أعمدتها، وقد شرحنا الفرق بين عمليات التطبيق OLTP والتحليل OLAP في تصميم قواعد البيانات، ولنقس ذلك على جدول القراءات:
docker exec lab-pgall-pg psql -U postgres -c "\timing on" \
  -c "SELECT date_trunc('day', ts) AS day, round(avg(temp_c)::numeric, 2) AS avg_temp, count(*) AS readings
      FROM metrics GROUP BY 1 ORDER BY 1 LIMIT 3;"
day | avg_temp | readings
------------------------+----------+----------
2026-10-01 00:00:00+00 | 27.45 | 863999
2026-10-02 00:00:00+00 | 27.45 | 864000
2026-10-03 00:00:00+00 | 27.45 | 864000
(3 rows)
Time: 1867.155 msتقرير بسيط على ستة ملايين صف أخذ نحو ثانيتين من المعالج والقرص، وهذا مقبول لتقرير يطلب مرة في اليوم، وغير مقبول للوحة تحكم يفتحها مئة موظف كل صباح على سيرفر الطلبات نفسه، والحل الأول هو العرض المحفوظ الذي رأيناه في قسم الكاش، والحل الثاني نسخة قراءة Read Replica للتقارير، فإذا لم يكفيا فهناك إضافات تضيف محركاً عمودياً داخل PostgreSQL، وحالتها اليوم كما يلي:
- pg_duckdb برخصة MIT، وهي الإضافة الرسمية من DuckDB وآخر إصدار لها 1.1.1 في ديسمبر 2025، وتدعم PostgreSQL من 14 إلى 18، وتنفذ استعلامات التحليل بمحرك DuckDB على جداولك أو على ملفات Parquet وIceberg.
- pg_mooncake برخصة MIT، وهي تنشئ نسخة عمودية من جداولك بصيغة Iceberg، وآخر إصدار منشور على GitHub هو 0.1.2 في فبراير 2025، لذلك تعامل معها كمشروع في بدايته.
- Hydra Columnar برخصة Apache-2.0، وآخر تحديث لمستودعها في فبراير 2025، وقد شارك فريقها في بناء pg_duckdb.
- التخزين العمودي في TimescaleDB، وهو في نسخة Community بالرخصة الخاصة كما ذكرنا في قسم السلاسل الزمنية.
ولاحظ أن أياً من هذه الإضافات ليس في قائمة الإضافات المدعومة في Amazon RDS ولا في Cloud SQL عند كتابة هذا المقال، أي أنها تناسب PostgreSQL الذي تديره بنفسك.
الثمن: ماذا تدفع مقابل قاعدة واحدة؟
كل ما سبق يعمل، ولكن الكلمة المهمة في الفكرة هي "واحدة"، فكل هذه الأعمال تتقاسم المعالج والذاكرة والقرص وسجل WAL والاتصالات وعمليات autovacuum نفسها، والصورة التالية تبين ذلك:
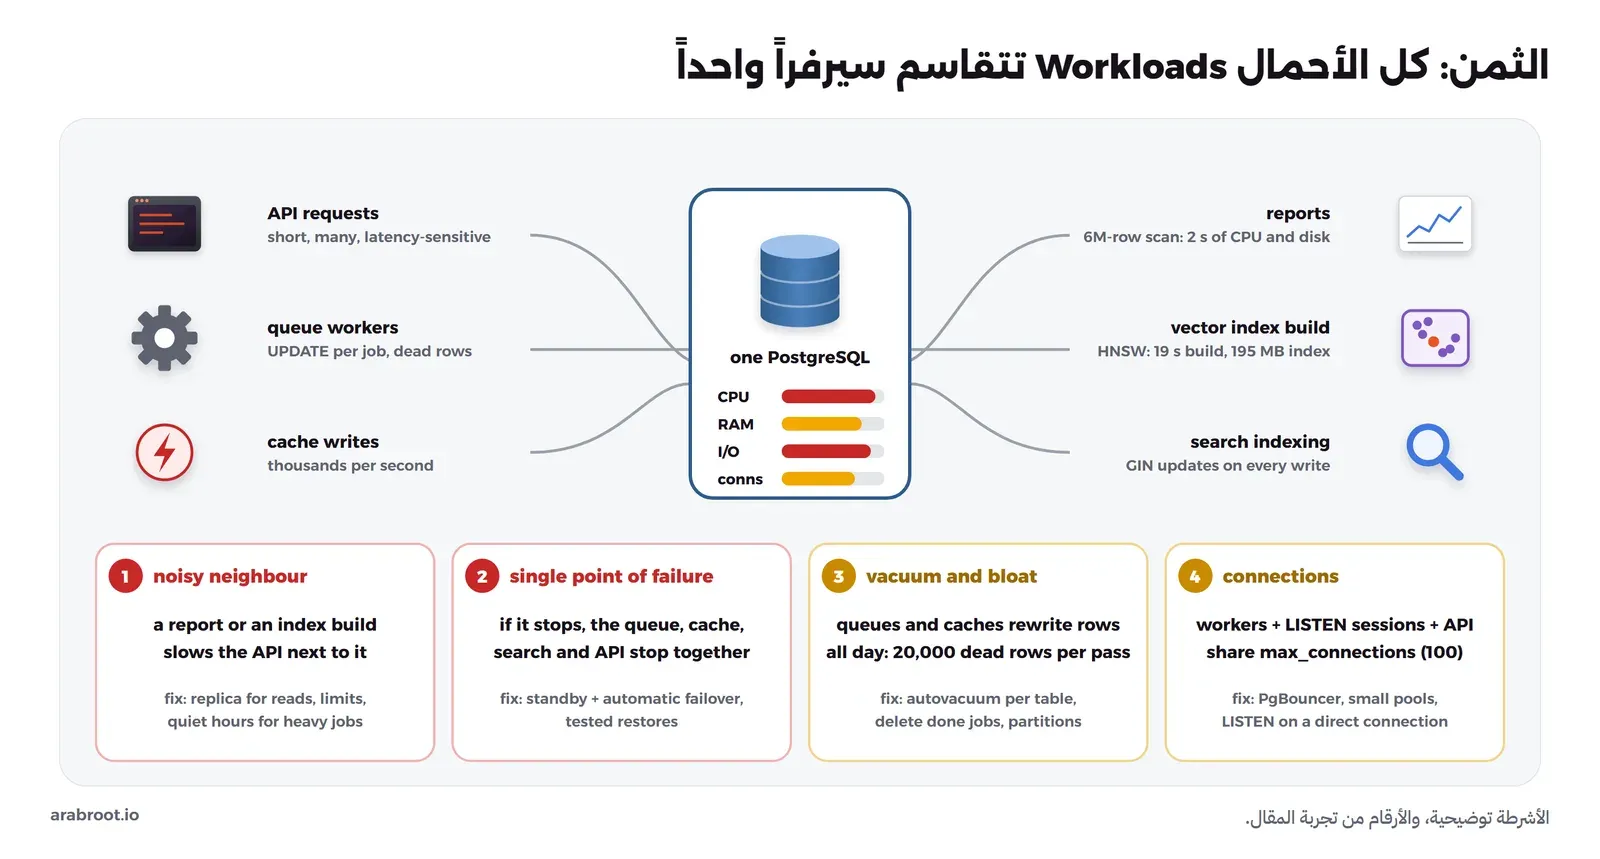
- الجار المزعج Noisy Neighbour: تقرير ثقيل أو بناء فهرس HNSW أو تحديث عرض محفوظ يأخذ المعالج والقرص من طلبات المستخدمين في اللحظة نفسها، فيرتفع زمن الاستجابة في صفحة لا علاقة لها بالتقرير، والحل أن تنقل القراءات الثقيلة إلى نسخة قراءة، وأن تشغل الأعمال الثقيلة في ساعات الهدوء، وأن تضع حداً لوقت الاستعلامات بالإعداد
statement_timeoutلكل دور. - نقطة فشل واحدة Single Point of Failure: عندما يتوقف السيرفر يتوقف الطابور والكاش والبحث والواجهة معاً، وعندما تفسد ترقية فاشلة القاعدة تفقد كل شيء، لذلك فقاعدة لكل شيء تحتاج نسخة احتياطية Standby مع انتقال تلقائي Failover ونسخاً احتياطية جربت استعادتها، وقد شرحنا ذلك في عناقيد قواعد البيانات.
- الانتفاخ Bloat وVACUUM: الطابور والكاش والجلسات أعمال تعيد كتابة الصفوف طوال اليوم، ورأينا أن مرور الطابور مرة واحدة ترك 20,000 صف ميت، وإذا لم يلحق autovacuum بها كبرت الجداول والفهارس وبطؤت، وأخطر من ذلك أن معاملة واحدة مفتوحة طويلاً تمنع تنظيف الجميع.
- الاتصالات Connections: القيمة الافتراضية لـ
max_connectionsهي 100 كما تذكر الوثائق، وكل Worker للطابور وكل جلسة LISTEN وكل نسخة من التطبيق تأخذ منها، والحل PgBouncer مع ترك جلسات LISTEN على اتصال مباشر، وقد شرحنا ذلك بالأرقام في تضاعف الاتصالات Connection Multiplication. - الإضافات في الخدمات المدارة: إذا كنت على خدمة مدارة فأنت محصور في قائمة إضافاتها، ففي قائمة Amazon RDS وقائمة Cloud SQL تجد pg_cron وpgvector وPostGIS وpg_trgm، ولا تجد TimescaleDB ولا pgmq ولا pg_duckdb، لذلك راجع القائمة قبل أن تبني ميزة على إضافة.
- الترقية الكبرى: كل إضافة يجب أن يكون لها إصدار يدعم إصدار PostgreSQL الجديد قبل أن تستطيع الترقية، فكلما زادت الإضافات زاد ما تنتظره عند كل ترقية.
جدول القرار Decision Table
الجدول التالي يجمع ما رأيناه في كل حالة، ونقاط القوة ونقاط الضعف هي ما قسناه أو وثقناه أعلاه:
| العمل | النظام المعتاد | في PostgreSQL | نقاط القوة | نقاط الضعف | إشارة الفصل |
|---|---|---|---|---|---|
| طابور المهام Job Queue | RabbitMQ، SQS | FOR UPDATE SKIP LOCKED، pgmq، River، pg-boss | المهمة والبيانات في معاملة واحدة، ولا تكرار | صفوف ميتة مع كل مهمة، ولا يوجد بث لعدة مستهلكين | n_dead_tup يزيد رغم الضبط، أو تحتاج إعادة قراءة الأحداث |
| النشر والاشتراك Pub/Sub | Redis Pub/Sub، وسيط رسائل | LISTEN/NOTIFY | يصل بعد COMMIT فقط، دون نظام إضافي | لا يحفظ، وحمولة أقل من 8000 بايت، وقفل عند COMMIT | آلاف عمليات الكتابة في الثانية ترسل إشعارات |
| التخزين المؤقت Cache | Redis، Valkey | جدول UNLOGGED، عرض محفوظ | كتابة 0.43 مللي ثانية في المختبر، ونفس النسخ الاحتياطي | يفرغ بعد التوقف، ولا طرد تلقائي، ويأخذ من معالج السيرفر | الكاش جزء كبير من وقت المعالج، أو تحتاج Eviction وعدادات سريعة |
| البحث النصي Full-Text Search | Elasticsearch، OpenSearch، Meilisearch | tsvector وGIN، إعداد arabic، pg_trgm | بحث بالعربية مع توحيد، 6 مللي ثانية على 300 ألف مستند | لا يوجد BM25 ولا Facets، وجموع التكسير لا ترجع | البحث هو المنتج، أو مئات الملايين من المستندات |
| المستندات Documents | MongoDB | JSONB مع GIN وفهارس التعبيرات | قيود وعلاقات ومعاملات مع المرونة | المخطط لا يعرف الكثير عن الحقول الداخلية | أغلب الاستعلامات والفهارس داخل JSONB |
| البيانات الجغرافية Geospatial | أنظمة GIS متخصصة | PostGIS مع GiST | هو المعيار نفسه، 0.5 مللي ثانية لأقرب خمسة | لا يوجد توجيه طرق ولا تقديم مربعات | تحديث مواقع المركبات يأخذ أغلب الكتابة |
| المتجهات Embeddings | Qdrant، Pinecone | pgvector مع HNSW | 1.2 مللي ثانية واسترجاع 10 من 10 في المختبر | الشرط WHERE بعد الفهرس، والفهرس أكبر من الجدول | الفهرس لا يتسع في الذاكرة، أو الدقة لا تصل دون زمن كبير |
| السلاسل الزمنية Time Series | InfluxDB | التقسيم، BRIN، pg_cron، TimescaleDB | قسم واحد يقرأ، وحذف اليوم بأمر DROP | لا يوجد ضغط في النسخة المفتوحة دون TimescaleDB Community | مئات الآلاف من القراءات في الثانية، أو القرص يسبق الميزانية |
| المهام المجدولة Scheduled Jobs | cron، Airflow | pg_cron | سجل تنفيذ في جدول، ولا سيرفر إضافي | لا يوجد اعتماد بين المهام، والسيرفر الرئيسي فقط | سلاسل مهام تعتمد على بعضها وتخرج من القاعدة |
| سجل الأحداث Event Log | وسيط رسائل مع كود مزدوج | جدول Outbox | الطلب والحدث معاً أو لا شيء | التسليم مرة واحدة على الأقل | عدة مستهلكين يحتاجون بثاً مستمراً، فأضف Kafka بعد Outbox |
| التحليلات Analytics | مستودع بيانات | عروض محفوظة، نسخة قراءة، pg_duckdb | ملخص في أقل من مللي ثانية | تقرير الملايين يأخذ ثواني من سيرفر الطلبات | تقارير بالدقائق حتى على نسخة القراءة |
متى تفصل؟ قائمة إشارات قابلة للقياس Signals
الخطأ الأول في هذا الموضوع أن تفصل لأن مقالاً قال إن Redis أسرع، والخطأ الثاني أن تبقي كل شيء في قاعدة واحدة لأن مقالاً قال إن PostgreSQL يكفي لكل شيء، والطريقة الصحيحة أن تصعد السلم درجة درجة، وأن لا تصعد إلا عندما تقول لك إشارة مقاسة ذلك، والصورة التالية تبين الدرجات:
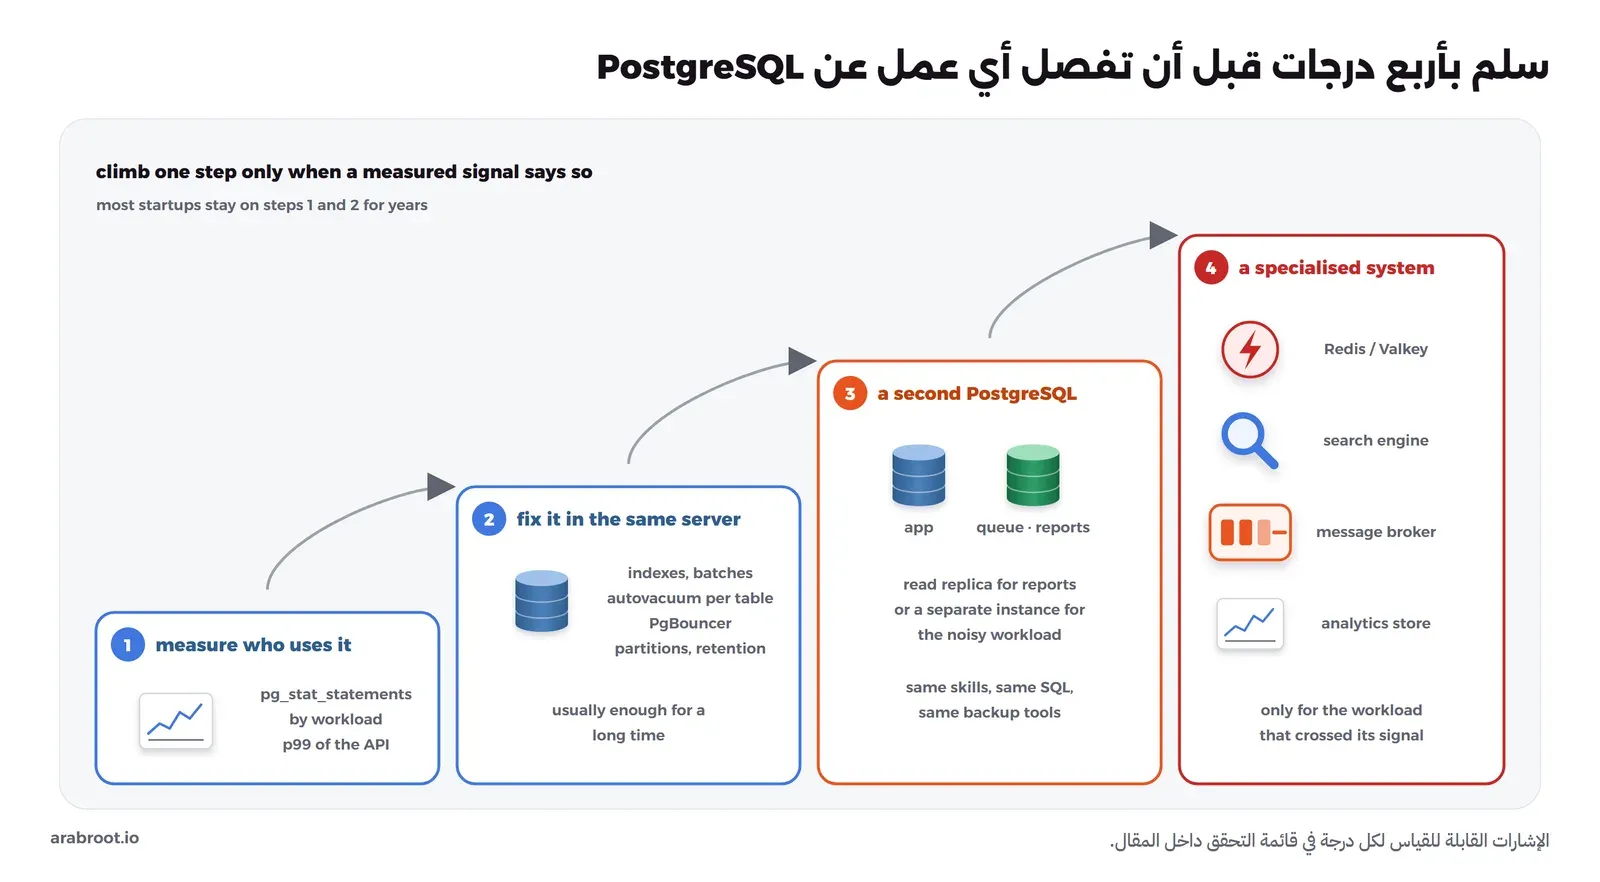
ولاحظ الدرجة الثالثة، فهي التي ينساها كثيرون، فعندما يزعج الطابور أو التقارير بقية الأعمال فالخطوة التالية غالباً قاعدة PostgreSQL ثانية لهذا العمل، بنفس المهارات ونفس أدوات النسخ الاحتياطي ونفس الكود، وليس نظاماً جديداً تتعلمه من الصفر. وفيما يلي قائمة الإشارات، وكل واحدة منها تقاس من PostgreSQL نفسه:
- حصة كل عمل من وقت السيرفر: اجمع
total_exec_timeفيpg_stat_statementsحسب العمل، فإذا أخذ الكاش أو الطابور أو البحث أكثر من نصف وقت السيرفر وهو ليس العمل الأساسي لمنتجك فقد حان وقت فصله. - زمن الاستجابة للطلبات أثناء الأعمال الثقيلة: قارن p99 لواجهة التطبيق في ساعة تحديث العروض أو بناء الفهارس مع ساعة هادئة، فإذا تضاعف فالأعمال الثقيلة تحتاج سيرفراً آخر أو نسخة قراءة.
- الصفوف الميتة Dead Tuples: راقب
n_dead_tupوlast_autovacuumفيpg_stat_user_tablesلجداول الطابور والكاش، فإذا كانت تزيد أسبوعاً بعد أسبوع رغم ضبط autovacuum فهذا العمل يكتب أكثر مما يحتمل الجدول. - الاتصالات: إذا كان عدد الاتصالات في
pg_stat_activityيقترب منmax_connectionsفي الذروة حتى مع PgBouncer، فوزع الأعمال على أكثر من سيرفر. - طابور الإشعارات: إذا كانت
pg_notification_queue_usage()أكبر من صفر بشكل مستمر، أو رأيت انتظار القفل على COMMIT في السجلات، فأخرج الإشعارات من مسار الكتابة. - الذاكرة والفهارس: إذا كانت نسبة القراءة من الذاكرة في
pg_statio_user_indexesلفهرس HNSW أو GIN تنخفض لأن الفهرس لم يعد يتسع، فالمتجهات أو البحث يحتاجان سيرفراً بذاكرة أكبر أو نظاماً متخصصاً. - الدقة المطلوبة: للبحث والمتجهات حدد على أسئلة حقيقية نسبة النجاح التي تقبلها، فإذا لم تصل إليها دون زمن لا تقبله فالحل نظام متخصص وليس ضبطاً إضافياً.
- الميزة غير الموجودة: إذا احتجت شيئاً لا يوجد في PostgreSQL أصلاً، مثل طرد الكاش تلقائياً أو إعادة قراءة الأحداث من نقطة سابقة أو Facets في البحث، فلا تبنيه بنفسك فوق الجداول.
وعندما تفصل عملاً فافصل ذلك العمل وحده، وأبق الباقي حيث هو، فإذا فصلت البحث فلا تنقل الطابور معه، والسبب أن لكل عمل إشارته الخاصة.
أخطاء شائعة
- طابور دون حذف المهام المنتهية: الجدول يكبر بلا نهاية رغم الفهرس الجزئي، فاحذف المنتهي أو انقله على دفعات أو قسم الجدول حسب اليوم.
- الإشعار بدل الجدول: الاعتماد على NOTIFY وحده يضيع المهام عند أي انقطاع، فالجدول هو المصدر والإشعار تنبيه فقط.
- بيانات مهمة في جدول UNLOGGED: رأينا أنه فرغ تماماً بعد التوقف المفاجئ، فلا تضع فيه إلا ما يمكن إعادة بنائه.
- التوحيد في الكتابة دون السؤال: إذا وحدت النص المحفوظ ونسيت توحيد سؤال المستخدم فلن تتطابق الكلمات، فاستخدم الدالة نفسها في الجهتين.
- الاعتماد على unaccent للحركات العربية: لا تحذفها، فاكتب دالة توحيد خاصة كما فعلنا.
- شرط WHERE مع فهرس المتجهات دون اختبار: رأينا استعلاماً طلب خمس نتائج فرجع صفراً، فاختبر الاستعلامات بشروطها الحقيقية وفعل البحث المتكرر أو استخدم فهرساً جزئياً.
- بناء فهرس HNSW أو تحديث عرض محفوظ في ساعة الذروة: كلاهما يأخذ ثواني إلى دقائق من المعالج، فجدولهما في وقت هادئ وراقب مدتهما في
cron.job_run_details. - إضافة لا تدعمها الخدمة المدارة: بناء ميزة على إضافة ثم اكتشاف أن مزود الخدمة لا يدعمها يوم الانتقال، فراجع القائمة أولاً.
- قاعدة واحدة دون نسخة احتياطية جاهزة: كل شيء في مكان واحد يعني أن توقف هذا المكان يوقف كل شيء، فقاعدة لكل شيء تحتاج Standby ونسخاً احتياطية جربت استعادتها أكثر من أي قاعدة أخرى.
حذف المختبر
بعد أن تنتهي احذف ال Container وال Volume المجهول الذي أنشأه، ولا تحذف غيرهما:
docker rm -f -v lab-pgall-pgالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- فكرة "Just use Postgres" تأتي من مبدأ اختيار التقنية المملة Boring Technology: كل نظام إضافي يكلف فريقك تعلماً وتشغيلاً، وقاعدة واحدة تعطيك نسخة احتياطية واحدة ومعاملة واحدة عبر الميزات ومهارة واحدة.
- الطابور بـ
FOR UPDATE SKIP LOCKEDوزع 20,000 مهمة على اثنين من ال Workers دون تكرار، ولكنه ترك 20,000 صف ميت، فاستخدم أداة جاهزة مثل pgmq أو River أو pg-boss أو Graphile Worker واحذف المهام المنتهية. LISTEN/NOTIFYجرس وليس صندوق بريد: يصل بعد COMMIT فقط، ولا يحفظ، وحمولته أقل من 8000 بايت، ويأخذ قفلاً عند COMMIT يصبح مشكلة مع آلاف عمليات الكتابة المتزامنة.- جدول
UNLOGGEDأسرع بعشر مرات في الكتابة في المختبر ولكنه فرغ تماماً بعد التوقف المفاجئ، والعرض المحفوظ مع pg_cron يحول تقرير الثانيتين إلى قراءة أقل من مللي ثانية. - PostgreSQL فيه إعداد بحث عربي
arabicمنذ الإصدار 12، ومع دالة توحيد للحروف تحولت النتائج من صفر إلى 5,357، وpg_trgm يلتقط الأخطاء الإملائية وجموع التكسير. - JSONB مع GIN للاحتواء وفهرس تعبير للمقارنات، وPostGIS هو المعيار نفسه، وpgvector أعطى 1.2 مللي ثانية واسترجاعاً كاملاً، مع فخ الشرط WHERE بعد الفهرس.
- السلاسل الزمنية بالتقسيم اليومي وBRIN وpg_cron تقرأ قسماً واحداً وتحذف اليوم القديم بأمر DROP، وTimescaleDB خيار جيد بشرط أن تعرف أي ميزاتها بالرخصة الخاصة.
- الثمن حقيقي: جار مزعج، ونقطة فشل واحدة، وانتفاخ، واتصالات محدودة، وإضافات قد لا تجدها في الخدمة المدارة، لذلك اصعد سلم الفصل درجة درجة، وابدأ بقاعدة PostgreSQL ثانية قبل أي نظام جديد، وافصل العمل الذي تجاوز إشارته وحده.
وفي مقالات قادمة بإذن الله سوف نشرح النسخ المتماثل والانتقال التلقائي مع Patroni، والنسخ الاحتياطي مع pgBackRest والاستعادة إلى نقطة زمنية، وهما ما تحتاجه أي قاعدة تحمل كل شيء.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليلتطبيق SaaS متعدد المستأجرين عملياً مع Row-Level Securityنبني على PostgreSQL تطبيق SaaS يعزل كل مستأجر Tenant عن غيره بسياسات Row-Level Security، ونرى أين تتسرب البيانات رغم ذلك.
 دليلخارطة CTO لشركة SaaS ناشئة من اليوم الأول إلى خمسين موظفاًماذا يجهز المدير التقني في كل مرحلة من نمو شركة SaaS ناشئة، وما الذي يؤجله حتى يحتاجه فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على PostgreSQL 18.6 مع PostGIS 3.6.4 وpgvector 0.8.7 وpg_cron 1.6.8 وpg_trgm وunaccent في Container واحد.


