

كل تطبيق تكتبه تقريباً يحفظ بياناته في قاعدة بيانات، فالمستخدمون والطلبات والفواتير والرسائل كلها صفوف في جداول، وحتى لو كان الإطار الذي تستخدمه يكتب الاستعلامات نيابة عنك عبر ORM، فسوف يأتي يوم تفتح فيه السجلات Logs وتجد استعلاماً بطيئاً، أو تقريراً يعطي رقماً أكبر من الحقيقة، أو مديرك يطلب رقماً لا توجد له شاشة في النظام، وفي تلك اللحظة لا يفيدك إلا أن تعرف لغة SQL نفسها. والخبر الجيد أن SQL من أسهل اللغات بداية، فهي قريبة من الإنجليزية وتصف ما تريد ولا تصف كيف تجده، ولكن أخطاءها الخطيرة لا تعطيك رسالة خطأ، وإنما تعطيك نتيجة تبدو معقولة وهي خاطئة، لذلك سوف نتعلمها من البداية بالطريقة الصحيحة: نفهم الفكرة، ثم نشغل مثالاً صغيراً ونرى المخرج الحقيقي، ثم نكسر المثال عن قصد ونرى ماذا يحدث.
وهذه سلسلة من ثلاثة أجزاء نعمل فيها كلها على قاعدة بيانات واحدة صغيرة لمعهد تدريب، تنشئها بيدك في هذا الجزء وتستخدمها في الجزأين التاليين.
المواضيع في السلسلة:
- تعلم SQL (1): ما هو SQL وكيف تكتب أول استعلام (الموضوع الحالي): قواعد البيانات العلائقية وتاريخ اللغة، وأنواع الأوامر، وإنشاء الجداول والقيود، والإضافة والتعديل والحذف، والاستعلام SELECT والدوال والقيمة NULL.
- تعلم SQL (2): الربط JOIN والتجميع والاستعلامات الفرعية: أنواع الربط كلها، والتجميع GROUP BY وHAVING، والاستعلامات الفرعية Subqueries، وعمليات المجموعات UNION وINTERSECT وEXCEPT.
- تعلم SQL (3): CTE ودوال النوافذ والمعاملات: جمل WITH والاستعلام التكراري، ودوال النوافذ Window Functions، والعروض Views، والإضافة أو التحديث UPSERT، وJSON، والمعاملات ومستويات العزل، وحقن SQL.
وسوف نتناول في هذا الجزء ما يلي:
- ما هي قاعدة البيانات العلائقية، وما معنى الجدول والصف والعمود والمفتاح الأساسي والمفتاح الأجنبي.
- من أين جاءت SQL، من ورقة Codd عام 1970 حتى المعيار SQL:2023، والمحركات المشهورة ولهجاتها.
- المجموعات الخمس من الأوامر DDL وDML وDQL وDCL وTCL، ومثال من كل واحدة.
- أنواع البيانات، وإنشاء الجداول وتعديلها وحذفها، والقيود Constraints التي تمنع البيانات الخاطئة.
- الإضافة INSERT والتعديل UPDATE والحذف DELETE بأمان داخل معاملة.
- الاستعلام SELECT مع WHERE وORDER BY وLIMIT وDISTINCT، ثم الدوال والعبارة CASE والقيمة NULL والمنطق الثلاثي.
- الترتيب الذي تقرأ به قاعدة البيانات الجملة، والأخطاء الشائعة في البداية، وتمارين مع حلولها.
وأما تصميم الجداول نفسها والتطبيع Normalization فلهما مقال مستقل هو تصميم قواعد البيانات، والمقارنة بين أنواع قواعد البيانات العلائقية وغير العلائقية في أنواع قواعد البيانات ومتى تختار كل نوع، لذلك لن نعيد شرحها هنا.
ما هي قاعدة البيانات العلائقية؟
قاعدة البيانات Database هي مجموعة منظمة من البيانات يحفظها برنامج متخصص يسمى نظام إدارة قواعد البيانات Database Management System واختصاراً DBMS، مثل PostgreSQL وMySQL وSQL Server، وهذا البرنامج هو الذي يكتب البيانات على القرص ويقرؤها ويمنع تطبيقين من إفساد بعضهما ويعيد البيانات سليمة بعد انقطاع الكهرباء. وقد يتساءل البعض: لماذا لا أحفظ بياناتي في ملف JSON أو Excel وأنتهي؟ والإجابة أن الملف يكفي ما دام شخص واحد يقرؤه ويكتبه، أما عندما يكتب مئة مستخدم في نفس اللحظة، ويريد أحدهم تقريراً من مليون صف، ويجب ألا يضيع أي طلب إذا توقف السيرفر في منتصف الكتابة، فأنت تحتاج برنامجاً صمم لهذا العمل بالضبط.
والنوع الأشهر هو قاعدة البيانات العلائقية Relational Database، وهي تحفظ البيانات في جداول Tables، والفكرة قريبة جداً من جدول Excel الذي تعرفه:
- الجدول Table: مجموعة من الأشياء من نفس النوع، مثل جدول الطلاب students وجدول الدورات courses.
- الصف Row ويسمى أيضاً السجل Record: شيء واحد، مثل الطالبة سارة بكل بياناتها.
- العمود Column: معلومة واحدة لكل الصفوف ولها نوع ثابت، مثل الاسم name من نوع نص، وتاريخ التسجيل joined_on من نوع تاريخ.
- المفتاح الأساسي Primary Key: عمود قيمته مختلفة في كل صف ولا تكون فارغة، فيعرف به الصف دون لبس، مثل
id، فقد يوجد طالبان باسم Sara ولكن لا يوجد طالبان بنفس الرقم. - المفتاح الأجنبي Foreign Key: عمود في جدول يشير إلى المفتاح الأساسي في جدول آخر، مثل
student_idفي جدول التسجيلات الذي يشير إلى رقم الطالب، وقاعدة البيانات تمنع أن يشير إلى طالب غير موجود.
والكلمة «علائقية» لا تأتي من العلاقات بين الجداول كما يظن الكثير، وإنما من المصطلح الرياضي العلاقة Relation الذي سمى به Codd الجدول في ورقته، فالجدول في نموذجه هو مجموعة من الصفوف لها نفس الأعمدة، وأهم فكرة فيه أن الصفوف ترتبط ببعضها عن طريق القيم نفسها، فالتسجيل يعرف طالبه لأن فيه رقم الطالب، وليس لأنه مربوط به بمؤشر في الذاكرة. وهذه الفكرة هي التي سمحت لاحقاً بلغة مثل SQL، تسأل فيها عن البيانات بقيمها دون أن تعرف أين تخزن ولا كيف تصل إليها.
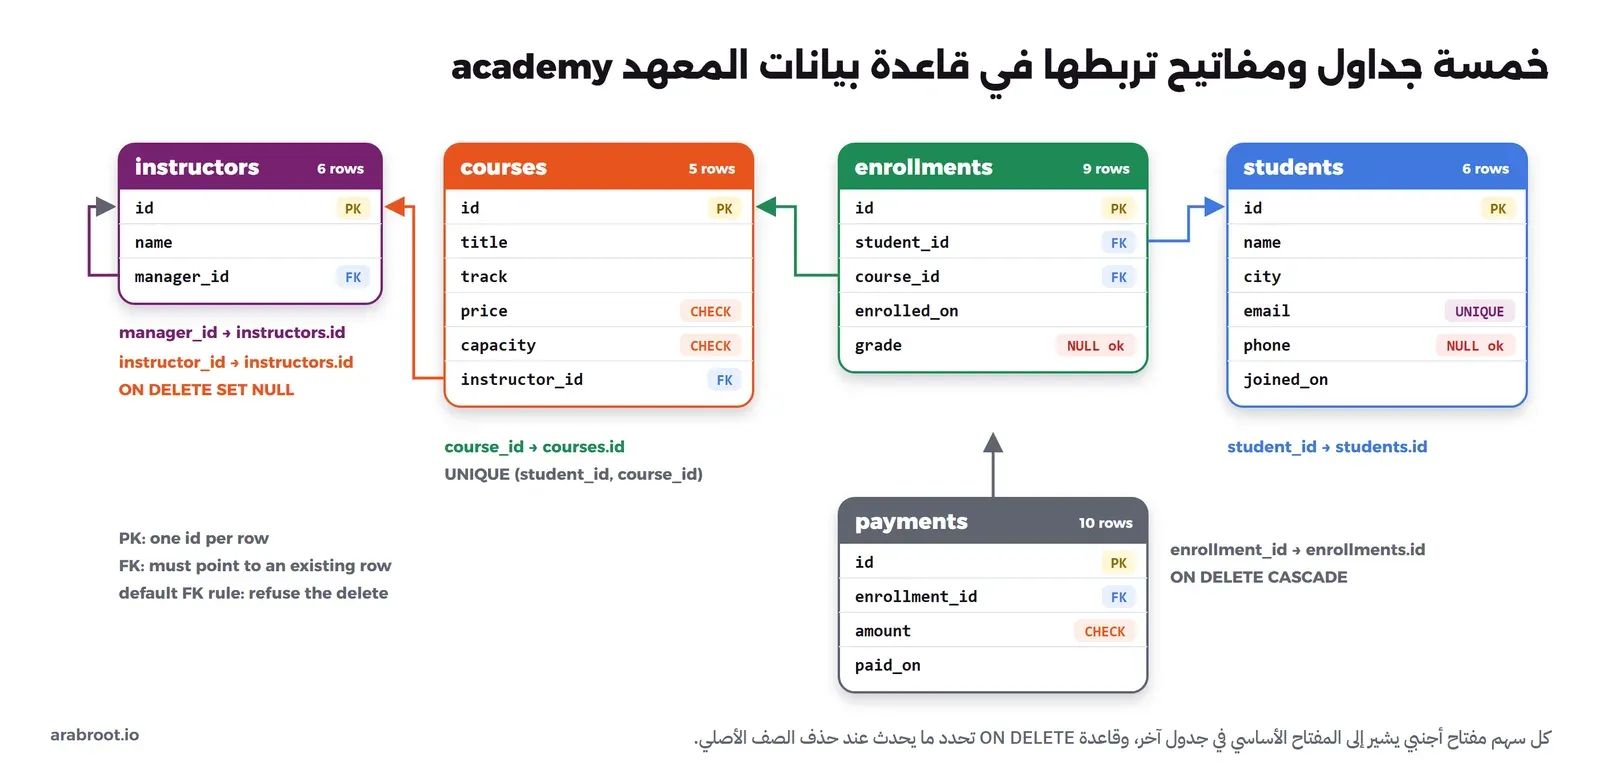
وفي هذه السلسلة سوف نعمل على قاعدة بيانات لمعهد تدريب اسمها academy فيها خمسة جداول: المدربون instructors، والدورات courses، والطلاب students، والتسجيلات enrollments التي تربط الطالب بالدورة وتحفظ درجته إن انتهى منها، والدفعات payments التي دفعها الطالب عن كل تسجيل. والبيانات صغيرة عن قصد، والسبب أنك تستطيع أن ترى كل صف بعينك فتحسب النتيجة في رأسك قبل أن تشغل الاستعلام، وهذه أهم عادة تتعلمها في SQL. والصورة التالية تبين الجداول الخمسة وأعمدتها والمفاتيح التي تربطها:
من أين جاءت لغة SQL؟
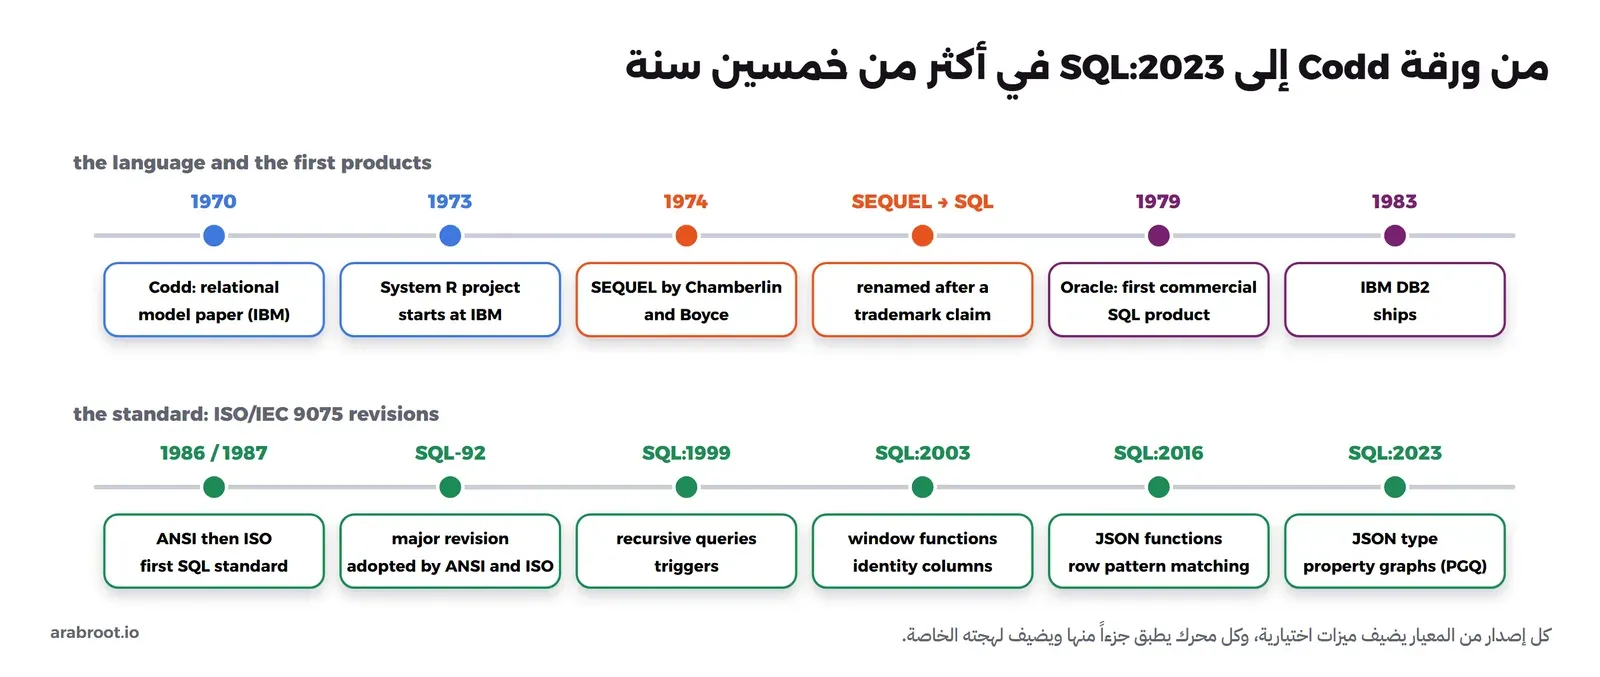
في يونيو 1970 نشر Edgar F. Codd، وهو رياضي يعمل في مختبر IBM للأبحاث في مدينة San Jose، ورقة بعنوان A Relational Model of Data for Large Shared Data Banks في مجلة Communications of the ACM، واقترح فيها النموذج العلائقي الذي شرحناه في الجزء السابق، وكما تذكر صفحة IBM عن Codd فقد كانت الفكرة في ذلك الوقت نظرية فقط. وفي عام 1973 بدأ في IBM مشروع اسمه System R لبناء نظام حقيقي على هذا النموذج، وكان في فريقه Donald Chamberlin وRaymond Boyce اللذان صمما لغة للاستعلام سمياها Structured English Query Language واختصاراً SEQUEL، ونشرا ورقتها في مايو 1974، وتوفي Boyce في نفس العام، وهذه التفاصيل يرويها Chamberlin بنفسه في نص لقاء رواد System R عام 1995.
ويروي Chamberlin في نفس اللقاء سبب تغيير الاسم: فقد اعترضت شركة الطائرات البريطانية Hawker Siddeley بأن SEQUEL علامة تجارية مسجلة لها، فحذف Chamberlin حروف العلة من الاسم فصار SQL، ولهذا ما زال كثير من المطورين ينطقونه «سيكوال» حتى اليوم، ويكتب توثيق Oracle نفسه أن الاسم ما زال ينطق «sequel»، بينما ينطقه آخرون حرفاً حرفاً «إس كيو إل»، والاثنان مقبولان في الشغل.
وبعد ذلك خرجت اللغة من المختبر إلى السوق، فبحسب توثيق Oracle قدمت شركة Relational Software، التي أصبح اسمها Oracle لاحقاً، أول تطبيق تجاري للغة SQL عام 1979، وأصدرت IBM قاعدة البيانات DB2 عام 1983 كما تذكر صفحة IBM عن قواعد البيانات العلائقية. ولأن كل شركة بدأت تضيف ما تريد، احتاج السوق إلى معيار واحد، فاعتمد المعهد الأمريكي ANSI أول معيار للغة عام 1986، ثم اعتمدته المنظمة الدولية ISO عام 1987 تحت الرقم ISO 9075، وتوالت الإصدارات بعده كما يلخصها جدول تاريخ المعيار:
- SQL-92: مراجعة كبيرة للمعيار الأول، وهي الأساس الذي ما زالت أغلب الكتب تشرح منه.
- SQL:1999: أضاف الاستعلامات التكرارية Recursive Queries والقوادح Triggers.
- SQL:2003: أضاف دوال النوافذ Window Functions والأعمدة التي تولد قيمها تلقائياً Identity Columns.
- SQL:2011: أضاف البيانات الزمنية Temporal Data التي تحفظ تاريخ تغير الصف.
- SQL:2016: أضاف دوال JSON ومطابقة أنماط الصفوف Row Pattern Matching.
- SQL:2023: أضاف النوع JSON نفسه، وجزءاً جديداً للاستعلام عن البيانات كرسم بياني Property Graph Queries واختصاراً SQL/PGQ، كما يلخص Peter Eisentraut في مقاله عن ما الجديد في SQL:2023.
والاسم الرسمي للمعيار اليوم هو ISO/IEC 9075، وآخر إصدار له هو SQL:2023 كما يذكر توثيق PostgreSQL عن التوافق مع المعيار، ويقول نفس التوثيق إن كل إصدار يلغي الذي قبله. والصورة التالية تجمع هذا التاريخ:
المحركات المشهورة ولهجاتها
المعيار يحدد اللغة، ولكن لا يوجد محرك يطبق المعيار كله، وكل محرك يضيف أوامر ودوال خاصة به، لذلك نتكلم عن لهجات Dialects للغة SQL، تماماً مثل اللهجات العربية: الأساس واحد ويفهمه الجميع، والاختلاف في التفاصيل. والجدول التالي يلخص أشهر المحركات:
| المحرك | اللهجة واللغة الإجرائية | ملاحظة |
|---|---|---|
| Oracle Database | Oracle SQL وPL/SQL | أول تطبيق تجاري للغة عام 1979، ويعامل النص الفارغ كأنه NULL |
| IBM Db2 | SQL PL | صدر عام 1983 وهو من نتائج مشروع System R نفسه |
| Microsoft SQL Server | Transact-SQL واختصاراً T-SQL | يستخدم TOP بدل LIMIT، وOUTPUT بدل RETURNING |
| MySQL وMariaDB | MySQL SQL | مقارنة النصوص فيه لا تفرق بين الحروف الكبيرة والصغيرة افتراضياً |
| PostgreSQL | PostgreSQL SQL وPL/pgSQL | المحرك الذي نستخدمه في هذه السلسلة، وهو قريب جداً من المعيار |
| SQLite | SQLite SQL | مكتبة تعمل داخل التطبيق نفسه بلا سيرفر منفصل |
وتواريخ PostgreSQL من صفحة تاريخه في التوثيق، فقد بدأ تطبيق POSTGRES عام 1986، ثم أضاف إليه Andrew Yu وJolly Chen مفسراً للغة SQL عام 1994 باسم Postgres95، ثم تغير الاسم إلى PostgreSQL عام 1996. وتاريخ SQLite من سجل إصداراته الذي يبدأ بالإصدار 1.0 في أغسطس 2000. وأما معاملة النص الفارغ كأنه NULL في Oracle فيذكرها توثيق Oracle عن NULL صراحة.
والخبر الجيد أن ما سوف تتعلمه في هذه السلسلة يعمل في كل هذه المحركات تقريباً كما هو، والسبب أن الأساسيات من المعيار نفسه، وسوف نستخدم PostgreSQL 18 كمحرك أساسي، وحيث يختلف المحرك عن غيره سوف نذكر الفرق، وقد شغلنا هذه المواضع بأنفسنا على MySQL 8.4 وSQL Server 2022 وSQLite 3.49 حتى نتأكد منها.
خمس مجموعات من الأوامر
أوامر SQL كثيرة، ولكنها تنقسم بحسب ما تعمل عليه إلى خمس مجموعات، ومعرفة المجموعة تخبرك فوراً بخطورة الأمر: فأمر من DQL لا يغير شيئاً، أما أمر من DDL فقد يحذف جدولاً كاملاً. والجدول التالي يلخصها مع مثال من كل واحدة:
| المجموعة | ما تعمل عليه | الأوامر | مثال |
|---|---|---|---|
| DDL واختصارها Data Definition Language | هيكل البيانات: الجداول والأعمدة والقيود | CREATE وALTER وDROP وTRUNCATE | CREATE TABLE notes (id int PRIMARY KEY, body text); |
| DML واختصارها Data Manipulation Language | الصفوف نفسها: إضافة وتعديل وحذف | INSERT وUPDATE وDELETE وMERGE | UPDATE courses SET price = 320 WHERE id = 1; |
| DQL واختصارها Data Query Language | قراءة البيانات دون تغييرها | SELECT | SELECT title, price FROM courses; |
| DCL واختصارها Data Control Language | الصلاحيات: من يستطيع أن يفعل ماذا | GRANT وREVOKE | GRANT SELECT ON courses TO report_reader; |
| TCL واختصارها Transaction Control Language | المعاملة: مجموعة أوامر تنفذ كلها أو لا شيء | BEGIN وCOMMIT وROLLBACK وSAVEPOINT | BEGIN; … ROLLBACK; |
والصورة التالية تبين المجموعات الخمس:
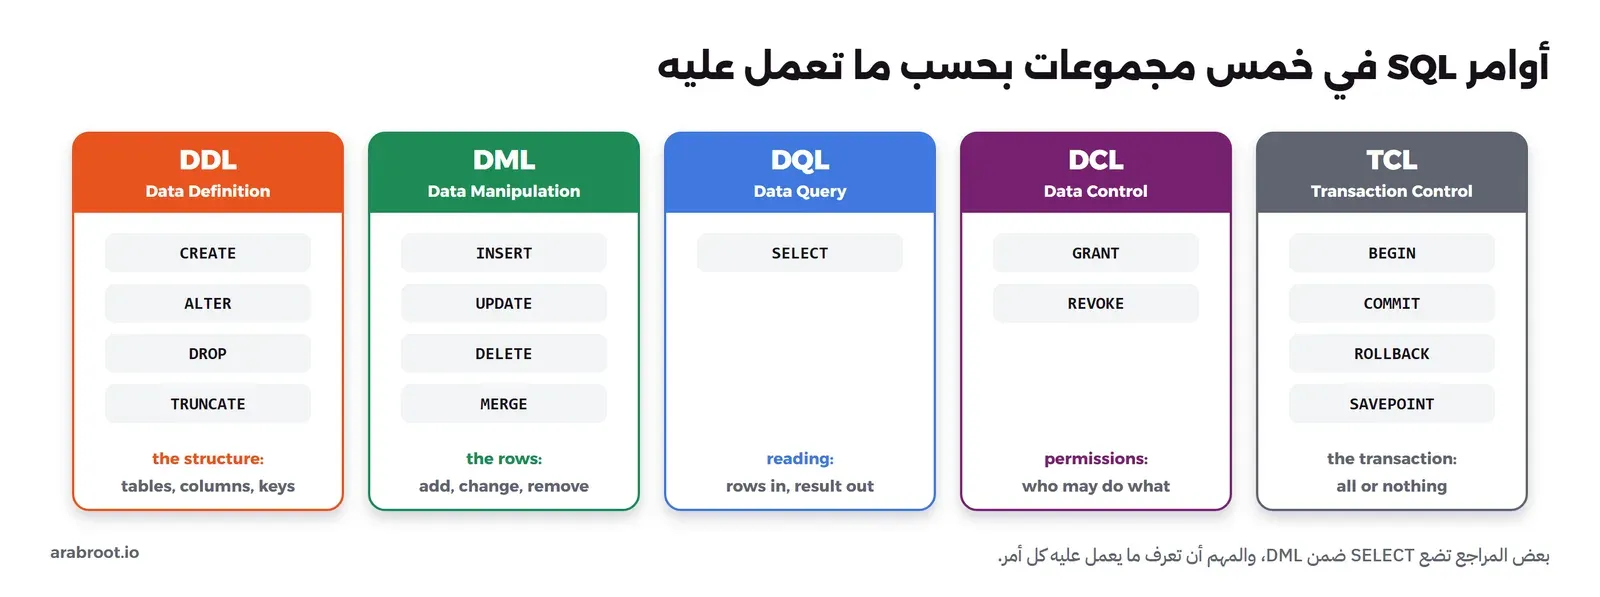
يجدر الإشارة هنا أن بعض المراجع تضع SELECT ضمن DML ولا تفصل DQL، وهذا اختلاف في التسمية فقط، والمهم أن تعرف ما يعمل عليه كل أمر. وسوف ترى كل مجموعة منها تعمل على قاعدة بياناتنا في الأقسام التالية، بنفس الترتيب الذي تحتاجها به: ننشئ الجداول بأوامر DDL، ثم نضيف البيانات ونعدلها بأوامر DML داخل معاملات TCL، ثم نعطي مستخدماً صلاحية القراءة بأوامر DCL، ثم نقضي بقية الجزء في SELECT.
تجهيز المختبر Lab
سوف نشغل PostgreSQL 18 في Container يستمع على العنوان المحلي فقط، والسبب أن قاعدة بيانات بباسورد بسيط مثل lab يجب ألا تكون مفتوحة على الشبكة، وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في تثبيت Docker على Ubuntu:
docker run -d --name lab-sql-pg -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=academy \
  -p 127.0.0.1:21471:5432 postgres:18.6
ثم ادخل إلى psql، وهو الكلاينت النصي الرسمي لـ PostgreSQL:
docker exec -it lab-sql-pg psql -U postgres -d academy
وأول أمر داخل psql هو التالي، والسبب أن psql يعرض القيمة NULL كخانة فارغة لا تفرقها عن النص الفارغ، وهذا الأمر من أوامر psql يجعلها تظهر بالاسم، وكل المخرجات في هذه السلسلة مأخوذة بهذا الإعداد:
\pset null NULL
والأوامر التي تبدأ بشرطة مائلة عكسية مثل \pset و\dt هي أوامر psql نفسه وليست من SQL، لذلك لا تنتهي بفاصلة منقوطة ولا تعمل في برنامج آخر. أما جمل SQL فتنتهي دائماً بفاصلة منقوطة ;، وإذا ضغطت Enter دون أن تكتبها فسوف ينتظر psql بقية الجملة ويتغير شكل المحث Prompt، وهذا أول ما يربك المبتدئ.
أنواع البيانات Data Types
كل عمود في الجدول له نوع ثابت يحدد ما يقبله، والفكرة قريبة من المتغيرات في لغات البرمجة ذات الأنواع الثابتة، والفائدة أن قاعدة البيانات ترفض القيمة الخاطئة عند الكتابة بدل أن تكتشفها أنت بعد شهر في تقرير. والجدول التالي يجمع الأنواع التي تحتاجها في أغلب الجداول، مع اسمها في المحركات الأخرى:
| الاستخدام | PostgreSQL | MySQL | SQL Server | SQLite |
|---|---|---|---|---|
| عدد صحيح | int وbigint | INT وBIGINT | int وbigint | INTEGER |
| مبلغ مالي بخانات عشرية ثابتة | numeric(8,2) | DECIMAL(8,2) | decimal(8,2) | NUMERIC |
| رقم عشري تقريبي للقياسات | double precision | DOUBLE | float | REAL |
| نص | text وvarchar(n) | VARCHAR(n) وTEXT | nvarchar(n) | TEXT |
| صح أو خطأ | boolean | BOOLEAN وهو اسم آخر لـ TINYINT(1) | bit | INTEGER بالقيمتين 0 و1 |
| تاريخ | date | DATE | date | TEXT أو REAL أو INTEGER |
| لحظة زمنية | timestamptz | DATETIME وTIMESTAMP | datetimeoffset | TEXT أو REAL أو INTEGER |
| مستند JSON | jsonb | JSON | nvarchar مع دوال JSON | TEXT مع دوال JSON |
والمصادر هنا هي صفحات الأنواع في PostgreSQL وMySQL وSQL Server وSQLite، ولاحظ أن SQLite مختلف عن البقية، فالنوع فيه يخص القيمة وليس العمود، ولا يوجد فيه نوع منفصل للتاريخ ولا للقيمة المنطقية. ولنرى الآن لماذا يهم النوع، فالمثال التالي يقسم 7 على 2 بطريقتين:
SELECT 7 / 2 AS int_div, 7 / 2.0 AS num_div, 7 % 2 AS remainder;
والمخرج سوف يكون كما يلي:
 int_div |      num_div       | remainder
---------+--------------------+-----------
       3 | 3.5000000000000000 |         1
(1 row)
قسمة عدد صحيح على عدد صحيح تعطي عدداً صحيحاً وترمي الكسر، فالنتيجة 3 وليست 3.5، وهذا يحدث في PostgreSQL وSQL Server وSQLite، وقد شغلنا نفس الجملة عليها فأعطت 3، أما MySQL فأعطى 3.5000، لذلك إذا كنت تحسب نسبة مئوية من عمودين صحيحين فاجعل أحدهما عشرياً. والمثال الثاني يقارن نوع المال numeric بالنوع التقريبي:
SELECT 0.1 + 0.2 = 0.3 AS numeric_ok,
       0.1::float8 + 0.2::float8 = 0.3::float8 AS float_ok;
 numeric_ok | float_ok
------------+----------
 t          | f
(1 row)
النوع numeric يحفظ الرقم العشري كما هو، أما float8 وهو اسم آخر لـ double precision فيحفظ أقرب رقم ثنائي، فلا تساوي 0.1 + 0.2 القيمة 0.3 بالضبط، وقد شرحنا السبب بالتفصيل في الأرقام العشرية Floating Point من الداخل، والقاعدة: المال دائماً numeric. وإذا أردت أن تعرف نوع أي قيمة فاسأل قاعدة البيانات بالدالة pg_typeof:
SELECT pg_typeof(42) AS a, pg_typeof(42.5) AS b, pg_typeof('Sara'::text) AS c,
       pg_typeof(current_date) AS d, pg_typeof(now()) AS e;
    a    |    b    |  c   |  d   |            e
---------+---------+------+------+--------------------------
 integer | numeric | text | date | timestamp with time zone
(1 row)
والعلامة :: هي طريقة PostgreSQL المختصرة لتحويل النوع Cast، وصيغة المعيار التي تعمل في كل المحركات هي CAST('Sara' AS text). والآن لنكسر الأنواع عن قصد، فنعطيها تاريخاً غير موجود وقيمة منطقية غير مفهومة:
SELECT '2026-02-30'::date;
SELECT 'abc'::boolean;
ERROR:  date/time field value out of range: "2026-02-30"
LINE 1: SELECT '2026-02-30'::date;
               ^
ERROR:  invalid input syntax for type boolean: "abc"
LINE 1: SELECT 'abc'::boolean;
               ^
وهذا بالضبط ما تريده: لو كان العمود نصاً لقبل «30 فبراير» بصمت، ولاكتشفت الخطأ عندما يفشل تقرير الشهر. وأخيراً النص المحدود الطول، فالنوع varchar(3) يرفض نصاً أطول من ثلاثة حروف عند الإضافة:
CREATE TABLE t_demo (code varchar(3));
INSERT INTO t_demo VALUES ('Riyadh');
DROP TABLE t_demo;
CREATE TABLE
ERROR:  value too long for type character varying(3)
DROP TABLE
وكذلك يرفضه MySQL 8.4 بالخطأ Data too long for column لأن الوضع الصارم Strict Mode مفعل فيه افتراضياً، أما SQLite فقد قبل النص كاملاً Riyadh في عمود varchar(3) دون أي خطأ، لأنه لا يطبق الطول أصلاً، فلا تعتمد عليه في التحقق Validation. وفي PostgreSQL يفضل أغلب المطورين النوع text ويضعون الحد الأقصى في قيد CHECK إن احتاجوه، والسبب أن توثيق أنواع النصوص يقول إنه لا يوجد فرق في الأداء بين الأنواع الثلاثة.
إنشاء الجداول CREATE TABLE
الأمر CREATE TABLE ينشئ جدولاً، وتكتب فيه اسم كل عمود ونوعه والقيود عليه. واحفظ الجداول الخمسة في ملف باسم schema.sql، فهذا الملف هو الذي سوف نستخدمه في الأجزاء الثلاثة:
CREATE TABLE instructors (
    id          int   GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name        text  NOT NULL,
    manager_id  int   REFERENCES instructors(id)
);

CREATE TABLE students (
    id         int   GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name       text  NOT NULL,
    city       text  NOT NULL,
    email      text  NOT NULL UNIQUE,
    phone      text,
    joined_on  date  NOT NULL DEFAULT current_date
);

CREATE TABLE courses (
    id             int           GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    title          text          NOT NULL,
    track          text          NOT NULL,
    price          numeric(8,2)  NOT NULL CHECK (price >= 0),
    capacity       int           NOT NULL CHECK (capacity > 0),
    instructor_id  int           REFERENCES instructors(id) ON DELETE SET NULL
);

CREATE TABLE enrollments (
    id           int   GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    student_id   int   NOT NULL REFERENCES students(id),
    course_id    int   NOT NULL REFERENCES courses(id),
    enrolled_on  date  NOT NULL DEFAULT current_date,
    grade        int   CHECK (grade BETWEEN 0 AND 100),
    UNIQUE (student_id, course_id)
);

CREATE TABLE payments (
    id             int           GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    enrollment_id  int           NOT NULL REFERENCES enrollments(id) ON DELETE CASCADE,
    amount         numeric(8,2)  NOT NULL CHECK (amount > 0),
    paid_on        date          NOT NULL
);
ثم نفذ الملف من الطرفية Terminal، خارج psql:
docker exec -i lab-sql-pg psql -U postgres -d academy < schema.sql
والمخرج سوف يكون كما يلي:
CREATE TABLE
CREATE TABLE
CREATE TABLE
CREATE TABLE
CREATE TABLE
في الإعداد أعلاه لاحظ التالي:
- المفتاح الأساسي
idفي كل جدول تولده قاعدة البيانات بالصيغة GENERATED ALWAYS AS IDENTITY، وهي صيغة المعيار منذ SQL:2003، ويقابلهاAUTO_INCREMENTفي MySQL وIDENTITY(1,1)في SQL Server وINTEGER PRIMARY KEYفي SQLite. - الكلمة
REFERENCESتعرف المفتاح الأجنبي، والجدول instructors يشير إلى نفسه عبرmanager_idلأن لكل مدرب مديراً من نفس الجدول، إلا رئيسة المعهد فمديرها NULL. - ترتيب الجداول في الملف مهم، فلا يمكن أن تنشئ courses قبل instructors لأن المفتاح الأجنبي يشير إلى جدول يجب أن يكون موجوداً.
- الكلمة
DEFAULT current_dateتعني أن قاعدة البيانات تضع تاريخ اليوم إذا لم تعطها قيمة، وسوف تراها تعمل في قسم الإضافة. - القيود NOT NULL وUNIQUE وCHECK وON DELETE نشرحها في قسم القيود بعد أن نضيف البيانات، لأننا نحتاج بيانات حتى نرى كل قيد يرفض شيئاً، وكذلك تعديل الجداول وحذفها في قسم ALTER وDROP.
والآن ارجع إلى psql واطلب قائمة الجداول بالأمر \dt ثم وصف جدول الدورات بالأمر \d courses:
             List of tables
 Schema |    Name     | Type  |  Owner
--------+-------------+-------+----------
 public | courses     | table | postgres
 public | enrollments | table | postgres
 public | instructors | table | postgres
 public | payments    | table | postgres
 public | students    | table | postgres
(5 rows)

                               Table "public.courses"
    Column     |     Type     | Collation | Nullable |           Default
---------------+--------------+-----------+----------+------------------------------
 id            | integer      |           | not null | generated always as identity
 title         | text         |           | not null |
 track         | text         |           | not null |
 price         | numeric(8,2) |           | not null |
 capacity      | integer      |           | not null |
 instructor_id | integer      |           |          |
Indexes:
    "courses_pkey" PRIMARY KEY, btree (id)
Check constraints:
    "courses_capacity_check" CHECK (capacity > 0)
    "courses_price_check" CHECK (price >= 0::numeric)
Foreign-key constraints:
    "courses_instructor_id_fkey" FOREIGN KEY (instructor_id) REFERENCES instructors(id) ON DELETE SET NULL
Referenced by:
    TABLE "enrollments" CONSTRAINT "enrollments_course_id_fkey" FOREIGN KEY (course_id) REFERENCES courses(id)
لاحظ أن PostgreSQL أعطى كل قيد اسماً مثل courses_price_check، وهذا الاسم هو الذي سوف تراه في رسائل الخطأ، فإذا كنت تريد رسائل أوضح فاكتب للقيد اسماً بنفسك بالصيغة CONSTRAINT price_not_negative CHECK (price >= 0).
إضافة البيانات INSERT
الأمر INSERT يضيف صفاً أو أكثر، وتكتب بعد اسم الجدول الأعمدة التي ستعطيها قيماً، ثم القيم بنفس الترتيب بعد الكلمة VALUES، ويمكنك أن تضيف صفوفاً كثيرة في جملة واحدة بفصلها بفاصلة، وهذا أسرع بكثير من جملة لكل صف لأن قاعدة البيانات تستقبل طلباً واحداً. واحفظ البيانات التالية في ملف باسم seed.sql:
INSERT INTO instructors (name, manager_id) VALUES
 ('Nora',   NULL),
 ('Majed',  1),
 ('Rania',  1),
 ('Tariq',  2),
 ('Yasser', 2),
 ('Dana',   3);

INSERT INTO students (name, city, email, phone, joined_on) VALUES
 ('Sara',   'Riyadh', '[email protected]',   '0500000001', '2026-08-20'),
 ('Omar',   'Jeddah', '[email protected]',   NULL,         '2026-08-25'),
 ('Lina',   'Riyadh', '[email protected]',   '0500000003', '2026-09-01'),
 ('Khalid', 'Dammam', '[email protected]', NULL,         '2026-09-02'),
 ('Huda',   'Jeddah', '[email protected]',   '0500000005', '2026-09-03'),
 ('Faisal', 'Abha',   '[email protected]', '0500000006', '2026-09-15');

INSERT INTO courses (title, track, price, capacity, instructor_id) VALUES
 ('Linux Basics', 'ops',  300, 20, 4),
 ('PostgreSQL',   'data', 450, 15, 3),
 ('Docker',       'ops',  400,  3, 5),
 ('Python',       'dev',  350, 25, 6),
 ('Kubernetes',   'ops',  600, 10, NULL);

INSERT INTO enrollments (student_id, course_id, enrolled_on, grade) VALUES
 (1, 1, '2026-09-01', 90),
 (1, 2, '2026-09-03', 85),
 (2, 1, '2026-09-02', 70),
 (2, 3, '2026-09-10', NULL),
 (3, 2, '2026-09-05', 95),
 (3, 4, '2026-09-06', NULL),
 (4, 4, '2026-09-07', 60),
 (5, 2, '2026-09-08', NULL),
 (5, 3, '2026-09-12', 88);

INSERT INTO payments (enrollment_id, amount, paid_on) VALUES
 (1, 300, '2026-09-01'),
 (2, 225, '2026-09-03'),
 (2, 225, '2026-10-03'),
 (3, 300, '2026-09-02'),
 (4, 200, '2026-09-10'),
 (5, 450, '2026-09-05'),
 (7, 350, '2026-09-07'),
 (8, 450, '2026-09-08'),
 (9, 200, '2026-09-12'),
 (9, 200, '2026-10-01');
ثم نفذه من الطرفية:
docker exec -i lab-sql-pg psql -U postgres -d academy < seed.sql
INSERT 0 6
INSERT 0 6
INSERT 0 5
INSERT 0 9
INSERT 0 10
في البيانات أعلاه لاحظ التالي:
- الرقم الأخير في
INSERT 0 6هو عدد الصفوف التي أضيفت، أما الصفر فهو من بقايا إصدارات قديمة ويبقى صفراً دائماً. - لم نكتب قيمة للعمود
id، لأن قاعدة البيانات تولده بالترتيب 1 ثم 2 ثم 3، ولهذا نستطيع أن نكتب(1, 2, ...)في التسجيلات ونحن نعرف أن الطالب 1 هو سارة والدورة 2 هي PostgreSQL. - النص بين علامتي تنصيص مفردة
'Riyadh'، والتاريخ نص بالصيغة'2026-09-01'وهي صيغة ISO 8601 التي تفهمها كل المحركات، والأرقام بلا علامات تنصيص. - عمر وخالد بلا رقم جوال، وثلاثة تسجيلات بلا درجة لأن أصحابها لم ينهوا الدورة، ودورة Kubernetes بلا مدرب بعد، وفيصل لم يسجل في أي دورة، وهذه الفراغات مقصودة لأنها مصدر أغلب الأخطاء التي سوف نراها.
- سارة دفعت دورة PostgreSQL على دفعتين، وهدى دفعت Docker على دفعتين، وعمر دفع نصف Docker، ولينا لم تدفع Python بعد، وهذا ما سوف نحتاجه في الجزء الثاني.
تعديل الجداول وحذفها ALTER وDROP
بعد أن أصبحت في الجداول بيانات، لنرى كيف نعدل جدولاً موجوداً، وهذا بالأمر ALTER TABLE، فالمثال التالي يضيف عموداً لسنة الميلاد ثم يحذفه:
ALTER TABLE students ADD COLUMN birth_year int;
SELECT id, name, birth_year FROM students WHERE id <= 2;
ALTER TABLE students DROP COLUMN birth_year;
والمخرج سوف يكون كما يلي:
ALTER TABLE
 id | name | birth_year
----+------+------------
  1 | Sara |       NULL
  2 | Omar |       NULL
(2 rows)

ALTER TABLE
العمود الجديد ظهر في كل الصفوف الموجودة بالقيمة NULL، لأن قاعدة البيانات لا تعرف سنة ميلاد أحد. وأما حذف جدول كامل فهو بالأمر DROP TABLE، وإذا حاولت حذف جدول غير موجود فسوف تحصل على خطأ، إلا إذا أضفت IF EXISTS:
CREATE TABLE notes (id int PRIMARY KEY, body text);
DROP TABLE notes;
DROP TABLE notes;
DROP TABLE IF EXISTS notes;
CREATE TABLE
DROP TABLE
ERROR:  table "notes" does not exist
NOTICE:  table "notes" does not exist, skipping
DROP TABLE
والصيغة IF EXISTS مفيدة في سكربتات الإعداد التي تشغلها أكثر من مرة. وهنا ميزة في PostgreSQL قد لا تتوقعها، وهي أن أوامر DDL نفسها تعمل داخل المعاملة Transaction، فإذا حذفت جدولاً بالخطأ داخل BEGIN فإن ROLLBACK يعيده بكل بياناته:
BEGIN;
DROP TABLE payments;
SELECT count(*) FROM payments;
ROLLBACK;
SELECT count(*) FROM payments;
BEGIN
DROP TABLE
ERROR:  relation "payments" does not exist
LINE 1: SELECT count(*) FROM payments;
                             ^
ROLLBACK
 count
-------
    10
(1 row)
وهذا لا يعمل في كل المحركات، فقد شغلنا نفس الفكرة على MySQL 8.4 فحذف DROP TABLE الجدول نهائياً ولم يعده ROLLBACK، والسبب أن MySQL ينهي المعاملة تلقائياً قبل أوامر DDL، كما يذكر توثيق التأكيد الضمني Implicit Commit. أما SQL Server 2022 وSQLite فأعادا الجدول بعد ROLLBACK مثل PostgreSQL. لذلك إذا كنت تعمل على MySQL فخذ نسخة احتياطية قبل أي تعديل في الهيكل على بيانات حقيقية.
القيود Constraints تحمي بياناتك
القيد Constraint قاعدة تكتبها مرة واحدة في تعريف الجدول، وقاعدة البيانات تطبقها على كل INSERT وUPDATE وDELETE من أي تطبيق أو شخص، لذلك هي آخر خط دفاع عن بياناتك حتى لو نسي مطور التحقق في الكود، وقد شرحنا لماذا تحمي قاعدة البيانات نفسها بالقيود في جزء القيود Constraints من مقال التصميم، والآن سوف نرى كل قيد منها يرفض بيانات خاطئة، والمرجع هو توثيق القيود في PostgreSQL. ونبدأ بالقيد NOT NULL، فالمدينة إلزامية:
INSERT INTO students (name, city, email) VALUES ('Reem', NULL, '[email protected]');
ERROR:  null value in column "city" of relation "students" violates not-null constraint
DETAIL:  Failing row contains (7, Reem, null, [email protected], null, 2026-10-10).
ثم UNIQUE، فالبريد لا يتكرر:
INSERT INTO students (name, city, email) VALUES ('Reem', 'Riyadh', '[email protected]');
ERROR:  duplicate key value violates unique constraint "students_email_key"
DETAIL:  Key (email)=([email protected]) already exists.
ثم CHECK، فالسعر لا يكون سالباً، ولاحظ أن القيد يعمل على UPDATE كما يعمل على INSERT:
UPDATE courses SET price = -50 WHERE id = 1;
ERROR:  new row for relation "courses" violates check constraint "courses_price_check"
DETAIL:  Failing row contains (1, Linux Basics, ops, -50.00, 20, 4).
ثم المفتاح الأجنبي، فلا يوجد تسجيل في دورة غير موجودة، ثم القيد UNIQUE على عمودين معاً، فالطالب لا يسجل في نفس الدورة مرتين:
INSERT INTO enrollments (student_id, course_id) VALUES (1, 99);
INSERT INTO enrollments (student_id, course_id) VALUES (1, 1);
ERROR:  insert or update on table "enrollments" violates foreign key constraint "enrollments_course_id_fkey"
DETAIL:  Key (course_id)=(99) is not present in table "courses".
ERROR:  duplicate key value violates unique constraint "enrollments_student_id_course_id_key"
DETAIL:  Key (student_id, course_id)=(1, 1) already exists.
والمفتاح الأجنبي يعمل من الجهة الأخرى أيضاً، فإذا حاولت حذف صف تشير إليه صفوف أخرى، فالسؤال: ماذا يحدث للتسجيلات التي تشير إلى طالب محذوف؟ والإجابة تحددها أنت بالعبارة ON DELETE، ولها ثلاثة خيارات شائعة نستخدمها كلها في قاعدتنا. الخيار الافتراضي هو أن ترفض قاعدة البيانات الحذف، وهو ما كتبناه للطلاب:
DELETE FROM students WHERE id = 1;
ERROR:  update or delete on table "students" violates foreign key constraint "enrollments_student_id_fkey" on table "enrollments"
DETAIL:  Key (id)=(1) is still referenced from table "enrollments".
والخيار الثاني ON DELETE SET NULL كتبناه للمدرب في جدول الدورات، فإذا ترك المدرب المعهد بقيت دورته بلا مدرب. والخيار الثالث ON DELETE CASCADE كتبناه للدفعات، فإذا حذف تسجيل حذفت دفعاته معه. وسوف نجرب الخيارين داخل معاملة ونلغيها بعد ذلك حتى تبقى البيانات كما هي:
BEGIN;
DELETE FROM instructors WHERE id = 5;
SELECT title, instructor_id FROM courses WHERE id = 3;
ROLLBACK;

BEGIN;
SELECT count(*) FROM payments WHERE enrollment_id = 9;
DELETE FROM enrollments WHERE id = 9;
SELECT count(*) FROM payments WHERE enrollment_id = 9;
ROLLBACK;
BEGIN
DELETE 1
 title  | instructor_id
--------+---------------
 Docker |          NULL
(1 row)

ROLLBACK
BEGIN
 count
-------
     2
(1 row)

DELETE 1
 count
-------
     0
(1 row)

ROLLBACK
في المخرج أعلاه لاحظ التالي:
- حذف المدرب Yasser نجح، وأصبح مدرب دورة Docker هو NULL بدل أن يرفض الحذف.
- حذف التسجيل رقم 9 حذف معه دفعتي هدى دون أن نكتب DELETE على جدول الدفعات، والعبارة
DELETE 1تعد الصفوف التي حذفتها الجملة نفسها فقط، لذلك لا تخبرك بالدفعات التي حذفت معها، وهذا هو خطر CASCADE: حذف واحد قد يمسح آلاف الصفوف في جداول أخرى دون أن تراها. - القاعدة العملية أن تستخدم الرفض الافتراضي للبيانات المهمة مثل الطلاب والفواتير، وCASCADE للبيانات التي لا معنى لها بدون صاحبها، وSET NULL عندما يبقى الصف مفيداً بعد اختفاء ما يشير إليه.
وفي MySQL لم تكن قيود CHECK تطبق إلا من الإصدار 8.0.16 كما يذكر توثيق قيود CHECK في MySQL، وقد رفض MySQL 8.4 السعر السالب برسالة Check constraint 'c_chk_1' is violated، وكذلك رفضه SQLite 3.49 برسالة CHECK constraint failed، لذلك إذا كنت تعمل على نسخة قديمة من MySQL فلا تفترض أن القيد يعمل لأنه مكتوب.
التعديل والحذف بأمان
بعد أن رأيت الإضافة الأساسية، هناك إضافة مفيدة في PostgreSQL هي RETURNING، وهي ترجع لك ما كتبته قاعدة البيانات فعلاً، مثل الرقم الذي ولدته والقيمة الافتراضية، دون استعلام ثان:
INSERT INTO students (name, city, email)
VALUES ('Reem', 'Riyadh', '[email protected]')
RETURNING id, name, phone, joined_on;
 id | name | phone | joined_on
----+------+-------+------------
  9 | Reem | NULL  | 2026-10-10
(1 row)

INSERT 0 1
وقد يتساءل البعض: لدينا ستة طلاب، فلماذا أخذت ريم الرقم 9 وليس 7؟ والإجابة في قسم القيود، فمحاولتا إضافة ريم اللتان فشلتا بسبب NOT NULL وUNIQUE أخذتا الرقمين 7 و8 من المولد ثم فشلتا، والمولد لا يرجع الأرقام التي أخذها، والسبب كما يذكر توثيق المولدات Sequences أن إرجاعها يجعل الإضافات المتزامنة تنتظر بعضها. لذلك لا تكتب كوداً يفترض أن الأرقام متتالية بلا فراغات، والعمود joined_on أخذ تاريخ يوم التشغيل لأننا لم نعطه قيمة. ويقابل RETURNING في SQL Server الكلمة OUTPUT، ويدعمها SQLite منذ الإصدار 3.35 كما يذكر توثيق SQLite، أما MySQL فلا يدعمها، ويستخدم المطور فيه الدالة LAST_INSERT_ID() بعد الإضافة. والمثال التالي يضيف طالبين في جملة واحدة، ثم يحاول أن يفرض رقماً بنفسه:
INSERT INTO students (name, city, email, phone) VALUES
 ('Yousef', 'Makkah', '[email protected]', '0500000010'),
 ('Maha',   'Riyadh', '[email protected]',   NULL)
RETURNING id, name;

INSERT INTO students (id, name, city, email) VALUES (100, 'Test', 'Riyadh', '[email protected]');
 id |  name
----+--------
 10 | Yousef
 11 | Maha
(2 rows)

INSERT 0 2
ERROR:  cannot insert a non-DEFAULT value into column "id"
DETAIL:  Column "id" is an identity column defined as GENERATED ALWAYS.
HINT:  Use OVERRIDING SYSTEM VALUE to override.
والكلمة ALWAYS في تعريف العمود هي التي منعت الرقم 100، وهذا مقصود حتى لا يصطدم رقم كتبه شخص بيده برقم سوف يولده المولد لاحقاً.
أما UPDATE وDELETE فهما أخطر جملتين في SQL، والسبب أن نسيان WHERE لا يعطي خطأ وإنما ينفذ الجملة على الجدول كله. لذلك القاعدة التي ننصح بها ثلاث خطوات: شغل الشرط أولاً في SELECT count(*) واعرف كم صفاً تتوقع، ثم نفذ الجملة داخل معاملة تبدأ بـ BEGIN، ثم قارن عدد الصفوف الذي تطبعه قاعدة البيانات بما توقعته قبل أن تكتب COMMIT. والمثال التالي يخفض أسعار دورات العمليات ops بنسبة 10%:
SELECT count(*) FROM courses WHERE track = 'ops';

BEGIN;
UPDATE courses SET price = price * 0.9
WHERE track = 'ops'
RETURNING title, price;
ROLLBACK;
 count
-------
     3
(1 row)

BEGIN
    title     | price
--------------+--------
 Linux Basics | 270.00
 Docker       | 360.00
 Kubernetes   | 540.00
(3 rows)

UPDATE 3
ROLLBACK
توقعنا ثلاث دورات فوجدنا UPDATE 3، ورأينا الأسعار الجديدة بفضل RETURNING قبل أن نقرر، ولو كان الأمر حقيقياً لكتبنا COMMIT بدل ROLLBACK. والآن لنكسر المثال عن قصد وننسى الشرط:
BEGIN;
UPDATE courses SET price = 0;
ROLLBACK;
BEGIN
UPDATE 5
ROLLBACK
الرقم 5 بدل 3 هو جرس الإنذار، ولأننا داخل معاملة فالأمر ROLLBACK أعاد كل الأسعار كما كانت. ولو نفذت نفس الجملة خارج معاملة في psql لأصبحت كل الدورات مجانية فوراً، والسبب أن psql يؤكد كل جملة وحدها افتراضياً وهذا ما يسمى Autocommit، ولا رجوع عنها إلا من نسخة احتياطية.
المعاملة BEGIN وCOMMIT وROLLBACK
المعاملة Transaction التي استخدمناها في الأمثلة السابقة هي مجموعة جمل تبدأ بـ BEGIN، ولا يراها أحد غيرك ولا تصبح دائمة حتى تكتب COMMIT، وإذا كتبت ROLLBACK ألغيت كلها كأنها لم تحدث، وهذا هو سبب نصيحتنا بتنفيذ UPDATE وDELETE داخلها. والمعاملة لها أداة صغيرة مفيدة هي نقطة الحفظ SAVEPOINT، وهي تسمح لك أن تلغي جزءاً من المعاملة وتبقي الباقي، مثل نقطة الحفظ في الألعاب:
BEGIN;
UPDATE courses SET price = price + 50 WHERE id = 1;
SAVEPOINT before_delete;
DELETE FROM payments WHERE id = 1;
ROLLBACK TO SAVEPOINT before_delete;
SELECT (SELECT price FROM courses WHERE id = 1) AS linux_price,
       (SELECT count(*) FROM payments)           AS payments;
ROLLBACK;
BEGIN
UPDATE 1
SAVEPOINT
DELETE 1
ROLLBACK
 linux_price | payments
-------------+----------
      350.00 |       10
(1 row)

ROLLBACK
الحذف ألغي لأنه بعد نقطة الحفظ، فبقيت الدفعات عشراً، أما زيادة السعر فبقيت 350 لأنها قبلها، ثم ألغى ROLLBACK الأخير كل شيء. ووعود المعاملة الأربعة التي تختصر بكلمة ACID، وكيف يلغي PostgreSQL المعاملة كلها من أول خطأ، شرحناها مع أمثلتها في الجزء الثالث.
وماذا لو عملت جلستان على نفس الصفوف؟
كل أمثلة هذا الجزء جلسة واحدة، أما التطبيق الحقيقي فيخدم مئات المستخدمين في نفس اللحظة، فلنفرض أن طالبين طلبا آخر مقعد في دورة Docker في نفس الثانية، وكل طلب قرأ عدد المسجلين فوجد مقعداً فارغاً ثم سجل، فأصبح في الدورة طالب زائد دون أي رسالة خطأ. وما تراه كل معاملة من تغييرات المعاملات الأخرى يحدده مستوى العزل Isolation Level، وقد شغلنا هذه الحالة بالضبط على جلستين حقيقيتين في مستويات العزل في الجزء الثالث، ورأينا متى يمنعها PostgreSQL ومتى لا يمنعها.
الحذف DELETE
وآخر شيء هنا هو الحذف، فالمثال التالي يحذف الطلاب الثلاثة الذين أضفناهم في هذا القسم، بعد أن نراهم أولاً:
SELECT id, name FROM students WHERE id > 6;

BEGIN;
DELETE FROM students WHERE id > 6 RETURNING id, name;
COMMIT;
 id |  name
----+--------
  9 | Reem
 10 | Yousef
 11 | Maha
(3 rows)

BEGIN
 id |  name
----+--------
  9 | Reem
 10 | Yousef
 11 | Maha
(3 rows)

DELETE 3
COMMIT
الصلاحيات GRANT وREVOKE
التطبيق لا يجب أن يتصل بقاعدة البيانات بالمستخدم postgres الذي يستطيع كل شيء، وإنما بمستخدم له الصلاحيات التي يحتاجها فقط، فإذا سرق مخترق باسورد أداة التقارير فلن يستطيع أن يحذف شيئاً. والمثال التالي ينشئ دوراً Role للتقارير، ويعطيه صلاحية قراءة جدول الدورات فقط، ثم يتصرف كأنه هو بالأمر SET ROLE:
CREATE ROLE report_reader LOGIN PASSWORD 'lab';
GRANT SELECT ON courses TO report_reader;
SET ROLE report_reader;
SELECT title, price FROM courses WHERE id = 1;
SELECT name FROM students WHERE id = 1;
RESET ROLE;
REVOKE SELECT ON courses FROM report_reader;
DROP ROLE report_reader;
CREATE ROLE
GRANT
SET
    title     | price
--------------+--------
 Linux Basics | 300.00
(1 row)

ERROR:  permission denied for table students
RESET
REVOKE
DROP ROLE
الدور قرأ الدورات ورفض له جدول الطلاب، وهذا ما نريده. وفي PostgreSQL المستخدم والمجموعة كلاهما دور Role، أما في MySQL فالمستخدم يعرف باسمه والجهاز الذي يتصل منه مثل 'report'@'10.0.0.%'، وقد شرحنا تصميم الصلاحيات لفريق كامل في PostgreSQL للفرق: تثبيت آمن وصلاحيات واضحة.
الاستعلام SELECT: اختيار الصفوف والأعمدة
الجملة SELECT تقول لقاعدة البيانات ما تريد، ولا تقول لها كيف تجده، وهذا هو الفرق الأساسي بين SQL ولغات البرمجة العادية: أنت تصف النتيجة، والمخطط Planner داخل قاعدة البيانات يختار الطريقة. وأبسط شكل لها هو كل الأعمدة من جدول واحد:
SELECT * FROM courses;
 id |    title     | track | price  | capacity | instructor_id
----+--------------+-------+--------+----------+---------------
  1 | Linux Basics | ops   | 300.00 |       20 |             4
  2 | PostgreSQL   | data  | 450.00 |       15 |             3
  3 | Docker       | ops   | 400.00 |        3 |             5
  4 | Python       | dev   | 350.00 |       25 |             6
  5 | Kubernetes   | ops   | 600.00 |       10 |          NULL
(5 rows)
والنجمة * مناسبة في psql وأنت تستكشف، ولكن لا تقم بكتابتها في كود التطبيق، والسبب أن الاستعلام يجلب أعمدة لا تحتاجها، ويتغير شكله بصمت إذا أضاف أحد عموداً للجدول. والأفضل أن تسمي الأعمدة، ويمكنك أن تحسب عموداً جديداً من عمود موجود، وأن تعطي أي عمود اسماً مستعاراً Alias بالكلمة AS:
SELECT title AS course, price AS "Price (SAR)", price * 1.15 AS with_vat FROM courses;
    course    | Price (SAR) | with_vat
--------------+-------------+----------
 Linux Basics |      300.00 | 345.0000
 PostgreSQL   |      450.00 | 517.5000
 Docker       |      400.00 | 460.0000
 Python       |      350.00 | 402.5000
 Kubernetes   |      600.00 | 690.0000
(5 rows)
لاحظ أن الاسم الذي فيه مسافة وحروف كبيرة يكتب بين علامتي تنصيص مزدوجة "Price (SAR)"، لأن العلامة المزدوجة في PostgreSQL وفي المعيار هي لأسماء الأعمدة والجداول، أما المفردة فهي للنصوص، وخلطهما من أشهر أخطاء البداية كما سوف ترى في قسم الأخطاء.
اختيار الصفوف بالشرط WHERE
الشرط WHERE يختار الصفوف التي تريدها، ومعه دائماً ORDER BY حتى تكون النتيجة مرتبة بشكل تعرفه، والمثال التالي يجلب طلاب الرياض:
SELECT name, city FROM students WHERE city = 'Riyadh' ORDER BY name;
 name |  city
------+--------
 Lina | Riyadh
 Sara | Riyadh
(2 rows)
وعمليات المقارنة هي = و<> للاختلاف، ويقبل PostgreSQL أيضاً !=، ثم < و> و<= و>=، والمثال التالي يجلب كل الدورات ما عدا التي سعرها 400:
SELECT title, price FROM courses WHERE price <> 400 ORDER BY price;
    title     | price
--------------+--------
 Linux Basics | 300.00
 Python       | 350.00
 PostgreSQL   | 450.00
 Kubernetes   | 600.00
(4 rows)
والنطاق BETWEEN يشمل الطرفين، فالشرط التالي يعني السعر من 350 حتى 450 بما فيهما:
SELECT title, price FROM courses WHERE price BETWEEN 350 AND 450 ORDER BY price;
   title    | price
------------+--------
 Python     | 350.00
 Docker     | 400.00
 PostgreSQL | 450.00
(3 rows)
والقائمة IN أقصر من كتابة OR عدة مرات:
SELECT name, city FROM students WHERE city IN ('Jeddah', 'Dammam') ORDER BY name;
  name  |  city
--------+--------
 Huda   | Jeddah
 Khalid | Dammam
 Omar   | Jeddah
(3 rows)
والبحث داخل النص هو LIKE، وفيه رمزان: النسبة % تعني أي عدد من الحروف حتى صفر، والشرطة السفلية _ تعني حرفاً واحداً بالضبط. فالشرط الأول يجلب الأسماء التي تنتهي بحرف a، والثاني الأسماء التي حرفها الثاني a:
SELECT name FROM students WHERE name LIKE '%a' ORDER BY name;
SELECT name FROM students WHERE name LIKE '_a%' ORDER BY name;
 name
------
 Huda
 Lina
 Sara
(3 rows)

  name
--------
 Faisal
 Sara
(2 rows)
والآن لنبحث عن الأسماء التي تبدأ بحرف s صغير:
SELECT name FROM students WHERE name LIKE 's%';
SELECT name FROM students WHERE name ILIKE 's%';
 name
------
(0 rows)

 name
------
 Sara
(1 row)
المقارنة في PostgreSQL تفرق بين الحرف الكبير والصغير، فلم تجد LIKE سارة، أما ILIKE فلا تفرق، وهي خاصة بـ PostgreSQL. وهنا يختلف المحركان الآخران كثيراً، فقد أعطى MySQL 8.4 النتيجة 1 للمقارنة 'Sara' = 'sara' لأن الترتيب Collation الافتراضي فيه لا يفرق بين الحروف، وكذلك SQL Server 2022 بترتيبه الافتراضي SQL_Latin1_General_CP1_CI_AS، والحرفان CI في اسمه تعنيان Case Insensitive، أما SQLite فيفرق في = ولا يفرق في LIKE للحروف الإنجليزية فقط. لذلك نفس الاستعلام قد يجد صفاً في محرك ولا يجده في آخر.
وأخيراً جمع الشروط بـ AND وOR، وهنا فخ مشهور، فلنفرض أنك تريد دورات العمليات أو البيانات التي سعرها أكبر من 500، فتكتب:
SELECT title, track, price FROM courses
WHERE track = 'ops' OR track = 'data' AND price > 500
ORDER BY price;
    title     | track | price
--------------+-------+--------
 Linux Basics | ops   | 300.00
 Docker       | ops   | 400.00
 Kubernetes   | ops   | 600.00
(3 rows)
ظهرت دورات بسعر 300 و400، والسبب أن AND تنفذ قبل OR، تماماً مثل الضرب قبل الجمع في الحساب، كما يبين جدول أولوية العمليات، فقرأت قاعدة البيانات الشرط هكذا: track = 'ops' OR (track = 'data' AND price > 500). والحل أن تكتب الأقواس بنفسك:
SELECT title, track, price FROM courses
WHERE (track = 'ops' OR track = 'data') AND price > 500;
   title    | track | price
------------+-------+--------
 Kubernetes | ops   | 600.00
(1 row)
والقاعدة: كلما خلطت AND مع OR في شرط واحد فاكتب الأقواس، حتى لو كنت متأكداً من الأولوية، لأن من يقرأ الكود بعدك قد لا يكون متأكداً.
الترتيب والصفحات ORDER BY وLIMIT
الترتيب ORDER BY يقبل أكثر من عمود، فيرتب بالأول ثم يرتب الصفوف المتساوية فيه بالثاني، والكلمة DESC تعكس الترتيب، والافتراضي ASC أي تصاعدي:
SELECT title, track, price FROM courses ORDER BY track, price DESC;
    title     | track | price
--------------+-------+--------
 PostgreSQL   | data  | 450.00
 Python       | dev   | 350.00
 Kubernetes   | ops   | 600.00
 Docker       | ops   | 400.00
 Linux Basics | ops   | 300.00
(5 rows)
وإذا أردت أول عدد من الصفوف فقط، مثل أغلى ثلاث دورات، فاستخدم LIMIT، وللصفحة الثانية وما بعدها أضف OFFSET وهو عدد الصفوف التي تتخطاها:
SELECT title, price FROM courses ORDER BY price DESC LIMIT 3;
SELECT id, title FROM courses ORDER BY id LIMIT 2 OFFSET 2;
   title    | price
------------+--------
 Kubernetes | 600.00
 PostgreSQL | 450.00
 Docker     | 400.00
(3 rows)

 id | title
----+--------
  3 | Docker
  4 | Python
(2 rows)
في الأمثلة أعلاه لاحظ التالي:
- دون ORDER BY لا يوجد أي ضمان لترتيب الصفوف، حتى لو ظهرت مرتبة في تجربتك، لذلك LIMIT دون ORDER BY تعطيك «أي ثلاثة صفوف» وليس الثلاثة الأولى، وكذلك الصفحات دون ترتيب ثابت قد تكرر صفاً أو تتخطاه.
- الكلمة LIMIT موجودة في PostgreSQL وMySQL وSQLite، أما SQL Server فيستخدم TOP مثل
SELECT TOP 3 …، أو صيغة المعيارOFFSET 0 ROWS FETCH NEXT 3 ROWS ONLYبعد ORDER BY، وقد شغلناهما على SQL Server 2022. وصيغة المعيارFETCH FIRST 3 ROWS ONLYيقبلها PostgreSQL أيضاً وأعطت نفس الدورات الثلاث. - الصفحات بـ OFFSET تصبح بطيئة في الصفحات البعيدة، لأن قاعدة البيانات تقرأ كل الصفوف التي تتخطاها ثم ترميها، وهذا موضوع نرجع إليه في مقال الفهارس.
حذف التكرار DISTINCT
عندما تطلب المدن من جدول الطلاب فسوف تتكرر كل مدينة بعدد طلابها، والكلمة DISTINCT تبقي كل قيمة مرة واحدة:
SELECT DISTINCT city FROM students ORDER BY city;
  city
--------
 Abha
 Dammam
 Jeddah
 Riyadh
(4 rows)
وإذا كتبت بعدها أكثر من عمود فهي تحذف التكرار في الأعمدة معاً وليس في الأول فقط، فالمثال التالي يعطي كل مسار مع هل فيه دورة أغلى من 400 أم لا، ولاحظ أن ops ظهر مرتين لأن فيه الحالتين:
SELECT DISTINCT track, price > 400 AS expensive FROM courses ORDER BY track;
 track | expensive
-------+-----------
 data  | t
 dev   | f
 ops   | t
 ops   | f
(4 rows)
ولا تستخدم DISTINCT لإخفاء صفوف مكررة لا تفهم سببها، فالتكرار غالباً علامة على ربط خاطئ بين الجداول، وهذا ما سوف نراه في الجزء الثاني.
العبارات والدوال Functions
في SELECT يمكنك أن تحسب أي عبارة Expression على الأعمدة، ولكل محرك مئات الدوال الجاهزة، وسوف نمر على أكثرها استخداماً. ونبدأ بدوال النصوص من توثيق دوال النصوص:
SELECT name,
       upper(name)                  AS upper_name,
       length(name)                 AS len,
       name || ' (' || city || ')'  AS label,
       split_part(email, '@', 2)    AS domain
FROM students
ORDER BY id
LIMIT 3;
 name | upper_name | len |     label     |   domain
------+------------+-----+---------------+-------------
 Sara | SARA       |   4 | Sara (Riyadh) | example.com
 Omar | OMAR       |   4 | Omar (Jeddah) | example.com
 Lina | LINA       |   4 | Lina (Riyadh) | example.com
(3 rows)
والعلامة || هي طريقة المعيار لدمج النصوص، ولكنها من أكثر المواضع اختلافاً بين المحركات، فقد أعطت الجملة SELECT 'a' || 'b' في MySQL 8.4 الرقم 0 مع تحذير، لأن || فيه تعني OR المنطقية، أما SQL Server فيدمج النصوص بعلامة +. والدالة concat موجودة في الأربعة، ولكن انتبه لسلوكها مع NULL:
SELECT concat('Sara', NULL, '!') AS with_concat, 'Sara' || NULL || '!' AS with_pipes;
 with_concat | with_pipes
-------------+------------
 Sara!       | NULL
(1 row)
في PostgreSQL تتجاهل concat القيمة NULL، أما || فإذا دخلت فيها NULL أصبحت النتيجة كلها NULL، وأعطت concat نفس النتيجة Sara! في SQL Server وSQLite، أما في MySQL فأعطت NULL كما يذكر توثيق دوال النصوص في MySQL. وهذا فرق يظهر عندما تبني اسماً كاملاً من ثلاثة أعمدة أحدها فارغ. وأما الأرقام فأشهر دوالها التقريب:
SELECT title,
       price * 1.15             AS raw_vat,
       round(price * 1.15, 1)   AS rounded,
       ceil(price * 1.15)       AS ceil_vat,
       floor(price * 1.15)      AS floor_vat
FROM courses
ORDER BY id;
    title     | raw_vat  | rounded | ceil_vat | floor_vat
--------------+----------+---------+----------+-----------
 Linux Basics | 345.0000 |   345.0 |      345 |       345
 PostgreSQL   | 517.5000 |   517.5 |      518 |       517
 Docker       | 460.0000 |   460.0 |      460 |       460
 Python       | 402.5000 |   402.5 |      403 |       402
 Kubernetes   | 690.0000 |   690.0 |      690 |       690
(5 rows)
الدالة round تقرب لعدد الخانات الذي تعطيه، وceil للأعلى دائماً، وfloor للأسفل دائماً. ثم التواريخ من توثيق دوال التاريخ، وفي PostgreSQL يمكنك أن تجمع عدد أيام على تاريخ، وأن تطرح تاريخين فتحصل على عدد الأيام بينهما:
SELECT enrolled_on,
       enrolled_on + 30                       AS plus_30_days,
       DATE '2026-10-01' - enrolled_on        AS days_until_oct,
       extract(dow FROM enrolled_on)          AS day_of_week,
       to_char(enrolled_on, 'YYYY-MM')        AS month,
       date_trunc('month', enrolled_on)::date AS month_start
FROM enrollments
WHERE id IN (1, 4, 9)
ORDER BY id;
 enrolled_on | plus_30_days | days_until_oct | day_of_week |  month  | month_start
-------------+--------------+----------------+-------------+---------+-------------
 2026-09-01  | 2026-10-01   |             30 |           2 | 2026-09 | 2026-09-01
 2026-09-10  | 2026-10-10   |             21 |           4 | 2026-09 | 2026-09-01
 2026-09-12  | 2026-10-12   |             19 |           6 | 2026-09 | 2026-09-01
(3 rows)
في المخرج أعلاه لاحظ التالي:
- الدالة
extract(dow …)ترجع رقم اليوم في الأسبوع بدءاً من الأحد بالرقم 0، فالأول من سبتمبر 2026 يوم ثلاثاء. - الدالة
date_truncتقص التاريخ إلى بداية الشهر، وهي التي سوف تستخدمها في التقارير الشهرية في الجزء الثاني. - الصيغة
DATE '2026-10-01'هي طريقة المعيار لكتابة تاريخ ثابت، وأما دوال التاريخ نفسها فتختلف أسماؤها كثيراً بين المحركات، فمثلاً يقابل طرح التاريخين في SQL Server الدالةDATEDIFF، وأما المناطق الزمنية والتقويم الهجري فلهما مقال مستقل هو التاريخ والوقت للمطورين.
القرار داخل الاستعلام CASE وCOALESCE
العبارة CASE هي if داخل SQL، وتمر على الشروط بالترتيب وتأخذ أول شرط يتحقق، والمثال التالي يعطي كل درجة وصفاً:
SELECT student_id, course_id, grade,
       CASE
           WHEN grade >= 90   THEN 'excellent'
           WHEN grade >= 75   THEN 'good'
           WHEN grade IS NULL THEN 'in progress'
           ELSE 'pass'
       END AS level
FROM enrollments
ORDER BY id;
 student_id | course_id | grade |    level
------------+-----------+-------+-------------
          1 |         1 |    90 | excellent
          1 |         2 |    85 | good
          2 |         1 |    70 | pass
          2 |         3 |  NULL | in progress
          3 |         2 |    95 | excellent
          3 |         4 |  NULL | in progress
          4 |         4 |    60 | pass
          5 |         2 |  NULL | in progress
          5 |         3 |    88 | good
(9 rows)
لاحظ أن ترتيب الشروط مهم، فالدرجة 95 تحقق الشرطين الأول والثاني، وأخذت الأول. والدالة COALESCE ترجع أول قيمة ليست NULL من القيم التي تعطيها، وهي الطريقة المعتادة لعرض قيمة بديلة:
SELECT name, COALESCE(phone, 'no phone') AS phone FROM students ORDER BY id;
  name  |   phone
--------+------------
 Sara   | 0500000001
 Omar   | no phone
 Lina   | 0500000003
 Khalid | no phone
 Huda   | 0500000005
 Faisal | 0500000006
(6 rows)
وعكسها الدالة NULLIF، فهي ترجع NULL إذا تساوت القيمتان، وأشهر استخدام لها هو منع القسمة على صفر:
SELECT 10 / 0;
SELECT 10 / NULLIF(0, 0) AS safe_div;
ERROR:  division by zero
 safe_div
----------
     NULL
(1 row)
والقسمة على صفر خطأ في PostgreSQL وSQL Server الذي أعطى Divide by zero error encountered، أما MySQL وSQLite فأعطيا NULL مع تحذير في MySQL، أي أن نفس التقرير قد يتوقف في محرك ويعطي خانة فارغة في آخر.
القيمة NULL والمنطق الثلاثي
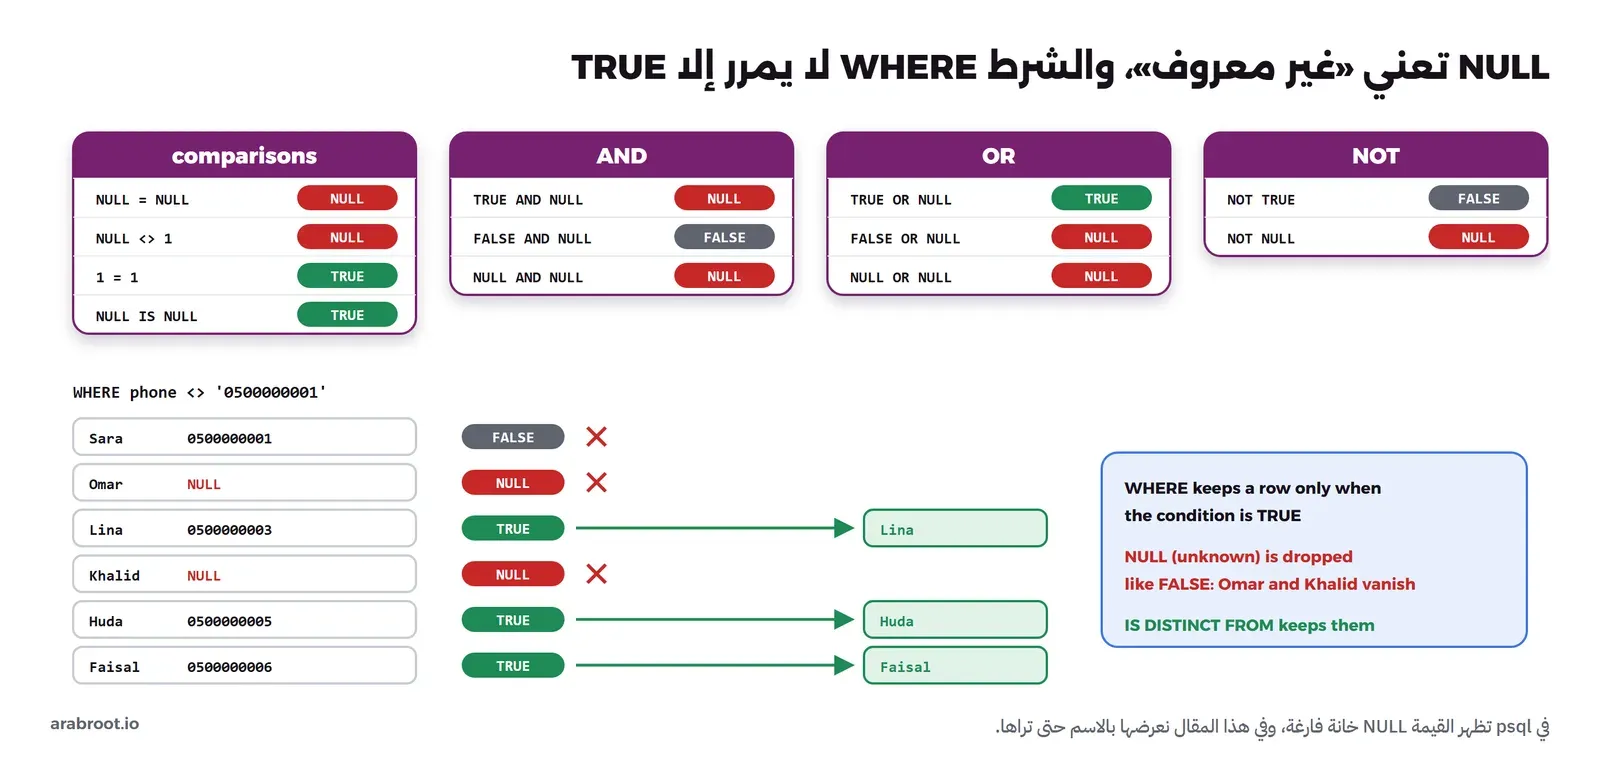
القيمة NULL لا تعني صفراً ولا نصاً فارغاً، وإنما تعني «غير معروف»: عمر لديه رقم جوال على الأغلب، ولكننا لا نعرفه. وهذا المعنى هو سبب أغرب سلوك في SQL، فلنفرض أنك تريد الطلاب الذين لم يسجلوا رقم جوال، فتكتب الشرط كما تكتبه في أي لغة برمجة:
SELECT name FROM students WHERE phone = NULL;
 name
------
(0 rows)
لا يوجد خطأ، ولا يوجد أي طالب، مع أن عمر وخالد بلا رقم. والسبب أن مقارنة أي شيء بـ «غير معروف» نتيجتها «غير معروف»، حتى NULL = NULL، والشرط WHERE لا يمرر الصف إلا إذا كانت النتيجة TRUE. والطريقة الصحيحة هي IS NULL:
SELECT name FROM students WHERE phone IS NULL;
  name
--------
 Omar
 Khalid
(2 rows)
ولكي ترى المنطق الثلاثي Three-Valued Logic بنفسك اطلب من قاعدة البيانات أن تحسب بعض العبارات مباشرة:
SELECT NULL = NULL    AS eq,
       NULL <> 1      AS ne,
       NULL AND false AS and_false,
       NULL OR true   AS or_true,
       NULL IS NULL   AS is_null;
  eq  |  ne  | and_false | or_true | is_null
------+------+-----------+---------+---------
 NULL | NULL | f         | t       | t
(1 row)
لاحظ أن NULL AND false نتيجتها FALSE، لأنه مهما كانت القيمة المجهولة فالنتيجة خاطئة، وكذلك NULL OR true نتيجتها TRUE، وهذا هو المنطق الثلاثي الذي يشرحه توثيق العمليات المنطقية. والفخ الأخطر أن الشرط العكسي يخفي الصفوف أيضاً، فإذا طلبت كل الطلاب الذين رقمهم ليس رقم سارة:
SELECT name FROM students WHERE phone <> '0500000001';
  name
--------
 Lina
 Huda
 Faisal
(3 rows)
اختفى عمر وخالد، مع أن رقمهما بكل تأكيد ليس رقم سارة. وإذا كنت تريدهما في النتيجة فاستخدم IS DISTINCT FROM التي تعامل NULL كقيمة عادية في المقارنة:
SELECT name FROM students WHERE phone IS DISTINCT FROM '0500000001';
  name
--------
 Omar
 Lina
 Khalid
 Huda
 Faisal
(5 rows)
والصورة التالية تجمع جداول المنطق الثلاثي، وما يحدث لكل طالب في الشرط السابق:
وآخر مكان تظهر فيه NULL في هذا الجزء هو الترتيب، فـ PostgreSQL يضعها في آخر الترتيب التصاعدي:
SELECT student_id, course_id, grade FROM enrollments ORDER BY grade;
 student_id | course_id | grade
------------+-----------+-------
          4 |         4 |    60
          2 |         1 |    70
          1 |         2 |    85
          5 |         3 |    88
          1 |         1 |    90
          3 |         2 |    95
          3 |         4 |  NULL
          5 |         2 |  NULL
          2 |         3 |  NULL
(9 rows)
ويقول توثيق الترتيب إن NULL تعامل كأنها أكبر من أي قيمة، لذلك تأتي في آخر ASC وأول DESC، ويمكنك تغيير ذلك بـ NULLS FIRST أو NULLS LAST. أما MySQL وSQL Server وSQLite فيفعلون العكس، فقد شغلنا جدولاً صغيراً فيه 60 و90 وNULL على الثلاثة فظهرت NULL أولاً في الترتيب التصاعدي في كل منها، وهذا ما يذكره توثيق ORDER BY في SQL Server: تعامل NULL كأصغر قيمة ممكنة. ويقبل SQLite الكلمتين NULLS FIRST وNULLS LAST كما يذكر توثيق SELECT فيه، أما MySQL وSQL Server فلا يقبلانهما، لذلك إذا كان تقريرك ينتقل بين قاعدتي بيانات فاكتب موضع NULL صراحة حيث يدعمه المحرك. وأما NULL في الدوال التجميعية مثل count وavg فهي موضوع الجزء الثاني.
بأي ترتيب تنفذ قاعدة البيانات الجملة؟
نكتب الجملة بالترتيب SELECT ثم FROM ثم WHERE، ولكن قاعدة البيانات تقرؤها بترتيب آخر، وفهم هذا الترتيب يفسر نصف رسائل الخطأ التي ستراها. والمثال التالي يحسب السعر مع ضريبة 15% ويعطيه اسماً مستعاراً هو with_vat، ثم يحاول أن يستخدم الاسم في الشرط:
SELECT title, price * 1.15 AS with_vat
FROM courses
WHERE with_vat > 400;
ERROR:  column "with_vat" does not exist
LINE 3: WHERE with_vat > 400;
              ^
وقد يتساءل البعض: كيف لا يوجد العمود وقد عرفناه في نفس الجملة؟ والإجابة أن توثيق SELECT يرتب المعالجة بهذا الشكل: يحسب أولاً FROM والربط، ثم يحذف الصفوف بالشرط WHERE، ثم يجمع GROUP BY ويطبق HAVING، وبعدها فقط يحسب أعمدة SELECT وأسماءها المستعارة، ثم يرتب ORDER BY ثم يقطع LIMIT. ويقول التوثيق صراحة إن اسم العمود في المخرج يمكن استخدامه في ORDER BY وGROUP BY ولكن ليس في WHERE أو HAVING، لذلك نكرر العبارة في الشرط ونستخدم الاسم في الترتيب:
SELECT title, price * 1.15 AS with_vat
FROM courses
WHERE price * 1.15 > 400
ORDER BY with_vat;
   title    | with_vat
------------+----------
 Python     | 402.5000
 Docker     | 460.0000
 PostgreSQL | 517.5000
 Kubernetes | 690.0000
(4 rows)
والصورة التالية تبين الترتيب الذي نكتب به والترتيب الذي تطبقه قاعدة البيانات:
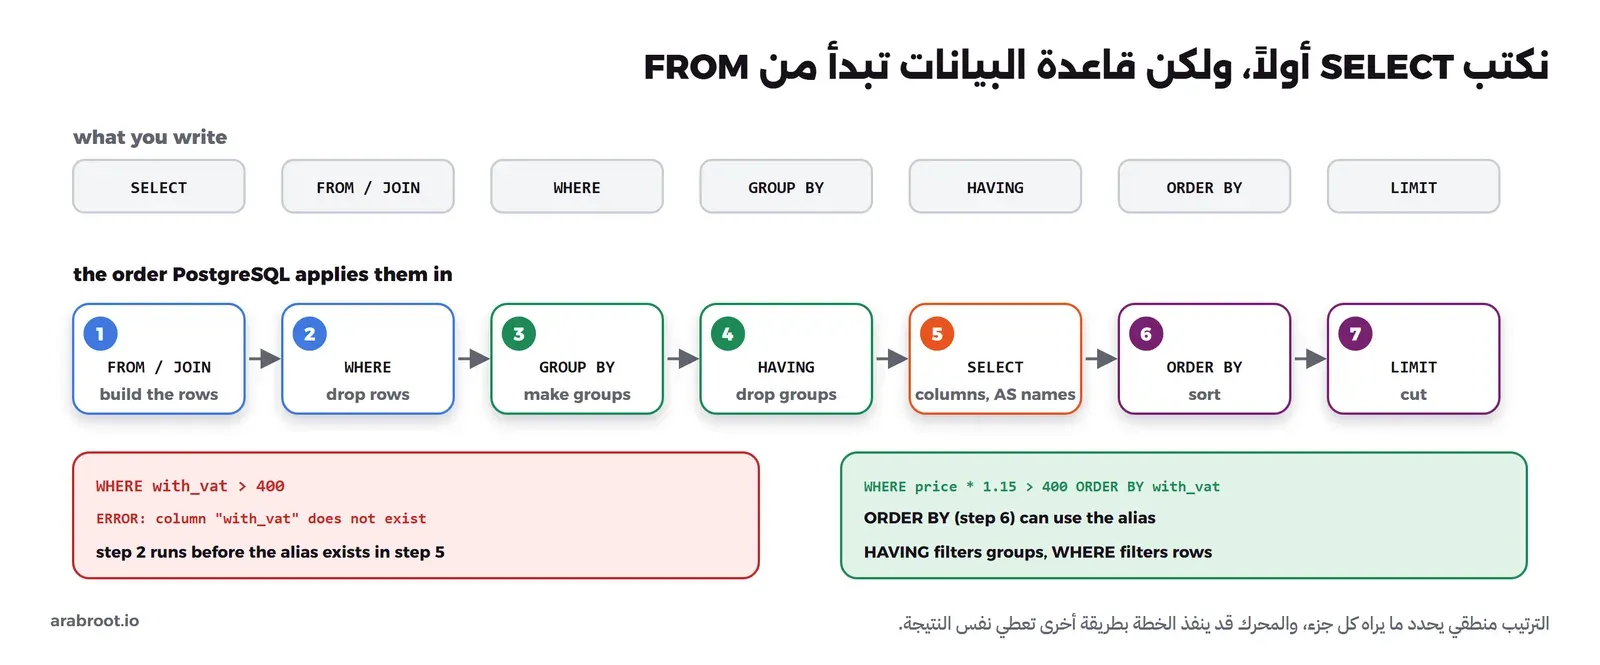
يجدر الإشارة هنا أن هذا ترتيب منطقي يحدد ما يراه كل جزء من الجملة، وليس ترتيب التنفيذ الفعلي، فالمخطط حر أن يستخدم فهرساً ويرتب ويقطع في خطوة واحدة طالما أن النتيجة نفسها، وهذا ما تراه في خطة التنفيذ EXPLAIN التي شرحناها في مقال PostgreSQL للجداول الضخمة. والخطوات GROUP BY وHAVING سوف نشرحها في الجزء الثاني، وعندها سوف يتضح لك لماذا ترتيبها بين WHERE وSELECT.
أخطاء شائعة في البداية
هذه أخطاء يقع فيها كل من يبدأ بلغة SQL، وبعضها يعطي رسالة خطأ واضحة، وبعضها أخطر لأنه يعطي نتيجة خاطئة بصمت. وأولها فاصلة زائدة قبل FROM، وهي تحدث عندما تحذف آخر عمود من القائمة:
SELECT name, city, FROM students;
ERROR:  syntax error at or near "FROM"
LINE 1: SELECT name, city, FROM students;
                           ^
والعلامة ^ تشير إلى المكان الذي توقف عنده المحلل Parser، والخطأ غالباً قبله مباشرة وليس عنده. والخطأ الثاني علامات التنصيص المزدوجة للنص:
SELECT name FROM students WHERE city = "Riyadh";
ERROR:  column "Riyadh" does not exist
LINE 1: SELECT name FROM students WHERE city = "Riyadh";
                                               ^
فهم PostgreSQL أن "Riyadh" اسم عمود، أما MySQL فقد قبل نفس الجملة وأعاد النص لأن العلامة المزدوجة فيه للنصوص افتراضياً، وهذا يجعل من يتعلم على MySQL يتفاجأ عندما ينتقل. والخطأ الثالث علامة التنصيص داخل النص، مثل اسم O'Brien، فالعلامة الثانية تغلق النص قبل نهايته، وقد أرسلنا الجملة من الطرفية حتى ترى رد السيرفر:
docker exec lab-sql-pg psql -U postgres -d academy -c "SELECT 'O'Brien' AS name;"
ERROR:  unterminated quoted string at or near "' AS name;"
LINE 1: SELECT 'O'Brien' AS name;
                       ^
والحل داخل SQL أن تكتب العلامة مرتين:
SELECT 'O''Brien' AS name;
  name
---------
 O'Brien
(1 row)
ولكن لا تقم بذلك في كود التطبيق، وإنما أرسل القيمة كمعامل Parameter منفصل عن الجملة، والسبب أن نفس هذه العلامة هي باب حقن SQL الذي نشرحه في الجزء الثالث. والخطأ الرابع أخطر لأنه بلا رسالة، وهو القسمة الصحيحة:
SELECT title, capacity / 2 AS half, capacity / 2.0 AS half_exact FROM courses WHERE id = 3;
 title  | half |     half_exact
--------+------+--------------------
 Docker |    1 | 1.5000000000000000
(1 row)
وبقية الأخطاء الصامتة رأيتها في الأقسام السابقة، وهذه قائمتها حتى ترجع إليها:
- المقارنة
= NULLبدلIS NULLتعطي صفر صفوف دون خطأ. - الشرط
<>يخفي الصفوف التي فيها NULL، فاستخدمIS DISTINCT FROMإذا كنت تريدها. - خلط AND مع OR دون أقواس يغير معنى الشرط.
- LIMIT دون ORDER BY يعطي صفوفاً عشوائية في الواقع.
- المقارنة
name = 'sara'لا تجد Sara في PostgreSQL، وتجدها في MySQL وSQL Server. - UPDATE أو DELETE دون WHERE ينفذ على الجدول كله، فاعمل داخل BEGIN واقرأ عدد الصفوف.
- عدم وجود قيد في الجدول يعني أن البيانات الخاطئة سوف تدخل يوماً ما، مهما كان الكود حريصاً.
تمارين
حل هذه التمارين على نفس قاعدة البيانات قبل أن تفتح الحل، واكتب قبل التشغيل كم صفاً تتوقع، فهذه هي العادة التي تحميك من الأخطاء الصامتة.
التمرين 1: اعرض عنوان وسعر دورات مسار العمليات ops من الأرخص للأغلى.
الحل Answer
SELECT title, price
FROM courses
WHERE track = 'ops'
ORDER BY price;
    title     | price
--------------+--------
 Linux Basics | 300.00
 Docker       | 400.00
 Kubernetes   | 600.00
(3 rows)
التمرين 2: اعرض الطلاب من الرياض أو جدة الذين لديهم رقم جوال، مرتبين بالاسم.
الحل Answer
SELECT name, city, phone
FROM students
WHERE (city = 'Riyadh' OR city = 'Jeddah')
  AND phone IS NOT NULL
ORDER BY name;
 name |  city  |   phone
------+--------+------------
 Huda | Jeddah | 0500000005
 Lina | Riyadh | 0500000003
 Sara | Riyadh | 0500000001
(3 rows)
بدون الأقواس سوف يظهر عمر لأن شرط الجوال يرتبط بجدة فقط.
التمرين 3: اعرض عنوان كل دورة وسعرها مع الضريبة 15% مقرباً لأقرب ريال، للدورات التي سعرها مع الضريبة أقل من 500 فقط، من الأرخص للأغلى.
الحل Answer
SELECT title, round(price * 1.15) AS with_vat
FROM courses
WHERE price * 1.15 < 500
ORDER BY with_vat;
    title     | with_vat
--------------+----------
 Linux Basics |      345
 Python       |      403
 Docker       |      460
(3 rows)
كررنا العبارة في WHERE لأن الاسم المستعار لا يوجد بعد في تلك الخطوة، واستخدمناه في ORDER BY.
التمرين 4: اعرض رقم الطالب ورقم الدورة للتسجيلات التي لم تحصل على درجة بعد.
الحل Answer
SELECT student_id, course_id
FROM enrollments
WHERE grade IS NULL
ORDER BY student_id;
 student_id | course_id
------------+-----------
          2 |         3
          3 |         4
          5 |         2
(3 rows)
التمرين 5: صفحة الطلاب في التطبيق تعرض طالبين في كل صفحة مرتبين بالاسم، اكتب استعلام الصفحة الثانية.
الحل Answer
SELECT name
FROM students
ORDER BY name
LIMIT 2 OFFSET 2;
  name
--------
 Khalid
 Lina
(2 rows)
التمرين 6: اعرض كل دورة مع تصنيف premium إذا كان سعرها 450 أو أكثر وstandard لغيرها، من الأغلى للأرخص.
الحل Answer
SELECT title,
       CASE WHEN price >= 450 THEN 'premium' ELSE 'standard' END AS tier
FROM courses
ORDER BY price DESC;
    title     |   tier
--------------+----------
 Kubernetes   | premium
 PostgreSQL   | premium
 Docker       | standard
 Python       | standard
 Linux Basics | standard
(5 rows)
التمرين 7: المعهد يريد رفع سعة دورة Docker إلى 5 مقاعد، اكتب الخطوات الآمنة لذلك، ثم ألغ التغيير حتى تبقى البيانات كما هي.
الحل Answer
BEGIN;
SELECT count(*) FROM courses WHERE title = 'Docker';
UPDATE courses SET capacity = 5
WHERE title = 'Docker'
RETURNING title, capacity;
ROLLBACK;
BEGIN
 count
-------
     1
(1 row)

 title  | capacity
--------+----------
 Docker |        5
(1 row)

UPDATE 1
ROLLBACK
توقعنا صفاً واحداً فوجدنا UPDATE 1، ولو كان التغيير حقيقياً لكتبنا COMMIT.
التمرين 8: اكتب جدولاً للقاعات rooms فيه رقم يولد تلقائياً، واسم إلزامي لا يتكرر، وعدد مقاعد إلزامي أكبر من صفر، ثم أضف قاعتين في جملة واحدة، ثم تأكد أن القيد يرفض قاعة بلا مقاعد، ثم احذف الجدول.
الحل Answer
CREATE TABLE rooms (
    id     int   GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name   text  NOT NULL UNIQUE,
    seats  int   NOT NULL CHECK (seats > 0)
);
INSERT INTO rooms (name, seats) VALUES ('Lab A', 20), ('Lab B', 12);
INSERT INTO rooms (name, seats) VALUES ('Lab C', 0);
DROP TABLE rooms;
CREATE TABLE
INSERT 0 2
ERROR:  new row for relation "rooms" violates check constraint "rooms_seats_check"
DETAIL:  Failing row contains (3, Lab C, 0).
DROP TABLE
وإذا انتهيت من التجارب فأوقف المختبر واحذفه، أو اتركه يعمل إذا كنت ستكمل مباشرة إلى الجزء الثاني، فهو يستخدم نفس قاعدة البيانات:
docker rm -f lab-sql-pg
الخلاصة
وصلنا لنهاية الجزء الأول، وأهم ما تخرج به منه:
- قاعدة البيانات العلائقية تحفظ البيانات في جداول، والمفتاح الأساسي يعرف كل صف، والمفتاح الأجنبي يربط الصفوف بالقيم نفسها، وهذه فكرة Codd عام 1970 التي بنيت عليها لغة SEQUEL ثم SQL.
- SQL معيار دولي آخر إصداراته SQL:2023، ولكل محرك لهجته، والأساسيات تعمل في كل المحركات تقريباً كما هي.
- الأوامر خمس مجموعات: DDL للهيكل، وDML للصفوف، وDQL للقراءة، وDCL للصلاحيات، وTCL للمعاملات.
- اختر النوع المناسب لكل عمود، والمال numeric دائماً، واكتب القيود في الجدول نفسه لأنها تعمل على كل تطبيق وكل شخص.
- نفذ UPDATE وDELETE داخل BEGIN وقارن عدد الصفوف بما تتوقعه قبل COMMIT.
- القيمة NULL تعني «غير معروف»، فاستخدم IS NULL وIS DISTINCT FROM وCOALESCE، وتذكر أن موضعها في الترتيب يختلف بين المحركات.
- قاعدة البيانات تقرأ الجملة بالترتيب FROM ثم WHERE ثم GROUP BY ثم HAVING ثم SELECT ثم ORDER BY ثم LIMIT، وهذا يفسر لماذا لا ترى WHERE الأسماء المستعارة.
وفي الجزء التالي سوف نجمع الصفوف من أكثر من جدول بالربط JOIN، ونحسب المجاميع والمتوسطات بالتجميع GROUP BY، ونرى كيف يتضاعف رقم في تقرير دون أي رسالة خطأ. وإذا أردت أن تطبق ما قرأته على قاعدة بيانات أكبر، فتمارين Kata في SQL مكتوبة لهذا الغرض، والمستوى الأول منها يناسب هذا الجزء:
 دليلتعلم SQL (2): الربط JOIN والتجميع والاستعلامات الفرعيةكيف تجمع الصفوف من أكثر من جدول وتلخصها بالتجميع والاستعلامات الفرعية، دون أن تتضاعف أرقام تقاريرك.
 دليلتعلم SQL (3): CTE ودوال النوافذ والمعاملاتكيف تكتب استعلامات أوضح بجمل WITH ودوال النوافذ، وتحمي بياناتك بالمعاملات ومستويات العزل ومن حقن SQL.
 دليلتمارين Kata في SQL بثلاثة مستويات مع الحلولتمارين SQL تحلها بيدك دون ذكاء اصطناعي على متجر من مئتي ألف طلب، من فخاخ LEFT JOIN إلى اختيار الفهرس المناسب.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
وبعد الأجزاء الثلاثة تكمل مرحلة لغات البرمجة بمقال الخيوط Threads والتزامن، وفيه نفس مشكلة الجلستين اللتين تعملان على نفس البيانات في الجزء الثالث، ولكن داخل ذاكرة برنامجك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل الاستعلامات والتجارب على جلستين في PostgreSQL 18.6 (postgres:18، Debian 18.6-1.pgdg13+2)، والمقارنات على MySQL 8.4.11 وSQL Server 2022 (16.0.4295.3، CU27) Developer Edition، في Docker Engine 29.8.0 (Docker Desktop).
- أكتوبر 2026: إعادة كتابة المقال كجزء أول من سلسلة «تعلم SQL» من ثلاثة أجزاء، بإضافة النموذج العلائقي وتاريخ اللغة ومجموعات الأوامر وأنواع البيانات والقيود والدوال وتمارين بحلولها، على قاعدة بيانات جديدة من خمسة جداول. ونقلنا الربط والتجميع والاستعلامات الفرعية إلى الجزء الثاني، ودوال النوافذ والمعاملات ومستويات العزل وحقن SQL إلى الجزء الثالث. وأعدنا تشغيل كل الأمثلة على PostgreSQL 18.6 (postgres:18.6)، والمقارنات على MySQL 8.4.11 وSQL Server 2022 (16.0.4295.3، CU27) وSQLite 3.49.1.


