عندما تبدأ مشروعاً جديداً، فأول سؤال يسأله الفريق في الغالب: أي قاعدة بيانات نستخدم؟ ثم يبدأ النقاش من الأسماء: PostgreSQL أم MongoDB أم Redis، وكأنها منتجات متنافسة على الشيء نفسه. والحقيقة أن كل واحدة منها تنتمي إلى عائلة مختلفة، ولكل عائلة طريقة في ترتيب البيانات Data Model، وأسئلة تجيب عنها بسهولة وأسئلة تجيب عنها بصعوبة، ووعود مختلفة عن الاتساق Consistency عندما يكتب أكثر من شخص في الوقت نفسه. فإذا فهمت العائلات، أصبح اختيار المنتج سؤالاً ثانوياً.
وهذا المقال هو المدخل لمرحلة قواعد البيانات في خارطة الطريق، والمفاهيم الأساسية للغة SQL شرحناها في أساسيات SQL، وتصميم الجداول في تصميم قواعد البيانات، ومتى تكفيك PostgreSQL وحدها للطوابير والبحث والمتجهات في PostgreSQL لكل شيء، فلن نكررها هنا.
 دليلتعلم SQL (1): ما هو SQL وكيف تكتب أول استعلامتتعلم SQL من الصفر: ما هي قاعدة البيانات العلائقية، وكيف تنشئ الجداول وتضيف البيانات وتكتب أول استعلام بأمان.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
وسوف نناقش في هذا المقال ما يلي:
- العائلات الرئيسية: العلائقية Relational، والمستندات Document، والمفتاح والقيمة Key-Value، والأعمدة العريضة Wide-Column، والرسوم البيانية Graph، والسلاسل الزمنية Time-Series، والمتجهات Vector.
- نموذج البيانات في كل عائلة، والسؤال الذي يناسبها، والسؤال الذي يتعبها.
- الاتساق والمعاملات: ما الذي تضمنه كل عائلة عندما يكتب أكثر من طرف.
- تجربة عملية: المتجر نفسه في PostgreSQL وMongoDB وValkey، وثلاثة أسئلة تكشف الفرق، ثم نكسر النسخ المكررة عمداً.
- دليل قرار مختصر، والخطأ الأشهر: اختيار العائلة قبل معرفة الأسئلة.
خريطة العائلات
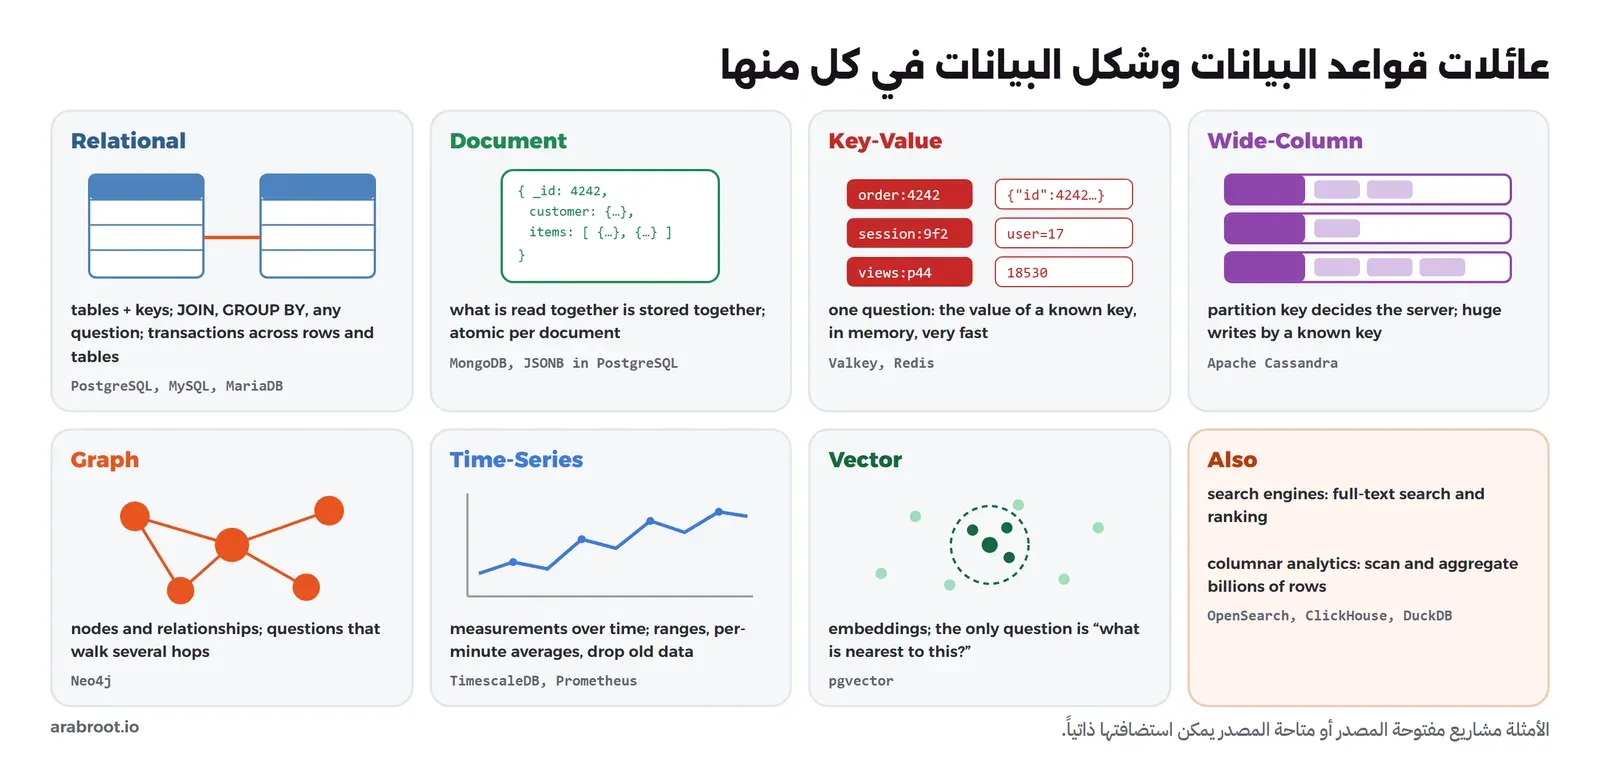
الصورة التالية تبين العائلات السبع الأكثر انتشاراً، وشكل البيانات في كل منها، وأمثلة مفتوحة المصدر تقابلها في الاستضافة الذاتية:
العلائقية Relational
البيانات في جداول، لكل جدول أعمدة بأنواع محددة، والعلاقات بين الجداول بالمفاتيح، وتسأل عنها بلغة SQL التي تستطيع أن تربط أي جدول بأي جدول وتجمع وترتب كما تشاء، حتى لأسئلة لم تفكر فيها عند التصميم. وتضمن المعاملات Transactions بخصائص ACID على أي عدد من الصفوف والجداول، وتحمي البيانات بالقيود Constraints، فلا يدخل طلب لعميل غير موجود. ومثالها PostgreSQL برخصة PostgreSQL License المتساهلة، وMySQL وMariaDB. ونقطة ضعفها التقليدية أن الكتابة تتركز على سيرفر رئيسي واحد، والتوزيع على عدة سيرفرات ممكن ولكنه ليس مدمجاً، كما شرحنا في مقال التقسيم والتوزيع.
المستندات Document
كل سجل مستند بصيغة تشبه JSON، فيه حقول ومصفوفات ومستندات متداخلة، ولا يشترط أن تتشابه المستندات في المجموعة الواحدة Collection. والفكرة أن تحفظ معاً ما يقرأ معاً: الطلب مع بنوده وملخص العميل في مستند واحد، فتقرأ الصفحة كاملة بقراءة واحدة. وتضمن MongoDB أن الكتابة على مستند واحد ذرية Atomic دائماً، ومعه المستندات المتداخلة فيه، أما المعاملة على أكثر من مستند فمدعومة على مجموعة النسخ Replica Set أو العنقود المقسم، وتنصح الوثائق بأن تبقى استثناء وليست بديلاً عن تصميم المستند، كما في توثيق الذرية في MongoDB. والحد الأقصى لحجم المستند الواحد 16 ميبيبايت كما في صفحة الحدود. ورخصة MongoDB هي SSPL، وهي رخصة مصدر متاح وليست مفتوحة المصدر بتعريف OSI، وقد شرحنا الفرق في مقال الرخص.
المفتاح والقيمة Key-Value
أبسط العائلات: قاموس ضخم، تعطيه مفتاحاً فيعيد قيمة، وغالباً في الذاكرة، لذلك فهو أسرع ما يكون في سؤال واحد: «أعطني قيمة هذا المفتاح». وValkey وRedis يضيفان أنواعاً للقيمة مثل القوائم والمجموعات والعدادات، ولكنهما لا يعرفان ما داخل القيمة، فلا يوجد استعلام بشرط على محتوى القيم، ولا ربط، وكل سؤال لم تصمم له مفتاحاً مسبقاً يعني أن تمر على المفاتيح كلها. والمعاملة فيهما بالأمر MULTI تنفذ الأوامر متتالية دون أن يدخل بينها أحد، ولكن لا يوجد تراجع Rollback إذا فشل أمر في وسطها، كما يوضح توثيق Valkey، والحفظ على القرص اختياري بلقطات دورية أو سجل للأوامر حسب إعدادات الحفظ. وValkey برخصة BSD-3-Clause، وهي النسخة المفرعة التي ظهرت بعد أن نقلت Redis رخصتها إلى SSPL في مارس 2024، ثم أضافت Redis خيار AGPLv3 كما في مدونتها، والتفصيل في قسم الرخصة في مقال التخزين المؤقت.
الأعمدة العريضة Wide-Column
جداول بالاسم فقط، فكل صف يحدد بمفتاح تقسيم Partition Key يقرر على أي سيرفر يعيش، ومفتاح ترتيب Clustering Key يرتب الصفوف داخل القسم، والاستعلام المسموح به عملياً هو ما يبدأ بمفتاح التقسيم. ومثالها Apache Cassandra برخصة Apache-2.0، التي تستخدم شجرة LSM التي شرحناها في مقال التخزين من الداخل، وتوزع البيانات على عشرات السيرفرات دون سيرفر رئيسي، وتسمح لك أن تختار مع كل استعلام كم نسخة يجب أن توافق. وهي تناسب كتابة ضخمة جداً بمفتاح معروف، مثل أحداث الأجهزة أو سجل الرسائل لكل محادثة، وتصمم فيها الجداول حول الاستعلامات وليس حول الكيانات، فاستعلام جديد غالباً يعني جدولاً جديداً.
الرسوم البيانية Graph
البيانات عقد Nodes وعلاقات Edges لكل منها خصائص، والاستعلام يمشي على العلاقات: أصدقاء أصدقائي الذين اشتروا هذا المنتج، أو أقصر طريق بين حسابين في شبكة تحويلات مشبوهة. وهذه الأسئلة في SQL تصبح ربطاً للجدول بنفسه مرات بعدد الخطوات، أما في قاعدة الرسوم فهي المشي الطبيعي. ومثالها Neo4j، ونسختها Community برخصة GPLv3 كما في صفحة الرخص. ولا تحتاجها إلا عندما تكون العلاقات نفسها هي السؤال، وليس لمجرد أن بياناتك فيها علاقات، فكل قاعدة علائقية فيها علاقات.
السلاسل الزمنية Time-Series
قياسات تأتي مع الوقت: حرارة، أسعار، استهلاك المعالج، وكل نقطة تكتب مرة ولا تعدل تقريباً، والأسئلة دائماً بمدى زمني ومتوسط في كل دقيقة أو ساعة، والبيانات القديمة تلخص أو تحذف. ومثالها TimescaleDB، وهي إضافة إلى PostgreSQL، جزء منها برخصة Apache-2.0 وجزء برخصة Timescale الخاصة كما في صفحة رخصها، وقد رأينا ما تقدمه PostgreSQL وحدها لهذه البيانات بالتقسيم وBRIN في PostgreSQL لكل شيء، وأنظمة المراقبة مثل Prometheus لها مخزنها الزمني الخاص.
المتجهات Vector
كل سجل متجه من مئات الأرقام يمثل معنى نص أو صورة، والسؤال الوحيد تقريباً: ما أقرب السجلات إلى هذا المتجه؟ وهو أساس البحث الدلالي وأنظمة RAG التي شرحناها في مقال RAG. والفهارس هنا تقريبية Approximate، تعطيك نتائج قريبة جداً من الأقرب بسرعة كبيرة بدل المقارنة مع كل سجل. ومثالها الإضافة pgvector لPostgreSQL برخصة PostgreSQL، وقد شرحناها بتجربة في PostgreSQL لكل شيء، وهناك قواعد متخصصة للمتجهات عندما تصل إلى مئات الملايين منها.
ويضاف إلى هذه العائلات محركات البحث النصي مثل OpenSearch، وقواعد التحليل العمودية مثل ClickHouse وDuckDB، وقد شرحنا البحث في كيف يعمل البحث، والفرق بين قواعد التطبيق وقواعد التحليل في OLTP أم OLAP.
الاتساق: ماذا تضمن لك كل عائلة؟
يقال عادة إن القواعد العلائقية تعطي ACID والقواعد الأخرى تعطي الاتساق النهائي Eventual Consistency، وهذا التقسيم قديم وغير دقيق اليوم. والسؤال الذي يهمك فعلاً من جزأين: ما أكبر شيء تستطيع أن تعدله دفعة واحدة دون أن يرى أحد نصفه؟ وإذا قرأت بعد أن كتبت مباشرة، هل ترى ما كتبته؟
| العائلة | وحدة الكتابة الذرية | المعاملة على عدة سجلات | ملاحظة |
|---|---|---|---|
| Relational | أي عدد من الصفوف والجداول | نعم، وهي الأساس | مستويات العزل تحدد ما تراه المعاملات الأخرى، كما في مقال الأقفال |
| Document | مستند واحد بكل ما داخله | نعم في MongoDB على Replica Set، بثمن في الأداء | صمم المستند بحيث يكون التعديل المهم داخل مستند واحد |
| Key-Value | أمر واحد على مفتاح، وMULTI لعدة أوامر | دون تراجع Rollback | الحفظ على القرص اختياري حسب الإعداد |
| Wide-Column | صف أو قسم واحد | محدودة جداً | تختار مستوى الاتساق مع كل استعلام |
| Graph | حسب المحرك | Neo4j تدعم المعاملات | التوزيع على عدة سيرفرات أصعب من غيرها |
وعندما توزع أي قاعدة على عدة سيرفرات تظهر أسئلة النسخ والتأخر واختيار الاتساق أو التوفر، وقد شرحناها في نظرية CAP.
تجربة عملية: المتجر نفسه في ثلاث قواعد
الكلام عن العائلات يبقى نظرياً حتى ترى السؤال نفسه على البيانات نفسها، لذلك سوف نبني متجراً صغيراً فيه 1000 عميل و50 منتجاً و20 ألف طلب، كل طلب فيه من بند إلى خمسة بنود، ونضعه في ثلاث قواعد: PostgreSQL 18.6 وMongoDB 8.0.32 وValkey 9.1.2، وكلها على 127.0.0.1:
name: lab-types
services:
  pg:
    image: postgres:18.6
    container_name: lab-types-pg
    environment:
      POSTGRES_PASSWORD: lab-only-password
      POSTGRES_DB: shop
    ports: ["127.0.0.1:15481:5432"]
  mongo:
    image: mongo:8.0.32
    container_name: lab-types-mongo
    command: ["mongod", "--replSet", "rs0", "--bind_ip_all"]   # a one-member replica set, so transactions work
    ports: ["127.0.0.1:15482:27017"]
  valkey:
    image: valkey/valkey:9.1.2-alpine
    container_name: lab-types-valkey
    ports: ["127.0.0.1:15483:6379"]
  app:
    image: python:3.13.16-slim
    container_name: lab-types-app
    command: sh -c "pip install --root-user-action=ignore -q 'psycopg[binary]==3.3.6' 'pymongo==4.15.3' 'valkey==6.1.1' && sleep infinity"
    volumes: ["./:/lab"]
    working_dir: /lab
docker compose -p lab-types up -d
docker exec lab-types-mongo mongosh --quiet --eval 'rs.initiate({_id: "rs0", members: [{_id: 0, host: "mongo:27017"}]})'
docker exec lab-types-app python shop.py loadوالسكربت shop.py كاملاً في مجلد lab مع المقال، وهو يولد البيانات نفسها بالبذرة العشوائية نفسها ثم يحفظها بالشكل المناسب لكل عائلة:
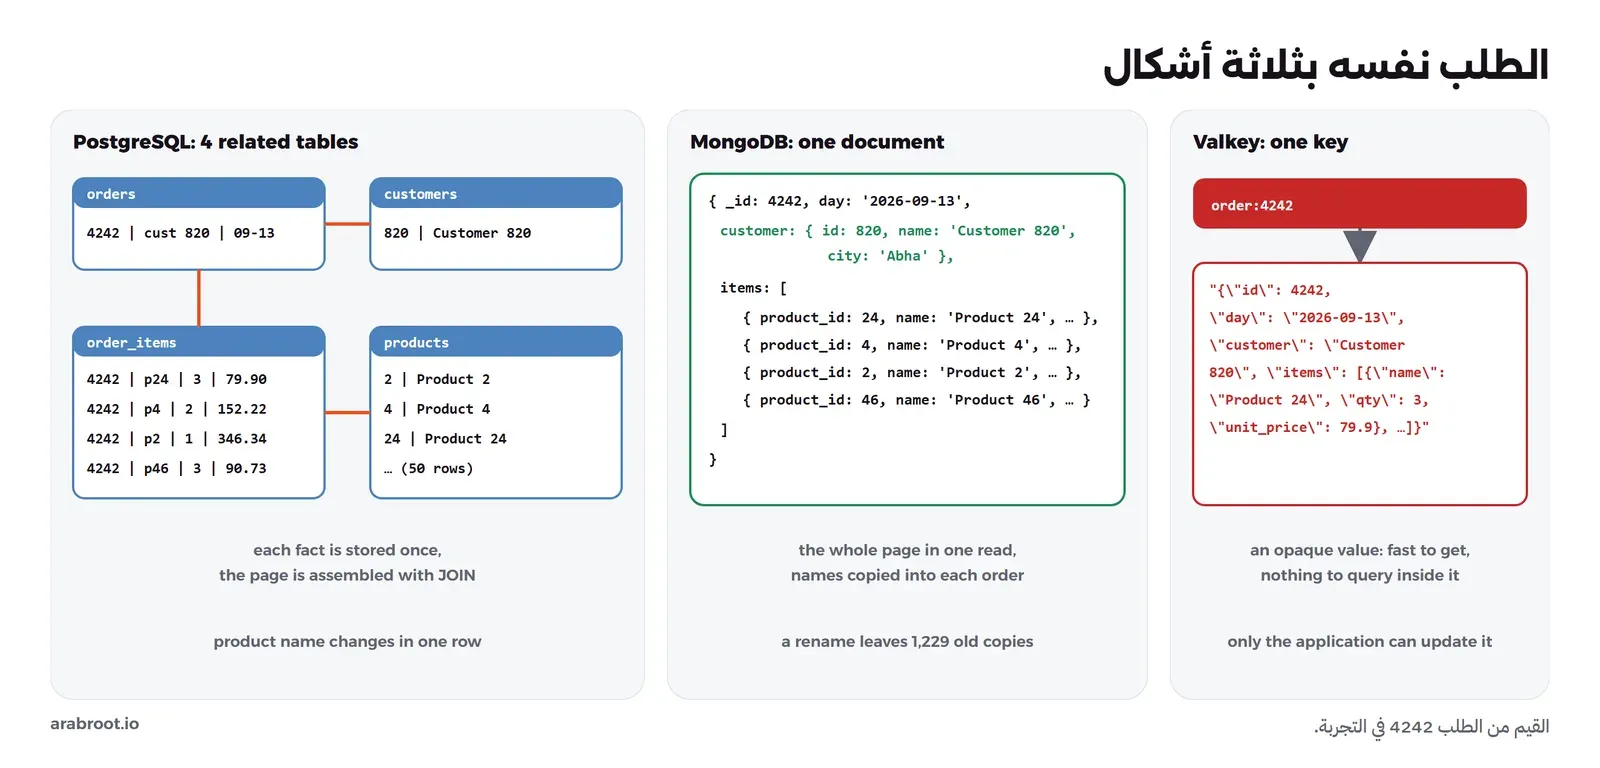
- في PostgreSQL أربعة جداول مطبعة Normalized: العملاء والمنتجات والطلبات وبنود الطلبات، وفي كل بند سعر الوحدة وقت الشراء.
- في MongoDB مستند لكل طلب، داخله ملخص العميل والبنود باسم المنتج وسعره، لأن صفحة الطلب تحتاجها كلها معاً.
- في Valkey مفتاح لكل طلب
order:4242قيمته الطلب كاملاً بصيغة JSON، وهذا تصميم لسؤال واحد: اعرض الطلب رقم كذا.
### python shop.py load
PostgreSQL: 4 tables loaded in 4.7 s
MongoDB: 20,000 order documents loaded in 1.5 s
Valkey: 20,000 keys loaded in 1.3 s
والصورة التالية تبين الطلب نفسه بالأشكال الثلاثة:
السؤال الأول: اعرض الطلب 4242
في PostgreSQL نربط الجداول الأربعة:
SELECT o.id, o.day, c.name AS customer, p.name AS product, i.qty, i.unit_price
FROM orders o JOIN customers c ON c.id = o.customer_id
JOIN order_items i ON i.order_id = o.id JOIN products p ON p.id = i.product_id
WHERE o.id = 4242 ORDER BY p.name;
id | day | customer | product | qty | unit_price
------+------------+--------------+------------+-----+------------
4242 | 2026-09-13 | Customer 820 | Product 2 | 1 | 346.34
4242 | 2026-09-13 | Customer 820 | Product 24 | 3 | 79.90
4242 | 2026-09-13 | Customer 820 | Product 4 | 2 | 152.22
4242 | 2026-09-13 | Customer 820 | Product 46 | 3 | 90.73
(4 rows)وفي MongoDB نقرأ مستنداً واحداً بالأمر db.orders.findOne({_id: 4242}):
{
  _id: 4242,
  day: '2026-09-13',
  customer: { id: 820, name: 'Customer 820', city: 'Abha' },
  items: [
    { product_id: 24, name: 'Product 24', qty: 3, unit_price: 79.9 },
    { product_id: 4, name: 'Product 4', qty: 2, unit_price: 152.22 },
    { product_id: 2, name: 'Product 2', qty: 1, unit_price: 346.34 },
    { product_id: 46, name: 'Product 46', qty: 3, unit_price: 90.73 }
  ]
}
وفي Valkey نقرأ مفتاحاً واحداً بالأمر GET order:4242:
{"id": 4242, "day": "2026-09-13", "customer": "Customer 820", "items": [{"name": "Product 24", "qty": 3, "unit_price": 79.9}, {"name": "Product 4", "qty": 2, "unit_price": 152.22}, {"name": "Product 2", "qty": 1, "unit_price": 346.34}, {"name": "Product 46", "qty": 3, "unit_price": 90.73}]}وقسنا متوسط 200 تكرار لكل طريقة من داخل Container التطبيق:
### python shop.py order
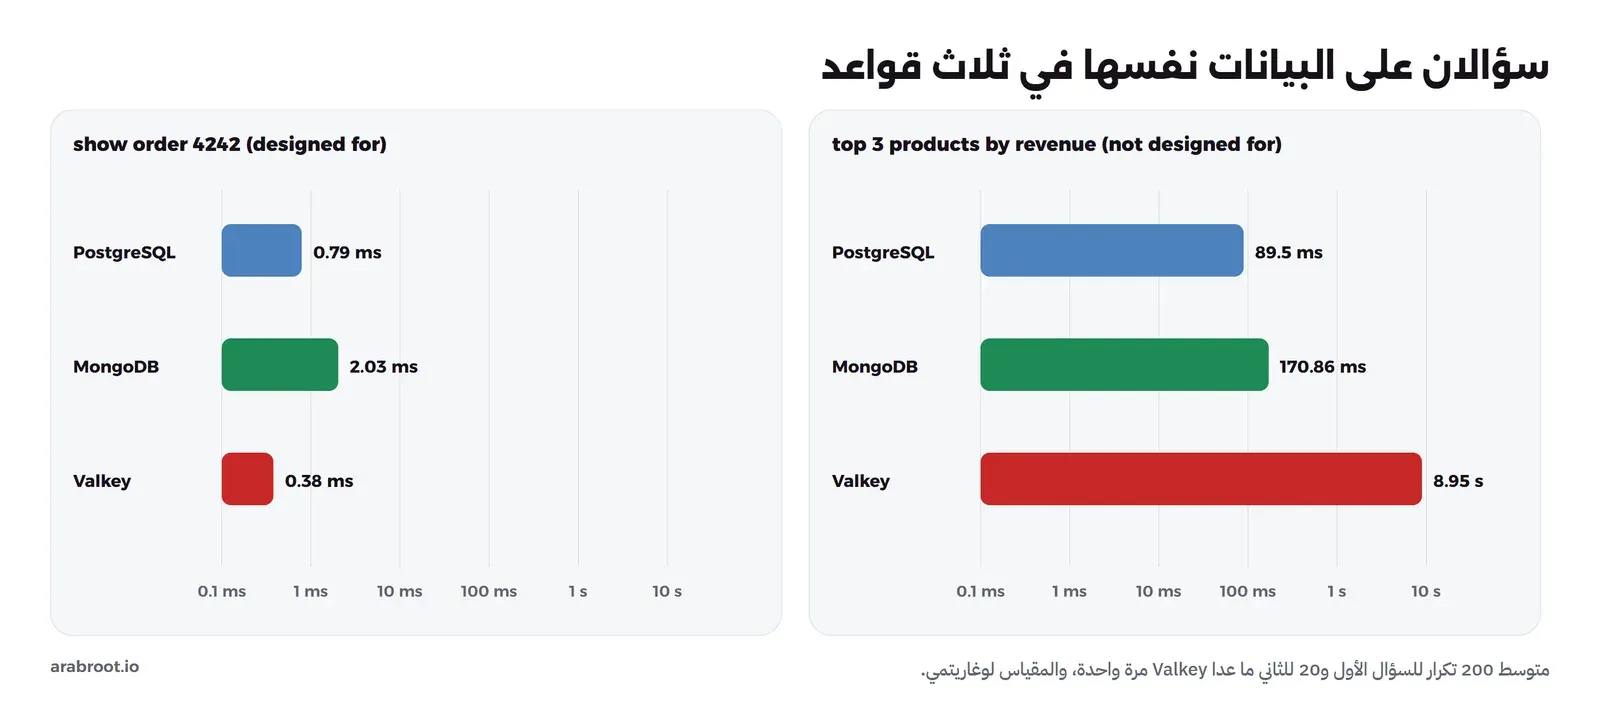
PostgreSQL (join of 4 tables)          0.79 ms
   (4242, datetime.date(2026, 9, 13), 'Customer 820', 'Product 2', 1, Decimal('346.34')) ... 4 rows
MongoDB (one document)                 2.03 ms
   {'_id': 4242, 'day': '2026-09-13', 'customer': {'id': 820, 'name': 'Customer 820', 'city': 'Abha'}} ... 4 items
Valkey (one GET)                       0.38 ms
   {"id": 4242, "day": "2026-09-13", "customer": "Customer 820", "items": [{"name": "Product  ...
الثلاثة أقل من ملي ثانيتين، وهذا هو الدرس الأول: للسؤال الذي يحدد سجلاً بمفتاحه، كل العائلات سريعة جداً، والربط في PostgreSQL مع الفهارس على المفاتيح ليس المشكلة التي يظنها البعض. وValkey أسرع لأنه يعيد نصاً جاهزاً من الذاكرة دون أي معالجة، وMongoDB أبطأ قليلاً هنا لأن المكتبة تحول المستند من BSON إلى كائنات Python. والفروق بأجزاء الملي ثانية لا تقرر اختيار قاعدة بيانات، والذي يقرره هو السؤال التالي.
السؤال الثاني: أعلى ثلاثة منتجات في الإيراد
هذا سؤال لم نصمم له شيئاً خاصاً، يأتي من المدير بعد أشهر من الإطلاق، وهو بالضبط نوع الأسئلة الذي يكشف الفرق بين العائلات:
sql = '''SELECT p.name, sum(i.qty * i.unit_price) AS revenue FROM order_items i JOIN products p ON p.id = i.product_id
         GROUP BY p.name ORDER BY revenue DESC LIMIT 3'''

pipeline = [{'$unwind': '$items'},
            {'$group': {'_id': '$items.name', 'revenue': {'$sum': {'$multiply': ['$items.qty', '$items.unit_price']}}}},
            {'$sort': {'revenue': -1}}, {'$limit': 3}]

def kv_scan():
    revenue, keys = {}, 0
    for key in kv.scan_iter('order:*', count=1000):
        keys += 1
        for it in json.loads(kv.get(key))['items']:
            revenue[it['name']] = revenue.get(it['name'], 0) + it['qty'] * it['unit_price']
    return keys, sorted(revenue.items(), key=lambda x: -x[1])[:3]
### python shop.py top
PostgreSQL GROUP BY 89.50 ms
[('Product 44', Decimal('1225295.33')), ('Product 8', Decimal('1210291.56')), ('Product 3', Decimal('1143275.28'))]
MongoDB aggregate pipeline 170.86 ms
[{'_id': 'Product 44', 'revenue': 1225295.3299999998}, {'_id': 'Product 8', 'revenue': 1210291.56}, {'_id': 'Product 3', 'revenue': 1143275.28}]
Valkey SCAN + GET every key 8949.84 ms
read 20,000 keys: [('Product 44', 1225295.33), ('Product 8', 1210291.56), ('Product 3', 1143275.28)]في المخرج أعلاه لاحظ التالي:
- PostgreSQL أجاب بجملة SQL واحدة في 90 ملي ثانية، وMongoDB أجاب بخط تجميع Aggregation Pipeline من أربع مراحل في 171 ملي ثانية، والاثنان يقرآن كل البيانات، والفرق بينهما لا يهم في هذا الحجم.
- Valkey لا يملك أي طريقة ليسأل عن محتوى القيم، فمر التطبيق على 20 ألف مفتاح بالأمر SCAN، وقرأ كل واحد، وحسب المجموع بنفسه، في قرابة تسع ثوان، أي مئة ضعف، ومع مليون طلب يصبح هذا غير ممكن، فضلاً عن أنه يحمل السيرفر طوال المسح.
- المجموع في MongoDB ظهر
1225295.3299999998لأن السعر محفوظ كرقم عشري Double، أما في PostgreSQL فالنوعnumericدقيق، وقد شرحنا لماذا تحفظ المبالغ كأعداد صحيحة أو بنوع دقيق في مقال المحفظة الرقمية، وفي MongoDB يوجد النوع Decimal128 لهذا الغرض.
وقد يتساءل البعض: أليس الحل في Valkey أن نحسب الإيراد عند كل طلب بعداد HINCRBY؟ والإجابة نعم، وهذا هو طريقة التفكير في قواعد المفتاح والقيمة: كل سؤال تحتاجه تصمم له مفتاحاً يحدث مع الكتابة، ولكن هذا يعني أنك تعرف الأسئلة كلها مسبقاً، وأي سؤال جديد يحتاج كوداً جديداً وإعادة حساب من مصدر آخر. والصورة التالية تجمع نتيجتي السؤالين:
نكسرها: تغيير اسم منتج
في المستند والقيمة حفظنا اسم المنتج داخل كل طلب، وهذا ما جعل القراءة سريعة، ولكن ماذا يحدث عندما يتغير الاسم؟
docker exec lab-types-app python shop.py rename### python shop.py rename
PostgreSQL: 1 row updated, 1,229 order lines now show the new name
MongoDB: products updated, 1,229 orders still say "Product 7" inside their documents
MongoDB: update_many fixed 1,229 documents in 297 ms (if you want them changed)
Valkey: 1,229 order values still contain "Product 7" until the application rewrites themفي PostgreSQL الاسم في مكان واحد، فتغير سطر واحد وظهر الاسم الجديد في 1229 بنداً فوراً. وفي MongoDB تغير المنتج، ولكن 1229 طلباً ما زال فيها الاسم القديم، وتصحيحها يحتاج أمراً منفصلاً يعدل كل المستندات، وفي Valkey بقيت القيم القديمة حتى يعيد التطبيق كتابتها. وهنا السؤال الذي يجب أن تجيب عنه قبل التصميم وليس بعده: هل تريد الاسم الحالي أم الاسم وقت الشراء؟ فالفاتورة يجب أن تبقى كما صدرت، ولذلك حفظنا سعر الوحدة في بنود الطلب حتى في PostgreSQL، وأما صفحة المنتج فيجب أن تعرض الاسم الحالي. والنسخ المكررة Denormalization ليست خطأ في ذاتها، وإنما قرار يجب أن تعرف من يحدث النسخ فيه، كما شرحنا في ثمن كسر التطبيع.
المعاملة على مستندين
نقل خمس قطع من مخزون الرياض إلى مخزون جدة يغير مستندين، وفي MongoDB هذا يحتاج معاملة على عدة مستندات:
with mongo.client.start_session() as s, s.start_transaction():
    mongo.stock.update_one({'_id': 'riyadh'}, {'$inc': {'qty': -5}}, session=s)
    mongo.stock.update_one({'_id': 'jeddah'}, {'$inc': {'qty': 5}}, session=s)
عندما شغلنا MongoDB أول مرة كسيرفر مستقل Standalone بالإعداد الافتراضي ظهر الخطأ التالي، ولم يتغير المخزون:
### python shop.py txn
MongoDB: Transaction numbers are only allowed on a replica set member or mongos
stock now: [{'_id': 'riyadh', 'qty': 10}, {'_id': 'jeddah', 'qty': 0}]
والسبب أن المعاملات على عدة مستندات تحتاج مجموعة نسخ Replica Set حتى لو كانت من عضو واحد، كما في توثيق المعاملات، لذلك أضفنا --replSet rs0 في ملف ال Compose ثم rs.initiate، وبعدها:
### python shop.py txn
MongoDB transaction committed
stock now: [{'_id': 'riyadh', 'qty': 5}, {'_id': 'jeddah', 'qty': 5}]
وفي PostgreSQL هذه معاملة عادية لا تحتاج أي إعداد، وفي Valkey تستطيع أن ترسل الأمرين داخل MULTI وEXEC فينفذان معاً، ولكن لا يوجد تراجع إذا فشل أحدهما.
أي عائلة تختار؟
ابدأ من الأسئلة التي سوف يسألها التطبيق، وليس من اسم المنتج، والجدول التالي يلخص ما رأيناه:
| العائلة | تناسب | لا تناسب | أمثلة |
|---|---|---|---|
| Relational | أغلب التطبيقات: كيانات مرتبطة، ومعاملات، وتقارير لم تعرفها مسبقاً | كتابة أكبر من سيرفر واحد بكثير دون تصميم للتوزيع | PostgreSQL، MySQL، MariaDB |
| Document | سجلات تقرأ وتكتب كوحدة واحدة، وشكلها يختلف من سجل لآخر | علاقات كثيرة بين الكيانات، ونسخ مكررة تحتاج تحديثاً دائماً | MongoDB، وJSONB في PostgreSQL |
| Key-Value | التخزين المؤقت، والجلسات، والعدادات، وأي قراءة بمفتاح معروف | أي سؤال على محتوى القيم، وأن تكون المصدر الوحيد للبيانات المهمة | Valkey، Redis |
| Wide-Column | كتابة ضخمة بمفتاح معروف على عشرات السيرفرات | استعلامات مرنة وربط ومعاملات | Cassandra |
| Graph | أسئلة تمشي على العلاقات بعدة خطوات | بيانات جدولية عادية | Neo4j |
| Time-Series | قياسات بالوقت، تجميع بمدى زمني، وحذف القديم | بيانات تعدل كثيراً | TimescaleDB، Prometheus |
| Vector | البحث بالمعنى وRAG | أي شيء غير البحث عن الأقرب | pgvector |
والصورة التالية دليل قرار مختصر:
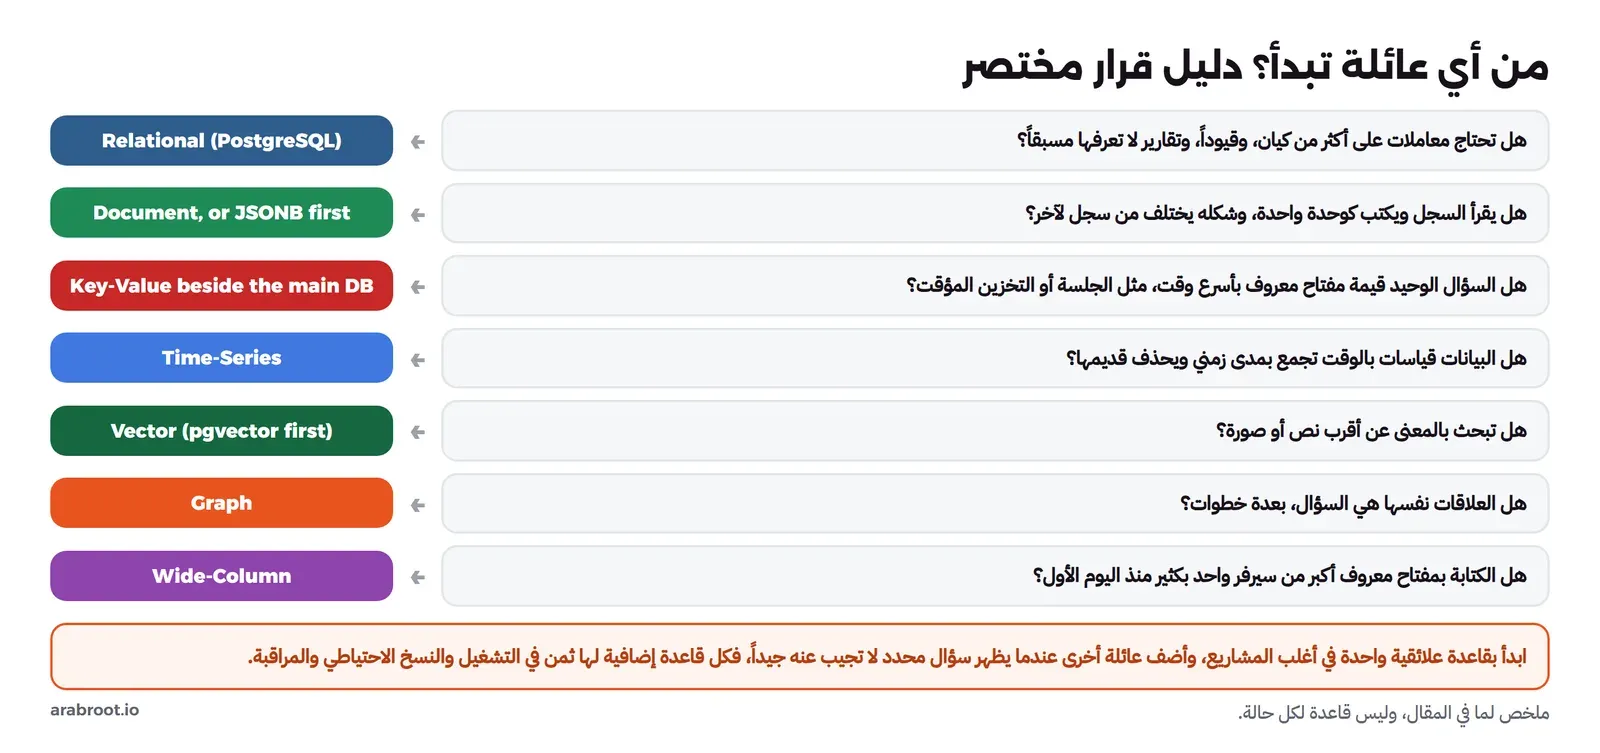
وفي الواقع لا تختار عائلة واحدة للنظام كله: المتجر الحقيقي فيه PostgreSQL للطلبات، وValkey للجلسات والتخزين المؤقت، وربما محرك بحث للمنتجات، وكل واحدة تجيب عن أسئلتها. ولكن كل قاعدة إضافية لها ثمن في التشغيل والنسخ الاحتياطي والمراقبة، لذلك لا تضف واحدة إلا عندما يظهر سؤال لا تجيب عنه قاعدتك الحالية جيداً، كما ناقشنا في متى تفصل.
أخطاء شائعة
- اختيار قاعدة مستندات لأن «البيانات JSON» أو «لا نريد مخططاً Schema»، والمخطط موجود دائماً، والسؤال أين يفرض: في قاعدة البيانات أم في كود التطبيق.
- جعل Valkey أو Redis المصدر الوحيد لبيانات مهمة دون أن تعرف إعدادات الحفظ على القرص.
- نسخ البيانات داخل المستندات دون خطة لتحديثها، أو تحديثها حيث كان يجب أن تبقى كما هي وقت الحدث.
- حفظ المبالغ كأرقام عشرية Float في أي عائلة.
- الاعتماد على معاملات MongoDB على عدة مستندات في كل عملية، بدل تصميم المستند حول ما يتغير معاً.
- إضافة قاعدة رسوم بيانية أو متجهات لحجم بيانات تكفيه إضافة في PostgreSQL.
- مقارنة القواعد بزمن قراءة سجل واحد، وهو سريع في كلها، بدل مقارنتها بالأسئلة الصعبة.
حذف المختبر
docker compose -p lab-types down -vالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- العائلة تحدد شكل البيانات والأسئلة السهلة والصعبة، والمنتج تفصيل بعد ذلك.
- السؤال بمفتاح معروف سريع في كل العائلات، وفي التجربة كان أقل من ملي ثانيتين في الثلاث.
- السؤال الذي لم تصمم له يكشف الفرق: جملة SQL في 90 ملي ثانية، وخط تجميع في MongoDB في 171، ومسح لكل المفاتيح في Valkey في تسع ثوان.
- النسخ المكررة تسرع القراءة وتحتاج قراراً واضحاً عند التغيير، وقد بقي الاسم القديم في 1229 طلباً حتى صححناه.
- وحدة الكتابة الذرية تختلف: صفوف وجداول في العلائقية، ومستند في MongoDB ومعاملات على عدة مستندات مع Replica Set، وأوامر دون تراجع في Valkey.
- ابدأ بقاعدة علائقية واحدة في أغلب المشاريع، وأضف عائلة أخرى عندما يظهر سؤال محدد يحتاجها.
وفي المقالات التالية من هذه المرحلة ندخل إلى داخل القاعدة العلائقية نفسها: الفهارس، ثم التخزين، ثم الأقفال، ثم التقسيم والتوزيع:
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلكيف تخزن قاعدة البيانات بياناتك من الداخلماذا يحدث على القرص عند INSERT وUPDATE وCOMMIT، ولماذا تنجو قاعدة البيانات من الانهيار، وكيف تختلف LSM عن B-tree.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
 دليلتقسيم الجداول Partitioning وتوزيعها على السيرفرات Shardingمتى تقسم الجدول داخل سيرفر واحد، ومتى توزع البيانات على عدة سيرفرات، وكيف تضيف سيرفراً وتتعامل مع العميل الضخم.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع PostgreSQL 18.6 وMongoDB 8.0.32 وValkey 9.1.2 وPython 3.13.16 والمكتبات psycopg 3.3.6 وpymongo 4.15.3 وvalkey 6.1.1.