

في مدخل إلى تصميم الأنظمة وضعنا Valkey أمام PostgreSQL بنمط Cache-Aside، فنزل زمن صفحة المنتج من استعلام كامل إلى قراءة من الذاكرة، وقلنا هناك إن هذا يكفي أغلب التطبيقات في البداية. ولكن عندما يزيد عدد الزوار تظهر مشكلات لا تراها وأنت تختبر وحدك: مفتاح مشهور تنتهي مدته فتصل مئات الطلبات إلى قاعدة البيانات في نفس اللحظة، وسعر تغير في قاعدة البيانات وما زال ال Cache يعرض السعر القديم لخمس دقائق، ومفتاح واحد يقرؤه الجميع فيصبح هو عنق الزجاجة. وهذا المقال يكمل من حيث توقفنا هناك، فلن نعيد شرح Cache-Aside ولا مدة الصلاحية TTL من البداية، وإنما نأخذ كل مشكلة ونرى لماذا تحدث، وما الحل البسيط ولماذا لا يكفي، ثم الحل الذي تستخدمه الأنظمة الكبيرة.
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
 دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
وسوف نناقش في هذا المقال ما يلي:
- أنماط القراءة والكتابة الأربعة: Cache-Aside وRead-Through وWrite-Through وWrite-Behind، ومتى يناسب كل منها.
- كيف تختار مدة الصلاحية TTL، ولماذا تضيف إليها قيمة عشوائية، وماذا تفعل بالقيمة غير الموجودة.
- الإبطال Invalidation: لماذا نحذف المفتاح بدل أن نحدثه، والقيمة القديمة التي تعود بعد الحذف Stale Set، وكيف حلتها Facebook بما سمته Lease.
- الاندفاع إلى قاعدة البيانات Cache Stampede وثلاثة حلول له: القفل، والتجديد المبكر الاحتمالي، وتقديم القيمة القديمة أثناء التجديد.
- المفاتيح الساخنة Hot Keys، والاتساق مع ما كتبه المستخدم للتو، والتخزين المؤقت على عدة طبقات من المتصفح إلى قاعدة البيانات.
- تجربة عملية على Valkey وPostgreSQL تقيس كل ذلك بأرقام حقيقية: 200 طلب على مفتاح فارغ، ثم نفس الطلبات مع القفل، ثم مفتاح ينتهي تحت حمل مستمر، ثم نكسر الإبطال عمداً.
لماذا يصعب التخزين المؤقت رغم بساطة فكرته؟
التخزين المؤقت Caching هو أن تحتفظ بنسخة من نتيجة مكلفة في مكان أسرع، حتى لا تحسبها مرة أخرى في كل طلب، والمثال الذي تعرفه من حياتك هو ورقة الأسعار المعلقة على باب المحل، فالبائع لا يذهب إلى المستودع ليسأل عن السعر في كل مرة، ولكن إذا تغير السعر ونسي أحد أن يغير الورقة فسوف يدفع العميل سعراً خاطئاً. وهذه هي المشكلة كلها في سطر واحد: كل نسخة مؤقتة هي نسخة ثانية من الحقيقة، ولذلك يجب أن تجيب عن ثلاثة أسئلة لكل قيمة تضعها في ال Cache: من يملؤها، ومتى تتوقف عن تصديقها، وماذا يحدث عندما تختفي فجأة.
والرقم الذي تراقبه هو نسبة الإصابة Hit Ratio، أي عدد الطلبات التي وجدت القيمة مقسوماً على كل الطلبات، ويعطيك Valkey العدادين في الأمر INFO stats باسم keyspace_hits وkeyspace_misses. ولاحظ أن نسبة 99% لا تعني أن كل شيء بخير، والسبب أن ال 1% المتبقي قد يأتي كله في نفس الثانية عندما ينتهي مفتاح مشهور، وهذا ما سوف تراه في التجربة العملية.
أنماط القراءة والكتابة
هناك أربعة أنماط مشهورة لربط ال Cache بقاعدة البيانات، اثنان يخصان القراءة واثنان يخصان الكتابة، والصورة التالية تبين الفرق بينها:
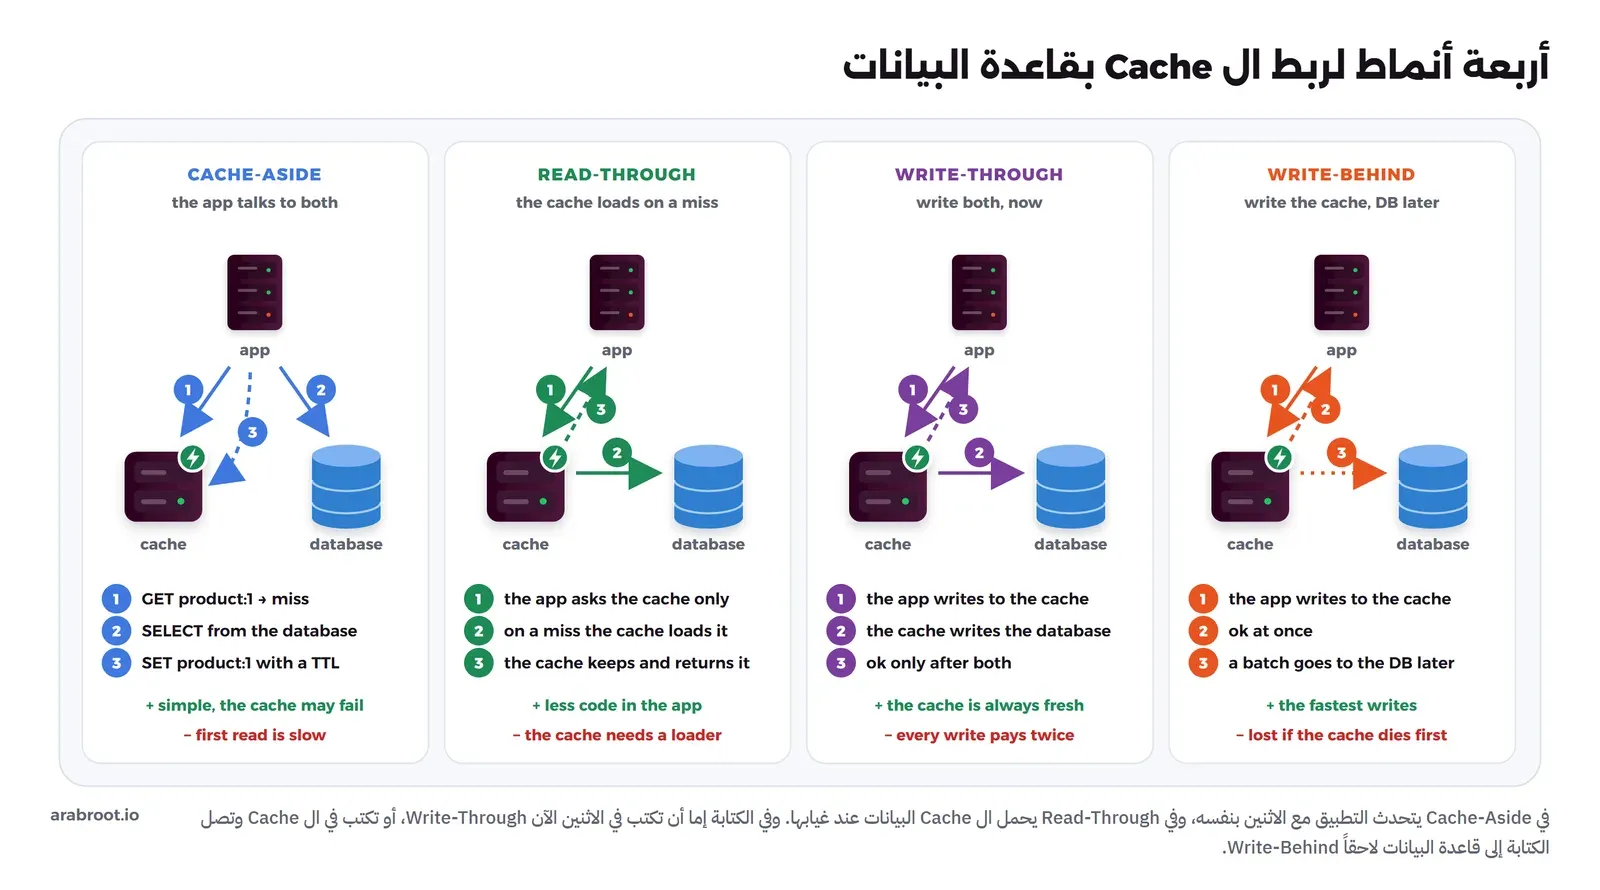
- Cache-Aside: التطبيق يتحدث مع الاثنين بنفسه، فيسأل ال Cache، وإذا لم يجد القيمة قرأها من قاعدة البيانات وكتبها في ال Cache، وهو النمط الذي يصفه توثيق Microsoft لأنماط التصميم، وميزته الكبيرة أن تعطل ال Cache لا يوقف التطبيق، وإنما يبطئه فقط.
- Read-Through: التطبيق يسأل ال Cache فقط، وال Cache نفسه يعرف كيف يحمل القيمة عند غيابها، وهذا يحتاج مكتبة أو طبقة تعرف قاعدة بياناتك، مثل مكتبات التخزين المؤقت داخل التطبيق التي تأخذ دالة تحميل Loader، أما Valkey فلا يقرأ من PostgreSQL بنفسه، ولذلك ستجد أغلب التطبيقات معه تستخدم Cache-Aside.
- Write-Through: كل كتابة تذهب إلى ال Cache وإلى قاعدة البيانات في نفس الطلب، فيبقى ال Cache حديثاً دائماً، والثمن أن كل كتابة تدفع مرتين، وأنك تملأ ال Cache بقيم قد لا يقرؤها أحد.
- Write-Behind أو Write-Back: الكتابة تذهب إلى ال Cache ويأخذ المستخدم الرد فوراً، ثم تصل إلى قاعدة البيانات لاحقاً على دفعات، وهو أسرع الأنماط في الكتابة وأخطرها، والسبب أن ال Cache إذا توقف قبل أن يرسل الدفعة ضاعت كتابات أكد التطبيق للمستخدم أنها تمت.
وقد يتساءل البعض: أي نمط أختار؟ والإجابة في أغلب التطبيقات هي Cache-Aside للقراءة، مع حذف المفتاح عند الكتابة كما سيأتي، والسبب أنه الأبسط والأقل خطراً، وقاعدة البيانات فيه تبقى المصدر الوحيد للحقيقة. أما Write-Behind فلا تستخدمه لبيانات لا تحتمل الضياع مثل الطلبات والمدفوعات، ومكانه الطبيعي عدادات المشاهدات والإعجابات وآخر ظهور للمستخدم، حيث ضياع بضع ثوان من التحديثات لا يضر أحداً. والجدول التالي يلخص ذلك:
| النمط | من يملأ ال Cache | طريق الكتابة | الخطر الأساسي | يناسب |
|---|---|---|---|---|
| Cache-Aside | التطبيق عند الغياب Miss | قاعدة البيانات ثم حذف المفتاح | قيمة قديمة حتى الحذف أو انتهاء المدة | أغلب صفحات القراءة |
| Read-Through | ال Cache بدالة تحميل | كما يقرره التطبيق | نفس مخاطر Cache-Aside | Cache داخل التطبيق بمكتبة |
| Write-Through | كل كتابة | ال Cache وقاعدة البيانات معاً | كتابة أبطأ، وقيم لا يقرؤها أحد | قيم تقرأ كثيراً بعد كتابتها مباشرة |
| Write-Behind | كل كتابة | ال Cache الآن وقاعدة البيانات لاحقاً | ضياع الكتابات إذا توقف ال Cache | العدادات والإحصاءات |
مدة الصلاحية TTL: كيف تختارها؟
مدة الصلاحية TTL هي أطول مدة تقبل فيها أن يرى المستخدم قيمة قديمة إذا فشل كل شيء آخر، ولذلك لا تختارها من سرعة قاعدة البيانات، وإنما من سؤال تسأله لصاحب المنتج: إذا تغير هذا الرقم، كم دقيقة يمكن أن يراه العميل قديماً دون ضرر؟ فقائمة التصنيفات تتحمل ساعة، وسعر المنتج يتحمل دقيقة واحدة مع الحذف عند التغيير، ورصيد المحفظة لا يتحمل ولا ثانية، فلا يوضع في ال Cache أصلاً كما شرحنا في دليل المحفظة الرقمية.
وهناك تفصيلتان صغيرتان تمنعان مشكلات كبيرة:
- أضف قيمة عشوائية Jitter إلى المدة: إذا ملأت ألف مفتاح في نفس الدقيقة بعد نشر نسخة جديدة أو بعد إعادة تشغيل ال Cache، ووضعت لها جميعاً 3600 ثانية، فسوف تنتهي كلها معاً بعد ساعة بالضبط، وتذهب كل طلباتها إلى قاعدة البيانات في نفس الدقيقة. والحل أن تجعل المدة مثلاً 3600 زائد رقم عشوائي بين 0 و300، فتتوزع نهايات المفاتيح على خمس دقائق.
- احفظ «غير موجود» أيضاً Negative Caching: إذا طلب أحد المنتج رقم 99999999 وهو غير موجود، فإن Cache-Aside البسيط لا يجد شيئاً في ال Cache ولا يجد شيئاً في قاعدة البيانات فلا يحفظ شيئاً، فيذهب الطلب التالي لنفس الرقم إلى قاعدة البيانات مرة أخرى، وهذا ما يسمى Cache Penetration، وهو باب مفتوح لمن يريد إغراق قاعدة بياناتك بطلبات لمعرفات عشوائية. والحل أن تحفظ علامة «غير موجود» بمدة قصيرة مثل 30 ثانية، مع حد لمعدل الطلبات Rate Limiting أمام التطبيق.
الإبطال Invalidation: حذف أم تحديث؟
عندما يتغير سعر المنتج في قاعدة البيانات فأمامك خياران: أن تكتب السعر الجديد في ال Cache، أو أن تحذف المفتاح ليملأه أول طلب بعد ذلك. والحل الذي يبدو أذكى هو التحديث، لأن القارئ التالي يجد القيمة جاهزة، ولكنه يفشل عندما يكتب طلبان في نفس الوقت: الطلب A يغير السعر إلى 120 في قاعدة البيانات، ثم الطلب B يغيره إلى 130، ثم يكتب B في ال Cache القيمة 130، ثم يكتب A المتأخر القيمة 120، فتبقى قاعدة البيانات على 130 وال Cache على 120 حتى تنتهي المدة. أما الحذف فلا يهم ترتيبه، فالحذف مرتين يعطي نفس النتيجة، ولذلك القاعدة: عدل قاعدة البيانات أولاً، ثم احذف المفتاح.
وقد يتساءل البعض: لماذا لا نحذف المفتاح قبل تعديل قاعدة البيانات؟ والإجابة أن هناك فترة بين الحذف والتعديل، فإذا جاء قارئ فيها لن يجد المفتاح، فيقرأ السعر القديم من قاعدة البيانات ويكتبه في ال Cache، ثم يأتي التعديل بعده ولا يحذفه أحد.
وعندما تحتاج أن تبطل مجموعة كاملة من المفاتيح، مثل كل صفحات تصنيف معين، فلا تبحث عنها بالأمر KEYS الذي يمر على كل المفاتيح ويوقف السيرفر أثناء ذلك، وإنما ضع رقم إصدار في اسم المفتاح، مثل category:7:v12:page:3، واحفظ الرقم الحالي 12 في مفتاح صغير، فإذا تغير التصنيف زدت الرقم إلى 13، فتصبح كل المفاتيح القديمة غير مستخدمة وتختفي وحدها عند انتهاء مدتها.
القيمة القديمة التي تعود بعد الحذف Stale Set
حتى مع الترتيب الصحيح هناك حالة سباق Race Condition تفلت من Cache-Aside، والصورة التالية تبينها خطوة بخطوة:
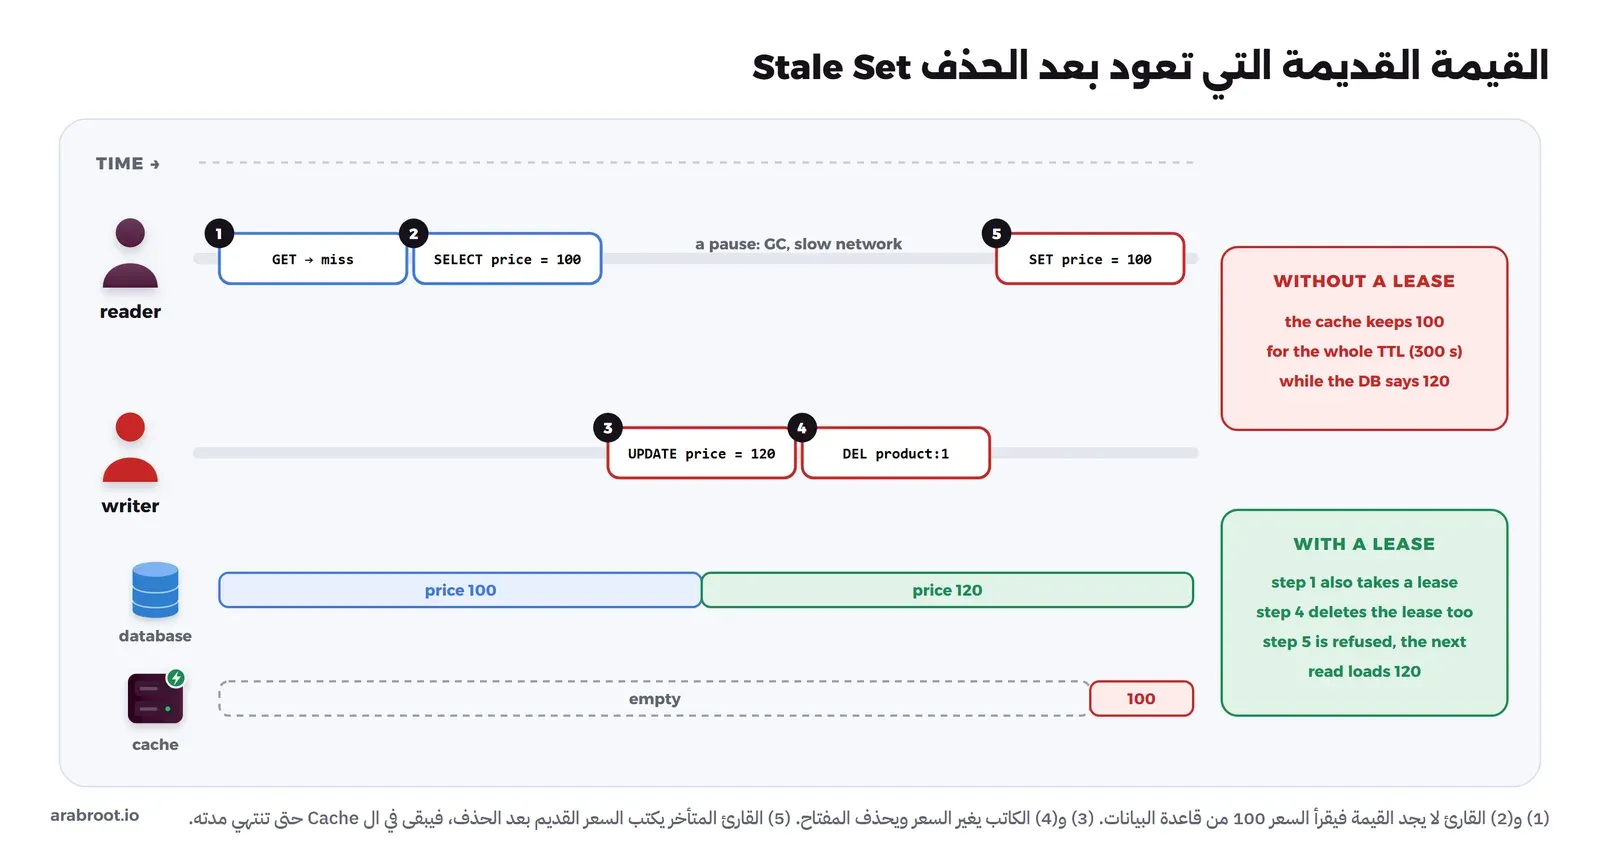
القارئ قرأ السعر القديم قبل التعديل، ثم تأخر لأي سبب، مثل توقف جامع النفايات Garbage Collector أو شبكة بطيئة، وخلال تأخره عدل الكاتب السعر وحذف المفتاح، ثم أكمل القارئ وكتب ما قرأه، فأصبح ال Cache يحمل سعراً قديماً حتى تنتهي مدته، ولا يوجد حذف آخر قادم ليصلحه. وهذه المشكلة وصفتها Facebook في ورقتها Scaling Memcache at Facebook المنشورة في مؤتمر NSDI سنة 2013 باسم Stale Set، وحلتها بآلية سمتها Lease: عندما لا يجد العميل المفتاح يعطيه سيرفر memcached توكناً من 64 بت مرتبطاً بهذا المفتاح، ولا يقبل الكتابة إلا مع التوكن، فإذا وصل حذف للمفتاح قبل الكتابة أصبح التوكن غير صالح ورفضت الكتابة القديمة.
وValkey لا يملك هذه الآلية جاهزة، ولكن تستطيع أن تبنيها بمفتاح صغير وسكربت Lua واحد، فعند الغياب تكتب lease:product:1 بقيمة عشوائية بالأمر SET … NX PX، وعند التعديل تحذف المفتاح وال Lease معاً، وعند الكتابة يتحقق السكربت أن ال Lease ما زال يحمل نفس القيمة قبل أن يكتب، وسوف تراه يرفض الكتابة القديمة في التجربة العملية.
الاندفاع إلى قاعدة البيانات Cache Stampede
لنفرض أن صفحة المنتج الأكثر مبيعاً يطلبها 500 زائر في الثانية، واستعلامها الكامل يحتاج 200 ملي ثانية، وهي محفوظة في ال Cache لمدة دقيقة. فطوال الدقيقة لا تشعر قاعدة البيانات بشيء، ثم تنتهي المدة، وفي ال 200 ملي ثانية التي يحتاجها أول طلب ليعيد بناء القيمة يصل مئة طلب آخر، كلها لا تجد المفتاح، فيرسل كل منها نفس الاستعلام الثقيل، وهذا ما يسمى Cache Stampede أو Thundering Herd أو Dogpile. والأسوأ أن هذه الاستعلامات تتنافس على نفس اتصالات قاعدة البيانات، فيصبح كل استعلام أبطأ، فتصل طلبات أكثر قبل أن يكتب أحد القيمة، وهكذا. والصورة التالية تبين المشكلة وحلين لها، والأرقام فيها من التجربة العملية:
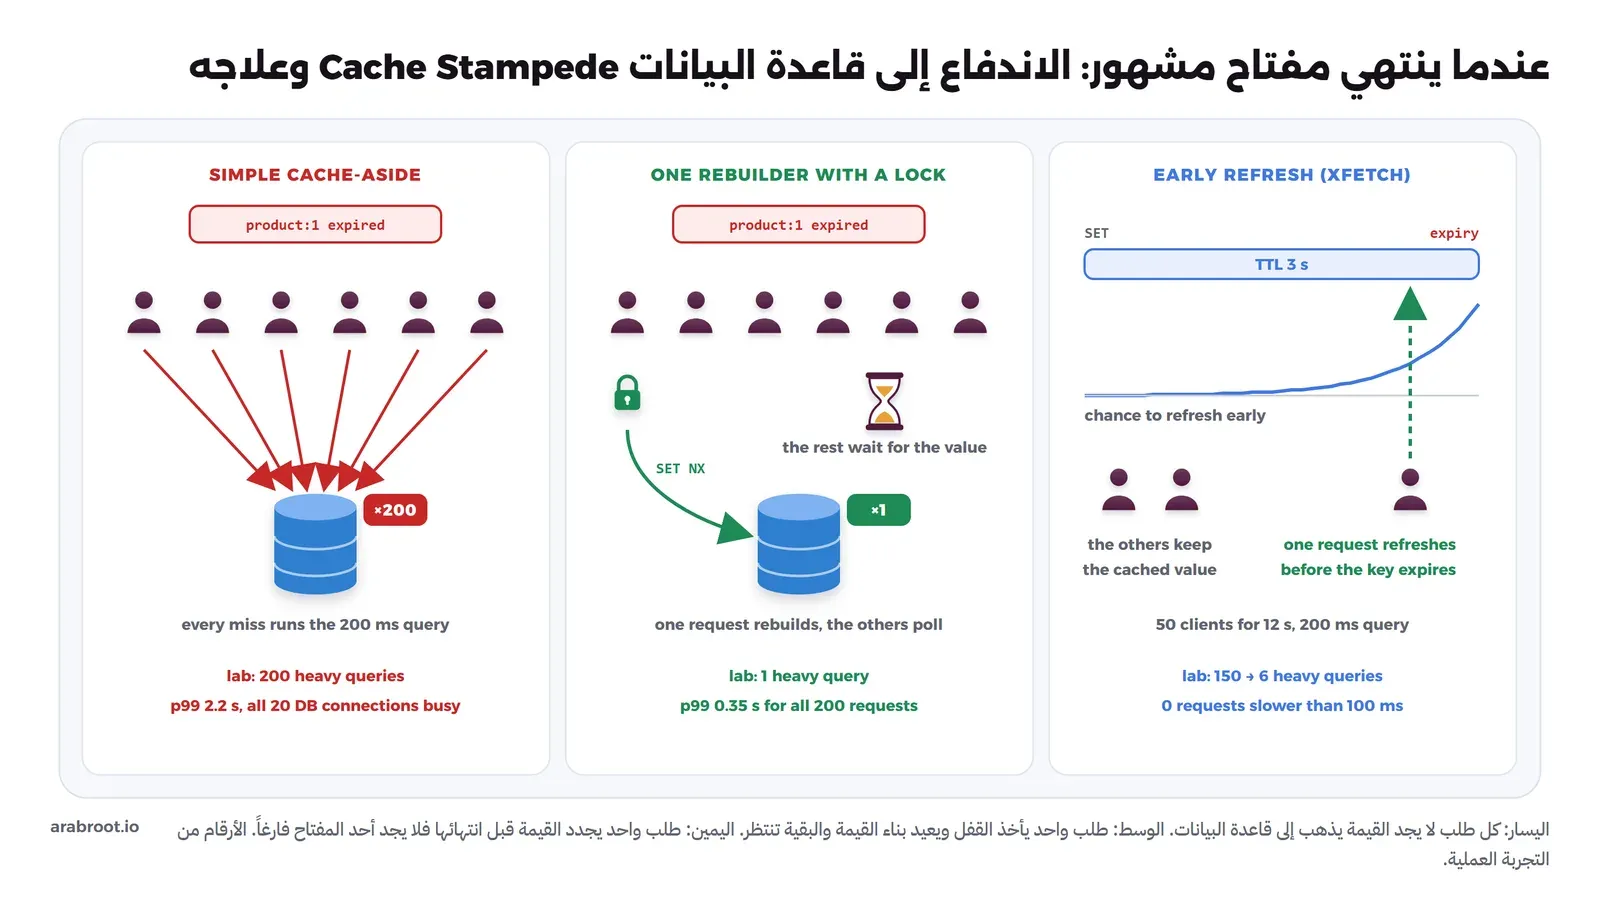
وهناك ثلاثة حلول، وتستطيع أن تجمع بينها:
- طلب واحد يعيد البناء Single Flight: عند الغياب يحاول الطلب أن يأخذ قفلاً قصيراً بالأمر
SET lock:product:1 <token> NX PX 3000، والفائز وحده يذهب إلى قاعدة البيانات، أما البقية فتنتظر وتسأل ال Cache كل 25 ملي ثانية حتى تظهر القيمة. ولاحظ أن الفائز يجب أن يسأل ال Cache مرة أخرى بعد أخذ القفل، لأن فائزاً قبله ربما ملأه للتو، وأن للقفل مهلة حتى لا يبقى للأبد إذا توقف صاحبه، وأن المنتظرين يجب أن يكون لهم حد أقصى ثم يذهبون إلى قاعدة البيانات بأنفسهم بدل أن يفشل الطلب. وفي الأنظمة الكبيرة يعمل هذا القفل داخل كل نسخة من التطبيق أيضاً، فتجمع النسخة الطلبات المتشابهة في طلب واحد Request Coalescing قبل أن تصل إلى Valkey. - التجديد المبكر الاحتمالي Probabilistic Early Expiration: بدل أن ينتظر الجميع انتهاء المدة، يقرر كل طلب يجد القيمة أن يجددها مبكراً باحتمال صغير يكبر كلما اقتربت النهاية، فيجددها غالباً طلب واحد قبل أن تنتهي، ولا يجد أحد المفتاح فارغاً. وهذه الطريقة نشرها Andrea Vattani وزملاؤه في ورقة Optimal Probabilistic Cache Stampede Prevention في مؤتمر VLDB سنة 2015 باسم XFetch، والشرط فيها سطر واحد: جدد إذا كان
now - delta * beta * log(rand()) >= expiry، حيثdeltaهو الزمن الذي استغرقه آخر بناء للقيمة، وbetaرقم قيمته الافتراضية 1، فإذا كبر زاد التجديد المبكر. - قدم القيمة القديمة أثناء التجديد Stale While Revalidate: احفظ القيمة لمدة أطول من مدتها المنطقية، فإذا انتهت المدة المنطقية أعدت القيمة القديمة للمستخدم فوراً، وطلبت من عملية في الخلفية أن تجددها. وهذه الفكرة نفسها موجودة في HTTP في التوجيه
stale-while-revalidateالذي يعرفه RFC 5861، فتستطيع أن تطلبها من المتصفح وال CDN أيضاً.
وفي التجربة العملية جمعنا الحل الثاني والثالث: الشرط الاحتمالي يقرر متى نجدد، والقفل يضمن أن طلباً واحداً فقط يجدد، والتجديد يحدث في الخلفية فلا ينتظره أحد، والنتيجة أن 50 عميلاً لمدة 12 ثانية سببوا 6 استعلامات ثقيلة فقط بدل 150، ولم يتجاوز أي طلب 100 ملي ثانية.
المفاتيح الساخنة Hot Keys
المفتاح الساخن Hot Key هو مفتاح واحد تقرؤه نسبة كبيرة من الطلبات، مثل صفحة المنتج في يوم عرض كبير أو إعدادات الموقع التي تحتاجها كل صفحة. والمشكلة أن المفتاح الواحد يعيش على سيرفر واحد، حتى لو كان عندك عنقود Valkey Cluster من عشرة سيرفرات، لأن العنقود يوزع المفاتيح المختلفة وليس الطلبات على نفس المفتاح، فيصبح سيرفر واحد مشغولاً بالكامل والتسعة الباقية مرتاحة، بالإضافة إلى بطاقة الشبكة التي تنقل نفس القيمة آلاف المرات في الثانية.
والحلول مرتبة من الأبسط:
- Cache صغير داخل كل نسخة من التطبيق L1 بمدة قصيرة جداً، مثل ثانية أو ثانيتين، فتسأل كل نسخة Valkey مرة في الثانية بدل ألف مرة، وثمن ذلك أن النسخ قد تختلف فيما بينها لثانية، وهذا مقبول لصفحة منتج وغير مقبول لحالة دفع.
- نسخ المفتاح Key Replication: احفظ نفس القيمة في ثمانية مفاتيح مثل
product:1#0إلىproduct:1#7، واقرأ من واحد عشوائي منها، فتتوزع على عدة سيرفرات في العنقود، وثمن ذلك أن الإبطال يجب أن يحذف الثمانية. - اقرأ من النسخ المتماثلة Replicas في Valkey، مع ملاحظة تأخر النسخ الذي شرحناه في مقال الأنظمة الموزعة.
ولكي تعرف المفاتيح الساخنة عندك يوفر valkey-cli الخيار --hotkeys كما في توثيق valkey-cli، ويعمل فقط عندما تكون سياسة الطرد Eviction Policy من نوع LFU، مثل allkeys-lfu، والسبب أنه يقرأ عداد مرات الاستخدام الذي تحفظه هذه السياسات لكل مفتاح، كما يشرح توثيق سياسات الطرد.
الاتساق: ماذا يرى المستخدم بعد أن يكتب؟
أكثر ما يزعج المستخدم ليس أن يرى سعراً قديماً لدقيقة، وإنما أن يغير اسمه في صفحة الحساب ثم يعود إلى الصفحة فيجد الاسم القديم، فيظن أن الحفظ فشل ويحاول مرة أخرى. وهذا ما يسمى قراءة ما كتبته Read Your Writes، وشرحناه مع تأخر النسخ في نماذج الاتساق، والحلول العملية له في ال Cache بسيطة: احذف المفتاح في نفس الطلب الذي يكتب قبل أن ترد على المستخدم، أو اجعل الصفحات التي يعدلها المستخدم بنفسه تقرأ من قاعدة البيانات مباشرة لبضع ثوان بعد الكتابة، وذلك بعلامة صغيرة في جلسته.
والقاعدة الأهم هنا: ال Cache لعرض البيانات وليس لاتخاذ القرار. فتستطيع أن تعرض المخزون المتوفر من ال Cache، ولكن عند تأكيد الطلب تتحقق منه في قاعدة البيانات داخل المعاملة نفسها، كما فعلنا في نظام حجز التذاكر.
التخزين المؤقت على عدة طبقات
الطلب الواحد قد يمر بخمس طبقات تحفظ نسخة، والصورة التالية تبينها من الأقرب إلى المستخدم إلى المصدر:
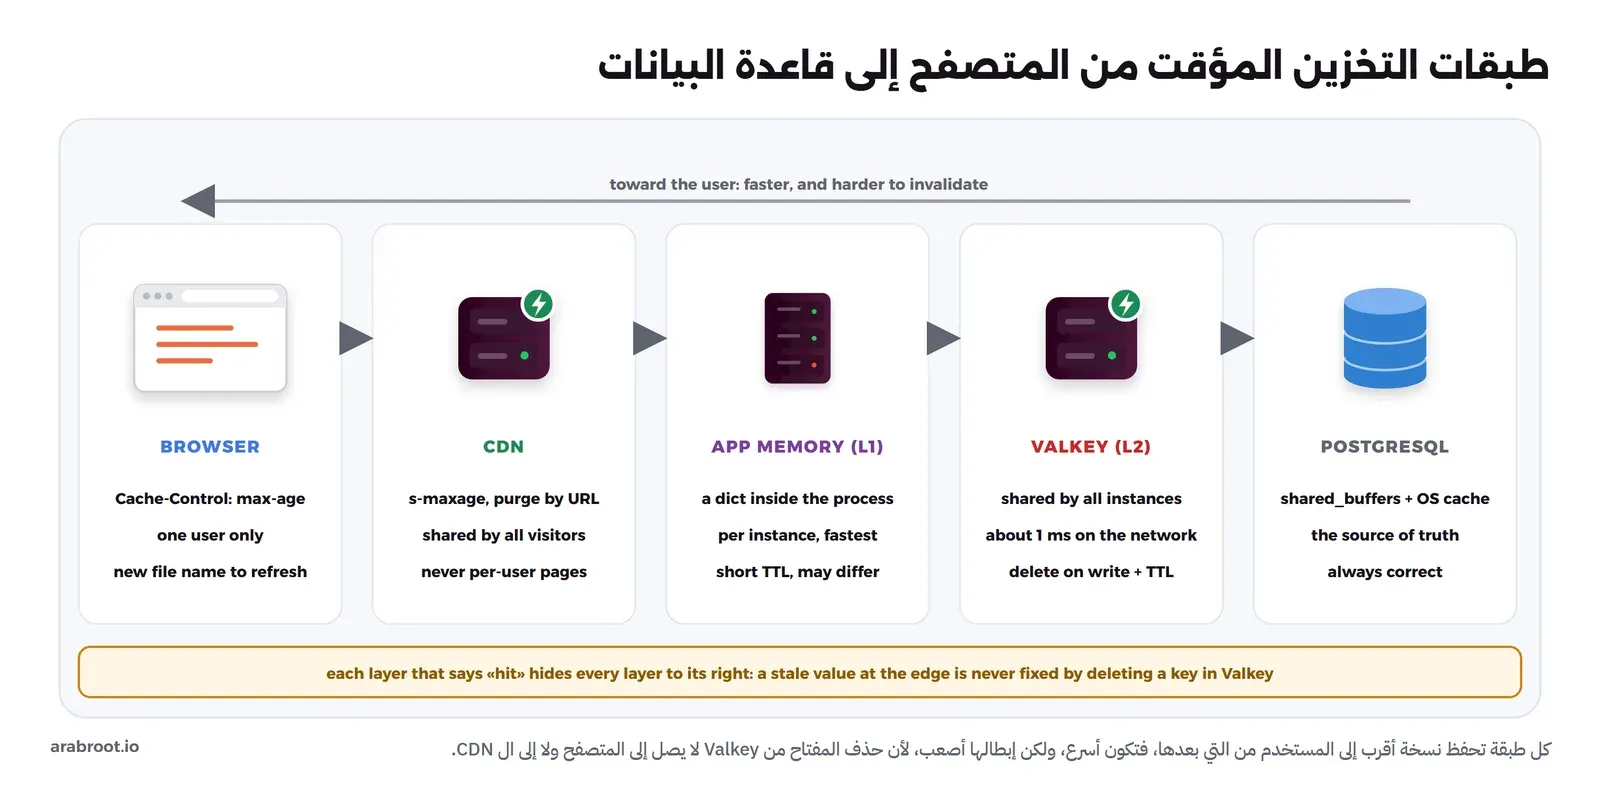
- المتصفح وال CDN تتحكم فيهما ترويسة
Cache-Control، وقد شرحناها معno-cacheوs-maxageوتغيير اسم الملف في دليل ال CDN، والمهم هنا أن حذف مفتاح من Valkey لا يصل إليهما أبداً، فإذا أرسلت صفحة بمدة ساعة إلى المتصفح فلن تستطيع سحبها، ولذلك اجعل مدد الطبقات الخارجية قصيرة لكل ما قد يتغير، وطويلة فقط للملفات التي يتغير اسمها مع محتواها. - ذاكرة التطبيق L1 أسرع من أي شيء عبر الشبكة، ولكن لكل نسخة من التطبيق نسختها، فإذا عدلت قيمة لم تعلم بها النسخ الأخرى. والحل إما مدة قصيرة جداً، أو أن ترسل رسالة إبطال عبر Pub/Sub إلى كل النسخ، أو أن تستخدم التخزين المؤقت من طرف الكلاينت Client-side Caching في Valkey، حيث يتذكر السيرفر بعد الأمر
CLIENT TRACKING ONأي المفاتيح قرأها كل كلاينت، ويرسل له رسالة إبطال عندما يتغير أحدها، كما يشرح توثيق Valkey. - Valkey هو الطبقة المشتركة L2 بين كل النسخ، وهي المكان الطبيعي للحذف عند الكتابة.
- وقاعدة البيانات نفسها تحفظ الصفحات المستخدمة كثيراً في ذاكرتها، في
shared_buffersفي PostgreSQL وفي Page Cache الخاص بنظام التشغيل، ولذلك أول استعلام بعد إعادة التشغيل أبطأ من الذي بعده، فلا تحكم على سرعة استعلام من تشغيله مرة واحدة.
تجربة عملية: الاندفاع وعلاجه بأرقام حقيقية
في هذه التجربة نشغل PostgreSQL وValkey في Container لكل منهما، ونضع في PostgreSQL دالة product_page تمثل استعلام صفحة المنتج الثقيل، فتنتظر 200 ملي ثانية وتزيد عداداً في كل مرة تعمل فيها، حتى نعرف بالضبط كم مرة وصل الطلب إلى قاعدة البيانات. ثم سكربت Python يمثل التطبيق، بمجموعة اتصالات Connection Pool من 20 اتصالاً كما في أغلب التطبيقات الحقيقية، ويرسل الطلبات بطرق مختلفة ويطبع النتيجة. والأزمنة في هذه التجربة من جهاز واحد وتختلف من تشغيل لآخر، فانظر إلى عدد الاستعلامات الثقيلة أولاً، فهو الرقم الذي لا يتغير.
المتطلبات: جهاز عليه Docker Engine وDocker Compose، ولا تحتاج نشر أي منفذ على جهازك، فكل الاتصال داخل شبكة Docker الخاصة بالتجربة.
ملفات التجربة
أنشئ مجلداً فيه أربعة ملفات، الأول compose.yaml:
name: lab-cache
services:
  db:
    image: postgres:18.6
    container_name: lab-cache-db
    environment:
      POSTGRES_PASSWORD: lab-only-password
      POSTGRES_DB: shop
    volumes:
      - ./schema.sql:/docker-entrypoint-initdb.d/01-schema.sql:ro
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres -d shop"]
      interval: 2s
      retries: 30
  cache:
    image: valkey/valkey:9.1.2-alpine
    container_name: lab-cache-valkey
    command: ["valkey-server", "--maxmemory", "64mb", "--maxmemory-policy", "allkeys-lru", "--save", "", "--appendonly", "no"]
    healthcheck:
      test: ["CMD", "valkey-cli", "ping"]
      interval: 2s
      retries: 30
  app:
    build: .
    image: lab-cache-app:1
    container_name: lab-cache-app
    environment:
      DATABASE_URL: postgresql://postgres:lab-only-password@db:5432/shop
      VALKEY_URL: valkey://cache:6379/0
    depends_on:
      db:
        condition: service_healthy
      cache:
        condition: service_healthy
    profiles: ["run"]
في الإعداد أعلاه لاحظ التالي:
- Valkey يعمل بحد ذاكرة 64 ميجابايت وسياسة
allkeys-lru، ودون حفظ على القرص بالخيارين--save ""و--appendonly no، لأنه هنا Cache فقط، وكل ما فيه يمكن بناؤه من قاعدة البيانات. - خدمة
appفي الملف الشخصي Profile باسمrun، فلا تعمل معdocker compose up، وإنما نشغلها عند الحاجة بالأمرdocker compose run.
والملف الثاني schema.sql، وفيه جدول المنتجات والعداد والدالة الثقيلة:
CREATE TABLE products (
    id            int PRIMARY KEY,
    name          text NOT NULL,
    price_halala  int  NOT NULL
);
INSERT INTO products SELECT g, 'product ' || g, 10000 FROM generate_series(1, 1000) g;

-- counts how many times the heavy query really ran
CREATE SEQUENCE heavy_calls;

-- stands for the heavy page query (joins, reviews, stock in every warehouse): 200 ms each time
CREATE FUNCTION product_page(p_id int) RETURNS json LANGUAGE plpgsql AS $$
BEGIN
    PERFORM nextval('heavy_calls');
    PERFORM pg_sleep(0.2);
    RETURN (SELECT json_build_object('id', id, 'name', name, 'price', price_halala) FROM products WHERE id = p_id);
END $$;
والملف الثالث Dockerfile لصورة التطبيق، بإصدارات مثبتة لمكتبة psycopg ومجموعة الاتصالات ومكتبة valkey الرسمية للغة Python:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir "psycopg[binary]==3.3.6" "psycopg-pool==3.3.3" "valkey==6.1.1"
WORKDIR /app
COPY cache.py .
ENTRYPOINT ["python", "-u", "cache.py"]
والملف الرابع cache.py، وفيه كل الطرق التي سوف نقارنها:
# Cache stampede and stale-set lab: Valkey in front of a 200 ms PostgreSQL query.
#   python cache.py hits | stampede | lock | steady | xfetch | xfetch-single | race | lease
import asyncio, json, math, os, random, sys, time, uuid

from psycopg_pool import AsyncConnectionPool
import valkey.asyncio as valkey

KEY = "product:1"
r = valkey.Valkey.from_url(os.environ["VALKEY_URL"], decode_responses=True, max_connections=300)
pool = AsyncConnectionPool(os.environ["DATABASE_URL"], min_size=20, max_size=20, open=False)   # the app has 20 DB connections

async def heavy_query(pid=1):
    async with pool.connection() as c:
        row = await (await c.execute("SELECT product_page(%s)", (pid,))).fetchone()
        return json.dumps(row[0])

async def reset_counter():
    async with pool.connection() as c:
        await c.execute("ALTER SEQUENCE heavy_calls RESTART")

async def heavy_calls():
    async with pool.connection() as c:
        last, called = await (await c.execute("SELECT last_value, is_called FROM heavy_calls")).fetchone()
        return last if called else 0

async def report(title, lat, started):
    lat = sorted(lat)
    p = lambda q: lat[min(len(lat) - 1, int(q * len(lat)))] * 1000
    print(title)
    print(f"  requests: {len(lat)}   heavy queries in PostgreSQL: {await heavy_calls()}")
    print(f"  latency ms: p50 {p(0.50):.0f}   p99 {p(0.99):.0f}   max {lat[-1] * 1000:.0f}   total {time.perf_counter() - started:.2f} s")

# ---------- 1. cache-aside as everyone writes it first ----------
async def get_simple(ttl=60):
    v = await r.get(KEY)
    if v is None:
        v = await heavy_query()
        await r.set(KEY, v, ex=ttl)
    return v

# ---------- 2. one rebuilder: a short lock, the others wait for the value ----------
RELEASE = "if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) end return 0"

async def get_with_lock():
    v = await r.get(KEY)
    if v is not None:
        return v
    token = str(uuid.uuid4())
    if await r.set("lock:" + KEY, token, nx=True, px=3000):    # only one request wins the right to rebuild
        try:
            v = await r.get(KEY)                               # check again: the previous winner may have just filled it
            if v is not None:
                return v
            v = await heavy_query()
            await r.set(KEY, v, ex=60)
            return v
        finally:
            await r.eval(RELEASE, 1, "lock:" + KEY, token)
    deadline = time.monotonic() + 3
    while time.monotonic() < deadline:                         # the others poll the cache for a short while
        await asyncio.sleep(0.025)
        v = await r.get(KEY)
        if v is not None:
            return v
    return await heavy_query()                                 # the winner died: fall back instead of failing

async def burst(fn, n=200, warm=False):
    await r.delete(KEY)
    if warm:
        await get_simple()
    await reset_counter()
    lat = []
    async def one():
        t = time.perf_counter(); await fn(); lat.append(time.perf_counter() - t)
    started = time.perf_counter()
    await asyncio.gather(*(one() for _ in range(n)))           # 200 requests in the same instant
    return lat, started

# ---------- 3. a popular key that expires under steady traffic ----------
TTL = 3

async def get_xfetch(beta=1.0):
    # Vattani et al. (VLDB 2015): recompute early, with a probability that grows as the expiry gets close
    raw = await r.get(KEY)
    if raw is not None:
        item = json.loads(raw)
        if time.time() - item["delta"] * beta * math.log(random.random()) < item["expiry"]:
            return item["value"]
    start = time.time()
    value = await heavy_query()
    delta = time.time() - start
    await r.set(KEY, json.dumps({"value": value, "delta": delta, "expiry": time.time() + TTL}), ex=TTL)
    return value

async def refresh(token):
    try:
        start = time.time()
        value = await heavy_query()
        delta = time.time() - start
        await r.set(KEY, json.dumps({"value": value, "delta": delta, "expiry": time.time() + TTL}), ex=TTL)
    finally:
        await r.eval(RELEASE, 1, "lock:" + KEY, token)

async def get_xfetch_single(beta=1.0):
    # the same early decision, but only the lock holder refreshes, in the background; everyone gets the current value
    raw = await r.get(KEY)
    if raw is None:
        return await get_xfetch(beta)
    item = json.loads(raw)
    if time.time() - item["delta"] * beta * math.log(random.random()) >= item["expiry"]:
        token = str(uuid.uuid4())
        if await r.set("lock:" + KEY, token, nx=True, px=3000):
            asyncio.create_task(refresh(token))
    return item["value"]

async def steady(fn, workers=50, seconds=12):
    await r.delete(KEY); await fn(); await reset_counter()     # warm the cache, then count from zero
    lat, stop = [], time.monotonic() + seconds
    async def loop():
        while time.monotonic() < stop:
            t = time.perf_counter(); await fn(); lat.append(time.perf_counter() - t)
            await asyncio.sleep(0.01)
    started = time.perf_counter()
    await asyncio.gather(*(loop() for _ in range(workers)))
    await report(f"{workers} clients for {seconds} s, key TTL {TTL} s", lat, started)
    print(f"  requests slower than 100 ms: {sum(1 for x in lat if x > 0.1)}")

# ---------- 4. the stale set: an old value written after the invalidation ----------
async def set_price(halala):
    async with pool.connection() as c:
        await c.execute("UPDATE products SET price_halala = %s WHERE id = 1", (halala,))

SET_IF_LEASE = """
if redis.call('get', KEYS[2]) == ARGV[1] then
  redis.call('set', KEYS[1], ARGV[2], 'EX', ARGV[3]); redis.call('del', KEYS[2]); return 1
end
return 0"""

async def race(use_lease):
    await set_price(10000); await r.delete(KEY, "lease:" + KEY)
    reader_has_read, writer_done = asyncio.Event(), asyncio.Event()
    async def reader():
        token = str(uuid.uuid4())
        if use_lease:
            await r.set("lease:" + KEY, token, nx=True, px=5000)   # the right to fill this key, given on the miss
        v = await heavy_query()                                  # reads price 10000
        print(f"  reader: cache miss, read from PostgreSQL price={json.loads(v)['price']}")
        reader_has_read.set(); await writer_done.wait()          # a pause (GC, slow network) right here
        if use_lease:
            ok = await r.eval(SET_IF_LEASE, 2, KEY, "lease:" + KEY, token, v, 300)
            print(f"  reader: set with lease -> {'stored' if ok else 'refused, the lease was taken away'}")
        else:
            await r.set(KEY, v, ex=300)
            print("  reader: wrote its value to the cache")
    async def writer():
        await reader_has_read.wait()
        await set_price(12000)
        await r.delete(KEY, "lease:" + KEY)                      # invalidation removes the value and any lease
        print("  writer: price=12000 in PostgreSQL, cache key deleted")
        writer_done.set()
    await asyncio.gather(reader(), writer())
    cached = await r.get(KEY)
    async with pool.connection() as c:
        db = (await (await c.execute("SELECT price_halala FROM products WHERE id = 1")).fetchone())[0]
    print(f"  now: PostgreSQL price={db}, cache price={json.loads(cached)['price'] if cached else 'empty'}, cache TTL={await r.ttl(KEY)} s")

async def main(mode):
    await pool.open(wait=True)
    await asyncio.gather(*(r.ping() for _ in range(200)))       # open the Valkey connections before measuring
    if mode == "hits":
        await report("200 requests at once on a warm key (all hits)", *await burst(get_simple, warm=True))
    elif mode == "stampede":
        await report("200 requests at once on an empty key, simple cache-aside", *await burst(get_simple))
    elif mode == "lock":
        await report("200 requests at once on an empty key, one rebuilder with a lock", *await burst(get_with_lock))
    elif mode == "steady":
        await steady(lambda: get_simple(TTL))
    elif mode == "xfetch":
        await steady(get_xfetch)
    elif mode == "xfetch-single":
        await steady(get_xfetch_single)
    elif mode == "race":
        print("cache-aside, delete on update:"); await race(False)
    elif mode == "lease":
        print("cache-aside with a lease token:"); await race(True)
    await pool.close(); await r.aclose()

asyncio.run(main(sys.argv[1] if len(sys.argv) > 1 else "stampede"))
في الكود أعلاه لاحظ التالي:
- الدالة
get_simpleهي Cache-Aside كما يكتبه أغلب المطورين في المرة الأولى، والدالةget_with_lockهي نفسها مع القفل والفحص الثاني بعد أخذه والحد الأقصى للانتظار. - الدالة
burstتطلق 200 طلب في نفس اللحظة بالأمرasyncio.gather، وهي حالة المفتاح المشهور عند انتهاء مدته. - الدالة
get_xfetchتحفظ مع القيمة زمن بنائهاdeltaووقت انتهائهاexpiry، وتطبق شرط XFetch في سطر واحد، والدالةget_xfetch_singleتضيف إليها القفل والتجديد في الخلفية. - السكربت
SET_IF_LEASEينفذ داخل Valkey بالأمرEVAL، فيقرأ ال Lease ويكتب القيمة في عملية واحدة لا يدخل بينها أحد.
الآن نشغل قاعدة البيانات وValkey ونبني صورة التطبيق:
docker compose up -d --wait
docker compose --profile run build app
نقطة البداية: 200 طلب على مفتاح موجود
قبل أن نقيس المشكلة نقيس الحالة الطبيعية، أي 200 طلب في نفس اللحظة على مفتاح موجود في ال Cache، حتى نعرف كم يضيف السكربت نفسه من زمن:
docker compose run --rm -q app hitsوالمخرج سوف يكون كما يلي:
200 requests at once on a warm key (all hits)
  requests: 200   heavy queries in PostgreSQL: 0
  latency ms: p50 63   p99 90   max 90   total 0.12 s
لاحظ أن قاعدة البيانات لم تستقبل أي استعلام، وأن 63 ملي ثانية هو زمن خروج 200 طلب من عملية Python واحدة في نفس اللحظة، فهو الحد الأدنى الذي نقارن به.
المفتاح ينتهي: Cache-Aside البسيط
الآن نحذف المفتاح ونطلق نفس ال 200 طلب، وكل طلب يتبع Cache-Aside البسيط:
docker compose run --rm -q app stampedeوالمخرج سوف يكون كما يلي:
200 requests at once on an empty key, simple cache-aside
  requests: 200   heavy queries in PostgreSQL: 200
  latency ms: p50 1289   p99 2216   max 2247   total 2.32 s
في المخرج أعلاه لاحظ التالي:
- كل الطلبات ال 200 وصلت إلى قاعدة البيانات، لأن كلها سألت ال Cache قبل أن ينتهي أي استعلام ويكتب القيمة.
- الزمن الكلي 2.32 ثانية يساوي تقريباً 200 استعلام × 0.2 ثانية ÷ 20 اتصالاً، أي أن الطلبات اصطفت على مجموعة الاتصالات، فالطلب الأخير انتظر أكثر من ثانيتين ليحصل على قيمة كانت موجودة قبل لحظة.
- في نظام حقيقي لا تتوقف الطلبات بعد 200، فالطلبات التي تصل خلال هاتين الثانيتين لا تجد المفتاح أيضاً، وهكذا تتحول ثانية واحدة إلى عطل.
نفس الطلبات مع قفل لطلب واحد
docker compose run --rm -q app lockوالمخرج سوف يكون كما يلي:
200 requests at once on an empty key, one rebuilder with a lock
  requests: 200   heavy queries in PostgreSQL: 1
  latency ms: p50 309   p99 352   max 353   total 0.36 s
استعلام ثقيل واحد بدل 200، والطلب الأبطأ انتظر 353 ملي ثانية بدل 2247، والسبب أن البقية انتظرت القيمة من ال Cache ولم تشغل اتصالات قاعدة البيانات. وفي تشغيل سابق قبل أن نضيف الفحص الثاني بعد أخذ القفل كان العدد 2 أحياناً، لأن طلباً لم يجد المفتاح ثم أخذ القفل مباشرة بعد أن تركه الفائز الأول، وهذا سبب السطر v = await r.get(KEY) داخل الفرع الفائز.
مفتاح ينتهي تحت حمل مستمر
الحالة الواقعية ليست 200 طلب مرة واحدة، وإنما عملاء يطلبون الصفحة طوال الوقت ومفتاح تنتهي مدته كل فترة، لذلك نشغل 50 عميلاً لمدة 12 ثانية، يطلب كل منهم الصفحة ثم ينتظر 10 ملي ثانية ويعيد، والمدة 3 ثوان، مرة بالطريقة البسيطة ومرة بالتجديد المبكر وحده ومرة بالتجديد المبكر مع القفل والخلفية:
docker compose run --rm -q app steady
docker compose run --rm -q app xfetch
docker compose run --rm -q app xfetch-single
والمخرج سوف يكون كما يلي:
50 clients for 12 s, key TTL 3 s
  requests: 22424   heavy queries in PostgreSQL: 150
  latency ms: p50 5   p99 30   max 1668   total 12.07 s
  requests slower than 100 ms: 150
50 clients for 12 s, key TTL 3 s
  requests: 27160   heavy queries in PostgreSQL: 28
  latency ms: p50 3   p99 29   max 296   total 12.04 s
  requests slower than 100 ms: 28
50 clients for 12 s, key TTL 3 s
  requests: 26266   heavy queries in PostgreSQL: 6
  latency ms: p50 4   p99 29   max 45   total 12.05 s
  requests slower than 100 ms: 0
في المخرج أعلاه لاحظ التالي:
- الطريقة البسيطة: 150 استعلاماً ثقيلاً، أي 50 عميلاً في كل مرة من المرات الثلاث التي انتهى فيها المفتاح، وكل واحد منهم انتظر، والأبطأ 1.6 ثانية، ولاحظ أن p99 بقي 30 ملي ثانية، لأن 150 طلباً بطيئاً من بين 22 ألفاً أقل من 1%، وهذا مثال على ما قلناه في البداية: المتوسط والنسب المئوية قد تخفي المشكلة، فانظر دائماً إلى الحد الأقصى وعدد الطلبات البطيئة.
- XFetch وحده خفض العدد إلى 28، والسبب أن عدة طلبات تقرر التجديد في نفس اللحظات القريبة من النهاية عندما يكون عدد الطلبات كبيراً، ولكن لم يجد أحد المفتاح فارغاً، فلم يتجاوز أي طلب 300 ملي ثانية.
- XFetch مع القفل والتجديد في الخلفية: 6 استعلامات فقط في 12 ثانية، أي تجديد كل ثانيتين تقريباً قبل أن تنتهي المدة، ولم ينتظر أي مستخدم قاعدة البيانات، فأبطأ طلب كان 45 ملي ثانية.
نكسر الإبطال: القيمة القديمة تعود بعد الحذف
الآن نعيد حالة السباق التي في الصورة السابقة بالضبط: القارئ يقرأ السعر ثم يتوقف، والكاتب يعدل السعر ويحذف المفتاح، ثم يكمل القارئ:
docker compose run --rm -q app race
docker compose run --rm -q app lease
والمخرج سوف يكون كما يلي:
cache-aside, delete on update:
  reader: cache miss, read from PostgreSQL price=10000
  writer: price=12000 in PostgreSQL, cache key deleted
  reader: wrote its value to the cache
  now: PostgreSQL price=12000, cache price=10000, cache TTL=300 s
cache-aside with a lease token:
  reader: cache miss, read from PostgreSQL price=10000
  writer: price=12000 in PostgreSQL, cache key deleted
  reader: set with lease -> refused, the lease was taken away
  now: PostgreSQL price=12000, cache price=empty, cache TTL=-2 s
في الحالة الأولى فعل الكود كل شيء بالترتيب الصحيح، عدل قاعدة البيانات ثم حذف المفتاح، ومع ذلك بقي السعر القديم في ال Cache لمدة 300 ثانية. وفي الحالة الثانية رفض السكربت كتابة القارئ المتأخر لأن الحذف أزال ال Lease، فبقي المفتاح فارغاً، والقيمة -2 من الأمر TTL تعني أن المفتاح غير موجود، فيقرأ الطلب التالي السعر الصحيح 12000.
حذف التجربة
docker compose --profile run down -v
docker image rm lab-cache-app:1
Valkey أم Redis؟ كلمة عن الرخصة
استخدمنا Valkey في هذه التجربة لأنه مفتوح المصدر برخصة BSD-3-Clause كما في مستودعه، وقد بدأ من نسخة Redis بعد أن أعلنت Redis في 20 مارس 2024 أن الإصدارات من 7.4 تصدر برخصتي RSALv2 وSSPLv1 بدل BSD، ثم أضافت في مايو 2025 رخصة AGPLv3 خياراً ثالثاً بدءاً من Redis 8. وكل ما في هذا المقال من أوامر وسكربتات Lua يعمل على الاثنين، لأن Valkey يتكلم نفس البروتوكول، والفرق عندك هو الرخصة التي يقبلها فريقك القانوني، والميزات التي تضيفها كل جهة في الإصدارات الجديدة.
أخطاء شائعة
- Cache-Aside دون أي حماية من الاندفاع على مفتاح يطلبه الجميع، والاكتفاء بأن نسبة الإصابة عالية.
- نفس مدة الصلاحية لكل المفاتيح التي تملأ معاً، فتنتهي معاً.
- تحديث القيمة في ال Cache عند الكتابة بدل حذفها، أو حذفها قبل تعديل قاعدة البيانات.
- قفل إعادة البناء دون مهلة، أو دون فحص ثان بعد أخذه، أو دون حد أقصى لانتظار البقية.
- عدم حفظ «غير موجود»، فتصل كل الطلبات على المعرفات غير الموجودة إلى قاعدة البيانات.
- اتخاذ قرار مالي أو قرار مخزون من قيمة في ال Cache بدل قاعدة البيانات داخل المعاملة.
- Write-Behind لبيانات لا تحتمل الضياع، أو Valkey دون حد ذاكرة
maxmemory، وسياسته الافتراضيةnoevictionترفض الكتابات الجديدة عندما تمتلئ الذاكرة. - مدة طويلة في ترويسة
Cache-Controlلصفحة قد تتغير، ثم محاولة إصلاحها بحذف مفتاح من Valkey. - الحكم على أداء ال Cache من المتوسط أو p99 وحدهما دون النظر إلى الحد الأقصى وعدد الطلبات البطيئة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Cache-Aside مع حذف المفتاح بعد تعديل قاعدة البيانات هو الاختيار الأنسب لأغلب التطبيقات، وWrite-Behind للعدادات فقط.
- مدة الصلاحية تأتي من سؤال «كم يتحمل المستخدم قيمة قديمة؟»، وتضاف إليها قيمة عشوائية، و«غير موجود» يحفظ أيضاً بمدة قصيرة.
- الحذف يحل تعارض الكتابات، ولكن القارئ المتأخر قد يعيد قيمة قديمة بعد الحذف، والحل Lease يرفض كتابته كما فعلت Facebook.
- انتهاء مفتاح مشهور أرسل في التجربة 200 استعلام ثقيل إلى قاعدة البيانات، وقفل واحد خفضها إلى استعلام واحد، والتجديد المبكر مع القفل في الخلفية خفض 150 استعلاماً إلى 6 دون أن ينتظر أحد.
- المفتاح الساخن يعيش على سيرفر واحد مهما كبر العنقود، فقسمه أو احفظه في ذاكرة التطبيق لثوان.
- كل طبقة أقرب إلى المستخدم أسرع وأصعب في الإبطال، فاجعل مددها قصيرة لكل ما قد يتغير.
وفي مقالات هذا القسم نكمل أدوات الأنظمة التي تكبر، فحد معدل الطلبات يحمي قاعدة البيانات من الطوفان الذي لا يوقفه ال Cache، وجعل العمليات آمنة عند التكرار يجعل إعادة المحاولة ممكنة، والمعاملات الموزعة تربط عدة خدمات دون أن تضيع خطوة:
 دليلتحديد معدل الطلبات Rate Limiting وخوارزمياتهكيف تعمل خوارزميات تحديد معدل الطلبات، وأيها يناسب واجهتك، وكيف تطبقها على عدة سيرفرات وترد بالرمز 429 الصحيح.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلالمعاملات الموزعة: Saga ونمط Outbox بدل 2PCكيف تنفذ عملية تمتد على عدة خدمات دون 2PC، بخطوات محلية وتعويضات وجدول Outbox لا يضيع فيه أي حدث.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع PostgreSQL 18.6 وValkey 9.1.2 وPython 3.13.16 وpsycopg 3.3.6 وpsycopg-pool 3.3.3 وvalkey-py 6.1.1.


