

لنفرض أن لديك متجراً إلكترونياً عربياً صغيراً يبيع القهوة وأدواتها، بدأ بسيرفر افتراضي واحد عليه التطبيق وقاعدة البيانات وصور المنتجات، ويعمل كل شيء بشكل ممتاز في الأشهر الأولى، ثم يأتي موسم التخفيضات فتبطئ صفحة المنتج، ويتأخر بريد تأكيد الطلب دقيقة كاملة، ويعيد أحد الزملاء تشغيل السيرفر لتحديث النظام فيتوقف المتجر كله عشر دقائق في أكثر ساعات السنة بيعاً. وعندها تبدأ الأسئلة التي يسميها الناس تصميم الأنظمة System Design: هل نشتري سيرفراً أكبر أم نضيف سيرفراً ثانياً؟ وأين نضع الجلسات إذا صار لدينا نسختان من التطبيق؟ وهل نحتاج Redis أو Kafka أو Kubernetes؟ وكيف نعرف أصلاً أين المشكلة قبل أن نصرف المال على حلها؟
وتصميم الأنظمة ليس رسماً جميلاً لعشرين صندوقاً، وإنما سلسلة قرارات صغيرة، كل قرار منها يحل مشكلة ظهرت فعلاً ويضيف ثمناً جديداً في التشغيل والتعقيد، لذلك سوف نحكي في هذا المقال قصة المتجر نفسه وهو يكبر خطوة خطوة، وفي كل خطوة نذكر المشكلة التي ظهرت، ثم التغيير الذي يحلها، ثم ما يكلفه هذا التغيير. وهذا المقال هو المدخل إلى قسم تصميم الأنظمة والأنظمة الموزعة في خارطة الطريق، والمفاهيم النظرية للأنظمة الموزعة مثل CAP والاتساق Consistency والإجماع Consensus شرحناها في مقال مستقل هو الأنظمة الموزعة للمبتدئين، فلن نكررها هنا.
وسوف نناقش في هذا المقال ما يلي:
- البداية بسيرفر واحد، ولماذا هي البداية الصحيحة، ولماذا تقيس قبل أن تغير أي شيء.
- فصل قاعدة البيانات، والفرق بين التوسع العمودي Vertical Scaling والتوسع الأفقي Horizontal Scaling.
- نسخ متعددة من التطبيق بلا حالة Stateless خلف موزع حمل Load Balancer، مع فحوص الصحة Health Checks.
- التخزين المؤقت Caching على طبقتين: شبكة توزيع المحتوى CDN للملفات الثابتة، وValkey داخل التطبيق بنمط Cache-Aside.
- نسخ القراءة Read Replicas وتجميع الاتصالات Connection Pooling، ثم التقسيم Partitioning والتوزيع Sharding.
- العمل غير المتزامن بالطوابير Queues والعمال Workers، ومحرك البحث، وتخزين الكائنات Object Storage للملفات.
- عدة مراكز بيانات، والتوفر العالي، ولماذا لا يحتاجها أغلب الفرق، وخطأ الخدمات المصغرة Microservices المبكرة.
- تجربة عملية بـ Docker Compose: نسختان من تطبيق خلف HAProxy مع Valkey وPostgreSQL، نرى فيها توزيع الطلبات والتخزين المؤقت وفحص الصحة بأعيننا.
- التقدير السريع Back-of-the-envelope Estimation بمثال كامل، وأرقام زمن الاستجابة Latency التي يجب أن يعرفها كل مطور.
- طريقة عملية تبدأ بها أي تصميم، وخريطة الأدوات مفتوحة المصدر لكل طبقة.
البداية: سيرفر واحد يكفي أكثر مما تتوقع
في اليوم الأول يعمل المتجر على سيرفر افتراضي VPS واحد، عليه Reverse Proxy يستقبل HTTPS، والتطبيق نفسه، وقاعدة بيانات PostgreSQL، ومجلد فيه صور المنتجات التي يرفعها فريق المتجر، ومهام مجدولة Cron Jobs ترسل البريد وتأخذ النسخ الاحتياطية، والصورة التالية تبين هذا الشكل:
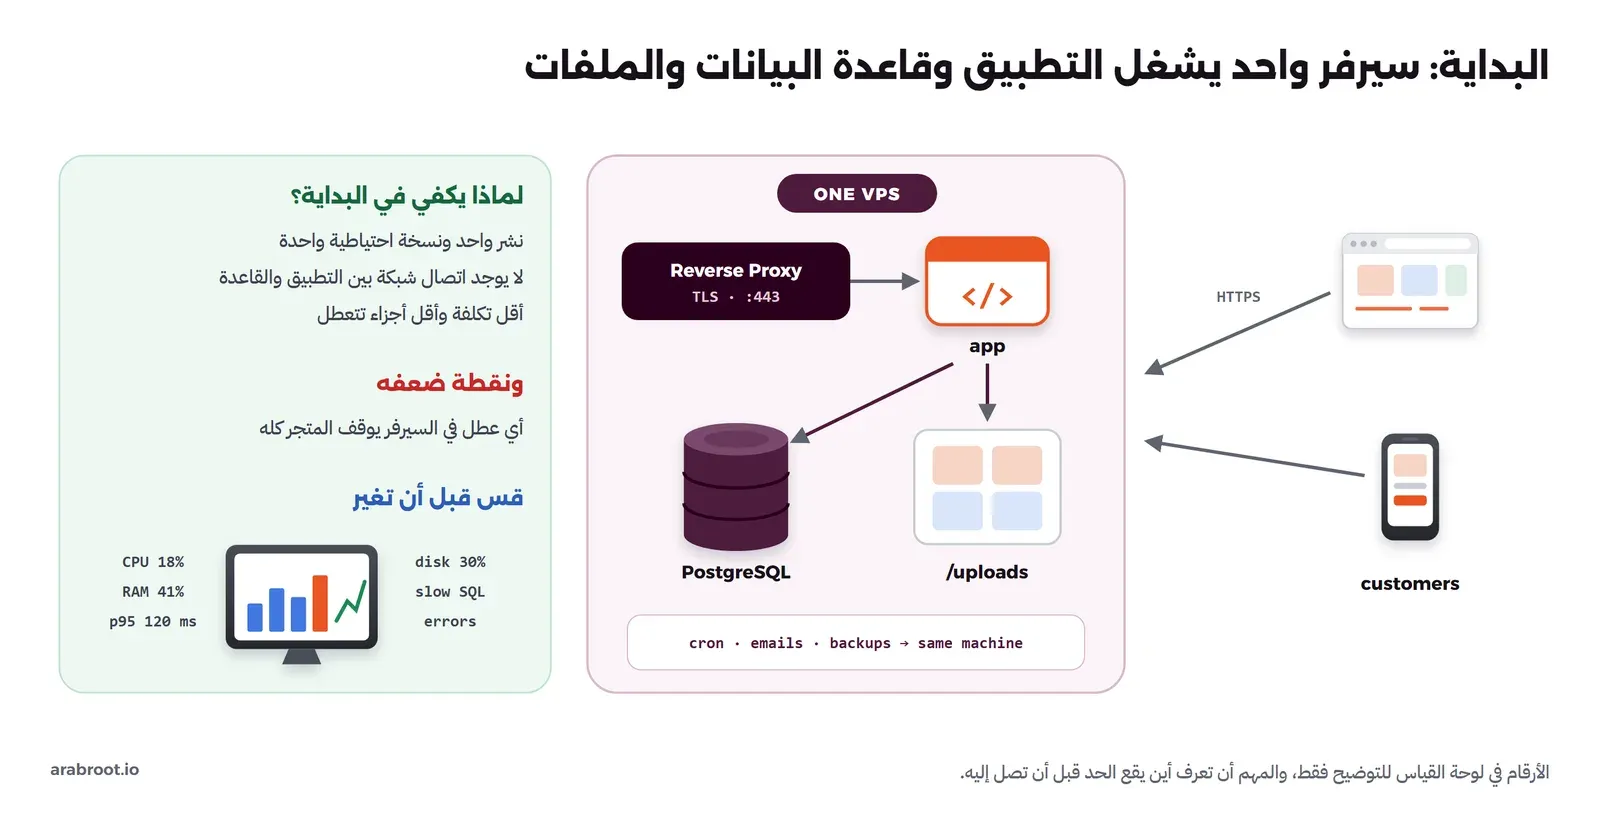
وقد يتساءل البعض: أليس هذا تصميماً سيئاً لا يتحمل؟ والإجابة أنه التصميم الصحيح لأغلب المشاريع في بدايتها، والسبب أن كل جزء تضيفه لاحقاً له ثمن: سيرفر آخر تدفع له وتؤمنه وتحدثه، واتصال شبكة يمكن أن يفشل أو يبطئ، وإعداد جديد يجب أن يعرفه كل من في الفريق. والسيرفر الحديث المتوسط فيه عدة أنوية وذاكرة بعشرات الجيجابايتات وقرص NVMe، وهذا يكفي متجراً بآلاف الطلبات يومياً إذا كانت الاستعلامات مفهرسة والكود لا يرتكب أخطاء واضحة مثل مشكلة N+1. وإذا كنت تختار هذا السيرفر الآن فقد شرحنا المعايير في دليل كيف تختار خادماً افتراضياً VPS، وشرحنا كيف تقرأ عدد الأنوية وما تعنيه vCPU في مقال المعالج والخيوط والتزامن.
ونقطة الضعف الحقيقية في هذا الشكل ليست الأداء، وإنما أن السيرفر نقطة فشل واحدة Single Point of Failure: إذا تعطل القرص أو أعيد تشغيل الجهاز توقف كل شيء، وهذا مقبول في البداية ما دامت لديك نسخة احتياطية مجربة وتعرف كم دقيقة تحتاج لإعادة المتجر.
قس قبل أن تغير
أكثر خطأ يتكرر عندما يبطئ الموقع أن يقرر الفريق الحل قبل أن يعرف السبب، فيشتري سيرفراً أكبر والمشكلة استعلام بلا فهرس، أو يضيف Redis والمشكلة أن التطبيق يرسل البريد داخل الطلب. لذلك قبل أي خطوة في هذا المقال يجب أن تعرف أربعة أشياء على الأقل من لوحة مراقبة حقيقية، وليس من الإحساس:
- استهلاك المعالج CPU والذاكرة RAM والقرص Disk I/O على السيرفر، في الساعة العادية وفي الذروة.
- زمن الاستجابة Latency لأهم الصفحات بالنسب المئوية، مثل p95 وp99، وليس المتوسط فقط، والسبب أن المتوسط يخفي الطلبات البطيئة التي يشعر بها العملاء فعلاً.
- أبطأ الاستعلامات في قاعدة البيانات وعدد مرات تنفيذها.
- نسبة الأخطاء Error Rate، مثل الردود 5xx والمهلات Timeouts.
وهذه الأرقام هي موضوع قسم المراقبة والسجلات Observability وقسم الأداء والموثوقية SRE في خارطة الطريق، وفيهما مواضيع مخطط لها عن Prometheus وGrafana وتخطيط السعة Capacity Planning واختبار الأحمال Load Testing. والقاعدة التي سوف نعود إليها في كل خطوة: لا تنتقل إلى الخطوة التالية إلا عندما يقول القياس إنك وصلت إلى حد الخطوة الحالية. وقد شرحنا طريقة التحقيق نفسها والحالات الشائعة في دليل استكشاف الأخطاء وتحليل الأداء.
الخطوة الأولى: فصل قاعدة البيانات
بعد أشهر من النمو تظهر المشكلة الأولى: التطبيق وقاعدة البيانات يتنافسان على نفس الذاكرة ونفس القرص، فعندما يعمل تقرير ثقيل أو نسخة احتياطية كبيرة تبطئ صفحات العملاء، وعندما يستهلك التطبيق الذاكرة يقل ما يبقى لقاعدة البيانات لتحتفظ بالصفحات المستخدمة في الذاكرة. والتغيير الطبيعي هو نقل قاعدة البيانات إلى سيرفر خاص بها، يتصل به التطبيق عبر شبكة خاصة Private Network، فيضبط كل سيرفر لعمله: سيرفر قاعدة البيانات بذاكرة كبيرة وقرص سريع، وسيرفر التطبيق بمعالج أقوى.
وثمن هذا التغيير أن كل استعلام صار يعبر الشبكة، وهذا يضيف زمناً صغيراً لكل استعلام، فإذا كانت الصفحة ترسل مئتي استعلام صغير فسوف تشعر بالفرق فوراً، وهذا سبب إضافي لحل مشكلة N+1 قبل الفصل وليس بعده. وصار لديك سيرفران تؤمنهما وتراقبهما بدل سيرفر واحد، والمنفذ 5432 يجب ألا يكون مفتوحاً على الإنترنت إطلاقاً، وإنما على الشبكة الخاصة فقط.
التوسع العمودي والتوسع الأفقي
بعد الفصل يبقى السؤال المتكرر: عندما يصل أحد السيرفرين إلى حده، هل نكبره أم نضيف سيرفراً بجانبه؟ والطريقتان لهما اسمان معروفان:
- التوسع العمودي Vertical Scaling أو Scale Up: تزيد موارد السيرفر نفسه، فينتقل من 4 أنوية و8 جيجابايت إلى 16 نواة و64 جيجابايت مثلاً. وميزته أن الكود والتصميم لا يتغيران إطلاقاً، ولكن له سقف لا تتجاوزه، وسعره يرتفع بسرعة كلما اقتربت من الأحجام الكبيرة، ويبقى السيرفر نقطة فشل واحدة، والترقية في الغالب تحتاج إعادة تشغيل.
- التوسع الأفقي Horizontal Scaling أو Scale Out: تضيف سيرفرات متشابهة وتوزع العمل عليها، فلا يوجد سقف واضح، وسقوط سيرفر واحد لا يوقف الخدمة. ولكنه يحتاج أن يكون التطبيق مصمماً لذلك، كما سوف نرى في الخطوة التالية، ويضيف موزع حمل وأجزاء أكثر تراقبها، وهو أصعب بكثير مع قاعدة البيانات منه مع التطبيق.
الصورة التالية تبين الفصل والطريقتين جنباً إلى جنب:
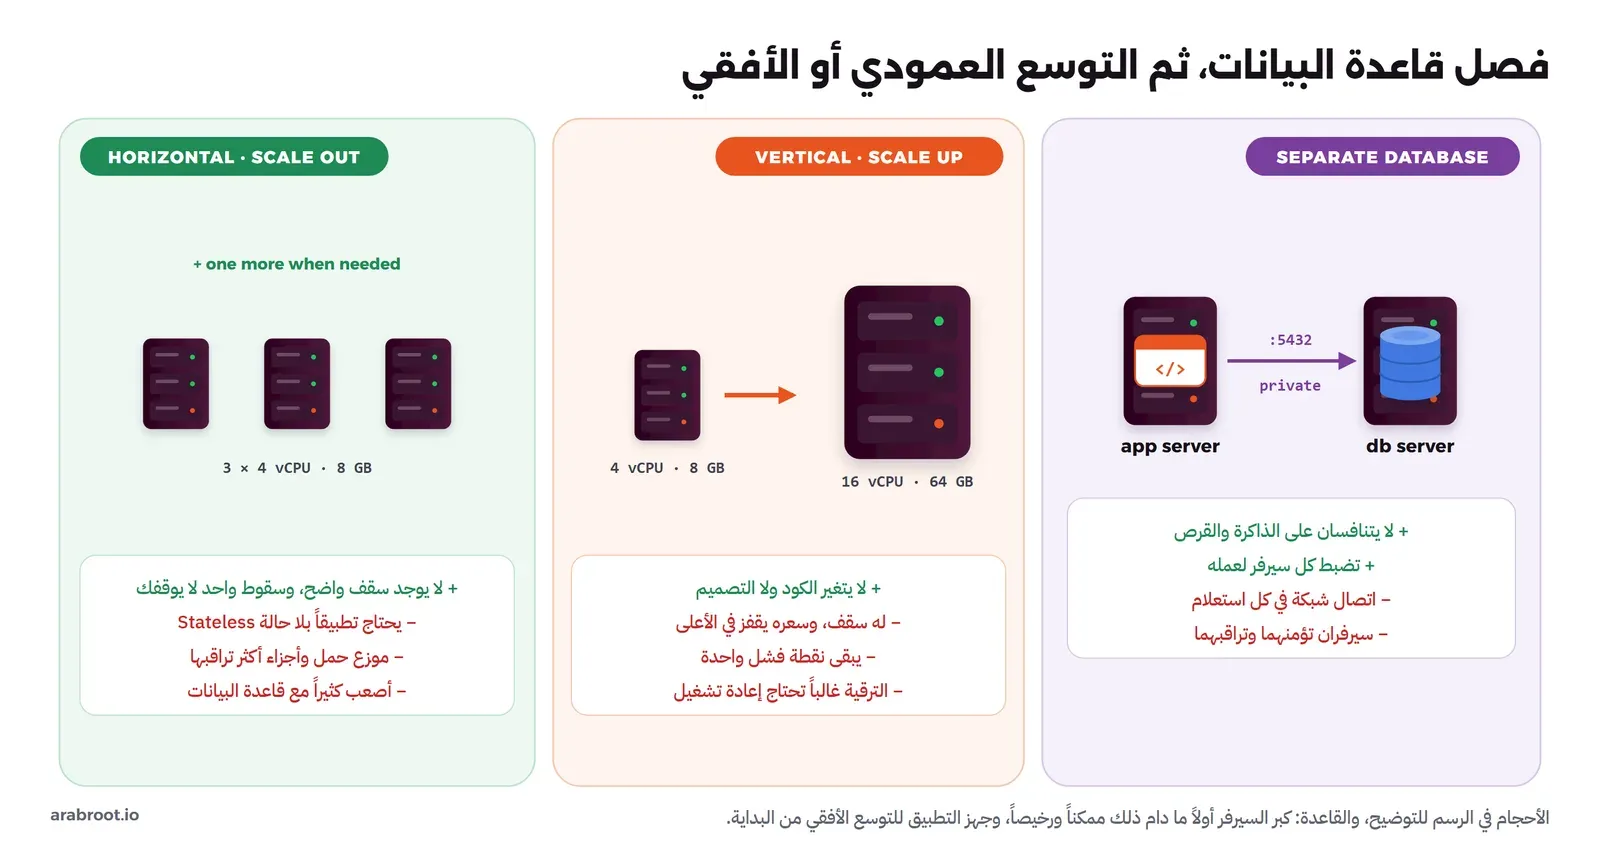
والقرار العملي في أغلب الحالات أن تكبر سيرفر قاعدة البيانات عمودياً لأطول فترة ممكنة، لأن توزيع قاعدة البيانات أصعب خطوة في هذا المقال كله، وأن تجعل التطبيق قابلاً للتوسع الأفقي من اليوم الأول حتى لو بقي على سيرفر واحد، لأن ذلك لا يكلف شيئاً تقريباً إذا بدأت به، ويكلف كثيراً إذا اكتشفته بعد سنة.
الخطوة الثانية: نسخ متعددة من التطبيق خلف موزع الحمل
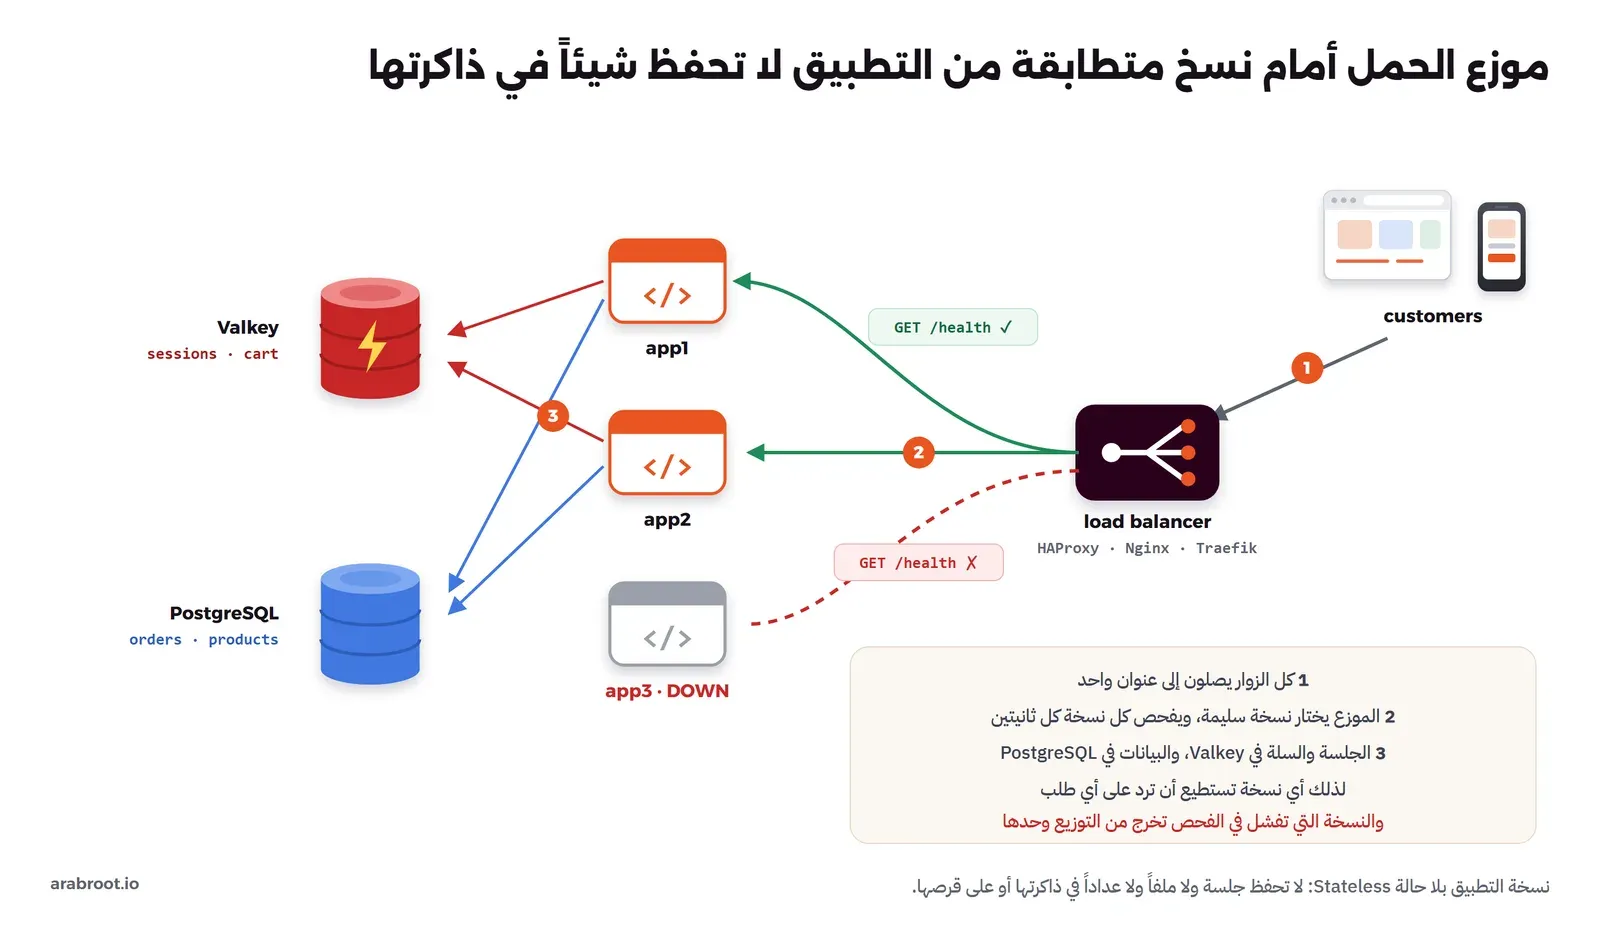
المشكلة التالية تظهر عادة في يوم تخفيضات: المعالج على سيرفر التطبيق عند 100% وقاعدة البيانات مرتاحة، أو تحتاج إلى نشر إصدار جديد دون أن يتوقف المتجر. والحل أن تشغل نسختين أو أكثر من التطبيق نفسه، وتضع أمامها موزع حمل Load Balancer يستقبل كل الطلبات على عنوان واحد ويوزعها على النسخ.
والطريقة البسيطة أن تشغل النسخة الثانية كما هي، وعندها تظهر مشكلات غريبة: العميل يسجل الدخول ثم يظهر وكأنه خرج في الطلب التالي، والسلة تفرغ أحياناً، والصورة التي رفعها الموظف تظهر مرة وتختفي مرة. والسبب في كل ذلك أن التطبيق كان يحفظ أشياء في ذاكرته أو على قرصه المحلي، والطلب التالي وصل إلى نسخة أخرى لا تعرف عنها شيئاً.
والحل أن تكون النسخة بلا حالة Stateless، أي أنها لا تحتفظ بأي شيء يحتاجه الطلب التالي، وإنما تقرأ كل شيء من خدمات مشتركة، وهذا هو العامل السادس في منهجية The Twelve-Factor App الذي ينص على أن عمليات التطبيق لا تشارك شيئاً، وأن أي بيانات يجب أن تبقى تحفظ في خدمة خلفية لها حالة مثل قاعدة البيانات. وعملياً يعني ذلك ثلاثة أشياء:
- الجلسات في مخزن مشترك: مثل Valkey أو Redis أو قاعدة البيانات نفسها، وليس في ذاكرة النسخة. وقد شرحنا هذه المشكلة بالتفصيل وجربناها بنسختين في مقال الجلسات وملفات تعريف الارتباط وJWT، مع سبب ضعف الجلسات اللاصقة Sticky Sessions كحل دائم.
- الملفات المرفوعة خارج القرص المحلي: في تخزين كائنات Object Storage متوافق مع S3، كما سوف نرى في خطوة لاحقة.
- المهام المجدولة لا تعمل في كل نسخة: إذا كانت كل نسخة تشغل نفس Cron Job فسوف يرسل التقرير اليومي ثلاث مرات، لذلك تخرج المهام المجدولة إلى عامل واحد أو إلى طابور، وإذا كانت مواعيدها بمناطق زمنية مختلفة فراجع مقال التاريخ والوقت.
الصورة التالية تبين الشكل بعد هذه الخطوة:
فحوص الصحة: كيف يعرف الموزع أن النسخة معطلة؟
موزع الحمل الذي يرسل الطلبات بالتناوب دون أن يفحص النسخ أسوأ من عدمه، لأن نسخة معطلة واحدة من ثلاث تعني أن ثلث العملاء يرون خطأ. لذلك يرسل الموزع طلب فحص Health Check إلى كل نسخة كل ثانيتين مثلاً، مثل GET /health، فإذا فشل الفحص عدداً محدداً من المرات المتتالية أخرج النسخة من التوزيع، وإذا نجح عدداً محدداً أعادها. ولاحظ أمرين في تصميم هذا الفحص:
- الفحص يجب أن يكون خفيفاً وسريعاً، فلا يقوم باستعلامات ثقيلة، والسبب أنه يعمل آلاف المرات في اليوم من كل موزع.
- لا تجعل فحص كل النسخ يعتمد على خدمة مشتركة واحدة بشكل أعمى، فإذا كان
/healthيفشل كلما بطأت قاعدة البيانات لحظة، فسوف يخرج الموزع كل النسخ معاً ويحول البطء البسيط إلى توقف كامل.
وأي Reverse Proxy معروف يستطيع أن يوزع الحمل ويفحص النسخ، وقد قارنا بين الأدوات وقلنا متى يناسب كل منها في مقال مقارنة Nginx Proxy Manager وTraefik وHAProxy، وشرحنا فحوص الصحة في HAProxy بالتفصيل في دليل تثبيت HAProxy. والموزع نفسه صار الآن نقطة فشل واحدة، وحلها موزعان مع عنوان IP عائم بينهما، وهذا موضوع قسم التوفر العالي.
الخطوة الثالثة: التخزين المؤقت على طبقتين
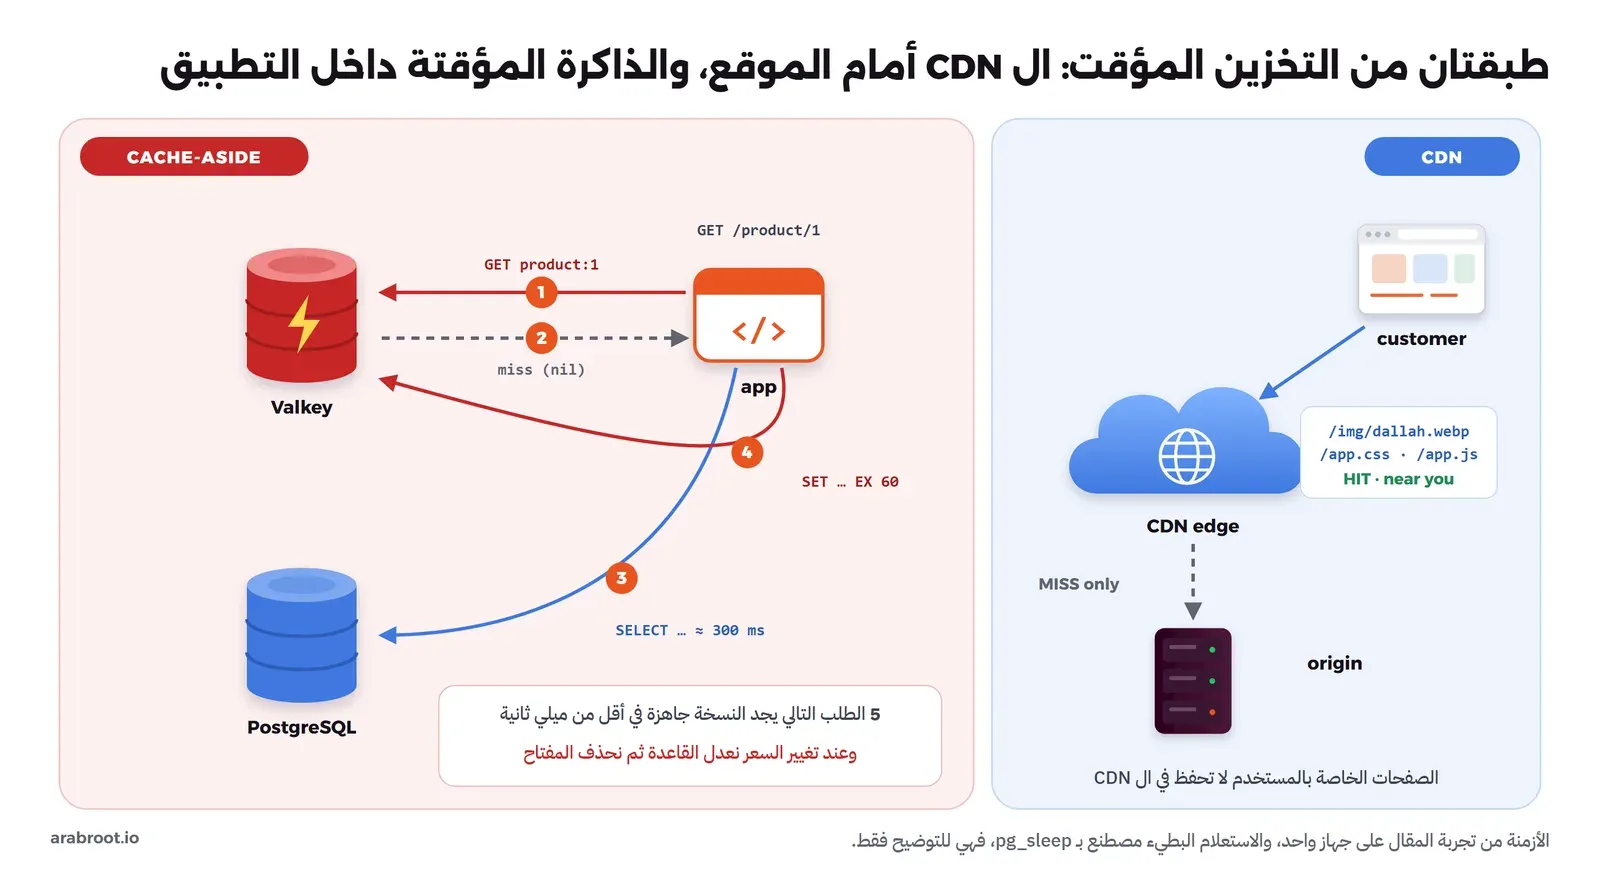
بعد توزيع التطبيق تنتقل المشكلة إلى مكانين: الشبكة، لأن كل زائر يحمل صور المنتجات وملفات CSS وJavaScript من سيرفرك، وقاعدة البيانات، لأن كل زيارة لصفحة المنتج تكرر نفس الاستعلامات على بيانات لا تتغير إلا مرة في اليوم. والحل في الحالتين واحد في فكرته: احتفظ بنسخة جاهزة قريبة من المكان الذي يحتاجها، ولكن التنفيذ مختلف.
شبكة توزيع المحتوى CDN للملفات الثابتة
الملفات الثابتة Static Files مثل الصور وCSS وJavaScript لا تختلف من عميل لآخر، لذلك تستطيع شبكة توزيع المحتوى CDN أن تحتفظ بنسخة منها في سيرفرات قريبة من الزائر، فلا يصل إلى سيرفرك إلا أول طلب لكل ملف، وتصل بقية الطلبات إلى أقرب نقطة في الشبكة. وقد شرحنا كيف يعمل ذلك في Cloudflare وما يحفظه افتراضياً وما لا يحفظه في قسم التخزين المؤقت CDN من مقال خدمات Cloudflare. والقاعدة الأهم هنا هي التي ذكرناها في نفس المقال: لا تحفظ في ال CDN ما يخص مستخدماً واحداً، مثل صفحة السلة أو حسابي، والسبب أن الخطأ هنا يعرض بيانات عميل لعميل آخر.
التخزين المؤقت داخل التطبيق بنمط Cache-Aside
الطبقة الثانية داخل التطبيق نفسه: مخزن مفتاح وقيمة Key-Value في الذاكرة مثل Valkey، وهو مشروع مفتوح المصدر برخصة BSD-3-Clause انفصل عن Redis بعد تغيير رخصته، ويتكلم نفس البروتوكول فتعمل معه مكتبات Redis دون تغيير. والنمط الأشهر لاستخدامه اسمه Cache-Aside، ويشرحه توثيق Microsoft لأنماط التصميم بالخطوات التالية:
- عندما يطلب العميل المنتج رقم 1، يبحث التطبيق أولاً في Valkey عن المفتاح
product:1. - إذا وجده Cache Hit أعاده فوراً دون أن يلمس قاعدة البيانات.
- إذا لم يجده Cache Miss قرأ المنتج من PostgreSQL.
- ثم كتب نسخة منه في Valkey مع مدة صلاحية TTL، مثل 60 ثانية، وأعاده للعميل.
- وعندما يتغير سعر المنتج، يعدل التطبيق قاعدة البيانات أولاً ثم يحذف المفتاح من Valkey، فيملؤه أول طلب بعد ذلك بالقيمة الجديدة.
الصورة التالية تبين الطبقتين، والأزمنة فيها من التجربة العملية في هذا المقال:
ماذا تحفظ في التخزين المؤقت، وماذا لا تحفظ؟
ليس كل شيء يستحق التخزين المؤقت، والسؤال الذي تسأله لكل قيمة: كم مرة تقرأ مقابل كل مرة تتغير، وما الذي يحدث إذا رآها العميل قديمة لدقيقة؟
- مناسب جداً: صفحة المنتج وتفاصيله، وقائمة التصنيفات، ونتيجة استعلام ثقيل يتكرر مثل «الأكثر مبيعاً هذا الأسبوع»، وإعدادات الموقع.
- مناسب بحذر: المخزون المتوفر، فتستطيع أن تعرضه من التخزين المؤقت في صفحة المنتج، ولكن عند تأكيد الطلب يجب أن تتحقق منه في قاعدة البيانات داخل المعاملة Transaction نفسها، والسبب أن بيع آخر قطعة لعميلين أسوأ بكثير من صفحة أبطأ قليلاً.
- غير مناسب: رصيد العميل والمبالغ المالية وحالة الدفع، وكل ما يجب أن يكون صحيحاً في كل لحظة.
مدة الصلاحية TTL والإبطال Invalidation باختصار
هناك جملة مشهورة ينسبها Martin Fowler إلى Phil Karlton، أن أصعب شيئين في علوم الحاسب هما إبطال التخزين المؤقت Cache Invalidation وتسمية الأشياء. والسبب أن كل نسخة مؤقتة هي نسخة ثانية من الحقيقة، ويجب أن تقرر متى تتوقف عن تصديقها، ولذلك استخدم دائماً الطريقتين معاً: احذف المفتاح عندما تعرف أن القيمة تغيرت، وضع TTL لكل مفتاح كشبكة أمان للحالات التي نسيت فيها الحذف أو فشل فيها. وضع حداً لذاكرة Valkey مع سياسة طرد Eviction Policy مثل allkeys-lru التي تحذف المفاتيح الأقل استخداماً عندما تمتلئ الذاكرة، كما يشرح توثيق Valkey.
وهناك مشكلات أخرى تظهر مع الأحمال الكبيرة، مثل انتهاء صلاحية مفتاح مشهور فتصل آلاف الطلبات إلى قاعدة البيانات في نفس اللحظة Cache Stampede، واستراتيجيات أخرى غير Cache-Aside مثل Write-Through، وهذه كلها موضوع مخطط له بعنوان «التخزين المؤقت Caching بالتفصيل» في قسم تصميم الأنظمة.
الخطوة الرابعة: قاعدة البيانات تحت الضغط
مع ثلاث نسخ من التطبيق وتخزين مؤقت جيد، يصبح الحد التالي في الغالب هو قاعدة البيانات، ويظهر بطريقتين: عدد الاتصالات، والقراءة الثقيلة. وقبل أي شيء مما يلي، تأكد أن الفهارس صحيحة، لأن فهرساً واحداً ناقصاً قد يكلفك أكثر من كل ما في هذا القسم.
- تجميع الاتصالات Connection Pooling: كل نسخة من التطبيق تفتح عشرات الاتصالات، وكل اتصال في PostgreSQL عملية Process كاملة تستهلك ذاكرة، فإذا ضاعفت عدد النسخ ضاعفت الاتصالات حتى يرفض PostgreSQL اتصالات جديدة. والحل أداة مثل PgBouncer بين التطبيق والقاعدة، تستقبل مئات الاتصالات وتمررها عبر عدد صغير من الاتصالات الحقيقية، وقد شرحنا الفكرة في تصميم قواعد البيانات، ولماذا لا يزيد العمل بزيادة الاتصالات في قسم اتصالات قاعدة البيانات.
- نسخ القراءة Read Replicas: في المتجر القراءة أكثر من الكتابة بكثير، كما سوف نرى بالأرقام في قسم التقدير، لذلك تضيف سيرفرات تستقبل نسخة مستمرة من كل تغيير على السيرفر الرئيسي Primary، وتوجه إليها القراءات والتقارير وتبقى الكتابة على الرئيسي. والنسخة في الوضع الافتراضي متأخرة قليلاً عن الرئيسي، لذلك العميل الذي غير عنوانه ثم فتح صفحته فوراً يجب أن يقرأ من الرئيسي، والتفاصيل في قسم نسخ للقراءة، وأما لماذا لا يمكن أن تكون النسخ متطابقة ومتاحة وسريعة في نفس الوقت فهو موضوع مقال الأنظمة الموزعة للمبتدئين.
الصورة التالية تبين هذه الطبقة:
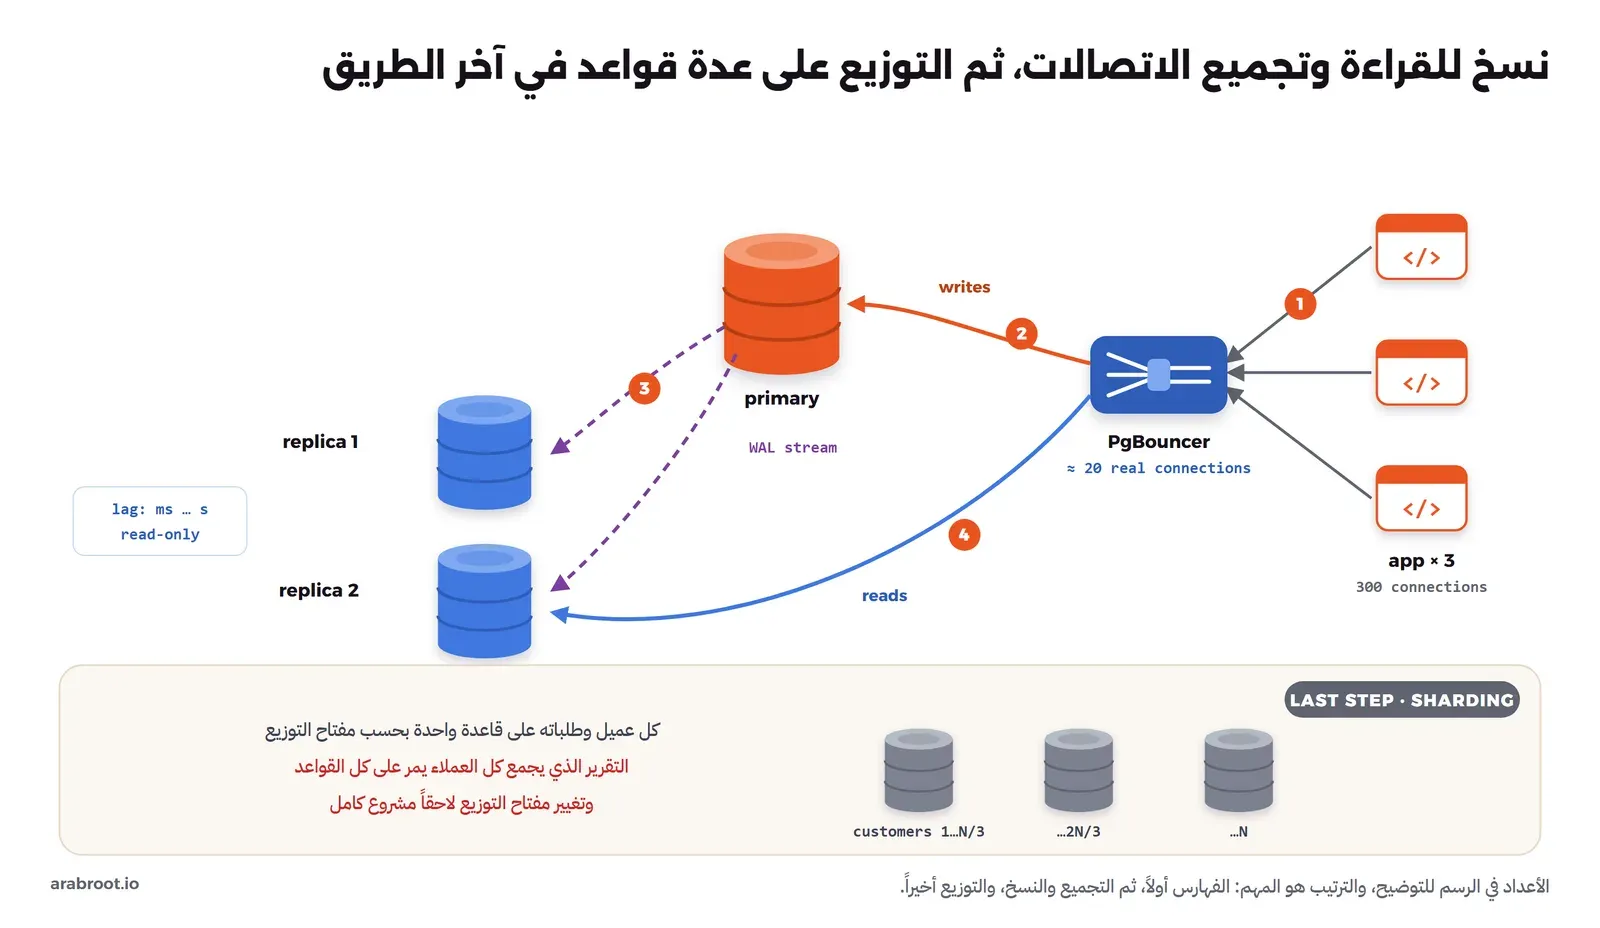
وعندما يصبح جدول الطلبات مئات الملايين من الأسطر، تأتي خطوة التقسيم Partitioning داخل نفس السيرفر، بحسب الشهر مثلاً، فيقرأ الاستعلام جزءاً واحداً ويصبح حذف بيانات سنة قديمة أمراً واحداً، وهذا ما نتعمق فيه بالتجربة في مقال PostgreSQL للجداول الضخمة. وإذا لم يعد سيرفر واحد يكفي للكتابة نفسها، تأتي آخر خطوة وأصعبها، وهي التوزيع على عدة سيرفرات Sharding بحسب مفتاح مثل رقم العميل، وقد ذكرنا ثمنها في قسم التوزيع على عدة سيرفرات. ولاحظ أن المعرفات Primary Keys يجب أن تبقى فريدة عبر كل السيرفرات، وهذا سبب من أسباب اختيار UUIDv7 أو Snowflake بدل الرقم المتسلسل، كما شرحنا في مقال المعرفات الفريدة.
الخطوة الخامسة: العمل البطيء يخرج من الطلب
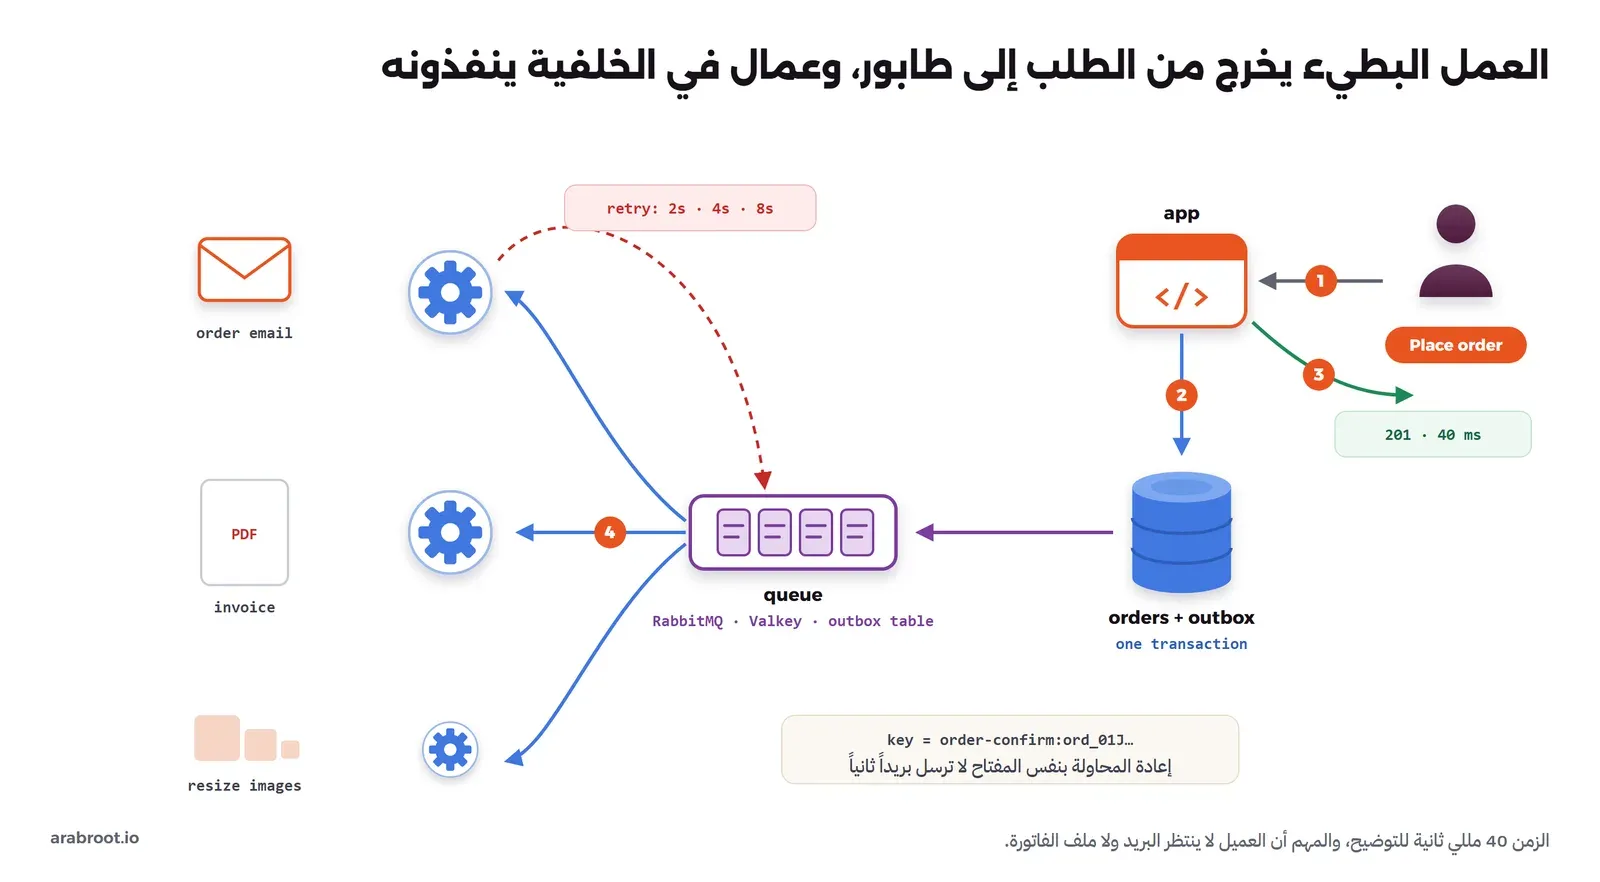
المشكلة التالية لا تظهر في المعالج ولا في قاعدة البيانات، وإنما في زمن الصفحة نفسها: العميل يضغط «تأكيد الطلب» وينتظر ثلاث ثوان، والسبب أن التطبيق يحفظ الطلب ثم يرسل بريد التأكيد عبر SMTP، ثم ينشئ ملف PDF للفاتورة، ثم يخبر نظام الشحن، وكل ذلك داخل الطلب نفسه. وإذا تأخر سيرفر البريد تأخر العميل، وإذا فشل الاتصال ضاع البريد، وإذا ضغط العميل الزر مرة ثانية من القلق وصله بريدان.
والحل أن يحفظ الطلب ما يجب فعله في طابور Queue ثم يرد على العميل فوراً، ويأتي عامل خلفي Background Worker يأخذ المهام من الطابور وينفذها، ويعيد المحاولة Retry بفترات تتزايد إذا فشلت، والصورة التالية تبين ذلك:
في الشكل أعلاه لاحظ التالي:
- الطلب وسطر المهمة يكتبان في نفس المعاملة في قاعدة البيانات، في جدول اسمه صندوق الصادر Outbox، والسبب أنك إذا حفظت الطلب ثم سقط التطبيق قبل أن يكتب في الطابور ضاع البريد، وإذا كتبت في الطابور ثم فشلت المعاملة وصل العميل بريد لطلب غير موجود. وقد بنينا هذا النمط بالكود كاملاً في قسم كيف ترسل البريد التفاعلي من تطبيقك.
- إعادة المحاولة تعني أن المهمة قد تنفذ أكثر من مرة، لذلك يجب أن تكون كل مهمة آمنة عند التكرار Idempotent، وأبسط طريقة أن تحمل مفتاحاً فريداً يمنع تنفيذها مرتين، ويمكن أن تبنيه من معرف فريد مثل رقم الطلب.
- الطابور قد يكون جدولاً في PostgreSQL في البداية، ثم Valkey أو RabbitMQ عندما يكبر العدد، ثم Kafka عندما تحتاج بث أحداث Event Streaming بأحجام ضخمة يقرؤها أكثر من نظام. والفرق بين هذه الأدوات ومفاهيمها مثل Producer وConsumer وAck هو موضوع قسم الطوابير وبث الأحداث، والمعاملات الموزعة بنمط Saga والنمط Outbox موضوع مخطط له في قسم تصميم الأنظمة.
والطابور يحل مشكلة ثانية لا تقل أهمية: امتصاص الذروة، فإذا وصل في دقيقة واحدة ألف طلب يحتاج كل منها إلى تصغير عشر صور، فإن الطابور يحتفظ بها ويعمل العمال بسرعتهم الطبيعية، بدل أن يحاول السيرفر تنفيذ عشرة آلاف عملية في نفس اللحظة. وشرحنا لماذا تبطئ زيادة العمليات المتزامنة كل شيء في قسم المهام الخلفية والطوابير.
الخطوة السادسة: البحث والملفات خارج قاعدة البيانات
هناك عملان يبدآن في قاعدة البيانات وعلى القرص المحلي، ثم يخرجان منهما عندما يكبر المتجر:
- البحث في المنتجات: الاستعلام
WHERE name LIKE '%قهوة%'يقرأ الجدول كله، ولا يفهم أن «القهوه» و«القهوة» نفس الكلمة، ولا يرتب النتائج بحسب الأهمية. ومحرك البحث مثل OpenSearch أو Meilisearch يبني فهرساً معكوساً Inverted Index يجد الكلمة في أجزاء من الثانية، ويتحمل الأخطاء الإملائية، ويرتب النتائج. وثمنه أنه نسخة ثانية من البيانات يجب أن تبقى متزامنة مع قاعدة البيانات، عبر الطابور أو عبر نقل التغييرات CDC، وقاعدة البيانات تبقى مصدر الحقيقة دائماً. وكل ذلك، مع البحث في النصوص العربية وجذورها وهمزاتها، موضوع قسم محركات البحث والفهرسة. - صور المنتجات والفواتير: عندما يصبح للتطبيق ثلاث نسخ لا يصح أن تحفظ الصورة على قرص النسخة التي استقبلتها، والحل تخزين الكائنات Object Storage المتوافق مع واجهة S3، حيث يرفع التطبيق الملف ويحفظ رابطه فقط في قاعدة البيانات، ويقدم ال CDN الصور للعملاء. ومن الخيارات التي تستضيفها بنفسك Garage برخصة AGPL-3.0، وSeaweedFS برخصة Apache-2.0. وأما MinIO الشهير فإن مستودعه أصبح مؤرشفاً للقراءة فقط ويقول إنه لم يعد يصان، فلا تبدأ به مشروعاً جديداً. وشرحنا تخزين الكائنات وبدائله على سيرفرك في أنواع التخزين للمبتدئين.
الخطوة الأخيرة: عدة مراكز بيانات، ومتى لا تحتاجها
كل ما سبق يعمل في مركز بيانات واحد، أو منطقة Region واحدة عند مزودي السحابة، وهذا يعني أن انقطاع هذا المركز كله يوقف المتجر. والحل النظري أن تشغل نسخة كاملة من النظام في منطقة ثانية، مع قاعدة بيانات تنسخ بين المنطقتين، وتوجيه للزوار إلى أقرب منطقة سليمة. ولكن هذه الخطوة تختلف عن كل ما سبق في حجم ثمنها، والسبب أن النسخ بين منطقتين بعيدتين يضيف عشرات المللي ثانية لكل عملية متزامنة، فإما أن تنتظر الكتابة تأكيد المنطقة الثانية فتبطئ، وإما ألا تنتظره فقد تفقد آخر الطلبات عند الانقطاع، وهذا بالضبط المفاضلة التي يشرحها مقال الأنظمة الموزعة للمبتدئين. ثم إن التبديل بين المنطقتين يجب أن يجرب بانتظام، وإلا فإنه لن يعمل يوم تحتاجه.
لذلك اسأل قبلها السؤال الذي يطرحه قسم التوفر العالي High Availability: كم يكلفك التوقف ساعة فعلاً؟ وأغلب المتاجر والفرق تحصل على ما تحتاجه من التوفر بأشياء أبسط بكثير: نسختان من كل شيء داخل نفس المنطقة، ونسخ احتياطية في منطقة أخرى، وخطة استعادة مجربة.
سيرفر متواضع يتحمل أكثر مما تظن
وهنا النقطة الصادقة التي يتجاوزها كثير ممن يكتبون عن تصميم الأنظمة: أغلب ما سبق لن تحتاجه، وأكثر خطأ مكلف رأيناه في هذا المجال ليس نقص التوسع، وإنما التعقيد المبكر، مثل أن يبدأ فريق من ثلاثة مطورين بعشر خدمات مصغرة Microservices، ولكل خدمة قاعدة بيانات وطابور ونشر مستقل، فيقضي وقته في الشبكة بين الخدمات بدل الميزات التي يطلبها العملاء. ولذلك ينصح Martin Fowler في مقاله MonolithFirst بأن تبدأ بتطبيق واحد Monolith منظم جيداً، ولا تقسمه إلا عندما تعرف حدود أجزائه من الاستخدام الحقيقي. وقرار التقسيم نفسه موضوع مخطط له بعنوان «Monolith أم Microservices؟» في قسم تصميم الأنظمة.
الصورة الكاملة بعد كل الخطوات
إذا جمعنا كل الخطوات في شكل واحد، نحصل على البنية التالية، وكل طبقة فيها تحمل رقم الخطوة التي أضافتها:
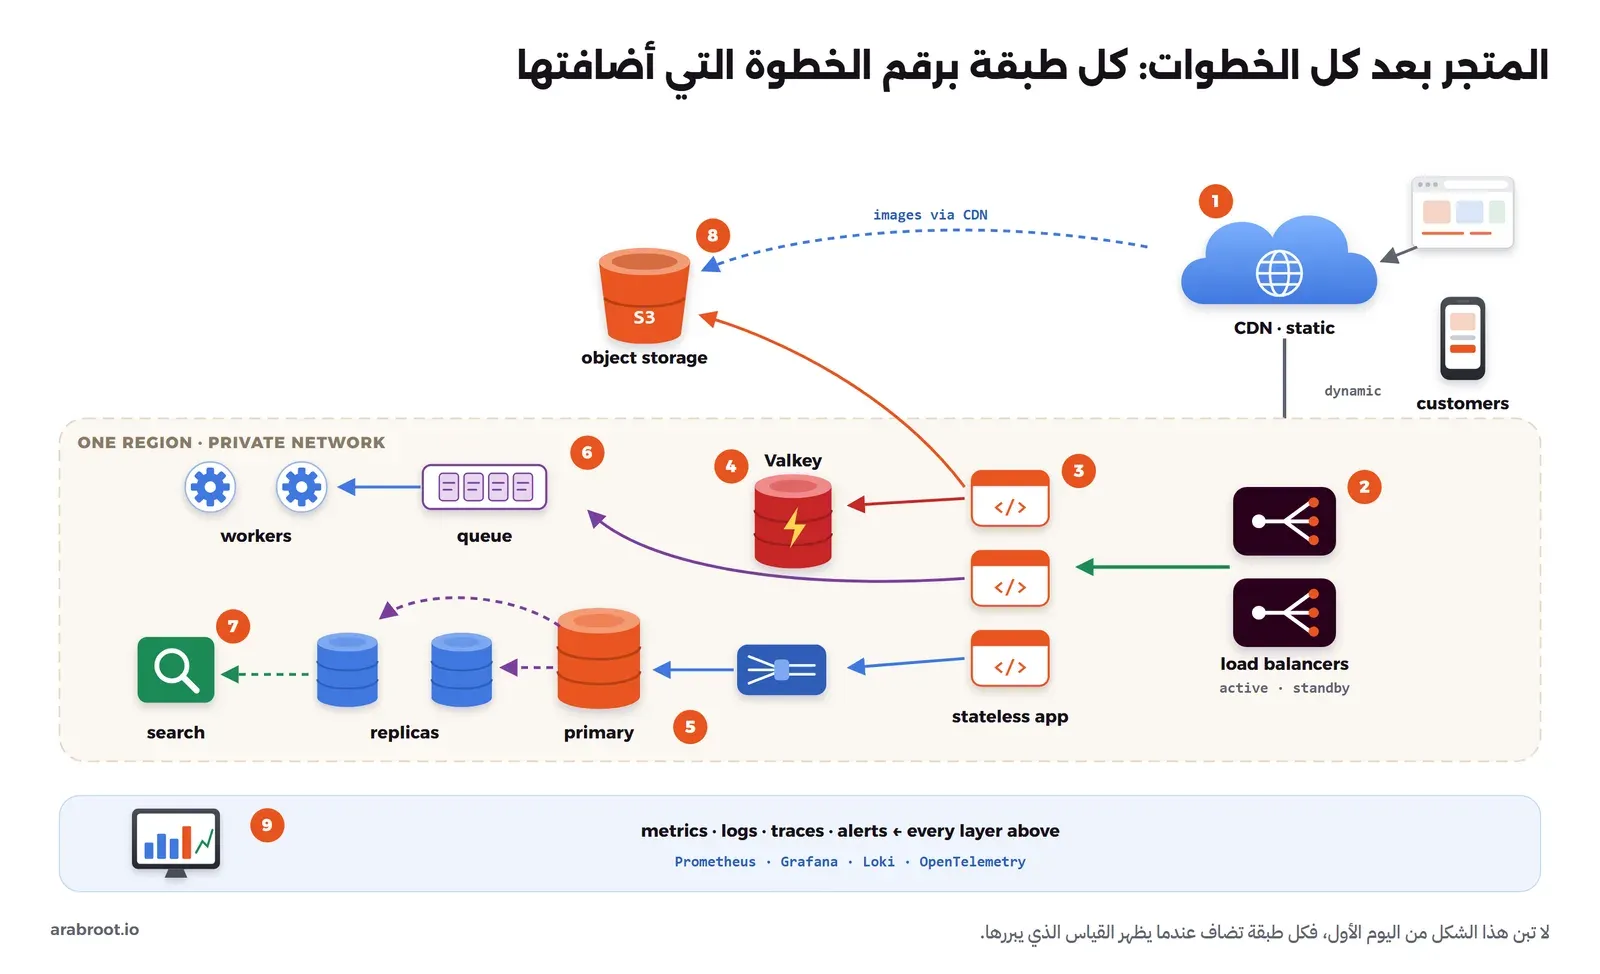
ولاحظ أن الطبقة التاسعة تمر على كل الطبقات، لأنه كلما زادت الأجزاء صار السؤال «أين البطء؟» أصعب، وصار التتبع Tracing الذي يتبع الطلب الواحد عبر الموزع والتطبيق والتخزين المؤقت وقاعدة البيانات ضرورة وليس رفاهية. ولاحظ أيضاً أن كل هذه الأجزاء تحتاج طريقة واحدة منظمة للنشر بين البيئات، وهذا موضوع مقال البيئات ومعاينة الميزات وGitOps.
تجربة عملية: نسختان من التطبيق وموزع حمل وتخزين مؤقت
الآن سوف نبني الخطوتين الثانية والثالثة على جهازك بـ Docker Compose: تطبيق صغير بلغة Python بلا حالة، نشغل منه نسختين خلف HAProxy، ويقرأ المنتجات من PostgreSQL بنمط Cache-Aside عبر Valkey، ثم نرى توزيع الطلبات والتخزين المؤقت وفحص الصحة بأعيننا. وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu، والمنفذ الوحيد المنشور هو 58080 على 127.0.0.1 فقط.
ملفات المشروع
أنشئ مجلداً باسم lab-sysdesign وضع فيه الملفات التالية، وأولها التطبيق نفسه في ملف app.py:
import json, os, socket, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

import psycopg_pool
import redis

INSTANCE = socket.gethostname()
cache = redis.Redis(host="cache", port=6379, decode_responses=True)
db = psycopg_pool.ConnectionPool(os.environ["DATABASE_URL"], min_size=1, max_size=5)
TTL = 60  # seconds


def get_product(pid):
    key = f"product:{pid}"
    cached = cache.get(key)                      # 1. look in the cache first
    if cached:
        return json.loads(cached), "cache"
    with db.connection() as conn:                # 2. miss: read from the database
        row = conn.execute(
            "SELECT id, name, price, pg_sleep(0.3) FROM products WHERE id = %s", (pid,)
        ).fetchone()
    if row is None:
        return None, "db"
    product = {"id": row[0], "name": row[1], "price": float(row[2])}
    cache.set(key, json.dumps(product, ensure_ascii=False), ex=TTL)  # 3. keep a copy with a TTL
    return product, "db"


def set_price(pid, price):
    with db.connection() as conn:
        conn.execute("UPDATE products SET price = %s WHERE id = %s", (price, pid))
    cache.delete(f"product:{pid}")               # invalidate: the next read fills the cache again


class Handler(BaseHTTPRequestHandler):
    def send(self, code, body):
        data = json.dumps(body, ensure_ascii=False).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def do_GET(self):
        if self.path == "/health":
            return self.send(200, {"status": "ok"})
        if self.path == "/whoami":
            visits = cache.incr("visits")        # shared state lives in Valkey, not in the app
            return self.send(200, {"instance": INSTANCE, "visits": visits})
        if self.path.startswith("/product/"):
            start = time.perf_counter()
            product, source = get_product(int(self.path.rsplit("/", 1)[1]))
            ms = round((time.perf_counter() - start) * 1000, 1)
            if product is None:
                return self.send(404, {"error": "not found"})
            return self.send(200, {"instance": INSTANCE, "source": source, "ms": ms, "product": product})
        self.send(404, {"error": "not found"})

    def do_PUT(self):
        if self.path.startswith("/product/"):
            length = int(self.headers.get("Content-Length", 0))
            body = json.loads(self.rfile.read(length))
            set_price(int(self.path.rsplit("/", 1)[1]), body["price"])
            return self.send(200, {"updated": True, "instance": INSTANCE})
        self.send(404, {"error": "not found"})

    def log_message(self, *args):
        pass


ThreadingHTTPServer(("0.0.0.0", 8000), Handler).serve_forever()
في الكود أعلاه لاحظ التالي:
- التطبيق لا يحفظ أي شيء في ذاكرته: عداد الزيارات في
/whoamiيزيد في Valkey بالأمرINCR، والمنتجات في PostgreSQL، لذلك نستطيع تشغيل أي عدد من النسخ. - الدالة
get_productهي نمط Cache-Aside بخطواته الثلاث، وex=TTLتضع مدة صلاحية 60 ثانية على المفتاح عبر الخيارEXفي الأمر SET. - الدالة
set_priceتعدل القاعدة أولاً ثم تحذف المفتاح، ولا تكتب القيمة الجديدة في التخزين المؤقت بنفسها، فيملؤه أول طلب بعدها من القاعدة. - الاستعلام فيه
pg_sleep(0.3)عن قصد، ليمثل استعلاماً ثقيلاً يأخذ 300 مللي ثانية، لأن جدولاً من ثلاثة أسطر يقرأ في جزء من المللي ثانية ولن يظهر الفرق. لذلك الأزمنة في هذه التجربة للتوضيح فقط. - الاتصال بقاعدة البيانات عبر مجمع اتصالات Connection Pool صغير من مكتبة psycopg_pool بحد أقصى 5 اتصالات لكل نسخة، وهو نفس فكرة PgBouncer داخل التطبيق.
ثم ملف Dockerfile لبناء التطبيق:
FROM python:3.13-slim
RUN pip install --no-cache-dir "redis==7.*" "psycopg[binary,pool]==3.*"
WORKDIR /app
COPY app.py .
CMD ["python", "app.py"]
ثم ملف init.sql الذي ينشئ جدول المنتجات عند أول تشغيل لقاعدة البيانات:
CREATE TABLE products (
    id    bigint PRIMARY KEY,
    name  text NOT NULL,
    price numeric(10,2) NOT NULL
);
INSERT INTO products VALUES
    (1, 'دلة قهوة نحاسية', 120.00),
    (2, 'فناجين قهوة (6 قطع)', 45.00),
    (3, 'بن عربي 500 غرام', 38.50);
ثم إعداد HAProxy في ملف haproxy.cfg:
global
    log stdout format raw local0

defaults
    mode http
    log global
    option httplog
    timeout connect 2s
    retries 2
    option redispatch 1
    timeout client  30s
    timeout server  30s

resolvers docker
    nameserver dns 127.0.0.11:53
    hold valid 5s

frontend web
    bind :80
    default_backend app

backend app
    balance roundrobin
    option httpchk GET /health
    http-response set-header X-Served-By %s
    server-template app 1-4 app:8000 check inter 2s fall 2 rise 2 resolvers docker init-addr none
في الإعداد أعلاه لاحظ التالي:
server-template app 1-4 app:8000ينشئ أربع خانات لسيرفرات اسمهاapp1إلىapp4، ويملؤها من عناوين الاسمappفي خادم DNS الداخلي لـ Docker على127.0.0.11، فعندما نزيد عدد النسخ أو ننقصه يراها HAProxy دون إعادة تشغيل. وشرحنا DNS الداخلي في Docker في مقال شبكات Docker، وتفاصيل هذه الخيارات في توثيق إعداد HAProxy 3.4.check inter 2s fall 2 rise 2معoption httpchk GET /health: فحص كل ثانيتين، والنسخة تخرج من التوزيع بعد فحصين فاشلين وتعود بعد فحصين ناجحين.retries 2وoption redispatch 1معtimeout connect 2s: إذا فشل الاتصال بنسخة، يعيد HAProxy المحاولة على نسخة أخرى بدل أن يعيدها على نفس النسخة المعطلة. وفي نسختنا الأولى من الإعداد كانت هذه الأسطر غير موجودة، فأوقفنا نسخة وظل أحد الطلبات معلقاً حتى أوقفهcurlبعد 10 ثوان.http-response set-header X-Served-By %sيضيف إلى كل رد ترويسة باسم السيرفر الذي خدمه، لنرى التوزيع بأعيننا.
وأخيراً ملف compose.yaml الذي يجمع كل ذلك:
name: lab-sysdesign

services:
  lb:
    image: haproxy:3.4.6
    ports:
      - "127.0.0.1:58080:80"
    volumes:
      - ./haproxy.cfg:/usr/local/etc/haproxy/haproxy.cfg:ro
    depends_on: [app]

  app:
    build: .
    environment:
      DATABASE_URL: postgresql://shop:shop@db:5432/shop
    depends_on:
      db:
        condition: service_healthy
      cache:
        condition: service_started

  cache:
    image: valkey/valkey:9-alpine
    command: ["valkey-server", "--maxmemory", "64mb", "--maxmemory-policy", "allkeys-lru"]

  db:
    image: postgres:18
    environment:
      POSTGRES_USER: shop
      POSTGRES_PASSWORD: shop
      POSTGRES_DB: shop
    volumes:
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql:ro
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U shop -d shop"]
      interval: 2s
      retries: 15
في الإعداد أعلاه لاحظ أن الخدمة app لا تحمل اسم Container ثابتاً ولا تنشر أي منفذ، وهذا شرط لتشغيل أكثر من نسخة منها، وأن كلمات المرور مكتوبة في الملف لأنها تجربة محلية فقط، ولا تقم بذلك في الإنتاج Production. وValkey محدود بذاكرة 64 ميجابايت مع سياسة allkeys-lru كما ذكرنا.
التشغيل بنسختين
الآن نشغل كل شيء، ونطلب من Compose نسختين من التطبيق بالخيار --scale الذي يشرحه توثيق docker compose up:
cd lab-sysdesign
docker compose up -d --build --scale app=2
docker compose ps --format 'table {{.Name}}\t{{.Image}}\t{{.Status}}\t{{.Ports}}'
والمخرج سوف يكون كما يلي:
NAME                    IMAGE                    STATUS                    PORTS
lab-sysdesign-app-1     lab-sysdesign-app        Up 16 seconds
lab-sysdesign-app-2     lab-sysdesign-app        Up 15 seconds
lab-sysdesign-cache-1   valkey/valkey:9-alpine   Up 19 seconds             6379/tcp
lab-sysdesign-db-1      postgres:18              Up 19 seconds (healthy)   5432/tcp
lab-sysdesign-lb-1      haproxy:3.4.6            Up 15 seconds             127.0.0.1:58080->80/tcp
ثم نرسل أربعة طلبات إلى /whoami ونعرض الترويسة التي أضافها HAProxy مع الرد:
for i in 1 2 3 4; do
  curl -s -i 127.0.0.1:58080/whoami | tr -d '\r' | grep -iE "x-served-by|instance"
done
والمخرج سوف يكون كما يلي:
x-served-by: app1
{"instance": "1c22c337ee44", "visits": 1}
x-served-by: app2
{"instance": "aa6f261fefda", "visits": 2}
x-served-by: app1
{"instance": "1c22c337ee44", "visits": 3}
x-served-by: app2
{"instance": "aa6f261fefda", "visits": 4}
في المخرج أعلاه لاحظ التالي:
- الطلبات تتناوب بين النسختين بالترتيب، وهذا ما تعنيه
balance roundrobin، والحقلinstanceهو اسم ال Container الذي نفذ الطلب. - العداد
visitsيزيد بشكل صحيح 1 ثم 2 ثم 3 ثم 4 مع أن كل طلب ذهب إلى نسخة مختلفة عن التي قبله، والسبب أنه محفوظ في Valkey وليس في ذاكرة أي نسخة. ولو كان متغيراً داخل التطبيق لرأيت 1 و1 ثم 2 و2.
ولو أضفت نسخة ثالثة بالأمر docker compose up -d --scale app=3 فسوف تجد في سجلات HAProxy أن الخانة app3 أخذت عنوان ال Container الجديد من DNS وأصبحت UP خلال ثوان، وأن الطلبات صارت تدور على ثلاث نسخ، دون أن تلمس ملف الإعداد.
التخزين المؤقت: Miss ثم Hit ثم الإبطال
الآن نطلب نفس المنتج ثلاث مرات، ثم ننظر إلى مدة الصلاحية المتبقية للمفتاح في Valkey:
for i in 1 2 3; do curl -s 127.0.0.1:58080/product/1; echo; done
docker compose exec cache valkey-cli TTL product:1
والمخرج سوف يكون كما يلي:
{"instance": "1c22c337ee44", "source": "db", "ms": 314.1, "product": {"id": 1, "name": "دلة قهوة نحاسية", "price": 120.0}}
{"instance": "aa6f261fefda", "source": "cache", "ms": 0.6, "product": {"id": 1, "name": "دلة قهوة نحاسية", "price": 120.0}}
{"instance": "1c22c337ee44", "source": "cache", "ms": 0.8, "product": {"id": 1, "name": "دلة قهوة نحاسية", "price": 120.0}}
59
في المخرج أعلاه لاحظ التالي:
- الطلب الأول وصل إلى النسخة الأولى ولم يجد المنتج في Valkey، فقرأه من PostgreSQL في حوالي 314 مللي ثانية.
- الطلب الثاني وصل إلى النسخة الثانية، ومع ذلك وجد المنتج في التخزين المؤقت في أقل من مللي ثانية، والسبب أن التخزين المؤقت مشترك بين النسخ، ولو كانت كل نسخة تحفظ نسختها في ذاكرتها لدفعت كل نسخة ثمن ال Miss الأول بنفسها، ولربما عرضت كل نسخة سعراً مختلفاً بعد التعديل.
- الأمر
TTLيعيد 59، أي أن المفتاح سوف يحذف وحده بعد 59 ثانية إذا لم يحذفه التطبيق قبل ذلك. - الأزمنة من جهاز واحد والاستعلام البطيء مصطنع، فهي للتوضيح، والمهم هو حجم الفرق بين القراءة من الذاكرة والقراءة من قاعدة بيانات مشغولة.
ثم نغير السعر ونطلب المنتج مرتين:
curl -s -X PUT -H 'Content-Type: application/json' -d '{"price": 99}' 127.0.0.1:58080/product/1; echo
for i in 1 2; do curl -s 127.0.0.1:58080/product/1; echo; done
والمخرج سوف يكون كما يلي:
{"updated": true, "instance": "aa6f261fefda"}
{"instance": "1c22c337ee44", "source": "db", "ms": 303.1, "product": {"id": 1, "name": "دلة قهوة نحاسية", "price": 99.0}}
{"instance": "aa6f261fefda", "source": "cache", "ms": 0.5, "product": {"id": 1, "name": "دلة قهوة نحاسية", "price": 99.0}}
لاحظ أن التعديل وصل إلى النسخة الثانية، وحذفت المفتاح، فالطلب التالي على النسخة الأولى لم يجد المفتاح وقرأ السعر الجديد 99 من القاعدة، ثم عاد التخزين المؤقت يعمل. ولو حذفت السطر cache.delete(...) من الدالة set_price وأعدت التجربة، فسوف يبقى السعر القديم 120 ظاهراً للعملاء حتى تنتهي ال 60 ثانية، وهذا هو الخطأ الأكثر شيوعاً مع التخزين المؤقت.
نسخة تتجمد: ماذا يفعل فحص الصحة؟
الآن نكسر شيئاً عن قصد: نجمد النسخة الأولى بالأمر docker pause، فتبقى موجودة وعنوانها في DNS ولكنها لا ترد، وهذا يشبه تطبيقاً علق في حلقة أو ينتظر قفلاً للأبد، ثم نرسل ستة طلبات ونقيس زمن كل منها:
docker pause lab-sysdesign-app-1
for i in 1 2 3 4 5 6; do
  curl -s -o /dev/null -w "%{http_code} %{time_total}s\n" --max-time 15 127.0.0.1:58080/whoami
done
docker unpause lab-sysdesign-app-1
docker compose logs --no-log-prefix lb | grep -E "DOWN|UP,|15001"
والمخرج سوف يكون كما يلي:
000 15.001417s
200 0.017281s
200 0.009392s
200 0.013536s
200 0.008529s
200 0.025754s
Server app/app1 is DOWN, reason: Layer7 timeout, check duration: 2003ms. 1 active and 0 backup servers left. 1 sessions active, 0 requeued, 0 remaining in queue.
192.168.96.1:54792 [05/Oct/2026:23:42:10.569] web app/app1 0/0/0/-1/15001 400 0 - - CH-- 1/1/0/0/0 0/0 "GET /whoami HTTP/1.1"
Server app/app1 is UP, reason: Layer7 check passed, code: 200, check duration: 3ms. 2 active and 0 backup servers online. 0 sessions requeued, 0 total in queue.
في المخرج أعلاه لاحظ التالي:
- الطلب الأول ذهب إلى النسخة المجمدة قبل أن يكتشف الفحص أنها معطلة، فانتظر حتى أوقفه
curlبعد 15 ثانية، والسجل يبين ذلك:CH--تعني أن العميل أغلق الاتصال وهو ينتظر رد السيرفر. - خلال ثوان فشل فحصان متتاليان، فكتب HAProxy أن
app1أصبحتDOWNبسببLayer7 timeout، وكل الطلبات بعدها ذهبت إلى النسخة الثانية ونجحت في أجزاء من الثانية. - بعد
docker unpauseنجح فحصان فعادتapp1إلى التوزيع وحدها دون أي تدخل. - والدرس المهم أن فحص الصحة يحمي الطلبات التالية، ولا يحمي الطلب الذي كان في الطريق، لذلك ضع
timeout serverبقيمة مناسبة لتطبيقك بدل 30 ثانية، وضع مهلات Timeouts داخل التطبيق نفسه على كل اتصال بقاعدة البيانات أو بخدمة خارجية.
وفي حالة مختلفة، عندما أوقفنا ال Container بالكامل بالأمر docker stop بدل تجميده، أخذ أول طلب ثانيتين ثم نجح، والسجل يبين السبب:
200 2.012174s
192.168.96.1:55334 [05/Oct/2026:23:38:46.512] web app/app2 0/2003/1/1/2005 200 201 - - ---- 1/1/0/0/+1 0/0 "GET /whoami HTTP/1.1"
والقيمة 2003 هي زمن انتظار الاتصال بالنسخة المتوقفة حتى انتهى timeout connect 2s، و+1 في آخر السطر تعني أن HAProxy أعاد إرسال الطلب إلى سيرفر آخر Redispatch، فخدمته app2 ونجح الطلب بدل أن يفشل.
حذف التجربة
بعد الانتهاء احذف ال Containers والشبكة وال Docker Image التي بنيناها للتطبيق:
docker compose down -v --rmi localالتقدير السريع: الأرقام قبل الصناديق
كل القرارات السابقة تحتاج أرقاماً، وفي بداية أي تصميم لا توجد لديك قياسات بعد، لذلك يستخدم المهندسون ما يسمى التقدير على ظهر الظرف Back-of-the-envelope Estimation، وهو حساب تقريبي سريع بافتراضات مكتوبة بوضوح، هدفه أن تعرف حجم المشكلة: هل نتحدث عن عشرات الطلبات في الثانية أم عشرات الآلاف؟ وهل البيانات جيجابايتات أم تيرابايتات؟ والفرق بين الحالتين أكبر من أي تفصيل في التصميم.
لنأخذ المتجر نفسه بافتراضات للتوضيح فقط، وليست قياساً لمتجر حقيقي: 100 ألف مستخدم نشط يومياً، كل منهم يفتح 10 صفحات، وكل صفحة ترسل 3 طلبات إلى التطبيق (الصفحة نفسها وطلبان من الواجهة)، والذروة في موسم التخفيضات 10 أضعاف المتوسط، و2% من الزوار يشترون، والطلب الواحد مع منتجاته وفهارسه حوالي 5 كيلوبايت، والملفات الثابتة للصفحة حوالي 1 ميجابايت، والرد الديناميكي حوالي 20 كيلوبايت. والحساب كما يلي:
| ماذا نحسب | الحساب | النتيجة |
|---|---|---|
| الصفحات في اليوم | 100,000 × 10 | 1,000,000 صفحة |
| طلبات التطبيق في اليوم | 1,000,000 × 3 | 3,000,000 طلب |
| متوسط الطلبات في الثانية | 3,000,000 ÷ 86,400 | حوالي 35 طلباً في الثانية |
| الطلبات في الثانية وقت الذروة | 35 × 10 | حوالي 350 طلباً في الثانية |
| طلبات الشراء في اليوم | 100,000 × 2% | 2,000 طلب شراء |
| طلبات الشراء في الثانية وقت الذروة | 2,000 ÷ 86,400 × 10 | حوالي 0.23 في الثانية |
| نمو قاعدة البيانات في السنة | 2,000 × 5 KB × 365 | حوالي 3.7 GB |
| الملفات الثابتة في اليوم | 1,000,000 × 1 MB | حوالي 1 TB |
| الردود الديناميكية في اليوم | 3,000,000 × 20 KB | حوالي 60 GB |
الصورة التالية تبين نفس الورقة مع القرار الذي يخرج من كل رقم:
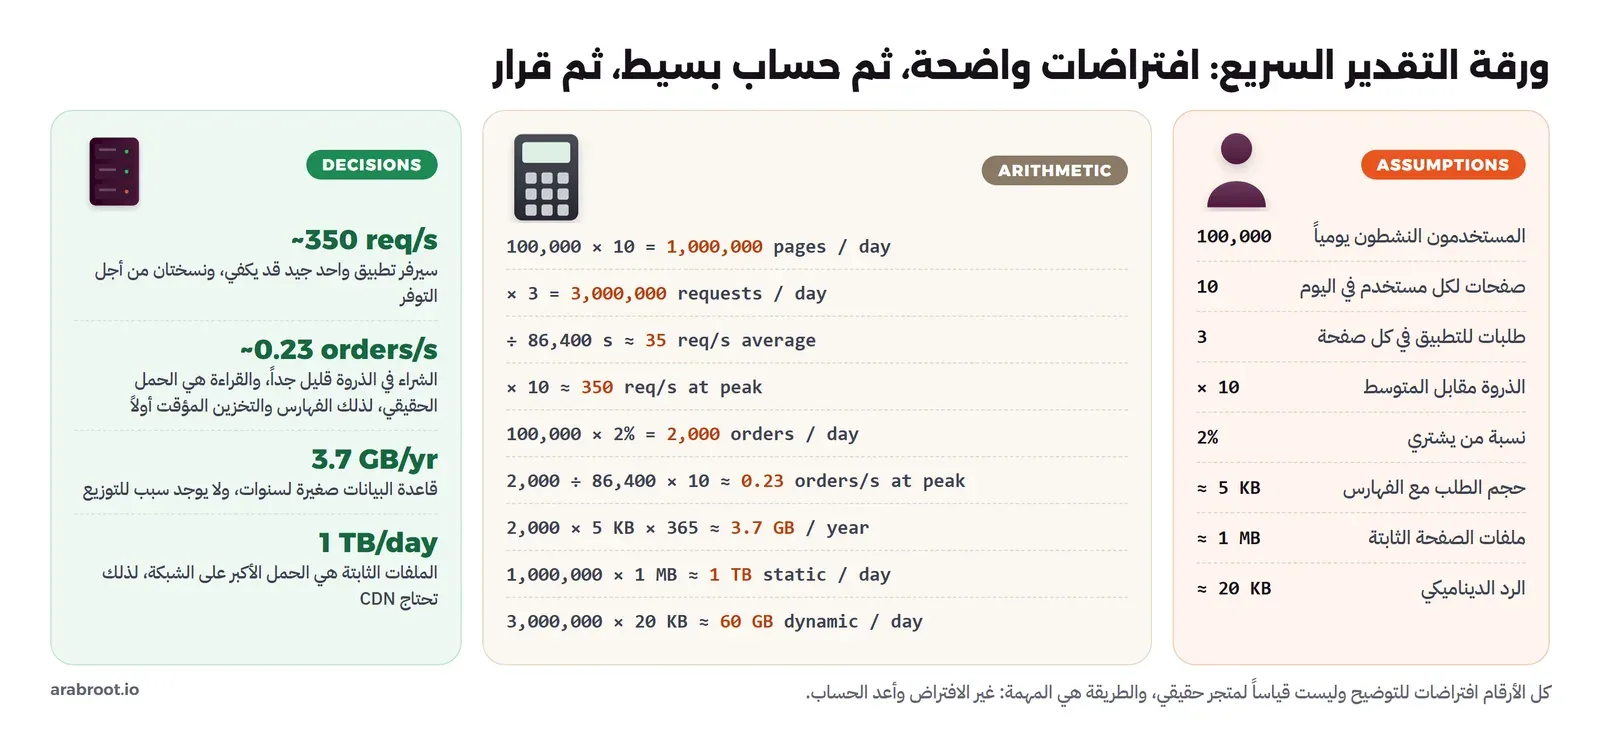
وفي الأرقام أعلاه لاحظ التالي:
- 350 طلباً في الثانية في الذروة رقم يخدمه في الغالب سيرفر تطبيق واحد جيد إذا كان أغلبها من التخزين المؤقت، ونشغل نسختين من أجل التوفر وليس من أجل الأداء. وللمقارنة فإن 209.4 مليون طلب يومياً في مثال Stack Overflow السابق تعني حوالي 2,400 طلب في الثانية في المتوسط.
- الكتابة أقل من طلب شراء واحد في الثانية حتى في الذروة، والقراءة هي الحمل الحقيقي، لذلك الفهارس والتخزين المؤقت ونسخ القراءة أولويات، والتوزيع على عدة قواعد ليس له سبب.
- قاعدة بيانات تنمو 3.7 جيجابايت في السنة تبقى على سيرفر واحد لسنوات طويلة، وصور المنتجات على الأغلب أكبر منها بكثير، وهذا سبب إضافي لوضعها في تخزين الكائنات.
- تيرابايت يومياً من الملفات الثابتة مقابل 60 جيجابايت فقط من الردود الديناميكية يعني أن الحمل الأكبر على الشبكة هو الصور وCSS وJavaScript، فإذا وزعتها 116 صفحة في الثانية في الذروة مع ميجابايت لكل صفحة فهذا حوالي 930 ميجابت في الثانية، وهو ما يملأ منفذ 1 Gbps كاملاً، لذلك ال CDN وتخزين المتصفح المؤقت هما أول ما تضيفه هنا وليس سيرفرات تطبيق أكثر.
أرقام زمن الاستجابة التي يجب أن تعرفها
الجزء الثاني من التقدير أن تعرف تقريباً كم تأخذ كل عملية، وأشهر مرجع لذلك القائمة التي نشرها Peter Norvig ثم وسعها Jeff Dean، وتجدها مجمعة في Latency Numbers Every Programmer Should Know، وقد استخدمنا جزءها الخاص بالذاكرة في هرم الذاكرة في مقال كيف يعمل برنامج Hello World. والأرقام تعود إلى حوالي سنة 2012 كما يذكر المرجع نفسه، والأجهزة الحديثة أسرع في بعضها، ولكن الفروق بين المستويات هي المهمة:
| العملية | الزمن التقريبي | ماذا تعني لتصميمك |
|---|---|---|
| قراءة من الذاكرة الرئيسية RAM | 100 نانوثانية | لهذا السبب التخزين المؤقت في الذاكرة سريع جداً |
| إرسال 1 KB عبر شبكة 1 Gbps | 10 ميكروثانية | حجم الرد مهم عندما يتكرر ملايين المرات |
| قراءة 4 KB عشوائية من SSD | 150 ميكروثانية | استعلام يقرأ آلاف الصفحات من القرص يأخذ مئات المللي ثانية |
| قراءة 1 MB متتالية من الذاكرة | 250 ميكروثانية | الذاكرة أسرع من أي قرص بفرق كبير |
| ذهاب وعودة داخل نفس مركز البيانات | 500 ميكروثانية | كل استعلام عبر الشبكة له ثمن، و200 استعلام صغير تساوي 100 مللي ثانية |
| قراءة 1 MB متتالية من SSD | 1 مللي ثانية | القرص السريع ما زال أبطأ من الذاكرة بأربع مرات |
| قراءة 1 MB متتالية من قرص دوار HDD | 20 مللي ثانية | لا تضع قاعدة بيانات نشطة على HDD |
| حزمة من كاليفورنيا إلى هولندا والعودة | 150 مللي ثانية | المسافة الجغرافية لا يمكن تحسينها بالكود، ولذلك يوجد ال CDN وتصعب الكتابة بين المناطق |
كيف تبدأ أي تصميم؟ قائمة تحقق
سواءً كنت تصمم نظاماً جديداً لعملك أو تجيب عن سؤال في مقابلة عمل، فالترتيب نفسه يعمل في الحالتين، والخطأ الأشهر أن تبدأ برسم الصناديق قبل أن تعرف ماذا يجب أن يفعل النظام:
- المتطلبات الوظيفية Functional Requirements: ماذا يفعل النظام بالضبط؟ اكتبها جملاً قصيرة: العميل يتصفح المنتجات ويبحث فيها، ويضيف إلى السلة، ويدفع، ويصله بريد التأكيد، والموظف يضيف المنتجات ويعدل الأسعار. وحدد ما ليس في النطاق الآن، مثل تطبيق الجوال أو التوصيات.
- المتطلبات غير الوظيفية Non-functional Requirements: كم مستخدماً، وما زمن الاستجابة المقبول، وما نسبة التوفر المطلوبة، وهل يحتمل النظام أن يرى العميل بيانات قديمة لدقيقة، وما الذي لا يحتمل الخطأ إطلاقاً مثل المال والمخزون، وأين يجب أن تبقى البيانات بحسب الأنظمة.
- القيود Constraints: حجم الفريق وما يعرفه، والميزانية، والموعد، والأنظمة الموجودة التي يجب أن يتكامل معها. وفريق من ثلاثة أشخاص لا يستطيع تشغيل Kafka وKubernetes وعشر خدمات مهما كان التصميم جميلاً على الورق.
- التقدير السريع: الطلبات في الثانية في المتوسط والذروة، ونسبة القراءة إلى الكتابة، وحجم البيانات بعد سنة وبعد ثلاث سنوات، وعرض النطاق Bandwidth، كما فعلنا في القسم السابق.
- أبسط تصميم يعمل: ارسم أقل عدد من الأجزاء يحقق المتطلبات، وغالباً هو التطبيق وقاعدة البيانات والملفات، وصمم الجداول والواجهات API الأساسية، وتحقق أن كل متطلب وظيفي له مسار واضح في الرسم.
- نقاط الاختناق Bottlenecks: الآن فقط اسأل: ما أول شيء ينكسر عندما يتضاعف الحمل عشر مرات؟ وما نقاط الفشل الواحدة؟ وما الذي يحدث إذا تعطل كل جزء؟ ولكل نقطة اختر من الخطوات في هذا المقال أرخص ما يحلها، واكتب ثمنه بجانبه.
- التشغيل: كيف تراقب كل جزء، وكيف تنشر إصداراً جديداً دون توقف، وكيف تأخذ النسخ الاحتياطية وتجربها، ومن يستيقظ ليلاً عندما ينقطع شيء.
وهذه بعض الأخطاء التي تتكرر في التصميم، وكل منها رأيناه في خطوة من خطوات المقال:
- إضافة التخزين المؤقت لإخفاء استعلام بلا فهرس، والحل الصحيح هو الفهرس أولاً.
- تشغيل نسختين من التطبيق والجلسات أو الملفات ما زالت على النسخة نفسها.
- إرسال البريد أو الاتصال بخدمة خارجية داخل الطلب دون مهلة Timeout ودون إعادة محاولة.
- القراءة من نسخة القراءة مباشرة بعد الكتابة، فيرى المستخدم البيانات القديمة ويظن أن التعديل لم يحفظ.
- تقسيم التطبيق إلى خدمات مصغرة قبل أن يعرف الفريق حدود الأجزاء، أو بناء عدة مناطق قبل أن يعرف كم يكلفه التوقف.
خريطة الأدوات مفتوحة المصدر لكل طبقة
كل طبقة في البنية السابقة لها أدوات مفتوحة المصدر تستضيفها بنفسك، والجدول التالي يجمع أشهرها مع سطر واحد لكل منها، ومكان شرحها في عرب رووت أو في خارطة الطريق:
| الطبقة | الأداة | دورها باختصار | في عرب رووت |
|---|---|---|---|
| موزع الحمل وال Reverse Proxy | HAProxy | موزع حمل متخصص لعدة سيرفرات خلفية وحركة كثيفة، مع فحوص صحة وصفحة إحصاءات ووضع TCP | دليل التثبيت |
| Nginx | خادم ويب و Reverse Proxy منتشر جداً، ويوزع الحمل على مجموعة سيرفرات بقسم upstream | Nginx Proxy Manager | |
| Traefik | يكتشف ال Containers تلقائياً من ال labels ويوزع الحمل على نسخها | دليل التثبيت | |
| المقارنة بينها | متى يناسب كل واحد منها، والجمع بين HAProxy وTraefik | المقارنة | |
| التخزين المؤقت والجلسات | Valkey | مخزن مفتاح وقيمة في الذاكرة برخصة BSD-3-Clause، متوافق مع بروتوكول Redis | الجلسات المشتركة وقسم قواعد البيانات |
| Redis | الأصل الذي انفصل عنه Valkey، ومن الإصدار 8 يتيح رخصة AGPL-3.0 من بين رخصه | قسم قواعد البيانات | |
| الطوابير وبث الأحداث | RabbitMQ | طوابير رسائل موثوقة مع تأكيد الاستلام وإعادة المحاولة، برخصة MPL 2.0 | قسم الطوابير |
| Apache Kafka | سجل أحداث موزع يحتفظ بالرسائل ويقرؤها أكثر من نظام، للأحجام الكبيرة، برخصة Apache 2.0 | ||
| NATS | رسائل خفيفة وسريعة بين الخدمات، مع تخزين دائم عبر JetStream، برخصة Apache 2.0 | ||
| البحث | OpenSearch | محرك بحث وتحليل للأحجام الكبيرة والسجلات، برخصة Apache 2.0 | قسم محركات البحث |
| Meilisearch | بحث فوري داخل التطبيق يتحمل الأخطاء الإملائية، النسخة المجتمعية برخصة MIT وبعض الميزات برخصة BUSL | ||
| تخزين الكائنات S3 | Garage | تخزين S3 خفيف مصمم لعدة سيرفرات صغيرة في أماكن مختلفة، برخصة AGPL-3.0 | قسم الملفات |
| SeaweedFS | تخزين ملفات وكائنات للأحجام الكبيرة مع واجهة S3، برخصة Apache 2.0 | ||
| MinIO | كان الأشهر، ومستودعه الآن مؤرشف ويقول إنه لم يعد يصان، فلا تبدأ به مشروعاً جديداً | ||
| قواعد البيانات | PostgreSQL | قاعدة بيانات علائقية مع نسخ القراءة والتقسيم وJSONB، وهي اختيارنا في أغلب أمثلة الموقع | تصميم قواعد البيانات والجداول الضخمة |
| MySQL | قاعدة بيانات علائقية منتشرة جداً في تطبيقات الويب | قسم قواعد البيانات | |
| PgBouncer | تجميع اتصالات PostgreSQL بين التطبيق والقاعدة | تجميع الاتصالات | |
| المراقبة | Prometheus | جمع المقاييس Metrics وتخزينها والتنبيه عليها، برخصة Apache 2.0 | قسم المراقبة |
| Grafana | لوحات ورسوم بيانية فوق Prometheus والسجلات والتتبع، برخصة AGPL-3.0 | ||
| OpenTelemetry | معيار ومكتبات لجمع التتبع Traces والمقاييس والسجلات من الكود، برخصة Apache 2.0 | ||
| شبكة توزيع المحتوى والحماية | Cloudflare وبدائله | التخزين المؤقت قرب الزائر والحماية من الهجمات، مع البدائل التي تستضيفها بنفسك | خدمات Cloudflare وبدائلها |
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- تصميم الأنظمة سلسلة قرارات، كل قرار يحل مشكلة قستها ويضيف ثمناً تعرفه، والبداية الصحيحة سيرفر واحد مع نسخة احتياطية مجربة ولوحة قياس.
- افصل قاعدة البيانات أولاً، وكبر السيرفرات عمودياً ما دام ذلك ممكناً، واجعل التطبيق بلا حالة من اليوم الأول: الجلسات في مخزن مشترك، والملفات في تخزين الكائنات، والمهام المجدولة في عامل واحد.
- موزع الحمل بلا فحوص صحة يوزع الأخطاء على العملاء، والفحص يحمي الطلبات التالية فقط، لذلك تحتاج مهلات Timeouts وإعادة المحاولة على سيرفر آخر.
- التخزين المؤقت على طبقتين: CDN للملفات الثابتة، وCache-Aside في Valkey للقراءات المتكررة، مع TTL لكل مفتاح وحذف المفتاح عند التعديل، ولا تحفظ ما يخص مستخدماً واحداً في ال CDN.
- لقاعدة البيانات: الفهارس، ثم تجميع الاتصالات ونسخ القراءة مع الانتباه لتأخرها، ثم التقسيم، والتوزيع على عدة سيرفرات آخر خطوة.
- العمل البطيء يخرج إلى طابور وعمال، والمهمة تكتب مع الطلب في نفس المعاملة، وكل مهمة آمنة عند التكرار.
- عدة مناطق والخدمات المصغرة لها ثمن كبير لا يحتاجه أغلب الفرق، وسيرفر متواضع مع كود جيد يتحمل أكثر بكثير مما تتوقع.
- ابدأ أي تصميم بالمتطلبات والقيود والتقدير السريع، ثم أبسط تصميم يعمل، ثم نقاط الاختناق.
وفي مقالات قادمة بإذن الله سوف نتعمق في كل خطوة من هذه الخطوات ضمن قسم تصميم الأنظمة والأنظمة الموزعة: التخزين المؤقت بالتفصيل، وتحديد معدل الطلبات Rate Limiting، وIdempotency، وقرار Monolith أم Microservices، وتصميم واجهات API. وأقرب المقالات إلى هذا الموضوع على الموقع:
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلTransactional Email: كيف تصل رسائل تطبيقك في وقتهالماذا تفصل رسائل تطبيقك مثل استعادة كلمة المرور عن النشرات البريدية، وكيف ترسلها بحيث تصل في وقتها ولا تذهب إلى Spam.
 مقارنةأي Reverse Proxy يناسب سيرفرك وفريقك؟مقارنة بين أشهر أدوات ال Reverse Proxy في سهولة الإعداد وشهادات HTTPS وتوزيع الحمل، لتعرف أيها يناسب سيرفرك.
 دليلخدمات Cloudflare بكلمات بسيطة وبدائلها مفتوحة المصدرما الذي تقدمه كل خدمة من Cloudflare، وما المتاح منها مجاناً، وما البديل مفتوح المصدر الذي تشغله على سيرفرك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع HAProxy 3.4.6 وValkey 9.1.2 وPostgreSQL 18.6 وPython 3.13.16.


