

لنفرض أن لديك متجراً إلكترونياً بدأ بعشرات الطلبات في اليوم، وكان جدول الطلبات orders في قاعدة بيانات PostgreSQL صغيراً لا يشعر به أحد، ثم نجح المتجر فأصبح الجدول بعد ثلاث سنوات عشرات الملايين من الصفوف وفي الطريق إلى مئات الملايين، وفجأة أصبحت لوحة التحكم Dashboard تتوقف بسبب انتهاء المهلة Timeout، وصفحة "طلباتي" عند العميل تأخذ ثلاث ثوان، والنسخة الاحتياطية الليلية لا تنتهي قبل الصباح، والقرص يمتلئ رغم أنك حذفت طلبات قديمة. وقد يتساءل البعض: هل نحتاج إلى Cluster من عدة سيرفرات؟ والإجابة في أغلب الحالات لا، فالسيرفر الواحد مع الفهارس الصحيحة والتقسيم Partitioning والأرشفة والصيانة يحمل مئات الملايين من الصفوف، وعندما لا يكفي فهناك ترتيب واضح لما تفعله بعده.
وهذا المقال عملي من أوله إلى آخره، فقد شرحنا الأساس النظري في مقالين منفصلين: تصميم قواعد البيانات والتطبيع والتوسع للجداول والمفاتيح ومشكلة N+1، والمعرفات الفريدة UUID وULID وSnowflake لاختيار نوع المفتاح الأساسي، أما هنا فسوف نأخذ جدول طلبات من 30 مليون صف على PostgreSQL 18 ونطبق عليه كل خطوة ونرى المخرج الحقيقي، وسوف نناقش في هذا المقال ما يلي:
- الأعراض التي تظهر عندما يكبر الجدول، وكيف تقيس قبل أن تغير أي شيء بأدوات
pg_stat_statementsوEXPLAIN (ANALYZE, BUFFERS). - الفهارس الصحيحة: B-tree المركب، والفهرس الجزئي Partial Index، والفهرس المغطي Covering Index، وفهرس BRIN للتواريخ، وحذف الفهارس التي لا يستخدمها أحد.
- أنماط الاستعلام: الترقيم بالمفتاح Keyset Pagination بدل OFFSET، والعمل على دفعات Batches، وبدائل
COUNT(*). - تقسيم الجدول حسب الشهر Range Partitioning، وحذف الشهور القديمة دون DELETE، وأتمتة ذلك مع pg_partman.
- ال VACUUM والانتفاخ Bloat وضبط autovacuum لكل جدول، وتحذير التفاف أرقام المعاملات Transaction ID Wraparound.
- الأرشفة، ونسخ القراءة Read Replicas، وPgBouncer، والعروض المحفوظة Materialized Views.
- متى لا يكفي سيرفر واحد: الفرق بين التوفر العالي High Availability وتوزيع الكتابة، وPatroni وCitus وCloudNativePG.
- إعدادات الذاكرة والقرص الأساسية، والنسخ الاحتياطي لقاعدة كبيرة، ثم قائمة تحقق بالأخطاء الشائعة.
تجهيز المختبر: جدول طلبات من 30 مليون صف
سوف نشغل PostgreSQL 18 في Container واحد على المنفذ 55480 المربوط على العنوان المحلي فقط، ونحمل معه الإضافة pg_stat_statements التي سوف نحتاجها للقياس، وإذا لم يكن Docker مثبتاً لديك فابدأ بدليل تثبيت Docker على Ubuntu:
docker run -d --name lab-pgscale-pg -p 127.0.0.1:55480:5432 \
  -e POSTGRES_PASSWORD="$(openssl rand -hex 16)" --shm-size=1g \
  postgres:18.6 \
  -c shared_preload_libraries=pg_stat_statements \
  -c shared_buffers=2GB -c work_mem=16MB -c maintenance_work_mem=1GB \
  -c max_wal_size=8GB -c effective_cache_size=6GB -c track_io_timing=on
في الإعداد أعلاه لاحظ التالي:
- الإضافة
pg_stat_statementsيجب أن تحمل عند تشغيل السيرفر من خلالshared_preload_libraries، والسبب كما تذكر الوثائق الرسمية أنها تحتاج ذاكرة مشتركة، وبالتالي فإضافتها لاحقاً تتطلب إعادة تشغيل السيرفر، لذلك فعلها على سيرفر الإنتاج Production من اليوم الأول. - القيمة
track_io_timing=onتجعلEXPLAINيعرض الوقت الذي ذهب في القراءة من القرص، وهو ما يفرق بين استعلام بطيء لأنه يحسب كثيراً واستعلام بطيء لأنه ينتظر القرص. - قيم الذاكرة هنا تناسب جهاز المختبر فقط، وسوف نشرح في قسم الإعدادات كيف تختار قيم سيرفرك.
بعد ذلك ندخل إلى psql ونفعل الإضافة:
docker exec -it lab-pgscale-pg psql -U postgres -c "CREATE EXTENSION pg_stat_statements;"الآن ننشئ جدول الطلبات ونملؤه بثلاثين مليون طلب موزعة على ثلاث سنوات من أكتوبر 2023 إلى سبتمبر 2026، ونجعل عدد الطلبات يزيد شهراً بعد شهر كما يحدث في متجر ينمو، وذلك بالدالة generate_series ودالة sqrt على رقم الصف، وآخر عشرين ألف طلب حالتها pending أي تنتظر التجهيز:
CREATE TABLE orders (
    id             bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id    bigint        NOT NULL,
    status         text          NOT NULL,
    total          numeric(12,2) NOT NULL,
    items_count    int           NOT NULL,
    payment_method text          NOT NULL,
    created_at     timestamptz   NOT NULL,
    updated_at     timestamptz   NOT NULL
);

INSERT INTO orders (customer_id, status, total, items_count, payment_method, created_at, updated_at)
SELECT (random() * 1999999)::bigint + 1,
       CASE WHEN g > 30000000 - 20000 THEN 'pending'
            WHEN random() < 0.08 THEN 'cancelled'
            WHEN random() < 0.03 THEN 'refunded'
            ELSE 'delivered' END,
       round((random() * 950 + 20)::numeric, 2),
       (random() * 6)::int + 1,
       (ARRAY['card','mada','apple_pay','cash_on_delivery'])[(random() * 3)::int + 1],
       ts, ts
FROM generate_series(1, 30000000) AS g,
     LATERAL (SELECT timestamptz '2023-10-01 00:00+00'
                     + (timestamptz '2026-10-01 00:00+00' - timestamptz '2023-10-01 00:00+00') * sqrt(g / 30000000.0) AS ts) t;
ANALYZE orders;
والمخرج سوف يكون كما يلي، ولاحظ أن إدخال 30 مليون صف استغرق قرابة 28 دقيقة على جهاز المختبر، لذلك إذا كان جهازك محدوداً فابدأ بعشرة ملايين، فكل النتائج في المقال تظهر بالشكل نفسه مع أرقام أصغر:
CREATE TABLE
Time: 159.483 ms
INSERT 0 30000000
Time: 1668422.449 ms (27:48.422)
ANALYZE
Time: 117365.569 ms (01:57.366)
وهذا توزيع الطلبات على الحالات، وعدد الطلبات في أول الشهور وآخرها، ولاحظ كيف تضاعف عدد الطلبات الشهري من 24 ألفاً إلى أكثر من مليون ونصف:
  status   |  count
-----------+----------
 delivered | 26755474
 cancelled |  2397383
 refunded  |   827143
 pending   |    20000

     m      |  count
------------+---------
 2023-10-01 |   24000
 2023-11-01 |   68930
 2023-12-01 |  118455
 2026-07-01 | 1578625
 2026-08-01 | 1626627
 2026-09-01 | 1619858
الأعراض: كيف تعرف أن الجدول أصبح كبيراً؟
لا يوجد رقم سحري يصبح عنده الجدول "ضخماً"، فجدول من مئة مليون صف بفهارس صحيحة قد يكون أسرع من جدول من خمسة ملايين بلا فهارس، ولكن الأعراض تظهر بترتيب شبه ثابت مع نمو الجدول، والصورة التالية تبين ما يظهر عند كل حجم لجدول مثل جدولنا:
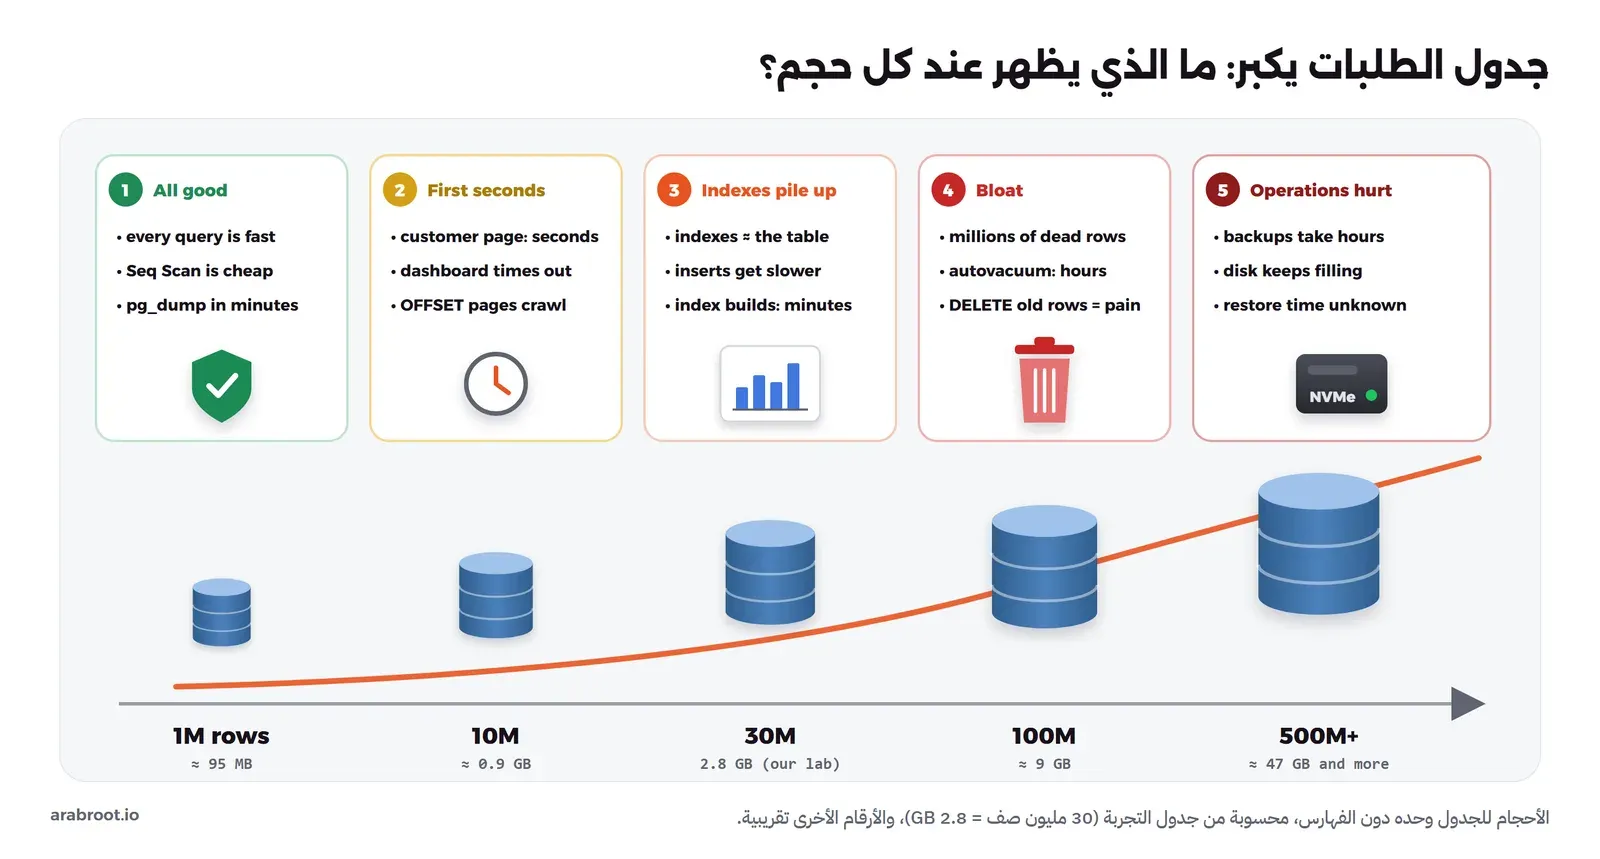
- استعلام لوحة التحكم ينتهي بخطأ المهلة: استعلام كان يأخذ أجزاء من الثانية أصبح يقرأ الجدول كاملاً في كل مرة، وهذا ما يسمى المسح الكامل Sequential Scan، وهو رخيص على مئة ألف صف ومكلف على ثلاثين مليوناً.
- الإدخال Insert يبطئ: كل فهرس على الجدول يجب أن يحدث مع كل طلب جديد، فإذا أضفت فهرساً لكل شكوى من البطء فسوف تجد أن الكتابة هي التي أصبحت بطيئة.
- انتفاخ الجدول والفهارس Bloat: التحديث والحذف في PostgreSQL يتركان نسخاً ميتة من الصفوف، فيكبر الملف على القرص أكثر من حجم البيانات الحية.
- ال autovacuum لا ينتهي: عملية التنظيف التلقائية تعمل ساعات على الجدول الكبير، وقد تلغى كلما احتاجت عملية أخرى قفلاً على الجدول، فتبدأ من جديد.
- النسخ الاحتياطي يأخذ ساعات: و
pg_dumpالذي كان يكفي أصبح لا ينتهي في نافذة الليل، والأسوأ أنك لا تعرف كم تستغرق الاستعادة Restore. - القرص يمتلئ: رغم أنك حذفت طلبات قديمة، لأن DELETE لا يعيد المساحة إلى نظام التشغيل كما سوف نرى.
قس أولاً: أين يذهب الوقت فعلاً؟
أكثر خطأ نراه في هذه المرحلة هو أن يضيف المطور فهرساً على أي عمود يظن أنه السبب، أو أن يرفع الذاكرة، أو أن يطلب سيرفراً أكبر، قبل أن يعرف أي استعلام يستهلك الوقت، والطريقة الصحيحة أن تبدأ من ثلاث أدوات مدمجة في PostgreSQL وتقرر بناءً على أرقامها.
ال pg_stat_statements: أي الاستعلامات تأخذ أكثر الوقت؟
هذه الإضافة تجمع كل استعلام بعد استبدال القيم فيه بمتغيرات، فتحسب لكل شكل من الاستعلامات عدد مرات تشغيله ومجموع وقته ومتوسطه وعدد الصفحات التي قرأها. سوف نصفر الإحصاءات ثم نشغل ثلاثة استعلامات يشغلها المتجر طوال اليوم: صفحة طلبات العميل، ومجموع مبيعات الشهر للوحة التحكم، وقائمة الطلبات التي تنتظر التجهيز:
SELECT pg_stat_statements_reset();

SELECT id, status, total, created_at FROM orders WHERE customer_id = 123456 ORDER BY created_at DESC LIMIT 20;
SELECT count(*), sum(total) FROM orders WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
SELECT id, customer_id, total FROM orders WHERE status = 'pending' ORDER BY created_at LIMIT 50;
SELECT id, status, total, created_at FROM orders WHERE customer_id = 777 ORDER BY created_at DESC LIMIT 20;
SELECT count(*), sum(total) FROM orders WHERE created_at >= '2026-08-01' AND created_at < '2026-09-01';

SELECT calls, round(total_exec_time) AS total_ms, round(mean_exec_time) AS mean_ms,
       shared_blks_hit + shared_blks_read AS blocks, left(query, 70) AS query
FROM pg_stat_statements ORDER BY total_exec_time DESC LIMIT 5;
والمخرج سوف يكون كما يلي:
 calls | total_ms | mean_ms | blocks |                                 query
-------+----------+---------+--------+------------------------------------------------------------------------
     2 |     5915 |    2957 | 717783 | SELECT id, status, total, created_at FROM orders WHERE customer_id = $
     2 |     4367 |    2184 | 717780 | SELECT count(*), sum(total) FROM orders WHERE created_at >= $1 AND cre
     1 |     3688 |    3688 | 358890 | SELECT id, customer_id, total FROM orders WHERE status = $1 ORDER BY c
     1 |        1 |       1 |      0 | SELECT pg_stat_statements_reset()
في المخرج أعلاه لاحظ التالي:
- صفحة طلبات العميل، وهي صفحة يفتحها كل عميل، تأخذ قرابة ثلاث ثوان في المتوسط، وتقرأ في كل مرة قرابة 359 ألف صفحة Page من الجدول، أي الجدول كله تقريباً، لتعيد 15 صفاً فقط.
- العمود
blocksهو عدد صفحات البيانات التي لمسها الاستعلام، وكل صفحة 8 كيلوبايت، فالاستعلام الأول قرأ قرابة 2.7 جيجابايت في مرتين، وهذا الرقم أصدق من الوقت لأنه لا يتغير مع حمل السيرفر. - القيم في نص الاستعلام أصبحت
$1، وبالتالي فكل استعلامات صفحة العميل لكل العملاء تجمع في سطر واحد، وهذا ما يجعلك ترى الاستعلام الذي يتكرر آلاف المرات بوقت متوسط، وهو غالباً أهم من استعلام نادر بطيء.
ال EXPLAIN (ANALYZE, BUFFERS): لماذا هذا الاستعلام بطيء؟
بعد أن عرفت أي استعلام تبدأ به، فالسؤال التالي هو كيف ينفذه PostgreSQL، والأمر EXPLAIN مع ANALYZE ينفذ الاستعلام فعلاً ويعرض الخطة Plan مع الوقت الحقيقي لكل خطوة، ومع BUFFERS يعرض الصفحات التي قرأها من الذاكرة ومن القرص، ويجدر الإشارة هنا أن PostgreSQL 18 أصبح يعرض BUFFERS تلقائياً مع ANALYZE كما في ملاحظات الإصدار 18، ولكننا نكتبها صراحة حتى يعمل الأمر نفسه على الإصدارات الأقدم:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, status, total, created_at FROM orders
WHERE customer_id = 123456 ORDER BY created_at DESC LIMIT 20;
والمخرج سوف يكون كما يلي:
 Limit  (cost=516147.95..516147.98 rows=14 width=31) (actual time=3714.745..3862.983 rows=15.00 loops=1)
   Buffers: shared hit=233167 read=125726
   I/O Timings: shared read=3044.353
   ->  Sort  (cost=516147.95..516147.98 rows=14 width=31) (actual time=3474.098..3622.334 rows=15.00 loops=1)
         Sort Key: created_at DESC
         Sort Method: quicksort  Memory: 26kB
         Buffers: shared hit=233167 read=125726
         I/O Timings: shared read=3044.353
         ->  Gather  (cost=1000.00..516147.68 rows=14 width=31) (actual time=473.299..3622.183 rows=15.00 loops=1)
               Workers Planned: 2
               Workers Launched: 2
               Buffers: shared hit=233164 read=125726
               I/O Timings: shared read=3044.353
               ->  Parallel Seq Scan on orders  (cost=0.00..515146.28 rows=6 width=31) (actual time=1423.496..3434.840 rows=5.00 loops=3)
                     Filter: (customer_id = 123456)
                     Rows Removed by Filter: 9999995
                     Buffers: shared hit=233164 read=125726
                     I/O Timings: shared read=3044.353
 Planning:
   Buffers: shared hit=94
 Planning Time: 0.578 ms
 JIT:
   Functions: 13
   Options: Inlining true, Optimization true, Expressions true, Deforming true
   Timing: Generation 1.732 ms (Deform 0.611 ms), Inlining 789.617 ms, Optimization 95.681 ms, Emission 80.345 ms, Total 967.374 ms
 Execution Time: 3906.400 ms
اقرأ الخطة من الداخل إلى الخارج، أي من السطر الأكثر إزاحة، وفي المخرج أعلاه لاحظ التالي:
Parallel Seq Scan on ordersيعني أن ثلاث عمليات (العملية الرئيسية واثنان من العمال Workers) قرأت الجدول كاملاً، وRows Removed by Filter: 9999995معloops=3يعني أن قرابة 30 مليون صف قرئت ورميت للوصول إلى 15 صفاً.read=125726صفحة جاءت من القرص، وI/O Timingsيقول إن ثلاث ثوان من أربع ذهبت في انتظار القرص، وهذا يعني أن رفع سرعة المعالج لن يفيد هنا.- قرابة ثانية كاملة ذهبت في ترجمة الاستعلام JIT لأن المخطط Planner قدر أن الاستعلام مكلف، وهذه علامة أخرى على أن المشكلة في طريقة الوصول إلى البيانات وليس في الحساب.
- قارن دائماً
rowsالمقدرة معactual rows، فإذا كان الفرق كبيراً جداً فالإحصاءات قديمة ويحتاج الجدول إلىANALYZE، وهنا التقدير 14 والحقيقي 15، وهذا ممتاز.
ويشرح دليل Using EXPLAIN في الوثائق كل نوع من العقد Nodes التي سوف تقابلها، وقد شرحنا فكرة الفهرس نفسها في قسم الفهارس في مقال تصميم قواعد البيانات، لذلك سوف نركز هنا على أنواعه واختيار الصحيح منها.
حجم الجدول والفهارس والصفوف الميتة
الأداة الثالثة هي معرفة الحجم الحقيقي على القرص بالدوال pg_relation_size وpg_total_relation_size، وعدد الصفوف الحية والميتة من العرض pg_stat_user_tables:
SELECT pg_size_pretty(pg_relation_size('orders'))       AS table_only,
       pg_size_pretty(pg_indexes_size('orders'))        AS indexes,
       pg_size_pretty(pg_total_relation_size('orders')) AS total;

SELECT n_live_tup, n_dead_tup, last_autovacuum, last_autoanalyze, autovacuum_count
FROM pg_stat_user_tables WHERE relname = 'orders';
والمخرج سوف يكون كما يلي:
 table_only | indexes |  total
------------+---------+---------
 2804 MB    | 643 MB  | 3447 MB

 n_live_tup | n_dead_tup | last_autovacuum | last_autoanalyze | autovacuum_count
------------+------------+-----------------+------------------+------------------
   30000261 |          0 |                 |                  |                0
الجدول 2.8 جيجابايت والفهرس الوحيد هو فهرس المفتاح الأساسي بحجم 643 ميجابايت، ولا توجد صفوف ميتة بعد لأننا لم نحدث شيئاً، وسوف نعود إلى هذه الأرقام بعد كل خطوة.
الفهارس الصحيحة لكل استعلام
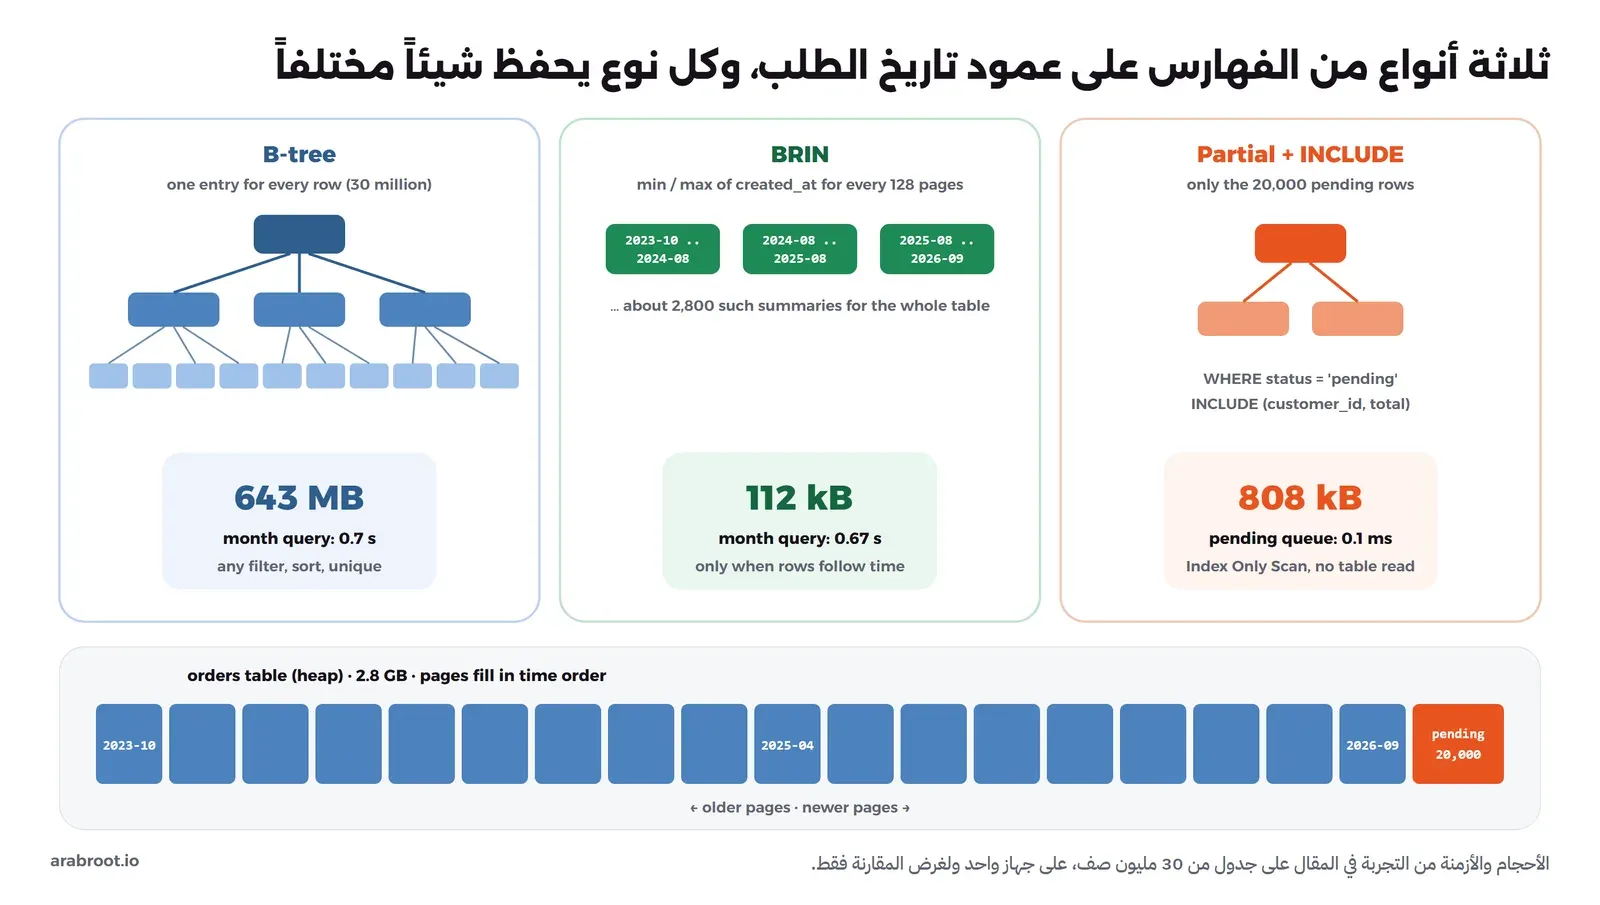
الصورة التالية تبين ثلاثة أنواع من الفهارس سوف نبنيها على الجدول نفسه، ولاحظ الفرق في الحجم بينها رغم أن كل واحد منها يسرع استعلاماً مختلفاً:
فهرس B-tree مركب: ترتيب الأعمدة مهم
صفحة طلبات العميل تبحث بعمود customer_id وترتب بعمود created_at، والفهرس المناسب لها هو فهرس مركب Composite Index على العمودين بهذا الترتيب: عمود المساواة أولاً ثم عمود الترتيب أو المدى. وعلى جدول يعمل في الإنتاج لا تقم بإنشاء الفهرس بالأمر العادي، والسبب أن CREATE INDEX يمنع الكتابة على الجدول حتى ينتهي، وقد ينتهي بعد دقائق طويلة، لذلك استخدم CONCURRENTLY الذي يبني الفهرس والطلبات مستمرة:
CREATE INDEX CONCURRENTLY orders_customer_created_idx ON orders (customer_id, created_at);

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, status, total, created_at FROM orders
WHERE customer_id = 123456 ORDER BY created_at DESC LIMIT 20;
والمخرج سوف يكون كما يلي:
CREATE INDEX
Time: 481054.795 ms (08:01.055)

 Limit  (cost=0.56..60.81 rows=14 width=31) (actual time=32.799..34.285 rows=15.00 loops=1)
   Buffers: shared hit=14 read=8
   I/O Timings: shared read=0.109
   ->  Index Scan Backward using orders_customer_created_idx on orders  (cost=0.56..60.81 rows=14 width=31) (actual time=32.797..34.277 rows=15.00 loops=1)
         Index Cond: (customer_id = 123456)
         Index Searches: 1
         Buffers: shared hit=14 read=8
         I/O Timings: shared read=0.109
 Planning:
   Buffers: shared hit=76 read=1
   I/O Timings: shared read=0.028
 Planning Time: 1.809 ms
 Execution Time: 34.333 ms
في المخرج أعلاه لاحظ التالي:
- الاستعلام نزل من 3906 مللي ثانية إلى 34، وعدد الصفحات من قرابة 359 ألفاً إلى 22 صفحة فقط، وهذا هو الرقم الذي يهمك أكثر من الوقت.
Index Scan Backwardيعني أن PostgreSQL قرأ الفهرس من آخره لأن الاستعلام يطلبDESC، لذلك لا تحتاج إلى فهرس منفصل بترتيب تنازلي، واختفت خطوةSortكاملة.- بناء الفهرس على 30 مليون صف استغرق ثماني دقائق على جهاز المختبر، وحجمه 902 ميجابايت، أي قرابة ثلث حجم الجدول، وهذا ثمن كل فهرس تضيفه: مساحة على القرص، وعمل إضافي مع كل INSERT.
وقد يتساءل البعض: لماذا لا نجعل الترتيب (created_at, customer_id)؟ والإجابة أن ال B-tree مرتب بالعمود الأول ثم الثاني داخله، كدليل الهاتف المرتب بالعائلة ثم الاسم، فإذا بدأ الفهرس بالتاريخ فإن طلبات العميل الواحد تكون متفرقة في كل الفهرس. وقد أضاف PostgreSQL 18 ميزة البحث بالتخطي Skip Scan التي تسمح باستخدام الفهرس المركب في حالات لا يكون فيها شرط على العمود الأول، ولكنها تفيد عندما يكون للعمود الأول قيم قليلة، لذلك تبقى القاعدة كما هي في وثائق الفهارس المركبة: ضع أولاً العمود الذي تبحث عنه بالمساواة في أغلب الاستعلامات.
الفهرس الجزئي والمغطي: قائمة الطلبات المعلقة
شاشة التجهيز في المستودع تعرض الطلبات المعلقة pending بالأقدم أولاً، وهي 20 ألف طلب فقط من 30 مليوناً، فلماذا نبني فهرساً على 30 مليون صف؟ الفهرس الجزئي Partial Index يحفظ فقط الصفوف التي تحقق شرط WHERE، ومع INCLUDE نضيف إليه الأعمدة التي تعرضها الشاشة فيصبح فهرساً مغطياً Covering Index يجيب عن الاستعلام دون أن يقرأ الجدول:
CREATE INDEX CONCURRENTLY orders_pending_idx ON orders (created_at)
    INCLUDE (customer_id, total) WHERE status = 'pending';

EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT created_at, customer_id, total FROM orders
WHERE status = 'pending' ORDER BY created_at LIMIT 50;
والمخرج سوف يكون كما يلي:
CREATE INDEX
Time: 23302.946 ms (00:23.303)

 Limit (actual time=0.066..0.081 rows=50.00 loops=1)
   Buffers: shared hit=3
   ->  Index Only Scan using orders_pending_idx on orders (actual time=0.064..0.072 rows=50.00 loops=1)
         Heap Fetches: 0
         Index Searches: 1
         Buffers: shared hit=3
 Planning:
   Buffers: shared hit=44
 Planning Time: 5.186 ms
 Execution Time: 0.110 ms
الاستعلام نزل من 3688 مللي ثانية إلى 0.11 مللي ثانية، وقرأ ثلاث صفحات فقط، والفهرس كله 808 كيلوبايت، وHeap Fetches: 0 يعني أنه لم يلمس الجدول إطلاقاً. ولاحظ شرطين حتى يعمل هذا الفهرس: الاستعلام يجب أن يحتوي على الشرط نفسه status = 'pending' حرفياً، وIndex Only Scan يحتاج أن تكون صفحات الجدول معلمة بأنها مرئية للجميع Visibility Map، وهذا عمل ال VACUUM، لذلك شغلنا VACUUM orders قبل القياس، وفي الإنتاج يقوم autovacuum بذلك.
فهرس BRIN للتاريخ في جدول لا يكتب إلا في آخره
استعلام مبيعات الشهر يبحث بمدى من التواريخ، والجدول عندنا يكتب بترتيب الزمن، أي أن طلبات سبتمبر كلها في آخر صفحات الملف، وهنا يفيد فهرس BRIN، أي Block Range Index، الذي لا يحفظ مدخلاً لكل صف وإنما يحفظ أقل قيمة وأكبر قيمة لكل مجموعة من 128 صفحة. سوف نبني BRIN وB-tree على العمود نفسه ونقارن:
CREATE INDEX CONCURRENTLY orders_created_brin  ON orders USING brin (created_at);
CREATE INDEX CONCURRENTLY orders_created_btree ON orders (created_at);

SELECT indexrelname AS index, pg_size_pretty(pg_relation_size(indexrelid)) AS size
FROM pg_stat_user_indexes WHERE relname = 'orders' ORDER BY pg_relation_size(indexrelid) DESC;
والمخرج سوف يكون كما يلي:
CREATE INDEX
Time: 58527.166 ms (00:58.527)
CREATE INDEX
Time: 219897.711 ms (03:39.898)

            index            |  size
-----------------------------+--------
 orders_customer_created_idx | 902 MB
 orders_created_btree        | 643 MB
 orders_pkey                 | 643 MB
 orders_pending_idx          | 808 kB
 orders_created_brin         | 112 kB
فهرس BRIN حجمه 112 كيلوبايت مقابل 643 ميجابايت لل B-tree، أي أصغر بقرابة ستة آلاف مرة، وبني في دقيقة مقابل ثلاث دقائق ونصف. والآن نشغل استعلام الشهر بالفهرسين ثم دون فهرس، وقد أوقفنا التوازي Parallelism و JIT حتى تكون المقارنة عادلة، وحذفنا الفهارس داخل معاملة Transaction ثم ألغيناها بالأمر ROLLBACK:
SET jit = off; SET max_parallel_workers_per_gather = 0;
\timing on
SELECT count(*), sum(total) FROM orders WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
BEGIN;
DROP INDEX orders_created_btree;
SELECT count(*), sum(total) FROM orders WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
DROP INDEX orders_created_brin;
SELECT count(*), sum(total) FROM orders WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
ROLLBACK;
والمخرج سوف يكون كما يلي، فالاستعلامات الثلاثة أعادت النتيجة نفسها 1619858 | 802310730.22، والوقت الأول باستخدام B-tree، والثاني باستخدام BRIN، والثالث دون أي فهرس، وقد شغلنا الاستعلامين الأولين مرتين ونعرض المرة الثانية:
Time: 697.420 ms
Time: 666.119 ms
Time: 13783.707 ms (00:13.784)
النتيجة أن BRIN أعطى السرعة نفسها تقريباً بجزء صغير جداً من الحجم، والسبب أن الاستعلام يقرأ 1.6 مليون صف في كل الأحوال، والفهرس هنا وظيفته أن يقول "هذه الصفحات فقط"، وهذا يكفي فيه ملخص لكل 128 صفحة. ولكن لاحظ حدود BRIN:
- يعمل جيداً فقط عندما يكون ترتيب الصفوف في الملف قريباً من ترتيب العمود، كالتاريخ في جدول لا يكتب إلا في آخره، أما إذا كانت القيم متفرقة في كل الصفحات كعمود
customer_idفإن كل ملخص سوف يغطي كل القيم ولن يستبعد شيئاً. - لا يصلح لاستعلام يبحث عن صف واحد أو عدد قليل من الصفوف، ولا يضمن الترتيب ولا التفرد Unique، لذلك صفحة العميل تبقى على B-tree.
- من مزاياه أيضاً أنه فهرس تلخيصي Summarizing Index، وبالتالي لا يمنع التحديث السريع HOT الذي سوف نشرحه في قسم fillfactor.
الفهارس التي لا يستخدمها أحد
بعد هذه التجربة أصبح لدينا فهرسان على created_at يقومان بالعمل نفسه، وهذا يحدث في كل مشروع عمره سنوات: فهرس أضافه مطور لاستعلام حذف لاحقاً، وفهرس مكرر بترتيب آخر، وكل فهرس منها يأخذ مساحة ويبطئ كل INSERT. والعرض pg_stat_user_indexes يحسب عدد مرات استخدام كل فهرس:
SELECT indexrelname AS index, idx_scan, pg_size_pretty(pg_relation_size(indexrelid)) AS size
FROM pg_stat_user_indexes WHERE relname = 'orders' ORDER BY idx_scan;
والمخرج سوف يكون كما يلي:
            index            | idx_scan |  size
-----------------------------+----------+--------
 orders_pkey                 |        0 | 643 MB
 orders_customer_created_idx |        1 | 902 MB
 orders_pending_idx          |        2 | 808 kB
 orders_created_brin         |        3 | 112 kB
 orders_created_btree        |        8 | 643 MB
اقرأ هذه الأرقام بحذر، فالعداد يبدأ من آخر تصفير للإحصاءات، والفهرس الذي يستخدم مرة في الشهر لتقرير مهم سوف يظهر بصفر إذا نظرت بعد أسبوع، وفهرس المفتاح الأساسي يبقى دائماً لأنه يحمي التفرد حتى لو لم يقرأه استعلام. لذلك راقب الأرقام أسابيع على سيرفر الإنتاج، وعلى كل نسخ القراءة أيضاً لأن لكل سيرفر إحصاءاته، ثم احذف الفهرس الذي لم يستخدم بالأمر الذي لا يوقف الكتابة:
DROP INDEX CONCURRENTLY orders_created_btree;أنماط الاستعلام التي تتعب الجدول الكبير
الترقيم بالمفتاح بدل OFFSET
شاشة إدارة الطلبات تعرض 50 طلباً في الصفحة، والطريقة التي يكتبها أغلب الناس هي LIMIT 50 OFFSET n، والمشكلة أن OFFSET لا يقفز إلى الصف رقم n وإنما يقرأ كل الصفوف قبله ثم يرميها، كما تذكر الوثائق. والحل هو الترقيم بالمفتاح Keyset Pagination: تحفظ آخر id رأيته في الصفحة الحالية، وتطلب الصفحة التالية بشرط id < تلك القيمة:
\timing on
-- OFFSET: page 2, page 2,001 and page 100,001
SELECT id, customer_id, total, created_at FROM orders ORDER BY id DESC LIMIT 50 OFFSET 50;
SELECT id, customer_id, total, created_at FROM orders ORDER BY id DESC LIMIT 50 OFFSET 100000;
SELECT id, customer_id, total, created_at FROM orders ORDER BY id DESC LIMIT 50 OFFSET 5000000;
-- keyset: the same depth, starting after the last id of the previous page
SELECT id, customer_id, total, created_at FROM orders WHERE id < 25000000 ORDER BY id DESC LIMIT 50;
والمخرج سوف يكون كما يلي:
Time: 24.598 ms
Time: 107.307 ms
Time: 6934.327 ms (00:06.934)
Time: 0.800 ms
ومع EXPLAIN يظهر السبب بوضوح، فاستعلام OFFSET قرأ rows=5000050 صفاً من الفهرس ليعيد 50، واستعلام المفتاح قرأ خمس صفحات فقط:
 Limit (actual time=5687.343..5687.367 rows=50.00 loops=1)
   Buffers: shared hit=74294
   ->  Index Scan Backward using orders_pkey on orders (actual time=0.015..4882.181 rows=5000050.00 loops=1)

 Limit (actual time=0.024..0.062 rows=50.00 loops=1)
   Buffers: shared hit=5
   ->  Index Scan Backward using orders_pkey on orders (actual time=0.023..0.055 rows=50.00 loops=1)
         Index Cond: (id < 25000000)
وإذا كان الترتيب بعمود غير فريد مثل created_at فاجعل المفتاح عمودين (created_at, id) وقارن بالصيغة WHERE (created_at, id) < ($1, $2) مع فهرس على العمودين، حتى لا تضيع الطلبات التي تشترك في الوقت نفسه بين صفحتين. والثمن أنك لا تستطيع القفز إلى "الصفحة 4000" مباشرة، وهذا مقبول لأن أحداً لا يقرأ الصفحة 4000، والبحث والتصفية Filters هما الطريقة الصحيحة للوصول إلى طلب قديم.
لا تطلب أعمدة لا تحتاجها
استعلام SELECT * على جدول الطلبات يمنع الفهرس المغطي من العمل، فقد رأيت أن orders_pending_idx أجاب دون قراءة الجدول لأن الأعمدة المطلوبة كلها فيه، ولو طلبنا id معها لعاد PostgreSQL إلى الجدول لكل صف. والأمر نفسه يزيد حجم ما ينقل إلى التطبيق، ويكسر الكود عندما يضاف عمود كبير مثل jsonb لاحقاً، لذلك اكتب الأعمدة بأسمائها في كل استعلام يتكرر.
التحديث والحذف على دفعات
أمر واحد يحدث ثلاثة ملايين صف يبدو أبسط حل، ولكنه معاملة واحدة طويلة تمسك أقفال الصفوف حتى تنتهي، وتولد WAL بحجم كبير دفعة واحدة فتتأخر نسخ القراءة، وتمنع VACUUM من تنظيف أي صف مات بعد بدايتها في كل قاعدة البيانات. وعلى جهاز المختبر استغرق هذا الأمر أكثر من 14 دقيقة:
UPDATE orders SET updated_at = now() WHERE id % 10 = 0;UPDATE 2999999
Time: 854224.618 ms (14:14.225)والطريقة الصحيحة أن تقسم العمل إلى دفعات من آلاف الصفوف، كل دفعة في معاملة قصيرة، وسوف نرى مثالاً كاملاً في قسم الأرشفة ينقل كل دفعة من 10 آلاف طلب في قرابة 100 مللي ثانية، وبين الدفعات يستطيع التطبيق أن يكتب، وautovacuum أن ينظف، ونسخة القراءة أن تلحق.
عدد الصفوف: هل تحتاج الرقم الدقيق؟
لوحة التحكم تعرض "إجمالي الطلبات"، وcount(*) في PostgreSQL يقرأ الجدول أو فهرساً كاملاً، والسبب أن كل معاملة قد ترى عدداً مختلفاً من الصفوف حسب لحظة بدايتها، فلا يوجد عداد واحد محفوظ. أما إذا كان الرقم التقريبي يكفي، وهو يكفي في أغلب لوحات التحكم، فاقرأ التقدير الذي يحفظه ANALYZE وautovacuum في pg_class، كما في صفحة Count estimate في ويكي PostgreSQL:
\timing on
SELECT count(*) FROM orders;
SELECT reltuples::bigint AS estimate FROM pg_class WHERE oid = 'orders'::regclass;
count
----------
29999999
Time: 5218.147 ms (00:05.218)
estimate
----------
30000260
Time: 14.066 msالفرق بين الرقمين 261 صفاً من 30 مليوناً، والوقت 5 ثوان مقابل 14 مللي ثانية. وإذا احتجت عدداً دقيقاً لجزء محدد مثل "الطلبات المعلقة الآن" فاجعل الشرط يستفيد من فهرس جزئي كالذي بنيناه، أو احفظ الأرقام اليومية في جدول ملخص كما سوف نرى في العروض المحفوظة.
مشكلة N+1
شرحنا مشكلة N+1 بالتفصيل في مقال تصميم قواعد البيانات، وما يضاف هنا أن الجدول الكبير يكبر أثرها، فاستعلام سريع يتكرر 50 مرة في كل صفحة يصبح في pg_stat_statements السطر الأول بعدد calls يفوق كل شيء آخر، لذلك عندما ترى استعلاماً بسيطاً بمتوسط صغير ومجموع كبير فابحث في الكود عن حلقة Loop تستدعيه.
تقسيم الجدول حسب الشهر Partitioning
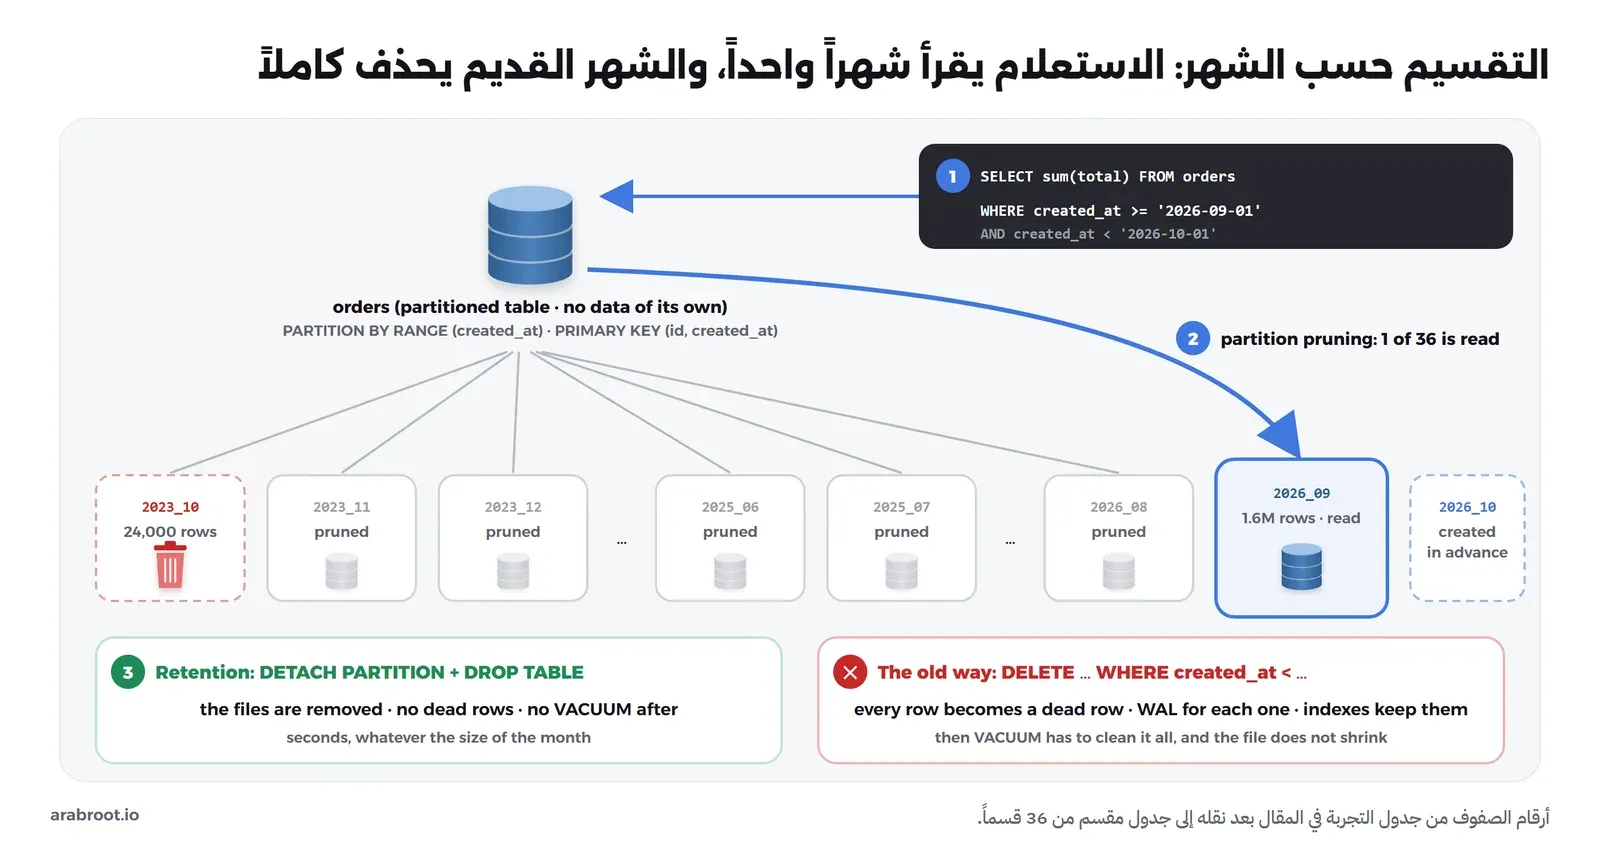
الفهارس حلت مشكلة القراءة، ولكن بقيت مشكلتان لا تحلهما الفهارس: الجدول يكبر بلا توقف فكل VACUUM وكل فهرس جديد يعمل على 30 مليون صف، وحذف الطلبات القديمة بالأمر DELETE يترك ملايين الصفوف الميتة. والحل هو التقسيم التعريفي Declarative Partitioning: جدول أب لا يحفظ بيانات، وتحته جدول لكل شهر، والصورة التالية تبين الفكرة:
إنشاء الجدول المقسم: المفتاح الأساسي يجب أن يشمل عمود التقسيم
سوف ننشئ جدولاً مقسماً orders_p بالأعمدة نفسها، والخطأ الأول الذي سوف تقابله هو المفتاح الأساسي:
CREATE TABLE orders_p (
    id             bigint        NOT NULL,
    customer_id    bigint        NOT NULL,
    status         text          NOT NULL,
    total          numeric(12,2) NOT NULL,
    items_count    int           NOT NULL,
    payment_method text          NOT NULL,
    created_at     timestamptz   NOT NULL,
    updated_at     timestamptz   NOT NULL,
    PRIMARY KEY (id)
) PARTITION BY RANGE (created_at);
ERROR: unique constraint on partitioned table must include all partitioning columns
DETAIL: PRIMARY KEY constraint on table "orders_p" lacks column "created_at" which is part of the partition key.والسبب كما تشرح الوثائق أن كل قسم له فهرسه الخاص، ولا يستطيع فهرس قسم سبتمبر أن يتأكد أن الرقم نفسه غير موجود في قسم أغسطس، فيجب أن يكون عمود التقسيم جزءاً من المفتاح حتى يضمن التقسيم نفسه عدم التكرار. لذلك نجعل المفتاح (id, created_at)، وتبقى id فريدة عملياً لأنها تأتي من تسلسل Sequence واحد، ولكن تذكر أن قاعدة البيانات لم تعد تضمن ذلك وحدها، وأن أي مفتاح أجنبي Foreign Key يشير إلى الطلبات يجب أن يحمل العمودين:
CREATE TABLE orders_p (
    id             bigint        NOT NULL,
    customer_id    bigint        NOT NULL,
    status         text          NOT NULL,
    total          numeric(12,2) NOT NULL,
    items_count    int           NOT NULL,
    payment_method text          NOT NULL,
    created_at     timestamptz   NOT NULL,
    updated_at     timestamptz   NOT NULL,
    PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);

DO $$
DECLARE m date := '2023-10-01';
BEGIN
  WHILE m < '2026-10-01' LOOP
    EXECUTE format('CREATE TABLE orders_p_%s PARTITION OF orders_p FOR VALUES FROM (%L) TO (%L)',
                   to_char(m, 'YYYY_MM'), m, m + interval '1 month');
    m := m + interval '1 month';
  END LOOP;
END $$;

CREATE INDEX ON orders_p (customer_id, created_at);
في الإعداد أعلاه لاحظ التالي:
- الحدود
FROM ... TOتشمل البداية ولا تشمل النهاية، لذلك أول لحظة من أكتوبر تذهب إلى قسم أكتوبر وليس سبتمبر، ولا تحتاج أن تكتب23:59:59. - الفهرس الذي ننشئه على الجدول الأب ينشأ تلقائياً على كل قسم، وعلى كل قسم ينشأ لاحقاً.
- العمود
timestamptzيحفظ الوقت بتوقيت UTC، فحدود الشهر هنا بتوقيت UTC وليست بتوقيتك المحلي، وقد شرحنا أثر ذلك على التقارير في مقال التاريخ والوقت.
ولأن نسخ 30 مليون صف مرة أخرى يأخذ وقتاً طويلاً على جهاز المختبر، فسوف ننسخ عينة من 10% من الطلبات، أي 3 ملايين طلب موزعة على كل الشهور:
INSERT INTO orders_p SELECT * FROM orders WHERE id % 10 = 1;
ANALYZE orders_p;
INSERT 0 3000000
Time: 56772.992 ms (00:56.773)وفي سيرفر الإنتاج لا تنقل الجدول القديم بأمر واحد، وإنما تنشئ الجدول المقسم وتنقل البيانات على دفعات بالطريقة التي في قسم الأرشفة، أو تجعل الجدول القديم نفسه قسماً بالأمر ATTACH PARTITION للبيانات التاريخية وتبدأ الشهور الجديدة في أقسام جديدة.
استبعاد الأقسام Partition Pruning في EXPLAIN
الآن نشغل استعلام مبيعات سبتمبر على الجدول المقسم:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*), sum(total) FROM orders_p
WHERE created_at >= '2026-09-01' AND created_at < '2026-10-01';
والمخرج سوف يكون كما يلي:
 Finalize Aggregate (actual time=63.516..68.745 rows=1.00 loops=1)
   Buffers: shared hit=1937
   ->  Gather (actual time=63.274..68.725 rows=2.00 loops=1)
         Workers Planned: 1
         Workers Launched: 1
         Buffers: shared hit=1937
         ->  Partial Aggregate (actual time=39.272..39.273 rows=1.00 loops=2)
               Buffers: shared hit=1937
               ->  Parallel Seq Scan on orders_p_2026_09 orders_p (actual time=0.024..24.570 rows=80992.50 loops=2)
                     Filter: ((created_at >= '2026-09-01 00:00:00+00'::timestamp with time zone) AND (created_at < '2026-10-01 00:00:00+00'::timestamp with time zone))
                     Buffers: shared hit=1937
 Planning:
   Buffers: shared hit=333 read=2
 Planning Time: 2.183 ms
 Execution Time: 68.910 ms
لاحظ أن الخطة فيها قسم واحد فقط orders_p_2026_09، أما الأقسام الخمسة والثلاثون الأخرى فقد استبعدها المخطط قبل التنفيذ، ولاحظ أيضاً أنه قرأ القسم كاملاً بمسح متسلسل دون أي فهرس على التاريخ، والسبب أن القسم كله هو الشهر المطلوب، فالقسم نفسه أصبح هو "الفهرس". ولكن انظر ماذا يحدث لصفحة العميل التي لا تحدد التاريخ:
EXPLAIN (COSTS OFF)
SELECT id, total FROM orders_p WHERE customer_id = 123456 ORDER BY created_at DESC LIMIT 20;
Limit
-> Append
-> Index Scan Backward using orders_p_2026_09_customer_id_created_at_idx on orders_p_2026_09 orders_p_36
Index Cond: (customer_id = 123456)
-> Index Scan Backward using orders_p_2026_08_customer_id_created_at_idx on orders_p_2026_08 orders_p_35
Index Cond: (customer_id = 123456)
... (the same two lines for every month down to 2023_10)
-> Index Scan Backward using orders_p_2023_10_customer_id_created_at_idx on orders_p_2023_10 orders_p_1
Index Cond: (customer_id = 123456)اختصرنا المخرج، والخطة الكاملة فيها 36 بحثاً في 36 فهرساً، واحد لكل شهر، وهذا هو ثمن التقسيم الذي يغفل عنه كثيرون: الاستعلام الذي لا يحمل شرطاً على عمود التقسيم يصبح أبطأ من الجدول غير المقسم، لأنه يبحث في كل الأقسام بدل فهرس واحد. لذلك اختر عمود التقسيم من الاستعلامات الأكثر تكراراً وأهمية، وإذا كانت صفحة العميل تعرض آخر سنة فقط فأضف لها شرط التاريخ حتى يستبعد المخطط الأقسام القديمة.
حذف الشهور القديمة: DROP بدل DELETE
أهم فائدة للتقسيم في الجداول الضخمة ليست السرعة وإنما سياسة الاحتفاظ Retention، فحذف شهر كامل يصبح حذفاً لملف وليس حذفاً لملايين الصفوف واحداً بعد الآخر. لنقارن الطريقتين على شهرين من العينة:
\timing on
DROP TABLE orders_p_2023_10;
DELETE FROM orders_p WHERE created_at >= '2024-06-01' AND created_at < '2024-07-01';
\timing off
SELECT pg_size_pretty(pg_relation_size('orders_p_2024_06')) AS still_on_disk;
DROP TABLE
Time: 12.673 ms
DELETE 38810
Time: 196.488 ms
still_on_disk
---------------
3720 kBالحذف بالأمر DROP أخذ 12 مللي ثانية ولا يترك شيئاً خلفه، أما DELETE فأخذ وقتاً أطول على 38 ألف صف فقط، والأهم أن الملف بقي على القرص بحجمه، وكل صف محذوف أصبح صفاً ميتاً ينتظر VACUUM، وكتب سجلاً في WAL ينتقل إلى نسخ القراءة والنسخ الاحتياطي. والآن تخيل الأرقام نفسها على شهر من 1.6 مليون طلب في الجدول الكامل.
وفي الإنتاج افصل القسم أولاً بالأمر DETACH PARTITION، فيصبح جدولاً عادياً تستطيع أن تأخذ منه نسخة بالأمر pg_dump أو تنقله إلى الأرشيف ثم تحذفه، ومع CONCURRENTLY يحتاج الفصل قفلاً أخف على الجدول الأب فلا يوقف الطلبات، ولكن لهذا الخيار شرط سوف نراه الآن.
القسم الافتراضي: مفيد ولكن له ثمن
ماذا يحدث إذا وصل طلب بتاريخ لا يوجد له قسم، مثلاً لأن مهمة إنشاء قسم الشهر القادم لم تعمل؟ الإدخال يفشل بخطأ، ولذلك يضيف بعض الناس قسماً افتراضياً DEFAULT يستقبل كل ما لا مكان له، ولكن انظر ما يحدث بعد ذلك:
CREATE TABLE orders_p_default PARTITION OF orders_p DEFAULT;
INSERT INTO orders_p VALUES (900000001, 42, 'pending', 99.00, 1, 'card', '2026-10-02 10:00+00', '2026-10-02 10:00+00');
CREATE TABLE orders_p_2026_10 PARTITION OF orders_p FOR VALUES FROM ('2026-10-01') TO ('2026-11-01');
CREATE TABLE
INSERT 0 1
ERROR: updated partition constraint for default partition "orders_p_default" would be violated by some rowطلب واحد من أكتوبر في القسم الافتراضي منع إنشاء قسم أكتوبر، والحل أن تنقل الصفوف من القسم الافتراضي يدوياً ثم تنشئ القسم. والمشكلة الثانية أن PostgreSQL عند إضافة أي قسم جديد يفحص القسم الافتراضي كاملاً وهو يمسك قفلاً حصرياً عليه، كما تحذر الوثائق، فإذا امتلأ بالملايين أصبحت إضافة كل قسم عملية ثقيلة. والمشكلة الثالثة ظهرت عندنا عند فصل القسم الأقدم:
ALTER TABLE orders_p DETACH PARTITION orders_p_2023_10 CONCURRENTLY;ERROR: cannot detach partitions concurrently when a default partition existsلذلك القاعدة: أنشئ أقسام الشهور القادمة مسبقاً بشهرين أو ثلاثة، وإذا استخدمت القسم الافتراضي فاجعله شبكة أمان تراقبها، وأي صف فيه هو تنبيه Alert يجب أن تعالجه فوراً، وليس مكاناً تتجمع فيه البيانات.
أتمتة الأقسام مع pg_partman
إنشاء أقسام الشهور القادمة وحذف القديمة يدوياً يعمل حتى ينسى أحد ذلك في شهر رمضان، والإضافة pg_partman تقوم بالعمل كاملاً: تنشئ الأقسام مسبقاً، وتطبق سياسة الاحتفاظ. وهي مشروع نشط مرخص برخصة PostgreSQL License المتساهلة، وآخر إصدار عند كتابة المقال 5.5.0 في يوليو 2026، وتجدها في مستودع PostgreSQL الرسمي للتوزيعات باسم postgresql-18-partman. وفي المختبر ثبتناها داخل ال Container مع pg_repack الذي سوف نستخدمه لاحقاً:
docker exec lab-pgscale-pg bash -c "apt-get update -qq && apt-get install -y -qq postgresql-18-partman postgresql-18-repack"وفي الإنتاج ثبتها في ال Image الخاصة بك أو من حزم التوزيعة على السيرفر، وليس داخل Container يعمل، والسبب أن ما تثبته داخل ال Container يضيع عند إعادة إنشائه. والآن ننشئ جدولاً تديره pg_partman بأقسام شهرية، وثلاثة أشهر مسبقاً، واحتفاظ بأربعة وعشرين شهراً:
CREATE SCHEMA partman;
CREATE EXTENSION pg_partman SCHEMA partman;

CREATE TABLE orders_pm (
    id          bigint        NOT NULL,
    customer_id bigint        NOT NULL,
    status      text          NOT NULL,
    total       numeric(12,2) NOT NULL,
    created_at  timestamptz   NOT NULL,
    PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);

SELECT partman.create_parent(
    p_parent_table := 'public.orders_pm',
    p_control      := 'created_at',
    p_interval     := '1 month',
    p_premake      := 3
);

UPDATE partman.part_config
SET retention = '24 months', retention_keep_table = false
WHERE parent_table = 'public.orders_pm';

SELECT partition_tablename FROM partman.show_partitions('public.orders_pm');
CALL partman.run_maintenance_proc();
والمخرج سوف يكون كما يلي:
 create_parent
---------------
 t

 partition_tablename
---------------------
 orders_pm_p20260701
 orders_pm_p20260801
 orders_pm_p20260901
 orders_pm_p20261001
 orders_pm_p20261101
 orders_pm_p20261201
 orders_pm_p20270101
في الإعداد أعلاه لاحظ التالي:
- pg_partman أنشأ ثلاثة أشهر قبل الشهر الحالي وثلاثة بعده بناءً على
p_premake، وكلما شغلتrun_maintenance_proc()أضاف الأشهر القادمة وحذف ما تجاوز سياسة الاحتفاظ. - الدالة
create_parentتنشئ قسماً افتراضياً أيضاً ما لم تمررp_default_table := false، فطبق عليه ما ذكرناه في القسم السابق. - يجب أن تشغل الصيانة دورياً، إما بالعامل الخلفي Background Worker الذي يأتي مع الإضافة، أو بمهمة مجدولة Cron Job، والتفاصيل في وثائق pg_partman.
- القيمة
retention_keep_table = falseتعني حذف القسم القديم نهائياً، فإذا كانت سياستك أن تؤرشفه أولاً فاجعلهاtrueفيفصله فقط وتنقله أنت إلى الأرشيف.
كم قسماً أكثر من اللازم؟
تقول أفضل الممارسات في الوثائق إن المخطط يتعامل جيداً مع ما يصل إلى بضعة آلاف من الأقسام بشرط أن تستبعد الاستعلامات أغلبها، وأن وقت التخطيط والذاكرة يزيدان كلما بقي عدد أكبر من الأقسام بعد الاستبعاد. لذلك لا تقسم باليوم جدولاً يكفيه الشهر، فعشر سنوات بالشهر هي 120 قسماً، وبالأيام أكثر من 3600، ولا تقسم جدولاً صغيراً أصلاً، فجدول من مليوني صف يعمل بفهرس جيد أفضل من 36 قسماً صغيراً. والقاعدة العملية: قسم عندما يكون لديك سبب واضح، وأوضح الأسباب حذف البيانات القديمة بالجملة، أو استعلامات تحمل دائماً مدى من التاريخ.
ال VACUUM والانتفاخ Bloat
حتى تفهم لماذا يكبر الجدول بعد التحديث ولا يصغر بعد الحذف، تحتاج فكرة واحدة عن طريقة عمل PostgreSQL: التحكم في التزامن بتعدد النسخ MVCC، ويعني أن التحديث لا يكتب فوق الصف القديم وإنما يكتب نسخة جديدة ويترك القديمة حتى لا تتوقف أي معاملة كانت تقرأها، فلا ينتظر القارئ الكاتب ولا الكاتب القارئ. والصورة التالية تبين ما يحدث بعد ذلك:
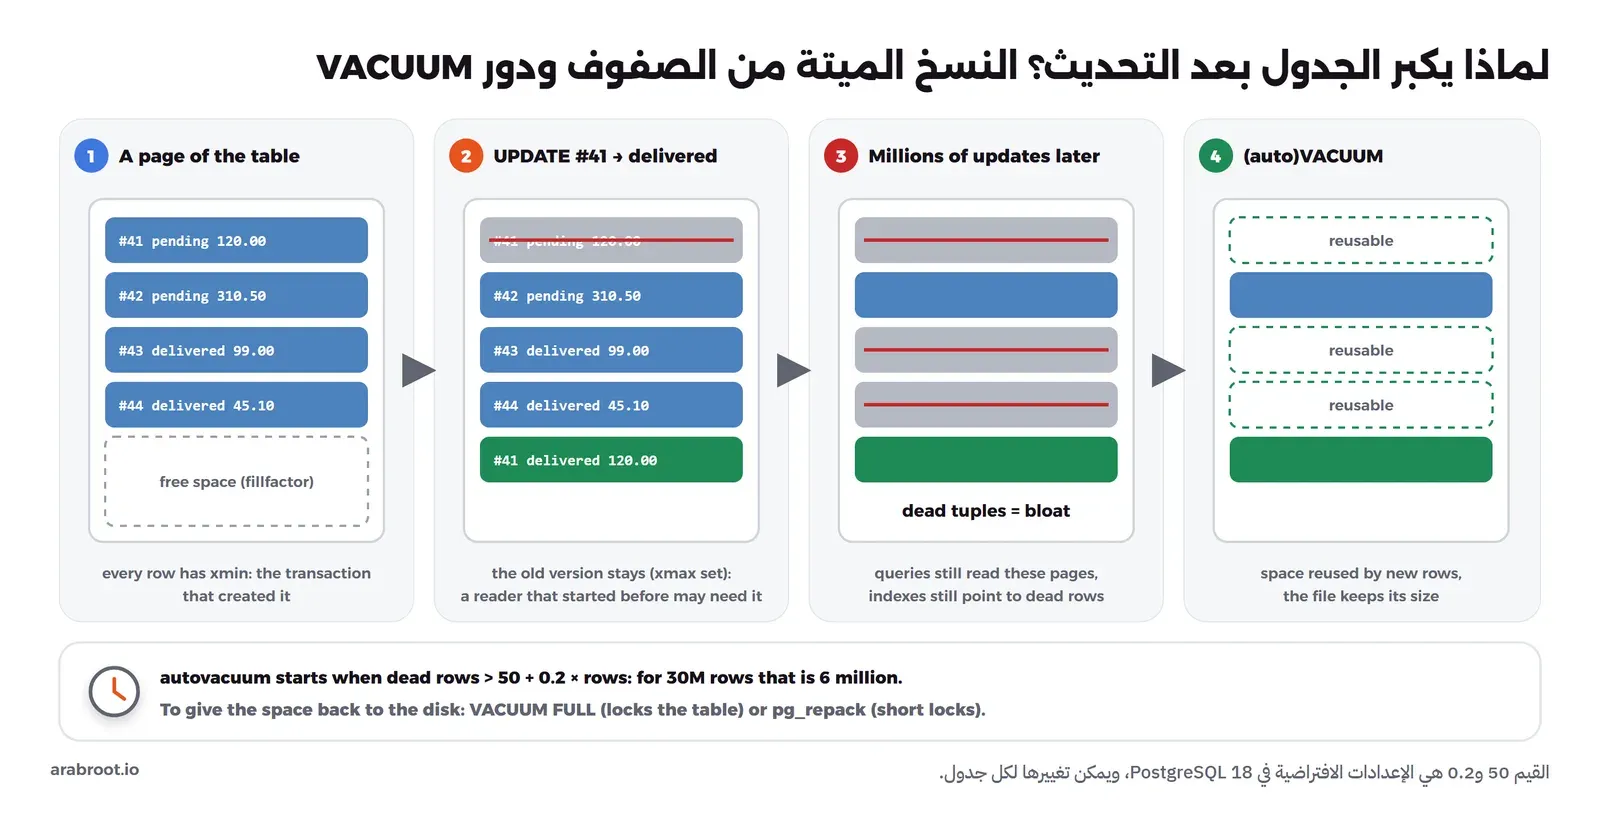
الصفوف الميتة بعد تحديث ثلاثة ملايين طلب
بعد أمر التحديث الذي شغلناه في قسم الدفعات، هذه حالة الجدول:
SELECT n_live_tup, n_dead_tup, last_autovacuum FROM pg_stat_user_tables WHERE relname = 'orders';
SELECT pg_size_pretty(pg_relation_size('orders')) AS table_only;
n_live_tup | n_dead_tup | last_autovacuum
------------+------------+-----------------
30000261 | 2999999 |
table_only
------------
3083 MBثلاثة ملايين صف ميت، والجدول كبر من 2804 إلى 3083 ميجابايت دون أن يزيد طلب واحد، والسؤال: لماذا لم يعمل autovacuum؟ والإجابة في المعادلة التي يقرر بها، فهو يبدأ عندما تتجاوز الصفوف الميتة autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × عدد الصفوف، والقيم الافتراضية كما في وثائق الإعدادات هي 50 و0.2:
SELECT current_setting('autovacuum_vacuum_threshold')     AS threshold,
       current_setting('autovacuum_vacuum_scale_factor')  AS scale_factor,
       current_setting('autovacuum_vacuum_max_threshold') AS max_threshold;

SELECT relname, n_live_tup, n_dead_tup,
       least(50 + 0.2 * n_live_tup, 100000000)::bigint AS autovacuum_starts_at
FROM pg_stat_user_tables WHERE relname = 'orders';
threshold | scale_factor | max_threshold
-----------+--------------+---------------
50 | 0.2 | 100000000
relname | n_live_tup | n_dead_tup | autovacuum_starts_at
---------+------------+------------+----------------------
orders | 30000261 | 2999999 | 6000102أي أن autovacuum ينتظر ستة ملايين صف ميت على هذا الجدول، وعلى جدول من 500 مليون صف ينتظر 100 مليون، وهي القيمة القصوى التي أضافها PostgreSQL 18 بالإعداد autovacuum_vacuum_max_threshold، وقبله كان ينتظر 20% من الجدول مهما كبر. ونسبة 20% مناسبة لجدول صغير، أما على الجدول الضخم فتعني أن التنظيف يحدث نادراً، وعندما يحدث يكون عملاً ضخماً يستمر ساعات.
ضبط autovacuum لكل جدول
الحل ألا تغير القيم لكل قاعدة البيانات، وإنما للجدول الكبير وحده، بحيث يعمل autovacuum كثيراً وعلى كمية صغيرة في كل مرة:
ALTER TABLE orders SET (autovacuum_vacuum_scale_factor = 0.01, autovacuum_vacuum_threshold = 10000);
SELECT reloptions FROM pg_class WHERE relname = 'orders';
reloptions
-------------------------------------------------------------------------
{autovacuum_vacuum_scale_factor=0.01,autovacuum_vacuum_threshold=10000}أصبح الحد 10000 + 1% من 30 مليوناً، أي قرابة 310 آلاف صف ميت، وبعد دقائق بدأ autovacuum من تلقاء نفسه وأنهى الجدول في قرابة ثماني دقائق على جهاز المختبر، والنتيجة:
 n_live_tup | n_dead_tup |        last_autovacuum        | autovacuum_count
------------+------------+-------------------------------+------------------
   29999999 |          0 | 2026-10-05 23:31:00.296813+00 |                1

 table_only
------------
 3083 MB
الصفوف الميتة أصبحت صفراً، ولكن لاحظ أن حجم الملف بقي 3083 ميجابايت، وهذا متوقع، فال VACUUM العادي يجعل المساحة قابلة لإعادة الاستخدام داخل الملف للطلبات القادمة، ولا يعيدها إلى نظام التشغيل إلا إذا كانت الصفحات الفارغة في آخر الملف. وتستطيع متابعة autovacuum وهو يعمل من العرض pg_stat_progress_vacuum، وإذا رأيته يبدأ ويلغى مراراً في سجلات السيرفر Logs بسبب أوامر تحتاج قفلاً على الجدول، فهذا سبب آخر لجعله يعمل على كميات صغيرة.
ويجدر الإشارة هنا إلى أن جدول الطلبات يكتب فيه أكثر مما يحدث، ومنذ PostgreSQL 13 يعمل autovacuum أيضاً على الجداول التي يدخل فيها كثير من الصفوف دون تحديث، بالإعداد autovacuum_vacuum_insert_scale_factor، وهذا مهم لأنه يحدث خريطة الرؤية Visibility Map التي يحتاجها Index Only Scan، ويجمد Freeze الصفوف القديمة تدريجياً كما سوف نرى.
ال fillfactor للجداول التي تحدث كثيراً
الطلب في متجر يحدث عدة مرات: مدفوع، ثم قيد التجهيز، ثم مشحون، ثم مستلم، وكل تحديث يكتب نسخة جديدة، فإذا كتبت النسخة الجديدة في صفحة أخرى احتاج كل فهرس مدخلاً جديداً. وهناك تحسين اسمه HOT، أي Heap-Only Tuples يكتب النسخة الجديدة في الصفحة نفسها دون لمس الفهارس، بشرطين: ألا يغير التحديث عموداً موجوداً في فهرس (عدا الفهارس التلخيصية مثل BRIN)، وأن توجد مساحة فارغة في الصفحة. والإعداد fillfactor يترك هذه المساحة، وقيمته الافتراضية 100 أي صفحات ممتلئة تماماً:
ALTER TABLE orders SET (fillfactor = 90);هذا الإعداد يطبق على الصفحات التي تكتب بعد تغييره فقط، ويعني ملفاً أكبر بقرابة 10% مقابل تحديثات أخف على الفهارس، لذلك استخدمه للجداول التي يكثر فيها التحديث، وراقب النسبة بين العمودين n_tup_hot_upd وn_tup_upd في pg_stat_user_tables قبل التغيير وبعده. ولاحظ أن الفهرس على عمود status يمنع HOT عند كل تغيير للحالة، وهذا سبب آخر لتفضيل الفهرس الجزئي الذي لا يحتوي على العمود إلا في شرطه.
تحذير التفاف أرقام المعاملات Transaction ID Wraparound
كل معاملة تكتب في PostgreSQL تأخذ رقماً Transaction ID من 32 بت، وهذه الأرقام تلتف بعد قرابة أربعة مليارات، لذلك يجب أن يجمد VACUUM الصفوف القديمة قبل أن يصل العداد إليها. وتشرح الوثائق ما يحدث إذا لم يحصل ذلك: عندما يبقى 40 مليون معاملة على نقطة الالتفاف يبدأ السيرفر بإصدار تحذيرات من نوع WARNING: database "mydb" must be vacuumed within ... transactions، وإذا تجاهلتها حتى يبقى أقل من ثلاثة ملايين يرفض السيرفر أي أمر يكتب، وتصبح قاعدة البيانات للقراءة فقط حتى تنتهي VACUUM على كامل القاعدة. والوثائق الحالية تقول إن الحل هو VACUUM عادي من مستخدم Superuser، وإن الطريقة القديمة بتشغيل السيرفر في وضع المستخدم الواحد Single-User Mode لم تعد ضرورية في الحالات المعتادة ويجب تجنبها لأنها توقف الخدمة وتعطل وسائل الحماية.
وهذا لا يحدث فجأة، فautovacuum يجبر نفسه على تجميد أي جدول تجاوز عمره autovacuum_freeze_max_age (200 مليون معاملة افتراضياً) حتى لو كان autovacuum معطلاً، ولكنه يحدث عندما يلغى هذا العمل مراراً على جدول ضخم، أو تبقى معاملة مفتوحة أياماً، أو يبقى Replication Slot مهجوراً. لذلك راقب عمر أقدم معاملة في كل جدول كبير:
SELECT relname, age(relfrozenxid) AS xid_age,
       current_setting('autovacuum_freeze_max_age') AS freeze_max_age
FROM pg_class WHERE relname = 'orders';
relname | xid_age | freeze_max_age
---------+---------+----------------
orders | 103 | 200000000جدول المختبر عمره 103 معاملات فقط لأننا أنشأناه للتو، وعلى سيرفر إنتاج مشغول اجعل هذا الرقم في نظام المراقبة، ونبه إذا تجاوز نصف مليار، فهذه مشكلة تحلها وأنت مرتاح قبل أشهر من أن تصبح توقفاً للخدمة.
استعادة المساحة من جدول منتفخ: pg_repack
إذا انتفخ جدول بالفعل، مثلاً بعد حذف نصف بياناته، فالطريقة المدمجة لاستعادة المساحة هي VACUUM FULL التي تعيد كتابة الجدول في ملف جديد، ولكنها تمسك قفلاً حصرياً يمنع القراءة والكتابة طوال مدتها، وهذا على جدول الطلبات يعني توقف المتجر. والبديل هو الإضافة pg_repack بالرخصة BSD-3-Clause، وآخر إصدار لها 1.5.3، وهي تعيد بناء الجدول في الخلفية وتنقل التغييرات التي تحدث أثناء ذلك، ولا تمسك القفل الحصري إلا لحظات في البداية والنهاية كما في وثائقها، وشرطها أن يكون للجدول مفتاح أساسي أو فهرس فريد. وفي المثال التالي نطبقها على قسم من الجدول المقسم بعد أن حدثنا كل صفوفه مرتين:
CREATE EXTENSION pg_repack;
UPDATE orders_p_2025_06 SET updated_at = now();
UPDATE orders_p_2025_06 SET updated_at = now();
VACUUM orders_p_2025_06;
SELECT pg_size_pretty(pg_total_relation_size('orders_p_2025_06')) AS before_repack;
docker exec lab-pgscale-pg pg_repack -U postgres -d postgres --table=public.orders_p_2025_06 before_repack
---------------
39 MB
INFO: repacking table "public.orders_p_2025_06"
after_repack
--------------
14 MBالقسم نزل من 39 إلى 14 ميجابايت وعدد صفوفه كما هو 93506. ولاحظ أن pg_repack يحتاج مساحة فارغة على القرص بحجم الجدول وفهارسه لأنه ينشئ نسخة كاملة، فلا تنتظر حتى يمتلئ القرص، ومع الجداول المقسمة يكفي غالباً أن تعيد بناء قسم واحد منتفخ بدل الجدول كله.
الأرشفة وسياسة الاحتفاظ بالبيانات
الطلب الذي أغلق قبل سنتين لا يفتحه العميل تقريباً، ولكنه يبقى في الجدول الساخن الذي يقرأ منه التطبيق كل ثانية، فيكبر الفهرس ويطول VACUUM والنسخ الاحتياطي. والحل أن تتفق مع الإدارة على سياسة احتفاظ Retention Policy مكتوبة قبل أي سطر كود، تحدد ثلاثة أشياء: كم شهراً يبقى الطلب في الجدول الأساسي، وأين يذهب بعدها (جدول أرشيف في القاعدة نفسها، أو قاعدة منفصلة، أو ملفات في تخزين أرخص)، ومتى يحذف نهائياً. وتذكر أن الفواتير والسجلات المالية لها مدد احتفاظ نظامية تختلف من بلد إلى آخر، فاسأل المحاسب أو المستشار القانوني قبل أن تكتب سطر DELETE واحداً.
ومع الجدول المقسم تصبح الأرشفة نقل أقسام كاملة: افصل قسم الشهر القديم، وخذ منه نسخة بالأمر pg_dump --table أو انقله إلى قاعدة الأرشيف، ثم احذفه. ومع جدول غير مقسم انقل الطلبات المغلقة على دفعات، وفي المثال التالي نحذف عشرة آلاف طلب ونضيفها إلى جدول الأرشيف في أمر واحد، أي في معاملة واحدة لا يضيع فيها طلب بين الجدولين:
CREATE TABLE orders_archive (LIKE orders INCLUDING DEFAULTS);

WITH batch AS (
    SELECT id FROM orders
    WHERE created_at < '2024-04-01' AND status IN ('delivered', 'cancelled', 'refunded')
    ORDER BY id
    LIMIT 10000
), moved AS (
    DELETE FROM orders o USING batch b
    WHERE o.id = b.id
    RETURNING o.*
)
INSERT INTO orders_archive SELECT * FROM moved;
والمخرج سوف يكون كما يلي لدفعتين متتاليتين:
INSERT 0 10000
Time: 72.706 ms
INSERT 0 10000
Time: 113.732 ms
في الإعداد أعلاه لاحظ التالي:
- كل دفعة معاملة قصيرة تأخذ أقل من ثانية، فتكررها من سكربت أو مهمة مجدولة مع توقف قصير بين الدفعات حتى تنتهي الصفوف، ولا تقفل الجدول على التطبيق.
- الشرط على
statusيضمن أننا لا ننقل طلباً ما زال مفتوحاً، ولا تؤرشف طلباً عليه نزاع أو إرجاع لم ينته. - الحذف هنا يترك صفوفاً ميتة كما رأينا، لذلك ضبط autovacuum للجدول ضروري مع هذه الطريقة، وهذا بالضبط ما يتجنبه التقسيم.
توزيع القراءة: النسخ والاتصالات والملخصات
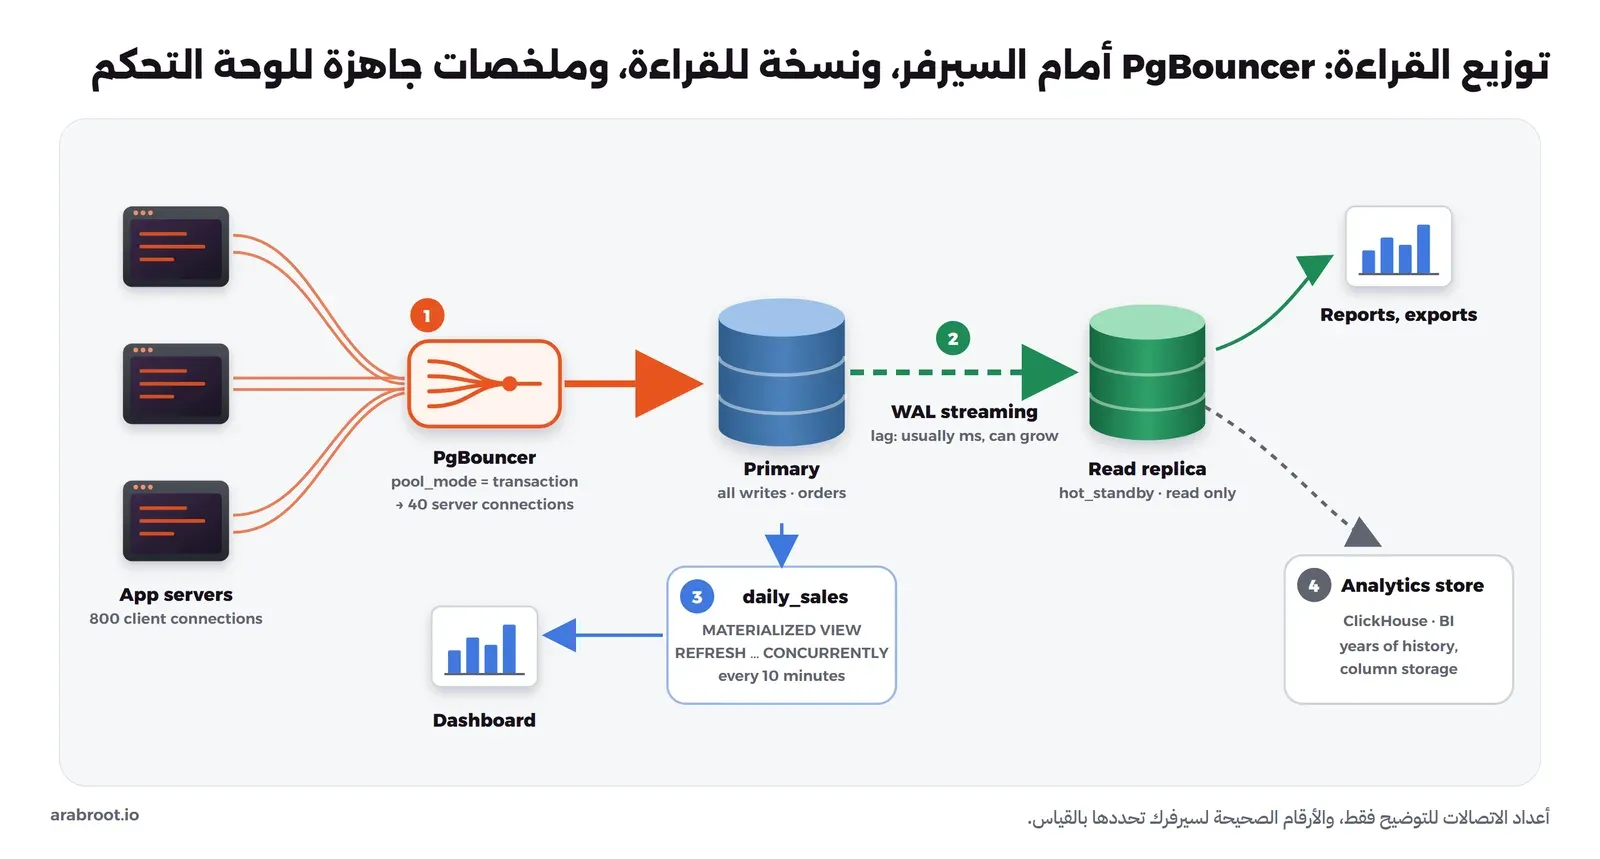
بعد الفهارس والتقسيم والأرشفة، المشكلة التالية في المتجر عادة ليست الجدول وإنما ما حوله: تقارير ثقيلة يشغلها فريق المبيعات على السيرفر نفسه الذي يكتب الطلبات، ومئات الاتصالات من التطبيق، ولوحة تحكم تحسب الأرقام نفسها كل دقيقة، والصورة التالية تبين البنية التي تحل الثلاثة:
نسخ القراءة Read Replicas للتقارير
النسخ المتماثل المتدفق Streaming Replication يرسل سجل WAL من السيرفر الأساسي Primary إلى سيرفر آخر يطبقه باستمرار، ومع Hot Standby يقبل هذا السيرفر استعلامات القراءة، فتوجه إليه التقارير والتصدير ولوحات BI، ويبقى الأساسي للطلبات. وهناك ثلاثة أمور يجب أن تعرفها قبل أن توجه أي قراءة إليه:
- التأخر Replication Lag: النسخة متأخرة عن الأساسي بأجزاء من الثانية عادة، وقد يزيد التأخر مع التحديثات الكبيرة، لذلك لا تقرأ من النسخة شيئاً كتبه المستخدم للتو، مثل صفحة "تم إنشاء طلبك"، وراقب التأخر من العرض
pg_stat_replicationعلى الأساسي. - إلغاء الاستعلامات الطويلة: إذا احتاج استعلام على النسخة صفوفاً نظفها VACUUM على الأساسي، فإن النسخة تؤخر تطبيق WAL حتى حد معين ثم تلغي الاستعلام، وهذا يحكمه
max_standby_streaming_delayكما في الوثائق، فالتقرير الذي يستمر ساعة قد يحتاج إعداداً مختلفاً على نسخة مخصصة للتقارير. - النسخة ليست نسخة احتياطية: أمر DELETE خاطئ على الأساسي يصل إلى النسخة خلال ثانية.
وقد شرحنا متى تحتاج نسخ القراءة في مقال تصميم قواعد البيانات، أما إعداد النسخ المتماثل مع الانتقال التلقائي Failover فهو موضوع مستقل في مرحلة التوفر العالي في خريطة التعلم.
ال PgBouncer وتجميع الاتصالات
كل اتصال بقاعدة PostgreSQL هو عملية Process منفصلة على السيرفر تأخذ ذاكرة، والقيمة الافتراضية لعدد الاتصالات max_connections هي 100 كما في الوثائق، فإذا شغلت عشرة سيرفرات للتطبيق كل واحد بمجمع اتصالات Connection Pool من 50 اتصالاً وصلت إلى 500 اتصال أغلبها ينتظر دون عمل. وقد يتساءل البعض: لماذا لا نرفع max_connections إلى 1000؟ والإجابة أن كل اتصال يستطيع أن يستخدم work_mem عدة مرات في استعلام واحد، وأن مئات العمليات النشطة على عدد محدود من الأنوية تتنافس على المعالج كما شرحنا في مقال المعالج والخيوط والتزامن. والحل هو PgBouncer، برخصة ISC، الذي يقف بين التطبيق وقاعدة البيانات ويستقبل مئات الاتصالات من التطبيق ويوزعها على عدد قليل من الاتصالات الحقيقية.
وفي وضع pool_mode = transaction يعطي PgBouncer الاتصال الحقيقي للتطبيق طوال المعاملة فقط ثم يعيده إلى المجمع، وهذا أكثر الأوضاع توفيراً، ولكن جدول الميزات في وثائقه يوضح أن هذا الوضع يكسر الميزات المرتبطة بالجلسة Session: الأمر SET خارج المعاملة، وLISTEN، والأقفال الاستشارية Advisory Locks على مستوى الجلسة، والأمر PREPARE بالصيغة النصية، والجداول المؤقتة التي تبقى بعد المعاملة. أما الاستعلامات المجهزة Prepared Statements على مستوى البروتوكول، وهي ما تستخدمه أغلب المكتبات، فيدعمها PgBouncer في هذا الوضع عندما تضبط max_prepared_statements بقيمة أكبر من صفر. لذلك اختبر التطبيق خلف PgBouncer قبل الإنتاج، وسوف نشرح إعداده كاملاً في موضوع ضبط الأداء مع PgBouncer في مرحلة قواعد البيانات في خريطة التعلم، وقد شرحنا الأوضاع الثلاثة وما ينكسر في وضع transaction والمصادقة والأحجام بمختبر حقيقي في مقال تجميع الاتصالات Connection Pooling للمبتدئين.
العروض المحفوظة للوحة التحكم
لوحة التحكم تعرض مبيعات كل يوم، وكل من يفتحها يشغل استعلاماً يقرأ ملايين الطلبات ليحسب الأرقام نفسها، والعرض المحفوظ Materialized View يحسب النتيجة مرة ويحفظها كجدول، ثم تحدثه دورياً. وقد شرحنا فكرته كتكرار مقصود للبيانات في مقال التصميم، وهنا نطبقه على جدولنا:
CREATE MATERIALIZED VIEW daily_sales AS
SELECT date_trunc('day', created_at) AS day, status,
       count(*) AS orders, sum(total) AS revenue
FROM orders GROUP BY 1, 2;

CREATE UNIQUE INDEX ON daily_sales (day, status);

SELECT day::date, sum(orders) AS orders, sum(revenue) AS revenue
FROM daily_sales WHERE day >= '2026-09-24' GROUP BY 1 ORDER BY 1 DESC LIMIT 3;

REFRESH MATERIALIZED VIEW CONCURRENTLY daily_sales;
والمخرج سوف يكون كما يلي:
SELECT 3289
Time: 26635.307 ms (00:26.635)
CREATE INDEX
Time: 26.460 ms
    day     | orders |   revenue
------------+--------+-------------
 2026-09-30 |  54719 | 27098285.47
 2026-09-29 |  54670 | 27003346.05
 2026-09-28 |  54619 | 27167885.49
Time: 1.671 ms
REFRESH MATERIALIZED VIEW
Time: 24338.764 ms (00:24.339)
في المخرج أعلاه لاحظ التالي:
- حساب الملخص من 30 مليون صف أخذ 26 ثانية مرة واحدة، ثم أصبح استعلام لوحة التحكم 1.7 مللي ثانية على 3289 صفاً فقط.
- الخيار
CONCURRENTLYيحدث العرض دون أن يمنع القراءة منه، وشرطه كما في الوثائق فهرس فريد على أعمدة عادية يشمل كل الصفوف، لذلك أنشأنا الفهرس على(day, status). - التحديث يعيد حساب كل شيء في كل مرة، أي 24 ثانية هنا، وعلى مئات الملايين يصبح ثقيلاً، وعندها احسب ملخص الأيام المغلقة مرة في جدول عادي، وأعد حساب اليوم الحالي فقط، أو شغل التحديث على نسخة القراءة.
- الأرقام في العرض قديمة بقدر الفترة بين تحديثين، فاكتب في لوحة التحكم "آخر تحديث" حتى لا يستغرب أحد.
مخزن منفصل للتحليلات
عندما يريد فريق المبيعات تحليل ثلاث سنوات من الطلبات بكل الأبعاد، فهذا عمل مختلف عن عمل التطبيق، فالتطبيق يقرأ ويكتب صفوفاً قليلة بسرعة، والتحليل يقرأ أعمدة قليلة من ملايين الصفوف، وهو الفرق بين OLTP وOLAP الذي شرحناه في مقال التصميم. وفي هذه الحالة انقل الطلبات إلى قاعدة تحليلية تحفظ البيانات بالأعمدة مثل ClickHouse وابن عليها أدوات ذكاء الأعمال BI، وسوف تجد هذه الأدوات في مرحلة البيانات وذكاء الأعمال في خريطة التعلم، ويبقى PostgreSQL للتطبيق وحده.
متى لا يكفي سيرفر واحد؟ خيارات ال Cluster بصراحة
السؤال الذي يأتي عادة في هذه المرحلة: هل نحتاج PostgreSQL Cluster؟ وكلمة Cluster هنا تخلط بين هدفين مختلفين تماماً، والصورة التالية تفصل بينهما: سلم التوسع من الأرخص إلى الأغلى، والتوفر العالي كمحور مستقل:
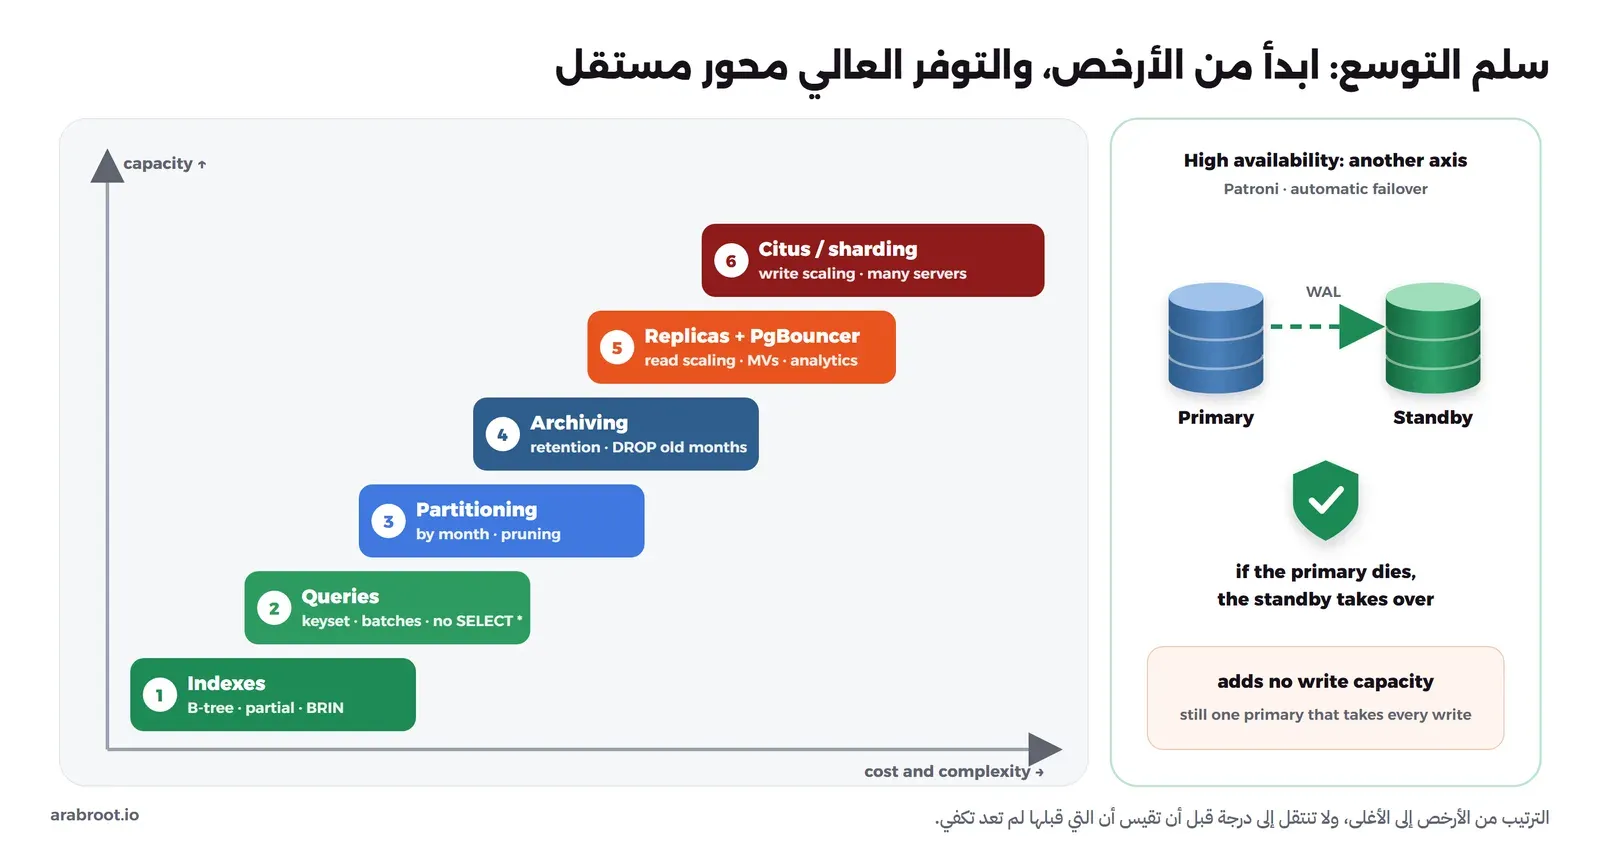
التوفر العالي ليس توسعاً للكتابة
التوفر العالي High Availability يعني أن تبقى الخدمة تعمل إذا توقف السيرفر الأساسي، بأن تكون لديك نسخة احتياطية Standby تتلقى WAL باستمرار وتصبح هي الأساسي خلال ثوان. وهذا ضروري لأي متجر لا يحتمل التوقف، ولكنه لا يجعل الكتابة أسرع، فما زال هناك سيرفر أساسي واحد يستقبل كل الطلبات، والنسخة الاحتياطية تفيد القراءة فقط إذا وجهت إليها استعلامات. لذلك إذا كانت مشكلتك أن الجدول بطيء فالحل في الدرجات السابقة من هذا المقال، وإذا كانت مشكلتك أن السيرفر قد يتعطل ليلاً فالحل هو HA، وأغلب المتاجر تحتاج الاثنين ولكن لسببين مختلفين.
ال Patroni للانتقال التلقائي
الأداة الأكثر استخداماً لإدارة HA على سيرفرات عادية هي Patroni برخصة MIT، وهي تدير PostgreSQL على كل سيرفر وتنتخب الأساسي وتنقل الدور تلقائياً إذا توقف، وتحتاج لذلك مخزن توافق موزع DCS مثل etcd أو Consul أو ZooKeeper، وتنص وثائقها على أن هذا المخزن يجب أن يعمل على 3 أو 5 سيرفرات حتى يكون التوافق صحيحاً. أي أن "Cluster من سيرفرين" يعني في الحقيقة سيرفري قاعدة بيانات وثلاثة سيرفرات (صغيرة) للتوافق، مع موجه للاتصالات يعرف من هو الأساسي الآن. وسوف نشرح إعداده كاملاً في موضوع النسخ المتماثل والانتقال التلقائي مع Patroni في مرحلة التوفر العالي.
ال Citus لتوزيع الكتابة على عدة سيرفرات
عندما يصبح السيرفر الأساسي نفسه غير قادر على الكتابة، بعد أن جربت كل ما سبق وأكبر سيرفر معقول، فالخطوة التالية هي التوزيع Sharding، أي أن تقسم البيانات على عدة سيرفرات وكل سيرفر يكتب جزءاً منها. والإضافة Citus تفعل ذلك داخل PostgreSQL: سيرفر منسق Coordinator يستقبل الاستعلامات، وجداول موزعة Distributed Tables على سيرفرات عاملة Workers حسب عمود تختاره، مثل customer_id أو رقم المستأجر Tenant في نظام SaaS. وهي مفتوحة المصدر بالكامل بالرخصة AGPL-3.0، وأحدث إصدار عند كتابة المقال 14.2.0 ويدعم PostgreSQL 18، وتشرح وثائقها أنها تناسب تطبيقات SaaS متعددة المستأجرين ولوحات التحليل اللحظية والسلاسل الزمنية.
والثمن حقيقي: الاستعلام الذي يجمع بيانات من كل الأجزاء أبطأ وأعقد، والمفاتيح الأجنبية والمعاملات بين الأجزاء لها قيود، واختيار عمود التوزيع قرار يصعب الرجوع عنه، والتشغيل والنسخ الاحتياطي لعدة سيرفرات يحتاج فريقاً. وانتبه للرخصة AGPL إذا كنت تعدل الإضافة نفسها وتقدمها خدمة لآخرين، وقد شرحنا ما تعنيه في مقال رخص البرمجيات مفتوحة المصدر.
ال CloudNativePG على Kubernetes
إذا كانت بنيتك كلها على Kubernetes فالمشغل CloudNativePG برخصة Apache-2.0 يدير دورة حياة PostgreSQL كاملة داخل ال Cluster: سيرفر أساسي ونسخ احتياطية بالنسخ المتماثل المتدفق، وانتقال تلقائي، ونسخ احتياطي، وأحدث إصدار له 1.30.1. وهو لا يضيف قدرة على الكتابة أكثر من Patroni، وإنما يجعل HA جزءاً من Kubernetes نفسه، لذلك لا تنقل قاعدة بيانات إلى Kubernetes من أجل الأداء، وإنما لأن فريقك يدير كل شيء آخر هناك.
التوزيع في التطبيق حسب العميل
الخيار الأقدم هو أن يقرر التطبيق نفسه أين يكتب: قاعدة بيانات لكل مجموعة من العملاء أو لكل منطقة، وجدول صغير يحدد أي عميل في أي قاعدة. وهو يعمل جيداً عندما لا تحتاج استعلامات تجمع كل العملاء معاً، ولكنه ينقل التعقيد إلى الكود، وأي تقرير شامل يحتاج أن يجمع من كل القواعد، ونقل عميل كبير من قاعدة إلى أخرى عملية يدوية حساسة. وفي الحالتين، اختيار نوع المعرف الذي لا يتكرر بين السيرفرات مهم هنا، وقد شرحنا الخيارات في مقال المعرفات الفريدة.
| الخيار | ما يحله | ما لا يحله | الثمن |
|---|---|---|---|
| Patroni | توقف السيرفر الأساسي، الانتقال التلقائي | بطء الكتابة أو الجدول | سيرفر احتياطي وثلاثة سيرفرات DCS وموجه اتصالات |
| نسخ القراءة | التقارير والقراءة الثقيلة | الكتابة، والقراءة بعد الكتابة مباشرة | سيرفر إضافي ومراقبة التأخر |
| Citus | كتابة وبيانات أكبر من سيرفر واحد | تصميم سيء للجداول والاستعلامات | عدة سيرفرات، قيود على الاستعلامات، رخصة AGPL |
| CloudNativePG | HA ونسخ احتياطي داخل Kubernetes | قدرة الكتابة | معرفة Kubernetes والتخزين فيه |
| التوزيع في التطبيق | فصل العملاء على قواعد مستقلة | التقارير الشاملة | تعقيد في الكود والتشغيل |
الذاكرة والقرص: إعدادات البداية
لا توجد أرقام سحرية للإعدادات، وكل قيمة هنا نقطة بداية من الوثائق الرسمية تعدلها بعد أن تقيس، ومن يعطيك ملف إعدادات "للأداء العالي" دون أن يسألك عن ذاكرة السيرفر وعدد الاتصالات ونوع العمل فهو يخمن:
- ال shared_buffers: الذاكرة التي يحفظ فيها PostgreSQL الصفحات، والوثائق تقول إن نقطة بداية معقولة لسيرفر مخصص بذاكرة 1 جيجابايت أو أكثر هي 25% من الذاكرة، وإنه من غير المرجح أن يكون أكثر من 40% أفضل، والسبب أن PostgreSQL يعتمد أيضاً على ذاكرة نظام التشغيل Page Cache، وتغييرها يحتاج إعادة تشغيل.
- ال effective_cache_size: لا يحجز ذاكرة، وإنما يخبر المخطط بحجم الذاكرة المتاحة للتخزين المؤقت في PostgreSQL ونظام التشغيل معاً، فيقرر على أساسه هل الفهرس مناسب، كما في وثائق إعدادات المخطط، وأداة PGTune تجعله ثلاثة أرباع الذاكرة لسيرفرات الويب.
- ال work_mem: الذاكرة لكل عملية ترتيب Sort أو جدول Hash قبل أن يكتب إلى ملفات مؤقتة، والافتراضي 4 ميجابايت، ولكن الاستعلام الواحد قد يستخدمه عدة مرات، وكل اتصال قد يشغل استعلاماً، لذلك تحسبه PGTune بالقسمة على عدد الاتصالات مضروباً في ثلاثة بعد طرح shared_buffers. وإذا رأيت
Sort Method: external merge Diskفي EXPLAIN لاستعلام مهم فارفعه لذلك الاستعلام أو للمستخدم الذي يشغل التقارير، وليس للسيرفر كله. - ال maintenance_work_mem: ذاكرة VACUUM وبناء الفهارس، والافتراضي 64 ميجابايت، ورفعه إلى 1 جيجابايت أو أكثر على سيرفر بذاكرة كبيرة يسرع بناء الفهارس على الجداول الضخمة، والسبب أن هذه العمليات قليلة في الوقت نفسه.
- ال max_connections: اتركه قريباً من الافتراضي 100 أو أكثر قليلاً، وضع PgBouncer أمامه، فرفعه إلى آلاف يعني ذاكرة أكثر وتنافساً أكثر على المعالج دون فائدة.
- القرص: الجداول الضخمة لا تدخل في الذاكرة، فسرعة القرص تحدد كل شيء تقريباً، وقد رأيت في EXPLAIN أن ثلاث ثوان من أربع كانت انتظاراً للقرص، لذلك اختر قرص NVMe بأداء IOPS مضمون، وانتبه لعروض VPS التي لا تذكر أداء القرص كما شرحنا في دليل اختيار VPS، ومع قرص SSD يقلل كثير من الفرق القيمة
random_page_costمن الافتراضي 4.0 حتى يفضل المخطط الفهارس، بعد أن تقيس أثر ذلك. - ال WAL وال Checkpoints: كل تغيير يكتب أولاً في WAL، وكل فترة يكتب PostgreSQL الصفحات المعدلة إلى الملفات في نقطة تفتيش Checkpoint، والقيم الافتراضية
max_wal_size = 1GBوcheckpoint_timeout = 5minكما في وثائق WAL، ومع كتابة كثيرة يؤدي الحجم الصغير إلى نقاط تفتيش متقاربة وكتابة أكثر على القرص، لذلك رفعناه في المختبر إلى 8 جيجابايت، والثمن وقت أطول للاستعادة بعد التوقف المفاجئ، والسجل يحذرك برسالةcheckpoints are occurring too frequentlyإذا كانت القيمة صغيرة.
وتذكر أن هذه الإعدادات تغير ما يحدث داخل السيرفر الواحد، ولن تعوض استعلاماً يقرأ الجدول كاملاً، فالفهرس الذي أضفناه في البداية أعطى فرقاً بمئة مرة، ولا يوجد إعداد ذاكرة يعطي ذلك.
النسخ الاحتياطي لقاعدة كبيرة
الأمر pg_dump يكتب البيانات كأوامر SQL أو ملف مضغوط، وهو ممتاز لقاعدة صغيرة ولنقل جدول أو قسم واحد، وقد استخدمناه في دليل نقل Containers إلى سيرفر جديد، ولكن مع مئات الجيجابايتات يظهر ضعفه: النسخة تأخذ ساعات، والاستعادة أطول لأنها تعيد بناء كل الفهارس، والنسخة تمثل لحظة واحدة فقط، فإذا تعطل السيرفر في المساء خسرت كل طلبات اليوم.
والطريقة المناسبة للقواعد الكبيرة هي النسخ الفيزيائي Physical Backup: نسخة من ملفات قاعدة البيانات نفسها بالأداة pg_basebackup أو أداة متخصصة، مع أرشفة مستمرة لملفات WAL، فتستطيع الاستعادة إلى أي لحظة بين نسختين، وهذا ما يسمى الاستعادة إلى نقطة زمنية PITR كما في وثائق الأرشفة المستمرة، أي أنك تستطيع استعادة القاعدة كما كانت قبل دقيقة من أمر DELETE الخاطئ. والأداتان الأشهر:
- pgBackRest: برخصة MIT، وآخر إصدار له 2.59.3 في أكتوبر 2026، ويدعم النسخ والاستعادة المتوازية والضغط بخوارزميات مثل lz4 وzstd، ويحسب Checksum لكل ملف ويتحقق منه عند الاستعادة، ويحفظ النسخ على قرص آخر أو تخزين متوافق مع S3.
- Barman: من EDB برخصة GPL-3.0، وآخر إصدار له 3.20.1، ويدير النسخ من سيرفر مركزي لعدة قواعد بيانات.
ومع الجدول المقسم تصبح الأقسام القديمة التي لا تتغير مرشحة لنسخة واحدة تحفظ في الأرشيف ثم تخرج من القاعدة، فيصغر ما تنسخه كل ليلة. وأهم قاعدة هنا لا تتعلق بالأداة: النسخة التي لم تجرب استعادتها ليست نسخة، فقس وقت الاستعادة على سيرفر منفصل مرة كل فترة، واكتبه في خطة التعافي من الكوارث. وسوف نشرح pgBackRest مع PITR خطوة بخطوة في موضوع مستقل في مرحلة قواعد البيانات في خريطة التعلم.
قائمة تحقق وأخطاء شائعة
قبل أن تقول إن قاعدة البيانات لا تتحمل، راجع هذه القائمة بالترتيب:
- هل
pg_stat_statementsمفعل، وهل تعرف أكثر خمسة استعلامات استهلاكاً للوقت؟ - هل لكل استعلام متكرر خطة EXPLAIN تستخدم فهرساً، وتقرأ عدداً من الصفحات قريباً من عدد الصفوف التي تعيدها؟
- هل الفهارس المركبة بالترتيب الصحيح، وهل استخدمت الفهرس الجزئي للحالات القليلة وBRIN للتواريخ في الجداول التي تكتب في آخرها؟
- هل حذفت الفهارس المكررة والتي لم تستخدم منذ أسابيع، بعد أن تحققت على كل نسخ القراءة؟
- هل تنشئ الفهارس بالأمر
CONCURRENTLYوتتأكد بعدها أن الفهرس ليسINVALIDإذا فشل البناء؟ - هل الترقيم بالمفتاح بدل OFFSET، والتحديث والحذف الكبير على دفعات؟
- هل autovacuum مضبوط للجداول الكبيرة بنسبة أصغر من 20%، وهل تراقب
n_dead_tupوعمرrelfrozenxid؟ - هل لديك سياسة احتفاظ مكتوبة، وهل الجدول مقسم إذا كنت تحذف بيانات قديمة كل شهر؟
- هل أقسام الشهور القادمة تنشأ تلقائياً، وهل القسم الافتراضي فارغ؟
- هل التقارير الثقيلة على نسخة قراءة، والاتصالات خلف PgBouncer؟
- هل لديك نسخة فيزيائية مع أرشفة WAL، وهل جربت الاستعادة وتعرف كم تستغرق؟
وهذه الأخطاء التي نراها أكثر من غيرها:
- فهرس على كل عمود: كل فهرس يبطئ الكتابة ويأخذ مساحة، وفهرس على عمود
statusبأربع قيم لا يفيد إلا إذا كان جزئياً على القيمة النادرة. - CREATE INDEX دون CONCURRENTLY في الإنتاج: يمنع الكتابة على الجدول دقائق طويلة، وقد رأيت أن بناء فهرس واحد استغرق ثماني دقائق في المختبر.
- حذف البيانات القديمة بأمر DELETE واحد: معاملة طويلة، وملايين الصفوف الميتة، وWAL ضخم، ثم ملف لا يصغر.
- إطفاء autovacuum لأنه "يبطئ السيرفر": هذا يؤجل المشكلة إلى انتفاخ لا يحتمل، أو إلى تحذير الالتفاف، والصحيح أن تجعله يعمل أكثر وعلى كميات أصغر.
- التقسيم قبل الفهارس: التقسيم لا يعوض فهرساً ناقصاً، وقد رأيت أن الاستعلام دون شرط التاريخ أصبح يبحث في 36 فهرساً.
- معاملات مفتوحة طوال الليل: جلسة
idle in transactionمن أداة إدارة أو كود نسيCOMMITتمنع VACUUM من تنظيف أي صف مات بعد بدايتها، فاضبطidle_in_transaction_session_timeout. - شراء Cluster لحل بطء استعلام: التوفر العالي لا يسرع الكتابة، والتوزيع على عدة سيرفرات يضاعف تعقيد الاستعلام البطيء بدل أن يحله.
حذف المختبر
بعد أن تنتهي احذف ال Container وال Volume المجهول الذي أنشأه، فهو يحمل أكثر من 13 جيجابايت من البيانات وملفات WAL:
docker rm -f -v lab-pgscale-pgالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- السيرفر الواحد يحمل جدولاً بمئات الملايين من الصفوف إذا كانت الفهارس والاستعلامات والصيانة صحيحة، والتوسع بعدة سيرفرات هو الدرجة الأخيرة وليس الأولى.
- ابدأ دائماً بالقياس:
pg_stat_statementsلتعرف أي استعلام، وEXPLAIN (ANALYZE, BUFFERS)لتعرف لماذا، وعدد الصفحات أصدق من الوقت. - الفهرس المركب بالترتيب الصحيح أنزل صفحة العميل من 3.9 ثانية إلى 34 مللي ثانية، والفهرس الجزئي المغطي أعطى قائمة التجهيز في 0.1 مللي ثانية بحجم 808 كيلوبايت، وBRIN أعطى سرعة B-tree لاستعلام الشهر بحجم 112 كيلوبايت مقابل 643 ميجابايت.
- الترقيم بالمفتاح بدل OFFSET، والدفعات بدل الأوامر الضخمة، والتقدير بدل
count(*)عندما يكفي. - التقسيم حسب الشهر يجعل الاستعلام بالتاريخ يقرأ قسماً واحداً، ويحول حذف الشهر القديم من DELETE إلى DROP، ولكن المفتاح الأساسي يجب أن يشمل عمود التقسيم، والاستعلام دون التاريخ يبحث في كل الأقسام، والقسم الافتراضي يحتاج مراقبة.
- كل تحديث يترك صفاً ميتاً، فاضبط autovacuum للجدول الكبير بنسبة صغيرة، وراقب عمر المعاملات، واستخدم pg_repack بدل VACUUM FULL لاستعادة المساحة.
- نسخ القراءة للتقارير، وPgBouncer للاتصالات، والعروض المحفوظة للوحات التحكم، ومخزن تحليلي للتاريخ الطويل.
- التوفر العالي مع Patroni يحميك من التوقف ولا يضيف قدرة على الكتابة، وCitus والتوزيع في التطبيق للحالة النادرة التي لا يكفي فيها أكبر سيرفر.
وفي مقالات قادمة بإذن الله سوف نشرح النسخ المتماثل والانتقال التلقائي مع Patroni، والنسخ الاحتياطي مع pgBackRest والاستعادة إلى نقطة زمنية، أما ضبط PgBouncer وأوضاعه فقد شرحناه في تجميع الاتصالات Connection Pooling.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلكيف تختار خادماً افتراضياً VPSكم تحتاج من المعالج والذاكرة والقرص، وما الذي يميز مزوداً عن آخر غير السعر، حتى تختار VPS يناسب احتياجك.
 دليلنقل Containers إلى خادم جديد دون فقدان البياناتكيف تنقل ال Containers مع بياناتها إلى سيرفر جديد، دفعة واحدة أو تطبيقاً بعد تطبيق، مع خطة للتراجع إذا تعثر النقل.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على PostgreSQL 18.6 بجدول من 30 مليون طلب، مع pg_partman 5.5.0 وpg_repack 1.5.3.