

كل تطبيق ويب تقريباً يبدأ بنفس السطر: يصل الطلب، فيفتح الكود اتصالاً بقاعدة البيانات، وينفذ استعلاماً يأخذ مللي ثانية أو اثنتين، ثم يغلق الاتصال ويعود الرد. وهذا يعمل بلا مشاكل في بيئة التطوير، ثم يزيد عدد الزوار وتضيف عمالاً ونسخاً من التطبيق، فتظهر فجأة في السجلات رسالة FATAL: sorry, too many clients already، أو تجد أن نصف زمن الطلب يذهب في فتح الاتصال وليس في الاستعلام نفسه. وقد ذكرنا تجميع الاتصالات Connection Pooling باختصار في عدة مقالات: في مقال تصميم قواعد البيانات، وفي مقال المعالج والخيوط والتزامن عند حساب عدد العمال، وفي مقال PostgreSQL للجداول الضخمة، وفي المدخل إلى تصميم الأنظمة، وهذا المقال هو المرجع الذي يشرح الفكرة كاملة مرة واحدة: لماذا الاتصال مكلف، وكيف يعمل المجمع، وأين تضعه، وكيف تضبط PgBouncer، وما الذي ينكسر إذا أخطأت في الإعداد.
وسوف نناقش في هذا المقال ما يلي:
- ماذا يكلف فتح اتصال واحد بقاعدة البيانات، ولماذا يرفض PostgreSQL الاتصالات بعد حد معين.
- ما هو مجمع الاتصالات Connection Pool، وإعداداته الأساسية، وكيف تختار حجمه بدل أن تخمنه.
- أين يكون المجمع: داخل التطبيق مثل HikariCP وSQLAlchemy، أو أداة مستقلة مثل PgBouncer، أو الاثنين معاً.
- أوضاع PgBouncer الثلاثة، وما الذي ينكسر في وضع transaction، والاستعلامات المجهزة Prepared Statements، والمصادقة، والحجم.
- مختبر حقيقي على PostgreSQL 18 وPgBouncer 1.26: الرفض المباشر، ثم نفس الحمل عبر PgBouncer، وثمن فتح الاتصال، وخطأ
SETفي وضع transaction. - تضاعف الاتصالات Connection Multiplication مع النسخ الكثيرة وال Serverless.
- المجمع بين Nginx والتطبيق Upstream Keepalive: نفاد المنافذ المؤقتة و
TIME_WAIT، وإعداداتkeepalive، ومهلة التطبيق، مع مختبر يعد الاتصالات. - مجمع الاتصالات في Redis وValkey: ماذا يكلف الاتصال، وسلوك مكتبات Python وNode.js وGo، والأوامر الحاجبة وPub/Sub، مع مختبر.
- المراقبة، والأخطاء الشائعة، وقائمة تحقق.
ماذا يكلف فتح اتصال واحد؟
الاتصال بقاعدة البيانات ليس سطراً في الكود فقط، وإنما سلسلة خطوات على الشبكة وعلى السيرفر، فالكلاينت يفتح اتصال TCP عبر المصافحة الثلاثية Three-way Handshake، ثم إذا كان الاتصال مشفراً يتفاوض على TLS، ثم يرسل اسم المستخدم وقاعدة البيانات ويمر بالمصادقة Authentication، وفي PostgreSQL الحديث تكون المصادقة الافتراضية scram-sha-256 التي تحسب الهاش بعدد جولات قيمته الافتراضية 4096 كما يظهر من SHOW scram_iterations، وهذا الحساب مقصود ليكون بطيئاً على من يحاول تخمين كلمة المرور، وبالتالي فهو بطيء عليك أيضاً عندما تكرره مع كل طلب.
ثم يأتي الجزء الأهم في PostgreSQL، حيث تقول الوثائق الرسمية إنه يعمل بنموذج «عملية لكل مستخدم» Process per User، وإن العملية المشرفة postmaster تنشئ عملية خلفية Backend Process جديدة في كل مرة يطلب فيها كلاينت اتصالاً، وهذه العملية هي التي تكمل التشفير والمصادقة ثم تخدم هذا الكلاينت وحده حتى يغلق الاتصال. وهذا يعني أن كل اتصال مفتوح هو عملية كاملة على سيرفر قاعدة البيانات لها ذاكرتها، حتى لو كانت لا تفعل شيئاً سوى الانتظار.
الصورة التالية تبين ما يدفعه كل طلب عندما لا يوجد مجمع اتصالات:
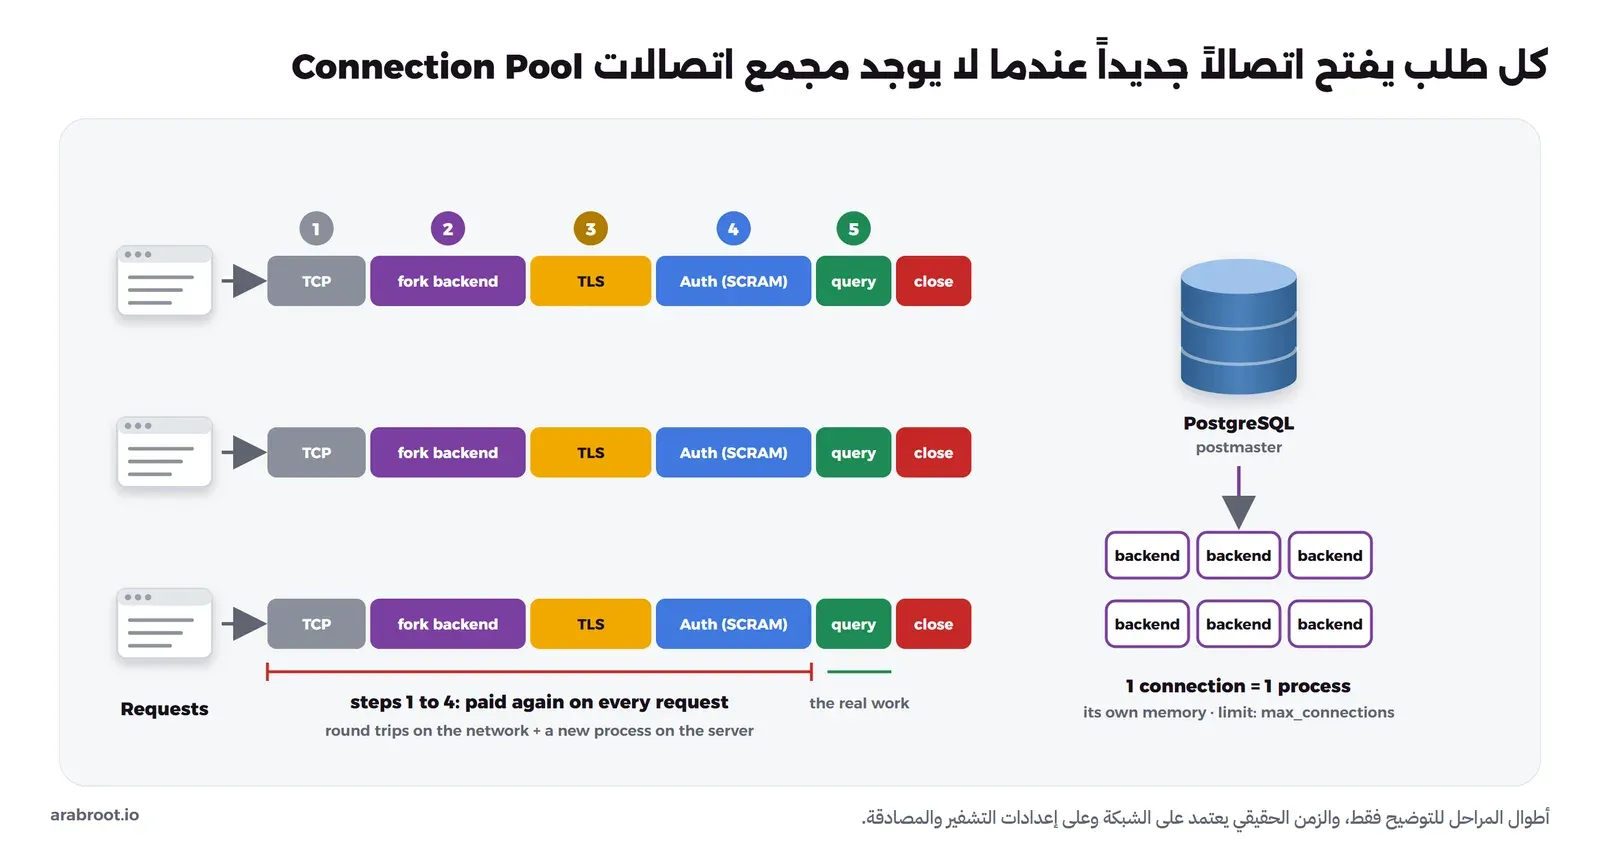
وهنا مشكلتان منفصلتان يحلهما تجميع الاتصالات:
- زمن فتح الاتصال Connection Latency: إذا كان الاستعلام يأخذ مللي ثانية واحدة وفتح الاتصال يأخذ عشرين، فأنت تدفع عشرين ضعفاً مقابل عمل لا يحتاجه المستخدم، وسوف نقيس ذلك في المختبر.
- عدد الاتصالات المفتوحة: القيمة الافتراضية للإعداد
max_connectionsهي 100، ومنها ثلاثة محجوزة للمستخدمين الخارقين Superusers عبرsuperuser_reserved_connections، وتذكر الوثائق أن PostgreSQL يحدد حجم بعض موارده، ومنها الذاكرة المشتركة Shared Memory، مباشرة من قيمةmax_connections، لذلك فرفعها ليس مجانياً. وعندما تمتلئ الخانات العادية يرى المستخدم العادي الرسالةremaining connection slots are reserved for roles with the SUPERUSER attribute، وعندما تمتلئ كلها يرى الجميعsorry, too many clients already.
وقد يتساءل البعض: لماذا لا نرفع max_connections إلى ألفين وننتهي؟ والإجابة أن المشكلة لم تكن في الرقم، فقد شرحنا في مقال المعالج والخيوط والتزامن أن العمليات النشطة أكثر من الأنوية لا تنهي العمل أسرع، وإنما تتنافس على المعالج والأقفال والذاكرة، وكل اتصال يستطيع أن يستخدم work_mem أكثر من مرة في استعلام واحد كما ذكرنا في مقال الجداول الضخمة، لذلك الحل أن تقلل عدد الاتصالات الحقيقية وتعيد استخدامها، وهذا بالضبط ما يفعله المجمع.
ما هو مجمع الاتصالات Connection Pool؟
مجمع الاتصالات Connection Pool هو مجموعة من الاتصالات المفتوحة مسبقاً بقاعدة البيانات، يستعير Acquire منها الكود اتصالاً عندما يحتاجه، ثم يعيده Release إلى المجمع Pool بدل أن يغلقه، فيبقى الاتصال الحقيقي مفتوحاً ويخدم الطلب التالي دون أن يدفع ثمن المصافحة والمصادقة وإنشاء العملية مرة أخرى. والتشبيه الأقرب هو شبابيك البنك، فالبنك لا يوظف موظفاً جديداً لكل عميل يدخل ثم يفصله عندما يخرج، وإنما لديه عدد ثابت من الشبابيك، وإذا كانت كلها مشغولة يأخذ العميل رقماً وينتظر في الصالة.
الصورة التالية تبين دورة الاتصال داخل المجمع:
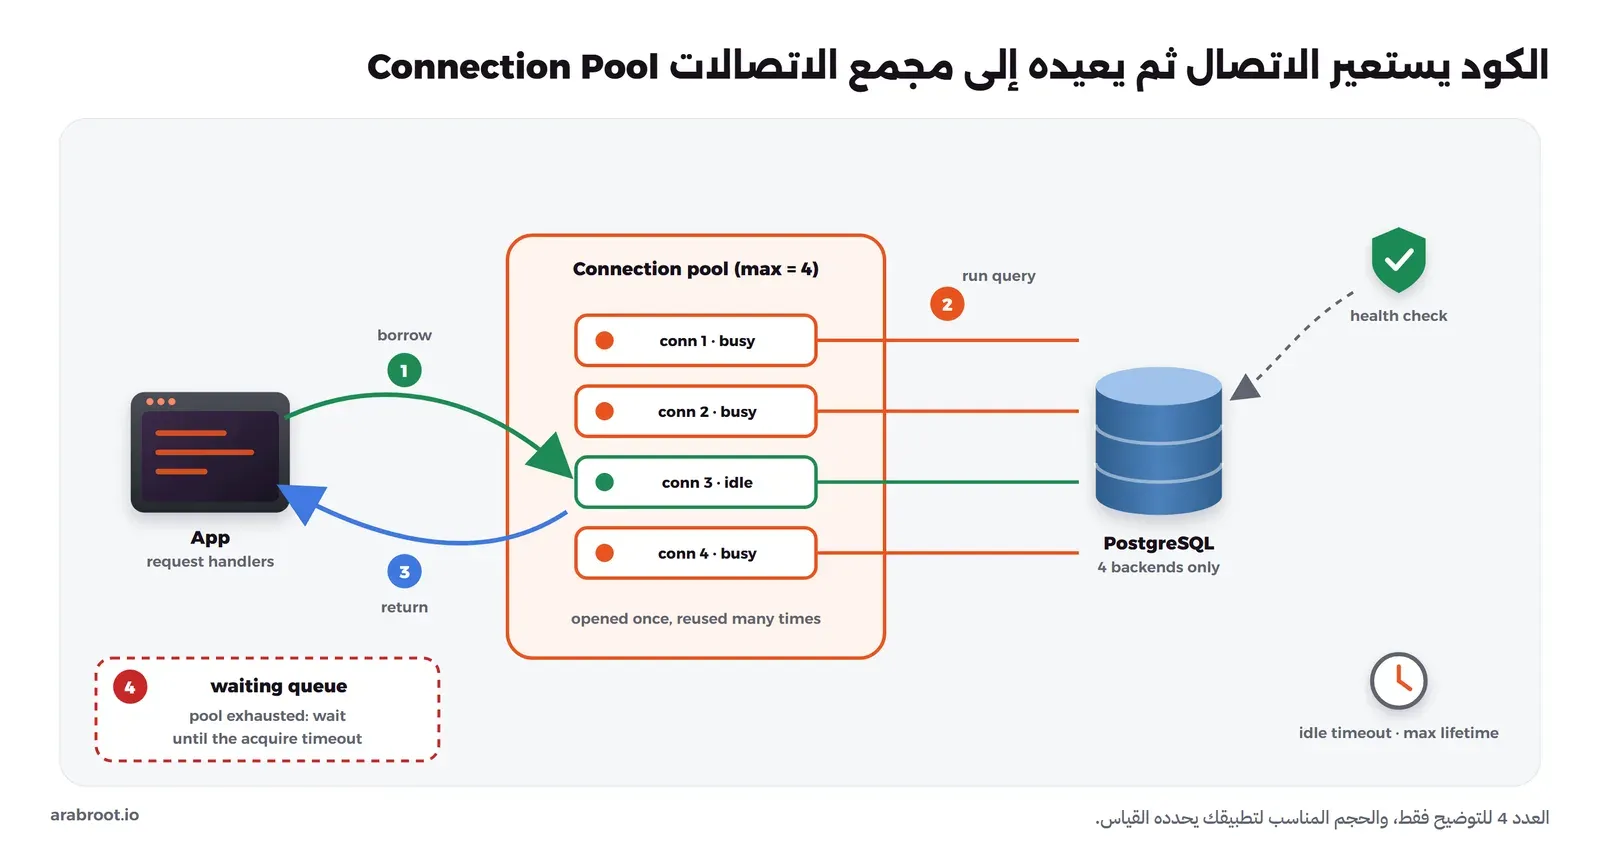
لاحظ أن الخطوة 4 هي ما يجعل المجمع مفيداً تحت الضغط، فبدل أن يفتح الطلب رقم خمسين اتصالاً جديداً ويوصل قاعدة البيانات إلى حدها، ينتظر بضعة مللي ثوان حتى يعود اتصال، والانتظار القصير في طابور Queue أفضل بكثير من رفض الاتصال أو من خمسين عملية تتنافس على أربع أنوية.
إعدادات المجمع Pool التي تجدها في كل مكتبة
الأسماء تختلف من مكتبة لأخرى، ولكن المفاهيم واحدة تقريباً في كل المجمعات:
- الحد الأدنى Min Size أو Min Idle: عدد الاتصالات التي يبقيها المجمع مفتوحة حتى لو لم يكن هناك عمل، فيجد أول طلب بعد فترة هدوء اتصالاً جاهزاً.
- الحد الأقصى Max Size: أهم رقم في المجمع، لأنه أكبر عدد من الاتصالات الحقيقية يفتحه هذا المجمع بقاعدة البيانات، وهو الرقم الذي سوف يتضاعف لاحقاً بعدد النسخ.
- مهلة الخمول Idle Timeout: الاتصال الخامل أكثر من هذه المدة يغلق، فيصغر المجمع بعد انتهاء الضغط.
- العمر الأقصى Max Lifetime: كل اتصال يغلق ويستبدل بعد مدة معينة حتى لو كان سليماً، والسبب أن جدران الحماية Firewalls وموزعات الحمل قد تقطع الاتصالات الطويلة بصمت، وأن تغيير إعدادات قاعدة البيانات أو الانتقال إلى سيرفر جديد يحتاج اتصالات جديدة.
- مهلة الاستعارة Acquire Timeout أو Connection Timeout: أقصى مدة ينتظرها الطلب في الطابور قبل أن يفشل بخطأ واضح، وهذه المهلة أفضل من انتظار بلا نهاية يحجز عامل الويب ويظهر للمستخدم صفحة معلقة.
- فحص الصحة Health Check أو Validation: التأكد من أن الاتصال ما زال حياً قبل إعطائه للكود، إما بإرسال استعلام صغير قبل كل استعارة (مثل
pool_pre_pingفي SQLAlchemy) أو بفحص دوري للاتصالات الخاملة (مثلkeepaliveTimeفي HikariCP)، والسبب أن إعادة تشغيل قاعدة البيانات تترك في المجمع اتصالات ميتة سوف يفشل أول استعلام عليها.
كم يكون حجم المجمع Pool Size؟
الخطأ الأشهر أن يفترض المطور أن المجمع الأكبر أسرع، فيضع 100 أو 200 اتصال لكل نسخة من التطبيق. وصفحة About Pool Sizing في مشروع HikariCP من أفضل ما كتب في هذا الموضوع، فهي تنقل تجربة من فريق الأداء في Oracle خفض فيها حجم المجمع من 2048 اتصالاً إلى 96 فقط، فنزل زمن الاستجابة من حوالي 100 مللي ثانية إلى حوالي 2 مللي ثانية. والسبب نفس ما شرحناه في مقال المعالج والخيوط: قاعدة البيانات لا تنفذ في نفس اللحظة أكثر من عدد أنويتها، والباقي ينتظر ويضيف تبديلاً للسياق Context Switching وتنافساً على الأقفال والقرص.
وتقترح الصفحة نقطة بداية بالمعادلة التالية:
connections = ((core_count * 2) + effective_spindle_count)حيث core_count عدد الأنوية في سيرفر قاعدة البيانات وليس في سيرفر التطبيق، وeffective_spindle_count يساوي صفراً إذا كانت البيانات النشطة كلها في الذاكرة ويقترب من عدد الأقراص كلما قلت نسبة القراءة من الذاكرة. فسيرفر بأربع أنوية وقرص واحد يعطي 9، وتقربها الصفحة إلى 10. لاحظ أن هذا الرقم هو مجموع الاتصالات النشطة على قاعدة البيانات من كل التطبيقات، وليس حجم المجمع في كل نسخة، وأنه نقطة بداية تعدلها بالقياس وليس قانوناً.
وهناك طريقة ثانية للتفكير تأتي من قانون ليتل Little's Law، وهو أن متوسط العناصر داخل النظام يساوي معدل وصولها مضروباً في متوسط بقائها، أي L = λ × W. فإذا كان تطبيقك يحتاج 500 معاملة في الثانية، وكل معاملة تمسك الاتصال 10 مللي ثوان في المتوسط، فأنت تحتاج في المتوسط 500 × 0.01 = 5 اتصالات مشغولة، ولو جعلتها 10 لتحمل التذبذب فهذا يكفي، ولن يفيدك أن تجعلها 100. وهذا الحساب يبين أيضاً أن الطريق الأسرع لتقليل الاتصالات هو تقصير مدة إمساك الاتصال: استعلامات أسرع بالفهارس الصحيحة، ومعاملات قصيرة، وعدم استدعاء API خارجي والاتصال محجوز.
أين يكون المجمع Pool؟
هناك ثلاثة أماكن للمجمع، والصورة التالية تبينها:
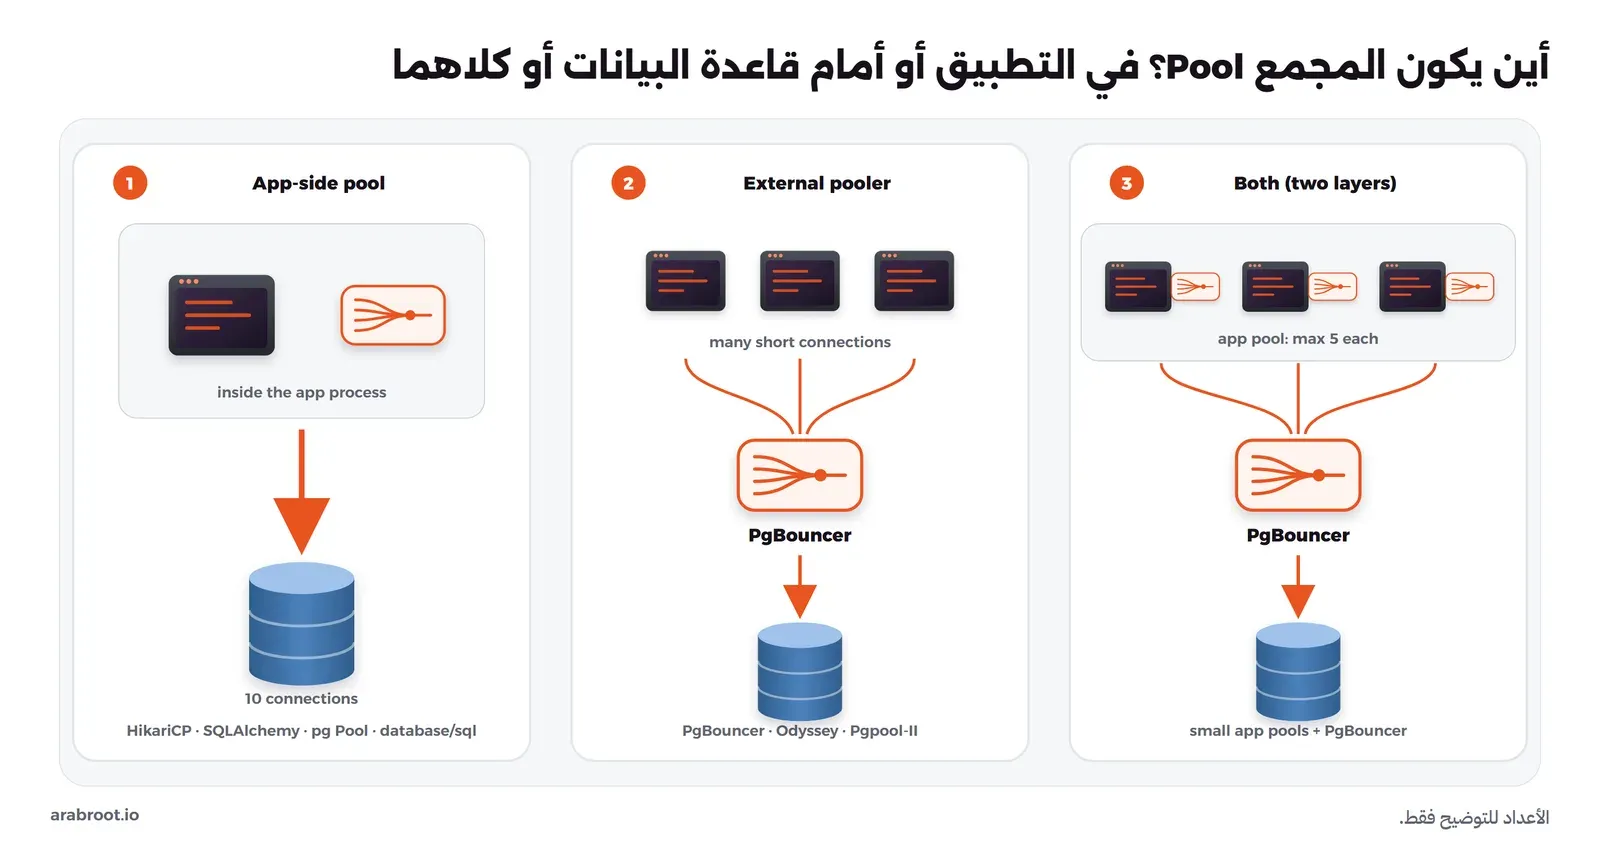
المجمع Pool داخل التطبيق
أغلب لغات البرمجة فيها مجمع جاهز في مكتبة الاتصال أو في ال ORM، وهو أول ما يجب أن تستخدمه، لأنه لا يحتاج سيرفراً إضافياً ولا يضيف خطوة على الشبكة. والجدول التالي يبين القيم الافتراضية لأشهرها كما في وثائقها الرسمية، ولاحظ كم تختلف:
| المكتبة | الحد الأقصى الافتراضي | مهلة الاستعارة Acquire Timeout | ملاحظات |
|---|---|---|---|
| HikariCP (Java) | maximumPoolSize = 10 | connectionTimeout = 30 ثانية | minimumIdle يساوي الحد الأقصى، وidleTimeout 10 دقائق، وmaxLifetime 30 دقيقة، وkeepaliveTime دقيقتان، وهو المجمع الذي يختاره Spring Boot كلما كان متاحاً. |
| SQLAlchemy (Python) | pool_size = 5 مع max_overflow = 10، أي 15 | pool_timeout = 30 ثانية | pool_recycle معطل افتراضياً، وpool_pre_ping معطل، ولا ينشئ أي اتصال قبل أول استخدام. |
| psycopg_pool (Python) | min_size = 4، وmax_size يساوي min_size إذا لم تحدده | timeout = 30 ثانية | max_idle 10 دقائق، وmax_lifetime ساعة، ولا يوجد فحص صحة إلا إذا مررت check. |
node-postgres (pg.Pool) | max = 10 | connectionTimeoutMillis = 0، أي لا توجد مهلة | idleTimeoutMillis 10 ثوان، وmaxLifetimeSeconds معطل. |
| Go database/sql | SetMaxOpenConns = 0، أي بلا حد | لا توجد مهلة خاصة، والمهلة من ال Context | الاتصالات الخاملة المحفوظة 2 فقط افتراضياً، وSetConnMaxLifetime وSetConnMaxIdleTime معطلان. |
في الجدول أعلاه لاحظ التالي:
- Go بلا حد أعلى افتراضياً: النوع
sql.DBهو مجمع اتصالات بنفسه كما تقول وثائقه، ولكن دونSetMaxOpenConnsسوف يفتح اتصالاً لكل Goroutine تحتاجه تحت الضغط، لذلك حدد الرقم دائماً، وارفعSetMaxIdleConnsإلى قريب منه، وإلا فالمجمع سوف يغلق ويفتح الاتصالات باستمرار لأنه لا يحفظ إلا اثنين. - node-postgres ينتظر للأبد افتراضياً: إذا امتلأ المجمع ولم تحدد
connectionTimeoutMillisفالطلب ينتظر بلا نهاية، لذلك ضع مهلة بالثواني. - SQLAlchemy يتجاوز حجمه: الحد الحقيقي هو
pool_size + max_overflow، وهذا الرقم هو ما تحسب به الاتصالات وليسpool_sizeوحده. - المجمع لكل عملية Process وليس لكل سيرفر: تطبيق Python مع Gunicorn بتسعة عمال Workers يعني تسعة مجمعات Pools منفصلة، وتطبيق Node.js في وضع cluster بثماني عمليات يعني ثمانية، وهنا يبدأ تضاعف الاتصالات Connection Multiplication الذي نشرحه في قسم النسخ الكثيرة. وتنبه وثائق SQLAlchemy إلى أن الاتصالات لا يجب أن تنتقل من العملية الأم إلى العمليات الفرعية بعد
fork، وأن تستدعيengine.dispose(close=False)في بداية كل عملية فرعية.
وأخطر خطأ مع أي مجمع هو أن تستعير اتصالاً ثم لا تعيده، فتقول وثائق node-postgres إنك يجب أن تعيد الاتصال بعد الانتهاء منه، وإلا ينفد المجمع وتنتظر كل الطلبات التالية أو تفشل بانتهاء المهلة. والطريقة الصحيحة أن تعيده في finally مهما حدث، كما في المثال التالي:
import pg from 'pg';

const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: 5,                          // counted in the connection budget
  idleTimeoutMillis: 30_000,
  connectionTimeoutMillis: 5_000,  // fail fast instead of waiting forever
  maxLifetimeSeconds: 1800,
});

// Simple queries: pool.query borrows and returns the connection for you.
export const getOrder = (id) => pool.query('SELECT * FROM orders WHERE id = $1', [id]);

// Transactions need ONE connection for all statements, returned in finally.
export async function payOrder(id) {
  const client = await pool.connect();
  try {
    await client.query('BEGIN');
    await client.query("UPDATE orders SET status = 'paid' WHERE id = $1", [id]);
    await client.query('INSERT INTO payments (order_id) VALUES ($1)', [id]);
    await client.query('COMMIT');
  } catch (err) {
    await client.query('ROLLBACK');
    throw err;
  } finally {
    client.release();
  }
}
في الكود أعلاه لاحظ التالي:
- المجمع ينشأ مرة واحدة عند تشغيل التطبيق ويصدر من الملف، ولا تنشئه داخل دالة الطلب، فالمجمع لكل طلب هو نفس فتح اتصال لكل طلب مع خطوات إضافية.
- المعاملة لا تستخدم
pool.query، والسبب كما تشرح الوثائق أن المعاملة في PostgreSQL مرتبطة باتصال واحد، وpool.queryقد يرسل كل أمر على اتصال مختلف. client.release()فيfinally، فحتى لو فشل الاستعلام يعود الاتصال للمجمع.
أداة مستقلة أمام قاعدة البيانات
المجمع داخل التطبيق لا يرى إلا تطبيقه، فإذا كان لديك عشر خدمات وكل خدمة بعدة نسخ، أو عمليات قصيرة العمر مثل سكربتات Cron وال Serverless التي لا تستطيع الاحتفاظ بمجمع أصلاً، فأنت تحتاج مجمعاً مستقلاً يقف بين كل التطبيقات وقاعدة البيانات، ويتكلم بروتوكول PostgreSQL نفسه، فيظن التطبيق أنه يتصل بقاعدة البيانات مباشرة. والجدول التالي يجمع أشهر هذه الأدوات كما في مستودعاتها عند كتابة المقال:
| الأداة | الترخيص | ما يميزها | الحالة |
|---|---|---|---|
| PgBouncer | ISC | خفيف جداً ومكتوب بلغة C، يفعل شيئاً واحداً هو التجميع، وموجود في حزم كل التوزيعات وفي مستودع PGDG. | نشط، وآخر إصدار 1.26.0 في سبتمبر 2026 كما في سجل التغييرات. |
| Pgpool-II | ترخيص على نمط BSD | أكثر من مجمع: توزيع القراءة على النسخ Load Balancing، والانتقال التلقائي Failover، وال Watchdog، وتخزين نتائج الاستعلامات. | نشط، والإصدار في الوثائق 4.7.3، وهو أثقل وأعقد في الإعداد. |
| Odyssey | BSD-3-Clause | من Yandex، متعدد الخيوط Multi-threaded فيستخدم عدة أنوية، بينما PgBouncer كما تذكر وثائقه يعمل بخيط واحد على نواة واحدة لكل نسخة، وتحتاج عدة نسخ منه مع so_reuseport لتستخدم أكثر من نواة. | نشط، وآخر إصدار v1.5.2 في سبتمبر 2026. |
| Supavisor | Apache-2.0 | من Supabase، مكتوب بلغة Elixir، مصمم لعدد ضخم من الكلاينتات ولقواعد بيانات كثيرة Multi-tenant في Cluster. | نشط، وآخر إصدار v2.9.13 في سبتمبر 2026. |
| PgCat | MIT | مكتوب بلغة Rust، مع توزيع القراءة والتوزيع على أكثر من قاعدة Sharding. | آخر إصدار 0.2.5 في نوفمبر 2024 وآخر تحديث للمستودع في فبراير 2025، لذلك لا ننصح به لمشروع جديد. |
| ProxySQL | GPL-3.0 | المقابل المعروف في عالم MySQL وMariaDB: تجميع، وتوجيه القراءة والكتابة، وقواعد على الاستعلامات. | نشط، وآخر إصدار v3.0.11 في أغسطس 2026. |
والاختيار الافتراضي لأغلب من يستضيف PostgreSQL بنفسه هو PgBouncer، والسبب أنه صغير ومستقر ويفعل شيئاً واحداً، وأن أغلب المقالات والأدوات تفترضه، أما Pgpool-II فيناسب من يريد أداة واحدة للتجميع والتوزيع والانتقال التلقائي ويقبل تعقيدها، وOdyssey عندما يصبح PgBouncer محدوداً بنواة واحدة مع آلاف الاتصالات المشفرة. وإذا كنت على خدمة سحابية مدارة فغالباً تجد مجمعاً جاهزاً، مثل RDS Proxy في AWS الذي يذكر توثيقه أنه يعيد استخدام الاتصالات ويضع الطلبات الزائدة في طابور بدل أن يرهق قاعدة البيانات.
الطبقتان معاً
وقد يتساءل البعض: إذا وضعت PgBouncer، فهل أحذف المجمع من التطبيق؟ والإجابة لا، فالأفضل غالباً أن تبقي مجمعاً صغيراً في كل تطبيق، لأنه يوفر على التطبيق فتح اتصال بPgBouncer مع كل طلب، وهذا الاتصال نفسه فيه TCP وربما TLS ومصادقة كما سوف ترى في المختبر، ثم يقوم PgBouncer بالتجميع الثاني بين كل التطبيقات، فيستقبل مئات الاتصالات من المجمعات الصغيرة ويمررها على عدد قليل من الاتصالات الحقيقية. ولكن انتبه إلى أمرين: المجمع في التطبيق يجب أن يكون صغيراً، لأن PgBouncer هو الذي يحدد العدد الحقيقي الآن، وإذا كانت الاتصالات الخاملة في التطبيق تبقى مفتوحة طويلاً فهي لا تكلف قاعدة البيانات شيئاً في وضع transaction لأن PgBouncer لا يربطها باتصال حقيقي إلا أثناء المعاملة.
إعادة استخدام اتصالات HTTP
نفس الفكرة موجودة في HTTP، فالاتصال بين المتصفح والسيرفر أو بين ال Reverse Proxy والتطبيق فيه مصافحة TCP وربما TLS، وإعادة استخدامه توفر هذا الثمن. وتنص مواصفة HTTP/1.1 على أن الاتصالات الدائمة Persistent Connections هي السلوك الافتراضي، أي أن الاتصال يحمل عدة طلبات واحداً بعد الآخر حتى يرسل أحد الطرفين Connection: close، وهذا ما يسمى Keep-Alive، ثم جاءت HTTP/2 بتعدد التدفقات Multiplexing، فتقول المواصفة إن ذلك يسمح باستخدام اتصالات TCP أقل من HTTP/1.x. وقد شرحنا هذه الأساسيات ومعها HTTP/3 في مقال HTTP وHTTPS للمبتدئين، والصورة التالية تبين الفرق:
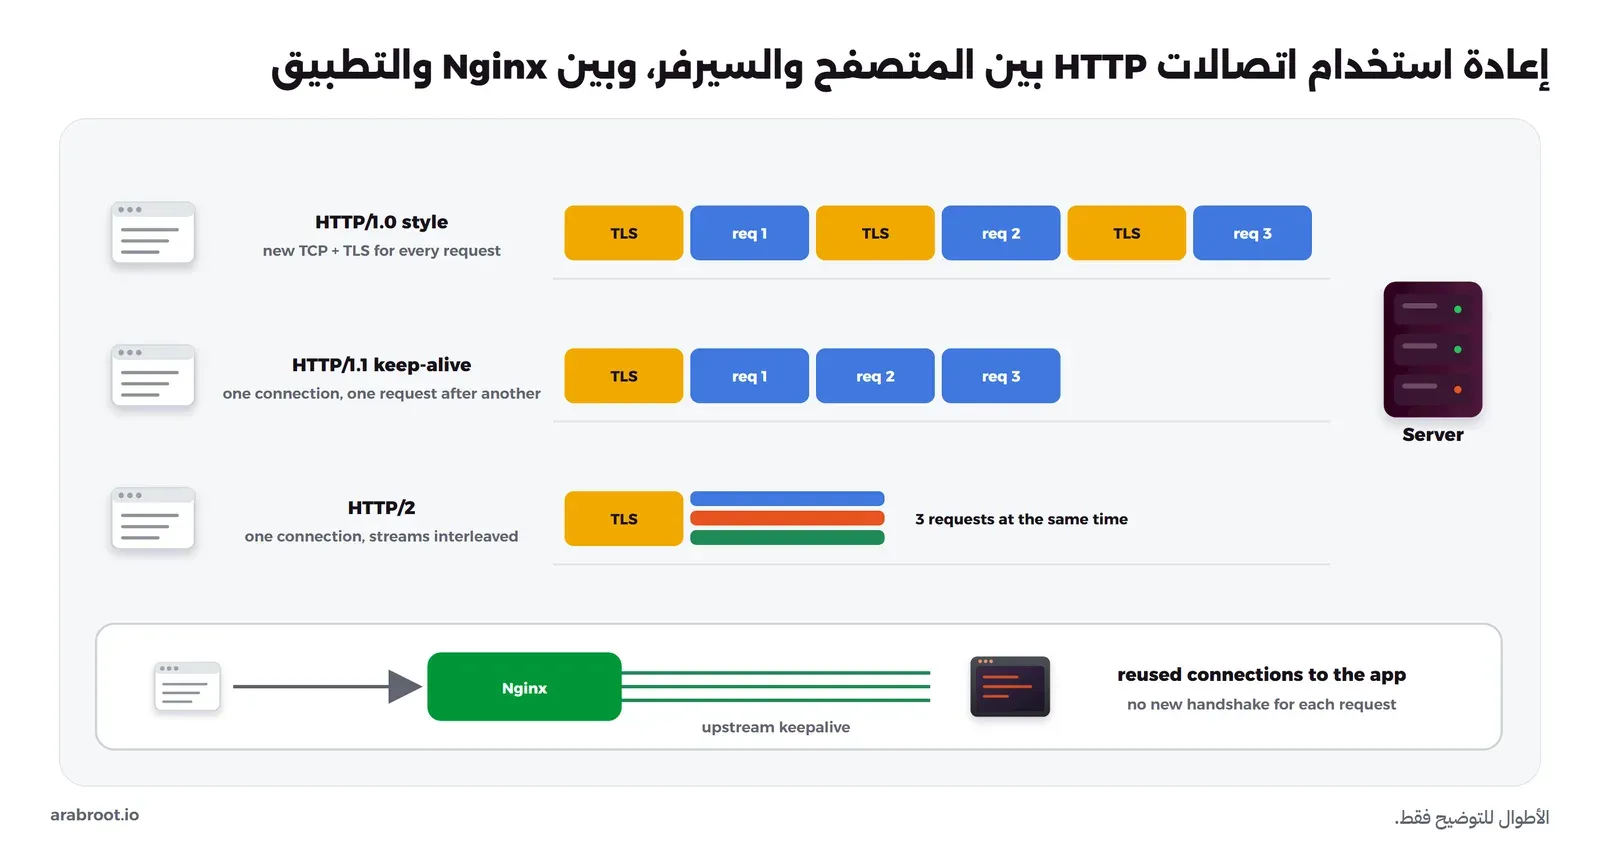
والجزء الذي يهمك في هذا المقال هو الاتصال بين Nginx والتطبيق، لأن Nginx هنا هو الكلاينت الذي يفتح الاتصالات ويجب أن يعيد استخدامها مثل أي مجمع، وقد خصصنا له قسماً كاملاً مع مختبر بعد أقسام PgBouncer.
مجمعات Pools أخرى تستخدمها دون أن تنتبه
- Redis وValkey: مكتبات الكلاينت تحتفظ باتصالاتها في مجمع، مثل
ConnectionPoolفي redis-py، والقاعدة نفسها: أنشئ الكلاينت مرة واحدة عند تشغيل التطبيق ولا تنشئه مع كل طلب، وقد خصصنا لها قسماً مع مختبر في هذا المقال. - SMTP: إرسال آلاف الرسائل بفتح اتصال SMTP وTLS ومصادقة لكل رسالة بطيء، لذلك مكتبات مثل Nodemailer فيها الخيار
pool: trueالذي يبقي حتى 5 اتصالات مفتوحة افتراضياً، ويرسل حتى 100 رسالة على الاتصال الواحد قبل أن يفتح غيره، وقد شرحنا كيف يمر البريد عبر SMTP وكيف يعاد استخدام الاتصال في مقال كيف يعمل البريد الإلكتروني، والإرسال من التطبيق عبر SMTP أو API في دليل البريد التفاعلي. - مجمعات الخيوط Thread Pools: نفس الفكرة مع الخيوط بدل الاتصالات، فإنشاء الخيط مكلف، لذلك تحتفظ بعدد ثابت منها وتعطيها المهام، وقد شرحناها في مقال المعالج والخيوط والتزامن.
أوضاع PgBouncer: متى يعود الاتصال إلى المجمع Pool؟
أهم إعداد في PgBouncer هو pool_mode، لأنه يحدد متى يعيد PgBouncer الاتصال الحقيقي بقاعدة البيانات إلى المجمع ليخدم كلاينت آخر، والصورة التالية تبين الأوضاع الثلاثة على اتصال حقيقي واحد:
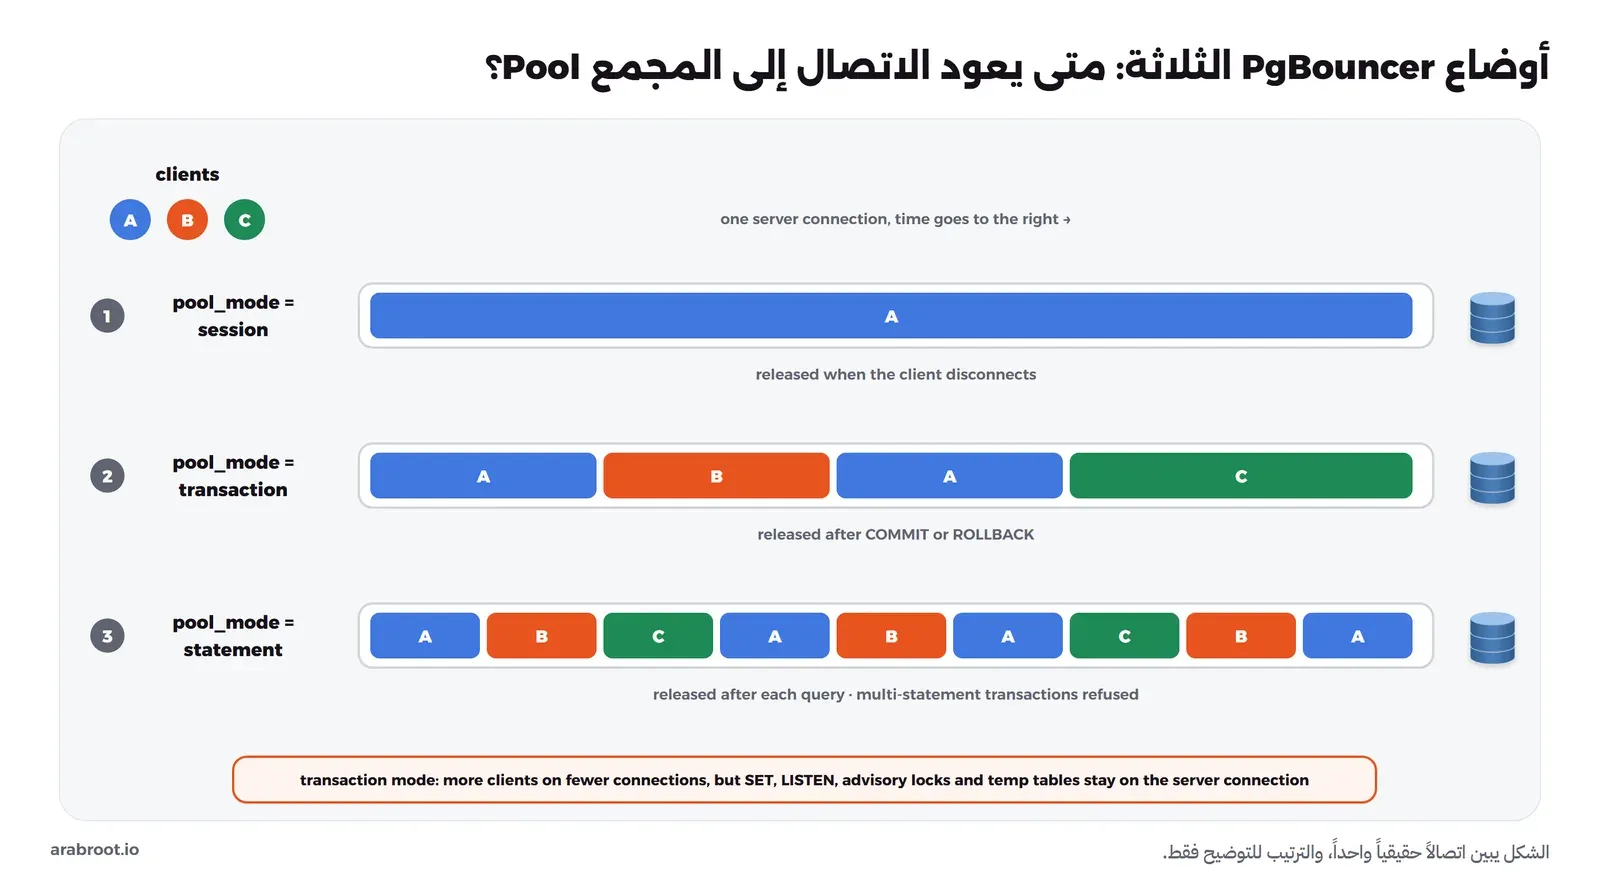
- الجلسة
session: وهو الوضع الافتراضي، فيبقى الاتصال الحقيقي للكلاينت طوال اتصاله ولا يعود إلا عندما ينقطع، وهذا الوضع يدعم كل ميزات PostgreSQL، ولكنه لا يقلل عدد الاتصالات الحقيقية إلا إذا كانت التطبيقات تفتح وتغلق اتصالاتها كثيراً، لأنه يوفر عليها المصافحة والمصادقة وإنشاء العملية فقط. - المعاملة
transaction: يمسك الكلاينت الاتصال الحقيقي طوال المعاملة فقط، ثم يعود للمجمع بعدCOMMITأوROLLBACK، والأمر خارج أي معاملة صريحة يعد معاملة وحده. وهذا هو الوضع الذي يعطيك الفائدة الكبيرة، فمئات الكلاينتات التي تقضي أغلب وقتها خاملة تتشارك عشرة اتصالات حقيقية. - الأمر
statement: يعود الاتصال بعد كل استعلام، ولا يسمح بمعاملة من عدة أوامر، وتذكر صفحة الميزات أنه موجه أساساً ل PL/Proxy، لذلك لن تحتاجه في تطبيق عادي.
ما الذي ينكسر في وضع transaction؟
في وضع transaction لا يملك الكلاينت اتصالاً حقيقياً ثابتاً، لذلك كل شيء يحفظه PostgreSQL على مستوى الجلسة Session لا يتبع الكلاينت، وإنما يبقى على الاتصال الحقيقي ويراه الكلاينت التالي. والجدول التالي من صفحة الميزات في وثائق PgBouncer:
| الميزة | وضع session | وضع transaction |
|---|---|---|
SET وRESET | تعمل | لا تعمل |
LISTEN | تعمل | لا تعمل (أما NOTIFY فتعمل) |
المؤشرات WITH HOLD | تعمل | لا تعمل |
| الاستعلامات المجهزة على مستوى البروتوكول Protocol-level Prepared Statements | تعمل | تعمل بشرط أن تكون max_prepared_statements أكبر من صفر |
PREPARE وDEALLOCATE بالصيغة النصية | تعمل | لا تعمل |
الجداول المؤقتة ON COMMIT DROP | تعمل | تعمل |
الجداول المؤقتة PRESERVE ROWS أو DELETE ROWS | تعمل | لا تعمل |
| الأقفال الاستشارية Advisory Locks على مستوى الجلسة | تعمل | لا تعمل |
LOAD | تعمل | لا تعمل |
وكلمة «لا تعمل» هنا أخطر مما تبدو، فالأمر لا يفشل بخطأ واضح، وإنما ينفذ على اتصال حقيقي ثم يذهب هذا الاتصال لكلاينت آخر، فيفقد الكلاينت الأول إعداده ويرثه كلاينت لا يعرف عنه شيئاً، وسوف ترى ذلك بالمخرج الحقيقي في المختبر. والحل لكل حالة:
- الإعدادات: استخدم
SET LOCALداخل المعاملة، فتقول وثائق SET إن أثره ينتهي مع نهاية المعاملة سواء نجحت أم لا، أو ضع الإعداد الدائم على المستخدم نفسه بالأمرALTER ROLE app SET statement_timeout = '5s'. - الأقفال الاستشارية: استخدم النسخة المرتبطة بالمعاملة
pg_advisory_xact_lockبدلpg_advisory_lock. - LISTEN وأدوات الترحيل Migrations والمهام الطويلة: اجعلها تتصل بقاعدة البيانات مباشرة، أو عبر قاعدة ثانية في PgBouncer بوضع session، فيمكن تحديد
pool_modeلكل قاعدة في قسم[databases].
الاستعلامات المجهزة Prepared Statements
أغلب مكتبات الاتصال والأطر تستخدم الاستعلامات المجهزة على مستوى البروتوكول، فترسل نص الاستعلام مرة باسم معين، ثم تنفذه بعد ذلك بالاسم والقيم، وهذا الاسم محفوظ في الاتصال الحقيقي الذي جهز عليه. وفي وضع transaction قد يجهز الكلاينت الاستعلام على اتصال وينفذه على اتصال آخر لا يعرف هذا الاسم، وكانت هذه أكبر مشكلة في PgBouncer لسنوات، حتى أضاف الإصدار 1.21.0 في أكتوبر 2023 دعم الاستعلامات المجهزة على مستوى البروتوكول عبر الإعداد max_prepared_statements، ثم أصبح مفعلاً افتراضياً بقيمة 200 منذ الإصدار 1.24.0 في يناير 2025 كما في سجل التغييرات. وفي هذا الوضع يتتبع PgBouncer الاستعلامات المجهزة لكل كلاينت، ويجهزها على الاتصال الحقيقي الذي يعطيه له عند الحاجة، لذلك تأكد أن إصدارك 1.21 أو أحدث، وأن القيمة لم توضع على صفر في ملف إعداد قديم، وسوف ترى في المختبر ماذا يحدث عندما تكون صفراً. أما PREPARE بالصيغة النصية فما زال لا يعمل في وضع transaction كما في الجدول أعلاه.
المصادقة: ملف المستخدمين أو auth_query
الكلاينت يتصل ب PgBouncer كأنه قاعدة البيانات، لذلك PgBouncer يحتاج أن يتحقق من كلمة المرور بنفسه، ثم يتصل بقاعدة البيانات بنفس المستخدم، وهناك طريقتان كما في وثائق الإعداد:
- ملف المستخدمين
auth_file: ملف نصي يسمى عادةuserlist.txtفيه سطر لكل مستخدم بالاسم وكلمة المرور أو الهاش، والأفضل أن تضع هاش SCRAM كما هو محفوظ فيpg_authid، فلا تكتب كلمة المرور الأصلية في أي ملف، وهذه الطريقة بسيطة ولكنك تحتاج تحديث الملف عند كل تغيير لكلمة مرور. - الاستعلام
auth_query: يتصل PgBouncer بقاعدة البيانات بمستخدم واحد محدد فيauth_user، ويقرأ هاش كلمة مرور الكلاينت من قاعدة البيانات نفسها، والاستعلام الافتراضي يقرأ منpg_authid، وهذا الجدول لا يقرؤه إلا مستخدم خارق، لذلك الطريقة الشائعة أن تنشئ دالة بصلاحيةSECURITY DEFINERتعيد الاسم والهاش فقط، وتعطي مستخدم PgBouncer صلاحية تنفيذها وحدها. وهذه الطريقة أنسب عندما يكثر المستخدمون أو تتغير كلمات المرور.
أحجام المجمع Pool Size في PgBouncer
هذه الإعدادات هي التي تحدد كم اتصالاً حقيقياً يصل إلى PostgreSQL، وقيمها الافتراضية من وثائق الإعداد:
max_client_conn(الافتراضي 100): أقصى عدد من الكلاينتات يقبله PgBouncer، وهذا رقم رخيص لأن كل كلاينت خامل لا يكلف إلا القليل من الذاكرة، لذلك ترفعه إلى مئات أو آلاف.default_pool_size(الافتراضي 20): عدد الاتصالات الحقيقية لكل زوج من المستخدم وقاعدة البيانات، ولاحظ «لكل زوج»، فثلاثة مستخدمين على قاعدتين يعني حتى ستة مجمعات.max_db_connections(الافتراضي 0، أي بلا حد): سقف للاتصالات الحقيقية لكل قاعدة بيانات من كل المستخدمين، وهو الحماية من مشكلة «لكل زوج» السابقة.min_pool_sizeوreserve_pool_size(الافتراضي 0): الأول يبقي عدداً من الاتصالات مفتوحاً دائماً، والثاني يسمح باتصالات إضافية مؤقتة إذا طال انتظار الكلاينتات.server_idle_timeout(الافتراضي 600 ثانية) وserver_lifetime(الافتراضي 3600 ثانية): مهلة الخمول والعمر الأقصى للاتصال الحقيقي.query_wait_timeout(الافتراضي 120 ثانية): أقصى مدة ينتظرها الكلاينت حتى يجد اتصالاً حقيقياً، ثم يقطع PgBouncer اتصاله.
والقاعدة أن يكون مجموع الاتصالات الحقيقية من PgBouncer، مضافاً إليه كل ما يتصل مباشرة مثل أدوات الترحيل والنسخ الاحتياطي والمراقبة، أقل من max_connections مع هامش، ولاحظ أن الاتصالات الخاملة التي يحتفظ بها PgBouncer تحسب من الحد مثل غيرها، وهذا ما سوف تراه في المختبر.
المختبر: نفس الحمل مع PgBouncer ودونه
سوف نشغل PostgreSQL 18 بحد اتصالات صغير عمداً هو 20، ثم PgBouncer أمامه، ونرسل الحمل بأداة pgbench الموجودة مع PostgreSQL، وكل شيء في شبكة Docker واحدة والمنافذ مربوطة على العنوان المحلي فقط. وإذا لم يكن Docker مثبتاً لديك فابدأ بدليل تثبيت Docker على Ubuntu.
تجهيز قاعدة البيانات وPgBouncer
نبدأ بالشبكة وقاعدة البيانات، ثم ننشئ مستخدماً عادياً للتطبيق ونجهز بيانات pgbench:
docker network create lab-pool-net
docker run -d --name lab-pool-pg --network lab-pool-net -p 127.0.0.1:55490:5432 \
  -e POSTGRES_PASSWORD=labpass -e POSTGRES_DB=shop \
  postgres:18 -c max_connections=20

docker exec lab-pool-pg psql -U postgres -d shop \
  -c "CREATE ROLE app LOGIN PASSWORD 'apppass';" \
  -c "GRANT ALL ON SCHEMA public TO app;" \
  -c "ALTER DATABASE shop OWNER TO app;"
docker exec -e PGPASSWORD=apppass lab-pool-pg pgbench -h 127.0.0.1 -U app -i -s 10 -q shop
ولا توجد Docker Image رسمية من مشروع PgBouncer، وصفحة التثبيت في وثائقه تشرح البناء من الكود فقط، أما Docker Image الخاصة ب Bitnami التي كان كثيرون يستخدمونها فلم تعد متاحة مجاناً على Docker Hub كما يذكر وصفها هناك. لذلك سوف نبني Docker Image صغيرة فوق postgres:18 ونثبت فيها PgBouncer من مستودع PGDG، وهو مستودع حزم مجتمع PostgreSQL الموجود أصلاً في تلك ال Image:
FROM postgres:18
RUN apt-get update && apt-get install -y --no-install-recommends pgbouncer && rm -rf /var/lib/apt/lists/*
USER postgres
CMD ["pgbouncer", "/etc/pgbouncer/pgbouncer.ini"]
docker build -t lab-pool-pgbouncer:local .
docker run --rm lab-pool-pgbouncer:local pgbouncer --versionوالمخرج سوف يكون كما يلي:
PgBouncer 1.26.0
libevent 2.1.13-stable
adns: c-ares 1.34.5
tls: OpenSSL 3.5.7 9 Jun 2026
systemd: yes
الآن نجهز ملف المستخدمين من هاش SCRAM المحفوظ في قاعدة البيانات، ثم ملف الإعداد:
docker exec lab-pool-pg psql -U postgres -d shop -Atc \
  "SELECT format('\"%s\" \"%s\"', rolname, rolpassword) FROM pg_authid WHERE rolname='app';" > userlist.txt
[databases]
shop = host=lab-pool-pg port=5432 dbname=shop
[pgbouncer]
listen_addr = 0.0.0.0
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
admin_users = app
pool_mode = transaction
default_pool_size = 10
max_client_conn = 500
max_db_connections = 15
max_prepared_statements = 200في الإعداد أعلاه لاحظ التالي:
default_pool_size = 10يعني أن PgBouncer لن يفتح أكثر من 10 اتصالات حقيقية للمستخدمappعلى قاعدةshop، وmax_db_connections = 15سقف لكل المستخدمين على هذه القاعدة، وكلاهما أقل من 17 خانة متاحة للمستخدمين العاديين.max_client_conn = 500يسمح بخمسمئة كلاينت، أي خمسين ضعف الاتصالات الحقيقية.admin_users = appيسمح لهذا المستخدم بالدخول إلى قاعدة الإدارة الوهميةpgbouncerلتنفيذSHOW POOLS، وفي الإنتاج Production اجعله مستخدماً منفصلاً.- الملف
userlist.txtفيه هاش SCRAM وليس كلمة المرور، ومع ذلك احمه بصلاحيات الملف، فمن يملك الهاش يستطيع محاولة تخمين كلمة المرور منه دون اتصال.
docker run -d --name lab-pool-bouncer --network lab-pool-net -p 127.0.0.1:55491:6432 \
  -v "$PWD/pgbouncer.ini:/etc/pgbouncer/pgbouncer.ini:ro" \
  -v "$PWD/userlist.txt:/etc/pgbouncer/userlist.txt:ro" \
  lab-pool-pgbouncer:local
docker logs lab-pool-bouncer
LOG kernel file descriptor limit: 1048576 (hard: 1048576); max_client_conn: 500, max expected fd use: 532
LOG listening on 0.0.0.0:6432
LOG listening on unix:/tmp/.s.PGSQL.6432
LOG process up: PgBouncer 1.26.0, libevent 2.1.13-stable (epoll), adns: c-ares 1.34.5, tls: OpenSSL 3.5.7 9 Jun 2026خمسون كلاينت مباشرة على قاعدة البيانات
نرسل 50 كلاينت من pgbench مباشرة إلى PostgreSQL، وهو ما يحدث عندما تشغل عدة نسخ من تطبيق كل واحدة بمجمع كبير:
docker run --rm --network lab-pool-net -e PGPASSWORD=apppass postgres:18 \
  pgbench -h lab-pool-pg -U app -c 50 -j 1 -T 10 -S shop
والمخرج سوف يكون كما يلي:
pgbench (18.6 (Debian 18.6-1.pgdg13+2))
starting vacuum...end.
pgbench: error: connection to server at "lab-pool-pg" (192.168.48.2), port 5432 failed: FATAL:  remaining connection slots are reserved for roles with the SUPERUSER attribute
pgbench: error: could not create connection for client 17
لاحظ أن الكلاينتات من 0 إلى 16 اتصلت، أي 17 اتصالاً، وهي 20 ناقص الخانات Slots الثلاث المحجوزة للمستخدم الخارق، ثم رفض الكلاينت رقم 17 وتوقفت التجربة كلها. وإذا كررت نفس التجربة بالمستخدم الخارق postgres بخمسة وعشرين كلاينت فسوف تصل إلى الحد الكامل وترى الرسالة الأشهر:
pgbench: error: connection to server at "lab-pool-pg" (192.168.48.2), port 5432 failed: FATAL:  sorry, too many clients already
pgbench: error: could not create connection for client 20
مئتا كلاينت عبر PgBouncer
الآن نرسل أربعة أضعاف العدد، 200 كلاينت، ولكن عبر PgBouncer على المنفذ 6432، وأثناء التشغيل نسأل PgBouncer عن حالة المجمع ونسأل PostgreSQL عن عدد الاتصالات الحقيقية:
docker run --rm --network lab-pool-net -e PGPASSWORD=apppass postgres:18 \
  pgbench -h lab-pool-bouncer -p 6432 -U app -c 200 -j 1 -T 15 -S shop

# in a second terminal, while the test runs:
docker run --rm --network lab-pool-net -e PGPASSWORD=apppass postgres:18 \
  psql -h lab-pool-bouncer -p 6432 -U app pgbouncer -c "SHOW POOLS;"
docker exec lab-pool-pg psql -U postgres -d shop -c \
  "SELECT usename, state, count(*) FROM pg_stat_activity WHERE backend_type='client backend' GROUP BY 1,2 ORDER BY 1,2;"
ومخرج SHOW POOLS أثناء الحمل سوف يكون كما يلي:
 database  |   user    | cl_active | cl_waiting | cl_active_cancel_req | cl_waiting_cancel_req | sv_active | sv_active_cancel | sv_being_canceled | sv_idle | sv_used | sv_tested | sv_login | maxwait | maxwait_us |  pool_mode  | load_balance_hosts
-----------+-----------+-----------+------------+----------------------+-----------------------+-----------+------------------+-------------------+---------+---------+-----------+----------+---------+------------+-------------+--------------------
 pgbouncer | pgbouncer |         1 |          0 |                    0 |                     0 |         0 |                0 |                 0 |       0 |       0 |         0 |        0 |       0 |          0 | statement   |
 shop      | app       |        17 |        183 |                    0 |                     0 |        10 |                0 |                 0 |       0 |       0 |         0 |        0 |       0 |      23655 | transaction |
(2 rows)
ومن جهة PostgreSQL:
 usename  | state  | count
----------+--------+-------
 app      | idle   |    10
 postgres | active |     1
(2 rows)
ونتيجة pgbench في النهاية:
number of clients: 200
number of threads: 1
maximum number of tries: 1
duration: 15 s
number of transactions actually processed: 97971
number of failed transactions: 0 (0.000%)
latency average = 27.035 ms
initial connection time = 1855.751 ms
tps = 7397.719846 (without initial connection time)
في المخرج أعلاه لاحظ التالي:
- 200 كلاينت ولا يوجد أي خطأ، و97971 معاملة نفذت على 10 اتصالات حقيقية فقط، وهو ما يظهر في
sv_active = 10وفيpg_stat_activityالذي لا يرى إلا 10 اتصالات من المستخدمapp. cl_waiting = 183يعني أن 183 كلاينت أرسلوا استعلاماً وينتظرون اتصالاً حقيقياً في تلك اللحظة، وmaxwait_usيبين أن أقدمهم ينتظر 23 مللي ثانية تقريباً، وهذا هو الطابور الذي رأيته في الخطوة 4 من صورة المجمع، وبسببه متوسط زمن المعاملة 27 مللي ثانية رغم أن الاستعلام نفسه أسرع بكثير. فالمجمع لم يجعل قاعدة البيانات أسرع، وإنما جعلها تخدم 200 كلاينت دون رفض ودون أن تتجاوز 10 عمليات.- حالة الاتصالات في PostgreSQL
idleفي لحظة القياس، والسبب أن الاستعلام سريع جداً، فأغلب الوقت يذهب في نقل النتائج بين PgBouncer وpgbench.
وبعد انتهاء الحمل نعرض الإحصاءات المتراكمة بالأمر SHOW STATS (اختصرنا الأعمدة إلى أهمها):
database                      | shop
total_server_assignment_count | 97976
total_xact_count              | 97976
total_query_count             | 97976
total_wait_time               | 2216970445
total_client_login_count      | 201
avg_wait_time                 | 22627
لاحظ أن total_client_login_count = 201 هي 200 كلاينت من pgbench وكلاينت الإدارة، بينما الاتصالات الحقيقية بقيت 10، وأن total_wait_time بالميكروثانية، وهو مجموع وقت انتظار الكلاينتات في الطابور، وتعرف وثائق الأوامر كل عمود من هذه الأعمدة.
ثمن فتح الاتصال: الخيار -C
الخيار -C في pgbench يفتح اتصالاً جديداً لكل معاملة بدل اتصال واحد لكل كلاينت، كما تقول وثائقه، وهو بالضبط سلوك التطبيق الذي لا يستخدم مجمعاً. سوف نشغل ستة كلاينتات أربع مرات: مباشرة مع اتصال دائم، ومباشرة مع اتصال لكل معاملة، ثم نفس الحالتين عبر PgBouncer:
for args in "-h lab-pool-pg" "-h lab-pool-pg -C" "-h lab-pool-bouncer -p 6432" "-h lab-pool-bouncer -p 6432 -C"; do
  echo "== pgbench $args"
  docker run --rm --network lab-pool-net -e PGPASSWORD=apppass postgres:18 \
    pgbench $args -U app -c 6 -j 1 -T 10 -S shop 2>&1 | grep -E "error|processed|latency average|connection time|tps"
done
والمخرج سوف يكون كما يلي:
== pgbench -h lab-pool-pg
number of transactions actually processed: 92522
latency average = 0.641 ms
initial connection time = 123.778 ms
tps = 9366.346731 (without initial connection time)
== pgbench -h lab-pool-pg -C
number of transactions actually processed: 522
latency average = 114.978 ms
average connection time = 18.981 ms
tps = 52.183969 (including reconnection times)
== pgbench -h lab-pool-bouncer -p 6432
number of transactions actually processed: 159002
latency average = 0.376 ms
initial connection time = 34.433 ms
tps = 15954.328249 (without initial connection time)
== pgbench -h lab-pool-bouncer -p 6432 -C
number of transactions actually processed: 1323
latency average = 45.417 ms
average connection time = 7.514 ms
tps = 132.108245 (including reconnection times)
في المخرج أعلاه لاحظ التالي:
- الاتصال لكل معاملة مباشرة أنزل المعاملات من 92522 إلى 522 في عشر ثوان، أي أقل بأكثر من مئة مرة، وكل اتصال جديد أخذ حوالي 19 مللي ثانية بينما الاستعلام نفسه أقل من مللي ثانية، وهذا كله داخل جهاز واحد دون TLS ودون شبكة حقيقية.
- الاتصال لكل معاملة عبر PgBouncer أسرع من المباشر (7.5 مللي ثانية للاتصال بدل 19)، والسبب أن PgBouncer لا ينشئ عملية جديدة على PostgreSQL، وإنما يعطي الكلاينت اتصالاً حقيقياً مفتوحاً، ولكنه ما زال بطيئاً لأن الكلاينت يدفع ثمن TCP ومصادقة SCRAM مع PgBouncer نفسه. لذلك PgBouncer لا يغني عن المجمع داخل التطبيق إذا كان التطبيق قادراً على الاحتفاظ باتصالاته، وهذا سبب الطبقتين.
- مع الاتصال الدائم في الحالتين كان الفرق بين المباشر وPgBouncer يتغير من تشغيل لآخر، فعند تكرار نفس الأمر حصلنا على 13895 و21037 معاملة في الثانية مباشرة، و11791 و12107 عبر PgBouncer، لذلك لا تستنتج من هذه الأرقام أن PgBouncer يسرع الاستعلام، فهو خطوة إضافية على الشبكة، وفائدته في عدد الاتصالات وفي ثمن فتحها.
وحدث شيء مفيد قبل هذا القياس، فقد شغلنا أولاً ثمانية كلاينتات مباشرة بعد تجربة ال 200 كلاينت، فرفض الكلاينت الثامن:
pgbench: error: connection to server at "lab-pool-pg" (192.168.48.2), port 5432 failed: FATAL:  remaining connection slots are reserved for roles with the SUPERUSER attribute
pgbench: error: could not create connection for client 7
والسبب أن PgBouncer ما زال يحتفظ بعشرة اتصالات حقيقية خاملة من التجربة السابقة، ولن يغلقها قبل server_idle_timeout وهو 600 ثانية افتراضياً، فبقي للاتصال المباشر 7 خانات فقط من 17. وهذا ما قصدناه بأن اتصالات المجمع الخاملة تحسب من max_connections مثل غيرها، لذلك عندما تحسب ميزانية الاتصالات اجمع الحد الأقصى لكل مجمع، وليس ما تراه مستخدماً في لحظة معينة.
خطأ SET في وضع transaction
الآن نرى بالمخرج ما يعنيه «SET لا يعمل» في جدول الميزات. السكربت التالي يشغل ثلاثة كلاينتات عبر PgBouncer: الكلاينت A يضع statement_timeout على ثانيتين خارج أي معاملة ثم ينتظر ثانية في جهة الكلاينت، وأثناء انتظاره يبدأ الكلاينت B معاملة فيها pg_sleep(3)، ثم يسأل A عن إعداده مرة أخرى، وبعد انتهاء الاثنين يتصل كلاينت ثالث C:
#!/bin/sh
# set-pitfall.sh: A sets statement_timeout outside a transaction, then waits on the client side;
# B borrows a server connection for a 3-second transaction; A asks again; C connects after B.
P="psql -h lab-pool-bouncer -p 6432 -U app -d shop -Atq"
$P <<'SQL' &
SET statement_timeout = '2s';
SELECT 'A1 pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');
\! sleep 1
SELECT 'A2 pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');
SQL
sleep 0.5
$P <<'SQL' &
BEGIN;
SELECT 'B  pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');
SELECT pg_sleep(3);
COMMIT;
SQL
wait
$P -c "SELECT 'C  pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');"
docker restart lab-pool-bouncer # start with fresh server connections
docker run --rm --network lab-pool-net -e PGPASSWORD=apppass \
-v "$PWD/set-pitfall.sh:/set-pitfall.sh:ro" postgres:18 sh /set-pitfall.shوالمخرج سوف يكون كما يلي:
A1 pid=1520 statement_timeout=2s
B  pid=1520 statement_timeout=2s
A2 pid=1521 statement_timeout=0
ERROR:  canceling statement due to statement timeout
C  pid=1520 statement_timeout=2s
في المخرج أعلاه لاحظ التالي:
- الأمر
SETمن A نفذ على العملية 1520، وبعد انتهائه عاد الاتصال الحقيقي للمجمع ومعه الإعداد. - B أخذ نفس الاتصال 1520 فورث إعداد A دون أن يطلبه، فألغى PostgreSQL الأمر
pg_sleep(3)بعد ثانيتين بالخطأcanceling statement due to statement timeout، وتخيل هذا في الإنتاج: تقرير طويل يفشل مرة وينجح مرة بحسب الاتصال الذي حصل عليه. - A نفسه عندما سأل مرة ثانية حصل على الاتصال 1521 فوجد القيمة الافتراضية 0، أي أنه فقد إعداده.
- C بعد انتهاء الجميع حصل أيضاً على 1520 وورث الإعداد، فالإعداد يبقى على الاتصال الحقيقي حتى يغلق، لأن PgBouncer لا ينفذ أمر التنظيف
server_reset_queryفي وضع transaction.
والحل كما ذكرنا هو SET LOCAL داخل المعاملة، والمخرج التالي من نفس المختبر يبين أن الإعداد ينتهي مع المعاملة ولا يرثه أحد حتى على نفس الاتصال الحقيقي:
BEGIN;
SET LOCAL statement_timeout = '2s';
SELECT 'inside  pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');
COMMIT;
-- then, from a new client:
SELECT 'after   pid=' || pg_backend_pid() || ' statement_timeout=' || current_setting('statement_timeout');
inside pid=1571 statement_timeout=2s
after pid=1571 statement_timeout=0الاستعلامات المجهزة مع max_prepared_statements
الخيار -M prepared في pgbench يستخدم الاستعلامات المجهزة على مستوى البروتوكول مثل أغلب المكتبات، ونشغله عبر PgBouncer مرتين: بالقيمة الافتراضية 200، ثم بعد تغيير max_prepared_statements إلى 0 في الملف وإعادة تشغيل PgBouncer:
docker run --rm --network lab-pool-net -e PGPASSWORD=apppass postgres:18 \
  pgbench -h lab-pool-bouncer -p 6432 -U app -M prepared -c 20 -j 1 -T 5 -S shop
مع القيمة 200 كانت النتيجة:
number of transactions actually processed: 39850
number of failed transactions: 0 (0.000%)
tps = 8592.247098 (without initial connection time)
ومع القيمة 0 (اختصرنا الأسطر المتكررة):
pgbench: error: client 1 script 0 aborted in command 1 query 0: ERROR:  prepared statement "P_0" does not exist
pgbench: error: client 5 script 0 aborted in command 1 query 0: ERROR:  prepared statement "P_0" does not exist
pgbench: error: client 8 script 0 aborted in command 1 query 0: ERROR:  prepared statement "P_0" does not exist
...
pgbench: error: client 13 script 0 aborted in command 1 query 0: ERROR:  prepared statement "P_0" does not exist
pgbench: error: Run was aborted; the above results are incomplete.
لاحظ أن كل الكلاينتات العشرين توقفت، والرسالة prepared statement "P_0" does not exist تعني أن الكلاينت جهز الاستعلام على اتصال حقيقي ثم حاول تنفيذه على اتصال آخر، وفي تشغيل آخر بنفس الإعداد ظهرت الرسالة العكسية prepared statement "P_0" already exists عندما حاول كلاينت أن يجهز اسماً جهزه كلاينت آخر على نفس الاتصال. فإذا رأيت إحدى الرسالتين خلف PgBouncer فأول ما تفحصه هو هذا الإعداد وإصدار PgBouncer.
حذف المختبر
بعد أن تنتهي احذف ال Containers والشبكة وال Image التي بنيتها، وال Volume المجهول الذي أنشأه PostgreSQL يحذف مع الخيار -v:
docker rm -f -v lab-pool-bouncer lab-pool-pg
docker network rm lab-pool-net
docker rmi lab-pool-pgbouncer:local
تضاعف الاتصالات Connection Multiplication: النسخ الكثيرة وال Serverless
المجمع في التطبيق يحل المشكلة لنسخة واحدة، ثم تأتي ال Containers وتوزيع الحمل Load Balancing فيتضاعف عدد الاتصالات مع كل نسخة جديدة. الصورة التالية تبين المثال الذي نراه كثيراً:
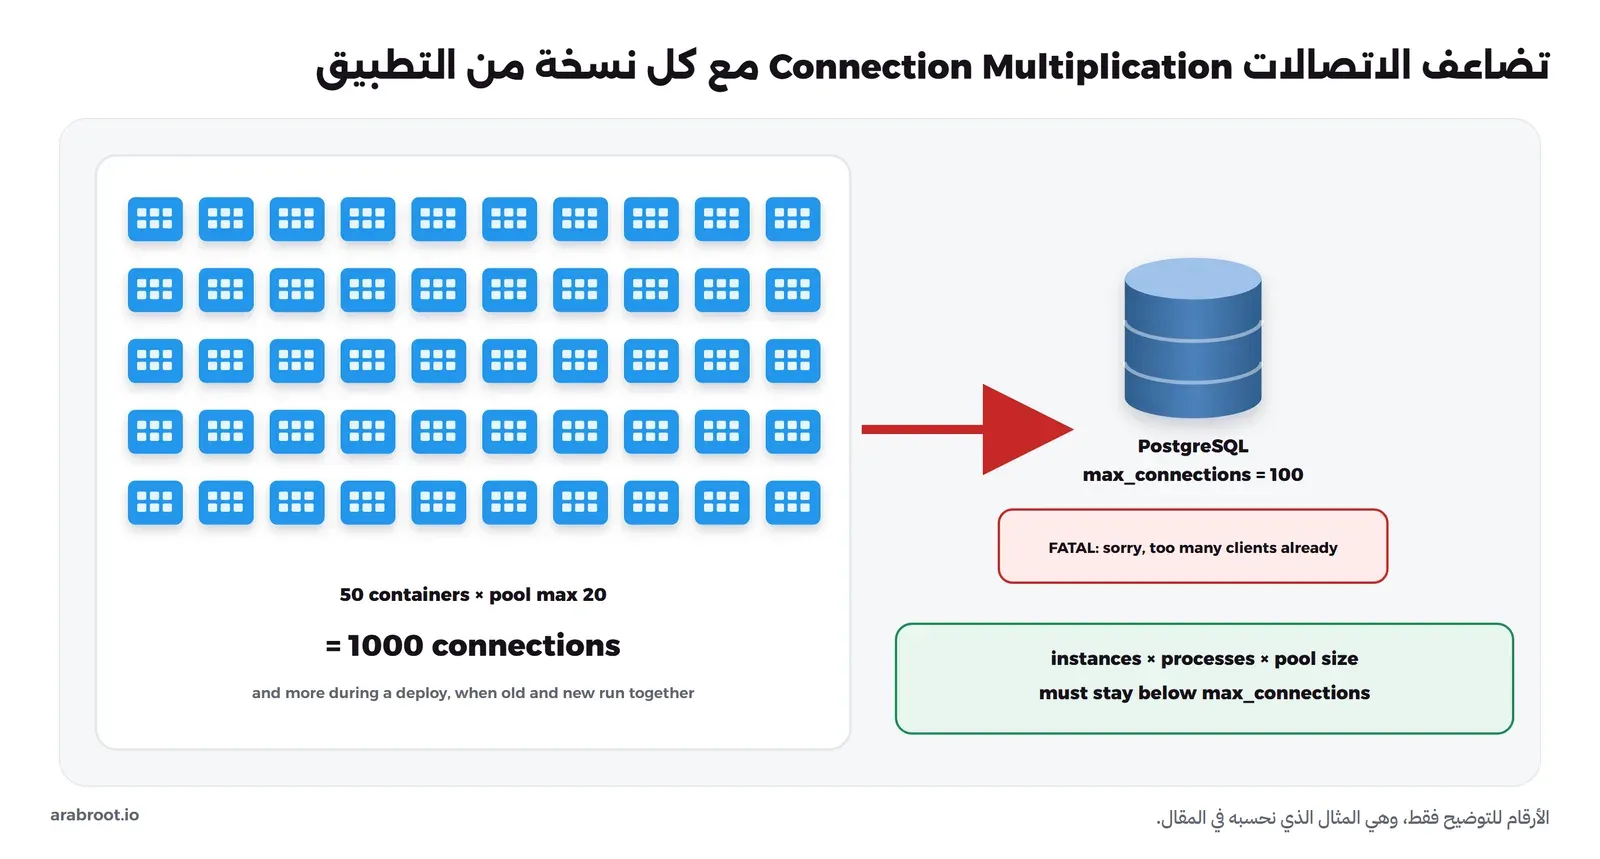
والحساب الصحيح هو حاصل ضرب هذه الأرقام ببعضها: عدد النسخ × عدد العمليات داخل كل نسخة (عمال Gunicorn أو عمليات PM2 مثلاً) × الحد الأقصى للمجمع في كل عملية، ثم تضيف العمال الخلفيين Background Workers، ثم تضاعف ما يعمل أثناء النشر إذا كانت النسخة الجديدة تبدأ قبل أن تتوقف القديمة، ثم تضيف أدوات الإدارة والنسخ الاحتياطي. فخمسون Container بمجمع 20 هي 1000 اتصال، وهذا الرقم لا يصلح لقاعدة بحد 100 ولا لقاعدة بحد 1000، والسبب أن قاعدة بثماني أنوية لا تستفيد من أكثر من بضع عشرات من الاستعلامات النشطة في نفس الوقت كما رأيت في قسم الحجم. والحل أحد أمرين أو كلاهما:
- مجمع أصغر في كل نسخة: إذا كانت ميزانيتك 80 اتصالاً و10 نسخ بعاملين، فحجم المجمع في كل عامل 4، وهذا يكفي غالباً إذا كانت الاستعلامات سريعة.
- PgBouncer في وضع transaction: فتبقى المجمعات في التطبيقات كما هي، وتتصل كلها ب PgBouncer، وهو يحدد العدد الحقيقي بـ
default_pool_sizeوmax_db_connections.
أما ال Serverless، مثل الدوال التي تعمل عند الطلب، فالمشكلة فيها أسوأ، لأن كل نسخة من الدالة قد تفتح اتصالها الخاص، وعدد النسخ يرتفع مع الطلبات دون سقف تتحكم فيه، والنسخة قد تتجمد ثم تختفي دون أن تغلق اتصالها. لذلك المجمع الخارجي هنا ليس تحسيناً وإنما شرط، سواء كان PgBouncer أمام قاعدتك، أو المجمع الذي يقدمه مزود الخدمة مثل RDS Proxy، مع مجمع بحد 1 أو 2 داخل الدالة نفسها.
وتوزيع القراءة والكتابة Read/Write Splitting يدخل في نفس الصورة، فإذا أضفت نسخاً للقراءة Read Replicas كما شرحنا في مقال تصميم قواعد البيانات، فكل نسخة لها max_connections خاص بها وتحتاج مجمعها الخاص، والطريقة الأبسط أن يكون لديك عنوانان في التطبيق، واحد للكتابة وواحد للقراءة، كل واحد بمجمعه، أما أدوات مثل Pgpool-II وPgCat التي توجه الاستعلامات تلقائياً بحسب نوعها فتحتاج اختباراً دقيقاً، لأن القراءة بعد الكتابة مباشرة قد تذهب إلى نسخة متأخرة.
المجمع Pool بين Nginx والتطبيق Upstream Keepalive
كل ما قلناه عن قاعدة البيانات ينطبق على الخطوة التي قبلها، فعندما يقف Nginx أمام تطبيقك كما شرحنا في دليل تطبيقك خلف Reverse Proxy، يصبح Nginx هو الكلاينت والتطبيق هو السيرفر، وكل طلب يصل من المتصفح يحتاج اتصالاً من Nginx إلى التطبيق. فإذا كان Nginx يفتح اتصالاً جديداً لكل طلب ثم يغلقه، فأنت تدفع مصافحة TCP مع كل طلب، وتستهلك شيئاً آخر لا يظهر في أي رسم بياني حتى ينفد، وهو المنافذ المؤقتة Ephemeral Ports.
لماذا يهم الاتصال بين Nginx والتطبيق؟
كل اتصال TCP يخرج من Nginx إلى التطبيق يأخذ منفذاً محلياً من مجال المنافذ المؤقتة، وتقول وثائق نواة Linux إن المجال الافتراضي في الإعداد ip_local_port_range هو من 32768 إلى 60999، أي 28232 منفذاً. ثم إن الطرف الذي يغلق الاتصال أولاً يبقيه في حالة الانتظار TIME_WAIT مدة ثابتة هي 60 ثانية كما في الثابت TCP_TIMEWAIT_LEN في كود النواة، والسبب أن TCP يريد أن يتأكد من أن الحزم المتأخرة من الاتصال القديم لن تختلط باتصال جديد على نفس المنافذ. فعندما يغلق Nginx اتصاله بالتطبيق بعد كل طلب يبقى كل منفذ محجوزاً دقيقة كاملة، وبحساب بسيط فإن 28232 منفذاً على 60 ثانية تعطي حوالي 470 اتصالاً جديداً في الثانية إلى نفس عنوان التطبيق ومنفذه، وبعدها يفشل فتح الاتصال ويرى المستخدم الخطأ 502، وسوف ترى ذلك بالمخرج الحقيقي في المختبر.
وقد يتساءل البعض: لماذا لم أر هذه المشكلة من قبل وتطبيقي على نفس السيرفر؟ والإجابة أن القيمة الافتراضية للإعداد tcp_tw_reuse في نفس الوثائق هي 2، أي أن النواة تعيد استخدام منافذ TIME_WAIT عندما يكون ذلك آمناً لحركة loopback فقط، فإذا كان التطبيق على 127.0.0.1 فالنواة تخفي عنك المشكلة غالباً، ثم تظهر فجأة عندما تنقل التطبيق إلى Container على شبكة Docker أو إلى سيرفر آخر.
إعدادات keepalive في كتلة upstream
الحل هو مجمع اتصالات على جهة Nginx، تسميه وثائقه ذاكرة الاتصالات Cache for Connections، فيبقي Nginx الاتصال بالتطبيق مفتوحاً بعد انتهاء الطلب ويعيد استخدامه للطلب التالي. وقد كان Nginx حتى وقت قريب يفتح اتصالاً جديداً بالتطبيق مع كل طلب إلا إذا أضفت keepalive في كتلة upstream مع proxy_http_version 1.1 وحذف ترويسة Connection. ومنذ الإصدار 1.29.7 في 24 مارس 2026 تغير ذلك كما في سجل تغييرات Nginx: أصبح keepalive مفعلاً افتراضياً بقيمة 32 اتصالاً خاملاً لكل عامل، وأصبحت القيمة الافتراضية ل proxy_http_version هي 1.1، ولم يعد Nginx يرسل ترويسة Connection إلى التطبيق افتراضياً. لذلك إذا كان إصدارك أقدم فأضف الإعداد بنفسك:
upstream app_backend {
    server 127.0.0.1:8080;
    keepalive 16;                      # idle connections kept per worker
}

server {
    listen 443 ssl;
    server_name app.example.com;

    location / {
        proxy_pass http://app_backend;
        proxy_http_version 1.1;          # keep-alive needs HTTP/1.1 to the upstream
        proxy_set_header Connection "";  # do not forward "Connection: close"
    }
}
في الإعداد أعلاه لاحظ التالي:
proxy_http_version 1.1: الإصدار 1.0 كان الافتراضي قبل 1.29.7 كما في وثائق الوحدة، وفي HTTP/1.0 يغلق الاتصال بعد كل رد، لذلك لا يعملkeepaliveإلا مع 1.1، أو مع 2 منذ الإصدار 1.29.4 إذا كانت وحدة HTTP/2 موجودة في نسختك.proxy_set_header Connection "": الإصدارات القديمة كانت ترسلConnection: closeإلى التطبيق، فيغلق التطبيق الاتصال بعد الرد مهما كانت قيمةkeepalive.- إذا كان التطبيق PHP-FPM عبر FastCGI فالإعداد المقابل هو
fastcgi_keep_conn onمعkeepaliveفي كتلةupstreamكما في وثائق upstream.
وبقية إعدادات المجمع في كتلة upstream من نفس الوثائق هي:
keepalive(الافتراضي 32 منذ 1.29.7): أقصى عدد من الاتصالات الخاملة Idle التي يحتفظ بها كل عامل Worker لهذا ال upstream، وإذا زادت أغلق الأقل استخداماً مؤخراً. ولاحظ أمرين: الرقم لكل عامل وليس ل Nginx كله، فإذا كانworker_processes autoعلى سيرفر بثماني أنوية فالسقف 8 × 32 = 256 اتصالاً خاملاً، والرقم لا يحدد عدد الاتصالات الكلي، فتنبه الوثائق إلى أنkeepaliveلا يحد عدد الاتصالات التي يفتحها العامل، وأن تجعله صغيراً بما يكفي ليبقى التطبيق قادراً على قبول اتصالات جديدة. ومنذ 1.29.7 لا تتشارك ال locations المختلفة نفس الاتصالات افتراضياً، وهذا معنى المعاملlocalفي القيمة الافتراضيةkeepalive 32 local.keepalive_requests(الافتراضي 1000): بعد هذا العدد من الطلبات يغلق الاتصال ويفتح غيره، والسبب كما في الوثائق تحرير الذاكرة المرتبطة بالاتصال، وكانت القيمة 100 قبل الإصدار 1.19.10.keepalive_time(الافتراضي ساعة): أقصى مدة يخدم فيها الاتصال الواحد الطلبات، وهو المقابل للعمر الأقصى Max Lifetime في مجمعات قواعد البيانات.keepalive_timeout(الافتراضي 60 ثانية): الاتصال الخامل أكثر من هذه المدة يغلق، وهو المقابل لمهلة الخمول Idle Timeout.
وإذا كنت تستخدم طريقة توزيع غير الافتراضية مثل least_conn أو ip_hash على إصدار أقدم من 1.29.7، فالوثائق تطلب أن تكتبها قبل سطر keepalive داخل كتلة upstream.
مهلة التطبيق يجب أن تكون أطول من مهلة Nginx
المجمع هنا له طرفان، وكل طرف يغلق الاتصال الخامل بعد مهلته، فNginx يحتفظ بالاتصال الخامل 60 ثانية، بينما سيرفر HTTP في Node.js يغلقه بعد 5 ثوان كما في وثائق server.keepAliveTimeout مع ثانية إضافية في الإصدارات الحديثة عبر keepAliveTimeoutBuffer، وGunicorn في Python ينتظر ثانيتين فقط كما في وثائق الإعداد keepalive، أي أن التطبيق هو الذي يغلق أولاً. وفي أغلب الأحيان يرى Nginx إغلاق الاتصال الخامل ويحذفه من المجمع، ولكن إذا أغلقه التطبيق في نفس اللحظة التي أرسل فيها Nginx طلباً جديداً عليه، يصل الطلب إلى اتصال مغلق، وعندها قد يعيد Nginx المحاولة على اتصال آخر لطلب مثل GET، أما POST وPATCH فتقول وثائق proxy_next_upstream إنها لا ترسل إلى سيرفر آخر افتراضياً بعد إرسالها، فيرى المستخدم الخطأ 502 مرة كل فترة دون أي أثر في سجلات التطبيق، وهذا من أزعج الأخطاء لأنه يظهر تحت الحمل ولا يتكرر عندما تحاول إعادته.
والقاعدة، وهي نفس ما توصي به وثائق موزع الحمل في AWS لتطبيقاتها، أن تكون مهلة الخمول في التطبيق أطول من مهلة الخمول في الطرف الذي أمامه، فيكون Nginx هو من يغلق الاتصال الخامل دائماً. فإما أن ترفع مهلة التطبيق فوق 60 ثانية، كما في السطر server.keepAliveTimeout = Number(process.env.KEEPALIVE_MS || 65000) في تطبيق المختبر، وفي Gunicorn الخيار --keep-alive 65 مع عمال gthread أو gevent، لأن العامل sync لا يدعم الاتصالات الدائمة أصلاً كما تذكر الوثائق، وإما أن تخفض keepalive_timeout في كتلة upstream إلى أقل من مهلة التطبيق، مثل keepalive_timeout 4s أمام Node.js بقيمته الافتراضية.
المختبر: نفس الحمل مع keepalive ودونه
سوف نشغل تطبيق Node.js صغيراً يعد اتصالات TCP التي تصله من Nginx، ثم Nginx 1.31.6 أمامه بعاملين، ونرسل 20000 طلب من 50 كلاينت في نفس الوقت بأداة ab الموجودة في Docker Image الرسمية ل httpd، وذلك ثلاث مرات: keepalive 0 الذي يعطل المجمع مثل الإصدارات الأقدم من 1.29.7، ثم keepalive 4، ثم القيمة الافتراضية دون أي سطر. والتطبيق كما يلي:
// app.js: a tiny HTTP app that counts the TCP connections it accepts from Nginx.
const http = require('node:http');
let fromProxy = 0, requests = 0;

const server = http.createServer((req, res) => {
  if (req.url === '/stats') return res.end(JSON.stringify({ connections_from_nginx: fromProxy, requests }) + '\n');
  if (req.url === '/reset') { fromProxy = 0; requests = 0; return res.end('reset\n'); }
  requests++;
  res.end('ok\n');
});

// Count every new TCP connection, except our own checks from inside the container.
server.on('connection', (socket) => { if (socket.remoteAddress !== '127.0.0.1') fromProxy++; });

server.keepAliveTimeout = Number(process.env.KEEPALIVE_MS || 65000);  // longer than Nginx's 60s
server.listen(3000, () => console.log(`listening on :3000, keepAliveTimeout=${server.keepAliveTimeout}ms`));
وملف Nginx للحالة الافتراضية كما يلي، وفي الملفين الآخرين nginx-off.conf وnginx-small.conf نضع مكان التعليق داخل upstream السطر keepalive 0; أو keepalive 4;:
worker_processes 2;
events { worker_connections 1024; }

http {
    access_log off;

    upstream app_backend {
        server lab-pool2-app:3000;
        # no keepalive line: since 1.29.7 the default is keepalive 32
    }

    server {
        listen 80;
        location / {
            proxy_pass http://app_backend;
        }
    }
}
في الإعداد أعلاه لاحظ التالي:
worker_processes 2حتى يكون معنى «لكل عامل» واضحاً في الأرقام، فالسقف في الحالة الافتراضية 2 × 32 = 64 اتصالاً خاملاً.- لا يوجد
proxy_http_versionولاproxy_set_header Connection، لأن الإصدار 1.31.6 يستخدم 1.1 ولا يرسل الترويسة افتراضياً. - مهلة التطبيق 65 ثانية، أي أطول من 60 ثانية في Nginx كما شرحنا في القسم السابق.
ثم ننشئ الشبكة ونشغل التطبيق، والسكربت التالي يشغل Nginx بالملف المطلوب ويرسل الحمل، ثم يسأل التطبيق عن عدد الاتصالات، ويعد الاتصالات في حالة TIME_WAIT من الملف /proc/net/tcp، حيث الحالة 06 هي TIME_WAIT و0BB8 هو المنفذ 3000 بالنظام السداسي عشر:
docker network create lab-pool2-net
docker run -d --name lab-pool2-app --network lab-pool2-net -p 127.0.0.1:18780:3000 \
  -v "$PWD/app.js:/app.js:ro" node:26-alpine node /app.js
#!/bin/sh
# run-nginx.sh <off|small|default>: same load through Nginx, then count the connections the app accepted.
v=$1
docker rm -f lab-pool2-nginx >/dev/null 2>&1
docker run -d --name lab-pool2-nginx --network lab-pool2-net -p 127.0.0.1:18781:80 \
-v "$PWD/nginx-$v.conf:/etc/nginx/nginx.conf:ro" nginx:1.31-alpine >/dev/null
sleep 1
docker exec lab-pool2-app wget -qO- http://127.0.0.1:3000/reset >/dev/null
docker run --rm --network lab-pool2-net httpd:2.4-alpine \
ab -k -n ${N:-20000} -c 50 http://lab-pool2-nginx/ 2>&1 | grep -E "Complete requests|Failed requests|Requests per second|Time per request.*mean\)"
echo "app: $(docker exec lab-pool2-app wget -qO- http://127.0.0.1:3000/stats)"
echo "nginx TIME_WAIT to app: $(docker exec lab-pool2-nginx sh -c "cat /proc/net/tcp | awk '\$3 ~ /:0BB8\$/ && \$4 == \"06\"' | wc -l")"
echo "app TIME_WAIT: $(docker exec lab-pool2-app sh -c "cat /proc/net/tcp | awk '\$2 ~ /:0BB8\$/ && \$4 == \"06\"' | wc -l")"for v in off small default; do echo "== $v"; sh run-nginx.sh $v; doneوالمخرج سوف يكون كما يلي:
== off
Complete requests:      20000
Failed requests:        0
Requests per second:    867.64 [#/sec] (mean)
Time per request:       57.628 [ms] (mean)
app:   {"connections_from_nginx":20001,"requests":20000}
nginx TIME_WAIT to app:  20000
app   TIME_WAIT:         0
== small
Complete requests:      20000
Failed requests:        0
Requests per second:    12414.16 [#/sec] (mean)
Time per request:       4.028 [ms] (mean)
app:   {"connections_from_nginx":1757,"requests":20000}
nginx TIME_WAIT to app:  1748
app   TIME_WAIT:         0
== default
Complete requests:      20000
Failed requests:        0
Requests per second:    7925.34 [#/sec] (mean)
Time per request:       6.309 [ms] (mean)
app:   {"connections_from_nginx":102,"requests":20000}
nginx TIME_WAIT to app:  52
app   TIME_WAIT:         0
في المخرج أعلاه لاحظ التالي:
- دون المجمع فتح Nginx اتصالاً جديداً لكل طلب تقريباً، 20001 اتصال مقابل 20000 طلب، وبقي 20000 منفذ في حالة
TIME_WAITعلى جهة Nginx وصفر على جهة التطبيق، لأن Nginx هو الذي يغلق الاتصال أولاً، فالمنافذ التي تنفد هي منافذ Nginx. - مع
keepalive 4نزل العدد إلى 1757، ولكنه ما زال كبيراً، والسبب أن الحمل 50 طلباً في نفس الوقت والمجمع لا يحتفظ إلا بأربعة اتصالات خاملة لكل عامل، فكل ما زاد عنها يغلق بعد الطلب ثم يفتح غيره في الدفعة التالية، فالرقم الصغير جداً يضيع جزءاً كبيراً من الفائدة. - مع القيمة الافتراضية خدم 102 اتصال كل الطلبات، أي أن كل اتصال حمل حوالي 200 طلب، وال 52 اتصالاً في
TIME_WAITهي ما زاد عن 32 لكل عامل في لحظات الذروة. - عدد الطلبات في الثانية تغير كثيراً بين الحالات وبين التشغيلات، فلا تستنتج منه أن
keepalive 4أسرع من 32، فالحمل والتطبيق وNginx كلها على جهاز واحد عليه Docker، والرقم الذي يهمك هنا هو عدد الاتصالات.
الآن نكسر الإعداد عمداً، فنرسل 45000 طلب بدل 20000 مع keepalive 0، أي أكثر من المنافذ المتاحة في دقيقة واحدة، ثم نعد أخطاء Nginx:
N=45000 sh run-nginx.sh off
docker logs lab-pool2-nginx 2>&1 | grep -c "Address not available"
docker logs lab-pool2-nginx 2>&1 | grep -m1 "Address not available"
والمخرج سوف يكون كما يلي:
Complete requests:      45000
Failed requests:        2592
Requests per second:    675.16 [#/sec] (mean)
Time per request:       74.056 [ms] (mean)
app:   {"connections_from_nginx":42409,"requests":42408}
nginx TIME_WAIT to app:  25560
app   TIME_WAIT:         0
2592
2026/10/06 04:34:33 [crit] 31#31: *41 connect() to 192.168.96.2:3000 failed (99: Address not available) while connecting to upstream, client: 192.168.96.4, server: , request: "GET / HTTP/1.0", upstream: "http://192.168.96.2:3000/", host: "lab-pool2-nginx"
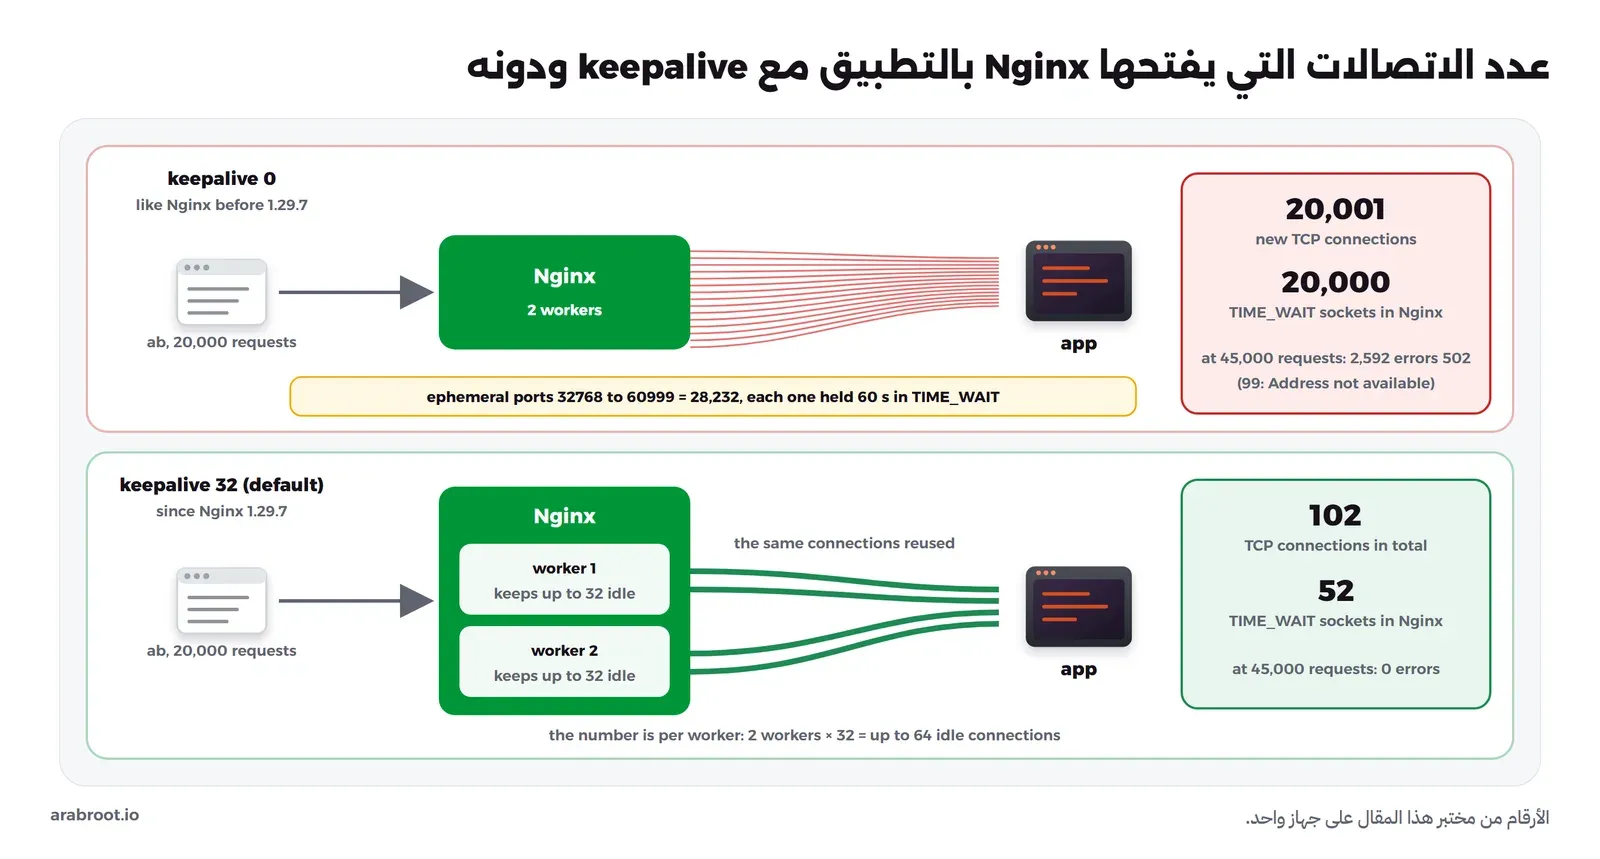
لاحظ أن 2592 طلباً فشلت، وهو نفس عدد أسطر الخطأ في سجل Nginx، والطلبات التي وصلت للتطبيق 42408 أي 45000 ناقص 2592، وأن عدد المنافذ في TIME_WAIT وصل إلى 25560 قريباً من سقف 28232، فالرسالة connect() failed (99: Address not available) تعني أن النواة لم تجد منفذاً محلياً حراً لاتصال جديد، وكل طلب من هذه رأى المستخدم مقابله الخطأ 502. وبعد دقيقة من الانتظار حتى تفرغ المنافذ، أعدنا نفس ال 45000 طلب بالإعداد الافتراضي:
N=45000 sh run-nginx.sh defaultComplete requests: 45000
Failed requests: 0
Requests per second: 3150.08 [#/sec] (mean)
Time per request: 15.873 [ms] (mean)
app: {"connections_from_nginx":322,"requests":45000}
nginx TIME_WAIT to app: 275
app TIME_WAIT: 0لا يوجد أي خطأ، و322 اتصالاً فقط خدمت 45000 طلب. والصورة التالية تبين نتيجة المختبر:
احذف Container ال Nginx بعد الانتهاء، أما التطبيق والشبكة فسوف نحذفهما مع مختبر Redis في القسم التالي:
docker rm -f lab-pool2-nginxمجمع الاتصالات Pool في Redis وValkey
Redis وبديله المفتوح Valkey يقفان غالباً بجانب قاعدة البيانات للتخزين المؤقت Cache والجلسات Sessions والطوابير Queues، وسوف نشرحهما بالتفصيل في مرحلة قواعد البيانات في خريطة التعلم، أما هنا فيهمنا جانب واحد هو الاتصال، لأن نفس الخطأ الذي رأيته مع PostgreSQL يتكرر معهما كثيراً، وهو أن ينشئ الكود كلاينت جديداً مع كل طلب.
ماذا يكلف الاتصال في Redis وValkey؟
الاتصال ب Valkey أرخص بكثير من الاتصال ب PostgreSQL، فلا توجد عملية جديدة لكل اتصال، ولكنه ليس مجانياً. فتقول وثائق Valkey إنه يستخدم في الغالب تصميماً أحادي الخيط Single-threaded لتنفيذ الأوامر، أي أن عملية واحدة تنفذ أوامر كل الكلاينتات واحداً بعد الآخر، وقد تعالج عمليات الإدخال والإخراج I/O في الخلفية ولكن لا ينفذ إلا أمر واحد في اللحظة، لذلك مئة اتصال لا تجعل Valkey ينفذ مئة أمر في نفس الوقت، كما رأيت مع أنوية PostgreSQL. وكل اتصال مفتوح يحجز واصف ملف File Descriptor وذاكرة لمخازن الإدخال والإخراج Buffers، وتذكر وثائق الكلاينتات أن القيمة الافتراضية للإعداد maxclients هي 10000، وأن Valkey يحجز 32 واصفاً لنفسه ويخفض الحد تلقائياً إذا كان حد نظام التشغيل ulimit -n أقل، وأن الكلاينت الزائد يستقبل خطأ ثم يغلق اتصاله، وأن اتصالات الكلاينتات عندما تكثر قد تستهلك ذاكرة كبيرة تصل إلى حذف البيانات Eviction أو نفاد الذاكرة، لذلك فيه آلية لقطعها اسمها Client Eviction.
وتعرف حال الاتصالات من ثلاثة أوامر:
INFO clients: الحقلconnected_clientsهو عدد الاتصالات المفتوحة الآن، وblocked_clientsعدد الكلاينتات المنتظرة في أمر حاجب مثلBLPOP، وmaxclientsهو الحد.INFO stats: الحقلtotal_connections_receivedهو عدد الاتصالات التي قبلها السيرفر منذ تشغيله، وهو أهم رقم لكشف الكلاينت الذي يفتح اتصالاً مع كل طلب، لأنconnected_clientsقد يبقى صغيراً بينما هذا الرقم يرتفع بالآلاف كما سوف ترى في المختبر، وrejected_connectionsعدد الاتصالات المرفوضة بسببmaxclients.CLIENT LIST: سطر لكل اتصال فيه العنوان وعمر الاتصالageومدة خمولهidleوآخر أمرcmdواسم المكتبةlib-name، فتعرف أي تطبيق يفتح هذه الاتصالات.
المجمع Pool في مكتبات Redis المشهورة
المكتبات هنا تختلف أكثر من مكتبات PostgreSQL، والسبب أن بروتوكول Redis يسمح بإرسال عدة أوامر على نفس الاتصال دون انتظار رد كل واحد، وهذا ما يسمى Pipelining، فبعض المكتبات تكتفي باتصال واحد يخدم كل الطلبات، وبعضها يستخدم مجمعاً مثل مكتبات قواعد البيانات. والجدول التالي من وثائق كل مكتبة وكودها عند كتابة المقال:
| المكتبة | السلوك الافتراضي | ملاحظات |
|---|---|---|
| redis-py (Python) | كل Redis() معه ConnectionPool، وحده الأقصى max_connections = 100 منذ الإصدار 8.0، وإذا امتلأ يرفع ConnectionError فوراً. | BlockingConnectionPool ينتظر بدل أن يفشل، وقيمه الافتراضية في الكود 50 اتصالاً ومهلة 20 ثانية، ومنذ الإصدار 8.0 أصبحت مهلة القراءة socket_timeout 5 ثوان افتراضياً. |
| node-redis (Node.js) | createClient() اتصال واحد لكل الأوامر. | للأوامر الحاجبة وWATCH يوجد createClientPool() بحد أدنى 1 وأقصى 100 ومهلة انتظار 3000 مللي ثانية، وكان اسمه في الإصدار 4 مجمع العزل Isolation Pool فوق الاتصال الرئيسي ثم أصبح كلاساً مستقلاً في الإصدار 5. |
| ioredis (Node.js) | كل كائن new Redis() هو اتصال واحد كما يذكر ال README. | الخيار enableAutoPipelining يجمع الأوامر التي تصدر في نفس دورة ال Event Loop في Pipeline واحد، وللاشتراكات Pub/Sub والأوامر الحاجبة تنشئ كائناً ثانياً. |
| go-redis (Go) | PoolSize = 10 × runtime.GOMAXPROCS(0)، أي 10 اتصالات لكل نواة. | تذكر التعليقات في الكود أن المجمع قد يفتح اتصالات فوق PoolSize عند الحاجة، وأن الحد الحقيقي هو MaxActiveConns. |
في الجدول أعلاه لاحظ التالي:
- اتصال واحد في Node.js يكفي غالباً: لأن Node.js يعمل بخيط واحد وحلقة أحداث Event Loop، فالأوامر من كل الطلبات تصطف على نفس الاتصال وتعود ردودها بالترتيب، ولا تحتاج مجمعاً إلا للحالات التي تحجز الاتصال كما في دليل المجمع في node-redis.
- go-redis يتضاعف مع الأنوية: نسخة واحدة على سيرفر ب 32 نواة تعني مجمعاً من 320 اتصالاً، وعشرون نسخة تعني 6400 من أصل 10000 في
maxclients، وهذا نفس تضاعف الاتصالات الذي شرحناه في قسم النسخ الكثيرة. - الأوامر الحاجبة تحجز الاتصال: تقول وثائق BLPOP إنه يحجب الاتصال Blocks the Connection حتى يصل عنصر أو تنتهي المهلة، فالعامل الذي ينتظر المهام ب
BLPOPيمسك اتصالاً من المجمع طوال انتظاره، وإذا كان المجمع صغيراً ينتظر باقي الكود، وسوف ترى ذلك في المختبر، لذلك أعط العمال الذين ينتظرون المهام كلاينت أو مجمعاً منفصلاً. - Pub/Sub يحتاج اتصالاً خاصاً به: تقول وثائق Pub/Sub إن الكلاينت المشترك في قناة لا يرسل في بروتوكول RESP2 إلا أوامر الاشتراك وإلغائه و
PINGوQUITوRESET، بينما يسمح RESP3 بكل الأوامر، لذلك تطلب وثائق node-redis نسخة مستقلة بالدالةduplicate()للمشترك.
المختبر: كلاينت لكل طلب أو مجمع واحد
نشغل Valkey 9.1.2 على نفس الشبكة، ثم Container ل Python نثبت فيه redis-py، والسكربت التالي ينفذ 2000 طلب، وكل طلب هنا أمر SET ثم GET، مرة بكلاينت جديد لكل طلب ومرة بكلاينت واحد مشترك، ثم يرسل 50 خيطاً Thread في نفس الوقت على مجمعين، ويطبع بعد كل مرحلة connected_clients وtotal_connections_received:
# pool_lab.py: client per request vs one shared pool against Valkey (timings are illustrative).
import sys, time, threading
import redis

HOST, N = "lab-pool2-valkey", 2000
admin = redis.Redis(host=HOST)          # a separate client only for reading INFO

def stats(label):
    c, s = admin.info("clients"), admin.info("stats")
    print(f"{label:<28} connected_clients={c['connected_clients']:<4} total_connections_received={s['total_connections_received']}")

def handle_request_new_client(i):
    r = redis.Redis(host=HOST)          # WRONG: a new client (and a new pool) for every request
    r.set(f"user:{i}", "x")
    return r.get(f"user:{i}")

shared = redis.Redis(host=HOST)         # RIGHT: created once when the app starts
def handle_request_shared(i):
    shared.set(f"user:{i}", "x")
    return shared.get(f"user:{i}")

def bench(label, fn):
    t = time.perf_counter()
    for i in range(N):
        fn(i)
    ms = (time.perf_counter() - t) * 1000
    print(f"{label:<28} {N} requests in {ms:.0f} ms ({ms / N:.3f} ms each)")
    stats(label)

print("redis-py", redis.__version__)
stats("start")
bench("client per request", handle_request_new_client)
bench("shared client", handle_request_shared)

# 50 threads on one client: the default pool opens a connection for each busy thread.
def burst(client, label):
    ths = [threading.Thread(target=lambda: [client.get("k") for _ in range(200)]) for _ in range(50)]
    [t.start() for t in ths]; [t.join() for t in ths]
    stats(label)
burst(redis.Redis(host=HOST), "50 threads, default pool")
burst(redis.Redis(connection_pool=redis.BlockingConnectionPool(host=HOST, max_connections=10)),
      "50 threads, blocking pool 10")
docker run -d --name lab-pool2-valkey --network lab-pool2-net -p 127.0.0.1:18782:6379 valkey/valkey:9-alpine
docker run -d --name lab-pool2-py --network lab-pool2-net -v "$PWD:/lab:ro" python:3.13-slim sleep infinity
docker exec lab-pool2-py pip install -q redis
docker exec lab-pool2-py python /lab/pool_lab.pyوالمخرج سوف يكون كما يلي:
redis-py 8.1.0
start                        connected_clients=1    total_connections_received=1
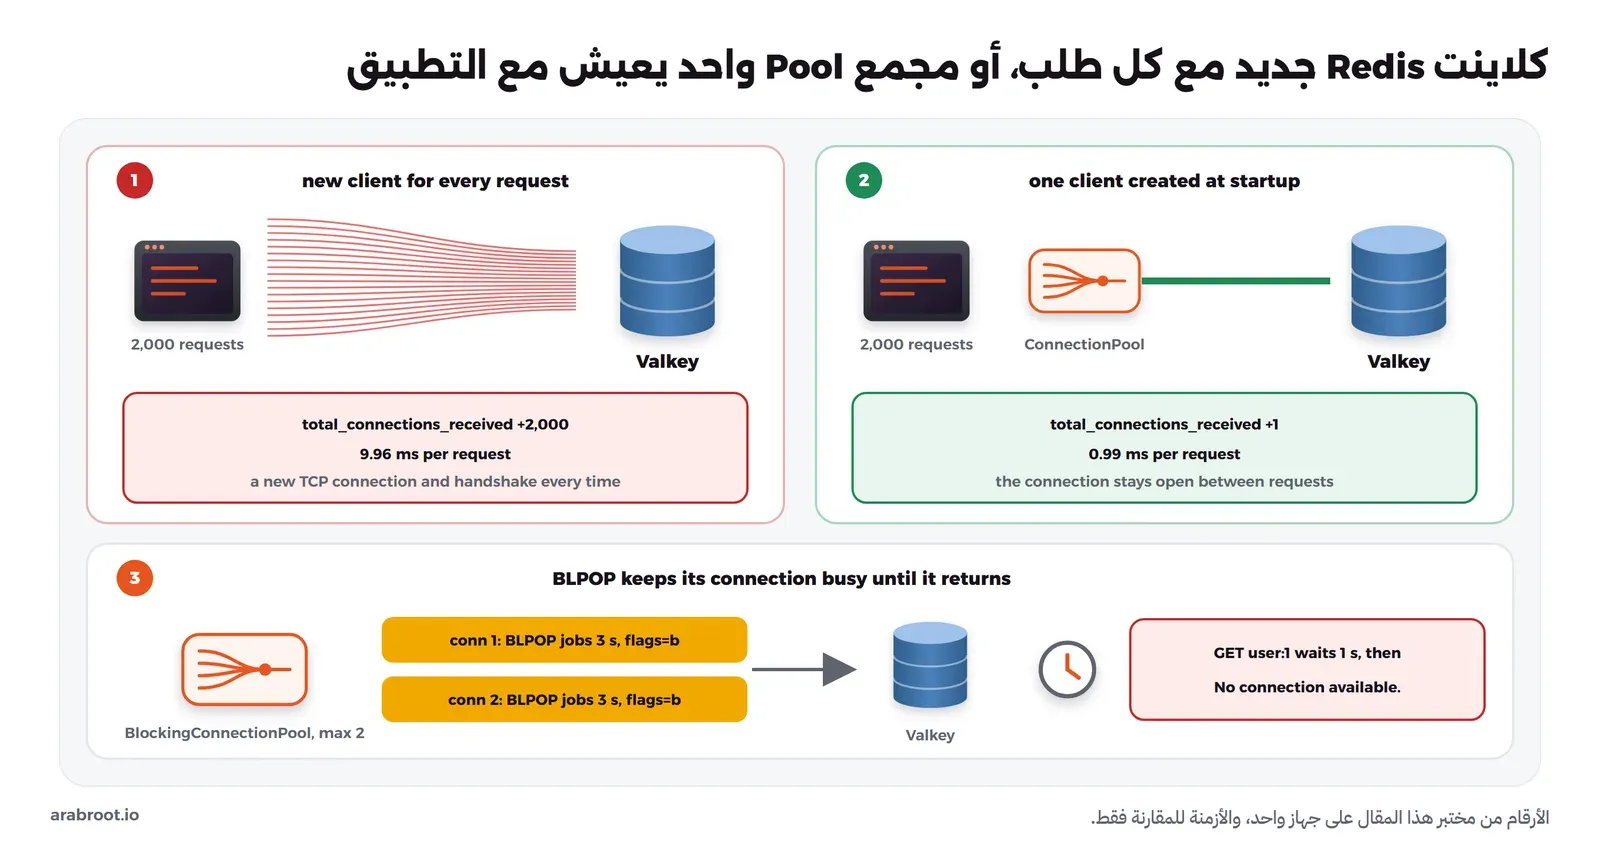
client per request           2000 requests in 19928 ms (9.964 ms each)
client per request           connected_clients=1    total_connections_received=2001
shared client                2000 requests in 1979 ms (0.990 ms each)
shared client                connected_clients=2    total_connections_received=2002
50 threads, default pool     connected_clients=52   total_connections_received=2052
50 threads, blocking pool 10 connected_clients=12   total_connections_received=2062
في المخرج أعلاه لاحظ التالي:
- الكلاينت لكل طلب فتح 2000 اتصال لألفي طلب، وأخذ الطلب الواحد حوالي 10 مللي ثوان مقابل مللي ثانية واحدة مع الكلاينت المشترك، والسبب أن كل كلاينت جديد يبحث عن عنوان السيرفر ويفتح اتصال TCP ويرسل أوامر التعريف بالمكتبة قبل أمرنا، وهذه الأزمنة من جهاز واحد عليه Docker وهي للمقارنة فقط.
connected_clientsبقي 1 بعد الكلاينت لكل طلب، فلو نظرت إليه وحده لظننت أن كل شيء سليم، والسبب أن Python يغلق اتصال الكلاينت القديم عندما يتخلص من الكائن، أماtotal_connections_receivedفقفز 2000، لذلك راقب معدل هذا الرقم وليسconnected_clientsوحده. وفي بيئة لا يغلق فيها الكلاينت القديم فوراً، أو تحت حمل حقيقي متزامن، ترتفع الاتصالات المفتوحة نفسها حتى تصل إلىmaxclients.- الكلاينت المشترك فتح اتصالاً واحداً فقط لكل الطلبات، فارتفع الرقم من 2001 إلى 2002.
- 50 خيطاً على المجمع الافتراضي فتحت 50 اتصالاً، أي اتصالاً لكل خيط مشغول، فوصل
connected_clientsإلى 52 مع كلاينت المراقبة والكلاينت المشترك، بينماBlockingConnectionPoolبحد 10 خدم نفس الخيوط الخمسين بعشرة اتصالات، والباقي انتظر دوره في المجمع كما يفعل أي مجمع جيد.
الآن نرى ماذا يفعل الأمر الحاجب بالمجمع، فالسكربت التالي يضع خيطين ينتظران المهام ب BLPOP مدة 3 ثوان على مجمع بحد 2، ثم يحاول نفس التطبيق أن ينفذ GET عادياً:
# blpop_lab.py: a blocking command holds its pooled connection until it returns.
import threading, time
import redis

pool = redis.BlockingConnectionPool(host="lab-pool2-valkey", max_connections=2, timeout=1)
r = redis.Redis(connection_pool=pool)

for n in range(2):  # two workers wait up to 3 seconds for a job
    threading.Thread(target=lambda: r.blpop("jobs", timeout=3), daemon=True).start()
time.sleep(0.5)

admin = redis.Redis(host="lab-pool2-valkey")   # outside the pool, to look at the server
for line in admin.client_list():
    print(f"id={line['id']} cmd={line['cmd']} flags={line['flags']} idle={line['idle']}")
print("blocked_clients =", admin.info("clients")["blocked_clients"])

t = time.perf_counter()
try:
    r.get("user:1")                   # a normal request from the same app
except redis.exceptions.ConnectionError as e:
    print(f"GET failed after {time.perf_counter() - t:.1f} s: {e}")
docker exec lab-pool2-py python /lab/blpop_lab.pyوالمخرج سوف يكون كما يلي:
id=2079 cmd=blpop flags=b idle=0
id=2080 cmd=blpop flags=b idle=0
id=2081 cmd=client|list flags=N idle=0
blocked_clients = 2
GET failed after 1.0 s: No connection available.
لاحظ أن CLIENT LIST يبين الاتصالين وآخر أمر عليهما blpop والعلامة flags=b التي تعني أن الكلاينت محجوب Blocked، وأن الأمر GET البسيط انتظر ثانية كاملة ثم فشل بالخطأ No connection available. رغم أن Valkey نفسه لا يفعل شيئاً، فالمشكلة في المجمع وليست في السيرفر. والصورة التالية تبين نتائج هذا المختبر:
وهناك فخ آخر ظهر أثناء المختبر يتعلق بمهلة القراءة الافتراضية في redis-py 8، فعندما أرسلنا BLPOP بمهلة 10 ثوان على كلاينت بالإعدادات الافتراضية، بعد تصفير الإحصاءات بالأمر CONFIG RESETSTAT:
docker exec lab-pool2-valkey valkey-cli CONFIG RESETSTAT
docker exec lab-pool2-py python -c "
import redis, time
r = redis.Redis(host='lab-pool2-valkey')
t = time.perf_counter()
try:
    r.blpop('jobs', timeout=10)
except redis.exceptions.TimeoutError as e:
    print(f'BLPOP failed after {time.perf_counter() - t:.1f} s: {e}')
"
docker exec lab-pool2-valkey valkey-cli INFO stats | grep total_connections_received
BLPOP failed after 58.9 s: Timeout reading from socket
total_connections_received:13لاحظ أن الأمر لم ينتظر 10 ثوان كما طلبنا، وإنما فشل بعد 58.9 ثانية، والسبب كما تذكر ملاحظات الإصدار 8.0 أن socket_timeout أصبح 5 ثوان افتراضياً، فتنتهي مهلة القراءة قبل أن ينتهي BLPOP، وأن المكتبة أصبحت تعيد المحاولة 10 مرات افتراضياً، فأرسلت الأمر على اتصال جديد بعد كل فشل، وهذا ما يظهر في total_connections_received: 13 اتصالاً منها 11 من محاولات BLPOP واثنان من أوامر valkey-cli. لذلك إذا استخدمت الأوامر الحاجبة مع redis-py 8 فاجعل لها كلاينت منفصلاً بقيمة socket_timeout أكبر من مهلة الأمر.
وبعد الانتهاء احذف ال Containers والشبكة التي أنشأناها في المختبرين:
docker rm -f lab-pool2-app lab-pool2-valkey lab-pool2-py
docker network rm lab-pool2-net
كيف تراقب المجمع Pool؟
المجمع الذي لا تراقبه سوف يخبرك بمشكلته عن طريق المستخدمين، لذلك راقب هذه الأرقام:
- وقت الانتظار Wait Time: أهم رقم على الإطلاق، فهو الوقت الذي ينتظره الطلب حتى يحصل على اتصال، وفي PgBouncer تجده في
maxwaitوcl_waitingمنSHOW POOLS، وتقول الوثائق إن ارتفاعmaxwaitيعني أن الاتصالات الحقيقية لا تخدم الطلبات بالسرعة الكافية. وفي HikariCP تجده في مقياس انتظار الاستعارة إذا ربطته بنظام المراقبة. - الاتصالات النشطة والخاملة Active/Idle: إذا كانت كل اتصالات المجمع نشطة دائماً فإما أن المجمع صغير، وإما أن الاستعلامات بطيئة، وغالباً الثاني، فابدأ بالاستعلامات كما شرحنا في مقال الجداول الضخمة قبل أن تكبر المجمع.
- الحالة في PostgreSQL: العمود
stateفيpg_stat_activityيبين لك كم اتصالاًactiveوكمidle، والأخطر هوidle in transaction، أي كود بدأ معاملة واستعار الاتصال ثم نسيه، وهذا يحجز الاتصال ويمنع VACUUM، فاضبطidle_in_transaction_session_timeoutلينهي هذه الجلسات. - اتصالات Nginx بالتطبيق: الأمر
ss -sعلى سيرفر Nginx يبين عدد الاتصالات في حالةtimewait، فإذا اقترب من عشرات الآلاف فالمجمع معطل أو صغير، والسطرconnect() failed (99: Address not available)في سجل الأخطاء يعني أن المنافذ نفدت فعلاً. - اتصالات Redis وValkey: معدل ارتفاع
total_connections_receivedفي الدقيقة، فإذا كان قريباً من عدد الطلبات فهناك كلاينت ينشأ مع كل طلب، ثمconnected_clientsمقارنة بmaxclients، وrejected_connectionsالذي يجب أن يبقى صفراً. - أخطاء انتهاء مهلة الاستعارة: كل خطأ من نوع «لم أحصل على اتصال خلال 30 ثانية» يعني طلباً فشل، فاجعله تنبيهاً وليس سطراً في السجل فقط.
الأخطاء الشائعة
- المجمع الكبير جداً: 100 اتصال لكل نسخة لأن «الأكثر أسرع»، وقد رأيت في قسم الحجم أن الأقل أسرع غالباً، فابدأ صغيراً وكبر بالقياس.
- مجمع لكل طلب: إنشاء المجمع داخل دالة الطلب أو داخل ال Controller يعني أن كل طلب يفتح اتصالاته ثم يتركها، وهذا أسوأ من عدم وجود مجمع، فأنشئه مرة واحدة عند تشغيل التطبيق.
- نسيان إعادة الاتصال: استعارة دون
releaseفيfinallyأو دونwithأوtry-with-resources، فيتسرب Leak اتصال مع كل خطأ حتى يفرغ المجمع ويتوقف التطبيق كله، وHikariCP فيه الإعدادleakDetectionThresholdالذي يسجل تحذيراً عندما يبقى الاتصال مستعاراً أكثر من المدة التي تحددها. - نسيان تضاعف الاتصالات: حساب المجمع لنسخة واحدة ثم تشغيل 50 نسخة، أو نسيان أن Gunicorn بتسعة عمال هو تسعة مجمعات، أو نسيان النشر الذي يضاعف كل شيء دقيقة.
- رفع max_connections بدل التجميع: يؤجل الرسالة ويزيد استهلاك الذاكرة والتنافس، والحل المجمع وPgBouncer.
- وضع transaction مع SET وLISTEN والأقفال الاستشارية: رأيت في المختبر أن الإعداد يضيع من صاحبه ويذهب لغيره، فراجع الكود والمكتبات قبل التحويل، وانقل ما يحتاج الجلسة إلى اتصال مباشر أو مجمع بوضع session.
- إمساك الاتصال أثناء عمل بطيء: استعارة الاتصال ثم استدعاء API خارجي أو إرسال بريد قبل
COMMIT، فيبقى الاتصال محجوزاً ثواني، والحل أن تنهي عمل قاعدة البيانات وتعيد الاتصال، ثم تنفذ العمل البطيء أو ترسله إلى طابور كما شرحنا في قسم المهام الخلفية. - Nginx دون مجمع أمام التطبيق: إصدار أقدم من 1.29.7 دون
keepalive، أوproxy_http_versionباقية على 1.0، فيفتح Nginx اتصالاً لكل طلب حتى تنفد المنافذ ويظهر الخطأ 502 كما رأيت في المختبر. - مهلة التطبيق أقصر من مهلة Nginx: Node.js بخمس ثوان وGunicorn بثانيتين خلف Nginx بستين ثانية، فتظهر أخطاء 502 متفرقة تحت الحمل، والحل أن يغلق Nginx الاتصال الخامل أولاً.
- كلاينت Redis لكل طلب: إنشاء
Redis()أوcreateClient()داخل دالة الطلب، فيرتفعtotal_connections_receivedمع كل طلب ويتضاعف زمنه، ومثله استخدام نفس المجمع الصغير لأوامرBLPOPولطلبات المستخدمين. - مجمع دون مهلة ودون فحص صحة: طلبات تنتظر للأبد عندما يمتلئ المجمع، أو تفشل بعد كل إعادة تشغيل لقاعدة البيانات لأن المجمع يعطيها اتصالات ميتة Dead Connections انقطعت دون أن يعلم.
قائمة تحقق
- هل يوجد مجمع واحد لكل عملية في التطبيق، ينشأ عند التشغيل وليس مع كل طلب؟
- هل حسبت ميزانية الاتصالات: النسخ × العمليات × الحد الأقصى للمجمع + العمال الخلفيون + النشر + أدوات الإدارة، وهل المجموع أقل من
max_connectionsمع هامش؟ - هل لكل مجمع مهلة استعارة بالثواني، وفحص صحة، وعمر أقصى للاتصال؟
- هل كل استعارة تعاد في
finallyأو ما يقابلها في لغتك، وهل المعاملات قصيرة ولا تنتظر خدمات خارجية؟ - إذا كثرت النسخ أو الخدمات أو كان لديك Serverless، هل يوجد PgBouncer أو مجمع خارجي أمام قاعدة البيانات؟
- إذا كان PgBouncer في وضع transaction، هل راجعت
SETوLISTENوالأقفال الاستشارية والجداول المؤقتة، وهل الإصدار 1.21 أو أحدث معmax_prepared_statementsأكبر من صفر؟ - هل
max_db_connectionsمضبوط حتى لا تفتح أزواج المستخدمين وقواعد البيانات أكثر من الحد؟ - هل تراقب وقت الانتظار في المجمع، و
idle in transactionفي PostgreSQL، وأخطاء انتهاء مهلة الاستعارة؟ - هل اتصالات Nginx مع التطبيق تعاد استخدامها، إما بإصدار 1.29.7 أو أحدث أو بإعداد
keepaliveيدوياً، وهل مهلة الخمول في التطبيق أطول منkeepalive_timeoutفي Nginx؟ - هل كلاينت Redis أو Valkey ينشأ مرة واحدة عند التشغيل، وهل للأوامر الحاجبة وPub/Sub اتصالات منفصلة عن طلبات المستخدمين؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- فتح الاتصال بقاعدة البيانات مكلف: TCP وTLS ومصادقة، وفي PostgreSQL عملية كاملة لكل اتصال، وفي المختبر أخذ كل اتصال حوالي 19 مللي ثانية مقابل استعلام أقل من مللي ثانية.
- المجمع يفتح الاتصالات مرة ويعيرها للطلبات، والطلب الزائد ينتظر في طابور بدل أن يرهق القاعدة، وحجمه الصحيح صغير ويبدأ من عدد أنوية قاعدة البيانات وليس من عدد المستخدمين.
- ابدأ بالمجمع داخل التطبيق وحدد حده الأقصى ومهلته دائماً، ثم أضف PgBouncer عندما تكثر النسخ أو الخدمات أو تستخدم Serverless، وأبق المجمعات الصغيرة في التطبيقات.
- وضع transaction في PgBouncer هو الذي يعطي الفائدة الكبيرة، فقد خدم 200 كلاينت بعشرة اتصالات حقيقية، ولكنه يكسر ما يرتبط بالجلسة، فاستخدم
SET LOCALوالأقفال المرتبطة بالمعاملة، وتأكد من دعم الاستعلامات المجهزة. - كل مجمع صغير معقول وحده، والمشكلة في تضاعفها مع عدد النسخ والعمليات، فاحسب المجموع، وتذكر أن الاتصالات الخاملة في المجمعات تحسب من الحد.
- Nginx نفسه مجمع اتصالات أمام التطبيق، ودون
keepaliveفتح في المختبر اتصالاً لكل طلب حتى نفدت المنافذ وظهر الخطأ 502، ومع القيمة الافتراضية منذ 1.29.7 خدم 322 اتصالاً 45000 طلب، واجعل مهلة التطبيق أطول من مهلة Nginx. - في Redis وValkey أنشئ الكلاينت مرة واحدة، فالكلاينت لكل طلب فتح 2000 اتصال لألفي طلب وكان أبطأ بعشر مرات، وراقب
total_connections_received، وافصل الأوامر الحاجبة وPub/Sub عن مجمع الطلبات. - نفس الفكرة في HTTP مع Keep-Alive وHTTP/2، وفي SMTP ومجمعات الخيوط.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على PostgreSQL 18.6 وPgBouncer 1.26.0 من مستودع PGDG مع Docker Engine 29.8.0.
- أكتوبر 2026: إضافة مجمع Redis وValkey ومجمع اتصالات Nginx بالتطبيق، مع مختبر على Nginx 1.31.6 وNode.js 26.10.0 وValkey 9.1.2 وredis-py 8.1.0.


