

تشتري خادماً افتراضياً VPS فيه أربعة معالجات افتراضية vCPU، وتنشر عليه تطبيقك، ثم تفتح top في يوم مزدحم فتجد المعالج عند 100% والتطبيق بطيء، أو تجد متوسط الحمل Load Average يقول 8 على سيرفر فيه أربع أنوية فقط ولا تعرف هل هذه كارثة أم أمر عادي. وفي يوم آخر يشكو تطبيقك في Container من البطء والسيرفر نفسه شبه فارغ، أو تكتشف أن تطبيق Node.js يستخدم نواة واحدة من ثمانية، أو أن الخيوط Threads التي أضفتها لكود Python لم تسرع الحساب أبداً، أو تقرأ في السجلات Logs أن قاعدة البيانات Database ترفض الاتصالات لأن عددها تجاوز الحد.
وكل هذه الأعراض لها سبب واحد في الأصل، وهو أن أغلبنا يتعامل مع المعالج CPU كرقم في عرض المزود، بينما الذي يحدث فعلاً أن نظام التشغيل يوزع الوقت على عمليات Processes وخيوط Threads تتنافس على أنوية محدودة، وأن طريقة كتابة التطبيق تحدد هل يستفيد من هذه الأنوية أم يبقى ينتظر. وهذا المقال يشرح ما يحدث فعلاً من العتاد حتى إعدادات تطبيقاتك، مع تجارب حقيقية في Docker تقيس كل فكرة بالأرقام.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي يوجد داخل المعالج: المقبس Socket والنواة Core والخيط العتادي Hardware Thread، وما هو ال vCPU الذي تشتريه، وكيف تقرأ
lscpuوnproc. - كيف يوزع Linux الوقت: العملية والخيط، والمجدول Scheduler، وتبديل السياق Context Switch، وما الذي يحسبه متوسط الحمل فعلاً.
- الفرق بين التزامن Concurrency والتوازي Parallelism، وطرق البرمجة المختلفة: الخيوط المتعددة Multithreading، والعمليات المتعددة Multiprocessing، وحلقة الأحداث Event Loop، والخيوط الافتراضية Virtual Threads، وقفل GIL في Python.
- تجارب بالأرقام على Python وNode.js وJava تبين متى يفيد كل نموذج ومتى لا يفيد.
- ما يعنيه ذلك لتطبيقاتك: عدد العمال Workers في Gunicorn وPHP-FPM وNginx وNode.js، واتصالات قاعدة البيانات، والمهام الخلفية.
- حدود المعالج في ال Containers، والخنق Throttling الذي يبطئ تطبيقك والسيرفر فارغ، وكيف تكتشف كل لغة عدد المعالجات المتاحة لها.
- أدوات القياس، وكيف تختار عدد ال vCPU لسيرفرك، ثم الأخطاء الشائعة وقائمة تحقق.
أعراض تراها على سيرفرك ولا تفهم سببها
قبل الشرح لنضع الأعراض في جدول واحد، والسبب أن كل عرض منها له تفسير في جزء محدد من المقال، فإذا كنت جئت من أجل مشكلة معينة فابدأ من الجزء الذي يخصها:
| ما تراه | السبب الغالب | أين تجد الشرح |
|---|---|---|
| المعالج عند 100% والتطبيق بطيء على VPS بأربعة vCPU | عمل حسابي أكثر من الأنوية، أو وقت سرقة Steal Time من جيرانك على نفس السيرفر الفعلي | ال vCPU في الخادم الافتراضي والقياس |
| متوسط الحمل 8 على أربع أنوية | قد يكون طابوراً على المعالج، وقد يكون عمليات تنتظر القرص | متوسط الحمل |
| Container بطيء والسيرفر شبه فارغ | الخنق Throttling بسبب حد --cpus | ال Containers وحدود المعالج |
| تطبيق Node.js يستخدم نواة واحدة من ثمانية | حلقة الأحداث تعمل في خيط واحد | حلقة الأحداث وعمال الويب |
| خيوط Python لا تسرع العمل الحسابي | قفل GIL | Python وقفل GIL |
FATAL: sorry, too many clients already من PostgreSQL | عدد العمال والخيوط في التطبيق أكبر من اتصالات قاعدة البيانات | اتصالات قاعدة البيانات |
ما الذي يوجد داخل المعالج؟
المقبس والنواة والخيط العتادي
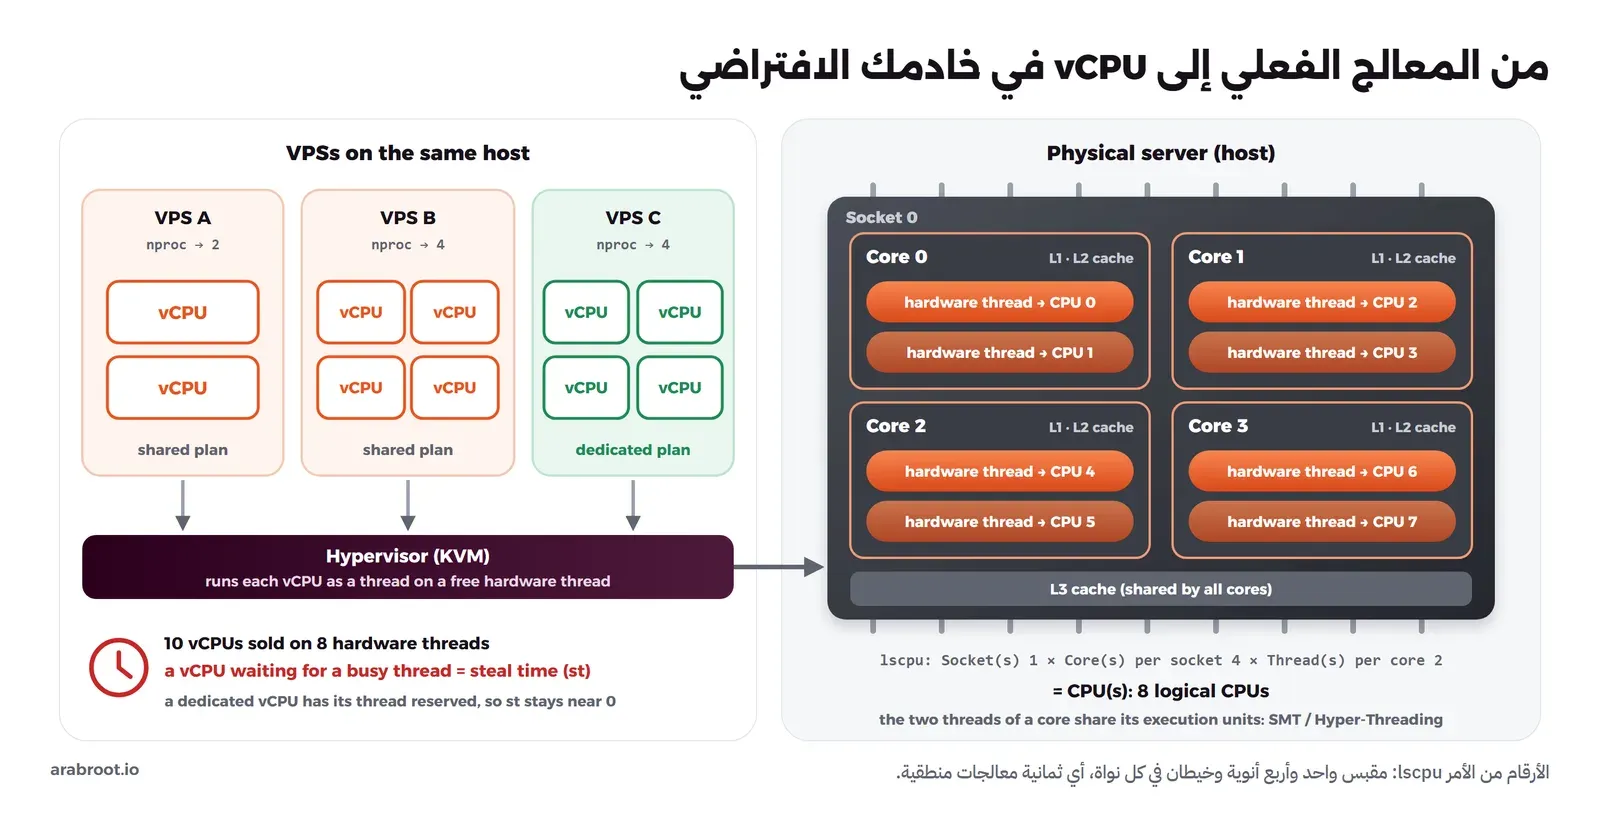
المعالج CPU هو الشريحة التي تنفذ أوامر البرامج، وتركب في السيرفر في مقبس Socket على اللوحة الأم، وسيرفرات مراكز البيانات فيها غالباً مقبس أو اثنان. وداخل الشريحة عدة أنوية Cores، وكل نواة معالج كامل بذاته يستطيع أن ينفذ برنامجاً مستقلاً عن بقية الأنوية، وبالتالي فالمعالج الذي فيه أربع أنوية يستطيع أن ينفذ أربعة أشياء في نفس اللحظة فعلاً.
ثم جاءت تقنية تعدد الخيوط المتزامن Simultaneous Multithreading واختصاراً SMT، وتسميها Intel باسم Hyper-Threading، وفكرتها أن النواة الواحدة تظهر لنظام التشغيل كمعالجين منطقيين Logical CPUs، أي خيطين عتاديين Hardware Threads. والسبب أن وحدات التنفيذ داخل النواة تبقى معطلة جزءاً من الوقت وهي تنتظر بيانات من الذاكرة، فإذا كان هناك خيط ثان جاهز استغل هذه الفراغات. ولكن لاحظ أن الخيطين يتقاسمان نفس وحدات التنفيذ، لذلك فالخيط العتادي الثاني لا يساوي نواة ثانية، والمكسب الحقيقي منه يختلف بحسب نوع العمل، فقد يكون كبيراً في عمل كثير الانتظار للذاكرة، وقد يكون قريباً من الصفر في حساب مكثف يشغل وحدات التنفيذ كلها.
وقد يتساءل البعض: لماذا لا نقارن المعالجات بالسرعة Clock Speed فقط، أي 4.2 GHz مقابل 3.0 GHz؟ والإجابة أن السرعة هي عدد الدورات في الثانية، أما كمية العمل في كل دورة Instructions Per Cycle واختصاراً IPC فتختلف من جيل لآخر، لذلك قد يكون معالج حديث بسرعة 3 GHz أسرع من معالج قديم بسرعة 4 GHz، وأفضل مقارنة هي قياس تطبيقك نفسه على الخطتين. ويبقى عنصر أخير هو الذاكرة المؤقتة Cache داخل المعالج: L1 وL2 لكل نواة وهي صغيرة وسريعة جداً، وL3 مشتركة بين الأنوية وهي أكبر وأبطأ قليلاً، وكلها أسرع بكثير من الذاكرة RAM، ولهذا السبب سوف ترى لاحقاً أن نقل خيط من نواة لأخرى ليس مجانياً.
ال vCPU في الخادم الافتراضي
عندما تشتري VPS بأربعة vCPU فأنت لا تحصل على أربع أنوية فعلية، وإنما على أربعة معالجات افتراضية، وكل واحد منها في الغالب يعمل كخيط عادي على سيرفر المزود، ويجدوله ال Hypervisor مثل KVM على أي خيط عتادي متاح، وبالتالي فال vCPU الواحد يقابل غالباً خيطاً عتادياً واحداً وليس نواة كاملة. وكما شرحنا في دليل مصطلحات الاستضافة الذاتية فالآلة الافتراضية Virtual Machine تحمل نظام تشغيل كاملاً فوق ال Hypervisor، ولذلك يرى Linux داخلها هذه المعالجات الافتراضية وكأنها معالجات حقيقية.
والمزود يبيع عادة ال vCPU بطريقتين: المشترك Shared، وفيه يبيع على السيرفر الفعلي معالجات افتراضية أكثر من خيوطه العتادية لأن أغلب العملاء لا يستخدمون المعالج طوال الوقت، والمخصص Dedicated، وفيه يحجز لك خيوطاً عتادية لا يشاركك فيها أحد بسعر أعلى. وفي الخطة المشتركة إذا احتاج جيرانك المعالج في نفس الوقت الذي تحتاجه أنت انتظر ال vCPU الخاص بك حتى يفرغ خيط عتادي، وهذا الانتظار يسجله Linux داخل سيرفرك باسم وقت السرقة Steal Time، ويظهر في عمود st في top وvmstat. وقد شرحنا في دليل كيف تختار خادماً افتراضياً متى يكفيك المشترك ومتى تحتاج المخصص، وسوف نعود لقراءة هذا العمود في جزء القياس.
كيف تقرأ lscpu وnproc؟
الأمر lscpu يعرض ما يراه Linux من المعالج، والأمر nproc يعرض عدد المعالجات المتاحة للعملية الحالية. والمثال التالي يعرض الأسطر المهمة فقط من مخرج lscpu:
lscpu | grep -E '^(CPU\(s\)|Model name|Thread|Core|Socket|Hypervisor|L1d|L2|L3)'
nproc
والمخرج سوف يكون كما يلي:
CPU(s):                               8
Model name:                           Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
Thread(s) per core:                   2
Core(s) per socket:                   4
Socket(s):                            1
Hypervisor vendor:                    Microsoft
L1d cache:                            128 KiB (4 instances)
L2 cache:                             1 MiB (4 instances)
L3 cache:                             8 MiB (1 instance)
8
في المخرج أعلاه لاحظ التالي:
- عدد المعالجات المنطقية
CPU(s)هو حاصل ضرب الأسطر الثلاثة: مقبس واحد في أربع أنوية في خيطين لكل نواة، أي ثمانية. - السطر
Hypervisor vendorيعني أن هذا النظام نفسه آلة افتراضية، وعلى VPS سوف تجد فيه غالباًKVM، وعندها يكونThread(s) per coreوCore(s) per socketما يعرضه المزود على الآلة الافتراضية، وقد لا يطابق العتاد الحقيقي تحته. - الذاكرة L1 وL2 أربع نسخ أي واحدة لكل نواة، وL3 نسخة واحدة مشتركة، تماماً كما في المخطط أعلاه.
nprocأعاد 8، ولكن تذكر هذا الرقم، فسوف ترى في جزء ال Containers أنه يبقى 8 حتى داخل Container مسموح له بمعالج واحد فقط.
كيف يوزع نظام التشغيل العمل على المعالج؟
العملية Process والخيط Thread
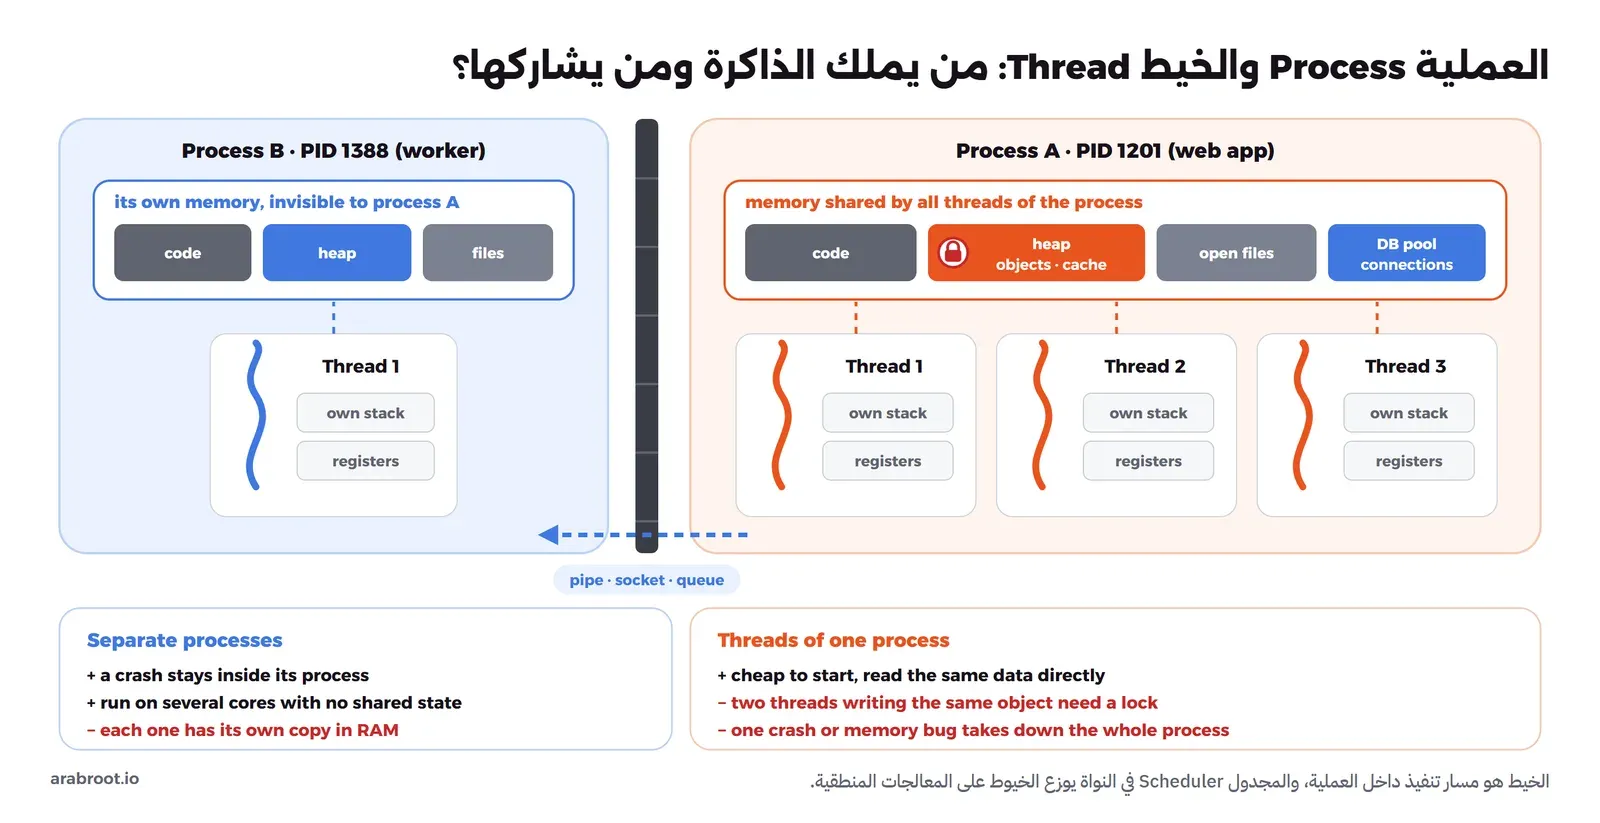
العملية Process هي برنامج يعمل، ولها مساحة ذاكرة خاصة بها لا تراها العمليات الأخرى، وفيها الكود والبيانات والملفات المفتوحة، أما الخيط Thread فهو مسار تنفيذ داخل العملية، وكل عملية تبدأ بخيط واحد ويمكنها أن تنشئ خيوطاً أخرى. والفرق المهم أن خيوط العملية الواحدة تشترك في نفس الذاكرة، ولكل خيط مكدس Stack وسجلات Registers خاصة به فقط، وبالتالي فالخيوط تتبادل البيانات بسرعة لأنها تقرأ نفس المتغيرات، ولكنها تحتاج أقفالاً Locks حتى لا يكتب خيطان على نفس الكائن في نفس اللحظة، وإذا انهار خيط بسبب خطأ في الذاكرة سقطت العملية كلها. أما العمليات المنفصلة فكل واحدة معزولة، فإذا انهارت واحدة بقيت الأخرى، ولكن كل واحدة تحمل نسختها من البيانات في الذاكرة، وتتواصل مع غيرها عبر Pipe أو Socket أو طابور Queue.
المجدول وتبديل السياق
على سيرفرك عادة مئات الخيوط وعدد قليل من المعالجات المنطقية، والذي يقرر أي خيط يعمل على أي معالج وإلى متى هو المجدول Scheduler في نواة Linux. وأغلب هذه الخيوط نائمة تنتظر شيئاً، مثل طلب من الشبكة أو رد من القرص، أما الخيوط الجاهزة للعمل فتقف في طابور التشغيل Run Queue، والمجدول يعطي كل واحد منها شريحة زمنية Time Slice ثم ينقل المعالج لغيره. وقد كان المجدول الافتراضي في Linux لسنوات هو CFS، ومنذ الإصدار 6.6 بدأ الانتقال إلى EEVDF، والفكرة العامة واحدة في الحالتين وهي توزيع الوقت بعدل بين الخيوط الجاهزة.
وكل انتقال من خيط لآخر اسمه تبديل السياق Context Switch، وفيه يحفظ النظام سجلات الخيط الأول ويحمل سجلات الثاني، وقد يجد الخيط الجديد أن بياناته ليست في ال Cache فيجلبها من الذاكرة. وهذا التبديل سريع جداً، ولكنه يصبح مكلفاً عندما يتكرر عشرات الآلاف من المرات في الثانية لأنك أنشأت خيوطاً أكثر بكثير من المعالجات، وسوف تراه في عمود cs من مخرج vmstat.
ما الذي يحسبه متوسط الحمل Load Average فعلاً؟
الأمر uptime يعرض ثلاثة أرقام هي متوسط الحمل في آخر دقيقة وخمس دقائق وخمس عشرة دقيقة، والتفسير الشائع أنه عدد العمليات التي تستخدم المعالج أو تنتظره، وبالتالي فإذا تجاوز عدد المعالجات فالسيرفر مشغول. وهذا التفسير ناقص في Linux تحديداً، والسبب أن Linux يحسب في المتوسط أيضاً الخيوط في حالة الانتظار غير القابل للمقاطعة Uninterruptible Sleep، وتظهر بالحرف D في ps، وهي غالباً خيوط تنتظر القرص أو نظام ملفات عبر الشبكة، كما يشرح Brendan Gregg في مقاله عن متوسط الحمل في Linux وصفحة /proc/loadavg. لذلك فالحمل المرتفع قد يعني معالجاً مزدحماً، وقد يعني قرصاً بطيئاً والمعالج نصف فارغ.
والمثال التالي من سيرفر فيه ثمانية معالجات منطقية في وقت كان القرص فيه تحت ضغط كبير:
nproc
uptime
vmstat 1 5
والمخرج سوف يكون كما يلي:
8
 22:29:22 up  1:30,  0 user,  load average: 14.78, 15.55, 16.50

procs -----------memory---------- ---swap-- -----io---- -system-- -------cpu-------
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st gu
12  2  45588 468364 1371660 26726772    0    8  1204 10286 2836   22 29 16 37 18  0  0
 5  3  45588 453568 1371732 26732188    0    0  3400 51388 2972 10492 28 37 17 18  0  0
 4  7  45588 439992 1371772 26741268    0    0  4080 60112 1525 6539 33 21 15 30  0  0
13  4  45588 453380 1371852 26756084    0    0  3920 31036  984 6948 41 32  8 20  0  0
 3  3  45588 490408 1371928 26765376    0    0  3480 35760 1787 8213 11 16 37 36  0  0
في المخرج أعلاه لاحظ التالي:
- متوسط الحمل قرابة 15 على ثمانية معالجات، ومن ينظر إليه وحده يظن أن المعالج مختنق.
- العمود
rهو عدد الخيوط الجاهزة للعمل، والعمودbهو عدد الخيوط المحجوزة Blocked في انتظار القرص، ومتوسط الحمل يجمع الاثنين. - العمود
idيقول إن المعالج كان فارغاً بين 8% و37% من الوقت، والعمودwaيقول إن ما بين 18% و36% كان انتظاراً للقرص I/O Wait، والعمودboيعرض كتابة عشرات الآلاف من الكتل في الثانية، لذلك فجزء كبير من هذا الحمل قرص وليس معالجاً. - العمود
stصفر، أي لا يوجد وقت سرقة، ولو كان مرتفعاً لكان السبب جيرانك على السيرفر الفعلي.
والقاعدة العملية أن تقارن متوسط الحمل بعدد المعالجات من nproc، ثم لا تحكم قبل أن تنظر في us وsy وwa وst وفي العمودين r وb، والسبب أن الرقم الواحد يجمع مشكلتين مختلفتين تماماً في العلاج.
مهمة تحسب ومهمة تنتظر
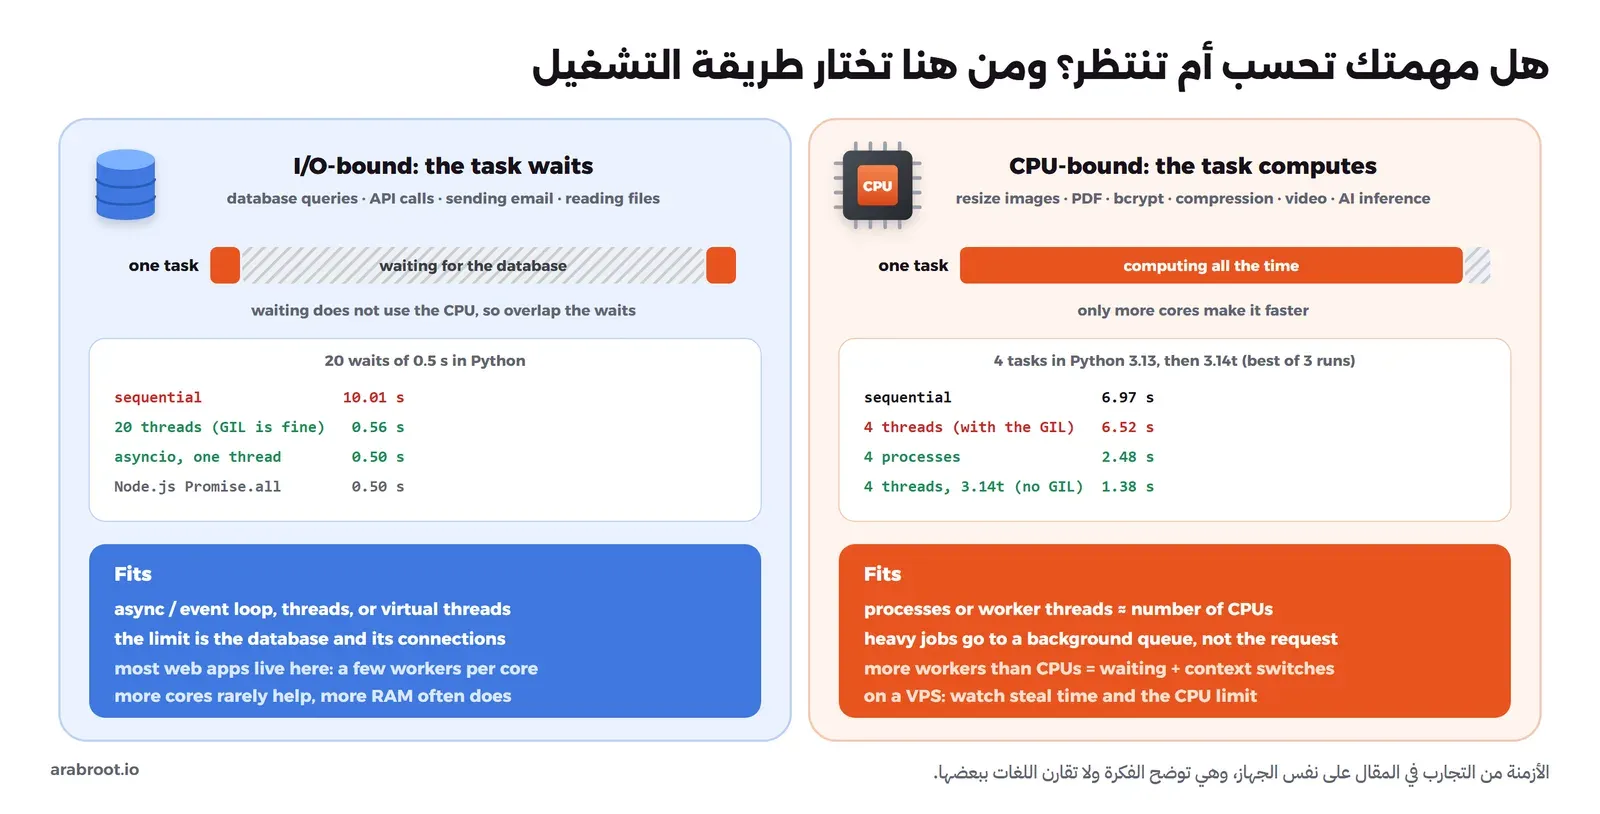
قبل أن ننتقل لطرق البرمجة نحتاج تقسيماً واحداً سوف نعود إليه في كل قسم من المقال: المهمة المحدودة بالمعالج CPU-bound هي التي تقضي وقتها في الحساب، مثل تغيير حجم الصور وتوليد ملفات PDF وتشفير كلمات المرور بخوارزمية bcrypt والضغط Compression، وهذه لا يسرعها إلا معالج أكثر. أما المهمة المحدودة بالإدخال والإخراج I/O-bound فتقضي أغلب وقتها في الانتظار، مثل استعلام قاعدة البيانات وطلب API خارجي وإرسال البريد وقراءة الملفات، وفي وقت الانتظار هذا لا تستخدم المعالج أصلاً، لذلك يسرعها أن تتداخل فترات الانتظار، وليس أن تضيف أنوية. وأغلب تطبيقات الويب من النوع الثاني، فالطلب يصرف بضعة أجزاء من الثانية في الكود، ثم ينتظر قاعدة البيانات أضعاف ذلك.
التزامن Concurrency والتوازي Parallelism: ما الفرق؟
التزامن أن يكون لديك عدة مهام قيد التنفيذ في نفس الفترة، تتقدم كل واحدة منها خطوة ثم تفسح المجال لغيرها، أما التوازي فهو أن تعمل عدة مهام في نفس اللحظة فعلاً على أنوية مختلفة. والتشبيه الأقرب هو المطبخ: طباخ واحد عنده ثلاثة طلبات، فيضع الأول في الفرن، وأثناء انتظاره يقطع خضار الثاني، ثم يقلب الثالث، فالطلبات الثلاثة قيد التنفيذ معاً وهذا تزامن، ولكن في أي لحظة لا يعمل إلا على طلب واحد. أما إذا أحضرت ثلاثة طباخين فكل واحد يطبخ طلبه في نفس الوقت، وهذا توازي.
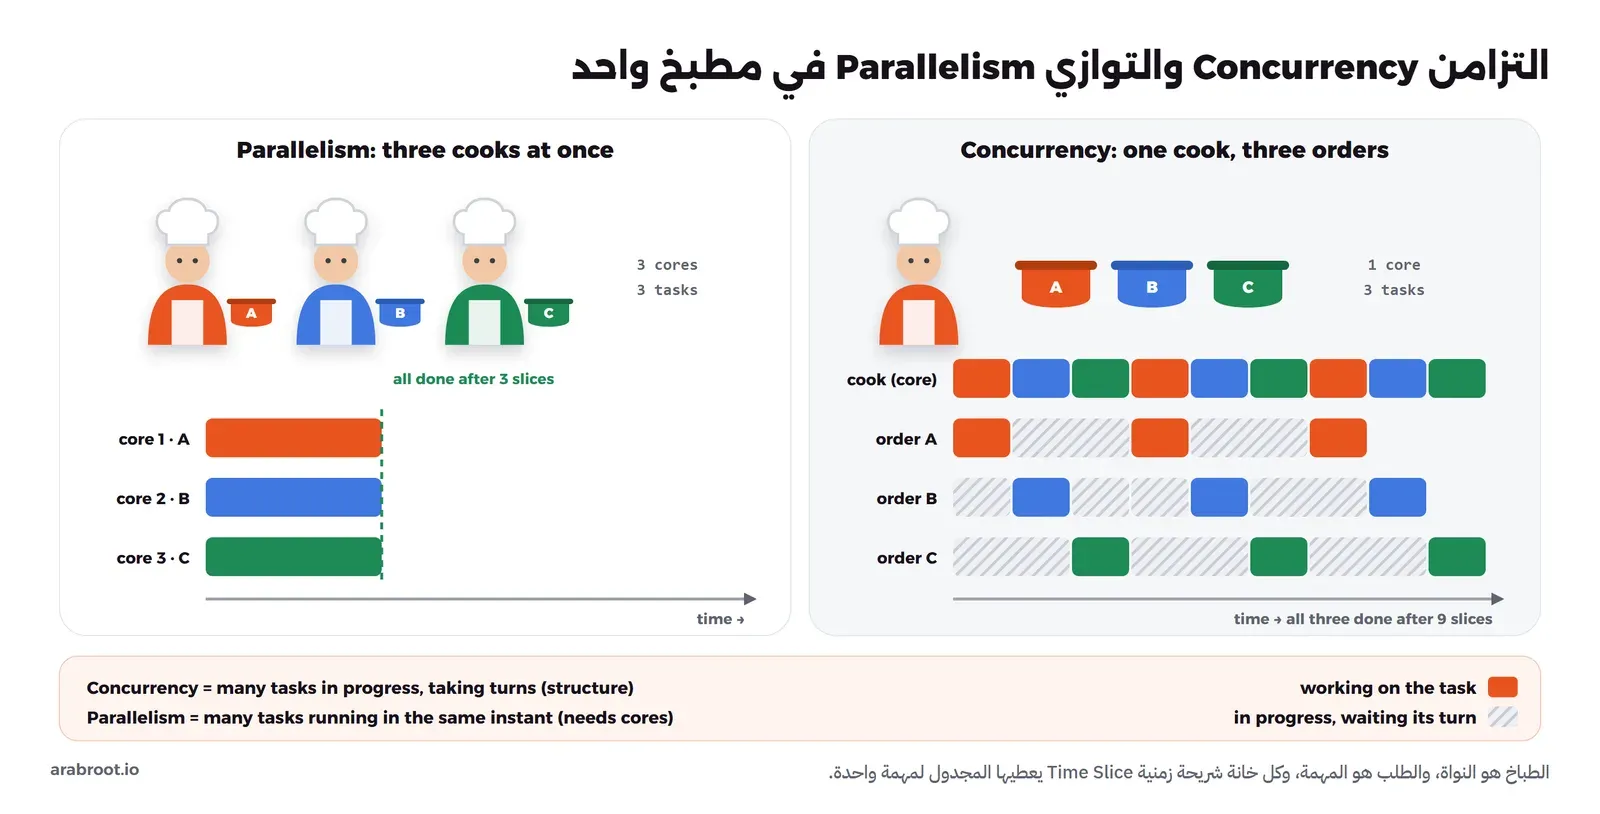
ولاحظ في المخطط أمرين: الأول أن الطباخ الواحد لم يصبح أسرع في الطبخ نفسه، فمجموع العمل تسع شرائح في الحالتين، وإنما استغل أوقات الانتظار، وهذا بالضبط ما يحدث في المهام التي تنتظر. والثاني أن التوازي يحتاج أنوية حقيقية، فلو أعطيت برنامجاً ثلاثة خيوط على معالج واحد فلن تحصل إلا على التزامن. والسيرفر الحقيقي يجمع الاثنين، فهو يشغل عدة أنوية بالتوازي، وعلى كل نواة يتناوب عدد كبير من المهام.
طرق كتابة البرامج التي تعمل على أكثر من مهمة
الخيوط المتعددة Multithreading
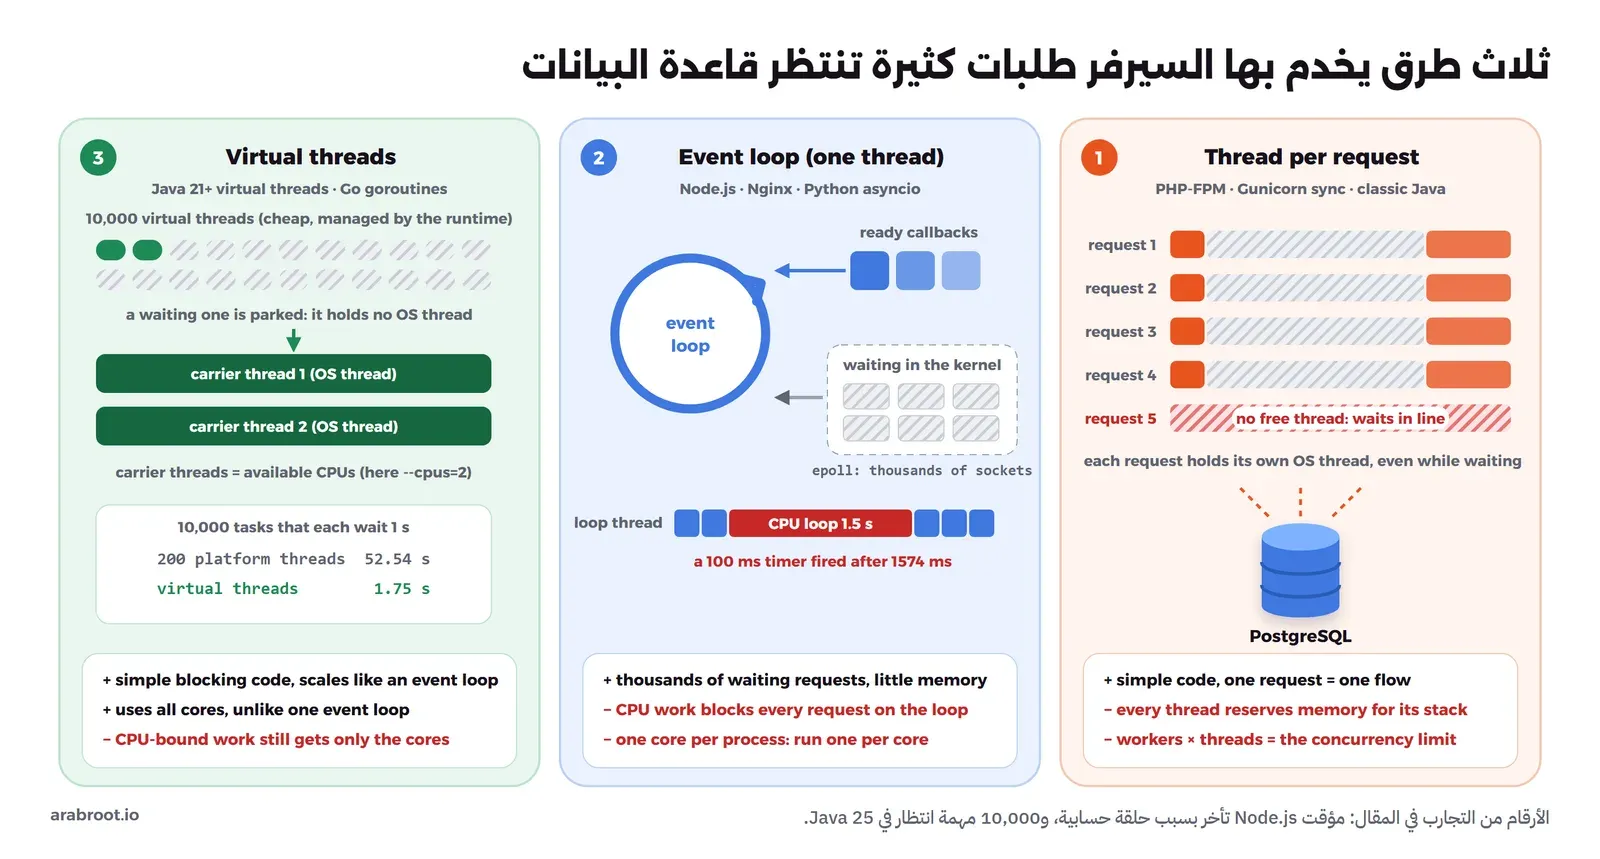
أول طريقة يفكر فيها المطور أن ينشئ خيطاً لكل مهمة، وفي السيرفرات خيطاً لكل طلب Thread per Request، وهذه هي الطريقة التقليدية في Java وفي Apache وكثير من الأطر. وهي بسيطة لأن الكود يكتب بالترتيب الطبيعي، فالخيط يطلب من قاعدة البيانات وينتظر الرد ثم يكمل، وأثناء انتظاره يعمل خيط آخر. ولكن مشكلتها أن كل خيط من خيوط نظام التشغيل يحجز ذاكرة لمكدسه ويكلف المجدول تبديلاً للسياق، لذلك لا تستطيع أن تنشئ مئة ألف خيط لمئة ألف اتصال مفتوح، وتنتهي في الواقع بمجمع خيوط Thread Pool بحجم ثابت، وإذا امتلأ وقفت الطلبات الجديدة في الطابور حتى لو كان المعالج فارغاً.
العمليات المتعددة Multiprocessing
الطريقة الثانية أن تشغل عدة نسخ من البرنامج كعمليات منفصلة، وهذا ما يفعله Gunicorn مع عماله Workers وPHP-FPM مع عملياته الفرعية وNginx مع worker_processes. ونقاط قوتها أن كل عملية تعمل على نواة مستقلة دون أقفال مشتركة، وأن انهيار عامل لا يسقط البقية، أما نقطة ضعفها فهي الذاكرة، فكل عامل يحمل نسخته من التطبيق ومكتباته، وعشرون عاملاً لتطبيق Django أو Laravel قد تعني عدة جيجابايت من الذاكرة.
حلقة الأحداث Event Loop في Node.js
الطريقة الثالثة لا تنتظر أصلاً، فبدلاً من أن يقف الخيط حتى يصل رد قاعدة البيانات، يسجل البرنامج دالة Callback تعمل عندما يصل الرد ثم ينتقل فوراً لطلب آخر، ويتولى النظام مراقبة آلاف الاتصالات المفتوحة معاً عبر epoll، وحلقة الأحداث تأخذ كل رد يصل وتنفذ الدالة الخاصة به. وبهذا الشكل يخدم خيط واحد آلاف الطلبات التي تنتظر بذاكرة قليلة، وهذا هو نموذج Node.js وNginx وasyncio في Python.
ولكن هناك مشكلة رئيسية في هذا النموذج، وهي أن الكود نفسه يعمل في خيط واحد، فإذا قام أحد الطلبات بعمل حسابي طويل توقفت الحلقة كلها ولم يخدم أي طلب آخر حتى ينتهي. والمثال التالي فيه مؤقت Timer يفترض أن يعمل كل 100 ms، وبعد 350 ms تبدأ حلقة حسابية مدتها ثانية ونصف في نفس الخيط، احفظه باسم block.mjs:
// A timer that should fire every 100 ms, and a CPU-bound loop on the same thread
let last = performance.now();
const timer = setInterval(() => {
  const now = performance.now();
  console.log(`tick after ${Math.round(now - last)} ms`);
  last = now;
}, 100);

setTimeout(() => {
  console.log('CPU work starts');
  const end = Date.now() + 1500;
  while (Date.now() < end) {}          // 1.5 s of pure computation
  console.log('CPU work ends');
}, 350);

setTimeout(() => clearInterval(timer), 2400);
ثم شغله في Container من Node.js 24:
docker run --rm --name lab-cpu-node -v "$PWD":/lab -w /lab node:24-alpine node block.mjsوالمخرج سوف يكون كما يلي:
tick after 101 ms
tick after 109 ms
tick after 104 ms
CPU work starts
CPU work ends
tick after 1574 ms
tick after 101 ms
tick after 105 ms
tick after 100 ms
tick after 101 ms
tick after 113 ms
لاحظ السطر tick after 1574 ms، فالمؤقت الذي يعمل كل 100 ms انتظر أكثر من ثانية ونصف، ولو كان هذا سيرفر ويب لانتظر كل زائر في تلك اللحظة نفس المدة، حتى من يطلب صفحة لا تحتاج أي حساب. لذلك القاعدة في Node.js أن العمل الحسابي الطويل لا يكون في حلقة الأحداث، وإنما في Worker Threads أو في عامل خلفي منفصل. والنقطة الثانية أن عملية Node.js الواحدة تستخدم نواة واحدة لتنفيذ الكود، لذلك إذا أردت أن تستفيد من كل الأنوية فشغل عدة عمليات كما سيأتي في جزء عمال الويب.
الخيوط الافتراضية Virtual Threads وGoroutines
الطريقة الرابعة تجمع بساطة الخيوط وخفة حلقة الأحداث، وفكرتها أن الخيط الذي يراه المطور ليس خيطاً من نظام التشغيل، وإنما خيط خفيف تديره بيئة التشغيل Runtime، وعندما ينتظر الشبكة أو قاعدة البيانات تنزله البيئة عن خيط النظام وتضع مكانه خيطاً آخر جاهزاً. وبالتالي يكتب المطور كوداً عادياً ينتظر بالترتيب الطبيعي، وتعمل خلفه بضعة خيوط حقيقية تسمى Carrier Threads بعدد المعالجات. وهذا هو نموذج Goroutines في Go منذ بدايتها، وهو أيضاً الخيوط الافتراضية في Java التي أصبحت ميزة نهائية في JDK 21 عبر JEP 444، وتقول وثيقتها إن الفائدة الأكبر تكون عندما يكون عدد المهام المتزامنة كبيراً، أي أكثر من بضعة آلاف، ولا يكون العمل محدوداً بالمعالج.
والمثال التالي ينفذ 10,000 مهمة، كل واحدة تنتظر ثانية كأنها تنتظر قاعدة البيانات، مرة على مجمع من 200 خيط من خيوط النظام، ومرة على خيوط افتراضية، احفظه باسم Threads.java:
import java.time.Duration;
import java.util.concurrent.Executors;

public class Threads {
    static void run(String label, java.util.concurrent.ExecutorService pool) {
        long start = System.nanoTime();
        try (pool) {
            for (int i = 0; i < 10_000; i++) {
                pool.submit(() -> { Thread.sleep(Duration.ofSeconds(1)); return null; });  // waiting for I/O
            }
        }
        System.out.printf("%-22s %5.2f s%n", label, (System.nanoTime() - start) / 1e9);
    }

    public static void main(String[] args) {
        System.out.println("Java " + Runtime.version() + ", availableProcessors: " + Runtime.getRuntime().availableProcessors());
        run("200 platform threads", Executors.newFixedThreadPool(200));
        run("virtual threads", Executors.newVirtualThreadPerTaskExecutor());
    }
}
ثم شغله في Container حده معالجان:
docker run --rm --name lab-cpu-java --cpus=2 -v "$PWD":/lab -w /lab eclipse-temurin:25-jdk-alpine java Threads.javaوالمخرج سوف يكون كما يلي:
Java 25.0.4.1+1-LTS, availableProcessors: 2
200 platform threads   52.54 s
virtual threads         1.75 s
والنتيجة منطقية، فمجمع ال 200 خيط ينهي 200 مهمة في كل ثانية، أي يحتاج خمسين ثانية للعشرة آلاف، أما الخيوط الافتراضية فتنتظر كلها معاً على خيطين حقيقيين فقط. ولكن تذكر أن هذا المكسب في الانتظار وحده، فلو كانت المهام حساباً لما أسرعها شيء غير الأنوية، والخيوط الافتراضية في هذه الحالة لا تضيف شيئاً. ولاحظ أيضاً السطر الأول، فقد قرأت Java حد ال Container وأعادت availableProcessors: 2، وسوف نعود لذلك في جزء اكتشاف عدد المعالجات.
Python وقفل GIL
في التنفيذ المعتاد للغة Python المسمى CPython يوجد قفل عام اسمه Global Interpreter Lock واختصاراً GIL، ولا يسمح إلا لخيط واحد بتنفيذ كود Python في أي لحظة. لذلك فالخيوط في Python تفيد في الانتظار، لأن الخيط يترك القفل وهو ينتظر الشبكة أو القرص، ولا تفيد في الحساب، لأن الخيوط الحسابية تتناوب على قفل واحد. والحل التقليدي للحساب هو multiprocessing أو ProcessPoolExecutor، أي عمليات منفصلة لكل منها مفسر وقفل خاص بها.
وقد اقترحت PEP 703 نسخة من CPython دون هذا القفل تسمى Free-threaded، فظهرت نسخة تجريبية منها في Python 3.13، ثم أصبحت في Python 3.14 مدعومة رسمياً عبر PEP 779، ولكنها ما زالت نسخة اختيارية تنصبها بنفسك وليست الافتراضية، ويذكر دليلها الرسمي أن الكود ذا الخيط الواحد يصبح فيها أبطأ بنسبة تتراوح بين 1% و8% بحسب النظام. ويجب أن تتأكد أن المكتبات التي تعتمد عليها، خاصة التي فيها كود C، تدعم هذه النسخة قبل أن تنقل إليها تطبيقاً حقيقياً، ونتيجة القياس في التجربة العملية أدناه.
تجربة عملية: نقيس الفرق بأنفسنا
الآن سوف نقوم بقياس الأفكار السابقة على نفس الجهاز، وتذكر أن هذه الأرقام توضح الفكرة ولا تقارن اللغات ببعضها، وأنها تتغير بحسب الجهاز والحمل عليه، لذلك يعرض كل اختبار حسابي أفضل زمن من ثلاث محاولات حتى يقل أثر البرامج الأخرى العاملة على الجهاز. أنشئ مجلداً فارغاً وضع فيه الملفات التالية، وكل الأوامر تشغل من داخله.
مهمة حسابية: خيوط أم عمليات؟
البرنامج التالي ينفذ نفس الحساب أربع مرات بثلاث طرق: بالتتابع، ثم في أربعة خيوط، ثم في أربع عمليات، احفظه باسم cpu_bound.py:
import os, sys, time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def work(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

def once(pool, tasks, n):
    start = time.perf_counter()
    if pool is None:
        for _ in range(tasks):
            work(n)
    else:
        with pool(max_workers=tasks) as ex:
            list(ex.map(work, [n] * tasks))
    return time.perf_counter() - start

def run(label, pool, tasks=4, n=5_000_000):
    best = min(once(pool, tasks, n) for _ in range(3))   # best of 3 runs
    print(f"{label:<14}{best:6.2f} s")

if __name__ == "__main__":
    print(sys.version.split()[0], "GIL:", sys._is_gil_enabled(), "cpu_count:", os.cpu_count())
    run("sequential", None)
    run("4 threads", ThreadPoolExecutor)
    run("4 processes", ProcessPoolExecutor)
docker run --rm --name lab-cpu-py -v "$PWD":/lab -w /lab python:3.13-slim python cpu_bound.pyوالمخرج سوف يكون كما يلي:
3.13.16 GIL: True cpu_count: 8
sequential      6.97 s
4 threads       6.52 s
4 processes     2.48 s
والخيوط الأربعة لم توفر شيئاً تقريباً بسبب قفل GIL، أما العمليات الأربع فأنهت العمل في قرابة ثلث الوقت، ولم تصل إلى الربع لأن إنشاء العمليات ونقل البيانات إليها له ثمن، ولأن الأنوية الأربع تشارك الجهاز مع برامج أخرى. والآن نكرر نفس البرنامج على Python 3.14 العادية والنسخة الحرة منها 3.14t، ونستخدم uv لتنزيل النسختين:
docker run --rm --name lab-cpu-ft -v "$PWD":/lab -w /lab python:3.13-slim sh -c '
  pip install -q uv
  uv python install -q 3.14 3.14t
  for v in 3.14 3.14t; do $(uv python find $v) cpu_bound.py; done'
والمخرج سوف يكون كما يلي:
3.14.8 GIL: True cpu_count: 8
sequential      2.63 s
4 threads       2.33 s
4 processes     0.75 s
3.14.8 GIL: False cpu_count: 8
sequential      3.10 s
4 threads       1.38 s
4 processes     1.90 s
في المخرج أعلاه لاحظ التالي:
- مع القفل بقيت الخيوط قريبة من التتابع، والعمليات هي التي أسرعت، تماماً كما في 3.13.
- في النسخة الحرة
GIL: Falseأصبحت الخيوط الأربعة أسرع من التتابع بأكثر من الضعف، وهذا هو الهدف من PEP 703. - التتابع في النسخة الحرة أبطأ من النسخة العادية، وهذا ثمن إزالة القفل الذي ذكره الدليل الرسمي، وأرقام العمليات هنا تتأثر بالحمل على الجهاز أكثر من غيرها، فلا تبن عليها قراراً من محاولة واحدة.
- الفرق الكبير بين أزمنة 3.13 و3.14 يرجع إلى اختلاف الإصدار وطريقة بنائه، ولا علاقة له بموضوعنا، لذلك قارن دائماً داخل الإصدار الواحد.
مهمة تنتظر: التتابع أم الخيوط أم asyncio؟
البرنامج التالي ينفذ عشرين انتظاراً مدة كل واحد نصف ثانية كأنها استعلامات لقاعدة البيانات، احفظه باسم io_bound.py:
import asyncio, time
from concurrent.futures import ThreadPoolExecutor

def fake_query():
    time.sleep(0.5)          # waiting for a database or an API

async def fake_query_async():
    await asyncio.sleep(0.5)

def timed(label, fn):
    start = time.perf_counter()
    fn()
    print(f"{label:<14}{time.perf_counter() - start:6.2f} s")

def sequential():
    for _ in range(20):
        fake_query()

def threads():
    with ThreadPoolExecutor(max_workers=20) as ex:
        for _ in range(20):
            ex.submit(fake_query)

async def gather():
    await asyncio.gather(*(fake_query_async() for _ in range(20)))

timed("sequential", sequential)
timed("20 threads", threads)
timed("asyncio", lambda: asyncio.run(gather()))
docker run --rm --name lab-cpu-py -v "$PWD":/lab -w /lab python:3.13-slim python io_bound.pyوالمخرج سوف يكون كما يلي:
sequential     10.01 s
20 threads      0.56 s
asyncio         0.50 s
وهنا انعكست الصورة، فالخيوط العشرون أسرعت العمل عشرين مرة تقريباً رغم وجود القفل، والسبب أن الخيط يترك القفل وهو ينتظر، أما asyncio فوصلت لنفس النتيجة بخيط واحد. ونفس الفكرة في Node.js، احفظ الملف التالي باسم io.mjs:
const wait = (ms) => new Promise((r) => setTimeout(r, ms));   // a database or API call

let start = performance.now();
for (let i = 0; i < 20; i++) await wait(500);
console.log(`sequential     ${((performance.now() - start) / 1000).toFixed(2)} s`);

start = performance.now();
await Promise.all(Array.from({ length: 20 }, () => wait(500)));
console.log(`Promise.all    ${((performance.now() - start) / 1000).toFixed(2)} s`);
docker run --rm --name lab-cpu-node -v "$PWD":/lab -w /lab node:24-alpine node io.mjsوالمخرج سوف يكون كما يلي:
sequential     10.04 s
Promise.all    0.50 s
وهذا من أشهر الأخطاء في كود Node.js، أي أن يكتب المطور await داخل حلقة for لطلبات لا يعتمد بعضها على بعض، فيحول التزامن الذي يقدمه له Node.js إلى تتابع. أما العمل الحسابي في Node.js فيحتاج خيوطاً حقيقية، والملف التالي يقارن أربع مهام حسابية بالتتابع مع أربعة Worker Threads، احفظه باسم workers.mjs:
import { Worker, isMainThread, parentPort } from 'node:worker_threads';
import os from 'node:os';

const work = (n) => { let t = 0; for (let i = 0; i < n; i++) t += i % 7; return t; };
const N = 400_000_000;

if (!isMainThread) {
  parentPort.postMessage(work(N));
} else {
  console.log('availableParallelism:', os.availableParallelism());
  let start = performance.now();
  for (let i = 0; i < 4; i++) work(N);
  console.log(`sequential     ${((performance.now() - start) / 1000).toFixed(2)} s`);

  start = performance.now();
  await Promise.all(Array.from({ length: 4 }, () => new Promise((resolve) => {
    new Worker(new URL(import.meta.url)).on('message', resolve);
  })));
  console.log(`4 workers      ${((performance.now() - start) / 1000).toFixed(2)} s`);
}
docker run --rm --name lab-cpu-node -v "$PWD":/lab -w /lab node:24-alpine node workers.mjsوالمخرج سوف يكون كما يلي:
availableParallelism: 8
sequential     13.48 s
4 workers      5.01 s
والمخطط التالي يجمع النتائج كلها في قاعدة واحدة تختار بها النموذج المناسب لعملك:
ماذا يعني هذا لتطبيقاتك على السيرفر؟
عمال الويب Workers والخيوط
كل خادم تطبيقات تقريباً يسألك سؤالاً واحداً بصيغ مختلفة: كم عاملاً تريد؟ والإجابة تبدأ من نوع العمل، ثم من الذاكرة المتاحة، ثم من الأرقام الرسمية لكل أداة:
- Gunicorn: يقترح دليل تصميمه البدء بالمعادلة
(2 × CPU cores) + 1، ثم التعديل بحسب اختبار الحمل، ويذكر أن 4 إلى 12 عاملاً تكفي غالباً لحمل كبير. والضرب في اثنين مبني على أن العامل يقضي جزءاً من وقته في الانتظار، فإذا كان التطبيق يحسب طوال الوقت فلن يفيدك أن يزيد العمال عن الأنوية. ويمكنك مع العاملgthreadأن تجمع عمالاً وخيوطاً، فالخيوط أخف على الذاكرة والعمال أفضل في العزل. - PHP-FPM: الإعداد
pm.max_childrenهو الحد الأعلى للعمليات، أي الحد الأعلى للطلبات التي تخدم في نفس الوقت، وpmيحدد الطريقة:staticعدد ثابت، وdynamicعدد يتغير بين حدين، وondemandينشئ العمليات عند الطلب. وطريقة الحساب العملية أن تقسم الذاكرة التي تخصصها ل PHP على استهلاك العملية الواحدة كما تراه فيpsأوdocker stats، والسبب أن الذاكرة تنفد هنا قبل المعالج غالباً. - Nginx: القيمة
worker_processes autoتجعله يكتشف عدد الأنوية ويشغل عاملاً لكل واحدة، وكل عامل حلقة أحداث تخدم آلاف الاتصالات، ولاحظ أن القيمة الافتراضية إذا لم تكتب شيئاً هي1. - Node.js: العملية الواحدة تستخدم نواة واحدة للكود كما رأيت، فإذا أردت الأنوية كلها فشغل عدة عمليات عبر وحدة cluster أو عبر وضع cluster في PM2، أو شغل عدة Containers خلف ال Reverse Proxy. واحسب العدد من
os.availableParallelism()وليس منos.cpus().length، مع الانتباه لما سوف تراه في جزء ال Containers.
اتصالات قاعدة البيانات
لنفرض أن لديك تطبيق Python فيه 9 عمال Gunicorn، وكل عامل فيه 4 خيوط، وكل خيط يفتح اتصالاً بقاعدة البيانات، ثم أضفت عاملين للمهام الخلفية في كل واحد 10 خيوط، وأنت الآن تحتاج 56 اتصالاً، وعند النشر تعمل النسخة الجديدة بجانب القديمة دقيقة، فيصبح الرقم 112. وقيمة max_connections الافتراضية في PostgreSQL هي 100 عادة، لذلك تظهر فجأة الرسالة التالية في سجلات التطبيق، وهي من تجربة على PostgreSQL 17 بحد خمسة اتصالات:
psql: error: connection to server on socket "/var/run/postgresql/.s.PGSQL.5432" failed: FATAL: sorry, too many clients alreadyوالحل البسيط أن ترفع max_connections إلى 1000، وهو حل غير مناسب، والسبب أن كل اتصال في PostgreSQL عملية كاملة على سيرفر قاعدة البيانات لها ذاكرتها، وأن ألف اتصال يعمل منها مئة في نفس الوقت على أربع أنوية لن تنهي العمل أسرع، وإنما تزيد التنافس والأقفال وتبديل السياق. والحل الأنسب أن تحسب الاتصالات كما فعلنا أعلاه، وأن تحدد حجم مجمع الاتصالات Connection Pool في التطبيق بحيث يبقى المجموع أقل من الحد، ثم إذا كثرت التطبيقات والعمال فضع أمام قاعدة البيانات PgBouncer، فهو يستقبل اتصالات كثيرة من التطبيقات ويمررها على عدد قليل من الاتصالات الحقيقية، وفي وضع transaction يعيد الاتصال للمجمع بعد كل معاملة بدلاً من أن يحجزه طوال جلسة العميل، وقد شرحنا حساب حجم المجمع وإعداد PgBouncer بالتفصيل في مقال تجميع الاتصالات Connection Pooling للمبتدئين.
المهام الخلفية Background Jobs والطوابير
إذا كان في تطبيقك عمل حسابي ثقيل، مثل تصدير تقرير كبير أو تحويل فيديو أو توليد ملفات PDF، فلا تتركه داخل الطلب، والسبب أنه يحجز عامل الويب طوال مدته، وقد يتجاوز مهلة ال Reverse Proxy فيعود للمستخدم خطأ 504 كما شرحنا في دليل تطبيقك خلف Reverse Proxy. والحل أن يكتب الطلب المهمة في طابور Queue ويعود فوراً، ثم يأخذها عامل خلفي Worker مستقل، وقد شرحنا هذا النمط بالتفصيل مع إعادة المحاولة في دليل البريد التفاعلي. والفائدة هنا أنك تحدد عدد العمال الخلفيين بحسب نوع العمل: عامل لكل نواة تقريباً للمهام الحسابية، وعدد أكبر للمهام التي تنتظر خدمات خارجية، دون أن يؤثر ذلك على سرعة صفحات الموقع.
لماذا لا تكون الخيوط الأكثر أسرع دائماً؟
قد تبدو الفكرة من الوهلة الأولى بسيطة: إذا كانت أربعة خيوط أسرع من خيط واحد، فأربعون أسرع من أربعة. ولكن في الواقع فهي غير كذلك، والأسباب أربعة:
- الأنوية محدودة: في العمل الحسابي لا يعمل في نفس اللحظة أكثر من عدد المعالجات المنطقية، والبقية تنتظر في الطابور وتضيف تبديلاً للسياق.
- التنافس على الأقفال Lock Contention: إذا كانت الخيوط تكتب على نفس البيانات، فهي تقف في طابور أمام القفل، وقد تصبح أبطأ من خيط واحد.
- الذاكرة: كل عامل يحمل نسخة من التطبيق، وكل خيط يحجز مكدساً، وعندما تمتلئ الذاكرة يبدأ النظام في استخدام ال swap أو ينهي عمليات، وهذا أسوأ من أي بطء في المعالج.
- الطرف الآخر: إذا كانت الخيوط تنتظر قاعدة البيانات، فإن زيادتها تنقل الطابور من التطبيق إلى قاعدة البيانات، ولا تزيد عدد الاستعلامات التي تنتهي في الثانية.
ال Containers وحدود المعالج
الخيار --cpus والخيار --cpuset-cpus
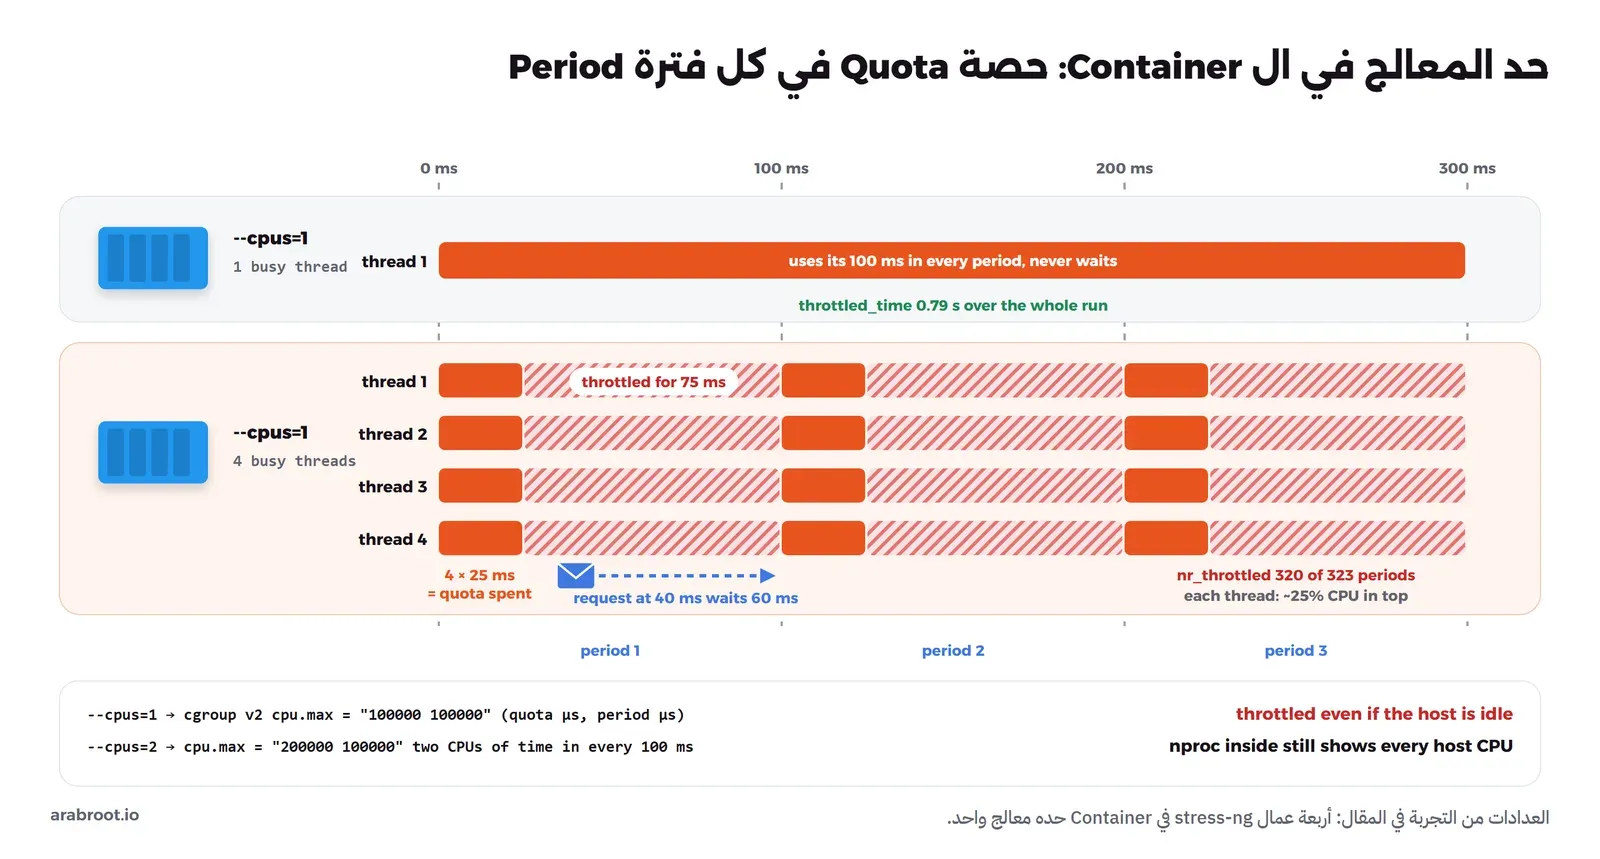
يعطيك Docker طريقتين لتحديد المعالج، كما في صفحة قيود الموارد. الأولى --cpus=1.5، وهي حد للوقت وليست حداً للأنوية، فال Container يستطيع أن يعمل على كل أنوية السيرفر، ولكن مجموع ما يستخدمه في كل فترة Period مدتها 100 ms لا يتجاوز حصة Quota قدرها 150 ms. وهذا ما يسميه Linux التحكم في عرض النطاق للمجدول CFS Bandwidth Control، وعندما تنفد الحصة يوقف النظام خيوط ال Container حتى تبدأ الفترة التالية، وهذا هو الخنق Throttling. أما الطريقة الثانية --cpuset-cpus=0,1 فتحدد معالجات منطقية بعينها، فلا يعمل ال Container إلا عليها.
والمثال التالي يقارن ما يراه ال Container في الحالتين:
docker run --rm --name lab-cpu-limit --cpus=1.5 ubuntu:24.04 sh -c "nproc; cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us /sys/fs/cgroup/cpu/cpu.cfs_period_us"
docker run --rm --name lab-cpu-set --cpuset-cpus=0,1 ubuntu:24.04 nproc
والمخرج سوف يكون كما يلي:
8
150000
100000
2
لاحظ أن nproc أعاد 8 مع --cpus=1.5، لأنه يقرأ المعالجات المسموح للعملية أن تعمل عليها وليس حصة الوقت، بينما أعاد 2 مع --cpuset-cpus. والسطران بعده هما الحصة والفترة بالميكروثانية، أي 150 ms من وقت المعالج في كل 100 ms. وهذه الملفات من الإصدار الأول cgroup v1، أما أغلب السيرفرات الحديثة فتستخدم الإصدار الثاني cgroup v2، وهو الافتراضي منذ Ubuntu 21.10 وDebian 11 كما تذكر وثائق Kubernetes، وتعرف إصدار نظامك بالأمر:
stat -fc %T /sys/fs/cgroup/فإذا كان المخرج cgroup2fs فنظامك يستخدم الإصدار الثاني، وتجد الحصة والفترة معاً في الملف /sys/fs/cgroup/cpu.max بالصيغة 150000 100000، والعدادات في /sys/fs/cgroup/cpu.stat باسم nr_periods وnr_throttled وthrottled_usec، كما في وثيقة cgroup v2. وإذا كان المخرج tmpfs فهو الإصدار الأول، والملفات كما في المثال أعلاه.
تجربة الخنق: Container بطيء والسيرفر فارغ
سوف نقوم الآن بتشغيل اثنين من ال Containers لكل منهما حد معالج واحد، الأول فيه خيط حسابي واحد، والثاني فيه أربعة خيوط حسابية، ونستخدم stress-ng لتوليد الحمل، ونضيفه مع أدوات القياس في Image صغيرة عبر ملف Dockerfile التالي:
FROM ubuntu:24.04
RUN apt-get update && apt-get install -y --no-install-recommends stress-ng sysstat procps python3 util-linux && rm -rf /var/lib/apt/lists/*
docker build -t lab-cpu-tools:1 .
docker run -d --name lab-cpu-one --cpus=1 lab-cpu-tools:1 stress-ng --cpu 1 --timeout 90s
docker run -d --name lab-cpu-four --cpus=1 lab-cpu-tools:1 stress-ng --cpu 4 --timeout 90sوبعد عشرين ثانية تقريباً نقرأ الاستهلاك والعدادات:
docker stats --no-stream lab-cpu-one lab-cpu-four
docker exec lab-cpu-one cat /sys/fs/cgroup/cpu/cpu.stat
docker exec lab-cpu-four cat /sys/fs/cgroup/cpu/cpu.stat
docker exec lab-cpu-four top -b -n1 | head -14
والمخرج سوف يكون كما يلي:
CONTAINER ID   NAME           CPU %     MEM USAGE / LIMIT     MEM %     NET I/O         BLOCK I/O   PIDS
8bad8f2df1ef   lab-cpu-one    110.34%   13.72MiB / 31.29GiB   0.04%     1.25kB / 126B   0B / 0B     2
07d6347ed8e4   lab-cpu-four   96.75%    23.03MiB / 31.29GiB   0.07%     1.04kB / 126B   0B / 0B     5

nr_periods 369
nr_throttled 128
throttled_time 786834600

nr_periods 323
nr_throttled 320
throttled_time 92745814400

top - 21:45:58 up 47 min,  0 user,  load average: 5.82, 7.84, 7.73
Tasks:   6 total,   5 running,   1 sleeping,   0 stopped,   0 zombie
%Cpu(s): 45.6 us,  1.8 sy,  0.0 ni, 50.0 id,  0.0 wa,  0.0 hi,  2.7 si,  0.0 st
MiB Mem :  32036.0 total,  13948.6 free,   6445.4 used,  13188.3 buff/cache
MiB Swap:   8192.0 total,   8192.0 free,      0.0 used.  25590.6 avail Mem

  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
   10 root      20   0   52600   6728   2520 R  26.3   0.0   0:08.67 stress-ng+
    8 root      20   0   52600   6728   2520 R  21.1   0.0   0:08.75 stress-ng+
    9 root      20   0   52600   6728   2520 R  21.1   0.0   0:08.85 stress-ng+
   11 root      20   0   52600   6728   2520 R  21.1   0.0   0:08.81 stress-ng+
    1 root      20   0   52600  19204  17840 S   0.0   0.1   0:00.15 stress-ng
في المخرج أعلاه لاحظ التالي:
- كلا ال Containers عند 100% تقريباً في
docker stats، أي معالج واحد كامل، والرقم وحده لا يكشف أن أحدهما مخنوق. - ال Container ذو الخيوط الأربعة خنق في 320 فترة من 323، أي في كل فترة تقريباً، ومجموع وقت الخنق
throttled_timeبالنانوثانية أكبر بأكثر من مئة مرة من ال Container ذي الخيط الواحد. - في
topكل خيط من الأربعة يأخذ ربع معالج تقريباً، بينما السطر%Cpu(s)يقول إن نصف معالجات الجهاز فارغة50.0 id، وهذا هو العرض الذي تراه: Container بطيء والسيرفر فارغ.
وما يحدث داخل كل فترة يبينه المخطط التالي، فالخيوط الأربعة تعمل معاً على أربع أنوية فتستهلك الحصة كلها في أول 25 ms، ثم تتوقف 75 ms حتى بداية الفترة التالية، وأي طلب يصل في هذه المدة ينتظر حتى لو كان صغيراً:
وقد يتساءل البعض: هل الحل أن أزيل الحد؟ والإجابة لا، فالحد يحمي بقية الخدمات على السيرفر من تطبيق واحد يستهلك كل شيء، وإنما الحل أن يتوافق عدد الخيوط والعمال في التطبيق مع الحد، أو أن ترفع الحد إذا كانت الأرقام تقول إن التطبيق يحتاج أكثر. وتأخير الطلبات بسبب الخنق يظهر في زمن الاستجابة Latency وليس في متوسط استهلاك المعالج، لذلك راقب nr_throttled لأي خدمة تشكو من البطء وعليها حد.
وفي Kubernetes نفس الآلية، فحد المعالج Limit في ال Pod ينفذ بالخنق كحد صارم، أما الطلب Request فيستخدمه المجدول ليختار العقدة Node التي تتسع لل Pod، ووحدته أن 1 CPU يساوي 1000m.
كيف تعرف كل لغة عدد المعالجات المتاحة لها؟
هذه نقطة مهمة جداً، والسبب أن أغلب البيئات تحدد عدد الخيوط وأحجام المجمعات تلقائياً من عدد المعالجات، فإذا رأى التطبيق 8 معالجات وحده الحقيقي معالجان، أنشأ خيوطاً أكثر من حصته فزاد الخنق. والمثال التالي يقرأ عدد المعالجات من Go وNode.js وPython تحت الحدين، وبرنامج Go هو الملف procs.go:
package main

import (
	"fmt"
	"runtime"
)

func main() {
	fmt.Println(runtime.Version(), "NumCPU:", runtime.NumCPU(), "GOMAXPROCS:", runtime.GOMAXPROCS(0))
}
for opt in "--cpus=2" "--cpuset-cpus=0,1"; do
echo "### $opt"
docker run --rm --name lab-cpu-go $opt -v "$PWD":/lab -w /lab golang:1.27.1-alpine3.24 go run procs.go
docker run --rm --name lab-cpu-node $opt node:22-alpine node -e 'const os=require("os");console.log(process.version,"availableParallelism:",os.availableParallelism(),"cpus:",os.cpus().length)'
docker run --rm --name lab-cpu-pyd $opt python:3.13-slim python -c 'import os,sys;print(sys.version.split()[0],"cpu_count:",os.cpu_count(),"process_cpu_count:",os.process_cpu_count())'
doneوالمخرج سوف يكون كما يلي:
### --cpus=2
go1.27.1 NumCPU: 8 GOMAXPROCS: 2
v22.23.3 availableParallelism: 8 cpus: 8
3.13.16 cpu_count: 8 process_cpu_count: 8
### --cpuset-cpus=0,1
go1.27.1 NumCPU: 2 GOMAXPROCS: 2
v22.23.3 availableParallelism: 2 cpus: 8
3.13.16 cpu_count: 8 process_cpu_count: 2
والجدول التالي يلخص النتيجة مع ما وجدناه في Node.js 24 وJava 25 بنفس الطريقة:
| البيئة | مع --cpus=2 | مع --cpuset-cpus=0,1 | ما يجب أن تفعله |
|---|---|---|---|
| Go 1.25 وما بعده | GOMAXPROCS يساوي 2 | 2 | لا شيء، فمنذ Go 1.25 يقرأ ال Runtime حد cgroup ويحدث القيمة دورياً، ولا يأخذ ال Request في Kubernetes في الحساب |
| Java 10 وما بعده | availableProcessors يساوي 2 | 2 | لا شيء غالباً، فدعم ال Containers موجود منذ JDK 10، ويمكنك فرض الرقم بالخيار -XX:ActiveProcessorCount |
| Node.js 22 و24 | availableParallelism يساوي 8 | 2 | حدد عدد العمليات في cluster أو PM2 بنفسك عبر متغير بيئة |
| Python 3.13 | cpu_count وprocess_cpu_count يساويان 8 | process_cpu_count يساوي 2 | حدد عدد العمال في Gunicorn وProcessPoolExecutor بنفسك |
والخلاصة العملية أن --cpuset-cpus تراه كل البيئات، أما --cpus فلا تراه إلا Go وJava، لذلك إذا استخدمت --cpus مع تطبيق Node.js أو Python فاكتب عدد العمال صراحة في الإعداد، مثل --workers 3 في Gunicorn، ولا تعتمد على الاكتشاف التلقائي.
وبعد أن تنتهي من التجارب احذف ما أنشأته بأسمائه فقط:
docker rm -f lab-cpu-one lab-cpu-four
docker rmi lab-cpu-tools:1
كيف تقيس استهلاك المعالج؟
أول أداة هي top أو نسختها الأوضح htop، وأهم سطر فيها هو %Cpu(s) الذي رأيته في التجربة السابقة، ومعنى أعمدته كما يلي:
| العمود | معناه | إذا كان مرتفعاً |
|---|---|---|
us | وقت كود التطبيقات User | تطبيقك يحسب، ابحث عن العملية في القائمة |
sy | وقت نواة النظام System | شبكة كثيفة، أو تبديل سياق كثير، أو خيوط أكثر من اللازم |
id | وقت الفراغ Idle | المعالج ليس مشكلتك |
wa | انتظار القرص I/O Wait | القرص بطيء، وهذا يرفع متوسط الحمل دون أن يكون المعالج مشغولاً |
st | وقت السرقة Steal | جيرانك على السيرفر الفعلي، والحل خطة مخصصة أو مزود آخر |
والأداتان mpstat وpidstat من الحزمة sysstat تفصلان ما تراه في top، فالأولى تعرض كل معالج منطقي وحده، والثانية تعرض كل عملية. والمثال التالي يعرض كل معالج على حدة:
mpstat -P ALL 1 1والمخرج سوف يكون كما يلي:
22:29:27     CPU    %usr   %nice    %sys %iowait    %irq   %soft  %steal  %guest  %gnice   %idle
22:29:28     all   20.94    0.00   19.28   27.27    0.00    4.68    0.00    0.00    0.00   27.82
22:29:28       0   17.00    0.00    6.00   29.00    0.00   18.00    0.00    0.00    0.00   30.00
22:29:28       1   13.95    0.00   17.44   13.95    0.00   17.44    0.00    0.00    0.00   37.21
22:29:28       2   20.99    0.00   37.04   22.22    0.00    0.00    0.00    0.00    0.00   19.75
22:29:28       3   38.14    0.00   12.37   20.62    0.00    1.03    0.00    0.00    0.00   27.84
22:29:28       4   12.50    0.00   26.14   38.64    0.00    0.00    0.00    0.00    0.00   22.73
22:29:28       5   21.88    0.00   18.75   43.75    0.00    0.00    0.00    0.00    0.00   15.62
22:29:28       6   27.59    0.00   20.69   27.59    0.00    0.00    0.00    0.00    0.00   24.14
22:29:28       7   14.29    0.00   19.78   20.88    0.00    0.00    0.00    0.00    0.00   45.05
وفائدة هذا العرض أنه يكشف تطبيقاً عالقاً على نواة واحدة، فإذا رأيت معالجاً واحداً عند 100% والبقية فارغة فالتطبيق يعمل في خيط واحد، مثل عملية Node.js واحدة أو تطبيق Python لا يستخدم إلا خيطاً، والحل هنا عمال أكثر وليس سيرفراً أكبر. أما pidstat فيعرض عموداً مفيداً جداً هو %wait، أي نسبة الوقت التي كانت فيها العملية جاهزة وتنتظر المعالج، والمثال التالي من Container حده معالج واحد وفيه خيطان حسابيان:
docker run -d --name lab-cpu-pid --cpus=1 lab-cpu-tools:1 stress-ng --cpu 2 --timeout 60s
docker exec lab-cpu-pid pidstat -u 5 1
والمخرج سوف يكون كما يلي:
22:32:15      UID       PID    %usr %system  %guest   %wait    %CPU   CPU  Command
22:32:20        0         7   46.31    3.59    0.00   49.90   49.90     4  stress-ng-cpu
22:32:20        0         8   50.70    0.20    0.00   49.50   50.90     6  stress-ng-cpu
وكل خيط هنا عمل نصف الوقت وانتظر النصف الآخر، وهذا ما تتوقعه من خيطين على حصة معالج واحد. وإذا رأيت %wait مرتفعاً لخدمة على سيرفر لا يوجد عليه حد، فالمعالج نفسه لا يكفي، أما مع حد ال Container فارجع إلى nr_throttled. واحذف ال Container بعد التجربة بالأمر docker rm -f lab-cpu-pid.
كم vCPU تحتاج لسيرفرك؟
ابدأ من الأرقام الرسمية لكل تطبيق تنوي تشغيله، ثم من نوع العمل، وقد وضعنا في دليل كيف تختار خادماً افتراضياً جدول نقاط بداية للسيناريوهات الشائعة، وهنا ما يضيفه هذا المقال على ذلك الجدول:
- اقرأ متطلبات التطبيق الرسمية كما هي: فمثلاً يطلب Mailcow معالجاً بسرعة 1 GHz فقط مقابل 6 GiB من الذاكرة على الأقل، أما GitLab فيجعل 8 vCPU و16 GB نقطة البداية لتثبيت على سيرفر واحد، ولا ينصح بالأنواع التي تعتمد على رصيد المعالج Burstable.
- الذاكرة قبل المعالج في أغلب الحالات: أغلب الخدمات المستضافة ذاتياً تنتظر أكثر مما تحسب، لذلك تنفد الذاكرة قبل المعالج، وكل عامل إضافي يحتاج ذاكرة قبل أن يحتاج نواة، وإذا كان المعالج فارغاً والسيرفر بطيئاً فانظر في الذاكرة وال swap والقرص أولاً.
- المشترك للأحمال المتقطعة والمخصص للمستمرة: موقع وأدوات داخلية تعمل بشكل متقطع يكفيها vCPU مشترك، أما بناء الكود Build في CI وتحويل الفيديو وقواعد البيانات المزدحمة والنماذج المحلية فتحتاج vCPU مخصصاً، والسبب أن الحمل المستمر هو أول ما يتأثر بوقت السرقة.
- اختبر قبل أن تقرر: شغل حملك الحقيقي أسبوعاً وراقب
stو%waitومتوسط الحمل مقارنة بnproc، ثم قرر، فالانتقال لخطة أكبر يأخذ دقائق عند أغلب المزودين.
أخطاء شائعة
- الحكم من متوسط الحمل وحده: الحمل في Linux يحسب انتظار القرص أيضاً، فانظر في
waوالعمودbقبل أن تشتري معالجاً أكبر. - عدد عمال أكبر من الذاكرة: رفع
pm.max_childrenأو عمال Gunicorn دون حساب استهلاك العامل ينتهي بإنهاء العمليات Out of Memory، وهو أسوأ من البطء. - الاعتماد على الاكتشاف التلقائي داخل Container له
--cpus: Node.js وPython يريان كل معالجات السيرفر، فيحسبان عدد عمال أكبر من الحصة ويزداد الخنق. - الخيوط في Python للعمل الحسابي: مع قفل GIL لن تسرع الحساب، فاستخدم العمليات، أو جرب النسخة الحرة بعد التأكد من دعم مكتباتك.
- عمل حسابي داخل حلقة الأحداث: حلقة واحدة طويلة في Node.js تؤخر كل الطلبات، فانقلها إلى Worker Threads أو عامل خلفي.
awaitداخل حلقة لطلبات مستقلة: تحول التزامن إلى تتابع، كما رأيت 10.04 ثانية مقابل نصف ثانية.- رفع
max_connectionsبدلاً من حساب الاتصالات: الحل حجم مجمع مناسب في التطبيق، وPgBouncer عندما تكثر التطبيقات. - عمل ثقيل داخل الطلب: يحجز عامل الويب وينتهي بخطأ
504، ومكانه طابور وعامل خلفي.
قائمة تحقق قبل أن تضبط تطبيقك
- اعرف عدد المعالجات المنطقية من
nprocوlscpu، وهل هي مشتركة أم مخصصة في خطتك. - حدد نوع العمل في كل خدمة: هل تحسب أم تنتظر؟
- اضبط عدد العمال صراحة:
worker_processes autoفي Nginx، والمعادلة(2 × cores) + 1نقطة بداية ل Gunicorn، وpm.max_childrenمن حساب الذاكرة في PHP-FPM، وعملية لكل نواة ل Node.js. - اجمع اتصالات قاعدة البيانات من كل العمال والخيوط والمهام الخلفية، وتأكد أنها أقل من
max_connectionsمع هامش للنشر. - انقل العمل الحسابي الطويل إلى طابور وعمال خلفيين.
- إذا وضعت
--cpusعلى Container فاجعل عدد العمال يتوافق معه، وراقبnr_throttled. - راقب
usوwaوstومتوسط الحمل مقارنة بعدد المعالجات أسبوعاً قبل أن تغير الخطة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المقبس فيه أنوية، والنواة فيها خيطان عتاديان مع SMT، وال vCPU الذي تشتريه هو غالباً خيط عتادي يجدوله ال Hypervisor، وانتظاره لخيط مشغول يظهر في عمود
st. - متوسط الحمل في Linux يجمع الخيوط التي تنتظر المعالج والخيوط التي تنتظر القرص، فلا تحكم منه وحده.
- التزامن أن تتقدم عدة مهام بالتناوب، والتوازي أن تعمل معاً على أنوية مختلفة، والعمل الذي ينتظر يستفيد من التزامن، والعمل الذي يحسب لا يستفيد إلا من الأنوية.
- الخيوط في Python لا تسرع الحساب بسبب GIL إلا في النسخة الحرة 3.14t، وحلقة الأحداث في Node.js تتوقف كلها عند أي حساب طويل، والخيوط الافتراضية في Java وGo تجعل الانتظار رخيصاً ولا تسرع الحساب.
- عدد العمال يحدده نوع العمل والذاكرة واتصالات قاعدة البيانات، والعمل الثقيل مكانه طابور وعامل خلفي.
--cpusحصة وقت في كل 100 ms، وتجاوزها يعني خنقاً يبطئ التطبيق والسيرفر فارغ، وGo وJava يقرآن هذه الحصة، أما Node.js وPython فحدد لهما عدد العمال بنفسك.
 دليلكيف تختار خادماً افتراضياً VPSكم تحتاج من المعالج والذاكرة والقرص، وما الذي يميز مزوداً عن آخر غير السعر، حتى تختار VPS يناسب احتياجك.
 دليلمصطلحات الاستضافة الذاتية Self-hosting للمبتدئينمرجع مبسط لأهم المصطلحات التي سوف تقابلها في أدلة الاستضافة الذاتية، بأسمائها الإنجليزية كما تظهر في لوحات التحكم، مع شرح قصير لكل منها.
 دليلتثبيت Docker Engine وCompose على Ubuntuكيف تثبت Docker على Ubuntu من المستودع الرسمي، وتضبطه من البداية حتى لا يمتلئ القرص أو تنكشف منافذك للإنترنت.
 دليلTransactional Email: كيف تصل رسائل تطبيقك في وقتهالماذا تفصل رسائل تطبيقك مثل استعادة كلمة المرور عن النشرات البريدية، وكيف ترسلها بحيث تصل في وقتها ولا تذهب إلى Spam.
 دليلقبل أن تنشر تطبيقك على خادمك: قائمة تحقق للمطورالأخطاء التي لا تظهر إلا بعد نشر تطبيقك في Docker خلف Reverse Proxy، وكيف تعالج كل واحد منها قبل أن يصل إلى المستخدمين.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Docker Engine 29.8.0 مع Python 3.13.16 و3.14.8 والنسخة الحرة 3.14t، وNode.js 22.23.3 و24.21.0، وJava 25.0.4.1، وGo 1.27.1، وstress-ng 0.17.06، وPostgreSQL 17.


