إذا جربت يوماً أن تدرب نموذجاً صغيراً أو تشغل نموذج لغة على جهازك فغالباً سمعت هذه الجملة من أول شخص سألته: «تحتاج GPU». وإذا اشتريت لابتوب جديداً في السنتين الأخيرتين فربما وجدت على علبته شعاراً يقول إن فيه وحدة NPU بقدرة 40 TOPS أو أكثر، وإذا قرأت أخبار الشركات الكبيرة فسوف تجد أنها تشتري عشرات الآلاف من بطاقات NVIDIA أو تبني شرائح خاصة بها مثل TPU من Google. والسؤال الطبيعي هنا: معالج حاسبك يعمل بسرعة 4 GHz وفيه عدة أنوية، فلماذا لا يكفي؟ وما الذي تفعله هذه الشرائح ولا يفعله هو؟ وهل كل GPU أسرع من أي CPU في هذا العمل؟
والإجابة المختصرة أن أغلب حساب الذكاء الاصطناعي عملية واحدة تتكرر مليارات المرات، وهي ضرب المصفوفات، وأن هذه العملية تحتاج شيئين: وحدات حساب كثيرة تعمل معاً، وذاكرة سريعة تغذيها. وفي هذا المقال سوف نرى ذلك بالأرقام على جهاز عادي، فنضرب نفس المصفوفات على المعالج CPU وعلى المعالج الرسومي المدمج فيه، ونرى نتيجة قد لا تتوقعها، ثم ننتقل إلى ما تفعله بطاقات مراكز البيانات ووحدات NPU وTPU بشكل مختلف. وسوف نناقش في هذا المقال ما يلي:
- لماذا يتحول كل شيء في الشبكات العصبية إلى ضرب مصفوفات، وكم عملية يحتاج ذلك.
- الحد الأقصى لمعالج عادي، وكيف نحسبه من عدد الأنوية ووحدات SIMD والتردد.
- مختبر حقيقي: ضرب المصفوفات بلغة Python العادية ثم بمكتبة NumPy بعدد مختلف من الخيوط، ثم على المعالج الرسومي المدمج عن طريق OpenCL بثلاثة Kernels، مع قياس سرعة الذاكرة.
- كيف يعمل GPU من الداخل: آلاف المسارات البسيطة، ومجموعات Warp، ولماذا يكره الشروط المتفرعة.
- الذاكرة قبل الحساب: نموذج السقف Roofline، ولماذا تحدد سرعة الذاكرة سرعة توليد النص في نماذج اللغة.
- Tensor Cores والدقة المنخفضة، ووحدات NPU في اللابتوب والجوال، ووحدات TPU في مراكز Google، بأرقام من صفحات الشركات الرسمية.
- أخطاء شائعة، وجدول يساعدك على اختيار العتاد المناسب لعملك.
وقد شرحنا في مقال المعالج CPU من الداخل كيف تنفذ النواة التعليمة الواحدة، وكيف تعمل تعليمات SIMD على عدة أرقام معاً، وفي مقال تشغيل نماذج اللغة على جهازك شرحنا كيف تختار جهازاً لتشغيل نموذج لغة وكم ذاكرة يحتاج كل حجم. وهذا المقال يقف بينهما: لا يكرر اختيار الجهاز، وإنما يشرح لماذا تتصرف هذه الأجهزة بهذه الطريقة.
أربع عائلات من العتاد: CPU وGPU وNPU وTPU
قبل الأرقام لنشاهد هذه الشرائح كما هي. الصورة التالية فيها بطاقة رسومات للحاسب المكتبي، وشريحة Apple M1 التي تجمع المعالج والرسومات والمحرك العصبي Neural Engine في قطعة سيليكون واحدة، ولوحتان من مراكز بيانات Google تحمل كل منهما أربع شرائح TPU:
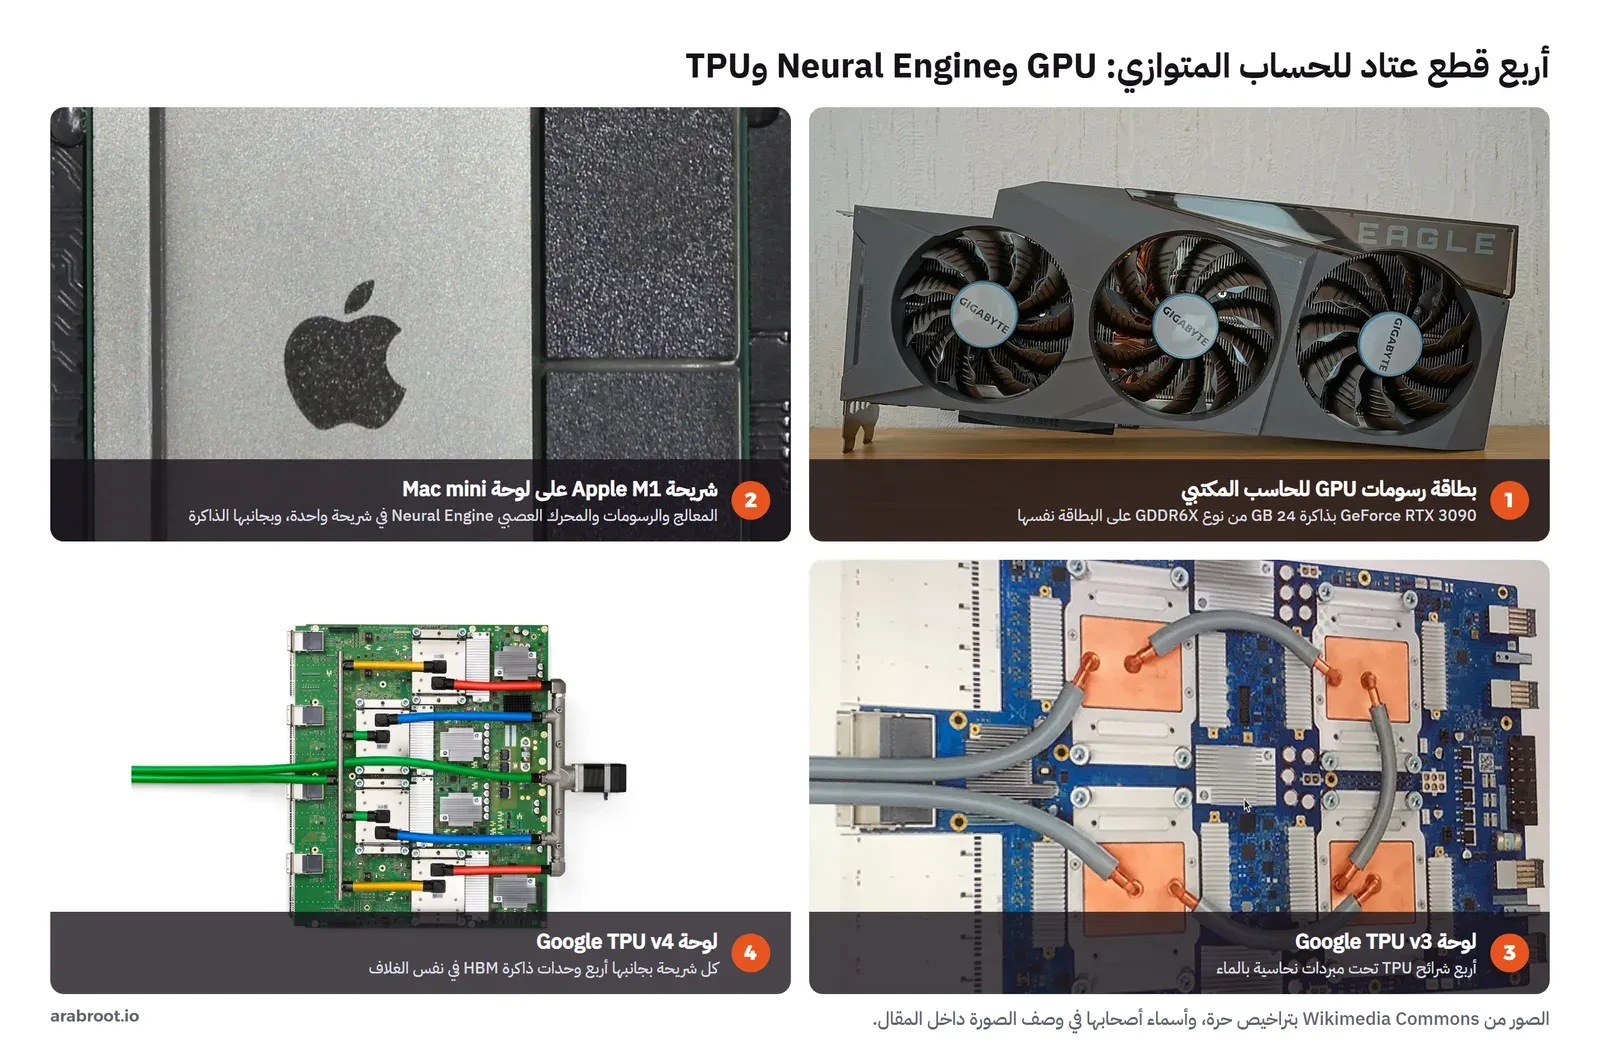
وفي الصورة أعلاه لاحظ التالي:
- بطاقة الرسومات GPU: شريحة كبيرة في الوسط تحت المراوح، وحولها شرائح ذاكرة خاصة بها على نفس البطاقة، وهذا تفصيل مهم: البطاقة لا تقرأ من ذاكرة الجهاز RAM أثناء الحساب، وإنما من ذاكرتها هي، وهي أسرع بكثير كما سوف نرى.
- شريحة Apple M1: المعالج والرسومات والمحرك العصبي في شريحة واحدة، والقطعتان السوداوان بجانبها هما الذاكرة، يشترك فيها الجميع، وهذا ما تسميه Apple الذاكرة الموحدة Unified Memory.
- لوحة TPU v3: أربع شرائح تحت مبردات نحاسية بالماء، فهذه الشرائح تستهلك من الطاقة ما يجعل التبريد بالهواء غير كاف.
- لوحة TPU v4: كل شريحة فيها الحساب في الوسط ومعها أربع وحدات ذاكرة HBM داخل نفس الغلاف، أي أن الذاكرة أصبحت ملاصقة للحساب تقريباً.
لاحظ أن كل هذه الشرائح، مهما اختلف شكلها، تتفق على شيئين: حساب كثير يقبل التوازي بالكامل، وذاكرة قريبة وسريعة. والآن لنفهم لماذا.
لماذا يتحول كل شيء إلى ضرب مصفوفات Matrix Multiplication؟
كل طبقة في شبكة عصبية تأخذ متجهاً من الأرقام، وتضربه في مصفوفة من الأوزان Weights، وتضيف إليه قيمة، ثم تمرره على دالة بسيطة. وإذا أدخلت إلى الشبكة عدة أمثلة معاً، أو عدة كلمات من نفس النص، تصبح المتجهات مصفوفة، ويصبح العمل ضرب مصفوفة في مصفوفة. وقد شرحنا في مقال كيف تعمل نماذج اللغة الكبيرة أن كل كتلة Transformer فيها الانتباه Attention ثم طبقات المعالجة، وكلاهما في النهاية مصفوفات تضرب في مصفوفات.
وعدد العمليات هنا يكبر بسرعة: ضرب مصفوفتين مربعتين بحجم n يحتاج n³ عملية ضرب وn³ عملية جمع تقريباً، أي 2n³ عملية على أرقام عشرية، ولذلك نقيس السرعة بعدد هذه العمليات في الثانية FLOPS، وبالمليار منها GFLOPS، وبالألف مليار TFLOPS. ومصفوفتان بحجم 4096 تحتاجان 137 مليار عملية، ونموذج لغة متوسط يحتاج لكل كلمة يولدها عمليات بعدد يقارب ضعف عدد أوزانه، فنموذج بسبعة مليارات وزن يحتاج نحو 14 مليار عملية لكل كلمة، وتدريب نموذج من الصفر يحتاج أرقاماً بعشرات الأصفار.
والخبر الجيد أن ضرب المصفوفات من أسهل الأعمال على التوازي: كل خانة في الناتج مستقلة عن الأخرى، ويمكن حسابها في نفس الوقت، ولا توجد شروط معقدة ولا تفرعات. فهو عمل مثالي لعتاد يملك وحدات حساب كثيرة بسيطة، وهذا تعريف المعالج الرسومي تقريباً.
ماذا يستطيع المعالج CPU نظرياً؟
لنحسب الحد الأقصى لمعالج جهاز المختبر، وهو Intel Core i7-7700K بأربع أنوية. كل نواة فيها وحدتان للضرب والجمع المدمج FMA، اختصاراً لـ Fused Multiply-Add، وكل وحدة تعمل على مسجل عرضه 256 بت، أي 8 أرقام من نوع float32، وعملية FMA تحسب ضرباً وجمعاً معاً، فتكون النتيجة 2 × 8 × 2 = 32 عملية في كل نبضة لكل نواة، كما يشرح دليل Intel لتحسين الأداء لهذه العائلة. وعند التردد الأساسي 4.2 GHz يصبح الحد الأقصى 4 × 32 × 4.2 = 537.6 GFLOPS.
وهذا رقم نظري لا يصل إليه أحد، فهو يفترض أن كل نواة تنفذ تعليمتي FMA في كل نبضة دون توقف، وأن البيانات جاهزة دائماً في المسجلات. وقد شرحنا تعليمات SIMD وما يقلل مكسبها في جزء SIMD من مقال المعالج. والسؤال العملي: كم نصل منه فعلاً؟ هذا ما سوف نقيسه.
المختبر Lab: نفس الضرب على CPU والمعالج الرسومي المدمج
جهاز المختبر لا يحتوي بطاقة رسومات منفصلة، وفيه فقط المعالج الرسومي المدمج داخل المعالج نفسه، وهو Intel HD Graphics 630. وقد يبدو هذا عيباً في التجربة، ولكنه في الحقيقة يجعلها أوضح، لأننا سوف نرى بالضبط متى يفيد GPU ومتى لا يفيد. والتجربة في جزأين: جزء CPU داخل Container من Linux، وجزء GPU على Windows مباشرة، لأن تعريف المعالج الرسومي موجود في Windows.
الجزء الأول: NumPy على المعالج
نبني Image فيها Python ومكتبة NumPy، وهي تأتي معها بمكتبة OpenBLAS المكتوبة بلغة C وAssembly لكل عائلة معالجات:
# cs3-np: NumPy (with the OpenBLAS it ships) on Debian trixie
FROM python:3.13-slim
RUN pip install --no-cache-dir numpy==2.5.5
WORKDIR /lab
وهذا البرنامج الذي يقيس، وفيه أربعة اختبارات: ضرب مصفوفتين GEMM، وضرب مصفوفة في متجه GEMV، ونسخ مصفوفة كبيرة لقياس سرعة الذاكرة، ونفس الضرب بحلقات Python عادية:
# cpu_bench.py <test>: matrix work on the CPU with NumPy (OpenBLAS). Thread count comes from OPENBLAS_NUM_THREADS.
#   gemm N DTYPE   C = A @ B, two N x N matrices      -> GFLOPS (2*N^3 operations)
#   gemv N         y = A @ x, an N x N matrix and a vector -> GFLOPS and GB/s read
#   copy MB        copy one big array to another        -> GB/s
#   python N       the same multiply in pure Python loops (small N only)
import os, sys, time
import numpy as np

def best(f, reps=5):
    f()                                       # warm up: first call pays for page faults and thread start
    ts = []
    for _ in range(reps):
        t = time.perf_counter(); f(); ts.append(time.perf_counter() - t)
    return min(ts)

test = sys.argv[1]
threads = os.environ.get("OPENBLAS_NUM_THREADS", "default")
rng = np.random.default_rng(1)
if test == "gemm":
    n, dt = int(sys.argv[2]), np.dtype(sys.argv[3])
    a = rng.random((n, n), dtype=np.float64).astype(dt); b = rng.random((n, n), dtype=np.float64).astype(dt)
    t = best(lambda: a @ b, 3)
    print(f"gemm  n={n} {dt} threads={threads}: {t*1000:8.1f} ms  {2*n**3/t/1e9:7.1f} GFLOPS")
elif test == "gemv":
    n = int(sys.argv[2])
    a = rng.random((n, n), dtype=np.float32); x = rng.random(n, dtype=np.float32)
    t = best(lambda: a @ x, 10)
    print(f"gemv  n={n} float32 threads={threads}: {t*1000:8.2f} ms  {2*n*n/t/1e9:7.1f} GFLOPS  {a.nbytes/t/1e9:5.1f} GB/s read")
elif test == "copy":
    mb = int(sys.argv[2]); a = np.ones(mb * 2**20 // 4, dtype=np.float32); b = np.empty_like(a)
    t = best(lambda: np.copyto(b, a), 5)
    print(f"copy  {mb} MiB: {t*1000:8.1f} ms  {2*a.nbytes/t/1e9:5.1f} GB/s (read + write)")
elif test == "python":
    n = int(sys.argv[2])
    a = [[float(i * n + j) for j in range(n)] for i in range(n)]; b = [row[:] for row in a]
    def mm():
        c = [[0.0] * n for _ in range(n)]
        for i in range(n):
            ai, ci = a[i], c[i]
            for k in range(n):
                aik, bk = ai[k], b[k]
                for j in range(n):
                    ci[j] += aik * bk[j]
        return c
    t = best(mm, 1)
    print(f"python n={n}: {t*1000:8.1f} ms  {2*n**3/t/1e9:7.3f} GFLOPS")
ولاحظ أن البرنامج يشغل كل اختبار مرة للإحماء ثم يأخذ أفضل زمن من عدة مرات، لأن المرة الأولى تدفع ثمن حجز الذاكرة وتشغيل الخيوط. وعدد الخيوط يحدده المتغير OPENBLAS_NUM_THREADS، ولذلك يشغل السكربت التالي عملية جديدة لكل إعداد:
#!/bin/sh
# cpu-run.sh: all the CPU measurements, one process per setting so the thread count really applies
python -c "import numpy, platform; print('numpy', numpy.__version__, 'python', platform.python_version())"
python -c "import numpy; numpy.show_runtime()" 2>/dev/null | grep -E "'found'|'not_found'|internal_api|threading_layer|architecture|num_threads|version" | head -12
echo "load average: $(cat /proc/loadavg)"
python cpu_bench.py python 128
for t in 1 2 4 8; do OPENBLAS_NUM_THREADS=$t python cpu_bench.py gemm 2048 float32; done
OPENBLAS_NUM_THREADS=4 python cpu_bench.py gemm 4096 float32
OPENBLAS_NUM_THREADS=4 python cpu_bench.py gemm 2048 float64
for t in 1 4; do OPENBLAS_NUM_THREADS=$t python cpu_bench.py gemv 8192; done
python cpu_bench.py copy 512
echo "load average: $(cat /proc/loadavg)"
docker build -t cs3-np:1 .
docker run --rm -v "$PWD:/lab" cs3-np:1 sh cpu-run.shوالمخرج سوف يكون كما يلي:
numpy 2.5.5 python 3.13.18
[{'numpy_version': '2.5.5',
  'uname': uname_result(system='Linux', node='30bb5258538d', release='5.15.167.4-microsoft-standard-WSL2', version='#1 SMP Tue Nov 5 00:21:55 UTC 2024', machine='x86_64')},
                      'found': ['X86_V3'],
                      'not_found': ['X86_V4', 'AVX512_ICL', 'AVX512_SPR']}},
load average: 1.07 3.55 4.61 1/527 25
python n=128:    337.4 ms    0.012 GFLOPS
gemm  n=2048 float32 threads=1:    320.3 ms     53.6 GFLOPS
gemm  n=2048 float32 threads=2:    118.1 ms    145.5 GFLOPS
gemm  n=2048 float32 threads=4:    119.2 ms    144.2 GFLOPS
gemm  n=2048 float32 threads=8:    142.0 ms    121.0 GFLOPS
gemm  n=4096 float32 threads=4:    629.7 ms    218.3 GFLOPS
gemm  n=2048 float64 threads=4:    190.0 ms     90.4 GFLOPS
gemv  n=8192 float32 threads=1:    15.92 ms      8.4 GFLOPS   16.9 GB/s read
gemv  n=8192 float32 threads=4:    12.39 ms     10.8 GFLOPS   21.7 GB/s read
copy  512 MiB:     54.0 ms   19.9 GB/s (read + write)
load average: 1.28 3.52 4.59 1/526 70
وفي المخرج أعلاه لاحظ التالي:
'found': ['X86_V3']: NumPy وجد أن المعالج يدعم مستوى x86-64-v3، أي AVX2 وFMA، ولم يجد AVX-512، وهذا صحيح لمعالج من عام 2017.- Python العادية: مصفوفتان صغيرتان بحجم 128 أخذتا 337 ملي ثانية، أي 0.012 GFLOPS. ونفس المعالج مع NumPy وصل إلى 218 GFLOPS، أي أن الفرق نحو ثمانية عشر ألف ضعف على نفس العتاد، وهذا أول درس: العتاد لا يساوي شيئاً إذا كان البرنامج لا يستعمله، فكل عملية في Python العادية تمر على المفسر وتنشئ كائناً جديداً للرقم.
- خيط واحد: 53.6 GFLOPS، أي نحو 40% من الحد النظري لنواة واحدة وهو 134.4 GFLOPS، وهذا معقول لأن جزءاً من الوقت يذهب في نقل البيانات بين مستويات ال Cache.
- خيطان وأربعة خيوط: 145 و144 GFLOPS بحجم 2048، وكان المتوقع أن تكون الأربعة ضعف الاثنين، ولكن المصفوفة بحجم 2048 صغيرة نسبياً، فكلفة تقسيم العمل ومزامنة الخيوط تأكل المكسب. وعند الحجم 4096 مع أربعة خيوط وصلنا إلى 218 GFLOPS، أي نحو 41% من الحد النظري للمعالج كله.
- ثمانية خيوط: 121 GFLOPS، أي أقل من أربعة! والسبب أن المعالج فيه 4 أنوية حقيقية فقط، وكل خيطين على نفس النواة يتشاركان نفس وحدتي FMA، فلا يوجد حساب إضافي، ويوجد تنافس على ال Cache. وقد شرحنا الفرق بين النواة والخيط العتادي في مقال المعالج والخيوط والتزامن، وهذا هو سبب أن مكتبات الحساب تضبط عدد الخيوط على عدد الأنوية الحقيقية.
- float64: 90.4 GFLOPS بدلاً من 144، لأن المسجل الذي يحمل 8 أرقام float32 يحمل 4 فقط من float64. والدقة الأقل تعني حساباً أكثر بنفس العتاد، وسوف نعود إلى هذه الفكرة مع Tensor Cores.
- GEMV: ضرب مصفوفة بحجم 8192 في متجه وصل إلى 10.8 GFLOPS فقط بأربعة خيوط، أي عشرين ضعفاً أقل من GEMM على نفس المعالج، ولكن انظر إلى العمود الأخير: 21.7 GB/s، وهو قريب من سرعة النسخ 19.9 GB/s في السطر التالي. فالمعالج هنا لا ينتظر الحساب، وإنما ينتظر الذاكرة، وهذا أهم سطر في التجربة كلها.
مشكلة حقيقية: الأرقام تتغير بضعفين
هذا ليس أول تشغيل، فقد شغلنا نفس السكربت ثلاث مرات قبله، والملفات cpu-run-1.out وcpu-run-2.out وcpu-run-3.out موجودة في مجلد المختبر. في أحدها كان الضرب بأربعة خيوط 51.9 GFLOPS بدلاً من 144، وفي آخر كانت سرعة النسخ 5.9 GB/s بدلاً من 19.9، والسبب أن الجهاز مشترك، وكانت عليه Containers أخرى تستهلك أكثر من ثلاث أنوية، ومتوسط الضغط Load Average وصل إلى 13 على 8 خيوط. والحل كان بسيطاً: سكربت ينتظر حتى ينزل متوسط الضغط تحت 1.2 ثم يشغل جزأي التجربة مباشرة واحداً بعد الآخر، ولذلك ترى في أول المخرج سطر load average: 1.07. والدرس هنا عام: قبل أن تقارن عتاداً بعتاد اكتب متوسط الضغط مع كل قياس، وإذا رأيت أن أربعة خيوط أبطأ من خيطين فشك في القياس قبل أن تشك في المكتبة.
الجزء الثاني: OpenCL على المعالج الرسومي المدمج
للوصول إلى المعالج الرسومي نستعمل OpenCL، وهو معيار مفتوح من Khronos تدعمه Intel وAMD وNVIDIA، ومن Python نستعمله عن طريق مكتبة PyOpenCL. ونثبتها في بيئة Python معزولة على Windows:
python -m venv venv-cl
venv-cl\Scripts\python -m pip install pyopencl==2026.1.5 numpy==2.5.5
venv-cl\Scripts\python gpu_bench.py 2048
والبرنامج يكتب الكود الذي يعمل على GPU، ويسمى Kernel، بلغة تشبه C، ثم يرسله إلى التعريف ليترجمه للمعالج الرسومي. وفيه ثلاث نسخ من ضرب المصفوفات تزداد ذكاءً، ونسختان من ضرب المصفوفة في متجه، وكل نتيجة يقارنها بنتيجة NumPy حتى نتأكد أن الحساب صحيح:
# gpu_bench.py: the same matrix work on the integrated GPU (Intel HD Graphics 630) through OpenCL, from Windows.
#   python gpu_bench.py            prints the device, then copy bandwidth, then two SGEMM kernels and one GEMV
import sys, time
import numpy as np
import pyopencl as cl

ctx = cl.Context([d for p in cl.get_platforms() for d in p.get_devices(cl.device_type.GPU)][:1])
dev = ctx.devices[0]
q = cl.CommandQueue(ctx, properties=cl.command_queue_properties.PROFILING_ENABLE)
print(f"device: {dev.name}, {dev.max_compute_units} compute units (EUs), {dev.max_clock_frequency} MHz, driver {dev.driver_version}")
print(f"memory: {dev.global_mem_size/2**30:.1f} GiB (shared system RAM), local memory {dev.local_mem_size//1024} KiB per work-group")

SRC = r"""
__kernel void copy(__global const float4 *a, __global float4 *b) { size_t i = get_global_id(0); b[i] = a[i]; }

// one work-item per element of C, reads A and B straight from global memory
__kernel void sgemm_naive(const int n, __global const float *A, __global const float *B, __global float *C) {
    int row = get_global_id(1), col = get_global_id(0);
    float acc = 0.0f;
    for (int k = 0; k < n; k++) acc += A[row * n + k] * B[k * n + col];
    C[row * n + col] = acc;
}

// tiles of 16 x 16 kept in local (on-chip) memory: each value from global memory is used 16 times
#define TS 16
__kernel void sgemm_tiled(const int n, __global const float *A, __global const float *B, __global float *C) {
    __local float As[TS][TS], Bs[TS][TS];
    int r = get_local_id(1), c = get_local_id(0);
    int row = get_group_id(1) * TS + r, col = get_group_id(0) * TS + c;
    float acc = 0.0f;
    for (int t = 0; t < n / TS; t++) {
        As[r][c] = A[row * n + t * TS + c];
        Bs[r][c] = B[(t * TS + r) * n + col];
        barrier(CLK_LOCAL_MEM_FENCE);
        for (int k = 0; k < TS; k++) acc += As[r][k] * Bs[k][c];
        barrier(CLK_LOCAL_MEM_FENCE);
    }
    C[row * n + col] = acc;
}

// 64 x 64 tile of C per work-group of 16 x 16, and each work-item keeps a 4 x 4 block of C in registers:
// every value loaded from local memory is now used 4 times, and from global memory 64 times
#define TSM 64
#define TSN 64
#define TSK 16
__kernel void sgemm_reg(const int n, __global const float *A, __global const float *B, __global float *C) {
    __local float As[TSM][TSK], Bs[TSK][TSN];
    int tx = get_local_id(0), ty = get_local_id(1), tid = ty * 16 + tx;
    int gr = get_group_id(1) * TSM, gc = get_group_id(0) * TSN;
    float acc[4][4] = {{0}};
    for (int t = 0; t < n; t += TSK) {
        for (int i = 0; i < 4; i++) { int idx = tid + i * 256; As[idx / TSK][idx % TSK] = A[(gr + idx / TSK) * n + t + idx % TSK]; }
        for (int i = 0; i < 4; i++) { int idx = tid + i * 256; Bs[idx / TSN][idx % TSN] = B[(t + idx / TSN) * n + gc + idx % TSN]; }
        barrier(CLK_LOCAL_MEM_FENCE);
        for (int k = 0; k < TSK; k++) {
            float b[4];
            for (int j = 0; j < 4; j++) b[j] = Bs[k][tx + j * 16];
            for (int i = 0; i < 4; i++) { float a = As[ty + i * 16][k]; for (int j = 0; j < 4; j++) acc[i][j] += a * b[j]; }
        }
        barrier(CLK_LOCAL_MEM_FENCE);
    }
    for (int i = 0; i < 4; i++) for (int j = 0; j < 4; j++) C[(gr + ty + i * 16) * n + gc + tx + j * 16] = acc[i][j];
}

// y = A x, the simple way: one work-item per row, every element of A is read once and used once
__kernel void sgemv(const int n, __global const float *A, __global const float *x, __global float *y) {
    int row = get_global_id(0); float acc = 0.0f;
    for (int k = 0; k < n; k++) acc += A[row * n + k] * x[k];
    y[row] = acc;
}

// y = A x, one work-group of 64 per row: neighbouring work-items read neighbouring addresses, then add up the 64 parts
__kernel void sgemv_wg(const int n, __global const float *A, __global const float *x, __global float *y) {
    __local float part[64];
    int row = get_group_id(0), l = get_local_id(0); float acc = 0.0f;
    for (int k = l; k < n; k += 64) acc += A[row * n + k] * x[k];
    part[l] = acc; barrier(CLK_LOCAL_MEM_FENCE);
    for (int s = 32; s > 0; s >>= 1) { if (l < s) part[l] += part[l + s]; barrier(CLK_LOCAL_MEM_FENCE); }
    if (l == 0) y[row] = part[0];
}
"""
prg = cl.Program(ctx, SRC).build()
mf = cl.mem_flags

def run(kernel, gsize, lsize, *args, reps=5):
    best = 1e9
    for i in range(reps + 1):                       # first run is a warm-up
        ev = kernel(q, gsize, lsize, *args); ev.wait()
        t = (ev.profile.end - ev.profile.start) * 1e-9
        if i: best = min(best, t)
    return best

# 1. copy bandwidth
nbytes = 256 * 2**20
a = np.ones(nbytes // 4, dtype=np.float32)
da = cl.Buffer(ctx, mf.READ_ONLY | mf.COPY_HOST_PTR, hostbuf=a); db = cl.Buffer(ctx, mf.WRITE_ONLY, nbytes)
t = run(prg.copy, (nbytes // 16,), None, da, db)
print(f"copy  256 MiB: {t*1000:7.1f} ms  {2*nbytes/t/1e9:5.1f} GB/s (read + write)")

# 2. SGEMM, checked against NumPy on the CPU
n = int(sys.argv[1]) if len(sys.argv) > 1 else 2048
rng = np.random.default_rng(1)
A = rng.random((n, n), dtype=np.float32); B = rng.random((n, n), dtype=np.float32)
dA = cl.Buffer(ctx, mf.READ_ONLY | mf.COPY_HOST_PTR, hostbuf=A); dB = cl.Buffer(ctx, mf.READ_ONLY | mf.COPY_HOST_PTR, hostbuf=B)
dC = cl.Buffer(ctx, mf.WRITE_ONLY, A.nbytes)
ref = A @ B
for name, k, g, l in (("naive", prg.sgemm_naive, (n, n), None), ("tiled", prg.sgemm_tiled, (n, n), (16, 16)),
                      ("reg4x4", prg.sgemm_reg, (n // 4, n // 4), (16, 16))):
    t = run(k, g, l, np.int32(n), dA, dB, dC, reps=3)
    C = np.empty_like(A); cl.enqueue_copy(q, C, dC).wait()
    err = np.abs(C - ref).max() / np.abs(ref).max()
    print(f"sgemm {name:6} n={n}: {t*1000:7.1f} ms  {2*n**3/t/1e9:6.1f} GFLOPS  max rel. error vs NumPy {err:.1e}")

# 3. GEMV: the memory-bound case
m = 8192
M = rng.random((m, m), dtype=np.float32); x = rng.random(m, dtype=np.float32)
dM = cl.Buffer(ctx, mf.READ_ONLY | mf.COPY_HOST_PTR, hostbuf=M); dx = cl.Buffer(ctx, mf.READ_ONLY | mf.COPY_HOST_PTR, hostbuf=x)
dy = cl.Buffer(ctx, mf.WRITE_ONLY, m * 4)
refy = M @ x
for name, k, g, l in (("row", prg.sgemv, (m,), None), ("wg64", prg.sgemv_wg, (m * 64,), (64,))):
    t = run(k, g, l, np.int32(m), dM, dx, dy, reps=10)
    y = np.empty(m, dtype=np.float32); cl.enqueue_copy(q, y, dy).wait()
    err = np.abs(y - refy).max() / np.abs(refy).max()
    print(f"sgemv {name:4} n={m}: {t*1000:7.2f} ms  {2*m*m/t/1e9:6.1f} GFLOPS  {M.nbytes/t/1e9:5.1f} GB/s read  max rel. error {err:.1e}")
وفي الكود أعلاه لاحظ التالي:
sgemm_naive: الطريقة البسيطة، فكل مسار Work-item يحسب خانة واحدة في الناتج، ويقرأ صفاً كاملاً وعموداً كاملاً من الذاكرة الرئيسية، فكل رقم يقرأ من الذاكرة ويستعمل مرة واحدة.sgemm_tiled: مجموعة من 16 × 16 مساراً تنسخ معاً قطعة Tile من كل مصفوفة إلى الذاكرة المحلية Local Memory داخل الشريحة، ثم تستعملها 16 مرة، والدالةbarrierتجعل المسارات تنتظر بعضها حتى تكتمل القطعة.sgemm_reg: نفس الفكرة خطوة أبعد، فكل مسار يحسب 16 خانة في مسجلاته، فكل رقم يقرأ من الذاكرة المحلية يستعمل 4 مرات، ومن الذاكرة الرئيسية 64 مرة.sgemvوsgemv_wg: الأولى تعطي كل صف لمسار واحد، والثانية تعطي كل صف لمجموعة من 64 مساراً تقرأ عناوين متجاورة ثم تجمع نتائجها.
والمخرج سوف يكون كما يلي:
device: Intel(R) HD Graphics 630, 24 compute units (EUs), 1150 MHz, driver 31.0.101.2140
memory: 25.5 GiB (shared system RAM), local memory 64 KiB per work-group
copy  256 MiB:    26.1 ms   20.6 GB/s (read + write)
sgemm naive  n=2048:   996.8 ms    17.2 GFLOPS  max rel. error vs NumPy 2.9e-06
sgemm tiled  n=2048:   470.5 ms    36.5 GFLOPS  max rel. error vs NumPy 2.9e-06
sgemm reg4x4 n=2048:   196.8 ms    87.3 GFLOPS  max rel. error vs NumPy 2.9e-06
sgemv row  n=8192:  219.41 ms     0.6 GFLOPS    1.2 GB/s read  max rel. error 4.6e-06
sgemv wg64 n=8192:   14.24 ms     9.4 GFLOPS   18.9 GB/s read  max rel. error 3.5e-07
وفي المخرج أعلاه لاحظ التالي:
- الجهاز: 24 وحدة تنفيذ EU بتردد 1150 MHz، وذاكرة 25.5 GiB، وهي ليست ذاكرة خاصة به، وإنما جزء من ذاكرة الجهاز نفسها التي يقرأ منها المعالج.
- النسخ: 20.6 GB/s، أي نفس سرعة نسخ المعالج تقريباً، وهذا منطقي لأنهما يقرآن من نفس شرائح DDR4.
- Kernel البسيط: 17.2 GFLOPS، أي أبطأ بثلاث مرات من خيط واحد على المعالج مع OpenBLAS، والخطأ النسبي 2.9e-06 يعني أن الحساب صحيح، فالمشكلة في السرعة فقط.
- Tiles في الذاكرة المحلية: 36.5 GFLOPS، أي ضعف البسيط، بنفس العتاد ونفس عدد العمليات، فقط لأن كل رقم يقرأ مرة ويستعمل عدة مرات.
- 4 × 4 في المسجلات: 87.3 GFLOPS، خمسة أضعاف البسيط، ولكنها ما زالت أقل من نصف ما وصل إليه المعالج بأربعة خيوط.
- GEMV بمسار لكل صف: 0.6 GFLOPS فقط و1.2 GB/s، أما بمجموعة لكل صف فوصلنا إلى 9.4 GFLOPS و18.9 GB/s، أي خمسة عشر ضعفاً، والفرق كله في ترتيب الوصول إلى الذاكرة كما سوف نشرح.
والصورة التالية تجمع أرقام الجزأين على مقياس واحد:
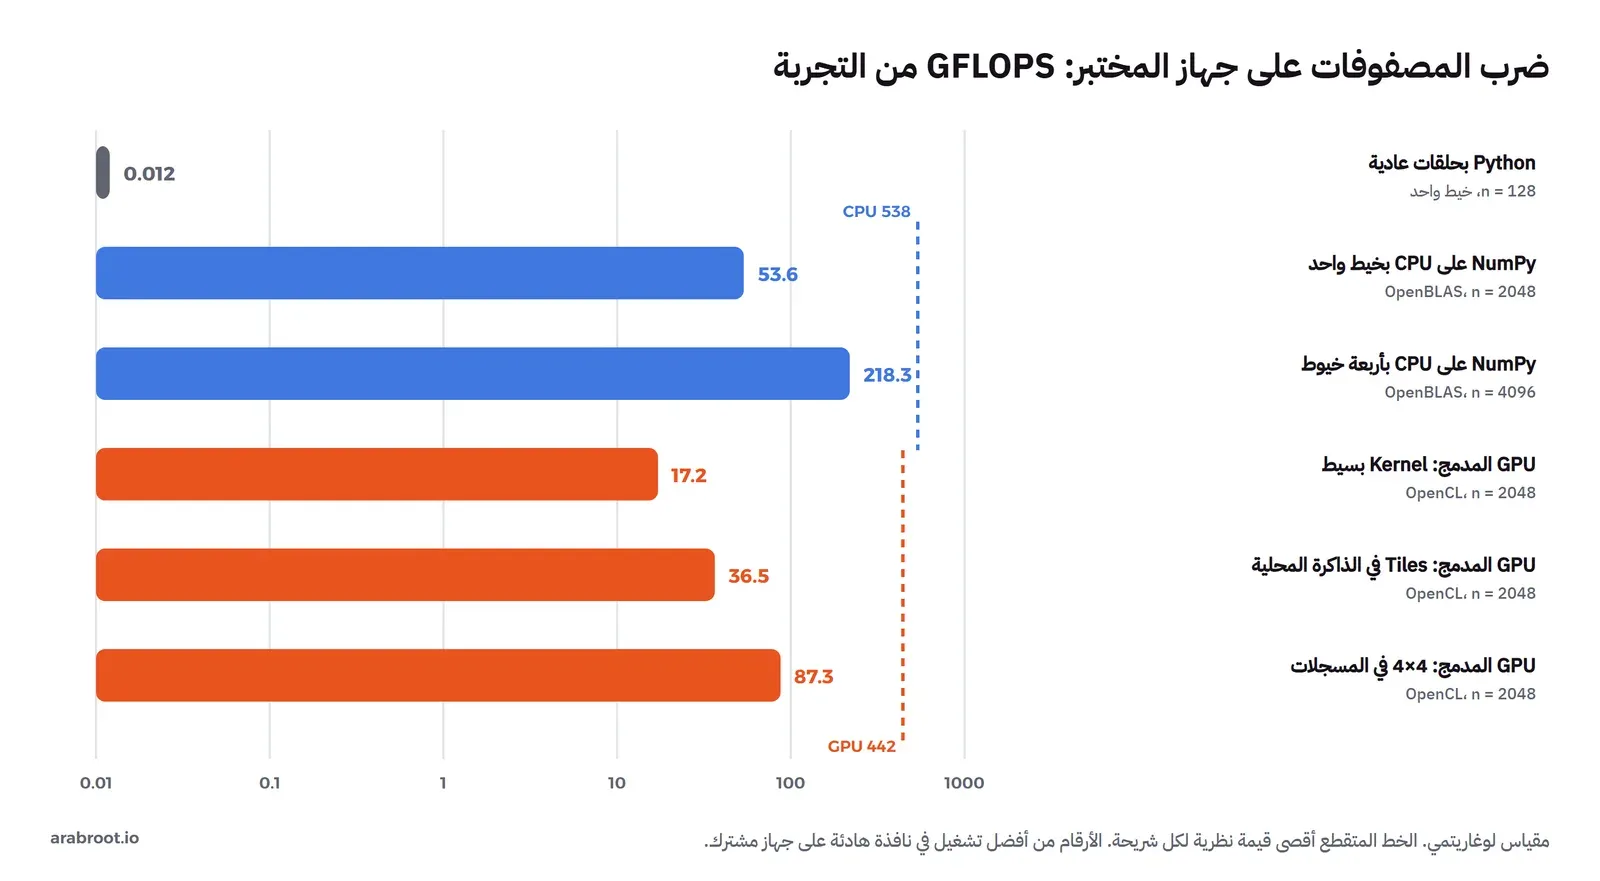
فهل يعني هذا أن المعالج الرسومي أبطأ من المعالج؟ في هذا الجهاز نعم، ولسببين يمكن حسابهما. الأول أن الحد النظري لهذا المعالج الرسومي أصلاً أقل من المعالج: ورقة Intel عن معمارية Gen9 تقول إن كل وحدة EU فيها وحدتان SIMD-4 كل منهما تحسب ضرباً وجمعاً، أي 16 عملية في النبضة، فيكون الحد 24 × 16 × 1.15 = 441.6 GFLOPS، مقابل 537.6 للمعالج. والثاني أن Kernel نكتبه نحن في دقائق لا ينافس مكتبة مثل OpenBLAS عمل عليها الناس سنوات. فالمعالج الرسومي المدمج في حاسب مكتبي من 2017 صمم للعرض على الشاشة، وليس للحساب الثقيل، والذي يجعل بطاقات NVIDIA مختلفة هو حجمها، وهذا ما سوف نراه.
ماذا لو قرأت المسارات من عناوين متباعدة؟ What If
الفرق بين نسختي GEMV هو أفضل مثال على أن GPU لا يكفي أن تعطيه عملاً متوازياً، وإنما يجب أن تعطيه عملاً بالشكل الذي يحبه. في النسخة الأولى يأخذ كل مسار صفاً، فعندما تنفذ مجموعة من المسارات نفس التعليمة في نفس اللحظة يقرأ كل منها العنصر رقم k من صفه، والصفوف متباعدة بمقدار 32 KB في الذاكرة، فيحتاج كل مسار طلباً مستقلاً للذاكرة. وفي النسخة الثانية تقرأ المسارات المتجاورة عناوين متجاورة من نفس الصف، فيجمعها العتاد في طلبات قليلة كبيرة، وهذا ما يسمى دمج الوصول للذاكرة Memory Coalescing. ونفس الحساب ونفس عدد العمليات أصبح أسرع بخمسة عشر ضعفاً. وإذا كتبت يوماً Kernel بـ CUDA أو OpenCL أو Metal ورأيت أداءً أقل بكثير مما تتوقع فهذا أول ما تفحصه.
كيف يعمل المعالج الرسومي GPU من الداخل؟
الصورة التالية تبين الفرق في توزيع مساحة السيليكون بين المعالج والمعالج الرسومي:
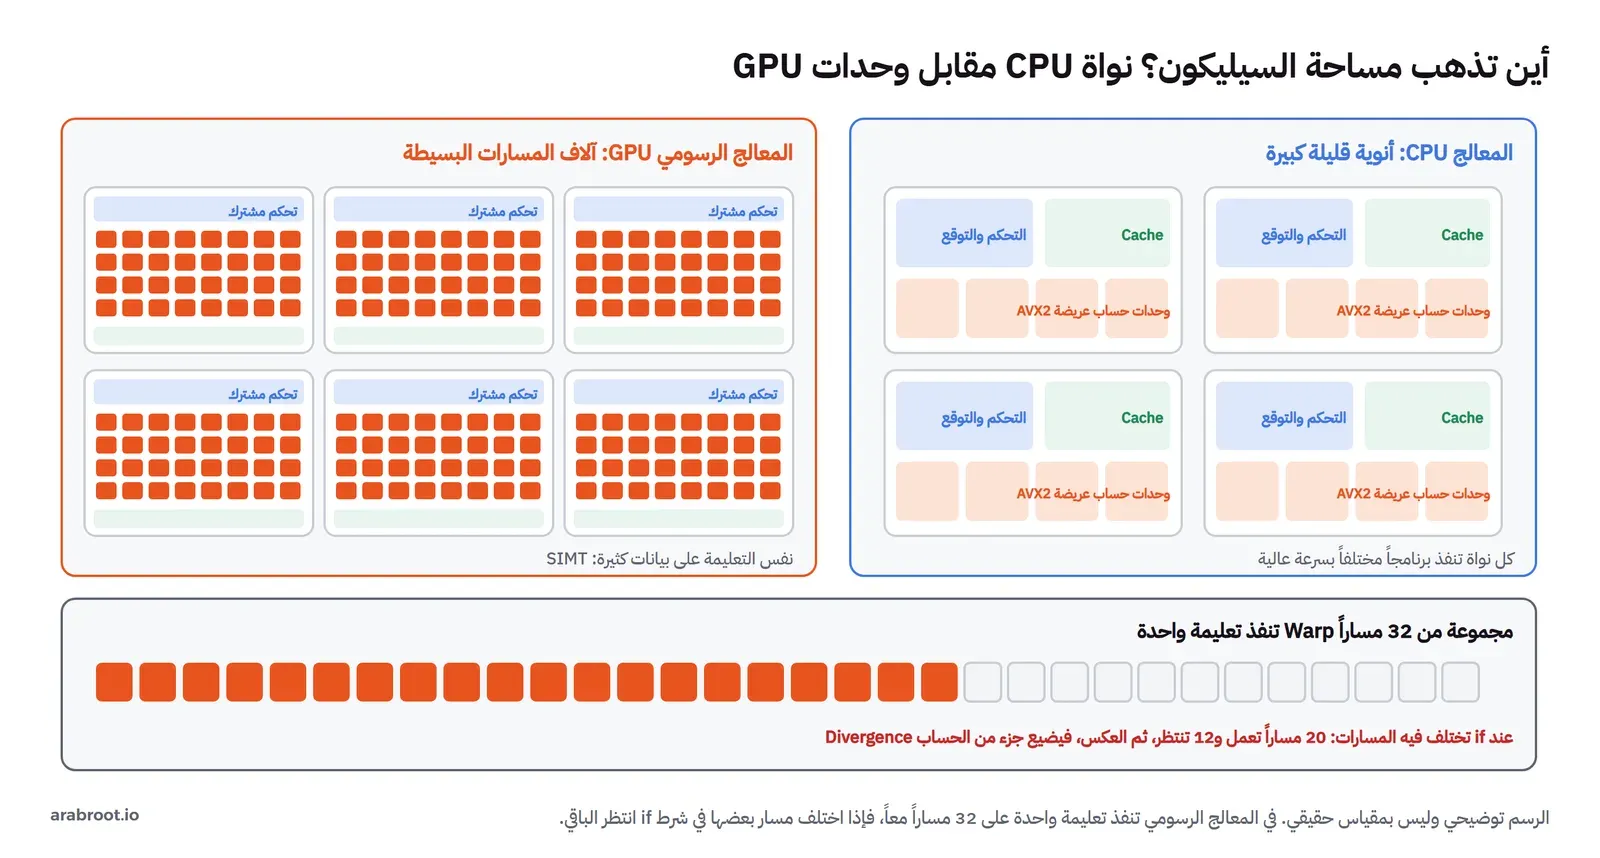
نواة المعالج مصممة لتنفذ برنامجاً واحداً معقداً بأسرع ما يمكن، ولذلك تصرف جزءاً كبيراً من مساحتها على توقع التفرعات والتنفيذ خارج الترتيب وال Cache الكبير، وكلها أشياء شرحناها في مقال المعالج من الداخل. أما المعالج الرسومي فمصمم لعمل مختلف تماماً: نفس الحساب على ملايين البكسلات أو الأرقام، فيصرف المساحة على وحدات حساب بسيطة كثيرة، ويجعل كل مجموعة منها تشترك في وحدة تحكم واحدة.
وتسمي NVIDIA هذا الأسلوب SIMT، اختصاراً لـ Single Instruction Multiple Threads، وكما يشرح دليل CUDA فإن كل 32 خيطاً تشكل مجموعة اسمها Warp تنفذ تعليمة واحدة في نفس الوقت، كل خيط على بياناته. وأنت تكتب الكود كأنه لخيط واحد، كما فعلنا في Kernels المختبر، والعتاد يجمع الخيوط. وفي OpenCL الأسماء مختلفة: Work-item للخيط وSub-group للمجموعة، ولكن الفكرة واحدة.
وهذا يفسر ثلاثة أشياء رأيناها أو سوف تراها:
- الشروط مكلفة: إذا كان في الكود شرط
ifوأخذ بعض خيوط ال Warp طريقاً وأخذ الباقي طريقاً آخر، ينفذ العتاد الطريقين واحداً بعد الآخر، وفي كل مرة تنتظر الخيوط التي لا يخصها الطريق، وهذا ما يسمى التباعد Divergence. - الذاكرة يجب أن تقرأ معاً: كما رأينا في GEMV، الخيوط المتجاورة يجب أن تقرأ عناوين متجاورة.
- الانتظار يختفي بالكثرة: المعالج يخفي بطء الذاكرة بال Cache الكبير والتنفيذ خارج الترتيب، أما المعالج الرسومي فيخفيه بأن يحمل آلاف الخيوط في نفس الوقت، فإذا انتظرت مجموعة بياناتها من الذاكرة انتقل العتاد فوراً إلى مجموعة أخرى جاهزة، ولذلك يحتاج GPU عملاً كثيراً جداً حتى يكون سريعاً، ومع المصفوفات الصغيرة لا يفيد كثيراً.
والآن ضع حجم بطاقات مراكز البيانات بجانب جهازنا: صفحة NVIDIA H100 تقول إن نسخة SXM منها تصل إلى 67 TFLOPS بدقة FP32، أي أكثر من 150 ضعف الحد النظري للمعالج الرسومي في جهازنا، ومقالة NVIDIA عن معمارية Hopper تقول إن هذه النسخة فيها 132 وحدة SM على شريحة مساحتها 814 mm² وفيها 80 مليار ترانزستور. فالفكرة هي نفس فكرة المعالج الرسومي المدمج في جهازنا، ولكن بحجم مختلف تماماً، ومع ذاكرة مختلفة تماماً.
نسخ البيانات إلى البطاقة: الكلفة التي لا تظهر في الإعلان
هناك فرق مهم بين المعالج الرسومي المدمج في جهازنا وبطاقة منفصلة لم يظهر في المختبر: المدمج يقرأ من نفس ذاكرة المعالج، أما البطاقة المنفصلة فلها ذاكرتها، وكل بيانات تريد أن تحسب عليها يجب أن تنسخ أولاً من ذاكرة الجهاز إلى ذاكرة البطاقة عبر منفذ PCIe، ثم تنسخ النتيجة عائدة. وهذا المنفذ أبطأ بكثير من ذاكرة البطاقة نفسها، ولذلك يضع دليل أفضل الممارسات في CUDA تقليل النقل بين المضيف والبطاقة في أعلى أولوياته. والنتيجة العملية أن البطاقة تفيد عندما تنقل البيانات مرة ثم تحسب عليها كثيراً، كما يحدث عندما تحمل أوزان نموذج مرة واحدة ثم تولد آلاف الكلمات، ولا تفيد عندما تنقل مصفوفة صغيرة لتضربها مرة واحدة ثم تعيدها، فقد يكون النقل وحده أطول من الضرب كله على المعالج. ولذلك تجد مكتبات مثل PyTorch تطلب منك أن تنقل النموذج والبيانات إلى البطاقة صراحة، وتجد أن أول خطأ في الأداء عند المبتدئين هو نقل كل دفعة صغيرة ذهاباً وإياباً داخل حلقة.
التدريب والاستنتاج: عملان مختلفان Training vs Inference
وقبل أن ننتقل إلى الذاكرة يجب أن نفرق بين عملين يخلط بينهما كثير من الناس عند الحديث عن العتاد. التدريب Training هو تعديل أوزان النموذج بتمرير ملايين الأمثلة عليه، ولكل مثال يمر الحساب إلى الأمام ثم يعود إلى الخلف ليحسب كيف تتغير كل قيمة، ويجب أن تحفظ في الذاكرة الأوزان ونتائج الطبقات الوسيطة وحالة خوارزمية التحسين، ولذلك يحتاج حساباً هائلاً وذاكرة كبيرة وعدداً كبيراً من الشرائح المتصلة ببعضها، وهذا عالم بطاقات مراكز البيانات وTPU. أما الاستنتاج Inference فهو تشغيل نموذج جاهز للحصول على إجابة، ويحتاج حساباً أقل بكثير لكل طلب، ولكنه يتكرر لكل مستخدم ولكل طلب، ويمكن غالباً أن يتم بدقة أقل، وهذا هو المجال الذي صممت له وحدات NPU في الأجهزة، والذي يمكن أن يعمل فيه المعالج نفسه لنماذج صغيرة. فإذا قرأت أن شريحة ما «أسرع في الذكاء الاصطناعي» فاسأل أولاً: أسرع في أي العملين؟
الذاكرة قبل الحساب: نموذج السقف Roofline
رأينا في المختبر أن نفس المعالج يصل إلى 218 GFLOPS في GEMM وإلى 10.8 فقط في GEMV، ورأينا أن المعالج الرسومي لم يتفوق في أي منهما. ولفهم ذلك يستعمل المهندسون نموذجاً بسيطاً اسمه نموذج السقف Roofline، نشره Samuel Williams وAndrew Waterman وDavid Patterson من جامعة Berkeley في تقرير تقني عام 2008. والفكرة أن لكل برنامج رقماً اسمه الكثافة الحسابية Arithmetic Intensity، وهو عدد العمليات التي يقوم بها لكل بايت يقرؤه من الذاكرة:
- GEMM بحجم n: يقرأ ثلاث مصفوفات، أي 3 × 4 × n² بايت، ويقوم بـ 2n³ عملية، فتكون الكثافة n / 6، أي نحو 683 عملية لكل بايت عند الحجم 4096.
- GEMV: يقرأ المصفوفة مرة واحدة، 4 بايت لكل رقم، ويقوم بعمليتين لكل رقم، فتكون الكثافة 0.5 عملية لكل بايت مهما كبر الحجم.
والسرعة التي يصل إليها أي برنامج لا يمكن أن تتجاوز أصغر رقمين: الحد الأقصى للحساب، وسرعة الذاكرة مضروبة في الكثافة الحسابية. والصورة التالية ترسم ذلك بأرقام جهازنا:
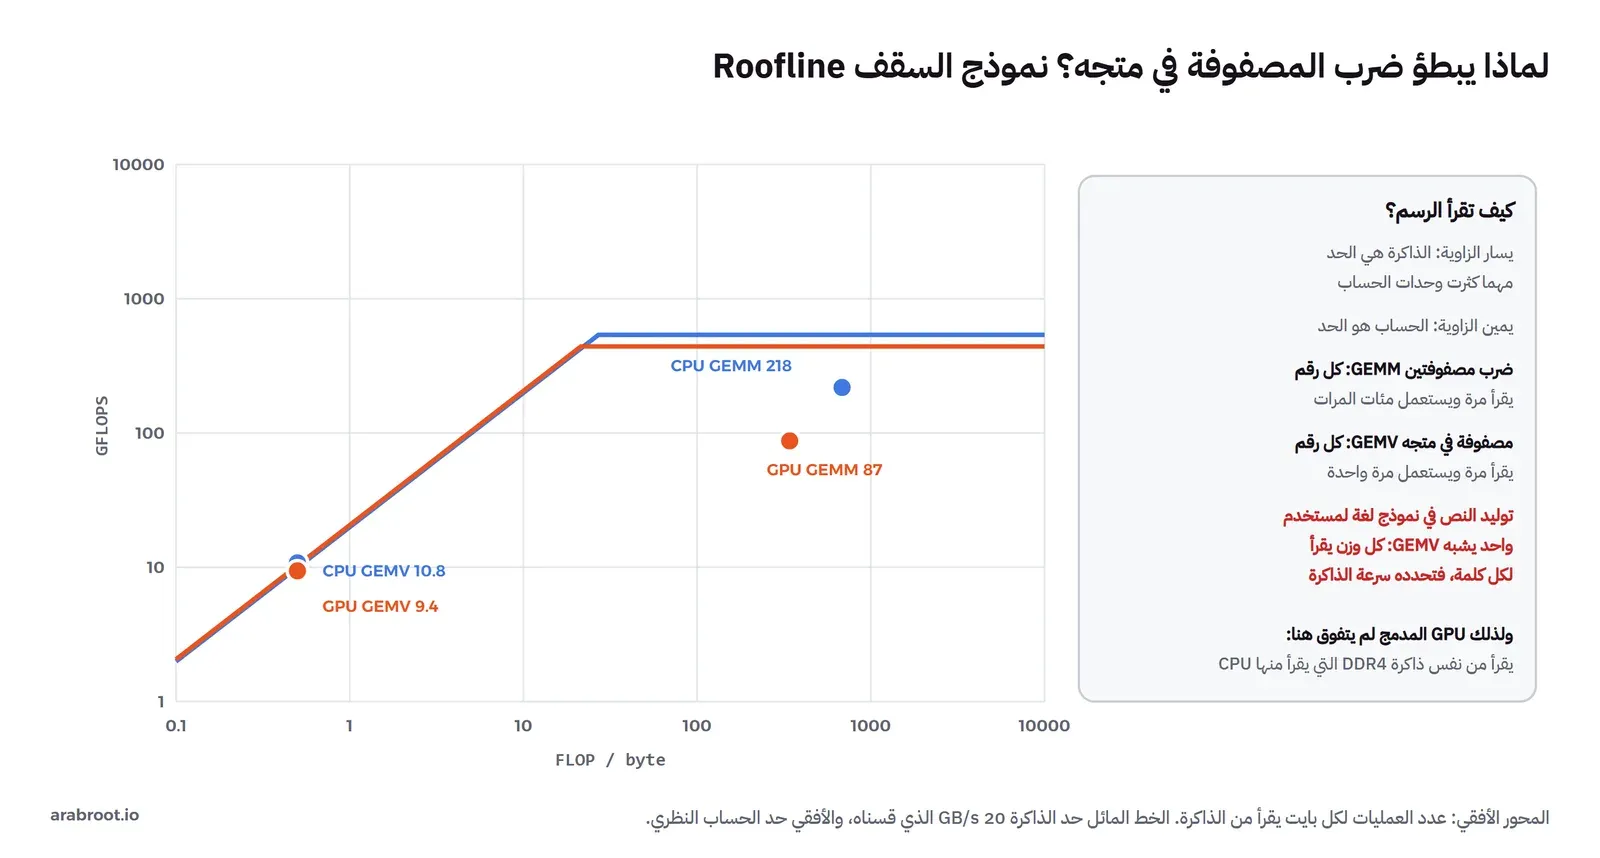
وفي الصورة أعلاه لاحظ أن نقطتي GEMV للمعالج وللمعالج الرسومي فوق بعضهما تقريباً، ملتصقتان بالخط المائل، فكلاهما يقرأ من نفس الذاكرة بسرعة 20 GB/s، ومهما أضفت من وحدات حساب فلن تتحرك النقطة إلى الأعلى. أما نقطتا GEMM ففي الجزء الأفقي، حيث يحدد الحساب السرعة، وهناك فقط يفيد عدد وحدات الحساب.
وهنا نصل إلى أهم نتيجة عملية في المقال: عندما يولد نموذج لغة إجابة لمستخدم واحد فهو يولد كلمة بعد كلمة، ولكل كلمة يمر على كل أوزان النموذج مرة واحدة ويضربها في متجه واحد، وهذا GEMV بكثافة قريبة من عملية واحدة لكل بايت إذا كانت الأوزان بدقة 16 بت. ولذلك تكون سرعة توليد الكلمات محددة بسرعة الذاكرة وليس بعدد وحدات الحساب، وهذا ما شرحناه بأرقام حقيقية في مقال تشغيل نماذج اللغة على جهازك. أما التدريب، وقراءة النص الطويل الذي تدخله قبل أن يبدأ النموذج بالإجابة، وخدمة عدد كبير من المستخدمين معاً، فهي أقرب إلى GEMM، وهناك يظهر الحساب. والصورة التالية تبين لماذا تبدو أرقام الذاكرة في عتاد مراكز البيانات من عالم آخر:
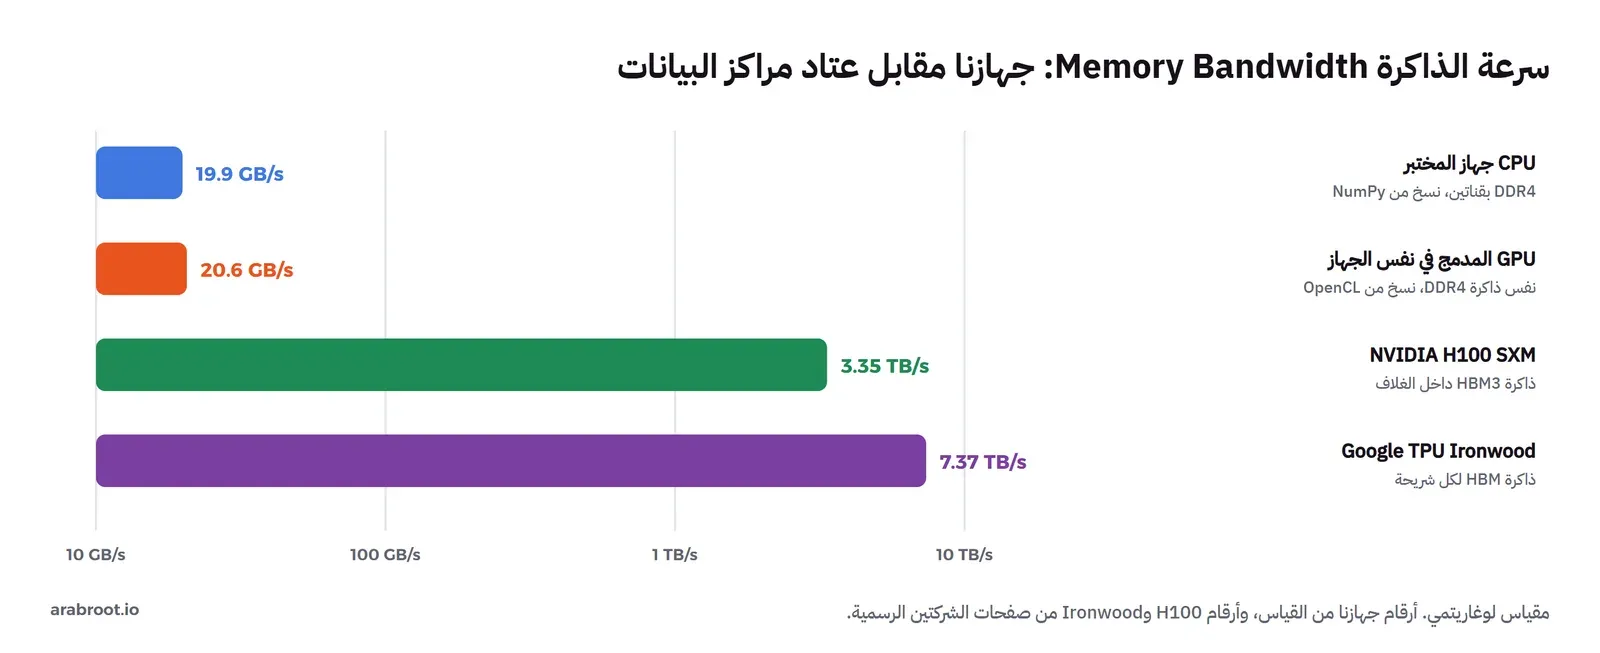
فبطاقة H100 تقرأ من ذاكرتها أسرع من جهازنا بأكثر من 160 ضعفاً، وهذا الرقم، وليس عدد وحدات الحساب وحده، هو ما يجعلها تولد الكلمات بسرعة. والسر في نوع الذاكرة: HBM، اختصاراً لـ High Bandwidth Memory، وهي شرائح ذاكرة مكدسة فوق بعضها وموضوعة داخل نفس الغلاف بجانب الشريحة، تتصل بها بآلاف الأسلاك القصيرة بدلاً من 128 سلكاً للبيانات في قناتي DDR4 على اللوحة الأم. وهذا هو ما رأيته في صورة لوحة TPU v4 في بداية المقال: أربع وحدات ذاكرة حول كل شريحة.
Tensor Cores والدقة المنخفضة Low Precision
رأينا في المختبر أن float64 أبطأ من float32 تقريباً بالنصف لأن المسجل يحمل أرقاماً أقل. والشبكات العصبية اكتشفت شيئاً مفيداً جداً هنا: هي لا تحتاج دقة عالية، فأغلب الحساب يمكن أن يتم بأرقام من 16 بت مثل FP16 وBF16، بل وبـ 8 بت مثل FP8 وINT8 في كثير من حالات التشغيل، وقد شرحنا تمثيل هذه الأرقام في مقال الأرقام العشرية من الداخل. والرقم الأصغر يعني ذاكرة أقل، وسرعة قراءة أعلى بنفس سرعة الذاكرة، ووحدات حساب أصغر يمكن وضع عدد أكبر منها في نفس المساحة.
ولذلك أضافت NVIDIA إلى معالجاتها الرسومية منذ جيل Volta وحدات خاصة اسمها Tensor Cores، وكل واحدة منها لا تحسب ضرباً واحداً، وإنما تضرب مصفوفتين صغيرتين وتجمع النتيجة في تعليمة واحدة. والفرق يظهر في صفحة H100 نفسها: 67 TFLOPS بدقة FP32 العادية، مقابل 1,979 TFLOPS بدقة FP16 على Tensor Cores، وهذا الرقم كما تكتب الصفحة «with sparsity»، أي بافتراض أن نصف الأوزان أصفار بنمط معين، ودونه يكون نصفه تقريباً، أي نحو 990 TFLOPS. فالزيادة الكبيرة في الأداء بين جيل وآخر في هذا العتاد يأتي في جزء كبير منه من تخفيض الدقة ومن وحدات المصفوفات، وليس من زيادة التردد.
والصورة التالية تبين الفكرة التي تشترك فيها Tensor Cores ووحدات NPU وTPU:
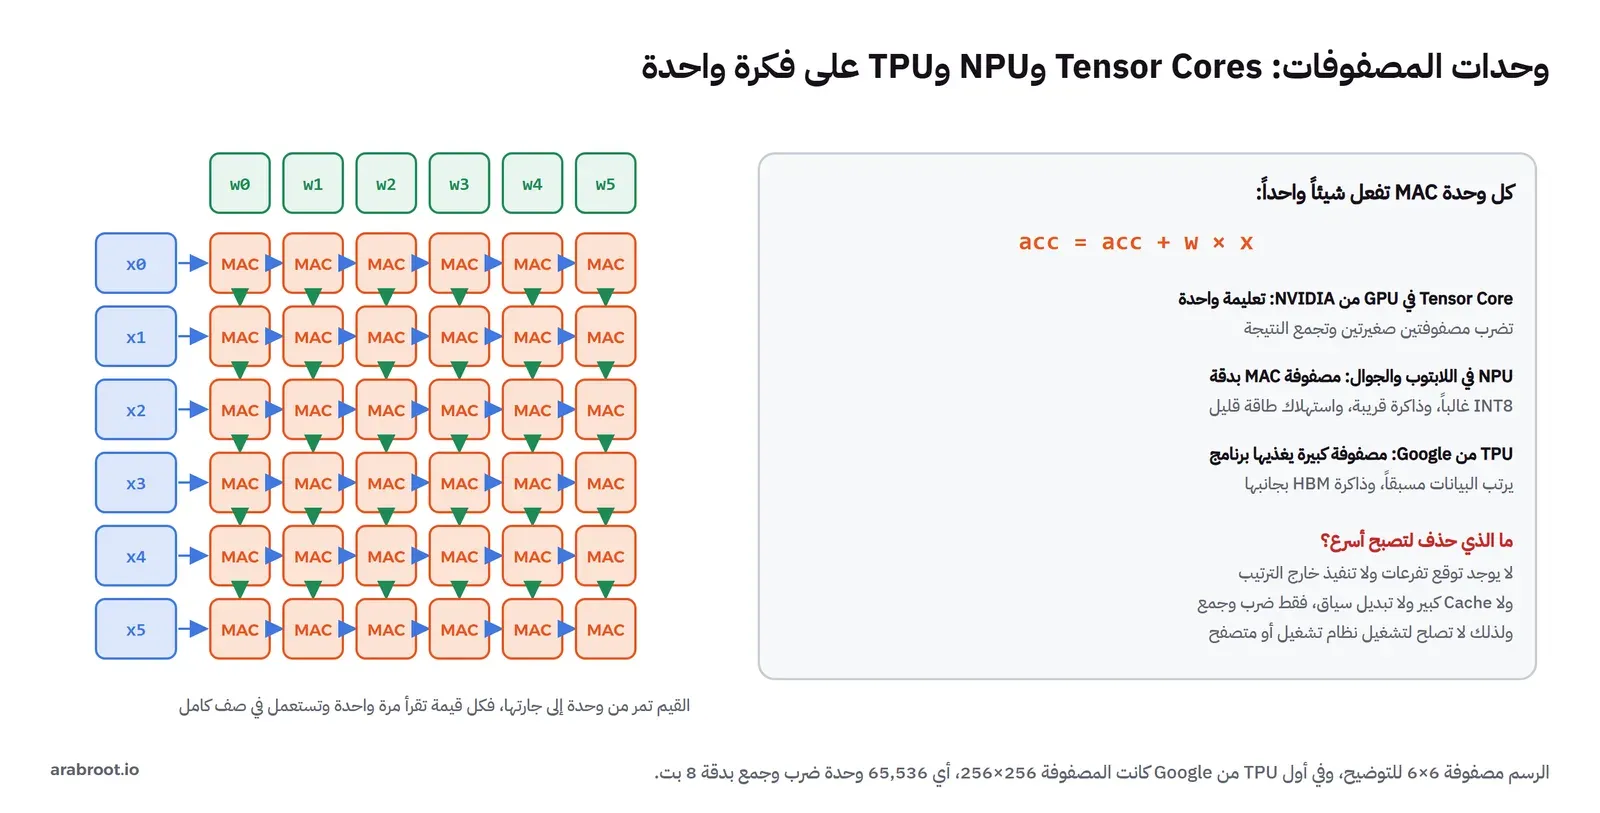
وفي الصورة أعلاه لاحظ أن كل وحدة تفعل شيئاً واحداً فقط: تضرب رقمين وتضيف النتيجة إلى مجموع، ثم تمرر الرقم إلى جارتها. وهذا الترتيب يسمى المصفوفة النابضة Systolic Array، وفائدته أن القيمة تقرأ من الذاكرة مرة واحدة ثم تستعمل في صف كامل من الوحدات، وهي نفس الفكرة التي جعلت Kernel المسجلات في المختبر أسرع بخمسة أضعاف، ولكن مبنية في العتاد نفسه.
وحدات NPU في اللابتوب والجوال
وحدة المعالجة العصبية NPU، اختصاراً لـ Neural Processing Unit، هي مصفوفة من وحدات الضرب والجمع مثل التي في الصورة، مع ذاكرة صغيرة قريبة، داخل نفس شريحة المعالج في اللابتوب أو الجوال، وهدفها ليس أن تكون أسرع من GPU، وإنما أن تشغل نماذج الذكاء الاصطناعي الصغيرة بأقل طاقة ممكنة، مثل تمويه خلفية الكاميرا في مكالمة فيديو، أو الترجمة الفورية، أو التعرف على الوجه، دون أن تفرغ البطارية.
وقد بدأت Apple هذا الطريق في الجوال مبكراً: في سبتمبر 2017 أعلنت عن شريحة A11 Bionic ومعها محرك عصبي Neural Engine من نواتين بقدرة 600 مليار عملية في الثانية، وفي مايو 2024 أعلنت عن شريحة M4 بمحرك عصبي يصل إلى 38 تريليون عملية في الثانية، أي أكثر من ستين ضعفاً في سبع سنوات. وفي عالم Windows وضعت Microsoft رقماً واضحاً: حسب دليل المطورين لأجهزة Copilot+ يجب أن يحتوي الجهاز على NPU تزيد قدرته عن 40 تريليون عملية في الثانية، أي 40 TOPS، حتى تعمل عليه ميزات الذكاء الاصطناعي الخاصة بهذه الأجهزة، ومن الشرائح التي حققت ذلك Qualcomm Snapdragon X وAMD Ryzen AI 300 وIntel Core Ultra 200V.
ولكن انتبه إلى ثلاثة أشياء عندما تقرأ رقم TOPS:
- الوحدة عمليات وليست FLOPS: رقم TOPS يحسب غالباً بأرقام صحيحة INT8، ونفس الصفحة من Microsoft تقول إن كثيراً من وحدات NPU لا تدعم إلا الحساب الصحيح بدقة منخفضة مثل INT8، ولذلك يجب تحويل النموذج إليها بعملية التكميم Quantization قبل أن يعمل عليها. فلا تقارن 40 TOPS بـ 67 TFLOPS لبطاقة رسومات، لأنهما ليسا نفس الشيء.
- البرنامج يجب أن يطلب NPU: لن يستعمل Python أو المتصفح أو أداة تشغيل النماذج الوحدة إلا إذا كتبت لها، وMicrosoft توصي حالياً بـ Windows ML الذي يستعمل ONNX Runtime ويختار مزود التنفيذ المناسب لكل شريحة.
- الذاكرة ما زالت هي الحد: وحدة NPU في لابتوب تقرأ من نفس ذاكرة الجهاز التي يقرأ منها المعالج، فإذا كان العمل مثل GEMV، كما في توليد النص بنموذج لغة، فلن تجعله NPU أسرع من سرعة الذاكرة، وإنما ستجعله يستهلك طاقة أقل.
وجهاز المختبر من عام 2017 لا يحتوي NPU أصلاً، ولذلك لم نقس هذه الوحدات، والأرقام هنا من صفحات الشركات كما هي.
وحدات TPU من Google
في عام 2017 نشرت Google ورقة بعنوان In-Datacenter Performance Analysis of a Tensor Processing Unit عن شريحة كانت تعمل في مراكز بياناتها منذ 2015، وكان قلبها مصفوفة من 65,536 وحدة ضرب وجمع بدقة 8 بت، أي مصفوفة 256 × 256 مثل التي في الرسم، تصل إلى 92 TOPS، ومعها 28 MiB من الذاكرة داخل الشريحة يديرها البرنامج. وقالت الورقة إنها كانت في المتوسط أسرع من المعالجات والمعالجات الرسومية المعاصرة لها بـ 15 إلى 30 ضعفاً في أعمال الاستنتاج Inference التي قاستها، وأكفأ في الطاقة بـ 30 إلى 80 ضعفاً. والسبب ليس سحراً، وإنما حذف: لا يوجد توقع تفرعات، ولا تنفيذ خارج الترتيب، ولا Cache كبير، ولا كل ما تحتاجه شريحة عامة الغرض، فكل المساحة تقريباً لضرب المصفوفات.
ومن ذلك الوقت صدرت عدة أجيال، وفي أبريل 2025 أعلنت Google عن الجيل السابع Ironwood، وحسب إعلانها تصل الشريحة الواحدة إلى 4,614 TFLOPS بدقة FP8، ومعها 192 GB من ذاكرة HBM بسرعة 7.37 TB/s، وتجمع حتى 9,216 شريحة في نظام واحد تبرده المياه. ولاحظ أن أغلب الأرقام في هذا الإعلان عن الذاكرة والربط بين الشرائح وليس عن الحساب وحده، وهذا يتفق مع ما رأيناه في نموذج السقف.
وقد يتساءل البعض: إذا كانت TPU بهذه الكفاءة فلماذا لا يشتريها الجميع؟ والإجابة أن Google لا تبيعها كقطعة، وإنما تؤجرها في Google Cloud، وأن البرامج يجب أن تكتب بإطارات تدعمها مثل JAX وTensorFlow وPyTorch مع طبقة XLA، وأن عالم CUDA من NVIDIA ما زال أوسع في المكتبات والأمثلة والخبرة المتاحة. فالاختيار بين العتادين قرار عن البرمجيات بقدر ما هو قرار عن الأرقام.
مقارنة سريعة: من يناسب أي عمل؟
| العتاد | نقاط القوة | نقاط الضعف | أين تجده |
|---|---|---|---|
| CPU | يشغل أي برنامج، سهل البرمجة، ومكتبات مثل OpenBLAS تصل به إلى جزء جيد من حده | وحدات حساب قليلة، وذاكرة DDR بطيئة نسبياً | كل جهاز وكل سيرفر |
| GPU مدمج | موجود مجاناً، ويشترك مع المعالج في الذاكرة دون نسخ | حده قريب من المعالج أو أقل في الأجهزة القديمة، ونفس سرعة الذاكرة | أغلب اللابتوبات والحواسب المكتبية |
| GPU منفصل | آلاف المسارات، وذاكرة GDDR أو HBM سريعة جداً، وCUDA ومكتباته | السعر والطاقة، وحجم الذاكرة يحدد أكبر نموذج يدخل فيه | حواسب الألعاب ومحطات العمل والسيرفرات |
| NPU | استنتاج بطاقة قليلة جداً، مناسب للبطارية | دقة منخفضة غالباً، ويحتاج تحويل النموذج وبرامج تدعمه | الجوالات وأجهزة Copilot+ وMac |
| TPU | كفاءة عالية جداً في ضرب المصفوفات، وذاكرة HBM، وتجمع آلاف الشرائح | متاحة فقط كخدمة سحابية، وتحتاج إطارات معينة | Google Cloud |
أخطاء شائعة Common Mistakes
- شراء GPU قبل استعمال مكتبة صحيحة على المعالج: رأينا فرقاً بثمانية عشر ألف ضعف بين حلقات Python وNumPy على نفس المعالج، فإذا كان كودك يحسب بحلقات عادية فابدأ من هنا.
- توقع أن أي GPU أسرع من أي CPU: المعالج الرسومي المدمج في جهازنا كان أبطأ من المعالج في كل اختبار، فالمهم هو الحد النظري لكل شريحة وسرعة ذاكرتها، وليس اسمها.
- تشغيل خيوط بعدد الخيوط العتادية في الحساب الثقيل: ثمانية خيوط على أربع أنوية كانت أبطأ من أربعة، فاضبط عدد خيوط مكتبة الحساب على عدد الأنوية الحقيقية وجرب.
- مقارنة TOPS بـ TFLOPS: الأول غالباً بأرقام صحيحة INT8 وأحياناً مع افتراض الأصفار Sparsity، والثاني بأرقام عشرية، فاقرأ الدقة والشروط المكتوبة بجانب الرقم.
- تجاهل سرعة الذاكرة عند اختيار عتاد لنموذج لغة: توليد النص لمستخدم واحد عمل محدود بالذاكرة، فبطاقة بذاكرة أسرع قد تكون أسرع في التوليد من بطاقة بحساب أكثر.
- كتابة Kernel يقرأ فيه كل خيط عناوين بعيدة عن جيرانه: رأينا خمسة عشر ضعفاً بين نسختين من نفس الحساب بسبب ترتيب القراءة فقط.
- الحكم من قياس واحد على جهاز مشغول: أرقامنا تغيرت بضعفين حسب ما يعمل على الجهاز، فاكتب متوسط الضغط مع كل قياس وكرره.
قبل أن تختار عتاداً للذكاء الاصطناعي: قائمة تحقق Checklist
- ما نوع العمل: تدريب، أم استنتاج لمستخدم واحد، أم استنتاج لعدد كبير من المستخدمين؟ الأول والثالث يحتاجان حساباً، والثاني يحتاج ذاكرة سريعة.
- كم حجم النموذج بالدقة التي سوف تستعملها، وهل يدخل في ذاكرة العتاد كاملاً؟
- ما سرعة ذاكرة العتاد بالـ GB/s، وما حده الحسابي بالدقة التي تحتاجها، وليس بأعلى رقم في الإعلان؟
- هل البرامج التي تستعملها تدعم هذا العتاد فعلاً: CUDA، أم ROCm، أم Metal، أم Windows ML، أم XLA؟
- هل جربت أولاً على المعالج بمكتبة صحيحة، حتى تعرف من أين تبدأ ومقدار المكسب الحقيقي؟
- كم تستهلك من الطاقة، وهل تستطيع تبريدها في المكان الذي سوف تعمل فيه؟
تدريب عملي
- شغل
cpu-run.shعلى جهازك واحسب الحد النظري لمعالجك بنفس الطريقة، ثم قارن أفضل رقم وصلت إليه بالحد، وإذا كان معالجك يدعم AVX-512 فلاحظ هل يظهر في سطرfound. - إذا كان في جهازك معالج رسومي، مدمجاً أو منفصلاً، فشغل
gpu_bench.pyعليه، واحسب حده النظري من عدد الوحدات والتردد اللذين يطبعهما البرنامج، وقارن سرعة النسخ بسرعة ذاكرة المعالج. - غير في
sgemm_tiledقيمةTSإلى 8 ثم إلى 32، وتوقع قبل التشغيل أيهما أسرع، ثم انظر هل يقبل التعريف حجم 32 × 32 مساراً في المجموعة الواحدة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- حساب الذكاء الاصطناعي في أغلبه ضرب مصفوفات، وهو عمل يقبل التوازي بالكامل تماماً، ولذلك يناسب عتاداً بوحدات حساب كثيرة بسيطة.
- البرنامج يحدد السرعة قبل العتاد: على نفس المعالج قسنا 0.012 GFLOPS بحلقات Python و218 GFLOPS مع NumPy، وعلى نفس المعالج الرسومي ضاعفنا السرعة خمس مرات بتغيير طريقة استعمال الذاكرة فقط.
- المعالج الرسومي ليس سحراً: المدمج في جهازنا كان أبطأ من المعالج، لأن حده النظري أقل ولأنه يقرأ من نفس الذاكرة، أما بطاقات مراكز البيانات فتتفوق بعدد الوحدات وبذاكرة HBM أسرع بأكثر من مئة ضعف.
- نموذج السقف يقول لك أي الحدين يحكم عملك: GEMM يحكمه الحساب، وGEMV يحكمه سرعة الذاكرة، وتوليد النص في نماذج اللغة لمستخدم واحد أقرب إلى GEMV.
- Tensor Cores ووحدات NPU وTPU كلها مصفوفات من وحدات الضرب والجمع بدقة منخفضة، حذفت كل ما لا يحتاجه ضرب المصفوفات، فكسبت السرعة أو الطاقة على حساب المرونة.
- عند قراءة الأرقام انتبه للدقة وللشروط: TOPS ليست TFLOPS، والأرقام «with sparsity» ضعف الأرقام العادية.
وفي المقال التالي من مقالات المعالجات بإذن الله ننزل إلى السيليكون نفسه: كيف تصنع هذه الشرائح من الرمل، وما معنى النانومتر، ولماذا تصنع أغلبها شركة واحدة:
 دليلكيف تصنع الرقاقة؟ من الرمل إلى المعالج والنانومترنتتبع الشريحة من الرمل إلى الغلاف مروراً بأجهزة EUV، ونحسب بسكربت صغير كم شريحة تخرج من الرقاقة وكم منها يعمل ولماذا تغلو الشرائح الكبيرة.
 دليلدعم المعالج للأجهزة الافتراضية: VT-x وAMD-V من الداخلنكتب مشرفاً صغيراً على KVM يشغل ضيفاً من 63 بايت، ونعد مرات الخروج VM Exit ونقيس كلفتها لنفهم ما يفعله VT-x وEPT داخل المعالج.
 دليلARM من الجوال إلى السيرفر: Apple Silicon وGravitonكيف تربح Arm من شرائح لا تصنعها، ولماذا صار في كل سحابة معالج ARM، مع مختبر يبني Image لـ arm64 ويقيس كلفة تشغيلها تحت المحاكاة.
 دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
 دليلعائلات Intel وAMD: كيف تقرأ اسم المعالج وجيله؟نفك أسماء معالجات Intel وAMD من المصادر الرسمية، ثم نقرأ معالجاً حقيقياً بأدوات Windows وLinux ونفك هويته الرقمية التي لا تتغير مع الاسم.
سجل التحديثات Changelog
- 16 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على معالج Intel Core i7-7700K مع المعالج الرسومي المدمج Intel HD Graphics 630: NumPy 2.5.5 مع OpenBLAS على Python 3.13.18 في Container على Docker Desktop، وPyOpenCL 2026.1.5 مع تعريف Intel OpenCL 3.0 (31.0.101.2140) على Windows 11، مع صور حقيقية من Wikimedia Commons ورسوم من عرب رووت.