

عندما تقرأ في صفحة معالج أو خطة سيرفر عبارة مثل «8 أنوية و16 خيطاً وسرعة تصل إلى 4.5 GHz» فأنت غالباً تقارن الأرقام كما هي، وتختار الأكبر، ثم تفاجأ بأشياء لا تفسرها هذه الأرقام: كود يجمع نفس الأرقام بنفس عدد العمليات ولكنه أبطأ بعشر مرات لأنك غيرت ترتيب الحلقتين فقط، وحلقة تصبح أسرع بمرتين لأنك رتبت البيانات قبلها، ومعالج سرعته المكتوبة 4.5 GHz لا يصل إليها إلا لحظات ثم ينزل، وملف تنفيذي يعمل على جهازك ويرفض العمل على سيرفر ARM. وكل هذه الأشياء تفهمها بسهولة إذا عرفت ما الذي يوجد داخل الشريحة فعلاً وكيف تمر التعليمة الواحدة فيها.
وهذا المقال أول مقالات مرحلة العتاد Hardware في خارطة عرب رووت، وهو يكمل مقالات سبقته ولا يكررها: في مقال Hello World من الداخل رأينا أن المعالج حلقة من الجلب والفك والتنفيذ، ورأينا هرم الذاكرة بأرقامه التقريبية، وفي مقال المعالج والخيوط والتزامن شرحنا الأنوية Cores والخيوط Threads وتعدد الخيوط المتزامن Hyper-Threading وتبديل السياق Context Switch، وفي مقال الأنظمة العددية للمبرمجين شرحنا البت والبايت والثنائي، وفي مقال الذاكرة للمبرمجين شرحنا كيف يرى برنامجك الذاكرة. أما هنا فسوف نفتح الشريحة نفسها، وسوف نناقش في هذا المقال ما يلي:
- المعالج من الخارج: الغطاء المعدني والشريحة واللوحة التي تحملها والمقبس، بصور حقيقية ورسم مفكك طبقة طبقة.
- داخل الشريحة: الأنوية والذاكرة المؤقتة Cache بمستوياتها ومتحكم الذاكرة وبطاقة الرسومات المدمجة، على صورة حقيقية لشريحة معالج.
- كيف تقرأ معلومات معالجك من Windows ومن Linux.
- ماذا يفعل الترانزستور، وكيف تصبح المفاتيح الصغيرة بوابات ثم وحدة حساب.
- دورة الجلب والفك والتنفيذ خطوة خطوة، والمسجلات Registers ووحدة الحساب ALU ووحدة التحكم Control Unit والساعة Clock.
- خط التنفيذ Pipeline ولماذا يهم توقع القفزات Branch Prediction، مع تجربة حقيقية، ثم ثغرة Spectre في فقرة واحدة.
- سطر ال Cache وطوله 64 بايت، ولماذا يكون المرور على المصفوفة صفاً بصف أسرع بعشر مرات من المرور عليها عموداً بعمود.
- مجموعة التعليمات ISA وما الذي يختلف فعلاً بين x86-64 وARM، على نفس الدالة مترجمة للمعماريتين.
- تعليمة واحدة على عدة أرقام SIMD، والحرارة وال TDP والخنق الحراري Throttling، وكيف تقرأ مواصفات أي معالج.
المعالج من الخارج: الغطاء والشريحة والمقبس
الشيء الذي تمسكه في يدك وتسميه «المعالج» هو في الحقيقة غلاف Package يحمي قطعة صغيرة جداً من السيليكون ويوصلها بالعالم الخارجي، والقطعة نفسها اسمها الشريحة Die. والصورة التالية فيها ثلاث صور حقيقية: معالج Intel Core i7-6700K من الأعلى ومن الأسفل، وهو من نفس المقبس LGA 1151 الذي يركب فيه معالج جهاز التجارب في هذا المقال، وبينهما معالج Pentium G2020 أزيل غطاؤه المعدني فظهرت الشريحة السوداء الصغيرة في وسطه:
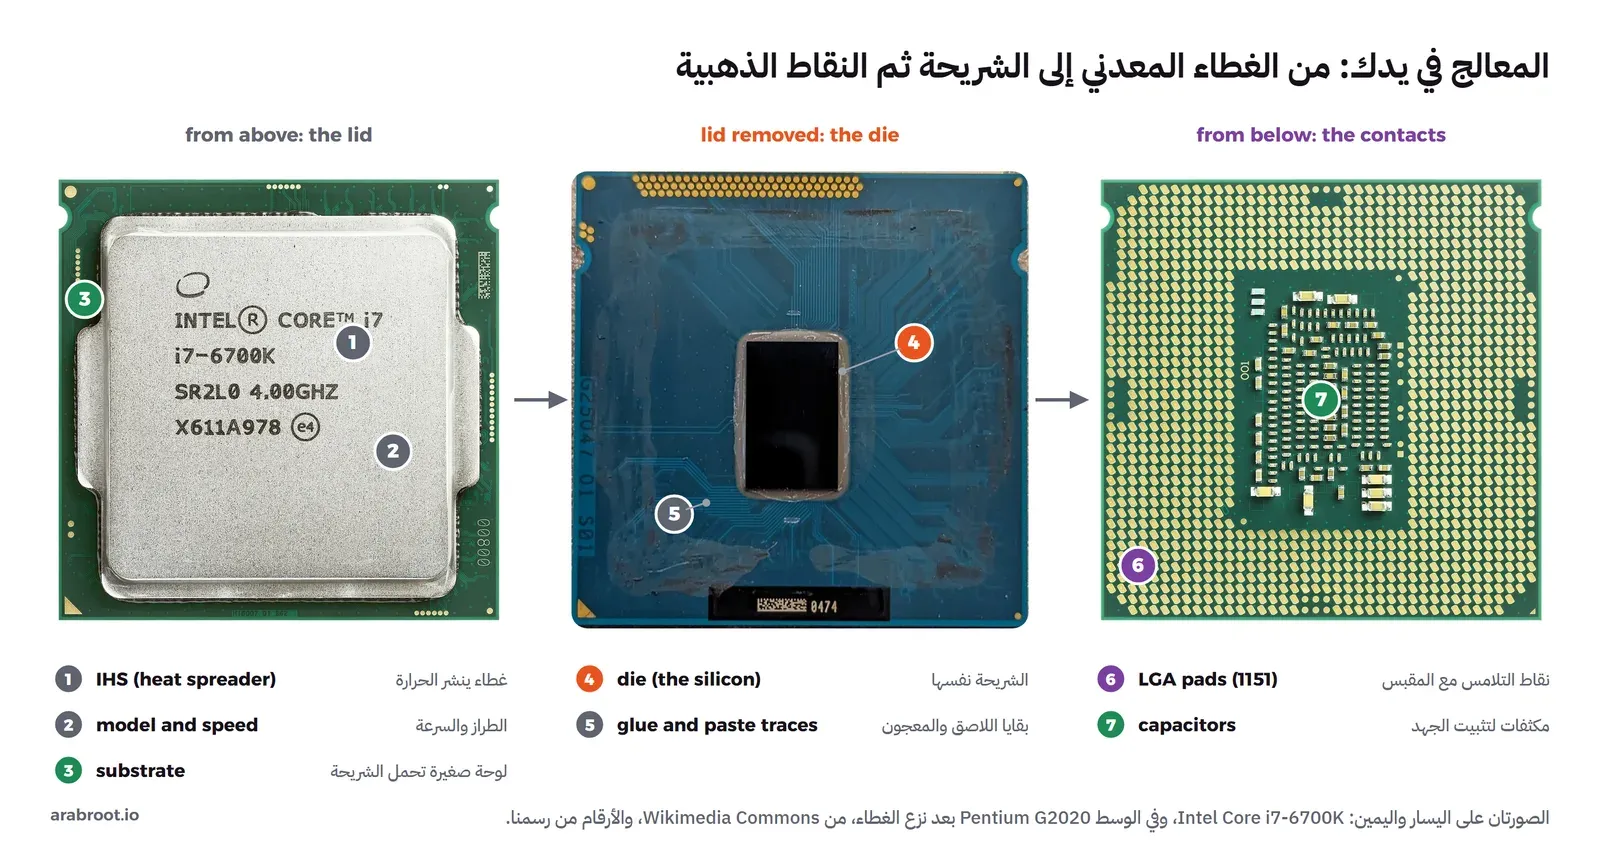
في الصورة أعلاه لاحظ التالي:
- الغطاء المعدني IHS: اختصاراً لـ Integrated Heat Spreader، أي ناشر الحرارة، ووظيفته أن يأخذ الحرارة من الشريحة الصغيرة وينشرها على مساحة أكبر يلمسها المبرد، وأن يحمي الشريحة من الكسر عند تركيب المبرد.
- الطراز والسرعة: المكتوب على الغطاء هو اسم المعالج وسرعته الأساسية، وسوف نرى في آخر المقال لماذا لا تكون هذه السرعة هي السرعة التي تراها دائماً.
- اللوحة الصغيرة Substrate: اللوحة الخضراء التي تحمل الشريحة، وفيها طبقات من الأسلاك الدقيقة توصل آلاف النقاط الصغيرة جداً تحت الشريحة بالنقاط الأكبر في أسفل المعالج.
- الشريحة Die: المستطيل الأسود في الوسط، وهو المعالج الحقيقي، وكل ما سوف نتحدث عنه في بقية المقال موجود داخله.
- بقايا اللاصق والمعجون: الغطاء ملصق على اللوحة، وبينه وبين الشريحة مادة توصل الحرارة، وهذه بقاياها بعد النزع.
- نقاط التلامس LGA: اختصاراً لـ Land Grid Array، وهي نقاط مسطحة تضغط على دبابيس في المقبس Socket على اللوحة الأم، ورقم المقبس LGA 1151 هو عدد هذه النقاط تقريباً، ومنها تدخل الكهرباء وتخرج وتدخل الإشارات من الذاكرة والأقراص وبطاقات PCIe.
- المكثفات Capacitors: تثبت الجهد الكهربائي الذي تحتاجه الشريحة عندما يتغير استهلاكها فجأة آلاف المرات في الثانية.
والصورة السابقة تبين كل جزء وحده، أما ترتيب هذه الأجزاء فوق بعضها عندما يركب المعالج في الجهاز فتبينه الصورة التالية، وهي رسم مفكك Exploded View من الأعلى إلى الأسفل:
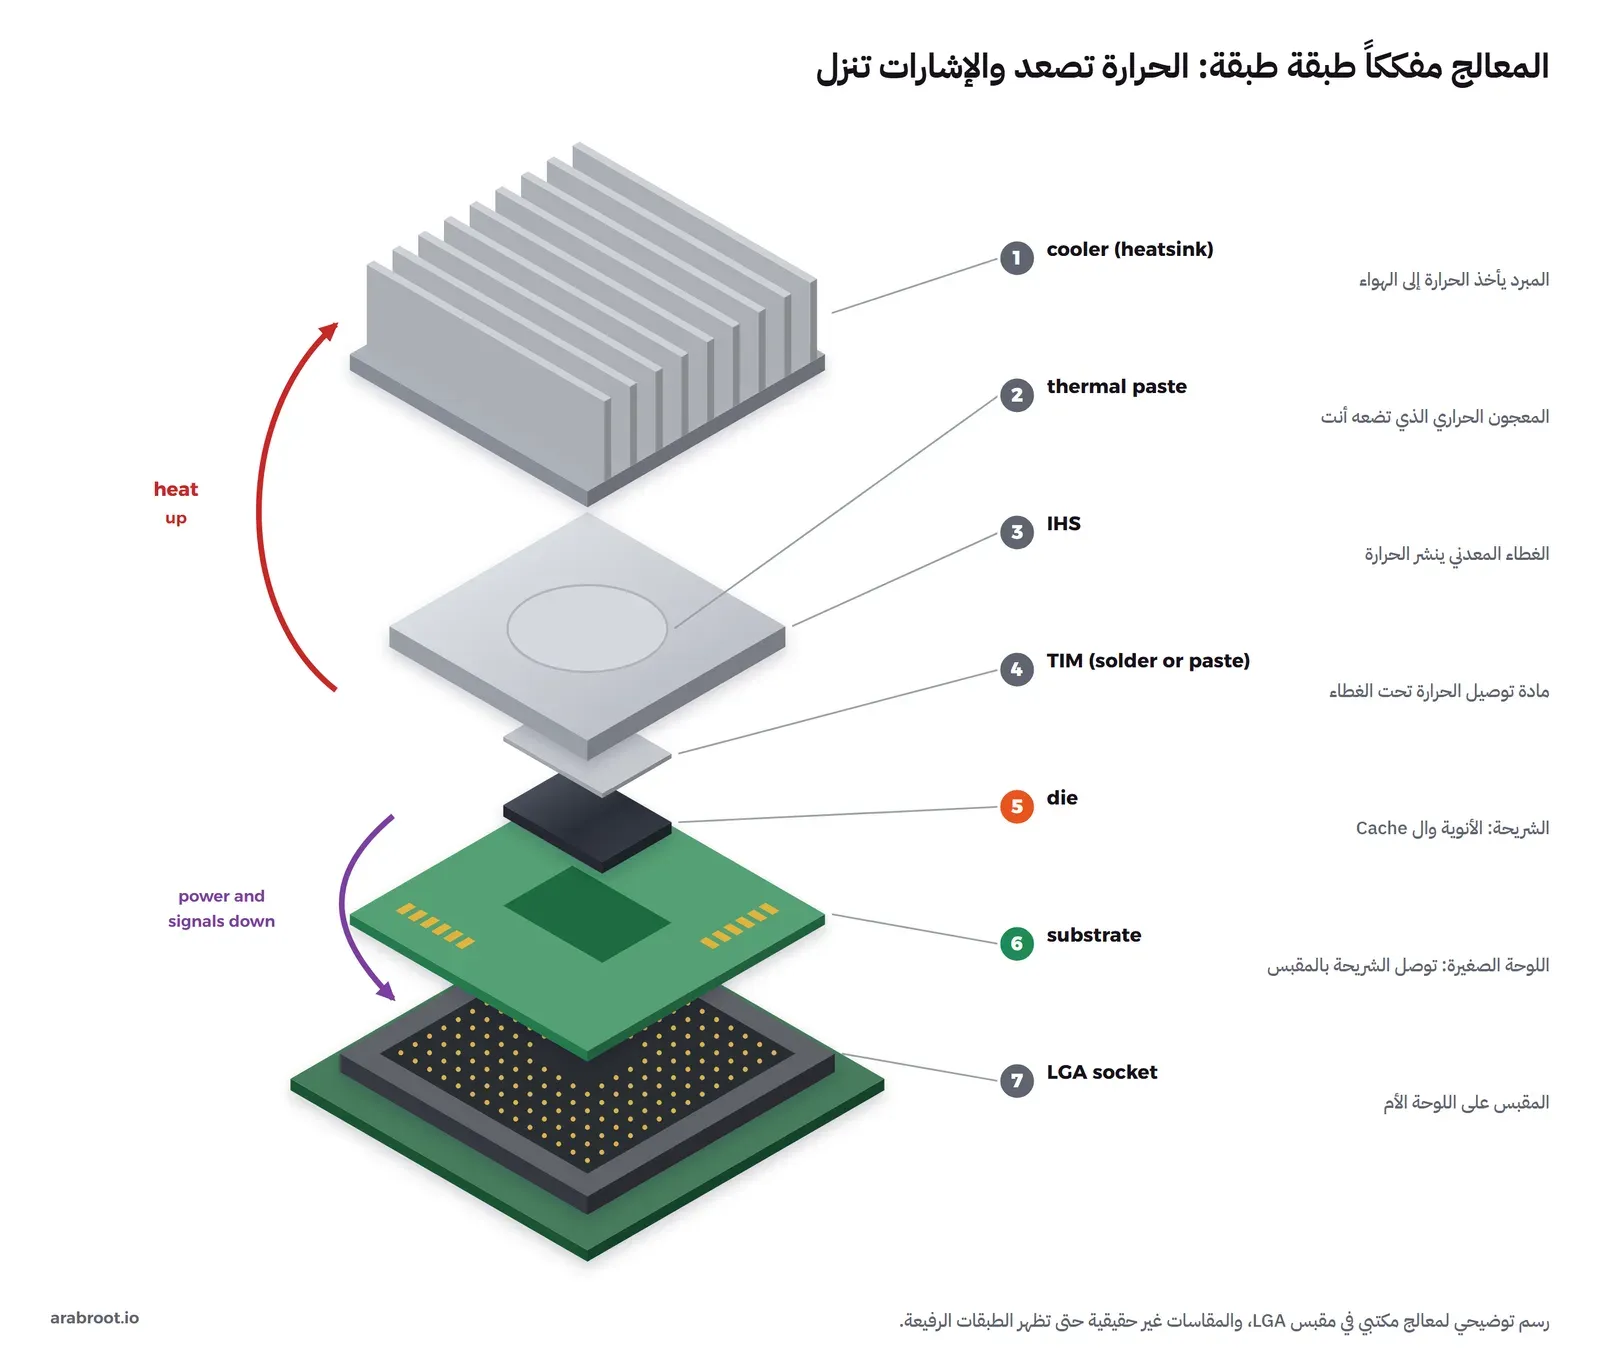
لاحظ في الرسم أن الحرارة تسير في اتجاه والإشارات في الاتجاه المعاكس: كل ما تحت الشريحة مصمم لإيصال الكهرباء والبيانات، وكل ما فوقها مصمم لإخراج الحرارة، ولذلك تجد أن أي طبقة رديئة فوق الشريحة، مثل معجون حراري جف أو مبرد لم يركب جيداً، تظهر مباشرة في سرعة المعالج كما سوف نرى في جزء الحرارة.
داخل الشريحة: الأنوية وال Cache ومتحكم الذاكرة
إذا كبرت الشريحة تحت المجهر بعد إزالة الطبقات العليا منها فسوف تجد أنها ليست قطعة واحدة متشابهة، وإنما مدينة صغيرة لها أحياء واضحة، لكل حي وظيفة. والصورة التالية صورة حقيقية لشريحة معالج Intel Core i9-13900K، صورها المصور الألماني المعروف بصور الشرائح Fritzchens Fritz، ووضع عليها JmsDoug أسماء الأجزاء بالإنجليزية، ووضعنا نحن الأرقام والشرح:
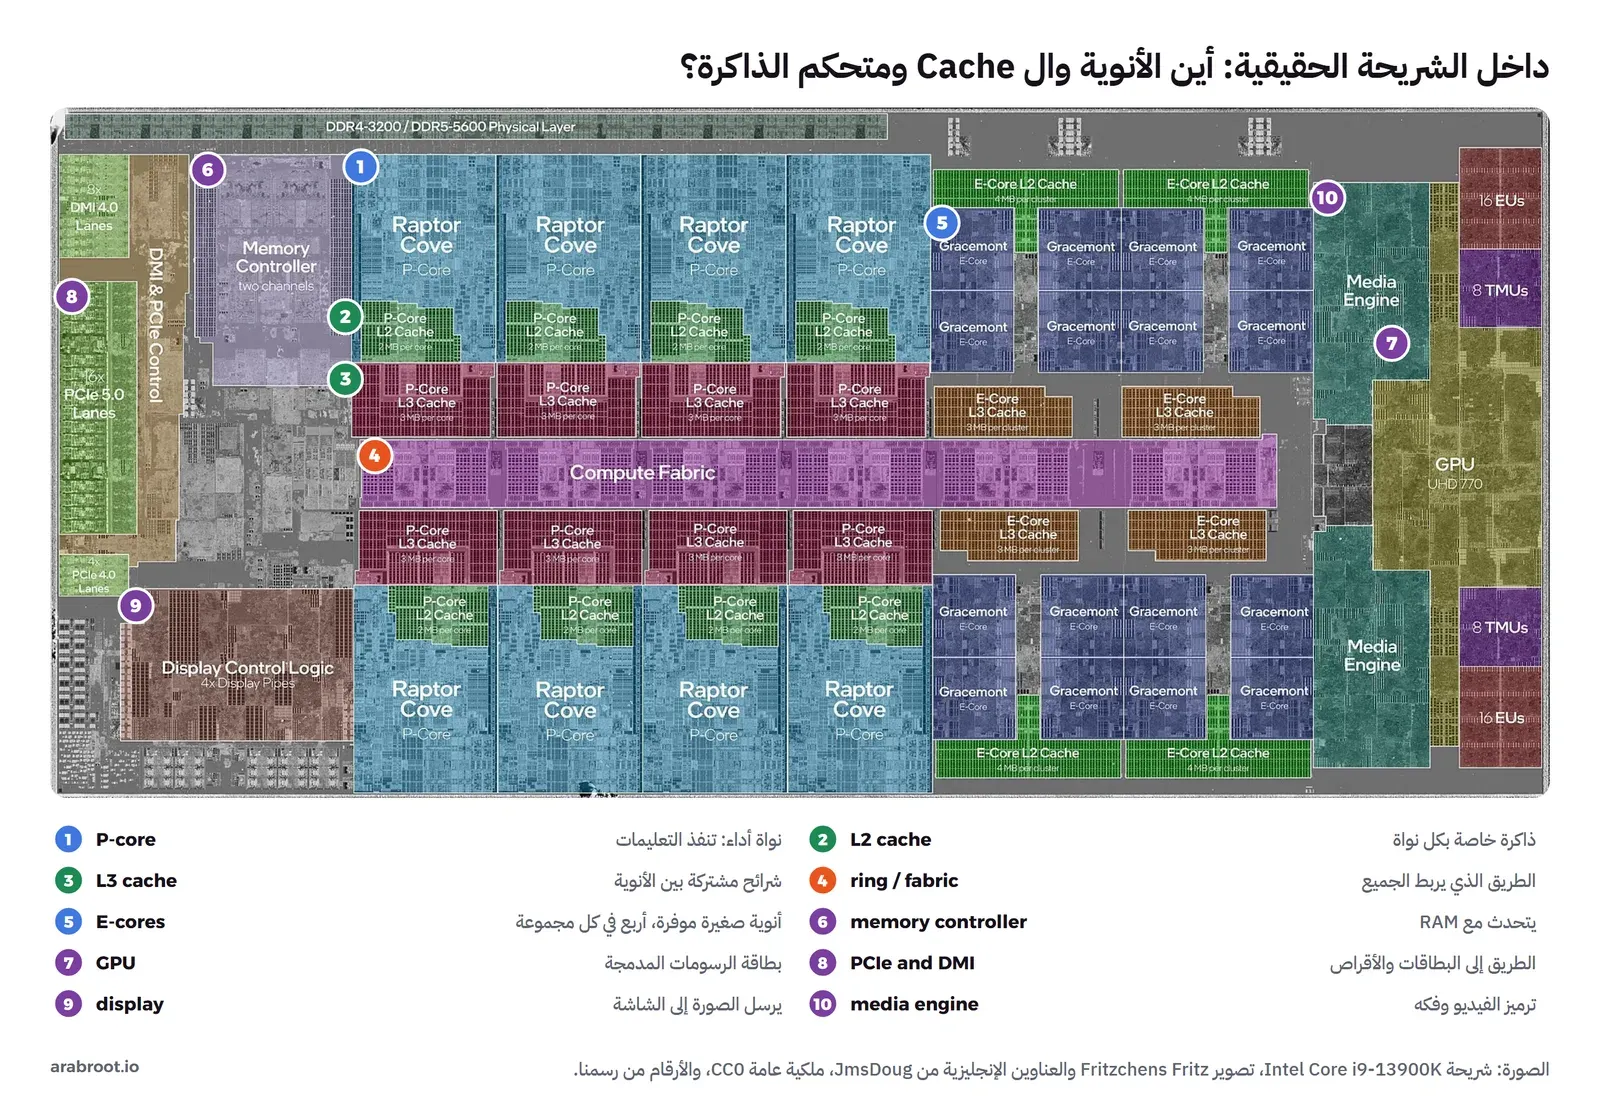
في الصورة أعلاه لاحظ التالي:
- الأنوية Cores (1 و5): كل نواة معالج كامل ينفذ برنامجاً مستقلاً، وفي هذا المعالج نوعان كما تذكر صفحته عند Intel: 8 أنوية أداء Performance-cores كبيرة، و16 نواة موفرة Efficient-cores أصغر بكثير تجمع كل أربع منها في مجموعة، والمجموع 24 نواة و32 خيطاً، لأن أنوية الأداء فقط فيها Hyper-Threading. وقد شرحنا ما يعنيه الخيط العتادي في مقال المعالج والخيوط.
- ال Cache بمستوياته (2 و3): لاحظ مساحتها، فجزء كبير من الشريحة ليس حساباً وإنما ذاكرة سريعة، وهذا وحده يخبرك كم هي مهمة. L2 خاصة بكل نواة، وL3 مقسمة إلى شرائح Slices بجانب الأنوية ولكنها مشتركة بينها كلها.
- الطريق الذي يربط الجميع (4): الأنوية وشرائح L3 ومتحكم الذاكرة وبطاقة الرسومات تتبادل البيانات عبر شبكة داخلية، وهي في هذه الشريحة حلقة Ring تمر بالجميع.
- متحكم الذاكرة Memory Controller (6): هو الذي يتحدث مع وحدات RAM عبر قناتين، وكونه داخل المعالج هو السبب في أن نوع الذاكرة وسرعتها يحددهما المعالج وليس اللوحة الأم فقط، وما يحدث بعد أن يخرج الطلب منه هو موضوع مقال كيف تعمل الذاكرة RAM من الداخل.
- بطاقة الرسومات المدمجة GPU والعرض والفيديو (7 و9 و10): المعالج المكتبي يحمل معه بطاقة رسومات صغيرة ومحرك لترميز الفيديو ووحدة ترسل الصورة إلى الشاشة، وما يحدث للصورة بعد أن تخرج من هنا شرحناه في مقال كيف تعمل الشاشة من الداخل.
- PCIe وDMI (8): الطريق إلى بطاقات التوسعة وأقراص NVMe وإلى شريحة اللوحة الأم Chipset.
وقد يتساءل البعض: لماذا لا تملأ الشركات الشريحة كلها أنوية بدل كل هذه ال Cache؟ والإجابة أن النواة السريعة لا تفيد شيئاً إذا كانت تنتظر البيانات، والوصول إلى RAM أبطأ من الوصول إلى L1 بنحو مئتي مرة كما رأينا في هرم الذاكرة، لذلك فكل مساحة تعطى لل Cache هي في الحقيقة استثمار في إبقاء الأنوية مشغولة، وسوف ترى أثر ذلك بالأرقام في جزء ال Cache.
كيف تقرأ معلومات معالجك؟
قبل أن نكمل الشرح لنأخذ مثالاً حقيقياً هو جهاز التجارب الذي نفذنا عليه كل أمثلة هذا المقال، وهو حاسب مكتبي فيه معالج Intel Core i7-7700K ويعمل بنظام Windows 11. في Windows تقرأ معلومات المعالج من خدمة WMI عبر الأمر Get-CimInstance في PowerShell والصنف Win32_Processor، وهو الأمر الذي حل محل wmic القديم:
Get-CimInstance Win32_Processor | Select-Object Name, NumberOfCores, NumberOfLogicalProcessors, MaxClockSpeed, L2CacheSize, L3CacheSize, AddressWidth, SocketDesignation | Format-Listوالمخرج سوف يكون كما يلي:
Name                      : Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
NumberOfCores             : 4
NumberOfLogicalProcessors : 8
MaxClockSpeed             : 4201
L2CacheSize               : 1024
L3CacheSize               : 8192
AddressWidth              : 64
SocketDesignation         : LGA1151
وفي Linux، أو داخل Container على نفس الجهاز كما فعلنا هنا، تقرأ نفس المعلومات بالأمر lscpu، وتسأل عن طول سطر ال Cache بالأمر getconf الذي يقرأ القيم التي تعرضها الدالة sysconf، وتبحث عن ميزات المعالج في الملف /proc/cpuinfo:
docker run --rm --name lab-hw-cpu ubuntu:24.04 bash -c "lscpu | grep -E '^(Architecture|Model name|Thread|Core|L1d|L1i|L2|L3|Vulnerability Spectre)'; getconf LEVEL1_DCACHE_LINESIZE; grep -o -w -E 'avx2|sse4_2|aes|ht' /proc/cpuinfo | sort -u"والمخرج سوف يكون كما يلي:
Architecture:                         x86_64
Model name:                           Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
Thread(s) per core:                   2
Core(s) per socket:                   4
L1d cache:                            128 KiB (4 instances)
L1i cache:                            128 KiB (4 instances)
L2 cache:                             1 MiB (4 instances)
L3 cache:                             8 MiB (1 instance)
Vulnerability Spectre v1:             Mitigation; usercopy/swapgs barriers and __user pointer sanitization
Vulnerability Spectre v2:             Mitigation; IBRS; IBPB conditional; STIBP conditional; RSB filling; PBRSB-eIBRS Not affected; BHI SW loop, KVM SW loop
64
aes
avx2
ht
sse4_2
في المخرجين أعلاه لاحظ التالي:
- الأنوية أربع والمعالجات المنطقية ثمانية، أي خيطان عتاديان لكل نواة، وقد شرحنا قراءة هذه الأسطر بالتفصيل في مقال المعالج والخيوط.
- القيمة
MaxClockSpeedهي 4201 MHz، أي السرعة الأساسية المكتوبة على الغطاء، وليست 4.5 GHz التي تذكرها صفحة المعالج عند Intel كأقصى سرعة Max Turbo Frequency، فلا تعتمد على هذا الحقل لتعرف أقصى سرعة يصل إليها معالجك. - L1 مقسمة إلى ذاكرة للبيانات L1d وذاكرة للتعليمات L1i، كل واحدة 128 KiB موزعة على أربع نسخ، أي 32 KiB لكل نواة، وL2 حجمها 256 KiB لكل نواة، وL3 حجمها 8 MiB مشتركة، بينما يعرض Windows حجم L2 مجموعاً للأنوية الأربع 1024 KB.
- الرقم 64 هو طول سطر ال Cache بالبايت، وهو الرقم الذي سوف نبني عليه تجربة جزء ال Cache.
- الأسطر التي تبدأ بـ
Vulnerability Spectreتخبرك أن النواة تعرف بثغرات Spectre في هذا المعالج وأنها فعلت لها حلولاً Mitigations، وسوف نشرح الثغرة في جزء خط التنفيذ. - الكلمات في النهاية ميزات يدعمها المعالج:
avx2تعليمات SIMD التي سوف نجربها في جزء SIMD، وaesتعليمات تسرع التشفير، وhtتعني دعم Hyper-Threading.
من الترانزستور إلى وحدة الحساب
كل ما في الشريحة من أنوية وCache مبني من عنصر واحد يتكرر مليارات المرات، وهو الترانزستور Transistor، وفكرته في أبسط صورة أنه مفتاح كهربائي ليس فيه أجزاء متحركة: له طرفان يمر بينهما التيار، المصدر Source والمصرف Drain، وطرف ثالث اسمه البوابة Gate، فإذا وضعت على البوابة جهداً كهربائياً سمح الترانزستور للتيار بالمرور، وإذا أزلته منع المرور، وبالتالي فكل ترانزستور يمثل في أي لحظة إما 0 وإما 1، وهو البت الذي شرحناه في مقال الأنظمة العددية. والصورة التالية تبين كيف تصبح هذه المفاتيح وحدة حساب في أربع خطوات:
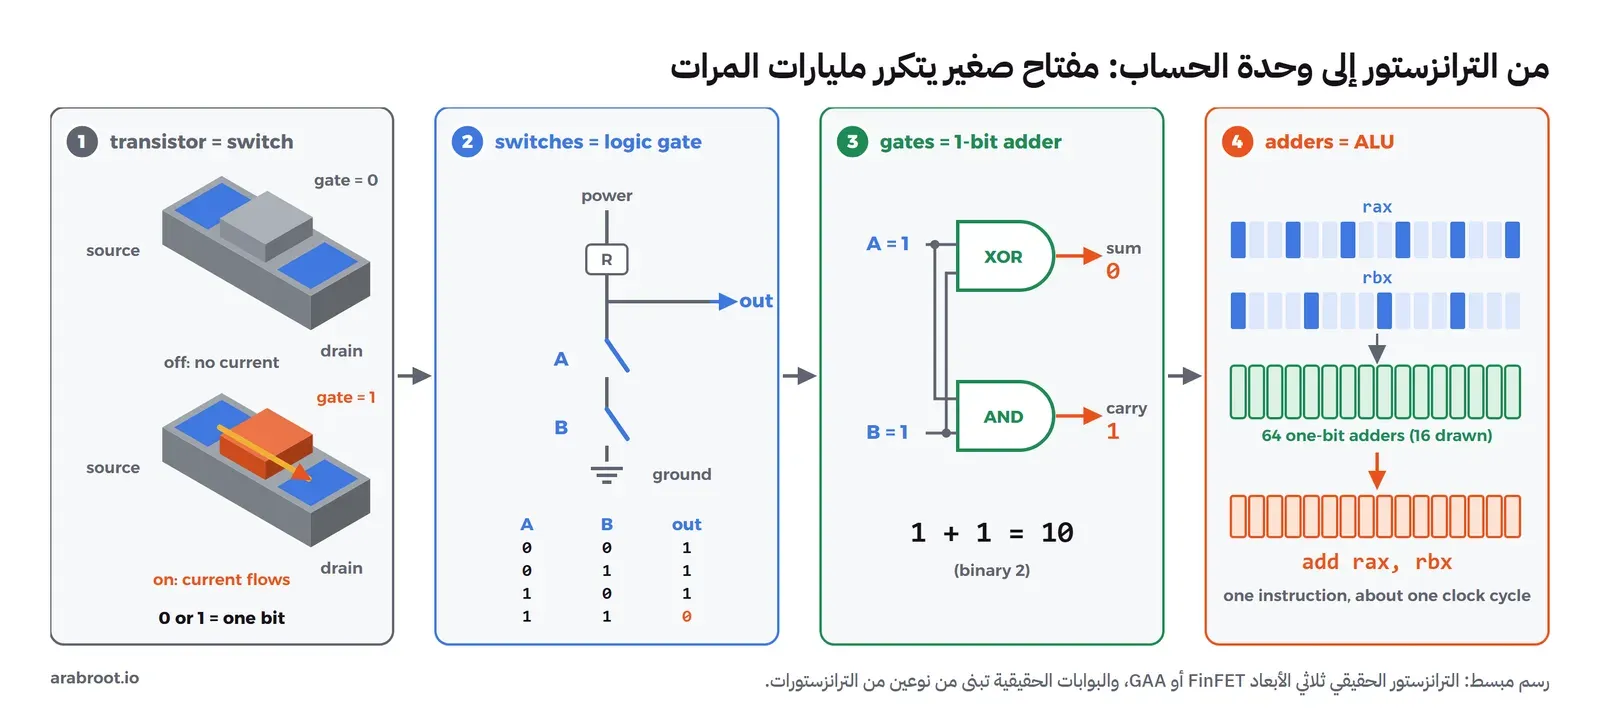
- الترانزستور مفتاح: البوابة تتحكم في مرور التيار، فيكون الناتج 0 أو 1.
- المفاتيح تصبح بوابة منطقية Logic Gate: إذا وصلت مفتاحين على التوالي بين الكهرباء والأرض فلن ينزل المخرج إلى 0 إلا إذا كان المفتاحان مفتوحين معاً، وهذه هي البوابة NAND، ومنها وحدها يمكن بناء كل البوابات الأخرى، وهذا بالضبط ما يفعله مشروع Nand2Tetris الذي يبني حاسباً كاملاً من هذه البوابة إذا أردت أن تتعمق.
- البوابات تصبح جامعاً Adder: بوابة XOR تعطي مجموع بتين، وبوابة AND تعطي الحمل Carry، فإذا جمعت 1 و1 كان المجموع 0 والحمل 1، أي 10 بالثنائي وهي القيمة 2.
- الجوامع تصبح وحدة الحساب ALU: اختصاراً لـ Arithmetic Logic Unit، وفيها جامع يتكون من 64 جامعاً لبت واحد بجانب بعضها، يمرر كل منها الحمل إلى الذي بعده، فتجمع رقمين من 64 بت في تعليمة واحدة، وبجانبه دوائر للطرح والمقارنة والإزاحة والعمليات المنطقية.
والمعالجات الحديثة لا تستخدم الترانزستور المسطح المرسوم أعلاه، وإنما ترانزستورات ثلاثية الأبعاد مثل FinFET وGAA تتحكم البوابة فيها في القناة من عدة جهات، ولكن الفكرة كما هي: مفتاح يفتح ويغلق مليارات المرات في الثانية، وكل ما فوقه طبقات من التنظيم.
دورة الجلب والفك والتنفيذ خطوة خطوة
ذكرنا في مقال Hello World أن المعالج يعمل في حلقة: يجلب Fetch التعليمة من العنوان الموجود في عداد البرنامج rip، ثم يفكها Decode، ثم ينفذها Execute. والآن لنتابع تعليمة حقيقية واحدة داخل النواة، وهي add rax, rbx التي تجمع المسجلين وتضع الناتج في rax، وطولها في ذاكرة البرنامج ثلاثة بايتات هي 48 01 d8 كما سوف تراها في مخرج objdump في جزء ISA:
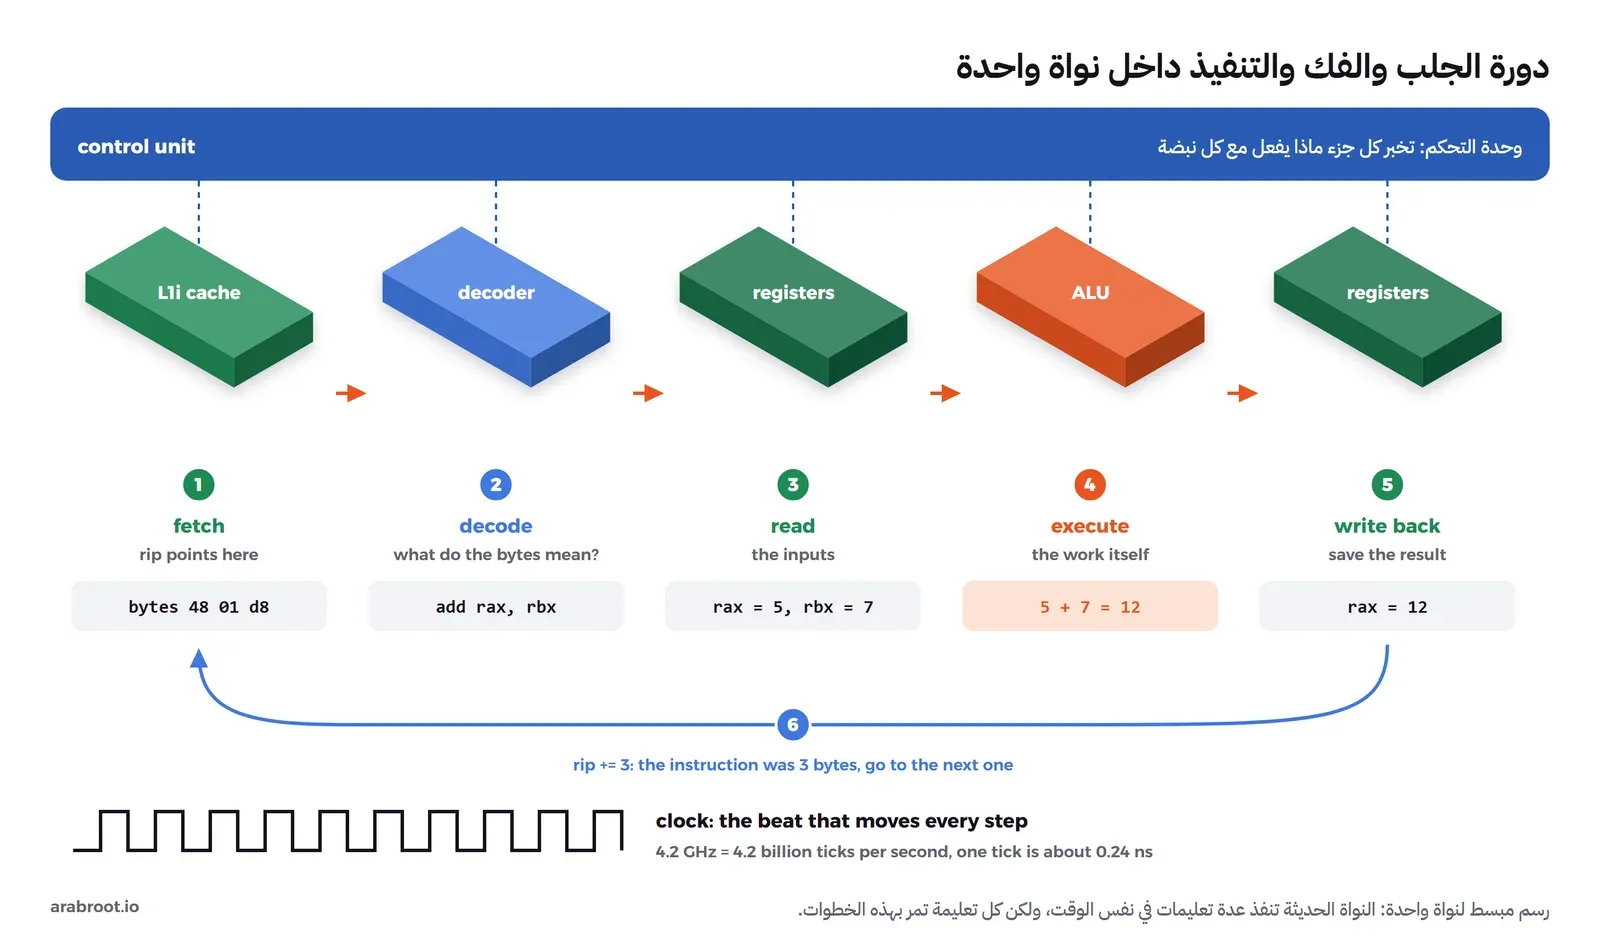
- الجلب Fetch: المسجل
ripيحمل عنوان التعليمة التالية، فتقرأ النواة البايتات من ذاكرة التعليمات L1i، وإذا لم تجدها هناك طلبتها من L2 ثم L3 ثم RAM. - الفك Decode: المفكك Decoder يقرأ البايتات
48 01 d8ويعرف منها أن المطلوب جمع وأن المدخلين هماraxوrbx، ويحولها إلى أوامر داخلية صغيرة تسميها Intel العمليات الصغيرة Micro-operations. - قراءة المسجلات: المسجلات Registers خانات تخزين قليلة داخل النواة نفسها، وهي أسرع ذاكرة في الجهاز، فتقرأ منها النواة القيمتين 5 و7.
- التنفيذ Execute: وحدة الحساب ALU تجمع القيمتين بالدوائر التي رأيناها في الجزء السابق.
- الكتابة Write Back: الناتج 12 يكتب في المسجل
rax. - التعليمة التالية: يزيد
ripبثلاثة لأن التعليمة كانت ثلاثة بايتات، فيشير إلى التي بعدها، إلا إذا كانت التعليمة قفزة فيأخذ عنوان القفزة.
ومن يرتب كل هذا هو وحدة التحكم Control Unit، فهي التي تقول لكل جزء ماذا يفعل ومتى، ومتى تعني هنا: مع كل نبضة من الساعة Clock. والساعة إشارة كهربائية تتردد بين 0 و1 بانتظام، وسرعة المعالج المكتوبة بال GHz هي عدد هذه النبضات في الثانية، فمعالج سرعته 4.2 GHz ينبض 4.2 مليار مرة في الثانية، أي أن النبضة الواحدة تستغرق نحو ربع نانوثانية. ولكن تذكر أن عدد النبضات وحده لا يخبرك بالسرعة الحقيقية، لأن كمية العمل التي تنجزها النواة في كل نبضة، وتسمى IPC، تختلف من تصميم لآخر، وهذا ما شرحناه في مقال المعالج والخيوط، والجزء التالي يشرح لماذا تختلف.
خط التنفيذ Pipeline ولماذا يهم توقع القفزات
الحل البسيط: تعليمة واحدة في كل مرة
الطريقة البسيطة أن تنتظر النواة حتى تنتهي التعليمة من كل مراحلها ثم تبدأ التي بعدها، وهذه الطريقة تعمل ولكنها تهدر أغلب الشريحة، لأن المفكك يبقى بلا عمل بينما وحدة الحساب تجمع، ووحدة الحساب تبقى بلا عمل بينما المفكك يقرأ. والحل هو نفس فكرة خط الإنتاج في المصنع: بمجرد أن تنتقل التعليمة الأولى من مرحلة الجلب إلى مرحلة الفك، تبدأ مرحلة الجلب في التعليمة الثانية، وهكذا تعمل كل المراحل في نفس الوقت على تعليمات مختلفة، وهذا هو خط التنفيذ Pipeline. والصورة التالية تبين الفرق في ثلاث حالات:
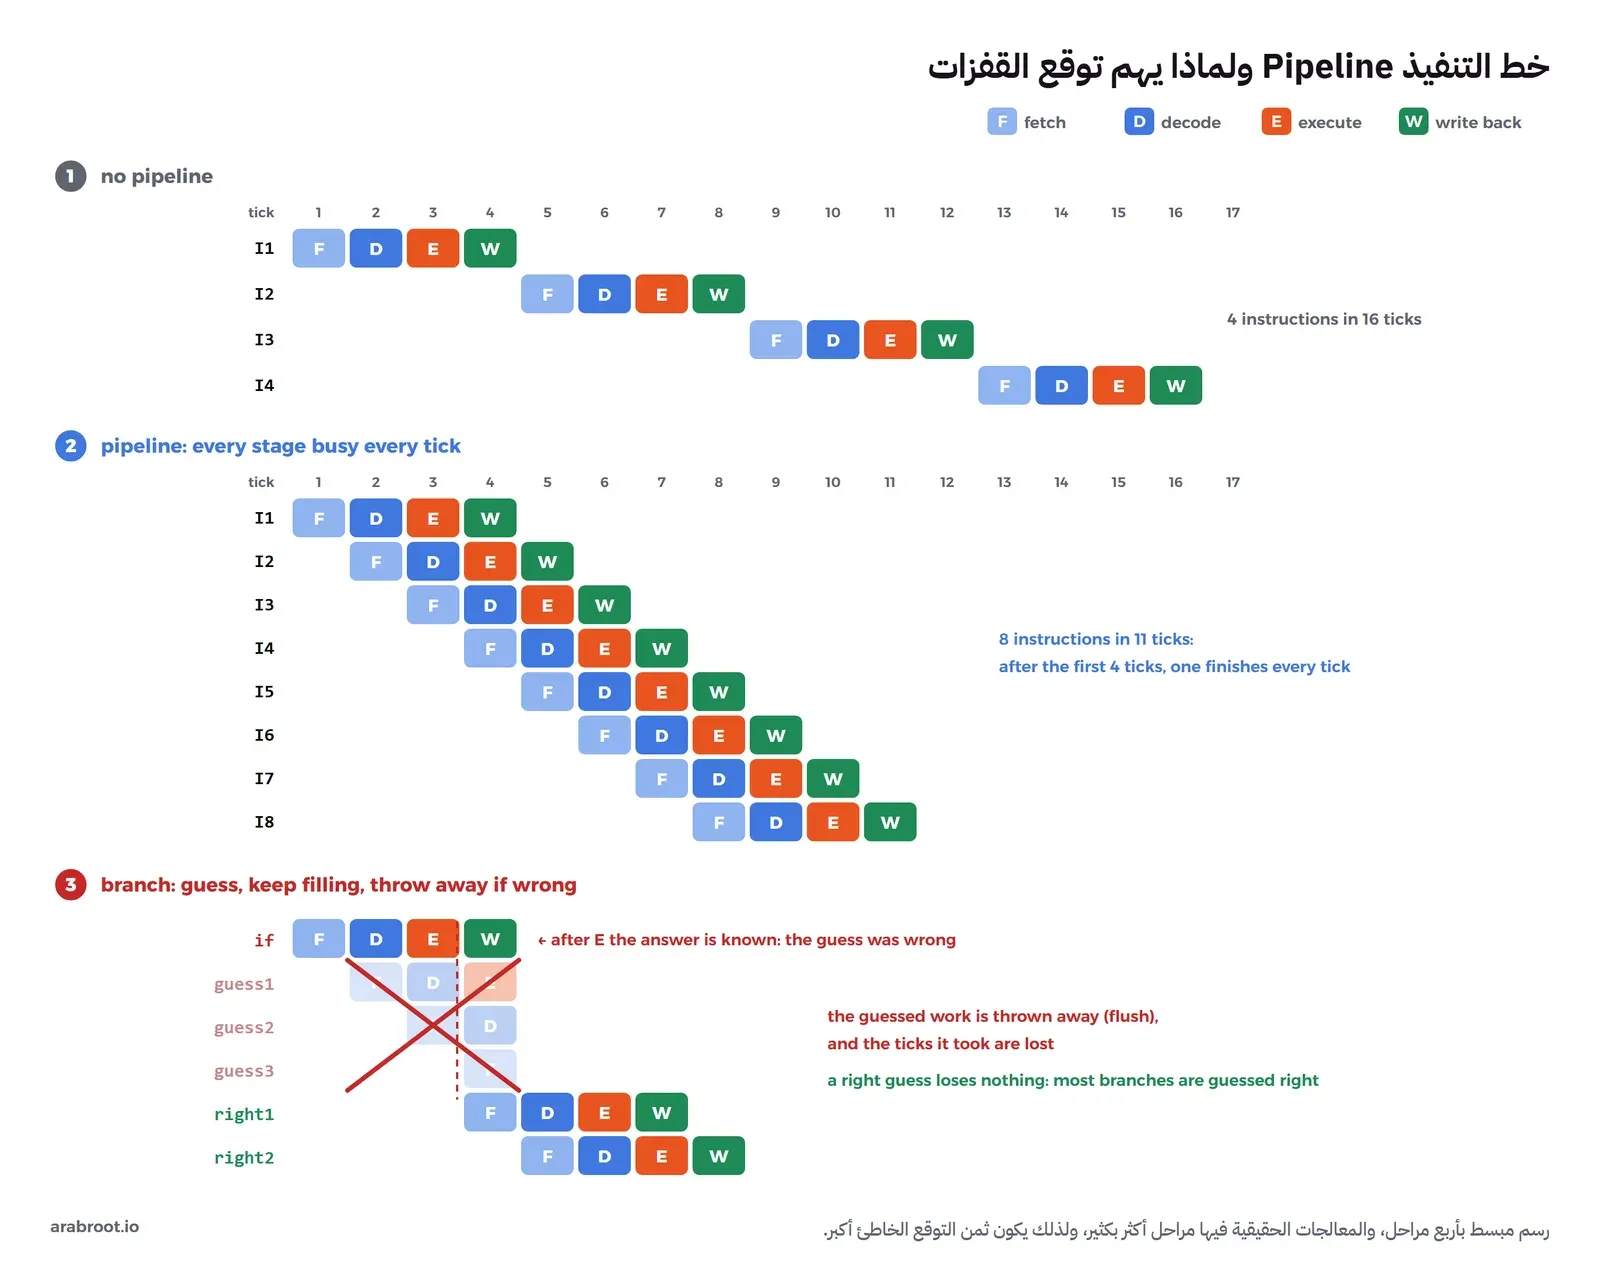
في الحالة الأولى تنتهي تعليمة كل أربع نبضات، وفي الحالة الثانية، بعد أن يمتلئ الخط، تنتهي تعليمة مع كل نبضة رغم أن كل تعليمة ما زالت تحتاج أربع مراحل. والمعالجات الحقيقية فيها مراحل أكثر بكثير من الأربع في الرسم، وهذا يعطيها سرعة أكبر، ولكنه يجعل المشكلة التالية أغلى.
المشكلة: القفزة Branch
عندما تصل إلى الخط تعليمة شرط مثل if (x >= 128) فالنواة لا تعرف أين التعليمة التالية حتى تنتهي مرحلة التنفيذ وتحسب نتيجة الشرط، فإذا انتظرت فرغ الخط، وإذا لم تنتظر فعليها أن تخمن. والمعالجات الحديثة تخمن، ولديها لهذا الغرض وحدة اسمها متوقع القفزات Branch Predictor تتذكر ما فعلته كل قفزة في المرات السابقة وتتوقع على أساسه، ثم تملأ الخط بالتعليمات من الطريق المتوقع وتنفذها مقدماً، وهذا يسمى التنفيذ التخميني Speculative Execution. فإذا صح التوقع لم تخسر النواة شيئاً، وإذا أخطأ ألقت كل العمل الذي أنجزته على الطريق الخاطئ، وهذا يسمى التفريغ Flush، ثم بدأت من العنوان الصحيح، كما في الحالة الثالثة في الصورة أعلاه.
والسؤال المهم لك كمبرمج: متى يخطئ التوقع؟ والإجابة: عندما لا يكون هناك نمط يتعلمه المتوقع، مثل شرط على بيانات عشوائية، وهذا ما سوف نقيسه الآن. الكود التالي يجمع الأرقام الأكبر من أو تساوي 128 في مصفوفة من 32 مليون رقم عشوائي بين 0 و255، مرة والأرقام بترتيبها العشوائي، ومرة بعد ترتيبها، والأرقام نفسها في المرتين:
// branch.cs: sum the values >= 128, first in random order, then the same values sorted
using System.Diagnostics;
using System.Runtime.CompilerServices;

const int N = 32 * 1024 * 1024;
var data = new int[N];
var rnd = new Random(42);
for (int i = 0; i < N; i++) data[i] = rnd.Next(256);   // random values 0..255

[MethodImpl(MethodImplOptions.NoInlining)]
static long SumBig(int[] d)
{
    long sum = 0;
    for (int i = 0; i < d.Length; i++)
        if (d[i] >= 128) { sum += d[i]; }             // the branch the CPU has to guess
    return sum;
}
static double Best(int[] d) { double m = double.MaxValue; for (int r = 0; r < 5; r++) { var sw = Stopwatch.StartNew(); SumBig(d); m = Math.Min(m, sw.Elapsed.TotalMilliseconds); } return m; }

long s1 = SumBig(data); var unsorted = Best(data);
Array.Sort(data);                                      // same values, now in order
long s2 = SumBig(data); var sorted = Best(data);
Console.WriteLine($"unsorted: {unsorted,7:F1} ms");
Console.WriteLine($"sorted:   {sorted,7:F1} ms");
Console.WriteLine($"same sum: {s1 == s2}, x{unsorted / sorted:F1}");
ونشغله كتطبيق من ملف واحد File-based App، وهي ميزة في .NET 10 تسمح بتشغيل ملف .cs مباشرة كما يشرح توثيق Microsoft:
dotnet run branch.csوالمخرج سوف يكون كما يلي:
unsorted:   319.2 ms
sorted:     134.7 ms
same sum: True, x2.4
في المخرج أعلاه لاحظ التالي:
- نفس الأرقام ونفس عدد العمليات ونفس المجموع، ولكن المصفوفة المرتبة أسرع بنحو مرتين ونصف، والسبب أن الشرط في المصفوفة المرتبة يكون خطأ في النصف الأول كله ثم صحيحاً في النصف الثاني كله، فيتعلمه المتوقع فوراً، أما في المصفوفة العشوائية فالشرط مثل رمي العملة، فيخطئ المتوقع في نحو نصف المرات ويفرغ الخط في كل مرة.
- الأزمنة من جهاز التجربة وهي للتوضيح فقط، والجهاز كان مشغولاً ببرامج أخرى أثناء القياس، لذلك أخذنا أفضل زمن من خمس محاولات، وكررنا التجربة فتراوحت النسبة بين مرتين ومرتين ونصف، والمهم هو الفرق بين الحالتين وليس الأرقام نفسها.
- ولا تفهم من هذا أن عليك ترتيب بياناتك قبل كل حلقة، فالترتيب نفسه أغلى من الفرق في أغلب الحالات، وإنما المقصود أن الشرط الذي لا يمكن توقعه داخل حلقة ساخنة له ثمن حقيقي.
وقد يتساءل البعض: هل يحدث نفس الشيء في C؟ والإجابة أنه قد لا يحدث، لأن المترجم أحياناً يزيل القفزة كلها ويستبدلها بتعليمة اختيار مشروطة لا تحتاج تخميناً، وسوف ترى هذا بعينك في مخرج objdump في جزء ISA، حيث أصبح الشرط نفسه تعليمة cmovg على x86-64 وتعليمة csel على ARM، وليس فيهما قفزة. أما في تجربة .NET أعلاه فالفرق في الزمن يدل على أن المترجم JIT ترك القفزة كما هي.
التنفيذ خارج الترتيب وعدة تعليمات في النبضة
وفوق خط التنفيذ تضيف المعالجات الحديثة فكرتين باختصار: الأولى أن النواة فيها عدة وحدات تنفيذ تعمل في نفس الوقت، فتستطيع أن تبدأ أكثر من تعليمة في النبضة الواحدة، وهذا يسمى Superscalar، والثانية أن النواة لا تلتزم بترتيب التعليمات في البرنامج، فإذا كانت تعليمة تنتظر قيمة من الذاكرة نفذت التعليمات التي بعدها ولا تعتمد عليها، ثم ترتب النتائج في النهاية بنفس ترتيب البرنامج، وهذا يسمى التنفيذ خارج الترتيب Out-of-Order Execution. ولهذا السبب تحديداً يختلف ال IPC بين التصاميم، ولهذا السبب لا تقارن معالجين بال GHz وحدها.
ثغرة Spectre: عندما يترك التخمين أثراً
lscpu أعلاه، وتشرحها وثيقة نواة Linux عن Spectre.ال Cache وسطر ال Cache: لماذا يهم ترتيب المرور على البيانات
الإصابة والإخفاق: Cache Hit وCache Miss
عندما تطلب النواة قيمة من الذاكرة فهي تبحث أولاً في L1، فإذا وجدتها هناك فهذه إصابة Cache Hit وتصلها القيمة في جزء من النانوثانية، وإذا لم تجدها فهذا إخفاق Cache Miss، فتبحث في L2 ثم L3 ثم RAM. والنقطة التي يغفل عنها كثير من المبرمجين أن ال Cache لا ينقل القيمة التي طلبتها وحدها، وإنما ينقل دائماً كتلة كاملة اسمها سطر ال Cache Cache Line، وطوله 64 بايت على هذا المعالج كما رأينا في مخرج getconf، أي 16 رقماً من النوع int. والصورة التالية تبين المسارين:
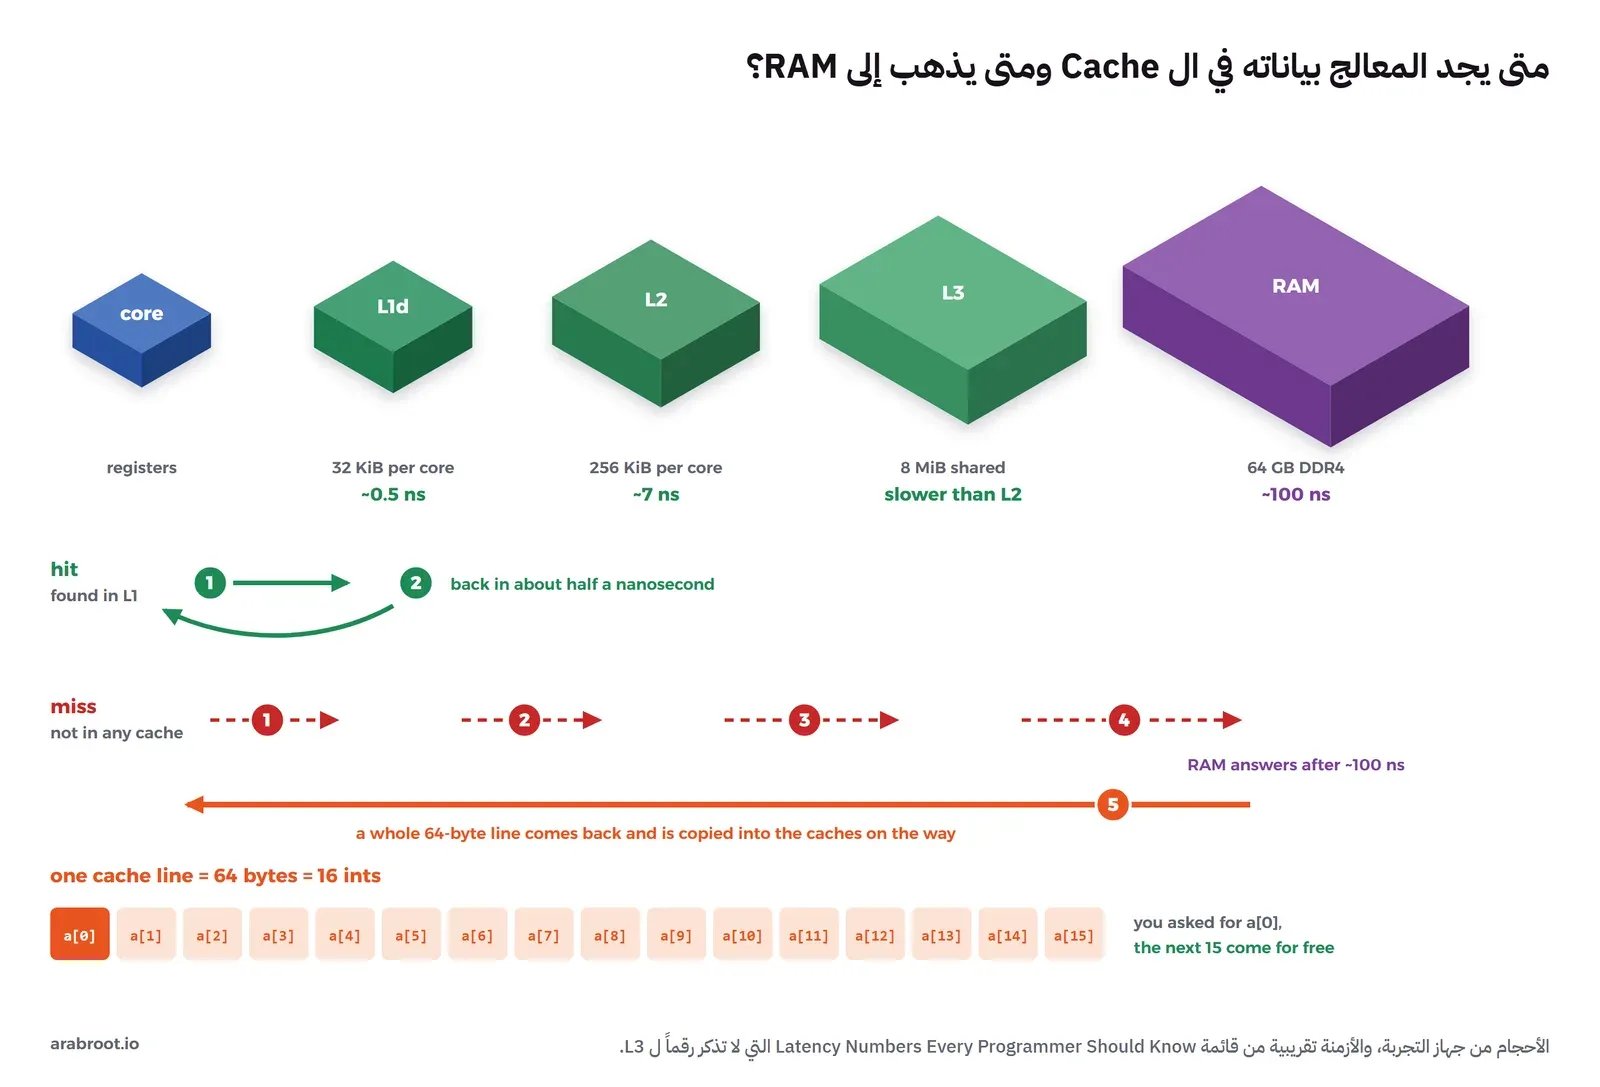
وهذا السلوك في صالحك إذا قرأت البيانات بالترتيب، لأنك عندما تطلب a[0] تأتيك معها a[1] حتى a[15] مجاناً، وفوق ذلك يلاحظ المعالج أنك تقرأ بالترتيب فيجلب الأسطر التالية قبل أن تطلبها، وهذا يسمى الجلب المسبق Prefetching. أما إذا قفزت في الذاكرة فكل قراءة تحتاج سطراً جديداً، وتضيع بقية السطر.
تجربة: نفس الجمع صفاً بصف وعموداً بعمود
لنفرض أن لديك جدولاً من 4096 صفاً و4096 عموداً من الأرقام، أي 64 MiB، وهو أكبر بكثير من L3، وتريد مجموعه. الكود التالي يجمع نفس الجدول مرتين: مرة صفاً بصف ومرة عموداً بعمود، وثلاث جولات حتى ترى ثبات النتيجة:
// cache.cs: the same sum over the same 2D array, once row by row and once column by column
using System.Diagnostics;

const int N = 4096;                       // 4096 x 4096 ints = 64 MiB, much larger than L3
var a = new int[N * N];                   // one flat block, row-major: a[row * N + col]
for (int i = 0; i < a.Length; i++) a[i] = i & 0xFF;

long RowByRow() { long s = 0; for (int r = 0; r < N; r++) for (int c = 0; c < N; c++) s += a[r * N + c]; return s; }
long ColByCol() { long s = 0; for (int c = 0; c < N; c++) for (int r = 0; r < N; r++) s += a[r * N + c]; return s; }

RowByRow(); ColByCol();                   // warm-up so the JIT has compiled both
for (int round = 1; round <= 3; round++)
{
    var sw = Stopwatch.StartNew(); long s1 = RowByRow(); var t1 = sw.Elapsed.TotalMilliseconds;
    sw.Restart();                  long s2 = ColByCol(); var t2 = sw.Elapsed.TotalMilliseconds;
    Console.WriteLine($"round {round}: row by row {t1,7:F1} ms | column by column {t2,7:F1} ms | x{t2 / t1:F1} | same sum: {s1 == s2}");
}
dotnet run cache.csوالمخرج سوف يكون كما يلي:
round 1: row by row    72.0 ms | column by column   772.0 ms | x10.7 | same sum: True
round 2: row by row    92.5 ms | column by column  1044.2 ms | x11.3 | same sum: True
round 3: row by row    78.7 ms | column by column   781.1 ms | x9.9 | same sum: True
والصورة التالية تبين ما يحدث في الحالتين:
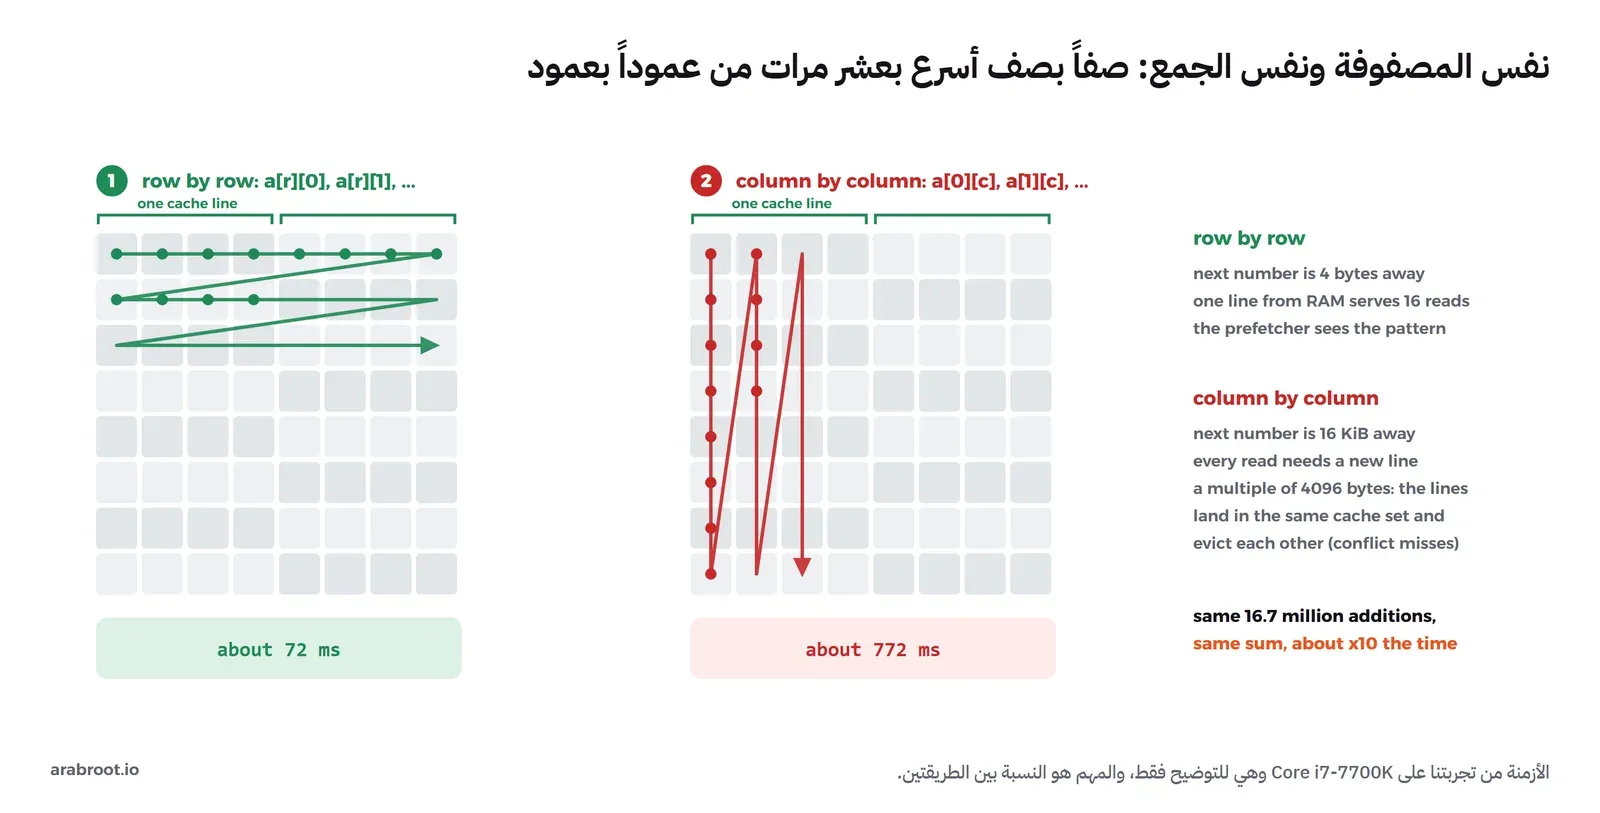
في التجربة والصورة أعلاه لاحظ التالي:
- المصفوفة محفوظة في الذاكرة صفاً بعد صف Row-major، فالرقم التالي في نفس الصف على بعد 4 بايتات، أما الرقم التالي في نفس العمود فعلى بعد 4096 × 4 بايت، أي 16 KiB.
- المرور صفاً بصف يستخدم كل سطر يصله كاملاً، 16 رقماً لكل جلب، ويرى المعالج النمط فيجلب ما بعده مقدماً.
- المرور عموداً بعمود يحتاج سطراً جديداً لكل رقم، والعمود الواحد يلمس 4096 سطراً مختلفاً، وهذا أكثر بكثير مما تتسع له L1، وفوق ذلك فال Cache مقسم إلى مجموعات Sets، ويحدد عنوان السطر المجموعة التي يوضع فيها، ولكل مجموعة عدد محدود من الأماكن، فإذا وقعت أسطر كثيرة تستخدمها معاً في نفس المجموعة طرد بعضها بعضاً رغم أن بقية ال Cache فارغة، وتسمى هذه الحالة إخفاق التعارض Conflict Miss كما يشرح Ulrich Drepper في القسم 6.2.1 والشكل 6.5 من ورقته What Every Programmer Should Know About Memory، حيث يبين أن العناصر التي تفصل بينها مضاعفات 4096 بايت تقع كلها في نفس المجموعة في L1d، وتبدأ في الخروج منها بمجرد أن يتجاوز عددها عدد أماكن المجموعة. وخطوتنا 16 KiB من مضاعفات 4096، أي أن أرقام العمود الواحد تقع في نفس المجموعة، لذلك عندما ينتقل إلى العمود التالي، وهو في نفس الأسطر التي جلبها للتو، يكون أغلبها قد خرج، فيدفع ثمن الذهاب إلى RAM مرة بعد مرة، والنتيجة نحو عشر مرات أبطأ بنفس عدد العمليات تماماً.
- الأزمنة للتوضيح فقط، والنسبة هي المهمة، وسوف تجد نسبة مختلفة على جهازك ولكن الاتجاه نفسه.
وهذه ليست مشكلة أكاديمية، فنفس الفكرة هي السبب في أن قراءة مصفوفة بالترتيب أسرع من المرور على قائمة مرتبطة Linked List عناصرها متفرقة في ال Heap، وهو ما سنراه في مقال هياكل البيانات، وهي أيضاً السبب في أن قواعد البيانات التحليلية تحفظ البيانات عموداً بعمود عندما تكون أغلب الاستعلامات على عمود واحد.
مجموعة التعليمات ISA: ما الذي يختلف بين x86-64 وARM؟
مجموعة التعليمات Instruction Set Architecture، واختصاراً ISA، هي «اللغة» التي يفهمها المعالج: ما التعليمات الموجودة، وكم مسجلاً هناك، وكيف تكتب كل تعليمة بالبايتات. ومعالجات Intel وAMD في الحواسب والسيرفرات تتكلم x86-64، بينما معالجات الهواتف وأجهزة Apple الحديثة وكثير من سيرفرات السحابة تتكلم ARM64، واسمها الرسمي AArch64، وبرنامج مترجم لإحداهما لا يعمل على الأخرى، وهذا هو سبب الخطأ exec format error الذي شرحناه في مقال Hello World. ولنرى الفرق بأعيننا، الدالة التالية هي نفس الشرط الذي جربناه في تجربة القفزات، مكتوبة بلغة C:
// add.c: one small function, compiled for two instruction sets
long add_big(const int *d, long n)
{
    long sum = 0;
    for (long i = 0; i < n; i++)
        if (d[i] >= 128)
            sum += d[i];
    return sum;
}
ونترجمها مرة لـ x86-64 ومرة لـ ARM64 في Container واحد، بالمترجم gcc ونسخته المترجمة لـ ARM aarch64-linux-gnu-gcc، ثم نعرض التعليمات بالأمر objdump:
docker run --rm -it --name lab-hw-isa -v "$PWD:/src" -w /src ubuntu:24.04 bash
apt-get update && apt-get install -y gcc gcc-aarch64-linux-gnu binutils-aarch64-linux-gnu
gcc -O1 -c add.c -o add-x86.o && objdump -d add-x86.o
aarch64-linux-gnu-gcc -O1 -c add.c -o add-arm.o && aarch64-linux-gnu-objdump -d add-arm.o
والمخرج سوف يكون كما يلي، بعد حذف أسطر العنوان الأولى من مخرج كل أمر:
0000000000000000 <add_big>:
   0:	f3 0f 1e fa          	endbr64
   4:	48 85 f6             	test   %rsi,%rsi
   7:	7e 28                	jle    31 <add_big+0x31>
   9:	48 89 f8             	mov    %rdi,%rax
   c:	48 8d 3c b7          	lea    (%rdi,%rsi,4),%rdi
  10:	b9 00 00 00 00       	mov    $0x0,%ecx
  15:	8b 30                	mov    (%rax),%esi
  17:	48 63 d6             	movslq %esi,%rdx
  1a:	48 01 ca             	add    %rcx,%rdx
  1d:	83 fe 7f             	cmp    $0x7f,%esi
  20:	48 0f 4f ca          	cmovg  %rdx,%rcx
  24:	48 83 c0 04          	add    $0x4,%rax
  28:	48 39 f8             	cmp    %rdi,%rax
  2b:	75 e8                	jne    15 <add_big+0x15>
  2d:	48 89 c8             	mov    %rcx,%rax
  30:	c3                   	ret
  31:	b9 00 00 00 00       	mov    $0x0,%ecx
  36:	eb f5                	jmp    2d <add_big+0x2d>

0000000000000000 <add_big>:
   0:	f100003f 	cmp	x1, #0x0
   4:	5400016d 	b.le	30 <add_big+0x30>
   8:	aa0003e2 	mov	x2, x0
   c:	8b010804 	add	x4, x0, x1, lsl #2
  10:	d2800000 	mov	x0, #0x0                   	// #0
  14:	b8404441 	ldr	w1, [x2], #4
  18:	8b21c003 	add	x3, x0, w1, sxtw
  1c:	7101fc3f 	cmp	w1, #0x7f
  20:	9a80c060 	csel	x0, x3, x0, gt
  24:	eb04005f 	cmp	x2, x4
  28:	54ffff61 	b.ne	14 <add_big+0x14>  // b.any
  2c:	d65f03c0 	ret
  30:	d2800000 	mov	x0, #0x0                   	// #0
  34:	17fffffe 	b	2c <add_big+0x2c>
والصورة التالية ترسم نفس المخرج بحيث يكون عرض كل مربع بعدد بايتات التعليمة:
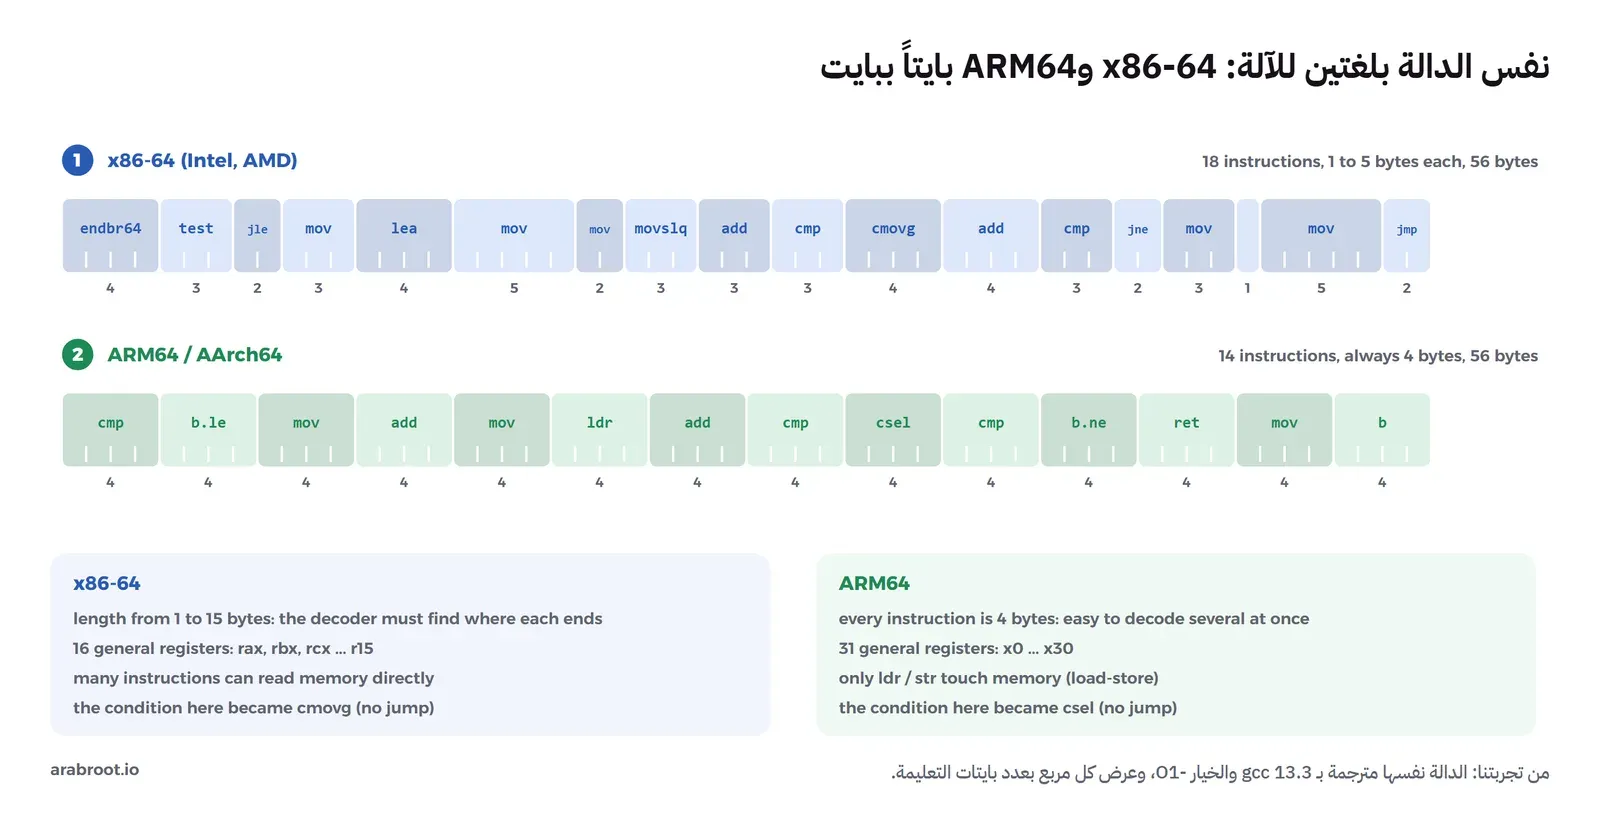
في المخرج والصورة أعلاه لاحظ التالي:
- طول التعليمة: تعليمات x86-64 هنا من بايت واحد (
c3هيret) إلى خمسة بايتات، والحد الأقصى في هذه المعمارية 15 بايتاً كما يذكر دليل Intel للمطورين، بينما كل تعليمة ARM64 أربعة بايتات بالضبط كما يذكر دليل معمارية Arm. والطول الثابت يجعل فك عدة تعليمات في نفس النبضة أسهل، لأن المفكك يعرف مكان التعليمة التالية دون أن يقرأ التي قبلها، بينما على x86-64 لا يعرف أين تنتهي التعليمة حتى يفك بدايتها. - عدد المسجلات: x86-64 فيها 16 مسجلاً عاماً من
raxإلىr15، وARM64 فيها 31 مسجلاً منx0إلىx30، ولاحظ أن الدالة في ARM استقبلت المعاملات فيx0وx1وفي x86-64 فيrdiوrsi، وهذا الترتيب تحدده اتفاقية الاستدعاء لكل منصة. - الوصول إلى الذاكرة: في x86-64 تستطيع تعليمات كثيرة أن تقرأ من الذاكرة مباشرة، مثل
mov (%rax),%esi، أما ARM64 فمعمارية Load-Store، أي أنldrوstrفقط تلمسان الذاكرة وكل الحسابات على المسجلات. - الشرط أصبح بلا قفزة: الشرط
if (d[i] >= 128)لم يصبح قفزة في أي منهما، وإنما أصبحcmovgوcsel، وهما تعليمتان تختاران إحدى قيمتين بحسب نتيجة المقارنة، لذلك لن يتأثر هذا الكود بترتيب البيانات كما تأثر كود .NET، والقفزات الوحيدة الباقية هي قفزة الحلقةjneوb.ne، وهي سهلة التوقع لأنها تتكرر بنفس النتيجة حتى آخر الحلقة.
وقد يتساءل البعض: أيهما أسرع؟ والإجابة أن مجموعة التعليمات وحدها لا تحدد السرعة، فالذي يحددها هو التصميم الداخلي للنواة، أي عمق خط التنفيذ وعدد وحدات التنفيذ وحجم ال Cache ودقة متوقع القفزات، وهذه أشياء تختلف من شريحة لأخرى داخل نفس المعمارية. أما ما يهمك عملياً كمدير سيرفر فهو أن تبني البرامج وال Docker Images للمعمارية التي سوف تعمل عليها.
تعليمة واحدة على عدة أرقام: SIMD
التعليمة add التي رأيناها تجمع رقماً واحداً مع رقم واحد، أما تعليمات SIMD، اختصاراً لـ Single Instruction Multiple Data، فتعمل على مسجلات كبيرة فيها عدة أرقام، وتطبق نفس العملية عليها كلها في تعليمة واحدة. ومعالج جهاز التجارب يدعم AVX2 كما رأينا في مخرج /proc/cpuinfo، ومسجلاتها بطول 256 بت، أي ثمانية أرقام من النوع int:
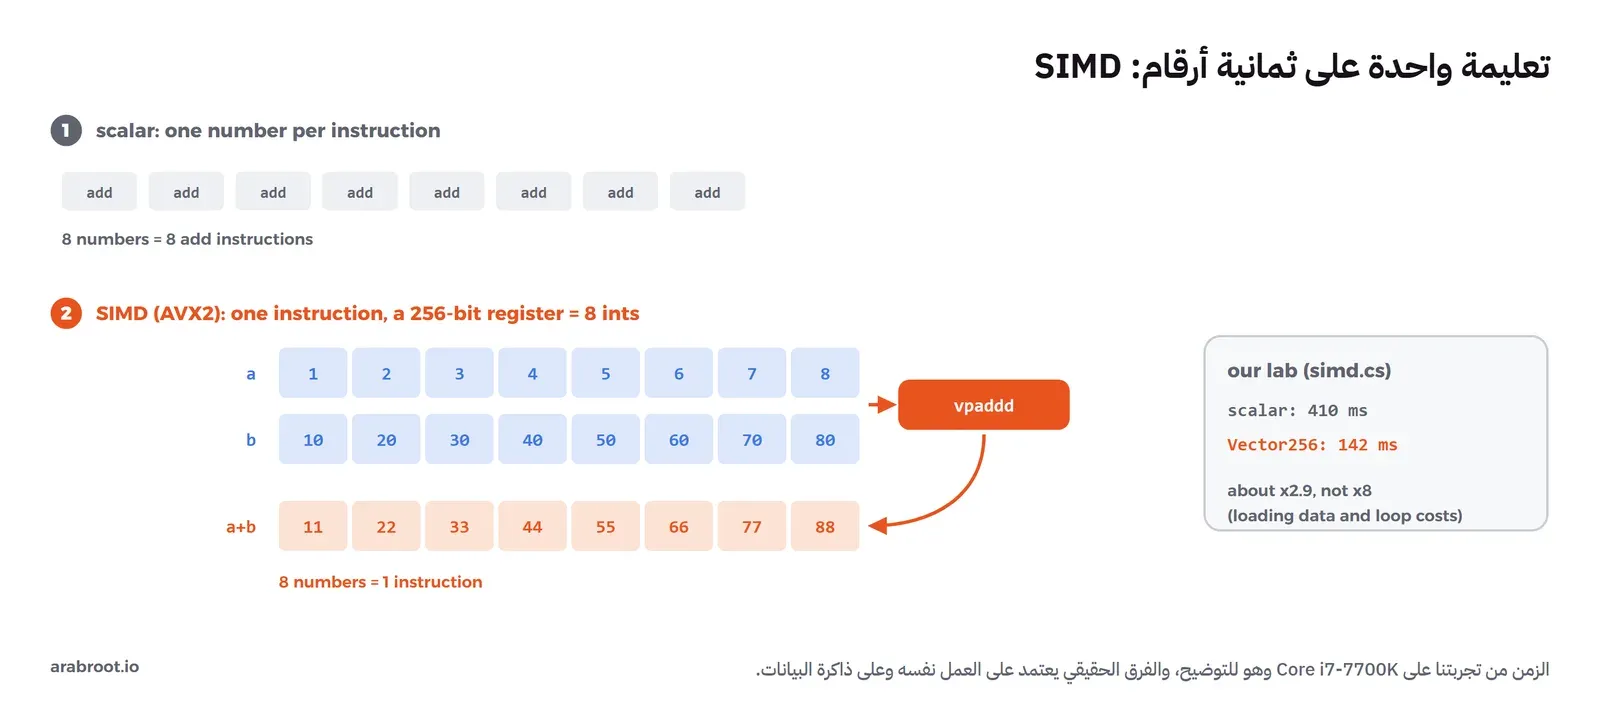
وفي .NET تستخدم هذه التعليمات من خلال الأنواع Vector256 كما يشرح توثيق SIMD في .NET. والكود التالي يجمع مصفوفة صغيرة حجمها 32 KiB، أي بحجم L1d حتى نقيس المعالج وليس RAM، عشرين ألف مرة، مرة رقماً برقم ومرة ثمانية أرقام في كل تعليمة:
// simd.cs: add up 8 Ki ints (32 KiB, fits in L1) 20,000 times, one at a time and then 8 at a time with Vector256 (AVX2)
using System.Diagnostics;
using System.Runtime.InteropServices;
using System.Runtime.Intrinsics;

var data = new int[8 * 1024];             // 32 KiB: small, so we measure the CPU and not RAM
for (int i = 0; i < data.Length; i++) data[i] = i % 100;

static int Scalar(int[] d) { int s = 0; for (int i = 0; i < d.Length; i++) s += d[i]; return s; }
static int Simd(int[] d)
{
    ref int start = ref MemoryMarshal.GetArrayDataReference(d);
    var acc = Vector256<int>.Zero; int i = 0;
    for (; i <= d.Length - 8; i += 8)
        acc += Vector256.LoadUnsafe(ref start, (nuint)i);   // one instruction adds 8 ints (32 bytes)
    int s = Vector256.Sum(acc);
    for (; i < d.Length; i++) s += d[i];
    return s;
}
static long Repeat(Func<int[], int> f, int[] d) { long s = 0; for (int r = 0; r < 20_000; r++) s += f(d); return s; }

Console.WriteLine($"Vector256 hardware accelerated: {Vector256.IsHardwareAccelerated}, ints per vector: {Vector256<int>.Count}");
Repeat(Scalar, data); Repeat(Simd, data);
double Best(Func<long> f) { double m = double.MaxValue; for (int r = 0; r < 5; r++) { var sw = Stopwatch.StartNew(); f(); m = Math.Min(m, sw.Elapsed.TotalMilliseconds); } return m; }
var t1 = Best(() => Repeat(Scalar, data)); var t2 = Best(() => Repeat(Simd, data));
Console.WriteLine($"scalar: {t1,6:F1} ms | Vector256: {t2,6:F1} ms | same sum: {Scalar(data) == Simd(data)} | x{t1 / t2:F1}");
dotnet run simd.csوالمخرج سوف يكون كما يلي:
Vector256 hardware accelerated: True, ints per vector: 8
scalar:  410.3 ms | Vector256:  142.1 ms | same sum: True | x2.9
في المخرج أعلاه لاحظ التالي:
- السطر الأول يؤكد أن المعالج يدعم المسجلات ذات 256 بت وأن كل مسجل يحمل ثمانية أرقام.
- المكسب نحو ثلاث مرات وليس ثماني مرات، والسبب أن هناك عملاً لا يتسارع، مثل تحميل البيانات واستدعاء الدالة عشرين ألف مرة، وهذا هو الوضع الطبيعي، فلا تتوقع أن يضرب SIMD السرعة في عدد الأرقام في المسجل.
- أغلب الوقت لن تكتب هذا الكود بنفسك، فمكتبات مثل
System.Linqوالدوال علىSpanفي .NET، ومكتبات مثل NumPy، ومحركات ضغط البيانات وتشفيرها تستخدم هذه التعليمات بالفعل، ويكفيك أن تعرف لماذا تكون أسرع من الحلقة التي تكتبها بيدك.
الحرارة والطاقة: TDP والخنق الحراري Throttling
كل نبضة من الساعة تفتح وتغلق مليارات الترانزستورات، وكل فتح وإغلاق يستهلك قليلاً من الكهرباء تتحول كلها إلى حرارة، وكلما رفعت السرعة رفعت الاستهلاك، ولذلك فسرعة المعالج ليست رقماً ثابتاً وإنما قرار يأخذه المعالج نفسه كل لحظة بحسب الحرارة والطاقة المتاحة. وهنا يأتي الرقم الذي يساء فهمه كثيراً وهو TDP، اختصاراً لـ Thermal Design Power، وتعرفه صفحة Intel عن TDP بأنه القدرة بال Watt التي يجب أن يصمم النظام والمبرد على أساسها. فمعالج جهاز التجارب TDP له 91 W، أي أنك تحتاج مبرداً يستطيع أن يخرج هذه الحرارة باستمرار، أما إذا لم يستطع فتحدث الحلقة التي تبينها الصورة التالية على اليمين:
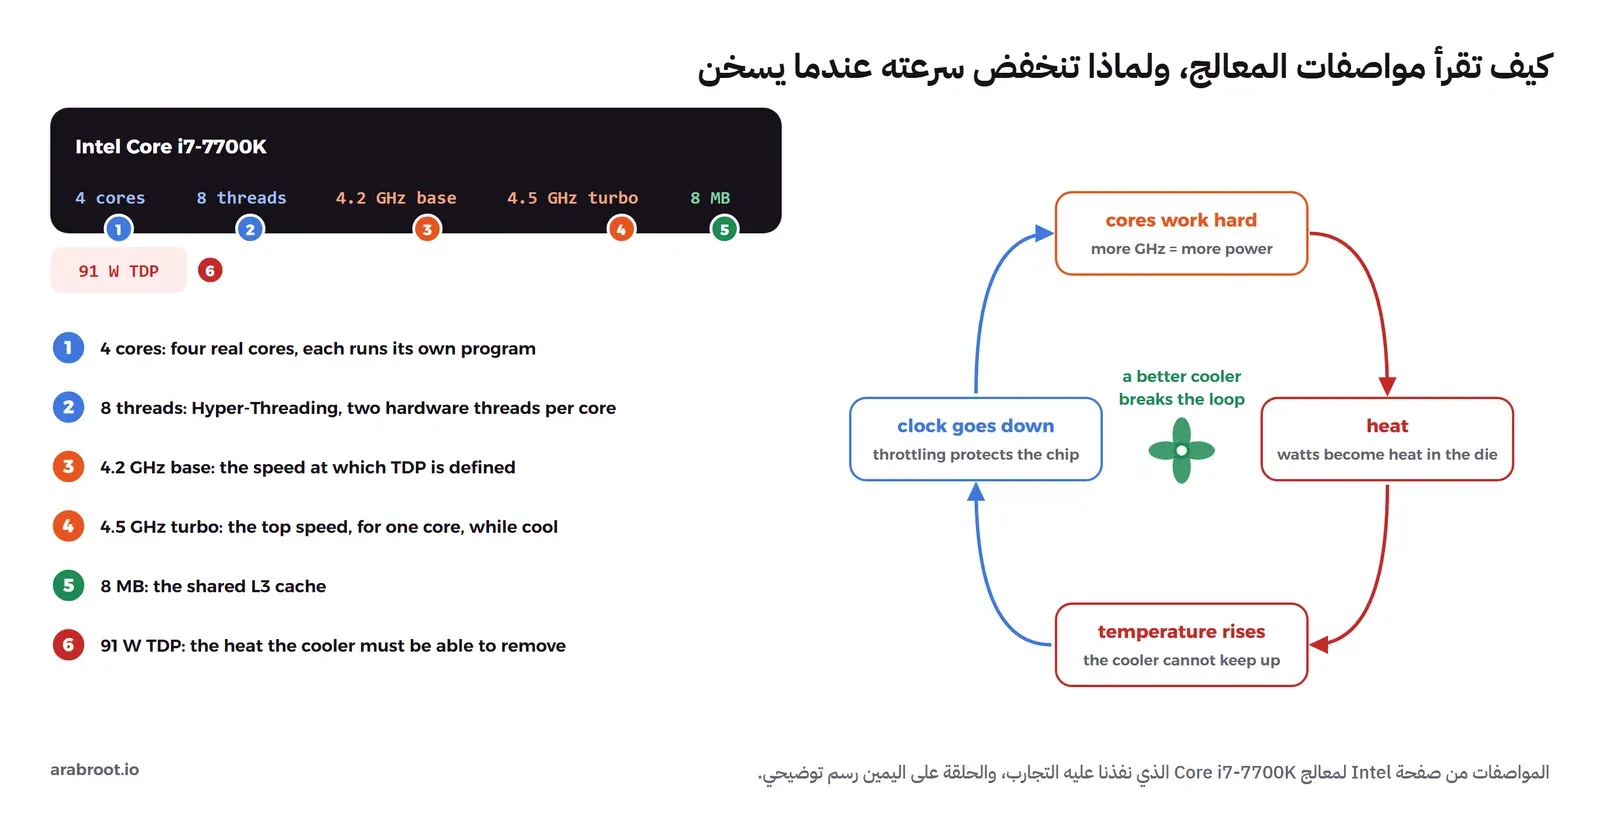
عندما ترتفع درجة حرارة الشريحة إلى الحد الذي حددته الشركة يخفض المعالج سرعته وجهده حتى تنزل الحرارة، وهذا يسمى الخنق الحراري Thermal Throttling، وهو حماية وليس عطلاً، ولكن نتيجته أن معالجاً قوياً في جهاز مبرده ضعيف أو مغبر أو معجونه جاف يعمل أبطأ من معالج أضعف في جهاز مبرده جيد. وقد يتساءل البعض: هل TDP هو أقصى ما يستهلكه المعالج؟ والإجابة لا، فالمعالجات الحديثة تتجاوزه لفترات، ولهذا السبب غيرت Intel التسمية في معالجاتها الجديدة، فمعالج i9-13900K مثلاً تذكر صفحته قدرة أساسية Processor Base Power مقدارها 125 W وقدرة قصوى في التسريع Maximum Turbo Power مقدارها 253 W، أي أكثر من الضعف، لذلك صمم التبريد والكهرباء على الرقم الأكبر إذا كان جهازك سيعمل تحت حمل طويل.
ماذا تعني «8 أنوية و16 خيطاً و4.5 GHz Boost»؟
الآن أصبح عندك كل ما تحتاجه لتقرأ أي سطر مواصفات، فخذ السطر الشائع «8 cores / 16 threads / 4.5 GHz boost» واقرأه كما يلي:
- 8 cores: ثماني أنوية حقيقية، كل واحدة تنفذ برنامجاً مستقلاً، ولكن تأكد هل هي كلها من نفس النوع أم فيها أنوية أداء وأنوية موفرة كما في الشريحة التي رأيناها.
- 16 threads: خيطان عتاديان لكل نواة بتقنية Hyper-Threading أو SMT، والخيط الثاني لا يساوي نواة ثانية كما شرحنا في مقال المعالج والخيوط.
- 4.5 GHz boost: أعلى سرعة يصل إليها المعالج، وتعرفها Intel بأنها أقصى سرعة لنواة واحدة، فلا تتوقعها على كل الأنوية تحت حمل طويل، والرقم الذي يهمك في الحمل الطويل هو السرعة الأساسية Base مع تبريد كاف.
- ما لا يكتب في السطر: حجم ال Cache، وال IPC الذي يختلف من جيل لجيل، ومجموعة التعليمات وميزاتها مثل AVX2، وال TDP الذي يحدد المبرد ومزود الطاقة، وهذه الأشياء قد تهمك أكثر من الأرقام الثلاثة، وأفضل مقارنة كما قلنا من قبل هي قياس تطبيقك نفسه.
أخطاء شائعة وأفكار غير صحيحة
- «ال GHz الأعلى يعني معالجاً أسرع»: هذا صحيح فقط بين معالجين من نفس التصميم، لأن ال IPC يختلف، فقس تطبيقك ولا تقارن الأرقام وحدها.
- قراءة
MaxClockSpeedفي Windows على أنها أقصى سرعة: رأينا أنها أعادت 4201، أي السرعة الأساسية، بينما أقصى سرعة 4.5 GHz. - «TDP هو أقصى استهلاك للمعالج»: هو رقم لتصميم التبريد، والمعالجات الحديثة تتجاوزه، كما في الفرق بين 125 W و253 W لمعالج i9-13900K.
- المرور على المصفوفات ثنائية الأبعاد عموداً بعمود في حلقة ساخنة: نفس العمليات، ولكن بعشرة أضعاف الزمن في تجربتنا، فاجعل الحلقة الداخلية على البعد المتجاور في الذاكرة.
- الحكم على أداء كود بالنظر إلى عدد العمليات فقط: تجربتا ال Cache والقفزات فيهما نفس عدد العمليات ونتائج مختلفة تماماً، فالمعالج الحديث يتأثر بترتيب الوصول إلى الذاكرة وقابلية التوقع أكثر من عدد التعليمات.
- ترتيب البيانات «لتسريع» حلقة تمر عليها مرة واحدة: الترتيب نفسه أغلى بكثير من المكسب، والمكسب يظهر فقط إذا مررت على نفس البيانات مرات كثيرة.
- بناء Docker Image على حاسب x86-64 ثم تشغيلها على سيرفر ARM: سوف تحصل على
exec format error، فابن للمعمارية الصحيحة أو لعدة معماريات. - إهمال التبريد في جهاز يعمل تحت حمل طويل: الخنق الحراري يخفض السرعة بصمت، وما تراه في المراقبة هو أن الخدمة أبطأ من المعتاد وليس رسالة خطأ.
تدريب عملي
- شغل أمر PowerShell أو
lscpuعلى جهازك وعلى سيرفرك، واكتب لكل منهما: عدد الأنوية والخيوط، وحجم كل مستوى من ال Cache لكل نواة، وطول سطر ال Cache، وهل يدعمavx2. - شغل
cache.csعلى جهازك، ثم غيرNإلى 512 بحيث يصبح الجدول 1 MiB فقط، وأعد التشغيل، ولاحظ كيف يصغر الفرق عندما يتسع الجدول في ال Cache. - في
branch.csغير الشرط إلىd[i] >= 0، وهو شرط صحيح دائماً، وتوقع النتيجة قبل التشغيل.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المعالج غلاف يحمل شريحة صغيرة من السيليكون: الحرارة تخرج منها إلى الأعلى عبر الغطاء والمعجون والمبرد، والكهرباء والإشارات تدخل إليها من الأسفل عبر المقبس.
- الشريحة فيها أنوية، ومساحة كبيرة من ال Cache، ومتحكم الذاكرة، وغالباً بطاقة رسومات، وكلها مبنية من ترانزستورات تعمل كمفاتيح تصبح بوابات ثم جوامع ثم وحدة حساب.
- كل تعليمة تمر بالجلب والفك وقراءة المسجلات والتنفيذ والكتابة، والساعة تحرك الخطوات، والسرعة بال GHz هي عدد النبضات وليست كمية العمل.
- خط التنفيذ والتنفيذ خارج الترتيب يجعلان النواة تعمل على عشرات التعليمات معاً، ولذلك تخمن القفزات، والتخمين الخاطئ له ثمن قسناه بنحو مرتين ونصف، وله أيضاً جانب أمني كما في Spectre.
- ال Cache ينقل سطوراً من 64 بايت، فالمرور على البيانات المتجاورة بالترتيب أسرع بكثير من القفز بينها، وقسنا نحو عشرة أضعاف بنفس العمليات.
- x86-64 وARM64 لغتان مختلفتان للآلة: أطوال متغيرة و16 مسجلاً مقابل طول ثابت و31 مسجلاً، والبرنامج يبنى لمعمارية بعينها.
- SIMD يعمل على عدة أرقام بتعليمة واحدة، والسرعة القصوى تحكمها الحرارة، فاقرأ المواصفات كاملة واقس تطبيقك قبل أن تحكم.
وفي مرحلة العتاد نفسها نكمل بإذن الله إلى الذاكرة RAM من الداخل، ثم إلى الشاشة وكيف تصل إليها الصورة من بطاقة الرسومات:
 دليلكيف تعمل الذاكرة RAM من الداخل، ولماذا تحتاج التحديث Refreshنفتح وحدة الذاكرة من الشريحة إلى الخلية، لتفهم ما تعنيه الأرقام المكتوبة عليها عندما تشتري جهازاً أو تختار سيرفراً.
 دليلكيف تعمل الشاشة من الداخل: من بطاقة الرسومات إلى عينككيف يصل الإطار من بطاقة الرسومات إلى البكسل، وما الفرق بين LCD وOLED، ولماذا قد تعمل شاشتك بنصف ترددها بسبب الكابل.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلالذاكرة للمبرمجين: كيف تعمل ال Stack وال Heapلماذا تتغير قائمة لم تطلب تغييرها، وكيف تتسرب الذاكرة في لغة فيها جامع قمامة Garbage Collector، بأمثلة حقيقية من عدة لغات.
 دليلالأنظمة العددية للمبرمجين: من Binary إلى Floating Pointلماذا يظهر القرص 465 بدل 500، ويصبح العداد سالباً فجأة، ولا يساوي 0.1 + 0.2 القيمة 0.3؟ الإجابة في طريقة تخزين الأرقام.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على Windows 11 مع معالج Intel Core i7-7700K: قراءة المعالج بأمر PowerShell وبالأمر lscpu داخل Container من ubuntu:24.04، وتجارب ال Cache والقفزات وSIMD بـ .NET SDK 10.0.400 (Runtime 10.0.11)، وترجمة نفس الدالة لـ x86-64 وARM64 بـ gcc 13.3، مع صور حقيقية للمعالجات من Wikimedia Commons ورسوم من عرب رووت.





