

تكتب صفحة تعرض طلبات العملاء وتجربها على عشرين طلباً فتفتح في لحظة، ثم يكبر الجدول إلى مئة ألف طلب فتصبح الصفحة نفسها بطيئة، أو تضع قائمة سوداء من العناوين في مصفوفة وتبحث فيها مع كل طلب يصل إلى السيرفر فيرتفع استهلاك المعالج دون سبب واضح، أو يتوقف تطبيقك برسالة Maximum call stack size exceeded ولا تعرف أي «مكدس» هذا الذي امتلأ. وفي أغلب هذه الحالات لم يتغير الكود، وإنما تغير حجم البيانات، وظهر أن الطريقة التي رتبنا بها البيانات في الذاكرة لا تناسب ما نطلبه منها.
وهياكل البيانات Data Structures هي هذه الطرق: كل هيكل منها طريقة لترتيب البيانات في الذاكرة تجعل بعض العمليات سريعة جداً وبعضها بطيئاً، ولا يوجد هيكل سريع في كل شيء. وهذا المقال من مرحلة أساسيات علوم الحاسب Computer Science Fundamentals في خارطة عرب رووت، وهو أول مقالين متتاليين: هنا نشرح الهياكل نفسها وأين تقابلها في السيرفرات والتطبيقات، وفي مقال الخوارزميات والتعقيد Big-O نقيس كيف يكبر الزمن مع البيانات ونختار بين الخوارزميات.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يهم شكل البيانات في الذاكرة، وما العمليات الأربع التي نقارن بها أي هيكل.
- المصفوفة Array والمصفوفة الديناميكية Dynamic Array والقائمة المترابطة Linked List، مع تجربة تقيس الذاكرة والسرعة.
- المكدس Stack والطابور Queue والطابور ذو الطرفين Deque، ومكدس الاستدعاءات Call Stack وطوابير المهام الخلفية.
- جدول الهاش Hash Table والمجموعة Set، والتصادم Collision ومعامل التحميل Load Factor، وهجوم حقيقي استغل التصادم سنة 2011.
- الشجرة Tree بأنواعها: شجرة البحث الثنائية BST والشجرة المتوازنة و B-tree التي تبني فهارس قواعد البيانات، والكومة Heap وطابور الأولوية Priority Queue.
- الرسم البياني Graph وشجرة البادئات Trie، وأين تقابلها في الشبكات والإكمال التلقائي.
- أسماء كل هيكل في C# وJava وPython وJavaScript، وجدول يساعدك على الاختيار، ثم الأخطاء الشائعة.
لماذا يهم شكل البيانات في الذاكرة Memory؟
الذاكرة RAM في النهاية صف طويل من البايتات، ولكل بايت عنوان Address، وكل هيكل بيانات هو اتفاق على طريقة وضع العناصر في هذا الصف وطريقة الوصول إليها. فإما أن نضع العناصر متجاورة في كتلة واحدة، فنعرف مكان أي عنصر بعملية حساب واحدة، وإما أن نضع كل عنصر في مكان مستقل ونربط العناصر ببعضها بمؤشرات Pointers تحمل عناوين بعضها، فنستطيع الإضافة والحذف دون تحريك شيء ولكن ندفع ثمن المشي من عنصر إلى آخر. وكل الهياكل في هذا المقال مبنية من هاتين الفكرتين أو من خليط بينهما، وتفاصيل الذاكرة نفسها من Stack وHeap ومؤشرات في مقال الذاكرة للمبرمجين، وشكل شريحة الذاكرة من الداخل في قسم تشريح الذاكرة RAM من نفس المقال. ولهذا السبب سوف ترى مع كل هيكل في هذا المقال رسماً لشكله في الذاكرة: خانات بعناوين توضيحية مثل 0x1000 و0x1004، وأسهم زرقاء للمراجع والمؤشرات، ومناطق منفصلة لل Stack وال Heap.
ولكي نقارن بين الهياكل نسأل عن كل هيكل أربعة أسئلة: كم يكلف الوصول Access إلى عنصر بموقعه، وكم يكلف البحث Search عن قيمة، وكم تكلف الإضافة Insert، وكم يكلف الحذف Delete. ونكتب الإجابة بترميز Big-O الذي يصف كيف يكبر العمل مع عدد العناصر n: فالرمز O(1) يعني أن العمل ثابت مهما كبرت البيانات، والرمز O(log n) يعني أنه يزيد خطوة واحدة كلما تضاعفت البيانات، والرمز O(n) يعني أنه يتضاعف مع تضاعفها. وهذا يكفي لهذا المقال، أما شرح الترميز بالتفصيل مع قياس حقيقي للمنحنيات فهو موضوع مقال الخوارزميات.
تجهيز التجربة العملية Lab
كل التجارب في هذا المقال شغلناها فعلاً على جهاز واحد يعمل بنظام Windows 11 بمعالج Intel Core i7-7700K، باستخدام .NET SDK 10.0.400 مع Python 3.13.3 وNode.js 22.14.0، ولا تحتاج أي مكتبة خارجية. وكود C# مكتوب كتطبيق من ملف واحد File-based App، وهي ميزة جاءت مع .NET 10 تسمح بتشغيل ملف .cs مباشرة دون مشروع، كما يشرح توثيق Microsoft. والأرقام الزمنية في المقال توضيحية من هذا الجهاز وحده، وسوف تختلف عندك، لكن النسب بينها هي المهمة.
الملف الكامل للتجربة بلغة C# هو ds.cs، ونعرض أجزاءه في أقسامها:
// ds.cs: data structures lab (.NET 10 file-based app)
// dotnet run -c Release ds.cs
using System.Diagnostics;

const int N = 1_000_000;

// 1) Dynamic array: when does List<T> grow?
var grow = new List<int>();
int lastCap = -1;
for (int i = 1; i <= 40; i++)
{
    grow.Add(i);
    if (grow.Capacity != lastCap) { Console.WriteLine($"Count={grow.Count,3}  Capacity={grow.Capacity,3}"); lastCap = grow.Capacity; }
}

// 2) Array vs linked list: memory and walking through all items
long before = GC.GetAllocatedBytesForCurrentThread();
var list = new List<int>(N);
for (int i = 0; i < N; i++) list.Add(i);
long listBytes = GC.GetAllocatedBytesForCurrentThread() - before;

before = GC.GetAllocatedBytesForCurrentThread();
var linked = new LinkedList<int>();
for (int i = 0; i < N; i++) linked.AddLast(i);
long linkedBytes = GC.GetAllocatedBytesForCurrentThread() - before;

double Best(Func<long> f) { double best = double.MaxValue; for (int r = 0; r < 7; r++) { var sw = Stopwatch.StartNew(); f(); best = Math.Min(best, sw.Elapsed.TotalMilliseconds); } return best; }
double tList = Best(() => { long s = 0; foreach (var x in list) s += x; return s; });
double tLinked = Best(() => { long s = 0; foreach (var x in linked) s += x; return s; });
Console.WriteLine($"\n{N:N0} ints  List<int>:       {listBytes / 1e6,6:F1} MB  walk {tList,5:F2} ms");
Console.WriteLine($"{N:N0} ints  LinkedList<int>: {linkedBytes / 1e6,6:F1} MB  walk {tLinked,5:F2} ms");

// 3) Hash table: a good hash code against a hash code that always collides (best of 3 runs)
double InsertGood(int n) { var sw = Stopwatch.StartNew(); var d = new Dictionary<GoodKey, int>(); for (int i = 0; i < n; i++) d[new GoodKey(i)] = i; return sw.Elapsed.TotalMilliseconds; }
double InsertBad(int n) { var sw = Stopwatch.StartNew(); var d = new Dictionary<BadKey, int>(); for (int i = 0; i < n; i++) d[new BadKey(i)] = i; return sw.Elapsed.TotalMilliseconds; }
foreach (int n in new[] { 5_000, 10_000, 20_000, 40_000 })
{
    double tGood = Enumerable.Range(0, 3).Min(_ => InsertGood(n));
    double tBad = Enumerable.Range(0, 3).Min(_ => InsertBad(n));
    Console.WriteLine($"insert {n,6:N0} keys  good hash {tGood,6:F2} ms   same hash for all {tBad,8:F1} ms");
}

// 4) Stack, queue and priority queue: who comes out first?
var stack = new Stack<string>(); var queue = new Queue<string>(); var pq = new PriorityQueue<string, int>();
foreach (var (job, prio) in new[] { ("backup", 3), ("email", 2), ("password-reset", 1) })
{ stack.Push(job); queue.Enqueue(job); pq.Enqueue(job, prio); }
Console.WriteLine($"\nStack         : {string.Join(" -> ", Drain(() => stack.Count > 0 ? stack.Pop() : null))}");
Console.WriteLine($"Queue         : {string.Join(" -> ", Drain(() => queue.Count > 0 ? queue.Dequeue() : null))}");
Console.WriteLine($"PriorityQueue : {string.Join(" -> ", Drain(() => pq.Count > 0 ? pq.Dequeue() : null))}");

static IEnumerable<string> Drain(Func<string?> next) { for (var x = next(); x != null; x = next()) yield return x; }

readonly record struct GoodKey(int Id);
readonly struct BadKey(int id) : IEquatable<BadKey>
{
    public int Id { get; } = id;
    public bool Equals(BadKey o) => Id == o.Id;
    public override bool Equals(object? o) => o is BadKey k && Equals(k);
    public override int GetHashCode() => 42;   // every key lands in the same bucket
}
وتشغيله يكون بالأمر التالي، والخيار -c Release مهم لأن القياس في وضع Debug يعطي أرقاماً لا تمثل التطبيق الحقيقي:
dotnet run -c Release ds.csوالمخرج سوف يكون كما يلي:
Count=  1  Capacity=  4
Count=  5  Capacity=  8
Count=  9  Capacity= 16
Count= 17  Capacity= 32
Count= 33  Capacity= 64

1,000,000 ints  List<int>:          4.0 MB  walk  1.83 ms
1,000,000 ints  LinkedList<int>:   48.0 MB  walk  5.68 ms
insert  5,000 keys  good hash   0.50 ms   same hash for all     77.9 ms
insert 10,000 keys  good hash   0.78 ms   same hash for all    142.7 ms
insert 20,000 keys  good hash   0.88 ms   same hash for all    576.8 ms
insert 40,000 keys  good hash   1.54 ms   same hash for all   2951.4 ms

Stack         : password-reset -> email -> backup
Queue         : backup -> email -> password-reset
PriorityQueue : password-reset -> email -> backup
وسوف نعود إلى كل جزء من هذا المخرج في القسم الذي يخصه.
المصفوفة Array: العناصر متجاورة في كتلة واحدة
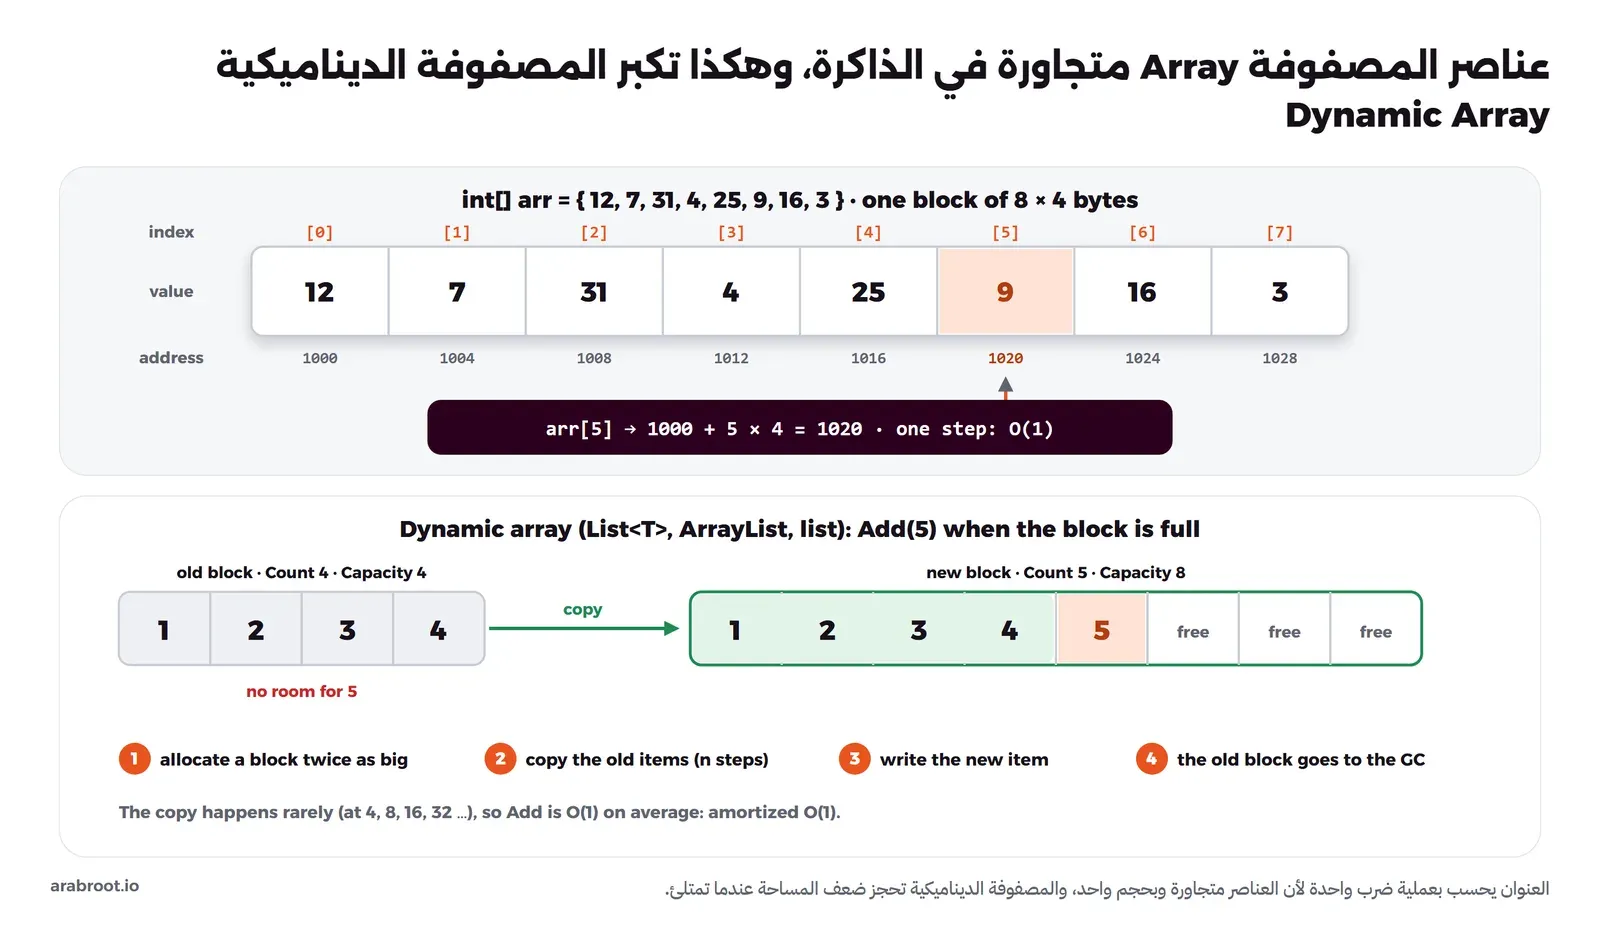
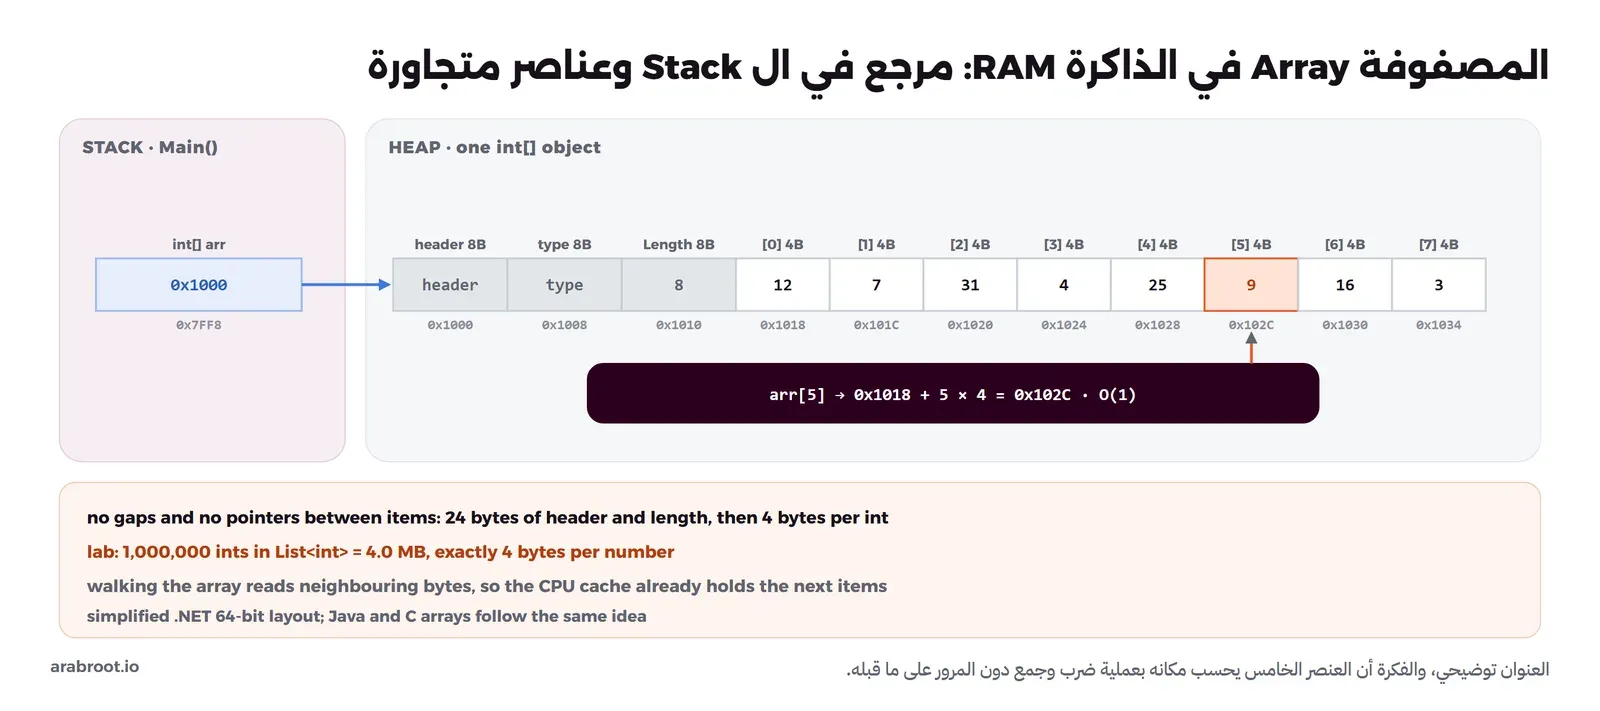
المصفوفة Array هي أبسط هيكل وأقدمه: عدد ثابت من العناصر من نفس النوع موضوعة متجاورة في كتلة واحدة من الذاكرة. فإذا كانت لدينا مصفوفة من ثمانية أعداد صحيحة int وكل عدد أربعة بايتات، فهي كتلة من 32 بايتاً، وإذا عرفنا عنوان أول عنصر نعرف عنوان أي عنصر آخر بعملية ضرب وجمع واحدة: العنوان = عنوان البداية + الموقع Index × حجم العنصر. ولذلك فالوصول إلى arr[5] يكلف نفس الوقت سواء كانت المصفوفة ثمانية عناصر أو مليوناً، أي O(1).
الصورة التالية تبين مصفوفة في الذاكرة، ثم كيف تكبر المصفوفة الديناميكية التي سنشرحها بعد قليل:
وهكذا تبدو المصفوفة فعلاً في الذاكرة RAM، والصورة التالية تبين مصفوفة int[] في .NET بتخطيط مبسط وعناوين توضيحية:
ولكن لاحظ ثمن هذا التجاور: إذا أردت إضافة عنصر في بداية المصفوفة أو وسطها فعليك تحريك كل العناصر التي بعده خانة واحدة لتفرغ له مكاناً، والحذف من الوسط يحتاج تحريكها في الاتجاه الآخر، وبالتالي فالإضافة والحذف في الوسط O(n)، والبحث عن قيمة في مصفوفة غير مرتبة يعني المرور على العناصر واحداً واحداً، وهو O(n) أيضاً. أما إذا كانت مرتبة فالبحث الثنائي Binary Search يجدها في O(log n)، كما سوف نرى في مقال الخوارزميات.
وهناك ميزة للمصفوفة لا تظهر في جدول Big-O ولكنها تظهر في الأرقام الحقيقية، وهي أن المعالج يقرأ الذاكرة على شكل قطع متجاورة إلى الذاكرة المؤقتة Cache، فعندما تمر على مصفوفة بالترتيب تكون العناصر التالية قد وصلت قبل أن تطلبها. وقد شرحنا هذه الفكرة في قسم حدس الأداء في مقال Hello World، وسوف تراها بالأرقام في القائمة المترابطة.
المصفوفة الديناميكية Dynamic Array: مصفوفة تكبر وحدها
المصفوفة العادية حجمها ثابت، ونحن في أغلب الأحيان لا نعرف كم عنصراً سنضيف، لذلك تستخدم كل اللغات الحديثة المصفوفة الديناميكية Dynamic Array: وهي مصفوفة عادية في الداخل، ومعها رقمان، عدد العناصر الفعلي Count والسعة Capacity وهي عدد الخانات المحجوزة. وعندما تضيف عنصراً وما زالت هناك خانة فارغة تكتبه فيها مباشرة، وعندما تمتلئ تحجز كتلة جديدة أكبر وتنسخ إليها العناصر القديمة ثم تضيف الجديد. وهذا ما يقوله توثيق List<T>.Capacity نصاً: إذا تجاوز العدد السعة فإن السعة تزيد بإعادة حجز المصفوفة الداخلية ونسخ العناصر القديمة قبل إضافة الجديدة.
وقد يتساءل البعض: إذا كان النسخ يكلف O(n) فهل تصبح كل إضافة بطيئة؟ والإجابة لا، والسبب في أول سطور مخرج التجربة: السعة في List<T> انتقلت من 4 إلى 8 ثم 16 ثم 32 ثم 64، أي أنها تتضاعف، فالنسخ يحدث عند العنصر الخامس ثم التاسع ثم السابع عشر ثم الثالث والثلاثين، ويصبح نادراً كلما كبرت القائمة. وإذا وزعت تكلفة النسخ على كل الإضافات تجد أن متوسط الإضافة ثابت، ويسمى هذا التكلفة المستهلكة Amortized O(1)، وهو الوصف الذي يستخدمه توثيق ArrayList في Java حرفياً: إضافة n عنصر تحتاج O(n) من الوقت.
والصورة التالية تبين ما يوجد في الذاكرة خلف List<int> بعد إضافة العنصر الخامس، وخلف قائمة Python:
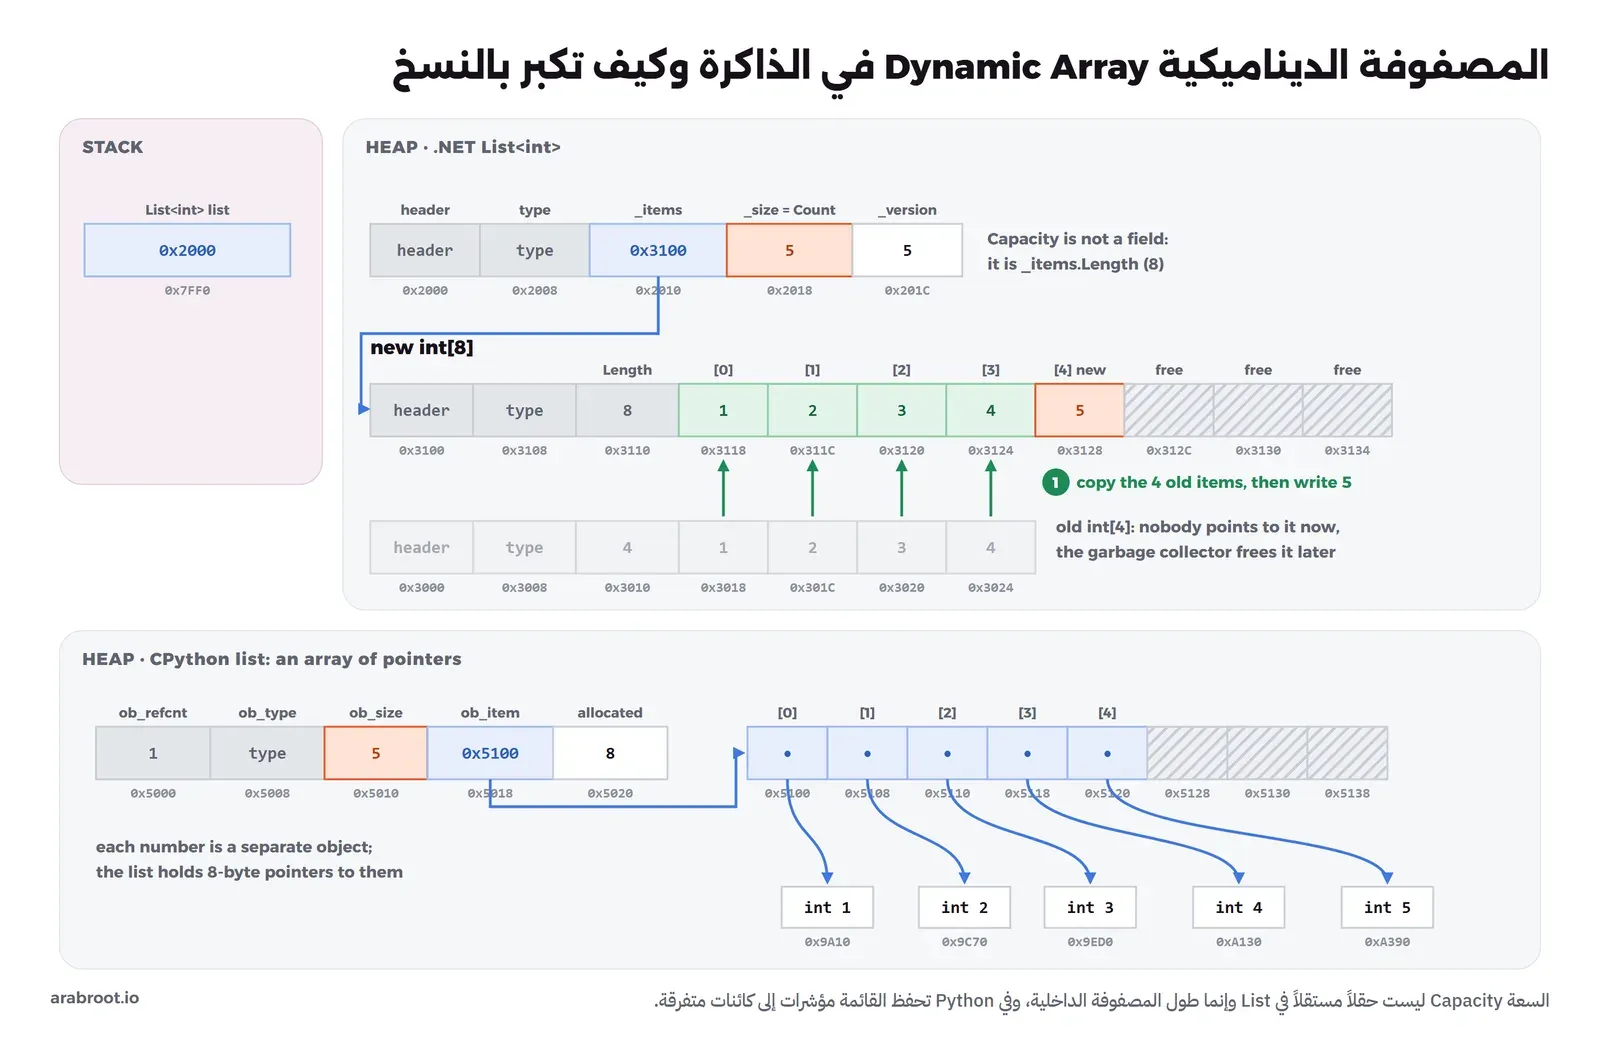
وفي Python تعمل list بنفس الفكرة ولكن بنمو أهدأ من المضاعفة، والملف التالي يبين ذلك بقياس حجم القائمة بالدالة sys.getsizeof بعد كل إضافة، ثم يختبر حد الاستدعاء الذاتي الذي سنحتاجه في قسم المكدس:
# grow.py: when does a Python list reserve more memory?
import sys

items, last = [], sys.getsizeof([])
print(f"len=  0  bytes={last}")
for i in range(1, 41):
    items.append(i)
    size = sys.getsizeof(items)
    if size != last:
        print(f"len={len(items):3}  bytes={size}  room for {(size - sys.getsizeof([])) // 8} items")
        last = size

def depth(n):
    return depth(n + 1)

print("recursion limit:", sys.getrecursionlimit())
try:
    depth(0)
except RecursionError as e:
    print("RecursionError:", e)
python grow.pyوالمخرج سوف يكون كما يلي:
len=  0  bytes=56
len=  1  bytes=88  room for 4 items
len=  5  bytes=120  room for 8 items
len=  9  bytes=184  room for 16 items
len= 17  bytes=248  room for 24 items
len= 25  bytes=312  room for 32 items
len= 33  bytes=376  room for 40 items
recursion limit: 1000
RecursionError: maximum recursion depth exceeded
في المخرج أعلاه لاحظ التالي:
- القائمة الفارغة 56 بايتاً، وكل خانة مؤشر بثمانية بايتات، لذلك قسمنا الفرق على 8 لنعرف عدد الخانات المحجوزة.
- السعة في Python كانت 4 ثم 8 ثم 16 ثم 24 ثم 32 ثم 40، وهو بالضبط التسلسل المكتوب في تعليق دالة
list_resizeفي كود CPython الذي يحجز زيادة تقارب ثمن الحجم الحالي مع ثابت صغير، وهذا أقل هدراً للذاكرة من المضاعفة ويبقى Amortized O(1). - القائمة في Python تحفظ مؤشرات إلى الكائنات وليس الأعداد نفسها، فكل عدد كائن مستقل في مكان آخر من الذاكرة، وهذا أحد أسباب أن نفس الحلقة أبطأ في Python منها في C#.
وبما أن كل نسخة تعني حجز ذاكرة جديدة ونسخاً، فإذا كنت تعرف العدد مسبقاً فأخبر الهيكل به من البداية، مثل new List<int>(N) في التجربة، وهذا ما جعل List<int> لمليون عدد تحجز 4.0 MB فقط، أي أربعة بايتات لكل عدد دون أي هدر.
القائمة المترابطة Linked List: كل عنصر يشير إلى التالي
القائمة المترابطة Linked List تحل مشكلة الإضافة في الوسط بطريقة مختلفة تماماً: كل عنصر يحجز وحده في أي مكان من الذاكرة ويسمى عقدة Node، وفيه القيمة ومؤشر إلى العقدة التالية، وفي القائمة المترابطة المزدوجة Doubly Linked List مؤشر إلى السابقة أيضاً. فإذا كانت معك عقدة وأردت إضافة عنصر بعدها فإنك تغير مؤشرين فقط ولا تحرك أي عنصر، وهذا O(1) مهما كان طول القائمة. والصورة التالية تبين ذلك:
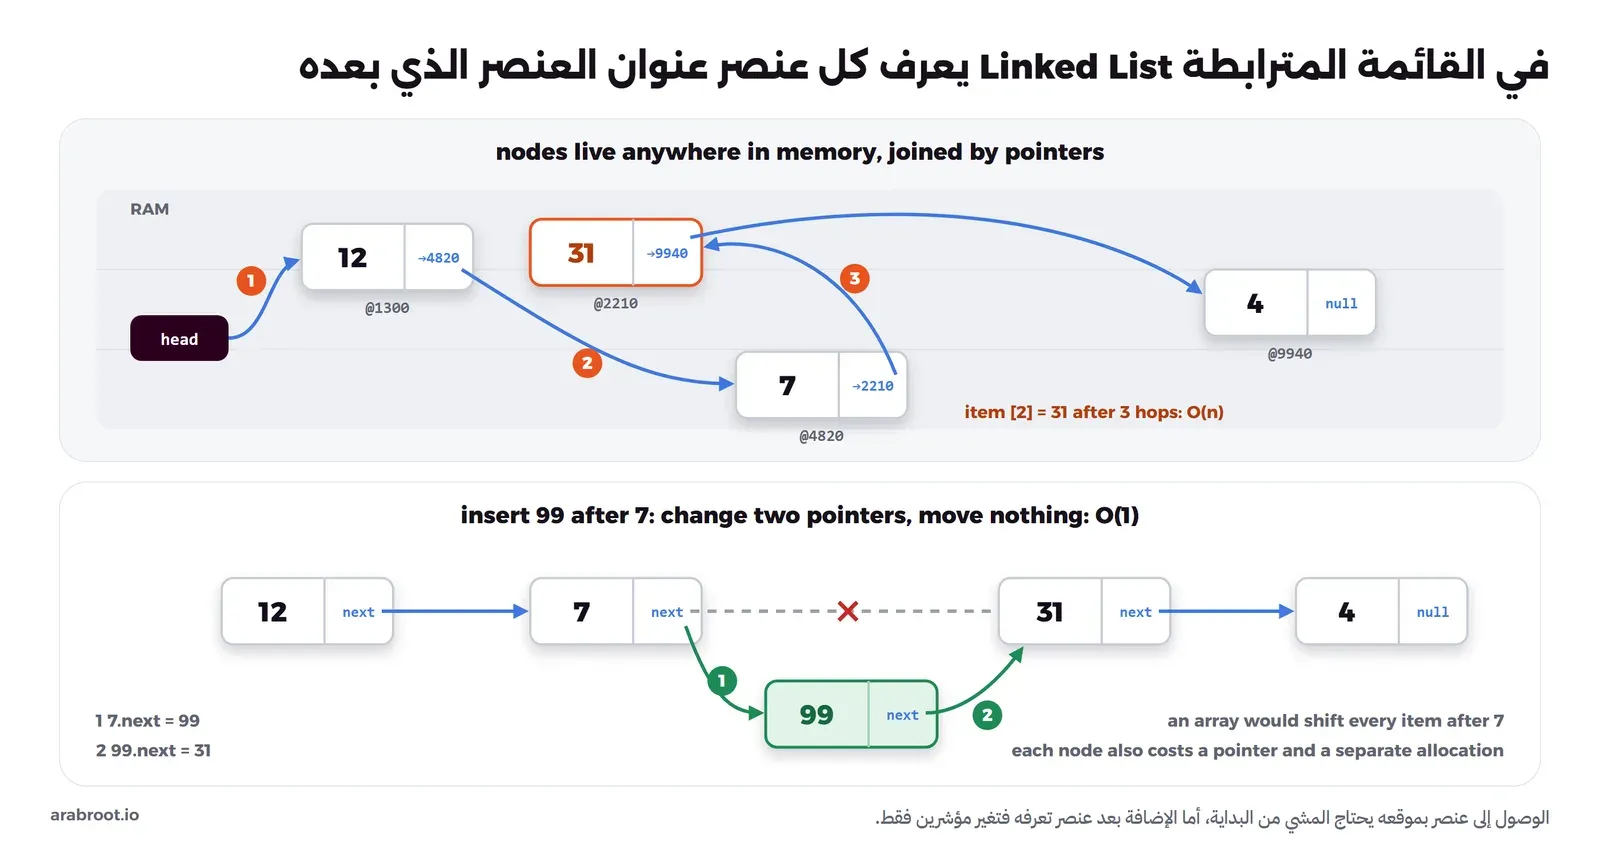
ولكن لاحظ ما خسرناه: لا توجد طريقة لحساب مكان العنصر العاشر، وإنما تبدأ من أول عقدة وتتبع المؤشرات عشر مرات، فالوصول بالموقع O(n)، والبحث عن قيمة O(n) أيضاً، وحتى «الإضافة في الوسط بتكلفة O(1)» تفترض أنك وصلت إلى المكان أصلاً. وهناك ثمن آخر يظهر في الجزء الثاني من مخرج التجربة: مليون عدد في List<int> أخذت 4.0 MB، ونفس المليون في LinkedList<int> أخذت 48.0 MB، أي 48 بايتاً لكل عدد من أربعة بايتات، والسبب أن كل عقدة كائن مستقل له ترويسة في الذاكرة ومؤشر للتالي ومؤشر للسابق ومؤشر للقائمة نفسها. والمرور على كل العناصر أخذ 1.83 ms في المصفوفة و5.68 ms في القائمة المترابطة، رغم أن الخوارزمية واحدة وهي O(n) في الحالتين، لأن المصفوفة متجاورة ويستفيد منها ال Cache، والعقد متفرقة يتبعها المعالج من عنوان إلى آخر.
والصورة التالية تبين من أين جاءت ال 48 بايتاً: كل عقدة LinkedListNode في .NET كائن مستقل فيه ترويسة ومؤشر نوع ومرجع للقائمة ومرجعان للتالي والسابق، ثم العدد نفسه مع حشو Padding حتى يكتمل مضاعف الثمانية:
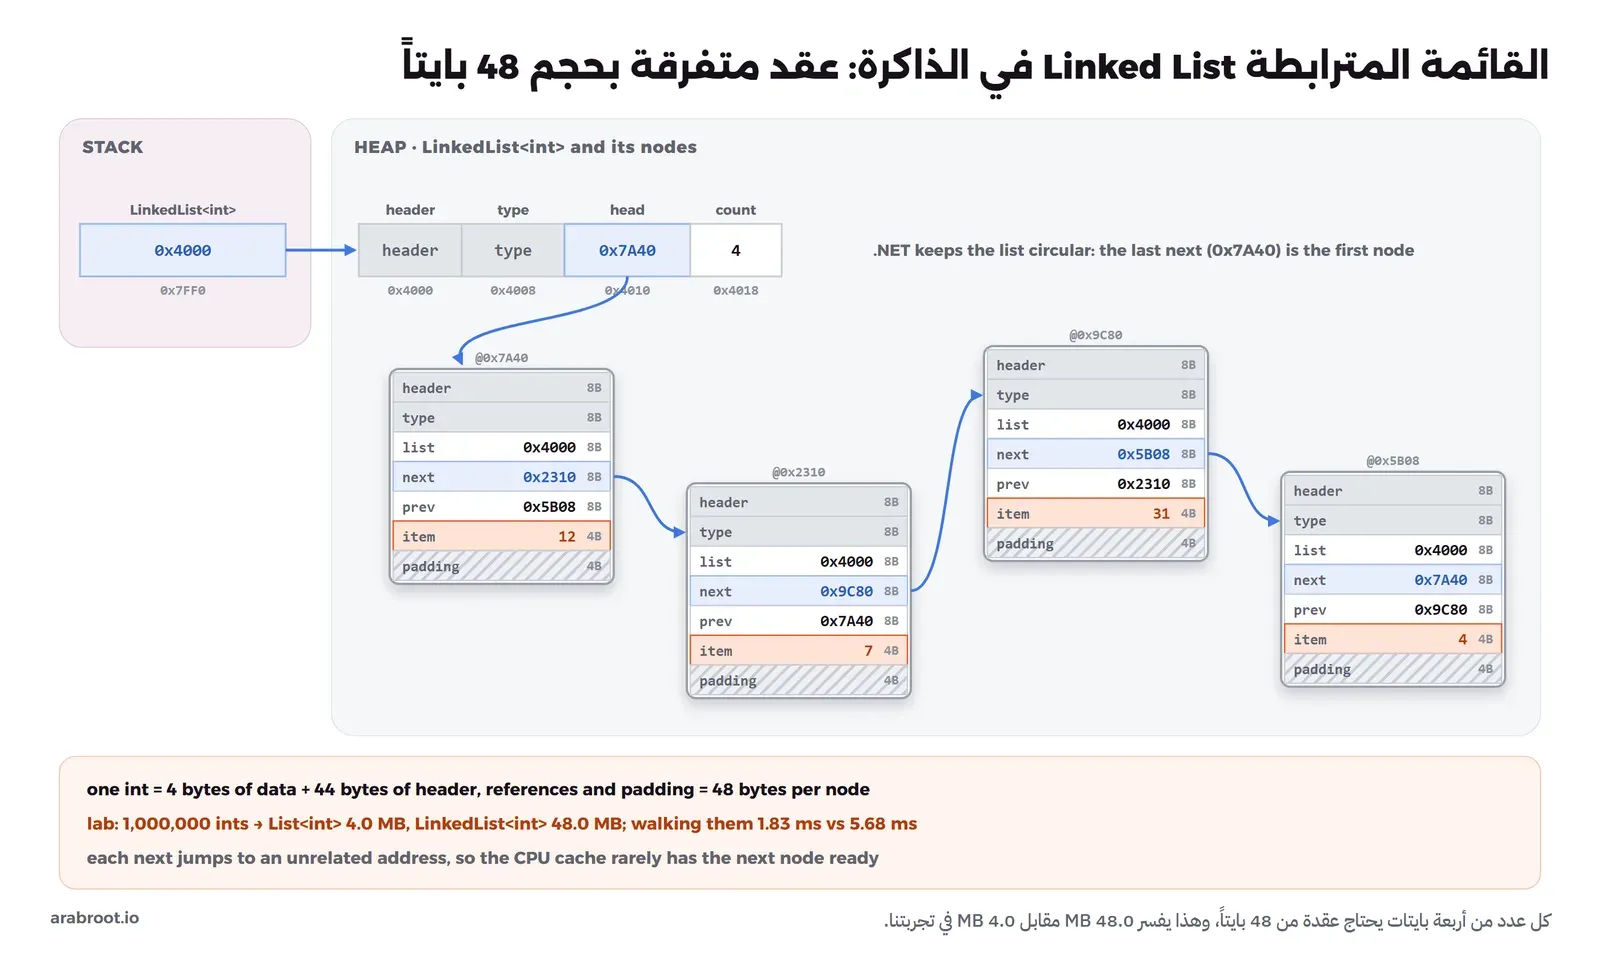
لذلك فالقاعدة العملية أن تبدأ دائماً بالمصفوفة الديناميكية، ولا تستخدم القائمة المترابطة إلا إذا كنت تضيف وتحذف كثيراً في أماكن تحمل مؤشرها مسبقاً. ومن أشهر هذه الحالات ذاكرة التخزين المؤقت من نوع LRU Cache، أي التي تحذف العنصر الأقدم استخداماً عندما تمتلئ: جدول هاش يوصلك إلى العقدة مباشرة، وقائمة مترابطة مزدوجة تنقل العقدة إلى المقدمة عند كل استخدام وتحذف من النهاية، وفي Java يوجد هذا الهيكل جاهزاً في LinkedHashMap الذي يقول توثيقه إنه مناسب لبناء LRU Cache عند تشغيله بترتيب الوصول Access Order.
المكدس Stack: آخر ما يدخل أول ما يخرج
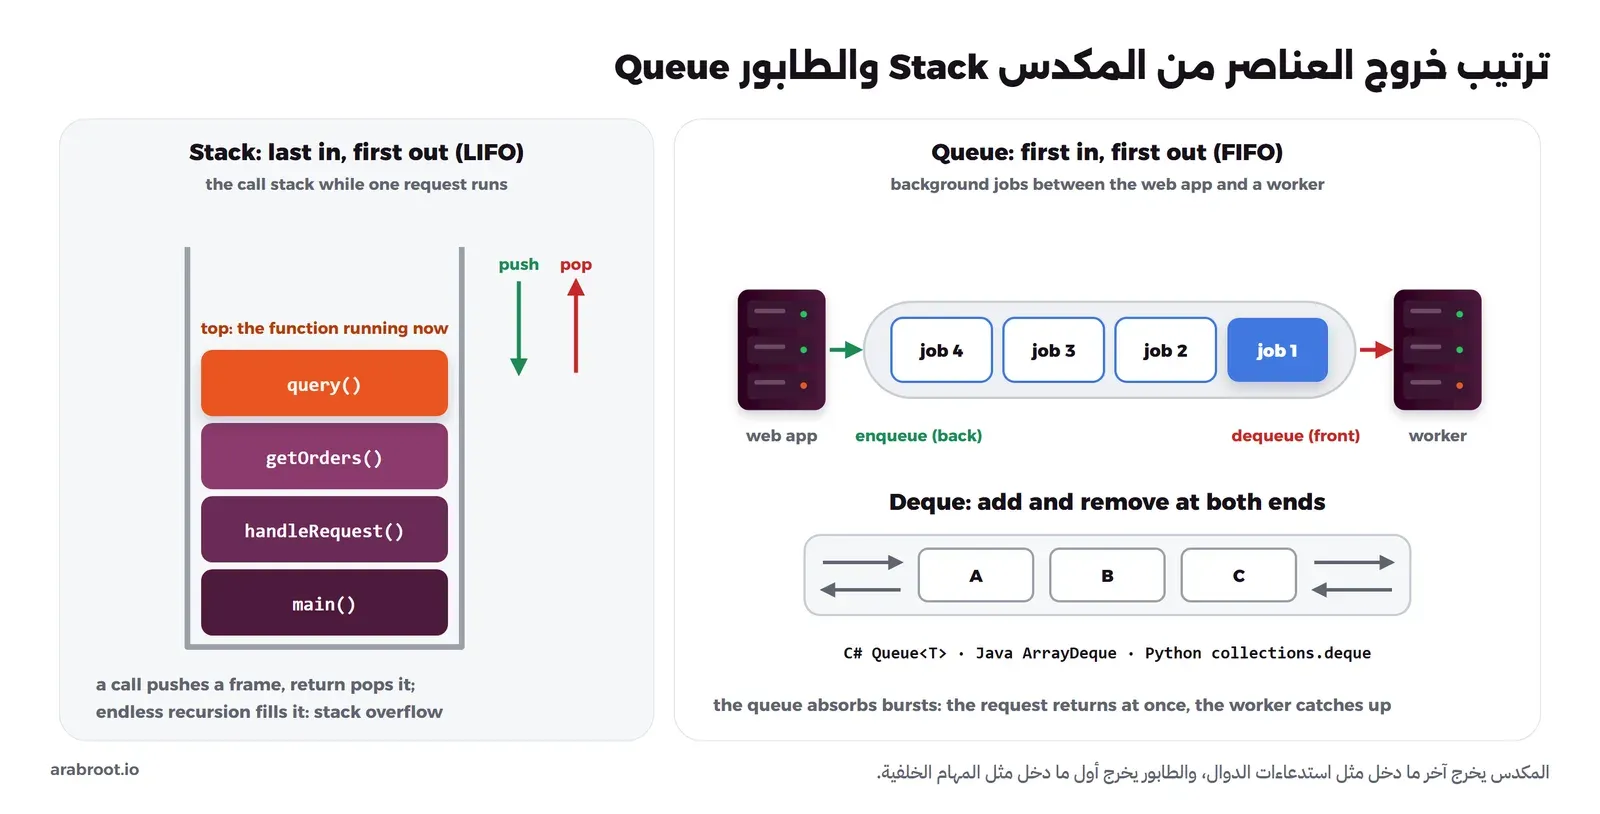
المكدس Stack هيكل له طرف واحد تضيف منه وتأخذ منه، مثل كومة الصحون في المطبخ: تضع الصحن الجديد فوق الكومة Push، وتأخذ الصحن الذي في الأعلى Pop، ولذلك يسمى «آخر من يدخل أول من يخرج» Last In First Out واختصاراً LIFO. والعمليتان O(1) لأنهما لا تلمسان إلا القمة، ويبنى المكدس عادة فوق مصفوفة ديناميكية.
الصورة التالية تبين المكدس والطابور معاً، لأن الفرق بينهما هو ترتيب الخروج فقط:
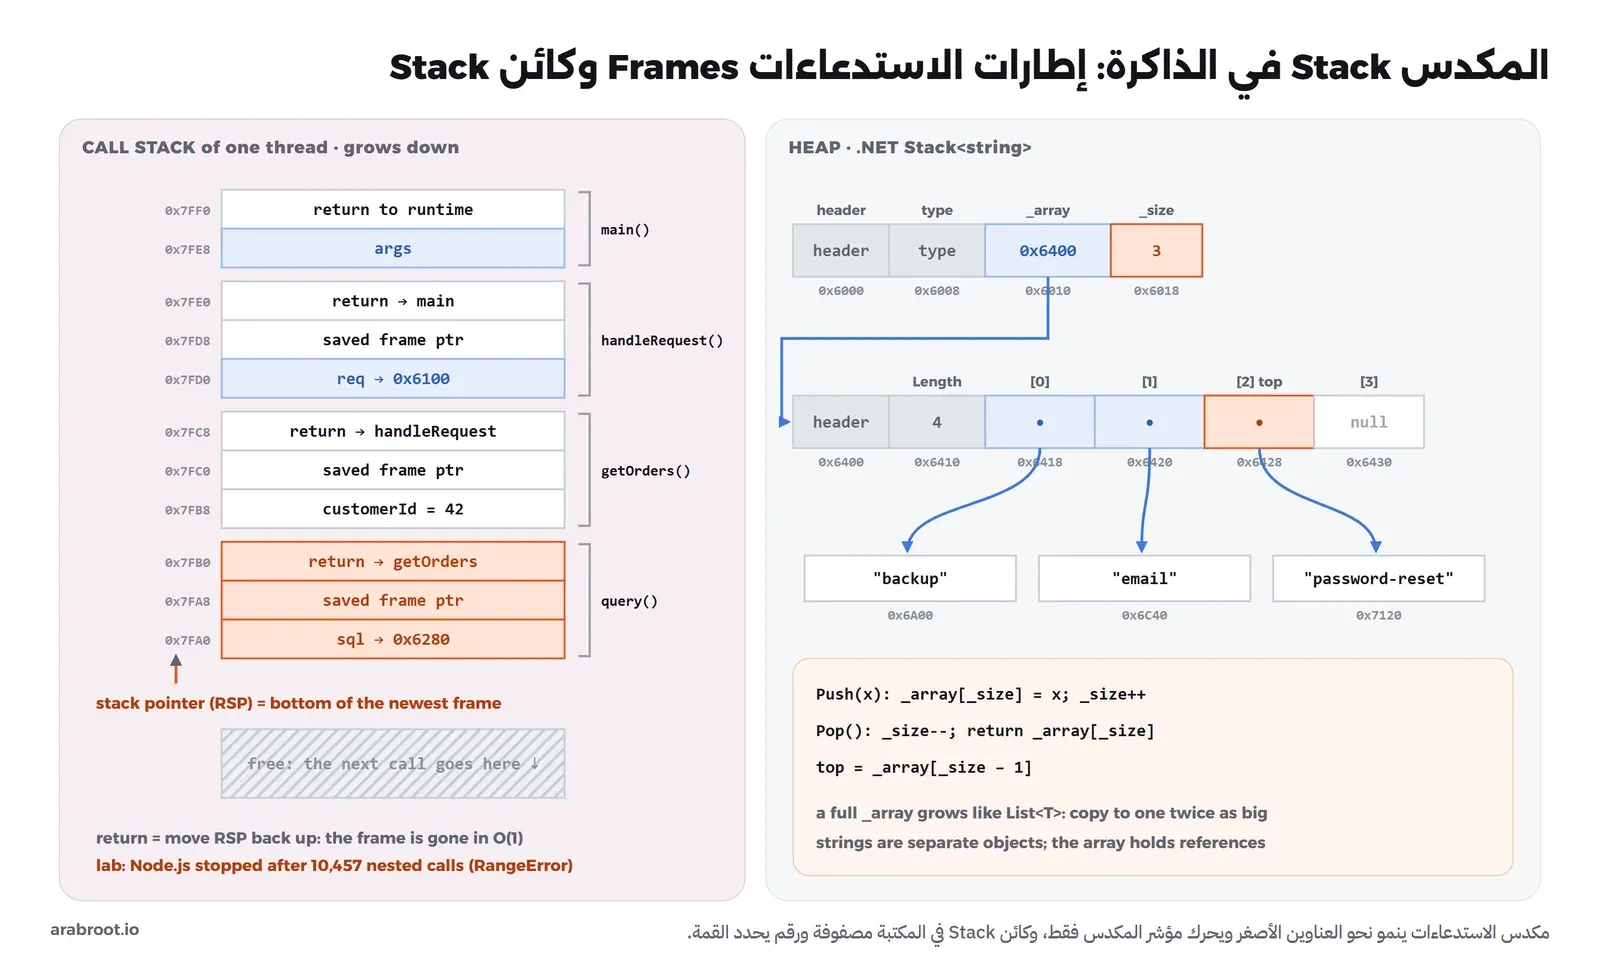
وأهم مكدس في حياة أي مبرمج هو مكدس الاستدعاءات Call Stack: فعندما تستدعي دالة يضيف البرنامج إطاراً Frame فيه متغيراتها المحلية ومكان الرجوع، وعندما تنتهي الدالة يحذف الإطار ويرجع إلى الدالة التي استدعتها، كما يشرح تعريف MDN. ولهذا السبب ترى في رسالة الخطأ Stack Trace قائمة الدوال من الأحدث إلى الأقدم، فهي ببساطة محتوى المكدس لحظة الخطأ. وهذا المكدس محدود الحجم، فإذا استدعت دالة نفسها دون توقف فإنه يمتلئ، والملف التالي يقيس متى يحدث ذلك في Node.js:
// stack.js: how deep can the call stack go before Node.js gives up?
let deepest = 0;
function depth(n) { deepest = n; return depth(n + 1) + 1; }
try { depth(0); } catch (e) { console.log(`${e.name}: ${e.message} (after ${deepest.toLocaleString('en')} calls)`); }
node stack.jsوالمخرج سوف يكون كما يلي:
RangeError: Maximum call stack size exceeded (after 10,457 calls)أي أن Node.js 22 على هذا الجهاز توقف بعد 10,457 استدعاء متداخلاً لهذه الدالة الصغيرة، والعدد يتغير مع حجم إطار الدالة. وفي Python رأينا في مخرج grow.py أن الحد الافتراضي 1000 استدعاء من sys.getrecursionlimit ثم يظهر RecursionError. لذلك لا تكتب دالة تستدعي نفسها على بيانات قد يكون عمقها كبيراً، مثل شجرة مجلدات أو تعليقات متداخلة يتحكم فيها المستخدم، وإنما استخدم مكدساً صريحاً في حلقة، والسبب أن المكدس الذي تبنيه بنفسك يعيش في ال Heap ويكبر حتى حدود الذاكرة.
والصورة التالية تبين المكدسين في الذاكرة: مكدس الاستدعاءات الذي يديره البرنامج نفسه، وكائن Stack<T> الذي تنشئه أنت في ال Heap:
ومن الاستخدامات اليومية الأخرى للمكدس: زر التراجع Undo في المحررات، وزر الرجوع في المتصفح، والتحقق من أن الأقواس في نص JSON أو كود مغلقة بالترتيب الصحيح، فكل قوس مفتوح يدخل المكدس وكل قوس مغلق يجب أن يطابق ما في القمة.
الطابور Queue والطابور ذو الطرفين Deque
الطابور Queue عكس المكدس في الترتيب: تضيف من الخلف Enqueue وتأخذ من المقدمة Dequeue، مثل طابور المراجعين في أي مكتب، ولذلك يسمى «أول من يدخل أول من يخرج» First In First Out واختصاراً FIFO، وهذا ما ظهر في مخرج التجربة: المكدس أخرج المهام بعكس ترتيب دخولها password-reset -> email -> backup، والطابور أخرجها بنفس الترتيب backup -> email -> password-reset.
والطابور في السيرفرات في كل مكان: الطلبات التي تنتظر عاملاً Worker متفرغاً، والاتصالات التي تنتظر في مجمع الاتصالات حتى يتحرر اتصال كما شرحنا في مقال تجميع الاتصالات Connection Pooling، والحزم التي تنتظر دورها في كرت الشبكة، والمهام الخلفية Background Jobs مثل إرسال البريد وتحويل الصور. والفكرة في المهام الخلفية أن الطلب يضع المهمة في الطابور ويرجع للمستخدم فوراً، وعامل آخر يأخذ المهام بالترتيب بسرعته، فإذا جاءت دفعة كبيرة مرة واحدة امتصها الطابور بدل أن تسقط السيرفر، وقد شرحنا هذا النمط في مدخل تصميم الأنظمة وفي مقال المعالج والخيوط.
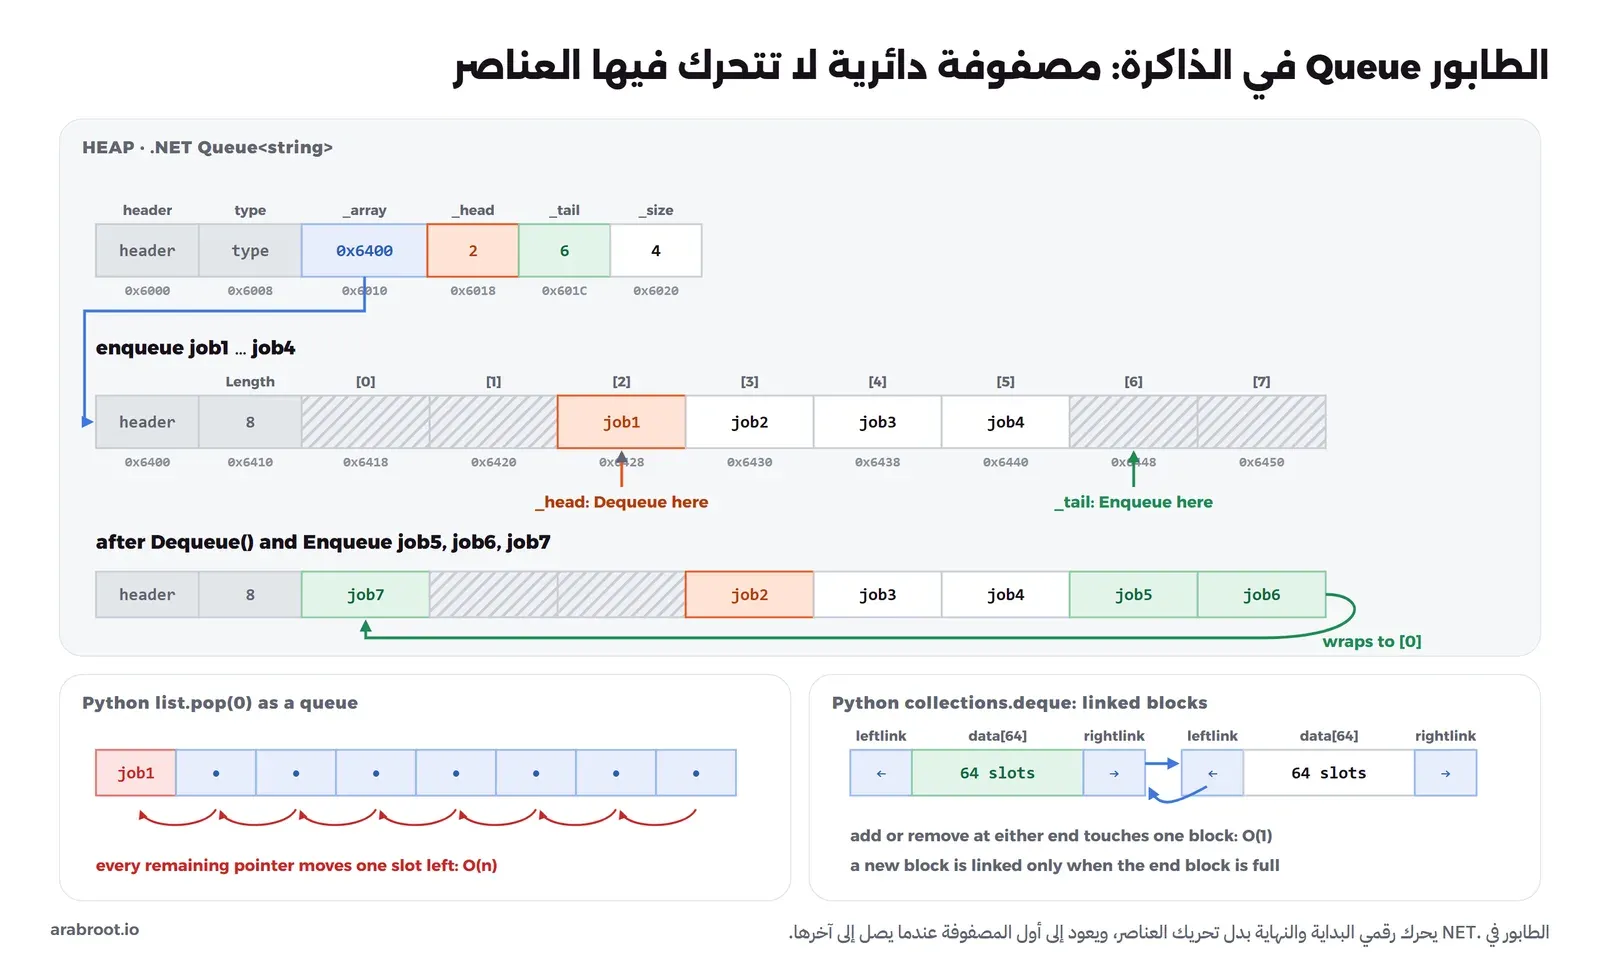
وهنا خطأ شائع يستحق الانتباه: قد يستخدم البعض القائمة العادية كطابور، فيضيف في آخرها ويحذف من أولها، وهذا يعمل ولكنه يعيد مشكلة المصفوفة، لأن الحذف من البداية يحرك كل العناصر الباقية. وتوثيق Python يذكر ذلك صراحة: القائمة list تدفع تكلفة O(n) في pop(0) وinsert(0, v)، أما collections.deque فتضيف وتحذف من الطرفين بتكلفة O(1) تقريباً. والطابور ذو الطرفين Deque واختصاره من Double-Ended Queue يسمح بالإضافة والحذف من الجهتين، فيصلح مكدساً وطابوراً معاً، وفي Java يقول توثيق ArrayDeque إنه غالباً أسرع من Stack عند استخدامه مكدساً وأسرع من LinkedList عند استخدامه طابوراً.
والصورة التالية تبين لماذا لا يحرك Queue<T> في .NET أي عنصر: المصفوفة تستخدم كدائرة Circular Buffer، ورقمان يحددان البداية والنهاية:
ويجدر الإشارة هنا إلى أن الطوابير بين الخدمات المختلفة على أكثر من سيرفر، مثل RabbitMQ وقوائم Redis، هي نفس الفكرة ولكن في خدمة مستقلة تحفظ المهام حتى لو توقف التطبيق، ويعرض Redis مثلاً نمط الطابور على قوائمه بالأمرين LPUSH وRPOP كما في توثيق Redis Lists.
جدول الهاش Hash Table: الوصول بالمفتاح مباشرة
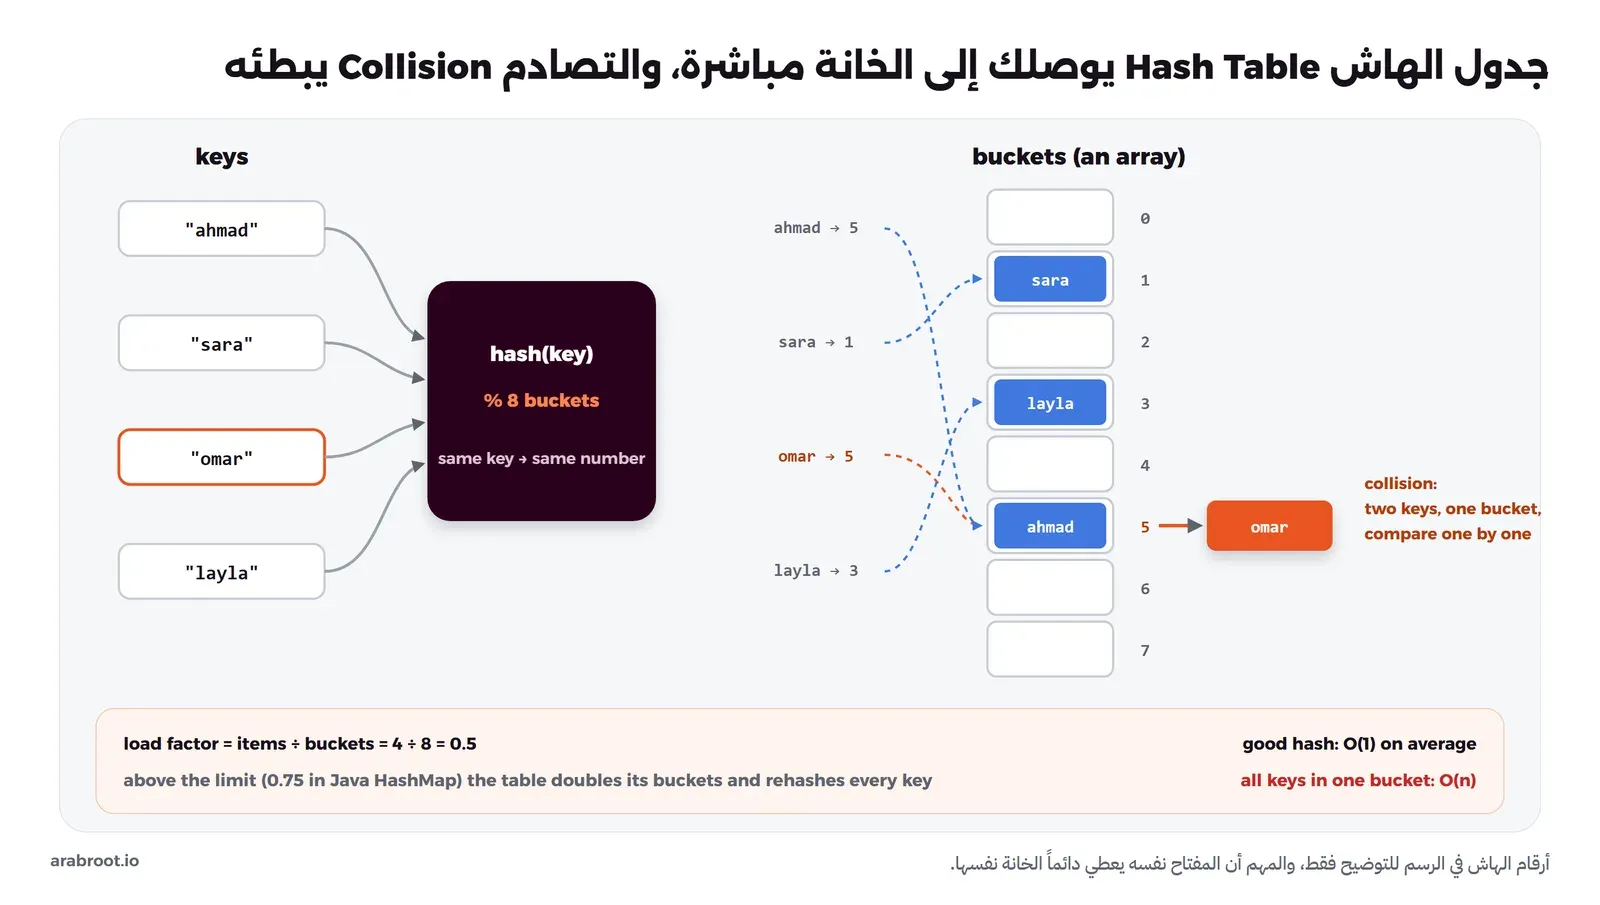
كل الهياكل السابقة تبحث عن قيمة بالمرور على العناصر، فإذا أردت أن تعرف هل المستخدم omar موجود في قائمة من مليون مستخدم فعليك أن تمر عليهم. وجدول الهاش Hash Table يحل هذه المشكلة بفكرة ذكية: نحول المفتاح نفسه إلى رقم بدالة هاش Hash Function، ثم نأخذ باقي قسمة هذا الرقم على عدد الخانات فنعرف رقم الخانة Bucket التي يوضع فيها المفتاح في مصفوفة داخلية. وبما أن نفس المفتاح يعطي دائماً نفس الرقم، فعندما نبحث عنه لاحقاً نحسب نفس الرقم ونذهب إلى نفس الخانة مباشرة دون المرور على الباقي، وبالتالي فالإضافة والبحث والحذف O(1) في المتوسط. والصورة التالية تبين ذلك:
ولاحظ أن دالة الهاش هنا ليست دالة الهاش التشفيرية مثل SHA-256 التي تستخدم لحماية كلمات المرور والتوقيعات، فالمطلوب هنا السرعة وتوزيع المفاتيح على الخانات بالتساوي، وقد شرحنا الفرق بين الهاش والترميز والتشفير في مقال الترميز.
التصادم Collision ومعامل التحميل Load Factor
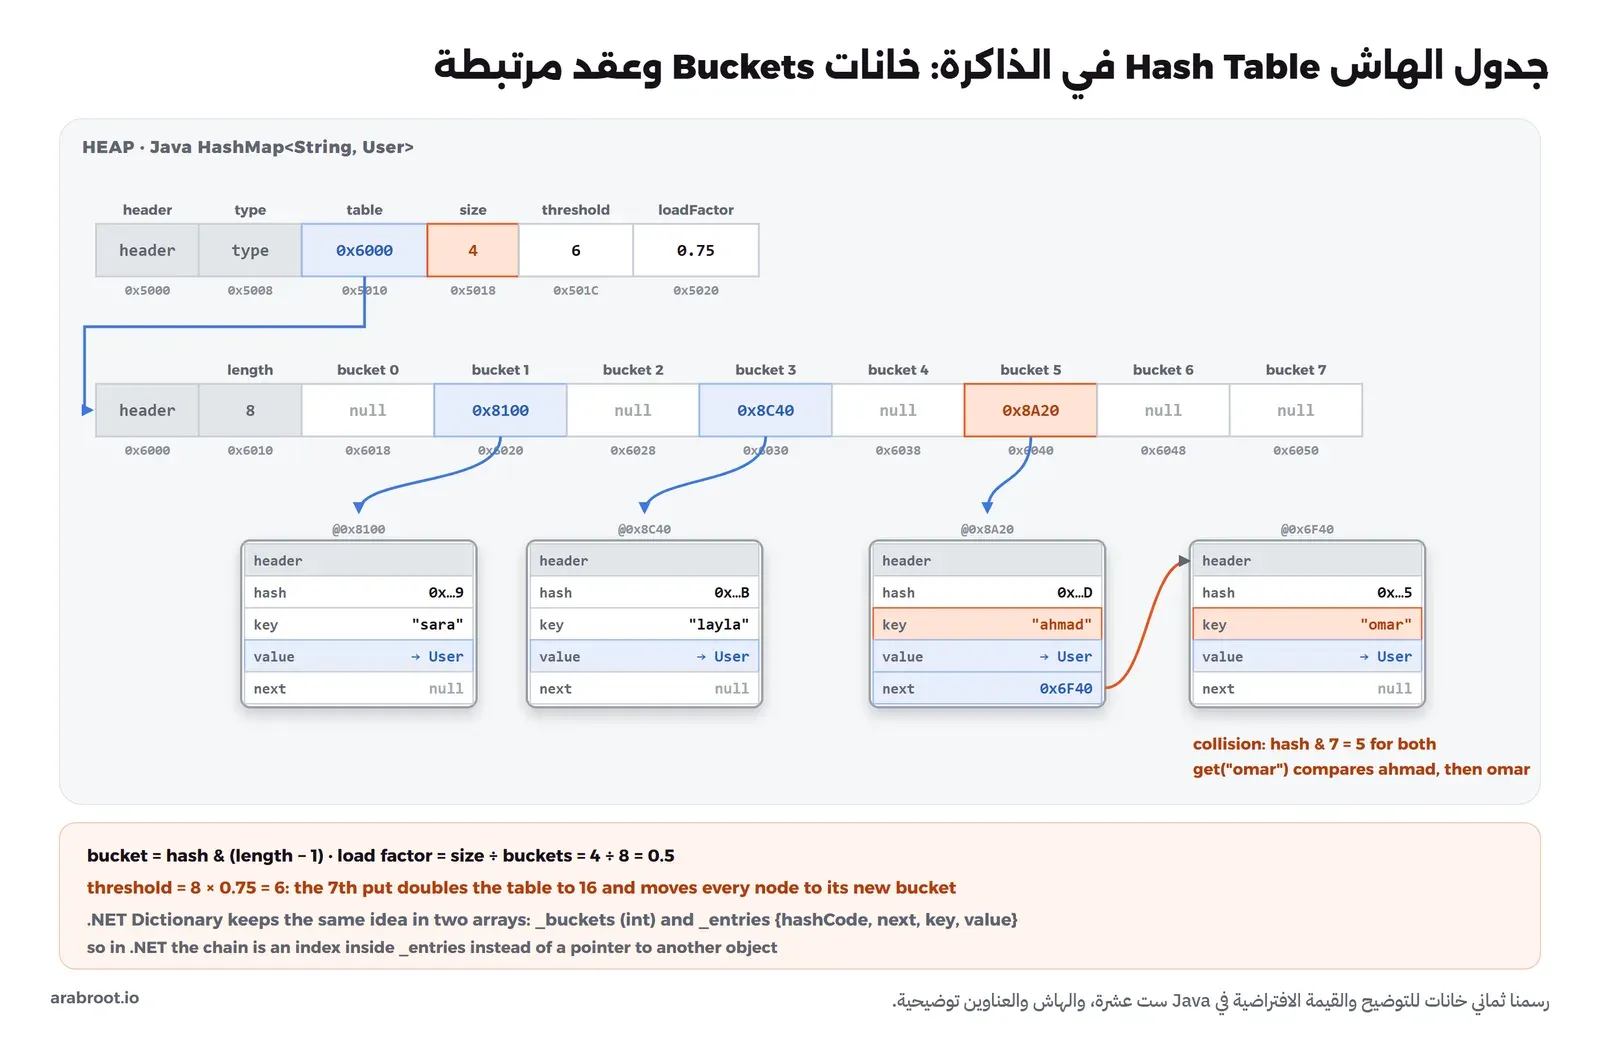
عدد المفاتيح الممكنة لا نهائي تقريباً وعدد الخانات محدود، لذلك لا بد أن يقع مفتاحان في نفس الخانة، ويسمى هذا التصادم Collision. والحل الشائع أن تحمل كل خانة سلسلة صغيرة من العناصر، فإذا وصلنا إلى خانة فيها أكثر من عنصر نقارن المفتاح بكل واحد منها بالدالة Equals، وهذا سريع ما دامت السلسلة قصيرة. ولكي تبقى السلاسل قصيرة يراقب الجدول نسبة العناصر إلى الخانات وتسمى معامل التحميل Load Factor، فإذا تجاوزت حداً معيناً ضاعف عدد الخانات وأعاد توزيع كل المفاتيح Rehash، وتوثيق HashMap في Java يذكر أن الحد الافتراضي 0.75 وأن هذا توازن جيد بين الوقت والذاكرة، وأن الأداء الثابت مشروط بأن تكون دالة الهاش توزع العناصر جيداً على الخانات.
والصورة التالية تبين جدول الهاش في ذاكرة Java بنفس المفاتيح، مع خانات أقل من الافتراضي للتوضيح:
وهذا الشرط هو بالضبط ما اختبرناه في الجزء الثالث من التجربة: المفتاح GoodKey يستخدم دالة الهاش الافتراضية للسجل record، والمفتاح BadKey يعيد الرقم 42 لكل المفاتيح، فتقع كلها في خانة واحدة. والنتيجة أن إضافة 40 ألف مفتاح أخذت 1.54 ms مع الهاش الجيد و2951.4 ms مع الهاش السيئ، أي أبطأ بنحو ألفي مرة، ولاحظ أن مضاعفة المفاتيح من 20 ألفاً إلى 40 ألفاً ضاعفت الزمن مع الهاش الجيد تقريباً وضربته في خمسة مع الهاش السيئ، لأن كل إضافة أصبحت تقارن المفتاح الجديد بكل المفاتيح السابقة، فتحول الجدول إلى قائمة عادية وأصبحت الإضافات كلها O(n²). وتوثيق Dictionary في .NET يقول نفس الشيء: الاسترجاع قريب من O(1) لأن الكلاس مبني على جدول هاش، وسرعته تعتمد على جودة خوارزمية الهاش لنوع المفتاح.
لذلك إذا كتبت كلاساً تستخدمه مفتاحاً في Dictionary أو HashMap فلا تكتب GetHashCode أو hashCode بنفسك بطريقة يدوية، وإنما استخدم ما تولده اللغة مثل record في C# وrecord في Java و@dataclass(frozen=True) في Python، أو الدالة HashCode.Combine في .NET، والسبب أن دالة الهاش السيئة لا تعطيك أي خطأ، وإنما تبطئ التطبيق ببطء يكبر مع البيانات حتى يظهر في الإنتاج Production.
أين تقابل جدول الهاش Hash Table في عملك؟
جدول الهاش أكثر هيكل تستخدمه دون أن تنتبه: الكائن في JavaScript وdict في Python وDictionary في C#، وجلسات المستخدمين المحفوظة في الذاكرة، والتخزين المؤقت Cache داخل التطبيق، وخوادم المفتاح والقيمة Key-Value مثل Redis وValkey التي تعطيك نفس الفكرة كخدمة على الشبكة يشترك فيها أكثر من سيرفر. وفي قواعد البيانات يوجد فهرس الهاش Hash Index الذي يحفظ رقم هاش من 32 بت لكل قيمة، ولذلك لا يصلح إلا للمساواة كما يذكر توثيق أنواع الفهارس في PostgreSQL، أما البحث بالمدى والترتيب فيحتاج الشجرة التي سنصل إليها بعد قليل. وعندما تتوزع المفاتيح على عدة سيرفرات بدل عدة خانات تظهر نفس المشكلة بشكل أكبر: إضافة سيرفر تغير باقي القسمة لأغلب المفاتيح، والحل هو الهاش المتسق الذي شرحناه في مقال الأنظمة الموزعة.
المجموعة Set: جدول هاش بدون قيم
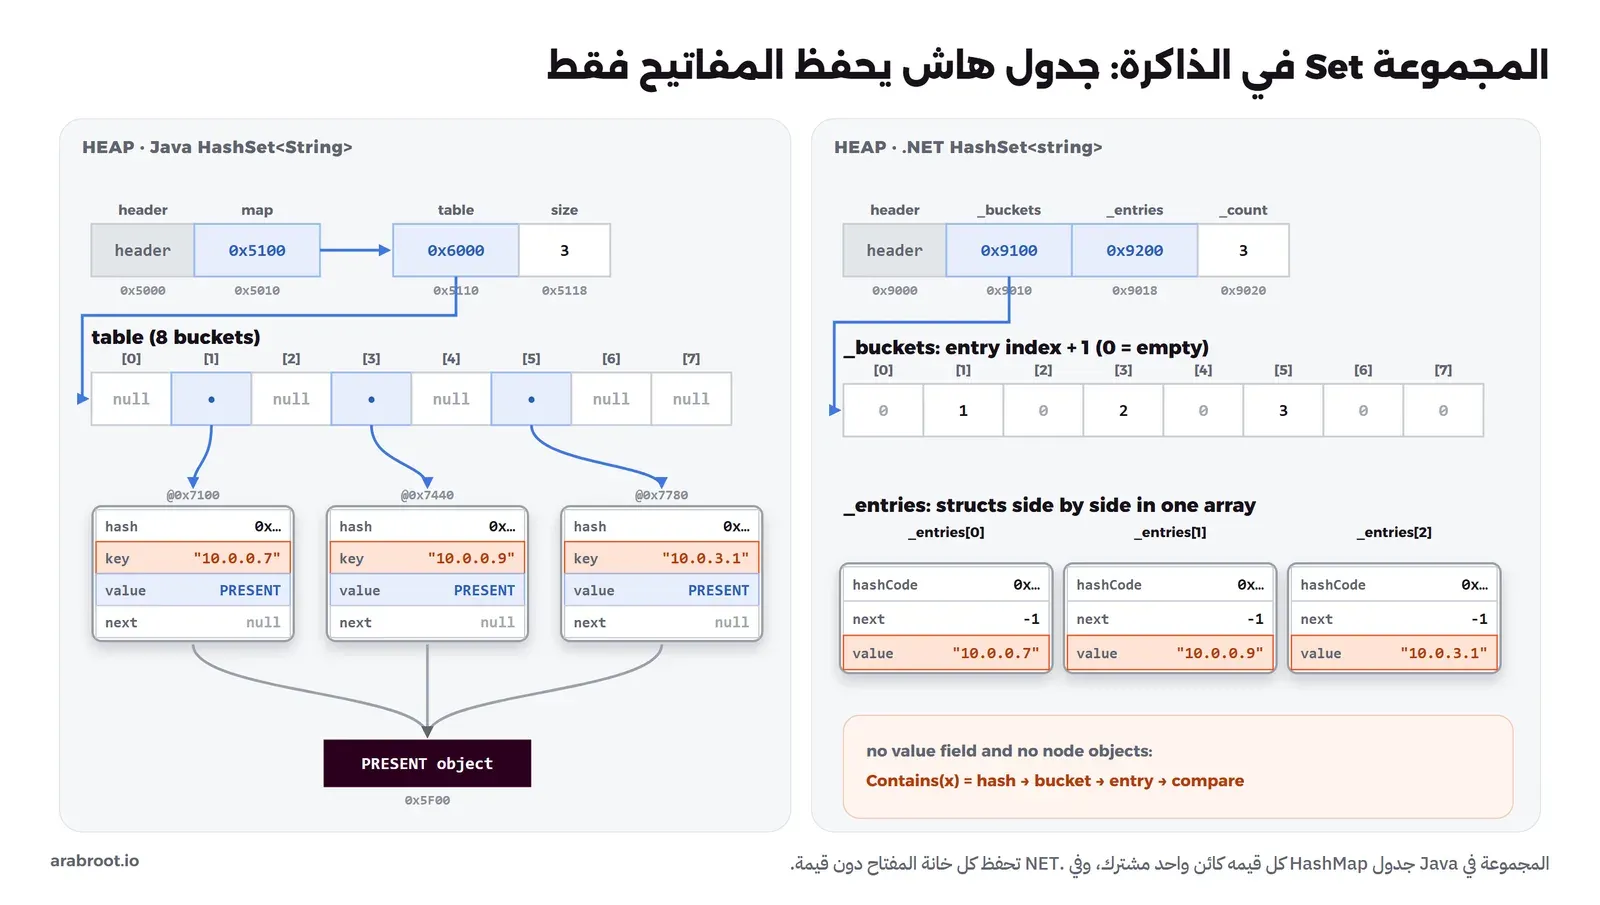
المجموعة Set هي جدول هاش يحفظ المفاتيح فقط دون قيم مرتبطة بها، ووظيفتها أن تجيب بسرعة عن سؤال واحد: هل هذا العنصر موجود؟ ولا تقبل التكرار، فإضافة نفس العنصر مرتين لا تغير شيئاً. وهي الحل الصحيح لأشياء كثيرة تكتب خطأً بقائمة عادية، مثل قائمة العناوين المحظورة، والمعرفات التي عالجتها حتى لا تعالجها مرتين، وحذف التكرار من بيانات مستوردة. وفي مقال الخوارزميات قسنا الفرق بين حذف التكرار بقائمة وحذفه بمجموعة على نفس البيانات في ثلاث لغات، وكان الفرق مئات المرات مع بيانات متوسطة الحجم.
والصورة التالية تبين المجموعة في ذاكرة Java و.NET، لترى أنها فعلاً جدول هاش دون قيم، فالكلاس HashSet في Java كما يقول توثيقه مبني على HashMap:
الشجرة Tree: الترتيب الذي يختصر البحث
جدول الهاش سريع في سؤال «هل هذا المفتاح موجود؟» ولكنه لا يعرف الترتيب، فإذا طلبت كل الطلبات بين تاريخين أو أول عشرة أسماء أبجدياً فعليه أن يمر على كل شيء. والشجرة Tree هيكل يحفظ الترتيب ويبقي البحث سريعاً: عقد مرتبطة ببعضها من الأعلى إلى الأسفل، وفي الأعلى عقدة واحدة تسمى العقدة العليا Root، ولكل عقدة أبناء Children، والعقد التي ليس لها أبناء تسمى الأوراق Leaves. وأنت تعرف أشجاراً كثيرة دون أن تسميها كذلك: مجلدات القرص، ومستند JSON المتداخل، وصفحة HTML التي يبنيها المتصفح كشجرة DOM.
شجرة البحث الثنائية Binary Search Tree
شجرة البحث الثنائية Binary Search Tree واختصاراً BST لكل عقدة فيها ابنان على الأكثر، وتلتزم بقاعدة واحدة: كل ما في الجهة اليسرى أصغر من العقدة، وكل ما في الجهة اليمنى أكبر منها. فإذا بحثت عن 60 تقارن بالعقدة العليا 50 فتعرف أنه في اليمين، ثم تقارن ب 70 فتعرف أنه في اليسار، وتجده في الخطوة الثالثة، وكل مقارنة تستبعد نصف الباقي تقريباً، ولذلك فالبحث والإضافة والحذف O(log n). والصورة التالية تبين ذلك، ومعه الشجرة التي تستخدمها قواعد البيانات:
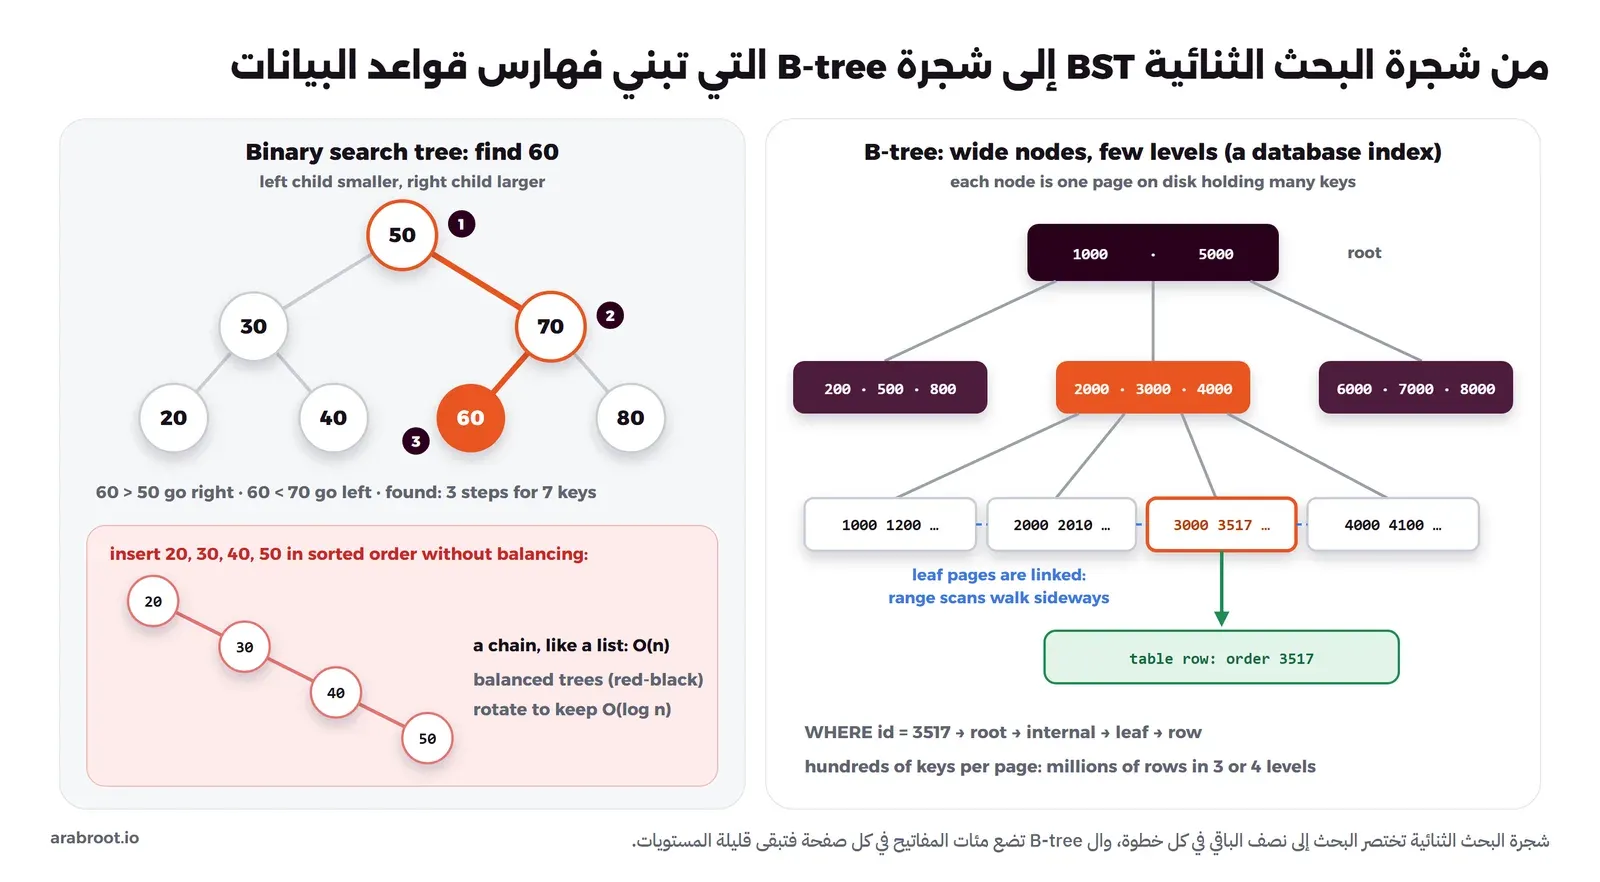
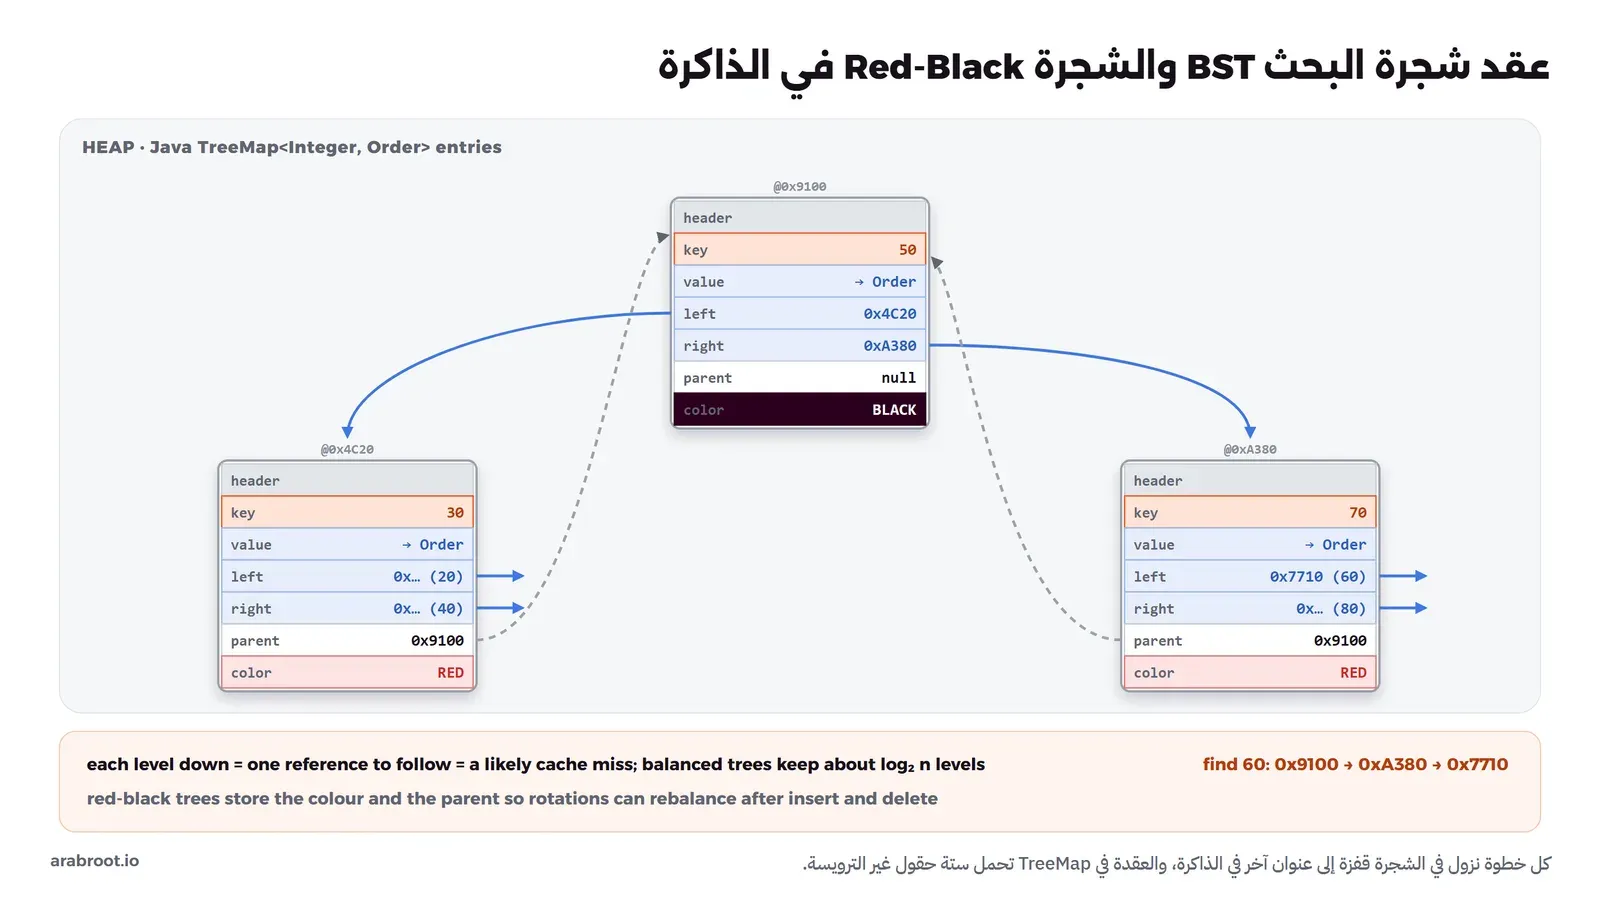
ولكن هناك مشكلة رئيسية في الشجرة البسيطة تظهر في أسفل الجهة اليسرى من الصورة: إذا أضفت الأعداد وهي مرتبة أصلاً، مثل معرفات متسلسلة أو تواريخ، فإن كل عدد أكبر من الذي قبله فيذهب دائماً إلى اليمين، وتصبح الشجرة سلسلة طويلة هي في الحقيقة قائمة مترابطة، والبحث فيها O(n). والحل هو الشجرة المتوازنة Balanced Tree التي تعيد ترتيب نفسها بعمليات تدوير Rotations بعد كل إضافة وحذف حتى يبقى ارتفاعها قريباً من log n، وأشهرها الشجرة الحمراء والسوداء Red-Black Tree التي يقوم عليها TreeMap في Java بضمان log(n) لعملياته الأساسية، وتصف Microsoft كلاس SortedDictionary بأنه شجرة بحث ثنائية بتكلفة O(log n) للاسترجاع. وحتى مجدول المهام في نواة Linux استخدم شجرة حمراء وسوداء مرتبة بالوقت ليعرف أي عملية تستحق المعالج بعد ذلك، كما يشرح توثيق CFS في النواة، وقد ذكرنا المجدول في مقال المعالج والخيوط.
والصورة التالية تبين الشجرة الحمراء والسوداء في ذاكرة Java، وكل عقدة فيها كائن مستقل:
شجرة B-tree وفهارس قواعد البيانات Database Indexes
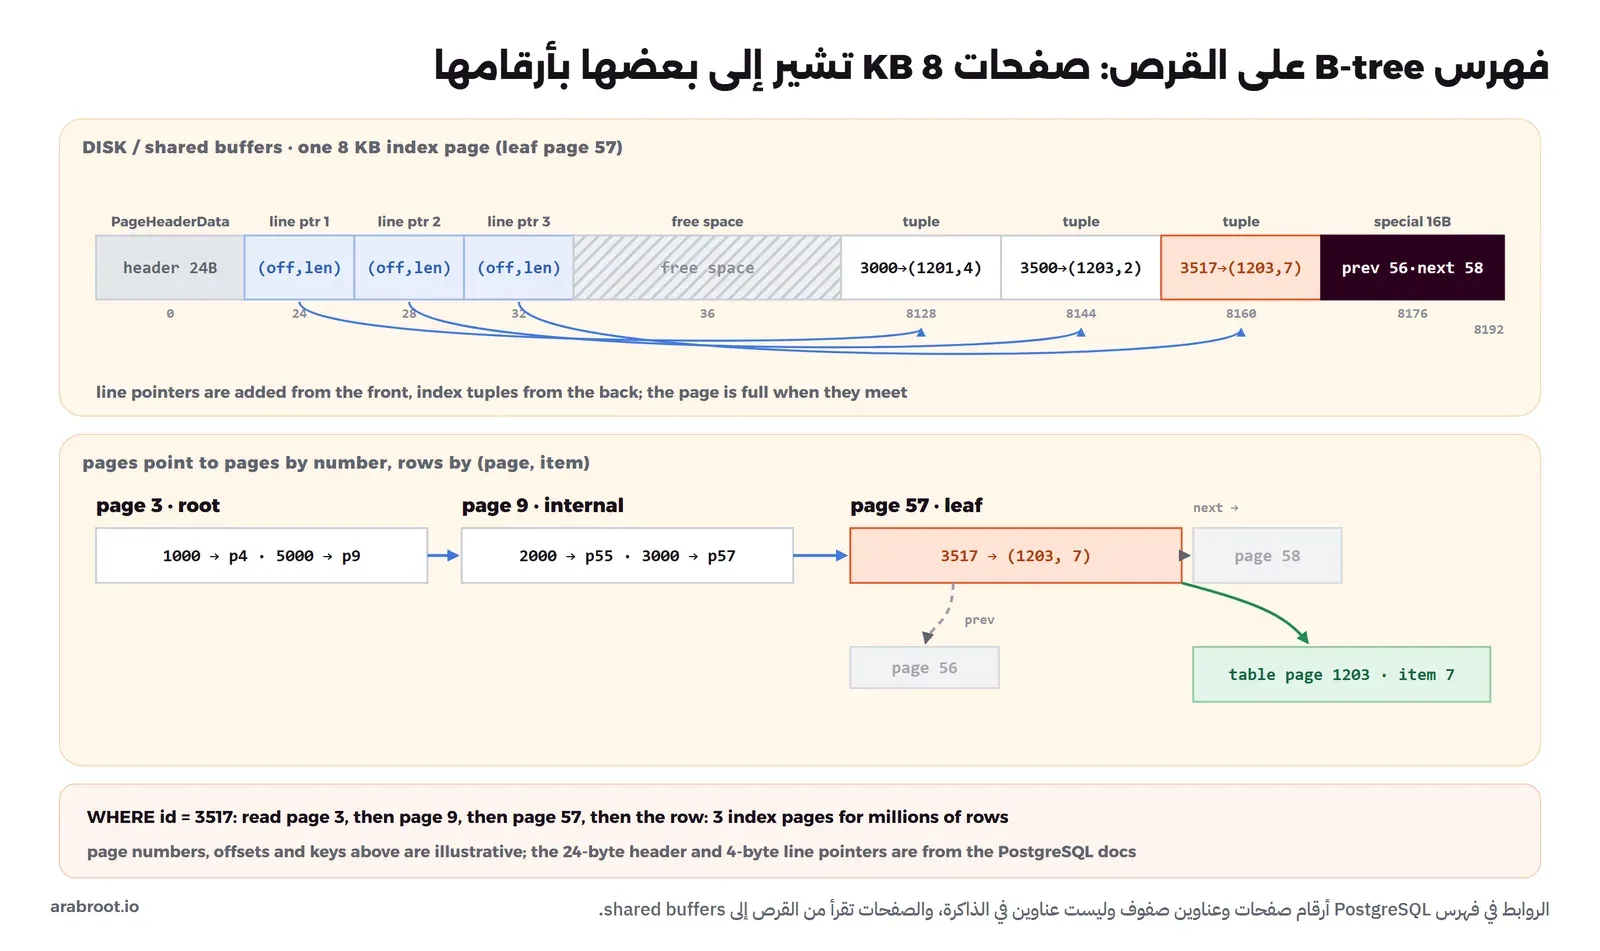
شجرة البحث الثنائية ممتازة في الذاكرة، ولكن قاعدة البيانات تحفظ الفهرس على القرص، وكل انتقال من عقدة إلى أخرى قد يعني قراءة صفحة جديدة من القرص، وشجرة ثنائية فيها مليون مفتاح ارتفاعها نحو عشرين مستوى، أي عشرين قراءة للبحث عن مفتاح واحد. ولذلك تستخدم قواعد البيانات شجرة B-tree، وهي شجرة متوازنة متعددة الفروع Multi-way Balanced Tree كما يسميها توثيق PostgreSQL، وكل عقدة فيها صفحة كاملة من القرص تحمل مئات المفاتيح ومئات الأبناء بدل مفتاح واحد وابنين، فيبقى ارتفاع الشجرة ثلاثة أو أربعة مستويات حتى مع ملايين الصفوف، وصفحات الأوراق مرتبطة ببعضها جانبياً، فإذا طلبت مدى من القيم تنزل إلى أول ورقة ثم تمشي في الأوراق بالترتيب.
وهنا يختلف شكل الروابط عن كل ما سبق، فالفهرس يعيش على القرص وتقرأ صفحاته إلى ذاكرة PostgreSQL، لذلك تشير العقد إلى بعضها بأرقام الصفحات وليس بعناوين الذاكرة، كما في توثيق تخطيط الصفحة، والصورة التالية تبين ذلك:
وهذه الشجرة هي الفهرس الافتراضي الذي تنشئه عندما تكتب CREATE INDEX في PostgreSQL وMySQL، وهي التي جعلت الاستعلام في مقال تصميم قواعد البيانات ينتقل من مسح الجدول كله إلى خطوات قليلة، وترتيب أعمدتها المركبة هو موضوع قسم الفهرس المركب في مقال الجداول الضخمة، وطريقة امتلاء صفحاتها هي السبب في أن UUIDv4 العشوائي يتعب الفهرس كما شرحنا في مقال المعرفات الفريدة.
وقد تقابل كلمة الشجرة في سياق آخر هو شجرة القرار Decision Tree في التعلم الآلي، وهي نفس الشكل ولكن كل عقدة فيها سؤال عن البيانات وليس مفتاحاً مرتباً، وقد شرحناها في مقال التعلم الآلي.
الكومة Heap وطابور الأولوية Priority Queue
أحياناً لا تحتاج كل البيانات مرتبة، وإنما تحتاج أن تعرف دائماً العنصر الأصغر أو الأهم، مثل المهمة ذات الأولوية الأعلى أو المؤقت Timer الذي سينتهي أولاً. وترتيب كل شيء بعد كل إضافة مكلف، والكومة Heap تحل ذلك بشرط أضعف من الترتيب الكامل: في الكومة الصغرى Min-Heap كل أب أصغر من أبنائه أو يساويهم، دون أي ترتيب بين الإخوة، وبالتالي فالأصغر دائماً في القمة، والنظر إليه O(1)، وأخذه أو إضافة عنصر جديد O(log n) لأن العنصر يتحرك صعوداً أو نزولاً في مستويات الشجرة فقط. والصورة التالية تبين كومة صغيرة، وكيف تحفظ في مصفوفة عادية دون مؤشرات:
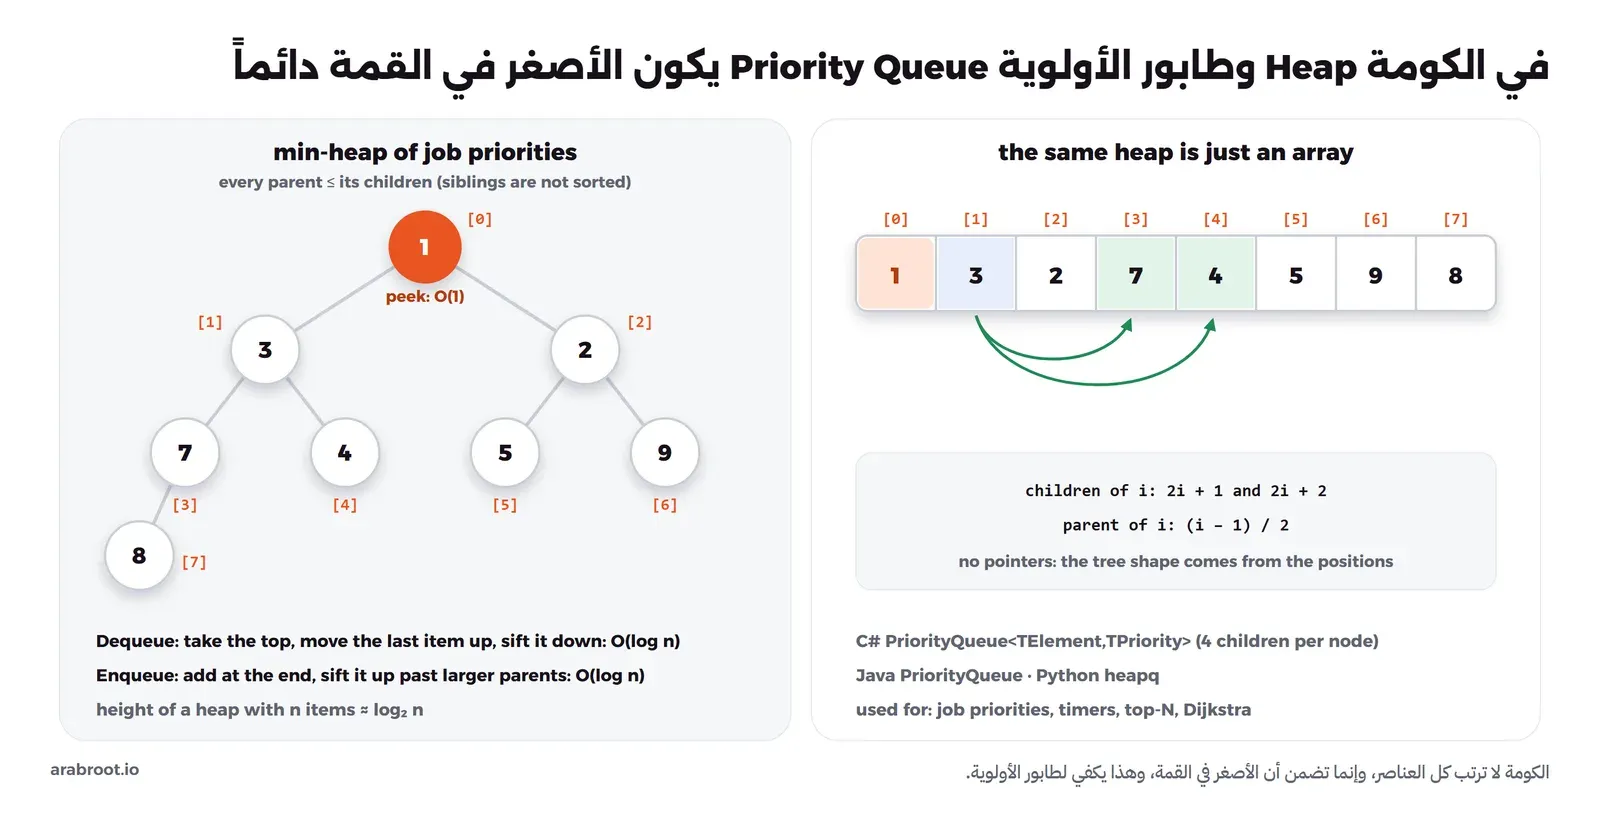
والكومة هي الطريقة المعتادة لبناء طابور الأولوية Priority Queue: طابور لا يخرج فيه الأقدم أولاً وإنما الأعلى أولوية، وهذا ما ظهر في السطر الأخير من مخرج التجربة، فالمهمة password-reset دخلت أخيراً بأولوية 1 وخرجت أولاً. وتوثيق PriorityQueue في .NET يذكر أنه كومة صغرى رباعية Quaternary Min-Heap مبنية على مصفوفة، أي لكل عقدة أربعة أبناء بدل اثنين لتقليل عدد المستويات، وأن العناصر ذات الأولوية المتساوية لا يضمن خروجها بترتيب دخولها، وفي Java يوجد PriorityQueue المبني على كومة أولوية، وفي Python الوحدة heapq التي تعمل على قائمة عادية ويؤكد توثيقها أن أصغر عنصر دائماً في الموقع heap[0].
والصورة التالية تبين الكومة كما تعيش في الذاكرة فعلاً، مصفوفة واحدة دون أي مؤشرات:
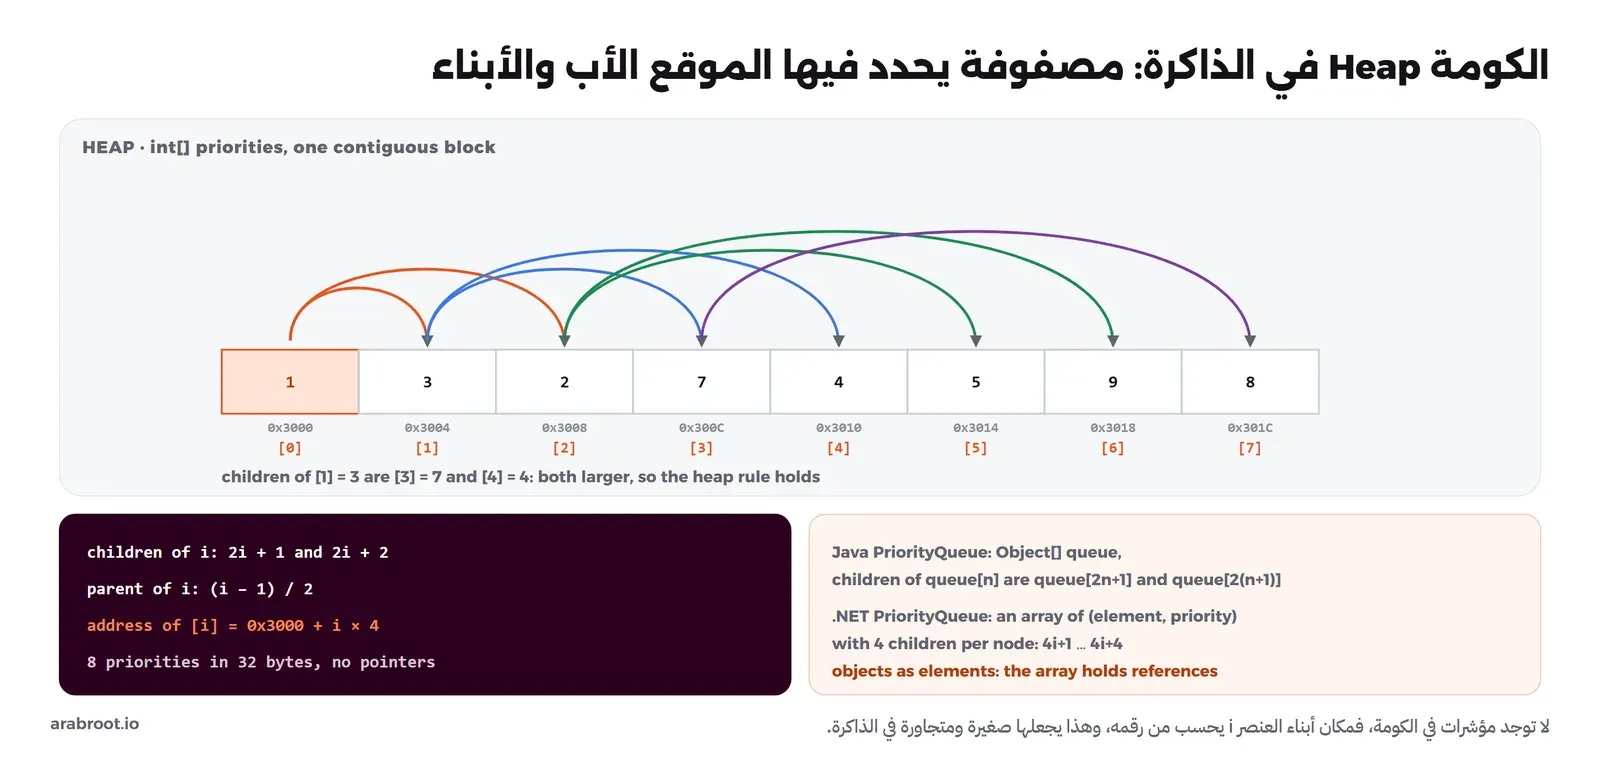
وتقابل الكومة في السيرفرات في جدولة المهام حسب الأولوية، وفي المؤقتات التي تحتاج أقرب موعد انتهاء، وفي استعلامات «أعلى عشرة» Top-N، وقد ظهرت فعلاً في مخرج EXPLAIN في مقال RAG باسم top-N heapsort، وهو PostgreSQL يحتفظ بأقرب أربع نتائج في كومة صغيرة بدل ترتيب كل الصفوف.
الرسم البياني Graph: عقد Nodes وروابط Edges
الشجرة لها اتجاه واحد من الأعلى إلى الأسفل وطريق واحد إلى كل عقدة، أما الرسم البياني Graph فهو أعم من ذلك: مجموعة عقد Nodes أو Vertices، وروابط Edges بينها في أي اتجاه، وقد يكون بين عقدتين أكثر من طريق، وقد يكون للرابط اتجاه Directed مثل المتابعة في الشبكات الاجتماعية، أو وزن Weight مثل تكلفة الرابط بين راوترين. وأنت تتعامل مع الرسوم البيانية كل يوم: الشبكة نفسها راوترات وروابط، والاعتماديات بين الحزم في مدير الحزم، والخدمات التي تستدعي بعضها في نظام موزع.
وحفظ الرسم البياني في الذاكرة له طريقتان مشهورتان تبينهما الصورة التالية:
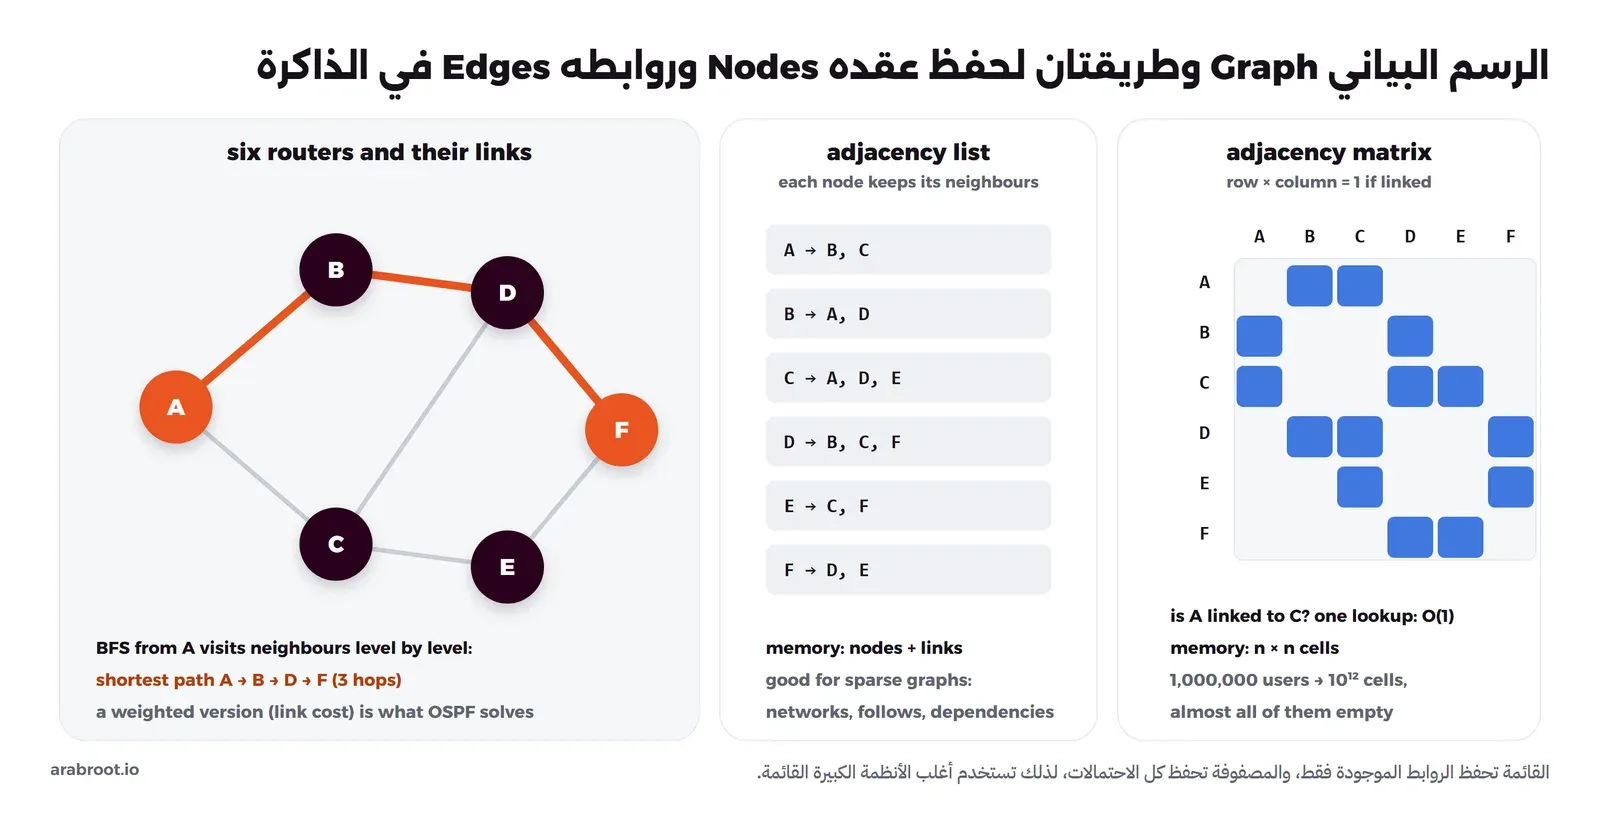
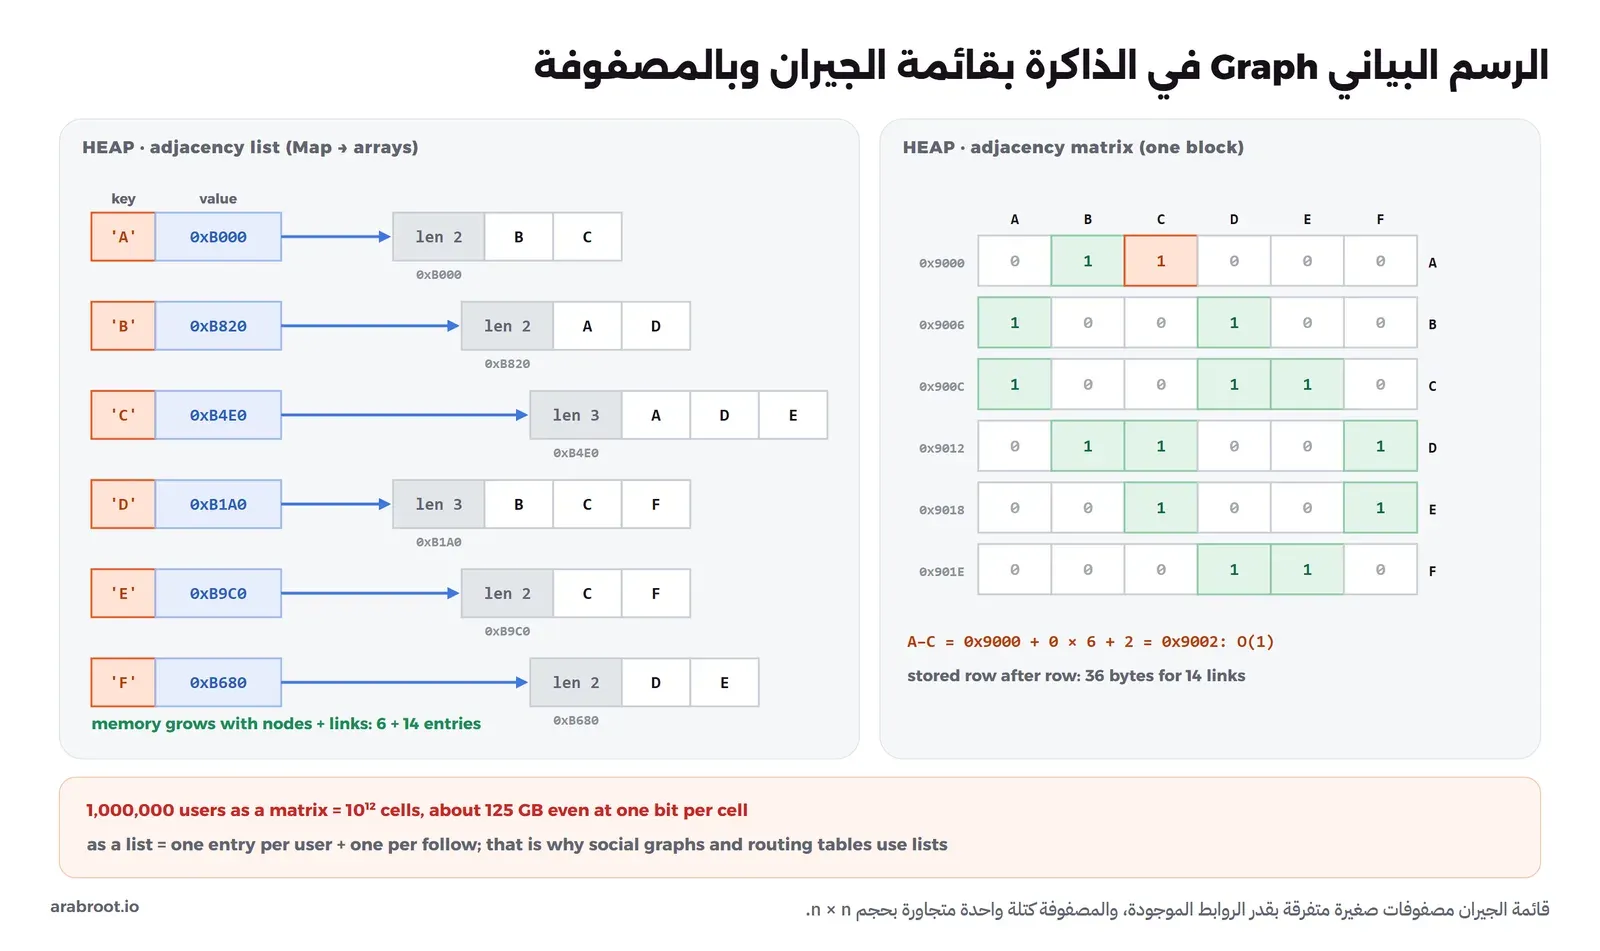
- قائمة الجيران Adjacency List: لكل عقدة قائمة بالعقد المرتبطة بها، وغالباً تكون جدول هاش من العقدة إلى قائمة جيرانها، والذاكرة التي تحتاجها بقدر عدد العقد والروابط فعلاً، لذلك هي الطريقة المعتادة للرسوم الكبيرة المتناثرة Sparse مثل الشبكات الاجتماعية والشبكات الحقيقية.
- مصفوفة الجيران Adjacency Matrix: مصفوفة مربعة n × n، والخانة في الصف i والعمود j قيمتها 1 إذا كان بينهما رابط، فالسؤال «هل A مرتبط ب C؟» O(1)، ولكن الذاكرة n² مهما كان عدد الروابط قليلاً، فمليون مستخدم يحتاجون مليون مليون خانة أغلبها فارغ.
والصورة التالية تبين الطريقتين في الذاكرة لنفس الشبكة:
والخوارزمية الأولى التي تتعلمها على الرسوم البيانية هي البحث بالعرض Breadth-First Search واختصاراً BFS: تبدأ من عقدة وتزور كل جيرانها، ثم جيران جيرانها، وهكذا مستوى بعد مستوى، وتستخدم لذلك طابوراً، ولأنها تزور الأقرب أولاً فهي تجد أقصر طريق بعدد القفزات. والملف التالي يبني الشبكة التي في الصورة كقائمة جيران ويبحث فيها، ومعه شجرة البادئات التي سنشرحها في القسم التالي:
// trie-graph.js: autocomplete with a trie, and the shortest path in a graph with BFS
// 1) Trie: every node is one letter, words that share a start share the path
class Trie {
  constructor() { this.root = { children: new Map(), end: false }; }
  insert(word) {
    let node = this.root;
    for (const ch of word) {
      if (!node.children.has(ch)) node.children.set(ch, { children: new Map(), end: false });
      node = node.children.get(ch);
    }
    node.end = true;
  }
  startsWith(prefix) {
    let node = this.root;
    for (const ch of prefix) { node = node.children.get(ch); if (!node) return []; }
    const out = [];
    const walk = (n, word) => { if (n.end) out.push(word); for (const [ch, c] of n.children) walk(c, word + ch); };
    walk(node, prefix);
    return out;
  }
}
const t = new Trie();
for (const w of ['docker', 'docs', 'dns', 'domain', 'database', 'debian', 'deploy']) t.insert(w);
console.log('do  ->', t.startsWith('do').join(', '));
console.log('de  ->', t.startsWith('de').join(', '));
console.log('git ->', t.startsWith('git').join(', ') || '(nothing)');

// 2) Graph as an adjacency list: which routers can each router reach directly?
const links = new Map([
  ['A', ['B', 'C']],
  ['B', ['A', 'D']],
  ['C', ['A', 'D', 'E']],
  ['D', ['B', 'C', 'F']],
  ['E', ['C', 'F']],
  ['F', ['D', 'E']],
]);
function shortestPath(from, to) {
  const queue = [[from]];           // BFS: a queue of paths, the shortest ones first
  const seen = new Set([from]);
  while (queue.length) {
    const path = queue.shift();
    const last = path[path.length - 1];
    if (last === to) return path;
    for (const next of links.get(last)) if (!seen.has(next)) { seen.add(next); queue.push([...path, next]); }
  }
  return null;
}
console.log('A to F ->', shortestPath('A', 'F').join(' -> '));
node trie-graph.jsوالمخرج سوف يكون كما يلي:
do  -> docker, docs, domain
de  -> debian, deploy
git -> (nothing)
A to F -> A -> B -> D -> F
في الإعداد أعلاه لاحظ التالي:
- الدالة
shortestPathتجمع ثلاثة هياكل من هذا المقال: جدول هاشMapللجيران، وطابور للمسارات بالترتيب، ومجموعةSetللعقد التي زرناها حتى لا ندور في حلقة لا تنتهي، لأن الرسم البياني بخلاف الشجرة قد يحتوي دوائر. - الطريق A ثم B ثم D ثم F ثلاث قفزات، وهناك طريق آخر بنفس الطول عبر C، وBFS أعاد أول طريق وصل إليه.
- عندما تكون للروابط أوزان مختلفة يصبح أقصر طريق هو الأقل تكلفة وليس الأقل قفزات، وهنا تستخدم خوارزمية Dijkstra مع طابور أولوية، وهي نفسها التي يحسب بها بروتوكول التوجيه OSPF شجرة أقصر الطرق كما في RFC 2328.
وتجد الرسوم البيانية أيضاً في فهارس البحث بالمعنى، فالفهرس HNSW الذي استخدمناه في مقال RAG هو رسم بياني من عدة طبقات يربط كل مقطع بأقرب جيرانه، فيصل البحث إلى المقاطع المتشابهة بالقفز بين الجيران بدل مقارنة السؤال بكل المقاطع.
شجرة البادئات Trie والإكمال التلقائي Autocomplete
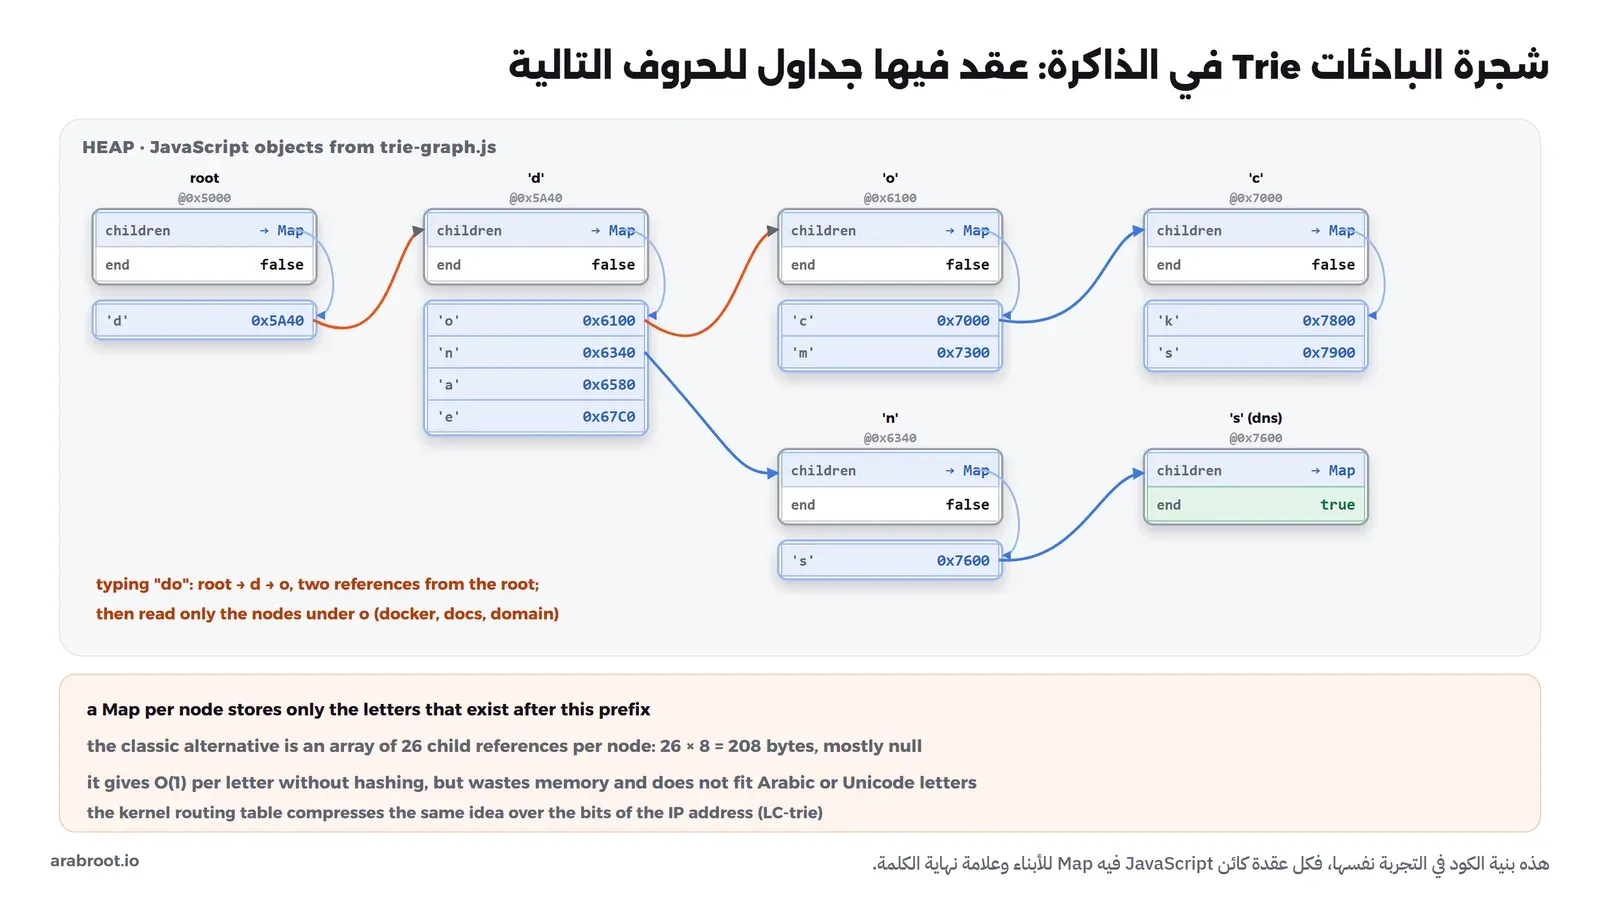
شجرة البادئات Trie، ويأتي اسمها من كلمة Retrieval، شجرة كل عقدة فيها حرف، وكل طريق من العقدة العليا إلى عقدة معلمة بنهاية كلمة هو كلمة كاملة، فالكلمات التي تبدأ بنفس الحروف تتشارك نفس الطريق في البداية. والصورة التالية تبين الشجرة التي بنيناها في التجربة من سبع كلمات:
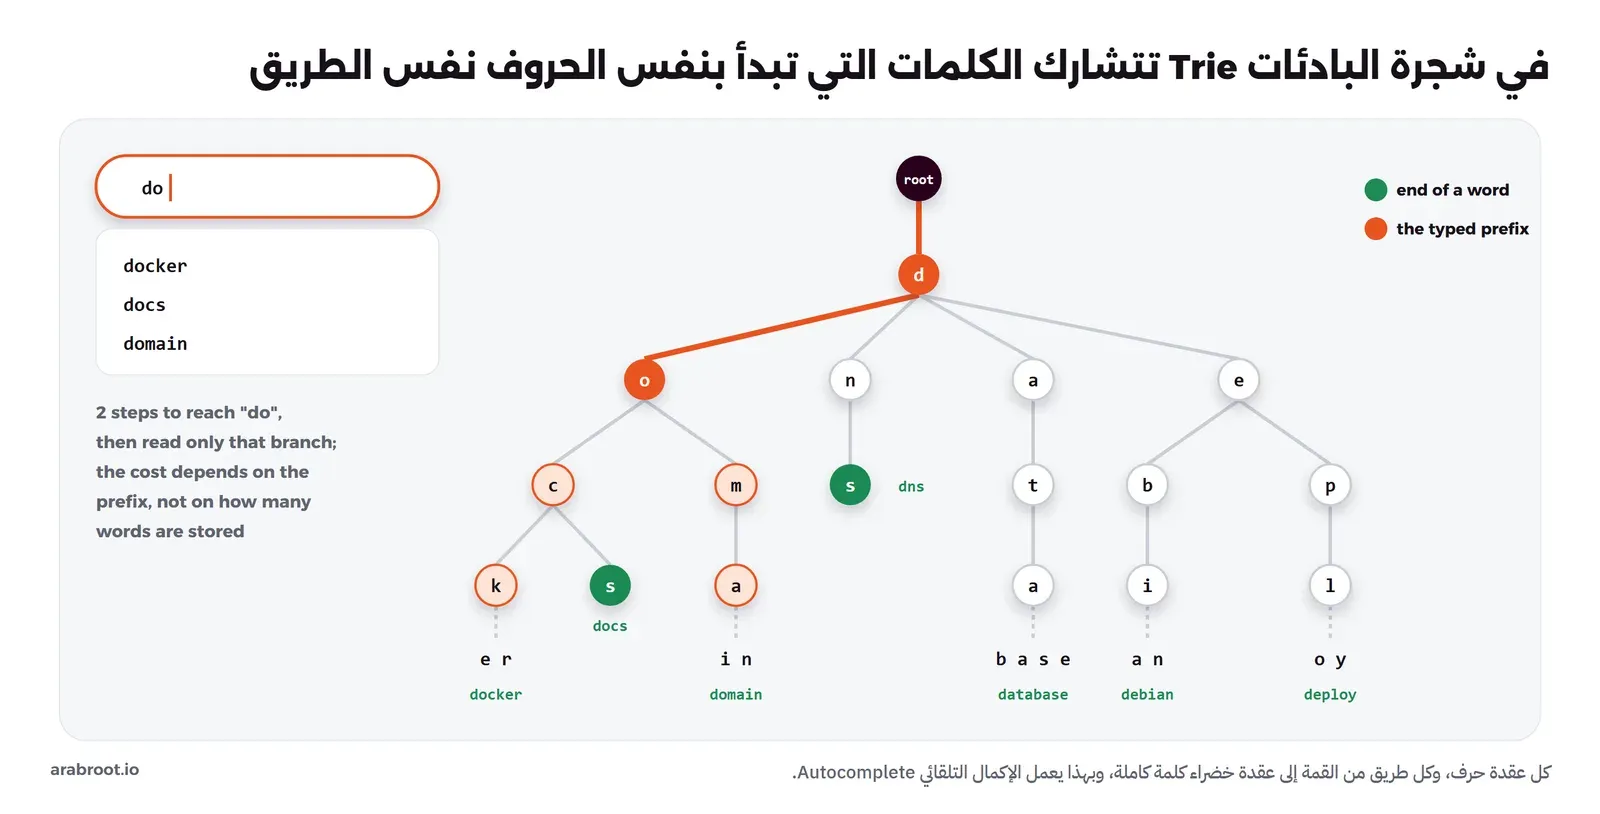
وفائدتها في سؤال «ما الكلمات التي تبدأ بهذه الحروف؟»: فبعد كتابة do تنزل خطوتين فقط ثم تقرأ الفرع الذي تحته، ولا يهم كم كلمة أخرى في الشجرة، وتكلفة الوصول تعتمد على طول البادئة وليس على عدد الكلمات. وهذا ما يجعلها مناسبة للإكمال التلقائي Autocomplete في مربعات البحث، وللقواميس والتدقيق الإملائي. ولها استخدام مهم في الشبكات أيضاً، فجدول التوجيه Routing Table في الراوتر يبحث عن أطول بادئة مطابقة Longest Prefix Match لعنوان IP، أي الشبكة الأكثر تحديداً التي ينتمي إليها العنوان، وهذا سؤال بادئات بطبيعته، ونواة Linux تحفظ جدول التوجيه في نوع مضغوط من هذه الشجرة اسمه LC-trie كما في توثيق fib_trie، حيث المفتاح هو بتات العنوان بدل حروف الكلمة.
والصورة التالية تبين الشجرة التي بنيناها في trie-graph.js كما تبدو في ذاكرة JavaScript:
هياكل البيانات في المكتبات القياسية Standard Libraries للغات
في عملك اليومي لن تكتب أغلب هذه الهياكل بنفسك، فكل لغة فيها نسخ مجربة ومحسنة، والمهم أن تعرف ما الذي يوجد خلف كل اسم. والجدول التالي يجمع الأسماء في أربع لغات، مع روابط التوثيق الرسمي لما ذكرنا تفاصيله:
| الهيكل | C# | Java | Python | JavaScript |
|---|---|---|---|---|
| مصفوفة ديناميكية | List<T> | ArrayList | list | Array |
| قائمة مترابطة مزدوجة | LinkedList<T> | LinkedList | لا يوجد نوع عام، و deque تكفي غالباً | لا يوجد نوع جاهز |
| مكدس | Stack<T> | ArrayDeque | list مع append وpop | Array مع push وpop |
| طابور وطابور ذو طرفين | Queue<T> | ArrayDeque | collections.deque | لا يوجد نوع جاهز |
| جدول هاش | Dictionary<TKey,TValue> | HashMap | dict | Map |
| مجموعة | HashSet<T> | HashSet | set | Set |
| شجرة مرتبة | SortedDictionary وSortedSet | TreeMap وTreeSet | لا يوجد في المكتبة القياسية، و bisect على قائمة مرتبة | لا يوجد نوع جاهز |
| كومة وطابور أولوية | PriorityQueue<TElement,TPriority> | PriorityQueue | heapq | لا يوجد نوع جاهز |
وفي الجدول أعلاه لاحظ التالي:
- الكلاس
Stackالقديم في Java ما زال موجوداً، ولكن توثيق ArrayDeque يوصي به بدلاً منه كما ذكرنا، لأنه أسرع. - الكائن العادي
{}في JavaScript يعمل كجدول هاش، ولكنMapمصمم لهذا العمل: يقبل أي نوع مفتاحاً ويحفظ ترتيب الإضافة كما يذكر توثيق MDN، والمواصفة ECMAScript نفسها تشترط أن يكون الوصول فيه أسرع من الخطي في المتوسط، أي جدول هاش أو ما يشبهه، كما في قسم Map في المواصفة. - الكلمة
listفي Python والكلمةListفي C# مصفوفة ديناميكية وليست قائمة مترابطة رغم الاسم، وهذا يحير كثيراً من القادمين من الكتب الأكاديمية. - عندما لا يوجد نوع جاهز في JavaScript تجد مكتبات معروفة على npm، ولكن قبل أن تضيف اعتمادية تذكر أن المصفوفة مع
pushوshiftتكفي للطوابير الصغيرة كما في تجربة BFS.
كيف تختار هيكل البيانات Data Structure المناسب؟
لا تبدأ الاختيار من اسم الهيكل، وإنما من السؤال الذي سيسأله الكود للبيانات أكثر من غيره، والجدول التالي يربط الأسئلة الشائعة بالهيكل المناسب وتكلفته:
| ما الذي تحتاجه أكثر؟ | الهيكل المناسب | التكلفة | مثال من السيرفر |
|---|---|---|---|
| المرور على العناصر بالترتيب والوصول بالموقع | مصفوفة ديناميكية | الوصول O(1)، والإضافة في النهاية Amortized O(1) | نتائج استعلام تعرضها في صفحة |
| هل هذا العنصر موجود؟ | مجموعة Set | O(1) في المتوسط | قائمة العناوين المحظورة |
| القيمة المرتبطة بمفتاح | جدول هاش | O(1) في المتوسط | الجلسات والتخزين المؤقت |
| آخر ما دخل أولاً | مكدس | O(1) | مكدس الاستدعاءات والتراجع |
| أول ما دخل أولاً | طابور أو Deque | O(1) | المهام الخلفية وطلبات الانتظار |
| الأعلى أولوية أولاً | كومة Heap | الإضافة والأخذ O(log n) | جدولة المهام والمؤقتات |
| البحث بالمدى والترتيب | شجرة متوازنة أو B-tree | O(log n) | فهارس قواعد البيانات |
| كل ما يبدأ ببادئة معينة | Trie | بطول البادئة | الإكمال التلقائي وجداول التوجيه |
| العلاقات والطرق بين العناصر | رسم بياني بقائمة جيران | BFS يساوي O(عدد العقد + عدد الروابط) | الشبكات والاعتماديات |
وإذا كان الكود يسأل أكثر من سؤال فلا مانع من هيكلين معاً على نفس البيانات، كما فعلنا في LRU Cache بجدول هاش وقائمة مترابطة، وكما تفعل قاعدة البيانات عندما تحفظ الجدول ومعه عدة فهارس، والثمن ذاكرة إضافية وعمل إضافي عند كل تعديل.
أخطاء شائعة
- البحث في قائمة داخل حلقة: الدالة
containsأوincludesأوinعلى قائمة O(n)، وداخل حلقة على n عنصر تصبح O(n²)، والحل مجموعة Set كما سترى بالأرقام في مقال الخوارزميات. - استخدام القائمة كطابور:
list.pop(0)في Python وRemoveAt(0)في C# تحرك كل العناصر، فاستخدم deque أو Queue. - اختيار القائمة المترابطة من أجل «الإضافة السريعة»: في الواقع تخسر ال Cache والذاكرة، كما رأيت 48 MB مقابل 4 MB، ولا تكسب إلا إذا كنت تحمل مؤشر المكان.
- دالة هاش مكتوبة باليد: تعيد نفس الرقم لمفاتيح كثيرة فيتحول جدول الهاش إلى قائمة، فاترك اللغة تولدها.
- تغيير مفتاح بعد إضافته إلى جدول هاش: إذا تغير الحقل الذي يحسب منه الهاش فإن الجدول يبحث في خانة غير التي وضع فيها، فيختفي العنصر وهو موجود، لذلك اجعل المفاتيح ثابتة Immutable.
- الاستدعاء الذاتي على بيانات يتحكم فيها المستخدم: عمق كبير يكسر مكدس الاستدعاءات، فاستخدم حلقة مع مكدس صريح.
- عدم تحديد السعة عندما تعرف العدد: إذا كنت ستضيف مليون عنصر فأخبر المصفوفة أو القاموس بذلك من البداية لتتجنب النسخ المتكرر.
تدريب عملي Practice
- غير في
ds.csالدالةGetHashCodeفيBadKeyلتعيدId % 10بدل 42، وقس الزمن مرة أخرى، ثم اشرح لماذا أصبح أفضل من الهاش الثابت وأسوأ من الهاش الجيد. - عدل
shortestPathفيtrie-graph.jsلتطبع ترتيب زيارة العقد، وتأكد بنفسك أنها تزور الأقرب أولاً. - أضف إلى شجرة البادئات كلمات عربية مثل «سيرفر» و«سحابة» و«سجل» وجرب البادئة «س»، ولاحظ أن الكود يعمل على الحروف وليس على البايتات.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كل هيكل بيانات طريقة لترتيب العناصر في الذاكرة، فإما متجاورة يحسب مكانها بعملية واحدة، وإما متفرقة تربطها المؤشرات، ولا يوجد هيكل سريع في كل العمليات.
- المصفوفة الديناميكية هي الاختيار الافتراضي: وصول O(1) وإضافة في النهاية Amortized O(1) واستفادة من ال Cache، والقائمة المترابطة لحالات خاصة فقط.
- المكدس آخر ما يدخل أول ما يخرج وعلى فكرته يعمل مكدس الاستدعاءات، والطابور أول ما يدخل أول ما يخرج وعلى فكرته تعمل المهام الخلفية وطوابير الانتظار.
- جدول الهاش والمجموعة يجيبان عن «هل هذا موجود؟» في O(1) بشرط دالة هاش جيدة، والتصادم المتعمد أسقط سيرفرات حقيقية سنة 2011.
- الأشجار تحفظ الترتيب ببحث O(log n) إذا بقيت متوازنة، وال B-tree هي فهرس قاعدة بياناتك، والكومة تعطيك الأعلى أولوية دون ترتيب كل شيء.
- الرسم البياني يصف العلاقات والشبكات، وBFS يجد أقصر طريق بعدد القفزات، وشجرة البادئات تجيب عن أسئلة البادئات في الإكمال التلقائي وجداول التوجيه.
وفي المقال التالي بإذن الله نقيس بالأرقام كيف يكبر زمن الخوارزميات مع البيانات، ونرى لماذا يتحول اختيار الهيكل الخاطئ إلى صفحة بطيئة. وبقية مواضيع المرحلة تجدها في صفحة الخارطة.
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلالذاكرة للمبرمجين: كيف تعمل ال Stack وال Heapلماذا تتغير قائمة لم تطلب تغييرها، وكيف تتسرب الذاكرة في لغة فيها جامع قمامة Garbage Collector، بأمثلة حقيقية من عدة لغات.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Windows 11 بمعالج Intel Core i7-7700K باستخدام .NET SDK 10.0.400 (Runtime 10.0.11) وPython 3.13.3 وNode.js 22.14.0.


