

لنفرض أن مديرك طلب منك فلتراً يوقف الرسائل المزعجة Spam التي تصل إلى بريد الشركة، فجلست وكتبت أول قاعدة: إذا احتوت الرسالة على «free money» فهي مزعجة، ثم أضفت قائمة سوداء للمرسلين، ثم قاعدة لعدد الروابط، وبعد أسبوع وصلت رسالة مكتوب فيها «fr3e m0ney» فمرت من كل قواعدك، فأضفت قاعدة جديدة، ثم جاءت حيلة أخرى، وهكذا حتى أصبح عندك ملف فيه مئات الشروط لا يجرؤ أحد على تعديله. وهذه بالضبط هي المشكلة التي جاء التعلم الآلي Machine Learning ليحلها: بدلاً من أن تكتب القواعد بيدك، تعطي البرنامج آلاف الأمثلة المصنفة، وهو يستنتج القواعد منها بنفسه، ويعيد استنتاجها كلما جاءت أمثلة جديدة.
وقد شرحنا في كيف تعمل نماذج اللغة الكبيرة LLM نوعاً واحداً من النماذج هو الذي يقف خلف ChatGPT، وحكينا في قصة الذكاء الاصطناعي من تورنغ إلى ChatGPT تاريخ المجال وأشخاصه، أما هذا المقال فهو الأساس الذي يقف تحت الاثنين: ما هو التعلم الآلي، وما أنواعه، وكيف تعرف أن النموذج جيد فعلاً وليس حافظاً للإجابات، وما هي الخوارزميات الكلاسيكية التي ما زالت تعمل في أغلب الأنظمة الحقيقية اليوم، ومتى تحتاج الشبكات العصبية والخوارزميات الجينية وأدوات البيانات الضخمة ومتى لا تحتاجها. وكل فكرة معها تجربة حقيقية على مكتبة scikit-learn داخل Docker Container، بمخرجات حقيقية ورسومات ناتجة من التجربة نفسها.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين البرمجة بالقواعد والتعلم من الأمثلة، ومعنى النموذج Model والخصائص Features والتسميات Labels والتدريب Training والاستنتاج Inference.
- أنواع التعلم: الموجه Supervised وغير الموجه Unsupervised والذاتي Self-supervised والمعزز Reinforcement Learning.
- دورة حياة المشروع من جمع البيانات إلى مراقبة النموذج بعد النشر.
- كيف تقيم النموذج: خط الأساس Baseline والدقة Accuracy ولماذا تكذب، وPrecision وRecall ومصفوفة الالتباس Confusion Matrix، وOverfitting، والتحقق المتقاطع Cross-validation، وتسرب البيانات Data Leakage.
- الخوارزميات الكلاسيكية واحدة واحدة مع رسمة لكل منها ومتى تستخدمها.
- الشبكات العصبية Neural Networks في صورة واحدة.
- الخوارزميات الجينية Genetic Algorithms مع برنامج كامل من الصفر.
- البيانات الضخمة Big Data، ومتى لا تحتاج أدواتها أصلاً.
- الأدوات ورخصها، ومنها ML.NET لمطوري C# وTribuo وSmile لمطوري Java، ثم الأخلاقيات والخصوصية والأخطاء الشائعة.
من القواعد المكتوبة باليد Rules إلى التعلم من الأمثلة Examples
البرمجة التقليدية تعمل هكذا: أنت تفهم المشكلة، ثم تكتب القواعد في الكود، ثم يطبقها البرنامج على البيانات فيخرج النتيجة. وهذا ممتاز عندما تكون القاعدة معروفة وثابتة، مثل حساب ضريبة القيمة المضافة أو التحقق من صيغة رقم الهوية، والسبب أن الإجابة الصحيحة واحدة ولن تتغير. ولكن في فلتر الرسائل المزعجة لا توجد قاعدة ثابتة، فالمرسل يغير أسلوبه كل يوم، والكلمة التي تدل على رسالة مزعجة في سياق قد تكون طبيعية في سياق آخر، فتجد نفسك تطارد الحالات واحدة بعد الأخرى، وكل قاعدة جديدة قد تكسر قاعدة قديمة وتوقف رسالة مهمة من عميل.
والتعلم الآلي يقلب الترتيب: أنت تعطي البرنامج البيانات ومعها الإجابات الصحيحة، وهو يخرج القواعد. وهذه القواعد لا تكون مكتوبة كشروط if، وإنما كأرقام داخل ما يسمى النموذج، ثم تستخدم النموذج على رسائل جديدة لم يرها من قبل. وقد كانت الرسائل المزعجة من أوائل الأماكن التي نجحت فيها هذه الفكرة عملياً، فقد نشر Paul Graham في أغسطس 2002 مقالته A Plan for Spam التي شرح فيها كيف تفوق فلتر إحصائي يتعلم من رسائل صندوقك على كل القواعد التي كتبها بيده. الصورة التالية تبين الفرق بين الطريقتين:
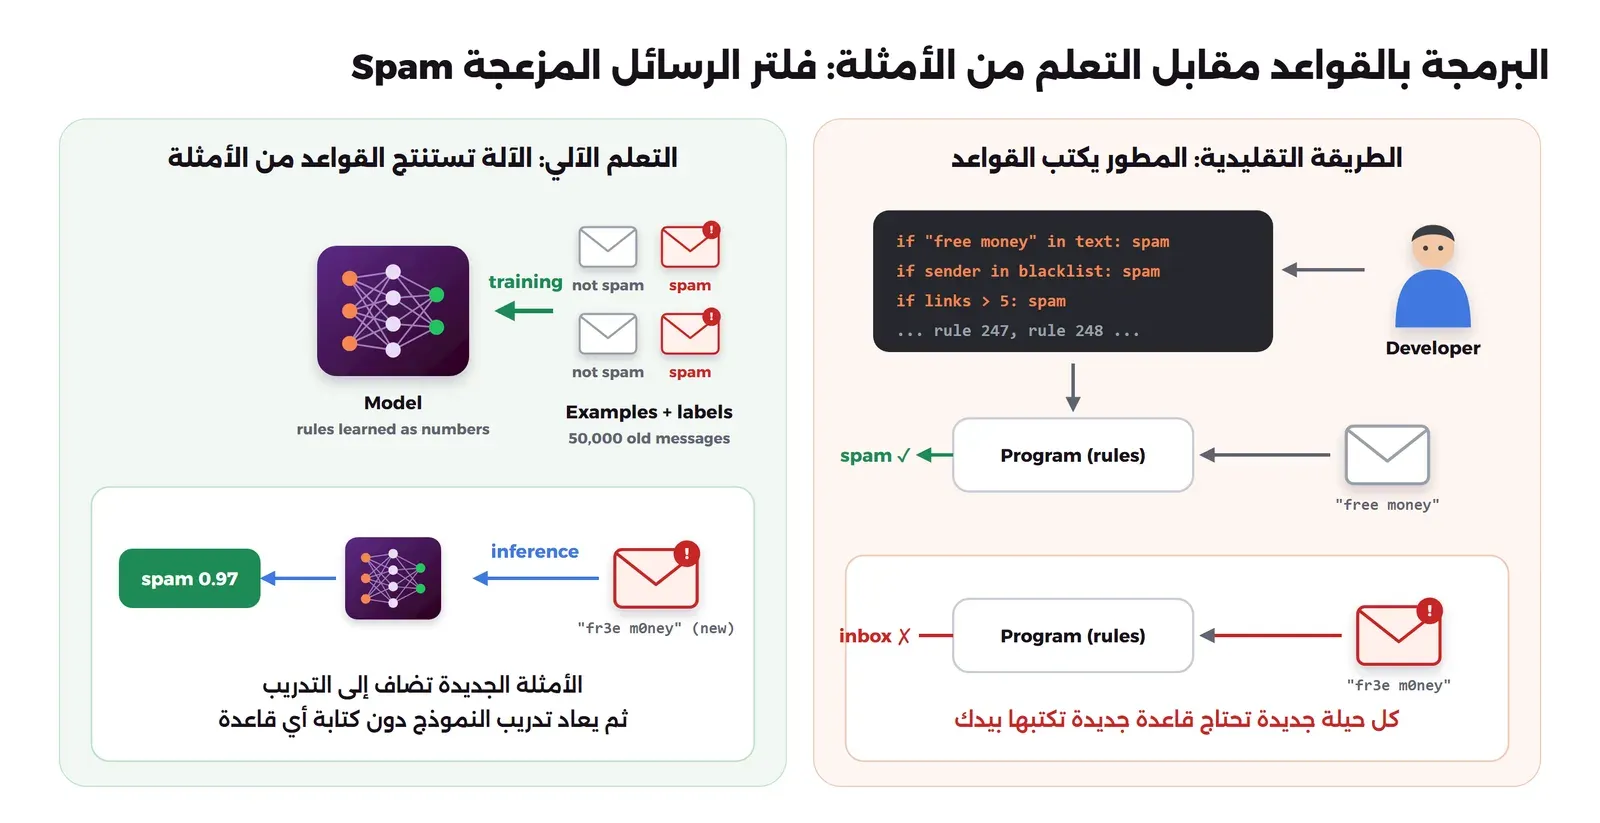
وقبل أن نكمل نحتاج خمسة مصطلحات سوف تتكرر في كل المقال، وكلها ظاهرة في الصورة:
- الخصائص Features: الأرقام التي تصف كل مثال، مثل عدد الروابط في الرسالة ونسبة الحروف الكبيرة وهل تحتوي كلمة free، وتسمى في الكود عادة
X، وكل صف فيها مثال وكل عمود خاصية. - التسمية Label: الإجابة الصحيحة لكل مثال، مثل spam أو not spam، وتسمى في الكود
y، وتسمى أحياناً الهدف Target. - النموذج Model: الدالة التي تأخذ الخصائص وتخرج التوقع، وبداخلها أرقام تسمى المعاملات Parameters يتم ضبطها أثناء التدريب.
- التدريب Training: عملية ضبط هذه المعاملات بحيث تقترب توقعات النموذج من التسميات الصحيحة في الأمثلة، وفي scikit-learn هو السطر
model.fit(X_train, y_train). - الاستنتاج Inference: استخدام النموذج بعد التدريب على أمثلة جديدة، وهو السطر
model.predict(X_new)، وهذا ما يحدث في الإنتاج Production آلاف المرات في الثانية أحياناً.
وقد يتساءل البعض: هل يعني هذا أن التعلم الآلي أفضل من الكود العادي دائماً؟ والإجابة لا، فإذا كانت القاعدة معروفة وثابتة فالكود العادي أدق وأرخص وأسهل في الفهم والتصحيح، والتعلم الآلي يستحق تكلفته فقط عندما تكون القاعدة غير معروفة أو كثيرة التغير أو أعقد من أن يكتبها إنسان، وعندما تتوفر أمثلة كافية للتعلم منها. وقد فصلنا متى تختار الكود ومتى تختار النموذج التقليدي ومتى تختار نموذج اللغة في جدول القرار في مقال لماذا تفوقت نماذج اللغة.
أنواع التعلم Types of Learning: من أين تأتي الإجابة الصحيحة؟
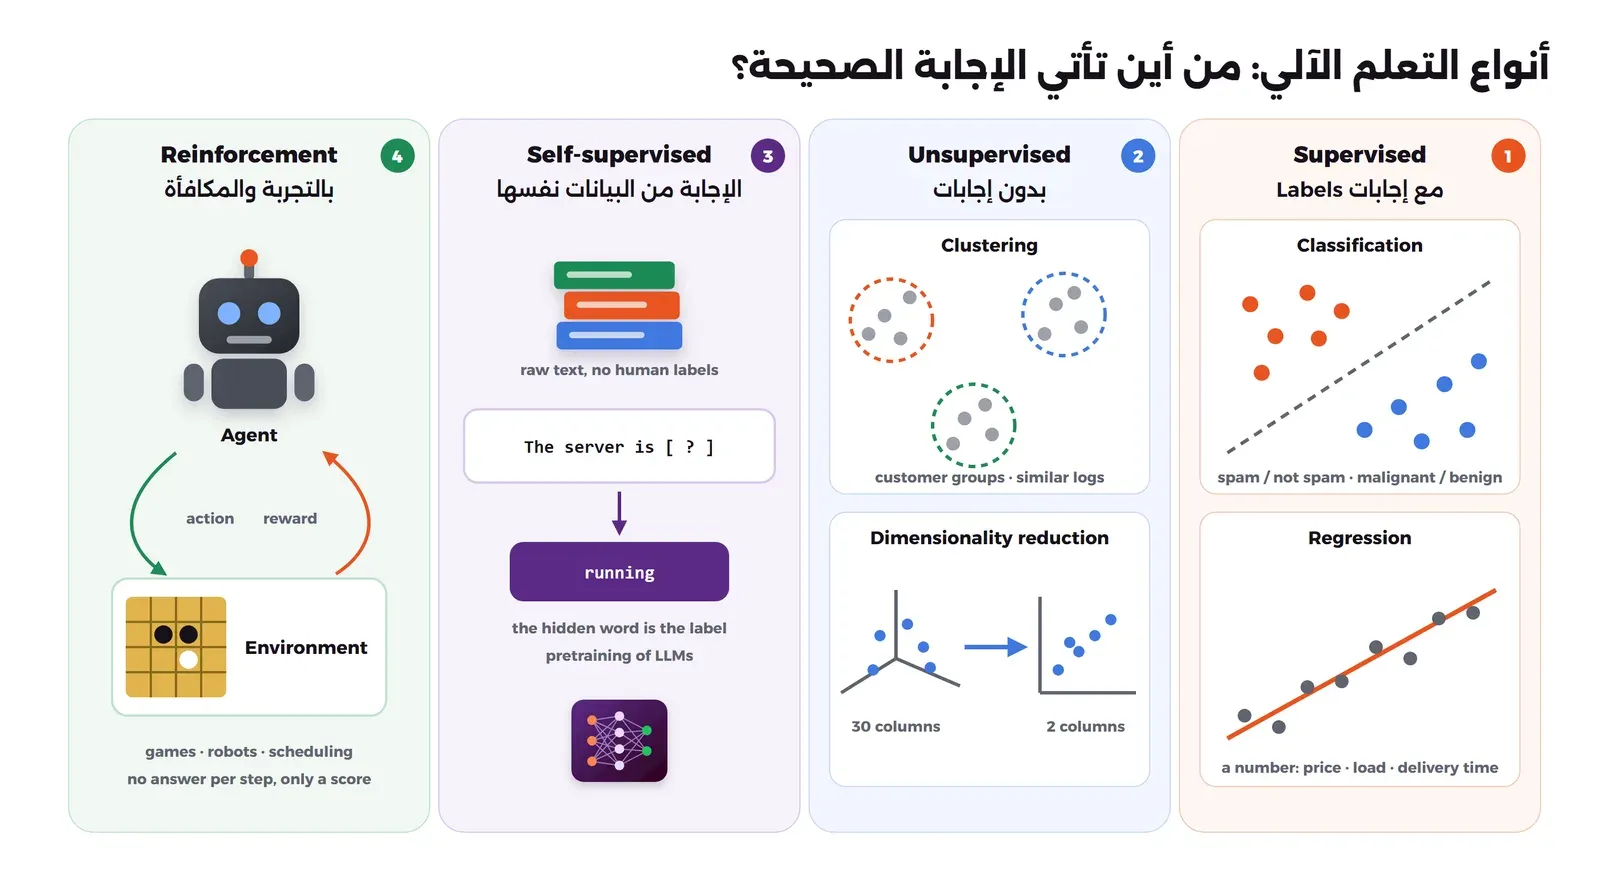
الطريقة الأسهل لفهم أنواع التعلم الآلي أن تسأل سؤالاً واحداً: أثناء التدريب، من أين يعرف النموذج أنه أخطأ؟ والإجابة تقسم المجال إلى أربع عائلات كما في الصورة التالية:
التعلم الموجه Supervised Learning: التصنيف Classification والانحدار Regression
في التعلم الموجه كل مثال في بيانات التدريب معه إجابته الصحيحة، كرسالة معها كلمة spam، أو صورة أشعة معها تشخيص الطبيب، أو شقة معها سعر بيعها الفعلي، فيقارن النموذج توقعه بالإجابة ويعدل نفسه. وهو أكثر الأنواع استخداماً في الأنظمة الحقيقية، وينقسم إلى نوعين بحسب شكل الإجابة:
- التصنيف Classification: الإجابة فئة من فئات محددة، مثل spam أو not spam، وورم خبيث أو حميد، وعملية احتيال أو عادية، وإذا كانت الفئات اثنتين فقط سمي التصنيف الثنائي Binary Classification.
- الانحدار Regression: الإجابة رقم متصل، مثل سعر الشقة أو حمل السيرفر بعد ساعة أو مدة توصيل الطلب، والاسم قديم من الإحصاء ولا علاقة له بمعنى «التراجع» في العربية.
والمشكلة الكبيرة في هذا النوع أن الإجابات تكلف، فلا بد أن يجلس أحد ويصنف آلاف الرسائل أو الصور بيده، وأحياناً يجب أن يكون هذا الشخص طبيباً أو محامياً، لذلك فالبيانات المصنفة Labeled Data هي غالباً أغلى جزء في المشروع.
التعلم غير الموجه Unsupervised Learning: التجميع Clustering وتقليل الأبعاد Dimensionality Reduction
هنا لا توجد إجابات أبداً، فقط بيانات، والمطلوب أن يكتشف النموذج البنية الموجودة فيها بنفسه، وأشهر مهمتين:
- التجميع Clustering: تقسيم البيانات إلى مجموعات متشابهة، مثل تقسيم العملاء بحسب سلوك الشراء دون أن تخبره مسبقاً ما هي المجموعات، أو تجميع رسائل الأخطاء المتشابهة في السجلات Logs.
- تقليل الأبعاد Dimensionality Reduction: تحويل بيانات فيها عشرات أو مئات الأعمدة إلى عدد قليل من الأعمدة يحفظ أغلب المعلومات، إما لرسمها على الشاشة في بعدين، أو لتسريع نموذج آخر بعدها.
والصعوبة هنا أنه لا توجد إجابة صحيحة تقارن بها، فإذا قسم النموذج عملاءك إلى أربع مجموعات فلا يوجد رقم واحد يخبرك أن هذا التقسيم صحيح، وإنما تحكم عليه بمعرفتك بالمجال وبمدى فائدته، وسوف نرى ذلك في تجربة k-means.
التعلم الذاتي Self-supervised Learning: البيانات تصنع إجاباتها
وهذا النوع بين الاثنين، فالبيانات لا تحتاج أحداً يصنفها، ولكن النموذج يتدرب كأنه في تعلم موجه، والسبب أن الإجابة مأخوذة من البيانات نفسها: تخفي كلمة من الجملة وتطلب من النموذج توقعها، والإجابة الصحيحة هي الكلمة التي أخفيتها. وهذه هي الطريقة التي تدربت بها نماذج اللغة الكبيرة على ترليونات الكلمات دون أن يصنفها أحد، وقد شرحناها في قسم التدريب المسبق Pretraining، وشرحنا لماذا غيرت هذه الفكرة المجال كله في مقال لماذا تفوقت نماذج اللغة. وقريب منه التعلم شبه الموجه Semi-supervised Learning، حيث يكون عندك قليل من البيانات المصنفة وكثير من غير المصنفة، فتستفيد من الاثنين معاً.
التعلم المعزز Reinforcement Learning: الوكيل Agent والمكافأة Reward
في التعلم المعزز لا توجد إجابة صحيحة لكل خطوة، وإنما وكيل Agent يتخذ قرارات داخل بيئة Environment، وبعد كل قرار أو بعد سلسلة قرارات يحصل على مكافأة Reward أو عقوبة، ومع آلاف المحاولات يتعلم أي القرارات تقود إلى مكافأة أكبر على المدى الطويل. وهو مناسب للألعاب والروبوتات والتحكم، وأشهر قصة فيه برنامج AlphaGo الذي هزم بطل العالم في لعبة Go، وقد حكيناها في قصة الذكاء الاصطناعي، كما يستخدم في المرحلة الأخيرة من تدريب المساعدات الذكية عبر RLHF. ولكنه أصعب الأنواع في التطبيق، لأنه يحتاج بيئة يستطيع الوكيل أن يخطئ فيها آلاف المرات دون ضرر، ولهذا السبب ستجد أغلب المشاريع في الشركات من النوع الموجه.
تجهيز بيئة التجربة Lab Setup
سوف نشغل كل التجارب داخل Container فيه Python 3.12 ومكتبة scikit-learn، وهي المكتبة الأشهر للتعلم الآلي الكلاسيكي ورخصتها BSD-3-Clause، ومعها pandas للجداول وMatplotlib للرسومات. ولن نحمل أي بيانات من الإنترنت، لأن scikit-learn تأتي معها مجموعات بيانات صغيرة مدمجة، وأهمها لنا ثلاث:
- بيانات سرطان الثدي Breast Cancer Wisconsin (Diagnostic) من مستودع UCI: 569 عينة، لكل عينة 30 قياساً رقمياً لأنوية الخلايا في صورة مجهرية، والإجابة ورم خبيث malignant أو حميد benign، ورخصتها CC BY 4.0، وسوف تكون مثالنا الرئيسي.
- بيانات النبيذ Wine من UCI: 178 عينة من ثلاثة أصناف عنب، لكل عينة 13 قياساً كيميائياً، ورخصتها CC BY 4.0، وسوف نستخدمها للتجميع وتقليل الأبعاد.
- بيانات السكري Diabetes: 442 مريضاً و10 قياسات، والمطلوب رقم يقيس تقدم المرض بعد سنة، وهي من ورقة Efron وزملائه عن Least Angle Regression سنة 2004 كما في توثيق المكتبة، وسوف نستخدمها للانحدار.
وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu، والآن نجهز المجلد وال Container:
mkdir ml-lab && cd ml-lab && mkdir out mlnet
docker run -d --name lab-ml-py -v "$PWD":/lab -w /lab python:3.12-slim sleep infinity
docker exec lab-ml-py pip install -q scikit-learn matplotlib pandas
docker exec lab-ml-py python -c "import sklearn,numpy,pandas,matplotlib,sys;print(sys.version.split()[0],sklearn.__version__,numpy.__version__,pandas.__version__,matplotlib.__version__)"
والمخرج سوف يكون كما يلي:
3.12.15 1.9.1 2.5.3 3.0.6 3.11.2في الإعداد أعلاه لاحظ التالي:
- ال Container لا ينشر أي منفذ، لأننا لا نحتاج واجهة ويب، وكل برنامج نكتبه في المجلد
ml-labنشغله بالأمرdocker exec lab-ml-py python file.py. - المجلد
outللرسومات التي تحفظها البرامج، والمجلدmlnetلتجربة ML.NET في آخر المقال. - الأرقام هي إصدارات Python وscikit-learn وNumPy وpandas وMatplotlib التي ظهرت عندنا، وإذا ظهرت لك إصدارات أحدث فقد تختلف بعض الأرقام في المخرجات قليلاً.
ولنلق نظرة أولى على البيانات، احفظ البرنامج التالي في الملف data.py:
from sklearn.datasets import load_breast_cancer
data = load_breast_cancer(as_frame=True)
df = data.frame
print("rows, columns:", df.shape)
print("classes:", dict(zip(map(str, data.target_names),[int((df.target == i).sum()) for i in range(2)])))
print()
print(df[["mean radius", "mean texture", "mean area", "worst concavity", "target"]].head(5).to_string())
docker exec lab-ml-py python data.pyوالمخرج سوف يكون كما يلي:
rows, columns: (569, 31)
classes: {'malignant': 212, 'benign': 357}

   mean radius  mean texture  mean area  worst concavity  target
0        17.99         10.38     1001.0           0.7119       0
1        20.57         17.77     1326.0           0.2416       0
2        19.69         21.25     1203.0           0.4504       0
3        11.42         20.38      386.1           0.6869       0
4        20.29         14.34     1297.0           0.4000       0
كل صف هنا عينة، وكل عمود خاصية Feature، والعمود الأخير target هو التسمية Label، حيث 0 تعني ورماً خبيثاً و1 تعني حميداً، ولاحظ أن الفئتين غير متساويتين: 212 خبيثاً مقابل 357 حميداً، وهذا التفصيل سوف يهمنا كثيراً بعد قليل.
دورة حياة مشروع التعلم الآلي Machine Learning Workflow
أغلب الدروس تبدأ من سطر model.fit وتنتهي عند رقم الدقة، ولكن في المشاريع الحقيقية هذا السطر أصغر جزء من العمل، والجزء الأكبر قبله وبعده. الصورة التالية تبين المراحل الثمانية، ولاحظ أنها دائرة وليست خطاً:
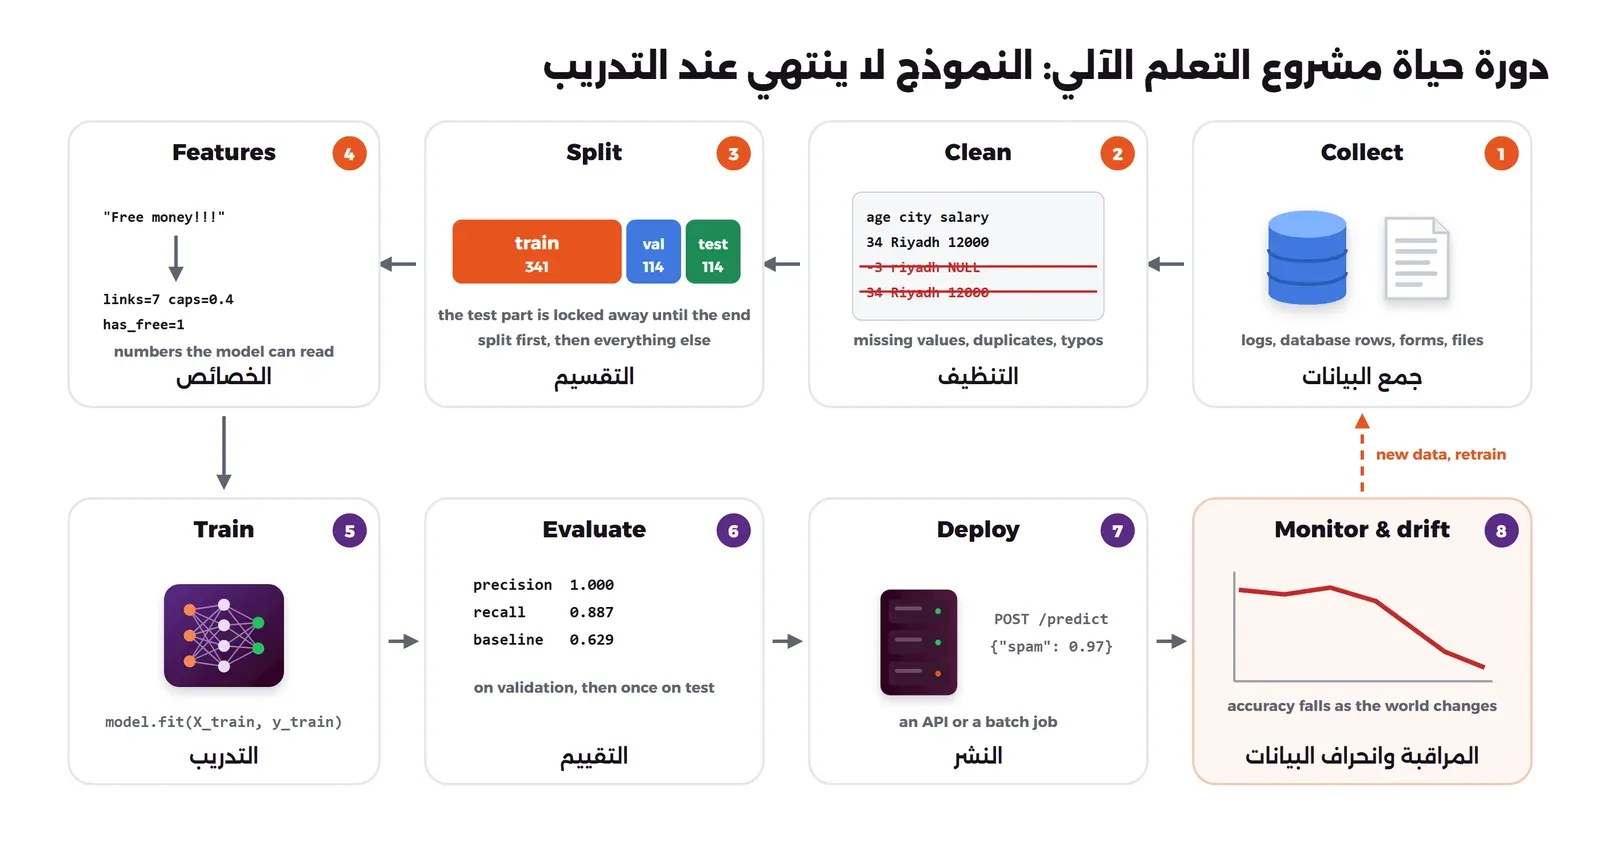
- جمع البيانات Data Collection: من قاعدة بيانات التطبيق أو السجلات أو النماذج التي يملؤها المستخدمون، والسؤال الأول هنا هل البيانات تمثل الواقع الذي سوف يعمل فيه النموذج، فنموذج تدرب على رسائل 2015 قد لا يعرف حيل 2026.
- التنظيف Data Cleaning: حذف المكرر، والتعامل مع القيم الناقصة، وتصحيح القيم المستحيلة مثل عمر سالب، وتوحيد الكتابة مثل «Riyadh» و«riyadh»، وهذه المرحلة تأخذ غالباً وقتاً أكثر من التدريب نفسه.
- التقسيم Split: تقسم البيانات إلى جزء للتدريب Training Set وجزء للتحقق Validation Set تختار به الإعدادات، وجزء للاختبار Test Set تقفله في الدرج ولا تنظر إليه إلا مرة واحدة في النهاية، والسبب أن الاختبار على بيانات رآها النموذج يشبه امتحاناً تعرف أسئلته مسبقاً.
- هندسة الخصائص Feature Engineering: تحويل البيانات الخام إلى أرقام يفهمها النموذج، مثل تحويل نص الرسالة إلى عدد الروابط ووجود كلمات معينة، أو تحويل التاريخ إلى يوم الأسبوع والساعة.
- التدريب Training: اختيار الخوارزمية وتشغيل
fit. - التقييم Evaluation: قياس الأداء على جزء التحقق بالمقياس المناسب للمشكلة، ثم على جزء الاختبار مرة واحدة.
- النشر Deployment: وضع النموذج خلف واجهة برمجية API أو في مهمة دورية Batch Job تعالج البيانات كل ليلة.
- المراقبة Monitoring: تتبع جودة التوقعات بعد النشر، والسبب أن العالم يتغير، فالمرسلون يغيرون أسلوبهم، والعملاء يغيرون سلوكهم، فتنخفض دقة النموذج تدريجياً دون أن يتغير سطر واحد في الكود، وهذا يسمى انحراف البيانات Data Drift، وعلاجه جمع بيانات جديدة وإعادة التدريب، فتعود إلى الخطوة الأولى.
تقييم النموذج Model Evaluation: كيف تعرف أنه جيد فعلاً؟
هذا أهم قسم في المقال، لأن تدريب نموذج أصبح سطراً واحداً، ولكن معرفة هل هذا النموذج يصلح للاستخدام هي المهارة الحقيقية، وأغلب الأخطاء المكلفة في المشاريع تأتي من تقييم خاطئ وليس من خوارزمية خاطئة.
ابدأ دائماً بخط الأساس Baseline
قبل أن تدرب أي نموذج، اسأل: ما هي النتيجة التي أحصل عليها دون أي ذكاء؟ في بياناتنا 357 من 569 عينة حميدة، أي قرابة 63%، فلو كتبت برنامجاً يقول «حميد» لكل عينة دون أن ينظر إليها لحصل على دقة 63% تقريباً. وهذا البرنامج الغبي هو خط الأساس Baseline، وأي نموذج لا يتفوق عليه بوضوح لم يتعلم شيئاً، وفي scikit-learn يوجد كلاس جاهز اسمه DummyClassifier يقوم بهذا بالضبط.
التدريب Training والاختبار Testing: شجرة تحفظ وغابة تفهم
الآن نقسم البيانات إلى 75% للتدريب و25% للاختبار، وندرب أربعة نماذج: خط الأساس، وشجرة قرار Decision Tree بلا حدود، وشجرة عمقها ثلاثة أسئلة فقط، وغابة عشوائية Random Forest فيها 300 شجرة، وسوف نشرح الشجرة والغابة بالتفصيل في قسم الخوارزميات، والمهم الآن أن نقارن الدقة على بيانات التدريب بالدقة على بيانات الاختبار. احفظ البرنامج التالي في الملف split.py:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42)
print("train:", X_train.shape, " test:", X_test.shape)

models = {
    "baseline (most frequent)": DummyClassifier(strategy="most_frequent"),
    "decision tree (no limit)": DecisionTreeClassifier(random_state=42),
    "decision tree (depth 3)": DecisionTreeClassifier(max_depth=3, random_state=42),
    "random forest (300 trees)": RandomForestClassifier(n_estimators=300, random_state=42),
}
print(f"{'model':<28}{'train acc':>10}{'test acc':>10}")
for name, m in models.items():
    m.fit(X_train, y_train)
    tr = accuracy_score(y_train, m.predict(X_train))
    te = accuracy_score(y_test, m.predict(X_test))
    print(f"{name:<28}{tr:>10.3f}{te:>10.3f}")
print("tree leaves (no limit):", models["decision tree (no limit)"].get_n_leaves())
docker exec lab-ml-py python split.pyوالمخرج سوف يكون كما يلي:
train: (426, 30)  test: (143, 30)
model                        train acc  test acc
baseline (most frequent)         0.627     0.629
decision tree (no limit)         1.000     0.923
decision tree (depth 3)          0.977     0.944
random forest (300 trees)        1.000     0.958
tree leaves (no limit): 18
في المخرج أعلاه لاحظ التالي:
- الخيار
stratify=yيجعل نسبة الخبيث والحميد في جزء الاختبار مثل نسبتها في البيانات كلها، والخيارrandom_state=42يجعل التقسيم نفسه في كل تشغيل، فتحصل على نفس الأرقام التي عندنا. - خط الأساس 0.629 على الاختبار، فأي نموذج أقل من ذلك أسوأ من التخمين.
- الشجرة بلا حدود حصلت على 1.000 في التدريب، أي أنها لم تخطئ في أي عينة رأتها، ثم نزلت إلى 0.923 على عينات جديدة، والسبب أنها استمرت في التفرع حتى أصبح لكل مجموعة صغيرة من العينات ورقة خاصة بها، فحفظت بيانات التدريب بما فيها من ضجيج Noise بدلاً من أن تفهم النمط العام.
- الشجرة المحدودة بثلاثة مستويات أخطأت قليلاً في التدريب (0.977) ولكنها أفضل على الجديد (0.944)، والغابة العشوائية هي الأفضل على الاختبار (0.958).
والفرق الكبير بين دقة التدريب ودقة الاختبار هو أول علامة على المشكلة التالية.
الحفظ مقابل الفهم: Overfitting وUnderfitting
الإفراط في التعلم Overfitting يعني أن النموذج حفظ بيانات التدريب بتفاصيلها وضجيجها، فأصبح ممتازاً عليها وضعيفاً على أي شيء جديد، مثل طالب حفظ إجابات امتحانات السنوات الماضية حرفاً حرفاً فرسب عندما تغيرت صياغة السؤال. والعكس هو قصور التعلم Underfitting، حيث يكون النموذج أبسط من أن يرى النمط أصلاً، فيخطئ في التدريب والاختبار معاً، مثل طالب لم يذاكر. الصورة التالية تبين الحالات الثلاث على نفس النقاط، ثم كيف يتغير الخطأ مع زيادة تعقيد النموذج:
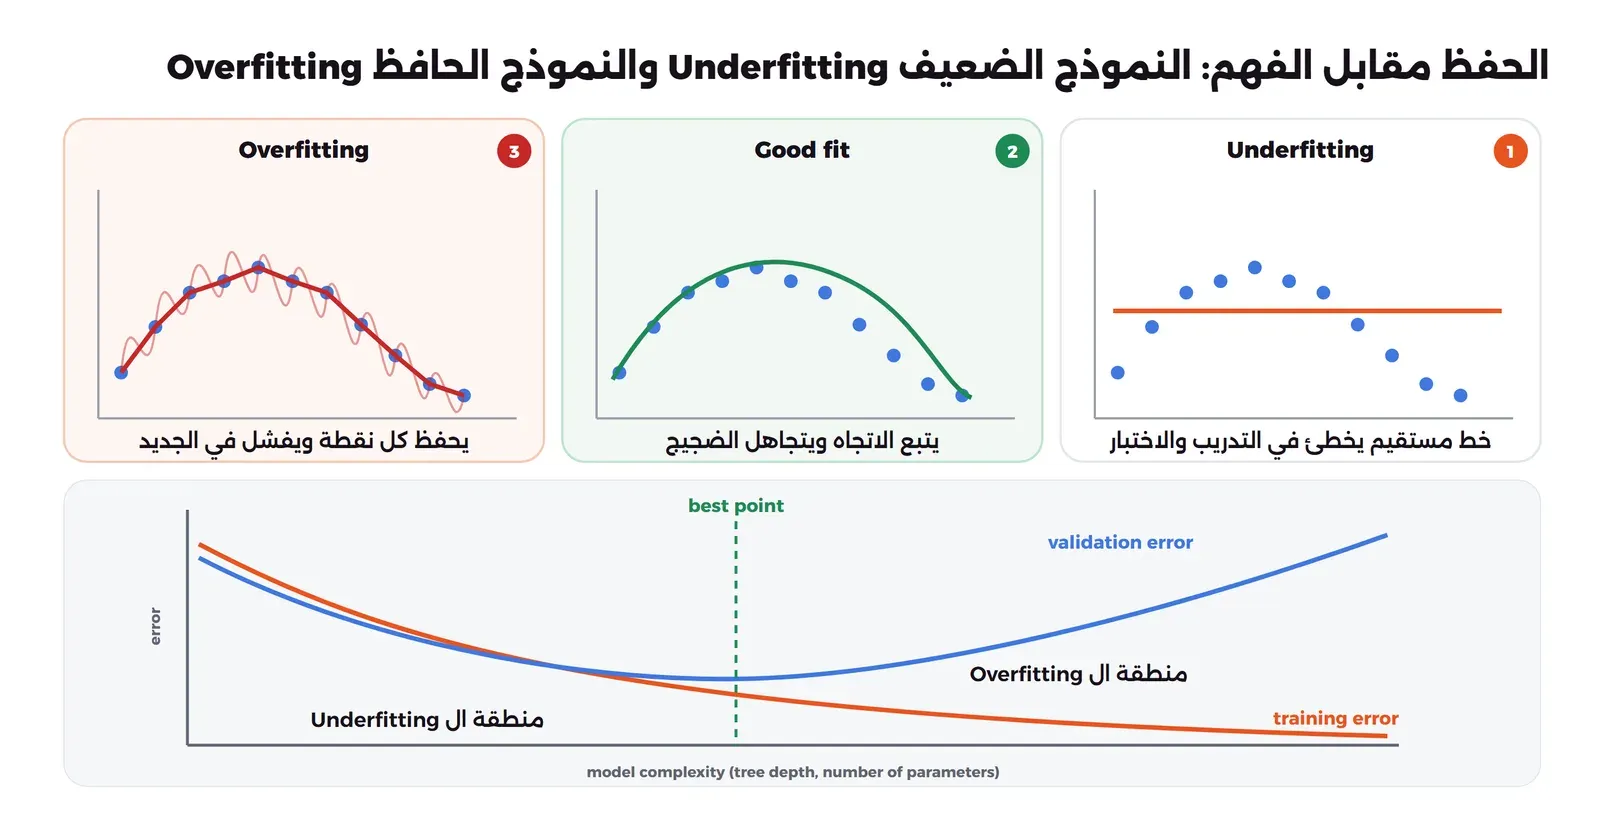
وفي كلمات بسيطة، هذا ما يسمى في الكتب الانحياز Bias والتباين Variance: الانحياز هو خطأ النموذج البسيط الذي يفترض شكلاً أبسط من الواقع، فهو يخطئ بنفس الطريقة دائماً، والتباين هو حساسية النموذج المعقد لبيانات التدريب بالذات، فلو دربته على عينة أخرى من نفس المصدر لخرج نموذجاً مختلفاً تماماً. وكلما زدت التعقيد قل الانحياز وزاد التباين، والمطلوب نقطة التوازن بينهما.
ولنر ذلك بأرقام حقيقية، فالبرنامج التالي يقسم البيانات إلى ثلاثة أجزاء، ويدرب شجرة بعمق من 1 إلى 12، ويختار أفضل عمق على جزء التحقق، ثم يختبر الاختيار مرة واحدة على جزء الاختبار. احفظه في الملف curve.py:
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = load_breast_cancer(return_X_y=True)
X_tmp, X_test, y_tmp, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=0)
X_train, X_val, y_train, y_val = train_test_split(X_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=0)
print("train/validation/test:", len(y_train), len(y_val), len(y_test))
depths = range(1, 13)
tr, va = [], []
for d in depths:
    m = DecisionTreeClassifier(max_depth=d, random_state=0).fit(X_train, y_train)
    tr.append(m.score(X_train, y_train)); va.append(m.score(X_val, y_val))
    print(f"depth {d:>2}: train {tr[-1]:.3f}  validation {va[-1]:.3f}")
best = max(depths, key=lambda d: va[d - 1])
final = DecisionTreeClassifier(max_depth=best, random_state=0).fit(X_tmp, y_tmp)
print(f"best depth on validation: {best}  ->  test accuracy {final.score(X_test, y_test):.3f}")
plt.figure(figsize=(8, 4.5), dpi=120)
plt.plot(depths, tr, "o-", label="train accuracy", color="#E95420")
plt.plot(depths, va, "s-", label="validation accuracy", color="#3F78E0")
plt.axvline(best, ls="--", color="#5F6470"); plt.xlabel("tree max_depth"); plt.ylabel("accuracy")
plt.title("Decision tree on breast cancer data: train vs validation"); plt.legend(); plt.grid(alpha=.3)
plt.tight_layout(); plt.savefig("out/curve.png")
docker exec lab-ml-py python curve.pyوالمخرج سوف يكون كما يلي:
train/validation/test: 341 114 114
depth  1: train 0.927  validation 0.904
depth  2: train 0.962  validation 0.939
depth  3: train 0.982  validation 0.930
depth  4: train 0.994  validation 0.947
depth  5: train 0.997  validation 0.965
depth  6: train 1.000  validation 0.912
depth  7: train 1.000  validation 0.912
depth  8: train 1.000  validation 0.912
depth  9: train 1.000  validation 0.912
depth 10: train 1.000  validation 0.912
depth 11: train 1.000  validation 0.912
depth 12: train 1.000  validation 0.912
best depth on validation: 5  ->  test accuracy 0.947
والرسم الذي حفظه البرنامج في out/curve.png كما يلي:
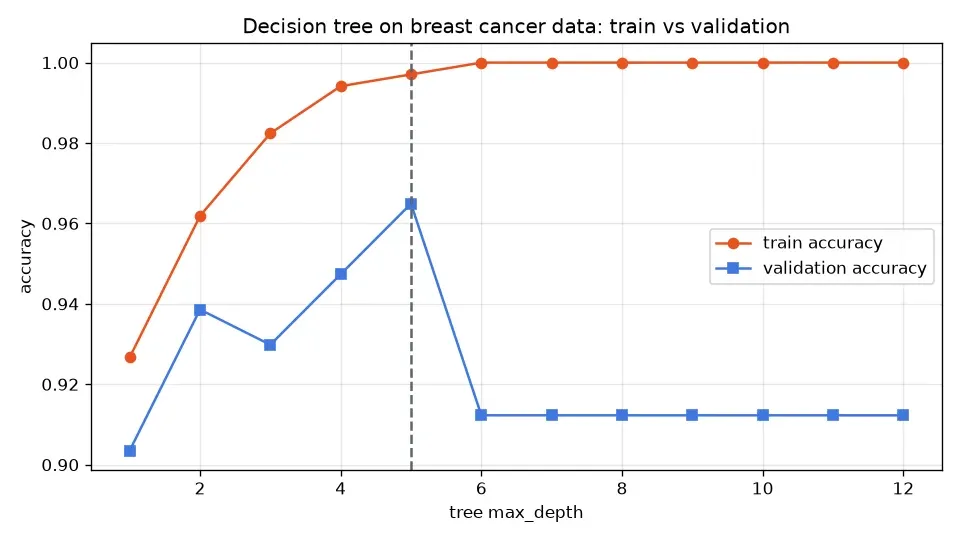
في المخرج أعلاه لاحظ التالي:
- من العمق 6 وما بعده أصبحت دقة التدريب 1.000، أي أن الشجرة حفظت كل العينات، وفي نفس اللحظة سقطت دقة التحقق من 0.965 إلى 0.912 وبقيت هناك، وهذا هو ال Overfitting بالأرقام.
- العمق 1 (سؤال واحد فقط) أعطى 0.904 على التحقق، وهذا هو ال Underfitting، فالسؤال الواحد لا يكفي لوصف البيانات.
- اخترنا العمق 5 بناءً على جزء التحقق وحده، ثم اختبرناه مرة واحدة على جزء الاختبار فحصل على 0.947، وهذا الرقم الأخير هو الذي تكتبه في تقريرك، وليس 0.965، والسبب أن 0.965 هو الأفضل من بين 12 محاولة على نفس البيانات، ففيه شيء من الحظ.
- بيانات التحقق هنا 114 عينة فقط، لذلك فالقفزة بين 0.930 و0.947 تعني عينتين، وهذا سبب أن الأرقام تتذبذب، والحل في القسم التالي بعد قليل.
مصفوفة الالتباس Confusion Matrix وPrecision وRecall
الدقة Accuracy هي نسبة الإجابات الصحيحة من الكل، وهي رقم مريح ولكنه يخفي نوع الخطأ، فالنموذج الذي يخطئ في 6 عينات قد يخطئ بقول «خبيث» لست عينات حميدة، أو بقول «حميد» لست عينات خبيثة، والفرق بين الحالتين عند المريض كبير جداً. لذلك نفصل الأخطاء في جدول اسمه مصفوفة الالتباس Confusion Matrix، ونجعل الورم الخبيث هو الفئة الإيجابية Positive لأنه الفئة التي نبحث عنها. احفظ البرنامج التالي في الملف metrics.py:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix, classification_report

data = load_breast_cancer()
X, y = data.data, (data.target == 0).astype(int)   # 1 = malignant, the class we look for
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42)
model = RandomForestClassifier(n_estimators=300, random_state=42).fit(X_train, y_train)
pred = model.predict(X_test)
tn, fp, fn, tp = confusion_matrix(y_test, pred).ravel()
print(f"TN={tn}  FP={fp}  FN={fn}  TP={tp}")
print(classification_report(y_test, pred, target_names=["benign", "malignant"], digits=3))
docker exec lab-ml-py python metrics.pyوالمخرج سوف يكون كما يلي:
TN=90  FP=0  FN=6  TP=47
              precision    recall  f1-score   support

      benign      0.938     1.000     0.968        90
   malignant      1.000     0.887     0.940        53

    accuracy                          0.958       143
   macro avg      0.969     0.943     0.954       143
weighted avg      0.961     0.958     0.957       143
والصورة التالية تبين كيف تخرج كل المقاييس من الخانات الأربع في هذا المخرج:
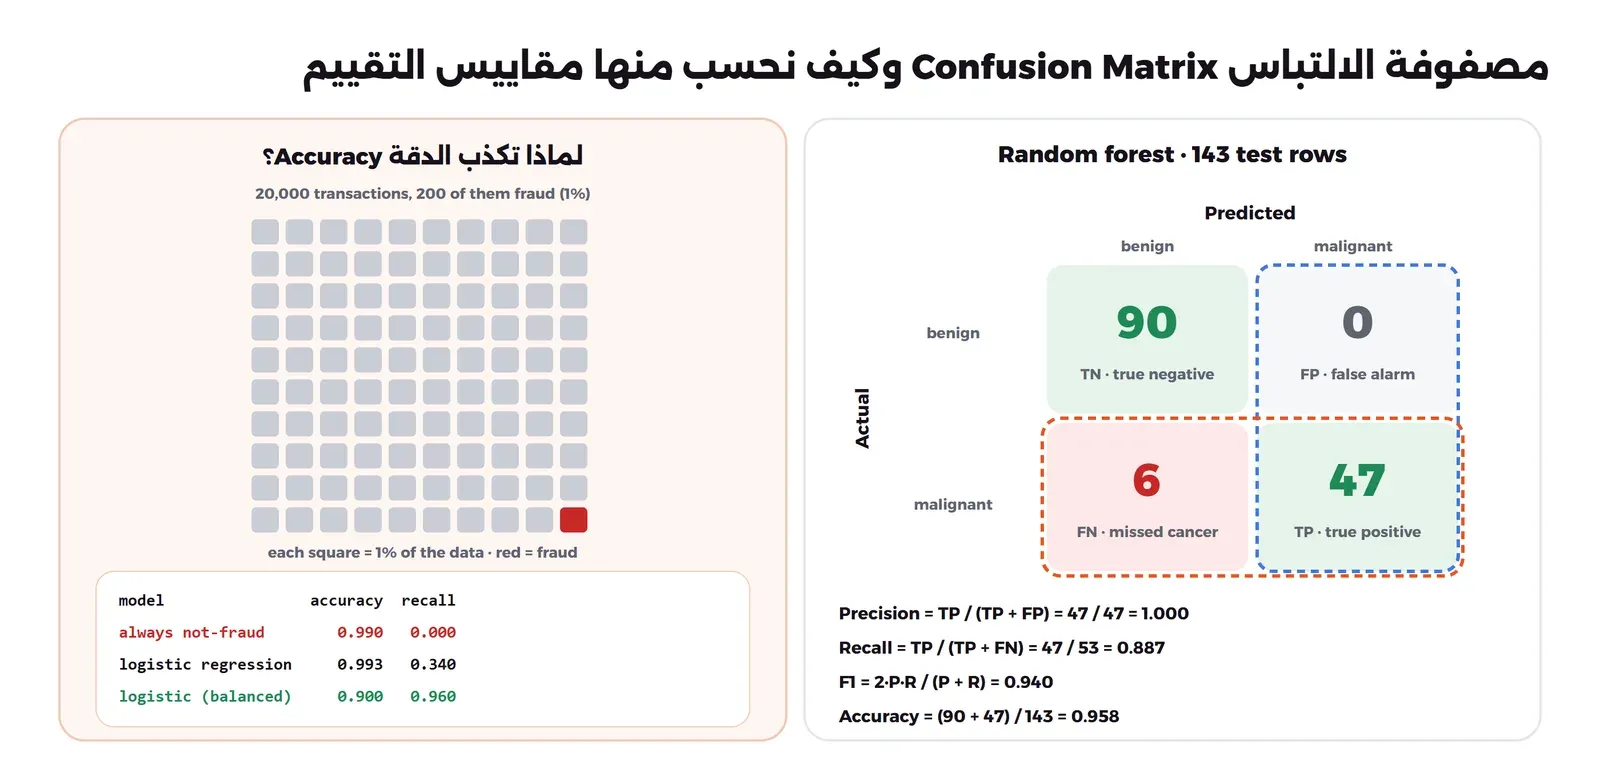
- الإيجابي الصحيح True Positive واختصاراً TP: خبيث وقال عنه النموذج خبيث، وهنا 47.
- السلبي الصحيح True Negative واختصاراً TN: حميد وقال عنه حميد، وهنا 90.
- الإنذار الكاذب False Positive واختصاراً FP: حميد وقال عنه خبيث، وهنا 0.
- الإيجابي الفائت False Negative واختصاراً FN: خبيث وقال عنه حميد، وهنا 6، وهذه أخطر خانة في هذه المشكلة.
ومن هذه الخانات نحسب مقياسين يجيبان على سؤالين مختلفين:
- الضبط Precision يساوي TP ÷ (TP + FP)، ويجيب على السؤال: عندما يقول النموذج «خبيث»، كم مرة يكون محقاً؟ وهنا 1.000، أي أنه لم يطلق إنذاراً كاذباً واحداً.
- الاستدعاء Recall يساوي TP ÷ (TP + FN)، ويجيب على السؤال: من كل الحالات الخبيثة الموجودة فعلاً، كم حالة اكتشف النموذج؟ وهنا 0.887، أي أنه فوت 6 من 53.
- مقياس F1 Score هو المتوسط التوافقي Harmonic Mean للاثنين، ويكون مرتفعاً فقط إذا ارتفع الاثنان معاً، وهنا 0.940.
وقد يتساءل البعض: أيهما أهم؟ والإجابة أن هذا قرار من المجال وليس من البرمجة، ففي فحص السرطان أو كشف الاحتيال فوات حالة حقيقية أغلى بكثير من إنذار كاذب يراجعه إنسان، لذلك تهتم بال Recall، أما في فلتر الرسائل المزعجة فإيقاف رسالة عميل مهمة أسوأ من مرور رسالة مزعجة، لذلك تهتم بال Precision. ومعظم النماذج تخرج احتمالاً وليس قراراً، فتستطيع أن تحرك عتبة القرار Threshold فوق 0.5 أو تحتها لترفع أحد المقياسين على حساب الآخر.
لماذا تكذب الدقة Accuracy على البيانات غير المتوازنة Imbalanced Data؟
لنأخذ مثالاً أصعب: عمليات بطاقات بنكية فيها 1% فقط احتيال، وهي نسبة واقعية في هذا النوع من المشاكل حيث الحالة التي تبحث عنها نادرة. البرنامج التالي يصنع 20 ألف عملية اصطناعية بهذه النسبة عبر make_classification، ثم يقارن ثلاثة نماذج. احفظه في الملف imbalance.py:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score

# 20,000 synthetic "transactions", about 1% of them fraud
X, y = make_classification(n_samples=20000, n_features=10, n_informative=4,
                           weights=[0.99], flip_y=0, random_state=7)
print("fraud cases:", int(y.sum()), "of", len(y))
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=7)
models = {
    "always not-fraud": DummyClassifier(strategy="most_frequent"),
    "logistic regression": LogisticRegression(max_iter=1000),
    "logistic (balanced)": LogisticRegression(max_iter=1000, class_weight="balanced"),
}
print(f"{'model':<22}{'accuracy':>9}{'precision':>10}{'recall':>8}{'F1':>7}")
for name, m in models.items():
    p = m.fit(X_train, y_train).predict(X_test)
    print(f"{name:<22}{accuracy_score(y_test, p):>9.3f}"
          f"{precision_score(y_test, p, zero_division=0):>10.3f}"
          f"{recall_score(y_test, p):>8.3f}{f1_score(y_test, p):>7.3f}")
docker exec lab-ml-py python imbalance.pyوالمخرج سوف يكون كما يلي:
fraud cases: 200 of 20000
model                  accuracy precision  recall     F1
always not-fraud          0.990     0.000   0.000  0.000
logistic regression       0.993     0.810   0.340  0.479
logistic (balanced)       0.900     0.088   0.960  0.162
في المخرج أعلاه لاحظ التالي:
- النموذج الذي يقول «ليس احتيالاً» لكل العمليات حصل على دقة 99%، ولم يكتشف عملية احتيال واحدة، فلو قدمت هذا الرقم في اجتماع لصفق لك الحاضرون وأنت لم تكتب أي ذكاء.
- الانحدار اللوجستي Logistic Regression العادي رفع الدقة قليلاً إلى 0.993، ولكنه اكتشف 34% فقط من الاحتيال، والسبب أن النموذج يتعلم أن قول «عادي» آمن غالباً لأن الأمثلة العادية تسيطر على التدريب.
- الخيار
class_weight="balanced"يجعل الخطأ في المثال النادر يكلف أكثر أثناء التدريب، فارتفع الاستدعاء إلى 0.960، ونزلت الدقة إلى 0.900 والضبط إلى 0.088، أي أنه يطلق إنذارات كثيرة، فكل إنذار صحيح يأتي معه قرابة عشرة كاذبة. وهذا ليس فشلاً، وإنما قرار عمل: هل تستطيع إدارة الاحتيال مراجعة هذا العدد من الإنذارات أم لا؟
لذلك لا تقم بتقييم نموذج على بيانات غير متوازنة بالدقة وحدها أبداً، والسبب أن النموذج الذي لا يفعل شيئاً سوف يحصل على رقم ممتاز، وانظر دائماً إلى مصفوفة الالتباس وPrecision وRecall للفئة النادرة.
قياس أخطاء الانحدار Regression بمقياسي MAE وRMSE
في الانحدار لا توجد إجابة صحيحة أو خاطئة، وإنما توقع قريب أو بعيد، فنقيس متوسط البعد بطريقتين:
- متوسط الخطأ المطلق Mean Absolute Error واختصاراً MAE: متوسط الفرق بين التوقع والحقيقة دون إشارة، وهو سهل الفهم لأنه بنفس وحدة الهدف، فإذا كان MAE لسعر الشقة 20 ألف ريال فالنموذج يخطئ بعشرين ألفاً في المتوسط.
- جذر متوسط مربع الخطأ Root Mean Squared Error واختصاراً RMSE: يربع الأخطاء قبل المتوسط ثم يأخذ الجذر، فيعاقب الأخطاء الكبيرة أكثر، وإذا كان أكبر من MAE بكثير فعندك أخطاء كبيرة قليلة تستحق البحث.
البرنامج التالي يقارن خط الأساس (توقع المتوسط دائماً) مع الانحدار الخطي Linear Regression والغابة العشوائية على بيانات السكري. احفظه في الملف regression.py:
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

X, y = load_diabetes(return_X_y=True)
print("rows:", len(y), " target range:", int(y.min()), "to", int(y.max()))
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=1)
models = {"baseline (mean)": DummyRegressor(), "linear regression": LinearRegression(),
          "random forest": RandomForestRegressor(n_estimators=300, random_state=1)}
for name, m in models.items():
    p = m.fit(X_train, y_train).predict(X_test)
    print(f"{name:<18} MAE {mean_absolute_error(y_test, p):6.1f}   RMSE {np.sqrt(mean_squared_error(y_test, p)):6.1f}")
docker exec lab-ml-py python regression.pyوالمخرج سوف يكون كما يلي:
rows: 442  target range: 25 to 346
baseline (mean)    MAE   61.6   RMSE   72.5
linear regression  MAE   42.0   RMSE   53.9
random forest      MAE   48.0   RMSE   62.3
لاحظ أن الانحدار الخطي البسيط تفوق على الغابة العشوائية هنا (MAE 42.0 مقابل 48.0)، والسبب أن البيانات صغيرة (442 مريضاً) والعلاقة فيها قريبة من الخطية، فالنموذج المعقد يجد في الضجيج أنماطاً غير موجودة. وهذا درس يتكرر كثيراً: النموذج الأعقد ليس الأفضل تلقائياً، وجرب البسيط أولاً دائماً.
التحقق المتقاطع Cross-validation: لا تثق برقم واحد
رأينا أن نتيجة الاختبار على 114 أو 143 عينة تتأثر بالحظ: أي العينات وقعت في جزء الاختبار. والحل التحقق المتقاطع Cross-validation، وأشهر نوع منه K-fold: تقسم البيانات إلى خمسة أجزاء، وتدرب النموذج خمس مرات، وفي كل مرة تختبره على جزء مختلف وتدربه على الأربعة الباقية، ثم تأخذ المتوسط والانحراف المعياري Standard Deviation، فيصبح عندك خمسة أرقام بدلاً من رقم واحد، كما في توثيق scikit-learn. احفظ البرنامج التالي في الملف cv.py:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier

X, y = load_breast_cancer(return_X_y=True)
scores = cross_val_score(RandomForestClassifier(n_estimators=300, random_state=42), X, y, cv=5)
print("5 folds:", [round(float(s), 3) for s in scores])
print(f"mean {scores.mean():.3f}  std {scores.std():.3f}")
docker exec lab-ml-py python cv.pyوالمخرج سوف يكون كما يلي:
5 folds: [0.921, 0.947, 0.991, 0.974, 0.973]
mean 0.961  std 0.025
نفس النموذج على نفس البيانات أعطى بين 0.921 و0.991 بحسب الجزء الذي اختبر عليه، أي أن الفرق بين أسوأ وأفضل تقسيم سبعون نقطة في الألف، فإذا قارنت نموذجين بتقسيم واحد وكان الفرق بينهما 0.01 فقد يكون هذا الفرق حظاً بالكامل. لذلك قارن النماذج دائماً بالتحقق المتقاطع، واذكر المتوسط مع الانحراف.
تسرب البيانات Data Leakage: النموذج يرى الإجابة دون أن تنتبه
تسرب البيانات Data Leakage يعني أن معلومة من بيانات الاختبار أو من المستقبل وصلت إلى النموذج أثناء التدريب، فيظهر النموذج ممتازاً في التقييم ثم يفشل في الإنتاج، وهو أخطر خطأ في هذا القسم لأنه لا يظهر في أي رقم. والمثال التالي يبينه بشكل صارخ: 200 صف و5000 عمود من الأرقام العشوائية تماماً، وتسميات عشوائية أيضاً، أي أنه لا يوجد شيء يمكن تعلمه، والدقة الصحيحة يجب أن تكون قرابة 0.5. ثم نختار أفضل 20 عموداً بطريقتين، مرة على كل البيانات قبل التحقق المتقاطع، ومرة داخل ال Pipeline كما توصي صفحة الأخطاء الشائعة في scikit-learn. احفظ البرنامج في الملف leakage.py:
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline

rng = np.random.default_rng(0)
X = rng.normal(size=(200, 5000))     # 5000 columns of pure noise
y = rng.integers(0, 2, size=200)     # random labels: there is nothing to learn

# wrong: pick the 20 "best" columns using ALL rows, then cross-validate
X_sel = SelectKBest(f_classif, k=20).fit_transform(X, y)
wrong = cross_val_score(LogisticRegression(max_iter=1000), X_sel, y, cv=5).mean()

# right: the selection is a step of the pipeline, refit inside every fold on its training rows only
pipe = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression(max_iter=1000))
right = cross_val_score(pipe, X, y, cv=5).mean()
print(f"selection before split (leak): {wrong:.3f}")
print(f"selection inside pipeline   : {right:.3f}")
docker exec lab-ml-py python leakage.pyوالمخرج سوف يكون كما يلي:
selection before split (leak): 0.795
selection inside pipeline   : 0.510
نموذج على ضجيج خالص حصل على 0.795، والسبب أن اختيار الأعمدة نظر إلى كل الصفوف بإجاباتها، بما فيها الصفوف التي سوف تستخدم للاختبار بعد ذلك، فاختار الأعمدة التي تصادف أنها تتوافق مع إجابات الاختبار. وعندما وضعنا الاختيار داخل ال Pipeline، أصبح يعاد في كل جزء من التحقق المتقاطع على صفوف التدريب وحدها، فعادت الدقة إلى 0.510، وهي الحقيقة. وفي المشاريع الحقيقية يأتي التسرب بأشكال أهدأ من هذا:
- توحيد المقياس Scaling أو ملء القيم الناقصة بمتوسط محسوب على كل البيانات قبل التقسيم.
- عمود يعرف الإجابة دون قصد، مثل «تاريخ إغلاق الحساب» في نموذج يتوقع هل سيغلق العميل حسابه.
- تقسيم عشوائي لبيانات زمنية، فيتدرب النموذج على يوم الأربعاء ويختبر على يوم الثلاثاء قبله، والصحيح أن يكون الاختبار دائماً بعد التدريب زمنياً.
- نفس العميل أو نفس المريض في التدريب والاختبار بصفوف مختلفة.
والقاعدة التي تحميك: قسم البيانات أولاً، ثم ضع كل خطوة تتعلم من البيانات (التوحيد والاختيار والملء) داخل Pipeline، والسبب أن ال Pipeline يضمن أن هذه الخطوات لا ترى إلا بيانات التدريب.
الخوارزميات الكلاسيكية Classic Algorithms: الفكرة ومتى تستخدم كل واحدة
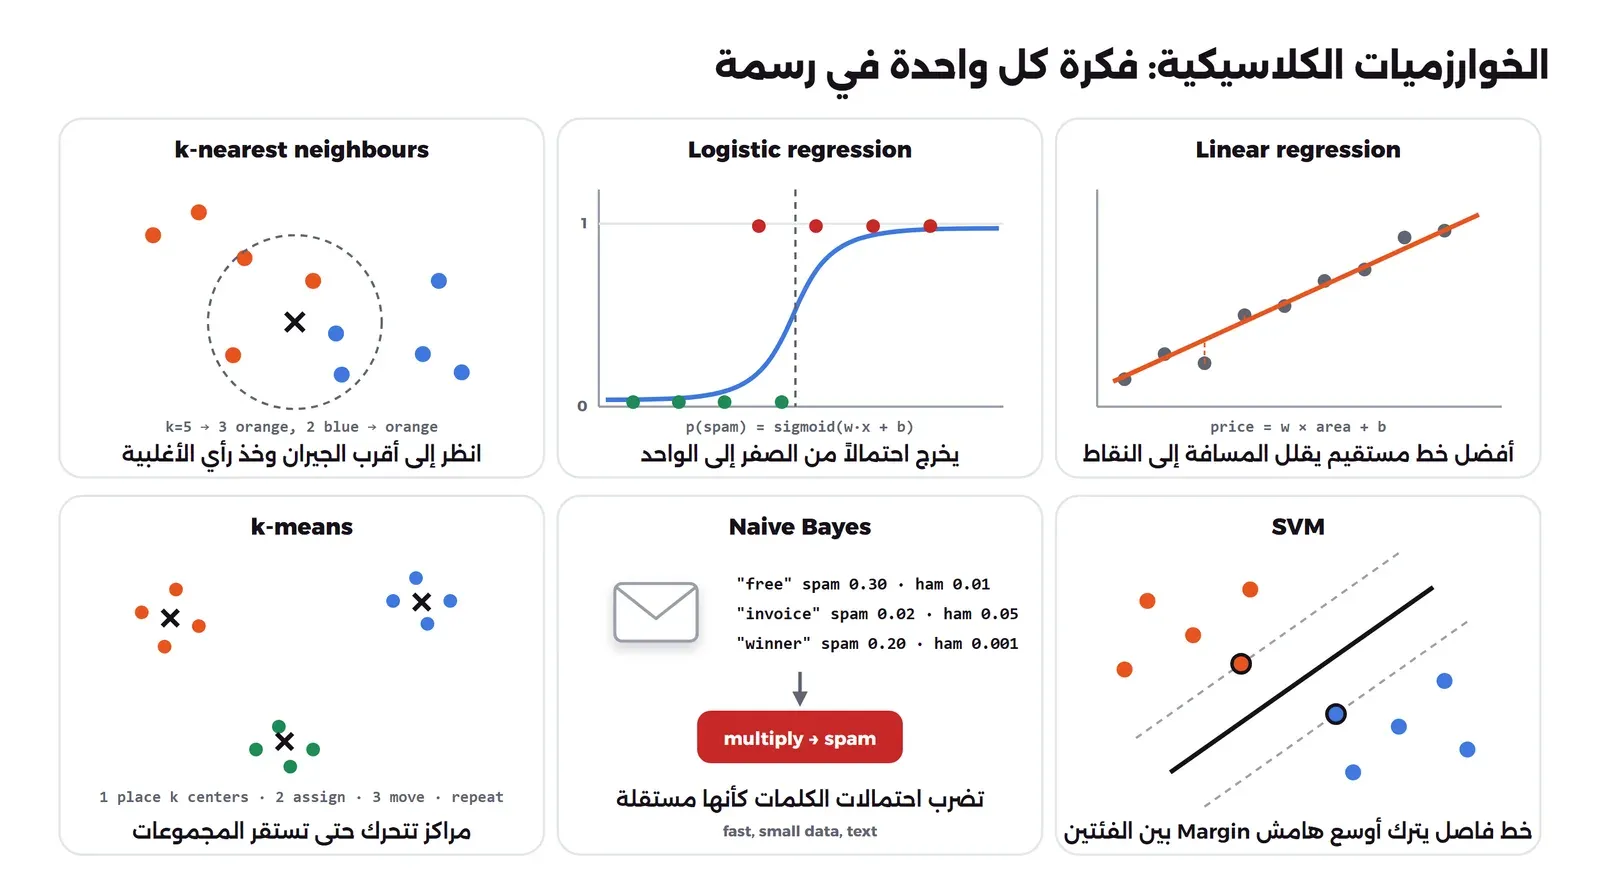
الآن بعد أن عرفنا كيف نقيس، نتعرف على الخوارزميات نفسها. والصورة التالية تجمع فكرة ست منها، كل واحدة في رسمة:
الانحدار الخطي Linear Regression
أبسط نموذج على الإطلاق: يفترض أن الهدف مجموع موزون للخصائص، مثل «السعر = وزن × المساحة + وزن × عدد الغرف + ثابت»، ويبحث عن الأوزان التي تجعل الخط أقرب ما يمكن إلى النقاط. ونقاط قوته أنه سريع جداً، ويحتاج بيانات قليلة، وتستطيع قراءة أوزانه وفهم أثر كل خاصية، ونقطة ضعفه أنه لا يرى العلاقات غير الخطية إلا إذا صنعتها له يدوياً في الخصائص. استخدمه كأول نموذج في أي مشكلة انحدار، وقد رأيت أنه تفوق على الغابة في بيانات السكري.
الانحدار اللوجستي Logistic Regression
رغم اسمه فهو نموذج تصنيف: يحسب نفس المجموع الموزون، ثم يمرره في دالة اسمها Sigmoid تحوله إلى احتمال بين الصفر والواحد، فإذا تجاوز 0.5 قال «spam». وهو خط الأساس الجاد لأي مشكلة تصنيف، وسريع في التدريب والاستنتاج، ويخرج احتمالات يمكن الوثوق بها نسبياً، ويستخدم كثيراً في المجالات التي تحتاج تفسيراً للقرار مثل الائتمان. ولاحظ في مقارنة الخوارزميات بعد قليل أنه حصل على أعلى نتيجة على بيانات السرطان.
أقرب الجيران k-Nearest Neighbours
لا يتعلم شيئاً أثناء التدريب، وإنما يحفظ كل الأمثلة، وعندما يأتي مثال جديد يبحث عن أقرب k أمثلة إليه (مثلاً خمسة) ويأخذ رأي الأغلبية. وفكرته سهلة جداً، ولكن له نقطتا ضعف: الأولى أنه يصبح بطيئاً مع البيانات الكبيرة لأنه يقارن كل مثال جديد بكل الأمثلة المحفوظة، والثانية أنه حساس جداً لمقياس الأرقام، فإذا كانت خاصية «المساحة» بالآلاف وخاصية «النعومة» بالأجزاء من عشرة، فالمسافة تحددها المساحة وحدها. وسوف ترى في المقارنة أن توحيد المقياس Scaling رفع دقته من 0.928 إلى 0.965.
شجرة القرار Decision Tree
شجرة القرار سلسلة أسئلة نعم أو لا، تبدأ بالسؤال الذي يقسم البيانات أفضل تقسيم، ثم تسأل سؤالاً آخر في كل فرع، وهكذا. ولكي نراها كما تعلمتها المكتبة فعلاً، احفظ البرنامج التالي في الملف tree.py، وهو يدرب شجرة بعمق سؤالين فقط ويطبعها:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, export_text

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, stratify=data.target, random_state=42)
tree = DecisionTreeClassifier(max_depth=2, random_state=42).fit(X_train, y_train)
print(export_text(tree, feature_names=list(data.feature_names), show_weights=True))
print("classes: 0 =", data.target_names[0], " 1 =", data.target_names[1])
print(f"test accuracy: {tree.score(X_test, y_test):.3f}")
docker exec lab-ml-py python tree.pyوالمخرج سوف يكون كما يلي:
|--- worst radius <= 16.80
|   |--- worst concave points <= 0.14
|   |   |--- weights: [4.00, 248.00] class: 1
|   |--- worst concave points >  0.14
|   |   |--- weights: [21.00, 11.00] class: 0
|--- worst radius >  16.80
|   |--- texture error <= 0.47
|   |   |--- weights: [0.00, 5.00] class: 1
|   |--- texture error >  0.47
|   |   |--- weights: [134.00, 3.00] class: 0

classes: 0 = malignant  1 = benign
test accuracy: 0.909
تقرأ هذه الشجرة كما تقرأ الكود: إذا كان أكبر نصف قطر للخلايا 16.80 أو أقل، وكان مقياس التقعر 0.14 أو أقل، فالورم حميد، وقد وصلت إلى هذه الورقة 252 عينة من التدريب منها 4 خبيثة فقط. وهذه أكبر نقطة قوة في الأشجار: تستطيع أن تشرح القرار لطبيب أو لمدقق، ولا تحتاج توحيد مقياس الأرقام، وثلاثة أسئلة فقط أعطت 0.909 على الاختبار. ونقطة ضعفها التي رأيناها أنها تحفظ البيانات إذا تركتها تتعمق، وأن تغييراً صغيراً في البيانات قد يغير الشجرة كلها.
الغابة العشوائية Random Forest والتعزيز التدريجي Gradient Boosting
والحل لضعف الشجرة الواحدة أن تستخدم أشجاراً كثيرة، وهذا يسمى التجميع Ensemble، وله طريقتان مشهورتان تبينهما الصورة التالية:
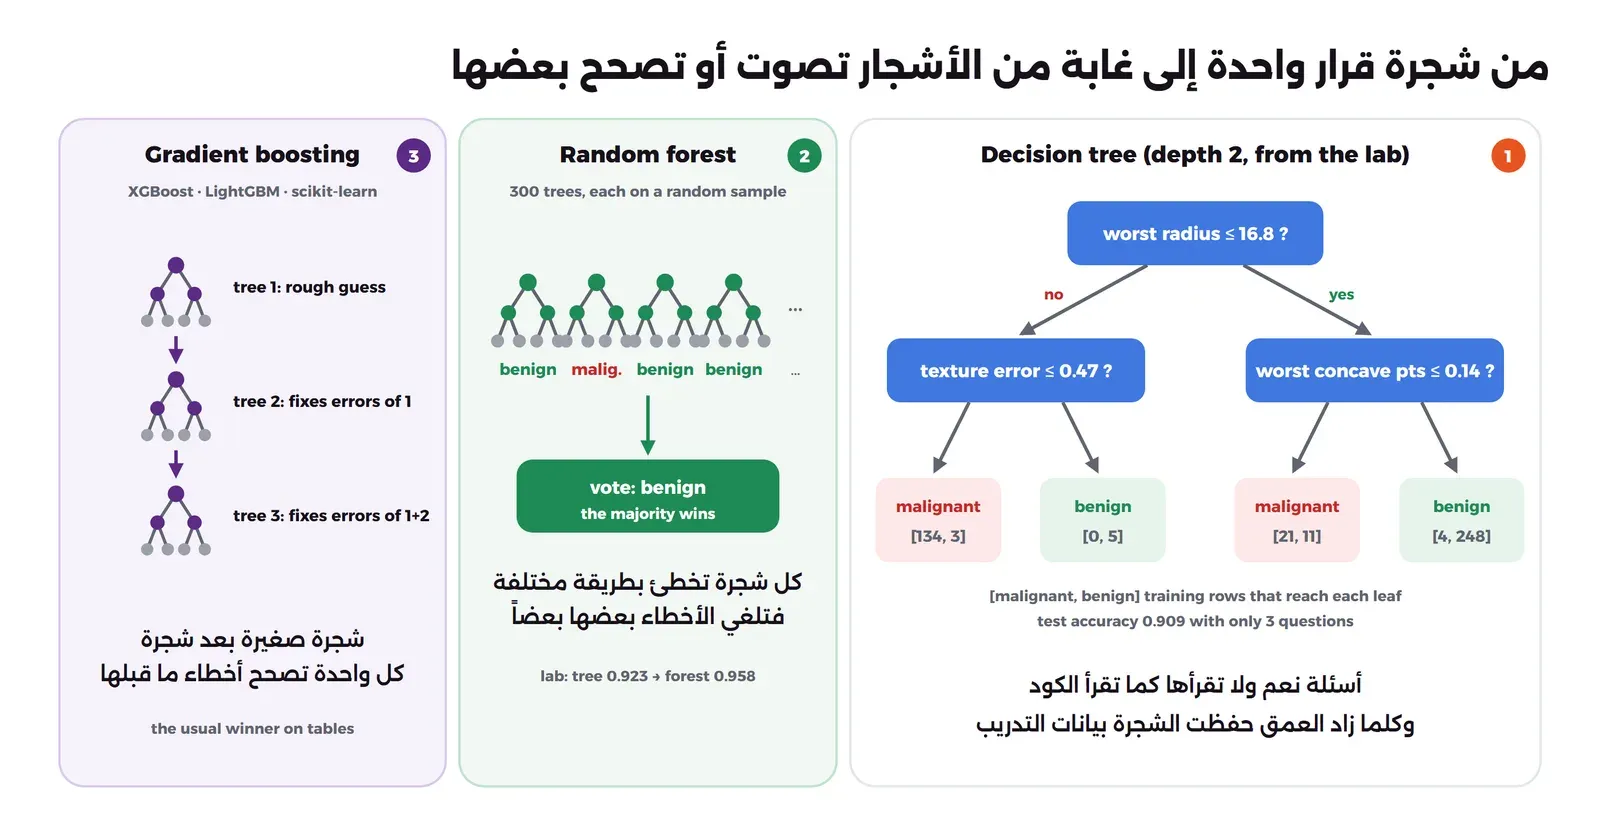
- الغابة العشوائية Random Forest: تدرب مئات الأشجار، كل شجرة على عينة عشوائية من الصفوف ومجموعة عشوائية من الأعمدة، ثم تصوت كلها على القرار، والسبب في نجاحها أن كل شجرة تحفظ ضجيجاً مختلفاً، فتلغي الأخطاء بعضها بعضاً في التصويت، وقد رأيت ذلك في التجربة: شجرة واحدة 0.923 وغابة 0.958.
- التعزيز التدريجي Gradient Boosting: يدرب أشجاراً صغيرة واحدة بعد الأخرى، وكل شجرة جديدة تتعلم تصحيح الأخطاء التي تركتها الأشجار قبلها. وهو الخيار الأقوى غالباً على البيانات الجدولية Tabular Data، أي جداول قواعد البيانات وملفات Excel، وأشهر مكتباته XGBoost ورخصتها Apache-2.0 وقد شرحتها ورقة Chen وGuestrin سنة 2016، وLightGBM من Microsoft ورخصتها MIT، كما يوجد في scikit-learn نفسها الكلاس
HistGradientBoostingClassifierالمستوحى من LightGBM كما في توثيق المكتبة.
وإذا كانت مشكلتك جدولاً من الأرقام والفئات، مثل توقع تسرب العملاء أو الاحتيال أو الأعطال، فابدأ بالانحدار اللوجستي كخط أساس جاد ثم بال Gradient Boosting، والسبب أنهما يغطيان أغلب الحالات بدقة عالية وتكلفة قليلة، وقد قارنا ذلك مع الشبكات العصبية ونماذج اللغة على بيانات حقيقية في تجربة البيانات الجدولية.
آلة المتجهات الداعمة Support Vector Machine
تبحث SVM عن الخط (أو المستوى في أبعاد أكثر) الذي يفصل الفئتين بأوسع هامش Margin ممكن، والنقاط التي تقع على حافة الهامش هي المتجهات الداعمة Support Vectors التي تحدد الخط وحدها. ومع حيلة رياضية اسمها النواة Kernel تستطيع أن تفصل بيانات لا يفصلها خط مستقيم. وهي قوية جداً على البيانات الصغيرة والمتوسطة ذات الأعمدة الكثيرة، وكانت الخيار الأول في تصنيف النصوص قبل التعلم العميق، ونقطة ضعفها أنها تبطؤ كثيراً عندما تصل البيانات إلى مئات الآلاف من الصفوف، وتحتاج توحيد المقياس.
مصنف بايز البسيط Naive Bayes
يحسب لكل كلمة احتمال ظهورها في الرسائل المزعجة واحتمال ظهورها في العادية، ثم يضرب احتمالات كلمات الرسالة الجديدة ليعرف أي الفئتين أرجح. وكلمة «البسيط» Naive سببها أنه يفترض أن الكلمات مستقلة عن بعضها، وهو افتراض خاطئ بكل تأكيد، فكلمة «free» تأتي غالباً مع «money»، ولكنه يعمل بشكل جيد جداً في تصنيف النصوص رغم ذلك. وهو أسرع الخوارزميات في التدريب، ويعمل مع بيانات قليلة، وهو قريب من الفكرة التي استخدمها Paul Graham في فلتره، لذلك استخدمه كخط أساس لأي مشكلة نصوص.
التجميع k-means وتحليل المكونات الرئيسية PCA
هاتان خوارزميتان من التعلم غير الموجه، أي أننا لن نعطيهما أي إجابة:
- ال k-means: تضع k مراكز عشوائية، ثم تضم كل نقطة إلى أقرب مركز، ثم تحرك كل مركز إلى وسط نقاطه، وتكرر حتى تتوقف المراكز عن الحركة. ونقطة ضعفها أنك يجب أن تحدد k بنفسك، وأنها تفترض مجموعات مستديرة متقاربة الحجم.
- تحليل المكونات الرئيسية Principal Component Analysis واختصاراً PCA: يبحث عن الاتجاهات التي تتغير فيها البيانات أكثر من غيرها، ويحول الأعمدة الكثيرة إلى عدد قليل من الأعمدة الجديدة على هذه الاتجاهات، فتستطيع رسم 13 عموداً على شاشة ببعدين.
البرنامج التالي يأخذ بيانات النبيذ، ويخفي أصناف العنب الحقيقية عن k-means، ثم يطلب منها تقسيم 178 عينة إلى ثلاث مجموعات، ويقارن النتيجة بالأصناف الحقيقية، ويرسم البيانات بعد PCA. احفظه في الملف unsup.py:
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score

wine = load_wine()
X = StandardScaler().fit_transform(wine.data)          # 178 wines, 13 chemical measurements
pca = PCA(n_components=2).fit(X)
X2 = pca.transform(X)
print("features:", X.shape[1], "-> 2 components")
print("variance kept by PC1, PC2:", [round(float(v), 3) for v in pca.explained_variance_ratio_],
      " total:", round(float(pca.explained_variance_ratio_.sum()), 3))
for k in range(2, 7):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    print(f"k={k}: inertia {km.inertia_:8.1f}")
km = KMeans(n_clusters=3, n_init=10, random_state=0).fit(X)
print("k=3 cluster sizes:", sorted(int((km.labels_ == c).sum()) for c in range(3)))
print("real cultivar sizes:", sorted(int((wine.target == c).sum()) for c in range(3)))
print("agreement with the real cultivars (ARI):", round(adjusted_rand_score(wine.target, km.labels_), 3))

colors = ["#E95420", "#3F78E0", "#1F8A55"]
fig, ax = plt.subplots(1, 2, figsize=(11, 4.6), dpi=120)
for c in range(3):
    ax[0].scatter(*X2[wine.target == c].T, s=18, color=colors[c], label=f"cultivar {c}")
    ax[1].scatter(*X2[km.labels_ == c].T, s=18, color=colors[c], label=f"cluster {c}")
ax[0].set_title("PCA: 13 features in 2 (colour = real cultivar)")
ax[1].set_title("k-means, k=3 (labels never shown to it)")
centers = pca.transform(km.cluster_centers_)
ax[1].scatter(*centers.T, marker="X", s=160, color="black", label="centroids")
for a in ax:
    a.set_xlabel("PC1"); a.set_ylabel("PC2"); a.grid(alpha=.3); a.legend(fontsize=8)
plt.tight_layout(); plt.savefig("out/kmeans-pca.png")
docker exec lab-ml-py python unsup.pyوالمخرج سوف يكون كما يلي:
features: 13 -> 2 components
variance kept by PC1, PC2: [0.362, 0.192]  total: 0.554
k=2: inertia   1659.0
k=3: inertia   1277.9
k=4: inertia   1180.7
k=5: inertia   1110.4
k=6: inertia   1044.5
k=3 cluster sizes: [51, 62, 65]
real cultivar sizes: [48, 59, 71]
agreement with the real cultivars (ARI): 0.897
والرسم الذي حفظه البرنامج في out/kmeans-pca.png كما يلي:
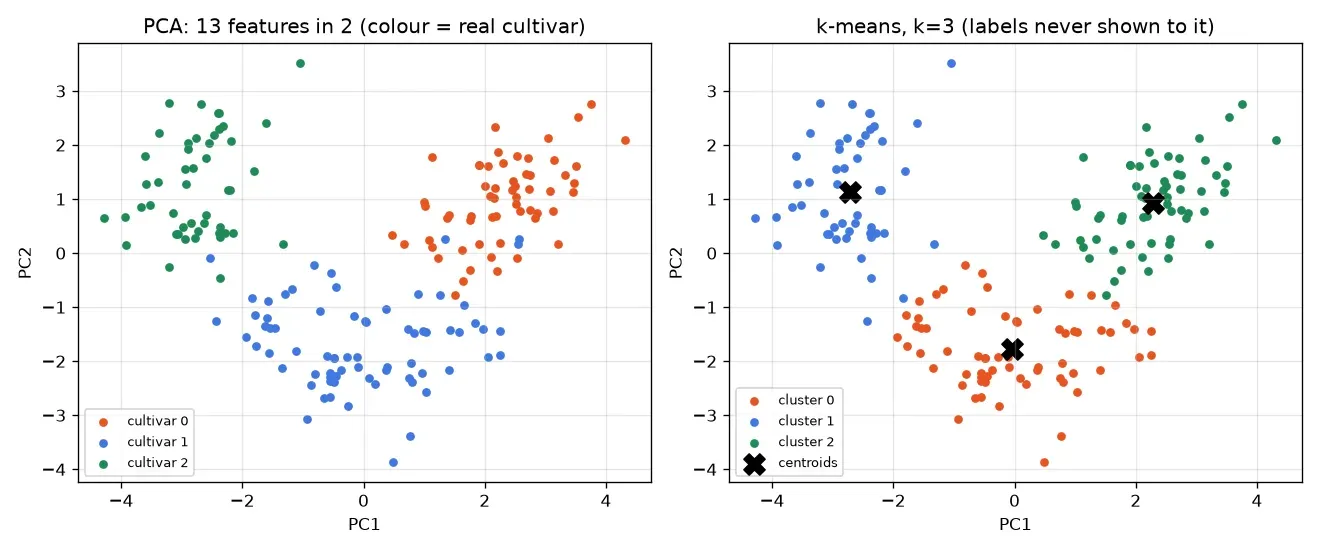
في المخرج أعلاه لاحظ التالي:
- أول مكونين في PCA يحملان 55.4% من التباين Variance في الأعمدة الثلاثة عشر، وهذا كاف للرسم، ولكنه يعني أن قرابة نصف المعلومات ليست في الرسم، لذلك درب k-means على الأعمدة كلها، واستخدمنا PCA للرسم فقط.
- الرقم inertia هو مجموع مربعات بعد النقاط عن مراكزها، وهو ينخفض دائماً كلما زاد k، لذلك لا تختار k بأقل inertia، وإنما ابحث عن النقطة التي يتوقف عندها الانخفاض الكبير، وهنا الانخفاض من k=2 إلى k=3 هو الأكبر (1659.0 إلى 1277.9) ثم يصبح بطيئاً.
- أحجام المجموعات (51 و62 و65) قريبة من أحجام الأصناف الحقيقية (48 و59 و71)، ومقياس Adjusted Rand Index وصل إلى 0.897، حيث 1 تعني تطابقاً كاملاً و0 تعني تقسيماً عشوائياً، أي أن الخوارزمية اكتشفت أصناف العنب تقريباً من القياسات الكيميائية وحدها.
- توحيد المقياس بال
StandardScalerضروري هنا، والسبب أن k-means وPCA يعتمدان على المسافات، وعمود المغنيسيوم بالعشرات وعمود الحموضة بالأجزاء من عشرة.
مقارنة الخوارزميات Algorithm Comparison على نفس البيانات
الآن نضع كل الخوارزميات في سباق واحد على بيانات السرطان بالتحقق المتقاطع، ومعها شبكة عصبية صغيرة سوف نشرحها في القسم التالي. احفظ البرنامج في الملف compare.py:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.dummy import DummyClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, HistGradientBoostingClassifier
from sklearn.svm import SVC
from sklearn.naive_bayes import GaussianNB
from sklearn.neural_network import MLPClassifier

X, y = load_breast_cancer(return_X_y=True)
S = StandardScaler
models = {
    "baseline": DummyClassifier(),
    "logistic regression": make_pipeline(S(), LogisticRegression(max_iter=1000)),
    "k-NN (k=5, raw)": KNeighborsClassifier(),
    "k-NN (k=5, scaled)": make_pipeline(S(), KNeighborsClassifier()),
    "decision tree": DecisionTreeClassifier(random_state=0),
    "random forest": RandomForestClassifier(n_estimators=300, random_state=0),
    "gradient boosting": HistGradientBoostingClassifier(random_state=0),
    "SVM (RBF, scaled)": make_pipeline(S(), SVC()),
    "naive Bayes": GaussianNB(),
    "neural net (MLP)": make_pipeline(S(), MLPClassifier(hidden_layer_sizes=(32, 16), max_iter=2000, random_state=0)),
}
print(f"{'model':<22}{'5-fold accuracy':>16}")
for name, m in models.items():
    s = cross_val_score(m, X, y, cv=5)
    print(f"{name:<22}{s.mean():>16.3f}")
docker exec lab-ml-py python compare.pyوالمخرج سوف يكون كما يلي:
model                  5-fold accuracy
baseline                         0.627
logistic regression              0.981
k-NN (k=5, raw)                  0.928
k-NN (k=5, scaled)               0.965
decision tree                    0.917
random forest                    0.963
gradient boosting                0.965
SVM (RBF, scaled)                0.974
naive Bayes                      0.939
neural net (MLP)                 0.975
في المخرج أعلاه لاحظ التالي:
- الانحدار اللوجستي، أبسط نموذج في القائمة، حصل على أعلى نتيجة (0.981)، تليه الشبكة العصبية وSVM، والسبب أن البيانات صغيرة وأغلب المعلومات فيها شبه خطية، أما على بياناتك فالأفضل يتحدد بالتجربة عليها وحدها.
- الدالة
make_pipeline(StandardScaler(), …)توحد المقياس داخل كل جزء من التحقق المتقاطع، وقد رفعت k-NN من 0.928 إلى 0.965 دون أي تغيير آخر، وهذا مثال على أن تحضير البيانات قد يهم أكثر من اختيار الخوارزمية. - الفروق بين أفضل ستة نماذج أقل من الانحراف الذي رأيناه بين أجزاء التحقق المتقاطع (0.025)، لذلك فالاختيار بينها على هذه البيانات يجب أن يعتمد على أشياء أخرى: سرعة الاستنتاج، وقابلية التفسير، وسهولة الصيانة.
- لم نطبع الزمن هنا عمداً، والسبب أن الجهاز كان مشغولاً بأعمال أخرى أثناء التجربة، فأرقام الزمن لن تكون عادلة، وإذا أردت المقارنة فقس على جهازك بنفس الظروف.
والجدول التالي يلخص متى تختار كل خوارزمية:
| الخوارزمية | النوع | متى تستخدمها | نقاط الضعف |
|---|---|---|---|
| Linear Regression | انحدار | أول نموذج لأي رقم تتوقعه، وعندما تحتاج تفسير أثر كل خاصية | لا يرى العلاقات غير الخطية |
| Logistic Regression | تصنيف | خط الأساس الجاد لأي تصنيف، والمجالات التي تحتاج تفسيراً | نفس حدود النموذج الخطي |
| k-NN | تصنيف وانحدار | بيانات صغيرة، والبحث عن الأمثلة المشابهة | بطيء مع البيانات الكبيرة، وحساس للمقياس |
| Decision Tree | تصنيف وانحدار | عندما يجب أن تشرح القرار خطوة خطوة | يحفظ البيانات إذا تعمق |
| Random Forest | تصنيف وانحدار | نموذج قوي دون ضبط كثير | أبطأ في الاستنتاج وأصعب في التفسير |
| Gradient Boosting | تصنيف وانحدار | البيانات الجدولية، وهو الأقوى غالباً عليها | يحتاج ضبطاً للإعدادات، وقد يحفظ البيانات |
| SVM | تصنيف وانحدار | بيانات صغيرة ومتوسطة بأعمدة كثيرة | بطيء مع مئات الآلاف من الصفوف |
| Naive Bayes | تصنيف | النصوص، وخط أساس سريع جداً | افتراض الاستقلال يجعل احتمالاته غير دقيقة |
| k-means | تجميع | تقسيم العملاء أو السجلات إلى مجموعات | تحدد k بنفسك، ويفترض مجموعات مستديرة |
| PCA | تقليل أبعاد | الرسم، وتسريع نموذج آخر، وضغط الأعمدة المترابطة | الأعمدة الجديدة صعبة التفسير |
وتجد خريطة مشابهة في صفحة Choosing the right estimator في توثيق scikit-learn.
الشبكات العصبية Neural Networks في صورة واحدة
الشبكة العصبية مبنية من وحدة صغيرة جداً اسمها الخلية العصبية Neuron، وكل ما تفعله الخلية أن تضرب كل مدخل في وزن Weight، وتجمع النتائج مع رقم ثابت اسمه الانحياز Bias، ثم تمرر المجموع في دالة تنشيط Activation Function، وأشهرها ReLU التي تحول كل رقم سالب إلى صفر وتترك الموجب كما هو. ولاحظ أن الخلية الواحدة بدون دالة التنشيط هي الانحدار الخطي نفسه، وبدالة Sigmoid هي الانحدار اللوجستي نفسه، فلا يوجد سحر في الخلية.
والقوة تأتي من التكرار: الخلايا ترتب في طبقات Layers، طبقة مدخلات Input Layer تستقبل الخصائص، ثم طبقة مخفية Hidden Layer أو أكثر، ثم طبقة مخرجات Output Layer، وكل خلية في طبقة متصلة بكل خلايا الطبقة التالية. ودالة التنشيط هي التي تجعل الطبقات المتتالية تتعلم علاقات غير خطية، والسبب أن تركيب دوال خطية فوق بعضها يبقى دالة خطية، فلولا ReLU لكانت الشبكة كلها بعشرات الطبقات انحداراً خطياً واحداً. الصورة التالية تجمع الفكرة:
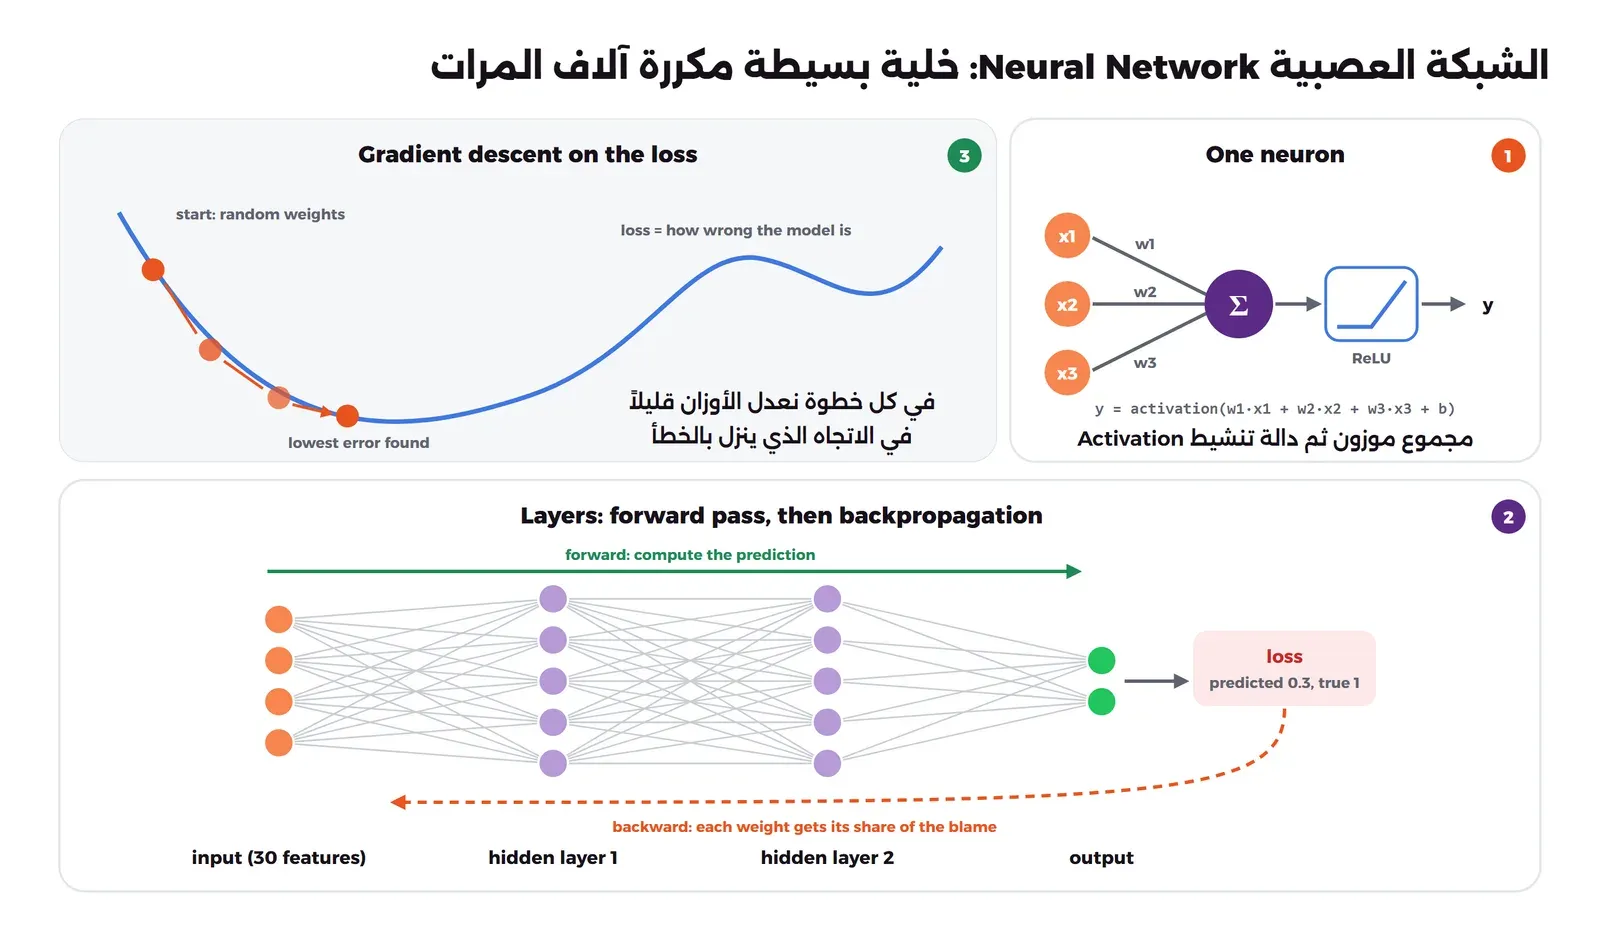
وتتدرب الشبكة بهذه الخطوات:
- تبدأ الأوزان أرقاماً عشوائية صغيرة.
- الانتشار الأمامي Forward Pass: تمر الخصائص في الطبقات حتى تخرج التوقع.
- دالة الخسارة Loss Function تقيس كم أخطأ التوقع، فإذا قالت الشبكة 0.3 والإجابة 1 فالخسارة كبيرة.
- الانتشار العكسي Backpropagation: يحسب لكل وزن في الشبكة كم ساهم في هذا الخطأ، أي التدرج Gradient، بالرجوع من المخرج إلى المدخل.
- النزول بالتدرج Gradient Descent: يعدل كل وزن خطوة صغيرة في الاتجاه الذي يقلل الخسارة، وحجم الخطوة يسمى معدل التعلم Learning Rate.
- تكرر الخطوات على كل البيانات مرات كثيرة، وكل مرة على البيانات كاملة تسمى Epoch.
وهذه الخطوات هي نفسها التي تدرب أكبر نماذج اللغة، والفرق في الحجم فقط. وإذا أردت أن تفهم كيف يحسب الانتشار العكسي التدرج فعلاً، فقد بنينا محرك التدرج Autograd وشبكة صغيرة تتعلم من الصفر بلغة C# دون أي مكتبة في ابن نموذج لغة بلغة C# (1): محرك التعلم، وهو أفضل طريق لفهم هذا القسم بيدك. أما في تجربتنا فقد استخدمنا MLPClassifier من scikit-learn بطبقتين مخفيتين من 32 و16 خلية، وحصل على 0.975، أي أنه لم يتفوق على الانحدار اللوجستي في هذه البيانات الصغيرة.
وهناك أنواع من الشبكات مصممة لأشكال معينة من البيانات:
- الشبكات الالتفافية Convolutional Neural Networks واختصاراً CNN: للصور، حيث تمرر مرشحات صغيرة على الصورة تكتشف الحواف ثم الأشكال ثم الأشياء، وهي التي بدأت عصر التعلم العميق في 2012 كما في قصة AlexNet.
- الشبكات المتكررة Recurrent Neural Networks واختصاراً RNN: للتسلسلات مثل النصوص والإشارات الزمنية، حيث تقرأ عنصراً بعد عنصر وتحمل ذاكرة مما قبله، وقد حلت محلها بنية Transformer في أغلب مهام النصوص، وشرحناها في كتلة Transformer.
وقد يتساءل البعض: لماذا لا نستخدم الشبكات العصبية لكل شيء إذا كانت هي التي صنعت ChatGPT؟ والإجابة أنها تتفوق بوضوح عندما تكون البيانات ضخمة وغير منظمة، كالصور والصوت والنصوص، أما على الجداول الصغيرة والمتوسطة فالانحدار اللوجستي وال Gradient Boosting أدق غالباً وأرخص بكثير، وقد فصلنا هذا في مقال لماذا تفوقت نماذج اللغة.
الخوارزميات الجينية Genetic Algorithms: عندما لا يوجد تدرج
كل ما سبق يعتمد على أن تقيس الخطأ وتحسب اتجاه التحسين، ولكن هناك مشاكل كثيرة لا يوجد فيها اتجاه تحسين أصلاً، مثل جدولة المحاضرات على القاعات، أو توزيع الطلبات على سيارات التوصيل، أو اختيار أي الأغراض تضع في حقيبة سعتها محدودة. وفي هذه المشاكل الحلول الممكنة عددها هائل، والحل البسيط أن تجرب كل الاحتمالات، والمشكلة أن 25 غرضاً فقط يعطيك 225 أي أكثر من 33 مليون تركيبة، وكل غرض إضافي يضاعف العدد، فلا يمكنك تجربتها كلها في الحالات الواقعية.
والخوارزميات الجينية Genetic Algorithms، وهي جزء من مجال أوسع اسمه الحوسبة التطورية Evolutionary Computation، تستعير فكرة الانتقاء الطبيعي، وقد حكينا أصلها في قصة الذكاء الاصطناعي. والفكرة كما في الصورة التالية:
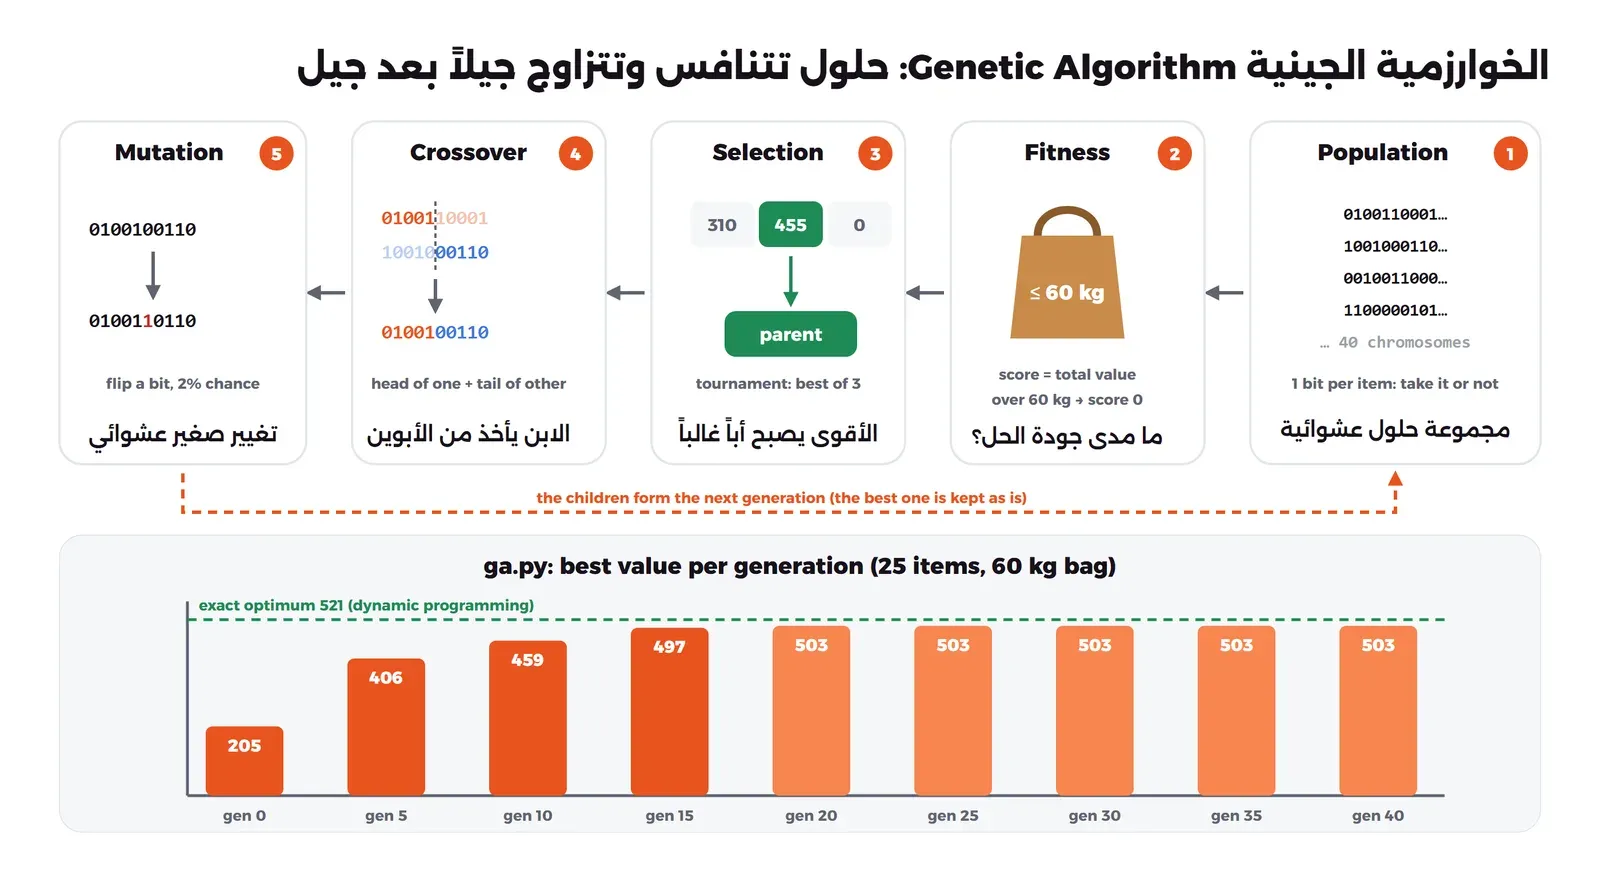
- المجتمع Population: مجموعة حلول عشوائية، وكل حل يكتب كسلسلة تسمى الكروموسوم Chromosome، وفي مشكلة الحقيبة كل بت يقول هل نأخذ الغرض أم لا.
- اللياقة Fitness: دالة تعطي كل حل درجة، وهنا مجموع قيمة الأغراض، وصفر إذا تجاوز الوزن سعة الحقيبة.
- الانتقاء Selection: نختار الآباء بحيث تكون فرصة الحل الأفضل أكبر، وهنا بطريقة البطولة Tournament: نسحب ثلاثة حلول عشوائياً ونأخذ أفضلها.
- التزاوج Crossover: نصنع ابناً يأخذ أول جزء من أب وباقي الكروموسوم من الآخر.
- الطفرة Mutation: نقلب بعض البتات باحتمال صغير، والسبب أن الطفرة تجلب أفكاراً جديدة لا توجد في أي أب، فلا يعلق المجتمع في حل واحد.
البرنامج التالي يحل مشكلة الحقيبة Knapsack من الصفر في 35 سطراً دون أي مكتبة: 25 غرضاً بأوزان وقيم عشوائية ثابتة، وحقيبة سعتها 60 كيلو، ومجتمع من 40 حلاً لمدة 40 جيلاً، ثم يحسب الحل الأمثل بالبرمجة الديناميكية Dynamic Programming لنعرف كم اقتربت الخوارزمية. احفظه في الملف ga.py:
import random
random.seed(1)
# 25 items as (weight kg, value); the bag holds 60 kg
items = [(random.randint(1, 15), random.randint(5, 60)) for _ in range(25)]
CAP, POP, GENS, MUT = 60, 40, 40, 0.02

def fitness(ch):                                   # total value, or 0 if the bag is overloaded
    w = sum(it[0] for it, g in zip(items, ch) if g)
    return 0 if w > CAP else sum(it[1] for it, g in zip(items, ch) if g)

def select(pop):                                   # tournament: the best of 3 random chromosomes
    return max(random.sample(pop, 3), key=fitness)

def crossover(a, b):                               # one cut point: head of a + tail of b
    cut = random.randrange(1, len(a))
    return a[:cut] + b[cut:]

def mutate(ch):                                    # flip each gene with a small probability
    return [1 - g if random.random() < MUT else g for g in ch]

pop = [[1 if random.random() < 0.2 else 0 for _ in items] for _ in range(POP)]
for gen in range(GENS + 1):
    best = max(pop, key=fitness)
    if gen % 5 == 0:
        avg = sum(map(fitness, pop)) / POP
        print(f"gen {gen:>2}: best {fitness(best):>3}  average {avg:6.1f}")
    pop = [best] + [mutate(crossover(select(pop), select(pop))) for _ in range(POP - 1)]

# the exact answer by dynamic programming, to check the GA
dp = [0] * (CAP + 1)
for w, v in items:
    for c in range(CAP, w - 1, -1):
        dp[c] = max(dp[c], dp[c - w] + v)
print("GA best:", fitness(best), " weight:", sum(it[0] for it, g in zip(items, best) if g),
      " optimum (DP):", dp[CAP], " chromosomes evaluated:", POP * (GENS + 1), "of", 2 ** len(items))
docker exec lab-ml-py python ga.pyوالمخرج سوف يكون كما يلي:
gen  0: best 205  average  107.2
gen  5: best 406  average  241.1
gen 10: best 459  average  388.2
gen 15: best 497  average  354.2
gen 20: best 503  average  413.8
gen 25: best 503  average  332.0
gen 30: best 503  average  378.9
gen 35: best 503  average  389.4
gen 40: best 503  average  391.6
GA best: 503  weight: 58  optimum (DP): 521  chromosomes evaluated: 1640 of 33554432
في المخرج أعلاه لاحظ التالي:
- أفضل حل بدأ بقيمة 205 في الجيل الأول العشوائي، ووصل إلى 503 في الجيل العشرين، بعد تقييم 1640 حلاً فقط من أكثر من 33 مليون حل ممكن.
- الحل الأمثل 521، والخوارزمية توقفت عند 503، أي 96.5% منه، وهذه طبيعة الخوارزميات الجينية: تعطيك حلاً جيداً بسرعة، ولا تضمن أفضل حل أبداً.
- متوسط المجتمع يصعد وينزل بين الأجيال (354.2 ثم 413.8 ثم 332.0)، والسبب أن التزاوج والطفرة يصنعان أبناء تتجاوز أوزانهم سعة الحقيبة فيأخذون صفراً، ولكن أفضل حل لا يضيع أبداً، لأن البرنامج ينقل أفضل حل إلى الجيل التالي كما هو، وهذا يسمى النخبوية Elitism.
- جرب بنفسك زيادة
GENSأوPOPأو تغييرMUTوراقب هل يصل إلى 521، فهذه الإعدادات هي ما يضبطه المطور في هذا النوع من الخوارزميات.
وقد يتساءل البعض: لماذا لم نستخدم البرمجة الديناميكية مباشرة إذا كانت تعطي الحل الأمثل؟ والإجابة أنها تعمل هنا لأن مشكلة الحقيبة البسيطة لها بنية خاصة، ولكن أضف قيداً واحداً مثل «الغرض 3 لا يوضع مع الغرض 7» أو «المحاضر لا يدرس صباحاً يوم الأحد» فتفقد الطريقة المتخصصة قدرتها، بينما الخوارزمية الجينية لا تحتاج إلا تعديل دالة اللياقة. لذلك فالخوارزميات الجينية مناسبة لمشاكل التحسين والجدولة Scheduling التي فيها قيود كثيرة متشابكة ولا يوجد لها تدرج، وغير مناسبة أبداً لتصنيف البيانات أو التوقع، والسبب أن ال Gradient Descent أسرع منها بمراحل عندما يكون التدرج متاحاً.
البيانات الضخمة Big Data ومتى لا تحتاجها
كل تجاربنا السابقة كانت على بيانات تدخل في ذاكرة جهاز واحد، ولكن مع بداية هذا القرن بدأت شركات مثل Google تجمع بيانات لا تدخل في أي جهاز مهما كبر، والتعريف الذي انتشر لوصف هذه المشكلة جاء من Doug Laney حين كان محللاً في شركة META Group، ففي فبراير 2001 نشر مذكرة بعنوان «3-D Data Management: Controlling Data Volume, Velocity and Variety» كما يحكي في تدوينته عنها، ومنها جاءت ال 3 Vs:
- الحجم Volume: البيانات أكبر من قرص وذاكرة سيرفر واحد.
- السرعة Velocity: البيانات تصل أسرع مما يستطيع نظام واحد أن يكتبه ويعالجه، مثل أحداث النقر في موقع كبير أو قراءات أجهزة الاستشعار.
- التنوع Variety: البيانات بأشكال مختلفة، جداول وملفات نصية وصور وسجلات JSON، لا تدخل كلها في قاعدة بيانات واحدة بتصميم واحد.
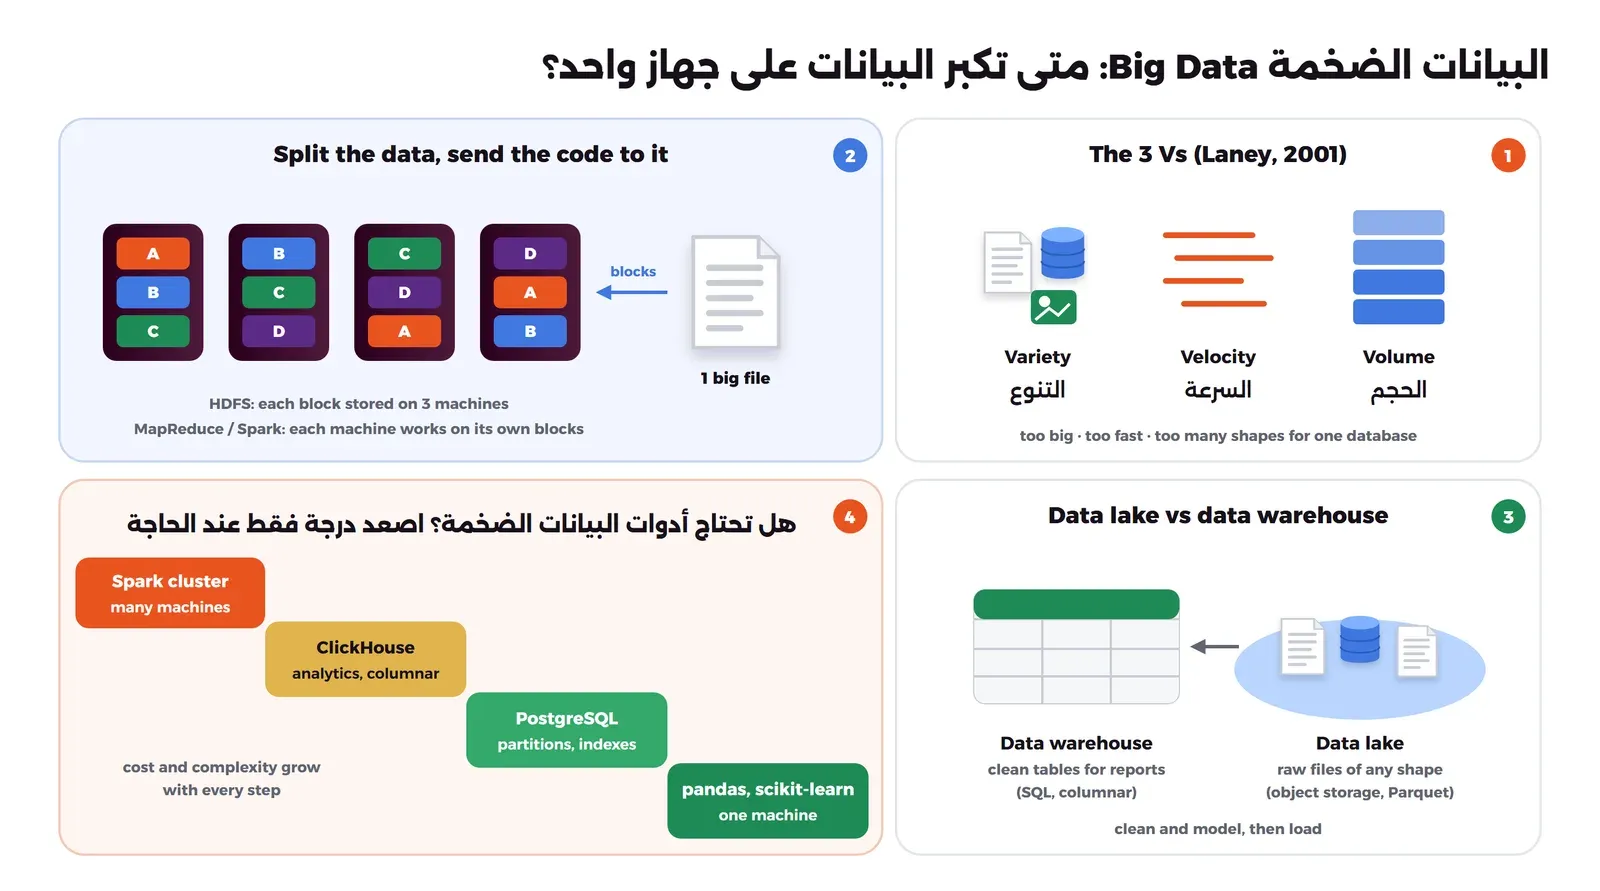
والحل الذي غير المجال كان عكس التفكير المعتاد: بدلاً من أن تنقل البيانات إلى الكود، تقسم البيانات على أجهزة كثيرة رخيصة وترسل الكود إليها. وقد نشرت Google فكرتين في هذا الاتجاه: نظام ملفات موزع، ونموذج MapReduce في 2004، حيث يعالج كل جهاز قطعته (Map) ثم تجمع النتائج (Reduce). ثم جاء مشروع Apache Hadoop مفتوح المصدر برخصة Apache-2.0 بتطبيق للفكرتين، ونظام ملفاته HDFS يقسم الملف إلى كتل Blocks ويحفظ كل كتلة على ثلاثة أجهزة افتراضياً بحسب الإعداد dfs.replication في إعدادات HDFS، حتى لا تضيع البيانات إذا تعطل جهاز. والمشكلة في MapReduce أنه يكتب النتائج على القرص بعد كل خطوة، فالمعالجة التي تحتاج عشر خطوات متتالية، مثل تدريب نموذج يمر على البيانات مرات كثيرة، تصبح بطيئة جداً، ولهذا جاء Apache Spark برخصة Apache-2.0، والذي يحفظ البيانات في الذاكرة بين الخطوات كما في ورقته في مؤتمر NSDI 2012، ومعه مكتبة MLlib للتعلم الآلي على البيانات الموزعة، وواجهة PySpark لمن يكتب بلغة Python. وقد حكينا قصة هذه المرحلة في قسم عصر البيانات الضخمة.
وستسمع أيضاً مصطلحين عن مكان حفظ هذه البيانات:
- بحيرة البيانات Data Lake: مكان واحد تحفظ فيه البيانات الخام بكل أشكالها كما هي، غالباً على تخزين الكائنات Object Storage الذي شرحناه في أنواع التخزين، وتقرر لاحقاً كيف تستخدمها.
- مستودع البيانات Data Warehouse: قاعدة بيانات تحليلية فيها جداول منظمة ونظيفة مصممة للتقارير والاستعلامات بلغة SQL، تملؤها بعد التنظيف والتحويل.
وهنا أهم نصيحة في هذا القسم: أغلب المؤسسات لا تحتاج أدوات البيانات الضخمة، والسبب أن الأجهزة كبرت كثيراً منذ 2004، فسيرفر واحد اليوم فيه ذاكرة بمئات الجيجابايت وأقراص بعشرات الترابايت، وجدول فيه عشرات الملايين من الصفوف يعمل بشكل ممتاز على PostgreSQL بالفهارس والتقسيم الصحيح كما شرحنا في PostgreSQL للجداول الضخمة، والتحليلات الثقيلة على مليارات الصفوف تعمل على قاعدة بيانات عمودية Columnar Database مثل ClickHouse على سيرفر واحد، وهي من المواضيع القادمة بإذن الله في مرحلة قواعد البيانات. أما ال Spark Cluster فله تكلفة حقيقية: أجهزة كثيرة، وشبكة، ومراقبة، وفريق يفهمه، لذلك لا تقم ببنائه لأن البيانات «قد تكبر يوماً ما»، وإنما اصعد درجة في السلم فقط عندما تثبت بالقياس أن الدرجة التي تحتها لم تعد تكفي.
الأدوات Tools ورخصها Licenses
الجدول التالي يجمع الأدوات الأساسية، وكلها مفتوحة المصدر، وقد شرحنا معنى كل رخصة في البرمجيات مفتوحة المصدر وتراخيصها:
| الأداة | الاستخدام | الرخصة |
|---|---|---|
| Python | اللغة الأساسية في المجال | PSF License |
| NumPy | المصفوفات والحسابات الرقمية السريعة، وكل المكتبات الأخرى مبنية عليها | BSD-3-Clause |
| pandas | قراءة الجداول وتنظيفها وتحويلها | BSD-3-Clause |
| scikit-learn | كل الخوارزميات الكلاسيكية والتقييم وال Pipeline | BSD-3-Clause |
| Jupyter | دفاتر تفاعلية تجمع الكود والمخرجات والرسومات في صفحة واحدة، وهي طريقة العمل اليومية لأغلب من في المجال | BSD-3-Clause |
| Matplotlib | الرسومات البيانية | Matplotlib License (مبنية على رخصة PSF) |
| XGBoost وLightGBM | Gradient Boosting السريع للبيانات الجدولية | Apache-2.0 وMIT |
| PyTorch | الشبكات العصبية والتعلم العميق، وعليها يبنى أغلب النماذج الكبيرة اليوم | BSD-3-Clause |
| MLflow | تتبع التجارب Experiment Tracking: يسجل إعدادات كل تدريب ونتائجه والنموذج الناتج، حتى تعرف بعد شهر أي إعدادات أعطت أي رقم | Apache-2.0 |
| Apache Spark وPySpark | معالجة البيانات الموزعة على عدة أجهزة، وMLlib للتعلم عليها | Apache-2.0 |
| ML.NET | التعلم الآلي داخل تطبيقات .NET بلغة C# | MIT |
| Tribuo | مكتبة تعلم آلي للغة Java من Oracle | Apache-2.0 |
| Smile | مكتبة تعلم آلي واسعة للغة Java وScala وKotlin | GPLv3 أو رخصة تجارية |
وعلى الجدول أعلاه لاحظ التالي:
- إذا كان فريقك يكتب بلغة C# فلا تحتاج أن تنقل النظام كله إلى Python، فمكتبة ML.NET من Microsoft فيها التصنيف والانحدار والتجميع وال Gradient Boosting، وتعمل داخل تطبيقك مباشرة، وسوف نجربها في القسم التالي.
- مكتبة Tribuo برخصة Apache-2.0 وآخر إصدار لها v4.3.2 في أبريل 2025، فهي مستقرة ولكن وتيرة تطويرها بطيئة، فراجع نشاطها قبل أن تبني عليها مشروعاً طويلاً.
- مكتبة Smile تغيرت رخصتها مع الإصدارات، ورخصتها الحالية GPLv3 أو رخصة تجارية بحسب ملف الرخصة في مستودعها، وهذا يعني أنك إذا استخدمتها في منتج مغلق المصدر تحتاج الرخصة التجارية، فاقرأ الرخصة جيداً قبل أن تضيفها إلى مشروع شركتك.
- كثير من الفرق تدرب النموذج بلغة Python ثم تصدره بصيغة ONNX لتشغله من C# أو Java، فلا يلزم أن تكون لغة التدريب هي لغة التشغيل.
نفس المصنف Classifier بلغة C# مع ML.NET
لكي نرى أن الأفكار نفسها تنتقل بين اللغات، سوف ندرب غابة عشوائية على نفس بيانات السرطان داخل Container فيه .NET SDK. أولاً نصدر البيانات من Python إلى ملف CSV، احفظ هذا في الملف export.py:
from sklearn.datasets import load_breast_cancer
df = load_breast_cancer(as_frame=True).frame
df["Malignant"] = (df.pop("target") == 0).astype(int)   # 1 = malignant
df.columns = [c.replace(" ", "_") for c in df.columns]
df.to_csv("mlnet/cancer.csv", index=False)
print(df.shape, "->", "mlnet/cancer.csv")
docker exec lab-ml-py python export.py(569, 31) -> mlnet/cancer.csvثم ننشئ في المجلد mlnet ملف المشروع cancer.csproj:
<Project Sdk="Microsoft.NET.Sdk">
  <PropertyGroup>
    <OutputType>Exe</OutputType>
    <TargetFramework>net10.0</TargetFramework>
    <ImplicitUsings>enable</ImplicitUsings>
    <Nullable>enable</Nullable>
  </PropertyGroup>
  <ItemGroup>
    <PackageReference Include="Microsoft.ML" Version="5.0.0" />
    <PackageReference Include="Microsoft.ML.FastTree" Version="5.0.0" />
  </ItemGroup>
</Project>
والبرنامج نفسه في الملف mlnet/Program.cs:
using Microsoft.ML;
using Microsoft.ML.Data;

var ml = new MLContext(seed: 42);
var data = ml.Data.LoadFromTextFile<Row>("cancer.csv", separatorChar: ',', hasHeader: true);
var split = ml.Data.TrainTestSplit(data, testFraction: 0.25, seed: 42);

var pipeline = ml.Transforms.NormalizeMeanVariance("Features")
    .Append(ml.BinaryClassification.Trainers.FastForest(numberOfTrees: 300));

var model = pipeline.Fit(split.TrainSet);                    // = model.fit(X_train, y_train)
var m = ml.BinaryClassification.EvaluateNonCalibrated(model.Transform(split.TestSet));
Console.WriteLine($"accuracy {m.Accuracy:F3}  precision {m.PositivePrecision:F3}  recall {m.PositiveRecall:F3}  F1 {m.F1Score:F3}");
Console.WriteLine(m.ConfusionMatrix.GetFormattedConfusionTable());

public class Row
{
    [LoadColumn(0, 29), VectorType(30)] public float[] Features { get; set; } = [];
    [LoadColumn(30), ColumnName("Label")] public bool Malignant { get; set; }
}
docker run -d --name lab-ml-dotnet -v "$PWD/mlnet":/app -w /app mcr.microsoft.com/dotnet/sdk:10.0 sleep infinity
docker exec lab-ml-dotnet dotnet runوالمخرج سوف يكون كما يلي:
accuracy 0.957  precision 0.900  recall 0.978  F1 0.938
TEST POSITIVE RATIO:	0.3286 (46.0/(46.0+94.0))
Confusion table
          ||======================
PREDICTED || positive | negative | Recall
TRUTH     ||======================
 positive ||       45 |        1 | 0.9783
 negative ||        5 |       89 | 0.9468
          ||======================
Precision ||   0.9000 |   0.9889 |
في الإعداد أعلاه لاحظ التالي:
- الخطوات هي نفسها التي رأيتها في Python: تحميل البيانات، ثم التقسيم بال
TrainTestSplit، ثم Pipeline فيه توحيد المقياس ثم الخوارزمية، ثمFitللتدريب، ثم التقييم، وحتى أسماء المقاييس هي نفسها. - ال
FastForestهو الغابة العشوائية في ML.NET، ويوجد في الحزمةMicrosoft.ML.FastTreeوليس في الحزمة الأساسية. - التقسيم في ML.NET عشوائي بطريقته الخاصة، فجاء جزء الاختبار 140 عينة وليس 143، لذلك لا تقارن الرقمين مقارنة دقيقة، والمهم أن النتيجة في نفس المستوى (0.957 مقابل 0.958)، ولاحظ أن هذا النموذج فوت حالة خبيثة واحدة وأطلق خمسة إنذارات كاذبة، أي عكس توازن نموذج Python.
- أول تشغيل لل
dotnet runيحمل حزم NuGet، فيأخذ وقتاً أطول من التشغيلات التالية.
الأخلاقيات Ethics: الانحياز Bias والخصوصية Privacy وقابلية التفسير Explainability
النموذج يتعلم من البيانات كل ما فيها، الجيد والسيئ، فإذا كانت قرارات الماضي التي تدرب عليها منحازة فسوف يتعلم الانحياز ويطبقه بسرعة الآلة وعلى نطاق واسع، وهو لا يعرف أنه منحاز.
- الانحياز في البيانات Data Bias: قبل التدريب اسأل من الذي تمثله البيانات ومن الغائب عنها، وبعد التدريب قس الأداء لكل مجموعة على حدة (الرجال والنساء، المدن والقرى، العملاء الجدد والقدامى)، وليس للكل فقط، والسبب أن الدقة الكلية الممتازة قد تخفي نموذجاً فاشلاً لمجموعة صغيرة.
- الخصوصية Privacy: بيانات التدريب غالباً بيانات أشخاص، وفي المملكة يحكمها نظام حماية البيانات الشخصية الذي تشرف عليه سدايا SDAIA وصدر في 9/2/1443هـ الموافق 16 سبتمبر 2021، فلا تقم بنسخ بيانات العملاء الحقيقية إلى جهازك للتجربة، واحذف ما لا تحتاجه من الأعمدة قبل التدريب، وتذكر أن النموذج نفسه قد يحفظ أجزاء من بيانات تدريبه.
- قابلية التفسير Explainability: إذا رفض النموذج طلب تمويل فسوف يسأل العميل والمدقق لماذا، والنموذج الخطي والشجرة الصغيرة يجيبان بسهولة، أما الغابة والشبكة العصبية فتحتاج أدوات تفسير إضافية تقدر أثر كل خاصية في القرار. لذلك في القرارات التي تمس الناس مباشرة اختر النموذج الذي تستطيع شرحه، حتى لو كان أقل دقة بقليل.
أخطاء شائعة Common Mistakes
- الاختبار على بيانات التدريب: الشجرة في تجربتنا حصلت على 1.000 في التدريب و0.923 في الاختبار، فرقم التدريب لا يقول شيئاً عن الأداء الحقيقي، لذلك اختبر دائماً على بيانات لم يرها النموذج.
- استخدام جزء الاختبار لاختيار الإعدادات: إذا جربت عشرين إعداداً واخترت الأفضل على جزء الاختبار، فقد أصبح جزءاً من التدريب، واستخدم جزء التحقق أو التحقق المتقاطع للاختيار، والاختبار مرة واحدة في النهاية.
- الدقة على البيانات غير المتوازنة: نموذج لا يفعل شيئاً حصل على 99% في تجربة الاحتيال، فانظر دائماً إلى Precision وRecall للفئة النادرة.
- عدم وجود خط أساس: نتيجة 0.93 تبدو ممتازة حتى تعرف أن قول «حميد» دائماً يعطي 0.63، أو أن النظام الحالي في الشركة يعطي 0.95.
- تسرب البيانات عبر خطوات التحضير: توحيد المقياس أو ملء القيم الناقصة أو اختيار الأعمدة على كل البيانات قبل التقسيم، وقد رأيت كيف أعطى الضجيج الخالص 0.795.
- تقسيم عشوائي لبيانات زمنية: إذا كان النموذج سيتوقع المستقبل، فيجب أن يكون الاختبار بعد التدريب زمنياً.
- البدء بأعقد نموذج: الانحدار الخطي تفوق على الغابة في بيانات السكري، والانحدار اللوجستي تفوق على الجميع في بيانات السرطان.
- نسيان توحيد المقياس للخوارزميات التي تعتمد على المسافة: k-NN وSVM وk-means وPCA والشبكات العصبية.
- نشر النموذج ونسيانه: بدون مراقبة لن تعرف أن دقته انخفضت حتى يشتكي العملاء.
قائمة التحقق Checklist قبل أن تعتمد نموذجاً
- هل المشكلة تحتاج تعلماً آلياً أصلاً، أم أن القاعدة معروفة ويكفيها كود عادي؟
- هل البيانات تمثل الواقع الذي سيعمل فيه النموذج، وهل فيها كل المجموعات التي سيخدمها؟
- هل قسمت البيانات قبل أي خطوة تتعلم منها، وهل الاختبار بعد التدريب زمنياً إن كانت البيانات زمنية؟
- هل كل خطوات التحضير داخل Pipeline؟
- هل عندك خط أساس، وهل يتفوق النموذج عليه بفرق واضح؟
- هل اخترت المقياس المناسب للمشكلة (Recall أو Precision أو MAE)، وهل نظرت إلى مصفوفة الالتباس؟
- هل قارنت النماذج بالتحقق المتقاطع، واستخدمت جزء الاختبار مرة واحدة فقط؟
- هل الفرق بين أداء التدريب والاختبار معقول، أم أن النموذج يحفظ البيانات؟
- هل قست الأداء لكل مجموعة مهمة على حدة؟
- هل تستطيع شرح قرار النموذج لمن يتأثر به؟
- هل البيانات الشخصية محمية، وهل يتوافق استخدامها مع نظام حماية البيانات الشخصية؟
- هل سجلت إعدادات التدريب ونتائجه، بأداة مثل MLflow أو حتى في ملف؟
- هل عندك خطة لمراقبة النموذج بعد النشر وإعادة تدريبه؟
تدريب عملي
- غير
metrics.pyليستخدمpredict_probaبدلاً منpredict، ثم جرب عتبات 0.3 و0.5 و0.7 للورم الخبيث، وراقب كيف يتبادل Precision وRecall الأدوار. - في
ga.pyضعMUT = 0ثمMUT = 0.2وقارن تطور أفضل حل، ثم أضف قيداً مثل «الغرض 3 والغرض 7 لا يجتمعان» داخل دالةfitnessفقط. - غير
n_clustersفيunsup.pyإلى 2 ثم 5، وانظر كيف تتغير المجموعات في الرسم ورقم ARI.
وعند الانتهاء احذف ما أنشأته في التجربة:
docker rm -f lab-ml-py lab-ml-dotnet
docker image rm python:3.12-slim mcr.microsoft.com/dotnet/sdk:10.0
ولاحظ أن الأمر الثاني يحذف ال Images، فلا تشغله إذا كانت مشاريع أخرى عندك تستخدمها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التعلم الآلي يستنتج القواعد من الأمثلة بدلاً من أن تكتبها بيدك، ويستحق تكلفته فقط عندما تكون القاعدة غير معروفة أو كثيرة التغير وتتوفر أمثلة كافية.
- الأنواع الأربعة تتحدد بمصدر الإجابة الصحيحة: موجه مع إجابات، وغير موجه بلا إجابات، وذاتي يصنع إجاباته من البيانات، ومعزز بالمكافأة.
- التدريب سطر واحد، والعمل الحقيقي في البيانات والتقييم والمراقبة بعد النشر.
- ابدأ بخط أساس، وقسم البيانات قبل أي شيء، وضع التحضير داخل Pipeline، وقارن بالتحقق المتقاطع، واستخدم جزء الاختبار مرة واحدة.
- الدقة تكذب على البيانات غير المتوازنة، فانظر إلى مصفوفة الالتباس وPrecision وRecall، واختر بينهما بحسب تكلفة كل خطأ في مجالك.
- على الجداول ابدأ بالانحدار الخطي أو اللوجستي ثم Gradient Boosting، واترك الشبكات العصبية للصور والصوت والنصوص والبيانات الضخمة.
- الخوارزميات الجينية لمشاكل التحسين والجدولة التي لا يوجد فيها تدرج، وتعطي حلاً جيداً بسرعة دون ضمان الأفضل.
- أغلب المؤسسات لا تحتاج أدوات البيانات الضخمة، فاصعد من جهاز واحد إلى PostgreSQL إلى قاعدة عمودية إلى Spark فقط عندما يثبت القياس الحاجة.
- النموذج يتعلم انحياز بياناته، فقس الأداء لكل مجموعة، واحم البيانات الشخصية، واختر نموذجاً تستطيع شرحه في القرارات التي تمس الناس.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي على سيرفرك بإذن الله نكمل من هنا إلى تشغيل النماذج على سيرفرك وبناء تطبيقات عليها، وتجد شرح المصطلحات التي ستقابلها في مصطلحات الذكاء الاصطناعي ونماذج اللغة.
 دليلقصة الذكاء الاصطناعي من تورنغ إلى ChatGPTكيف تطور الذكاء الاصطناعي خلال ثمانين سنة، ولماذا انتظرت أفكاره البيانات والحوسبة عقوداً حتى وصلنا إلى ChatGPT.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليللماذا تفوقت نماذج اللغة LLM على التعلم الآلي التقليدي؟ما الذي جعل نموذج لغة واحداً يحل مهاماً كانت تحتاج نموذجاً لكل منها، وأين ما زالت الخوارزميات التقليدية هي الخيار الأفضل.
 دليلابن نموذج لغة بلغة C# من الصفر (1): محرك التعلم Autogradنبني بلغة C# ودون أي مكتبة المحرك الذي تتعلم به كل الشبكات العصبية، ونتأكد بالأرقام أن كل عملية فيه صحيحة.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Docker Engine 29.8.0 مع Python 3.12.15 (python:3.12-slim) وscikit-learn 1.9.1 وNumPy 2.5.3 وpandas 3.0.6 وMatplotlib 3.11.2، و.NET SDK 10.0.401 مع Microsoft.ML وMicrosoft.ML.FastTree 5.0.0.


