

لو طلب منك مديرك قبل عشر سنوات برنامجاً يقرأ فواتير الموردين الممسوحة ضوئياً ويستخرج منها رقم الفاتورة والمبلغ والضريبة، فغالب الظن أنك كنت ستقضي أشهراً في العمل: برنامج للتعرف على الحروف OCR يتعثر في الحروف العربية المتصلة، ثم قواعد تكتبها بيدك لتعرف أين يقع المبلغ في كل نوع من الفواتير، ثم نموذج صغير يتعلم من مئات الفواتير التي صنفها موظف بيده، وكل مورد جديد بتصميم جديد يكسر جزءاً من هذا كله. أما اليوم فترسل صورة الفاتورة إلى نموذج يفهم الصور والنصوص، وتكتب له «استخرج رقم الفاتورة والمبلغ والضريبة بصيغة JSON»، فيعيدها لك في ثوان، حتى لو كانت الصورة مائلة أو مأخوذة بكاميرا الجوال.
ومن هنا جاءت الفكرة التي يسمعها الكثيرون اليوم: سنوات من العمل في التعلم الآلي Machine Learning لم تستطع أن تحل مشكلة مثل OCR بالشكل الذي تحلها به نماذج اللغة الكبيرة LLM. وفي هذه الفكرة جزء صحيح وجزء يحتاج تدقيقاً، فالذي تفوق أولاً على الطرق القديمة في قراءة الصور هو التعلم العميق Deep Learning قبل ظهور نماذج اللغة بسنوات طويلة، والذي أضافته نماذج اللغة والنماذج الأساسية Foundation Models هو العمومية: نموذج واحد مدرب مسبقاً يؤدي مهاماً كثيرة من تعليمات وأمثلة قليلة، ويتعامل مع مدخلات فوضوية ومتنوعة وباللغة العربية. وفي المقابل ما زالت الخوارزميات التقليدية تتفوق في مواقع كثيرة، أولها البيانات الجدولية Tabular Data، ثم التكلفة والسرعة والثبات والقدرة على التفسير.
وهذا المقال يكمل مقال كيف تعمل نماذج اللغة الكبيرة LLM، فإذا لم تكن تعرف التوكن Token والانتباه Attention والتدريب المسبق Pretraining فابدأ به، كما أن قصة الأشخاص والسنوات في قصة الذكاء الاصطناعي من تورنغ إلى ChatGPT، ومفاهيم التعلم الآلي والخوارزميات التقليدية نفسها في التعلم الآلي Machine Learning للمبتدئين، وإذا مر بك مصطلح لا تعرفه فستجده في مصطلحات الذكاء الاصطناعي ونماذج اللغة.
وسوف نناقش في هذا المقال ما يلي:
- الطريقة القديمة: نموذج لكل مهمة، وخصائص يصممها المهندس بيده، وبيانات مصنفة لكل مهمة، ولماذا كانت هشة.
- من الذي تفوق فعلاً: التعلم العميق قبل نماذج اللغة، والدليل من قراءة الشيكات في التسعينات ومن Tesseract.
- ما الذي تغير خطوة بخطوة: تعلم التمثيل، والحجم، والتعلم بالنقل، وTransformer، والتعلم الذاتي، والتعلم من أمثلة قليلة، وضبط التعليمات، والنماذج التي تقرأ الصور.
- تجربة حقيقية على فاتورة عربية: Tesseract بنسختين من بيانات اللغة العربية، ونموذج صغير يفهم الصور، مع قياس نسبة الخطأ في الحروف.
- أين تكون نماذج اللغة الأداة الخطأ، مع تجربة حقيقية على بيانات جدولية: Gradient Boosting مقابل شبكة عصبية صغيرة مقابل نموذج لغة.
- النمط الهجين Hybrid، وجدول القرار، والأخطاء الشائعة، وقائمة تحقق قبل أن تختار.
الطريقة القديمة: نموذج لكل مهمة وخصائص يصممها الإنسان Feature Engineering
لنأخذ مثالاً من عمل أي فريق تقنية في مؤسسة: لديك ثلاث مشاكل، فلترة الرسائل المزعجة Spam، ومعرفة هل تعليق العميل إيجابي أم سلبي (تحليل المشاعر Sentiment Analysis)، وقراءة الفواتير الممسوحة. والطريقة التي عمل بها الجميع لسنوات كانت أن تبني لكل مشكلة نظاماً مستقلاً بنفس الخطوات:
- جمع بيانات مصنفة Labelled Data للمهمة نفسها: آلاف الرسائل التي حدد شخص بيده أيها مزعج، وآلاف التعليقات التي حدد أيها إيجابي، وعشرات الآلاف من صور الحروف مع الحرف الصحيح لكل صورة.
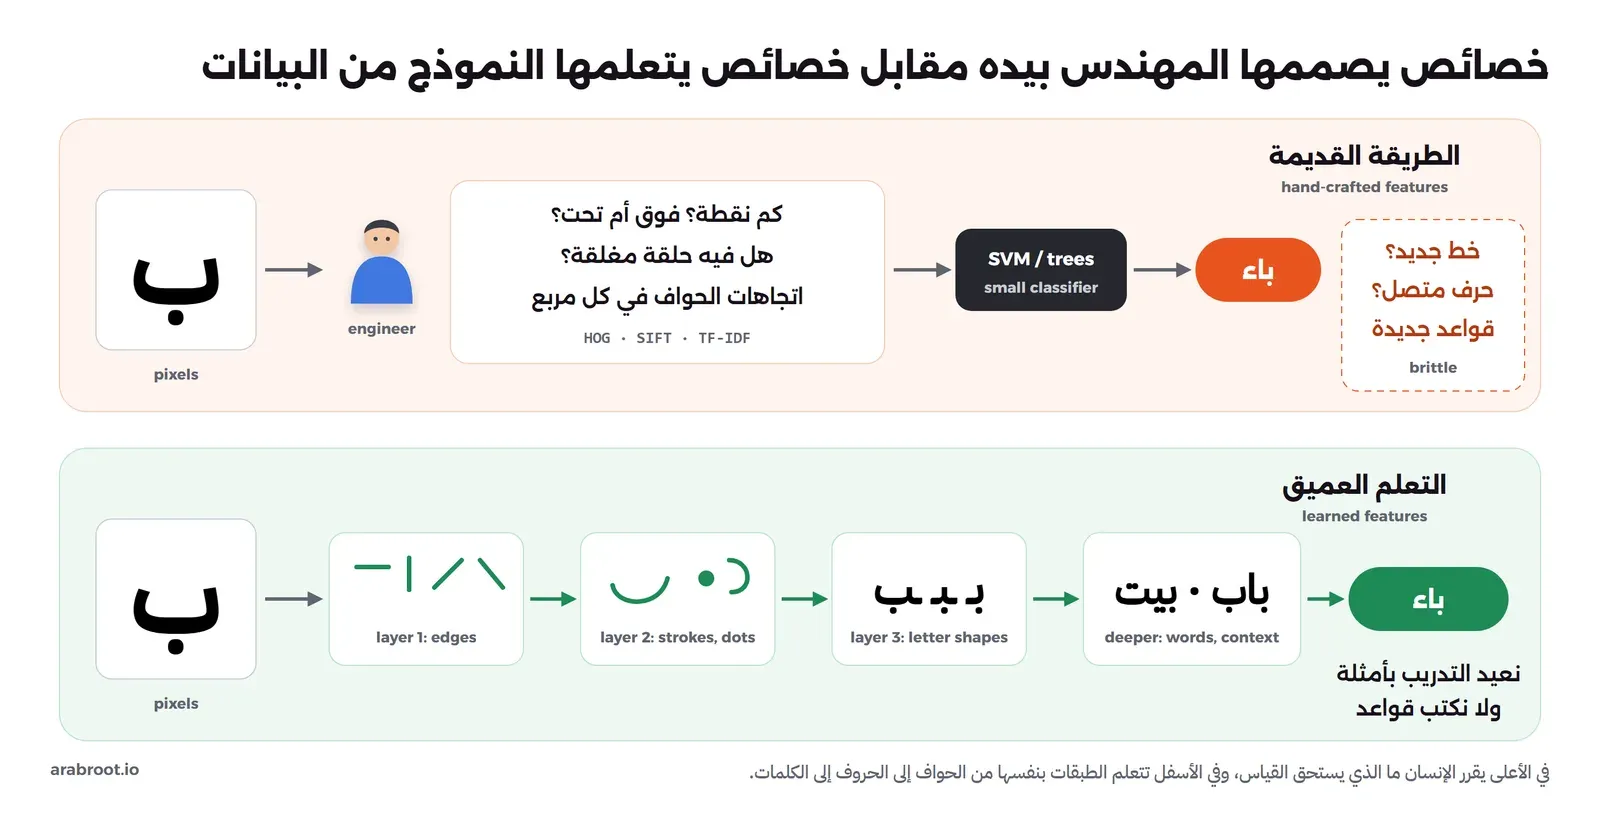
- تصميم الخصائص Features بيدك، وهذه هي هندسة الخصائص Feature Engineering: أي أن تقرر أنت كمهندس ما الذي يستحق أن يقاس في المدخل، لأن الخوارزمية لا ترى النص أو الصورة وإنما ترى قائمة أرقام تصنعها أنت.
- تدريب نموذج صغير، مثل آلة المتجهات الداعمة Support Vector Machine واختصاراً SVM أو شجرة قرار Decision Tree أو الانحدار اللوجستي Logistic Regression، على هذه الأرقام، وقد شرحنا هذه الخوارزميات في مقال التعلم الآلي للمبتدئين.
وفي النصوص كانت الخصائص الأشهر هي حقيبة الكلمات Bag of Words، أي عدد مرات ظهور كل كلمة في النص بغض النظر عن ترتيبها، ثم نسختها المحسنة TF-IDF التي تعطي الكلمة النادرة وزناً أكبر من الكلمة المكررة في كل النصوص. وفي الصور كانت هناك خصائص مثل مخطط اتجاهات الحواف Histogram of Oriented Gradients واختصاراً HOG الذي نشره Dalal وTriggs في 2005، وSIFT الذي نشره David Lowe في 2004، وكلاهما طريقة صممها باحث بيده ليصف شكل الحواف في كل جزء من الصورة بأرقام. وفي قراءة الحروف العربية تحديداً كان المهندس يكتب أسئلة مثل: كم نقطة في الحرف؟ هل هي فوق أم تحت؟ هل فيه حلقة مغلقة مثل الصاد والطاء؟ والصورة التالية تبين الفرق بين هذه الطريقة وبين الطريقة التي سوف نشرحها بعد قليل:
وهذه الطريقة عملت فعلاً، وما زالت فلاتر البريد المزعج القائمة على Naive Bayes وTF-IDF تعمل في أماكن كثيرة إلى اليوم، ولكن فيها أربع مشاكل تظهر بوضوح كلما خرجت من المختبر إلى الواقع:
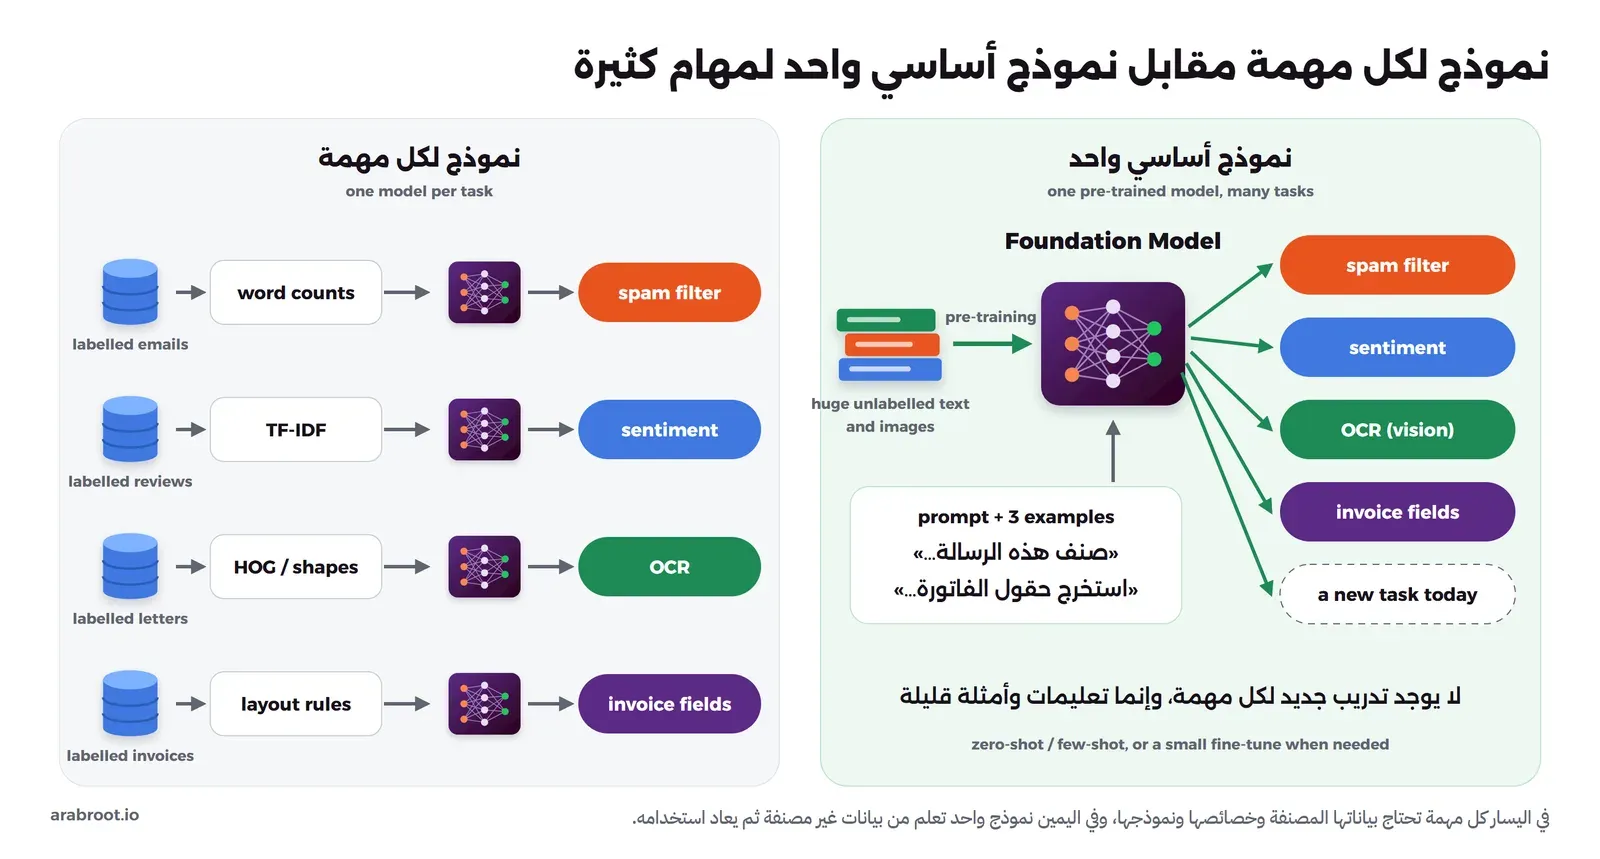
- نموذج لكل مهمة: نموذج الرسائل المزعجة لا يعرف شيئاً عن تحليل المشاعر، وكل مهمة جديدة تعني بيانات جديدة وخصائص جديدة وتدريباً جديداً من الصفر.
- البيانات المصنفة مكلفة: كل مثال يحتاج إنساناً يقرأه ويصنفه، والمهام التي ليس لها آلاف الأمثلة لا تجد من يبني لها نموذجاً أصلاً.
- الهشاشة Brittleness: الخصائص التي صممتها على خط معين أو تصميم فاتورة معين أو لهجة معينة تنكسر مع خط جديد أو تصميم جديد أو تعليق بالعامية، والسبب أن النموذج لم يتعلم الفكرة وإنما تعلم الأرقام التي اخترتها أنت.
- سلاسل من النماذج الصغيرة Pipelines: نظام قراءة الفاتورة كان في الحقيقة عدة أنظمة متتالية، تنظيف الصورة ثم تقطيع الأسطر ثم تقطيع الحروف ثم التعرف عليها ثم فهم تخطيط الصفحة Layout ثم استخراج الحقول، وخطأ صغير في الخطوة الأولى يكبر في كل خطوة بعدها.
الصورة التالية تجمع الفرق الكبير بين هذا العالم وبين العالم الذي نعيش فيه اليوم:
من الذي تفوق فعلاً؟ التعلم العميق Deep Learning قبل نماذج اللغة
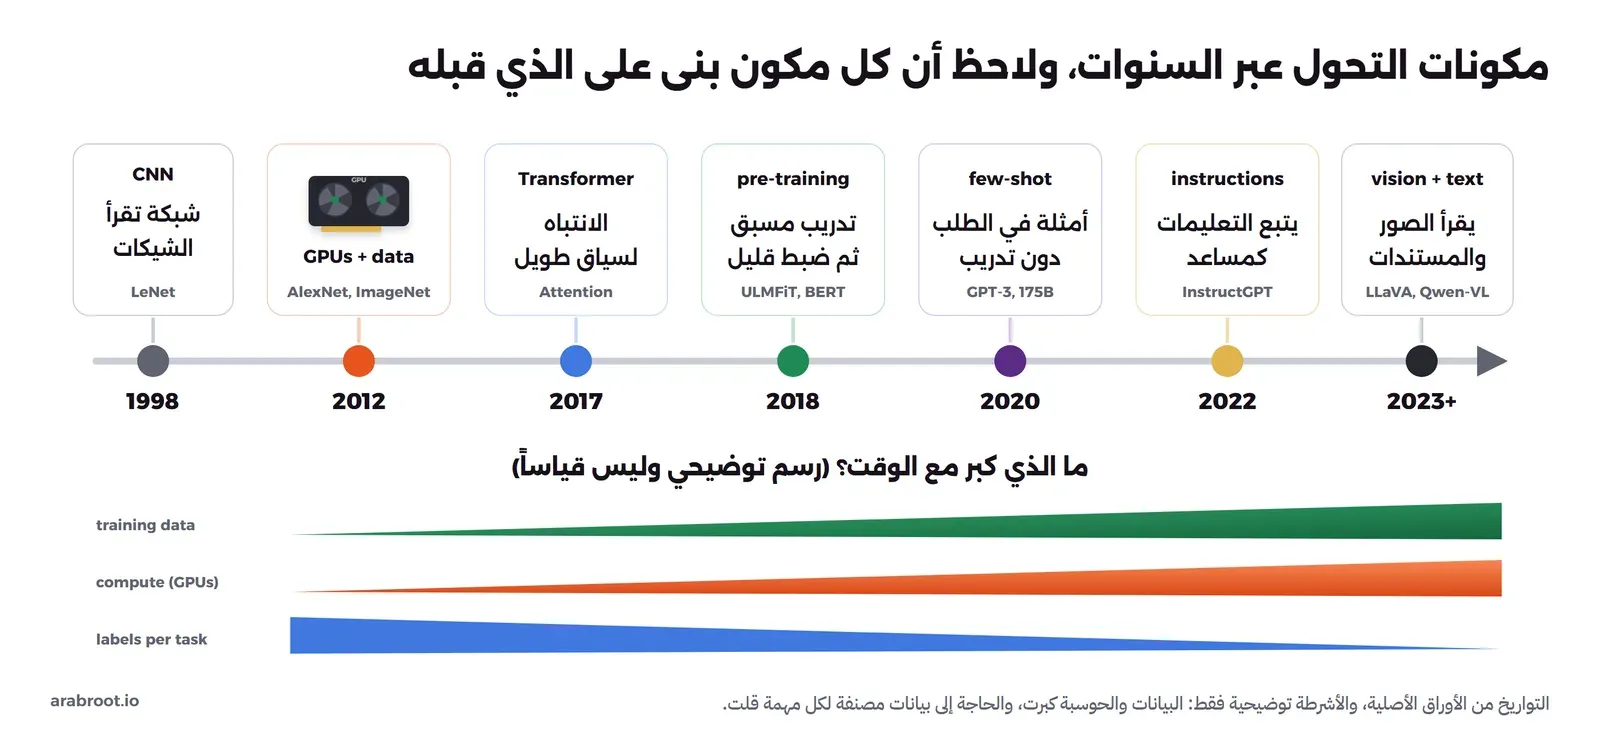
وقد يتساءل البعض: إذا كانت الطرق القديمة بهذه الهشاشة، فهل بقي OCR مشكلة بلا حل حتى ظهر ChatGPT؟ والإجابة لا، والتاريخ هنا مهم لأنه يصحح الفكرة الشائعة. ففي 1998 نشر Yann LeCun وLéon Bottou وYoshua Bengio وPatrick Haffner ورقة Gradient-Based Learning Applied to Document Recognition في مجلة Proceedings of the IEEE، وفيها شبكة عصبية التفافية Convolutional Neural Network واختصاراً CNN من عائلة LeNet تتعلم شكل الحروف المكتوبة بخط اليد من البكسلات مباشرة، دون أن يصمم لها أحد خصائص بيده، ويذكر ملخص الورقة أن نظاماً مبنياً عليها لقراءة الشيكات البنكية «مستخدم تجارياً ويقرأ عدة ملايين من الشيكات يومياً». أي أن شبكة عصبية كانت تقرأ خط اليد في البنوك قبل ChatGPT بأكثر من عشرين سنة.
ثم في 2012 فازت شبكة AlexNet التي بناها Alex Krizhevsky وIlya Sutskever وGeoffrey Hinton في مسابقة ImageNet لتصنيف الصور، وقد تدربت على 1.3 مليون صورة في 1000 فئة باستخدام البطاقات الرسومية GPU، وتفوقت بفارق كبير على الطرق القائمة على الخصائص اليدوية، ومن هنا بدأ التعلم العميق يحل محل هندسة الخصائص في الصور ثم في الصوت ثم في النصوص، وتجد القصة كاملة بأشخاصها في قصة الذكاء الاصطناعي.
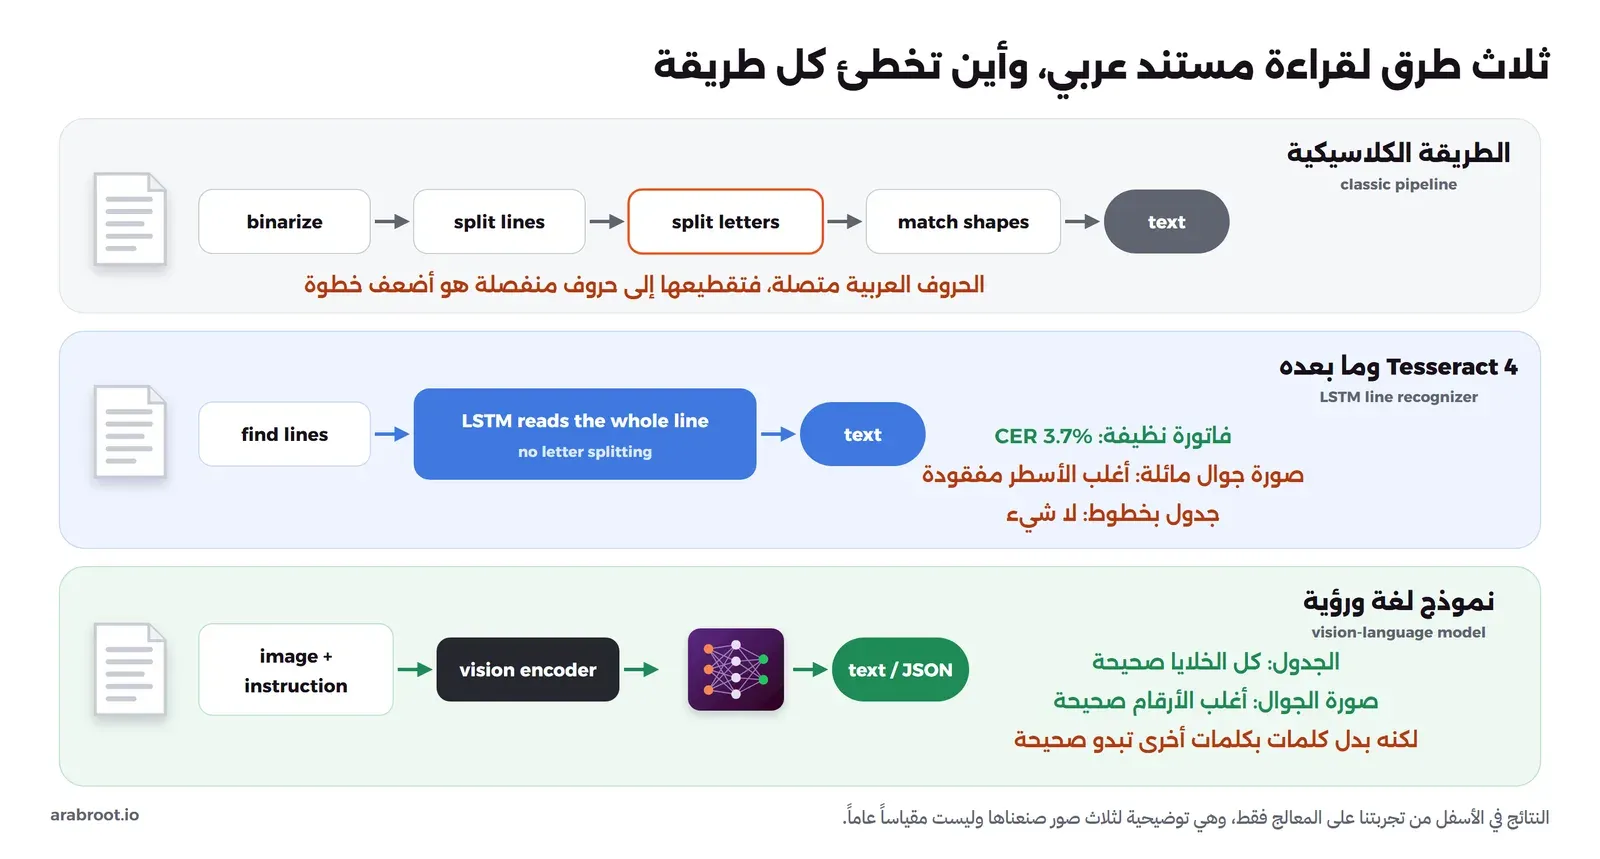
وأوضح مثال قريب من عملك هو Tesseract، أشهر برنامج OCR مفتوح المصدر برخصة Apache 2.0، فصفحته الرسمية تقول إن الإصدار 4 «أضاف محرك OCR جديداً قائماً على شبكة عصبية من نوع LSTM يركز على التعرف على السطر كاملاً»، مع إبقاء المحرك القديم عبر الخيار --oem 0. والذاكرة طويلة قصيرة المدى Long Short-Term Memory واختصاراً LSTM نوع من الشبكات العصبية يقرأ تسلسلاً، هنا شريط السطر من اليمين إلى اليسار، فلا يحتاج أن يقطع الكلمة العربية المتصلة إلى حروف منفصلة قبل التعرف عليها، وهذا بالضبط ما كان يكسر الطرق القديمة في العربية.
إذن فالجزء الأول من الإجابة على سؤال المقال: الذي هزم الخصائص اليدوية في الصور والصوت هو التعلم العميق، وفكرته الأساسية أن الخصائص تتعلم من البيانات ولا تصمم باليد. أما نماذج اللغة فجاءت بعد ذلك بشيء آخر، وهو ما نشرحه في القسم التالي.
ما الذي تغير خطوة بخطوة؟
التحول لم يحدث في يوم واحد، وإنما هو مجموعة مكونات جاء كل منها في وقت مختلف وبنى على الذي قبله، والصورة التالية تضعها على خط زمني، والتواريخ فيها من الأوراق الأصلية، أما الأشرطة في أسفلها فهي رسم توضيحي وليست قياساً:
تعلم التمثيل Representation Learning: الخصائص تتعلم ولا تصمم
هذا هو المكون الذي رأيناه في القسم السابق: بدلاً من أن تحول أنت الصورة أو النص إلى أرقام بقواعد تكتبها، تتعلم طبقات الشبكة نفسها كيف تمثل المدخل، فالطبقات الأولى في شبكة الصور تتعلم الحواف، والتي بعدها تتعلم الخطوط والنقاط، والأعمق تتعلم أشكال الحروف والكلمات. وفي النصوص يسمى هذا التمثيل التضمين Embedding، وقد شرحناه بأرقام حقيقية في قسم التضمين في مقال نماذج اللغة، ولن نعيده هنا. والنتيجة العملية أن تحسين النموذج أصبح يعني أن تعطيه أمثلة أكثر وأفضل، وليس أن تكتب قواعد أكثر.
الحجم Scale: بيانات أكثر وبطاقات رسومية أقوى
الشبكات العصبية كانت معروفة منذ عقود، ولكنها لم تتفوق إلا عندما توفر شيئان معاً: بيانات ضخمة مثل ImageNet ثم نصوص الإنترنت، وحوسبة رخيصة متوازية عبر البطاقات الرسومية GPU التي صممت أصلاً للألعاب. والسبب أن الشبكة الكبيرة تحتاج أمثلة كثيرة لتتعلم دون أن تحفظ الأمثلة حفظاً، وتحتاج مليارات العمليات لكل مثال، ولهذا السبب بالذات تحتاج النماذج اليوم ذاكرة كبيرة وبطاقات رسومية لتعمل، كما شرحنا في تشغيل نماذج اللغة على جهازك للمبتدئين.
التعلم بالنقل Transfer Learning والتدريب المسبق Pretraining
هنا بدأ التحول الأكبر من نموذج لكل مهمة إلى نموذج واحد لمهام كثيرة: تدرب نموذجاً كبيراً مرة واحدة على مهمة عامة، ثم تنقل ما تعلمه إلى مهمتك الخاصة بقليل من التدريب الإضافي، وهذا يسمى الضبط الدقيق Fine-tuning. وفي النصوص جاءت ورقة ULMFiT في يناير 2018، وذكرت أن طريقتها «بمئة مثال مصنف فقط» تصل إلى أداء التدريب من الصفر على بيانات أكبر بمئة مرة، ثم جاءت BERT من Google في أكتوبر 2018، وهي نموذج مدرب مسبقاً على نصوص غير مصنفة يمكن ضبطه بإضافة «طبقة مخرج واحدة» فقط لمهام كثيرة، وقد حققت أفضل النتائج وقتها في إحدى عشرة مهمة لغوية. ولاحظ ماذا يعني هذا لمشروعك: بدلاً من عشرة آلاف مثال مصنف لكل مهمة أصبحت تحتاج مئات فقط.
بنية Transformer والانتباه Attention لسياق طويل
الطرق القديمة للنصوص كانت إما تتجاهل ترتيب الكلمات تماماً مثل حقيبة الكلمات، أو تقرأ النص كلمة بعد كلمة مثل LSTM فتنسى أول الفقرة عندما تصل إلى آخرها، وتصعب تدريبها بالتوازي على البطاقات الرسومية. ثم جاءت بنية Transformer في ورقة Attention Is All You Need في 2017، وفيها ينظر كل توكن إلى التوكنز الأخرى ويأخذ منها بقدر أهميتها، فتقرأ الجملة كلها معاً وتتدرب بالتوازي، وتفهم أن «البنك» في جملة عن النهر غير «البنك» في جملة عن الحساب. وقد شرحنا الانتباه بتجربة حقيقية في قسم الانتباه وكتلة Transformer في القسم الذي يليه، والمهم هنا أن هذه البنية هي التي جعلت التدريب على كميات هائلة من النصوص ممكناً عملياً.
التعلم الذاتي Self-supervised Learning: النص هو المعلم
بقيت مشكلة البيانات المصنفة: من أين تأتي بمليارات الأمثلة المصنفة؟ والإجابة أنك لا تحتاجها، فنموذج اللغة يتدرب على توقع التوكن التالي في نص حقيقي، والإجابة الصحيحة موجودة في النص نفسه، وBERT تدرب على توقع كلمات مخفية في الجملة، وكلاهما لا يحتاج إنساناً يصنف شيئاً. وهذا يسمى التعلم الذاتي Self-supervised Learning، وتفاصيله في قسم التدريب المسبق. وبهذا الشكل أصبحت كل صفحة في الإنترنت مثالاً تدريبياً مجانياً، وهذا ما لم يكن ممكناً في عالم «نموذج لكل مهمة».
التعلم من أمثلة قليلة Few-shot دون أي تدريب
وفي مايو 2020 نشرت OpenAI ورقة Language Models are Few-Shot Learners عن GPT-3 بحجم 175 مليار معامل، والجديد فيها أن النموذج يؤدي المهمة «دون أي تحديث للأوزان أو ضبط دقيق»، وإنما بوصف المهمة وبضعة أمثلة مكتوبة في الطلب نفسه، وهذا يسمى التعلم من أمثلة قليلة Few-shot، وإذا لم تعط أي مثال فهو Zero-shot. أي أن المهمة الجديدة لم تعد تحتاج تدريباً أصلاً، وإنما تحتاج نصاً جيداً في الطلب، وهذه هي العمومية التي جعلت الناس يشعرون أن نماذج اللغة «تحل كل شيء».
ضبط التعليمات Instruction Tuning: من مكمل نصوص إلى مساعد
النموذج الذي يكمل النصوص لا يجيب عن الأسئلة بالضرورة، والذي حوله إلى مساعد يتبع التعليمات هو ضبط التعليمات ثم ضبط التفضيلات، كما في InstructGPT في 2022، وقد شرحنا ذلك بتجربة حقيقية بين النموذج الأساسي ونموذج التعليمات في قسم ضبط التعليمات. والذي يهمنا هنا أن هذه الخطوة جعلت كتابة المهمة بلغة عادية، مثل «استخرج حقول هذه الفاتورة»، كافية في أغلب الحالات دون أمثلة أصلاً.
النماذج التي تقرأ الصور Vision-Language Models
آخر مكون هو الذي يعيدنا إلى OCR: في 2021 نشرت OpenAI نموذج CLIP الذي تعلم من 400 مليون زوج من الصور ونصوصها في الإنترنت، ثم جاءت نماذج اللغة والرؤية Vision-Language Models واختصاراً VLM مثل LLaVA في أبريل 2023 وQwen-VL في أغسطس 2023، وفكرتها أن يضاف إلى نموذج اللغة مشفر للصور Vision Encoder يحول الصورة إلى متجهات يفهمها النموذج كأنها توكنز، فيقرأ الصورة والسؤال معاً ويكتب الإجابة. وهذا يعني أن النموذج لم يعد يقرأ الحروف فقط، وإنما يفهم أن الرقم المكتوب بجانب كلمة «الإجمالي» هو المبلغ النهائي، وهذا ما كان يحتاج عدة نماذج في سلسلة الطريقة القديمة. والآن لنر ذلك على أرض الواقع.
تجهيز بيئة التجربة
سوف نقيس الفكرة بأنفسنا بدلاً من أن نصدقها أو نرفضها، فنصنع ثلاث صور لمستندات عربية نعرف نصها الصحيح حرفاً بحرف، ثم نقرؤها ببرنامج Tesseract وبنموذج صغير يفهم الصور، ونقيس الخطأ في كل حالة. ثم ننتقل إلى بيانات جدولية ونقارن نموذجاً تقليدياً بنموذج لغة. ولن نثبت شيئاً على جهازك، وإنما نشغل Container فيه Python وTesseract، وContainer آخر فيه Ollama، وكلاهما على شبكة Docker خاصة بالتجربة. وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu:
mkdir why-lab && cd why-lab
docker network create lab-why-net

# Python مع Tesseract وبيانات اللغة العربية وخطين عربيين مجانيين
docker volume create lab-why-pip
docker run -d --name lab-why-py --network lab-why-net -v lab-why-pip:/root/.cache -v "$PWD":/lab -w /lab python:3.12-slim sleep infinity
docker exec lab-why-py sh -c "apt-get update -qq && apt-get install -y -qq tesseract-ocr tesseract-ocr-ara fonts-noto-core fonts-hosny-amiri libraqm0"
docker exec lab-why-py pip install -q pillow scikit-learn pandas

# نسخة tessdata_best من بيانات العربية للمقارنة
mkdir tessdata_best
curl -sL -o tessdata_best/ara.traineddata https://github.com/tesseract-ocr/tessdata_best/raw/main/ara.traineddata

# Ollama على منفذ محلي فقط، مع نموذج يفهم الصور ونموذج نصي
docker volume create lab-why-ollama
docker run -d --name lab-why-ollama --network lab-why-net -p 127.0.0.1:20280:11434 -v lab-why-ollama:/root/.ollama ollama/ollama:0.35.1
docker exec lab-why-ollama ollama pull qwen3-vl:2b
docker exec lab-why-ollama ollama pull qwen2.5:3b
في الإعداد أعلاه لاحظ التالي:
- الحزمة tesseract-ocr-ara في Debian هي بيانات اللغة العربية لبرنامج Tesseract، والإصدار الذي ثبتته هو Tesseract 5.5.0، وهذه الحزمة مأخوذة من مستودع tessdata_fast، والسبب أن توثيق Tesseract يذكر أن tessdata_fast «الأسرع والأقل دقة» وهو الذي يأتي مع توزيعات Linux، بينما tessdata_best «الأبطأ والأدق»، لذلك حملناه أيضاً للمقارنة.
- الحزمة
libraqm0تسمح لمكتبة Pillow برسم النص العربي متصلاً ومن اليمين إلى اليسار، ودونها تظهر الحروف منفصلة ومعكوسة. - النموذج qwen3-vl:2b نموذج لغة ورؤية من Alibaba حجمه في Ollama قرابة 1.9 GB، وفيه 2.1 مليار معامل Parameters بتكميم Quantization من نوع Q4_K_M، ورخصته Apache 2.0 بحسب صفحته على Hugging Face التي تذكر أنه يدعم OCR في 32 لغة. أما qwen2.5:3b فنموذج نصي فيه 3.1 مليار معامل، ولاحظ أن رخصته Qwen Research وليست Apache، فهو للتجربة وليس للاستخدام التجاري.
- منفذ Ollama منشور على
127.0.0.1فقط، والسبب أن واجهة Ollama لا تطلب أي مصادقة، أما Container ال Python فيصل إلى Ollama باسمهlab-why-ollamaعبر الشبكةlab-why-net. - كل التجارب في هذا المقال على جهاز واحد بمعالج Intel Core i7-7700K (أربع أنوية وثمانية خيوط) و32 GB ذاكرة دون أي بطاقة رسومية، عبر Docker Desktop مع WSL2، وكان الجهاز يشغل أعمالاً أخرى في نفس الوقت، لذلك فكل الأزمنة في المقال توضيحية لهذا الجهاز وليست قياساً عاماً.
مثال حي: قراءة فاتورة عربية بالتعرف الضوئي على الحروف OCR بثلاث طرق
الصورة التالية تبين الطرق الثلاث التي سوف نقارنها، ومعها النتائج التي سوف تراها بعد قليل:
صناعة صور الاختبار Test Images
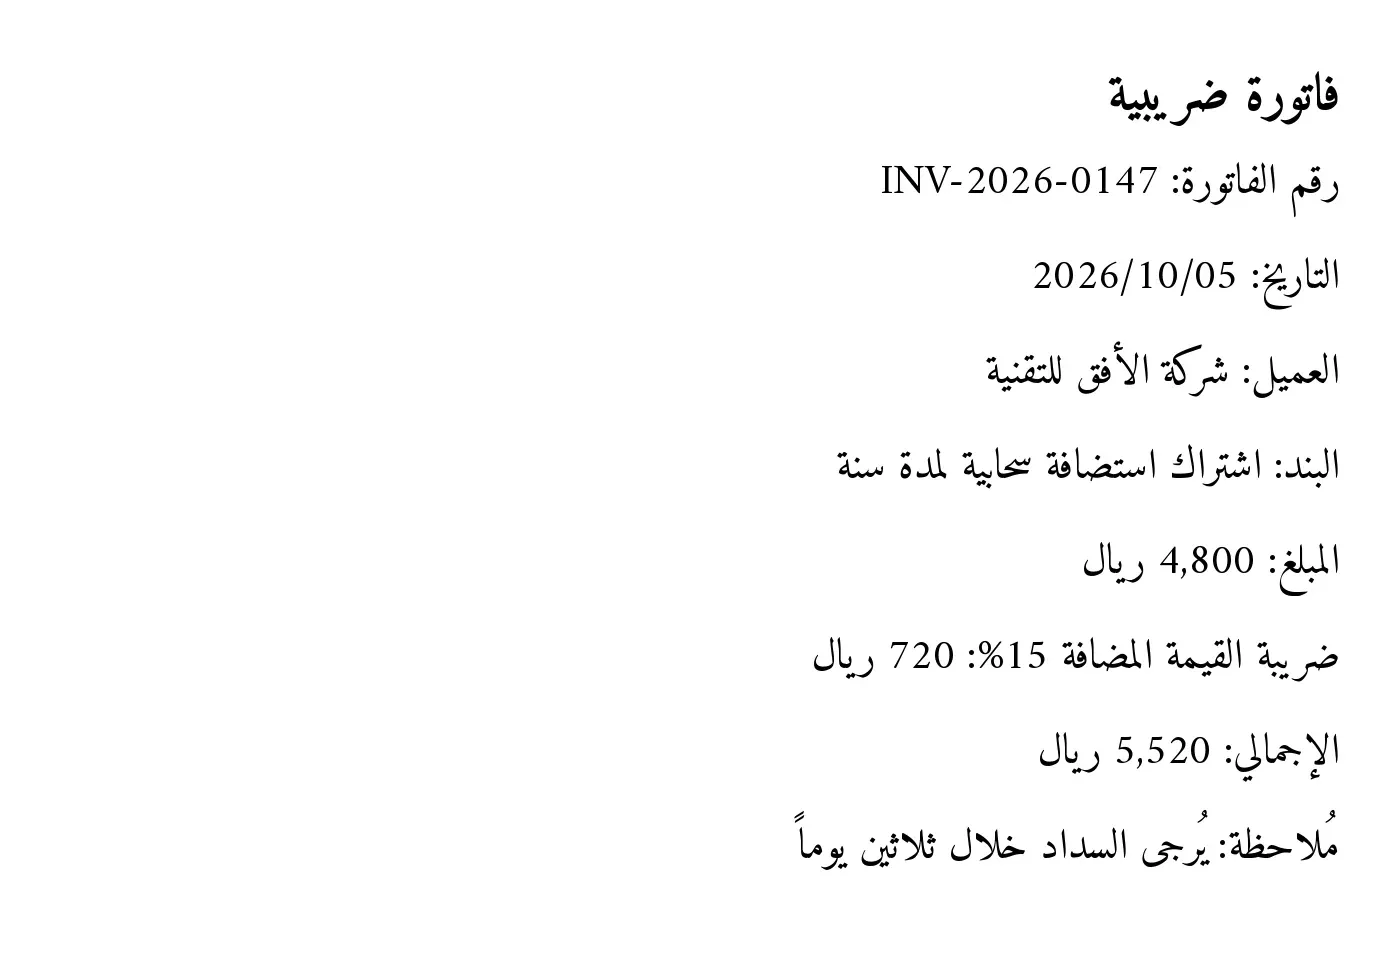
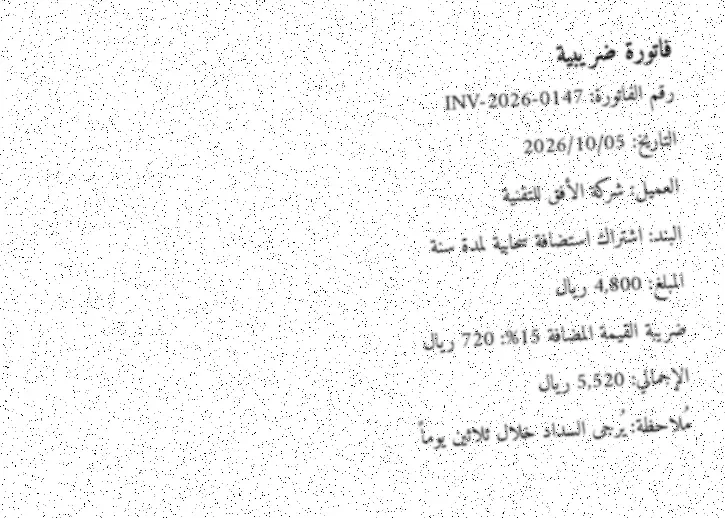
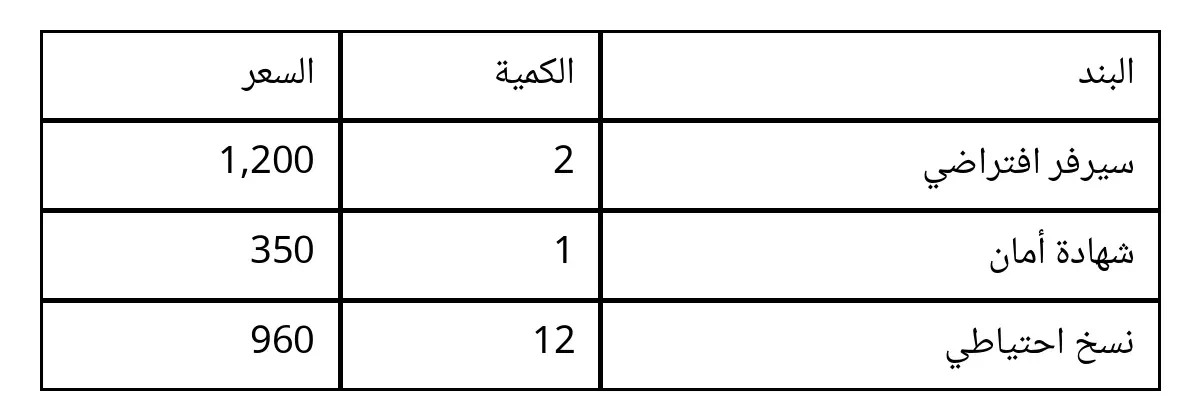
لكي نقيس الخطأ يجب أن نعرف النص الصحيح، لذلك لا نستخدم فاتورة حقيقية، وإنما نرسم فاتورة بأنفسنا بخط Amiri المجاني، فيها ما يصعب على أي برنامج OCR في العربية: حروف متصلة، ورقم فاتورة بحروف إنجليزية داخل سطر عربي، وتاريخ وأرقام بفواصل، وعلامة نسبة مئوية، وكلمتان فيهما تشكيل. ثم نصنع منها نسخة تشبه صورة جوال سيئة: مائلة ثلاث درجات، وبنصف الدقة، ومموهة، وفيها نقاط عشوائية. ثم جدولاً صغيراً بخطوط وبخط Noto Naskh Arabic. احفظ البرنامج التالي في الملف make_images.py:
from PIL import Image, ImageDraw, ImageFont, ImageFilter
import random, json

AMIRI = "/usr/share/fonts/opentype/fonts-hosny-amiri/Amiri-Regular.ttf"      # has Latin letters too
AMIRI_BOLD = "/usr/share/fonts/opentype/fonts-hosny-amiri/Amiri-Bold.ttf"
NASKH = "/usr/share/fonts/truetype/noto/NotoNaskhArabic-Regular.ttf"  # Arabic and digits only

invoice = [
    "فاتورة ضريبية",
    "رقم الفاتورة: INV-2026-0147",
    "التاريخ: 2026/10/05",
    "العميل: شركة الأفق للتقنية",
    "البند: اشتراك استضافة سحابية لمدة سنة",
    "المبلغ: 4,800 ريال",
    "ضريبة القيمة المضافة 15%: 720 ريال",
    "الإجمالي: 5,520 ريال",
    "مُلاحظة: يُرجى السداد خلال ثلاثين يوماً",
]

def draw_lines(lines, w=1400):
    img = Image.new("L", (w, 110 + 95 * len(lines)), 255)
    d = ImageDraw.Draw(img)
    y = 50
    for i, t in enumerate(lines):
        f = ImageFont.truetype(AMIRI_BOLD if i == 0 else AMIRI, 52 if i == 0 else 42)
        d.text((w - 60, y), t, font=f, fill=0, anchor="ra", direction="rtl", language="ar")
        y += 95
    return img

# 1) clean invoice, like a PDF printed straight to an image
clean = draw_lines(invoice)
clean.save("invoice.png")

# 2) the same invoice as a bad phone photo: rotated, smaller, blurred, noisy
random.seed(7)
scan = clean.rotate(3, expand=True, fillcolor=255, resample=Image.BICUBIC)
scan = scan.resize((scan.width // 2, scan.height // 2), Image.BILINEAR).filter(ImageFilter.GaussianBlur(0.9))
px = scan.load()
for _ in range(scan.width * scan.height // 25):
    x, y = random.randrange(scan.width), random.randrange(scan.height)
    px[x, y] = random.choice((0, 90, 170, 255))
scan.save("invoice-scan.png")

# 3) a small table with grid lines in another font (Noto Naskh Arabic)
rows = [["البند", "الكمية", "السعر"],
        ["سيرفر افتراضي", "2", "1,200"],
        ["شهادة أمان", "1", "350"],
        ["نسخ احتياطي", "12", "960"]]
cw, rh, W = [560, 260, 300], 90, 1200
tab = Image.new("L", (W, 60 + rh * len(rows)), 255)
d = ImageDraw.Draw(tab)
f = ImageFont.truetype(NASKH, 38)
for r, row in enumerate(rows):
    x = W - 40
    for c, cell in enumerate(row):
        y = 30 + r * rh
        d.rectangle([x - cw[c], y, x, y + rh], outline=0, width=3)
        d.text((x - 25, y + rh // 2), cell, font=f, fill=0, anchor="rm", direction="rtl", language="ar")
        x -= cw[c]
tab.save("table.png")

truth = {"invoice.png": invoice, "invoice-scan.png": invoice, "table.png": [" ".join(r) for r in rows]}
json.dump(truth, open("truth.json", "w", encoding="utf-8"), ensure_ascii=False, indent=1)
print({k: Image.open(k).size for k in truth})
docker exec lab-why-py python make_images.py{'invoice.png': (1400, 965), 'invoice-scan.png': (725, 518), 'table.png': (1200, 420)}والصور الثلاث كما خرجت، الفاتورة النظيفة أولاً، وهي مثل فاتورة طبعت من برنامج المحاسبة إلى PDF مباشرة:
كيف نقيس الخطأ؟ نسبة الخطأ في الحروف CER
المقياس المعتاد في OCR هو نسبة الخطأ في الحروف Character Error Rate واختصاراً CER، وهو عدد الحروف التي يجب أن تضيفها أو تحذفها أو تغيرها لتحول ناتج البرنامج إلى النص الصحيح (وهذه هي مسافة Levenshtein)، مقسوماً على طول النص الصحيح، فالصفر يعني نصاً مطابقاً، و100% تعني أن الناتج لا يشبه النص أو أنه فارغ. ولاحظ أن هذا المقياس يتأثر بترتيب الكلمات، فإذا قرأ البرنامج كل الكلمات صحيحة ولكن بترتيب آخر ارتفعت النسبة، لذلك سوف نضيف بعد قليل مقياساً ثانياً لا يتأثر بالترتيب. والبرنامج التالي ocr_compare.py يقرأ كل صورة بثلاث طرق: Tesseract ببيانات tessdata_fast التي جاءت مع الحزمة، وTesseract ببيانات tessdata_best، والنموذج qwen3-vl:2b عبر واجهة Ollama بدرجة حرارة 0، ثم يطبع CER والوقت لكل حالة:
import json, re, subprocess, time, base64, urllib.request, sys

OLLAMA = "http://lab-why-ollama:11434/api/chat"
VLM = sys.argv[1] if len(sys.argv) > 1 else "qwen3-vl:2b"
PROMPT = ("Read all the text in this image exactly as written, line by line, in the original language. "
          "Do not translate, do not explain, do not add anything.")

def norm(s):
    s = re.sub(r"[|*#`>]", " ", s)          # markdown that a model may add around a table
    s = re.sub(r"^\s*-{3,}\s*$", " ", s, flags=re.M)
    return " ".join(s.split())

def cer(pred, truth):
    a, b = norm(pred), norm(truth)
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1] / len(b)

def tesseract(img, tessdata):
    out = subprocess.run(["tesseract", img, "-", "-l", "ara", "--tessdata-dir", tessdata],
                         capture_output=True, text=True)
    return out.stdout

def vlm(img):
    body = {"model": VLM, "stream": False, "options": {"temperature": 0, "num_predict": 3000},
            "messages": [{"role": "user", "content": PROMPT,
                          "images": [base64.b64encode(open(img, "rb").read()).decode()]}]}
    req = urllib.request.Request(OLLAMA, json.dumps(body).encode(), {"Content-Type": "application/json"})
    r = json.load(urllib.request.urlopen(req, timeout=3600))
    print(f"    ({r['eval_count']} tokens generated, {len(r['message'].get('thinking') or '')} characters of thinking)")
    return r["message"]["content"]

if __name__ == "__main__":
    truth = json.load(open("truth.json", encoding="utf-8"))
    engines = {
        "tesseract fast": lambda i: tesseract(i, "/usr/share/tesseract-ocr/5/tessdata"),
        "tesseract best": lambda i: tesseract(i, "/lab/tessdata_best"),
        VLM: vlm,
    }
    results = {}
    for img, lines in truth.items():
        for name, fn in engines.items():
            t = time.time()
            text = fn(img)
            sec = time.time() - t
            results[f"{img} | {name}"] = text
            print(f"{img:<17} {name:<15} CER {cer(text, chr(10).join(lines)) * 100:5.1f}%   {sec:6.1f} s")
    json.dump(results, open(f"ocr-out-{VLM.replace(':', '_')}.json", "w", encoding="utf-8"), ensure_ascii=False, indent=1)
docker exec lab-why-py python ocr_compare.py qwen3-vl:2bوالمخرج سوف يكون كما يلي:
invoice.png       tesseract fast  CER   3.7%      0.2 s
invoice.png       tesseract best  CER   3.7%      0.7 s
    (1341 tokens generated, 2994 characters of thinking)
invoice.png       qwen3-vl:2b     CER  29.0%    480.9 s
invoice-scan.png  tesseract fast  CER  81.3%      0.4 s
invoice-scan.png  tesseract best  CER  82.6%      7.6 s
    (335 tokens generated, 554 characters of thinking)
invoice-scan.png  qwen3-vl:2b     CER  27.8%     48.3 s
table.png         tesseract fast  CER 100.0%      0.0 s
table.png         tesseract best  CER 100.0%      0.1 s
    (1300 tokens generated, 3386 characters of thinking)
table.png         qwen3-vl:2b     CER  44.7%    135.3 s
ثم البرنامج التالي score.py يعيد حساب النتائج من الملف الذي حفظه البرنامج السابق، ويضيف مقياس «الكلمات الموجودة»، أي نسبة كلمات النص الصحيح التي ظهرت في الناتج بغض النظر عن ترتيبها:
import json, sys
from collections import Counter
from ocr_compare import norm, cer

truth = json.load(open("truth.json", encoding="utf-8"))
out = json.load(open(sys.argv[1], encoding="utf-8"))
print(f"{'image':<17} {'engine':<15} {'CER':>6} {'words found':>12}")
for key, text in out.items():
    img, engine = key.split(" | ")
    gt = "\n".join(truth[img])
    want, got = Counter(norm(gt).split()), Counter(norm(text).split())
    found = sum((want & got).values()) / sum(want.values())
    print(f"{img:<17} {engine:<15} {cer(text, gt) * 100:5.1f}% {found * 100:11.0f}%")
docker exec lab-why-py python score.py ocr-out-qwen3-vl_2b.jsonimage engine CER words found
invoice.png tesseract fast 3.7% 89%
invoice.png tesseract best 3.7% 89%
invoice.png qwen3-vl:2b 29.0% 83%
invoice-scan.png tesseract fast 81.3% 0%
invoice-scan.png tesseract best 82.6% 0%
invoice-scan.png qwen3-vl:2b 27.8% 46%
table.png tesseract fast 100.0% 0%
table.png tesseract best 100.0% 0%
table.png qwen3-vl:2b 44.7% 100%ماذا قرأ Tesseract والنموذج فعلاً؟
الأرقام وحدها لا تكفي، فلنقرأ النص الذي خرج من كل طريقة، وهو في الملف ocr-out-qwen3-vl_2b.json. في الفاتورة النظيفة أعاد Tesseract ببيانات tessdata_best ما يلي:
فاتورة ضريبية

رقم الفاتورة: 1117-2026-0147
التاريج: 2026/10/05

العميل: شركة الأفق للتقنية

البند: اشتراك استضافة سحابية لمدة سنة
المبلغ: 4,800 ريال

ضريبة القيمة المضافة 9615: 720 ريال
الإجمالي: 5,520 ريال

مُلاحظة: يُرَجى السداد خلال ثلاثين يوماً
في المخرج أعلاه لاحظ التالي:
- كل الأسطر العربية تقريباً صحيحة، بما فيها الحروف المتصلة والتشكيل في
مُلاحظةويُرجى، وهذا عمل شبكة LSTM التي تقرأ السطر كاملاً، وقد استغرق أقل من ثانية على المعالج CPU. - رقم الفاتورة
INV-2026-0147أصبح1117-2026-0147، والسبب أننا طلبنا العربية فقط بالخيار-l ara، فقرأ Tesseract الحروف الإنجليزية I وN وV كأنها أرقام. وإذا جربت-l ara+engفسوف يقرأ رقم الفاتورة صحيحاً، ولكن السطر العربي نفسه يفسد في تجربتنا، فلا يوجد إعداد واحد يناسب السطر المختلط. - النسبة
15%أصبحت9615، فقد قرأ علامة النسبة كأنها الرقمان 9 و6، وهذا خطأ صامت في رقم مالي، لن يلاحظه أحد إذا لم يتحقق منه كود. - نسخة tessdata_fast أخطأت في «سحابية» فكتبتها «حابية»، ونسخة tessdata_best أخطأت في «التاريخ» فكتبتها «التاريج»، والنتيجة النهائية نفس النسبة 3.7%.
والأمر التالي يقرأ نفس الفاتورة بالعربية والإنجليزية معاً، ويطبع سطر رقم الفاتورة وسطر المبلغ فقط:
docker exec lab-why-py sh -c "tesseract invoice.png - -l ara+eng | sed -n '3p;9p'"INV-2026-0147 :3) sla) رقم
المبلغ: 4,800 ريالرقم الفاتورة أصبح صحيحاً، ولكن كلمة «الفاتورة:» في نفس السطر تحولت إلى رموز غير مفهومة، أما سطر المبلغ فبقي صحيحاً.
أما النموذج qwen3-vl:2b فأعاد للفاتورة النظيفة ما يلي:
فاتورة ضريبية
INV-2026-0147 : رقم الفاتورة:
2026/10/05 : التاريخ
العميل: شركة الأفق للتكنينة
البند: اشتراك استضافة سحابة لمدة سنة
المبلغ: 4,800 ريال
720 ريال
720 :15 ضريبة القيمة المضافة
الإجمالي: 5,520 ريال
ملاحظة: يرجى السداد خلال ثلاثين يوماً
وهنا ترى نوعاً مختلفاً تماماً من الأخطاء: رقم الفاتورة صحيح بحروفه الإنجليزية، ولكنه وضعه قبل النص العربي بترتيب العرض على الشاشة، وهذا وحده رفع CER، ثم كتب «للتكنينة» بدلاً من «للتقنية» و«سحابة» بدلاً من «سحابية»، وكرر «720 ريال» وكتب النسبة دون علامتها في سطر غريب، وحذف التشكيل من سطر الملاحظة. ونسبة الكلمات الموجودة 83% أقل من Tesseract في هذه الصورة، أي أن الطريقة القديمة نسبياً كانت أفضل في المستند النظيف.
والصورة تنقلب تماماً في صورة الجوال المائلة، فقد أعاد Tesseract ببيانات tessdata_best ما يلي:
الإمالي 5320 لا( :
ٍِ ملاحظة: رن السشاق: عاد ثلثين

الي الفتافة ا
أي أن أغلب الأسطر اختفت، وما بقي حروف مشوهة، والكلمة الوحيدة الصحيحة تقريباً هي «ملاحظة» دون تشكيلها، ولهذا السبب كانت نسبة الكلمات الموجودة 0%، فمقياسنا صارم ويعد الكلمة التي فقدت تشكيلها كلمة خاطئة. بينما أعاد النموذج ما يلي:
قائمة ضريبية
INV-2026-0147: رقم القائمة
2026/10/05: التاريخ
المعدل: شرکة الأقتصاد
البلد: اتحاد استعادة حماية لمدة سنة
البلغ: 4,800 ريال
ضررية القبضة المضافة 720%: 720 ريال
الإجمالي: 5,520 ريال
ملاحظة: يرجى السداد خلال ثلاثين يوماً
في المخرج أعلاه لاحظ التالي:
- كل الأسطر موجودة وبترتيبها، ورقم الفاتورة والتاريخ والمبلغ والإجمالي صحيحة، وجملة الملاحظة صحيحة كاملة لولا أنه حذف تشكيلها، وهذا ما لم يستطعه Tesseract إطلاقاً في نفس الصورة.
- ولكن انظر إلى الأخطاء: «فاتورة» أصبحت «قائمة»، و«العميل: شركة الأفق للتقنية» أصبحت «المعدل: شركة الأقتصاد»، و«البند: اشتراك استضافة سحابية» أصبحت «البلد: اتحاد استعادة حماية»، و«15%» أصبحت «720%». أي أن النموذج عندما لا يرى الكلمة بوضوح لا يكتب حروفاً مشوهة كما يفعل Tesseract، وإنما يكتب كلمة عربية حقيقية تبدو مناسبة، وهذا هو نفس سلوك الهلوسة Hallucination الذي شرحناه في قسم لماذا يخطئ النموذج، وهو أخطر من الحروف المشوهة، لأن القارئ لا يلاحظه بسهولة.
وفي الجدول لم يعد Tesseract أي نص في النسختين، بينما أعاد النموذج كل خلية صحيحة، ولكن خلية في كل سطر بترتيب الأعمدة من اليسار إلى اليمين، ولهذا السبب كانت CER عنده 44.7% رغم أن نسبة الكلمات الموجودة 100%:
السعر
الكمية
البند
1,200
2
سيرفر افتراضي
350
1
شهادة أمان
960
12
نسخ احتياطي
إصلاح الجدول بالمعالجة المسبقة Pre-processing
وقد يتساءل البعض: هل Tesseract عاجز عن قراءة الجداول؟ والإجابة لا، فالمشكلة أن خطوط الجدول تربك خطوة البحث عن الأسطر، والحل في عالم OCR التقليدي هو خطوة معالجة مسبقة Pre-processing تحذف الخطوط قبل القراءة، والبرنامج التالي remove_lines.py يحذف كل صف وكل عمود من البكسلات أغلبه أسود، أي خطوط الجدول:
# The classic fix: a pre-processing step that erases the table grid before OCR
from PIL import Image
import numpy as np
a = np.array(Image.open("table.png"))
dark = a < 128
rows = dark.mean(axis=1) > 0.5      # a row that is mostly black is a horizontal line
cols = dark.mean(axis=0) > 0.5      # a column that is mostly black is a vertical line
a[rows, :] = 255
a[:, cols] = 255
Image.fromarray(a).save("table-nolines.png")
print("removed", rows.sum(), "line rows and", cols.sum(), "line columns")
docker exec lab-why-py python remove_lines.py
docker exec lab-why-py tesseract table-nolines.png - -l ara --psm 6
docker exec lab-why-py tesseract table-nolines.png - -l ara --psm 6 --tessdata-dir /lab/tessdata_bestremoved 21 line rows and 16 line columns
البند الكمية السعر
سيرفر افتراضي 2 1,0
شهادة أمان 1 350
نسخ احتياطي 12 5260
البند الكمية السعر
سيرفر افتراضي 2 1,0
شهادة أمان 1 350
نسخ احتياطي 12 960في المخرج أعلاه لاحظ التالي:
- الخيار
--psm 6يقول لبرنامج Tesseract إن الصورة كتلة نص واحدة منتظمة، وبعد حذف الخطوط قرأ كل الكلمات العربية صحيحة وبترتيبها الصحيح من اليمين. - ولكن السعر
1,200أصبح1,0في النسختين، والسعر960أصبح5260في نسخة tessdata_fast، والسبب أن حذف الخطوط بهذه الطريقة البسيطة يحذف أيضاً أي جزء من الأرقام يقع على نفس الصفوف أو الأعمدة. وهذا بالضبط ما وصفناه في الطريقة القديمة: كل مستند جديد يحتاج خطوة معالجة جديدة، وكل خطوة لها أخطاؤها الخاصة.
ماذا نستنتج من تجربة OCR؟
- في المستند النظيف المطبوع كان Tesseract أدق من النموذج الصغير، وأسرع منه بمئات المرات: أقل من ثانية مقابل 481 ثانية في أول طلب، وهذا الزمن يشمل تحميل النموذج و1341 توكناً كتبها النموذج قبل أن يجيب.
- والسبب في هذا العدد من التوكنز أن qwen3-vl:2b في Ollama نموذج تفكير Thinking، فهو يكتب تفكيره أولاً في الحقل
thinkingثم الإجابة، وقد رأيت في المخرج أنه كتب قرابة 3000 حرف من التفكير للفاتورة الواحدة. وفي محاولتنا الأولى حددناnum_predictبأربعمئة توكن فانتهت كلها في التفكير وعادت الإجابة فارغة، فانتبه لهذا عند استخدام نماذج التفكير. - في صورة الجوال السيئة والجدول تفوق النموذج بوضوح، وهذا هو المكان الذي تعطي فيه نماذج اللغة والرؤية قيمة حقيقية: المدخلات الفوضوية والمتنوعة.
- أخطاء Tesseract حروف مشوهة يسهل اكتشافها، وأخطاء النموذج كلمات حقيقية خاطئة يصعب اكتشافها، لذلك فالتحقق بالكود من الحقول المهمة ليس اختيارياً مع النموذج، كما سوف نرى في النمط الهجين.
- هذا نموذج صغير جداً من ملياري معامل على المعالج، والنماذج الأكبر أدق بكثير وأبطأ وتحتاج ذاكرة أكبر، أما ثلاث صور صنعناها فهي مثال للتوضيح وليست مقياساً، وعليك أن تقيس على مستنداتك الحقيقية بنفس الطريقة.
أين تكون نماذج اللغة LLM الأداة الخطأ؟
رأيت في تجربة OCR أن النموذج لم يكن الأفضل في كل الحالات، وهناك مجالات كاملة تكون فيها نماذج اللغة والشبكات العميقة الاختيار الخطأ من البداية، وأشهرها البيانات الجدولية Tabular Data: الصفوف والأعمدة التي تعيش في قواعد بياناتك، مثل معاملات بطاقة فيها مبلغ ووقت ومدينة لكشف الاحتيال Fraud Detection، أو بيانات عملاء لتوقع من سيترك الخدمة Churn Prediction، أو مواصفات عقار لتوقع سعره.
وفي هذه البيانات نشر Léo Grinsztajn وEdouard Oyallon وGaël Varoquaux ورقة Why do tree-based models still outperform deep learning on typical tabular data? في مؤتمر NeurIPS 2022، وقارنوا فيها الشبكات العميقة بالنماذج القائمة على الأشجار مثل XGBoost والغابات العشوائية Random Forests على 45 مجموعة بيانات، ووجدوا أن النماذج القائمة على الأشجار «ما زالت الأفضل على البيانات متوسطة الحجم (قرابة 10 آلاف صف) حتى دون احتساب سرعتها الأعلى»، وفسروا ذلك بأن الشبكات العصبية تتأثر بالأعمدة التي لا فائدة منها، وتصعب عليها الحدود غير المنتظمة التي تقسم بها الأشجار البيانات بسهولة. وطريقة Gradient Boosting تحديداً تبني شجرة قرار صغيرة بعد شجرة، وكل شجرة تصحح أخطاء الأشجار التي قبلها، وقد شرحناها في مقال التعلم الآلي.
تجربة على البيانات الجدولية Tabular Data
سوف نستخدم مجموعة البيانات Adult من مستودع UCI، وهي 48,842 صفاً من تعداد سكان الولايات المتحدة لعام 1994 فيها 14 عموداً مثل العمر والتعليم والمهنة وساعات العمل، والمطلوب توقع هل يزيد دخل الشخص السنوي عن 50 ألف دولار، ورخصتها CC BY 4.0، وتحملها مكتبة scikit-learn من OpenML. ونقارن عليها ثلاثة أشياء:
- Gradient Boosting عبر HistGradientBoostingClassifier بالإعدادات الافتراضية.
- شبكة عصبية صغيرة MLPClassifier بطبقتين مخفيتين من 64 و32 خلية، بعد تحويل الأعمدة النصية إلى أعمدة رقمية وتوحيد مقياس الأرقام.
- نموذج اللغة qwen2.5:3b نعطيه كل صف كجملة إنجليزية، مع ثمانية أمثلة مصنفة في الطلب (أربعة فوق 50 ألفاً وأربعة تحتها)، أي Few-shot كما وصفته ورقة GPT-3، ونطلب منه الإجابة
>50Kأو<=50Kفقط.
احفظ البرنامج التالي في الملف tabular.py:
import json, time, urllib.request, sys
import numpy as np
from sklearn.datasets import fetch_openml
from sklearn.model_selection import train_test_split
from sklearn.compose import make_column_transformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler, OrdinalEncoder
from sklearn.pipeline import make_pipeline
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.neural_network import MLPClassifier

X, y = fetch_openml("adult", version=2, as_frame=True, return_X_y=True)
y = (y == ">50K").astype(int)
cat = X.select_dtypes("category").columns.tolist()
num = [c for c in X.columns if c not in cat]
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y)
print(f"rows: train {len(Xtr)}  test {len(Xte)}  features {X.shape[1]}  share of >50K {y.mean():.1%}")

gb = make_pipeline(make_column_transformer(
        (OrdinalEncoder(handle_unknown="use_encoded_value", unknown_value=-1, encoded_missing_value=-1), cat),
        remainder="passthrough"),
    HistGradientBoostingClassifier(categorical_features=list(range(len(cat))), random_state=0))
mlp = make_pipeline(make_column_transformer(
        (OneHotEncoder(handle_unknown="ignore"), cat), (StandardScaler(), num)),
    MLPClassifier(hidden_layer_sizes=(64, 32), early_stopping=True, max_iter=200, random_state=0))

def per_row_ms(model, rows):
    t = time.perf_counter()
    for i in range(len(rows)):
        model.predict(rows.iloc[[i]])
    return (time.perf_counter() - t) / len(rows) * 1000

for name, model in (("gradient boosting", gb), ("MLP (64,32)", mlp)):
    t = time.perf_counter(); model.fit(Xtr, ytr); fit = time.perf_counter() - t
    acc = (model.predict(Xte) == yte).mean()
    print(f"{name:<18} train {fit:5.1f} s   test accuracy {acc:.1%}   one row at a time {per_row_ms(model, Xte.iloc[:200]):.2f} ms")

# the LLM sees each row as a sentence, with a few labelled examples (few-shot)
def describe(r):
    return (f"age {r['age']}, {r['workclass']}, education {r['education']}, {r['marital-status']}, "
            f"occupation {r['occupation']}, {r['relationship']}, {r['sex']}, "
            f"capital gain {r['capital-gain']}, capital loss {r['capital-loss']}, {r['hours-per-week']} hours/week")

rng = np.random.RandomState(1)
shots = list(rng.choice(np.where(ytr == 1)[0], 4, replace=False)) + list(rng.choice(np.where(ytr == 0)[0], 4, replace=False))
rng.shuffle(shots)
examples = "\n".join(f"Person: {describe(Xtr.iloc[i])}\nIncome: {'>50K' if ytr.iloc[i] else '<=50K'}" for i in shots)
N = int(sys.argv[1]) if len(sys.argv) > 1 else 200
MODEL = sys.argv[2] if len(sys.argv) > 2 else "qwen2.5:3b"
ok = bad = 0; t = time.perf_counter()
for i in range(N):
    prompt = ("Predict whether the yearly income of a person in the 1994 US census is above 50K dollars. "
              "Answer with >50K or <=50K only.\n\n" + examples + f"\nPerson: {describe(Xte.iloc[i])}\nIncome:")
    body = {"model": MODEL, "prompt": prompt, "stream": False, "options": {"temperature": 0, "num_predict": 6}}
    req = urllib.request.Request("http://lab-why-ollama:11434/api/generate", json.dumps(body).encode(), {"Content-Type": "application/json"})
    ans = json.load(urllib.request.urlopen(req))["response"].strip()
    pred = 1 if ans.startswith(">50K") else 0 if ans.startswith("<=50K") else None
    if pred is None: bad += 1
    ok += pred == yte.iloc[i]
llm_ms = (time.perf_counter() - t) / N * 1000
print(f"{MODEL + ' few-shot':<18} first {N} test rows: accuracy {ok / N:.1%}   invalid answers {bad}   {llm_ms:.0f} ms per row")
print(f"same {N} rows: gradient boosting {(gb.predict(Xte.iloc[:N]) == yte.iloc[:N]).mean():.1%}   "
      f"MLP {(mlp.predict(Xte.iloc[:N]) == yte.iloc[:N]).mean():.1%}   always '<=50K' {(yte.iloc[:N] == 0).mean():.1%}")
docker exec lab-why-py python tabular.py 200 qwen2.5:3bوالمخرج سوف يكون كما يلي:
rows: train 39073  test 9769  features 14  share of >50K 23.9%
gradient boosting  train   1.5 s   test accuracy 87.3%   one row at a time 16.82 ms
MLP (64,32)        train   9.7 s   test accuracy 85.6%   one row at a time 16.96 ms
qwen2.5:3b few-shot first 200 test rows: accuracy 44.0%   invalid answers 0   4347 ms per row
same 200 rows: gradient boosting 87.0%   MLP 88.5%   always '<=50K' 76.0%
في المخرج أعلاه لاحظ التالي:
- Gradient Boosting تدرب على 39,073 صفاً في 1.5 ثانية ووصل إلى 87.3% على 9,769 صفاً للاختبار، والشبكة العصبية الصغيرة احتاجت 9.7 ثانية ووصلت إلى 85.6%، أي أن النموذج التقليدي أدق وأسرع في التدريب، وهذا يتفق مع ما وجدته الورقة.
- نموذج اللغة جربناه على أول 200 صف فقط لأنه بطيء، ووصل إلى 44.0%، بينما الإجابة الثابتة «<=50K» لكل الصفوف تصل إلى 76.0% على نفس الصفوف، أي أن نموذج اللغة كان أسوأ من عدم استخدام أي نموذج. ولاحظ أنه لم يعط أي إجابة غير صالحة، فقد التزم بالصيغة تماماً وأخطأ في المضمون، وهذا يذكرك بأن الالتزام بالصيغة لا يعني الصحة.
- وعلى نفس ال 200 صف جاءت الشبكة الصغيرة 88.5% وGradient Boosting بنسبة 87.0%، أي عكس الترتيب على مجموعة الاختبار الكاملة، وهذا مثال حي على أن عينة صغيرة قد تعطيك ترتيباً مضللاً، لذلك قس دائماً على مجموعة تقييم كافية.
- الوقت لكل صف 4,347 ملي ثانية في نموذج اللغة، مقابل قرابة 17 ملي ثانية في النموذجين التقليديين عندما نرسل لهما صفاً واحداً في كل مرة، وأغلب هذه الملي ثواني هي تكلفة تحويل الأعمدة في scikit-learn لصف واحد، وعندما نتنبأ بكل الصفوف معاً يصبح الوقت أقل بكثير. أي أن نموذج اللغة أبطأ هنا بأكثر من مئتين وخمسين مرة، وتصنيف مليون صف به على هذا الجهاز يحتاج قرابة خمسين يوماً.
- نموذج من 3 مليارات معامل نموذج صغير، والنماذج الكبيرة أفضل بكثير في هذا النوع من الطلبات، ولكن الفكرة تبقى: النموذج التقليدي تعلم من 39 ألف مثال، ونموذج اللغة رأى ثمانية أمثلة فقط، ولا يمكن لثمانية أمثلة في الطلب أن تحمل ما في 39 ألف صف.
والأرقام في هذه التجربة توضيحية لهذا الجهاز ولهذه البيانات، وقد ثبتنا البذرة العشوائية Random Seed random_state=0 فتحصل على نفس تقسيم البيانات إذا أعدت التجربة، أما الأزمنة فسوف تختلف على جهازك.
حالات أخرى لا يناسبها نموذج اللغة LLM
- البيانات القليلة جداً Small Data: إذا كان لديك خمسون مثالاً فقط فلن تدرب شبكة عميقة عليها أبداً، والأنسب قواعد واضحة أو نموذج بسيط مثل الانحدار اللوجستي أو شجرة قرار صغيرة تستطيع أن تقرأها وتتحقق منها، ونموذج اللغة بأمثلة قليلة قد يعمل هنا، ولكنك لن تعرف هل يعمل إلا بمجموعة تقييم.
- السرعة والتكلفة الصارمة Latency and Cost: قرار الموافقة على عملية بطاقة يجب أن يتم في أجزاء من الثانية ولملايين العمليات، وقد رأيت أن نموذج لغة صغيراً على المعالج يحتاج ثواني للصف الواحد، والخدمات السحابية تحاسبك على كل توكن كما شرحنا في قسم التوكن.
- الحاجة إلى إجابة ثابتة ودقيقة Deterministic: نموذج اللغة قد يعطي إجابة مختلفة لنفس المدخل إذا كانت درجة الحرارة أعلى من صفر أو تغير إصدار النموذج أو إعدادات تشغيله، أما الكود والنموذج التقليدي فيعطيان نفس الناتج لنفس المدخل دائماً، وهذا شرط في الفوترة والمحاسبة.
- التفسير أمام جهة رقابية Explainability: إذا رفضت طلب تمويل لعميل فقد يطلب منك القانون أو الجهة الرقابية سبباً واضحاً، والنموذج التقليدي يمكن أن يبين لك أي الأعمدة أثرت في القرار، أما نموذج اللغة فيكتب لك تفسيراً يبدو مقنعاً، ولكنه ليس بالضرورة السبب الحقيقي للإجابة.
- الحساب Arithmetic: النموذج يتوقع التوكن التالي ولا يحسب، والمثال التالي
arithmetic.pyيطلب منه ثلاث عمليات ضرب ويقارنها ب Python:
import json, time, urllib.request
def ask(q):
    body = {"model": "qwen2.5:3b", "prompt": q, "stream": False, "options": {"temperature": 0, "num_predict": 30}}
    req = urllib.request.Request("http://lab-why-ollama:11434/api/generate", json.dumps(body).encode(), {"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req))["response"].strip()
for a, b in ((4837, 2969), (18.75, 3), (7041, 389)):
    t = time.perf_counter(); llm = ask(f"What is {a} * {b}? Reply with the number only."); ms = (time.perf_counter() - t) * 1000
    t = time.perf_counter(); py = a * b; us = (time.perf_counter() - t) * 1e6
    print(f"{a} * {b}:  LLM {llm:<12} ({ms:.0f} ms)   Python {py} ({us:.1f} µs)")
docker exec lab-why-py python arithmetic.py4837 * 2969: LLM 14245713 (4570 ms) Python 14361053 (0.8 µs)
18.75 * 3: LLM 56.25 (5611 ms) Python 56.25 (1.3 µs)
7041 * 389: LLM 2740829 (11649 ms) Python 2738949 (0.8 µs)أخطأ النموذج في عمليتين من ثلاث، والإجابة الخاطئة 14245713 تبدو معقولة تماماً، فهي قريبة من الصحيحة وبنفس عدد الأرقام، ولن يكتشفها أحد إذا لم يحسبها، وقد استغرقت ثواني مقابل أقل من ميكروثانيتين في Python. ولهذا السبب تعطى النماذج في الأنظمة الحقيقية أداة Tool تحسب بها، كما شرحنا في قسم الأخطاء، فلا تقم أبداً بالاعتماد على نموذج لغة في رقم مالي دون كود يحسبه أو يتحقق منه.
النمط الهجين Hybrid: نموذج اللغة يقرأ والنموذج التقليدي يقرر
بعد كل ما سبق قد تظن أن عليك أن تختار بين العالمين، والحقيقة أن أفضل الأنظمة في الواقع تجمعهما، فكل طرف يعمل في المكان الذي يجيده. والصورة التالية تبين نمطين شائعين:
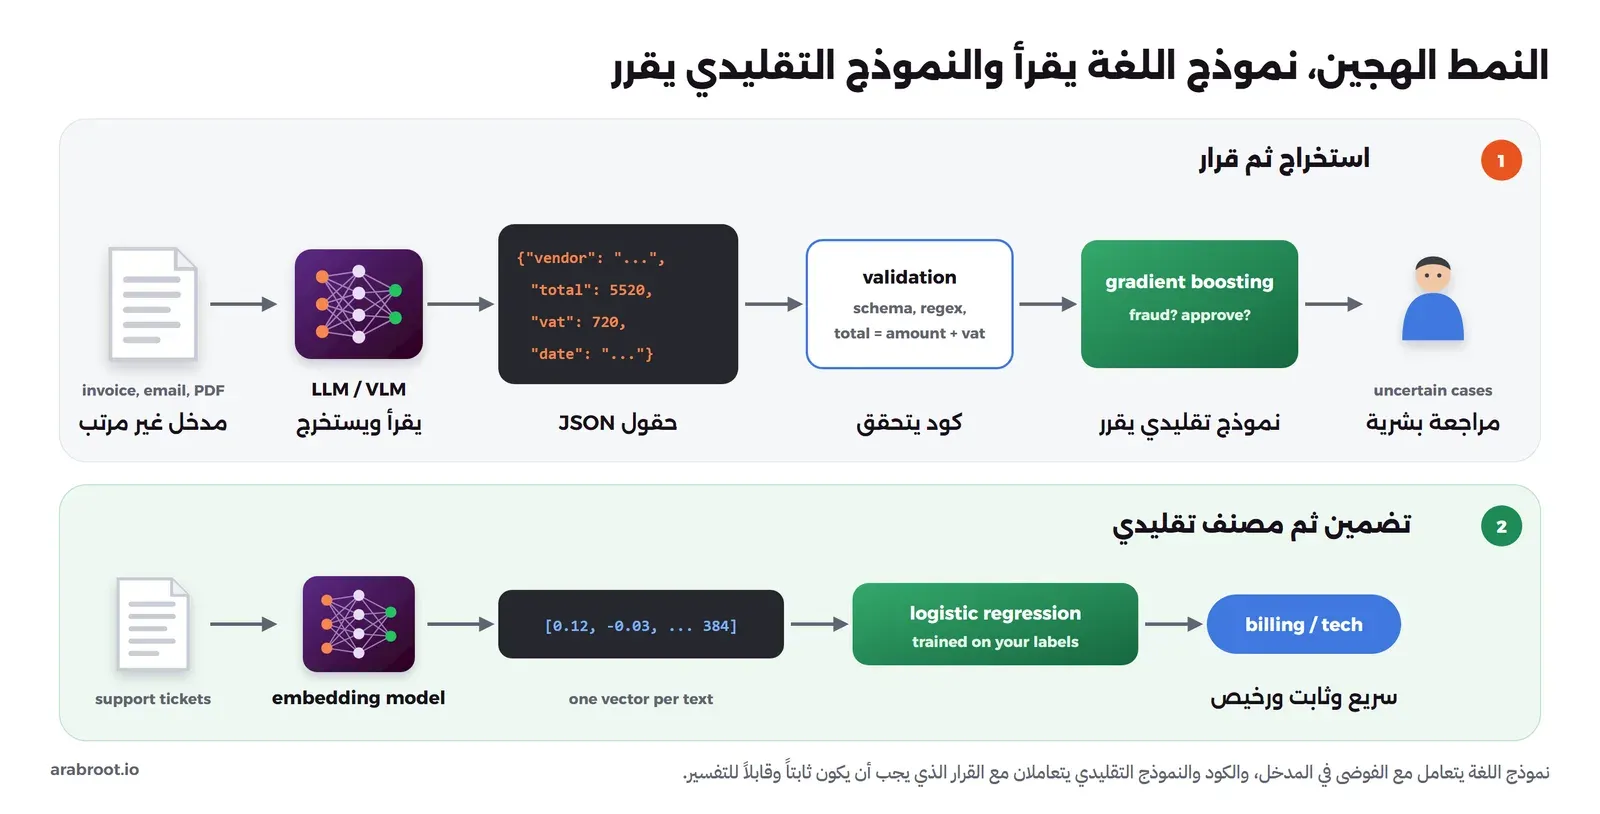
- الاستخراج ثم القرار: نموذج اللغة أو نموذج الرؤية يقرأ الفاتورة أو البريد أو العقد، ويستخرج الحقول بصيغة JSON، ثم يتحقق كودك من كل حقل (Validation) بقواعد ثابتة، مثل أن الرقم الضريبي بطول صحيح وأن الإجمالي يساوي المبلغ مع الضريبة، ثم تدخل الحقول إلى نموذج تقليدي تدرب على بياناتك التاريخية ليقرر هل الفاتورة مشبوهة، وما لم يتأكد منه يذهب إلى موظف. وبهذا الشكل يعمل كل جزء في مكانه: النموذج الكبير يتعامل مع تنوع المستندات، والنموذج الصغير يعطي قراراً ثابتاً يمكن قياسه وتفسيره.
- التضمين ثم المصنف التقليدي: إذا كان لديك عدد كبير من الرسائل تريد تصنيفها كل يوم، فلا ترسل كل رسالة إلى نموذج لغة كبير، وإنما حول كل رسالة إلى متجه بنموذج تضمين صغير، ثم درب عليه مصنفاً تقليدياً مثل الانحدار اللوجستي بالأمثلة التي صنفها فريقك، فتحصل على تصنيف بأجزاء من الثانية وبنفس الإجابة في كل مرة، وتستفيد في نفس الوقت من فهم النموذج للمعنى والعامية.
ولاحظ أن نموذج اللغة في النمطين لا يتخذ القرار النهائي في شيء مهم وحده، والسبب ما رأيناه في قسم الأخطاء: النموذج لا يعرف أنه أخطأ، فاجعل بعده دائماً شيئاً يمكن التحقق منه.
أي أداة لأي مشكلة؟ جدول القرار Decision Table
الصورة التالية تبين ترتيب الأسئلة الذي ننصح به، والترتيب مقصود: الأرخص والأثبت أولاً، ونموذج اللغة عندما تفشل الخيارات قبله:
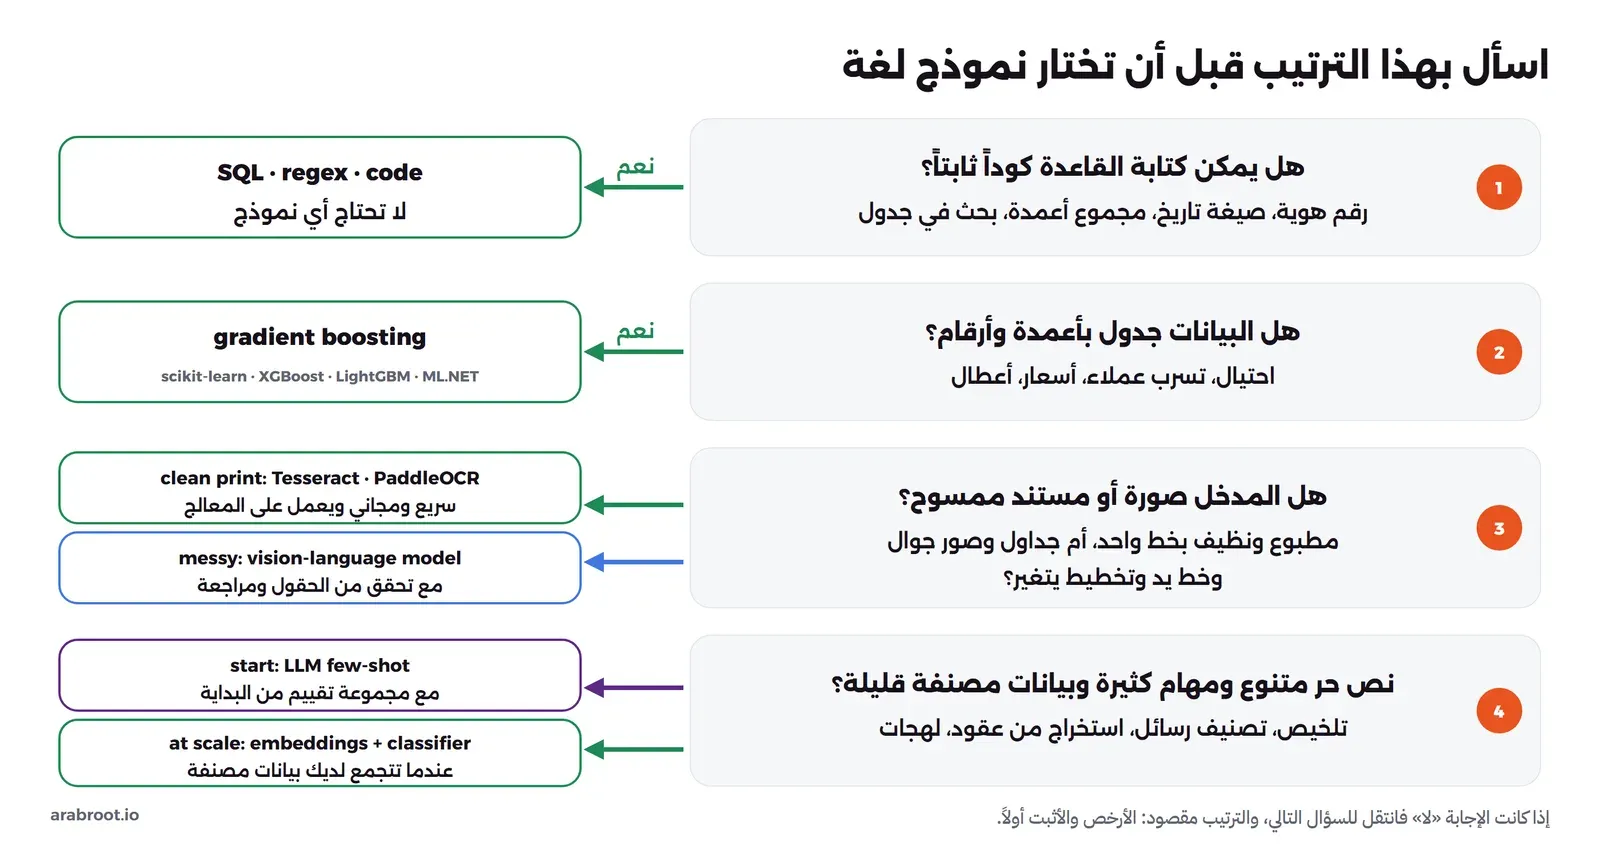
والجدول التالي يفصل ذلك مع الأدوات، وكل الأدوات فيه مفتوحة المصدر، وقد تحققنا من رخصة كل منها من صفحتها الرسمية:
| نوع المشكلة | الحل المقترح | والسبب | الأدوات |
|---|---|---|---|
| قاعدة ثابتة: صيغة بريد، رقم هوية، بحث في جدول، مجموع | كود عادي | إجابة صحيحة دائماً، بأجزاء من الملي ثانية، ودون تكلفة | SQL، التعابير النمطية Regex |
| تنبؤ من جدول: احتيال، تسرب العملاء Churn، أسعار، أعطال | Gradient Boosting | الأدق غالباً على البيانات الجدولية، وسريع وثابت وقابل للتفسير | scikit-learn (BSD-3)، XGBoost (Apache 2.0)، LightGBM، وML.NET (MIT) لمطوري C# |
| بيانات قليلة جداً، عشرات الصفوف | نموذج بسيط أو قواعد | النماذج الكبيرة تحفظ الأمثلة القليلة ولا تتعلم منها، والنموذج البسيط أسهل في التحقق | Logistic Regression، شجرة قرار صغيرة |
| OCR لمستندات مطبوعة ونظيفة بتصميم ثابت | محرك OCR مخصص | سريع جداً على المعالج، ولا يخترع نصاً غير موجود | Tesseract (Apache 2.0)، PaddleOCR (Apache 2.0) ويدعم أكثر من 100 لغة |
| مستندات متنوعة: صور جوال، جداول، تخطيط يتغير، استخراج حقول | نموذج لغة ورؤية VLM | يفهم التخطيط والمعنى ويعيد JSON مباشرة، مع تحقق بالكود ومراجعة | qwen3-vl في Ollama (Apache 2.0)، وgranite3.2-vision (Apache 2.0، للإنجليزية فقط بحسب صفحته) |
| نص حر متنوع، مهام كثيرة، بيانات مصنفة قليلة | نموذج لغة بأمثلة قليلة | يعمل من اليوم الأول دون تدريب، ويفهم العامية والسياق | نموذج تعليمات عبر Ollama أو خدمة سحابية |
| تصنيف عدد كبير من النصوص كل يوم | تضمين ثم مصنف تقليدي | فهم المعنى من النموذج، والسرعة والثبات من المصنف | نموذج تضمين مع scikit-learn |
| حساب، تواريخ، أرقام مالية | كود، أو نموذج لغة يستدعي أداة | النموذج يتوقع التوكن التالي ولا يحسب، كما رأيت في التجربة | Python، SQL، الأدوات Tools |
أخطاء شائعة عند اختيار النموذج
- استخدام نموذج لغة حيث يكفي استعلام SQL أو تعبير نمطي Regex: إذا كان السؤال «كم طلباً أرسل هذا العميل الشهر الماضي؟» فهذا استعلام في قاعدة البيانات، وإذا كان «هل هذا بريد إلكتروني صحيح الصيغة؟» فهذا تعبير نمطي، ولا تقم بإرسال هذه الأسئلة إلى نموذج لغة، والسبب أنه أبطأ بآلاف المرات وأغلى وقد يخطئ في ما لا يخطئ فيه الكود أبداً.
- تجاهل التكلفة لكل طلب: الطلب الواحد يبدو رخيصاً، ولكن مليون صف في الليلة الواحدة مضروبة في التوكنز وفي ثوان المعالجة تصنع فاتورة سحابية أو طابوراً لا ينتهي على سيرفرك، فاحسب التكلفة والوقت لكل طلب على حجمك الحقيقي قبل أن تبدأ، كما فعلنا في التجربة.
- عدم وجود مجموعة تقييم Evaluation Set: أغلب الفرق تجرب نموذج اللغة على خمس فواتير، فتعجبها النتيجة، فتعتمده. والصحيح أن تجمع من البداية مئة أو مئتي مثال حقيقي بإجاباتها الصحيحة، وتقيس عليها كل نموذج وكل تعديل في الطلب، كما قسنا نسبة الخطأ في الحروف ودقة التصنيف في هذا المقال، وقد شرحنا فكرة المعيار الذي تقارن به في أتمتة الاختبارات بالذكاء الاصطناعي.
- مقارنة نموذج اللغة بلا شيء: إذا لم تقس دقة نموذج بسيط أو دقة الإجابة الأكثر تكراراً على نفس البيانات، فلن تعرف هل أضاف نموذج اللغة شيئاً أصلاً، وقد رأيت في التجربة الجدولية أن الإجابة الثابتة وحدها تحصل على نسبة عالية.
- الثقة في المخرج دون تحقق: النموذج يكتب الرقم الخاطئ بنفس ثقة الرقم الصحيح، فتحقق من كل حقل مهم بالكود، وأرسل الحالات غير المؤكدة إلى إنسان.
قائمة التحقق Checklist قبل أن تختار
- هل يمكن كتابة الحل كقاعدة ثابتة أو استعلام؟ إذا كانت الإجابة نعم فلا تستخدم أي نموذج.
- هل البيانات جدول بأعمدة؟ ابدأ بـ Gradient Boosting وقس دقته قبل أي شيء آخر.
- هل جمعت مجموعة تقييم من بياناتك الحقيقية بإجاباتها الصحيحة؟
- هل قست دقة الحل البسيط والإجابة الأكثر تكراراً على نفس المجموعة؟
- هل حسبت الوقت والتكلفة لكل طلب على الحجم اليومي الحقيقي؟
- هل تحتاج نفس الإجابة دائماً لنفس المدخل، أو تفسيراً لكل قرار أمام جهة رقابية؟ إذا نعم فاجعل القرار في كود أو نموذج تقليدي.
- هل تتحقق من مخرجات نموذج اللغة بالكود، وهل يوجد إنسان للحالات غير المؤكدة؟
- هل تخرج البيانات إلى خدمة خارجية؟ إذا كان ذلك ممنوعاً فشغل النموذج محلياً، كما شرحنا في تشغيل نماذج اللغة على جهازك.
تدريب عملي
- غير النص في
make_images.pyإلى فقرة بالعامية أو بخط اليد إذا استطعت تصويرها، وقارن نسبة الخطأ في Tesseract والنموذج. - غير الطلب في
ocr_compare.pyإلى «استخرج رقم الفاتورة والإجمالي بصيغة JSON»، ثم اكتب دالة تتحقق من أن الإجمالي يساوي المبلغ مع الضريبة، وهذا هو النمط الهجين في أبسط صورة. - غير عدد الأمثلة في
tabular.pyمن ثمانية إلى صفر ثم إلى عشرين، وراقب الدقة والوقت لكل صف.
وعند الانتهاء احذف ما أنشأته في التجربة، ومعه ال Volume الذي يحفظ النموذجين (قرابة 3.8 GB):
docker rm -f lab-why-py lab-why-ollama
docker volume rm lab-why-ollama lab-why-pip
docker network rm lab-why-net
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الطريقة القديمة كانت نموذجاً لكل مهمة، بخصائص يصممها المهندس وبيانات مصنفة لكل مهمة، ولذلك كانت هشة أمام خط جديد أو تصميم جديد أو لهجة جديدة.
- الذي تفوق أولاً في الصور وOCR هو التعلم العميق وليس نماذج اللغة، فشبكة LeNet كانت تقرأ ملايين الشيكات يومياً في التسعينات، وTesseract يستخدم شبكة LSTM منذ الإصدار 4.
- الذي أضافته نماذج اللغة والنماذج الأساسية هو العمومية: تدريب مسبق ذاتي على بيانات غير مصنفة، وبنية Transformer، ثم أداء مهام كثيرة من تعليمات وأمثلة قليلة، ثم قراءة الصور والمستندات.
- في تجربتنا على فاتورة عربية كان Tesseract أدق وأسرع بكثير في الصورة النظيفة، ونموذج اللغة والرؤية الصغير أفضل بكثير في صورة الجوال السيئة والجدول، ولكن أخطاءه كلمات حقيقية خاطئة يصعب اكتشافها، لذلك تحقق من كل حقل مهم بالكود.
- في البيانات الجدولية وصل Gradient Boosting إلى 87.3% في ثانية ونصف من التدريب، بينما كان نموذج اللغة بأمثلة قليلة أسوأ من الإجابة الثابتة وأبطأ بمئات المرات، وأخطأ في عمليتي ضرب من ثلاث، وهذا يتفق مع ورقة Grinsztajn وزملائه: النماذج القائمة على الأشجار ما زالت الأفضل في الجداول.
- الخوارزميات التقليدية والكود ما زالت الأنسب حيث تحتاج الثبات والسرعة والتكلفة المنخفضة والتفسير والحساب الدقيق، وأفضل الأنظمة تجمع الاثنين: نموذج اللغة يقرأ، والكود والنموذج التقليدي يتحققان ويقرران.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي على سيرفرك بإذن الله سوف نتحدث عن تشغيل النماذج المفتوحة لفريقك، ثم RAG وقواعد البيانات الشعاعية.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلقصة الذكاء الاصطناعي من تورنغ إلى ChatGPTكيف تطور الذكاء الاصطناعي خلال ثمانين سنة، ولماذا انتظرت أفكاره البيانات والحوسبة عقوداً حتى وصلنا إلى ChatGPT.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلمصطلحات الذكاء الاصطناعي ونماذج اللغة للمبتدئينشرح قصير مع مثال لكل مصطلح ستسمعه في نقاشات الذكاء الاصطناعي ونماذج اللغة، حتى تفهم ما يعرضه عليك أي فريق أو مزود.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Docker Engine 29.8.0 (معالج Intel Core i7-7700K فقط دون بطاقة رسومية) مع Ollama 0.35.1 والنموذجين qwen3-vl:2b وqwen2.5:3b، وTesseract 5.5.0 مع بيانات العربية tessdata_fast من حزمة Debian وtessdata_best، وPython 3.12.15 مع scikit-learn 1.9.1 وpandas 3.0.6 وnumpy 2.5.3 وPillow 12.3.0.