

عندما ظهر ChatGPT في نهاية 2022 بدا للكثيرين أن الذكاء الاصطناعي Artificial Intelligence ولد فجأة في تلك الليلة، فبرنامج يكتب ويشرح ويترجم ويكتب الكود ظهر من لا شيء، ولكن الحقيقة أن هذه اللحظة جاءت بعد أكثر من سبعين سنة من الأفكار والتجارب، فيها نجاحات أعلنت في الصحف على أنها «آلة تفكر»، وفيها فترات طويلة توقف فيها التمويل وصار مجرد ذكر الاسم يضر بصاحبه، وهي الفترات التي يسميها أهل المجال «شتاء الذكاء الاصطناعي AI Winter». والسبب في أهمية هذه القصة لك كمطور أن أغلب ما تسمعه اليوم من وعود ومخاوف سمعه الناس قبلك بنفس الحماس، ومعرفة ما حدث في المرات السابقة تساعدك على أن تفرق بين ما تغير فعلاً وما هو تكرار للضجة نفسها.
وهذا المقال قصة وليس درساً تقنياً، فلكل فكرة هنا فقرتان أو ثلاث ورابط إلى المقال الذي يشرحها بالتفصيل: فالخوارزميات والمفاهيم نفسها مع تجارب عملية في مقال التعلم الآلي Machine Learning للمبتدئين، ولماذا تفوق التعلم العميق Deep Learning ثم نماذج اللغة على الطرق التقليدية في مقال لماذا تفوقت نماذج اللغة على التعلم الآلي التقليدي، وكيف يعمل النموذج من الداخل في مقال كيف تعمل نماذج اللغة الكبيرة LLM. أما هنا فسوف نحكي من فعل ماذا ومتى ولماذا، بتواريخ من مصادرها الأصلية: الأوراق العلمية نفسها، وصفحات الجامعات والمتاحف، وصفحات جائزة Turing وجائزة Nobel، مع صور حقيقية للأشخاص والأجهزة برخص حرة.
وسوف نناقش في هذا المقال ما يلي:
- الجذور قبل الحاسب: الخوارزمي والجزري وآدا لوفليس، ثم الخلية العصبية الصناعية Artificial Neuron في 1943 وسؤال تورنغ Turing في 1950.
- صيف 1956 في Dartmouth حيث ولد الاسم، والذكاء الرمزي Symbolic AI الذي يكتب فيه الإنسان القواعد بيده.
- آلة Perceptron التي تتعلم من أخطائها، والكتاب الذي أوقفها، ومثال صغير من عشرين سطراً يبين ما الذي كانت تستطيعه وما الذي عجزت عنه.
- ELIZA، ثم الشتاء الأول، ثم الأنظمة الخبيرة Expert Systems والشتاء الثاني.
- الخوارزميات الجينية Genetic Algorithms وهوائي فضائي صممته الآلة.
- عودة الشبكات العصبية Neural Networks مع Backpropagation، وقراءة الشيكات، وDeep Blue، ثم عصر البيانات الضخمة Big Data.
- من ImageNet وAlexNet في 2012 إلى Transformer وChatGPT، ثم جوائز Turing وNobel.
- النمط الذي يتكرر في كل هذه القصة، وما الذي يعلمنا إياه اليوم.
ثمانون سنة على خط زمني واحد
الصورة التالية تبين المحطات التي سوف نمر عليها، على محور سنوات حقيقي، مع ألوان للعصور الكبرى وشريطين أزرقين لفترتي الشتاء، ولاحظ كيف تتزاحم المحطات بعد 2009 مقارنة بالفراغ الطويل بين 1975 و1986:
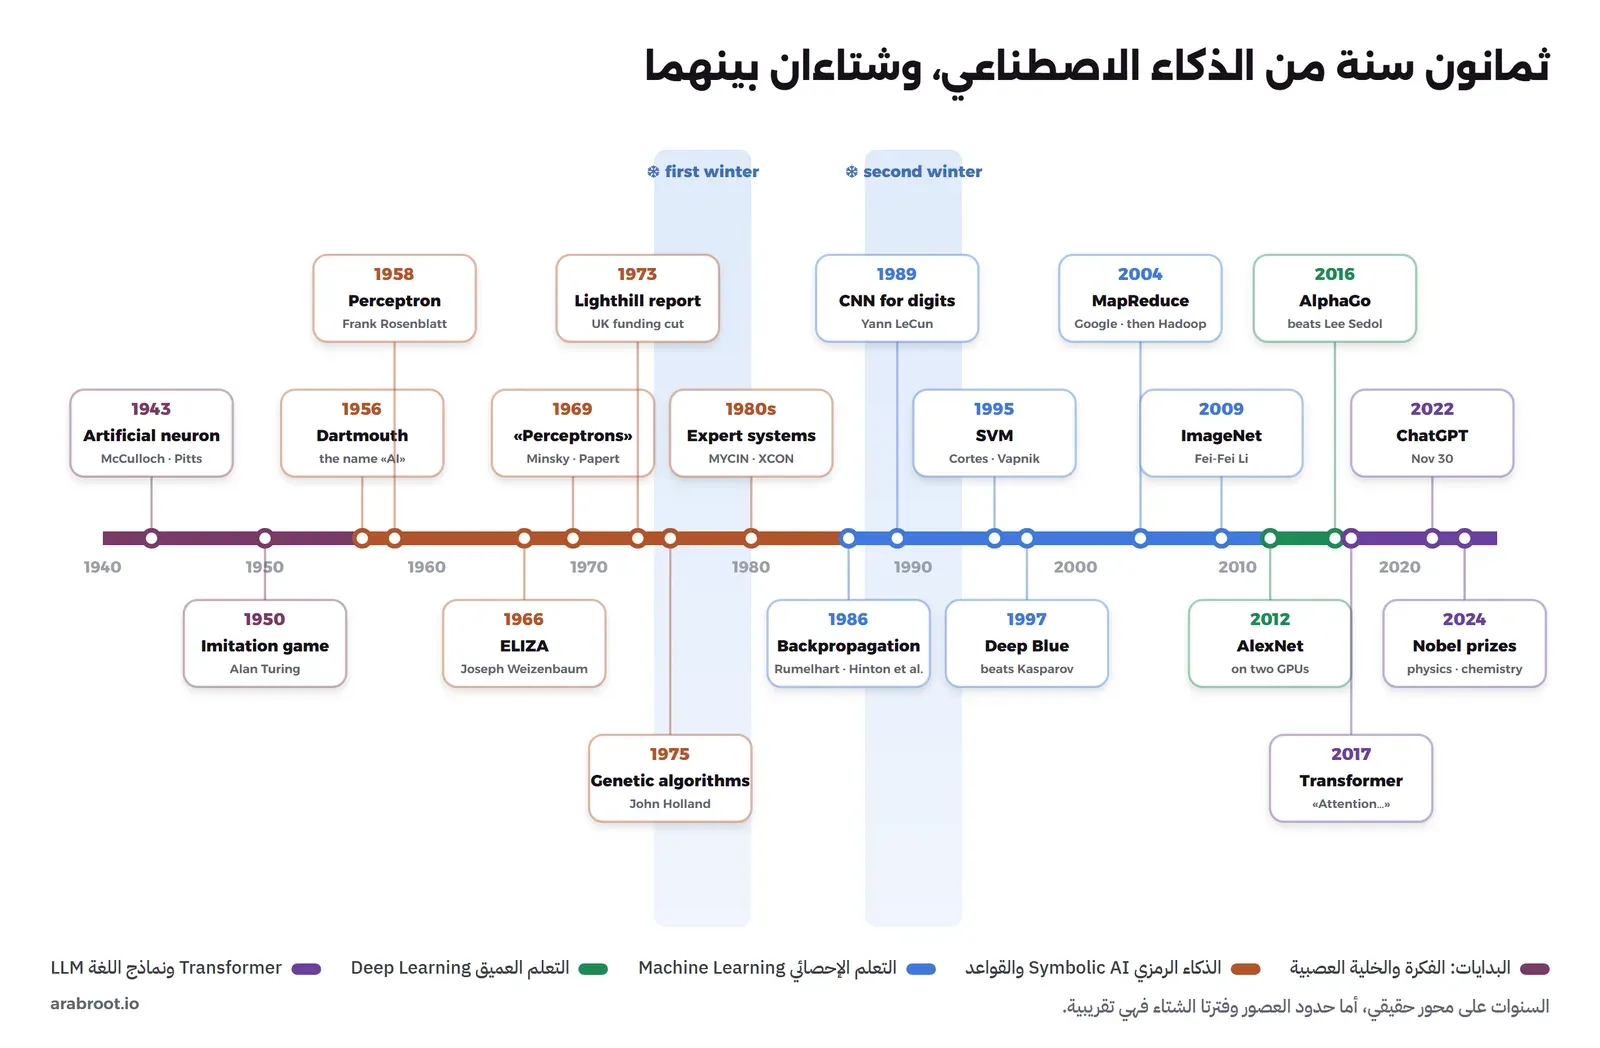
في الشكل أعلاه لاحظ التالي:
- الألوان تقسيم تقريبي للأفكار المسيطرة في كل فترة، وليست حدوداً حادة، فالشبكات العصبية مثلاً ولدت في الأربعينات وبقي من يعمل عليها في كل العصور.
- الشتاءان لم يكونا توقفاً كاملاً للبحث، وإنما فترتين انهار فيهما التمويل والثقة، ولهذا ترى ورقة Backpropagation في 1986 والشبكة التي تقرأ الأرقام المكتوبة باليد في 1989 قريبتين من الشتاء الثاني.
الجذور قبل الحاسب: الخوارزمي والجزري وآدا
قبل أن يوجد أي حاسب بقرون كانت هناك فكرتان سوف تحتاجهما هذه القصة: أن تكتب حل المسألة خطوات محددة يستطيع أي أحد أن ينفذها دون أن يفهمها، وأن تبني آلة تنفذ سلسلة من الحركات وحدها. والفكرة الأولى تحمل اسم عالم عربي مسلم، فمحمد بن موسى الخوارزمي الذي عمل في بيت الحكمة House of Wisdom في بغداد في القرن التاسع الميلادي كتب رسالة في الحساب بالأرقام الهندية، ضاع أصلها العربي وبقيت ترجمتها اللاتينية التي تبدأ بعبارة «Algoritmi de numero Indorum»، ومن هذا الاسم اللاتيني لاسمه جاءت كلمة الخوارزمية Algorithm، كما تذكر سيرته في أرشيف MacTutor بجامعة St Andrews، ومن كتابه في الجبر جاءت كلمة Algebra أيضاً. أي أن كل مرة تكتب فيها كلمة Algorithm في الكود فأنت تكتب اسم الخوارزمي محرفاً.
أما الفكرة الثانية فلها مثال جميل من القرن الثاني عشر، فبديع الزمان إسماعيل بن الرزاز الجزري كان كبير المهندسين في بلاط الأراتقة Artuqids في ديار بكر، وفي 1206 قدم لسلطانه «كتاب الجامع بين العلم والعمل النافع في صناعة الحيل»، المعروف بالإنجليزية باسم Book of Knowledge of Ingenious Mechanical Devices، وفيه بحسب مجموعة متحف العلوم البريطاني Science Museum Group وصف مفصل لآلات رفع الماء وعدة ساعات مع طريقة بنائها، ومن أشهرها ساعة الفيل التي تتحرك فيها الدمى وتسقط الكرات في مواعيد ثابتة دون أن يلمسها أحد.
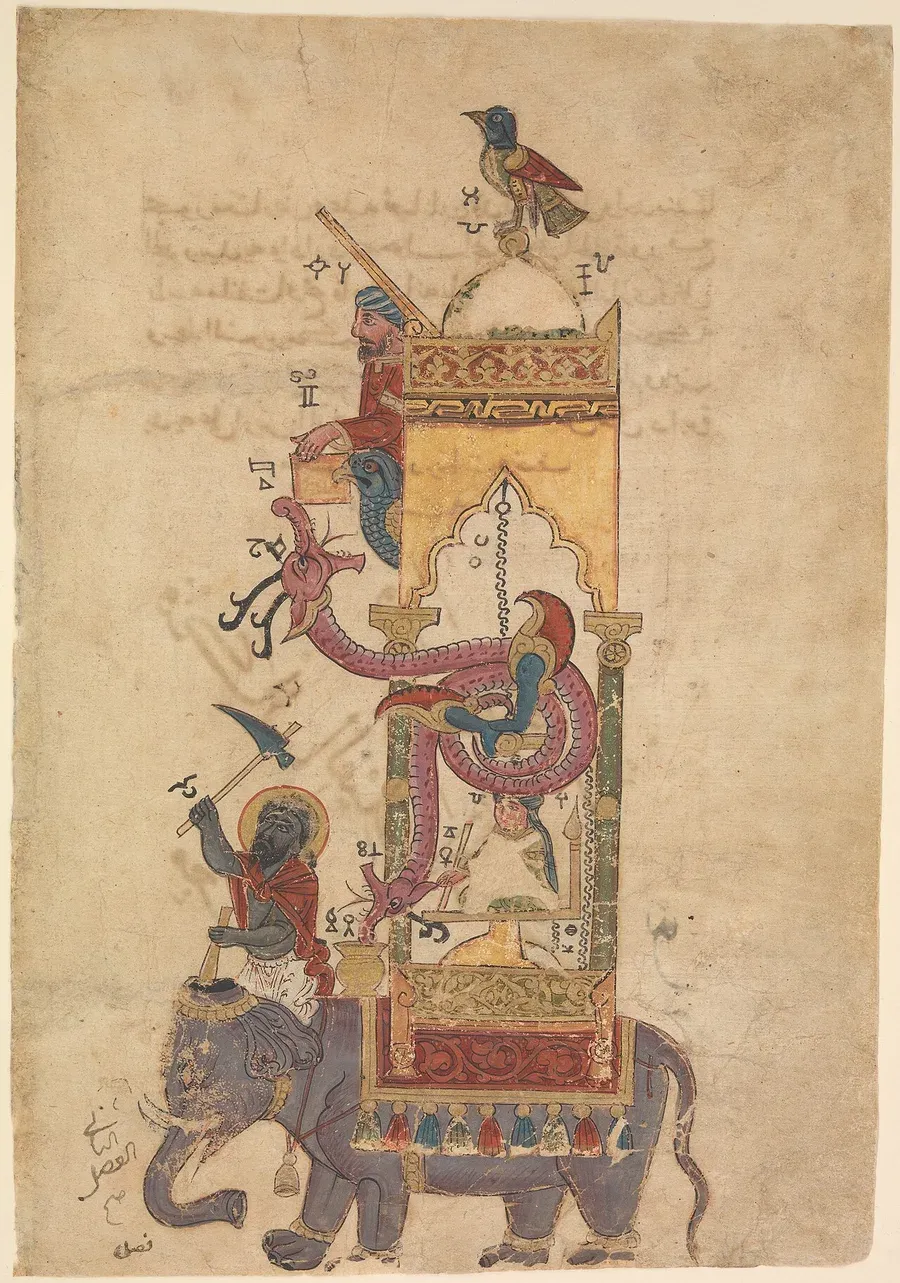
ويجب أن نكون دقيقين هنا، فآلات الجزري آلات ميكانيكية Automata تنفذ تسلسلاً ثابتاً صممه صانعها، ولا تتعلم ولا تقرر شيئاً، وإنما ذكرناها لأنها من أقدم الأمثلة الموثقة على حلم الإنسان بآلة تعمل وحدها، وليس لأنها «ذكاء اصطناعي» بالمعنى الحديث. وبعد ذلك بستة قرون كتبت آدا لوفليس Ada Lovelace في 1843 ملاحظاتها عن المحرك التحليلي Analytical Engine لتشارلز باباج Charles Babbage، وقد حكينا قصتها في مقال قصص لغات البرمجة، والذي يهمنا منها هنا جملة واحدة سوف تعود بعد قليل: أن هذه الآلة «لا تدعي أنها تبتكر أي شيء» ("has no pretensions to originate anything")، وإنما تفعل ما نعرف كيف نأمرها به.
من 1943 إلى 1950: خلية عصبية على الورق وسؤال تورنغ
خلية McCulloch وPitts: الدماغ كدائرة منطقية Logic Circuit
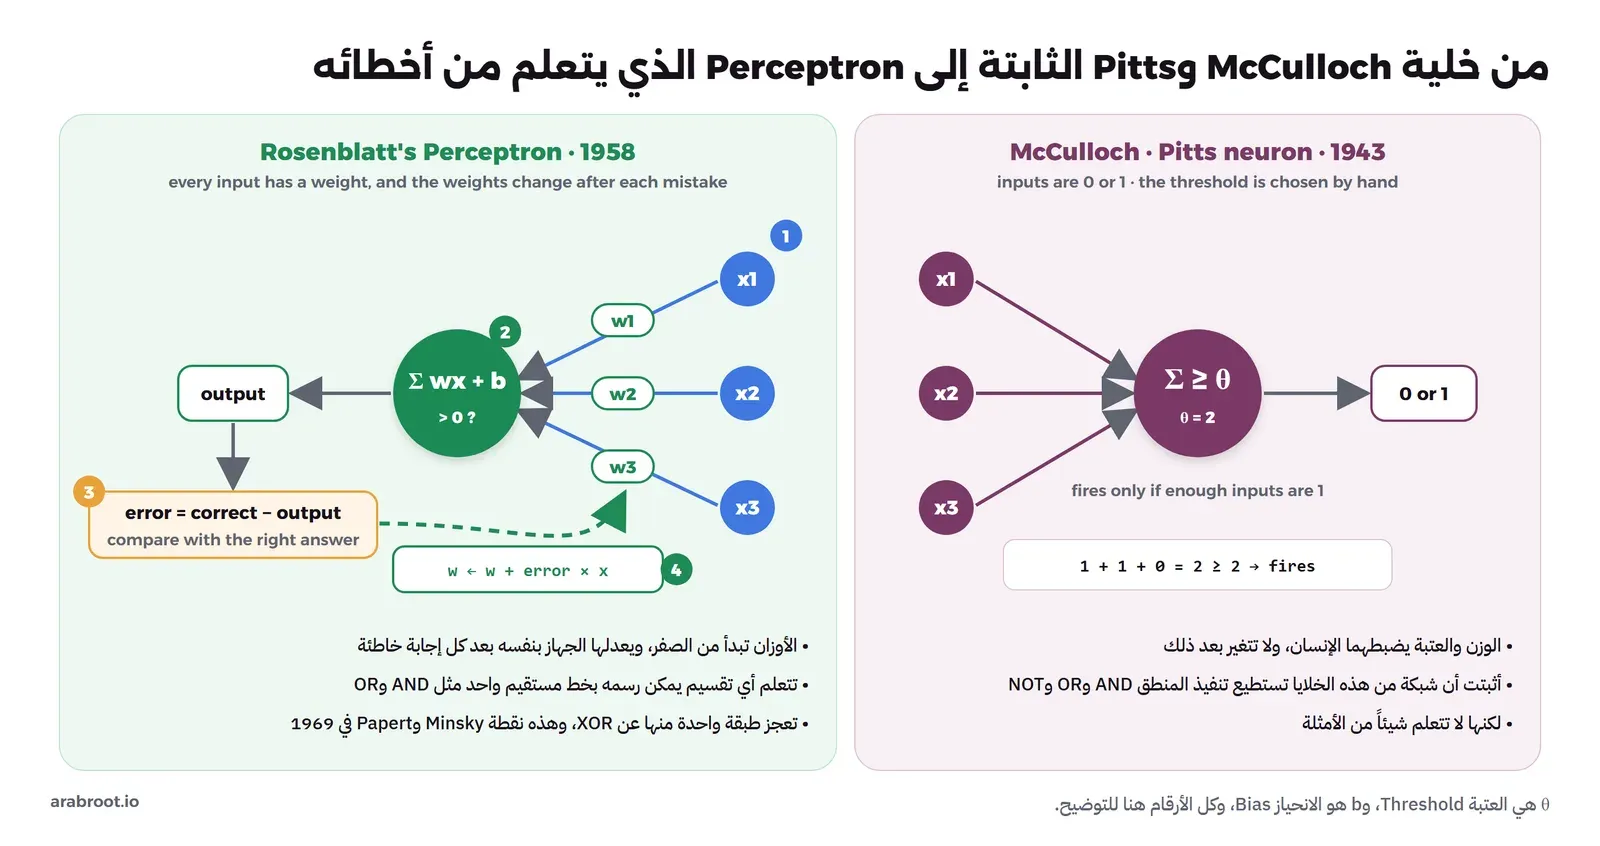
في ديسمبر 1943 نشر عالم الأعصاب وارن مكولوك Warren McCulloch والرياضي الشاب والتر بيتس Walter Pitts ورقة بعنوان A logical calculus of the ideas immanent in nervous activity، وفكرتها أن الخلية العصبية Neuron يمكن تبسيطها إلى وحدة تستقبل إشارات كل منها 0 أو 1، فإذا وصل عدد الإشارات إلى عتبة Threshold معينة أطلقت إشارة 1 وإلا بقيت 0، وأن شبكة من هذه الوحدات تستطيع أن تنفذ عمليات المنطق مثل AND وOR وNOT. وهذه أول مرة يوصف فيها «عصبون صناعي» بلغة الرياضيات، ولكن لاحظ أن العتبة والأوزان كان يضعها الإنسان بيده، أي أن الشبكة لا تتعلم شيئاً، وسوف نرى بعد قليل الخطوة التي جعلتها تتعلم.
آلان تورنغ Alan Turing: هل تستطيع الآلات أن تفكر؟
في أكتوبر 1950 نشر آلان تورنغ في مجلة Mind ورقته Computing Machinery and Intelligence، وتبدأ بجملة صارت من أشهر الجمل في الحوسبة: «أقترح أن ننظر في السؤال: هل تستطيع الآلات أن تفكر؟» ("I propose to consider the question, 'Can machines think?'"). ولكن تورنغ رأى أن كلمتي «آلة» و«تفكر» غامضتان، فاستبدل السؤال بلعبة سماها لعبة المحاكاة Imitation Game، وهي التي نعرفها اليوم باسم اختبار تورنغ Turing Test: محاور يكتب أسئلة لطرفين لا يراهما، أحدهما إنسان والآخر آلة، فإذا لم يستطع أن يميز الآلة من الإنسان بشكل موثوق فلا معنى لأن نقول إنها لا تفكر.
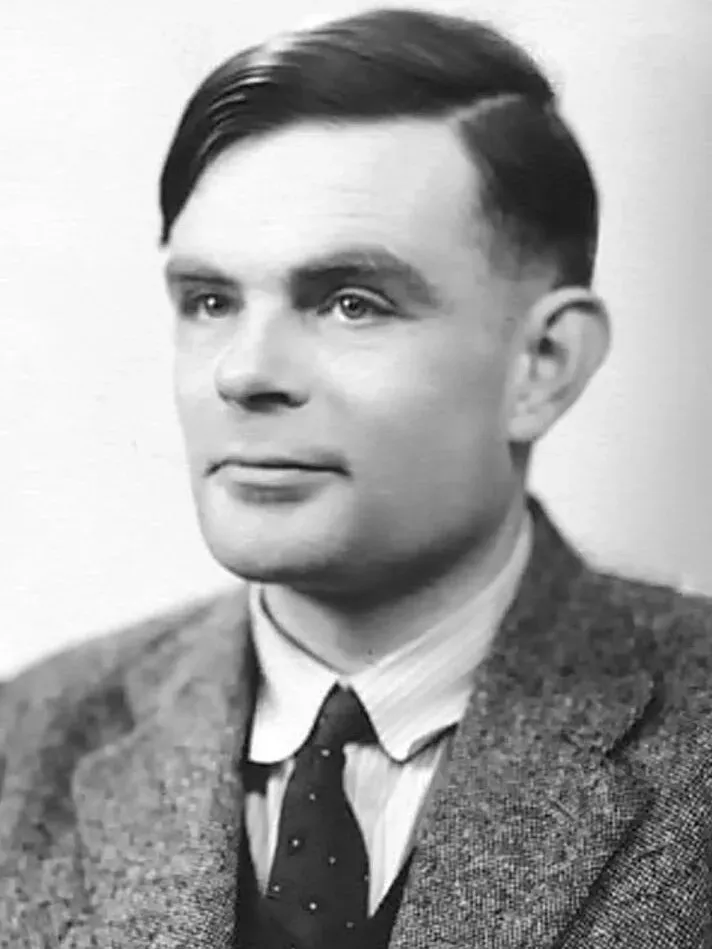
وفي الورقة نفسها شيئان يستحقان الانتباه بعد سبعين سنة، الأول أنه خصص قسماً للرد على «اعتراض السيدة لوفليس» Lady Lovelace's Objection، أي جملة آدا عن الآلة التي لا تبتكر شيئاً. والثاني أنه في قسم الآلات التي تتعلم Learning Machines اقترح ألا نحاول برمجة عقل إنسان بالغ مباشرة، وأن نبني بدلاً من ذلك برنامجاً «يحاكي عقل الطفل» ثم نعلمه كما يتعلم الطفل ("why not rather try to produce one which simulates the child's?")، وهذه بالضبط فكرة التعلم الآلي Machine Learning التي احتاجت ستين سنة حتى تنتصر. وتوقع تورنغ أن الحاسبات بعد قرابة خمسين سنة سوف تلعب لعبة المحاكاة بشكل جيد، وهو توقع لم يتحقق في الموعد، وهذه أول مرة في قصتنا يسبق فيها التوقع الواقع، ولن تكون الأخيرة.
كلود شانون Claude Shannon: المعلومات والشطرنج والفأر
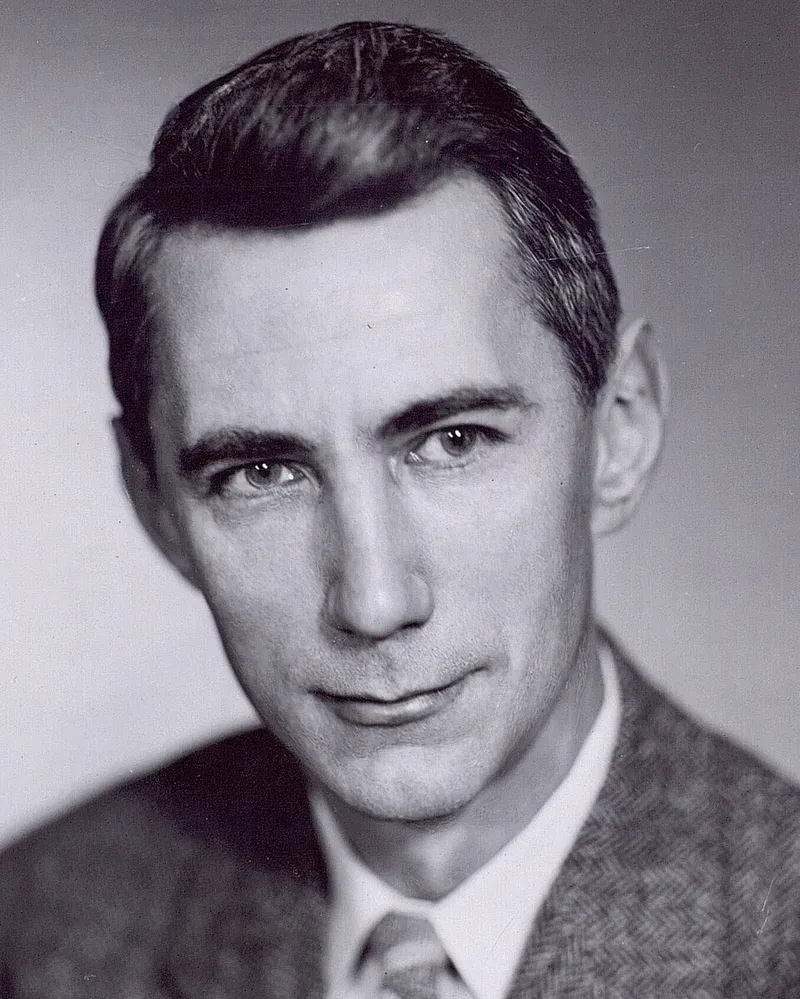
وفي الفترة نفسها كان كلود شانون في Bell Labs قد نشر في 1948 ورقته A Mathematical Theory of Communication التي أسست نظرية المعلومات Information Theory، أي الطريقة التي نقيس بها المعلومات وننقلها عبر قنوات فيها تشويش، وهي أساس كل اتصال رقمي تستخدمه اليوم. وتذكر جمعية نظرية المعلومات في IEEE أن أعماله اللاحقة على آلات تلعب الشطرنج وعلى فأر إلكتروني يجد طريقه في متاهة ساهمت في ولادة مجال الذكاء الاصطناعي، وفي أرشيف متحف تاريخ الحاسب صورة له حوالي 1950 مع بطل الشطرنج إدوارد لاسكر Edward Lasker أمام آلة شطرنج بناها من المرحلات Relays.
صيف 1956: Dartmouth وولادة الاسم
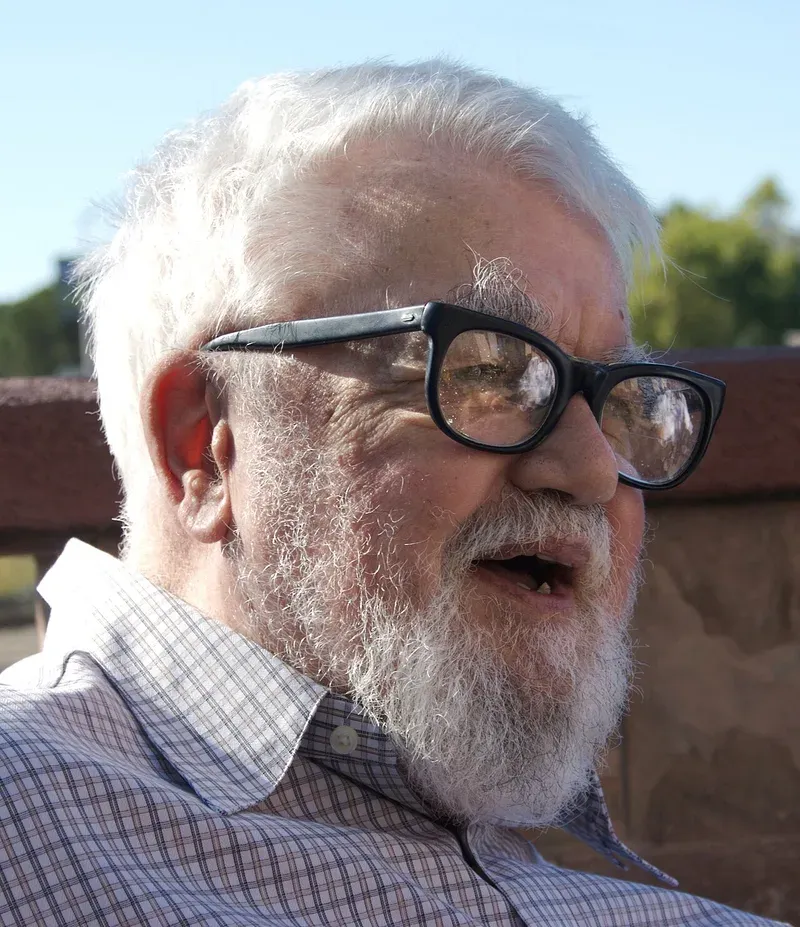
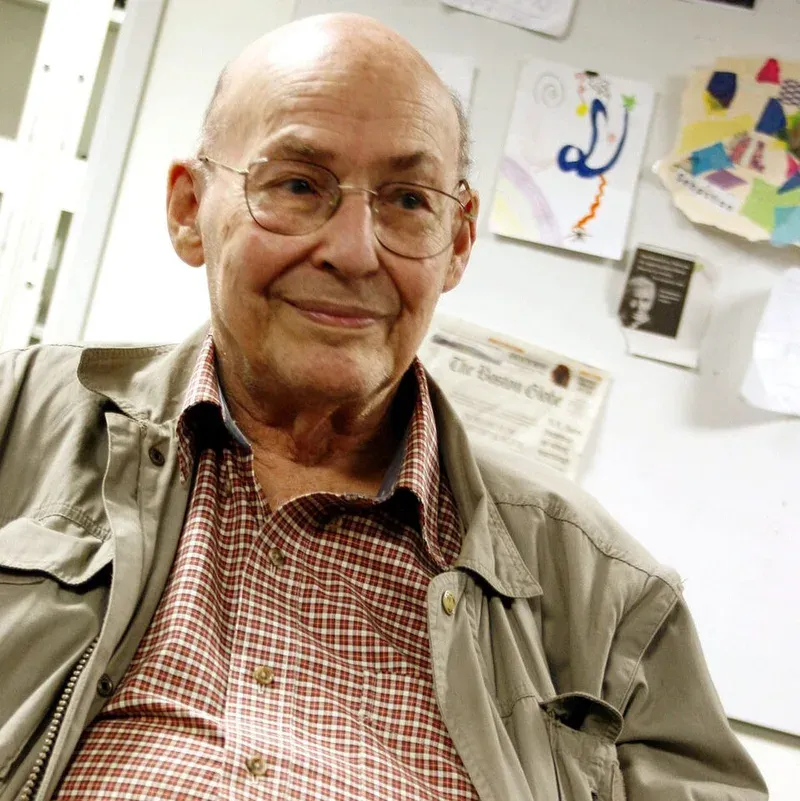
في 31 أغسطس 1955 كتب أربعة أشخاص مقترحاً من بضع صفحات يطلبون فيه تمويلاً لورشة صيفية: جون مكارثي John McCarthy من Dartmouth College، ومارفن مينسكي Marvin Minsky من Harvard، وناثانيال روتشستر Nathaniel Rochester من IBM، وكلود شانون من Bell Labs. وعنوان المقترح كما تحفظه صفحة مكارثي في جامعة Stanford هو «A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence»، وفيه ظهرت عبارة الذكاء الاصطناعي Artificial Intelligence، ولهذا تقول صفحة Dartmouth الرسمية إن الاسم صيغ هناك وإن ورشة صيف 1956 تعد ولادة هذا المجال.
والصورة التالية تبين الصفحة الأولى من نص المقترح، ولاحظ الجملة الثانية فيها، فهي فرضية المجال كله: أن «كل جانب من جوانب التعلم أو أي صفة أخرى من صفات الذكاء يمكن من حيث المبدأ أن يوصف بدقة تكفي لأن نصنع آلة تحاكيه»:
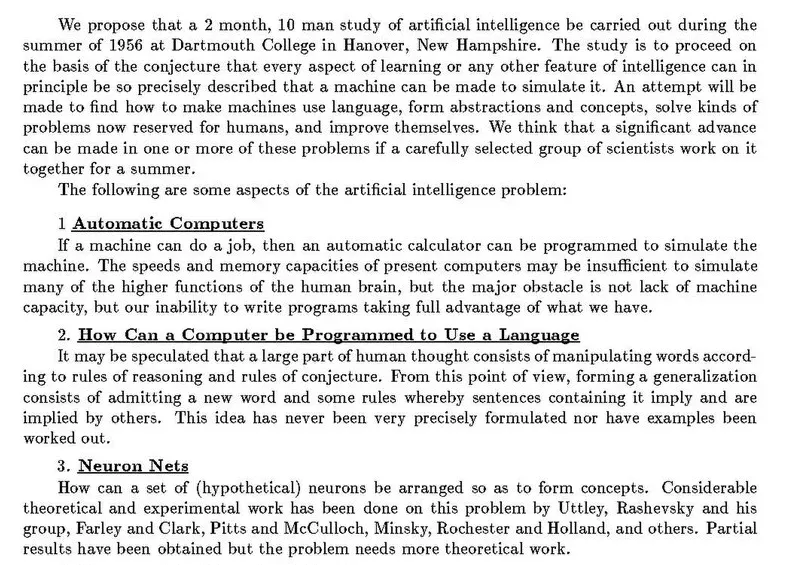
في المقترح أعلاه لاحظ التالي:
- طلبوا «دراسة لمدة شهرين يقوم بها عشرة رجال»، وكتبوا أنهم يعتقدون أن تقدماً كبيراً ممكن في مسألة أو أكثر «إذا عملت مجموعة مختارة بعناية من العلماء عليها معاً لصيف واحد»، وهذا تفاؤل سوف تفهمه أكثر في القسم الخاص بالشتاء.
- في البند الأول كتبوا أن سرعة الحاسبات وذاكرتها قد لا تكفي، ولكن «العائق الأكبر ليس نقص قدرة الآلة، وإنما عجزنا عن كتابة برامج تستفيد كاملاً مما لدينا»، وتذكر هذه الجملة جيداً لأننا سوف نعود إليها في النهاية.
- البند الثالث عنوانه شبكات الخلايا العصبية Neuron Nets، ويذكر Pitts وMcCulloch بالاسم، أي أن فكرة التعلم بالشبكات كانت حاضرة منذ اليوم الأول، بجانب فكرة القواعد والرموز.
الذكاء الرمزي Symbolic AI: Logic Theorist وLISP
وفي الورشة نفسها كما تذكر جامعة Carnegie Mellon عرض هربرت سايمون Herbert Simon وآلن نيوويل Allen Newell برنامجاً اسمه Logic Theorist، يعد أول برنامج يقوم بالاستدلال الآلي Automated Reasoning، فهو يثبت نظريات منطقية بالبحث بين خطوات الإثبات الممكنة، ثم حصل الاثنان لاحقاً على جائزة Turing. وبعدها بقليل بدأ مكارثي العمل على لغة LISP، ويكتب في تاريخه للغة أن أفكارها الأساسية تكونت بين صيف 1956 وصيف 1958 وأن تطبيقها بدأ في خريف 1958، وصارت LISP لغة الذكاء الاصطناعي لثلاثين سنة، لأن البرامج في ذلك العصر كانت تتعامل مع رموز وقوائم وقواعد أكثر مما تتعامل مع أرقام.
وهذا هو جوهر الذكاء الرمزي Symbolic AI: أن تمثل المعرفة برموز وقواعد يكتبها الإنسان، مثل «إذا كان كذا فالنتيجة كذا»، ثم يطبقها البرنامج بالاستدلال. وفي الجهة الأخرى فكرة أن تتعلم الآلة القواعد بنفسها من الأمثلة، والصورة التالية تبين الطريقتين على مسألة واحدة يعرفها كل من يملك بريداً، وهي فرز الرسائل المزعجة Spam:
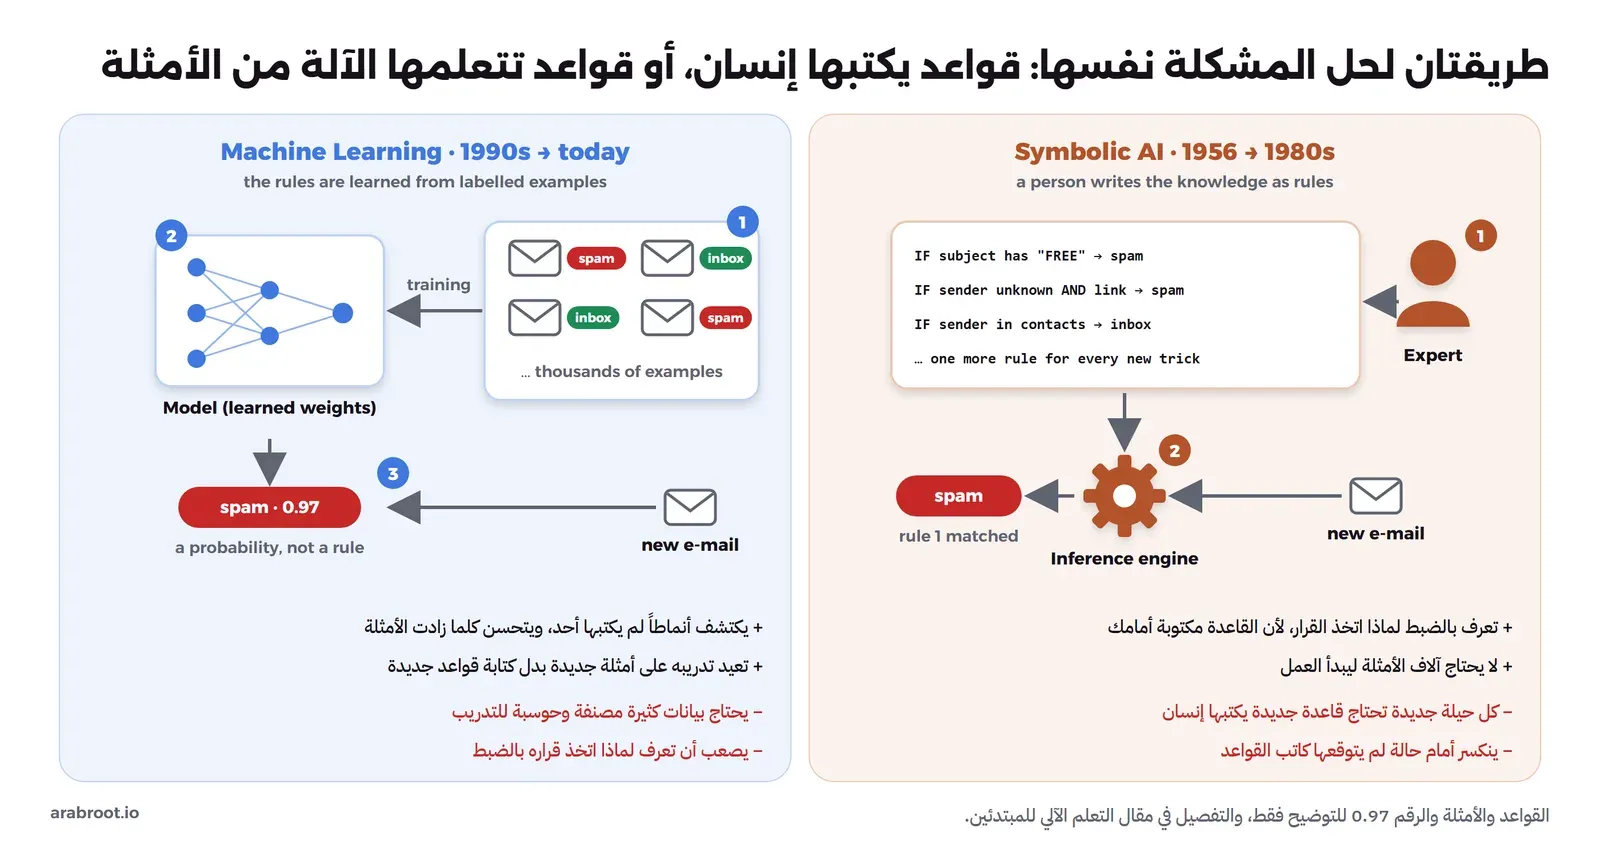
وقد يتساءل البعض: إذا كانت الطريقة الثانية هي التي انتصرت، فلماذا سيطرت الأولى ثلاثين سنة؟ والإجابة أن الطريقة الأولى كانت تعمل بالموارد المتاحة وقتها، فالقاعدة يكتبها خبير في دقائق وتشرح نفسها بنفسها، أما التعلم من الأمثلة فيحتاج آلاف الأمثلة وحوسبة لم تكن موجودة، وسوف ترى أن هذا السبب نفسه هو مفتاح القصة كلها. والتفصيل في الفرق بين الطريقتين وأنواع التعلم موجود في مقال التعلم الآلي للمبتدئين.
آلة Perceptron: أول آلة تتعلم من أخطائها
في يوليو 1958 عرض مكتب الأبحاث البحرية الأمريكية Office of Naval Research اختراعاً غريباً، فبحسب مقال جامعة Cornell عن صاحبه أدخلوا إلى حاسب IBM 704، وهو حاسب بحجم غرفة ووزنه خمسة أطنان، سلسلة من البطاقات المثقبة Punch Cards، وبعد خمسين محاولة علم الحاسب نفسه أن يميز البطاقات المعلمة من اليسار عن المعلمة من اليمين. وصاحب الفكرة عالم النفس فرانك روزنبلات Frank Rosenblatt من مختبر Cornell للطيران Cornell Aeronautical Laboratory، وسماها Perceptron، وكتبت New York Times يومها عن «جنين حاسب سوف يقرأ ويزداد حكمة».
ثم بنى روزنبلات آلة حقيقية مخصصة لهذه الفكرة اسمها Mark I Perceptron، وهي بحسب وصف البحرية الأمريكية جهاز كهروميكانيكي Electromechanical فيه «وحدة حس» من الخلايا الضوئية Photocells تعمل كعين تنظر إلى الحرف وتحمل ذاكرة الآلة، ووحدات استجابة تعرض ما تعرفت عليه، والصورة التالية للآلة نفسها من أرشيف البحرية:
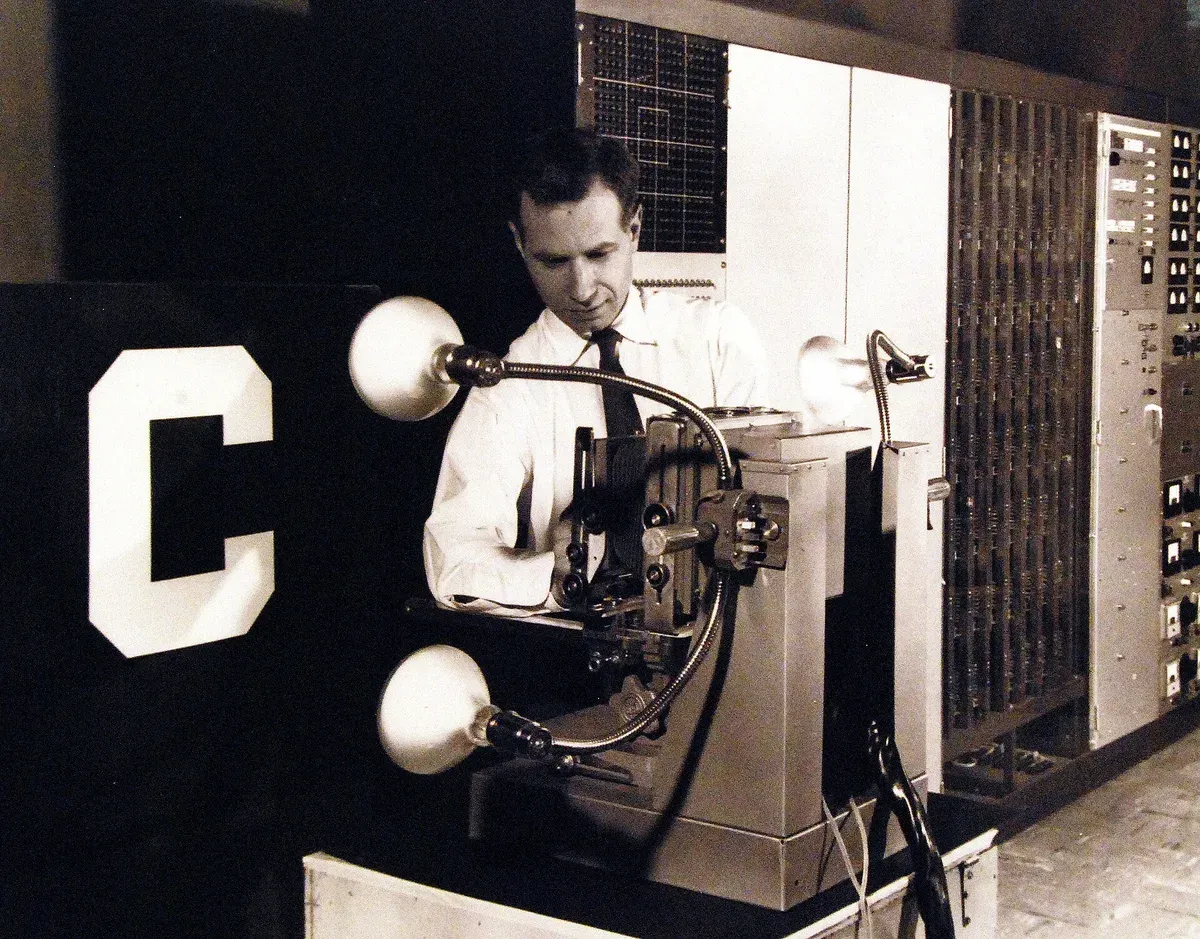
ويذكر وصف الصورة نفسه أن المدرب كان يضع الحرف أمام عين الآلة، فإذا أخطأت أجبرها على الإجابة الصحيحة بمفتاح كهربائي، وبعد التدريب كانت تتعرف على حروف خط واحد دون أخطاء، فلما أضافوا حروفاً بخط آخر صارت تصيب في 85% من الحالات. والفرق بين هذه الآلة وخلية McCulloch وPitts هو الفرق بين دائرة ثابتة ودائرة تتعلم، والصورة التالية تبين ذلك:
جرب Perceptron بنفسك في عشرين سطراً
لكي ترى قاعدة التعلم هذه تعمل فعلاً، كتبنا Perceptron بأبسط شكل ممكن بلغة Python دون أي مكتبة، والقاعدة هي نفسها التي في الرسم: احسب المجموع الموزون، فإذا كانت الإجابة خاطئة أضف إلى كل وزن قيمة الخطأ مضروبة في المدخل. ثم ندربه على ثلاث دوال منطقية: AND وOR وXOR. احفظ الكود التالي في ملف اسمه perceptron.py:
# Rosenblatt's learning rule: weighted sum, threshold, and correct the weights after every mistake
def train(samples, epochs=20, lr=1):
    w1, w2, b = 0, 0, 0
    for epoch in range(1, epochs + 1):
        mistakes = 0
        for (x1, x2), target in samples:
            out = 1 if w1 * x1 + w2 * x2 + b > 0 else 0
            err = target - out
            if err:
                mistakes += 1
                w1, w2, b = w1 + lr * err * x1, w2 + lr * err * x2, b + lr * err
        if mistakes == 0:
            return f"learned after {epoch} epochs: w1={w1} w2={w2} b={b}"
    return f"still {mistakes} mistakes after {epochs} epochs"

inputs = [(0, 0), (0, 1), (1, 0), (1, 1)]
for name, outputs in [("AND", [0, 0, 0, 1]), ("OR", [0, 1, 1, 1]), ("XOR", [0, 1, 1, 0])]:
    print(name, "->", train(list(zip(inputs, outputs))))
ثم شغله داخل Container من Docker Image الرسمية python:3.13-slim دون أن تثبت أي شيء على جهازك:
docker run --rm -i python:3.13-slim python3 - < perceptron.pyوالمخرج سوف يكون كما يلي:
AND -> learned after 6 epochs: w1=2 w2=1 b=-2
OR -> learned after 4 epochs: w1=1 w2=1 b=0
XOR -> still 4 mistakes after 20 epochs
في المخرج أعلاه لاحظ التالي:
- تعلم AND بعد ست دورات Epochs وOR بعد أربع، والأوزان التي وصل إليها لم يكتبها أحد، فالقيم
w1=2 w2=1 b=-2تعني أن المجموع لا يتجاوز الصفر إلا إذا كان المدخلان 1 معاً، وهذا هو AND بالضبط. - أما XOR، أي أن يكون المخرج 1 عندما يختلف المدخلان فقط، فلم يتعلمه أبداً، وبقيت أربعة أخطاء بعد عشرين دورة، ولو جعلتها ألف دورة لن يتغير شيء، والسبب أن Perceptron من طبقة واحدة لا يستطيع إلا أن يرسم خطاً مستقيماً واحداً يفصل الإجابات، ونقاط XOR الأربع لا يفصلها خط واحد.
كتاب Perceptrons في 1969
وهذه النقطة بالضبط هي التي فصلها مارفن مينسكي وسيمور بابيرت Seymour Papert رياضياً في كتابهما «Perceptrons» الذي نشر في 1969، ويذكر مقال Cornell أن مينسكي وروزنبلات كانا زميلين في المدرسة الثانوية نفسها في Bronx، وأنهما تناظرا علناً في المؤتمرات حول قدرات Perceptron، وأن الكتاب ساهم في انصراف التمويل عن الشبكات العصبية لسنوات طويلة. والمفارقة أن حل XOR معروف اليوم ببساطة: أضف طبقة مخفية Hidden Layer بين المدخلات والمخرج، ولكن لم تكن هناك طريقة عملية لتدريب الطبقات المتعددة، وهذه هي الحلقة المفقودة التي انتظرت حتى 1986. وتوفي روزنبلات في 1971 قبل أن يرى فكرته تعود، ويقول المقال نفسه إن المبادئ التي يقوم عليها Perceptron ساعدت في إطلاق الذكاء الاصطناعي الحديث.
ELIZA في 1966: أول برنامج محادثة Chatbot
في يناير 1966 نشر جوزيف وايزنباوم Joseph Weizenbaum من MIT ورقة في مجلة Communications of the ACM يصف فيها برنامجاً اسمه ELIZA يعمل على نظام المشاركة الزمنية في MIT، ويجعل المحادثة بالإنجليزية بين الإنسان والحاسب ممكنة. والفكرة بسيطة جداً: يبحث البرنامج في جملتك عن كلمة مفتاحية Keyword، ثم يعيد تركيب جملتك بقاعدة تحويل جاهزة، والقواعد نفسها محفوظة في ملف بيانات اسمه السكربت Script منفصل عن البرنامج، وأشهر سكربت له يجعله يرد كما يرد معالج نفسي من مدرسة Rogers، يعيد كلامك إليك على شكل سؤال، والمقطع التالي من المحادثة المنشورة في الورقة نفسها، وأسطر البرنامج بالحروف الكبيرة:
Men are all alike.
IN WHAT WAY
They're always bugging us about something or other.
CAN YOU THINK OF A SPECIFIC EXAMPLE
Well, my boyfriend made me come here.
YOUR BOYFRIEND MADE YOU COME HERE
He says I'm depressed much of the time.
I AM SORRY TO HEAR YOU ARE DEPRESSED
ولاحظ أن البرنامج لا يفهم كلمة واحدة مما يقال، فهو يقلب «my boyfriend made me» إلى «YOUR BOYFRIEND MADE YOU» بقاعدة نصية، ومع ذلك يكتب وايزنباوم في مقدمة الورقة أن برامج كهذه قد تبهر حتى أكثر المراقبين خبرة، وأنه بمجرد أن تشرح طريقة عملها «يتلاشى سحرها» ("its magic crumbles away") ويظهر أنها مجرد مجموعة من الإجراءات، فيقول المراقب لنفسه «كنت أستطيع أن أكتب هذا». والدرس هنا مهم لك اليوم أكثر من أي وقت: الإحساس بأن البرنامج يفهمك لا يكفي دليلاً على أنه يفهم فعلاً، وهذا الخلط بين الطلاقة والفهم سوف تقابله مع نماذج اللغة الحديثة أيضاً، والفرق أن ELIZA كان يعيد كلامك، أما النماذج الحديثة فتتوقع الكلمة التالية من أنماط تعلمتها من نصوص هائلة، كما شرحنا في قسم لماذا يخطئ النموذج.
الشتاء الأول AI Winter: تقرير Lighthill
بعد عقدين من الوعود جاء وقت الحساب، ففي 1972 طلب مجلس الأبحاث العلمية البريطاني Science Research Council من عالم الرياضيات جيمس لايتهيل James Lighthill تقريراً مستقلاً عن حال المجال، فكتب في يوليو 1972 تقريره Artificial Intelligence: A General Survey، ونشر في بداية 1973. ويقول لايتهيل في قسم «خيبات الماضي» إن أغلب الباحثين يعترفون بشعور واضح بخيبة الأمل، فقد دخلوا المجال حوالي 1950 و1960 بآمال «بعيدة جداً عن أن تتحقق في 1972»، وإن أشهر الخيبات كانت في الترجمة الآلية Machine Translation التي «أنفقت عليها مبالغ ضخمة بنتائج مفيدة قليلة جداً».
وأهم ما في التقرير تشخيصه للسبب: الانفجار التوافقي Combinatorial Explosion، أي أن عدد الاحتمالات التي يجب أن يبحث فيها البرنامج يكبر بشكل انفجاري كلما كبرت المسألة قليلاً، فالبرنامج الذي يحل لغزاً صغيراً في المختبر ينهار أمام مسألة حقيقية. وبحسب صفحة التقرير في أرشيف Chilton Computing فقد تسبب في فقدان كبير للثقة في الذكاء الاصطناعي لدى المؤسسة الأكاديمية البريطانية وجهات التمويل، واستمر ذلك قرابة عقد، وفي الفترة نفسها انخفض الحماس والتمويل في أماكن أخرى أيضاً، وهذا ما يسمى الشتاء الأول.
وقد يتساءل البعض: هل كان لايتهيل مخطئاً؟ والإجابة أنه كان محقاً في تشخيص الانفجار التوافقي، فالبحث في كل الاحتمالات لا يصلح لمسائل العالم الحقيقي، ولكن الحل الذي جاء لاحقاً لم يكن البحث الأذكى وحده، وإنما أن تتعلم الآلة من البيانات أين تبحث، وهذا احتاج بيانات وحوسبة لم تكن موجودة في 1973.
الأنظمة الخبيرة Expert Systems والشتاء الثاني
في الثمانينات عاد الذكاء الاصطناعي إلى الشركات من باب آخر: بدل محاولة صنع ذكاء عام، لماذا لا نسجل معرفة خبير واحد في مجال ضيق على شكل قواعد؟ وبحسب تقرير Funding a Revolution الصادر عن المجلس الوطني للبحوث الأمريكي National Research Council كان أهم الأمثلة نظام MYCIN في Stanford، الذي بدأ في 1972 واكتمل في 1980 ويساعد الأطباء على تشخيص أمراض الدم المعدية من الأعراض، وكان يفصل القواعد عن محرك الاستدلال Inference Engine الذي يطبقها، فصار أساس أول قشرة للأنظمة الخبيرة Expert-system Shell يملؤها غيرك بقواعده، ونظام XCON الذي بنته Carnegie Mellon لشركة DEC ليضبط مكونات Configuration حاسبات VAX، والذي يوصف بأنه من أول الأنظمة الخبيرة الناجحة تجارياً.
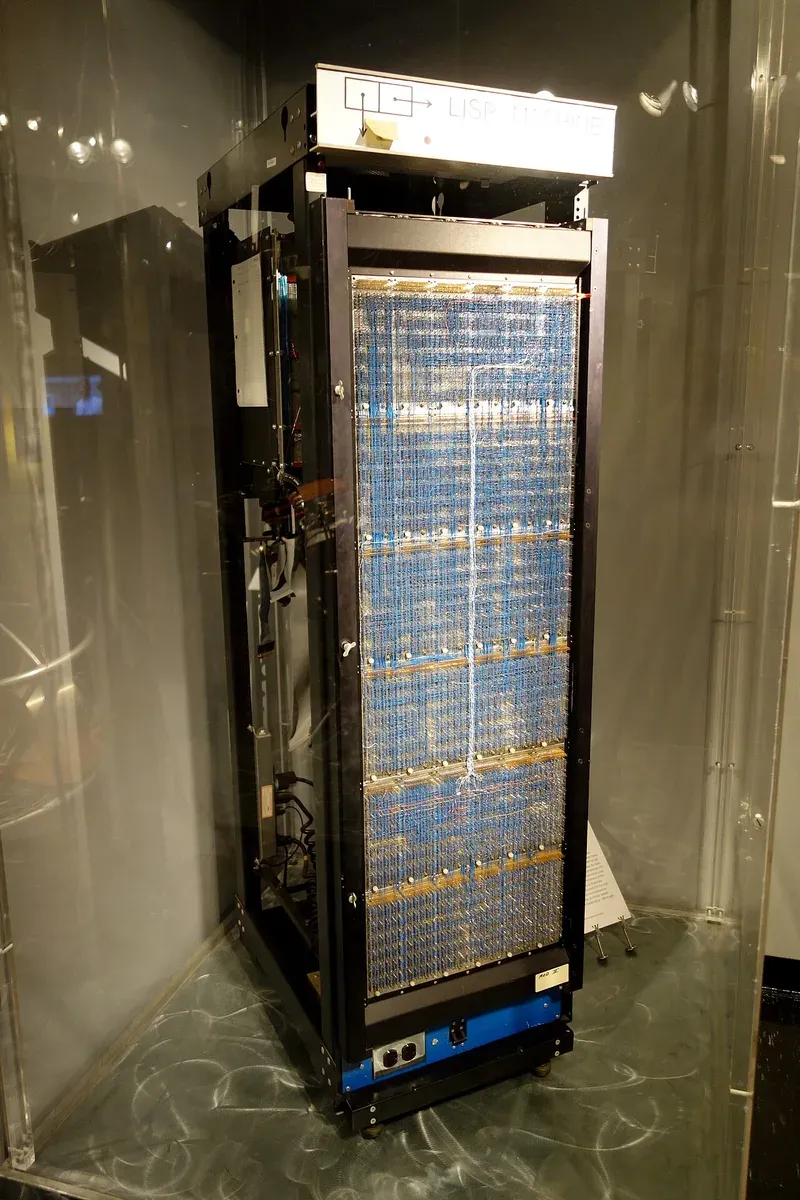
وانتشرت الشركات الناشئة، وكانت أغلب هذه الأنظمة تعمل على أجهزة مخصصة اسمها آلات LISP أو LISP Machines، وهي حاسبات صممت لتشغيل لغة LISP بسرعة، والصورة التالية لأحدها:
ثم انقلب كل شيء في أواخر الثمانينات، ويذكر التقرير نفسه السببين: الأول أن محطات العمل Workstations العادية، وخاصة أجهزة Sun Microsystems، تطورت بسرعة وصارت تشغل البرامج نفسها بتكلفة أقل بكثير، فانهار سوق آلات LISP الغالية، والثاني أن الشكوك بدأت تظهر في قدرات الأنظمة الخبيرة ومرونتها، فالنظام ممتاز في الحالات التي كتبت لها قواعد، ولكنه ينهار أمام حالة لم يتوقعها أحد، وكل تغيير في المعرفة يحتاج خبيراً ومبرمجاً يعدلان آلاف القواعد يدوياً. وهذا هو الشتاء الثاني، ولاحظ أنه بدأ بسبب اقتصادي قبل أن يكون علمياً: أداة غالية جداً لنتيجة أقل من الوعد.
وهذا النمط يجب أن تعرفه جيداً كمطور، فالأنظمة الخبيرة لم تمت، وإنما تحولت إلى ما تعرفه اليوم باسم محركات القواعد Rules Engines وأنظمة القرار في البنوك وشركات التأمين، أي أن الفكرة بقيت حيث تصلح، وسقطت فقط عندما وعدت بأكثر مما تستطيع.
الخوارزميات الجينية Genetic Algorithms: دع التطور يصمم الحل
وفي فرع آخر تماماً من القصة كان جون هولاند John Holland في جامعة Michigan يسأل سؤالاً مختلفاً: الطبيعة صممت كائنات معقدة دون أن يكتب أحد قواعدها، فهل نستطيع أن نقلد طريقتها؟ وفي 1975 نشر كتابه «Adaptation in Natural and Artificial Systems» الذي قدم فيه الخوارزميات الجينية بوصفها تبسيطاً رياضياً لفكرة التكيف، كما يذكر نعي مجلة Communications of the ACM له، وكان هولاند قد حصل في 1959 على أول دكتوراه في علوم الحاسب من جامعة Michigan.
والفكرة أن تكتب كل حل ممكن على شكل سلسلة، مثل سلسلة من البتات تصف شكل قطعة ما، ثم تترك مجموعة من الحلول تتنافس جيلاً بعد جيل، والصورة التالية تبين الحلقة كاملة:
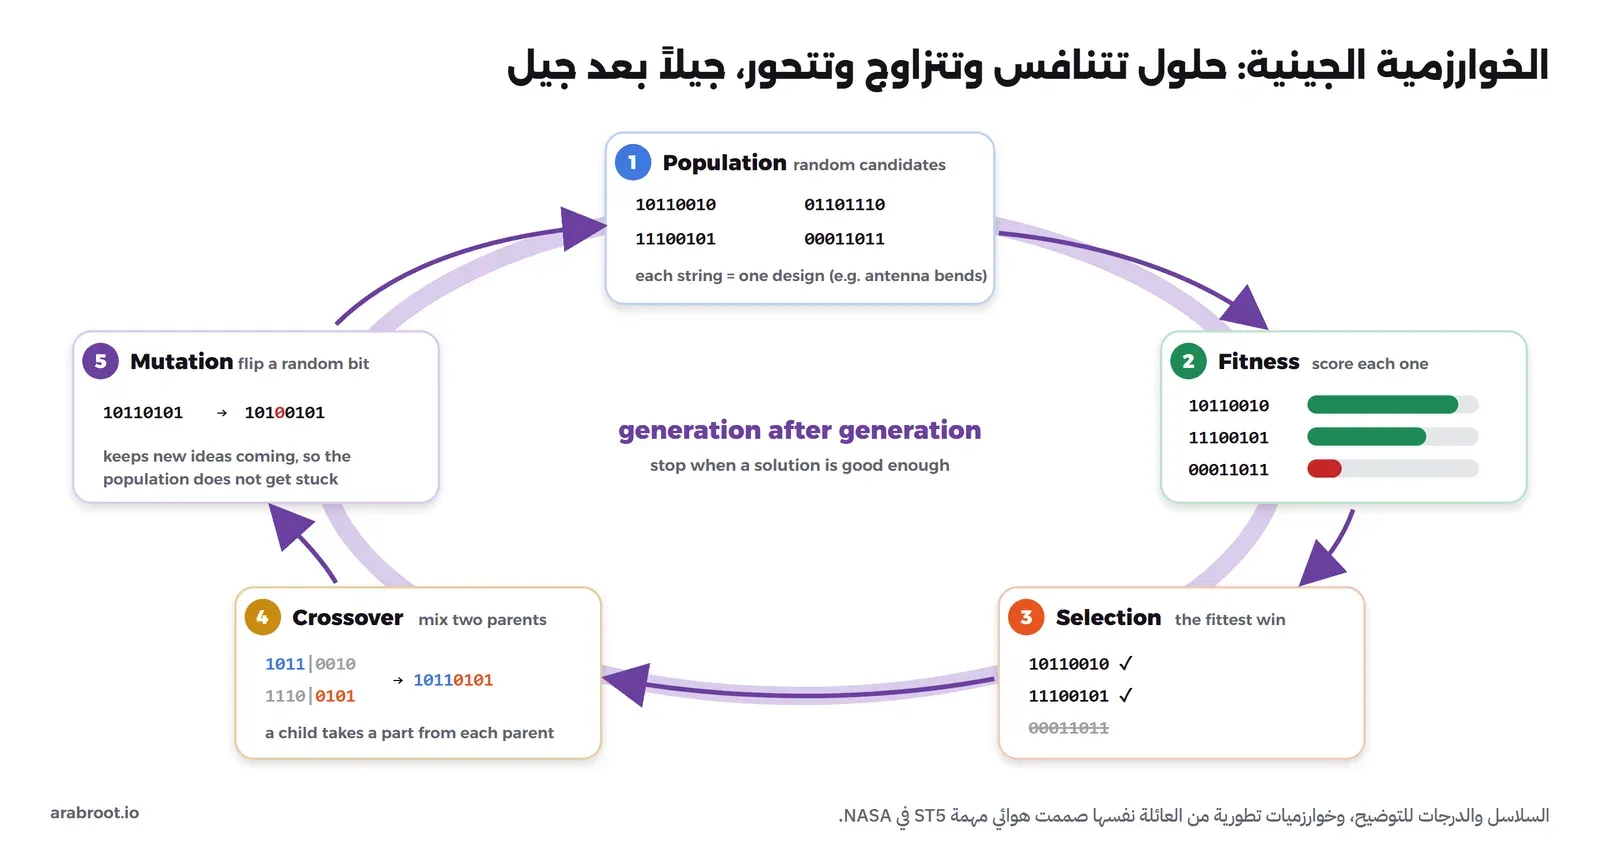
في الشكل أعلاه لاحظ التالي:
- المجتمع Population يبدأ بحلول عشوائية تماماً، ولا يحتاج أحد أن يعرف شكل الحل الجيد مسبقاً.
- دالة التقييم Fitness Function هي الشيء الوحيد الذي يكتبه الإنسان: كيف نقيس جودة الحل، وفي حالة هوائي مثلاً تكون الدرجة من محاكي يقيس قوة الإشارة.
- الاختيار Selection يعطي الحلول الأفضل فرصة أكبر لتكون آباء.
- التزاوج Crossover يأخذ جزءاً من كل أب، فيجمع ميزات حلين جيدين في حل واحد.
- الطفرة Mutation تقلب بتاً عشوائياً بنسبة صغيرة، والسبب أنها تضيف أفكاراً جديدة وتمنع المجتمع من أن يعلق في حل متوسط.
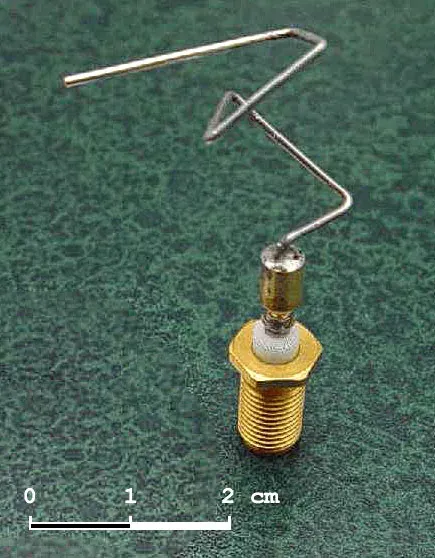
وأشهر مثال حقيقي على هذه العائلة من الخوارزميات التطورية Evolutionary Algorithms هوائي مهمة ST5 في NASA، فقد استخدم فريق مركز Ames خوارزميات تطورية لتصميم هوائي X-band لثلاثة أقمار صغيرة، وبحسب موجز NASA التقني أطلقت المهمة في 22 مارس 2006، وكانت هذه الهوائيات وقت كتابة الموجز أول عتاد صممه الحاسب بالتطور يطير في الفضاء، ويذكر بحث الفريق أن الهوائي المتطور كان أقل استهلاكاً للطاقة وأسرع في التصنيع وأفضل أداء. وانظر إلى شكله في الصورة التالية، فهو لا يشبه أي شيء كان سيرسمه مهندس:
والخوارزميات الجينية ما زالت مفيدة اليوم في مسائل التحسين Optimization التي لا يوجد لها اشتقاق رياضي سهل، مثل الجداول الزمنية وتصميم القطع، ولكنها ليست الطريقة التي تتعلم بها نماذج اللغة، فتلك تتعلم بالطريقة التي سوف نحكي قصتها الآن.
عودة الشبكات العصبية: Backpropagation وقراءة الشيكات
في 9 أكتوبر 1986 نشرت مجلة Nature ورقة من ثلاث صفحات ونصف بعنوان Learning representations by back-propagating errors، كتبها ديفيد روملهارت David Rumelhart وجيفري هينتون Geoffrey Hinton ورونالد ويليامز Ronald Williams، وفيها الحلقة المفقودة منذ كتاب Perceptrons: طريقة لتدريب شبكة من عدة طبقات. والفكرة اسمها الانتشار العكسي Backpropagation، وهي أن تحسب خطأ المخرج ثم ترجعه طبقة بعد طبقة إلى الخلف لتعرف كم ساهم كل وزن في هذا الخطأ، فتعدله بقدر مساهمته. وتقول صفحة جائزة Turing لعام 2018 إن هذه الورقة أثبتت أن الشبكات تستطيع أن تكتشف بنفسها تمثيلات داخلية Internal Representations للبيانات، أي خصائص لم يكتبها أحد، وهذا بالضبط ما كان يعجز عنه Perceptron في مثال XOR.
وفي أواخر الثمانينات، بحسب الصفحة نفسها، كان يان ليكون Yann LeCun أول من درب شبكة عصبية التفافية Convolutional Neural Network واختصاراً CNN على صور أرقام مكتوبة باليد، وهي شبكة تنظر إلى الصورة قطعة صغيرة بعد قطعة بنفس الأوزان، فتتعلم الحواف ثم الأشكال، وصارت هذه الشبكات اليوم المعيار في رؤية الحاسب Computer Vision. وفي التسعينات دمج يوشوا بنجيو Yoshua Bengio الشبكات العصبية مع النماذج الاحتمالية للتسلسلات Sequence Models، ودخلت هذه الأفكار في نظام استخدمته AT&T وNCR لقراءة الشيكات المكتوبة باليد، أي أن شبكة عصبية كانت تقرأ أموالاً حقيقية في البنوك قبل ظهور الإنترنت التجاري بشكله الحالي.
SVM والترجمة الإحصائية Statistical Machine Translation
ولكن الشبكات العصبية لم تكن وحدها في الساحة، بل لم تكن الأقوى في التسعينات، ففي سبتمبر 1995 نشرت كورينا كورتيس Corinna Cortes وفلاديمير فابنيك Vladimir Vapnik ورقة Support-vector networks التي قدمت آلات المتجهات الداعمة Support Vector Machines واختصاراً SVM، وهي طريقة تبحث عن أعرض فاصل ممكن بين مجموعتين من الأمثلة، ولها أساس رياضي متين، فصارت مع أخواتها من الطرق الإحصائية الخيار الأول لكثير من مسائل التصنيف Classification في تلك الفترة. وفي اللغة حدث التحول نفسه، فبدل أن يكتب اللغويون قواعد الترجمة، نشر فريق IBM في 1993 ورقة The Mathematics of Statistical Machine Translation التي تتعلم الترجمة من إحصاءات نصوص مترجمة سلفاً، أي أن البيانات صارت هي القواعد. وكيف تعمل هذه الطرق، ومتى تبقى SVM وأخواتها الخيار الأفضل حتى اليوم، موجود في مقال التعلم الآلي وفي قسم أين تكون نماذج اللغة الأداة الخطأ.
Deep Blue يهزم كاسباروف في 1997
في مايو 1997 فعل حاسب IBM اسمه Deep Blue ما لم تفعله آلة قبله، فبحسب صفحة تاريخ IBM صار أول نظام حاسوبي يهزم بطل العالم في الشطرنج جاري كاسباروف Garry Kasparov في مباراة كاملة من ست أدوار بقوانين البطولات الرسمية، بعد أن خسر أمامه مباراة 1996 في Philadelphia رغم فوزه في الدور الأول منها. وكان Deep Blue يستخدم 32 معالجاً تعمل بالتوازي، ويقيم 200 مليون وضعية في الثانية.
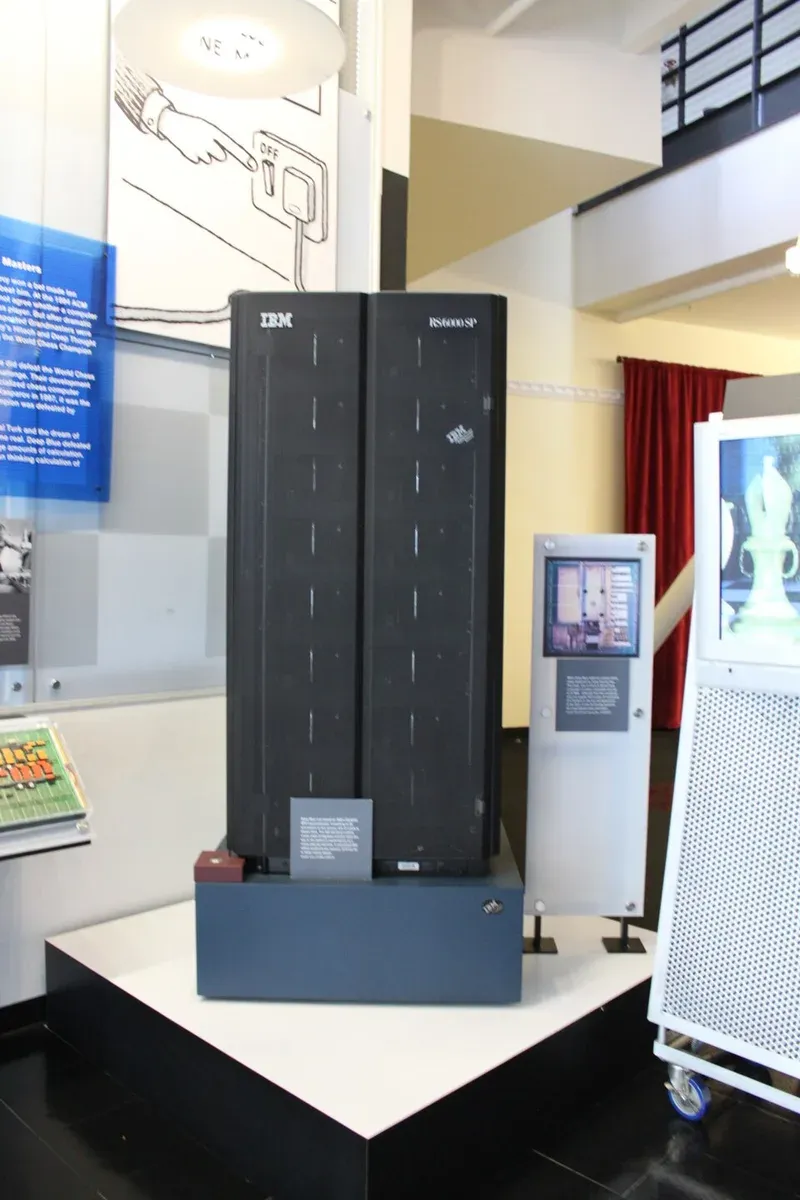
وقد يتساءل البعض: هل كان Deep Blue ذكاءً اصطناعياً يتعلم؟ والإجابة لا، فهو بحسب IBM نفسها استمد قوته من «قوة الحوسبة الخام» Brute Force، أي البحث السريع جداً في شجرة الحركات الممكنة مع دالة تقييم Evaluation Function صممها خبراء الشطرنج، وهي نفس فكرة شانون في 1950 مع حوسبة أكبر بملايين المرات. وهذا درس مهم: الحوسبة وحدها هزمت بطل العالم في لعبة قواعدها محددة تماماً، ولكنها لم تكن لتنفع في التعرف على صورة قطة أو فهم جملة، فتلك مسائل لا تكتب قواعدها، وتحتاج التعلم من البيانات.
عصر البيانات الضخمة Big Data: MapReduce وHadoop وImageNet
في بداية هذا القرن كانت الشبكات العصبية موجودة وBackpropagation معروفة، ولكن المكون الناقص كان البيانات، ثم جاء الإنترنت بكميات من النصوص والصور لم يرها أحد من قبل، وصار التخزين رخيصاً، وبقي سؤال: كيف تعالج كل هذا؟ وفي 2004 نشر جيفري دين Jeffrey Dean وسانجاي غيماوات Sanjay Ghemawat من Google ورقة MapReduce: Simplified Data Processing on Large Clusters في مؤتمر OSDI، وهي نموذج برمجي يقسم المعالجة على آلاف الأجهزة العادية بدل جهاز واحد عملاق. وبعدها بسنتين ظهر تطبيق مفتوح المصدر لهذه الأفكار، فأول تذكرة في مشروع Hadoop واسمها HADOOP-1 تحمل عنوان «نقل الكود من Nutch» وتاريخ فبراير 2006، وأول إصدار 0.1.0 موجود في أرشيف Apache بتاريخ أبريل 2006، وهو المشروع الذي جعل معالجة البيانات الضخمة متاحة لأي شركة.
ولكن البيانات الخام لا تكفي للتعلم، فالشبكة التي تتعلم التعرف على الصور تحتاج صوراً عليها إجابات صحيحة، أي بيانات مصنفة Labelled Data، وهنا يأتي دور في في لي Fei-Fei Li، فقد قادت مع فريق من باحثي Princeton وStanford بناء قاعدة ImageNet التي قدمت في مؤتمر CVPR سنة 2009، وتضم اليوم بحسب موقع المشروع أكثر من 14 مليون صورة مصنفة في قرابة 22 ألف فئة، وحصلت ورقتها في 2019 على جائزة PAMI Longuet-Higgins بوصفها أكثر أوراق مؤتمر 2009 أثراً. وعلى جزء منها تقام مسابقة سنوية اسمها ILSVRC، وهذه المسابقة هي المسرح الذي حدثت عليه قفزة 2012.
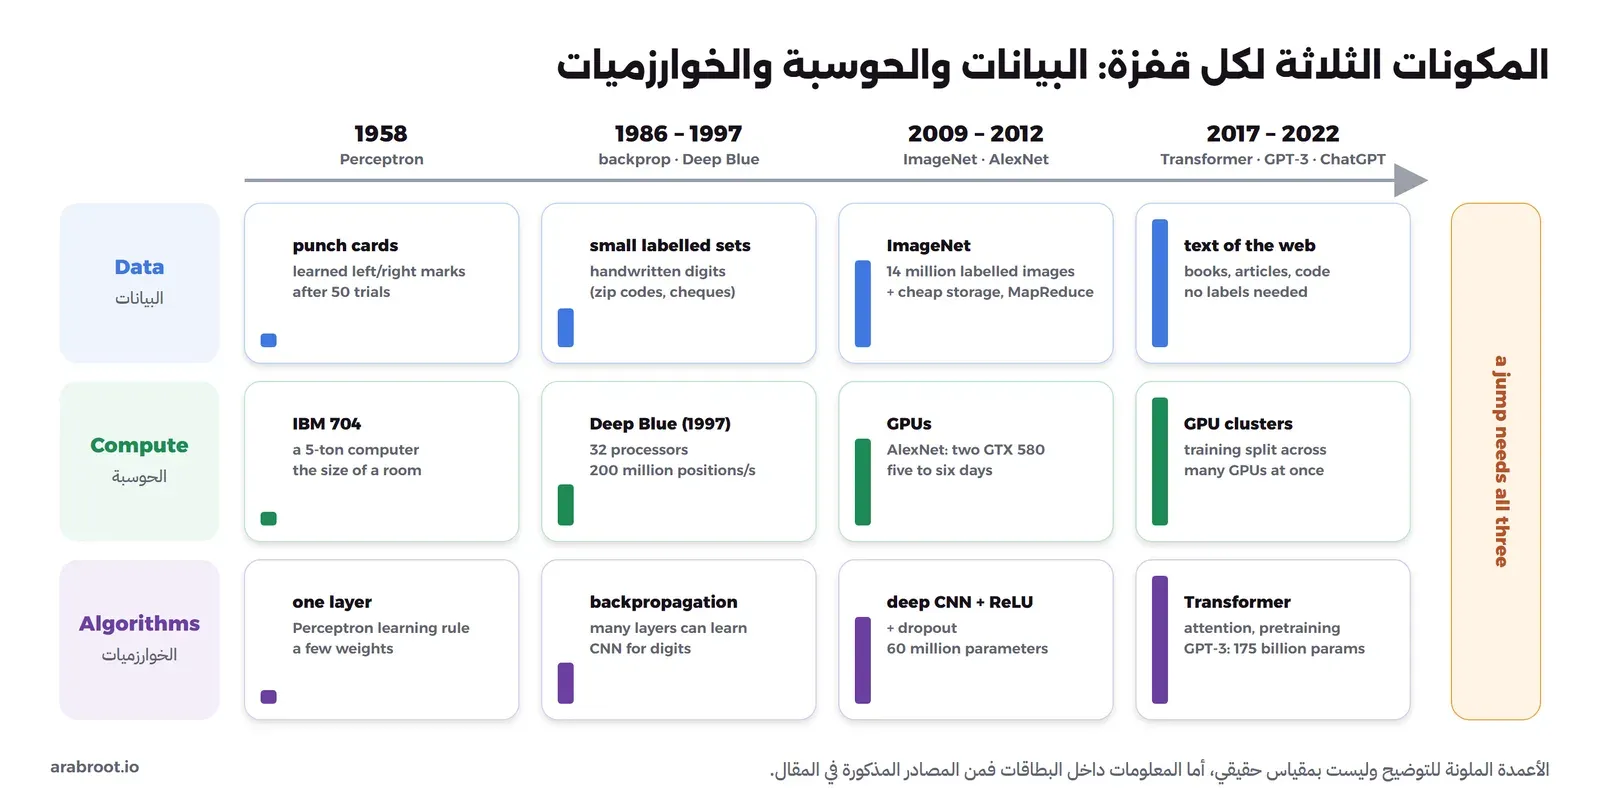
والآن تستطيع أن ترى النمط كاملاً، فكل قفزة في هذه القصة احتاجت ثلاثة مكونات معاً: بيانات كافية، وحوسبة كافية، وخوارزمية تستفيد منهما، والصورة التالية تبين المكونات الثلاثة في أربع لحظات من القصة:
2012: AlexNet وبداية التعلم العميق Deep Learning
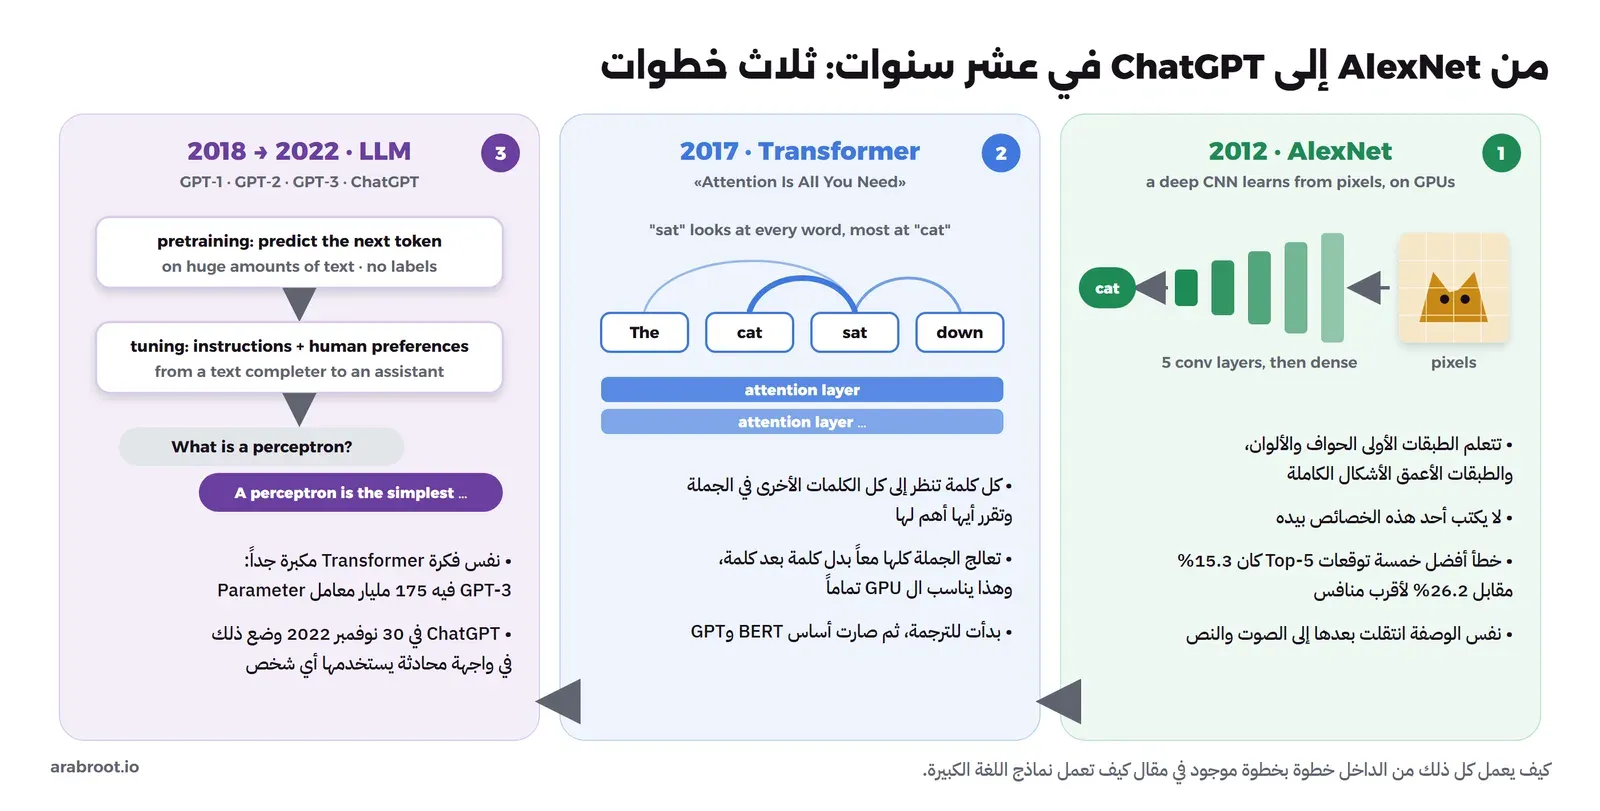
في مسابقة ImageNet لعام 2012 تقدم فريق صغير من جامعة Toronto هو أليكس كريجيفسكي Alex Krizhevsky وإيليا سوتسكيفر Ilya Sutskever ومشرفهما جيفري هينتون بشبكة التفافية عميقة صارت تعرف باسم AlexNet، وبحسب ورقتهم في مؤتمر NeurIPS كان خطأ أفضل خمسة توقعات Top-5 Error لنموذجهم 15.3%، مقابل 26.2% لأقرب منافس، أي أنهم قللوا الخطأ إلى قرابة النصف، وهو ما تصفه صفحة جائزة Turing بأنه أعاد تشكيل مجال رؤية الحاسب. وكانت الشبكة فيها 60 مليون معامل Parameter وخمس طبقات التفافية، واستخدمت دالة التنشيط ReLU وطريقة Dropout لتقليل الحفظ.
والجملة الأهم في الورقة ليست عن الخوارزمية، فقد كتبوا أن تدريب الشبكة استغرق من خمسة إلى ستة أيام على معالجين رسوميين GPU من نوع GTX 580 بذاكرة 3 جيجابايت لكل منهما، ثم أضافوا: «كل تجاربنا تشير إلى أن نتائجنا يمكن أن تتحسن ببساطة بانتظار معالجات رسومية أسرع ومجموعات بيانات أكبر» ("our results can be improved simply by waiting for faster GPUs and bigger datasets to become available"). أي أن الأفكار كانت موجودة منذ الثمانينات تقريباً، والذي تغير هو أن بطاقات الألعاب صارت تستطيع أن تقوم بملايين عمليات ضرب المصفوفات بالتوازي، وأن ImageNet أعطتها ما تتعلم منه. ولماذا غيرت هذه اللحظة طريقة بناء الأنظمة كلها، من خصائص يصممها الإنسان إلى خصائص تتعلمها الشبكة، موضوع مقال لماذا تفوقت نماذج اللغة.
word2vec وGANs: الكلمات أرقاماً، والشبكات تتنافس
وبعد AlexNet تتابعت الأفكار بسرعة، ففي يناير 2013 نشر توماس ميكولوف Tomas Mikolov وزملاؤه في Google ورقة Efficient Estimation of Word Representations in Vector Space التي عرفت باسم word2vec، وفكرتها أن تمثل كل كلمة بمتجه Vector من الأرقام بحيث تتقارب الكلمات المتشابهة في المعنى، وهي الفكرة التي تعيش اليوم داخل كل نموذج لغة باسم التضمين Embedding، وقد شرحناها في قسم التضمين في مقال كيف تعمل نماذج اللغة. وفي يونيو 2014 نشر إيان جودفيلو Ian Goodfellow وزملاؤه ومنهم بنجيو ورقة Generative Adversarial Networks، وفيها شبكتان تتنافسان: واحدة تولد صوراً مزيفة والأخرى تحاول كشفها، فتتحسن الاثنتان معاً، وكانت هذه بداية عصر النماذج التي تولد Generative Models.
AlphaGo يهزم لي سيدول في 2016
وفي مارس 2016 في سيول هزم برنامج AlphaGo من شركة DeepMind بطل لعبة Go الكوري لي سيدول Lee Sedol بنتيجة أربعة مقابل واحد، وبحسب صفحة DeepMind شاهد المباراة أكثر من 200 مليون شخص. ولعبة Go أصعب من الشطرنج بكثير لأن عدد الحركات الممكنة في كل دور ضخم جداً، فطريقة Deep Blue في البحث الشامل لا تنفع، ولهذا جمع AlphaGo بين شبكات عصبية عميقة تعلمت من مباريات البشر ومن اللعب ضد نفسها وبين البحث، كما تشرح ورقته في مجلة Nature. وفي الدور الثاني لعب حركته رقم 37 التي تقول DeepMind إن احتمال أن يلعبها إنسان كان واحداً من عشرة آلاف، وقال لي سيدول بعدها إنه كان يظن AlphaGo مجرد آلة تحسب الاحتمالات، ثم غير رأيه عندما رأى تلك الحركة.
من Transformer إلى ChatGPT
في 12 يونيو 2017 نشر ثمانية باحثين أغلبهم من Google ورقة بعنوان طريف هو Attention Is All You Need، قدموا فيها بنية اسمها Transformer للترجمة الآلية، تعتمد على آلية الانتباه Attention: كل كلمة في الجملة تنظر إلى كل الكلمات الأخرى وتقرر أيها أهم لفهمها، والجملة كلها تعالج معاً بدل كلمة بعد كلمة، وهذا يناسب المعالجات الرسومية تماماً. وكيف يعمل الانتباه بالتفصيل موجود في قسم الانتباه في مقال كيف تعمل نماذج اللغة، أما هنا فيكفي أن تعرف أن هذه البنية هي أساس كل نموذج لغة كبير Large Language Model واختصاراً LLM تستخدمه اليوم.
ثم جاءت الخطوة التالية بسرعة: بدل أن تدرب نموذجاً لكل مهمة، درب نموذجاً واحداً كبيراً على نصوص هائلة دون تصنيف، بمهمة بسيطة هي توقع الكلمة التالية، ثم اضبطه لما تريد، وهذا ما يسمى التدريب المسبق Pretraining. ففي 11 يونيو 2018 نشرت OpenAI نموذج GPT الأول، وفي 11 أكتوبر 2018 نشرت Google نموذج BERT الذي يقرأ الجملة في الاتجاهين، وفي 14 فبراير 2019 أعلنت OpenAI عن GPT-2، وفي 28 مايو 2020 نشرت ورقة GPT-3 بنموذج فيه 175 مليار معامل، أي عشرة أضعاف أي نموذج لغة غير متفرق Non-sparse قبله، وبينت الورقة أن النموذج الكبير يستطيع أن يؤدي مهمة جديدة من أمثلة قليلة في السؤال نفسه Few-shot دون أي تدريب إضافي.
وفي 30 نوفمبر 2022 أعلنت OpenAI عن ChatGPT، وهو نموذج من عائلة GPT ضبط بالتعليمات وبتفضيلات البشر ليصبح مساعداً يحاور، ووضع في واجهة محادثة بسيطة يستخدمها أي شخص، وهذه هي اللحظة التي بدأنا بها المقال. والصورة التالية تلخص الخطوات الثلاث من AlexNet إلى ChatGPT:
ويجدر بك أن تعرف أن هذه القصة لم تبق داخل الشركات الكبيرة، فبعد ChatGPT ظهرت نماذج كثيرة بأوزان مفتوحة Open-weight Models تستطيع أن تنزلها وتشغلها على سيرفرك، ولكن انتبه إلى أن «الأوزان المفتوحة» ليست دائماً «مفتوحة المصدر» بمعنى الرخص التي شرحناها في مقال البرمجيات مفتوحة المصدر ورخصها، والتفصيل في قسم النماذج المفتوحة ورخصها، وكيف تختار الجهاز وتشغل النموذج عليه في مقال تشغيل نماذج اللغة على جهازك. وإذا اختلطت عليك المصطلحات من نموذج ووكيل Agent وRAG فقد جمعناها في مقال مصطلحات الذكاء الاصطناعي.
الاعتراف الرسمي: جائزة Turing وجائزتا Nobel
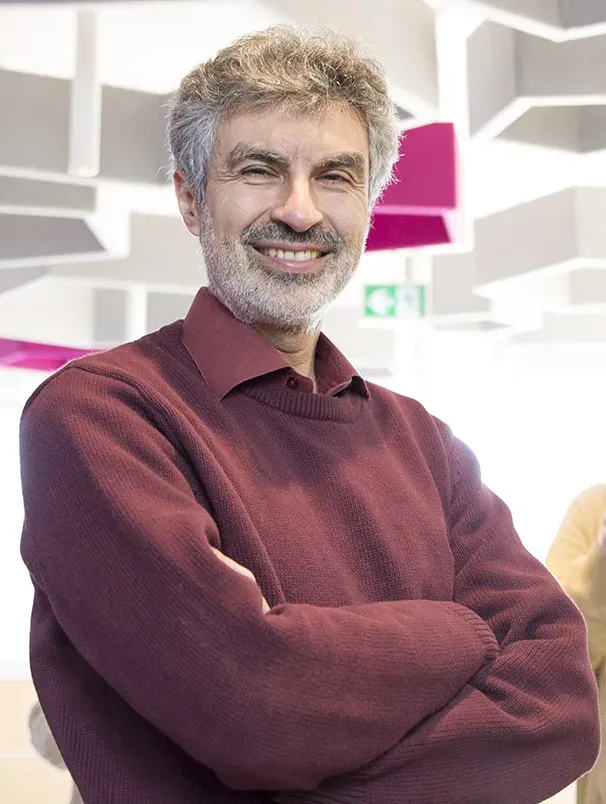
في 2019 أعلنت جمعية ACM أن جائزة Turing لعام 2018، وهي أعلى جائزة في علوم الحاسب، ذهبت إلى يوشوا بنجيو وجيفري هينتون ويان ليكون «للاختراقات المفاهيمية والهندسية التي جعلت الشبكات العصبية العميقة مكوناً أساسياً في الحوسبة»، وتصفهم الصفحة بآباء التعلم العميق Deep Learning، وتذكر أنهم عملوا معاً ومنفردين على هذه الأفكار. ومن مساهمات بنجيو التي تذكرها الصفحة ورقة 2000 عن نموذج اللغة العصبي الاحتمالي A Neural Probabilistic Language Model التي قدمت تمثيل الكلمات بمتجهات، أي الجذور المبكرة لما صار لاحقاً word2vec والتضمين في نماذج اللغة.
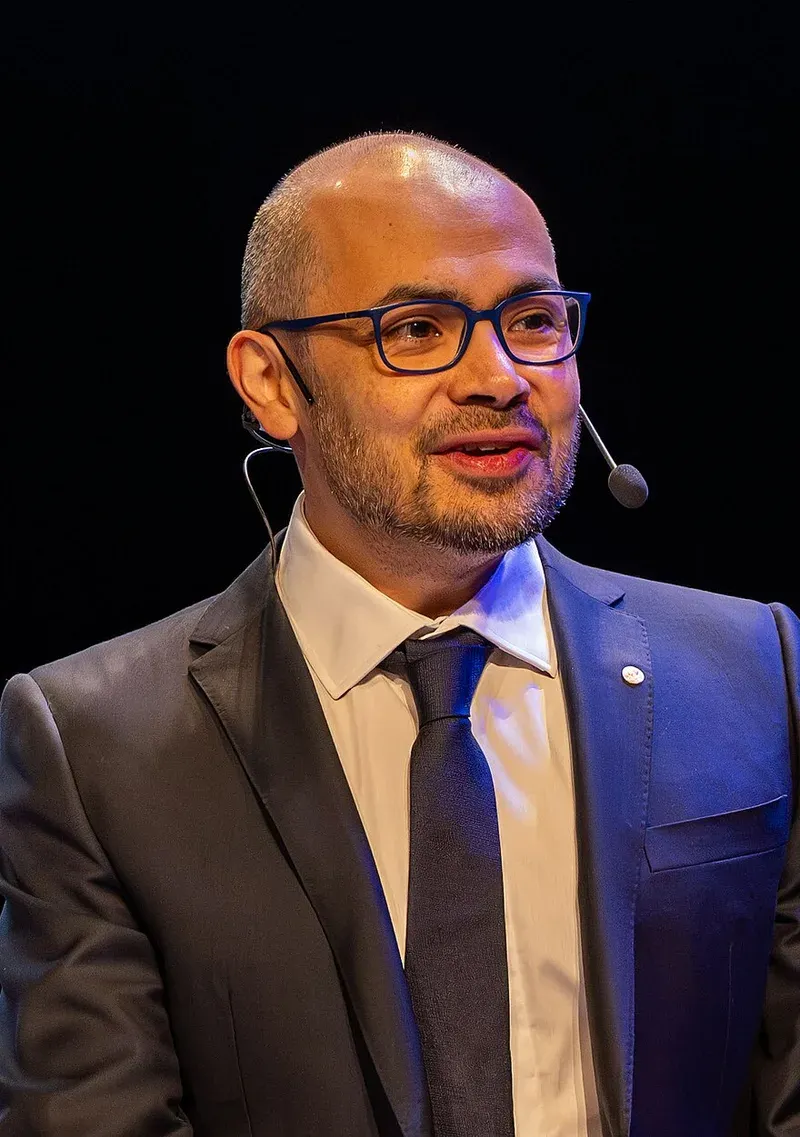
وفي أكتوبر 2024 حدث ما لم يتوقعه أحد قبل عشر سنوات: جائزتا Nobel في الفيزياء والكيمياء ذهبتا لأعمال في الذكاء الاصطناعي. فبحسب بيان جائزة Nobel في الفيزياء فاز جون هوبفيلد John Hopfield وجيفري هينتون «للاكتشافات والاختراعات الأساسية التي تمكن التعلم الآلي بالشبكات العصبية الاصطناعية»، فهوبفيلد صنع ذاكرة ترابطية Associative Memory تخزن الصور والأنماط وتعيد بناءها من نسخة ناقصة، وهي ما يعرف بشبكة Hopfield، وبنى هينتون عليها آلة Boltzmann التي تتعلم الخصائص المميزة للبيانات، واستخدم الاثنان أدوات من الفيزياء الإحصائية. وفي الكيمياء ذهب نصف الجائزة إلى ديفيد بيكر David Baker لتصميم البروتينات بالحاسب، والنصف الآخر إلى ديميس هاسابيس Demis Hassabis وجون جمبر John Jumper من DeepMind لتوقع بنية البروتينات، فقد قدما في 2020 نموذج AlphaFold2 الذي استطاع أن يتوقع بنية كل البروتينات المعروفة تقريباً، وعددها قرابة 200 مليون، بعد أن كانت هذه المسألة من أصعب مسائل الأحياء منذ السبعينات.
ولاحظ أن هينتون نفسه ظهر في القصة ثلاث مرات: في ورقة 1986 التي أعادت الشبكات العصبية من الشتاء، وفي AlexNet في 2012، ثم في Nobel في 2024، أي أنه بقي يعمل على فكرة واحدة قرابة أربعين سنة، أغلبها والمجال لا يصدقها.
النمط الذي يتكرر، وما الذي يعلمنا إياه
إذا وضعت هذه القصص بجانب بعضها فسوف تجد ثلاثة أشياء تتكرر بشكل لافت، وأولها أن الأفكار كانت تنتظر البيانات والحوسبة أكثر مما تنتظر العباقرة، فالخلية العصبية الصناعية من 1943، وقاعدة تعلم Perceptron من 1958، وBackpropagation منشورة في 1986، والشبكات الالتفافية تقرأ الشيكات في التسعينات، ومع ذلك لم يحدث الانفجار إلا في 2012 عندما اجتمعت ImageNet مع المعالجات الرسومية. وتذكر جملة مقترح Dartmouth في 1955: «العائق الأكبر ليس نقص قدرة الآلة، وإنما عجزنا عن كتابة البرامج»، ثم قارنها بجملة ورقة AlexNet بعد 57 سنة: نتائجنا سوف تتحسن «ببساطة بانتظار معالجات رسومية أسرع ومجموعات بيانات أكبر». كلا الطرفين كان محقاً جزئياً، فالبرامج كانت تحتاج فكرة التعلم من البيانات، والتعلم من البيانات كان يحتاج آلات لم تكن موجودة في 1955.
والشيء الثاني دورة الضجة ثم الشتاء، وهي تتكرر بالشكل نفسه تقريباً: نجاح حقيقي في مسألة محدودة، ثم وعود بأن المسألة العامة سوف تحل خلال سنوات قليلة، ثم استثمار ضخم على هذه الوعود، ثم اصطدام بالواقع وانهيار التمويل. حدث هذا مع Perceptron والترجمة الآلية حتى تقرير Lighthill، ثم مع الأنظمة الخبيرة وآلات LISP، ولاحظ أن الأفكار نفسها لم تكن خاطئة في المرتين، وإنما كان الوعد أكبر من الأداة، والأفكار التي سقطت مع الضجة عادت لاحقاً حيث تصلح: محركات القواعد في البنوك، والشبكات العصبية في كل مكان.
والشيء الثالث أن الإحساس بالفهم يسبق الفهم دائماً، من برنامج ELIZA الذي قال صاحبه في 1966 إنه يبهر حتى الخبراء قبل أن تشرح طريقة عمله، إلى عناوين الصحف عن «آلة تقرأ وتزداد حكمة» في 1958، وهذا يضع عليك كمطور مسؤولية أن تختبر الأداة على مسألتك أنت قبل أن تصدق ما يقال عنها.
فهل نحن اليوم في ضجة جديدة سوف يتبعها شتاء ثالث؟ والإجابة الصادقة أن أحداً لا يعرف، ولن نقدم لك هنا توقعاً على أنه حقيقة، ولكن الذي نستطيع قوله من القصة أمران: الأول أن الفرق هذه المرة أن الأدوات تستخدم فعلاً في عمل يومي لملايين الناس وليست في المختبرات فقط، وهذا لم يكن صحيحاً في 1973 ولا في 1987. والثاني أن الوعود التي تسمعها اليوم عن ذكاء عام خلال سنوات قليلة تشبه في صياغتها وعود صيف 1956 تماماً، لذلك القاعدة العملية لك: لا تبن نظامك على وعد، وإنما على ما تستطيع أن تقيسه اليوم، واستخدم نموذج اللغة حيث يتفوق فعلاً، والطرق التقليدية حيث تكون أرخص وأدق، كما فصلنا في جدول القرار في مقال لماذا تفوقت نماذج اللغة.
الخلاصة
- كلمة Algorithm جاءت من اسم الخوارزمي، وآلات الجزري في 1206 من أقدم الأمثلة الموثقة على آلة تعمل وحدها، دون أن تكون ذكاءً اصطناعياً بالمعنى الحديث.
- في 1943 وصف McCulloch وPitts خلية عصبية صناعية بعتبة ثابتة، وفي 1950 استبدل تورنغ سؤال «هل تفكر الآلات؟» بلعبة المحاكاة، واقترح أن نبني آلة تتعلم كالطفل.
- ولد اسم الذكاء الاصطناعي في مقترح Dartmouth بتاريخ 31 أغسطس 1955 لورشة صيف 1956، وسيطر الذكاء الرمزي بقواعده المكتوبة باليد ثلاثين سنة.
- تعلم Perceptron من أخطائه في 1958 ولكنه عجز عن XOR بطبقة واحدة، كما بين كتاب Minsky وPapert في 1969، وكما رأيت في مثال العشرين سطراً.
- جاء الشتاء الأول بعد تقرير Lighthill في 1973، والشتاء الثاني في أواخر الثمانينات مع انهيار سوق آلات LISP والشكوك في الأنظمة الخبيرة.
- قدم Holland الخوارزميات الجينية في 1975، وصممت خوارزميات تطورية هوائي ST5 الذي طار في 2006.
- أعادت Backpropagation في 1986 الشبكات متعددة الطبقات، وقرأت الشبكات الالتفافية الشيكات في التسعينات، وهزم Deep Blue كاسباروف في 1997 بالحوسبة الخام لا بالتعلم.
- جمعت AlexNet في 2012 بين ImageNet والمعالجات الرسومية فقللت الخطأ إلى قرابة النصف، ثم جاءت Transformer في 2017 وGPT-3 في 2020 وChatGPT في 30 نوفمبر 2022.
- حصل Bengio وHinton وLeCun على جائزة Turing لعام 2018، وفي 2024 ذهبت Nobel الفيزياء إلى Hopfield وHinton، وNobel الكيمياء إلى Baker وHassabis وJumper.
- الدرس: الأفكار انتظرت البيانات والحوسبة، والضجة سبقت الواقع في كل مرة، فابن على ما تقيسه اليوم وليس على الوعود.
وإذا أردت أن تكمل من هنا، فهذه المقالات تشرح الأفكار التي مررنا عليها بالتفصيل مع تجارب عملية:
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليللماذا تفوقت نماذج اللغة LLM على التعلم الآلي التقليدي؟ما الذي جعل نموذج لغة واحداً يحل مهاماً كانت تحتاج نموذجاً لكل منها، وأين ما زالت الخوارزميات التقليدية هي الخيار الأفضل.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلمصطلحات الذكاء الاصطناعي ونماذج اللغة للمبتدئينشرح قصير مع مثال لكل مصطلح ستسمعه في نقاشات الذكاء الاصطناعي ونماذج اللغة، حتى تفهم ما يعرضه عليك أي فريق أو مزود.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات (Changelog)
- أكتوبر 2026: كتابة المقال اعتماداً على الأوراق الأصلية (McCulloch وPitts، وTuring، ومقترح Dartmouth، وELIZA، وتقرير Lighthill، وNature 1986، وAlexNet، وTransformer، وGPT-3) وصفحات جائزتي Turing وNobel وأرشيف IBM وNASA وجامعات Cornell وStanford وCarnegie Mellon، مع صور من Wikimedia Commons برخص حرة تم التحقق منها، وتشغيل مثال Perceptron داخل Container.





