

تكتب سؤالاً في ChatGPT أو في أي مساعد ذكي، فتظهر الإجابة كلمة بعد كلمة وكأن أحداً يكتبها لك في نفس اللحظة، وقد تكون الإجابة دقيقة ومرتبة، وقد تكون خاطئة تماماً وهي مكتوبة بنفس الثقة. ثم تقرأ أن بإمكانك تشغيل نموذج مثل هذا على سيرفرك حتى لا تخرج بيانات مؤسستك إلى خدمة خارجية، فتجد نفسك أمام كلمات كثيرة لا تعرف معناها: التوكن Token والمعاملات Parameters ونافذة السياق Context Window والتكميم Quantization و7B وQ4، ولا تعرف هل يكفي سيرفرك أم تحتاج بطاقة رسومية GPU بآلاف الدولارات.
والحقيقة أن الفكرة التي تقوم عليها هذه النماذج بسيطة جداً، وكل التعقيد الذي تسمع عنه هو تفاصيل في طريقة تنفيذ هذه الفكرة، لذلك سوف نبني الصورة في هذا المقال خطوة خطوة، وكل خطوة تجيب على السؤال الذي تثيره الخطوة السابقة، ومع كل خطوة تجربة حقيقية على نموذج صغير يعمل على المعالج CPU في أي جهاز. وهذا المقال هو أول مقالات مرحلة الذكاء الاصطناعي على سيرفرك في خريطة الطريق، وبقية المرحلة تبني عليه.
وسوف نناقش في هذا المقال ما يلي:
- الفكرة في جملة واحدة: النموذج يتوقع القطعة التالية من النص ثم يكرر ذلك.
- كيف يتحول النص إلى توكنز Tokens ثم إلى أرقام، ولماذا يكلف النص العربي توكنز أكثر من الإنجليزي.
- كيف تتحول الأرقام إلى معان عبر التضمين Embedding.
- كيف يفهم النموذج السياق عبر الانتباه Attention، وما هي كتلة Transformer.
- كيف يختار النموذج التوكن التالي: الاحتمالات ودرجة الحرارة Temperature وTop-p.
- نافذة السياق Context Window وذاكرة KV Cache، ولماذا يكلف النص الطويل ذاكرة ووقتاً.
- كيف يتعلم النموذج: التدريب المسبق Pretraining ثم ضبط التعليمات Instruction Tuning ثم ضبط التفضيلات Preference Tuning.
- لماذا يخطئ النموذج، وكيف تقلل RAG والأدوات Tools من ذلك.
- ما الذي تحتاجه لتشغيله على سيرفرك: حجم الملف والذاكرة والتكميم والسرعة والرخص.
الفكرة كلها في جملة واحدة
افتح لوحة المفاتيح في جوالك واكتب «السيرفر يعمل»، وسوف تجد فوق المفاتيح ثلاث كلمات مقترحة مثل «الآن» و«بشكل» و«على»، والسبب أن لوحة المفاتيح تعلمت مما كتبته أنت وما كتبه غيرك أي الكلمات تأتي غالباً بعد هذه الجملة. فإذا ضغطت على الكلمة المقترحة الأولى في كل مرة فسوف تحصل على جملة كاملة، قد تكون مفهومة وقد تكون غريبة، ولكنها جملة كتبتها الآلة كلمة بعد كلمة.
ونموذج اللغة الكبير Large Language Model واختصاراً LLM يقوم بنفس الشيء بالضبط، ولكن على نطاق أكبر بكثير: هو برنامج يأخذ نصاً، ويحسب احتمال كل قطعة نص ممكنة أن تكون القطعة التالية، ثم يختار واحدة منها ويضيفها إلى النص، ثم يعيد العملية على النص الجديد، وهكذا حتى تكتمل الإجابة. والفرق بينه وبين لوحة المفاتيح أنه لا ينظر إلى آخر كلمتين فقط، وإنما إلى آلاف الكلمات قبلها، وأنه تعلم من كمية نصوص هائلة، لذلك تبدو إجاباته وكأنها تفكير، بينما هي في الأصل توقع للقطعة التالية مرة بعد مرة.
الصورة التالية تبين هذه الحلقة، وفي أسفلها خطوات حقيقية من تجربة سوف نشغلها بعد قليل على نموذج صغير:
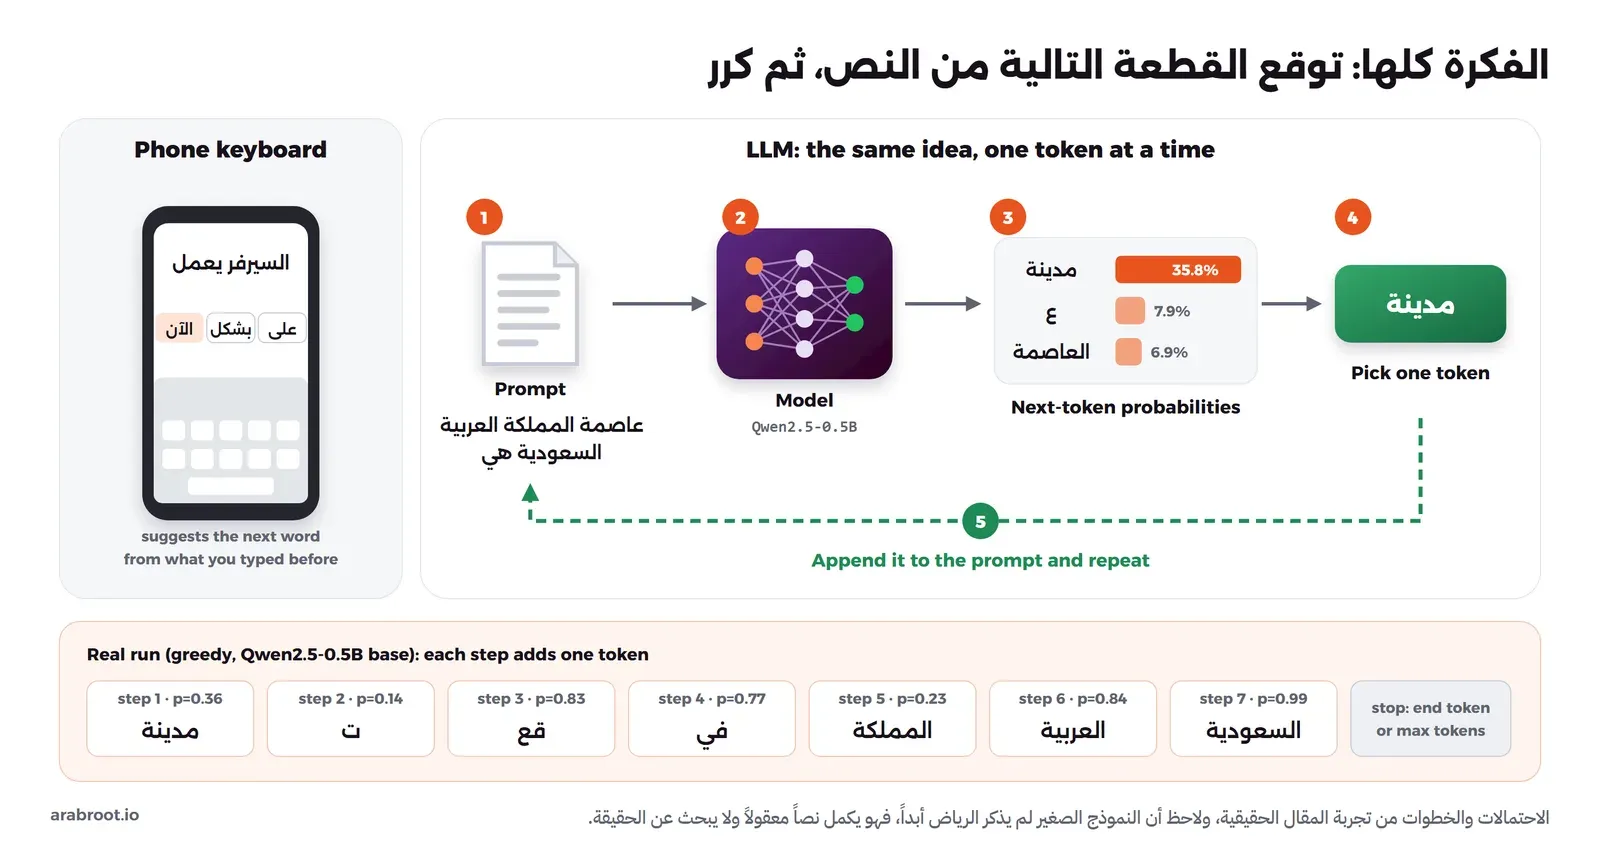
وكل ما تبقى من المقال هو إجابة على الأسئلة التي تثيرها هذه الصورة: ما هي «القطعة» التي يتوقعها النموذج؟ وكيف يقرأ النص وهو برنامج لا يفهم إلا الأرقام؟ وكيف يعرف أن «مدينة» أنسب من «تفاحة»؟ ولماذا يختار أحياناً كلمة غير الأعلى احتمالاً؟ ومن أين جاءت هذه الاحتمالات أصلاً؟
تجهيز بيئة التجربة
لن نثبت شيئاً على جهازك، وإنما نشغل Container فيه Python مع مكتبات Hugging Face لنرى ما يحدث داخل النموذج، وContainer آخر فيه Ollama لتشغيل النموذج كما ستشغله على سيرفرك. وسوف نستخدم عائلة Qwen2.5-0.5B من Alibaba، وهي نماذج صغيرة فيها نحو نصف مليار معامل، ورخصتها Apache-2.0، وتعمل على المعالج دون بطاقة رسومية. والتحميلات كلها نحو ثلاثة جيجابايت: المكتبات، ونسختان من النموذج كل منهما قرابة 1 GB، ونموذج تضمين صغير، ونسخة Ollama المضغوطة 398 MB. وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu:
mkdir llm-lab && cd llm-lab

# Python مع مكتبات Hugging Face (نسخة PyTorch للمعالج فقط)
docker volume create lab-llm-hf
docker run -d --name lab-llm-py -v lab-llm-hf:/root/.cache -v "$PWD":/lab -w /lab python:3.12-slim sleep infinity
docker exec lab-llm-py pip install -q --index-url https://download.pytorch.org/whl/cpu torch
docker exec lab-llm-py pip install -q transformers tokenizers tiktoken sentence-transformers

# Ollama على منفذ محلي فقط
docker volume create lab-llm-ollama
docker run -d --name lab-llm-ollama -p 127.0.0.1:41434:11434 -v lab-llm-ollama:/root/.ollama ollama/ollama:0.35.1
docker exec lab-llm-ollama ollama pull qwen2.5:0.5b
في الإعداد أعلاه لاحظ التالي:
- ال Volume المسمى
lab-llm-hfيحفظ النماذج التي تحملها مكتبات Hugging Face، حتى لا تحملها مرة أخرى إذا أعدت إنشاء ال Container. - المجلد الحالي مربوط داخل ال Container على
/lab، فكل ملف Python تكتبه فيllm-labتشغله بالأمرdocker exec lab-llm-py python file.py. - منفذ Ollama منشور على
127.0.0.1فقط، والسبب أن واجهة Ollama لا تطلب أي مصادقة، فلا تنشرها على كل الواجهات أبداً.
من النص إلى الأرقام: ما هو التوكن Token؟
النموذج برنامج يتعامل مع أرقام فقط، لذلك فأول سؤال: كيف نحول النص إلى أرقام؟ الحل البسيط الأول أن نعطي كل حرف رقماً، والمشكلة أن الجملة تصبح سلسلة طويلة جداً، والنموذج يدفع ثمناً في الذاكرة والوقت عن كل عنصر كما سوف ترى لاحقاً، كما أن الحرف وحده لا يحمل معنى. والحل البسيط الثاني أن نعطي كل كلمة رقماً، والمشكلة هنا أن عدد الكلمات في اللغات لا ينتهي، فالعربية وحدها فيها «السيرفر» و«سيرفرات» و«بسيرفرك» و«وسيرفراتهم»، وأي كلمة لم تكن في القائمة لن يستطيع النموذج قراءتها أبداً.
والحل المستخدم بين الاثنين: قطع النص إلى قطع متوسطة تسمى التوكنز Tokens، فالكلمة الشائعة تكون توكناً واحداً، والكلمة النادرة تقطع إلى عدة توكنز، وأي نص في العالم يمكن كتابته بهذه القطع. والبرنامج الذي يقطع النص يسمى ال Tokenizer، وقائمة القطع التي يعرفها تسمى المفردات Vocabulary، ولكل قطعة فيها رقم ثابت يسمى رقم التوكن Token ID.
وأشهر طريقة لبناء هذه القائمة هي ترميز أزواج البايتات Byte-Pair Encoding واختصاراً BPE، وفكرتها باختصار: ابدأ بالحروف أو البايتات المفردة، ثم ابحث في كمية كبيرة من النصوص عن الزوج الذي يتكرر أكثر من غيره وادمجه في قطعة جديدة، ثم كرر الدمج حتى تصل القائمة إلى الحجم الذي تريده، وتجد شرحاً مفصلاً بالأمثلة في دورة Hugging Face. وأغلب النماذج الحديثة تبدأ من البايتات وليس من الحروف، وهذا ما يسمى Byte-level BPE، وهنا يظهر سؤال مهم للقارئ العربي: الحرف العربي في UTF-8 يكتب في بايتين، كما شرحنا في مقال الترميز، فهل يعني هذا أن العربية تكلف أكثر؟
لنقس ذلك بأنفسنا. البرنامج التالي يعد التوكنز لنفس الجملة بالعربية والإنجليزية في أربعة Tokenizers: ثلاثة من مكتبة tiktoken التابعة ل OpenAI، وهي r50k_base القديم الذي استخدمته نماذج GPT-3 الأولى، وcl100k_base الذي يستخدمه GPT-4، وo200k_base الذي يستخدمه GPT-4o بحسب جدول المكتبة، والرابع Tokenizer نموذج Qwen2.5 الذي سوف نستخدمه في بقية المقال. احفظه في الملف tok.py:
import tiktoken
from transformers import AutoTokenizer
ar = "السيرفر يعمل الآن والنسخة الاحتياطية اكتملت بنجاح"
en = "The server is running now and the backup completed successfully"
toks = {
  "r50k_base": tiktoken.get_encoding("r50k_base"),
  "cl100k_base": tiktoken.get_encoding("cl100k_base"),
  "o200k_base": tiktoken.get_encoding("o200k_base"),
}
qwen = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B")
print(f"{'tokenizer':<18} {'vocab':>7} {'EN tokens':>9} {'AR tokens':>9}")
for n,t in toks.items():
    print(f"{n:<18} {t.n_vocab:>7} {len(t.encode(en)):>9} {len(t.encode(ar)):>9}")
print(f"{'Qwen2.5':<18} {len(qwen):>7} {len(qwen.encode(en)):>9} {len(qwen.encode(ar)):>9}")
print()
print("chars EN/AR:", len(en), len(ar), " UTF-8 bytes EN/AR:", len(en.encode()), len(ar.encode()))
docker exec lab-llm-py python tok.pyوالمخرج سوف يكون كما يلي:
tokenizer            vocab EN tokens AR tokens
r50k_base            50257        10        47
cl100k_base         100277        10        38
o200k_base          200019        10        16
Qwen2.5             151665        10        19

chars EN/AR: 63 49  UTF-8 bytes EN/AR: 63 92
في المخرج أعلاه لاحظ التالي:
- الجملة الإنجليزية عشرة توكنز في كل ال Tokenizers، أي توكن لكل كلمة تقريباً، والسبب أن الإنجليزية كانت الجزء الأكبر من النصوص التي بنيت منها هذه القوائم.
- الجملة العربية نفسها كانت 47 توكناً في ال Tokenizer القديم، أي قرابة خمسة أضعاف، ثم نزلت إلى 16 في
o200k_baseالذي يحوي 200 ألف قطعة، والسبب أن القائمة الأكبر التي بنيت من نصوص متعددة اللغات فيها قطع عربية كاملة. - الجملة العربية أقصر بالحروف (49 حرفاً مقابل 63) ولكنها أكبر بالبايتات (92 مقابل 63)، لأن كل حرف عربي بايتان.
وقد يتساءل البعض: لماذا يهمني عدد التوكنز؟ والإجابة أن كل شيء في عالم النماذج يقاس بالتوكن: الخدمات السحابية تحاسبك بعدد التوكنز، وحجم نافذة السياق يقاس بالتوكنز، والسرعة تقاس بالتوكنز في الثانية، وبالتالي فالنص الذي يحتاج ضعف التوكنز يكلف ضعف المال ويأخذ ضعف المساحة في الذاكرة ويحتاج ضعف الوقت. لذلك عندما تختار نموذجاً لعمل باللغة العربية فاختبر ال Tokenizer الخاص به على نصوصك أولاً.
والآن لنر القطع نفسها وأرقامها في Tokenizer نموذج Qwen2.5، احفظ هذا في pieces.py:
from transformers import AutoTokenizer
q = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B")
for s in ["السيرفر يعمل الآن", "The server is running now"]:
    ids = q.encode(s)
    print(s)
    print("ids:   ", ids)
    print("pieces:", [q.decode([i]) for i in ids])
    print()
السيرفر يعمل الآن
ids: [31382, 129989, 124261, 135048, 129968]
pieces: ['ال', 'سير', 'فر', ' يعمل', ' الآن']
The server is running now
ids: [785, 3538, 374, 4303, 1431]
pieces: ['The', ' server', ' is', ' running', ' now']لاحظ أن كلمة «السيرفر» أصبحت ثلاث قطع، «ال» و«سير» و«فر»، لأنها كلمة معربة أقل شيوعاً في النصوص من «يعمل» و«الآن» اللتين جاءت كل منهما توكناً واحداً، ولاحظ أن المسافة قبل الكلمة جزء من التوكن نفسه، فالقطعة ' يعمل' تبدأ بمسافة. وهذه الأرقام هي كل ما يراه النموذج، فهو لا يرى الحروف أبداً.
ولنذهب خطوة أعمق ونرى البايتات، فالبرنامج التالي bytes.py يطبع بايتات كل توكن لكلمة «السيرفر» في ال Tokenizer القديم والحديث:
import tiktoken
w = "السيرفر"
print("UTF-8 bytes:", w.encode().hex(" "), f"({len(w.encode())} bytes)")
for name in ["r50k_base", "o200k_base"]:
    e = tiktoken.get_encoding(name)
    ids = e.encode(w)
    print(f"{name}: {len(ids)} tokens", [e.decode_single_token_bytes(i).hex(" ") for i in ids])
UTF-8 bytes: d8 a7 d9 84 d8 b3 d9 8a d8 b1 d9 81 d8 b1 (14 bytes)
r50k_base: 7 tokens ['d8 a7 d9 84', 'd8 b3', 'd9 8a', 'd8 b1', 'd9', '81', 'd8 b1']
o200k_base: 3 tokens ['d8 a7 d9 84 d8 b3', 'd9 8a d8 b1', 'd9 81 d8 b1']وهنا ترى شيئاً غريباً: في ال Tokenizer القديم انقسم حرف الفاء نفسه، وبايتاه d9 81، إلى توكنين، أي أن التوكن قد يكون أصغر من حرف واحد. ولهذا السبب ترى أحياناً في مخرجات الواجهات البرمجية للنماذج توكنز لا تظهر كحروف مقروءة، فهي نصف حرف ينتظر نصفه الآخر في التوكن التالي. والصورة التالية تجمع ما رأيناه في هذا القسم:
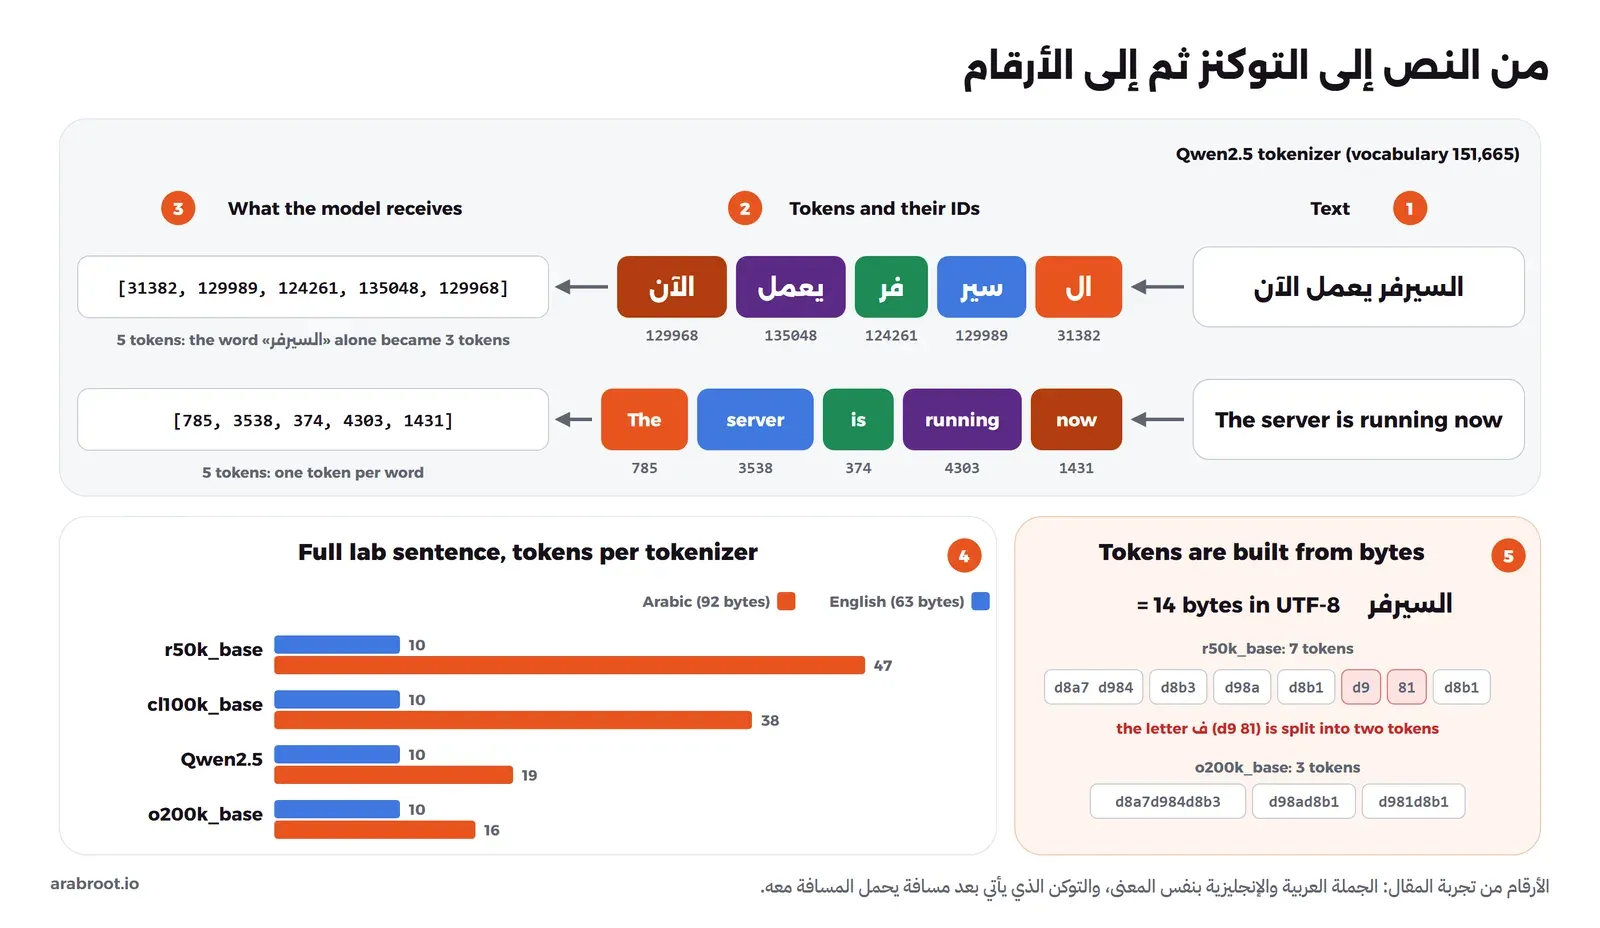
يبقى رقم أخير في المخرج: حجم المفردات في Qwen2.5 هو 151,665 توكناً، أي أن النموذج في كل خطوة يختار القطعة التالية من بين هذا العدد كله، وسوف نعود إلى هذا الرقم عندما نصل إلى الاحتمالات.
من الأرقام إلى المعنى: التضمين Embedding
الآن أصبح النص قائمة أرقام مثل [31382, 129989, 124261]، ولكن هذه الأرقام مجرد أرقام ترتيب في القائمة، فالرقم 3538 للكلمة server لا يعني أنها قريبة من الرقم 3539، وبالتالي لا يمكن للنموذج أن يستنتج منها أي معنى. والحل أن يحول كل رقم توكن إلى قائمة طويلة من الأعداد العشرية تسمى المتجه Vector، وهذا التحويل يسمى التضمين Embedding.
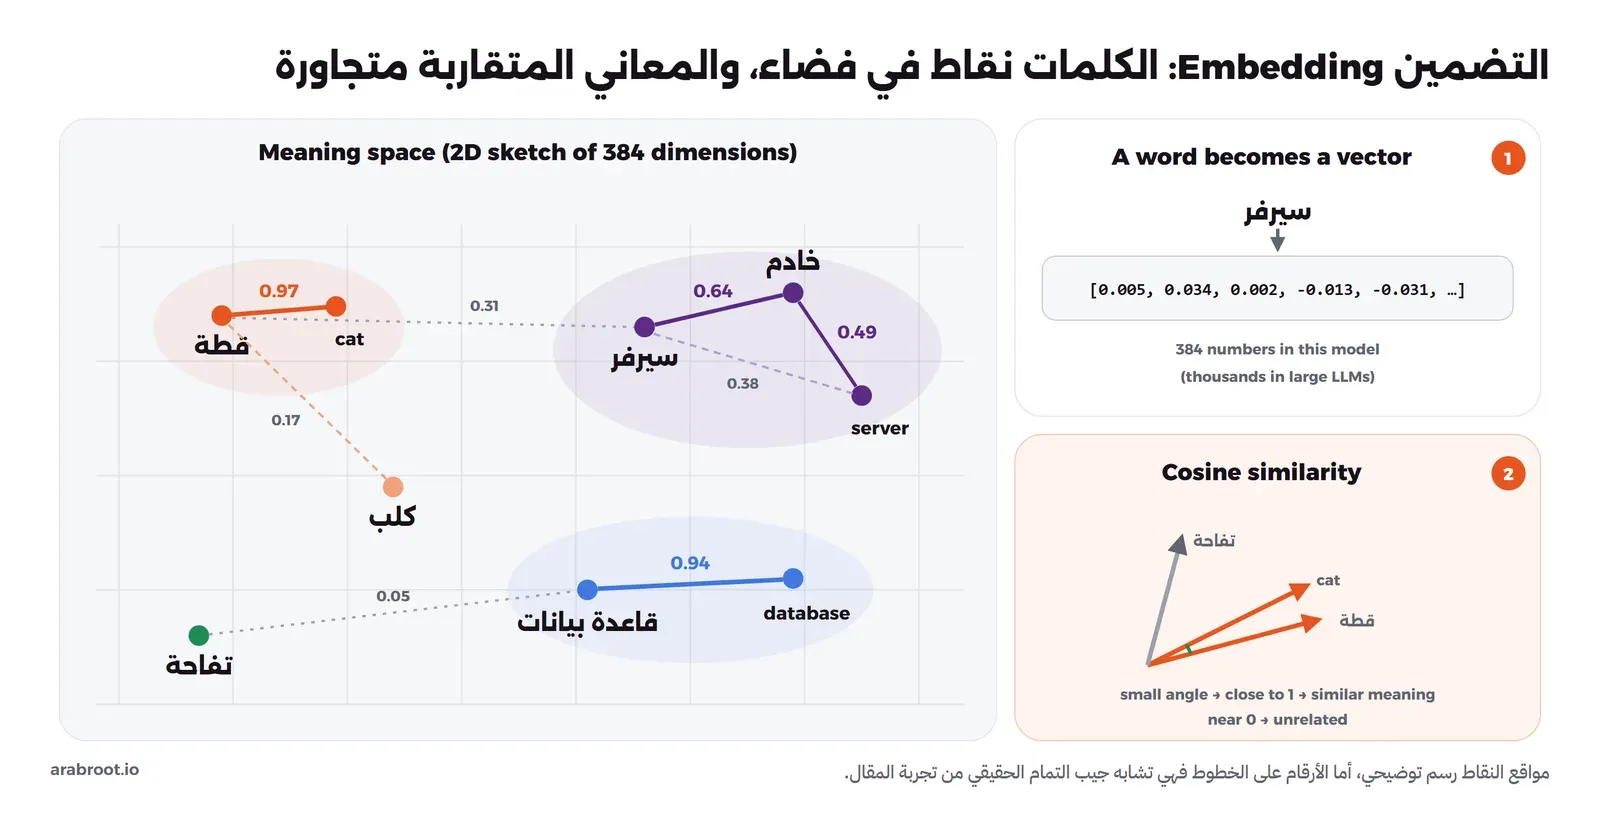
وطريقته بسيطة: داخل النموذج جدول كبير فيه صف لكل توكن في المفردات، وفي كل صف مئات أو آلاف الأعداد، فإذا جاء التوكن رقم 3538 أخذ النموذج الصف رقم 3538. وهذه الأعداد ليست مكتوبة بيد أحد، وإنما تعلمها النموذج أثناء التدريب، والنتيجة أن الكلمات المتقاربة في المعنى تحصل على متجهات متقاربة، فلو تخيلت كل متجه كنقطة في فضاء كبير لوجدت «قطة» قريبة من «cat»، و«قاعدة بيانات» قريبة من «database»، وكلاهما بعيد عن «تفاحة».
ولنقس هذا التقارب بالأرقام، وسوف نستخدم نموذج تضمين صغير متعدد اللغات هو paraphrase-multilingual-MiniLM-L12-v2، ورخصته Apache-2.0، ونقيس التقارب بمقياس تشابه جيب التمام Cosine Similarity، وهو رقم يقترب من 1 عندما يشير المتجهان إلى نفس الاتجاه، ويقترب من 0 عندما لا تكون بينهما علاقة. احفظ هذا في emb.py:
from sentence_transformers import SentenceTransformer
m = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
pairs = [("خادم","server"),("قطة","dog"),("سيرفر","خادم"),("سيرفر","server"),("قطة","cat"),("قطة","كلب"),("سيرفر","قطة"),("قاعدة بيانات","database"),("قاعدة بيانات","تفاحة")]
words = sorted({w for p in pairs for w in p})
E = m.encode(words, normalize_embeddings=True)
v = dict(zip(words, E))
print("dimensions:", E.shape[1])
print("first 5 numbers of 'سيرفر':", [round(float(x),3) for x in v["سيرفر"][:5]])
for a,b in pairs:
    print(f"{a:>14} | {b:<12} {float(v[a]@v[b]):.2f}")
والمخرج سوف يكون كما يلي:
dimensions: 384
first 5 numbers of 'سيرفر': [0.005, 0.034, 0.002, -0.013, -0.031]
          خادم | server       0.49
           قطة | dog          0.17
         سيرفر | خادم         0.64
         سيرفر | server       0.38
           قطة | cat          0.97
           قطة | كلب          0.17
         سيرفر | قطة          0.31
  قاعدة بيانات | database     0.94
  قاعدة بيانات | تفاحة        0.05
في المخرج أعلاه لاحظ التالي:
- كل كلمة أصبحت 384 عدداً في هذا النموذج، أما نماذج اللغة الكبيرة فمتجهاتها أطول بكثير، ففي Qwen2.5-0.5B طول المتجه 896 عدداً كما سوف ترى.
- «قطة» و«cat» عند 0.97، و«قاعدة بيانات» و«database» عند 0.94، أي أن النموذج وضع الكلمة وترجمتها في نفس المكان تقريباً، وهذا ما يجعل البحث بالمعنى ممكناً بين لغتين.
- «قاعدة بيانات» و«تفاحة» عند 0.05، أي لا توجد علاقة تقريباً.
- كلمة «سيرفر» المعربة أقرب إلى «خادم» (0.64) من قربها إلى «server» (0.38)، و«قطة» و«كلب» عند 0.17 فقط، وهذا يذكرك بأن هذا نموذج صغير له حدوده، وأن الأرقام تعكس ما رآه في بيانات تدريبه وليس قاموساً كاملاً.
الصورة التالية تبين الفكرة على شكل فضاء ببعدين، ومواقع النقاط فيها رسم توضيحي، لأن الفضاء الحقيقي فيه 384 بعداً لا يمكن رسمها، أما الأرقام على الخطوط فهي من المخرج أعلاه:
وهذه الفكرة نفسها هي أساس البحث بالمعنى في قواعد البيانات الشعاعية Vector Databases وأنظمة RAG، وقد خصصنا لها مقالاً قادماً في مرحلة الذكاء الاصطناعي.
فهم السياق: الانتباه Attention
هناك مشكلة رئيسية في التضمين وحده: كل توكن يحصل على نفس المتجه في كل مكان، فكلمة «عين» لها صف واحد في الجدول، سواء جاءت في «عين الماء» أو في «طبيب العيون» أو في «عين على السيرفر»، وكذلك الكلمة الإنجليزية bank في «the bank of the river» أي ضفة النهر، وفي «the bank account» أي البنك. والإنسان يعرف المعنى من الكلمات حوله، فكيف يفعل النموذج ذلك؟
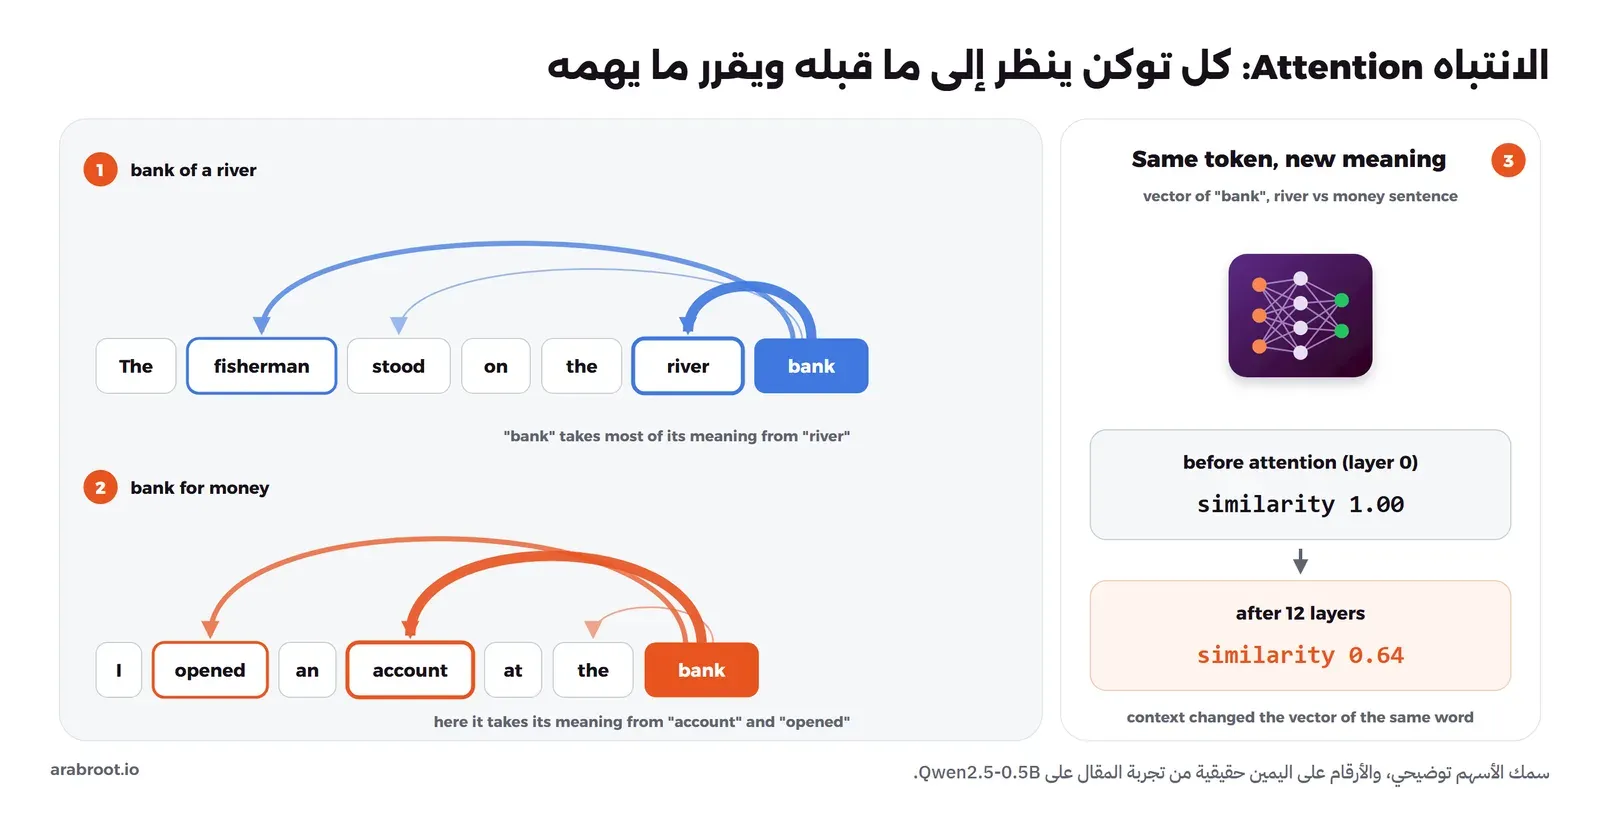
والإجابة هي الانتباه Attention، وفكرته دون أي رياضيات: كل توكن ينظر إلى التوكنز التي قبله في النص، ويقرر أيها يهمه لفهم معناه هنا، ثم يأخذ من متجهاتها بقدر أهميتها ويضيف ذلك إلى متجهه. فكلمة bank في جملة الصياد تنظر إلى river وfisherman فتأخذ منهما الكثير، وفي جملة الحساب تنظر إلى account وopened، وبالتالي يتغير متجهها بحسب السياق، فلا يبقى متجهاً واحداً لكل المعاني.
ولنتأكد من ذلك في نموذج حقيقي، فالبرنامج التالي ctx.py يمرر ثلاث جمل تنتهي كلها بالكلمة bank إلى Qwen2.5-0.5B، ثم يقارن متجه هذا التوكن الأخير بين الجمل، مرة عند المدخل قبل أي انتباه (الطبقة 0) ومرة بعد 12 طبقة:
import torch
from transformers import AutoTokenizer, AutoModel
name = "Qwen/Qwen2.5-0.5B"
tok = AutoTokenizer.from_pretrained(name)
m = AutoModel.from_pretrained(name, dtype=torch.float32).eval()
S = {"river": "We sat on the bank", "river2": "The fisherman stood on the river bank", "money": "I opened an account at the bank"}
def vec(s, layer):
    ids = tok(s, return_tensors="pt").input_ids
    with torch.no_grad(): h = m(ids, output_hidden_states=True).hidden_states[layer][0, -1]
    return h / h.norm()
for layer in (0, 12):
    v = {k: vec(s, layer) for k, s in S.items()}
    print(f"layer {layer:>2}: river~river2 {float(v['river']@v['river2']):.2f}   river~money {float(v['river']@v['money']):.2f}   river2~money {float(v['river2']@v['money']):.2f}")
والمخرج سوف يكون كما يلي:
layer  0: river~river2 1.00   river~money 1.00   river2~money 1.00
layer 12: river~river2 0.83   river~money 0.69   river2~money 0.64
عند الطبقة 0 التشابه 1.00 في كل الحالات، لأن التوكن واحد والمتجه مأخوذ من نفس صف الجدول، أما بعد 12 طبقة فقد أصبح متجه bank في جملة الصياد مختلفاً عن متجهها في جملة الحساب (0.64)، وبقي أقرب إلى متجهها في الجملة الأخرى التي تتحدث عن الجلوس على الضفة (0.83). أي أن الطبقات أضافت إلى الكلمة معناها من سياقها، وهذا بالضبط عمل الانتباه.
يجدر بالذكر أن النموذج لا يقوم بهذا مرة واحدة، وإنما يقوم به عدة مرات بالتوازي في كل طبقة، وكل مرة تسمى رأس انتباه Attention Head، وكل رأس يتعلم نوعاً مختلفاً من العلاقات، فقد يهتم رأس بالعلاقة بين الفعل وفاعله، وآخر بالكلمة السابقة مباشرة، وفي Qwen2.5-0.5B في كل طبقة 14 رأساً.
كتلة Transformer: الانتباه ثم المعالجة، طبقة فوق طبقة
هذه الطريقة في البناء جاءت في ورقة بحثية مشهورة من Google عنوانها Attention Is All You Need، نشرها Ashish Vaswani وزملاؤه في يونيو 2017، وسموا البنية فيها Transformer، ومنها جاء الحرف T في GPT. والكتلة الواحدة في هذه البنية فيها جزءان:
- الانتباه Attention: كل توكن يقرأ التوكنز التي قبله ويأخذ منها ما يحتاجه، كما شرحنا أعلاه.
- الشبكة الأمامية Feed-forward Network: شبكة صغيرة تعالج كل توكن وحده بعد أن جمع سياقه، وفيها يخزن قسم كبير مما يعرفه النموذج من معلومات وأنماط.
ثم تتكرر هذه الكتلة عشرات المرات، ومخرج كل كتلة هو مدخل الكتلة التي بعدها، فالطبقات الأولى تلتقط علاقات بسيطة بين الكلمات، والطبقات العميقة تبني معاني أعقد. وقد يتساءل البعض: إذا كان الانتباه ينظر إلى كل التوكنز معاً، فكيف يعرف النموذج ترتيبها، وأن «أكل الولد التفاحة» تختلف عن «أكلت التفاحة الولد»؟ والإجابة أن النموذج يضيف معلومة الموقع إلى كل توكن، وفي النماذج الحديثة مثل Qwen وLlama تستخدم طريقة اسمها RoPE تدير المتجه بزاوية تتغير بحسب موقع التوكن، فيصبح الموقع جزءاً من الحساب.
ولنر الأحجام الحقيقية للنموذج الذي نجربه، فالسطور الأولى من البرنامج probs.py الذي سوف نكتبه في القسم التالي تطبع ما يلي:
parameters: 494032768
layers: 24  hidden size: 896  attention heads: 14  context: 32768
أي أن هذا النموذج الصغير فيه 24 كتلة، وطول المتجه 896 عدداً، وفي كل كتلة 14 رأس انتباه، ويقرأ حتى 32,768 توكناً، ومجموع الأعداد التي تعلمها 494 مليون عدد، وهذه الأعداد هي المعاملات Parameters التي سوف نتحدث عنها لاحقاً. والصورة التالية تبين المسار كاملاً من أرقام التوكنز إلى الاحتمالات:
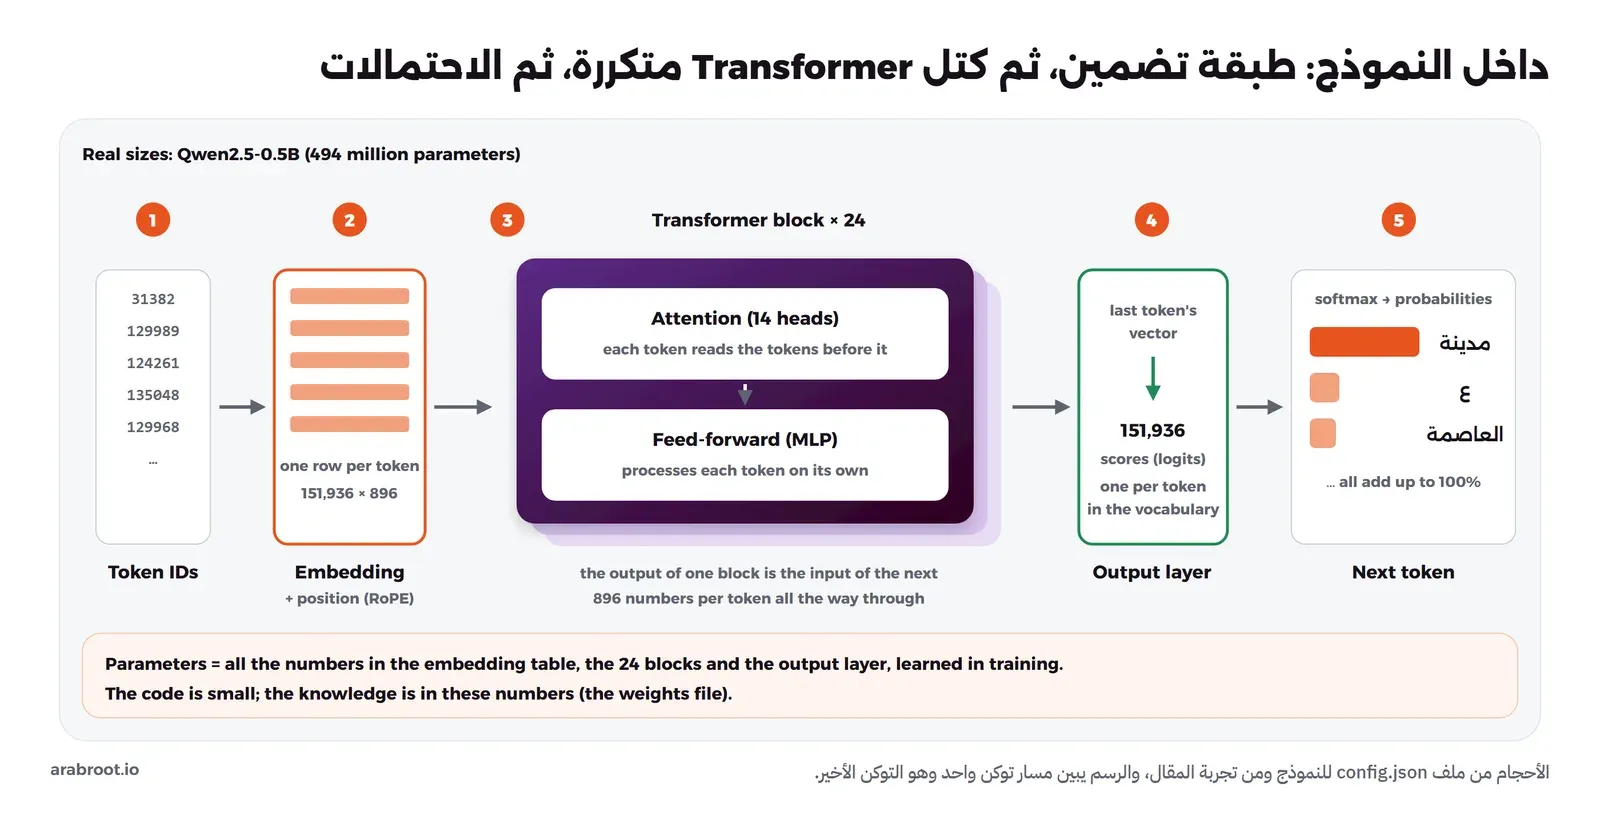
لاحظ في الصورة أن عدد صفوف الجدول وطبقة المخرج 151,936، وهو أكبر قليلاً من حجم المفردات الذي رأيناه في ال Tokenizer (151,665)، والسبب أن ملف إعدادات النموذج يحدد 151,936 صفاً، فهناك صفوف إضافية لا يقابلها أي توكن في ال Tokenizer، ولن يختارها النموذج عملياً لأنه لم يرها في التدريب.
إنتاج Production الإجابة: كيف يختار النموذج التوكن التالي؟
بعد آخر كتلة يأخذ النموذج متجه التوكن الأخير في النص، ويضربه في طبقة المخرج، فيحصل على درجة لكل توكن في المفردات، أي 151,936 رقماً، وكل رقم يقول إلى أي حد يناسب هذا التوكن أن يكون التالي، وتسمى هذه الدرجات Logits. ولأن هذه الدرجات أرقام بأي قيمة، موجبة أو سالبة، تحولها دالة اسمها softmax إلى احتمالات بين 0 و1 مجموعها 1، فالدرجة الأعلى تحصل على الاحتمال الأعلى.
والبرنامج التالي probs.py يعطي النموذج بداية جملة، ويطبع أعلى ثمانية توكنز مرشحة مع درجاتها واحتمالاتها بثلاث درجات حرارة سوف نشرحها بعد المخرج:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM
name = "Qwen/Qwen2.5-0.5B"
tok = AutoTokenizer.from_pretrained(name)
model = AutoModelForCausalLM.from_pretrained(name, dtype=torch.float32)
model.eval()
print("parameters:", sum(p.numel() for p in model.parameters()))
print("layers:", model.config.num_hidden_layers, " hidden size:", model.config.hidden_size, " attention heads:", model.config.num_attention_heads, " context:", model.config.max_position_embeddings)
import sys; prompt = sys.argv[1]
ids = tok(prompt, return_tensors="pt").input_ids
with torch.no_grad():
    logits = model(ids).logits[0, -1]
print("prompt tokens:", ids.shape[1], " logits per step:", logits.shape[0])
top = torch.topk(logits, 8)
print(f"{'token':<12}{'logit':>8}{'T=0.5':>8}{'T=1.0':>8}{'T=2.0':>8}")
P = {T: torch.softmax(logits / T, -1) for T in (0.5, 1.0, 2.0)}
for l, i in zip(top.values, top.indices):
    t = repr(tok.decode([int(i)]))
    print(f"{t:<12}{float(l):>8.2f}" + "".join(f"{float(P[T][i])*100:>7.1f}%" for T in (0.5,1.0,2.0)))
docker exec lab-llm-py python probs.py "عاصمة المملكة العربية السعودية هي"والمخرج سوف يكون كما يلي (بعد سطري الأحجام اللذين رأيتهما في القسم السابق):
prompt tokens: 7  logits per step: 151936
token          logit   T=0.5   T=1.0   T=2.0
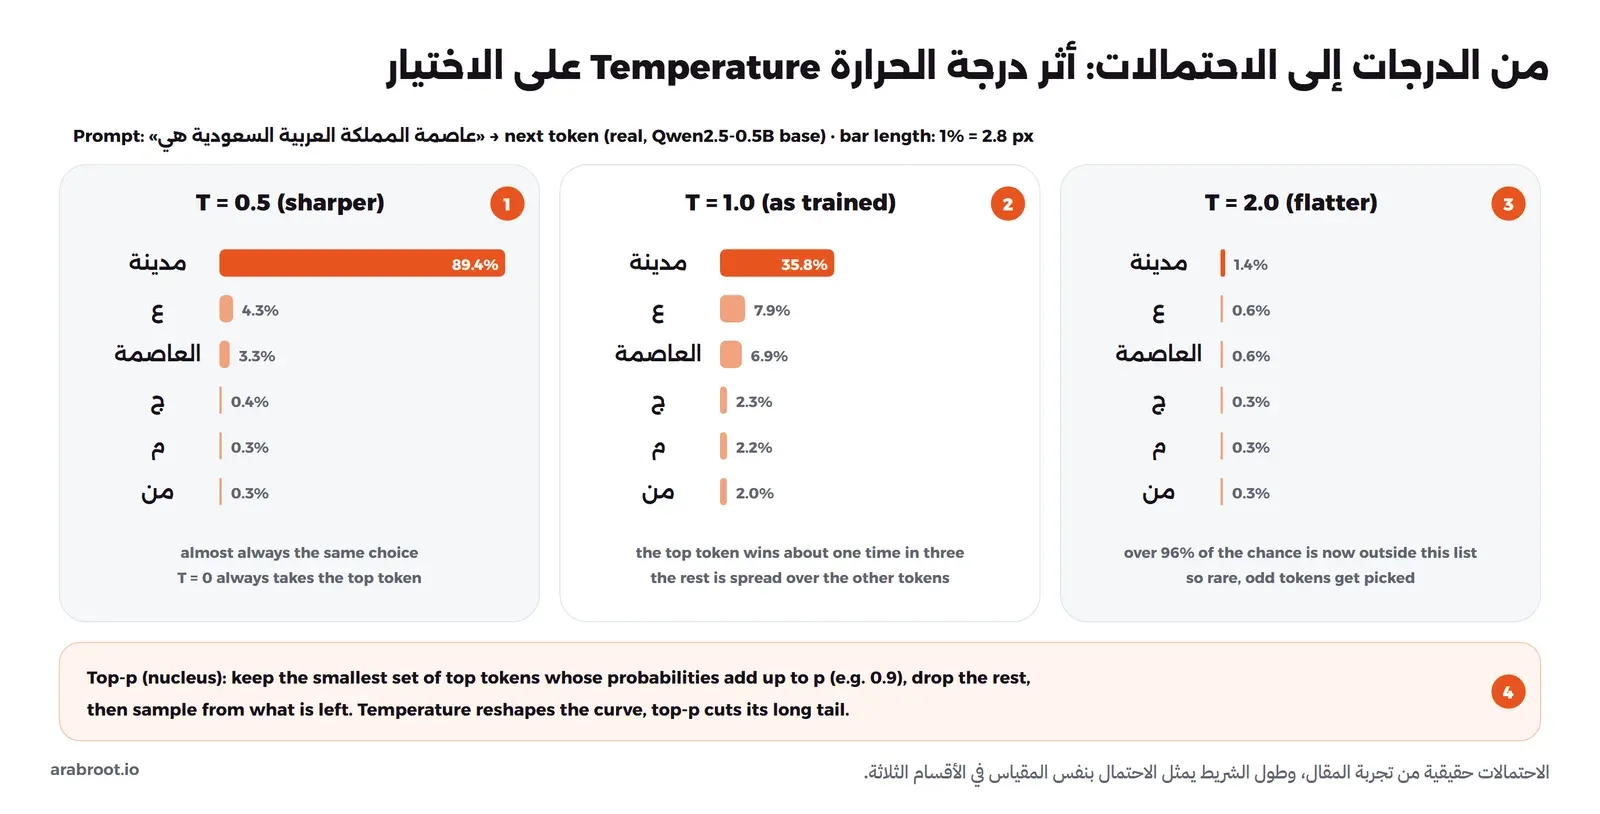
' مدينة'       14.44   89.4%   35.8%    1.4%
' ع'           12.92    4.3%    7.9%    0.6%
' العاصمة'     12.79    3.3%    6.9%    0.6%
' ج'           11.68    0.4%    2.3%    0.3%
' م'           11.63    0.3%    2.2%    0.3%
' ق'           11.62    0.3%    2.1%    0.3%
' من'          11.55    0.3%    2.0%    0.3%
' منطقة'       11.43    0.2%    1.8%    0.3%
في المخرج أعلاه لاحظ التالي:
- العمود
T=1.0هو الاحتمال كما تعلمه النموذج: «مدينة» 35.8%، ثم توكنز قصيرة مثل «ع» و«ج» و«م» وهي بدايات كلمات سوف تكتمل في التوكن التالي. - النموذج لم يقترح «الرياض» في أعلى ثمانية توكنز، فهذا نموذج صغير جداً، ومعرفته باللغة العربية محدودة، وسوف نعود إلى هذه النقطة في قسم الأخطاء.
- مجموع الاحتمالات في الجدول أقل من 100%، لأن الباقي موزع على بقية التوكنز ال 151 ألفاً.
وإذا شغلت نفس البرنامج على الجملة الإنجليزية "The capital of Saudi Arabia is" فسوف تجد في المخرج ما يلي:
token          logit   T=0.5   T=1.0   T=2.0
' __'          16.82   33.5%   16.0%    1.3%
' ____'        16.75   29.3%   15.0%    1.3%
' Riyadh'      16.59   20.9%   12.7%    1.2%
'____'         15.90    5.3%    6.4%    0.8%
' ______'      15.61    3.0%    4.8%    0.7%
' located'     15.45    2.2%    4.1%    0.7%
' the'         15.30    1.6%    3.5%    0.6%
' Saudi'       14.97    0.8%    2.5%    0.5%
والتوكن الأعلى هنا خط فارغ __ وليس Riyadh، والسبب أن هذا النموذج الأساسي رأى في بيانات تدريبه أسئلة امتحانات كثيرة من نوع «أكمل الفراغ: The capital of ... is ____»، فهو يتوقع ما يأتي عادة بعد هذا النص في الإنترنت، وليس الإجابة الصحيحة. وهذه أوضح صورة لما يفعله النموذج: إكمال النص بأكثر شيء معقول، وليس البحث عن الحقيقة.
درجة الحرارة Temperature وTop-p
الآن عند النموذج احتمالات، فأي توكن يختار؟ الحل البسيط أن يختار دائماً التوكن الأعلى احتمالاً، وهذا يسمى الاختيار الجشع Greedy Decoding، والمشكلة أن النص يصبح مكرراً ومملاً، بل قد يدخل النموذج في حلقة يكرر فيها نفس الجملة، كما وثقت ذلك ورقة The Curious Case of Neural Text Degeneration. والحل البسيط الثاني أن يسحب توكناً عشوائياً بحسب الاحتمالات كما هي، والمشكلة هنا أن آلاف التوكنز ذات الاحتمال الصغير جداً تحصل مجتمعة على فرصة كبيرة، فتظهر كلمة غريبة في وسط الجملة بين حين وآخر.
والحل المستخدم أن نتحكم في شكل الاحتمالات قبل السحب بأداتين:
- درجة الحرارة Temperature: تقسم الدرجات على رقم قبل softmax، فإذا كانت أقل من 1 زادت الفروق، فصار الأعلى أعلى أكثر، وفي الجدول أعلاه ارتفعت «مدينة» من 35.8% إلى 89.4% عند 0.5، وإذا كانت أكبر من 1 تقاربت الاحتمالات، فنزلت «مدينة» إلى 1.4% عند 2.0 وأصبح أكثر من 96% من الفرصة خارج أعلى ثمانية توكنز. ودرجة الحرارة 0 تعني الاختيار الجشع.
- Top-p ويسمى أيضاً Nucleus Sampling من نفس الورقة: يرتب التوكنز من الأعلى، ويأخذ أقل عدد منها يصل مجموع احتمالاته إلى p، مثل 0.9، ويحذف الباقي، ثم يسحب مما بقي، وبالتالي يقطع الذيل الطويل من التوكنز الغريبة.
وفي Ollama القيم الافتراضية بحسب توثيق ملف Modelfile هي temperature 0.8 وtop_p 0.9، ويمكنك تغييرهما في كل طلب. ولنر أثر درجة الحرارة على النموذج كما يعمل في Ollama، فالبرنامج التالي temp.py يطلب نفس الجملة ست مرات، ثلاثاً بدرجة حرارة 0 وثلاثاً بدرجة حرارة 1، مع بذرة عشوائية Seed مختلفة كل مرة. وهو يعمل على جهازك مباشرة لأنه يستخدم مكتبات Python الأساسية فقط:
import json, urllib.request
def chat(t, seed):
    body = {"model": "qwen2.5:0.5b", "stream": False,
            "messages": [{"role": "user", "content": "اكتب جملة واحدة قصيرة عن أهمية النسخ الاحتياطي للسيرفر."}],
            "options": {"temperature": t, "seed": seed, "num_predict": 40}}
    r = urllib.request.urlopen(urllib.request.Request("http://127.0.0.1:41434/api/chat", json.dumps(body).encode(), {"Content-Type": "application/json"}))
    return json.load(r)["message"]["content"].replace("\n", " ")
for t in (0, 1.0):
    for seed in (1, 2, 3):
        print(f"T={t} seed={seed}: {chat(t, seed)}")
python3 temp.pyوالمخرج سوف يكون كما يلي:
T=0 seed=1: "النسخ الاحتياطي للسيرفر يلعب دورًا هامًا في تأمين البيانات والحفاظ على سرية المعلومات."
T=0 seed=2: "النسخ الاحتياطي للسيرفر يلعب دورًا هامًا في تأمين البيانات والحفاظ على سرية المعلومات."
T=0 seed=3: "النسخ الاحتياطي للسيرفر يلعب دورًا هامًا في تأمين البيانات والحفاظ على سرية المعلومات."
T=1.0 seed=1: السهرفير هو منتج يستند إلى سهولة التغييرات في نصف الحياة أو الحياة. يتمتع بإمكانية النقل والتغليف، مما يسهل عملية تخ
T=1.0 seed=2: "التغطية النسخ الاحتياطي تساعد في تعزيز القدرة الاستيعابية للسيرفر وحمايته من أي أزمات ناتجة عن التخ
T=1.0 seed=3: "لدينا القدرة على استعادة التسجيلات المفقود بفضل النسخ الاحتياطي للسيرفر."
في المخرج أعلاه لاحظ التالي:
- عند درجة الحرارة 0 كانت الإجابة نفسها حرفاً بحرف في المرات الثلاث رغم اختلاف البذرة، لأن النموذج يأخذ التوكن الأعلى في كل خطوة، فلا يوجد أي سحب عشوائي.
- عند درجة الحرارة 1 جاءت ثلاث إجابات مختلفة، إحداها جيدة، والأولى بدأت بكلمة لا معنى لها «السهرفير»، والسبب أن هذا النموذج الصغير ضعيف في العربية فاحتمالاته موزعة على توكنز كثيرة، والسحب العشوائي يصل إليها.
- بعض الإجابات انقطعت في منتصف كلمة، لأننا حددنا
num_predictبأربعين توكناً، وهذا أحد شروط التوقف كما سيأتي. - حتى الإجابة الثابتة عند 0 فيها خطأ في المعنى، فالنسخ الاحتياطي لا يحفظ سرية المعلومات، وهذا تذكير بأن الثبات لا يعني الصحة.
لذلك استخدم درجة حرارة منخفضة للمهام التي تريد فيها إجابة ثابتة، مثل استخراج بيانات من نص أو تصنيف رسائل، ودرجة أعلى للمهام التي تريد فيها تنوعاً، مثل اقتراح عناوين.
حلقة التوليد ومتى تتوقف
الآن نعرف كيف يختار النموذج توكناً واحداً، والإجابة الكاملة هي تكرار هذه الخطوة: اختر توكناً، أضفه إلى النص، ثم أعد الحساب على النص الجديد. والبرنامج التالي loop.py يكتب هذه الحلقة بنفسه بدلاً من الدالة الجاهزة، بالاختيار الجشع، ويطبع كل خطوة:
import torch, sys
from transformers import AutoTokenizer, AutoModelForCausalLM
name = "Qwen/Qwen2.5-0.5B"
tok = AutoTokenizer.from_pretrained(name)
model = AutoModelForCausalLM.from_pretrained(name, dtype=torch.float32).eval()
prompt = sys.argv[1]
ids = tok(prompt, return_tensors="pt").input_ids
for step in range(1, int(sys.argv[2]) + 1):
    with torch.no_grad():
        p = torch.softmax(model(ids).logits[0, -1], -1)
    i = int(torch.argmax(p))
    print(f"step {step:>2}: {repr(tok.decode([i])):<14} p={float(p[i]):.2f}   text so far: {tok.decode(ids[0].tolist() + [i])}")
    if i == tok.eos_token_id: break
    ids = torch.cat([ids, torch.tensor([[i]])], 1)
docker exec lab-llm-py python loop.py "عاصمة المملكة العربية السعودية هي" 8step 1: ' مدينة' p=0.36 text so far: عاصمة المملكة العربية السعودية هي مدينة
step 2: ' ت' p=0.14 text so far: عاصمة المملكة العربية السعودية هي مدينة ت
step 3: 'قع' p=0.83 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع
step 4: ' في' p=0.77 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع في
step 5: ' المملكة' p=0.23 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع في المملكة
step 6: ' العربية' p=0.84 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع في المملكة العربية
step 7: ' السعودية' p=0.99 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع في المملكة العربية السعودية
step 8: ' في' p=0.19 text so far: عاصمة المملكة العربية السعودية هي مدينة تقع في المملكة العربية السعودية فيلاحظ أن الكلمة «تقع» جاءت من توكنين، «ت» باحتمال 0.14 ثم «قع» باحتمال 0.83، فبعد أن اختار النموذج «ت» أصبح إكمالها شبه مؤكد، ولاحظ أن «السعودية» بعد «المملكة العربية» احتمالها 0.99، لأن هذا التسلسل تكرر كثيراً في بيانات التدريب. والجملة كلها صحيحة لغوياً وفارغة من المعلومة، وهذا ما يفعله النموذج الصغير عندما لا يعرف.
ويتوقف التوليد في الواقع عند أحد ثلاثة شروط: أن يختار النموذج توكناً خاصاً يعني نهاية النص End of Sequence واختصاراً EOS، وقد تعلم النموذج المساعد أن يضعه عند نهاية الإجابة، أو أن يصل عدد التوكنز إلى الحد الأقصى الذي حددته، وهو num_predict في Ollama، أو أن يظهر نص توقف Stop Sequence حددته في الطلب. ولهذا السبب تظهر الإجابة في الواجهات كلمة بعد كلمة، فالخادم يرسل كل توكن بمجرد أن يختاره، ولا ينتظر نهاية الحلقة.
وإذا أردت رؤية الاحتمالات من Ollama نفسه دون Python، فواجهة Ollama API تدعم الحقلين logprobs وtop_logprobs، والبرنامج التالي logprobs.py يطبع التوكن المختار وأعلى ثلاثة بدائل في كل خطوة:
import json, math, urllib.request
import sys
QUESTION = sys.argv[1]
body = {"model": "qwen2.5:0.5b", "stream": False, "logprobs": True, "top_logprobs": 3,
        "messages": [{"role": "user", "content": QUESTION}],
        "options": {"temperature": 0, "num_predict": 5}}
r = json.load(urllib.request.urlopen(urllib.request.Request("http://127.0.0.1:41434/api/chat", json.dumps(body).encode(), {"Content-Type": "application/json"})))
print("answer:", r["message"]["content"])
for step in r["logprobs"]:
    alts = "  ".join(f"{a['token']!r} {math.exp(a['logprob'])*100:.1f}%" for a in step["top_logprobs"])
    print(f"chosen {step['token']!r:<10} | top 3: {alts}")
python3 logprobs.py "What is the capital of Saudi Arabia? Answer in one word."
python3 logprobs.py "ما هي عاصمة المملكة العربية السعودية؟ أجب بكلمة واحدة."answer: Riyadh
chosen ' Riyadh' | top 3: ' Riyadh' 34.1% 'O' 17.9% 'R' 9.4%
answer: عاصمة المملكة العربية
chosen 'ع' | top 3: 'ع' 80.6% 'ال' 7.8% 'عم' 3.2%
chosen 'اص' | top 3: 'اص' 99.7% 'اج' 0.0% 'صر' 0.0%
chosen 'مة' | top 3: 'مة' 99.9% 'مت' 0.1% 'م' 0.0%
chosen ' المملكة' | top 3: ' المملكة' 99.7% ' السعودية' 0.2% ' Saudi' 0.0%
chosen ' العربية' | top 3: ' العربية' 100.0% ' هي' 0.0% 'ُ' 0.0%والنتيجة واضحة: نفس النموذج أجاب عن السؤال الإنجليزي بكلمة Riyadh من أول توكن، أما السؤال العربي فبدأ يعيد صياغته «عاصمة المملكة العربية» ثم توقف عند الحد الذي وضعناه وهو خمسة توكنز. ولاحظ أن الاحتمالات بعد التوكن الأول قريبة من 100%، فبعد «ع» لم يعد هناك خيار حقيقي غير «اص» ثم «مة». ومن هنا القاعدة العملية: النموذج الصغير قد يكفي لعمل بالإنجليزية ولا يكفي لنفس العمل بالعربية، فاختبره على لغتك قبل أن تعتمد عليه.
نافذة السياق وذاكرة KV Cache
رأيت في الحلقة أعلاه أن النموذج يعيد الحساب على النص كله في كل خطوة، فإذا كان النص ألف توكن والإجابة خمسمئة فهل يمرر النص كله في 24 طبقة خمسمئة مرة؟ هذا هو الحل البسيط وهو مكلف جداً، والسبب أن الانتباه في كل خطوة يحتاج قيمتين لكل توكن سابق في كل طبقة، تسميان المفتاح Key والقيمة Value، وهما لا تتغيران بعد حسابهما. لذلك تحفظهما محركات التشغيل في ذاكرة تسمى KV Cache، فتحسب في كل خطوة قيم التوكن الجديد فقط، وتقرأ الباقي من الذاكرة.
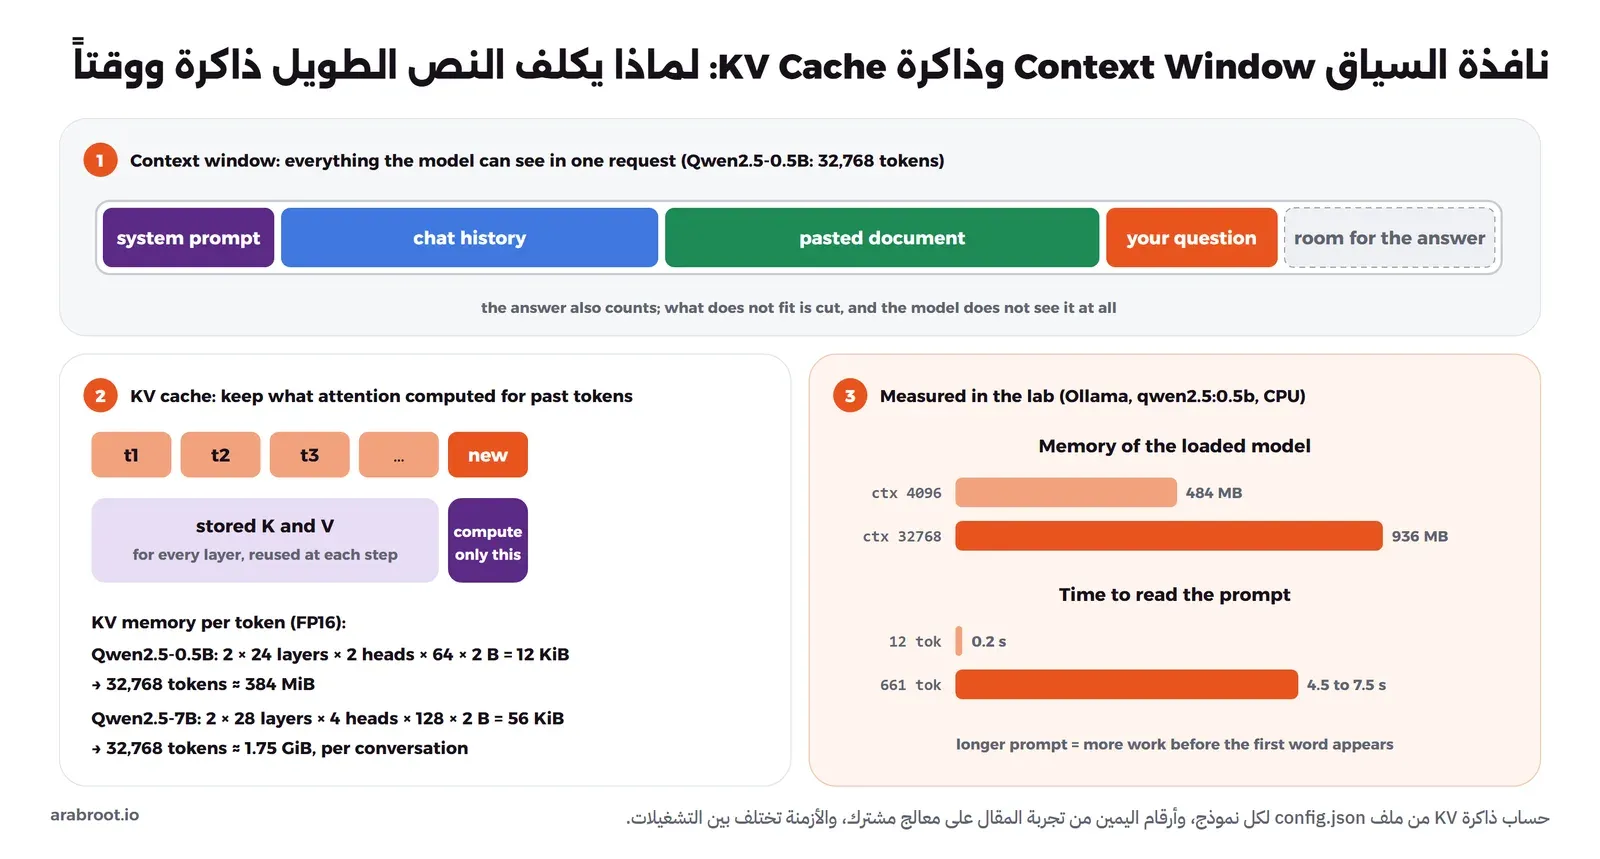
وهنا تظهر الكلفة الحقيقية للنص الطويل: هذه الذاكرة تكبر مع كل توكن في النص. ويمكنك حسابها من ملف إعدادات أي نموذج بهذه المعادلة: 2 (للمفتاح والقيمة) × عدد الطبقات × عدد رؤوس KV × طول الرأس × 2 بايت في دقة FP16، فإذا طبقناها على Qwen2.5-0.5B (24 طبقة ورأسا KV بطول 64) كانت 12 KiB لكل توكن، أي نحو 384 MiB لنافذة كاملة من 32,768 توكناً، وفي Qwen2.5-7B (28 طبقة وأربعة رؤوس KV بطول 128) تصبح 56 KiB لكل توكن، أي نحو 1.75 GiB للنافذة الكاملة، وهذا لكل محادثة تعمل في نفس الوقت.
والحد الأقصى لعدد التوكنز التي يراها النموذج في الطلب الواحد يسمى نافذة السياق Context Window، وهي تشمل كل شيء: تعليمات النظام System Prompt، وتاريخ المحادثة، والمستند الذي ألصقته، وسؤالك، والإجابة نفسها. والنموذج لا يتذكر شيئاً بين الطلبات، فالذي يبدو لك كذاكرة في المحادثة هو أن الواجهة ترسل المحادثة كلها مع كل رسالة جديدة. وما لا يدخل في النافذة لا يراه النموذج أبداً، فإما أن ترفض الأداة الطلب أو تقص جزءاً منه بحسب إعدادها.
ولنقس هذا في Ollama، فالبرنامج التالي ctxlen.py يرسل نصاً قصيراً ثم نصاً أطول بستين مرة، مرة بنافذة 4096 ومرة بنافذة 32768، ويطبع عدد توكنز النص ووقت قراءته وحجم النموذج في الذاكرة من ollama ps:
import json, urllib.request, subprocess
def gen(prompt, ctx):
    body = {"model": "qwen2.5:0.5b", "prompt": prompt, "stream": False, "raw": True, "options": {"num_ctx": ctx, "num_predict": 20, "temperature": 0}}
    r = json.load(urllib.request.urlopen(urllib.request.Request("http://127.0.0.1:41434/api/generate", json.dumps(body).encode(), {"Content-Type": "application/json"})))
    return r
short = "The server is running now and the backup completed successfully. "
for n, ctx in ((1, 4096), (60, 4096), (60, 32768)):
    subprocess.run(["docker", "exec", "lab-llm-ollama", "ollama", "stop", "qwen2.5:0.5b"], capture_output=True)
    r = gen(short * n, ctx)
    ps = subprocess.run(["docker", "exec", "lab-llm-ollama", "ollama", "ps"], capture_output=True, text=True).stdout.splitlines()[1]
    print(f"num_ctx={ctx:<6} prompt tokens={r['prompt_eval_count']:<5} prompt time={r['prompt_eval_duration']/1e6:>7.0f} ms   | {' '.join(ps.split())}")
num_ctx=4096 prompt tokens=12 prompt time= 185 ms | qwen2.5:0.5b a8b0c5157701 484 MB 100% CPU 4096 4 minutes from now
num_ctx=4096 prompt tokens=661 prompt time= 7514 ms | qwen2.5:0.5b a8b0c5157701 484 MB 100% CPU 4096 4 minutes from now
num_ctx=32768 prompt tokens=661 prompt time= 4541 ms | qwen2.5:0.5b a8b0c5157701 936 MB 100% CPU 32768 4 minutes from nowفي المخرج أعلاه لاحظ التالي:
- حجم النموذج في الذاكرة قفز من 484 MB إلى 936 MB بمجرد أن رفعنا النافذة من 4096 إلى 32768، رغم أن النص نفسه، والفرق قريب من 384 MiB التي حسبناها لذاكرة KV مع مخازن الحساب، لأن Ollama يحجز الذاكرة للنافذة كلها عند التحميل.
- قراءة 12 توكناً أخذت أقل من خمس ثانية، وقراءة 661 توكناً أخذت عدة ثوان قبل أن يظهر أول حرف من الإجابة، وأزمنة القراءة تختلف بين التشغيلات على معالج مشترك، فقد قسناها ثلاث مرات وتراوحت بين 4.5 و7.5 ثانية، ولكنها في كل مرة أطول بعشرات المرات من النص القصير.
- قيمة النافذة الافتراضية في Ollama 4096 في تجربتنا، وهي بحسب توثيق Ollama تعتمد على ذاكرة البطاقة الرسومية VRAM، فتكون 4k إذا كانت أقل من 24 GiB، وتزيد مع الذاكرة الأكبر، ويمكنك تغييرها بالخيار
num_ctxأو بالمتغيرOLLAMA_CONTEXT_LENGTH.
لذلك لا تقم برفع نافذة السياق إلى الحد الأقصى «احتياطاً»، والسبب أنها تحجز ذاكرة لكل محادثة ولو لم تستخدمها، بل اجعلها على قدر أطول نص تحتاجه فعلاً، ولا تلصق مستنداً كاملاً إذا كان الجواب في صفحة واحدة منه، وهذا ما تحله أنظمة RAG كما سيأتي.
كيف يتعلم النموذج؟
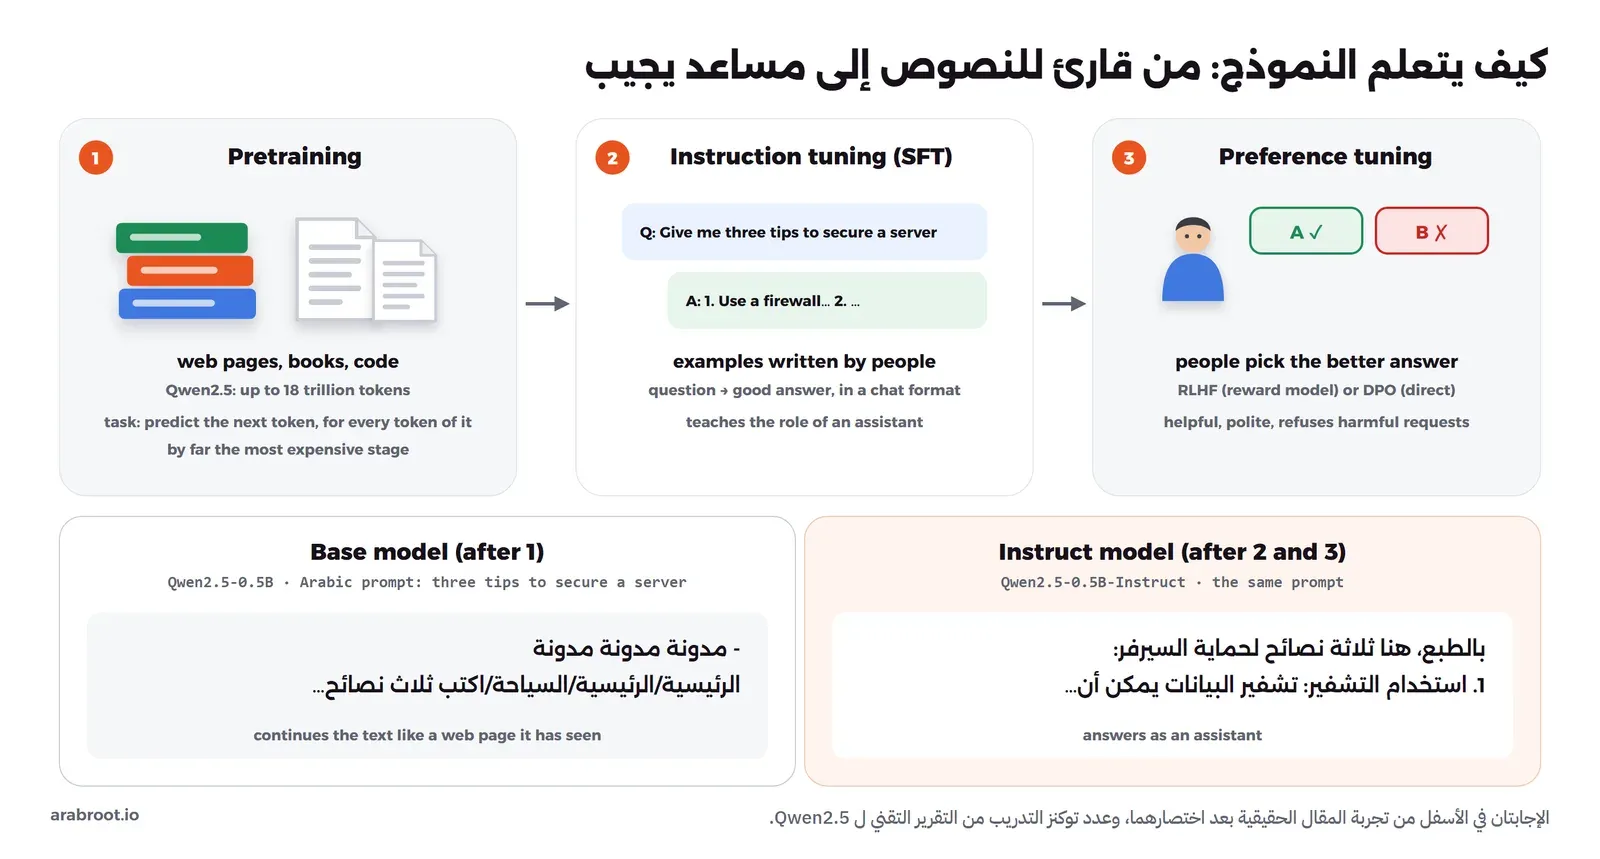
وصلنا إلى السؤال الأهم: من أين جاءت كل هذه الأرقام، جدول التضمين وأوزان الانتباه والشبكات الأمامية؟ والإجابة أنها تبدأ أرقاماً عشوائية، فيخرج النموذج كلاماً بلا معنى، ثم يتعلم على ثلاث مراحل.
التدريب المسبق Pretraining: توقع التوكن التالي ملايين المليارات من المرات
يجمع المطورون كمية ضخمة من النصوص: صفحات ويب وكتب وكود وأوراق علمية، ثم يعطون النموذج جزءاً من نص حقيقي ويطلبون منه توقع التوكن التالي، وهم يعرفون الإجابة الصحيحة لأنها موجودة في النص الأصلي. فإذا أعطى النموذج الإجابة الصحيحة احتمالاً صغيراً عدلت الأرقام قليلاً في الاتجاه الذي يرفع هذا الاحتمال، ثم ينتقل إلى التوكن التالي، وهكذا لكل توكن في كل النصوص. ولاحظ أن هذه الطريقة لا تحتاج أحداً يكتب إجابات بيده، فالنص نفسه هو المعلم، ولهذا السبب أمكن التدريب على كميات هائلة، فقد تدربت عائلة Qwen2.5 مثلاً على ما يصل إلى 18 ترليون توكن بحسب تقريرها التقني.
وهذه الأرقام التي تعدل في التدريب هي المعاملات Parameters، وتسمى أيضاً الأوزان Weights، وعددها هو الرقم الذي تراه في اسم النموذج: 0.5B تعني نصف مليار معامل، و7B تعني سبعة مليارات، حيث B اختصار Billion. ولكي يتوقع النموذج التوكن التالي بدقة في نصوص عن البرمجة والتاريخ والطب، فلا بد أن تحمل هذه الأرقام أنماط اللغة والكثير من المعلومات، لذلك فالنموذج الأكبر يعرف أكثر غالباً، ولكنه يحتاج ذاكرة أكبر ويعمل أبطأ، كما سوف ترى في قسم التشغيل.
والنتيجة بعد هذه المرحلة تسمى النموذج الأساسي Base Model، وهو يكمل النصوص ولا يجيب عن الأسئلة، وقد رأيت ذلك حين أكمل «The capital of Saudi Arabia is» بخط فارغ لامتحان.
ضبط التعليمات وضبط التفضيلات: من مكمل نصوص إلى مساعد
لكي يصبح النموذج مساعداً يجيب عن الأسئلة يمر بمرحلتين إضافيتين أصغر بكثير من التدريب المسبق:
- ضبط التعليمات Instruction Tuning ويسمى أيضاً Supervised Fine-Tuning واختصاراً SFT: يتدرب النموذج على أمثلة كتبها أو راجعها أشخاص، كل مثال فيه سؤال أو طلب ثم إجابة جيدة، بصيغة محادثة لها علامات خاصة تفصل بين المستخدم والمساعد، فيتعلم أن ما يأتي بعد السؤال هو إجابة، وليس سؤالاً آخر أو صفحة ويب.
- ضبط التفضيلات Preference Tuning: يعطى النموذج سؤالاً ويكتب إجابتين، فيختار شخص الإجابة الأفضل، ثم يتدرب النموذج على تفضيل هذا النوع من الإجابات. وأشهر طريقة لذلك التعلم المعزز من ملاحظات البشر Reinforcement Learning from Human Feedback واختصاراً RLHF، الذي استخدمته OpenAI في InstructGPT، وفيه يدرب نموذج مساعد يعطي درجة لكل إجابة ثم يتعلم النموذج من هذه الدرجات، وطريقة أبسط اسمها Direct Preference Optimization واختصاراً DPO تتعلم من أزواج الإجابات مباشرة دون النموذج المساعد. وفي هذه المرحلة يتعلم النموذج أن يكون مفيداً ومهذباً، وأن يرفض الطلبات الضارة.
والنتيجة تسمى نموذج التعليمات Instruct Model أو نموذج المحادثة Chat Model، وهو الذي تستخدمه في ChatGPT وفي Ollama. ولنر الفرق بأنفسنا، فالبرنامج التالي base_vs_instruct.py يعطي نفس الطلب للنموذج الأساسي Qwen2.5-0.5B ولنموذج التعليمات Qwen2.5-0.5B-Instruct، ويطبع في النهاية النص الذي يصل فعلاً إلى نموذج التعليمات بعد تطبيق قالب المحادثة Chat Template:
import torch, sys
from transformers import AutoTokenizer, AutoModelForCausalLM
qs = sys.argv[1:]
for name in ["Qwen/Qwen2.5-0.5B", "Qwen/Qwen2.5-0.5B-Instruct"]:
    tok = AutoTokenizer.from_pretrained(name)
    m = AutoModelForCausalLM.from_pretrained(name, dtype=torch.float32).eval()
    for q in qs:
        if name.endswith("Instruct"):
            text = tok.apply_chat_template([{"role": "user", "content": q}], tokenize=False, add_generation_prompt=True)
        else:
            text = q
        ids = tok(text, return_tensors="pt").input_ids
        out = m.generate(ids, max_new_tokens=50, do_sample=False)
        print(f"--- {name} | {q}")
        print(tok.decode(out[0, ids.shape[1]:], skip_special_tokens=True).strip())
    if name.endswith("Instruct"): print("=== chat template:\n" + text)
docker exec lab-llm-py python base_vs_instruct.py "اكتب ثلاث نصائح لحماية السيرفر." "Give me three tips to secure a Linux server."والمخرج سوف يكون كما يلي:
--- Qwen/Qwen2.5-0.5B | اكتب ثلاث نصائح لحماية السيرفر.
- مدونة مدونة مدونة
الرئيسية/الرئيسية/السياحة/اكتب ثلاث نصائح لحماية السيرفر.
اكتب ثلاث نصائح لحماية السيرفر.
الس
--- Qwen/Qwen2.5-0.5B | Give me three tips to secure a Linux server.
1. Use strong passwords: Use a strong password for your Linux server and change it regularly. Avoid using common passwords such as "123456" or "password".
2. Enable two-factor authentication: Two-factor authentication adds an
--- Qwen/Qwen2.5-0.5B-Instruct | اكتب ثلاث نصائح لحماية السيرفر.
بالطبع، هنا ثلاثة نصائح لحماية السيرفر:
1. استخدام التشفير: تشفير البيانات يمكن أن يقلل من خطر الهجمات الإلكترونية. يمكنك استخدام برامج التشفير مثل AES (ال
--- Qwen/Qwen2.5-0.5B-Instruct | Give me three tips to secure a Linux server.
Certainly! Here are three tips to help secure your Linux server:
1. **Enable and Configure Firewall**: A firewall is essential for protecting your server from unauthorized access. You can use the `ufw` (Uncomplicated Firewall) or `iptables
=== chat template:
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
Give me three tips to secure a Linux server.<|im_end|>
<|im_start|>assistant
في المخرج أعلاه لاحظ التالي:
- النموذج الأساسي أكمل الطلب العربي وكأنه عنوان في صفحة مدونة: «مدونة مدونة مدونة» ثم مسار صفحة «الرئيسية/السياحة» ثم كرر الطلب، لأنه رأى نصوصاً كهذه في الإنترنت.
- النموذج الأساسي نفسه أجاب عن الطلب الإنجليزي بقائمة معقولة، والسبب أن بيانات التدريب المسبق الحديثة فيها كثير من الأسئلة والإجابات، فالفرق بين النوعين ليس دائماً بهذا الوضوح، ولكنه يظهر في الحالات الأقل شيوعاً.
- نموذج التعليمات بدأ في الحالتين بجملة مساعد «بالطبع» و«Certainly» ثم قائمة، وهذه بصمة ضبط التعليمات.
- قالب المحادثة يبين أن المحادثة نفسها نص عادي مع علامات خاصة مثل
<|im_start|>، والنموذج يكمل بعدassistant، أي أن المساعد ما زال يتوقع التوكن التالي، ولكن في نص شكله محادثة. ولاحظ أن القالب أضاف تعليمات نظام System Prompt لم نكتبها، وهي جزء من إعداد النموذج.
وقد يتساءل البعض: هل أحتاج أن أدرب نموذجاً بنفسي؟ والإجابة في أغلب الحالات لا، فالتدريب المسبق يحتاج آلاف البطاقات الرسومية وأشهراً من العمل، والذي تفعله المؤسسات عادة أنها تأخذ نموذج تعليمات جاهزاً، وتعطيه معلوماتها في السياق عبر RAG، وقد تضبطه أحياناً على أمثلة من عملها.
لماذا يخطئ النموذج؟
بعد كل ما سبق أصبح سبب الأخطاء واضحاً: النموذج لا يبحث في قاعدة بيانات للحقائق، وإنما يختار توكناً معقولاً بعد توكن، فإذا كانت المعلومة غير موجودة في أرقامه، أو كانت ضعيفة، فسوف يكمل بنص معقول الشكل بنفس الثقة. وهذا ما يسمى الهلوسة Hallucination. وقد رأيته في تجاربنا: «عاصمة المملكة... مدينة تقع في المملكة العربية السعودية» دون ذكر الرياض، و«سرية المعلومات» كفائدة للنسخ الاحتياطي. والمثال التالي أوضح، فقد سألنا النموذج عن معنى «السيرفر» بالعربية، والمخرج التالي هو الإجابة بعد حذف سطور الإحصائيات:
docker exec -it lab-llm-ollama ollama run qwen2.5:0.5b --verbose "ما هو السيرفر؟ أجب في ثلاث جمل."السرير هو حزمة من الملابس والكميات والأدوية اللازمة للاستخراج والتوصية بأي
نوع من الأدوية أو المedicamentos.النموذج قرأ «السيرفر» وكأنها «السرير»، ثم كتب جملة لا علاقة لها بأي شيء، وظهرت في آخرها كلمة إسبانية، وكل ذلك بثقة كاملة. ونحن هنا أمام نموذج صغير جداً لذلك الخطأ فاضح، ولكن النماذج الكبيرة تخطئ بنفس الطريقة في الأسئلة الأصعب، والفرق أن خطأها يكون مقنعاً أكثر، وهذا أخطر.
والسبب الثاني للأخطاء هو تاريخ انتهاء المعرفة Knowledge Cutoff: النموذج يعرف ما كان في بيانات تدريبه فقط، فلا يعرف إصدار البرنامج الذي صدر بعدها، ولا سياسة شركتك الداخلية، ولا محتوى مستنداتك، وإذا سألته عنها فقد يخترع إجابة. والحل في الحالتين ليس نموذجاً أكبر فقط، وإنما أن تعطيه المعلومة الصحيحة في السياق:
- التوليد المعزز بالاسترجاع Retrieval-Augmented Generation واختصاراً RAG، وأصله ورقة Lewis وزملائه 2020: قبل أن يصل سؤالك إلى النموذج، يبحث النظام في مستنداتك بالمعنى باستخدام التضمين الذي رأيناه، ويأخذ أقرب المقاطع إلى السؤال، ويضعها في النص قبل السؤال مع تعليمات مثل «أجب من هذه المقاطع فقط». فيصبح عمل النموذج قراءة نص أمامه وتلخيصه، وهذا ما يجيده، بدلاً من التذكر، وهذا ما لا يمكن الاعتماد عليه.
- الأدوات Tools: يعطى النموذج وصفاً لأدوات يستطيع طلبها، مثل البحث في قاعدة بيانات أو استدعاء واجهة برمجية أو قراءة ملف، فإذا احتاج معلومة كتب طلباً بصيغة محددة، فينفذه برنامجك ويعيد النتيجة إلى السياق، ثم يكمل النموذج إجابته منها. ولاحظ أن النموذج نفسه لا ينفذ شيئاً، وإنما برنامجك هو الذي ينفذ، لذلك فالصلاحيات التي تعطيها لهذه الأدوات هي مسؤوليتك. وبروتوكول MCP هو طريقة موحدة لربط هذه الأدوات بالنماذج.
وقد خصصنا لكل من RAG وقواعد البيانات الشعاعية وبروتوكول MCP مقالاً في مرحلة الذكاء الاصطناعي على سيرفرك. أما القاعدة التي تبدأ بها من الآن: لا تقم بنشر إجابات النموذج للمستخدمين في أي أمر مهم دون مصدر يمكن التحقق منه أو مراجعة بشرية، والسبب أن النموذج لا يعرف أنه أخطأ.
تشغيله على سيرفرك
الآن نعرف ما يحدث داخل النموذج، فلنترجم ذلك إلى أسئلة السيرفر: كم حجم الملف؟ وكم ذاكرة يحتاج؟ وهل يكفي المعالج؟ وكم سيكون سريعاً؟ وسوف نشرح في هذا القسم الفكرة التي تقف خلف كل إجابة، أما التطبيق العملي على كل نوع من الأجهزة، من اللابتوب إلى بطاقات NVIDIA وAMD وأجهزة Mac والسيرفر بعدة بطاقات، مع جداول الأحجام واختيار التكميم والأدوات، فقد خصصنا له مقالاً كاملاً: تشغيل نماذج اللغة على جهازك للمبتدئين.
كم ذاكرة يحتاج النموذج؟
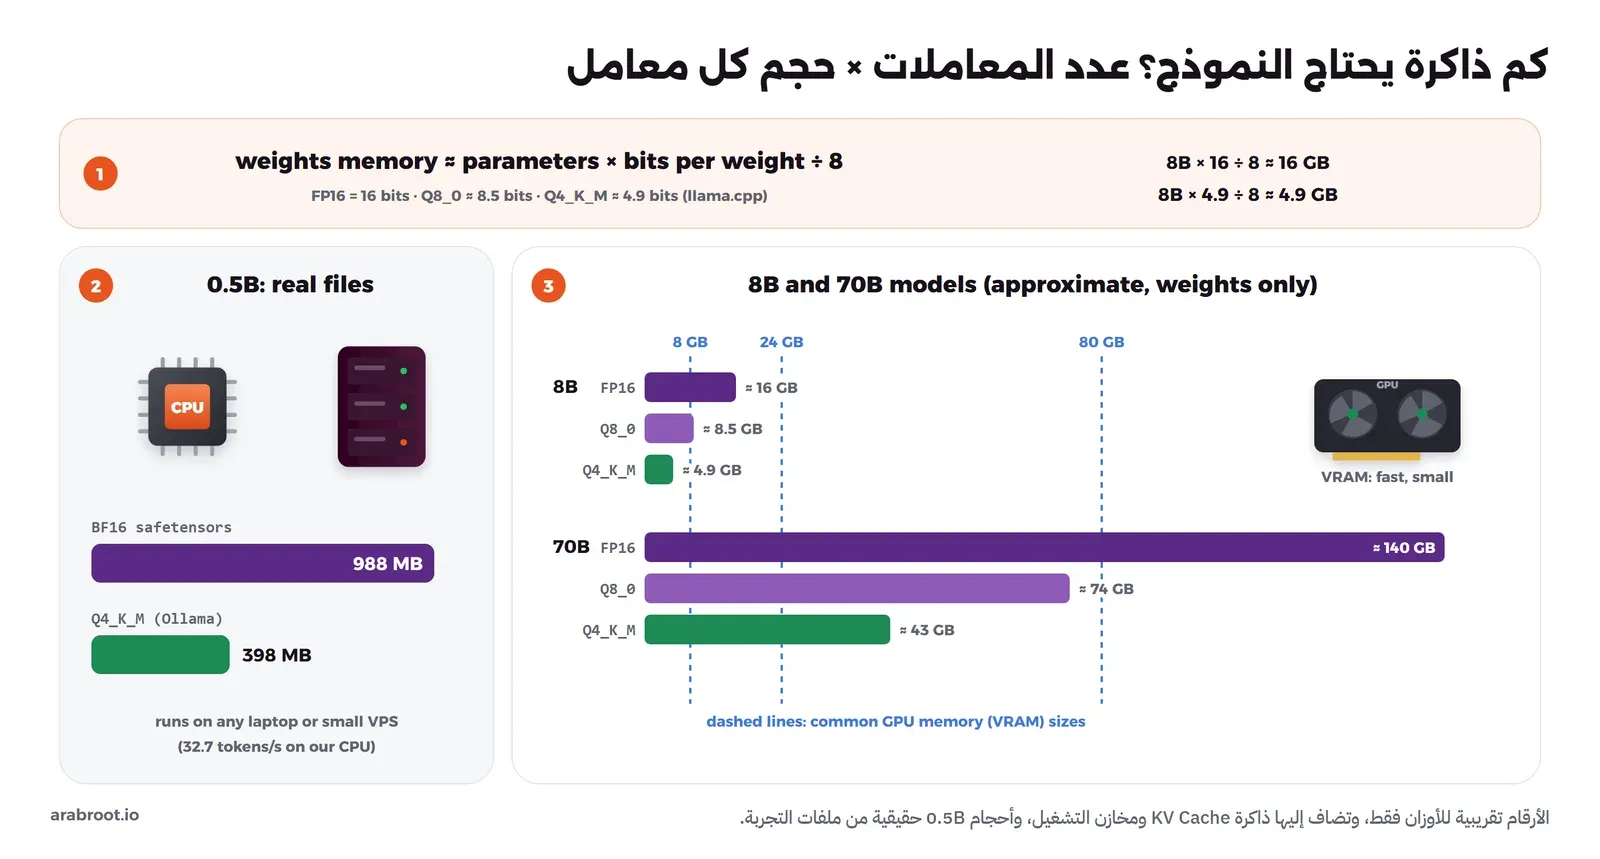
النموذج على القرص هو ملف فيه المعاملات كلها، وعند التشغيل يجب أن يحمل كله في الذاكرة، لأن كل توكن يمر على كل الطبقات. لذلك فالحساب الأول بسيط: الذاكرة ≈ عدد المعاملات × حجم كل معامل. وقد رأينا ملفين حقيقيين للنموذج نفسه في تجربتنا:
- ملف Hugging Face
model.safetensorsلنموذج Qwen2.5-0.5B حجمه 988,097,824 بايت، أي 494 مليون معامل × 2 بايت، لأن كل معامل محفوظ بدقة BF16 أي 16 بت. - نسخة Ollama من نفس النموذج حجمها 397,807,936 بايت، أي أقل من النصف، والسبب أنها مكممة Quantized بطريقة Q4_K_M كما يظهر في
ollama show.
docker exec lab-llm-ollama ollama show qwen2.5:0.5b Model
architecture qwen2
parameters 494.03M
context length 32768
embedding length 896
quantization Q4_K_M
Capabilities
completion
tools
System
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.
License
Apache License
Version 2.0, January 2004
... والتكميم Quantization هو أن تحفظ كل معامل بعدد أقل من البتات: بدلاً من 16 بت تحفظه في 8 بتات أو 4 بتات تقريباً، فيصغر الملف والذاكرة إلى النصف أو الربع، ويصبح التشغيل أسرع غالباً لأن المعالج يقرأ بيانات أقل من الذاكرة، والثمن أن الأرقام تصبح أقل دقة فتنخفض جودة الإجابات قليلاً، ويزداد الانخفاض كلما قلت البتات. والصيغة الشائعة لهذه الملفات المكممة هي GGUF التي يستخدمها llama.cpp وOllama. ويعطي توثيق أداة التكميم في llama.cpp عدد البتات الفعلي لكل معامل في كل نوع، فهو تقريباً 16 في F16، و8.5 في Q8_0، و4.89 في Q4_K_M، ويزيد عن الرقم في الاسم لأن كل مجموعة صغيرة من المعاملات تحفظ معها أرقاماً إضافية للتحجيم.
ولنحسب مثالاً لنموذج من 8 مليارات معامل، والأرقام تقريبية للأوزان وحدها:
| الدقة | البتات لكل معامل | الحساب | الذاكرة التقريبية |
|---|---|---|---|
| FP16 أو BF16 | 16 | 8 مليار × 16 ÷ 8 | نحو 16 GB |
| Q8_0 | 8.5 | 8 مليار × 8.5 ÷ 8 | نحو 8.5 GB |
| Q4_K_M | 4.89 | 8 مليار × 4.89 ÷ 8 | نحو 4.9 GB |
والرقم الأخير يطابق ما في جدول llama.cpp نفسه، الذي يذكر أن Llama 3.1 8B حجمه 4.9 GB بعد التكميم Q4_K_M، و70B حجمه 43.1 GB. ثم أضف إلى ذلك ذاكرة KV التي حسبناها في القسم السابق، ومخازن الحساب، وذاكرة نظام التشغيل، لذلك فحجم الملف هو الحد الأدنى وليس الذاكرة المطلوبة. وتجد ذلك واضحاً في مكتبة Ollama، فنموذج qwen2.5:7b حجمه 4.7 GB، وقد فصلنا الميزانية كاملة بأمثلة من 1B إلى 70B في قسم القاعدة الوحيدة: النموذج يجب أن يدخل في الذاكرة.
المعالج أم البطاقة الرسومية؟
توليد كل توكن يحتاج أن يمر على كل المعاملات مرة واحدة، أي أن النموذج من 4.9 GB يقرأ قرابة 4.9 GB من الذاكرة لكل توكن، لذلك فسرعة التوليد تحددها في الغالب سرعة نقل البيانات من الذاكرة إلى المعالج أكثر من قوة الحساب. وكما شرحنا في مقال Hello World فالمعالج ينتظر الذاكرة RAM وقتاً طويلاً بمقياسه، والبطاقة الرسومية GPU فيها ذاكرة خاصة بها اسمها VRAM أسرع بكثير في النقل، وفيها آلاف الأنوية الصغيرة التي تحسب ضرب المصفوفات بالتوازي، بينما المعالج فيه عدد قليل من الأنوية القوية كما شرحنا في مقال المعالج والخيوط والتزامن. والنتيجة العملية:
- إذا دخل النموذج كله في VRAM فسوف يعمل بسرعة كبيرة.
- إذا لم يدخل فيمكن لأدوات مثل Ollama وllama.cpp أن تضع جزءاً من الطبقات في البطاقة والباقي في RAM، والسرعة تنزل كثيراً بقدر ما يبقى خارج البطاقة.
- المعالج وحده يكفي للنماذج الصغيرة، ولتجربة الأفكار، وللمهام التي لا يهم فيها الانتظار، مثل تلخيص ليلي لعدد من المستندات.
ولنقس السرعة على المعالج في تجربتنا، فالخيار --verbose في Ollama يطبع الإحصائيات بعد الإجابة (حذفنا نص الإجابة نفسها):
docker exec -it lab-llm-ollama ollama run qwen2.5:0.5b --verbose "Explain what a server is in five short sentences."total duration: 2.61318316s
load duration: 1.155271ms
prompt eval count: 40 token(s)
prompt eval cached: 24 token(s)
prompt eval duration: 104.777ms
prompt eval rate: 152.71 tokens/s
eval count: 82 token(s)
eval duration: 2.504307s
eval rate: 32.74 tokens/sفي المخرج أعلاه لاحظ التالي:
prompt evalهو قراءة النص، وقد كانت بسرعة 152.71 توكن في الثانية، وevalهو توليد الإجابة، وقد كان بسرعة 32.74 توكن في الثانية، أي أن التوليد أبطأ بكثير من القراءة، لأن القراءة تعالج توكنز النص معاً بالتوازي، أما التوليد فتوكن بعد توكن.prompt eval cached: 24تعني أن 24 توكناً من النص كانت في ذاكرة KV من طلب سابق، وهي تعليمات النظام وعلامات القالب التي تتكرر في كل طلب، فلم يعد Ollama حسابها.- هذه سرعة نموذج من نصف مليار معامل على ثمانية معالجات افتراضية في جهازنا، والنموذج من ثمانية مليارات أكبر منه بست عشرة مرة، فتوقع على نفس المعالج سرعة أقل بكثير، ولا تعتمد على هذا الرقم، وإنما قس على عتادك بنفس الأمر.
أما ماذا تتوقع من كل جهاز، ولماذا تنهار السرعة عندما يخرج جزء من الطبقات إلى المعالج، وكيف تختار البطاقة وحجم الذاكرة قبل الشراء، فهذا موضوع مقال تشغيل نماذج اللغة على جهازك للمبتدئين في مرحلة الذكاء الاصطناعي، وفيه قياسات حقيقية لأربعة نماذج من 0.5B إلى 7B على المعالج.
النماذج المفتوحة ورخصها
النماذج التي تستطيع تشغيلها على سيرفرك تسمى نماذج الأوزان المفتوحة Open Weights، أي أن ملف المعاملات متاح للتحميل، وهذا لا يعني دائماً أنها مفتوحة المصدر بالمعنى الذي شرحناه في مقال البرمجيات مفتوحة المصدر وتراخيصها، فبيانات التدريب وكوده غالباً غير منشورة، والرخص تختلف من نموذج لآخر بل من حجم لآخر في نفس العائلة. لذلك اقرأ رخصة كل نموذج قبل استخدامه في عمل تجاري، وفيما يلي أمثلة موثقة:
- Qwen2.5: أغلب الأحجام بما فيها 0.5B و7B برخصة Apache-2.0، أما 3B فبرخصة Qwen Research، و72B برخصة Qwen خاصة.
- Mistral 7B: أعلنته Mistral AI برخصة Apache 2.0.
- DeepSeek-R1: الكود والأوزان برخصة MIT، مع ملاحظة أن نسخه المصغرة المبنية على Qwen وLlama تتبع رخص النماذج الأصلية.
- Llama: تصدر برخصة Meta الخاصة Llama Community License، وفيها مثلاً أن الشركة التي يزيد مستخدموها النشطون شهرياً عن 700 مليون تحتاج رخصة منفصلة من Meta، لذلك فهي ليست مفتوحة المصدر بحسب Open Source Initiative، لأنها تقيد بعض المستخدمين وبعض الاستخدامات.
والمقارنة بين هذه العائلات وأيها يناسب العربية ولأي عمل هي موضوع مقال النماذج المفتوحة في نفس المرحلة.
الصورة الكاملة
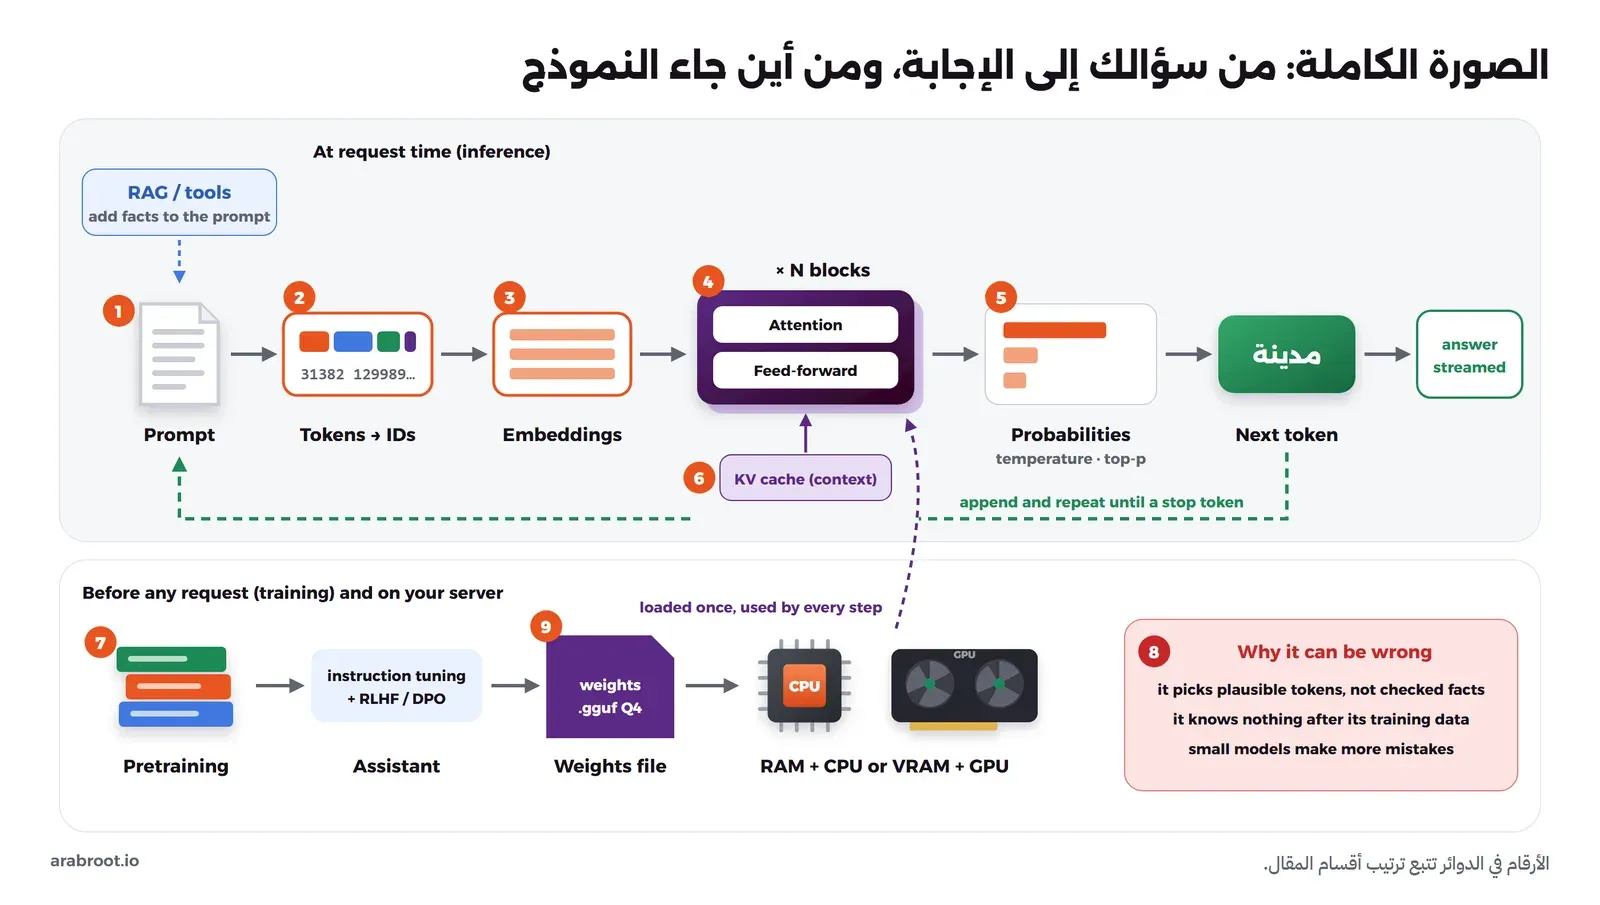
الآن يمكننا أن نجمع كل الخطوات في صورة واحدة: نصك، ومعه ما يضيفه RAG أو الأدوات، يقطع إلى توكنز، وتتحول أرقامها إلى متجهات، وتمر المتجهات على عشرات الكتل من الانتباه والشبكات الأمامية مع ذاكرة KV للتوكنز السابقة، فيخرج احتمال لكل توكن في المفردات، فيختار النموذج واحداً بحسب درجة الحرارة وTop-p، ويضيفه، ويكرر حتى يصل إلى توكن النهاية. وكل ذلك يعتمد على ملف المعاملات الذي صنعه التدريب المسبق ثم ضبط التعليمات والتفضيلات، والذي يجب أن يدخل في ذاكرة سيرفرك أو بطاقته الرسومية:
جدول المصطلحات
| المصطلح | بالعربية | معناه باختصار |
|---|---|---|
| LLM | نموذج اللغة الكبير | برنامج يتوقع التوكن التالي من النص، وتدرب على كمية ضخمة من النصوص |
| Token | التوكن | قطعة نص، كلمة أو جزء من كلمة أو حتى جزء من حرف، وهي وحدة القياس في كل شيء |
| Tokenizer | مقطع النص | البرنامج الذي يقطع النص إلى توكنز ويحولها إلى أرقام |
| BPE | ترميز أزواج البايتات | طريقة بناء قائمة التوكنز بدمج الأزواج الأكثر تكراراً |
| Vocabulary | المفردات | قائمة كل التوكنز التي يعرفها النموذج، 151,665 في Qwen2.5 |
| Token ID | رقم التوكن | الرقم الثابت للتوكن في المفردات، وهو ما يدخل النموذج فعلاً |
| Embedding | التضمين | تحويل التوكن إلى متجه أعداد تتقارب فيه المعاني المتشابهة |
| Vector | المتجه | قائمة أعداد عشرية تمثل معنى التوكن، 896 عدداً في Qwen2.5-0.5B |
| Cosine Similarity | تشابه جيب التمام | مقياس لتقارب متجهين، قريب من 1 للمتشابهين وقريب من 0 لغير المرتبطين |
| Attention | الانتباه | كل توكن يأخذ من التوكنز السابقة بقدر أهميتها فيتغير معناه بحسب السياق |
| Attention Head | رأس الانتباه | عملية انتباه واحدة من عدة عمليات متوازية في كل طبقة، تتعلم نوعاً من العلاقات |
| Feed-forward Network | الشبكة الأمامية | الجزء الثاني من كل كتلة، يعالج كل توكن وحده ويخزن كثيراً من المعرفة |
| Transformer | المحول | البنية التي تكرر كتل الانتباه والشبكة الأمامية، من ورقة Attention Is All You Need |
| Layer / Block | الطبقة أو الكتلة | نسخة واحدة من الانتباه والشبكة الأمامية، 24 في Qwen2.5-0.5B |
| RoPE | ترميز الموقع بالدوران | طريقة لإضافة موقع كل توكن إلى الحساب حتى يعرف النموذج الترتيب |
| Logits | الدرجات | رقم لكل توكن في المفردات يقول إلى أي حد يناسب أن يكون التالي |
| Softmax | دالة softmax | تحول الدرجات إلى احتمالات مجموعها 1 |
| Temperature | درجة الحرارة | تجعل الاحتمالات أحد أو أكثر تقارباً، و0 تعني اختيار الأعلى دائماً |
| Top-p | أخذ النواة | الاختيار من أقل مجموعة توكنز يصل مجموع احتمالاتها إلى p |
| Greedy Decoding | الاختيار الجشع | اختيار التوكن الأعلى احتمالاً في كل خطوة |
| EOS | توكن النهاية | توكن خاص يعني أن الإجابة انتهت فيتوقف التوليد |
| Context Window | نافذة السياق | أقصى عدد توكنز يراها النموذج في الطلب الواحد، بما فيها الإجابة |
| KV Cache | ذاكرة المفاتيح والقيم | حفظ حسابات الانتباه للتوكنز السابقة حتى لا تعاد، وتكبر مع طول النص |
| System Prompt | تعليمات النظام | نص في بداية المحادثة يحدد دور المساعد، ويأخذ مكاناً من النافذة |
| Parameters / Weights | المعاملات أو الأوزان | الأعداد التي تعلمها النموذج، وعددها هو الرقم في اسمه مثل 7B |
| Pretraining | التدريب المسبق | تعليم النموذج توقع التوكن التالي على كمية ضخمة من النصوص |
| Base Model | النموذج الأساسي | نتيجة التدريب المسبق، يكمل النصوص ولا يتصرف كمساعد |
| Instruction Tuning / SFT | ضبط التعليمات | تدريب على أمثلة سؤال وإجابة بصيغة محادثة |
| RLHF | التعلم المعزز من ملاحظات البشر | ضبط النموذج على الإجابات التي يفضلها الناس عبر نموذج يعطي درجات |
| DPO | التحسين المباشر للتفضيلات | ضبط النموذج من أزواج إجابات مفضلة ومرفوضة مباشرة |
| Instruct / Chat Model | نموذج التعليمات | النموذج بعد ضبط التعليمات والتفضيلات، وهو الذي تتحدث معه |
| Chat Template | قالب المحادثة | العلامات الخاصة التي تحول المحادثة إلى نص يكمله النموذج |
| Hallucination | الهلوسة | إجابة خاطئة مكتوبة بثقة، لأن النموذج يختار نصاً معقولاً لا حقيقة مؤكدة |
| Knowledge Cutoff | تاريخ انتهاء المعرفة | آخر تاريخ في بيانات التدريب، ولا يعرف النموذج ما بعده |
| RAG | التوليد المعزز بالاسترجاع | البحث في مستنداتك ووضع المقاطع المناسبة في السياق قبل السؤال |
| Tools | الأدوات | وظائف يطلبها النموذج وينفذها برنامجك ثم يعيد نتيجتها إلى السياق |
| Quantization | التكميم | حفظ المعاملات بعدد بتات أقل لتصغير الذاكرة مقابل دقة أقل قليلاً |
| GGUF | صيغة GGUF | صيغة ملفات النماذج المكممة في llama.cpp وOllama |
| VRAM | ذاكرة البطاقة الرسومية | الذاكرة السريعة في ال GPU، ويجب أن يدخل فيها النموذج ليعمل بسرعة |
| Tokens per second | التوكنز في الثانية | مقياس السرعة، ويقاس منفصلاً لقراءة النص ولتوليد الإجابة |
| Open Weights | الأوزان المفتوحة | ملف المعاملات متاح للتحميل، والرخصة تحدد ما يسمح لك به |
تدريب عملي
- غير الجملة في
tok.pyإلى نص من عملك الحقيقي، رسالة بريد أو فقرة من سياسة، وقارن عدد التوكنز بالعربية والإنجليزية، ثم احسب كم صفحة من نصوصك تدخل في نافذة 4096 توكناً. - شغل
probs.pyعلى بداية جملة من مجال عملك، وراقب كيف تتغير الاحتمالات بين 0.5 و2.0، ثم أعدtemp.pyبدرجة حرارة 0.3 وقارنها بالدرجتين 0 و1. - اسأل النموذج الصغير سؤالاً تعرف إجابته بالعربية وبالإنجليزية، ثم ضع في السؤال فقرة تحتوي الإجابة وقل له «أجب من هذه الفقرة فقط»، وقارن، وهذه هي فكرة RAG في أبسط صورها.
وعند الانتهاء احذف ما أنشأته في التجربة:
docker rm -f lab-llm-py lab-llm-ollama
docker volume rm lab-llm-hf lab-llm-ollama
docker image rm ollama/ollama:0.35.1 python:3.12-slim
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- نموذج اللغة يتوقع التوكن التالي ويضيفه ويكرر، وكل ما يبدو كتفكير يأتي من هذه الحلقة ومن كمية النصوص التي تعلم منها.
- النص يقطع إلى توكنز لها أرقام، والعربية تكلف توكنز أكثر خاصة في ال Tokenizers القديمة، فاختبر ال Tokenizer على نصوصك لأن التكلفة والنافذة والسرعة كلها تقاس بالتوكن.
- التضمين يحول كل توكن إلى متجه تتقارب فيه المعاني، والانتباه يغير هذا المتجه بحسب السياق، والنموذج كتل Transformer متكررة من الانتباه والشبكة الأمامية.
- النموذج يخرج احتمالاً لكل توكن، ودرجة الحرارة وTop-p تحددان كيف يختار، والدرجة 0 تعطي نفس الإجابة دائماً ولكنها لا تجعلها صحيحة.
- نافذة السياق وذاكرة KV تكبران مع كل توكن، فالنص الطويل يكلف ذاكرة ووقتاً قبل أول حرف.
- التدريب المسبق يصنع نموذجاً يكمل النصوص، وضبط التعليمات والتفضيلات يصنع المساعد، والهلوسة نتيجة طبيعية لطريقة العمل، وعلاجها إعطاء المعلومة في السياق عبر RAG والأدوات.
- الذاكرة ≈ المعاملات × البتات ÷ 8، والتكميم Q4 يجعل نموذج 8B قرابة 5 GB، والسرعة تحددها سرعة الذاكرة، والبطاقة الرسومية أسرع بكثير إذا دخل فيها النموذج كله، واقرأ رخصة كل نموذج قبل استخدامه.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي على سيرفرك بإذن الله سوف نتحدث عن النماذج المفتوحة، وتشغيل Ollama مع Open WebUI لفريقك، ثم RAG وMCP.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات
- أكتوبر 2026: إضافة روابط إلى مقال تشغيل نماذج اللغة على جهازك للمبتدئين في قسم التشغيل على السيرفر، الذي أصبح يملك التطبيق العملي على كل نوع من الأجهزة.
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Docker Engine 29.8.0 (معالج فقط) مع Ollama 0.35.1 والنموذج qwen2.5:0.5b، وPython 3.12.15 مع torch 2.14.1 وtransformers 5.18.0 وtokenizers 0.23.2 وtiktoken 0.14.0 وsentence-transformers 6.1.0، والنماذج Qwen2.5-0.5B وQwen2.5-0.5B-Instruct وparaphrase-multilingual-MiniLM-L12-v2.


