

إذا فتحت أي ملف إعدادات أو Token أو بريد إلكتروني من الداخل فسوف تجد سلاسل غريبة مثل 2LnYsdio وeyJhbGciOi… وJBSWY3DPEHPK3PXP، وكلها تقريباً ليست أسراراً ولا هاش، وإنما بيانات عادية تم تحويلها إلى حروف حتى تمر في مكان لا يقبل إلا النص. والسبب أن أغلب البيانات التي نتعامل معها في الحقيقة بايتات Bytes خام، صورة أو مفتاح تشفير أو ناتج هاش أو ملف مضغوط، بينما أغلب القنوات التي ننقلها عبرها صممت لنقل النص، مثل البريد الإلكتروني والروابط وملفات JSON وصفحات HTML وحتى الإنسان الذي يقرأ رمزاً لزميله في الهاتف. والحل الذي اتفق عليه الجميع هو الترميز Encoding، أي أن نكتب البايتات بأبجدية صغيرة من الحروف الآمنة ثم نعيدها كما هي في الطرف الآخر، ومن هنا جاءت عائلة Base16 وBase32 وBase58 وBase64 وأخواتها.
وهذا المقال جزء من مرحلة المطورين في خارطة الطريق، وهو مرجع ترجع إليه كلما رأيت سلسلة من هذا النوع وأردت أن تعرف ما هي وكيف تفكها ولماذا اختار من صمم النظام هذا الترميز دون غيره. وسوف نناقش في هذا المقال ما يلي:
- المشكلة: لماذا لا تمر البايتات الخام في القنوات المصممة للنص.
- القاعدة الذهبية: الترميز ليس تشفيراً Encryption وليس هاش Hashing، مع تجربة تفك فيها «سراً» دون أي مفتاح.
- تذكير سريع بالبت والبايت، والفرق بين مجموعة الحروف Character Set والترميز، وكيف تخزن الحروف العربية في UTF-8.
- Hex وBase64 وBase64url وBase32 وCrockford Base32 وBase58 وBase62 وBase36 وAscii85: المشكلة التي حلها كل واحد منها وأين تراه.
- الترميز داخل النص: Percent-encoding في الروابط وHTML Entities وQuoted-printable في البريد.
- الأوامر العملية في سطر الأوامر وNode.js وPython مع المخرجات الحقيقية، ثم الأخطاء الشائعة وجدول مقارنة.
لماذا نحتاج الترميز أصلاً؟
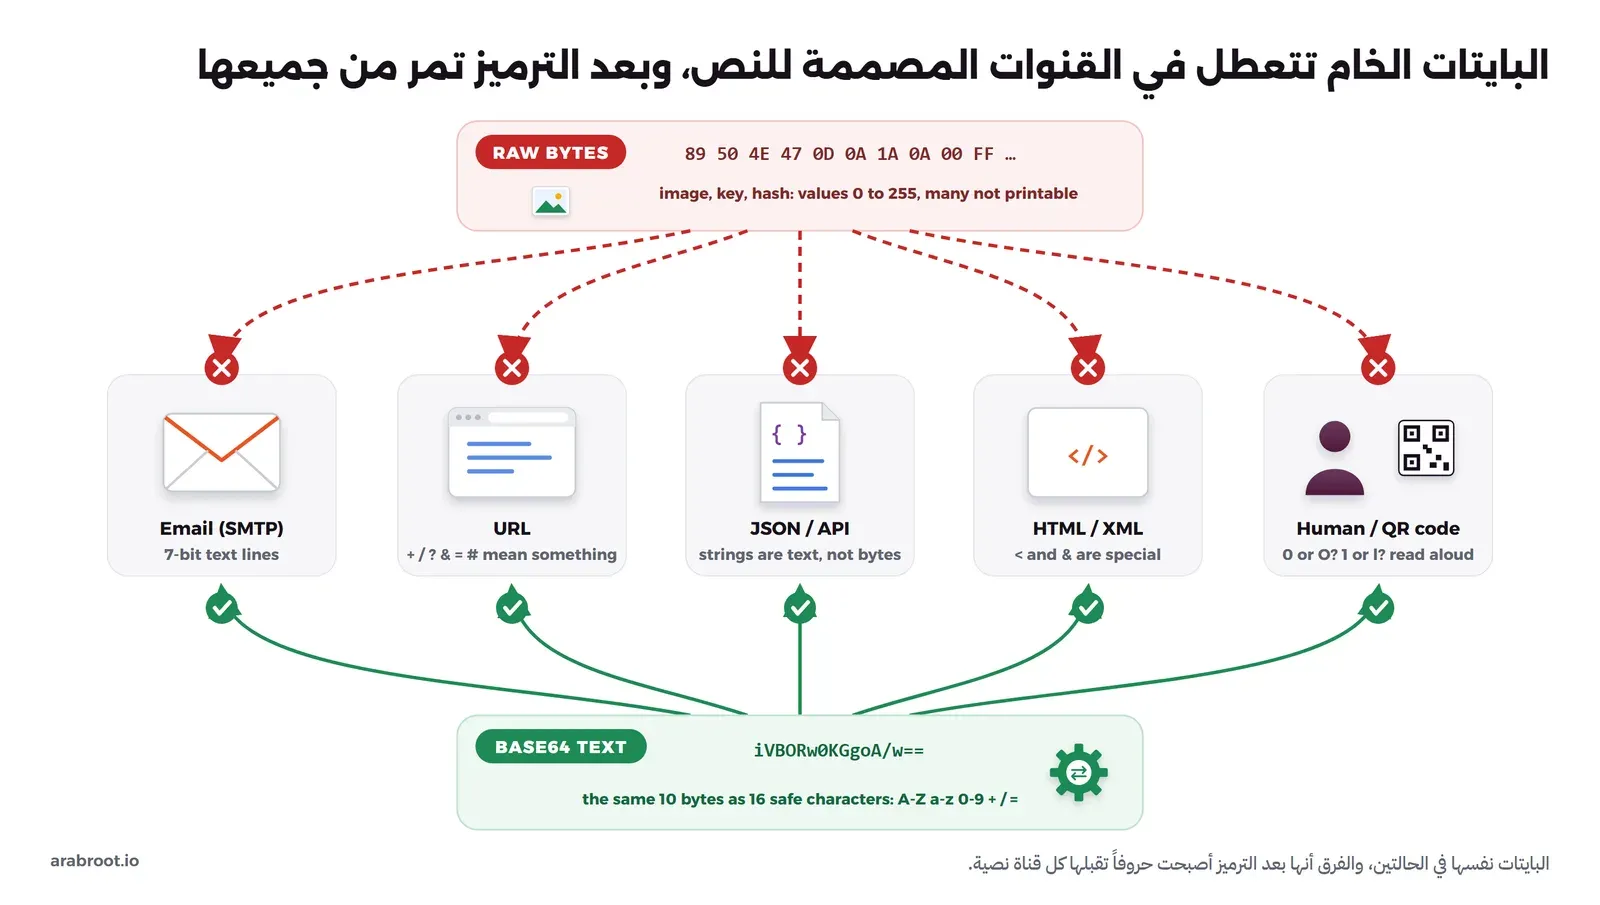
البايت Byte يحمل أي قيمة من 0 إلى 255، والملف الثنائي Binary File مثل الصورة أو المفتاح أو الملف المضغوط يستخدم كل هذه القيم بلا استثناء. فمثلاً أول 8 بايتات في أي صورة PNG هي 89 50 4E 47 0D 0A 1A 0A، وفيها البايت 0D و0A وهما في جدول ASCII حرفا نهاية السطر CR وLF، وفيها 1A وهو حرف تحكم Control Character لا يظهر على الشاشة، وفيها 89 وهو خارج جدول ASCII تماماً. والآن لنفرض أنك تريد أن تضع هذه البايتات كما هي في واحدة من القنوات التالية:
- البريد الإلكتروني SMTP: البروتوكول في أصله ينقل نصاً من 7 بتات فقط، وهذا مذكور صراحة في RFC 5321، ويقسم الرسالة إلى أسطر تنتهي بـ CRLF ولا يزيد طول السطر عن 1000 حرف، فإذا وضعت فيه بايتات خام فقد تتغير أو تحذف أو يقطع السطر في منتصف الصورة. والإضافة 8BITMIME في RFC 6152 سمحت بالبايتات فوق 127 في نص الرسالة، ولكنها لم تسمح بالبيانات الثنائية الحرة، ولذلك ما زالت المرفقات ترسل مرمزة إلى اليوم.
- الروابط URL: الحروف
/ ? # & = +لها معنى محدد في الرابط بحسب RFC 3986، فإذا ظهرت داخل قيمة تحملها فسوف يقرأها السيرفر كفاصل وليس كجزء من القيمة. - JSON والواجهات البرمجية API: النص في JSON سلسلة من حروف Unicode، ويجب أن ينقل ملف JSON بترميز UTF-8 كما في RFC 8259، ولا يوجد فيه نوع اسمه «بايتات»، فإذا أردت أن ترسل صورة المستخدم أو مفتاحاً عاماً داخل JSON فيجب أن تحوله إلى نص أولاً.
- HTML وXML: الحرفان
<و&لهما معنى خاص، وأغلب حروف التحكم غير مسموح بها أصلاً في مستندات XML. - الإنسان ورمز QR: عندما يقرأ موظف الدعم رمز تفعيل لعميل في الهاتف، أو يكتب المستخدم السر الظاهر تحت رمز QR بيده، فالمشكلة هنا ليست في البروتوكول وإنما في العين، فهل هذا الحرف صفر 0 أم حرف O؟ وهل هو رقم 1 أم حرف l الصغير؟
والحل في كل هذه الحالات واحد: نأخذ البايتات ونكتبها بأبجدية صغيرة من الحروف التي تمر في القناة دون مشاكل، وفي الطرف الآخر نعكس العملية فنحصل على البايتات نفسها بالضبط، بت ببت. وهذا هو تعريف الترميز من ثنائي إلى نص Binary-to-Text Encoding، وكل ترميز في هذا المقال يختلف عن الآخر فقط في الأبجدية التي اختارها، والسبب الذي جعله يختارها.
الصورة التالية تبين الفكرة:
الترميز ليس تشفيراً وليس هاش
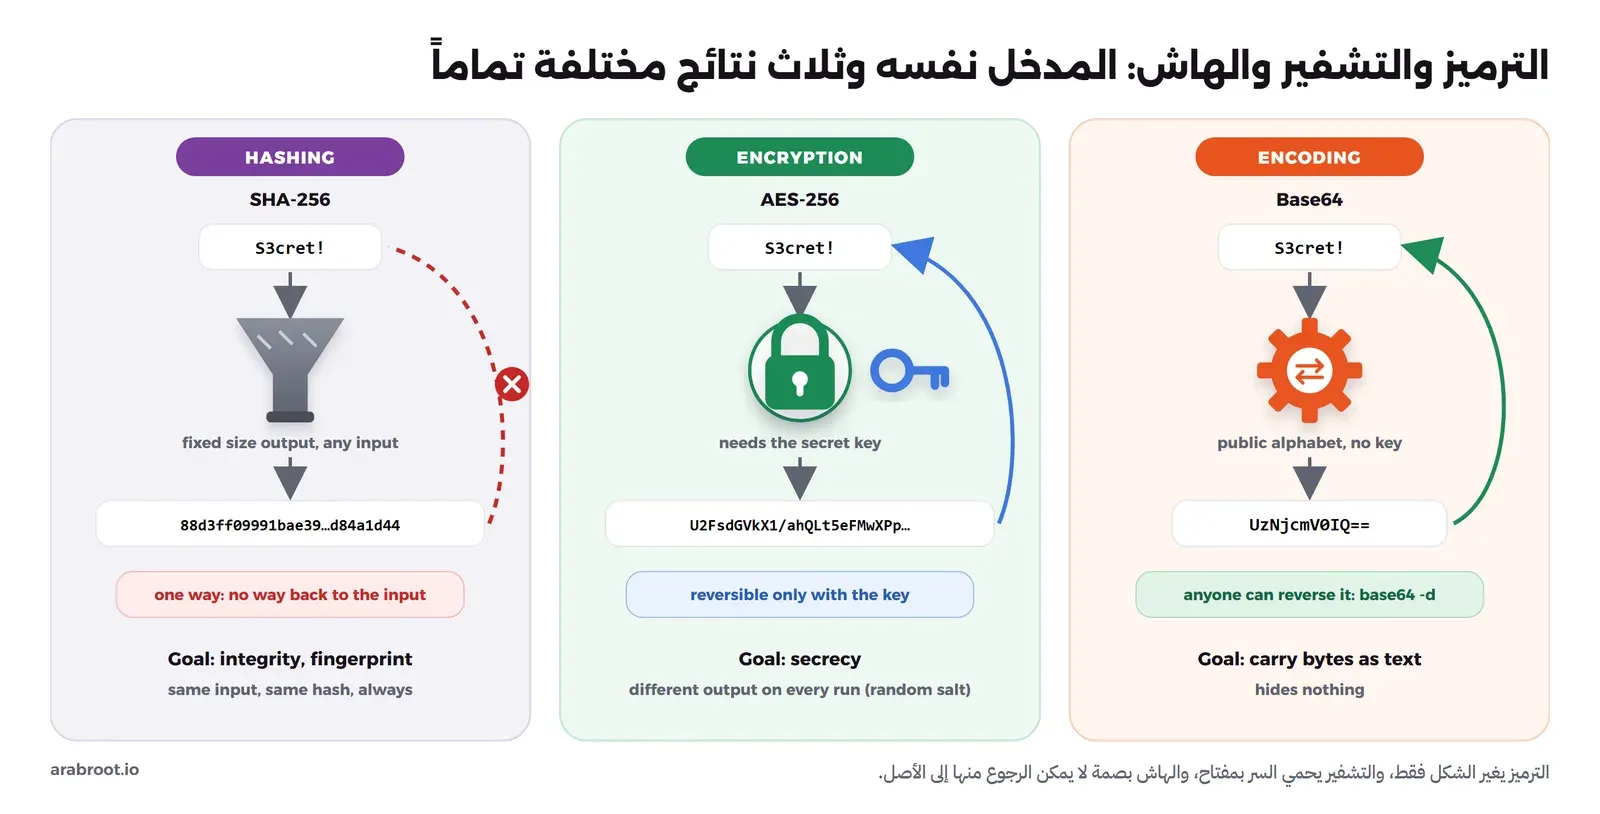
قبل أن ندخل في التفاصيل هناك قاعدة واحدة يجب أن تبقى في ذهنك طوال المقال: الترميز لا يخفي أي شيء. فالترميز يغير شكل البيانات فقط حتى تمر في قناة معينة، وخوارزميته وأبجديته منشورة في معيار عام، ولا يوجد فيه أي مفتاح، وبالتالي فأي شخص يرى الناتج يستطيع أن يعيده إلى الأصل بأمر واحد. وهذا يختلف تماماً عن التشفير والهاش، ويمكن أن نلخص الفرق كما يلي:
- الترميز Encoding مثل Base64: دالة باتجاهين Two-Way دون مفتاح، والهدف منها نقل البيانات أو تخزينها في مكان يقبل النص فقط.
- التشفير Encryption مثل AES: دالة باتجاهين ولكن بمفتاح Key، فمن يملك المفتاح يفك التشفير ومن لا يملكه لا يرى إلا بيانات عشوائية، والهدف منه السرية Confidentiality.
- الهاش Hashing مثل SHA-256: دالة باتجاه واحد One-Way Function تعطي بصمة بطول ثابت مهما كان طول المدخل، ولا يمكن الرجوع منها إلى المدخل، والهدف منها التأكد من سلامة البيانات Integrity وأنها لم تتغير ولو بت واحد.
ولاحظ أن الثلاثة يجتمعون كثيراً في المكان نفسه، وهذا سبب الخلط الشائع بينهم: فناتج التشفير وناتج الهاش كلاهما بايتات خام، ولذلك نرمزهما بعد ذلك بـ Base64 أو Hex حتى نطبعهما أو نخزنهما في قاعدة البيانات أو نرسلهما في JSON. فالسلسلة التي تراها في النهاية قد تكون Base64 لنص مشفر، ولكن الحماية جاءت من التشفير وليس من Base64.
الصورة التالية تبين المدخل نفسه في الحالات الثلاث، والمخرجات فيها هي المخرجات الحقيقية من التجربة التالية:
جرب بنفسك: فك «السر» دون أي مفتاح
لنأخذ مثالاً من الواقع اليومي: المصادقة الأساسية في HTTP، واسمها Basic Authentication، ترسل اسم المستخدم وكلمة المرور في الترويسة Header بهذا الشكل Authorization: Basic YWRtaW46UzNjcmV0IQ==، وقد يظن من يرى هذه السلسلة لأول مرة أنها مشفرة. والآن نقوم بفكها بأمر base64 العادي الموجود في أي توزيعة Linux:
echo -n 'YWRtaW46UzNjcmV0IQ==' | base64 -d; echoوالمخرج سوف يكون كما يلي:
admin:S3cret!هذا كل شيء، فلم نحتج إلى مفتاح ولا إلى أداة اختراق، وهذا متوقع لأن RFC 7617 الذي يعرف Basic Authentication لا يعتبرها طريقة آمنة للمصادقة إلا إذا استخدمت مع حماية خارجية مثل TLS، لأنها ترسل كلمة المرور كما هي بعد الترميز. والآن نقارن الحالات الثلاث على المدخل نفسه S3cret!:
echo -n 'S3cret!' | base64
echo -n 'S3cret!' | openssl enc -aes-256-cbc -pbkdf2 -salt -pass pass:MyKey -base64
echo -n 'S3cret!' | openssl enc -aes-256-cbc -pbkdf2 -salt -pass pass:MyKey -base64
echo -n 'S3cret!' | sha256sum
والمخرج سوف يكون كما يلي:
UzNjcmV0IQ==
U2FsdGVkX1/ahQLt5eFMwXPpLwlj8QAINpXoyLlHWqc=
U2FsdGVkX19MyGLPo3x+D4keLXZBOwjpFNvV2vhKIrU=
88d3ff09991bae39cb844746c78ab09d4c62050857d336751e37c4b1d84a1d44  -
في المخرج أعلاه لاحظ التالي:
- ناتج Base64 هو نفسه في كل مرة، ويعود إلى الأصل بـ
base64 -dدون أي شيء إضافي. - ناتج AES يختلف في كل تشغيل رغم أن المدخل والمفتاح لم يتغيرا، والسبب أن
opensslيولد قيمة عشوائية Salt جديدة في كل مرة. ولاحظ أن الناتج نفسه مكتوب بـ Base64 لأننا طلبنا ذلك بالخيار-base64، فالتشفير أنتج بايتات ثم رمزناها حتى تطبع على الشاشة، بل إن أول جزء منهU2FsdGVkX1هو مجرد Base64 للكلمةSalted__التي يكتبهاopensslفي بداية كل ملف مشفر. - ناتج SHA-256 طوله 64 حرف Hex دائماً، أي 32 بايت، مهما كان طول المدخل، ولا يوجد أمر يعيده إلى
S3cret!.
وللتأكد من الفرق بين الترميز والتشفير، نحاول فك ناتج AES بالمفتاح الصحيح ثم بمفتاح خاطئ:
echo 'U2FsdGVkX1/ahQLt5eFMwXPpLwlj8QAINpXoyLlHWqc=' | openssl enc -d -aes-256-cbc -pbkdf2 -pass pass:MyKey -base64; echo
echo 'U2FsdGVkX1/ahQLt5eFMwXPpLwlj8QAINpXoyLlHWqc=' | openssl enc -d -aes-256-cbc -pbkdf2 -pass pass:WrongKey -base64
والمخرج سوف يكون كما يلي:
S3cret!
bad decrypt
402707FD147F0000:error:1C800064:Provider routines:ossl_cipher_unpadblock:bad decrypt:../providers/implementations/ciphers/ciphercommon_block.c:107:تذكير سريع: البت والبايت
البت Bit هو أصغر وحدة، وقيمته 0 أو 1، والبايت Byte هو 8 بتات، وبالتالي يحمل 28 أي 256 قيمة مختلفة من 0 إلى 255. وكل ترميز في هذا المقال يقوم على فكرة بسيطة: إذا كانت أبجديته فيها 2n حرفاً فكل حرف منها يحمل n بت، فحرف Hex يحمل 4 بتات لأن 16 = 24، وحرف Base32 يحمل 5 بتات، وحرف Base64 يحمل 6 بتات. والآن نرى كلمة Root كبتات بالأمر xxd:
echo -n 'Root' | xxd -bوالمخرج سوف يكون كما يلي:
00000000: 01010010 01101111 01101111 01110100 Rootولاحظ أن كل حرف إنجليزي هنا بايت واحد، فالحرف R هو 01010010 أي 82 بالعشري و0x52 بالست عشري Hexadecimal. وسوف نستخدم هذه البتات نفسها بعد قليل عندما نرمزها بـ Base64 يدوياً.
مجموعة الحروف والترميز: ASCII وUnicode وUTF-8
كلمة «ترميز» تستخدم في الحقيقة لشيئين مختلفين، وهذا مصدر خلط آخر يجب أن نفصله قبل أن نكمل. الأول هو ترميز الحروف Character Encoding، أي كيف يتحول النص الذي تكتبه إلى بايتات، والثاني هو الترميز من ثنائي إلى نص الذي يدور حوله هذا المقال، أي كيف تتحول البايتات إلى نص. والاثنان يجتمعان دائماً، فعندما تكتب base64 لكلمة عربية فأنت تمر بالأول ثم بالثاني:
- ASCII: جدول قديم من 128 حرفاً فقط، أي 7 بتات، فيه الحروف الإنجليزية والأرقام والرموز وحروف التحكم، ولا يوجد فيه أي حرف عربي.
- Unicode: مجموعة الحروف Character Set التي تعطي كل حرف في لغات العالم رقماً فريداً اسمه Code Point، والحروف العربية الأساسية في الجدول من U+0600 إلى U+06FF، فحرف العين مثلاً هو U+0639. ولاحظ أن Unicode يحدد الرقم فقط ولا يحدد كيف يخزن بالبايتات.
- UTF-8: الطريقة الأكثر انتشاراً لتحويل أرقام Unicode إلى بايتات، وهي معرفة في RFC 3629، وتستخدم من بايت واحد إلى 4 بايتات للحرف، فحروف ASCII تبقى بايتاً واحداً كما هي، والحروف العربية تأخذ بايتين لكل حرف، وأغلب الرموز التعبيرية Emoji تأخذ 4 بايتات.
المثال التالي يبين ذلك على كلمة «عرب»، حيث نطبع البايتات بالأمر xxd ثم بالأمر od، ثم نعد البايتات:
echo -n 'عرب' | xxd
echo -n 'عرب' | od -An -tx1
echo -n 'عرب' | wc -c
echo -n 'Arab' | xxd
والمخرج سوف يكون كما يلي:
00000000: d8b9 d8b1 d8a8                           ......
 d8 b9 d8 b1 d8 a8
6
00000000: 4172 6162                                Arab
في المخرج أعلاه لاحظ التالي:
- كلمة «عرب» ثلاثة حروف ولكنها 6 بايتات، كل حرف منها بايتان: العين
d8 b9والراءd8 b1والباءd8 a8، بينما كلمةArabأربعة حروف وأربعة بايتات فقط. - الحروف تخزن بترتيب كتابتها، فالعين أولاً رغم أنها تظهر على يمين الشاشة، واتجاه العرض من اليمين إلى اليسار شأن الشاشة وليس شأن البايتات.
- العمود الأخير في مخرج
xxdيعرض النقاط......لأنه يطبع البايتات كحروف ASCII فقط، وأي بايت فوق 127 يظهر كنقطة.
len("عرب") يعطي 3 بينما len("عرب".encode("utf-8")) يعطي 6.Hex أو Base16: كل بايت في حرفين
أبسط ترميز على الإطلاق هو الست عشري Hexadecimal أو Hex، واسمه في RFC 4648 هو Base16، وأبجديته 16 حرفاً فقط هي 0-9 وA-F، وكل حرف يحمل 4 بتات، وبالتالي كل بايت يصبح حرفين بالضبط. ومن مزاياه أنه سهل القراءة لأي مطور، فتستطيع أن ترى البايت d8 وتعرف أنه 216 دون أي حساب، وأن طول الناتج ضعف طول المدخل دائماً، ولذلك تراه في كل مكان يحتاج الإنسان فيه أن يقرأ البايتات أو يقارنها:
- ناتج دوال الهاش، مثل ناتج
sha256sumالذي رأيناه في الأعلى. - عناوين الشبكة MAC Address مثل
3c:22:fb:9a:10:4e. - الألوان في CSS مثل
#E95420، أي ثلاثة بايتات للأحمر والأخضر والأزرق. - المعرفات UUID مثل
550e8400-e29b-41d4-a716-446655440000، وقد شرحناها مع بدائلها في مقال المعرفات الفريدة.
echo -n 'عرب' | basenc --base16والمخرج سوف يكون كما يلي:
D8B9D8B1D8A8وعيب Hex الوحيد هو الحجم، فهو يضاعف البيانات، أي زيادة 100%، وهذا لا يهم في هاش من 32 بايت، ولكنه يهم كثيراً في صورة من 2 ميجابايت.
Base64: كيف تصبح كل 3 بايتات 4 حروف؟
وقد يتساءل البعض: إذا كان Hex يضاعف الحجم، فلماذا لا نستخدم أبجدية أكبر حتى يحمل كل حرف بتات أكثر؟ والإجابة على ذلك هي Base64 بالضبط. فالحروف المطبوعة في ASCII حوالي 95 حرفاً، وأكبر قوة للعدد 2 تحتها هي 64، فإذا اخترنا 64 حرفاً آمناً حمل كل حرف 6 بتات بدلاً من 4، وبما أن 3 بايتات هي 24 بت و24 تقبل القسمة على 6، فكل 3 بايتات تصبح 4 حروف بالضبط، والزيادة في الحجم 33% فقط بدلاً من 100%.
والأبجدية القياسية في RFC 4648 القسم 4 هي الحروف الكبيرة A-Z وقيمها من 0 إلى 25، ثم الحروف الصغيرة a-z من 26 إلى 51، ثم الأرقام 0-9 من 52 إلى 61، ثم + للقيمة 62 و/ للقيمة 63، مع الحرف = للحشو Padding. والخطوات كما يلي:
- نحول النص إلى بايتات، فكلمة
Rootهي52 6F 6F 74. - نكتب البايتات كبتات متتالية، 8 بتات لكل بايت.
- نعيد تقسيم البتات نفسها إلى مجموعات من 6 بتات، وإذا بقيت مجموعة ناقصة في النهاية نكملها بأصفار.
- كل مجموعة من 6 بتات رقم من 0 إلى 63، فنأخذ الحرف المقابل له في الأبجدية.
- إذا لم يكن طول المدخل من مضاعفات 3 نضيف
=في النهاية حتى يصبح طول الناتج من مضاعفات 4.
الصورة التالية تبين هذه الخطوات على كلمة Root:
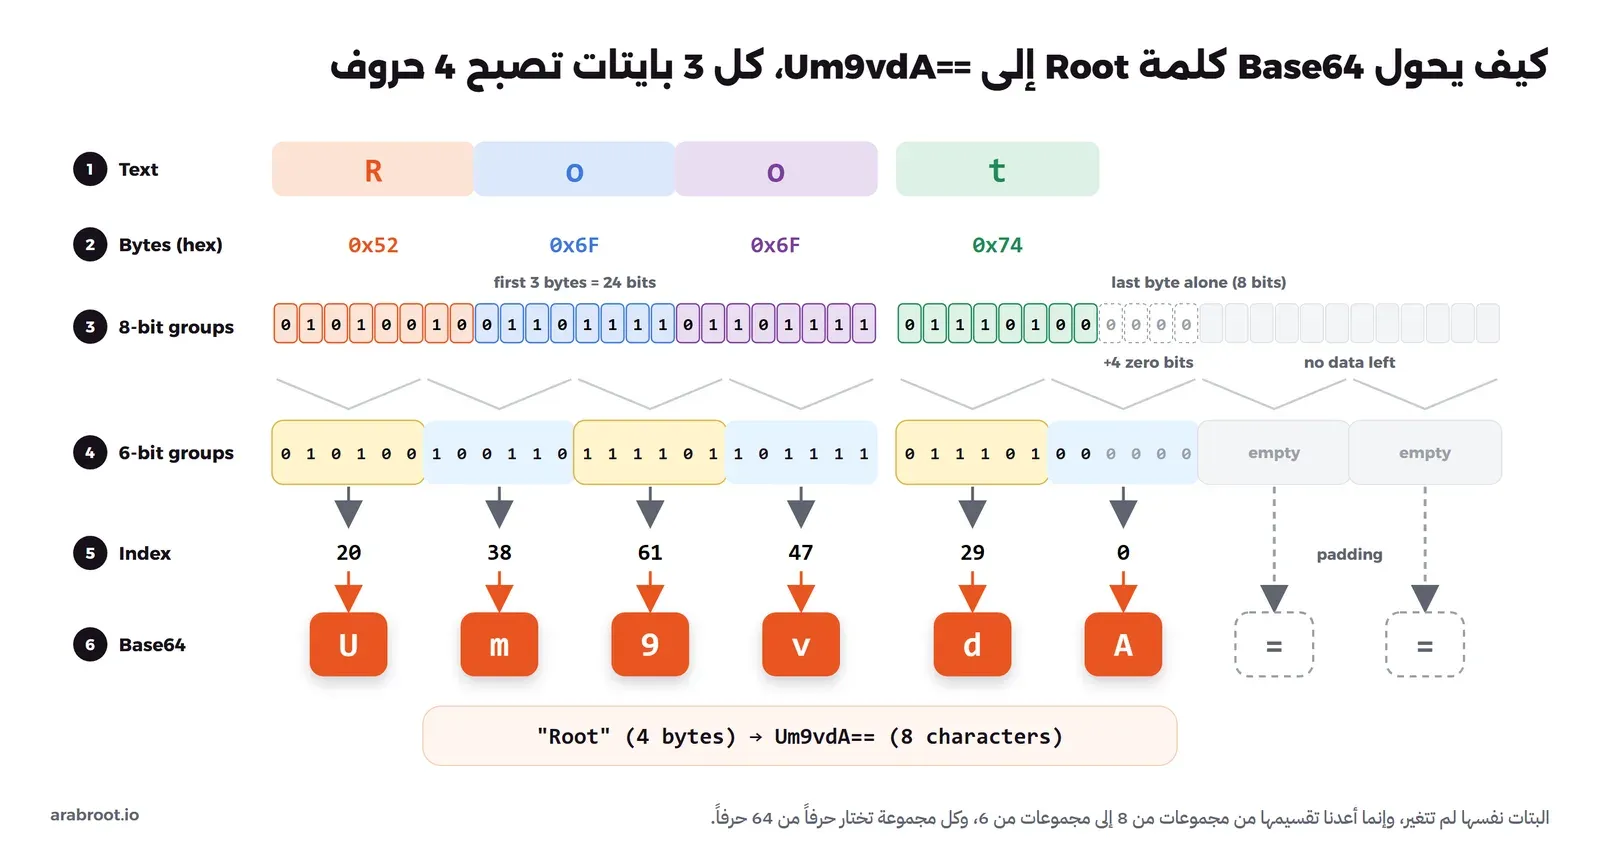
في الصورة أعلاه لاحظ أن أول 3 بايتات Roo أصبحت 4 حروف كاملة Um9v، وأن البايت الأخير t بقي وحده بـ 8 بتات، فأخذنا منه 6 بتات للحرف d، وبقي بتان أكملناهما بأربعة أصفار فأصبحا الحرف A، ثم أضفنا == مكان الحرفين الناقصين. وللتأكد من الحساب نشغل الأمر:
echo -n 'Root' | base64والمخرج سوف يكون كما يلي:
Um9vdA==الحشو Padding وعلامة =
عدد علامات = في النهاية يخبرك بطول المجموعة الأخيرة: إذا كان المدخل من مضاعفات 3 فلا يوجد حشو، وإذا بقي بايتان ففي النهاية = واحدة، وإذا بقي بايت واحد ففي النهاية ==، والمثال التالي يبين الحالات الثلاث:
echo -n 'Hi!' | base64
echo -n 'Hi' | base64
echo -n 'H' | base64
والمخرج سوف يكون كما يلي:
SGkh
SGk=
SA==
وقد يتساءل البعض: إذا كان فك الترميز ممكناً دون الحشو، فلماذا نضيفه؟ والإجابة أن الحشو يجعل طول الناتج دائماً من مضاعفات 4، فإذا جمعت عدة سلاسل Base64 متتالية في ملف أو تيار بيانات Stream عرف من يفكها أين تنتهي كل واحدة. ولذلك ينص RFC 4648 القسم 3.2 على أن الحشو إلزامي إلا إذا نص المعيار الذي يستخدم Base64 صراحة على حذفه، كما يفعل JWT في القسم التالي.
والآن على كلمة عربية
في قسم مجموعة الحروف رأينا أن «عرب» هي 6 بايتات في UTF-8، و6 بايتات تقبل القسمة على 3، وبالتالي سوف تصبح 8 حروف بالضبط دون أي حشو. الصورة التالية تبين الطريق كاملاً من الحروف إلى Unicode ثم إلى بايتات UTF-8 ثم إلى Base64، ومعها البايتات نفسها بـ Hex وبترميز الروابط Percent-encoding الذي سوف نشرحه لاحقاً:
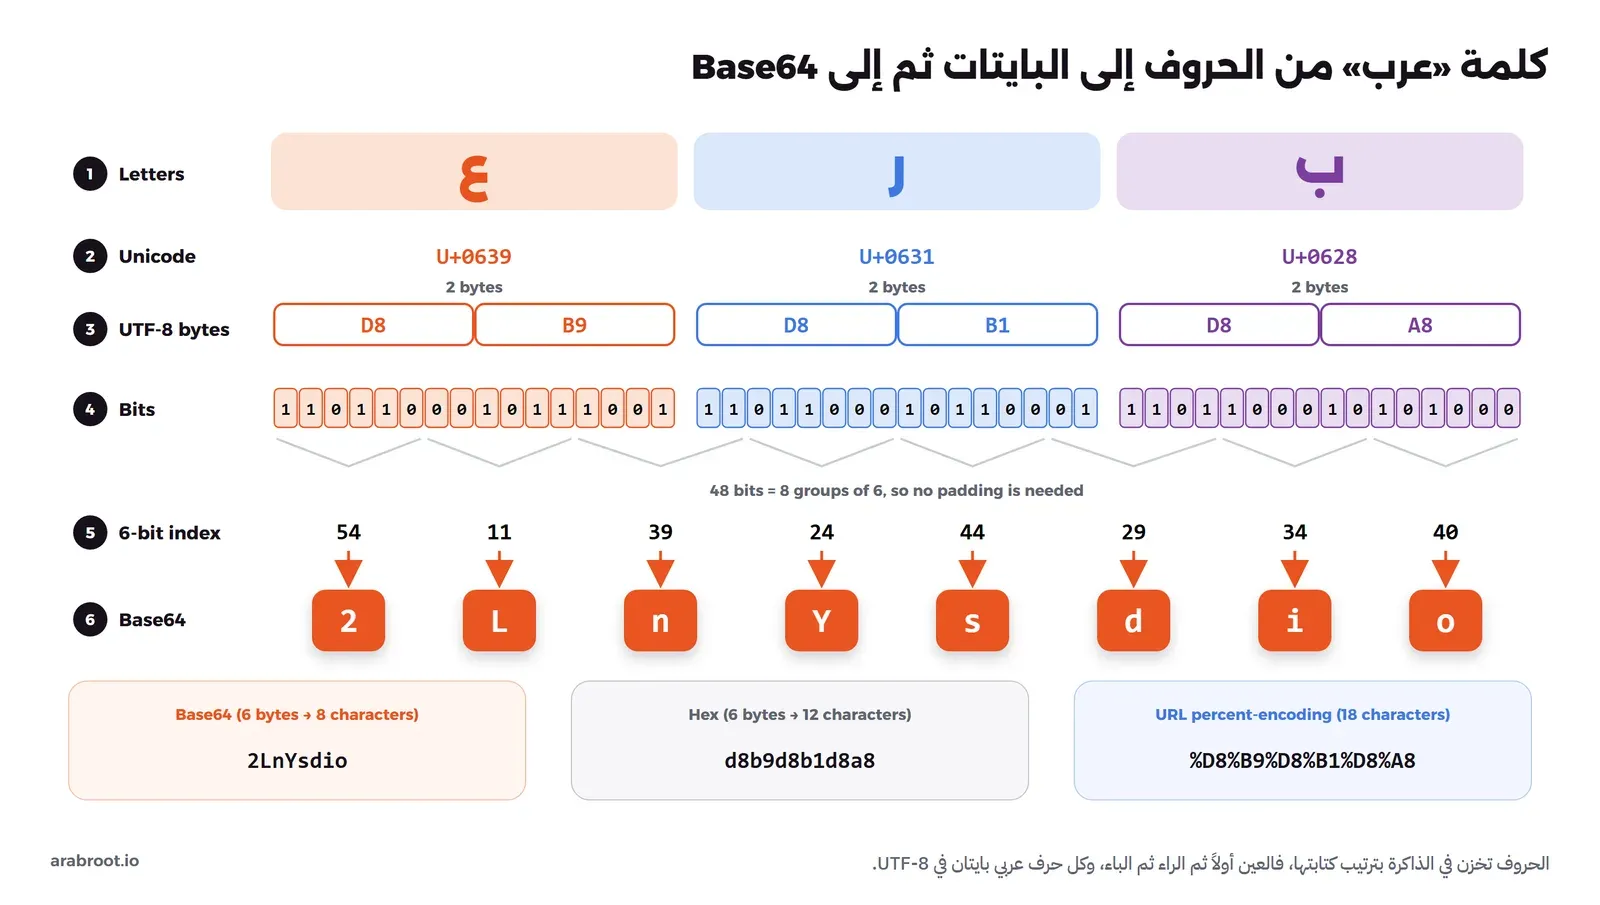
echo -n 'عرب' | base64
echo -n '2LnYsdio' | base64 -d; echo
والمخرج سوف يكون كما يلي:
2LnYsdio
عرب
ولاحظ أن Base64 لا يعرف شيئاً عن اللغة العربية، فهو يرمز البايتات الستة كما هي، والذي جعل الكلمة تعود سليمة هو أن الطرفين اتفقا على أن هذه البايتات UTF-8. فإذا رمزت النص بترميز حروف آخر مثل Windows-1256 فسوف تحصل على بايتات مختلفة وبالتالي Base64 مختلف، وهذا مصدر أغلب مشاكل «الحروف الغريبة» التي سوف نراها في قسم الأخطاء.
Base64url: النسخة الآمنة للروابط وJWT
المشكلة في Base64 القياسي أن حرفين من أبجديته، + و/، لهما معنى في الروابط، فالشرطة المائلة تفصل أجزاء المسار، وعلامة الجمع تفهم في كثير من الأنظمة كمسافة داخل Query String، بالإضافة إلى = التي تفصل الاسم عن القيمة. والحل في RFC 4648 القسم 5 هو أبجدية ثانية اسمها Base64url، وهي الأبجدية نفسها مع استبدال + بـ - واستبدال / بـ _، وغالباً يحذف معها الحشو. والمثال التالي يبين الفرق على ثلاثة بايتات اخترناها بحيث تعطي الحرفين المختلفين:
printf '\xfb\xff\xbf' | base64
printf '\xfb\xff\xbf' | basenc --base64url
والمخرج سوف يكون كما يلي:
+/+/
-_-_
وأشهر مكان ترى فيه Base64url هو JWT، فكل جزء من أجزاء التوكن الثلاثة المفصولة بنقطة هو Base64url دون حشو، وهذا منصوص عليه في تعريف Base64url Encoding في RFC 7515 الذي يعتمد عليه JWT. ولذلك تستطيع أن تقرأ ترويسة أي JWT دون أي مكتبة:
echo -n 'eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9' | basenc --base64url -d; echoوالمخرج سوف يكون كما يلي:
{"alg":"HS256","typ":"JWT"}وهذا يعني أن محتوى JWT مقروء لأي شخص يحمل التوكن، والذي يحميه من التعديل هو التوقيع في الجزء الثالث وليس الترميز، ولذلك لا تضع فيه معلومات سرية. وقد شرحنا أجزاء JWT والتحقق من توقيعه في شرح OAuth وOpenID Connect، ومتى تستخدمه بدلاً من الجلسات في مقال الجلسات وملفات تعريف الارتباط وJWT.
Base64 في البريد الإلكتروني MIME
Base64 الذي نستخدمه اليوم ولد أصلاً لحل مشكلة البريد التي ذكرناها في البداية، فمعيار MIME في RFC 2045 القسم 6.8 عرفه كطريقة لإرسال المرفقات والنصوص غير الإنجليزية عبر SMTP، واشترط أن لا يزيد طول السطر المرمز عن 76 حرفاً. ولذلك ترى في المصدر الخام لأي بريد فيه مرفق كتلة طويلة من Base64 مقسمة إلى أسطر متساوية، وهذا أيضاً سبب أن الأمر base64 في GNU يقسم مخرجه إلى أسطر من 76 حرفاً افتراضياً كما في توثيقه. والمثال التالي ينشئ رسالة بمكتبة البريد في Python وعنوانها ونصها بالعربية:
from email.message import EmailMessage

m = EmailMessage()
m["Subject"] = "عرب"
m["From"] = "[email protected]"
m["To"] = "[email protected]"
m.set_content("مرحبا من عرب رووت", cte="base64")
print(m.as_string())
والمخرج سوف يكون كما يلي:
Subject: =?utf-8?b?2LnYsdio?=
From: [email protected]
To: [email protected]
Content-Type: text/plain; charset="utf-8"
Content-Transfer-Encoding: base64
MIME-Version: 1.0

2YXYsdit2KjYpyDZhdmGINi52LHYqCDYsdmI2YjYqgo=
في المخرج أعلاه لاحظ التالي:
- العنوان «عرب» أصبح
=?utf-8?b?2LnYsdio?=، وهذه صيغة الكلمات المرمزة Encoded Words في RFC 2047: ترميز الحروف ثمbأي Base64 ثم البايتات المرمزة، ولاحظ أنها2LnYsdioنفسها التي حسبناها في الأعلى. - الترويسة
Content-Transfer-Encoding: base64تخبر برنامج البريد أن النص مرمز وأن عليه فكه قبل عرضه.
وهذه التفاصيل لا تحتاجها عادة لأن برنامج البريد ومكتبات الإرسال تقوم بها عنك، ولكنها مفيدة عندما تقرأ المصدر الخام لرسالة لم تصل كما تريد، وقد تحدثنا عن إرسال البريد من التطبيقات في مقال البريد التفاعلي وعن تشغيل البريد كاملاً في دليل استضافة البريد للمؤسسات. ومن الأماكن الأخرى التي ترى فيها Base64 في البريد المفتاح العام في سجل DKIM، فالقيمة بعد p= في السجل هي المفتاح العام مرمزاً بـ Base64 كما في RFC 6376، وقد شرحنا السجل نفسه في شرح SPF وDKIM وDMARC. والأمر نفسه في ملفات المفاتيح والشهادات بصيغة PEM التي تبدأ بـ -----BEGIN CERTIFICATE-----، فما بين السطرين هو Base64 للشهادة بأسطر من 64 حرفاً كما في RFC 7468.
Data URLs: الملف داخل الصفحة نفسها
الاستخدام الثالث الذي تراه كثيراً هو وضع ملف صغير داخل صفحة HTML أو ملف CSS مباشرة بدلاً من طلبه من السيرفر، وذلك عبر Data URL المعرف في RFC 2397 بالصيغة data:[نوع الملف];base64,[البيانات]. والمثال التالي يرمز أيقونة SVG صغيرة:
echo -n '<svg xmlns="http://www.w3.org/2000/svg" width="8" height="8"><circle cx="4" cy="4" r="4" fill="#E95420"/></svg>' | base64 -w 0; echoوالمخرج سوف يكون كما يلي:
PHN2ZyB4bWxucz0iaHR0cDovL3d3dy53My5vcmcvMjAwMC9zdmciIHdpZHRoPSI4IiBoZWlnaHQ9IjgiPjxjaXJjbGUgY3g9IjQiIGN5PSI0IiByPSI0IiBmaWxsPSIjRTk1NDIwIi8+PC9zdmc+ثم تستخدمه في الصفحة هكذا:
<img src="data:image/svg+xml;base64,PHN2ZyB4bWxucz0iaHR0cDovL3d3dy53My5vcmcvMjAwMC9zdmciIHdpZHRoPSI4IiBoZWlnaHQ9IjgiPjxjaXJjbGUgY3g9IjQiIGN5PSI0IiByPSI0IiBmaWxsPSIjRTk1NDIwIi8+PC9zdmc+" alt="">ولاحظ أننا استخدمنا الخيار -w 0 حتى لا يقسم base64 الناتج إلى أسطر، لأن الرابط يجب أن يكون سطراً واحداً. وهذه الطريقة مناسبة للأيقونات الصغيرة فقط، والسبب أن الملف المرمز أكبر بثلث حجمه، ولا يحفظه المتصفح في الذاكرة المؤقتة Cache منفصلاً عن الصفحة، فيعاد تحميله مع كل صفحة تحتويه.
Base32: للإنسان ولرموز TOTP
Base64 ممتاز للآلات، ولكنه سيء جداً عندما يحتاج الإنسان أن يقرأ الرمز أو يكتبه، فهو حساس لحالة الأحرف Case-Sensitive، أي أن a وA قيمتان مختلفتان، وفيه رموز مثل + و/، وحروف متشابهة مثل 0 وO و1 وl وI. ومن هنا جاء Base32 في RFC 4648 القسم 6، وأبجديته الحروف الكبيرة A-Z والأرقام من 2 إلى 7 فقط، أي 32 حرفاً كل واحد منها يحمل 5 بتات، فكل 5 بايتات تصبح 8 حروف، والزيادة في الحجم 60%. ولاحظ أن الأرقام 0 و1 غير موجودة أصلاً حتى لا تختلط بالحرفين O وI، وأن المعيار ينص على أن Base32 صمم للأماكن التي تحتاج ترميزاً لا يتأثر بحالة الأحرف.
echo -n 'عرب' | basenc --base32والمخرج سوف يكون كما يلي:
3C45RMOYVA======وأشهر مكان يستخدم Base32 هو السر المشترك في تطبيقات رموز الدخول المؤقتة TOTP، مثل Google Authenticator وAegis، فالرابط الذي يحمله رمز QR عند تفعيل المصادقة الثنائية يكون بالشكل otpauth://totp/Example:[email protected]?secret=JBSWY3DPEHPK3PXP&issuer=Example، والقيمة بعد secret= هي السر مرمزاً بـ Base32 دون حشو كما في مواصفات Key Uri Format. واختيار Base32 هنا منطقي لأن المستخدم الذي لا يستطيع مسح رمز QR يكتب السر بيده، فلا يهم إن كتبه بحروف صغيرة أو كبيرة، ولا يحتار بين الصفر وحرف O. وقد شرحنا لماذا يسقط TOTP وحده أمام التصيد في مقال Passkeys.
base32 -d في GNU coreutils يرفض 3c45rmoyva====== بالخطأ base32: invalid input، ويقبلها بعد تحويلها إلى حروف كبيرة: tr a-z A-Z | base32 -d. فإذا كان تطبيقك يستقبل سراً بـ Base32 من المستخدم فحوله إلى حروف كبيرة واحذف المسافات قبل فكه.وهناك نوع ثان في المعيار نفسه اسمه Base32hex في القسم 7، وأبجديته 0-9 ثم A-V، وميزته أن ترتيب السلاسل المرمزة أبجدياً يطابق ترتيب البايتات الأصلية، ولذلك يستخدمه DNSSEC في سجلات NSEC3 كما في RFC 5155.
Crockford Base32 وULID
Douglas Crockford اقترح نسخة أخرى من Base32 موجهة أكثر للإنسان: الأبجدية هي 0-9 والحروف الكبيرة دون I وL وO وU، وعند فك الترميز يقبل الحروف الصغيرة، ويقرأ I وL كأنهما الرقم 1 ويقرأ O كأنه الصفر، فإذا أخطأ المستخدم في الكتابة فهم النظام ما يقصده. وحذف الحرف U كان لسبب طريف ذكره صاحب المواصفات، وهو تقليل احتمال أن يكون الناتج كلمة بذيئة بالإنجليزية. وهذه النسخة هي التي يستخدمها ULID لكتابة معرفاته الـ 128 بت في 26 حرفاً، وقد قارنا ULID بـ UUID وSnowflake وNanoID في مقال المعرفات الفريدة.
Base58 وعناوين Bitcoin
Base58 يحل المشكلة نفسها التي حلها Crockford ولكن من الجهة الأخرى: بدلاً من حرف واحد لكل حالة، نأخذ أبجدية Base64 ونحذف منها كل ما قد يسبب مشكلة، فنحذف + و/ حتى يكون الرمز حروفاً وأرقاماً فقط، ونحذف الحروف المتشابهة 0 وO وI وl، فيبقى 58 حرفاً. وهذا الترميز اشتهر مع Bitcoin، والأسباب مكتوبة كتعليق في الكود المصدري لـ Bitcoin Core نفسه: عدم الخلط بين الحروف المتشابهة في بعض الخطوط، وأن النص الذي فيه رموز غير الحروف والأرقام قد لا يقبل كمدخل، وأن برامج البريد لا تقسم السلسلة إلى سطرين إذا لم يكن فيها رموز، وأن النقر المزدوج يحدد السلسلة كاملة ككلمة واحدة. والسبب الأخير تحديداً تشعر به كل يوم عندما تحاول نسخ معرف فيه شرطة - فيتوقف التحديد عندها.
ولكن 58 ليس قوة للعدد 2، وبالتالي لا يمكن تقسيم البتات إلى مجموعات ثابتة كما في Base64، وإنما نعامل البايتات كلها كعدد كبير واحد ونقسمه على 58 مرة بعد مرة. ولذلك فهو أبطأ ومناسب للبيانات الصغيرة فقط مثل العناوين والمعرفات، وهذا ما يذكره أيضاً توثيق basenc.
Base58Check: خطأ في حرف واحد يكتشف قبل الإرسال
عنوان Bitcoin ليس Base58 فقط، وإنما Base58Check، والفكرة أننا قبل الترميز نضيف بايت الإصدار Version Byte في البداية، ثم نحسب SHA-256 مرتين للبيانات ونأخذ أول 4 بايتات منه كمجموع تحقق Checksum ونضيفها في النهاية، كما في الدالة EncodeBase58Check في base58.cpp. فإذا أخطأ المستخدم في نسخ حرف واحد من العنوان فلن يتطابق مجموع التحقق، وترفض المحفظة العنوان قبل أن ترسل المال إلى عنوان غير موجود. والمثال التالي ينفذ Base58 وBase58Check في Python دون أي مكتبة، ثم يبني عنوان أول كتلة في Bitcoin من ال Hash الخاص بمفتاحها العام:
import hashlib

ALPHABET = "123456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnopqrstuvwxyz"

def b58encode(data: bytes) -> str:
    n = int.from_bytes(data, "big")
    out = ""
    while n > 0:
        n, r = divmod(n, 58)
        out = ALPHABET[r] + out
    # every leading zero byte becomes a leading "1"
    zeros = len(data) - len(data.lstrip(b"\x00"))
    return "1" * zeros + out

def b58check(version: bytes, payload: bytes) -> str:
    body = version + payload
    checksum = hashlib.sha256(hashlib.sha256(body).digest()).digest()[:4]
    return b58encode(body + checksum)

h160 = bytes.fromhex("62e907b15cbf27d5425399ebf6f0fb50ebb88f18")
print(len(ALPHABET))
print(b58encode("عرب".encode("utf-8")))
print(b58check(b"\x00", h160))
print(b58check(b"\x00", bytes.fromhex("62e907b15cbf27d5425399ebf6f0fb50ebb88f19")))
والمخرج سوف يكون كما يلي:
58
2rvYeKs2f
1A1zP1eP5QGefi2DMPTfTL5SLmv7DivfNa
1A1zP1eP5QGefi2DMPTfTL5SLmv7KQDgGJ
في المثال أعلاه لاحظ التالي:
- الدالة
b58encodeتقسم العدد الكبير على 58 مرة بعد مرة، وكل باق يختار حرفاً، ولا يوجد فيها أي تقسيم للبتات. - كل بايت صفري في البداية يصبح الحرف
1، والسبب أن الأصفار في بداية العدد تختفي عند تحويله إلى عدد، فنحتفظ بها بهذه الطريقة، ولذلك تبدأ عناوين Bitcoin القديمة كلها بالرقم 1 لأن بايت الإصدار فيها صفر. - العنوان الثالث
1A1zP1eP5QGefi2DMPTfTL5SLmv7DivfNaهو العنوان المعروف لأول كتلة في Bitcoin، أي أن الكود يطابق التطبيق الحقيقي. - في السطر الأخير غيرنا آخر بايت فقط في المدخل، من
18إلى19، فتغيرت آخر 6 حروف في العنوان بسبب مجموع التحقق، والمحفظة التي تستقبل العنوان القديم مع حرف خاطئ سوف تحسب مجموع التحقق وترفضه.
والإصدارات الحديثة من GNU coreutils أضافت Base58 إلى الأمر basenc بداية من الإصدار 9.8 كما في سجل التغييرات، فإذا كان الإصدار عندك 9.8 أو أحدث تستطيع أن تفك العنوان نفسه وترى بايت الإصدار ثم ال Hash ثم مجموع التحقق:
basenc --version | head -1
echo -n '1A1zP1eP5QGefi2DMPTfTL5SLmv7DivfNa' | basenc --base58 -d | basenc --base16
والمخرج سوف يكون كما يلي:
basenc (GNU coreutils) 9.11
0062E907B15CBF27D5425399EBF6F0FB50EBB88F18C29B7D93
ولاحظ أن الناتج يبدأ بـ 00 وهو بايت الإصدار، ثم الـ 20 بايت التي أدخلناها في مثال Python، ثم آخر 4 بايتات C29B7D93 وهي مجموع التحقق. أما Debian 13 مثلاً فيأتي بالإصدار 9.7 الذي لا يعرف الخيار --base58 بعد.
Base62 وBase36 وAscii85
بقيت ثلاثة ترميزات تراها أقل، ولكن من الجيد أن تعرفها عندما تقابلها:
- Base62: الأبجدية هي
0-9وA-Zوa-zفقط، أي Base64 دون+و/، ولا يحذف الحروف المتشابهة. ويستخدم كثيراً في الروابط المختصرة Short Links، لأن الرقم التسلسلي للرابط في قاعدة البيانات يتحول إلى رمز قصير من حروف وأرقام فقط يصلح في أي رابط. - Base36: الأرقام والحروف الصغيرة فقط، أي
0-9وa-z، فلا يتأثر بحالة الأحرف ولكنه أطول قليلاً من Base62. وفي JavaScript تحول أي عدد إليه مباشرة بـ(123456789).toString(36)فيكون الناتج21i3v9. وأداة اختصار الروابط مفتوحة المصدر YOURLS مثال جيد على الاثنين، فإعدادهاYOURLS_URL_CONVERTيقبل 36 لرموز بحروف صغيرة فقط، وهو الافتراضي، أو 62 لرموز تخلط الحروف الصغيرة والكبيرة، كما في ملف الإعداد النموذجي. - Ascii85 وBase85: هنا الاتجاه معاكس، فبدلاً من حذف الحروف نستخدم 85 حرفاً من ASCII المطبوع، والسبب أن 855 أكبر من 232، فكل 4 بايتات تصبح 5 حروف، والزيادة في الحجم 25% فقط. وتراه في ملفات PDF عبر المرشح
ASCII85Decodeفي مواصفات PDF المعيارية ISO 32000، وفي الرقع الثنائية Binary Patches التي ينتجها Git، وكوده موجود في الملف base85.c، وهناك نسخة اسمها Z85 من مشروع ZeroMQ موثقة في مواصفاتها ويدعمهاbasenc --z85. وعيبه أن أبجديته فيها رموز مثل"و<و\، فلا يصلح للروابط ولا لـ JSON دون معالجة إضافية.
الترميز داخل النص: Percent-encoding وHTML Entities وQuoted-printable
كل ما سبق يحول البيانات كاملة إلى أبجدية جديدة، ولكن هناك عائلة قريبة تعمل بطريقة مختلفة، فهي تترك الحروف الآمنة كما هي وتستبدل الحروف التي تسبب مشكلة فقط، ويسمى ذلك أحياناً التهريب Escaping. والنتيجة أن النص يبقى مقروءاً، ولكن الحجم يكبر كثيراً إذا كانت أغلب البيانات غير آمنة، كما هو الحال مع النص العربي:
- Percent-encoding في الروابط: كل بايت غير مسموح به في الرابط يكتب كعلامة
%متبوعة بحرفي Hex، كما في RFC 3986 القسم 2.1. والحروف العربية تحول أولاً إلى بايتات UTF-8 ثم يرمز كل بايت، فكلمة «عرب» تصبح%D8%B9%D8%B1%D8%A8، أي البايتات نفسها التي رأيناها فيxxd. وهذا بالضبط ما يحدث لروابط مقالات هذا الموقع، فعنوان هذه الصفحة الذي تراه بالعربية في المتصفح يرسل إلى السيرفر بهذا الشكل. - HTML Entities: الحرف الذي له معنى في HTML يكتب باسمه أو رقمه، فـ
<تصبح<و&تصبح&، والقائمة الكاملة في مواصفات HTML. وهذا التهريب هو خط الدفاع الأساسي ضد هجمات XSS عندما تعرض نصاً كتبه المستخدم. - Quoted-printable في البريد: البديل الثاني لـ Base64 في MIME، ومعرف في RFC 2045 القسم 6.7، ويكتب كل بايت غير مطبوع كعلامة
=وحرفي Hex، وهو مناسب للنص الإنجليزي الذي فيه حروف خاصة قليلة لأنه يبقى مقروءاً، أما النص العربي فيصبح ثلاثة أضعاف حجمه، ولذلك تفضل برامج البريد Base64 للعربية.
والمثال التالي يبين الثلاثة على الكلمة نفسها ونص فيه رموز، باستخدام Python:
import html, quopri, urllib.parse

print(urllib.parse.quote("عرب"))
print(urllib.parse.quote("a b&c=د"))
print(html.escape('<script>alert("x")</script>'))
print(quopri.encodestring("عرب".encode("utf-8")))
والمخرج سوف يكون كما يلي:
%D8%B9%D8%B1%D8%A8
a%20b%26c%3D%D8%AF
<script>alert("x")</script>
b'=D8=B9=D8=B1=D8=A8'
ولاحظ في السطر الثاني أن الحرفين a وb بقيا كما هما، بينما تحولت المسافة إلى %20 و& إلى %26 و= إلى %3D، وهذا هو الفرق بين التهريب والترميز الكامل.
مقارنة الترميزات
الصورة التالية تبين أبجدية كل ترميز، وأي الحروف التي تسبب المشاكل يبقيها وأيها يحذفها:
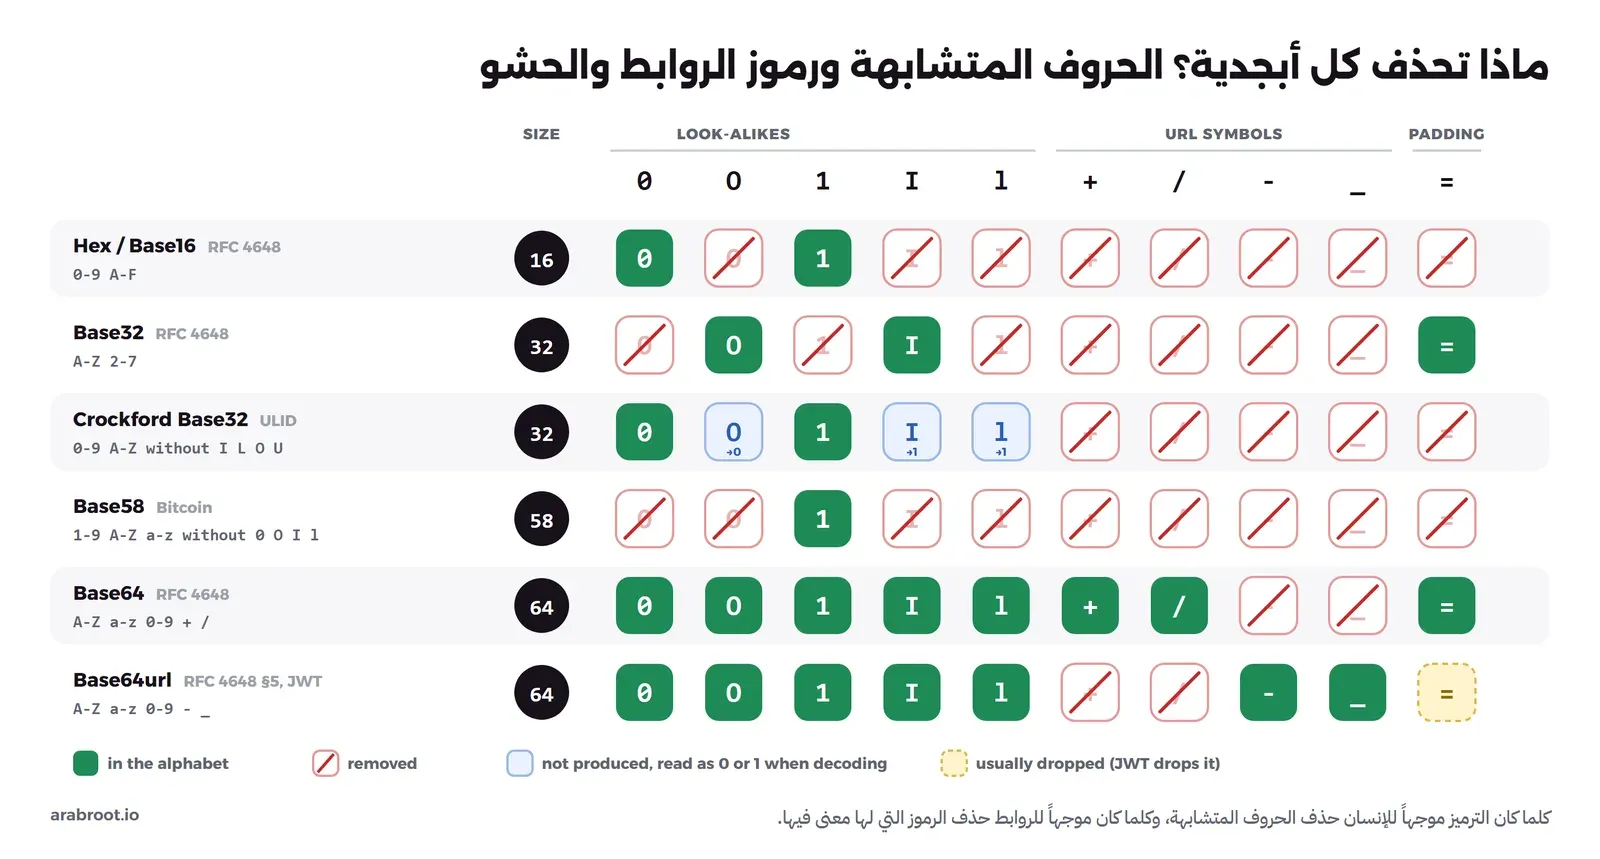
والجدول التالي يجمع كل ما مررنا عليه، ولاحظ أن الزيادة في الحجم لـ Base36 وBase58 وBase62 تقريبية، لأن أبجدياتها ليست قوة للعدد 2 فيختلف طول الناتج قليلاً بحسب البيانات:
| الترميز | حجم الأبجدية | الحجم الناتج والزيادة | حساس لحالة الأحرف | آمن في الروابط | أين تراه |
|---|---|---|---|---|---|
| Hex أو Base16 | 16 | بايت إلى حرفين، 100% | لا | نعم | الهاش، عناوين MAC، الألوان، UUID |
| Base32 | 32 | 5 بايتات إلى 8 حروف، 60% | لا، حالة واحدة | نعم دون الحشو | أسرار TOTP، وBase32hex في DNSSEC |
| Crockford Base32 | 32 | 5 بايتات إلى 8 حروف، 60% | لا | نعم | ULID، رموز يكتبها الإنسان |
| Base36 | 36 | حوالي 55% | لا، حروف صغيرة | نعم | معرفات قصيرة، YOURLS افتراضياً |
| Base58 | 58 | حوالي 37% | نعم | نعم | عناوين Bitcoin، معرفات ينسخها الإنسان |
| Base62 | 62 | حوالي 34% | نعم | نعم | الروابط المختصرة |
| Base64 | 64 | 3 بايتات إلى 4 حروف، 33% | نعم | لا، بسبب + و/ و= | مرفقات البريد، Data URLs، PEM، DKIM، Basic Auth |
| Base64url | 64 | 33%، وأقل قليلاً دون الحشو | نعم | نعم | JWT، التوكنات في الروابط |
| Ascii85 وBase85 | 85 | 4 بايتات إلى 5 حروف، 25% | نعم | لا | PDF، رقع Git الثنائية، Z85 |
الأدوات العملية: سطر الأوامر وNode.js وPython
جمعنا في هذا القسم الأوامر التي سوف تحتاجها في العمل اليومي في مكان واحد، وكل المخرجات فيه حقيقية من تشغيل الأوامر نفسها.
في سطر الأوامر
الأمر base64 موجود في كل توزيعة Linux لأنه جزء من GNU coreutils، والأمر basenc من الحزمة نفسها يجمع كل الترميزات تحت أمر واحد، وهو متوفر بداية من الإصدار 8.31، وتوثيق خياراته كاملة في دليل coreutils. والمثال التالي يرمز الكلمة نفسها بكل الخيارات:
echo -n 'عرب' | basenc --base16
echo -n 'عرب' | basenc --base32
echo -n 'عرب' | basenc --base32hex
echo -n 'عرب' | basenc --base64
echo -n 'عرب' | basenc --base64url
echo -n 'عرب' | basenc --base2msbf
echo -n '1234' | basenc --z85
والمخرج سوف يكون كما يلي:
D8B9D8B1D8A8
3C45RMOYVA======
R2STHCEOL0======
2LnYsdio
2LnYsdio
110110001011100111011000101100011101100010101000
f!$Kw
في المخرج أعلاه لاحظ التالي:
- ناتج
--base64و--base64urlمتطابق هنا لأن البايتات لم تنتج أياً من الحرفين المختلفين، وهذا يحدث كثيراً، وهو سبب أن خطأ اختيار الأبجدية الخاطئة لا يظهر في الاختبار ثم يظهر فجأة مع بيانات أخرى. --base2msbfيطبع البتات نفسها، وهي الـ 48 بت التي رأيتها في صورة كلمة «عرب».--z85يحتاج مدخلاً طوله من مضاعفات 4، ولذلك استخدمنا1234.- لفك أي ترميز أضف الخيار
-d، ولقراءة البايتات بشكل مفصل استخدمxxdأوod -An -tx1كما في قسم مجموعة الحروف.
في Node.js والمتصفح
في Node.js الطريقة الصحيحة هي الكلاس Buffer، فهو يتعامل مع البايتات مباشرة ويدعم base64 وbase64url وhex كما في توثيقه. أما الدالتان btoa وatob الموجودتان في المتصفح وفي Node.js فهما قديمتان وتعملان على «سلسلة ثنائية» كل حرف فيها بايت واحد، وبالتالي لا تقبلان أي حرف خارج النطاق من 0 إلى 255، وهذا ما يشرحه توثيق MDN في قسم Unicode strings، حيث ينصح بتحويل النص إلى بايتات UTF-8 أولاً ثم ترميز البايتات. والمثال التالي يبين الطريقتين:
const word = 'عرب';
console.log(Buffer.from(word, 'utf8'));
console.log(Buffer.from(word).toString('base64'));
console.log(Buffer.from(word).toString('base64url'));
console.log(Buffer.from('2LnYsdio', 'base64').toString('utf8'));
console.log(btoa('Hi'));
try { btoa(word); } catch (e) { console.log(e.name + ': ' + e.message); }
console.log(atob('2LnYsdio'));
const bytes = new TextEncoder().encode(word);
const b64 = btoa(String.fromCharCode(...bytes));
console.log(b64);
const back = Uint8Array.from(atob(b64), c => c.charCodeAt(0));
console.log(new TextDecoder().decode(back));
console.log(encodeURIComponent(word));
console.log(Buffer.from('-_-_', 'base64'));
والمخرج سوف يكون كما يلي:
<Buffer d8 b9 d8 b1 d8 a8>
2LnYsdio
2LnYsdio
عرب
SGk=
InvalidCharacterError: Invalid character
عرب
2LnYsdio
عرب
%D8%B9%D8%B1%D8%A8
<Buffer fb ff bf>
في المثال أعلاه لاحظ التالي:
btoa('عرب')يرمي الخطأInvalidCharacterErrorلأن رقم حرف العين 1593 وهو أكبر من 255.atob('2LnYsdio')لا يرمي خطأ ولكنه يعيدعرب، لأنه أعاد البايتات الستة كحروف منفصلة ولم يفكها كـ UTF-8، وهذا الشكل من الحروف الغريبة علامة مميزة على نص UTF-8 قرئ بترميز خاطئ.- الحل في المتصفح هو
TextEncoderلتحويل النص إلى بايتات UTF-8 قبلbtoa، ثمTextDecoderبعدatob، كما في السطور التي تليها. - السطر الأخير يبين أن
Bufferيقبل حروف Base64url عند فكbase64العادي، وهذا موثق ومريح، ولكن لا تعتمد على أن كل لغة أخرى تفعل الشيء نفسه، كما سوف ترى في Python.
في Python
في Python الوحدة base64 تجمع كل الترميزات، وكل دوالها تأخذ بايتات bytes وترجع بايتات، فإذا كان لديك نص فحوله أولاً بـ .encode("utf-8"):
import base64, binascii

w = "عرب"
b = w.encode("utf-8")
print(b)
print(len(w), len(b))
print(base64.b64encode(b))
print(base64.b64decode("2LnYsdio").decode("utf-8"))
print(base64.urlsafe_b64encode(b"\xfb\xff\xbf"))
print(base64.b32encode(b))
print(base64.b16encode(b))
print(base64.b85encode(b))
print(base64.a85encode(b))
print(b.hex())
try:
    base64.b64decode("SGk")
except binascii.Error as e:
    print("binascii.Error:", e)
print(base64.b64decode("SGk" + "=" * (-len("SGk") % 4)))
print(base64.b64decode("-_-_"))
try:
    print(base64.b64decode("-_-_", validate=True))
except binascii.Error as e:
    print("binascii.Error:", e)
print(base64.urlsafe_b64decode("-_-_"))
والمخرج سوف يكون كما يلي:
b'\xd8\xb9\xd8\xb1\xd8\xa8'
3 6
b'2LnYsdio'
عرب
b'-_-_'
b'3C45RMOYVA======'
b'D8B9D8B1D8A8'
b'*tyuT*r)'
b'fX]Y>fVe'
d8b9d8b1d8a8
binascii.Error: Incorrect padding
b'Hi'
b''
binascii.Error: Only base64 data is allowed
b'\xfb\xff\xbf'
في المثال أعلاه لاحظ التالي:
b64decode("SGk")يرفض السلسلة بسبب الحشو المحذوف، والحل هو إعادة الحشو بالمعادلة"=" * (-len(s) % 4)كما في السطر الذي يليه.b64decode("-_-_")لم يرم أي خطأ وأعادb''، أي بايتات فارغة، والسبب أن الدالة افتراضياً تتجاهل أي حرف خارج أبجدية Base64 القياسية دون أن تخبرك، وهذا أخطر من الخطأ الصريح لأن البيانات تضيع بصمت. استخدمvalidate=Trueحتى ترفض الدالة الحروف الغريبة، أو استخدمurlsafe_b64decodeإذا كانت البيانات Base64url.b85encodeوa85encodeيعطيان ناتجين مختلفين للبايتات نفسها لأن Base85 الذي يستخدمه Git وAscii85 الذي يستخدمه PDF يختلفان في الأبجدية.
أخطاء شائعة
أغلب مشاكل الترميز التي تصلك في تذاكر الدعم تعود إلى واحد من الأخطاء التالية، وكلها رأيناها في الأمثلة أعلاه:
- اعتبار Base64 حماية: كلمات مرور «مشفرة» بـ Base64 في قاعدة البيانات، أو أسرار في ملف إعداد أو في Kubernetes Secret بلا تشفير، وكلها تفك بأمر واحد كما رأينا مع Basic Authentication. والحل الهاش للكلمات والتشفير للأسرار.
- سطر جديد زائد من echo: الأمر
echoدون-nيضيف بايت نهاية السطر0Aقبل الترميز، فتحصل على2LnYsdioCg==بدلاً من2LnYsdio، والحرفانCgفي النهاية هما Base64 لنهاية السطر، وهذا الخطأ الأشهر عندما تولد قيمة لملف.envأو لـ Kubernetes Secret ثم يفشل التطبيق في الدخول بكلمة مرور تبدو صحيحة. استخدمecho -nأوprintf '%s'دائماً. - الترميز مرتين Double Encoding: طبقة ترمز البيانات ثم تمررها لطبقة أخرى ترمزها مرة ثانية، فيصبح
2LnYsdioهوMkxuWXNkaW8K، ويحتاج الطرف الآخرbase64 -d | base64 -dليصل إلى الأصل. وعلامة هذا الخطأ أن فك الترميز ينجح ولكن الناتج سلسلة Base64 أخرى بدلاً من البيانات المتوقعة، ونفس الشيء في الروابط عندما ترى%2520بدلاً من%20. - حذف الحشو أو إضافته في المكان الخطأ: JWT وكثير من الواجهات البرمجية تحذف
=، ومكتبة Python العادية ترفضها دون حشو، بينماbase64 -dفي coreutils وNode.js يقبلانها. فإذا نقلت قيمة من نظام إلى آخر فأعد الحشو قبل الفك، ولا تقارن قيمتين Base64 كنصوص إذا كانت إحداهما بحشو والأخرى دونه. - الأبجدية الخاطئة: فك Base64url بدالة Base64 العادية، فيعطيك
base64 -dالخطأbase64: invalid input، أو تضيع البيانات بصمت في Python كما رأينا. والأسوأ أن الخطأ لا يظهر إلا عندما تنتج البيانات الحرفين-أو_، أي في نسبة من الحالات فقط. - تقسيم الأسطر:
base64في GNU يقسم الناتج كل 76 حرفاً، فإذا وضعته في متغير بيئة أو ترويسة HTTP أو حقل JSON انكسرت القيمة. استخدمbase64 -w 0، أوtr -d '\n'بعده. - نسيان ترميز الحروف:
btoaمع نص عربي، أوatobدونTextDecoder، أو ترميز النص بـ Windows-1256 في طرف وفكه بـ UTF-8 في طرف آخر. القاعدة أن تحدد ترميز الحروف صراحة في الطرفين، ويفضل أن يكون UTF-8 دائماً. - اعتبار Base64 وسيلة لنقل الملفات الكبيرة: الملف بعد Base64 أكبر بالثلث، ويحتاج ذاكرة إضافية للترميز وفكه، فصورة من 9 ميجابايت داخل JSON تصبح 12 ميجابايت، وقد تتجاوز حدود حجم الطلب في السيرفر. للملفات الكبيرة استخدم رفع الملفات العادي Multipart أو رابط تخزين مباشر.
تدريب عملي
- افتح المصدر الخام لرسالة بريد فيها مرفق صغير، وابحث عن
Content-Transfer-Encoding: base64، ثم انسخ كتلة Base64 إلى ملف وفكها بـbase64 -dوتأكد أن الناتج هو الملف نفسه. - خذ أي JWT من بيئة تطوير، وافصله عند النقاط، وفك الجزأين الأولين بـ
basenc --base64url -d. ولاحظ إن احتاج أحدهما إلى إعادة الحشو.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الترميز Encoding يحول البايتات إلى حروف من أبجدية صغيرة حتى تمر في قنوات صممت للنص، مثل البريد والروابط وJSON وHTML والإنسان، ثم يعيدها كما هي بالضبط.
- الترميز ليس تشفيراً ولا هاش، فلا يوجد فيه مفتاح ويفكه أي شخص بأمر واحد، ولذلك لا يصلح لحماية كلمات المرور ولا الأسرار.
- ترميز الحروف مثل UTF-8 يحول النص إلى بايتات، والحرف العربي بايتان فيه، ثم يأتي Base64 أو غيره فيرمز هذه البايتات.
- Hex يضاعف الحجم ولكنه الأسهل قراءة، وBase64 يزيد الحجم بالثلث فقط وهو الأنسب للآلات، وBase64url هو نفسه للروابط وJWT.
- Base32 وCrockford Base32 وBase58 صممت للإنسان، فتحذف الحروف المتشابهة والرموز، وتراها في أسرار TOTP وفي ULID وفي عناوين Bitcoin مع مجموع تحقق يكتشف الخطأ.
- أغلب الأخطاء العملية تأتي من سطر جديد زائد، أو ترميز مرتين، أو حشو محذوف، أو أبجدية خاطئة، أو نسيان UTF-8، فحدد كل ذلك صراحة في الطرفين.
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلكيف يتذكرك الموقع بعد تسجيل الدخول؟ الجلسات وJWTبروتوكول HTTP لا يتذكر أحداً، فكيف يبقى المستخدم مسجلاً بين الصفحات، ومتى تختار الجلسة على السيرفر ومتى تختار JWT.
 دليلشرح OAuth وOpenID Connect للمبتدئينلماذا لا يجب أن يعرف أي تطبيق كلمة مرورك، وكيف يحل OAuth ذلك بتوكنات محدودة، وكيف يضيف OpenID Connect الدخول الموحد.
 دليلالدخول دون كلمة مرور: شرح Passkeys وWebAuthnلماذا لا تحميك رموز SMS وTOTP من التصيد الحديث، وكيف تحل Passkeys المشكلة بمفتاح خاص لا يغادر جهازك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ الأمثلة على Debian 13 مع GNU coreutils 9.7 وPython 3.13 وNode.js 22، ومثال
basenc --base58على Alpine 3.24 مع coreutils 9.11.


