

تسأل مساعد البرمجة عن مكتبة تتحقق من رقم الهوية الوطنية، فيعطيك اسم الحزمة وأمر التثبيت في سطر واحد، بلا تردد ولا «ربما»، وتنسخ الأمر وتشغله. والمشكلة أن هذه الحزمة غير موجودة، وأن المساعد كتبها بالنبرة نفسها التي كتب بها قبل دقيقة إجابة صحيحة تماماً، فلا يوجد في النص ما يفرق بين الحالتين. وهذا ما نقصده في هذا المقال بالخطأ الواثق: إجابة خاطئة أو قديمة، مكتوبة بثقة كاملة، وتبدو معقولة لدرجة أنك لا تفكر في فحصها.
وقد رأينا مثالاً من هذا النوع في مقال الترميز الطبي بالذكاء الاصطناعي، حيث يخترع النموذج رموزاً طبية غير موجودة إذا طلبت منه الرموز مباشرة، ورأينا في مقال الاختبارات التي يكتبها الذكاء الاصطناعي كيف يحرس الاختبار المولد الخطأ بدل أن يكشفه. وهذا المقال يجمع الصورة كاملة لمساعدات البرمجة: ما هي الأنماط التي تتكرر، ولماذا تحدث، وكيف تكشف كل نمط منها، مع تجربة على 13 مهمة حقيقية لنموذج محلي شغلنا كل مخرجاتها.
وسوف نناقش في هذا المقال ما يلي:
- أنماط الخطأ الواثق: الحزم والواجهات المخترعة ومنها هجوم Slopsquatting، والواجهات القديمة، والاختبارات التي تتحقق من الشيء الخطأ، والإصلاحات الأمنية الشكلية، واستعلامات SQL التي تخطئ عند الحالات الحدية، والادعاءات الخاطئة عن سلوك المكتبات، والتفسير الواثق للسجلات Logs.
- لماذا يحدث ذلك: تاريخ توقف بيانات التدريب، وغياب التشغيل، وتدريب يكافئ التخمين والموافقة.
- تجربة عملية: نموذج محلي عبر Ollama على 13 مهمة، وكيف عرفنا الخطأ في كل واحدة.
- خمس طرق للكشف: التشغيل، والتوثيق، وطلب المصدر، واختبارات الخصائص Property Tests، واختبار الكناري Canary Test.
أنماط الخطأ الواثق
الأخطاء التالية ليست نادرة ولا عشوائية، فكل نمط منها موثق في أبحاث منشورة، وأغلبها ظهر في تجربتنا أيضاً كما سيأتي. والفكرة من معرفتها أنك عندما تعرف أين يخطئ النموذج عادة، تعرف أين تضع الفحص.
الحزم والواجهات المخترعة Hallucinated Packages and APIs
النموذج يقترح اسم حزمة أو دالة يبدو منطقياً من حيث التسمية، ولكنه غير موجود. وأوسع دراسة لهذا النمط هي ورقة We Have a Package for You! التي كتبها Spracklen وزملاؤه، ونشرت في مؤتمر USENIX Security سنة 2025، وقد حللوا فيها 576,000 عينة كود من 16 نموذجاً بلغتي Python وJavaScript، فوجدوا أن نسبة الحزم المخترعة لا تقل في المتوسط عن 5.2% في النماذج التجارية، وتصل إلى 21.7% في النماذج مفتوحة المصدر، بمجموع 205,474 اسماً فريداً لحزم غير موجودة، وقارنوا الأسماء بقوائم PyPI وnpm كما كانت في 10 يناير 2024. وقد ذكرنا هذه الأرقام باختصار في مقال OWASP Top 10 لتطبيقات نماذج اللغة، والذي يهمنا هنا من الورقة نفسها ثلاث نتائج عملية:
- الاسم المخترع يتكرر: عند تكرار السؤال نفسه عشر مرات تكررت 43% من الحزم المخترعة في المرات العشر كلها، وتكرر الاسم المخترع أكثر من مرة في 58% من الحالات، وهذا يعني أن المهاجم يستطيع أن يتوقع الأسماء التي سوف يخترعها النموذج.
- الحرارة تزيد المشكلة: كل النماذج زادت فيها نسبة الاختراع مع رفع درجة الحرارة Temperature.
- النموذج يستطيع أحياناً أن يكتشف نفسه: ثلاثة من أربعة نماذج اختبروها عرفت حزمها المخترعة بدقة أكثر من 75% عندما سئلت عنها بعد ذلك، وهذا أساس طرق التخفيف التي اقترحتها الورقة.
وتكرار الاسم هو ما يجعل الخطأ هجوماً، فإذا كان النموذج يقترح الاسم نفسه لآلاف المطورين، فالمهاجم يسجل هذا الاسم في PyPI أو npm ويضع فيه كوداً خبيثاً، ثم ينتظر. وهذا الهجوم صار اسمه Slopsquatting، وهو دمج لكلمة Slop التي تطلق على المحتوى الرديء المولد، وTyposquatting وهو تسجيل أسماء قريبة من أسماء معروفة بخطأ إملائي. والصورة التالية تبين خطواته:
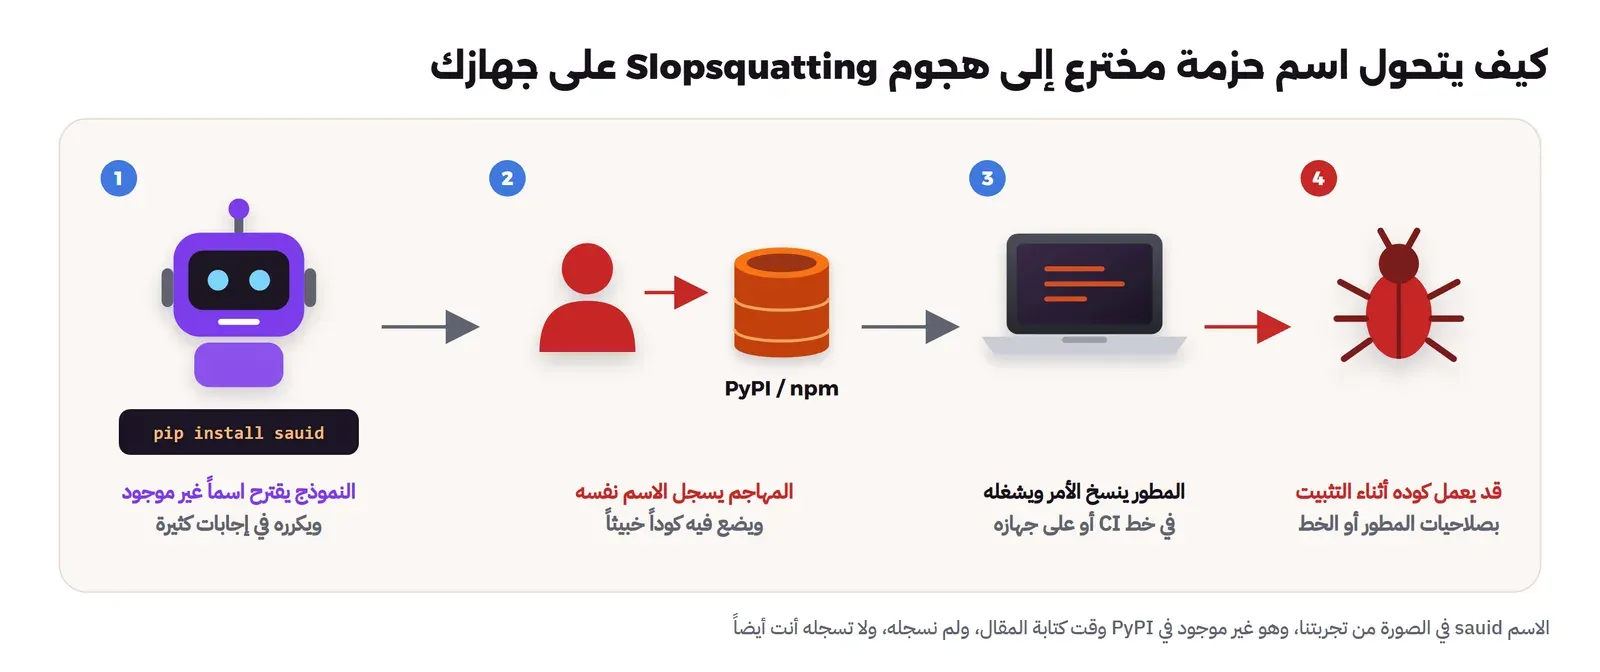
huggingface-cli، وهو اسم أمر سطر الأوامر في Hugging Face وليس اسم الحزمة، فالأمر الصحيح هو pip install -U "huggingface_hub[cli]". فسجل الاسم في PyPI بحزمة فارغة غير ضارة ليختبر الفكرة، فحصلت بحسب تقرير The Register على أكثر من 15,000 تنزيل حقيقي في ثلاثة أشهر، ووجد أن ملف README في مستودع GraphTranslator من Alibaba صار يطلب من المستخدمين تثبيتها. ولو كانت الحزمة خبيثة لعمل كودها على كل جهاز اتبع التعليمات.والدوال المخترعة داخل مكتبة حقيقية أقل خطراً من الحزم، لأنها تفشل عند أول تشغيل بخطأ مثل AttributeError، ولكنها تستهلك وقتك إذا لم تشغل الكود قبل أن تبني عليه.
الواجهات القديمة Deprecated APIs
هذا النمط أخطر من الاختراع في جانب واحد: الدالة كانت موجودة فعلاً، والنموذج رآها في آلاف الأمثلة، لذلك يكتبها بثقة أكبر. وقد درست ورقة LLMs Meet Library Evolution المقبولة في مؤتمر ICSE 2025 هذه المشكلة على سبعة نماذج و145 ربطاً بين واجهة قديمة وبديلتها في ثماني مكتبات Python، عبر 28,125 طلب إكمال، ووجدت أن النماذج تستخدم الواجهات القديمة بوضوح، واقترحت طريقتين للتخفيف. وفي تجربتنا كتب النموذج df.append() التي حذفتها pandas في الإصدار 2.0، وdatetime.utcnow() التي أصبحت مهملة Deprecated منذ Python 3.12.
اختبارات تمر أو تفشل وهي تتحقق من الشيء الخطأ
عندما تطلب من النموذج اختبارات لدالة، فهو يحتاج أن يعرف الجواب الصحيح لكل حالة، وهذا ما يسمى مشكلة المرجع Test Oracle التي شرحناها في مقال الاختبارات التي يكتبها الذكاء الاصطناعي. والنموذج إما أن ينسخ سلوك الكود الحالي، فيحرس الخطأ ويمر، وإما أن يحسب القيم المتوقعة في رأسه، فيخطئ في الحساب. والنتيجة في الحالتين اختبارات كثيرة تبدو جادة، ولا يوجد فيها ما يقارن الكود بالمتطلب. وفي تجربتنا كتب النموذج 25 Assertion لدالة أيام العمل، صح منها اثنان على الكود وواحد على المتطلب.
الإصلاحات الأمنية الشكلية
تطلب من النموذج أن يصلح ثغرة، فيضيف سطراً يبدو كأنه يحمي، مثل حذف ../ من النص، أو هروب بعض الرموز يدوياً، بينما الثغرة تبقى بمدخل آخر. والأخطر من الكود نفسه هو أثره على ثقة المطور، ففي دراسة Perry وزملائه من Stanford المنشورة في مؤتمر CCS سنة 2023 على 47 مشاركاً، كتب المشاركون الذين استخدموا مساعداً مبنياً على codex-davinci-002 كوداً أقل أماناً بشكل واضح من الذين لم يستخدموه، وكانوا في الوقت نفسه أكثر اعتقاداً أن كودهم آمن، ففي مهمة SQL Injection مثلاً كانت الحلول الآمنة 36% عند مستخدمي المساعد مقابل 50% عند المجموعة الأخرى. ووجدت الدراسة أيضاً أن المشاركين الذين وثقوا بالمساعد أقل، وعدلوا طلباتهم أكثر، كتبوا ثغرات أقل. وقبلها وجدت دراسة Asleep at the Keyboard في مؤتمر IEEE S&P 2022 أن قرابة 40% من 1,689 برنامجاً أكملها GitHub Copilot في 89 سيناريو كانت فيها ثغرات.
والإنصاف يقتضي أن نذكر أن النموذج في تجربتنا أصلح ثغرة تجاوز المسار Path Traversal إصلاحاً صمد أمام سبعة مدخلات هجومية، لذلك لا تفترض أن كل إصلاح شكلي، وإنما اختبر كل إصلاح أمني بالمدخلات الهجومية نفسها، ولا تكتف بقراءته.
استعلامات SQL المعقولة التي تخطئ عند الحدود
SQL لغة تعطيك نتيجة في كل الأحوال تقريباً، فالاستعلام الخاطئ لا يرمي خطأ، وإنما يرجع أرقاماً تبدو صحيحة. وأشهر حدين يخطئ عندهما الكود المولد هما القيمة الفارغة NULL والمنطقة الزمنية Time Zone: الأول لأن NOT IN مع قائمة فيها NULL يرجع صفر صفوف دون أي تحذير، والثاني لأن timestamptz في PostgreSQL يقسم إلى أيام بحسب المنطقة الزمنية للجلسة، وهي غالباً UTC على السيرفر، وليس بحسب توقيت عملك. وإذا لم تكن مرتاحاً لفكرة اللحظة والتوقيت المحلي فقد شرحناها في مقال التاريخ والوقت.
ادعاءات خاطئة عن سلوك المكتبات
تسأل «ماذا ترجع هذه الدالة؟» أو «ما القيمة الافتراضية لهذا الخيار؟»، فيأتيك جواب قصير ودقيق الشكل. وهذه أسئلة يبدو جوابها كأنه معلومة محفوظة، ولكن النموذج لا يسترجع التوثيق، وإنما يولد نصاً محتملاً، فإذا كان السلوك الحقيقي غير متوقع، مثل تقريب نصف الرقم إلى الزوجي في Python، فالنص المحتمل هو الجواب الخاطئ. وفي تجربتنا قال النموذج إن round(0.125, 2) تعطي 0.13، والحقيقة 0.12.
التفسير الواثق للسجلات
تعطي النموذج سجلاً Log فيه خطأ، فيشرح السبب بثقة ويعطيك خمس خطوات لإصلاحه. والمشكلة أن السبب الحقيقي يكون غالباً في سطر قبل الخطأ، مثل تحذير WARNING صغير، بينما النموذج يتجه إلى الرسالة الأوضح، وهي آخر خطأ. وفي تجربتنا كان السبب متغير بيئة ناقصاً جعل الخدمة تتصل بنفسها، وكان الجواب «تأكد أن قاعدة البيانات تعمل». وهذه الإجابة ليست خاطئة تماماً، ولكنها ترسل المهندس المناوب للبحث في المكان الخطأ، وقد شرحنا طريقة قراءة السجل من أول خطأ في مقال التعامل مع الأخطاء.
لماذا يخطئ النموذج وهو واثق؟
قد يتساءل البعض: إذا كان النموذج يعرف أحياناً أن الحزمة مخترعة عندما تسأله، فلماذا يكتبها أصلاً؟ والإجابة في ثلاثة أسباب، تبينها الصورة التالية:
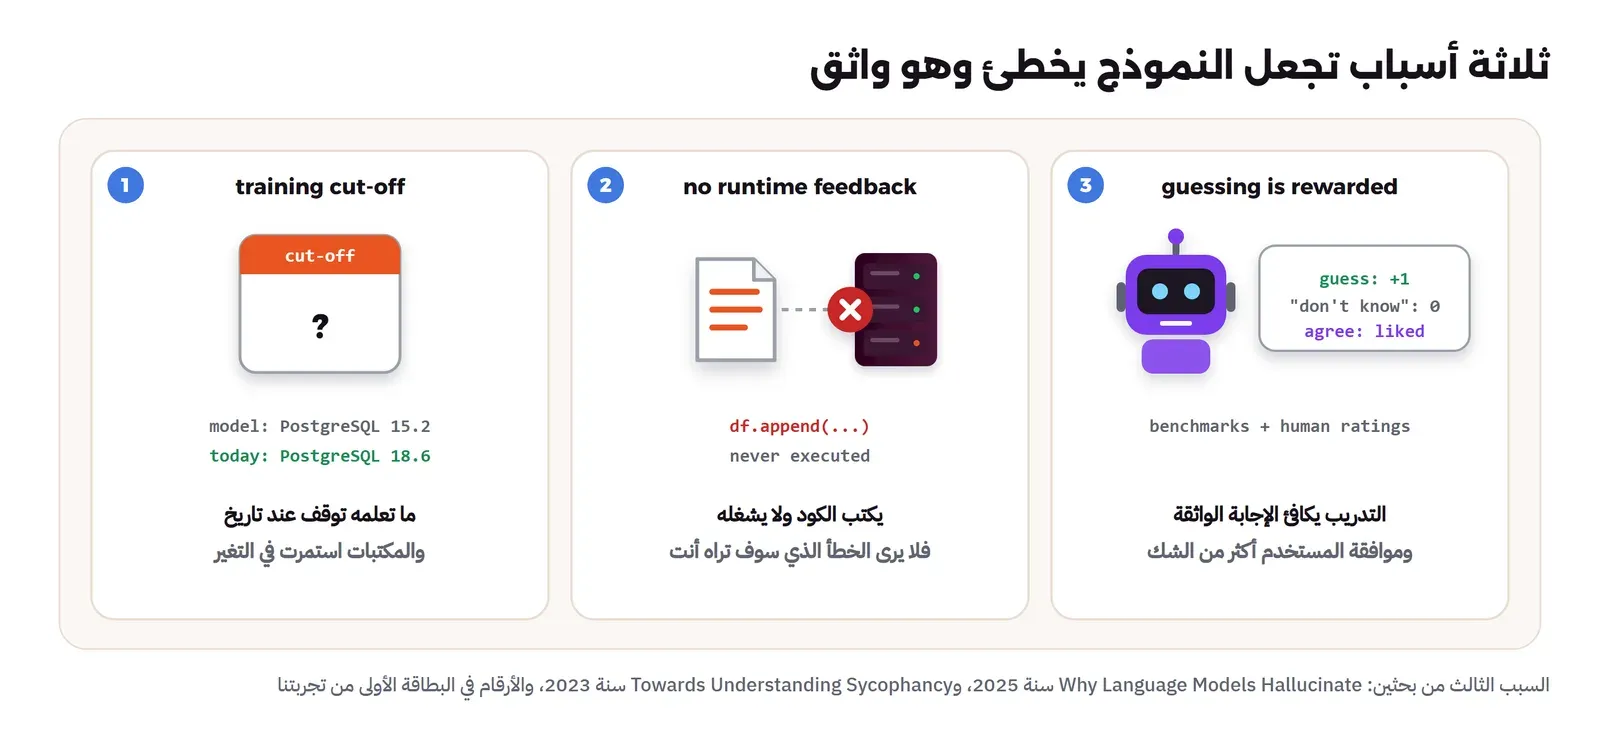
- تاريخ توقف بيانات التدريب Training Cut-off: النموذج تعلم من نصوص جمعت حتى تاريخ معين، والمكتبات استمرت بعده، فالواجهة التي حذفت بعد ذلك التاريخ ما زالت في ذاكرته هي الطريقة الصحيحة، وآخر إصدار يعرفه هو آخر إصدار في نظره. وفي تجربتنا قال النموذج إن آخر إصدار من PostgreSQL هو 15.2، وهو إصدار صدر في فبراير 2023، بينما الإصدار الحالي عند كتابة المقال هو 18.6 بحسب صفحة الإصدارات.
- غياب التشغيل No Runtime Feedback: المساعد في المحادثة يكتب الكود ولا ينفذه، فلا يرى
AttributeErrorولا التحذير ولا النتيجة الخاطئة، وكل ما يملكه هو احتمال أن هذا النص يشبه كوداً صحيحاً. والوكلاء Agents الذين يشغلون الاختبارات يقللون هذا السبب، ولكنهم يرون فقط ما تقيسه الاختبارات، كما رأيت في نمط الاختبارات الخاطئة. - تدريب يكافئ التخمين والموافقة: في ورقة Why Language Models Hallucinate التي نشرها Kalai وزملاؤه في سبتمبر 2025 يشرح الباحثون أن الخطأ ينشأ من ضغط إحصائي طبيعي عندما لا يمكن تمييز الخطأ من الحقيقة في بيانات التدريب، وأن طرق التقييم الشائعة تكافئ التخمين، لأن الجواب الواثق قد يكسب نقطة بينما «لا أعرف» يكسب صفراً، فالنموذج يتعلم أن يكون طالباً جيداً في الامتحانات. ويضاف إلى ذلك التملق Sycophancy، ففي ورقة Towards Understanding Sycophancy in Language Models من Anthropic سنة 2023 وجد الباحثون أن خمسة مساعدات حديثة تميل إلى موافقة رأي المستخدم، وأن المقيمين من البشر ونماذج التفضيل يفضلون أحياناً الإجابة المقنعة الموافقة على الإجابة الصحيحة، والسبب أن هذه التفضيلات نفسها تستخدم في تدريب المساعد.
والنتيجة العملية من الأسباب الثلاثة أن نبرة الإجابة لا تحمل أي معلومة عن صحتها، فلا تستخدم ثقة النموذج دليلاً، واستخدم بدلاً منها فحصاً خارجياً، وهو موضوع بقية المقال.
تجربة عملية: 13 مهمة لنموذج محلي
في هذه التجربة نعطي نموذج برمجة يعمل محلياً عبر Ollama ثلاث عشرة مهمة من العمل اليومي، ونحفظ إجاباته كما هي، ثم نشغل كل إجابة أو نتحقق منها من مصدر رسمي، ونسجل هل كانت صحيحة، وكيف عرفنا إذا لم تكن. والنموذج هو Qwen2.5-Coder 7B Instruct برخصة Apache-2.0، بالوسم qwen2.5-coder:7b في Ollama والبصمة dae161e27b0e وحجمه 4.7 GB بتكميم Q4_K_M، ولا نستخدم أي مفتاح API ولا خدمة مدفوعة. ولاحظ أن نموذجاً بسبعة مليارات معامل أضعف من النماذج التجارية الكبيرة، فلا تقرأ النسب هنا على أنها نسب كل النماذج، وإنما على أنها أمثلة حقيقية للأنماط، وكل نمط منها موثق في الأبحاث التي ذكرناها مع نماذج أكبر.
تجهيز بيئة التجربة
نحتاج ثلاثة Containers في شبكة Docker خاصة: Ollama مع النموذج، وPython مع الأدوات التي نشغل بها المخرجات، وPostgreSQL لمهمتي SQL:
cd lab
docker network create lab-aiq-net

# Ollama with the model, no published port
docker volume create lab-aiq-ollama
docker run -d --name lab-aiq-ollama --network lab-aiq-net -v lab-aiq-ollama:/root/.ollama ollama/ollama:0.40.3
docker exec lab-aiq-ollama ollama pull qwen2.5-coder:7b

# Python to send the prompts and run the answers
docker run -d --name lab-aiq-py --network lab-aiq-net -v "$PWD":/lab -w /lab python:3.13.16-slim sleep infinity
docker exec lab-aiq-py pip install -q --root-user-action=ignore pandas requests pytest hypothesis "psycopg[binary]"

# PostgreSQL for the SQL tasks
docker run -d --name lab-aiq-pg --network lab-aiq-net -e POSTGRES_PASSWORD=lab postgres:17-alpine
ثم السكربت ask.py الذي يرسل كل ملف في مجلد prompts إلى النموذج ويحفظ الجواب كما هو في مجلد out:
"""Send every prompt in prompts/ to the local Ollama model and save the raw answers in out/.

Usage (inside the lab-aiq-py container):  python ask.py [prompt-name-filter]
Each prompts/NN-name.txt is one task. A line "@file inputs/x" inside a prompt is replaced by that file's text.
"""
import json
import pathlib
import sys
import urllib.request

MODEL = "qwen2.5-coder:7b"
URL = "http://lab-aiq-ollama:11434/api/generate"
HERE = pathlib.Path(__file__).parent


def expand(text):
    lines = []
    for line in text.splitlines():
        if line.startswith("@file "):
            lines.append((HERE / line[6:].strip()).read_text(encoding="utf-8"))
        else:
            lines.append(line)
    return "\n".join(lines)


def ask(prompt):
    body = json.dumps({
        "model": MODEL,
        "prompt": prompt,
        "stream": False,
        "options": {"temperature": 0, "seed": 42, "num_predict": 900},
    }).encode()
    req = urllib.request.Request(URL, data=body, headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1800) as r:
        return json.load(r)


only = sys.argv[1] if len(sys.argv) > 1 else ""
for p in sorted((HERE / "prompts").glob("*.txt")):
    if only not in p.name:
        continue
    res = ask(expand(p.read_text(encoding="utf-8")))
    out = HERE / "out" / (p.stem + ".md")
    out.write_text(res["response"], encoding="utf-8", newline="\n")
    secs = res["total_duration"] / 1e9
    print(f"{p.stem}: {res['eval_count']} tokens in {secs:.0f}s")
docker exec lab-aiq-py python ask.pyفي الإعداد أعلاه لاحظ التالي:
- درجة الحرارة صفر مع
seedثابت حتى تكون الإجابة أقرب ما يمكن إلى الثبات إذا أعدت التجربة، وتذكر من ورقة Spracklen أن رفع الحرارة يزيد الاختراع، فنحن هنا في أفضل حالات النموذج. num_predictيوقف النموذج بعد 900 توكن، وقد وصلت مهمة واحدة إلى هذا الحد كما سيأتي.- الطلبات مكتوبة كما يكتبها مطور مستعجل، بلا تعليمات خاصة مثل «تحقق من وجود الحزمة»، والسبب أننا نريد السلوك الافتراضي.
- Ollama لا ينشر أي منفذ على الجهاز، والوصول إليه من داخل الشبكة
lab-aiq-netفقط، والسبب أن واجهة Ollama لا تطلب مصادقة.
وكان التشغيل على المعالج فقط دون GPU، بسرعة تقارب توكنين في الثانية لأن سيرفر التجربة كان يشغل مختبرات أخرى في الوقت نفسه، فأخذت أطول مهمة 541 ثانية.
المهمة 1: خمس حزم، أربع منها غير موجودة
طلبنا من النموذج أفضل حزمة pip لخمس حاجات في مشروع سعودي: تحويل التاريخ الهجري، والتحقق من رقم الهوية والإقامة، وقراءة رمز QR في الفاتورة الإلكترونية من هيئة الزكاة والضريبة والجمارك ZATCA، والإجازات الرسمية، وتنسيق الريال بالأرقام العربية الهندية. وهذا جزء من جوابه كما هو:
2. Validate Saudi national ID and Iqama numbers.
   - Package: `sauid`
   - Command: `pip install sauid`

3. Decode the QR code of a ZATCA e-invoice (the TLV base64 payload) into seller name, VAT number, timestamp, total and VAT.
   - Package: `zatca`
   - Command: `pip install zatca`
ثم سألنا واجهة PyPI عن كل اسم بالسكربت run/t01_pypi.py، والمخرج سوف يكون كما يلي:
hijri-converter      exists   2.3.2.post1  [DEPRECATED] Use 'hijridate' package instead
sauid                HTTP 404 (no such project)
zatca                HTTP 404 (no such project)
sa-holidays          HTTP 404 (no such project)
arabic-indic-digits  HTTP 404 (no such project)
أربعة أسماء غير موجودة، والخامس موجود ولكنه مهمل ويطلب منك استخدام hijridate. ولاحظ أن أي شخص يستطيع اليوم أن يسجل sauid أو zatca، وأن هذه الأسماء بالضبط هي ما سوف يقترحه النموذج نفسه لمطور آخر يسأل السؤال نفسه. وللإنصاف فالحاجة الرابعة لها حزمة حقيقية هي holidays، وفيها السعودية برمز SA، وقد ثبتناها وتأكدنا أنها ترجع إجازات 2026، ولكن النموذج لم يذكرها.
المهمتان 2 و3: واجهات قديمة
في المهمة الثانية طلبنا دالة تبني DataFrame بإضافة الطلبات واحداً واحداً، فكتب النموذج:
    for order in order_dicts:
        df = df.append(order, ignore_index=True)
وعند تشغيل الدالة كما هي على pandas 3.0.6 كان المخرج:
pandas 3.0.6
Traceback (most recent call last):
  File "/lab/run/t02_pandas.py", line 15, in <module>
    print(build_dataframe([{"id": 1, "total": 115.0}]))
          ~~~~~~~~~~~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
  File "/lab/run/t02_pandas.py", line 10, in build_dataframe
    df = df.append(order, ignore_index=True)
         ^^^^^^^^^
  File "/usr/local/lib/python3.13/site-packages/pandas/core/generic.py", line 6194, in __getattr__
    return object.__getattribute__(self, name)
           ~~~~~~~~~~~~~~~~~~~~~~~^^^^^^^^^^^^
AttributeError: 'DataFrame' object has no attribute 'append'
وفي المهمة الثالثة طلبنا الوقت الحالي بتوقيت UTC بصيغة ISO 8601، فكتب datetime.utcnow().isoformat()، وعند تشغيلها كان المخرج:
/lab/run/t03_utcnow.py:5: DeprecationWarning: datetime.datetime.utcnow() is deprecated and scheduled for removal in a future version. Use timezone-aware objects to represent datetimes in UTC: datetime.datetime.now(datetime.UTC).
  return datetime.utcnow().isoformat()
2026-10-13T06:18:52.374614
ولاحظ مشكلتين: التحذير يقول إن الدالة سوف تحذف، والأخطر أن النص الناتج لا يحمل المنطقة الزمنية، فمن يقرؤه بعد ذلك لا يعرف أنه UTC وقد يعامله كتوقيت محلي. والطريقة الحديثة datetime.now(UTC).isoformat() تعطي 2026-10-13T06:18:54.547849+00:00. ولو شغلت اختباراتك بالخيار -W error::DeprecationWarning لصار التحذير خطأ يوقف الخط، وهذه طريقة رخيصة لكشف هذا النمط.
المهام 4 و5 و6: أسئلة عن السلوك
في المهمة الرابعة طلبنا الوسيط الموزون Weighted Median بالمكتبة القياسية فقط، فكتب النموذج حلقة قصيرة صحيحة، ومثاله المكتوب في التعليق # Output: 2 صحيح عند التشغيل. وفي المهمة الخامسة سألنا عن المهلة الافتراضية في requests.get()، فكان الجواب:
The default timeout of requests.get() in the Python requests library is None, meaning it will not time out unless specified. For more information, see the official documentation: https://docs.python-requests.org/en/latest/api/#requests.getوالجواب صحيح، والرابط يفتح، ولكن عندما قرأنا الصفحة لم نجد فيها هذه الجملة، فهي تصف الخيار timeout فقط، والجملة الصريحة «If no timeout is specified explicitly, requests do not time out» موجودة في صفحة أخرى هي Quickstart. وهذا درس في طلب المصدر: الرابط الذي يفتح ليس دليلاً، والدليل هو الجملة داخل الصفحة.
وفي المهمة السادسة سألنا عن ثلاث قيم للدالة round، فكان الجواب 2, 4, 0.13، وعند التشغيل:
docker exec lab-aiq-py python -c "print(round(2.5), round(3.5), round(0.125, 2))"2 4 0.12أصاب في القيمتين الأوليين وأخطأ في الثالثة، والسبب أن 0.125 يمكن تمثيلها بدقة في الأرقام العشرية الثنائية، فتقرب إلى الرقم الزوجي كما تقول وثائق round، وقد شرحنا القاعدة في مقال الأرقام العشرية. ولاحظ أن الخطأ في القيمة التي تهم فعلاً، أي حساب مبلغ بالهللات.
المهمة 7: اختبارات بأرقام لم يحسبها أحد
أعطينا النموذج دالة تعد أيام العمل بين تاريخين، وفي وصفها أن الشركة في السعودية وأن عطلة نهاية الأسبوع الجمعة والسبت، بينما الكود نفسه يستثني السبت والأحد، أي أن فيها خطأ مقصوداً، وطلبنا اختبارات pytest. فكتب النموذج اختباراً واحداً فيه Assertions متتالية تبدأ هكذا:
def test_business_days():
    assert business_days(date(2023, 1, 1), date(2023, 1, 1)) == 1
    assert business_days(date(2023, 1, 1), date(2023, 1, 2)) == 1
    assert business_days(date(2023, 1, 1), date(2023, 1, 3)) == 2
واستمر حتى وصل إلى حد 900 توكن فانقطع في منتصف سطر، فحذفنا السطر الناقص الأخير وشغلنا الباقي، فكان المخرج مختصراً كما يلي:
>       assert business_days(date(2023, 1, 1), date(2023, 1, 1)) == 1
E       assert 0 == 1
FAILED test_business_days.py::test_business_days - assert 0 == 1
1 failed in 4.20s
ولأن pytest يتوقف عند أول Assertion فاشل، كتبنا سكربتاً صغيراً run/t07/score.py يقيم كل Assertion وحده مقابل الكود كما هو، ومقابل المتطلب أي الجمعة والسبت:
25 assertions: 2 match the code, 1 match the requirement
2023-01-01 is a Sunday
أي أن النموذج لم ينسخ سلوك الكود ولم يطبق المتطلب، وإنما كتب أرقاماً تبدو منتظمة لم يحسبها أحد، ولم يكتب أي حالة عن الجمعة أو السبت مع أن المتطلب مكتوب في الوصف أمامه. ولو كان المطور مستعجلاً لصحح الأرقام حتى تنجح على الكود، فيصبح لديه 25 اختباراً تحرس الخطأ.
المهمة 8: إصلاح أمني صمد
أعطينا النموذج دالة تقرأ تقريراً باسم ملف يأتي من الرابط، وفيها ثغرة تجاوز المسار، وطلبنا الإصلاح، فأضاف شرطاً يرفض أي اسم يختلف عن os.path.basename(name). ثم شغلنا الدالة المعدلة بسبعة مدخلات بالسكربت run/t08_traversal.py:
'q3.txt' -> 'Q3 report\n'
'../../etc/passwd' -> ValueError Invalid filename
'/etc/passwd' -> ValueError Invalid filename
'....//....//etc/passwd' -> ValueError Invalid filename
'..' -> IsADirectoryError [Errno 21] Is a directory: '/tmp/reports/..'
'' -> IsADirectoryError [Errno 21] Is a directory: '/tmp/reports/'
'q3.txt\x00.pdf' -> ValueError embedded null byte
الإصلاح صمد، ولا يوجد مدخل من السبعة قرأ ملفاً خارج المجلد، والملاحظة الوحيدة أن .. والنص الفارغ يرميان IsADirectoryError الذي قد يظهر للمستخدم خطأ 500 بدل رسالة واضحة. ولاحظ أننا لم نعرف أن الإصلاح جيد من قراءته، وإنما من تشغيل المدخلات الهجومية عليه، وهذا ما يجب أن تفعله مع كل إصلاح أمني، خاصة بعد ما وجدته دراسة Perry عن ثقة المطورين الزائدة.
المهمتان 9 و10: SQL على بيانات فيها حدود
أعطينا النموذج جدولين، العملاء والطلبات، وفي جدول الطلبات customer_id يقبل NULL لطلبات الضيف، ووضعنا في PostgreSQL ثلاثة عملاء وثلاثة طلبات بالسكربت run/seed.sql، أحدها طلب ضيف، وأحدها في الساعة 01:30 بتوقيت الرياض، أي قبل منتصف الليل بتوقيت UTC، وهذا الطلب هو الكناري Canary الذي نعرف مسبقاً في أي يوم يجب أن يقع:
 id | customer_id | total  |      utc_time       |     riyadh_time
----+-------------+--------+---------------------+---------------------
  1 |           1 | 100.00 | 2026-10-11 22:30:00 | 2026-10-12 01:30:00
  2 |             |  50.00 | 2026-10-12 09:00:00 | 2026-10-12 12:00:00
  3 |           2 | 200.00 | 2026-10-12 23:00:00 | 2026-10-13 02:00:00
(3 rows)
في المهمة التاسعة طلبنا العملاء الذين لم يطلبوا شيئاً، فكتب النموذج LEFT JOIN مع WHERE o.id IS NULL، وهو صحيح، ورجع Sara وحدها. ثم شغلنا للمقارنة الصيغة الأخرى الشائعة التي كتبناها نحن وليس النموذج، أي WHERE id NOT IN (SELECT customer_id FROM orders)، فرجعت صفر صفوف، والسبب أن NULL في القائمة يجعل الشرط غير معروف لكل صف. أي أن النموذج نجا هنا من الفخ، ولكن الفخ حقيقي، ولن يكشفه إلا صف فيه NULL في بيانات الاختبار.
وفي المهمة العاشرة قلنا إن العمل في الرياض، وطلبنا مجموع المبيعات لكل يوم في آخر سبعة أيام، فكتب النموذج استعلاماً يجمع بـ DATE_TRUNC('day', created_at)، وهذا مخرجه ثم مخرج الاستعلام الصحيح بأيام الرياض:
       sale_date        | total_sales
------------------------+-------------
 2026-10-11 00:00:00+00 |      100.00
 2026-10-12 00:00:00+00 |      250.00
(2 rows)

 riyadh_day | total_sales
------------+-------------
 2026-10-12 |      150.00
 2026-10-13 |      200.00
(2 rows)
كل طلب انتقل إلى اليوم السابق، لأن الجلسة بتوقيت UTC، ومجموع 11 أكتوبر في تقرير النموذج لطلب حدث فعلاً يوم 12 بتوقيت الرياض. ولاحظ أن النموذج كتب في شرحه أن الاستعلام «يجمع الطلبات حسب اليوم»، ولم يذكر المنطقة الزمنية إطلاقاً مع أن كلمة الرياض في الطلب. والإصلاح هو التحويل قبل التقسيم: (created_at AT TIME ZONE 'Asia/Riyadh')::date، وحساب بداية الأيام السبعة بتوقيت الرياض أيضاً، والاستعلام الكامل في run/t10.sql.
المهمة 11: سجل يقول السبب ولم يقرأه
شغلنا خدمة صغيرة inputs/orders_api.py في Container، وأعطيناها متغير بيئة باسم خاطئ DB_HOSTNAME بدل DB_HOST، كما يحدث عند خطأ إملائي في ملف Compose، فكان سجلها الحقيقي:
2026-10-12 21:49:41,758 INFO orders-api starting orders-api 2.4.1
2026-10-12 21:49:41,759 WARNING orders-api settings incomplete, using defaults
2026-10-12 21:49:41,759 INFO orders-api connecting to database 127.0.0.1:5432
2026-10-12 21:49:41,870 ERROR orders-api database connection failed (attempt 1/3): [Errno 111] Connection refused
2026-10-12 21:49:43,876 ERROR orders-api database connection failed (attempt 2/3): [Errno 111] Connection refused
2026-10-12 21:49:45,877 ERROR orders-api database connection failed (attempt 3/3): [Errno 111] Connection refused
2026-10-12 21:49:47,877 CRITICAL orders-api giving up, database unreachable
وسألنا النموذج عن السبب الحقيقي Root Cause، فكان أول سطرين في جوابه:
The root cause of the issue is that the `orders-api` container is unable to connect to the database at `127.0.0.1:5432`. This is indicated by the error messages showing a connection refused error.ثم خمس خطوات: تأكد أن قاعدة البيانات تعمل، وتحقق من الشبكة، ومن نص الاتصال، ومن توفر قاعدة البيانات، ومن سجلاتها. وهذا يصف العرض وليس السبب، فالسطر الثاني في السجل يقول إن الإعدادات ناقصة وإن الخدمة استخدمت القيم الافتراضية، والسطر الثالث يقول إنها تتصل بـ 127.0.0.1، وهو داخل Container يعني الـ Container نفسه وليس قاعدة البيانات. وعندما شغلنا الخدمة نفسها بالمتغير الصحيح DB_HOST=lab-aiq-pg كان المخرج:
2026-10-12 22:15:29,218 INFO orders-api starting orders-api 2.4.1
2026-10-12 22:15:29,218 INFO orders-api connecting to database lab-aiq-pg:5432
2026-10-12 22:15:29,272 INFO orders-api database connected
وقاعدة البيانات كانت تعمل طوال الوقت، فلو اتبع المناوب الخطوات الخمس لصرف وقته في المكان الخطأ.
المهمة 12: تقسيط فاتورة لا يساوي مجموعها
طلبنا دالة تقسم مبلغ فاتورة بالريال على عدد من الأقساط بخانتين عشريتين، فكتب النموذج:
def split_amount(total: Decimal, n: int) -> list[Decimal]:
    base_amount = total / n
    remainder = total % n
    result = [base_amount + Decimal(1) if i < remainder else base_amount for i in range(n)]
    return [amount.quantize(Decimal('0.00'), rounding=ROUND_HALF_UP) for amount in result]
الكود يبدو أنه يعالج الباقي، وهذا ما يجعله مقنعاً. والسكربت run/t12_split.py يفحصه بطريقتين: حالة كناري واحدة نعرف جوابها، ثم اختبار خصائص Property-based Test بمكتبة Hypothesis يتحقق من قاعدة واحدة على مدخلات كثيرة، وهي أن مجموع الأقساط يساوي المبلغ. والمخرج مختصراً، أي أول سطر ثم آخر الـ Traceback:
split_amount(100, 3) = [Decimal('34.33'), Decimal('33.33'), Decimal('33.33')]
...
AssertionError
Failing test case: test_installments_add_up(
    total=Decimal('0.01'),
    n=1,  # or any other generated value
)
مئة ريال على ثلاثة أقساط صارت 100.99، وأبسط حالة وجدتها Hypothesis هي هللة واحدة على قسط واحد، فصارت 1.01 ريال، والسبب أن الكود يخلط باقي القسمة بالريال مع الهللات، فيضيف ريالاً كاملاً بدل هللة. ولاحظ أن أي اختبار بمبلغ يقبل القسمة، مثل 90 على 3، كان سينجح.
المهمة 13: أحدث الإصدارات
سألنا عن أحدث إصدار مستقر من PostgreSQL وPython، فكان الجواب كاملاً:
PostgreSQL 15.2
Python 3.10.4
وPython 3.10.4 صدر في مارس 2022، بينما صدر Python 3.15.0 في 9 أكتوبر 2026، وPostgreSQL 15.2 صدر في فبراير 2023 والحالي 18.6. وهذا هو تاريخ توقف بيانات التدريب بأوضح صورة، ولاحظ أن الجواب لم يقل «بحسب معلوماتي حتى تاريخ كذا»، ولذلك نستخدم هذا السؤال اختبار كناري سريعاً لأي نموذج جديد: إذا كان لا يعرف ما بعد تاريخ معين، فلا تثق بما يقوله عن أي مكتبة تغيرت بعده.
النتيجة كاملة
الصورة التالية تجمع المهام الثلاث عشرة:
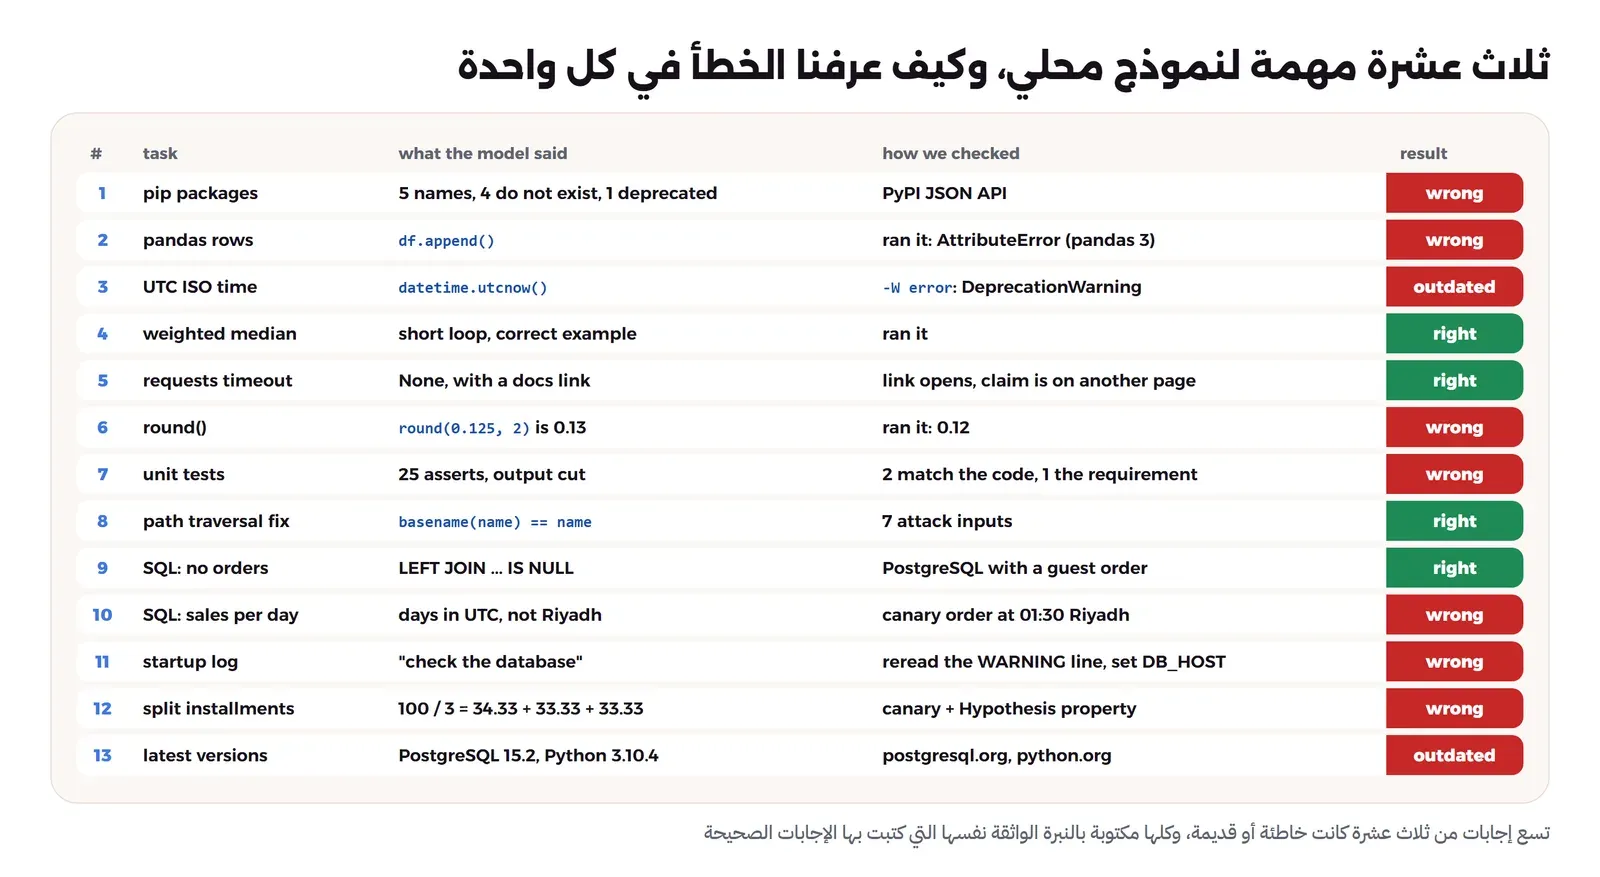
ولاحظ ثلاثة أشياء في النتيجة: أولاً لم يعتذر النموذج ولم يتردد في أي إجابة، فالثقة كانت ثابتة والصحة متغيرة. وثانياً أن الإجابات الخاطئة لم تكشفها قراءتنا لها، وإنما كشفها شيء خارج النموذج: تشغيل، أو واجهة PyPI، أو صف كناري، أو قاعدة تصح على كل المدخلات. وثالثاً أن بعض الأخطاء، مثل المنطقة الزمنية وتفسير السجل، لا ترمي أي خطأ ولا يكشفها التشغيل البسيط، وتحتاج بيانات اختبار صممت عند الحد.
تنظيف بيئة التجربة
docker rm -f lab-aiq-ollama lab-aiq-py lab-aiq-pg
docker volume rm lab-aiq-ollama
docker network rm lab-aiq-net
كيف تكشف الخطأ الواثق؟
الطريقة البسيطة أن تقرأ الإجابة بانتباه، وهي لا تكفي، لأن الخطأ الواثق مصمم بطبيعته ليبدو صحيحاً عند القراءة. والطرق التالية تعمل لأنها تسأل شيئاً خارج النموذج، والصورة التالية تربط كل طريقة بالمهام التي كشفتها في التجربة:
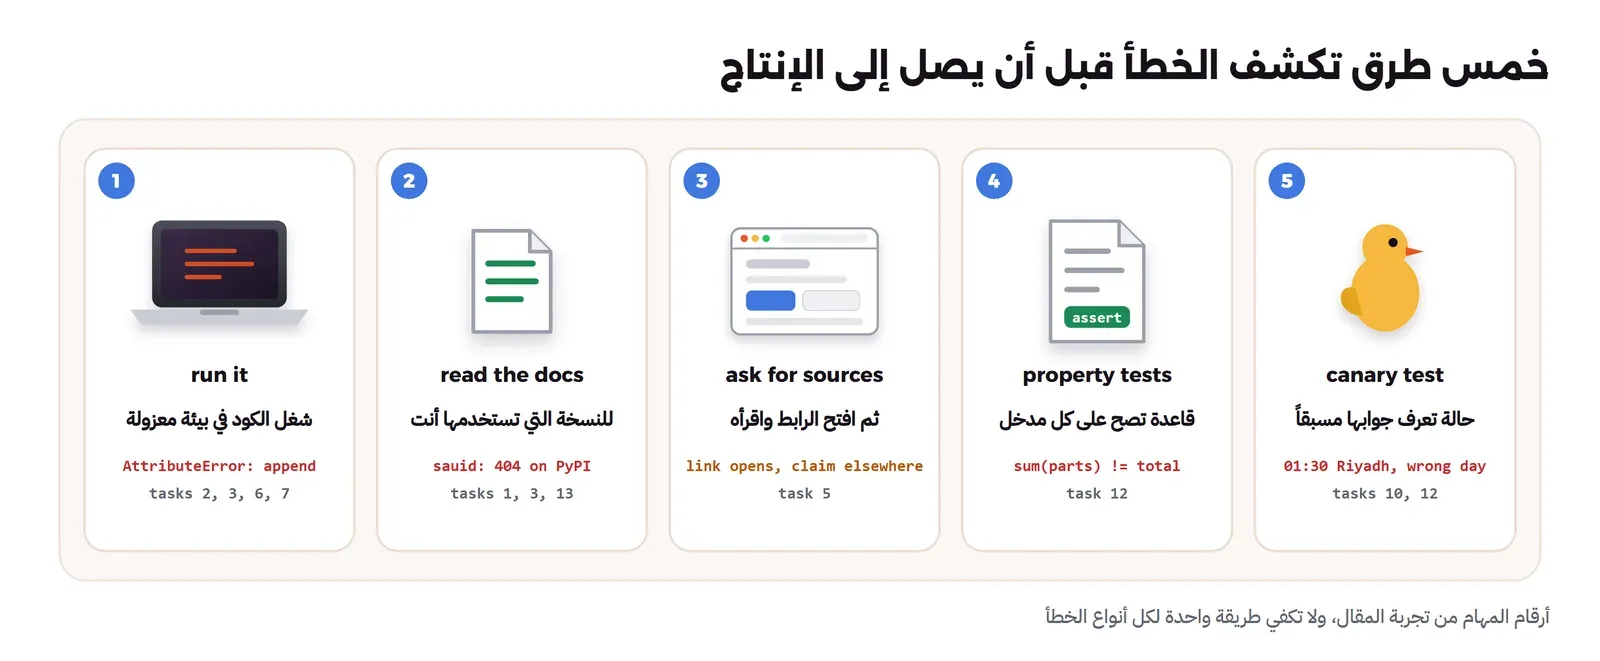
- شغله Run it: في Container أو بيئة معزولة، وبنفس نسخ المكتبات التي في مشروعك، ومع
-W error::DeprecationWarningفي Python أو ما يقابله في لغتك حتى تصبح التحذيرات أخطاء. وهذه أرخص طريقة، وقد كشفت أربع مهام. - اقرأ التوثيق Read the docs: لكل حزمة جديدة افتح صفحتها في PyPI أو npm قبل التثبيت، وتأكد من الاسم والمستودع وتاريخ آخر إصدار وعدد التنزيلات، ولكل دالة افتح توثيق النسخة التي تستخدمها أنت وليس آخر نسخة.
- اطلب المصدر Ask for sources: ثم افتح الرابط وابحث فيه عن الجملة نفسها، فالرابط الذي يفتح ليس دليلاً كما رأيت في المهمة الخامسة.
- اختبارات الخصائص Property Tests: بدل أن تكتب أمثلة يختارها الكاتب، تكتب قاعدة يجب أن تصح دائماً، مثل «مجموع الأقساط يساوي المبلغ» أو «التحويل ثم العكس يعيد القيمة»، وتترك الأداة تبحث عن مدخل يكسرها. وقد شرحنا Hypothesis في مقال الاختبارات التي يكتبها الذكاء الاصطناعي.
- اختبار الكناري Canary Test: حالة واحدة تعرف جوابها مسبقاً وتقع عند الحد، مثل طلب في الساعة 01:30 بتوقيت الرياض، أو صف فيه NULL، أو مبلغ لا يقبل القسمة، أو سؤال عن إصدار تعرف تاريخه. والمهم أن تكتب الجواب المتوقع قبل أن تشغل الكود، وليس بعده.
وعندما يصل هذا الكود إلى طلب دمج Pull Request، فالمراجع يحتاج قائمة تحقق خاصة به، وقد كتبنا عنها وعن البوابات الآلية في مقال مراجعة كود الذكاء الاصطناعي دون أن تصبح شكلية. وفحوص الجودة نفسها، مثل التكرار والتعقيد والتغطية، في مقالي جودة الكود وSonarQube عملياً.
أخطاء شائعة
- اعتبار الثقة دليلاً: النبرة كانت واحدة في الإجابات الصحيحة والخاطئة، فلا تقرأ «بالتأكيد» أو غياب «ربما» على أنه صحة.
- تثبيت الحزمة قبل البحث عنها: أمر
pip installمن إجابة نموذج قد يشغل كوداً من مهاجم أثناء التثبيت، فابحث عن الاسم أولاً. - تعديل الاختبار حتى ينجح: إذا فشل اختبار كتبه النموذج فاسأل أولاً من الخطأ، الكود أم الاختبار أم المتطلب، ولا تغير الرقم المتوقع لأن الكود أعطى غيره.
- بيانات اختبار نظيفة: استعلام SQL الذي يعمل على بيانات بلا NULL وبلا طلبات قرب منتصف الليل سوف يعمل في الاختبار ويخطئ في الإنتاج.
- قبول تفسير السجل دون قراءته: اقرأ السجل من أول WARNING وليس من آخر ERROR، واستخدم تفسير النموذج فرضية تتحقق منها.
- رفع درجة الحرارة في أدوات البرمجة: الحرارة العالية تزيد الاختراع كما وجدت ورقة Spracklen، فأبقها منخفضة في توليد الكود.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الخطأ الواثق إجابة خاطئة أو قديمة بنبرة الإجابة الصحيحة نفسها، وفي تجربتنا كانت 9 من 13 إجابة لنموذج Qwen2.5-Coder 7B خاطئة أو قديمة.
- أخطر الأنماط الحزم المخترعة، لأن الأسماء تتكرر، فيسجلها المهاجم وينتظر، وهذا هجوم Slopsquatting الذي جربه باحث فعلياً بحزمة
huggingface-cli. - الأسباب ثلاثة: معرفة توقفت عند تاريخ، وكود لا يشغله النموذج، وتدريب يكافئ التخمين وموافقة المستخدم أكثر من «لا أعرف».
- القراءة لا تكشف الخطأ الواثق، وما يكشفه هو مصدر خارج النموذج: التشغيل، والتوثيق، والمصدر المقروء، واختبارات الخصائص، والكناري.
- بعض الأخطاء لا ترمي أي خطأ، مثل المنطقة الزمنية وتفسير السجل، وتحتاج بيانات اختبار صممت عند الحد.
 دليلمراجعة كود الذكاء الاصطناعي دون أن تصبح شكليةكيف تراجع طلبات الدمج التي يكتبها الذكاء الاصطناعي بحسب خطرها، وتترك للبوابات الآلية ما تستطيع قياسه.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلالترميز الطبي بالذكاء الاصطناعي: أين ينجح وأين يخطئ؟كيف تساعد القواعد ونماذج اللغة المرمز في اختيار الرموز، وكيف تقيس دقتها وتمنعها من اختراع رموز غير موجودة.
 دليلما هي جودة الكود Code Quality وكيف تقيسها؟ما الذي يجعل الكود سهل التغيير، وماذا تقيس أدوات الفحص فعلاً، ولماذا يحتاج كود الوكلاء الأذكياء إلى بوابة جودة.
 دليلSonarQube عملياً: بوابة جودة لكود الذكاء الاصطناعيكيف تثبت SonarQube مع PostgreSQL وتضبط قواعده وبوابته، ثم تجعل الوكيل الذكي يقرأ نتيجتها ويصلح كوده حتى تنجح.
 دليلكيف تتعامل لغات البرمجة مع الأخطاء؟لماذا ترمي Java وPython الاستثناءات بينما ترجع Go وRust الخطأ كقيمة، وكيف تمنع الخطأ من أن يختفي بصمت في كودك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على Docker Engine 29.8.0 مع Ollama 0.40.3 والنموذج qwen2.5-coder:7b (البصمة dae161e27b0e، تكميم Q4_K_M) على المعالج فقط، وPython 3.13.16 (python:3.13.16-slim) مع pandas 3.0.6 وrequests 2.34.2 وpytest 9.1.1 وHypothesis 6.169.0 وholidays 0.106 وhijridate 2.6.0، وPostgreSQL 17.11 (postgres:17-alpine).


