

في مقال الأنظمة العددية للمبرمجين رأينا أن 0.1 + 0.2 تعطي 0.30000000000000004، وعرفنا أن السبب هو أن 0.1 كسر لا ينتهي بالنظام الثنائي، ثم قلنا في قسم المبالغ المالية إن double لا يصلح للمال. ولكن هذه القاعدة وحدها لا تفسر لماذا يجمع برنامج الرقم 0.1 عشرة ملايين مرة فيعطي 1087937 بدلاً من مليون، ولا لماذا يصل معرف الطلب من ال API ناقصاً آخر خاناته، ولا لماذا يعطي Math.Round(2.5) في C# القيمة 2، ولا لماذا عجزت بطارية صواريخ Patriot في الظهران سنة 1991 عن اعتراض صاروخ لأن ساعتها تعد بأعشار الثانية. والإجابة في كل هذه الحالات موجودة في البتات نفسها، أي في الطريقة التي يقسم بها المعيار IEEE 754 الرقم إلى إشارة وأس وكسر، وما يترتب على هذا التقسيم من فجوات بين الأرقام وقيم خاصة وقواعد للتقريب.
وهذا المقال من مرحلة أساسيات علوم الحاسب Computer Science Fundamentals، ويأتي بعد مقال الأنظمة العددية مباشرة، فإذا لم تقرأه فابدأ به لأننا لن نعيد شرح الثنائي والـ Hex والمتمم الثنائي هنا. وسوف نناقش في هذا المقال ما يلي:
- تشريح الرقم حسب IEEE 754 في
floatوdouble: الإشارة والأس مع الإزاحة Bias والكسر والبت المخفي، وفك بتات 0.1 و3.14 الحقيقية بيدك. - كم رقماً عشرياً يحفظ كل نوع فعلاً، ولماذا تكبر المسافة بين الرقم والذي يليه ULP كلما كبر الرقم.
- القيم الخاصة: الصفر السالب واللانهاية و NaN والأرقام دون الطبيعية Subnormal، وكيف تتعامل معها كل لغة بطريقتها.
- التقريب Rounding إلى الزوجي، والمقارنة بقيمة سماح نسبية، وتراكم الخطأ وجمع Kahan مع قياس حقيقي.
- الأرقام الصحيحة الكبيرة داخل
doubleومعرفات JSON، والأنواع العشرية في اللغات وفي PostgreSQL. - الأنواع الصغيرة في الذكاء الاصطناعي: fp16 وbfloat16 وfp8، ثم حادثتان موثقتان: Patriot وAriane 5.
- تجربة عملية كاملة في Containers بلغة C# وPython وJavaScript (Node.js) وقاعدة PostgreSQL، مع المخرجات الحقيقية.
تشريح الرقم: الإشارة والأس والكسر
الفكرة التي ذكرناها في مقال الأنظمة العددية هي أن الرقم يكتب بصيغة علمية بالأساس 2، والآن سوف ننزل إلى التفاصيل، فكل رقم طبيعي Normal في IEEE 754 قيمته تساوي:
value = (-1)^sign × 1.fraction × 2^(exponent - bias)والجدول التالي يبين كيف يقسم المعيار البتات في النوعين الأشهر، وهما float بحجم 32 بت، ويسميه المعيار binary32، وdouble بحجم 64 بت، ويسميه binary64، وهو النوع الافتراضي للأرقام العشرية في C# وJava وPython، والنوع الوحيد للأرقام في JavaScript:
| النوع | الإشارة Sign | الأس Exponent | الإزاحة Bias | الكسر Fraction | الدقة الفعلية |
|---|---|---|---|---|---|
float (binary32) | 1 بت | 8 بتات | 127 | 23 بتاً | 24 بتاً |
double (binary64) | 1 بت | 11 بتاً | 1023 | 52 بتاً | 53 بتاً |
وفي هذا الجدول شيئان يحتاجان إلى شرح. الأول هو البت المخفي Hidden Bit، ويسمى أيضاً الواحد الضمني Implicit Leading 1، فكل رقم طبيعي بالثنائي إذا كتبته بالصيغة العلمية يبدأ بالواحد قبل الفاصلة، تماماً كما أن الرقم العشري بالصيغة العلمية يبدأ برقم من 1 إلى 9، والفرق أن الثنائي ليس فيه إلا رقم واحد غير الصفر، وهو الواحد، ولذلك لا داعي لحفظه أصلاً، فيخزن المعيار ما بعد الفاصلة فقط ويضيف الواحد عند القراءة، وبهذا يكسب بتاً إضافياً من الدقة مجاناً، فتصبح دقة double الفعلية 53 بتاً مع أن الكسر 52 بتاً فقط.
والثاني هو الإزاحة Bias، وقد يتساءل البعض: لماذا يخزن الأس بعد إضافة 1023 إليه بدلاً من استخدام المتمم الثنائي Two's Complement الذي شرحناه في قسم الأرقام السالبة؟ والإجابة أن الإزاحة تجعل الأس المخزن رقماً موجباً دائماً، وبالتالي إذا وضعت الأس قبل الكسر وقرأت بتات رقمين موجبين كأنهما عددان صحيحان، فإن ترتيبهما كأعداد صحيحة هو نفس ترتيبهما كأرقام عشرية، وهذا يجعل المقارنة والترتيب أبسط في العتاد Hardware، وهو أيضاً السبب في أن الرقم الذي يلي أي رقم موجب هو ببساطة بتاته زائد واحد، كما سوف نرى في تجربة Node.js.
مثال: نفك بتات 3.14 بيدنا
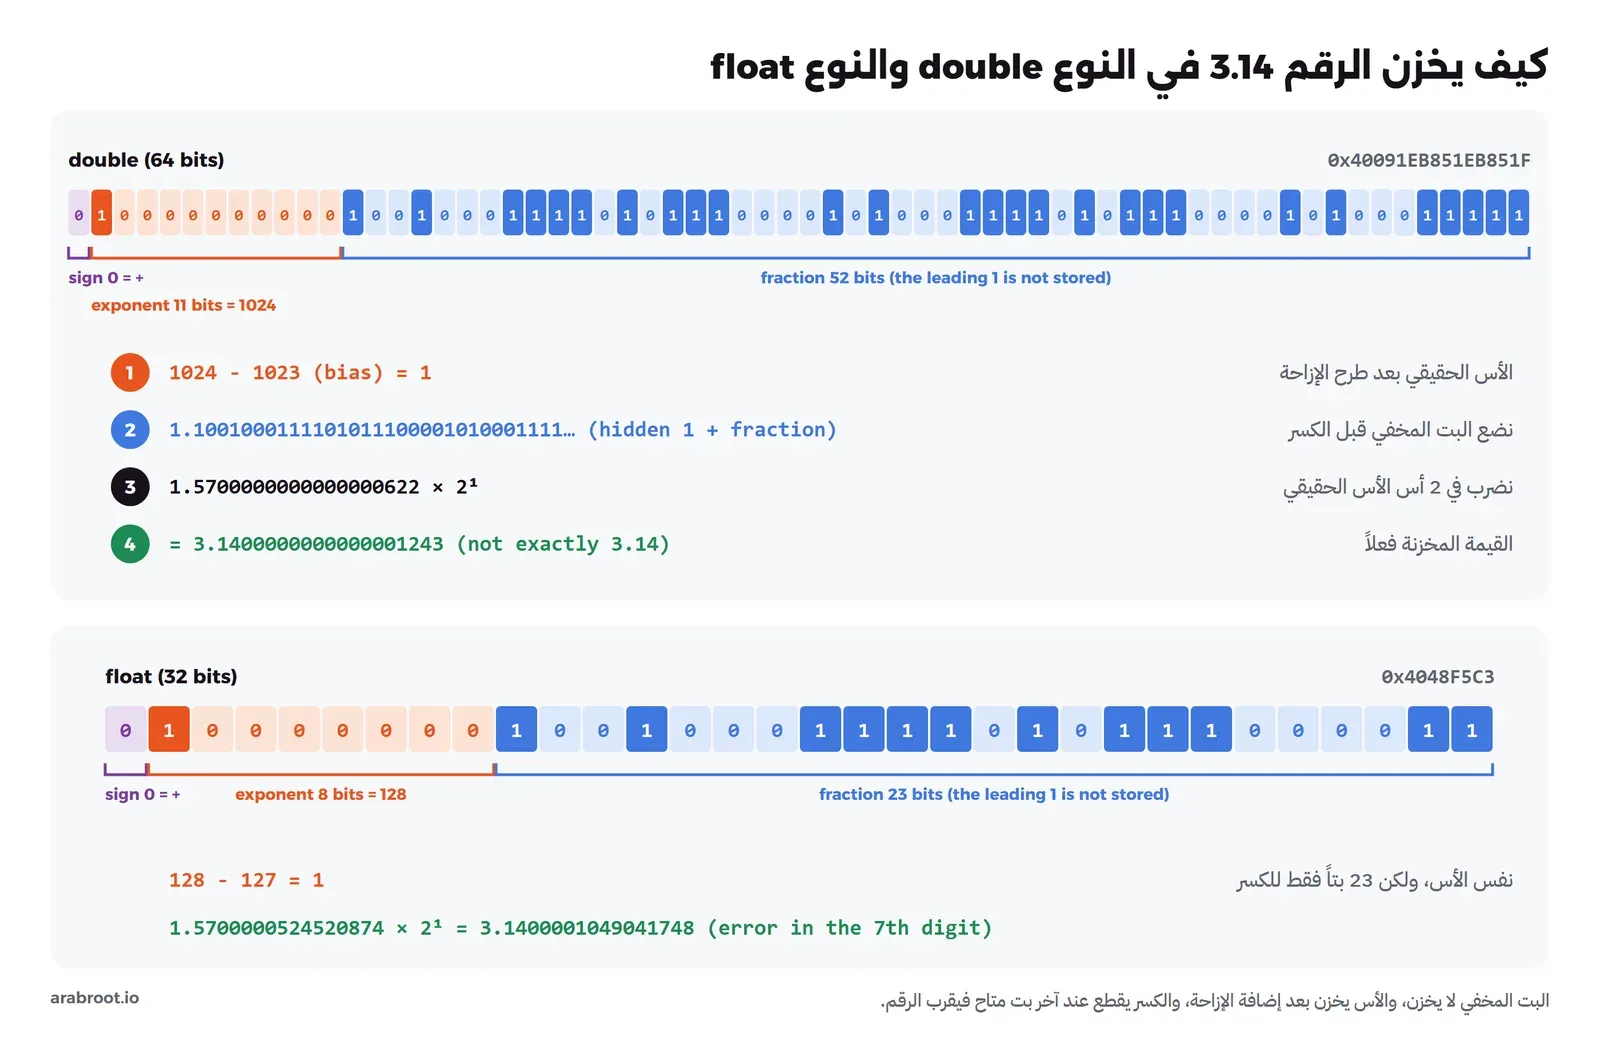
لنأخذ الرقم 3.14، فقد طبعت بتاته البرامج الثلاثة في التجربة العملية بنفس القيمة 0x40091EB851EB851F، وطريقة فكها كما يلي:
- نحول الـ Hex إلى ثنائي ونقسمه 1 و11 و52، فالإشارة
0، أي أن الرقم موجب. - الأس المخزن
10000000000وقيمته 1024، فنطرح الإزاحة 1024 - 1023 ويكون الأس الحقيقي 1. - الكسر
1001000111101011100001010001111010111000010100011111، فنضع قبله البت المخفي فيصبح1.1001000111101011100001010001111…، وقيمته بالعشري 1.5700000000000000621724893790087662637233734130859375. - نضرب في 21 فيكون الناتج 3.140000000000000124344978758017532527446746826171875، وهذه بالضبط القيمة التي طبعتها
Decimal(3.14)في Python.
لاحظ أن الكسر ينتهي بالبتات …0001111 ثم يقطع، والسبب أن 0.14 بالثنائي مثل 0.1 كسر لا ينتهي، فقرب المعيار آخر بت إلى أقرب قيمة، وكانت هذه القيمة أكبر قليلاً من 3.14 الحقيقية. أما في float فبتات 3.14 هي 0x4048F5C3، والأس المخزن 128 - 127 = 1 أيضاً، ولكن الكسر 23 بتاً فقط، فالقيمة المخزنة 3.1400001049041748046875، أي أن الخطأ ظهر في الخانة السابعة بدلاً من الخانة السابعة عشرة. والصورة التالية تبين البتات الحقيقية للرقم 3.14 في النوعين وكيف تتحول إلى القيمة:
كم رقماً عشرياً يحفظ float وdouble؟
الدقة في IEEE 754 تقاس بالبتات وليس بالخانات العشرية، فـ float يحفظ 24 بتاً من الأرقام المهمة، و224 يساوي 16,777,216، أي أكثر قليلاً من سبع خانات عشرية، وdouble يحفظ 53 بتاً، و253 يساوي تقريباً 9 × 10¹⁵، أي قرابة 16 خانة. ولهذا تجد في جدول أنواع C# أن دقة float من 6 إلى 9 خانات، ودقة double من 15 إلى 17، وهذان الرقمان لهما معنيان مختلفان:
- الرقم الأصغر (6 و15): هو عدد الخانات العشرية الذي تضمن أن يعود كما هو إذا كتبته كنص ثم حولته إلى الرقم ثم أعدته نصاً، ولهذا تطبع Python القيمة
sys.float_info.dig = 15، وتقول وثائق PostgreSQL إن دقةrealست خانات على الأقل ودقةdouble precisionخمس عشرة خانة على الأقل. - الرقم الأكبر (9 و17): هو عدد الخانات الذي تحتاجه لتطبع الرقم المخزن بحيث لا يختلط بجاره، ولهذا طبعت Python الرقم 0.1 من النوع
floatبسبع عشرة خانة فظهر0.10000000149011612.
وبعد هذه الحدود يبدأ الرقم في فقدان خاناته بصمت، فالرقم 16777217 أصبح 16777216 في float، والرقم 9007199254740993 أصبح 9007199254740992 في double، ولم تظهر أي رسالة خطأ في الحالتين. وفي PostgreSQL ظهرت مفاجأة إضافية، فالاستعلام SELECT 0.1::real يعرض 0.1، بينما تحويل نفس القيمة إلى float8 يعرض 0.10000000149011612، والسبب أن PostgreSQL يعرض أقصر نص يعيد نفس القيمة، أما تحويل 16777217::real إلى numeric فأعطى 16777200، أي أن التحويل احتفظ بست خانات فقط، وهذا مثال واضح على أن الرقم الذي تراه على الشاشة ليس دائماً الرقم المخزن.
والقاعدة العملية: اجعل double هو الاختيار الافتراضي، واستخدم float فقط عندما تكون الأرقام تقريبية أصلاً وكثيرة جداً، مثل الرسوميات وقراءات الحساسات وأوزان نماذج التعلم الآلي، والسبب أن float يأخذ نصف ذاكرة double كما شرحنا في مقال الذاكرة، ويتسع منه في مسجل SIMD بحجم 256 بت ثمانية أرقام بدلاً من أربعة، كما رأينا في مقال المعالج، ولكن مقابل ذلك تخسر نصف الخانات تقريباً.
المسافة بين الرقم والذي يليه تكبر مع حجمه
من القسم السابق ينتج أمر مهم، وهو أن الأرقام العشرية في الحاسب ليست موزعة بالتساوي على خط الأعداد، فبين 1 و2 يوجد 252 رقماً في double، وبين 2 و4 يوجد نفس العدد بالضبط، وبين 1024 و2048 كذلك، لأن الأس يحدد المجال والكسر يقسمه إلى نفس عدد الخطوات دائماً، وبالتالي كلما تضاعف حجم الرقم تضاعفت المسافة بينه وبين الرقم الذي يليه. وهذه المسافة تسمى ULP، اختصاراً لـ Unit in the Last Place، أي قيمة آخر بت في الكسر عند هذا الحجم. والصورة التالية تبين ذلك:
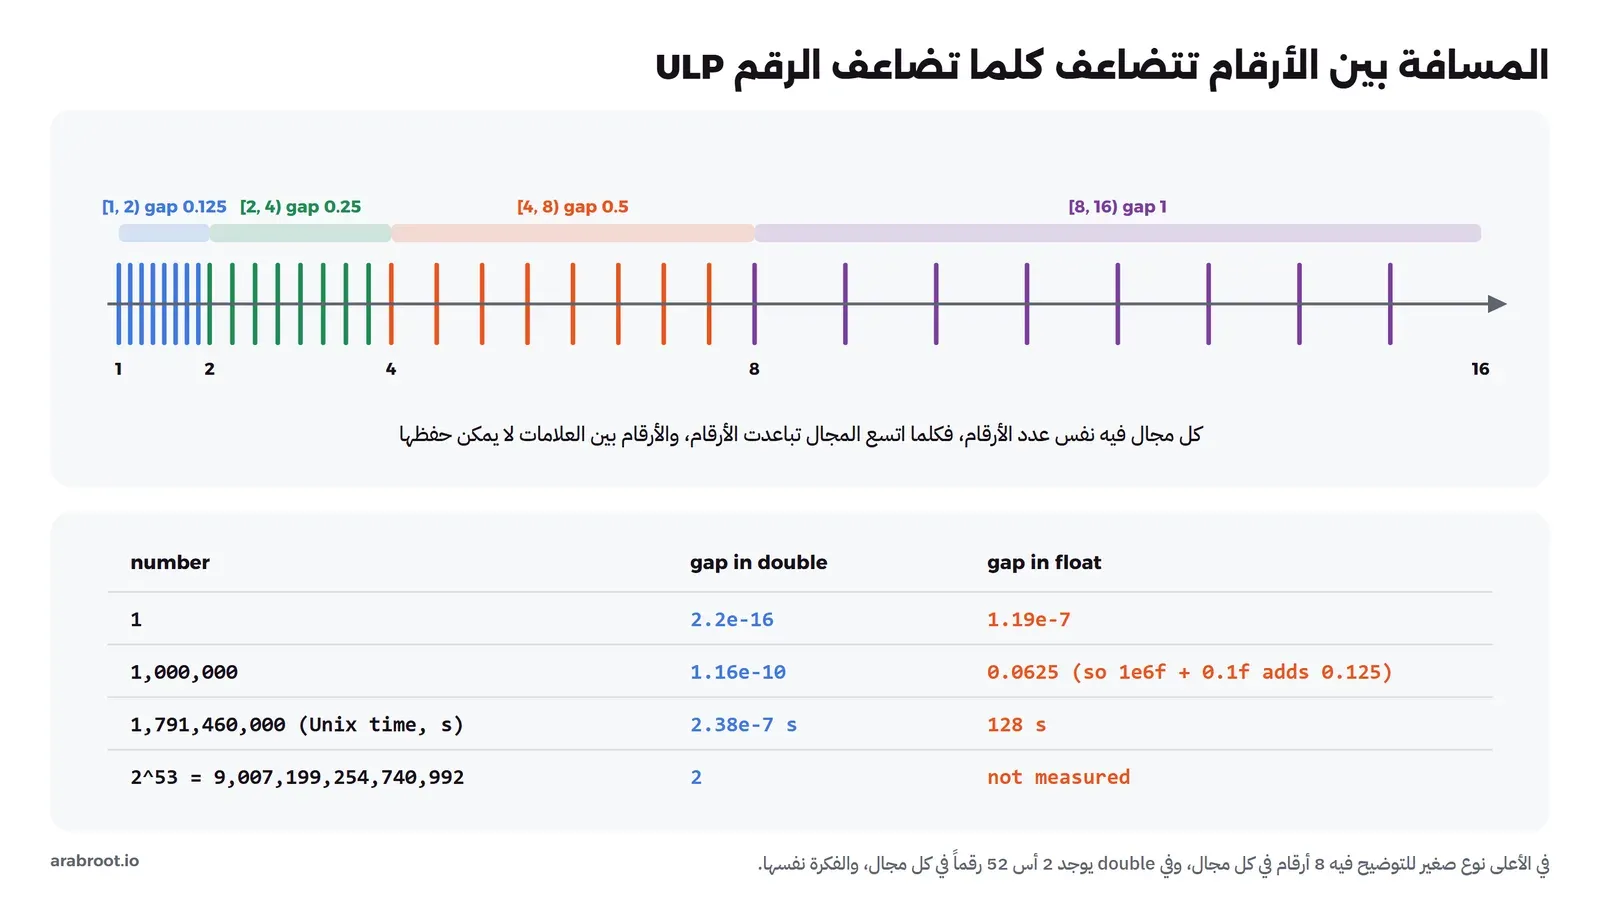
وفي Python تحسب هذه المسافة بالدالة math.ulp، وتحصل على الرقم التالي بالدالة math.nextafter، وفي C# بالدالة Math.BitIncrement، وفي Java بالدالتين Math.ulp وMath.nextUp في الكلاس Math، أما JavaScript فليس فيها دالة جاهزة، فكتبنا في التجربة دالة تزيد بتات الرقم بمقدار واحد، وهذه بعض القيم الحقيقية من المخرجات:
| الرقم | المسافة إلى الرقم التالي في double | المسافة في float |
|---|---|---|
| 1 | 2.22 × 10⁻¹⁶ | 1.19 × 10⁻⁷ |
| 1,000,000 | 1.16 × 10⁻¹⁰ | 0.0625 |
| 1,000,000,000 | 1.19 × 10⁻⁷ | لم نقسها |
| 1,791,460,000 (وقت Unix بالثواني في أكتوبر 2026) | 2.38 × 10⁻⁷ ثانية | 128 ثانية |
| 253 و1016 | 2 | |
| 10300 | 1.49 × 10284 |
وفي الجدول أعلاه لاحظ التالي:
- عند 1016 أصبحت المسافة 2، ولهذا طبعت Python أن
1e16 + 1 == 1e16صحيح، فالرقم 1 أصغر من نصف المسافة، فيقرب الناتج إلى نفس الرقم ويضيع الجمع كله. - في
floatعند مليون المسافة 0.0625، فإذا أضفت 0.1 إلى مليون لا يمكن أن يزيد الرقم 0.1، وإنما يقرب إلى أقرب مضاعف للمسافة، ولهذا طبعت C# أن(1e6f + 0.1f) - 1e6fيساوي 0.125، وهذا هو سر الرقم 1087937 الذي سوف نراه في قسم تراكم الخطأ. - وقت Unix الحالي في
floatيحفظ بفجوة 128 ثانية، فالرقم 1791460000 خزن كـ 1791459968، لذلك لا تحفظ الوقت أبداً فيfloat، واحفظه كعدد صحيح 64 بت كما شرحنا في مقال التاريخ والوقت.
double.Epsilon كقيمة سماح في المقارنة، فهو حسب توثيقه أصغر رقم موجب أكبر من الصفر، أي 5E-324 كما طبعته التجربة، وهو رقم دون طبيعي Subnormal وليس إبسلون الآلة Machine Epsilon، والمقارنة به تساوي تقريباً المقارنة بـ ==. أما إبسلون الآلة، أي المسافة بين 1 والرقم التالي، فهو 2.220446049250313E-16، ويسمى Number.EPSILON في JavaScript وsys.float_info.epsilon في Python.القيم الخاصة: صفران ولا نهاية و NaN
حجز المعيار قيمتين من قيم الأس لحالات خاصة، فإذا كانت كل بتات الأس أصفاراً فالرقم صفر أو رقم دون طبيعي، وإذا كانت كلها آحاداً فالرقم لا نهاية Infinity أو ليس رقماً NaN، اختصاراً لـ Not a Number. والصورة التالية تبين بتات كل حالة في double:
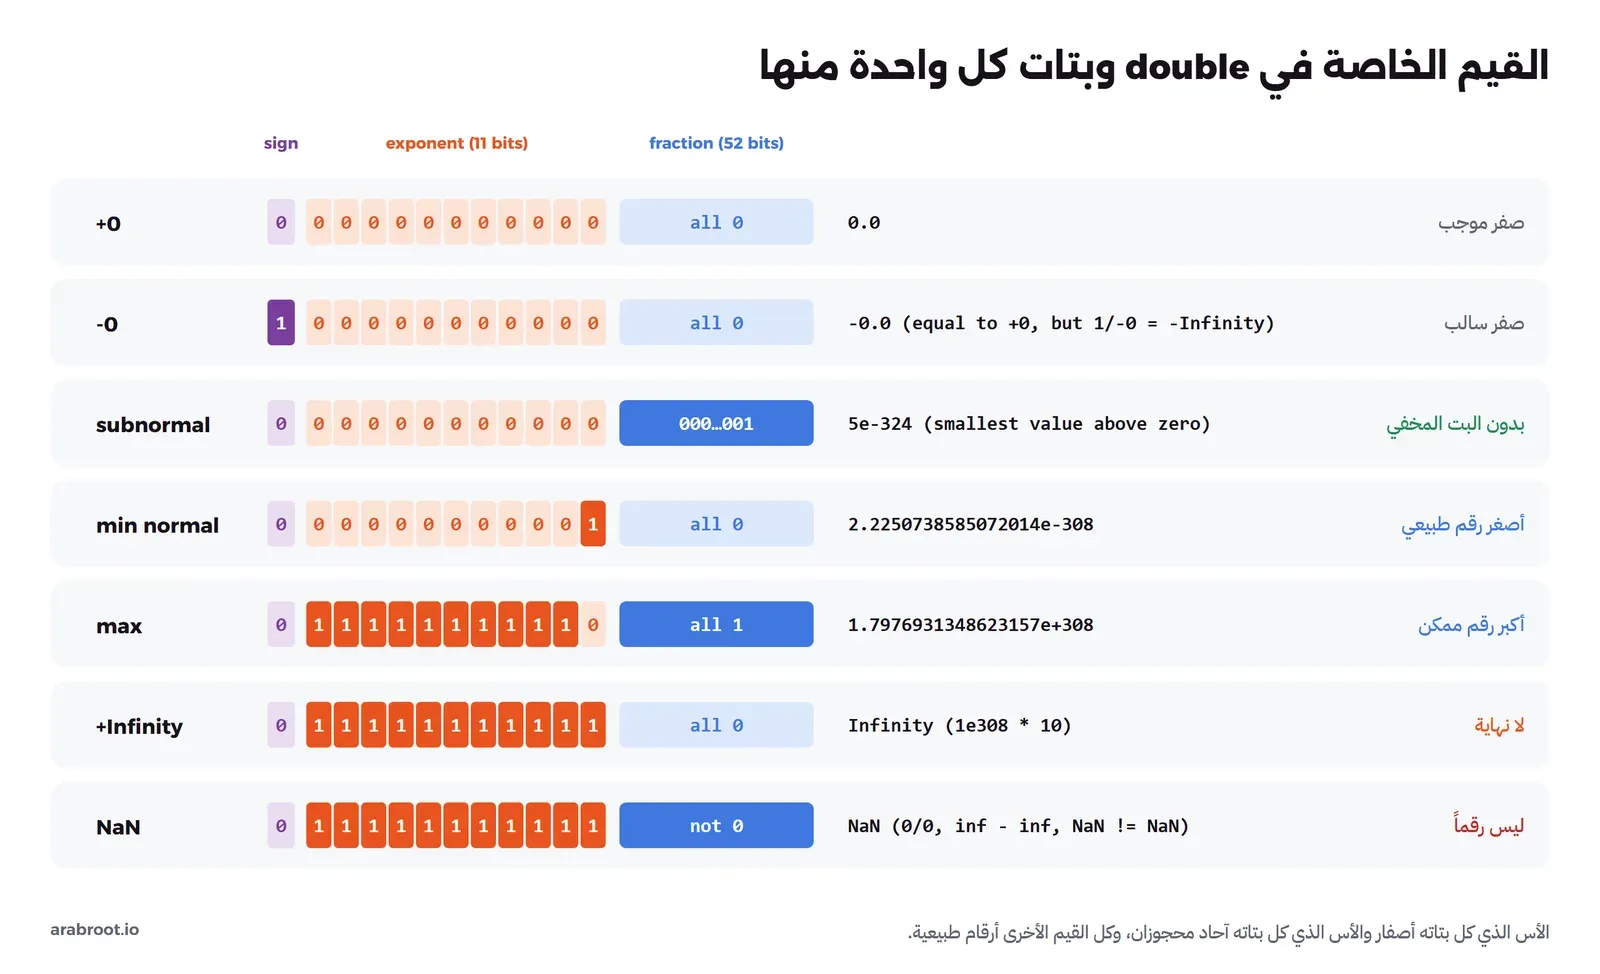
وكل قيمة من هذه القيم لها سلوك يفاجئ المطور عندما يقابله لأول مرة، وهذا ما ظهر في التجربة:
- الصفر السالب Negative Zero: بما أن الإشارة بت مستقل، فهناك صفر موجب وصفر سالب، وهما متساويان في المقارنة، فـ
0.0 == -0.0صحيح في كل اللغات، ولكن القسمة عليهما مختلفة، فـ1 / -0في JavaScript يعطي-Infinity، ولا يفرق بينهما في JavaScript إلاObject.is. ويظهر الصفر السالب عادة عندما تقرب رقماً سالباً صغيراً، فـMath.round(-0.5)أعطى-0، وقد يظهر في التقارير كـ-0فيسأل عنه المستخدم. - اللانهاية Infinity: ناتج الفيضان، فـ
1e308 * 10يعطيinfبدلاً من رمي خطأ، و1.0 / 0.0يعطيInfinityفي C# وJavaScript، أما Python فاختارت أن ترميZeroDivisionError، وهذا اختيار اللغة وليس المعيار. - NaN: ناتج العمليات التي ليس لها جواب، مثل
inf - infو0.0 / 0.0وMath.Sqrt(-1). والقاعدة الأغرب في المعيار أن NaN لا يساوي أي شيء ولا حتى نفسه، فـNaN == NaNخطأ في اللغات الثلاث، وتحقق منه بـmath.isnanأوdouble.IsNaNأوNumber.isNaN. - الأرقام دون الطبيعية Subnormal: عندما يصبح الأس أصغر من أقل قيمة طبيعية، وهي 2.2250738585072014e-308، يتوقف المعيار عن إضافة البت المخفي، فتصغر الأرقام تدريجياً مع فقدان الدقة حتى أصغر رقم ممكن 5e-324، وهذا يسمى التناقص التدريجي Gradual Underflow، ونصف هذا الرقم يقرب إلى صفر كما طبعت Python و
Number.MIN_VALUE / 2في Node.js.
والمشكلة الحقيقية في NaN أن كل لغة وكل دالة تتعامل معه بطريقة مختلفة، والجدول التالي من مخرجات التجربة نفسها:
| البيئة | السلوك | الناتج |
|---|---|---|
| Python | nan in [nan] مع نفس الكائن، ثم مع كائنين مختلفين | True ثم False، لأن البحث يقارن هوية الكائن قبل القيمة |
| Python | max(nan, 1) وmax(1, nan) | nan و1، فالنتيجة تعتمد على الترتيب |
| Python | sorted([3, nan, 1, 2]) | [3, nan, 1, 2]، أي أن الترتيب فشل بصمت |
| JavaScript | [NaN].indexOf(NaN) و[NaN].includes(NaN) | -1 وtrue |
| JavaScript | JSON.stringify([NaN, Infinity, -0]) | [null,null,0] |
| Python | json.dumps(nan) | NaN، وهو نص ليس JSON صحيحاً |
| C# | nan == double.NaN وnan.Equals(nan) | False وTrue |
| C# | Array.Sort على مصفوفة فيها NaN | [NaN, 1, 2, 3] |
| PostgreSQL | 'NaN'::float8 = 'NaN'::float8 | t، وNaN أكبر من Infinity |
والسبب في سلوك PostgreSQL مذكور صراحة في وثائق الأنواع الرقمية: المعيار يقول إن NaN لا يساوي شيئاً، ولكن قاعدة البيانات تحتاج أن ترتب القيم وتبني عليها فهارس Indexes، لذلك تعامل NaN كقيمة تساوي نفسها وأكبر من كل الأرقام. وهذا يعني أن نفس البيانات قد تعطي نتيجة مختلفة إذا قارنتها في الكود وإذا قارنتها في الاستعلام، فلا تسمح لـ NaN بالدخول إلى بياناتك أصلاً، وتحقق منه عند الإدخال. أما json.dumps في Python فيكتب NaN افتراضياً مع أن صيغة JSON في RFC 8259 لا تسمح به، فإذا قرأ الملف برنامج آخر فسوف يفشل، لذلك مرر allow_nan=False كما في توثيق الوحدة json حتى ترمي الدالة خطأ واضحاً بدلاً من كتابة ملف لا يقرأ.
التقريب: لماذا يعطي Math.Round(2.5) القيمة 2؟
كل عملية على الأرقام العشرية تنتهي بتقريب، لأن الناتج الحقيقي لجمع أو ضرب رقمين نادراً ما يكون له تمثيل دقيق، فيختار المعالج أقرب رقم ممكن. والطريقة الافتراضية في IEEE 754 هي التقريب إلى الأقرب، وعند التعادل إلى الزوجي Round Half to Even، أي إذا كان الناتج في المنتصف تماماً بين رقمين، اختر الرقم الذي ينتهي آخر بت فيه بصفر. ونفس القاعدة تستخدمها بعض دوال التقريب في اللغات، ويسميها البعض تقريب البنوك Banker's Rounding:
- في Python أعطت
round(0.5), round(1.5), round(2.5), round(3.5)القيم 0 و2 و2 و4، وتوثيق round يقول إن التقريب يتجه إلى الخيار الزوجي. - في C# أعطى
Math.Round(2.5)القيمة 2، لأن الوضع الافتراضي فيMath.RoundهوMidpointRounding.ToEven، وحتى(2.5).ToString("F0")أعطى 2. - في PostgreSQL أعطى
round(2.5::float8)القيمة 2، بينما أعطىround(2.5::numeric)القيمة 3، وتوثيق الدوال الرياضية يقول إنnumericيقرب التعادل بعيداً عن الصفر، أماdouble precisionفيعتمد على النظام والأشهر هو التقريب إلى الزوجي. - أما JavaScript فتختلف عن الجميع، فـ
Math.roundيقرب التعادل نحو الموجب، فأعطىMath.round(2.5)القيمة 3 وMath.round(-2.5)القيمة-2.
وقد يتساءل البعض: لماذا يختار أحد التقريب إلى الزوجي وهو يخالف ما تعلمناه في المدرسة؟ والإجابة أن التقريب الذي تعلمناه يرفع كل حالة تعادل إلى الأعلى، فإذا قربت الأرقام 0.5 و1.5 و2.5 و3.5 بالطريقة المدرسية فمجموعها بعد التقريب 1 + 2 + 3 + 4 = 10، بينما مجموعها الحقيقي 8، أما التقريب إلى الزوجي فيعطي 0 + 2 + 2 + 4 = 8، لأن نصف حالات التعادل تنزل ونصفها يصعد، فلا يتراكم انحياز Bias في اتجاه واحد عندما تجمع آلاف القيم المقربة. ولهذا يستخدمه المعيار داخل كل عملية حسابية.
وهناك فخ ثان أخطر، وهو أن الرقم الذي تظن أنه في المنتصف ليس في المنتصف أصلاً، فقد رأينا في مقال الأنظمة العددية أن 2.675 مخزنة كـ 2.67499999999999982236431605997495353221893310546875، فأعطت round(2.675, 2) في Python القيمة 2.67. والجديد هنا أن C# أعطت لنفس الرقم Math.Round(2.675, 2, MidpointRounding.AwayFromZero) القيمة 2.68، والسبب أن خوارزمية التقريب إلى خانتين تختلف بين اللغتين، فالأولى تعمل على القيمة المخزنة بالضبط والثانية تضرب في 100 أولاً، وهذا وحده كاف لتعرف أن تقريب double إلى خانات عشرية لا يعطي نتيجة يمكن الاعتماد عليها بين نظامين. والحل أن تقرب بنوع عشري وتحدد الطريقة صراحة، فـ Decimal("2.675").quantize(Decimal("0.01"), rounding=ROUND_HALF_UP) في Python وMath.Round(2.675m, 2, MidpointRounding.AwayFromZero) في C# وround(2.675::numeric, 2) في PostgreSQL أعطت كلها 2.68، وفي Java تحدد الطريقة بـ RoundingMode مثل HALF_UP أو HALF_EVEN. واختر الطريقة التي يطلبها النظام المحاسبي أو الضريبي الذي تعمل له، ولا تتركها للقيمة الافتراضية للغة.
كيف تقارن رقمين عشريين؟
ذكرنا في مقال الأنظمة العددية أن المقارنة بـ == لا تصلح، والآن سوف نرى لماذا لا تصلح أيضاً قيمة السماح الثابتة التي يستخدمها أغلب المطورين. فالحل البسيط هو abs(a - b) < 1e-9، وهو يعمل مع 0.1 + 0.2 و0.3 لأن الفرق بينهما 5.551115123125783e-17 كما طبعته Python، ولكنه يفشل في الاتجاهين:
- مع الأرقام الكبيرة: الرقمان
1e15 + 0.3و1e15 + 0.5متجاوران تقريباً عند هذا الحجم، لأن المسافة بين الأرقام هناك 0.125، ومع ذلك أعطت المقارنة بقيمة السماح الثابتةFalse، فقيمة 1e-9 أصغر من المسافة نفسها، وبالتالي فهي تساوي == عند هذا الحجم. - مع الأرقام الصغيرة جداً: إذا كانت أرقامك قياسات بحجم 10-10، فقيمة السماح 1e-9 أكبر من الأرقام نفسها، فتعتبر كل القياسات مساوية للصفر.
والطريقة الصحيحة هي قيمة سماح نسبية Relative Tolerance، أي أن يكون الفرق صغيراً بالنسبة لحجم الرقمين، مع قيمة سماح مطلقة Absolute Tolerance للأرقام القريبة من الصفر فقط. وهذا ما تفعله math.isclose في Python، فهي تعتبر الرقمين متساويين إذا كان abs(a - b) <= max(rel_tol * max(abs(a), abs(b)), abs_tol)، والقيمة الافتراضية rel_tol=1e-09 وabs_tol=0.0. ولاحظ النتائج في التجربة: isclose أعطت True للرقمين الكبيرين، وأعطت False عند مقارنة 1e-10 بالصفر، لأن أي نسبة من الصفر تساوي صفراً، فلما أضفنا abs_tol=1e-9 أصبحت True. وفي C# وJavaScript لا توجد دالة جاهزة، فاكتب نفس المعادلة في دالة مساعدة واحدة في مشروعك، واختر قيمة السماح من طبيعة المسألة، فدقة الحساس أو أصغر وحدة في العملة هي التي تحدد متى يكون الرقمان «متساويين»، وليس رقماً تنسخه من الإنترنت.
تراكم الخطأ: جمع 0.1 عشرة ملايين مرة
خطأ التقريب في عملية واحدة لا يتجاوز نصف المسافة بين الأرقام عند حجم الناتج، وهو صغير جداً، ولكن عندما تجمع ملايين القيم في متغير واحد فإن كل عملية تضيف خطأها، والأسوأ أن المجموع يكبر فتكبر المسافة بين الأرقام عنده، فيكبر خطأ كل عملية جديدة. ولكي نرى ذلك بالأرقام جمعنا 0.1 عشرة ملايين مرة، والناتج الصحيح مليون، في أربع بيئات على نفس الجهاز:
| البيئة | الطريقة | الناتج | الوقت |
|---|---|---|---|
| C# | double بالجمع العادي | 999999.9998389754 | 22 ms |
| C# | double مع Kahan | 1000000 | 81 ms |
| C# | decimal | 1000000.0 | 196 ms |
| C# | float بالجمع العادي | 1087937 | 22 ms |
| Node.js | Number بالجمع العادي | 999999.9998389754 | 41 ms |
| Node.js | Number مع Kahan | 1000000 | 59 ms |
| Node.js | عدد صحيح بالهللات ثم القسمة على 100 | 1000000 | 19 ms |
| Node.js | float32 عبر Math.fround | 1087937 | 39 ms |
| Python | float بالجمع العادي | 999999.9998389754 | 3.09 s |
| Python | Kahan | 1000000.0 | 6.37 s |
| Python | math.fsum | 1000000.0 | 0.78 s |
| Python | Decimal | 1000000.0 | 7.35 s |
| PostgreSQL | sum على عمود float8 | 999999.9998389754 | 2.2 s |
| PostgreSQL | sum على عمود real | 1.087937e+06 | 1.7 s |
| PostgreSQL | sum على عمود numeric(12,2) | 1000000.00 | 2.1 s |
والأوقات في الجدول للتوضيح فقط، فقد قسناها مرة واحدة على جهاز تطوير وهي تتغير بين تشغيل وآخر، فوقت Kahan في C# تراوح بين 81 و204 ms في ثلاثة تشغيلات، وأوقات PostgreSQL الثلاثة تراوحت بين 1.1 و4 ثوان في تشغيلات متتالية، لأن قراءة عشرة ملايين صف تأخذ أغلب الوقت. أما النتائج نفسها فثابتة ومتطابقة، وفي الجدول أعلاه لاحظ التالي:
- نتيجة
doubleهي 999999.9998389754 في البيئات الأربع حرفاً بحرف، لأنها كلها تطبق نفس المعيار بنفس طريقة التقريب، فالخطأ ليس في لغة معينة. - نتيجة
floatأكبر من مليون بـ 87937، والسبب ما رأيناه في قسم المسافة بين الأرقام، فعندما يقترب المجموع من مليون تصبح المسافة 0.0625، فيقرب كل 0.1 إلى 0.125، فيزيد المجموع أكثر مما يجب في كل خطوة. - جمع Kahan أعطى الناتج الصحيح بنفس النوع
double، ودفعنا مقابله وقتاً أطول، أماmath.fsumفي Python فكان أسرع من الجمع العادي نفسه لأنه مكتوب بلغة C، وتصفه الوثائق بأنه يتتبع عدة مجاميع جزئية حتى لا يفقد الدقة. - العدد الصحيح بالهللات هو الأسرع والأدق معاً، وهذا يؤكد ما قلناه في قسم المبالغ المالية.
كيف يعمل جمع Kahan؟
الفكرة التي نشرها William Kahan، ويشرحها David Goldberg في ورقته المشهورة What Every Computer Scientist Should Know About Floating-Point Arithmetic، أن الجزء الذي يضيع من الرقم الصغير عند جمعه مع المجموع الكبير يمكن حسابه، فنحفظه في متغير تعويض Compensation ونضيفه في الخطوة التالية. والخطوات في كل دورة أربع:
y = x - c: نطرح من القيمة الجديدة ما ضاع في الخطوة السابقة.t = sum + y: نجمع، وهنا تضيع البتات المنخفضة منyلأنsumكبير.c = (t - sum) - y: الفرقt - sumهو ما أضيف فعلاً، وطرحyمنه يعطي ما ضاع بالسالب.sum = t: ونكمل.
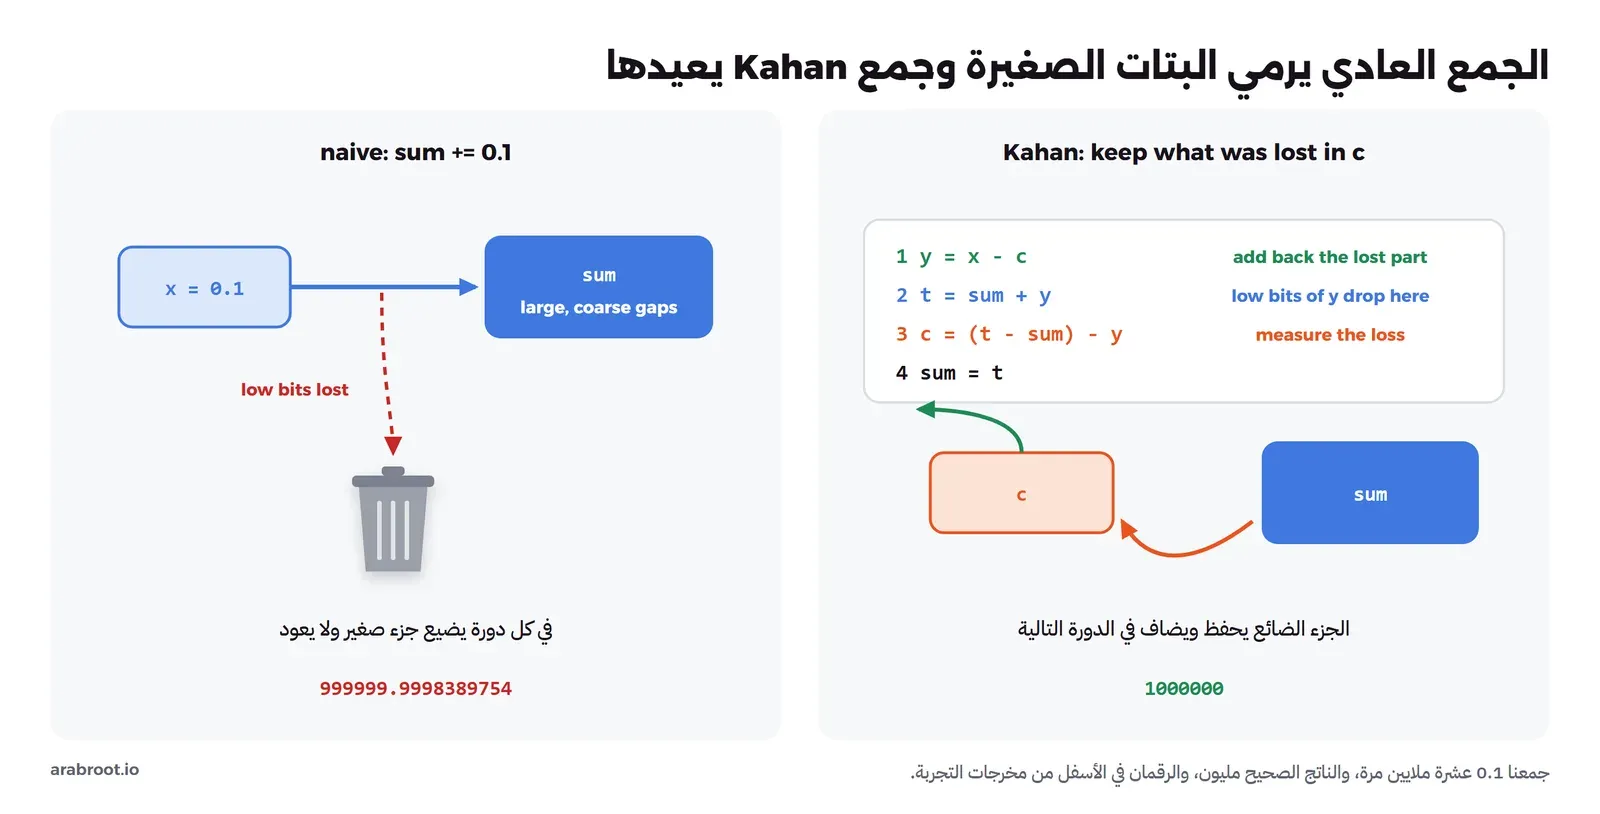
ويجدر الانتباه إلى أن هذه الخطوات تبدو للمترجم Compiler كأنها لا تفعل شيئاً، لأن (t - sum) - y يساوي صفراً في الرياضيات العادية، وتذكر ورقة Goldberg أن المترجم الذي يعيد ترتيب العمليات كأنها أرقام حقيقية قد يحذف التعويض كله، لذلك إذا استخدمت Kahan في C أو C++ فلا تفعل على هذا الكود خيارات المترجم التي تسمح بإعادة ترتيب العمليات العشرية، مثل -ffast-math في GCC. وفي C# وJavaScript وPython لم يحدث ذلك، والدليل أن الناتج كان مليوناً بالضبط.
الأرقام الصحيحة الكبيرة في double ومعرفات JSON
الكسر في double مع البت المخفي 53 بتاً، لذلك يمثل كل الأرقام الصحيحة حتى 253 بالضبط، وبعدها تصبح المسافة بين الأرقام 2 كما رأينا، فتختفي الأرقام الفردية، ثم تصبح 4 بعد 254، وهكذا. ولهذا فإن Number.MAX_SAFE_INTEGER في JavaScript هو 9007199254740991، أي 253 - 1، و2**53 + 1 === 2**53 صحيح كما طبعته التجربة. وقد ذكرنا هذا الحد في مقال الأنظمة العددية، والآن سوف نرى أين يؤذيك فعلاً، وهو JSON.
فصيغة JSON نفسها لا تحدد حجماً للأرقام، ولكن القسم 6 من RFC 8259 ينبه إلى أن أغلب البرامج تقرأ الأرقام كـ double، وأن الأرقام الصحيحة مضمونة التوافق بين الأنظمة فقط إذا كانت قيمتها المطلقة لا تتجاوز 253 - 1. ولنفرض أن السيرفر يرسل طلباً معرفه 1234567890123456789، وهو معرف 64 بت عادي، فهذا ما حدث في التجربة:
- في Node.js أعطى
JSON.parseالقيمة 1234567890123456800، أي أن آخر ثلاث خانات تغيرت دون أي خطأ، فإذا استخدم الكلاينت هذا المعرف ليطلب تفاصيل الطلب فسوف يطلب طلباً آخر أو لا يجد شيئاً. - في Python أعطى
json.loadsالرقم الصحيح، لأنintفي Python بدقة غير محدودة، ولكن عندما حولناه إلىfloatأصبح 1234567890123456768، وهو نفس الرقم الذي خزنته JavaScript، ولكنها تطبع أقصر نص يعيده فتظهر 800 بدلاً من 768. - في PostgreSQL أعطى
9007199254740993::float8::bigintالقيمة 9007199254740992، فإذا مر المعرف بعمود أو حساب من نوعfloat8في أي مرحلة فقد يتغير.
والحل أن ترسل المعرفات الكبيرة كنصوص في JSON، وهذا ما تفعله مواصفة ProtoJSON في gRPC تلقائياً، فالأنواع int64 وuint64 تكتب في JSON كنص عشري، ولهذا السبب تحديداً، وقد شرحنا تصميم الواجهات وأنواع الحقول في مقال تصميم واجهات API، والمعرفات من نوع Snowflake في مقال المعرفات الفريدة. وإذا كنت تستقبل JSON لا تتحكم فيه، فإن JSON.parse في النسخ الحديثة يمرر للدالة Reviver معاملاً ثالثاً فيه النص الأصلي للقيمة context.source، فتستطيع تحويله إلى BigInt قبل أن يضيع، وقد نجح ذلك في Node.js 22 فأعطى 1234567890123456789n. ولكن انتبه إلى أن JSON.stringify لا يعرف BigInt، فقد رمى TypeError: Do not know how to serialize a BigInt، لذلك حوله إلى نص قبل الإرسال.
الأنواع العشرية: ما الذي تحله وما الذي لا تحله
في مقال الأنظمة العددية قلنا إن المال يحفظ بنوع عشري أو بعدد صحيح بأصغر وحدة، والآن سوف نرى ما الذي يحدث داخل هذه الأنواع، لأن فهمها يمنعك من خطأين: أن تظن أنها دقيقة في كل شيء، وأن تستخدمها في مكان لا تحتاجها فيه.
فالنوع decimal في C# هو أيضاً فاصلة عائمة، ولكن بالأساس 10 بدلاً من 2، فهو يخزن عدداً صحيحاً بحجم 96 بت ومعه معامل قياس Scale يحدد مكان الفاصلة العشرية، وحجمه 16 بايتاً كما طبعت sizeof(decimal)، وأكبر قيمة له 79228162514264337593543950335. وبما أن الأساس 10، فكل كسر عشري مثل 0.1 و0.01 يمثل بالضبط، فأعطى 0.1m + 0.2m القيمة 0.3 والمقارنة بـ 0.3m صحيحة. ولكن الكسور التي لا تنتهي بالعشري ما زالت مقربة، فـ 1m / 3m * 3m أعطى 0.9999999999999999999999999999 وليس 1، لأن الثلث بالعشري لا ينتهي، تماماً كما لا تنتهي 0.1 بالثنائي. ونفس الشيء في Python، فالوحدة decimal تقرب كل عملية إلى دقة السياق Context، وهي 28 خانة افتراضياً، وفي Java يرمي BigDecimal.divide الاستثناء ArithmeticException إذا كان الناتج كسراً لا ينتهي ولم تحدد له الدقة وطريقة التقريب، وهذا السلوك من Java أوضح في رأينا لأنه يجبرك على القرار.
وفي قواعد البيانات الصورة مشابهة، فـ PostgreSQL فيه real بحجم 4 بايتات وdouble precision أو float8 بحجم 8 بايتات، وكلاهما IEEE 754، وnumeric بحجم متغير يحفظ الخانات العشرية بالضبط، والجدول التالي يجمع ما ظهر في التجربة:
| الاختبار | real | float8 | numeric |
|---|---|---|---|
0.1 + 0.2 | 0.3 (العرض مختصر) | 0.30000000000000004 | 0.3 |
| جمع 0.1 عشرة ملايين مرة | 1.087937e+06 | 999999.9998389754 | 1000000.00 |
round(2.5) | 2 | 3 | |
الحجم بالأمر pg_column_size | 4 | 8 | 12 للقيمة 123456.78 |
| NaN وInfinity | نعم | نعم | نعم، و Infinity فقط في عمود بدون دقة محددة |
والقاعدة في اختيار النوع، سواء في الكود أو في قاعدة البيانات، كما يلي:
- المال والكميات التي لها خانات عشرية محددة قانوناً، مثل الأسعار والضرائب والأرصدة:
decimalأوBigDecimalأوDecimalأوnumeric(p, s)، أو عدد صحيح بأصغر وحدة، والسبب أن المحاسب يقارن بالخانة الأخيرة، ووثائق PostgreSQL تنصح بـnumericصراحة لهذه الحالة. - القياسات والحسابات العلمية والإحصاءات والرسوميات:
doubleأوfloat8، لأن القياس نفسه تقريبي، والسرعة والمساحة أهم من آخر خانة، والنوع العشري هنا أبطأ بكثير دون فائدة، فقد كانdecimalفي تجربتنا أبطأ منdoubleقرابة 9 مرات في نفس التشغيل. - الأعداد الهائلة من القيم التقريبية، مثل أوزان نماذج الذكاء الاصطناعي ومصفوفات الصور:
floatأو أصغر منه، وهذا موضوع القسم التالي.
الأرقام العشرية في الذكاء الاصطناعي: fp16 وbfloat16 وfp8
نموذج اللغة عبارة عن مليارات الأرقام العشرية، وكل بت في كل رقم يكلف ذاكرة وعرض نطاق للذاكرة Memory Bandwidth، لذلك ظهرت أنواع أصغر من float، وكلها تتبع نفس فكرة IEEE 754، أي إشارة وأس وكسر، والفرق في عدد البتات لكل جزء، وهذا الاختيار هو الذي يحدد ما تخسره:
| النوع | إشارة / أس / كسر | أكبر قيمة | الرقم 0.1 المخزن (من التجربة) |
|---|---|---|---|
fp32 (float) | 1 / 8 / 23 | تقريباً 3.4 × 1038 | 0.100000001490116 |
fp16 (Half) | 1 / 5 / 10 | 65504 | 0.0999755859375 |
| bfloat16 | 1 / 8 / 7 | نفس مجال fp32 تقريباً | 0.10009765625 |
| fp8 E4M3 | 1 / 4 / 3 | 448 | لم نقسه |
| fp8 E5M2 | 1 / 5 / 2 | 57344 | لم نقسه |
وفي الجدول أعلاه لاحظ التالي:
- fp16 فيه كسر أطول من bfloat16، أي دقة أعلى، ولكن الأس 5 بتات فقط، فأكبر قيمة 65504، وفي التجربة أصبح الرقم 70000 لا نهاية في C# بالنوع
Half، ورمت PythonOverflowError، والرقم 1e-8 أصبح صفراً، والرقم 2049 أصبح 2048. ولاحظ أن C# طبعتHalf.MaxValueكـ 65500 لأنها تطبع أقصر نص يعيد نفس القيمة، بينما القيمة الحقيقية 65504 كما طبعتها Python. - bfloat16 هو ببساطة أعلى 16 بتاً من fp32، فبتات 0.1 فيه
0x3DCDوهي بداية بتاتfloatنفسها0x3DCCCCCDبعد التقريب، ولذلك له نفس الأس ونفس المجال كما تشرح مدونة Google Cloud، فالنوع ظهرت فكرته في فريق Google Brain واستخدم في معالجات TPU، فالرقم 70000 أصبح 70144 بدلاً من أن يفيض، و1e-8 بقي تقريباً كما هو، ولكن الدقة أقل بكثير، فالرقم 1000.5 أصبح 1000. - fp8 له نوعان حسب ورقة FP8 Formats for Deep Learning من NVIDIA وArm وIntel: E4M3 بدقة أعلى ومجال حتى 448، وE5M2 بمجال حتى 57344 ودقة أقل، والقيم القصوى في الجدول من جدول الورقة نفسها.
والدرس من هذه الأنواع أن عدد بتات الأس يحدد المجال، أي هل يفيض الرقم أو يختفي، وعدد بتات الكسر يحدد الدقة، ونماذج التعلم العميق تتحمل خسارة الدقة أكثر بكثير من خسارة المجال، لأن قيمة واحدة تفيض إلى لا نهاية قد تفسد التدريب كله، بينما خطأ صغير في كل وزن لا يغير النتيجة كثيراً، وتقول مدونة Google نفسها إن الشبكات العصبية أكثر حساسية لحجم الأس منها لحجم الكسر، ولهذا اختاروا لـ bfloat16 أس fp32 كاملاً. والصورة التالية تقارن البتات في هذه الأنواع:
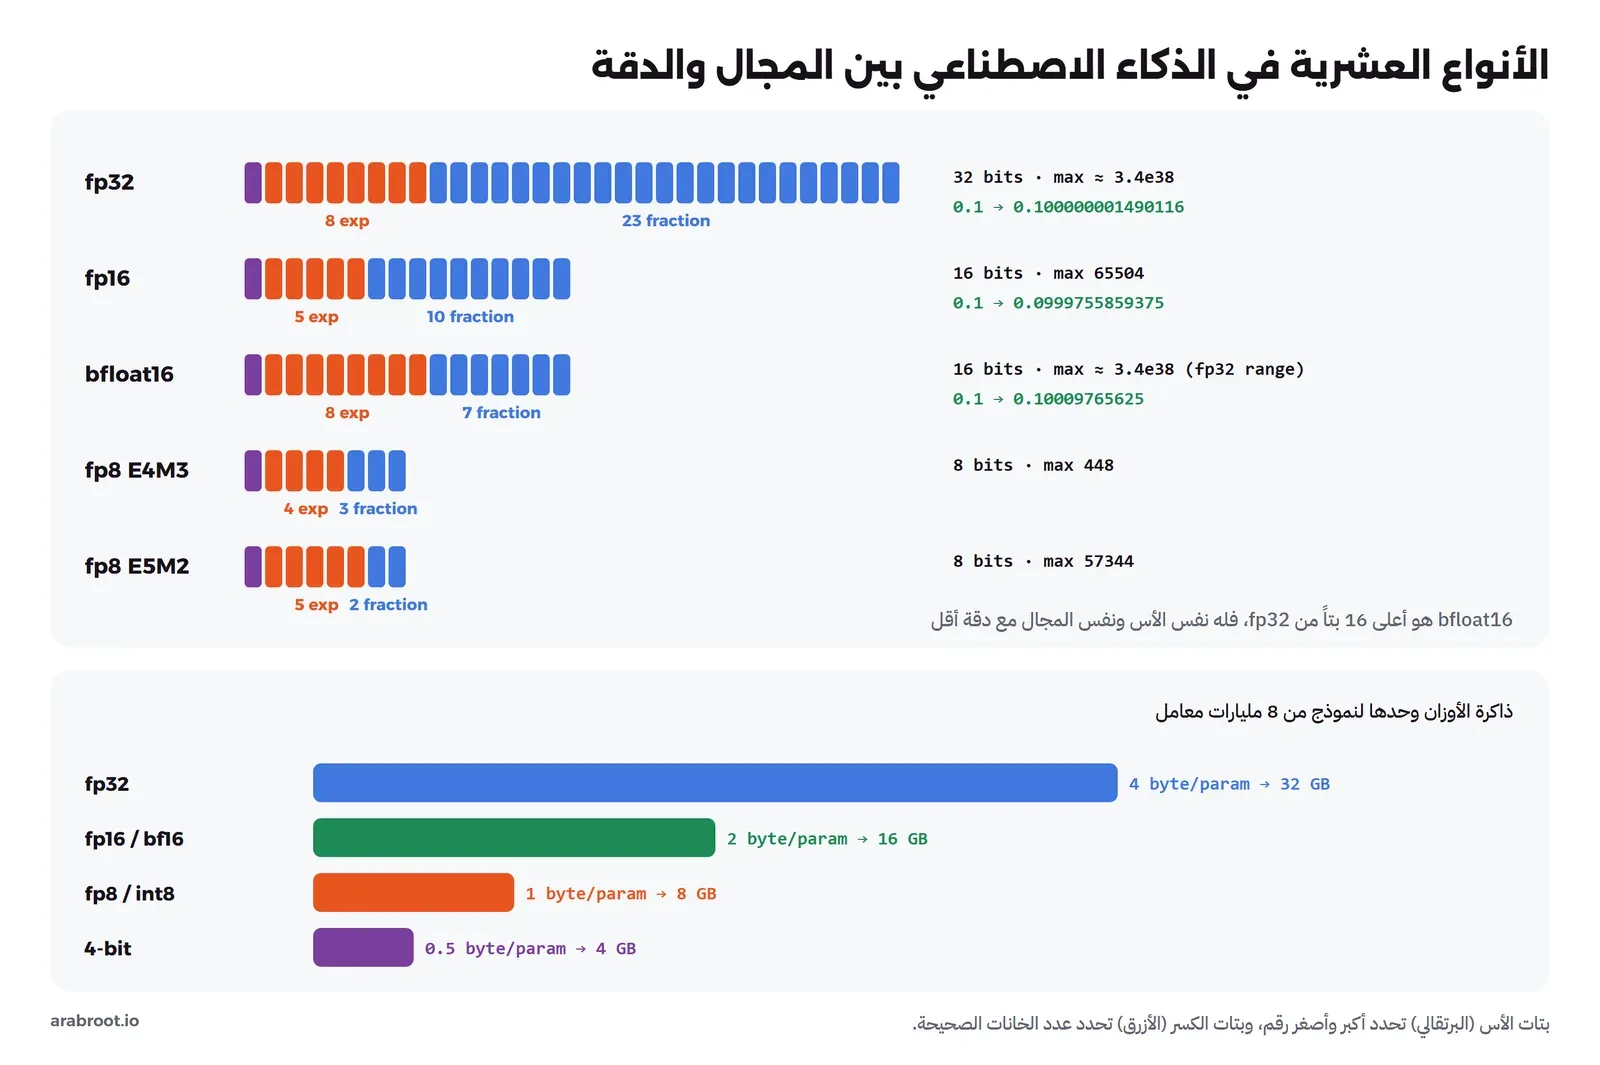
أما التكميم Quantization إلى int8 أو int4 فهو فكرة مختلفة، فالأوزان تحفظ كأعداد صحيحة صغيرة ومعها معامل قياس Scale مشترك لكل مجموعة من الأوزان، فتضرب العدد الصحيح في المعامل لتحصل على قيمة تقريبية للوزن الأصلي. والحساب البسيط للذاكرة هو عدد المعاملات في عدد البايتات لكل معامل: 4 بايتات في fp32 و2 في fp16 وbfloat16 و1 في fp8 وint8 ونصف بايت في 4 بت، فنموذج من 8 مليارات معامل يحتاج للأوزان وحدها قرابة 32 GB أو 16 أو 8 أو 4 على الترتيب. وقد شرحنا هذا الحساب بالتفصيل في مقال كيف تعمل نماذج اللغة، وكيف تختار نوع التكميم لجهازك في مقال تشغيل النماذج على جهازك.
حادثتان موثقتان: Patriot وAriane 5
الحادثتان التاليتان تذكران كثيراً كأمثلة على أخطاء الأرقام العشرية، ولكن الكثير من الشروح تخلط بينهما، فالأولى خطأ دقة تراكم مع الوقت، والثانية ليست خطأ دقة أصلاً وإنما تحويل رقم عشري إلى عدد صحيح أصغر منه، ولهذا سوف نعرض كل واحدة كما في تقريرها الرسمي.
والتقرير لا يذكر طريقة التمثيل الداخلية بالتفصيل، ولكننا نستطيع أن نعيد حساب أرقامه، فإذا قطعنا الرقم 0.1 بعد 23 بتاً من الفاصلة الثنائية دون تقريب، فالقيمة المخزنة 0.09999990463256836، والخطأ في كل عشر ثانية 9.5367e-08 ثانية، وبضربه في عدد الأعشار في كل فترة نحصل على هذا الجدول من تجربة Python، وبجانبه أرقام الملحق الثاني من تقرير GAO:
| مدة التشغيل | عدد الأعشار | الانحراف من حسابنا | الانحراف في تقرير GAO | انزياح منطقة البحث في التقرير |
|---|---|---|---|---|
| 1 ساعة | 36,000 | 0.0034 ثانية | 0.0034 ثانية | 7 أمتار |
| 8 ساعات | 288,000 | 0.0275 ثانية | 0.0275 ثانية | 55 متراً |
| 20 ساعة | 720,000 | 0.0687 ثانية | 0.0687 ثانية | 137 متراً |
| 48 ساعة | 1,728,000 | 0.1648 ثانية | 0.1648 ثانية | 330 متراً |
| 72 ساعة | 2,592,000 | 0.2472 ثانية | 0.2472 ثانية | 494 متراً |
| 100 ساعة | 3,600,000 | 0.3433 ثانية | 0.3433 ثانية | 687 متراً |
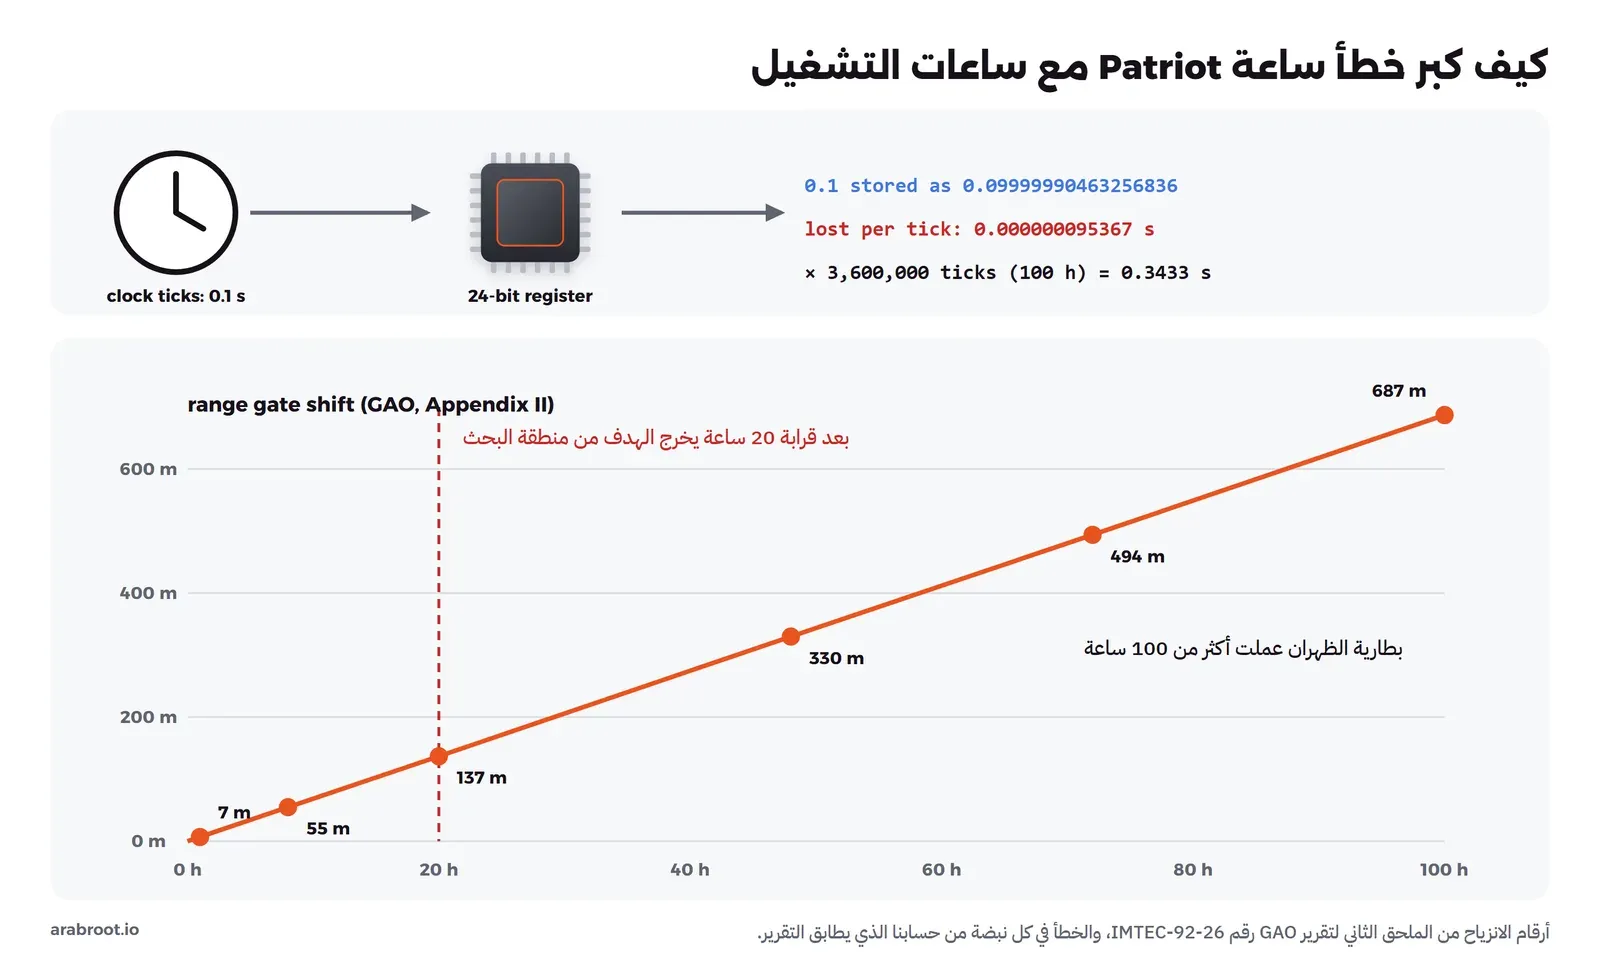
والدرس هنا ليس أن 24 بتاً قليلة فقط، وإنما أن ثابتاً لا يمثل بالضبط بالثنائي، مثل 0.1، إذا ضرب في عداد يكبر مع الوقت فإن خطأه يكبر مع الوقت أيضاً، وأن إعادة تشغيل النظام كانت تصفر العداد وتخفي المشكلة، فلم تظهر في الاختبارات القصيرة. لذلك عد الوقت بعدد صحيح بالوحدة الأصغر، مثل الميلي ثانية، وحوله عند الحاجة فقط، واختبر الأنظمة التي تعمل طويلاً لمدة طويلة فعلاً.
لاحظ أن Ariane 5 لم يفشل بسبب دقة الرقم العشري، فالرقم المحسوب كان صحيحاً، وإنما بسبب تحويله إلى نوع أصغر دون التحقق من المجال. ونفس الخطأ تستطيع أن تكتبه في C# اليوم، ففي التجربة حولنا 40000.5 إلى short، وأكبر قيمة لـ short هي 32767:
- بدون فحص Unchecked أعطى التحويل
-25536بصمت، وهذا أسوأ من خطأ واضح، لأن البرنامج يكمل بقيمة خاطئة. - مع
checkedرمىOverflowException، وهذا ما حدث في Ariane، والفرق أن عليك أن تقرر ماذا تفعل بالاستثناء، لا أن توقف النظام كله. - وتحويل
1e10إلىintأعطى 2147483647، وتحويل NaN أعطى صفراً، لأن .NET 9 جعل هذه التحويلات تتوقف عند الحد الأقصى Saturating على x86 وx64 كما في صفحة التغييرات، أي أن نفس الكود كان يعطي نتيجة مختلفة في النسخ السابقة.
لذلك كل تحويل من رقم عشري إلى عدد صحيح أصغر يحتاج إلى فحص للمجال وقرار مكتوب لما يحدث إذا خرجت القيمة عنه، ولا تعتمد على السلوك الافتراضي للغة لأنه يختلف بين اللغات وبين نسخ اللغة الواحدة.
التجربة العملية: الكود والمخرجات كاملة
شغلنا كل الأمثلة في Containers منفصلة على جهاز x86-64 بإصدارات محددة من ال Images، حتى تستطيع إعادة التجربة بنفس النتائج. ضع الملفات الأربعة في مجلد واحد، ثم شغل كل لغة بالأمر الخاص بها من داخل المجلد.
Python: البتات والمسافات والقيم الخاصة والجمع وساعة Patriot
الملف floats.py يستخدم الوحدة struct لقراءة البتات، والصيغة e فيها هي fp16، أما bfloat16 فحسبناه بأخذ أعلى 16 بتاً من float مع التقريب إلى الزوجي:
import json, math, struct, sys, time
from decimal import Decimal, ROUND_HALF_UP, ROUND_HALF_EVEN
from fractions import Fraction

def bits64(x):
    (u,) = struct.unpack('>Q', struct.pack('>d', x))
    b = f'{u:064b}'
    return u, b[0], b[1:12], b[12:]

def bits32(x):
    (u,) = struct.unpack('>I', struct.pack('>f', x))
    b = f'{u:032b}'
    return u, b[0], b[1:9], b[9:]

print('== 1) the real bits')
for x in (0.1, 3.14):
    u, s, e, m = bits64(x)
    print(f'double {x}: 0x{u:016X}')
    print(f'  sign={s} exponent={e} ({int(e, 2)} - 1023 = {int(e, 2) - 1023})')
    print(f'  mantissa={m}')
    print(f'  value = (-1)^{s} x 1.{m[:12]}... x 2^{int(e, 2) - 1023}')
    print(f'  exact stored value = {Decimal(x)}')
    u, s, e, m = bits32(x)
    f32 = struct.unpack('>f', struct.pack('>f', x))[0]
    print(f'float  {x}: 0x{u:08X} sign={s} exponent={e} ({int(e, 2)} - 127 = {int(e, 2) - 127}) mantissa={m}')
    print(f'  exact stored value = {Decimal(f32)}')

print('== 2) precision in decimal digits')
print('float32(0.1) printed with 17 digits:', f'{struct.unpack(">f", struct.pack(">f", 0.1))[0]:.17g}')
print('sys.float_info.dig =', sys.float_info.dig, ' mant_dig =', sys.float_info.mant_dig)
print('16777217 as float32 ->', struct.unpack('>f', struct.pack('>f', 16777217.0))[0])
print('9007199254740993 as double ->', float(9007199254740993))

print('== 3) the gap between neighbours (ULP)')
for x in (1.0, 1000.0, 1e6, 1e9, 2.0**53, 1e16, 1e300):
    print(f'math.ulp({x:g}) = {math.ulp(x):.6g}')
print('math.nextafter(1.0, 2.0) =', repr(math.nextafter(1.0, 2.0)))
print('1e16 + 1 == 1e16 ?', 1e16 + 1 == 1e16)
print('sys.float_info.epsilon =', sys.float_info.epsilon)
now = 1791460000.0  # a Unix time in October 2026, in seconds
f32 = struct.unpack('>f', struct.pack('>f', now))[0]
up = struct.unpack('>f', struct.pack('>I', struct.unpack('>I', struct.pack('>f', now))[0] + 1))[0]
print(f'Unix time {now:.0f}: double gap = {math.ulp(now):.3g} s, float32 stores {f32:.0f}, float32 gap = {up - f32:.0f} s')

print('== 4) special values')
print('0.0 == -0.0 ?', 0.0 == -0.0, ' copysign(1, -0.0) =', math.copysign(1, -0.0))
inf, nan = float('inf'), float('nan')
print('inf - inf =', inf - inf, ' inf * 0 =', inf * 0, ' 1e308 * 10 =', 1e308 * 10)
print('nan == nan ?', nan == nan, ' math.isnan(nan) =', math.isnan(nan))
print('nan in [nan] ?', nan in [nan], ' float("nan") in [float("nan")] ?', float('nan') in [float('nan')])
print('max(nan, 1) =', max(nan, 1), ' max(1, nan) =', max(1, nan))
print('sorted([3, nan, 1, 2]) =', sorted([3, nan, 1, 2]))
print('smallest normal  =', sys.float_info.min)
print('smallest subnormal =', math.ulp(0.0), ' half of it =', math.ulp(0.0) / 2)
print('json.dumps(nan) =', json.dumps(nan))
try:
    json.dumps(nan, allow_nan=False)
except ValueError as e:
    print('json.dumps(nan, allow_nan=False) ->', e)
try:
    1.0 / 0.0
except ZeroDivisionError as e:
    print('1.0 / 0.0 ->', type(e).__name__, e)

print('== 5) rounding')
print('round(0.5), round(1.5), round(2.5), round(3.5) =', round(0.5), round(1.5), round(2.5), round(3.5))
print('round(2.675, 2) =', round(2.675, 2), ' because 2.675 is', Decimal(2.675))
print('Decimal("2.5") HALF_EVEN ->', Decimal('2.5').quantize(Decimal('1'), rounding=ROUND_HALF_EVEN),
      ' HALF_UP ->', Decimal('2.5').quantize(Decimal('1'), rounding=ROUND_HALF_UP))
print('Decimal("2.675") to 2 places HALF_UP ->', Decimal('2.675').quantize(Decimal('0.01'), rounding=ROUND_HALF_UP))

print('== 6) comparing')
a = 0.1 + 0.2
print('a == 0.3 ?', a == 0.3, ' abs(a - 0.3) =', abs(a - 0.3))
print('math.isclose(a, 0.3) =', math.isclose(a, 0.3))
print('math.isclose(1e-10, 0.0) =', math.isclose(1e-10, 0.0), ' with abs_tol=1e-9 ->', math.isclose(1e-10, 0.0, abs_tol=1e-9))
big1, big2 = 1e15 + 0.3, 1e15 + 0.5
print('abs(big1 - big2) < 1e-9 ?', abs(big1 - big2) < 1e-9, ' isclose ->', math.isclose(big1, big2))

print('== 7) summing 0.1 ten million times')
N = 10_000_000
t = time.perf_counter(); s = 0.0
for _ in range(N):
    s += 0.1
t1 = time.perf_counter() - t
t = time.perf_counter(); s2 = 0.0; c = 0.0
for _ in range(N):
    y = 0.1 - c
    tt = s2 + y
    c = (tt - s2) - y
    s2 = tt
t2 = time.perf_counter() - t
t = time.perf_counter(); s3 = math.fsum(0.1 for _ in range(N)); t3 = time.perf_counter() - t
t = time.perf_counter(); s4 = sum(Decimal('0.1') for _ in range(N)); t4 = time.perf_counter() - t
print(f'naive  {s!r:<22} error {s - 1e6:+.3e}  {t1:.2f}s')
print(f'kahan  {s2!r:<22} error {s2 - 1e6:+.3e}  {t2:.2f}s')
print(f'fsum   {s3!r:<22} error {s3 - 1e6:+.3e}  {t3:.2f}s')
print(f'Decimal {s4!s:<21}                  {t4:.2f}s')

print('== 8) the Patriot clock: 0.1 chopped to 23 bits after the binary point')
tenth = Fraction(int(Fraction(1, 10) * 2**23), 2**23)
err = Fraction(1, 10) - tenth
print('stored 0.1 =', float(tenth), ' error per tick =', f'{float(err):.4e}')
for hours in (1, 8, 20, 48, 72, 100):
    ticks = hours * 3600 * 10
    print(f'{hours:>3} h: {ticks:>9} ticks, clock drift = {float(err * ticks):.4f} s')

print('== 9) big integers in JSON')
doc = '{"id": 1234567890123456789}'
print('json.loads ->', json.loads(doc)['id'])
print('as float  ->', float(json.loads(doc)['id']), '->', int(float(json.loads(doc)['id'])))

print('== 10) fp16 and bfloat16')
def f16(x):
    return struct.unpack('<e', struct.pack('<e', x))[0]
def bf16_bits(x):
    (u,) = struct.unpack('>I', struct.pack('>f', x))
    r = ((u >> 16) & 1) + 0x7FFF
    return (u + r) >> 16
def bf16(x):
    return struct.unpack('>f', struct.pack('>I', bf16_bits(x) << 16))[0]
for x in (0.1, 3.14159265, 1000.5, 65504.0, 70000.0, 1e-8):
    try:
        h = f16(x)
    except OverflowError:
        h = 'OverflowError'
    print(f'{x:>12g} -> fp16 {h!s:<22} bf16 {bf16(x)!r}')
print('fp16 bits of 0.1 = 0x%04X' % struct.unpack('<H', struct.pack('<e', 0.1))[0], ' bf16 bits of 0.1 = 0x%04X' % bf16_bits(0.1))
docker run --rm --name lab-float-python -v "$PWD:/lab" -w /lab python:3.13.8-slim python floats.pyوالمخرج سوف يكون كما يلي:
== 1) the real bits
double 0.1: 0x3FB999999999999A
  sign=0 exponent=01111111011 (1019 - 1023 = -4)
  mantissa=1001100110011001100110011001100110011001100110011010
  value = (-1)^0 x 1.100110011001... x 2^-4
  exact stored value = 0.1000000000000000055511151231257827021181583404541015625
float  0.1: 0x3DCCCCCD sign=0 exponent=01111011 (123 - 127 = -4) mantissa=10011001100110011001101
  exact stored value = 0.100000001490116119384765625
double 3.14: 0x40091EB851EB851F
  sign=0 exponent=10000000000 (1024 - 1023 = 1)
  mantissa=1001000111101011100001010001111010111000010100011111
  value = (-1)^0 x 1.100100011110... x 2^1
  exact stored value = 3.140000000000000124344978758017532527446746826171875
float  3.14: 0x4048F5C3 sign=0 exponent=10000000 (128 - 127 = 1) mantissa=10010001111010111000011
  exact stored value = 3.1400001049041748046875
== 2) precision in decimal digits
float32(0.1) printed with 17 digits: 0.10000000149011612
sys.float_info.dig = 15  mant_dig = 53
16777217 as float32 -> 16777216.0
9007199254740993 as double -> 9007199254740992.0
== 3) the gap between neighbours (ULP)
math.ulp(1) = 2.22045e-16
math.ulp(1000) = 1.13687e-13
math.ulp(1e+06) = 1.16415e-10
math.ulp(1e+09) = 1.19209e-07
math.ulp(9.0072e+15) = 2
math.ulp(1e+16) = 2
math.ulp(1e+300) = 1.48702e+284
math.nextafter(1.0, 2.0) = 1.0000000000000002
1e16 + 1 == 1e16 ? True
sys.float_info.epsilon = 2.220446049250313e-16
Unix time 1791460000: double gap = 2.38e-07 s, float32 stores 1791459968, float32 gap = 128 s
== 4) special values
0.0 == -0.0 ? True  copysign(1, -0.0) = -1.0
inf - inf = nan  inf * 0 = nan  1e308 * 10 = inf
nan == nan ? False  math.isnan(nan) = True
nan in [nan] ? True  float("nan") in [float("nan")] ? False
max(nan, 1) = nan  max(1, nan) = 1
sorted([3, nan, 1, 2]) = [3, nan, 1, 2]
smallest normal  = 2.2250738585072014e-308
smallest subnormal = 5e-324  half of it = 0.0
json.dumps(nan) = NaN
json.dumps(nan, allow_nan=False) -> Out of range float values are not JSON compliant: nan
1.0 / 0.0 -> ZeroDivisionError float division by zero
== 5) rounding
round(0.5), round(1.5), round(2.5), round(3.5) = 0 2 2 4
round(2.675, 2) = 2.67  because 2.675 is 2.67499999999999982236431605997495353221893310546875
Decimal("2.5") HALF_EVEN -> 2  HALF_UP -> 3
Decimal("2.675") to 2 places HALF_UP -> 2.68
== 6) comparing
a == 0.3 ? False  abs(a - 0.3) = 5.551115123125783e-17
math.isclose(a, 0.3) = True
math.isclose(1e-10, 0.0) = False  with abs_tol=1e-9 -> True
abs(big1 - big2) < 1e-9 ? False  isclose -> True
== 7) summing 0.1 ten million times
naive  999999.9998389754      error -1.610e-04  3.09s
kahan  1000000.0              error +0.000e+00  6.37s
fsum   1000000.0              error +0.000e+00  0.78s
Decimal 1000000.0                              7.35s
== 8) the Patriot clock: 0.1 chopped to 23 bits after the binary point
stored 0.1 = 0.09999990463256836  error per tick = 9.5367e-08
  1 h:     36000 ticks, clock drift = 0.0034 s
  8 h:    288000 ticks, clock drift = 0.0275 s
 20 h:    720000 ticks, clock drift = 0.0687 s
 48 h:   1728000 ticks, clock drift = 0.1648 s
 72 h:   2592000 ticks, clock drift = 0.2472 s
100 h:   3600000 ticks, clock drift = 0.3433 s
== 9) big integers in JSON
json.loads -> 1234567890123456789
as float  -> 1.2345678901234568e+18 -> 1234567890123456768
== 10) fp16 and bfloat16
         0.1 -> fp16 0.0999755859375        bf16 0.10009765625
     3.14159 -> fp16 3.140625               bf16 3.140625
      1000.5 -> fp16 1000.5                 bf16 1000.0
       65504 -> fp16 65504.0                bf16 65536.0
       70000 -> fp16 OverflowError          bf16 70144.0
       1e-08 -> fp16 0.0                    bf16 1.0011717677116394e-08
fp16 bits of 0.1 = 0x2E66  bf16 bits of 0.1 = 0x3DCD
في المخرج أعلاه لاحظ التالي:
- القسم الأول يطبع البتات مقسمة إلى إشارة وأس وكسر، وهي نفس البتات التي في الصورة الأولى، و
Decimal(x)يطبع القيمة المخزنة بكل خاناتها دون تقريب. sorted([3, nan, 1, 2])أعاد القائمة دون ترتيب، لأن كل مقارنة مع NaN خطأ، فتظن الخوارزمية أن القائمة مرتبة.- القسم الثامن يعيد حساب جدول تقرير Patriot بالكسور الدقيقة
Fraction، حتى لا يدخل خطأdoubleنفسه في الحساب.
Node.js: البتات والمعرفات الكبيرة وتقريب JavaScript
الملف floats.js يقرأ البتات بـ DataView، والدالة nextUp تزيد بتات الرقم بواحد لتحصل على الرقم التالي، وهذا يعمل للأرقام الموجبة بفضل الإزاحة التي شرحناها في أول المقال:
const dv = new DataView(new ArrayBuffer(8));
const bits = (x) => { dv.setFloat64(0, x); return dv.getBigUint64(0); };
const fromBits = (u) => { dv.setBigUint64(0, u); return dv.getFloat64(0); };
const nextUp = (x) => fromBits(bits(x) + 1n);

console.log('== 1) the real bits');
for (const x of [0.1, 3.14]) console.log(x, '0x' + bits(x).toString(16).toUpperCase(), ' Math.fround:', Math.fround(x));

console.log('== 2) the gap between neighbours');
console.log('Number.EPSILON =', Number.EPSILON);
for (const x of [1, 1e6, 2 ** 53, 1e16]) console.log(`next after ${x} = ${nextUp(x)}  gap = ${nextUp(x) - x}`);

console.log('== 3) big integers');
console.log('MAX_SAFE_INTEGER =', Number.MAX_SAFE_INTEGER, ' isSafeInteger(2**53) =', Number.isSafeInteger(2 ** 53));
console.log('2**53 + 1 =', 2 ** 53 + 1, ' 2**53 + 1 === 2**53 ?', 2 ** 53 + 1 === 2 ** 53);
const doc = '{"id": 1234567890123456789, "id_str": "1234567890123456789"}';
const o = JSON.parse(doc);
console.log('JSON.parse id     ->', o.id);
console.log('JSON.parse id_str ->', o.id_str, '-> BigInt', BigInt(o.id_str));
const keep = JSON.parse(doc, (k, v, ctx) => (k === 'id' && ctx && ctx.source) ? BigInt(ctx.source) : v);
console.log('reviver with source ->', keep.id, typeof keep.id);
try { JSON.stringify({ id: 10n }); } catch (e) { console.log('JSON.stringify(10n) ->', e.constructor.name + ':', e.message); }

console.log('== 4) special values');
console.log('0 === -0 ?', 0 === -0, ' Object.is(0, -0) =', Object.is(0, -0), ' 1 / -0 =', 1 / -0);
console.log('NaN === NaN ?', NaN === NaN, ' Object.is(NaN, NaN) =', Object.is(NaN, NaN));
console.log('[NaN].indexOf(NaN) =', [NaN].indexOf(NaN), ' [NaN].includes(NaN) =', [NaN].includes(NaN));
console.log('Math.max(1, NaN) =', Math.max(1, NaN), ' JSON.stringify([NaN, Infinity, -0]) =', JSON.stringify([NaN, Infinity, -0]));
console.log('Number.MIN_VALUE =', Number.MIN_VALUE, ' Number.MIN_VALUE / 2 =', Number.MIN_VALUE / 2);

console.log('== 5) rounding');
console.log('Math.round(2.5), Math.round(-2.5), Math.round(-0.5) =', Math.round(2.5), Math.round(-2.5), Math.round(-0.5));
console.log('(2.5).toFixed(0) =', (2.5).toFixed(0), ' (1.005).toFixed(2) =', (1.005).toFixed(2), ' (1.005).toPrecision(20) =', (1.005).toPrecision(20));

console.log('== 6) summing 0.1 ten million times');
const N = 10_000_000;
let t = performance.now(), s = 0;
for (let i = 0; i < N; i++) s += 0.1;
const t1 = performance.now() - t;
t = performance.now(); let s2 = 0, c = 0;
for (let i = 0; i < N; i++) { const y = 0.1 - c; const tt = s2 + y; c = (tt - s2) - y; s2 = tt; }
const t2 = performance.now() - t;
t = performance.now(); let cents = 0;
for (let i = 0; i < N; i++) cents += 10;
const t3 = performance.now() - t;
t = performance.now(); let f = Math.fround(0);
for (let i = 0; i < N; i++) f = Math.fround(f + Math.fround(0.1));
const t4 = performance.now() - t;
console.log(`naive double  ${s}  ${t1.toFixed(0)} ms`);
console.log(`kahan double  ${s2}  ${t2.toFixed(0)} ms`);
console.log(`integer cents ${cents / 100}  ${t3.toFixed(0)} ms`);
console.log(`naive float32 ${f}  ${t4.toFixed(0)} ms`);
docker run --rm --name lab-float-node -v "$PWD:/lab" -w /lab node:22.20.0-alpine node floats.jsوالمخرج سوف يكون كما يلي:
== 1) the real bits
0.1 0x3FB999999999999A  Math.fround: 0.10000000149011612
3.14 0x40091EB851EB851F  Math.fround: 3.140000104904175
== 2) the gap between neighbours
Number.EPSILON = 2.220446049250313e-16
next after 1 = 1.0000000000000002  gap = 2.220446049250313e-16
next after 1000000 = 1000000.0000000001  gap = 1.1641532182693481e-10
next after 9007199254740992 = 9007199254740994  gap = 2
next after 10000000000000000 = 10000000000000002  gap = 2
== 3) big integers
MAX_SAFE_INTEGER = 9007199254740991  isSafeInteger(2**53) = false
2**53 + 1 = 9007199254740992  2**53 + 1 === 2**53 ? true
JSON.parse id     -> 1234567890123456800
JSON.parse id_str -> 1234567890123456789 -> BigInt 1234567890123456789n
reviver with source -> 1234567890123456789n bigint
JSON.stringify(10n) -> TypeError: Do not know how to serialize a BigInt
== 4) special values
0 === -0 ? true  Object.is(0, -0) = false  1 / -0 = -Infinity
NaN === NaN ? false  Object.is(NaN, NaN) = true
[NaN].indexOf(NaN) = -1  [NaN].includes(NaN) = true
Math.max(1, NaN) = NaN  JSON.stringify([NaN, Infinity, -0]) = [null,null,0]
Number.MIN_VALUE = 5e-324  Number.MIN_VALUE / 2 = 0
== 5) rounding
Math.round(2.5), Math.round(-2.5), Math.round(-0.5) = 3 -2 -0
(2.5).toFixed(0) = 3  (1.005).toFixed(2) = 1.00  (1.005).toPrecision(20) = 1.0049999999999998934
== 6) summing 0.1 ten million times
naive double  999999.9998389754  41 ms
kahan double  1000000  59 ms
integer cents 1000000  19 ms
naive float32 1087937  39 ms
في المخرج أعلاه لاحظ التالي:
Math.froundيقرب الرقم إلى أقربfloatثم يعيدهNumber، ولهذا استخدمناه لمحاكاة جمع float32 فظهر نفس الرقم 1087937 الذي ظهر في C# وPostgreSQL.- الحقل
id_strوصل سليماً لأنه نص، والحقلidتغير، والـ Reviver معcontext.sourceأنقذ القيمة الأصلية. (1.005).toFixed(2)أعطى1.00لأن القيمة المخزنة 1.0049999999999998934 كما طبعهاtoPrecision(20).
C#: الأنواع والتقريب والتحويل إلى عدد صحيح
الملف floats.cs يعمل دون مشروع بالأمر dotnet run floats.cs، وهي ميزة التطبيقات المكونة من ملف واحد في .NET 10:
using System;
using System.Diagnostics;

Console.WriteLine("== 1) the real bits");
foreach (double x in new[] { 0.1, 3.14 })
{
    long b = BitConverter.DoubleToInt64Bits(x);
    int sign = (int)(b >> 63), exp = (int)((b >> 52) & 0x7FF);
    long frac = b & 0xFFFFFFFFFFFFF;
    Console.WriteLine($"{x}: 0x{b:X16} sign={sign} exponent={exp}-1023={exp - 1023} fraction=0x{frac:X13}");
    Console.WriteLine($"  float: 0x{BitConverter.SingleToInt32Bits((float)x):X8}  (float){x} = {(float)x:G9}");
}

Console.WriteLine("== 2) neighbours and the confusing double.Epsilon");
Console.WriteLine($"Math.BitIncrement(1.0) - 1.0 = {Math.BitIncrement(1.0) - 1.0:R}");
Console.WriteLine($"double.Epsilon = {double.Epsilon:R}  (the smallest subnormal, not the machine epsilon)");
Console.WriteLine($"float: 16777216f + 1f = {16777216f + 1f:R}");
float million = 1_000_000f;
Console.WriteLine($"float gap at 1 = {MathF.BitIncrement(1f) - 1f:R}  float gap at 1e6 = {MathF.BitIncrement(million) - million:R}  (1e6f + 0.1f) - 1e6f = {(million + 0.1f) - million:R}");

Console.WriteLine("== 3) special values");
double zero = 0.0, negZero = -0.0;
Console.WriteLine($"0.0 == -0.0: {zero == negZero}  1/-0.0 = {1 / negZero}  double.IsNegative(-0.0) = {double.IsNegative(negZero)}");
double nan = double.NaN;
Console.WriteLine($"NaN == NaN: {nan == double.NaN}  NaN.Equals(NaN): {nan.Equals(nan)}  double.IsNaN: {double.IsNaN(nan)}");
Console.WriteLine($"1.0 / 0.0 = {1.0 / zero}  0.0 / 0.0 = {zero / zero}  Math.Sqrt(-1) = {Math.Sqrt(-1)}");
var arr = new[] { 3.0, double.NaN, 1.0, 2.0 }; Array.Sort(arr);
Console.WriteLine($"Array.Sort with NaN: [{string.Join(", ", arr)}]");

Console.WriteLine("== 4) rounding");
Console.WriteLine($"Math.Round(0.5)={Math.Round(0.5)} Math.Round(1.5)={Math.Round(1.5)} Math.Round(2.5)={Math.Round(2.5)}");
Console.WriteLine($"Math.Round(2.5, MidpointRounding.AwayFromZero) = {Math.Round(2.5, MidpointRounding.AwayFromZero)}");
Console.WriteLine($"Math.Round(2.675, 2, AwayFromZero) = {Math.Round(2.675, 2, MidpointRounding.AwayFromZero)}");
Console.WriteLine($"Math.Round(2.675m, 2, AwayFromZero) = {Math.Round(2.675m, 2, MidpointRounding.AwayFromZero)}");
Console.WriteLine($"(2.5).ToString(\"F0\") = {(2.5).ToString("F0")}");

Console.WriteLine("== 5) float to integer: what happened to Ariane 5");
double bh = 40000.5;
Console.WriteLine($"(short){bh} unchecked = {unchecked((short)bh)}");
try { short s = checked((short)bh); Console.WriteLine(s); }
catch (OverflowException e) { Console.WriteLine($"checked((short){bh}) -> {e.GetType().Name}: {e.Message}"); }
double huge = 1e10;
Console.WriteLine($"(int)1e10 = {(int)huge}  (int)NaN = {(int)nan}");

Console.WriteLine("== 6) decimal");
Console.WriteLine($"0.1m + 0.2m = {0.1m + 0.2m}  equal to 0.3m: {0.1m + 0.2m == 0.3m}");
Console.WriteLine($"1m / 3m * 3m = {1m / 3m * 3m}");
Console.WriteLine($"decimal.MaxValue = {decimal.MaxValue}");
Console.WriteLine($"sizeof: float {sizeof(float)}, double {sizeof(double)}, decimal {sizeof(decimal)}, Half 2");

Console.WriteLine("== 7) Half (fp16)");
Console.WriteLine($"(Half)0.1 = {(Half)0.1}  bits 0x{BitConverter.HalfToUInt16Bits((Half)0.1):X4}  Half.MaxValue = {Half.MaxValue}  (Half)70000 = {(Half)70000.0}");
Console.WriteLine($"(Half)2049 = {(Half)2049.0}  Half.Epsilon = {Half.Epsilon}");

Console.WriteLine("== 8) summing 0.1 ten million times");
const int N = 10_000_000;
var sw = Stopwatch.StartNew(); double sum = 0; for (int i = 0; i < N; i++) sum += 0.1; var t1 = sw.ElapsedMilliseconds;
sw.Restart(); double ks = 0, c = 0; for (int i = 0; i < N; i++) { double y = 0.1 - c; double t = ks + y; c = (t - ks) - y; ks = t; } var t2 = sw.ElapsedMilliseconds;
sw.Restart(); decimal ds = 0; for (int i = 0; i < N; i++) ds += 0.1m; var t3 = sw.ElapsedMilliseconds;
sw.Restart(); float fs = 0; for (int i = 0; i < N; i++) fs += 0.1f; var t4 = sw.ElapsedMilliseconds;
Console.WriteLine($"double naive  {sum:R}  {t1} ms");
Console.WriteLine($"double kahan  {ks:R}  {t2} ms");
Console.WriteLine($"decimal       {ds}  {t3} ms");
Console.WriteLine($"float naive   {fs:R}  {t4} ms");
docker run --rm --name lab-float-dotnet -v "$PWD:/lab" -w /lab mcr.microsoft.com/dotnet/sdk:10.0.100 dotnet run floats.csوالمخرج سوف يكون كما يلي:
== 1) the real bits
0.1: 0x3FB999999999999A sign=0 exponent=1019-1023=-4 fraction=0x999999999999A
  float: 0x3DCCCCCD  (float)0.1 = 0.100000001
3.14: 0x40091EB851EB851F sign=0 exponent=1024-1023=1 fraction=0x91EB851EB851F
  float: 0x4048F5C3  (float)3.14 = 3.1400001
== 2) neighbours and the confusing double.Epsilon
Math.BitIncrement(1.0) - 1.0 = 2.220446049250313E-16
double.Epsilon = 5E-324  (the smallest subnormal, not the machine epsilon)
float: 16777216f + 1f = 16777216
float gap at 1 = 1.1920929E-07  float gap at 1e6 = 0.0625  (1e6f + 0.1f) - 1e6f = 0.125
== 3) special values
0.0 == -0.0: True  1/-0.0 = -Infinity  double.IsNegative(-0.0) = True
NaN == NaN: False  NaN.Equals(NaN): True  double.IsNaN: True
1.0 / 0.0 = Infinity  0.0 / 0.0 = NaN  Math.Sqrt(-1) = NaN
Array.Sort with NaN: [NaN, 1, 2, 3]
== 4) rounding
Math.Round(0.5)=0 Math.Round(1.5)=2 Math.Round(2.5)=2
Math.Round(2.5, MidpointRounding.AwayFromZero) = 3
Math.Round(2.675, 2, AwayFromZero) = 2.68
Math.Round(2.675m, 2, AwayFromZero) = 2.68
(2.5).ToString("F0") = 2
== 5) float to integer: what happened to Ariane 5
(short)40000.5 unchecked = -25536
checked((short)40000.5) -> OverflowException: Arithmetic operation resulted in an overflow.
(int)1e10 = 2147483647  (int)NaN = 0
== 6) decimal
0.1m + 0.2m = 0.3  equal to 0.3m: True
1m / 3m * 3m = 0.9999999999999999999999999999
decimal.MaxValue = 79228162514264337593543950335
sizeof: float 4, double 8, decimal 16, Half 2
== 7) Half (fp16)
(Half)0.1 = 0.1  bits 0x2E66  Half.MaxValue = 65500  (Half)70000 = Infinity
(Half)2049 = 2048  Half.Epsilon = 6E-08
== 8) summing 0.1 ten million times
double naive  999999.9998389754  22 ms
double kahan  1000000  81 ms
decimal       1000000.0  196 ms
float naive   1087937  22 ms
في المخرج أعلاه لاحظ التالي:
(Half)0.1طبع 0.1 مع أن القيمة المخزنة 0.0999755859375 كما طبعتها Python، لأن C# تطبع أقصر نص يعيد نفس القيمة، وبتاته0x2E66مطابقة لبتات Python.NaN.Equals(NaN)صحيح بينما==خطأ، وهذا مذكور صراحة في توثيق Double.Equals، ونتيجته أن NaN يعمل كمفتاح فيDictionaryبينما يفشل في المقارنة العادية.- لاحظ أيضاً أن المترجم رفض في المحاولة الأولى السطر
(int)1e10برسالةerror CS0221: Constant value '10000000000' cannot be converted to a 'int'، لأن القيمة ثابتة ويعرف أنها لا تتسع، لذلك وضعناها في متغير حتى يحدث التحويل وقت التشغيل.
PostgreSQL: real وfloat8 وnumeric جنباً إلى جنب
الملف floats.sql ينفذ نفس الاختبارات داخل قاعدة البيانات، ثم ينشئ جدولاً مؤقتاً فيه عشرة ملايين صف ويجمع العمود بالأنواع الثلاثة:
\pset footer off
\echo == 1) the same sum in three types
SELECT 0.1::float8 + 0.2::float8 AS float8_sum,
       0.1::real + 0.2::real     AS real_sum,
       0.1::numeric + 0.2::numeric AS numeric_sum,
       0.1::float8 + 0.2::float8 = 0.3::float8 AS float8_equal;
\echo == 2) what real really stores
SELECT 0.1::real AS shown, 0.1::real::float8 AS stored, 16777217::real::numeric AS big_real;
\echo == 3) rounding: numeric vs float8
SELECT round(2.5::numeric) AS numeric_2_5, round(2.5::float8) AS float8_2_5,
       round(3.5::float8) AS float8_3_5, round(2.675::numeric, 2) AS numeric_2_675;
\echo == 4) NaN and Infinity
SELECT 'NaN'::float8 = 'NaN'::float8 AS nan_equal,
       'NaN'::float8 > 'Infinity'::float8 AS nan_biggest,
       'Infinity'::numeric AS numeric_inf,
       '-0'::float8 AS neg_zero, '-0'::float8 = 0 AS neg_zero_equal;
\echo == 5) big integers through float8
SELECT 9007199254740993::bigint AS exact,
       9007199254740993::float8::bigint AS through_float8;
\echo == 6) summing 0.1 ten million times
CREATE TEMP TABLE t AS SELECT 0.1::float8 AS f, 0.1::real AS r, 0.1::numeric(12,2) AS n FROM generate_series(1, 10000000);
\timing on
SELECT sum(f) AS sum_float8 FROM t;
SELECT sum(r) AS sum_real FROM t;
SELECT sum(n) AS sum_numeric FROM t;
\timing off
SELECT pg_column_size(1.5::real) AS real_bytes, pg_column_size(1.5::float8) AS float8_bytes,
       pg_column_size(123456.78::numeric) AS numeric_bytes;
SELECT version();
docker run -d --name lab-float-pg -e POSTGRES_PASSWORD=lab -v "$PWD:/lab" postgres:17.11
docker exec lab-float-pg psql -U postgres -f /lab/floats.sql
docker rm -f -v lab-float-pgوالمخرج سوف يكون كما يلي:
== 1) the same sum in three types
     float8_sum      | real_sum | numeric_sum | float8_equal
---------------------+----------+-------------+--------------
 0.30000000000000004 |      0.3 |         0.3 | f

== 2) what real really stores
 shown |       stored        | big_real
-------+---------------------+----------
   0.1 | 0.10000000149011612 | 16777200

== 3) rounding: numeric vs float8
 numeric_2_5 | float8_2_5 | float8_3_5 | numeric_2_675
-------------+------------+------------+---------------
           3 |          2 |          4 |          2.68

== 4) NaN and Infinity
 nan_equal | nan_biggest | numeric_inf | neg_zero | neg_zero_equal
-----------+-------------+-------------+----------+----------------
 t         | t           |    Infinity |       -0 | t

== 5) big integers through float8
      exact       |  through_float8
------------------+------------------
 9007199254740993 | 9007199254740992

== 6) summing 0.1 ten million times
SELECT 10000000
Timing is on.
    sum_float8
-------------------
 999999.9998389754

Time: 2159.382 ms (00:02.159)
   sum_real
--------------
 1.087937e+06

Time: 1731.492 ms (00:01.731)
 sum_numeric
-------------
  1000000.00

Time: 2143.081 ms (00:02.143)
Timing is off.
 real_bytes | float8_bytes | numeric_bytes
------------+--------------+---------------
          4 |            8 |            12

                                                       version
----------------------------------------------------------------------------------------------------------------------
 PostgreSQL 17.11 (Debian 17.11-1.pgdg13+2) on x86_64-pc-linux-gnu, compiled by gcc (Debian 14.2.0-19) 14.2.0, 64-bit
في المخرج أعلاه لاحظ التالي:
real_sumظهر 0.3 لأن PostgreSQL يعرض أقصر نص يعيد القيمة، أما القيمة المخزنة فليست 0.3، كما ظهر في السطر التالي عند تحويل 0.1 إلىfloat8.'-0'::float8عرض-0وهو يساوي الصفر في المقارنة، تماماً كما في اللغات.- الخيار
-vفي الأمر الأخير يحذف ال Volume الذي ينشئه Docker Image الخاص بـ PostgreSQL تلقائياً، فلا يبقى على جهازك بعد التجربة.
أخطاء شائعة
- المقارنة بقيمة سماح ثابتة لكل الأحجام:
1e-9أكبر من اللازم للأرقام الصغيرة وأصغر من المسافة بين الأرقام الكبيرة، فاستخدم قيمة سماح نسبية مثلmath.isclose. double.Epsilonفي C# كقيمة سماح: هو 5E-324 وليس إبسلون الآلة، فالمقارنة به تساوي ==.- الجمع الطويل في
float: عداد أو مجموع يكبر مع الوقت يجب أن يكونdoubleعلى الأقل، أو عدداً صحيحاً، وإلا توقف عن الزيادة أو زاد أكثر مما يجب كما رأينا مع 1087937. - الوقت في رقم عشري صغير: وقت Unix في
floatفجوته 128 ثانية، وعداد بأعشار الثانية مضروب في 0.1 يتراكم خطأه كما في Patriot، فاحفظ الوقت كعدد صحيح بأصغر وحدة. - إدخال NaN إلى البيانات: يكسر الترتيب في Python ويتصرف بشكل مختلف في كل لغة وفي قاعدة البيانات، فتحقق منه عند الإدخال وارفضه.
- تقريب
doubleإلى خانات عشرية للعرض أو المال: اللغات تختلف في النتيجة لنفس الرقم، فقرب بنوع عشري وحدد طريقة التقريب صراحة. - معرفات 64 بت كأرقام في JSON: أرسلها كنصوص، فـ JavaScript تغير آخر خاناتها بصمت.
- تحويل رقم عشري إلى عدد صحيح أصغر دون فحص: هذا خطأ Ariane 5 نفسه، فافحص المجال أو استخدم
checkedوقرر ما يحدث عند الفشل. - اختيار fp16 لقيم مجالها كبير: أكبر قيمة فيه 65504، فإذا كانت قيمك قد تتجاوز ذلك أو تصغر جداً فاستخدم bfloat16 أو fp32.
تدريب عملي
- فك بيدك بتات الرقم
-2.5فيdouble: اكتب الإشارة والأس المخزن والكسر، ثم تأكد من الناتج بالأمرstruct.pack('>d', -2.5).hex()في Python. - احسب المسافة بين الأرقام عند 224 في
float، ثم فسر لماذا لا يستطيع عداد من النوعfloatأن يتجاوز 16777216 إذا زاد بواحد في كل مرة، وجربه في الكود. - اكتب دالة
isCloseفي C# أو JavaScript بنفس معادلةmath.isclose، واختبرها على الأمثلة الثلاثة في قسم المقارنة. - عدل جدول PostgreSQL في التجربة ليستخدم
numericبدون دقة محددة، ثم جرب إدخال'Infinity'فيه وفي عمودnumeric(12,2)، وقارن الرسالتين.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الرقم في IEEE 754 إشارة وأس مع إزاحة وكسر مع بت مخفي، فدقة
float24 بتاً، أي 6 إلى 9 خانات عشرية، ودقةdouble53 بتاً، أي 15 إلى 17 خانة. - المسافة بين الرقم والذي يليه تتضاعف كلما تضاعف الرقم، لذلك تضيع الإضافات الصغيرة إلى الأرقام الكبيرة، ويفقد
doubleالأرقام الصحيحة الفردية بعد 253. - الصفر السالب واللانهاية و NaN قيم حقيقية في المعيار، و NaN لا يساوي نفسه في الكود ولكنه يساوي نفسه في PostgreSQL، فامنعه من الدخول إلى بياناتك.
- التقريب الافتراضي إلى الزوجي يمنع الانحياز، ولكنه يفاجئ من ينتظر 3 من
round(2.5)، فحدد طريقة التقريب صراحة بنوع عشري عندما يهمك الناتج. - قارن بقيمة سماح نسبية، واجمع الأعداد الكثيرة بـ Kahan أو
math.fsumأو بنوع عشري أو بعدد صحيح بأصغر وحدة. - الأنواع العشرية دقيقة في الكسور العشرية فقط، والثلث يبقى مقرباً فيها، وأنواع الذكاء الاصطناعي الصغيرة تختار بين المجال والدقة.
- Patriot خطأ دقة تراكم مع وقت التشغيل، وAriane 5 تحويل من رقم عشري إلى عدد صحيح من 16 بت دون حماية، ولكل منهما درس مختلف.
وفي مرحلة أساسيات علوم الحاسب نفسها تجد المقالات التي يعتمد عليها هذا المقال أو يكملها:
 دليلالأنظمة العددية للمبرمجين: من Binary إلى Floating Pointلماذا يظهر القرص 465 بدل 500، ويصبح العداد سالباً فجأة، ولا يساوي 0.1 + 0.2 القيمة 0.3؟ الإجابة في طريقة تخزين الأرقام.
 دليلالذاكرة للمبرمجين: كيف تعمل ال Stack وال Heapلماذا تتغير قائمة لم تطلب تغييرها، وكيف تتسرب الذاكرة في لغة فيها جامع قمامة Garbage Collector، بأمثلة حقيقية من عدة لغات.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
 دليلأساسيات SQL للمطورين من SELECT إلى المعاملات Transactionsتتعلم SQL من الصفر على قاعدة بيانات صغيرة في PostgreSQL، من أول SELECT إلى المعاملات ومستويات العزل التي تحمي بياناتك.
 دليلكيف تصمم API لا تضطر إلى كسره بعد سنةمبادئ تصميم API يتطور دون أن يكسر التطبيقات التي تعتمد عليه، وكيف تختار الشكل المناسب لنظامك.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ الأمثلة في Containers على x86-64 مع Python 3.13.8 وNode.js 22.20.0 و.NET SDK 10.0.100 وPostgreSQL 17.11.


