

لنفرض أن لديك دالة تحسب سعر الطلب في متجر إلكتروني، وهي تعمل منذ سنتين ولم يشتك منها أحد، ثم جاء طلب صغير من قسم المبيعات: خصم جديد لفئة الكتب في شهر رمضان. والمطور الذي استلم الطلب فتح الدالة فوجدها أربعين سطراً من الشروط المتداخلة، ووجد نسخة ثانية منها تقريباً في ملف آخر، ولا يوجد اختبار يخبره إن كسر شيئاً، فاستغرق التعديل أسبوعاً بدل ساعة. الكود هنا صحيح بمعنى أنه يعطي الرقم المطلوب، ولكنه غالي الثمن، وكل تعديل عليه يدفع ثمناً إضافياً، وهذا بالضبط ما نقصده عندما نتحدث عن جودة الكود Code Quality.
وهذا المقال هو الأول في سلسلة من ثلاثة مقالات عن جودة الكود، نبدأ فيه بالفكرة والمقاييس، ثم نقارن الأدوات، ثم ندخل في SonarQube بالتفصيل.
المواضيع في السلسلة:
- ما هي جودة الكود Code Quality وكيف تقيسها؟ (الموضوع الحالي): المعنى والمقاييس وبوابات الجودة، وأين تعمل الفحوص، ولماذا يحتاج كود الذكاء الاصطناعي إلى انتباه خاص.
- أدوات جودة الكود: أيها تختار لفريقك؟: أدوات كل لغة والمنصات الكاملة وأسعارها وتراخيصها، وتجربة على المستودع نفسه.
- أداة SonarQube عملياً: التثبيت مع PostgreSQL والماسحات وملفات القواعد Quality Profiles والبوابات وCI، وأدوات Sonar للوكلاء الأذكياء AI Agents.
وسوف نناقش في هذا المقال ما يلي:
- ما معنى أن يكون الكود جيداً، ولماذا الأمان جزء من الجودة وليس كلها.
- الفرق بين أداة التنسيق Formatter والمدقق Linter ومدقق الأنواع Type Checker وأداة التحليل الثابت للجودة.
- المقاييس المشهورة: التعقيد الدوري Cyclomatic Complexity والتعقيد الإدراكي Cognitive Complexity والتكرار Duplication والتغطية Coverage ورائحة الكود Code Smell والدين التقني Technical Debt، وحدود كل منها.
- القواعد وملفات القواعد Quality Profiles وبوابة الجودة Quality Gate، وفكرة الحكم على الكود الجديد فقط في المشاريع القديمة.
- أين تعمل الفحوص: في المحرر، وقبل الحفظ في Git، وفي خط CI، وفي طلب الدمج.
- لماذا يكرر الوكيل الذكي الكود ويبتلع الأخطاء، وماذا تقول الأرقام المنشورة عن أثر الذكاء الاصطناعي على التسليم.
- تجربة عملية: مستودع صغير فيه ست مشاكل مقصودة، نقيسه بمدقق وأداة تعقيد وأداة تغطية، ونرى ما يجده كل واحد وما يفوته.
ما معنى أن يكون الكود جيداً؟
جودة الكود هي مدى سهولة أن تفهم الكود وتغيره وتثق به، وليست مجرد أنه يعمل اليوم، والسبب أن أغلب تكلفة البرنامج تأتي بعد كتابته الأولى، في التعديلات والإصلاحات وإضافة الميزات. ولذلك نقسم الجودة عادة إلى عدة صفات، وكل صفة تجيب عن سؤال مختلف:
- الصحة Correctness: هل يعطي الكود النتيجة المطلوبة في كل الحالات، وليس في الحالة التي جربها المطور فقط؟ وهذه تقيسها الاختبارات Tests أولاً، والأدوات تساعد قليلاً بكشف أخطاء معروفة مثل مقارنة خاطئة.
- قابلية الصيانة Maintainability: كم يكلف تعديل الكود؟ دالة من مئة سطر بشروط متداخلة، أو منطق منسوخ في ثلاثة أماكن، يرفع هذه التكلفة حتى لو كان صحيحاً.
- سهولة القراءة Readability: هل يفهم مطور جديد ما تفعله الدالة من اسمها وشكلها؟ وهي جزء من قابلية الصيانة، ولكنها تستحق ذكراً مستقلاً لأن الكود يقرأ أكثر بكثير مما يكتب.
- الموثوقية Reliability: كيف يتصرف الكود عندما يفشل شيء حوله، مثل ملف ناقص أو شبكة منقطعة؟ وابتلاع الخطأ بصمت من أكثر ما يضر هذه الصفة، وقد شرحنا طرق التعامل مع الأخطاء في كل لغة في مقال كيف تتعامل لغات البرمجة مع الأخطاء.
- الأمان Security: هل يمكن لمستخدم سيئ النية أن يستغل الكود؟ وهذا جزء من الجودة، ولكنه مجال له أدواته وطرقه الخاصة، وقد خصصنا له مقال تحليل الكود الثابت SAST، فلن نكرره هنا.
وتستخدم منصة SonarQube في تعريف مقاييسها ثلاث صفات من هذه، وهي الأمان والموثوقية وقابلية الصيانة، وتصنف كل مشكلة تجدها تحت واحدة منها أو أكثر. ولاحظ أن الصحة غير موجودة في القائمة، والسبب بسيط: الأداة لا تعرف ما المطلوب من برنامجك، فهي لا تعرف أن الخصم يجب أن يكون 10% وليس 12%، وهذه المعلومة موجودة في المتطلبات وفي رأس المطور وفي الاختبارات فقط.
من يفحص ماذا؟ أنواع أدوات الفحص
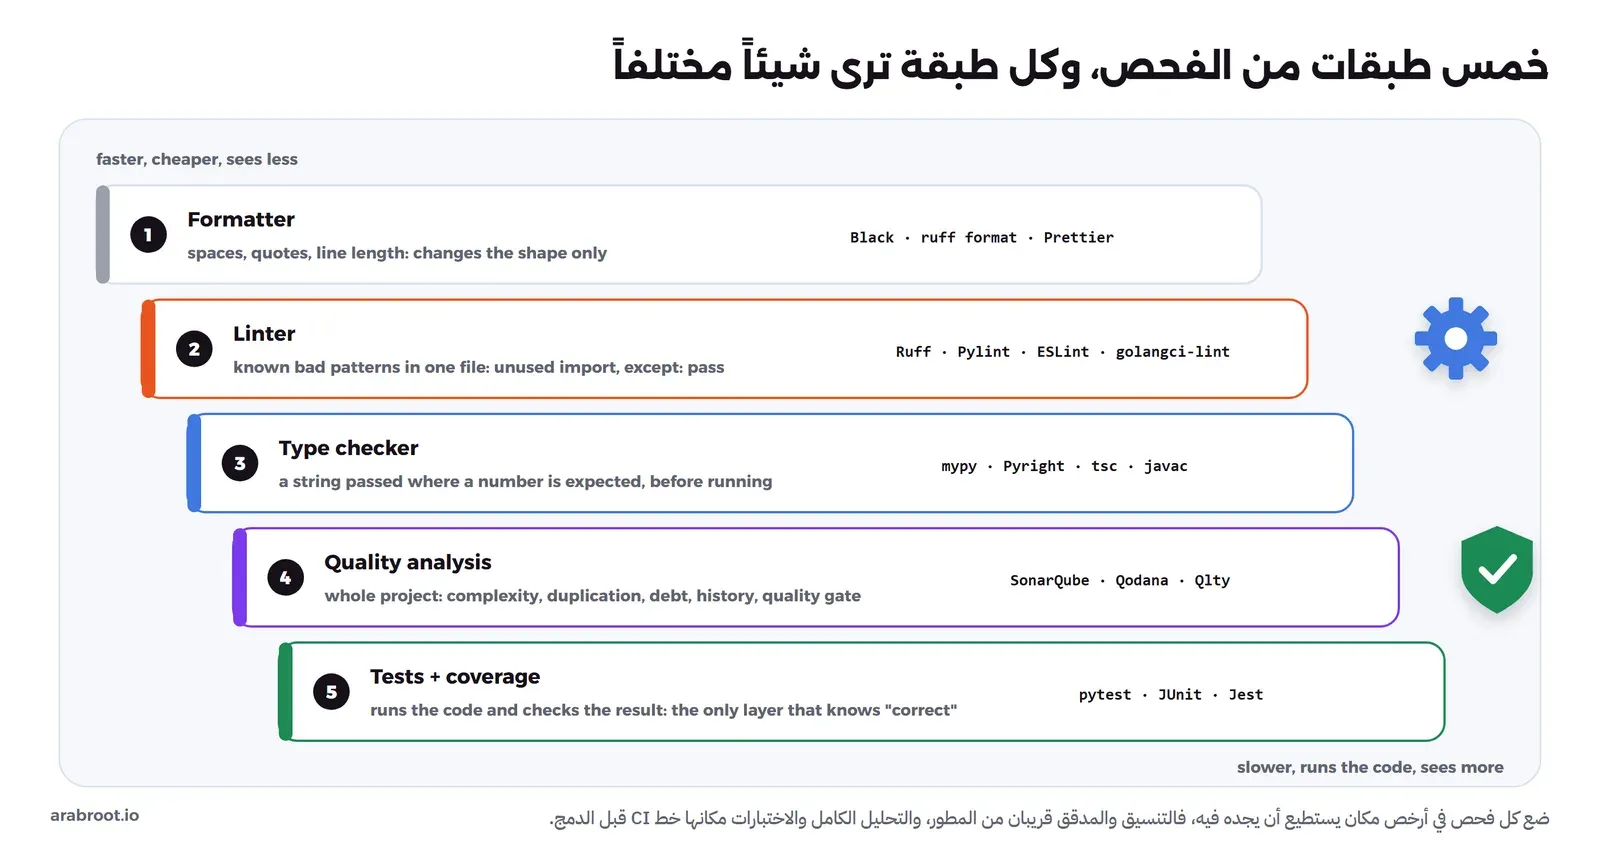
قد يتساءل البعض: لماذا يوجد في المشروع الواحد أكثر من أداة تقرأ الكود، أليست كلها تفعل الشيء نفسه؟ والإجابة أن كل نوع منها يرى طبقة مختلفة من الكود، والصورة التالية تبين الطبقات الخمس من الأسرع والأبسط إلى الأعمق:
وفيما يلي كل نوع باختصار:
- أداة التنسيق Formatter: مثل Black وRuff format في Python وPrettier في JavaScript، وهي تعيد كتابة المسافات والأقواس وطول السطر بشكل موحد، ولا تحكم على الكود. وفائدتها الكبرى أنها تنهي النقاش في مراجعة الكود حول الشكل، فلا يضيع وقت المراجع في تعليق «ضع مسافة هنا».
- المدقق Linter: مثل Ruff وPylint وESLint وgolangci-lint وRuboCop، ويقرأ الملف بحثاً عن أنماط معروفة بأنها خاطئة أو خطرة: استيراد غير مستخدم، ومقارنة
== None، وقيمة افتراضية قابلة للتغيير، وexceptفارغ. وهو سريع جداً لأنه يعمل على ملف واحد في المرة غالباً. - مدقق الأنواع Type Checker: مثل mypy وPyright في Python والمترجم نفسه في TypeScript وJava وC#، ويكتشف أن الدالة تتوقع رقماً وأنت ترسل نصاً قبل التشغيل، وقد شرحنا أنظمة الأنواع في مقال أنماط البرمجة وأنظمة الأنواع.
- التحليل الثابت للجودة Static Analysis: مثل SonarQube وQodana وQlty، وهي تشغل محللات كثيرة ثم تضيف ما لا يراه المدقق: التكرار بين الملفات، والتعقيد لكل دالة، والدين التقني Technical Debt للمشروع كله، والتاريخ بين تحليل وآخر، والحكم بالنجاح أو الفشل عبر بوابة الجودة Quality Gate.
- الاختبارات Tests مع التغطية Coverage: وهي الطبقة الوحيدة التي تشغل الكود فعلاً وتتحقق من النتيجة، وقد شرحنا أنواعها في مقال أنواع الاختبارات.
والقاعدة العملية من هذا التقسيم أن تضع كل فحص في المكان الأرخص الذي يستطيع أن يجده فيه، فلا تنتظر خط CI ليخبرك بمسافة زائدة، ولا تتوقع من المدقق أن يكتشف منطقاً منسوخاً في ملفين.
المقاييس: ماذا تقيس الأدوات فعلاً؟
كل أداة جودة تعرض أرقاماً، والخطر أن تتحول هذه الأرقام إلى أهداف بحد ذاتها، لذلك يجب أن تعرف كيف يحسب كل رقم وما الذي لا يقوله.
التعقيد الدوري Cyclomatic Complexity
اقترحه توماس مكيب Thomas McCabe في ورقة A Complexity Measure سنة 1976، وهو عدد المسارات المستقلة في الدالة. وتلخصه وثائق SonarQube بأنه واحد زائد عدد التفرعات الشرطية، أي أن كل if وكل for وكل and يضيف واحداً. وفائدته الأوضح أنه يعطيك الحد الأدنى لعدد الاختبارات التي تحتاجها لتمر على كل فرع، فدالة تعقيدها 15 تحتاج 15 حالة اختبار على الأقل لتغطي فروعها.
التعقيد الإدراكي Cognitive Complexity
المشكلة في الرقم السابق أنه يعامل switch بعشر حالات مسطحة مثل عشرة شروط متداخلة بعضها داخل بعض، مع أن الأولى سهلة القراءة والثانية متعبة جداً. ولذلك نشرت G. Ann Campbell من شركة Sonar ورقة التعقيد الإدراكي Cognitive Complexity، وفكرته أن يقيس صعوبة فهم الدالة على الإنسان، فيضيف نقطة لكل تفرع مثل السابق، ثم يضيف نقاطاً إضافية كلما زاد التداخل Nesting، لأن كل مستوى تداخل يطلب من القارئ أن يتذكر شرطاً إضافياً في رأسه.
والصورة التالية تبين الدالة نفسها من تجربتنا بالمقياسين:
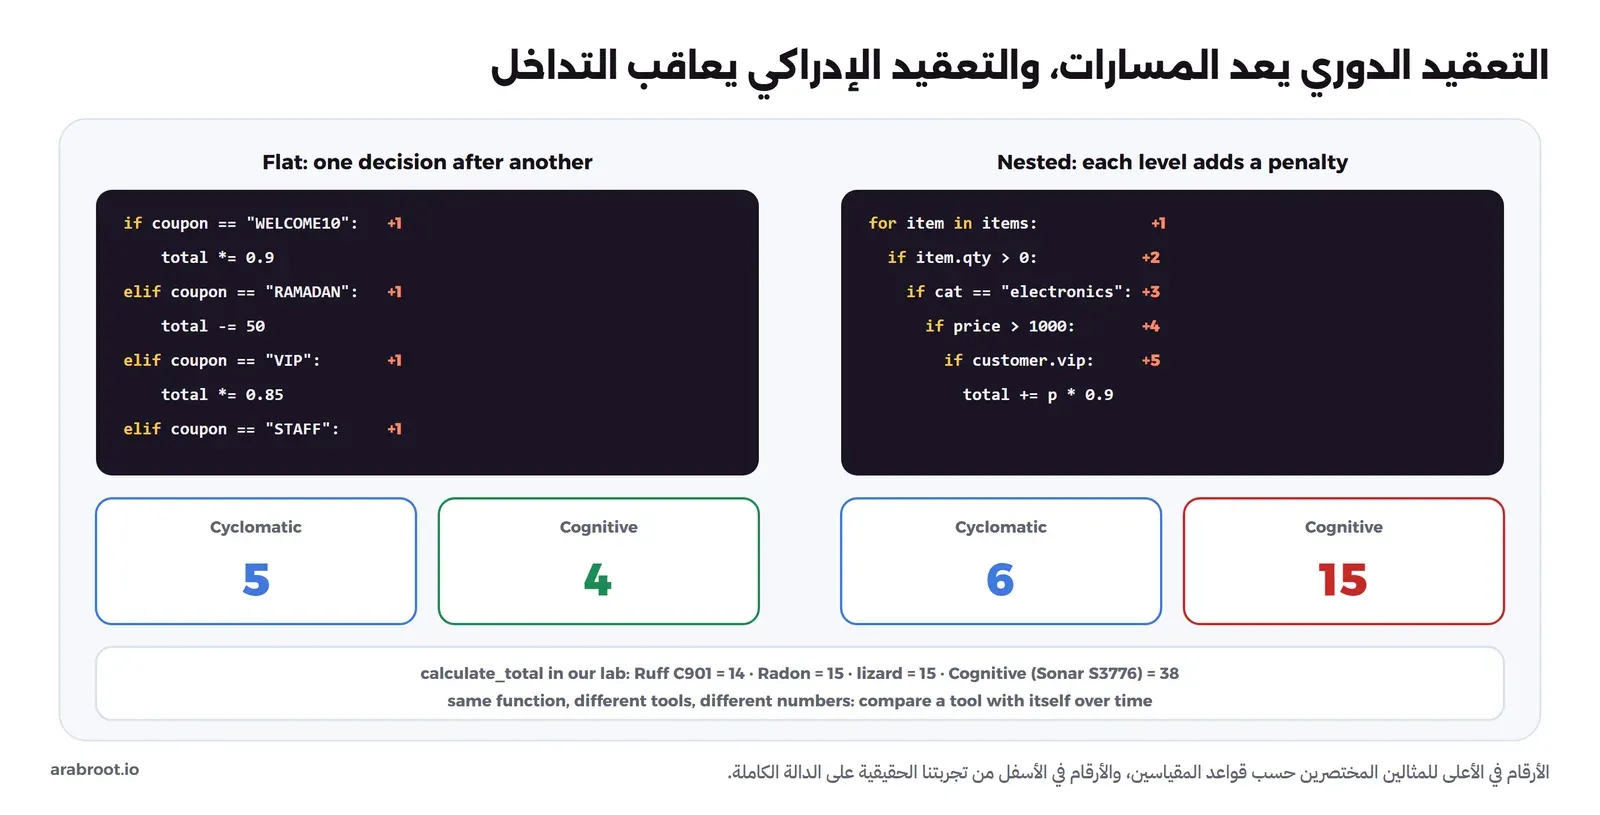
ولاحظ في الصورة أن الأدوات لا تتفق حتى على الرقم الواحد، فقد أعطت دالة calculate_total في تجربتنا 14 في Ruff و15 في Radon وlizard، والسبب اختلاف بسيط في طريقة عد بعض التعبيرات، وأعطاها مقياس التعقيد الإدراكي 38. لذلك لا تقارن رقماً من أداة برقم من أداة أخرى، وقارن الأداة بنفسها عبر الزمن.
التكرار Duplication
التكرار هو نسبة الأسطر المنسوخة في أكثر من مكان، وتحسبه SonarQube بالمعادلة duplicated_lines / lines * 100 كما في تعريف المقاييس. وخطره ليس في الحجم، وإنما في أن الإصلاح يصل إلى نسخة واحدة وتبقى الأخرى بالخطأ، وهذا ما سوف تراه في التجربة. ولا تقم بمحاربة كل تكرار، فسطران متشابهان في اختبارين أفضل غالباً من دالة مساعدة يصعب فهمها، وقد ناقشنا هذا التوازن في قسم DRY من مقال مبادئ التصميم.
التغطية Coverage
التغطية هي نسبة الأسطر أو الفروع التي نفذت أثناء الاختبارات، وكلمة «نفذت» هنا مهمة، فالسطر الذي نفذ دون أن يتحقق اختبار من نتيجته يحسب مغطى. وقد شرحنا هذه النقطة بمثال كامل في قسم التغطية من مقال أنواع الاختبارات، لذلك يكفي هنا أن تتذكر أن التغطية تخبرك بما لم يختبر، ولا تخبرك بأن ما غطي مختبر جيداً.
رائحة الكود Code Smell
استخدم كينت بيك Kent Beck هذا التعبير ونشره مارتن فاولر Martin Fowler في كتاب Refactoring، ويعرفها فاولر في مقاله القصير عنها بأنها علامة سطحية يمكن رؤيتها بسرعة وتشير غالباً إلى مشكلة أعمق في التصميم. والكلمة المهمة هي «غالباً»، فرائحة الكود Code Smell ليست خطأ، وإنما سبب لتنظر أقرب: دالة طويلة جداً، أو كلاس يعرف كل شيء، أو قائمة معاملات من ثمانية عناصر. وفي SonarQube كانت رائحة الكود Code Smell نوعاً من أنواع المشاكل، وصارت اليوم تقريباً ما تسميه المنصة مشاكل قابلية الصيانة Maintainability Issues.
الدين التقني Technical Debt وحدوده
صاغ وارد كننغهام Ward Cunningham هذا التشبيه في تقرير مؤتمر OOPSLA سنة 1992، وفكرته أن إطلاق كود غير مكتمل الفهم يشبه أخذ قرض: تحصل على السرعة الآن، ثم تدفع فائدة في كل تعديل لاحق حتى تسدد الأصل بإعادة كتابة الجزء. وقد شرح كننغهام لاحقاً في صفحة على موقعه أنه لم يقصد بالدين كتابة كود سيئ، وإنما كتابة كود يعبر عن فهمك الحالي للمشكلة ثم تعديله عندما يتحسن فهمك.
أما الأدوات فتحول الدين التقني Technical Debt إلى رقم بالدقائق، ففي SonarQube لكل قاعدة تكلفة إصلاح تقديرية، والدين هو مجموع تكاليف مشاكل قابلية الصيانة، ونسبة الدين هي هذا المجموع مقسوماً على تكلفة كتابة الكود نفسه، كما في تعريف المقاييس، ومنها يأتي تقييم قابلية الصيانة من A إلى E. وهذا الرقم مفيد للمقارنة عبر الزمن، ولكن له حدوداً يجب أن تعرفها:
- الرقم يعد ما تعرفه القواعد فقط، فتصميم خاطئ بالكامل، مثل حدود خدمات في المكان الخطأ، لا يظهر فيه أبداً.
- التكلفة تقديرية ثابتة لكل قاعدة، فإصلاح استيراد غير مستخدم في كود لا يلمسه أحد له الوزن نفسه في كود يتغير كل يوم، مع أن الفائدة مختلفة تماماً.
- الفائدة الحقيقية للدين تدفع في الأماكن التي تتغير كثيراً، لذلك اسأل دائماً: هل هذا الملف يعدل كثيراً؟ فإذا كان ملفاً قديماً لا يلمسه أحد، فالدين فيه لا يكلفك شيئاً اليوم.
القواعد وملفات القواعد Quality Profiles وبوابة الجودة Quality Gate
كل أداة تعمل بمجموعة قواعد Rules، وكل قاعدة تبحث عن نمط واحد، مثل «لا تستخدم قيمة افتراضية قابلة للتغيير». والمجموعة المفعلة من القواعد لكل لغة اسمها في SonarQube ملف القواعد Quality Profile، وفي Ruff وESLint اسمها ملف الإعداد، والفكرة واحدة: الفريق يقرر ما الذي يعتبره مشكلة.
أما بوابة الجودة Quality Gate فهي الشرط الذي يقرر النجاح أو الفشل، مثل «لا توجد مشاكل جديدة» و«تغطية الكود الجديد 80% على الأقل»، وقد ذكرنا في مقال SAST أن بوابة Sonar way الافتراضية تطبق شروطها على الكود الجديد فقط. والفرق بين الاثنين مهم: ملف القواعد Quality Profile يحدد ماذا ترى، وبوابة الجودة Quality Gate تحدد ماذا يوقف الدمج.
فكرة الكود الجديد New Code في المشاريع القديمة
لنفرض أنك شغلت أداة جودة لأول مرة على مشروع عمره خمس سنوات، فظهرت لك 4000 مشكلة. الطريقة البسيطة هي أن تطلب من الفريق إصلاحها كلها قبل أي ميزة جديدة، وهذه الطريقة تفشل دائماً، والسبب أن إصلاح كود قديم يعمل له خطر، ولا يوجد مدير يوقف المنتج شهرين لإصلاح استيرادات غير مستخدمة. والطريقة الأسوأ أن تجعل بوابة الجودة Quality Gate تفشل على المشروع كله، فيتعلم الفريق خلال أسبوع أن يتجاهلها.
والحل الذي تعتمده SonarQube ومعظم الأدوات الحديثة اسمه الكود الجديد New Code، وتشرحه صفحة الكود الجديد: تحكم بوابة الجودة Quality Gate على ما أضيف أو عدل منذ نقطة معينة فقط، مثل آخر إصدار أو آخر 30 يوماً، والكود القديم يبقى كما هو. ولأن من يعدل دالة قديمة يصلح غالباً ما حولها، يتحسن الكود القديم تدريجياً دون خطة إصلاح منفصلة. والصورة التالية تبين الفكرة:
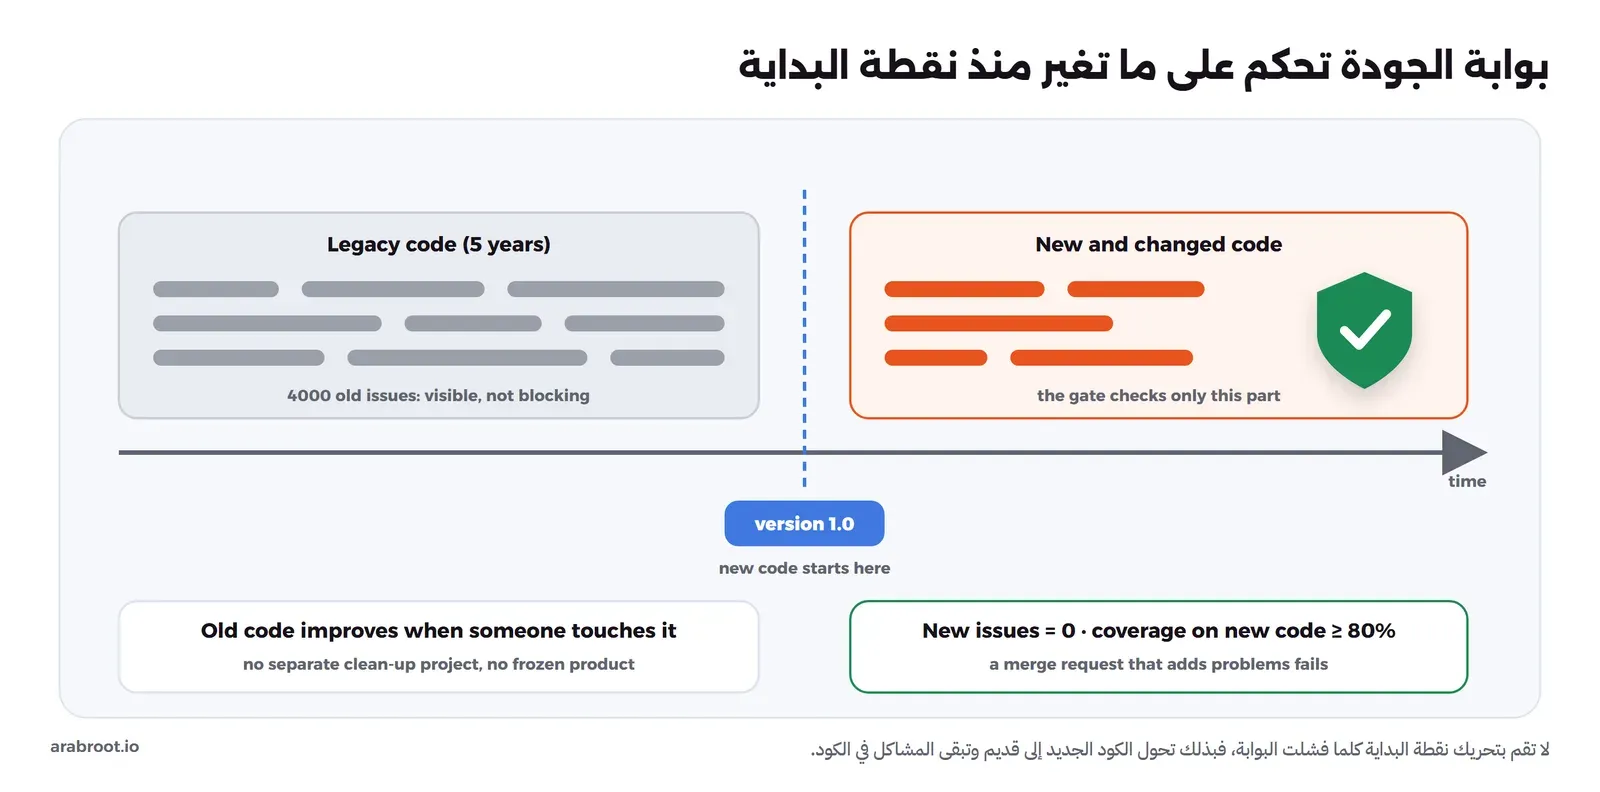
وهي الفكرة نفسها التي سميناها الخط الأساسي Baseline في مقال SAST عند الحديث عن نتائج الأمان، ولها شرط واحد يجب أن تحترمه: لا تقم بتحريك نقطة البداية كلما فشلت البوابة، والسبب أنك بذلك تحول الكود الجديد إلى كود قديم فتختفي المشاكل من الشاشة وتبقى في الكود.
أين تعمل الفحوص؟ من المحرر إلى طلب الدمج
الفحص نفسه يكلف أقل كلما كان أقرب إلى لحظة كتابة الكود، فالمطور الذي يرى التحذير في المحرر يصلحه في ثانية لأن السياق في رأسه، أما إذا وصله بعد يومين في تعليق على طلب الدمج فسوف يحتاج دقائق ليتذكر لماذا كتب هذا السطر. والصورة التالية تبين الأماكن الأربعة وما يناسب كل مكان:
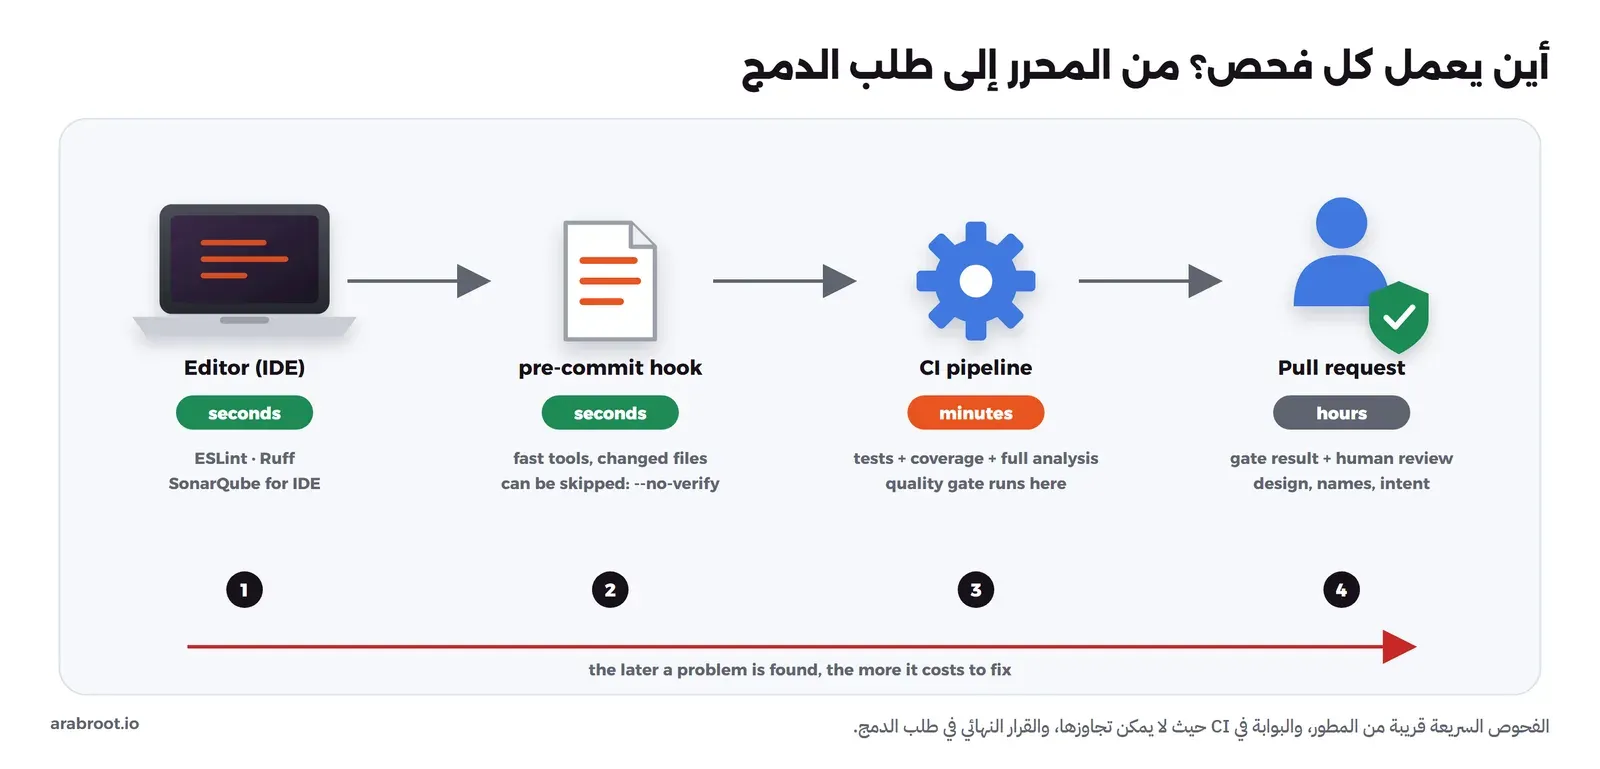
- المحرر IDE: إضافات مثل ESLint وRuff وSonarQube for IDE تعرض المشكلة تحت السطر وأنت تكتب، وهي مجانية وتوقف أغلب المشاكل البسيطة قبل أن تولد.
- قبل الحفظ في Git: إطار pre-commit يشغل أدوات سريعة على الملفات المعدلة فقط قبل كل Commit، والشرط هنا السرعة، فإذا استغرق الخطاف أكثر من ثوان قليلة فسوف يتجاوزه المطورون بالخيار
--no-verify. وقد استخدمنا pre-commit فعلاً في المرحلة الأولى من مقال خط CI/CD الآمن. - خط CI: هنا يعمل كل ما هو بطيء أو يحتاج المشروع كاملاً، أي الاختبارات مع التغطية والتحليل الكامل وحساب التكرار بين الملفات، وهنا يجب أن تعمل بوابة الجودة Quality Gate، لأن ما يعمل على جهاز المطور يمكن تجاوزه، وما يعمل في CI لا يمكن تجاوزه بسهولة.
- طلب الدمج Pull Request: هنا تظهر نتيجة بوابة الجودة Quality Gate بجانب الكود المعدل، ويقرأ الإنسان ما لا تراه الأدوات، وقد شرحنا حماية الفروع وطلبات الدمج في مقال Git في العمل اليومي.
مراجعة الكود Code Review أم الأدوات؟
قد يتساءل البعض: إذا كانت الأدوات تجد كل هذا، فلماذا نراجع الكود يدوياً؟ والإجابة أن الأداة والمراجع يبحثان عن أشياء مختلفة تماماً. فالأداة ممتازة في الأشياء الصغيرة المتكررة التي يمل منها الإنسان، مثل استيراد غير مستخدم أو مقارنة خاطئة، وهي لا تتعب ولا تجامل زميلها. أما المراجع فيرى ما لا تفهمه أي قاعدة: هل هذا التعديل يحل المشكلة المطلوبة أصلاً؟ هل الاسم يصف ما تفعله الدالة؟ هل وضعنا هذا المنطق في الطبقة الصحيحة؟
لذلك اجعل الأدوات تعمل أولاً، ولا تقم بفتح المراجعة البشرية قبل أن تنجح الفحوص الآلية، والسبب أن وقت المراجع غالي، ولا يجوز أن يضيع في تعليقات تستطيع آلة أن تكتبها. وقد وضعنا أسئلة عملية للمراجعة في قسم مراجعة الكود من مقال مبادئ التصميم، وقائمة للمراجعة الأمنية في مقال متطلبات الأمان ومراجعة الكود.
كود الذكاء الاصطناعي: لماذا يحتاج انتباهاً خاصاً؟
الوكيل الذكي AI Agent مثل Claude Code وCursor وCopilot يكتب كوداً يعمل في أغلب الأحيان، ولكن طريقة عمله تجعله يميل إلى أنواع محددة من مشاكل الجودة، وفهم السبب يساعدك على وضع الفحص المناسب:
- التكرار: الوكيل يرى جزءاً من المشروع في سياقه Context، فإذا لم تكن الدالة المساعدة الموجودة في الملفات التي قرأها، فسوف يكتب نسخة جديدة منها بدل أن يستدعي القديمة، والكود الناتج صحيح ولكنه منطق مكرر في مكانين.
- ابتلاع الأخطاء: عندما يطلب منه أن يجعل الاختبار أو البرنامج يعمل، فأسرع طريقة لإخفاء الخطأ هي
tryواسع معexceptفارغ أوcatchيسجل الخطأ ثم يكمل، وهي المشكلة نفسها التي ناقشناها في قسم تجاهل الخطأ في مقال الأخطاء. - كود بلا اختبارات، أو اختبارات بلا تحقق: الوكيل قد يكتب اختباراً ينفذ الكود ويتحقق من نتيجته الحالية، فيحرس الخطأ بدل أن يكشفه، وهذه مشكلة المرجع Test Oracle التي شرحناها في مقال الاختبارات التي يكتبها الذكاء الاصطناعي.
- تعديلات كبيرة: لأن كتابة 500 سطر لا تكلف الوكيل شيئاً، يكبر حجم التغيير الواحد، ومراجعة 500 سطر أصعب بكثير من مراجعة 50.
وماذا تقول الأرقام المنشورة؟ في تقرير DORA لسنة 2024 من Google، وهو مبني على استبيان شمل أكثر من 39 ألف شخص، قدر الباحثون أن زيادة اعتماد الذكاء الاصطناعي بنسبة 25% ترتبط بتحسن تقديري في جودة الكود بنسبة 3.4% وانخفاض في التعقيد بنسبة 1.8% بحسب ما يقيمه المشاركون أنفسهم، ولكنها ترتبط أيضاً بانخفاض تقديري في ثبات التسليم Delivery Stability بنسبة 7.2% وفي سرعة التسليم Throughput بنسبة 1.5%. وتوقع الباحثون في التقرير نفسه أن السبب هو نسيان مبدأ التغييرات الصغيرة Small Batch Sizes، لأن الذكاء الاصطناعي يسمح بكتابة كود أكثر في الوقت نفسه، والتغييرات الكبيرة أبطأ وأكثر عرضة لعدم الاستقرار. ولاحظ أن هذه أرقام ارتباط من استبيان، وليست تجربة مضبوطة، ولكنها تعطيك رسالة عملية واضحة: الوكيل يسرع الكتابة، والفحوص الآلية وبوابة الجودة Quality Gate والتغييرات الصغيرة هي ما يحمي التسليم.
وهذا تحديداً موضوع المقال الثالث من السلسلة، فهناك سوف نرى كيف تعطي SonarQube الوكيل الذكي نتائجها عبر سيرفر MCP وأداة سطر الأوامر، فيصلح الوكيل ما كتبه حتى تنجح البوابة، وإذا لم تكن تعرف MCP فابدأ من مقال بروتوكول MCP للمبتدئين.
تجربة عملية: ماذا يجد المدقق وأداة التعقيد والتغطية؟
الآن سوف نبني مستودعاً صغيراً لمتجر فيه ست مشاكل جودة وضعناها عمداً ورقمناها من Q1 إلى Q6، ونقيسه بثلاث أدوات من ثلاثة أنواع مختلفة: المدقق Ruff، وأداتي التعقيد Radon وlizard، وأداة التغطية pytest-cov، ثم نرى ما يجده كل واحد. وسوف نستخدم المستودع نفسه في المقالين التاليين من السلسلة، لذلك تجده كاملاً في مجلد lab/shop مع المقال.
المستودع والمشاكل المقصودة
المستودع فيه ثلاثة ملفات Python وملف اختبارات وملف JavaScript صغير، والجدول التالي يبين المشاكل الست:
| الرقم | المكان | المشكلة | الصفة المتأثرة |
|---|---|---|---|
| Q1 | الدالة calculate_total في pricing.py | شروط متداخلة خمسة مستويات في دالة واحدة | قابلية الصيانة |
| Q2 | الملف pricing.py | أرقام سحرية Magic Numbers مثل ضريبة 1.15 مكتوبة داخل المنطق | قابلية الصيانة |
| Q3 | الملف discounts.py | دالتان منسوختان من بعضهما بفرق رقم واحد | قابلية الصيانة |
| Q4 | الدالة save_order في storage.py | عبارة except Exception: pass تبتلع خطأ الحفظ | الموثوقية |
| Q5 | الدالة save_order | قائمة كقيمة افتراضية تتشارك بين الاستدعاءات | الصحة والموثوقية |
| Q6 | الملف test_pricing.py | اختبار ينفذ الدالة ولا يتحقق من شيء | الصحة |
والملف التالي يبين المشكلتين Q4 وQ5 كما كتبناهما:
"""Saving orders (lab code with planted quality problems)."""
import json
import os
import sys


def save_order(order, path, history=[]):
    # Q5: mutable default argument, shared between calls
    history.append(order["id"])
    try:
        with open(path, "w", encoding="utf-8") as f:
            json.dump(order, f)
    except Exception:
        # Q4: the error is swallowed, the caller thinks the order was saved
        pass
    return len(history)


def load_order(path):
    with open(path, encoding="utf-8") as f:
        data = json.load(f)
    if data == None:
        return {}
    return data
نشغل الأدوات كلها داخل Container واحد بإصدارات مثبتة، وننسخ المستودع إلى داخله ونحفظه في Git حتى نستطيع مقارنة أي تعديل:
docker run -d --name lab-cq-py -v "$PWD:/src" -w /src python:3.13.16-slim sleep 3600
docker exec lab-cq-py pip install -q ruff==0.17.0 radon==6.0.1 lizard==1.24.1 \
  pytest==9.1.1 pytest-cov==7.1.0 pylint==4.1.3
docker exec lab-cq-py sh -c "apt-get -qq update && apt-get -qq install -y git"
docker exec lab-cq-py sh -c "cp -r /src /work && cd /work && git init -q -b main && git add . && git commit -qm 'shop 1.0'"
المدقق Ruff بالإعداد الافتراضي
نبدأ بالمدقق Ruff دون أي ملف إعداد:
docker exec lab-cq-py sh -c "cd /work && ruff check --output-format concise ."والمخرج سوف يكون كما يلي:
shop/discounts.py:17:5: PLR1730 [*] Replace `if` statement with `discount = min(discount, 500)`
shop/discounts.py:36:5: PLR1730 [*] Replace `if` statement with `discount = min(discount, 800)`
shop/storage.py:3:8: F401 [*] `os` imported but unused
shop/storage.py:4:8: F401 [*] `sys` imported but unused
shop/storage.py:7:37: B006 Do not use mutable data structures for argument defaults
shop/storage.py:13:5: S110 `try`-`except`-`pass` detected, consider logging the exception
shop/storage.py:13:12: BLE001 Do not catch blind exception: `Exception`
tests/test_pricing.py:1:1: I001 [*] Import block is un-sorted or un-formatted
Found 8 errors.
[*] 5 fixable with `--fix` (1 unsafe fix available with `--fix --unsafe-fixes`).
في المخرج أعلاه لاحظ التالي:
- وجد Ruff المشكلة Q4 بقاعدتين، S110 لأن الكتلة فيها
passفقط، وBLE001 لأن الاستثناء عام جداً، ووجد Q5 بالقاعدة B006، وهذا كله في جزء من الثانية. - لم يذكر الدالة المعقدة Q1، ولا المقارنة
data == None، والسبب أن الإعداد الافتراضي في Ruff 0.17 يفعل فئات معينة فقط من القواعد هي correctness وsuspicious وcomplexity وperformance وstyle كما في وثائق Ruff، وعددها في هذا الإصدار 407 قواعد، وقاعدة التعقيد C901 والقاعدة E711 ليستا منها. - لم يذكر التكرار Q3 أبداً، لأن المدقق يقرأ كل دالة وحدها ولا يقارن الدوال ببعضها.
وهذا هو الدرس الأول: المدقق يجد ما فعلته من قواعد فقط، والإعداد الافتراضي اختيار شخص آخر لمشروع آخر. لذلك نضيف ملف pyproject.toml نفعل فيه قاعدتين إضافيتين ونحدد حد التعقيد:
[tool.ruff.lint]
extend-select = ["C901", "E711"]

[tool.ruff.lint.mccabe]
max-complexity = 10
ونعيد تشغيل الأمر على مجلد shop، فيضاف سطران إلى النتيجة:
shop/pricing.py:4:5: C901 `calculate_total` is too complex (14 > 10)
shop/storage.py:22:16: E711 Comparison to `None` should be `cond is None`
Found 9 errors.
ولاحظ أننا استخدمنا extend-select وليس select، والفرق أن الأولى تضيف إلى القواعد الافتراضية، والثانية تستبدلها كلها بما تكتبه، وهذا خطأ شائع يجعل الفريق يظن أنه أضاف قاعدة وهو في الحقيقة أطفأ 400 قاعدة.
أداتا التعقيد Radon وlizard
المدقق أعطانا رقماً واحداً للتعقيد عندما تجاوز الحد، أما أدوات التعقيد فتعطي الرقم لكل دالة دائماً، فنشغل Radon ثم lizard بحد 10:
docker exec lab-cq-py sh -c "cd /work && radon cc -s -a shop && lizard -C 10 shop web"ومخرج Radon سوف يكون كما يلي:
shop/pricing.py
    F 4:0 calculate_total - C (15)
    F 40:0 shipping_cost - A (3)
shop/discounts.py
    F 4:0 member_discount - B (7)
    F 24:0 staff_discount - B (7)
shop/storage.py
    F 7:0 save_order - A (2)
    F 19:0 load_order - A (2)

6 blocks (classes, functions, methods) analyzed.
Average complexity: B (6.0)
ومن مخرج lizard نأخذ جزء التحذيرات:
!!!! Warnings (cyclomatic_complexity > 10 or length > 1000 or nloc > 1000000 or parameter_count > 100) !!!!
================================================
  NLOC    CCN   token  PARAM  length  location
------------------------------------------------
      32     15    236      4      34 calculate_total@4-37@shop/pricing.py
في المخرج أعلاه لاحظ التالي:
- الأداتان أعطتا
calculate_totalالرقم 15، وRuff أعطاها 14، وهذا الفرق الذي ذكرناه في قسم التعقيد الدوري. - الدالتان
member_discountوstaff_discountلهما الرقم نفسه 7، وهذه إشارة غير مباشرة إلى التكرار، ولكن أداة التعقيد لا تقول ذلك صراحة. - أداة lizard قرأت ملف JavaScript أيضاً، فهي تدعم لغات كثيرة، وهذا مفيد إذا كان المشروع بأكثر من لغة.
التغطية مع pytest-cov
نشغل الاختبارات مع قياس التغطية للأسطر والفروع:
docker exec lab-cq-py sh -c "cd /work && python -m pytest -q --cov=shop --cov-branch --cov-report=term-missing"والمخرج سوف يكون كما يلي:
Name                Stmts   Miss Branch BrPart  Cover   Missing
---------------------------------------------------------------
shop/__init__.py        0      0      0      0   100%
shop/discounts.py      34     23     24      4    26%   7, 12-15, 18, 20, 25-40
shop/pricing.py        31     13     28      6    51%   8->7, 13, 15-21, 24, 30-34, 43
shop/storage.py        17     17      2      0     0%   2-24
---------------------------------------------------------------
TOTAL                  82     53     54     10    33%
4 passed in 0.23s
في المخرج أعلاه لاحظ التالي:
- ملف
storage.pyبنسبة 0%، أي أن المشكلتين Q4 وQ5 لا يوجد اختبار واحد يمر عليهما، وهذا ما تجيده التغطية: أن تريك أين لا يوجد أي اختبار. - ملف
discounts.pyبنسبة 26%، وهذه النسبة كلها جاءت من الاختبار Q6 الذي لا يتحقق من شيء، فالتغطية حسبت أسطره مغطاة. - العمود
Missingيبين الأسطر بالضبط، والسطر8->7يعني فرعاً من السطر 8 إلى 7 لم ينفذ، أي حالةqtyصفر.
التجربة الفاصلة: نكسر النسخة المنسوخة
الآن سوف نفعل ما يحدث في الفرق كل يوم: طلب قسم المبيعات رفع خصم الأعضاء القدامى من 10% إلى 12%، فعدل المطور الدالة member_discount، ولم ينتبه إلى أن staff_discount نسخة منها وفيها القاعدة نفسها، ثم شغل كل الأدوات:
docker exec lab-cq-py bash -c "cd /work
sed -i '0,/        rate = 0.10/s//        rate = 0.12/' shop/discounts.py
ruff check --statistics shop; python -m pytest -q | tail -1
radon cc -s shop/discounts.py; grep -n 'rate = 0.1' shop/discounts.py"
والمخرج سوف يكون كما يلي:
2	PLR1730	[*] if-stmt-min-max
2	F401   	[*] unused-import
1	BLE001 	[ ] blind-except
1	B006   	[ ] mutable-argument-default
1	S110   	[ ] try-except-pass
Found 7 errors.
4 passed in 0.05s
shop/discounts.py
    F 4:0 member_discount - B (7)
    F 24:0 staff_discount - B (7)
11:        rate = 0.12
30:        rate = 0.10
كل الأدوات تقول إن شيئاً لم يتغير: المدقق يعطي المشاكل القديمة نفسها، والاختبارات تنجح، والتعقيد كما هو، ولكن السطرين الأخيرين يبينان أن المتجر صار يعطي الأعضاء 12% والموظفين 10% بعد أن كانت القاعدة واحدة، ولا أحد يعرف هل هذا مقصود. والسبب أن أياً من الأدوات الثلاث لا يقارن الدوال ببعضها، فالتكرار Q3 لا يظهر إلا لأداة تحسب التكرار مثل SonarQube أو Qlty، وهذا ما سوف تراه في المقال التالي عندما نشغل هذه الأدوات على المستودع نفسه. ولاحظ أن رقمي التعقيد المتساويين كانا الإشارة الوحيدة، وهي إشارة لا يلاحظها إلا من يبحث عنها.
أعدنا الملف إلى حالته بالأمر git checkout shop/discounts.py، والحل الصحيح هنا ليس أن تتذكر النسخة الثانية، وإنما أن تستخرج القاعدة المشتركة إلى دالة واحدة تأخذ الحد الأعلى كمعامل، ثم تكتب اختباراً يتحقق من الرقم بالضبط، مثل assert member_discount({"years": 6}, 1000) == 100.0.
ماذا وجد كل نوع من الأدوات؟
| المشكلة | المدقق Ruff بعد الإعداد | أداتا التعقيد | التغطية |
|---|---|---|---|
| Q1 الدالة المعقدة | نعم بالقاعدة C901 بعد تفعيلها | نعم بالرقم 15 | جزئياً، فالفروع غير المنفذة ظاهرة |
| Q2 الأرقام السحرية | لا بالإعداد الافتراضي، ونعم بالقاعدة PLR2004 إذا فعلتها | لا | لا |
| Q3 التكرار | لا | لا، إلا إشارة الرقم المتساوي | لا |
| Q4 ابتلاع الخطأ | نعم بالقاعدتين S110 وBLE001 | لا | نعم، فلا يوجد اختبار له |
| Q5 القيمة الافتراضية القابلة للتغيير | نعم بالقاعدة B006 | لا | نعم، فلا يوجد اختبار له |
| Q6 اختبار بلا تحقق | لا | لا | لا، بل رفع النسبة |
ولإزالة التجربة نحذف ال Container بالاسم فقط:
docker rm -f lab-cq-pyأخطاء شائعة
- اعتبار الرقم هدفاً: عندما يصبح «التغطية 80%» هدفاً، يكتب الفريق اختبارات مثل Q6 ترفع الرقم ولا تكشف شيئاً، فاستخدم الأرقام لتسأل أسئلة ولا تقم بمكافأة الناس عليها.
- تشغيل كل القواعد من اليوم الأول: مئات التحذيرات في أول تشغيل تعلم الفريق أن يتجاهل الأداة، فابدأ بقواعد قليلة يوافق عليها الجميع، وزدها تدريجياً.
- بوابة على المشروع كله: بوابة جودة Quality Gate تفشل بسبب كود عمره خمس سنوات لن تنجح أبداً، فاحكم على الكود الجديد فقط كما شرحنا.
- الفحص في CI فقط: إذا لم يكن المدقق في المحرر وفي pre-commit، فسوف يكتشف المطور المشكلة بعد أن انتقل إلى عمل آخر، وكل إصلاح سوف يكلف أكثر.
- إطفاء التحذير بدل فهمه: تعليق مثل
# noqaعلى كل سطر يحول الأداة إلى ديكور، فإذا كانت القاعدة لا تناسب الفريق فأطفئها في ملف الإعداد مع السبب، وإذا كانت تناسبه فأصلح الكود. - الثقة بالأداة في الصحة: لا توجد قاعدة تعرف أن الخصم يجب أن يكون 10%، فالأدوات تحرس الشكل والأنماط، والاختبارات والمراجعة تحرسان المعنى.
الخلاصة
- جودة الكود هي سهولة فهمه وتغييره والثقة به، وتنقسم إلى الصحة وقابلية الصيانة والقراءة والموثوقية والأمان، والأمان له أدواته في مقال SAST.
- أداة التنسيق والمدقق ومدقق الأنواع وأداة تحليل الجودة والاختبارات خمس طبقات، وكل طبقة ترى ما لا تراه التي قبلها.
- التعقيد الدوري يعد المسارات، والتعقيد الإدراكي يعاقب التداخل، والأدوات تعطي أرقاماً مختلفة للدالة نفسها، فقارن الأداة بنفسها عبر الزمن.
- الدين التقني Technical Debt رقم تقديري مفيد للاتجاه، ولا يرى أخطاء التصميم الكبيرة ولا يعرف أي الملفات تتغير كثيراً.
- بوابة الجودة Quality Gate يجب أن تحكم على الكود الجديد فقط، وأن تعمل في CI حيث لا يمكن تجاوزها، والفحوص السريعة مكانها المحرر وpre-commit.
- الوكيل الذكي يميل إلى التكرار وابتلاع الأخطاء والتغييرات الكبيرة، وتقرير DORA 2024 ربط زيادة اعتماد الذكاء الاصطناعي بانخفاض ثبات التسليم.
- في التجربة وجد المدقق ابتلاع الخطأ والقيمة الافتراضية، ووجدت أدوات التعقيد الدالة المعقدة، وكشفت التغطية الملف غير المختبر، ولم تجد أي منها النسخة المنسوخة ولا الاختبار الذي لا يتحقق من شيء.
وفي المقال التالي من السلسلة بإذن الله سوف نشغل على المستودع نفسه Pylint وESLint وSemgrep وQlty وSonarQube، ونقارن ما يجده كل واحد وتراخيصه وأسعاره. وهذه مقالات مرتبطة بالموضوع:
 دليلSAST: كيف يجد تحليل الكود الثابت الثغرات قبل التشغيلكيف تقرأ أداة SAST الكود بحثاً عن الثغرات، وما الذي لا تراه أبداً، وكيف تمنع الإنذارات الخاطئة من أن تفقد الفريق ثقته بها.
 دليلDevSecOps للمبتدئين: الأمن داخل خط CI/CD ومتى يعمل كل فحصما الذي يجده كل فحص أمني في خط CI/CD وما الذي يفوته، وكيف ترتب نتائجه حتى تصل إلى قرار بدل قائمة طويلة.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلكيف تتعامل لغات البرمجة مع الأخطاء؟لماذا ترمي Java وPython الاستثناءات بينما ترجع Go وRust الخطأ كقيمة، وكيف تمنع الخطأ من أن يختفي بصمت في كودك.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلمبادئ التصميم Design Principles بأمثلة قبل وبعدلماذا يكسر تعديل صغير في الفاتورة شيئاً في المحاسبة، وكيف تساعدك مبادئ مثل SOLID وDRY على كود يتغير دون مفاجآت.
سجل التحديثات
- أكتوبر 2026: كتابة المقال اعتماداً على ورقة McCabe وورقة التعقيد الإدراكي من Sonar ونص Ward Cunningham ووثائق SonarQube وRuff وتقرير DORA 2024، مع تجربة حقيقية على مستودع فيه ست مشاكل مقصودة باستخدام Ruff 0.17.0 وRadon 6.0.1 وlizard 1.24.1 وpytest-cov 7.1.0 على Python 3.13.16.


