


إذا كنت قائد فريق Team Lead أو مدير هندسة Engineering Manager، فغالباً جاءك هذا السؤال بعد أن أدخلتم خط CI/CD أو انتقلتم إلى الفروع القصيرة Short-lived Branches: «هل أصبحنا أسرع فعلاً؟». والإجابة التي تخطر على البال أولاً هي الإحساس Gut Feeling: الفريق يشعر أن النشر Deployment أسهل، والمدير يشعر أن الميزات Features تتأخر كما كانت، وكل طرف عنده أمثلة تؤيد رأيه. وفي مقال ما هو DevOps؟ قلنا إن السؤال «هل نحن DevOps؟» لا جواب له، وإن البديل أسئلة لها أرقام، وأشهر هذه الأسئلة مقاييس DORA. وهذا المقال يأخذ الخطوة التالية: كيف تحسب هذه المقاييس Metrics لفريقك بنفسك من البيانات الخام، وكيف تقرأها، ومتى تكذب عليك.
والمقال مكتوب لمن يعرف Git وطلبات الدمج Pull Requests وفكرة خط CI/CD، فإذا كانت هذه الأشياء جديدة عليك فابدأ بمقال مفهوم CI/CD للمبتدئين ثم عد إلى هنا. وسوف نناقش في هذا المقال ما يلي:
- ما هي DORA، والمقاييس الأربعة الأصلية Four Keys، وكيف أصبحت خمسة.
- تعريف كل مقياس بالضبط، ومن أين تبدأ الساعة وأين تتوقف، لأن أغلب الأخطاء تأتي من هنا.
- مستويات الأداء Performance Levels في تقرير 2024، وما الذي تغير في تقرير 2025 الذي ترك المستويات الأربعة.
- مختبر على جهازك: مستودع حقيقي في Gitea، وطلبات دمج، وخط CI ونشر بـ Gitea Actions، وحادثتان Incidents حقيقيتان، ثم سكربت Script قصير يحسب المقاييس الخمسة من Git وسجل النشر Deploy Log والحوادث خطوة بخطوة.
- تشغيل Apache DevLake على البيانات نفسها ومقارنة أرقامه بأرقامنا، ولماذا تختلف.
- كيف يتلاعب الفريق بالأرقام دون قصد، وقانون Goodhart's Law، وأخطاء المقارنة بين الفرق Teams والأفراد Individuals.
ما هي DORA؟ DevOps Research and Assessment
DORA اختصار DevOps Research and Assessment، وهو برنامج بحثي تديره اليوم Google Cloud، وبدأ قبل أكثر من عشر سنوات بسؤال واحد: ما الذي يميز الفرق التي تسلم البرمجيات بسرعة وثبات عن غيرها؟ ولكي يجيب عنه يجري البرنامج كل سنة استبياناً Survey كبيراً للعاملين في تطوير البرمجيات وتشغيلها، ثم ينشر تقريراً Report كان اسمه سنوات طويلة Accelerate State of DevOps. وفي سنة 2018 نشرت Nicole Forsgren وJez Humble وGene Kim كتاب Accelerate الذي جمع نتائج السنوات الأولى، ومنه انتشرت فكرة «المقاييس الأربعة» في الشركات Companies.
وحجم البيانات هو ما يعطي هذه المقاييس وزنها، ففي تقرير 2024 يقول الفريق إنه سمع من أكثر من 39,000 شخص على مدى سنوات البحث، وفي تقرير 2025 أجاب على الاستبيان 4,867 شخصاً بين 13 يونيو و21 يوليو 2025، ويقول التقرير إن مجموع من شاركوا عبر السنوات نحو 45,000. ولاحظ أن هذه البيانات من استبيان، أي أن الناس يقدرون أرقام فرقهم بأنفسهم، ولذلك فالتقرير يعطيك صورة عن الصناعة، أما رقم فريقك فتحسبه من بياناتك أنت، وهذا ما يفعله المختبر في هذا المقال.
المقاييس الأربعة الأصلية Four Keys
الفكرة الأساسية في DORA بسيطة: تسليم البرمجيات له وجهان، السرعة Throughput والثبات Stability، والفريق الجيد ليس من ينشر بسرعة فقط ولا من لا يتعطل نظامه أبداً، وإنما من يجمع الاثنين. ولذلك جاءت المقاييس الأربعة في زوجين، والصورة التالية تبينها كما هي اليوم بعد أن أصبحت خمسة:
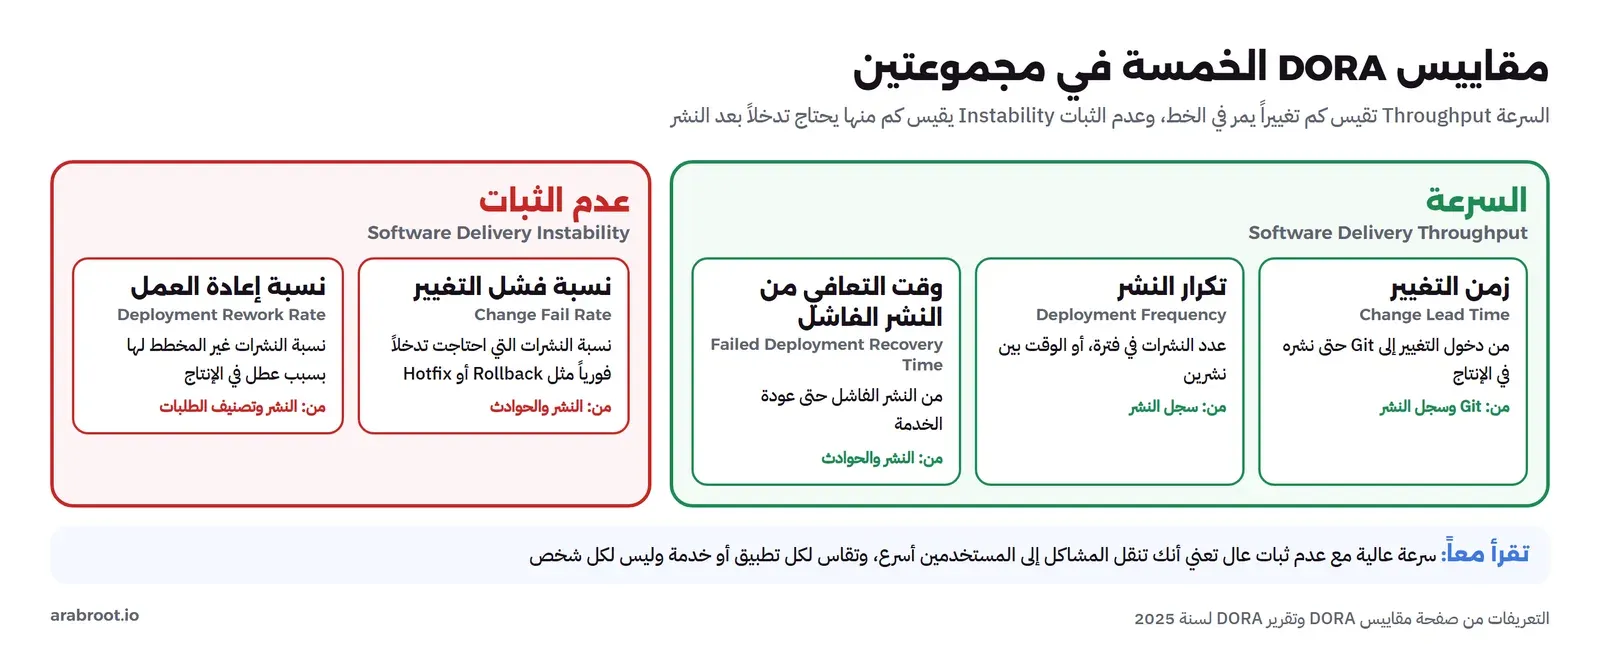
والتعريفات التالية منقولة من صفحة مقاييس DORA، ومعها ما يجب أن تقرره أنت قبل أن تحسب أي رقم:
تكرار النشر Deployment Frequency
تعرفه الصفحة بأنه «The number of deployments over a given period or the time between deployments»، أي عدد النشرات في فترة، أو الوقت بين نشر والذي يليه. ويبدو أسهل المقاييس، ولكن أول سؤال يجب أن تجيب عنه هو: ما هو النشر؟ هل هو تشغيل خط النشر، أم وصول الكود إلى الإنتاج Production بنجاح؟ وهل النشر إلى بيئة الاختبار Staging نشر؟ والإجابة التي نعتمدها في هذا المقال، وهي ما يقصده DORA، أن النشر هو وصول تغيير إلى الإنتاج Production حيث يراه المستخدم User، فالتشغيل الذي فشل قبل أن يصل لا يحسب، والنشر إلى Staging لا يحسب.
ولماذا يهمنا هذا المقياس أصلاً؟ لأن تكرار النشر مؤشر غير مباشر على حجم الدفعة Batch Size، فالفريق الذي ينشر مرة في الشهر يجمع في كل نشر عمل أسابيع، وكل عطل بعده يأخذ وقتاً أطول ليعرف سببه، وهذا ما تشرحه صفحة العمل في دفعات صغيرة في موقع DORA، وشرحناه من جهة الفروع في مقال Trunk-Based Development.
زمن التغيير Change Lead Time
وتعرفه الصفحة بأنه «The amount of time it takes for a change to go from committed to version control to deployed in production»، أي الوقت من دخول التغيير إلى نظام إدارة النسخ حتى نشره في الإنتاج. ولاحظ أن الساعة تبدأ عند ال Commit وليس عند فتح التذكرة Ticket ولا عند أول فكرة، وأن الوقت قبل ال Commit لا يظهر هنا أبداً، وهذا مقصود، لأن DORA يقيس خط التسليم وليس التخطيط Planning، أما الوقت من الفكرة إلى العميل فهو موضوع مقاييس التدفق Flow Metrics التي نشرحها في مقال إنتاجية المطورين بعد DORA.
والقرار الذي تحتاجه هنا: أي Commit؟ فطلب الدمج الواحد فيه عادة عدة Commits، وأولها قد يكون قبل أيام من الدمج، وآخرها قبل دقائق، وGitea أو GitHub يضيف Commit دمج Merge Commit عند الدمج. وفي المختبر سوف نحسب الزمن لكل Commit كتبه المطور، ونترك Commit الدمج لأنه لم يكتبه أحد، وسوف نرى أن DevLake يحسبه بطريقة أخرى قريبة.
نسبة فشل التغيير Change Fail Rate
وتعرفها الصفحة بأنها «The ratio of deployments that require immediate intervention following a deployment»، أي نسبة النشرات التي احتاجت تدخلاً فورياً بعدها، وتذكر أن هذا التدخل يكون غالباً تراجعاً Rollback أو إصلاحاً عاجلاً Hotfix. والسؤال الذي تقرره: ما هو الفشل؟ وقاعدتنا: النشر فاشل إذا وصل إلى الإنتاج ثم احتاج تدخلاً عاجلاً لأن المستخدمين Users تأثروا، فخطأ إملائي في صفحة لا ينتظر النشر القادم ليس فشلاً بهذا المعنى، وخط CI الذي فشل قبل أن ينشر ليس فشلاً لأنه لم يصل إلى أحد، بل هو الخط يعمل كما يجب.
وقت التعافي من النشر الفاشل Failed Deployment Recovery Time
وكان اسمه سنوات طويلة متوسط وقت الاستعادة MTTR، واليوم تعرفه الصفحة بأنه «The time it takes to recover from a deployment that fails and requires immediate intervention»، أي الوقت اللازم للتعافي من نشر فشل واحتاج تدخلاً عاجلاً. والفرق بين الاسمين مهم: MTTR كان يشمل أي عطل، حتى انقطاع مركز البيانات Data Center الذي لا علاقة للفريق به، أما التعريف الجديد فيقيس التعافي من تغيير أدخله الفريق نفسه. والقرار هنا: متى تبدأ الساعة؟ عند انتهاء النشر الفاشل، أم عند اكتشاف المشكلة وفتح الحادثة Incident؟ وسوف نحسب الاثنين في المختبر، لأن الفرق بينهما هو وقت الاكتشاف، وهو رقم يستحق أن تعرفه وحده.
من أربعة مقاييس إلى خمسة: ماذا تغير؟ History of the Metrics
إذا قرأت مقالات قديمة عن DORA فسوف تجد «المقاييس الأربعة» وMTTR والمستويات الأربعة، ثم تجد في الموقع اليوم خمسة مقاييس بأسماء مختلفة، والسبب أن المقاييس تغيرت مع البحث نفسه، وصفحة تاريخ المقاييس تشرح ذلك سنة بسنة، وهذا ملخصها في صورة:
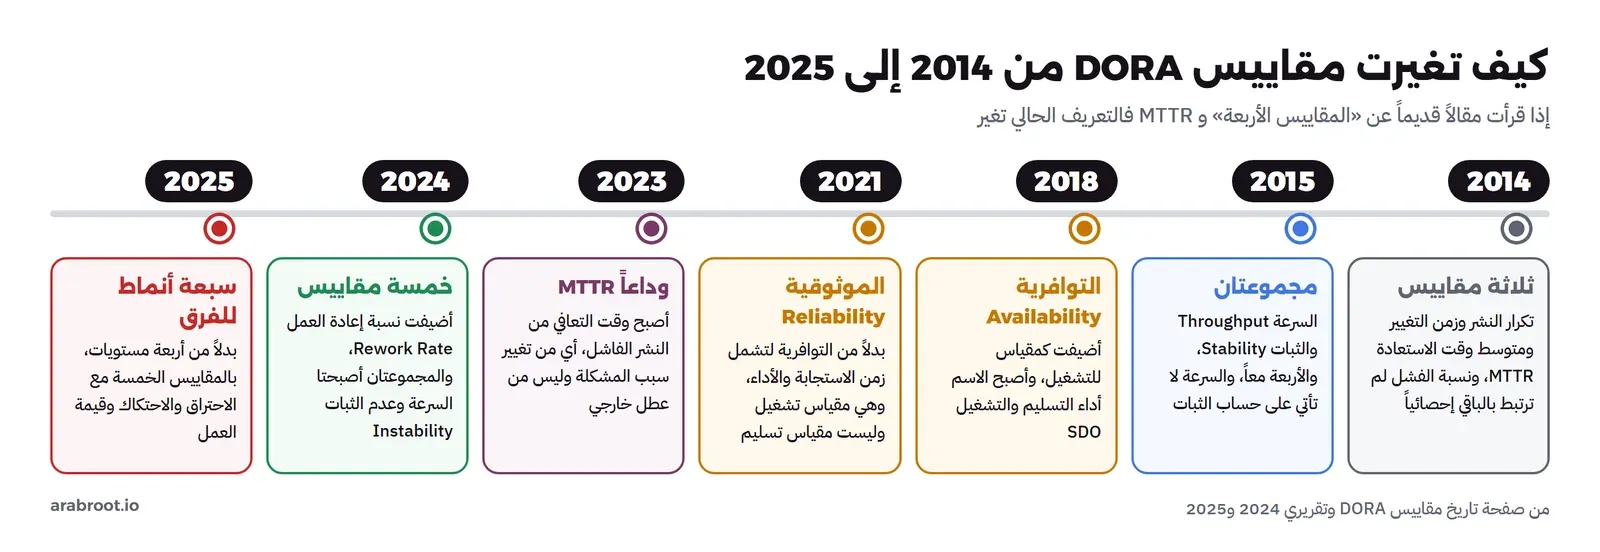
وأهم ما في هذا الخط الزمني ثلاث محطات:
- 2014، ثلاثة مقاييس فقط: تقول صفحة التاريخ إن نسبة فشل التغيير لم ترتبط إحصائياً بالمقاييس الأخرى في الدراسة الأولى، فعرف أداء التقنية بتكرار النشر وزمن التغيير وMTTR، ثم انضمت نسبة الفشل في 2015 عندما أصبح التقسيم مجموعتين: السرعة Throughput والثبات Stability. ومن هذه السنة جاءت النتيجة التي تكررت في كل تقرير بعدها، أن السرعة لا تأتي على حساب الثبات، وأن أفضل الفرق جيدة في الاثنين.
- 2021، الموثوقية Reliability ليست المقياس الخامس: كان تقرير 2021 قد سمى الموثوقية Reliability «المقياس الخامس»، وصفحة التاريخ نفسها تقول إن هذه التسمية كانت خطأ، لأن الموثوقية مقياس تشغيل Operations وليست مقياس تسليم، وهي أقرب إلى أهداف الخدمة SLO التي شرحناها في مقال ماذا تعني 99.9%؟.
- 2024، نسبة إعادة العمل: كان عند الباحثين افتراض قديم أن نسبة الفشل تقيس في الحقيقة كمية إعادة العمل Rework التي يطلب من الفريق، لأن النشر الفاشل يحتاج تغييراً جديداً يصلحه. فأضافوا في استبيان 2024 سؤالاً: كم نشراً في الأشهر الستة الأخيرة لم يكن مخططاً له، وإنما جاء لإصلاح خطأ يراه المستخدم؟ فوجدوا أن هذا الرقم ونسبة الفشل يرتبطان ويصنعان معاً عاملاً واحداً سموه عدم ثبات التسليم Software Delivery Instability، وانتقل وقت التعافي إلى مجموعة السرعة.
وقد يتساءل البعض: لماذا انتقل وقت التعافي إلى مجموعة السرعة وهو يبدو مقياس ثبات؟ والإجابة في تعريف التقرير نفسه، فمجموعة السرعة تقيس سرعة إيصال أي تغيير، سواء كان تغييراً عادياً أو تغييراً يصلح فشلاً، والفريق الذي يستطيع أن ينشر إصلاحاً خلال ساعة هو فريق خطه سريع، أما مجموعة عدم الثبات فتقيس احتمال أن يولد النشر عملاً إضافياً فورياً لم يكن في الخطة.
مستويات الأداء في تقرير 2024 Performance Clusters
كل سنة حتى 2024 كان التقرير يقسم المشاركين إلى مستويات أداء بتحليل إحصائي يسمى التحليل العنقودي Cluster Analysis، أي أنه لا يضع حدوداً مسبقة وإنما يجمع الإجابات المتشابهة في مجموعات، ولذلك تتغير الحدود من سنة لأخرى. والصورة التالية تبين مستويات 2024 كما في الصفحة 13 من التقرير:
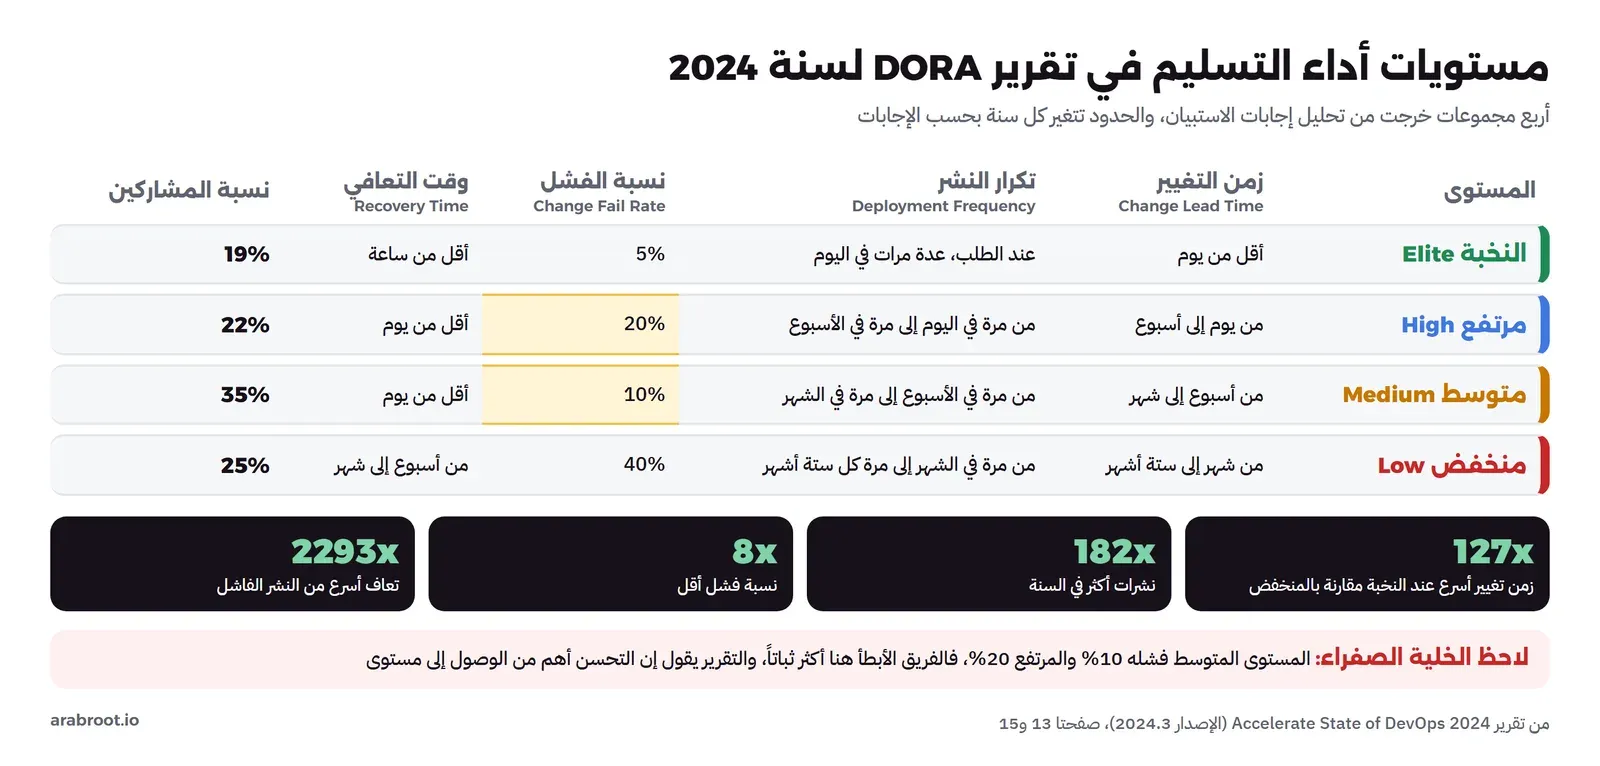
وفي الجدول أعلاه لاحظ التالي:
- المتوسط أكثر ثباتاً من المرتفع: نسبة فشل المستوى المتوسط 10% والمرتفع 20%، والتقرير يعترف أنه هو من قرر أن يسمي الفرق الأسرع «مرتفعة» والأبطأ الأكثر ثباتاً «متوسطة»، ويقول إن هذا يبين أحد مخاطر استخدام المستويات، وإن الأفضل أن يهتم الفريق بالتحسن Improvement أكثر من الوصول إلى مستوى، بعبارته: «achieve elite improvement, not necessarily elite performance».
- الفروق كبيرة جداً: يقول التقرير إن النخبة مقارنة بالمنخفض زمن تغييرها أسرع 127 مرة، وتنشر أكثر 182 مرة في السنة، ونسبة فشلها أقل 8 مرات، وتتعافى من النشر الفاشل أسرع 2293 مرة.
- القطاع Industry لا يحدد المستوى: يقول التقرير إن بحثه نادراً ما يجد القطاع Industry عاملاً يتنبأ بأداء التسليم، وإنه يجد فرقاً عالية الأداء في كل القطاعات، وهذه إجابة مباشرة لمن يقول «نحن بنك ولا نستطيع أن ننشر كل يوم»، وصفحة مقاييس DORA تسمي هذا الخطأ «استخدام القطاع كدرع Using industry as a shield».
ماذا تغير في تقرير 2025؟ Seven Team Profiles
تقرير 2025 اسمه State of AI-assisted Software Development، وتركيزه على أدوات الذكاء الاصطناعي، ولكن الذي يهمنا هنا أنه ترك المستويات الأربعة. فالتقرير يقول إن المقاييس الخمسة نتائج تخبرك بما يحدث ولا تشرح السبب، ويضرب مثالاً بأن انخفاض تكرار النشر قد يكون سببه الدين التقني أو إجراءات بيروقراطية أو احتراق الفريق، ولذلك أجرى التحليل العنقودي على المقاييس الخمسة مع مقاييس عن الناس، مثل الاحتراق Burnout والاحتكاك Friction وأداء الفريق والمنتج، فخرجت سبعة أنماط للفرق Team Profiles، والجدول التالي يبينها بنسبها:
| النمط | الاسم في التقرير | نسبة المشاركين | الوصف المختصر |
|---|---|---|---|
| 1 | Foundational challenges | 10% | فرق في وضع النجاة، ضعيفة في الأداء والثبات، مع احتراق واحتكاك عاليين |
| 2 | The legacy bottleneck | 11% | بيئة عمل مرهقة، والنظام القديم والدين التقني يحددان كل شيء |
| 3 | Constrained by process | 17% | احتراق واحتكاك عاليان بسبب إجراءات غير فعالة |
| 4 | High impact, low cadence | 7% | أثر وفاعلية فردية عاليان، مع سرعة تسليم منخفضة وعدم ثبات عال |
| 5 | Stable and methodical | 15% | احتراق واحتكاك منخفضان وبيئة صحية، مع سرعة أقل |
| 6 | Pragmatic performers | 20% | سرعة وثبات جيدان، ولكن الحماس للعمل أقل من القمة |
| 7 | Harmonious high-achievers | 20% | جيدة في التسليم والمنتج وصحة الفريق معاً |
والتقرير يستخدم هذه الأنماط ليؤكد النتيجة القديمة نفسها، أن التعارض بين السرعة والثبات «خرافة»، فالنمطان 6 و7 وهما نحو 40% من المشاركين جيدان في الاثنين معاً. ونشر التقرير أيضاً توزيع الإجابات على كل مقياس بدلاً من حدود المستويات، والجدول التالي يأخذ منه مقياسين مثالاً، حتى ترى أين يقف أغلب الناس:
| زمن التغيير في 2025 | نسبة المشاركين | تكرار النشر في 2025 | نسبة المشاركين |
|---|---|---|---|
| أقل من ساعة | 9.4% | عند الطلب، عدة مرات في اليوم | 16.2% |
| أقل من يوم | 15% | من مرة في الساعة إلى مرة في اليوم | 6.5% |
| من يوم إلى أسبوع | 31.9% | من مرة في اليوم إلى مرة في الأسبوع | 21.9% |
| من أسبوع إلى شهر | 28.3% | من مرة في الأسبوع إلى مرة في الشهر | 31.5% |
| من شهر إلى ستة أشهر | 13.2% | من مرة في الشهر إلى مرة كل ستة أشهر | 20.3% |
| أكثر من ستة أشهر | 2% | أقل من مرة كل ستة أشهر | 3.6% |
ولاحظ أن أكثر من نصف المشاركين ينشرون مرة في الأسبوع أو أقل، وأن ثلثي المشاركين تقريباً زمن تغييرهم أكثر من يوم، فإذا كان فريقك ينشر مرة في الأسبوع فأنت في وسط الصناعة وليس في آخرها. ويضيف التقرير ملاحظة مهمة لمن يريد أن يقارن: أفضل مقارنة هي للتطبيق نفسه مع الوقت، والهدف التعلم والتحسن المستمر وليس الوصول إلى القمة.
ومن الأرقام التي نشرها التقرير أيضاً عن نسبة إعادة العمل: 6.9% فقط من المشاركين قالوا إن أقل من 2% من نشراتهم كانت غير مخطط لها، و26.1% قالوا إنها بين 8% و16%، وهو أكثر جواب تكرر. وقد يبدو هذا عالياً، ولكنه يعني ببساطة أن نشراً من كل عشرة تقريباً في فرق كثيرة جاء لإصلاح خطأ وصل إلى المستخدم.
تجربة عملية: احسب المقاييس الخمسة من البيانات الخام Lab
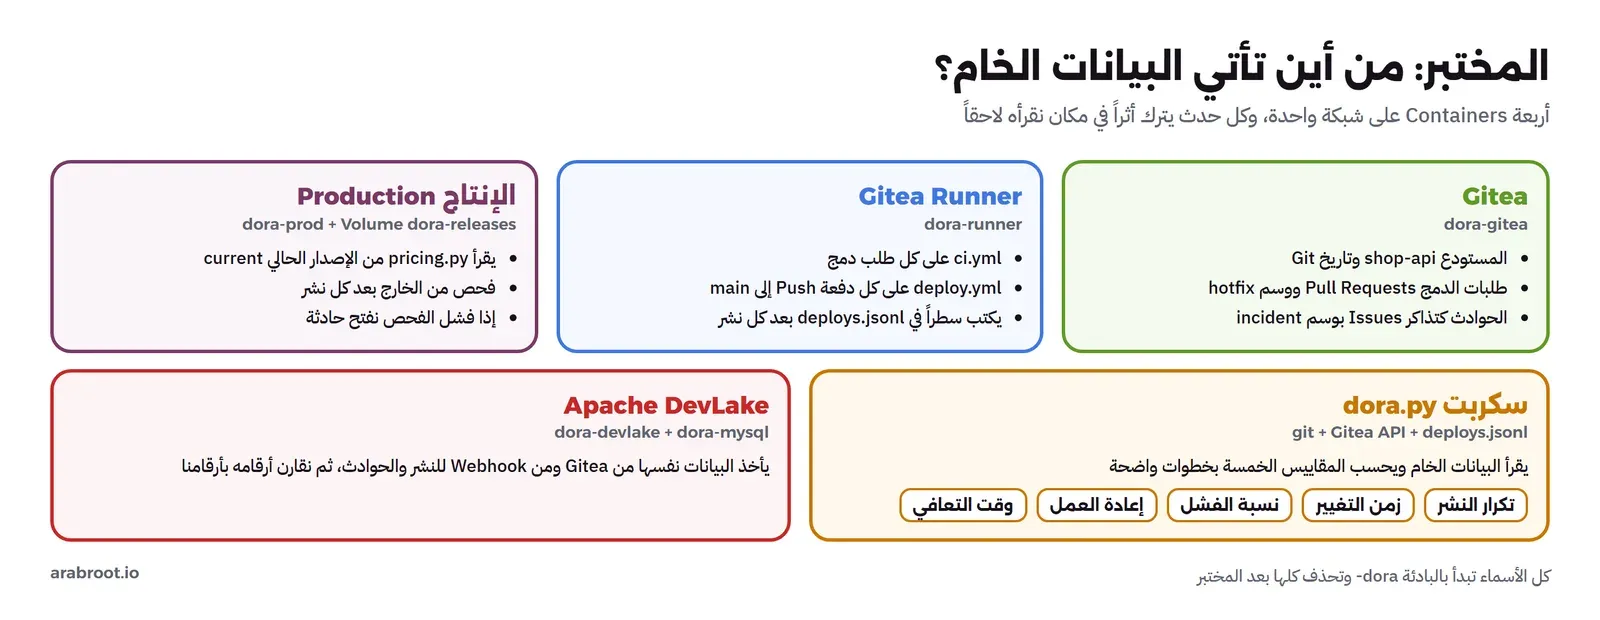
أغلب الأدوات التي تعرض لوحات DORA تخفي عنك القرارات التي شرحناها أعلاه: ما هو النشر، ومن أين تبدأ الساعة، وكيف ترتبط الحادثة بالنشر. ولذلك نبني في هذا المختبر مستودعاً Repository حقيقياً له تاريخ حقيقي، ثم نحسب المقاييس بأنفسنا بسكربت قصير تقرأ كل سطر فيه، وبعد ذلك نعطي البيانات نفسها لأداة Apache DevLake ونقارن. والصورة التالية تبين مكونات المختبر ومن أين يأتي كل رقم:
تجهيز المختبر Lab Setup
نحتاج أربعة أشياء: Gitea ليحفظ المستودع Repository وطلبات الدمج والحوادث، وRunner يشغل خطوط Gitea Actions، وContainer صغير يمثل الإنتاج، وVolume مشترك بين خط النشر والإنتاج يحفظ الإصدارات وسجل النشر. وقد شرحنا تثبيت Gitea في مقال تثبيت Gitea وتشغيل Runner في مقال Gitea Actions، فهنا نختصرها في أوامر قليلة، كل الأسماء فيها تبدأ بالبادئة dora- حتى تحذفها بسهولة في النهاية:
docker network create dora-net
docker volume create dora-releases

docker run -d --name dora-gitea --network dora-net -p 3575:3000 \
  -e GITEA__security__INSTALL_LOCK=true \
  -e GITEA__server__ROOT_URL=http://localhost:3575/ \
  -e GITEA__database__DB_TYPE=sqlite3 \
  -e GITEA__actions__ENABLED=true \
  -e GITEA__actions__DEFAULT_ACTIONS_URL=github \
  -v dora-gitea-data:/data gitea/gitea:28.4.0

docker exec -u git dora-gitea gitea admin user create --username dev \
  --password 'DoraLab-2026!' --email [email protected] --admin --must-change-password=false
docker exec -u git dora-gitea gitea actions generate-runner-token
والأمر الأخير يطبع رمز تسجيل Registration Token للـ Runner، ثم نشغل ال Runner بملف إعداد صغير اسمه runner-config.yaml:
runner:
  capacity: 1
  labels:
    - "ubuntu-latest:docker://node:24-alpine"
container:
  network: dora-net
  valid_volumes:
    - dora-releases
وفي الإعداد أعلاه لاحظ التالي:
- السطر labels: أي مهمة Job تطلب
ubuntu-latestسوف تعمل في Container منnode:24-alpine، وهو صغير ويكفي لتشغيلactions/checkout. - السطر network: يضع Containers المهام على شبكة المختبر حتى تصل إلى
dora-giteaباسمه. - السطر valid_volumes: يسمح لخط النشر فقط بأن يربط ال Volume المسمى
dora-releases، والسبب أن Runner بلا هذا القيد يسمح لأي Workflow بأن يربط أي مجلد من السيرفر. - السطر capacity: 1: مهمة واحدة في الوقت نفسه، وهذا سوف يظهر في الأرقام لاحقاً، لأن مهمة النشر تنتظر في الطابور Queue خلف مهمة CI.
docker run -d --name dora-runner --network dora-net \
  -e GITEA_INSTANCE_URL=http://dora-gitea:3000/ \
  -e GITEA_RUNNER_REGISTRATION_TOKEN="$RUNNER_TOKEN" \
  -e GITEA_RUNNER_NAME=dora-runner -e CONFIG_FILE=/config.yaml \
  -v "$PWD/runner-config.yaml:/config.yaml:ro" \
  -v /var/run/docker.sock:/var/run/docker.sock \
  -v dora-runner-data:/data gitea/runner:6.0.0

docker logs dora-runner
والمخرج سوف يكون كما يلي:
.runner is missing or not a regular file
level=info msg="Registering runner, arch=amd64, os=linux, version=v6.0.0."
level=debug msg="Successfully pinged the Gitea instance server"
level=info msg="Runner registered successfully."
SUCCESS
time="2026-11-18T18:52:22Z" level=info msg="Starting runner daemon"
time="2026-11-18T18:52:23Z" level=info msg="runner: dora-runner, with version: v6.0.0, with labels: [ubuntu-latest], declare successfully"
السطر الأول ليس خطأ، وإنما يقول إن ال Runner لم يسجل من قبل، فيسجل نفسه ثم يعلن الوسم ubuntu-latest الذي سوف تطلبه الخطوط. بعد ذلك نشغل «الإنتاج»، وهو Container من python:3.13-alpine يشغل سيرفر HTTP صغيراً في الملف server.py، يقرأ في كل طلب الملف pricing.py من المجلد /releases/current، أي من الإصدار Release الذي نشره الخط آخر مرة، ويجيب على /?qty=N بالسعر وعلى /version بال Commit المنشور:
docker run -d --name dora-prod --network dora-net -p 8575:8000 \
  -v dora-releases:/releases -v "$PWD/server.py:/server.py:ro" \
  python:3.13-alpine python /server.py
وأخيراً ننشئ المستودع shop-api ووسمين Labels: الوسم incident للتذاكر التي تمثل حادثة في الإنتاج، والوسم hotfix لطلبات الدمج التي تصلح حادثة، والأوامر الكاملة في الملف lab/setup.sh مع المقال.
خطا CI والنشر: أين يولد سجل النشر Deploy Log؟
التطبيق نفسه بسيط عن قصد: دالة price(qty) تحسب سعر الطلب بعشرين ريالاً للقطعة، ومعها اختبارات بالمكتبة Library unittest. والمهم هو الخطان، فالأول .gitea/workflows/ci.yml يشغل الاختبارات Tests على كل طلب دمج وعلى كل دفعة إلى main:
name: ci
on:
  pull_request:
  push:
    branches: [main]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: apk add --no-cache python3 >/dev/null && python3 -m unittest -v
والثاني .gitea/workflows/deploy.yml ينشر كل دفعة إلى main، وهو الذي يكتب البيانات الخام لأهم مقياسين:
name: deploy
on:
  push:
    branches: [main]
jobs:
  deploy:
    runs-on: ubuntu-latest
    container:
      image: node:24-alpine
      volumes:
        - dora-releases:/releases
    steps:
      - uses: actions/checkout@v4
      - name: Test before deploy
        run: apk add --no-cache python3 >/dev/null && python3 -m unittest
      - name: Deploy to production
        run: |
          STARTED=$(date -u +%Y-%m-%dT%H:%M:%SZ)
          mkdir -p /releases/$GITHUB_SHA
          cp pricing.py /releases/$GITHUB_SHA/
          ln -sfn /releases/$GITHUB_SHA /releases/current
          FINISHED=$(date -u +%Y-%m-%dT%H:%M:%SZ)
          echo "{\"run\":$GITHUB_RUN_NUMBER,\"sha\":\"$GITHUB_SHA\",\"started\":\"$STARTED\",\"finished\":\"$FINISHED\",\"env\":\"production\"}" >> /releases/deploys.jsonl
          echo "deployed $GITHUB_SHA"
وفي الملف أعلاه لاحظ التالي:
- الخطوة Test before deploy: نعيد الاختبارات على
mainنفسه قبل النشر، لأن طلبين نجح كل منهما وحده قد يفشلان معاً بعد الدمج، وهذا بالضبط ما سوف يحدث في التاريخ التالي. - السطر ln -sfn: النشر هو تغيير الرابط
currentإلى مجلد الإصدار الجديد، فيبدأ الإنتاج بقراءة الكود الجديد من الطلب التالي، والتراجع Rollback هو إعادة الرابط إلى مجلد قديم. - السطر echo … >> deploys.jsonl: هذا هو سجل النشر Deploy Log، سطر JSON واحد لكل نشر ناجح فيه رقم التشغيل وال Commit ووقت البداية والنهاية. ولاحظ أنه آخر خطوة، فإذا فشلت أي خطوة قبله لا يكتب شيئاً، وبالتالي يحسب السجل النشرات التي وصلت إلى الإنتاج فقط، وهو التعريف الذي اتفقنا عليه.
وقد يتساءل البعض: لماذا لا نأخذ النشرات من سجل تشغيلات Gitea Actions مباشرة بدل ملف منفصل؟ والإجابة أن سجل التشغيلات يخلط الناجح بالفاشل والنشر بالاختبار، ويحتاج قاعدة تحدد أي تشغيل هو نشر إلى الإنتاج، وهذا ما تفعله الأدوات بأنماط Regex على اسم الخط، أما السطر الذي يكتبه الخط بنفسه بعد النجاح فلا يحتاج تفسيراً. وفي فريق حقيقي يكون هذا السطر طلب HTTP إلى أداة القياس بدلاً من ملف، كما سوف نرى مع DevLake.
تاريخ حقيقي في أقل من ساعتين: ماذا حدث في المستودع Repository؟
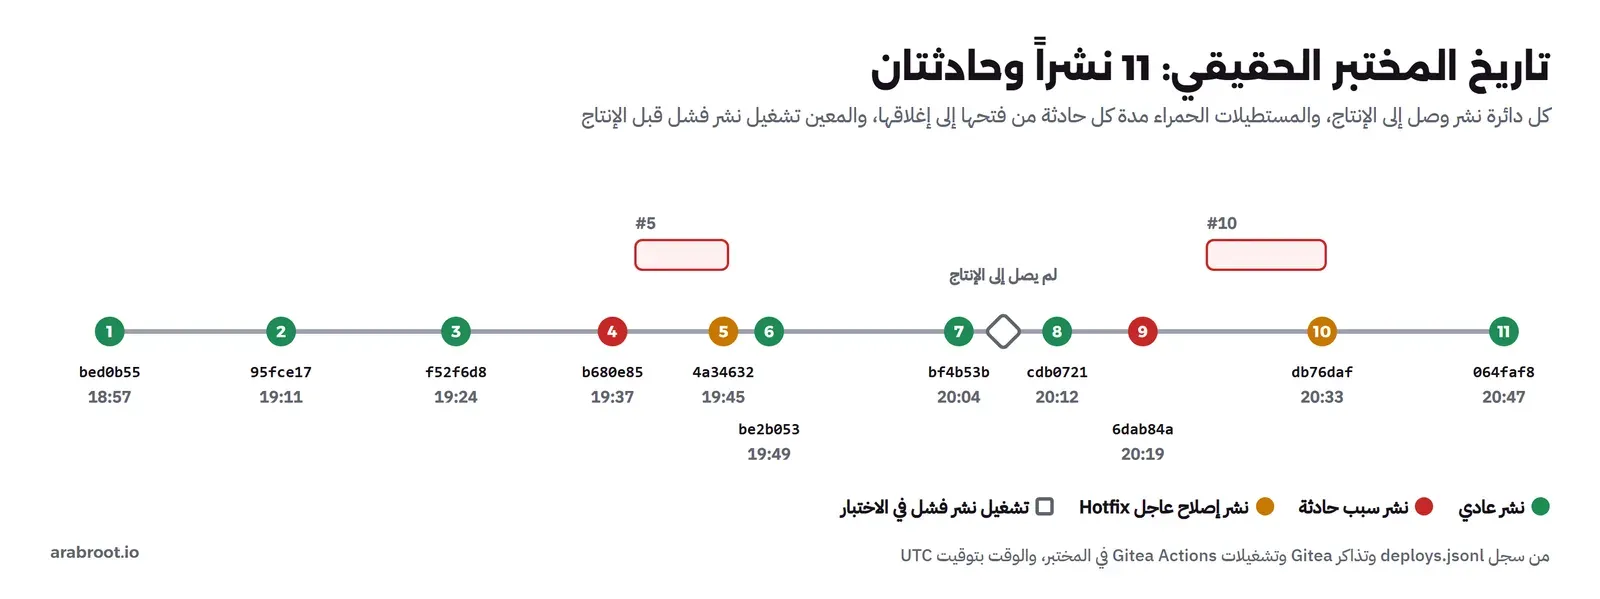
بعد ذلك عملنا على المستودع كما يعمل فريق صغير من مطورين، dev-a وdev-b: فروع قصيرة، وطلب دمج لكل تغيير، وCI يجب أن ينجح قبل الدمج، ونشر آلي بعد كل دمج. ولكي لا يأخذ المختبر أسابيع ضغطناه في جلسة واحدة بين 18:57 و20:47 بالتوقيت العالمي UTC، ولذلك سوف تجد الأزمنة بالدقائق وليس بالأيام، والمهم أن كل حدث حقيقي بوقته الحقيقي، فلا يوجد أي تاريخ معدل. وقد كتبنا الخطوات في سكربت Python صغير ينفذ الأوامر بالترتيب ويستخدم Gitea API لفتح الطلبات ودمجها، وهو في الملف lab/scenario.py مع المقال، والجدول التالي يلخص ما حدث:
| الحدث | ماذا حدث | أثره على المقاييس |
|---|---|---|
| Commit مباشر على main | الخدمة الأولى مع الخطين، ونشر أول | نشر عادي |
| طلب #1 | خصم 10% لعشر قطع فأكثر، في Commitين بينهما دقائق | نشر عادي، وزمن تغيير مختلف لكل Commit |
| طلب #2 | توثيق أن الأسعار دون ضريبة VAT، فتح مبكراً وانتظر المراجعة | أطول زمن تغيير في المختبر |
| طلب #3 | توثيق نقطة الوصول Endpoint | نشر عادي |
| طلب #4 | خصم متدرج فيه خطأ: كتب المطور 0.2 بدلاً من 20، فأصبح طلب 50 قطعة أغلى من طلب 10 قطع، والاختبارات لم تغط هذه الحالة | نشر فاشل، والحادثة #5 |
| طلب #6 بوسم hotfix | تراجع Revert عن الطلب #4 | نشر إعادة عمل، وإغلاق الحادثة #5 |
| طلبا #7 و#8 | الأول غير اسم الثابت UNIT_PRICE إلى BASE_PRICE، والثاني بدأ قبله وأضاف دالة تستخدم الاسم القديم، ونجح CI لكل منهما وحده | تشغيل النشر بعد #8 فشل في الاختبار ولم يصل إلى الإنتاج |
| Commit مباشر على main | إصلاح الدالة بعد تغيير الاسم | نشر عادي يحمل Commit الطلب #8 معه |
| طلب #9 | حد أقصى للطلب 100 قطعة، وكتب المطور 10 بدلاً من 100 | نشر فاشل، وكل طلب أكثر من 10 قطع يعيد HTTP 500، والحادثة #10 |
| طلب #11 بوسم hotfix | إصلاح إلى الأمام Fix Forward مع اختبار لمئة قطعة | نشر إعادة عمل، وإغلاق الحادثة #10 |
| طلب #12 | كوبون خصم في ثلاثة Commits على مدى دقائق | نشر عادي |
ولاحظ أن رقم الحادثة يأتي بين أرقام الطلبات، والسبب أن Gitea يعطي التذاكر وطلبات الدمج أرقاماً من العداد نفسه. وكل حادثة فتحناها بعد فحص من الخارج على الإنتاج، يطلب السعر لقطعة و10 و12 و50، ويتأكد أن سعر القطعة لا يرتفع كلما زادت الكمية، وهذا مثال الفحص بعد الحادثة الأولى كما سجله السكربت Script بتوقيت الجهاز، أي UTC+3:
22:39:01 prod check: {1: 20.0, 10: 180.0, 12: 216.0, 50: 998.0}
22:39:02 incident #5 opened: Orders of 50+ items charged more than orders of 10
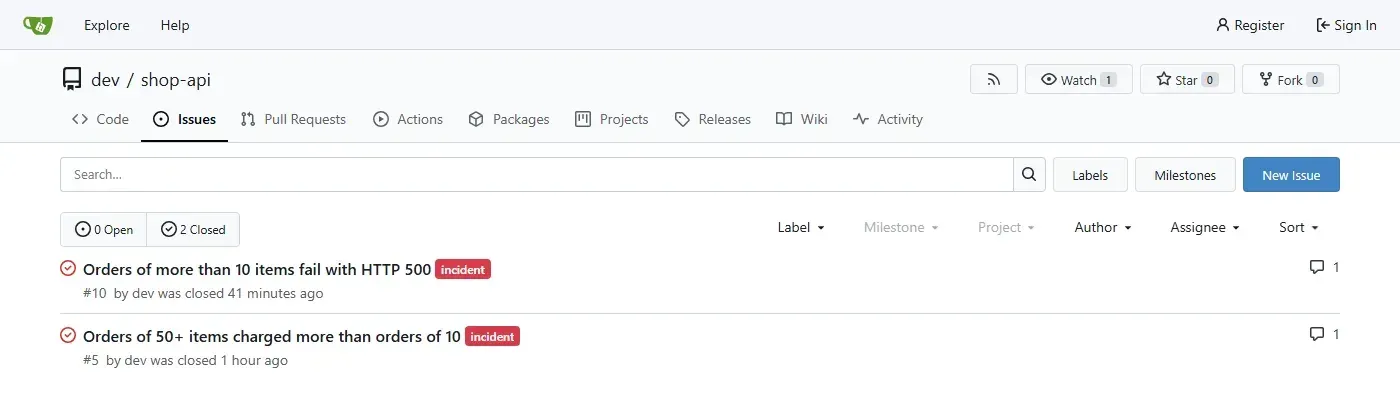
وفي هذا المخرج لاحظ أن طلب 50 قطعة كلف 998 ريالاً، أي 19.96 للقطعة، بينما كلف طلب 10 قطع 180 ريالاً أي 18 للقطعة، فالعميل الذي يشتري أكثر يدفع أكثر للقطعة، وهذا ما فتح الحادثة. وفي جسم كل حادثة سطر بسيط يربطها بالنشر الذي سببها، وعند إغلاقها تعليق يذكر النشر الذي أصلحها، وهذان السطران هما كل ما يحتاجه السكربت لاحقاً:
Monitor alert after deploy of b680e856802acab6b4b2d1bb1ec18142076ddb5b.

Caused-by: b680e856802acab6b4b2d1bb1ec18142076ddb5b

Resolved-by: 4a34632a1898f715451f676d72d808008f97e9bd
والصورة التالية لقطة من قائمة التذاكر في Gitea بعد إغلاق الحادثتين، وكل حادثة عليها الوسم incident وتعليق واحد هو سطر Resolved-by:
والصورة التالية لقطة حقيقية من صفحة تشغيلات خط النشر في Gitea، والتشغيلات الأربعة في أعلاها من تجربة سوف نشرحها في آخر المختبر، ولاحظ فيها التشغيل الأحمر رقم 23 بعد دمج الطلب #8، وهو تشغيل نشر فشل في خطوة الاختبار قبل أن يصل إلى الإنتاج:
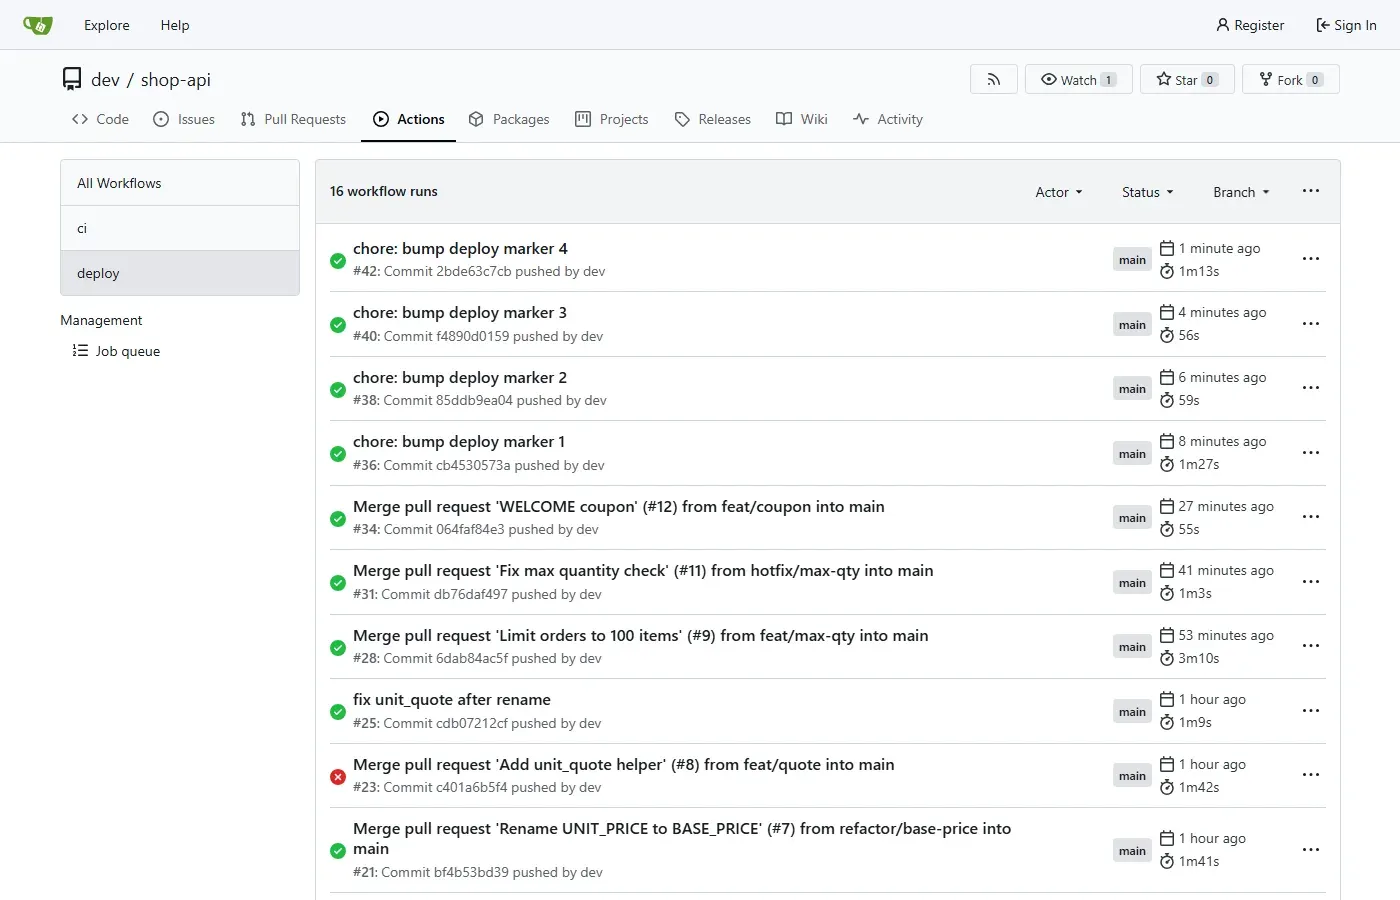
وهذا مخرج الاختبار في ذلك التشغيل كما في سجل المهمة:
ERROR: test_unit_quote (test_pricing.PriceTest.test_unit_quote)
----------------------------------------------------------------------
Traceback (most recent call last):
  File "/workspace/dev/shop-api/test_pricing.py", line 13, in test_unit_quote
    self.assertEqual(unit_quote(), 20)
                     ~~~~~~~~~~^^
  File "/workspace/dev/shop-api/pricing.py", line 17, in unit_quote
    return UNIT_PRICE
           ^^^^^^^^^^
NameError: name 'UNIT_PRICE' is not defined
----------------------------------------------------------------------
Ran 4 tests in 0.030s

FAILED (errors=1)
##[error]Process completed with exit code 1.
والخطأ NameError واضح: الطلب #8 أضاف دالة تعيد UNIT_PRICE، والطلب #7 الذي دمج قبله بدقائق غير الاسم إلى BASE_PRICE، وكل طلب نجح وحده لأن CI جرب كل طلب على الفرع الذي كان عليه وقت فتحه. وهذا النوع من المشاكل يسمى تعارضاً دلالياً Semantic Conflict، لأن Git دمج النصين دون أي تعارض نصي، والتعارض في المعنى فقط. ولذلك وضعنا خطوة الاختبار داخل خط النشر نفسه، فأوقفت النشر قبل أن يصل الكود المعطل إلى الإنتاج، والسؤال المهم لنا هنا: هل هذا فشل تغيير Change Failure؟ والإجابة لا، لأن المستخدم لم ير شيئاً، وسوف ترى أن السكربت لا يحسبه نشراً أصلاً.
السكربت dora.py: من البيانات الخام إلى خمسة أرقام
بعد انتهاء التاريخ أصبح عندنا ثلاثة مصادر للبيانات الخام: تاريخ Git، والملف deploys.jsonl في ال Volume، وطلبات الدمج والتذاكر في Gitea. والسكربت التالي يقرأها ويحسب المقاييس بالترتيب الذي شرحناه، وهو أقل من 120 سطراً ولا يحتاج أي مكتبة خارج Python نفسه، والملف الكامل في lab/dora.py. وسوف نمر عليه جزءاً جزءاً، فأول جزء يقرأ سجل النشر ويعرف ماذا حمل كل نشر من Commits:
deploys = [json.loads(l) for l in open(DEPLOY_LOG) if l.strip()]
deploys.sort(key=lambda d: d["finished"])

prev, shipped = None, {}
for d in deploys:
    rng = d["sha"] if prev is None else f"{prev}..{d['sha']}"
    d["commits"] = git("rev-list", "--no-merges", rng)
    if SKIP_EMPTY and prev is not None and not git("diff", "--name-only", prev, d["sha"]):
        d["empty"] = True
    for c in d["commits"]:
        shipped.setdefault(c, d)
    prev = d["sha"]
وفي الكود أعلاه لاحظ التالي:
- الأمر git rev-list prev..sha: يعطي كل Commit موجود في النشر الحالي وغير موجود في النشر السابق، أي ما حمله هذا النشر بالضبط، وهذا هو الربط بين Git والنشر الذي تبنى عليه كل أدوات DORA.
- الخيار --no-merges: يستبعد Commits الدمج التي يصنعها Gitea عند الضغط على زر الدمج، لأن أحداً لم يكتبها، ولو حسبناها لظهر زمن تغيير قصير جداً لا معنى له.
- الدالة setdefault: يرتبط كل Commit بأول نشر وصل به إلى الإنتاج فقط، وهذا مهم لل Commit الذي علق في النشر الفاشل، كما سوف نرى.
- المتغير SKIP_EMPTY: نتركه الآن، ونعود إليه في التجربة الأخيرة.
والجزء الثاني يحدد النشرات الفاشلة ونشرات إعادة العمل من Gitea، فالفشل هو النشر الذي تذكره حادثة في سطر Caused-by، وإعادة العمل هي النشر الذي جاء من طلب دمج بوسم hotfix:
prs = [p for p in api("/pulls?state=closed") if p.get("merged")]
hotfix_shas = {p["merge_commit_sha"] for p in prs
               if any(l["name"] == "hotfix" for l in p["labels"])}

for i in api("/issues?state=all&type=issues&labels=incident"):
    cause = next(l.split(":", 1)[1].strip() for l in i["body"].splitlines() if l.startswith("Caused-by:"))
    fixed = next(c["body"].split(":", 1)[1].strip() for c in api(f"/issues/{i['number']}/comments")
                 if c["body"].startswith("Resolved-by:"))
ولاحظ أن الربط بين الحادثة والنشر صريح هنا، أي أن شخصاً كتبه في الحادثة، وهذا أدق طريقة ولكنها تعتمد على انضباط الفريق، وسوف نرى أن DevLake يربط بطريقة أخرى بالوقت. أما الجزء الأخير فيحسب المقاييس الخمسة، وأهم ما فيه زمن التغيير ووقت التعافي:
committed = ts(... "git show -s --format=%cI" ...)
leads.append(minutes(ts(d["finished"]) - committed))

x["recovery"] = minutes(ts(fix["finished"]) - ts(bad["finished"]))
x["detect"] = minutes(ts(x["opened"]) - ts(bad["finished"]))
فزمن التغيير لكل Commit هو الفرق بين وقت ال Commit ووقت انتهاء النشر الذي حمله، ووقت التعافي هو الفرق بين انتهاء النشر الفاشل وانتهاء النشر الذي أصلحه، ومعه وقت الاكتشاف من انتهاء النشر الفاشل إلى فتح الحادثة. ونشغل السكربت كما يلي، بعد أن ننسخ سجل النشر من ال Volume ونأخذ نسخة من المستودع:
docker cp dora-prod:/releases/deploys.jsonl data/deploys.jsonl
git clone -q http://localhost:3575/dev/shop-api.git data/shop-api
GITEA_URL=http://localhost:3575 GITEA_REPO=dev/shop-api GITEA_TOKEN=$TOKEN \
  python lab/dora.py data/shop-api data/deploys.jsonl
والمخرج سوف يكون كما يلي:
 # deploy   finished (UTC)       commits  flags
 1 bed0b551 2026-11-18T18:57:27Z       1
 2 95fce172 2026-11-18T19:11:02Z       2
 3 f52f6d8d 2026-11-18T19:24:51Z       1
 4 b680e856 2026-11-18T19:37:15Z       1  FAILED
 5 4a34632a 2026-11-18T19:45:58Z       1  REWORK
 6 be2b0531 2026-11-18T19:49:39Z       1
 7 bf4b53bd 2026-11-18T20:04:36Z       1
 8 cdb07212 2026-11-18T20:12:26Z       2
 9 6dab84ac 2026-11-18T20:19:11Z       1  FAILED
10 db76daf4 2026-11-18T20:33:22Z       1  REWORK
11 064faf84 2026-11-18T20:47:46Z       3

Deployment frequency : 11 deploys in 1.8 h, median gap 13.0 min
Change lead time     : median 7.7 min, max 44.6 min over 15 commits
Change fail rate     : 2/11 = 18%
Deployment rework    : 2/11 = 18%
  incident #10: detected after 5.0 min, recovered after 14.2 min
  incident #5: detected after 1.8 min, recovered after 8.7 min
Recovery time        : median 11.45 min
وفي المخرج أعلاه لاحظ التالي:
- 11 نشراً وليس 12: عدد التشغيلات الناجحة لخط النشر 11، والتشغيل رقم 23 الذي فشل في الاختبار لا يظهر، لأنه لم يكتب سطراً في السجل. فلو حسبنا تكرار النشر من عدد تشغيلات الخط لحصلنا على 12، ولو حسبنا نسبة الفشل من التشغيلات الفاشلة لأضفنا فشلاً لم يره أي مستخدم.
- النشر 8 حمل Commitين: الأول
3d7a8babمن الطلب #8 الذي علق بعد فشل التشغيل 23، والثاني إصلاح الاسم المباشر علىmain. ولذلك فزمن تغيير ال Commit الأول 15.3 دقيقة، أي أن التعارض الدلالي لم يصل إلى المستخدم ولكنه أبطأ التسليم، وهذا بالضبط ما يجب أن يظهر في زمن التغيير. - أطول زمن تغيير 44.6 دقيقة: وهو ال Commit الوحيد في الطلب #2 الذي فتح مبكراً وبقي ينتظر المراجعة بينما دمجت طلبات بعده، فالسبب ليس CI ولا النشر وإنما الانتظار، وهذا هو النوع الذي يخفيه المتوسط ويظهره الحد الأعلى.
- الوسيط Median وليس المتوسط Mean: لو حسبنا المتوسط لرفعه هذا ال Commit وحده، والوسيط 7.7 دقيقة يقول إن نصف التغييرات وصلت في أقل من ذلك. ولذلك تستخدم DORA والأدوات الوسيط في زمن التغيير ووقت التعافي.
- نسبة الفشل ونسبة إعادة العمل متساويتان هنا: كل نشر فاشل تبعه نشر إصلاح واحد، فالرقمان 18%، وفي فريق حقيقي يختلفان، فقد يحتاج نشر فاشل ثلاثة نشرات إصلاح، وقد يأتي نشر إصلاح لخطأ قديم لم يرتبط بنشر محدد، ولهذا السبب أضافت DORA نسبة إعادة العمل في 2024.
- وقت التعافي 8.7 و14.2 دقيقة: والفرق بينهما في الاكتشاف وطريقة الإصلاح، فالحادثة الأولى اكتشفت بعد 1.8 دقيقة وأصلحت بتراجع Revert، والثانية اكتشفت بعد 5 دقائق وأصلحت بإصلاح إلى الأمام مع اختبار جديد، فالتراجع أسرع غالباً لأنه لا يحتاج كوداً جديداً.
والصورة التالية ترسم هذا التاريخ من البيانات نفسها، حتى ترى أين وقعت الحوادث بين النشرات:
مشاكل حقيقية ظهرت في المختبر Real Problems
لم يجر المختبر كما خططنا تماماً، وهذه المشاكل تستحق أن تعرفها لأنها سوف تظهر لك أيضاً:
- قاعدة SQLite مشغولة: شغلنا Gitea بقاعدة SQLite لأنها أبسط، وعندما كان الجهاز تحت ضغط من Containers أخرى ظهرت في سجل Gitea رسائل
database is locked (5) (SQLITE_BUSY)، وأعاد Gitea لسكربت التاريخ ردوداً بالرمز 401 وكأن الرمز غير صحيح، ثم ردوداً بالرمز 500، ثم عاد كل شيء يعمل بعد ثوان. والحل Solution في السكربت إعادة المحاولة Retry بعد ثوان، والحل الصحيح لفريق حقيقي هو PostgreSQL بدلاً من SQLite. - ال Runner بسعة مهمة واحدة: بعد كل دمج كانت مهمة CI ومهمة النشر تنتظران في الطابور نفسه، فكان النشر يبدأ بعد انتهاء CI بدقيقة أو اثنتين، وهذا الوقت جزء من زمن التغيير الذي حسبناه. فإذا كان زمن التغيير في فريقك طويلاً، فانظر إلى طابور ال Runners قبل أن تلوم المراجعة.
- اختبارات ناقصة: الحادثتان مرتا من CI لأن الاختبارات لم تجرب 50 قطعة ولا 12 قطعة، والإصلاح الثاني أضاف اختباراً لمئة قطعة. وهذا هو الدرس الذي تعطيه نسبة الفشل: هي لا تقول لك أين الخلل، ولكنها تخبرك أن شبكة الأمان فيها ثقب.
المقارنة مع Apache DevLake
السكربت يكفي فريقاً صغيراً، ولكن أغلب الفرق تبحث عن أداة جاهزة، وأشهر أداتين مفتوحتي المصدر هما مشروع Four Keys من فريق DORA نفسه، وApache DevLake. أما Four Keys فيقول مستودعه في أول سطر إنه «not currently maintained»، أي لا يطور حالياً، وهو مبني على خدمات Google Cloud مثل BigQuery، فلا يناسب سيرفرك. وأما DevLake فمشروع نشط من مؤسسة Apache، يقرأ بيانات GitHub وGitLab وJenkins وJira وغيرها، ويستقبل أي بيانات أخرى عبر Webhook، ثم يحسب مقاييس DORA ويعرضها في لوحات Grafana. وقد ذكرناه مع غيره من أدوات المقاييس في مقال أدوات تقييم الأداء، وهنا نشغله على بيانات المختبر نفسها.
شغلنا الإصدار v1.0.3-beta19 مع MySQL 8.4 بملف Docker Compose في lab/devlake-compose.yml، ولم نشغل Grafana لأن Image لوحة DevLake وحدها حجمها نحو 800 MB مضغوطة، وبدلاً منها شغلنا استعلامات SQL نفسها التي تستخدمها لوحة DORA في Grafana مباشرة على MySQL، فالأرقام هي الأرقام نفسها التي سوف تراها في اللوحة Dashboard. والخدمة الأساسية لا تحتاج إلا هذه الإعدادات:
  devlake:
    image: apache/devlake:v1.0.3-beta19
    container_name: dora-devlake
    ports:
      - "8576:8080"
    environment:
      DB_URL: "mysql://merico:merico@dora-mysql:3306/lake?charset=utf8mb4&parseTime=True&loc=UTC"
      ENCRYPTION_SECRET: "128 حرفاً عشوائياً"
    depends_on:
      - mysql
    restart: on-failure
وأول مشكلة ظهرت عند التشغيل أن DevLake توقف عدة مرات بالخطأ التالي قبل أن يعمل:
panic: dial tcp 172.25.0.6:3306: connect: connection refusedوالسبب أن depends_on ينتظر أن يبدأ Container قاعدة البيانات، ولا ينتظر أن تصبح MySQL جاهزة لقبول الاتصالات، والذي أنقذ التشغيل هو السطر restart: on-failure، فأعاد Docker تشغيل DevLake حتى نجح الاتصال. ثم أخذ DevLake عدة دقائق في تطبيق ترحيلات Migrations قاعدة البيانات Migrations في أول تشغيل قبل أن يجيب على /ping، فلا تقلق إذا لم يعمل مباشرة.
ربط DevLake بـ Gitea: طريقة غير رسمية
هنا ظهرت المشكلة الأكبر: لا يوجد في DevLake Plugin لـ Gitea، فقائمة ال Plugins في المستودع فيها GitHub وGitLab وBitbucket وGitee وغيرها، ولكن ليس فيها Gitea. ولأن واجهة Gitea API تشبه واجهة GitHub في أغلب المسارات، جربنا أن نعطي Plugin ال GitHub عنوان Gitea بدلاً من عنوان GitHub، مع إيقاف GraphQL الذي لا يدعمه Gitea:
curl -s -X POST localhost:8576/plugins/github/connections -H 'Content-Type: application/json' -d '{
  "name": "gitea-as-github",
  "endpoint": "http://dora-gitea:3000/api/v1/",
  "authMethod": "AccessToken", "token": "'$TOKEN'",
  "enableGraphql": false, "rateLimitPerHour": 3000 }'
ونجح الاتصال، وظهر المستودع dev/shop-api في قائمة المستودعات، ثم ربطنا به إعداد نطاق Scope Config يقول إن التذكرة بوسم incident حادثة، وأنشأنا مشروعاً Project فيه مقياس DORA. ولكن أول تشغيل للجمع فشل بالرسالة التالية:
github TASK_FAILED Collect Events subtask Collect Events ended unexpectedly
  Retry exceeded 3 times calling repos/dev/shop-api/issues/events.
والسبب أن Gitea لا يوفر المسار /issues/events الذي يوفره GitHub، ثم فشل التشغيل الثاني للسبب نفسه في المسار /pulls/comments. والحل أن نشغل خطة الجمع Pipeline Plan نفسها بعد حذف المهام الفرعية Subtasks التي تعتمد على هذين المسارين، وهي أربع مهام لا تحتاجها مقاييس DORA، فاكتمل التشغيل الثالث. ولكن الحوادث لم تظهر، والسبب الذي وجدناه في سجل DevLake أن الجمع تراكمي Incremental، أي أنه يستخرج البيانات التي جمعت في هذا التشغيل فقط، والتذاكر جمعت في التشغيل الأول الذي فشل قبل أن يستخرجها، فاحتجنا تشغيلاً رابعاً بالخيار fullSync. ولاحظنا أيضاً أن DevLake قرأ طلبات الدمج كتذاكر عادية بجانب قراءتها كطلبات دمج، لأن Gitea يرسل حقل pull_request دون الحقل url الذي يفحصه DevLake، وهذا لا يغير مقاييس DORA لأنها تحسب التذاكر من نوع الحادثة فقط.
أما النشرات فأرسلناها بالطريقة المدعومة، أي Webhook، بسكربت صغير في lab/devlake_feed.py يرسل لكل سطر في deploys.jsonl طلباً واحداً بهذا الشكل، وفي فريق حقيقي يكون هذا الطلب آخر خطوة في خط النشر بدلاً من السطر الذي يكتب في الملف:
{"id": "run-12", "startedDate": "2026-11-18T19:37:15Z", "finishedDate": "2026-11-18T19:37:15Z",
 "result": "SUCCESS", "environment": "PRODUCTION",
 "deploymentCommits": [{"repoUrl": "http://dora-gitea:3000/dev/shop-api", "refName": "main",
   "startedDate": "2026-11-18T19:37:15Z", "finishedDate": "2026-11-18T19:37:15Z",
   "commitSha": "b680e856802acab6b4b2d1bb1ec18142076ddb5b"}]}
أرقامنا وأرقام DevLake جنباً إلى جنب Side by Side
وبعد التشغيل الرابع شغلنا استعلامات لوحة DORA على MySQL، والمخرج كان كما يلي:
== lt
median_change_lead_time
0.2(elite)
== cfr
change_failure_rate
18.2%(low)
== fdrt
median_time_in_hour
0.2(elite)
== df week
Deployment Frequency
1 deployment days per month(medium)
deploys	deploy_days
11	1
والجدول التالي يضع الرقمين بجانب بعض مع سبب الاختلاف، وهو أهم جدول في هذا المقال، لأنه يبين أن «الرقم الصحيح» يعتمد على التعريف الذي تختاره:
| المقياس | سكربتنا dora.py | Apache DevLake | سبب الاختلاف |
|---|---|---|---|
| تكرار النشر | 11 نشراً في 1.8 ساعة | يوم نشر واحد في الشهر، ومستوى «متوسط» | DevLake يعد أيام النشر Deployment Days في الأسبوع والشهر ويأخذ الوسيط، مثل سؤال استبيان DORA، وكل نشراتنا في يوم واحد |
| زمن التغيير | وسيط 7.7 دقيقة لخمسة عشر Commit | وسيط 0.2 ساعة، أي نحو 11 دقيقة، لعشرة طلبات دمج | DevLake يحسب لكل طلب دمج من أول Commit فيه إلى النشر، ولا يرى ال Commits المباشرة على main، ونحن نحسب لكل Commit |
| نسبة الفشل | 2 من 11، أي 18% | 18.2%، ومستوى «منخفض» | متطابق، وربط الحادثة بالنشر صحيح في الطريقتين |
| وقت التعافي | 8.7 و14.2 دقيقة، والوسيط 11.45 | 9.1 و14.5 دقيقة، ويعرض 0.2 ساعة | DevLake يوقف الساعة عند إغلاق الحادثة، ونحن عند انتهاء نشر الإصلاح، والفرق ثوان إلى دقيقة |
| نسبة إعادة العمل | 2 من 11، أي 18% | لا تعرضه لوحة DORA في هذا الإصدار | المقياس الخامس أضيف في 2024، وتحتاج أن تحسبه بنفسك أو بأداة أخرى |
وفي الجدول أعلاه لاحظ التالي: الأداة والسكربت اتفقا تماماً على نسبة الفشل، واتفقا تقريباً على وقت التعافي، واختلفا في تكرار النشر وزمن التغيير لأن كل واحد يعرفهما بطريقة مختلفة، وكلا التعريفين مقبول. ولاحظ أيضاً أن DevLake ربط كل حادثة بآخر نشر انتهى قبل فتحها، وفي المختبر كان هذا هو النشر الذي سببها فعلاً، ولكن في فريق ينشر كل ساعة قد ينشر شخص آخر بين النشر الفاشل وفتح الحادثة، فتنسب الحادثة إلى نشر بريء، وهذا سبب أن نحتفظ بسطر Caused-by حتى مع الأداة. والدرس العملي: إذا انتقلت من سكربت إلى أداة، أو من أداة إلى أخرى، فلا تقارن الأرقام القديمة بالجديدة مباشرة، لأن التعريف تغير معها.
ماذا يحدث إذا أصبح تكرار النشر هدفاً؟ What If
لنفرض أن الإدارة أعلنت أن هدف الربع «نشر أكثر»، فما أسهل طريقة لتحقيقه؟ ندفع إلى main أربعة Commits فارغة، كل واحد منها بعنوان مثل chore: bump deploy marker، وكل واحد يشغل خط النشر وينجح، لأنه لا يغير شيئاً. وهذا ما فعلناه بعد انتهاء التاريخ بالسكربت lab/gaming.py، ثم شغلنا dora.py من جديد على سجل النشر كما هو:
12 cb453057 2026-11-18T21:06:32Z       1
13 85ddb9ea 2026-11-18T21:08:39Z       1
14 f4890d01 2026-11-18T21:10:55Z       1
15 2bde63c7 2026-11-18T21:13:22Z       1

Deployment frequency : 15 deploys in 2.3 h, median gap 10.55 min
Change lead time     : median 6.8 min, max 44.6 min over 19 commits
Change fail rate     : 2/15 = 13%
Deployment rework    : 2/15 = 13%
وفي المخرج أعلاه لاحظ أن كل المقاييس «تحسنت» دون أن يصل أي شيء جديد إلى المستخدم: النشرات ارتفعت من 11 إلى 15، والوقت بين النشرات انخفض من 13 دقيقة إلى 10.55، وزمن التغيير انخفض من 7.7 دقيقة إلى 6.8 لأن ال Commits الفارغة تنشر بعد دقيقتين من كتابتها، ونسبة الفشل انخفضت من 18% إلى 13% لأن المقام كبر والحوادث كما هي. وهذا هو قانون Goodhart's Law في أربعة أسطر، وسوف نعود إليه بعد قليل.
والحل في السكربت سطر واحد شرحناه في الجزء الأول، وهو المتغير SKIP_EMPTY، فإذا كان 1 يقارن السكربت كل نشر بالنشر الذي قبله بالأمر git diff --name-only، ويستبعد النشر الذي لم يغير أي ملف:
SKIP_EMPTY=1 GITEA_URL=http://localhost:3575 GITEA_REPO=dev/shop-api GITEA_TOKEN=$TOKEN \
  python lab/dora.py data/shop-api data/deploys.jsonl
Deployment frequency : 11 deploys in 1.8 h, median gap 13.0 min
Change lead time : median 7.7 min, max 44.6 min over 15 commits
Change fail rate : 2/11 = 18%
Deployment rework : 2/11 = 18%فعادت الأرقام كما كانت تماماً. ولكن انتبه إلى حدود هذا الحل: هو يكشف النشر الفارغ فقط، أما تقسيم تغيير حقيقي إلى عشرة نشرات صغيرة لا معنى لكل منها وحده فلا يكشفه أي سطر في سكربت، وإنما يكشفه أن تقرأ تكرار النشر بجانب زمن التدفق من التذكرة وبجانب ما وصل فعلاً إلى المستخدم، وأن لا يكون الرقم هدفاً من الأساس.
وهناك تجربة ثانية لا تحتاج تشغيلاً جديداً، وهي سؤال: من أين تبدأ ساعة التعافي؟ فإذا بدأتها عند فتح الحادثة بدلاً من انتهاء النشر الفاشل، يصبح وقت التعافي للحادثة #5 نحو 6.9 دقيقة بدلاً من 8.7، وللحادثة #10 نحو 9.2 دقيقة بدلاً من 14.2، لأنك تحذف وقت الاكتشاف من الحساب. ويبدو هذا تحسناً، ولكنه يخفي أن المراقبة Monitoring احتاجت 5 دقائق لتكتشف أن كل طلب أكثر من 10 قطع يفشل، ولذلك نحسب الاثنين: وقت الاكتشاف وحده، ووقت التعافي من النشر.
التنظيف Cleanup
كل ما أنشأه المختبر يبدأ بالبادئة dora-، فتحذفه كله بالأوامر التالية:
docker compose -f lab/devlake-compose.yml down -v
docker rm -f dora-gitea dora-runner dora-prod
docker volume rm dora-gitea-data dora-runner-data dora-releases
docker network rm dora-net
عندما يصبح المقياس هدفاً: Goodhart's Law
في المختبر رأيت كيف يرتفع تكرار النشر دون أن يتغير شيء، وهذا ليس مثالاً نظرياً، فهو ما يحدث في أي فريق يقال له «هدفنا هذا الربع أن ننشر كل يوم». والفكرة معروفة باسم قانون Goodhart's Law، وصيغتها المشهورة «عندما يصبح المقياس هدفاً، يتوقف عن أن يكون مقياساً جيداً». وصفحة مقاييس DORA تضعها أول خطأ في قائمة الأخطاء، وتقول إن فرض المقاييس كأهداف يدفع الناس إلى التلاعب Gaming بها Gaming.
والتلاعب في الغالب ليس غشاً مقصوداً، وإنما ناس أذكياء يحسنون الرقم الذي يقاسون به، وهذه أشهر صوره مع كل مقياس:
| المقياس | كيف يرتفع أو ينخفض دون تحسن | كيف تكشفه |
|---|---|---|
| تكرار النشر | تقسيم النشر الواحد إلى عدة نشرات، أو نشرات فارغة لا تغير شيئاً | عد النشرات التي فيها تغيير فعلي فقط، وراقب عدد ال Commits في كل نشر |
| زمن التغيير | ال Commit في آخر لحظة بعد أيام من العمل على الجهاز، أو Squash يخفي ال Commits القديمة | اقرأه مع حجم التغيير ومع زمن التدفق من التذكرة |
| نسبة الفشل | عدم فتح حادثة للمشاكل الصغيرة، أو تسمية الإصلاح العاجل «تحسيناً» | قارن عدد الحوادث بشكاوى الدعم الفني Technical Support وبتنبيهات المراقبة |
| وقت التعافي | إغلاق الحادثة قبل أن يصل الإصلاح فعلاً، أو بدء الساعة عند الاكتشاف لا عند النشر | اربط الإغلاق بالنشر الذي أصلح المشكلة، كما يفعل السكربت |
| نسبة إعادة العمل | عدم وضع وسم hotfix على طلبات الإصلاح | اقرأ عناوين الطلبات بعد كل حادثة، أو اربط الطلب بالحادثة |
ولاحظ أن كل خانة في العمود الأخير تعتمد على قراءة مقياس آخر بجانب المقياس الأول، وهذا ما تسميه صفحة DORA «الشد الصحي Healthy Tension» بين المقاييس: لا تقرأ مقياساً واحداً وحده أبداً، والسبب أن كل مقياس وحده يمكن تحسينه على حساب غيره.
أخطاء شائعة Common Mistakes
صفحة مقاييس DORA تعدد أخطاء الاستخدام، ونضيف إليها ما رأيناه في المختبر، وهذه أهمها:
- مقارنة الفرق بعضها ببعض: فريق يعمل على تطبيق جوال يحتاج موافقة المتجر لا يقارن بفريق خدمة ويب، وفريق نظام مالي قديم لا يقارن بفريق منتج جديد. والصفحة تقول إن المقاييس تطبق على تطبيق أو خدمة واحدة، وإن الهدف أن يتحسن الفريق مع الوقت «not to compete against other teams»، أي لا أن يتنافس مع غيره. فإذا أردت لوحة للإدارة فاعرض اتجاه كل فريق مع نفسه، ولا تقم بوضع الفرق في ترتيب.
- أهداف للأفراد: لا تقم بحساب تكرار النشر أو نسبة الفشل لكل مطور، والسبب أن النشر والتعافي عمل فريق، والمطور الذي يعمل على أصعب جزء في النظام سوف يظهر أسوأ دائماً. وقد شرحنا ما يقاس للفرد وما لا يقاس في مقال تقييم أداء المطورين.
- ملكية مقسمة Siloed Ownership: إذا كان فريق التطوير يملك السرعة وفريق التشغيل يملك الثبات، فقد عدت إلى جدار الارتباك الذي شرحناه في مقال DevOps، والصفحة تقول إن المقاييس الخمسة يجب أن يتشاركها الجميع حتى لا يلوم كل فريق الآخر.
- القياس بدلاً من التحسين: بناء لوحة كاملة بأدوات وربط مع كل نظام قد يأخذ شهوراً قبل أن تعرف أين المشكلة. والصفحة تذكر أن المحادثة مع الفريق أو الفحص السريع Quick Check في موقع DORA قد يكفي للبداية، والسكربت في هذا المقال مثال على أن البيانات الخام تكفي فريقاً صغيراً.
- خلط بيئات النشر: حساب النشر إلى Staging أو إلى بيئة المعاينة كأنه نشر إلى الإنتاج يضاعف تكرار النشر دون أن يصل شيء إلى المستخدم.
- حساب تشغيل الخط الفاشل كفشل تغيير: رأينا في المختبر نشراً توقف عند الاختبار ولم يصل إلى الإنتاج، وهذا ليس فشل تغيير بمعنى DORA، لأن المستخدم لم يتأثر، والخط فعل ما يجب أن يفعله.
- نسيان مصدر الحوادث: إذا كانت الحوادث تسجل في مكان ونشرات الإصلاح في مكان آخر بلا رابط بينهما، فلن تعرف أي نشر سبب أي حادثة، فاتفق على سطر بسيط في الحادثة يذكر النشر الذي سببها والنشر الذي أصلحها.
- قراءة رقم واحد في فترة قصيرة: أسبوع فيه عطل واحد يرفع نسبة الفشل إلى 20% في فريق ينشر خمس مرات في الأسبوع، فاقرأ الاتجاه على أشهر وليس على أسبوع.
قائمة تحقق قبل أن تعرض الأرقام Checklist
| السؤال | إذا كانت الإجابة لا |
|---|---|
| هل اتفق الفريق على تعريف النشر، وأنه وصول إلى الإنتاج فقط؟ | اكتب التعريف في صفحة الفريق قبل أن تحسب أي رقم |
| هل يكتب خط النشر سجلاً بالوقت وال Commit لكل نشر ناجح؟ | أضف سطراً واحداً في آخر خطوة النشر كما في deploy.yml |
| هل كل حادثة مرتبطة بالنشر الذي سببها والنشر الذي أصلحها؟ | أضف سطري Caused-by وResolved-by إلى قالب الحادثة |
| هل طلبات الإصلاح العاجل موسومة؟ | أضف وسم hotfix واجعله جزءاً من قالب الطلب |
| هل تستبعد النشرات التي لا تغير شيئاً؟ | قارن ال Commit بالنشر السابق كما يفعل SKIP_EMPTY |
| هل تعرض المقاييس الخمسة معاً، لكل تطبيق، كاتجاه على أشهر؟ | احذف أي رقم منفرد أو ترتيب للفرق أو للأفراد من اللوحة |
| هل يناقش الفريق نفسه الأرقام في اجتماع المراجعة Retrospective؟ | اعرضها في المراجعة القادمة واسأل لماذا تحرك كل رقم |
ماذا تقرأ بعد ذلك؟
المقاييس تقول لك أين تقف، والممارسات هي ما يحركها، وهذه المقالات تأخذ كل واحدة منها وحدها:
 دليلما هو DevOps؟ الثقافة والممارسات قبل الأدواتلماذا يتعطل الإصدار ليلة النشر ويبدأ البحث عن المسؤول، وكيف يغير DevOps طريقة عمل الفريق قبل أن يغير أدواته، مع تجربة تبين ما يفعله نشر يدوي نسي سيرفراً واحداً.
 دليلTrunk-Based Development: فروع قصيرة ودمج يوميلماذا تنفجر الفروع الطويلة يوم الإصدار، وكيف يدمج الفريق عمله في main كل يوم بأمان مع CI وFeature Flags.
 دليلمفهوم CI/CD للمبتدئين: من كل Push إلى سيرفر يعملما الذي يعنيه التكامل المستمر والتسليم المستمر فعلاً، وكيف تبني خطاً صغيراً يختبر كل Push وينشر إلى staging ويتحقق منه، مع الأخطاء الحقيقية التي يكشفها وتلك التي لا يكشفها.
 دليلهندسة المنصات Platform Engineering والمشكلة التي تحلهالماذا تبني الشركات منصة داخلية لمطوريها ومتى لا تحتاجها، مع قالب في Backstage ينشئ خدمة جاهزة بخط CI.
 دليلكيف تقيم أداء المطورين Developer Performance دون قياس الأشياء الخطأ؟ماذا تقيس في أداء المطور والفريق، ولماذا تضلل أرقام مثل عدد الأسطر وطلبات الدمج، وكيف تقلل تحيز من يقيم.
 دليلإنتاجية المطورين بعد DORA: إطار SPACE وتجربة المطور DevExماذا تقيس في فريق التطوير بعد مقاييس DORA، وكيف تجمع إطار SPACE وتجربة المطور ومقاييس التدفق في لوحة صغيرة واستبيان قصير.
فإذا كان زمن التغيير طويلاً لأن الفروع تعيش أسابيع فابدأ بـ Trunk-Based Development، وإذا كان طويلاً لأن النشر يدوي فابدأ بـ مفهوم CI/CD ثم Gitea Actions، وإذا كان كل فريق يبني خطه بنفسه ويضيع الوقت في ذلك فاقرأ هندسة المنصات Platform Engineering، وإذا كانت نسبة الفشل عالية فاقرأ Feature Flags والإطلاق التدريجي، وإذا أردت أن تعرف لماذا تتحرك الأرقام من جهة الناس فاقرأ مقال إنتاجية المطورين بعد DORA في البطاقات أعلاه.
الخلاصة
- مقاييس DORA اليوم خمسة في مجموعتين: السرعة Throughput وفيها زمن التغيير وتكرار النشر ووقت التعافي من النشر الفاشل، وعدم الثبات Instability وفيها نسبة فشل التغيير ونسبة إعادة العمل التي أضيفت في 2024.
- قبل أن تحسب أي رقم اتفق مع الفريق على التعريفات: النشر هو الوصول إلى الإنتاج فقط، والفشل هو ما احتاج تدخلاً عاجلاً بعد أن رآه المستخدم، والساعة تبدأ عند ال Commit وعند انتهاء النشر الفاشل.
- تقرير 2024 وضع أربعة مستويات كان فيها المستوى المتوسط أكثر ثباتاً من المرتفع، وتقرير 2025 ترك المستويات إلى سبعة أنماط للفرق تجمع التسليم مع صحة الفريق، والرسالة في الاثنين أن التحسن أهم من المستوى.
- في المختبر حسب سكربت من أقل من 120 سطراً المقاييس الخمسة من Git وسجل النشر وتذاكر Gitea: 11 نشراً، ووسيط زمن تغيير 7.7 دقيقة، ونسبة فشل 18%، ونسبة إعادة عمل 18%، ووسيط تعاف 11.45 دقيقة.
- اتفق Apache DevLake مع السكربت في نسبة الفشل ووقت التعافي، واختلف في تكرار النشر وزمن التغيير لأنه يعد أيام النشر ويحسب من أول Commit في طلب الدمج، فالرقم يتبع التعريف.
- أربعة نشرات فارغة «حسنت» كل المقاييس دون أن يصل شيء للمستخدم، فلا تقم بتحويل المقاييس إلى أهداف للأفراد أو ترتيب للفرق، واقرأ كل مقياس بجانب مقياس آخر يكشف التلاعب به.
سجل التحديثات
- 2026-11-19: كتابة المقال واختبار المختبر على Gitea 28.4.0 وGitea Runner 6.0.0 وApache DevLake v1.0.3-beta19 مع MySQL 8.4 وPython 3.13.


