بقي عند فريق المتجر الإلكتروني سؤال لم تجب عنه أي أداة من أدوات ال Flags التي جربوها. فقد أطلقوا صفحة الدفع الجديدة new_checkout لنصف العملاء مع Unleash، ثم غيروا إعداداتها مع Flagsmith، وكانت اللوحتان تقولان بدقة كم عميلاً رأى الصفحة الجديدة، ولا تقولان شيئاً عن الأهم: هل اشترى هؤلاء أكثر؟ وفي اجتماع الأسبوع عرض مدير المنتج رسماً فيه المبيعات ترتفع منذ يوم الإطلاق، فقال مسؤول التشغيل إن الأسبوع نفسه فيه راتب آخر الشهر، وقالت مطورة الدفع إن أخطاء بوابة الدفع زادت في الأسبوع نفسه أيضاً. والثلاثة محقون، والرسم لا يفرق بين ما فعلته الصفحة وما فعله التقويم.
والطريقة التي تفرق بينهما هي التجربة العشوائية Randomized Experiment: نصف العملاء يرون الصفحة الجديدة ونصفهم القديمة في الأيام نفسها، ثم تقارن ما فعله كل نصف. وقد شرحنا أساس اختبارات A/B وقراءة فرصة الفوز والهامش في اختبارات A/B بدقة مع GrowthBook، وحجم العينة والتوقف المبكر في تجارب النمو عملياً، وكلاهما على صفحة تسجيل ونسبة واحدة. أما هنا فنأخذ حالة فريق هندسي: ميزة موجودة أصلاً خلف Flag، ونريد أن نقيس أثرها بالمال، وأن نتأكد أنها لم تفسد شيئاً، والمال لا يتصرف كالنسب. وسوف نناقش في هذا المقال ما يلي:
- كيف يتحول ال Feature Flag إلى تجربة في GrowthBook، ولماذا لا يكفي عد من رأى الميزة.
- مقاييس الهدف ومقاييس الحماية Guardrail Metrics، ولماذا الإيراد لكل عميل وليس متوسط الطلب.
- تجربة عملية على GrowthBook 5.2.0، معدة كلها عبر ال API، بحركة محاكاة نعرف حقيقتها مسبقاً: شراء أعلى بنسبة 5.8% وأخطاء أعلى بنسبة 80%.
- ماذا قال GrowthBook مع 2,000 ثم 10,000 ثم 30,000 عميل، وأين أصاب وأين أخطأ.
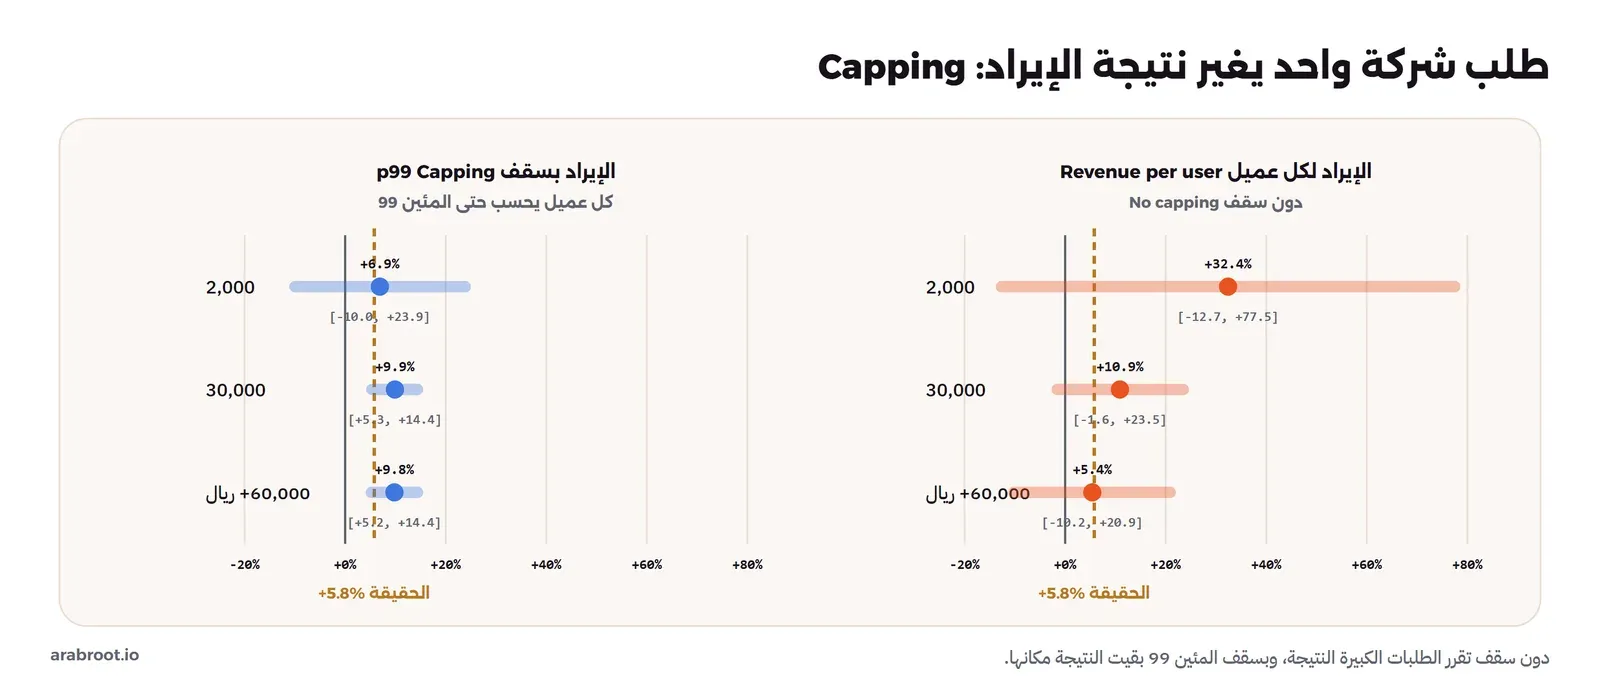
- طلب شركة واحد بستين ألف ريال، والسقف Capping الذي يحمي النتيجة منه.
- كم عميلاً يحتاج كل مقياس، وكم يوماً تستمر التجربة.
- تحذير SRM ظهر لنا، وحقول في نتائج ال API تكذب إذا قرأتها دون انتباه، وإعدادات قبلها الخادم ولم يطبقها.
- كيف تقرأ النتيجة بصدق، والقرار الذي اتخذه الفريق، وحدود النسخة المفتوحة.
من ال Flag إلى التجربة Experiment Flag
في مقال مفهوم Feature Flags قسمنا ال Flags إلى أنواع، ومنها Experiment Flag الذي يضع كل مستخدم في مجموعة ثابتة ويقاس سلوك كل مجموعة. والفرق بينه وبين الإطلاق التدريجي ليس في طريقة التقسيم، فكلاهما يستخدم هاشاً ثابتاً لمعرف المستخدم، وإنما في السؤال. فالإطلاق التدريجي يسأل «هل الميزة آمنة؟» ويرفع النسبة كلما اطمأن، أما التجربة فتسأل «كم تغير الميزة؟» وتثبت النسبة حتى تكتمل العينة، لأن تغيير النسبة في منتصف التجربة يخلط مستخدمين دخلوا في أوقات مختلفة.
وقد يتساءل البعض: لماذا لا نقارن من رأى الصفحة الجديدة في الإطلاق التدريجي بمن لم يرها؟ والإجابة أن المقارنة صحيحة فقط إذا كان التقسيم عشوائياً وكان كل من في المجموعتين قد دخل في الفترة نفسها، وفي الإطلاق التدريجي لا يتحقق الشرطان: الموظفون رأوا الميزة أولاً وهم ليسوا عملاء عاديين، والنسبة تغيرت من 10% إلى 50% في أيام مختلفة. لذلك يحتاج القياس إلى ثلاثة أمور لا تقدمها أدوات ال Flags وحدها: تسجيل لحظة رأى العميل الصفحة، ونتائج سلوكه بعدها، وحساب إحصائي يقول كم من الفرق حقيقي وكم منه صدفة.
وGrowthBook يجمع الثلاثة: فيه Feature Flags مثل غيره، وقاعدة من نوع تجربة Experiment Rule تقسم المستخدمين، و SDK يستدعي دالة تسجيل عندما يرى المستخدم التجربة، ثم يقرأ النتائج من قاعدة بياناتك أنت بـ SQL ويحسبها. وصدر الإصدار 5.2.0 في 3 نوفمبر 2026، والكود بترخيص MIT عدا مجلدات enterprise كما في ملف الترخيص. والصورة التالية تبين المسار الذي سوف نبنيه:
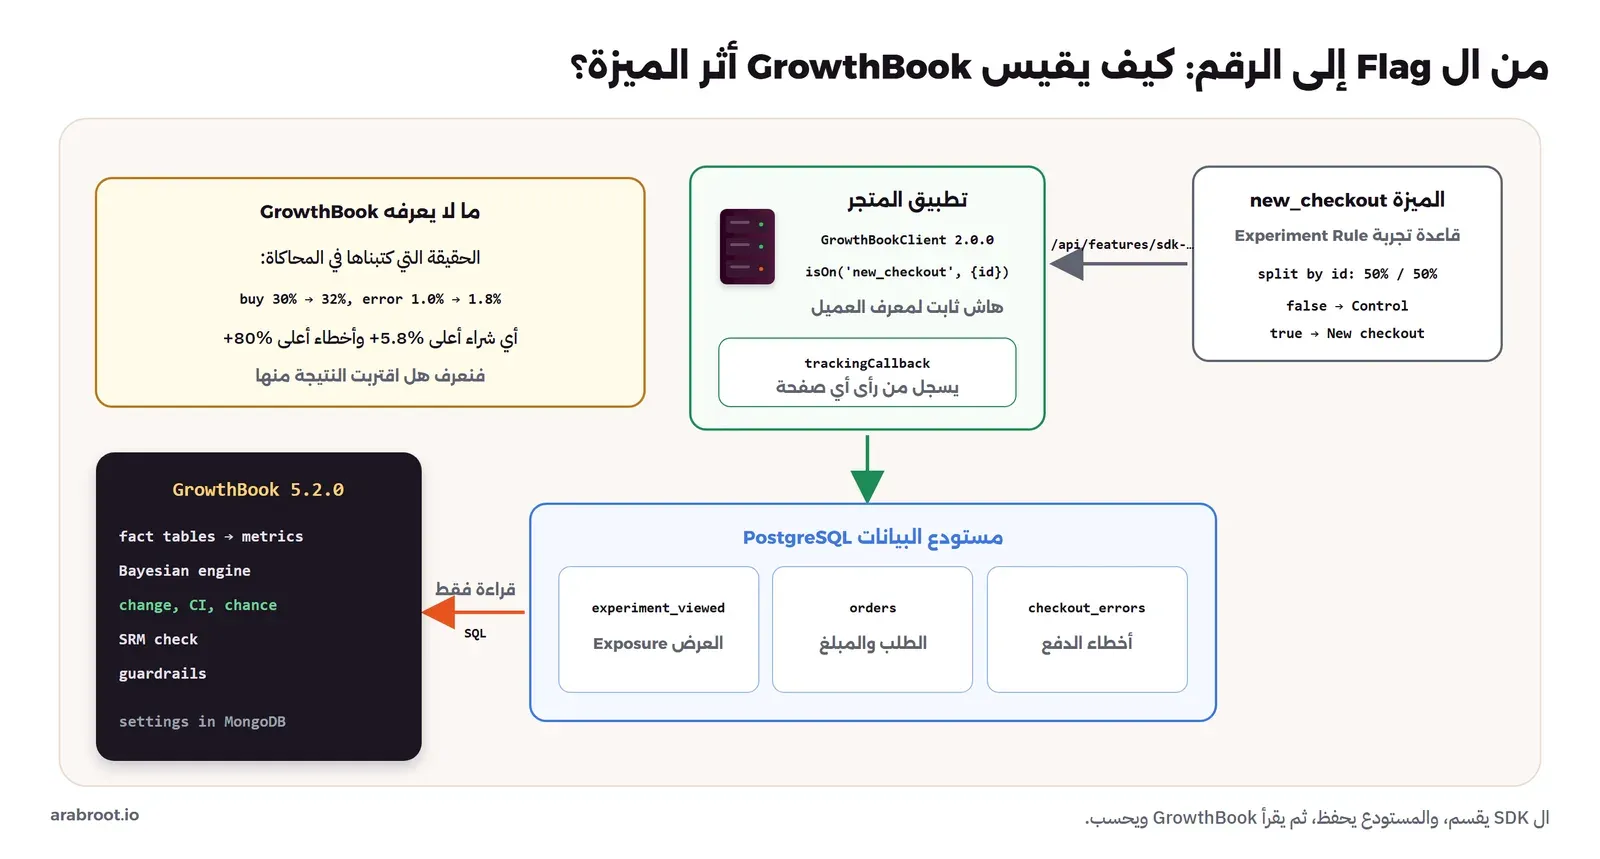
ولاحظ في الصورة أن GrowthBook لا يستقبل أحداث العملاء، وإنما يقرؤها بـ SQL من جداولك، وهذا يعني أن البيانات لا تخرج من سيرفرك، وأن المقياس الذي يحسبه هو المقياس نفسه الذي تحسبه الإدارة من الجدول نفسه، ولكنه يعني أيضاً أن جودة النتيجة لا تتجاوز جودة الجداول التي تكتبها أنت.
أين تسجل العرض؟ Exposure Logging
أهم سطر في كل التجربة ليس في GrowthBook، وإنما في كود المتجر: السطر الذي يسجل أن العميل رأى صفحة الدفع، أي العرض Exposure. فالتحليل كله يبدأ من جدول experiment_viewed، ومن لا يظهر فيه لا يدخل في أي مقياس. ولذلك يجب أن يتحقق فيه أمران: أن يسجل العرض في اللحظة التي يقرر فيها الكود أي صفحة يعرض، وأن يسجل بالطريقة نفسها في المجموعتين.
وأكثر خطأ رأيناه في الفرق أن التقسيم يحدث في مكان والتسجيل في مكان آخر، كأن يقرر السيرفر الصفحة ثم يرسل المتصفح حدث «رأى الصفحة» بعد أن تكتمل، وهذا أول سبب يذكره دليل حل مشاكل التجارب لاختلال النسبة. فإذا كانت الصفحة الجديدة أثقل، يغلق بعض العملاء المتصفح قبل أن يكتمل تحميلها، فلا يصل حدثهم، فتختفي من مجموعة الصفحة الجديدة الزيارات الأسوأ، ويبدو أداؤها أفضل مما هو. والحل الذي استخدمناه هو أن يكون التسجيل داخل trackingCallback نفسه، أي في اللحظة التي يقيم فيها ال SDK القاعدة على السيرفر، قبل أي عرض.
والخطأ الثاني أن يقيم الكود ال Flag في مكان لا يصل إليه العميل فعلاً، كأن يقيمه عند فتح السلة لكل العملاء بينما الصفحة الجديدة تظهر في خطوة الدفع فقط، فيدخل التجربة آلاف لم يروا الصفحة أصلاً، وتصبح الفروق أصغر من حقيقتها لأنها مخففة بمن لم يروا شيئاً. لذلك قيم ال Flag في النقطة نفسها التي يتغير فيها ما يراه العميل، وليس قبلها.
ماذا نقيس؟ Goal and Guardrail Metrics
جلس الفريق قبل التجربة واتفق على أربعة مقاييس، والاتفاق قبل رؤية الأرقام هو ما يمنع أن يختار كل شخص بعد التجربة المقياس الذي يوافق رأيه:
- الشراء Purchase، مقياس الهدف: نسبة من اشترى ممن رأى صفحة الدفع، وهو في GrowthBook من نوع النسبة Proportion، أي هل للعميل صف واحد على الأقل في جدول الطلبات بعد أن رأى الصفحة.
- الإيراد لكل عميل Revenue per User: مجموع ما دفعه العميل مقسوماً على كل من رأى الصفحة، سواء اشترى أو لم يشتر، وهو من نوع المتوسط Mean.
- الإيراد لكل عميل بسقف عند المئين 99: المقياس نفسه، ولكن كل عميل يحسب حتى قيمة المئين 99 فقط، وسوف ترى لماذا أضفناه.
- خطأ الدفع Checkout Error، مقياس حماية: نسبة من ظهر له خطأ في الدفع، وهو معكوس Inverse، أي الأقل أفضل.
ولماذا الإيراد لكل عميل وليس متوسط قيمة الطلب AOV؟ والإجابة أن متوسط الطلب يقسم على من اشترى فقط، فإذا جعلت الصفحة الجديدة عملاء مترددين يشترون طلبات صغيرة، انخفض متوسط الطلب رغم أن المتجر ربح أكثر، وإذا طردت الصفحة كل من يشتري طلباً صغيراً ارتفع المتوسط والمتجر يخسر. أما الإيراد لكل عميل رأى الصفحة فيجمع الأثرين في رقم واحد يفهمه المدير المالي: كم ريالاً يجلبه كل زائر لصفحة الدفع. وفي الإحصاء للمهندسين شرحنا لماذا يخدع المتوسط عندما تكون القيم بذيل طويل، والمال بذيل طويل دائماً.
ومقياس الحماية هو ما يميز تجربة فريق هندسي عن تجربة تسويقية. فالصفحة الجديدة غيرت طريقة عرض بوابة الدفع، والفريق يعرف أن كل تغيير في الدفع قد يكسب مبيعات ويخسر عملاء يفشل معهم الدفع ثم لا يعودون، وهؤلاء لا يظهرون في مقياس الشراء إلا بعد أشهر. لذلك قرروا قبل البدء أن أي ارتفاع واضح في الأخطاء يوقف الإطلاق مهما كان مقياس الهدف.
تجربة عملية Lab: GrowthBook مع PostgreSQL
الآن سوف نشغل GrowthBook 5.2.0 مع MongoDB لإعداداته وPostgreSQL كمستودع بيانات للمتجر، وننشئ كل شيء عبر ال API بدل الواجهة، حتى تكون التجربة قابلة للإعادة من سكربت، ثم نرسل حركة عملاء محاكاة بحقيقة نعرفها، ونرى ماذا يقول GrowthBook عند كل حجم. وتحتاج التجربة إلى Docker فقط.
تشغيل الخدمات Docker Compose
المستودع فيه ثلاثة جداول، ومستخدم قراءة فقط لـ GrowthBook، والسبب أن GrowthBook ينفذ استعلامات SQL يكتبها أي شخص له صلاحية تعديل المقاييس، فلا يجوز أن يستطيع الكتابة:
-- The shop's events warehouse: who saw which checkout, and what happened in checkout.
CREATE TABLE experiment_viewed (
  user_id       TEXT NOT NULL,
  experiment_id TEXT NOT NULL,
  variation_id  TEXT NOT NULL,
  timestamp     TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE TABLE orders (
  user_id   TEXT NOT NULL,
  order_id  TEXT NOT NULL,
  amount    NUMERIC(10,2) NOT NULL,      -- SAR
  timestamp TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE TABLE checkout_errors (
  user_id   TEXT NOT NULL,
  code      TEXT NOT NULL,
  timestamp TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE INDEX ON experiment_viewed (experiment_id, user_id);
CREATE INDEX ON orders (user_id);
CREATE INDEX ON checkout_errors (user_id);
-- GrowthBook only reads: a role that cannot write
CREATE ROLE growthbook LOGIN PASSWORD 'gb-read-only';
GRANT SELECT ON ALL TABLES IN SCHEMA public TO growthbook;
وملف Compose مبني على توثيق الاستضافة الذاتية:
name: wr-ff-gb

services:
  mongo:                       # GrowthBook's own data: features, metrics, experiments, users
    image: mongo:8.0.34
    container_name: wr-ff-gb-mongo
    environment:
      MONGO_INITDB_ROOT_USERNAME: root
      MONGO_INITDB_ROOT_PASSWORD: lab-mongo-pass
    volumes: [mongodata:/data/db]

  warehouse:                   # the shop writes exposures, orders and errors here; GrowthBook reads them with SQL
    image: postgres:18-alpine
    container_name: wr-ff-gb-warehouse
    environment:
      POSTGRES_DB: shop
      POSTGRES_USER: shop
      POSTGRES_PASSWORD: lab-shop-pass
    volumes:
      - pgdata:/var/lib/postgresql
      - ./warehouse.sql:/docker-entrypoint-initdb.d/01-warehouse.sql:ro
    healthcheck:
      test: ["CMD", "pg_isready", "-U", "shop", "-d", "shop"]
      interval: 3s

  growthbook:
    image: growthbook/growthbook:5.2.0
    container_name: wr-ff-gb-app
    ports:
      - "127.0.0.1:43000:3000"   # web UI
      - "127.0.0.1:43100:3100"   # API and SDK endpoint
    depends_on: [mongo, warehouse]
    environment:
      MONGODB_URI: mongodb://root:lab-mongo-pass@mongo:27017/growthbook?authSource=admin
      APP_ORIGIN: http://localhost:43000
      API_HOST: http://localhost:43100
      JWT_SECRET: lab-jwt-secret-change-me-0123456789abcdef
      ENCRYPTION_KEY: lab-encryption-key-change-me-0123456789
      NODE_ENV: production
    volumes: [uploads:/usr/local/src/app/packages/back-end/uploads]

volumes:
  mongodata: { name: wr-ff-gb-mongodata }
  pgdata: { name: wr-ff-gb-pgdata }
  uploads: { name: wr-ff-gb-uploads }

networks:
  default:
    name: wr-ff-gb-net
في الإعداد أعلاه لاحظ أن ENCRYPTION_KEY يشفر كلمة مرور المستودع داخل MongoDB، فإذا ضاع لا يستطيع GrowthBook الاتصال بقاعدتك بعد الاستعادة، لذلك يحفظ مع النسخة الاحتياطية كما ذكرنا في المقال السابق عن GrowthBook. وصورة GrowthBook كبيرة، 2.9 جيجابايت على القرص، واستهلكت بعد التجربة 1.14 جيجابايت من الذاكرة، وMongoDB نحو 328 ميجابايت، والمستودع 47 ميجابايت، وهو الأثقل بين الأدوات الثلاث في هذه السلسلة، والسبب أنه يحمل محرك الإحصاء والواجهة وأداة التحليل كلها.
الإعداد كله عبر API
بدل أن نضغط في الواجهة، كتبنا ملف Python صغيراً يستدعي واجهتين: الواجهة الداخلية التي تستخدمها اللوحة نفسها، لإنشاء أول مستخدم ومفتاح الإدارة ومصدر البيانات، وREST API الرسمية لما بعد ذلك. وأول نداء ينشئ المدير والمؤسسة عندما تكون القاعدة فارغة:
curl -s -X POST localhost:43100/auth/firsttime -H 'Content-Type: application/json' \
-d '{"email":"[email protected]","name":"Lab Admin","password":"Lab-Pass-2026-x9","companyname":"Shop"}'{"status":200,"token":"eyJhbGciOiJIUzI1NiIs…","projectId":"prj_2CgjZFz5pqqEpgYAii89eS"}ثم سألنا الخادم عن المؤسسة، وفي ردها سطر سوف نعود إليه في آخر المقال:
{'email': '[email protected]', 'superAdmin': True} [('org_2j44gemw3craad', 'Shop')]
license/plan: {'enterpriseLicense': None, 'licenseKey': None, 'commercialFeatures': [], 'plan': None}
ثم أنشأنا مصدر البيانات باسم الخدمة warehouse والمستخدم growthbook، ومعه استعلام العرض Exposure Query الذي يقول لـ GrowthBook من رأى أي نسخة، ثم جدولي حقائق Fact Tables للطلبات والأخطاء، ثم المقاييس الأربعة من الجدولين:
m['purchase'] = fm({'name': 'Purchase', 'metricType': 'proportion', 'numerator': {'factTableId': O, 'column': '$$distinctUsers'}})
m['revenue'] = fm({'name': 'Revenue per user', 'metricType': 'mean', 'numerator': {'factTableId': O, 'column': 'amount', 'aggregation': 'sum'}})
m['revenue_capped'] = fm({'name': 'Revenue per user (capped p99)', 'metricType': 'mean', 'numerator': {'factTableId': O, 'column': 'amount', 'aggregation': 'sum'},
                          'cappingSettings': {'type': 'percentile', 'value': 0.99}})
m['error'] = fm({'name': 'Checkout error', 'metricType': 'proportion', 'inverse': True, 'numerator': {'factTableId': E, 'column': '$$distinctUsers'}})
purchase fact__2CgjZMNZKffkttURXBgxwR proportion {'type': 'none', 'value': 0}
revenue fact__2CgjZMXRNbCDJnvVM4Xwek mean {'type': 'none', 'value': 0}
revenue_capped fact__2CgjZMgGgR7wEM2shtxf65 mean {'type': 'percentile', 'value': 0.99, 'ignoreZeros': False}
error fact__2CgjZMq5GEkGWkqHt4d5bB proportion {'type': 'none', 'value': 0} inverseفي الإعداد أعلاه لاحظ أن $$distinctUsers يعني «هل للعميل صف واحد على الأقل»، فالعميل الذي اشترى مرتين يحسب مرة في مقياس الشراء، أما sum على العمود amount فيجمع كل ما دفعه. وسقف المئين 99 بحسب توثيق المقاييس يختار القيمة من بيانات التجربة نفسها، فكل عميل مجموع مشترياته فوق المئين 99 يحسب عند المئين 99. ثم أنشأنا التجربة والميزة التي تشير إليها، واتصال ال SDK الذي يعطينا مفتاح العميل:
exp = gb.call('POST', '/api/v1/experiments', {
  'datasourceId': 'ds_2j44gemw3csaj0', 'assignmentQueryId': 'user_id', 'trackingKey': 'new-checkout',
  'name': 'New checkout page', 'hypothesis': 'The new checkout page raises the share of visitors who buy, without more checkout errors.',
  'metrics': [M['purchase'], M['revenue'], M['revenue_capped']], 'guardrailMetrics': [M['error']],
  'variations': [{'key': '0', 'name': 'Control'}, {'key': '1', 'name': 'New checkout'}],
  'statsEngine': 'bayesian'}, rest=True)['experiment']
f = gb.call('POST', '/api/v1/features', {'id': 'new_checkout', 'owner': 'payments team', 'valueType': 'boolean', 'defaultValue': 'false',
  'environments': {'production': {'enabled': True, 'rules': [{'type': 'experiment-ref', 'experimentId': exp['id'], 'enabled': True,
      'variations': [{'variationId': v0, 'value': 'false'}, {'variationId': v1, 'value': 'true'}]}]}}}, rest=True)
experiment exp_2j44gemw3ctb3o draft [('var_2j44gemw3ctb3m', '0', 'Control'), ('var_2j44gemw3ctb3n', '1', 'New checkout')]
experiment status running phases [([{'variationId': 'var_2j44gemw3ctb3m', 'weight': 0.5}, {'variationId': 'var_2j44gemw3ctb3n', 'weight': 0.5}], 1)]ثم طلبنا ما يراه ال SDK بمفتاح العميل، وهو ما يجلبه تطبيق المتجر:
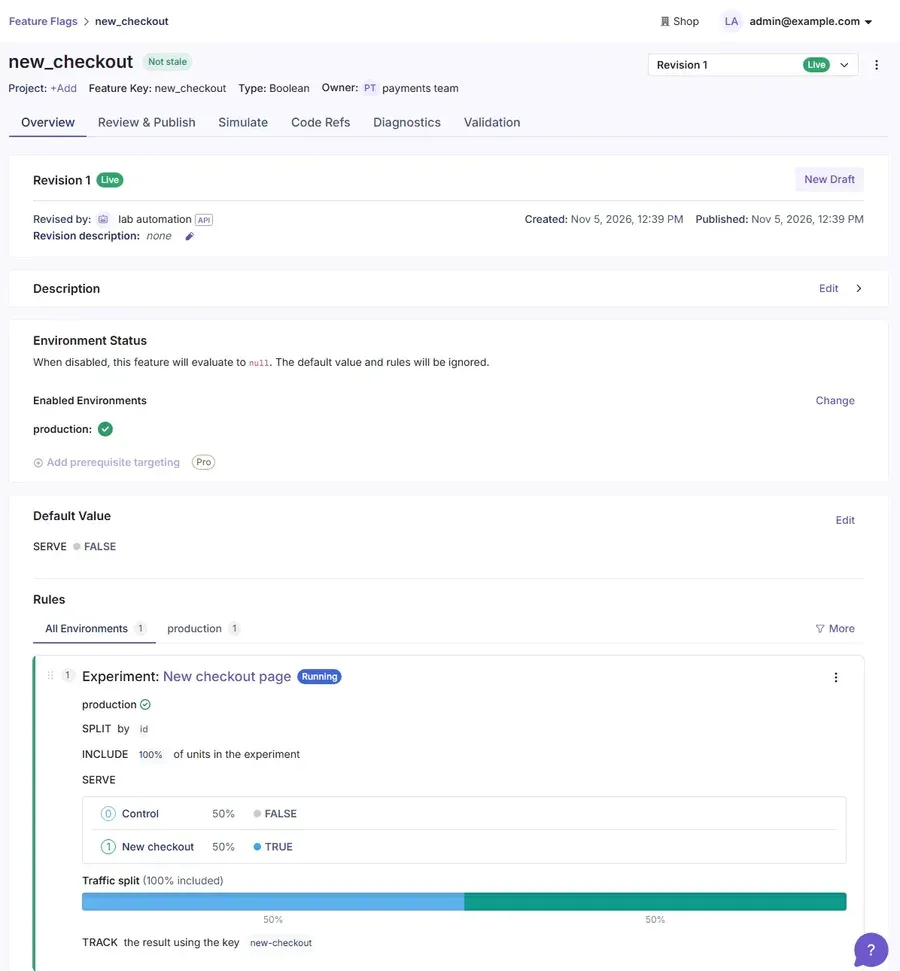
{"status":200,"features":{"new_checkout":{"defaultValue":false,"rules":[{"coverage":1,"seed":"1659ce76-0e7c-4ecf-8d48-efbab0ac59db","hashVersion":2,"variations":[false,true],"weights":[0.5,0.5],"key":"new-checkout","meta":[{"key":"0"},{"key":"1"}],"phase":"0"}]}},…}لاحظ seed: هاش كل عميل يحسب من معرفه مع هذه البذرة، وليس مع اسم ال Flag، فإذا أنشأت تجربة جديدة على ال Flag نفسه تتغير البذرة ويعاد توزيع العملاء، وهذا ما تريده عندما تبدأ تجربة نظيفة بعد إصلاح. ولاحظ coverage: 1، أي أن كل العملاء داخل التجربة، وتستطيع أن تجعلها 0.2 فيدخل خمس العملاء فقط، والباقون يرون القيمة الافتراضية ولا يسجلون. والصورة التالية من لوحة GrowthBook للميزة بعد هذه الخطوات:
حركة عملاء نعرف حقيقتها Simulation
لا نستطيع أن نعرف هل أصاب GrowthBook إلا إذا عرفنا الجواب مسبقاً، لذلك كتبنا محاكاة تأخذ التقسيم من GrowthBook نفسه، وتقرر سلوك كل عميل بمولد أرقام عشوائية ببذرة ثابتة، والحقيقة فيها مكتوبة في أول الملف:
const TRUTH = {
  false: { buy: 0.30, error: 0.010 },   // old checkout
  true:  { buy: 0.32, error: 0.018 },   // new checkout: more buyers, but more errors
};
const BULK = 0.004;                     // 0.4% of orders are bulk orders of 5,000..15,000 SAR, in both variations
const gb = new GrowthBookClient({
apiHost: process.env.GB_API_HOST, clientKey: process.env.GB_CLIENT_KEY,
trackingCallback: (experiment, result, user) =>
exposures.push([user.attributes.id, experiment.key, String(result.key)]),
});
const init = await gb.init({ timeout: 3000 });
if (init.error) throw init.error;
for (let i = first; i < first + count; i++) {
const id = `user-${i}`;
const on = gb.isOn('new_checkout', { attributes: { id } });
seen[on]++;
const t = TRUTH[on];
if (rand() < t.error) { errors.push([id, on ? 'PAYMENT_SHEET_TIMEOUT' : 'CARD_DECLINED_UI']); continue; }
if (rand() < t.buy) orders.push([id, `o-${i}`, amount().toFixed(2)]);
}في الكود أعلاه لاحظ التالي:
GrowthBookClientهو الطريقة التي يوصي بها توثيق Node.js للسيرفر: عميل واحد مشترك، والمستخدم يمرر مع كل استدعاء، وهو أسرع من إنشاء نسخة لكل طلب.initلا يرمي خطأ إذا فشل الاتصال، وإنما يعيده فيerror، وكل الميزات تكونnullحتى تصل البيانات، فإذا لم تفحص النتيجة فسوف يعمل المتجر بالقيمة الافتراضية دون أن تعرف، وهذه هي المشكلة نفسها التي رأيناها مع Unleash بشكل آخر.trackingCallbackيستدعى مرة لكل عميل يدخل التجربة، والمعامل الثالثuserأضيف في الإصدار 1.7.0 من المكتبة، والتوثيق ينصح بأن تأخذ الصفات منه حتى يتطابق ما تسجله مع ما قسم به العميل.- العميل الذي ظهر له خطأ لا يشتري في هذه المحاكاة، فالشراء الفعلي في الصفحة القديمة 0.99 × 30% = 29.7%، وفي الجديدة 0.982 × 32% = 31.4%، أي أن الحقيقة في مقياس الشراء ارتفاع نسبي +5.8%، وفي الأخطاء +80%، وفي الإيراد لكل عميل +5.8% أيضاً لأن قيمة الطلب لا تتغير بين الصفحتين.
- الطلبات الكبيرة، من 5,000 إلى 15,000 ريال، موجودة بالنسبة نفسها في الصفحتين، فهي لا تغير الحقيقة، ولكنها كما سوف ترى تغير ما يراه GrowthBook.
واستخدمنا المكتبة @growthbook/growthbook بإصدارها 2.0.0 الذي صدر قبل التجربة بأسبوع، وفي سجل تغييراتها تغييرات لا تتوافق مع الإصدارات السابقة يجب أن تقرأها قبل الترقية من 1.x: عوامل المقارنة لم تعد تحول الأنواع ضمنياً، والهاش لم يعد يقبل إلا نصاً أو رقماً كمعرف، وإصلاح في حدود خانات الإطلاق يغير مجموعة «أقلية صغيرة جداً» من المستخدمين. والنقطة الأخيرة مهمة لتجربة جارية: لا تقم بترقية المكتبة في منتصف تجربة، والسبب أن بعض العملاء قد ينتقلون من مجموعة إلى أخرى.
أول 2,000 عميل: ضجيج Noise
أرسلنا أول 2,000 عميل، ثم طلبنا من GrowthBook أن يحدث التحليل عبر ال API، وقرأنا النتائج بسكربت صغير:
users 2000: control 1036, new 964 | exposures 2000 | orders 634 | errors 37users 2000 | SRM p-value 0.1074
## purchase
control users 1036 mean 0.3147
new users 964 mean 0.3195 change +1.5% CI [ -11.5%, +14.6%] chance to win 59.1% p 0.0000
## revenue
control users 1036 mean 64.6800
new users 964 mean 85.6361 change +32.4% CI [ -12.7%, +77.5%] chance to win 92.1% p 0.0000
## revenue_capped
control users 1036 mean 63.4666
new users 964 mean 67.8632 change +6.9% CI [ -10.0%, +23.9%] chance to win 78.8% p 0.0000
## error
control users 1036 mean 0.0125
new users 964 mean 0.0249 change +98.4% CI [ -34.4%, +231.2%] chance to win 7.3% p 0.0000في المخرج أعلاه لاحظ التالي:
- الشراء +1.5% والحقيقة +5.8%، والفترة من -11.5% إلى +14.6%، أي أن ألفي عميل لا يكفون لتمييز فرق بهذا الحجم، وكل ما يقوله GrowthBook هنا: لا أعرف بعد. وحساب العدد الكافي قبل البدء شرحناه في مقال تجارب النمو.
- الإيراد +32.4% مع فرصة فوز 92.1%، وهذا هو الرقم الذي سوف يرسله أحدهم في قناة الفريق صباح الغد. والحقيقة +5.8%.
- الإيراد بسقف +6.9%، وهو أقرب كثيراً إلى الحقيقة بالعينة نفسها.
- العمود
pيقول 0.0000 لكل المقاييس، حتى للشراء الذي لا يعرف GrowthBook عنه شيئاً، وهذه أول مشكلة حقيقية، وسوف نعود إليها بعد قليل.
ومن أين جاء +32.4% في الإيراد؟ سألنا المستودع مباشرة:
SELECT e.variation_id AS variation, count(*) AS orders, count(*) FILTER (WHERE o.amount >= 5000) AS bulk_orders,
       round(sum(o.amount)) AS revenue, round(sum(o.amount) FILTER (WHERE o.amount < 5000)) AS revenue_without_bulk,
       round(percentile_cont(0.5) WITHIN GROUP (ORDER BY o.amount)::numeric, 2) AS median_order
FROM orders o JOIN experiment_viewed e USING (user_id) GROUP BY 1 ORDER BY 1;
variation | orders | bulk_orders | revenue | revenue_without_bulk | median_order
-----------+--------+-------------+---------+----------------------+--------------
0 | 326 | 0 | 67009 | 67009 | 168.60
1 | 308 | 2 | 82553 | 65464 | 178.96طلبان كبيران وقعا بالصدفة في مجموعة الصفحة الجديدة، مجموعهما أكثر من 17 ألف ريال، وصنعا الفرق كله. ودون هذين الطلبين كان إيراد الصفحة الجديدة أقل من القديمة. فالصفحة لم تجعل أحداً يشتري طلب جملة، وإنما الصدفة وضعت عميلين من 2,000 في جانب واحد، ومع المال تكفي الصدفة الصغيرة لتصنع رقماً كبيراً.
مشكلة حقيقية Real Problem: حقول تقول صفراً
عندما رأينا p 0.0000 لكل المقاييس ظننا أن شيئاً في حسابنا خطأ، فقرأنا الرد الخام من ال API لمقياس واحد:
{"engine": "bayesian", "numerator": 65420.109999999986, "denominator": 0, "mean": 67.86318464730289, "stddev": 121.38877694715433,
 "percentChange": 0.06927411412299908, "effectStandardError": 0.08652773068858158, "ciLow": -0.10031712169060203, "ciHigh": 0.23886534993660014,
 "pValue": 0, "risk": 0.010390262114532254, "chanceToBeatControl": 0.7883184179097402}
المحرك bayesian لا يحسب قيمة p أصلاً، والحقل pValue موجود في الرد بقيمة صفر. والأمر نفسه بالعكس، فعندما غيرنا المحرك إلى Frequentist، وهو ما سوف نفعله في قسم لاحق، صار chanceToBeatControl صفراً لكل المقاييس، فكتب سكربتنا «فرصة الفوز 0.0%» بجانب نتيجة ممتازة:
## purchase
  control users 15146  mean    0.2918
  new     users 14854  mean    0.3192  change   +9.4%  CI [  +5.6%,  +13.1%]  chance to win 0.0%  p 0.0000
وهذا خطر حقيقي إذا بنى أحدهم لوحة أو تقريراً آلياً يقرأ النتائج من ال API، فقيمة p تساوي صفراً تقرأ «النتيجة مؤكدة تماماً»، وهي هنا تعني «لم يحسب». والإصلاح أن تقرأ الحقل engine أولاً، ثم تأخذ حقول ذلك المحرك فقط، وهذا ما فعلناه في السكربت:
if a.get('engine') == 'bayesian': line += f"  chance to win {100 * a['chanceToBeatControl']:.1f}%"
if a.get('engine') == 'frequentist': line += f"  p {a['pValue']:.4f}"
10,000 عميل وتحذير SRM
أضفنا 8,000 عميل آخر، فصار المجموع 10,000:
users 10000 | SRM p-value 0.0083
## purchase
  control users  5132  mean    0.2975
  new     users  4868  mean    0.3274  change  +10.0%  CI [  +3.6%,  +16.5%]  chance to win 99.9%
## revenue
  control users  5132  mean   79.7525
  new     users  4868  mean   97.6974  change  +22.5%  CI [  -5.4%,  +50.4%]  chance to win 94.3%
## revenue_capped
  control users  5132  mean   62.3914
  new     users  4868  mean   70.5152  change  +13.0%  CI [  +5.0%,  +21.1%]  chance to win 99.9%
## error
  control users  5132  mean    0.0101
  new     users  4868  mean    0.0193  change  +90.6%  CI [ +26.5%, +154.7%]  chance to win 0.3%
أول ما لفت انتباهنا السطر الأول: قيمة p لفحص اختلال نسبة العينة Sample Ratio Mismatch، واختصاراً SRM، تساوي 0.0083. وهذا الفحص يسأل: إذا كانت القسمة 50% و50% فعلاً، فما احتمال أن نرى 5,132 مقابل 4,868 أو أبعد؟ والجواب أقل من 1%. واختلال النسبة من أخطر الإشارات في أي تجربة، لأنه يعني غالباً أن شيئاً في التسجيل لا يعمل بالتساوي، مثل صفحة جديدة تتعطل قبل أن تستدعي دالة التسجيل لبعض العملاء، فيختفي من التجربة من تعطلت معهم، ويبقى من نجحوا، فتبدو الصفحة أفضل مما هي. ويعدد دليل حل مشاكل التجارب أسباب ذلك، ومنها دالة تسجيل لا تعمل إلا في حالات معينة، وتغيير الاستهداف في منتصف التجربة.
ولكن GrowthBook لم يعرض تحذيراً، والسبب أن حد التحذير الافتراضي DEFAULT_SRM_THRESHOLD = 0.001 كما في كود الإصدار 5.2.0، أي أنه لا يحذر إلا تحت واحد في الألف. فهل في تجربتنا خلل؟ في المحاكاة نعرف أن التسجيل يحدث لكل عميل، فقد سجلنا 2,000 عرض لألفي عميل ثم 8,000 لثمانية آلاف، لذلك سألنا ال SDK نفسه كيف يقسم مجموعات أخرى من المعرفات، دون أي تسجيل:
user-1..user-10000: new 4868, control 5132, z -2.64
user-10001..user-20000: new 5009, control 4991, z 0.18
user-20001..user-30000: new 4977, control 5023, z -0.46
user-1..user-100000: new 49736, control 50264, z -1.67
أول عشرة آلاف معرف وقعت بالصدفة بانحراف 2.64 من الانحراف المعياري، والعشرة آلاف التالية متوازنة تماماً، والمئة ألف قريبة من النصف. أي أن القسمة سليمة، وما رأيناه صدفة تحدث مرة تقريباً من كل 120 تجربة. وهذا بالضبط سبب أن الحد الافتراضي صارم: لو كان التحذير عند 1% لظهر في تجارب سليمة كثيرة، ولتعلم الفريق أن يتجاهله. والقاعدة التي نقترحها: إذا ظهرت قيمة SRM بين 0.001 و0.01 فافحص التسجيل كما فعلنا، بعدد العروض مقابل عدد العملاء، وإذا نزلت تحت 0.001 فلا تقرأ أي نتيجة قبل أن تجد السبب.
وبالمناسبة، لاحظ الشراء: +10.0% بفترة من +3.6% إلى +16.5%، والحقيقة +5.8% داخلها، ولكن التقدير نفسه ضعف الحقيقة تقريباً. وهذه ظاهرة معروفة في كل التجارب: عندما تكون العينة متوسطة، تبدو النتائج التي «نجحت» أكبر من حقيقتها، لأن ما يجعلها تتجاوز الصفر هو في جزء منه الصدفة نفسها.
النتيجة النهائية Final Results: 30,000 عميل
أكملنا العينة إلى 30,000 عميل، وهو العدد الذي كان الفريق قد حدده قبل البدء:
users 20000: control 10014, new 9986 | exposures 20000 | orders 6040 | errors 267users 30000 | SRM p-value 0.0918
## purchase
control users 15146 mean 0.2918
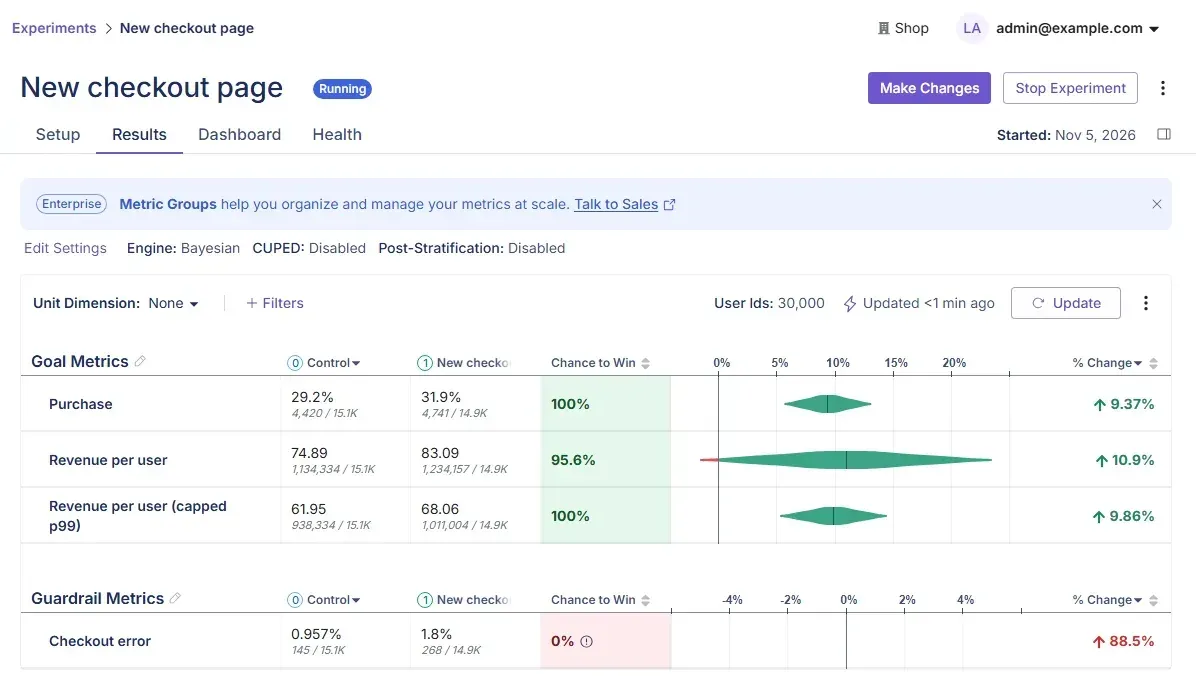
new users 14854 mean 0.3192 change +9.4% CI [ +5.6%, +13.1%] chance to win 100.0%
## revenue
control users 15146 mean 74.8933
new users 14854 mean 83.0859 change +10.9% CI [ -1.6%, +23.5%] chance to win 95.6%
## revenue_capped
control users 15146 mean 61.9526
new users 14854 mean 68.0628 change +9.9% CI [ +5.3%, +14.4%] chance to win 100.0%
## error
control users 15146 mean 0.0096
new users 14854 mean 0.0180 change +88.5% CI [ +50.6%, +126.3%] chance to win 0.0% variation | users | orders | bulk_orders | revenue | p99_order
-----------+-------+--------+-------------+---------+-----------
0 | 15146 | 4420 | 19 | 1134334 | 768
1 | 14854 | 4741 | 23 | 1234157 | 837والصورة التالية تجمع ما قاله GrowthBook عند كل حجم، مع الحقيقة التي كتبناها:
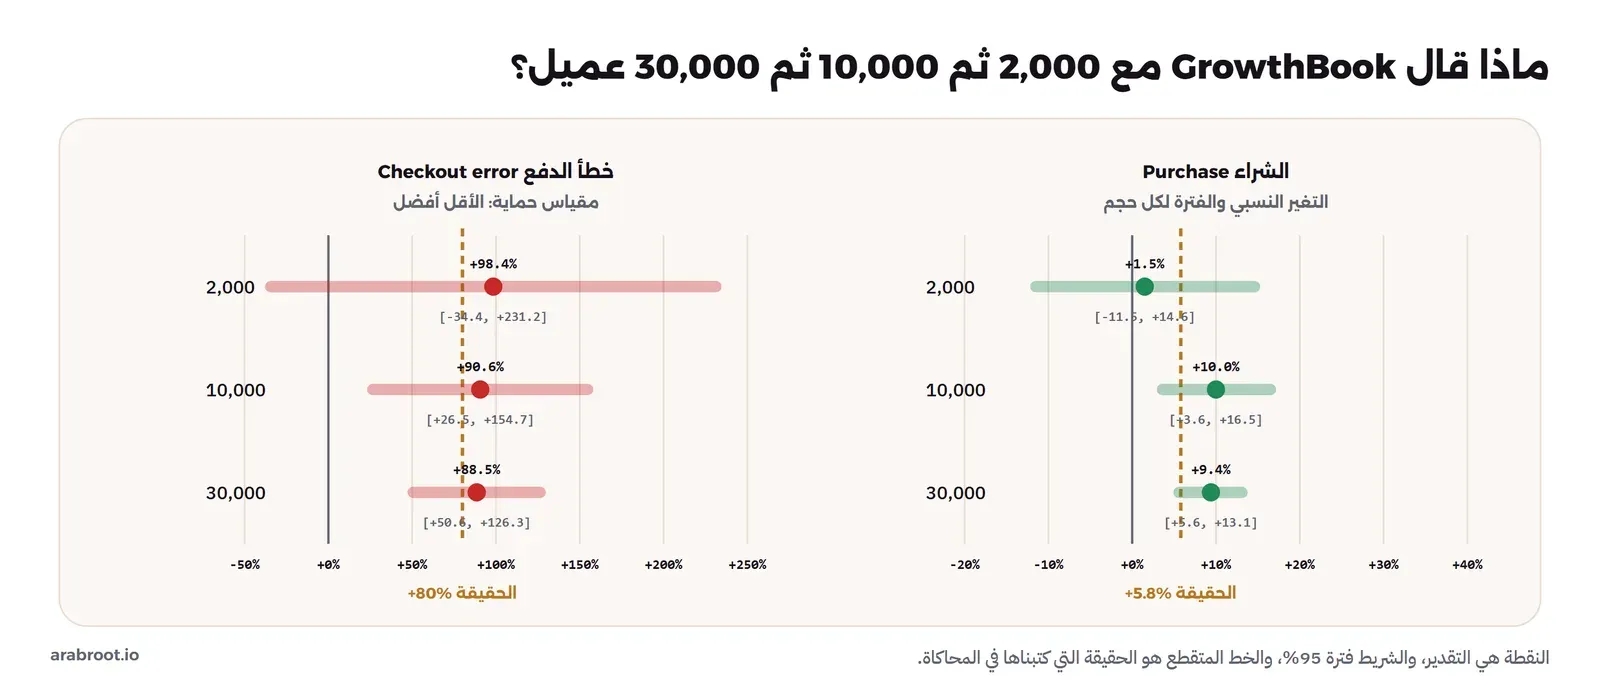
وفي الصورة أعلاه نتيجة لم نتوقعها، ونكتبها كما هي: في 30,000 عميل كانت فترة الشراء من +5.6% إلى +13.1%، والحقيقة +5.8% تقع داخلها بالكاد، على بعد 0.2 نقطة من حدها الأدنى، والتقدير +9.4% أبعد من الحقيقة بأكثر من النصف. وحتى نتأكد أن الخطأ ليس في GrowthBook، حسبنا الفترة بأنفسنا بطريقة Delta من الأعداد في الجدول:
control 0.2918 new 0.3192 change +9.37% 95% CI [+5.6%, +13.1%] truth +5.8%الرقم نفسه. فما الذي حدث؟ لا شيء غير طبيعي: فترة 95% تعني أن الطريقة تحوي الحقيقة في 95 تجربة من 100، وتخطئ في خمس، وتجربتنا اقتربت من أن تكون إحدى الخمس، لأن العملاء في الصفحة القديمة اشتروا بنسبة 29.18% بالصدفة، وهي أقل من حقيقتها 29.7%. وهذه أهم جملة في قراءة أي تجربة: الفترة ليست حدود الحقيقة، وإنما ما تقوله البيانات التي جمعتها، وفي واحدة من كل عشرين تجربة تقول البيانات شيئاً بعيداً عن الحقيقة دون أن يكون في التجربة أي خطأ.
ماذا لو اشترت شركة بستين ألف ريال؟ What If
في يوم من أيام التجربة دخلت شركة تجهز مكاتبها، فاشترت من المتجر بستين ألف ريال في طلب واحد، ووقعت في مجموعة الصفحة القديمة. أضفنا هذا الطلب إلى المستودع لعميل في مجموعة Control لم يشتر قبل، وأعدنا التحليل:
one corporate order of 60,000 SAR from user-3 (control)
## revenue
  control users 15146  mean   78.8547
  new     users 14854  mean   83.0859  change   +5.4%  CI [ -10.2%,  +20.9%]  chance to win 75.0%
## revenue_capped
  control users 15146  mean   62.0042
  new     users 14854  mean   68.0796  change   +9.8%  CI [  +5.2%,  +14.4%]  chance to win 100.0%
طلب واحد من 30,000 عميل نقل الإيراد من +10.9% إلى +5.4%، وفرصة الفوز من 95.6% إلى 75%، والفترة صارت أعرض. ولو وقع الطلب في الجانب الآخر لصارت الصفحة الجديدة «تزيد الإيراد 15%». أما المقياس بالسقف فتحرك من +9.9% إلى +9.8% فقط، لأن الستين ألفاً حسبت عند المئين 99 مثل أي عميل كبير آخر. والصورة التالية تبين الفرق بين المقياسين في الحالات الثلاث:
ولكن السقف ليس مجاناً، وثمنه يجب أن تعرفه قبل أن تضعه على كل مقياس مالي:
- السقف يغير السؤال: المقياس بالسقف يقيس «إيراد العميل العادي»، فإذا كانت الميزة نفسها تجعل الشركات تشتري أكثر، كصفحة دفع تقبل الفواتير، فالسقف سوف يخفي أثرها الحقيقي.
- سقف المئين يختلف بين التجارب: لأنه يحسب من بيانات كل تجربة، فلا تقارن رقم «الإيراد بسقف» في تجربة برقمه في أخرى.
- لا تحذف الطلبات الكبيرة من المستودع: الحل هو السقف في المقياس، أو مقياس منفصل لطلبات الجملة، وليس أن تقرر بعد رؤية النتيجة أي الطلبات «غير طبيعية».
لذلك اتفق الفريق على أن يكون المقياس بالسقف هو مقياس القرار للإيراد، وأن يبقى المقياس دون سقف في التقرير للاطلاع، وأن تراجع طلبات الجملة وحدها إذا ظهر فيها فرق.
المحرك الآخر Frequentist
المحرك الافتراضي في GrowthBook هو Bayesian كما يقول توثيق الإحصاء، لأنه يعطي «فرصة الفوز» التي يفهمها غير المختصين. وغيرناه إلى Frequentist للتجربة نفسها لنرى الفرق:
users 30000 | SRM p-value 0.0918
## purchase
  control users 15146  mean    0.2918
  new     users 14854  mean    0.3192  change   +9.4%  CI [  +5.6%,  +13.1%]  p 0.0000
## revenue
  control users 15146  mean   74.8933
  new     users 14854  mean   83.0859  change  +10.9%  CI [  -1.6%,  +23.5%]  p 0.0875
## revenue_capped
  control users 15146  mean   61.9526
  new     users 14854  mean   68.0628  change   +9.9%  CI [  +5.3%,  +14.4%]  p 0.0000
## error
  control users 15146  mean    0.0096
  new     users 14854  mean    0.0180  change  +88.5%  CI [ +50.6%, +126.3%]  p 0.0000
الفترات نفسها تقريباً، والقرار نفسه، والفرق في اللغة: «فرصة الفوز 95.6%» للإيراد دون سقف تصبح «p = 0.0875»، أي غير دال بالمعيار المعتاد 0.05. والمحركان لا يختلفان على البيانات، وإنما على طريقة عرضها، وكثير من الفرق يخدعها رقم 95.6% لأنه يبدو كأنه «شبه مؤكد»، بينما الفترة تقول إن الأثر قد يكون سالباً. والقاعدة التي اعتمدها الفريق: لا تقرأ فرصة الفوز دون الفترة، ولا تقرأ قيمة p دون الفترة. وقيمة p 0.0000 هنا حقيقية، وتعني أصغر من واحد في عشرة آلاف، بخلاف الصفر الذي رأيناه في المحرك الآخر.
إعدادات قبلتها ال API لكنها لم تطبقها Silent Settings
الاختبار المتتابع Sequential Testing يسمح لك بالنظر إلى النتائج كل يوم دون أن تزيد احتمال الخطأ، وتقليل التباين CUPED يضيق الفترة باستخدام سلوك العميل قبل التجربة، وكلاهما مذكور في توثيق الإحصاء. فطلبنا تفعيلهما للتجربة عبر ال API:
commercialFeatures: [] | license: None
{'sequentialTestingEnabled': True} -> accepted; settings: {'sequentialTestingEnabled': True, 'regressionAdjustmentEnabled': False}
{'regressionAdjustmentEnabled': True} -> accepted; settings: {'sequentialTestingEnabled': True, 'regressionAdjustmentEnabled': True}
قبل الخادم الطلبين وحفظ الإعدادين، ثم أعدنا التحليل، فجاءت النتائج مطابقة رقماً برقم لما قبل التفعيل، والإعدادات المستخدمة في النتيجة تقول المحرك فقط:
## purchase
  new     users 14854  mean    0.3192  change   +9.4%  CI [  +5.6%,  +13.1%]  p 0.0000
…
{'statsEngine': 'frequentist'}
والسبب في السطر الذي رأيناه عند الإعداد: commercialFeatures فارغة، وبحسب صفحة الأسعار فإن CUPED والاختبار المتتابع في الخطط المدفوعة، وفي الاستضافة الذاتية لا توجد خطة Pro، فهي في Enterprise. والمشكلة ليست أنها مدفوعة، وإنما أن ال API قبلتها بصمت، فلو كتب أحدهم في تقرير «النتيجة بالاختبار المتتابع» لأنه فعله من سكربت، لكان التقرير خطأ، فالفترة هنا لم تصحح لتكرار النظر إليها. لذلك تحقق من الإعدادات في نتيجة التحليل نفسها، وليس في رد طلب التفعيل.
والصورة التالية من صفحة نتائج التجربة في الواجهة بعد إعادتها إلى المحرك Bayesian، ولاحظ السطر تحت الإعلان: CUPED معطل:
التنظيف Cleanup
docker rm -f wr-ff-gb-shop
docker compose -p wr-ff-gb down -v
كم عميلاً يحتاج كل مقياس؟ Sample Size
شرحنا طريقة حساب حجم العينة لمقياس نسبة في مقال تجارب النمو، والجديد هنا أن المقاييس الأربعة في تجربة واحدة لا تحتاج إلى العدد نفسه، والفرق كبير إلى درجة أنه يغير طريقة تصميم التجربة. فأخذنا من نتائج GrowthBook متوسط كل مقياس وانحرافه المعياري في مجموعة الصفحة القديمة، وحسبنا كم عميلاً تحتاج كل مجموعة حتى تكتشف الفرق الحقيقي +5.8% بمستوى دلالة 0.05 وقوة 0.8:
z = 1.959964 + 0.841621            # alpha 0.05 two-sided, power 0.8
for m in r['metrics']:
    a = m['variations'][0]['analyses'][0]
    mean, sd = a['mean'], a['stddev']
    delta = 0.058 * mean           # detect the true +5.8% relative change
    n = 2 * z * z * sd * sd / (delta * delta)
purchase control mean 0.2918 sd 0.4546 cv 1.56 users per variation for +5.8%: 11,324
revenue control mean 74.8933 sd 383.1090 cv 5.12 users per variation for +5.8%: 122,107
revenue_capped control mean 61.9526 sd 117.4488 cv 1.90 users per variation for +5.8%: 16,772
error control mean 0.0096 sd 0.0974 cv 10.17 users per variation for +5.8%: 482,763
error users per variation for +80%: 2,525في المخرج أعلاه لاحظ العمود cv، وهو معامل الاختلاف Coefficient of Variation، أي الانحراف المعياري مقسوماً على المتوسط، وهو الذي يقرر حجم العينة، لأن العدد المطلوب يكبر مع مربعه:
- الشراء يحتاج إلى نحو 11 ألف عميل في كل مجموعة، وتجربتنا فيها 15 ألفاً، لذلك ظهر الفرق بوضوح.
- الإيراد دون سقف يحتاج إلى 122 ألفاً، أي عشرة أضعاف الشراء، لأن الطلبات الكبيرة تجعل انحرافه المعياري خمسة أضعاف متوسطه. وهذا هو التفسير الرقمي لما رأيناه: الإيراد دون سقف لم يصل إلى نتيجة واضحة في 30 ألف عميل، ولن يصل قبل ربع مليون.
- الإيراد بسقف يحتاج إلى 17 ألفاً تقريباً، أي أن السقف خفض العينة المطلوبة سبع مرات، وهذه فائدته الحقيقية قبل أن تكون حماية من طلب الشركة.
- الأخطاء نادرة، فاكتشاف تغير صغير فيها يحتاج إلى نصف مليون، ولكن اكتشاف تضاعفها يحتاج إلى 2,525 فقط، لذلك ظهر مقياس الحماية أحمر منذ 10 آلاف عميل.
والدرس العملي أن تحسب العينة لمقياس القرار قبل البدء، فإذا كان مقياس القرار مالياً فاحسبه بالسقف، وإلا فسوف تنتظر أشهراً لنتيجة لا تأتي. وأن تعرف أن مقياس الحماية يكتشف المشاكل الكبيرة مبكراً، وهذا ما تريده منه، فلا تنتظر اكتمال العينة إذا ظهر فيه تضاعف واضح.
كم يوماً تستمر التجربة؟ Duration
العدد وحده لا يكفي، فالمتجر لا يرى العملاء أنفسهم في كل يوم من أيام الأسبوع. فعملاء ليلة الخميس يختلفون عن عملاء صباح الأحد، وعملاء آخر الشهر بعد الراتب يختلفون عن عملاء منتصفه، وهذا بالضبط ما قاله مسؤول التشغيل عن رسم المبيعات في أول المقال. لذلك اتفق الفريق على ثلاث قواعد للمدة:
- أسبوع كامل على الأقل: حتى لو اكتمل العدد في أربعة أيام، لأن تجربة من الأحد إلى الأربعاء لا تعرف شيئاً عن عملاء نهاية الأسبوع، وقد تكون الصفحة الجديدة أفضل في يوم وأسوأ في آخر.
- أسابيع كاملة: إذا احتاجت التجربة إلى أكثر من أسبوع فاجعلها أسبوعين، لا عشرة أيام، حتى يتساوى عدد كل يوم من أيام الأسبوع.
- انتبه لأثر الجدة Novelty Effect: العميل الذي يرى صفحة جديدة قد يتصرف بشكل مختلف في أول زيارة فقط، لأنها جديدة وليس لأنها أفضل، فإذا كان عملاؤك يعودون كثيراً فقارن أول أسبوع بالثاني قبل القرار.
وفي المحاكاة أرسلنا 30 ألف عميل في دقائق، لأن المحاكاة لا تعرف الأيام، أما في متجر حقيقي يزوره ألفا عميل في اليوم فهذه التجربة تحتاج إلى خمسة عشر يوماً، فتصبح أسبوعين ويوماً، والفريق يكتب هذا الموعد في الفرضية قبل البدء، ولا يفتح النتائج ليقرر قبله إلا إذا احمر مقياس الحماية.
كيف تقرأ النتيجة بصدق؟ Honest Statistics
بعد التجربة كتب الفريق صفحة واحدة عن قراءة النتائج، لأن أكثر الأخطاء التي رأيناها لم تكن في الأداة، وإنما في من يقرأ:
- الفترة أولاً، ثم أي رقم آخر: التقدير وحده لا يعني شيئاً، فالإيراد +32.4% عند 2,000 عميل كان فترته من -12.7% إلى +77.5%، أي «لا أعرف» بلغة الأرقام.
- فرصة الفوز ليست احتمال أن القرار صحيح: 95.6% تعني أن الأثر أكبر من الصفر في نموذج GrowthBook، ولا تقول كم أكبر، ولا تقول شيئاً عن الأخطاء.
- التقدير المبكر يبالغ: رأينا الشراء +10% عند 10,000 والحقيقة +5.8%، فلا تعد الإدارة بالرقم الذي رأيته في أول نتيجة جيدة.
- واحدة من كل عشرين تخطئ: حتى دون أي خلل، فلا تبن قراراً كبيراً على تجربة واحدة بالكاد عبرت الحد، وأعدها إذا كان القرار مكلفاً.
- كل مقياس إضافي فرصة إضافية للصدفة: أربعة مقاييس تعني أربع فرص ليبدو أحدها «فائزاً» بالصدفة، لذلك حدد مقياس قرار واحداً قبل البدء، ويذكر توثيق الإحصاء أن تصحيح المقارنات المتعددة متاح في المحرك Frequentist فقط.
- المال يحتاج إلى سقف: مقياس دون سقف على مبالغ بذيل طويل يقرره عدد قليل من الطلبات.
ولاحظ أن هذه القائمة تكمل ما شرحناه في مقال اختبارات A/B عن التوقف المبكر والتجربة دون فرق A/A، فهي هنا عن المقاييس المالية ومقاييس الحماية، وهما ما يواجهه فريق هندسي يطلق ميزة في مسار الدفع.
القرار: هل نطلق الصفحة الجديدة؟ Decision
اجتمع الفريق على النتيجة النهائية، والصورة التالية تلخص ما رأوه:
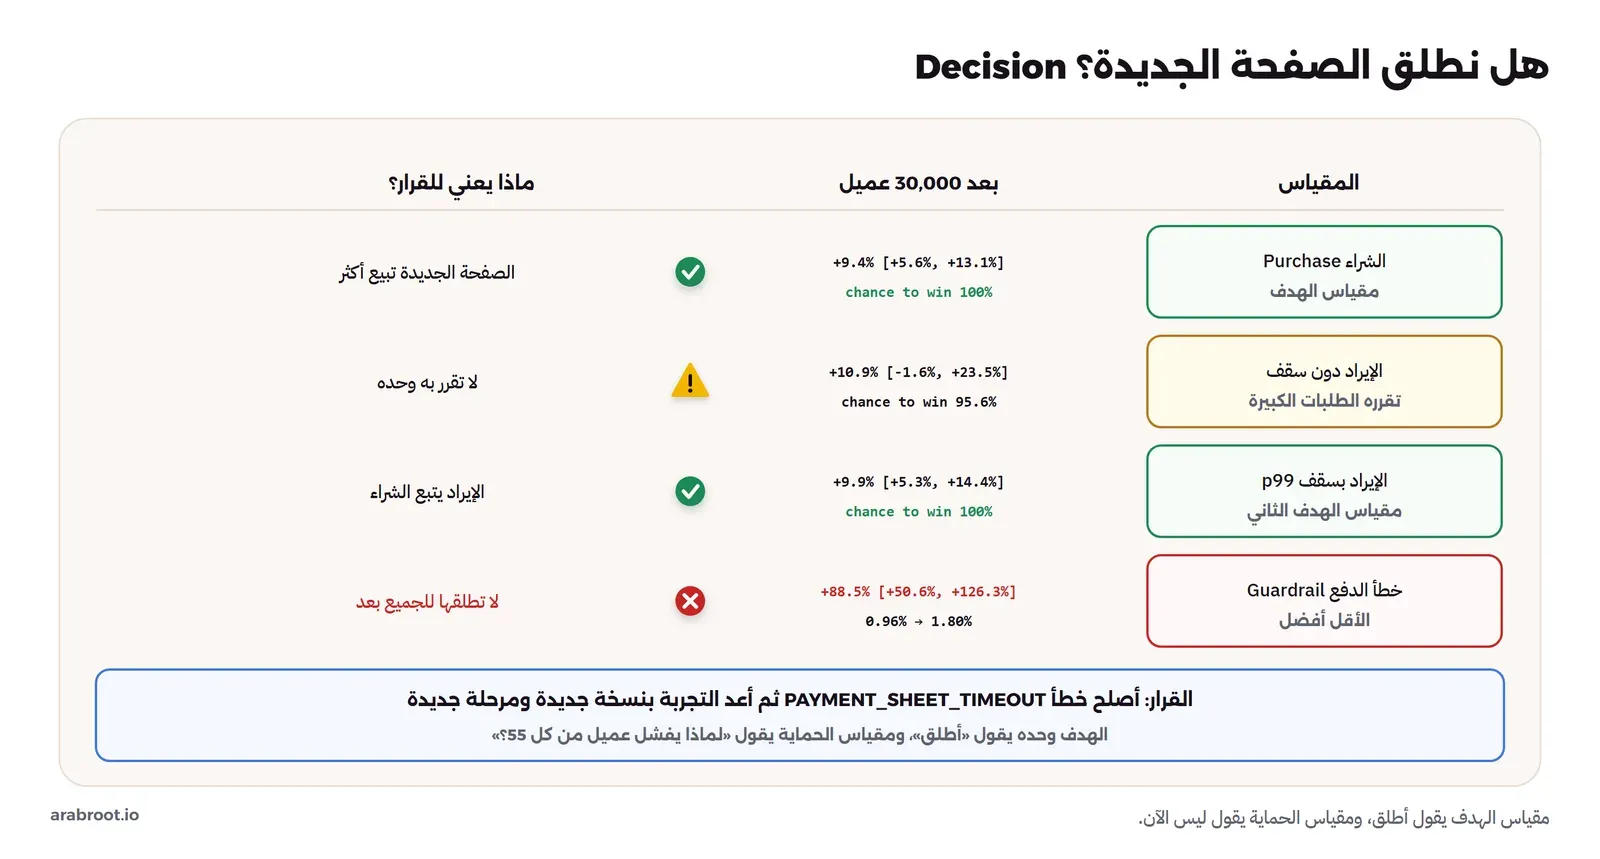
لو نظر الفريق إلى مقياس الهدف وحده لأطلق الصفحة للجميع في اليوم نفسه، فالشراء أعلى بفترة كلها فوق الصفر. ولكن الأخطاء تقريباً تضاعفت، من عميل في كل مئة إلى عميل في كل 55، وأغلبها برمز واحد هو PAYMENT_SHEET_TIMEOUT، وهذا يعني أن الصفحة الجديدة تبيع أكثر رغم أنها تفشل مع عدد أكبر، وأن إصلاح هذا الخطأ قد يجعل أثرها أكبر. فكان القرار ثلاث خطوات:
- تبقى التجربة بنسبتها حتى يصل الإصلاح، ولا ترفع النسبة، لأن رفعها يعرض عملاء أكثر لخطأ معروف.
- تصلح مطورة الدفع مهلة نافذة الدفع، ويتحقق الفريق من الإصلاح في staging بالأخطاء نفسها، وتتبع الخطأ في السجلات كما شرحنا في سجلات تساعدك فعلاً.
- تبدأ مرحلة جديدة للتجربة بعد الإصلاح، لأن مقارنة عملاء قبل الإصلاح بعملاء بعده تخلط صفحتين مختلفتين في مجموعة واحدة.
وفي هذه المرحلة يصبح ال Flag نفسه Kill Switch كما في مقالات السلسلة السابقة: إذا ارتفعت الأخطاء أكثر قبل الإصلاح، يطفئ المناوب القاعدة من GrowthBook فيعود كل العملاء إلى الصفحة القديمة. والإطلاق الآمن Safe Rollouts في GrowthBook، الذي يراقب مقاييس الحماية ويوقف الإطلاق وحده، موجود في الخطط المدفوعة فقط، لذلك كتب الفريق تنبيهاً على نسبة أخطاء الدفع في نظام المراقبة الذي عنده، كما في التنبيهات.
ما الذي تعطيه النسخة المفتوحة؟ Open Source Limits
جمعنا في الصورة التالية ما وجدناه في صفحة الأسعار بتاريخ 5 نوفمبر 2026، وما رأيناه على خادمنا دون رخصة:
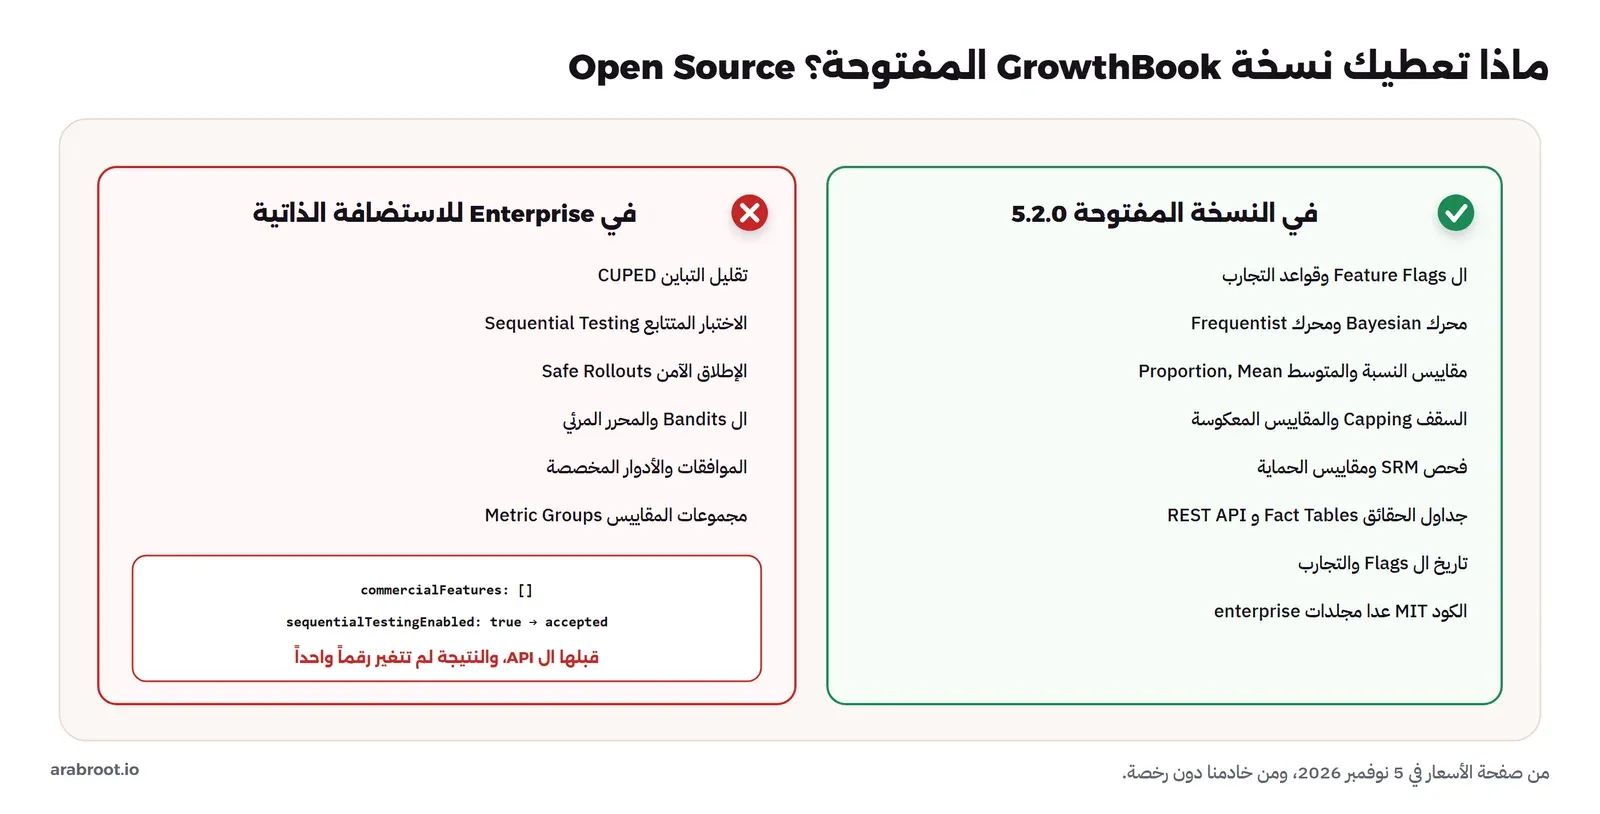
ولاحظ أن كل ما استخدمناه في هذا المقال للوصول إلى قرار صحيح، أي التقسيم والتسجيل والمقاييس الأربعة والسقف وفحص SRM والمحركان، موجود في النسخة المفتوحة. أما ما ينقصها فيوفر الوقت أو يضيق الفترة، مثل CUPED الذي يحتاج عينة أصغر للدقة نفسها، والاختبار المتتابع الذي يسمح بالنظر كل يوم، والإطلاق الآمن الذي يوقف الإطلاق تلقائياً. فإذا كانت التجارب عندكم قليلة وكبيرة، فالنسخة المفتوحة تكفي، وإذا كانت كثيرة وتريدون أن تنتهي أسرع، فهذه الميزات هي ما تدفعون ثمنه.
أخطاء شائعة Common Mistakes
- مقارنة من رأى الميزة في الإطلاق التدريجي بمن لم يرها: المجموعتان ليستا عشوائيتين ولا في الفترة نفسها.
- متوسط قيمة الطلب كمقياس قرار: يقسم على المشترين فقط، فيخفي أثر الميزة على عدد من يشتري.
- إيراد دون سقف: طلبان كبيران صنعا +32% من لا شيء.
- قراءة
pValueأوchanceToBeatControlدونengine: الحقل الذي لا يخص المحرك يعود صفراً. - تجاهل SRM أو الذعر منه: افحص عدد العروض مقابل عدد العملاء، ولا تقرأ النتائج تحت 0.001.
- مقياس هدف دون مقياس حماية: كانت الصفحة سوف تطلق للجميع ومعها ضعف الأخطاء.
- ترقية ال SDK أو تغيير النسبة في منتصف التجربة: بعض العملاء ينتقلون بين المجموعتين.
- الثقة بأن إعداداً فعل لأن ال API قبلته: تحقق من الإعدادات في نتيجة التحليل.
- مستخدم المستودع بصلاحية كتابة: استعلامات المقاييس يكتبها أي شخص له صلاحية في GrowthBook.
قائمة تحقق قبل التجربة التالية Checklist
| البند | كيف تتحقق |
|---|---|
| مقياس قرار واحد مكتوب قبل البدء | في حقل الفرضية، ومعه الحجم المطلوب والمدة |
| مقياس حماية لكل مسار حساس | أخطاء الدفع أو زمن الرد، ومعه الحد الذي يوقف الإطلاق |
| المقاييس المالية بسقف | cappingSettings ليس none لمقياس القرار |
| التسجيل يطابق العملاء | عدد صفوف experiment_viewed يساوي عدد العملاء الذين وصلوا إلى الصفحة |
| فحص SRM فوق 0.001 | السطر الأول في النتائج، ويراجع عند كل تحديث |
| ال SDK لا يبدأ صامتاً دون بيانات | نتيجة init مفحوصة، والخطأ مسجل |
| التقارير الآلية تقرأ حقول المحرك الصحيح | السكربت يفحص engine قبل pValue أو chanceToBeatControl |
| المستودع للقراءة فقط | محاولة INSERT بمستخدم GrowthBook ترفض |
| مفتاح التشفير محفوظ | ENCRYPTION_KEY مع النسخة الاحتياطية لـ MongoDB |
| ال Flag يحذف بعد القرار | تذكرة حذف الشرط والمسار الخاسر من الكود |
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- أدوات ال Flags تقول من رأى الميزة، والتجربة العشوائية تقول ماذا فعلت الميزة، وGrowthBook يجمع ال Flag والتقسيم والتحليل من جداولك أنت.
- مقياس الهدف للمتجر هو الشراء والإيراد لكل عميل، وليس متوسط الطلب، ومعهما مقياس حماية لأخطاء الدفع.
- في 2,000 عميل قال الإيراد +32.4% بسبب طلبين كبيرين، والحقيقة +5.8%، والسقف عند المئين 99 أعطى +6.9%.
- في 30,000 عميل كان الشراء +9.4% بفترة بالكاد تحوي الحقيقة، وهذا ما تعنيه فترة 95%، والأخطاء +88.5% والحقيقة +80%.
- المقاييس لا تحتاج إلى العينة نفسها: الشراء نحو 11 ألف عميل لكل مجموعة، والإيراد بسقف 17 ألفاً، والإيراد دون سقف 122 ألفاً، لأن حجم العينة يكبر مع مربع معامل الاختلاف.
- طلب شركة واحد بستين ألف ريال غير الإيراد دون سقف من +10.9% إلى +5.4%، والمقياس بالسقف لم يتحرك.
- فحص SRM أعطى 0.0083 عند 10,000 عميل، والتسجيل كان سليماً، وحد التحذير في GrowthBook هو 0.001.
- نتائج ال API تضع صفراً في حقول المحرك الآخر، والإعدادات المدفوعة تقبل ولا تطبق في النسخة المفتوحة.
- قرر الفريق ألا يطلق الصفحة حتى يصلح الخطأ، ثم يعيد التجربة بمرحلة جديدة.
وفي المقال القادم من هذه السلسلة بإذن الله نفصل الكود عن الأدوات الثلاث بمعيار OpenFeature، ونبدل بينها دون أن نغير سطراً في المتجر. والمقالات المرتبطة بهذا المقال:
 دليلاختبارات A/B بدقة مع GrowthBook على سيرفركنشغل GrowthBook مع PostgreSQL ونجري تجربة نعرف فرقها الحقيقي مسبقاً، لنتعلم قراءة فرصة الفوز والهامش وقيمة p دون أن نخدع أنفسنا.
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
تدريب عملي Practice
- شغل المختبر، وغير الحقيقة في المحاكاة بحيث لا يوجد أي فرق بين الصفحتين، ثم أرسل 30,000 عميل، وانظر كم مقياساً من الأربعة يبدو «فائزاً» أو «خاسراً» بالصدفة.
- أضف طلب جملة كبيراً إلى مجموعة الصفحة الجديدة بدل القديمة، وقارن ما يقوله المقياس دون سقف بالمقياس بالسقف، ثم جرب سقفاً مطلقاً بدل المئين.
- عدل دالة التسجيل بحيث لا تسجل العرض لمن ظهر له خطأ في الصفحة الجديدة، وانظر كيف يتغير فحص SRM، وكيف تبدو الأخطاء والشراء بعد ذلك.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال وتنفيذ التجربة على GrowthBook 5.2.0 مع MongoDB 8.0.34 وPostgreSQL 18، ومكتبة @growthbook/growthbook 2.0.0 وpg 8.23.1 على Node.js 22.23.4، على Docker Engine 29.8.0، ومراجعة صفحة الأسعار وسجل تغييرات ال SDK في 5 نوفمبر 2026.