

يصل بلاغ من الدعم الفني بأن عميلاً حاول الدفع ثلاث مرات وفشل، فتفتح سجلات الخدمة وتبحث، فتجد مئات السطور التي تقول ERROR Error occurred، وتحت كل منها اثنان وثلاثون سطراً من ال Stack Trace، ولا يوجد في أي منها رقم الطلب أو اسم العميل أو نوع البطاقة، بينما تجد بريد العميل ورقم جواله كاملين في سطر آخر لا علاقة له بالخطأ. والمشكلة هنا ليست أن الفريق لم يكتب سجلات، فهو كتب كثيراً، وإنما أن السجلات كتبت لتقول «حدث خطأ» ولم تكتب لتجيب عن الأسئلة التي سوف تسألها وقت الحادثة: أي طلب؟ أي عميل؟ ماذا فشل بالضبط؟ وهل يتكرر مع الجميع أم مع جزء منهم؟
المواضيع في السلسلة:
- السجلات Logging للمطورين: ماذا تسجل وماذا لا تسجل
- سجلات تساعدك فعلاً: من «حدث خطأ» إلى سبب المشكلة (الموضوع الحالي)
- مسار السجل من التطبيق إلى البحث والتنبيه Log Pipeline
وقد شرحنا القواعد نفسها في المقال الأول من السلسلة: المستويات، وماذا تسجل، وما لا يدخل السجل، والسجلات المنظمة، وتسجيل الاستثناء مرة واحدة، فلن نكررها هنا. أما هذا المقال فتطبيق عملي لها على خدمة حقيقية صغيرة: نكتب السجلات بالطريقة التي نراها في أغلب المشاريع، ونسبب عطلاً حقيقياً، ونحاول أن نجد سببه، ثم نعيد كتابة السجلات ونحقق في العطل نفسه من جديد ونقيس الفرق. وسوف نناقش في هذا المقال ما يلي:
- خدمة طلبات صغيرة بلغة Python تتصل بمزود دفع، بسجلات مكتوبة كما نراها عادة.
- حادثة حقيقية في المختبر: مزود الدفع يبطئ مع نوع واحد من البطاقات، فتفشل بعض الطلبات.
- التحقيق بالسجلات السيئة فقط، وما وجدناه وما لم نستطع أن نجده.
- إعادة كتابة السجلات: حقول السياق، وأسماء أحداث ثابتة، ورموز أخطاء، ومعرف الطلب ومعرف التتبع، وحدث واسع Wide Event واحد لكل طلب.
- التحقيق نفسه من جديد باستعلامات jq، والقياس قبل وبعد: عدد الاستعلامات، والخطوات حتى السبب، وحجم السجلات، والسطور لكل طلب.
- أخذ العينات Sampling في الإنتاج، ونكسر الحدث الواسع لنرى نقطة ضعفه، ثم قائمة مراجعة للسجلات في مراجعة الكود Code Review.
الخدمة التي سوف نحقق فيها
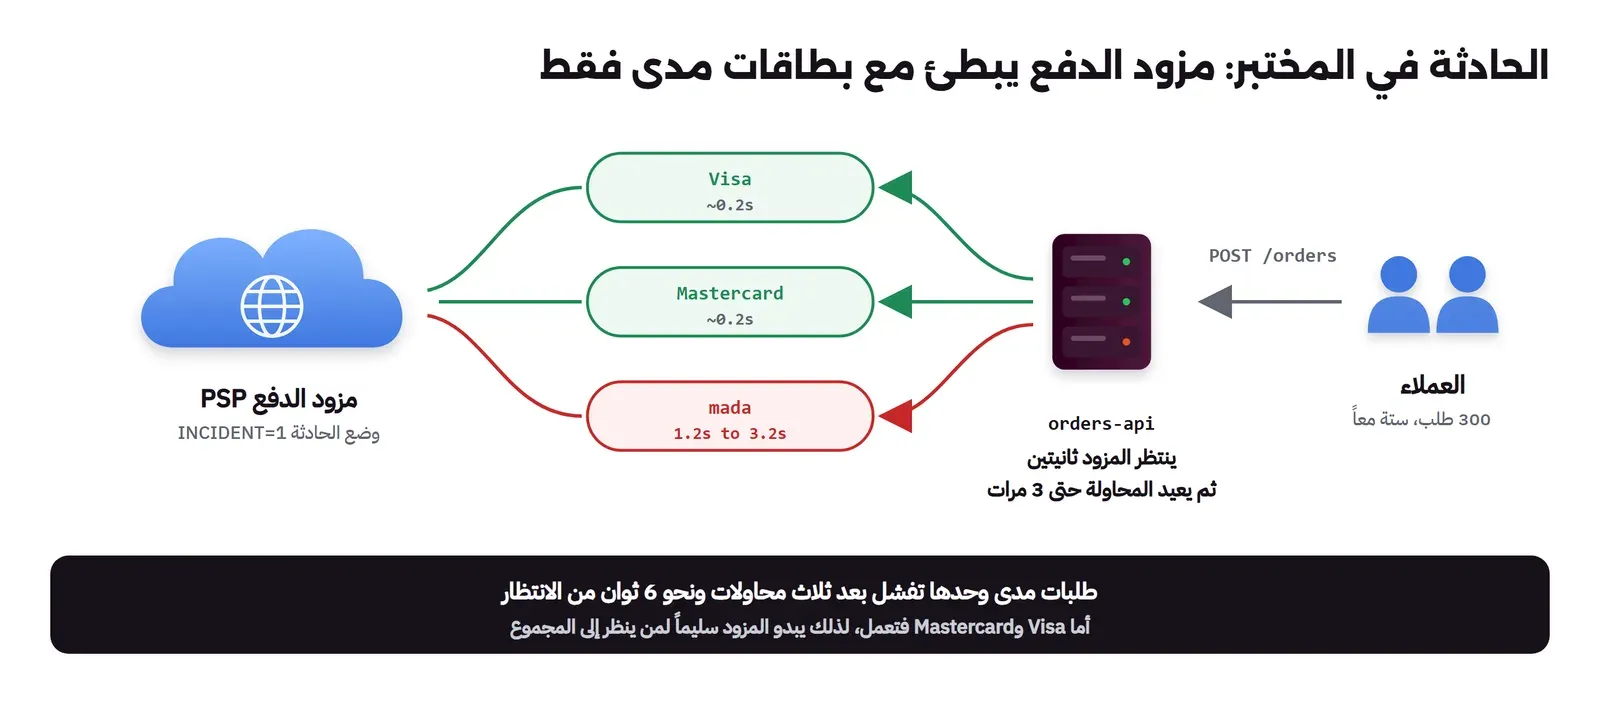
الخدمة واجهة برمجية لإنشاء الطلبات Orders API، تستقبل الطلب مع بيانات البطاقة، ثم تتصل بمزود الدفع Payment Service Provider واختصاراً PSP لتخصم المبلغ، وتنتظر رده ثانيتين على الأكثر، وإذا انتهت المهلة Timeout تعيد المحاولة حتى ثلاث مرات ثم ترد بالخطأ 502. ومزود الدفع في المختبر خدمة صغيرة نكتبها نحن، وفيها وضع الحادثة INCIDENT=1 الذي يجعل مسار بطاقات مدى mada وحده بطيئاً، بين 1.2 و3.2 ثانية، أما Visa وMastercard فترد خلال ربع ثانية. والصورة التالية تبين الخدمة والحادثة:
والكود التالي هو مزود الدفع psp.py:
# Fake payment provider (PSP). In incident mode the "mada" route is slow.
import json, os, random, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

INCIDENT = os.environ.get("INCIDENT", "0") == "1"

class PSP(BaseHTTPRequestHandler):
    def log_message(self, *args):
        pass

    def do_POST(self):
        body = json.loads(self.rfile.read(int(self.headers.get("Content-Length", 0))))
        if INCIDENT and body["brand"] == "mada":
            time.sleep(random.uniform(1.2, 3.2))   # degraded acquirer route
        else:
            time.sleep(random.uniform(0.05, 0.25))
        out = json.dumps({"status": "approved", "psp_ref": "ch_" + os.urandom(6).hex()}).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.end_headers()
        self.wfile.write(out)

ThreadingHTTPServer(("0.0.0.0", 9000), PSP).serve_forever()
أما الخدمة نفسها app_bad.py فمكتوبة بالسجلات التي نراها في أغلب المشاريع، وكل سطر فيها له سبب يبدو منطقياً لمن كتبه:
# Orders API with the logs most teams actually ship.
import json, logging, socket, traceback, urllib.request
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

logging.basicConfig(level=logging.DEBUG, format="%(asctime)s %(levelname)s %(message)s")
log = logging.getLogger("orders")
PSP_URL, PSP_TIMEOUT, PSP_RETRIES = "http://psp:9000/charge", 2.0, 3

def charge(card, amount):
    for attempt in range(PSP_RETRIES):
        try:
            log.debug("calling payment provider")
            req = urllib.request.Request(PSP_URL, json.dumps({"brand": card["brand"], "amount": amount}).encode(),
                                         {"Content-Type": "application/json"})
            with urllib.request.urlopen(req, timeout=PSP_TIMEOUT) as r:
                return json.loads(r.read())
        except (socket.timeout, TimeoutError) as e:
            log.error("Error occurred")
            traceback.print_exc()                # stack trace straight to stderr
            if attempt == PSP_RETRIES - 1:
                raise

def create_order(order):
    log.info("Processing order %s", order)       # the whole payload, PII included
    try:
        res = charge(order["card"], order["amount"])
        log.info("Payment OK")
        return res
    except Exception as e:
        log.error("Payment failed: %s", e)
        raise

class API(BaseHTTPRequestHandler):
    def log_message(self, *args):
        pass

    def do_POST(self):
        order = json.loads(self.rfile.read(int(self.headers.get("Content-Length", 0))))
        try:
            res = create_order(order)
            self.send_response(201); self.end_headers()
            self.wfile.write(json.dumps({"psp_ref": res["psp_ref"]}).encode())
        except Exception:
            log.exception("Error occurred")
            self.send_response(502); self.end_headers()
            self.wfile.write(b'{"error":"payment failed"}')

ThreadingHTTPServer(("0.0.0.0", 8000), API).serve_forever()
في الكود أعلاه لاحظ التالي:
- رسالة بلا معلومة:
Error occurredتتكرر في مكانين مختلفين بالنص نفسه، فلا تعرف من السطر أي جزء من الكود كتبه. - ال Stack Trace في كل طبقة: الدالة
chargeتطبعه في كل محاولة فاشلة، ثم يسجله معالج الطلب مرة أخرى، وهذا عكس قاعدة تسجيل الاستثناء مرة واحدة. - لا يوجد أي معرف: لا رقم طلب ولا معرف طلب Request ID، فلا يمكن ربط سطور الطلب الواحد ببعضها عندما تعمل عدة طلبات في الوقت نفسه.
- بيانات شخصية: السطر
Processing orderيطبع الطلب كاملاً، ومنه البريد ورقم الجوال، وهذا مما شرحنا أنه لا يدخل السجل. - مستوى DEBUG في الإنتاج: لأن أحدهم احتاجه مرة ونسي أن يرجعه.
- رسالة الاستثناء وحدها:
Payment failed: timed outلا تقول ما الذي انتهت مهلته، ولا بعد كم ثانية، ولا في أي محاولة.
والملف compose.yaml يشغل مزود الدفع في وضع الحادثة، والخدمة بنسختين، السيئة الآن والمحسنة لاحقاً، وContainer نرسل منه الطلبات، وكل الأسماء تبدأ بالبادئة lab-log-help-:
name: lab-log-help
services:
  psp:
    image: python:3.13.16-slim
    container_name: lab-log-help-psp
    command: python -u /lab/psp.py
    environment: { INCIDENT: "1" }
    volumes: ["./:/lab:ro"]
  api-bad:
    image: python:3.13.16-slim
    container_name: lab-log-help-api-bad
    command: python -u /lab/app_bad.py
    volumes: ["./:/lab:ro"]
  api-good:
    image: python:3.13.16-slim
    container_name: lab-log-help-api-good
    command: python -u /lab/app_good.py
    volumes: ["./:/lab:ro"]
  client:
    image: python:3.13.16-slim
    container_name: lab-log-help-client
    command: sleep infinity
    volumes: ["./:/lab"]
والملف load.py يرسل 300 طلب من 60 عميلاً، ستة في الوقت نفسه، بالترتيب نفسه في كل مرة لأن البذرة Seed ثابتة، ثم يحفظ ما رآه كل عميل في ملف حتى نقارن السجلات بالحقيقة:
# Sends the same 300 orders to an API, 6 at a time, and prints what the clients saw.
import json, random, sys, time, urllib.request
from concurrent.futures import ThreadPoolExecutor

random.seed(42)
BRANDS = ["mada"] * 4 + ["visa"] * 4 + ["mastercard"] * 2
orders = []
for i in range(300):
    c = random.randint(1000, 1059)
    orders.append({"customer_id": f"cus_{c}", "email": f"user{c}@example.com", "phone": f"05{c:04d}{c % 97:04d}",
                   "items": [{"sku": f"SKU-{random.randint(1, 40)}", "qty": 1}] * random.randint(1, 3),
                   "amount": random.randint(20, 900), "card": {"brand": random.choice(BRANDS), "last4": f"{random.randint(0, 9999):04d}"}})

def send(o):
    t0 = time.perf_counter()
    req = urllib.request.Request(sys.argv[1], json.dumps(o).encode(), {"Content-Type": "application/json"})
    try:
        with urllib.request.urlopen(req, timeout=15) as r:
            code = r.status
    except urllib.error.HTTPError as e:
        code = e.code
    return o, code, time.perf_counter() - t0

with ThreadPoolExecutor(6) as ex:
    res = list(ex.map(send, orders))
ok = sum(1 for _, c, _ in res if c == 201)
with open(sys.argv[2], "w") as f:                      # what each client saw, to check the logs against
    for o, c, t in res:
        f.write(f"{o['customer_id']}\t{o['card']['brand']}\t{c}\t{t:.1f}\n")
print(f"sent={len(res)} ok={ok} failed={len(res) - ok} slowest_s={max(t for _, _, t in res):.1f}")
الحادثة: الطلبات تفشل عند بعض العملاء
نشغل ال Containers ونرسل الطلبات إلى النسخة السيئة، ثم نحفظ سجلها في ملف نبحث فيه:
docker compose up -d
docker exec lab-log-help-client python /lab/load.py http://api-bad:8000/orders /lab/out/client-bad.tsv
docker logs lab-log-help-api-bad > out/bad.log 2>&1
والمخرج سوف يكون كما يلي:
sent=300 ok=276 failed=24 slowest_s=6.8أربعة وعشرون طلباً فشلت من 300، وأبطأ عميل انتظر قرابة سبع ثوان. ثم يصل البلاغ من الدعم الفني: العميل cus_1037 صاحب البريد [email protected] يقول إن الدفع فشل معه بعد انتظار طويل. وهذه هي الأسئلة التي يجب أن نجيب عنها: كم طلباً فشل فعلاً؟ ولماذا؟ وأي طلب من طلبات هذا العميل فشل؟ وهل المشكلة عند الجميع أم عند فئة من العملاء؟ وكم انتظر العملاء؟
التحقيق بالسجلات السيئة
نبدأ بما يفعله أي شخص أمام سجل نصي، وهو البحث بالكلمات بأداة grep، وقد حفظنا السجل كما هو في الملف bad.log.
السؤال الأول: كم طلباً فشل؟
grep -c "Error occurred" bad.log
grep -c "Payment failed" bad.log
grep -c "Traceback" bad.log
144
24
144الرقم الذي يظهر أولاً لأي شخص يبحث عن الأخطاء هو 144، وهو ستة أضعاف العدد الحقيقي، والسبب أن Error occurred تكتب مع كل محاولة فاشلة، ثم مرة أخرى في معالج الطلب. والعدد الصحيح 24 لا نعرفه إلا إذا قرأنا الكود وفهمنا أن Payment failed تكتب مرة واحدة لكل طلب فاشل.
السؤال الثاني: ما الخطأ؟
grep "Payment failed" bad.log | head -32026-10-14 21:43:58,714 ERROR Payment failed: timed out
2026-10-14 21:43:58,847 ERROR Payment failed: timed out
2026-10-14 21:43:59,916 ERROR Payment failed: timed outشيء ما انتهت مهلته، ولا نعرف ما هو من السطر نفسه، لذلك نقرأ ال Stack Trace الذي قبله:
grep -m1 -B1 -A3 "Payment failed" bad.logTimeoutError: timed out
2026-10-14 21:43:58,714 ERROR Payment failed: timed out
2026-10-14 21:43:58,714 ERROR Error occurred
Traceback (most recent call last):
File "/lab/app_bad.py", line 40, in do_POSTوبعد أن نتبع ال Stack Trace الطويل إلى السطر 15 في الدالة charge نعرف أن المهلة انتهت أثناء انتظار رد مزود الدفع، وهذه أول معلومة مفيدة، ولكنها احتاجت ثلاثة أوامر وقراءة الكود.
السؤال الثالث: أي طلب للعميل cus_1037 فشل؟ نبحث ببريده لأنه موجود في السجل للأسف:
grep user1037 bad.log2026-10-14 21:43:52,209 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-28', 'qty': 1}], 'amount': 50, 'card': {'brand': 'mada', 'last4': '3582'}}
2026-10-14 21:44:00,075 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-15', 'qty': 1}], 'amount': 92, 'card': {'brand': 'mada', 'last4': '3750'}}
2026-10-14 21:44:22,236 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-16', 'qty': 1}], 'amount': 733, 'card': {'brand': 'visa', 'last4': '9837'}}
2026-10-14 21:44:34,040 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-22', 'qty': 1}], 'amount': 885, 'card': {'brand': 'visa', 'last4': '1633'}}
2026-10-14 21:44:38,100 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-20', 'qty': 1}, {'sku': 'SKU-20', 'qty': 1}, {'sku': 'SKU-20', 'qty': 1}], 'amount': 454, 'card': {'brand': 'visa', 'last4': '7484'}}
2026-10-14 21:44:43,342 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-10', 'qty': 1}, {'sku': 'SKU-10', 'qty': 1}], 'amount': 690, 'card': {'brand': 'mada', 'last4': '8017'}}
2026-10-14 21:44:44,891 INFO Processing order {'customer_id': 'cus_1037', 'email': '[email protected]', 'phone': '0510370067', 'items': [{'sku': 'SKU-10', 'qty': 1}], 'amount': 198, 'card': {'brand': 'visa', 'last4': '0858'}}سبعة طلبات للعميل، وكل سطر فيها يحمل بريده وجواله، ولا يقول أي منها هل نجح أم فشل. والحل الذي يلجأ إليه الجميع هنا هو البحث بالوقت: ماذا حدث في الثواني التي تلت أول طلب؟
awk '$2 >= "21:43:52,209" && $2 <= "21:43:59,000"' bad.log | grep -oE "Payment (OK|failed)" | sort | uniq -c 27 Payment OK
2 Payment failedفي تلك الثواني السبع انتهى 29 طلباً، منها طلبان فاشلان، ولا يوجد في السجل ما يقول هل أحدهما طلب هذا العميل.
السؤال الرابع: هل المشكلة عند الجميع؟ عندنا نوع البطاقة في سطر Processing order فقط:
grep -oE "'brand': '[a-z]+" bad.log | sort | uniq -c 107 'brand': 'mada
64 'brand': 'mastercard
129 'brand': 'visaنعرف كم طلباً لكل نوع، ولا نعرف كم فشل من كل نوع، لأن سطور الفشل لا تحمل النوع ولا أي شيء يربطها بسطر الطلب.
وأخيراً: مما يتكون هذا السجل؟
grep -E "^2026" bad.log | awk '{print $3}' | sort | uniq -c
grep -v "^2026" bad.log | wc -lc
396 DEBUG
168 ERROR
576 INFO
4704 247440من 5844 سطراً في السجل هناك 4704 سطور Stack Trace لا تحمل وقتاً ولا مستوى، وهي 80% من السطور و68% من الحجم، وكلها تقول الشيء نفسه: انتهت مهلة القراءة من ال Socket.
وبعد ستة أسئلة وتسعة أوامر هذه هي الحصيلة:
| السؤال | الجواب من السجلات السيئة |
|---|---|
| كم طلباً فشل؟ | 24، بعد أن نتجاهل الرقم 144 الذي يظهر أولاً ونقرأ الكود |
| لماذا فشل؟ | انتهت مهلة مزود الدفع، بعد قراءة ال Stack Trace والكود |
| أي طلب للعميل cus_1037 فشل؟ | لا نعرف |
| هل المشكلة عند الجميع أم عند فئة؟ | لا نعرف |
| كم انتظر العملاء، وكم محاولة؟ | لا نعرف |
| هل في السجل ما لا يجب أن يكون فيه؟ | نعم، بريد العميل وجواله في 300 سطر |
ولاحظ أن الجواب الصحيح، وهو أن بطاقات مدى وحدها تفشل، موجود في البيانات التي مرت بالتطبيق، ولكن التطبيق لم يكتبه في المكان الذي نحتاجه. والفريق في هذه الحالة يفتح تذكرة مع مزود الدفع يقول فيها «عندكم بطء»، فيرد المزود بأن خدمته تعمل، لأن أغلب الطلبات تنجح فعلاً.
إعادة كتابة السجلات
الإصلاح لا يعني أن نكتب سطوراً أكثر، وإنما أن نكتب السطر الذي يجيب عن أسئلة التحقيق، وهذه هي التغييرات التي سوف نطبقها:
- حدث واسع Wide Event واحد في نهاية كل طلب، يجمع كل ما عرفه التطبيق عن الطلب.
- أسماء أحداث ثابتة ورموز أخطاء ثابتة بدل الرسائل الحرة.
- معرف الطلب ومعرف التتبع ورقم الطلب في كل سطر.
- حقول سياق تجيب عن «من» و«ماذا» دون أي بيانات شخصية.
- سطر WARN لكل محاولة فاشلة مع مزود الدفع، مربوط بالطلب، ودون Stack Trace لأن الخطأ متوقع ومعروف.
حدث واسع Wide Event واحد لكل طلب
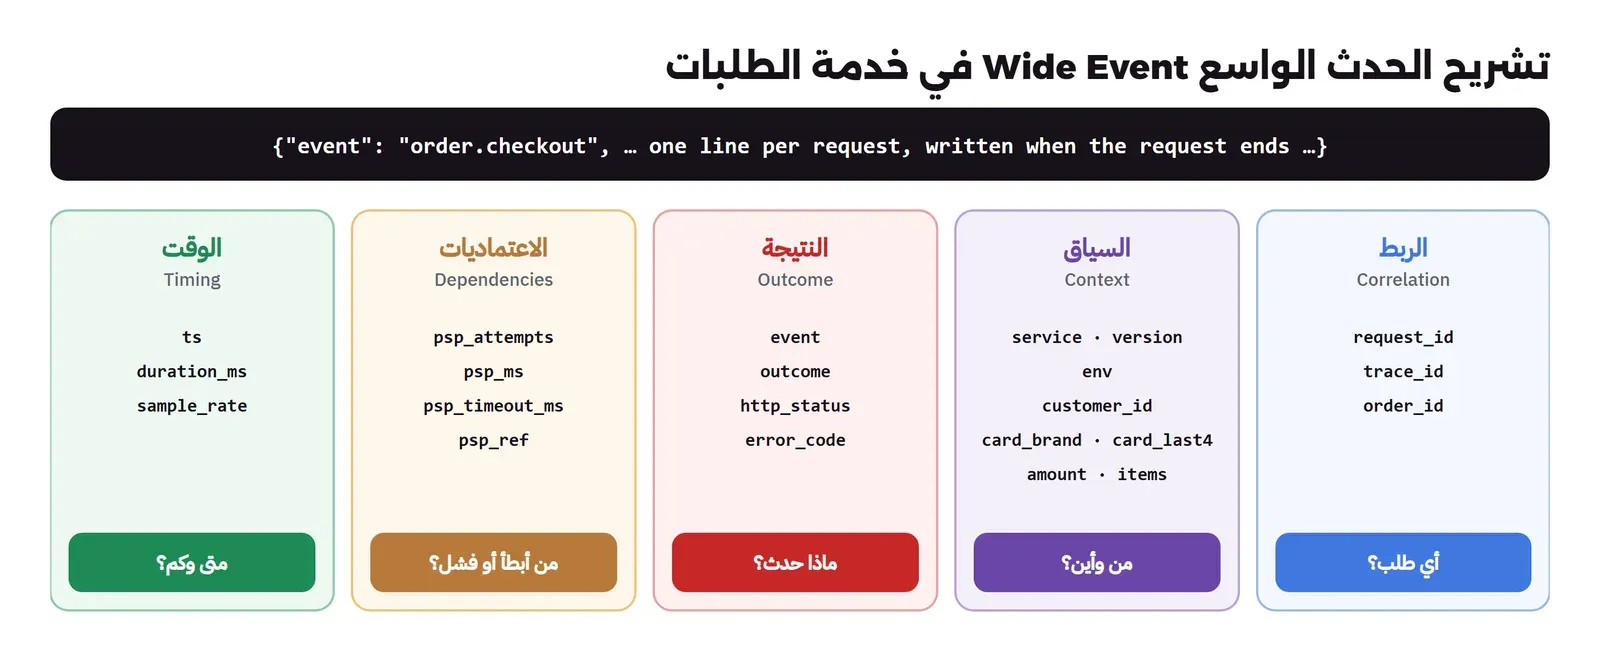
الفكرة أن يبني التطبيق أثناء معالجة الطلب قاموساً واحداً، وكل جزء من الكود يضيف إليه ما يعرفه: من العميل، وما نوع البطاقة، وكم محاولة مع مزود الدفع، وكم أخذت، ثم يكتب هذا القاموس سطراً واحداً في نهاية الطلب، سواء نجح أو فشل. ونشرت Stripe هذه الفكرة باسم سطر السجل المرجعي Canonical Log Line في يوليو 2019، ووصفته بأنه «سطر طويل واحد في النهاية يتضمن كثيراً من الخصائص الأساسية» للطلب، وأنه «يجمع كل القياسات المهمة في مكان واحد»، والمثال في مقالهم يحمل حقولاً مثل http_status وduration وdatabase_queries وuser_id وrequest_id. وتسمي Honeycomb الفكرة نفسها الأحداث الواسعة، وتقول في توثيقها إن الحدث واسع «لأنه يحتوي على حقول كثيرة مختلفة»، وإن من أشهر الاستخدامات «أن ترسل حدثاً واحداً لكل طلب HTTP أو RPC».
وقد يتساءل البعض: أليس هذا هو سطر نهاية الطلب الذي ذكرناه في ماذا تسجل في كل حدث؟ والإجابة نعم، والفرق أن سطر نهاية الطلب يحمل عادة المسار والنتيجة والمدة، أما الحدث الواسع فيحمل أيضاً كل ما يخص العمل نفسه، مثل نوع البطاقة وعدد المحاولات ورمز الخطأ، وهذه هي الحقول التي سوف تجيب عن أسئلة التحقيق. والصورة التالية تبين أجزاء الحدث الواسع في خدمتنا:
أسماء أحداث ثابتة Event Names ورموز أخطاء Error Codes
الرسالة الحرة مثل Payment failed: timed out تتغير كلما عدلها أحدهم، وتحمل قيماً متغيرة، فلا تستطيع أن تعد بها ولا أن تبني عليها تنبيهاً. والحل حقلان ثابتان لا يتغيران إلا بقرار:
- اسم الحدث Event Name: مثل
order.checkoutوpsp.attempt.failed، بصيغة واحدة في الفريق مثل «المجال ثم الشيء ثم ما حدث له»، وهو ما تعد به الأحداث وتبحث، وفي نموذج بيانات السجلات في OpenTelemetry حقل اسمه EventName لهذا الغرض بالضبط. - رمز الخطأ Error Code: مثل
PSP_TIMEOUTوPSP_DECLINEDوVALIDATION_FAILED، وهو ما يميز سبب الفشل، ويمكن أن يرجع إلى الكلاينت أيضاً كما فعلنا في رد الخطأ، فيذكره العميل للدعم الفني.
والرسالة النصية تبقى للإنسان، ويمكن أن تتغير، أما الاسم والرمز فهما ما تكتب عليه الاستعلامات والتنبيهات، لذلك عاملهما معاملة واجهة برمجية API: لا تغير اسماً قائماً دون أن تعدل ما يعتمد عليه.
معرف الطلب ومعرف التتبع Correlation IDs في كل سطر
شرحنا في معرف الطلب Request ID كيف يربط السطور ببعضها، وشرحنا في ربط السجلات بال Trace كيف ينتقل معرف التتبع Trace ID بين الخدمات في الترويسة traceparent بحسب معيار W3C Trace Context. وفي الخدمة المحسنة نستخدم ثلاثة معرفات، ولكل منها دور:
- معرف الطلب
request_id: يأتي من ال Reverse Proxy أو ينشئه التطبيق، ويرجع إلى الكلاينت في رد الخطأ، فيكون هو الرقم الذي يرسله العميل للدعم الفني. - معرف التتبع
trace_id: يقرؤه التطبيق منtraceparentإذا وصل، ويمرره إلى مزود الدفع في الطلب الخارج، فيربط سجلنا بسجلات الخدمات الأخرى وبال Trace إن وجد. - رقم الطلب
order_id: معرف العمل نفسه، وهو ما يعرفه فريق المبيعات والمحاسبة، ويربط سطر المحاولات بالحدث الواسع.
حقول السياق: ماذا يدخل الحدث وماذا لا يدخل
القاعدة في اختيار الحقول أن تسأل: لو فشل هذا الطلب، ما الذي سوف أحتاج أن أعرفه عنه؟ وفي خدمتنا كان الجواب كما يلي:
- يدخل: معرف العميل
customer_id، ونوع البطاقة وآخر أربعة أرقام منها، والمبلغ وعدد الأصناف، وعدد المحاولات مع مزود الدفع ومجموع وقتها والمهلة المستخدمة، والإصدار والبيئة. - لا يدخل: البريد والجوال ورقم البطاقة كاملاً، والطلب كاملاً بكل حقوله، لأن معرف العميل يكفي لتصل إلى بياناته من قاعدة البيانات بصلاحيات واضحة عند الحاجة.
ولاحظ حقل psp_timeout_ms، فقد يبدو غريباً أن تسجل إعداداً ثابتاً في كل طلب، ولكنه أول ما سوف تحتاجه إذا غير أحدهم المهلة في إصدار جديد، فتعرف من السجل نفسه أي الطلبات عملت بأي مهلة.
الكود بعد إعادة الكتابة
الملف app_good.py يفعل الشيء نفسه تماماً، والفرق في السجلات فقط:
# Same orders API, same behaviour, rewritten logs: one wide event per request.
import contextvars, json, os, random, re, socket, sys, time, urllib.request, uuid
from datetime import datetime, timezone
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

SERVICE, VERSION, ENV = "orders-api", os.environ.get("VERSION", "1.8.2"), os.environ.get("ENV", "prod")
SAMPLE_OK = float(os.environ.get("LOG_SAMPLE_OK", "1"))     # keep this share of fast successful requests
PSP_URL, PSP_TIMEOUT, PSP_RETRIES = "http://psp:9000/charge", 2.0, 3
event = contextvars.ContextVar("event")                    # the wide event of the current request

def emit(level, name, **fields):
    rec = {"ts": datetime.now(timezone.utc).isoformat(timespec="milliseconds").replace("+00:00", "Z"),
           "level": level, "event": name, "service": SERVICE, "version": VERSION, "env": ENV}
    ev = event.get(None)
    if ev:                                                  # every line carries the ids of its request
        rec.update({k: ev[k] for k in ("request_id", "trace_id", "order_id") if k in ev})
    rec.update(fields)
    sys.stdout.write(json.dumps(rec, ensure_ascii=False) + "\n"); sys.stdout.flush()

class PaymentError(Exception):
    def __init__(self, code, msg):
        super().__init__(msg); self.code = code

def charge(card, amount):
    ev = event.get()
    ev["psp_attempts"], ev["psp_ms"] = 0, 0.0
    for attempt in range(1, PSP_RETRIES + 1):
        ev["psp_attempts"] = attempt
        t0 = time.perf_counter()
        try:
            req = urllib.request.Request(PSP_URL, json.dumps({"brand": card["brand"], "amount": amount}).encode(),
                                         {"Content-Type": "application/json", "traceparent": ev["traceparent"]})
            with urllib.request.urlopen(req, timeout=PSP_TIMEOUT) as r:
                res = json.loads(r.read())
            ev["psp_ms"] += (time.perf_counter() - t0) * 1000
            ev["psp_ref"] = res["psp_ref"]
            return res
        except (socket.timeout, TimeoutError):
            ms = (time.perf_counter() - t0) * 1000
            ev["psp_ms"] += ms
            emit("warn", "psp.attempt.failed", attempt=attempt, error_code="PSP_TIMEOUT",
                 elapsed_ms=round(ms), timeout_ms=int(PSP_TIMEOUT * 1000), card_brand=card["brand"])
    raise PaymentError("PSP_TIMEOUT", f"payment provider timed out {PSP_RETRIES} times")

class API(BaseHTTPRequestHandler):
    def log_message(self, *args):
        pass

    def do_POST(self):
        t0 = time.perf_counter()
        rid = self.headers.get("X-Request-ID", "")
        tp = self.headers.get("traceparent", "")
        m = re.fullmatch(r"00-([0-9a-f]{32})-[0-9a-f]{16}-0[01]", tp)
        trace_id = m.group(1) if m else uuid.uuid4().hex
        ev = {"request_id": rid if re.fullmatch(r"[0-9a-f-]{8,64}", rid) else uuid.uuid4().hex,
              "trace_id": trace_id, "traceparent": f"00-{trace_id}-{os.urandom(8).hex()}-01",
              "order_id": "ord_" + uuid.uuid4().hex[:10]}
        event.set(ev)
        status, outcome = 201, "ok"
        try:
            order = json.loads(self.rfile.read(int(self.headers.get("Content-Length", 0))))
            ev.update(customer_id=order["customer_id"], amount=order["amount"], currency="SAR",
                      items=len(order["items"]), card_brand=order["card"]["brand"], card_last4=order["card"]["last4"])
            res = charge(order["card"], order["amount"])
            body = {"order_id": ev["order_id"], "psp_ref": res["psp_ref"]}
        except PaymentError as e:
            status, outcome = 502, "failed"
            ev.update(error_code=e.code, error=str(e))
            body = {"error": e.code, "request_id": ev["request_id"]}
        self.send_response(status)
        self.send_header("X-Request-ID", ev["request_id"]); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
        dur = (time.perf_counter() - t0) * 1000
        ev.pop("traceparent")
        if outcome == "ok" and dur < 1000 and random.random() >= SAMPLE_OK:
            return                                             # sampled out: fast and successful
        emit("error" if outcome == "failed" else "info", "order.checkout",
             **{k: v for k, v in ev.items() if k not in ("request_id", "trace_id", "order_id", "psp_ms")},
             http_method="POST", http_route="/orders", http_status=status, outcome=outcome,
             psp_timeout_ms=int(PSP_TIMEOUT * 1000), duration_ms=round(dur, 1),
             psp_ms=round(ev.get("psp_ms", 0), 1), sample_rate=SAMPLE_OK if outcome == "ok" and dur < 1000 else 1.0)

ThreadingHTTPServer(("0.0.0.0", 8000), API).serve_forever()
في الكود أعلاه لاحظ التالي:
- الحدث الواسع قاموس في
ContextVar، فكل جزء من الكود يضيف إليه دون أن يمرره كمعامل، وهي الطريقة نفسها التي شرحناها لمعرف الطلب في المقال الأول. - الدالة
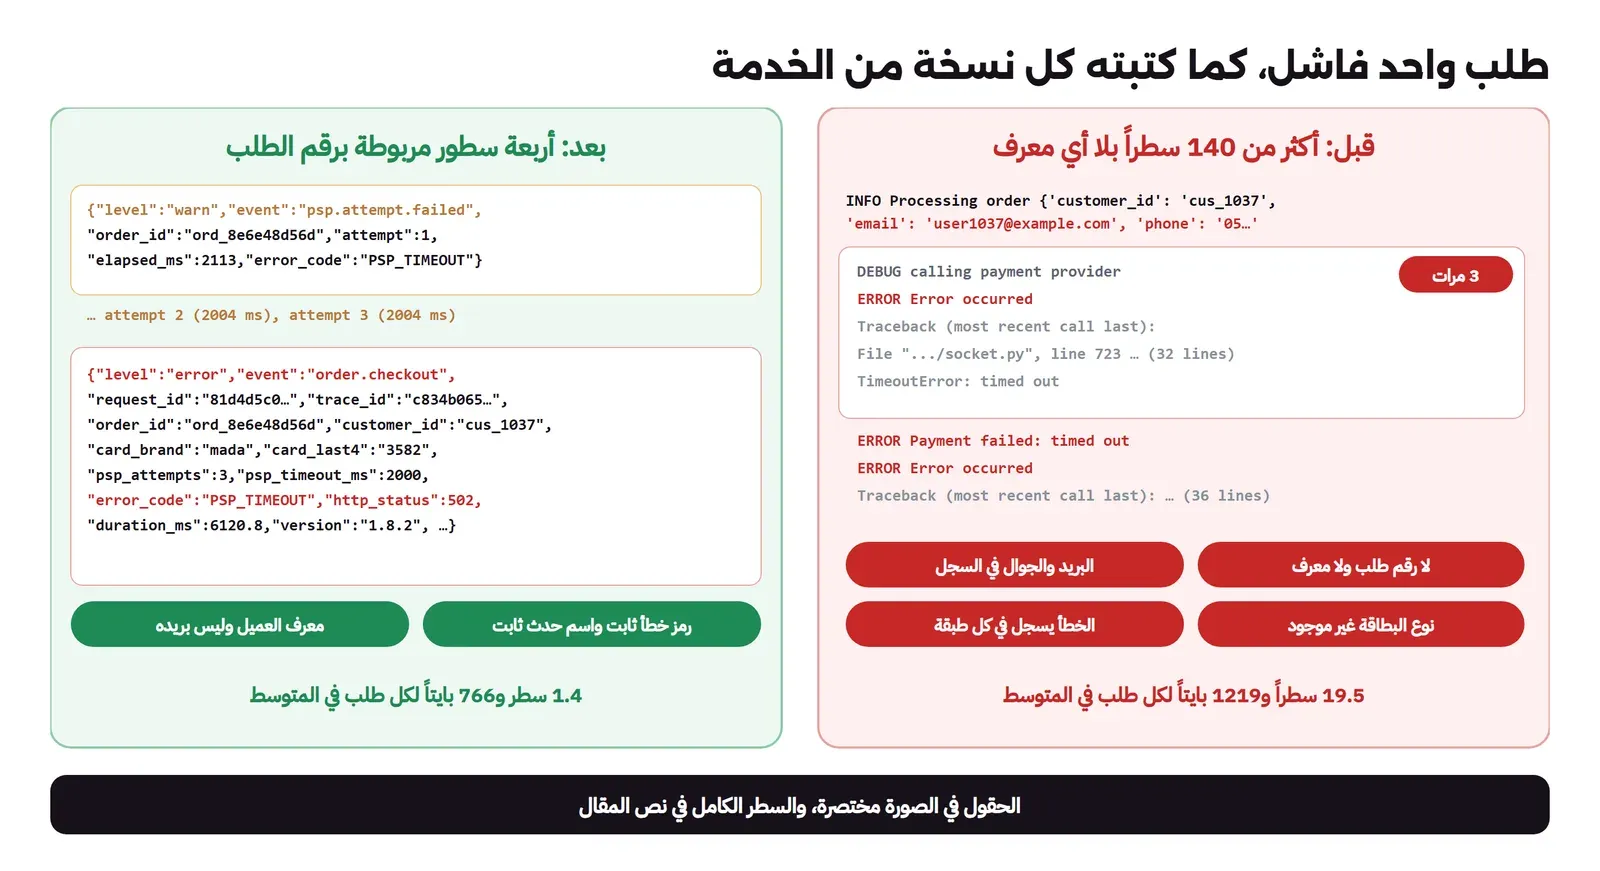
emitتضع في كل سطر الخدمة والإصدار والبيئة والمعرفات الثلاثة، فسطر المحاولة الفاشلة مربوط بالحدث الواسع برقم الطلب. - المحاولة الفاشلة سطر WARN واحد فيه رقم المحاولة والوقت المنقضي والمهلة ورمز الخطأ، ولا يوجد Stack Trace لأن انتهاء المهلة خطأ متوقع نعرف مكانه، أما الاستثناء غير المتوقع فمكانه الحدث الواسع مرة واحدة، ولم نضفه هنا لأن الخدمة صغيرة وتعالج مسار الدفع فقط.
- الحدث الواسع بمستوى ERROR إذا فشل الطلب، وINFO إذا نجح، والاسم
order.checkoutنفسه في الحالتين، فتعد الطلبات كلها بالاسم وتفصلها بالحقلoutcome. - الطلب الذي يرد بالخطأ يحمل
request_idورمز الخطأ في جسم الرد، فيصل الرقم إلى الدعم الفني دون أن يبحث أحد بالبريد. - متغير البيئة
LOG_SAMPLE_OKسوف نشرحه في قسم أخذ العينات، وهو هنا 1، أي أن كل الطلبات تسجل.
والصورة التالية تبين الفرق بين ما كتبته النسختان لطلب واحد فاشل:
التحقيق نفسه من جديد
نرسل الطلبات نفسها إلى النسخة المحسنة ونحفظ سجلها:
docker exec lab-log-help-client python /lab/load.py http://api-good:8000/orders /lab/out/client-good.tsv
docker logs lab-log-help-api-good > out/good.log 2>&1
sent=300 ok=280 failed=20 slowest_s=7.1ولاحظ أن عدد الطلبات الفاشلة هنا 20 وليس 24، والسبب أن زمن مسار مدى في مزود الدفع عشوائي بين 1.2 و3.2 ثانية، فيختلف عدد الطلبات التي تتجاوز المهلة ثلاث مرات من تشغيل إلى آخر، أما الطلبات نفسها وترتيبها فثابتة. ونستخدم jq 1.8.2، وقد شغلناه في Container من alpine:3.22 على الملف المحفوظ.
السؤال الأول: كم طلباً فشل، ولماذا؟
jq -c -s 'map(select(.event=="order.checkout")) | group_by(.outcome, .error_code) | map({outcome: .[0].outcome, error_code: .[0].error_code, orders: length})' good.log[{"outcome":"failed","error_code":"PSP_TIMEOUT","orders":20},{"outcome":"ok","error_code":null,"orders":280}]الرقم صحيح من أول استعلام، ويطابق ما رآه العملاء، والسبب ظاهر في رمز الخطأ دون أن نقرأ سطراً من الكود.
السؤال الثاني: هل المشكلة عند الجميع؟
jq -c -s 'map(select(.event=="order.checkout")) | group_by(.card_brand) | map({brand: .[0].card_brand, orders: length, failed: map(select(.outcome=="failed")) | length})' good.log[{"brand":"mada","orders":107,"failed":20},{"brand":"mastercard","orders":64,"failed":0},{"brand":"visa","orders":129,"failed":0}]كل الطلبات الفاشلة بطاقات مدى، ولا يوجد طلب فاشل واحد من Visa أو Mastercard.
السؤال الثالث: هل البطء عند المزود في مسار مدى وحده؟ نعد المحاولات التي انتهت مهلتها بحسب نوع البطاقة، ثم نقيس زمن مزود الدفع في الطلبات الناجحة:
jq -c -s 'map(select(.event=="psp.attempt.failed")) | group_by(.card_brand) | map({brand: .[0].card_brand, timeouts: length})' good.log
jq -c -s 'def pct(p): sort | .[(length*p|floor)]; map(select(.event=="order.checkout" and .outcome=="ok")) | group_by(.card_brand) | map({brand: .[0].card_brand, p50_ms: (map(.psp_ms)|pct(0.5)), p95_ms: (map(.psp_ms)|pct(0.95)), retried: map(select(.psp_attempts>1))|length})' good.log
[{"brand":"mada","timeouts":128}]
[{"brand":"mada","p50_ms":3425.3,"p95_ms":5859.9,"retried":49},{"brand":"mastercard","p50_ms":169.3,"p95_ms":339.5,"retried":0},{"brand":"visa","p50_ms":183.1,"p95_ms":336.1,"retried":0}]وهنا السبب كاملاً: كل المحاولات التي انتهت مهلتها، وعددها 128، كانت لبطاقات مدى، وحتى طلبات مدى الناجحة أخذت عند مزود الدفع 3.4 ثانية في المنتصف p50 و5.9 ثانية في p95، و49 منها لم تنجح إلا بعد إعادة المحاولة، أما Visa وMastercard فأقل من 0.2 ثانية في المنتصف. والتذكرة التي نفتحها مع مزود الدفع الآن تقول: «مسار مدى عندكم يتجاوز ثانيتين منذ وقت كذا، و128 محاولة انتهت مهلتها، والمسارات الأخرى سليمة»، وهذه تذكرة يستطيع المزود أن يتصرف بها.
السؤال الرابع: ماذا حدث للعميل cus_1037؟
jq -c 'select(.customer_id=="cus_1037" and .outcome=="failed") | {ts, order_id, request_id, card_brand, psp_attempts, error_code, duration_ms}' good.log
jq -c 'select(.order_id=="ord_8e6e48d56d") | {ts, level, event, attempt, elapsed_ms, error_code, outcome}' good.log
{"ts":"2026-10-14T21:49:21.446Z","order_id":"ord_8e6e48d56d","request_id":"81d4d5c0c2d848c8b0437a6deca1b24a","card_brand":"mada","psp_attempts":3,"error_code":"PSP_TIMEOUT","duration_ms":6120.8}
{"ts":"2026-10-14T21:49:17.438Z","level":"warn","event":"psp.attempt.failed","attempt":1,"elapsed_ms":2113,"error_code":"PSP_TIMEOUT","outcome":null}
{"ts":"2026-10-14T21:49:19.442Z","level":"warn","event":"psp.attempt.failed","attempt":2,"elapsed_ms":2004,"error_code":"PSP_TIMEOUT","outcome":null}
{"ts":"2026-10-14T21:49:21.445Z","level":"warn","event":"psp.attempt.failed","attempt":3,"elapsed_ms":2004,"error_code":"PSP_TIMEOUT","outcome":null}
{"ts":"2026-10-14T21:49:21.446Z","level":"error","event":"order.checkout","attempt":null,"elapsed_ms":null,"error_code":"PSP_TIMEOUT","outcome":"failed"}القصة كاملة لهذا العميل: طلب واحد ببطاقة مدى، ثلاث محاولات انتهت كل منها بعد ثانيتين تقريباً، ثم الخطأ بعد 6.1 ثانية. وفي الإنتاج سوف يرسل العميل رقم request_id الذي ظهر له في رد الخطأ، فتبحث به مباشرة بدل رقم العميل. والسطر الكامل للحدث الواسع لهذا الطلب كما كتبه التطبيق:
{"ts": "2026-10-14T21:49:21.446Z", "level": "error", "event": "order.checkout", "service": "orders-api", "version": "1.8.2", "env": "prod", "request_id": "81d4d5c0c2d848c8b0437a6deca1b24a", "trace_id": "c834b065e44d44e58837ddd9fef3f708", "order_id": "ord_8e6e48d56d", "customer_id": "cus_1037", "amount": 50, "currency": "SAR", "items": 1, "card_brand": "mada", "card_last4": "3582", "psp_attempts": 3, "error_code": "PSP_TIMEOUT", "error": "payment provider timed out 3 times", "http_method": "POST", "http_route": "/orders", "http_status": 502, "outcome": "failed", "psp_timeout_ms": 2000, "duration_ms": 6120.8, "psp_ms": 6119.7, "sample_rate": 1.0}السؤال الخامس: متى بدأت المشكلة، وكم عميلاً تأثر بالبطء دون أن يفشل طلبه؟
jq -r -s 'map(select(.event=="order.checkout" and .outcome=="failed")) | "first=\(.[0].ts) last=\(.[-1].ts) failed=\(length)"' good.log
jq -r -s 'map(select(.event=="order.checkout" and .card_brand=="mada")) | "mada_orders=\(length) waited_over_2s=\(map(select(.duration_ms>2000))|length)"' good.log
first=2026-10-14T21:49:21.446Z last=2026-10-14T21:50:32.215Z failed=20
mada_orders=107 waited_over_2s=73وهذا سؤال لم نكن نستطيع حتى أن نطرحه على السجل السيئ: من 107 طلبات بمدى انتظر 73 عميلاً أكثر من ثانيتين، أي أن أثر الحادثة أكبر بكثير من 20 طلباً فاشلاً، وهو ما يجب أن يظهر في تقرير الحادثة، كما شرحنا في تقرير ما بعد الحادثة Postmortem.
القياس قبل وبعد
قسنا حجم السجلين بالأمر wc، ومعهما سجل ثالث من تشغيل بأخذ العينات نشرحه في القسم التالي:
wc -lc bad.log good.log sampled.log
grep -c '@example.com' bad.log good.log sampled.log
5844 365761 bad.log
428 229936 good.log
257 127628 sampled.log
6529 723325 total
bad.log:300
good.log:0
sampled.log:0والجدول التالي يجمع النتائج لثلاثمئة طلب في كل تشغيل، والأرقام لكل طلب محسوبة من المخرج أعلاه:
| المقياس | السجلات السيئة | الحدث الواسع | الحدث الواسع مع أخذ العينات |
|---|---|---|---|
| السطور لكل طلب | 19.5 | 1.4 | 0.9 |
| البايتات لكل طلب | 1219 | 766 | 425 |
| سطور ال Stack Trace | 4704 من 5844 | 0 | 0 |
| سطور فيها بريد العميل | 300 | 0 | 0 |
| الاستعلامات حتى العدد الصحيح للفشل | 3 مع قراءة الكود | 1 | 1 |
| الاستعلامات حتى السبب | 9، ولم نصل إلى أن مدى وحدها تفشل | 3 | 3 |
| قصة طلب عميل محدد | غير ممكنة | استعلامان | استعلامان، لأن الطلب الفاشل لا يسقط |
ولاحظ أن الحدث الواسع أطول بكثير من أي سطر في السجل السيئ، فالسطر الواحد قرابة 540 بايتاً، ومع ذلك فالحجم الكلي أقل بنسبة 37%، والسبب أن أغلب حجم السجل السيئ كان Stack Trace مكرراً يقول الشيء نفسه. وقد يتساءل البعض: هل المقارنة عادلة والسجل السيئ يعمل بمستوى DEBUG؟ والإجابة أن سطور DEBUG كلها 21780 بايتاً، أي قرابة 6% من حجمه، فلو أطفأناها لبقي أكبر من سجل الحدث الواسع بنحو 50%، وبقيت الأسئلة نفسها بلا جواب.
أخذ العينات Sampling والمستويات في الإنتاج
في خدمة تستقبل آلاف الطلبات في الثانية قد يكون حتى سطر واحد لكل طلب مكلفاً، والحل أن تأخذ عينة Sample من الطلبات العادية فقط، وتحتفظ دائماً بما تحتاجه في التحقيق. والقاعدة التي طبقناها في الخدمة كما يلي:
- كل طلب فاشل يسجل: مهما كانت النسبة.
- كل طلب بطيء يسجل: وهو هنا كل طلب أخذ ثانية أو أكثر.
- الطلبات السريعة الناجحة: تسجل منها نسبة، مثل 10%، ويكتب في الحدث الحقل
sample_rateحتى تعرف عند العد أن كل سطر منها يمثل عشرة طلبات.
وشغلنا الخدمة المحسنة مرة ثالثة بالقيمة LOG_SAMPLE_OK=0.1 في Container اسمه lab-log-help-api-sampled، ثم عددنا ما بقي:
jq -c -s 'map(select(.event=="order.checkout")) | {kept: length, failed: map(select(.outcome=="failed"))|length, ok_sampled: map(select(.sample_rate==0.1))|length, ok_slow: map(select(.outcome=="ok" and .sample_rate==1.0))|length}' sampled.log{"kept":131,"failed":25,"ok_sampled":24,"ok_slow":82}في هذا التشغيل فشل 25 طلباً، وكلها في السجل، وبقي كل طلب بطيء، وعددها 82، ومن الطلبات السريعة الناجحة بقي 24، أي قرابة 10%، فانخفض الحجم إلى 425 بايتاً لكل طلب، والتحقيق في الحادثة نفسها يعمل كما هو لأن كل ما يخصها لم يسقط. ولاحظ أن العد بعد أخذ العينات يحتاج وزناً، فعدد الطلبات السريعة الحقيقي تقريباً هو مجموع 1 / sample_rate لكل سطر، وليس عدد السطور. وهذه الطريقة تسمى أخذ العينات بعد معرفة النتيجة، لأن القرار يأتي في نهاية الطلب، وهي الفكرة نفسها التي شرحناها لل Traces في أخذ العينات في التتبع الموزع.
أما المستويات في الإنتاج، فالقاعدة في المقال الأول كما هي: INFO في الإنتاج، وDEBUG يفتح لمكون واحد ولمدة محددة. والذي يضيفه هذا المقال أن أغلب الأسئلة التي كان يجيب عنها DEBUG، مثل «هل اتصلنا بالمزود؟ وكم مرة؟»، صارت حقولاً في الحدث الواسع بمستوى INFO، فلم تعد تحتاج DEBUG أصلاً.
نكسر الحدث الواسع: ماذا لو توقف التطبيق قبل نهاية الطلب؟
الحدث الواسع يكتب في نهاية الطلب، وهذه نقطة ضعفه: إذا توقفت العملية قبل النهاية، بسبب انهيار أو نفاد الذاكرة أو إعادة نشر، فلن يكتب أبداً. ولنرى ذلك نرسل طلباً بمدى إلى الخدمة المحسنة، ثم نوقف ال Container بالأمر docker kill بعد ثلاث ثوان، أي في منتصف المحاولة الثانية:
docker exec -d lab-log-help-client python -c "
import json,urllib.request
o={'customer_id':'cus_1099','items':[{'sku':'SKU-1','qty':1}],'amount':300,'card':{'brand':'mada','last4':'1111'}}
urllib.request.urlopen(urllib.request.Request('http://api-good:8000/orders',json.dumps(o).encode(),{'Content-Type':'application/json'}),timeout=15)"
sleep 3; docker kill lab-log-help-api-good
docker logs lab-log-help-api-good
والمخرج سوف يكون كما يلي:
{"ts": "2026-10-14T22:11:53.415Z", "level": "warn", "event": "psp.attempt.failed", "service": "orders-api", "version": "1.8.2", "env": "prod", "request_id": "9df3d5598306458a91e1394c6358f217", "trace_id": "eaec12b74be14c69a86c4c8d9d64b0df", "order_id": "ord_4f7e731759", "attempt": 1, "error_code": "PSP_TIMEOUT", "elapsed_ms": 2070, "timeout_ms": 2000, "card_brand": "mada"}لا يوجد حدث order.checkout لهذا الطلب، فلو اعتمدنا على الحدث الواسع وحده لما عرفنا أن هذا الطلب وجد أصلاً، أما سطر المحاولة الفاشلة فكتب لأنه وقع قبل التوقف، وهو الذي يقول إن هناك طلباً برقم ord_4f7e731759 لم ينته. لذلك فالحدث الواسع لا يلغي كل ما سواه، وإنما يحتاج معه ما يلي:
- سطر للأحداث المهمة أثناء الطلب: مثل المحاولة الفاشلة هنا، أو بداية عملية طويلة.
- سطر عند بداية العمليات الطويلة: مثل المهام التي تأخذ دقائق، فتعرف ما بدأ ولم ينته.
- سجل ال Reverse Proxy: الذي يسجل الطلب حتى لو مات التطبيق، كما في سجل ال Reverse Proxy.
قائمة مراجعة السجلات في مراجعة الكود Code Review
أسهل وقت لإصلاح السجل هو قبل أن يدمج الكود، وهذه أسئلة يسألها المراجع لكل تغيير يضيف سجلاً أو يغيره:
- هل يمكن أن تجيب من هذا السطر وحده عن سؤال حقيقي في التحقيق؟ وما هو السؤال؟
- هل للحدث اسم ثابت بصيغة الفريق، وهل الرسالة ثابتة والقيم في حقول منفصلة؟
- إذا كان فشلاً: هل فيه رمز خطأ ثابت، وهل المستوى يطابق قاعدة المستويات؟
- هل يحمل السطر
request_idوtrace_idومعرف العمل مثل رقم الطلب، من السياق وليس يدوياً؟ - هل هذا الاستثناء يسجل مرة واحدة فقط في الكود كله، مع ال Stack Trace إن كان غير متوقع؟
- هل فيه بريد أو جوال أو اسم أو رقم بطاقة أو توكن أو كائن كامل مثل الطلب أو الترويسات؟
- هل المعلومة الجديدة حقل في الحدث الواسع بدل سطر مستقل؟
- عند الاتصال بخدمة خارجية: هل يسجل اسم الخدمة والمدة والمهلة وعدد المحاولات والنتيجة؟
- هل يمكن أن يتكرر هذا السطر آلاف المرات في الدقيقة، مثل سطر في حلقة Loop أو في فحص الصحة؟ وهل يحتاج أخذ عينات؟
- هل الوحدات في أسماء الحقول، مثل
duration_ms، وهل الأسماء من قاموس الفريق كما في أسماء الحقول الموحدة؟ - هل تغيير اسم حدث أو حقل قائم سوف يكسر استعلاماً أو تنبيهاً أو لوحة يعتمد عليه؟
- هل يعيد رد الخطأ للكلاينت
request_idورمز الخطأ، دون تفاصيل داخلية؟
أخطاء شائعة Common Mistakes
- رسالة عامة مثل «حدث خطأ» أو Error occurred: تقول إن هناك مشكلة ولا تقول شيئاً عنها، ونفس النص في عدة أماكن يجعل البحث بها بلا فائدة.
- العد بالكلمة: البحث عن ERROR وعدها يعطي رقماً مضخماً عندما يسجل الخطأ في كل طبقة، كما رأينا 144 مقابل 24.
- معلومات العمل في سطر وفشله في سطر آخر: نوع البطاقة في سطر البداية والخطأ في سطر النهاية دون معرف يربطهما، فلا تستطيع أن تسأل «ما نوع البطاقات التي تفشل؟».
- الاعتماد على الحدث الواسع وحده: فيضيع كل ما حدث في طلب توقفت عمليته قبل النهاية.
- أسماء أحداث تتغير مع كل تعديل: فتنكسر التنبيهات بصمت.
- حقول بلا وحدات أو بأسماء مختلفة في كل خدمة: فلا تستطيع أن تسأل سؤالاً واحداً عن كل الخدمات.
- أخذ عينات يسقط الأخطاء: نسبة عشوائية على كل الطلبات تسقط أغلب الطلبات الفاشلة وهي أهم ما تحتاجه.
- ال Stack Trace لخطأ متوقع: انتهاء المهلة أو رفض البطاقة يحتاج رمزاً وحقولاً، وليس عشرين سطراً من مكتبة HTTP.
تدريب عملي
- أضف إلى الخدمة المحسنة رفضاً من مزود الدفع برمز
PSP_DECLINEDلنسبة من الطلبات، ثم اكتب استعلام jq يفصل الرفض عن انتهاء المهلة لكل نوع بطاقة. - أضف إلى الحدث الواسع حقلاً بزمن قاعدة البيانات، ثم اسأل: ما نسبة وقت الطلب التي تذهب إلى مزود الدفع؟
- خذ خدمة من خدماتك، واكتب خمسة أسئلة سألتها في آخر حادثة، ثم تحقق: هل يجيب عنها سجلها الحالي باستعلام واحد لكل سؤال؟
حذف المختبر
نحذف ال Containers والشبكة بالأسماء التي أنشأناها فقط:
docker rm -f lab-log-help-api-sampled lab-log-help-jq
docker compose down
ولم نسحب أي Docker Image جديد، فقد كانت python:3.13.16-slim وalpine:3.22 موجودة مسبقاً، لذلك لا يوجد ما نحذفه منها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- السجل الجيد يكتب للأسئلة التي سوف تسألها وقت الحادثة، والسجل الذي يقول «حدث خطأ» يخبرك فقط بما تعرفه أصلاً.
- في المختبر احتاج السجل السيئ تسعة أوامر وقراءة الكود ليقول إن مزود الدفع بطيء، ولم يستطع أن يقول إن بطاقات مدى وحدها تفشل، أما الحدث الواسع فقالها في ثلاثة استعلامات.
- الحدث الواسع سطر واحد في نهاية كل طلب يجمع المعرفات والسياق والنتيجة ورمز الخطأ وزمن الاعتماديات، ومعه سطر لكل حدث مهم أثناء الطلب مربوط به.
- أسماء الأحداث ورموز الأخطاء واجهة يعتمد عليها غيرك، فاجعلها ثابتة، واجعل الرسالة النصية للإنسان فقط.
- السجل الأفضل كان أصغر بنسبة 37% بلا أي بيانات شخصية، وأخذ العينات من الطلبات السريعة الناجحة فقط خفضه أكثر دون أن يسقط أي طلب فاشل.
وفي المقال التالي من السلسلة نتابع السطر بعد أن يخرج من التطبيق: كيف ينقله الناقل Shipper ويحلله ويخفي ما فيه من بيانات شخصية ويوجهه إلى المخزن المناسب، وماذا يحدث إذا توقف المخزن.
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلمسار السجل Log Pipeline من التطبيق إلى البحث والتنبيهكيف ينتقل السجل من التطبيق إلى المخزن عبر الناقل Shipper، وكيف تخفي البيانات الشخصية وتوجه الأخطاء وتحمي السجلات إذا توقفت الوجهة.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلمن يتحمل المسؤولية Accountability عندما يتعطل الإنتاج؟كيف تحدد ملكية الخدمات وتدير الحادثة بأدوار واضحة، ثم تكتب تقرير ما بعد الحادثة دون لوم وبإجراءات تغلق فعلاً.
 دليلكيف تتعامل لغات البرمجة مع الأخطاء؟لماذا ترمي Java وPython الاستثناءات بينما ترجع Go وRust الخطأ كقيمة، وكيف تمنع الخطأ من أن يختفي بصمت في كودك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ المختبر بخدمة Python 3.13.16 ومزود دفع وهمي في Docker، والتحقيق بأداة grep وjq 1.8.2.


