

يوم الخميس بعد الظهر نشر فريق المدفوعات الإصدار الجديد من خدمة الدفع checkout، وفيه دعم لأكواد الخصم، وبعد دقيقة واحدة بدأ ثلث طلبات حساب السعر يفشل بالخطأ 500. والسؤال الذي يسأله الجميع في هذه اللحظة: من المسؤول؟ المطور الذي كتب الكود؟ أم الزميل الذي راجعه؟ أم أداة الذكاء الاصطناعي التي اقترحت نصفه؟ أم من ضغط زر النشر؟ أم المدير الذي حدد موعد الإطلاق؟ وهذا السؤال بهذه الصيغة يقود غالباً إلى شخص يلام ونظام لا يتغير، فيتكرر نفس العطل بعد شهرين مع شخص آخر.
والسؤال الأصح له شقان: من يملك هذه الخدمة الآن، فيقود إصلاحها ويتواصل مع المتأثرين؟ وما الذي في النظام سمح لهذا الخطأ أن يصل إلى الإنتاج؟ وفي هذا المقال سوف نجيب عن الشقين، ثم نشغل حادثة حقيقية على مختبر صغير: نشر سيئ يرفع نسبة الأخطاء، وتنبيه يصل للمناوب، وتراجع، وخط زمني من السجلات الحقيقية، ثم نكتب منه تقرير ما بعد الحادثة Postmortem كاملاً.
وسوف نناقش في هذا المقال ما يلي:
- مبدأ «من يبني الخدمة يشغلها» You Build It, You Run It كما قاله Werner Vogels سنة 2006.
- خريطة الملكية: فهرس الخدمات Service Catalog وملف CODEOWNERS.
- مناوبة On-call لا تحرق الفريق.
- أدوار الحادثة: قائد الحادثة Incident Commander والتواصل والتوثيق، ومستويات الخطورة Severity.
- التواصل مع المستخدمين عبر صفحة الحالة Status Page.
- مختبر كامل لحادثة نشر سيئ مع Prometheus وAlertmanager، وخطها الزمني من السجلات.
- تقرير ما بعد الحادثة دون لوم Blameless Postmortem، ولماذا لا يتعارض مع المحاسبة.
- إجراءات المتابعة Action Items التي تغلق فعلاً، والمسؤولية عندما يكتب الذكاء الاصطناعي الكود.
ونفترض أنك تعرف طريقة التحقيق في العطل نفسه، فقد شرحناها في استكشاف الأخطاء وتحليل الأداء للمبتدئين، وهذا المقال عن الجانب الآخر: الناس والأدوار والمسؤولية حول العطل.
من يبني الخدمة يشغلها You Build It, You Run It
في مقابلة مع مجلة ACM Queue نشرت في يونيو 2006، سأل Jim Gray المدير التقني لAmazon Werner Vogels عن طريقة عمل فرقهم، فشرح أن كل خدمة لها فريق مسؤول عنها بالكامل، من تحديد وظائفها وتصميمها إلى بنائها وتشغيلها، وأن الطريقة التقليدية أن يرمي المطورون البرنامج من فوق الجدار الذي يفصلهم عن فريق التشغيل وينسوه، ثم قال العبارة التي انتشرت بعدها: «You build it, you run it». وأضاف أن هذا يضع المطورين في تواصل يومي مع تشغيل برنامجهم ومع العميل، وأن إعطاء المطورين مسؤوليات التشغيل حسن جودة الخدمات كثيراً.
والفكرة بسيطة: الفريق الذي يستيقظ ليلاً بسبب خدمته هو الفريق الذي سوف يكتب لها سجلات Logs أفضل، ويضيف لها اختبارات، ويتردد قبل أن ينشر يوم الخميس عصراً. أما الفريق الذي يسلم الكود ويذهب، فلا يرى ثمن قراراته أبداً. ولكن تطبيق المبدأ دون أدوات مشتركة يرهق كل فريق بإعادة بناء نفس البنية، وقد شرحنا هذا التوازن في الفرق بين DevOps وSRE وPlatform Engineering.
خريطة الملكية Ownership: من يملك ماذا؟
في الدقيقة الأولى من أي حادثة يجب أن تعرف من يملك الخدمة المتعطلة، وأين لوحة مراقبتها، ومن المناوب عليها الآن. وإذا كانت الإجابة «اسأل فلاناً، فهو يعرف» فقد خسرت عشر دقائق قبل أن تبدأ، والسبب أن فلاناً قد يكون في إجازة. ولهذا تحتاج خريطة ملكية مكتوبة على مستويين: مستوى الخدمة ومستوى الكود.
فهرس الخدمات Service Catalog
فهرس الخدمات Service Catalog قائمة بكل خدمة في الإنتاج ومعها الفريق المالك وما يحتاجه المناوب، ويمكن أن يكون جدولاً في صفحة توثيق عندما تكون الخدمات قليلة، كما في المثال التالي:
| الخدمة | الفريق المالك | جدول المناوبة | دليل التشغيل Runbook | الأهمية |
|---|---|---|---|---|
| خدمة checkout | فريق المدفوعات | مناوبة المدفوعات الأسبوعية | صفحة checkout في الويكي | حرجة |
| خدمة الإشعارات | فريق المنصة | مناوبة المنصة | صفحة الإشعارات في الويكي | عالية |
| لوحة التقارير الداخلية | فريق البيانات | ساعات العمل فقط | صفحة التقارير في الويكي | منخفضة |
وعندما تكثر الخدمات ينتقل الفهرس إلى ملف بجانب كود كل خدمة، فلا ينسى أحد تحديثه عندما يتغير المالك، وهذه طريقة فهرس Backstage الذي شرحناه في هندسة المنصات Platform Engineering، حيث يكون حقل المالك owner إجبارياً في وصف كل مكون:
apiVersion: backstage.io/v1alpha1
kind: Component
metadata:
  name: checkout
  description: Price calculation and payment for orders
spec:
  type: service
  lifecycle: production
  owner: payments-team
  system: payments
ملف CODEOWNERS
ملكية الخدمة تقول من يستيقظ ليلاً، وملكية الكود تقول من يجب أن يراجع التغيير قبل دمجه، والأداة المعروفة لذلك ملف CODEOWNERS. وفي Gitea يبحث المستودع عن الملف في ./CODEOWNERS أو ./docs/CODEOWNERS أو ./.gitea/CODEOWNERS، وكل سطر فيه تعبير منتظم Regular Expression بصيغة Go ثم أسماء المالكين، ويطلب Gitea مراجعتهم تلقائياً في كل Pull Request يغير ملفاً يطابق القاعدة، كما في توثيق Gitea:
.*                       @org/platform-team
services/checkout/.*     @org/payments-team
.*\.sql                  @org/payments-team @org/dba-team
deploy/.*\.ya?ml         @org/platform-team
ولاحظ أن صيغة GitHub مختلفة، فهي أنماط ملفات وليست تعبيرات منتظمة، وفيها القاعدة الأخيرة المطابقة هي التي تطبق كما في توثيق GitHub، فلا تنسخ الملف بين المنصتين دون مراجعته. والملف وحده لا يمنع الدمج، وإنما يطلب المراجعة، فإذا أردت أن تكون موافقة المالك شرطاً للدمج فاجعلها كذلك في إعدادات حماية الفرع Branch Protection.
المناوبة On-call دون أن تحرق الفريق
المناوبة On-call أن يكون شخص محدد مسؤولاً عن الاستجابة لتنبيهات خدمة في فترة محددة، والمشكلة ليست في وجود المناوبة وإنما في شكلها، فالمناوبة التي يرن فيها الهاتف كل ليلة لتنبيهات لا تحتاج تدخلاً تجعل الناس يتجاهلون التنبيه الحقيقي، ثم يتركون الفريق. وفي فصل المناوبة في كتاب Google SRE أرقام مفيدة كنقطة بداية: لا يزيد وقت المناوبة عن 25% من وقت المهندس، وأقل عدد لفريق في موقع واحد يغطي المناوبة طوال الأسبوع بمناوب أساسي واحتياطي هو ثمانية أشخاص، بحيث يناوب كل واحد أسبوعاً في الشهر، وأن الحادثة الواحدة تحتاج في المتوسط حوالي ست ساعات بين التحليل والإصلاح وكتابة التقرير، ولهذا يكون الحد الأعلى حادثتين في نوبة من 12 ساعة.
وقد يتساءل البعض: فريقنا أربعة أشخاص، فهل نترك المناوبة؟ والإجابة لا، ولكن عدل التوقعات: ناوب على الخدمات الحرجة فقط، واجعل التنبيهات الليلية للأعطال التي يراها المستخدم فقط، واجعل الباقي ينتظر الصباح. وفيما يلي قواعد تجعل المناوبة محتملة مهما كان حجم الفريق:
- نبه على العرض وليس على السبب: نسبة الأخطاء التي يراها المستخدم وزمن الاستجابة Latency أهم من استهلاك المعالج، والسبب أن المعالج قد يصل 90% دون أن يتأثر أحد.
- كل تنبيه له دليل تشغيل Runbook: رابط في التنبيه نفسه يقول ماذا تفحص أولاً وكيف تتراجع، كما في الحقل
runbook_urlفي قاعدة التنبيه التي سوف نراها في المختبر. - كل تنبيه لا يحتاج تدخلاً يصلح أو يحذف: راجع التنبيهات أسبوعياً، فالتنبيه الذي أيقظ أحداً ولم يحتج شيئاً هو خطأ في المراقبة.
- مناوب احتياطي وتسليم مكتوب: في نهاية النوبة يكتب المناوب ما حدث وما بقي مفتوحاً للمناوب التالي.
- تعويض واضح: وقت راحة بعد ليلة صعبة، أو مقابل مالي حسب سياسة شركتك، والسبب أن المناوبة عمل حقيقي حتى لو لم يحدث شيء.
وقد شرحنا ما تسجله الخدمة حتى يجد المناوب ما يحتاجه في السجلات Logging للمطورين ومديري السيرفرات، وتتبع الطلب بين الخدمات في التتبع الموزع Distributed Tracing مع OpenTelemetry.
أدوار الحادثة Incident Roles
الحادثة Incident هي عطل يحتاج استجابة منظمة، وليس كل خطأ في السجلات حادثة. وفي فصل إدارة الحوادث في كتاب Google SRE ثلاثة أسئلة بسيطة تقرر بها: هل تحتاج فريقاً ثانياً لإصلاح المشكلة؟ هل يرى العملاء العطل؟ هل بقيت المشكلة دون حل بعد ساعة من التحليل المركز؟ فإذا كانت إجابة أحدها نعم فهي حادثة، والفصل نفسه ينصح بإعلان الحادثة مبكراً، لأن إعلانها ثم إغلاقها بسرعة أفضل من تشغيل إدارة الحادثة بعد ساعات من التخبط.
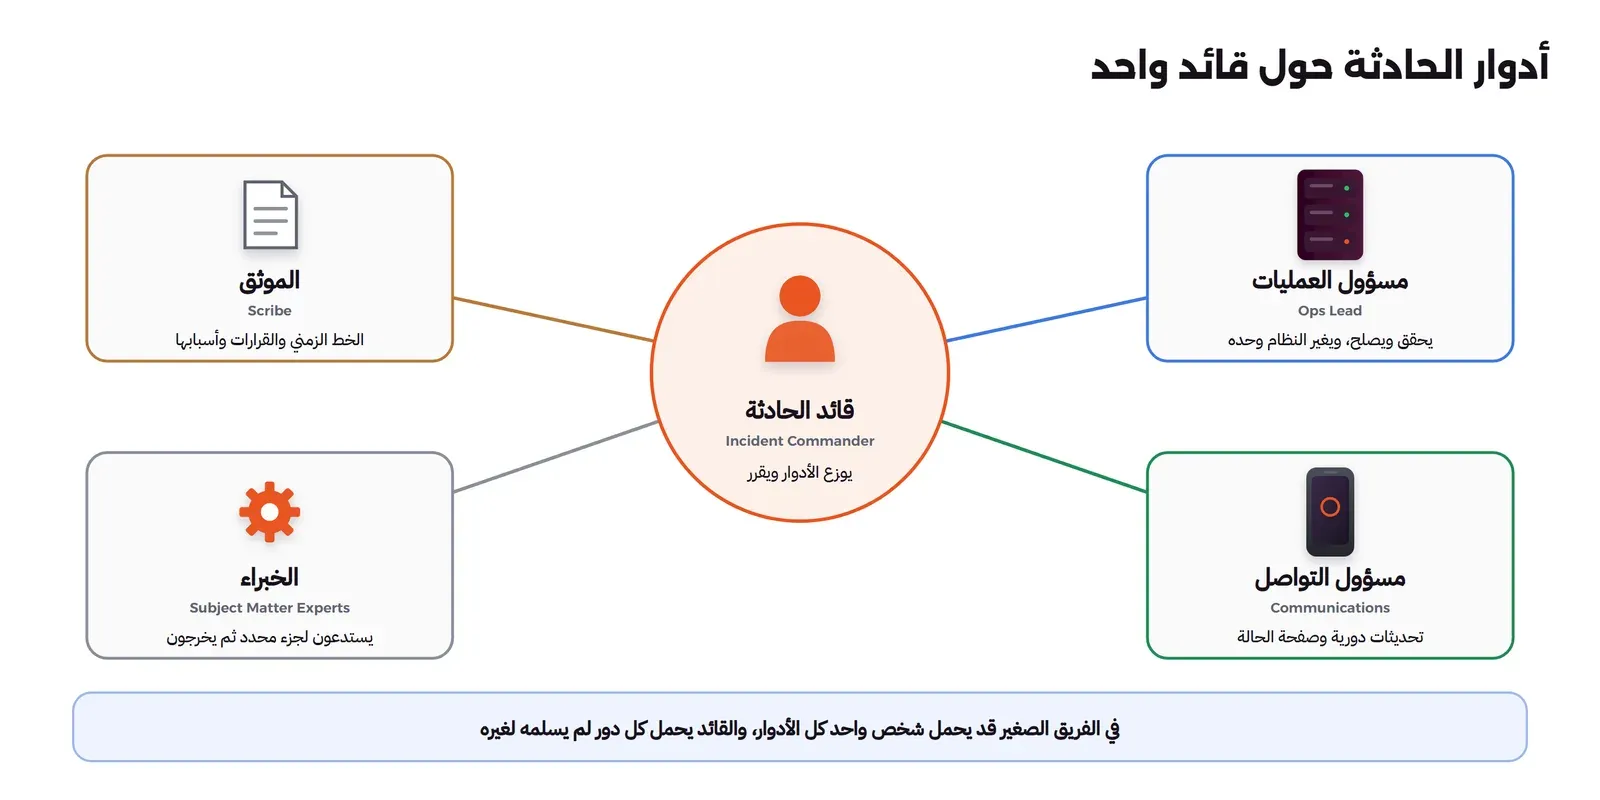
وعندما تعلن الحادثة يجب أن يعرف كل شخص دوره، والسبب أن الحادثة دون أدوار تتحول إلى خمسة أشخاص يغيرون النظام في نفس الوقت دون أن يعرف أحد ماذا غير الآخر. والجدول التالي يجمع الأدوار كما وردت في كتاب Google SRE وتوثيق الاستجابة للحوادث من PagerDuty المنشور برخصة مفتوحة:
| الدور | مسؤوليته | ما لا يفعله |
|---|---|---|
| قائد الحادثة Incident Commander | يملك الصورة الكاملة، ويوزع الأدوار، ويقرر التراجع أو التصعيد، ويحمل كل دور لم يسلمه لأحد | لا يكتب الأوامر على السيرفرات بنفسه في الحادثة الكبيرة |
| مسؤول العمليات Ops Lead | يحقق وينفذ الإصلاح، وفريقه هو الوحيد الذي يغير النظام أثناء الحادثة | لا يرد على رسائل الإدارة |
| مسؤول التواصل Communications | يرسل تحديثات دورية لأصحاب المصلحة والمستخدمين ويحدث صفحة الحالة | لا يعد بموعد إصلاح لم يقره القائد |
| الموثق Scribe | يكتب الخط الزمني والقرارات وأسبابها أثناء الحادثة | لا يحلل، وإنما يسجل |
| الخبير Subject Matter Expert | يستدعى لجزء محدد مثل قاعدة البيانات أو الشبكة | لا يبقى في الحادثة بعد انتهاء دوره |
وفي الفريق الصغير قد يحمل شخص واحد كل الأدوار، وهذا مقبول ما دام يعرف أنه يحملها، فيكتب الخط الزمني وهو يعمل، ويرسل تحديثاً كل نصف ساعة. والنقطة الأهم أن الأدوار تسلم بوضوح عند تبديل الأشخاص، بعبارة مثل «أنا أسلم قيادة الحادثة لفلان الآن»، ويكتبها الموثق.
مستويات الخطورة Severity
مستوى الخطورة Severity يحدد حجم الاستجابة: من يستيقظ، ومن يبلغ، وهل نعلن على صفحة الحالة. والجدول التالي مثال مبسط لفريق صغير، وليس معياراً عاماً، فكل شركة تكتب تعريفاتها، ويمكنك أن تقارنه بمستويات PagerDuty المنشورة:
| المستوى | الوصف | الاستجابة |
|---|---|---|
| SEV-1 | الخدمة الأساسية متوقفة لأغلب المستخدمين، أو تسرب بيانات | المناوب وقائد حادثة ومدير التقنية فوراً، وإعلان على صفحة الحالة، وتقرير ما بعد الحادثة إلزامي |
| SEV-2 | ميزة مهمة معطلة لجزء كبير من المستخدمين، مثل فشل ثلث طلبات الدفع | المناوب يقود الحادثة ويستدعي من يحتاج، وإعلان على صفحة الحالة، وتقرير ما بعد الحادثة إلزامي |
| SEV-3 | عطل جزئي له حل مؤقت، أو بطء محدود | المناوب في ساعات العمل، وتقرير مختصر إذا تكرر |
| SEV-4 | مشكلة داخلية لا يراها المستخدم | تذكرة عادية في قائمة الفريق |
ولاحظ قاعدة مهمة يذكرها توثيق PagerDuty: إذا لم تكن متأكداً من المستوى فاختر الأعلى، والسبب أن وقت الحادثة ليس وقت النقاش في التصنيف، وتعديل المستوى بعدها سهل.
التواصل عبر صفحة الحالة Status Page
صفحة الحالة Status Page صفحة عامة تخبر المستخدمين بحالة الخدمة والحوادث الجارية، وهدفها أن يعرف المستخدم أنك تعرف بالمشكلة، فلا يرسل لك مئة تذكرة دعم، ولا يقرأ عن العطل لأول مرة على وسائل التواصل. والقاعدة في الكتابة أن تقول ما يراه المستخدم وما تفعله ومتى التحديث القادم، دون تفاصيل داخلية ودون وعود بمواعيد لا تعرفها. وفيما يلي رسائل حادثتنا في مراحلها الأربع:
| المرحلة | الرسالة |
|---|---|
| نحقق في المشكلة | بعض محاولات الدفع التي تستخدم كود خصم تفشل الآن، ونحن نحقق في السبب، والتحديث القادم خلال 30 دقيقة. |
| عرفنا السبب | عرفنا سبب فشل الدفع مع أكواد الخصم، وهو مرتبط بتحديث نشرناه اليوم، ونقوم الآن بالتراجع عنه. |
| نراقب الإصلاح | تراجعنا عن التحديث وعاد الدفع للعمل، ونراقب الخدمة للتأكد من استقرارها. |
| انتهت الحادثة | انتهت المشكلة، وكانت بعض محاولات الدفع بكود خصم قد فشلت لمدة ثلاث دقائق تقريباً، ونعتذر عن الإزعاج. |
مختبر: نشر سيئ وتنبيه وتراجع
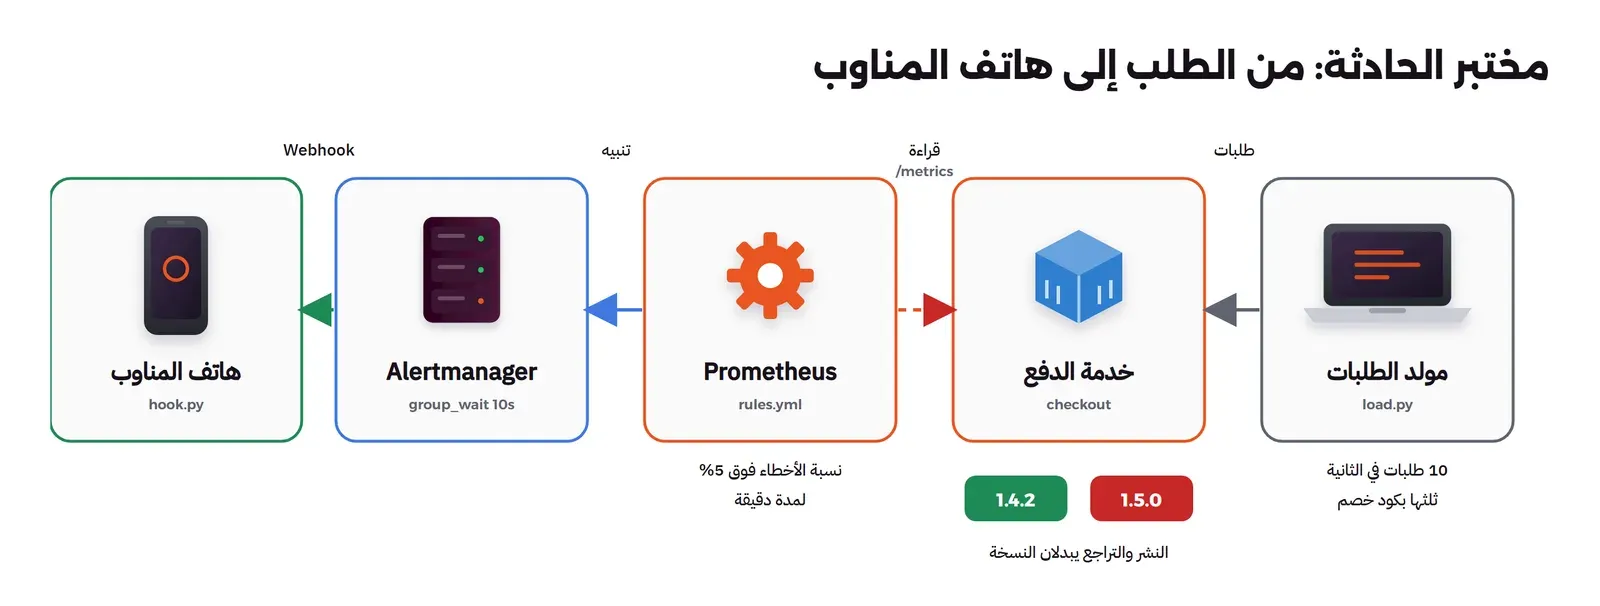
الآن سوف نشغل حادثة حقيقية على مختبر صغير، والهدف ليس المراقبة نفسها، وإنما أن نحصل على سجلات حقيقية نبني منها الخط الزمني والتقرير. والمختبر فيه خمسة أجزاء: خدمة checkout صغيرة بلغة Python تعرض عدادات بصيغة Prometheus، ومولد طلبات يرسل حوالي عشرة طلبات في الثانية ثلثها تقريباً بكود خصم، وPrometheus يقيس نسبة الأخطاء، وAlertmanager يرسل التنبيه، ومستقبل Webhook صغير يمثل هاتف المناوب.
ملفات المختبر
الإصدار السليم 1.4.2 من الخدمة يحسب السعر مع الضريبة ويتجاهل كود الخصم، والملف التالي هو الخدمة كاملة:
import json, logging, os, sys, threading
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
from urllib.parse import urlparse, parse_qs

VERSION = os.environ.get("APP_VERSION", "dev")
CONFIG = {"currency": "SAR", "tax_rate": 0.15}
COUNTS, LOCK = {}, threading.Lock()
logging.basicConfig(stream=sys.stdout, level=logging.INFO,
                    format='{"ts":"%(asctime)s","level":"%(levelname)s","version":"' + VERSION + '","msg":"%(message)s"}')
log = logging.getLogger("checkout")


def price_order(qs):
    subtotal = 100.0
    total = subtotal * (1 + CONFIG["tax_rate"])
    return {"subtotal": subtotal, "total": round(total, 2), "currency": CONFIG["currency"]}


class Handler(BaseHTTPRequestHandler):
    def count(self, code):
        with LOCK:
            COUNTS[code] = COUNTS.get(code, 0) + 1

    def send(self, code, body, ctype="application/json"):
        data = body.encode()
        self.send_response(code)
        self.send_header("Content-Type", ctype)
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def do_GET(self):
        url = urlparse(self.path)
        if url.path == "/metrics":
            with LOCK:
                lines = [f'http_requests_total{{version="{VERSION}",code="{c}"}} {n}' for c, n in sorted(COUNTS.items())]
            self.send(200, "# TYPE http_requests_total counter\n" + "\n".join(lines) + "\n", "text/plain; version=0.0.4")
            return
        if url.path != "/api/price":
            self.send(404, '{"error":"not found"}')
            return
        try:
            body = json.dumps(price_order(parse_qs(url.query)))
            self.count("200")
            self.send(200, body)
        except Exception as e:
            self.count("500")
            log.error(f"price_order failed: {type(e).__name__}: {e}")
            self.send(500, '{"error":"internal"}')

    def log_message(self, *args):
        pass


if __name__ == "__main__":
    log.info("starting checkout service")
    ThreadingHTTPServer(("0.0.0.0", 8080), Handler).serve_forever()
والإصدار 1.5.0 يضيف دعم أكواد الخصم، والفرق بين الإصدارين كما يلي:
--- v1.4.2/app.py
+++ v1.5.0/app.py
@@ -4,6 +4,8 @@

 VERSION = os.environ.get("APP_VERSION", "dev")
 CONFIG = {"currency": "SAR", "tax_rate": 0.15}
+if os.environ.get("DISCOUNT_RULES"):
+    CONFIG["discount_rules"] = json.loads(os.environ["DISCOUNT_RULES"])
 COUNTS, LOCK = {}, threading.Lock()
 logging.basicConfig(stream=sys.stdout, level=logging.INFO,
                     format='{"ts":"%(asctime)s","level":"%(levelname)s","version":"' + VERSION + '","msg":"%(message)s"}')
@@ -12,6 +14,10 @@

 def price_order(qs):
     subtotal = 100.0
+    coupon = qs.get("coupon", [None])[0]
+    if coupon:
+        rules = CONFIG.get("discount_rules", {})
+        subtotal -= subtotal * rules[coupon]
     total = subtotal * (1 + CONFIG["tax_rate"])
     return {"subtotal": subtotal, "total": round(total, 2), "currency": CONFIG["currency"]}
ولاحظ الخطأ: الكود يقرأ قواعد الخصم من متغير البيئة DISCOUNT_RULES، وإذا لم يكن موجوداً تصبح القواعد قاموساً فارغاً Dictionary، فيفشل كل طلب فيه كود خصم بالخطأ KeyError ويعود للمستخدم الخطأ 500. والمتغير غير موجود في إعداد الإنتاج، والتطبيقات التي ترسل كود الخصم موجودة قبل أن يدعمه السيرفر، وهذا وارد عندما يصدر تطبيق الجوال قبل الخادم.
ونبني لكل إصدار Docker Image بالملف التالي:
FROM python:3.13.16-slim
COPY app.py /app/app.py
USER nobody
CMD ["python", "-u", "/app/app.py"]
ومولد الطلبات يطبع كل 30 ثانية عدد الطلبات الناجحة والفاشلة:
import random, time, urllib.request, urllib.error
from datetime import datetime, timezone

ok = err = 0
last = time.time()
while True:
    url = "http://app:8080/api/price"
    if random.random() < 0.3:
        url += "?coupon=RAMADAN10"
    try:
        urllib.request.urlopen(url, timeout=2).read()
        ok += 1
    except urllib.error.HTTPError:
        err += 1
    except Exception:
        err += 1
    if time.time() - last >= 30:
        ts = datetime.now(timezone.utc).strftime("%H:%M:%S")
        print(f"{ts} last 30s: ok={ok} errors={err} error_rate={err / max(ok + err, 1):.1%}", flush=True)
        ok = err = 0
        last = time.time()
    time.sleep(0.1)
ومستقبل التنبيهات يطبع كل تنبيه يصله مع وقته، وهو هنا بديل عن تطبيق المناوبة على الهاتف:
import json
from datetime import datetime, timezone
from http.server import HTTPServer, BaseHTTPRequestHandler


class Hook(BaseHTTPRequestHandler):
    def do_POST(self):
        body = json.loads(self.rfile.read(int(self.headers["Content-Length"])))
        now = datetime.now(timezone.utc).strftime("%H:%M:%S")
        for a in body["alerts"]:
            l = a["labels"]
            print(f'{now} PAGE {a["status"].upper()} {l["alertname"]} severity={l.get("severity")} '
                  f'team={l.get("team")} startsAt={a["startsAt"][11:19]} endsAt={a["endsAt"][11:19]} '
                  f'summary="{a["annotations"].get("summary")}"', flush=True)
        self.send_response(200)
        self.end_headers()

    def log_message(self, *args):
        pass


HTTPServer(("0.0.0.0", 9000), Hook).serve_forever()
وإعداد Prometheus يقرأ عدادات الخدمة كل خمس ثوان ويقيم القواعد كل 15 ثانية:
global:
  scrape_interval: 5s
  evaluation_interval: 15s
rule_files:
  - /etc/prometheus/rules.yml
alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager:9093"]
scrape_configs:
  - job_name: checkout
    static_configs:
      - targets: ["app:8080"]
وقاعدة التنبيه هي أهم ملف في المختبر:
groups:
  - name: checkout
    rules:
      - alert: CheckoutHighErrorRate
        expr: |
          sum(rate(http_requests_total{job="checkout", code=~"5.."}[1m]))
            / sum(rate(http_requests_total{job="checkout"}[1m])) > 0.05
        for: 1m
        labels:
          severity: page
          team: payments
        annotations:
          summary: "checkout error rate above 5% for 1 minute"
          runbook_url: "https://wiki.example.com/runbooks/checkout"
في الإعداد أعلاه لاحظ التالي:
- التنبيه على نسبة الأخطاء التي يراها المستخدم، وليس على عدد الأخطاء أو على المعالج، فخمسة أخطاء في الدقيقة مع ألف طلب تختلف عن خمسة أخطاء مع عشرة طلبات.
- الحقل
for: 1mيعني أن النسبة يجب أن تبقى فوق 5% لمدة دقيقة كاملة قبل التنبيه، وهذا يمنع التنبيه على ارتفاع لحظي، ولكنه يضيف دقيقة إلى زمن الاكتشاف، وهذه موازنة يجب أن تقررها لكل خدمة. - التسمية
team: paymentsتربط التنبيه بالفريق المالك، والحقلrunbook_urlيعطي المناوب دليل التشغيل مباشرة.
وإعداد Alertmanager يرسل التنبيه إلى المستقبل بعد 10 ثوان من تجميع التنبيهات، ويرسل إشعاراً آخر عند انتهاء المشكلة:
route:
  receiver: payments-oncall
  group_by: ["alertname"]
  group_wait: 10s
  group_interval: 30s
  repeat_interval: 1h
receivers:
  - name: payments-oncall
    webhook_configs:
      - url: http://hook:9000/
        send_resolved: true
وملف Docker Compose يجمع الأجزاء الخمسة، ونسخة الخدمة تأتي من المتغير APP_VERSION:
name: lab-skl-incident
services:
  app:
    image: lab-skl-app:${APP_VERSION:-1.4.2}
    container_name: lab-skl-app
    environment:
      APP_VERSION: ${APP_VERSION:-1.4.2}
  load:
    image: python:3.13.16-slim
    container_name: lab-skl-load
    command: ["python", "-u", "/load.py"]
    volumes: ["./load.py:/load.py:ro"]
  prometheus:
    image: prom/prometheus:v3.13.4
    container_name: lab-skl-prom
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./rules.yml:/etc/prometheus/rules.yml:ro
    ports: ["127.0.0.1:19090:9090"]
  alertmanager:
    image: prom/alertmanager:v0.34.1
    container_name: lab-skl-am
    volumes: ["./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro"]
    ports: ["127.0.0.1:19093:9093"]
  hook:
    image: python:3.13.16-slim
    container_name: lab-skl-hook
    command: ["python", "-u", "/hook.py"]
    volumes: ["./hook.py:/hook.py:ro"]
networks:
  default:
    name: lab-skl-net
تشغيل الحادثة
نبني الإصدارين أولاً:
docker build -t lab-skl-app:1.4.2 v1
docker build -t lab-skl-app:1.5.0 v2
ثم نشغل الحادثة بالسكربت التالي، وهو ينشر الإصدار السليم ويتركه دقيقتين، ثم ينشر الإصدار السيئ، وينتظر وصول التنبيه، ثم يمثل استجابة المناوب: يسجل الإقرار بالتنبيه، وينتظر دقيقة تمثل وقت التحقق والقرار، ثم يتراجع إلى 1.4.2. ولاحظ أن خطوات المناوب هنا مكتوبة في السكربت حتى يتكرر المختبر بنفس الشكل، وفي الحادثة الحقيقية يكون هذا الوقت وقت إنسان يقرأ لوحة المراقبة والسجلات:
#!/bin/sh
# Drives the incident: baseline, bad deploy, wait for the page, rollback, wait for resolve.
cd "$(dirname "$0")"
say() { echo "$(date -u +%H:%M:%S) $*" >> deploy.log; }
: > deploy.log
say "deploy checkout 1.4.2 (baseline)"
APP_VERSION=1.4.2 docker compose up -d --quiet-pull > compose.out 2>&1
docker inspect -f "{{.State.Status}}" lab-skl-app | grep -q running || { echo app not running; exit 1; }
sleep 120
say "deploy checkout 1.5.0 (coupon support, PR #418)"
APP_VERSION=1.5.0 docker compose up -d app >> compose.out 2>&1
until docker logs lab-skl-hook 2>&1 | grep -q 'PAGE FIRING'; do sleep 5; done
say "on-call acknowledged page, declared SEV-2, decision: roll back"
sleep 60
docker logs -t lab-skl-app > app-1.5.0.log 2>&1
say "rollback checkout to 1.4.2"
APP_VERSION=1.4.2 docker compose up -d app >> compose.out 2>&1
until docker logs lab-skl-hook 2>&1 | grep -q 'PAGE RESOLVED'; do sleep 5; done
say "alert resolved"
sleep 40
say "done"
وبعد انتهاء السكربت نقرأ أربعة مصادر، أولها سجل النشر الذي كتبه السكربت بالتوقيت العالمي UTC:
22:07:54 deploy checkout 1.4.2 (baseline)
22:10:14 deploy checkout 1.5.0 (coupon support, PR #418)
22:11:49 on-call acknowledged page, declared SEV-2, decision: roll back
22:12:51 rollback checkout to 1.4.2
22:14:23 alert resolved
22:15:03 done
ثم ما وصل إلى هاتف المناوب:
22:11:48 PAGE FIRING CheckoutHighErrorRate severity=page team=payments startsAt=22:11:33 endsAt=00:00:00 summary="checkout error rate above 5% for 1 minute"
22:14:18 PAGE RESOLVED CheckoutHighErrorRate severity=page team=payments startsAt=22:11:33 endsAt=22:14:03 summary="checkout error rate above 5% for 1 minute"
ثم ما رآه المستخدمون من جهة مولد الطلبات:
22:08:40 last 30s: ok=248 errors=1 error_rate=0.4%
22:09:10 last 30s: ok=288 errors=0 error_rate=0.0%
22:09:40 last 30s: ok=285 errors=0 error_rate=0.0%
22:10:10 last 30s: ok=285 errors=0 error_rate=0.0%
22:10:40 last 30s: ok=208 errors=57 error_rate=21.5%
22:11:10 last 30s: ok=212 errors=76 error_rate=26.4%
22:11:40 last 30s: ok=203 errors=86 error_rate=29.8%
22:12:10 last 30s: ok=198 errors=93 error_rate=32.0%
22:12:40 last 30s: ok=198 errors=92 error_rate=31.7%
22:13:10 last 30s: ok=217 errors=52 error_rate=19.3%
22:13:41 last 30s: ok=291 errors=0 error_rate=0.0%
22:14:11 last 30s: ok=286 errors=0 error_rate=0.0%
22:14:41 last 30s: ok=287 errors=0 error_rate=0.0%
22:15:11 last 30s: ok=288 errors=0 error_rate=0.0%
ثم أول سطور سجل الخدمة في الإصدار 1.5.0، وقد حفظه السكربت قبل التراجع لأن سجل ال Container يحذف مع استبداله:
2026-10-12T22:10:21.430262438Z {"ts":"2026-10-12 22:10:21,429","level":"INFO","version":"1.5.0","msg":"starting checkout service"}
2026-10-12T22:10:21.681394146Z {"ts":"2026-10-12 22:10:21,681","level":"ERROR","version":"1.5.0","msg":"price_order failed: KeyError: 'RAMADAN10'"}
2026-10-12T22:10:22.095120281Z {"ts":"2026-10-12 22:10:22,094","level":"ERROR","version":"1.5.0","msg":"price_order failed: KeyError: 'RAMADAN10'"}
2026-10-12T22:10:22.448750928Z {"ts":"2026-10-12 22:10:22,448","level":"ERROR","version":"1.5.0","msg":"price_order failed: KeyError: 'RAMADAN10'"}
وعند عد الأخطاء في السجل كاملاً بالأمر grep -c ERROR app-1.5.0.log كانت النتيجة 423 خطأ، آخرها في الساعة 22:12:50، ثم بدأ الإصدار 1.4.2 في الساعة 22:13:03 كما في سجله:
2026-10-12T22:13:03.194722259Z {"ts":"2026-10-12 22:13:03,194","level":"INFO","version":"1.4.2","msg":"starting checkout service"}وأخيراً نسبة الأخطاء من Prometheus كل 30 ثانية، وقد أخذناها من استعلام query_range ثم حولنا مخرجه JSON بسكربت صغير إلى سطر لكل نقطة فيه الوقت والقيمة، فالقيم كما هي والشكل فقط تغير:
curl -s -G http://127.0.0.1:19090/api/v1/query_range \
  --data-urlencode 'query=round(sum(rate(http_requests_total{job="checkout",code=~"5.."}[1m])) / sum(rate(http_requests_total{job="checkout"}[1m])), 0.001)' \
  --data-urlencode 'start=2026-10-12T22:09:30Z' --data-urlencode 'end=2026-10-12T22:15:00Z' \
  --data-urlencode 'step=30s'
22:10:30 0.049
22:11:00 0.196
22:11:30 0.264
22:12:00 0.313
22:12:30 0.328
22:13:00 0.294
22:13:30 0.143في المخرجات أعلاه لاحظ التالي:
- أول خطأ ظهر في السجل بعد أقل من ثانية من بدء الإصدار 1.5.0، أما التنبيه فوصل بعد حوالي 87 ثانية، منها دقيقة كاملة بسبب
for: 1m، والباقي بين نافذة الحساب[1m]وتقييم القاعدة وانتظار Alertmanager. - نسبة الأخطاء استقرت حول 30%، وهي تقريباً نسبة الطلبات التي فيها كود خصم في مولد الطلبات، وهذا دليل مهم أثناء التحقيق: الخطأ مرتبط بنوع معين من الطلبات وليس بالخدمة كلها.
- في نافذة الثلاثين ثانية التي فيها التراجع زاد عدد الأخطاء في مولد الطلبات على ما في سجل الخدمة، والسبب أن
docker compose up -dيوقف ال Container القديم ثم يشغل الجديد، فلم تكن هناك أي نسخة تستقبل الطلبات لحوالي 12 ثانية بين 22:12:51 و22:13:03، أي أن التراجع نفسه سبب توقفاً قصيراً كاملاً. - الاستعلام لا يعيد قيماً قبل النشر ولا بعد التراجع، وليس صفراً، والسبب أن عداد الأخطاء 500 لا يظهر حتى يحدث أول خطأ، ويختفي عندما يبدأ Container جديد، فلوحة المراقبة سوف تظهر فراغاً وليس صفراً، وهذه ملاحظة سوف تصبح إجراء متابعة في التقرير.
- السطر الأول في مولد الطلبات فيه خطأ واحد في أول ثلاثين ثانية بعد تشغيل المختبر، قبل نشر الإصدار السيئ بدقيقتين، فهو ليس جزءاً من الحادثة.
ولحذف المختبر نستخدم down -v حتى تحذف أيضاً ال Volumes المجهولة التي ينشئها Prometheus وAlertmanager، ثم نحذف ال Images التي بنيناها:
docker compose down -v
docker rmi lab-skl-app:1.4.2 lab-skl-app:1.5.0
تقرير ما بعد الحادثة Postmortem دون لوم
تقرير ما بعد الحادثة Postmortem كما يعرفه فصل ثقافة التقارير في كتاب Google SRE سجل مكتوب للحادثة وأثرها وما فعلناه لإيقافها وأسبابها والإجراءات التي تمنع تكرارها. ويذكر الفصل محفزات شائعة لكتابته، منها أن يرى المستخدم توقفاً أو تراجعاً فوق حد معين، أو أن يتدخل المناوب بتراجع عن إصدار، وحادثتنا فيها الاثنان.
دون لوم لا تعني دون محاسبة
يقول نفس الفصل إن التقرير دون لوم Blameless يركز على الأسباب التي ساهمت في الحادثة دون أن يتهم شخصاً أو فريقاً بسلوك سيئ، ويفترض أن كل من شارك كانت نيته جيدة وفعل الصحيح بالمعلومات التي كانت لديه، وإن ثقافة توجيه الأصابع تجعل الناس يخفون المشكلات بدلاً من إظهارها، وإن كتابة التقرير ليست عقوبة وإنما فرصة تعلم للشركة كلها.
وقد يتساءل البعض: إذا لم نلم أحداً، فمن يتحمل المسؤولية؟ والإجابة أن اللوم والمسؤولية شيئان مختلفان. فاللوم ينظر إلى الخلف ويسأل «من أخطأ؟»، وإجابته اسم شخص، والمسؤولية تنظر إلى الأمام وتسأل «من يملك جعل هذا لا يتكرر؟»، وإجابتها فريق يملك الخدمة وإجراءات لها مالك وموعد. ففي حادثتنا لا يهم التقرير اسم من كتب الكود في الطلب رقم 418، لأن أي مطور في مكانه قد يفترض أن الإعداد موجود، وإنما يهمه لماذا لم يكتشف اختبار أو مراجعة أو نشر تدريجي هذا الافتراض. وفي نفس الوقت فريق المدفوعات مسؤول بالكامل عن إغلاق الإجراءات، ومن دمج الطلب مسؤول عن أن يشارك في كتابة التقرير ويشرح ما رآه وقت المراجعة، وهذه هي المحاسبة: أن تملك النتيجة والتحسين، وليس أن تعاقب.
التقرير الكامل للحادثة
القالب التالي مبني على الأقسام التي يقترحها كتاب Google SRE وطريقة PagerDuty لتقارير ما بعد الحادثة، والأرقام كلها من سجلات المختبر أعلاه:
| القسم | المحتوى |
|---|---|
| العنوان | فشل حوالي ثلث طلبات حساب السعر في خدمة checkout بعد نشر الإصدار 1.5.0 |
| الخطورة والحالة | SEV-2، والحادثة مغلقة، والتقرير قيد المراجعة |
| الملخص | نشرنا الإصدار 1.5.0 الذي يدعم أكواد الخصم دون إعداد قواعد الخصم في الإنتاج، ففشل كل طلب فيه كود خصم بالخطأ 500 لمدة 2 دقيقة و42 ثانية، ثم تراجعنا إلى 1.4.2 |
| الأثر | من 22:10:21 إلى 22:13:03 بالتوقيت العالمي، سجلت الخدمة 423 خطأ، ورأى مولد الطلبات 456 طلباً فاشلاً من 1692 طلباً في النوافذ الست التي شملت الحادثة، والفرق بين الرقمين طلبات فشلت أثناء استبدال ال Container في التراجع |
| الاكتشاف | بالتنبيه الآلي بعد حوالي 87 ثانية من أول خطأ، وليس من بلاغ عميل |
| الإيقاف | التراجع إلى 1.4.2 بعد 62 ثانية من الإقرار بالتنبيه، واكتمل بعد 12 ثانية أخرى |
| السبب المباشر | الكود يفترض وجود قواعد الخصم في الإعداد، والإعداد غير موجود في الإنتاج، فيرفع KeyError |
| الأسباب المساهمة | لا يوجد اختبار لحالة غياب الإعداد، والخدمة لا تتحقق من إعدادها عند البدء، والميزة لم تكن خلف Feature Flag، والنشر استبدل النسخة كاملة دفعة واحدة، والتطبيقات كانت ترسل أكواد الخصم قبل أن يدعمها الخادم |
| ما سار بشكل جيد | التنبيه وصل للفريق المالك خلال أقل من دقيقة ونصف، والتراجع أمر واحد ومعروف، وإشعار انتهاء المشكلة وصل آلياً |
| ما سار بشكل سيئ | التراجع أوقف الخدمة كاملة 12 ثانية، ولوحة نسبة الأخطاء تظهر فراغاً بدل الصفر قبل الحادثة وبعدها |
| أين كنا محظوظين | الخطأ أصاب طلبات الخصم فقط، ولو كان في مسار كل الطلبات لتوقف الدفع بالكامل |
والخط الزمني يأتي من السجلات وليس من الذاكرة، ولكل سطر مصدره:
| الوقت UTC | الحدث | المصدر |
|---|---|---|
| 22:10:14 | بدء نشر الإصدار 1.5.0 | سجل النشر |
| 22:10:21 | الإصدار 1.5.0 يبدأ، وأول KeyError بعدها بأقل من ثانية | سجل الخدمة |
| 22:10:40 | مولد الطلبات يرى 21.5% أخطاء في آخر 30 ثانية | سجل مولد الطلبات |
| 22:11:33 | قاعدة التنبيه تصبح في حالة إطلاق Firing | حقل startsAt في التنبيه |
| 22:11:48 | التنبيه يصل لمناوب فريق المدفوعات | مستقبل التنبيهات |
| 22:11:49 | الإقرار بالتنبيه وإعلان SEV-2 وقرار التراجع | سجل النشر |
| 22:12:51 | بدء التراجع إلى 1.4.2 | سجل النشر |
| 22:13:03 | الإصدار 1.4.2 يبدأ | سجل الخدمة |
| 22:13:41 | مولد الطلبات لا يرى أي خطأ في آخر 30 ثانية | سجل مولد الطلبات |
| 22:14:18 | إشعار انتهاء التنبيه يصل للمناوب | مستقبل التنبيهات |
إجراءات المتابعة Action Items التي تغلق فعلاً
التقرير الذي ينتهي بعبارة «يجب أن نكون أكثر حذراً» لم يغير شيئاً، والسبب أن الحذر ليس إجراء يمكن إغلاقه، فالناس كانوا حذرين أصلاً. وإجراء المتابعة Action Item الجيد تغيير محدد في النظام، له مالك واحد وموعد وتذكرة، ويمكن أن تقول عنه «تم» أو «لم يتم». ويفيد أن تصنف الإجراءات حسب أثرها: منع Prevent يجعل الخطأ مستحيلاً، واكتشاف Detect يجعلنا نراه أسرع، وتخفيف Mitigate يقلل أثره عندما يحدث. والجدول التالي إجراءات حادثتنا:
| الإجراء | النوع | المالك | الأولوية والموعد |
|---|---|---|---|
| الخدمة ترفض البدء إذا كانت ميزة الخصم مفعلة وقواعدها غير موجودة، فيفشل النشر قبل أن يصل أي طلب | منع | فريق المدفوعات | عالية، أسبوع |
| كود الخصم غير المعروف يعيد 400 مع رسالة واضحة بدلاً من 500 | تخفيف | فريق المدفوعات | عالية، أسبوع |
اختبار يشغل الخدمة دون DISCOUNT_RULES ويرسل طلباً بكود خصم | منع | فريق المدفوعات | عالية، أسبوع |
| كل ميزة جديدة في مسار الدفع تنشر خلف Feature Flag | تخفيف | قائد فريق المدفوعات | متوسطة، شهر |
| نشر تدريجي يبقي النسخة القديمة تعمل حتى تصبح الجديدة جاهزة، حتى لا يسبب التراجع توقفاً | تخفيف | فريق المنصة | متوسطة، شهر |
| الخدمة تنشئ عداد الأخطاء بقيمة صفر عند البدء، حتى تظهر اللوحة صفراً وليس فراغاً | اكتشاف | فريق المدفوعات | منخفضة، شهر |
وحتى تغلق الإجراءات فعلاً، اتبع أربع قواعد بسيطة: كل إجراء له تذكرة في نفس أداة عمل الفريق وليس في وثيقة التقرير فقط، وله مالك واحد باسمه وليس «الفريق»، ويراجع قائد الفريق الإجراءات المفتوحة في اجتماع أسبوعي حتى تغلق، وإذا تأجل إجراء عالي الأولوية أكثر من مرة فهذا قرار يرفع للإدارة ويكتب، لأن تأجيله يعني قبول خطر تكرار الحادثة. وقد شرحنا ال Feature Flags والنشر التدريجي في مفهوم Feature Flags والإطلاق التدريجي.
عندما يكتب الذكاء الاصطناعي الكود
لنفرض أن الطلب رقم 418 كتبه بالكامل مساعد برمجة بالذكاء الاصطناعي، فماذا يتغير في التقرير؟ والإجابة: لا شيء في الأسباب ولا في الإجراءات، فالخطأ نفسه، والاختبار المفقود نفسه، والنشر الذي استبدل كل شيء دفعة واحدة نفسه. والذي يجب أن يكون واضحاً أن الأداة لا تملك شيئاً، فهي لا تناوب ولا تحضر اجتماع المراجعة ولا تغلق التذاكر، والإنسان الذي طلب الكود وراجعه ودمجه هو صاحبه، تماماً كما لو كتبه بيده أو نسخه من موقع.
وهذا ما تقوله المشاريع التي كتبت سياسة لهذا، فمثلاً سياسة Fedora للمساهمات بمساعدة الذكاء الاصطناعي تنص على أن المساهم يتحمل المسؤولية عن مساهمته، وأنه هو المؤلف دائماً ومحاسب بالكامل عن كل ما قدمه، مهما كانت الأدوات التي ساعدته. وعملياً يعني هذا في فريقك:
- من يدمج الكود يجب أن يستطيع شرح كل سطر فيه في اجتماع التقرير، فإذا لم يستطع فلم يكن يجب أن يدمجه.
- الكود الذي ينتجه الذكاء الاصطناعي يحتاج نفس الاختبارات ونفس المراجعة، وغالباً أكثر، لأن الأداة تكتب كوداً يبدو صحيحاً بثقة عالية، وتفترض أشياء عن بيئتك لا تعرفها، مثل وجود متغير الإعداد في حادثتنا.
- ملكية الخدمة لا تتغير، فالتنبيه يذهب إلى فريق المدفوعات، وليس إلى من استخدم الأداة.
أخطاء شائعة
- البحث عن مذنب واحد: كل حادثة حقيقية لها عدة أسباب مساهمة، والتقرير الذي يجد شخصاً واحداً توقف عن البحث مبكراً.
- إصلاح العطل قبل إيقاف الضرر: التراجع أولاً ثم البحث، كما شرحنا في متى توقف الضرر أولاً ثم تبحث عن السبب؟، ففي حادثتنا لم نحتج أن نفهم الخطأ لنوقفه.
- خط زمني من الذاكرة: بعد يومين يتذكر كل شخص الحادثة بشكل مختلف، فاكتب أثناء الحادثة وخذ الأوقات من السجلات.
- إجراءات بلا مالك أو موعد: تبقى مفتوحة حتى الحادثة التالية التي تكون غالباً نفس الحادثة.
- مناوبة على كل شيء: التنبيه الذي لا يحتاج تدخلاً يعلم الفريق أن يتجاهل التنبيهات.
- خدمة بلا مالك: إذا لم يجد المناوب مالك الخدمة في فهرس الخدمات، فهذا بحد ذاته إجراء متابعة.
وتحديد المسؤوليات قبل التنفيذ موضوع مستقل شرحناه في مواءمة أصحاب المصلحة وسياسة المؤسسة، ومنه مصفوفة RACI.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
 دليلDevOps وSRE وهندسة المنصات: أين يلتقي كل منها؟ما الذي يعنيه كل مصطلح فعلاً، وكيف تحسب ميزانية الأخطاء، وما شكل الفريق المناسب لحجم شركتك.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الفريق الذي يبني الخدمة يشغلها، لأنه الوحيد الذي يستطيع أن يجعلها أفضل بعد كل عطل.
- اكتب الملكية في فهرس الخدمات وملف CODEOWNERS، حتى لا يبدأ المناوب بالبحث عن المالك.
- المناوبة المحتملة تنبه على ما يراه المستخدم فقط، ولكل تنبيه دليل تشغيل.
- أعلن الحادثة مبكراً، ووزع الأدوار، وقائد الحادثة يحمل كل دور لم يسلمه.
- الخط الزمني يأتي من السجلات، والتقرير دون لوم يبحث عن الأسباب المساهمة وليس عن مذنب.
- دون لوم لا تعني دون مسؤولية: الفريق المالك يغلق إجراءات محددة لها مالك وموعد.
- من يدمج الكود يملكه، سواءً كتبه بيده أو كتبه الذكاء الاصطناعي.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل مختبر الحادثة على Prometheus 3.13.4 وAlertmanager 0.34.1 وPython 3.13.16.
- أكتوبر 2026: إضافة المصطلحات الإنجليزية إلى العنوان والعناوين الفرعية.


