

الساعة الثالثة فجراً، والعميل يتصل ليقول إن الدفع لا يعمل، فتفتح السيرفر وتبحث عن أي أثر لما حدث، فتجد أن التطبيق لا يكتب إلا سطوراً مثل here 2 وdone!! بقيت من أيام التطوير، أو تجد ملفاً ضخماً فيه آلاف السطور في الدقيقة نفسها ولا تعرف أي سطر يخص هذا العميل، أو لا تجد شيئاً لأن ال Container أعيد إنشاؤه فضاع كل ما كتبه. وعلى جهازك يعمل كل شيء كما يجب، والسبب أن المشكلة لا تظهر إلا ببيانات الإنتاج Production وحمله وإعداداته، وأنت لا تستطيع أن تضع نقطة توقف Breakpoint على سيرفر الإنتاج في منتصف الليل. والشيء الوحيد الذي يخبرك بما حدث فعلاً في تلك اللحظة هو السجلات Logs التي كتبها التطبيق قبل أن تسأل، لذلك فالسؤال الحقيقي ليس «أين أبحث؟» وإنما «ماذا كتبنا قبل أن تقع المشكلة؟».
وهذا المقال جزء من مرحلة المراقبة والسجلات في خريطة التعلم، فالطريقة العامة في التحقيق من العرض إلى السبب تجدها في دليل استكشاف الأخطاء وتحليل الأداء، وتتبع الطلب البطيء في كل طبقة مع سجل Nginx ومعرف الطلب تجده في تتبع الطلب البطيء من المتصفح إلى قاعدة البيانات. أما هنا فنركز على السجل نفسه: كيف تكتبه في الكود، وأين يذهب على السيرفر. وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي
print، والفرق بين السجلات والمقاييس Metrics والتتبع Traces. - مستويات السجل Log Levels وقاعدة واضحة لكل مستوى.
- ماذا تسجل في كل حدث، وما الذي لا يدخل السجل أبداً مثل كلمات المرور والتوكنات وأرقام البطاقات.
- السجلات المنظمة Structured Logs بصيغة JSON، وأسماء الحقول الموحدة، ومعرف الطلب Request ID.
- حقن السجلات Log Injection، وتسجيل الاستثناءات Exceptions مرة واحدة، وأثر السجلات على الأداء.
- أين تذهب السجلات: stdout في ال Containers، وjournald، والملفات مع logrotate، وتدوير سجلات Docker، ثم الجمع المركزي والاحتفاظ والصلاحيات.
- المكتبات في Python وNode.js وJava وC# وGo مع أمثلة شغلناها فعلاً.
- تجربة عملية كاملة: تطبيق يكتب سجلاً نصياً وسجلاً منظماً، وحقن سطر مزور، وتسريب توكن وإصلاحه، وتدوير السجلات، ثم نقلها بأداة Vector إلى Loki والبحث فيها من Grafana بمعرف الطلب.
لماذا لا يكفي print؟
أول ما يفعله المطور عندما لا يفهم ما يحدث هو أن يضع print أو console.log في الكود، وهذه طريقة مقبولة على جهازك لدقائق، ولكنها لا تصلح سجلاً لتطبيق في الإنتاج، والسبب أن السطر المطبوع لا يحمل وقتاً ولا مستوى ولا اسم الجزء الذي كتبه، ولا تستطيع أن تخفيه في الإنتاج وتظهره عند الحاجة إلا بتعديل الكود ونشره من جديد، ولا تستطيع أن ترسله إلى مكان آخر غير الشاشة، ولا أن تعرف أي طلب كتبه عندما يعمل التطبيق على عشرات الطلبات في الوقت نفسه.
والحل الثاني الذي يخطر للبعض هو أن يكتب التطبيق في ملف بنفسه، مثل open("app.log", "a")، وهذا يحل مشكلة الحفظ ويفتح مشكلات أخرى: من يدور هذا الملف قبل أن يملأ القرص؟ وماذا يحدث عندما يكتب خيطان Threads في الملف في اللحظة نفسها؟ وأين يذهب الملف عندما يعاد إنشاء ال Container؟ لذلك فالحل الصحيح هو مكتبة سجلات Logging Library، وهي موجودة في كل لغة، وتعطيك أربعة أشياء لا يعطيها print: المستوى Level الذي يحدد أهمية السطر ويسمح لك بإخفاء التفاصيل في الإنتاج دون تعديل الكود، والوقت واسم المصدر في كل سطر تلقائياً، والصيغة Format التي تحددها مرة واحدة مثل JSON، والوجهة Handler أو Appender التي تحدد أين يذهب السطر دون أن يعرف الكود عنها شيئاً.
وقد يتساءل البعض: إذا كان عندي أداة تتبع للأخطاء مثل Sentry، فهل أحتاج السجلات؟ والإجابة نعم، لأن أداة الأخطاء تخبرك بالاستثناء الذي وقع، أما السجل فيخبرك بما حدث قبله: أي طلب، وأي مستخدم، وكم أخذ الاستعلام، وهل أعيدت المحاولة، وهذه هي القصة التي تحتاجها لتفهم لماذا وقع الاستثناء.
السجلات والمقاييس Metrics والتتبع Traces
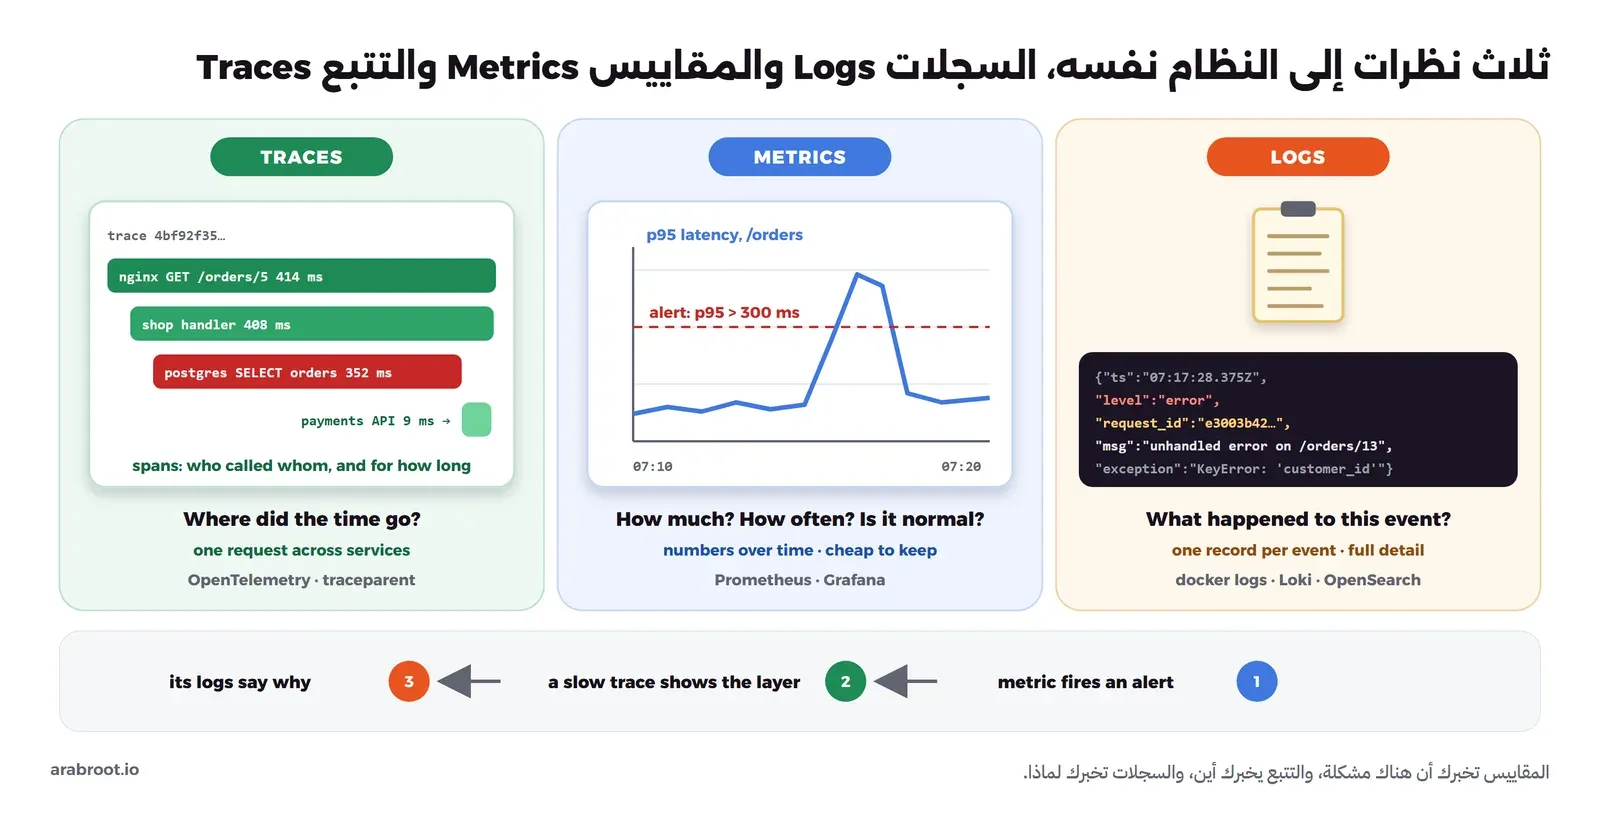
السجل هو سطر يصف حدثاً واحداً وقع في لحظة معينة بكل تفاصيله، أما المقاييس Metrics فهي أرقام تجمع على فترات، مثل عدد الطلبات في الدقيقة أو زمن الاستجابة p95، فتخبرك أن هناك مشكلة ومتى بدأت وتطلق التنبيه، وتكلفة حفظها صغيرة لأنها أرقام وليست نصوصاً، وأما التتبع Traces فيصف طلباً واحداً وهو يمر بعدة خدمات، وكل خدمة تسجل الجزء الذي قامت به Span مع توقيته، فترى أين ذهب الوقت. والثلاثة لا يغني أحدها عن الآخر، والصورة التالية تبين الفرق بينها وكيف تعمل معاً:
وفي هذا المقال نتعامل مع السجلات فقط، أما المقاييس مع Prometheus، والتتبع الموزع مع OpenTelemetry، والمنصات التي تجمع الثلاثة مثل SigNoz، فلها مقالات قادمة في مرحلة المراقبة والسجلات بإذن الله.
مستويات السجل Log Levels: قاعدة لكل مستوى
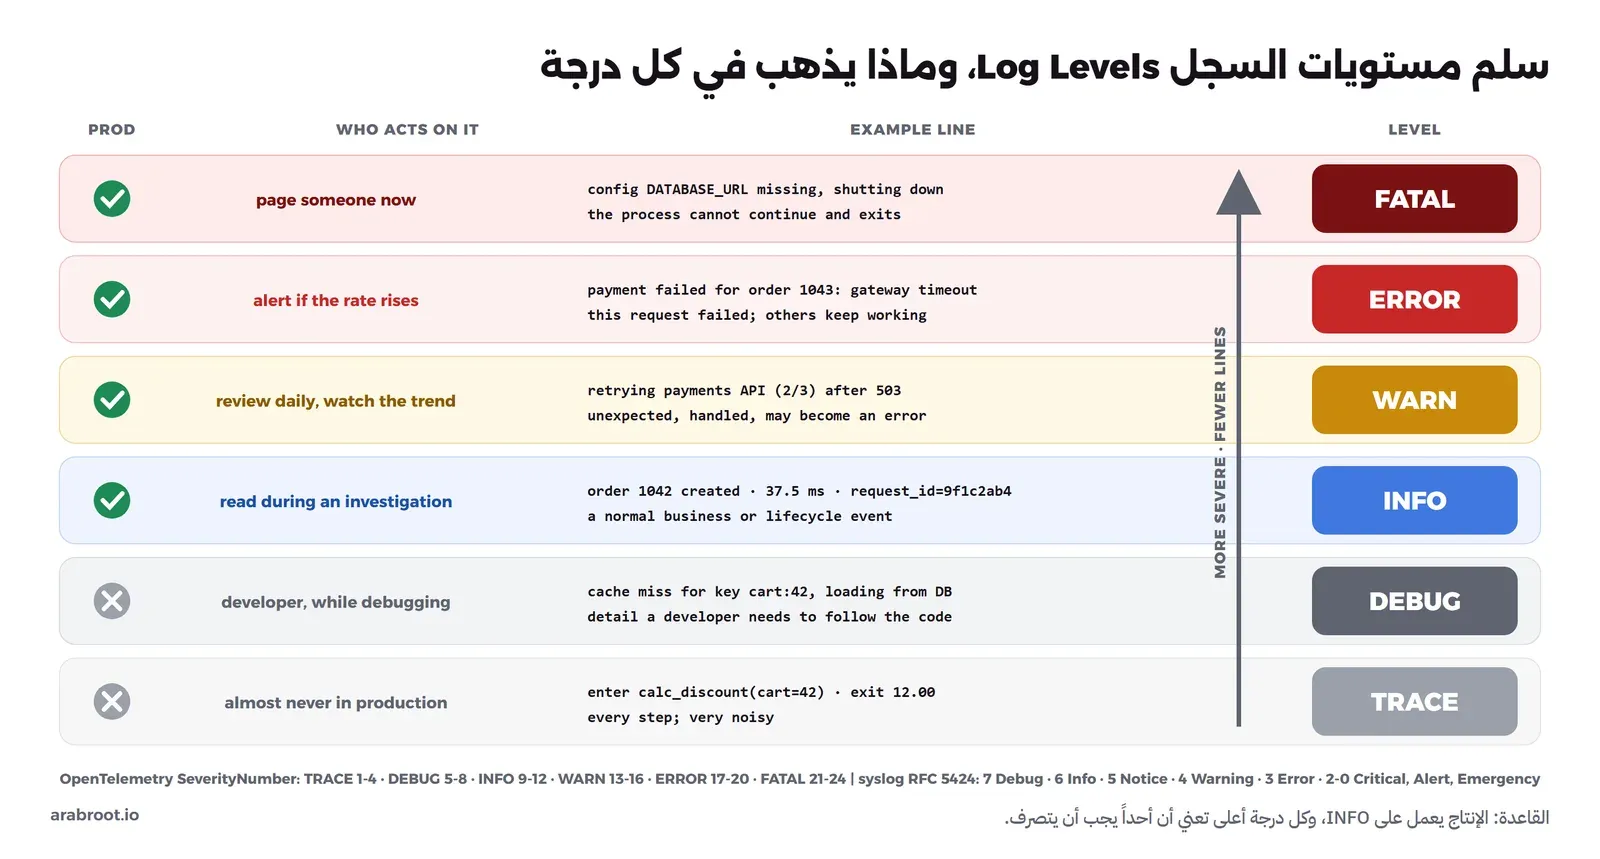
المستوى هو أهم حقل في السطر، لأنه يحدد من يجب أن يقرأه ومتى، ولأنه يسمح لك بأن تضبط التطبيق في الإنتاج على مستوى معين فيكتب ما فوقه فقط. والمشكلة أن أغلب المكتبات تعرف أسماء المستويات ولا تعرف معناها، فتوثيق Log4j مثلاً يقول صراحة إنه يعرف مجموعة مستويات ولا يحدد الغرض منها، لذلك يكتب كل مطور في الفريق بطريقته، فتجد خطأ حقيقياً بمستوى INFO وتفصيلاً عادياً بمستوى ERROR، فيفقد التنبيه معناه. وأقرب تعريف رسمي موحد هو جدول الشدة SeverityNumber في نموذج بيانات السجلات في OpenTelemetry، وهو الذي نعتمده هنا، والصورة التالية تبين المستويات الستة بالترتيب:
والقاعدة التي نقترحها لكل مستوى، مبنية على تعريفات OpenTelemetry، كما يلي:
- TRACE: كل خطوة صغيرة، مثل الدخول إلى دالة والخروج منها، ويصفه OpenTelemetry بأنه «مطفأ عادة في الإعداد الافتراضي»، ولا تشغله في الإنتاج إلا لدقائق على جزء محدد.
- DEBUG: ما يحتاجه المطور ليتبع الكود، مثل قيمة متغير أو أن القيمة لم توجد في ال Cache، ومكانه بيئة التطوير، أو الإنتاج مؤقتاً لمكون واحد أثناء التحقيق.
- INFO: حدث طبيعي يهم العمل أو دورة حياة التطبيق، مثل بدء التشغيل بإصداره وإعداداته غير السرية، أو إنشاء طلب شراء، أو انتهاء طلب HTTP بمدته ونتيجته، وهذا هو المستوى الذي يعمل عليه الإنتاج.
- WARN: شيء غير متوقع عالجه التطبيق، لكنه قد يتحول إلى خطأ إذا تكرر، مثل إعادة المحاولة مع خدمة خارجية، أو اقتراب المجمع Pool من الامتلاء، أو استخدام إعداد قديم سيلغى. ولا تضع في WARN ما لا ينوي أحد أن ينظر إليه، والسبب أن كثرة التحذيرات تعلم الفريق أن يتجاهلها كلها.
- ERROR: عملية فشلت ولم يحصل المستخدم على ما طلبه، مثل فشل الدفع أو استثناء لم يعالج في طلب، بينما يستمر التطبيق في خدمة الطلبات الأخرى. والسؤال الذي يحدد المستوى هو: هل يجب أن يعرف أحد بهذا؟ فإذا كان المستخدم أدخل كلمة مرور خاطئة فهذا ليس ERROR، لأن التطبيق عمل كما يجب، وإنما حدث أمني بمستوى INFO أو WARN.
- FATAL: التطبيق لا يستطيع أن يستمر وسوف يتوقف، مثل غياب إعداد ضروري عند التشغيل. وبعض المكتبات لا تملك هذا المستوى، مثل
log/slogفي Go، وتستخدم ERROR ثم تخرج العملية.
وأما سجلات النظام في Linux فتستخدم مستويات syslog الثمانية في RFC 5424، من 0 Emergency إلى 7 Debug، وبينها Notice للحدث الطبيعي المهم، وأداة journalctl -p err مثلاً تعرض ما كان بمستوى 3 Error وما هو أشد منه. والمقابل تقريبي بين الجدولين، فكل أداة جمع تحول مستويات المصدر إلى مستوياتها، ولذلك احرص أن يكون حقل المستوى في سجلك بأسماء ثابتة بحروف صغيرة أو كبيرة، ولا تخلط بين warn وwarning في التطبيقات المختلفة.
ومن الممارسات المفيدة أن تجعل المستوى إعداداً من متغير بيئة مثل LOG_LEVEL، ويمكنك أن تحدده لكل مكون على حدة، فترفع مستوى مكتبة HTTP الصاخبة إلى WARN وتبقي كودك على INFO، والسبب أن أغلب ضجيج السجلات يأتي من المكتبات وليس من كودك.
ماذا تسجل في كل حدث Event؟
السطر الذي يقول error occurred لا يفيد أحداً، والسطر الذي يطبع كل شيء يملأ القرص ويسرب الأسرار، والطريق الوسط تحدده ورقة OWASP للسجلات Logging Cheat Sheet بأربعة أسئلة لكل حدث: متى When، وأين Where، ومن Who، وماذا What. وبلغة الحقول يعني ذلك ما يلي:
- متى: الوقت بتوقيت UTC وبصيغة RFC 3339 مع الأجزاء من الثانية، مثل
2026-10-06T07:17:28.375Z، والسبب شرحناه في السجلات والساعة التي تنحرف. - أين: اسم الخدمة وإصدارها والبيئة، والمسار والطريقة في طلبات HTTP، واسم المكون أو ال Logger الذي كتب السطر.
- من: معرف المستخدم وليس اسمه أو بريده، وعنوان IP الحقيقي للكلاينت إذا كان التطبيق خلف Proxy يمرره بشكل صحيح.
- ماذا: اسم الحدث برسالة ثابتة مثل
order created، والتفاصيل في حقول منفصلة وليست داخل الرسالة، والنتيجة مثل رمز الحالة، والمدة بالمللي ثانية، ومعرف الطلب Request ID ومعرف التتبع Trace ID إن وجد.
أما الأحداث التي يجب أن تسجل دائماً، فتذكر OWASP منها: فشل التحقق من المدخلات Input Validation، ونجاح الدخول وفشله، وفشل الصلاحيات Authorization، وأخطاء الجلسات مثل توكن JWT مشبوه، وأخطاء التطبيق، وبدء التطبيق وإيقافه، واستخدام الوظائف عالية الخطورة مثل إدارة المستخدمين وتغيير الصلاحيات وتصدير البيانات. ولاحظ أن الأحداث الأمنية جزء من السجل العادي هنا، أما السجل الذي يثبت من فعل ماذا ومتى بطريقة لا يمكن تعديلها، وهو ما تطلبه المراجعات والأنظمة، فهو موضوع مختلف شرحناه في مقال سجل التدقيق Audit Trail.
واكتب سطراً واحداً في نهاية كل طلب HTTP يجمع المسار والنتيجة والمدة ووقت قاعدة البيانات وعدد الاستعلامات، كما فعلنا في تتبع الطلب البطيء، والسبب أن هذا السطر وحده يجيب عن أغلب أسئلة التحقيق، وهو أرخص من عشرة سطور متفرقة داخل الطلب.
ما لا يدخل السجل Log أبداً
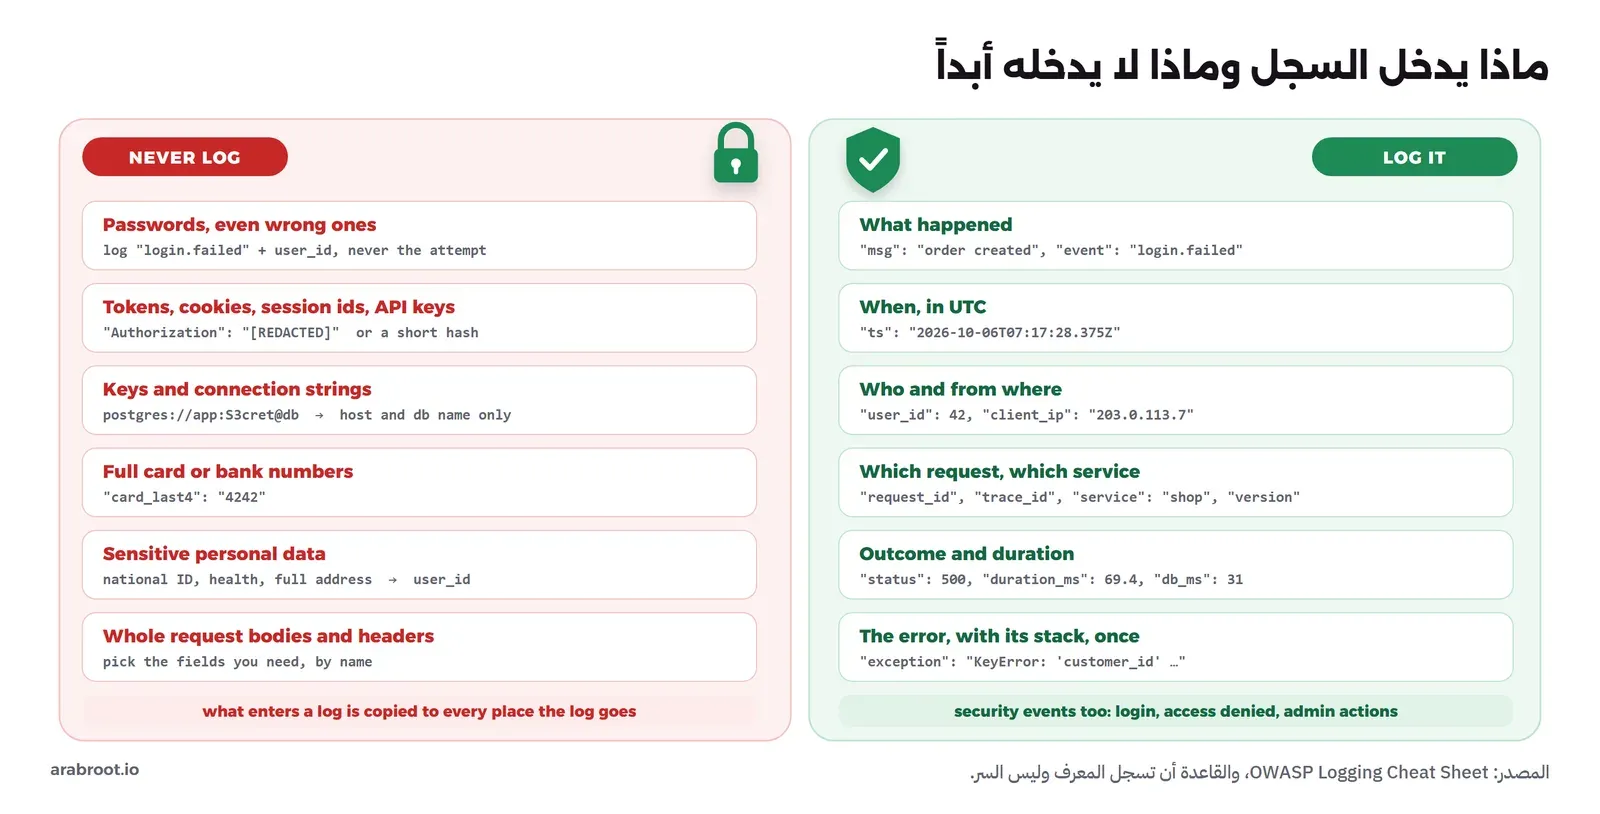
السجل ليس مكاناً آمناً، فهو ينسخ إلى ملفات على السيرفر، ثم إلى أداة الجمع، ثم إلى مخزن مركزي، ثم إلى النسخ الاحتياطية، ويقرؤه كل من في الفريق، وقد يرسل إلى مزود خارجي، لذلك فكل سر يدخل السجل يتكرر في كل هذه الأماكن، ولا تستطيع أن تحذفه منها بسهولة. وتذكر ورقة OWASP قائمة بما يجب ألا يسجل مباشرة، وإنما يحذف أو يخفى Masking أو يستبدل بهاش Hash، والصورة التالية تجمعها مع البديل الآمن لكل منها:
وأهم ما في القائمة، بحسب قسم البيانات المستبعدة في ورقة OWASP، كما يلي:
- كلمات المرور: حتى الخاطئة منها، والسبب أن كلمة المرور الخاطئة غالباً كلمة مرور صحيحة لموقع آخر، أو كلمة المرور الصحيحة بحرف ناقص. سجل أن الدخول فشل ومعرف المستخدم فقط.
- معرفات الجلسات Session IDs والتوكنات Access Tokens: لأن من يقرأ التوكن من السجل يستطيع أن يدخل باسم صاحبه حتى ينتهي، كما شرحنا في مقال الجلسات وJWT، وتقترح OWASP أن تسجل هاش المعرف إذا احتجت أن تربط أحداث الجلسة الواحدة.
- مفاتيح التشفير ونصوص الاتصال بقاعدة البيانات Connection Strings: وتظهر غالباً عندما يطبع التطبيق كل إعداداته عند التشغيل، أو عندما يطبع استثناء الاتصال الرابط كاملاً بكلمة مروره.
- بيانات البطاقات والحسابات البنكية: ويكفي آخر أربعة أرقام إذا احتجت أن تميز البطاقة.
- البيانات الشخصية الحساسة: مثل الهوية الوطنية والبيانات الصحية، وكذلك أي معلومة لم يوافق المستخدم على جمعها، ويكفي معرف المستخدم الداخلي لتصل إليه عند الحاجة من قاعدة البيانات بصلاحيات واضحة.
وفي المملكة يعد عنوان IP والبريد ورقم الجوال بيانات شخصية يحكمها نظام حماية البيانات الشخصية الذي بدأ العمل به في 14 سبتمبر 2023، لذلك فالسجل الذي يحتفظ بها يحتاج غرضاً واضحاً ومدة احتفاظ محددة وصلاحيات قراءة مقيدة مثل أي قاعدة بيانات أخرى.
والطريقة البسيطة في الحماية أن تطلب من كل مطور أن يتذكر ألا يسجل الأسرار، وهذه تفشل في أول سطر مثل log.info("request", headers=request.headers) كتبه أحدهم ليفهم مشكلة ثم نسيه، فيدخل توكن كل مستخدم إلى السجل. والطريقة الصحيحة طبقتان: الأولى أن تسجل الحقول التي تحتاجها بأسمائها ولا تسجل كائناً كاملاً مثل الطلب أو الترويسات أو المستخدم أبداً، والثانية أن يكون في إعداد السجل نفسه فلتر يخفي Redaction الحقول الحساسة بأسمائها، مثل authorization وcookie وpassword وtoken، فإذا نسي أحدهم القاعدة الأولى أمسكته الثانية، وسوف نرى الطريقتين في التجربة العملية وفي أمثلة المكتبات.
السجلات المنظمة Structured Logs
السطر النصي الحر مثل 2026-10-06 07:17:28,257 INFO GET /orders/13 500 63.4ms سهل القراءة لإنسان ينظر إلى عشرة أسطر، ولكنه صعب جداً على أداة تبحث في مليون سطر، والسبب أن معنى كل كلمة يأتي من مكانها في السطر، فإذا أردت أن تسأل «ما الطلبات التي أخذت أكثر من 300 مللي ثانية؟» احتجت تعبيراً منتظماً Regex يعرف أن الرقم الأخير هو المدة، ثم يغير زميلك صيغة الرسالة فيكسر كل تعابيرك دون أن يعرف. والسجل المنظم يكتب الحدث نفسه في حقول بأسماء، والصيغة الأشهر هي سطر JSON لكل حدث، ويسمى أحياناً JSON Lines، والصورة التالية تبين الحدث نفسه من التجربة العملية بالطريقتين:
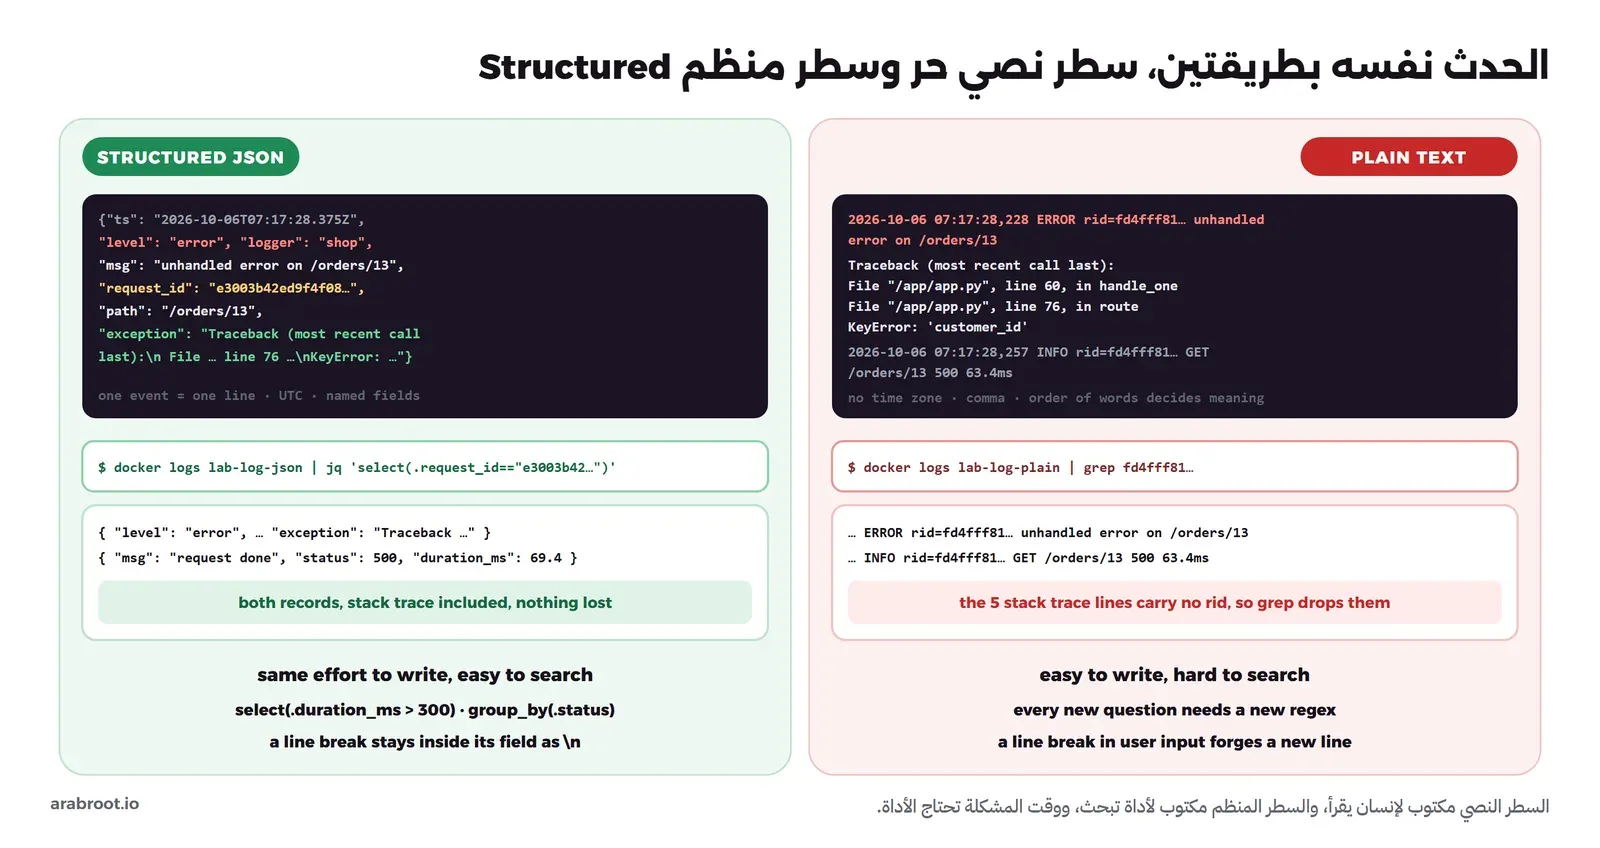
لاحظ في الصورة ثلاثة فروق تظهر وقت المشكلة: الأول أن السطر المنظم يحمل الاستثناء كاملاً في حقل واحد، أما النصي فيكتبه في عدة سطور لا تحمل معرف الطلب فيضيع عند البحث، والثاني أن السطر المنظم يحمل الوقت بتوقيت UTC بشكل صريح، أما النصي فيكتب 07:17:28,228 دون منطقة زمنية، والثالث أن أي سؤال جديد في السجل المنظم هو فلتر على حقل باسمه، مثل select(.duration_ms > 300) في jq أو | json | duration_ms > 300 في LogQL.
وقد يتساءل البعض: أليس JSON صعب القراءة في الطرفية أثناء التطوير؟ والإجابة نعم، والحل أن تبقى الصيغة إعداداً، فتكون نصاً ملوناً على جهازك وJSON في الإنتاج، وأغلب المكتبات تدعم ذلك، مثل ConsoleRenderer في structlog وpino-pretty في Node.js.
أسماء حقول Fields موحدة في كل الخدمات
السجل المنظم يفقد نصف قيمته إذا كتبت خدمة request_id والأخرى requestId والثالثة rid، أو كتبت إحداها المدة بالثواني والأخرى بالمللي ثانية، لأنك لن تستطيع أن تبحث في كل الخدمات بسؤال واحد. والحل أن تتفق على قاموس حقول واحد، والأفضل ألا تخترعه، فهناك معياران معروفان: الاتفاقيات الدلالية Semantic Conventions في OpenTelemetry التي تعرف أسماء مثل http.request.method وhttp.response.status_code وurl.path، ومخطط Elastic المشترك ECS الذي يعرف مثل log.level وtrace.id. وفي أبريل 2023 أعلن المشروعان دمج ECS في اتفاقيات OpenTelemetry حتى يصبح هناك مخطط واحد مفتوح، لذلك إذا كنت تبدأ اليوم فاتجه إلى أسماء OpenTelemetry. وفي التجربة العملية استخدمنا أسماء قصيرة مثل request_id وduration_ms لتكون الأمثلة واضحة، والمهم أن يكون القاموس واحداً ومكتوباً في مكان يعرفه الفريق، وأن تضع الوحدة في اسم الحقل كما في duration_ms.
معرف الطلب Request ID يربط السطور
شرحنا في تتبع الطلب البطيء كيف ينشئ Nginx معرفاً فريداً لكل طلب ويمرره إلى التطبيق في الترويسة X-Request-ID ويعيده إلى الكلاينت، والذي يخص هذا المقال هو الجانب الآخر: كيف يضع التطبيق هذا المعرف في كل سطر يكتبه دون أن تمرره يدوياً إلى كل دالة، وكيف يحمله إلى العمليات التي تعمل في الخلفية بعد انتهاء الطلب. والصورة التالية تبين ذلك:
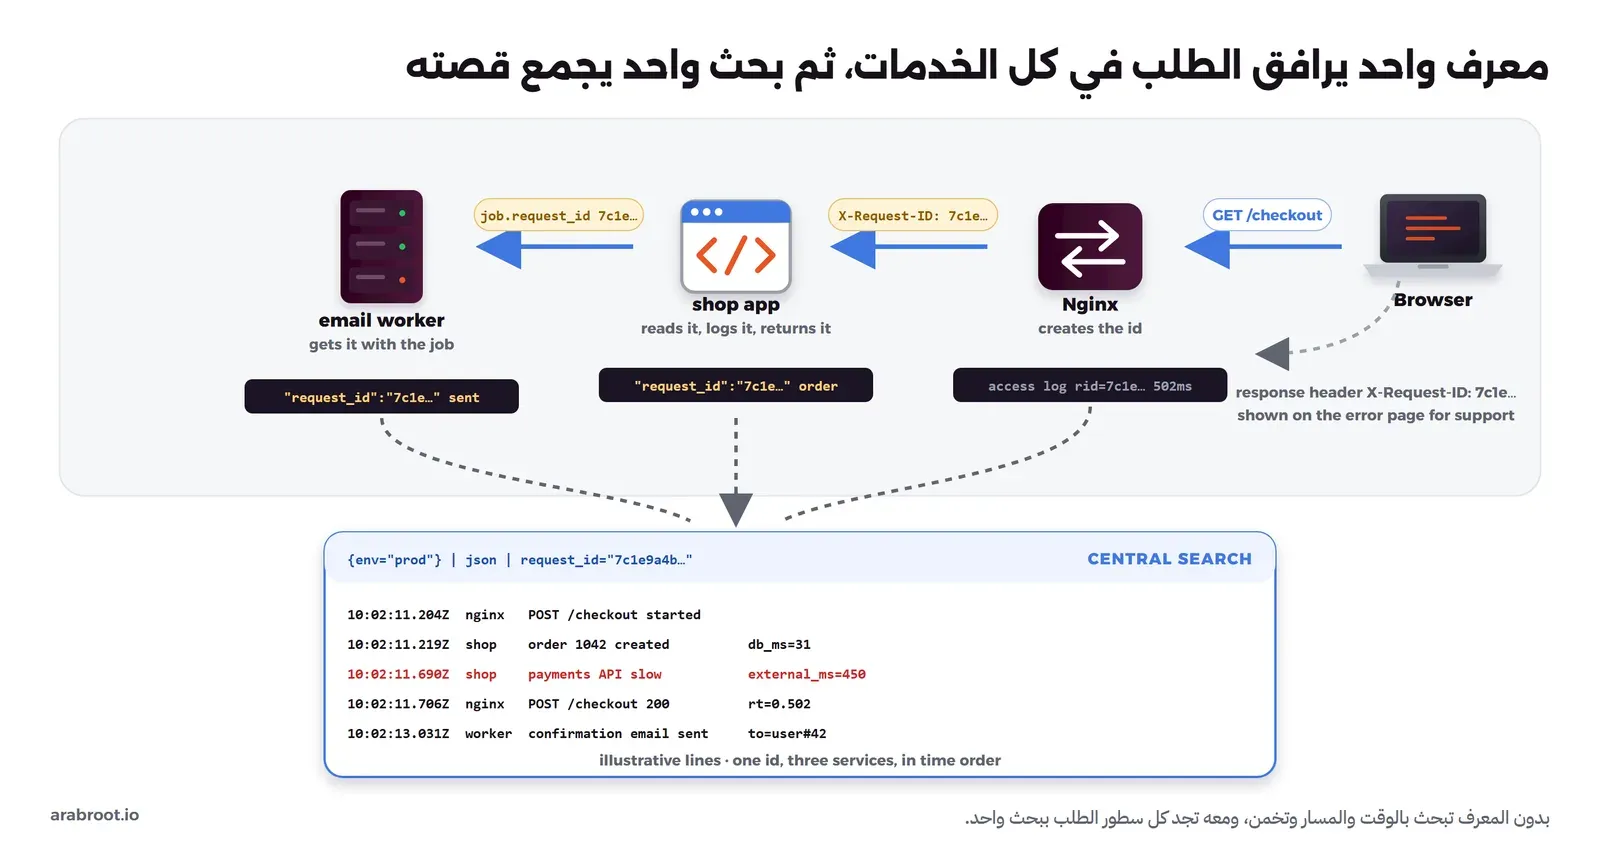
وكل لغة لها طريقة تحفظ بها قيمة تخص الطلب الحالي فقط، وتقرؤها مكتبة السجلات تلقائياً في كل سطر: في Python المتغيرات السياقية contextvars التي يستخدمها structlog، وفي Java ال MDC في SLF4J، وفي .NET ال Scopes في ILogger وال LogContext في Serilog، وفي Node.js وGo ال Child Logger الذي تنشئه في بداية الطلب وتمرره، وسوف ترى كل واحدة منها في أمثلة المكتبات. وعندما يضع التطبيق مهمة في طابور لتعمل في الخلفية، مثل إرسال البريد، فضع المعرف داخل بيانات المهمة نفسها، والسبب أن العامل Worker يعمل في عملية أخرى وفي وقت آخر، ولا يعرف شيئاً عن الطلب الذي أنشأ المهمة.
ولاحظ أن المعرف الذي يأتي في ترويسة من الكلاينت مدخل من المستخدم مثل أي مدخل آخر، لذلك تحقق من صيغته قبل أن تكتبه في السجل، كما فعلنا في التجربة العملية بتعبير يقبل الأرقام الست عشرية والشرطة فقط بطول محدود، وإذا لم تطابق القيمة فأنشئ معرفاً جديداً، وإلا فإن أي أحد يستطيع أن يرسل في هذه الترويسة نصاً يفسد سجلك، وهذا ما نشرحه في القسم التالي.
حقن السجلات Log Injection
لنفرض أن التطبيق يكتب عند فشل الدخول السطر التالي: login failed for user=%s، واسم المستخدم يأتي من نموذج الدخول كما هو، فإذا أرسل المخترق اسم مستخدم فيه سطر جديد ثم نص يشبه سطر سجل حقيقي، مثل alice\n2026-10-06 07:20:00,000 INFO login succeeded user=admin، فسوف يكتب السجل النصي سطرين، والثاني منهما مزور تماماً، ومن يقرأ السجل بعدها يرى أن admin دخل بنجاح. وهذا ما تسميه OWASP حقن السجلات Log Injection، ويصنف في CWE-117، والهدف منه تزوير الأدلة، أو إخفاء سطر حقيقي، أو حقن نص يفسد الأداة التي تعرض السجل، مثل HTML في لوحة ويب تعرض السجلات دون ترميز.
والحل الذي توصي به OWASP أن ترمز كل مدخل قبل أن يكتب في السجل، وتحديداً حرفي الرجوع Carriage Return والسطر الجديد Line Feed، واختصاراً CRLF، والفواصل التي تستخدمها صيغة السجل. والسجل المنظم بصيغة JSON يحل أغلب المشكلة تلقائياً، لأن السطر الجديد داخل القيمة يكتب \n ويبقى السجل سطراً واحداً، ولكن لاحظ أن القيمة نفسها ما زالت تحتوي النص المزور، فإذا عرضتها أداة تفك الترميز وتطبع النص كما هو فقد يعود السطر المزور للظهور، لذلك فالقاعدة أن تبقي مدخلات المستخدم في حقول منفصلة وألا تدمجها في الرسالة، وأن تعرض الأداة القيم كنص وليس HTML. وسوف ترى في التجربة العملية السطر المزور في السجل النصي، ثم الإصلاح بالطريقتين.
${jndi:ldap://...} إذا ظهرت داخل الرسالة المسجلة، فتتصل بالسيرفر المذكور وتحمل منه كوداً وتشغله، وبحسب صفحة أمان Apache Logging فإن «من يتحكم في رسائل السجل أو معاملاتها يستطيع تشغيل كود عشوائي»، أي أن المخترق كان يكفيه أن يضع هذا النص في ترويسة User-Agent أو في اسم المستخدم، والتطبيق يسجله كعادته. وأغلق الإصدار 2.15.0 هذا السلوك افتراضياً ثم حذفه 2.16.0 نهائياً، ووصف تقرير مجلس مراجعة الأمن السيبراني الأمريكي في يوليو 2022 الثغرة بأنها «مستوطنة» وأن نسخها الضعيفة سوف تبقى في الأنظمة سنوات. والدرس أن مكتبة السجلات جزء من سطح الهجوم، فحدثها كما تحدث إطار العمل، ولا تجعلها تفسر محتوى ما تسجله.تسجيل الاستثناءات Exceptions مرة واحدة
الخطأ الأشهر مع الاستثناءات أن يسجلها كل مستوى في الكود ثم يعيد رميها، فالمستودع Repository يلتقط الاستثناء ويسجله ثم يرميه، والخدمة تلتقطه وتسجله ثم ترميه، ومعالج الطلب يلتقطه ويسجله، فتجد ثلاثة أخطاء في السجل لمشكلة واحدة، وتظن أن عندك ثلاث مشكلات، ويرتفع عداد الأخطاء ثلاث مرات. والخطأ المقابل أن تسجل رسالة الاستثناء فقط، مثل log.error(str(e))، فيضيع ال Stack Trace الذي يخبرك في أي سطر وقع.
والقاعدة الصحيحة أن يسجل الاستثناء مرة واحدة، في المكان الذي يقرر ماذا يفعل به، وهو غالباً معالج الطلب الأعلى أو معالج الأخطاء العام في إطار العمل، ومع ال Stack Trace كاملاً. أما المستويات الوسطى فإما أن تعالج الاستثناء فعلاً، أو أن تضيف إليه سياقاً وتعيد رميه دون أن تسجله، مثل raise OrderError("order 1043") from e في Python. وفي Python تكتب ذلك بالدالة log.exception() التي تسجل بمستوى ERROR وتضيف معلومات الاستثناء، وفي Java تمرر الاستثناء آخر معامل أو بالدالة setCause، وفي .NET تمرره أول معامل في LogError(ex, ...). وفي السجل المنظم يدخل ال Stack Trace في حقل واحد، كما في exception في التجربة العملية، فيبقى الحدث سطراً واحداً.
ولاحظ أن ال Stack Trace نفسه قد يسرب أسراراً، فبعض المكتبات تضيف إليه قيم المتغيرات المحلية Local Variables، وعندما شغلنا مثال structlog بالمعالج dict_tracebacks بإعداده الافتراضي وجدنا في السجل حقلاً اسمه locals فيه قيم كل المتغيرات في الدالة التي وقع فيها الخطأ، ولو كان بينها توكن أو كلمة مرور لدخلت السجل، لذلك أطفأنا ذلك في المثال بالخيار show_locals=False.
السجلات Logs والأداء Performance
كل سطر تكتبه له ثمن: تحويل القيم إلى نص، وتحويل النص إلى JSON، والكتابة إلى stdout، ثم نقله وتخزينه وفهرسته، وعلى خدمة تستقبل آلاف الطلبات في الثانية يصبح هذا الثمن ملموساً في المعالج وفي فاتورة التخزين. وفيما يلي أهم ما يقلله:
- لا تبن الرسالة إذا كان المستوى مطفأ: في Python اكتب
log.debug("cart %s", cart)وليسlog.debug(f"cart {cart}")، والسبب أن توثيق Python يقول إن تنسيق معاملات الرسالة يؤجل حتى لا يمكن تجنبه، أما ال f-string فينفذ قبل أن تعرف المكتبة أن المستوى مطفأ. وإذا كان حساب القيمة نفسها مكلفاً فاسأل أولاً بالدالةisEnabledFor(). والفكرة نفسها في SLF4J مع{}، وفي .NET مع قوالب الرسائل Message Templates ومولد الكود LoggerMessage. - لا تشغل DEBUG في الإنتاج دائماً: فهو غالباً أكثر من نصف حجم السجلات، وإذا احتجته فشغله لمكون واحد ولفترة محددة.
- اكتب بشكل غير متزامن Asynchronous عند الحاجة: إذا كانت الوجهة بطيئة، مثل ملف على قرص مشغول أو اتصال شبكة، فالطلب ينتظرها، والحل أن يضع الكود السطر في طابور في الذاكرة ويكتبه خيط آخر، مثل QueueHandler وQueueListener في Python و
AsyncAppenderفي Logback. ولاحظ أن الطابور يحتاج قراراً لما يحدث إذا امتلأ: هل ينتظر الطلب أم تسقط السطور؟ وسطور الأخطاء آخر ما يجب أن يسقط. - أخذ عينة Sampling من الأحداث المتكررة: إذا كانت نقطة فحص الصحة
/healthzتستدعى كل ثانيتين فلا تحتاج سطراً لكل استدعاء ناجح، فسجل الفاشل منها فقط، أو سجل نسبة من الطلبات الناجحة العادية وكل الطلبات الفاشلة والبطيئة. - لا تجعل فشل السجلات يوقف التطبيق: وهذه إحدى توصيات OWASP، فإذا امتلأ القرص أو توقف المخزن المركزي يجب أن يستمر التطبيق في خدمة المستخدمين.
أين تذهب السجلات Logs على السيرفر؟
القاعدة في التطبيقات الحديثة أن التطبيق لا يعرف أين تذهب سجلاته، فهو يكتبها إلى المخرج القياسي stdout وتتولى البيئة الباقي، وهذا ما ينص عليه مبدأ السجلات في Twelve-Factor App: التطبيق «لا يهتم أبداً بتوجيه مخرجه أو تخزينه، ولا يحاول أن يكتب ملفات السجلات أو يديرها»، وإنما تكتب كل عملية أحداثها إلى stdout دون تخزين مؤقت Unbuffered. وقد شرحنا ما يعنيه ذلك للتطبيق داخل ال Container في قائمة تحقق المطور، أما هنا فنرى ما يحدث للسطر بعد أن يخرج من التطبيق في كل بيئة.
في Docker: مشغل السجلات Logging Driver والتدوير
يجمع Docker كل ما يكتبه ال Container إلى stdout وstderr ويسلمه إلى مشغل السجلات، والمشغل الافتراضي هو json-file، ولا يقوم بأي تدوير Log Rotation افتراضياً، فالقيمة الافتراضية للخيار max-size هي -1 أي بلا حد، وقد رأينا في تحليل أداء سيرفر Linux Container يكتب 355 MB في أقل من نصف دقيقة. والحل إما أن تضبط max-size وmax-file، أو أن تستخدم المشغل local الذي يحتفظ افتراضياً بقرابة 100MB لكل Container في خمسة ملفات حجم كل منها 20MB مع الضغط، والإعداد الدائم لكل ال Containers في daemon.json شرحناه في دليل تثبيت Docker. وإذا اخترت مشغلاً يرسل السجلات إلى مكان آخر مثل syslog أو fluentd، فالأمر docker logs يبقى يعمل لأن Docker يحتفظ بنسخة محلية مؤقتة، وهو ما يسميه التوثيق التسجيل المزدوج Dual Logging.
ولاحظ أن التدوير يحمي القرص لكنه يحذف التاريخ، فالسطور الأقدم تختفي عندما يمتلئ آخر ملف، وفي التجربة العملية كتب Container ستين ألف سطر فبقي منها 15760 فقط، لذلك فالتدوير المحلي ليس مكان الاحتفاظ بالسجلات، وإنما ذاكرة قصيرة حتى تنقلها أداة الجمع إلى المخزن المركزي.
في systemd: journald
الخدمات التي تعمل مباشرة على السيرفر بملف وحدة systemd تكتب إلى stdout أيضاً، وsystemd يسلم ذلك إلى journald الذي يخزنه بصيغة ثنائية مفهرسة مع حقول مثل اسم الوحدة ورقم العملية والمستوى، فتقرؤه بأوامر مثل journalctl -u myapp --since "10 min ago" وjournalctl -u myapp -p warning وjournalctl -u myapp -o json. وحجم journald محدود افتراضياً بالقيمة SystemMaxUse، وهي 10% من نظام الملفات بحد أقصى 4G كما في صفحة journald.conf، وأوامر قياس حجمه وتقليصه شرحناها في قسم السجلات في تحليل أداء سيرفر Linux.
الملفات النصية وأداة التدوير logrotate
وبعض البرامج تكتب في ملفات بنفسها، مثل Nginx في /var/log/nginx/، وهنا تحتاج logrotate الذي يعمل يومياً من systemd timer أو cron ويدور الملفات بحسب الإعداد، والإعداد التالي مثال لتطبيق يكتب في /var/log/myapp/:
/var/log/myapp/*.log {
    daily
    rotate 14
    compress
    delaycompress
    missingok
    notifempty
    create 0640 myapp adm
    postrotate
        systemctl kill -s HUP myapp.service
    endscript
}
في الإعداد أعلاه لاحظ التالي:
dailyوrotate 14تعني ملفاً لكل يوم والاحتفاظ بأربعة عشر ملفاً قديماً، وما قبلها يحذف، والقيمة الافتراضية للخيارrotateهي صفر، أي أن الملف القديم يحذف مباشرة إذا لم تحددها.compressيضغط الملفات القديمة بأداة gzip، وdelaycompressيؤخر ضغط آخر ملف دورة واحدة، لأن البرنامج قد يكون ما زال يكتب فيه.create 0640 myapp admينشئ الملف الجديد بصلاحيات تمنع غير المالك ومجموعة adm من قراءته، لأن السجلات فيها بيانات المستخدمين.postrotateيرسل إشارة HUP إلى البرنامج حتى يغلق الملف القديم ويفتح الجديد، وإلا بقي يكتب في الملف المدور. وإذا كان البرنامج لا يفهم هذه الإشارة فهناك الخيارcopytruncateالذي ينسخ الملف ثم يفرغه، ولكن توثيقه يحذر من أن هناك لحظة صغيرة بين النسخ والتفريغ قد تضيع فيها بعض السطور.
وتختبر الإعداد دون أن تدور شيئاً بالأمر sudo logrotate -d /etc/logrotate.d/myapp.
الجمع المركزي Centralized Logging
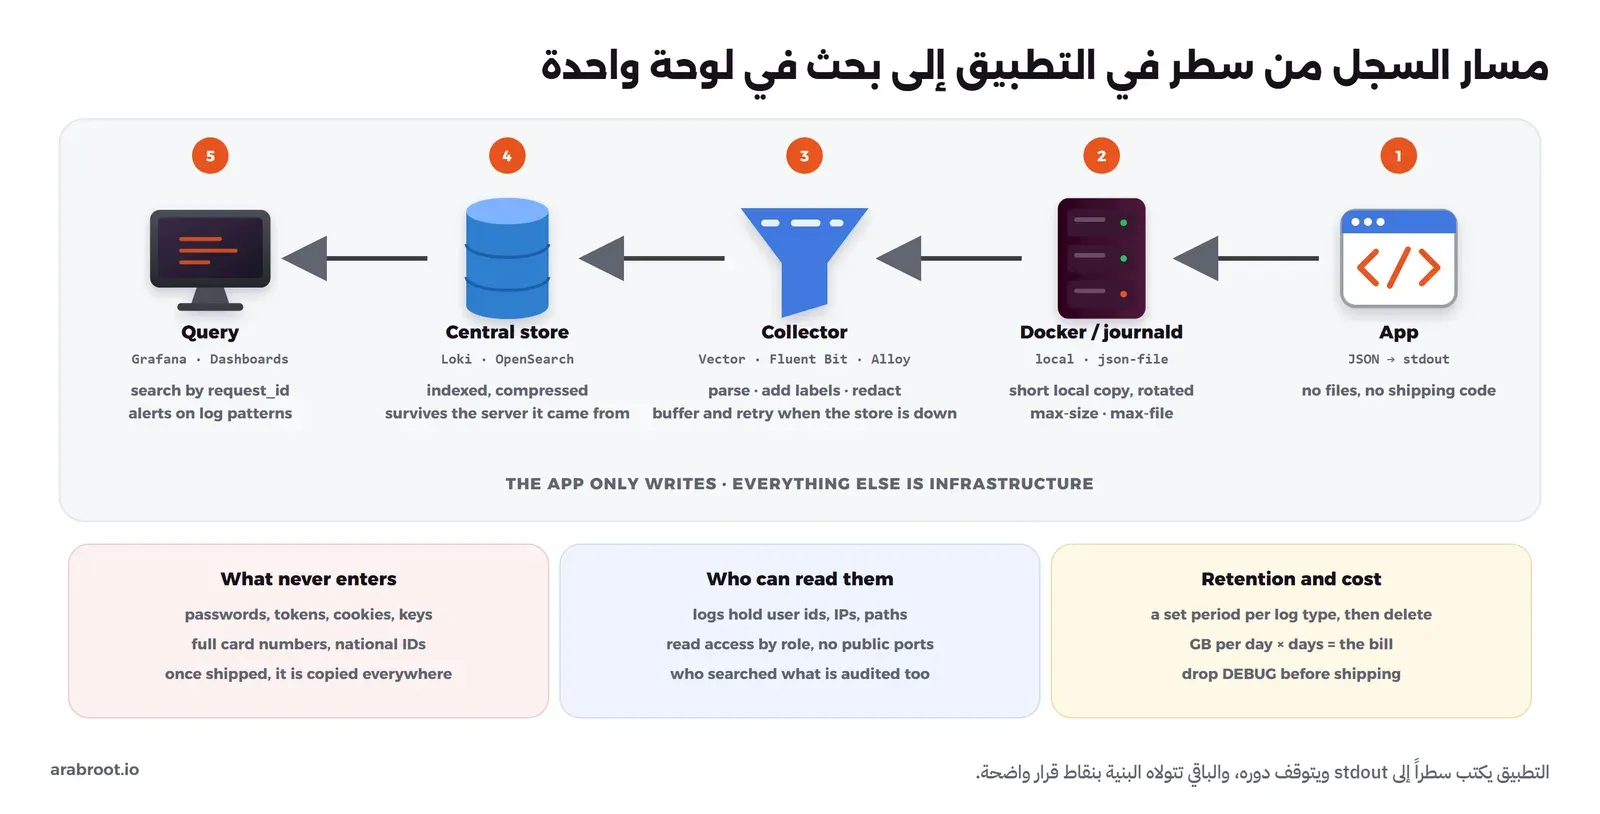
عندما يكون لديك سيرفر واحد وتطبيق واحد فالأمر docker logs مع jq يكفي، ولكن عندما يعمل التطبيق على ثلاث نسخ في سيرفرين، ومعه عامل في الخلفية وNginx وقاعدة بيانات، فلن تفتح خمس طرفيات وتبحث في كل واحدة بالمعرف، وإذا سقط السيرفر نفسه أو أعيد إنشاؤه فسجلاته تذهب معه وهي أهم ما تحتاجه لتعرف لماذا سقط. والحل أن تنقل السجلات أولاً بأول إلى مخزن مركزي خارج السيرفرات التي تنتجها، والصورة التالية تبين مسار السطر من التطبيق إلى البحث:
أدوات الجمع Collectors
أداة الجمع تقرأ السجلات من مصدرها، مثل ملفات Docker أو journald أو الملفات، ثم تحللها وتضيف إليها حقولاً مثل اسم السيرفر وال Container، وتحذف منها ما لا تريده، ثم ترسلها إلى المخزن مع ذاكرة مؤقتة Buffer وإعادة محاولة إذا كان المخزن متوقفاً. والأدوات المفتوحة الأشهر اليوم ثلاث:
- Vector: مكتوب بلغة Rust برخصة MPL-2.0، وتملكه Datadog منذ أن استحوذت على الشركة التي طورته في فبراير 2021، ويتميز بلغة VRL لتحويل السجلات، وهو الذي نستخدمه في التجربة العملية.
- Fluent Bit: مكتوب بلغة C برخصة Apache-2.0، وهو مشروع متخرج Graduated في CNCF ضمن مشروع Fluentd، وخفيف جداً، ويستخدم كثيراً في Kubernetes.
- Grafana Alloy: برخصة Apache-2.0، وهو أداة Grafana الموحدة للسجلات والمقاييس والتتبع، وقد حلت محل Promtail الذي انتهى دعمه End of Life في 2 مارس 2026، لذلك لا تبدأ مشروعاً جديداً بأداة Promtail ولو وجدتها في دروس كثيرة.
أين تخزن السجلات مركزياً، Loki أم OpenSearch؟
هناك طريقتان في تخزين السجلات: الأولى أن تفهرس كل كلمة في كل سطر، كما يفعل OpenSearch وElasticsearch وGraylog الذي يعتمد على أحدهما، فيكون البحث النصي الحر سريعاً جداً، ولكن الفهرس يأخذ مساحة وذاكرة كبيرة. والثانية أن تفهرس تسميات Labels قليلة فقط، مثل اسم الخدمة والبيئة والمستوى، وتحفظ السطور نفسها مضغوطة، ثم تبحث داخلها وقت الاستعلام، وهذه طريقة Loki، فتكون تكلفة التخزين أقل بكثير والبحث أبطأ إذا لم تحدد التسميات. وتختلف الرخص أيضاً، فLoki وGrafana برخصة AGPL-3.0 منذ أبريل 2021، وOpenSearch برخصة Apache-2.0، وتفاصيل الرخص في مقال رخص البرمجيات مفتوحة المصدر. ولكل منها دليل تثبيت قادم في مرحلة المراقبة والسجلات: Loki مع Grafana، وGraylog، وOpenSearch، وSigNoz، بإذن الله.
| json كما في التجربة العملية.الاحتفاظ Retention والتكلفة والصلاحيات Access Control
السؤال الذي ينساه الجميع حتى تصل الفاتورة أو يمتلئ القرص هو: كم يوماً نحتفظ بالسجلات؟ والحساب بسيط: حجم السجلات اليومي مضروباً في عدد الأيام هو المساحة التي تحتاجها، لذلك قس حجمك اليومي الحقيقي أولاً، ثم حدد لكل نوع من السجلات مدة بحسب الغرض منه، فسجلات التطبيق العادية تحتاجها للتحقيق في المشكلات القريبة، والسجلات الأمنية قد تحتاج مدة أطول تحددها سياسة الجهة أو الأنظمة التي تخضع لها، وما بعد المدة يحذف تلقائياً من المخزن، ولا تنس أن النسخ الاحتياطية تحتفظ بنسخة أيضاً. وأرخص سطر هو الذي لم ترسله أصلاً، لذلك احذف DEBUG وأسطر فحص الصحة الناجحة في أداة الجمع قبل أن تصل إلى المخزن.
والصلاحيات لا تقل أهمية، لأن المخزن المركزي يجمع في مكان واحد معرفات المستخدمين وعناوينهم وما فعلوه في كل الخدمات، لذلك لا تفتح منفذه للإنترنت، واجعل الدخول إلى واجهة البحث بحساب لكل شخص وبصلاحيات بحسب الدور، فمطور الخدمة يرى سجلات خدمته، والسجلات الأمنية لفريق الأمن، وسجل من بحث عن ماذا في السجلات نفسها، وهذا الأخير من موضوع سجل التدقيق.
مكتبات السجلات Logging Libraries في كل لغة
الأمثلة التالية تكتب الأحداث نفسها في كل لغة: سطر INFO بإنشاء طلب مع المدة، وسطر DEBUG لا يظهر لأن المستوى INFO، ومعرف الطلب يدخل كل سطر من السياق، ثم خطأ مع الاستثناء أو حقل سري مخفي. وقد شغلنا كل مثال في Container بالإصدار المذكور، والمخرج المعروض هو المخرج الحقيقي.
Python: الوحدة logging وstructlog
الوحدة logging في المكتبة القياسية تكفي، وتكتب JSON بمنسق Formatter صغير كما في التجربة العملية، ولكن structlog برخصة MIT أو Apache-2.0 يجعل السجل المنظم هو الأصل، فتمرر الحقول بأسمائها، وتربط معرف الطلب بالسياق مرة واحدة:
import logging
import structlog

structlog.configure(
    processors=[
        structlog.contextvars.merge_contextvars,      # request_id and anything bound for this request
        structlog.processors.add_log_level,
        structlog.processors.TimeStamper(fmt="iso", utc=True),
        structlog.processors.ExceptionRenderer(       # the exception becomes a field, not extra lines
            structlog.tracebacks.ExceptionDictTransformer(show_locals=False)),
        structlog.processors.JSONRenderer(),
    ],
    wrapper_class=structlog.make_filtering_bound_logger(logging.INFO),
)
log = structlog.get_logger()

structlog.contextvars.bind_contextvars(request_id="9f1c2ab4")
log.debug("cart loaded", items=3)                    # below INFO: dropped
log.info("order created", order_id=1042, duration_ms=37.5)
try:
    {}["customer_id"]
except KeyError:
    log.exception("order failed", order_id=1043)
والمخرج سوف يكون كما يلي، مع structlog 26.1.0 وPython 3.13:
{"order_id": 1042, "duration_ms": 37.5, "event": "order created", "request_id": "9f1c2ab4", "level": "info", "timestamp": "2026-10-06T07:47:25.549201Z"}
{"order_id": 1043, "event": "order failed", "request_id": "9f1c2ab4", "level": "error", "timestamp": "2026-10-06T07:47:25.549391Z", "exception": [{"exc_type": "KeyError", "exc_value": "'customer_id'", "exc_notes": [], "syntax_error": null, "is_cause": false, "frames": [{"filename": "/work/app.py", "lineno": 21, "name": "<module>"}], "is_group": false, "exceptions": []}]}
في المثال أعلاه لاحظ التالي:
- سطر
cart loadedلم يظهر لأنmake_filtering_bound_logger(logging.INFO)يسقط ما تحت INFO قبل أن يبني أي شيء. bind_contextvarsيضعrequest_idفي السياق مرة واحدة، فيظهر في كل سطر بعدها، وفي تطبيق ويب تضعه في Middleware في بداية كل طلب وتمسحه بالدالةclear_contextvars().- الاستثناء أصبح حقلاً منظماً فيه النوع والرسالة والملف والسطر، وأطفأنا المتغيرات المحلية بالخيار
show_locals=Falseللسبب الذي ذكرناه في قسم الاستثناءات.
Node.js: pino
pino برخصة MIT هو أسرع مكتبات السجلات في Node.js وأكثرها استخداماً مع Fastify، ويكتب JSON افتراضياً، وفيه خيار redact الذي يخفي الحقول بمساراتها:
const pino = require('pino');

const log = pino({
  level: 'info',
  timestamp: pino.stdTimeFunctions.isoTime,
  redact: ['req.headers.authorization', 'req.headers.cookie', '*.password'],
});

const reqLog = log.child({ request_id: '9f1c2ab4' });
reqLog.debug({ items: 3 }, 'cart loaded');
reqLog.info({ order_id: 1042, duration_ms: 37.5 }, 'order created');
reqLog.warn({ req: { headers: { authorization: 'Bearer eyJhbGciOi...', cookie: 'session=7f3c' } }, body: { user: 'alice', password: 'hunter2' } }, 'login failed');
reqLog.error({ err: new Error('customer_id missing'), order_id: 1043 }, 'order failed');
والمخرج سوف يكون كما يلي، مع pino 10.4.0 وNode.js 22:
{"level":30,"time":"2026-10-06T07:34:58.923Z","pid":1,"hostname":"487dc6db7b07","request_id":"9f1c2ab4","order_id":1042,"duration_ms":37.5,"msg":"order created"}
{"level":40,"time":"2026-10-06T07:34:58.931Z","pid":1,"hostname":"487dc6db7b07","request_id":"9f1c2ab4","req":{"headers":{"authorization":"[Redacted]","cookie":"[Redacted]"}},"body":{"user":"alice","password":"[Redacted]"},"msg":"login failed"}
{"level":50,"time":"2026-10-06T07:34:58.931Z","pid":1,"hostname":"487dc6db7b07","request_id":"9f1c2ab4","err":{"type":"Error","message":"customer_id missing","stack":"Error: customer_id missing\n    at Object.<anonymous> (/work/app.js:13:21)\n    at Module._compile (node:internal/modules/cjs/loader:1781:14)\n    at Object..js (node:internal/modules/cjs/loader:1913:10)\n    at Module.load (node:internal/modules/cjs/loader:1505:32)\n    at Function._load (node:internal/modules/cjs/loader:1309:12)\n    at wrapModuleLoad (node:internal/modules/cjs/loader:254:19)\n    at Function.executeUserEntryPoint [as runMain] (node:internal/modules/run_main:171:5)\n    at node:internal/main/run_main_module:36:49"},"order_id":1043,"msg":"order failed"}
لاحظ أن المستوى يكتب رقماً، 30 لل INFO و40 لل WARN و50 لل ERROR، وأن child() أنشأ Logger يحمل request_id في كل سطر، وأن الترويسات وكلمة المرور ظهرت بالقيمة [Redacted] رغم أن الكود مررها كاملة، وأن الخطأ أصبح حقلاً err فيه النوع والرسالة وال Stack.
Java: SLF4J مع Logback أو Log4j 2
في Java تكتب الكود على واجهة SLF4J برخصة MIT، وتختار التطبيق الذي يكتب فعلاً: Logback برخصة EPL-2.0 أو LGPL-2.1، أو Log4j 2 برخصة Apache-2.0، وإذا اخترت Log4j 2 فتأكد أنك على إصدار حديث للسبب الذي في قصة Log4Shell أعلاه. والمثال التالي يستخدم واجهة SLF4J 2 التي تضيف الحقول بالدالة addKeyValue، وال MDC لمعرف الطلب:
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.slf4j.MDC;

public class App {
    private static final Logger log = LoggerFactory.getLogger(App.class);

    public static void main(String[] args) {
        MDC.put("request_id", "9f1c2ab4");
        log.debug("cart loaded items={}", 3);
        log.atInfo().addKeyValue("order_id", 1042).addKeyValue("duration_ms", 37.5).log("order created");
        try {
            throw new IllegalStateException("customer_id missing");
        } catch (IllegalStateException e) {
            log.atError().addKeyValue("order_id", 1043).setCause(e).log("order failed");
        }
        MDC.clear();
    }
}
وإعداد Logback يكتب JSON بالمرمز JsonEncoder المدمج فيه:
<configuration>
  <appender name="STDOUT" class="ch.qos.logback.core.ConsoleAppender">
    <encoder class="ch.qos.logback.classic.encoder.JsonEncoder"/>
  </appender>
  <root level="INFO">
    <appender-ref ref="STDOUT"/>
  </root>
</configuration>
والمخرج سوف يكون كما يلي، مع SLF4J 2.0.20 وLogback 1.6.5 وJava 25، وقد اختصرنا ال Stack Trace في السطر الثاني:
{"sequenceNumber":0,"timestamp":1791272925247,"nanoseconds":247179401,"level":"INFO","threadName":"main","loggerName":"App","context":{"name":"default","birthdate":1791272886625,"properties":{}},"mdc": {"request_id":"9f1c2ab4"},"kvpList": [{"order_id":"1042"},{"duration_ms":"37.5"}],"message":"order created","throwable":null}
{"sequenceNumber":0,"timestamp":1791272925517,"nanoseconds":517299668,"level":"ERROR","threadName":"main","loggerName":"App","context":{"name":"default","birthdate":1791272886625,"properties":{}},"mdc": {"request_id":"9f1c2ab4"},"kvpList": [{"order_id":"1043"}],"message":"order failed","throwable":{"className":"java.lang.IllegalStateException","message":"customer_id missing","stepArray":[{"className":"App","methodName":"main","fileName":"App.java","lineNumber":13},…]}}
لاحظ أن المعرف جاء في mdc والحقول في kvpList، وأن الوقت رقم بالمللي ثانية منذ 1970 وليس نصاً، وأن قيم الحقول كتبت نصوصاً مثل "1042"، لذلك إذا احتجت صيغة حقول مسطحة وأسماء موحدة فاستخدم مرمزاً أغنى مثل logstash-logback-encoder، أو حول الحقول في أداة الجمع.
C#: Microsoft.Extensions.Logging وSerilog
في .NET تكتب الكود على واجهة ILogger من Microsoft.Extensions.Logging، وهي سجلات منظمة من الأصل بفضل قوالب الرسائل Message Templates، فالأسماء بين الأقواس في "Order {OrderId} created" تصبح حقولاً، لذلك لا تكتب الرسالة بال String Interpolation مثل $"Order {id}" لأنك تفقد الحقل. والمنسق JSON المدمج يكفي لل Containers:
using Microsoft.Extensions.Logging;

using var factory = LoggerFactory.Create(b => b
    .SetMinimumLevel(LogLevel.Information)
    .AddJsonConsole(o => { o.IncludeScopes = true; o.TimestampFormat = "yyyy-MM-ddTHH:mm:ss.fffZ"; o.UseUtcTimestamp = true; }));
var log = factory.CreateLogger("Shop");

using (log.BeginScope(new Dictionary<string, object> { ["request_id"] = "9f1c2ab4" }))
{
    log.LogDebug("Cart loaded with {Items} items", 3);
    log.LogInformation("Order {OrderId} created in {DurationMs} ms", 1042, 37.5);
    try { throw new KeyNotFoundException("customer_id"); }
    catch (Exception ex) { log.LogError(ex, "Order {OrderId} failed", 1043); }
}
والمخرج سوف يكون كما يلي، مع .NET 10 والحزمة Microsoft.Extensions.Logging.Console 10.0.12:
{"Timestamp":"2026-10-06T07:42:56.509Z","EventId":0,"LogLevel":"Information","Category":"Shop","Message":"Order 1042 created in 37.5 ms","State":{"OrderId":1042,"DurationMs":37.5,"{OriginalFormat}":"Order {OrderId} created in {DurationMs} ms"},"Scopes":[{"Message":"System.Collections.Generic.Dictionary\u00602[System.String,System.Object]","request_id":"9f1c2ab4"}]}
{"Timestamp":"2026-10-06T07:42:56.827Z","EventId":0,"LogLevel":"Error","Category":"Shop","Message":"Order 1043 failed","Exception":"System.Collections.Generic.KeyNotFoundException: customer_id\n   at Program.\u003CMain\u003E$(String[] args) in /work/Program.cs:line 12","State":{"OrderId":1043,"{OriginalFormat}":"Order {OrderId} failed"},"Scopes":[{"Message":"System.Collections.Generic.Dictionary\u00602[System.String,System.Object]","request_id":"9f1c2ab4"}]}
وإذا أردت مرونة أكبر في الوجهات Sinks والتحويل فهناك Serilog برخصة Apache-2.0، والمثال التالي يكتب بصيغة CLEF المضغوطة، ويضع معرف الطلب في السياق بالدالة LogContext.PushProperty:
using Serilog;
using Serilog.Context;
using Serilog.Formatting.Compact;

Log.Logger = new LoggerConfiguration()
    .MinimumLevel.Information()
    .Enrich.FromLogContext()
    .WriteTo.Console(new CompactJsonFormatter())
    .CreateLogger();

using (LogContext.PushProperty("request_id", "9f1c2ab4"))
{
    Log.Information("Order {OrderId} created in {DurationMs} ms", 1042, 37.5);
}
Log.CloseAndFlush();
والمخرج مع Serilog 4.4.0:
{"@t":"2026-10-06T07:52:39.1231215Z","@mt":"Order {OrderId} created in {DurationMs} ms","OrderId":1042,"DurationMs":37.5,"request_id":"9f1c2ab4"}لاحظ أن Serilog يحفظ القالب نفسه في الحقل @mt، وهذا مفيد لأنك تستطيع أن تعد كم مرة وقع الحدث نفسه مهما اختلفت قيمه.
Go: log/slog
منذ Go 1.21 أصبح السجل المنظم جزءاً من المكتبة القياسية في الحزمة log/slog كما في إعلان فريق Go، فلا تحتاج مكتبة خارجية في أغلب الحالات، والدالة ReplaceAttr مكان مناسب لإخفاء الحقول الحساسة:
package main

import (
	"log/slog"
	"os"
)

func main() {
	logger := slog.New(slog.NewJSONHandler(os.Stdout, &slog.HandlerOptions{
		Level: slog.LevelInfo,
		ReplaceAttr: func(groups []string, a slog.Attr) slog.Attr {
			if a.Key == "password" || a.Key == "authorization" {
				return slog.String(a.Key, "[REDACTED]")
			}
			return a
		},
	}))

	reqLog := logger.With("request_id", "9f1c2ab4")
	reqLog.Debug("cart loaded", "items", 3)
	reqLog.Info("order created", "order_id", 1042, "duration_ms", 37.5)
	reqLog.Warn("login failed", "user", "alice", "password", "hunter2")
}
والمخرج سوف يكون كما يلي، مع Go 1.27.1:
{"time":"2026-10-06T07:36:47.153701353Z","level":"INFO","msg":"order created","request_id":"9f1c2ab4","order_id":1042,"duration_ms":37.5}
{"time":"2026-10-06T07:36:47.180339496Z","level":"WARN","msg":"login failed","request_id":"9f1c2ab4","user":"alice","password":"[REDACTED]"}
لاحظ أن logger.With أنشأ Logger يحمل المعرف، وأن DEBUG لم يظهر، وأن كلمة المرور مخفية رغم أن الكود مررها.
تجربة عملية: من سطر نصي إلى بحث مركزي بمعرف الطلب Request ID
في هذه التجربة نشغل تطبيقاً صغيراً بلغة Python دون أي مكتبة خارجية، يكتب سجله نصاً حراً أو JSON بحسب متغير البيئة LOG_FORMAT، ويفعل الإصلاحات بالمتغير SAFE، ثم نسأله أسئلة لا يجيب عنها السجل النصي، ونحقن فيه سطراً مزوراً، ونسرب فيه توكن، ثم ننقل سجله إلى Loki بأداة Vector ونبحث فيه من Grafana. وكل ال Containers تبدأ بالبادئة lab-log- وكل المنافذ على 127.0.0.1 فقط.
ملفات التجربة وال Containers
الملف app.py هو التطبيق كاملاً:
import json, logging, os, re, sys, time, uuid, random, contextvars
from datetime import datetime, timezone
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

FORMAT = os.environ.get("LOG_FORMAT", "plain")      # plain | json
SAFE = os.environ.get("SAFE", "0") == "1"           # redaction + CR/LF escaping
request_id = contextvars.ContextVar("request_id", default="-")
SECRET_KEYS = {"authorization", "cookie", "password", "token"}

def redact(value):
    if isinstance(value, dict):
        return {k: "[REDACTED]" if k.lower() in SECRET_KEYS else redact(v) for k, v in value.items()}
    return value

class PlainFormatter(logging.Formatter):
    def format(self, record):
        line = f"{self.formatTime(record)} {record.levelname} rid={request_id.get()} {record.getMessage()}"
        if SAFE:
            line = line.replace("\r", "\\r").replace("\n", "\\n")
        if record.exc_info:
            line += "\n" + self.formatException(record.exc_info)
        return line

class JsonFormatter(logging.Formatter):
    def format(self, record):
        entry = {
            "ts": datetime.fromtimestamp(record.created, timezone.utc).isoformat(timespec="milliseconds").replace("+00:00", "Z"),
            "level": record.levelname.lower(),
            "logger": record.name,
            "msg": record.getMessage(),
            "request_id": request_id.get(),
        }
        entry.update(getattr(record, "fields", {}))
        if SAFE:
            entry = redact(entry)
        if record.exc_info:
            entry["exception"] = self.formatException(record.exc_info)
        return json.dumps(entry, ensure_ascii=False)

handler = logging.StreamHandler(sys.stdout)
handler.setFormatter(JsonFormatter() if FORMAT == "json" else PlainFormatter())
logging.basicConfig(level=os.environ.get("LOG_LEVEL", "INFO"), handlers=[handler])
log = logging.getLogger("shop")

class App(BaseHTTPRequestHandler):
    def log_message(self, *args):   # silence the default access log of http.server
        pass

    def reply(self, status, body):
        self.send_response(status)
        self.send_header("X-Request-ID", request_id.get())
        self.end_headers()
        self.wfile.write((body + "\n").encode())

    def handle_one(self):
        rid = self.headers.get("X-Request-ID", "")
        request_id.set(rid if re.fullmatch(r"[0-9a-f-]{8,64}", rid) else uuid.uuid4().hex)
        start, status = time.perf_counter(), 200
        try:
            status = self.route()
        except Exception:
            status = 500
            log.exception("unhandled error on %s", self.path, extra={"fields": {"path": self.path}})
            self.reply(500, "internal error, request id " + request_id.get())
        ms = round((time.perf_counter() - start) * 1000, 1)
        if FORMAT == "json":
            log.info("request done", extra={"fields": {"method": self.command, "path": self.path, "status": status, "duration_ms": ms}})
        else:
            log.info("%s %s %s %sms", self.command, self.path, status, ms)

    def route(self):
        if self.path.startswith("/orders/"):
            order = int(self.path.rsplit("/", 1)[1])
            time.sleep(random.uniform(0.01, 0.05) if order % 5 else 0.4)   # every fifth order is slow
            if order == 13:
                raise KeyError("customer_id")
            self.reply(200, f"order {order}")
            return 200
        if self.path == "/login":
            user = self.rfile.read(int(self.headers.get("Content-Length", 0))).decode()
            log.warning("login failed for user=%s", user, extra={"fields": {"user": user}})
            self.reply(401, "bad credentials")
            return 401
        if self.path == "/pay":
            log.info("payment accepted", extra={"fields": {"amount": 120, "headers": dict(self.headers)}})
            self.reply(200, "paid")
            return 200
        self.reply(404, "not found")
        return 404

    do_GET = do_POST = handle_one

ThreadingHTTPServer(("0.0.0.0", 8000), App).serve_forever()
في الكود أعلاه لاحظ التالي:
- المتغير
request_idمن نوعContextVar، فقيمته تخص الطلب الحالي فقط حتى لو عمل التطبيق على عدة طلبات في خيوط مختلفة، والمنسقان يقرآنه في كل سطر. - المعرف يؤخذ من الترويسة
X-Request-IDإذا طابق تعبيراً يقبل الأرقام الست عشرية والشرطة بطول من 8 إلى 64، وإلا ينشأ معرف جديد، ثم يعاد إلى الكلاينت في ترويسة الرد. - كل طلب ينتهي بسطر واحد فيه الطريقة والمسار والنتيجة والمدة، والطلب رقم 13 يرمي استثناء يسجل مرة واحدة بالدالة
log.exception، وكل طلب خامس بطيء عمداً. - المسار
/loginيكتب اسم المستخدم كما وصل، والمسار/payيسجل الترويسات كاملة، وهما الخطآن اللذان سوف نصلحهما. - عند
SAFE=1يرمز المنسق النصي CR وLF، ويخفي المنسق المنظم أي حقل اسمه فيSECRET_KEYSمهما كان عمقه.
والملف compose.yaml يشغل التطبيق نفسه أربع مرات بإعدادات مختلفة، ومعه Container فيه curl نرسل منه الطلبات:
name: lab-log
services:
  plain:
    image: python:3.13-slim
    container_name: lab-log-plain
    command: python -u /app/app.py
    environment: { LOG_FORMAT: plain }
    volumes: ["./app.py:/app/app.py:ro"]
    ports: ["127.0.0.1:20080:8000"]
  json:
    image: python:3.13-slim
    container_name: lab-log-json
    command: python -u /app/app.py
    environment: { LOG_FORMAT: json }
    volumes: ["./app.py:/app/app.py:ro"]
    ports: ["127.0.0.1:20081:8000"]
  safe:
    image: python:3.13-slim
    container_name: lab-log-safe
    command: python -u /app/app.py
    environment: { LOG_FORMAT: json, SAFE: "1" }
    volumes: ["./app.py:/app/app.py:ro"]
    ports: ["127.0.0.1:20082:8000"]
    logging:
      driver: json-file
      options: { max-size: "10m", max-file: "3" }
  plain-safe:
    image: python:3.13-slim
    container_name: lab-log-plain-safe
    command: python -u /app/app.py
    environment: { LOG_FORMAT: plain, SAFE: "1" }
    volumes: ["./app.py:/app/app.py:ro"]
  client:
    image: curlimages/curl:8.22.0
    container_name: lab-log-client
    command: sleep infinity
ثم نشغلها ونرسل عشرين طلباً لكل من النسخة النصية والنسخة المنظمة:
docker compose up -d
docker exec lab-log-client sh -c 'for host in plain json; do for i in $(seq 1 20); do curl -s -o /dev/null http://$host:8000/orders/$i; done; done'
الخطوة 1: أسئلة لا يجيب عنها السجل النصي Plain Text
نرسل الطلب الفاشل رقم 13 إلى النسختين ونقرأ معرفه من ترويسة الرد، كما يفعل الدعم الفني عندما يرسل له المستخدم صورة صفحة الخطأ:
docker exec lab-log-client sh -c 'curl -s -D - -o /dev/null http://plain:8000/orders/13; curl -s -D - -o /dev/null http://json:8000/orders/13' | grep -i x-requestوالمخرج سوف يكون كما يلي:
X-Request-ID: fd4fff81fa9b4e149accd4c8c8492bce
X-Request-ID: e3003b42ed9f4f08a24736e24c8a868c
والسؤال الأول: ماذا حدث في هذا الطلب بالضبط؟ نبحث بالمعرف في السجل النصي:
docker logs lab-log-plain 2>&1 | grep fd4fff81fa9b4e149accd4c8c8492bceوالمخرج سوف يكون كما يلي:
2026-10-06 07:17:28,228 ERROR rid=fd4fff81fa9b4e149accd4c8c8492bce unhandled error on /orders/13
2026-10-06 07:17:28,257 INFO rid=fd4fff81fa9b4e149accd4c8c8492bce GET /orders/13 500 63.4ms
عرفنا أن هناك خطأ، ولكن السبب نفسه غير موجود، لأن الاستثناء كتب في خمسة سطور بعد سطر الخطأ ولا يحمل أي منها المعرف، وفي سيرفر يعمل على عشرات الطلبات في الثانية قد تختلط هذه السطور بسطور طلبات أخرى. والآن نسأل السجل المنظم السؤال نفسه بأداة jq:
docker logs lab-log-json 2>&1 | jq 'select(.request_id=="e3003b42ed9f4f08a24736e24c8a868c")'والمخرج سوف يكون كما يلي:
{
  "ts": "2026-10-06T07:17:28.375Z",
  "level": "error",
  "logger": "shop",
  "msg": "unhandled error on /orders/13",
  "request_id": "e3003b42ed9f4f08a24736e24c8a868c",
  "path": "/orders/13",
  "exception": "Traceback (most recent call last):\n  File \"/app/app.py\", line 60, in handle_one\n    status = self.route()\n  File \"/app/app.py\", line 76, in route\n    raise KeyError(\"customer_id\")\nKeyError: 'customer_id'"
}
{
  "ts": "2026-10-06T07:17:28.424Z",
  "level": "info",
  "logger": "shop",
  "msg": "request done",
  "request_id": "e3003b42ed9f4f08a24736e24c8a868c",
  "method": "GET",
  "path": "/orders/13",
  "status": 500,
  "duration_ms": 69.4
}
القصة كاملة: الطلب فشل لأن المفتاح customer_id غير موجود في السطر 76، وأخذ 69.4 مللي ثانية. والسؤال الثاني: ما الطلبات التي أخذت أكثر من 300 مللي ثانية؟
docker logs lab-log-json 2>&1 | jq -r 'select(.duration_ms > 300) | [.ts, .path, .duration_ms] | @tsv'والمخرج سوف يكون كما يلي:
2026-10-06T07:16:09.403Z	/orders/5	414.2
2026-10-06T07:16:10.445Z	/orders/10	400.6
2026-10-06T07:16:11.446Z	/orders/15	405.0
2026-10-06T07:16:12.191Z	/orders/20	409.7
والسؤال الثالث: كم طلباً انتهى بكل رمز حالة، وما متوسط مدته؟
docker logs lab-log-json 2>&1 | jq -s -c 'map(select(.msg=="request done")) | group_by(.status) | map({status: .[0].status, count: length, avg_ms: (map(.duration_ms) | add / length | floor)})'والمخرج سوف يكون كما يلي:
[{"status":200,"count":19,"avg_ms":109},{"status":500,"count":2,"avg_ms":126}]لاحظ أن كل سؤال هو فلتر على حقول بأسمائها، ولا يعتمد على مكان الكلمة في السطر، فلو أضاف أحدهم حقلاً جديداً إلى السطر غداً لبقيت الأوامر تعمل. والطلبان الفاشلان هنا هما الطلب 13 في الدفعة الأولى والطلب الذي أرسلناه بعدها. وقد شغلنا jq 1.8.2.
الخطوة 2: نحقن سطراً مزوراً بحقن السجلات Log Injection ثم نصلحه
نرسل إلى /login اسم مستخدم فيه سطر جديد ثم نص يشبه سطر نجاح دخول المدير، إلى النسخة النصية البسيطة والنسخة المنظمة:
docker exec lab-log-client sh -c 'for h in plain json; do curl -s -o /dev/null --data-binary "$(printf "alice\n2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin")" http://$h:8000/login; done'
docker logs lab-log-plain 2>&1 | tail -3
والمخرج سوف يكون كما يلي:
2026-10-06 07:22:59,485 WARNING rid=abcae1989325451bb42f7b57bc2700a3 login failed for user=alice
2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin
2026-10-06 07:22:59,650 INFO rid=abcae1989325451bb42f7b57bc2700a3 POST /login 401 165.5ms
السطر الثاني لم يكتبه التطبيق، وإنما كتبه المخترق، وهو يشبه السطور الحقيقية تماماً بوقته ومستواه، بل إن وقته قبل وقت السطر الذي حمله. أما النسخة المنظمة فكتبت الحدث نفسه هكذا:
docker logs lab-log-json 2>&1 | grep 'login failed'{"ts": "2026-10-06T07:22:59.755Z", "level": "warning", "logger": "shop", "msg": "login failed for user=alice\n2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin", "request_id": "443f33935d9149e18ace32e98365760a", "user": "alice\n2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin"}السطر الجديد أصبح \n داخل القيمة، والحدث بقي سجلاً واحداً بمستوى warning ومعرف الطلب الحقيقي، ولا أحد يخلط بينه وبين دخول ناجح. ولاحظ مع ذلك أن الكود أدخل اسم المستخدم في الرسالة msg أيضاً، والأفضل أن تبقى الرسالة ثابتة login failed وأن يبقى المدخل في الحقل user وحده. وإذا كان لا بد من السجل النصي، فالإصلاح أن يرمز المنسق CR وLF، وهذا ما تفعله النسخة lab-log-plain-safe:
docker exec lab-log-client sh -c 'curl -s -o /dev/null --data-binary "$(printf "alice\n2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin")" http://plain-safe:8000/login'
docker logs lab-log-plain-safe 2>&1 | tail -2
والمخرج سوف يكون كما يلي:
2026-10-06 07:25:15,063 WARNING rid=538e0e0f23134042b6629a585b9ae61d login failed for user=alice\n2026-10-06 07:20:00,000 INFO rid=0 login succeeded user=admin
2026-10-06 07:25:15,063 INFO rid=538e0e0f23134042b6629a585b9ae61d POST /login 401 0.6ms
النص المحقون ما زال ظاهراً، ولكنه داخل السطر الحقيقي ولا يبدأ سطراً جديداً، فلا يمكن أن يظن أحد أنه حدث مستقل.
الخطوة 3: توكن Token في السجل، ثم الإخفاء Redaction
نرسل طلب دفع بتوكن وملف تعريف ارتباط إلى النسخة المنظمة البسيطة والنسخة الآمنة:
docker exec lab-log-client sh -c 'for h in json safe; do curl -s -o /dev/null -H "Authorization: Bearer eyJhbGciOiJIUzI1NiJ9.eyJzdWIiOiI0MiJ9.lab-signature" -H "Cookie: session=7f3c9a1e" http://$h:8000/pay; done'
docker logs lab-log-json 2>&1 | grep payment
docker logs lab-log-safe 2>&1 | grep payment
والمخرج سوف يكون كما يلي:
{"ts": "2026-10-06T07:25:28.180Z", "level": "info", "logger": "shop", "msg": "payment accepted", "request_id": "fe4df3589c1846b997fe2ca31bdd1ed8", "amount": 120, "headers": {"Host": "json:8000", "User-Agent": "curl/8.22.0", "Accept": "*/*", "Authorization": "Bearer eyJhbGciOiJIUzI1NiJ9.eyJzdWIiOiI0MiJ9.lab-signature", "Cookie": "session=7f3c9a1e"}}
{"ts": "2026-10-06T07:25:28.308Z", "level": "info", "logger": "shop", "msg": "payment accepted", "request_id": "56fc789b6a7040a390a5c1eb079ead78", "amount": 120, "headers": {"Host": "safe:8000", "User-Agent": "curl/8.22.0", "Accept": "*/*", "Authorization": "[REDACTED]", "Cookie": "[REDACTED]"}}
في النسخة الأولى أصبح التوكن والجلسة في السجل، ومن يقرأ السجل، أو يصل إلى المخزن المركزي أو إلى نسخة احتياطية منه، يستطيع أن يستخدمهما حتى ينتهيا. وفي النسخة الثانية أخفاهما الفلتر رغم أن الكود نفسه لم يتغير، وهذه هي الطبقة الثانية التي ذكرناها، أما الطبقة الأولى فهي أن تحذف headers من السطر أصلاً، لأنك لا تحتاجها. وإذا أردت أن تعرف هل تسرب شيء إلى سجلاتك الحالية، فابحث فيها عن أنماط معروفة مثل Bearer وpassword وeyJ التي يبدأ بها كل JWT:
docker logs lab-log-json 2>&1 | grep -c 'Bearer '
docker logs lab-log-safe 2>&1 | grep -c 'Bearer '
1
0وإذا وجدت توكن في السجلات فلا يكفي أن تحذف السطر، لأنه نسخ إلى أماكن أخرى، وإنما يجب أن تلغي التوكن نفسه وتنهي الجلسات المتأثرة ثم تصلح الكود.
الخطوة 4: تدوير السجلات Log Rotation في Docker
النسخة lab-log-safe في الملف أعلاه تحدد max-size وmax-file، والنسخة lab-log-json لا تحدد شيئاً، والأمر التالي يبين الفرق:
for c in lab-log-json lab-log-safe; do echo "$c $(docker inspect --format '{{json .HostConfig.LogConfig}}' $c)"; doneوالمخرج سوف يكون كما يلي:
lab-log-json {"Type":"json-file","Config":{}}
lab-log-safe {"Type":"json-file","Config":{"max-file":"3","max-size":"10m"}}
الإعداد الفارغ يعني القيم الافتراضية، أي ملفاً واحداً بلا حد. ولنرى التدوير يعمل فعلاً، نشغل Container يكتب ستين ألف سطر JSON مع حد صغير، ملف 1 MB وثلاثة ملفات:
docker run -d --name lab-log-rotate --log-opt max-size=1m --log-opt max-file=3 alpine:3.24 sh -c 'i=0; while [ $i -lt 60000 ]; do echo "{\"level\":\"info\",\"msg\":\"order created\",\"order_id\":$i}"; i=$((i+1)); done; sleep 3600'
sudo ls -l $(dirname $(docker inspect --format '{{.LogPath}}' lab-log-rotate)) | grep json.log
docker logs lab-log-rotate | wc -l
docker logs lab-log-rotate | head -1
والمخرج سوف يكون كما يلي:
-rw-r-----    1 root     root        141332 Oct  6 07:53 020fc3e6e0de…-json.log
-rw-r-----    1 root     root       1000118 Oct  6 07:53 020fc3e6e0de…-json.log.1
-rw-r-----    1 root     root       1000126 Oct  6 07:53 020fc3e6e0de…-json.log.2
15760
{"level":"info","msg":"order created","order_id":44240}
الملفات لم تتجاوز ثلاثة، ومجموعها قرابة 2.1 MB، ولكن لاحظ النتيجة الأخرى: من ستين ألف سطر بقي 15760 فقط، وأقدم سطر باق هو الطلب رقم 44240، أي أن كل ما قبله حذف. ولهذا السبب ننقل السجلات إلى مخزن مركزي قبل أن يحذفها التدوير، وهي الخطوة التالية. ثم نحذف هذا ال Container بالأمر docker rm -f lab-log-rotate. وقد اختصرنا معرف ال Container في أسماء الملفات، وعدلنا الأمر ls قليلاً، فعلى Docker Desktop الذي شغلنا عليه التجربة قرأنا مجلد السجلات من Container يقرأ /var/lib/docker/containers، أما على سيرفر Linux فالأمر كما هو مكتوب.
الخطوة 5: ننقل السجلات إلى Loki ونبحث من Grafana
الآن نضيف ثلاثة Containers: Loki مخزناً، وVector أداة جمع تقرأ سجلات ال Containers من Docker مباشرة، وGrafana للبحث. والملف vector.yaml كما يلي:
sources:
  docker:
    type: docker_logs
    include_containers: ["lab-log-json", "lab-log-safe"]

transforms:
  parse:
    type: remap
    inputs: ["docker"]
    source: |
      parsed, err = parse_json(.message)
      .level = if err == null { parsed.level } else { "unknown" }

sinks:
  loki:
    type: loki
    inputs: ["parse"]
    endpoint: "http://loki:3100"
    encoding:
      codec: text
    labels:
      container: "{{ container_name }}"
      level: "{{ level }}"
في الإعداد أعلاه لاحظ التالي:
- المصدر docker_logs يقرأ السجلات من Docker عبر ال Socket، ويقتصر هنا على Containerين بالاسم، ويضيف إلى كل حدث حقولاً مثل
container_name. - التحويل
remapبلغة VRL يحلل السطر بالدالةparse_json، ويأخذ منه المستوى فقط ليصبح تسمية، وإذا لم يكن السطر JSON صحيحاً أعطاهunknownبدل أن يفشل. - الوجهة loki ترسل السطر الأصلي كما هو بالترميز
text، مع تسميتين فقط: اسم ال Container والمستوى، ولا يوجد معرف الطلب بين التسميات للسبب الذي في التحذير أعلاه.
والملف compose.central.yaml يضيف الخدمات الثلاث، ومعه ملف صغير grafana-datasource.yaml يعرف Loki مصدراً للبيانات في Grafana:
services:
  loki:
    image: grafana/loki:3.7.8
    container_name: lab-log-loki
    command: -config.file=/etc/loki/local-config.yaml
  vector:
    image: timberio/vector:0.58.0-alpine
    container_name: lab-log-vector
    volumes:
      - ./vector.yaml:/etc/vector/vector.yaml:ro
      - /var/run/docker.sock:/var/run/docker.sock:ro
    depends_on: [loki]
  grafana:
    image: grafana/grafana:13.2.3
    container_name: lab-log-grafana
    environment:
      GF_AUTH_ANONYMOUS_ENABLED: "true"
      GF_AUTH_ANONYMOUS_ORG_ROLE: Admin
      GF_AUTH_DISABLE_LOGIN_FORM: "true"
    volumes:
      - ./grafana-datasource.yaml:/etc/grafana/provisioning/datasources/loki.yaml:ro
    ports: ["127.0.0.1:20083:3000"]
    depends_on: [loki]
apiVersion: 1
datasources:
- name: Loki
type: loki
url: http://loki:3100
isDefault: trueولاحظ أن Grafana هنا يعمل دون تسجيل دخول وبصلاحية المدير لكل زائر حتى نأخذ الصورة بسهولة، وهذا مناسب لتجربة على 127.0.0.1 فقط، ولا تفعله أبداً على سيرفر، للسبب الذي ذكرناه في قسم الصلاحيات. وكذلك فإن Vector يقرأ Socket الخاص ب Docker، وهذا يعطيه تحكماً كاملاً في Docker، لذلك ثبته للقراءة فقط كما في الملف، ولا تعطه لأداة لا تثق بها. ثم نشغل الخدمات ونرسل طلبات جديدة، ومنها الطلب الفاشل:
docker compose -f compose.yaml -f compose.central.yaml up -d loki vector grafana
docker exec lab-log-client sh -c 'for i in $(seq 1 15); do curl -s -o /dev/null http://json:8000/orders/$i; done; curl -s -D - -o /dev/null http://json:8000/orders/13 | grep -i x-request'
والمخرج سوف يكون كما يلي:
X-Request-ID: 08119e116e174820bef79adaa1afe9c0ونسأل Loki مباشرة من واجهته البرمجية بلغة LogQL: اختر سلسلة ال Container، وحلل كل سطر بالمحلل json، وأبق السطور التي معرفها هو المعرف أعلاه، ثم اطبع الوقت والمستوى والرسالة:
docker exec lab-log-client sh -c 'curl -s -G http://loki:3100/loki/api/v1/query_range --data-urlencode "query={container=\"lab-log-json\"} | json | request_id=\"08119e116e174820bef79adaa1afe9c0\" | line_format \"{{.ts}} {{.level}} {{.msg}}\"" --data-urlencode "since=1h"' | jq -r '.data.result[].values[][1]'والمخرج سوف يكون كما يلي:
2026-10-06T17:01:33.616Z error unhandled error on /orders/13
2026-10-06T17:01:33.618Z info request done
والاستعلام نفسه في صفحة Explore في Grafana على العنوان http://127.0.0.1:20083، والصورة التالية تبين النتيجة:
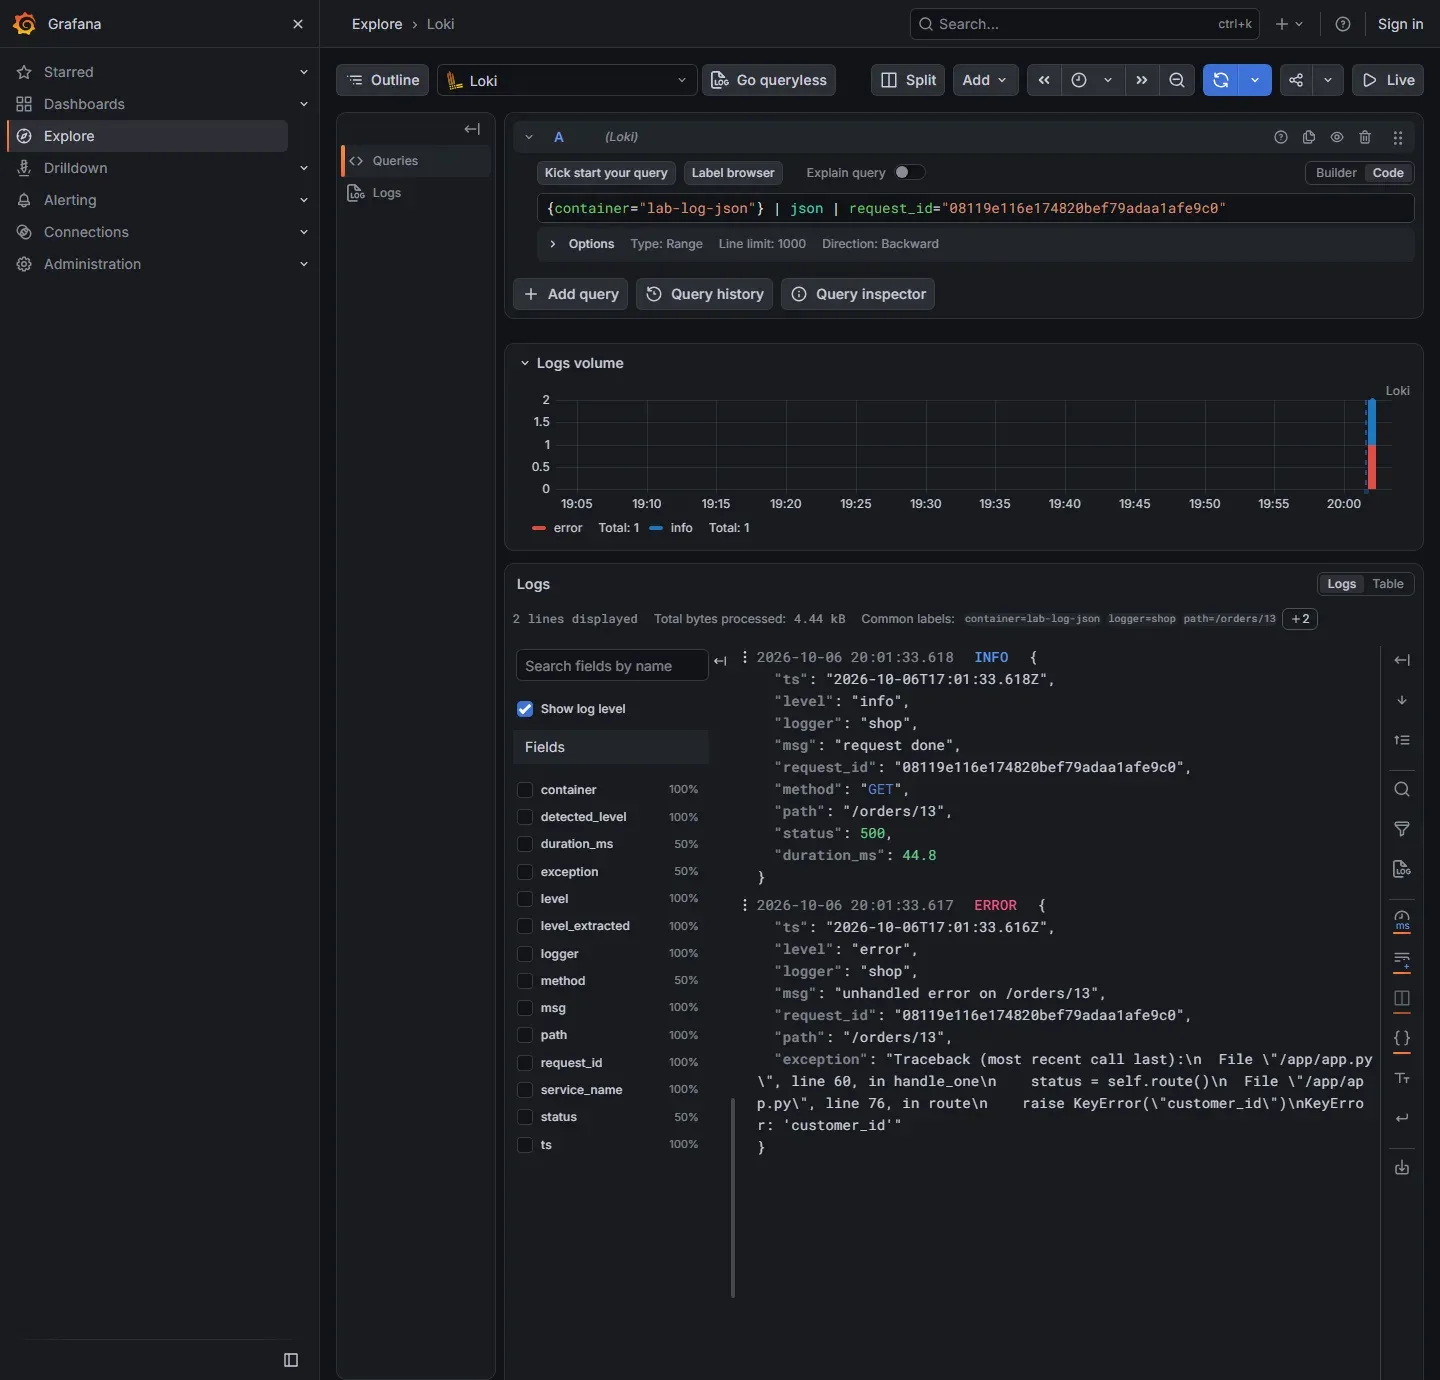
لاحظ في الصورة أن Grafana يعرض الوقت في العمود الأول بالمنطقة الزمنية للمتصفح، وهي هنا UTC+3، أما الحقل ts داخل السطر فبتوقيت UTC، وأن قائمة الحقول على اليسار استخرجها المحلل json وقت الاستعلام دون أن تكون مفهرسة، وأن Loki لم يستقبل إلا السطور التي كتبت بعد تشغيل Vector، والسبب أن Vector يبدأ القراءة من لحظة تشغيله ثم يحفظ موضعه، لذلك فالأداة التي تبدأ متأخرة لا تنقل ما حذفه التدوير قبلها.
إزالة التجربة Cleanup
نحذف ال Containers والشبكة التي أنشأتها التجربة بالاسم فقط:
docker compose -f compose.yaml -f compose.central.yaml down
docker rm -f lab-log-rotate 2>/dev/null
ولا تستخدم docker system prune أو docker volume prune لتنظيف تجربة، والسبب أنهما يحذفان كل ما لا يستخدمه Container يعمل الآن، وقد يكون بينها بيانات خدمة أخرى متوقفة مؤقتاً.
أخطاء شائعة Common Mistakes
- سجل بلا معرف طلب: فلا تستطيع أن تربط سطور الطلب الواحد، وتبحث بالوقت وتخمن.
- رسالة متغيرة بدل حقول: مثل
f"user {id} paid {amount}"، فلا تستطيع أن تعد الحدث ولا أن تبحث بالقيمة، والصحيح رسالة ثابتة وحقول منفصلة. - تسجيل كائنات كاملة: الطلب أو الترويسات أو المستخدم أو الإعدادات، وهي الطريق الأقصر لتسريب التوكنات وكلمات المرور.
- تسجيل الاستثناء في كل طبقة: فتظهر المشكلة الواحدة ثلاث مرات، أو تسجيله دون ال Stack Trace فتضيع أهم معلومة.
- كل شيء ERROR: فيفقد التنبيه معناه ويتعلم الفريق تجاهل الأخطاء، والعكس أيضاً: خطأ حقيقي بمستوى INFO لا يراه أحد.
- الوقت بالتوقيت المحلي ودون منطقة: فلا تستطيع أن ترتب سطوراً من سيرفرين.
- التطبيق يكتب ملفاته داخل ال Container: فتضيع عند إعادة إنشائه، ولا تراها أداة الجمع.
- Docker بلا تدوير: حتى يمتلئ القرص ويتوقف كل شيء، ومنها السجلات نفسها.
- معرف الطلب أو المستخدم تسمية في Loki: فيتضخم الفهرس ويبطئ المخزن.
- مدخلات المستخدم في السجل النصي دون ترميز: فيستطيع أي أحد أن يزور سطراً.
- مخزن السجلات مفتوح للإنترنت أو لكل الفريق: وهو يحتوي بيانات المستخدمين من كل الخدمات في مكان واحد.
- لا أحد يعرف كم نحتفظ: فإما أن يمتلئ المخزن، أو تحذف السجلات قبل أن تحتاجها.
قائمة تحقق Checklist
- التطبيق يستخدم مكتبة سجلات وليس
print، والمستوى إعداد من متغير بيئة، والإنتاج على INFO. - كل سطر JSON واحد فيه الوقت بتوقيت UTC والمستوى والخدمة والرسالة الثابتة ومعرف الطلب.
- الفريق متفق على أسماء الحقول ووحداتها، والأفضل اتفاقيات OpenTelemetry.
- كل طلب ينتهي بسطر واحد فيه المسار والنتيجة والمدة، والمعرف يمر إلى المهام في الخلفية.
- الاستثناءات تسجل مرة واحدة مع ال Stack Trace، دون المتغيرات المحلية.
- لا تسجل كلمات المرور والتوكنات وملفات تعريف الارتباط والمفاتيح ونصوص الاتصال وأرقام البطاقات والبيانات الشخصية الحساسة، وفي إعداد السجل فلتر يخفيها بأسمائها.
- مدخلات المستخدم في حقول منفصلة، والسجل النصي إن وجد يرمز CR وLF، والمعرف القادم في ترويسة يتحقق من صيغته.
- الأحداث الأمنية مسجلة: الدخول وفشله، ورفض الصلاحيات، وتغيير الصلاحيات، والتصدير.
- مكتبة السجلات محدثة مثل أي مكتبة أخرى، وخاصة Log4j 2.
- التطبيق يكتب إلى stdout، وDocker عليه تدوير بالمشغل
localأوmax-sizeوmax-file، وحدود journald وlogrotate معروفة. - السجلات تنقل إلى مخزن مركزي خارج السيرفر، بأداة جمع حديثة وليس Promtail.
- لكل نوع من السجلات مدة احتفاظ تحذف بعدها تلقائياً، والحجم اليومي معروف.
- الدخول إلى المخزن بحسابات شخصية وصلاحيات بحسب الدور، ومنفذه غير مفتوح للإنترنت.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- السجل هو الشاهد الوحيد على ما حدث في الإنتاج، لذلك يكتب قبل المشكلة بمكتبة سجلات، وليس بأوامر
printتضاف بعدها. - المستويات لها معنى: INFO لما يحدث عادة، وWARN لما عولج ويستحق المتابعة، وERROR لما فشل ويجب أن يعرف به أحد، وDEBUG وTRACE للتطوير.
- السجل المنظم بصيغة JSON مع أسماء حقول موحدة ومعرف طلب في كل سطر يحول كل سؤال وقت المشكلة إلى فلتر بسيط، والسجل النصي يحتاج تعبيراً جديداً لكل سؤال ويضيع ال Stack Trace.
- سجل المعرف وليس السر، واجعل الإخفاء طبقة في إعداد السجل، ورمز مدخلات المستخدم حتى لا يزور أحد سطراً، وتذكر أن مكتبة السجلات نفسها كانت باباً للاختراق في Log4Shell.
- التطبيق يكتب إلى stdout فقط، والتدوير المحلي يحمي القرص ويحذف التاريخ، والجمع المركزي مع مدة احتفاظ وصلاحيات واضحة هو ما يحفظ السجلات عندما تحتاجها.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلAudit Trail: كيف تبني سجل تدقيق لا يقبل العبثكيف تصمم سجلاً يجيب عن سؤال من غير هذه الصلاحية ومتى، وتحميه من الحذف والتعديل بعد كتابته.
 دليلقبل أن تنشر تطبيقك على خادمك: قائمة تحقق للمطورالأخطاء التي لا تظهر إلا بعد نشر تطبيقك في Docker خلف Reverse Proxy، وكيف تعالج كل واحد منها قبل أن يصل إلى المستخدمين.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة بتطبيق Python 3.13.16 في Docker مع Vector 0.58.0 وLoki 3.7.8 وGrafana 13.2.3، وتشغيل أمثلة structlog 26.1.0 وpino 10.4.0 وSLF4J 2.0.20 مع Logback 1.6.5 وMicrosoft.Extensions.Logging 10.0.12 وSerilog 4.4.0 وGo 1.27.1.


