

يصلك في صباح يوم عمل عادي سطر واحد من زميل في فريق المبيعات: «الموقع بطيء جداً»، وبعد دقائق تصل رسالة ثانية من عميل يقول إن صفحة الدفع تعطيه خطأ، وفي نفس الوقت يقترح أحد الزملاء في مجموعة الفريق أن نرفع السيرفر إلى حجم أكبر، ويقترح آخر أن نعيد تشغيل كل شيء، ويقترح ثالث أن نضيف Redis. وكل هذه الاقتراحات قد تكون صحيحة وقد تكون خاطئة تماماً، والمشكلة أن أحداً لم يقس شيئاً بعد، ولا يعرف أحد ما الذي تغير منذ أمس. وقد ذكرنا في قسم قس قبل أن تغير من مقال تصميم الأنظمة أن أكثر خطأ يتكرر عندما يبطئ الموقع هو أن يقرر الفريق الحل قبل أن يعرف السبب، وهذا الدليل هو الجواب العملي على سؤال «كيف أعرف السبب؟».
واستكشاف الأخطاء Troubleshooting وتحليل الأداء Performance Analysis ليسا موهبة يولد بها بعض المهندسين، وإنما طريقة منظمة تتعلمها: تحدد العرض بدقة، وتسأل ما الذي تغير، وتضع فرضية واحدة، وتقيسها بقياس واحد، وتغير شيئاً واحداً، وتكتب كل ذلك. وهذا الدليل هو المقال الرئيسي في هذا الموضوع، فهو يملك الطريقة ودليل الحالات الشائعة، ومعه مقالان يتعمقان في التفاصيل:
- استكشاف الأخطاء وتحليل الأداء للمبتدئين: الطريقة والحالات الشائعة (هذا المقال).
- تحليل أداء سيرفر Linux في 60 ثانية: أدوات المعالج والذاكرة والقرص والشبكة واحدة واحدة، مثل
vmstatوiostatوpidstatوss. - تتبع الطلب البطيء من المتصفح إلى قاعدة البيانات: توقيت الطلب الواحد بـ
curlوأدوات المتصفح وسجلات Nginx، وأخطاء 502 و504، والتحليل Profiling.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يفشل التخمين، ولماذا لا يحل السيرفر الأكبر مشكلة لا تعرف سببها.
- طريقة التحقيق خطوة بخطوة: وصف العرض، وسؤال «ما الذي تغير؟»، والخط الزمني، والفرضية والقياس، والملاحظات، ومتى تتراجع أولاً ثم تبحث عن السبب.
- ثلاث قوائم تحقق من مصادرها الأصلية: طريقة USE وطريقة RED والإشارات الذهبية الأربع، ولماذا تقيس النسب المئوية Percentiles وليس المتوسط.
- خريطة الطبقات التي يمر بها الطلب، وأين يعيش كل عرض، وأول أداة تفتحها له.
- تجربة عملية كاملة: بطء بعد نشر إصدار جديد، نحققه بالطريقة نفسها من العرض إلى السبب ثم التراجع.
- دليل الحالات الشائعة: البطء على الجميع أو على بعضهم، و502 و504، والمعالج والذاكرة والقرص، والاتصالات بقاعدة البيانات، وDNS والشهادات، والبطء بعد النشر، والأخطاء المتقطعة، والمهام المجدولة.
- حوادث حقيقية نشرتها شركات معروفة عن نفسها، ونموذج ملاحظات للحادثة تنسخه، والأخطاء الشائعة.
الخلاصة في دقيقة واحدة
إذا لم يكن لديك وقت إلا لهذا القسم، فهذه القواعد التي سوف نشرحها في بقية الدليل:
- اكتب العرض في جملة دقيقة قبل أي شيء: من يتأثر، وما الذي يحدث بالضبط، ومنذ متى، وكيف قسته.
- اسأل «ما الذي تغير؟» قبل أن تسأل «ما الخطأ؟»، والسبب أن أغلب الأعطال تأتي بعد تغيير: نشر إصدار، أو تعديل إعداد، أو تحديث حزمة، أو زيادة في الزيارات، أو شهادة انتهت.
- إذا كان العملاء متأثرين الآن وهناك تغيير حديث، فتراجع عنه أولاً ثم ابحث عن السبب بهدوء، فإيقاف الضرر Mitigation يسبق معرفة السبب الجذري Root Cause.
- فرضية واحدة، ثم قياس واحد يثبتها أو ينفيها، ثم تغيير واحد، ثم قياس جديد، ولا تغير ثلاثة أشياء معاً لأنك لن تعرف أيها أصلح المشكلة.
- استخدم قائمة USE لكل مورد في السيرفر، وقائمة RED لكل خدمة، وانظر إلى p95 وp99 وليس إلى المتوسط وحده.
- اتبع الطلب طبقة طبقة من المتصفح إلى القرص، وابدأ بالطبقة التي تقول الأرقام إنها تأخذ الوقت، وليس بالطبقة التي تعرفها أكثر.
- اكتب ملاحظاتك بالوقت أثناء التحقيق، فهي التي تمنعك من تكرار نفس التجربة، وهي التي يبنى عليها تقرير ما بعد الحادثة.
لماذا يفشل التخمين؟
لنأخذ المثال الأشهر: صفحة الطلبات في متجرك صارت تأخذ ثلاث ثوان بعد أن كانت تأخذ نصف ثانية. والحل الذي يخطر للجميع أولاً هو أن نرفع السيرفر من 4 أنوية إلى 8 أنوية، لأن السيرفر «يبدو مضغوطاً». وقد ينجح هذا الحل يوماً أو يومين، ثم يعود البطء كما كان، والسبب أن المشكلة الحقيقية استعلام بلا فهرس Index يقرأ الجدول كله في كل طلب، والجدول يكبر كل يوم، فكلما زادت الطلبات زادت القراءة الكاملة، ولا يوجد سيرفر كبير بما يكفي لعمل يتضاعف مع كل صف جديد. والفهرس الصحيح كان سيجعل نفس الاستعلام يأخذ جزءاً من المللي ثانية على السيرفر الصغير نفسه، كما سوف نرى بالأرقام في التجربة العملية بعد قليل.
والحل الثاني الذي يخطر للبعض هو إعادة التشغيل، وهي تخفي العرض فعلاً لبعض الوقت، لأنها تفرغ الذاكرة وتغلق الاتصالات المعلقة، ولكنها تمسح معها الدليل الذي كنت تحتاجه لتعرف السبب: العمليات التي كانت تستهلك المعالج، والاتصالات المفتوحة، وحالة الذاكرة. لذلك إذا اضطررت لإعادة التشغيل لتعيد الخدمة للعملاء، فخذ قبلها دقيقة واحدة تحفظ فيها ما تستطيع، مثل مخرج top وdocker stats وآخر سطور السجلات.
والطريقة الصحيحة أن تعامل المشكلة كما يعامل الطبيب المريض: لا يصف الدواء قبل أن يسمع الأعراض ويقيس الحرارة ويسأل ما الذي تغير في الأيام الأخيرة. وهذا بالضبط ما يسميه فصل Effective Troubleshooting في كتاب Google عن هندسة موثوقية المواقع Site Reliability Engineering بالطريقة الافتراضية الاستنتاجية Hypothetico-Deductive Method: تجمع ملاحظات عن النظام، وتضع فرضية عن السبب، ثم تختبرها، وتكرر حتى تصل.
طريقة التحقيق خطوة بخطوة
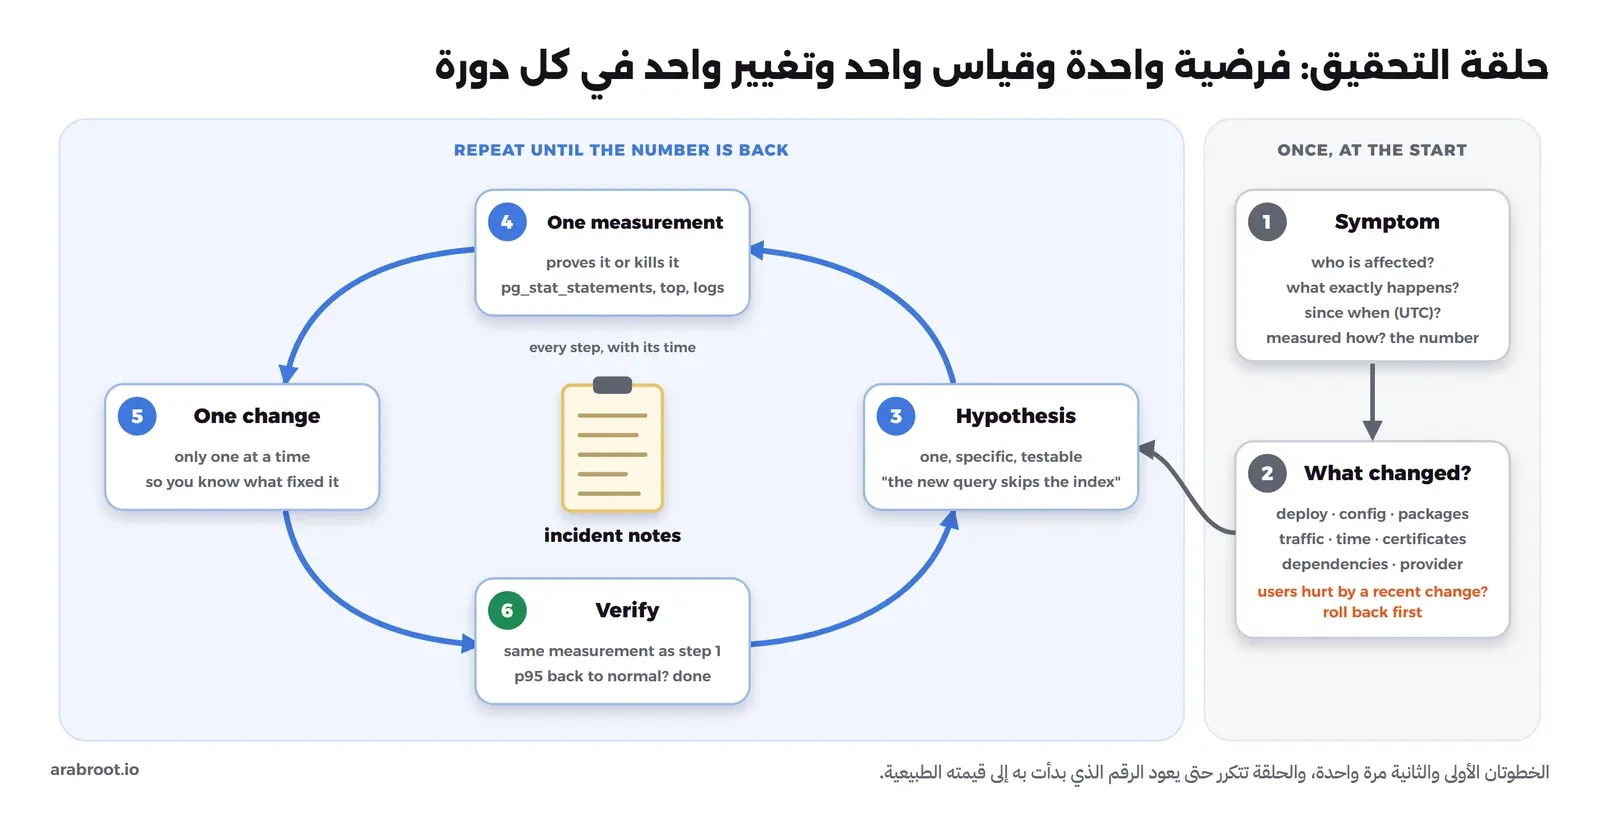
الطريقة التي نستخدمها في كل حالة في هذا الدليل حلقة من ست خطوات، تعيدها حتى تصل إلى السبب، وفي وسطها ملف ملاحظات تكتب فيه كل خطوة بوقتها، والصورة التالية تبين هذه الحلقة:
الخطوة الأولى: صف العرض بدقة
جملة «الموقع بطيء» لا تكفي لتبدأ، لأنها قد تعني صفحة واحدة بطيئة لعميل واحد على شبكة جواله، وقد تعني أن كل الصفحات تعطي 502 لكل العملاء. لذلك حول البلاغ إلى وصف دقيق يجيب عن أربعة أسئلة، وهي قريبة مما يطلبه فصل Google في تقرير المشكلة Problem Report، أي السلوك المتوقع والسلوك الفعلي وطريقة إعادة المشكلة:
- من يتأثر؟ كل المستخدمين، أم مستخدمو دولة معينة، أم من يستخدم تطبيق الجوال فقط، أم المستخدمون المسجلون دون الزوار؟
- ماذا يحدث بالضبط؟ بطء أم خطأ؟ وإذا كان خطأ فما رمزه بالضبط، 500 أم 502 أم 504، أم رسالة شهادة في المتصفح؟ وأي صفحة أو أي نقطة API؟
- منذ متى؟ بدأ فجأة في ساعة محددة، أم يزيد تدريجياً منذ أسابيع، أم يتكرر في نفس الساعة كل يوم؟
- كيف قسته؟ من لوحة المراقبة، أم من سجلات ال Reverse Proxy، أم من متصفح شخص واحد؟ وما الرقم قبل المشكلة وما الرقم الآن؟
والفرق كبير بين البلاغين التاليين: «الموقع بطيء»، و«منذ الساعة 10:40 صار زمن p95 لصفحة /orders حوالي 900 مللي ثانية بعد أن كان 60، لكل المستخدمين، والصفحة الرئيسية طبيعية، بحسب سجل Nginx». فالبلاغ الثاني يخبرك أين تبحث، ويعطيك رقماً تقارن به بعد كل تغيير لتعرف هل نجح.
الخطوة الثانية: ما الذي تغير؟
يقول فصل المقدمة في كتاب Google SRE إن قرابة 70% من الأعطال التي رآها الفريق سببها تغيير في نظام يعمل، لذلك فأسرع طريق إلى السبب في الغالب أن تسأل ما الذي تغير قريباً من وقت بداية العرض، وابحث في هذه القائمة:
- النشر Deployment: إصدار جديد من التطبيق، أو Docker Image جديدة، أو ترحيل Migration في قاعدة البيانات.
- الإعداد Configuration: تعديل في Nginx أو في متغيرات البيئة أو في حدود الذاكرة، أو قاعدة جديدة في جدار الحماية Firewall.
- النظام والحزم: تحديث تلقائي لحزمة، أو إعادة تشغيل السيرفر، أو إصدار جديد من Docker.
- الزيارات Traffic: حملة تسويقية، أو بداية الدوام بعد إجازة، أو زاحف Crawler جديد، أو هجوم.
- الوقت: شهادة انتهت، أو نطاق انتهى تسجيله، أو مهمة مجدولة Cron Job تعمل في هذه الساعة، أو جدول وصل حجماً معيناً.
- الخدمات الخارجية Dependencies: مزود الدفع، أو خدمة البريد، أو مزود DNS، أو ال CDN، أو مزود السيرفر نفسه.
والأوامر التالية تجيب عن جزء كبير من هذا السؤال على سيرفر Linux يعمل عليه Docker:
# what restarted or was redeployed recently? (look at STATUS and CREATED)
docker ps --format 'table {{.Names}}\t{{.Image}}\t{{.Status}}\t{{.CreatedAt}}'

# when did the server itself start?
uptime -s

# packages installed or upgraded recently (Ubuntu / Debian)
tail -n 30 /var/log/apt/history.log

# warnings and errors from the system in the last two hours
journalctl --since "2 hours ago" -p warning --no-pager | tail -n 50

# what did the team change in the code and the configuration?
git log --since="2 days ago" --oneline
في الأوامر أعلاه لاحظ التالي:
- عمود
Statusفيdocker psيقول منذ متى يعمل كل Container، فإذا وجدت Container عمره 20 دقيقة والمشكلة بدأت قبل 20 دقيقة فهذا أول خيط. - السجل
/var/log/apt/history.logيكتب فيه apt كل عملية تثبيت وتحديث بتاريخها، ومنها التحديثات التلقائية Unattended Upgrades. - آخر أمر يفترض أن الإعداد نفسه في Git، وإذا لم يكن كذلك فهذه أول حادثة تقنعك بأن تضعه فيه.
الخطوة الثالثة: ارسم خطاً زمنياً
ضع في ملف الملاحظات خطاً زمنياً بسيطاً من سطر لكل حدث: متى بدأ العرض بحسب المراقبة، ومتى وصل أول بلاغ، ومتى نشر آخر إصدار، ومتى عمل آخر Cron Job، ومتى بدأت أنت التحقيق. والخط الزمني يكشف علاقات لا تراها وأنت تنظر إلى لوحة واحدة، مثل أن البطء بدأ بعد النشر بدقيقتين، أو أنه يبدأ كل ليلة في الثانية بعد منتصف الليل. ولاحظ أن كل الأوقات يجب أن تكون بمنطقة زمنية واحدة، والأفضل UTC، والسبب أن السجلات من أنظمة مختلفة قد تكتب بمناطق زمنية مختلفة، وقد شرحنا ذلك في مقال التاريخ والوقت.
الخطوة الرابعة: فرضية واحدة، وقياس واحد، وتغيير واحد
بعد أن عرفت العرض وما تغير، ضع فرضية محددة يمكن اختبارها، مثل «الاستعلام الجديد في صفحة الطلبات لا يستخدم الفهرس»، وليس «قاعدة البيانات فيها مشكلة». ثم اختر قياساً واحداً يثبتها أو ينفيها، مثل ترتيب الاستعلامات بالوقت في pg_stat_statements، وبعده نفذ تغييراً واحداً فقط، ثم أعد نفس القياس الذي بدأت به في الخطوة الأولى.
وقد يتساءل البعض: لماذا لا أغير ثلاثة أشياء معاً لأوفر الوقت والعملاء ينتظرون؟ والإجابة أنك إذا غيرت حجم الذاكرة وإعداد ال Pool وأعدت تشغيل قاعدة البيانات في نفس الوقت ثم تحسن الموقع، فلن تعرف أي التغييرات أصلحه، وقد يكون أحدها أضر بشيء آخر سوف يظهر غداً، وستبقى بقية التغييرات في الإنتاج Production دون سبب يعرفه أحد. والاستثناء الوحيد هو التراجع عن تغيير معروف لإيقاف الضرر، كما سوف نرى بعد قليل.
وانتبه في هذه الخطوة إلى خطأين يحذر منهما فصل Google نفسه: الخلط بين الارتباط Correlation والسببية Causation، فكون رسالة خطأ تظهر بكثرة الآن لا يعني أنها السبب، فقد تكون موجودة منذ أشهر بنفس العدد، وأن تبدأ بالفرضيات النادرة قبل الشائعة، فخطأ في نواة Linux ممكن، ولكن استعلاماً بلا فهرس أو قرصاً ممتلئاً أكثر احتمالاً بكثير.
الخطوة الخامسة: اكتب كل شيء بوقته
اكتب أثناء التحقيق، وليس بعده، كل ما رأيته وكل ما جربته ونتيجته بالوقت، في ملف نصي أو في قناة الحادثة في نظام المحادثة لديكم. والسبب أنك بعد ساعة من الضغط لن تتذكر هل جربت إعادة تشغيل ال Container قبل تعديل الإعداد أم بعده، وأن زميلك الذي ينضم في منتصف الحادثة يقرأ الملف بدل أن يسألك عشرة أسئلة، وأن هذه الملاحظات هي المادة التي يبنى منها تقرير ما بعد الحادثة Postmortem. وتجد نموذجاً جاهزاً تنسخه في قسم نموذج ملاحظات الحادثة في آخر هذا الدليل.
متى توقف الضرر أولاً ثم تبحث عن السبب؟
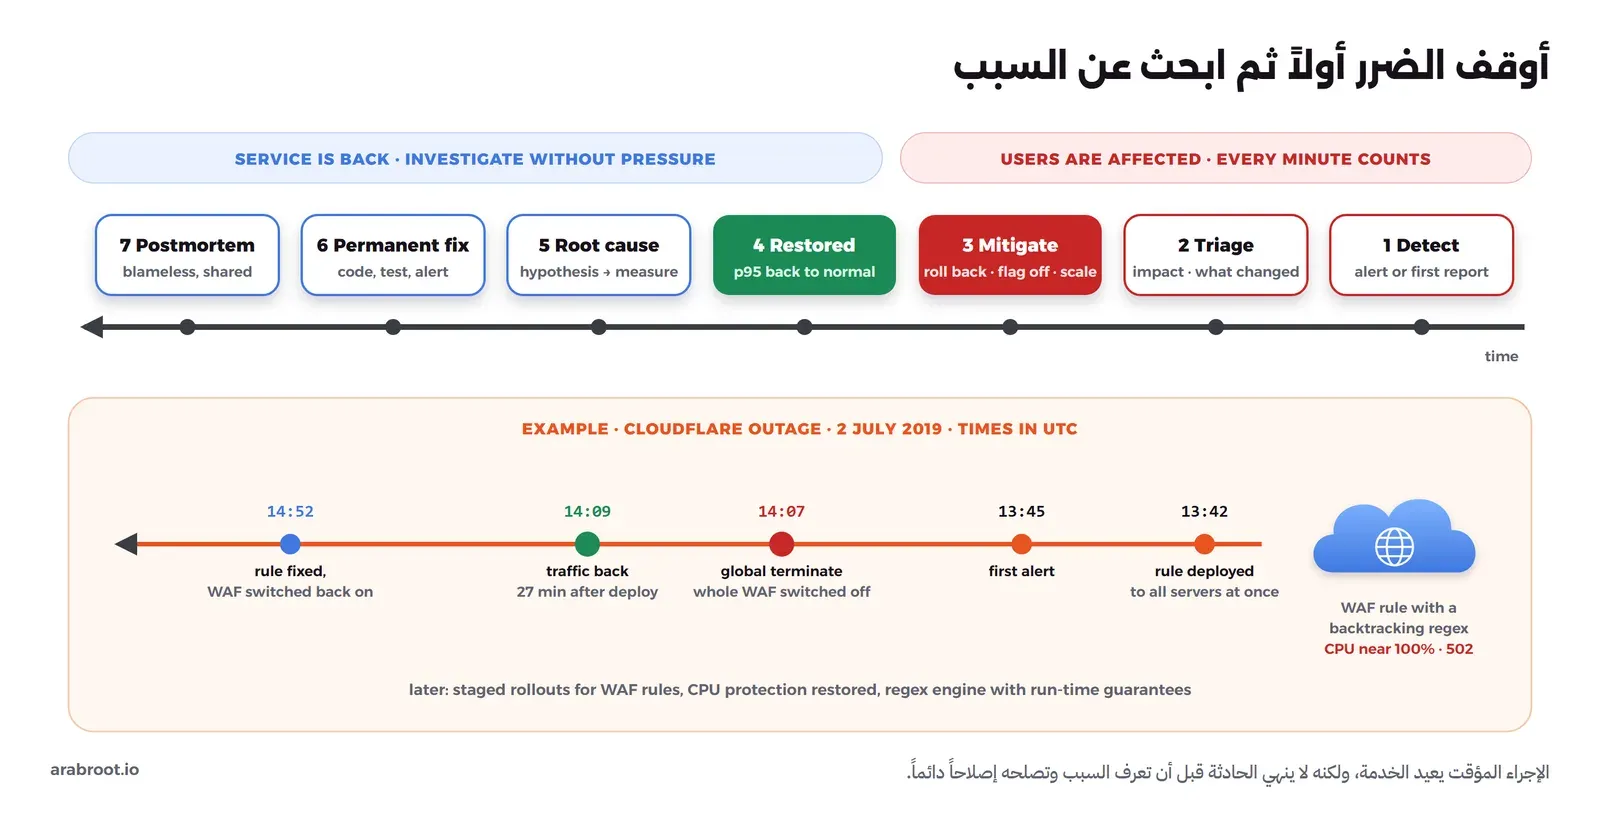
هناك قاعدة يكررها فصل Google بتشبيه من الطيران: الطيار المبتدئ يتعلم أن أول مسؤولياته في الطوارئ أن يبقي الطائرة في الجو، واستكشاف العطل يأتي بعد ذلك. وفي عملنا تعني هذه القاعدة أنه إذا كان العملاء متأثرين الآن، وكان لديك إجراء معروف يعيد الخدمة، فنفذه أولاً ثم ابحث عن السبب. ومن هذه الإجراءات:
- التراجع Rollback: إعادة الإصدار السابق من التطبيق أو الإعداد السابق، وهو الأهم والأكثر استخداماً، لذلك يجب أن يكون التراجع أمراً واحداً مجرباً، وليس عملية تخترعها أثناء الحادثة.
- إيقاف الميزة Feature Flag: إطفاء الميزة الجديدة دون نشر جديد، إذا كان تطبيقك يدعم ذلك.
- زيادة السعة مؤقتاً: نسخة إضافية من التطبيق، أو سيرفر أكبر، وهنا يصبح السيرفر الأكبر مقبولاً، لأنه إجراء مؤقت لكسب الوقت وليس الحل.
- تحويل الحركة Failover: إلى نسخة أو منطقة سليمة إذا كانت موجودة.
- تخفيف الحمل Load Shedding: إيقاف المهام غير الضرورية مؤقتاً، مثل تقرير ثقيل أو مزامنة خلفية.
ولاحظ أن الإجراء المؤقت لا ينهي الحادثة، وإنما ينقلها من «العملاء متأثرون» إلى «لدينا وقت لنفهم»، وبعده يجب أن تصل إلى السبب الجذري وتصلحه إصلاحاً دائماً، وإلا فسوف تعود المشكلة في النشر التالي. والصورة التالية تبين هذا الترتيب على حادثة حقيقية:
ثلاث قوائم تحقق تبدأ بها
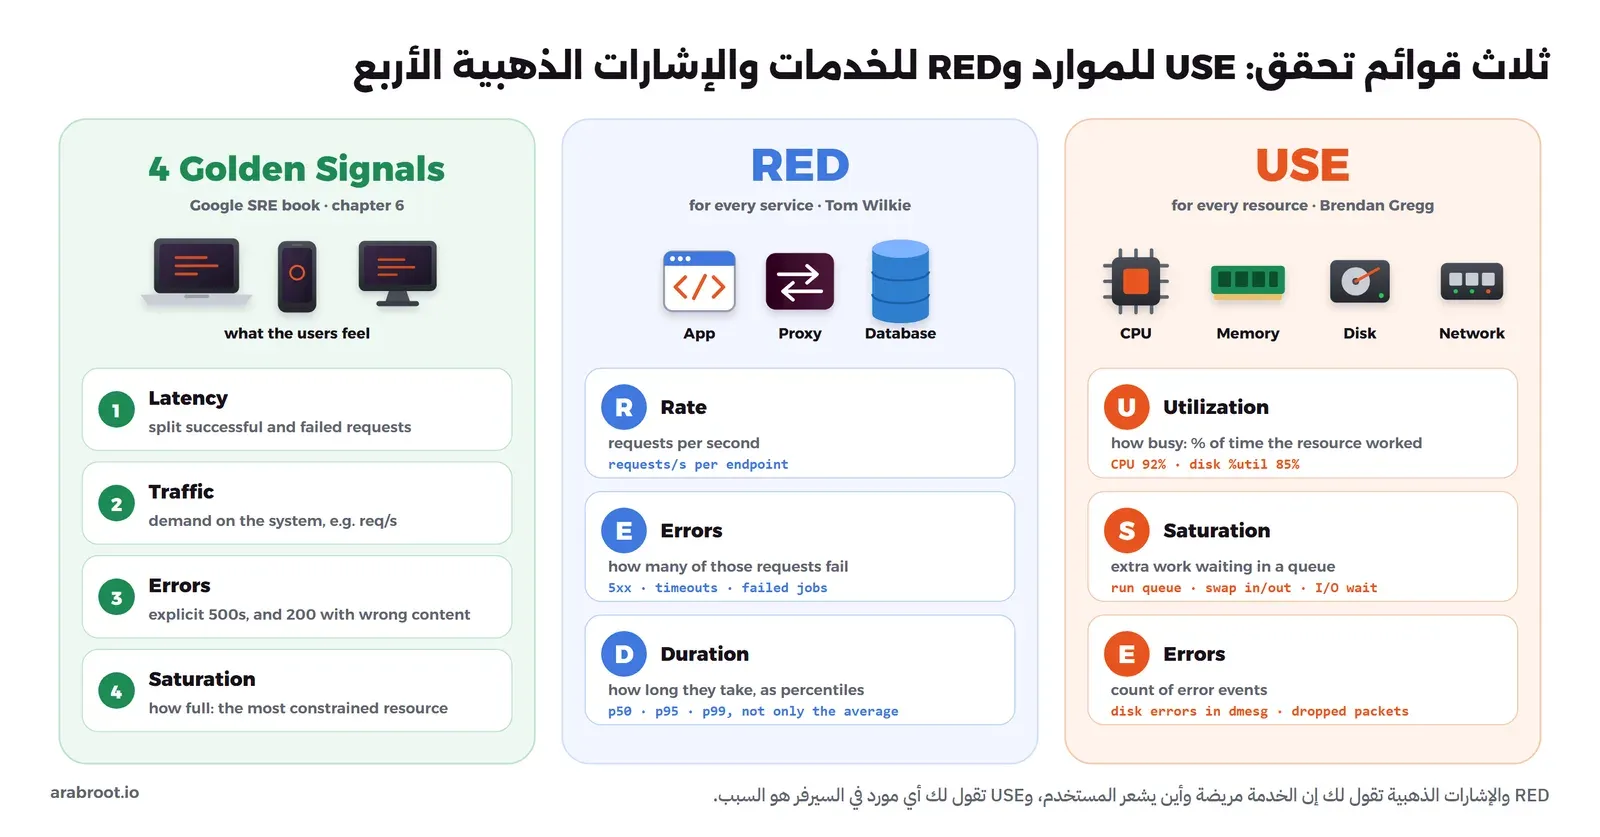
عندما لا تعرف من أين تبدأ، فالقائمة المكتوبة أفضل من الذاكرة، والسبب أن الذاكرة تقودك إلى ما تعرفه وما حدث في المرة السابقة، بينما القائمة تجبرك أن تنظر إلى كل شيء ولو نظرة سريعة. وهناك ثلاث قوائم معروفة كتبها أصحابها من خبرة طويلة، والصورة التالية تجمعها:
طريقة USE للموارد
وضع Brendan Gregg طريقة USE في جملة واحدة: لكل مورد، افحص الاستخدام والتشبع والأخطاء. والمورد Resource هو كل جزء في السيرفر له سعة محدودة: المعالج، والذاكرة، والقرص، وواجهة الشبكة، وحتى الحدود البرمجية مثل عدد الملفات المفتوحة. وتعريفاته الثلاثة كما يلي:
- الاستخدام Utilization: متوسط الوقت الذي كان فيه المورد مشغولاً، مثل معالج مشغول 90% من الوقت.
- التشبع Saturation: العمل الإضافي الذي لا يستطيع المورد أن يخدمه فينتظر في طابور، مثل عمليات تنتظر دورها على المعالج، أو طلبات قراءة تنتظر القرص، أو ذاكرة تنقل إلى Swap.
- الأخطاء Errors: عدد أحداث الخطأ، مثل أخطاء القرص في سجل النواة، أو حزم الشبكة المرفوضة.
وقوة هذه الطريقة أنها تمر على كل مورد بالترتيب، فلا تترك القرص لأنك مقتنع أن المشكلة في المعالج. والأدوات التي تقرأ بها هذه الأرقام على Linux، مثل vmstat وmpstat وiostat وfree وsar، وكيف تقرأ متوسط الحمل Load Average ووقت السرقة Steal Time، هي موضوع مقال تحليل أداء سيرفر Linux في 60 ثانية، فلن نكررها هنا.
طريقة RED للخدمات
طريقة USE ممتازة للسيرفر، ولكنها لا تخبرك مباشرة بما يشعر به المستخدم، لذلك وضع Tom Wilkie طريقة RED للخدمات التي تستقبل طلبات، وقال في شرحها إن USE تناسب العتاد والشبكة والأقراص ولا تناسب الخدمات. ولكل خدمة، مثل التطبيق أو ال API أو قاعدة البيانات، تقيس ثلاثة أرقام:
- المعدل Rate: عدد الطلبات في الثانية.
- الأخطاء Errors: عدد الطلبات التي تفشل منها.
- المدة Duration: الزمن الذي تأخذه هذه الطلبات، ويقاس بالنسب المئوية كما سوف نرى.
وإذا لم تكن لديك لوحة مراقبة بعد، فسجل ال Reverse Proxy فيه هذه الأرقام الثلاثة لكل طلب: الوقت ورمز الرد وزمن الطلب، وكيف تضيف زمن الطلب وزمن التطبيق إلى سجل Nginx وتقرؤهما هو موضوع مقال تتبع الطلب البطيء.
الإشارات الذهبية الأربع
وفي الفصل السادس من كتاب Google SRE، وعنوانه Monitoring Distributed Systems، أربع إشارات يقول الفصل إنك إذا لم تستطع أن تقيس إلا أربعة أشياء في نظام يخدم المستخدمين فقس هذه الأربعة:
- زمن الاستجابة Latency: الزمن الذي يأخذه الطلب، مع ملاحظة مهمة في الفصل نفسه، وهي أن تفصل زمن الطلبات الناجحة عن زمن الطلبات الفاشلة، فالرد السريع بخطأ 500 يجعل المتوسط يبدو جميلاً وهو في الحقيقة فشل.
- الحركة Traffic: حجم الطلب على النظام، مثل الطلبات في الثانية.
- الأخطاء Errors: نسبة الطلبات التي تفشل، سواءً فشلت صراحة مثل 500، أو ضمنياً مثل رد 200 بمحتوى خاطئ.
- التشبع Saturation: مدى امتلاء الخدمة، مع التركيز على المورد الأكثر ضيقاً فيها.
ولاحظ أن الطرق الثلاث متقاربة، وأنها تكمل بعضها: RED والإشارات الذهبية تقولان لك إن الخدمة مريضة وأين يشعر المستخدم بذلك، وUSE تقول لك أي مورد داخل السيرفر هو السبب.
لماذا p95 وp99 وليس المتوسط؟
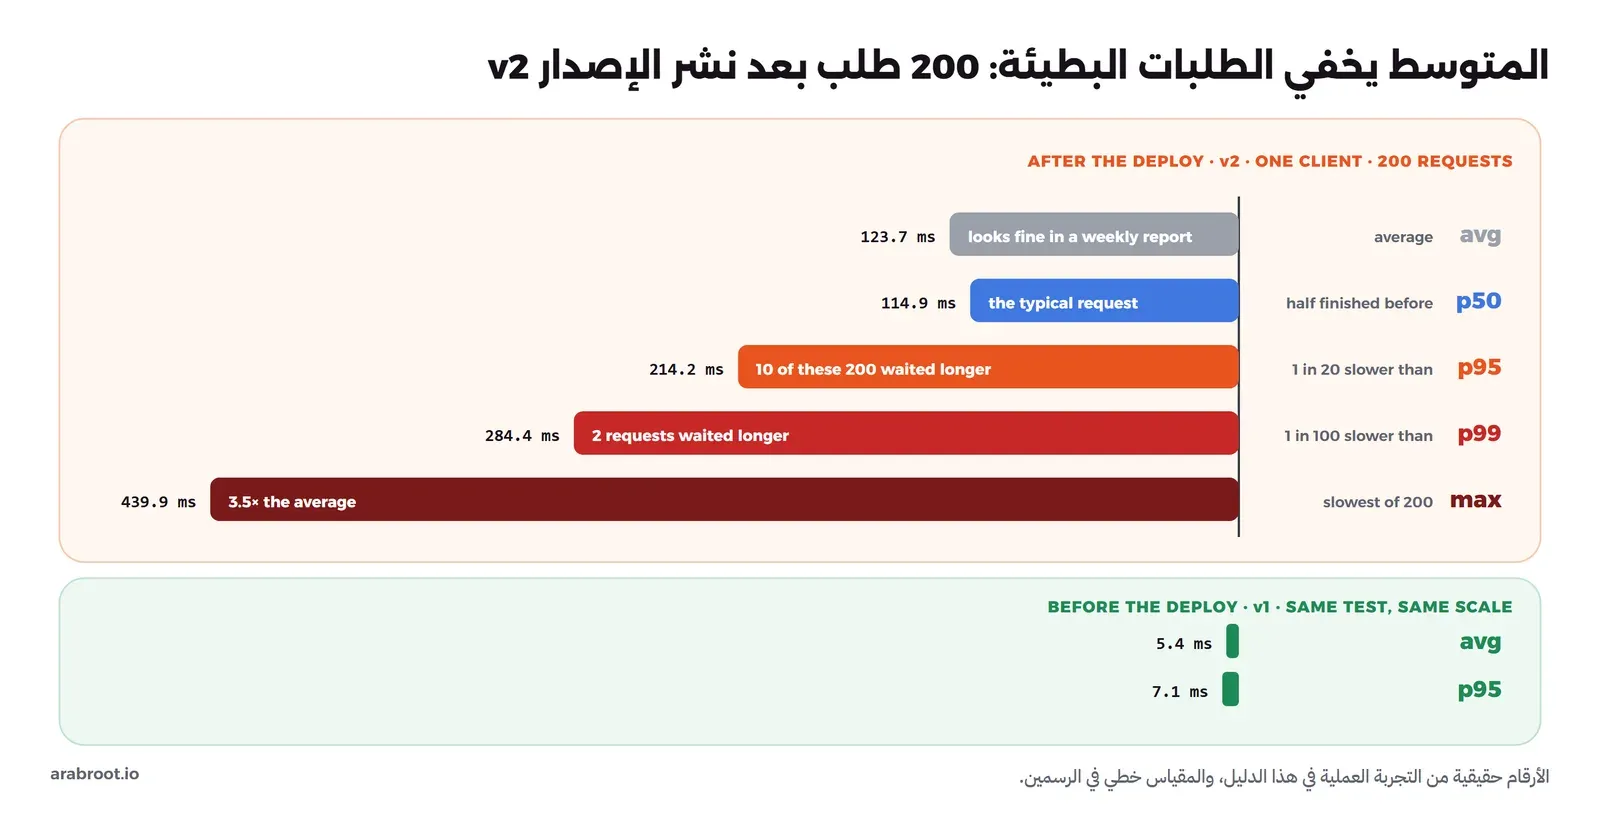
المتوسط Average رقم مريح ولكنه يكذب في الأداء، والسبب أن الطلبات البطيئة قليلة العدد ولكنها هي التي يشعر بها العملاء ويشتكون منها. ويضرب فصل Google مثالاً على ذلك: خدمة متوسط زمنها 100 مللي ثانية مع 1000 طلب في الثانية قد يكون 1% من طلباتها يأخذ 5 ثوان. والنسبة المئوية Percentile تحل هذه المشكلة: p50 هو الزمن الذي تنتهي قبله نصف الطلبات، وp95 هو الزمن الذي تنتهي قبله 95% منها، فالطلبات الخمسة في المئة الباقية أبطأ منه، وp99 هو الزمن الذي يتجاوزه طلب واحد من كل مئة.
والصورة التالية تبين الأرقام الحقيقية من التجربة العملية في هذا الدليل بعد نشر الإصدار البطيء ومع عميل واحد: المتوسط 123.7 مللي ثانية، وهو رقم قد يبدو مقبولاً في تقرير أسبوعي، ولكن طلباً من كل عشرين أخذ أكثر من 214 مللي ثانية، وطلباً من كل مئة أخذ أكثر من 284، وأبطأ طلب أخذ 440 مللي ثانية، أي أكثر من ثلاثة أضعاف المتوسط. ومع ثمانية عملاء في نفس الوقت صار المتوسط حوالي 300 مللي ثانية وp99 بين 750 و930 مللي ثانية، كما سوف ترى في التجربة:
لذلك اجعل لوحاتك وتنبيهاتك على p95 وp99 لأهم الصفحات، وقارن دائماً بنفس الرقم قبل المشكلة. وكيف تحول هذه الأرقام إلى أهداف تتفق عليها مع فريقك، مثل مستوى الخدمة المستهدف SLO وميزانية الأخطاء Error Budget، فهي مواضيع مخطط لها في قسم الأداء والموثوقية SRE في خارطة الطريق.
أين يمكن أن يبطئ الطلب أو يفشل؟
عندما يفتح العميل صفحة في متجرك، يمر طلبه بعدة طبقات قبل أن يعود إليه الرد، وكل طبقة منها يمكن أن تبطئ أو تفشل، ولكل طبقة أعراض تشبهها وأدوات تقيسها. والصورة التالية تبين الطبقات بالترتيب، وتحت كل طبقة الأعراض التي تعيش فيها في الغالب:
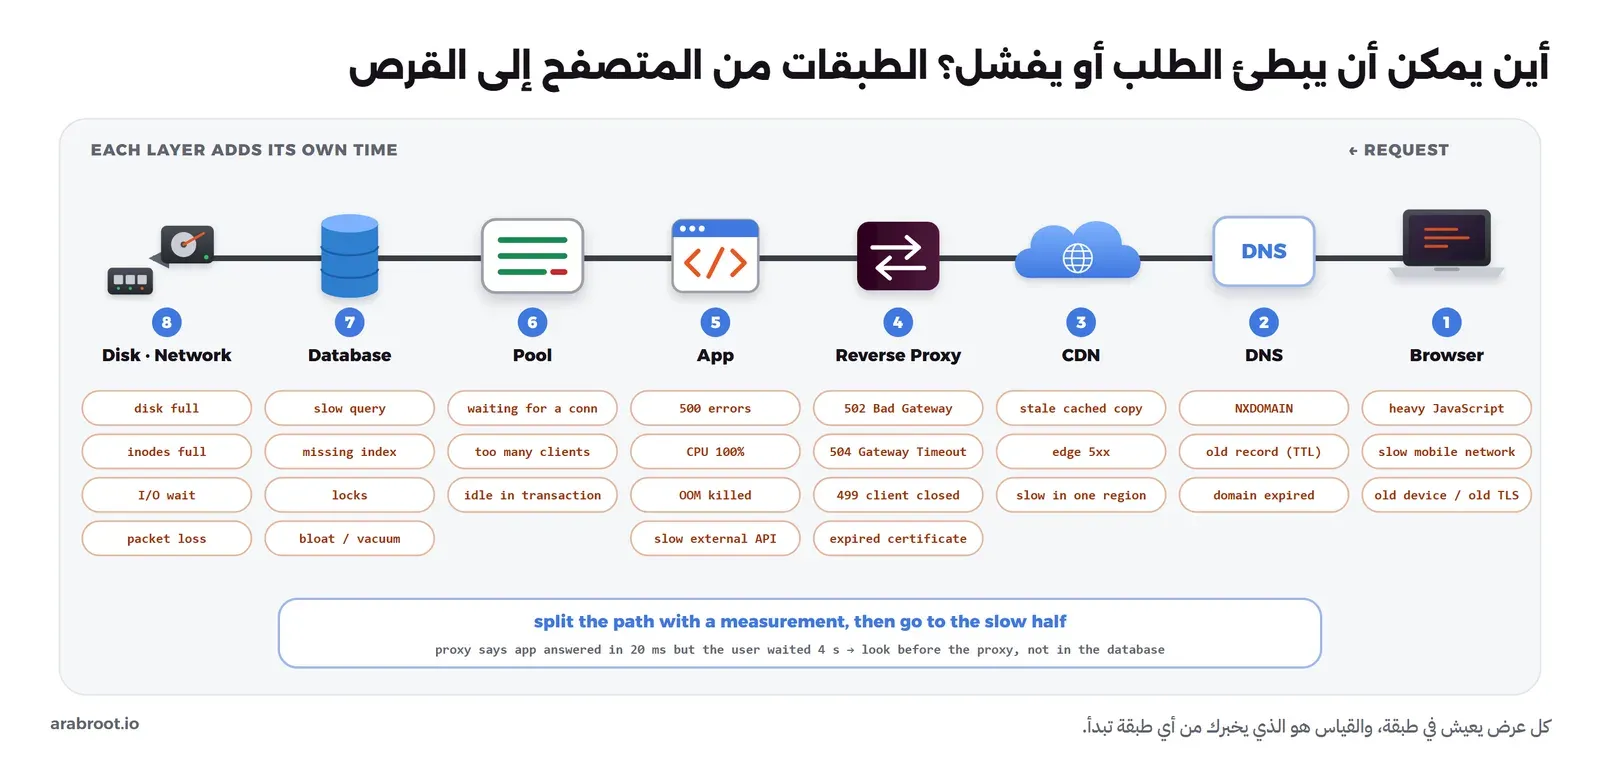
والقاعدة في استخدام هذه الخريطة أن تقسم المسار إلى نصفين بالقياس، كما يفعل من يبحث عن كلمة في قاموس، وهي طريقة فرق تسد Divide and Conquer التي يذكرها فصل Google أيضاً. فإذا قال سجل Nginx إن التطبيق رد في 20 مللي ثانية والعميل انتظر 4 ثوان، فالمشكلة قبل ال Reverse Proxy، في الشبكة أو ال CDN أو المتصفح، ولا داعي لأن تفتح قاعدة البيانات أصلاً. وإذا قال إن التطبيق نفسه أخذ 4 ثوان، فانتقل إلى داخل التطبيق ثم إلى قاعدة البيانات.
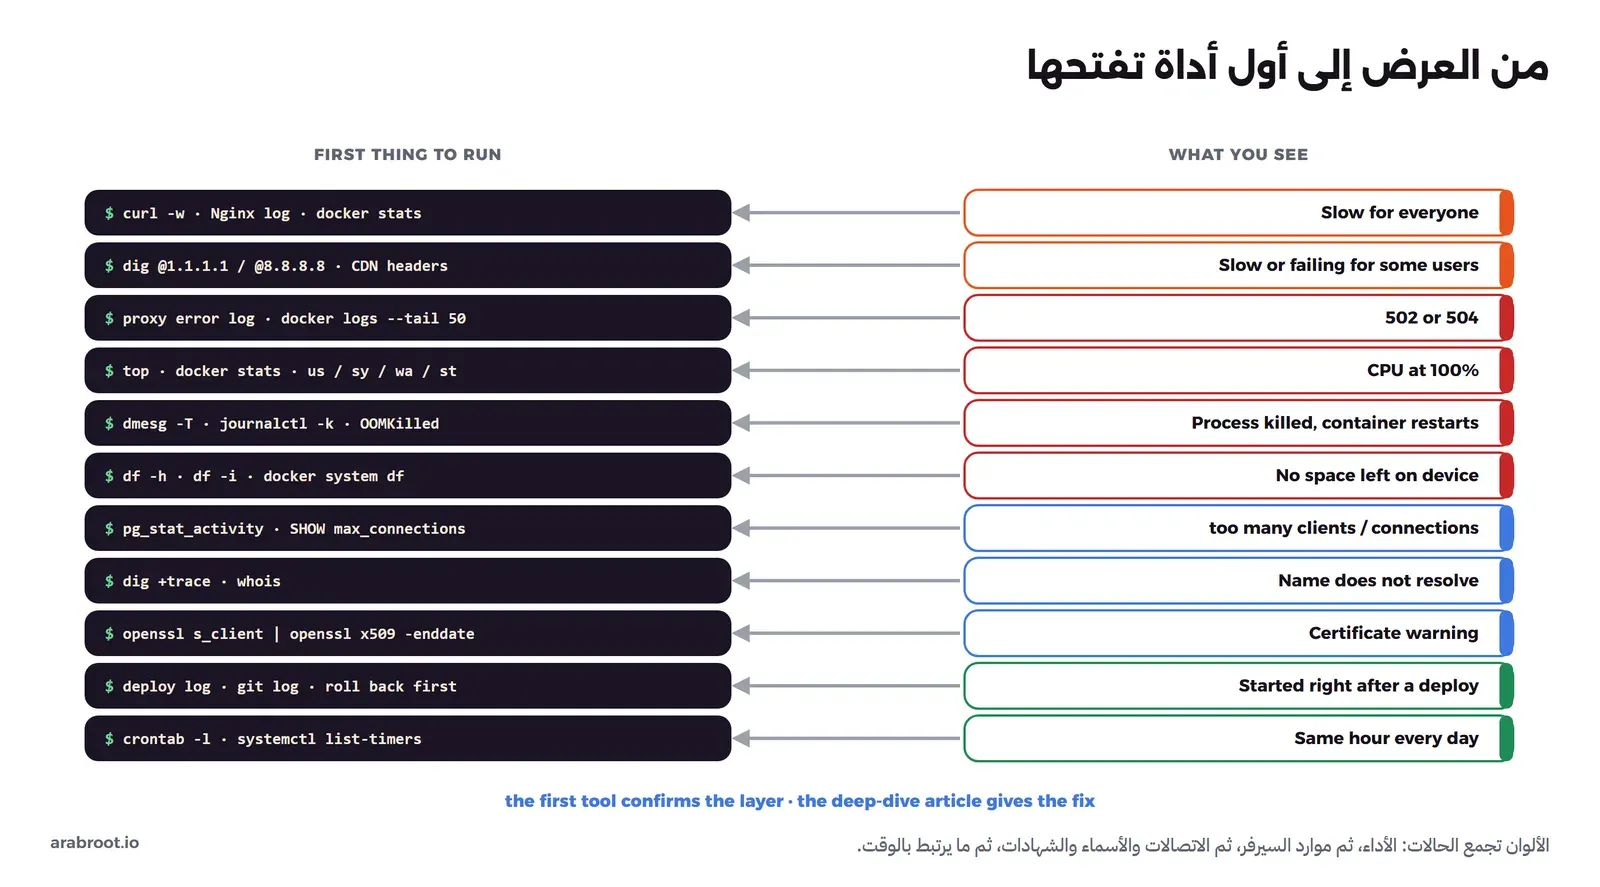
والجدول التالي يجمع الأعراض الشائعة مع أول مكان تنظر فيه وأول أداة تفتحها، وكل سطر منه حالة مشروحة في دليل الحالات بعد التجربة العملية:
| العرض | أول مكان تنظر فيه | أول أداة |
|---|---|---|
| كل الصفحات بطيئة لكل المستخدمين | زمن الطلب في سجل ال Reverse Proxy، ثم موارد السيرفر | curl -w وسجل Nginx، ثم uptime وdocker stats |
| بطء أو خطأ عند بعض المستخدمين فقط | ما يشترك فيه المتأثرون: منطقة، أو مزود، أو جهاز، أو متصفح | dig من أكثر من خادم DNS، وترويسات ال CDN |
| 502 أو 504 | سجل الأخطاء في ال Reverse Proxy، ثم حالة التطبيق خلفه | docker logs وسجل أخطاء Nginx |
| المعالج عند 100% | أي عملية أو Container يستهلكه | top وdocker stats |
| عمليات تموت فجأة أو Container يعيد التشغيل | سجل النواة | dmesg أو journalctl -k |
| أخطاء كتابة أو No space left on device | المساحة وعدد الملفات | df -h وdf -i وdocker system df |
| too many clients أو too many connections | الاتصالات المفتوحة في قاعدة البيانات | pg_stat_activity |
| الاسم لا يحل أو التغيير لم يصل | ما يرد به خادم DNS الرسمي للنطاق مقارنة بالخوادم العامة | dig |
| تحذير شهادة في المتصفح | تاريخ انتهاء الشهادة وسلسلتها | openssl s_client |
| بدأ كل شيء بعد النشر | الفرق بين الإصدارين، وقرار التراجع | سجل النشر وgit log |
| بطء في نفس الساعة كل يوم | المهام المجدولة والنسخ الاحتياطي | crontab -l وsystemctl list-timers |
والصورة التالية تبين نفس الخريطة بشكل يسهل أن تحفظه أو تعلقه بجانب شاشتك:
تجربة عملية: بطء بعد النشر نحققه بالطريقة كاملة
الآن سوف نطبق الطريقة على حالة كاملة على جهازك: تطبيق صغير بلغة Python يقرأ آخر طلبات العميل من جدول فيه مليونا طلب في PostgreSQL، ونشغل منه الإصدار v1 ونقيسه، ثم ننشر الإصدار v2 الذي فيه تعديل صغير في الاستعلام يبدو بريئاً، ونرى البطء، ثم نحققه خطوة بخطوة كما في الطريقة، ونتراجع، ونقيس من جديد. والتجربة كلها في Containers تبدأ أسماؤها بـ lab-trbl-، والمنفذ الوحيد المنشور هو 18880 على 127.0.0.1 فقط. وإذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu.
ملفات التجربة
أنشئ مجلداً باسم lab-trbl وضع فيه الملفات التالية، وأولها التطبيق في ملف app.py:
import json, os
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
from urllib.parse import urlparse, parse_qs

import psycopg_pool

VERSION = os.environ.get("APP_VERSION", "v1")
db = psycopg_pool.ConnectionPool(os.environ["DATABASE_URL"], min_size=2, max_size=10)

QUERIES = {
    # v1: the column is compared as a number, so the index on customer_id is used
    "v1": "SELECT id, total, created_at FROM orders WHERE customer_id = %s ORDER BY id DESC LIMIT 5",
    # v2: a "small" refactor compares the column as text, so the index cannot be used
    "v2": "SELECT id, total, created_at FROM orders WHERE customer_id::text = %s ORDER BY id DESC LIMIT 5",
}


class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        url = urlparse(self.path)
        if url.path == "/health":
            return self.reply(200, {"status": "ok", "version": VERSION})
        if url.path == "/orders":
            customer = parse_qs(url.query).get("customer", ["1"])[0]
            with db.connection() as conn:
                rows = conn.execute(QUERIES[VERSION], (customer,)).fetchall()
            return self.reply(200, {"version": VERSION, "orders": [r[0] for r in rows]})
        self.reply(404, {"error": "not found"})

    def reply(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def log_message(self, fmt, *args):
        pass


ThreadingHTTPServer(("0.0.0.0", 8000), Handler).serve_forever()
في الكود أعلاه لاحظ التالي:
- الإصداران في ملف واحد، والمتغير
APP_VERSIONيختار بينهما، حتى يكون «النشر» و«التراجع» في التجربة أمراً واحداً، كما يجب أن يكونا في الإنتاج. - الفرق الوحيد بين الإصدارين هو
customer_id::textفي v2، وهو تعديل يحدث فعلاً في الحياة الحقيقية عندما تمرر طبقة في الكود رقم العميل نصاً فيحول أحد الزملاء العمود إلى نص ليتطابق النوعان. والنتيجة أن PostgreSQL لا يستطيع استخدام الفهرس علىcustomer_id، لأن الفهرس مبني على قيم العمود نفسه وليس على نتيجة تحويلها إلى نص. - الاتصال بقاعدة البيانات عبر مجمع اتصالات Connection Pool بحد أقصى 10 اتصالات، وشرحنا فكرته في مقال تجميع الاتصالات.
ثم ملف Dockerfile:
FROM python:3.13-slim
RUN pip install --no-cache-dir "psycopg[binary,pool]==3.*"
WORKDIR /app
COPY app.py .
CMD ["python", "app.py"]
ثم ملف init.sql الذي ينشئ الجدول بمليوني طلب لمئة ألف عميل، مع فهرس على رقم العميل، ويفعل الإضافة pg_stat_statements التي تجمع إحصاءات كل استعلام:
CREATE EXTENSION pg_stat_statements;
CREATE TABLE orders (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL,
    total       numeric(10,2) NOT NULL,
    created_at  timestamptz NOT NULL DEFAULT now()
);
INSERT INTO orders (customer_id, total, created_at)
SELECT (random() * 100000)::bigint, (random() * 500)::numeric(10,2), now() - random() * interval '365 days'
FROM generate_series(1, 2000000);
CREATE INDEX orders_customer_id_idx ON orders (customer_id);
ANALYZE orders;
وأخيراً سكربت القياس measure.sh، وهو الذي يحول «الموقع بطيء» إلى رقم: يرسل 200 طلب لعملاء مختلفين، ويحسب المتوسط والنسب المئوية:
#!/bin/sh
# measure.sh <label> : 200 requests for different customers, then avg, p50, p95, p99 in milliseconds
label=$1
for i in $(seq 1 200); do
  curl -s -o /dev/null -w '%{time_total}\n' "http://127.0.0.1:18880/orders?customer=$(( (i * 7919) % 100000 ))"
done | sort -n | awk -v label="$label" '{ t[NR] = $1 * 1000; sum += t[NR] }
  END {
    n = NR
    printf "%s  n=%d  avg=%.1fms  p50=%.1fms  p95=%.1fms  p99=%.1fms  max=%.1fms\n", label, n, sum / n, t[int(n * 0.50)], t[int(n * 0.95)], t[int(n * 0.99)], t[n]
  }'
ولاحظ أن %{time_total} في curl هو الزمن الكامل للطلب من جهة العميل، وكيف تقسمه إلى زمن DNS والاتصال وTLS وانتظار أول بايت شرحناه في مقال تتبع الطلب البطيء.
التشغيل وقياس خط الأساس
الآن سوف نشغل قاعدة البيانات مع تحميل الإضافة pg_stat_statements، ونبني التطبيق:
chmod +x measure.sh
docker network create lab-trbl-net
docker run -d --name lab-trbl-db --network lab-trbl-net \
  -e POSTGRES_USER=shop -e POSTGRES_PASSWORD=shop -e POSTGRES_DB=shop \
  -v "$PWD/init.sql:/docker-entrypoint-initdb.d/init.sql:ro" \
  postgres:18 -c shared_preload_libraries=pg_stat_statements
docker build -t lab-trbl-app:1 .
وانتظر حتى تظهر في docker logs lab-trbl-db الرسالة database system is ready to accept connections للمرة الثانية، فالأولى من التشغيل المؤقت الذي ينفذ فيه init.sql، وإدخال مليوني صف يأخذ دقيقة تقريباً. ثم نصفر إحصاءات الاستعلامات حتى لا تظهر فيها استعلامات التجهيز، ونشغل الإصدار v1 ونقيسه:
docker exec lab-trbl-db psql -U shop -d shop -tc "SELECT pg_stat_statements_reset();"
docker run -d --name lab-trbl-app --network lab-trbl-net -p 127.0.0.1:18880:8000 \
  -e APP_VERSION=v1 -e DATABASE_URL=postgresql://shop:shop@lab-trbl-db:5432/shop lab-trbl-app:1
curl -s http://127.0.0.1:18880/health; echo
curl -s "http://127.0.0.1:18880/orders?customer=4242"; echo
./measure.sh "v1"
والمخرج سوف يكون كما يلي:
{"status": "ok", "version": "v1"}
{"version": "v1", "orders": [1671416, 1507342, 1433779, 1386030, 1371796]}
v1  n=200  avg=5.4ms  p50=5.1ms  p95=7.1ms  p99=10.3ms  max=17.7ms
هذا هو خط الأساس Baseline، أي الرقم الذي سوف نقارن به كل شيء بعد ذلك، ولاحظ أن أرقام المللي ثانية في هذه التجربة من Docker Desktop على جهاز تطوير، فهي للتوضيح فقط، والمهم هو الفرق بين الإصدارين على نفس الجهاز.
النشر، ثم يصل البلاغ
الآن ننشر الإصدار v2، أي نستبدل ال Container بآخر يعمل بالإصدار الجديد، ثم نقيس:
docker rm -f lab-trbl-app
docker run -d --name lab-trbl-app --network lab-trbl-net -p 127.0.0.1:18880:8000 \
  -e APP_VERSION=v2 -e DATABASE_URL=postgresql://shop:shop@lab-trbl-db:5432/shop lab-trbl-app:1
curl -s http://127.0.0.1:18880/health; echo
./measure.sh "v2"
والمخرج سوف يكون كما يلي:
{"status": "ok", "version": "v2"}
v2  n=200  avg=123.7ms  p50=114.9ms  p95=214.2ms  p99=284.4ms  max=439.9ms
ولاحظ أن فحص الصحة /health يقول إن كل شيء سليم، وهذا طبيعي، لأن الفحص لا يلمس الاستعلام المتغير، وهذا سبب يجعل المراقبة على زمن الطلبات الحقيقية أهم من فحص الصحة وحده. ولكن مع عميل واحد قد لا يشعر أحد بشيء، فلنرسل الطلبات من ثمانية عملاء في نفس الوقت، كما يحدث في ساعة الذروة، وننظر أثناء ذلك إلى استهلاك ال Containers:
for j in 1 2 3 4 5 6 7 8; do ./measure.sh "v2 client$j" > load$j.txt & done
sleep 20; docker stats --no-stream --format "table {{.Name}}\t{{.CPUPerc}}\t{{.MemUsage}}" lab-trbl-app lab-trbl-db
wait; cat load*.txt
والمخرج سوف يكون كما يلي:
NAME           CPU %     MEM USAGE / LIMIT
lab-trbl-app   5.16%     32.08MiB / 31.29GiB
lab-trbl-db    452.15%   303.5MiB / 31.29GiB
v2 client1  n=200  avg=308.2ms  p50=275.3ms  p95=611.9ms  p99=927.2ms  max=1143.9ms
v2 client2  n=200  avg=309.5ms  p50=269.9ms  p95=610.8ms  p99=751.9ms  max=779.4ms
v2 client3  n=200  avg=311.1ms  p50=277.5ms  p95=664.2ms  p99=873.1ms  max=1059.7ms
v2 client4  n=200  avg=318.2ms  p50=282.1ms  p95=611.1ms  p99=883.5ms  max=982.7ms
v2 client5  n=200  avg=296.6ms  p50=267.1ms  p95=531.6ms  p99=766.0ms  max=1304.0ms
v2 client6  n=200  avg=306.2ms  p50=272.5ms  p95=584.0ms  p99=889.7ms  max=1459.7ms
v2 client7  n=200  avg=315.6ms  p50=271.8ms  p95=672.8ms  p99=853.9ms  max=962.1ms
v2 client8  n=200  avg=321.8ms  p50=279.9ms  p95=671.3ms  p99=883.2ms  max=1117.3ms
وفي المخرج أعلاه لاحظ التالي، وهو تطبيق مباشر للخطوات الأولى من الطريقة:
- العرض بدقة: بعد النشر، ومع ثمانية عملاء، صار p95 لنقطة
/ordersبين 532 و673 مللي ثانية لكل العملاء، بعد أن كان 7.1 مللي ثانية مع عميل واحد قبل النشر. - ما الذي تغير: شيء واحد فقط، هو نشر v2، والعرض بدأ معه مباشرة.
- USE على الموارد: ال Container الخاص بقاعدة البيانات يستهلك 452% من المعالج، أي قرابة أربع أنوية ونصف من ثماني أنوية في هذا الجهاز، بينما التطبيق عند 5%. فالمورد المشغول هو معالج قاعدة البيانات، وليس التطبيق ولا الذاكرة.
وهنا تظهر بوضوح لماذا يفشل التخمين: لو رفعنا عدد نسخ التطبيق لما تغير شيء، لأن التطبيق مرتاح، ولو رفعنا أنوية قاعدة البيانات لخففنا الانتظار قليلاً ودفعنا ثمن سيرفر أكبر لاستعلام سوف يزداد بطئاً كلما كبر الجدول.
فرضية واحدة وقياس واحد
الفرضية الآن: «استعلام في الإصدار الجديد يقرأ صفوفاً أكثر بكثير من السابق». والقياس الذي يثبتها أو ينفيها هو ترتيب الاستعلامات بحسب الوقت الكلي في pg_stat_statements:
docker exec lab-trbl-db psql -U shop -d shop -c "SELECT calls, round(mean_exec_time::numeric, 2) AS mean_ms, round(total_exec_time::numeric) AS total_ms, left(query, 72) AS query FROM pg_stat_statements WHERE query LIKE 'SELECT id%' ORDER BY total_exec_time DESC;"والمخرج سوف يكون كما يلي:
 calls | mean_ms | total_ms |                                  query
-------+---------+----------+--------------------------------------------------------------------------
  1800 |  271.43 |   488568 | SELECT id, total, created_at FROM orders WHERE customer_id::text = $1 OR
   201 |    0.69 |      139 | SELECT id, total, created_at FROM orders WHERE customer_id = $1 ORDER BY
الاستعلام الجديد يأخذ في المتوسط 271 مللي ثانية، والقديم يأخذ 0.69 مللي ثانية، أي أن الفرق قرابة 400 ضعف، وعدد الاستدعاءات 1800 يطابق ما أرسلناه بعد النشر: 200 طلب من عميل واحد ثم 1600 من ثمانية عملاء. ثم نسأل PostgreSQL كيف ينفذ الاستعلام الجديد بـ EXPLAIN (ANALYZE, BUFFERS):
docker exec lab-trbl-db psql -U shop -d shop -c "EXPLAIN (ANALYZE, BUFFERS) SELECT id, total, created_at FROM orders WHERE customer_id::text = '4242' ORDER BY id DESC LIMIT 5;"والمخرج سوف يكون كما يلي:
 Limit  (cost=0.43..41.25 rows=5 width=22) (actual time=63.957..121.692 rows=5.00 loops=1)
   Buffers: shared hit=6339
   ->  Index Scan Backward using orders_pkey on orders  (cost=0.43..81653.43 rows=10000 width=22) (actual time=63.956..121.686 rows=5.00 loops=1)
         Filter: ((customer_id)::text = '4242'::text)
         Rows Removed by Filter: 628200
         Index Searches: 1
         Buffers: shared hit=6339
 Planning:
   Buffers: shared hit=97
 Planning Time: 0.243 ms
 Execution Time: 121.732 ms
وفي المخرج أعلاه لاحظ التالي:
- الفهرس
orders_customer_id_idxلا يظهر إطلاقاً، وإنما يمشي PostgreSQL على المفتاح الأساسي من آخر الجدول إلى أوله، ويحول رقم العميل في كل صف إلى نص ليقارنه. Rows Removed by Filter: 628200تعني أنه قرأ قرابة 628 ألف صف ورماها ليجد خمسة صفوف، وهذا هو عمل المعالج الذي رأيناه فيdocker stats.- نفس الاستعلام بالمقارنة الرقمية
customer_id = 4242يستخدم الفهرس ويقرأ 18 صفاً فقط، ونفذ عندنا في 0.418 مللي ثانية، مقابل 121.7 مللي ثانية للاستعلام الجديد.
وكيف تقرأ pg_stat_statements وEXPLAIN بالتفصيل، ومتى يختار PostgreSQL الفهرس ومتى يتركه، هو موضوع قسم قس أولاً في مقال PostgreSQL للجداول الضخمة.
التراجع، ثم القياس من جديد
عرفنا السبب هنا بسرعة، ولكن في الحياة الحقيقية كان القرار الصحيح أن نتراجع إلى v1 فور أن ربطنا العرض بالنشر، حتى قبل EXPLAIN، لأن العملاء ينتظرون، والتراجع أمر واحد مجرب:
docker rm -f lab-trbl-app
docker run -d --name lab-trbl-app --network lab-trbl-net -p 127.0.0.1:18880:8000 \
  -e APP_VERSION=v1 -e DATABASE_URL=postgresql://shop:shop@lab-trbl-db:5432/shop lab-trbl-app:1
curl -s http://127.0.0.1:18880/health; echo
./measure.sh "v1 after rollback"
for j in 1 2 3 4 5 6 7 8; do ./measure.sh "v1 client$j" > rb$j.txt & done
sleep 3; docker stats --no-stream --format "table {{.Name}}\t{{.CPUPerc}}\t{{.MemUsage}}" lab-trbl-app lab-trbl-db
wait; cat rb*.txt
والمخرج سوف يكون كما يلي:
{"status": "ok", "version": "v1"}
v1 after rollback  n=200  avg=5.3ms  p50=4.8ms  p95=8.3ms  p99=12.8ms  max=20.1ms
NAME           CPU %     MEM USAGE / LIMIT
lab-trbl-app   9.26%     29.55MiB / 31.29GiB
lab-trbl-db    3.02%     295.8MiB / 31.29GiB
v1 client1  n=200  avg=18.8ms  p50=15.8ms  p95=38.0ms  p99=62.2ms  max=72.5ms
v1 client2  n=200  avg=19.8ms  p50=16.4ms  p95=48.4ms  p99=69.8ms  max=76.7ms
v1 client3  n=200  avg=19.3ms  p50=15.7ms  p95=37.2ms  p99=80.4ms  max=85.4ms
v1 client4  n=200  avg=19.2ms  p50=16.1ms  p95=39.8ms  p99=59.4ms  max=82.1ms
v1 client5  n=200  avg=18.8ms  p50=15.7ms  p95=42.0ms  p99=64.5ms  max=77.7ms
v1 client6  n=200  avg=19.2ms  p50=16.3ms  p95=36.0ms  p99=57.3ms  max=105.0ms
v1 client7  n=200  avg=18.1ms  p50=15.3ms  p95=36.1ms  p99=75.0ms  max=79.4ms
v1 client8  n=200  avg=18.2ms  p50=15.6ms  p95=36.7ms  p99=64.9ms  max=95.6ms
وفي المخرج أعلاه لاحظ التالي:
- القياس الذي بدأنا به هو نفسه القياس الذي نتحقق به، فمع ثمانية عملاء نزل p95 من نطاق 532 إلى 673 مللي ثانية إلى نطاق 36 إلى 48 مللي ثانية، ونزل معالج قاعدة البيانات من 452% إلى 3.02%.
- أزمنة v1 مع ثمانية عملاء أعلى منها مع عميل واحد، والسبب في الغالب أن ثمانية برامج
curlتعمل على نفس الجهاز الذي يشغل ال Containers وتتنافس معها، لذلك لا تقارن إلا الأرقام التي قيست بنفس الطريقة. - التراجع أوقف الضرر، ولكنه لم ينه العمل: الإصلاح الدائم أن يمرر التطبيق رقم العميل رقماً، وأن يضاف إلى خط النشر اختبار يفحص خطة الاستعلامات المهمة أو زمنها قبل الإنتاج، وهذا ما يكتب في تقرير ما بعد الحادثة.
حذف التجربة
احذف ما أنشأته التجربة فقط، بالأسماء نفسها، والخيار -v يحذف معه ال Volume المجهول الذي أنشأته Docker Image الخاصة بـ PostgreSQL لبياناتها:
docker rm -fv lab-trbl-app lab-trbl-db
docker network rm lab-trbl-net
docker image rm lab-trbl-app:1
دليل الحالات الشائعة
كل حالة في هذا القسم مكتوبة بنفس الترتيب: العرض كما يصلك، وأول ما تفحصه، والأسباب الشائعة، والإصلاح، ثم المقال الذي يتعمق فيها. وهي ليست بديلاً عن الطريقة، وإنما اختصار لها في الحالات التي تتكرر كثيراً، فابدأ دائماً بوصف العرض وسؤال ما الذي تغير، ثم انتقل إلى الحالة التي تشبه ما تراه.
الموقع بطيء على الجميع
كل الصفحات أو أغلبها بطيئة، لكل المستخدمين، من كل مكان. وهذا العرض يقول إن المشكلة في الغالب في جهتك وليست في شبكة العميل.
- أول ما تفحصه: قس زمن الطلب من خارج السيرفر بـ
curl -wثم من داخله على التطبيق مباشرة، فإذا كان الفرق كبيراً فالمشكلة قبل التطبيق، وإذا كانا متقاربين فهي في التطبيق أو ما خلفه. ثم انظر إلى موارد السيرفر بـuptimeوdocker statsلترى أي Container يستهلك المعالج أو الذاكرة. - الأسباب الشائعة: استعلام بلا فهرس أو جدول كبر، أو مجمع اتصالات ممتلئ تنتظر فيه الطلبات، أو زيادة حقيقية في الزيارات، أو خدمة خارجية بطيئة يستدعيها التطبيق داخل الطلب دون مهلة Timeout، أو سيرفر افتراضي يسرق منه جيرانه وقت المعالج Steal Time.
- الإصلاح: بحسب الطبقة التي يشير إليها القياس، والإجراء المؤقت المعقول هنا زيادة السعة أو إيقاف ما ليس ضرورياً، ثم الإصلاح الدائم في الطبقة نفسها.
- التفاصيل: موارد السيرفر في تحليل أداء سيرفر Linux في 60 ثانية، وتقسيم زمن الطلب في تتبع الطلب البطيء، والاستعلامات في PostgreSQL للجداول الضخمة.
بطء أو خطأ عند بعض المستخدمين فقط
بعض العملاء يشتكون والبقية لا يلاحظون شيئاً، وأنت تفتح الموقع فيعمل بشكل ممتاز. وهذه من أصعب الحالات لأن قياسك من جهازك لا يرى المشكلة، لذلك أول خطوة أن تعرف ما يشترك فيه المتأثرون.
- أول ما تفحصه: اسأل عن الدولة ومزود الإنترنت ونوع الجهاز والمتصفح أو التطبيق، ووقت المحاولة، واطلب لقطة شاشة للخطأ. ثم قارن ما يرد به خادم DNS لنطاقك من أكثر من خادم عام، مثل
dig +short example.com @1.1.1.1وdig +short example.com @8.8.8.8، وانظر إلى ترويسات ال CDN في الرد لتعرف أي نقطة خدمت المستخدم وهل كان الرد من ال Cache. - الأسباب الشائعة: سجل DNS تغير ولم تنته صلاحيته في بعض الخوادم بعد، أو نقطة واحدة في ال CDN فيها مشكلة، أو أجهزة قديمة لا تثق بالجهة التي أصدرت شهادتك، أو نسخة واحدة من التطبيق معطلة خلف موزع الحمل فيصيب الخطأ من يصل إليها فقط، أو حظر في جدار الحماية لمدى عناوين معين، أو بطء في الشبكة بين منطقة العميل وسيرفرك.
- الإصلاح: بحسب ما يشترك فيه المتأثرون، فنسخة معطلة تخرج من التوزيع، وسجل DNS ينتظر انتهاء TTL، والمنطقة البعيدة يخدمها CDN قريب منها.
- التفاصيل: انتهاء صلاحية السجلات في قسم «انتشار» DNS، ونقاط ال CDN وترويساتها في كيف تقيس أثر ال CDN، وفحوص الصحة في موزع الحمل في دليل تثبيت HAProxy.
الخطأ 502 أو 504
الرمزان يأتيان من ال Reverse Proxy أو موزع الحمل، وليس من تطبيقك، ومعناهما مختلف بحسب معيار HTTP في RFC 9110: الرد 502 Bad Gateway يعني أن ال Proxy تلقى رداً غير صالح من السيرفر الذي خلفه، أو لم يستطع أن يتصل به أصلاً، والرد 504 Gateway Timeout يعني أنه اتصل به وانتظر رده حتى انتهت المهلة.
- أول ما تفحصه: سجل الأخطاء في ال Reverse Proxy، ففيه السبب بكلمات واضحة مثل
connect() failed (111: Connection refused)أوupstream timed out. ثم حالة التطبيق خلفه: هل ال Container يعمل أم يعيد التشغيل، وما آخر سطور سجله بـdocker logs --tail 50. - الأسباب الشائعة لـ 502: التطبيق متوقف أو يعيد التشغيل، أو قتله نظام التشغيل لنفاد الذاكرة، أو يستمع على منفذ أو عنوان غير الذي يتصل به ال Proxy، أو ال Proxy يتصل باسم Container تغير عنوانه.
- الأسباب الشائعة لـ 504: طلب طويل فعلاً مثل تقرير أو تصدير، أو استعلام بطيء، أو مجمع اتصالات ممتلئ ينتظر فيه الطلب، أو خدمة خارجية لا ترد والتطبيق ينتظرها دون مهلة.
- الإصلاح: لـ 502 أعد التطبيق إلى العمل وابحث لماذا توقف، ولـ 504 لا ترفع المهلة كحل دائم، وإنما أصلح البطء أو انقل العمل الطويل إلى مهمة في الخلفية.
- التفاصيل: المهلات وخطأ 504 في قسم الطلبات البطيئة وخطأ 504، وقراءة 499 و502 و504 في سجل Nginx مع زمن ال Upstream في تتبع الطلب البطيء.
المعالج عند 100%
لوحة المراقبة حمراء والمعالج ممتلئ، والموقع بطيء أو لا يرد. ولاحظ أولاً أن المعالج الممتلئ عرض وليس سبباً، والسؤال الحقيقي: من يستهلكه، ولماذا الآن؟
- أول ما تفحصه: أي عملية أو Container يستهلك المعالج بـ
topوdocker stats، وهل هو وقت المستخدمusأم وقت النظامsyأم انتظار القرصwaأم وقت مسروقstفي السيرفر الافتراضي، فلكل منها معنى مختلف تماماً. - الأسباب الشائعة: استعلام يقرأ الجدول كله كما في التجربة، أو حلقة لا تنتهي أو تعبير نمطي يتراجع تراجعاً كارثياً كما في حادثة Cloudflare وفي حادثة Stack Overflow سنة 2016 التي ذكرناها في قسم المراقبة من مقال بنية Stack Overflow، أو زيادة حقيقية في الزيارات أو زاحف يطلب آلاف الصفحات، أو برنامج تعدين عملات دخل إلى سيرفر مخترق، أو حد معالج على ال Container يجعله يبطئ والسيرفر فارغ.
- الإصلاح: إذا كان السبب تغييراً حديثاً فتراجع عنه، وإذا كان زيادة في الحركة فأضف سعة مؤقتاً وابحث عن الطلبات الأثقل، وإذا وجدت عملية لا تعرفها فتعامل مع السيرفر كسيرفر مخترق.
- التفاصيل: أعمدة المعالج ومتوسط الحمل والوقت المسروق في تحليل أداء سيرفر Linux في 60 ثانية، ومعنى متوسط الحمل في قسم ما الذي يحسبه متوسط الحمل، وخنق ال Container في قسم Container بطيء والسيرفر فارغ، وإذا شككت في اختراق فابدأ بمقال التحقيق الرقمي للمبتدئين.
الذاكرة تنفد والعمليات تموت فجأة
ال Container يعيد التشغيل كل ساعة دون رسالة خطأ في سجله، أو قاعدة البيانات توقفت فجأة ثم عادت، أو السيرفر كله صار بطيئاً جداً. وهذا العرض في الغالب سببه أن الذاكرة نفدت فقتل نظام التشغيل عملية ليحمي نفسه، وهو ما يفعله OOM Killer، أو أن النظام صار ينقل الذاكرة إلى Swap على القرص.
- أول ما تفحصه: سجل النواة بـ
dmesg -T | grep -i -E 'killed process|out of memory'أوjournalctl -k، وحالة ال Container بـdocker inspect --format '{{.State.OOMKilled}}' <name>، والذاكرة الكلية بـfree -h. - الأسباب الشائعة: تسرب ذاكرة Memory Leak في التطبيق يكبر مع الوقت، أو عمال Workers كثيرون كل منهم يحجز ذاكرة كبيرة، أو قاعدة بيانات مضبوطة على ذاكرة أكبر مما في السيرفر، أو حد ذاكرة على ال Container أصغر مما يحتاجه، أو طلب واحد يحمل ملفاً ضخماً كاملاً في الذاكرة.
- الإصلاح: إعادة التشغيل تشتري لك وقتاً فقط، والإصلاح أن تعرف من يكبر: إذا كان الاستهلاك يزيد خطاً مستقيماً مع الوقت فهو تسرب، وإذا كان يقفز مع طلبات معينة فابحث عنها، ثم اضبط عدد العمال والحدود بحسب ذاكرة السيرفر الحقيقية.
- التفاصيل: قراءة
freeوSwap وOOM Killer في تحليل أداء سيرفر Linux في 60 ثانية، وعدد العمال المناسب في قسم عمال الويب والخيوط.
القرص ممتلئ
قاعدة البيانات ترفض الكتابة، أو التطبيق يكتب في سجله No space left on device، أو لا تستطيع حتى أن تحفظ ملفاً صغيراً. ولهذه الحالة ثلاثة أشكال يجب أن تعرفها، لأن الأمر الأول قد يخدعك:
- أول ما تفحصه: المساحة بـ
df -h، وعدد الملفات بـdf -i، فقد يكون القرص نصف فارغ وجدول ال inodes ممتلئاً بسبب ملايين الملفات الصغيرة، مثل ملفات الجلسات أو ال Cache. ثم أين المساحة بـdu -xh --max-depth=1 / | sort -h، وما يستهلكه Docker بـdocker system df. - الأسباب الشائعة: سجلات ال Containers، لأن مشغل السجلات الافتراضي json-file لا يحدد حجم السجل افتراضياً، فالقيمة الافتراضية للخيار
max-sizeهي-1أي بلا حد كما في توثيق Docker، وDocker Images قديمة تراكمت مع كل نشر، ونسخ احتياطية محلية لا تحذف، وسجلات النظام، وملف حذفته ولكن عملية ما زالت تفتحه فلا تعود مساحته حتى تغلقه، وتجده بالأمرlsof +L1. - الإصلاح: احذف ما تعرفه فقط، فاحذف ال Images التي تعرف أنها لإصداراتك القديمة بأسمائها، والنسخ الاحتياطية المحلية التي نقلت إلى مكان آخر، ثم اضبط تدوير السجلات في
daemon.jsonحتى لا تتكرر المشكلة. ولا تشغل أوامر الحذف الشاملة مثلdocker system pruneعلى سيرفر يعمل عليه غيرك أو تعمل عليه خدمات لا تعرفها، والسبب أنها تحذف كل ما لا يستخدمه Container يعمل الآن، وقد يكون فيه بيانات يحتاجها زميلك أو خدمة متوقفة مؤقتاً. - التفاصيل: تدوير السجلات في قسم إعدادات المحرك وامتلاء القرص في قسم امتلاء القرص بمرور الوقت من دليل Docker، وقراءة
dfوال inodes وiostatفي تحليل أداء سيرفر Linux في 60 ثانية، وزيادة المساحة في دليل توسيع قرص النظام LVM.
قاعدة البيانات ترفض الاتصالات: too many connections
التطبيق يعطي أخطاء متفرقة، وفي سجله رسالة PostgreSQL المعروفة FATAL: sorry, too many clients already، أو رسالة MySQL Too many connections. وغالباً تظهر بعد أن زدت عدد نسخ التطبيق أو عدد العمال، أو مع زيادة الحركة.
- أول ما تفحصه: الحد بـ
SHOW max_connections;، والاتصالات المفتوحة وحالتها بـSELECT state, count(*) FROM pg_stat_activity GROUP BY state;. فإذا كانت أغلبهاidleفالتطبيق يحجز اتصالات لا يستخدمها، وإذا كان كثير منهاidle in transactionفهناك معاملات Transactions تفتح ولا تغلق، وإذا كانت أغلبهاactiveفقاعدة البيانات بطيئة والطلبات تتراكم عليها. - الأسباب الشائعة: تضاعف الاتصالات مع كل نسخة جديدة من التطبيق، لأن كل نسخة تفتح مجمعها الخاص، أو تسرب اتصالات في الكود لا تعاد إلى المجمع، أو استعلام بطيء يجعل كل اتصال يبقى مشغولاً أطول.
- الإصلاح: لا ترفع
max_connectionsكحل أول، والسبب أن كل اتصال في PostgreSQL عملية كاملة تستهلك ذاكرة، وإنما احسب حجم المجمع الصحيح لكل نسخة، وضع PgBouncer أمام قاعدة البيانات عندما تكثر النسخ، وأصلح الاستعلام البطيء إذا كان هو السبب. - التفاصيل: كل ذلك بمختبر حقيقي في مقال تجميع الاتصالات، ومراقبة المجمع في قسم كيف تراقب المجمع.
الاسم لا يحل، أو التغيير لم يصل
الموقع لا يفتح أصلاً ويقول المتصفح إن العنوان غير موجود، أو غيرت سجل A إلى سيرفر جديد وبعض الناس ما زالوا يصلون إلى القديم.
- أول ما تفحصه: ما يرد به خادم DNS الرسمي لنطاقك مباشرة، ثم ما ترد به الخوادم العامة، والفرق بينهما يقول لك هل المشكلة في السجل نفسه أم في نسخ قديمة مخزنة. والأمر
dig +trace example.comيمشي معك من الخوادم الجذرية Root Servers إلى خادم نطاقك خطوة خطوة، وwhoisيقول لك هل النطاق نفسه ما زال مسجلاً. - الأسباب الشائعة: قيمة TTL كبيرة على السجل القديم، أو خطأ كتابي في السجل الجديد، أو تغيير خوادم الأسماء NS عند المسجل دون نقل السجلات، أو نطاق انتهى تسجيله، أو ميزة الوكيل في Cloudflare تخفي العنوان الحقيقي فتظن أن السجل خطأ.
- الإصلاح: أصلح السجل عند المزود الرسمي، ثم انتظر انتهاء TTL القديم، ولا يوجد أمر يجبر خوادم العالم على نسيان النسخة القديمة، لذلك اخفض TTL قبل أي نقل بيوم على الأقل.
- التفاصيل: في مقال شرح DNS وسجلاته، وفي نفس المقال حادثة توقف Facebook في أكتوبر 2021 التي بدأت بتغيير في الشبكة جعل خوادم DNS الخاصة بها غير مرئية للعالم.
الشهادة منتهية أو غير موثوقة
المتصفح يعرض صفحة تحذير كاملة بدل موقعك، أو تطبيق الجوال يتوقف عن الاتصال بال API فجأة، أو أداة سطر الأوامر تقول certificate has expired.
- أول ما تفحصه: تاريخ انتهاء الشهادة التي يرسلها سيرفرك فعلاً، وليس الملف الذي تظن أنه يستخدمه:
openssl s_client -connect example.com:443 -servername example.com </dev/null 2>/dev/null \
| openssl x509 -noout -subject -issuer -enddate- الأسباب الشائعة: التجديد التلقائي توقف بصمت لأن المنفذ 80 أغلق أو تغير سجل DNS، أو تجدد الملف ولكن ال Proxy لم يعد تحميله، أو السيرفر لا يرسل الشهادة الوسيطة Intermediate Certificate فتفشل بعض الأجهزة دون غيرها، أو الاسم في الشهادة لا يطابق النطاق الفرعي الجديد.
- الإصلاح: جدد الشهادة وأعد تحميل ال Proxy، ثم أضف تنبيهاً على تاريخ الانتهاء قبله بأسبوعين على الأقل، والسبب أن فشل التجديد التلقائي لا يرسل لك أي رسالة في الغالب.
- التفاصيل: سلسلة الثقة والشهادة الوسيطة وقراءة تاريخ الانتهاء في مقال الشهادات الرقمية.
بطء أو أخطاء بعد النشر
هذه أسهل الحالات في التشخيص وأخطرها إذا ترددت فيها، لأن ما تغير معروف: إصدار جديد، والعرض بدأ معه.
- أول ما تفحصه: هل بدأ العرض فعلاً مع النشر؟ قارن وقت بداية الأخطاء أو البطء في المراقبة بوقت النشر في سجل خط النشر Pipeline.
- الأسباب الشائعة: استعلام جديد أو متغير كما في التجربة، أو ترحيل Migration يقفل جدولاً كبيراً، أو متغير بيئة ناقص في الإنتاج، أو مكتبة تحدثت ضمن الإصدار، أو إعداد يختلف بين بيئة الاختبار والإنتاج، أو ذاكرة مؤقتة فرغت بعد إعادة التشغيل فوصل الحمل كله إلى قاعدة البيانات.
- الإصلاح: تراجع أولاً إذا كان العملاء متأثرين، ثم ابحث في الفرق بين الإصدارين بهدوء. وانتبه إلى أن التراجع عن الكود سهل، أما التراجع عن ترحيل غير شكل البيانات فقد لا يكون ممكناً، لذلك اجعل الترحيلات متوافقة مع الإصدار السابق.
- التفاصيل: النشر بين البيئات والتراجع في مقال البيئات ومعاينة الميزات وGitOps، وحادثة Cloudflare في قسم إيقاف الضرر أولاً مثال على تغيير نشر للجميع دفعة واحدة.
أخطاء متقطعة
طلب من كل عشرين يفشل، أو الموقع يعطي خطأ دقيقة ثم يعود وحده، ولا تستطيع أن تعيد المشكلة عندما تحاول. وهذه الحالة تحتاج صبراً أكثر من غيرها، لأن القياس الواحد لا يكفي.
- أول ما تفحصه: نسبة الأخطاء على الزمن في سجل ال Reverse Proxy، وهل تتجمع في دقائق معينة أم تتوزع، وهل تأتي كلها من نسخة واحدة من التطبيق، وهل يرافقها شيء آخر في نفس الدقيقة، مثل إعادة تشغيل Container أو مهمة مجدولة أو نسخ احتياطي. وهنا يفيد معرف الطلب Request ID الذي يربط سطر ال Proxy بسطر التطبيق بسطر قاعدة البيانات.
- الأسباب الشائعة: نسخة واحدة معطلة من عدة نسخ، أو مجمع اتصالات يمتلئ في لحظات الذروة فقط، أو اتصالات قديمة في المجمع أغلقها الطرف الآخر أو جدار الحماية دون أن يعرف التطبيق، أو مهلات قصيرة جداً على خدمة خارجية، أو ذاكرة تقترب من الحد فيقتل OOM Killer عملية بين حين وآخر.
- الإصلاح: اجمع البيانات أولاً حتى يظهر النمط، ثم أصلح السبب نفسه، ولا تضف إعادة المحاولة Retry لإخفاء الخطأ قبل أن تفهمه، لأنها قد تضاعف الحمل في أسوأ لحظة.
- التفاصيل: معرفات الطلبات وربط السجلات في تتبع الطلب البطيء، والاتصالات القديمة في المجمع في إعدادات المجمع، وما يحدث عندما ينقطع الاتصال بين مركزي بيانات لثوان في حادثة GitHub في أكتوبر 2018 التي ذكرناها في دليل تثبيت HAProxy.
بطء في نفس الساعة كل يوم
الموقع يبطئ كل ليلة في الثانية بعد منتصف الليل، أو كل يوم أحد في التاسعة صباحاً، ثم يعود طبيعياً بعد نصف ساعة. والتكرار المنتظم هدية في التحقيق، لأنه يقول لك إن السبب على الأغلب مجدول.
- أول ما تفحصه: المهام المجدولة بـ
crontab -lلكل مستخدم وفي/etc/cron.d/، ومؤقتات systemd بـsystemctl list-timers، والمهام المجدولة داخل التطبيق نفسه، ومواعيد النسخ الاحتياطي عند مزود السيرفر، واستهلاك القرص في نفس الساعة. - الأسباب الشائعة: النسخ الاحتياطي لقاعدة البيانات يقرأ كل شيء من القرص، أو تقرير ثقيل يعمل على قاعدة الإنتاج، أو ضغط السجلات وتدويرها، أو مهمة تعمل في كل نسخة من التطبيق بدل نسخة واحدة، أو زاحف بحث يزور الموقع كل يوم في نفس الوقت، أو مهمة مضبوطة على منطقة زمنية غير التي تظنها.
- الإصلاح: انقل المهمة الثقيلة إلى وقت أهدأ أو إلى نسخة قراءة Read Replica، وحدد أولويتها بـ
niceوionice، واجعل المهام المجدولة تعمل في عامل واحد. - التفاصيل: المهام المجدولة مع عدة نسخ في قسم نسخ متعددة من التطبيق، والمناطق الزمنية في المهام المجدولة في قسم الجدولة، والنسخ الاحتياطي لقاعدة كبيرة في قسم النسخ الاحتياطي.
نموذج ملاحظات الحادثة
انسخ هذا النموذج إلى ملف جديد في بداية كل حادثة، أو إلى أول رسالة في قناة الحادثة، واملأه أثناء العمل وليس بعده:
# حادثة: [وصف قصير]   التاريخ: [YYYY-MM-DD]   المسؤول: [الاسم]

## العرض
- من يتأثر: [كل المستخدمين / منطقة / نوع جهاز / صفحة]
- ماذا يحدث: [بطء / رمز الخطأ / رسالة]
- منذ متى (UTC): [وقت البداية بحسب المراقبة]
- كيف قيس: [المصدر والرقم الآن، والرقم قبل المشكلة]

## ما الذي تغير قريباً
- النشر: [آخر إصدار ووقته]
- الإعداد والحزم: [...]
- الحركة والخدمات الخارجية: [...]

## الخط الزمني (UTC)
- HH:MM  [ما حدث أو ما رأيناه]
- HH:MM  [الفرضية] ← [القياس] ← [النتيجة]
- HH:MM  [التغيير الذي نفذ ومن نفذه]

## إيقاف الضرر
- الإجراء: [تراجع / إيقاف ميزة / سعة مؤقتة]   الوقت: [HH:MM]
- عادت الخدمة: [HH:MM، وبأي قياس تأكدنا]

## السبب والإصلاح الدائم
- السبب الجذري: [...]
- الإصلاح الدائم: [...]   المسؤول: [...]   الموعد: [...]
- ما الذي يمنع تكرارها: [تنبيه / اختبار / تغيير في خط النشر]
وقبل أن تغلق الحادثة، مر على هذه الأسئلة:
- هل القياس الذي بدأنا به عاد إلى قيمته قبل المشكلة، وليس فقط «يبدو أفضل»؟
- هل كل تغيير مؤقت نفذناه أثناء الحادثة مكتوب، ومعه قرار: يبقى أم يلغى؟
- هل يوجد تنبيه كان سيكشف المشكلة قبل أن يكتشفها العميل؟ وإذا لم يوجد فأضفه.
- هل الإصلاح الدائم له مسؤول وموعد؟
- هل تستحق الحادثة تقرير ما بعد الحادثة دون لوم Blameless Postmortem يقرؤه الفريق كله؟
أخطاء شائعة أثناء التحقيق
- البدء بالحل: شراء سيرفر أكبر أو إضافة Cache قبل أن تعرف السبب، فيختفي العرض أياماً ثم يعود، وتبقى معك تكلفة لا تحتاجها.
- إعادة التشغيل قبل حفظ الدليل: خذ دقيقة تحفظ فيها مخرج
topوdocker statsوآخر السجلات قبل أي إعادة تشغيل. - تغيير عدة أشياء معاً: فلا تعرف أيها أصلح المشكلة، ويبقى في الإنتاج ما لا يعرف أحد لماذا هو موجود.
- الثقة بالمتوسط: المتوسط الجميل يخفي العملاء الذين ينتظرون ثوان، فانظر إلى p95 وp99.
- الاكتفاء بفحص الصحة:
/healthيرد 200 والصفحة الحقيقية أبطأ بعشرات المرات كما رأينا في التجربة، لذلك راقب الطلبات الحقيقية. - البحث في الطبقة التي تعرفها: مطور قواعد البيانات يبدأ بالاستعلامات، ومهندس الشبكات يبدأ بالشبكة، والصحيح أن تبدأ بالطبقة التي يقول القياس إنها تأخذ الوقت.
- أوامر مدمرة تحت الضغط: لا تنفذ حذفاً أو إعادة بناء أثناء الحادثة دون أن يراجع الأمر زميل، ودون أن تتأكد على أي سيرفر أنت، وقد ذكرنا في مقال مصطلحات الاستضافة الذاتية كيف حذف مهندس في GitLab سنة 2017 مجلد البيانات على السيرفر الأساسي بدل الثانوي أثناء معالجة مشكلة.
- المراقبة على نفس النظام: إذا كانت المراقبة تعمل على نفس السيرفر أو تمر بنفس الشبكة، فسوف تتوقف معه، كما حدث في حادثتي Slack وRoblox.
- إغلاق الحادثة بعد التراجع: التراجع يوقف الضرر فقط، والسبب الجذري سوف يعود في النشر التالي إذا لم يصلح.
ماذا تقرأ بعد هذا الدليل؟
هذا الدليل يعطيك الطريقة ويحيلك في كل حالة إلى مقال يتعمق فيها، وهذه أهم المقالات مقسمة بحسب ما تحتاجه:
التعمق في الأدوات
أدوات السيرفر في Linux واحدة واحدة، وتتبع الطلب الواحد من المتصفح إلى قاعدة البيانات:
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
الطبقات التي تتكرر فيها المشكلات
قاعدة البيانات والاتصالات بها، والشبكة وال CDN وDNS والشهادات، وال Reverse Proxy، والمعالج والتزامن:
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.
 دليلشرح DNS وسجلاته للمبتدئين بمثال حقيقيكيف يتحول اسم نطاقك إلى عنوان سيرفرك، وما وظيفة كل سجل تضيفه في لوحة النطاق، والأخطاء التي تضيع فيها الساعات عادة.
 دليلالشهادات الرقمية TLS للمبتدئين وصيغ ملفاتهاكيف يعرف المتصفح أنه يتحدث مع الموقع الحقيقي، وماذا يوجد داخل الشهادة، ولماذا تأتي ملفاتها بأكثر من صيغة.
 دليلكيف يرى تطبيقك عنوان الزائر الحقيقي خلف ال Reverse Proxyإذا كان تطبيقك يرى عنوان ال Proxy بدلاً من الزائر أو يولد روابط http، فهذا هو السبب والإعداد الصحيح لإطار عملك.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
الصورة الأكبر
كيف يكبر النظام خطوة خطوة ولماذا يجب أن تقيس قبل كل خطوة:
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
الخلاصة
وصلنا لنهاية الدليل، وأهم ما فيه:
- استكشاف الأخطاء طريقة تتعلمها وليس موهبة: صف العرض بدقة، واسأل ما الذي تغير، وارسم خطاً زمنياً، ثم فرضية واحدة وقياس واحد وتغيير واحد، وتحقق بنفس القياس الذي بدأت به.
- إذا كان العملاء متأثرين وهناك تغيير حديث، فتراجع أولاً ثم ابحث عن السبب، والتراجع يجب أن يكون أمراً واحداً مجرباً قبل أن تحتاجه.
- USE تفحص كل مورد في السيرفر، وRED والإشارات الذهبية الأربع تفحص الخدمة كما يراها المستخدم، والنسب المئوية p95 وp99 تكشف ما يخفيه المتوسط.
- الطلب يمر بطبقات من المتصفح إلى القرص، فقسم المسار بالقياس وابدأ بالطبقة التي تأخذ الوقت، وليس بالطبقة التي تعرفها.
- في التجربة رأينا تعديلاً صغيراً في استعلام يرفع زمن الطلب عشرات المرات ويملأ معالج قاعدة البيانات، والسيرفر الأكبر ما كان ليصلحه، والتراجع أعاد الأرقام كما كانت.
- اكتب كل شيء بوقته، فالملاحظات هي التي تختصر الحادثة القادمة وتبنى منها تقارير ما بعد الحادثة.
وفي مقالات قادمة بإذن الله ضمن قسم الأداء والموثوقية SRE سوف نتحدث عن مستويات الخدمة SLO وميزانية الأخطاء، واختبار الأحمال Load Testing، وإدارة الحوادث والمناوبة، وتقرير ما بعد الحادثة دون لوم.
سجل التحديثات
- أكتوبر 2026: كتابة الدليل، وتنفيذ التجربة العملية على Docker Engine 29.8.0 (Docker Desktop) مع PostgreSQL 18.6 وPython 3.13.16 وpsycopg 3.3.6، ومراجعة الحوادث من تقارير Roblox وCloudflare وSlack وLet's Encrypt نفسها.


