

يصلك من أحد المستخدمين أن صفحة الطلبات بطيئة، أو أن زر الدفع يعطي خطأ 504 أحياناً، فتفتح الصفحة على جهازك فتجدها سريعة، وتفتح لوحة المراقبة فتجد المعالج والذاكرة في حدودهما الطبيعية، ولا تعرف من أين تبدأ. والسبب أن الطلب الواحد يمر من المتصفح إلى الشبكة ثم إلى ال Reverse Proxy ثم إلى التطبيق ثم إلى قاعدة البيانات أو إلى خدمة خارجية ثم يعود، وكل محطة من هذه المحطات تأخذ جزءاً من الوقت، والمستخدم لا يرى إلا المجموع. والطريقة التي سوف نشرحها هنا هي أن تأخذ طلباً واحداً بطيئاً أو فاشلاً وتتبعه في كل طبقة حتى تعرف أين ذهب الوقت فعلاً، بالأرقام وليس بالتخمين.
وهذا المقال جزء من سلسلة استكشاف الأخطاء، فالطريقة العامة في التعامل مع أي مشكلة، من جمع الأعراض إلى كتابة ما حدث بعدها، تجدها في دليل استكشاف الأخطاء وتحليل الأداء، وإذا كانت المشكلة في موارد السيرفر نفسه، أي المعالج أو الذاكرة أو القرص أو الشبكة، فابدأ من تحليل أداء سيرفر Linux في 60 ثانية. أما هنا فنركز على الطلب نفسه، وسوف نناقش في هذا المقال ما يلي:
- المحطات التي يمر بها الطلب، وما الذي يقيسه كل طرف منها.
- تقسيم الوقت من جهة الكلاينت باستخدام
curl -wوتبويب Timing في أدوات المطور، وترويسة Server-Timing التي تجعل التطبيق يخبرك بتوقيته. - سجل Nginx مع حقول التوقيت، وقراءة الأخطاء 499 و502 و504 ومعرفة من أغلق الطلب.
- ربط سطور الطلب الواحد في كل السجلات بمعرف الطلب Request ID.
- أين يختبئ الوقت داخل التطبيق، وكيف تستخدم ال Profiling وتقرأ ال Flame Graph.
- نظرة سريعة من جهة قاعدة البيانات.
- تجربة عملية كاملة تعيد إنتاج Production كل حالة ثم تصلح بعضها، وجدول يربط العرض بالطبقة المسؤولة.
أين يذهب وقت الطلب؟
عندما يضغط المستخدم على رابط في صفحتك، فإن المتصفح يبحث عن عنوان النطاق عبر DNS، ثم يفتح اتصال TCP، ثم يتفاوض على التشفير TLS، ثم يرسل الطلب إلى ال Reverse Proxy مثل Nginx، والذي يمرره إلى التطبيق، والتطبيق قد ينتظر حتى يحصل على اتصال بقاعدة البيانات من المجمع Pool، ثم ينفذ استعلاماً أو عدة استعلامات، وقد يتصل بخدمة خارجية مثل بوابة الدفع، ثم ينفذ الكود الخاص به ويبني الرد، ثم يعود الرد بالطريق نفسه إلى المتصفح. والصورة التالية تبين هذه المحطات، والشريط في أسفلها يقسم الوقت الكلي عليها:
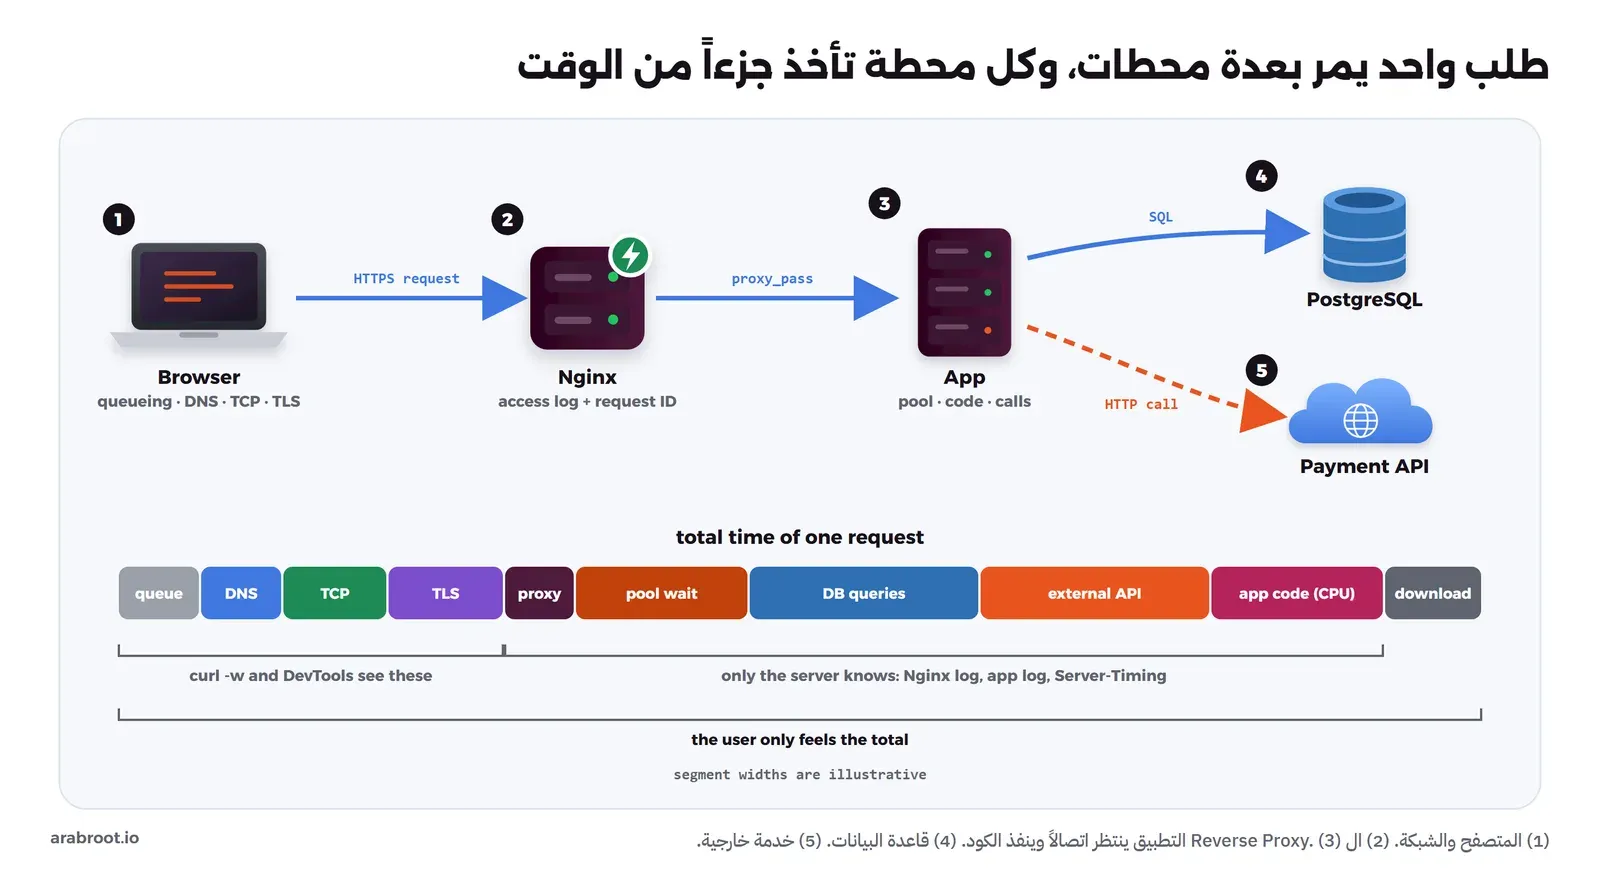
لاحظ في الصورة أن الأدوات التي على جهازك، مثل curl وأدوات المطور في المتصفح، تقيس بدقة ما يحدث قبل وصول الطلب إلى سيرفرك، أما ما يحدث داخل السيرفر فتراه كله كتلة واحدة اسمها «انتظار الرد»، ولكي تقسم هذه الكتلة تحتاج سجل ال Proxy وسجل التطبيق وأدوات قاعدة البيانات. لذلك فالقاعدة التي نتبعها في هذا المقال هي أن تقسم الوقت من الخارج إلى الداخل، طبقة بعد طبقة، وفي كل طبقة تسأل سؤالاً واحداً: هل ذهب أغلب الوقت هنا، أم في الطبقة التي بعدها؟
قسم الوقت من جهة الكلاينت أولاً
ال curl -w: خمسة أرقام تقسم الطلب
الخيار -w أو --write-out في curl يطبع بعد انتهاء الطلب متغيرات تصف ما حدث، ومنها متغيرات التوقيت التي يشرحها دليل curl، والأمر التالي يطلب الصفحة الرئيسية لموقعنا ويطبع خمسة منها:
curl -s -o /dev/null -w 'dns: %{time_namelookup}s\ntcp: %{time_connect}s\ntls: %{time_appconnect}s\nttfb: %{time_starttransfer}s\ntotal: %{time_total}s\ncode: %{http_code}\n' https://arabroot.io/والمخرج سوف يكون كما يلي:
dns:   0.066377s
tcp:   0.164739s
tls:   0.287433s
ttfb:  0.879366s
total: 0.902757s
code:  200
والخطأ الشائع في قراءة هذا المخرج أن تظن أن TLS أخذ 287 مللي ثانية، والصحيح أن كل رقم يقاس من لحظة بدء الطلب وليس من نهاية المرحلة السابقة، فالدليل يصف time_connect مثلاً بأنه الوقت «من البداية حتى اكتمال اتصال TCP»، وtime_starttransfer بأنه الوقت حتى وصول أول بايت، ويشمل ما قبله ويشمل «الوقت الذي احتاجه السيرفر لحساب النتيجة». لذلك فالمرحلة الحقيقية هي الفرق بين رقمين متتاليين، والصورة التالية تبين ذلك:
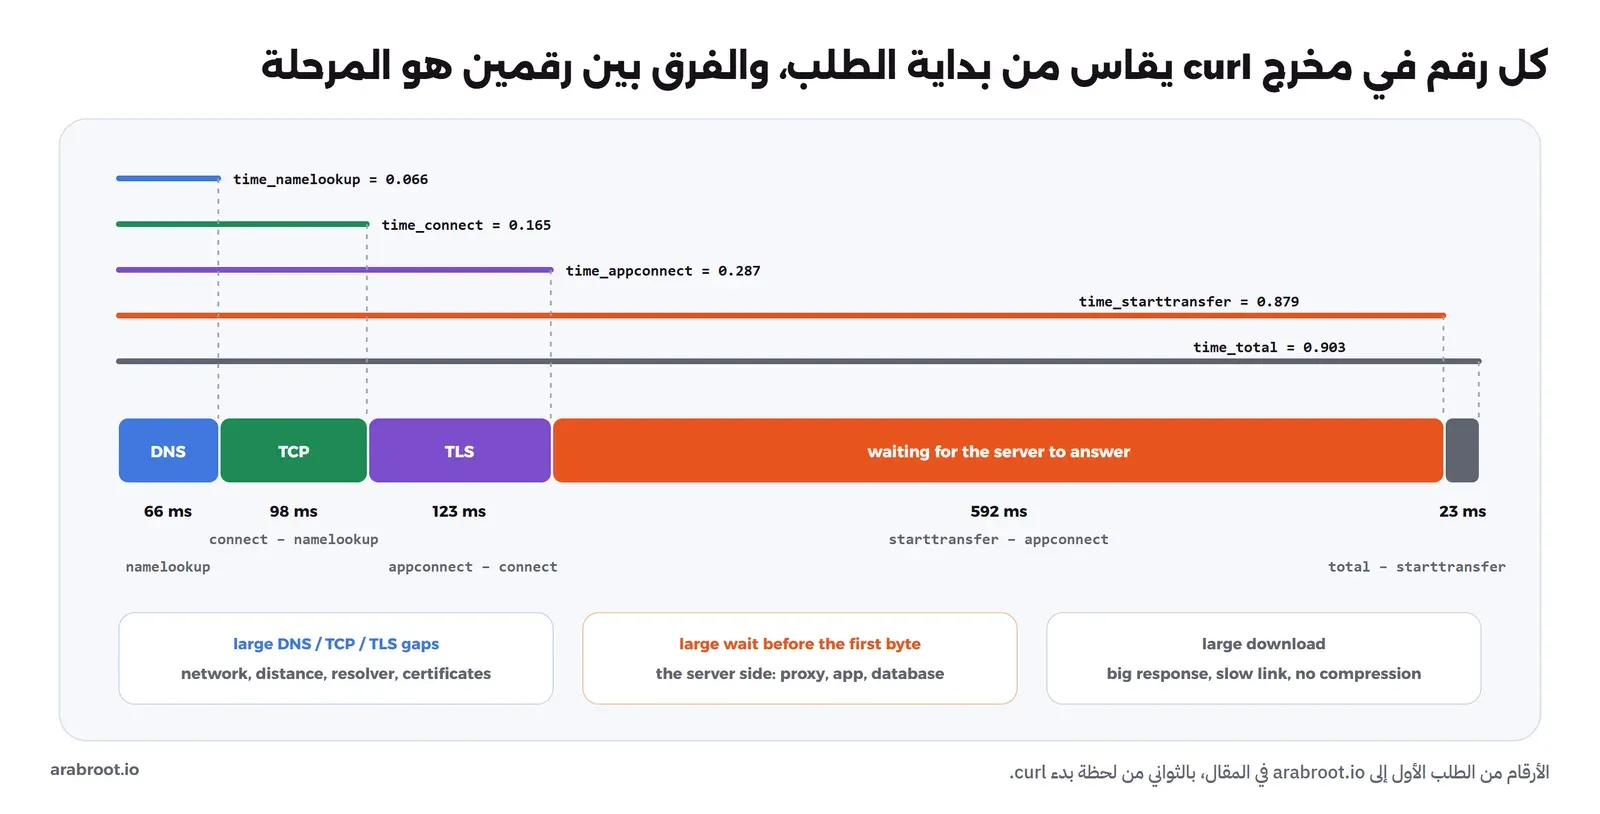
في المخرج أعلاه لاحظ التالي:
- البحث عن العنوان DNS أخذ 66 مللي ثانية، وعند تكرار الأمر نفسه بعد ثوان نزل إلى 3 مللي ثانية لأن ال Resolver أصبح يحفظ الجواب، كما شرحنا في التخزين المؤقت ومدة بقاء السجل TTL.
- اتصال TCP أخذ قرابة 98 مللي ثانية، وهذا تقريباً زمن ذهاب وعودة واحد إلى أقرب نقطة تستقبل الطلب، ومصافحة TLS أخذت 123 مللي ثانية، وتفاصيل المصافحة والشهادات في مقال الشهادات الرقمية.
- أكبر جزء هو 592 مللي ثانية بين انتهاء TLS ووصول أول بايت، وهذا هو الوقت الذي كان فيه الطلب عند السيرفر، وهو الجزء الذي لا يستطيع curl أن يقسمه، فإذا كان هذا الرقم هو الكبير فالمشكلة في جهة السيرفر وننتقل إلى سجلاته.
- التنزيل أخذ 23 مللي ثانية فقط لصفحة حجمها قرابة 55 كيلوبايت، فإذا كان التنزيل هو الكبير فابحث عن رد ضخم أو ضغط غير مفعل أو اتصال بطيء عند المستخدم.
ويجدر الإشارة هنا إلى أن time_appconnect يكون صفراً في الطلبات التي لا تستخدم TLS، كما في طلبات http:// في التجربة العملية، وأن curl يضيف متغيرات أخرى مثل time_pretransfer وtime_redirect، وtime_queue الذي أضيف في الإصدار 8.12.0. وإذا كانت ال CDN أمام موقعك فقد يأتي الرد من نقطة قريبة دون أن يصل إلى سيرفرك أصلاً، فانظر إلى ترويسة حالة ال Cache قبل أن تحكم على السيرفر، كما شرحنا في HIT وMISS وانتهاء الصلاحية. أما تفاصيل HTTP نفسه وإعادة استخدام الاتصال Keep-Alive التي تلغي مراحل DNS وTCP وTLS في الطلبات التالية فتجدها في مقال HTTP وHTTPS.
تبويب Timing في أدوات المطور DevTools
المتصفح يقسم الوقت بالطريقة نفسها، فإذا فتحت أدوات المطور في Chrome ثم لوحة الشبكة Network واخترت الطلب ثم تبويب Timing، سوف تجد المراحل التالية، وأسماؤها وتعريفاتها من مرجع لوحة الشبكة في Chrome:
- الانتظار في الطابور Queueing: المتصفح يؤخر الطلب قبل بدء الاتصال إذا كانت هناك طلبات أعلى أولوية، أو إذا كانت هناك ستة اتصالات TCP مفتوحة لنفس الأصل Origin وهو الحد في HTTP/1.x، أو أثناء حجز مساحة في ال Cache على القرص.
- التوقف Stalled: الطلب توقف بعد بدء الاتصال لأحد أسباب الانتظار نفسها.
- البحث عن العنوان DNS Lookup والاتصال الأولي Initial connection، ويشمل مصافحة TCP والتفاوض على SSL.
- إرسال الطلب Request sent.
- الانتظار Waiting (TTFB): المتصفح ينتظر أول بايت من الرد، واختصاراً TTFB أي Time To First Byte، وهو المقابل للفرق بين
time_starttransferوtime_appconnectفي curl. - تنزيل المحتوى Content Download: استقبال الرد.
وفائدة المتصفح على curl أنه يريك الصفحة كلها، فقد تكتشف أن الطلب الرئيسي سريع وأن البطء في عشرين طلباً بعده تنتظر في الطابور لأن الصفحة تطلب ملفات كثيرة من أصل واحد، أو أن طلب API واحداً يبدأ متأخراً لأنه ينتظر ملف JavaScript قبله. أما إذا كان الوقت كله في Waiting (TTFB) فالمشكلة في السيرفر، والخطوة التالية أن تجعل السيرفر يخبرك بالتفصيل.
ترويسة Server-Timing: اجعل التطبيق يخبرك بتوقيته
ترويسة Server-Timing يرسلها التطبيق مع الرد، وفيها مقاييس لكل منها اسم ومدة اختيارية بالمللي ثانية dur ووصف اختياري desc، مفصولة بفواصل، مثل:
Server-Timing: pool;dur=2.7, db;dur=112.8;desc="101 queries", ext;dur=0.0, app;dur=120.0وهذه الترويسة معرفة في مواصفة W3C التي تذكر عرضها في أدوات المطور من أهم استخداماتها، وتقرؤها من JavaScript عبر الخاصية serverTiming في Performance API، ويعرضها Chrome في تبويب Summary في لوحة Performance كما في ملاحظات إصدار DevTools 136. والمثال أعلاه حقيقي من تطبيق التجربة العملية، وهو يقول لك مباشرة إن الطلب أخذ 120 مللي ثانية داخل التطبيق، منها 113 في 101 استعلام إلى قاعدة البيانات، ولم يحتج أكثر من 3 مللي ثانية لانتظار اتصال، ولم يتصل بأي خدمة خارجية، وهذا تشخيص كامل في سطر واحد قبل أن تفتح أي سجل.
سجل ال Reverse Proxy: أين توقف الطلب؟
ال Reverse Proxy هو أول طرف على سيرفرك يرى الطلب وآخر طرف يرسل الرد، لذلك فسجله هو أهم سجل في هذا التتبع، لكن صيغة السجل الافتراضية في Nginx لا تحتوي أي توقيت، فتعرف منها أن الطلب حدث ولا تعرف كم أخذ ولا أين. والحل أن تعرف صيغة سجل خاصة بالأمر log_format، والصيغة التالية هي التي نستخدمها في التجربة العملية:
log_format timing '$remote_addr [$time_local] "$request" $status '
                  'rt=$request_time uct=$upstream_connect_time uht=$upstream_header_time '
                  'urt=$upstream_response_time ua=$upstream_addr us=$upstream_status rid=$request_id';
ومعنى كل حقل، بحسب توثيق وحدة السجل ووحدة upstream، كما يلي:
$request_time: الوقت من قراءة أول بايت من الكلاينت حتى كتابة السجل بعد إرسال آخر بايت إليه، بالثواني مع دقة مللي ثانية، أي عمر الطلب كاملاً كما رآه Nginx.$upstream_connect_time: وقت فتح الاتصال بالتطبيق، ويشمل المصافحة إذا كان الاتصال مشفراً.$upstream_header_time: الوقت حتى وصول ترويسات الرد من التطبيق، وهو أقرب رقم إلى «كم فكر التطبيق قبل أن يجيب».$upstream_response_time: الوقت حتى وصول الرد كاملاً من التطبيق.$upstream_addrو$upstream_status: أي نسخة من التطبيق أجابت وبأي رمز، وإذا حاول Nginx أكثر من سيرفر ظهرت القيم مفصولة بفواصل.$request_id: معرف فريد للطلب من 16 بايت عشوائية بالصيغة الست عشرية، بحسب توثيق الوحدة الأساسية، وسوف نستخدمه بعد قليل لربط السجلات.
والصورة التالية تبين ما يغطيه كل حقل على الطريق بين الكلاينت وNginx والتطبيق:
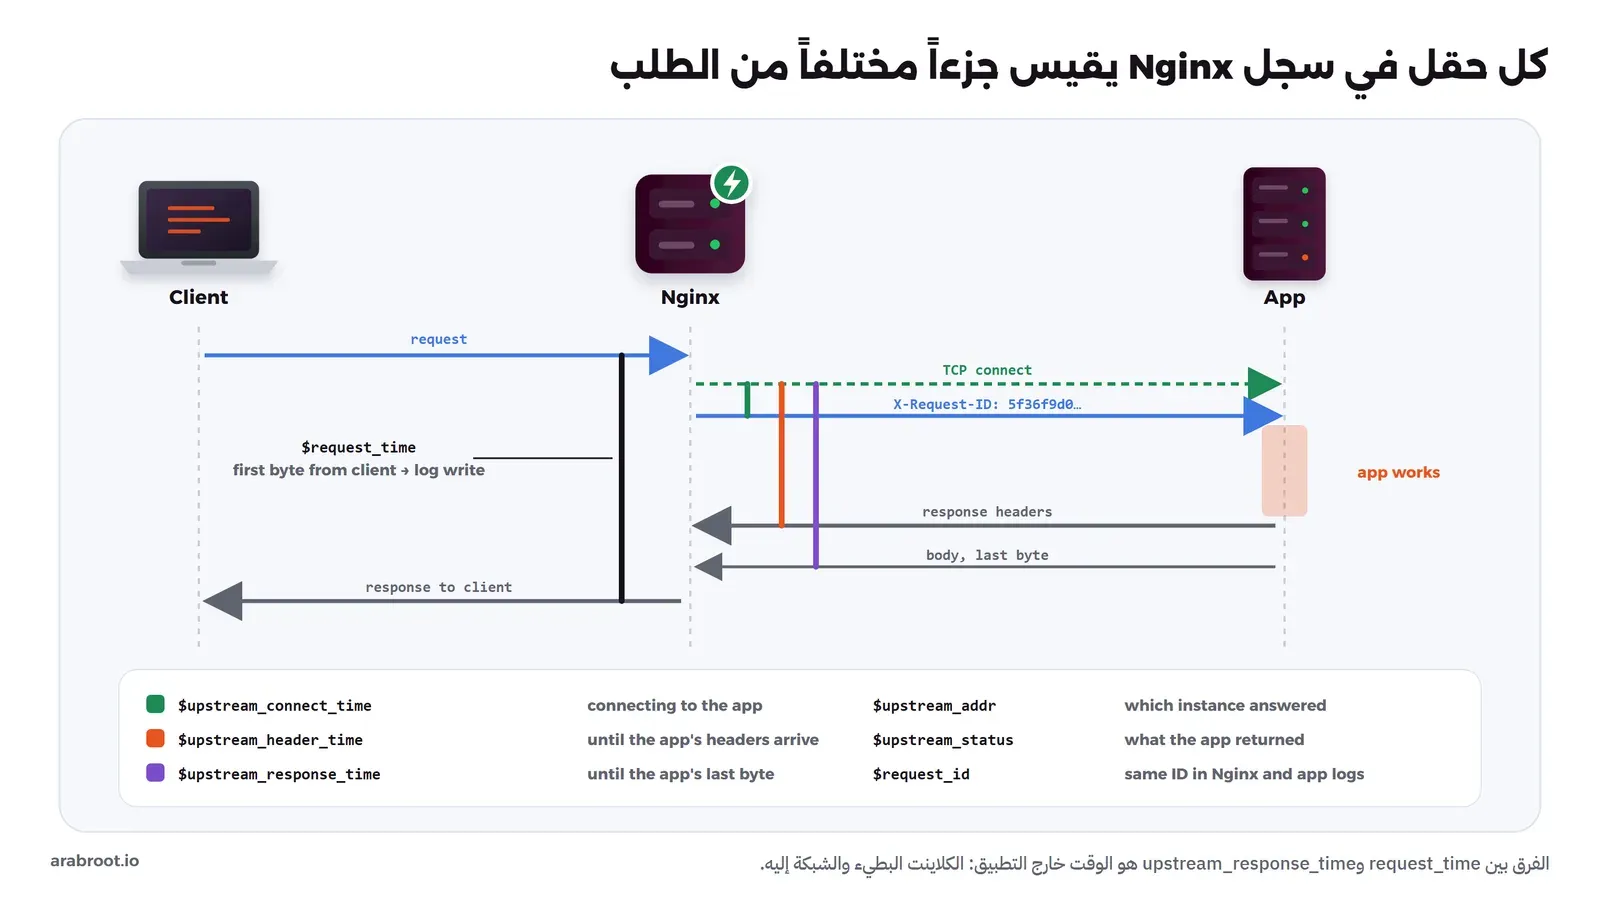
وبهذا الشكل تقرأ السطر الواحد كما يلي: إذا كان rt قريباً من urt فالوقت كله في التطبيق وما خلفه، وإذا كان rt أكبر بكثير من urt فالفرق ذهب بين Nginx والكلاينت، أي رفع ملف كبير من اتصال بطيء أو تنزيل رد كبير، وإذا كان uct كبيراً فالتطبيق لا يقبل الاتصالات بسرعة، أي أن كل العمال Workers مشغولون أو أن الطابور ممتلئ، وإذا ظهرت - مكان رقم فهذا يعني أن المرحلة لم تكتمل أصلاً.
من الذي أغلق الطلب؟ قراءة 499 و502 و504
رموز الرد Status Codes الثلاثة التالية تأتي من Nginx وليس من تطبيقك، ولكل منها معنى مختلف تماماً، والصورة التالية تبين من أين يأتي كل منها:
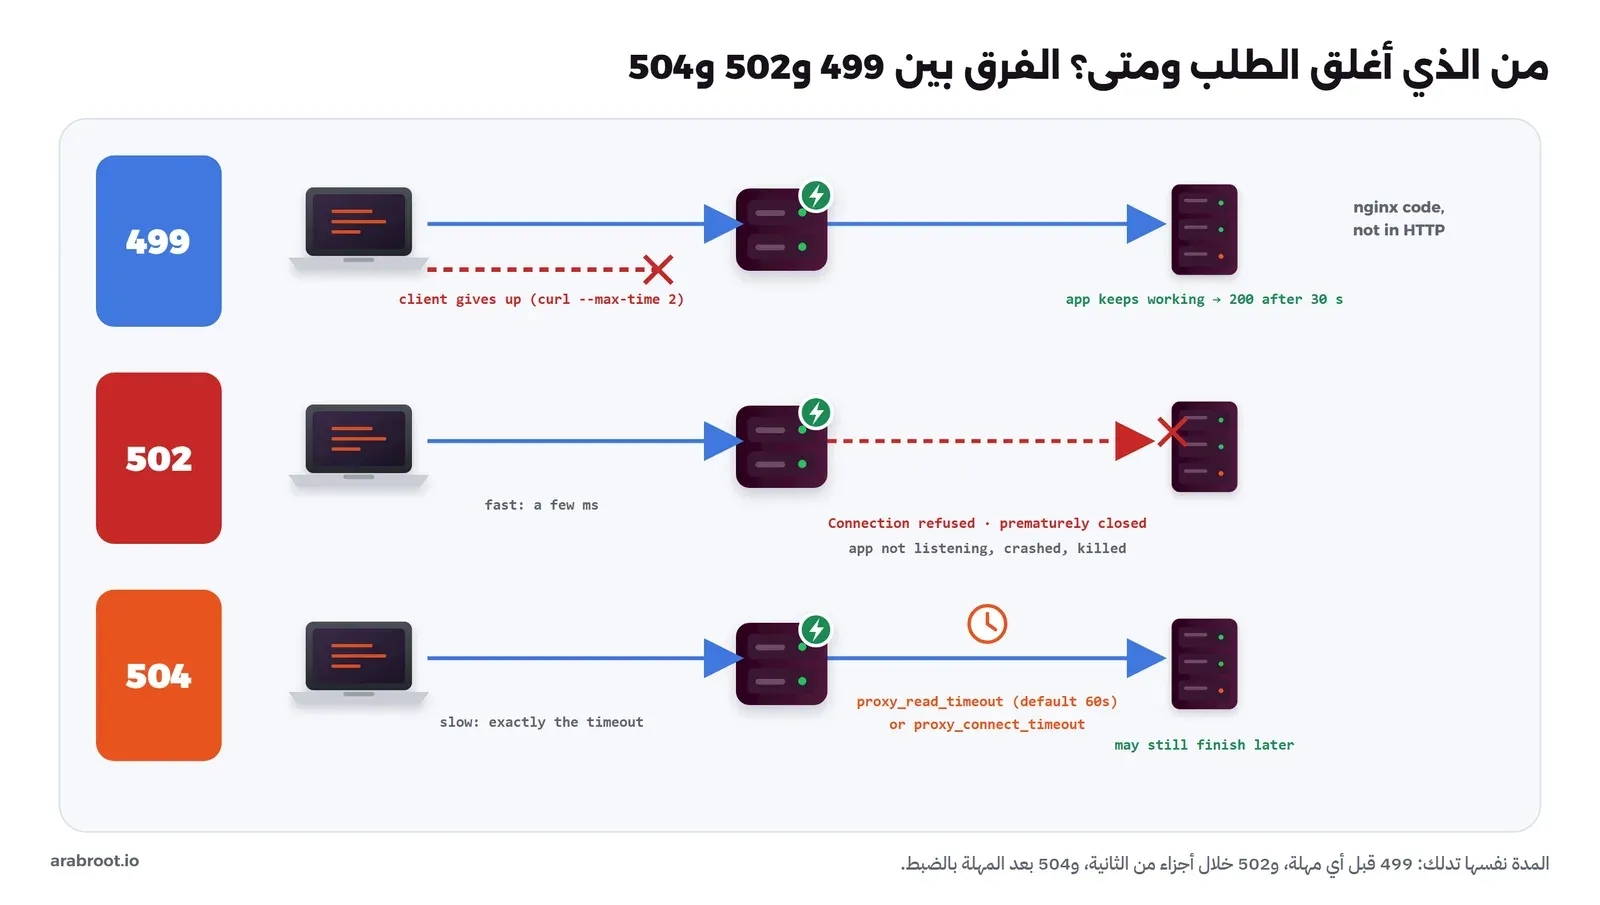
- 499: ليس رمزاً من HTTP أصلاً، وإنما رمز خاص بNginx يكتبه في السجل عندما يغلق الكلاينت الاتصال قبل أن يرسل Nginx الرد، والتعليق في كود Nginx يقول ذلك صراحة: HTTP لا يعرف رمزاً لهذه الحالة فأضافوا رمزاً خاصاً بهم. والكلاينت هنا قد يكون مستخدماً ضغط زر الرجوع، أو تطبيق جوال له مهلة 10 ثوان، أو Load Balancer أمامك مهلته أقصر من مهلتك. ولاحظ أن Nginx بشكل افتراضي يغلق اتصاله بالتطبيق عندما يغادر الكلاينت، بحسب proxy_ignore_client_abort، لكن هذا لا يوقف الكود الذي بدأ العمل في التطبيق كما سنرى.
- 502 Bad Gateway: Nginx لم يحصل من التطبيق على رد صالح، لأن الاتصال رفض Connection refused، أي لا أحد يستمع على المنفذ، أو لأن التطبيق أغلق الاتصال قبل أن يرسل الترويسات prematurely closed، وهذا يحدث عندما ينهار العامل أو يقتله نظام التشغيل لنفاد الذاكرة. وعلامة 502 أنها سريعة غالباً، خلال أجزاء من الثانية.
- 504 Gateway Timeout: Nginx انتظر حتى انتهت مهلته، والسجل يقول لك أي مهلة:
while connecting to upstreamتعنيproxy_connect_timeout، وwhile reading response header from upstreamتعنيproxy_read_timeout. وعلامة 504 أن مدتها في السجل تساوي المهلة بالضبط.
والمهلات الثلاث في وحدة proxy كلها 60 ثانية بشكل افتراضي، مع ملاحظتين مهمتين من التوثيق: الأولى أن proxy_read_timeout وproxy_send_timeout ليستا مدة الطلب كاملاً، وإنما المدة المسموحة بين عمليتي قراءة أو كتابة متتاليتين، فالتطبيق الذي يرسل شيئاً كل 50 ثانية لا ينتهي بمهلة 60 ثانية مهما طال، والثانية أن proxy_connect_timeout لا يمكن عادة أن يتجاوز 75 ثانية. وقد شرحنا ضبط المهلات للمسارات البطيئة، والخطأ 524 من Cloudflare، ونقل العمل الطويل إلى مهمة في الخلفية في الطلبات البطيئة وخطأ 504، فلا نكرره هنا.
اربط السطور ببعضها: معرف الطلب Request ID
سجل Nginx يقول لك إن الطلب أخذ خمس ثوان في التطبيق، وسجل التطبيق فيه آلاف السطور في تلك الدقيقة، فكيف تعرف أي سطر يخص هذا الطلب؟ الحل البسيط أن تبحث بالوقت والمسار، وهذا لا يعمل عندما يصل عشرون طلباً للمسار نفسه في الثانية نفسها. والحل الصحيح أن يحمل كل طلب معرفاً فريداً من أول طبقة، ثم تكتبه كل طبقة في سجلها، فتبحث عنه في كل السجلات فتجد قصة الطلب كاملة. وفي Nginx يكفي سطران:
proxy_set_header X-Request-ID $request_id;      # to the app
add_header X-Request-ID $request_id always;     # back to the client, even on 502/504
في الإعداد أعلاه لاحظ التالي:
- السطر الأول يرسل المعرف إلى التطبيق في الترويسة
X-Request-ID، والتطبيق يقرؤها ويضعها في كل سطر يكتبه في سجله. - السطر الثاني يعيده إلى الكلاينت، والكلمة
alwaysتجعله يظهر حتى في ردود الأخطاء، فإذا أرسل لك المستخدم صورة شاشة الخطأ أو نسخ الترويسة من أدوات المطور، فعندك المفتاح الذي تبحث به. - إذا كان أمام Nginx طرف آخر يضع معرفاً للطلب، مثل Load Balancer أو CDN، فالأفضل أن تستخدم معرفه بدل أن تنشئ معرفاً جديداً، بشرط أن تقبله منه وحده وليس من أي كلاينت، للسبب نفسه الذي شرحناه في ترويسة يكتبها أي أحد.
والسجل في التطبيق يجب أن يكون منظماً Structured Logs، أي سطر JSON لكل حدث فيه حقول ثابتة، كما شرحنا في السجلات إلى stdout وstderr، والسبب أن السطر النصي الحر يصعب البحث فيه ويصعب جمعه، أما سطر مثل التالي فتستطيع أن تبحث فيه بالمعرف وأن تجمع منه متوسط وقت قاعدة البيانات لكل مسار:
{"request_id": "a4d2afdcf2988f91339635dfbdf79fe7", "method": "GET", "path": "/orders/recent-n1", "status": 200, "ms": 120.0, "pool_wait_ms": 2.7, "db_ms": 112.8, "queries": 101}وعندما يمر الطلب بأكثر من خدمة، فالخطوة التالية بعد معرف الطلب هي التتبع الموزع Distributed Tracing، حيث يحمل الطلب ترويسة traceparent المعيارية، وتسجل كل خدمة أجزاء العمل التي قامت بها Spans مع توقيتها، فترى الطلب كله في شكل شجرة زمنية واحدة، والأداة المفتوحة الأشهر لذلك هي OpenTelemetry، وسوف نخصص لها مقالاً في مرحلة المراقبة والسجلات في خريطة التعلم بإذن الله.
داخل التطبيق: أين يختبئ الوقت؟
إذا قال لك سجل Nginx إن الوقت في التطبيق، فهذه هي الأماكن التي يختبئ فيها غالباً، مرتبة تقريباً من الأكثر شيوعاً إلى الأقل:
- انتظار اتصال من المجمع Pool Wait: كل اتصالات المجمع مشغولة، فينتظر الطلب دوره قبل أن ينفذ أي استعلام، والاستعلام نفسه سريع. وهذا لا يظهر في قاعدة البيانات إطلاقاً، لأن الطلب لم يصل إليها بعد، لذلك يجب أن تقيسه في التطبيق، وقد شرحنا أسبابه وحجم المجمع المناسب وكيف تراقب وقت الانتظار في كيف تراقب المجمع Pool.
- استعلام بطيء: فهرس ناقص Missing Index أو خطة تنفيذ Execution Plan سيئة، وطريقة إيجاده بـ pg_stat_statements وقراءة خطته بـ EXPLAIN شرحناها في قس أولاً: أين يذهب الوقت فعلاً؟.
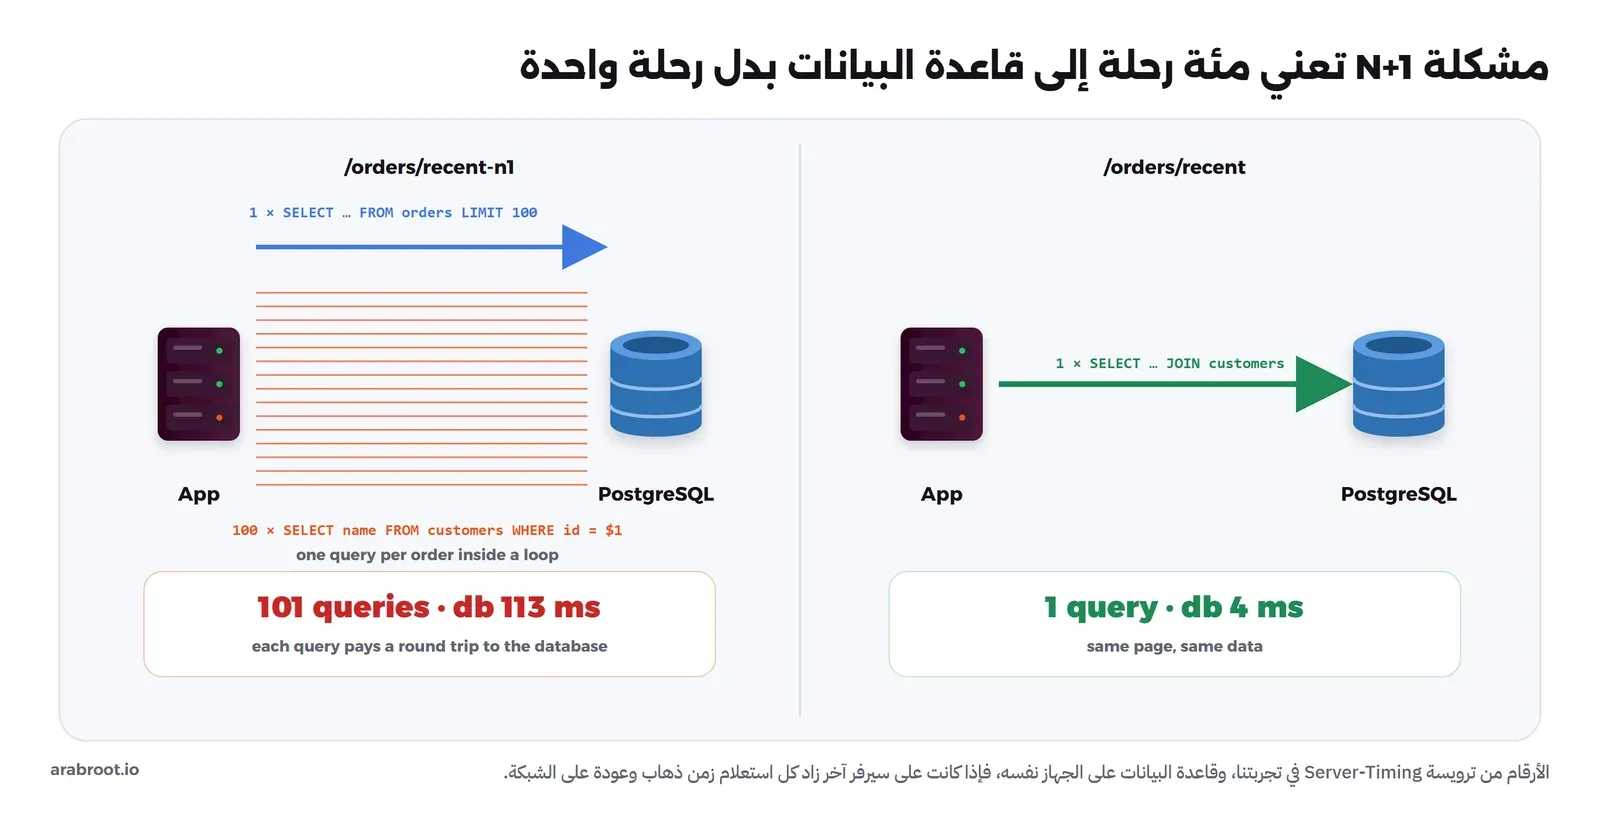
- مشكلة N+1: استعلام يجلب قائمة، ثم استعلام لكل عنصر في القائمة داخل حلقة Loop، وكل استعلام منها سريع، لكن المجموع كبير، والسبب أن كل استعلام يدفع زمن ذهاب وعودة إلى قاعدة البيانات، وتفاصيلها في مقال تصميم قواعد البيانات. والصورة التالية تبين الفرق في التجربة العملية:
- اتصال بخدمة خارجية بلا مهلة Timeout: وهذا أخطرها، لأن مكتبات كثيرة لا تضع مهلة بشكل افتراضي، فالمقبس Socket في Python مثلاً بلا مهلة ما لم تحدد واحدة، وتوثيق مكتبة requests يقول إن كل كود في الإنتاج تقريباً يجب أن يمرر المهلة في كل طلب تقريباً، وإلا فقد يتوقف البرنامج إلى ما لا نهاية. فإذا تعطلت بوابة الدفع أصبح كل طلب دفع يحجز عاملاً من عمال تطبيقك، وبعد قليل لا يبقى عامل لأي صفحة أخرى.
- إرسال البريد أو توليد ملف داخل الطلب: الاتصال بسيرفر SMTP أو توليد PDF أو تصغير صورة داخل الطلب يجعل المستخدم ينتظر شيئاً لا يحتاج أن ينتظره، والحل أن تضعه في طابور Queue ومهمة في الخلفية Background Job ويرد الطلب فوراً.
- انتظار قفل Lock Contention: طلبان يعدلان الصف نفسه، فينتظر الثاني حتى ينتهي الأول من المعاملة Transaction، وكلما طالت المعاملة طال الانتظار، وأسوأ الحالات معاملة تبدأ ثم تتصل بخدمة خارجية قبل أن تنتهي.
- توقف جمع الذاكرة GC Pause: في اللغات التي تجمع الذاكرة تلقائياً قد يتوقف البرنامج لحظات أثناء الجمع، وبعض أنواع جامع الذاكرة توقف البرنامج كله أثناء عمله Stop The World كما يشرح دليل جامع الذاكرة في Go، وهذا يظهر عادة بطئاً متفرقاً في طلبات عشوائية وليس في مسار واحد.
- كود يستهلك المعالج: حلقات متداخلة، أو تحويل JSON ضخم، أو تشفير، وفي Node.js يوقف هذا حلقة الأحداث فتتأخر كل الطلبات الأخرى معه، وفي Python يحجز قفل GIL، كما شرحنا في حلقة الأحداث Event Loop وPython وقفل GIL.
والقياس هنا بسيط: أحط كل جزء من هذه الأجزاء في التطبيق بمؤقت، واكتب النتيجة في سطر السجل وفي Server-Timing، كما يفعل تطبيق التجربة العملية بالحقول pool_wait_ms وdb_ms وqueries وext_ms. فإذا لم يفسر مجموع هذه الأجزاء الوقت الكلي، فالباقي في الكود نفسه، وهنا تحتاج ال Profiling.
ال Profiling: اسأل البرنامج أين يقضي وقته
ال Profiler أداة تراقب البرنامج وهو يعمل وتخبرك أي الدوال تأخذ أكثر الوقت، والنوع الأنسب لسيرفر يعمل هو ال Sampling Profiler، الذي ينظر إلى البرنامج عشرات أو مئات المرات في الثانية ويسجل الدالة التي يعمل فيها في كل مرة، فالدالة التي تظهر في نصف العينات أخذت قرابة نصف الوقت. ومن الأدوات المعروفة:
- py-spy لبرامج Python: مكتوب بلغة Rust ويعمل من خارج البرنامج، فلا تحتاج أن تعدل الكود أو تعيد تشغيله، ولذلك يصفه مطوروه بأنه آمن للاستخدام على كود الإنتاج. وله ثلاثة أوامر:
recordيسجل العينات ويكتب Flame Graph بصيغة SVG، وtopيعرض الدوال الأكثر استهلاكاً مباشرة مثل الأمر top، وdumpيطبع ما يفعله كل خيط Thread في هذه اللحظة. وداخل Docker يحتاج الصلاحيةSYS_PTRACE. - الخيار
--cpu-profفي Node.js: يشغل ال Profiler المدمج في V8 عند بدء البرنامج ويكتب ملفاً بامتداد.cpuprofileقبل خروجه، بحسب توثيق Node.js.
والنتيجة تعرض عادة في شكل Flame Graph، وهو تصور ابتكره Brendan Gregg في 2011، وطريقة قراءته من صفحته، والصورة التالية تبين أهم ما فيها:
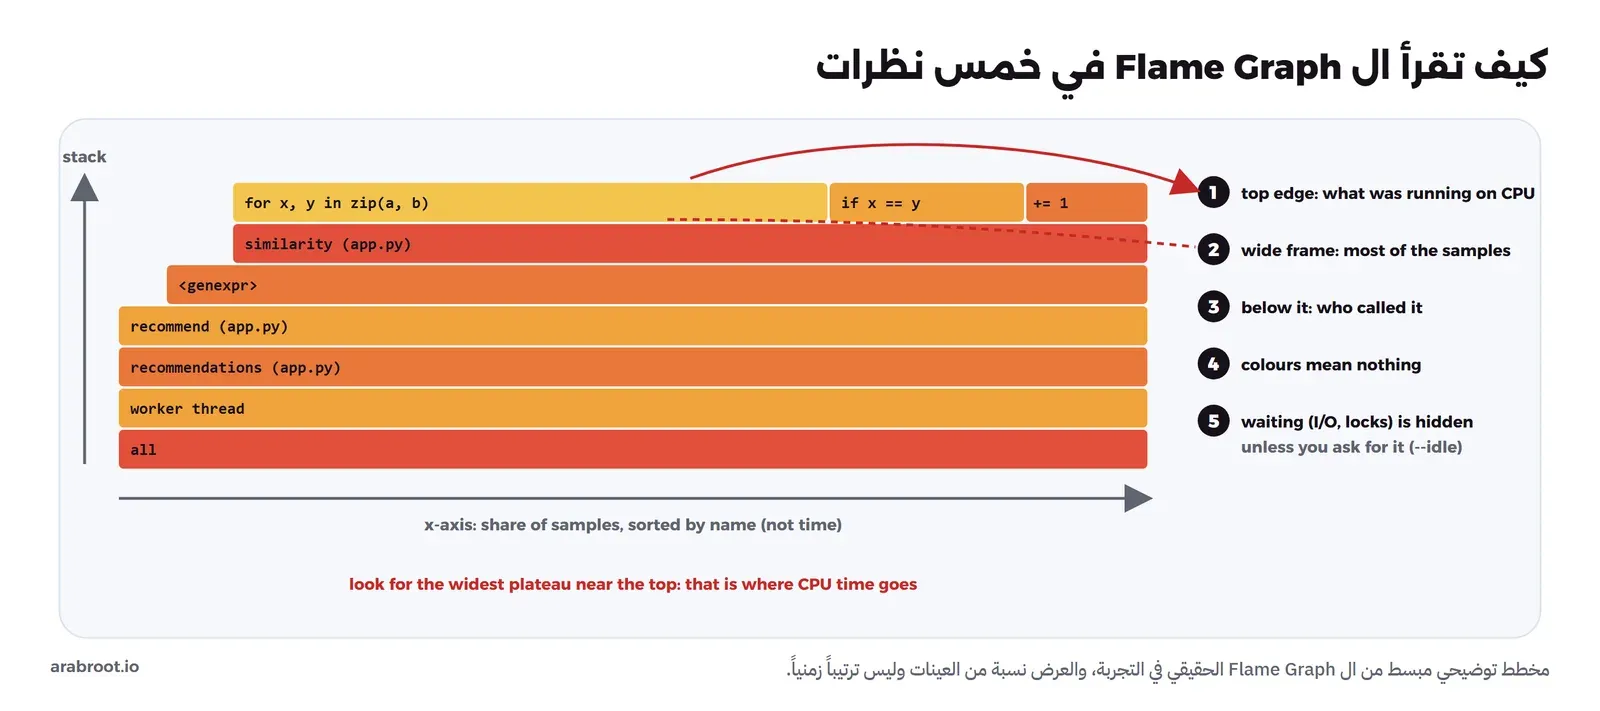
- المحور الأفقي ليس الزمن، وإنما مجموع العينات مرتباً أبجدياً، فلا تقرأ اليسار على أنه «قبل» واليمين على أنه «بعد».
- المحور الرأسي عمق الاستدعاءات، فكل إطار استدعاه الإطار الذي تحته.
- عرض الإطار هو عدد المرات التي ظهر فيها في العينات، فالإطار العريض هو الذي يأخذ الوقت، والحافة العليا هي ما كان يعمل على المعالج فعلاً.
- الألوان في الأصل عشوائية للتفريق بين الإطارات المتجاورة فقط.
ولاحظ أن ال Flame Graph العادي يعرض وقت المعالج On-CPU، أما الخيط الذي ينتظر الشبكة أو قفلاً فلا يظهر، وpy-spy مثلاً يتجاهل الخيوط الخاملة إلا إذا أضفت الخيار --idle، لذلك فال Flame Graph هو الأداة الصحيحة للكود الذي يحسب، أما الطلب العالق في انتظار خدمة خارجية فالأداة الأنسب له هي py-spy dump التي تريك أين يقف كل خيط الآن، كما سنرى في التجربة.
نظرة سريعة من جهة قاعدة البيانات
إذا وصلت إلى أن الوقت في قاعدة البيانات، فهناك ثلاث أدوات مدمجة في PostgreSQL تريك ما يحدث، والتفاصيل الكاملة لقياس الاستعلامات وقراءة خططها في مقال الجداول الضخمة:
- ال pg_stat_activity تعرض كل جلسة الآن: حالتها
stateومنذ متى يعمل استعلامها، والعمودانwait_event_typeوwait_eventيقولان على ماذا تنتظر إن كانت تنتظر، فقيمةLockتعني أنها تنتظر قفلاً، ومع الدالة pg_blocking_pids تعرف أي جلسة تحجزها. - الإعداد log_min_duration_statement يكتب في السجل كل استعلام يستغرق أكثر من المدة التي تحددها، وقيمته الافتراضية
-1أي معطل، ومعهlog_lock_waitsالذي يكتب رسالة عندما تنتظر جلسة قفلاً أطول منdeadlock_timeout، وقيمته الافتراضيةoff. - الإضافة auto_explain تكتب في السجل خطة التنفيذ للاستعلامات البطيئة تلقائياً دون أن تشغل EXPLAIN بنفسك، فتعرف لماذا كان الاستعلام بطيئاً في تلك اللحظة تحديداً، وتحتاج تحميلها في
shared_preload_librariesأوsession_preload_librariesوضبطauto_explain.log_min_duration، وانتبه إلى أن التوثيق يحذر من أن تفعيلauto_explain.log_analyzeيقيس توقيت كل خطوة في كل الاستعلامات حتى التي لا تكتب في السجل، وقد يكون أثره سلبياً جداً على الأداء.
تجربة عملية: نتتبع سبعة طلبات بطيئة أو فاشلة
الآن سوف نقوم ببناء تطبيق متجر صغير ب FastAPI أمام PostgreSQL، ونضع أمامه Nginx بصيغة السجل التي شرحناها ومعرف الطلب، ونضع بجانبه بوابة دفع وهمية تتأخر 30 ثانية، ثم نعيد إنتاج كل حالة من الحالات السابقة ونتتبعها بالأدوات التي شرحناها. والتجربة تحتاج Docker فقط، وتعمل على العنوان 127.0.0.1 فلا يصل إليها أحد من خارج جهازك، ولاحظ أن الأرقام في المخرجات من جهاز التجربة، وهي للتوضيح والمقارنة بين الحالات وليست قياساً للأداء.
تجهيز التطبيق وقاعدة البيانات والبروكسي
قم بإنشاء مجلد للتجربة، ثم أنشئ فيه الملف app.py التالي، وهو التطبيق كاملاً، وكل مسار فيه يعيد إنتاج مشكلة واحدة:
# A small shop API with the usual places where time hides (lab only)
import contextvars, json, os, time, urllib.request, uuid
from fastapi import FastAPI, Request
from fastapi.responses import JSONResponse
from psycopg_pool import ConnectionPool, PoolTimeout

pool = ConnectionPool(os.environ["DB_URL"], min_size=2, max_size=4, timeout=5, open=True)
app = FastAPI()
spans = contextvars.ContextVar("spans")


def add(name, value):
    s = spans.get()
    s[name] = s.get(name, 0) + value


def query(sql, params=()):
    t0 = time.perf_counter()
    with pool.connection() as conn:                 # waits here if all 4 connections are busy
        t1 = time.perf_counter()
        rows = conn.execute(sql, params).fetchall()
    add("pool_wait_ms", (t1 - t0) * 1000)
    add("db_ms", (time.perf_counter() - t1) * 1000)
    add("queries", 1)
    return rows


@app.middleware("http")
async def timing(request: Request, call_next):
    rid = request.headers.get("x-request-id") or uuid.uuid4().hex
    s = {}
    spans.set(s)
    t0 = time.perf_counter()
    try:
        response = await call_next(request)
    except PoolTimeout:
        response = JSONResponse({"error": "no database connection within 5 s"}, status_code=503)
    total = (time.perf_counter() - t0) * 1000
    response.headers["Server-Timing"] = (
        f'pool;dur={s.get("pool_wait_ms", 0):.1f}, '
        f'db;dur={s.get("db_ms", 0):.1f};desc="{s.get("queries", 0)} queries", '
        f'ext;dur={s.get("ext_ms", 0):.1f}, app;dur={total:.1f}')
    response.headers["X-Request-ID"] = rid
    print(json.dumps({"request_id": rid, "method": request.method, "path": request.url.path,
                      "status": response.status_code, "ms": round(total, 1),
                      **{k: round(v, 1) for k, v in s.items()}}), flush=True)
    return response


@app.get("/orders/recent-n1")
def recent_n1():
    orders = query("SELECT id, customer_id, total FROM orders ORDER BY id DESC LIMIT 100")
    out = []
    for oid, cid, total in orders:                   # one more query for every order: N+1
        name = query("SELECT name FROM customers WHERE id = %s", (cid,))[0][0]
        out.append({"id": oid, "customer": name, "total": float(total)})
    return out


@app.get("/orders/recent")
def recent():
    rows = query("""SELECT o.id, c.name, o.total FROM orders o JOIN customers c ON c.id = o.customer_id
                    ORDER BY o.id DESC LIMIT 100""")
    return [{"id": r[0], "customer": r[1], "total": float(r[2])} for r in rows]


@app.get("/customers/{cid}/orders")
def customer_orders(cid: int):
    rows = query("""SELECT id, total, created_at FROM orders WHERE customer_id = %s
                    ORDER BY created_at DESC LIMIT 20""", (cid,))
    return [{"id": r[0], "total": float(r[1]), "created_at": r[2].isoformat()} for r in rows]


@app.get("/checkout")
def checkout():
    t0 = time.perf_counter()
    with urllib.request.urlopen("http://lab-slow-payments:8000/pay") as r:   # no timeout at all
        body = r.read()
    add("ext_ms", (time.perf_counter() - t0) * 1000)
    return {"payment": body.decode()}


@app.get("/checkout-safe")
def checkout_safe():
    t0 = time.perf_counter()
    try:
        with urllib.request.urlopen("http://lab-slow-payments:8000/pay", timeout=2) as r:
            body = r.read()
    except OSError as e:                              # socket timeout, refused, DNS...
        add("ext_ms", (time.perf_counter() - t0) * 1000)
        return JSONResponse({"error": f"payment provider: {e}"}, status_code=503)
    add("ext_ms", (time.perf_counter() - t0) * 1000)
    return {"payment": body.decode()}


@app.get("/report")
def report():
    query("SELECT pg_sleep(3)")                      # a slow report holding a connection for 3 s
    return {"report": "done"}


@app.post("/products/{pid}/buy")
def buy(pid: int):
    rows = query("UPDATE products SET stock = stock - 1 WHERE id = %s RETURNING stock", (pid,))
    return {"stock": rows[0][0]}


def similarity(a, b):
    same = 0
    for x, y in zip(a, b):
        if x == y:
            same += 1
    return same / max(len(a), len(b))


def recommend(names):
    best = []
    for a in names:                                  # compares every name with every other name
        score = max(similarity(a, b) for b in names if b is not a)
        best.append((score, a))
    best.sort(reverse=True)
    return best[:5]


@app.get("/recommendations")
def recommendations():
    names = [r[0] for r in query("SELECT name FROM customers ORDER BY id LIMIT 1500")]
    return [{"name": n, "score": round(s, 2)} for s, n in recommend(names)]


@app.get("/export")
def export():
    os._exit(1)        # the worker dies mid-request, as if the OOM killer had killed it
في الكود أعلاه لاحظ التالي:
- الدالة
queryتقيس شيئين منفصلين: الوقت الذي انتظره الطلب حتى حصل على اتصال من المجمع، ثم وقت الاستعلام نفسه، وتعد الاستعلامات، والمجمع صغير عن قصد، أربعة اتصالات ومهلة خمس ثوان. - ال Middleware يقرأ
X-Request-IDالذي يرسله Nginx، أو ينشئ معرفاً إذا لم يجده، ثم يكتب سطر JSON واحداً لكل طلب، ويرسل الأرقام نفسها في ترويسة Server-Timing. - المسار
/checkoutيتصل ببوابة الدفع بدون مهلة، والمسار/checkout-safeهو نفسه مع مهلة ثانيتين. - المسار
/exportينهي العملية فجأة في منتصف الطلب، حتى نرى ما يراه Nginx عندما يقتل نظام التشغيل التطبيق.
ثم أنشئ الملف Dockerfile التالي بإصدارات ثابتة للمكتبات:
FROM python:3.13-slim
RUN pip install --no-cache-dir fastapi==0.142.2 uvicorn==0.54.0 "psycopg[binary]==3.3.6" psycopg-pool==3.3.3 py-spy==0.4.2
WORKDIR /app
COPY app.py .
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000", "--no-access-log"]
ثم بوابة الدفع الوهمية في الملف payments.py، وهي ترد بعد 30 ثانية على كل طلب:
# A payment provider having a bad day: answers after 30 seconds
import time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

class H(BaseHTTPRequestHandler):
    def do_GET(self):
        time.sleep(30)
        self.send_response(200)
        self.end_headers()
        self.wfile.write(b"paid")

ThreadingHTTPServer(("0.0.0.0", 8000), H).serve_forever()
ثم إعداد Nginx في الملف nginx.conf، ولاحظ أننا خفضنا proxy_read_timeout إلى خمس ثوان حتى نرى الخطأ 504 بسرعة في التجربة، بينما القيمة الافتراضية 60 ثانية:
log_format timing '$remote_addr [$time_local] "$request" $status '
                  'rt=$request_time uct=$upstream_connect_time uht=$upstream_header_time '
                  'urt=$upstream_response_time ua=$upstream_addr us=$upstream_status rid=$request_id';

upstream app {
    server lab-slow-app:8000;
}

server {
    listen 80;
    access_log /var/log/nginx/access.log timing;

    proxy_connect_timeout 2s;      # default 60s
    proxy_read_timeout    5s;      # default 60s, lowered so the lab shows 504 quickly

    location / {
        proxy_pass http://app;
        proxy_set_header Host $host;
        proxy_set_header X-Request-ID $request_id;
        proxy_hide_header X-Request-ID;             # the app echoes it too; send it once
        add_header X-Request-ID $request_id always;
    }
}
والسطر proxy_hide_header موجود لأن التطبيق يعيد الترويسة X-Request-ID أيضاً، فبدونه تصل الترويسة إلى الكلاينت مرتين. وأخيراً ملف البيانات seed.sql، وفيه مئة ألف عميل وثلاثة ملايين طلب، وعمدنا ألا نضع فهرساً على العمود customer_id:
CREATE TABLE customers (id int PRIMARY KEY, name text NOT NULL);
CREATE TABLE orders (
    id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id int NOT NULL REFERENCES customers(id),
    total      numeric(10,2) NOT NULL,
    created_at timestamptz NOT NULL
);
CREATE TABLE products (id int PRIMARY KEY, name text NOT NULL, stock int NOT NULL);

INSERT INTO customers SELECT g, 'customer-' || g FROM generate_series(1, 100000) g;
INSERT INTO orders (customer_id, total, created_at)
SELECT 1 + (random() * 99999)::int, round((random() * 500)::numeric, 2),
       now() - random() * interval '365 days'
FROM generate_series(1, 3000000);
INSERT INTO products SELECT g, 'product-' || g, 1000 FROM generate_series(1, 100) g;
ANALYZE;
الآن قم ببناء Docker Image للتطبيق وتشغيل ال Containers بالترتيب، ولاحظ أن إدخال البيانات قد يأخذ بضع دقائق:
docker build -t lab-slow-app:1 .
docker network create lab-slow-net

docker run -d --name lab-slow-db --network lab-slow-net \
  -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=shop postgres:18 \
  -c log_min_duration_statement=200 \
  -c shared_preload_libraries=auto_explain -c auto_explain.log_min_duration=200
until docker exec lab-slow-db pg_isready -q -h localhost; do sleep 1; done
docker exec -i lab-slow-db psql -U postgres -d shop -q < seed.sql

docker run -d --name lab-slow-payments --network lab-slow-net \
  -v "$PWD/payments.py:/payments.py:ro" python:3.13-alpine python /payments.py
docker run -d --name lab-slow-app --network lab-slow-net --cap-add SYS_PTRACE \
  -e DB_URL="postgresql://postgres:lab@lab-slow-db:5432/shop" lab-slow-app:1
docker run -d --name lab-slow-proxy --network lab-slow-net -p 127.0.0.1:19080:80 \
  -v "$PWD/nginx.conf:/etc/nginx/conf.d/default.conf:ro" nginx:1.31-alpine
في الأوامر أعلاه لاحظ التالي:
- قاعدة البيانات تكتب في سجلها كل استعلام أطول من 200 مللي ثانية مع خطته، عن طريق
log_min_duration_statementوauto_explain. - ننتظر
pg_isreadyعبرlocalhostوليس عبر ال Socket المحلي، والسبب أن Image الرسمي يشغل سيرفراً مؤقتاً للتهيئة يستمع على ال Socket فقط ثم يعيد التشغيل، فلا نريد أن نبدأ الإدخال قبل السيرفر النهائي. - الخيار
--cap-add SYS_PTRACEعلى التطبيق هو ما يسمح ل py-spy بقراءة العملية لاحقاً، ولا تضفه في الإنتاج إلا وقت التشخيص.
وفي كل الخطوات التالية سوف نستخدم صيغة curl قصيرة تطبع رمز الرد والوقت حتى أول بايت والوقت الكلي، مع ترويسة Server-Timing ومعرف الطلب:
W='code=%{http_code} ttfb=%{time_starttransfer}s total=%{time_total}s\n'الخطوة 1: صفحة N+1 مقابل JOIN
نطلب الصفحة التي تعرض آخر مئة طلب بطريقتين، الأولى تجلب اسم العميل باستعلام منفصل لكل طلب، والثانية باستعلام واحد:
for p in /orders/recent-n1 /orders/recent; do
  curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080$p | grep -i -E "server-timing|x-request-id|code="
done
docker logs --tail 2 lab-slow-proxy
docker logs --tail 2 lab-slow-app
والمخرج سوف يكون كما يلي:
server-timing: pool;dur=2.7, db;dur=112.8;desc="101 queries", ext;dur=0.0, app;dur=120.0
X-Request-ID: a4d2afdcf2988f91339635dfbdf79fe7
code=200 ttfb=0.127154s total=0.127337s
server-timing: pool;dur=0.1, db;dur=3.8;desc="1 queries", ext;dur=0.0, app;dur=7.4
X-Request-ID: adcfe02aaf8521f843619d4880c8ec3d
code=200 ttfb=0.016017s total=0.016175s

192.168.128.1 [06/Oct/2026:04:42:10 +0000] "GET /orders/recent-n1 HTTP/1.1" 200 rt=0.122 uct=0.000 uht=0.122 urt=0.122 ua=192.168.128.4:8000 us=200 rid=a4d2afdcf2988f91339635dfbdf79fe7
192.168.128.1 [06/Oct/2026:04:42:11 +0000] "GET /orders/recent HTTP/1.1" 200 rt=0.010 uct=0.000 uht=0.009 urt=0.010 ua=192.168.128.4:8000 us=200 rid=adcfe02aaf8521f843619d4880c8ec3d
{"request_id": "a4d2afdcf2988f91339635dfbdf79fe7", "method": "GET", "path": "/orders/recent-n1", "status": 200, "ms": 120.0, "pool_wait_ms": 2.7, "db_ms": 112.8, "queries": 101}
{"request_id": "adcfe02aaf8521f843619d4880c8ec3d", "method": "GET", "path": "/orders/recent", "status": 200, "ms": 7.4, "pool_wait_ms": 0.1, "db_ms": 3.8, "queries": 1}
في المخرج أعلاه لاحظ التالي:
- في سجل Nginx القيمة
rtتساويurtتقريباً، فالوقت كله في التطبيق، والمعرفa4d2afdc…نفسه موجود في الترويسة وفي سجل Nginx وفي سجل التطبيق. - سطر التطبيق يكمل القصة: 101 استعلام أخذت 113 مللي ثانية من 120، فالمشكلة ليست استعلاماً بطيئاً وإنما عدد الاستعلامات.
- الصفحة نفسها بالبيانات نفسها باستعلام واحد أخذت أقل من 8 مللي ثانية، وقاعدة البيانات هنا على الجهاز نفسه، فإذا كانت على سيرفر آخر أضيف إلى كل استعلام من المئة زمن ذهاب وعودة على الشبكة.
الخطوة 2: استعلام بدون فهرس
الآن نطلب آخر عشرين طلباً لعميل واحد، وهذا المسار يبحث في ثلاثة ملايين صف بعمود ليس عليه فهرس. وفي المحاولة الأولى لم يظهر شيء في سجل قاعدة البيانات، لأن الاستعلام أخذ قرابة 100 مللي ثانية والحد الذي وضعناه 200، لذلك نخفض الحد لهذه القاعدة وحدها بالأمر ALTER DATABASE، والذي يتقدم على قيمة سطر الأوامر ويطبق على الجلسات الجديدة فقط، ولذلك نعيد تشغيل التطبيق حتى يفتح المجمع اتصالات جديدة:
docker exec lab-slow-db psql -U postgres -d shop \
  -c "ALTER DATABASE shop SET log_min_duration_statement = '50ms'" \
  -c "ALTER DATABASE shop SET auto_explain.log_min_duration = '50ms'"
docker restart lab-slow-app
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/customers/4242/orders | grep -i -E "server-timing|x-request-id|code="
docker logs --tail 1 lab-slow-app
docker logs --since 10s lab-slow-db
والمخرج سوف يكون كما يلي:
server-timing: pool;dur=0.0, db;dur=83.0;desc="1 queries", ext;dur=0.0, app;dur=85.6
X-Request-ID: cf0c477c84a9ca2cf264d02593e2d0fc
code=200 ttfb=0.101509s total=0.101616s
{"request_id": "cf0c477c84a9ca2cf264d02593e2d0fc", "method": "GET", "path": "/customers/4242/orders", "status": 200, "ms": 85.6, "pool_wait_ms": 0.0, "db_ms": 83.0, "queries": 1}
2026-10-06 04:42:40.261 UTC [166] LOG:  duration: 79.925 ms  execute <unnamed>: SELECT id, total, created_at FROM orders WHERE customer_id = $1
	                    ORDER BY created_at DESC LIMIT 20
2026-10-06 04:42:40.261 UTC [166] DETAIL:  Parameters: $1 = '4242'
2026-10-06 04:42:40.262 UTC [166] LOG:  duration: 79.918 ms  plan:
	Query Text: SELECT id, total, created_at FROM orders WHERE customer_id = $1
	                    ORDER BY created_at DESC LIMIT 20
	Query Parameters: $1 = '4242'
	Limit  (cost=38684.26..38686.59 rows=20 width=22)
	  ->  Gather Merge  (cost=38684.26..38687.87 rows=31 width=22)
	        Workers Planned: 2
	        ->  Sort  (cost=37684.24..37684.27 rows=13 width=22)
	              Sort Key: created_at DESC
	              ->  Parallel Seq Scan on orders  (cost=0.00..37684.00 rows=13 width=22)
	                    Filter: (customer_id = '4242'::smallint)
في المخرج أعلاه لاحظ التالي:
- هذه المرة سطر التطبيق يقول استعلام واحد أخذ 83 مللي ثانية، أي أن الاستعلام نفسه هو البطيء وليس عددها.
- سجل قاعدة البيانات يعطيك الاستعلام كما وصل بقيمته، ثم خطة التنفيذ من auto_explain، والسطر المهم فيها
Parallel Seq Scan on orders، أي أن PostgreSQL قرأ الجدول كله بثلاث عمليات متوازية ليجد بضعة عشر صفاً. - الشرط يظهر
'4242'::smallintلأن المكتبة psycopg ترسل الرقم في Python بأصغر نوع يتسع له كما في توثيقها، وPostgreSQL يرفعه إلى integer تلقائياً، فلا أثر له هنا.
والإصلاح فهرس مركب على العميل والتاريخ بالترتيب الذي يطلبه الاستعلام، كما شرحنا في فهرس B-tree مركب:
docker exec lab-slow-db psql -U postgres -d shop -c "CREATE INDEX orders_customer_created_idx ON orders (customer_id, created_at DESC)"
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/customers/4242/orders | grep -i -E "server-timing|code="
docker logs --tail 1 lab-slow-proxy
والمخرج سوف يكون كما يلي:
CREATE INDEX
server-timing: pool;dur=0.2, db;dur=5.2;desc="1 queries", ext;dur=0.0, app;dur=7.9
code=200 ttfb=0.022248s total=0.022404s
192.168.128.1 [06/Oct/2026:04:43:45 +0000] "GET /customers/4242/orders HTTP/1.1" 200 rt=0.012 uct=0.001 uht=0.012 urt=0.012 ua=192.168.128.4:8000 us=200 rid=af2de39fb423e8ddc412455c8203b12e
وقت قاعدة البيانات نزل من 83 إلى 5 مللي ثانية، ولم يعد الاستعلام يظهر في سجلها لأنه أصبح تحت الحد. ولاحظ أن إنشاء الفهرس على ثلاثة ملايين صف أخذ قرابة دقيقة على جهاز التجربة، وفي الإنتاج استخدم CREATE INDEX CONCURRENTLY حتى لا تحجز الكتابة على الجدول طوال هذه المدة.
الخطوة 3: خدمة خارجية بدون مهلة، و504 و499
الآن نطلب صفحة الدفع التي تتصل ببوابة الدفع المعطلة بدون أي مهلة، ثم ننظر في سجل Nginx وسجل أخطائه، ثم نسأل py-spy عما يفعله التطبيق في هذه اللحظة:
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/checkout | grep -i -E "x-request-id|code="
docker logs --tail 1 lab-slow-proxy
docker logs --since 10s lab-slow-proxy 2>&1 | grep -i "timed out"
docker exec lab-slow-app py-spy dump --pid 1
والمخرج سوف يكون كما يلي، مع حذف خيوط المجمع الخاملة وبعض إطارات الخيط الرئيسي من مخرج py-spy للاختصار:
X-Request-ID: 5f36f9d0b795d113a07be1774e1cbfa4
code=504 ttfb=5.014196s total=5.014294s
192.168.128.1 [06/Oct/2026:04:43:56 +0000] "GET /checkout HTTP/1.1" 504 rt=5.010 uct=0.000 uht=- urt=5.010 ua=192.168.128.4:8000 us=504 rid=5f36f9d0b795d113a07be1774e1cbfa4
2026/10/06 04:43:56 [error] 59#59: *21 upstream timed out (110: Operation timed out) while reading response header from upstream, client: 192.168.128.1, server: , request: "GET /checkout HTTP/1.1", upstream: "http://192.168.128.4:8000/checkout", host: "127.0.0.1:19080"
Process 1: /usr/local/bin/python3.13 /usr/local/bin/uvicorn app:app --host 0.0.0.0 --port 8000 --no-access-log
Python v3.13.16 (/usr/local/bin/python3.13)

Thread 1 (idle): "MainThread"
    select (selectors.py:452)
    _run_once (asyncio/base_events.py:2023)
    run_forever (asyncio/base_events.py:684)
    ...
Thread 11 (idle): "AnyIO worker thread"
    readinto (socket.py:723)
    _read_status (http/client.py:304)
    begin (http/client.py:343)
    getresponse (http/client.py:1478)
    do_open (urllib/request.py:1335)
    http_open (urllib/request.py:1360)
    _call_chain (urllib/request.py:466)
    _open (urllib/request.py:507)
    open (urllib/request.py:489)
    urlopen (urllib/request.py:189)
    checkout (app.py:77)
    _run_sync_endpoint (fastapi/telemetry/_api.py:240)
    run (anyio/_backends/_asyncio.py:1100)
    _bootstrap_inner (threading.py:1044)
    _bootstrap (threading.py:1015)
في المخرج أعلاه لاحظ التالي:
- الرد 504 بعد 5 ثوان بالضبط، وهي قيمة
proxy_read_timeout، وقيمةuht=-تعني أن ترويسات الرد لم تصل أبداً، وسجل الأخطاء يقولwhile reading response header from upstream، فالتطبيق قبل الاتصال ثم لم يجب. - py-spy يقول أين يقف الخيط بالضبط: السطر 77 في
app.pyداخلurlopen، وأعلى الإطاراتreadinto (socket.py)، أي أنه ينتظر بيانات من الشبكة لم تصل، ويظهر الخيطidleلأنه لا يستخدم المعالج، ولذلك لن تراه في Flame Graph عادي. - سجل التطبيق ما زال فارغاً لهذا الطلب، لأن التطبيق يكتب السطر عند انتهاء الطلب، وهو لم ينته بعد.
الآن نجرب ما يحدث عندما يمل الكلاينت قبل Nginx، فنطلب الصفحة نفسها بمهلة ثانيتين في curl:
curl -s -o /dev/null -w 'code=%{http_code} total=%{time_total}s exit=%{exitcode}\n' --max-time 2 http://127.0.0.1:19080/checkout
docker logs --tail 1 lab-slow-proxy
والمخرج سوف يكون كما يلي:
code=000 total=2.003887s exit=28
192.168.128.1 [06/Oct/2026:04:44:10 +0000] "GET /checkout HTTP/1.1" 499 rt=1.983 uct=0.000 uht=- urt=1.983 ua=192.168.128.4:8000 us=- rid=29293d106c4cd287746ec7364a7b82e6
الكلاينت لم يحصل على أي رد ورمز خروج curl هو 28 أي انتهاء المهلة، وNginx كتب 499 بعد ثانيتين تقريباً، وus=- لأن التطبيق لم يرد بشيء. وبعد أن تمر 30 ثانية من كل طلب، نبحث في سجل التطبيق عن المعرفين:
docker logs lab-slow-app 2>&1 | grep -E "5f36f9d0|29293d10"والمخرج سوف يكون كما يلي:
{"request_id": "5f36f9d0b795d113a07be1774e1cbfa4", "method": "GET", "path": "/checkout", "status": 200, "ms": 30037.9, "ext_ms": 30036.1}
{"request_id": "29293d106c4cd287746ec7364a7b82e6", "method": "GET", "path": "/checkout", "status": 200, "ms": 30055.9, "ext_ms": 30019.0}
وهذا أهم ما في هذه الخطوة: المستخدم رأى 504 في المرة الأولى ولم ير شيئاً في الثانية، لكن التطبيق أكمل الطلبين وسجل كل منهما بالرمز 200 بعد 30 ثانية، أي أن الدفع قد يكون تم مرتين دون أن يعرف المستخدم، فإذا ضغط زر الدفع مرة ثالثة لأنه رأى خطأ فقد يدفع مرة ثالثة. لذلك فالمهلة على الاتصال الخارجي ليست تحسيناً للأداء فقط، وإنما هي التي تحدد من يقرر نتيجة الطلب، والصحيح أن تكون مهلة التطبيق على الخدمة الخارجية أقصر من مهلة ال Proxy، وأن يكون الطلب الذي يغير شيئاً قابلاً للتكرار بأمان Idempotent. والآن الصفحة نفسها مع مهلة ثانيتين في الكود:
curl -s -D - -w "$W" http://127.0.0.1:19080/checkout-safe | grep -i -E "server-timing|code=|error"
docker logs --tail 1 lab-slow-proxy
docker logs --tail 1 lab-slow-app
والمخرج سوف يكون كما يلي:
server-timing: pool;dur=0.0, db;dur=0.0;desc="0 queries", ext;dur=2003.2, app;dur=2008.6
{"error":"payment provider: timed out"}code=503 ttfb=2.076413s total=2.076470s
192.168.128.1 [06/Oct/2026:04:44:14 +0000] "GET /checkout-safe HTTP/1.1" 503 rt=2.022 uct=0.001 uht=2.011 urt=2.023 ua=192.168.128.4:8000 us=503 rid=55ff10822ffde34045907c842392136e
{"request_id": "55ff10822ffde34045907c842392136e", "method": "GET", "path": "/checkout-safe", "status": 503, "ms": 2008.6, "ext_ms": 2003.2}
الآن التطبيق هو من يقرر: بعد ثانيتين يعيد 503 برسالة واضحة، والسجلات الثلاثة متفقة على النتيجة نفسها، والعامل أصبح حراً لطلب آخر، وext;dur=2003.2 في Server-Timing يقول لك فوراً أين ذهب الوقت.
الخطوة 4: انتظار اتصال من المجمع Pool
المسار /report يحجز اتصالاً من المجمع ثلاث ثوان، فنرسل ستة منها في الوقت نفسه، والمجمع فيه أربعة اتصالات فقط، ثم نطلب بعدها مباشرة صفحة العميل التي أصبحت سريعة بعد الفهرس:
for i in $(seq 1 6); do curl -s -o /dev/null http://127.0.0.1:19080/report & done
sleep 0.5
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/customers/4242/orders | grep -i -E "server-timing|x-request-id|code="
wait
docker logs lab-slow-app 2>&1 | grep 52f9e9d5
docker logs lab-slow-proxy 2>/dev/null | grep 52f9e9d5
والمخرج سوف يكون كما يلي:
server-timing: pool;dur=2034.2, db;dur=5.0;desc="1 queries", ext;dur=0.0, app;dur=2045.4
X-Request-ID: 52f9e9d5c085abd346106633487505a7
code=200 ttfb=2.110942s total=2.111067s
{"request_id": "52f9e9d5c085abd346106633487505a7", "method": "GET", "path": "/customers/4242/orders", "status": 200, "ms": 2045.4, "pool_wait_ms": 2034.2, "db_ms": 5.0, "queries": 1}
192.168.128.1 [06/Oct/2026:04:45:12 +0000] "GET /customers/4242/orders HTTP/1.1" 200 rt=2.047 uct=0.000 uht=2.047 urt=2.047 ua=192.168.128.4:8000 us=200 rid=52f9e9d5c085abd346106633487505a7
الصفحة التي تأخذ 8 مللي ثانية أخذت ثانيتين، والاستعلام نفسه أخذ 5 مللي ثانية فقط، و2034 مللي ثانية ذهبت في انتظار اتصال فارغ. ولو بحثت عن هذا البطء في قاعدة البيانات لما وجدت شيئاً، لأن الطلب كان ينتظر في التطبيق قبل أن يصل إليها، وهذا سبب قياس pool_wait_ms منفصلاً عن db_ms.
وفي محاولة سابقة أرسلنا عشرة طلبات بدل ستة، فأصبح بعض الطلبات ينتظر أكثر من مهلة المجمع وهي خمس ثوان، وهي نفسها مهلة Nginx، فكانت النتيجة في السجلين كما يلي لنفس الطلب:
{"request_id": "b7874890a9981feb57c7c804e3a05365", "method": "GET", "path": "/customers/4242/orders", "status": 503, "ms": 5002.4}
192.168.128.1 [06/Oct/2026:04:44:55 +0000] "GET /customers/4242/orders HTTP/1.1" 504 rt=5.000 uct=0.000 uht=- urt=5.001 ua=192.168.128.4:8000 us=504 rid=b7874890a9981feb57c7c804e3a05365
التطبيق كتب 503 مع رسالة واضحة عن المجمع، لكن Nginx كان قد أغلق الطلب قبله بمللي ثانيتين تقريباً، فرأى المستخدم 504 عاماً لا يقول شيئاً. والقاعدة هنا أن تتدرج المهلات من الخارج إلى الداخل: مهلة ال Proxy أطول من مهلة التطبيق، ومهلة التطبيق أطول من مهلة المجمع والاستعلام والخدمة الخارجية، حتى يكون الخطأ الذي يصل إلى المستخدم والسجل هو الخطأ الحقيقي.
الخطوة 5: طلب ينتظر قفلاً
نفتح معاملة في psql تعدل المنتج رقم 7 وتبقى مفتوحة 15 ثانية، كأنها كود بدأ معاملة ثم اتصل بخدمة بطيئة، ثم نرسل طلب شراء للمنتج نفسه، ونسأل pg_stat_activity عما يحدث:
docker exec lab-slow-db psql -U postgres -d shop -q \
  -c "BEGIN; UPDATE products SET stock = stock WHERE id = 7; SELECT pg_sleep(15); COMMIT;" >/dev/null &
sleep 1
curl -s -o /dev/null -w 'code=%{http_code} total=%{time_total}s\n' -X POST http://127.0.0.1:19080/products/7/buy &
sleep 2
docker exec lab-slow-db psql -U postgres -d shop -c "SELECT pid, state, wait_event_type, wait_event,
  now() - query_start AS running_for, pg_blocking_pids(pid) AS blocked_by, left(query, 50) AS query
  FROM pg_stat_activity WHERE datname = 'shop' AND pid <> pg_backend_pid() AND state <> 'idle'
  ORDER BY query_start"
wait
والمخرج سوف يكون كما يلي:
 pid | state  | wait_event_type |  wait_event   |   running_for   | blocked_by |                       query
-----+--------+-----------------+---------------+-----------------+------------+----------------------------------------------------
 194 | active | Timeout         | PgSleep       | 00:00:03.208178 | {}         | BEGIN; UPDATE products SET stock = stock WHERE id
 184 | active | Lock            | transactionid | 00:00:02.826349 | {194}      | UPDATE products SET stock = stock - 1 WHERE id = $
(2 rows)

code=504 total=5.050056s
الجلسة 184 هي طلب الشراء من التطبيق، وحالتها active لكنها في الحقيقة لا تعمل، وإنما تنتظر Lock من نوع transactionid، والعمود blocked_by يقول إن الجلسة 194 هي التي تحجزها. والمستخدم رأى 504 بعد خمس ثوان، أما سجل التطبيق فكتب بعد انتهاء المعاملة الأخرى:
{"request_id": "d0b3d2c34501802bfe13f70d7f5b55d7", "method": "POST", "path": "/products/7/buy", "status": 200, "ms": 14642.1, "pool_wait_ms": 0.1, "db_ms": 14639.4, "queries": 1}أي أن الشراء تم فعلاً بعد قرابة 15 ثانية، والمستخدم يظن أنه فشل، وهي القصة نفسها التي رأيناها في الخطوة 3. وفي قاعدة بيانات حقيقية فعل log_lock_waits حتى يكتب PostgreSQL رسالة عن كل انتظار قفل أطول من ثانية، وهي قيمة deadlock_timeout الافتراضية.
الخطوة 6: التطبيق متوقف أو ينهار
نبدأ بإيقاف Container التطبيق كاملاً ثم نطلب أي صفحة:
docker stop lab-slow-app
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/orders/recent | grep -i -E "x-request-id|code="
docker logs --tail 2 lab-slow-proxy 2>&1
والمخرج سوف يكون كما يلي:
X-Request-ID: 1d4e00b914214fb7f8671b9656e89b2d
code=504 ttfb=2.016690s total=2.016776s
2026/10/06 04:47:48 [error] 54#54: *70 upstream timed out (110: Operation timed out) while connecting to upstream, client: 192.168.128.1, server: , request: "GET /orders/recent HTTP/1.1", upstream: "http://192.168.128.4:8000/orders/recent", host: "127.0.0.1:19080"
192.168.128.1 [06/Oct/2026:04:47:48 +0000] "GET /orders/recent HTTP/1.1" 504 rt=2.003 uct=- uht=- urt=2.002 ua=192.168.128.4:8000 us=504 rid=1d4e00b914214fb7f8671b9656e89b2d
وقد يتوقع البعض 502 هنا، والإجابة أن Nginx يحول اسم lab-slow-app إلى عنوان IP مرة واحدة عند بدء تشغيله، والعنوان 192.168.128.4 لم يعد موجوداً على الشبكة بعد إيقاف ال Container، فلم يرد أحد على طلب الاتصال حتى انتهت proxy_connect_timeout وهي ثانيتان في إعدادنا، فكان الخطأ 504 مع while connecting to upstream وuct=-. ولهذا السبب فإن Nginx يدعم المعامل resolve في الأمر server الذي يراقب تغير عنوان الاسم دون إعادة تشغيل.
الآن نشغل Container بالاسم نفسه لكن بدون التطبيق، كأن التطبيق انهار عند بدء التشغيل أو يستمع على منفذ آخر:
docker rm lab-slow-app
docker run -d --name lab-slow-app --network lab-slow-net lab-slow-app:1 sleep infinity
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/orders/recent | grep -i -E "x-request-id|code="
docker logs --tail 2 lab-slow-proxy 2>&1
والمخرج سوف يكون كما يلي:
X-Request-ID: de113130f49901d60885aef7a0a7d7ff
code=502 ttfb=0.013358s total=0.013481s
2026/10/06 04:48:07 [error] 54#54: *72 connect() failed (111: Connection refused) while connecting to upstream, client: 192.168.128.1, server: , request: "GET /orders/recent HTTP/1.1", upstream: "http://192.168.128.4:8000/orders/recent", host: "127.0.0.1:19080"
192.168.128.1 [06/Oct/2026:04:48:07 +0000] "GET /orders/recent HTTP/1.1" 502 rt=0.001 uct=- uht=- urt=0.000 ua=192.168.128.4:8000 us=502 rid=de113130f49901d60885aef7a0a7d7ff
حصل ال Container الجديد على العنوان نفسه، والجهاز يرد لكن لا شيء يستمع على المنفذ 8000، فرفض الاتصال فوراً، والنتيجة 502 خلال مللي ثانية واحدة. والحالة الثالثة أن يموت التطبيق في منتصف الطلب، فنعيد التطبيق الحقيقي ثم نطلب المسار /export:
docker rm -f lab-slow-app
docker run -d --name lab-slow-app --network lab-slow-net --cap-add SYS_PTRACE \
  -e DB_URL="postgresql://postgres:lab@lab-slow-db:5432/shop" lab-slow-app:1
sleep 3
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/export | grep -i -E "x-request-id|code="
docker logs --tail 3 lab-slow-proxy 2>&1
docker ps -a --filter name=lab-slow-app --format '{{.Names}} {{.Status}}'
والمخرج سوف يكون كما يلي:
X-Request-ID: a1bfc84d0643d646817fb58369aa85dc
code=502 ttfb=0.013053s total=0.013183s
2026/10/06 04:48:24 [error] 54#54: *82 upstream prematurely closed connection while reading response header from upstream, client: 192.168.128.1, server: , request: "GET /export HTTP/1.1", upstream: "http://192.168.128.4:8000/export", host: "127.0.0.1:19080"
2026/10/06 04:48:24 [error] 54#54: *82 connect() failed (111: Connection refused) while connecting to upstream, client: 192.168.128.1, server: , request: "GET /export HTTP/1.1", upstream: "http://192.168.128.4:8000/export", host: "127.0.0.1:19080"
192.168.128.1 [06/Oct/2026:04:48:24 +0000] "GET /export HTTP/1.1" 502 rt=0.009 uct=0.000, - uht=-, - urt=0.008, 0.001 ua=192.168.128.4:8000, 192.168.128.4:8000 us=502, 502 rid=a1bfc84d0643d646817fb58369aa85dc
lab-slow-app Exited (1) Less than a second ago
في المخرج أعلاه لاحظ التالي:
- الخطأ الأول
upstream prematurely closed connection: الاتصال فتح ثم أغلقه التطبيق قبل أن يرسل أي ترويسة، وهذه بصمة العامل الذي مات في منتصف الطلب، فابحث بعدها في سجل التطبيق عن آخر سطر قبل الموت، وفي سجل النظام عن رسائل نفاد الذاكرة OOM. - Nginx أعاد المحاولة بعد الخطأ الأول، فالقيمة الافتراضية ل proxy_next_upstream هي
error timeout، والمحاولة الثانية وجدت التطبيق قد خرج فرفض الاتصال، ولذلك تجد في السطر قيمتين مفصولتين بفاصلة في كل حقل من حقول upstream، وهذا سبب آخر لكتابة هذه الحقول في السجل. - ولاحظ أن إعادة المحاولة تشمل طلبات GET، لذلك لا تجعل طلب GET يغير بيانات، أما الطلبات غير القابلة للتكرار مثل POST فلا يعيدها Nginx إلا إذا أضفت
non_idempotent.
أعد تشغيل التطبيق قبل الخطوة التالية:
docker start lab-slow-appالخطوة 7: كود يستهلك المعالج و Flame Graph
المسار /recommendations يجلب 1500 اسم ثم يقارن كل اسم بكل اسم آخر بحلقة Python عادية، فنقيسه أولاً:
curl -s -o /dev/null -D - -w "$W" http://127.0.0.1:19080/recommendations | grep -i -E "server-timing|code="والمخرج سوف يكون كما يلي:
server-timing: pool;dur=0.0, db;dur=6.0;desc="1 queries", ext;dur=0.0, app;dur=4397.5
code=200 ttfb=4.409532s total=4.409652s
قاعدة البيانات أخذت 6 مللي ثانية من 4400، ولا يوجد انتظار للمجمع ولا خدمة خارجية، فالوقت كله في الكود، والسؤال الآن: في أي سطر؟ نشغل py-spy لمدة عشر ثوان وأثناءها نطلب الصفحة مرتين:
docker exec lab-slow-app py-spy record -d 10 -o /tmp/profile.svg --pid 1 &
sleep 1
for i in 1 2; do curl -s -o /dev/null -w 'code=%{http_code} total=%{time_total}s\n' http://127.0.0.1:19080/recommendations; done
wait
docker cp lab-slow-app:/tmp/profile.svg profile.svg
والمخرج سوف يكون كما يلي:
py-spy> Sampling process 100 times a second for 10 seconds. Press Control-C to exit.

code=200 total=4.469422s
py-spy> Wrote flamegraph data to '/tmp/profile.svg'. Samples: 905 Errors: 0
code=504 total=5.025712s
الطلب الثاني تجاوز مهلة الخمس ثوان لأنه كان قريباً منها أصلاً، وهذا تذكير بأن الصفحة التي تأخذ 4.4 ثانية بلا ضغط سوف تفشل عند أول زيادة في الحمل. والآن افتح الملف profile.svg في المتصفح، والصورة التالية تبين الملف الذي أنتجه py-spy كما هو:
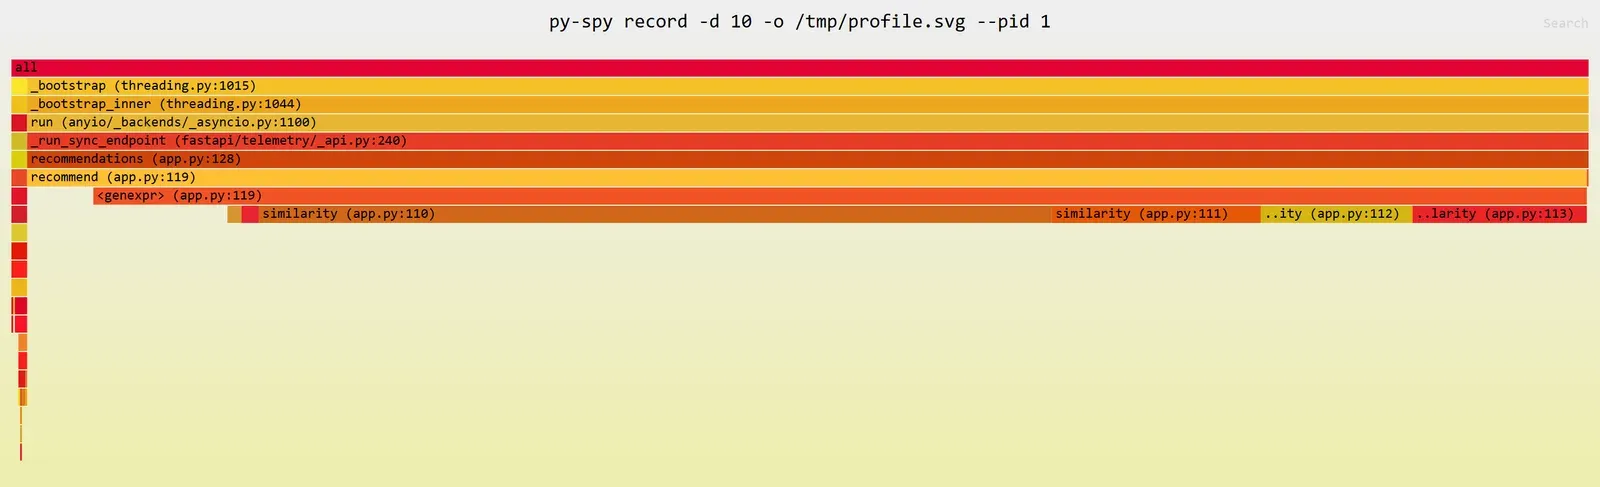
اقرأه من الأسفل إلى الأعلى: الخيط العامل استدعى recommendations في السطر 128، والتي استدعت recommend في السطر 119، والتي استدعت similarity مرات كثيرة، وهذه الأخيرة تأخذ تقريباً كل عرض الصورة، وأعرض جزء فيها هو السطر 110 أي الحلقة for x, y in zip(a, b). وعند وضع المؤشر على أي إطار في ملف SVG يظهر عدد عيناته، فالدالة recommendations ظهرت في 896 عينة من 905 أي 99%، والسطر 110 وحده في 455 عينة أي قرابة 50%، أما الشريط الضيق في أقصى اليسار فهو الخيط الرئيسي ل uvicorn وحلقة الأحداث، بأقل من 1% من العينات. فالإصلاح ليس في قاعدة البيانات ولا في السيرفر، وإنما في الخوارزمية نفسها التي تقارن مليوني زوج تقريباً في كل طلب، والحل أن تحسب التوصيات مرة واحدة في مهمة في الخلفية وتحفظ نتيجتها، أو أن تغير طريقة المقارنة. ولاحظ أن py-spy يعرض رقم السطر مع كل دالة بشكل افتراضي، وهذا ما جعل الحلقة تظهر منفصلة عن بقية الدالة.
الخطوة 8: أبطأ الطلبات من سجل Nginx
في الواقع لن تبدأ من طلب تعرفه، وإنما من السجل، والأمر التالي يرتب الطلبات بحسب rt ويعد رموز الردود، مستفيداً من أن الحقل الثامن في صيغتنا هو rt=:
docker logs lab-slow-proxy 2>/dev/null | grep ' rt=' | awk '{sub("rt=", "", $8); print $8, $7, $5}' | sort -rn | head -6
docker logs lab-slow-proxy 2>/dev/null | grep ' rt=' | awk '{print $7}' | sort | uniq -c | sort -rn
والمخرج سوف يكون كما يلي:
5.020 504 /report
5.010 504 /checkout
5.008 504 /report
5.008 504 /products/7/buy
5.005 504 /report
5.002 504 /report

     22 200
     13 504
      5 502
      1 503
      1 499
أطول الطلبات كلها 504 بخمس ثوان تقريباً، أي أنها كلها اصطدمت بالمهلة نفسها، وهذا وحده يقول لك إن الوقت الحقيقي لهذه الطلبات مجهول ويجب أن تأخذ معرفاتها وتبحث عنها في سجل التطبيق. وفي الإنتاج تقوم أداة جمع السجلات بهذا العمل لك، لكن الفكرة هي نفسها: رتب بالوقت، وجمع بالمسار والرمز، ثم خذ معرف أسوأ طلب وتتبعه.
إزالة التجربة
بعد الانتهاء احذف ال Containers مع ال Volume الخاص بقاعدة البيانات والشبكة وال Image التي أنشأناها فقط:
docker rm -f -v lab-slow-proxy lab-slow-app lab-slow-payments lab-slow-db
docker network rm lab-slow-net
docker rmi lab-slow-app:1
من العرض إلى الطبقة: جدول سريع
الجدول التالي يجمع ما رأيناه، فابدأ من العمود الأول بما تراه في القياس أو السجل:
| ما تراه | الطبقة الأرجح | الخطوة التالية |
|---|---|---|
فرق كبير بين time_namelookup والصفر، أو بين time_connect وtime_appconnect | DNS أو الشبكة أو TLS | قارن من شبكة أخرى، وراجع ال Resolver والشهادة، وفكر في CDN للزوار البعيدين |
| Queueing أو Stalled طويل في DevTools | المتصفح والصفحة | قلل عدد الطلبات للأصل نفسه، وفعل HTTP/2 |
TTFB كبير وrt قريب من urt | التطبيق أو ما خلفه | اقرأ سطر التطبيق بمعرف الطلب أو Server-Timing |
rt أكبر بكثير من urt | بين Nginx والكلاينت | رد كبير أو رفع بطيء، فراجع الحجم والضغط |
uct كبير | التطبيق لا يقبل الاتصالات | العمال مشغولون، فراجع عددهم وطابور الاتصالات |
pool_wait_ms كبير وdb_ms صغير | المجمع Pool | ابحث عن الاستعلامات أو المعاملات الطويلة التي تحجز الاتصالات قبل أن تكبر المجمع |
queries بالعشرات أو المئات | N+1 | JOIN أو تحميل مسبق في ال ORM |
استعلام واحد وdb_ms كبير | قاعدة البيانات | auto_explain أو EXPLAIN، ثم الفهرس المناسب |
wait_event_type = Lock في pg_stat_activity | قفل في قاعدة البيانات | pg_blocking_pids، وقصر المعاملات، وlog_lock_waits |
ext_ms كبير، أو py-spy dump يقف في socket | خدمة خارجية | مهلة أقصر من مهلة ال Proxy، أو نقل العمل إلى الخلفية |
| كل الأجزاء صغيرة والوقت الكلي كبير | كود التطبيق | Profiler وFlame Graph |
| بطء متفرق في طلبات عشوائية | GC أو موارد السيرفر | تحليل أداء السيرفر |
| 499 | الكلاينت أو طرف أمامك | قارن مهلة الكلاينت وال Load Balancer بوقت الطلب، وتأكد هل أكمل التطبيق العمل |
| 502 خلال مللي ثوان | التطبيق متوقف أو ينهار | Connection refused يعني لا أحد يستمع، وprematurely closed يعني أنه مات أثناء الطلب |
| 504 بعد مدة تساوي المهلة | التطبيق بطيء أو لا يمكن الوصول إليه | while connecting أو while reading response header يحددان أي مهلة |
أخطاء شائعة
- قراءة أرقام curl على أنها مراحل: كل رقم تراكمي من البداية، والمرحلة هي الفرق بين رقمين.
- رفع مهلة ال Proxy كلما ظهر 504: هذا يخفي الخطأ ويحجز العمال مدة أطول، فابحث أولاً أين ذهب الوقت، ثم اجعل المهلات متدرجة من الخارج إلى الداخل.
- اعتبار 504 أو 499 فشلاً للعملية: التطبيق قد يكمل العمل بعد أن يغادر الكلاينت كما رأيت في الدفع والشراء، فاجعل العمليات التي تغير البيانات قابلة للتكرار بأمان.
- اتصال خارجي بدون مهلة: مكتبات كثيرة بلا مهلة افتراضية، وخدمة واحدة معطلة تحجز كل عمال تطبيقك.
- البحث عن البطء في قاعدة البيانات وهو في المجمع: انتظار الاتصال لا يظهر في قاعدة البيانات، فقسه في التطبيق.
- سجل بدون توقيت وبدون معرف: صيغة السجل الافتراضية في Nginx لا تقول كم أخذ الطلب، والسجلات بدون معرف مشترك لا يمكن ربطها.
- تفعيل auto_explain.log_analyze على كل الاستعلامات في الإنتاج: التوثيق يحذر من أثره الكبير على الأداء، فابدأ بالخطة فقط وبحد مناسب.
- البحث في Flame Graph عن طلب ينتظر الشبكة: الانتظار لا يظهر فيه بشكل افتراضي، واستخدم
py-spy dumpأو الخيار--idle. - إرسال تفاصيل داخلية في Server-Timing: الترويسة عامة، فلا تضع فيها أسماء جداول أو سيرفرات.
قائمة تحقق
- سجل Nginx يحتوي
$request_timeو$upstream_connect_timeو$upstream_header_timeو$upstream_response_timeو$upstream_addrو$upstream_statusو$request_id. - كل طلب يحمل
X-Request-IDإلى التطبيق، ويعود إلى الكلاينت حتى في ردود الأخطاء. - التطبيق يكتب سطر JSON واحداً لكل طلب فيه المعرف والوقت الكلي ووقت قاعدة البيانات وعدد الاستعلامات ووقت انتظار المجمع ووقت الخدمات الخارجية.
- كل اتصال خارجي له مهلة، والمهلات متدرجة: ال Proxy أطول من التطبيق، والتطبيق أطول من المجمع والاستعلام والخدمات الخارجية.
- العمليات التي تغير البيانات قابلة للتكرار بأمان، لأن المستخدم سوف يعيد المحاولة بعد 504.
- البريد والملفات الكبيرة والتقارير تعمل في الخلفية وليس داخل الطلب.
- قاعدة البيانات تكتب الاستعلامات البطيئة بحد مناسب، و
log_lock_waitsمفعل. - تعرف كيف تشغل Profiler على تطبيقك في الإنتاج وما الصلاحيات التي يحتاجها قبل أن تحتاجه.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الطلب البطيء يتتبع من الخارج إلى الداخل: curl وأدوات المطور تقسم ما قبل السيرفر، وسجل Nginx يقول هل الوقت في التطبيق أم بين Nginx والكلاينت، وسجل التطبيق وServer-Timing يقسمان وقت التطبيق، وقاعدة البيانات وال Profiler يكملان ما بقي.
- أرقام
curl -wتراكمية، والفجوة الكبيرة بين انتهاء TLS وأول بايت تعني أن المشكلة في جهة السيرفر. - 499 يعني أن الكلاينت غادر، و502 أن التطبيق رفض الاتصال أو مات، و504 أن مهلة انتهت، والمدة ورسالة سجل الأخطاء تحددان أيها.
- معرف الطلب هو ما يربط سطور الطلب الواحد في كل السجلات، والتتبع الموزع هو الخطوة التالية عندما تكثر الخدمات.
- داخل التطبيق قس انتظار المجمع ووقت الاستعلامات وعددها ووقت الخدمات الخارجية منفصلة، وما بقي فهو الكود، وال Flame Graph يريك أين بالضبط.
- الطلب الذي يراه المستخدم فاشلاً قد يكون نجح في التطبيق، لذلك فالمهلات المتدرجة والعمليات القابلة للتكرار جزء من التشخيص وليست تفصيلاً.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلكيف يرى تطبيقك عنوان الزائر الحقيقي خلف ال Reverse Proxyإذا كان تطبيقك يرى عنوان ال Proxy بدلاً من الزائر أو يولد روابط http، فهذا هو السبب والإعداد الصحيح لإطار عملك.
 دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة Nginx 1.31.6 أمام تطبيق FastAPI على Python 3.13 وPostgreSQL 18.6 في Docker، مع py-spy 0.4.2، وقياس موقعنا ب curl 8.22.0.