

أغلب التطبيقات تبدأ بجدول واحد يشبه ملف Excel، فيه رقم الطلب وتاريخه واسم العميل وبريده ومدينته والمنتجات التي اشتراها، ويعمل كل شيء في الأسابيع الأولى، ثم تبدأ الأسئلة الغريبة: لماذا يظهر نفس العميل بمدينتين؟ ولماذا اختفى عميل من النظام عندما ألغينا طلبه؟ وكيف أعرف كم كوباً بعنا هذا الشهر والمنتجات مكتوبة نصاً في خانة واحدة؟ وبعد سنة يصبح الجدول ملايين الأسطر، وتصبح صفحة «طلباتي» تحتاج نصف ثانية، والتقرير الشهري يبطئ الموقع كله وقت تشغيله.
والسبب في كل ذلك ليس قاعدة البيانات نفسها، وإنما طريقة تصميم الجداول، لذلك سوف نأخذ في هذا المقال مثالاً واحداً لمتجر صغير يبيع القهوة وأدواتها، ونبني جداوله من الصفر على PostgreSQL 18 داخل Container، ونرى كل مشكلة بأعيننا قبل أن نحلها، ثم ننتقل إلى ما يتغير عندما تكبر البيانات. وإذا كانت بعض المصطلحات مثل السيرفر وال Container وال Backup جديدة عليك، فابدأ بدليل مصطلحات الاستضافة الذاتية.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يفشل الجدول الواحد الكبير، وما هي مشاكل التعديل والإضافة والحذف Anomalies التي يسببها.
- المفاتيح Keys: المفتاح الأساسي والمفتاح الأجنبي، والمفتاح الطبيعي مقابل المفتاح البديل، والعلاقات بين الجداول.
- التطبيع Normalization خطوة بخطوة على جدول الطلبات: 1NF ثم 2NF ثم 3NF، وBCNF باختصار.
- القيود Constraints التي تجعل قاعدة البيانات ترفض البيانات الخاطئة، مع رسائل الخطأ الحقيقية من PostgreSQL.
- متى تكسر التطبيع عن قصد Denormalization، وما ثمن ذلك.
- أفضل الممارسات عندما تكبر البيانات: الفهارس مع EXPLAIN ANALYZE على 5 ملايين طلب، ومشكلة N+1، والنسخ للقراءة، والتقسيم، وتغيير الجداول دون إيقاف التطبيق، والحذف المنطقي، والوقت بتوقيت UTC.
- الفرق بين عمليات التطبيق OLTP والتحليل OLAP، ولماذا لا تضعهما على نفس القاعدة.
تشغيل المختبر
كل الأوامر في هذا المقال تعمل على PostgreSQL 18 داخل Container على جهازك، والمنفذ مربوط على 127.0.0.1 فقط حتى لا يصل إليه أحد من الشبكة. إذا لم يكن Docker مثبتاً لديك فقد شرحنا تثبيته في دليل تثبيت Docker على Ubuntu.
docker run -d --name lab-dbdesign-pg \
  -e POSTGRES_PASSWORD=lab \
  -p 127.0.0.1:55432:5432 \
  postgres:18

docker exec lab-dbdesign-pg psql -U postgres -c 'select version()'
والمخرج سوف يكون كما يلي:
                                                      version
--------------------------------------------------------------------------------------------------------------------
 PostgreSQL 18.6 (Debian 18.6-1.pgdg13+2) on x86_64-pc-linux-gnu, compiled by gcc (Debian 14.2.0-19) 14.2.0, 64-bit
(1 row)
وبعد ذلك تستطيع أن تفتح سطر أوامر psql بالأمر docker exec -it lab-dbdesign-pg psql -U postgres وتلصق فيه أي مثال من المقال، أو تحفظ المثال في ملف وتمرره بالأمر docker exec -i lab-dbdesign-pg psql -U postgres < file.sql.
لماذا لا يكفي جدول واحد كبير؟
لنبدأ بالطريقة التي يبدأ بها أغلبنا: جدول واحد اسمه orders_sheet فيه كل ما نعرفه عن الطلب في سطر واحد، تماماً كما كنا نكتبه في ملف Excel.
CREATE TABLE orders_sheet (
    order_no       int,
    order_date     date,
    customer_name  text,
    customer_email text,
    customer_city  text,
    items          text,
    total          numeric(10,2)
);

INSERT INTO orders_sheet VALUES
 (1001, '2026-09-01', 'Sara Ali',  '[email protected]',  'Riyadh', 'Coffee beans x2, Mug x1', 145.00),
 (1002, '2026-09-03', 'Omar Saad', '[email protected]',  'Jeddah', 'Coffee beans x1',          55.00),
 (1003, '2026-09-07', 'Sara Ali',  '[email protected]',  'Riyadh', 'Kettle x1',               210.00);

SELECT * FROM orders_sheet;
والمخرج سوف يكون كما يلي:
 order_no | order_date | customer_name |  customer_email  | customer_city |          items          | total
----------+------------+---------------+------------------+---------------+-------------------------+--------
     1001 | 2026-09-01 | Sara Ali      | [email protected] | Riyadh        | Coffee beans x2, Mug x1 | 145.00
     1002 | 2026-09-03 | Omar Saad     | [email protected] | Jeddah        | Coffee beans x1         |  55.00
     1003 | 2026-09-07 | Sara Ali      | [email protected] | Riyadh        | Kettle x1               | 210.00
(3 rows)
الجدول يبدو مرتباً، ويجيب على سؤال «ما هي الطلبات؟» بسهولة. والآن لنفرض أن سارة انتقلت إلى الدمام، وقام التطبيق بتعديل مدينتها في آخر طلب لها فقط، وهذا ما يحدث فعلاً عندما يكون الكود يعدل «الطلب الحالي» وليس «العميل»، ثم ألغى عمر طلبه الوحيد فحذفناه:
-- Sara moved to Dammam; the app updated only her latest order
UPDATE orders_sheet SET customer_city = 'Dammam' WHERE order_no = 1003;

SELECT customer_email, array_agg(DISTINCT customer_city) AS cities
FROM orders_sheet GROUP BY customer_email;

-- Omar cancelled his only order
DELETE FROM orders_sheet WHERE order_no = 1002;

SELECT count(*) AS rows_for_omar FROM orders_sheet WHERE customer_email = '[email protected]';
والمخرج سوف يكون كما يلي:
UPDATE 1
  customer_email  |     cities
------------------+-----------------
 [email protected] | {Jeddah}
 [email protected] | {Dammam,Riyadh}
(2 rows)

DELETE 1
 rows_for_omar
---------------
             0
(1 row)
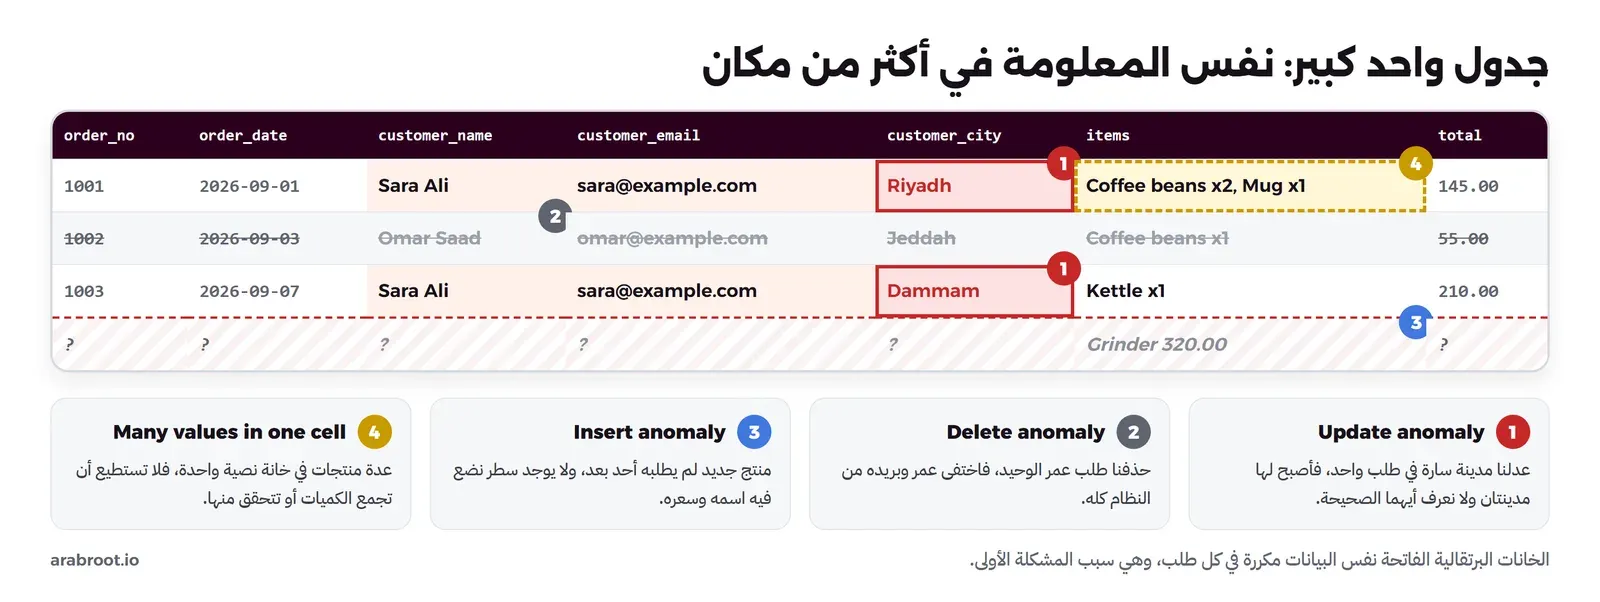
الصورة التالية تبين الجدول بعد هاتين العمليتين، والمشاكل الأربع التي يحملها هذا التصميم:
في المخرج أعلاه لاحظ التالي:
- مشكلة التعديل Update Anomaly: أصبح لسارة مدينتان، والسبب أن المدينة مكتوبة في كل طلب، فأي تعديل ينسى سطراً واحداً يجعل البيانات تناقض نفسها، ولا يستطيع أحد بعد ذلك أن يعرف أي القيمتين صحيحة.
- مشكلة الحذف Delete Anomaly: حذفنا طلباً فاختفى عميل، والسبب أن عمر لم يكن له وجود في النظام إلا من خلال طلبه، فخسرنا بريده واسمه مع أننا أردنا حذف الطلب فقط.
- مشكلة الإضافة Insert Anomaly: لو وصلتنا مطحنة قهوة جديدة سعرها 320 ريالاً، فلا يوجد مكان نسجل فيه اسمها وسعرها حتى يطلبها أحد، وكذلك العميل الذي سجل في الموقع ولم يشتر بعد.
- عدة قيم في خانة واحدة: المنتجات مكتوبة نصاً مثل
Coffee beans x2, Mug x1، فلا تستطيع أن تسأل قاعدة البيانات «كم كوباً بعنا؟» إلا بتقطيع النصوص، ولا تستطيع أن تمنع كتابةMug x0أوMugg x1.
وقد يتساءل البعض: لماذا لا نحل ذلك في الكود، فنعدل كل أسطر العميل معاً ونمنع الحذف إذا كان آخر طلب؟ والإجابة أن هذا ينجح يوماً ثم يفشل، فالبيانات يكتبها أكثر من مكان: التطبيق ولوحة الإدارة وسكربت الاستيراد ومطور يصلح مشكلة مستعجلة من سطر الأوامر، وكل واحد منها يجب أن يتذكر نفس القواعد. والحل الصحيح أن يكون التصميم نفسه لا يسمح بالتناقض، أي أن تكون كل معلومة مكتوبة في مكان واحد فقط، وهذا بالضبط هو التطبيع.
المفاتيح: كيف تعرف كل سطر وتربطه بغيره
قبل أن نقسم الجدول نحتاج إلى أداتين: طريقة نعرف بها كل سطر بشكل لا يتكرر، وطريقة نربط بها سطراً في جدول بسطر في جدول آخر.
المفتاح الأساسي Primary Key
المفتاح الأساسي هو العمود (أو مجموعة الأعمدة) الذي يميز كل سطر عن غيره، فلا يتكرر ولا يكون فارغاً، وPostgreSQL ينشئ عليه فهرساً Index تلقائياً، كما يوضح فصل القيود في توثيق PostgreSQL. ويمكن تشبيهه برقم الهوية الوطنية، فقد يتشابه اسمان، ولكن لا يتشابه رقمان.
المفتاح الطبيعي أم المفتاح البديل؟
المفتاح الطبيعي Natural Key قيمة موجودة أصلاً في البيانات وتميز السطر، مثل البريد الإلكتروني للعميل أو رمز المنتج SKU. والمفتاح البديل Surrogate Key رقم أو معرف لا معنى له خارج قاعدة البيانات، تولده القاعدة لكل سطر جديد. وقد يبدو البريد مفتاحاً مناسباً للعميل، ولكن العميل قد يغير بريده، وعندها يجب أن تعدل البريد في كل جدول يشير إليه، وهذه نفس مشكلة التكرار التي هربنا منها.
لذلك الحل الأنسب في أغلب الجداول هو مفتاح بديل يكون هو المفتاح الأساسي، مع قيد UNIQUE على المفتاح الطبيعي حتى لا يتكرر البريد أو ال SKU، وهذا ما سوف نفعله في المثال. أما نوع المفتاح البديل نفسه، رقم متسلسل bigint أم UUID أم ULID، ومتى يصلح كل منها، فقد خصصنا له مقالاً كاملاً هو المعرفات الفريدة: UUID وULID وSnowflake، وسوف نستخدم في هذا المقال bigint GENERATED ALWAYS AS IDENTITY لأنه الأبسط.
المفتاح الأجنبي Foreign Key
المفتاح الأجنبي عمود في جدول يحمل قيمة المفتاح الأساسي لسطر في جدول آخر، مثل orders.customer_id الذي يشير إلى customers.id. وعندما تعرفه كقيد Constraint، فإن قاعدة البيانات نفسها ترفض طلباً لعميل غير موجود، وترفض حذف عميل له طلبات إلا إذا حددت لها ماذا تفعل، كما سوف نرى في قسم القيود.
العلاقات بين الجداول
عندما تقسم البيانات إلى جداول، فكل علاقة بين جدولين تكون من ثلاثة أنواع، والصورة التالية تبين كل نوع بمثال من المتجر:
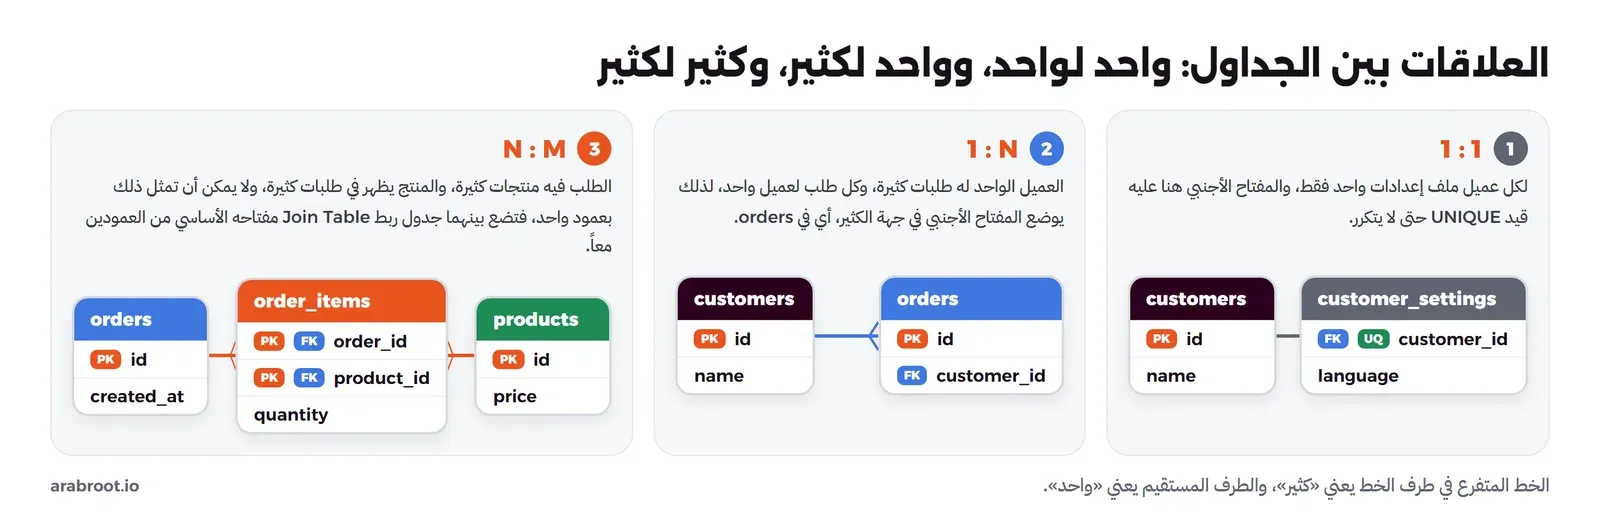
- واحد لواحد One-to-One: لكل عميل سطر واحد من الإعدادات. وغالباً تكفي أعمدة في نفس الجدول، ولكن الفصل يفيد عندما تكون الأعمدة كثيرة ونادرة الاستخدام، أو حساسة وتريد صلاحيات مختلفة عليها. ويطبق بمفتاح أجنبي عليه
UNIQUE. - واحد لكثير One-to-Many: العميل له طلبات كثيرة، والطلب لعميل واحد. وهي أكثر العلاقات انتشاراً، والقاعدة فيها أن المفتاح الأجنبي يوضع دائماً في جهة «الكثير»، أي
orders.customer_id، وليس قائمة طلبات في جدول العملاء. - كثير لكثير Many-to-Many: الطلب فيه منتجات كثيرة، والمنتج يظهر في طلبات كثيرة، ولا يمكن تمثيل ذلك بعمود في أي من الجدولين، فتضع بينهما جدول ربط Join Table هو
order_items، فيه المفتاحان الأجنبيان ومعهما ما يخص العلاقة نفسها مثل الكمية والسعر وقت الشراء.
التطبيع خطوة بخطوة على جدول الطلبات
التطبيع Normalization هو تقسيم البيانات إلى جداول بحيث تكون كل معلومة مكتوبة في مكان واحد، ويعتمد كل عمود على مفتاح جدوله فقط. وقد وضع Edgar F. Codd فكرته والشكل الأول 1NF في ورقته عن النموذج العلائقي سنة 1970، ثم عرف الشكلين الثاني والثالث سنة 1971، وأضاف هو وRaymond Boyce الشكل BCNF سنة 1974، كما يلخص ملخص تاريخ التطبيع. وهناك أشكال أعلى، ولكن الثالث هو ما تحتاجه عملياً في أغلب التطبيقات.
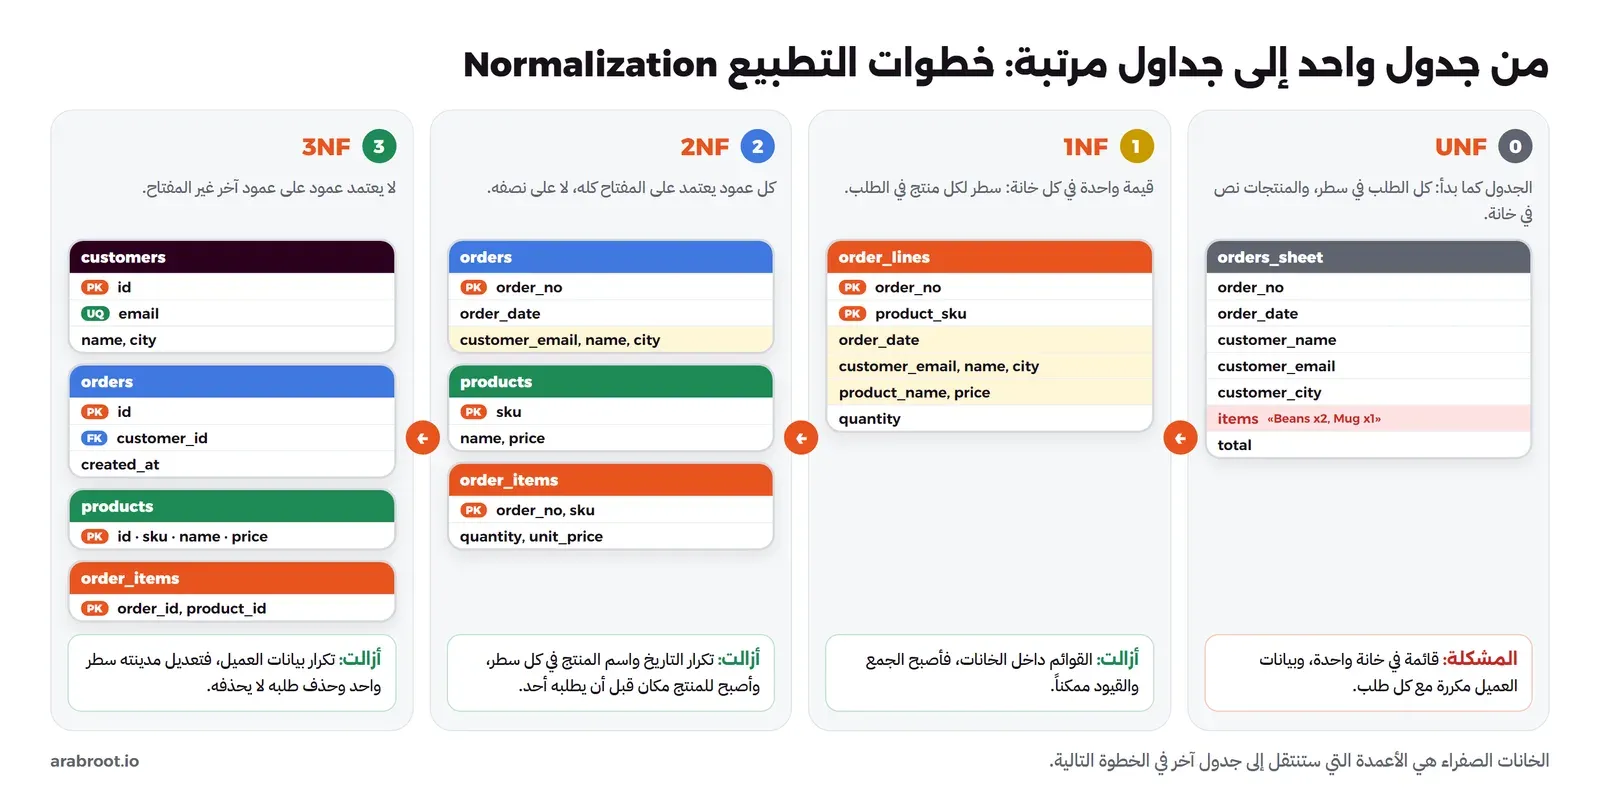
والطريقة السهلة لتذكر الأشكال الثلاثة هي الجملة التي يرددها مدرسو قواعد البيانات: كل عمود يجب أن يعتمد على «المفتاح، والمفتاح كله، ولا شيء غير المفتاح»، وهي قريبة من صياغة William Kent في مقاله A Simple Guide to Five Normal Forms. والصورة التالية تبين الخطوات على مثالنا قبل أن نشرح كل واحدة:
الشكل الأول 1NF: قيمة واحدة في كل خانة
القاعدة أن كل خانة تحمل قيمة واحدة لا تقسم، وألا توجد مجموعات مكررة مثل product1 وproduct2 وproduct3. وجدولنا يخالفها في عمود items، لذلك نجعل لكل منتج في الطلب سطراً خاصاً به، فيصبح عندنا جدول order_lines بأعمدة order_no وproduct_sku وquantity، والمفتاح الأساسي هو الاثنان معاً (order_no, product_sku)، لأن رقم الطلب وحده لم يعد يميز السطر.
وبهذا الشكل أصبح سؤال «كم كوباً بعنا؟» مجرد SUM(quantity)، وأصبح بإمكاننا أن نضع قيداً يمنع الكمية صفراً. ولكن لاحظ أن الطلب الذي فيه منتجان أصبح سطرين، وكل سطر يكرر تاريخ الطلب وبيانات العميل، فالتكرار زاد ولم ينقص.
الشكل الثاني 2NF: الاعتماد على المفتاح كله
القاعدة أن كل عمود ليس جزءاً من المفتاح يجب أن يعتمد على المفتاح كاملاً، وليس على جزء منه. وفي order_lines المفتاح هو (order_no, product_sku)، ولكن تاريخ الطلب وبيانات العميل تعتمد على order_no وحده، واسم المنتج وسعره يعتمدان على product_sku وحده، والوحيد الذي يعتمد على الاثنين هو الكمية.
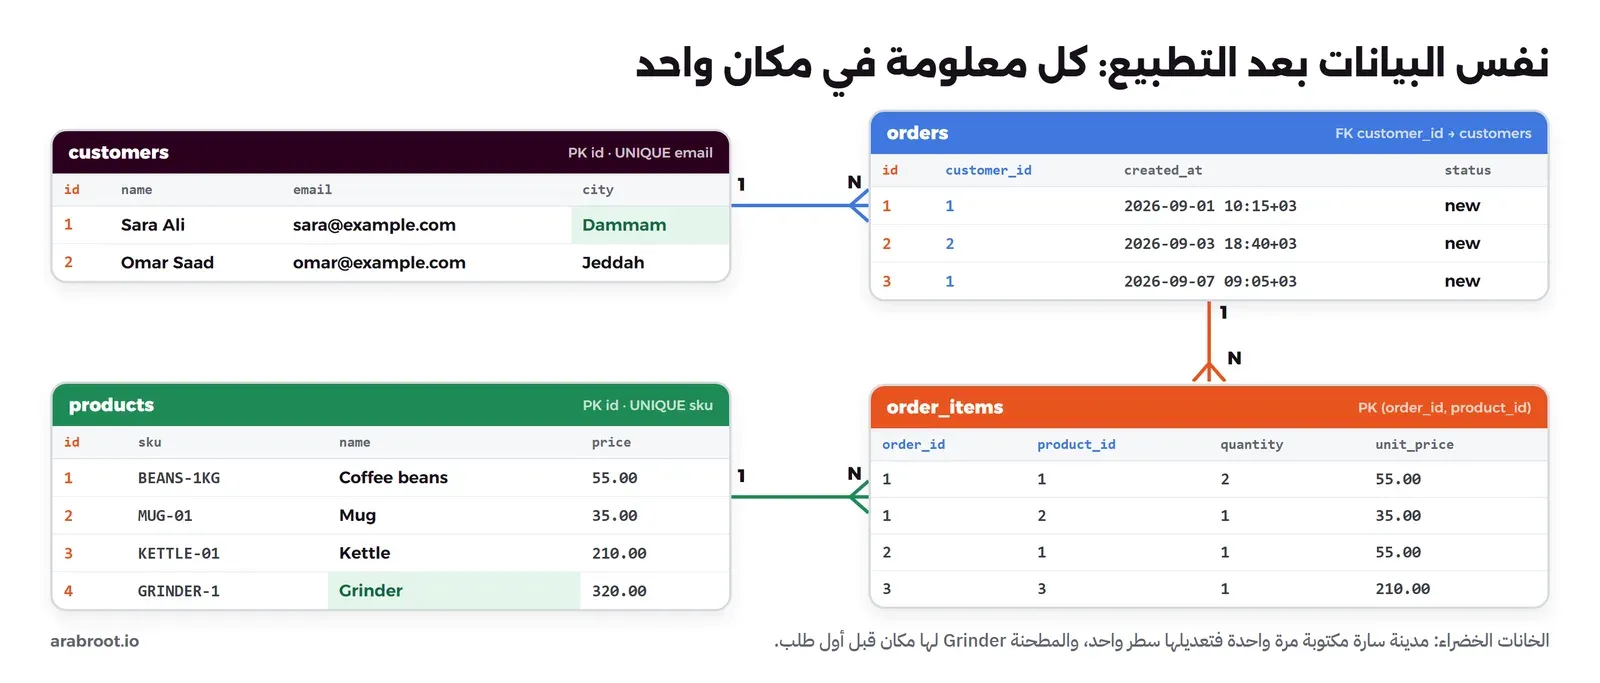
لذلك نقسم الجدول إلى ثلاثة: orders لما يخص الطلب، وproducts لما يخص المنتج، وorder_items للكمية. وهنا اختفت مشكلة الإضافة، فالمطحنة أصبح لها سطر في products قبل أن يطلبها أحد، وأصبح تعديل سعر منتج سطراً واحداً.
وقد يتساءل البعض: لماذا وضعنا unit_price في order_items مع أن السعر موجود في products، أليس هذا تكراراً؟ والإجابة أنه ليس نفس المعلومة، فسعر المنتج اليوم معلومة، والسعر الذي دفعه العميل يوم الطلب معلومة أخرى، فإذا رفعت سعر القهوة غداً فيجب ألا تتغير فواتير الأمس. وهذه من أكثر الأخطاء التي نراها في المتاجر: فاتورة قديمة يتغير مبلغها لأن التقرير يحسبها من السعر الحالي.
الشكل الثالث 3NF: لا شيء غير المفتاح
القاعدة أن العمود الذي ليس مفتاحاً لا يعتمد على عمود آخر ليس مفتاحاً. وفي جدول orders بقي اسم العميل ومدينته، وهما يعتمدان على بريد العميل، والبريد يعتمد على رقم الطلب، وهذا ما يسمى الاعتماد المتعدي Transitive Dependency، وهو سبب مشكلة المدينتين ومشكلة اختفاء عمر. لذلك نفصل العملاء في جدول customers، ويبقى في orders مفتاح أجنبي واحد هو customer_id.
والتصميم النهائي في PostgreSQL، مع القيود التي سوف نشرحها في القسم التالي، يكون كما يلي. وقد أنشأنا له قاعدة بيانات جديدة بالأمر CREATE DATABASE shop:
CREATE TABLE customers (
    id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name       text        NOT NULL,
    email      text        NOT NULL UNIQUE,
    city       text        NOT NULL,
    created_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE products (
    id    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    sku   text          NOT NULL UNIQUE,
    name  text          NOT NULL,
    price numeric(10,2) NOT NULL CHECK (price >= 0)
);

CREATE TABLE orders (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint      NOT NULL REFERENCES customers (id) ON DELETE RESTRICT,
    created_at  timestamptz NOT NULL DEFAULT now(),
    status      text        NOT NULL DEFAULT 'new'
                CHECK (status IN ('new', 'paid', 'shipped', 'cancelled'))
);

CREATE TABLE order_items (
    order_id   bigint        NOT NULL REFERENCES orders (id)   ON DELETE CASCADE,
    product_id bigint        NOT NULL REFERENCES products (id) ON DELETE RESTRICT,
    quantity   int           NOT NULL CHECK (quantity > 0),
    unit_price numeric(10,2) NOT NULL CHECK (unit_price >= 0),
    PRIMARY KEY (order_id, product_id)
);

INSERT INTO customers (name, email, city) VALUES
  ('Sara Ali',  '[email protected]', 'Riyadh'),
  ('Omar Saad', '[email protected]', 'Jeddah');

INSERT INTO products (sku, name, price) VALUES
  ('BEANS-1KG', 'Coffee beans', 55.00),
  ('MUG-01',    'Mug',          35.00),
  ('KETTLE-01', 'Kettle',      210.00),
  ('GRINDER-1', 'Grinder',     320.00);

INSERT INTO orders (customer_id, created_at) VALUES
  (1, '2026-09-01 10:15+03'), (2, '2026-09-03 18:40+03'), (1, '2026-09-07 09:05+03');

INSERT INTO order_items (order_id, product_id, quantity, unit_price) VALUES
  (1, 1, 2, 55.00), (1, 2, 1, 35.00), (2, 1, 1, 55.00), (3, 3, 1, 210.00);
والآن نسأل نفس الأسئلة التي كانت صعبة في الجدول الواحد: الطلبات مع أسماء العملاء ومبالغها، ثم ننقل سارة إلى الدمام، ثم نسأل كم بعنا من كل منتج:
SELECT o.id AS order_id, o.created_at::date AS day, c.name, c.city,
       sum(i.quantity * i.unit_price) AS total
FROM orders o
JOIN customers   c ON c.id = o.customer_id
JOIN order_items i ON i.order_id = o.id
GROUP BY o.id, c.name, c.city
ORDER BY o.id;

UPDATE customers SET city = 'Dammam' WHERE email = '[email protected]';

SELECT p.name, sum(i.quantity) AS sold
FROM products p LEFT JOIN order_items i ON i.product_id = p.id
GROUP BY p.name ORDER BY sold DESC NULLS LAST;
والمخرج سوف يكون كما يلي:
 order_id |    day     |   name    |  city  | total
----------+------------+-----------+--------+--------
        1 | 2026-09-01 | Sara Ali  | Riyadh | 145.00
        2 | 2026-09-03 | Omar Saad | Jeddah |  55.00
        3 | 2026-09-07 | Sara Ali  | Riyadh | 210.00
(3 rows)

UPDATE 1
     name     | sold
--------------+------
 Coffee beans |    3
 Mug          |    1
 Kettle       |    1
 Grinder      |
(4 rows)
في المخرج أعلاه لاحظ التالي:
- المبلغ الإجمالي لم نعد نخزنه في الطلب، وإنما نحسبه من الأسطر، فلا يمكن أن يختلف المبلغ عن مجموع المنتجات.
- تعديل مدينة سارة أصبح
UPDATE 1، أي سطراً واحداً مهما كان عدد طلباتها، فلا توجد نسخة ثانية يمكن أن تنسى. - المطحنة ظاهرة في التقرير بكمية فارغة، مع أن أحداً لم يطلبها، لأن لها مكاناً خاصاً بها.
والصورة التالية تبين نفس بيانات المتجر بعد التطبيع، والعلاقات بين الجداول الأربعة:
الشكل BCNF باختصار
الشكل BCNF أشد قليلاً من الثالث، وقاعدته أن كل عمود يحدد قيمة عمود آخر يجب أن يكون مفتاحاً مرشحاً Candidate Key. والحالة التي يفرق فيها نادرة: لنفرض أن كل مندوب توصيل يعمل في مدينة واحدة فقط، وفي كل مدينة عدة مناديب، وعندنا جدول (customer_id, city, courier) يحدد مندوب كل عميل في كل مدينة. المفتاح هو (customer_id, city)، والجدول في الشكل الثالث، ولكن courier يحدد city وهو ليس مفتاحاً، فلو نقلت مندوباً إلى مدينة أخرى فعليك أن تعدل كل أسطره. والحل جدول couriers(courier, city) وجدول customer_couriers(customer_id, courier). وإذا وصلت إلى الشكل الثالث بالطريقة التي شرحناها، فغالباً جداولك في BCNF أيضاً.
القيود Constraints: قاعدة البيانات تحمي نفسها
التصميم الجيد يقول أين تكتب كل معلومة، والقيود تضمن أن ما يكتب صحيح، والسبب أن الكود يتغير ويكتبه أشخاص مختلفون، أما القيد فيبقى في قاعدة البيانات ويطبق على كل من يكتب فيها. وفي الجداول أعلاه استخدمنا خمسة أنواع:
- NOT NULL: العمود لا يكون فارغاً، فلا يوجد عميل بلا بريد.
- UNIQUE: القيمة لا تتكرر، فلا يسجل نفس البريد مرتين.
- CHECK: شرط على القيمة، مثل كمية أكبر من صفر وحالة من قائمة محددة.
- PRIMARY KEY: هو
UNIQUEوNOT NULLمعاً. - FOREIGN KEY مع
ON DELETE: يحدد ما يحدث عند حذف السطر الذي يشار إليه، فاخترناRESTRICTللعملاء والمنتجات لأن حذفهما والطلبات موجودة خطأ، وCASCADEلأسطر الطلب لأنها لا معنى لها بدون الطلب. وتجد بقية الخيارات مثلSET NULLفي توثيق القيود.
والآن لنكسر هذه القيود عن قصد ونرى ما يقوله PostgreSQL، وكل سطر في المثال التالي محاولة خاطئة:
INSERT INTO customers (name, email, city) VALUES ('Sara A.', '[email protected]', 'Riyadh');
INSERT INTO customers (name, city) VALUES ('No Email', 'Abha');
INSERT INTO order_items (order_id, product_id, quantity, unit_price) VALUES (2, 2, 0, 35.00);
INSERT INTO orders (customer_id) VALUES (999);
DELETE FROM products WHERE sku = 'BEANS-1KG';
DELETE FROM customers WHERE email = '[email protected]';
UPDATE orders SET status = 'refunded' WHERE id = 2;
والمخرج سوف يكون كما يلي:
ERROR:  duplicate key value violates unique constraint "customers_email_key"
DETAIL:  Key (email)=([email protected]) already exists.
ERROR:  null value in column "email" of relation "customers" violates not-null constraint
DETAIL:  Failing row contains (4, No Email, null, Abha, 2026-10-05 21:46:59.25689+00).
ERROR:  new row for relation "order_items" violates check constraint "order_items_quantity_check"
DETAIL:  Failing row contains (2, 2, 0, 35.00).
ERROR:  insert or update on table "orders" violates foreign key constraint "orders_customer_id_fkey"
DETAIL:  Key (customer_id)=(999) is not present in table "customers".
ERROR:  update or delete on table "products" violates RESTRICT setting of foreign key constraint "order_items_product_id_fkey" on table "order_items"
DETAIL:  Key (id)=(1) is referenced from table "order_items".
ERROR:  update or delete on table "customers" violates RESTRICT setting of foreign key constraint "orders_customer_id_fkey" on table "orders"
DETAIL:  Key (id)=(2) is referenced from table "orders".
ERROR:  new row for relation "orders" violates check constraint "orders_status_check"
DETAIL:  Failing row contains (2, 2, 2026-09-03 15:40:00+00, refunded).
في المخرج أعلاه لاحظ التالي:
- كل رسالة تذكر اسم القيد الذي رفض العملية، مثل
customers_email_key، وسطرDETAILيذكر القيمة المسببة، لذلك تستطيع أن تحول هذه الأخطاء في التطبيق إلى رسالة واضحة للمستخدم مثل «هذا البريد مسجل مسبقاً» بدل أن تفحص قبل الإدخال، والسبب أن الفحص في الكود ثم الإدخال يترك فجوة يدخل فيها طلبان في نفس اللحظة. - حذف عمر رفض هذه المرة، وهو العكس تماماً مما حدث في الجدول الواحد، فالعميل الذي له طلبات لا يختفي بالخطأ.
- في الخطأ الثاني ظهر الرقم
4للسطر المرفوض، مع أن عندنا عميلين فقط، والسبب أن المحاولة الأولى المرفوضة استهلكت الرقم 3، فالأرقام المتسلسلة لا تعاد عند فشل العملية أو التراجع عنها، كما يذكر توثيق ال Sequences، لذلك لا تعتمد على أن أرقام الطلبات متتالية بلا فجوات، وإذا احتجت أرقام فواتير متتالية قانونياً فولدها بطريقة أخرى. - الوقت في السطر الأخير ظهر
15:40:00+00مع أننا أدخلناه18:40+03، وهو نفس اللحظة بتوقيت UTC، وسوف نعود لهذه النقطة في قسم الوقت.
أما ON DELETE CASCADE فنراه عندما نحذف طلباً:
DELETE FROM orders WHERE id = 2;
SELECT count(*) AS items_left_for_order_2 FROM order_items WHERE order_id = 2;
والمخرج سوف يكون كما يلي:
DELETE 1
 items_left_for_order_2
------------------------
                      0
(1 row)
حذفت أسطر الطلب معه في نفس العملية، فلا تبقى أسطر يتيمة تشير إلى طلب غير موجود.
ON DELETE CASCADE على كل مفتاح أجنبي لأنه يريحك من أخطاء الحذف، والسبب أن حذف عميل واحد قد يمسح طلباته وفواتيره وسجلاته كلها دون أي تحذير. استخدمه فقط عندما يكون السطر التابع جزءاً من السطر الأصلي، مثل أسطر الطلب مع الطلب.متى تكسر التطبيع عن قصد؟
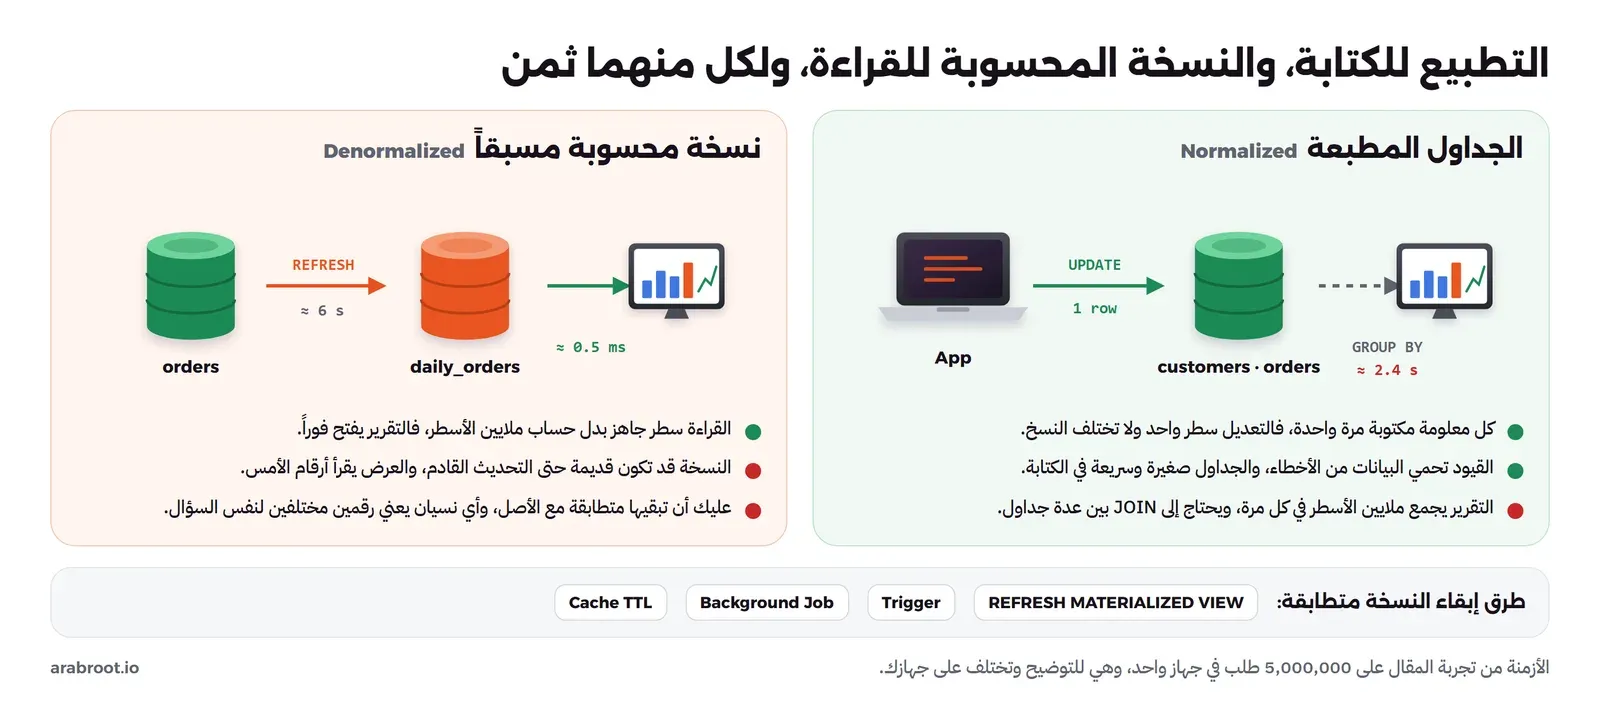
التطبيع يجعل الكتابة صحيحة ورخيصة، لأن كل معلومة تعدل في مكان واحد، ولكن القراءة تحتاج إلى ربط عدة جداول وحساب المبالغ في كل مرة. وفي أغلب التطبيقات هذا ثمن صغير، والقاعدة أن تبدأ مطبعاً دائماً، ثم تكسر التطبيع Denormalization في مكان محدد عندما تقيس بطئاً حقيقياً في قراءة معينة، وتعرف كيف ستبقي النسخة متطابقة مع الأصل. والصورة التالية تبين الفكرة:
وأشهر الحالات التي يستحق فيها كسر التطبيع:
- التقارير الثقيلة: لوحة المدير التي تعرض عدد الطلبات لكل يوم لا تحتاج أن تحسب ملايين الأسطر عند كل فتح، فتحسبها مرة وتحفظ النتيجة.
- العدادات Counters: عدد طلبات العميل أو عدد التعليقات على مقال، تحفظه في عمود مثل
customers.orders_countبدلcount(*)في كل صفحة، وتحدثه مع كل طلب جديد. - نسخة للقراءة من بيانات تتغير قليلاً: مثل اسم المنتج في نتائج البحث، أو ملخص الطلب في صفحة «طلباتي».
- الخصائص المرنة: منتجات لكل نوع منها خصائص مختلفة، وهنا عمود JSONB أنسب من عشرات الأعمدة الفارغة.
العرض المحفوظ Materialized View
العرض المحفوظ هو استعلام تحفظ قاعدة البيانات نتيجته في جدول، وتعيد حسابها عندما تطلب ذلك بالأمر REFRESH، كما في توثيق Materialized Views. ولكي نرى الفرق بأرقام حقيقية، أنشأنا قاعدة بيانات ثانية اسمها bench بنفس الجداول، وولدنا فيها 100 ألف عميل و5 ملايين طلب على ثلاث سنوات تقريباً:
INSERT INTO customers (name, email, city)
SELECT 'Customer ' || g, 'c' || g || '@example.com',
       (ARRAY['Riyadh','Jeddah','Dammam','Abha','Tabuk'])[1 + g % 5]
FROM generate_series(1, 100000) AS g;

INSERT INTO orders (customer_id, created_at, status)
SELECT 1 + (random() * 99999)::int,
       timestamptz '2024-01-01' + random() * interval '1000 days',
       (ARRAY['paid','shipped','cancelled'])[1 + (random() * 2)::int]
FROM generate_series(1, 5000000);
ANALYZE;
SELECT count(*) FROM orders;
SELECT pg_size_pretty(pg_total_relation_size('orders')) AS orders_size;
ويحتاج هذا التوليد عدة دقائق، والمخرج في آخره كما يلي:
  count
---------
 5000000
(1 row)

 orders_size
-------------
 405 MB
(1 row)
ثم نقارن تقرير عدد الطلبات لكل يوم مباشرة من الجدول، ومن عرض محفوظ:
\timing on
SELECT created_at::date AS day, count(*) AS orders
FROM orders WHERE status <> 'cancelled'
GROUP BY day ORDER BY day DESC LIMIT 3;

CREATE MATERIALIZED VIEW daily_orders AS
SELECT created_at::date AS day, count(*) AS orders
FROM orders WHERE status <> 'cancelled'
GROUP BY day;
CREATE UNIQUE INDEX ON daily_orders (day);

SELECT day, orders FROM daily_orders ORDER BY day DESC LIMIT 3;

REFRESH MATERIALIZED VIEW CONCURRENTLY daily_orders;
والمخرج سوف يكون كما يلي:
    day     | orders
------------+--------
 2026-09-26 |   3779
 2026-09-25 |   3676
 2026-09-24 |   3572
(3 rows)

Time: 2406.548 ms (00:02.407)
SELECT 1000
Time: 6747.124 ms (00:06.747)
CREATE INDEX
Time: 812.728 ms
    day     | orders
------------+--------
 2026-09-26 |   3779
 2026-09-25 |   3676
 2026-09-24 |   3572
(3 rows)

Time: 0.537 ms
REFRESH MATERIALIZED VIEW
Time: 6100.265 ms (00:06.100)
في المخرج أعلاه لاحظ التالي:
- نفس الأرقام في الاستعلامين، ولكن الأول احتاج حوالي ثانيتين ونصف لأنه يمر على 5 ملايين سطر، والثاني نصف مللي ثانية لأنه يقرأ ثلاثة أسطر جاهزة. وهذه الأزمنة من جهاز واحد وهي للتوضيح، فعلى سيرفرك ستختلف الأرقام ويبقى الفرق.
- التحديث
REFRESHيعيد الحساب كله في حوالي 6 ثوان، وCONCURRENTLYيسمح بالقراءة من العرض أثناء التحديث، ويحتاج فهرساًUNIQUEعليه، كما يذكر توثيق REFRESH. - بين تحديثين يعرض التقرير أرقاماً قديمة، فإذا حدثته كل ساعة فقد يتأخر بساعة، وهذا مقبول للوحة المدير وغير مقبول لرصيد العميل.
الخصائص المرنة في عمود JSONB
القهوة لها درجة تحميص وبلد منشأ، والكوب له سعة ولون، والغلاية لها قدرة كهربائية، وإنشاء عمود لكل خاصية يعني جدولاً بعشرات الأعمدة أغلبها فارغ. والحل المناسب هنا عمود jsonb للخصائص التي تختلف من منتج لآخر، مع بقاء الأعمدة المهمة مثل السعر والاسم أعمدة عادية بقيودها، وفهرس GIN على العمود يجعل البحث فيه سريعاً:
ALTER TABLE products ADD COLUMN attributes jsonb NOT NULL DEFAULT '{}';
UPDATE products SET attributes = '{"roast": "medium", "origin": "Yemen"}' WHERE sku = 'BEANS-1KG';
UPDATE products SET attributes = '{"capacity_ml": 350, "color": "white"}' WHERE sku = 'MUG-01';
CREATE INDEX products_attributes_idx ON products USING gin (attributes);

SELECT sku, name, attributes->>'origin' AS origin
FROM products WHERE attributes @> '{"roast": "medium"}';
والمخرج سوف يكون كما يلي:
ALTER TABLE
UPDATE 1
UPDATE 1
CREATE INDEX
    sku    |     name     | origin
-----------+--------------+--------
 BEANS-1KG | Coffee beans | Yemen
(1 row)
لا تجعل JSONB بديلاً عن الجداول، والسبب أن القيود والمفاتيح الأجنبية لا تعمل داخله، فلو وضعت customer_id داخل JSON فلن يمنعك أحد من كتابة رقم عميل غير موجود. والقاعدة أن ما تبحث به أو تربط به أو تحسب منه المبالغ يبقى عموداً، وما يعرض فقط ويختلف من سطر لآخر يمكن أن يكون في JSONB.
ثمن كسر التطبيع: من يبقي النسخ متطابقة؟
كل نسخة تضيفها هي معلومة مكتوبة في مكانين، أي أنك أعدت مشكلة المدينتين بيدك، والفرق أنك هذه المرة تعرف مكانها وتتحمل مسؤوليتها. وهناك ثلاث طرق لإبقاء النسخة متطابقة:
- Trigger في قاعدة البيانات: دالة تعمل تلقائياً مع كل
INSERTأوDELETEعلى الطلبات فتحدث العداد في نفس العملية Transaction، كما في توثيق Triggers. وهي الأدق، ولكنها تبطئ كل كتابة قليلاً، والعداد الواحد الذي يحدثه آلاف الطلبات في نفس اللحظة يصبح نقطة ازدحام لأن كل عملية تنتظر قفل نفس السطر. - مهمة في الخلفية Background Job: تحديث العرض المحفوظ أو إعادة حساب العدادات كل دقيقة أو كل ساعة، وهي أبسط وأخف على الكتابة، ولكن النسخة تتأخر قليلاً. ونمط الطابور والعامل الخلفي شرحناه في دليل البريد التفاعلي، وهو نفسه يصلح هنا.
- التخزين المؤقت Cache: النتيجة تحفظ في Redis أو Valkey لمدة محددة TTL ثم تحسب من جديد، وهو موضوع مخطط له في قسم قواعد البيانات في خارطة الطريق.
وفي كل الحالات احتفظ بالأصل المطبع كمصدر الحقيقة Source of Truth، فإذا شككت في النسخة تستطيع أن تحذفها وتعيد بناءها منه.
أفضل الممارسات عندما تكبر البيانات
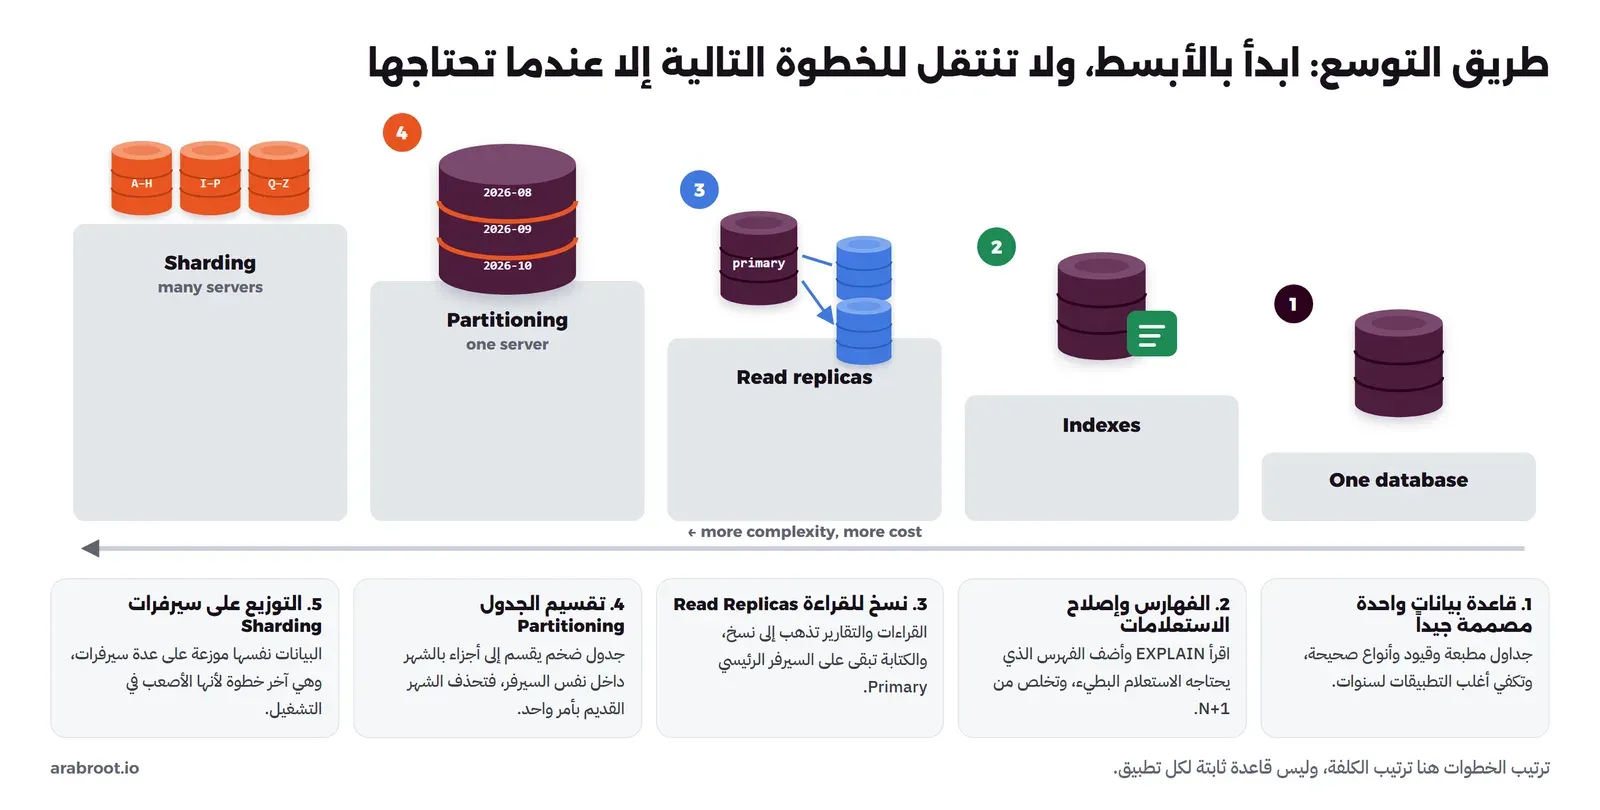
عندما يكبر التطبيق يبدأ أغلب المطورين بالحل الأكبر، مثل سيرفر أقوى أو قاعدة بيانات موزعة، مع أن المشكلة في الغالب استعلام بلا فهرس أو صفحة ترسل مئة استعلام. والترتيب الصحيح هو أن تبدأ بالأرخص، ولا تنتقل للخطوة التالية إلا عندما تقيس أنك تحتاجها، والصورة التالية تبين هذا الترتيب:
الفهارس Indexes: لماذا يسرع الاستعلام؟
الفهرس هيكل بيانات منفصل عن الجدول، مرتب حسب عمود أو أكثر، ويشبه فهرس الكتاب الذي يخبرك بالصفحة بدل أن تقرأ الكتاب كله. والنوع الافتراضي في PostgreSQL هو B-tree، وهو شجرة مرتبة تنزل فيها من الجذر إلى الورقة في خطوات قليلة حتى لو كان الجدول بالملايين، ويصلح للمساواة والمقارنة والترتيب، وهناك أنواع أخرى مثل GIN الذي استخدمناه مع JSONB، وتجدها في توثيق أنواع الفهارس.
لنأخذ أكثر استعلام يتكرر في صفحة «طلباتي»: آخر 20 طلباً لعميل معين، على جدول ال 5 ملايين طلب. ونستخدم EXPLAIN ANALYZE الذي ينفذ الاستعلام فعلاً ويعرض الخطة التي اختارها PostgreSQL والزمن الحقيقي لكل خطوة، كما يشرح توثيق EXPLAIN:
EXPLAIN ANALYZE
SELECT id, created_at, status
FROM orders
WHERE customer_id = 4242
ORDER BY created_at DESC
LIMIT 20;
شغلنا الاستعلام ثلاث مرات، والمخرج في المرة الثانية كما يلي:
                                                               QUERY PLAN
----------------------------------------------------------------------------------------------------------------------------------------
 Limit  (cost=65127.15..65129.48 rows=20 width=23) (actual time=457.861..473.200 rows=20.00 loops=1)
   Buffers: shared hit=15066 read=23095
   ->  Gather Merge  (cost=65127.15..65132.98 rows=50 width=23) (actual time=457.858..473.194 rows=20.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=15066 read=23095
         ->  Sort  (cost=64127.13..64127.18 rows=21 width=23) (actual time=442.582..442.584 rows=11.33 loops=3)
               Sort Key: created_at DESC
               Sort Method: quicksort  Memory: 26kB
               Buffers: shared hit=15066 read=23095
               Worker 0:  Sort Method: quicksort  Memory: 25kB
               Worker 1:  Sort Method: quicksort  Memory: 25kB
               ->  Parallel Seq Scan on orders  (cost=0.00..64126.67 rows=21 width=23) (actual time=21.700..442.409 rows=15.33 loops=3)
                     Filter: (customer_id = 4242)
                     Rows Removed by Filter: 1666651
                     Buffers: shared hit=14990 read=23095
 Planning:
   Buffers: shared hit=91
 Planning Time: 1.256 ms
 Execution Time: 473.337 ms
(20 rows)
في الخطة أعلاه لاحظ التالي:
- اقرأ الخطة من الأسفل إلى الأعلى:
Parallel Seq Scanيعني أن PostgreSQL قرأ الجدول كله صفحة صفحة، وقسمه على ثلاث عمليات (عمليتان مساعدتان Workers والعملية الرئيسية)، ثم رتب النتيجة وأخذ أول 20. Rows Removed by Filter: 1666651لكل عملية، أي أنه قرأ 5 ملايين سطر ورمى كلها تقريباً ليعيد 20 سطراً.Buffersتظهر تلقائياً معEXPLAIN ANALYZEفي PostgreSQL 18 كما تذكر ملاحظات الإصدار، وread=23095تعني صفحات قرئت من القرص، وكل صفحة 8 كيلوبايت.- الزمن حوالي 470 مللي ثانية، وفي المرة الأولى كان 627، وهذا لاستعلام واحد لعميل واحد، فإذا فتح مئة عميل صفحاتهم في نفس الوقت فالسيرفر كله مشغول بقراءة نفس الجدول.
والآن نضيف فهرساً على العمودين اللذين يستخدمهما الاستعلام، العميل أولاً ثم التاريخ، ونستخدم CONCURRENTLY حتى لا يمنع الكتابة في الجدول أثناء بناء الفهرس، كما يشرح توثيق CREATE INDEX:
\timing on
CREATE INDEX CONCURRENTLY orders_customer_created_idx
    ON orders (customer_id, created_at);
\timing off
SELECT pg_size_pretty(pg_relation_size('orders_customer_created_idx')) AS index_size;
والمخرج سوف يكون كما يلي:
Timing is on.
CREATE INDEX
Time: 27792.452 ms (00:27.792)
Timing is off.
 index_size
------------
 150 MB
(1 row)
ثم نعيد نفس EXPLAIN ANALYZE، والمخرج في المرة الثانية كما يلي:
                                                                        QUERY PLAN
-----------------------------------------------------------------------------------------------------------------------------------------------------------
 Limit  (cost=0.43..82.38 rows=20 width=23) (actual time=0.077..0.113 rows=20.00 loops=1)
   Buffers: shared hit=26
   ->  Index Scan Backward using orders_customer_created_idx on orders  (cost=0.43..205.30 rows=50 width=23) (actual time=0.075..0.110 rows=20.00 loops=1)
         Index Cond: (customer_id = 4242)
         Index Searches: 1
         Buffers: shared hit=26
 Planning:
   Buffers: shared hit=114
 Planning Time: 0.502 ms
 Execution Time: 0.139 ms
(10 rows)
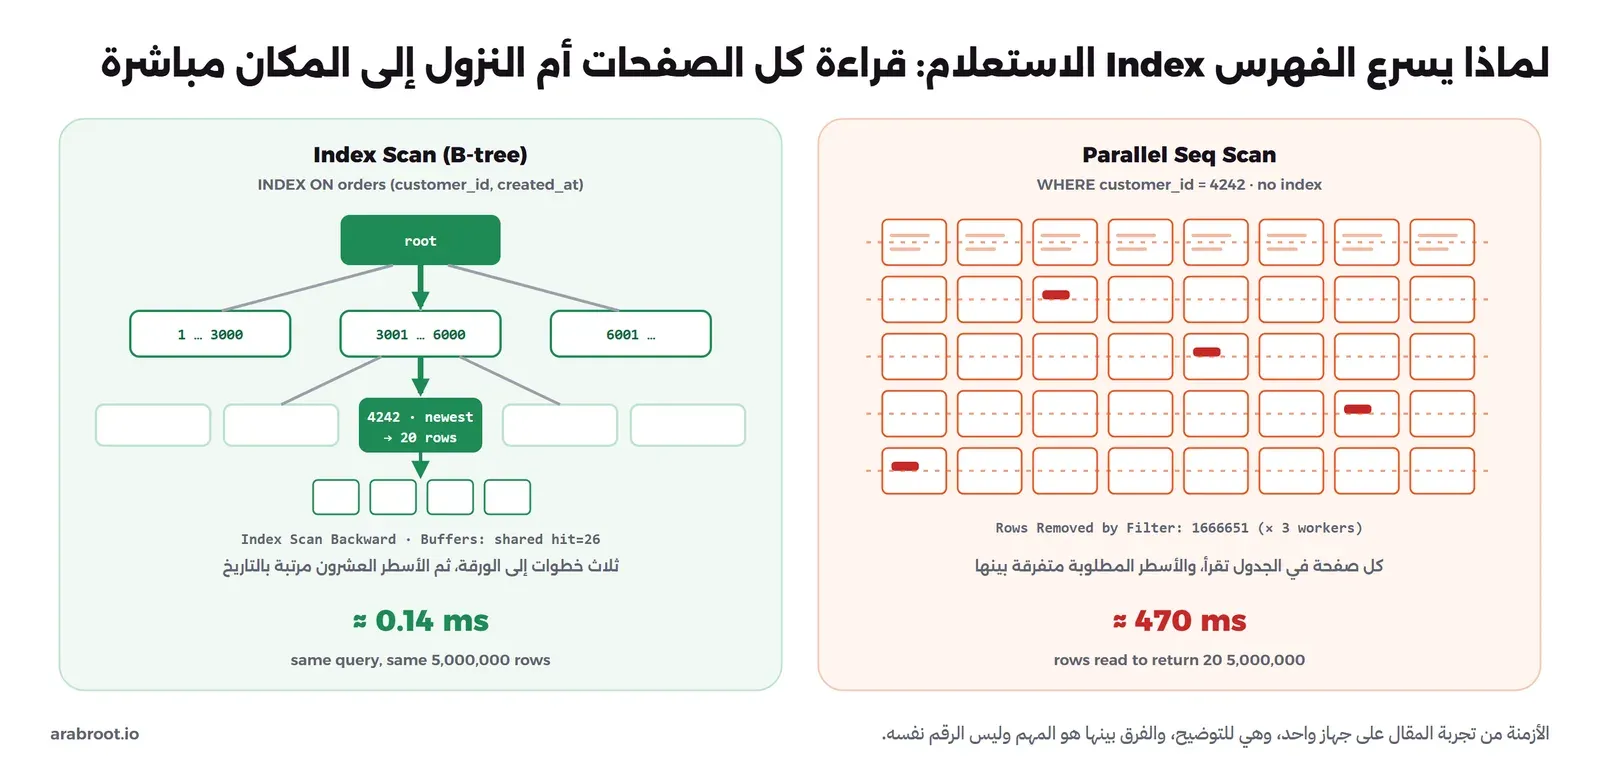
الصورة التالية تبين ما حدث في الحالتين:
في المخرج أعلاه لاحظ التالي:
Index Scan Backward: نزل في الفهرس إلى العميل 4242، ولأن الفهرس مرتب بالتاريخ داخل كل عميل، فقد قرأه من الآخر إلى الأول فخرجت الأسطر مرتبة دون عمليةSort.Buffers: shared hit=26، أي 26 صفحة فقط بدل حوالي 38 ألف صفحة، وكلها من الذاكرة.- الزمن نزل من حوالي 470 مللي ثانية إلى حوالي 0.14 مللي ثانية، أي أكثر من ثلاثة آلاف مرة. والأرقام للتوضيح من نفس الجهاز، والمهم هو الفرق بين قراءة الجدول كله والنزول إلى المكان مباشرة.
ترتيب الأعمدة في الفهرس المركب Composite Index مهم. فالفهرس (customer_id, created_at) مرتب بالعميل أولاً، ثم بالتاريخ داخل كل عميل، مثل دليل الهاتف المرتب باسم العائلة ثم الاسم الأول، فيفيد في البحث بالعميل، أو بالعميل والتاريخ معاً، ولكنه لا يفيد كثيراً في البحث بالتاريخ وحده، كما يشرح توثيق الفهارس متعددة الأعمدة:
EXPLAIN (ANALYZE, BUFFERS OFF)
SELECT count(*) FROM orders
WHERE created_at >= '2026-09-01' AND created_at < '2026-09-02';
والمخرج سوف يكون كما يلي:
                                                                               QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------------------------------------------
 Finalize Aggregate  (cost=70341.01..70341.02 rows=1 width=8) (actual time=1514.836..1514.923 rows=1.00 loops=1)
   ->  Gather  (cost=70340.79..70341.00 rows=2 width=8) (actual time=1489.411..1514.907 rows=3.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         ->  Partial Aggregate  (cost=69340.79..69340.80 rows=1 width=8) (actual time=1475.297..1475.298 rows=1.00 loops=3)
               ->  Parallel Seq Scan on orders  (cost=0.00..69335.00 rows=2317 width=0) (actual time=13.588..1471.358 rows=1702.00 loops=3)
                     Filter: ((created_at >= '2026-09-01 00:00:00+00'::timestamp with time zone) AND (created_at < '2026-09-02 00:00:00+00'::timestamp with time zone))
                     Rows Removed by Filter: 1664965
 Planning Time: 0.575 ms
 Execution Time: 1515.029 ms
(10 rows)
لاحظ أن PostgreSQL عاد إلى Parallel Seq Scan رغم وجود الفهرس، والسبب أن التاريخ هو العمود الثاني فيه. وقد أضاف PostgreSQL 18 ما يسمى Skip Scan الذي يسمح باستخدام الفهرس المركب دون شرط على العمود الأول، ولكنه كما يذكر التوثيق يستخدم عندما يكون للعمود الأول قيم مختلفة قليلة، وعندنا 100 ألف عميل، فاختار القراءة الكاملة. لذلك إذا كانت لوحة الإدارة تبحث بالتاريخ وحده فهي تحتاج فهرساً يبدأ بالتاريخ.
والفهرس له ثمن في الكتابة، لأن كل INSERT أو UPDATE يعدل الجدول وكل فهارسه. ولكي نرى ذلك أنشأنا جدولين بنفس الأعمدة، الأول بالمفتاح الأساسي فقط، والثاني معه ثلاثة فهارس إضافية، وأدخلنا في كل منهما نفس المليون سطر:
CREATE TABLE orders_a (id bigint PRIMARY KEY, customer_id bigint, created_at timestamptz, status text);
CREATE TABLE orders_b (LIKE orders_a INCLUDING ALL);
CREATE INDEX ON orders_b (customer_id, created_at);
CREATE INDEX ON orders_b (created_at);
CREATE INDEX ON orders_b (status);
\timing on
INSERT INTO orders_a SELECT id, customer_id, created_at, status FROM orders WHERE id <= 1000000;
INSERT INTO orders_b SELECT id, customer_id, created_at, status FROM orders WHERE id <= 1000000;
والمخرج سوف يكون كما يلي:
Timing is on.
INSERT 0 1000000
Time: 44682.164 ms (00:44.682)
INSERT 0 1000000
Time: 88112.296 ms (01:28.112)
نفس البيانات احتاجت ضعف الوقت تقريباً مع ثلاثة فهارس إضافية، والأرقام المطلقة بطيئة لأن جهاز التجربة كان مشغولاً، أما النسبة فهي المهمة. لذلك لا تضع فهرساً على كل عمود «للاحتياط»، وإنما أضف الفهرس عندما يوجد استعلام حقيقي بطيء، وتأكد بـ EXPLAIN ANALYZE أنه استخدم فعلاً، واحذف الفهارس التي لا يستخدمها أحد.
orders.customer_id، كما يذكر توثيق القيود، وإنما على المفتاح الأساسي فقط. وبدونه يصبح حذف عميل أو البحث عن طلباته قراءة للجدول كله، لذلك أضف الفهرس بنفسك على المفاتيح الأجنبية التي تبحث بها. وسوف نتعمق في أنواع الفهارس وقراءة EXPLAIN في موضوع خاص بالفهارس ضمن قسم قواعد البيانات في خارطة الطريق.مشكلة N+1
هذه أشهر مشكلة أداء في التطبيقات التي تستخدم ORM، وهي لا تظهر في قاعدة البيانات وإنما في الكود. لنفرض أن صفحة تعرض آخر 100 طلب مع اسم العميل لكل طلب، والكود يبدو بريئاً:
orders = db.query("SELECT * FROM orders ORDER BY created_at DESC LIMIT 100")
for order in orders:
    customer = db.query("SELECT name FROM customers WHERE id = %s", order.customer_id)
    print(order.id, customer.name)
استعلام واحد للطلبات، ثم استعلام لكل طلب، أي 101 استعلام، والصورة التالية تبين الفرق:
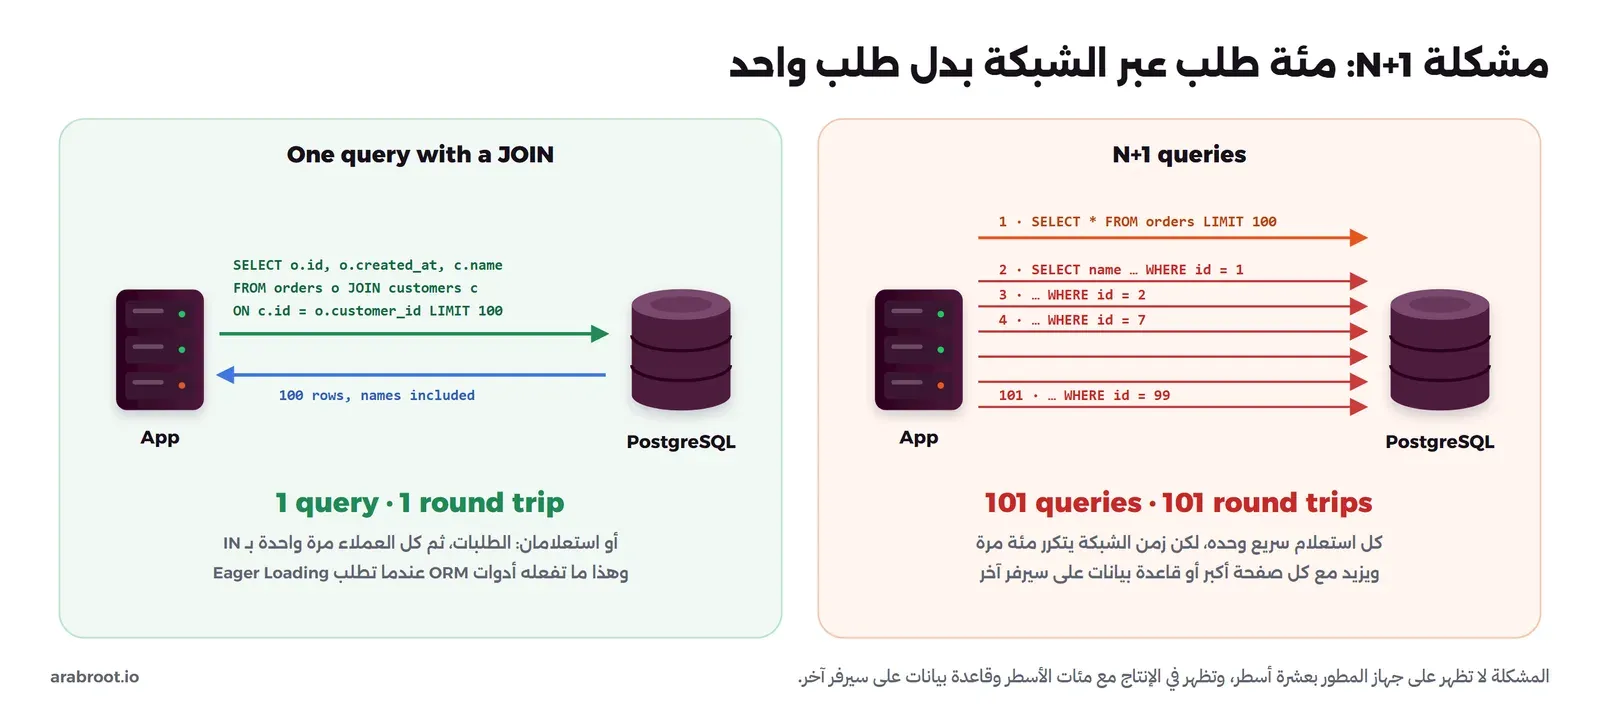
كل استعلام من ال 101 يحتاج أقل من مللي ثانية في قاعدة البيانات، ولكن كل واحد منها ذهاب وعودة عبر الشبكة Round Trip، فإذا كانت قاعدة البيانات على سيرفر آخر والذهاب والعودة يحتاج مللي ثانية واحدة، فالصفحة خسرت عشر الثانية في الانتظار فقط. والحل أن تطلب كل ما تحتاجه في استعلام واحد:
SELECT o.id, o.created_at, c.name
FROM orders o
JOIN customers c ON c.id = o.customer_id
ORDER BY o.created_at DESC
LIMIT 100;
أو استعلامين: الطلبات، ثم كل العملاء مرة واحدة بـ WHERE id IN (...)، وهذا ما تفعله أدوات ORM عندما تطلب منها التحميل المسبق Eager Loading، مثل includes في Rails وselect_related وprefetch_related في Django. وأسهل طريقة لاكتشاف المشكلة أن تفعل سجل الاستعلامات في بيئة التطوير، وتعد الاستعلامات في كل صفحة.
تجميع الاتصالات Connection Pooling
كل اتصال بـ PostgreSQL عملية Process كاملة على السيرفر تستهلك ذاكرة، لذلك لا يصلح أن يفتح كل طلب ويب اتصالاً جديداً، والحل أداة مثل PgBouncer تبقي عدداً صغيراً من الاتصالات مفتوحاً وتوزعه على الطلبات. وقد شرحنا لماذا لا يزيد العمل بزيادة عدد العمليات المتزامنة في مقال المعالج والخيوط والتزامن، أما المجمعات Pools داخل التطبيق وأوضاع PgBouncer وحساب الحجم الصحيح فقد شرحناها بمختبر كامل في مقال تجميع الاتصالات Connection Pooling للمبتدئين.
نسخ للقراءة Read Replicas
في أغلب التطبيقات القراءة أكثر من الكتابة بكثير، لذلك الخطوة التالية بعد الفهارس أن تضيف سيرفراً ثانياً يستقبل نسخة مستمرة من كل تغيير على السيرفر الرئيسي Primary عبر ال Streaming Replication، وتوجه إليه القراءات والتقارير، وتبقى الكتابة على الرئيسي. والنسخة في PostgreSQL تقبل الاستعلامات للقراءة فقط، كما يشرح توثيق Hot Standby.
ولكن انتبه إلى أن النسخ في الوضع الافتراضي غير متزامن Asynchronous، أي أن النسخة قد تتأخر عن الرئيسي بأجزاء من الثانية أو أكثر تحت الضغط، كما يذكر توثيق النسخ. لذلك المستخدم الذي غير اسمه ثم فتح صفحته فوراً قد يرى الاسم القديم إذا قرأت الصفحة من النسخة، والحل أن تقرأ من الرئيسي ما كتبه المستخدم نفسه للتو، وتترك للنسخة ما يتحمل التأخير.
تقسيم الجدول Partitioning
عندما يصل جدول الطلبات إلى مئات الملايين من الأسطر، تستطيع أن تقسمه داخل نفس السيرفر إلى أجزاء Partitions بحسب الشهر مثلاً، فيبقى في نظر التطبيق جدولاً واحداً، ولكن الاستعلام عن الشهر الحالي يقرأ جزءه فقط، وحذف بيانات سنة قديمة يصبح حذف جزء كامل بأمر واحد بدل DELETE على ملايين الأسطر. والتقسيم لا يناسب كل جدول، فالاستعلام الذي لا يحدد الشهر يمر على كل الأجزاء، والقيود UNIQUE يجب أن تحتوي عمود التقسيم، كما يشرح توثيق التقسيم. وسوف نتعمق فيه بالتفصيل في موضوع التقسيم ضمن قسم قواعد البيانات في خارطة الطريق.
التوزيع على عدة سيرفرات Sharding
عندما لا يكفي سيرفر واحد للكتابة أو للتخزين، توزع البيانات نفسها على عدة سيرفرات بحسب مفتاح، مثل رقم العميل، فيكون كل عميل وطلباته على سيرفر واحد. وهي آخر خطوة لأنها الأصعب: الاستعلام الذي يجمع بيانات عدة عملاء يمر على كل السيرفرات، والعملية التي تعدل بيانات في سيرفرين تحتاج تنسيقاً، وتغيير مفتاح التوزيع لاحقاً عملية كبيرة. وهناك أدوات تجعله أسهل في PostgreSQL مثل Citus، وهي موضوع مخطط له في خارطة الطريق أيضاً. والقاعدة أن سيرفراً واحداً قوياً مع فهارس صحيحة ونسخ للقراءة يكفي أغلب التطبيقات أكثر بكثير مما يتوقع أصحابها.
تغيير الجداول دون إيقاف التطبيق
عندما يعمل التطبيق على أكثر من سيرفر، أو تنشر النسخة الجديدة تدريجياً، فستجد لحظة تعمل فيها النسخة القديمة والجديدة من الكود على نفس قاعدة البيانات، فإذا حذفت عموداً أو غيرت اسمه في التحديث، فالنسخة القديمة تتوقف فوراً. والحل طريقة التوسيع ثم التقليص Expand / Contract، وتسمى أيضاً Parallel Change: تضيف الجديد بجانب القديم، وتنقل التطبيق إليه على مراحل، ثم تحذف القديم في آخر خطوة. والصورة التالية تبين المراحل على مثال نقل مدينة العميل من نص إلى جدول مدن:
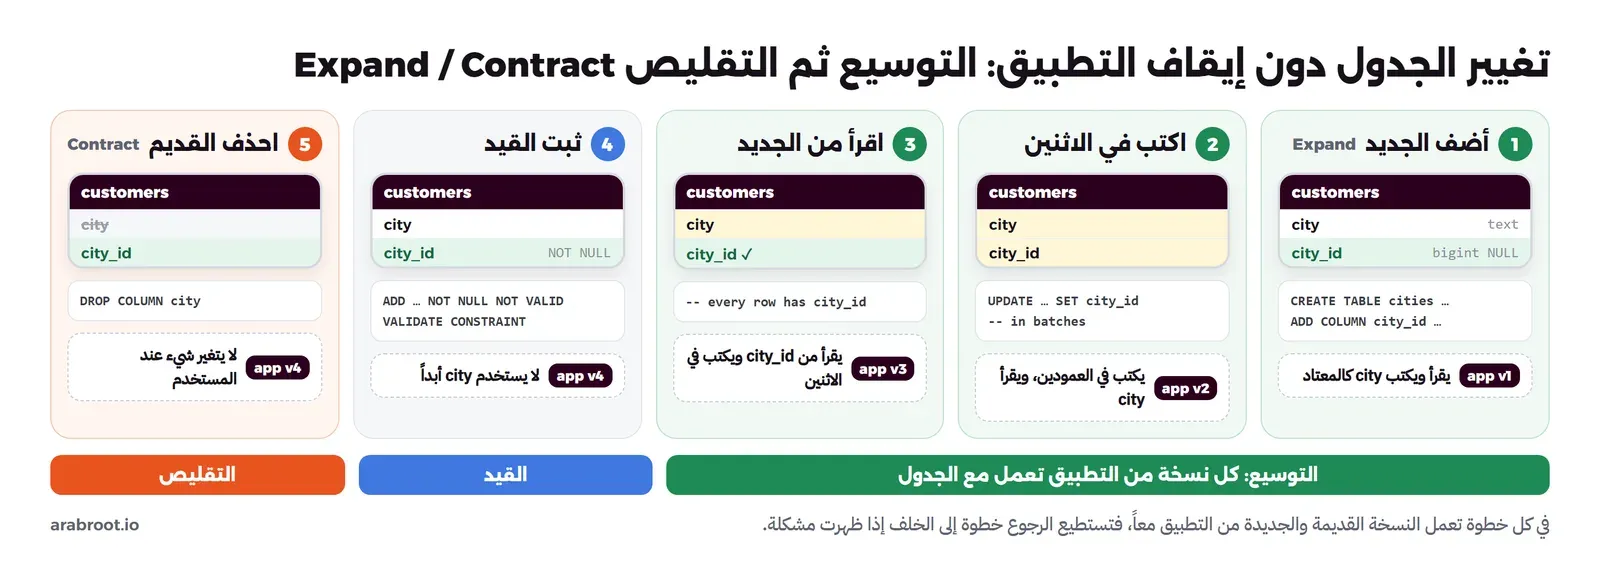
والأوامر التي نفذناها على قاعدة shop كما يلي، وبين كل خطوة وأخرى في الواقع نشر لنسخة من التطبيق:
-- 1) expand: new table and a nullable column, old column untouched
CREATE TABLE cities (
    id   bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name text NOT NULL UNIQUE
);
ALTER TABLE customers ADD COLUMN city_id bigint REFERENCES cities (id);

-- 2) backfill (on a big table: in batches of a few thousand rows)
INSERT INTO cities (name) SELECT DISTINCT city FROM customers ON CONFLICT DO NOTHING;
UPDATE customers c SET city_id = ci.id
FROM cities ci
WHERE ci.name = c.city AND c.city_id IS NULL;

-- 3) enforce without a long lock: add NOT VALID, then validate
ALTER TABLE customers ADD CONSTRAINT customers_city_id_not_null NOT NULL city_id NOT VALID;
ALTER TABLE customers VALIDATE CONSTRAINT customers_city_id_not_null;

-- 4) contract: only after every app version reads city_id
ALTER TABLE customers DROP COLUMN city;

SELECT c.name, ci.name AS city
FROM customers c JOIN cities ci ON ci.id = c.city_id ORDER BY c.id;
والمخرج سوف يكون كما يلي:
CREATE TABLE
ALTER TABLE
INSERT 0 2
UPDATE 2
ALTER TABLE
ALTER TABLE
ALTER TABLE
   name    |  city
-----------+--------
 Sara Ali  | Dammam
 Omar Saad | Jeddah
(2 rows)
في الإعداد أعلاه لاحظ التالي:
- العمود الجديد أضيف فارغاً بدون
NOT NULL، لأن النسخة القديمة من التطبيق لا تعرفه ولن تكتب فيه. - الملء Backfill في جدول كبير يكون على دفعات صغيرة، مثل
WHERE id BETWEEN 1 AND 5000ثم التي بعدها، لأنUPDATEواحد على ملايين الأسطر يقفلها كلها لوقت طويل ويضخم ملفات ال WAL دفعة واحدة. - القيد
NOT VALIDيطبق على الأسطر الجديدة فوراً دون أن يفحص الجدول كله، ثمVALIDATE CONSTRAINTيفحص القديمة بقفل لا يمنع الكتابة، كما يشرح توثيق ALTER TABLE، واستخدامNOT VALIDمعNOT NULLأصبح ممكناً في PostgreSQL 18.
وبعض التغييرات تبدو صغيرة وهي تعيد كتابة الجدول كله. ولكي نرى ذلك أضفنا عمودين إلى جدول ال 5 ملايين طلب، الأول بقيمة افتراضية ثابتة، والثاني بقيمة افتراضية تتغير مع كل سطر:
\timing on
ALTER TABLE orders ADD COLUMN currency text NOT NULL DEFAULT 'SAR';
ALTER TABLE orders ADD COLUMN imported_at timestamptz DEFAULT clock_timestamp();
والمخرج سوف يكون كما يلي:
Timing is on.
ALTER TABLE
Time: 410.651 ms
ALTER TABLE
Time: 268490.097 ms (04:28.490)
الأول احتاج أقل من نصف ثانية، لأن PostgreSQL يحفظ القيمة الثابتة في تعريف الجدول ولا يلمس الأسطر، والثاني احتاج أكثر من أربع دقائق، لأن القيمة تختلف لكل سطر فأعاد كتابة الجدول وفهارسه كلها، وطوال هذا الوقت كان الجدول مقفلاً أمام القراءة والكتابة، أي أن صفحة «طلباتي» كانت متوقفة. وهذا السلوك موثق في ملاحظات ALTER TABLE، لذلك اقرأ ملاحظات أي أمر ALTER قبل أن تشغله على جدول كبير في الإنتاج Production، وجربه أولاً على نسخة بنفس الحجم.
الحذف المنطقي أم الحذف الفعلي؟
الحذف الفعلي Hard Delete يمسح السطر نهائياً، والحذف المنطقي Soft Delete يضع تاريخاً في عمود مثل deleted_at ويبقي السطر، فتستطيع أن تستعيده، وتبقى الفواتير القديمة مرتبطة بعميل موجود. ولكن الحذف المنطقي له ثمن: كل استعلام في التطبيق يجب أن يضيف WHERE deleted_at IS NULL، ونسيانه مرة واحدة يعرض بيانات محذوفة، والقيود UNIQUE تمنع عميلاً جديداً من التسجيل ببريد عميل محذوف. والحل للمشكلة الأخيرة فهرس فريد جزئي Partial Unique Index يطبق على الأسطر غير المحذوفة فقط، كما في توثيق الفهارس الجزئية:
ALTER TABLE customers ADD COLUMN deleted_at timestamptz;
ALTER TABLE customers DROP CONSTRAINT customers_email_key;
CREATE UNIQUE INDEX customers_email_active_key ON customers (email) WHERE deleted_at IS NULL;

UPDATE customers SET deleted_at = now() WHERE email = '[email protected]';
INSERT INTO customers (name, email, city_id) VALUES ('Omar S.', '[email protected]', 2);
INSERT INTO customers (name, email, city_id) VALUES ('Omar 2', '[email protected]', 2);
SELECT id, name, email, deleted_at IS NOT NULL AS deleted FROM customers WHERE email = '[email protected]';
والمخرج سوف يكون كما يلي:
ALTER TABLE
ALTER TABLE
CREATE INDEX
UPDATE 1
INSERT 0 1
ERROR:  duplicate key value violates unique constraint "customers_email_active_key"
DETAIL:  Key (email)=([email protected]) already exists.
 id |   name    |      email       | deleted
----+-----------+------------------+---------
  2 | Omar Saad | [email protected] | t
  5 | Omar S.   | [email protected] | f
(2 rows)
الحساب المحذوف بقي، وسجل عمر من جديد بنفس البريد، والمحاولة الثالثة رفضت لأن هناك حساباً نشطاً بنفس البريد. وتذكر أن الحذف المنطقي لا يكفي عندما يطلب المستخدم حذف بياناته الشخصية، فهنا يجب أن تحذف أو تخفي البيانات فعلاً.
الوقت بتوقيت UTC دائماً
استخدم النوع timestamptz لكل لحظة حدثت، مثل وقت الطلب ووقت الدفع، وليس timestamp بدون منطقة زمنية. والسبب أن timestamptz يحول القيمة إلى UTC ويخزنها كذلك، ثم يعرضها بمنطقة الاتصال الزمنية، كما يذكر توثيق أنواع التاريخ والوقت، وهذا ما رأيناه عندما أدخلنا 18:40+03 فظهر 15:40:00+00. وقد شرحنا UTC والمناطق الزمنية والتوقيت الصيفي والتقويم الهجري بالتفصيل في مقال التاريخ والوقت.
النسخ الاحتياطي قبل كل شيء
كل ما سبق لا قيمة له إذا ضاعت البيانات، والنسخة للقراءة Replica ليست نسخة احتياطية، فالأمر DELETE الخاطئ ينتقل إليها خلال أجزاء من الثانية. لذلك تحتاج نسخاً احتياطية حقيقية خارج السيرفر، وتجربة استعادة دورية، كما يشرح فصل النسخ الاحتياطي في توثيق PostgreSQL. وقد عرفنا الفرق بين Backup وSnapshot وRAID في دليل مصطلحات الاستضافة الذاتية، أما نسخ قواعد البيانات بـ pg_dump والاستعادة إلى نقطة زمنية فهي مواضيع مخطط لها في قسم التشغيل والصيانة في خارطة الطريق.
عمليات التطبيق OLTP أم التحليل OLAP؟
قاعدة بيانات التطبيق مصممة لما يسمى OLTP، واختصاراً Online Transaction Processing: آلاف العمليات الصغيرة في الثانية، كل واحدة تقرأ أو تكتب أسطراً قليلة بالمفتاح، والتطبيع والفهارس التي شرحناها مناسبة لها تماماً. أما التقارير والتحليل، أو ما يسمى OLAP، واختصاراً Online Analytical Processing، فهي استعلامات قليلة ولكن كل واحدة تجمع ملايين الأسطر، مثل المبيعات لكل مدينة لكل شهر في ثلاث سنوات. وتشغيل هذه التقارير على القاعدة الرئيسية في وقت العمل يعني أن العملاء ينتظرون بينما يحسب المدير تقريره، والصورة التالية تبين الحل:
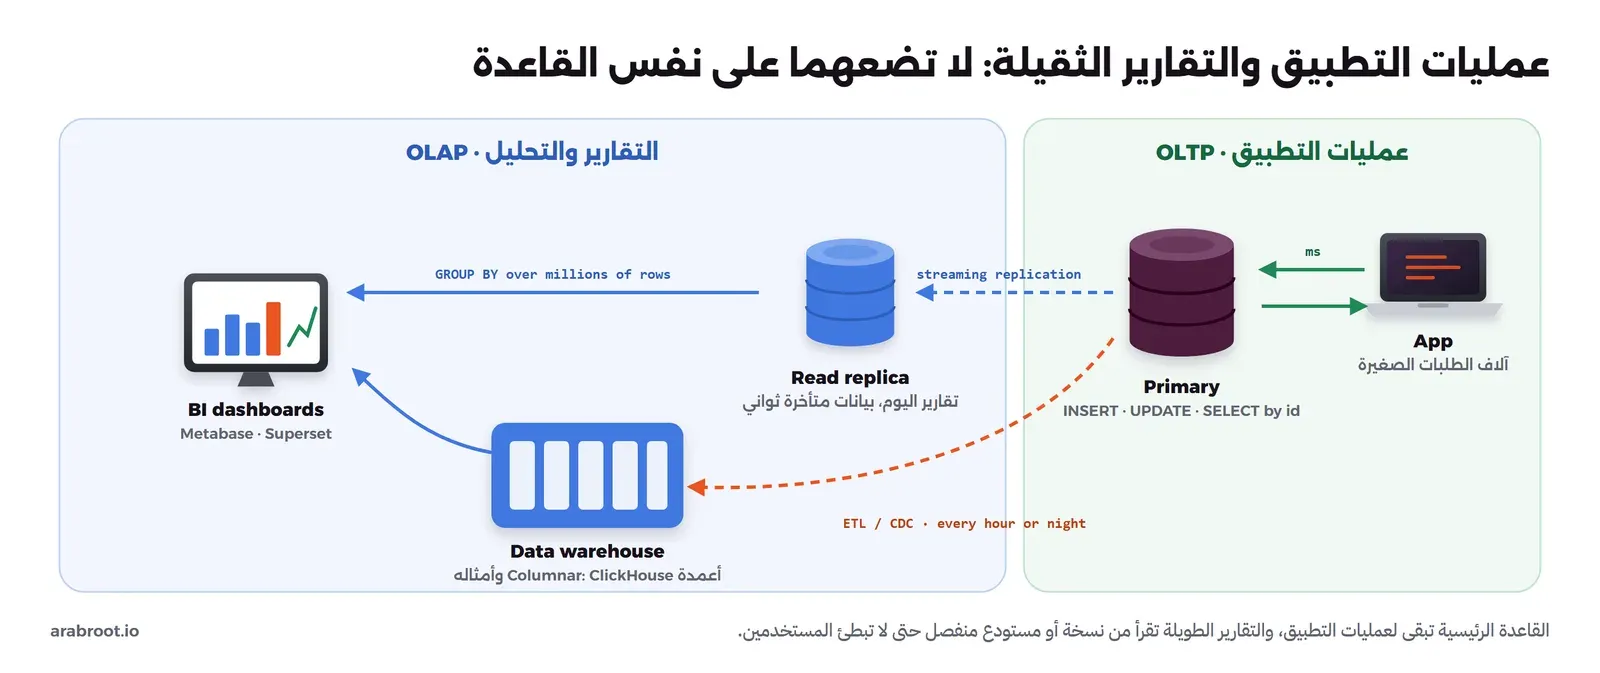
- البداية: التقارير الخفيفة على نسخة للقراءة Replica، فلا تؤثر على الكتابة، وتقبل تأخراً بسيطاً.
- عندما تكبر التقارير: تنقل البيانات كل ساعة أو كل ليلة بعملية ETL، أو باستمرار بنقل التغييرات CDC، إلى مستودع بيانات Data Warehouse بتخزين عمودي Columnar مثل ClickHouse، وهو مصمم لجمع ملايين الأسطر بسرعة، وفيه يكون كسر التطبيع هو القاعدة وليس الاستثناء.
- العرض: لوحات ذكاء الأعمال BI مثل Metabase وSuperset تقرأ من النسخة أو المستودع، وهي مواضيع مخطط لها في قسم البيانات وذكاء الأعمال في خارطة الطريق.
حذف المختبر
بعد أن تنتهي من التجارب احذف ال Container، والخيار -v يحذف معه ال Volume المجهول الذي أنشأه Docker Image الخاص بـ PostgreSQL للبيانات، ولا يلمس أي Volume آخر على جهازك:
docker rm -f -v lab-dbdesign-pgالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الجدول الواحد الكبير يكرر نفس المعلومة في عدة أسطر، ومن هذا التكرار تأتي مشاكل التعديل والإضافة والحذف، والحل أن تكون كل معلومة مكتوبة في مكان واحد.
- استخدم مفتاحاً أساسياً بديلاً لكل جدول مع
UNIQUEعلى المفتاح الطبيعي، وضع المفتاح الأجنبي في جهة «الكثير»، واستخدم جدول ربط لعلاقة كثير لكثير. - التطبيع حتى الشكل الثالث: قيمة واحدة في كل خانة، وكل عمود يعتمد على المفتاح كله، ولا شيء غير المفتاح، والسعر وقت الشراء معلومة مختلفة عن سعر المنتج اليوم.
- القيود
NOT NULLوUNIQUEوCHECKوالمفاتيح الأجنبية تحمي البيانات من كل من يكتب فيها، واستخدمCASCADEفقط للسطر الذي هو جزء من غيره. - ابدأ مطبعاً، واكسر التطبيع في مكان محدد عندما تقيس بطئاً حقيقياً، مع طريقة واضحة لإبقاء النسخة متطابقة، ويبقى الأصل هو مصدر الحقيقة.
- عند التوسع: الفهارس الصحيحة أولاً، وترتيب أعمدتها مهم ولها ثمن في الكتابة، ثم التخلص من N+1، ثم تجميع الاتصالات ونسخ القراءة، والتقسيم والتوزيع في آخر الطريق.
- غير الجداول بالتوسيع ثم التقليص، واقرأ ملاحظات أي
ALTERقبل تشغيله على جدول كبير، واستخدمtimestamptz، ولا تعتبر النسخة للقراءة نسخة احتياطية. - التقارير الثقيلة مكانها نسخة للقراءة أو مستودع بيانات منفصل، وليس القاعدة التي يكتب فيها التطبيق.
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلNocoDB: جداول على طريقة Airtable على سيرفرككيف تنقل جداول فريقك من Excel أو Airtable إلى NocoDB على سيرفرك، فتبقى البيانات عندك ويعمل عليها الجميع من المتصفح.
 دليلقبل أن تنشر تطبيقك على خادمك: قائمة تحقق للمطورالأخطاء التي لا تظهر إلا بعد نشر تطبيقك في Docker خلف Reverse Proxy، وكيف تعالج كل واحد منها قبل أن يصل إلى المستخدمين.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار كل الأمثلة على PostgreSQL 18.6 داخل Container، مع قياسات EXPLAIN ANALYZE والعرض المحفوظ وتغيير الجداول على 5 ملايين طلب مولدة.


