

عندما يفكر المطور في موقع يخدم مئات الملايين من الطلبات كل يوم، يتخيل في الغالب مئات السيرفرات وعشرات الخدمات المصغرة Microservices وفريقاً كاملاً لا عمل له إلا تشغيل Kubernetes، ثم يبني مشروعه الصغير على هذه الصورة من اليوم الأول فيدفع ثمن التعقيد قبل أن يأتيه أي مستخدم. وفي مقال مدخل إلى تصميم الأنظمة ذكرنا في سطور قليلة أن Stack Overflow كان في فبراير 2016 يخدم أكثر من 209 ملايين طلب HTTP يومياً بتسعة سيرفرات ويب وأربعة سيرفرات SQL Server، وأن الفريق قال إن سيرفر ويب واحداً يكفي لتشغيل الموقع. وفي هذا المقال سوف نحكي القصة كاملة: كيف كان الطلب يمر من المتصفح إلى قاعدة البيانات، وما العتاد الذي اشتروه ولماذا، وكيف كانوا ينشرون الكود عدة مرات في اليوم، ثم ما الذي تغير بعد ذلك حتى أخلوا مركز البيانات في 2025 وانتقلوا إلى السحابة.
والمصدر الأساسي لهذه القصة سلسلة كتبها Nick Craver، أحد مهندسي Stack Overflow، وبدأها بمقال تمهيدي شرح فيه أن الشركة تسمح لهم بالحديث عن كل شيء تقريباً، ثم نشر مقال البنية في فبراير 2016، ومقال العتاد في مارس، ومقال النشر في مايو. ونحن هنا لا نترجم هذه المقالات، وإنما نلخص الأرقام والقرارات بكلامنا ونرسم كل الصور من عندنا، ونضع رابطاً إلى القسم الذي أخذنا منه كل معلومة، وكل رقم في المقال منسوب إلى تاريخه، لأن الأرقام تتغير والقرارات التي كانت صحيحة في 2016 لم تبق كلها صحيحة في 2025.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تستحق هذه القصة وقتك، والأرقام في صورة واحدة.
- طريق الطلب في 2016: DNS ثم HAProxy ثم سيرفرات IIS ثم Redis وSQL Server وTag Engine وElasticsearch، وال Websockets.
- التخزين المؤقت على طبقتين L1 وL2، ولماذا بقي التطبيق تطبيقاً واحداً Monolith.
- القياس والمراقبة في كل طبقة، وعطل حقيقي في يوليو 2016 سببه تعبير نمطي Regex واحد.
- العتاد: كيف اختاروا كل سيرفر، ومركزا البيانات في New Jersey وColorado.
- النشر: من commit إلى الإنتاج Production في أقل من تسع دقائق، وترحيل قواعد البيانات دون توقف.
- ما الذي تغير بعد 2016: ASP.NET Core، وStack Overflow for Teams على Azure، ثم المواقع العامة على Google Cloud.
- الدروس التي تأخذها لمشروعك، ومتى لا تنطبق عليك.
لماذا تستحق هذه القصة وقتك؟
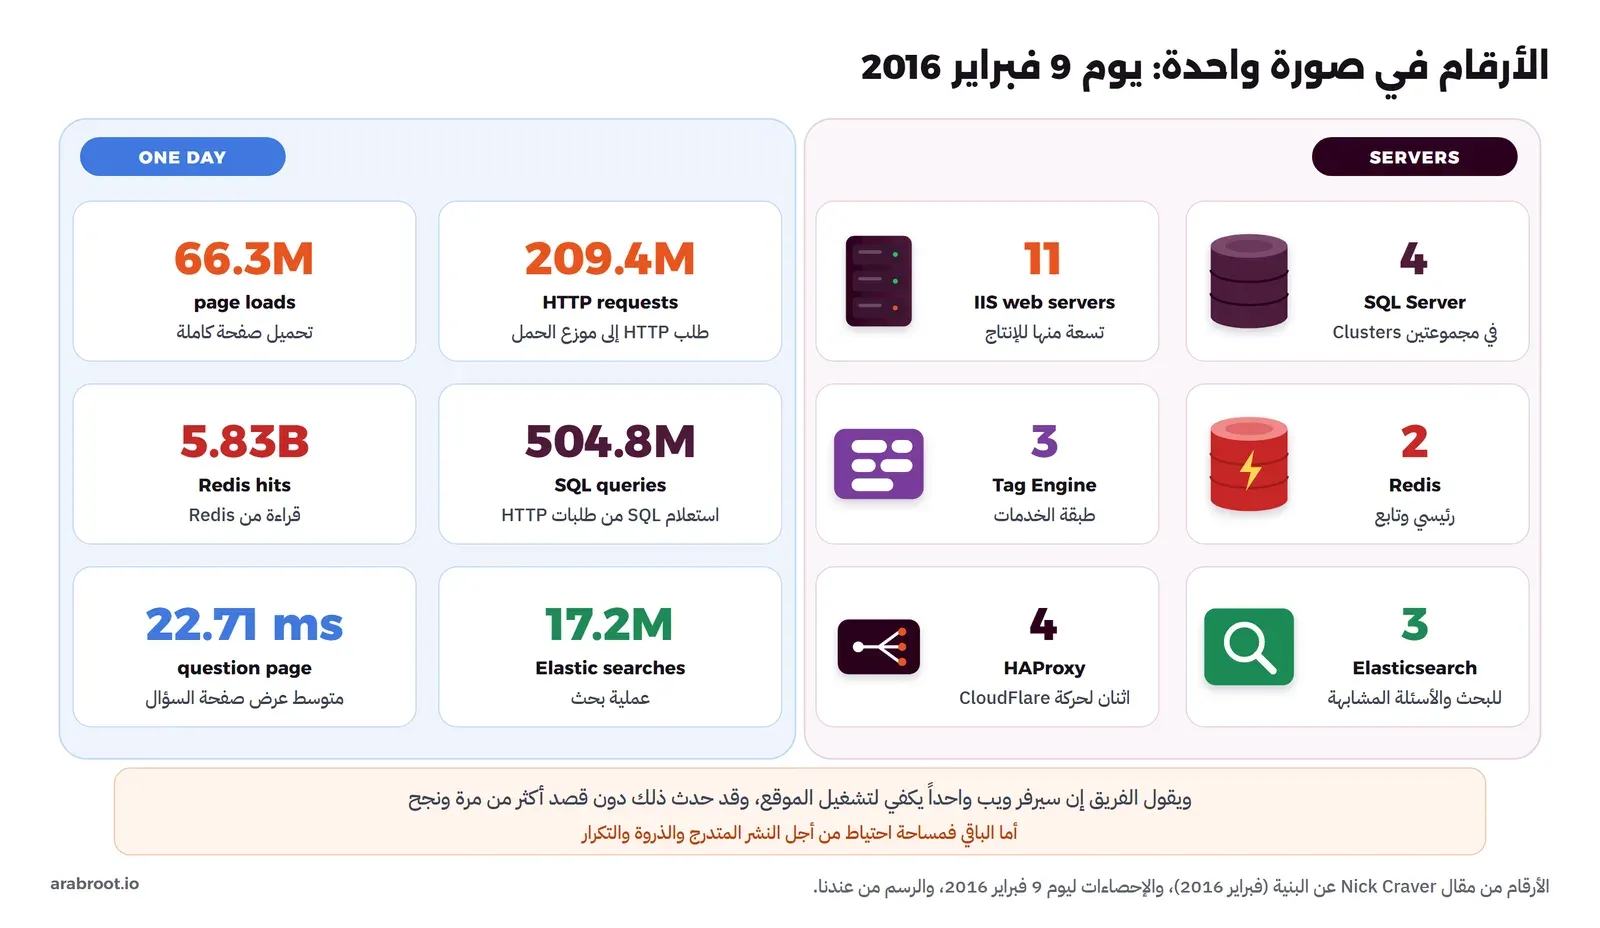
في مقال البنية نشر Nick Craver إحصاءات يوم واحد هو 9 فبراير 2016، والصورة التالية تبين أهم هذه الأرقام وعدد السيرفرات التي كانت تخدمها في نفس الفترة:
وفي الأرقام أعلاه لاحظ التالي:
- الطلبات التي وصلت إلى موزع الحمل Load Balancer كانت 209,420,973 طلباً، منها 66,294,789 تحميل صفحة كاملة، والباقي طلبات أصغر مثل الملفات والواجهات البرمجية.
- أكثر من 504 ملايين استعلام SQL في اليوم من طلبات HTTP وحدها، لكن عدد القراءات من Redis كان أكثر من عشرة أضعاف ذلك (5,831,683,114 قراءة)، وهذا يعني أن أغلب البيانات لم تكن تأتي من قاعدة البيانات أصلاً، وسوف نعود إلى هذا في قسم التخزين المؤقت.
- متوسط عرض صفحة السؤال كان 22.71 ميلي ثانية، منها 19.12 داخل ASP.NET، ومتوسط الصفحة الرئيسية 11.80 ميلي ثانية.
- الوقت الكلي الذي صرفته ASP.NET في المعالجة نزل من 757 ساعة في يوم من نوفمبر 2013 إلى 447 ساعة في هذا اليوم، رغم أن الطلبات زادت 61 مليون طلب يومياً، وسبب ذلك كما يقول المقال تحديث العتاد في بداية 2015 مع عمل كثير على تحسين أداء التطبيق نفسه.
وقد يتساءل البعض: إذا كانت هناك 11 سيرفر ويب، فلماذا قلنا في مقال المدخل إنها تسعة؟ والإجابة أن طبقة الويب كانت تسعة سيرفرات للإنتاج (WEB01 إلى WEB09) واثنين (WEB10 وWEB11) لبيئة التطوير وموقعي meta، فالرقمان صحيحان بحسب ما تعده. والأهم من ذلك أن Craver كتب أن سيرفر ويب واحداً يكفي لتشغيل الموقع، وأنهم جربوا ذلك دون قصد أكثر من مرة ونجح، مع أنه لا ينصح به، وذكر أن سبب الزيادة الكبيرة في السيرفرات هو النشر المتدرج Rolling Builds ومساحة الاحتياط Headroom والتكرار Redundancy، وليس الحاجة إلى قدرة معالجة أكبر.
وهذه هي الفكرة التي تجعل القصة مفيدة لك: الفريق كان يسأل قبل شراء أي سيرفر هل المشكلة مشكلة توسع عمودي Scale Up (سيرفر أكبر) أم توسع أفقي Scale Out (سيرفرات أكثر)، وهذا أول سؤال في قائمته عند اختيار العتاد، وكان يكرر أن «performance is a feature»، أي أن سرعة الموقع ميزة يعمل عليها الفريق مثل أي ميزة يراها المستخدم. وقد شرحنا الفرق بين نوعي التوسع في مقال المدخل، فلن نعيده هنا.
طريق الطلب من المتصفح إلى قاعدة البيانات
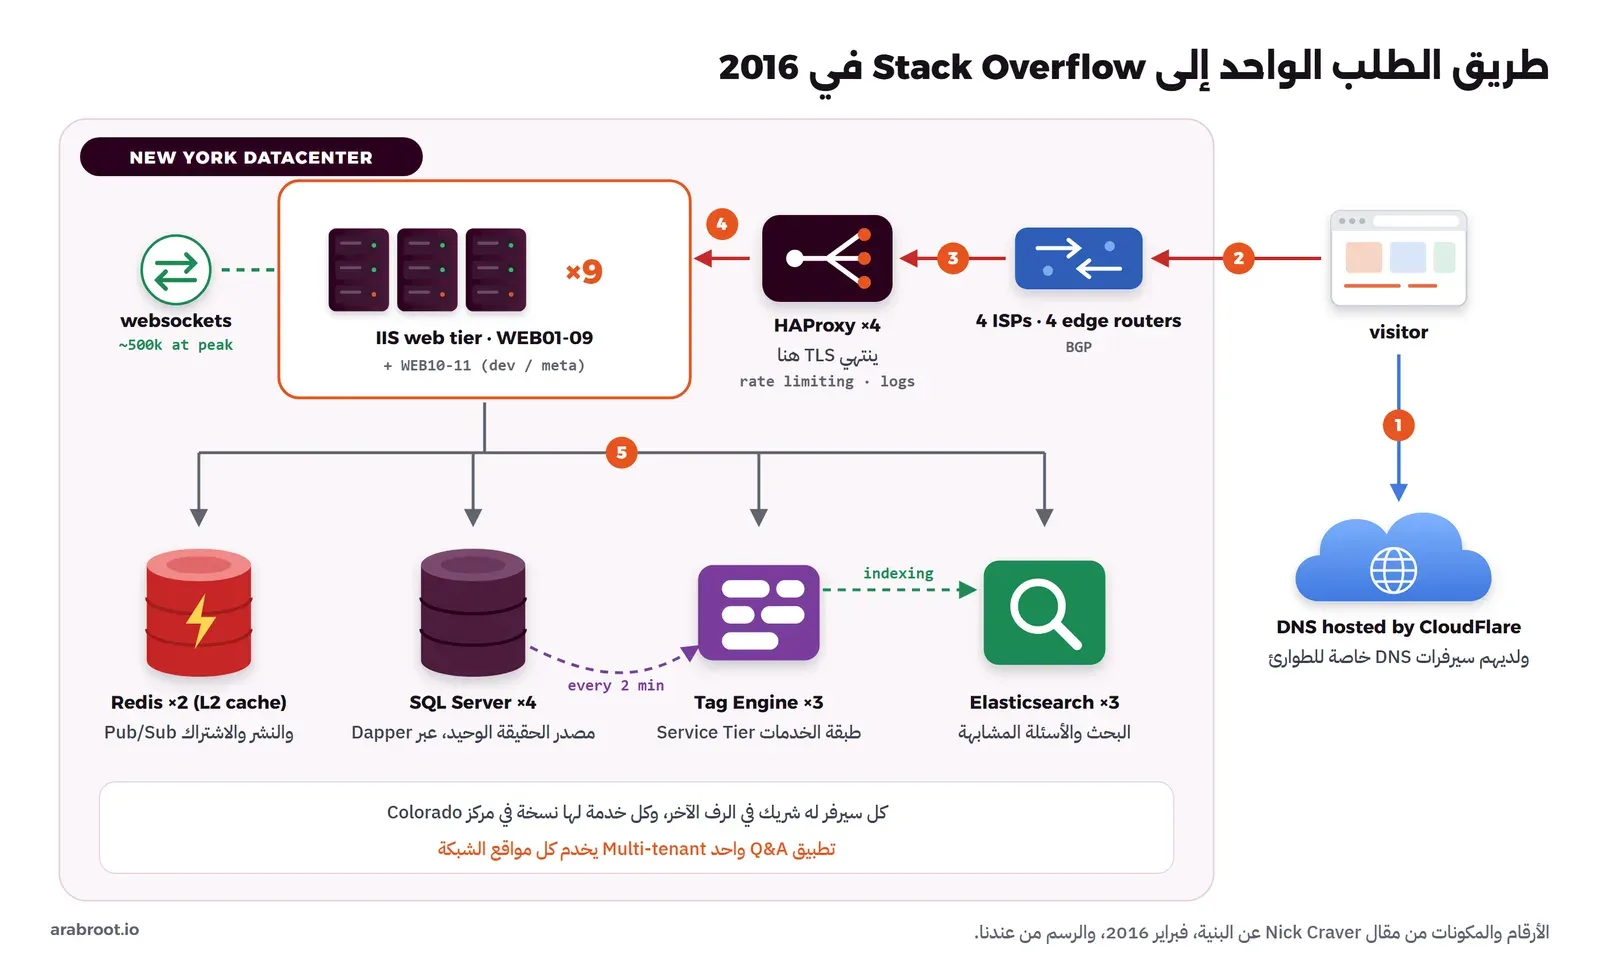
الصورة التالية تبين الطريق الذي كان يمر به طلب واحد إلى Stack Overflow في فبراير 2016 بحسب مقال البنية، والأرقام على الأسهم هي ترتيب الخطوات التي سوف نشرحها بعدها:
وفي الصورة أعلاه لاحظ التالي:
- الاسم أولاً: سجلات DNS كانت مستضافة عند CloudFlare لأن لديها سيرفرات قريبة من أغلب الناس، والفريق يحدث السجلات عبر API، ومع ذلك احتفظوا بسيرفرات DNS خاصة بهم جاهزة للتشغيل إذا تعطلت الخدمة الخارجية. وإذا أردت أن تفهم ما يحدث في هذه الخطوة فقد شرحنا ذلك في شرح DNS وسجلاته.
- الشبكة: يدخل الطلب عبر واحد من أربعة مزودي إنترنت ISP في نيويورك (Level 3 وZayo وCogent وLightower) وواحد من أربعة موجهات حافة Edge Routers من نوع Cisco ASR، مرتبة في زوجين يعملان معاً Active/Active، والربط مع المزودين ببروتوكول BGP للتحكم في مسار الحركة.
- موزع الحمل: أربعة سيرفرات HAProxy 1.5.15 على CentOS 7، وعندها ينتهي تشفير TLS، ولكل سيرفر منها 64 GB من الذاكرة أو أكثر حتى يحفظ جلسات TLS ويستأنفها بسرعة بدل أن يعيد حسابها، ويوجه الطلبات إلى الخلفيات Backends حسب ترويسة Host، ويطبق تحديد المعدل Rate Limiting، ويسجل في سجل syslog ترويسات يرسلها التطبيق فيها أزمنة كل طلب. وإذا أردت تشغيل HAProxy بنفسك فقد شرحنا التوجيه حسب النطاق وفحوص الصحة في دليل HAProxy.
- طبقة الويب: IIS 8.5 مع ASP.NET MVC 5.2.3 و.NET 4.6.1 على Windows، وتطبيق الأسئلة والأجوبة Q&A تطبيق واحد متعدد المستأجرين Multi-tenant، أي أن نفس التطبيق يخدم Stack Overflow وكل مواقع Stack Exchange، ويعرف الموقع المطلوب من اسم النطاق، وكتب Craver أنهم يستطيعون تشغيل الشبكة كلها من Application Pool واحد على سيرفر واحد. أما تطبيقات Careers وAPI v2 وواجهة تطبيقات الجوال فهي تطبيقات منفصلة.
- البيانات: من طبقة الويب يذهب الطلب إلى Redis للتخزين المؤقت، وإلى SQL Server لما ليس في الذاكرة، وإلى Tag Engine لصفحات الوسوم، وإلى Elasticsearch للبحث، وكل واحد منها نشرحه فيما يلي.
طبقة الخدمات Service Tier وTag Engine: خلف سيرفرات الويب ثلاثة سيرفرات للخدمات الداخلية، أهمها Stack Server الذي يشغل محرك الوسوم Tag Engine مباشرة فوق http.sys وليس خلف IIS. وعندما تفتح صفحة مثل /questions/tagged/java فإن هذا المحرك هو الذي يحدد الأسئلة المطابقة، وهو يحمل المنشورات ووسومها التي تغيرت من قاعدة البيانات كل دقيقتين. والسبب في وضعه على ثلاثة سيرفرات بدل تسعة أن هذا التحميل ليس رخيصاً، والفريق لا يريد أن يتكرر تسع مرات على طبقة الويب، وثلاث نسخ تكفي للأمان.
ال Websockets: الإشعارات وعدد الأصوات والأجوبة والتعليقات الجديدة تصل إلى المتصفح لحظياً عبر Websockets يخدمها تطبيق صغير على سيرفرات الويب نفسها مبني على مكتبتهم المفتوحة NetGain، وكان عدد الاتصالات المفتوحة في الذروة حوالي 500 ألف اتصال. واختاروا Websockets لأنها في حجمهم أوفر بكثير من أن يسأل المتصفح كل بضع ثوان Polling، مع أن لها مشكلاتها، وذكر Craver منها نفاد المنافذ المؤقتة Ephemeral Ports ومقابض الملفات File Handles على موزع الحمل.
البحث Elasticsearch: عنقود من ثلاثة سيرفرات في كل مركز بيانات بإصدار Elasticsearch 1.4، لكل موقع فهرس Index خاص، ويستخدم للبحث وللأسئلة المشابهة وللاقتراحات عند كتابة سؤال جديد. والفهرسة تتم بحيلة بسيطة: عمود ROWVERSION في SQL Server يتصرف مثل رقم متسلسل، فيقارنه المفهرس بآخر موضع حفظه ويفهرس ما تغير بعده فقط. وقد يتساءل البعض: لماذا لم يستخدموا البحث النصي داخل SQL Server نفسه؟ والإجابة كما كتبها Craver أن المعالجات في سيرفرات SQL Server غالية جداً مقارنة بغيرها، وأن Elasticsearch أرخص وفيه ميزات أكثر، فالقرار قرار توزيع للمال قبل أن يكون قراراً تقنياً.
قاعدة البيانات SQL Server: مصدر الحقيقة الوحيد Single Source of Truth، وكل ما في Redis وElasticsearch يأتي منه. وكانت هناك مجموعتان Clusters بتقنية AlwaysOn Availability Groups، في كل مجموعة سيرفر رئيسي يحمل أغلب الحمل ونسخة Replica في نيويورك ونسخة ثالثة في Colorado، وكل النسخ غير متزامنة Asynchronous. المجموعة الأولى لقاعدة Stack Overflow وقاعدة Sites المركزية التي فيها قائمة كل المواقع، على سيرفرات بذاكرة 384 GB، والثانية لبقية مواقع الشبكة والدردشة وغيرها على سيرفرات بذاكرة 768 GB. والتعامل مع القاعدة بسيط عن قصد: الكود الجديد يستخدم Dapper، وهي مكتبة Micro-ORM مفتوحة المصدر كتبها الفريق نفسه، ولم يكن في قاعدة Stack Overflow إلا إجراء مخزن Stored Procedure واحد يريد Craver نقله إلى الكود. وإذا أردت أن تفهم كيف تختار بين النسخ المتزامن وغير المتزامن وما ثمن كل منهما، فقد شرحنا ذلك في الأنظمة الموزعة للمبتدئين.
التخزين المؤقت على طبقتين L1 وL2
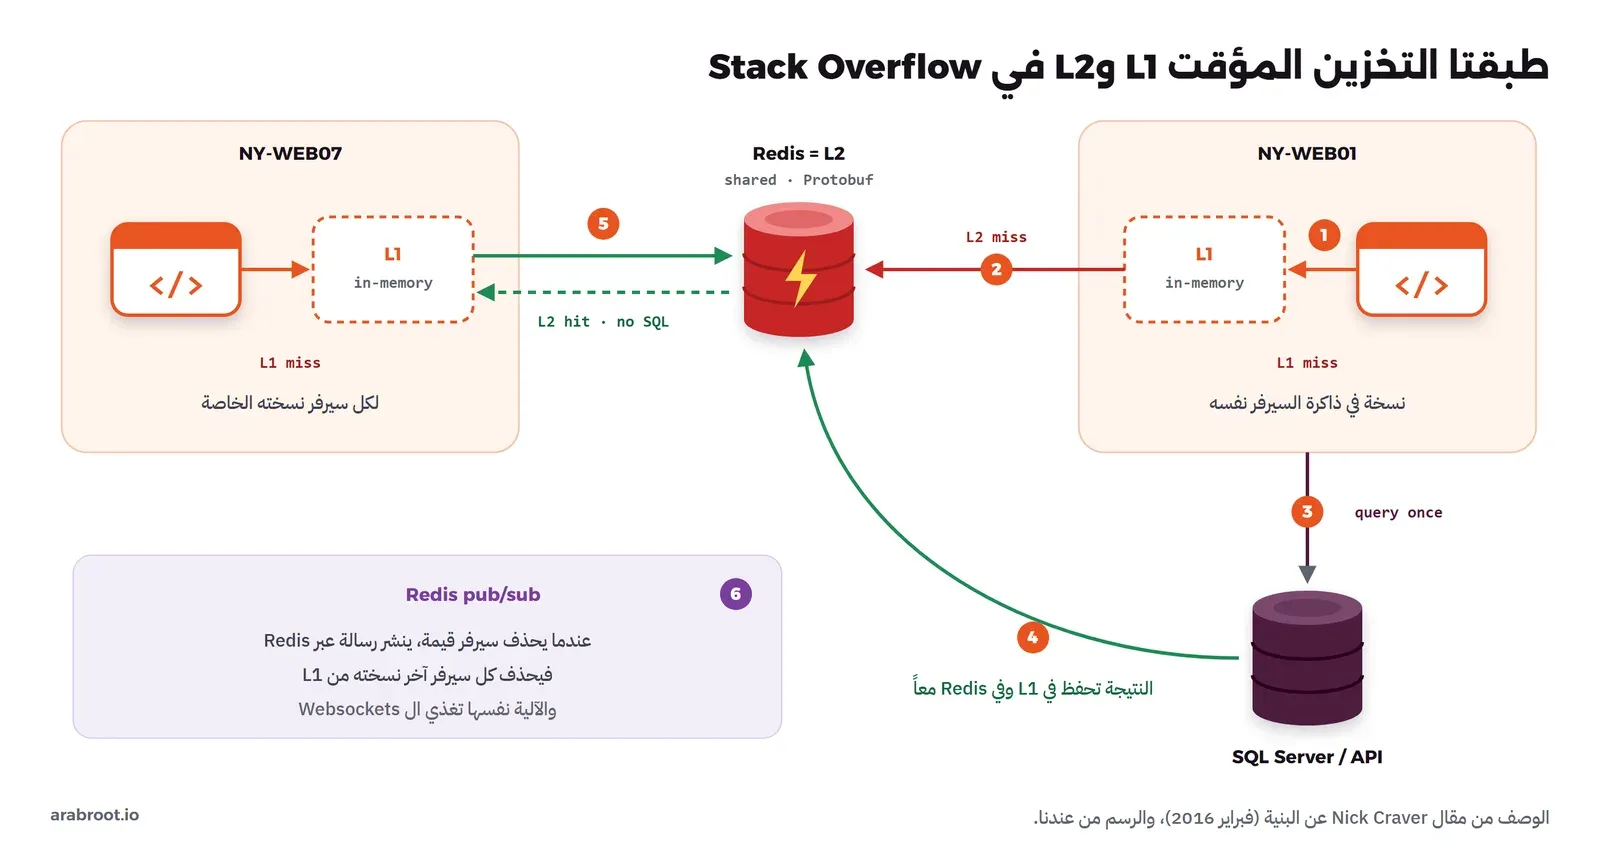
أكثر من خمسة مليارات قراءة من Redis في يوم واحد، مقابل نصف مليار استعلام SQL، وهذا الفرق هو سر الأرقام الصغيرة في عدد السيرفرات. والصورة التالية تبين نظام التخزين المؤقت بطبقتين كما وصفه مقال البنية:
وفي الصورة أعلاه لاحظ التالي:
- الطبقة الأولى L1 هي التخزين المؤقت في ذاكرة التطبيق على كل سيرفر، والطبقة الثانية L2 هي Redis المشترك بين كل السيرفرات، والقيم تحفظ فيه بصيغة Protobuf عبر مكتبتهم المفتوحة StackExchange.Redis.
- عندما لا يجد السيرفر القيمة في الطبقتين، يجلبها من مصدرها (استعلام SQL أو استدعاء API) ويحفظها في الطبقتين، فالسيرفر التالي قد لا يجدها في ذاكرته، لكنه يجدها في Redis ويوفر الاستعلام.
- لأن التطبيق يخدم عشرات المواقع، فلكل موقع مساحته الخاصة: ببادئة في اسم المفتاح Key Prefix في L1، وبرقم قاعدة بيانات مستقل في Redis.
- عندما يحذف سيرفر قيمة، ينشر رسالة عبر خاصية النشر والاشتراك Pub/Sub في Redis، فيحذف كل سيرفر آخر نسخته من L1، وهذا يبقي النسخ متطابقة، ونفس الآلية تغذي ال Websockets.
- سيرفرا Redis الرئيسيان (رئيسي وتابع) كان لكل منهما 256 GB من الذاكرة يستخدم منها حوالي 90 GB، ورغم حوالي 160 مليار عملية في الشهر كان كل منهما تحت 2% من المعالج.
وهذا هو نمط Cache-Aside الذي شرحناه في مقال المدخل، مع إضافة طبقة في ذاكرة كل سيرفر أمامه، وثمن هذه الطبقة أنك تحتاج طريقة لإبطال Invalidation النسخ المحلية على كل السيرفرات، وهو ما حلوه بال Pub/Sub. ولاحظ أن الملفات الثابتة مثل CSS وJavaScript لها قصة أخرى نذكرها في قسم النشر. وفي 2019 كتب Craver مقالاً كاملاً عن التخزين المؤقت لمن يريد التفاصيل.
لماذا بقي التطبيق تطبيقاً واحداً؟
لاحظ في كل ما سبق أنه لا توجد خدمات مصغرة Microservices بالمعنى الشائع، فتطبيق Q&A واحد يخدم كل المواقع، وبجانبه تطبيقات قليلة منفصلة لها سبب واضح: Careers منتج مختلف، وال API لها عملاء مختلفون، وTag Engine عمل ثقيل أخرجوه إلى ثلاثة سيرفرات حتى لا يتكرر تسع مرات. ولم يخرجوا أي جزء إلى خدمة مستقلة إلا عندما ظهر سبب يقاس، مثل تكلفة تحميل الوسوم، أو تكلفة معالجات SQL Server في البحث. وهذا يتفق مع ما ذكرناه في مقال المدخل من أن الخدمات المصغرة لها ثمن كبير لا يحتاجه أغلب الفرق.
لكن للقصة جانباً آخر يجب أن تعرفه قبل أن تقلدها: في 2025 كتب فريق Stack Overflow نفسه أن التحسينات التي عصروا بها كل قطرة أداء من سيرفراتهم صارت تقف في طريق ممارسات أحدث أرادوا تبنيها، مثل الخدمات المستقلة واستقلال الفرق، وسوف نرى ذلك بالتفصيل في قسم ما تغير بعد 2016.
القياس في كل طبقة
الفريق الذي يسأل «هل نحتاج سيرفراً أكبر؟» يحتاج قبل ذلك أن يعرف أين يذهب الوقت، لذلك بنى فريق Stack Overflow أدوات قياس ونشر أغلبها مفتوح المصدر، وهي مذكورة في قائمة المكتبات في مقال البنية:
- MiniProfiler: أداة قياس خفيفة تعمل على كل صفحة، وتبين للمطور أين ذهب وقت الطلب بين الكود والاستعلامات.
- Opserver: لوحة مراقبة تسأل أغلب الأنظمة مباشرة (HAProxy وSQL Server وRedis وغيرها)، ومنها أخذ Craver صور الحمل في مقاله.
- Bosun: نظام مراقبة وتنبيه للخلفية مكتوب بلغة Go.
- Exceptional: مسجل أخطاء Error Logger يحفظ الاستثناءات في SQL أو JSON أو غيرهما.
وبجانب الأدوات كانت هناك بيانات: كل طلب يمر على HAProxy كان يسجل في قاعدة SQL Server خاصة مع بعض الحقول المهمة فقط (الرابط والاستعلام والمتصفح وأزمنة SQL وRedis)، في جدول بفهرس Clustered Columnstore لكل يوم، ويستخدمونها لتتبع مشكلات المستخدمين واكتشاف شبكات البوتات Botnets. وسجلات الأجهزة والأنظمة تذهب إلى عنقود Logstash سعته الخام 288 TB، ويستخدمه Bosun ليضيف معلومات إلى التنبيهات. ولاحظ أن كل هذا القياس هو الذي سمح لهم بأن يقولوا بثقة إن سيرفراً واحداً يكفي، لأنهم يعرفون استهلاك كل طبقة بالأرقام. وفي 2018 كتب Craver مقالاً كاملاً عن المراقبة لمن يريد التعمق.
العتاد: كل سيرفر يختار لعمله
مقال العتاد يبدأ بملاحظة مهمة: مركز البيانات الذي يسمونه نيويورك هو في الحقيقة مركز QTS في New Jersey، وبقي الاسم لأنهم لا يريدون تغيير أسماء كل السيرفرات التي تبدأ بـ NY. والأهم من المكان هو طريقة الشراء: الفريق لا يشتري سيرفرات بالجملة ثم يوزع عليها المهام، وإنما يحدد مواصفات كل سيرفر حسب ما سوف يعمل عليه، بالتعاون مع المطورين الذين يعرفون حمل التطبيق. وقائمة الأسئلة التي كتبها Craver تستحق أن تنسخها لنفسك: هل المشكلة توسع عمودي أم أفقي؟ كم احتياطاً نريد؟ هل يكتب التطبيق على القرص، وكم، وهل نحتاج أقراص SSD؟ كم ذاكرة يحتاج، وكم يستطيع أن يستخدم؟ هل الحمل متوازي فنريد أنوية كثيرة، أم يعتمد على سرعة النواة الواحدة؟ هل نحتاج سيرفراً مقابلاً في مركز التعافي؟
والجدول التالي يلخص السيرفرات التي كانت تخدم المواقع في مارس 2016، وكلها من Dell:
| الدور | العدد | المعالج والذاكرة | التخزين |
|---|---|---|---|
| SQL Server (مجموعة Stack Overflow) | 2 | معالجان بـ 12 نواة لكل منهما، و384 GB | NVMe بسعة 4 TB وأقراص SSD |
| SQL Server (بقية الشبكة) | 2 | معالجان بـ 8 أنوية لكل منهما، و768 GB | ثلاثة أقراص NVMe بسعة 2 TB وأقراص HDD |
| سيرفرات الويب | 11 | معالجان بـ 12 نواة لكل منهما، و64 GB | قرصا SSD |
| طبقة الخدمات | 3 | معالجان بـ 6 أنوية، و64 GB (وواحد أقدم بـ 32 GB) | قرصا SSD |
| Redis | 2 | معالجان بـ 10 أنوية، و256 GB | قرصا SSD |
| Elasticsearch | 3 | معالجان بـ 8 أنوية، و192 GB | قرصا SSD |
| HAProxy | 4 | اثنان بذاكرة 192 GB لحركة CloudFlare، واثنان بـ 64 GB للحركة المباشرة | أقراص HDD للسجلات |
وفي الجدول أعلاه لاحظ أن الذاكرة هي العنصر الذي لم يبخلوا فيه أبداً: سيرفر SQL Server بذاكرة 768 GB يستطيع أن يحفظ أغلب البيانات التي يحتاجها في الذاكرة، فيرجع إلى القرص قليلاً، وموزع الحمل بذاكرة كبيرة يحفظ جلسات TLS، وكتب Craver في هذا أن الذاكرة رخيصة نسبياً فالقرار سهل. وكل سيرفر متصل بشبكة 10 Gbps عبر وصلتين على الأقل، وفي الشبكة جداران ناريان Firewalls من Fortinet ومحولات Cisco Nexus.
وقد يتساءل البعض: لماذا يملكون العتاد بدل أن يستأجروه من مزود سحابي؟ والإجابة الصادقة أن Craver كتب في مقدمة مقال العتاد أن امتلاك العتاد يعطيهم مزايا لا يجدونها على سيرفرات غيرهم، وأن له في نفس الوقت تكاليف مباشرة وغير مباشرة، ووعد بمقارنة مفصلة لاحقاً لم تكن ضمن هذه السلسلة، فلن ننسب إليه أرقام تكلفة لم يكتبها. لكن هناك قرارين قريبين شرح سببهما بوضوح:
- Git داخل الشبكة: كانوا يستضيفون مستودعاتهم على GitLab داخل مركز البيانات وليس على GitHub، والسبب سلسلة الاعتماد Dependency Chain: البناء يحتاج الكود، وإذا كان الكود عند طرف خارجي فأنت تعتمد على أن يكون ذلك الطرف يعمل وأن يكون الطريق إليه سليماً، بينما السحب عبر وصلتين 10 Gbps داخل الشبكة أسرع، وفيه أيضاً اعتبار أمني: ما لا يحتاج أن يخرج من شبكتك فالأفضل ألا يخرج.
- بعد المسافة: في 2017 كتب Craver في مقال الانتقال إلى HTTPS أن الكفاءة في عدد السيرفرات صارت مشكلة عندما يتعلق الأمر بزمن الوصول Latency، لأن الموقع يعمل من مركز واحد نشط، فكلما ابتعد الزائر عن نيويورك أو Denver صارت تجربته أبطأ، واعترف بأن هذه نقطة تفوز فيها السحابة، وكان حلهم وضع CloudFlare ثم Fastly أمام الموقع. وقد شرحنا كيف تقرب شبكة توصيل المحتوى الموقع من الزائر في شرح CDN للمبتدئين.
مركزا بيانات وكل شيء له نسختان
في بداية مقال البنية وضع Craver قواعد عامة تنطبق على كل شيء، والصورة التالية تبينها:
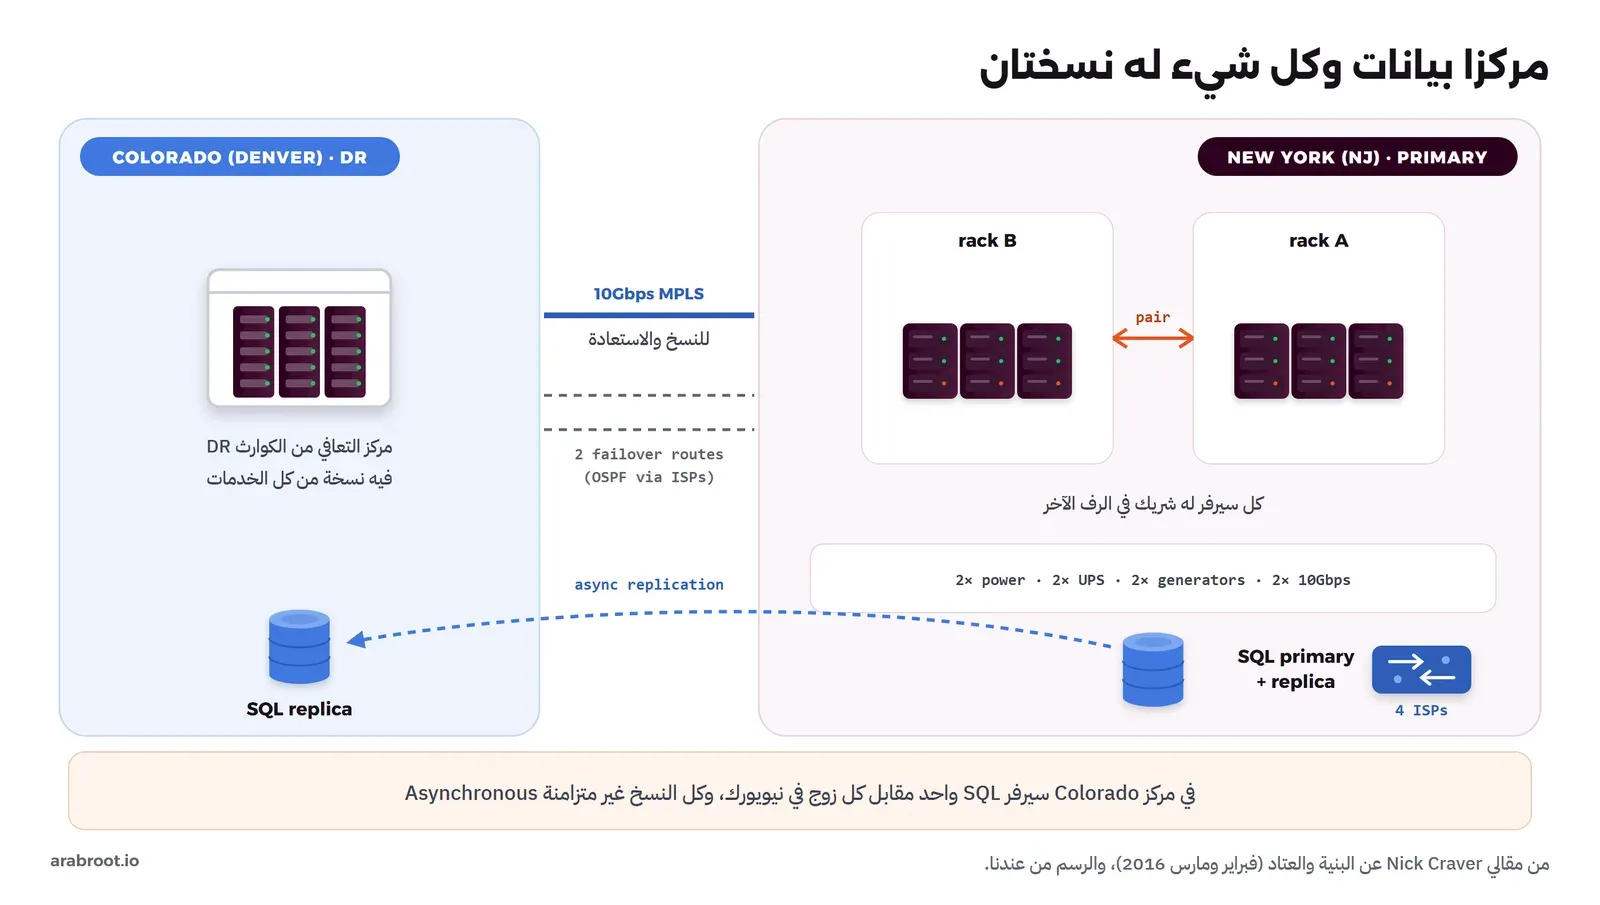
وفي الصورة أعلاه لاحظ التالي:
- كل سيرفر وجهاز شبكة متصل بوصلتين 10 Gbps على الأقل، وله مصدرا كهرباء من وحدتي UPS خلفهما مولدان وخطا كهرباء من الشبكة العامة.
- كل سيرفر له شريك في الرف الآخر (rack A وrack B)، فتعطل رف كامل لا يوقف الخدمة.
- كل الخدمات لها نسخة في مركز ثان في Colorado (في Denver) للتعافي من الكوارث Disaster Recovery، وفيه سيرفر SQL Server واحد مقابل كل زوج في نيويورك كما يذكر مقال العتاد.
- بين المركزين خط MPLS بسرعة 10 Gbps لنسخ البيانات والاستعادة السريعة، ولأن الخط الواحد نقطة فشل واحدة Single Point of Failure فهناك طريقان احتياطيان عبر مزودي الإنترنت بتوجيه OSPF.
ولاحظ أن النسخ إلى Colorado غير متزامن، وهذا يعني أن آخر الكتابات قد لا تكون وصلت إلى هناك لحظة الكارثة، وهذا ثمن يقبله أغلب الناس مقابل ألا تنتظر كل كتابة وصولها عبر الشبكة إلى مركز بعيد، وقد شرحنا هذا الاختيار وتأخر النسخ Replication Lag في الأنظمة الموزعة للمبتدئين.
النشر: من commit إلى الإنتاج Production في دقائق
في مقال النشر ذكر Craver أن تطبيق Q&A وحده كان ينشر حوالي 25 مرة يومياً إلى بيئة التطوير، ومن 5 إلى 10 مرات في اليوم العادي إلى الإنتاج، وأن حوالي 15 شخصاً يدفعون إلى هذا المستودع، وأن الطريق من أول push إلى النشر الكامل أقل من تسع دقائق: دقيقتان و15 ثانية للتطوير، ودقيقتان و40 ثانية لموقعي meta، و3 دقائق و20 ثانية لكل المواقع. والصورة التالية تبين هذا الطريق:
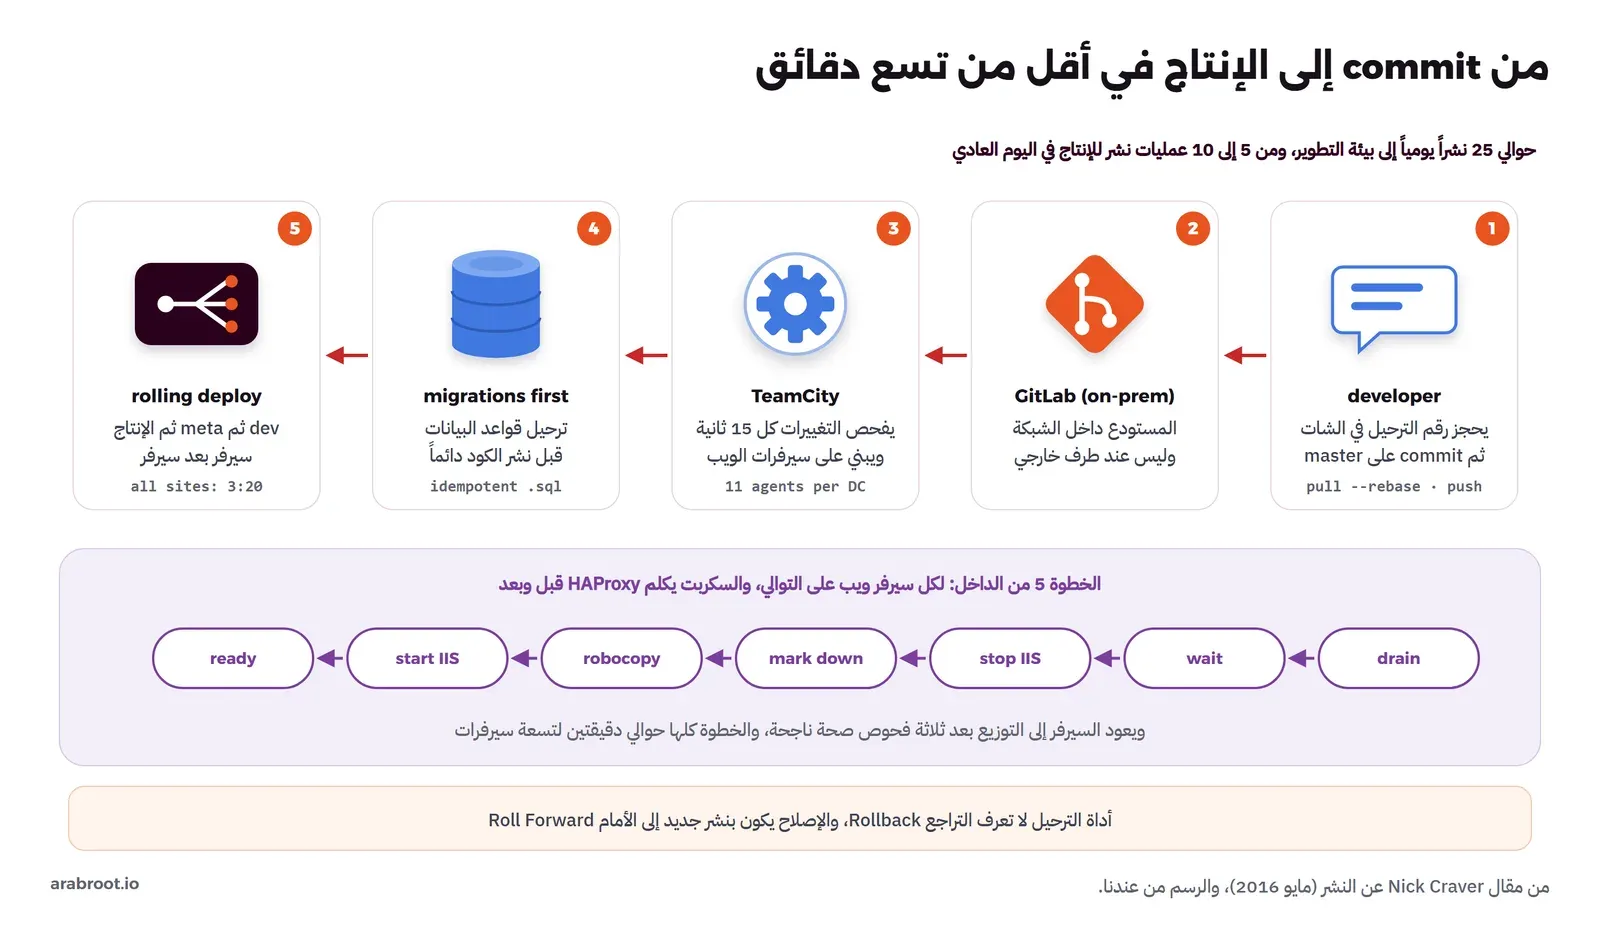
وفي الصورة أعلاه لاحظ التالي:
- رقم الترحيل في الشات: إذا كان التغيير يحتاج ترحيلاً لقاعدة البيانات Migration، يكتب المطور في غرفة الدردشة أنه أخذ الرقم التالي (مثلاً 727) فيثبت بوت Pinbot الرسالة، حتى لا يأخذ زميلان نفس الرقم. ثم يجرب الترحيل محلياً بنفس الأداة التي تعمل في الإنتاج، ثم
git commitوgit pull --rebaseوgit push. - الفرع الرئيسي: أغلب الالتزامات تذهب مباشرة إلى master وتنشر بعد قليل، والفروع قليلة ولها أسباب محددة: مطور جديد يحتاج مراجعة، أو ميزة كبيرة أو خطرة، أو عدة مطورين على ميزة واحدة، وعند دمج الفرع يضغطون التزاماته Squash حتى يكون التراجع عنه سهلاً. ويقول Craver صراحة إنه لا يوصي بهذه الطريقة لكل الفرق، وإنها تناسبهم هم.
- البناء: TeamCity على نفس الآلة الافتراضية مع GitLab، يسأل المستودع عن التغييرات كل 15 ثانية، ووكلاء البناء Build Agents يعملون على سيرفرات الويب نفسها لأن فيها قدرة فائضة، فيكون هناك 11 وكيلاً في كل مركز. ولاحظ أن خطوات البناء التسع التي نشرها لا تذكر خطوة اختبارات آلية مستقلة، والمقال لا يتحدث عن الاختبارات، لذلك لن نستنتج عنها شيئاً.
- الترحيل قبل الكود: قواعد البيانات ترحل دائماً قبل نشر الكود، وبناء meta هو الذي يرحل كل قواعد الإنتاج، فتصل التغييرات إلى قاعدة Stack Overflow قبل الكود الجديد بدقائق.
- البيئات: ثلاث طبقات: التطوير على WEB10 وWEB11، ثم meta على نفس السيرفرين، ثم الإنتاج على WEB01 إلى WEB09، ومع كل طبقة رسالة في الدردشة.
أما النشر على السيرفر نفسه فهو سكربت PowerShell بسيط عن قصد، والفكرة أن تحديث موقع على سيرفر يحتاج ثلاثة أشياء فقط: إيقاف الموقع، ونسخ الملفات، وتشغيله، مع إخبار موزع الحمل قبل وبعد. فلكل سيرفر على التوالي: يطلب السكربت من HAProxy أن يوقف الطلبات الجديدة Drain، وينتظر ثوان حتى تنتهي الطلبات الجارية، ويوقف الموقع في IIS، ويخبر HAProxy أن السيرفر متوقف، وينسخ الملفات بـ robocopy، ويشغل الموقع، ثم يخبر HAProxy أنه جاهز. ولاحظ هنا تفصيلاً مهماً: HAProxy لا يعيد السيرفر إلى التوزيع فوراً، وإنما بعد ثلاثة فحوص صحة ناجحة، والسبب أن إعادته فوراً قبل أن يسخن التطبيق تجعل الطلبات تنهال عليه دفعة واحدة. والخطوة كلها تأخذ حوالي دقيقتين لتسعة سيرفرات، ويكون في الغالب سبعة من تسعة في الخدمة أثناءها.
وفي نفس الخطوة مشكلة لطيفة مع الملفات الثابتة: هذه الملفات تحفظ في المتصفح سبعة أيام، ورابطها يحمل هاش محتواها فيتغير عندما يتغير الملف فقط، وهي تقدم من نطاق مستقل بلا كوكيز Cookieless هو sstatic.net خلفه سيرفرات الويب نفسها. فإذا وصل الزائر إلى سيرفر محدث أعطاه رابطاً بالهاش الجديد، ثم وصل طلب الملف إلى سيرفر لم يحدث بعد، فإن ال CDN تحفظ المحتوى القديم تحت الرابط الجديد لأيام. والحل كان أن ينشروا الملفات الثابتة أولاً إلى موقع IIS مستقل يخدم ال CDN، ثم ينشروا الكود الذي يصدر الروابط الجديدة. وقد شرحنا فكرة تغيير اسم الملف بدل انتظار انتهاء صلاحيته في شرح CDN.
ترحيل قواعد البيانات دون توقف
أداة الترحيل عندهم بسيطة جداً: تقرأ قائمة قواعد البيانات من قاعدة Sites، وتنفذ ملفات sql المرقمة على كل القواعد بالتوازي، وفي كل قاعدة جدول Migrations يحفظ ما نفذ مع هاش محتوى الملف، فإذا تغير ملف نفذ من قبل توقفت الأداة احتياطاً. وكل ترحيل مكتوب بحيث يكون آمناً عند التكرار Idempotent، مثل «أضف العمود إذا لم يكن موجوداً». والقواعد التي يتبعونها حتى لا يكسر الترحيل النسخة التي تعمل:
- لإضافة عمود: يضاف قابلاً للفراغ Nullable أو غير مستخدم في الكود، وإذا احتاج أن يكون إلزامياً أو مفتاحاً أجنبياً فذلك في نشر لاحق.
- لحذف عمود: يحذف من الكود أولاً، ثم ينشر، ثم يحذف من القاعدة في نشر آخر.
- لا تغيير لاسم جدول أو عمود في الإنتاج، والسبب أن تغيير الاسم والكود القديم يعمل يكاد يضمن عطلاً.
- لتغيير API: تضاف النقطة الجديدة أولاً، ثم ينقل المستخدمون إليها، ثم تحذف القديمة، أي ثلاث عمليات نشر.
- التراجع Rollback: كتب Craver أنه لا يتذكر أنهم تراجعوا عن ترحيل أبداً، والأداة لا تعرف التراجع أصلاً، وإذا أخطؤوا كتبوا ترحيلاً جديداً يصلح الخطأ، أي أنهم يصلحون إلى الأمام Roll Forward.
وهذا هو نفس نمط التوسيع ثم التقليص Expand and Contract الذي شرحناه في تصميم قواعد البيانات وفي البيئات وGitOps، وطريقة العمل على الفرع الرئيسي بالتزامات صغيرة متكررة شرحناها في التطوير على الفرع الرئيسي Trunk-Based، والأمرين git pull --rebase والدمج مع الضغط في Merge وRebase وCherry-pick.
ما الذي تغير بعد 2016؟
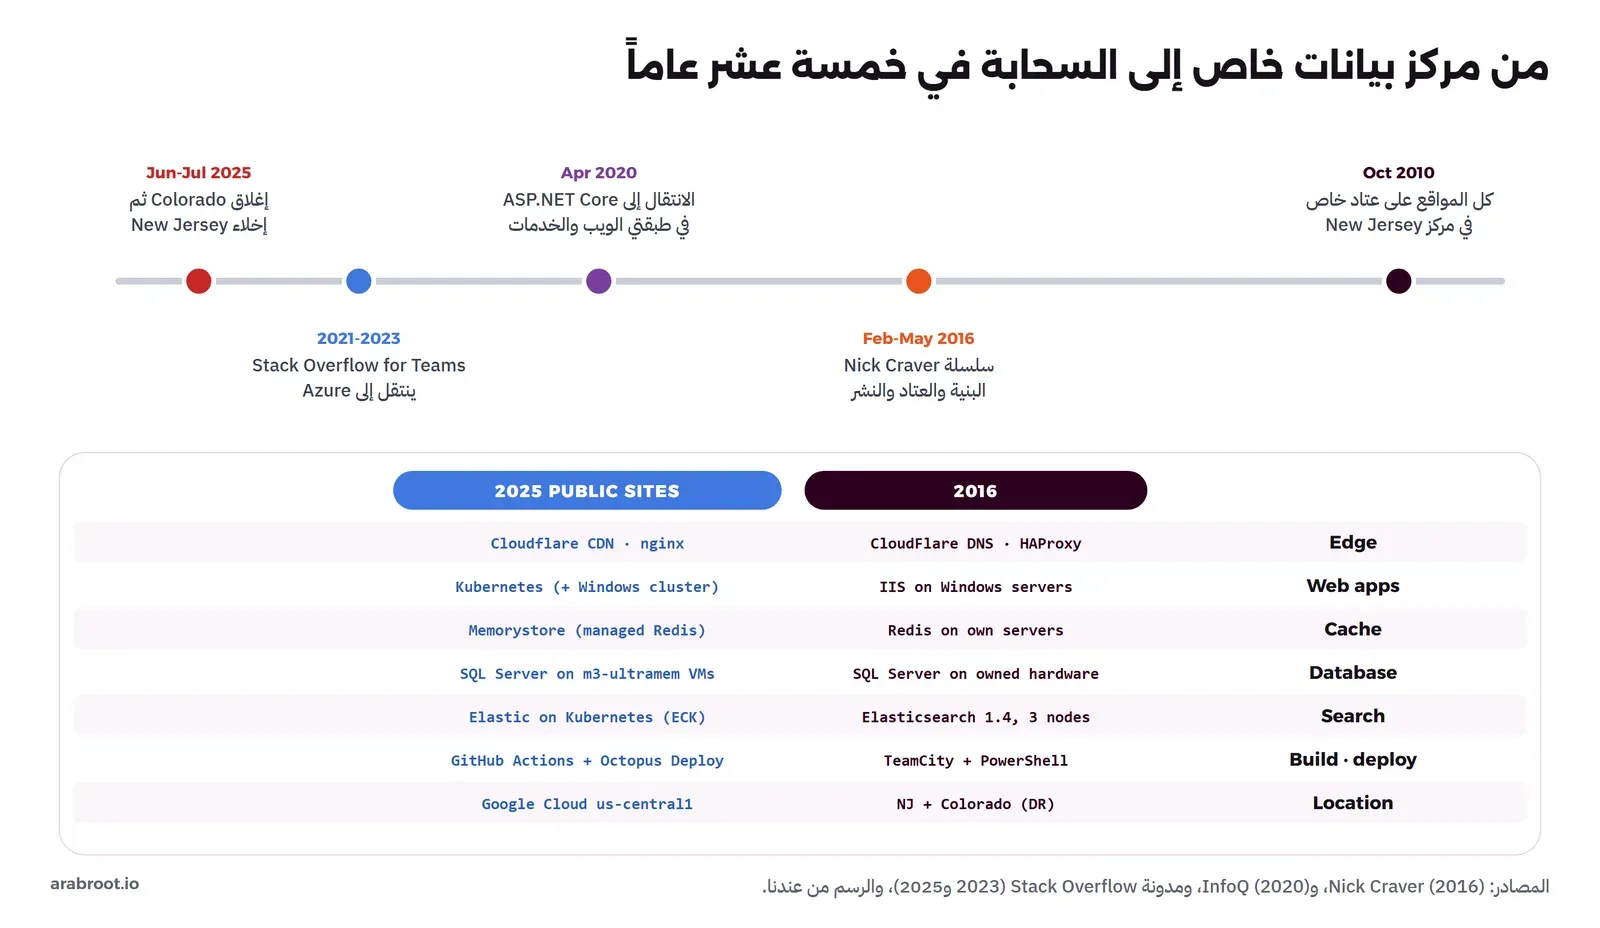
القصة لم تتوقف عند مقالات 2016، والصورة التالية تبين أهم المحطات بعدها، ومقارنة بين مكونات 2016 ومكونات المواقع العامة في 2025:
من .NET Framework إلى ASP.NET Core
في أبريل 2020 نشر موقع InfoQ حواراً مع Nick Craver بصفته قائد البنية في عملية الانتقال، وذكر فيه أن Stack Overflow أكمل نقل بنيته من .NET Framework إلى .NET Core، وأن طبقتي الويب والخدمات انتقلتا من ASP.NET MVC إلى ASP.NET Core، وقال Craver إن القرار اتخذ قبل ذلك بسنوات، فبدؤوا بجعل مكتباتهم المفتوحة (Dapper وMiniProfiler وStackExchange.Redis) متوافقة قبل أي تطبيق يعتمد عليها، ثم صار الانتقال المشروع الرئيسي لفريقه بعد إطلاق Stack Overflow for Teams، واستغرق ما بين سنة ونصف وسنتين من عمل المطورين Dev Person Years. وفي أغسطس 2025 كتب الفريق أن كل تطبيقات Teams صارت على إصدار حديث من .NET، لكن بقيت في المنصة العامة تطبيقات أقدم على .NET Framework لم يكن هناك وقت لترقيتها قبل موعد الانتقال إلى السحابة، فشغلوها على عنقود Kubernetes بعقد Windows.
Stack Overflow for Teams ينتقل إلى Azure
Stack Overflow for Teams منتج SaaS خاص للشركات، وبدأ حياته جزءاً من stackoverflow.com على نفس العتاد. وفي أغسطس 2023 كتب الفريق في الجزء الأول من قصة الانتقال أسباب نقله إلى Azure: عندما كبر هذا المنتج لم يعد تشغيل كل شيء على عدد ثابت من الأجهزة ممكناً، وهم لا يريدون أن يذهب المهندسون إلى مركز البيانات لإصلاح العتاد وتحديثه، والسحابة تسهل شهادات الامتثال مثل SOC 2، وتسمح بإنشاء بيئات مؤقتة Ephemeral Environments للاختبار. وفي القصة درس مهم: خطتهم الأولى كانت نقل فئة Business وحدها، وبعد حوالي سنة من العمل وجدوا أن تقسيم المنتج بين مكانين يكسر تسجيل الدخول والتكاملات مع Slack وJira وMicrosoft Teams، فغيروا الخطة إلى نقل كل العملاء معاً على مراحل صغيرة يمكن التراجع عنها.
وفي الجزء الثاني ذكروا أنهم فصلوا Teams عن بنية المواقع العامة في 11 مارس 2023 بخطة من 27 خطوة جربوها قبل اليوم الحقيقي، ثم نقلوا البيئة إلى Azure كما هي Lift and Shift على آلات Windows افتراضية، لأنهم لا يريدون تغيير البنية والتطبيق في نفس الوقت، وأن تحويل قاعدة البيانات إلى Azure تعثر بسبب زمن الشبكة حتى أجبروا العقد في Azure على أن تصبح رئيسية. والانتقال كله استغرق حوالي سنتين. ولاحظ في هذا الجزء أيضاً أنهم كانوا وقتها يستخدمون Fastly وHAProxy أمام الموقع في مركز البيانات، أي أن CloudFlare التي رأيناها في 2016 لم تعد وحدها في الصورة.
المواقع العامة تغادر مركز البيانات
بقي Stack Overflow نفسه وشبكة Stack Exchange على العتاد الخاص حتى 2025، وكما ذكر الفريق في مقال وداع السيرفرات (نشر أول مرة في يوليو 2025)، فإن كل المواقع كانت تعمل منذ أكتوبر 2010 على عتاد في New Jersey، والفريق هو الذي يدير كل شيء فيه من التركيب إلى تبديل الأقراص المعطلة. ثم قرر مزود مركز البيانات في بداية 2024 إغلاق ذلك الموقع، وصار عليهم الخروج قبل يوليو 2025. وفي يونيو 2025 أغلقوا مركز Colorado لأنه كان للتعافي من الكوارث ولم يعودوا بحاجة إليه، وفي 2 يوليو 2025 فككوا حوالي 50 سيرفراً في New Jersey، وأتلفوا كل الأجهزة حماية للبيانات الشخصية لمستخدميهم.
وفي أغسطس 2025 شرح الفريق في الجزء الأول من قصة نقل المواقع العامة كيف تم ذلك، وأهم ما فيه:
- الموعد: عقد مركز البيانات ينتهي في 31 يوليو 2025 دون إمكانية للتجديد لأن المركز نفسه يغلق، ومع ذلك طلبوا من الفرق مواعيد داخلية أبكر بكثير.
- المكان: النقاشات الأولى افترضت Azure لأن Teams هناك، لكنهم دخلوا في شراكة مع Google Cloud، واختاروا منطقة us-central1 لأنها الوحيدة التي توفر نوع الآلات الذي طلبه فريق قواعد البيانات في منطقتين Zones، وتكون بعيدة عن مناطق Azure التي يستخدمونها.
- قاعدة البيانات: الخدمات المدارة لم تعطهم الأداء الذي يحتاجونه، فشغلوا SQL Server على آلات افتراضية مخصصة، وكانوا يحتاجون حوالي 1.5 TB من الذاكرة لحفظ القاعدة في الذاكرة، فاختاروا آلة m3-ultramem-128 بـ 128 معالجاً افتراضياً و3.9 TB من الذاكرة، وعطلوا نصف الأنوية لتوفير تكلفة الرخص.
- التخزين المؤقت والبحث: Redis صار خدمة Memorystore المدارة، ولأن لها حداً لعدد قواعد البيانات غيروا التطبيق من قاعدة Redis لكل موقع إلى بادئة في اسم المفتاح، أما Elasticsearch فشغلوه بأنفسهم على Kubernetes بأداة Elastic Cloud on Kubernetes.
- التطبيقات والنشر: كل الخدمات على Kubernetes، وأمامها Cloudflare وnginx، والبنية تبنى بـ Terraform، والبناء انتقل من TeamCity إلى GitHub Actions، والنشر عبر Octopus Deploy، والسجلات التي كانت تأتي من HAProxy صارت تحلل في Snowflake.
- الصعوبة الحقيقية: التطبيق كان يعرف البنية التي يعمل عليها، من أسماء السيرفرات إلى زمن الاستجابة، وكتبوا أن أي رد يتجاوز 30 ميلي ثانية كان يمكن أن يسبب مشكلات خطيرة للموقع كله، لذلك بدؤوا باختبارات الحمل Load Testing على السحابة، وأصلحوا مشكلات أداء لم تكن ظاهرة في مركز البيانات حتى صار ما يتحمله النظام الجديد أعلى بكثير مما كان يأتيهم.
- بيئات الاختبار: في مركز البيانات كانت بيئات الاختبار مختلفة كثيراً عن الإنتاج بسبب حدود العتاد، فكانت النتائج غير متسقة وكانوا يختبرون في الإنتاج وتحدث أعطال، وفي السحابة صار إنشاء بيئة مطابقة ممكناً بالكود.
- ما تعلموه من Teams: مشروع بهذا الحجم يحتاج فريقاً متفرغاً من البداية، وخطوات صغيرة بدل التحويل الكبير دفعة واحدة Big Bang.
وقد يتساءل البعض: هل هذا يعني أن قرار 2016 كان خطأ؟ والإجابة بحسب ما كتبه الفريق نفسه أن السؤال تغير وليس الجواب القديم: في 2016 كان هناك منتج رئيسي واحد وفريق يعرف عتاده جيداً ويقيس كل شيء، فكان العتاد المملوك والتطبيق الواحد المحسن خياراً ممتازاً. ثم جاء منتج SaaS للشركات يحتاج توسعاً مرناً وشهادات امتثال، وصار الفريق يريد خدمات مستقلة وفرقاً مستقلة، وجاء قرار مزود مركز البيانات بالإغلاق فوضع موعداً لا يمكن تأجيله. والتحسينات التي جعلت الموقع سريعاً على عتاد يعرفونه هي نفسها التي جعلت الانتقال صعباً، لأن التطبيق كان مبنياً على افتراضات ذلك العتاد.
الدروس التي تأخذها لمشروعك
الهدف من هذه القصة ليس أن تشتري سيرفرات Dell وتثبت SQL Server، وإنما أن ترى كيف يفكر فريق يعرف ماذا يفعل، والدروس التالية مربوطة بالحقائق التي رأيناها:
- قس قبل أن تغير: الفريق كان يعرف أن سيرفر ويب واحداً يكفي لأنه يقيس كل طلب في HAProxy ويرى وقت كل صفحة في MiniProfiler، ويعرف أن Redis تحت 2% من المعالج. وأنت لست بحاجة إلى أدواتهم بالضبط، لكنك تحتاج أن تعرف أين يذهب وقت طلبك قبل أن تضيف سيرفراً أو أداة، وقد شرحنا ذلك في قس قبل أن تغير وفي تتبع الطلب البطيء.
- خزن مؤقتاً بكثافة ولكن بخطة: عشرة أضعاف القراءات من Redis مقارنة بالاستعلامات، لكن مع مفاتيح لكل موقع، وإبطال عبر Pub/Sub، وقاعدة واضحة عند تغير شكل القيمة: مفتاح جديد أو صيغة متوافقة. فلا تضع شيئاً في ال Cache دون أن تعرف متى وكيف يحذف.
- تطبيق واحد محسن على سيرفرات قوية قليلة يصل بعيداً: أكثر من 209 ملايين طلب يومياً بتطبيق Q&A واحد، والخدمات المنفصلة أخرجت فقط عندما ظهر سبب يقاس. فابدأ بتطبيق واحد، وأخرج الجزء الذي يثبت القياس أنه يحتاج ذلك.
- اختر العتاد لعمله: الذاكرة الكبيرة لقاعدة البيانات، والأنوية السريعة حيث يكون الحمل متسلسلاً، و SSD حيث يكتب التطبيق كثيراً، وهذه الأسئلة نفسها تسألها عندما تختار حجم سيرفر افتراضي عند مزود سحابي.
- البساطة في النشر: سكربت يوقف وينسخ ويشغل ويكلم موزع الحمل، وترحيل قبل الكود، وتغييرات قواعد البيانات على مراحل، ونشر صغير ومتكرر يجعل الإصلاح إلى الأمام أسهل من التراجع.
- استثمر في أدواتك: Dapper وMiniProfiler وOpserver وStackExchange.Redis كلها أدوات بنوها لحاجتهم ثم فتحوا مصدرها، والوقت الذي يصرفه فريق صغير على أدوات القياس والنشر يعود عليه في كل يوم عمل.
- الملكية أو الاستئجار قرار يتغير مع الوقت: نفس الشركة امتلكت عتادها خمسة عشر عاماً ثم انتقلت إلى السحابة، والأسباب التي كتبتها كانت محددة: منتج يحتاج مرونة وامتثالاً، ومهندسون لا تريد أن تصرف وقتهم في مركز البيانات، وعقد لا يتجدد. فاكتب أسباب قرارك اليوم، حتى تعرف متى تغيرت. وإذا كنت تفكر في هذا القرار لمشروعك فقد ناقشناه في متى تصبح الاستضافة الذاتية خياراً استراتيجياً.
- لا تجعل التطبيق يعرف عتاده: أسماء السيرفرات وزمن الاستجابة المتوقع ومكان القاعدة يجب أن تكون إعدادات وليست افتراضات في الكود، والسبب أن هذه الافتراضات هي التي جعلت انتقال 2025 مشروعاً كبيراً كتب الفريق أن الإطلاق فيه كان 80% من العمل.
- فحص الصحة جزء من التصميم: عطل يوليو 2016 لم يكن ليوقف الموقع كله لو كان رابط فحص الصحة مستقلاً عن الصفحة الرئيسية.
متى لا تنطبق عليك هذه الدروس؟
بكل تأكيد ليست كل تفاصيل القصة صالحة لكل فريق، وفيما يلي الحالات التي يجب أن تنتبه فيها:
- إذا لم يكن لديك من يدير العتاد: فريق Stack Overflow كان فيه مهندسون متخصصون في العتاد والشبكات يذهبون إلى مركز البيانات بأنفسهم، فإذا كان فريقك مطورين فقط فسيرفر مستأجر أو مزود سحابي أنسب لك، وقد تعلم Stack Overflow نفسه هذا عندما قرر أن وقت مهندسيه أثمن من صيانة العتاد.
- إذا كان زوارك موزعين على العالم وزمن الوصول مهم لك: مركز واحد نشط يعني أن الزائر البعيد ينتظر أكثر، وCraver نفسه اعترف بذلك، فأنت تحتاج CDN على الأقل.
- إذا كان منتجك SaaS لعملاء يطلبون شهادات امتثال وعزلاً للبيانات: هذا بالضبط ما دفع Teams إلى Azure قبل المواقع العامة.
- إذا كان فريقك كبيراً وفرقه تريد أن تنشر باستقلال: التطبيق الواحد يصبح عائقاً، وهذا ما كتبه الفريق عن ممارساتهم الأحدث.
- العمل المباشر على master: Craver نفسه قال إنه لا يوصي به لأغلب الفرق، وهو يناسب فريقاً صغيراً متمرساً عنده نشر سريع ومراقبة ممتازة، فإذا لم يكن لديك ذلك فابدأ بفروع قصيرة وطلبات دمج كما شرحنا في مقال Trunk-Based.
- الأرقام نفسها: أرقام 2016 تصف عتاد 2016 وكود 2016، فلا تستخدمها لتقدير حاجتك اليوم، وإنما استخدم الطريقة: قس حملك أنت ثم قرر.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- في فبراير 2016 خدم Stack Overflow أكثر من 209 ملايين طلب يومياً بأحد عشر سيرفر ويب وأربعة سيرفرات SQL Server وسيرفرين Redis وعدد قليل غيرها، وكان سيرفر ويب واحد يكفي فعلياً.
- طريق الطلب: DNS عند CloudFlare، ثم HAProxy ينهي TLS، ثم تطبيق Q&A واحد على IIS يخدم كل المواقع، ثم Redis وSQL Server وTag Engine وElasticsearch، وكل مكون له نسخة في الرف الآخر وفي مركز Colorado.
- السر في التخزين المؤقت بطبقتين L1 في ذاكرة كل سيرفر وL2 في Redis مع إبطال عبر Pub/Sub، وفي القياس المستمر لكل طلب بأدوات بنوها وفتحوا مصدرها.
- العتاد كان يختار لعمل كل سيرفر، مع ذاكرة كبيرة لقواعد البيانات، وكل شيء مكرر من الكهرباء إلى الشبكة.
- النشر من commit إلى الإنتاج في أقل من تسع دقائق، مع ترحيل قواعد البيانات قبل الكود، وتغييرات على مراحل، وإصلاح إلى الأمام بدل التراجع.
- بعد 2016 انتقل الكود إلى ASP.NET Core، وانتقل Teams إلى Azure بين 2021 و2023، ثم أغلق مركزا البيانات في 2025 وانتقلت المواقع العامة إلى Google Cloud بسبب انتهاء عقد المركز وتغير حاجات المنتج والفريق.
- الدرس الأهم: القرار الصحيح يعتمد على حجم فريقك ومنتجك ومرحلتك، فقس حملك واكتب أسباب قرارك، وراجعها عندما يتغير السؤال.
وأقرب المقالات إلى هذا الموضوع على الموقع:
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلكيف تعمل شبكة توصيل المحتوى CDN وما الذي تحفظهلماذا يبطؤ موقعك على الزائر البعيد، وكيف تقرب شبكة CDN ملفاتك منه، وكيف تمنعها من حفظ الصفحات الخاصة.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلHAProxy: توزيع الحمل Load Balancing أمام خدماتكعندما يعمل تطبيقك على أكثر من سيرفر، يوزع HAProxy الطلبات بينها ويستبعد المعطل منها تلقائياً مع شهادات HTTPS.
 دليلTrunk-Based Development: فروع قصيرة ودمج يوميلماذا تنفجر الفروع الطويلة يوم الإصدار، وكيف يدمج الفريق عمله في main كل يوم بأمان مع CI وFeature Flags.
 دليلمن الفرع إلى الإنتاج: البيئات وGitOps للفرقكيف يختبر فريقك كل ميزة وحدها ويعرضها على العميل دون أن تصل ميزة غير جاهزة إلى الإنتاج.
سجل التحديثات
- أكتوبر 2026: كتابة المقال من سلسلة Nick Craver (2016) ومقالاته اللاحقة، وحوار InfoQ (2020)، ومدونة Stack Overflow (2023 و2025)، وتقرير عطل يوليو 2016، مع رسم كل الصور من عندنا.


