

إذا فتحت إعلانات الوظائف التقنية اليوم فسوف تجد «مهندس DevOps» و«مهندس SRE» و«مهندس منصة Platform Engineer»، وأحياناً تجد الوصف نفسه تحت الأسماء الثلاثة: Kubernetes وTerraform وخطوط CI/CD والمراقبة والمناوبة. وهذا الخلط ليس في الإعلانات فقط، وإنما في الشركات نفسها، فشركة تغير اسم فريق التشغيل إلى «فريق DevOps» وتظن أنها طبقت DevOps، وأخرى توظف «SRE» ليعمل ما كان يعمله مدير السيرفرات بالضبط.
وفي هندسة المنصات Platform Engineering والمشكلة التي تحلها شرحنا الفكرة الثالثة بالتفصيل مع تجربة عملية، وفي هذا المقال نضع الثلاثة بجانب بعضها: من أين جاء كل مصطلح، وما الذي يعنيه فعلاً، وأين تتداخل، وما شكل الفريق المناسب لحجم شركتك. وسوف نناقش في هذا المقال ما يلي:
- DevOps كثقافة وممارسات، وإطار CALMS.
- هندسة الموثوقية SRE كما يشرحها كتاب Google المجاني: أهداف الخدمة SLO، وميزانية الأخطاء Error Budget بحسابات حقيقية، والعمل اليدوي المتكرر Toil.
- أين تتداخل الثلاثة، وشكل الفرق بحسب حجم الشركة.
- الأنماط الخاطئة: فريق تشغيل بعد تغيير اسمه، وفريق DevOps معزول، ومنصة لم يطلبها أحد.
- مقاييس DORA الخمسة وكيف تعرف أنك تتحسن.
DevOps: ثقافة قبل أن تكون وظيفة
بدأ المصطلح كما يذكر موقع DevOpsDays مع أول مؤتمر بهذا الاسم في مدينة Ghent في بلجيكا سنة 2009، وكان Patrick Debois منظمه الرئيسي، والمشكلة التي اجتمعوا حولها معروفة لكل من عمل في شركة قبل ذلك: فريق التطوير Dev يكتب الكود ويرميه من فوق الجدار إلى فريق التشغيل Ops، والأول يقاس بعدد الميزات والثاني يقاس بثبات النظام، فكل تغيير خطر في نظر Ops وكل تأخير عائق في نظر Dev، والنتيجة نشرات قليلة وكبيرة ومؤلمة.
ولذلك فإن DevOps في أصله ليس أداة ولا وظيفة، وإنما طريقة عمل تجعل من يبني البرنامج ومن يشغله فريقاً واحداً بهدف واحد. وأشهر طريقة لوصفه هي إطار CALMS، وكما تذكر صفحة Atlassian عن الإطار فقد صاغه Jez Humble أحد مؤلفي كتاب The DevOps Handbook، وحروفه خمسة:
- الثقافة Culture: مسؤولية مشتركة عن النظام في الإنتاج، ومراجعة الحوادث بدون لوم Blameless، فالسؤال هو «ما الذي في النظام سمح بالخطأ؟» وليس «من أخطأ؟».
- الأتمتة Automation: البناء والاختبار والنشر بخط آلي لا يعتمد على شخص، كما في Gitea Actions وخط CI/CD آمن من البداية للنهاية.
- التدفق المرن Lean: دفعات صغيرة وتغييرات صغيرة متكررة بدلاً من إصدار كبير كل شهر، وقد شرحنا ذلك في Trunk-Based Development.
- القياس Measurement: أرقام بدلاً من الإحساس، ومنها مقاييس DORA التي سوف نشرحها في آخر المقال.
- المشاركة Sharing: المعرفة والأدوات والتوثيق تتنقل بين الفرق ولا تبقى في رأس شخص واحد.
وقد يتساءل البعض: إذا كان DevOps ثقافة، فماذا يعمل «مهندس DevOps» في الإعلانات؟ والإجابة أنه في الغالب يبني الأتمتة والأدوات المشتركة، أي جزءاً من حرف A وحرف S، وهذا عمل مفيد، ولكن وجوده لا يعني أن الشركة طبقت DevOps إذا بقي المطورون لا يعرفون شيئاً عن تشغيل ما يكتبونه.
SRE: الموثوقية مشكلة هندسية
هندسة موثوقية المواقع Site Reliability Engineering واختصاراً SRE هي طريقة Google في تشغيل خدماتها، وقد نشرت Google عنها ثلاثة كتب متاحة مجاناً للقراءة على موقعها، أولها كتاب Site Reliability Engineering وثانيها The Site Reliability Workbook وهو الجانب التطبيقي. ويبدأ الكتاب الأول في فصل المقدمة بتعريف Ben Treynor Sloss الشهير: SRE هو ما يحدث عندما تطلب من مهندس برمجيات أن يصمم فريق تشغيل.
والفكرة أن مشكلة التوتر بين Dev وOps التي ذكرناها أعلاه تحل بالأرقام والهندسة بدلاً من الاجتماعات، وذلك بثلاث أدوات رئيسية نشرحها فيما يلي.
أهداف الخدمة SLO
شرحنا الفرق بين المؤشر SLI والهدف SLO والاتفاقية SLA في مفاهيم التوفر العالي، فلن نعيده هنا، وما يهمنا هو الخطوة التالية: ماذا تفعل بالهدف بعد أن تكتبه؟ وهنا تأتي ميزانية الأخطاء.
ميزانية الأخطاء Error Budget بالأرقام
يشرح فصل Embracing Risk طريقة تكوين الميزانية في أربع خطوات: يحدد مسؤول المنتج هدف SLO لمدة معينة، ويقيس نظام المراقبة التوفر الفعلي كطرف محايد، والفرق بين الرقمين هو «ميزانية» عدم الموثوقية المتبقية، وطالما بقي في الميزانية شيء يستمر نشر الإصدارات الجديدة. وهذا يحول السؤال من «هل النشر خطر؟» وهو سؤال لا ينتهي النقاش فيه، إلى «هل بقي في الميزانية ما يكفي؟» وهو سؤال جوابه رقم.
لنأخذ مثالاً بخدمة تستقبل 2,000,000 طلب في 30 يوماً، والسكربت التالي يحسب الميزانية لثلاثة أهداف شائعة:
# Error budget for a 30-day window: time and failed requests
WINDOW_MIN = 30 * 24 * 60          # 43,200 minutes
REQUESTS = 2_000_000               # requests in the same 30 days (example)

print(f"{'SLO':>8} {'budget':>8} {'minutes':>9} {'per 90 days':>12} {'failed req':>11}")
for slo in (99.9, 99.95, 99.99):
    budget = 1 - slo / 100
    minutes = WINDOW_MIN * budget
    print(f"{slo:>7}% {budget*100:>7.2f}% {minutes:>9.2f} {minutes*3:>12.2f} {round(REQUESTS*budget):>11,}")

# An incident that failed 300 requests, against the 99.95% budget
used = 300 / (REQUESTS * (1 - 99.95 / 100))
print(f"\nincident: 300 failed requests = {used:.0%} of the 99.95% budget")

# Burn rate: how fast the budget is spent (1 = exactly at the end of the window)
for rate, hours in ((14.4, 1), (6, 6), (1, 72)):
    print(f"burn rate {rate:>4} for {hours:>2}h uses {rate*hours/(30*24):.0%} of the budget")
وعند تشغيله بالأمر python error_budget.py على Python 3.13.3 سوف يكون المخرج كما يلي:
     SLO   budget   minutes  per 90 days  failed req
   99.9%    0.10%     43.20       129.60       2,000
  99.95%    0.05%     21.60        64.80       1,000
  99.99%    0.01%      4.32        12.96         200

incident: 300 failed requests = 30% of the 99.95% budget
burn rate 14.4 for  1h uses 2% of the budget
burn rate    6 for  6h uses 5% of the budget
burn rate    1 for 72h uses 10% of the budget
والصورة التالية تبين الأرقام الثلاثة الأولى:
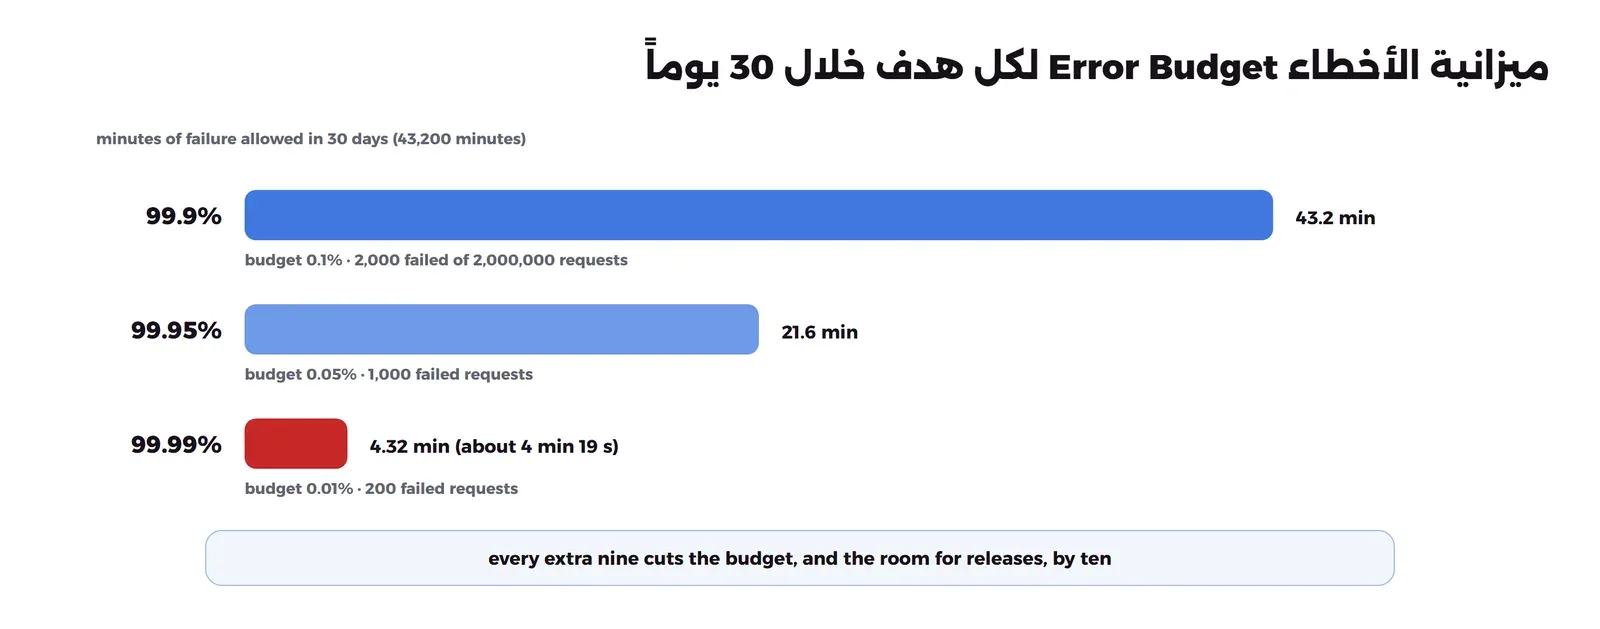
في المخرج أعلاه لاحظ التالي:
- الفرق بين 99.9% و99.99% يبدو صغيراً على الورق، ولكنه الفرق بين 43 دقيقة في الشهر وأربع دقائق وثوان، وأربع دقائق لا تكفي حتى لنشر واحد سيئ يكتشفه إنسان ويتراجع عنه يدوياً، ولذلك فالهدف 99.99% يحتاج تراجعاً آلياً ونشراً تدريجياً، وليس فقط فريقاً أكثر حرصاً.
- الحادث الذي أفشل 300 طلب صرف 30% من ميزانية الهدف 99.95%، وسياسة ميزانية الأخطاء النموذجية في كتاب Workbook تطلب مراجعة الحادث Postmortem إذا صرف حادث واحد أكثر من 20% من ميزانية أربعة أسابيع، وتوقف كل التغييرات ما عدا الإصلاحات العاجلة P0 وإصلاحات الأمن إذا تجاوزت الخدمة ميزانيتها، حتى تعود ضمن الهدف.
- معدل الصرف Burn Rate هو سرعة صرف الميزانية نسبة إلى الهدف، فالمعدل 1 يعني أن الميزانية تنتهي بالضبط مع نهاية الفترة، وفصل Alerting on SLOs يقترح لهدف 99.9% أن توقظ المناوب إذا صرفت 2% من الميزانية في ساعة (معدل 14.4) أو 5% في ست ساعات (معدل 6)، وأن تفتح تذكرة إذا صرفت 10% في ثلاثة أيام (معدل 1)، وهذا أفضل بكثير من التنبيه على كل خطأ.
ومن الأدوات التي تقلل صرف الميزانية مع كل نشر الإطلاق التدريجي، فالميزة الجديدة تصل إلى نسبة صغيرة من المستخدمين أولاً، وإذا فشلت فقد صرفت جزءاً صغيراً من الميزانية فقط، وقد شرحنا ذلك في مفهوم Feature Flags والإطلاق التدريجي.
العمل اليدوي المتكرر Toil
الأداة الثالثة هي الحد من العمل اليدوي المتكرر Toil، ويعرفه فصل Eliminating Toil بأنه العمل المرتبط بتشغيل خدمة في الإنتاج الذي يكون يدوياً Manual، ومتكرراً Repetitive، وقابلاً للأتمتة Automatable، وتكتيكياً يأتي كمقاطعة Tactical، وبلا قيمة دائمة No Enduring Value، ويكبر خطياً مع نمو الخدمة. ومثاله إعادة تشغيل خدمة يدوياً كل ليلة لأن الذاكرة تمتلئ، أو إنشاء حساب قاعدة بيانات لكل مطور جديد بتذكرة.
والقاعدة المعلنة في Google كما يذكر الكتاب أن لا يتجاوز العمل التشغيلي 50% من وقت كل مهندس SRE، وأن يذهب الباقي إلى مشاريع هندسية تقلل هذا العمل في المستقبل، ويذكر الكتاب أن متوسط ما قاسوه كان قرابة 33%. والسبب في هذا الحد أن الفريق الذي يقضي كل وقته في العمل اليدوي يتحول مع الوقت إلى فريق تشغيل تقليدي باسم جديد، وهذا أحد الأنماط الخاطئة التي سوف نذكرها.
وأين تقع هندسة المنصات؟
شرحنا هندسة المنصات بالتفصيل في المقال السابق، وخلاصتها أنها فريق يبني للمطورين منتجاً داخلياً من قدرات يستخدمونها بأنفسهم، مثل قوالب الخدمات وخطوط CI/CD والبيئات والمراقبة، بحيث يقل الحمل الذهني عليهم دون أن يعودوا إلى طابور التذاكر. فإذا كان DevOps يقول «اجعلوا من يبني هو من يشغل»، فهندسة المنصات تقول «وسوف نجعل التشغيل سهلاً بما يكفي لكي يستطيع ذلك فعلاً».
أين تتداخل الثلاثة؟
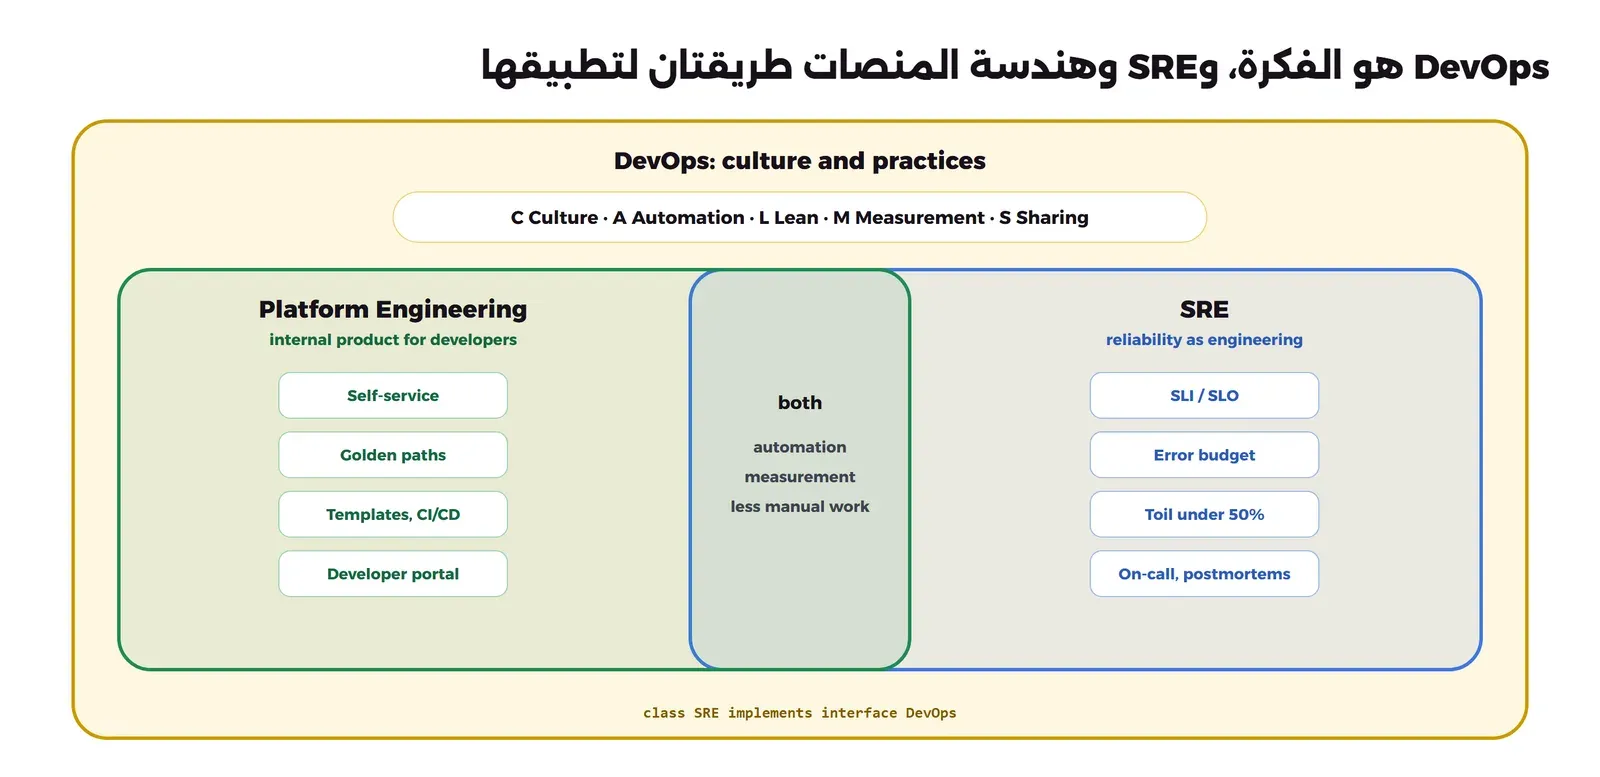
يلخص كتاب Workbook العلاقة بين SRE وDevOps في فصل How SRE Relates to DevOps بجملة مكتوبة بلغة المبرمجين: class SRE implements interface DevOps، أي أن DevOps هو الواجهة Interface التي تصف ما يجب أن يحدث، وSRE تطبيق محدد لها له ممارسات ومسؤوليات واضحة. وبالطريقة نفسها يمكن أن ترى هندسة المنصات تطبيقاً آخر يركز على تجربة المطور بدلاً من موثوقية الخدمة، والصورة التالية تبين ذلك:
والجدول التالي يضع الفروق بجانب بعضها:
| DevOps | SRE | هندسة المنصات | |
|---|---|---|---|
| ما هو؟ | ثقافة وممارسات | تخصص هندسي ودور وظيفي | تخصص هندسي وفريق يبني منتجاً داخلياً |
| السؤال الذي يجيب عنه | كيف يعمل التطوير والتشغيل كفريق واحد؟ | ما مقدار الموثوقية الكافي، وكيف نحققه؟ | كيف يحصل المطور على ما يحتاجه دون انتظار؟ |
| مستخدموه | الجميع | مستخدمو الخدمة النهائيون | المطورون داخل الشركة |
| أدواته المميزة | CI/CD، والأتمتة، ومراجعات بلا لوم | SLO، وميزانية الأخطاء، والمناوبة، وحد العمل اليدوي | القوالب، والطرق الممهدة، والخدمة الذاتية، والبوابة |
| كيف يقاس؟ | مقاييس DORA | تحقيق SLO وصرف الميزانية | التبني ورضا المطورين ومقاييس DORA |
| المرجع | DevOpsDays 2009، وCALMS | كتب Google المجانية | ورقة CNCF، وTeam Topologies |
شكل الفريق بحسب حجم الشركة
لا يوجد مرجع رسمي يقول «إذا كان عندك 30 مهندساً فأنشئ فريق منصة»، ولذلك فما يلي توصيتنا المبنية على ما سبق وعلى خارطة CTO لشركة SaaS ناشئة، فاقرأ الأرقام كحدود تقريبية تتغير بحسب منتجك:
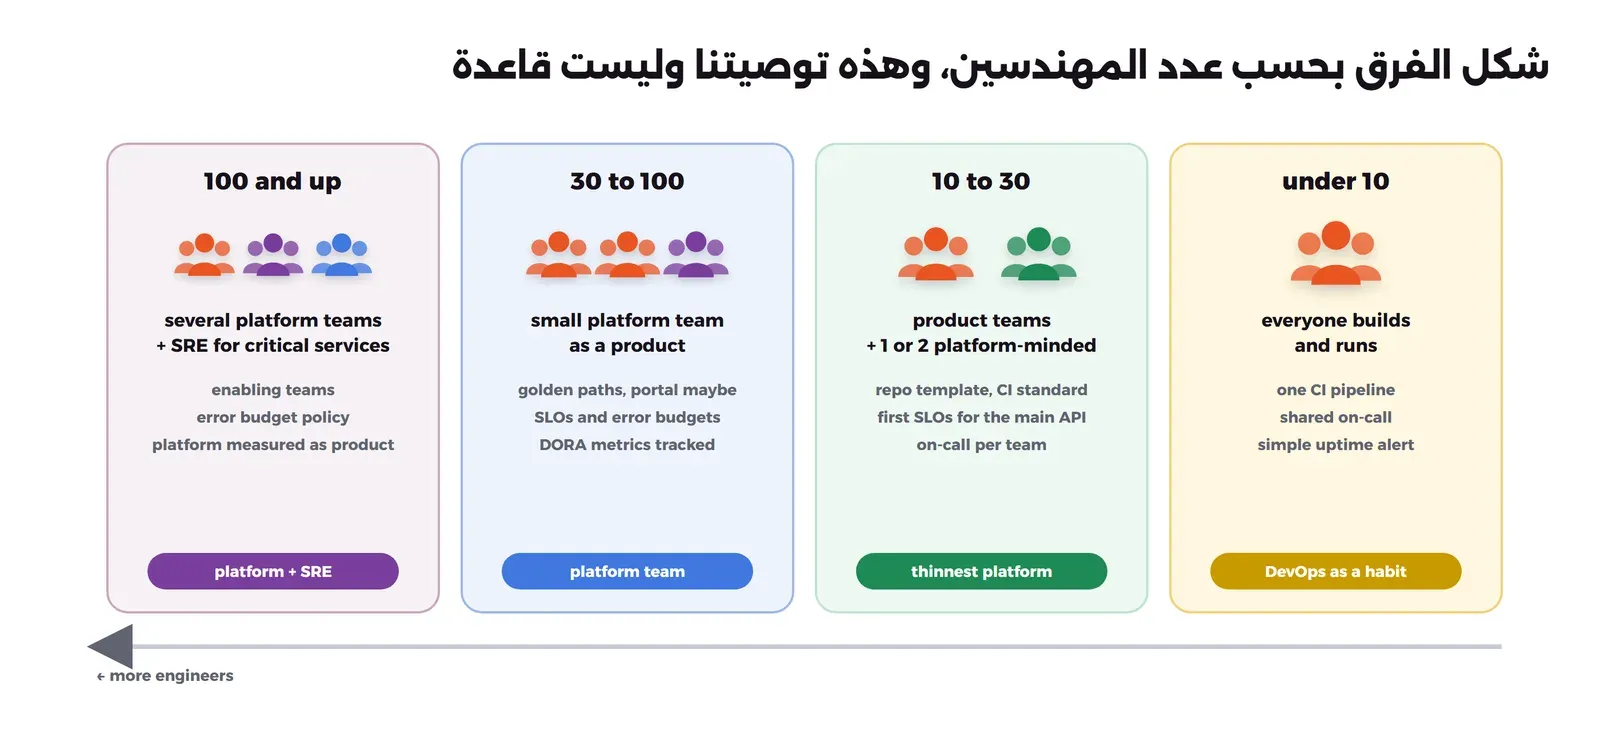
- أقل من 10 مهندسين: لا يوجد فريق DevOps ولا SRE ولا منصة، وإنما الجميع يبني ويشغل، مع خط CI واحد ومناوبة مشتركة وتنبيه بسيط على توقف الخدمة. وأهم ما تفعله هنا أن يعرف شخصان على الأقل كيف يعاد بناء كل شيء.
- من 10 إلى 30: فرق منتج مع مهندس أو اثنين يهتمان بالأدوات المشتركة جزءاً كبيراً من وقتهما، يبنيان قالب مستودع وخط CI موحداً، وأول هدف SLO للخدمة الأهم. وهذه هي أصغر منصة ممكنة.
- من 30 إلى 100: هنا يظهر فريق منصة صغير يعامل عمله كمنتج، وتكتب أهداف SLO وميزانيات أخطاء للخدمات المهمة، وتقاس مقاييس DORA بانتظام، وممارسات SRE تكون داخل كل فريق وليس في فريق منفصل.
- أكثر من 100: عدة فرق منصة لكل منها مجال، وفريق SRE متخصص للخدمات الحرجة فقط، وفرق تمكين Enabling Teams تساعد الفرق في مواضيع مثل الأمن والاختبار، وسياسة ميزانية أخطاء مكتوبة ومتفق عليها مع الإدارة.
وقد يتساءل البعض: لماذا لا نوظف فريق SRE من البداية ما دامت Google تفعل ذلك؟ والإجابة أن Google تشغل خدمات بحجم لا يشبه شركتك، وأن فريق SRE منفصلاً في شركة من عشرين مهندساً سوف يتحول غالباً إلى فريق تشغيل يستقبل ما يرميه المطورون، والسبب أنه لا يوجد عنده وقت ولا حجم يسمح له بالعمل الهندسي. وقد شرحنا لماذا لا يسرع الفريق الأكبر العمل دائماً في هل يسلم الفريق الأكبر أسرع؟.
الأنماط الخاطئة الشائعة
جمع Matthew Skelton وManuel Pais، مؤلفا كتاب Team Topologies، في موقع DevOps Topologies أشكال الفرق الصحيحة والخاطئة، ومن الأنماط الخاطئة Anti-Types فيه ثلاثة نراها كثيراً، ونضيف إليها ما تذكره DORA عن المنصات:
فريق التشغيل بعد تغيير اسمه. يسميه الموقع «مدير الأنظمة بعد إعادة التسمية» Rebranded SysAdmin، ويصف حالة أخرى يسميها «SRE الوهمي» Fake SRE: مهندسو التشغيل أصبح اسمهم SRE ولم يتغير شيء آخر، فالمطورون ما زالوا يرمون البرنامج «المكتمل من ناحية الميزات» فوق الجدار، وال SRE لا يجدون وقتاً للعمل مع المطورين على إصلاح المشاكل. والعلامة التي تكشف هذا النمط بسيطة: هل يوجد هدف SLO مكتوب وميزانية أخطاء تؤثر على قرار النشر؟ وهل يقضي الفريق أقل من نصف وقته على العمل اليدوي؟ فإذا كانت الإجابتان «لا» فالاسم وحده تغير.
فريق DevOps معزول. يسميه الموقع DevOps Team Silo، ويصف كيف يبدأ عادة عندما يقرر مدير أنه يحتاج «شيئاً من DevOps» فينشئ «فريق DevOps»، فيتحول الفريق بسرعة إلى جدار ثالث بين التطوير والتشغيل، يدافع عن أدواته ومهاراته من الطرفين، والنتيجة أن المسافة بين Dev وOps أصبحت أكبر مما كانت. ويذكر الموقع أن فريق DevOps مؤقتاً مهمته تقريب الطرفين ثم الانتهاء قد يكون مفيداً، والفرق هو المدة والنية.
منصة لم يطلبها أحد. تسميه DORA فخ «ابنها وسوف يأتون» Build It and They Will Come: فريق منصة يبني ما يظن أن المطورين يحتاجونه دون أن يسألهم، فيجد بعد سنة بوابة جميلة لا يستخدمها أحد لأن الفرق استمرت في طرقها القديمة. وعلاجه ما ذكرناه في مقال المنصات: ابدأ بمشكلة سمعتها من الفرق، وابن أصغر حل لها، وقس التبني.
وفيما يلي علامات سريعة تساعدك على كشف هذه الأنماط في شركتك:
- هل يستطيع المطور أن ينشر خدمته دون أن يطلب من فريق آخر؟
- هل يناوب المطورون على خدماتهم، أم أن فريقاً آخر يستيقظ ليلاً لأخطاء لم يكتبها؟
- هل يوجد هدف SLO واحد على الأقل مكتوب ومقاس للخدمة الأهم؟
- هل يعرف فريق المنصة كم فريقاً يستخدم كل قدرة يقدمها؟
مقاييس DORA: كيف تعرف أنك تتحسن
DORA برنامج بحثي تديره Google Cloud ويصدر تقارير State of DevOps السنوية، وقد ذكرنا ما وجدته تقاريره الأخيرة عن الذكاء الاصطناعي في Agile في عصر الذكاء الاصطناعي، وما يهمنا هنا هو المقاييس نفسها. فحسب صفحة مقاييس DORA الحالية هي خمسة مقاييس في مجموعتين:
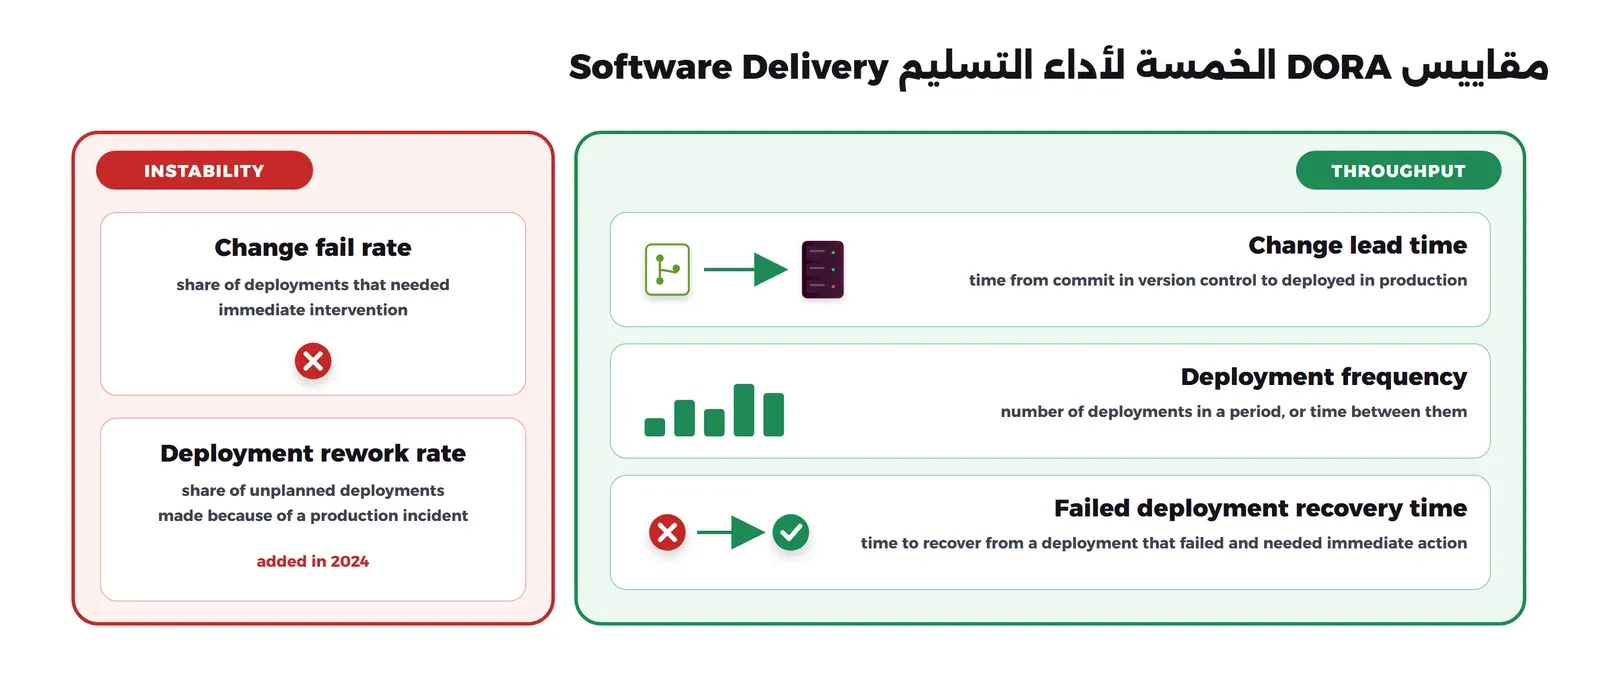
- مدة وصول التغيير Change Lead Time: الوقت من وصول التغيير إلى نظام إدارة النسخ حتى نشره في الإنتاج.
- تكرار النشر Deployment Frequency: عدد النشرات في فترة معينة، أو الوقت بين النشرات.
- وقت التعافي من النشر الفاشل Failed Deployment Recovery Time: الوقت اللازم للتعافي من نشر فشل واحتاج تدخلاً عاجلاً.
- نسبة فشل التغيير Change Fail Rate: نسبة النشرات التي احتاجت تدخلاً عاجلاً بعدها.
- نسبة إعادة النشر Deployment Rework Rate: نسبة النشرات غير المخطط لها التي حدثت بسبب حادث في الإنتاج.
وتشرح صفحة تاريخ المقاييس كيف تغيرت مع الوقت: بدأت أربعة مقاييس في 2014 و2015، وفي 2023 أعيدت تسمية متوسط وقت الاستعادة MTTR وتعريفه ليصبح وقت التعافي من النشر الفاشل، أي أنه يقيس التعافي من تغيير سبب مشكلة وليس من عطل خارجي، وفي 2024 أضيف المقياس الخامس وأعيد تقسيم المقاييس إلى مجموعتي السرعة Throughput وعدم الثبات Instability. ولذلك إذا قرأت في مقال قديم عن «المقاييس الأربعة» وMTTR فاعلم أن التعريف الحالي تغير.
وفي المقاييس أعلاه لاحظ التالي:
- تقرأ المقاييس معاً، فتكرار نشر عال مع نسبة فشل عالية لا يعني أنك سريع، وإنما أنك تنقل المشاكل إلى المستخدمين أسرع.
- أغلبها يحسب من سجل خط CI وسجل الحوادث دون أداة إضافية، فتاريخ كل commit ووقت نشره موجود في خطك، كما في خط CI/CD آمن من البداية للنهاية، وقد ذكرنا المقاييس نفسها مع سلم نضج النشر في طرق نشر التطبيقات.
- مقاييس DORA ومقاييس SRE يكمل بعضها بعضاً: DORA تقيس كيف تسلم التغيير، وSLO يقيس هل الخدمة تعمل كما وعدت، وفريق ينشر عشر مرات في اليوم ويصرف ميزانيته في الأسبوع الأول يحتاج أن يبطئ.
من أين تبدأ غداً؟
بدلاً من أن تبدأ بتغيير الأسماء أو التوظيف، ابدأ بالخطوات التالية بالترتيب، وكل خطوة تستحق أن تقف عندها حتى تعمل:
- اكتب هدف SLO واحداً للخدمة الأهم، مثل نسبة الطلبات الناجحة خلال 30 يوماً، واحسب ميزانيته بالسكربت أعلاه، واجعل المراقبة تقيسه.
- اتفق مع مسؤول المنتج على ما يحدث عندما تنتهي الميزانية، ولو كان جملة واحدة: «نوقف الميزات الجديدة ونصلح الثبات حتى نعود ضمن الهدف».
- احسب مقاييس DORA من سجل خطك للأشهر الثلاثة الأخيرة، دون أن تحاول تحسينها بعد، فالهدف أن تعرف أين أنت.
- اكتب قائمة بالعمل اليدوي المتكرر في أسبوع واحد، واختر أكثر بند يأخذ وقتاً وقم بأتمتته، وهذه أول خطوة في المنصة.
- اسأل الفرق عن أكثر شيء ينتظرون فيه غيرهم، فهذه هي القدرة الأولى في منصتك إذا احتجت منصة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- DevOps ثقافة وممارسات بدأت مع DevOpsDays في 2009، ويصفها إطار CALMS: الثقافة والأتمتة والتدفق المرن والقياس والمشاركة، وليست اسم فريق.
- SRE تطبيق هندسي لهذه الفكرة كما يشرحه كتاب Google المجاني: أهداف SLO، وميزانية أخطاء تقرر متى نبطئ، وحد 50% للعمل اليدوي المتكرر Toil.
- ميزانية الهدف 99.9% في 30 يوماً 43.2 دقيقة، و99.95% نصفها، و99.99% أربع دقائق وثوان، وكل تسعة إضافية تقسم المساحة المتاحة للنشر على عشرة.
- هندسة المنصات تطبيق آخر يركز على المطور كمستخدم، والثلاثة تلتقي في الأتمتة والقياس:
class SRE implements interface DevOps. - الشركة الصغيرة لا تحتاج فريق SRE ولا فريق منصة، وإنما عادات DevOps وخطاً موحداً وهدف SLO واحداً، وفرق المنصة وSRE تأتي مع الحجم.
- احذر ثلاثة أنماط: فريق تشغيل بعد تغيير اسمه، وفريق DevOps معزول، ومنصة لم يطلبها أحد.
- مقاييس DORA الحالية خمسة: ثلاثة للسرعة واثنان لعدم الثبات، وأضيف الخامس في 2024.
وفي مقالات قادمة بإذن الله، نكمل مرحلة منصات المطورين ببيئات التطوير في المتصفح، وأدوات Feature Flags، وبوابات API.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، ومراجعة موقع DevOpsDays، وصفحة Atlassian عن CALMS، وفصول كتابي Site Reliability Engineering وThe Site Reliability Workbook (Introduction وEmbracing Risk وEliminating Toil وHow SRE Relates to DevOps وError Budget Policy وAlerting on SLOs)، وموقع DevOps Topologies، وصفحات DORA عن المقاييس وتاريخها وهندسة المنصات، وحساب أمثلة ميزانية الأخطاء بسكربت على Python 3.13.3.


