

لنفرض أن لديك سيرفراً واحداً يشغل موقع شركتك ونظام الطلبات وقاعدة البيانات، وكل شيء يعمل منذ شهور دون مشكلة، ثم في يوم من الأيام يتوقف قرص السيرفر أو تنقطع الكهرباء عن مركز البيانات أو يفشل تحديث في منتصف الليل، فتتوقف كل الخدمات معاً، ويبدأ الهاتف بالرنين، ويسألك المدير السؤال المعروف: «لماذا لا يوجد سيرفر احتياطي؟». والإجابة السريعة هي أن تضيف سيرفراً ثانياً، ولكن السيرفر الثاني وحده لا يجعل الخدمة متوفرة، فمن يقرر أن الأول توقف؟ وكيف يصل المستخدم إلى الثاني؟ وماذا عن قاعدة البيانات والكهرباء والشبكة واسم النطاق؟ وهل تستحق الخدمة كل هذه التكلفة أصلاً؟
وهذا هو موضوع التوفر العالي High Availability، وهو أول مقال في مرحلة التوفر العالي في خريطة التعلم، لذلك سوف نركز فيه على المفاهيم التي تحتاجها قبل أن تبني أي شيء، ونترك التطبيق العملي لكل أداة إلى مقالها، وأولها مقال عنوان IP عائم بين سيرفرين مع Keepalived وVRRP. وسوف نناقش في هذا المقال ما يلي:
- معنى التوفر العالي بالأرقام، والفرق بينه وبين النسخ الاحتياطي واستعادة الخدمة بعد الكارثة.
- التكرار Redundancy والانتقال Failover، والفرق بين سيرفر احتياطي ينتظر Active-Passive وسيرفرين يعملان معاً Active-Active.
- البحث عن نقطة الفشل الواحدة SPOF في الكهرباء والشبكة وDNS وقاعدة البيانات وحتى في الأشخاص، مع حادثتين موثقتين.
- حساب التوفر في السلسلة Series وفي التوازي Parallel بأرقام حقيقية من سكربت صغير.
- الفرق بين المؤشر SLI والهدف SLO والاتفاقية SLA، وميزانية الأخطاء Error Budget.
- انقسام الدماغ Split Brain والنصاب Quorum، وفحوص الصحة Health Checks، واختبار التعطل قبل أن يحدث.
- متى لا تحتاج التوفر العالي أصلاً، لأن تكلفته قد تكون أكبر من تكلفة التوقف نفسه.
ما معنى التوفر العالي High Availability بالأرقام؟
التوفر Availability هو نسبة الوقت الذي تكون فيه الخدمة قادرة على خدمة المستخدمين، ويعرفه كتاب Site Reliability Engineering من Google بطريقتين: الأولى بالزمن، أي زمن العمل مقسوماً على زمن العمل مضافاً إليه زمن التوقف، والثانية بالطلبات، أي عدد الطلبات الناجحة مقسوماً على كل الطلبات، وهي الأنسب للخدمات الموزعة لأن الخدمة قد تعمل لبعض المستخدمين وتفشل لغيرهم في الوقت نفسه. أما التوفر العالي High Availability فهو تصميم الخدمة بحيث تستمر رغم تعطل جزء منها، فالسيرفر يتوقف والقرص يتلف والشبكة تنقطع، والمطلوب ألا يتحول عطل جزء واحد إلى توقف الخدمة كلها.
وتقاس النسبة عادة بعدد التسعات Nines، وقد شرحنا في مصطلحات الاستضافة الذاتية مع رسم توضيحي ما تعنيه كل نسبة بالدقائق والساعات، فلن نعيد الرسم هنا، ويكفي أن تتذكر أن 99.9% تسمح بحوالي 8.8 ساعة توقف في السنة، وأن كل تسعة إضافية تقسم هذا الوقت على عشرة، وأن كل تسعة إضافية تكلف أكثر من التي قبلها بكثير.
وهناك ثلاثة مفاهيم يخلط بينها الكثيرون، والفرق بينها مهم لأن كل واحد منها يحميك من شيء مختلف:
| المفهوم | يحميك من | لا يحميك من |
|---|---|---|
| التوفر العالي High Availability | توقف سيرفر أو قرص أو خدمة، فتستمر الخدمة خلال ثوان أو دقائق | حذف البيانات بالخطأ أو تشفيرها ببرنامج فدية، لأن الخطأ ينتقل إلى كل النسخ فوراً |
| النسخ الاحتياطي Backup | ضياع البيانات، فتستعيدها كما كانت في نقطة سابقة | التوقف، فالاستعادة نفسها قد تستغرق ساعات |
| استعادة الخدمة بعد الكارثة Disaster Recovery | خسارة موقع كامل، مثل حريق أو انقطاع طويل في مركز البيانات | الأعطال الصغيرة اليومية، لأنها خطة لموقف نادر وتشغيلها يأخذ وقتاً |
والرقمان اللذان يربطان الثلاثة هما RPO، أي كم من البيانات تقبل أن تخسر، وRTO، أي كم من الوقت تقبل أن تتوقف، وقد شرحناهما بالتفصيل في دليل النسخ الاحتياطي بقاعدة 3-2-1، لذلك سوف نستخدمهما هنا مباشرة دون إعادة شرح.
التكرار Redundancy والانتقال Failover
التكرار Redundancy هو أن يكون لكل جزء مهم في الخدمة نسخة ثانية تستطيع أن تقوم بعمله، والانتقال Failover هو عملية تحويل العمل من الجزء المعطل إلى نسخته، ثم الرجوع Failback إلى الوضع الأصلي بعد الإصلاح. ولاحظ أن التكرار وحده لا يكفي لتحقيق التوفر، والسبب أن السيرفر الثاني الذي لا يعرف أحد متى يجب أن يعمل هو مجرد سيرفر مطفأ تدفع ثمنه، فالتوفر العالي يحتاج ثلاثة أشياء معاً: نسخة ثانية، وطريقة لاكتشاف العطل، وطريقة لتحويل المستخدمين إلى النسخة السليمة. والصورة التالية تبين الشكلين الأساسيين لذلك:
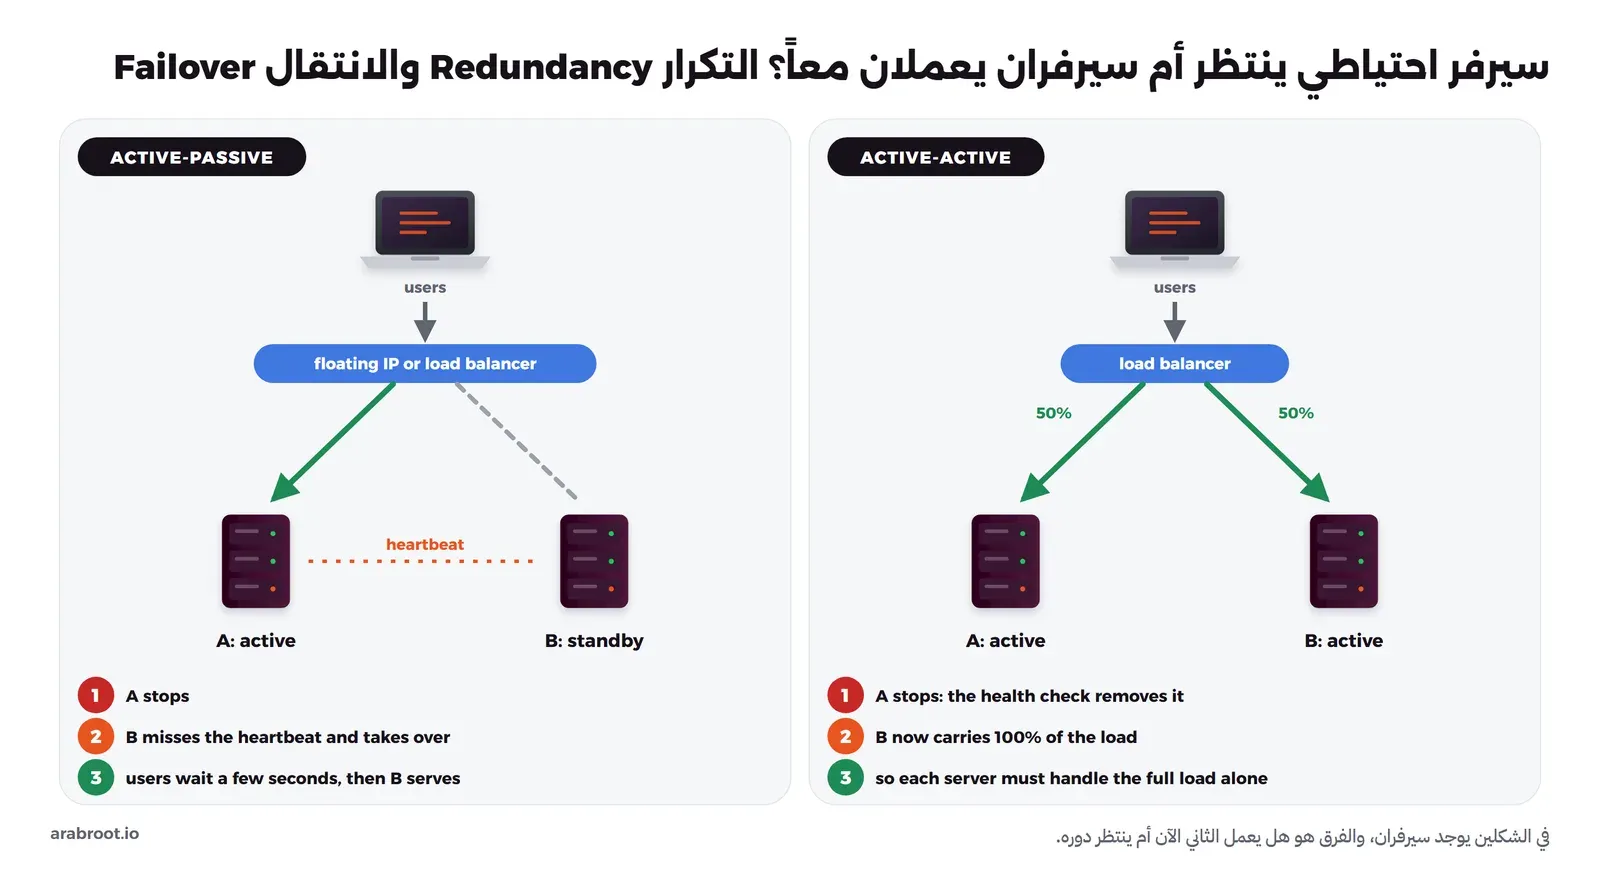
سيرفر نشط وآخر احتياطي Active-Passive
في هذا الشكل يخدم سيرفر واحد كل الطلبات، والثاني ينتظر، وبينهما رسائل نبض Heartbeat، فإذا غاب النبض عدداً معيناً من المرات أخذ الاحتياطي العمل، وأشهر طريقة لذلك عنوان IP عائم Floating IP ينتقل من سيرفر إلى آخر، وهو ما تفعله Keepalived كما سوف ترى في مقالها. ويقسم الاحتياطي عادة إلى ثلاث درجات بحسب جاهزيته:
- الاحتياطي الساخن Hot Standby: يعمل الآن وبياناته متزامنة مع الأساسي، ويأخذ العمل خلال ثوان، مثل نسخة PostgreSQL المتدفقة التي شرحناها في دليل عناقيد قواعد البيانات.
- الاحتياطي الدافئ Warm Standby: يعمل ولكنه يحتاج خطوات قبل أن يخدم، مثل تحميل آخر نسخة من البيانات أو تشغيل التطبيق، ويأخذ العمل خلال دقائق.
- الاحتياطي البارد Cold Standby: سيرفر مطفأ أو غير مجهز، تشغله وتستعيد عليه النسخة الاحتياطية عند الحاجة، ويأخذ العمل خلال ساعات، وهو أرخصها وأبطؤها.
ونقطة القوة في هذا الشكل أنه بسيط، والكتابة تحدث في مكان واحد فلا توجد تعارضات في البيانات، ونقطة الضعف أنك تدفع ثمن سيرفر لا يعمل أغلب الوقت، وأن الانتقال نفسه يقطع الاتصالات المفتوحة ويستغرق ثوان على الأقل، وأن السيرفر الاحتياطي الذي لا يستخدم قد يكون معطلاً دون أن تعرف حتى يوم تحتاجه.
سيرفران نشطان Active-Active
وفي هذا الشكل يخدم السيرفران الطلبات في الوقت نفسه خلف موزع حمل Load Balancer، فإذا توقف أحدهما أزاله فحص الصحة من القائمة وحمل الآخر كل الحمل. وقد شرحنا هذا الشكل لسيرفرات التطبيق في دليل مدخل إلى تصميم الأنظمة. ونقطة القوة أنك تستخدم كل العتاد الذي تدفع ثمنه، وأن عطل سيرفر لا يحتاج انتقالاً بالمعنى الكامل لأن الآخر يعمل أصلاً، ونقطة الضعف ثلاثة أشياء:
- السعة Capacity: إذا كان كل سيرفر يعمل بنسبة 70% من قدرته، فعندما يتوقف أحدهما سوف يحتاج الآخر 140% فيتوقف هو أيضاً، لذلك يجب أن يتحمل كل سيرفر الحمل الكامل وحده، أي أن يعمل في الأيام العادية بأقل من نصف قدرته، وهذا ما يسمى أحياناً N+1، أي عدد السيرفرات الذي يكفي الحمل مضافاً إليه سيرفر واحد.
- الحالة State: الشكل سهل مع التطبيقات التي لا تحتفظ بحالة Stateless، وصعب جداً مع قواعد البيانات، لأن سيرفرين يكتبان البيانات نفسها يحتاجان طريقة لحل التعارضات، كما شرحنا في قسم عدة سيرفرات رئيسية Multi-Primary.
- موزع الحمل نفسه: أصبح الآن نقطة يمر منها كل شيء، فإذا كان واحداً فقد نقلت نقطة الفشل من السيرفر إلى الموزع، وهذا ما يحله عنوان عائم بين موزعين، وهو موضوع مخطط له في مرحلة التوفر العالي بعنوان «HAProxy مع Keepalived».
وقد يتساءل البعض: أيهما أفضل؟ والإجابة أن الأمر يعتمد على الطبقة، فسيرفرات التطبيق التي لا تحتفظ بحالة مكانها الطبيعي Active-Active خلف موزع، وقواعد البيانات في أغلب الفرق Active-Passive بسيرفر رئيسي ونسخة، وموزع الحمل نفسه غالباً Active-Passive بعنوان عائم.
| Active-Passive | Active-Active | |
|---|---|---|
| من يخدم الطلبات | سيرفر واحد في كل لحظة | كل السيرفرات |
| عند العطل | انتقال يستغرق ثوان أو دقائق | الموزع يزيل المعطل، والباقي يعمل |
| السعة المطلوبة | كل سيرفر يتحمل الحمل كاملاً | كل سيرفر يتحمل الحمل كاملاً، أو N+1 |
| البيانات | الكتابة في مكان واحد | تحتاج حلاً للتعارضات إذا كتب الجميع |
| المكان المعتاد | قواعد البيانات، وموزعات الحمل | سيرفرات التطبيق، وال CDN، وDNS |
ابحث عن نقطة الفشل الواحدة SPOF
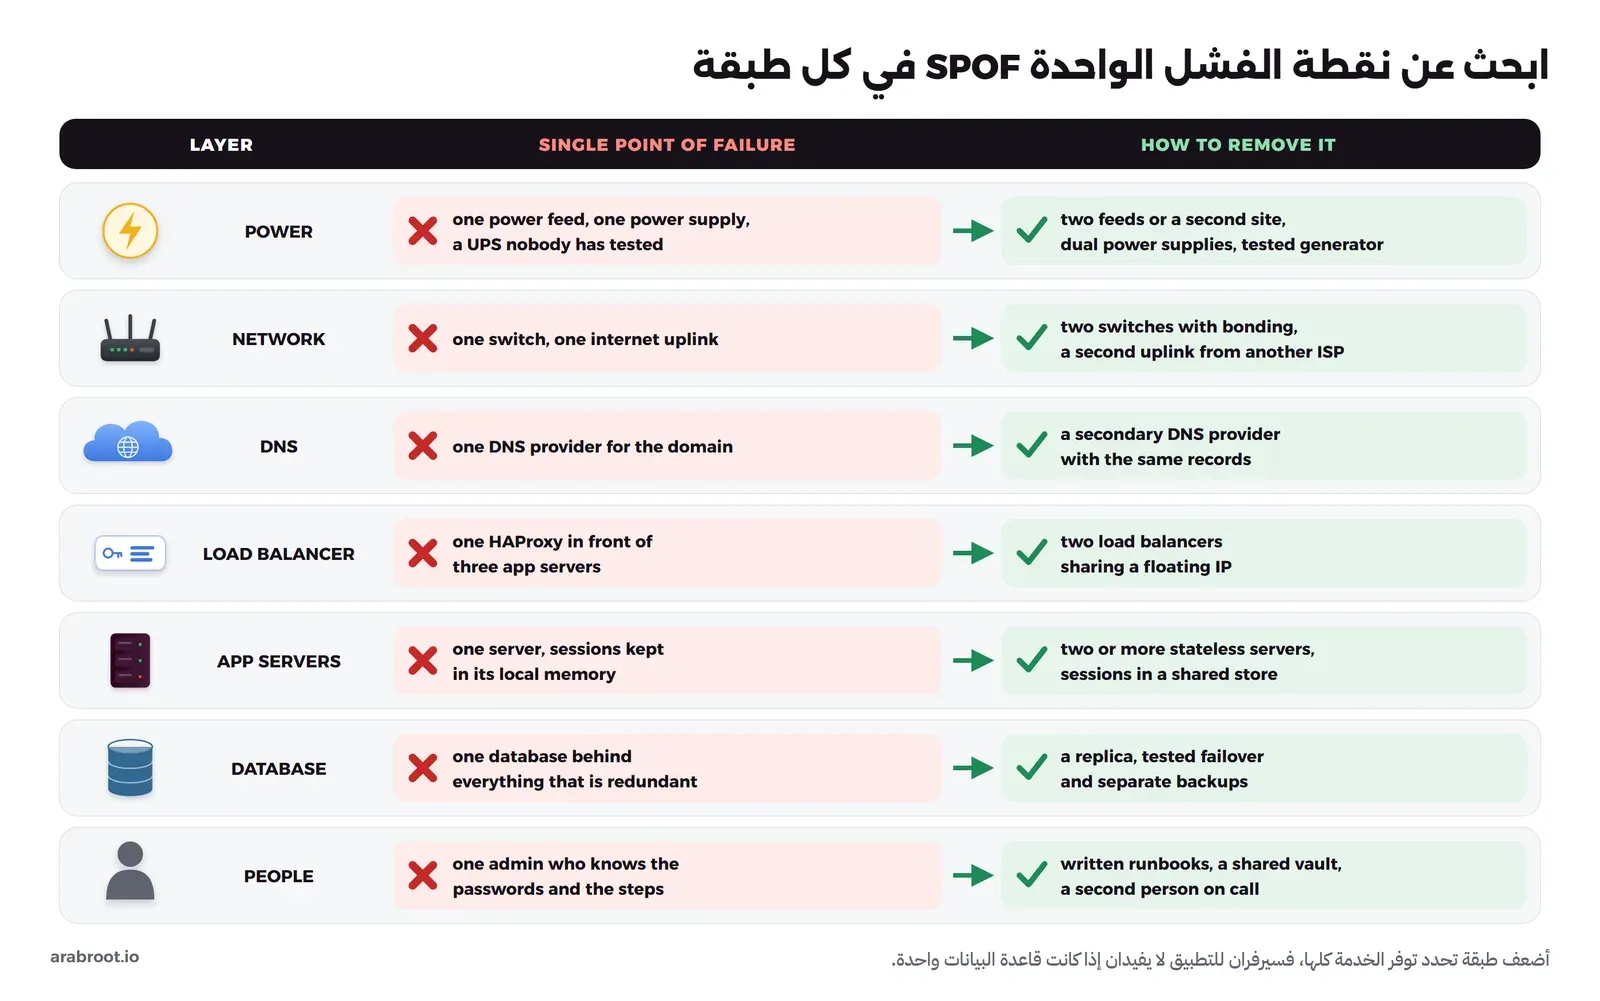
نقطة الفشل الواحدة SPOF (Single Point of Failure) هي أي جزء إذا توقف توقفت الخدمة كلها، والمشكلة أن أغلب الفرق تبحث عنها في السيرفرات فقط، فتضع سيرفرين للتطبيق ثم تتركهما يعملان على قاعدة بيانات واحدة، وعلى مصدر كهرباء واحد، وباسم نطاق عند مزود DNS واحد، ويديرهما شخص واحد يعرف كلمات المرور. والطريقة الصحيحة أن ترسم طريق الطلب من المستخدم حتى البيانات، ثم تسأل عن كل صندوق وكل خط في الرسم: ماذا يحدث إذا توقف هذا؟ والصورة التالية تبين الطبقات التي يجب أن تسأل عنها:
الكهرباء Power
الكهرباء هي الطبقة التي ينساها المطور لأنها ليست في الكود، وفي بيتك أو مكتبك يكفي انقطاع واحد لإيقاف كل شيء، وقد شرحنا دور جهاز UPS في مصطلحات الاستضافة الذاتية. وفي مراكز البيانات توجد مصادر متعددة ومولدات وبطاريات، ولكن السلسلة كلها يجب أن تعمل في اللحظة نفسها، والأهم من ذلك أن تكون خدمتك نفسها مصممة لتنجو من سقوط مركز بيانات كامل، وأن تكون قد اختبرت ذلك فعلاً.
الشبكة Network
سيرفران متكرران خلف سويتش واحد أو وصلة إنترنت واحدة يتوقفان معاً، لذلك تحتاج في الشبكة نفس التفكير: سويتشان مع ربط بطاقتي الشبكة Bonding في كل سيرفر، ووصلتان من مزودين مختلفين إذا كانت الخدمة في مكتبك، وقد شرحنا طريق الحركة من بيتك أو مكتبك إلى الإنترنت في دليل كيف يصل الإنترنت إلى بيتك. وفي ربط الفروع ينطبق الأمر نفسه على المحور، وقد شرحنا في دليل معمارية Hub and Spoke كيف يتحول المحور إلى نقطة فشل واحدة وكيف يحلها محوران Dual Hub في مكانين مختلفين.
أسماء النطاقات DNS
إذا كانت سجلات نطاقك عند مزود DNS واحد وتوقف هذا المزود، فلن يصل أحد إلى خدمتك مهما كان عدد سيرفراتك، والسبب أن المتصفح لا يعرف العنوان أصلاً. والحل أن تستخدم مزودين لسيرفرات الأسماء NS بالسجلات نفسها، أو مزوداً يوزع سيرفرات أسمائه على شبكات مختلفة، وقد شرحنا سجلات NS ومدة الصلاحية TTL في دليل شرح DNS وسجلاته. ولاحظ أن تغيير عنوان السجل A عند العطل ليس طريقة انتقال سريعة، لأن المتصفحات والمزودين يحفظون العنوان القديم حتى تنتهي مدة الصلاحية، وبعضهم يحفظه أطول منها.
قاعدة البيانات Database
وهي أشهر نقطة فشل واحدة على الإطلاق، لأن جعل سيرفرات التطبيق متكررة سهل، أما قاعدة البيانات فتحتاج نسخاً متماثلاً Replication وانتقالاً يعرف من هو السيرفر الرئيسي، وطريقة يجد بها التطبيق السيرفر الجديد، وهذا كله شرحناه في دليل عناقيد قواعد البيانات. وتذكر أن نسخة قاعدة البيانات ليست نسخة احتياطية، فأمر الحذف الخاطئ ينتقل إليها خلال جزء من الثانية.
الأشخاص People
إذا كان شخص واحد في الفريق يعرف كلمة مرور السيرفر، أو يعرف وحده خطوات الانتقال إلى السيرفر الاحتياطي، فهذا الشخص نقطة فشل واحدة، فقد يكون في إجازة أو نائماً أو في الطائرة عندما يتوقف السيرفر، وهذا ما يسمى أحياناً عامل الحافلة Bus Factor، أي كم شخصاً يجب أن يغيب حتى يتوقف المشروع. والحل ثلاثة أشياء: دليل تشغيل مكتوب Runbook لكل عملية مهمة مثل الانتقال والاستعادة، وخزنة كلمات مرور مشتركة بصلاحيات واضحة، وشخص ثان في المناوبة On-call يعرف الخطوات ونفذها مرة واحدة على الأقل.
الأعطال التي تصيب النسختين معاً
حساب التوفر الذي سوف نراه في القسم القادم يفترض أن النسختين تتعطلان بشكل مستقل، ولكن في الواقع هناك أسباب تصيب النسختين في اللحظة نفسها: إعداد خاطئ تنشره على كل السيرفرات معاً، أو تحديث فيه خطأ، أو شهادة TLS تنتهي على الجميع في اليوم نفسه، أو عملية استعادة تلقائية تضغط على الموارد المشتركة. لذلك انشر التغييرات على سيرفر واحد أولاً، وراقب ثم أكمل، كما شرحنا في دليل Feature Flags والإطلاق التدريجي.
كيف تحسب التوفر؟ السلسلة Series والتوازي Parallel
عندما تتكون الخدمة من عدة أجزاء، فهناك قاعدتان بسيطتان لحساب توفرها، والصورة التالية تبينهما بأرقام فعلية:
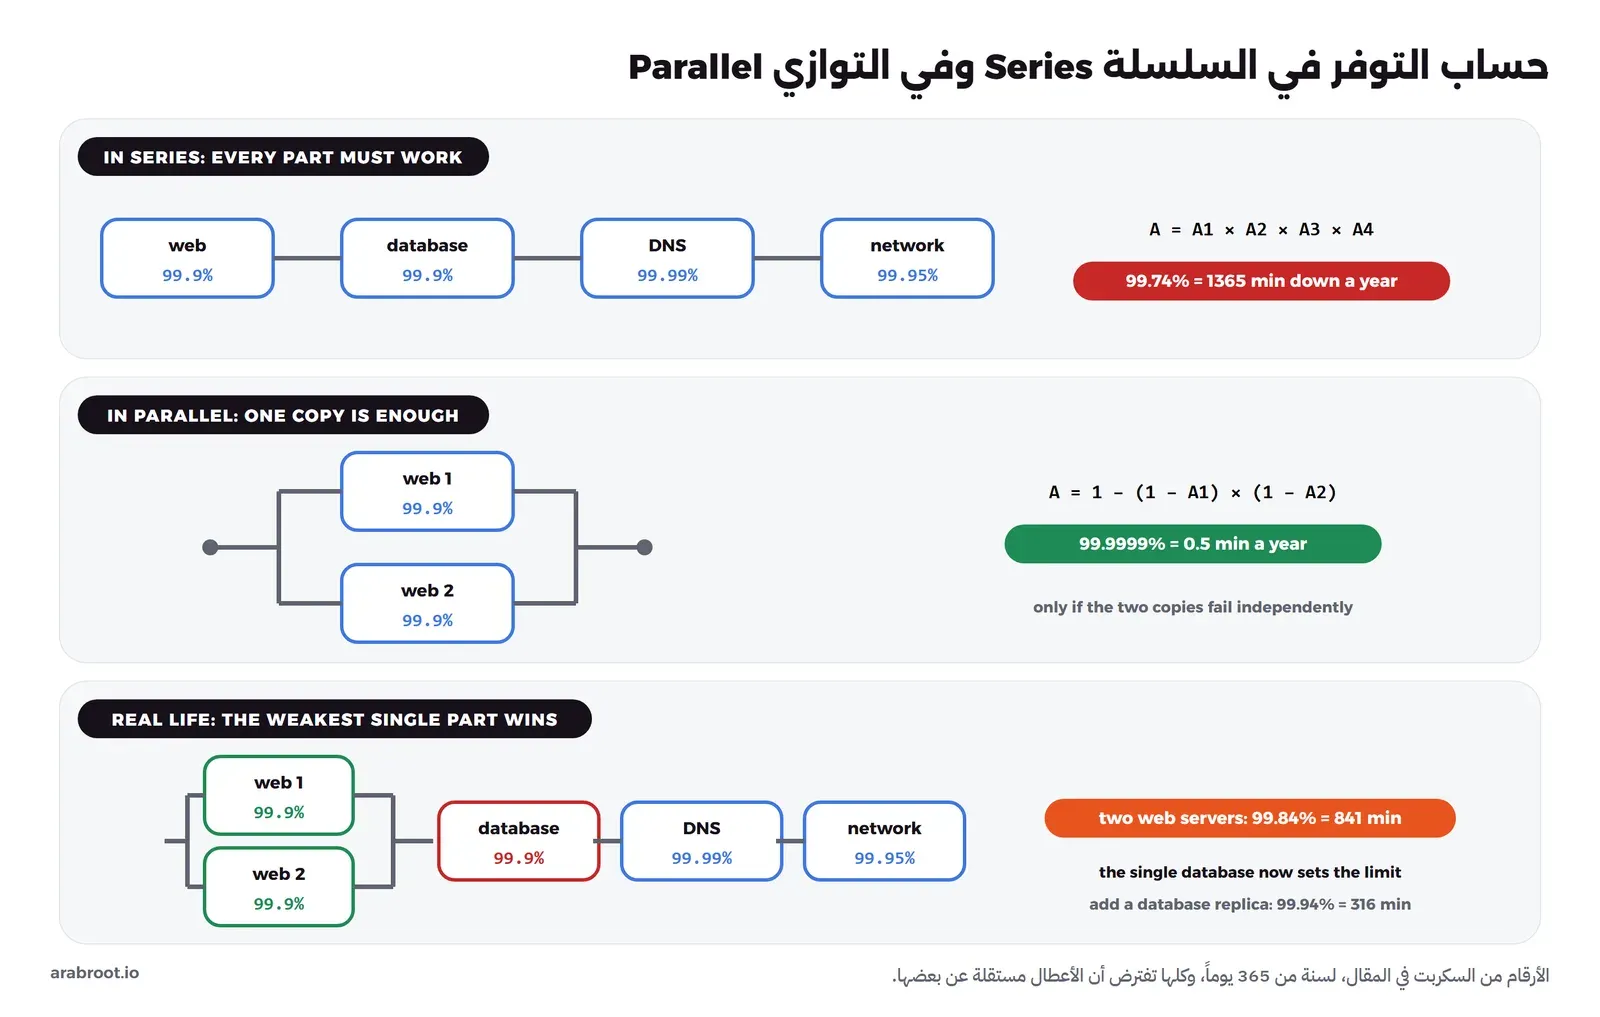
- السلسلة Series: عندما يجب أن تعمل كل الأجزاء حتى تعمل الخدمة، مثل التطبيق وقاعدة البيانات وDNS والشبكة، فالتوفر هو حاصل ضرب نسب التوفر: A = A1 × A2 × … ، والنتيجة دائماً أقل من أضعف جزء، لذلك كل جزء تضيفه في الطريق يخفض التوفر حتى لو كان ممتازاً.
- التوازي Parallel: عندما تكفي نسخة واحدة سليمة، مثل سيرفرين للتطبيق خلف موزع حمل، فاحتمال التوقف هو حاصل ضرب احتمالات تعطل كل نسخة، والتوفر: A = 1 − (1 − A1) × (1 − A2)، وهذا هو سبب قوة التكرار، فسيرفران بنسبة 99.9% يعطيان نظرياً 99.9999%.
ولنحسب ذلك بأرقام، احفظ السكربت التالي باسم availability.py، وهو يحسب التوفر والدقائق المسموح بها في السنة لعدة تصاميم، والنسب فيه أمثلة للتوضيح وليست أرقام مزود معين:
# availability.py: series and parallel availability, and the downtime they allow per year
MIN_PER_YEAR = 365 * 24 * 60

def series(*parts):          # every part must work
    a = 1.0
    for p in parts:
        a *= p
    return a

def parallel(*parts):        # one working copy is enough
    down = 1.0
    for p in parts:
        down *= (1 - p)
    return 1 - down

def show(name, a):
    print(f"{name:<42} {a*100:9.5f}%  {(1-a)*MIN_PER_YEAR:8.1f} min/year")

web, db, dns, net = 0.999, 0.999, 0.9999, 0.9995
show("one web server", web)
show("web + db (series)", series(web, db))
show("web + db + dns + network (series)", series(web, db, dns, net))
show("two web servers (parallel)", parallel(web, web))
show("two web + db + dns + network", series(parallel(web, web), db, dns, net))
show("two web + two db + dns + network", series(parallel(web, web), parallel(db, db), dns, net))
# failover that works 99% of the time: the second copy only helps when the switch succeeds
show("two web, failover works 99% of the time", 1 - (1 - web) * (1 - 0.99 * web))
# MTBF / MTTR: one failure every 60 days, 2 hours or 15 minutes to repair
for mttr_h in (2, 0.25):
    show(f"MTBF 60 days, MTTR {mttr_h} h", (60 * 24) / (60 * 24 + mttr_h))
ثم شغله بالأمر:
python3 availability.pyوالمخرج سوف يكون كما يلي:
one web server                              99.90000%     525.6 min/year
web + db (series)                           99.80010%    1050.7 min/year
web + db + dns + network (series)           99.74022%    1365.4 min/year
two web servers (parallel)                  99.99990%       0.5 min/year
two web + db + dns + network                99.83997%     841.1 min/year
two web + two db + dns + network            99.93981%     316.4 min/year
two web, failover works 99% of the time     99.99890%       5.8 min/year
MTBF 60 days, MTTR 2 h                      99.86130%     729.0 min/year
MTBF 60 days, MTTR 0.25 h                   99.98264%      91.2 min/year
في المخرج أعلاه لاحظ التالي:
- سيرفر واحد بنسبة 99.9% يسمح بحوالي 526 دقيقة توقف في السنة، وعندما تضع أمامه قاعدة البيانات وDNS والشبكة في سلسلة يصبح المسموح 1365 دقيقة، أي أن الخدمة أسوأ من أضعف جزء فيها.
- سيرفران للتطبيق في التوازي يعطيان نظرياً نصف دقيقة في السنة، ولكن عندما تضعهما في الخدمة الحقيقية مع قاعدة بيانات واحدة يصبح الناتج 841 دقيقة، والسبب أن قاعدة البيانات الواحدة أصبحت هي الحد، وإضافة نسخة لها تخفضه إلى 316 دقيقة. وهذا هو الدرس الأهم في هذا القسم: لا تضاعف الطبقة القوية وتترك الطبقة الضعيفة.
- عندما ينجح الانتقال 99% من المرات فقط، يرتفع التوقف من نصف دقيقة إلى حوالي ست دقائق، أي أكثر من عشرة أضعاف، فجودة آلية الانتقال واختبارها أهم من عدد النسخ.
- السطران الأخيران يكتبان الصيغة نفسها بطريقة أخرى: التوفر = MTBF ÷ (MTBF + MTTR)، حيث MTBF (Mean Time Between Failures) هو متوسط الزمن بين الأعطال وMTTR (Mean Time To Repair) هو متوسط زمن الإصلاح. ولاحظ أن تقليل زمن الإصلاح من ساعتين إلى ربع ساعة رفع التوفر من 99.86% إلى 99.98% دون أي سيرفر إضافي، لذلك قبل أن تشتري سيرفراً ثانياً اسأل: هل أستطيع أن أكتشف العطل وأصلحه أسرع؟ وهنا يأتي دور المراقبة والتنبيهات ودليل التشغيل المكتوب.
وتذكر أن كل هذه الحسابات تفترض أن الأعطال مستقلة، والقسم السابق بين أن هذا الافتراض يسقط عندما يكون السبب مشتركاً، لذلك استخدم الأرقام لتقارن بين التصاميم وتعرف أين الحلقة الأضعف، وليس لتعد العميل بعدد التسعات.
المؤشر SLI والهدف SLO والاتفاقية SLA
هذه ثلاثة اختصارات متشابهة، والخلط بينها يسبب مشاكل حقيقية مع العملاء، ويعرفها فصل Service Level Objectives في كتاب SRE كما يلي:
- المؤشر SLI (Service Level Indicator): مقياس رقمي محدد بعناية لجانب من الخدمة، مثل نسبة الطلبات الناجحة، أو نسبة الطلبات التي ترد في أقل من 300 ملي ثانية، وهو ما تقيسه المراقبة فعلاً.
- الهدف SLO (Service Level Objective): القيمة التي تريدها لهذا المؤشر، مثل «99.9% من الطلبات تنجح خلال 30 يوماً»، وهو هدف داخلي يتفق عليه الفريق.
- الاتفاقية SLA (Service Level Agreement): عقد صريح أو ضمني مع المستخدمين فيه عواقب إذا لم تحقق الأهداف، وغالباً تكون العاقبة مالية مثل خصم أو تعويض، ويقترح الكتاب سؤالاً بسيطاً للتفريق بينها وبين الهدف: ماذا يحدث إذا لم نحقق الهدف؟ فإذا لم توجد عاقبة صريحة فهو هدف SLO وليس اتفاقية.
والصورة التالية تبين العلاقة بين الثلاثة لخدمة واحدة:
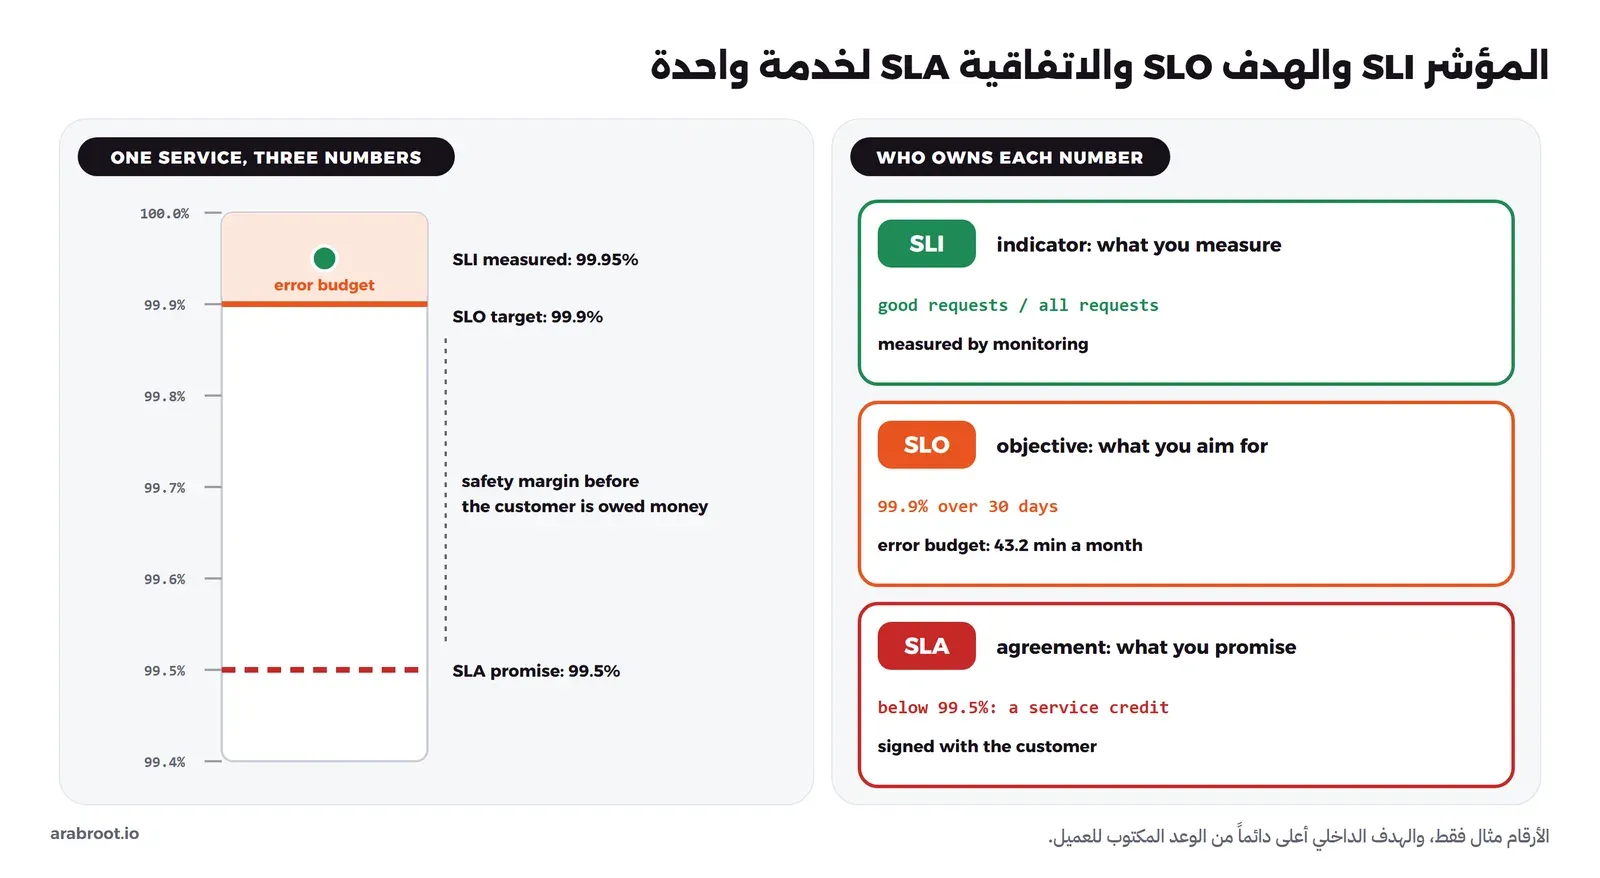
في الصورة أعلاه لاحظ أن الهدف الداخلي 99.9% أعلى من الوعد للعميل 99.5%، والسبب أنك تريد أن تعرف أنك في خطر قبل أن تدين للعميل بالمال. والفرق بين 100% والهدف هو ميزانية الأخطاء Error Budget، ففي الهدف 99.9% خلال 30 يوماً تملك 0.1% من الوقت، أي 43.2 دقيقة، تستطيع أن تصرفها على التحديثات والتجارب والأعطال، ويذكر الكتاب مثالاً بالطلبات: خدمة تستقبل 2.5 مليون طلب في اليوم بهدف 99.99% تستطيع أن تفشل في 250 طلباً وتبقى ضمن الهدف. فإذا صرفت الميزانية قبل نهاية الشهر توقف الفريق عن نشر الميزات الخطرة وركز على الثبات، وإذا بقيت فلا داعي للخوف من النشر.
وقد يتساءل البعض: لماذا لا نجعل الهدف 100%؟ والإجابة أن الهدف 100% غير ممكن عملياً، وأن كل تسعة إضافية تكلف أكثر بكثير من السابقة، وأن المستخدم لا يلاحظ الفرق بين 99.99% و99.999% لأن هاتفه وشبكته المنزلية أقل توفراً من ذلك كما يشرح الكتاب. أما التفاصيل العملية، مثل اختيار المؤشرات وحساب ميزانية الأخطاء والتنبيه عليها، فهي موضوع مخطط له في مرحلة الأداء والموثوقية SRE بعنوان «مفاهيم SRE للمبتدئين».
انقسام الدماغ Split Brain والنصاب Quorum
أخطر عطل في أي نظام فيه انتقال تلقائي ليس أن يتوقف السيرفر، وإنما أن يظن سيرفران في الوقت نفسه أن كل واحد منهما هو الأساسي، وهذا ما يسمى انقسام الدماغ Split Brain. والسبب أن السيرفر الاحتياطي لا يرى إلا غياب الرسائل، وهو لا يستطيع أن يفرق بين سيرفر أساسي توقف فعلاً، وسيرفر أساسي يعمل ولكن الشبكة بينهما انقطعت، والصورة التالية تبين ذلك:
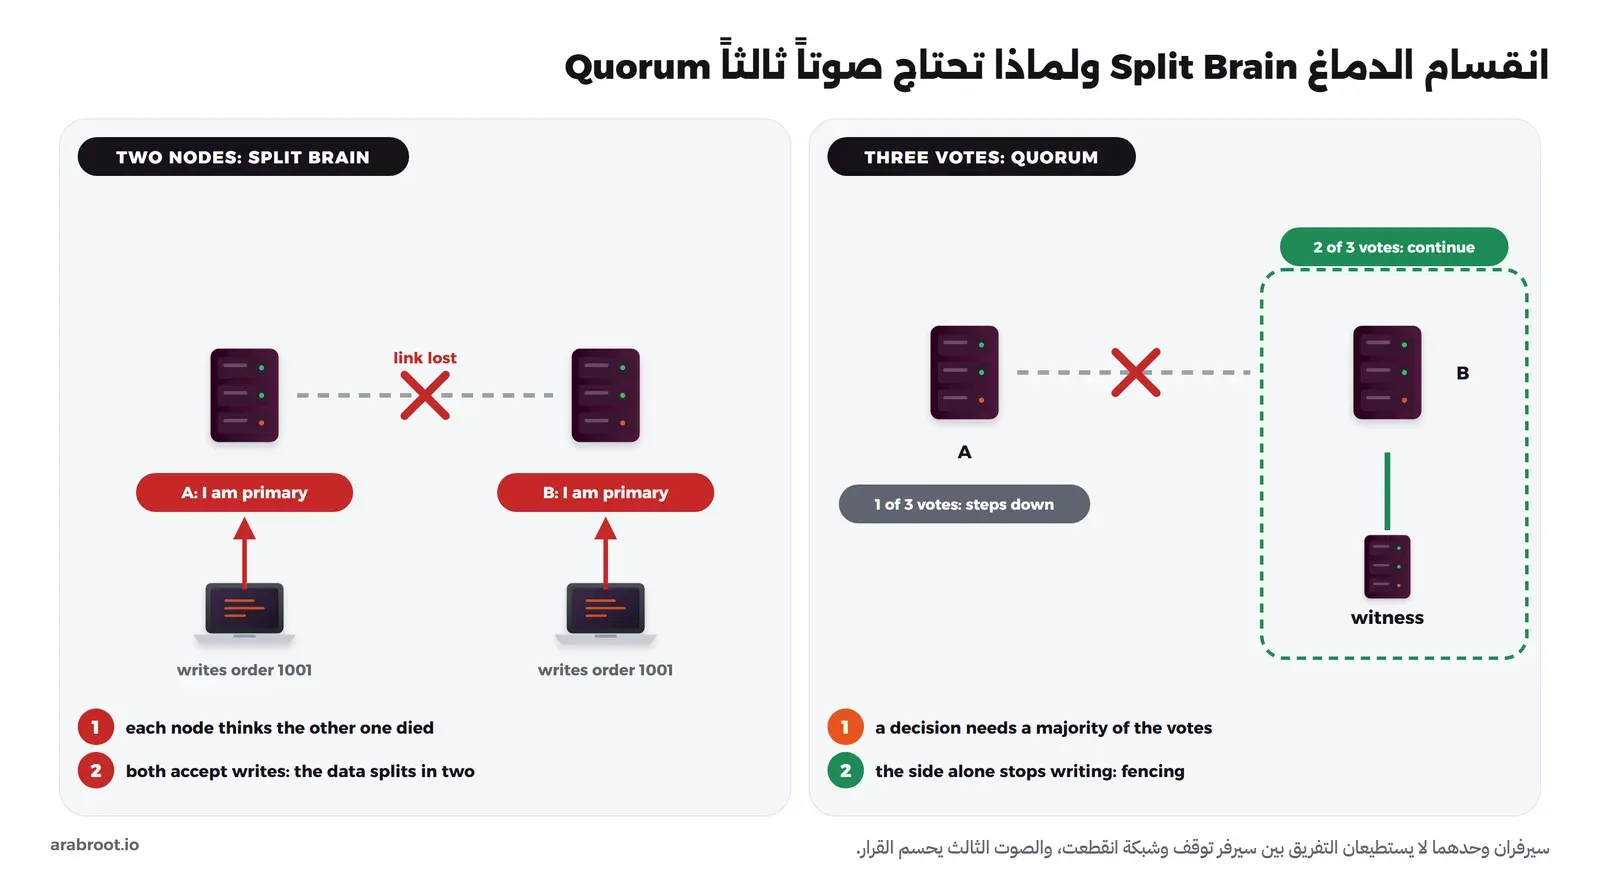
والنتيجة في قاعدة البيانات أن كل جهة من التطبيق تكتب على سيرفر مختلف، فتنقسم البيانات إلى نسختين لا يمكن دمجهما تلقائياً، وفي العنوان العائم أن سيرفرين يحملان العنوان نفسه، فتذهب الطلبات إلى أحدهما بحسب آخر رسالة ARP وصلت إلى الشبكة، وسوف ترى هذا بعينك في تجربة Keepalived العملية. والحل يتكون من فكرتين شرحناهما بالتفصيل في دليل الأنظمة الموزعة، لذلك سوف نذكرهما هنا باختصار:
- النصاب Quorum: لا يتخذ أي قرار إلا بأغلبية الأصوات، لذلك تحتاج ثلاثة أصوات على الأقل، وقد يكون الصوت الثالث سيرفراً صغيراً جداً يسمى الشاهد Witness، أو مخزن توافق مثل etcd. وعندما تنقطع الشبكة يستمر الجانب الذي يملك الأغلبية، ويتوقف الجانب الآخر بنفسه، ولهذا السبب يكون عدد السيرفرات في هذه الأنظمة فردياً.
- إيقاف السيرفر القديم Fencing: أن تضمن أن السيرفر القديم توقف عن الكتابة قبل أن يكتب أحد على الجديد، إما بأن يخفض نفسه عندما يفقد الأغلبية، أو بأن يقطع النظام الكهرباء عنه عبر واجهة إدارة العتاد، وقد شرحنا كيف يفعل ذلك Patroni في قسم إيقاف السيرفر القديم Fencing.
ولاحظ أن عنواناً عائماً بين سيرفرين فقط، مثل Keepalived بإعداده البسيط، لا يملك نصاباً، وهذا مقبول لموزع حمل لا يحمل بيانات، لأن أسوأ ما يحدث أن يرد السيرفران لفترة قصيرة، أما لقاعدة بيانات فهو غير مناسب إطلاقاً.
فحوص الصحة Health Checks: كيف تعرف أن الجزء توقف؟
كل انتقال يبدأ بسؤال بسيط: هل هذا السيرفر سليم؟ وقد شرحنا فكرة فحص الصحة ونبض القلب في دليل الأنظمة الموزعة، ورأيناها تعمل مع موزع الحمل في دليل مدخل إلى تصميم الأنظمة، أما هنا فالمهم ثلاثة قرارات:
- ماذا تفحص؟ الحل البسيط أن تفحص أن المنفذ مفتوح، وهذا يفشل في اكتشاف تطبيق يقبل الاتصال ولا يرد، وقد رأينا في دليل Monolith أم Microservices أن الخدمة المعلقة أخطر من الخدمة المتوقفة. والأفضل طلب HTTP إلى مسار مخصص للصحة يرد بالرمز 200 فقط عندما يستطيع التطبيق أن يخدم فعلاً.
- إلى أي عمق تفحص؟ إذا كان مسار الصحة يفحص قاعدة البيانات أيضاً، فعندما تتباطأ قاعدة البيانات لحظة تفشل كل الفحوص في كل السيرفرات معاً، فيزيل الموزع كل السيرفرات ويتحول البطء إلى توقف كامل. لذلك يفرق Kubernetes مثلاً في توثيق الفحوص بين فحص الحياة Liveness الذي يعيد تشغيل ال Container العالق، وفحص الجاهزية Readiness الذي يقرر هل يستقبل الطلبات الآن، فلا تجعل فحص الحياة يعتمد على خدمات خارجية.
- كم مرة قبل أن تقرر؟ فشل واحد قد يكون لحظة ازدحام، لذلك تستخدم كل الأدوات عدداً من المحاولات المتتالية، ففي HAProxy يعتبر السيرفر متوقفاً بعد ثلاثة فحوص فاشلة متتالية افتراضياً بالخيار
fall، ويعود بعد فحصين ناجحين بالخيارrise، وفي Keepalived الخياران نفسهما. والقيم الصغيرة تعني انتقالاً أسرع وانتقالات خاطئة أكثر، والقيم الكبيرة تعني العكس، والانتقال الخاطئ نفسه يقطع الاتصالات ويسبب أخطاء للمستخدمين.
اختبر التعطل قبل أن يحدث
الانتقال الذي لم تختبره هو انتقال لا تعرف هل يعمل، وقد رأيت في حادثة Cloudflare أن الشركة اختبرت فعلاً، ولكنها لم تختبر السيناريو الذي حدث. لذلك اجعل اختبار التعطل عملاً دورياً مثل النسخ الاحتياطي:
- ابدأ ببيئة الاختبار: أوقف السيرفر الأساسي، واقطع الشبكة عنه، واملأ قرصه، وأوقف الخدمة دون إيقاف السيرفر، وقس في كل مرة كم ثانية توقفت الخدمة من جهة المستخدم، وليس من سجلات الأداة فقط.
- ثم انتقال مخطط في الإنتاج: في وقت هادئ ومع إعلان مسبق، انقل الخدمة إلى السيرفر الاحتياطي واتركها عليه فترة، ثم أرجعها، وبهذا تعرف أن الاحتياطي يعمل فعلاً، وأن دليل التشغيل صحيح، وأن الفريق يعرف الخطوات.
- اختبر الاستعادة أيضاً: التوفر العالي لا يحميك من حذف البيانات، فاستعد النسخة الاحتياطية على سيرفر آخر وقس زمنها، كما شرحنا في دليل النسخ الاحتياطي.
ويذكر كتاب SRE قصة طريفة ومفيدة عن خدمة الأقفال Chubby في Google، فقد كانت تعمل بتوفر أعلى من هدفها لفترة طويلة، فبدأت فرق أخرى تبني خدماتها على افتراض أنها لا تتوقف أبداً، فلما توقفت فعلاً توقفت معها تلك الخدمات، والحل الذي يذكره الفصل أن الفريق يتأكد أن الخدمة تحقق هدفها دون أن تتجاوزه كثيراً، فإذا لم يحدث عطل حقيقي خلال الربع يوقفها عن قصد إيقافاً مخططاً، حتى تكتشف الفرق اعتمادها الخفي عليها. وسوف نتحدث عن اختبار التعطل بالتفصيل في موضوع «اختبار التعطل» في مرحلة التوفر العالي، وعن هندسة الفوضى Chaos Engineering في مرحلة SRE.
متى لا تحتاج التوفر العالي؟
قد تبدو الإجابة بديهية: كل خدمة تحتاج أن تعمل دائماً، ولكن في الواقع فالتوفر العالي يضاعف العتاد ويضاعف التعقيد، والتعقيد نفسه يسبب أعطالاً جديدة، مثل انتقال خاطئ في منتصف الليل، أو انقسام دماغ، أو نسخة احتياطية تعطلت دون أن يلاحظ أحد، لذلك قد يكون سيرفر واحد جيد أكثر توفراً من عنقود لا يفهمه الفريق. والسؤال الصحيح ليس «هل نحتاج التوفر العالي؟» وإنما «كم يكلفنا التوقف، وكم يكلفنا منعه؟»، ويمكنك أن تبدأ بالحساب التالي:
- تكلفة ساعة التوقف: المبيعات التي تضيع، والموظفون الذين يتوقفون عن العمل، والغرامات في الاتفاقيات، وثقة العملاء.
- عدد ساعات التوقف المتوقعة دون توفر عالي: من سجلاتك السابقة، أو من حساب MTTR الذي رأيته أعلاه، مع سيرفر جيد ونسخ احتياطية مختبرة ودليل استعادة مكتوب.
- تكلفة التوفر العالي في السنة: العتاد أو السيرفرات الإضافية، والترخيص إن وجد، ووقت الفريق في البناء والتحديث والاختبار والمناوبة، وهذا البند الأخير هو الأكبر عادة.
فإذا كانت الخدمة نظاماً داخلياً يستخدمه الموظفون في ساعات العمل، وتستطيع أن تقبل ساعة أو ساعتين من التوقف مرة في السنة، فالأنسب غالباً سيرفر واحد مع نسخ احتياطية مختبرة، واستعادة مكتوبة ومجربة، ومراقبة تنبهك بسرعة، وقد شرحنا في دليل مدخل إلى تصميم الأنظمة أن سيرفراً واحداً يكفي أكثر مما تتوقع. أما إذا كانت الخدمة متجراً أو نظام دفع يخسر مالاً حقيقياً في كل دقيقة، فالتوفر العالي يستحق تكلفته، وابدأ بأضعف طبقة كما رأيت في الحساب. وسوف نشرح هذا القرار بالأرقام في موضوع «هل تحتاج التوفر العالي فعلاً؟ احسب تكلفة التوقف قبل أن تبني» في مرحلة التوفر العالي.
ماذا بعد هذا المقال في مرحلة التوفر العالي؟
بعد المفاهيم يأتي التطبيق، والترتيب المنطقي هو أن تبدأ بالطبقة الأبسط ثم تنتقل إلى البيانات: عنوان عائم بين سيرفرين مع Keepalived، ثم موزع حمل متكرر بإضافة HAProxy، ثم قواعد البيانات. والمقالات التالية تغطي ما نشر من ذلك حتى الآن:
 دليلعنوان IP عائم بين سيرفرين مع Keepalived وVRRPكيف ينقل Keepalived عنواناً واحداً بين سيرفرين تلقائياً عندما يتوقف أحدهما، مع تجربة حقيقية تقيس زمن الانتقال بالثواني.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلHAProxy: توزيع الحمل Load Balancing أمام خدماتكعندما يعمل تطبيقك على أكثر من سيرفر، يوزع HAProxy الطلبات بينها ويستبعد المعطل منها تلقائياً مع شهادات HTTPS.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
وفي خريطة التعلم مواضيع مخطط لها بإذن الله في المرحلة نفسها: Patroni للانتقال التلقائي في PostgreSQL، وعنقود MariaDB Galera، وSentinel لـ Redis وValkey، وعنقود Proxmox VE للأجهزة الافتراضية.
قائمة تحقق
- كتبت RPO وRTO لكل خدمة مهمة بالأرقام، واتفقت عليهما مع الإدارة.
- رسمت طريق الطلب من المستخدم حتى البيانات، وسألت عن كل جزء: ماذا يحدث إذا توقف؟
- تعرف نقطة الفشل الواحدة في الكهرباء والشبكة وDNS وقاعدة البيانات والأشخاص، وقررت لكل واحدة هل تزيلها أم تقبلها.
- حسبت التوفر المتوقع للتصميم، وعرفت الطبقة الأضعف قبل أن تضيف أي نسخة.
- كل سيرفر في Active-Active يتحمل الحمل كاملاً وحده عند توقف الآخر.
- أي نظام يحمل بيانات وينتقل تلقائياً عنده نصاب من ثلاثة أصوات على الأقل وFencing للسيرفر القديم.
- فحوص الصحة تفحص قدرة التطبيق على الخدمة، ولا تسقط كل السيرفرات معاً عندما تتباطأ خدمة مشتركة.
- عندك هدف SLO داخلي أعلى من أي وعد SLA للعملاء، وتعرف ميزانية الأخطاء لكل شهر.
- نفذت انتقالاً مخططاً واستعادة من نسخة احتياطية خلال الأشهر الثلاثة الأخيرة، وقست زمنهما من جهة المستخدم.
- يوجد دليل تشغيل مكتوب، وشخصان على الأقل يعرفان خطوات الانتقال والاستعادة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التوفر العالي هو أن تستمر الخدمة رغم تعطل جزء منها، وهو يختلف عن النسخ الاحتياطي واستعادة الخدمة بعد الكارثة، وتحتاج الثلاثة معاً.
- التكرار وحده لا يكفي، فالتوفر يحتاج نسخة ثانية وطريقة لاكتشاف العطل وطريقة لتحويل المستخدمين، سواء كان الشكل Active-Passive أو Active-Active.
- ابحث عن نقطة الفشل الواحدة في كل طبقة، وتذكر أن الأعطال المشتركة مثل الإعداد الخاطئ والكهرباء تصيب النسختين معاً، كما في حادثتي Cloudflare في 2023 وAWS في 2011.
- في السلسلة تضرب نسب التوفر، وفي التوازي تضرب نسب التعطل، وأضعف طبقة واحدة تحدد توفر الخدمة كلها، وتقليل زمن الإصلاح قد يفيد أكثر من سيرفر إضافي.
- المؤشر SLI ما تقيسه، والهدف SLO ما تريده، والاتفاقية SLA ما تعد به وتدفع ثمن عدم تحقيقه، والفرق بين الهدف و100% هو ميزانية الأخطاء.
- سيرفران وحدهما لا يملكان نصاباً، فأي نظام يحمل بيانات يحتاج ثلاثة أصوات وFencing لتجنب انقسام الدماغ.
- اختبر الانتقال والاستعادة بانتظام، واحسب تكلفة التوقف قبل أن تبني، فقد يكون سيرفر واحد جيد مع نسخ احتياطية مختبرة هو القرار الصحيح.
دليلعنوان IP عائم بين سيرفرين مع Keepalived وVRRPكيف ينقل Keepalived عنواناً واحداً بين سيرفرين تلقائياً عندما يتوقف أحدهما، مع تجربة حقيقية تقيس زمن الانتقال بالثواني.دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة. دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل سكربت حساب التوفر على Python 3.13.3.


