

لنفرض أن فريقاً من أربعة مطورين يبدأ منتجاً جديداً، وفي أول اجتماع عن المعمارية يقترح أحدهم أن يقسم النظام من اليوم الأول إلى ثماني خدمات مصغرة Microservices، لكل خدمة قاعدة بياناتها وخط نشرها، والسبب أن الشركات الكبيرة تعمل بهذه الطريقة. ولنفرض في المقابل شركة لديها برنامج واحد عمره عشر سنوات، ونشر تعديل من سطرين فيه يحتاج ساعة كاملة وتنسيقاً بين خمسة فرق، فيقترح أحدهم الحل نفسه. والاقتراحان يبدوان متشابهين، لكن الإجابة الصادقة عليهما مختلفة تماماً، والسبب أن الخدمات المصغرة تحل مشكلة محددة بثمن محدد، فإذا لم تكن المشكلة عندك فأنت تدفع الثمن دون أن تأخذ المقابل.
وفي مقال أنماط المعمارية وضعنا البرنامج الواحد المقسم إلى وحدات Modular Monolith والخدمات المصغرة في مكانهما بين الأنماط الأخرى، ووعدنا بمقال كامل عن القرار بينهما، وهذا هو. وسوف نلتزم فيه بقاعدة واحدة: ما نقوله عن أي شركة نذكر مصدره المنشور من الشركة نفسها، وكل رقم من تجربتنا نعرض الأمر الذي أخرجه، وسوف نناقش في هذا المقال ما يلي:
- ما الذي نقارنه بالضبط: البرنامج الواحد Monolith، والبرنامج الواحد المقسم إلى وحدات، والخدمات المصغرة.
- ما الذي تشتريه الخدمات المصغرة فعلاً، وما الذي تدفعه مقابله في الشبكة والبيانات والتشغيل.
- علاقة القرار بحجم الفريق وقانون Conway.
- حالات موثقة في الاتجاهين: أداة مراقبة في Prime Video، وSegment، وUber، مع إشارة إلى Shopify وStack Overflow.
- ما الذي كتبه Martin Fowler في MonolithFirst وMicroservice Premium، ومن خالفه.
- تجربة عملية: نفس المتجر الصغير كبرنامج واحد وكخدمتين بينهما HTTP وطابور Queue، نقيس فيها زمن الطلب ونرى ماذا يحدث عندما تتوقف خدمة.
- دليل قرار حسب حجم الفريق والمجال، وكيف تخرج خدمة لاحقاً بطريقة Strangler Fig.
ما الذي نقارنه بالضبط؟
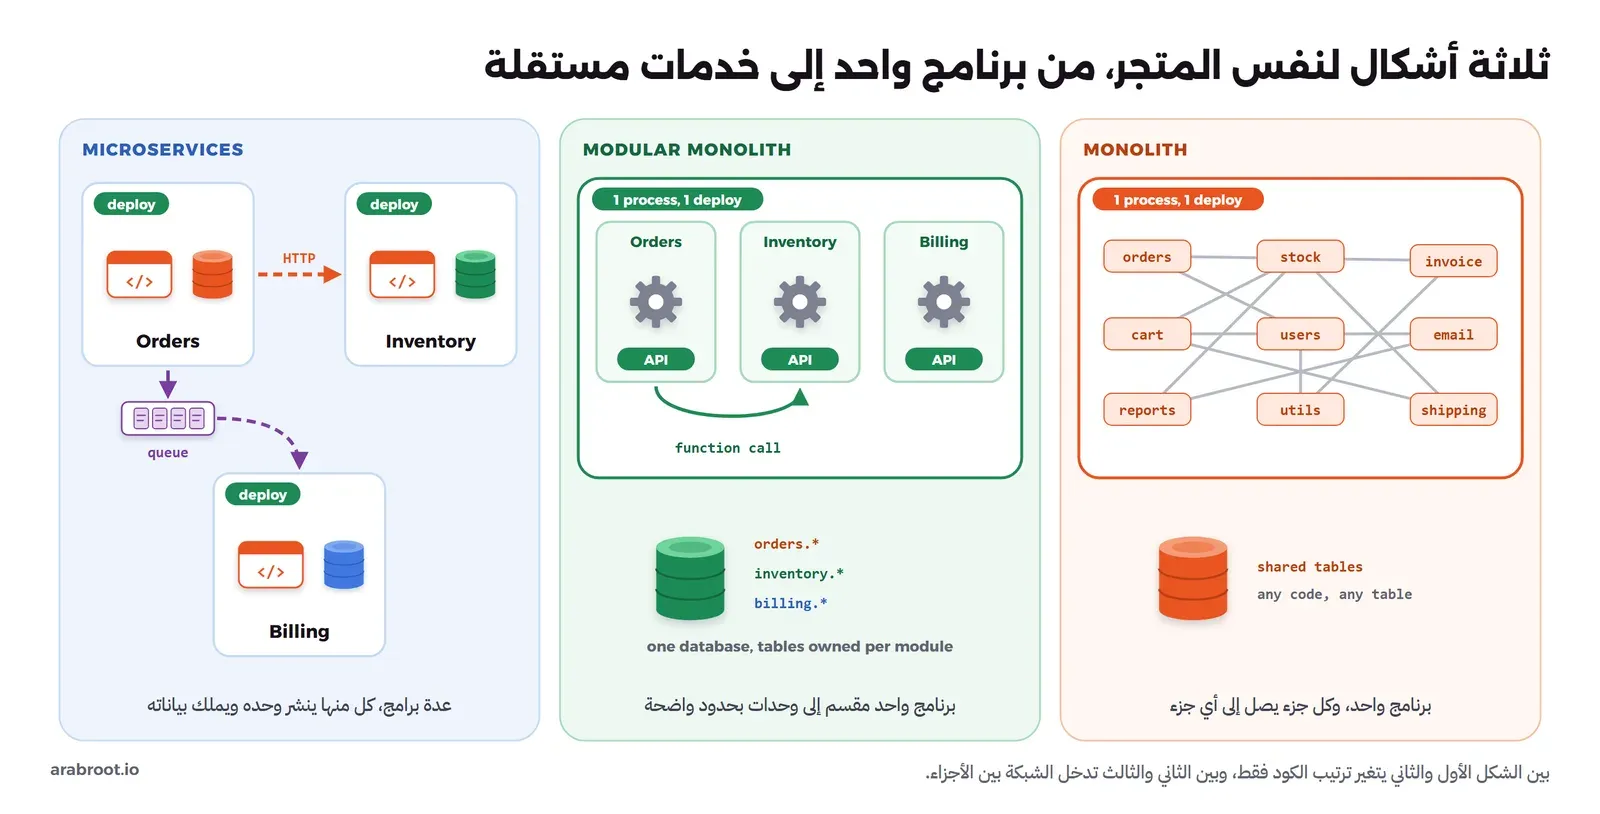
أبسط سؤال يفرق بين الأشكال الثلاثة هو: كم وحدة نشر Deployment Unit في النظام، وكيف يتكلم كل جزء مع الآخر؟ فالبرنامج الواحد ينشر مرة واحدة وأجزاؤه تتكلم باستدعاء دالة في نفس العملية Process، والخدمات المصغرة تنشر كل واحدة وحدها وتتكلم عبر الشبكة، وبينهما شكل ثالث يبقى وحدة نشر واحدة ولكن يرتب الكود داخله في وحدات بحدود واضحة. والصورة التالية تبين نفس المتجر بالأشكال الثلاثة:
البرنامج الواحد Monolith ليس كلمة سيئة
البرنامج الواحد Monolith هو نظام يبنى ويختبر وينشر كوحدة واحدة، ملف jar واحد أو Container واحد أو مجلد واحد على السيرفر، وأغلب الأنظمة الناجحة التي تعرفها بدأت بهذا الشكل، وكثير منها ما زال عليه. والمشكلة التي يشتكي منها الناس عادة ليست أن النظام وحدة نشر واحدة، وإنما أن الكود داخله بلا حدود، فكل جزء يستدعي أي جزء ويقرأ أي جدول، وتعديل الشحن يكسر الفوترة، وهذا ما تراه في اللوحة اليمنى من الصورة أعلاه. ويقول Martin Fowler في Microservice Premium إن كثيراً من المشكلات التي تنسب إلى البرنامج الواحد ليست من طبيعته، فمن يقول إن النشر المستمر Continuous Delivery مستحيل مع برنامج واحد يتجاهل شركات نجحت فيه مثل Facebook وEtsy، ومن يقول إن الأجزاء لا يمكن فصلها إلا بخدمات يتجاهل أنه لا يوجد مانع من بناء برنامج واحد بحدود وحدات واضحة، وإن كان يعترف بأن الحدود في الواقع تنكسر بسهولة إذا لم يحرسها أحد.
البرنامج الواحد المقسم إلى وحدات Modular Monolith
هذا هو الشكل الأوسط في الصورة: وحدة نشر واحدة، والكود داخلها مقسم حسب المجال إلى وحدات Modules، وكل وحدة تعرض واجهة عامة صغيرة وتخفي الباقي وتملك جداولها، والبناء نفسه يرفض أن تصل وحدة إلى داخل وحدة أخرى. وقد شرحنا هذا الشكل بالتفصيل في قسم Modular Monolith من مقال أنماط المعمارية، ورأينا هناك كيف يرفض مترجم C# الوصول إلى الفئات الداخلية، وكيف قسمت Shopify برنامجها الكبير، لذلك لن نعيد ذلك هنا، ويكفي أن تتذكر أنه يعطيك أغلب فوائد الحدود الواضحة دون أن يدخل الشبكة بين الأجزاء.
الخدمات المصغرة Microservices: النشر المستقل هو التعريف
عرف James Lewis وMartin Fowler الخدمات المصغرة بأنها خدمات صغيرة تعمل كل منها في عملية مستقلة، وتبنى حول قدرة من قدرات العمل، وتنشر وحدها، وتملك بياناتها، وقد ذكرنا تعريفهما في قسم الخدمات المصغرة. وأهم كلمة في هذا التعريف هي «تنشر وحدها»، فإذا كانت عندك عشر خدمات لا يمكن نشر واحدة منها دون الأخرى، أو تقرأ كلها من نفس الجداول، فأنت لم تحصل على خدمات مصغرة، وإنما على برنامج واحد موزع على الشبكة، وهذا ما يسمى Distributed Monolith، وهو أسوأ الشكلين معاً: ثمن الشبكة كاملاً دون استقلال النشر. ويقول بحث DORA عن الفرق المستقلة Loosely Coupled Teams ذلك بوضوح: الخدمات المصغرة يفترض أن تمكن الفرق من الاختبار والنشر باستقلال، لكن كثيراً مما يسمى معمارية خدمات لا يسمح بذلك فعلاً، ويمكن الوصول إلى هذه النتائج حتى بتقنيات Mainframe، ويمكن الفشل فيها مع أحدث التقنيات.
وبين الشكلين يوجد حل وسط عملي هو المعمارية القائمة على الخدمات Service-Based: عدد قليل من الخدمات الكبيرة، كل منها مجال كامل، وقد شرحناها في قسم Service-Based، وسوف تراها تظهر في دليل القرار لاحقاً.
ما الذي تشتريه الخدمات المصغرة فعلاً؟
قبل أن نتكلم عن الثمن، من العدل أن نرى المكاسب كما وصفها من عاشها. فقد كتبت Uber في مقالها عن DOMA في يوليو 2020 أنها كانت في حدود عامي 2012 و2013 تعمل ببرنامجين كبيرين، وأنها انتقلت إلى الخدمات المصغرة لأسباب محددة: خطأ واحد في الكود يمكن أن يسقط Uber كلها، والنشر خطير ومكلف ويحتاج تراجعاً كثيراً، والحدود بين الأجزاء ضعيفة، والفرق لا تستطيع أن تعمل باستقلال، وأن ذلك حدث عندما كبرت الشركة من عشرات المهندسين إلى مئات منهم. والصورة التالية تجمع المكاسب والثمن في مكان واحد:
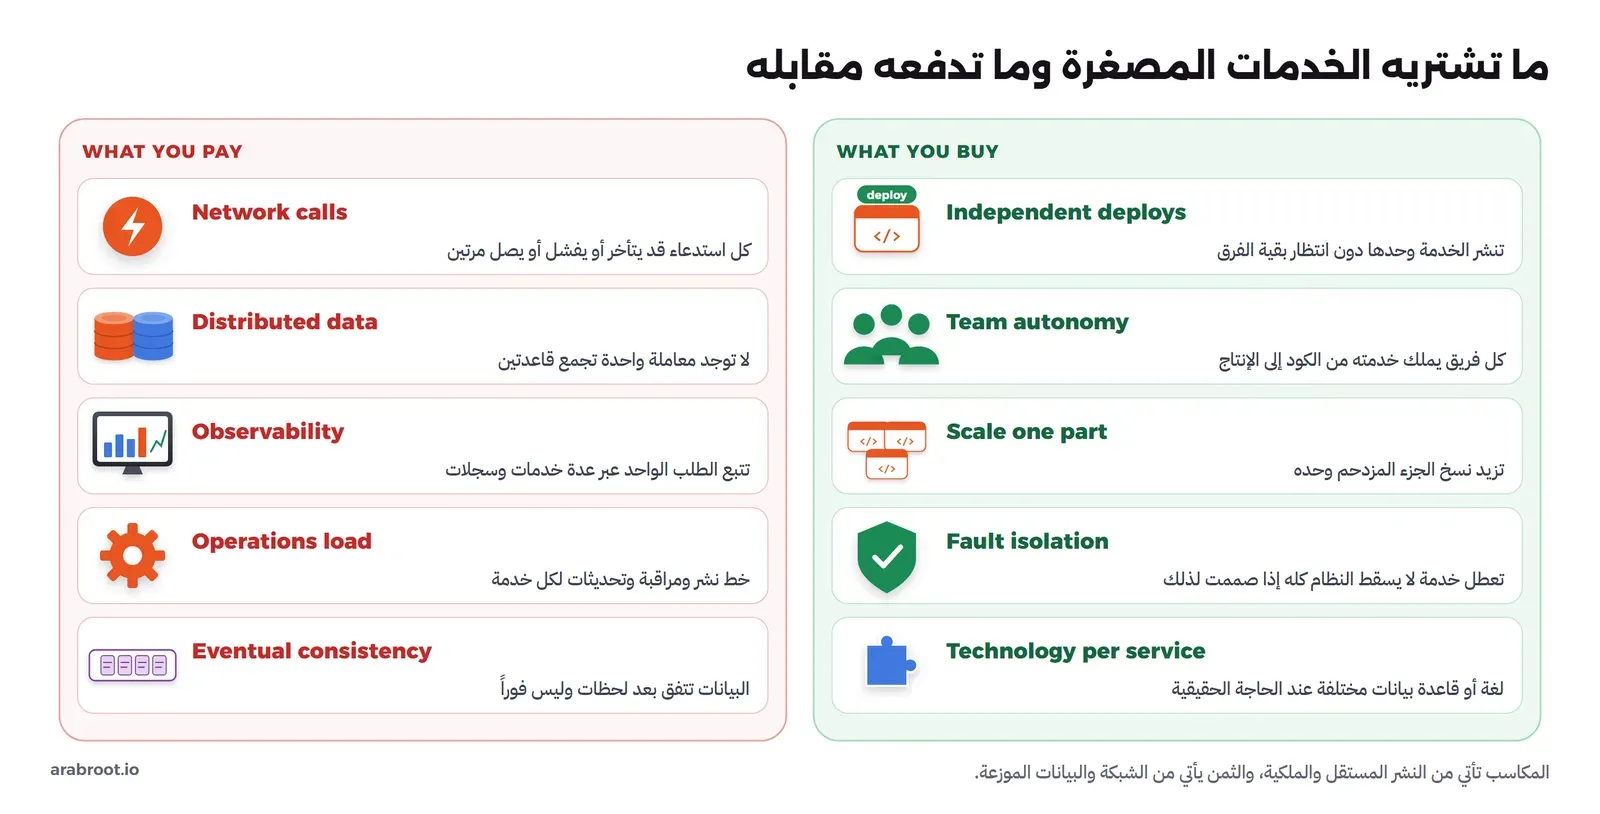
وفيما يلي كل مكسب، ومعه الشرط الذي لا تحصل عليه بدونه:
- النشر المستقل Independent Deployment: الفريق ينشر خدمته متى شاء دون أن ينتظر بقية الفرق، وهذا أهم مكسب على الإطلاق. وشرطه أن يكون العقد بين الخدمات متوافقاً مع الإصدارات السابقة، فإذا كان كل تغيير في API يكسر من يستدعيها فسوف تعود إلى النشر المشترك، وقد شرحنا ذلك في الإصدارات والتوافق في تصميم API.
- استقلال الفرق Team Autonomy: كل فريق يملك خدمته من الكود إلى الإنتاج، ويعرف الجميع من المسؤول عن ماذا. وشرطه أن تطابق حدود الخدمة حدود الفريق، أما إذا كان كل فريق يعدل في خدمات غيره، فقد كتبت Uber نفسها أن هذا يلغي وعد الملكية الواضحة.
- توسيع جزء واحد Independent Scaling: إذا كان البحث يحتاج عشرة أضعاف ما تحتاجه صفحة الحساب، فأنت تزيد نسخ البحث وحده. وشرطه أن يكون الحمل مختلفاً فعلاً، والسبب أن البرنامج الواحد الذي لا يحفظ حالة في الذاكرة يمكن تشغيل عدة نسخ منه خلف موزع حمل Load Balancer، وهذا يكفي أغلب الأنظمة كما شرحنا في هل تحتاج Kubernetes فعلاً؟
- عزل الأعطال Fault Isolation: تعطل خدمة التوصيات لا يوقف الدفع. وشرطه أن تصمم الاستدعاءات للفشل، بمهلة Timeout وقاطع دائرة Circuit Breaker واتصال غير متزامن حيث يمكن، وإلا انتقل العطل في سلسلة من خدمة إلى أخرى، وكتبت Uber أن ارتفاع زمن الاستجابة في خدمة بعيدة في السلسلة قد يسبب مشكلات متتالية في كل ما فوقها. وسوف ترى في التجربة كيف يبدو ذلك، والأدوات في قسم التعامل مع الفشل من مقال الأنظمة الموزعة.
- حرية التقنية لكل خدمة Technology per Service: خدمة معالجة الصور بلغة، وخدمة الطلبات بلغة أخرى. وهذا مكسب حقيقي في حالات قليلة، لكنه يتحول إلى عبء إذا صار عندك خمس لغات وثلاث قواعد بيانات يحتاج كل منها من يعرفها في المناوبة.
وما الذي تدفعه مقابلها؟
سمى Fowler هذا الثمن علاوة الخدمات المصغرة Microservice Premium في مايو 2015، وقال إن هذا الأسلوب يدير نظاماً معقداً لكنه يضيف تعقيده الخاص، فأنت تحتاج نشراً آلياً ومراقبة وتعاملاً مع الفشل واتساقاً نهائياً وغيرها مما يأتي مع أي نظام موزع، وقاعدته الأساسية: لا تفكر في الخدمات المصغرة إلا إذا كان عندك نظام أعقد من أن تديره كبرنامج واحد. وهذه بنود الثمن واحداً واحداً:
- كل استدعاء يصبح طلباً عبر الشبكة: استدعاء الدالة الذي يأخذ أجزاء من الميكروثانية ولا يفشل إلا بخطأ في الكود يصبح طلباً قد يتأخر أو ينقطع أو يصل مرتين، وهذه هي الافتراضات الخاطئة عن الشبكة، وسوف نقيس الفرق في التجربة.
- البيانات موزعة والمعاملة الواحدة اختفت: في البرنامج الواحد ينشئ الطلب ويحجز المخزون في معاملة Transaction واحدة، إما أن تنجح كلها أو تلغى كلها. وعندما يملك كل جزء قاعدته لا توجد معاملة تجمعهما، فتحتاج نمط Saga بخطوات تعويض ونمط Outbox حتى لا تضيع رسالة بعد الكتابة، وتقارير كانت استعلام JOIN واحداً تصبح تجميعاً من عدة خدمات.
- الاتساق النهائي Eventual Consistency: عندما تمر العملية بطابور، يرى المستخدم حالة وسطى مثل «قيد المعالجة»، وهذا قرار يجب أن يوافق عليه أصحاب العمل، وليس تفصيلاً تقنياً، كما شرحنا في الاتساق النهائي بلغة العمل.
- المراقبة والتتبع Observability: الطلب البطيء كان يظهر في سجل برنامج واحد، والآن يمر بخمس خدمات ولكل منها سجلها، فتحتاج معرف طلب يمر معه في كل خدمة كما في معرف الطلب Request ID، وسجلات مركزية كما في السجلات Logging. وقد ذكرت Uber في مقالها مثالاً لمهندسين احتاجوا أن يمروا بحوالي 50 خدمة تملكها 12 فرقاً مختلفة حتى يجدوا سبب مشكلة واحدة.
- عبء التشغيل Operations Load: لكل خدمة خط نشر وإعدادات ومراقبة وتنبيهات وتحديثات أمنية لاعتمادياتها، وكتب Fowler في Microservice Prerequisites سنة 2014 أن هناك أساسيات يجب أن تكون عندك قبل أن تفكر في هذا الأسلوب: أن تجهز سيرفراً جديداً في ساعات، ومراقبة أساسية تكشف المشكلات بسرعة، ونشراً سريعاً لكل خدمة، وتعاوناً قريباً بين المطورين والتشغيل.
- الاختبار بين الخدمات: الاختبار الذي كان يشغل البرنامج كله على جهاز المطور يصبح بيئة فيها عدة خدمات بإصدارات مختلفة، ويصبح العقد بين الخدمات شيئاً يجب أن يختبر وحده.
وقد يتساءل البعض: إذا كان الثمن بهذا الحجم، فلماذا تعمل بها الشركات الكبيرة؟ والإجابة أن الثمن ثابت تقريباً لكل خدمة، أما المكسب فيكبر مع عدد الفرق، ففي شركة فيها مئات المهندسين يكون انتظار الفرق لبعضها أغلى بكثير من ثمن الشبكة، وفي فريق من خمسة أشخاص يحدث العكس تماماً.
قانون Conway وحجم الفريق: السؤال الذي يسبق التقنية
شرحنا في مقال التصميم والمعمارية أن النظام يشبه بنية التواصل في المؤسسة التي بنته، وفي مقال حجم الفريق كيف يقسم الفريق الكبير إلى فرق صغيرة يملك كل منها جزءاً من النظام، وهذا هو المكان الذي يلتقي فيه الموضوعان: الخدمة المستقلة لها معنى عندما يكون خلفها فريق مستقل. فإذا رسمت ثماني خدمات لفريق واحد من أربعة أشخاص، فسوف ينشرها كلها نفس الأشخاص في نفس اليوم، فتحصل على ثمن الحدود الشبكية دون أن يكون هناك فريقان يحتاجان أن يستقلا عن بعضهما. وقد كتب Werner Vogels، المدير التقني لشركة Amazon، في Monoliths are not dinosaurs في مايو 2023 قاعدة عملية: إذا كانت هناك مجموعة خدمات تشارك دائماً في نفس الاستجابة، ولها نفس متطلبات التوسع والأداء، ويديرها فريق واحد، فمن المفيد أن تنظر في دمجها، وذكر مثالاً شركة ناشئة بخمسة مهندسين قد تختار برنامجاً واحداً لأنه أسهل في النشر.
والعكس صحيح أيضاً، فقد رأيت في قصة Uber أن البرنامج الواحد ربط مصير الفرق ببعضها عندما وصل عدد المهندسين إلى المئات، لذلك لا تسأل «ما هي المعمارية الأحدث؟» وإنما اسأل «كم فريقاً يحتاج أن ينشر دون أن ينتظر غيره اليوم، وليس بعد ثلاث سنوات؟».
حالات موثقة في الاتجاهين
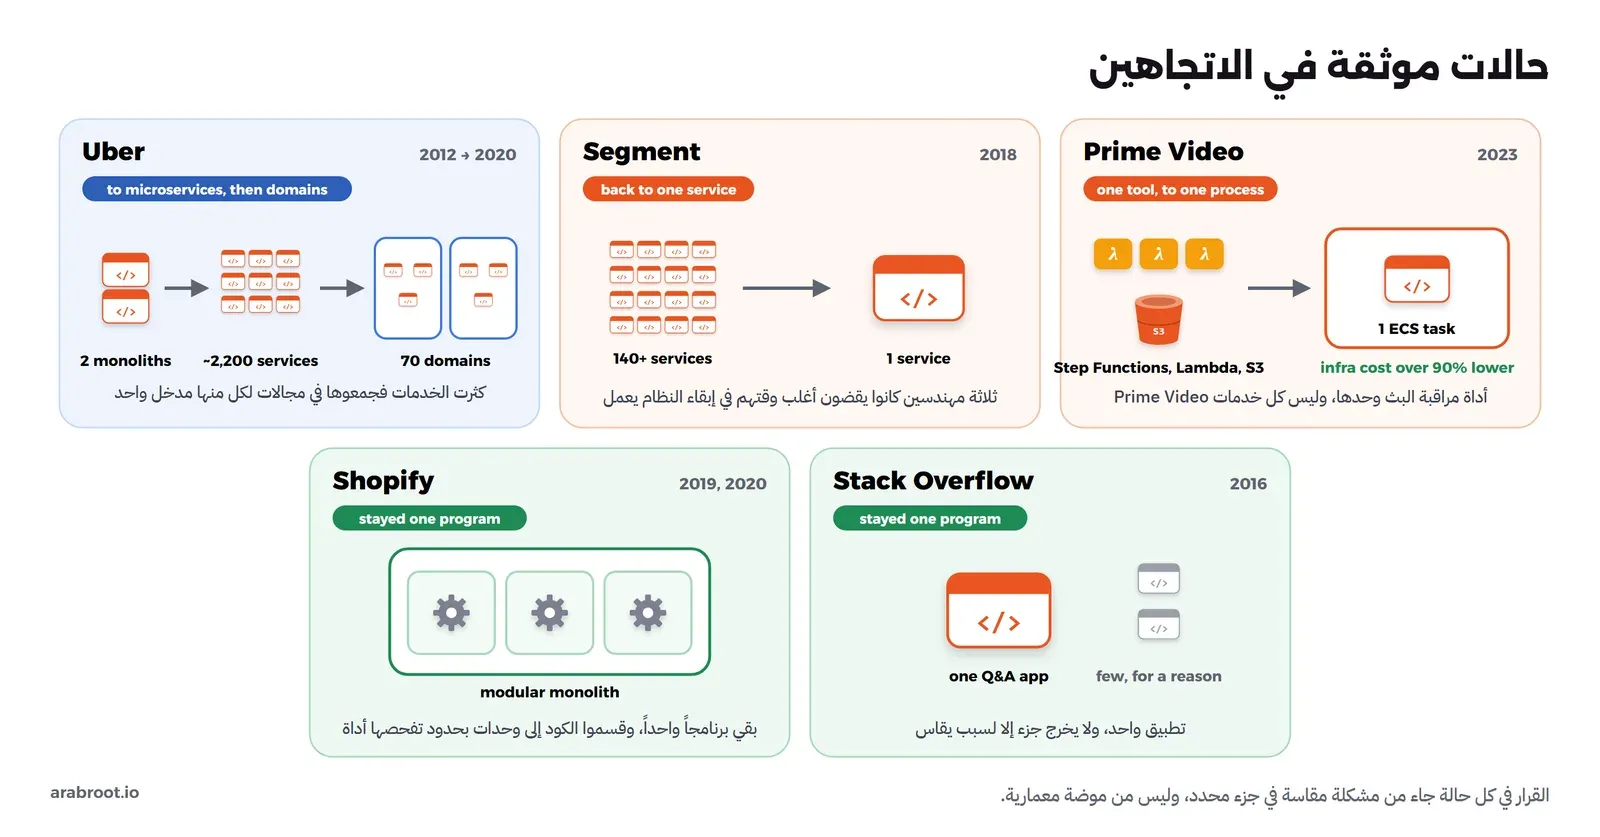
أكثر ما يضلل في هذا النقاش أن كل طرف يذكر القصة التي تناسبه، لذلك جمعنا هنا حالات في الاتجاهين، كلها من مقالات كتبتها فرق الشركات نفسها، والصورة التالية تلخصها:
Prime Video: أداة مراقبة عادت إلى عملية واحدة
في 22 مارس 2023 نشر Marcin Kolny من فريق تحليل جودة الفيديو في Prime Video مقالاً بعنوان Scaling up the Prime Video audio/video monitoring service and reducing costs by 90%، والموقع الأصلي لم يعد متاحاً لذلك نربط بنسخة Internet Archive. والأداة تراقب كل بث مباشر يشاهده العملاء وتبحث فيه عن عيوب مثل تجمد الصورة أو عدم تزامن الصوت مع الفيديو، ولها ثلاثة أجزاء: محول يقطع البث إلى إطارات Frames ومقاطع صوت، وكواشف عيوب Defect Detectors تحلل الإطارات، وجزء ينسق العمل بينها. وبنى الفريق النسخة الأولى كنظام موزع من مكونات Serverless، فالتنسيق في AWS Step Functions، والكواشف تعمل في AWS Lambda، والإطارات تمر بينها عبر Bucket في Amazon S3، وكتبوا أن هذا كان اختياراً جيداً لبناء الخدمة بسرعة.
لكن عند التوسع ظهرت مشكلتان: الأولى أن Step Functions كانت تنفذ عدة انتقالات حالة State Transitions لكل ثانية من البث، فوصلوا بسرعة إلى حدود الحساب، وكتبوا أنهم اصطدموا بحد صلب للتوسع عند حوالي 5% من الحمل المتوقع، إضافة إلى أن الخدمة تحسب سعرها لكل انتقال، والثانية أن رفع الإطارات إلى S3 ثم تنزيلها في كل كاشف كان يكلف كثيراً من الطلبات. فجمعوا المكونات كلها في عملية واحدة تعمل في ECS task، فأصبحت الإطارات تنتقل في الذاكرة دون S3، وصار التنسيق داخل نفس العملية، وكتبوا أن التكلفة على البنية التحتية انخفضت بأكثر من 90%، وأن قدرتهم على التوسع زادت.
ولاحظ ثلاثة أشياء قبل أن تستخدم هذه القصة في نقاش: أولاً هي أداة مراقبة واحدة يملكها فريق واحد، وليست Prime Video كلها، وثانياً المكونات بقيت هي نفسها، فما تغير هو مكان التشغيل وطريقة نقل البيانات، وهذا يشبه تماماً الانتقال من الشكل الثالث إلى الشكل الثاني في أول صورة، وثالثاً أن الحل الجديد له ثمنه، فقد كتبوا أن الكواشف أصبحت تتوسع رأسياً فقط داخل نفس الجهاز، وعندما تجاوزوا سعة جهاز واحد شغلوا عدة نسخ من الخدمة لكل منها مجموعة مختلفة من الكواشف، مع طبقة تنسيق خفيفة توزع الطلبات. وقد علق Werner Vogels على القصة في مقاله المذكور أعلاه بأنه لا يوجد شكل واحد يناسب كل شيء، وأن Amazon لا تفرض على مهندسيها نمطاً معمارياً بعينه.
Segment: من أكثر من 140 خدمة إلى خدمة واحدة
في 10 يوليو 2018 نشرت Alexandra Noonan من Segment مقالاً بعنوان Goodbye Microservices، وهو منشور اليوم على مدونة Twilio التي اشترت Segment. والمنتج يستقبل أحداث المستخدمين ويرسلها إلى وجهات Destinations خارجية كثيرة، وفي البداية كان هناك طابور واحد لكل الوجهات، فإذا تعطلت وجهة واحدة امتلأ الطابور بإعادة المحاولات وتأخرت كل الوجهات الأخرى، وهذا ما يسمى Head-of-Line Blocking. فكان الحل خدمة وطابوراً لكل وجهة، وهذا عزل الأعطال فعلاً، فالوجهة المعطلة لا يتأخر إلا طابورها.
ثم كبر العدد، فكل وجهة جديدة تعني مستودع كود Repository جديداً وطابوراً جديداً وخدمة جديدة، وكتبوا أنهم أضافوا أكثر من 50 وجهة، وأنهم بنوا مكتبات مشتركة لتوحيد الكود، ثم صار تحديث المكتبة يعني اختبار ونشر عشرات الخدمات، فكان المطورون تحت الضغط يحدثونها في وجهة واحدة فقط، حتى أصبحت كل وجهة تستخدم نسخة مختلفة. وأضافوا أن ضبط التوسع الآلي لكل خدمة صار فناً أكثر منه علماً، لأن كل خدمة لها مزيج مختلف من المعالج والذاكرة، وأن عبء التشغيل كان يكبر خطياً مع كل وجهة، حتى أصبح ثلاثة مهندسين يقضون أغلب وقتهم في إبقاء النظام يعمل.
فدمجوا أكثر من 140 خدمة في خدمة واحدة ومستودع واحد، وبنوا نظاماً اسمه Centrifuge بدل الطوابير المنفصلة، وأداة تسجل ردود الوجهات للاختبار حتى لا تفشل الاختبارات بسبب الشبكة، وكتبوا أن تحسينات المكتبات المشتركة ارتفعت من 32 في فترة الخدمات إلى 46 في السنة التالية. والجميل في المقال أنه يذكر ما خسروه: عزل الأعطال أصبح صعباً، فخطأ في وجهة واحدة يمكن أن يسقط الخدمة لكل الوجهات، والتخزين المؤقت في الذاكرة صار أقل فائدة، وتحديث مكتبة قد يكسر عدة وجهات. وختموا بأن الخدمات المصغرة تعمل جيداً في أجزاء أخرى من بنيتهم، وأن هذا الجزء تحديداً كان مثالاً على أنها قد تضر الإنتاجية والأداء.
Uber: من برنامجين إلى 2200 خدمة، ثم إلى مجالات
قصة Uber تسير في الاتجاه الآخر، فهي لم تعد إلى برنامج واحد، وإنما أضافت ترتيباً فوق الخدمات. ففي مقال Introducing Domain-Oriented Microservice Architecture الذي نشره Adam Gluck في 23 يوليو 2020، يذكر أن Uber وصلت إلى حوالي 2,200 خدمة حرجة، وأنه مع نمو المهندسين من المئات إلى الآلاف ظهرت مشكلات التعقيد: تتبع مشكلة واحدة يمر بعشرات الخدمات، وبناء ميزة بسيطة يحتاج العمل في خدمات تملكها فرق مختلفة، والفرق تعدل في خدمات غيرها بل وتنشرها نيابة عنها، حتى ظهر ما سماه «برامج واحدة متصلة بالشبكة» Networked Monoliths، أي خدمات تبدو مستقلة لكنها يجب أن تنشر معاً.
والحل الذي سموه DOMA يجمع الخدمات المترابطة في مجالات Domains، ويرتب المجالات في طبقات تحدد من يستطيع أن يستدعي من، ويضع أمام كل مجال مدخلاً واحداً Gateway يخفي الخدمات خلفه، ويعطي الفرق الأخرى نقاط توسعة Extensions بدل أن تعدل في كود غيرها، وكتبوا أنهم صنفوا 2,200 خدمة في 70 مجالاً، وأن وقت ربط ميزة جديدة بالمنصات انخفض بين 25% و50%، وأن نصف خدماتهم يتغير كل سنة ونصف تقريباً، وهذا سبب أهمية المدخل الثابت أمام المجال. والأهم لمن يقرأ هذا المقال من شركة صغيرة نصيحتهم الصريحة: في المؤسسات الصغيرة غالباً لا يعوض المكسب التشغيلي زيادة التعقيد، ومن المعقول أن تؤجل الخدمات المصغرة لفترة.
Shopify وStack Overflow: البقاء على برنامج واحد بقرار
الحالتان الأخريان في الصورة شرحناهما في مقالات مستقلة، لذلك نكتفي بالإشارة: Shopify واجهت برنامجاً كبيراً بلا حدود، فاختارت أن تبقيه برنامجاً واحداً وتقسمه إلى وحدات بحدود تفحصها أداة، وتفاصيل ذلك في قسم Shopify من مقال أنماط المعمارية. وStack Overflow خدم أكثر من 209 ملايين طلب يومياً بتطبيق Q&A واحد، ولم يخرج جزءاً إلى خدمة إلا عندما ظهر سبب يقاس، ثم كتب فريقه في 2025 أن بعض تلك القرارات صار يقف أمام استقلال الفرق، وكل ذلك في كيف بنى Stack Overflow موقعه بسيرفرات قليلة.
ما الذي تشترك فيه هذه القصص؟
- لا توجد قصة واحدة غيرت شكل الشركة كلها، فكل قرار كان عن جزء محدد: أداة مراقبة، أو نظام وجهات، أو طريقة ترتيب خدمات موجودة.
- كل انتقال بدأ من رقم: حد توسع عند 5% من الحمل، أو ثلاثة مهندسين في الصيانة، أو 50 خدمة لتتبع مشكلة، وليس من رأي عن المعمارية الأفضل.
- كل فريق كتب ما خسره في الاتجاه الجديد، فالدمج أفقد Segment عزل الأعطال، وأفقد Prime Video التوسع الأفقي للكواشف، وهذا يعني أن القرار مقايضة Trade-off وليس فوزاً كاملاً.
- الحدود الجيدة بقيت في كل الحالات، سواء كانت داخل برنامج واحد أو بين خدمات، والذي تغير هو هل تمر الحدود عبر الشبكة أم لا.
ماذا قال Fowler بالضبط، ومن خالفه؟
كثيراً ما يختصر مقال MonolithFirst الذي نشره Martin Fowler في 3 يونيو 2015 في جملة «ابدأ ببرنامج واحد»، لكن المقال أدق من ذلك. فهو يبدأ بملاحظة: أغلب قصص النجاح مع الخدمات المصغرة التي سمعها بدأت ببرنامج واحد كبر ثم قسم، وأغلب الأنظمة التي بنيت كخدمات مصغرة من الصفر انتهت في مشكلات كبيرة. ثم يذكر سببين: الأول أنك في بداية المنتج لا تعرف إن كان مفيداً للمستخدمين أصلاً، فتحتاج سرعة التجربة، وعلاوة الخدمات المصغرة تبطئك، والثاني أن الخدمات المصغرة لا تعمل جيداً إلا بحدود مستقرة بين الخدمات، ونقل وظيفة من خدمة إلى أخرى أصعب بكثير من نقلها داخل برنامج واحد، وحتى المعماري الخبير يصعب عليه أن يرسم الحدود الصحيحة من البداية.
ويذكر Fowler عدة طرق لتطبيق الفكرة: أن تصمم البرنامج الواحد بعناية في حدود وحداته وفي طريقة تخزين بياناته، أو أن تبدأ ببرنامج واحد ثم تقشر خدمات من أطرافه تدريجياً، أو أن تبني برنامجاً تعرف أنك سوف تستبدله، أو أن تبدأ بخدمات كبيرة قليلة ثم تقسمها عندما تستقر الحدود. ويعترف في الهامش بأنه لا يمكن أن تأخذ أي نظام وتقسمه إلى خدمات، لأن أغلب الأنظمة تتراكم فيها اعتماديات بين الوحدات تمنع ذلك، وأن الحالات الناجحة التي سمع بها كانت تبدأ بتصميم وحدات جيد نسبياً.
وبعد ستة أيام نشر Stefan Tilkov على نفس الموقع رداً بعنوان Don't start with a monolith، قال فيه إن البدء ببرنامج واحد غالباً هو الخطأ بعينه، لأن أجزاء البرنامج الواحد تترابط بسرعة عبر الكائنات المشتركة وقاعدة البيانات المشتركة والمعاملات التي لا تحتاج تعويضاً، فيصعب فصلها لاحقاً. لكن لاحظ شروطه: أن تكون واثقاً أن النظام كبير بما يكفي، وأن تعرف المجال جيداً جداً، والحالة المثالية عنده أن تبني الإصدار الثاني لنظام موجود، وأن الأجزاء التي يتكلم عنها أكبر غالباً من الخدمة المصغرة المعتادة، وهو يتفق مع Fowler على ألا تضيف تعقيد التوزيع دون سبب جيد جداً.
والخلاصة العملية من النقاشين أن الطرفين متفقان على أهم نقطة: الحدود حسب المجال من اليوم الأول. والخلاف في سؤال واحد: هل تمر هذه الحدود عبر الشبكة من البداية أم لا. وإذا كنت لا تعرف المجال جيداً، أو كان الفريق واحداً، فالحدود داخل برنامج واحد أرخص في التعديل عندما تكتشف أنك رسمتها خطأ، وهذا سوف يحدث.
تجربة عملية: نفس المتجر كبرنامج واحد وكخدمتين
الآن سوف نبني متجراً صغيراً فيه وحدتان: الطلبات Orders والمخزون Inventory، وعندما يصل طلب شراء تحجز وحدة الطلبات الكمية من المخزون ثم تؤكد الطلب. ونشغله بشكلين على نفس الجهاز: برنامج واحد تستدعي فيه وحدة الطلبات وحدة المخزون كدالة، وخدمتان منفصلتان بينهما HTTP للطريق المتزامن وطابور RabbitMQ للطريق غير المتزامن. ولاحظ أن الملفين orders.py وinventory.py هما نفس الكود في الشكلين، والذي يختلف هو طريقة ربطهما فقط، وهذا بالضبط ما يعنيه أن تكون الحدود جاهزة قبل أن تخرج خدمة. وللتبسيط نحفظ الطلبات والمخزون في الذاكرة، أما في نظام حقيقي فكل خدمة لها قاعدة بياناتها.
ملفات التجربة
أنشئ مجلداً فيه الملفات التالية، أولها Dockerfile يبني Image واحدة فيها Python ومكتبة pika لعميل RabbitMQ، ونستخدمها للبرنامج الواحد وللخدمتين:
FROM python:3.13.16-slim-trixie
RUN pip install --no-cache-dir pika==1.4.4
WORKDIR /app
COPY *.py ./
ENV PYTHONUNBUFFERED=1
ثم وحدة المخزون inventory.py، وهي لا تعرف شيئاً عن HTTP أو الطوابير:
import threading

_lock = threading.Lock()
_stock = {"book": 1_000_000, "pen": 1_000_000}


def reserve(sku: str, qty: int) -> bool:
    with _lock:
        if _stock.get(sku, 0) < qty:
            return False
        _stock[sku] -= qty
        return True


def available(sku: str) -> int:
    with _lock:
        return _stock.get(sku, 0)
ثم وحدة الطلبات orders.py، ولاحظ أن الدالة place تأخذ دالة الحجز من الخارج، فلا تعرف إن كان المخزون في نفس العملية أم خلف الشبكة، وتقيس الوقت الذي أخذه الحجز:
import itertools, threading, time

_lock = threading.Lock()
_ids = itertools.count(1)
_orders = {}


class Unavailable(Exception):
    pass


def create(sku: str, qty: int, status: str) -> int:
    with _lock:
        order_id = next(_ids)
        _orders[order_id] = {"id": order_id, "sku": sku, "qty": qty, "status": status}
        return order_id


def set_status(order_id: int, status: str) -> None:
    with _lock:
        _orders[order_id]["status"] = status


def get(order_id: int):
    with _lock:
        return dict(_orders[order_id]) if order_id in _orders else None


def place(sku: str, qty: int, reserve) -> dict:
    """Synchronous order: reserve stock first, then confirm. reserve is injected."""
    t0 = time.perf_counter()
    ok = reserve(sku, qty)
    inventory_ms = round((time.perf_counter() - t0) * 1000, 3)
    if not ok:
        return {"status": "REJECTED", "inventory_ms": inventory_ms}
    order_id = create(sku, qty, "CONFIRMED")
    return {"id": order_id, "status": "CONFIRMED", "inventory_ms": inventory_ms}
ثم ملف صغير web.py يشغل سيرفر HTTP من مكتبة Python القياسية، حتى يكون نفس السيرفر في الشكلين ولا يدخل إطار عمل مختلف في القياس:
import json
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer


def serve(port: int, routes: dict) -> None:
    """routes: {("POST", "/orders"): handler(body, path) -> (status_code, dict)}"""

    class Handler(BaseHTTPRequestHandler):
        def _route(self, method):
            key = (method, "/" + self.path.strip("/").split("/")[0])
            length = int(self.headers.get("Content-Length") or 0)
            body = json.loads(self.rfile.read(length) or "{}")
            if key not in routes:
                return self._send(404, {"error": "not found"})
            code, payload = routes[key](body, self.path)
            self._send(code, payload)

        def _send(self, code, payload):
            data = json.dumps(payload).encode()
            self.send_response(code)
            self.send_header("Content-Type", "application/json")
            self.send_header("Content-Length", str(len(data)))
            self.end_headers()
            self.wfile.write(data)

        def do_GET(self):
            self._route("GET")

        def do_POST(self):
            self._route("POST")

        def log_message(self, *args):
            pass

    ThreadingHTTPServer(("0.0.0.0", port), Handler).serve_forever()
والآن الشكل الأول، البرنامج الواحد monolith.py، ووحدة الطلبات فيه تستدعي inventory.reserve مباشرة:
# Modular monolith: the orders module calls the inventory module in the same process.
import inventory, orders, web


def post_order(body, path):
    result = orders.place(body["sku"], body["qty"], reserve=inventory.reserve)
    return (201 if result["status"] == "CONFIRMED" else 409), result


def get_order(body, path):
    order = orders.get(int(path.rsplit("/", 1)[1]))
    return (200, order) if order else (404, {"error": "no such order"})


print("[monolith] listening on :8000")
web.serve(8000, {("POST", "/orders"): post_order, ("GET", "/orders"): get_order})
والشكل الثاني خدمتان، أولاهما خدمة الطلبات orders_service.py، وفيها طريقان: /orders يحجز المخزون عبر HTTP بمهلة ثانيتين وينتظر الرد، و/orders-async ينشئ الطلب بحالة PENDING ويرسل رسالة إلى الطابور ويرد فوراً، ثم يستمع لنتيجة الحجز في طابور آخر:
# Orders as its own service: an HTTP call to inventory for /orders, a queue for /orders-async.
import json, os, threading, time, urllib.error, urllib.request
import pika
import orders, web

INVENTORY_URL = os.environ["INVENTORY_URL"]
TIMEOUT = float(os.environ.get("INVENTORY_TIMEOUT", "2"))
AMQP_URL = os.environ["AMQP_URL"]


def reserve_over_http(sku: str, qty: int) -> bool:
    req = urllib.request.Request(
        INVENTORY_URL + "/reserve",
        data=json.dumps({"sku": sku, "qty": qty}).encode(),
        headers={"Content-Type": "application/json"},
    )
    try:
        with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
            return json.load(resp)["reserved"]
    except urllib.error.HTTPError as e:
        if e.code == 409:
            return False
        raise orders.Unavailable(f"inventory answered {e.code}")
    except (urllib.error.URLError, TimeoutError, ConnectionError) as e:
        raise orders.Unavailable(f"inventory unreachable: {getattr(e, 'reason', e)}")


def post_order(body, path):
    t0 = time.perf_counter()
    try:
        result = orders.place(body["sku"], body["qty"], reserve=reserve_over_http)
    except orders.Unavailable as e:
        waited = round((time.perf_counter() - t0) * 1000)
        return 503, {"error": str(e), "waited_ms": waited}
    return (201 if result["status"] == "CONFIRMED" else 409), result


_pub_lock = threading.Lock()
_pub = {"ch": None}


def publish(queue: str, message: dict) -> None:
    with _pub_lock:  # pika channels are not thread-safe
        if _pub["ch"] is None or _pub["ch"].is_closed:
            ch = pika.BlockingConnection(pika.URLParameters(AMQP_URL)).channel()
            ch.queue_declare(queue=queue, durable=True)
            ch.confirm_delivery()
            _pub["ch"] = ch
        _pub["ch"].basic_publish(
            exchange="", routing_key=queue, body=json.dumps(message),
            properties=pika.BasicProperties(delivery_mode=2),
        )


def post_order_async(body, path):
    order_id = orders.create(body["sku"], body["qty"], "PENDING")
    publish("inventory.reserve", {"order_id": order_id, "sku": body["sku"], "qty": body["qty"]})
    return 202, orders.get(order_id)


def get_order(body, path):
    order = orders.get(int(path.rsplit("/", 1)[1]))
    return (200, order) if order else (404, {"error": "no such order"})


def consume_results():
    ch = pika.BlockingConnection(pika.URLParameters(AMQP_URL)).channel()
    ch.queue_declare(queue="inventory.results", durable=True)

    def on_result(channel, method, props, body):
        msg = json.loads(body)
        orders.set_status(msg["order_id"], "CONFIRMED" if msg["reserved"] else "REJECTED")
        print(f"[orders] order {msg['order_id']} -> reserved={msg['reserved']}")
        channel.basic_ack(method.delivery_tag)

    ch.basic_consume(queue="inventory.results", on_message_callback=on_result)
    ch.start_consuming()


threading.Thread(target=consume_results, daemon=True).start()
print("[orders] listening on :8000")
web.serve(8000, {
    ("POST", "/orders"): post_order,
    ("POST", "/orders-async"): post_order_async,
    ("GET", "/orders"): get_order,
})
والثانية خدمة المخزون inventory_service.py، وهي نفس الوحدة خلف HTTP وخلف مستهلك Consumer للطابور، ومعها رابط يعرض الكمية المتاحة:
# Inventory as its own service: the same inventory module behind HTTP and a queue consumer.
import json, os, threading
import pika
import inventory, web

AMQP_URL = os.environ["AMQP_URL"]


def post_reserve(body, path):
    ok = inventory.reserve(body["sku"], body["qty"])
    return (200 if ok else 409), {"reserved": ok}


def get_stock(body, path):
    sku = path.rsplit("/", 1)[1]
    return 200, {"sku": sku, "available": inventory.available(sku)}


def consume_requests():
    ch = pika.BlockingConnection(pika.URLParameters(AMQP_URL)).channel()
    ch.queue_declare(queue="inventory.reserve", durable=True)
    ch.queue_declare(queue="inventory.results", durable=True)

    def on_request(channel, method, props, body):
        msg = json.loads(body)
        ok = inventory.reserve(msg["sku"], msg["qty"])
        channel.basic_publish(
            exchange="", routing_key="inventory.results",
            body=json.dumps({"order_id": msg["order_id"], "reserved": ok}),
            properties=pika.BasicProperties(delivery_mode=2),
        )
        print(f"[inventory] order {msg['order_id']} reserved={ok}")
        channel.basic_ack(method.delivery_tag)

    ch.basic_qos(prefetch_count=10)
    ch.basic_consume(queue="inventory.reserve", on_message_callback=on_request)
    ch.start_consuming()


threading.Thread(target=consume_requests, daemon=True).start()
print("[inventory] listening on :8001")
web.serve(8001, {("POST", "/reserve"): post_reserve, ("GET", "/stock"): get_stock})
وملف القياس bench.py يرسل طلبات متتالية ويحسب المئين Percentile لزمن الطلب كاملاً ولزمن استدعاء المخزون وحده، بعد 200 طلب للتسخين لا تدخل في الحساب:
# Sends N sequential orders and prints latency percentiles (whole request and the inventory call).
import json, statistics, sys, time, urllib.request

url, n = sys.argv[1], int(sys.argv[2])


def order():
    req = urllib.request.Request(url, data=b'{"sku": "book", "qty": 1}',
                                 headers={"Content-Type": "application/json"})
    t0 = time.perf_counter()
    with urllib.request.urlopen(req, timeout=5) as resp:
        body = json.load(resp)
    return (time.perf_counter() - t0) * 1000, body["inventory_ms"]


for _ in range(200):  # warm-up, not measured
    order()
total, inv = zip(*(order() for _ in range(n)))


def pct(values, p):
    return statistics.quantiles(values, n=100)[p - 1]


for name, v in (("request", total), ("inventory call", inv)):
    print(f"{name:15} p50={pct(v, 50):7.3f} ms  p95={pct(v, 95):7.3f} ms  p99={pct(v, 99):7.3f} ms")
وأخيراً compose.yaml يشغل الأربعة معاً:
name: lab-msvc

services:
  rabbitmq:
    image: rabbitmq:4.3.6-alpine
    container_name: lab-msvc-rabbitmq
    healthcheck:
      test: ["CMD", "rabbitmq-diagnostics", "-q", "check_port_connectivity"]
      interval: 5s
      retries: 20

  monolith:
    build: .
    image: lab-msvc-app:1
    container_name: lab-msvc-monolith
    command: python monolith.py
    ports: ["127.0.0.1:18481:8000"]

  orders:
    image: lab-msvc-app:1
    container_name: lab-msvc-orders
    command: python orders_service.py
    environment:
      INVENTORY_URL: http://inventory:8001
      INVENTORY_TIMEOUT: "2"
      AMQP_URL: amqp://guest:guest@rabbitmq:5672/%2F
    ports: ["127.0.0.1:18482:8000"]
    depends_on:
      rabbitmq: { condition: service_healthy }
      monolith: { condition: service_started }

  inventory:
    image: lab-msvc-app:1
    container_name: lab-msvc-inventory
    command: python inventory_service.py
    ports: ["127.0.0.1:18483:8001"]
    environment:
      AMQP_URL: amqp://guest:guest@rabbitmq:5672/%2F
    depends_on:
      rabbitmq: { condition: service_healthy }
      monolith: { condition: service_started }
في الإعداد أعلاه لاحظ التالي:
- البرنامج الواحد على المنفذ 18481، وخدمة الطلبات على 18482، وخدمة المخزون على 18483، وكلها على
127.0.0.1فقط حتى لا تفتح على الشبكة. - فحص صحة RabbitMQ يستخدم
check_port_connectivityوليسping، والسبب أنpingيتأكد فقط أن الخادم يعمل، كما تشرح صفحة المراقبة في توثيق RabbitMQ، أما المنفذ 5672 فقد لا يكون جاهزاً بعد. وإذا استخدمتpingهنا فقد يفشل اتصال الخدمتين بالطابور عند التشغيل بالخطأpika.exceptions.AMQPConnectionError، لأن Docker Compose يعتبر RabbitMQ جاهزاً قبل أن يفتح منفذه. - المهلة
INVENTORY_TIMEOUTثانيتان، وسوف نرى أنها لا تغطي كل شيء.
التشغيل وأول طلب في الشكلين
شغل الملفات بالأمر التالي:
docker compose up -d --build
docker compose ps --format "table {{.Name}}\t{{.Image}}\t{{.Status}}\t{{.Ports}}"
والمخرج سوف يكون كما يلي:
NAME                 IMAGE                   STATUS                    PORTS
lab-msvc-inventory   lab-msvc-app:1          Up 4 seconds              127.0.0.1:18483->8001/tcp
lab-msvc-monolith    lab-msvc-app:1          Up 17 seconds             127.0.0.1:18481->8000/tcp
lab-msvc-orders      lab-msvc-app:1          Up 4 seconds              127.0.0.1:18482->8000/tcp
lab-msvc-rabbitmq    rabbitmq:4.3.6-alpine   Up 17 seconds (healthy)   4369/tcp, 5671-5672/tcp, 15691-15692/tcp, 25672/tcp
الآن نرسل نفس الطلب إلى البرنامج الواحد، ثم إلى خدمة الطلبات، ثم طلباً بكمية أكبر من المخزون:
curl -s -X POST http://127.0.0.1:18481/orders -H "Content-Type: application/json" -d '{"sku": "book", "qty": 2}'
curl -s -X POST http://127.0.0.1:18482/orders -H "Content-Type: application/json" -d '{"sku": "book", "qty": 2}'
curl -s -X POST http://127.0.0.1:18482/orders -H "Content-Type: application/json" -d '{"sku": "book", "qty": 5000000}'
والمخرج سوف يكون كما يلي:
{"id": 1, "status": "CONFIRMED", "inventory_ms": 0.01}
{"id": 1, "status": "CONFIRMED", "inventory_ms": 49.538}
{"status": "REJECTED", "inventory_ms": 2.251}
في المخرج أعلاه لاحظ التالي:
- نفس النتيجة في الشكلين، ونفس الكود قرر الحجز، والفرق كله في الحقل
inventory_ms. - أول استدعاء عبر الشبكة أخذ حوالي 50 ميلي ثانية، لأنه أول طلب تبحث فيه خدمة الطلبات عن اسم
inventoryفي DNS وتفتح الاتصال، ولذلك يسخن ملف القياس الخدمة قبل أن يحسب. - الطلب المرفوض رجع بالرمز 409 من خدمة المخزون، فحولته خدمة الطلبات إلى
REJECTED، أي أن رفض العمل وصل كرد عادي، وهذا يختلف عن تعطل الخدمة كما سوف نرى.
كم يكلف عبور الشبكة؟
نشغل ملف القياس من Container منفصل على نفس الشبكة، مرتين لكل شكل، وفي كل مرة 2000 طلب متتابع:
for i in 1 2; do
  echo "== run $i: monolith"
  docker run --rm --name lab-msvc-bench --network lab-msvc_default lab-msvc-app:1 python bench.py http://monolith:8000/orders 2000
  echo "== run $i: two services"
  docker run --rm --name lab-msvc-bench --network lab-msvc_default lab-msvc-app:1 python bench.py http://orders:8000/orders 2000
done
والمخرج سوف يكون كما يلي:
== run 1: monolith
request         p50=  1.924 ms  p95=  6.229 ms  p99= 12.567 ms
inventory call  p50=  0.003 ms  p95=  0.005 ms  p99=  0.011 ms
== run 1: two services
request         p50=  3.473 ms  p95=  6.378 ms  p99= 10.247 ms
inventory call  p50=  1.766 ms  p95=  3.177 ms  p99=  5.228 ms
== run 2: monolith
request         p50=  1.693 ms  p95=  3.499 ms  p99=  7.774 ms
inventory call  p50=  0.003 ms  p95=  0.005 ms  p99=  0.010 ms
== run 2: two services
request         p50=  3.736 ms  p95=  6.122 ms  p99=  9.342 ms
inventory call  p50=  1.915 ms  p95=  3.132 ms  p99=  5.066 ms
والصورة التالية تبين ما يحدث في الحالتين داخل سطر inventory call:
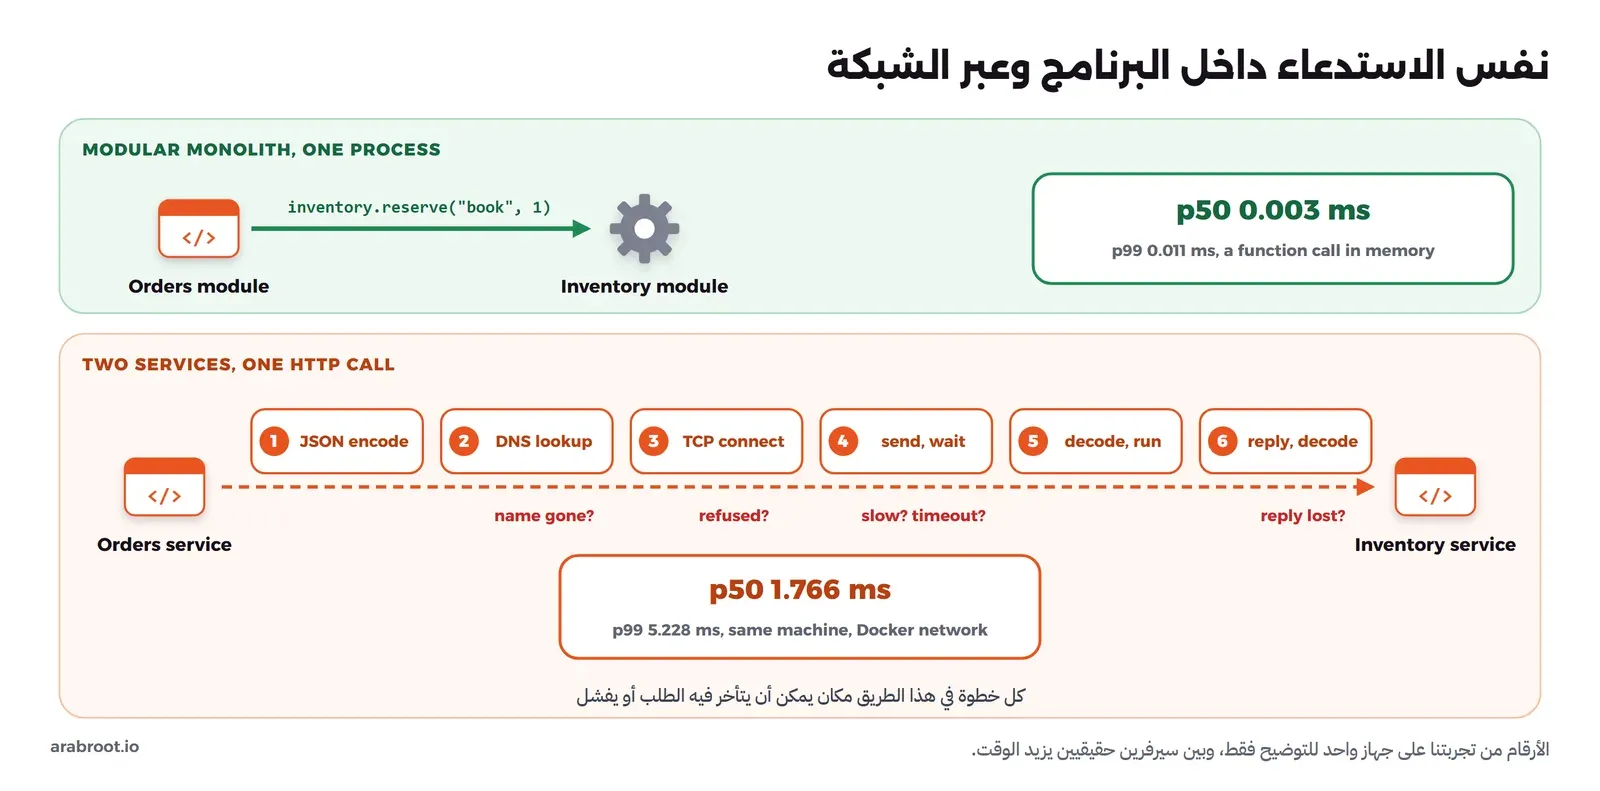
في المخرج أعلاه لاحظ التالي:
- استدعاء المخزون داخل البرنامج الواحد أخذ 3 ميكروثانية في الوسيط، وعبر الشبكة أخذ بين 1.7 و1.9 ميلي ثانية، أي أبطأ بمئات المرات، لأن الاستدعاء صار ترميز JSON وبحثاً في DNS وفتح اتصال TCP وإرسالاً وانتظاراً وفك ترميز في الجهتين.
- الطلب كاملاً صار حوالي ضعف زمنه، لأن زمن البرنامج الواحد نفسه أغلبه HTTP بين ملف القياس والسيرفر، وهذه الأرقام للتوضيح فقط، فقد قسناها على جهاز واحد عبر شبكة Docker، والأرقام تختلف بين تشغيل وآخر كما ترى، وبين سيرفرين حقيقيين يضاف زمن الشبكة الفعلية.
- ملف القياس وخدمة الطلبات يفتحان اتصالاً جديداً لكل طلب، وإعادة استخدام الاتصالات تقلل جزءاً من هذا الوقت كما شرحنا في تجميع الاتصالات Connection Pooling، لكنها لا تلغي الترميز والانتظار على الشبكة.
- ميلي ثانيتان رقم صغير لطلب واحد، والمشكلة تظهر عندما يمر الطلب بسلسلة، فإذا استدعت الخدمة الأولى ثانية والثانية ثالثة بالتتابع، فالأزمنة تجمع، وأسوأ زمن p99 في أي حلقة يصبح جزءاً من زمن الطلب كله.
الخدمة المعلقة أخطر من الخدمة المتوقفة
الآن نجعل خدمة المخزون تتوقف عن الرد دون أن تغلق، كأنها عالقة في عملية ثقيلة أو في Garbage Collection طويل، وذلك بالأمر docker pause، ثم نرسل طلبين ونعيد الخدمة وننظر إلى المخزون:
curl -s http://127.0.0.1:18483/stock/pen
docker pause lab-msvc-inventory
curl -s -w "  HTTP %{http_code} in %{time_total}s\n" -X POST http://127.0.0.1:18482/orders -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'
curl -s -w "  HTTP %{http_code} in %{time_total}s\n" -X POST http://127.0.0.1:18482/orders -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'
docker unpause lab-msvc-inventory
curl -s http://127.0.0.1:18483/stock/pen
والمخرج سوف يكون كما يلي:
{"sku": "pen", "available": 1000000}
lab-msvc-inventory
{"error": "inventory unreachable: timed out", "waited_ms": 2004}  HTTP 503 in 2.016298s
{"error": "inventory unreachable: timed out", "waited_ms": 2003}  HTTP 503 in 2.007593s
lab-msvc-inventory
{"sku": "pen", "available": 999998}
وهذا أهم مخرج في المقال كله، فلاحظ التالي:
- خدمة الطلبات انتظرت ثانيتين في كل طلب ثم ردت بالرمز 503، والمستخدم يرى أن الطلب فشل، ولا يوجد طلب مسجل.
- لكن المخزون نقص قطعتين، والسبب أن نظام التشغيل في Container المخزون قبل الاتصال وحفظ الطلب، وعندما عادت الخدمة قرأته ونفذ الحجز، ثم حاولت أن ترد على اتصال أغلقه الطرف الآخر، وهذا ما تجده في سجلها:
  File "/usr/local/lib/python3.13/socketserver.py", line 845, in write
    self._sock.sendall(b)
    ~~~~~~~~~~~~~~~~~~^^^
BrokenPipeError: [Errno 32] Broken pipe
والنتيجة أن انتهاء المهلة لا يعني أن العملية لم تحدث، وإنما يعني فقط أنك لا تعرف ماذا حدث، وفي البرنامج الواحد لا توجد هذه الحالة أصلاً، لأن الحجز وإنشاء الطلب يكونان في نفس العملية وفي معاملة واحدة إذا أردت. والحل في الخدمات ليس مهلة أطول، وإنما أن تصمم لهذه الحالة: مفتاح منع التكرار Idempotency Key حتى تعيد المحاولة بأمان، وحجز له وقت انتهاء أو خطوة تعويض بنمط Saga تفك الحجز إذا لم يتأكد الطلب.
الخدمة المتوقفة واسم لم يعد موجوداً
الآن نوقف خدمة المخزون تماماً، ونرسل طلباً إلى خدمة الطلبات، ثم نفس الطلب إلى البرنامج الواحد للمقارنة:
docker stop lab-msvc-inventory
curl -s -w "  HTTP %{http_code} in %{time_total}s\n" -X POST http://127.0.0.1:18482/orders -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'
curl -s -w "  HTTP %{http_code} in %{time_total}s\n" -X POST http://127.0.0.1:18481/orders -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'
والمخرج سوف يكون كما يلي:
lab-msvc-inventory
{"error": "inventory unreachable: [Errno -5] No address associated with hostname", "waited_ms": 4001}  HTTP 503 in 4.004947s
{"id": 4402, "status": "CONFIRMED", "inventory_ms": 0.003}  HTTP 201 in 0.003257s
في المخرج أعلاه لاحظ التالي:
- المهلة في الإعداد ثانيتان، لكن الطلب انتظر أربع ثوان، والسبب أن Docker يحذف اسم الخدمة المتوقفة من DNS الداخلي، فأخذ البحث عن الاسم نفسه حوالي أربع ثوان قبل أن يفشل، والمهلة في
urlopenكما يقول توثيق urllib.request للعمليات مثل محاولة الاتصال، والبحث عن الاسم يحدث قبلها. لذلك ضع حداً زمنياً على الاستدعاء كله من الخارج، وليس على الاتصال وحده، وقد رأينا مشكلة قريبة في خدمة خارجية بدون مهلة. - الخدمة المتوقفة هنا فشلت بشكل واضح، أما المعلقة في القسم السابق فقد تركت أثراً، لذلك فالخدمة التي تبطئ أخطر من التي تسقط.
- البرنامج الواحد أكمل الطلب في 3 ميلي ثانية، ورقم الطلب 4402 لأن ملف القياس أنشأ قبله 4400 طلب، وهذا طبيعي لأن المخزون عنده ليس شيئاً يمكن أن يتوقف وحده.
الطابور يحمل الطلب حتى تعود الخدمة
وخدمة المخزون ما زالت متوقفة، نرسل ثلاثة طلبات عبر الطريق غير المتزامن، ثم ننظر إلى الطوابير:
for i in 1 2 3; do curl -s -w "  HTTP %{http_code}\n" -X POST http://127.0.0.1:18482/orders-async -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'; done
docker exec lab-msvc-rabbitmq rabbitmqctl list_queues -q name messages consumers
والمخرج سوف يكون كما يلي:
{"id": 4402, "sku": "pen", "qty": 1, "status": "PENDING"}  HTTP 202
{"id": 4403, "sku": "pen", "qty": 1, "status": "PENDING"}  HTTP 202
{"id": 4404, "sku": "pen", "qty": 1, "status": "PENDING"}  HTTP 202
name	messages	consumers
inventory.reserve	3	0
inventory.results	0	1
خدمة الطلبات ردت فوراً بالرمز 202، أي «استلمت ولم أنته»، والرسائل الثلاث تنتظر في inventory.reserve ولا يوجد من يستهلكها. الآن نشغل المخزون من جديد وننظر إلى السجلات والطلب الأول:
docker start lab-msvc-inventory
docker logs --tail 3 lab-msvc-inventory
docker logs --tail 3 lab-msvc-orders
curl -s http://127.0.0.1:18482/orders/4402
curl -s http://127.0.0.1:18483/stock/pen
والمخرج سوف يكون كما يلي:
lab-msvc-inventory
[inventory] order 4402 reserved=True
[inventory] order 4403 reserved=True
[inventory] order 4404 reserved=True
[orders] order 4402 -> reserved=True
[orders] order 4403 -> reserved=True
[orders] order 4404 -> reserved=True
{"id": 4402, "sku": "pen", "qty": 1, "status": "CONFIRMED"}
{"sku": "pen", "available": 999997}
في المخرج أعلاه لاحظ التالي:
- لم يضع أي طلب، فقد انتظرت الرسائل في الطابور حتى عادت الخدمة، ثم تأكدت الطلبات الثلاثة بالترتيب، وهذا هو عزل الأعطال الذي تعد به الخدمات المصغرة، لكنه جاء من الطابور وليس من مجرد الفصل.
- الثمن أن المستخدم رأى
PENDINGفترة من الوقت، وعلى الواجهة أن تعرض هذه الحالة، وعلى أحدهم أن يقرر ماذا يحدث إذا رفض المخزون الطلب بعد أن قيل للمستخدم إنه استلم، وتفاصيل الطوابير وإعادة المحاولة في الطابور Queue للمبتدئين. - المخزون أصبح 999997 وليس 999995، لأن المخزون في هذه التجربة في الذاكرة، فبدأ من جديد عند إعادة التشغيل وخسر الحجزين السابقين، وفي نظام حقيقي تكون بيانات كل خدمة في قاعدتها.
وعندما يتوقف البرنامج الواحد
للمقارنة نوقف البرنامج الواحد ونرسل طلباً:
docker stop lab-msvc-monolith
curl -sS -X POST http://127.0.0.1:18481/orders -H "Content-Type: application/json" -d '{"sku": "pen", "qty": 1}'
docker start lab-msvc-monolith
والمخرج سوف يكون كما يلي:
lab-msvc-monolith
curl: (7) Failed to connect to 127.0.0.1 port 18481 after 2035 ms: Could not connect to server
lab-msvc-monolith
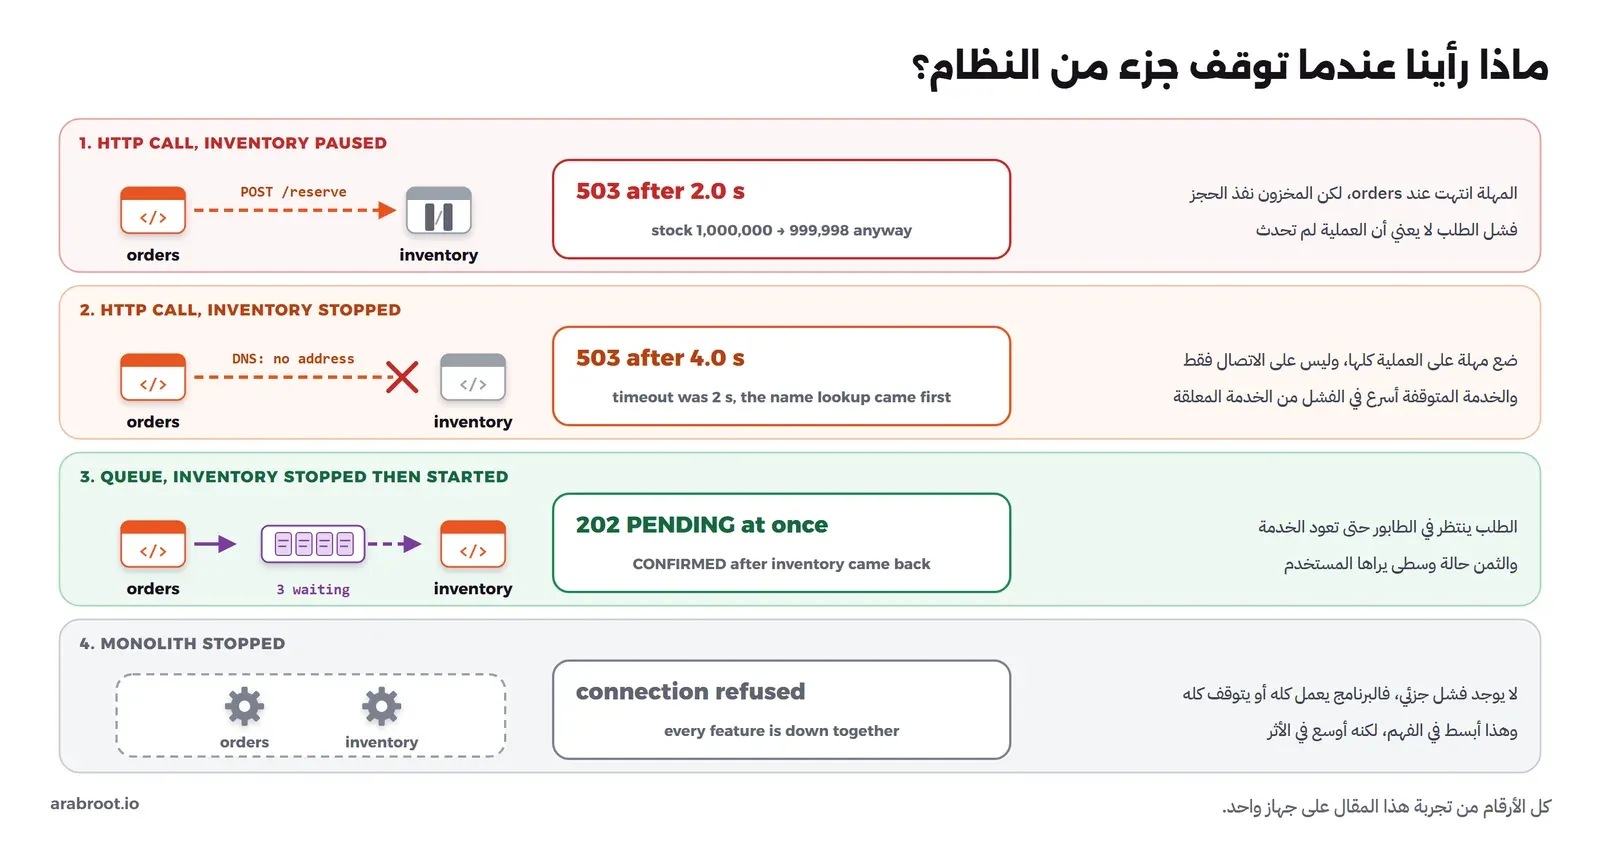
لا يوجد هنا فشل جزئي، فالطلبات والمخزون وكل ما في البرنامج توقف معاً، وهذا أبسط في الفهم والمراقبة، لكنه أوسع في الأثر، وهو ما كانت Uber تخافه في 2012 وما خسرته Segment عندما دمجت خدماتها. والصورة التالية تجمع الحالات الأربع التي رأيناها:
حذف التجربة
احذف ال Containers والشبكة وال Volume الذي أنشأته RabbitMQ، ثم ال Images:
docker compose down -v
docker rmi lab-msvc-app:1 rabbitmq:4.3.6-alpine python:3.13.16-slim-trixie
والخيار -v مهم هنا، لأن Image ال RabbitMQ تعلن Volume لمجلد بياناتها، ودونه يبقى Volume بلا اسم بعد كل تشغيل.
دليل القرار حسب حجم الفريق والمجال
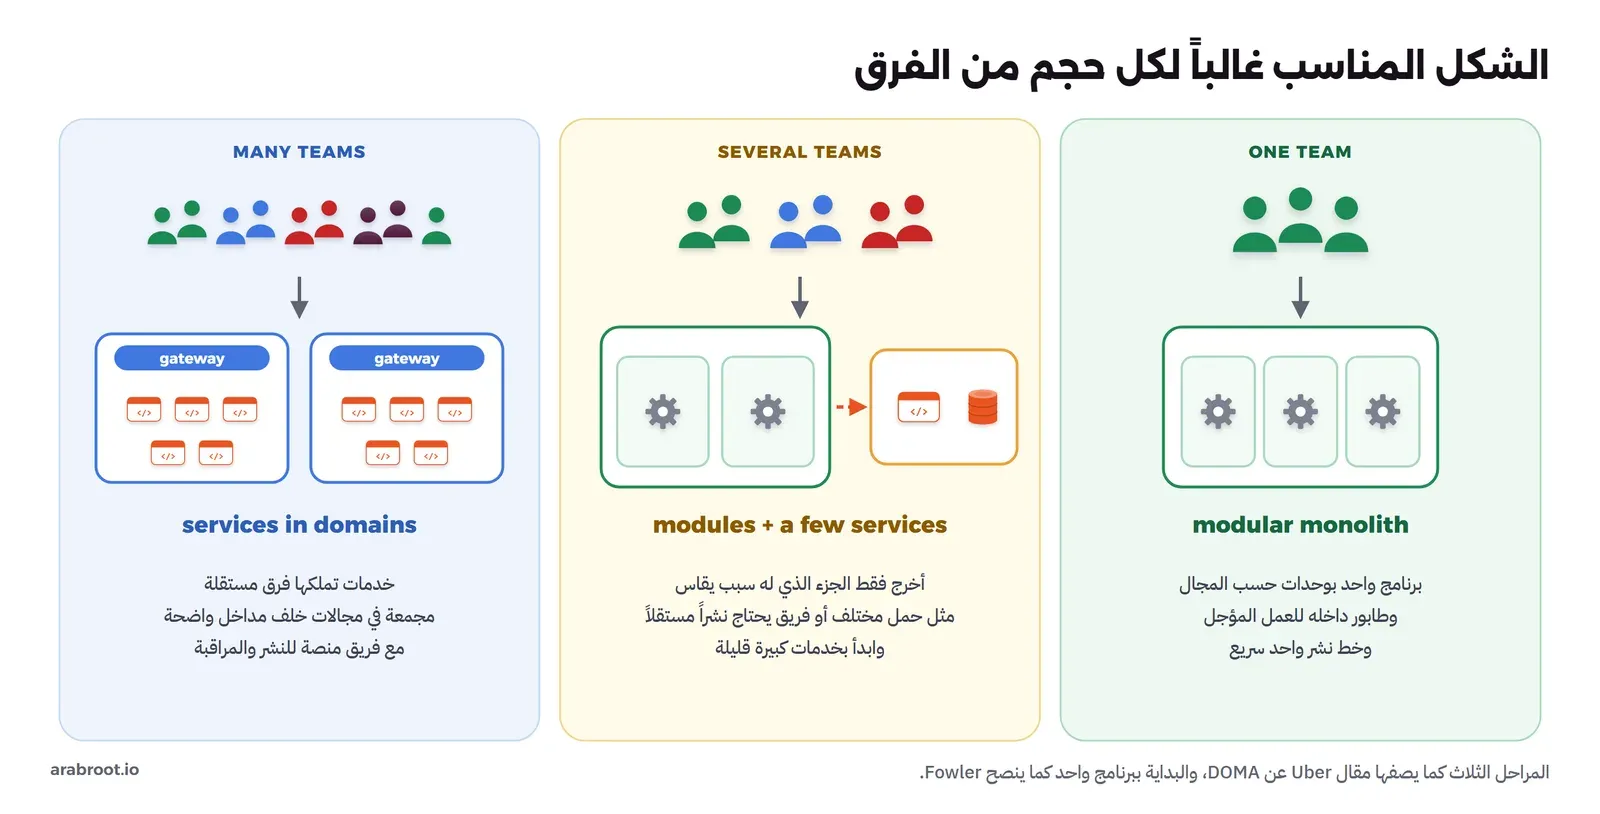
جمعنا ما سبق في دليل واحد، وهو مبني على المراحل الثلاث التي تذكرها Uber في نصائحها للشركات الصغيرة والمتوسطة والكبيرة، وعلى نصيحة Fowler بالبداية ببرنامج واحد، والصورة التالية تبين الشكل الذي يناسب غالباً كل حجم:
وفي الجدول التالي حالات أكثر تحديداً:
| حالتك | ما ننصح به | والسبب |
|---|---|---|
| فريق واحد ومنتج جديد ومجال لم يتضح بعد | Modular Monolith، وطابور داخله للعمل المؤجل | الحدود لم تستقر، وتعديلها داخل برنامج واحد أرخص بكثير كما يقول Fowler |
| فريق واحد يبني الإصدار الثاني لنظام يعرفه جيداً | Modular Monolith غالباً، أو أنظمة كبيرة قليلة إذا كان لكل منها سبب | هذه هي الحالة التي يرى Tilkov أن التقسيم المبكر ينجح فيها |
| عدة فرق تنتظر بعضها في كل نشر | حدود وحدات تفحصها أداة أولاً، ثم إخراج الجزء الذي يعطل النشر | المكسب الحقيقي هو النشر المستقل، ومعايير DORA تقيسه مباشرة |
| جزء حمله أو تقنيته مختلفة جداً، مثل معالجة الفيديو أو البحث | إخراج هذا الجزء وحده كخدمة | سبب يقاس، كما أخرج Stack Overflow محرك الوسوم |
| عشرات الفرق ومئات المهندسين | Microservices مجمعة في مجالات خلف مداخل واضحة، مع فريق منصة | انتظار الفرق لبعضها أغلى من ثمن الشبكة، كما في Uber |
| خدمات تشارك دائماً في نفس الاستجابة ويديرها فريق واحد | فكر في دمجها | قاعدة Vogels، وما فعله فريق Prime Video |
| منتج SaaS يحتاج عزل عملاء | سؤال منفصل عن هذا القرار | العزل بين العملاء يحدده نموذج العزل في تعدد المستأجرين Multi-Tenancy، وليس عدد الخدمات |
وأياً كان الشكل، فحدود الوحدات أو الخدمات ترسم حسب المجال وليس حسب الطبقة التقنية، والأداة المناسبة لذلك هي السياق المحدود Bounded Context الذي شرحناه في التصميم الموجه بالمجال DDD ببساطة، وإذا كانت قاعدة البيانات هي ما يدفعك إلى التقسيم فاقرأ أولاً متى تفصل في PostgreSQL لكل شيء.
قائمة تحقق قبل أن تخرج أول خدمة
- هل تستطيع أن تكتب المشكلة برقم، مثل وقت نشر أو حمل جزء محدد أو عدد مرات انتظار فريق لآخر، وليس بكلمة مثل «قابلية التوسع»؟
- هل الجزء الذي تريد إخراجه وحدة واضحة اليوم داخل البرنامج، يملك جداوله ولا يصل أحد إلى داخله؟ إذا لم يكن كذلك فابدأ من هنا.
- هل سوف يملك الخدمة الجديدة فريق يختلف عن الفريق الذي يملك ما يستدعيها؟
- ماذا يحدث للمستخدم إذا كانت الخدمة بطيئة أو متوقفة؟ هل كتبت المهلة وإعادة المحاولة ومفتاح منع التكرار وحالة PENDING إن وجدت؟
- أي عملية كانت معاملة واحدة وسوف تصبح موزعة، وما خطوة التعويض لها؟
- هل عندك نشر آلي ومراقبة وسجلات مركزية ومعرف طلب يمر بين الخدمات، قبل الخدمة الأولى وليس بعدها؟
- هل كتبت القرار وأسبابه والبدائل في سجل قرارات ADR كما في توثيق المعمارية، حتى يعرف من يأتي بعدك متى يعيد النظر فيه؟
كيف تخرج خدمة لاحقاً دون إعادة كتابة كل شيء؟
الحل البسيط عندما يقرر الفريق الانتقال هو إعادة كتابة النظام كله بالشكل الجديد في مشروع منفصل، ثم التحويل في يوم واحد، وهذا يفشل غالباً، والسبب كما يكتب Fowler في صفحة Strangler Fig التي حدثها في أغسطس 2024 أن استبدال نظام جاد يأخذ وقتاً طويلاً لا ينتظر فيه المستخدمون الميزات الجديدة، وأن تفاصيل سلوك النظام القديم أصعب في الفهم مما تبدو. والاسم مأخوذ من نبات التين الخانق الذي رآه في غابات Queensland، فهو ينمو حول شجرة حتى يأخذ مكانها تدريجياً، والفكرة أن يبنى الجديد حول القديم ويأخذ منه جزءاً بعد جزء. وتصف Microsoft التطبيق العملي في نمط Strangler Fig: واجهة Facade أو Proxy أمام النظام القديم، توجه بعض الطلبات إلى الجديد والباقي إلى القديم، حتى لا يبقى للقديم شيء. والصورة التالية تبين ذلك على المتجر:
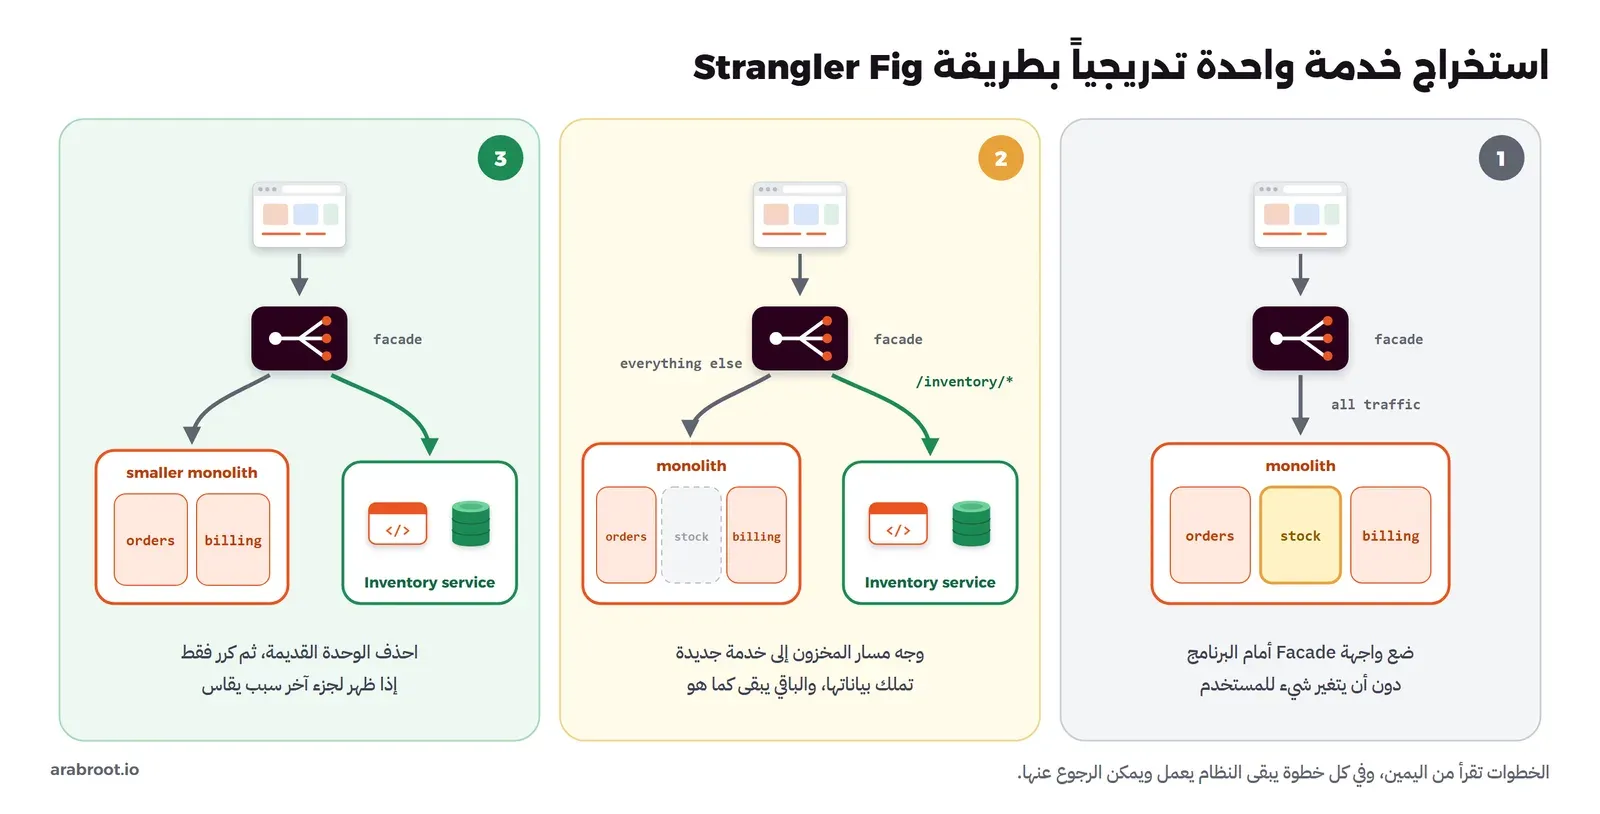
والخطوات بالترتيب:
- اجعل الجزء وحدة حقيقية داخل البرنامج أولاً: واجهة عامة واحدة، وجداول لا يقرؤها غيره، وأحداث داخلية بدل الاستدعاءات الدائرية، وهذا عمل داخل برنامج واحد ويمكن التراجع عنه بسهولة. ويكتب Fowler في MonolithFirst أن التقسيم الناجح يحتاج تصميم وحدات جيداً نسبياً من البداية، فلا تقفز فوق هذه الخطوة.
- ضع واجهة Facade أمام البرنامج: غالباً هي ال Reverse Proxy الذي عندك أصلاً، وكل الطلبات تمر بها إلى البرنامج القديم دون تغيير.
- اختر الجزء الأول بعناية: تنصح Zhamak Dehghani في How to break a Monolith into Microservices سنة 2018 بأن تبدأ بقدرة بسيطة ومنفصلة نسبياً حتى يتعلم الفريق، وأن تقلل اعتماد الخدمة الجديدة على البرنامج القديم، وأن تفصل القدرة كاملة مع بياناتها وليس الكود وحده، وأن تبدأ بخدمات كبيرة ثم تقسمها، وأن تتحرك بخطوات صغيرة كل منها يترك النظام في حالة سليمة.
- انقل البيانات ثم الكتابة: انسخ جداول الوحدة إلى قاعدة الخدمة، وأبقها متزامنة بنمط Outbox أو تغذية من سجل التغييرات، ثم حول القراءة ثم الكتابة، وتشرح صفحة Microsoft نفس الفكرة لفصل جداول كل مجال من قاعدة مشتركة.
- حول الطلبات تدريجياً: وجه مسار
/inventory/*إلى الخدمة الجديدة، لنسبة من المستخدمين أولاً إذا أمكن كما في Feature Flags والإطلاق التدريجي، وراقب الأخطاء والزمن. - احذف الوحدة القديمة: الكود الانتقالي الذي يجعل القديم والجديد يعملان معاً يجب أن يحذف في النهاية، ويسميه Fowler المعمارية الانتقالية Transitional Architecture، ويقول إن ثمنها أقل من خطر الاستبدال الكامل. ثم كرر فقط إذا ظهر لجزء آخر سبب يقاس.
أخطاء شائعة
- البدء بخدمات كثيرة لفريق صغير: ثمانية خطوط نشر ينشرها نفس الأشخاص في نفس اليوم ليست استقلالاً، وإنما برنامج واحد موزع على الشبكة.
- قاعدة بيانات مشتركة بين الخدمات: إذا كانت خدمتان تقرآن نفس الجداول فأي تغيير في جدول يحتاج نشرهما معاً، فإما أن تملك كل خدمة بياناتها، وإما أن تعترف بأنك في Service-Based وتنسق التغييرات.
- سلاسل استدعاءات متزامنة طويلة: كل حلقة تضيف زمنها واحتمال فشلها، فاجعل ما لا يحتاج المستخدم انتظاره يمر عبر طابور.
- استدعاء بلا مهلة أو بمهلة على الاتصال فقط: رأيت في التجربة أن الخدمة المعلقة تحجز الطلب ثانيتين، وأن البحث في DNS لم تشمله المهلة، فضع حداً زمنياً للعملية كلها.
- اعتبار انتهاء المهلة فشلاً مؤكداً: المخزون نقص رغم أن الطلب فشل، لذلك صمم كل عملية تغيير لتكون آمنة عند التكرار.
- التقسيم حسب الطبقة التقنية: خدمة للواجهة وخدمة للمنطق وخدمة للبيانات تعني أن كل ميزة تمر بكل الخدمات، والتقسيم الصحيح حسب المجال.
- إعادة الكتابة الكاملة بدل الاستخراج التدريجي: النظام القديم يستمر في التغير أثناء إعادة الكتابة، فتطارده ولا تلحقه.
- تقليد قصة دون سياقها: قصة Prime Video عن أداة واحدة، وقصة Uber عن آلاف المهندسين، فاقرأ الأرقام والشروط قبل الخلاصة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الفرق بين الأشكال الثلاثة في سؤالين: كم وحدة نشر في النظام، وهل تمر الحدود بين الأجزاء عبر الشبكة. والبرنامج الواحد المقسم إلى وحدات يعطيك الحدود دون الشبكة.
- الخدمات المصغرة تشتري النشر المستقل واستقلال الفرق وتوسيع جزء واحد وعزل الأعطال، وكل مكسب منها له شرط، وتدفع مقابلها الشبكة والبيانات الموزعة والاتساق النهائي والمراقبة وعبء التشغيل.
- المكسب يكبر مع عدد الفرق التي تحتاج أن تنشر باستقلال، والثمن ثابت تقريباً لكل خدمة، لذلك يناسب الفريق الواحد برنامج واحد بوحدات، وتناسب المئات خدمات مجمعة في مجالات.
- الحالات الموثقة في الاتجاهين: Prime Video جمعت أداة مراقبة في عملية واحدة وخفضت تكلفتها بأكثر من 90%، وSegment دمجت أكثر من 140 خدمة في واحدة، وUber رتبت 2,200 خدمة في 70 مجالاً، وكل منها كتب ما خسره.
- في تجربتنا أخذ استدعاء المخزون 3 ميكروثانية داخل البرنامج وحوالي ميلي ثانيتين عبر الشبكة على نفس الجهاز، والخدمة المعلقة جعلت الطلب يفشل بعد أن حجز المخزون، والمتوقفة فشلت بعد أربع ثوان رغم مهلة ثانيتين، والطابور حفظ الطلبات حتى عادت الخدمة.
- ابدأ بحدود حسب المجال داخل برنامج واحد، وأخرج خدمة فقط عندما يكون لها سبب يقاس، بطريقة Strangler Fig خطوة بعد خطوة، واكتب القرار وأسبابه.
 دليلأنماط المعمارية Architecture Styles ومتى تختار كلاً منهاكيف تختار بين التطبيق الواحد والخدمات التي تتبادل الأحداث، وما الذي يناسب نظامك من أشهر أنماط المعمارية.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلهل يسلم الفريق الأكبر أسرع؟ قانون Brooks والذكاء الاصطناعيماذا تقول الدراسات عن حجم فريق البرمجة وسرعة التسليم، ومتى تفيد إضافة الأشخاص، وما الذي يغيره الذكاء الاصطناعي فعلاً.
 دليلالتصميم والمعمارية: أربعة مستويات لنشاط واحدما الفرق بين تصميم البرمجيات ومعماريتها وتصميم الأنظمة ومعمارية المؤسسة، ومن يقرر في كل مستوى وكم يعيش قراره.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلكيف بنى Stack Overflow موقعه بسيرفرات قليلة؟كيف خدم Stack Overflow أكثر من مئتي مليون طلب يومياً بعدد قليل من السيرفرات، وما الدروس التي تأخذها منه لمشروعك.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلالتصميم الموجه بالمجال Domain-Driven Design ببساطةلماذا تعني كلمة «الطلب» ثلاثة أشياء في نفس الشركة، وكيف يقسم DDD النظام إلى سياقات لكل منها لغته ونموذجه.
سجل التحديثات
- أكتوبر 2026: كتابة المقال من مقالات Prime Video وSegment وUber وWerner Vogels الأصلية، ومقالات Martin Fowler وStefan Tilkov وZhamak Dehghani، وصفحة DORA ونمط Strangler Fig من Microsoft، مع تجربة على RabbitMQ 4.3.6 وPython 3.13.16 تقيس زمن الاستدعاء وسلوك الفشل في البرنامج الواحد والخدمتين، وسبع رسومات للأشكال الثلاثة والمكاسب والثمن والحالات والتجربة والقرار والاستخراج التدريجي.