

عندما يجتمع فريق لبدء نظام جديد، فغالباً أول نقاش يدور ليس عن اسم الجدول أو شكل الشاشة، وإنما عن سؤال أكبر: هل نبني تطبيقاً واحداً أم عدة خدمات؟ وهل تمر العمليات بين أجزاء النظام كاستدعاءات مباشرة أم كأحداث عبر وسيط Broker؟ وهل نترك مكاناً لإضافات يكتبها غيرنا؟ وهذه الأسئلة ليست أسئلة كود، فالكود نفسه قد يكون نظيفاً في كل الحالات، وإنما هي أسئلة عن الشكل العام للنظام، وهذا الشكل العام له أسماء معروفة يسميها المهندسون أنماط المعمارية Architecture Styles، ولكل نمط منها نقاط قوة يشتريها ونقاط ضعف يدفع ثمنها.
وفي مدخل هذه المرحلة شرحنا ما هي معمارية البرمجيات Software Architecture وما هي خصائص الجودة Quality Attributes التي تبنى عليها القرارات، فلن نعيد ذلك هنا، وسوف نناقش في هذا المقال ما يلي:
- ما هو نمط المعمارية Architecture Style، وما الفرق بينه وبين نمط التصميم Design Pattern.
- الأنماط التي تنشر كبرنامج واحد: الطبقات Layered، والأنابيب والمرشحات Pipes and Filters، والنواة والإضافات Microkernel، والبرنامج الواحد المقسم إلى وحدات Modular Monolith.
- الأنماط الموزعة: المعمارية القائمة على الأحداث Event-Driven بشكليها الوسيط Broker والمنسق Mediator، والمعمارية القائمة على الخدمات Service-Based، والخدمات المصغرة Microservices باختصار، ونمط Space-Based.
- تجربة عملية مع RabbitMQ نرى فيها حدثاً واحداً يصل إلى ثلاثة مستهلكين، ومستهلكاً متوقفاً يعود ويكمل، ومشتركاً متأخراً لا يرى ما فاته.
- تجربة صغيرة في .NET نرى فيها كيف يرفض البناء Build تجاوز حدود الوحدات.
- جدول يقارن الأنماط على خصائص الجودة، وكيف تختار بينها.
ما هو نمط المعمارية Architecture Style؟
نمط المعمارية هو عائلة من المعماريات تشترك في خصائص معينة، وهذا هو تعريف Microsoft في صفحة Architecture styles في Azure Architecture Center، وهي تضيف فكرة مهمة: النمط يضع قيوداً Constraints على التصميم، أي يحدد ما هي العناصر التي يمكن أن تظهر في النظام وما هي العلاقات المسموحة بينها، وعندما تلتزم بهذه القيود تحصل على خصائص معينة، فمثلاً من قيود الخدمات المصغرة أن كل خدمة مستقلة وأن بياناتها خاصة بها ولا تشاركها مع غيرها، والنتيجة التي تشتريها بهذه القيود هي أن تنشر كل خدمة وحدها وأن يبقى العطل محصوراً في خدمته.
وهذا يعني أن النمط ليس تقنية، فلا يوجد نمط اسمه Kafka ولا نمط اسمه Kubernetes، وإنما يوجد شكل للنظام، وبعض التقنيات تناسب بعض الأشكال أكثر من غيرها، وتقول Microsoft في نفس الصفحة إن الأهم أن تفهم لماذا تختار النمط قبل أن تسأل كيف تطبقه، لأن من يأخذ الشكل دون أن يفهم قيوده يبني نظاماً يشبه النمط من الخارج ولا يحصل على فوائده.
الفرق بين نمط المعمارية ونمط التصميم Design Pattern
وقد يتساءل البعض: ما الفرق بين هذا وبين أنماط التصميم Design Patterns التي نسمع عنها مثل Strategy وObserver؟ والإجابة أن الفرق في المستوى الذي يعمل عليه كل منهما، فنمط التصميم حل لمشكلة محلية داخل الكود، مثل كيف تختار خوارزمية في وقت التشغيل أو كيف تبلغ عدة كائنات بتغير حالة كائن، وقد شرحناها في أنماط التصميم التي تقابلها فعلاً، أما نمط المعمارية فيحدد الشكل العام للنظام كله: كم برنامجاً ننشر، وكيف تتصل الأجزاء، وأين تعيش البيانات. ولاحظ أن نفس الفكرة قد تظهر في المستويين، فنمط Observer داخل الكود هو نفس فكرة النشر والاشتراك Publish-Subscribe بين الخدمات، لكن الأول استدعاء دالة داخل نفس العملية Process، والثاني رسالة تعبر الشبكة وقد تتأخر أو تضيع، وهذا الفرق هو ما يجعل الثاني قراراً معمارياً.
ويجدر الإشارة هنا إلى أن بعض الكتب تستخدم كلمة Architecture Pattern لنفس المعنى، وتسمي أخرى الأنماط بأسماء مختلفة قليلاً، والتقسيم الذي نتبعه في هذا المقال قريب من تقسيم Mark Richards وNeal Ford في كتاب Fundamentals of Software Architecture الصادر عن O'Reilly عام 2020، مع شرح بكلماتنا وأمثلتنا، ومع مراجعة كل نمط على مصادره الرسمية.
برنامج واحد أم عدة برامج؟
أبسط طريقة لترتيب الأنماط هي أن تسأل: كم وحدة نشر Deployment Unit فيها؟ فبعض الأنماط تنشر كبرنامج واحد، ملف jar واحد أو Container واحد أو عملية واحدة، وبعضها ينشر كعدة برامج بينها شبكة، والصورة التالية تبين الأنماط التي سوف نشرحها في الجهتين:
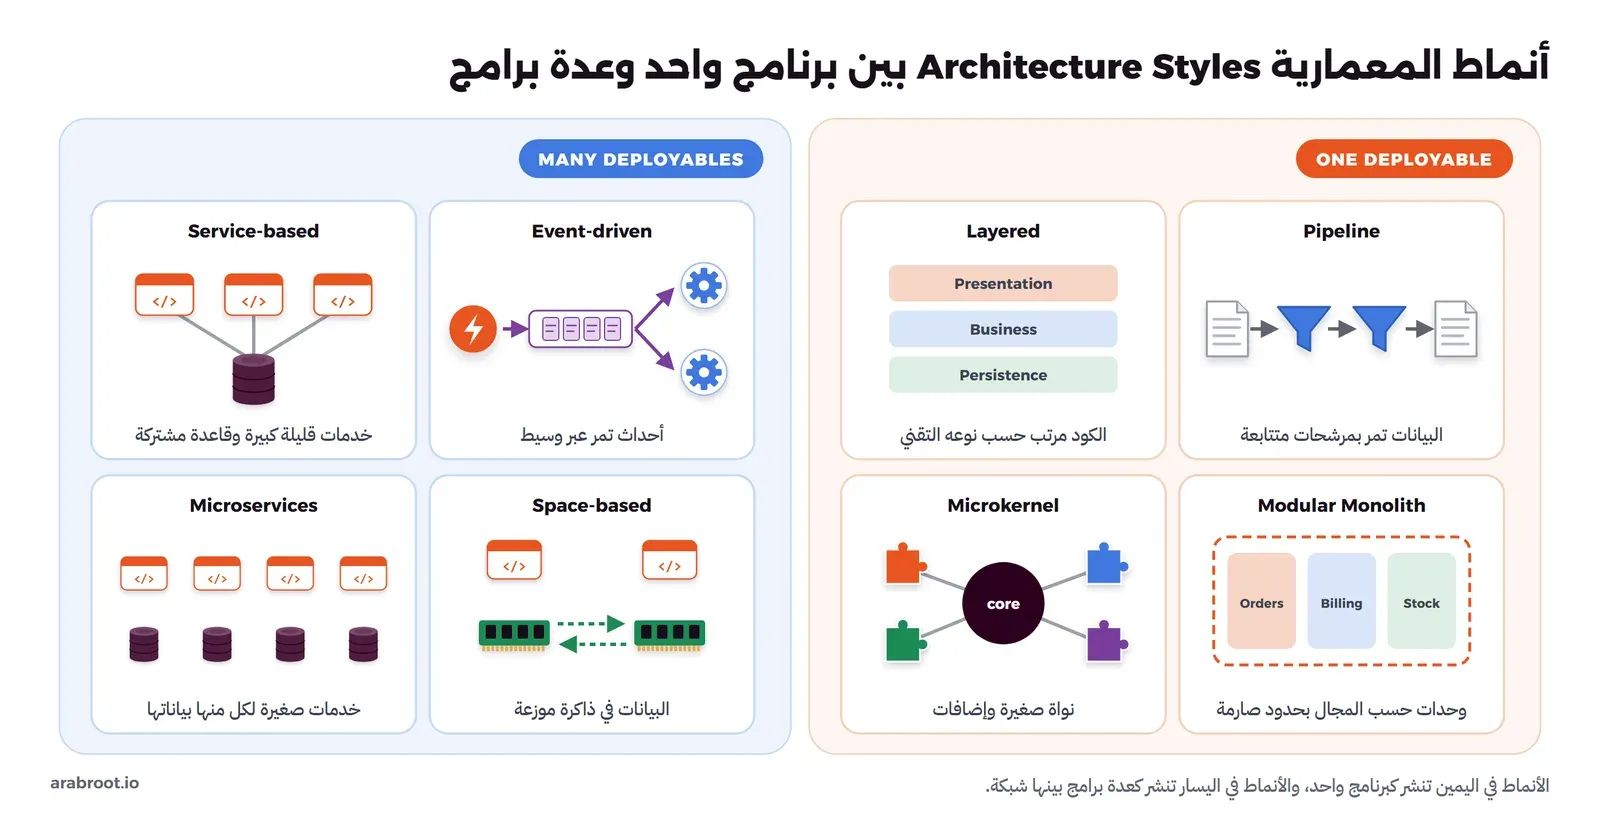
والسبب في أهمية هذا السؤال أن الانتقال من برنامج واحد إلى عدة برامج ينقلك إلى عالم مختلف تماماً، فكل استدعاء بين جزأين كان استدعاء دالة يأخذ أجزاء من الميكروثانية ولا يفشل إلا بخطأ في الكود، فأصبح طلباً عبر الشبكة قد يتأخر أو ينقطع أو يصل مرتين، وقد شرحنا هذه المشكلات في الأنظمة الموزعة للمبتدئين، وكل نمط في الجهة اليسرى يرث هذه المشكلات كلها مقابل ما يعطيه من مرونة في النشر والتوسع.
لماذا تبدأ أغلب الأنظمة بالطبقات Layered ومتى تتعبك؟
النمط الطبقي Layered Architecture يقسم النظام حسب نوع العمل التقني: طبقة للعرض Presentation تستقبل الطلب، وطبقة لمنطق العمل Business تطبق القواعد، وطبقة للوصول إلى البيانات Persistence تكلم قاعدة البيانات، وكل طبقة تنادي الطبقة التي تحتها فقط، وهذا هو الشكل الذي تحصل عليه تلقائياً عندما تنشئ مشروعاً جديداً بأغلب أطر العمل Frameworks، لذلك تجده في أغلب الأنظمة التي حولك. وتصف Microsoft في صفحة N-tier architecture style هذا الترتيب بأن الطبقات تدير الاعتماديات Dependencies بأن تنادي كل طبقة ما تحتها فقط.
ولاحظ أننا نتكلم هنا عن الطبقة Layer كتقسيم منطقي، أما توزيع الطبقات على أجهزة منفصلة بينها جدار ناري فهو المستوى Tier، وقد فصلنا الفرق في المعمارية متعددة الطبقات Tiers وLayers، وأما ترتيب الطبقات داخل الكود واتجاه الاعتماديات بينها فهو موضوع Clean Architecture وHexagonal. ما يهمنا هنا هو النمط الطبقي كشكل للنظام كله، وما يعطيه وما يأخذه.
الطبقات المغلقة والمفتوحة Closed and Open Layers
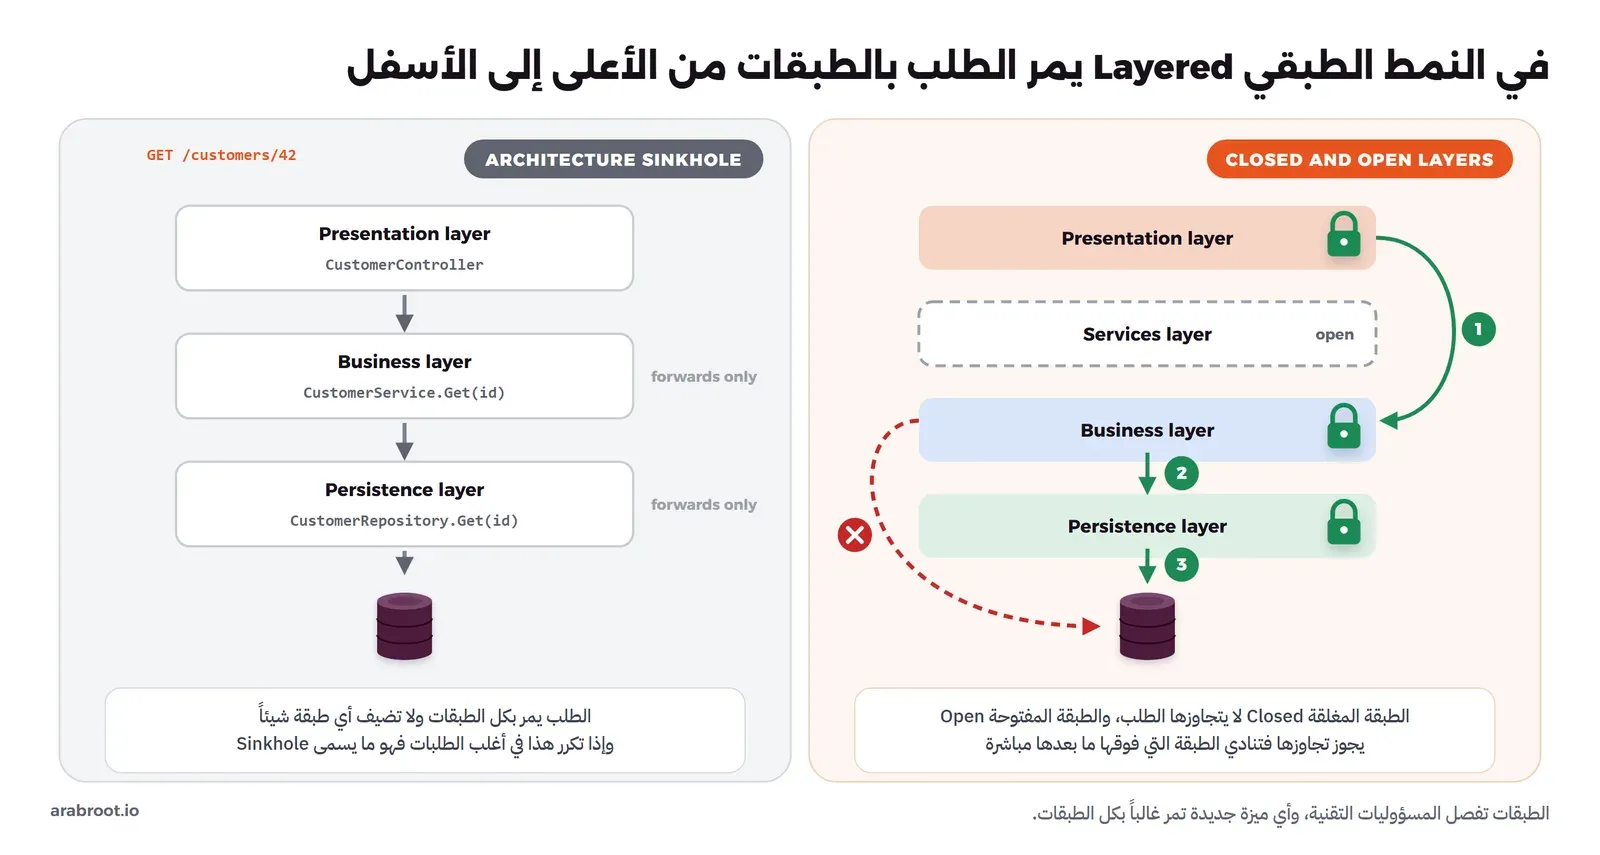
الطبقة المغلقة Closed Layer طبقة لا يجوز للطلب أن يتجاوزها، فإذا كانت طبقة الوصول إلى البيانات مغلقة فلا يجوز لطبقة منطق العمل أن تكتب SQL مباشرة إلى قاعدة البيانات، وعليها أن تمر عبر ال Repository، والسبب أن هذا هو ما يسمى عزل الطبقات Layers of Isolation: إذا قمت بتغيير قاعدة البيانات أو طريقة الوصول إليها، فالتغيير يبقى داخل طبقته ولا يصل إلى ما فوقها. أما الطبقة المفتوحة Open Layer فيجوز تجاوزها، ومثالها الشائع طبقة خدمات مشتركة Shared Services مثل التسجيل أو التحويلات، تستخدمها بعض الطلبات وتتجاوزها أخرى، والصورة التالية تبين الحالتين:
والخطأ الشائع هنا أن يفتح الفريق كل الطبقات بحجة السرعة، فتبدأ صفحة العرض بقراءة قاعدة البيانات مباشرة، ثم يكتب أحدهم قاعدة عمل في ال Controller، وبعد سنة تجد أن تغيير اسم عمود في قاعدة البيانات يكسر عشر شاشات، لذلك إذا قررت أن طبقة ما مفتوحة فاكتب هذا القرار ولماذا، وقد شرحنا طريقة ذلك في سجلات القرارات المعمارية ADR.
عندما تمرر الطبقات الطلب دون أن تعمل شيئاً Sinkhole
في اليسار من الصورة السابقة طلب يجلب عميلاً برقمه، يستقبله ال Controller فيمرره إلى ال Service التي تمرره إلى ال Repository التي تجلبه من قاعدة البيانات، ولا تضيف أي طبقة في الطريق شيئاً، وهذا يسميه Mark Richards في تقريره Software Architecture Patterns نمط البالوعة Architecture Sinkhole Anti-pattern. ووجود بعض هذه الطلبات طبيعي في كل نظام طبقي، أما إذا كانت أغلب الطلبات تمر بالطبقات دون عمل، فهذه علامة على أن الطبقات أكثر من حاجة النظام، وأنك تدفع ثمن ملفات ودوال إضافية في كل ميزة دون أن تحصل على عزل حقيقي، وفي هذه الحالة قد يكون فتح بعض الطبقات أو تقليل عددها هو القرار الصحيح.
متى يناسبك النمط الطبقي ومتى لا يناسبك؟
نقاط القوة: النمط مفهوم لكل مطور تقريباً، وتولده أطر العمل تلقائياً، وتكلفته منخفضة، ويناسب الفريق الصغير والنظام في بدايته، وهو نقطة بداية جيدة عندما لا تعرف بعد كيف سوف ينمو النظام.
نقاط الضعف: التقسيم تقني وليس حسب المجال Domain، أي أن ميزة جديدة مثل إضافة رقم جوال للعميل تمر غالباً بكل الطبقات، فتعدل الشاشة وال Service وال Repository وقاعدة البيانات، وتقول Microsoft في نفس الصفحة إن هذا التقسيم الأفقي يصعب معه إدخال تغيير دون أن يمس عدة أجزاء من التطبيق. ثم إن النظام كله ينشر كوحدة واحدة، فلا يمكنك أن توسع جزءاً منه وحده، وعطل في جزء واحد مثل تسرب ذاكرة Memory Leak يسقط النظام كله.
نمط الأنابيب والمرشحات Pipes and Filters
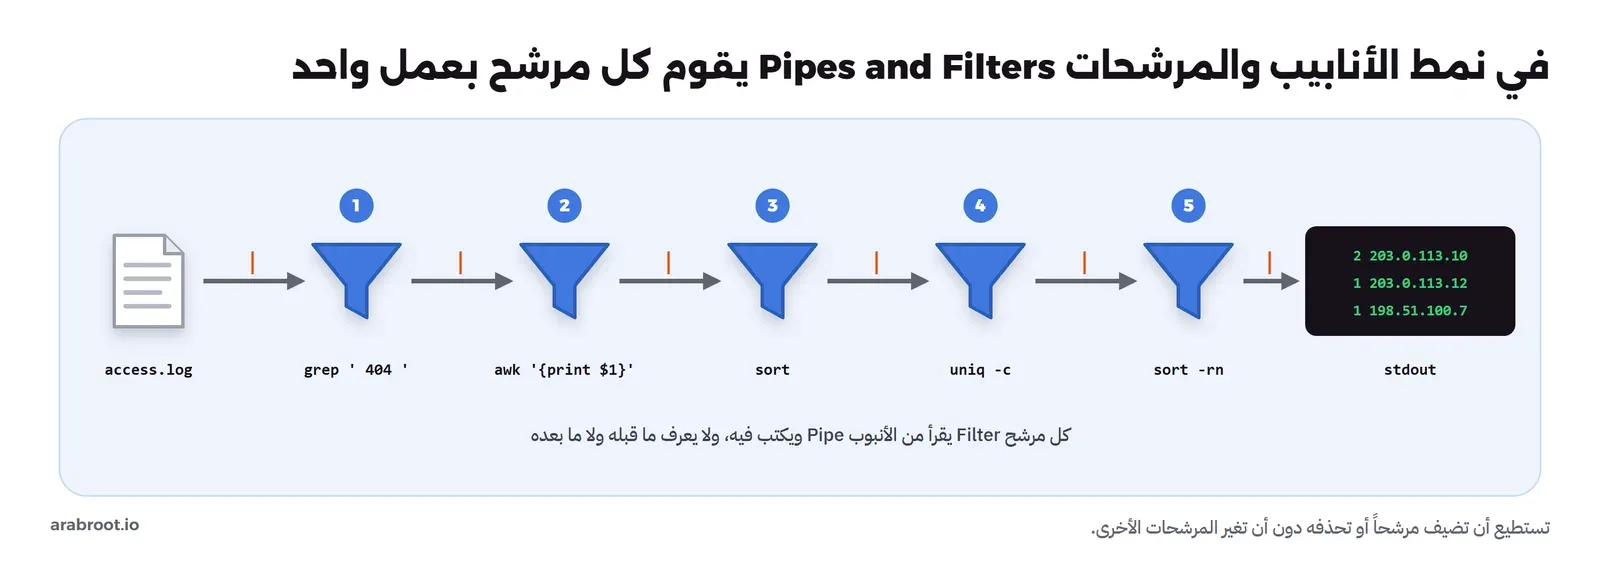
في هذا النمط تمر البيانات بسلسلة من المرشحات Filters، وكل مرشح يقوم بعمل واحد: يقرأ من مدخله ويكتب في مخرجه، ولا يعرف من قبله ولا من بعده، والأنبوب Pipe هو القناة التي تنقل الناتج من مرشح إلى الذي يليه، وأنت تستخدم هذا النمط كل يوم ربما دون أن تسميه، فأوامر Linux التي تربطها بالعلامة | هي هذا النمط بالضبط، وقد شرحنا الأنابيب في سطر الأوامر في Linux للمبتدئين. لنأخذ مثالاً: ملف سجل Log لسيرفر ويب، ونريد أن نعرف أي العناوين طلبت صفحات غير موجودة أكثر من غيرها، والأمر التالي يبين ذلك:
grep ' 404 ' access.log | awk '{print $1}' | sort | uniq -c | sort -rnوالمخرج سوف يكون كما يلي على ملف تجريبي من سبعة أسطر:
      2 203.0.113.10
      1 203.0.113.12
      1 198.51.100.7
والصورة التالية تبين نفس الأمر كمرشحات وأنابيب:
في الأمر أعلاه لاحظ التالي:
grepلا يعرف أن بعدهawk، وكل ما يعرفه أنه يقرأ أسطراً ويكتب أسطراً، لذلك تستطيع أن تضيف مرشحاً جديداً في المنتصف، مثلgrep -v '^198\.51'لاستبعاد شبكة معينة، دون أن تغير أي مرشح آخر.- كل مرشح يمكن اختباره وحده بإدخال نص صغير ومقارنة الناتج، وهذا ما يجعل هذا النمط سهل الاختبار Testability.
- العقد Contract بين المرشحات هنا هو «أسطر نصية»، وفي الأنظمة الحقيقية قد يكون ملف CSV أو رسالة JSON، وإذا تغير شكل العقد انكسرت السلسلة كلها.
وتجد هذا النمط خارج سطر الأوامر في أدوات ETL التي تستخرج البيانات Extract وتحولها Transform وتحملها Load، وفي خطوط ال CI/CD Pipelines، وفي معالجة الصور والفيديو، ونقاط قوته البساطة وسهولة إعادة الاستخدام، أما نقاط ضعفه فهي أنه يناسب المعالجة التي تسير في اتجاه واحد، ولا يناسب نظاماً تفاعلياً فيه ذهاب وإياب بين الأجزاء، ثم إن مرشحاً بطيئاً واحداً يحدد سرعة السلسلة كلها.
النواة والإضافات Microkernel أو Plug-in Architecture
في هذا النمط نظام أساسي صغير Core System فيه الحد الأدنى الذي يعمل به البرنامج، وإضافات Plug-ins تضيف الميزات، والنواة لا تعرف الإضافات بأسمائها، وإنما تعرف عقداً Contract ثابتاً تلتزم به كل إضافة، وسجلاً Registry تعرف منه ما هي الإضافات المثبتة ومتى تحملها. والمثال الذي تعرفه بكل تأكيد هو محرر VS Code، فالمحرر نفسه يقدم الواجهة والملفات والتحرير، وكل دعم للغة أو أداة Git أو مدقق Linter أو سمة Theme هو إضافة، وتصف كل إضافة نفسها في ملف package.json الذي توضح صفحة Extension Manifest حقوله، ومنها contributes لما تضيفه الإضافة إلى المحرر، وactivationEvents التي تشرحها صفحة Activation Events وتحدد متى يحمل المحرر الإضافة، فلا تحمل إضافة Python إلا عندما تفتح ملف Python مثلاً. ويشغل VS Code الإضافات في عملية خاصة بها اسمها Extension Host، وقد تكون محلية على نفس الجهاز أو بعيدة داخل Container أو سيرفر آخر، والصورة التالية تبين الفكرة:
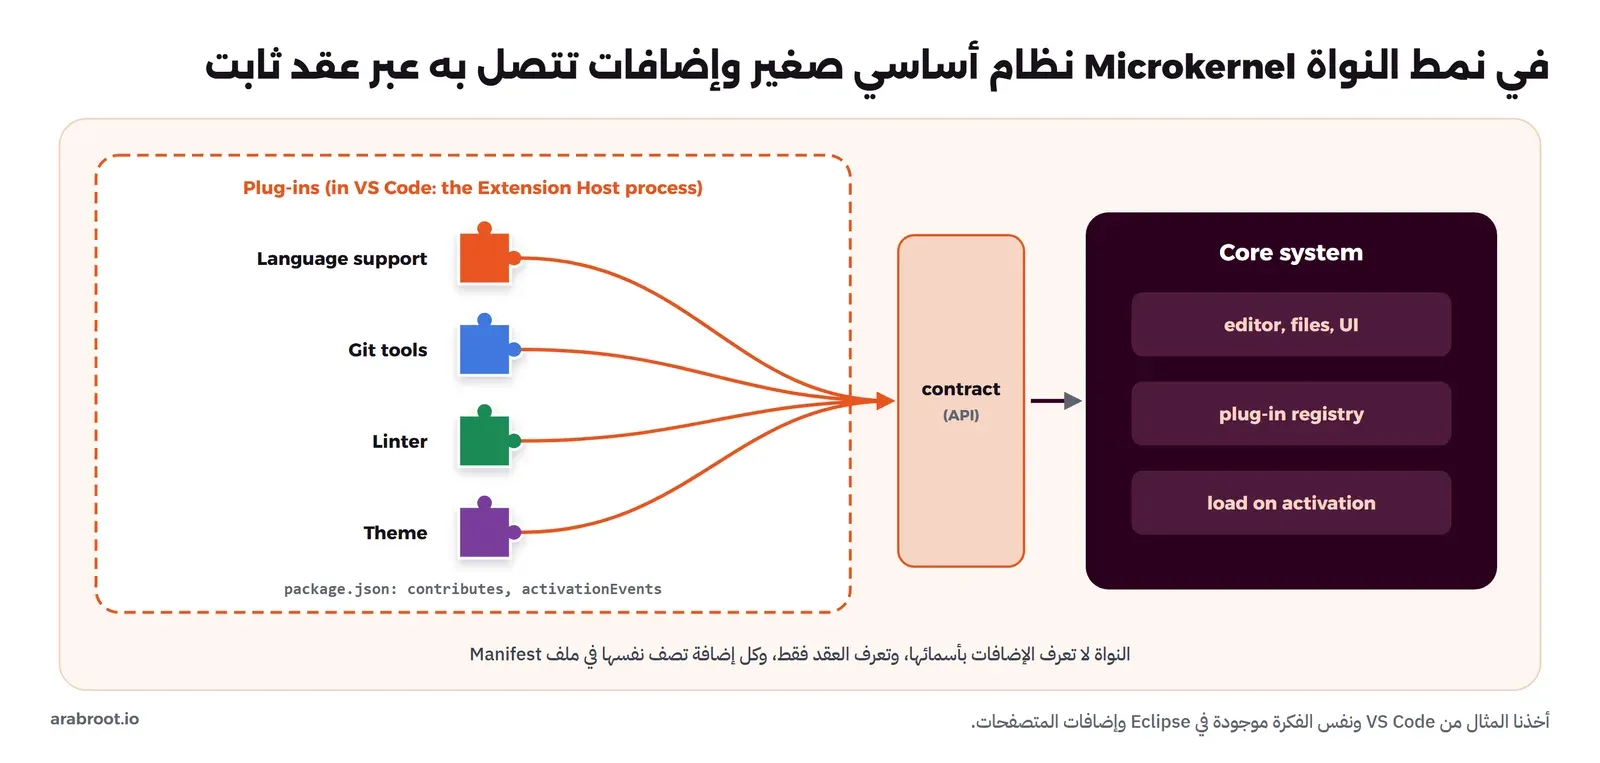
والفكرة أقدم من VS Code بكثير، ففي مقال Notes on the Eclipse Plug-in Architecture المنشور على موقع Eclipse عام 2003 تجد أن Eclipse نفسه مبني كنواة تشغيل Runtime صغيرة وكل ما فوقها إضافات، وأن الإضافة تعلن عن نقاط توسعة Extension Points يمكن لإضافات أخرى أن تتصل بها، وتجد نفس النمط في إضافات المتصفحات التي يشرحها توثيق WebExtensions في MDN، حيث تصف كل إضافة نفسها في ملف manifest.json.
وقد يتساءل البعض: هل هذا النمط للمحررات والمتصفحات فقط؟ والإجابة لا، فهو يناسب أي نظام أعمال فيه قواعد تختلف من عميل إلى آخر، فإذا كان لديك نظام فوترة يعمل في عدة دول ولكل دولة قواعد ضريبة مختلفة، فبدلاً من دالة فيها مئة شرط if (country == ...)، تبقى النواة تحسب الفاتورة، وتكون قواعد كل دولة إضافة تلتزم بعقد واحد، فإذا دخلت سوقاً جديدة كتبت إضافة جديدة ولم تلمس النواة.
نقاط القوة: تضيف الميزات دون تعديل النواة، وتختبر كل إضافة وحدها، ويستطيع غيرك أن يكتب إضافات لنظامك. نقاط الضعف: تصميم العقد صعب، لأن كل تغيير فيه يكسر كل الإضافات القديمة، لذلك يحتاج العقد إلى إصدارات Versioning وعناية كبيرة، ثم إن النظام كله غالباً وحدة نشر واحدة، فلا يتوسع جزء منه وحده.
البرنامج الواحد المقسم إلى وحدات Modular Monolith
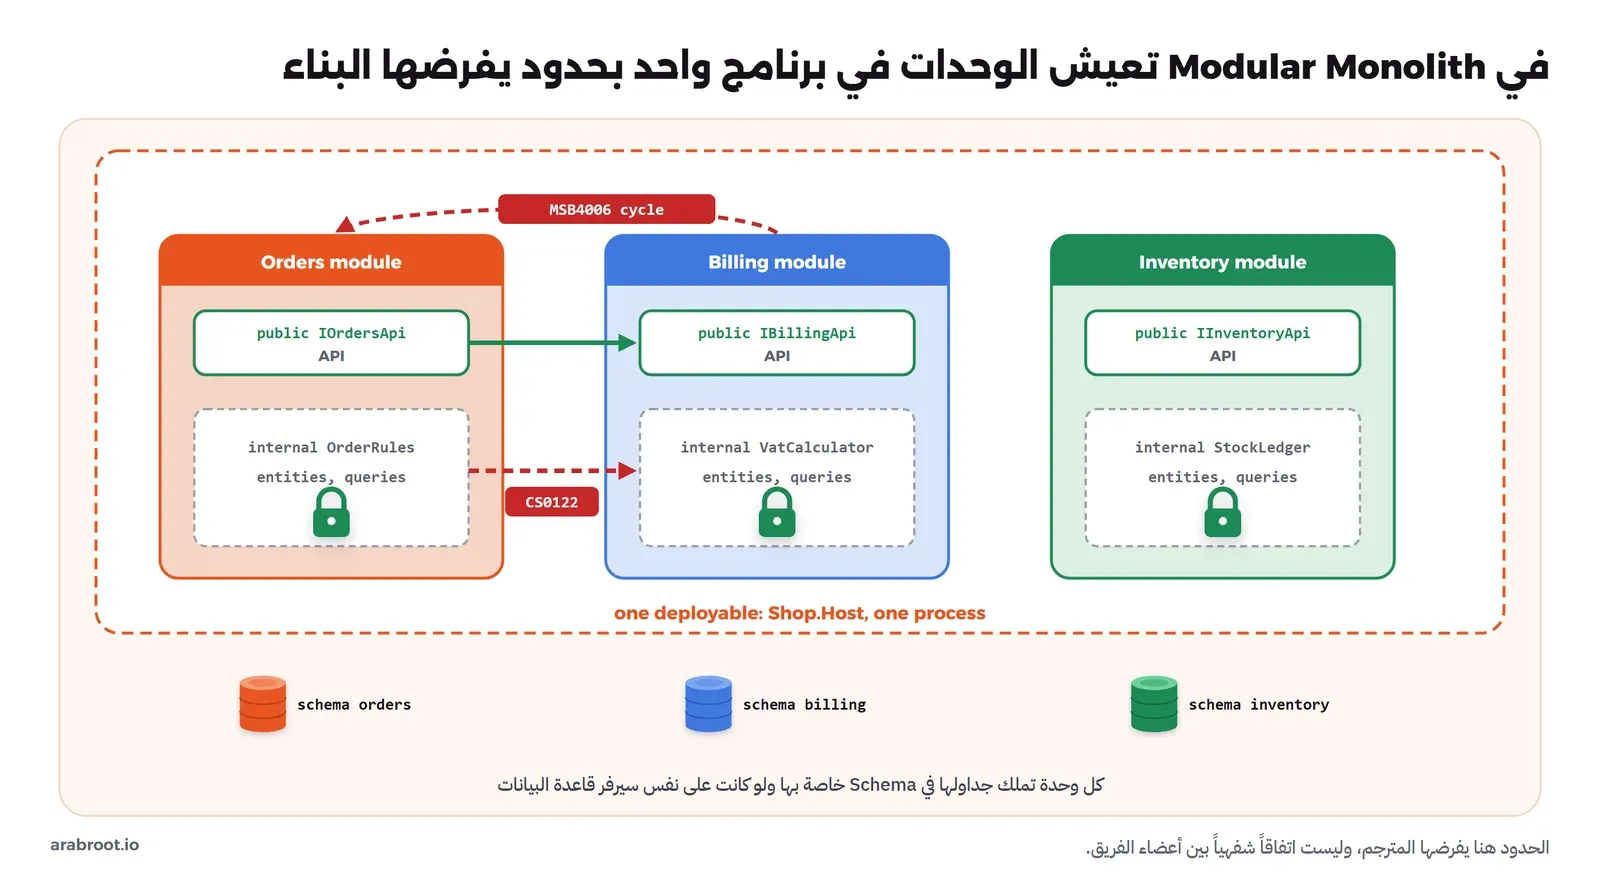
لنفرض أن لديك متجراً إلكترونياً مبنياً بالنمط الطبقي، ومع الوقت كبر الكود وكبر الفريق، فأصبح تعديل طريقة حساب الشحن يكسر اختبارات في الفوترة، ولا أحد يعرف أي جزء يستدعي أي جزء، والحل الذي يقفز إليه الكثيرون هو تقسيم النظام إلى خدمات مصغرة Microservices، وهذا الحل يحل مشكلة الحدود لكنه يضيف معها كل مشكلات الأنظمة الموزعة. وهناك حل في المنتصف: أن تبقي البرنامج وحدة نشر واحدة، لكن تقسم الكود داخله إلى وحدات Modules حسب المجال، مثل الطلبات Orders والفوترة Billing والمخزون Inventory، وكل وحدة تعرض واجهة عامة Public API صغيرة وتخفي كل ما عداها، وتملك جداولها في قاعدة البيانات، ولا يجوز لوحدة أن تصل إلى داخل وحدة أخرى، وهذا هو ال Modular Monolith.
والفرق بينه وبين النمط الطبقي أن التقسيم الأول هنا حسب المجال Domain Partitioning وليس حسب النوع التقني، فكود الشحن كله في وحدة الشحن، وإذا أردت أن تعرف أين تضع الحدود بين الوحدات، فالأداة المناسبة هي السياق المحدود Bounded Context الذي شرحناه في التصميم الموجه بالمجال DDD ببساطة، وداخل كل وحدة يمكنك أن تستخدم الطبقات أو أي ترتيب آخر. والصورة التالية تبين الشكل:
ماذا تعلمت Shopify من تقسيم برنامجها الكبير؟
أشهر قصة موثقة لهذا النمط هي قصة Shopify، ففي مقال Deconstructing the Monolith المنشور في فبراير 2019 يذكر فريقها أن نظامهم من أكبر أنظمة Ruby on Rails، وأنه بني في البداية كبرنامج واحد دون حدود بين أجزائه، وأنهم وصلوا عام 2016 إلى مرحلة أصبح فيها تغيير بسيط يسبب سلسلة من الاختبارات الفاشلة في أجزاء لا علاقة لها بالتغيير، ثم قرروا ألا ينتقلوا إلى الخدمات المصغرة، لأن ذلك يعني عدة خطوط نشر واتصالات شبكة تضيف التأخير وتقلل الموثوقية مع كل استدعاء، واختاروا بدلاً من ذلك Modular Monolith، فأعادوا ترتيب الكود حسب مفاهيم العمل مثل الطلبات والشحن والفوترة بدل ترتيبه حسب Models وViews وControllers، ووضعوا كل فئة من حوالي 6000 فئة Class في جدول ليحددوا الوحدة التي تنتمي إليها.
وفي المقال الثاني Under Deconstruction المنشور في سبتمبر 2020 ذكروا أن البرنامج تجاوز 2.8 مليون سطر من Ruby و500,000 Commit، وأنهم عندما حللوا الاعتماديات بين الوحدات وجدوا أن كل وحدة تعتمد على أكثر من نصف الوحدات الأخرى وأن الاعتماديات الدائرية Circular Dependencies كثيرة، وهذا يعني أن الوحدات لا يمكن فهمها أو تطويرها كل واحدة وحدها، فبنوا أداة مفتوحة المصدر اسمها Packwerk تحلل الإشارات بين الوحدات وتبين المخالفات. والدرس الذي ذكروه بوضوح أن الوحدات الجيدة تحتاج كوداً جيداً على مستوى الفئات والدوال أولاً، فإذا لم يكن الفريق يطبق مبادئ مثل التماسك Cohesion وقلة الترابط Coupling داخل الفئات، فلن تنجح الحدود بين الوحدات، وهذه المبادئ شرحناها في مبادئ التصميم SOLID وDRY وKISS.
كيف تفرض الحدود بالأدوات وليس بالاتفاق؟
الحدود التي تبقى اتفاقاً شفهياً بين أعضاء الفريق تنكسر في أول أسبوع ضغط، لذلك الحل الأنسب أن يفرضها المترجم Compiler أو أداة في خط CI. وفي .NET أبسط طريقة أن تكون كل وحدة مشروعاً Project مستقلاً، وأن تكون فئاتها الداخلية internal، وهي الكلمة التي تجعل الفئة مرئية داخل نفس ال Assembly فقط كما تشرح صفحة internal في توثيق C#. لنأخذ مثالاً بثلاثة مشاريع، وحدة الفوترة ووحدة الطلبات وبرنامج التشغيل الذي يجمعهما:
dotnet new classlib -n Shop.Billing -o Billing -f net10.0
dotnet new classlib -n Shop.Orders -o Orders -f net10.0
dotnet new console -n Shop.Host -o Host -f net10.0
dotnet add Orders reference Billing
dotnet add Host reference Orders Billing
ثم ملف وحدة الفوترة Billing/BillingModule.cs، وفيه واجهة عامة وفئة داخلية:
namespace Shop.Billing;

// The module's public API: the only thing other modules may use.
public interface IBillingApi
{
    decimal InvoiceTotal(decimal subtotal);
}

public sealed class BillingModule : IBillingApi
{
    private readonly VatCalculator _vat = new();
    public decimal InvoiceTotal(decimal subtotal) => subtotal + _vat.For(subtotal);
}

// Internal detail: visible inside Shop.Billing only.
internal sealed class VatCalculator
{
    public decimal For(decimal amount) => Math.Round(amount * 0.15m, 2);
}
ووحدة الطلبات Orders/OrdersModule.cs تستخدم الواجهة العامة فقط:
using Shop.Billing;

namespace Shop.Orders;

public sealed class OrdersModule(IBillingApi billing)
{
    public string PlaceOrder(int id, decimal subtotal) =>
        $"order {id}: total {billing.InvoiceTotal(subtotal)}";
}
وبرنامج التشغيل Host/Program.cs يجمع الوحدتين في عملية واحدة:
using Shop.Billing;
using Shop.Orders;

var orders = new OrdersModule(new BillingModule());
Console.WriteLine(orders.PlaceOrder(1001, 200m));
وعند تشغيل الأمر dotnet run --project Host سوف تجد أنه يطبع:
order 1001: total 230.00الآن سوف نكسر الحدود عمداً كما يفعل مطور مستعجل، فنضيف في وحدة الطلبات ملف Orders/Shortcut.cs يصل إلى الفئة الداخلية مباشرة:
using Shop.Billing;

namespace Shop.Orders;

public static class Shortcut
{
    // Skips the public API and reaches into Billing's internals
    public static decimal Vat(decimal amount) => new VatCalculator().For(amount);
}
وعند تشغيل dotnet build Orders يرفض المترجم البناء، والمخرج سوف يكون كما يلي (اختصرنا مسار المجلد):
Orders\Shortcut.cs(8,54): error CS0122: 'VatCalculator' is inaccessible due to its protection level [Orders\Shop.Orders.csproj]ثم نحذف هذا الملف ونجرب الخطأ الثاني: أن تعتمد وحدة الفوترة على وحدة الطلبات، مع أن الطلبات تعتمد على الفوترة أصلاً، أي اعتماد دائري:
dotnet add Billing reference Orders
dotnet build Host
والمخرج سوف يكون كما يلي:
C:\Program Files\dotnet\sdk\10.0.400\NuGet.targets(1298,5): error MSB4006: There is a circular dependency in the target dependency graph involving target "_GenerateRestoreProjectPathWalk". [Billing\Shop.Billing.csproj]في التجربة أعلاه لاحظ التالي:
- الخطأ CS0122 يعني أن الحد بين الوحدتين يفرضه المترجم، فلا يمكن أن يدخل هذا الكود إلى الفرع الرئيسي إذا كان خط CI يبني المشروع، وهذا أقوى من أي مراجعة كود.
- الخطأ MSB4006 يأتي من MSBuild وليس من C#، لأن مراجع المشاريع Project References يجب أن تكون رسماً بلا دوائر، والتوثيق في صفحة MSB4006. فإذا احتاجت الفوترة أن تعرف أن طلباً قد أكد، فالطريقة الصحيحة ليست أن تستدعي الطلبات، وإنما أن تنشر الطلبات حدثاً داخل البرنامج وتستمع له الفوترة، وهذا ما فعلته Shopify لعكس اتجاه الاعتماديات كما ذكرت في مقالها.
- برنامج التشغيل
Shop.Hostهو الذي يعرف كل الوحدات ويربطها، والوحدات لا تعرف إلا الواجهات العامة لما تحتاجه، وهذا هو المكان الطبيعي لحاوية حقن الاعتماديات Dependency Injection Container.
وفي Java يقدم مشروع Spring Modulith نفس الفكرة لتطبيقات Spring Boot، فكل حزمة Package في المستوى الأول من التطبيق تعد وحدة، والدالة ApplicationModules.of(Application.class).verify() تفحص البنية في اختبار عادي، وتذكر صفحة Verification قواعدها: لا توجد دوائر بين الوحدات، ولا يجوز الوصول إلى الحزم الداخلية لوحدة أخرى، ويمكن تحديد الاعتماديات المسموحة لكل وحدة. وفي Ruby تجد Packwerk التي ذكرناها.
نقاط القوة: تحصل على حدود واضحة حسب المجال وملكية واضحة لكل فريق، مع بقاء النشر بسيطاً والاستدعاءات سريعة داخل نفس العملية والمعاملات Transactions عادية في قاعدة بيانات واحدة، وإذا احتجت يوماً أن تخرج وحدة كخدمة مستقلة، فالحدود جاهزة. نقاط الضعف: النظام ما زال ينشر ويتوسع كوحدة واحدة، وعطل في وحدة قد يسقط العملية كلها، والحدود تحتاج انضباطاً وأدوات وإلا عادت الفوضى. ويجدر الإشارة هنا إلى أن Martin Fowler كتب عام 2015 في مقاله MonolithFirst أن أغلب قصص النجاح مع الخدمات المصغرة بدأت ببرنامج واحد كبر ثم قسم، وأن أغلب الأنظمة التي بدأت بالخدمات المصغرة من الصفر واجهت مشكلات كبيرة.
المعمارية القائمة على الأحداث Event-Driven Architecture
لنفرض أن العميل أكد طلباً في متجرك، وبعد التأكيد يجب أن ترسل له بريداً، وأن تخصم الكمية من المخزون، وأن تسجل الطلب في نظام التحليلات، والحل البسيط أن تستدعي خدمة الطلبات الخدمات الثلاث واحدة بعد الأخرى، وهذا الحل يعمل حتى يتعطل سيرفر البريد، فيفشل تأكيد الطلب كله بسبب بريد، ثم يطلب فريق التسويق إضافة خدمة رابعة، فتعدل خدمة الطلبات من جديد مع أنها لا علاقة لها بالتسويق. وفي المعمارية القائمة على الأحداث تعكس هذه العلاقة: خدمة الطلبات تنشر حدثاً اسمه OrderPlaced يقول «تم تأكيد طلب»، ثم تكمل عملها، وكل خدمة تهتم بهذا الحدث تستقبله من قناة أحداث Event Channel أو وسيط Broker وتقوم بعملها في وقتها.
وتصف Microsoft في صفحة Event-driven architecture style هذا النمط بأنه منتجون Producers يولدون الأحداث، ومستهلكون Consumers يستمعون لها، وقناة بينهما، وأن المنتج لا يعرف من يستمع، وأن المستهلكين منفصلون عن بعضهم أيضاً، وأنك تستطيع إضافة مستهلك جديد دون أن تعدل المنتج أو المستهلكين الآخرين. ولاحظ أن نفس الفكرة داخل برنامج واحد هي نمط Observer الذي شرحناه في أنماط التصميم، وأن البرمجة القائمة على الأحداث داخل الكود شرحناها في أنماط البرمجة، أما ما نتكلم عنه هنا فهو أحداث تعبر بين برامج منفصلة عبر وسيط على الشبكة، وأساسيات الطوابير Queues شرحناها في مدخل إلى تصميم الأنظمة.
الحدث Event والأمر Command
قبل أن نكمل يجب أن نفرق بين نوعين من الرسائل يخلط بينهما الكثيرون، فالحدث Event خبر عن شيء حدث فعلاً، ويكتب اسمه بصيغة الماضي مثل OrderPlaced وPaymentFailed، والمنتج ينشره ولا يهمه من يستقبله أو هل استقبله أحد أصلاً، أما الأمر Command فطلب موجه إلى جهة محددة لتقوم بعمل، ويكتب بصيغة الأمر مثل ChargeCard وSendEmail، والمرسل يتوقع أن تنفذه تلك الجهة وقد ينتظر النتيجة. والسبب في أهمية هذا الفرق أن تسمية أمر باسم حدث تخفي الترابط، فإذا نشرت خدمة الطلبات «حدثاً» اسمه SendConfirmationEmail فهي في الحقيقة تأمر خدمة البريد وتعتمد عليها، وكل ما فعلته أنك نقلت الاستدعاء المباشر إلى وسيط دون أن تحصل على الانفصال الذي تريده.
ويذكر Martin Fowler في مقاله What do you mean by "Event-Driven"? المنشور في فبراير 2017 أن الناس يقصدون بكلمة Event-Driven أربعة أشياء مختلفة: الإشعار بالحدث Event Notification وفيه رسالة صغيرة تخبر أن شيئاً تغير، ونقل الحالة مع الحدث Event-Carried State Transfer وفيه تحمل الرسالة البيانات كاملة حتى لا يحتاج المستهلك أن يسأل المنتج، وتخزين الأحداث Event Sourcing وفيه تكون الأحداث نفسها هي مصدر الحقيقة، وفصل القراءة عن الكتابة CQRS. وفي هذا المقال نتكلم عن الأول والثاني، أما Event Sourcing وCQRS فلهما مقال قادم بإذن الله.
الوسيط Broker والمنسق Mediator
هناك شكلان رئيسيان لهذا النمط تذكرهما صفحة Microsoft السابقة: طوبولوجيا الوسيط Broker Topology، وفيها ينشر كل جزء أحداثه إلى النظام كله، وكل مستهلك يقرر هل يتصرف أو يتجاهل، ولا يوجد طرف يعرف حالة العملية كاملة، وطوبولوجيا المنسق Mediator Topology، وفيها يستقبل منسق Mediator الحدث الأول ويعرف الخطوات المطلوبة وترتيبها، فيرسل أوامر Commands إلى قنوات محددة، ويحتفظ بحالة كل عملية، ويعالج الأخطاء ويعيد المحاولة، والصورة التالية تبين الشكلين:
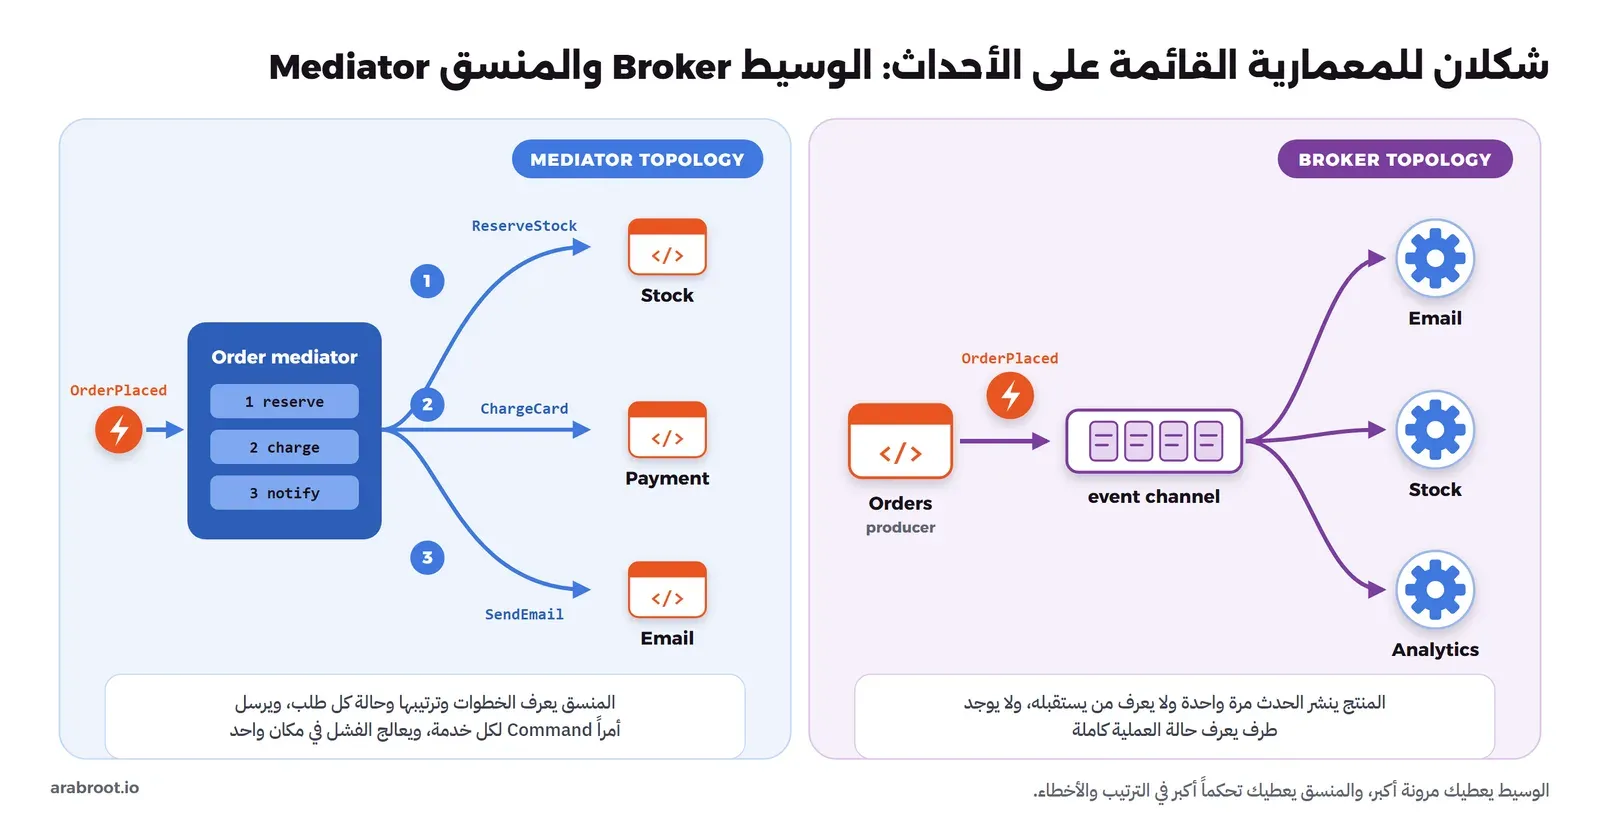
والوسيط يعطيك انفصالاً أكبر وقابلية للتوسع وتحملاً للأعطال، لكن لأنه لا يوجد من يملك العملية كاملة، فإذا فشلت الخطوة الثالثة من خمس خطوات فلا يوجد مكان واحد يعرف ذلك أو يعيد المحاولة، وتصفه Microsoft بأنه قد يكون مصدراً لعدم اتساق البيانات إذا لم تخطط لمعالجة الأخطاء. أما المنسق فيعطيك تحكماً أكبر في الترتيب والأخطاء واتساق البيانات، لكنه يزيد الترابط بين الأجزاء، وقد يصبح المنسق نفسه عنق زجاجة Bottleneck أو نقطة فشل. وعندما تمتد عملية واحدة على عدة خدمات وتحتاج أن تتراجع عن خطوات نجحت إذا فشلت خطوة لاحقة، فهذا هو نمط Saga الذي شرحناه في الأنظمة الموزعة، والمنسق هو الشكل الذي يسمى فيه Orchestration، والوسيط هو الشكل الذي يسمى Choreography.
النشر والاشتراك Publish-Subscribe أم سجل الأحداث Event Log؟
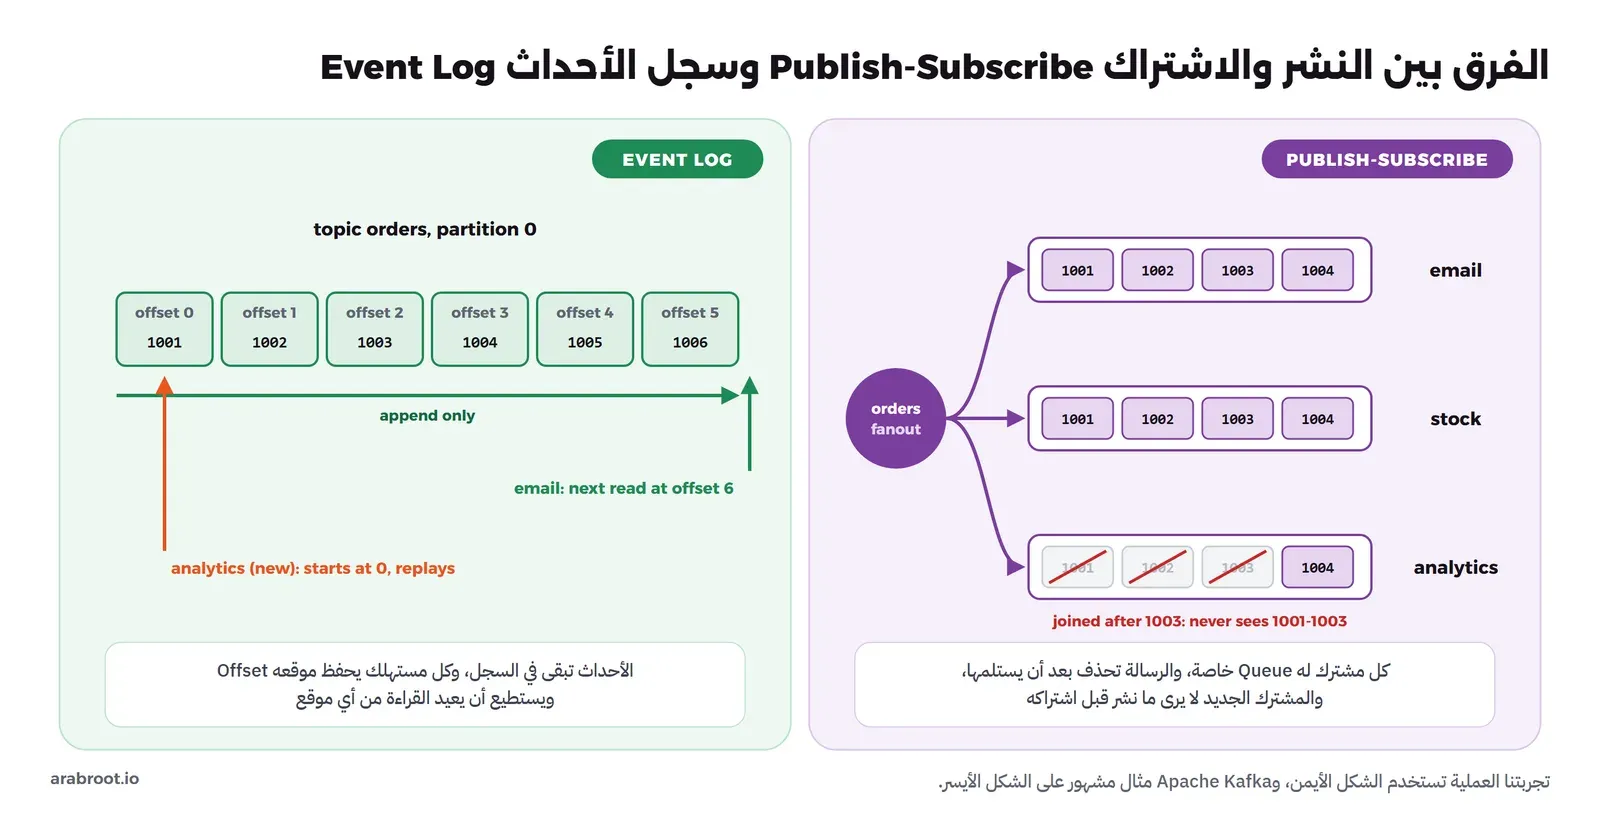
وهناك فرق آخر في طريقة عمل القناة نفسها تشرحه صفحة Microsoft أيضاً: في النشر والاشتراك Publish-Subscribe تحتفظ البنية بقائمة المشتركين، فإذا نشر حدث أرسلته إلى كل مشترك، وبعد أن يستلمه المشترك لا يبقى في سجل دائم، لذلك المشترك الجديد لا يرى الأحداث القديمة، وهذا ما يفعله RabbitMQ بال Exchange من نوع Fanout. أما في سجل الأحداث Event Streaming فالأحداث تكتب في سجل مرتب يضاف إليه فقط Append Only، ويبقى فيه مدة يحددها الإعداد، وكل مستهلك يحفظ موقعه Offset في السجل، فيستطيع مستهلك جديد أن يبدأ من أول السجل ويعيد قراءة كل شيء، وهذا ما يفعله Apache Kafka، والصورة التالية تبين الفرق:
الاتساق النهائي Eventual Consistency وثمن الفصل
هل هذا النمط مجاني؟ لا، والتفصيل فيما يلي. لأن المستهلكين يعالجون الأحداث في وقتهم، فهناك فترة بعد نشر الحدث يكون فيها المخزون لم يخصم بعد مع أن الطلب مؤكد، وهذا هو الاتساق النهائي Eventual Consistency الذي تصفه Microsoft بأنه مقايضة متعمدة، أي أن أجزاء النظام سوف تتفق في النهاية، لكن ليس في نفس اللحظة، فيجب أن تصمم الشاشات والتقارير لتتحمل بيانات متأخرة قليلاً. ثم إن الرسالة قد تصل مرتين، فعلى كل مستهلك أن يتعامل مع التكرار بمفتاح منع التكرار Idempotency Key، وقد شرحنا ضمانات التسليم في الأنظمة الموزعة. وأخيراً تتبع الخطأ أصعب، لأنه لا يوجد Call Stack واحد يمر بكل الأجزاء، لذلك تنصح Microsoft بأن تضع معرف ارتباط Correlation ID في كل حدث من البداية.
وتذكر Microsoft في نفس الصفحة متى لا يناسبك هذا النمط: إذا كانت العمليات طلباً واستجابة بسيطة تكفيها الاستدعاءات المباشرة، فالوسيط ومعالجة الأخطاء غير المتزامنة تكلفة بلا فائدة، وإذا كانت العملية تحتاج اتساقاً قوياً Strong Consistency بين عدة أجزاء ولا تقبل فترة يختلف فيها النظام مع نفسه، فالاتساق النهائي يعمل ضدك. أما نقاط قوته فهي الانفصال بين الأجزاء، وإضافة مستهلكين دون تعديل المنتج، وتوسيع كل مستهلك وحده، وتحمل الأعطال لأن تعطل مستهلك لا يوقف المنتج، ونقاط ضعفه الاتساق النهائي والتكرار وصعوبة الاختبار والتتبع، وهذا ما سوف نراه الآن في التجربة.
تجربة عملية مع RabbitMQ: حدث واحد وثلاثة مستهلكين
في هذه التجربة سوف نبني الشكل الأيمن من الصورة السابقة: منتج ينشر حدث OrderPlaced إلى Exchange اسمه orders من نوع Fanout، وهو النوع الذي يرسل كل رسالة إلى كل Queue مربوطة به كما يشرح توثيق Exchanges في RabbitMQ، ولكل مستهلك Queue خاصة به، ثم نوقف مستهلكاً وننشر أحداثاً، ثم نضيف مستهلكاً متأخراً، والصورة التالية تبين التجربة:
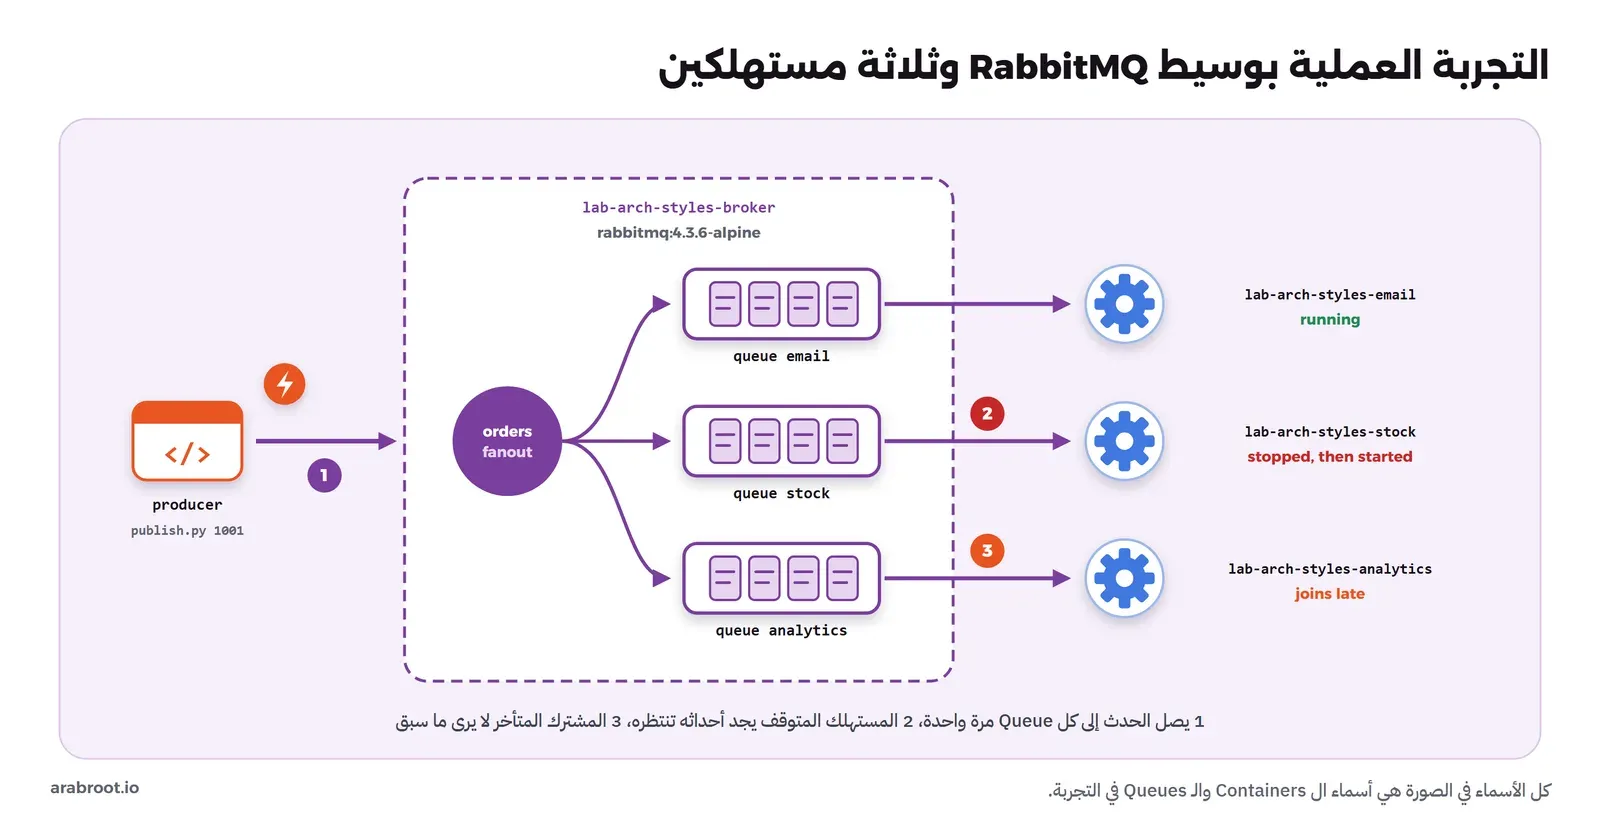
ملفات التجربة
أنشئ مجلداً فيه أربعة ملفات، أولها Dockerfile يبني Image صغيرة فيها Python ومكتبة pika لعميل RabbitMQ:
FROM python:3.13-slim
RUN pip install --no-cache-dir pika==1.4.4
WORKDIR /app
COPY publish.py consumer.py ./
ENV PYTHONUNBUFFERED=1
ثم المنتج publish.py الذي ينشر حدثاً لكل رقم طلب يأخذه من سطر الأوامر:
import json, os, sys, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
ch.exchange_declare(exchange="orders", exchange_type="fanout", durable=True)

for order_id in sys.argv[1:]:
    event = {"type": "OrderPlaced", "order_id": int(order_id), "total": 250}
    ch.basic_publish(
        exchange="orders",
        routing_key="",
        body=json.dumps(event),
        properties=pika.BasicProperties(delivery_mode=2),  # persistent
    )
    print(f"[orders] published {event}")
conn.close()
ثم المستهلك consumer.py، ونفس الملف يعمل لكل المستهلكين، واسم المستهلك هو اسم ال Queue الخاصة به:
import json, os, sys, pika

name = sys.argv[1]
conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
ch.exchange_declare(exchange="orders", exchange_type="fanout", durable=True)
ch.queue_declare(queue=name, durable=True)
ch.queue_bind(queue=name, exchange="orders")

def handle(channel, method, properties, body):
    event = json.loads(body)
    print(f"[{name}] got {event['type']} order={event['order_id']}")
    channel.basic_ack(delivery_tag=method.delivery_tag)

ch.basic_consume(queue=name, on_message_callback=handle)
print(f"[{name}] waiting for events on queue '{name}'")
ch.start_consuming()
وأخيراً docker-compose.yml:
name: lab-arch-styles

x-app: &app
  image: lab-arch-styles-app:1
  environment:
    AMQP_URL: amqp://lab:lab-pass-2026@broker:5672/%2F
  depends_on:
    broker:
      condition: service_healthy

services:
  broker:
    image: rabbitmq:4.3.6-alpine
    container_name: lab-arch-styles-broker
    hostname: broker
    user: rabbitmq
    environment:
      RABBITMQ_DEFAULT_USER: lab
      RABBITMQ_DEFAULT_PASS: lab-pass-2026
    healthcheck:
      test: ["CMD", "rabbitmq-diagnostics", "-q", "check_port_connectivity"]
      interval: 5s
      retries: 30

  email:
    <<: *app
    build: .
    container_name: lab-arch-styles-email
    command: ["python", "consumer.py", "email"]

  stock:
    <<: *app
    container_name: lab-arch-styles-stock
    command: ["python", "consumer.py", "stock"]

  analytics:
    <<: *app
    container_name: lab-arch-styles-analytics
    command: ["python", "consumer.py", "analytics"]
    profiles: ["later"]

  producer:
    <<: *app
    entrypoint: ["python", "publish.py"]
    profiles: ["tools"]
في الإعداد أعلاه لاحظ التالي:
- المنتج لا يعرف أي شيء عن ال Queues، فهو يعلن عن ال Exchange وينشر إليه فقط، وكل مستهلك هو الذي ينشئ ال Queue الخاصة به ويربطها بال Exchange، وهذا هو الانفصال الذي تكلمنا عنه في الكود نفسه.
- ال Exchange وال Queues معلنة بالخيار
durable=Trueوالرسائل بالخيارdelivery_mode=2، حتى تبقى بعد إعادة تشغيل الوسيط، والمستهلك يرسلbasic_ackبعد أن يعالج الرسالة، فإذا توقف قبل ذلك أعاد الوسيط الرسالة إلى ال Queue. - عرفنا مستخدماً وكلمة مرور للوسيط، والسبب أن المستخدم الافتراضي
guestلا يسمح له RabbitMQ بالاتصال إلا من نفس الجهاز localhost كما تشرح صفحة Access Control، والمستهلكون هنا في Containers أخرى. - الوسيط يعمل بالمستخدم
rabbitmq، فيعمل فحص الصحة Health Check بنفس المستخدم الذي يملك ملفات الوسيط، والفحصcheck_port_connectivityلا ينجح إلا عندما يقبل الوسيط الاتصالات فعلاً، فلا يبدأ المستهلكون قبل أن يكون جاهزاً. - لا يوجد أي منفذ Port منشور على الجهاز، فكل الاتصالات داخل شبكة Compose، والخدمتان
analyticsوproducerفي Profiles لا تعمل إلا عندما نطلبها.
التشغيل ونشر أول حدث
الآن نقوم ببناء ال Image وتشغيل الوسيط والمستهلكين، ثم ننشر الطلب 1001:
docker compose build
docker compose up -d
docker compose run --rm --name lab-arch-styles-producer producer 1001
docker compose logs email stock
والمخرج سوف يكون كما يلي (بعد حذف أسطر Docker عن إنشاء ال Containers):
[orders] published {'type': 'OrderPlaced', 'order_id': 1001, 'total': 250}
lab-arch-styles-email  | [email] waiting for events on queue 'email'
lab-arch-styles-email  | [email] got OrderPlaced order=1001
lab-arch-styles-stock  | [stock] waiting for events on queue 'stock'
lab-arch-styles-stock  | [stock] got OrderPlaced order=1001
لاحظ أن المنتج نشر الحدث مرة واحدة، ووصل إلى المستهلكين الاثنين، ولو أضفت مستهلكاً ثالثاً فلن تغير سطراً في المنتج.
مستهلك متوقف يعود ويكمل
الآن نفترض أن خدمة المخزون تعطلت، فنوقفها وننشر طلبين جديدين، ثم ننظر إلى ال Queues داخل الوسيط:
docker compose stop stock
docker compose run --rm --name lab-arch-styles-producer producer 1002 1003
docker exec lab-arch-styles-broker rabbitmqctl list_queues name messages consumers
docker compose logs email
والمخرج سوف يكون كما يلي:
[orders] published {'type': 'OrderPlaced', 'order_id': 1002, 'total': 250}
[orders] published {'type': 'OrderPlaced', 'order_id': 1003, 'total': 250}
Timeout: 60.0 seconds ...
Listing queues for vhost / ...
name	messages	consumers
email	0	1
stock	2	0
lab-arch-styles-email  | [email] waiting for events on queue 'email'
lab-arch-styles-email  | [email] got OrderPlaced order=1001
lab-arch-styles-email  | [email] got OrderPlaced order=1002
lab-arch-styles-email  | [email] got OrderPlaced order=1003
لاحظ أن تعطل المخزون لم يوقف المنتج ولم يوقف البريد، وأن الحدثين ينتظران في Queue المخزون، وفيها رسالتان ولا يوجد مستهلك. الآن نعيد تشغيل المخزون:
docker compose start stock
docker compose logs stock
والمخرج سوف يكون كما يلي:
lab-arch-styles-stock  | [stock] waiting for events on queue 'stock'
lab-arch-styles-stock  | [stock] got OrderPlaced order=1001
lab-arch-styles-stock  | [stock] waiting for events on queue 'stock'
lab-arch-styles-stock  | [stock] got OrderPlaced order=1002
lab-arch-styles-stock  | [stock] got OrderPlaced order=1003
السطران الأولان من التشغيل الأول، وبعد إعادة التشغيل استلم المخزون الطلبين اللذين فاتاه، وهذا هو تحمل الأعطال الذي يعطيه النمط، وهو أيضاً الاتساق النهائي بعينه: خلال فترة التوقف كان الطلبان 1002 و1003 مؤكدين والمخزون لم يخصم.
مشترك جديد لا يرى ما سبق
والآن نكسر توقعاً شائعاً، فنضيف مستهلك التحليلات بعد أن نشرنا ثلاثة طلبات، ثم ننشر طلباً رابعاً:
docker compose --profile later up -d analytics
docker compose run --rm --name lab-arch-styles-producer producer 1004
docker compose logs analytics
docker exec lab-arch-styles-broker rabbitmqctl list_queues -q name messages consumers
والمخرج سوف يكون كما يلي:
[orders] published {'type': 'OrderPlaced', 'order_id': 1004, 'total': 250}
lab-arch-styles-analytics  | [analytics] waiting for events on queue 'analytics'
lab-arch-styles-analytics  | [analytics] got OrderPlaced order=1004
name	messages	consumers
email	0	1
analytics	0	1
stock	0	1
لاحظ أن مستهلك التحليلات استلم الطلب 1004 فقط، ولن يرى الطلبات 1001 إلى 1003 أبداً، والسبب أن ال Queue الخاصة به لم تكن موجودة عندما نشرت تلك الأحداث، وال Exchange لا يخزن شيئاً، وإنما يوزع على ال Queues الموجودة لحظة النشر. فإذا كان نظامك يحتاج أن يضيف مستهلكين جدداً يقرأون التاريخ كله، مثل نظام تحليلات جديد يحتاج طلبات السنة الماضية، فأنت تحتاج سجل أحداث Event Log مثل Kafka، أو مصدراً آخر للبيانات القديمة، وهذا قرار يجب أن تتخذه قبل أن تبني، وليس بعد أن يسألك فريق التحليلات.
حذف التجربة
الأمر التالي يحذف ال Containers والشبكة الخاصة بالمشروع، ثم ال Images التي بنيناها وسحبناها بأسمائها:
docker compose --profile later --profile tools down -v
docker rmi lab-arch-styles-app:1 rabbitmq:4.3.6-alpine
المعمارية القائمة على الخدمات Service-Based
بين البرنامج الواحد والخدمات المصغرة يقع نمط يسميه Richards وFord في كتابهما المعمارية القائمة على الخدمات Service-Based Architecture: عدد قليل من الخدمات الكبيرة، كل خدمة تغطي مجالاً كاملاً مثل الطلبات أو الفوترة وتنشر وحدها، لكنها غالباً تتشارك قاعدة بيانات واحدة، وتأتيها الطلبات من واجهة واحدة. وهذا النمط عملي لكثير من الفرق المتوسطة، لأنه يعطيك نشراً مستقلاً لكل مجال وتوسعاً لكل خدمة وحدها، دون أن تدفع ثمن تقسيم البيانات والمعاملات الموزعة، وثمنه أن قاعدة البيانات المشتركة تبقى نقطة ترابط، فتغيير جدول تستخدمه خدمتان يحتاج تنسيقاً بينهما، وإذا كنت تبني Modular Monolith بحدود واضحة، فالانتقال إلى هذا النمط يعني غالباً أن تخرج كل وحدة إلى عملية مستقلة.
الخدمات المصغرة Microservices باختصار
عرف James Lewis وMartin Fowler في مقالهما Microservices المنشور في 25 مارس 2014 هذا النمط بأنه بناء التطبيق كمجموعة من الخدمات الصغيرة، كل خدمة تعمل في عملية مستقلة وتتصل بغيرها بوسائل خفيفة مثل HTTP، وتبنى حول قدرة من قدرات العمل Business Capability، وتنشر وحدها بشكل آلي، ومن الخصائص التي ذكراها إدارة البيانات بشكل لا مركزي Decentralized Data Management، أي أن كل خدمة تملك بياناتها، والنقاط الذكية مع الأنابيب البسيطة Smart Endpoints and Dumb Pipes، أي أن المنطق في الخدمات وليس في الوسيط، والصورة التالية تبين الشكل:
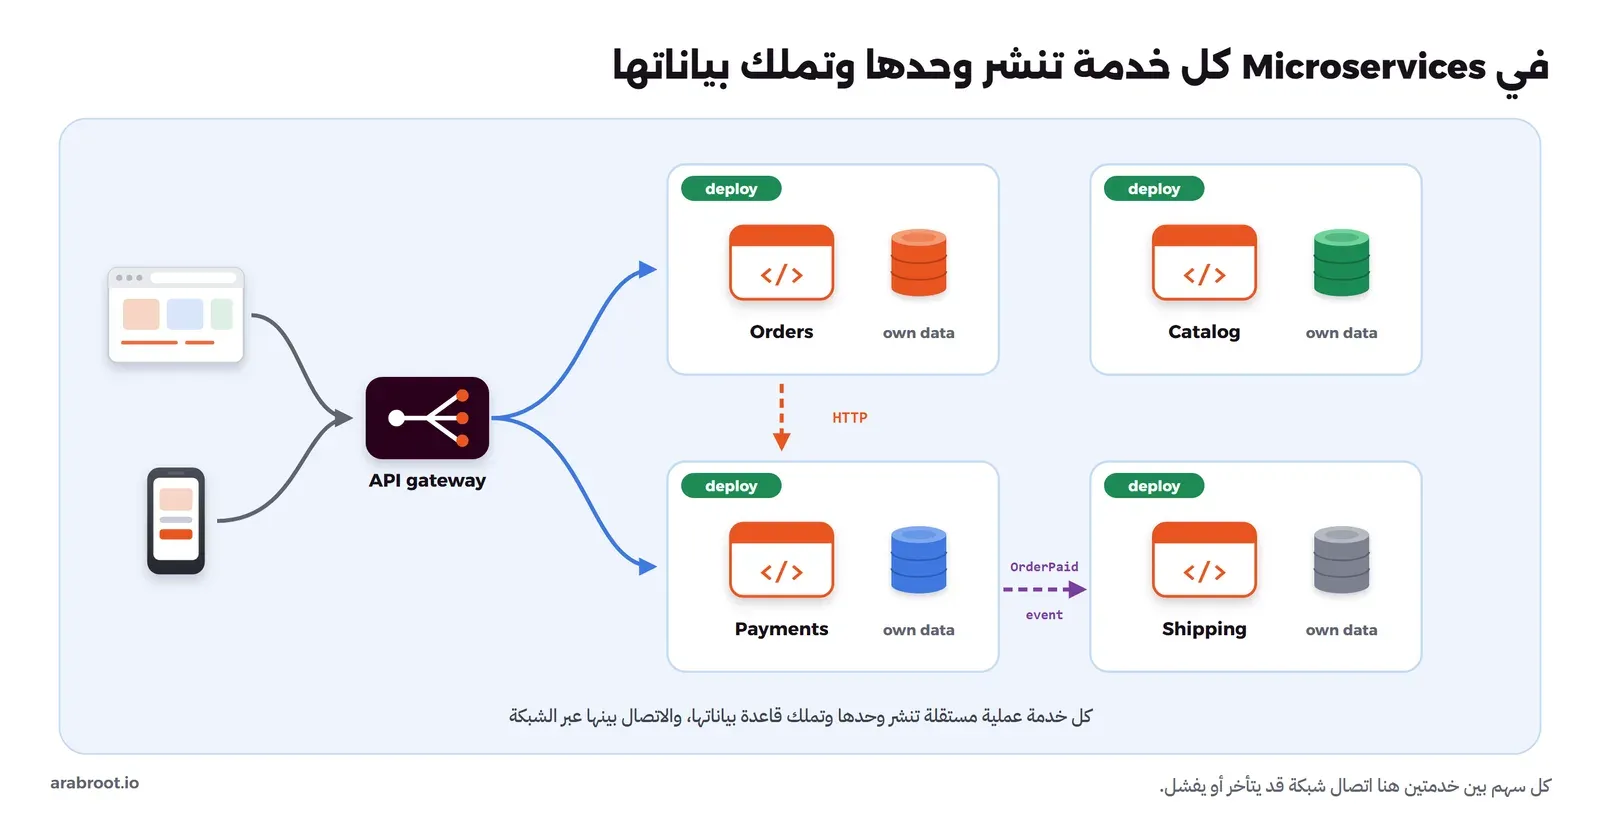
والقيود التي تذكرها Microsoft في صفحة Microservices architecture style تبين ما تشتريه وما تدفعه: تحصل على نشر مستقل وعزل للأعطال وتحديثات أكثر وحرية في اختيار التقنية لكل خدمة، وتدفع ثمن اكتشاف الخدمات Service Discovery واتساق البيانات وإدارة نظام موزع، وتقول Microsoft إن النجاح فيه يحتاج ممارسات تطوير وDevOps ناضجة. وبكل تأكيد ليست الخدمات المصغرة شرطاً للنجاح أو للحجم الكبير، فقد شرحنا في كيف بنى Stack Overflow موقعه بسيرفرات قليلة لماذا بقي تطبيقه تطبيقاً واحداً. والقرار بين البرنامج الواحد والخدمات المصغرة يستحق مقالاً كاملاً، وسوف نخصص له بإذن الله مقالاً قادماً بعنوان «Monolith أم Microservices؟ قرار صادق للفرق الصغيرة والكبيرة»، لذلك نكتفي هنا بمكانه بين الأنماط.
البيانات في الذاكرة الموزعة Space-Based Architecture
لنفرض أنك تبيع تذاكر مباراة نهائية، وفي الدقيقة الأولى من فتح البيع يدخل عشرات الآلاف في نفس اللحظة، فتستطيع أن تضيف نسخاً من التطبيق خلف موزع الحمل Load Balancer، لكن كل النسخ تكتب في نفس قاعدة البيانات، فتصبح قاعدة البيانات هي عنق الزجاجة مهما أضفت من سيرفرات. والفكرة في نمط Space-Based، وهو أيضاً من الأنماط التي يشرحها Richards وFord، أن تخرج قاعدة البيانات من مسار الطلب: كل وحدة معالجة Processing Unit فيها التطبيق ومعه البيانات التي يحتاجها في الذاكرة RAM، والبيانات في الذاكرة متزامنة بين كل الوحدات عبر شبكة بيانات في الذاكرة In-Memory Data Grid، والتغييرات ترسل إلى قاعدة البيانات لاحقاً وبشكل غير متزامن، والصورة التالية تبين ذلك:
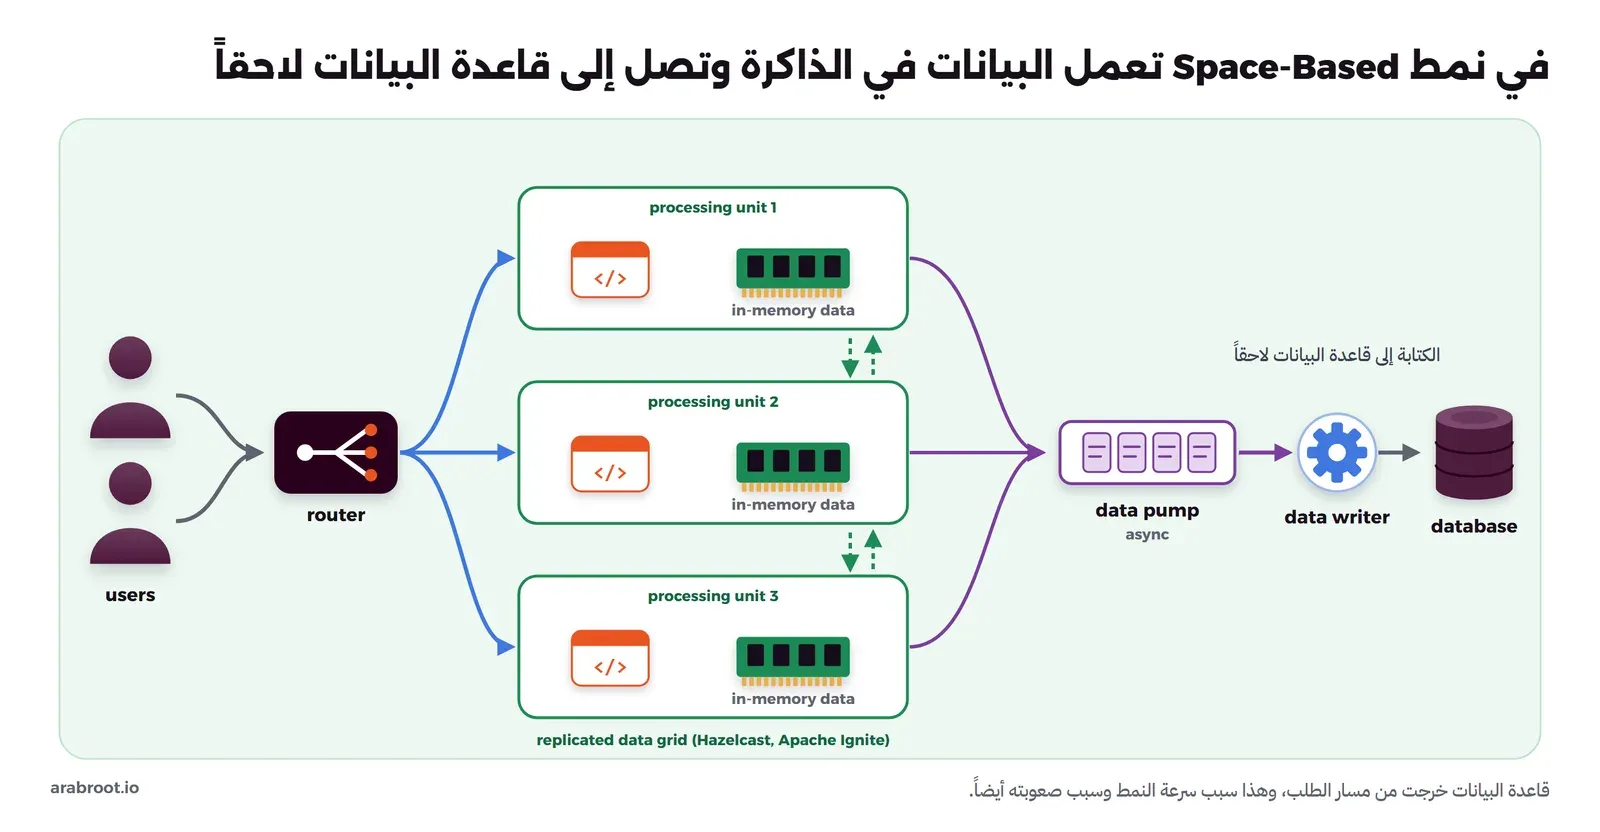
والأدوات التي تقدم هذه الذاكرة الموزعة موجودة ومفتوحة المصدر، مثل Apache Ignite وHazelcast، ويشرح توثيق Hazelcast في صفحة Data Partitioning and Replication كيف تقسم البيانات على الأعضاء وتحفظ نسخ احتياطية Backups لكل جزء، ويشرح توثيق Ignite في صفحة External Storage وضع الكتابة اللاحقة Write-Behind، حيث تجمع التحديثات وترسل إلى قاعدة البيانات دفعة واحدة بشكل غير متزامن، ويذكر صراحة أن هذا يرفع الأداء لكنه قد يضيع بعض التحديثات إذا تعطلت العقد Nodes قبل الكتابة. وهذه الجملة الأخيرة هي جوهر النمط: نقاط قوته التوسع والمرونة مع الأحمال المفاجئة Elasticity إلى حد لا تصله الأنماط الأخرى، ونقاط ضعفه التعقيد الكبير وتكلفة الذاكرة وصعوبة الاختبار تحت حمل حقيقي، واحتمال ضياع بيانات أو تعارضها بين الوحدات، لذلك لا ينصح به إلا لنظام يعرف أنه سيواجه هذه الأحمال فعلاً، ولا تبدأ به نظاماً عادياً.
مقارنة الأنماط في جدول واحد
الجدول التالي يلخص تقديرنا للأنماط على أهم خصائص الجودة، وهو تقدير نسبي يعتمد على طريقة التطبيق، فنظام Microservices مبني بشكل سيئ قد يكون أصعب نشراً من برنامج واحد مرتب، ويقدم Richards وFord في كتابهما تقييماً مشابهاً لكل نمط بطريقتهما، وما في هذا الجدول تقديرنا نحن:
| النمط | وحدات النشر | التقسيم Partitioning | البساطة Simplicity | التكلفة Cost | النشر المستقل Deployability | التوسع Scalability | تحمل الأعطال Fault Tolerance | سهولة الاختبار Testability |
|---|---|---|---|---|---|---|---|---|
| Layered | واحدة | تقني | عالية | منخفضة | منخفض | منخفض | منخفض | متوسطة |
| Pipes and Filters | واحدة | تقني | عالية | منخفضة | منخفض | منخفض | منخفض | عالية |
| Microkernel | واحدة غالباً | تقني ومجال | متوسطة | منخفضة | متوسط للإضافات | منخفض | منخفض | متوسطة |
| Modular Monolith | واحدة | مجال | عالية | منخفضة | منخفض | منخفض | منخفض | متوسطة |
| Service-Based | قليلة | مجال | متوسطة | متوسطة | متوسط | متوسط | متوسط | متوسطة |
| Event-Driven | كثيرة | تقني أو مجال | منخفضة | متوسطة | عال | عال | عال | منخفضة |
| Microservices | كثيرة | مجال | منخفضة | عالية | عال | عال | عال | متوسطة |
| Space-Based | كثيرة | تقني | منخفضة | عالية | متوسط | عال جداً | عال | منخفضة |
في الجدول أعلاه لاحظ التالي:
- كل الأنماط التي تنشر كوحدة واحدة منخفضة في النشر المستقل والتوسع وتحمل الأعطال، وعالية في البساطة ومنخفضة في التكلفة، والأنماط الموزعة عكسها تقريباً، وهذا هو الثمن الأساسي الذي تدفعه عند عبور الشبكة.
- الفرق بين Layered وModular Monolith ليس في عمود البساطة أو التكلفة، وإنما في عمود التقسيم، فالثاني يجمع الكود حسب المجال، وهذا يقلل عدد الأماكن التي تلمسها عند كل تغيير.
- عمود سهولة الاختبار في Microservices متوسط لأن كل خدمة وحدها سهلة الاختبار، لكن اختبار سيناريو يمر بعدة خدمات صعب، وقد شرحنا اختبارات العقود Contract Tests في أنواع الاختبارات.
كيف تختار نمطاً لنظامك؟
لا يوجد نمط أفضل من غيره بشكل عام، وإنما يوجد نمط أنسب لخصائص الجودة التي يحتاجها نظامك، لذلك ابدأ من هذه الخصائص وليس من النمط، وقد شرحنا كيف تحددها وترتبها في مدخل المرحلة، ثم اسأل نفسك الأسئلة التالية:
- هل يحتاج جزء من النظام أن يتوسع أو ينشر وحده فعلاً، بأرقام وليس بتوقع؟ إذا كانت الإجابة لا، فابدأ ببرنامج واحد، وقسمه إلى وحدات حسب المجال من اليوم الأول.
- كم فريقاً يعمل على النظام؟ فريق واحد من خمسة مطورين لا يحتاج عشرين خدمة، والخدمات المستقلة تفيد عندما تحتاج فرق متعددة أن تنشر دون أن تنتظر بعضها.
- هل هناك عمليات تحدث بعد الطلب ولا يحتاج المستخدم أن ينتظرها، مثل البريد والتحليلات؟ هذه مكان طبيعي للأحداث، حتى داخل برنامج واحد مع Queue.
- هل يحتاج النظام قواعد تختلف من عميل إلى آخر أو إضافات يكتبها غيرك؟ هذا مكان ال Microkernel.
- هل تعالج بيانات تمر بمراحل متتابعة في اتجاه واحد؟ هذا مكان الأنابيب والمرشحات.
ولاحظ أن الأنظمة الحقيقية تخلط الأنماط، فقد تجد Modular Monolith ترسل وحداته أحداثاً لبعضها، أو خدمات مصغرة كل منها مبنية بالطبقات من الداخل، أو محرراً مبنياً كنواة وإضافات وفيه خط معالجة للملفات. وأياً كان ما تختاره، فاكتب القرار وأسبابه والبدائل التي رفضتها في سجل قرارات معمارية ADR، وارسم الشكل الناتج بمخططات C4، وقد شرحنا الاثنين في توثيق المعمارية، والسبب أن من يأتي بعدك بسنة سوف يرى الشكل ولن يعرف لماذا اخترته إذا لم تكتبه.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- نمط المعمارية Architecture Style عائلة من المعماريات تضع قيوداً على الشكل العام للنظام، والالتزام بقيوده هو ما يعطيك خصائصه، أما نمط التصميم Design Pattern فحل محلي داخل الكود.
- أهم سؤال في اختيار النمط: برنامج واحد أم عدة برامج؟ لأن عبور الشبكة يضيف التأخير والفشل الجزئي والاتساق النهائي إلى كل استدعاء.
- النمط الطبقي Layered بسيط ورخيص ومقسم تقنياً، وكل ميزة تمر غالباً بكل الطبقات، وكثرة الطلبات التي تمر دون عمل Sinkhole علامة على طبقات زائدة.
- الأنابيب والمرشحات Pipes and Filters للمعالجة في اتجاه واحد، والنواة والإضافات Microkernel للأنظمة التي تتغير قواعدها أو يكتب غيرك إضافاتها، والعقد الثابت هو أصعب جزء فيها.
- ال Modular Monolith برنامج واحد مقسم حسب المجال بحدود يفرضها البناء، ورأينا في .NET كيف يرفض المترجم الوصول إلى الداخل بالخطأ CS0122 ويرفض MSBuild الاعتماد الدائري بالخطأ MSB4006، وقصة Shopify أشهر مثال موثق عليه.
- المعمارية القائمة على الأحداث Event-Driven تفصل المنتج عن المستهلكين، ورأينا في التجربة أن تعطل مستهلك لا يوقف غيره وأنه يكمل عند عودته، وأن المشترك المتأخر في النشر والاشتراك لا يرى ما سبق، وثمنها الاتساق النهائي والتكرار وصعوبة التتبع.
- Service-Based حل وسط عملي بخدمات قليلة كبيرة، وMicroservices تعطي نشراً مستقلاً وعزلاً للأعطال بثمن تشغيلي كبير، وSpace-Based للأحمال المفاجئة الكبيرة جداً فقط.
- ابدأ من خصائص الجودة وعدد الفرق وليس من النمط المشهور، واكتب قرارك في ADR.
وأقرب المقالات إلى هذا الموضوع على الموقع:
 دليلالتصميم والمعمارية: أربعة مستويات لنشاط واحدما الفرق بين تصميم البرمجيات ومعماريتها وتصميم الأنظمة ومعمارية المؤسسة، ومن يقرر في كل مستوى وكم يعيش قراره.
 دليلClean Architecture: كيف تعزل منطق العمل عن قاعدة البياناتلماذا تحتاج قاعدة بيانات لكي تختبر قاعدة عمل من سطر واحد، وكيف يعزل اتجاه الاعتماديات منطق العمل عن التفاصيل.
 دليلالتصميم الموجه بالمجال Domain-Driven Design ببساطةلماذا تعني كلمة «الطلب» ثلاثة أشياء في نفس الشركة، وكيف يقسم DDD النظام إلى سياقات لكل منها لغته ونموذجه.
 دليلتوثيق المعمارية: مخططات C4 وسجلات القرارات المعمارية ADRكيف ترسم نظامك بمخططات C4 يفهمها المطور الجديد، وتحفظ سبب كل قرار مهم في سجل ADR داخل المستودع.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلالفرق بين Tiers وLayers: متى يكون نظامك ثلاثي الطبقات فعلاً؟ماذا يعني أن يكون نظامك ثلاثي الطبقات 3-tier فعلاً، والفرق بين الطبقة داخل الكود والمستوى في الشبكة، وما تطلبه الضوابط بالنص.
وفي مقالات قادمة بإذن الله سوف نتحدث عن القرار بين Monolith وMicroservices بالتفصيل، وعن Event Sourcing وCQRS ومتى تستحق تعقيدها.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، ومراجعة الأنماط على صفحات Azure Architecture Center ومقالات Martin Fowler وShopify Engineering وتوثيق Spring Modulith وVS Code وHazelcast وApache Ignite، وتنفيذ تجربة الأحداث على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع RabbitMQ 4.3.6 وPython 3.13.16 وpika 1.4.4، وتجربة حدود الوحدات على .NET SDK 10.0.400.


