

عندما يضغط العميل في متجرك على «تأكيد الطلب» فإن التطبيق يحفظ الطلب، ثم يرسل بريد التأكيد، ثم ينشئ ملف PDF للفاتورة، ثم يخبر شركة الشحن، وكل ذلك والعميل ينتظر أمام الشاشة، وإذا تأخر سيرفر البريد تأخرت الصفحة معه، وإذا تعطل ظهر للعميل خطأ في طلب تم حفظه فعلاً. وقد ذكرنا في مقدمة تصميم الأنظمة أن الحل هو أن يخرج العمل البطيء من الطلب إلى طابور Queue، وهذا المقال هو أول مقالات مرحلة الطوابير وبث الأحداث في خريطة الطريق، ويشرح المفاهيم التي تجدها في كل أداة طوابير مهما كان اسمها، وسوف نناقش في هذا المقال ما يلي:
- لماذا تحتاج طابوراً أصلاً، وما المشكلات الثلاث التي يحلها.
- الأجزاء الأساسية: المنتج Producer والمستهلك Consumer والوسيط Broker والرسالة Message، والفرق بين ال Queue وال Topic.
- التأكيد Ack من جهة المستهلك، وتأكيد النشر Publisher Confirms من جهة المنتج، ولماذا لا تحذف الرسالة قبل أن تنتهي معالجتها.
- توزيع العمل بين عدة نسخ من برنامج المعالجة Worker على الطابور نفسه Competing Consumers، وضبط ال Prefetch.
- إعادة المحاولة Retry بانتظار يزيد، وحد المحاولات، ونقل الرسائل الفاشلة إلى Dead Letter Queue وماذا تفعل بها هناك.
- ضمانات التسليم والتكرار والترتيب باختصار.
- تجربة عملية كاملة على RabbitMQ 4.3 نرى فيها كل ما سبق بمخرجات حقيقية.
- أشهر الحالات العملية التي يستخدم فيها المطور الطابور، ومتى لا يناسبه، ثم أخطاء شائعة.
لماذا تحتاج طابوراً Queue؟
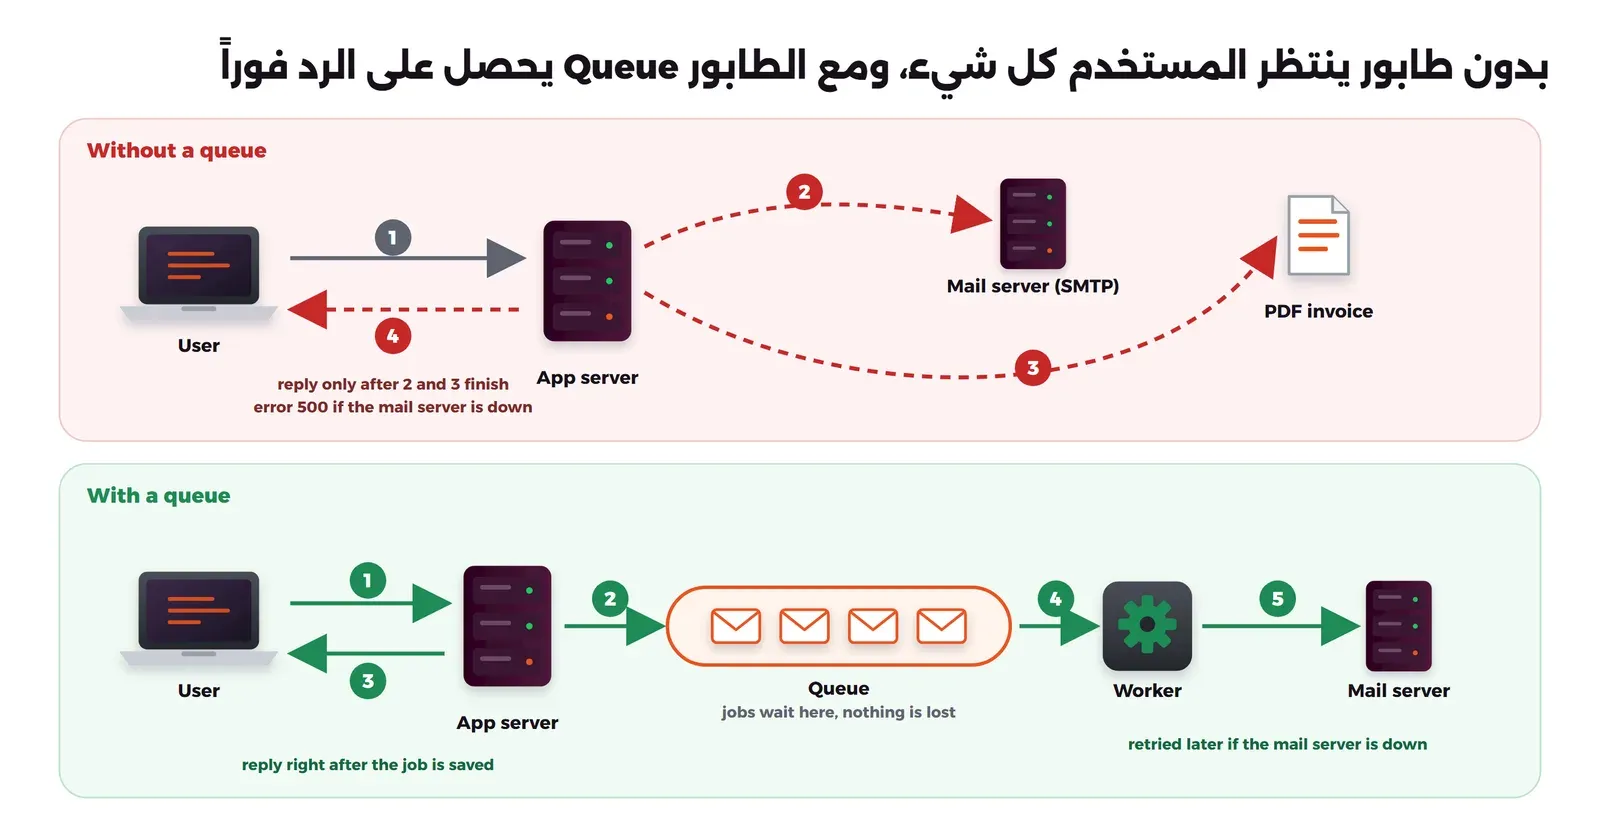
الطابور Queue مكان وسيط يضع فيه جزء من النظام عملاً أو خبراً، ويأخذه منه جزء آخر في وقت لاحق وبسرعته الخاصة، والتشبيه الأقرب هو صندوق الطلبات في مطعم مزدحم: الكاشير يأخذ الطلب ويعلقه على اللوحة ويعود للعميل التالي فوراً، والطباخون يأخذون الطلبات من اللوحة واحداً بعد الآخر، فلا ينتظر الكاشير الطباخ، وإذا غاب طباخ بقيت الطلبات على اللوحة ولم تضع. وهذا التشبيه يلخص المشكلات الثلاث التي يحلها الطابور:
- الفصل في الزمن Temporal Decoupling: المنتج لا ينتظر المستهلك، فالصفحة ترد على العميل بعد حفظ الطلب ووضع المهمة في الطابور، والبريد يرسل بعد ثوان دون أن يشعر العميل بأي تأخير.
- امتصاص الذروة Load Leveling: إذا وصل في دقيقة واحدة ألف طلب يحتاج كل منها إلى تصغير عشر صور، فإن الطابور يحتفظ بها وتعالجها ال Workers بسرعتها الطبيعية، بدل أن يحاول السيرفر تنفيذ عشرة آلاف عملية في اللحظة نفسها فيبطؤ كل شيء.
- تحمل الأعطال Fault Tolerance: إذا تعطل سيرفر البريد ساعة كاملة فالرسائل تبقى في الطابور، وتعاد محاولتها بعد عودته، ولا يرى العميل أي خطأ.
والصورة التالية تبين الفرق بين الطريقتين:
وقد يتساءل البعض: لماذا لا أشغل العمل البطيء في Thread منفصل داخل التطبيق نفسه وأرد على العميل فوراً؟ والإجابة أن هذا الحل البسيط يعمل حتى تعيد تشغيل التطبيق أثناء النشر Deployment أو يتوقف بسبب نفاد الذاكرة، فتضيع كل المهام التي كانت في الذاكرة دون أي أثر، ولا توجد طريقة لمعرفة أي بريد أرسل وأيها لم يرسل، ولا توجد إعادة محاولة، ولا يمكنك أن تضيف Worker على سيرفر آخر عندما يزيد الحمل. والطابور الحقيقي يحفظ الرسالة على القرص خارج التطبيق، فتبقى بعد سقوط التطبيق، ويأخذها أي Worker على أي سيرفر.
المنتج Producer والمستهلك Consumer والوسيط Broker
كل أنظمة الطوابير تتكون من الأجزاء نفسها، وإن اختلفت أسماؤها قليلاً من أداة إلى أخرى:
- الرسالة Message: وحدة البيانات التي تنتقل، ولها جسم Body وهو المحتوى نفسه، غالباً JSON مثل
{"order_id": 101, "to": "[email protected]"}، وخصائص Properties مثل المعرف الفريدmessage_idوالترويسات Headers. واجعل الرسالة صغيرة تحمل المعرفات وليس الملفات، فإذا كانت المهمة تصغير صورة فضع في الرسالة مسار الصورة في تخزين الكائنات Object Storage، وليس الصورة نفسها. - المنتج Producer أو الناشر Publisher: الكود الذي يرسل الرسالة، وهو في مثالنا تطبيق المتجر عند تأكيد الطلب.
- الوسيط Broker: السيرفر الذي يستقبل الرسائل ويحفظها ويوزعها، مثل RabbitMQ أو NATS أو Kafka، وهو الذي يضمن أن الرسالة لا تضيع إذا تعطل المنتج أو المستهلك.
- المستهلك Consumer أو برنامج المعالجة Worker: البرنامج الذي يأخذ الرسالة وينفذ العمل، ويعمل في الخلفية بشكل مستقل عن التطبيق الذي يستقبل طلبات المستخدمين، ويمكن أن تشغل منه نسخة واحدة أو عشرين نسخة على عدة سيرفرات.
ولاحظ أن المنتج والمستهلك لا يعرف أحدهما الآخر، فكل واحد منهما يعرف الوسيط واسم الطابور فقط، وهذا يعني أنك تستطيع أن تكتب المستهلك بلغة مختلفة، أو توقفه لتحديثه، أو تضاعف عدده، دون أن تغير سطراً واحداً في المنتج.
الطابور Queue والموضوع Topic
هناك طريقتان لتوزيع الرسائل، والخلط بينهما سبب كثير من الأخطاء في التصميم:
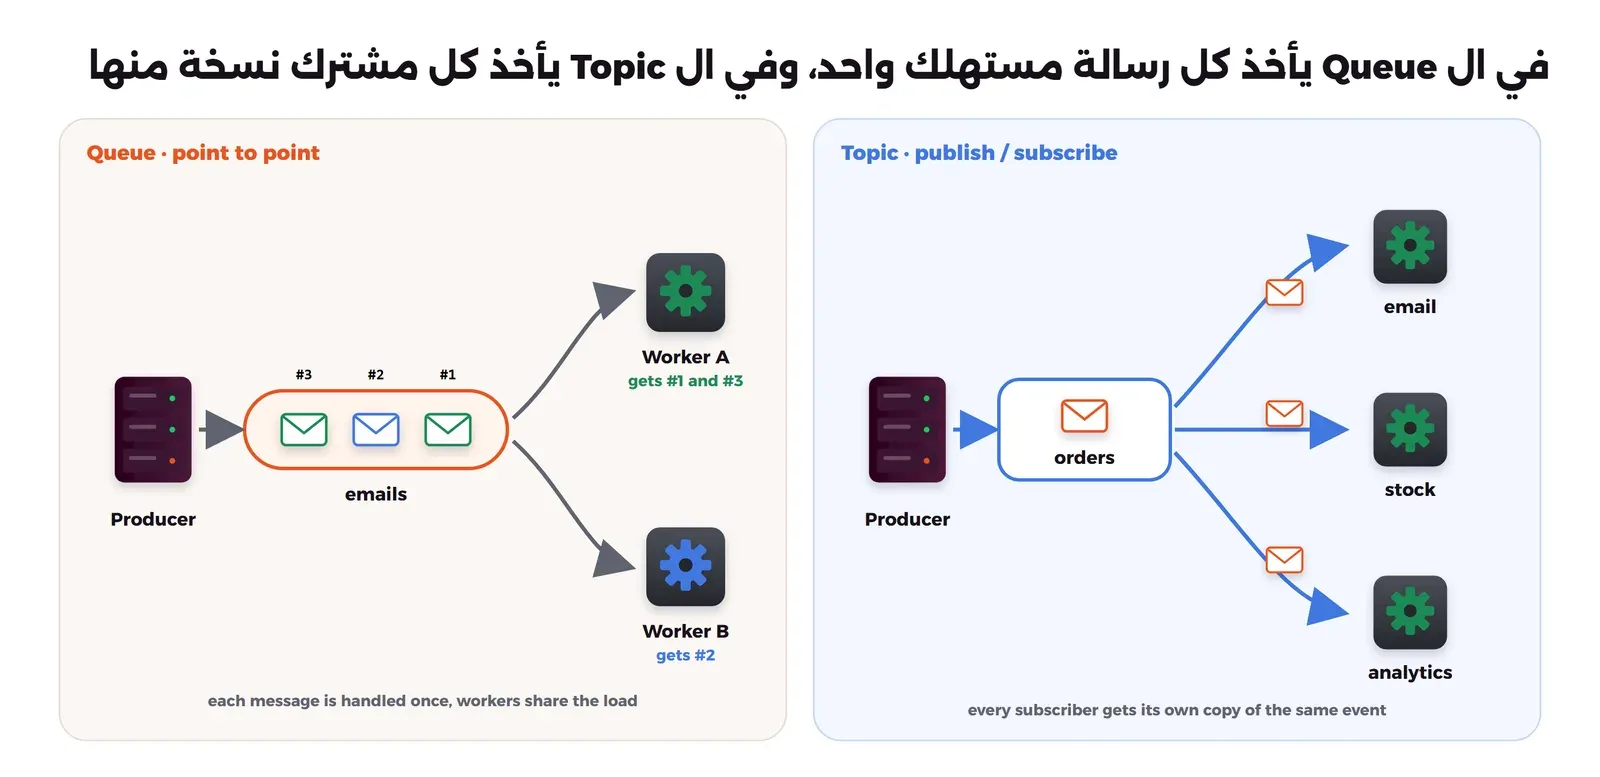
- الطابور Queue أو من نقطة إلى نقطة Point-to-Point: كل رسالة يأخذها مستهلك واحد فقط، فإذا كان هناك اثنان من ال Workers على طابور البريد فكل بريد يرسله أحدهما، وليس الاثنان معاً، وهذا هو المناسب للمهام Jobs مثل إرسال بريد أو إنشاء فاتورة، لأنك لا تريد أن يصل العميل البريد مرتين.
- الموضوع Topic أو النشر والاشتراك Publish-Subscribe: كل مشترك يأخذ نسخة من كل رسالة، فإذا نشرت خدمة الطلبات حدث
OrderPlacedأخذت خدمة البريد نسخة وخدمة المخزون نسخة وخدمة التحليلات نسخة، وهذا هو المناسب للأحداث Events التي تهم أكثر من جهة.
والصورة التالية تبين الفرق:
وفي RabbitMQ تحديداً لا ينشر المنتج إلى الطابور مباشرة في الحالة العامة، وإنما إلى Exchange، وهو المكون الذي يقرر إلى أي طابور تذهب الرسالة، فإذا ربطت ثلاثة طوابير ب Exchange من نوع Fanout حصلت على النشر والاشتراك، وقد بنينا هذا الشكل بالكود في تجربة أنماط المعمارية، وشرحنا هناك أيضاً الفرق بين الحدث Event والأمر Command. أما في هذا المقال فسوف نركز على الطابور الواحد الذي يتقاسمه ال Workers، لأنه المكان الذي تظهر فيه مشكلات التأكيد وإعادة المحاولة. ويجدر الإشارة هنا إلى أن كلمة Topic في Kafka تعني شيئاً أكبر من النشر والاشتراك، فهي سجل يبقى بعد القراءة، وهذا موضوع مقال الطابور أم بث الأحداث.
التأكيد Ack: متى تحذف الرسالة من الطابور؟
لنفرض أن الوسيط أعطى ال Worker رسالة البريد، ثم توقف ال Worker فجأة بعد نصف ثانية بسبب خطأ في الذاكرة قبل أن يرسل البريد، فهل ضاعت الرسالة؟ هذا يعتمد على متى يعتبر الوسيط أن الرسالة انتهت، وأمامك طريقتان:
- التأكيد التلقائي Automatic Acknowledgement: يحذف الوسيط الرسالة لحظة إرسالها إلى ال Worker، وهذا الحل البسيط هو الأسرع، لكنه يعني أن كل رسالة كانت مع Worker توقف فجأة قد ضاعت. ويصف توثيق RabbitMQ للتأكيدات هذا الوضع بأنه غير آمن ولا يناسب كل الأحمال، ويضيف مشكلة ثانية: لا يوجد حد لعدد الرسائل التي يدفعها الوسيط إلى ال Worker، فقد تتراكم في ذاكرته حتى تنفد.
- التأكيد اليدوي Manual Acknowledgement: يبقي الوسيط الرسالة محفوظة بحالة «غير مؤكدة Unacked» حتى يرسل ال Worker التأكيد
basic_ackبعد أن ينتهي من العمل فعلاً، فإذا انقطع اتصال ال Worker قبل التأكيد أعاد الوسيط الرسالة إلى الطابور وأعطاها ل Worker آخر، مع علامةredeliveredتخبره أنها وصلت من قبل.
والصورة التالية تبين ما يحدث في الحالتين:
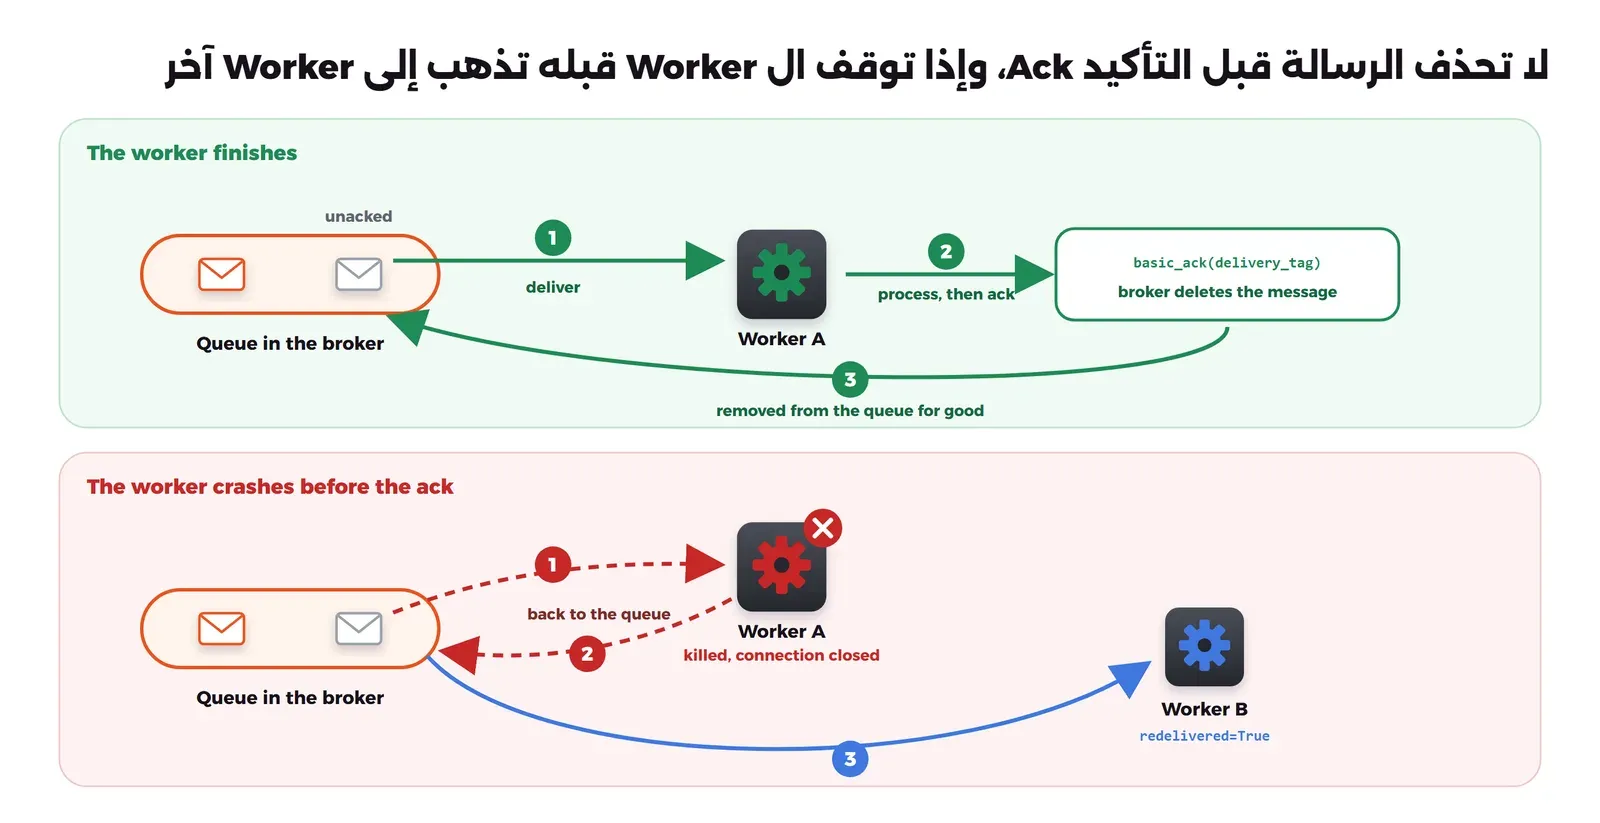
والقاعدة العملية أن ترسل التأكيد في آخر سطر من معالجة الرسالة، بعد أن يكتمل العمل وتحفظ نتيجته، ولا ترسله في أول سطر، والسبب أن التأكيد المبكر يعيدك إلى مشكلة التأكيد التلقائي نفسها. ويجدر الإشارة هنا إلى أن ال Worker الذي يأخذ رسالة ولا يؤكدها ولا يتوقف، كأن يعلق في حلقة لا تنتهي، لا يبقى ممسكاً بها إلى الأبد، فبحسب توثيق المستهلكين في RabbitMQ هناك مهلة للمستهلك Consumer Timeout قيمتها الافتراضية 30 دقيقة، وبعدها يغلق الوسيط القناة ويعيد رسائلها إلى الطابور، فإذا كان عملك يحتاج أكثر من ذلك فعليك بزيادة المهلة أو تقسيم العمل.
تأكيد النشر Publisher Confirms: الطرف الآخر من الطريق
التأكيد Ack يحمي الرسالة بين الوسيط والمستهلك، لكن ماذا عن الطريق بين المنتج والوسيط؟ إذا أرسل التطبيق الرسالة ثم انقطعت الشبكة فلا يعرف هل وصلت أم لا، ويشرح التوثيق نفسه أن الكلاينت الذي كتب الرسالة في ال Socket لا يستطيع أن يفترض أنها وصلت إلى السيرفر، والحل هو تأكيد النشر Publisher Confirms، أي أن يرد الوسيط على المنتج بعد أن يستلم الرسالة ويحفظها، فإذا لم يصل الرد أعاد المنتج الإرسال. ولاحظ أن إعادة الإرسال هذه قد تنتج رسالة مكررة إذا كانت الأولى قد وصلت وضاع ردها فقط، وهذا سبب آخر لموضوع التكرار الذي سيأتي بعد قليل.
عدة Workers على طابور واحد Competing Consumers
عندما يكبر الحمل لا تحتاج أن تغير أي شيء في التصميم، وإنما تشغل نسخة ثانية وثالثة من ال Worker على الطابور نفسه، ويوزع الوسيط الرسائل بينها، وهذا النمط يسمى Competing Consumers، أي عدة مستهلكين يتنافسون على رسائل طابور واحد، ويذكر توثيق المستهلكين أن RabbitMQ يوزع الرسائل على المستهلكين النشطين بالتناوب Round-Robin.
لكن التناوب وحده لا يكفي لتوزيع عادل، والسبب أن الوسيط بشكل افتراضي يدفع الرسائل إلى ال Worker بأسرع ما يستطيع، فإذا كان أحد ال Workers قد اتصل قبل الآخر بلحظة فقد يأخذ أغلب الرسائل في ذاكرته ويعالجها واحدة بعد الأخرى، بينما ال Worker الثاني لا يجد شيئاً. والحل هو ضبط ال Prefetch، وهو عدد الرسائل التي يسمح الوسيط بأن تكون مع ال Worker في الوقت نفسه قبل أن يؤكدها، فإذا جعلته 1 فلن يعطيه الوسيط رسالة جديدة حتى يؤكد التي معه، وتبقى بقية الرسائل في الطابور لأي Worker يفرغ، كما تبين الصورة التالية:
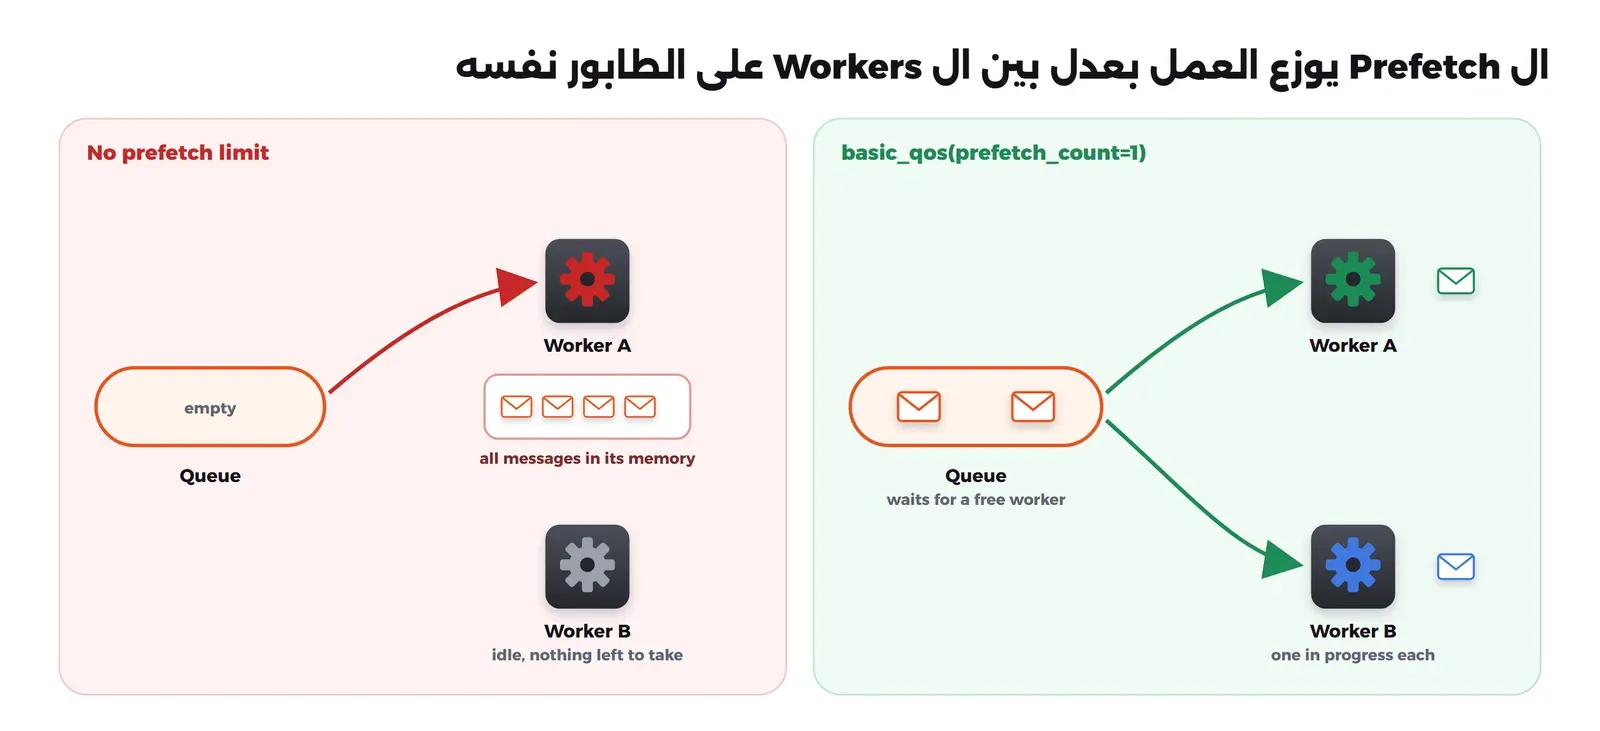
والقيمة 1 هي الأعدل لكنها ليست الأسرع دائماً، لأن ال Worker ينتظر ذهاب الطلب إلى الوسيط وعودة الرد بين كل رسالتين، فإذا كانت رسائلك صغيرة وسريعة المعالجة فقيمة مثل 10 أو 50 تعطي سرعة أكبر، أما إذا كانت كل رسالة تأخذ ثواني مثل إرسال بريد أو إنشاء PDF فاجعلها 1 أو قريبة منها.
إعادة المحاولة Retry: ماذا تفعل بالرسالة التي فشلت؟
لنفرض أن ال Worker حاول إرسال البريد فرد سيرفر البريد بخطأ مؤقت، فالحل البسيط أن يرفض ال Worker الرسالة ويعيدها إلى الطابور فوراً، وهذا يعمل مع الأخطاء المؤقتة القصيرة، لكنه يفشل في حالتين:
- الإعادة الفورية في حلقة: إذا كان سيرفر البريد متوقفاً عشر دقائق فإن الرسالة تعود وتفشل وتعود آلاف المرات في الثانية، فيستهلك ال Worker والوسيط المعالج والقرص بلا فائدة، ويضغطان على السيرفر المتعطل أصلاً.
- الرسالة التي تفشل في كل مرة Poison Message: رسالة لن تنجح أبداً مهما أعدتها، مثل بريد بعنوان غير صالح أو JSON ناقص بسبب خطأ في المنتج، فإذا أعدتها بلا حد بقيت تدور في الطابور إلى الأبد وأخذت من وقت ال Workers.
والطريقة الصحيحة تجمع ثلاثة أشياء: انتظار قبل كل محاولة جديدة يزيد مع عدد المحاولات، وحد أعلى لعدد المحاولات، ومكان تذهب إليه الرسالة بعد آخر محاولة بدل أن تحذف، وهو Dead Letter Queue واختصاراً DLQ، أي طابور جانبي تحفظ فيه الرسائل التي فشلت معالجتها، ولا يقرأ منه ال Worker الذي يعالج الطابور الأصلي، وإنما ينظر فيه شخص ليعرف سبب الفشل ويصلحه ثم يعيد إرسال الرسالة أو يحذفها، وسوف نشرحه بالتفصيل بعد قليل. والصورة التالية تبين هذه الدورة:
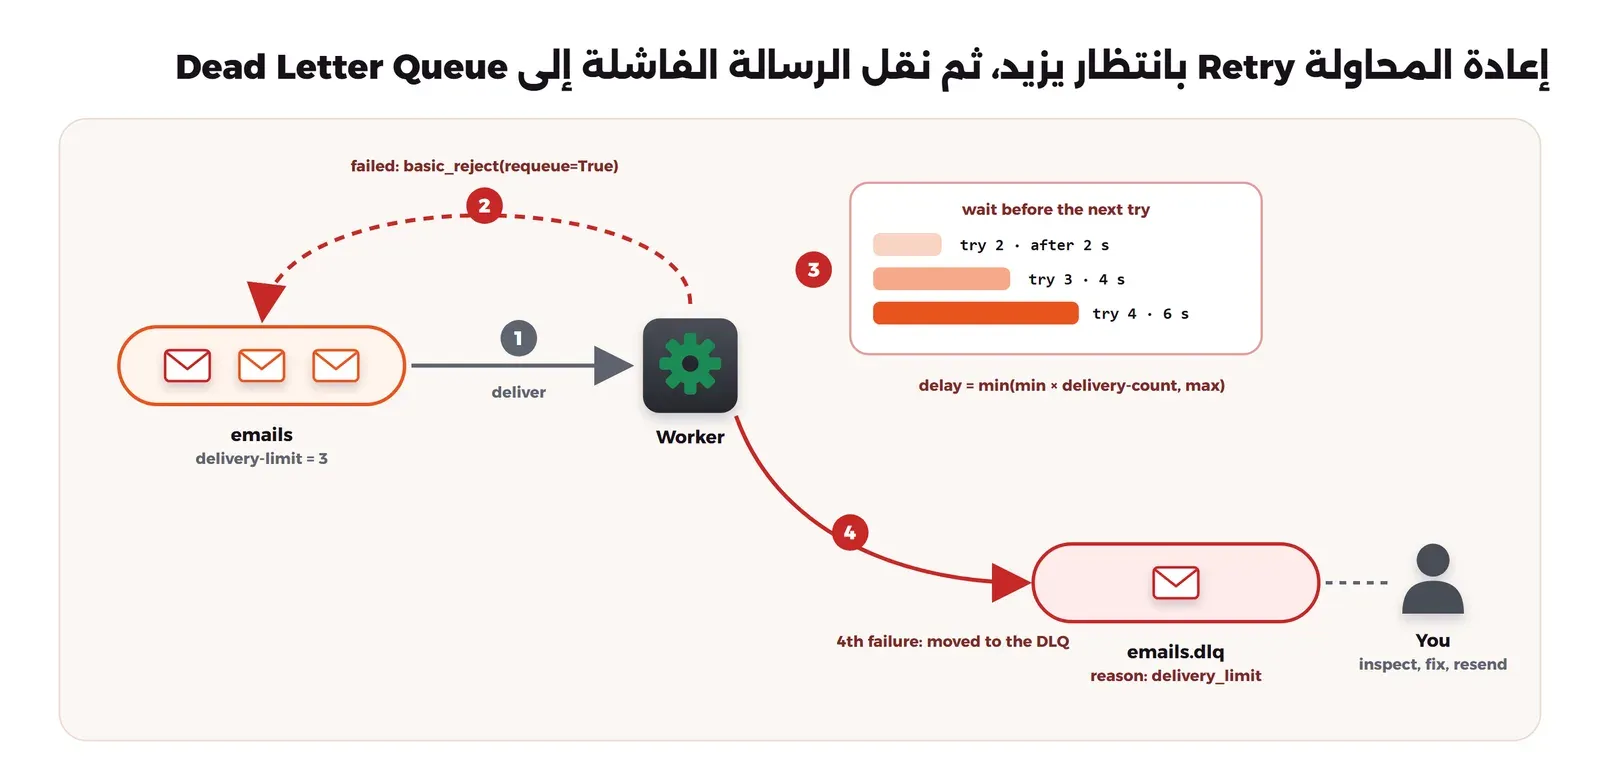
وفي RabbitMQ تحديداً تجد هذه الأجزاء الثلاثة جاهزة في الطوابير من نوع Quorum، وهي بحسب توثيقها مصممة للطوابير التي تعيش طويلاً وتحتاج توفراً عالياً وتحمل عملاً مهماً، مثل الطلبات الواردة في نظام مبيعات:
- حد التسليم Delivery Limit: بحسب توثيق Quorum Queues أصبح لهذه الطوابير منذ RabbitMQ 4.0 حد افتراضي قيمته 20 محاولة فاشلة، وتستطيع أن تغيره بالخيار
x-delivery-limit، ولا ينصح التوثيق بإلغائه لأن الإعادة المتكررة تهدد استقرار الطابور. ومنذ الإصدار 4.3 لا يزيد العداد إلا مع الفشل الحقيقي، أي الرفضbasic.rejectأو انقطاع اتصال ال Worker ومعه رسائل، أماbasic.nackفلا يزيده. - إعادة المحاولة المؤجلة Delayed Retry: ميزة جديدة في RabbitMQ 4.3 تؤجل الرسالة العائدة قبل أن تصبح متاحة من جديد، والانتظار يحسب بالمعادلة
min(min_delay × delivery_count, max_delay)، أي أنه يزيد خطياً مع كل فشل حتى الحد الأعلى، وتفعلها بالخياراتx-delayed-retry-typeوx-delayed-retry-minوx-delayed-retry-max. وقبل هذه الميزة كان الناس يبنون الانتظار بطابور إضافي له مدة صلاحية TTL يعيد الرسالة بعد انتهائها. - ال Dead Letter Exchange: وهو ال Exchange الذي تمر عبره الرسالة الفاشلة في طريقها إلى ال DLQ، وبحسب توثيق Dead Letter Exchanges تنتقل الرسالة إليه في أربع حالات: إذا رفضها المستهلك دون إعادتها إلى الطابور، أو انتهت صلاحيتها TTL، أو امتلأ الطابور إلى حده الأعلى، أو تجاوزت حد التسليم في طابور Quorum، ويضيف الوسيط إلى الرسالة ترويسات تقول السبب، مثل
delivery_limitأوrejected.
ولاحظ أن الانتظار الذي يزيد مع كل محاولة هو الفكرة نفسها التي شرحناها في إعادة المحاولة مع التأخير المتزايد بين الخدمات، والفرق هنا أن الطابور هو الذي يحفظ الرسالة أثناء الانتظار، فلا يمسكها ال Worker في ذاكرته.
ما هو Dead Letter Queue، وماذا تفعل بالرسائل التي فيه؟
ال Dead Letter Queue طابور عادي في الوسيط نفسه، لكن وظيفته مختلفة: تنتقل إليه الرسالة التي لم تنجح معالجتها بعد كل المحاولات المسموحة، ولا يأخذ منه ال Worker الذي يعالج الطابور الأصلي أي رسالة، والاسم مأخوذ من البريد التقليدي، حيث يذهب الخطاب الذي لا يمكن تسليمه ولا إعادته إلى مكتب خاص يفحصه. وفي مثال المطعم هو طلب لم يستطع الطباخ تنفيذه لأن الصنف غير موجود، فبدل أن يعيده إلى اللوحة كل دقيقة إلى الأبد يضعه في سلة جانبية يراجعها المدير.
وقد يتساءل البعض: لماذا لا أحذف الرسالة بعد آخر محاولة وأكتب الخطأ في ال Log وينتهي الأمر؟ والإجابة أن الرسالة هنا عمل حقيقي لم ينفذ، مثل بريد تأكيد لم يصل إلى عميل أو فاتورة لم تنشأ، وحذفها يعني أن هذا العمل ضاع، أما ال DLQ فيحفظ الرسالة كما هي بجسمها ومعرفها وسبب فشلها، فتستطيع أن تعيدها بعد الإصلاح دون أن تطلب من المنتج إرسالها من جديد. وفي المقابل لا تنقل الرسالة إلى ال DLQ مع أول خطأ، والسبب أن أغلب الأخطاء المؤقتة، مثل انقطاع قصير في الشبكة، تنجح في المحاولة الثانية أو الثالثة، لذلك يأتي ال DLQ بعد حد المحاولات وليس بدلاً منه.
أما ما تفعله بالرسائل التي وصلت إلى ال DLQ فهو أربع خطوات ثابتة:
- التنبيه Alerting: راقب عدد الرسائل في ال DLQ وأرسل تنبيهاً عندما يزيد على الصفر، أو عندما يزيد بسرعة، والسبب أن ال DLQ الذي لا ينظر فيه أحد هو عمل يضيع ببطء دون أن يشعر به أحد.
- الفحص Inspect: اقرأ الرسالة وسبب وصولها، وفي RabbitMQ تجد السبب في الترويسة
x-first-death-reasonكما سوف نرى في التجربة، ثم حدد مكان المشكلة: هل هي في الرسالة نفسها مثل JSON ناقص، أم في الكود الذي يعالجها، أم في خدمة خارجية كانت متوقفة. - الإصلاح Fix: أصلح الخطأ في الكود وانشر النسخة الجديدة، أو صحح البيانات، أو انتظر عودة الخدمة الخارجية.
- إعادة الإرسال Replay أو الحذف: أعد الرسالة إلى الطابور الأصلي لتعالج من جديد، بسكربت صغير يقرأ من ال DLQ وينشر إلى الطابور الأصلي، أو من واجهة الإدارة إذا كانت أداتك تدعم نقل الرسائل، ولاحظ أن ال Worker يجب أن يكون آمناً عند التكرار لأن جزءاً من العمل ربما نفذ في المحاولات السابقة. أما الرسالة التي لا فائدة من إعادتها، مثل بريد إلى عنوان غير موجود، فاحذفها بعد أن تسجل سببها.
الرسالة قد تصل مرتين، والترتيب ليس مضموناً
كل ما سبق يعني أن الطابور الذي لا يضيع الرسائل يعطيك ضمان «مرة على الأقل At-Least-Once»، أي أن الرسالة قد تصل إلى ال Worker أكثر من مرة: إذا أرسل ال Worker البريد ثم توقف فجأة قبل أن يرسل التأكيد فسوف تعود الرسالة ويرسل Worker آخر البريد مرة ثانية، وإذا أعاد المنتج النشر لأن تأكيد النشر ضاع فسوف تصل نسختان. وقد شرحنا الضمانات الثلاثة وحقيقة «مرة واحدة بالضبط» في مقال الأنظمة الموزعة، والنتيجة العملية واحدة: اجعل كل Worker آمناً عند التكرار Idempotent، كأن يحفظ message_id في جدول بقيد فريد Unique ويتجاهل الرسالة إذا وجد معرفها، وهي فكرة مفتاح منع التكرار نفسها التي طبقناها على الواجهات البرمجية في تصميم الواجهات البرمجية.
أما الترتيب فيذكر توثيق الطوابير في RabbitMQ أن الطابور مجموعة مرتبة بطريقة الأول يدخل أولاً يخرج FIFO، وأن الرسائل المنشورة على قناة واحدة تدخل الطابور بترتيب نشرها، لكن هذا الترتيب لا يصل إلى المعالجة كما هو في حالتين: عندما يتقاسم عدة Workers الطابور، فالرسالة 2 قد تنتهي قبل الرسالة 1 لأن ال Worker الذي أخذها أسرع، وعندما تفشل رسالة وتعود، فتعالج بعد رسائل جاءت بعدها. لذلك لا تبن منطقك على أن «تم الدفع» يصل دائماً بعد «تم إنشاء الطلب»، وإذا احتجت ترتيباً صارماً لكيان واحد، مثل كل أحداث عميل واحد، فهذا من الأسباب التي تجعل الناس يختارون سجل الأحداث المقسم بالمفتاح، وهو موضوع المقال التالي.
تجربة عملية على RabbitMQ: اثنان من ال Workers وإعادة المحاولة وال DLQ
الآن سوف نبني كل ما سبق على RabbitMQ 4.3.6 في Docker: طابور Quorum اسمه emails بحد تسليم 3 وإعادة محاولة مؤجلة، و DLQ اسمه emails.dlq، ومنتج ينشر مهام بريد مع تأكيد النشر، واثنان من ال Workers بقيمة Prefetch تساوي 1، ثم نشاهد التوزيع، ونوقف أحد ال Workers بالقوة (kill) أثناء العمل، ونرسل Poison Message. ولا يوجد أي منفذ Port منشور على الجهاز، فكل الاتصالات داخل شبكة Compose، والأوامر نفذناها من Git Bash على Windows مع Docker Engine 29.8.0، وتعمل كما هي على Linux.
ملفات التجربة
أنشئ مجلداً فيه الملفات التالية، أولها Dockerfile يبني Image فيها Python 3.13 ومكتبة pika لعميل RabbitMQ:
FROM python:3.13-slim
RUN pip install --no-cache-dir pika==1.4.4
WORKDIR /app
COPY *.py ./
ENV PYTHONUNBUFFERED=1
ثم setup.py الذي ينشئ الطابورين، وهو المكان الوحيد الذي يعرف إعدادات إعادة المحاولة:
import os, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
# the dead letter queue: where messages go after the last failed attempt
ch.queue_declare(queue="emails.dlq", durable=True, arguments={"x-queue-type": "quorum"})
# the work queue
ch.queue_declare(queue="emails", durable=True, arguments={
    "x-queue-type": "quorum",
    "x-delivery-limit": 3,                       # after 3 failed deliveries the message leaves the queue
    "x-dead-letter-exchange": "",                # ... and is republished through the default exchange
    "x-dead-letter-routing-key": "emails.dlq",   # ... to the dead letter queue
    "x-delayed-retry-type": "failed",            # wait before each retry (RabbitMQ 4.3+)
    "x-delayed-retry-min": 2000,
    "x-delayed-retry-max": 10000,
})
print("declared queues: emails (quorum, delivery-limit=3, delayed retry 2s..10s) and emails.dlq")
conn.close()
ثم المنتج publish.py، ويأخذ أرقام الطلبات من سطر الأوامر، والرقم الذي يتبعه :bad يصنع Poison Message، أي رسالة يفشل ال Worker في معالجتها في كل مرة، والذي يتبعه :slow يصنع مهمة تأخذ 30 ثانية:
import json, os, sys, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
ch.confirm_delivery()                      # publisher confirms: wait until the broker has the message
for arg in sys.argv[1:]:
    order_id, _, flag = arg.partition(":")
    job = {"order_id": int(order_id), "to": f"customer{order_id}@example.com", "bad": flag == "bad", "slow": flag == "slow"}
    ch.basic_publish(exchange="", routing_key="emails", body=json.dumps(job),
                     properties=pika.BasicProperties(delivery_mode=2, message_id=f"order-{order_id}"))
    print(f"[producer] confirmed order={order_id}")
conn.close()
ثم ال Worker worker.py، وهو يتظاهر بإرسال البريد بالانتظار عدداً من الثواني، ثم يؤكد الرسالة، أو يرفضها إذا كانت Poison Message:
import json, os, sys, time, pika

name = sys.argv[1]
seconds = float(os.environ.get("WORK_SECONDS", "1"))
conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
ch.basic_qos(prefetch_count=1)             # one message in progress per worker

def handle(channel, method, props, body):
    job = json.loads(body)
    count = (props.headers or {}).get("x-delivery-count", 0)
    now = time.strftime("%H:%M:%S")
    print(f"{now} [{name}] got order={job['order_id']} redelivered={method.redelivered} delivery-count={count}")
    time.sleep(30 if job["slow"] else seconds)   # "slow" simulates a big attachment
    if job["bad"]:
        print(f"{time.strftime('%H:%M:%S')} [{name}] order={job['order_id']} failed, reject")
        channel.basic_reject(delivery_tag=method.delivery_tag, requeue=True)
        return
    print(f"{time.strftime('%H:%M:%S')} [{name}] order={job['order_id']} sent, ack")
    channel.basic_ack(delivery_tag=method.delivery_tag)

ch.basic_consume(queue="emails", on_message_callback=handle)
print(f"[{name}] waiting")
ch.start_consuming()
ثم dlq.py الذي يقرأ أول رسالة في ال DLQ ويطبع سبب وصولها، ثم يعيدها كما هي حتى تبقى للفحص:
import json, os, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
method, props, body = ch.basic_get(queue="emails.dlq")
if method is None:
    print("emails.dlq is empty")
else:
    h = props.headers or {}
    print("body:", body.decode())
    print("message_id:", props.message_id)
    print("x-first-death-reason:", h.get("x-first-death-reason"))
    print("x-first-death-queue:", h.get("x-first-death-queue"))
    for d in h.get("x-death", []):
        print("x-death:", {"reason": d["reason"], "queue": d["queue"], "count": int(d["count"])})
    ch.basic_nack(delivery_tag=method.delivery_tag, requeue=True)   # leave it in the DLQ for inspection
conn.close()
وأخيراً docker-compose.yml:
name: lab-queue

x-app: &app
  image: lab-queue-app:1
  environment:
    AMQP_URL: amqp://lab:lab-pass-2026@broker:5672/%2F
    WORK_SECONDS: "5"
  depends_on:
    broker:
      condition: service_healthy

services:
  broker:
    image: rabbitmq:4.3.6-alpine
    container_name: lab-queue-broker
    hostname: broker
    environment:
      RABBITMQ_DEFAULT_USER: lab
      RABBITMQ_DEFAULT_PASS: lab-pass-2026
    healthcheck:
      test: ["CMD", "rabbitmq-diagnostics", "-q", "check_port_connectivity"]
      interval: 5s
      retries: 30

  worker-a:
    <<: *app
    build: .
    container_name: lab-queue-worker-a
    command: ["python", "worker.py", "worker-a"]
    profiles: ["workers"]

  worker-b:
    <<: *app
    container_name: lab-queue-worker-b
    command: ["python", "worker.py", "worker-b"]
    profiles: ["workers"]

  tools:
    <<: *app
    profiles: ["tools"]
في الإعداد أعلاه لاحظ التالي:
- الطابور من نوع
quorum، وهو الذي يدعم حد التسليم والانتظار قبل الإعادة، ولا تدعمهما الطوابير الكلاسيكية Classic بحسب جدول المقارنة في توثيق Quorum Queues. x-dead-letter-exchangeقيمته نص فارغ، وهو ال Default Exchange الذي يرسل الرسالة إلى الطابور الذي اسمه يساوي مفتاح التوجيه Routing Key، لذلك تصل الرسالة الفاشلة إلىemails.dlqدون أن ننشئ Exchange خاصاً.- المنتج يستدعي
confirm_delivery()فلا يطبع «confirmed» إلا بعد أن يرد الوسيط، والرسالة بالخيارdelivery_mode=2أي محفوظة على القرص، ولهاmessage_idثابت مبني على رقم الطلب حتى يستطيع ال Worker أن يكتشف التكرار. - ال Worker يضبط
prefetch_count=1ويؤكد في آخر الدالة فقط، ويقرأ الترويسةx-delivery-countالتي يضيفها الطابور لنرى عدد المحاولات السابقة. - عرفنا مستخدماً وكلمة مرور للوسيط، والسبب أن المستخدم الافتراضي guest لا يسمح له RabbitMQ بالاتصال إلا من الجهاز نفسه، وال Workers هنا في Containers أخرى.
النشر قبل تشغيل أي Worker
نشغل الوسيط وننشئ الطابورين، ثم ننشر ست مهام قبل تشغيل أي Worker:
docker compose --profile workers build
docker compose up -d --wait broker
docker compose run --rm tools python setup.py
docker compose run --rm tools python publish.py 101 102 103 104 105 106
docker exec lab-queue-broker rabbitmqctl -q list_queues name messages_ready messages_unacknowledged consumers
والمخرج سوف يكون كما يلي:
declared queues: emails (quorum, delivery-limit=3, delayed retry 2s..10s) and emails.dlq
[producer] confirmed order=101
[producer] confirmed order=102
[producer] confirmed order=103
[producer] confirmed order=104
[producer] confirmed order=105
[producer] confirmed order=106
name	messages_ready	messages_unacknowledged	consumers
emails.dlq	0	0	0
emails	6	0	0
لاحظ أن المنتج انتهى من عمله ورد عليه الوسيط بالتأكيد مع أنه لا يوجد أي مستهلك، والرسائل الست تنتظر في الطابور بحالة جاهزة Ready، وهذا هو الفصل في الزمن الذي تكلمنا عنه في أول المقال.
Worker A وWorker B يتقاسمان العمل
docker compose --profile workers up -d worker-a worker-b
sleep 25
docker compose logs --no-log-prefix worker-a worker-b
والمخرج بعد ترتيبه بالوقت سوف يكون كما يلي:
[worker-b] waiting
15:30:43 [worker-b] got order=101 redelivered=False delivery-count=0
[worker-a] waiting
15:30:44 [worker-a] got order=102 redelivered=False delivery-count=0
15:30:48 [worker-b] order=101 sent, ack
15:30:48 [worker-b] got order=103 redelivered=False delivery-count=0
15:30:49 [worker-a] order=102 sent, ack
15:30:49 [worker-a] got order=104 redelivered=False delivery-count=0
15:30:53 [worker-b] order=103 sent, ack
15:30:53 [worker-b] got order=105 redelivered=False delivery-count=0
15:30:54 [worker-a] order=104 sent, ack
15:30:55 [worker-a] got order=106 redelivered=False delivery-count=0
15:30:58 [worker-b] order=105 sent, ack
15:31:00 [worker-a] order=106 sent, ack
لاحظ أن Worker B اتصل قبل Worker A بثانية واحدة، ومع ذلك لم يأخذ كل الرسائل، وإنما أخذ الرسالة 101 فقط وبقيت الخمس الباقية في الطابور حتى اتصل A فأخذ 102، ثم صار كل Worker يأخذ رسالة جديدة فقط بعد أن يؤكد التي معه، فانتهت الرسائل الست في 17 ثانية بدل 30 ثانية ل Worker واحد. وهذا هو أثر prefetch_count=1، ولو حذفته لأخذ ال Worker الأول الرسائل الست إلى ذاكرته في اللحظة نفسها.
نوقف ال Worker بالقوة قبل التأكيد
الآن ننشر مهمة بطيئة تأخذ 30 ثانية، وننتظر حتى يأخذها أحد ال Workers، ثم نوقفه فجأة بالأمر docker kill وهو في منتصف العمل، أي قبل أن يرسل التأكيد:
docker compose run --rm tools python publish.py 201:slow
# wait until one of the workers prints "got order=201", then kill that worker
docker kill lab-queue-worker-b
sleep 40
docker compose logs --no-log-prefix worker-a worker-b | grep "order=201"
docker exec lab-queue-broker rabbitmqctl -q list_queues name messages_ready messages_unacknowledged consumers
والمخرج سوف يكون كما يلي:
[producer] confirmed order=201
lab-queue-worker-b
15:31:25 [worker-b] got order=201 redelivered=False delivery-count=0
15:31:31 [worker-a] got order=201 redelivered=True delivery-count=1
15:32:01 [worker-a] order=201 sent, ack
name	messages_ready	messages_unacknowledged	consumers
emails.dlq	0	0	0
emails	0	0	1
في المخرج أعلاه لاحظ التالي:
- Worker B أخذ الرسالة في الثانية 25 ثم أوقفناه بالقوة، فلم يرسل أي تأكيد، وعندما انقطع اتصاله أعاد الوسيط الرسالة إلى الطابور، فأخذها Worker A بعد ست ثوان وأكمل العمل، ولم تضع الرسالة.
- الرسالة وصلت إلى A مع
redelivered=Trueوdelivery-count=1، وهذه هي الإشارة التي يجب أن ينتبه لها ال Worker: ربما نفذ Worker سابق جزءاً من العمل، أو كله، قبل أن يتوقف، لذلك يجب أن يكون العمل آمناً عند التكرار كما شرحنا. - عدد المستهلكين أصبح 1 لأن Worker B متوقف، وفي بيئة حقيقية يعيد ال Orchestrator أو خيار
restartفي Compose تشغيله.
Poison Message تنتقل إلى ال DLQ
نعيد تشغيل Worker B، ثم ننشر Poison Message برقم 301 ورسالة سليمة برقم 302 معاً، وننتظر دقيقة:
docker compose --profile workers up -d worker-a worker-b
docker compose run --rm tools python publish.py 301:bad 302
sleep 60
docker compose logs --no-log-prefix worker-a worker-b | grep "order=30"
docker exec lab-queue-broker rabbitmqctl -q list_queues name messages_ready messages_unacknowledged consumers
docker compose run --rm tools python dlq.py
والمخرج سوف يكون كما يلي:
[producer] confirmed order=301
[producer] confirmed order=302
15:32:55 [worker-a] got order=301 redelivered=False delivery-count=0
15:32:55 [worker-b] got order=302 redelivered=False delivery-count=0
15:33:00 [worker-a] order=301 failed, reject
15:33:00 [worker-b] order=302 sent, ack
15:33:02 [worker-a] got order=301 redelivered=True delivery-count=1
15:33:07 [worker-a] order=301 failed, reject
15:33:11 [worker-b] got order=301 redelivered=True delivery-count=2
15:33:16 [worker-b] order=301 failed, reject
15:33:23 [worker-a] got order=301 redelivered=True delivery-count=3
15:33:28 [worker-a] order=301 failed, reject
name	messages_ready	messages_unacknowledged	consumers
emails.dlq	1	0	0
emails	0	0	2
body: {"order_id": 301, "to": "[email protected]", "bad": true, "slow": false}
message_id: order-301
x-first-death-reason: delivery_limit
x-first-death-queue: emails
x-death: {'reason': 'delivery_limit', 'queue': 'emails', 'count': 1}
في المخرج أعلاه لاحظ التالي:
- الرسالة السليمة 302 انتهت في خمس ثوان كالمعتاد، ولم تتأثر بال Poison Message التي بجانبها.
- الرسالة 301 جربت أربع مرات: المحاولة الأولى، ثم ثلاث إعادات بعد رفض
basic_reject، وكان الانتظار بين الرفض والمحاولة التالية قرابة 2 ثم 4 ثم 7 ثوان، أي أنه يزيد مع العداد كما تقول معادلة التوثيق، والثانية الزائدة في الأخيرة من دورة فحص الرسائل المؤجلة داخل الوسيط. - بعد الرفض الرابع تجاوز العداد الحد 3، فنقلها الوسيط إلى
emails.dlqولم يعطها لأي Worker بعد ذلك، والطابور الأصلي فارغ وال Workers متاحون لغيرها. - الرسالة في ال DLQ هي نفسها بجسمها ومعرفها، ومعها الترويسة
x-first-death-reason: delivery_limitالتي تقول لماذا وصلت، وهذا ما تحتاجه عندما تفحصها لتعرف هل المشكلة في الرسالة أم في ال Worker.
نكسر الإعداد: طابور بنفس الاسم وخيارات مختلفة
خطأ يقع فيه كثيرون: يغير المطور الحد في كود ال Worker من 3 إلى 5 مثلاً ويعيد تعريف الطابور، ويتوقع أن يتغير الحد. احفظ الملف التالي باسم redeclare.py في المجلد نفسه وأعد بناء ال Image ثم شغله:
import os, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
# the same queue name, but a different delivery limit than the one it was created with
ch.queue_declare(queue="emails", durable=True, arguments={"x-queue-type": "quorum", "x-delivery-limit": 5})
وعند تشغيل الأمر سوف تجد أنه يفشل، والسطر الأخير من المخرج كما يلي:
pika.exceptions.ChannelClosedByBroker: (406, "PRECONDITION_FAILED - inequivalent arg 'x-dead-letter-exchange' for queue 'emails' in vhost '/': received none but current is the value '' of type 'longstr'")والسبب أن تعريف الطابور في RabbitMQ يجب أن يطابق الطابور الموجود تماماً، فإذا اختلف أي خيار رفض الوسيط التعريف وأغلق القناة بالرمز 406، ولاحظ أن الرسالة تذكر أول خيار مختلف وجده، وهو هنا غياب x-dead-letter-exchange، وليس الحد الذي أردنا تغييره. والطريقة الصحيحة لتغيير الحد في طابور موجود هي السياسة Policy عبر rabbitmqctl set_policy بالمفتاح delivery-limit كما يبين توثيق Quorum Queues، أو إنشاء طابور جديد ونقل ال Workers إليه.
هل تحتاج وسيطاً منفصلاً أصلاً؟
ليس دائماً، فإذا كان تطبيقك يعمل على PostgreSQL وعدد المهام آلاف في الدقيقة وليس ملايين، فجدول مهام مع FOR UPDATE SKIP LOCKED يعطيك طابوراً حقيقياً يتقاسمه ال Workers، وميزته الكبرى أنك تكتب الطلب والمهمة في المعاملة نفسها، فلا يمكن أن يحفظ أحدهما دون الآخر، وقد بنيناه وقسناه بعشرين ألف مهمة في طابور المهام في PostgreSQL، وذكرنا هناك المكتبات الجاهزة التي تبنيه لك. والمفاهيم في هذا المقال كلها تبقى كما هي في الجدول: التأكيد هو تحديث حالة السطر بعد انتهاء العمل، وإعادة المحاولة عمود عداد ووقت تشغيل لاحق، وال DLQ حالة failed. أما الوسيط المنفصل مثل RabbitMQ فيصبح الأنسب عندما تتعدد الخدمات واللغات، أو تحتاج توجيهاً بين طوابير كثيرة، أو يصبح ضغط الطابور على قاعدة البيانات ملحوظاً.
متى يستخدم المطور الطابور Queue؟ أشهر الحالات العملية
بعد أن عرفنا المفاهيم يبقى السؤال الذي يهم المطور في عمله اليومي: في أي جزء من تطبيقي أضع طابوراً؟ والقاعدة العامة أن أي عمل لا يحتاج المستخدم نتيجته في الرد نفسه، أو يعتمد على خدمة خارجية قد تتأخر أو تتعطل، أو يأتي في دفعات كبيرة، هو مرشح للطابور، والجدول التالي يجمع أشهر الحالات، ولكل حالة سبب استخدام الطابور، والمفهوم الذي يجب أن تنتبه له أكثر من غيره:
| الحالة | لماذا الطابور | المفهوم الأهم | ملاحظة |
|---|---|---|---|
| إرسال بريد أو رسالة نصية SMS بعد التسجيل أو الطلب | مزود البريد أو ال SMS قد يتأخر أو يتعطل، والمستخدم لا يحتاج أن ينتظره | Retry وIdempotency | احفظ معرف الرسالة حتى لا يصل المستخدم البريد مرتين عند إعادة المحاولة |
| إنشاء ملفات PDF والتقارير | العملية تأخذ ثواني أو دقائق وتستهلك المعالج والذاكرة | Prefetch | اجعل ال Prefetch 1 أو قريباً منه، واحفظ الملف في Object Storage ثم أرسل للمستخدم رابطه أو إشعاراً |
| معالجة الصور والفيديو: تصغير وتحويل صيغة | عمل ثقيل يأتي على دفعات عند الرفع | Prefetch وAck | ضع في الرسالة مسار الملف وليس الملف نفسه، وأكد الرسالة بعد حفظ النتيجة فقط |
| إرسال Webhooks صادرة إلى أنظمة عملائك | سيرفر العميل قد يكون متوقفاً أو بطيئاً، ولا تريد أن يتعطل تطبيقك بسببه | Retry بانتظار يزيد وDLQ | أرسل مع كل Webhook معرفاً ثابتاً حتى يكتشف العميل التكرار، وضع حداً للمحاولات ثم DLQ |
| استقبال إشعارات بوابة الدفع Payment Callback ثم معالجتها | البوابة تنتظر رداً سريعاً وتعيد الإرسال إذا تأخر الرد | Idempotency وAck | احفظ الإشعار وضعه في الطابور ثم رد فوراً بالنجاح، ونفذ تحديث الطلب في ال Worker مع التحقق من رقم العملية حتى لا يحسب الدفع مرتين |
| استيراد ملفات CSV والإدخال الكبير Bulk Import | ملف بمئة ألف سطر لا ينتهي في مدة طلب HTTP واحد | Ack وDLQ | قسم الملف إلى دفعات، كل دفعة رسالة، والدفعات الفاشلة تذهب إلى DLQ لتراجعها بدل أن يفشل الملف كله |
| تحديث فهرس البحث Search Indexing بعد الكتابة | محرك البحث خدمة منفصلة قد تتأخر، والكتابة في قاعدة البيانات يجب ألا تنتظره | Idempotency | أرسل معرف السجل فقط، ودع ال Worker يقرأ آخر نسخة منه من قاعدة البيانات، فلا يضرك أن تصل الرسائل بغير ترتيبها |
| استدعاء API خارجية لها حد للطلبات Rate Limit | الخدمة الخارجية ترفض الطلبات الزائدة بالخطأ 429 | Prefetch وRetry | عدد ال Workers وقيمة ال Prefetch يحددان عدد الطلبات المتزامنة، فاضبطهما على حد الخدمة، وأعد المحاولة بعد المدة التي تطلبها في الترويسة Retry-After |
| توزيع الإشعارات Notifications Fan-out | حدث واحد يجب أن يصل إلى البريد وإشعار الجوال والإشعار داخل التطبيق | Topic وDLQ لكل قناة | استخدم Exchange من نوع Fanout مع طابور لكل قناة، حتى لا يوقف تعطل مزود الإشعارات إرسال البريد |
| المهام المؤجلة Delayed Jobs: تذكير بعد 24 ساعة، أو إلغاء طلب لم يدفع بعد 30 دقيقة | العمل يجب أن ينفذ لاحقاً حتى لو أعيد تشغيل التطبيق | Idempotency | عند التنفيذ تحقق من الحالة من جديد، فربما دفع العميل قبل أن يحين الوقت، أما المهام الدورية مثل تقرير كل يوم فمكانها Cron، وهو الذي يضع المهمة في الطابور |
| مزامنة البيانات مع أنظمة أخرى مثل ERP وCRM | النظام الآخر قد يتوقف للصيانة أو يكون أبطأ من تطبيقك | Retry وDLQ | إذا كان ترتيب التغييرات على السجل الواحد مهماً فهذه حالة تناسبها أداة Event Streaming أكثر من الطابور، واكتب التغيير والرسالة معاً بنمط Outbox |
متى لا يناسب الطابور
الطابور يضيف إلى نظامك مكوناً جديداً تراقبه وتحدثه وتأخذ له نسخاً احتياطية، ويجعل الخطأ أصعب في التتبع لأنه يحدث بعيداً عن الطلب الذي سببه، لذلك لا تضعه في الحالات التالية:
- المستخدم يحتاج الجواب الآن: مثل التحقق من كلمة المرور أو حساب سعر السلة أو التحقق من توفر المنتج قبل الدفع، فهذه نتائج تظهر في الصفحة نفسها، ووضعها في طابور يعني أن المستخدم ينتظر الطابور وال Worker معاً، وهذا أبطأ وأعقد من استدعاء الدالة مباشرة.
- الحجم صغير: عشرات أو آلاف المهام في اليوم لا تحتاج وسيطاً منفصلاً، فجدول مهام في قاعدة البيانات يكفي كما شرحنا في طابور المهام في PostgreSQL.
- ترتيب صارم لكل الرسائل: كما رأينا فإن تعدد ال Workers وإعادة المحاولة يغيران ترتيب المعالجة، وتشغيل Worker واحد فقط للحفاظ على الترتيب يلغي فائدة توزيع الحمل، فإذا كان الترتيب هو المطلوب الأساسي فانظر سجل الأحداث في مقال الطابور أم بث الأحداث.
- طلب ورد بين الخدمات Request/Response: إذا كانت خدمة تحتاج جواباً من خدمة أخرى لتكمل عملها، فالاستدعاء المباشر عبر REST أو gRPC أوضح من طابورين أحدهما للطلب والآخر للرد، وقد شرحنا اختيار نوع الواجهة في تصميم الواجهات البرمجية.
كيف تبدأ
- اختر عملاً واحداً بطيئاً في تطبيقك، وغالباً يكون إرسال البريد، وانقله وحده إلى الطابور قبل أي شيء آخر.
- اجعل الرسالة صغيرة: معرفات ومسارات فقط، ومعها
message_idثابت. - اجعل ال Worker آمناً عند التكرار Idempotent قبل أن تضيف أي ميزة أخرى.
- أرسل التأكيد Ack في آخر المعالجة فقط، واضبط ال Prefetch على قيمة تناسب زمن المعالجة.
- ضع حداً للمحاولات مع انتظار يزيد، واربط الطابور ب DLQ.
- راقب ثلاثة أرقام: طول الطابور، وعمر أقدم رسالة، وعدد الرسائل في ال DLQ، مع تنبيه على كل منها.
- جرب الفشل قبل الإنتاج: أوقف ال Worker بالقوة وأرسل Poison Message كما فعلنا في التجربة، وتأكد أن النتيجة كما تتوقع.
أخطاء شائعة
- التأكيد في أول الدالة: بعض الأمثلة على الإنترنت تؤكد الرسالة ثم تعالجها، أو تستخدم
auto_ack=True، فتضيع كل رسالة كانت مع Worker توقف فجأة. أكد بعد انتهاء العمل فقط. - Worker غير آمن عند التكرار: الرسالة سوف تصل مرتين في يوم ما، فإذا كان ال Worker يخصم المبلغ أو يرسل الرسالة النصية دون أن يتحقق من المعرف فسوف يصل العميل خصمان. احفظ المعرف بقيد فريد.
- إعادة فورية بلا حد: رفض الرسالة مع
requeue=Trueدون انتظار ودون حد يصنع حلقة تستهلك الوسيط. استخدم حد التسليم والانتظار وال DLQ معاً. - DLQ لا ينظر فيه أحد: ال DLQ الذي يكبر بصمت هو بيانات تضيع ببطء. راقب عدد رسائله وأرسل تنبيهاً عندما يزيد على الصفر.
- رسائل كبيرة: وضع ملفات PDF أو صور في جسم الرسالة يملأ ذاكرة الوسيط وقرصه. ضع الملف في تخزين الكائنات وأرسل مساره.
- Prefetch بلا حد: مع التأكيد اليدوي ودون
basic_qosقد يأخذ Worker واحد آلاف الرسائل إلى ذاكرته، وإذا توقف عادت كلها معاً. ضع حداً يناسب زمن المعالجة. - تجاهل طول الطابور: الطابور الذي يكبر باستمرار يعني أن ال Workers أبطأ من المنتجين، وهذا أهم رقم تراقبه في أي نظام طوابير، مع عمر أقدم رسالة.
حذف المختبر
الأوامر التالية تحذف ال Containers والشبكة التي أنشأتها التجربة، ثم ال Image التي بنيناها:
docker compose --profile workers --profile tools down -v
docker image rm lab-queue-app:1
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الطابور يفصل المنتج عن المستهلك في الزمن، ويمتص الذروة، ويحفظ العمل عندما تتعطل خدمة، وهو أفضل من Thread في الخلفية لأنه يبقى بعد سقوط التطبيق.
- في الطابور Queue يأخذ كل رسالة Worker واحد، وفي الموضوع Topic يأخذ كل مشترك نسخة، فاستخدم الأول للمهام والثاني للأحداث.
- التأكيد Ack بعد انتهاء العمل يمنع ضياع الرسالة إذا توقف ال Worker فجأة، وتأكيد النشر Publisher Confirms يمنع ضياعها في الطريق إلى الوسيط.
- عدة Workers على طابور واحد يوزعون الحمل، وضبط ال Prefetch يجعل التوزيع عادلاً.
- أعد المحاولة بانتظار يزيد وحد أعلى، ثم انقل الرسالة إلى ال DLQ، وراقبه وافحص رسائله وأعدها بعد الإصلاح، وفي RabbitMQ 4.3 تجد الثلاثة جاهزة في طوابير Quorum.
- الرسالة قد تصل مرتين، والترتيب لا يصل إلى المعالجة كما هو، فاجعل كل Worker آمناً عند التكرار ولا تبن منطقك على ترتيب الوصول.
- ضع في الطابور كل عمل لا يحتاج المستخدم نتيجته فوراً أو يعتمد على خدمة خارجية، مثل البريد والملفات وال Webhooks وإشعارات الدفع، واترك ما يحتاج جواباً فورياً للاستدعاء المباشر، وابدأ بجدول في قاعدة البيانات إذا كان الحجم صغيراً.
وفي المقال التالي من المرحلة نقارن هذا الطابور بسجل الأحداث في Kafka وRedpanda، ونرى لماذا يستطيع مستهلك جديد هناك أن يقرأ رسائل الأمس.
 دليلالطابور Queue أم بث الأحداث Event Streaming؟ما يحدث للرسالة بعد قراءتها هو الفرق بين طابور مثل RabbitMQ وسجل أحداث مثل Kafka، ومنه تعرف أيهما يناسب مشروعك.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلأنماط المعمارية Architecture Styles ومتى تختار كلاً منهاكيف تختار بين التطبيق الواحد والخدمات التي تتبادل الأحداث، وما الذي يناسب نظامك من أشهر أنماط المعمارية.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة RabbitMQ 4.3.6 مع طوابير Quorum وإعادة المحاولة المؤجلة وال Dead Letter Queue، باثنين من ال Workers بلغة Python 3.13 ومكتبة pika 1.4.4 في Docker.
- أكتوبر 2026: حالات الاستخدام للمطورين وتوضيح المصطلحات.


