

في مقال مفاهيم الطوابير بنينا طابوراً على RabbitMQ يأخذ منه ال Workers المهام، ويحذف الوسيط كل رسالة بعد أن يؤكدها ال Worker، وهذا بالضبط ما تريده لمهمة مثل إرسال بريد. لكن لنفرض أن فريق التحليلات طلب منك اليوم أن يقرأ كل الطلبات التي جاءت في الأسبوع الماضي ليبني تقريراً جديداً، أو أنك اكتشفت أن خدمة المخزون كان فيها خطأ منذ يومين وتريد أن تعيد معالجة كل الأحداث من تلك اللحظة، فالطابور لن يساعدك، لأن الرسائل حذفت لحظة تأكيدها. وهنا يظهر النوع الثاني من الأدوات، وهو بث الأحداث Event Streaming الذي تمثله Apache Kafka وRedpanda، وهذا المقال الثاني في مرحلة الطوابير وبث الأحداث، وسوف نناقش فيه ما يلي:
- الفرق الجوهري بين طابور الرسائل Message Queue وسجل الأحداث Event Log: ماذا يحدث للرسالة بعد قراءتها.
- مفاهيم السجل: رقم الرسالة Offset، وتقسيم الموضوع إلى Partitions، والمفتاح Key، ومجموعات المستهلكين Consumer Groups، ومدة الحفظ Retention.
- إعادة القراءة Replay، ولماذا هي الميزة التي تجعل الناس يختارون السجل.
- ما الذي يعطيه الطابور ولا يعطيه السجل، وكيف بدأت الأداتان تقتربان من بعضهما.
- تجربة عملية تضع RabbitMQ وRedpanda جنباً إلى جنب بمخرجات حقيقية، ثم جدول يساعدك على الاختيار.
ماذا يحدث للرسالة بعد قراءتها؟
هذا هو السؤال الذي يفرق بين النوعين، وكل الفروق الأخرى تأتي منه:
- طابور الرسائل Message Queue: القراءة فيه تستهلك الرسالة Destructive Consumption، فعندما يؤكد ال Worker أنه انتهى منها يحذفها الوسيط، والطابور يتابع حالة كل رسالة وحدها: هل سلمت، وهل أكدت، وكم مرة أعيدت. والطابور الصحي فارغ أو قريب من الفراغ، لأن وظيفته أن يوصل العمل لا أن يحفظه.
- سجل الأحداث Event Log: الحدث يكتب في آخر سجل يضاف إليه فقط Append Only، ولا يحذف بعد قراءته، وإنما يبقى مدة تحددها أنت، وكل حدث له رقم تسلسلي يسمى ال Offset، وكل قارئ يحفظ رقماً واحداً هو ال Offset الذي وصل إليه في السجل. ويقول تعريف Kafka الرسمي إن الأحداث في الموضوع Topic يمكن أن تقرأ عدد المرات الذي تحتاجه، وإنها على خلاف أنظمة الرسائل التقليدية لا تحذف بعد استهلاكها، وإنما تحدد بإعداد لكل موضوع كم تحتفظ بها Kafka قبل أن تحذف القديم منها.
والصورة التالية تبين الفرق:
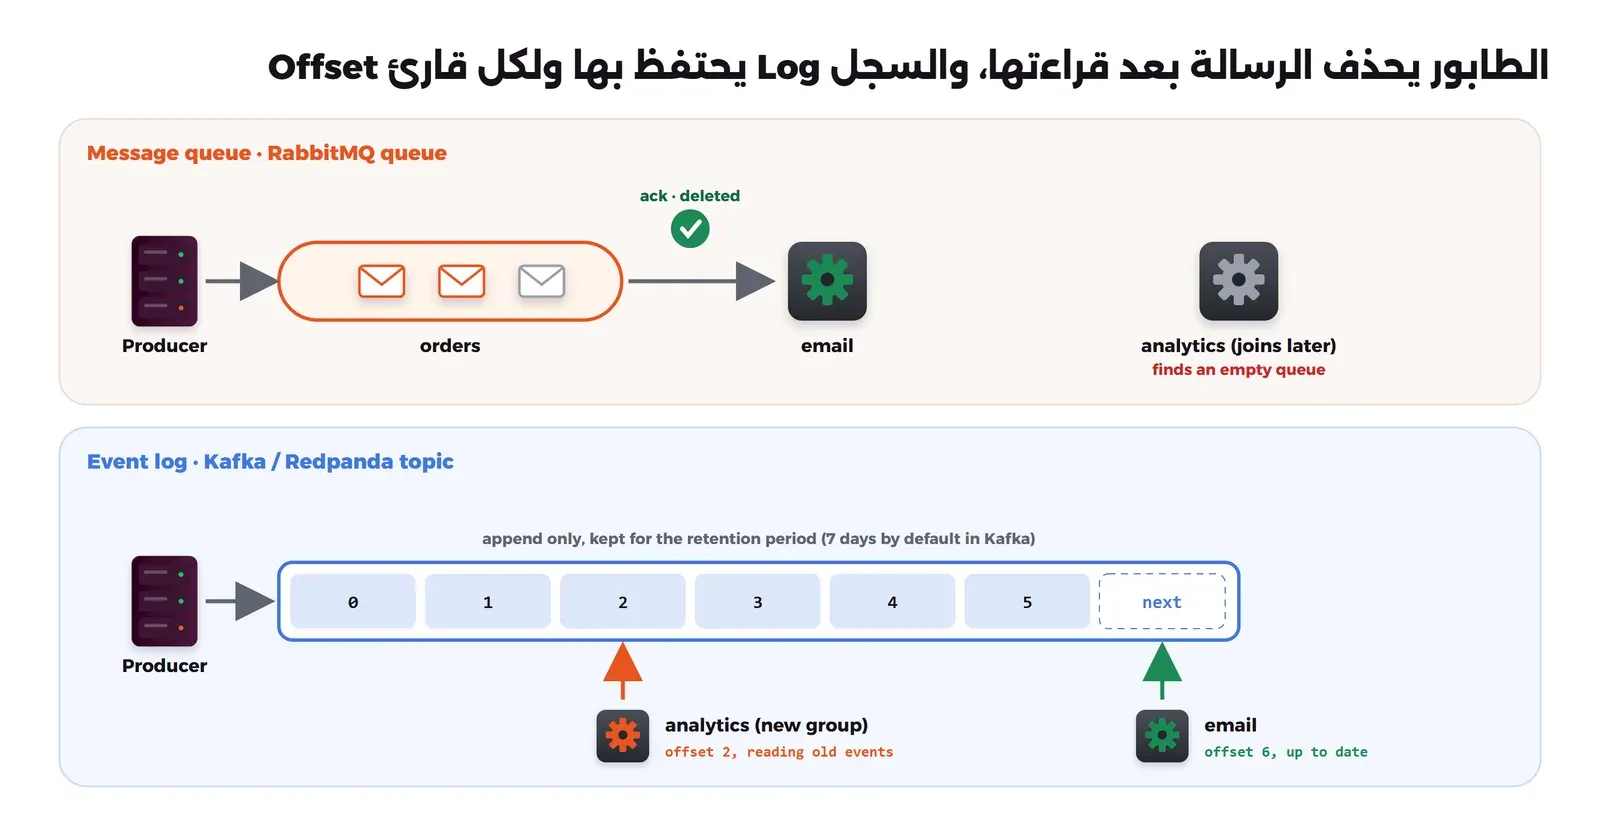
والتشبيه الأقرب هو الفرق بين صندوق البريد ودفتر محاضر الاجتماعات، فالرسالة في صندوق البريد يأخذها صاحبها ولا تبقى فيه، أما الدفتر فكل محضر يكتب في صفحة جديدة بعد آخر صفحة، ولا يمزق أحد صفحة بعد قراءتها، وكل موظف يضع ورقة صغيرة عند آخر صفحة قرأها، والموظف الجديد يستطيع أن يبدأ من أول الدفتر. وتشرح Kafka في صفحة التصميم لماذا اختارت هذا الشكل: أغلب أنظمة الرسائل تحفظ في الوسيط حالة كل رسالة، وهل سلمت وهل أكدت، وهذه الحالة صعبة ومكلفة، أما في Kafka فال Offset الخاص بالمستهلك في كل Partition هو رقم واحد، وهو رقم الرسالة التالية التي سيقرؤها، لذلك يصبح ما يعادل التأكيد رخيصاً جداً، ومعه ميزة جانبية: يستطيع المستهلك أن يرجع إلى Offset قديم ويعيد القراءة، وتضرب الصفحة نفسها مثلاً بمستهلك اكتشف خطأ في كوده بعد أن قرأ رسائل، فيعيد قراءتها بعد إصلاحه.
وقد ذكرنا هذا الفرق باختصار في أنماط المعمارية عند الكلام عن النشر والاشتراك وسجل الأحداث، أما هنا فسوف نفصل المفاهيم التي تحتاجها لتعمل على السجل فعلاً.
مفاهيم سجل الأحداث
تقسيم الموضوع إلى Partitions والمفتاح Key
السجل الواحد على سيرفر واحد له حد في سرعة الكتابة والقراءة، لذلك يقسم كل موضوع Topic إلى أجزاء تسمى Partitions، وكل Partition سجل مستقل له أرقام Offset خاصة به تبدأ من الصفر، ويمكن أن توضع ال Partitions على سيرفرات مختلفة فيكتب المنتجون ويقرأ المستهلكون منها في الوقت نفسه. والسؤال: إلى أي Partition يذهب الحدث؟ والإجابة أن المنتج يرسل مع الحدث مفتاحاً Key، مثل رقم العميل، ويحسب الكلاينت هاش المفتاح ليختار ال Partition، ويقول تعريف Kafka إن الأحداث التي لها المفتاح نفسه تكتب في ال Partition نفسه، وإن Kafka تضمن أن أي مستهلك يقرأ Partition ما سوف يقرأ أحداثه بالترتيب نفسه الذي كتبت به.
والصورة التالية تبين ال Partitions كما ظهرت في تجربتنا لاحقاً:
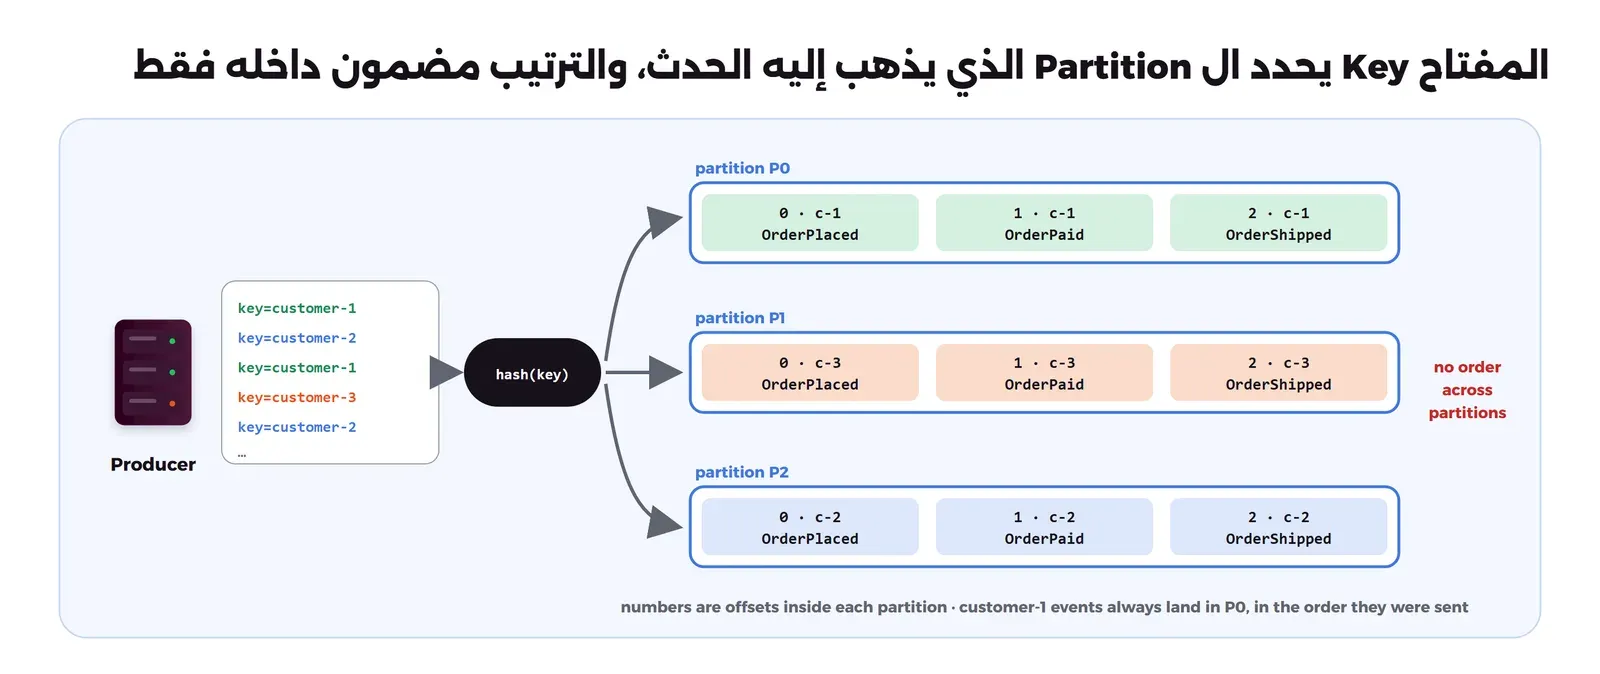
وهذا يحل مشكلة الترتيب التي ذكرناها في المقال السابق: في الطابور الذي يتقاسمه عدة Workers قد يعالج «تم الدفع» قبل «تم إنشاء الطلب»، أما هنا فكل أحداث العميل الواحد في Partition واحد يقرؤه مستهلك واحد بالترتيب. لكن لاحظ حدود هذا الضمان: الترتيب داخل ال Partition فقط، فلا تعرف هل حدث العميل 1 جاء قبل حدث العميل 2 أم بعده، وإذا غيرت عدد ال Partitions لاحقاً فقد يذهب المفتاح نفسه إلى Partition آخر، لذلك اختر عدد ال Partitions بتفكير من البداية، واختر المفتاح الذي يجمع الأحداث التي يهمك ترتيبها، وتجنب مفتاحاً يجمع أغلب الأحداث في Partition واحد، مثل اسم المدينة إذا كان أغلب عملائك في مدينة واحدة.
مجموعات المستهلكين Consumer Groups
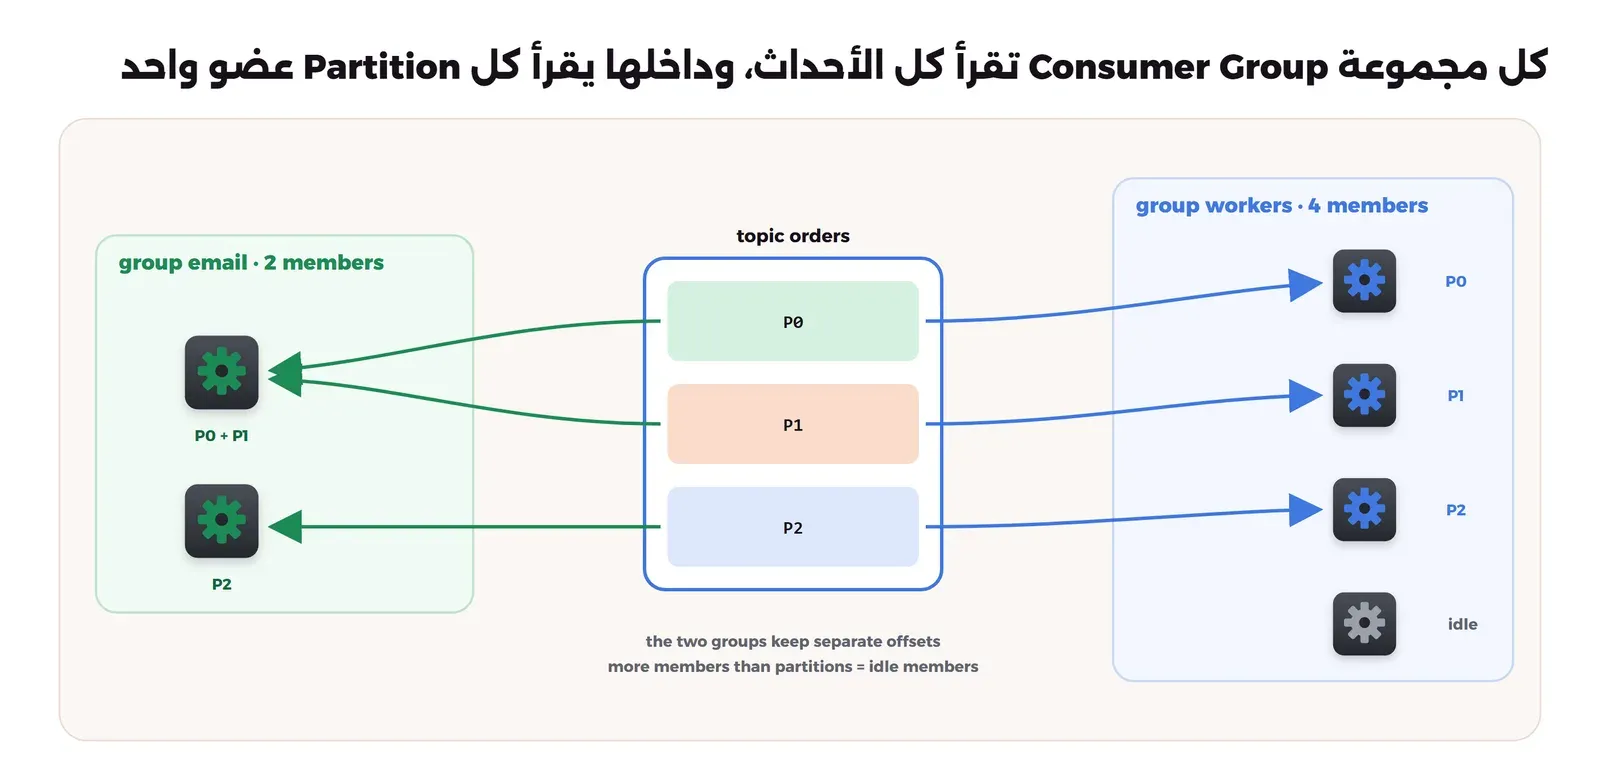
في الطابور يتقاسم ال Workers الرسائل، فكيف يتقاسمون العمل في السجل؟ بمجموعة المستهلكين Consumer Group، وهي اسم يشترك فيه عدة مستهلكين، والقاعدة كما تقولها صفحة التصميم: كل Partition يقرؤه مستهلك واحد فقط داخل كل مجموعة مشتركة في أي لحظة. وينتج عن هذه القاعدة ثلاثة أشياء:
- كل مجموعة تقرأ كل الأحداث مستقلة عن غيرها، فمجموعة
emailومجموعةanalyticsتقرآن الموضوع نفسه ولكل منهما ال Offset الخاص بها، وهذا هو النشر والاشتراك دون أن تنشئ طابوراً لكل مشترك. - داخل المجموعة الواحدة يتوزع العمل بال Partitions، فإذا كان للموضوع ثلاثة Partitions ولمجموعة
emailعضوان أخذ أحدهما اثنين من ال Partitions والآخر Partition واحداً. - عدد ال Partitions هو الحد الأعلى للتوازي داخل المجموعة، فالعضو الرابع في موضوع له ثلاثة Partitions لا يجد Partition يقرؤه ويبقى متوقفاً، وهذا ما سوف نراه في التجربة.
والصورة التالية تبين ذلك:
مدة الحفظ Retention
السجل لا يكبر إلى الأبد، فلكل موضوع مدة حفظ، وبعدها يحذف الوسيط الأجزاء القديمة من السجل سواء قرئت أم لا، والقيمة الافتراضية في Kafka هي 168 ساعة، أي سبعة أيام، كما في الإعداد log.retention.hours في إعدادات الوسيط، وتستطيع أن تغيرها لكل موضوع بالإعداد retention.ms، أو تحدد حجماً أعلى بدل المدة. ولاحظ الفرق في التفكير هنا: في الطابور الرسالة تبقى حتى يقرأها أحد ولو بقيت شهراً، أما في السجل فالحدث يبقى المدة المحددة ولو لم يقرأه أحد، فإذا توقف مستهلك أكثر من مدة الحفظ فقد فاتته أحداث لن يستطيع قراءتها أبداً، لذلك راقب تأخر كل مجموعة Consumer Lag كما تراقب طول الطابور.
إعادة القراءة Replay
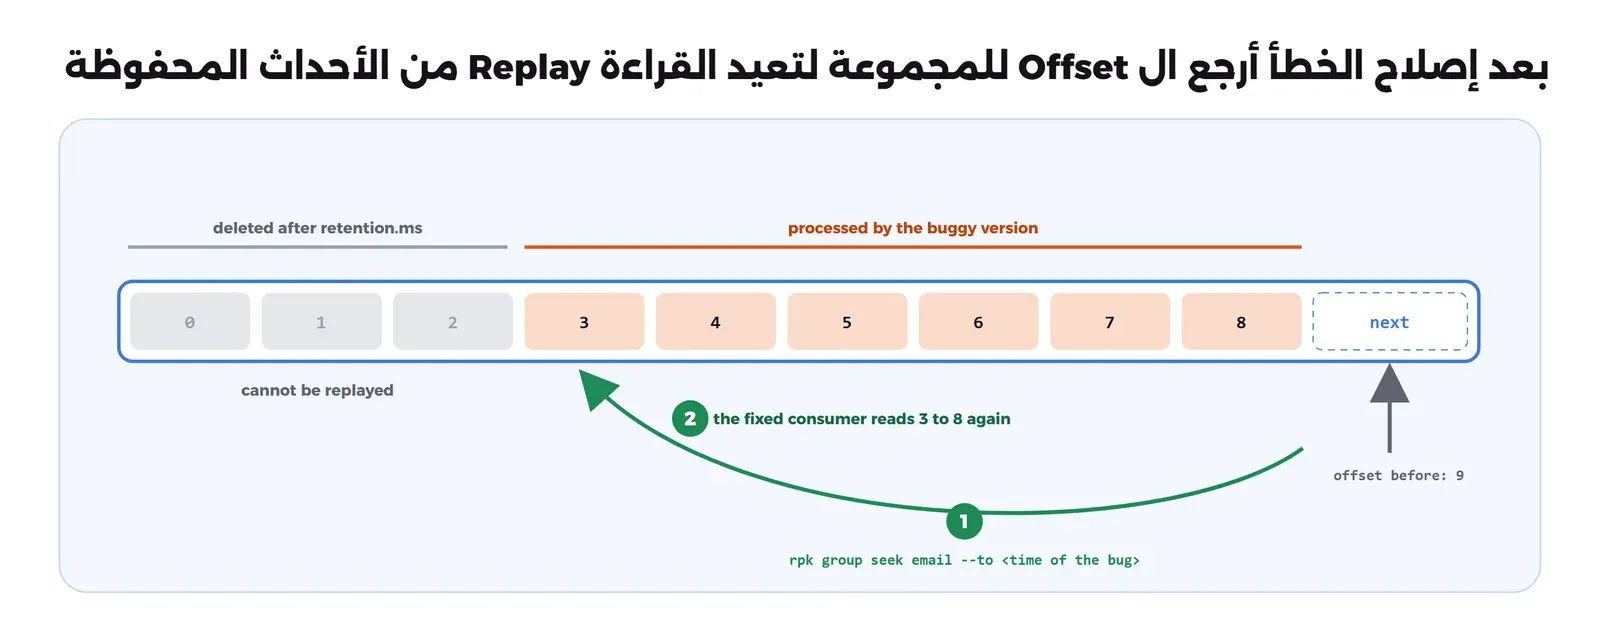
لأن الأحداث باقية وال Offset مجرد رقم، فإعادة القراءة هي تغيير هذا الرقم، وهي الميزة التي تجعل السجل مختلفاً فعلاً، وتستخدم في ثلاث حالات شائعة:
- إصلاح خطأ: خدمة المخزون عالجت الأحداث خطأً منذ يومين، فتصلح الكود ثم ترجع ال Offset الخاص بمجموعتها إلى وقت ظهور الخطأ وتتركها تعيد المعالجة، ولهذا يجب أن يكون المستهلك آمناً عند التكرار، كما شرحنا في المقال السابق.
- مستهلك جديد: نظام تحليلات جديد يبدأ من أول السجل ويبني بياناته من الأحداث المحفوظة، دون أن تطلب من الخدمات الأخرى إعادة إرسال أي شيء.
- بيئة اختبار: تشغل نسخة جديدة من الخدمة بمجموعة باسم جديد على الأحداث الحقيقية، وتقارن نتائجها بالنسخة الحالية قبل أن تنقل إليها العمل.
ما الذي يعطيه الطابور ولا يعطيه السجل؟
قد يبدو من الوهلة الأولى أن السجل يفعل كل ما يفعله الطابور وأكثر، لكن في الواقع فالطابور أنسب في أشياء كثيرة، والسبب أن السجل يتابع Offset واحداً لكل Partition ولا يتابع كل رسالة وحدها:
- التأكيد لكل رسالة: في الطابور إذا فشلت الرسالة 7 ونجحت 8 و9 أعيدت 7 وحدها، أما في مجموعة المستهلكين فال Offset رقم واحد، فإذا حفظت ال Offset 10 فقد قلت إن كل ما قبله انتهى، ولا يوجد مكان طبيعي لتقول «كل شيء انتهى إلا الرسالة 7». لذلك تبني إعادة المحاولة وال Dead Letter Queue في السجل بنفسك، بأن تكتب الحدث الفاشل في موضوع آخر للمحاولة لاحقاً.
- الرسالة البطيئة توقف ال Partition الخاص بها: المستهلك يقرأ ال Partition بالترتيب، فإذا علقت رسالة واحدة تأخرت كل الرسائل خلفها في ال Partition نفسه، بينما في الطابور يأخذ ال Worker التالي الرسالة التالية.
- التوازي بعدد ال Workers: في الطابور تضيف Worker جديداً متى شئت، وفي السجل لا تزيد على عدد ال Partitions، وزيادة ال Partitions لاحقاً تغير توزيع المفاتيح.
- التوجيه المرن Routing: RabbitMQ يوجه الرسائل بالموزعات Exchanges ومفاتيح التوجيه والأولويات Priorities وانتهاء الصلاحية TTL لكل رسالة، وهذه أشياء لا يقدمها السجل بالشكل نفسه.
- بساطة التشغيل لحمل صغير: وسيط طوابير واحد لمهام تطبيق واحد أسهل في الفهم والمراقبة من عنقود سجل أحداث ب Partitions ومجموعات.
الأداتان تقتربان من بعضهما
يجدر الإشارة هنا إلى أن الحد بين النوعين لم يعد حاداً كما كان، فكل أداة أضافت شكل الأخرى:
- RabbitMQ أضاف نوعاً اسمه Streams، ويصفه توثيق Streams بأنه سجل يضاف إليه فقط Append-Only Log يمكن أن تقرأ رسائله مرات كثيرة حتى تنتهي صلاحيتها، وأن القراءة فيه لا تحذف الرسالة Non-Destructive، وأنه يسمح بإعادة القراءة من أي نقطة.
- Kafka أضافت مجموعات المشاركة Share Groups ضمن المقترح KIP-932 الذي سمته Queues for Kafka، وفيها يتقاسم عدة مستهلكين ال Partition نفسه، ويمكن أن يزيد عددهم على عدد ال Partitions، وتؤكد كل رسالة وحدها، ويعد عدد محاولات تسليمها، كما تشرح صفحة التصميم، وبحسب إعلان Kafka 4.2 في فبراير 2026 أصبحت هذه الميزة جاهزة للإنتاج Production-Ready.
ومع ذلك يبقى السؤال الأول هو نفسه: هل تريد أن توصل عملاً إلى من ينفذه ثم تنساه، أم تريد سجلاً دائماً للأحداث يقرؤه أكثر من نظام بسرعته ويعود إليه وقت الحاجة؟ والأدوات التي أضافت الشكل الآخر تعطيك مرونة، لكنها لا تغير طبيعة الأداة الأساسية ولا طريقة تشغيلها.
تجربة عملية: الطابور والسجل جنباً إلى جنب
الآن سوف نشغل RabbitMQ 4.3.6 وRedpanda 26.2.4 في Docker، ونقرأ الرسائل نفسها من الاثنين بقارئين، ثم نجرب ال Partitions والمجموعات وإعادة القراءة في Redpanda. واخترنا Redpanda هنا لأنه يعمل بـ Container واحد خفيف ومعه أداة سطر الأوامر rpk، وهو متوافق مع واجهة Kafka API كما يذكر دليل البداية الرسمي، فكل ما تراه من Offsets وPartitions ومجموعات هو المفهوم نفسه في Kafka. ولاحظ أن رخصة Redpanda ليست رخصة مفتوحة المصدر، وإنما Business Source License 1.1 التي تسمح باستخدامه في عملك ما دمت لا تقدمه خدمة بث أو طوابير تجارية للآخرين، وتتحول كل نسخة إلى رخصة Apache 2.0 بعد أربع سنوات من إصدارها، فإذا كانت الرخصة المفتوحة شرطاً عندك فاستخدم Apache Kafka نفسها.
ملفات التجربة
أنشئ مجلداً فيه ثلاثة ملفات، أولها docker-compose.yml:
name: lab-queue-stream

services:
  rabbit:
    image: rabbitmq:4.3.6-alpine
    container_name: lab-queue-stream-rabbit
    hostname: rabbit
    environment:
      RABBITMQ_DEFAULT_USER: lab
      RABBITMQ_DEFAULT_PASS: lab-pass-2026
    healthcheck:
      test: ["CMD", "rabbitmq-diagnostics", "-q", "check_port_connectivity"]
      interval: 5s
      retries: 30

  redpanda:
    image: redpandadata/redpanda:v26.2.4
    container_name: lab-queue-stream-redpanda
    command: ["redpanda", "start", "--mode", "dev-container", "--smp", "1", "--memory", "1G"]
    healthcheck:
      test: ["CMD", "rpk", "cluster", "health", "--exit-when-healthy"]
      interval: 5s
      retries: 30

  tools:
    build: .
    image: lab-queue-stream-tools:1
    environment:
      AMQP_URL: amqp://lab:lab-pass-2026@rabbit:5672/%2F
    depends_on:
      rabbit:
        condition: service_healthy
    profiles: ["tools"]
ثم Dockerfile لأداة Python التي تتكلم مع RabbitMQ:
FROM python:3.13-slim
RUN pip install --no-cache-dir pika==1.4.4
WORKDIR /app
COPY queue_demo.py ./
ENV PYTHONUNBUFFERED=1
ثم queue_demo.py الذي ينشر ثلاث رسائل في طابور، ثم يقرؤها قارئ أول، ثم يحاول قارئ ثان أن يقرأها:
import json, os, pika

conn = pika.BlockingConnection(pika.URLParameters(os.environ["AMQP_URL"]))
ch = conn.channel()
ch.confirm_delivery()     # wait until the broker has each message
ch.queue_declare(queue="orders", durable=True, arguments={"x-queue-type": "quorum"})
for i in (1, 2, 3):
    ch.basic_publish(exchange="", routing_key="orders", body=json.dumps({"order_id": i}))
print("published 3 messages, queue depth:", ch.queue_declare(queue="orders", passive=True).method.message_count)

def read_all(who):
    while True:
        method, _, body = ch.basic_get(queue="orders")
        if method is None:
            print(f"[{who}] queue is empty")
            return
        print(f"[{who}] got {body.decode()}")
        ch.basic_ack(method.delivery_tag)

read_all("email")        # the first reader takes everything
read_all("analytics")    # a second, later reader finds nothing left
conn.close()
في الإعداد أعلاه لاحظ التالي:
- Redpanda يعمل بالوضع
dev-container، وهو الوضع الذي يستخدمه دليل البداية الرسمي للتجربة في Containers، ومعه نواة معالج واحدة--smp 1وذاكرة 1 GB، وهذا الوضع للتجربة والتطوير فقط وليس للإنتاج. - لا يوجد أي منفذ منشور على الجهاز، فكل أوامر Redpanda ننفذها بأداة rpk من داخل ال Container نفسه، وأوامر RabbitMQ من Container الأداة داخل شبكة Compose.
- فحص الصحة في Redpanda هو
rpk cluster health --exit-when-healthy، فلا يعتبر Compose الوسيط جاهزاً قبل أن يكون العنقود سليماً فعلاً.
الطابور: القارئ الثاني لا يجد شيئاً
docker compose --profile tools build
docker compose up -d --wait rabbit redpanda
docker compose run --rm tools python queue_demo.py
والمخرج سوف يكون كما يلي:
published 3 messages, queue depth: 3
[email] got {"order_id": 1}
[email] got {"order_id": 2}
[email] got {"order_id": 3}
[email] queue is empty
[analytics] queue is empty
لاحظ أن القارئ الأول أخذ الرسائل الثلاث وأكدها، فحذفها الوسيط، والقارئ الثاني وجد الطابور فارغاً، وهذا هو السلوك الصحيح للطابور وليس خطأ، فلو أردت أن يأخذ القارئان نسخة لكان عليك أن تنشئ طابوراً لكل واحد وتربطهما بموزع Fanout قبل النشر، ولن يحصل أي طابور جديد تنشئه بعد ذلك على الرسائل التي نشرت قبله.
السجل: موضوع بثلاثة Partitions وأحداث بمفاتيح
ننشئ موضوعاً اسمه orders بثلاثة Partitions ومدة حفظ سبعة أيام بالمللي ثانية، ثم ننشر تسعة أحداث لثلاثة عملاء، والكلمة الأولى في كل سطر هي المفتاح:
R="docker exec -i lab-queue-stream-redpanda"
$R rpk topic create orders -p 3 -c retention.ms=604800000
printf 'customer-1 OrderPlaced order=1\ncustomer-2 OrderPlaced order=2\ncustomer-1 OrderPaid order=1\ncustomer-3 OrderPlaced order=3\ncustomer-2 OrderPaid order=2\ncustomer-1 OrderShipped order=1\ncustomer-3 OrderPaid order=3\ncustomer-2 OrderShipped order=2\ncustomer-3 OrderShipped order=3\n' \
  | $R rpk topic produce orders -f '%k %v\n'
والمخرج سوف يكون كما يلي:
TOPIC   STATUS
orders  OK
Produced to partition 0 at offset 0 with timestamp 1791395416883.
Produced to partition 0 at offset 1 with timestamp 1791395416883.
Produced to partition 0 at offset 2 with timestamp 1791395416883.
Produced to partition 1 at offset 0 with timestamp 1791395416883.
Produced to partition 1 at offset 1 with timestamp 1791395416883.
Produced to partition 1 at offset 2 with timestamp 1791395416883.
Produced to partition 2 at offset 0 with timestamp 1791395416883.
Produced to partition 2 at offset 1 with timestamp 1791395416883.
Produced to partition 2 at offset 2 with timestamp 1791395416883.
لاحظ أن كل Partition بدأ أرقام ال Offset فيه من الصفر، فلا يوجد Offset عام للموضوع كله، وإنما الحدث يعرف بال Partition وال Offset معاً، مثل «Partition 1 وOffset 2».
القراءة بمجموعة email ثم الأحداث الجديدة فقط
$R rpk topic consume orders -g email -n 9 -f '%p/%o %k %v\n'
$R rpk group describe email
والمخرج سوف يكون كما يلي:
0/0 customer-1 OrderPlaced order=1
0/1 customer-1 OrderPaid order=1
0/2 customer-1 OrderShipped order=1
1/0 customer-3 OrderPlaced order=3
1/1 customer-3 OrderPaid order=3
1/2 customer-3 OrderShipped order=3
2/0 customer-2 OrderPlaced order=2
2/1 customer-2 OrderPaid order=2
2/2 customer-2 OrderShipped order=2
GROUP                  email
COORDINATOR-NODE       0
COORDINATOR-PARTITION  __consumer_offsets/2
STATE                  Empty
BALANCER
MEMBERS                0
TOTAL-LAG              0

TOPIC   PARTITION  CURRENT-OFFSET  LOG-START-OFFSET  LOG-END-OFFSET  LAG   MEMBER-ID  CLIENT-ID  HOST
orders  0          3               0                 3               0
orders  1          3               0                 3               0
orders  2          3               0                 3               0
في المخرج أعلاه لاحظ التالي:
- أحداث كل عميل في Partition واحد وبترتيب إرسالها: العميل 1 في ال Partition 0، والعميل 3 في ال Partition 1، والعميل 2 في ال Partition 2، وهذا التوزيع هو ما رسمناه في صورة ال Partitions.
- المجموعة
emailحفظت ال Offset الخاص بها في كل Partition:CURRENT-OFFSETيساوي 3، أي أن الحدث التالي الذي ستقرؤه هو ال Offset 3، والتأخرLAGصفر، أي أنها قرأت كل شيء. LOG-START-OFFSETصفر، أي أن الأحداث كلها ما زالت في السجل بعد قراءتها، وهذا عكس ما رأيناه في الطابور قبل قليل.
الآن ننشر حدثين جديدين، ثم نقرأ بالمجموعة نفسها، ثم نقرأ بمجموعة جديدة اسمها analytics لم تقرأ شيئاً من قبل:
printf 'customer-4 OrderPlaced order=4\ncustomer-1 OrderPlaced order=5\n' | $R rpk topic produce orders -f '%k %v\n'
$R rpk topic consume orders -g email -n 2 -f '%p/%o %k %v\n'
$R rpk topic consume orders -g analytics -n 11 -f '%p/%o %k %v\n'
والمخرج سوف يكون كما يلي:
Produced to partition 0 at offset 3 with timestamp 1791395457473.
Produced to partition 1 at offset 3 with timestamp 1791395457473.
0/3 customer-1 OrderPlaced order=5
1/3 customer-4 OrderPlaced order=4
0/0 customer-1 OrderPlaced order=1
0/1 customer-1 OrderPaid order=1
0/2 customer-1 OrderShipped order=1
0/3 customer-1 OrderPlaced order=5
1/0 customer-3 OrderPlaced order=3
1/1 customer-3 OrderPaid order=3
1/2 customer-3 OrderShipped order=3
1/3 customer-4 OrderPlaced order=4
2/0 customer-2 OrderPlaced order=2
2/1 customer-2 OrderPaid order=2
2/2 customer-2 OrderShipped order=2
لاحظ أن المجموعة email أكملت من حيث توقفت فقرأت الحدثين الجديدين فقط، أما المجموعة الجديدة analytics فقرأت الأحداث الأحد عشر كلها من البداية، مع أنها لم تكن موجودة عندما نشرت، وهذا ما لم يستطع القارئ الثاني فعله في الطابور. ولاحظ أيضاً أن الحدث الجديد للعميل 1 ذهب إلى ال Partition 0 نفسه الذي فيه أحداثه السابقة، أما العميل 4 الجديد فذهب إلى ال Partition 1.
إعادة القراءة: نرجع ال Offset الخاص بالمجموعة إلى البداية
لنفرض أن خدمة البريد كان فيها خطأ، وأصلحناه ونريد أن تعيد معالجة كل الأحداث، فنرجع ال Offset الخاص بمجموعتها إلى البداية بالأمر rpk group seek الذي يشرحه توثيق rpk group seek، ويقبل أيضاً وقتاً محدداً بدل البداية:
$R rpk group seek email --to start
$R rpk group describe email | tail -4
والمخرج سوف يكون كما يلي:
TOPIC   PARTITION  PRIOR-OFFSET  CURRENT-OFFSET
orders  0          4             0
orders  1          4             0
orders  2          3             0
TOPIC   PARTITION  CURRENT-OFFSET  LOG-START-OFFSET  LOG-END-OFFSET  LAG   MEMBER-ID  CLIENT-ID  HOST
orders  0          0               0                 4               4
orders  1          0               0                 4               4
orders  2          0               0                 3               3
لاحظ أن المجموعة رجعت إلى ال Offset 0 في كل Partition، وأصبح تأخرها 11 حدثاً، فإذا شغلنا مستهلكها الآن سوف يقرأ كل الأحداث من جديد. ولاحظ أن هذا لم يغير شيئاً في المجموعة analytics، فكل مجموعة تحفظ ال Offset الخاص بها وحدها.
أربعة مستهلكين على ثلاثة Partitions
نشغل أربعة مستهلكين في الخلفية بمجموعة واحدة اسمها workers، ثم ننظر كيف وزعت ال Partitions بينهم:
for i in 1 2 3 4; do
  docker exec -d lab-queue-stream-redpanda rpk topic consume orders -g workers -f '%p/%o %v\n'
done
sleep 15
$R rpk group describe workers
والمخرج سوف يكون كما يلي:
GROUP                  workers
COORDINATOR-NODE       0
COORDINATOR-PARTITION  __consumer_offsets/2
STATE                  Stable
BALANCER               cooperative-sticky
MEMBERS                4
TOTAL-LAG              0

TOPIC   PARTITION  CURRENT-OFFSET  LOG-START-OFFSET  LOG-END-OFFSET  LAG   MEMBER-ID                                 CLIENT-ID  HOST
orders  0          4               0                 4               0     rpk-e7fa3a65-122d-4fa5-b9ad-1880a3c38d5a  rpk        127.0.0.1
orders  1          4               0                 4               0     rpk-665c1a48-6180-4010-ae77-82ab58c1531c  rpk        127.0.0.1
orders  2          3               0                 3               0     rpk-d03c22ff-b967-45b5-8d50-945addc4f893  rpk        127.0.0.1
لاحظ أن المجموعة فيها أربعة أعضاء MEMBERS 4، لكن الجدول فيه ثلاثة أعضاء فقط لأن الموضوع فيه ثلاثة Partitions، والعضو الرابع لم يأخذ أي Partition ولن يقرأ شيئاً حتى يتوقف أحد الثلاثة، وهذا هو الفرق العملي عن الطابور: في الطابور كان ال Worker الرابع سيأخذ نصيبه من الرسائل فوراً.
نكسر الخطوة: إرجاع ال Offset لمجموعة تعمل
خطأ يقع فيه كثيرون: يحاول المطور إعادة القراءة والمستهلكون ما زالوا يعملون:
$R rpk group seek workers --to startوعند تشغيل الأمر سوف تجد أنه يرفض في كل Partition:
TOPIC   PARTITION  PRIOR-OFFSET  CURRENT-OFFSET  ERROR
orders  0          4             0               INVALID_OPERATION: seeking a non-empty group is not allowed.
orders  1          4             0               INVALID_OPERATION: seeking a non-empty group is not allowed.
orders  2          3             0               INVALID_OPERATION: seeking a non-empty group is not allowed.
والسبب أن المستهلكين النشطين يحفظون ال Offset باستمرار، فلو غير rpk ال Offset وهم يعملون لكتبوا فوقه بعد لحظات، لذلك يجب أن توقف كل أعضاء المجموعة أولاً حتى تصبح حالتها Empty كما رأينا مع المجموعة email، ثم ترجع ال Offset، ثم تشغلهم من جديد.
متى تختار الطابور ومتى تختار السجل؟
الجدول التالي يلخص ما سبق في قرار عملي:
| السؤال | طابور الرسائل Message Queue | سجل الأحداث Event Log |
|---|---|---|
| ماذا يحدث للرسالة بعد قراءتها؟ | تحذف بعد التأكيد | تبقى حتى تنتهي مدة الحفظ |
| قارئ جديد يريد الرسائل القديمة | غير ممكن | يقرأ من البداية أو من وقت محدد |
| إعادة معالجة بعد إصلاح خطأ | غير ممكنة دون نسخة خارجية | بإرجاع ال Offset الخاص بالمجموعة |
| الترتيب | لا يصل إلى المعالجة كما هو مع عدة Workers | مضمون داخل ال Partition لكل مفتاح |
| فشل رسالة واحدة | تعاد وحدها، مع حد محاولات و Dead Letter Queue | تبنيه بنفسك، والرسالة البطيئة توقف ال Partition الخاص بها |
| زيادة التوازي | أضف Workers متى شئت | حتى عدد ال Partitions فقط |
| الاستخدام الأنسب | مهام Jobs: بريد، فواتير، تصغير صور، استدعاء خدمات | أحداث يقرؤها أكثر من نظام، تحليلات، نقل تغييرات قواعد البيانات، سجلات بأحجام كبيرة |
| أدوات مفتوحة المصدر | RabbitMQ، وNATS، وطوابير فوق Valkey، وجدول في PostgreSQL | Apache Kafka، وRedpanda برخصة BSL، وRabbitMQ Streams |
والقاعدة العملية: ابدأ بالطابور للمهام، فأغلب التطبيقات تحتاج إرسال بريد وإنشاء ملفات قبل أن تحتاج سجلاً، وإذا كان عندك PostgreSQL فقد يكفيك طابور فوق جدول في البداية، وانتقل إلى سجل الأحداث عندما يظهر سؤال لا يجيب عنه الطابور: أكثر من نظام يريد الأحداث نفسها، أو تحتاج إعادة المعالجة، أو الترتيب لكل كيان، أو أحجام بمئات الآلاف في الثانية. ولا تختر Kafka لأن الشركات الكبيرة تستخدمها، والسبب أن تشغيل عنقود سجل أحداث في الإنتاج بنسخ متماثلة ومراقبة للتأخر عمل حقيقي يحتاج وقتاً، وقد يكون أكبر من المشكلة التي تحلها. وكثير من الأنظمة تستخدم الاثنين معاً: سجل للأحداث بين الخدمات، وطابور للمهام داخل كل خدمة.
أخطاء شائعة
- استخدام السجل كطابور مهام: مهام تأخذ دقائق في موضوع بثلاثة Partitions تعني ثلاثة Workers فقط، ومهمة واحدة عالقة توقف ال Partition الخاص بها كله. المهام مكانها الطابور، أو مجموعات المشاركة إذا كنت على Kafka 4.2 وما بعدها.
- مفتاح سيئ: مفتاح فارغ يوزع الأحداث دون ترتيب لكل كيان، ومفتاح يجمع أغلب الأحداث مثل اسم دولة واحدة يجعل Partition واحداً يعمل وحده والباقي ينتظر.
- نسيان مدة الحفظ: مستهلك توقف عشرة أيام على موضوع مدته سبعة أيام فقد ثلاثة أيام من الأحداث، وراقب تأخر كل مجموعة وأرسل تنبيهاً قبل أن يقترب من المدة.
- إعادة القراءة دون أمان عند التكرار: إرجاع ال Offset يعني أن كل حدث سوف يعالج مرة ثانية، فإذا كان المستهلك يرسل بريداً لكل حدث فسوف يصل العملاء البريد مرة ثانية.
- تغيير عدد ال Partitions دون تخطيط: زيادة ال Partitions تغير ال Partition الذي تذهب إليه بعض المفاتيح، فتختلط أحداث الكيان الواحد القديمة والجديدة بين اثنين من ال Partitions.
حذف المختبر
الأوامر التالية تحذف ال Containers والشبكة، ثم ال Image التي بنيناها:
docker compose --profile tools down -v
docker image rm lab-queue-stream-tools:1
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الفرق الجوهري هو ماذا يحدث للرسالة بعد قراءتها: الطابور يحذفها بعد التأكيد، والسجل يحتفظ بها مدة الحفظ ولكل قارئ ال Offset الخاص به.
- في السجل يحدد المفتاح Key ال Partition، والترتيب مضمون داخل ال Partition فقط، وعدد ال Partitions هو حد التوازي داخل مجموعة المستهلكين.
- كل مجموعة مستهلكين Consumer Group تقرأ كل الأحداث مستقلة عن غيرها، والمجموعة الجديدة تستطيع أن تبدأ من أول السجل، وتجربتنا أظهرت ذلك بينما القارئ الثاني في الطابور لم يجد شيئاً.
- إعادة القراءة Replay هي إرجاع رقم ال Offset بعد إيقاف المجموعة، وهي ممكنة فقط للأحداث التي لم تتجاوز مدة الحفظ.
- الطابور يتفوق في التأكيد لكل رسالة وإعادة المحاولة وال Dead Letter Queue والتوازي بعدد ال Workers، والسجل يتفوق في تعدد القراء وإعادة المعالجة والترتيب لكل كيان.
- الأداتان تقتربان: RabbitMQ Streams سجل داخل RabbitMQ، ومجموعات المشاركة في Kafka 4.2 طابور داخل Kafka، لكن اختر بحسب طبيعة عملك أولاً.
وفي المقالات القادمة من المرحلة بإذن الله سوف نشرح تثبيت RabbitMQ وKafka وRedpanda للإنتاج، ونقارن بينها وبين NATS.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلأنماط المعمارية Architecture Styles ومتى تختار كلاً منهاكيف تختار بين التطبيق الواحد والخدمات التي تتبادل الأحداث، وما الذي يناسب نظامك من أشهر أنماط المعمارية.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة RabbitMQ 4.3.6 مع Python 3.13 ومكتبة pika 1.4.4، وRedpanda 26.2.4 مع rpk في Docker.