

في مقال تقسيم الشبكة Network Segmentation قسمنا شبكة مكتب واحد إلى مناطق لا يمر بينها إلا ما يسمح به الجدار الناري Firewall، وفي مقال ما هو VPN؟ ربطنا موقعين بنفق Site-to-Site. فماذا يحدث عندما يصبح لديك مقر رئيسي وثلاثة فروع وشبكتان في السحابة، وكل منها يحتاج أن يصل إلى بعض الآخرين؟ الطريقة البسيطة أن تفتح نفقاً من كل موقع إلى كل موقع، وهي تعمل مع موقعين أو ثلاثة ثم تتحول إلى شبكة من الأنفاق لا يعرف أحد ما يمر فيها، والحل الذي تستخدمه أغلب الشركات ومزودي السحابة هو معمارية المحور والأطراف Hub and Spoke. وفي هذا المقال سوف نتناول:
- المشكلة: لماذا يتضاعف عدد الروابط في الربط الكامل Full Mesh، بالحساب.
- ما هو المحور Hub، وماذا يوضع فيه: الجدار الناري والفحص، وDNS، والهوية، والسجلات، والخروج إلى الإنترنت، وإنهاء أنفاق VPN، وال Bastion.
- ثمن المحور: نقطة الفشل الواحدة وحلها بمحورين، وزمن الاستجابة الإضافي، وتكلفة الحركة في السحابة.
- الحركة بين الأطراف Spoke-to-Spoke: عبر المحور أم مباشرة؟
- الأشكال الأخرى: الربط الجزئي Partial Mesh، وSD-WAN، وشبكات Mesh مثل Tailscale وHeadscale وNetBird.
- نفس الفكرة في Azure وAWS وGoogle Cloud، وما علاقتها بالضوابط الأساسية NCA ECC.
- تجربة عملية في Docker: محور WireGuard بقواعد nftables وثلاثة أطراف، ومخرجات حقيقية لما يمر وما يمنع، وماذا يحدث عندما يتوقف المحور.
المشكلة: كل موقع يريد أن يصل إلى كل موقع
لنفرض أن لديك ستة مواقع: المقر الرئيسي HQ، ومركز البيانات، وثلاثة فروع، وشبكة VPC في السحابة. إذا أردت أن يصل كل موقع إلى كل موقع آخر مباشرة فكل زوج من المواقع يحتاج نفقاً خاصاً به، وهذا ما يسمى الربط الكامل Full Mesh، وعدد الأنفاق فيه يحسب كما يلي: كل موقع من المواقع n يحتاج نفقاً إلى المواقع الباقية n-1، وكل نفق يحسب مرتين لأن له طرفين، فيكون العدد n(n-1)/2، ومع ستة مواقع يكون 6 × 5 / 2 = 15 نفقاً. والصورة التالية تبين الفرق بين الشكلين:
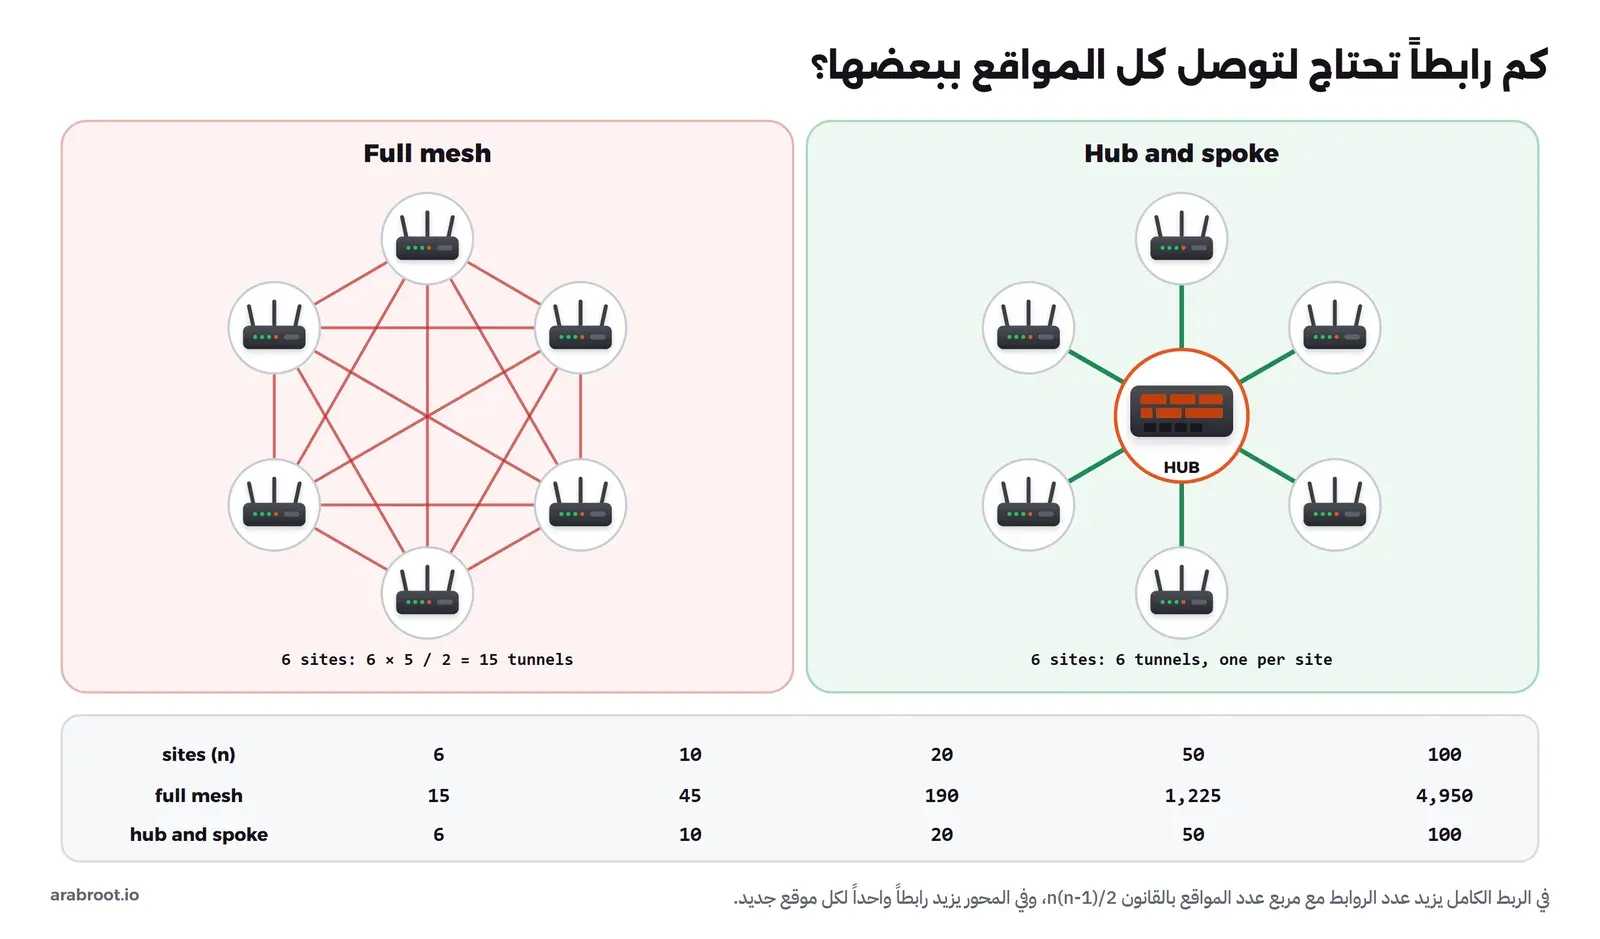
وقد يتساءل البعض: وما المشكلة في 15 نفقاً؟ والإجابة أن النفق ليس سطراً واحداً، فكل نفق يعني زوج مفاتيح على طرفين، ومساراً في كل طرف، وقواعد جدار ناري في كل طرف، ومراقبة لحالته، وعندما تضيف الموقع السابع فأنت تفتح ستة أنفاق جديدة وتعدل إعداد ستة مواقع قائمة، ومع 50 موقعاً يصبح العدد 1,225 نفقاً. والمشكلة الأكبر من العدد أن السياسة نفسها تتوزع: كل موقع يقرر وحده ما يقبله من كل موقع آخر، فلا يوجد مكان واحد تسأل فيه «هل يستطيع الفرع الثاني أن يصل إلى قاعدة بيانات المقر؟»، وإذا اخترق أحد الفروع فقد يكون له طريق مباشر إلى كل المواقع.
لذلك يجمع التصميم الشائع كل المواقع حول موقع مركزي واحد: كل موقع يفتح نفقاً واحداً فقط إلى المركز، فيكون عدد الأنفاق مساوياً لعدد المواقع، وإضافة الموقع الجديد تعني نفقاً واحداً وتعديلاً في المحور فقط، والسياسة كلها مكتوبة في مكان واحد.
ما هي معمارية المحور والأطراف Hub and Spoke؟
معمارية Hub and Spoke، وتسمى أيضاً طوبولوجيا النجمة Star Topology، هي تصميم شبكي تتصل فيه كل الشبكات الطرفية Spokes بشبكة مركزية واحدة تسمى المحور Hub، ولا تتصل الأطراف ببعضها مباشرة، فإذا أراد طرف أن يصل إلى طرف آخر مرت الحركة على المحور. والتشبيه الأقرب هو شركات الطيران: بدل أن تسير طائرة مباشرة بين كل مدينتين، تجمع الشركة رحلاتها في مطار محوري واحد، فيكون عدد الخطوط أقل بكثير، والثمن طريق أطول قليلاً لمن يسافر بين مدينتين طرفيتين.
وال Spoke في الشبكات قد يكون فرعاً متصلاً بنفق VPN، أو شبكة VPC في AWS، أو VNet في Azure، أو حتى بيئة الاختبار Staging في نفس السحابة، وال Hub قد يكون جدار ناري في مركز البيانات، أو شبكة VNet مركزية، أو خدمة مدارة مثل AWS Transit Gateway كما سيأتي. وتصف المعمارية المرجعية في Azure هذا التصميم بأنه الطوبولوجيا التي يوصي بها إطار Cloud Adoption Framework، وأن ال Hub هو نقطة الاتصال المركزية بالشبكات الخارجية، ونقطة الخروج الأساسية، والطريق الذي يمر به الطرف إلى طرف آخر عند الحاجة.
ماذا يوجد داخل المحور؟
الفكرة الأساسية أن كل ما يحتاجه أكثر من موقع يوضع مرة واحدة في المحور بدل أن يتكرر في كل موقع، والصورة التالية تبين أشهر ما يوضع فيه:
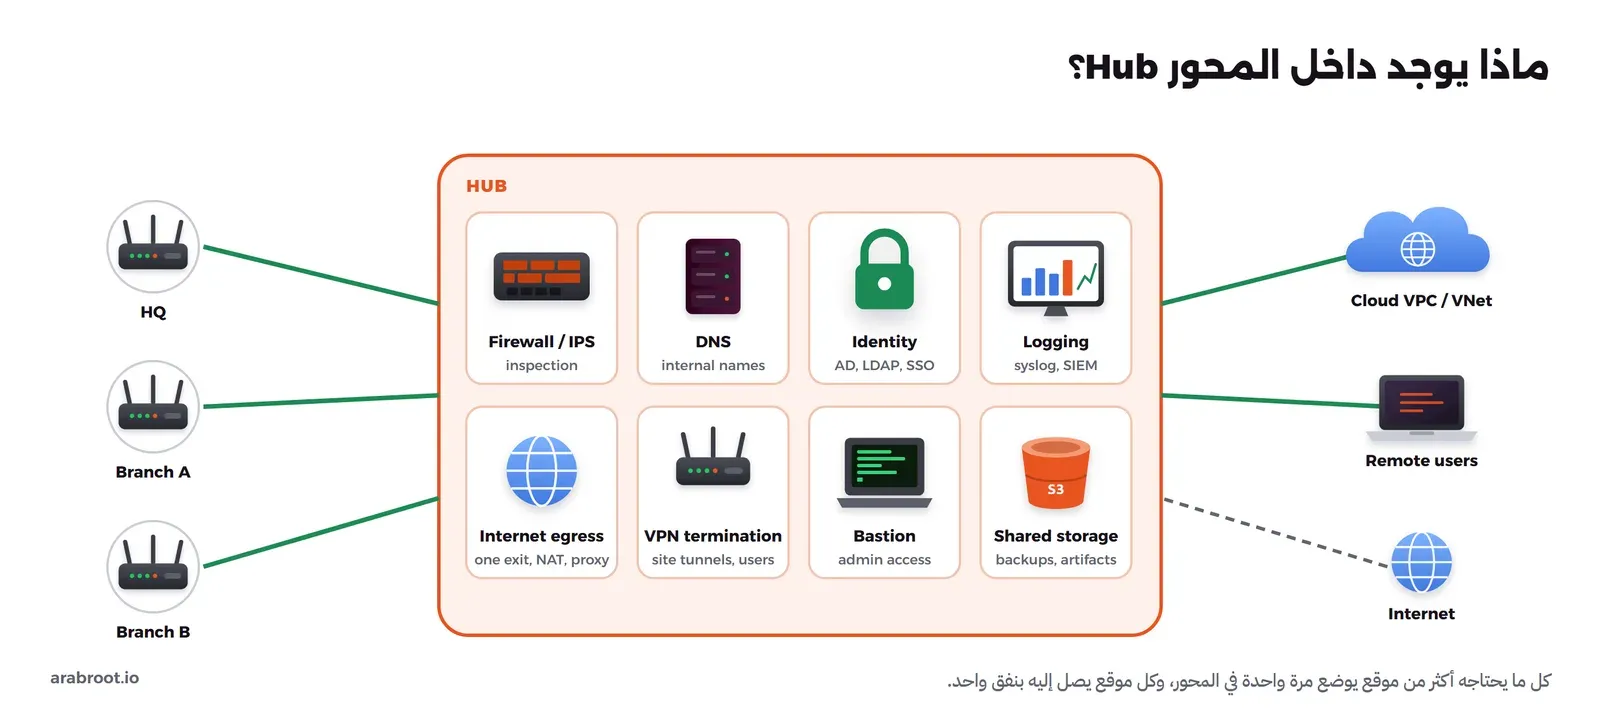
- الجدار الناري والفحص Firewall / IPS: كل حركة بين طرفين أو من طرف إلى الإنترنت تمر هنا، فتكتب السياسة مرة واحدة، وتسجل الحركة المرفوضة في مكان واحد، وتشغل نظام منع الاختراق IPS على جهاز واحد بدل عشرة. وهذا هو جدول التدفقات الذي بنيناه في تقسيم الشبكة، لكن بين المواقع هذه المرة وليس بين شبكات VLAN.
- خدمة الأسماء DNS: سيرفر DNS داخلي واحد يعرف أسماء كل المواقع، مثل
erp.hq.corp.internal، وتشير إليه كل الفروع، وتذكر المعمارية المرجعية في Azure أن حلول Hub and Spoke توفر غالباً DNS مشتركاً تستخدمه كل الأطراف. - الهوية Identity: سيرفرات Active Directory أو LDAP أو مزود الدخول الموحد SSO، فالفرع لا يحتاج نسخة خاصة به.
- السجلات Logging: سيرفر syslog أو نظام SIEM تصل إليه سجلات كل المواقع.
- الخروج إلى الإنترنت Internet Egress: بدل أن يخرج كل فرع إلى الإنترنت مباشرة، تمر الحركة على المحور فتخرج من عنوان IP واحد معروف ومن جدار ناري واحد يطبق سياسة التصفح، وهذا ما تسميه AWS الخروج المركزي إلى الإنترنت عبر VPC فيها NAT Gateway.
- إنهاء أنفاق VPN: أنفاق الفروع وأنفاق الموظفين عن بعد تنتهي كلها في المحور، فلا يحتاج كل فرع أن يفتح منفذاً للإنترنت.
- ال Bastion: نقطة الدخول الإدارية إلى سيرفرات كل الأطراف، وقد شرحناها بالتفصيل في Bastion Host أم Jump Server؟.
- التخزين المشترك: مستودع النسخ الاحتياطية، ومستودع ال Images والحزم الذي تسحب منه كل البيئات.
ولاحظ أن هذا لا يعني أن تضع كل شيء في المحور، فالمحور يجب أن يبقى صغيراً ومحمياً، والتطبيقات نفسها تبقى في الأطراف، والسبب أن كل خدمة تضيفها إلى المحور تصبح خدمة يعتمد عليها الجميع، وأي خلل فيها يصل إلى كل المواقع.
ثمن المحور: ماذا تدفع مقابل البساطة؟
المحور يبسط الإدارة لكنه يأتي بثلاثة أثمان يجب أن تعرفها قبل أن تختاره.
نقطة الفشل الواحدة Single Point of Failure
إذا كانت كل الحركة بين المواقع تمر على المحور، فتوقف المحور يعني أن الفروع لا تصل إلى المقر، ولا إلى DNS المشترك، ولا إلى بعضها، حتى لو كان كل فرع يعمل بشكل سليم، وسوف ترى ذلك بالمخرج في التجربة. والحل المعتاد محوران بدل محور واحد، كما في الصورة التالية:
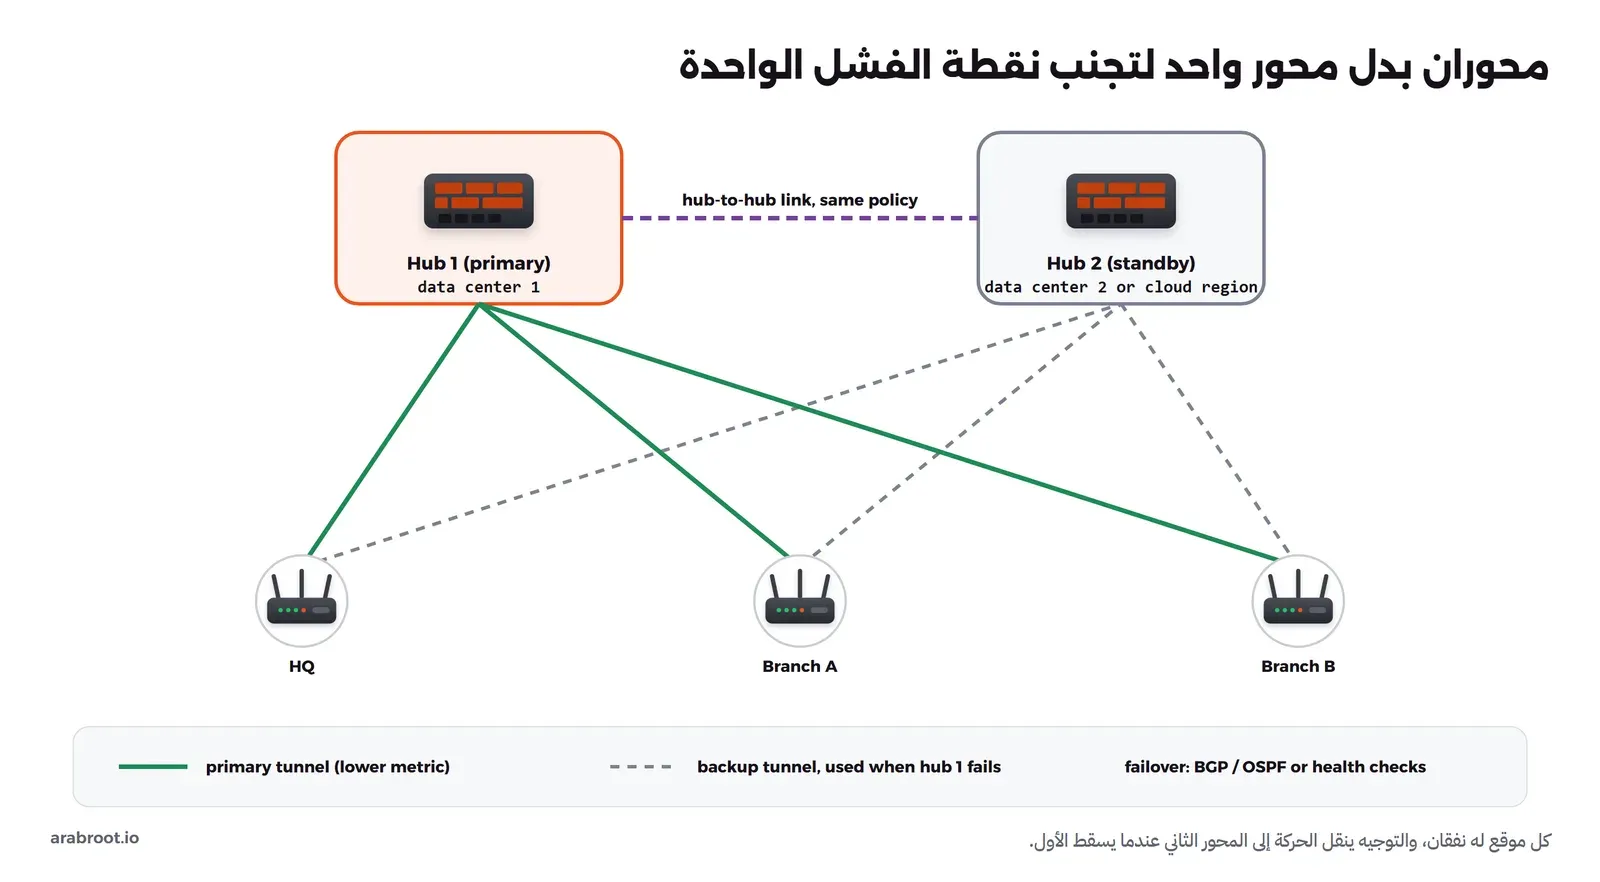
في الشكل أعلاه لاحظ التالي:
- كل طرف يفتح نفقين، الأول إلى المحور الأساسي والثاني إلى المحور الاحتياطي، والمحوران في مكانين مختلفين، فمحور ثان في نفس الغرفة يحميك من عطل الجهاز فقط ولا يحميك من انقطاع الكهرباء أو الإنترنت عن المبنى.
- الطرف يختار المحور بالتوجيه: إما ببروتوكول توجيه ديناميكي مثل BGP أو OSPF يسحب المسار عندما يسقط النفق، أو بفحص دوري Health Check يغير المسار.
- السياسة في المحورين يجب أن تكون واحدة، وأسهل طريقة أن تكون ملفات القواعد في مستودع Git وتطبق على الاثنين معاً.
- الجدار الناري Stateful يحتاج أن يرى الطلب والرد معاً، فإذا خرج الطلب من المحور الأول وعاد الرد من الثاني فسوف يرفضه الثاني لأنه لا يعرف الاتصال، لذلك اجعل الاتجاهين على نفس المحور، وهذا نفس سبب وجود خيار Appliance Mode في AWS Transit Gateway الذي يثبت كل تدفق على نفس الجهاز طوال عمره.
وتوصي المعمارية المرجعية في Azure بمحور واحد على الأقل في كل منطقة Region، وأن توصل به أطراف نفس المنطقة فقط، والسبب أن سقوط محور منطقة لا ينبغي أن يقطع التوجيه في منطقة أخرى لا علاقة لها بالعطل.
زمن الاستجابة الإضافي والمرور بالمحور Hairpinning
عندما يكلم الفرع (أ) الفرع (ب) فالحركة لا تسير بينهما مباشرة، وإنما تذهب إلى المحور ثم تعود منه، وهذا ما يسمى Hairpinning لأن مسار الحزمة يشبه دبوس الشعر. والثمن في هذه الحالة مسافة أطول، فإذا كان الفرعان في مدينة واحدة والمحور في مدينة بعيدة فكل حزمة تقطع المسافة إلى المحور مرتين، وثمن آخر أقل وضوحاً: الحزمة تفك من التشفير في المحور ثم تشفر مرة ثانية للنفق الآخر، وتمر على الجدار الناري، وهذا عمل معالج في كل حزمة. وفي التجربة سوف ترى بالأمر traceroute أن المحور قفزة إضافية في المسار، وبالأمر tcpdump أن نفس الحزمة تدخل واجهة المحور وتخرج منها.
وتذكر وثائق Azure أن مرور الحركة بين طرفين عبر جدار ناري أو جهاز توجيه في المحور يضيف قفزة Hop، وأن الربط المباشر بين الطرفين لا يضيفها وهو الموصى به عندما يكون زمن الاستجابة مهماً، وتنصح أيضاً بتجاوز المحور للتدفقات الحساسة لزمن الاستجابة مثل الوصول إلى التخزين.
Bandwidth المحور وتكلفة الحركة في السحابة
كل الحركة بين المواقع تمر في المحور، لذلك سرعة اتصاله بالإنترنت وقدرة جداره الناري هما الحد الأعلى للشبكة كلها، فإذا كان المحور على اتصال 100 Mbps فلن ينقل فرعان بينهما أكثر من ذلك ولو كان كل منهما على اتصال 1 Gbps، والفحص العميق مثل IPS يقلل الإنتاجية Throughput أكثر.
وفي السحابة يتحول هذا إلى فاتورة، فالخدمات المدارة للمحور تحسب أجرة على كل جيجابايت يمر بها، ومثال ذلك صفحة أسعار AWS Transit Gateway التي تعرض في أكتوبر 2026 لمنطقة US East (Ohio) سعر 0.05 دولار لكل ساعة لكل VPC متصل Attachment، و0.02 دولار لكل جيجابايت تعالجه الخدمة، وتحسب أجرة المعالجة على صاحب ال VPC الذي يرسل الحركة إلى ال Transit Gateway. ولنحسب مثالاً من هذه الأسعار المنشورة: عشرة VPCs متصلة طوال شهر من 730 ساعة تكلف 10 × 730 × 0.05 = 365 دولاراً، وإذا مر بينها 10 تيرابايت أي 10,240 جيجابايت فهذه 10,240 × 0.02 = 204.8 دولارات أخرى، وذلك قبل أجرة نقل البيانات بين المناطق أو إلى الإنترنت. وفي Azure تقول وثائق VNet Peering إنك تدفع رسماً على الحركة الداخلة والخارجة عبر كل Peering، فالحركة من طرف إلى طرف عبر المحور تمر على Peeringين، ثم تضاف أجرة معالجة الجدار الناري، لذلك تقترح المعمارية المرجعية الربط المباشر بين طرفين عندما تكون الحركة بينهما كبيرة وقليلة الخطر، مثل مزامنة قاعدة بيانات أو نسخ ملفات كبيرة. وقد شرحنا بقية بنود فاتورة الشبكة في التكاليف الخفية في السحابة.
الحركة بين الأطراف: عبر المحور أم مباشرة؟
هذا هو القرار الأهم بعد أن تختار المحور، فهناك طريقتان، والصورة التالية تبينهما:
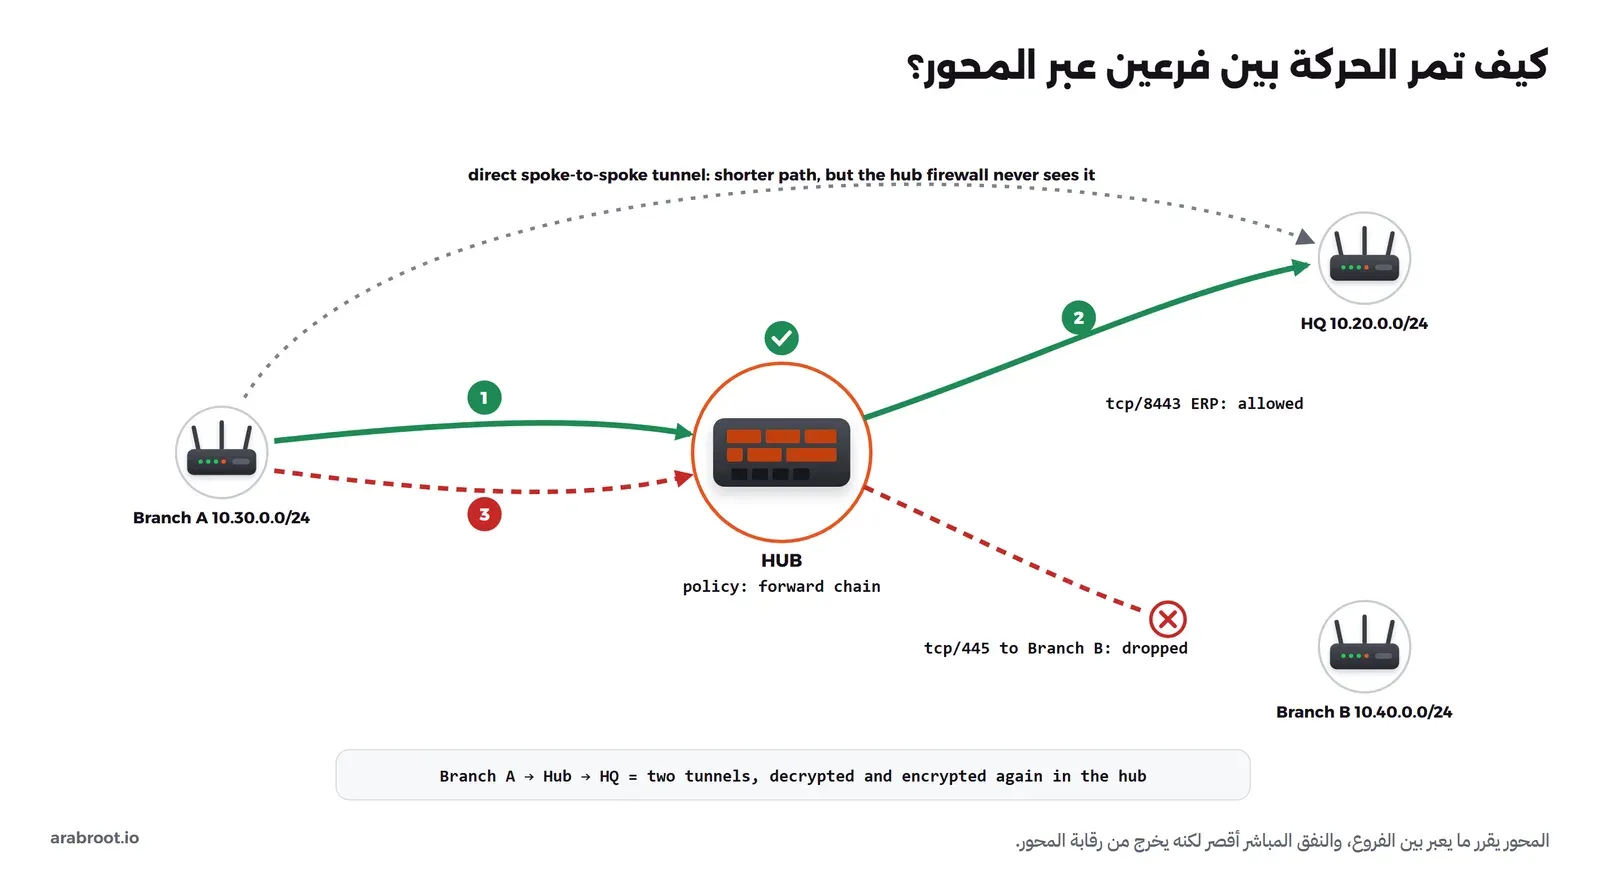
- عبر المحور: الطرف يرسل كل العناوين الداخلية إلى المحور، والمحور يطبق السياسة، ففي الشكل يصل الفرع (أ) إلى نظام ERP في المقر على المنفذ 8443 لأن القاعدة تسمح بذلك، ويمنع من الوصول إلى منفذ مشاركة الملفات SMB 445 في الفرع (ب) لأن الفروع لا تحتاج أن تكلم بعضها. وهذا هو الشكل الافتراضي الآمن، ولاحظ أن الرفض هنا هو الأصل، والسماح استثناء مكتوب له سبب.
- مباشرة: نفق أو Peering بين طرفين، فيكون المسار أقصر والتكلفة أقل، لكن الحركة لا تمر على جدار المحور، فيجب أن تطبق السياسة في الطرفين نفسيهما، وفي التجربة سوف ترى أن النفق المباشر فتح منفذ قاعدة البيانات الذي يمنعه المحور.
والقاعدة العملية: اجعل كل الحركة بين الأطراف عبر المحور، ثم أضف رابطاً مباشراً فقط بين طرفين بينهما حركة كبيرة ومعروفة ومن نفس مستوى الثقة، مثل بيئة الإنتاج ونسختها الاحتياطية في نفس المنطقة، وتوصي Azure بأن تحصر الربط المباشر في الأطراف التي تنتمي لنفس البيئة ونفس التطبيق. أما بيئة التطوير وبيئة الإنتاج فلا تربطهما مباشرة أبداً.
الأشكال الأخرى لربط المواقع
المحور ليس الشكل الوحيد، وأغلب الشبكات الحقيقية خليط من الأشكال التالية:
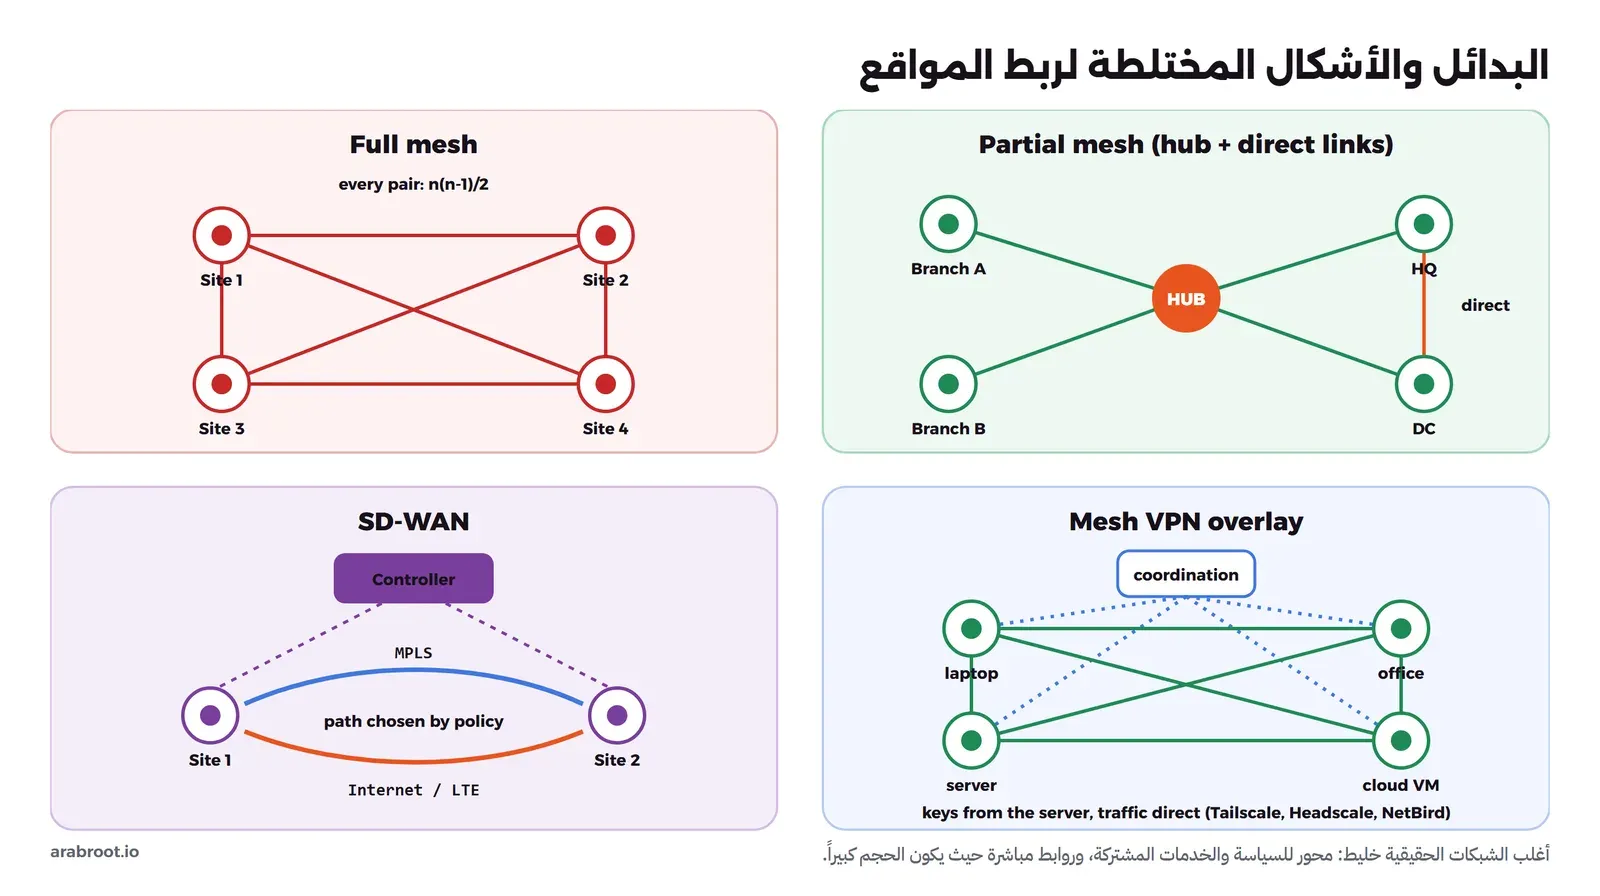
- الربط الكامل Full Mesh: مناسب لعدد صغير جداً من المواقع، ثلاثة أو أربعة، بينها حركة كثيفة في كل الاتجاهات، وفوق ذلك يصبح العدد كما حسبناه.
- الربط الجزئي Partial Mesh: محور لكل المواقع، مع روابط مباشرة إضافية بين مواقع محددة، مثل المقر ومركز البيانات، وهو الشكل الأكثر انتشاراً في الواقع.
- محوران Dual Hub: كما في القسم السابق، لإزالة نقطة الفشل الواحدة، وتكبر الفكرة إلى محور لكل منطقة جغرافية مع ربط المحاور ببعضها، وهذا ما تسميه Azure المحاور المتعددة Multi-hub.
- SD-WAN: الشبكة الواسعة المعرفة بالبرمجيات Software-Defined WAN، وفيها أجهزة الفروع لها أكثر من خط، مثل MPLS والإنترنت وشبكة الجوال، ووحدة تحكم مركزية Controller توزع السياسة وتختار لكل نوع حركة الخط الأنسب، وأغلب حلولها تبني فوق ذلك محوراً أو محوراً مع روابط مباشرة عند الطلب، وتشرح Azure كيف تدمج SD-WAN مع محور في السحابة.
- شبكات Mesh فوق VPN: أدوات مثل Tailscale وHeadscale وNetBird تجعل كل جهاز يتصل بكل جهاز مباشرة، ويوزع سيرفر التنسيق المفاتيح فقط، وقد شرحنا طريقة عملها في ما هو VPN؟. والفرق عن المحور أن السياسة هنا قوائم وصول ACL يوزعها سيرفر التنسيق إلى كل جهاز، والحركة لا تمر على جدار مركزي، لذلك تحصل على مسار مباشر دون أن تخسر السياسة المركزية، لكن على حساب أن كل جهاز يطبقها بنفسه، وأن الأجهزة التي لا تستطيع تثبيت البرنامج، مثل الطابعات والكاميرات، تحتاج جهازاً يمرر حركتها، وتسميه Tailscale Subnet Router.
المحور والأطراف في السحابة
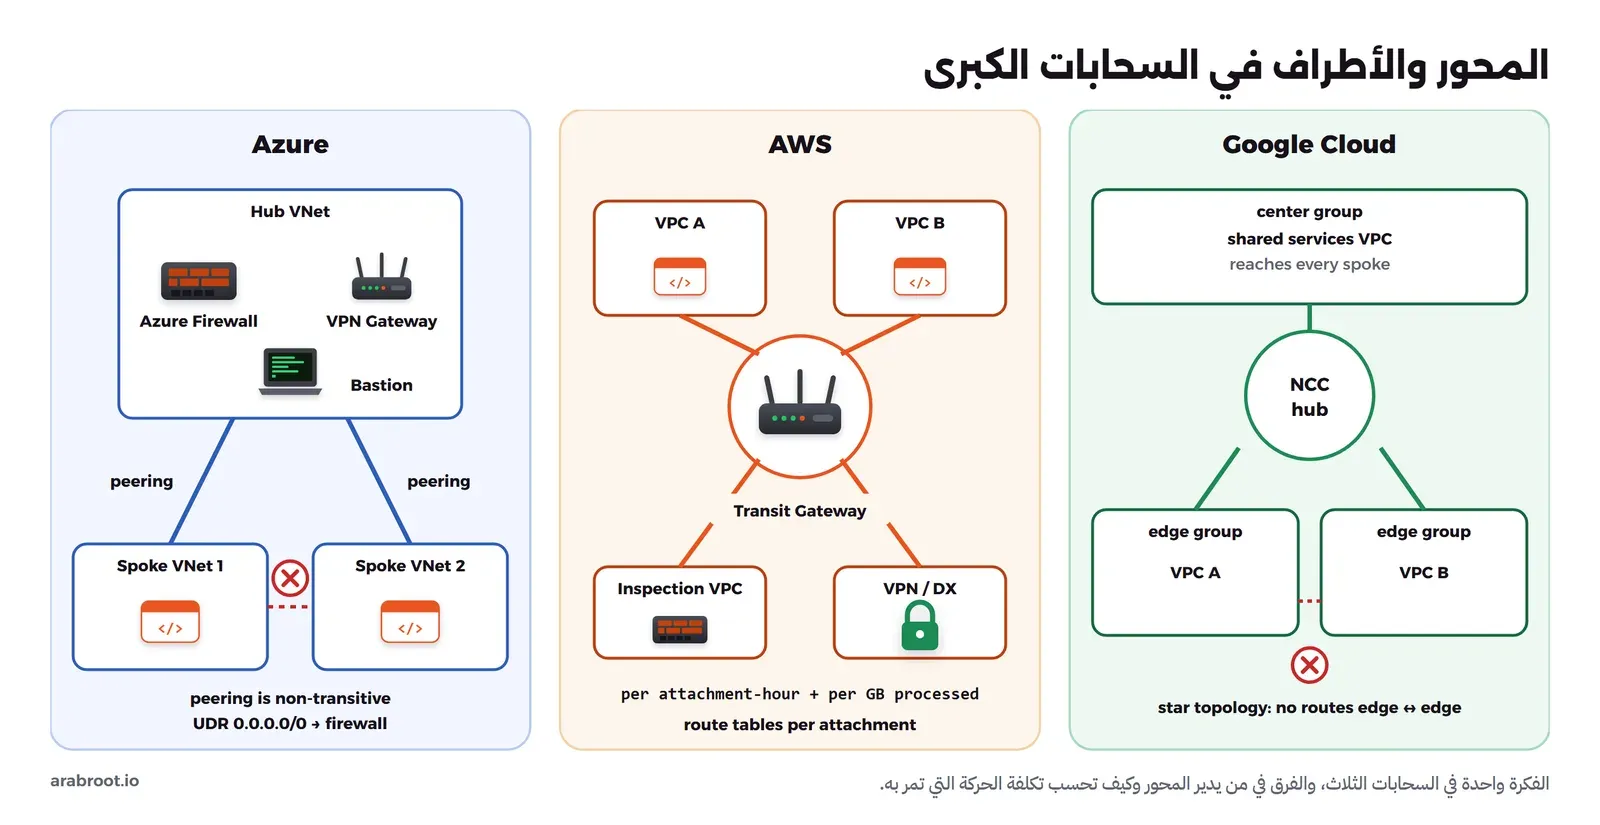
في السحابة تجد الفكرة نفسها في كل مزود، والسبب واحد: الربط المباشر بين الشبكات الافتراضية لا يمرر الحركة إلى طرف ثالث، والصورة التالية تبين الأشكال الثلاثة:
Azure: شبكة VNet مركزية وVNet Peering
في المعمارية المرجعية في Azure المحور شبكة VNet تديرها أنت، فيها Azure Firewall وبوابة VPN أو ExpressRoute وAzure Bastion، والأطراف شبكات VNet مربوطة بالمحور ب VNet Peering. والنقطة التي يجب أن تفهمها هنا أن ال Peering غير متعد Non-transitive، أي أن الطرف الأول المربوط بالمحور والطرف الثاني المربوط بالمحور لا يصلان إلى بعضهما تلقائياً، وتنص الوثائق على ذلك صراحة، وتقول إنك إذا أردت أن تتصل الأطراف ببعضها فإما أن تضيف Peering بينها، أو أن تستخدم مسارات يعرفها المستخدم User-Defined Routes، واختصاراً UDR، ترسل الحركة إلى Azure Firewall في المحور ليوجهها، وفي هذه الحالة يجب أن تسمح إعدادات ال Peering بالحركة المحولة Forwarded Traffic. ولاستخدام بوابة VPN المحور من الأطراف تفعل في ال Peering من جهة المحور خيار Gateway Transit، ومن جهة الطرف خيار استخدام بوابة الشبكة البعيدة. وإذا أردت محوراً تديره Microsoft بدل أن تبنيه بنفسك فهذا هو Azure Virtual WAN.
AWS: Transit Gateway
في AWS تقول وثائق VPC Peering إن ال Peering لا يدعم العلاقات المتعدية، فإذا ربطت VPC A ب VPC B و VPC A ب VPC C فلا تستطيع أن توجه حركة B إلى C عبر A، ولا يستطيع B أن يستخدم بوابة الإنترنت أو NAT أو VPN الموجودة في A. والحل هو AWS Transit Gateway، وتعرفه AWS بأنه محور عبور Transit Hub يربط ال VPCs والشبكات المحلية، ويعمل كما في شرح طريقة عمله كراوتر افتراضي على مستوى المنطقة يوجه في الطبقة الثالثة. وكل ما يتصل به يسمى Attachment: VPC أو اتصال VPN أو Direct Connect أو Transit Gateway آخر، ولكل Attachment جدول توجيه واحد يرتبط به، وهنا تكتب السياسة: إذا وضعت الأطراف في جدول لا يحتوي إلا مسار الخدمات المشتركة فلن تصل إلى بعضها، وهذا هو سيناريو Isolated VPCs with shared services في الوثائق، وإذا أردت فحص الحركة بجدار ناري فترسلها إلى Inspection VPC مع تفعيل Appliance Mode. وتذكر أن كل جيجابايت يمر يحسب كما رأينا في قسم التكلفة.
Google Cloud: Network Connectivity Center
في Google Cloud تعرف وثائق Network Connectivity Center الخدمة بأنها إطار تنسيق يبسط الاتصال بين أطراف Spokes متصلة بمورد إدارة مركزي اسمه Hub، والأطراف إما VPC Spokes تتبادل مسارات الشبكات الفرعية، أو Hybrid Spokes توصل شبكات خارجية عبر HA VPN أو Cloud Interconnect أو جهاز Router Appliance. والجزء الذي يهمنا هو الطوبولوجيا المسبقة: في Mesh تكون كل الأطراف في مجموعة واحدة وتصل إلى بعضها، وفي Star توجد مجموعتان بجدولي توجيه منفصلين، مجموعة المركز Center التي تصل إلى الجميع، ومجموعة الأطراف Edge التي تصل إلى المركز فقط، وتمنع NCC أي مسار بين طرفين في مجموعة Edge، فتضع VPC الخدمات المشتركة في المركز وبيئات الفرق في الأطراف.
| Azure | AWS | Google Cloud | |
|---|---|---|---|
| المحور | VNet تديرها أنت، أو Virtual WAN | Transit Gateway مدار | NCC Hub مدار |
| ربط الأطراف | VNet Peering | VPC Attachment | VPC Spoke |
| منع طرف عن طرف | لا يوجد Peering بينهما، أو قواعد الجدار في المحور | جدول توجيه للأطراف بلا مسارات بينها | طوبولوجيا Star ومجموعة Edge |
| الفحص المركزي | Azure Firewall أو NVA مع UDR | Inspection VPC مع Appliance Mode | NCC Gateway أو Router Appliance |
علاقة المحور بالضوابط الأساسية NCA ECC
المحور ليس ضابطاً بحد ذاته، لكنه المكان الطبيعي لتطبيق مكون إدارة أمن الشبكات 2-5 في الضوابط الأساسية للأمن السيبراني: عزل الشبكات وتقسيمها بجدار ناري، وعزل شبكة الإنتاج عن شبكات التطوير والاختبار، وتقييد المنافذ والبروتوكولات، وقد لخصناه في الضوابط الأساسية للأمن السيبراني NCA ECC بلغة بسيطة. فإذا كانت بيئة الإنتاج طرفاً وبيئة الاختبار طرفاً آخر، فملف قواعد المحور وعداداته هما الدليل الذي يطلبه المدقق على أن البيئتين لا تتصلان إلا بما هو مكتوب.
تجربة عملية: محور WireGuard وثلاثة أطراف في Docker
الآن سوف نبني شبكة صغيرة على جهازك من ستة Containers: محور، وشبكة خدمات مشتركة فيها DNS وصفحة إنترانت، وثلاثة أطراف هي المقر HQ وفيه نظام ERP على 8443 وقاعدة بيانات على 5432، والفرع (أ)، والفرع (ب) وفيه مشاركة ملفات على 445. وكل طرف يرتبط بالمحور بنفق WireGuard، والمحور يطبق السياسة بقواعد nftables. والصورة التالية تبين ما سنبنيه:
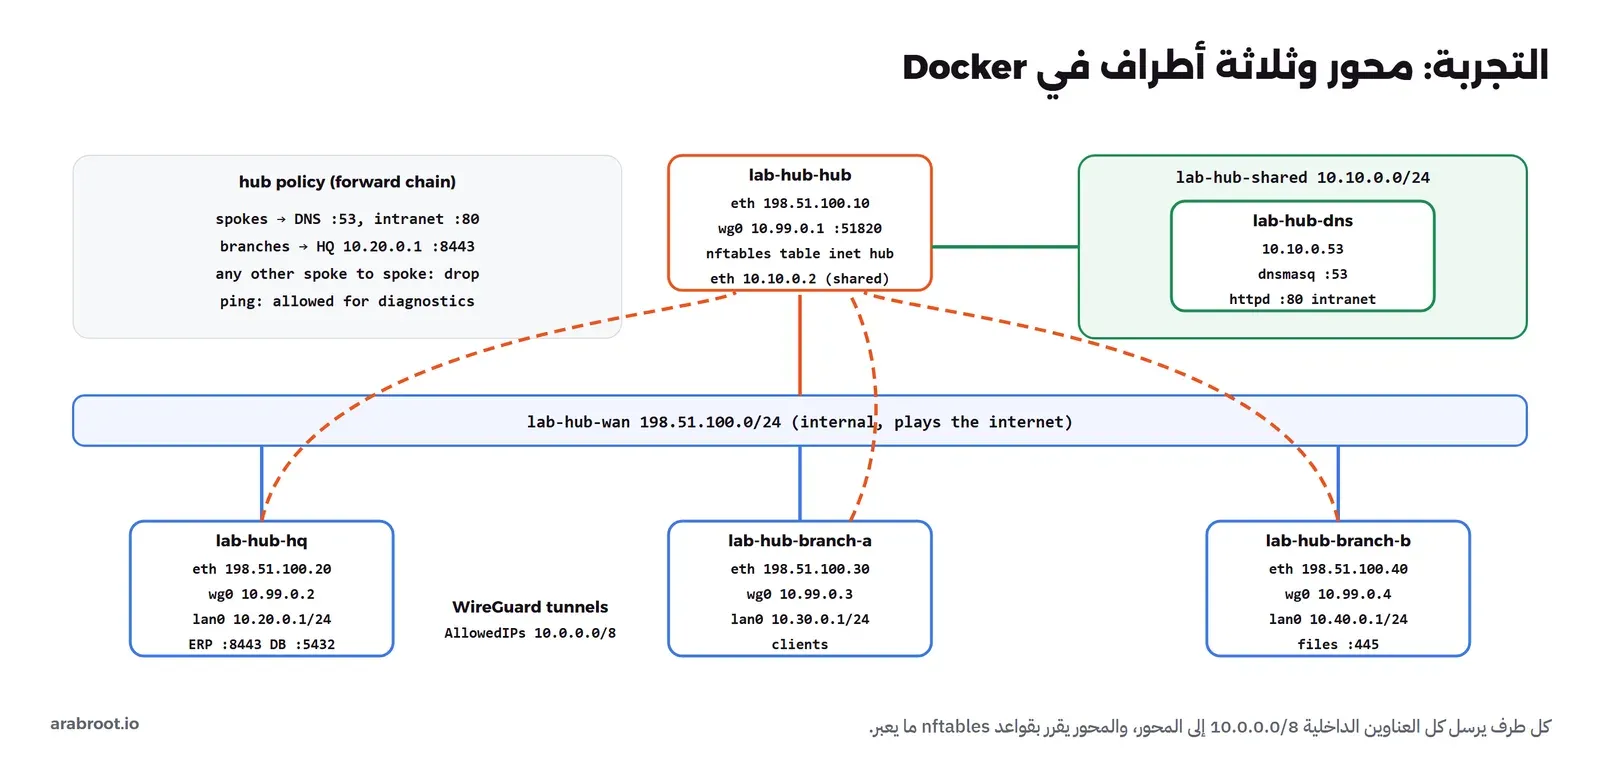
عناوين شبكة «الإنترنت» من النطاق 198.51.100.0/24 المخصص للتوثيق، ولا ننشر أي منفذ على جهازك، والصلاحية NET_ADMIN تعطى لل Containers داخل التجربة فقط لتنشئ واجهات WireGuard والقواعد. وإذا لم يكن Docker مثبتاً فانظر تثبيت Docker على Ubuntu، وإذا لم تكن تعرف WireGuard فابدأ ب تجربة النفق في مقال VPN.
تجهيز ال Image والشبكات
نبني Image صغيرة فوق alpine:3.24 فيها كل الأدوات، لأن شبكة «الإنترنت» في التجربة داخلية لا تخرج إلى الإنترنت الحقيقي، فلا يستطيع ال Container أن يثبت الحزم بعد تشغيله:
docker build -t lab-hub-node:1 - <<'EOF'
FROM alpine:3.24
RUN apk add --no-cache wireguard-tools nftables iproute2 iproute2-tc iputils-ping busybox-extras dnsmasq traceroute tcpdump
EOF
ثم ننشئ الشبكتين وال Containers الستة:
docker network create --internal --subnet 198.51.100.0/24 lab-hub-wan
docker network create --subnet 10.10.0.0/24 lab-hub-shared
run() { docker run -d --name lab-hub-$1 --hostname $1 --cap-add NET_ADMIN "${@:2}" lab-hub-node:1 sleep 14400; }
run hub --sysctl net.ipv4.ip_forward=1 --network lab-hub-wan --ip 198.51.100.10
docker network connect --ip 10.10.0.2 lab-hub-shared lab-hub-hub
run dns --network lab-hub-shared --ip 10.10.0.53
run hq --network lab-hub-wan --ip 198.51.100.20
run branch-a --network lab-hub-wan --ip 198.51.100.30
run branch-b --network lab-hub-wan --ip 198.51.100.40
docker ps --filter name=^lab-hub- --format '{{.Names}}'
والمخرج سوف يكون كما يلي:
lab-hub-branch-b
lab-hub-branch-a
lab-hub-hq
lab-hub-dns
lab-hub-hub
في الإعداد أعلاه لاحظ التالي:
- المحور وحده يأخذ
ip_forward=1لأنه الوحيد الذي يمرر الحركة بين واجهاته، والأطراف لا تحتاجه في هذه التجربة لأن كل طرف هو نفسه مصدر الحركة ووجهتها. - شبكة الخدمات
lab-hub-sharedليستinternal، والسبب أن Docker يسقط على الشبكة الداخلية الحزم القادمة من عناوين خارج نطاقها، وحزم الفروع تصل إلى سيرفر DNS بعناوين الفروع10.30.0.0/24وأمثالها، وفائدة جانبية أن المحور يأخذ منها مساره الافتراضي، فيصبح هو نقطة الخروج إلى الإنترنت كما في التصميم الحقيقي.
الآن نشغل الخدمات المشتركة: سيرفر dnsmasq بثلاثة أسماء داخلية، وصفحة إنترانت ب httpd من BusyBox، ثم نعطي كل طرف شبكته المحلية على واجهة وهمية lan0 من نوع dummy تمثل الأجهزة خلف راوتر الفرع، ونجعل DNS المشترك هو سيرفر الأسماء في كل طرف، ونشغل خدمات المقر والفرع (ب):
docker exec lab-hub-dns sh -c '
ip route add 10.0.0.0/8 via 10.10.0.2
dnsmasq --no-resolv --no-hosts --listen-address=10.10.0.53 --bind-interfaces \
  --local=/corp.internal/ \
  --host-record=intranet.corp.internal,10.10.0.53 \
  --host-record=erp.hq.corp.internal,10.20.0.1 \
  --host-record=files.branch-b.corp.internal,10.40.0.1
mkdir -p /srv/www && echo "intranet: shared service in the hub" > /srv/www/index.html
httpd -p 80 -h /srv/www'
lan() {
  docker exec lab-hub-$1 sh -c "ip link add lan0 type dummy && ip addr add $2 dev lan0 && ip link set lan0 up"
  docker exec lab-hub-$1 sh -c 'echo "nameserver 10.10.0.53" > /etc/resolv.conf'
}
lan hq 10.20.0.1/24
lan branch-a 10.30.0.1/24
lan branch-b 10.40.0.1/24
docker exec lab-hub-hq sh -c 'for p in 8443 5432; do mkdir -p /srv/$p; echo "hq port $p" > /srv/$p/index.html; httpd -p 10.20.0.1:$p -h /srv/$p; done'
docker exec lab-hub-branch-b sh -c 'mkdir -p /srv/445; echo "branch-b files" > /srv/445/index.html; httpd -p 10.40.0.1:445 -h /srv/445'
docker exec lab-hub-hub ip -br -4 addr
docker exec lab-hub-hub ip route
والمخرج سوف يكون كما يلي:
lo               UNKNOWN        127.0.0.1/8
eth0@if1814      UP             198.51.100.10/24
eth1@if1815      UP             10.10.0.2/24
default via 10.10.0.1 dev eth1
10.10.0.0/24 dev eth1 proto kernel scope link src 10.10.0.2
198.51.100.0/24 dev eth0 proto kernel scope link src 198.51.100.10
المحور له واجهتان: eth0 على «الإنترنت» وeth1 على شبكة الخدمات، وتذكر هذا الترتيب لأننا سوف نعود إليه عندما نوقف المحور ونعيد تشغيله. ولاحظ أن الخيار --local=/corp.internal/ يجعل dnsmasq يجيب عن النطاق الداخلي بنفسه ولا يبحث عنه في أي مكان آخر، وأن السطر الأول في سيرفر DNS يعيد كل العناوين الداخلية 10.0.0.0/8 إلى المحور، فبدونه يرسل ردوده إلى البوابة الافتراضية لشبكة Docker ولا تصل إلى الفروع.
الأنفاق: محور واحد يعرف كل الأطراف
ننشئ زوج مفاتيح في كل Container، ثم نكتب ملف المحور وفيه Peer لكل طرف، وملف كل طرف وفيه Peer واحد هو المحور، ونأخذ المفاتيح العامة بالأمر pub مباشرة من ال Containers:
for n in hub hq branch-a branch-b; do
  docker exec lab-hub-$n sh -c 'umask 077; wg genkey > /etc/wireguard/key; wg pubkey < /etc/wireguard/key > /etc/wireguard/key.pub'
done
pub() { docker exec lab-hub-$1 cat /etc/wireguard/key.pub; }
docker exec -i lab-hub-hub sh -c 'cat > /etc/wireguard/wg0.conf' <<EOF
[Interface]
Address = 10.99.0.1/24
ListenPort = 51820
PostUp = wg set %i private-key /etc/wireguard/key

[Peer]
# hq
PublicKey = $(pub hq)
AllowedIPs = 10.99.0.2/32, 10.20.0.0/24

[Peer]
# branch-a
PublicKey = $(pub branch-a)
AllowedIPs = 10.99.0.3/32, 10.30.0.0/24

[Peer]
# branch-b
PublicKey = $(pub branch-b)
AllowedIPs = 10.99.0.4/32, 10.40.0.0/24
EOF
spoke() {
  docker exec -i lab-hub-$1 sh -c 'cat > /etc/wireguard/wg0.conf' <<EOF
[Interface]
Address = $2/24
ListenPort = 51820
Table = off
PostUp = wg set %i private-key /etc/wireguard/key
PostUp = ip route add 10.0.0.0/8 dev %i src $3

[Peer]
# hub
PublicKey = $(pub hub)
Endpoint = 198.51.100.10:51820
AllowedIPs = 10.0.0.0/8
PersistentKeepalive = 25
EOF
}
spoke hq 10.99.0.2 10.20.0.1
spoke branch-a 10.99.0.3 10.30.0.1
spoke branch-b 10.99.0.4 10.40.0.1
for n in hub hq branch-a branch-b; do docker exec lab-hub-$n wg-quick up wg0; done
ويطبع wg-quick كل أمر ينفذه، والمخرج للمحور ثم للفرع (أ) سوف يكون كما يلي:
[#] ip link add dev wg0 type wireguard
[#] wg addconf wg0 /dev/fd/63
[#] ip -4 address add 10.99.0.1/24 dev wg0
[#] ip link set mtu 1420 up dev wg0
[#] ip -4 route add 10.40.0.0/24 dev wg0
[#] ip -4 route add 10.30.0.0/24 dev wg0
[#] ip -4 route add 10.20.0.0/24 dev wg0
[#] wg set wg0 private-key /etc/wireguard/key
...
[#] ip link add dev wg0 type wireguard
[#] wg addconf wg0 /dev/fd/63
[#] ip -4 address add 10.99.0.3/24 dev wg0
[#] ip link set mtu 1420 up dev wg0
[#] wg set wg0 private-key /etc/wireguard/key
[#] ip route add 10.0.0.0/8 dev wg0 src 10.30.0.1
في الإعداد أعلاه لاحظ التالي:
- في المحور يحمل كل Peer عنوانه في النفق وشبكة موقعه، وتشرح صفحة WireGuard أن قائمة AllowedIPs تعمل كجدول توجيه عند الإرسال، وكقائمة تحكم بالوصول عند الاستقبال، أي أن المحور يرسل حركة
10.30.0.0/24إلى مفتاح الفرع (أ) فقط، ويرفض أي حزمة تصل من مفتاح الفرع (أ) بعنوان مصدر خارج هذه القائمة، فلا يستطيع فرع أن ينتحل عنوان فرع آخر. - في الأطراف
AllowedIPs = 10.0.0.0/8، أي أن كل العناوين الداخلية تذهب إلى المحور، وهذا تجميع المسارات Route Summarization الذي شرحناه في الشبكات الفرعية، فإضافة فرع رابع لا تحتاج أي تعديل في الأطراف الحالية، وإنما Peer جديد في المحور فقط. Table = offيمنعwg-quickمن إضافة المسار بنفسه، ونضيفه نحن فيPostUpمعsrcعنوان الشبكة المحلية، فتخرج الحركة بعنوان الفرع10.30.0.1كما تخرج من أجهزة خلف راوتر حقيقي، والسياسة في المحور تكتب بعناوين الفروع.- السطر
PostUp = wg set %i private-keyيقرأ المفتاح الخاص من ملفه، فلا يكتب المفتاح الخاص داخل ملف الإعداد. PersistentKeepaliveفي الأطراف فقط، لأن الفرع خلف NAT في الواقع، وهو الذي يجب أن يبقي الطريق مفتوحاً إلى المحور.
ولنرى حالة الأنفاق من المحور:
docker exec lab-hub-hub wg show wg0والمخرج سوف يكون كما يلي، بعد اختصار المفاتيح العامة:
interface: wg0
  public key: +Ksl...uAs=
  private key: (hidden)
  listening port: 51820

peer: HCPR...GUo=
  endpoint: 198.51.100.40:51820
  allowed ips: 10.99.0.4/32, 10.40.0.0/24
  latest handshake: 15 seconds ago
  transfer: 180 B received, 92 B sent

peer: 12oM...fRY=
  endpoint: 198.51.100.30:51820
  allowed ips: 10.99.0.3/32, 10.30.0.0/24
  latest handshake: 17 seconds ago
  transfer: 180 B received, 92 B sent

peer: pW1t...lns=
  endpoint: 198.51.100.20:51820
  allowed ips: 10.99.0.2/32, 10.20.0.0/24
  latest handshake: 19 seconds ago
  transfer: 180 B received, 92 B sent
ثلاثة أنفاق لثلاثة أطراف، وكلها تمت مصافحتها Handshake. ولاحظ أن المحور لم يحتج أن يعرف Endpoint أي طرف مسبقاً، فقد عرفه من أول حزمة وصلت منه.
المحور بلا سياسة: كل شيء مفتوح
نكتب دالة صغيرة t تختبر الاتصال من طرف إلى عنوان ومنفذ، ونختبر قبل أن نكتب أي قاعدة:
t() {
  if docker exec lab-hub-$1 nc -z -w 2 $2 $3 2>/dev/null; then r=open; else r=blocked; fi
  printf '%-9s -> %-11s %-5s %s\n' $1 $2 $3 $r
}
docker exec lab-hub-branch-a nslookup -type=a erp.hq.corp.internal
docker exec lab-hub-branch-a wget -qO- http://intranet.corp.internal/
t branch-a 10.10.0.53 80
t branch-a 10.20.0.1 8443
t branch-a 10.20.0.1 5432
t branch-a 10.40.0.1 445
t branch-b 10.20.0.1 5432
والمخرج سوف يكون كما يلي:
Server:		10.10.0.53
Address:	10.10.0.53:53

Name:	erp.hq.corp.internal
Address: 10.20.0.1

intranet: shared service in the hub
branch-a  -> 10.10.0.53  80    open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   5432  open
branch-a  -> 10.40.0.1   445   open
branch-b  -> 10.20.0.1   5432  open
الفرع (أ) يحل أسماء المقر من DNS المشترك ويفتح صفحة الإنترانت، وهذا ما نريده، لكنه أيضاً يصل إلى قاعدة بيانات المقر وإلى مشاركة الملفات في الفرع (ب)، وهذا هو نفس الخطأ الذي رأيناه مع شبكات VLAN بلا قواعد: المحور بطبيعته Router يوجه كل شيء. ولنرى المسار بالأمر traceroute بحزم TCP على منفذ الخدمة:
docker exec lab-hub-branch-a traceroute -n -T -p 8443 -q 1 -w 1 10.20.0.1
docker exec lab-hub-branch-a traceroute -n -T -p 445 -q 1 -w 1 10.40.0.1
والمخرج سوف يكون كما يلي:
traceroute to 10.20.0.1 (10.20.0.1), 30 hops max, 60 byte packets
 1  10.99.0.1  5.599 ms
 2  10.20.0.1  47.793 ms
traceroute to 10.40.0.1 (10.40.0.1), 30 hops max, 60 byte packets
 1  10.99.0.1  4.221 ms
 2  10.40.0.1  13.962 ms
القفزة الأولى في المسارين هي المحور 10.99.0.1، ثم الوجهة، أي أن الحركة بين الفرعين لا تسير بينهما مباشرة مع أن الثلاثة على نفس الشبكة. ولنرى الحزمة نفسها داخل المحور، نراقب واجهات المحور ونحن نفتح اتصالاً من الفرع (أ) إلى الفرع (ب):
docker exec lab-hub-hub timeout 5 tcpdump -ni any -c 4 'tcp port 445 and tcp[tcpflags] & tcp-syn != 0' 2>/dev/null &
sleep 1.5
docker exec lab-hub-branch-a nc -z -w 2 10.40.0.1 445
wait
والمخرج سوف يكون كما يلي:
14:03:40.108622 wg0   In  IP 10.30.0.1.35153 > 10.40.0.1.445: Flags [S], seq 2533871137, win 64860, options [mss 1380,sackOK,TS val 4236017547 ecr 0,nop,wscale 7], length 0
14:03:40.108643 wg0   Out IP 10.30.0.1.35153 > 10.40.0.1.445: Flags [S], seq 2533871137, win 64860, options [mss 1380,sackOK,TS val 4236017547 ecr 0,nop,wscale 7], length 0
14:03:40.124351 wg0   In  IP 10.40.0.1.445 > 10.30.0.1.35153: Flags [S.], seq 3714638968, ack 2533871138, win 64296, options [mss 1380,sackOK,TS val 435673179 ecr 4236017547,nop,wscale 7], length 0
14:03:40.124364 wg0   Out IP 10.40.0.1.445 > 10.30.0.1.35153: Flags [S.], seq 3714638968, ack 2533871138, win 64296, options [mss 1380,sackOK,TS val 435673179 ecr 4236017547,nop,wscale 7], length 0
هذا هو ال Hairpinning بعينه: الطلب يدخل wg0 من نفق الفرع (أ) ويخرج من نفس الواجهة إلى نفق الفرع (ب)، والرد يعود بنفس الطريق، وفي كل مرة فك المحور تشفير الحزمة ثم شفرها بمفتاح النفق الآخر، ولاحظ أن عنوان المصدر 10.30.0.1 لم يتغير، فالمحور يوجه ولا يترجم العناوين، وبالتالي تستطيع أن تكتب السياسة بعناوين الفروع.
سياسة المحور بقواعد nftables
الآن نكتب السياسة في الملف /etc/hub.nft داخل المحور: الأطراف تصل إلى DNS والإنترانت، والفروع تصل إلى ERP في المقر على 8443 فقط، وكل حركة أخرى بين طرفين مرفوضة، مع السماح ب ping للتشخيص بمعدل محدود:
docker exec -i lab-hub-hub sh -c 'cat > /etc/hub.nft' <<'EOF'
flush ruleset

define SPOKES   = { 10.20.0.0/24, 10.30.0.0/24, 10.40.0.0/24 }
define BRANCHES = { 10.30.0.0/24, 10.40.0.0/24 }
define DNS      = 10.10.0.53
define ERP      = 10.20.0.1

table inet hub {
    chain forward {
        type filter hook forward priority filter; policy drop;
        ct state established,related accept
        ct state invalid drop
        icmp type echo-request limit rate 10/second accept comment "ping for diagnostics"
        iifname "wg0" oifname "eth1" ip saddr $SPOKES ip daddr $DNS meta l4proto { tcp, udp } th dport 53 counter accept comment "spokes -> shared DNS"
        iifname "wg0" oifname "eth1" ip saddr $SPOKES ip daddr $DNS tcp dport 80 counter accept comment "spokes -> intranet"
        iifname "wg0" oifname "wg0" ip saddr $BRANCHES ip daddr $ERP tcp dport 8443 counter accept comment "branches -> HQ ERP only"
        iifname "wg0" oifname "wg0" counter drop comment "spoke to spoke: everything else"
        counter comment "other drops"
    }
}
EOF
docker exec lab-hub-hub nft -f /etc/hub.nft && echo applied
t branch-a 10.10.0.53 80
t branch-a 10.20.0.1 8443
t branch-a 10.20.0.1 5432
t branch-a 10.40.0.1 445
t branch-b 10.20.0.1 8443
t hq 10.40.0.1 445
والمخرج سوف يكون كما يلي:
applied
branch-a  -> 10.10.0.53  80    open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   5432  blocked
branch-a  -> 10.40.0.1   445   blocked
branch-b  -> 10.20.0.1   8443  open
hq        -> 10.40.0.1   445   blocked
في الإعداد أعلاه لاحظ التالي:
- السلسلة
forwardسياستهاdrop، فكل ما لم يسمح به صراحة مرفوض، وهذه هي نفس طريقة جدول التدفقات في تجربة تقسيم الشبكة، وتفاصيل الصيغة في وثائق nftables. iifname "wg0" oifname "wg0"هو تعريف الحركة بين طرفين في هذا التصميم: تدخل من النفق وتخرج إلى النفق، وهذا ما رأيناه في مخرجtcpdump.- قاعدة ERP محددة بالمصدر والوجهة والمنفذ معاً، فالفرعان يصلان إلى 8443 في المقر ولا يصلان إلى 5432 على نفس العنوان، والمقر نفسه لا يصل إلى ملفات الفرع (ب) لأنه غير موجود في
$BRANCHESولا توجد قاعدة له. - لم نكتب أي قاعدة في سلسلة
input، لأن هذا الإعداد يحمي ما يمر عبر المحور، أما حماية المحور نفسه، أي منفذ SSH ومنفذ WireGuard فقط، فهي كما في مقال تقسيم الشبكة.
والآن نرى العدادات، ثم نعيد traceroute إلى المنفذ الممنوع والمنفذ المسموح:
docker exec lab-hub-hub nft list chain inet hub forward
docker exec lab-hub-branch-a traceroute -n -T -p 445 -q 1 -w 1 -m 4 10.40.0.1
docker exec lab-hub-branch-a traceroute -n -T -p 8443 -q 1 -w 1 10.20.0.1
والمخرج سوف يكون كما يلي:
table inet hub {
	chain forward {
		type filter hook forward priority filter; policy drop;
		ct state established,related accept
		ct state invalid drop
		icmp type echo-request limit rate 10/second burst 5 packets accept comment "ping for diagnostics"
		iifname "wg0" oifname "eth1" ip saddr { 10.20.0.0/24, 10.30.0.0/24, 10.40.0.0/24 } ip daddr 10.10.0.53 meta l4proto { tcp, udp } th dport 53 counter packets 1 bytes 74 accept comment "spokes -> shared DNS"
		iifname "wg0" oifname "eth1" ip saddr { 10.20.0.0/24, 10.30.0.0/24, 10.40.0.0/24 } ip daddr 10.10.0.53 tcp dport 80 counter packets 1 bytes 60 accept comment "spokes -> intranet"
		iifname "wg0" oifname "wg0" ip saddr { 10.30.0.0/24, 10.40.0.0/24 } ip daddr 10.20.0.1 tcp dport 8443 counter packets 2 bytes 120 accept comment "branches -> HQ ERP only"
		iifname "wg0" oifname "wg0" counter packets 8 bytes 480 drop comment "spoke to spoke: everything else"
		counter packets 0 bytes 0 comment "other drops"
	}
}
traceroute to 10.40.0.1 (10.40.0.1), 4 hops max, 60 byte packets
 1  10.99.0.1  8.395 ms
 2  *
 3  *
 4  *
traceroute to 10.20.0.1 (10.20.0.1), 30 hops max, 60 byte packets
 1  10.99.0.1  48.300 ms
 2  10.20.0.1  48.229 ms
العداد spoke to spoke سجل ثماني حزم مرفوضة، وهي محاولات الاتصال الممنوعة الثلاث مع إعادة إرسالها، وفي الإنتاج تضيف إليه log prefix "hub-drop " وترسل السجلات إلى نظام المراقبة، لأن فرعاً يحاول الوصول إلى SMB في فرع آخر علامة يجب أن يراها أحد. أما traceroute فيرى المحور في القفزة الأولى ثم لا شيء نحو المنفذ 445، فالحزمة وصلت إلى المحور وتوقفت عنده، وهذه طريقة سريعة لتعرف أين يقف الاتصال: إذا ظهر المحور واختفى ما بعده فابحث في قواعد المحور، وإذا لم يظهر المحور نفسه فالمشكلة في النفق.
ثمن القفزة الإضافية: النفق المباشر
نقيس زمن الذهاب والعودة RTT من الفرع (أ) إلى المحور، ثم إلى المقر عبر المحور:
docker exec lab-hub-branch-a ping -c 50 -i 0.2 -q 10.99.0.1 | tail -2
docker exec lab-hub-branch-a ping -c 50 -i 0.2 -q 10.20.0.1 | tail -2
والمخرج سوف يكون كما يلي:
50 packets transmitted, 50 received, 0% packet loss, time 10182ms
rtt min/avg/max/mdev = 0.339/2.481/19.673/4.293 ms
50 packets transmitted, 50 received, 0% packet loss, time 10091ms
rtt min/avg/max/mdev = 0.603/3.294/35.306/5.895 ms
الأرقام هنا على جهاز واحد، فالمتوسط فيه تذبذب كبير من Docker Desktop، والأوضح هو الحد الأدنى min: 0.339 ms إلى المحور، و0.603 ms إلى المقر عبر المحور، أي قريباً من الضعف، لأن الحزمة تقطع نفقين بدل نفق واحد. وعلى شبكة حقيقية الفرق هو المسافة: إذا كان المحور على بعد 20 ms من كل فرع فالفرعان يكلمان بعضهما في 40 ms مهما كانا متجاورين. الآن نضيف نفقاً مباشراً بين الفرع (أ) والمقر، أي ربطاً جزئياً Partial Mesh، دون أن نغير المحور:
pub() { docker exec lab-hub-$1 cat /etc/wireguard/key.pub; }
docker exec lab-hub-branch-a wg set wg0 peer $(pub hq) endpoint 198.51.100.20:51820 allowed-ips 10.20.0.0/24
docker exec lab-hub-hq wg set wg0 peer $(pub branch-a) endpoint 198.51.100.30:51820 allowed-ips 10.30.0.0/24
docker exec lab-hub-branch-a traceroute -n -T -p 8443 -q 1 -w 1 10.20.0.1
docker exec lab-hub-branch-a ping -c 50 -i 0.2 -q 10.20.0.1 | tail -1
t branch-a 10.20.0.1 5432
والمخرج سوف يكون كما يلي:
traceroute to 10.20.0.1 (10.20.0.1), 30 hops max, 60 byte packets
 1  10.20.0.1  18.633 ms
rtt min/avg/max/mdev = 0.301/2.441/29.567/4.899 ms
branch-a  -> 10.20.0.1   5432  open
في المخرج أعلاه لاحظ التالي:
- المقر أصبح القفزة الأولى، واختفى المحور من المسار، والحد الأدنى نزل إلى 0.301 ms، أي مثل الوصول إلى المحور نفسه.
- لم نحذف شيئاً من المسارات، فالطرف ما زال يرسل
10.0.0.0/8إلىwg0، لكن WireGuard يختار ال Peer الذي له أدق تطابق في AllowedIPs، فشبكة المقر10.20.0.0/24أدق من10.0.0.0/8وتذهب إلى المقر مباشرة، وكل ما عداها يبقى عبر المحور. - والأهم: منفذ قاعدة البيانات 5432 أصبح مفتوحاً، لأن الحركة لم تعد تمر على قواعد المحور، فكل رابط مباشر تضيفه يحتاج سياسته الخاصة في طرفيه، وهذا هو ثمن الربط المباشر الذي ذكرناه.
ونحذف النفق المباشر لنعود إلى المحور:
docker exec lab-hub-branch-a wg set wg0 peer $(pub hq) remove
docker exec lab-hub-hq wg set wg0 peer $(pub branch-a) remove
t branch-a 10.20.0.1 5432
والمخرج سوف يكون كما يلي:
branch-a -> 10.20.0.1 5432 blockedنكسر المحور: ماذا يحدث عندما يتوقف؟
نوقف المحور ونختبر من الفروع:
docker stop -t 1 lab-hub-hub
docker exec lab-hub-branch-a nslookup -type=a -timeout=2 erp.hq.corp.internal; echo "exit=$?"
t branch-a 10.20.0.1 8443
t branch-b 10.20.0.1 8443
docker exec lab-hub-branch-a ping -c 3 -W 1 10.20.0.1 | tail -2
docker exec lab-hub-hq wget -qO- http://10.20.0.1:8443/
والمخرج سوف يكون كما يلي:
lab-hub-hub
;; connection timed out; no servers could be reached

exit=1
branch-a  -> 10.20.0.1   8443  blocked
branch-b  -> 10.20.0.1   8443  blocked
3 packets transmitted, 0 received, 100% packet loss, time 2069ms

hq port 8443
نظام ERP في المقر يعمل، والسطر الأخير يثبت ذلك من داخل المقر، والفرعان يعملان، لكن لا أحد منهما يصل إلى ERP، ولا إلى DNS، فحتى الأسماء توقفت، وهذه هي نقطة الفشل الواحدة بالمخرج. الآن نعيد تشغيل المحور:
docker start lab-hub-hub
docker exec lab-hub-hub ip -br link show wg0
docker exec lab-hub-hub wg-quick up wg0 > /dev/null 2>&1
docker exec lab-hub-hub nft -f /etc/hub.nft
t branch-a 10.20.0.1 8443
docker exec lab-hub-branch-a nslookup -type=a erp.hq.corp.internal | tail -2
والمخرج سوف يكون كما يلي:
lab-hub-hub
Device "wg0" does not exist.
branch-a  -> 10.20.0.1   8443  blocked
;; connection timed out; no servers could be reached
بعد إعادة التشغيل لم تكن واجهة wg0 موجودة ولا القواعد، لأنهما في الذاكرة وليسا في ملف يقرأ عند الإقلاع، وعلى سيرفر حقيقي تفعل الخدمتين wg-quick@wg0 وnftables في systemd حتى تعودا وحدهما. ومع ذلك فشل أول اختبار بعد تشغيلهما، والسبب أن الأطراف ما زالت تستخدم مفاتيح الجلسة القديمة التي لا يعرفها المحور الجديد، فتحتاج مصافحة جديدة، وتبدأها بعد ثوان، وطلب DNS فشل أيضاً، وسوف نرى السبب بعد قليل. نعيد الاختبار بعد لحظات، ونرى حالة المحور:
docker exec lab-hub-hub ip -br -4 addr
for i in 1 2 3 4 5 6; do t branch-a 10.20.0.1 8443; done
docker exec lab-hub-hub nft list chain inet hub forward | grep -E "DNS|intranet|other"
والمخرج سوف يكون كما يلي:
lo               UNKNOWN        127.0.0.1/8
eth0@if1851      UP             10.10.0.2/24
eth1@if1852      UP             198.51.100.10/24
wg0              UNKNOWN        10.99.0.1/24
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.20.0.1   8443  open
		iifname "wg0" oifname "eth1" ip saddr { 10.20.0.0/24, 10.30.0.0/24, 10.40.0.0/24 } ip daddr 10.10.0.53 meta l4proto { tcp, udp } th dport 53 counter packets 0 bytes 0 accept comment "spokes -> shared DNS"
		iifname "wg0" oifname "eth1" ip saddr { 10.20.0.0/24, 10.30.0.0/24, 10.40.0.0/24 } ip daddr 10.10.0.53 tcp dport 80 counter packets 0 bytes 0 accept comment "spokes -> intranet"
		counter packets 4 bytes 264 comment "other drops"
ERP عاد، لكن عدادي قاعدتي DNS والإنترانت بقيا على صفر وعداد other drops سجل طلبات DNS المرفوضة. والسبب في السطرين الأولين من المخرج: بعد إعادة التشغيل أعطى Docker اسم eth0 لشبكة الخدمات وeth1 لشبكة «الإنترنت»، أي عكس ما كان عليه، فالقاعدة التي تقول oifname "eth1" أصبحت تشير إلى الواجهة الخطأ. وهذا خطأ شائع في أي سيرفر: أسماء الواجهات قد تتغير بعد إعادة التشغيل أو إضافة بطاقة شبكة، فإما أن تثبت الأسماء، كما تفعل في systemd بملفات .link تربط الاسم بعنوان MAC، أو أن تكتب القاعدة بما لا يتغير، وهو هنا عنوان الوجهة. نحذف شرط الواجهة من القاعدتين ونعيد التطبيق:
docker exec lab-hub-hub sed -i 's/iifname "wg0" oifname "eth1" /iifname "wg0" /' /etc/hub.nft
docker exec lab-hub-hub nft -f /etc/hub.nft
docker exec lab-hub-branch-a nslookup -type=a erp.hq.corp.internal | tail -2
t branch-a 10.10.0.53 80
t branch-a 10.20.0.1 8443
t branch-a 10.40.0.1 445
والمخرج سوف يكون كما يلي:
Address: 10.20.0.1

branch-a  -> 10.10.0.53  80    open
branch-a  -> 10.20.0.1   8443  open
branch-a  -> 10.40.0.1   445   blocked
عادت الشبكة كلها كما كانت، والفروع ما زالت معزولة عن بعضها. ولاحظ أن القاعدة ما زالت دقيقة دون اسم الواجهة، لأنها تشترط أن تأتي الحركة من النفق ومن شبكة طرف، وأن تذهب إلى عنوان DNS ومنفذه فقط.
التنظيف
نحذف ما أنشأناه بالاسم فقط:
docker rm -f lab-hub-hub lab-hub-dns lab-hub-hq lab-hub-branch-a lab-hub-branch-b
docker network rm lab-hub-wan lab-hub-shared
docker image rm lab-hub-node:1
كيف تبنيه في بيئتك بأدوات مفتوحة المصدر؟
سيرفر Linux بـ WireGuard وnftables
التجربة السابقة هي نفس الإعداد الذي تضعه على سيرفر Linux حقيقي أو VPS ليكون المحور، والفروق للإنتاج ثلاثة: تفعل التمرير net.ipv4.ip_forward=1 في ملف داخل /etc/sysctl.d/، وتضع ملف القواعد في /etc/nftables.conf وتفعل خدمة nftables، وتفعل الخدمة wg-quick@wg0 حتى يعود النفق بعد الإقلاع، ثم تحمي المحور نفسه بسلسلة input لا تقبل إلا منفذ WireGuard من الإنترنت وSSH من شبكة الإدارة، ويفضل أن يكون SSH عبر ال Bastion. وإذا أردت واجهة ويب لإضافة المستخدمين فقد شرحنا WireGuard مع wg-easy، أما أنفاق الفروع فالأفضل أن تبقى في ملف إعداد محفوظ في Git لأنها لا تتغير كثيراً.
OPNsense: محور بواجهة رسومية
إذا أردت جداراً نارياً مستقلاً بواجهة رسومية فاجعل OPNsense هو المحور، وتشرح وثائقه ربط موقعين ب WireGuard: تنشئ Instance بعنوان النفق، وتضيف Peer لكل فرع بمفتاحه العام وشبكته في Allowed IPs، وتفتح منفذ UDP على واجهة WAN، ثم تكتب قواعد الجدار على واجهة WireGuard، ومع عدة فروع تضيف Peer لكل فرع على نفس ال Instance، والقواعد التي تسمح أو تمنع الحركة بين الفروع تكتب على تلك الواجهة كما كتبناها في nftables. ويدعم OPNsense أيضاً IPsec إذا كان أحد الفروع جهازاً تجارياً لا يدعم WireGuard.
MikroTik في الفروع أو في المحور
أجهزة MikroTik شائعة في الفروع، وقد شرحنا ربط فرعين ب WireGuard على RouterOS بالأوامر في MikroTik في الواقع. ولتحويل ذلك إلى محور وأطراف فالفكرة نفسها: في راوتر الفرع Peer واحد إلى المحور، وفي allowed-address الشبكة الداخلية كلها مثل 10.0.0.0/8 بدل شبكة فرع واحد، وفي راوتر المحور Peer لكل فرع بشبكته، وقواعد السلسلة forward بين الفروع في جدار الحماية في MikroTik.
أخطاء شائعة
- محور بلا سياسة: كما رأينا في التجربة، المحور يوجه كل شيء بين الأطراف حتى تكتب سياسة رفض، فتحصل على شبكة مسطحة بين المواقع لكنها أبطأ.
- شبكات متداخلة: فرعان على
192.168.1.0/24لا يمكن توجيههما عبر محور واحد، فخطط عناوين كل المواقع والسحابة قبل الربط، كما في خطة العناوين. - محور واحد بلا بديل: كل الشركة تتوقف إذا توقف، فإما محور ثان، أو على الأقل خطة مكتوبة لإعادته وقياس كم يستغرق ذلك.
- رابط مباشر ينسى: نفق أو Peering مباشر أضيف لحل مشكلة سرعة، ثم بقي يتجاوز الجدار الناري سنوات، فاكتب كل رابط مباشر في سجل مع سببه وقواعده.
- Peering وكأنه متعد: افتراض أن ربط طرفين بنفس المحور في Azure أو AWS يوصلهما ببعض، أو أن ال VPC المربوط يستطيع استخدام NAT أو VPN في VPC آخر، والوثائق تقول عكس ذلك.
- مسار غير متماثل: الطلب يمر على محور والرد على آخر، أو يمر الطلب على الجدار الناري والرد يتجاوزه، فيرفض الجدار Stateful الرد وتنتهي الاتصالات بانتهاء المهلة.
- قواعد بأسماء واجهات غير ثابتة: كما رأينا بعد إعادة تشغيل المحور، فثبت الأسماء أو اكتب القواعد بالعناوين.
- نسيان فاتورة المعالجة: نقل نسخ احتياطية كبيرة بين طرفين عبر Transit Gateway أو جدار ناري مدار يحسب على كل جيجابايت، فاحسبها قبل أن تحسبها الفاتورة.
قائمة التحقق
- هل لكل موقع وشبكة سحابية نطاق عناوين لا يتداخل مع غيره، وهل يمكن تجميعها في مسار واحد مثل
10.0.0.0/8؟ - هل سياسة المحور «ارفض كل شيء» مع استثناءات مكتوبة بسببها، وهل جربت من كل طرف أن الممنوع ممنوع فعلاً؟
- هل الخدمات المشتركة في المحور قليلة ومحمية، والتطبيقات في الأطراف؟
- ماذا يحدث إذا توقف المحور؟ هل لديك محور ثان أو وقت استعادة معروف؟
- هل الواجهات والخدمات تعود وحدها بعد إعادة تشغيل المحور؟
- هل كل رابط مباشر بين طرفين له سبب مكتوب وقواعد في طرفيه؟
- هل تسجل الحركة المرفوضة بين الأطراف وتصل السجلات إلى من يراقبها؟
- في السحابة: هل حسبت أجرة الساعة لكل Attachment وأجرة كل جيجابايت يمر بالمحور؟
تدريب عملي
- أضف إلى التجربة طرفاً رابعاً
lab-hub-branch-cبالشبكة10.50.0.0/24، ولاحظ أنك لا تعدل إلا ملف المحور وقائمة$BRANCHES. - أضف إلى قاعدة الرفض بين الأطراف عبارة
log prefix "hub-drop "على سيرفر Linux حقيقي، وجرب الوصول من فرع إلى فرع، ثم ابحث عن السطر بالأمرjournalctl -k | grep hub-drop. - ارسم مواقع شركتك وشبكاتها السحابية، واحسب عدد الأنفاق في الربط الكامل وفي المحور، ثم حدد أي زوج من المواقع يستحق رابطاً مباشراً ولماذا.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الربط الكامل يحتاج
n(n-1)/2نفقاً، أي 15 لستة مواقع و1,225 لخمسين، والمحور يحتاج نفقاً واحداً لكل موقع، وسياسة في مكان واحد. - المحور يحمل ما يحتاجه الجميع: الجدار الناري والفحص، وDNS، والهوية، والسجلات، والخروج إلى الإنترنت، وإنهاء أنفاق VPN، وال Bastion، ويبقى صغيراً ومحمياً.
- الثمن: نقطة فشل واحدة تعالج بمحورين ومسار متماثل، وقفزة إضافية وفك تشفير وإعادته في كل حزمة بين طرفين، وفي السحابة أجرة على كل جيجابايت.
- الحركة بين الأطراف عبر المحور هي الأصل، والرابط المباشر استثناء لحركة كبيرة ومعروفة، وله سياسته الخاصة لأنه يتجاوز جدار المحور كما رأينا بالمخرج.
- في Azure المحور VNet وال Peering غير متعد، وفي AWS المحور Transit Gateway بجداول توجيه لكل Attachment، وفي Google Cloud المحور NCC بطوبولوجيا Star.
- بأدوات مفتوحة المصدر تبنيه بسيرفر Linux فيه WireGuard وnftables، أو OPNsense، أو MikroTik في الفروع، وشبكات Mesh مثل Headscale وNetBird بديل عندما تريد المسار المباشر.
وأقرب المقالات إلى هذا الموضوع على الموقع:
 دليلتقسيم الشبكة Network Segmentation بال VLAN وال VPCلماذا تصل كاميرا مخترقة إلى قاعدة بياناتك، وكيف تمنع ذلك بتقسيم الشبكة إلى مناطق لا يمر بينها إلا ما تسمح به.
 دليلما هو VPN؟ الشبكة الخاصة الافتراضية من المشكلة إلى الأنواعلماذا تحتاج شبكة خاصة افتراضية VPN، وكيف تغلف حزمك وتشفرها داخل نفق، وأي نوع منها يناسب فريقك.
 دليلما هو النفق Tunnel في الشبكات؟ ومتى تحتاج إليهكيف تصل إلى قاعدة بيانات لا تراها من الإنترنت، وتنشر خدمة من خلف CGNAT دون فتح منافذ، ومتى تحتاج إلى VPN بدل النفق.
 دليلشبكة خاصة مع WireGuard وواجهة wg-easyكيف تنشئ شبكة VPN خاصة مع WireGuard وواجهة wg-easy، فلا يصل إلى لوحات الإدارة على سيرفرك إلا أجهزة فريقك.
 دليلMikroTik في الواقع: سيناريوهات عملية للبيت والمكتبكيف تبني على RouterOS ما تحتاجه فعلاً في البيت والمكتب، من شبكة ضيوف معزولة إلى الوصول الآمن من الخارج عبر WireGuard.
 دليلBastion Host أم Jump Server؟ نقطة الدخول الآمنة إلى سيرفراتكلماذا لا يفتح كل سيرفر منفذ الإدارة للإنترنت، وكيف تبني نقطة دخول واحدة مقواة تمر عبرها إلى سيرفراتك بأمان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، ومراجعة وثائق Azure Hub-Spoke وVNet Peering وAWS VPC Peering وTransit Gateway وأسعاره، وGoogle Cloud Network Connectivity Center، وOPNsense، وتنفيذ التجربة العملية على Docker Engine 29.8.0 مع alpine:3.24 وwireguard-tools 1.0.20260223 وnftables 1.1.6 وiproute2 7.0.0 وdnsmasq 2.92.


