

عندما يكبر تطبيقك قليلاً ويصبح توقف قاعدة البيانات ساعة واحدة مشكلة حقيقية، فغالباً سوف يأتي أحد أعضاء الفريق بالاقتراح المعروف: «نحتاج Cluster لقاعدة البيانات». والمشكلة أن هذه الكلمة تعني أشياء مختلفة تماماً بحسب قاعدة البيانات ومن يتحدث، فقد يقصد بها نسخة احتياطية جاهزة تحل محل السيرفر الرئيسي إذا توقف، أو نسخاً للقراءة تخفف الضغط، أو تقسيم البيانات على عشرة سيرفرات، أو قاعدة بيانات موزعة من نوع جديد، ولكل واحد من هذه الخيارات ثمن مختلف ومشاكل مختلفة، وبعضها لا يحل المشكلة التي جاء من أجلها أصلاً.
وقد شرحنا النظرية التي تقف خلف كل ذلك في دليل الأنظمة الموزعة للمبتدئين: النسخ المتماثل Replication بأنواعه، وتأخر النسخ، والتقسيم Partitioning، ونظرية CAP، والإجماع Consensus بخوارزمية Raft، لذلك لن نعيد شرحها هنا، وإنما سوف نحيلك إلى القسم المناسب منها في جملة واحدة كلما احتجنا إليه. أما هذا المقال فهو الخريطة العملية: ماذا تقدم كل قاعدة بيانات مشهورة، وكيف يحدث الانتقال Failover فعلاً، وكيف يجد التطبيق السيرفر الجديد، ومتى لا تحتاج أي Cluster على الإطلاق، وسوف نناقش في هذا المقال ما يلي:
- معنى كلمة عنقود Cluster في PostgreSQL وMySQL وMongoDB وRedis وValkey، ولماذا يختلف من قاعدة إلى أخرى.
- لماذا تبني عنقوداً أصلاً: التوفر العالي، وتوسيع القراءة، وتوسيع الكتابة، والقرب من المستخدمين، وما لا يعطيك إياه العنقود.
- أشكال العناقيد: القرص المشترك، والسيرفر الرئيسي مع النسخ، وعدة سيرفرات رئيسية، والتقسيم Sharding، وقواعد SQL الموزعة.
- الانتقال التلقائي Failover خطوة بخطوة: اكتشاف العطل، والانتخاب عبر مخزن التوافق DCS، وإيقاف السيرفر القديم Fencing، وRPO وRTO.
- كيف يجد التطبيق السيرفر الرئيسي الجديد، وكيف توجه القراءة إلى النسخ دون أن يرى المستخدم بيانات قديمة.
- التقسيم Sharding في الواقع، وخريطة لكل محرك مع ترخيصه ونقاط القوة ونقاط الضعف.
- كم سيرفراً تحتاج وأين تضعها، والتشغيل اليومي، ودليل قرار يبدأ من سؤال: هل تحتاج عنقوداً أصلاً؟
- تجربة عملية حقيقية: PostgreSQL مع نسخة متدفقة وتأخر وانتقال يدوي وانقسام دماغ ثم إصلاحه بالأداة pg_rewind، ثم Valkey مع ثلاثة Sentinels تنقل الدور تلقائياً.
ماذا تعني كلمة عنقود Cluster في كل قاعدة بيانات؟
قبل أي شيء يجب أن نتفق على الكلمة، لأن أغلب سوء الفهم في هذا الموضوع يبدأ منها. والصورة التالية تبين معناها في أربع قواعد بيانات مشهورة:
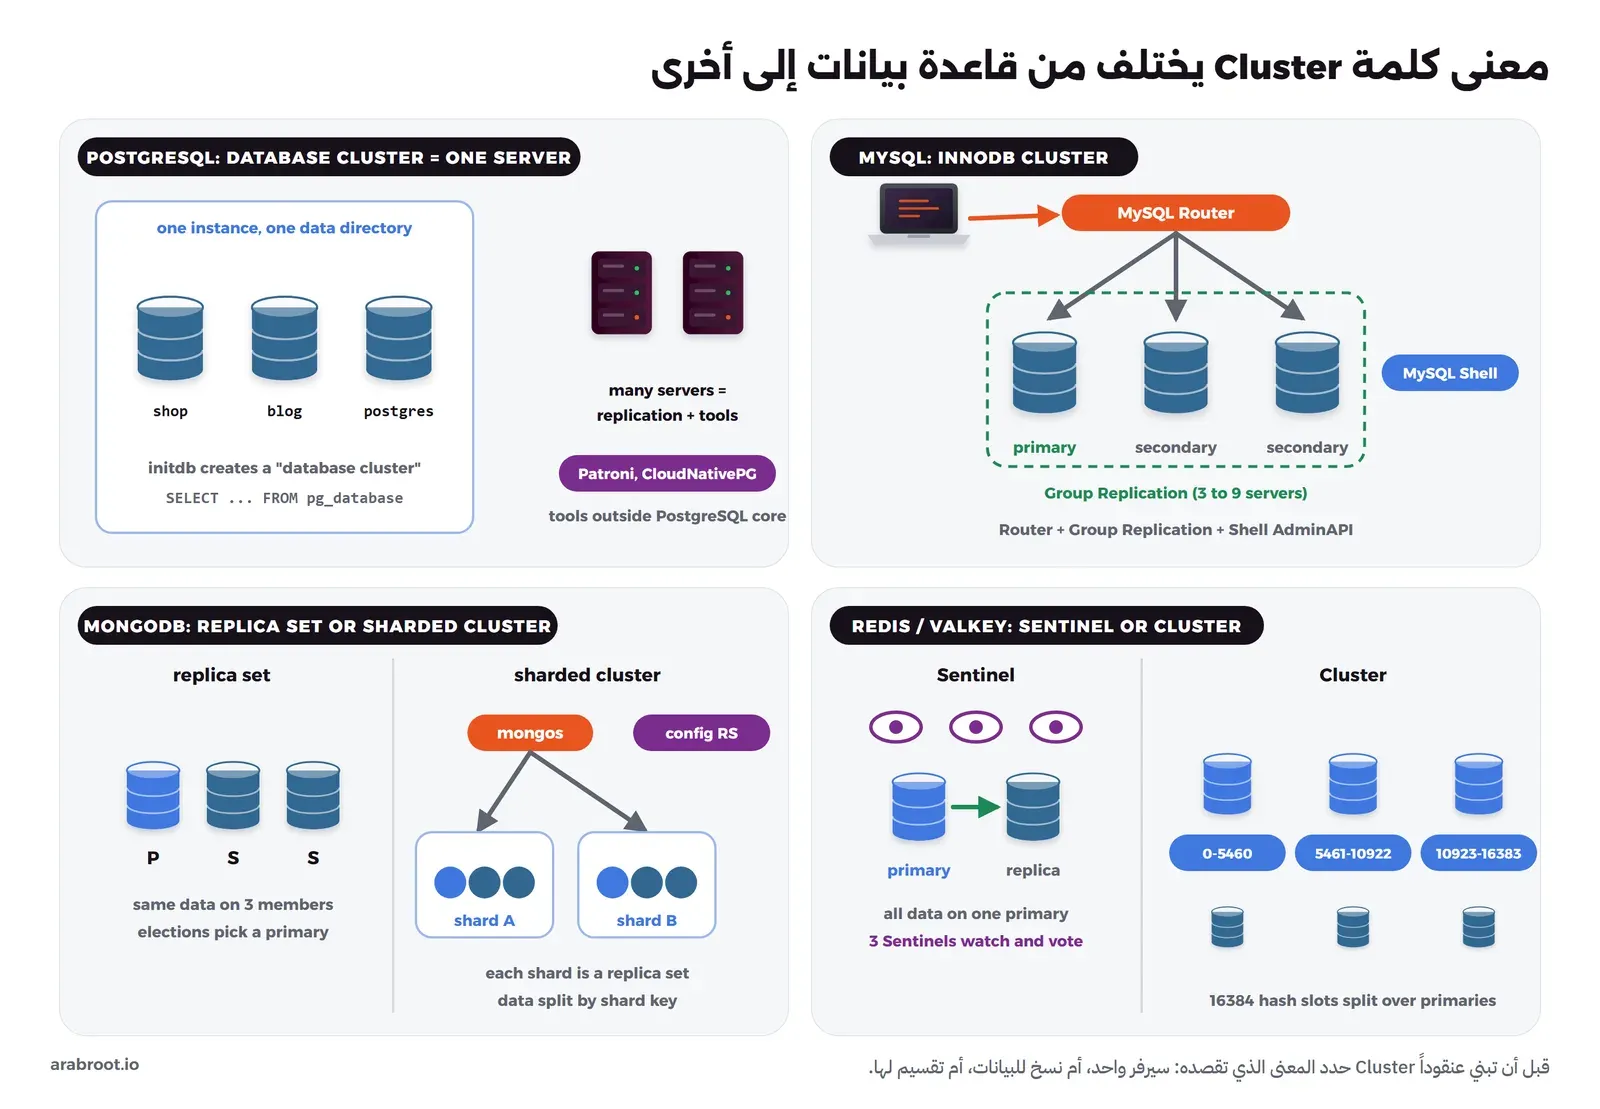
- PostgreSQL: في توثيق PostgreSQL نفسه، العنقود Database Cluster هو «مجموعة من قواعد البيانات يديرها سيرفر واحد يعمل»، أي ما ينشئه الأمر
initdbفي مجلد البيانات، والإعدادcluster_nameيصفه التوثيق بأنه اسم يميز «هذا العنقود (السيرفر)». لذلك عندما تقرأ في التوثيق كلمة Cluster فهي غالباً تعني سيرفراً واحداً، أما ما يقصده الناس بعنقود PostgreSQL من عدة سيرفرات فهو النسخ المتماثل المدمج في PostgreSQL مع أداة خارجية تدير الانتقال مثل Patroni أو CloudNativePG. - MySQL: المنتج المسمى InnoDB Cluster هو ثلاثة سيرفرات على الأقل تعمل بالنسخ الجماعي Group Replication، وأمامها MySQL Router الذي يوجه الاتصالات، وتديرها من MySQL Shell. وهناك منتج آخر مختلف تماماً اسمه MySQL NDB Cluster بمحرك تخزين آخر، فلا تخلط بينهما عند البحث.
- MongoDB: هنا مصطلحان: مجموعة النسخ Replica Set وهي نسخ للبيانات نفسها مع انتخاب Election للسيرفر الرئيسي، والعنقود المقسم Sharded Cluster وهو تقسيم البيانات على عدة أجزاء Shards، كل جزء منها Replica Set كامل.
- Redis وValkey: كذلك مصطلحان: Sentinel وهو مجموعة عمليات تراقب سيرفراً رئيسياً ونسخه وتنقل الدور عند العطل، وكل البيانات ما زالت على سيرفر رئيسي واحد، وCluster وهو تقسيم المفاتيح على عدة سيرفرات رئيسية عبر 16384 خانة هاش Hash Slot.
لذلك عندما يقول أحدهم «نحتاج Cluster» فاسأله مباشرة: هل تقصد أن يبقى النظام يعمل إذا توقف سيرفر، أم أن تتحمل قاعدة البيانات قراءة أكثر، أم كتابة وبيانات أكبر من سيرفر واحد؟ والسبب أن كل سؤال من هذه له جواب مختلف، كما سوف ترى في القسم التالي.
لماذا تبني عنقوداً Cluster أصلاً؟
هناك أربعة أهداف حقيقية تدفعك إلى أكثر من سيرفر لقاعدة البيانات، وكل هدف يخدمه أسلوب مختلف، والخطأ الشائع أن تبني الأسلوب الخطأ للهدف الصحيح، مثل أن تبني توفراً عالياً ثم تتفاجأ أن الكتابة ما زالت بطيئة:
| الهدف | ماذا يعني | الأسلوب الذي يخدمه | ما لا يحله |
|---|---|---|---|
| التوفر العالي High Availability | أن تبقى الخدمة تعمل إذا توقف السيرفر الرئيسي | سيرفر رئيسي ونسخة أو أكثر مع انتقال تلقائي Failover | بطء الكتابة، فما زال هناك سيرفر رئيسي واحد يكتب |
| توسيع القراءة Read Scaling | أن توزع استعلامات القراءة على عدة سيرفرات | نسخ للقراءة Read Replicas مع توجيه للقراءة | الكتابة، والقراءة بعد الكتابة مباشرة |
| توسيع الكتابة Write Scaling | أن تتحمل كتابة وبيانات أكبر من أقوى سيرفر معقول | التقسيم Sharding، أو قاعدة SQL موزعة | تصميم سيء للجداول والاستعلامات، وهو يضيف تعقيداً كبيراً |
| القرب الجغرافي Geography | أن تكون البيانات قريبة من مستخدمين في قارات مختلفة، أو أن تنجو من سقوط مركز بيانات كامل | نسخ في مناطق مختلفة، أو قاعدة SQL موزعة على عدة مناطق | سرعة الضوء، فالكتابة المتزامنة بين قارتين بطيئة دائماً |
وقد شرحنا في دليل PostgreSQL للجداول الضخمة أن التوفر العالي ليس توسعاً للكتابة، وهذه أهم جملة في هذا القسم، وقد شرحنا أسباب النسخ الثلاثة نفسها في قسم النسخ المتماثل Replication. فإذا كانت مشكلتك أن الاستعلامات بطيئة فالحل في الفهارس والاستعلامات والتقسيم داخل السيرفر نفسه قبل أي عنقود.
ما لا يعطيك إياه العنقود Cluster
هناك ثلاثة أشياء يظن الكثيرون أن العنقود يعطيها، وهو لا يعطيها:
- العنقود ليس نسخة احتياطية Backup: النسخ المتماثل ينقل كل تغيير إلى كل نسخة خلال أجزاء من الثانية، وهذا يشمل الأخطاء، فأمر
DROP TABLE ordersالذي نفذته بالخطأ على السيرفر الرئيسي سوف يحذف الجدول من كل النسخ قبل أن ترفع يدك عن لوحة المفاتيح. لذلك ما زلت تحتاج نسخاً احتياطية منفصلة مع الاستعادة إلى نقطة زمنية PITR كما شرحنا في قسم النسخ الاحتياطي، وقد ذكرنا في مصطلحات الاستضافة الذاتية كيف خسرت GitLab سنة 2017 ساعات من البيانات رغم وجود سيرفر ثانوي، لأن النسخ الاحتياطية نفسها لم تكن تعمل. ويوفر PostgreSQL الإعدادrecovery_min_apply_delayلنسخة متأخرة عن قصد بساعة مثلاً، وهي تعطيك فرصة لإنقاذ ما حذفته، ولكنها لا تغني عن النسخ الاحتياطي. - العنقود لا يصلح الاستعلام البطيء: الاستعلام الذي يقرأ عشرة ملايين صف دون فهرس سوف يكون بطيئاً على كل نسخة، وإذا وزعته على ثلاث نسخ فأنت توزع البطء على ثلاثة سيرفرات، والحل في قياس الاستعلامات وإصلاحها أولاً.
- العنقود لا يقلل التعقيد: كل سيرفر إضافي هو شيء آخر يتعطل ويحتاج تحديثاً ومراقبة، وكل عنقود يأتي معه أنواع جديدة من الأعطال لا توجد على سيرفر واحد، مثل انقسام الدماغ Split Brain وتأخر النسخ، فإذا لم يكن عندك الوقت لاختبار الانتقال بانتظام، فقد يكون العنقود أقل أماناً من سيرفر واحد مع نسخ احتياطية جيدة.
أشكال العناقيد Cluster Architectures: من يملك البيانات ومن يكتب؟
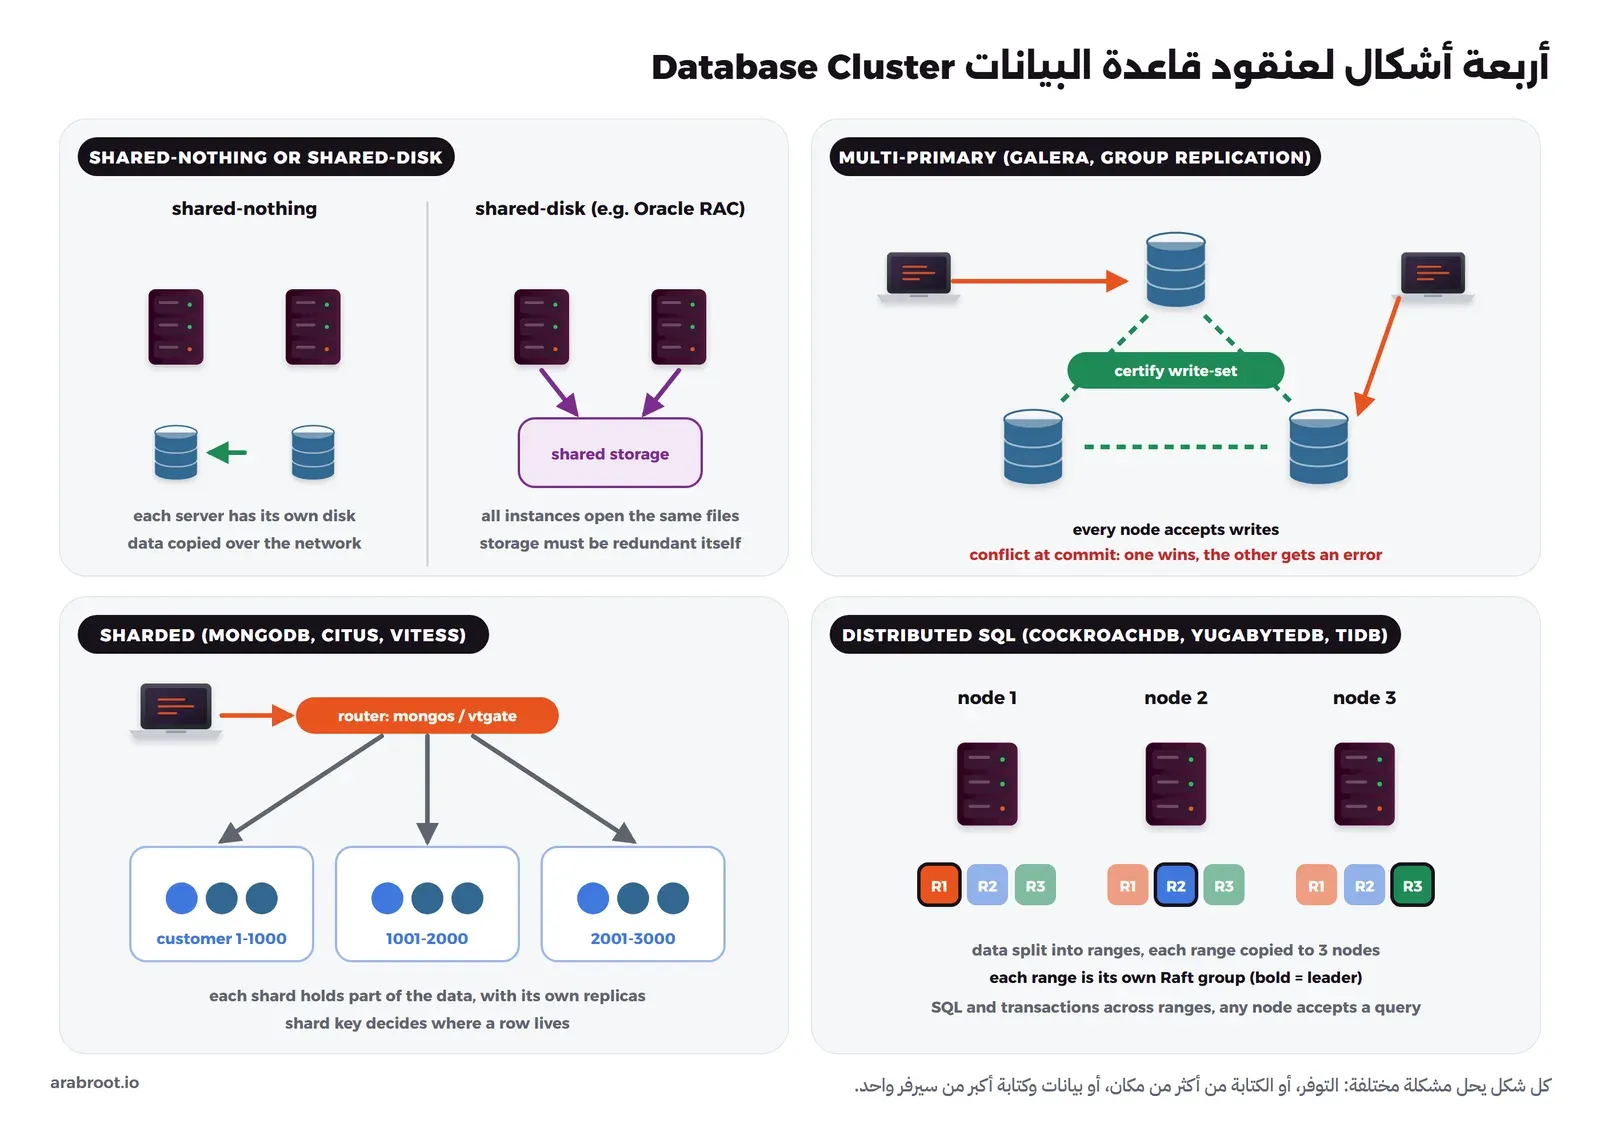
كل العناقيد التي ستقابلها تقريباً تقع في واحد من خمسة أشكال، والسؤالان اللذان يفرقان بينها هما: هل يملك كل سيرفر قرصه الخاص؟ وكم سيرفراً يقبل الكتابة؟ والصورة التالية تبين أربعة منها، والخامس وهو السيرفر الرئيسي مع النسخ له صورة خاصة بعدها. وهناك شكل سادس دون سيرفر رئيسي أصلاً Leaderless، تكتب فيه على عدة نسخ وتقرأ من عدة نسخ بقاعدة النصاب، وهو أسلوب Cassandra وScyllaDB، وقد شرحناه في قسم دون قائد Leaderless والنصاب Quorum، ولن نتوسع فيه هنا لأن قواعد هذا المقال كلها تعمل بسيرفر رئيسي:
لا شيء مشترك Shared-Nothing أم قرص مشترك Shared-Disk؟
في أسلوب لا شيء مشترك Shared-Nothing، لكل سيرفر معالجه وذاكرته وقرصه، وتنتقل البيانات بين السيرفرات عبر الشبكة، وهذا ما تفعله كل القواعد مفتوحة المصدر في هذا المقال. أما في أسلوب القرص المشترك Shared-Disk فعدة سيرفرات تفتح ملفات البيانات نفسها على تخزين مشترك، وأشهر مثال عليه Oracle RAC، الذي تصفه وثائق Oracle بأنه قاعدة «يشترك فيها كل شيء» Shared Everything، حيث يجب أن تكون ملفات البيانات وسجلات Redo على أقراص مشتركة يراها كل السيرفرات. ونقطة القوة أن أي سيرفر يقرأ ويكتب البيانات نفسها دون نسخ، ونقطة الضعف أن التخزين المشترك نفسه يجب أن يكون متكرراً وموثوقاً لأنه أصبح نقطة الفشل، وأن هذا النوع يحتاج عتاداً وترخيصاً خاصين. ويذكر توثيق PostgreSQL في مقارنة حلول التوفر شكلاً أبسط منه هو الانتقال بالقرص المشترك Shared Disk Failover، حيث يركب السيرفر الاحتياطي القرص نفسه بعد توقف الرئيسي، ولكنه نادر في البيئات التي يديرها فريق صغير.
سيرفر رئيسي ونسخ للقراءة Primary-Replica
وهو الشكل الأشهر بفارق كبير، وفيه يستقبل سيرفر رئيسي Primary كل الكتابة، ويرسل التغييرات إلى نسخ Replicas تقبل القراءة فقط، وقد شرحنا فكرته في قسم القائد والتابع Leader-Follower، والفرق بين النسخ المتزامن وغير المتزامن في قسم النسخ المتزامن وغير المتزامن. والصورة التالية تبين ما يحدث في هذا الشكل، والمشكلة التي يسببها التأخر للمستخدم:
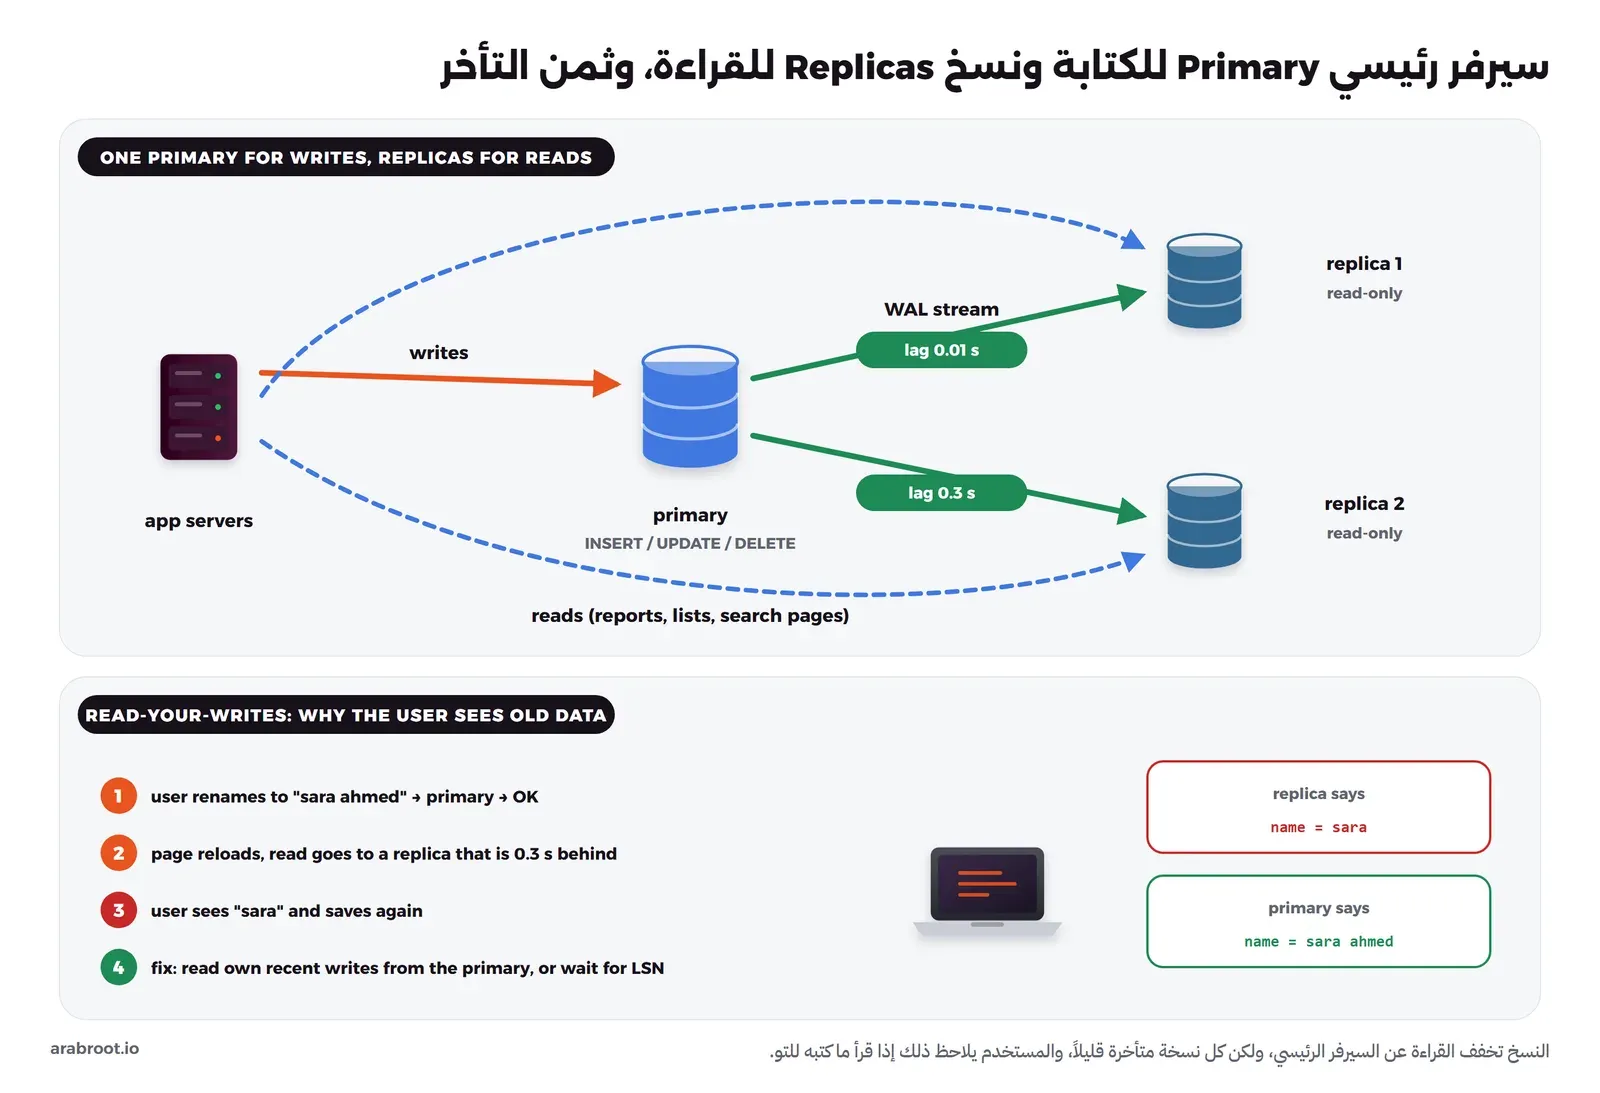
ونقطة القوة أنه بسيط ومدمج في كل المحركات تقريباً ولا توجد فيه تعارضات Conflicts لأن الكتابة في مكان واحد، ونقطة الضعف أن السيرفر الرئيسي ما زال واحداً، فقدرة الكتابة هي قدرة سيرفر واحد، وإذا توقف فأنت تحتاج من يرقي نسخة مكانه، وهو موضوع قسم الانتقال القادم.
عدة سيرفرات رئيسية Multi-Primary
هنا يقبل كل سيرفر في العنقود الكتابة، والفكرة جذابة من الوهلة الأولى: ثلاثة سيرفرات تكتب بدلاً من واحد. وأشهر مثالين هما Galera Cluster مع MariaDB، الذي يصف نفسه بالنسخ «شبه المتزامن» Virtually Synchronous، وGroup Replication في وضع عدة سيرفرات رئيسية في MySQL. والآلية في الاثنين تقريباً واحدة: كل سيرفر ينفذ المعاملة عنده بتفاؤل، ثم عند الالتزام Commit يرسل مجموعة التغييرات Write-Set إلى الجميع، ويتحقق كل سيرفر بالترتيب نفسه هل تتعارض مع معاملة سبقتها، وهذا ما تسميه وثائق Galera النسخ القائم على التحقق Certification-Based Replication. فإذا عدلت معاملتان السطر نفسه على سيرفرين في اللحظة نفسها، نجحت واحدة وفشلت الأخرى بخطأ عند الالتزام، وعلى التطبيق أن يعيد المحاولة.
وقد يتساءل البعض: إذا كان كل سيرفر يقبل الكتابة، فهل تتضاعف قدرة الكتابة بعدد السيرفرات؟ والإجابة لا، والسبب أن كل سيرفر يجب أن يطبق كل الكتابات التي حدثت على كل السيرفرات الأخرى، لأن كل سيرفر يحمل البيانات كاملة، فالفائدة الحقيقية هنا هي التوفر وأن أي سيرفر يصلح للكتابة إذا توقف غيره، وليس توسيع الكتابة. لذلك ينصح الكثيرون باستخدام Galera وكأنه سيرفر رئيسي واحد، أي توجيه كل الكتابة إلى سيرفر واحد في كل لحظة عبر موزع الحمل، لتجنب أخطاء التعارض، وقد شرحنا ثمن التعارضات بشكل عام في قسم عدة قادة Multi-Leader.
التقسيم على عدة سيرفرات Sharding
عندما تصبح الكتابة أو حجم البيانات أكبر من أقوى سيرفر معقول، فالحل الوحيد هو أن تقسم البيانات نفسها، فيحمل كل جزء Shard جزءاً من الصفوف، ويقف أمامها موجه Router يعرف أين يقع كل صف. وهذا ما يفعله العنقود المقسم في MongoDB بالموجه mongos وسيرفرات الإعداد Config Servers، والإضافة Citus في PostgreSQL بسيرفر منسق Coordinator وسيرفرات عاملة Workers، وVitess في MySQL بالموجه vtgate. ولاحظ أن كل جزء في هذه الأنظمة له نسخه الخاصة أيضاً، فالتقسيم لا يغني عن النسخ وإنما يضاف إليه. وقد شرحنا طرق التقسيم بالمدى وبالهاش في قسم تقسيم البيانات Partitioning، وسوف نعود إلى مشاكله العملية في قسم مستقل بعد قليل.
قواعد SQL الموزعة Distributed SQL
وهي جيل أحدث يحاول أن يعطيك الاثنين معاً: قاعدة SQL بمعاملات كاملة، وتقسيم ونسخ تلقائي تحت الغطاء. فالبيانات تقسم إلى مديات Ranges صغيرة، وكل مدى ينسخ على ثلاثة سيرفرات عادة، ولكل مدى مجموعة Raft خاصة به تنتخب قائداً له، وأي سيرفر يستقبل الاستعلام ويوجهه، وإذا توقف سيرفر انتخبت المديات التي كان يقودها قادة جدداً خلال ثوان. وأشهرها ثلاثة، وانتبه لتراخيصها:
- CockroachDB: متوافق مع بروتوكول PostgreSQL، ومنذ الإصدار 24.3 أصبح بترخيص CockroachDB Software License، وهو ترخيص مصدر متاح Source Available وليس مفتوح المصدر، ومجاني للشركات التي يقل دخلها السنوي عن 10 ملايين دولار بشروط منها إرسال بيانات الاستخدام Telemetry.
- YugabyteDB: يعيد استخدام كود PostgreSQL في طبقة الاستعلام، وقاعدة البيانات نفسها بترخيص Apache 2.0 كما في أسئلتهم الشائعة، أما أداة الإدارة YugabyteDB Anywhere فلها ترخيص آخر.
- TiDB: متوافق مع MySQL ويخزن البيانات في TiKV، وبترخيص Apache 2.0 كما في مستودعه.
وهذه القواعد تختار الاتساق عند انقسام الشبكة، فالجزء الذي لا يملك الأغلبية يرفض الكتابة بدلاً من أن يعطيك قيمة قديمة، وهو ما شرحناه في قسم نظرية CAP. ونقطة القوة أنك لا تختار مفتاح تقسيم بيدك ولا تكتب منطق التوجيه، ونقطة الضعف أن كل كتابة تنتظر أغلبية النسخ عبر الشبكة، فزمن الكتابة الواحدة أعلى من PostgreSQL على سيرفر واحد، وأن المعاملة التي تلمس مديات على سيرفرات مختلفة تحتاج تنسيقاً بينها، وأن التشغيل والمراقبة عالم جديد على الفريق. لذلك هي مناسبة عندما تحتاج فعلاً كتابة وبيانات أكبر من سيرفر واحد أو عدة مناطق جغرافية، وليست بديلاً تلقائياً عن PostgreSQL لتطبيق عادي.
ماذا يحدث عندما يتوقف السيرفر الرئيسي؟ الانتقال Failover خطوة بخطوة
لنفرض أن لديك سيرفراً رئيسياً ونسخة واحدة، والساعة الثالثة فجراً توقف السيرفر الرئيسي. الحل الأبسط أن يستيقظ أحد أعضاء الفريق على التنبيه، ويتأكد أن الرئيسي توقف فعلاً، ثم يرقي النسخة يدوياً ويغير عنوان قاعدة البيانات في التطبيق، وهذا الحل يعمل، ولكن التوقف فيه يقاس بالدقائق أو الساعات بحسب سرعة استيقاظ الشخص، وهو مقبول لأنظمة كثيرة فعلاً كما سوف نرى في دليل القرار.
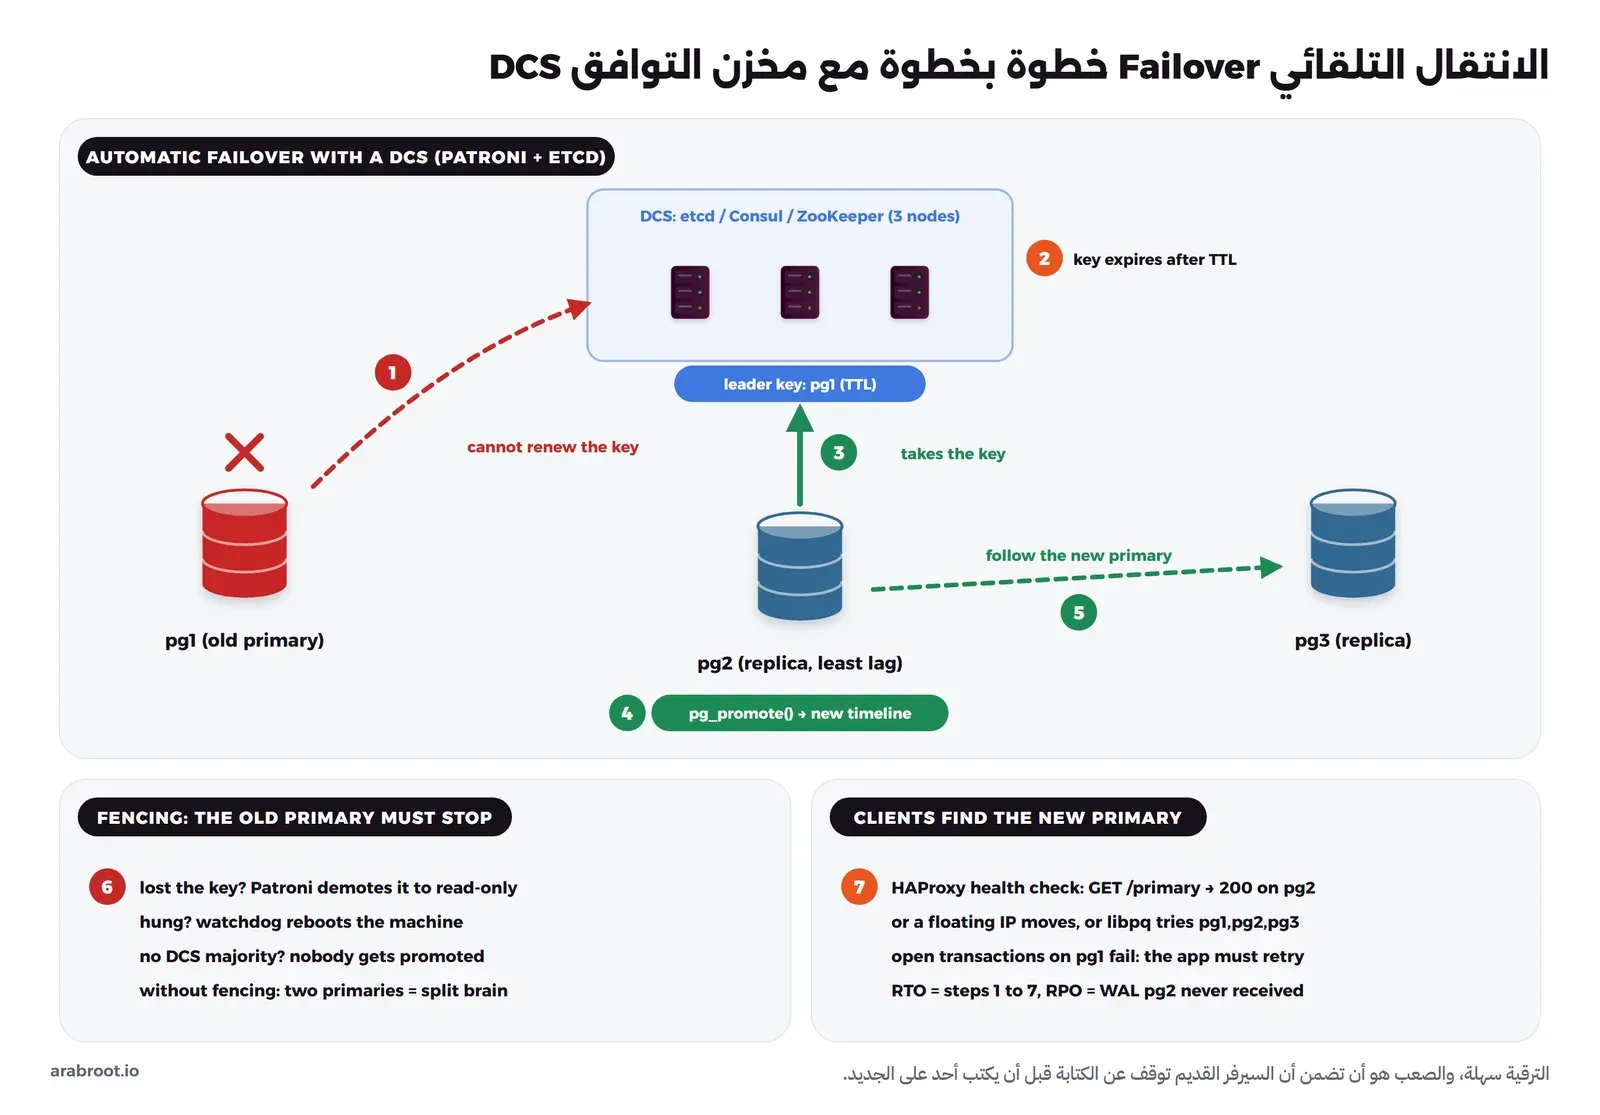
والحل الثاني الذي يخطر على البال هو سكربت صغير على النسخة يرسل Ping إلى الرئيسي كل ثانية، فإذا لم يرد ثلاث مرات رقى النسخة نفسها. وهذا الحل خطير جداً، والسبب أن النسخة لا تستطيع أن تفرق بين رئيسي توقف فعلاً، ورئيسي يعمل ولكن الشبكة بينهما انقطعت، ففي الحالة الثانية يصبح عندك سيرفران رئيسيان يقبلان الكتابة، كل منهما من جهة من التطبيق، وهذا ما يسمى انقسام الدماغ Split Brain، وقد شرحنا لماذا لا يحله سيرفران وحدهما في قسم لماذا ثلاثة أو خمسة. والحل الصحيح يتكون من أربعة أجزاء: اكتشاف العطل، وقرار بالأغلبية من يصبح الرئيسي، وإيقاف السيرفر القديم، وتوجيه التطبيق إلى الجديد، والصورة التالية تبينها بالترتيب كما يفعلها Patroni:
اكتشاف العطل Health Checks
كل أداة انتقال تفحص السيرفر الرئيسي بشكل دوري، والسؤال الحقيقي ليس كيف تفحص، وإنما كم تنتظر قبل أن تقرر أنه توقف. فإذا انتظرت قليلاً حدث انتقال كامل بسبب توقف لحظي في الشبكة أو عملية Garbage Collection طويلة، والانتقال نفسه يقطع الاتصالات ويسبب أخطاء للمستخدمين، وإذا انتظرت كثيراً طال التوقف الحقيقي. ولذلك تجد هذه المهلة إعداداً أساسياً في كل أداة: في Sentinel اسمه down-after-milliseconds كما سوف ترى في التجربة، وفي MongoDB اسمه electionTimeoutMillis وقيمته الافتراضية 10 ثوان، ويذكر توثيق الانتخابات أن متوسط الزمن حتى ينتخب العنقود سيرفراً رئيسياً جديداً لا يتجاوز عادة 12 ثانية بالإعدادات الافتراضية.
من يصبح الرئيسي الجديد؟ الانتخاب عبر مخزن التوافق DCS
أداة Patroni لا تتخذ القرار بنفسها، وإنما تعتمد على مخزن توافق موزع DCS (Distributed Configuration Store) مثل etcd أو Consul أو ZooKeeper أو Kubernetes، وهذه المخازن تعمل بالإجماع والأغلبية كما شرحنا في قسم Raft خطوة بخطوة. والفكرة بسيطة: هناك مفتاح واحد اسمه مفتاح القائد Leader Key، ومن يملكه هو الرئيسي، وله مدة صلاحية TTL، والرئيسي يجدده في كل دورة. ويذكر توثيق Patroni أن القيم الافتراضية هي ttl=30 وloop_wait=10 ثانية، فإذا توقف الرئيسي عن التجديد انتهى المفتاح، وتسابقت النسخ السليمة على أخذه، ولا تشارك في السباق النسخة المتأخرة أكثر من الحد الذي تضعه في الإعداد maximum_lag_on_failover، ومن يأخذ المفتاح يرقي PostgreSQL عنده إلى رئيسي.
ولاحظ أن هذا يعني أن عنقود Patroni من سيرفري PostgreSQL يحتاج في الحقيقة ثلاثة سيرفرات etcd أيضاً (يمكن أن تكون صغيرة جداً، أو أن تعمل على السيرفرات نفسها مع سيرفر ثالث صغير)، وقد ذكرنا هذا في قسم Patroni للانتقال التلقائي، وسوف نشرح إعداده كاملاً في موضوع Patroni في مرحلة التوفر العالي في خريطة التعلم.
إيقاف السيرفر القديم Fencing وانقسام الدماغ Split Brain
الجزء الذي ينساه أغلب من يكتب سكربت انتقال بنفسه هو السيرفر القديم: ماذا لو لم يتوقف فعلاً، وإنما انقطعت الشبكة بينه وبين بقية العنقود، وما زال بعض التطبيق يصل إليه ويكتب عليه؟ وهنا يأتي ما يسمى إيقاف السيرفر القديم Fencing، أي أن تضمن أن السيرفر القديم لا يقبل أي كتابة بعد أن يأخذ غيره الدور، وقد شرحنا الفكرة العامة في قسم رمز الحماية Fencing Token. ويفعل Patroni ذلك بثلاث طبقات كما في توثيقه: إذا فشل الرئيسي في تجديد مفتاح القائد خفض PostgreSQL فوراً إلى القراءة فقط، وإذا كان Patroni نفسه معلقاً أو بطيئاً فهناك Watchdog يعيد تشغيل الجهاز كله إذا لم يصله نبض في الوقت المحدد، وإذا لم توجد أغلبية في DCS فلا يرقى أحد أصلاً. وفي البيئات التقليدية تسمع أيضاً عن STONITH، وهو أن يقطع العنقود الكهرباء عن السيرفر القديم عبر واجهة إدارة العتاد قبل أن يرقي غيره.
وسوف ترى في التجربة العملية بعيونك ماذا يحدث عندما يعود سيرفر قديم دون Fencing: يقلع كسيرفر رئيسي، والتطبيق يكتب عليه، ثم تضيع تلك الكتابة عندما نعيده إلى العنقود.
كم بيانات تخسر وكم دقيقة تتوقف؟ RPO وRTO
هناك رقمان يجب أن تكتبهما مع الإدارة قبل أن تختار أي تصميم، وكلاهما بلغة بسيطة:
- هدف نقطة الاستعادة RPO (Recovery Point Objective): كم من البيانات الأخيرة تقبل أن تخسره عند العطل، مثلاً «آخر ثانية» أو «لا شيء على الإطلاق» أو «آخر ساعة». في النسخ غير المتزامن قد تخسر الكتابات التي أكدها الرئيسي للتطبيق ولم تصل إلى النسخة قبل توقفه.
- هدف زمن الاستعادة RTO (Recovery Time Objective): كم دقيقة تقبل أن تتوقف الخدمة، أي الزمن من العطل حتى يكتب التطبيق على الرئيسي الجديد، وهو مجموع الخطوات السبع في الصورة أعلاه.
وفي PostgreSQL يتحكم الإعداد synchronous_commit في RPO مباشرة، عندما تحدد النسخ المتزامنة في synchronous_standby_names:
| القيمة | متى يقول الرئيسي «تم»؟ | ماذا يعني لك |
|---|---|---|
off | قبل أن يكتب السجل على قرصه هو | أسرع شيء، وقد تضيع آخر المعاملات حتى دون أي عنقود |
local | بعد أن يكتب على قرصه، دون انتظار أي نسخة | مثل النسخ غير المتزامن |
remote_write | بعد أن تكتب النسخة السجل إلى نظام الملفات | ينجو من توقف PostgreSQL على النسخة، ولكن ليس من توقف نظام تشغيلها |
on (الافتراضي) | بعد أن تكتب النسخة السجل على قرصها بشكل دائم | لا تضيع الكتابة إلا إذا توقف الاثنان معاً |
remote_apply | بعد أن تطبق النسخة التغيير فيراه من يقرأ منها | الأبطأ، ويحل مشكلة قراءة ما كتبته من تلك النسخة |
والثمن كما ذكرنا في قسم النسخ المتزامن أن كل كتابة تنتظر ذهاباً وعودة عبر الشبكة، وأن النسخة المتزامنة الوحيدة إذا توقفت توقفت معها الكتابة، لذلك إذا اخترت النسخ المتزامن فاستخدم نسختين على الأقل مع صيغة ANY 1 (pg2, pg3) التي تنتظر أي واحدة منهما، أو اجعل Patroni يدير هذا الإعداد.
كيف يجد التطبيق السيرفر الرئيسي الجديد؟
لنفرض أن الانتقال حدث بشكل مثالي في عشر ثوان، ولكن التطبيق ما زال يحاول الاتصال بعنوان السيرفر القديم، فالنتيجة بالنسبة للمستخدم هي توقف كامل رغم أن قاعدة البيانات تعمل. وهناك أربع طرق معروفة لحل هذه المشكلة، والصورة التالية تبينها:
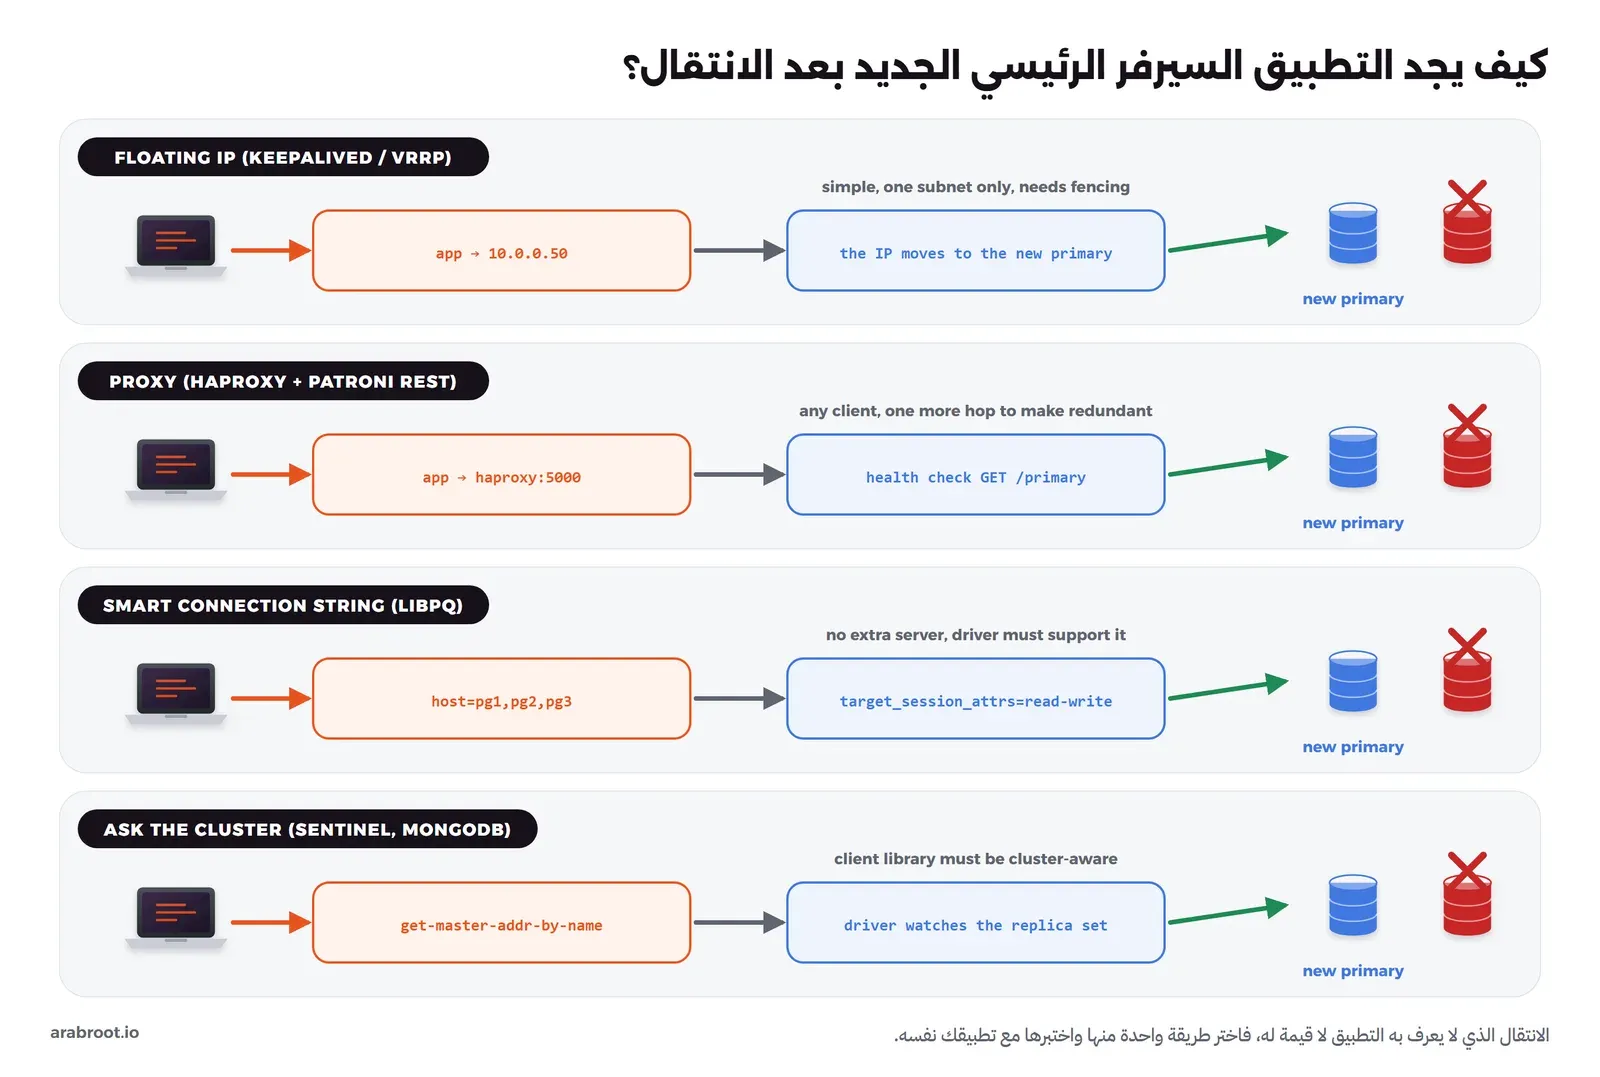
- عنوان IP عائم Floating IP: عنوان واحد يتصل به التطبيق دائماً، وينتقل بين السيرفرات ببروتوكول VRRP عبر Keepalived (ترخيص GPL-2.0 أو أحدث). نقطة القوة أن التطبيق لا يتغير إطلاقاً، ونقطة الضعف أنه يعمل داخل شبكة فرعية واحدة عادة، وأن قرار نقل العنوان يجب أن يرتبط بقرار الانتقال نفسه حتى لا يتحرك العنوان إلى نسخة لم ترق. وسوف نشرح Keepalived في موضوع مستقل في مرحلة التوفر العالي.
- وسيط Proxy يفحص الأدوار: يتصل التطبيق بالوسيط HAProxy، والوسيط يسأل كل سيرفر عن دوره، وPatroni يوفر لذلك واجهة REST ترد بالرمز 200 على الطلب
GET /primaryفقط من السيرفر الذي يملك مفتاح القائد، وعلىGET /replicaمن النسخ السليمة، فيوجه HAProxy الكتابة إلى منفذ والقراءة إلى منفذ آخر. وقد شرحنا تثبيت HAProxy ووضع TCP الذي يحتاجه PostgreSQL في دليل تثبيت HAProxy. ونقطة الضعف أن الوسيط نفسه أصبح نقطة فشل، فتحتاج اثنين منه مع عنوان عائم، أو وسيطاً على كل سيرفر تطبيق. - سلسلة اتصال بعدة عناوين: المكتبة libpq وكل المكتبات المبنية عليها تقبل عدة عناوين في سلسلة الاتصال، وتجربها بالترتيب، ومع الخيار
target_session_attrs=read-writeتتجاوز أي سيرفر لا يقبل الكتابة، وهناك قيم أخرى مثلprimaryوstandbyوprefer-standby، ومعload_balance_hosts=randomتوزع الاتصالات على العناوين عشوائياً. لا يوجد هنا سيرفر إضافي، ولكن المكتبة يجب أن تدعم ذلك، وسوف تجربه في المختبر وترى أيضاً متى يخدعك. - سؤال العنقود نفسه: في Redis وValkey يسأل الكلاينت أحد Sentinels عن عنوان الرئيسي الحالي، كما تشرح إرشادات مكتبات Sentinel، وفي MongoDB تعطي المكتبة عدة عناوين مع اسم مجموعة النسخ في سلسلة الاتصال، وهي تراقب المجموعة وتكتشف الرئيسي الجديد بنفسها. وهذا هو الأسلوب الأنظف لهذه المحركات، بشرط أن تستخدم مكتبة تدعمه وتفعله.
ومهما كانت الطريقة، فالمعاملات المفتوحة على السيرفر القديم لحظة العطل سوف تفشل، والاتصالات في المجمع Pool سوف تنقطع، لذلك يجب أن يعيد التطبيق محاولة المعاملة التي فشلت بخطأ اتصال، مع مفتاح منع التكرار Idempotency Key حتى لا تنفذ مرتين كما شرحنا في قسم مفتاح منع التكرار.
توجيه القراءة إلى النسخ وفخاخه
إذا كانت مشكلتك أن القراءة كثيرة، فالخطوة الطبيعية أن ترسل جزءاً منها إلى النسخ، وهنا ثلاثة أسئلة يجب أن تجيب عنها قبل أن تفعل ذلك.
السؤال الأول: ماذا يحدث مع التأخر؟ كل نسخة غير متزامنة متأخرة عن الرئيسي، والتأخر عادة أجزاء من الثانية، ولكنه يزيد مع التحديثات الكبيرة أو ضغط القرص، والنتيجة المعروفة أن المستخدم لا يرى ما كتبه للتو كما شرحنا في قسم تأخر النسخ. والحل الأبسط أن تقرأ من الرئيسي كل ما يخص المستخدم في الثواني الأولى بعد أن يكتب، والحل الأدق في PostgreSQL أن تحفظ رقم موقع السجل LSN بعد الكتابة، ثم تتأكد قبل القراءة من النسخة أنها وصلت إليه، وسوف تراه يعمل في المختبر.
السؤال الثاني: من يقرر أين تذهب القراءة؟ الطريقة الأوضح أن يكون في التطبيق مصدران للبيانات Data Sources، واحد للكتابة وواحد للقراءة، ويختار الكود صراحة أي واحد يستخدم، لأن الكود وحده يعرف أي قراءة تتحمل بيانات متأخرة. وهناك أدوات تفعل ذلك تلقائياً بتحليل الاستعلام: pgpool-II لـ PostgreSQL، بترخيص مشابه لترخيص PostgreSQL، يوزع استعلامات القراءة على النسخ ويرسل الكتابة إلى الرئيسي، وProxySQL لـ MySQL، بترخيص GPL-3.0، يوزع بقواعد على نص الاستعلام. ولاحظ أن توثيق ProxySQL نفسه يحذر من قاعدة عامة توجه كل SELECT إلى النسخ في الإنتاج Production، والسبب أن الأداة لا تعرف أن هذه القراءة تأتي بعد كتابة يجب أن تراها.
السؤال الثالث: ماذا عن تجميع الاتصالات Connection Pooling؟ كل نسخة تضيفها هي قاعدة بيانات أخرى بحد اتصالات خاص بها، فإذا كان كل سيرفر تطبيق يفتح مجمعاً للرئيسي ومجمعاً لكل نسخة، تضاعف عدد الاتصالات بسرعة، وقد شرحنا هذه المشكلة في قسم تضاعف الاتصالات Connection Multiplication. ولاحظ أن PgBouncer نفسه لا يعرف من هو الرئيسي، فهو يتصل بالعنوان الذي تعطيه إياه، لذلك ضعه أمام عنوان ثابت للرئيسي مثل HAProxy أو العنوان العائم، أو شغل PgBouncer على كل سيرفر قاعدة بيانات أمام PostgreSQL المحلي، كما شرحنا في قسم أداة مستقلة أمام قاعدة البيانات. وتذكر أيضاً أن الاستعلام الطويل على نسخة قد يلغى إذا احتاج صفوفاً نظفها VACUUM على الرئيسي، كما ذكرنا في قسم نسخ القراءة للتقارير.
التقسيم Sharding في الواقع: مفتاح التقسيم هو القرار الأصعب
قبل أن تقسم البيانات على عدة سيرفرات، تأكد أن التقسيم داخل السيرفر الواحد لا يكفيك، فالجدول المقسم حسب الشهر في PostgreSQL مع حذف الشهور القديمة يحل أغلب مشاكل الجداول الضخمة دون أي سيرفر إضافي، كما شرحنا في قسم تقسيم الجدول حسب الشهر. وإذا وصلت فعلاً إلى حد السيرفر الواحد، فأول قرار وأهمه هو مفتاح التقسيم Shard Key، أي العمود الذي يقرر في أي جزء يعيش كل صف، ولنأخذ مثالاً متجراً بجدول طلبات:
- التقسيم بتاريخ الطلب: يبدو منطقياً لأن التقارير تكون حسب الشهر، ولكنه أسوأ خيار للكتابة، والسبب أن كل الطلبات الجديدة لها تاريخ اليوم، فتذهب كل الكتابة إلى الجزء الأخير، ويصبح جزءاً ساخناً Hot Shard بينما تنام بقية الأجزاء.
- التقسيم برقم الطلب بالهاش: يوزع الكتابة بالتساوي، ولكن صفحة «طلباتي» لعميل واحد أصبحت تسأل كل الأجزاء، لأن طلبات العميل الواحد متفرقة، وهذا ما يسمى استعلام التجميع من كل الأجزاء Scatter-Gather، وهو يبطئ كلما زاد عدد الأجزاء.
- التقسيم برقم العميل أو المستأجر Tenant: وهو الأنسب لأغلب تطبيقات SaaS والمتاجر، فكل بيانات العميل الواحد في جزء واحد، واستعلاماته ومعاملاته محلية في ذلك الجزء، وتوزع العملاء بالهاش على الأجزاء. وهذا ما تقترحه وثائق Citus للتطبيقات متعددة المستأجرين.
وحتى مع المفتاح الصحيح تبقى أربع مشاكل يجب أن تعرفها قبل أن تبدأ:
- العميل الضخم: إذا كان عميل واحد أكبر من كل الباقين، فجزؤه ساخن مهما كانت دالة الهاش، والحل يكون أحياناً بجزء مخصص له وحده.
- المعاملات بين الأجزاء: المعاملة التي تنقل رصيداً بين عميلين في جزأين مختلفين تحتاج تنسيقاً مثل الالتزام على مرحلتين 2PC، وقد شرحنا لماذا يتجنبه الناس في قسم 2PC، لذلك صمم المفتاح بحيث تكون أغلب المعاملات داخل جزء واحد. وفي Redis وValkey Cluster لا تعمل الأوامر التي تلمس عدة مفاتيح إلا إذا كانت في الخانة نفسها، ولذلك توجد وسوم الهاش Hash Tags مثل
{user:42}:cartو{user:42}:ordersالتي تجبر المفتاحين على الخانة نفسها كما في مواصفات Cluster. - إعادة التقسيم Resharding: عندما تضيف أجزاء جديدة يجب أن تنقل بيانات حية بين السيرفرات دون توقف، وهي عملية طويلة وحساسة، وتغيير مفتاح التقسيم نفسه بعد سنوات أصعب بكثير، لذلك فكر في المفتاح على أنه قرار يصعب الرجوع عنه.
- المعرفات الفريدة: الرقم التسلسلي من سيرفر واحد لم يعد يكفي، لأن كل جزء يولد أرقامه، وقد شرحنا الخيارات في مقال المعرفات الفريدة UUID وULID وSnowflake.
خريطة المحركات: ماذا تقدم كل قاعدة بيانات؟
الجدول التالي يجمع ما يقدمه كل محرك مشهور، مع ترخيصه كما هو اليوم، وبعد الجدول تفصيل نقاط القوة ونقاط الضعف لكل واحد:
| المحرك | النسخ والتوفر | التقسيم على عدة سيرفرات | الترخيص |
|---|---|---|---|
| PostgreSQL | النسخ المتدفق Streaming Replication والنسخ المنطقي Logical Replication مدمجان، والانتقال التلقائي بأداة خارجية مثل Patroni أو CloudNativePG | ليس مدمجاً، ويتوفر بالإضافة Citus | PostgreSQL License، وPatroni بترخيص MIT، وCitus بترخيص AGPL-3.0، وCloudNativePG بترخيص Apache 2.0 |
| MySQL | نسخ غير متزامن افتراضياً، ونسخ شبه متزامن Semisynchronous، وGroup Replication وInnoDB Cluster | ليس مدمجاً، ويتوفر بأداة Vitess | نسخة المجتمع GPLv2، وVitess بترخيص Apache 2.0 |
| MariaDB | نسخ عادي، وGalera Cluster بعدة سيرفرات رئيسية | ليس مدمجاً | GPLv2، وGalera بترخيص GPLv2 |
| MongoDB | Replica Set مدمج مع انتخابات تلقائية | Sharded Cluster مدمج | نسخة المجتمع بترخيص SSPL منذ أكتوبر 2018، وهو مصدر متاح وليس مفتوح المصدر |
| Redis | نسخ غير متزامن مع Sentinel | Redis Cluster مدمج بـ 16384 خانة | منذ الإصدار 8 ثلاثة تراخيص يختار منها المستخدم: RSALv2 أو SSPLv1 أو AGPLv3، والإصدارات حتى 7.2 بترخيص BSD |
| Valkey | نسخ غير متزامن مع Sentinel | Valkey Cluster مدمج بـ 16384 خانة | BSD 3-Clause |
| CockroachDB وYugabyteDB وTiDB | نسخ بالإجماع Raft لكل مدى، وانتقال تلقائي مدمج | تلقائي ومدمج | CockroachDB مصدر متاح، وYugabyteDB وTiDB بترخيص Apache 2.0 |
PostgreSQL: نسخ قوي مدمج، والانتقال بأداة خارجية
يوفر PostgreSQL النسخ المتدفق Streaming Replication الذي ينسخ القاعدة كاملة على مستوى ملفات السجل WAL، وهو ما سوف نستخدمه في المختبر، والنسخ المنطقي Logical Replication الذي ينسخ جداول محددة بنموذج النشر والاشتراك Publish/Subscribe، وهو مفيد للترقية بين إصدارات رئيسية مختلفة ولنقل جزء من البيانات إلى قاعدة أخرى. وترقية النسخة تكون بالأمر pg_ctl promote أو الدالة pg_promote()، أما الانتقال التلقائي فليس في PostgreSQL نفسه، وإنما في Patroni على السيرفرات العادية أو CloudNativePG على Kubernetes، والتقسيم على عدة سيرفرات بالإضافة Citus، وقد عرضنا الثلاثة باختصار في قسم خيارات ال Cluster بصراحة.
- نقاط القوة: النسخ المتدفق ناضج وبسيط ومراقبته واضحة من
pg_stat_replication، والأدوات حوله مفتوحة المصدر بالكامل، وكل الخيارات من سيرفر واحد إلى Citus تبقى PostgreSQL نفسه بإضافاته وأدواته. - نقاط الضعف: الانتقال التلقائي يحتاج أداة إضافية ومخزن DCS يجب أن تتعلمه وتشغله، والنسخ المتدفق لا يعمل بين إصدارين رئيسيين مختلفين كما يقول التوثيق، والتقسيم ليس مدمجاً.
MySQL وMariaDB: نسخ قديم ومجرب، وثلاثة أشكال للعنقود
النسخ في MySQL غير متزامن افتراضياً، ويوفر النسخ شبه المتزامن Semisynchronous الذي ينتظر تأكيد نسخة واحدة على الأقل أنها استلمت التغيير. وفوقه Group Replication بوضع سيرفر رئيسي واحد أو عدة سيرفرات رئيسية، وبحد أقصى تسعة أعضاء في المجموعة، ويجمعه InnoDB Cluster مع MySQL Router وMySQL Shell. وفي MariaDB الخيار المعروف هو Galera Cluster، وللتقسيم هناك Vitess، وهو مشروع متخرج في مؤسسة CNCF منذ 2019.
- نقاط القوة: النسخ قديم ومجرب على نطاق ضخم، وInnoDB Cluster يعطيك الانتقال والتوجيه من الشركة نفسها دون أداة خارجية، وVitess أثبت نفسه في تقسيم MySQL على مئات السيرفرات.
- نقاط الضعف: هناك أشكال كثيرة ومتداخلة (نسخ عادي، وشبه متزامن، وGroup Replication، وGalera، وNDB) فيسهل أن تختار الخطأ، وMySQL وMariaDB افترقا في هذه الميزات فلا تفترض أن ما يعمل في واحد يعمل في الآخر، ووضع عدة سيرفرات رئيسية يحتاج تطبيقاً يعيد المحاولة عند تعارض الالتزام.
MongoDB: النسخ والتقسيم مدمجان من البداية
في MongoDB لا تحتاج أداة خارجية للانتقال، فمجموعة النسخ Replica Set تنتخب سيرفراً رئيسياً بنفسها، ويمكن أن تحتوي حتى 50 عضواً، منهم 7 فقط لهم حق التصويت، والمكتبات تكتشف الرئيسي الجديد تلقائياً، والتقسيم مدمج بالعنقود المقسم Sharded Cluster. ويجدر أن تعرف أن مستوى تأكيد الكتابة الافتراضي Write Concern هو w: majority، أي أن الكتابة لا تؤكد إلا بعد أن تصل إلى أغلبية الأعضاء، إلا في الحالة التي يكون فيها عدد الأعضاء الذين يحملون البيانات غير كاف للأغلبية كما في مجموعة فيها حكم Arbiter، فيصبح الافتراضي w: 1.
- نقاط القوة: الانتخابات واكتشاف الرئيسي في المكتبات مدمجة ومجربة، والتقسيم جزء من المنتج نفسه، ومستوى تأكيد الكتابة الافتراضي آمن.
- نقاط الضعف: الترخيص SSPL ليس مفتوح المصدر وله شروط على من يقدم MongoDB كخدمة، والعنقود المقسم يحتاج سيرفرات كثيرة (أجزاء كل منها Replica Set، وسيرفرات إعداد كـ Replica Set، وموجهات mongos)، واختيار مفتاح التقسيم يحمل كل مشاكل القسم السابق.
Redis وValkey: Sentinel للتوفر وCluster للتقسيم
النسخ في Redis وValkey غير متزامن دائماً، وSentinel هو عملية منفصلة تراقب الرئيسي، فإذا اتفق عدد منها يساوي النصاب Quorum أن الرئيسي لا يرد، انتخبت واحداً منها بالأغلبية لينفذ الانتقال، والتوثيق يطلب ثلاثة Sentinels على الأقل على أجهزة مستقلة. أما Cluster فيقسم المفاتيح على 16384 خانة هاش، تحسب لكل مفتاح بـ CRC16 ثم باقي القسمة على 16384 كما في المواصفات، ولكل سيرفر رئيسي مدى من الخانات ونسخ خاصة به.
- نقاط القوة: الإعداد بسيط نسبياً، والانتقال مع Sentinel يحدث في ثوان كما سوف ترى، وValkey بترخيص BSD المفتوح بالكامل.
- نقاط الضعف: يذكر التوثيق صراحة أن النظام لا يضمن بقاء الكتابات المؤكدة عند الانتقال لأن النسخ غير متزامن، والإعداد
min-replicas-to-writeيقلل النافذة ولا يغلقها، والأوامر متعددة المفاتيح في Cluster تحتاج وسوم الهاش، والمكتبة يجب أن تدعم Sentinel أو Cluster.
قواعد SQL الموزعة: التقسيم والانتقال دون أن تكتبهما
عرضنا فكرتها في قسم قواعد SQL الموزعة، وهنا الحكم المختصر:
- نقاط القوة: انتقال تلقائي مدمج بالإجماع دون أداة خارجية، وتقسيم تلقائي، ومعاملات SQL كاملة بين المديات، ودعم أصلي لعدة مناطق جغرافية.
- نقاط الضعف: زمن كتابة أعلى من قاعدة على سيرفر واحد، وثلاثة سيرفرات حد أدنى منطقي، وتوافقها مع PostgreSQL أو MySQL ليس كاملاً فاختبر تطبيقك قبل النقل، وCockroachDB لم يعد مفتوح المصدر.
كم سيرفراً تحتاج، وأين تضعها؟
القاعدة التي تحكم كل الانتقال التلقائي هي الأغلبية، فالعنقود الذي يتخذ قراراً بالتصويت يحتاج ثلاثة أصوات على الأقل حتى ينجو من توقف واحد منها، وقد شرحنا السبب بالأرقام في قسم لماذا ثلاثة أو خمسة. ولكن الأصوات لا يجب أن تكون كلها سيرفرات قواعد بيانات كاملة:
- Patroni: سيرفرا PostgreSQL مع ثلاثة أعضاء etcd، ويمكن أن يكون العضو الثالث سيرفراً صغيراً لا يحمل قاعدة بيانات.
- Galera: ثلاثة سيرفرات، أو سيرفران مع حكم Galera Arbitrator (garbd) الذي يصوت ولا يحمل البيانات، كما في وثائق النصاب في Galera.
- MongoDB: التصميم الموصى به في توثيق المعمارية هو ثلاثة أعضاء يحملون البيانات، أما رئيسي وثانوي وحكم Arbiter فهو خيار عندما تمنعك التكلفة فقط، والسبب كما في توثيق الحكم أن الكتابة بمستوى
majorityقد تتعطل أو تبطئ إذا توقف الثانوي الوحيد أو تأخر، وأن استخدام أكثر من حكم واحد غير موصى به. - Sentinel: ثلاث عمليات Sentinel على ثلاثة أجهزة مستقلة، ويمكن أن تعمل على سيرفرات التطبيق نفسها.
أما مشكلة مركزي البيانات فهي من أشهر الأخطاء في التصميم: لنفرض أن لديك مركز بيانات في الرياض بسيرفرين، ومركزاً في جدة بسيرفر واحد، فإذا انقطع الرابط بينهما بقيت الأغلبية في الرياض وهذا جيد، ولكن إذا سقط مركز الرياض كله فإن سيرفر جدة وحده أقلية لا يستطيع أن يرقي نفسه، أي أن العنقود لم يحمك من الحالة التي بنيته من أجلها. والحل المعروف هو موقع ثالث صغير يحمل صوتاً فقط، مثل عضو etcd أو حكم، حتى تبقى الأغلبية مع أي مركزين سليمين. وقد ذكرنا في دليل HAProxy ما حدث لـ GitHub في أكتوبر 2018 عندما نقلت أداة الانتقال السيرفرات الرئيسية إلى الساحل الآخر بعد انقطاع لم يتجاوز 43 ثانية، وفي مقال بنية Stack Overflow كيف وزعت نسخ SQL Server بين مركزي بيانات، فاقرأهما بعد هذا القسم.
تشغيل العنقود Cluster كل يوم
راقب التأخر بالبايت وبالثواني
أهم رقم في أي عنقود هو تأخر النسخ Replication Lag، وفي PostgreSQL تراه من العرض pg_stat_replication على الرئيسي، وفي MongoDB من rs.status()، وفي Valkey من INFO replication. ضع تنبيهاً على التأخر بالبايت وبالثواني معاً، لأن الأعمدة الزمنية كما سوف ترى في المختبر تعرض آخر قيمة قيست، وقد لا تتغير إذا توقفت النسخة عن التطبيق. وراقب أيضاً فتحات النسخ Replication Slots، فالفتحة لنسخة متوقفة تحتفظ بملفات WAL على الرئيسي دون حد افتراضياً كما يقول توثيق max_slot_wal_keep_size، وقد تملأ القرص وتوقف الرئيسي نفسه، فحدد لها حداً.
اختبر الانتقال قبل أن تحتاجه
الانتقال الذي لم تختبره هو مجرد أمنية، والسبب أن أغلب المشاكل لا تظهر في قاعدة البيانات نفسها وإنما حولها: مكتبة لا تعيد الاتصال، ومجمع اتصالات يحتفظ باتصالات ميتة، ومهمة مجدولة مكتوب فيها عنوان السيرفر القديم، وتنبيه لا يصل إلى أحد. لذلك نفذ انتقالاً مخططاً Switchover بشكل دوري في وقت هادئ، وقس كم ثانية توقف التطبيق فعلاً من جهة المستخدم، وسوف نشرح ذلك في موضوع «اختبار التعطل» في مرحلة التوفر العالي، وهندسة الفوضى Chaos Engineering في مرحلة SRE.
التحديث في العنقود: النسخ أولاً
ميزة العنقود في التحديثات الصغيرة أنك تحدث النسخ واحدة بعد أخرى، ثم تنقل الدور إلى نسخة محدثة بانتقال مخطط، ثم تحدث الرئيسي القديم، فيكون التوقف بقدر ثوان الانتقال فقط. أما الترقية بين إصدارين رئيسيين في PostgreSQL، مثل 17 إلى 18، فلا تعمل بالنسخ المتدفق لأنه لا يعمل بين إصدارين رئيسيين مختلفين، فتحتاج pg_upgrade على كل السيرفرات، أو النسخ المنطقي إلى عنقود جديد ثم نقل التطبيق إليه.
النسخ الاحتياطي من نسخة
بما أن النسخة تحمل البيانات كاملة، فخذ النسخ الاحتياطي منها بدلاً من الرئيسي حتى لا تضغط عليه، والأداة pg_basebackup كما يقول توثيقها تأخذ النسخة من الرئيسي أو من نسخة احتياطية، وكذلك تدعم الأدوات المتخصصة مثل pgBackRest ذلك، وسوف نشرحه مع الاستعادة إلى نقطة زمنية PITR في مرحلة قواعد البيانات في خريطة التعلم. وتذكر أن النسخ الاحتياطي يجب أن يستمر بعد الانتقال، فإذا كان مربوطاً باسم سيرفر محدد فقد يتوقف بصمت عندما يتغير الدور.
هل تحتاج عنقوداً Cluster أصلاً؟ دليل القرار
بعد كل ما سبق قد يبدو العنقود ضرورة، ولكن الحقيقة أن سيرفراً واحداً قوياً مع نسخ احتياطية مجربة واستعادة إلى نقطة زمنية يكفي عدداً كبيراً من التطبيقات، فإذا كان التوقف لساعة مرة في السنة مقبولاً لعملك، فأنت توفر على نفسك سيرفرات وأداة انتقال وأنواعاً جديدة من الأعطال. وقد يتساءل البعض: وكيف أعرف أن التوقف مقبول؟ والإجابة أن تحسب تكلفة ساعة التوقف على عملك بالأرقام، ثم تقارنها بتكلفة بناء التوفر العالي وتشغيله، وسوف نشرح هذا الحساب في موضوع «هل تحتاج التوفر العالي فعلاً؟» في مرحلة التوفر العالي. والصورة التالية تبين ترتيب الأسئلة:
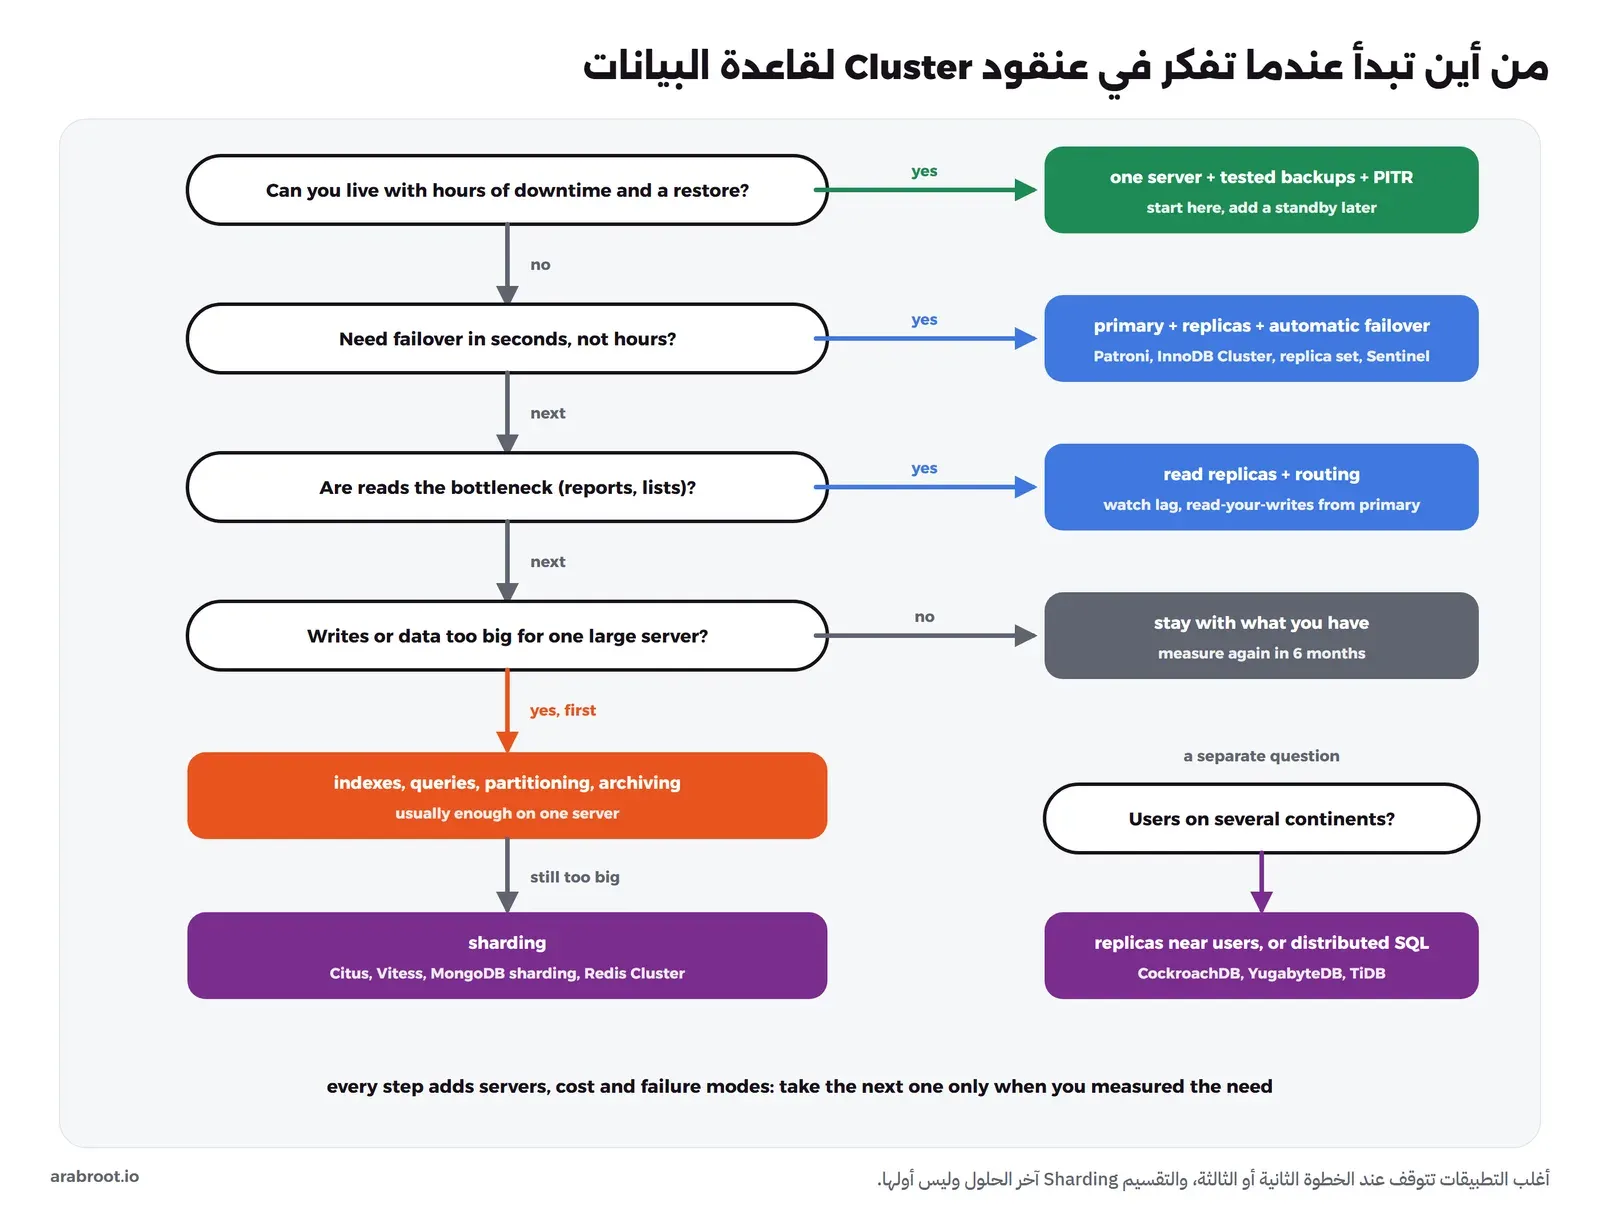
وبالكلمات، إذا احتجت توفراً عالياً فابدأ بالأداة الأقرب إلى محركك: Patroni مع PostgreSQL، وInnoDB Cluster مع MySQL، وGalera مع MariaDB، وReplica Set من ثلاثة أعضاء مع MongoDB، وSentinel مع Valkey. وإذا احتجت توسيع القراءة فأضف نسخاً مع توجيه صريح في التطبيق، وإذا احتجت توسيع الكتابة فاستنفد السيرفر الواحد أولاً كما في دليل PostgreSQL للجداول الضخمة، ثم التقسيم أو قاعدة SQL موزعة، وقد شرحنا الصورة الكاملة لنمو النظام في دليل مدخل إلى تصميم الأنظمة.
تجربة عملية: نسخة PostgreSQL وانتقال يدوي، ثم Valkey مع Sentinel
في هذه التجربة سوف نبني على جهاز واحد في Docker عنقودين صغيرين: PostgreSQL 18 بسيرفر رئيسي ونسخة متدفقة، ثم Valkey 9 بسيرفر رئيسي ونسخة وثلاثة Sentinels. وسوف نرى النسخ والتأخر ورفض الكتابة على النسخة وسلسلة الاتصال بعدة عناوين، ثم نوقف الرئيسي ونرقي النسخة يدوياً، ثم نعيد الرئيسي القديم لنرى انقسام الدماغ بأعيننا ونصلحه، وأخيراً نرى Sentinel ينقل الدور تلقائياً. كل الأوامر والمخرجات حقيقية من تشغيلنا، أما الأزمنة فهي للتوضيح فقط لأنها تختلف من جهاز إلى آخر.
ملفات التجربة
أنشئ مجلداً فارغاً، واحفظ فيه الملف التالي باسم init-primary.sh، وهو يعمل مرة واحدة عند إنشاء السيرفر الرئيسي:
#!/bin/bash
# runs once when the primary is created: a replication user and a pg_hba.conf line for it
set -e
psql -v ON_ERROR_STOP=1 -U postgres <<SQL
CREATE ROLE replicator WITH REPLICATION LOGIN PASSWORD 'lab-only-replication';
CREATE TABLE orders (id bigserial PRIMARY KEY, customer text NOT NULL,
                     total numeric(10,2) NOT NULL, created_at timestamptz NOT NULL DEFAULT now());
SQL
echo "host replication replicator all scram-sha-256" >> "$PGDATA/pg_hba.conf"
ثم احفظ الملف التالي باسم compose.yaml في المجلد نفسه:
# Lab: PostgreSQL primary + streaming replica, Valkey primary + replica + 3 Sentinels
#   docker compose -p lab-dbc up -d
name: lab-dbc

x-pg: &pg
  image: postgres:18
  environment:
    POSTGRES_PASSWORD: lab-only-password

x-valkey: &valkey
  image: valkey/valkey:9-alpine

services:
  pg1:
    <<: *pg
    container_name: lab-dbc-pg1
    hostname: pg1
    networks: { lab-dbc: { ipv4_address: 10.94.80.11 } }
    ports: ["127.0.0.1:19480:5432"]
    volumes:
      - pg1-data:/var/lib/postgresql
      - ./init-primary.sh:/docker-entrypoint-initdb.d/init-primary.sh:ro
    command: postgres -c cluster_name=pg1

  pg2:
    <<: *pg
    container_name: lab-dbc-pg2
    hostname: pg2
    networks: { lab-dbc: { ipv4_address: 10.94.80.12 } }
    ports: ["127.0.0.1:19481:5432"]
    user: postgres
    depends_on: [pg1]
    volumes:
      - pg2-data:/var/lib/postgresql
    entrypoint: ["bash", "-c"]
    command:
      - |
        if [ ! -s "$$PGDATA/PG_VERSION" ]; then
          until pg_isready -q -h pg1 -U postgres; do sleep 1; done
          PGPASSWORD=lab-only-replication pg_basebackup -h pg1 -U replicator \
            -D "$$PGDATA" -R -X stream -C -S replica_pg2
        fi
        exec postgres -c cluster_name=pg2

  valkey1:
    <<: *valkey
    container_name: lab-dbc-valkey1
    networks: { lab-dbc: { ipv4_address: 10.94.80.21 } }
    ports: ["127.0.0.1:19482:6379"]
    command: valkey-server --appendonly yes

  valkey2:
    <<: *valkey
    container_name: lab-dbc-valkey2
    networks: { lab-dbc: { ipv4_address: 10.94.80.22 } }
    ports: ["127.0.0.1:19483:6379"]
    command: valkey-server --appendonly yes --replicaof 10.94.80.21 6379

  sentinel1: &sentinel
    <<: *valkey
    container_name: lab-dbc-sentinel1
    networks: { lab-dbc: { ipv4_address: 10.94.80.31 } }
    depends_on: [valkey1, valkey2]
    entrypoint: ["sh", "-c"]
    command:
      - |
        cat > /data/sentinel.conf <<CONF
        port 26379
        sentinel monitor mymaster 10.94.80.21 6379 2
        sentinel down-after-milliseconds mymaster 5000
        sentinel failover-timeout mymaster 60000
        CONF
        exec valkey-sentinel /data/sentinel.conf
  sentinel2:
    <<: *sentinel
    container_name: lab-dbc-sentinel2
    networks: { lab-dbc: { ipv4_address: 10.94.80.32 } }
  sentinel3:
    <<: *sentinel
    container_name: lab-dbc-sentinel3
    networks: { lab-dbc: { ipv4_address: 10.94.80.33 } }

volumes:
  pg1-data:
  pg2-data:

networks:
  lab-dbc:
    name: lab-dbc
    ipam:
      config:
        - subnet: 10.94.80.0/24
في الإعداد أعلاه لاحظ التالي:
- ال Docker Image الرسمية
postgres:18كانت عند التشغيل PostgreSQL 18.6، وفي الإصدار 18 أصبح مجلد البيانات داخل ال Volume هو/var/lib/postgresql/18/docker، لذلك نركب ال Volume على/var/lib/postgresql. - السيرفر الرئيسي pg1 ينشئ مستخدماً للنسخ اسمه
replicatorبصلاحيةREPLICATION، ويضيف سطراً فيpg_hba.confيسمح له باتصال النسخ، والسبب أن السطر العام في ال Docker Image يغطي قواعد البيانات العادية فقط، أما اتصال النسخ فيحتاج كلمةreplicationصراحة. - النسخة pg2 لا تنشئ قاعدة جديدة، وإنما تنسخ الرئيسي كاملاً بالأداة
pg_basebackupفي أول تشغيل، والخيار-Rيكتب إعداد الاتصال بالرئيسي وملفstandby.signalالذي يجعلها نسخة، و-C -S replica_pg2ينشئ فتحة نسخ Replication Slot على الرئيسي حتى لا يحذف ملفات WAL قبل أن تستلمها النسخة. - الإعداد
cluster_nameيعطي كل سيرفر اسماً نستخدمه لنعرف من يجيبنا، والتوثيق يذكر أنه يصبح أيضاً اسم النسخةapplication_nameفي اتصالها بالرئيسي. - أعطينا كل Container عنواناً ثابتاً في شبكة خاصة، وسوف نشرح سبب ذلك في جزء Sentinel، والمنافذ مربوطة على
127.0.0.1فقط من 19480 إلى 19483، وكلمات المرور هنا للمختبر فقط. - كل Sentinel يراقب الرئيسي باسم
mymasterبنصاب 2 من 3، ويعتبره متوقفاً بعد 5 ثوان دون رد.
الآن نشغل التجربة:
docker compose -p lab-dbc up -dالنسخة تعمل: pg_stat_replication
بعد ثوان من التشغيل نسأل الرئيسي عن نسخه، ونسأل النسخة هل هي في وضع الاستعادة Recovery:
docker exec lab-dbc-pg1 psql -U postgres -x -c "SELECT application_name, client_addr, state, sync_state, sent_lsn, replay_lsn, write_lag, flush_lag, replay_lag FROM pg_stat_replication;"
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT current_setting('cluster_name') AS node, pg_is_in_recovery();"
والمخرج سوف يكون كما يلي:
-[ RECORD 1 ]----+----------------
application_name | pg2
client_addr      | 10.94.80.12
state            | streaming
sync_state       | async
sent_lsn         | 0/3026810
replay_lsn       | 0/3026810
write_lag        | 00:00:00.364365
flush_lag        | 00:00:00.392791
replay_lag       | 00:00:00.392797

 node | pg_is_in_recovery
------+-------------------
 pg2  | t
(1 row)
في المخرج أعلاه لاحظ التالي:
stateهيstreaming، أي أن النسخة متصلة وتستلم السجل باستمرار، وsync_stateهيasyncلأننا لم نحدد أي نسخة متزامنة.sent_lsnوreplay_lsnمتساويان، أي أن النسخة طبقت كل ما أرسله الرئيسي، وLSN هو رقم الموقع في سجل WAL.- الأعمدة الثلاثة
write_lagوflush_lagوreplay_lagهي الزمن بين أن يكتب الرئيسي التغيير وأن تؤكد النسخة أنها كتبته ثم ثبتته على القرص ثم طبقته، كما في التوثيق، وقيمتها هنا تقارب 0.4 ثانية لأن النسخة كانت تلحق بالرئيسي بعد تشغيلها مباشرة. pg_is_in_recovery()تعيدtعلى النسخة، وهي الطريقة البسيطة لتعرف من أي سيرفر هو النسخة.
نكتب على الرئيسي، ونحاول الكتابة على النسخة
docker exec lab-dbc-pg1 psql -U postgres -c "INSERT INTO orders (customer, total) VALUES ('sara', 120.50), ('omar', 75.00);"
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT id, customer, total FROM orders;"
docker exec lab-dbc-pg2 psql -U postgres -c "INSERT INTO orders (customer, total) VALUES ('ali', 10);"
والمخرج سوف يكون كما يلي:
INSERT 0 2
 id | customer | total
----+----------+--------
  1 | sara     | 120.50
  2 | omar     |  75.00
(2 rows)

ERROR:  cannot execute INSERT in a read-only transaction
الكتابة على الرئيسي ظهرت على النسخة فوراً، أما الكتابة على النسخة فرفضت، لأن كل الاتصالات على النسخة في وضع Hot Standby للقراءة فقط كما يقول التوثيق. وهذا الخطأ تحديداً هو ما سوف تراه في سجلات تطبيقك إذا أرسلت كتابة إلى نسخة بالخطأ، فاحفظ شكله.
نصنع تأخراً ونرى المستخدم الذي لا يرى ما كتبه
التأخر على جهاز واحد أجزاء من الملي ثانية، لذلك سوف نصنعه عمداً بإيقاف تطبيق السجل على النسخة مؤقتاً بالدالة pg_wal_replay_pause()، ثم نغير اسم العميل على الرئيسي ونقرأه من النسخة:
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_wal_replay_pause();"
docker exec lab-dbc-pg1 psql -U postgres -c "UPDATE orders SET customer = 'sara ahmed' WHERE id = 1;" -c "SELECT pg_current_wal_lsn();"
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT id, customer FROM orders WHERE id = 1;"
sleep 5
docker exec lab-dbc-pg1 psql -U postgres -c "SELECT application_name, sent_lsn, replay_lsn, pg_wal_lsn_diff(sent_lsn, replay_lsn) AS bytes_behind, replay_lag FROM pg_stat_replication;"
والمخرج سوف يكون كما يلي:
 pg_wal_replay_pause
---------------------

(1 row)

UPDATE 1
 pg_current_wal_lsn
--------------------
 0/302B700
(1 row)

 id | customer
----+----------
  1 | sara
(1 row)

 application_name | sent_lsn  | replay_lsn | bytes_behind |   replay_lag
------------------+-----------+------------+--------------+-----------------
 pg2              | 0/302B738 | 0/302B678  |          192 | 00:00:02.666674
(1 row)
في المخرج أعلاه لاحظ التالي:
- الرئيسي أكد التحديث، ولكن النسخة ما زالت تقول
sara، وهذه بالضبط قصة المستخدم الذي يغير اسمه ثم يرى الاسم القديم. - العمود
bytes_behindيبين أن النسخة متأخرة 192 بايت من السجل، وهو رقم يزيد باستمرار ما دامت متوقفة. - العمود
replay_lagيقول 2.7 ثانية رغم أن النسخة متوقفة منذ أكثر من خمس ثوان، والسبب أن هذا العمود يحسب عندما تصل تأكيدات النسخة، فهو آخر قيمة قيست وليس التأخر في هذه اللحظة، لذلك راقب الفرق بالبايت أيضاً كما ذكرنا في قسم المراقبة. - حفظنا رقم LSN بعد الكتابة وهو
0/302B700، وسوف نستخدمه الآن.
والحل الدقيق لقراءة ما كتبته Read-Your-Writes أن يحفظ التطبيق رقم LSN بعد كتابة المستخدم في جلسته، وقبل أن يقرأ من نسخة يسألها هل وصلت إليه، فإذا لم تصل قرأ من الرئيسي. نسأل النسخة الآن، ثم نعيد تشغيل التطبيق عليها بالدالة pg_wal_replay_resume()، ثم نسأل مرة ثانية:
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_last_wal_replay_lsn() >= '0/302B700' AS caught_up;"
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_wal_replay_resume();"
sleep 1
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_last_wal_replay_lsn() >= '0/302B700' AS caught_up;" -c "SELECT id, customer FROM orders WHERE id = 1;"
والمخرج سوف يكون كما يلي:
 caught_up
-----------
 f
(1 row)

 pg_wal_replay_resume
----------------------

(1 row)

 caught_up
-----------
 t
(1 row)

 id |  customer
----+------------
  1 | sara ahmed
(1 row)
قبل استئناف التطبيق أجابت النسخة f، فالتطبيق يعرف أنها لم تصل إلى كتابة المستخدم ويقرأ من الرئيسي، وبعد ثانية واحدة من الاستئناف أجابت t وظهر الاسم الجديد. وهذا الفحص رخيص جداً لأنه لا يقرأ أي جدول.
سلسلة اتصال بعنوانين: target_session_attrs
الآن نتصل من Container مؤقت بسلسلة اتصال تحتوي العنوانين pg1,pg2 مع قيم مختلفة للخيار target_session_attrs، ونسأل في كل مرة من أجاب:
for attrs in read-write read-only prefer-standby any; do
  docker run --rm --name lab-dbc-client --network lab-dbc -e PGPASSWORD=lab-only-password postgres:18 \
    psql "host=pg1,pg2 user=postgres dbname=postgres target_session_attrs=$attrs" \
    -Atc "SELECT '$attrs', current_setting('cluster_name'), pg_is_in_recovery();"
done
والمخرج سوف يكون كما يلي:
read-write|pg1|f
read-only|pg2|t
prefer-standby|pg2|t
any|pg1|f
المكتبة جربت العنوانين بالترتيب، واختارت في كل مرة السيرفر الذي يطابق الشرط: read-write اختارت الرئيسي pg1، وread-only وprefer-standby تجاوزتا pg1 إلى النسخة pg2، أما any وهي القيمة الافتراضية فأخذت أول عنوان يقبل الاتصال دون أن تسأل عن دوره، ولذلك لا تعتمد على عدة عناوين دون target_session_attrs.
نوقف الرئيسي ونرقي النسخة يدوياً
نحفظ أمر الاتصال السابق بقيمة read-write في ملف who.sh، لأننا سوف نكرره عدة مرات، ونضيف إليه مهلة اتصال قصيرة:
docker run --rm --name lab-dbc-client --network lab-dbc -e PGPASSWORD=lab-only-password postgres:18 \
  psql "host=pg1,pg2 user=postgres dbname=postgres connect_timeout=3 target_session_attrs=read-write" \
  -Atc "SELECT current_setting('cluster_name'), pg_is_in_recovery();"
ثم نوقف الرئيسي، ونحاول الاتصال، ثم نرقي النسخة بالدالة pg_promote()، ونحاول مرة ثانية، ونكتب على الرئيسي الجديد:
docker stop lab-dbc-pg1
bash who.sh
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_promote();"
bash who.sh
docker exec lab-dbc-pg2 psql -U postgres -c "INSERT INTO orders (customer, total) VALUES ('ali', 10) RETURNING id;"
والمخرج سوف يكون كما يلي:
lab-dbc-pg1
psql: error: could not translate host name "pg1" to address: No address associated with hostname
connection to server at "pg2" (10.94.80.12), port 5432 failed: session is read-only
 pg_promote
------------
 t
(1 row)

pg2|f
 id
----
 34
(1 row)

INSERT 0 1
وفي سجل pg2 تظهر لحظة الترقية كما يلي (حذفنا الوقت من بداية كل سطر):
LOG:  redo done at 0/302B738 system usage: CPU: user: 0.00 s, system: 0.02 s, elapsed: 213.63 s
LOG:  last completed transaction was at log time 2026-10-06 06:57:06.326534+00
LOG:  selected new timeline ID: 2
LOG:  archive recovery complete
LOG:  database system is ready to accept connections
في المخرج أعلاه لاحظ التالي:
- بعد إيقاف pg1 لم يجد التطبيق أي سيرفر يقبل الكتابة: pg1 غير موجود، وpg2 رفضت لأنها
session is read-only، أي أن الخدمة متوقفة للكتابة رغم أن البيانات كلها موجودة على pg2. ورسالة الخطأ الأولى خاصة ب Docker لأن اسم ال Container يختفي من الشبكة عندما يتوقف، أما على سيرفر حقيقي فسوف ترى انتهاء مهلة الاتصال أو رفضه. - بعد
pg_promote()أصبحت pg2 رئيسية، وانتقلت إلى خط زمني جديد Timeline رقم 2، وهو ما يميز تاريخها من هذه اللحظة عن تاريخ pg1، ووجدها التطبيق بالسلسلة نفسها دون أي تغيير في الإعداد. - رقم الطلب الجديد 34 وليس 3، والسبب أن PostgreSQL يسجل قيم ال Sequence في WAL مسبقاً بدفعات من 32 قيمة، كما في الثابت
SEQ_LOG_VALSفي كود PostgreSQL، فالنسخة المرقاة تبدأ بعد آخر دفعة مسجلة، لذلك لا تفترض أن الأرقام التسلسلية متصلة بعد أي انتقال. - هذا ما يفعله Patroni في الخطوات 3 و4 من الصورة السابقة، ولكنه يفعله بعد أن يتأكد بالأغلبية أن الرئيسي فقد مفتاح القائد، أما نحن فقررنا بأنفسنا.
السيرفر القديم يعود: انقسام الدماغ Split Brain
الآن نفعل ما يحدث كثيراً في الواقع: يعود السيرفر القديم بعد إصلاحه أو إعادة تشغيله، ولا يوجد أي شيء يمنعه من أن يقلع كسيرفر رئيسي. سوف نشغله، ونسأل السيرفرين عن دورهما، ونكتب عليه، ثم نوقفه فوراً:
docker start lab-dbc-pg1
for n in pg1 pg2; do docker exec lab-dbc-$n psql -U postgres -Atc "SELECT current_setting('cluster_name'), pg_is_in_recovery(), timeline_id FROM pg_control_checkpoint();"; done
bash who.sh
docker exec lab-dbc-pg1 psql -U postgres -c "INSERT INTO orders (customer, total) VALUES ('huda', 300) RETURNING id;"
for n in pg1 pg2; do echo "== $n"; docker exec lab-dbc-$n psql -U postgres -Atc "SELECT id, customer FROM orders ORDER BY id;"; done
docker stop lab-dbc-pg1
والمخرج سوف يكون كما يلي:
lab-dbc-pg1
pg1|f|1
pg2|f|2
pg1|f
 id
----
  3
(1 row)

INSERT 0 1
== pg1
1|sara ahmed
2|omar
3|huda
== pg2
1|sara ahmed
2|omar
34|ali
lab-dbc-pg1
في المخرج أعلاه لاحظ التالي:
- السيرفران كلاهما يقول إنه ليس في وضع الاستعادة، أي أن عندنا سيرفرين رئيسيين: pg1 على الخط الزمني 1 وpg2 على الخط الزمني 2.
- الأخطر أن سلسلة الاتصال نفسها
host=pg1,pg2 target_session_attrs=read-writeالتي وجدت pg2 قبل دقيقة، ذهبت الآن إلى pg1، لأنه أول عنوان في القائمة ويقبل الكتابة، فالمكتبة لا تعرف أي رئيسي هو الصحيح، وهذا هو السبب في أن عدة عناوين في سلسلة الاتصال تحتاج دائماً من يضمن أن هناك رئيسياً واحداً فقط. - الطلب
hudaكتب على pg1 فقط، والطلبaliعلى pg2 فقط، فأصبح عندنا تاريخان مختلفان للبيانات، ولا توجد أي طريقة تلقائية لدمجهما، وفي متجر حقيقي هذا يعني طلبات أو مدفوعات موجودة في نسخة دون الأخرى. - أوقفنا pg1 مباشرة، وهذا بالضبط ما يفعله Fencing تلقائياً في Patroni: سيرفر لا يملك مفتاح القائد لا يقبل الكتابة.
إعادة السيرفر القديم كنسخة بالأداة pg_rewind
لا يمكن أن يتبع pg1 السيرفر pg2 كما هو، لأن عنده كتابات على الخط الزمني القديم لا توجد عند pg2. والحل إما أن تحذف بياناته وتنسخ pg2 من جديد بالأداة pg_basebackup، وهو بطيء مع قاعدة كبيرة، أو أن تستخدم pg_rewind التي ترجع pg1 إلى النقطة التي افترق فيها الخطان وتنسخ ما تغير فقط. وشرطها كما في التوثيق أن يكون wal_log_hints مفعلاً أو أن يكون Checksum البيانات مفعلاً، وفي PostgreSQL 18 أصبح initdb يفعل Checksum البيانات افتراضياً كما في ملاحظات الإصدار، لذلك تعمل هنا دون أي إعداد إضافي. نحفظ الأوامر التالية في ملف rewind.sh وننفذه بينما pg1 متوقف:
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT pg_create_physical_replication_slot('replica_pg1');"

docker run --rm --name lab-dbc-rewind --network lab-dbc --user postgres \
  -v lab-dbc_pg1-data:/var/lib/postgresql postgres:18 bash -c '
pg_rewind --target-pgdata="$PGDATA" --progress \
  --source-server="host=pg2 user=postgres password=lab-only-password dbname=postgres"
touch "$PGDATA/standby.signal"
cat > "$PGDATA/postgresql.auto.conf" <<CONF
primary_conninfo = '"'"'host=pg2 user=replicator password=lab-only-replication application_name=pg1'"'"'
primary_slot_name = '"'"'replica_pg1'"'"'
CONF'
والمخرج سوف يكون كما يلي:
 pg_create_physical_replication_slot
-------------------------------------
 (replica_pg1,)
(1 row)

pg_rewind: connected to server
pg_rewind: servers diverged at WAL location 0/302B7B0 on timeline 1
pg_rewind: rewinding from last common checkpoint at 0/302B738 on timeline 1
pg_rewind: reading source file list
pg_rewind: reading target file list
pg_rewind: reading WAL in target
pg_rewind: need to copy 51 MB (total source directory size is 71 MB)
    0/52954 kB (0%) copied
16026/52954 kB (30%) copied
52954/52954 kB (100%) copied
pg_rewind: creating backup label and updating control file
pg_rewind: syncing target data directory
pg_rewind: Done!
في الإعداد أعلاه لاحظ التالي:
- أنشأنا أولاً على pg2 فتحة نسخ باسم
replica_pg1للنسخة الجديدة. - شغلنا
pg_rewindفي Container مؤقت يركب ال Volume الخاص ب pg1، لأن pg1 يجب أن يكون متوقفاً أثناءها، ووجدت الأداة النقطة التي افترق فيها الخطان ونسخت 51 ميجابايت من أصل 71. - الأداة تنسخ ملف
postgresql.auto.confمن pg2 أيضاً، وفيه إعدادات النسخ القديمة التي تشير إلى pg1 نفسه، لذلك كتبناه من جديد بسطرين يجعلان pg1 يتبع pg2، وأضفناstandby.signalليقلع كنسخة.
الآن نشغل pg1 ونتأكد أنه أصبح نسخة، وننظر إلى بياناته:
docker start lab-dbc-pg1
docker exec lab-dbc-pg2 psql -U postgres -c "SELECT application_name, state, sync_state FROM pg_stat_replication;"
docker exec lab-dbc-pg1 psql -U postgres -c "SELECT pg_is_in_recovery();" -c "SELECT id, customer FROM orders ORDER BY id;"
والمخرج سوف يكون كما يلي:
 application_name |   state   | sync_state
------------------+-----------+------------
 pg1              | streaming | async
(1 row)

 pg_is_in_recovery
-------------------
 t
(1 row)

 id |  customer
----+------------
  1 | sara ahmed
  2 | omar
 34 | ali
(3 rows)
عاد العنقود إلى رئيسي واحد ونسخة واحدة، ولكن الطلب huda رقم 3 اختفى تماماً، لأن pg_rewind أرجعت pg1 إلى نقطة الافتراق ثم طبقت تاريخ pg2. وهذا هو الدرس الأهم في التجربة كلها: كل كتابة قبلها سيرفر رئيسي قديم بعد الانتقال هي كتابة سوف تضيع، والتطبيق قيل له «تم»، لذلك فإن Fencing ليس تفصيلاً وإنما هو أهم جزء في الانتقال.
Valkey مع Sentinel: الانتقال التلقائي
الآن ننتقل إلى الجزء الثاني من المختبر، وفيه لا نرقي أي شيء بأيدينا. نتأكد أولاً من حالة النسخ وأن Sentinels متفقة، ثم نكتب على الرئيسي ونقرأ من النسخة ونحاول الكتابة عليها، ثم نوقف الرئيسي:
docker exec lab-dbc-valkey1 valkey-cli INFO replication | head -4
docker exec lab-dbc-sentinel1 valkey-cli -p 26379 SENTINEL get-master-addr-by-name mymaster
docker exec lab-dbc-sentinel1 valkey-cli -p 26379 SENTINEL ckquorum mymaster
docker exec lab-dbc-valkey1 valkey-cli SET cart:42 "3 items"
docker exec lab-dbc-valkey2 valkey-cli GET cart:42
docker exec lab-dbc-valkey2 valkey-cli SET cart:43 "1 item"
docker stop lab-dbc-valkey1
والمخرج سوف يكون كما يلي:
# Replication
role:master
connected_slaves:1
slave0:ip=10.94.80.22,port=6379,state=online,offset=158221,lag=1,type=replica
10.94.80.21
6379
OK 3 usable Sentinels. Quorum and failover authorization can be reached
OK
3 items
READONLY You can't write against a read only replica.
lab-dbc-valkey1
ثم ننتظر عشرين ثانية تقريباً، وننظر في سجل sentinel3:
docker logs lab-dbc-sentinel3والمخرج سوف يكون كما يلي (الأسطر الخاصة بالانتقال فقط):
1:X 06 Oct 2026 07:09:46.985 # +sdown master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:47.071 # +odown master mymaster 10.94.80.21 6379 #quorum 3/2
1:X 06 Oct 2026 07:09:47.071 # +new-epoch 1
1:X 06 Oct 2026 07:09:47.071 # +try-failover master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:48.128 * Sentinel new configuration saved on disk
1:X 06 Oct 2026 07:09:48.129 # +vote-for-leader f67f32cb1d3c5fea8b2de3f8b9d0ede227bd2762 1
1:X 06 Oct 2026 07:09:48.131 * 1e7bbd0cebcae63541ea38b2dd773aa2399dd7b8 voted for 1e7bbd0cebcae63541ea38b2dd773aa2399dd7b8 1
1:X 06 Oct 2026 07:09:53.197 # +sdown sentinel a0cf1b48a921d9239f66b188068db37fc08935b9 10.94.80.31 26379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.781 * a0cf1b48a921d9239f66b188068db37fc08935b9 voted for f67f32cb1d3c5fea8b2de3f8b9d0ede227bd2762 1
1:X 06 Oct 2026 07:09:53.813 # +elected-leader master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.813 # +failover-state-select-slave master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.813 # -sdown sentinel a0cf1b48a921d9239f66b188068db37fc08935b9 10.94.80.31 26379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.880 # +selected-slave slave 10.94.80.22:6379 10.94.80.22 6379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.880 * +failover-state-send-slaveof-noone slave 10.94.80.22:6379 10.94.80.22 6379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:53.935 * +failover-state-wait-promotion slave 10.94.80.22:6379 10.94.80.22 6379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:55.113 * Sentinel new configuration saved on disk
1:X 06 Oct 2026 07:09:55.114 # +promoted-slave slave 10.94.80.22:6379 10.94.80.22 6379 @ mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:55.114 # +failover-state-reconf-slaves master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:55.114 # +failover-end master mymaster 10.94.80.21 6379
1:X 06 Oct 2026 07:09:55.114 # +switch-master mymaster 10.94.80.21 6379 10.94.80.22 6379
1:X 06 Oct 2026 07:09:55.114 * +slave slave 10.94.80.21:6379 10.94.80.21 6379 @ mymaster 10.94.80.22 6379
في المخرج أعلاه لاحظ التالي:
+sdownتعني أن هذا Sentinel وحده يرى الرئيسي متوقفاً Subjectively Down، ثم+odownتعني أن النصاب اتفق على ذلك Objectively Down، والرقم3/2يعني أن ثلاثة Sentinels رأت العطل والنصاب المطلوب اثنان.- بعد ذلك تحتاج Sentinels إلى انتخاب واحد منها لينفذ الانتقال بالأغلبية، ولاحظ أن sentinel3 (المعرف
f67f32cb…) وsentinel2 (المعرف1e7bbd0c…) صوت كل منهما لنفسه، فلم يحصل أحد على الأغلبية حتى وصل صوت sentinel1 (المعرفa0cf1b48…) إلى sentinel3، فأصبح هو القائد+elected-leader، وهذه فكرة الانتخاب بالأغلبية نفسها التي شرحناها في قسم Raft. - اختار القائد النسخة الوحيدة
+selected-slave، وأرسل إليها أمر الترقية، ثم أعلن+switch-masterأن الرئيسي أصبح 10.94.80.22، وسجل الرئيسي القديم على أنه نسخة للرئيسي الجديد عندما يعود. - الانتقال كله استغرق قرابة 20 ثانية من أمر الإيقاف: ثوان ليتوقف ال Container، و5 ثوان من
down-after-milliseconds، ثم ثوان للانتخاب، وهي أزمنة للتوضيح على جهاز واحد. - في هذا التشغيل دخل sentinel1 في وضع الحماية TILT لثوان، وهو وضع يدخله Sentinel عندما يجد أن الوقت بين دورتين من مؤقته تجاوز ثانيتين كما في التوثيق، فيتوقف عن اتخاذ أي قرار لمدة 30 ثانية، ولم يمنع ذلك الانتقال لأن الاثنين الآخرين يكفيان للأغلبية، وهذا مثال حي على سبب الحاجة إلى ثلاثة Sentinels وليس اثنين.
ولماذا أعطينا كل Container عنواناً ثابتاً؟ في محاولة أولى استخدمنا أسماء ال Containers مع الإعداد sentinel resolve-hostnames yes، وعندما أوقفنا الرئيسي اختفى اسمه من شبكة Docker، فكانت محاولات حل الاسم تأخذ ثوان، فدخلت كل Sentinels في وضع TILT مرة بعد مرة ولم يحدث الانتقال أبداً. وهذه مشكلة خاصة بأسماء Docker التي تختفي مع ال Container، ولكنها تذكرك بأن تختبر الانتقال في بيئتك الحقيقية لا أن تفترض أنه يعمل.
الآن نتأكد من الرئيسي الجديد، ثم نعيد الرئيسي القديم ونرى ماذا يحدث له:
docker exec lab-dbc-valkey2 valkey-cli INFO replication | head -3
docker exec lab-dbc-valkey2 valkey-cli GET cart:42
docker exec lab-dbc-valkey2 valkey-cli SET cart:43 "1 item"
docker start lab-dbc-valkey1
sleep 15
docker logs lab-dbc-sentinel2 | tail -2
docker exec lab-dbc-valkey1 valkey-cli INFO replication | head -5
docker exec lab-dbc-valkey1 valkey-cli GET cart:43
والمخرج سوف يكون كما يلي:
# Replication
role:master
connected_slaves:0
3 items
OK
lab-dbc-valkey1
1:X 06 Oct 2026 07:13:08.653 # -sdown slave 10.94.80.21:6379 10.94.80.21 6379 @ mymaster 10.94.80.22 6379
1:X 06 Oct 2026 07:13:18.627 * +convert-to-slave slave 10.94.80.21:6379 10.94.80.21 6379 @ mymaster 10.94.80.22 6379
# Replication
role:slave
master_host:10.94.80.22
master_port:6379
master_link_status:up
1 item
في المخرج أعلاه لاحظ التالي:
- valkey2 أصبح
role:masterويقبل الكتابة، والمفتاحcart:42الذي كتبناه قبل العطل موجود لأنه وصل إلى النسخة قبل الإيقاف. - عندما عاد valkey1 قام كسيرفر رئيسي كما كان، ثم رآه Sentinel وحوله إلى نسخة
+convert-to-slaveبعد عشر ثوان تقريباً، وفي تلك الثواني العشر كان عندنا سيرفران رئيسيان، فإذا كان كلاينت قديم ما زال يكتب على valkey1 مباشرة فإن كتاباته ضاعت عند التحويل، وهذا ما يقصده التوثيق بأن النظام قد يخسر كتابات مؤكدة. - valkey1 يتبع الآن valkey2 ونسخ منه المفتاح
cart:43الذي كتب بعد الانتقال، أي أن العنقود أصلح نفسه دون أي تدخل منا، وهذا الفرق بين Sentinel والانتقال اليدوي الذي فعلناه مع PostgreSQL.
حذف المختبر
نحذف كل ال Containers وال Volumes والشبكة التي أنشأها المشروع lab-dbc فقط:
docker compose -p lab-dbc down -vوالمخرج سوف يكون كما يلي (الأسطر الأخيرة):
 Volume lab-dbc_pg2-data Removed
 Volume lab-dbc_pg1-data Removed
 Network lab-dbc Removed
ولا تستخدم docker volume prune أو docker system prune لتنظيف المختبر، والسبب أنها تحذف Volumes لمشاريع أخرى على الجهاز نفسه.
أخطاء شائعة
- بناء التوفر العالي لحل بطء الكتابة: الانتقال التلقائي لا يضيف أي قدرة على الكتابة، فقس أين يذهب الوقت أولاً.
- اعتبار النسخة نسخة احتياطية: الحذف الخاطئ يصل إلى كل النسخ خلال ثانية، فاحتفظ بنسخ احتياطية منفصلة مع PITR واختبر الاستعادة.
- عنقود من سيرفرين دون صوت ثالث: سيرفران وحدهما لا يستطيعان التفريق بين عطل السيرفر وانقطاع الشبكة، فإما أن يتوقف الانتقال أو يحدث انقسام الدماغ.
- سكربت انتقال كتبته بنفسك: الترقية سطر واحد، أما Fencing والأغلبية والتوجيه فهي الجزء الصعب، فاستخدم أداة مجربة مثل Patroni أو InnoDB Cluster أو Sentinel.
- إعادة السيرفر القديم دون إعادة بنائه كنسخة: كما رأيت في المختبر، يقلع كرئيسي ويقبل الكتابة، وتضيع تلك الكتابة لاحقاً.
- توجيه كل القراءة إلى النسخ تلقائياً: القراءة بعد الكتابة يجب أن تذهب إلى الرئيسي أو أن تنتظر LSN، وإلا رأى المستخدم بياناته القديمة.
- نسخة متزامنة واحدة: إذا توقفت توقفت كل الكتابة على الرئيسي، فاستخدم
ANY 1مع نسختين أو دع أداة الانتقال تدير الإعداد. - فتحة نسخ لنسخة ميتة: تحتفظ بملفات WAL حتى يمتلئ قرص الرئيسي، فحدد
max_slot_wal_keep_sizeواحذف الفتحات التي لا تحتاجها. - مكتبة لا تعرف العنقود: كلاينت Valkey يتصل بعنوان ثابت بدلاً من Sentinel، أو سلسلة MongoDB بعنوان واحد، فينجح الانتقال وتتوقف الخدمة.
- عدم اختبار الانتقال أبداً: أول انتقال حقيقي يجب ألا يكون أول انتقال على الإطلاق.
قائمة تحقق
- كتبت RPO وRTO المقبولين بالأرقام، واخترت التصميم على أساسهما.
- عندك نسخ احتياطية منفصلة عن العنقود مع PITR، وجربت الاستعادة على سيرفر آخر وقست زمنها.
- عدد الأصوات في العنقود فردي وثلاثة على الأقل، وموزع بحيث لا يسقط نصفه مع مركز بيانات واحد.
- أداة الانتقال تفعل Fencing، وتعرف ماذا يحدث للسيرفر القديم عندما يعود.
- التطبيق يجد الرئيسي الجديد بطريقة واحدة واضحة، ويعيد المحاولة عند خطأ الاتصال.
- القراءة من النسخ تتعامل مع التأخر، والقراءة بعد الكتابة تذهب إلى الرئيسي.
- عدد الاتصالات من كل نسخ التطبيق إلى كل سيرفر في العنقود محسوب، وأمامها مجمع اتصالات مناسب.
- هناك تنبيه على التأخر بالبايت وبالثواني، وعلى حجم WAL المحفوظ في فتحات النسخ.
- نفذت انتقالاً مخططاً في الأشهر الثلاثة الأخيرة، وقست زمن التوقف من جهة المستخدم.
- تحققت من ترخيص كل أداة في العنقود قبل أن تبني عليها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كلمة Cluster تعني سيرفراً واحداً في توثيق PostgreSQL، ونسخاً بالانتخاب في MySQL وMongoDB، ومراقبة ب Sentinel أو تقسيماً في Redis وValkey، فحدد ما تقصده قبل أن تبني أي شيء.
- التوفر العالي والقراءة والكتابة والجغرافيا أربعة أهداف مختلفة بأساليب مختلفة، والعنقود لا يغني عن النسخ الاحتياطي ولا يصلح الاستعلام البطيء.
- السيرفر الرئيسي مع النسخ هو الشكل الأشهر والأبسط، وعدة سيرفرات رئيسية تعطي التوفر وليس مضاعفة الكتابة، والتقسيم وقواعد SQL الموزعة هي الحل الحقيقي عندما تكبر الكتابة عن سيرفر واحد.
- الانتقال الصحيح يحتاج اكتشافاً للعطل وقراراً بالأغلبية وFencing للسيرفر القديم وطريقة يجد بها التطبيق الرئيسي الجديد، ورأيت في المختبر أن السيرفر القديم الذي يعود دون Fencing يقبل كتابة تضيع بعد ذلك.
- القراءة من النسخ تحتاج حلاً لقراءة ما كتبته، مثل القراءة من الرئيسي بعد الكتابة أو انتظار رقم LSN كما جربنا.
- مفتاح التقسيم قرار يصعب الرجوع عنه، والأنسب لأغلب التطبيقات رقم العميل أو المستأجر.
- تحقق من الترخيص: PostgreSQL وPatroni وValkey وMySQL مفتوحة المصدر، وMongoDB وCockroachDB مصدر متاح، وRedis 8 بثلاثة تراخيص منها AGPLv3.
- ابدأ من سيرفر واحد مع نسخ احتياطية مجربة، ولا تضف الخطوة التالية إلا عندما تقيس الحاجة إليها، واختبر الانتقال بانتظام.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلHAProxy: توزيع الحمل Load Balancing أمام خدماتكعندما يعمل تطبيقك على أكثر من سيرفر، يوزع HAProxy الطلبات بينها ويستبعد المعطل منها تلقائياً مع شهادات HTTPS.
 دليلكيف بنى Stack Overflow موقعه بسيرفرات قليلة؟كيف خدم Stack Overflow أكثر من مئتي مليون طلب يومياً بعدد قليل من السيرفرات، وما الدروس التي تأخذها منه لمشروعك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على PostgreSQL 18.6 (postgres:18) وValkey 9.1.2 (valkey/valkey:9-alpine) في Docker Engine 29.8.0 مع Docker Compose v5.5.1.


