

عندما يشتكي مستخدم من أن صفحة الدفع بطيئة أحياناً أو أنها تفشل مرة كل فترة، وكان تطبيقك برنامجاً واحداً على سيرفر واحد، فأنت تفتح سجله وتبحث بالوقت وتجد السطر غالباً. أما إذا كان الطلب نفسه يمر بخدمة الواجهة ثم خدمة الطلبات ثم خدمة الدفع ثم بنك خارجي، وكل خدمة لها سجلها وسيرفرها وفريقها، فإن السؤال البسيط «أين ذهبت هذه الثانية؟» يصبح بحثاً في ثلاثة سجلات عن سطور حدثت في الثانية نفسها مع مئات الطلبات الأخرى، ثم تخمين أي سطر في خدمة الدفع يخص أي سطر في خدمة الطلبات.
وفي دليل تتبع الطلب البطيء قسمنا وقت الطلب على سيرفر واحد من المتصفح إلى قاعدة البيانات، وذكرنا في آخر قسم معرف الطلب أن الأنظمة الموزعة تحتاج شيئاً أكبر، وفي دليل السجلات Logging فرقنا بين السجلات والمقاييس والتتبع وجمعنا السجلات في مكان واحد بمعرف الطلب Request ID. وهذا المقال يكمل من هناك، فلن نعيد شرح السجلات المنظمة ولا معرف الطلب، وسوف نركز على التتبع الموزع Distributed Tracing نفسه.
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يصعب العثور على الخطأ في نظام موزع، ولماذا لا يكفي معرف الطلب وحده.
- ال Trace وال Span وعلاقة الأب بالابن، وما يحمله كل Span من خصائص Attributes وأحداث Events وحالة Status.
- كيف ينتقل السياق Context بين الخدمات عبر ترويسة
traceparentالمعيارية من W3C، ومتى تستخدم Baggage. - مشروع OpenTelemetry: الفرق بين ال API وال SDK، والقياس التلقائي واليدوي، وبروتوكول OTLP، وال Collector.
- أين تخزن ال Traces: Jaeger أم Grafana Tempo، وترخيص كل منهما.
- أخذ العينات Sampling في البداية وفي النهاية، وتكلفة كل طريقة.
- ربط السجلات بال Trace عبر
trace_id. - تجربة عملية بثلاث خدمات وCollector وJaeger، نجد فيها Span بطيئاً وSpan فاشلاً، ثم نكسر انتقال السياق عمداً ونرى ال Trace ينقسم إلى اثنين.
لماذا يصعب العثور على الخطأ في نظام موزع؟
في البرنامج الواحد يحمل كل طلب مكدس الاستدعاءات Call Stack الخاص به، فإذا وقع استثناء Exception ترى في سطر واحد من أين دخل الطلب وأي دالة استدعت أي دالة حتى وصل إلى الخطأ. أما في النظام الموزع فهذا المكدس ينقطع عند كل استدعاء عبر الشبكة، فخدمة الدفع لا تعرف شيئاً عن الطلب الذي وصل إلى خدمة الواجهة، وكل ما تراه طلب HTTP جديد بلا تاريخ. وكما ذكرنا في الفشل الجزئي فإن جزءاً من النظام قد يتعطل أو يبطؤ والباقي يعمل، والمستخدم يرى النتيجة النهائية فقط: خطأ 502 أو صفحة تنتظر.
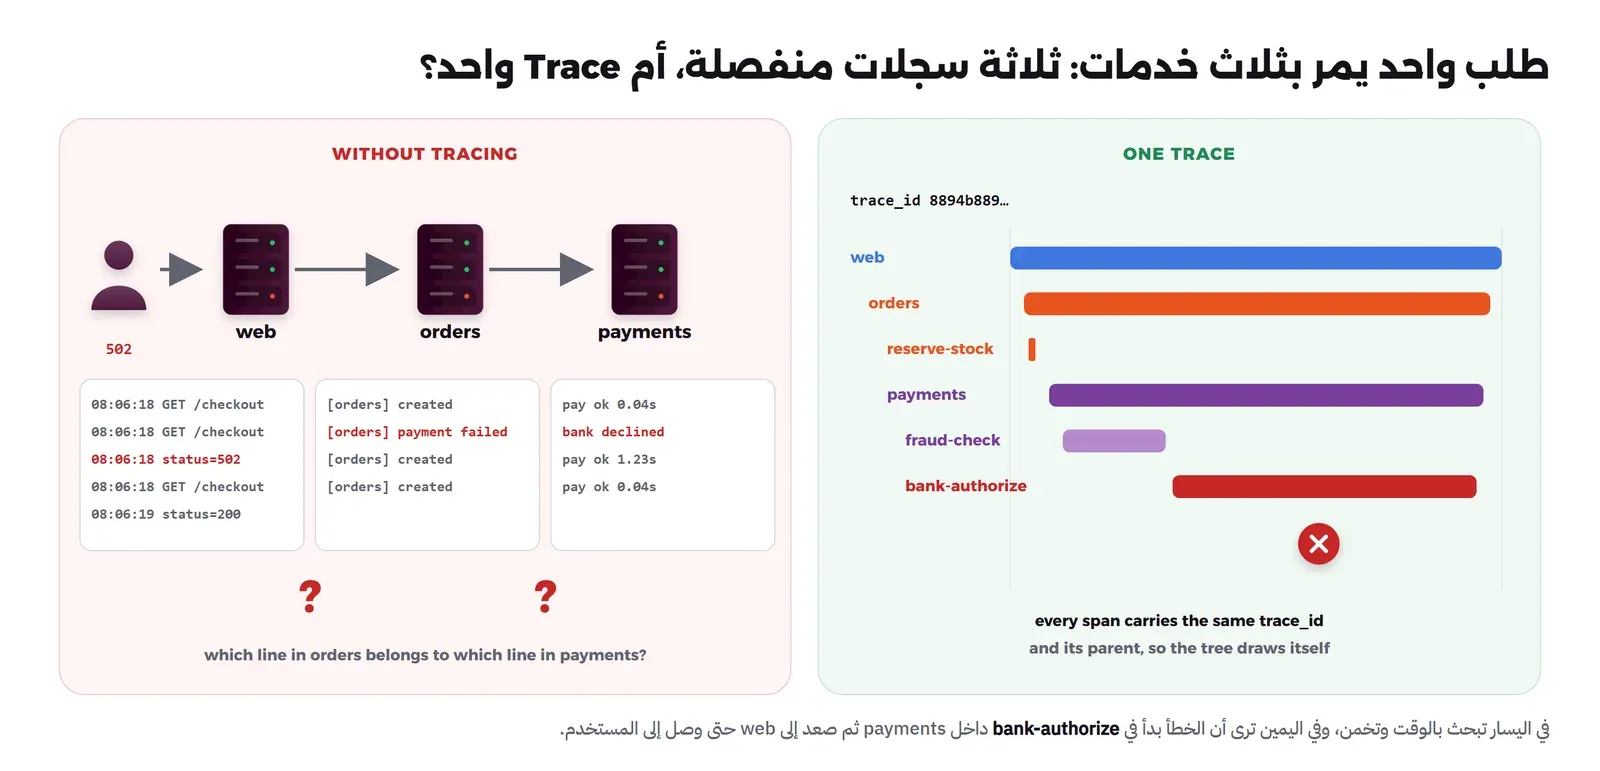
والحل البسيط الذي يبدأ به أغلب الفرق هو معرف الطلب Request ID، أي رقم تولده أول خدمة وتمرره في ترويسة وتكتبه كل خدمة في سجلها، فتبحث به في السجل المركزي وتجمع السطور. وهو حل مفيد ولا تتركه، ولكنه يجيب عن سؤال «ما السطور التي تخص هذا الطلب؟» فقط، ولا يجيب عن «من استدعى من؟» ولا عن «كم استغرقت كل خطوة، وهل كانت متتابعة أم متوازية؟»، والسبب أن السطر يسجل لحظة واحدة وليس فترة لها بداية ونهاية، ولا يعرف من هو أبوه. فإذا استدعت خدمة الطلبات خدمة الدفع مرتين وخدمة المخزون مرة، وكانت إحدى المحاولات بطيئة، فسوف ترى سطوراً متشابهة بأوقات متقاربة ولن تعرف أيها المحاولة الثانية.
والصورة التالية تبين الفرق بين الحالتين لطلب واحد فشل في التجربة العملية في آخر المقال:
وفكرة التتبع الموزع ليست جديدة، فقد نشرت Google سنة 2010 ورقة Dapper التي تصف نظام التتبع الذي بنته داخلياً لخدماتها، وأغلب الأدوات المفتوحة التي سوف تقابلها اليوم تبني على نفس المفاهيم: شجرة من الفترات الزمنية، ومعرف مشترك ينتقل مع الطلب، وأخذ عينات حتى لا تغرق في البيانات.
ال Trace وال Span: شجرة الطلب الواحد
ال Span هو وحدة عمل واحدة لها بداية ونهاية، مثل طلب HTTP وصل إلى خدمة، أو استدعاء أرسلته الخدمة إلى خدمة أخرى، أو استعلام إلى قاعدة البيانات، أو جزء من كودك أردت أن تقيسه. وال Trace هو مجموعة ال Spans التي تخص طلباً واحداً، ويعرفه توثيق OpenTelemetry بأنه مسار الطلب عبر التطبيق، وكل ال Spans فيه تحمل نفس معرف ال Trace واختصاراً trace_id، ولكل Span معرفه الخاص span_id، ويحمل معرف أبيه parent_span_id، وبهذين الحقلين فقط ترسم الأداة الشجرة كاملة.
والصورة التالية تبين Trace حقيقياً من التجربة لطلب دفع بمبلغ كبير، مرسوماً بالأرقام التي أعادها Jaeger:
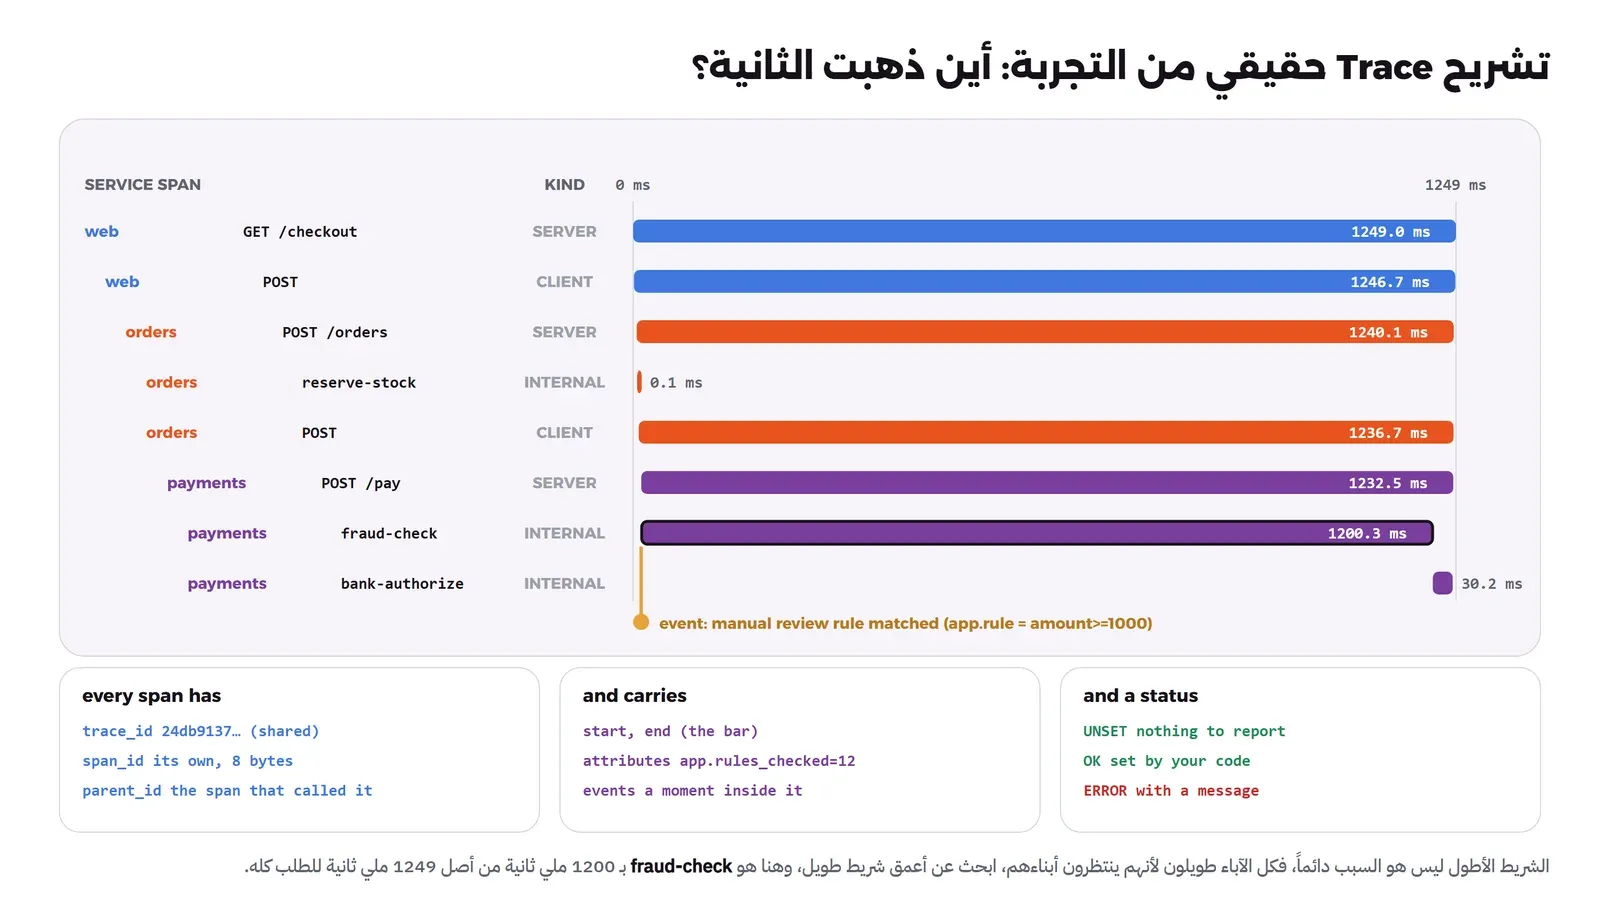
في الصورة أعلاه لاحظ التالي:
- ال Span الأعلى
GET /checkoutهو ال Span الأول Root Span، أي ال Span الذي لا أب له، ووقته هو ما شعر به المستخدم. - كل استدعاء عبر الشبكة يظهر مرتين: مرة في الخدمة المرسلة بنوع
CLIENT، ومرة في الخدمة المستقبلة بنوعSERVER، والفرق بينهما هو وقت الشبكة والانتظار في الطابور عند المستقبل. أماINTERNALفهو عمل داخل الخدمة نفسها، وهناك نوعان آخران للطوابير هماPRODUCERوCONSUMER. - القاعدة عند القراءة: لا تتوقف عند أطول شريط، فكل الآباء طويلون لأنهم ينتظرون أبناءهم، وإنما انزل حتى تجد أعمق Span طويل ليس له ابن يفسر طوله، وهنا هو
fraud-checkبـ 1200 ملي ثانية من أصل 1249.
الخصائص والأحداث والحالة
ال Span ليس اسماً ووقتاً فقط، وإنما يحمل ثلاثة أشياء تجعل البحث ممكناً:
- الخصائص Attributes: أزواج مفتاح وقيمة تصف العمل، مثل
http.request.methodوhttp.response.status_codeالتي تضيفها المكتبات تلقائياً بحسب الاتفاقيات الدلالية Semantic Conventions، ولاحظ أن إصدار مكتبة Flask في تجربتنا ما زال يكتب الأسماء القديمةhttp.methodوhttp.status_code، فتحقق من الأسماء التي تصلك قبل أن تبني عليها لوحات وتنبيهات. وتضيف أنت خصائصك مثلapp.amount. وهي التي تبحث بها لاحقاً: «كل ال Traces التي فيهاapp.amountأكبر من 1000». - الأحداث Events: لحظة لها وقت داخل ال Span، مثل «انطبقت قاعدة المراجعة اليدوية» أو استثناء وقع، وهي أقرب شيء إلى سطر السجل ولكنها مربوطة بال Span الذي حدثت فيه.
- الحالة Status: إما
Unsetوهي الافتراضية، أوErrorمع رسالة، أوOkإذا أراد كودك أن يؤكد النجاح صراحة.
وقد يتساءل البعض: إذا رد سيرفر الدفع بالرمز 402، فهل يكون Span السيرفر خطأ؟ والإجابة لا، فالاتفاقيات الدلالية لطلبات HTTP تنص على أن رموز 4xx تترك حالة ال Span من نوع SERVER دون تعيين، والسبب أن السيرفر قام بعمله بشكل صحيح ورفض طلباً غير صالح، بينما يعدها Span الكلاينت خطأ لأن طلبه لم ينجح. وسوف ترى هذا بالضبط في التجربة، فلذلك إذا أردت أن يظهر رفض البنك كخطأ في خدمة الدفع فعليك أن تعين الحالة بنفسك على ال Span الذي يعرف السبب.
كيف ينتقل السياق بين الخدمات؟
حتى تعرف خدمة الدفع أن الطلب الذي وصلها جزء من Trace بدأ في خدمة الواجهة، يجب أن يحمل الطلب نفسه معرف ال Trace ومعرف ال Span الذي أرسله، وهذا ما يسمى نشر السياق Context Propagation. وفي الماضي كانت كل أداة تستخدم ترويساتها الخاصة، فإذا كانت خدمة تستخدم Zipkin والأخرى تستخدم أداة تجارية انقطع ال Trace بينهما، ولذلك وضعت W3C معيار Trace Context الذي أصبح توصية رسمية W3C Recommendation، ويعرف ترويستين: traceparent وtracestate.
والصورة التالية تبين حقول ترويسة traceparent بقيمة حقيقية من سجل خدمة الدفع في التجربة، وكيف تتغير بين قفزة وأخرى:
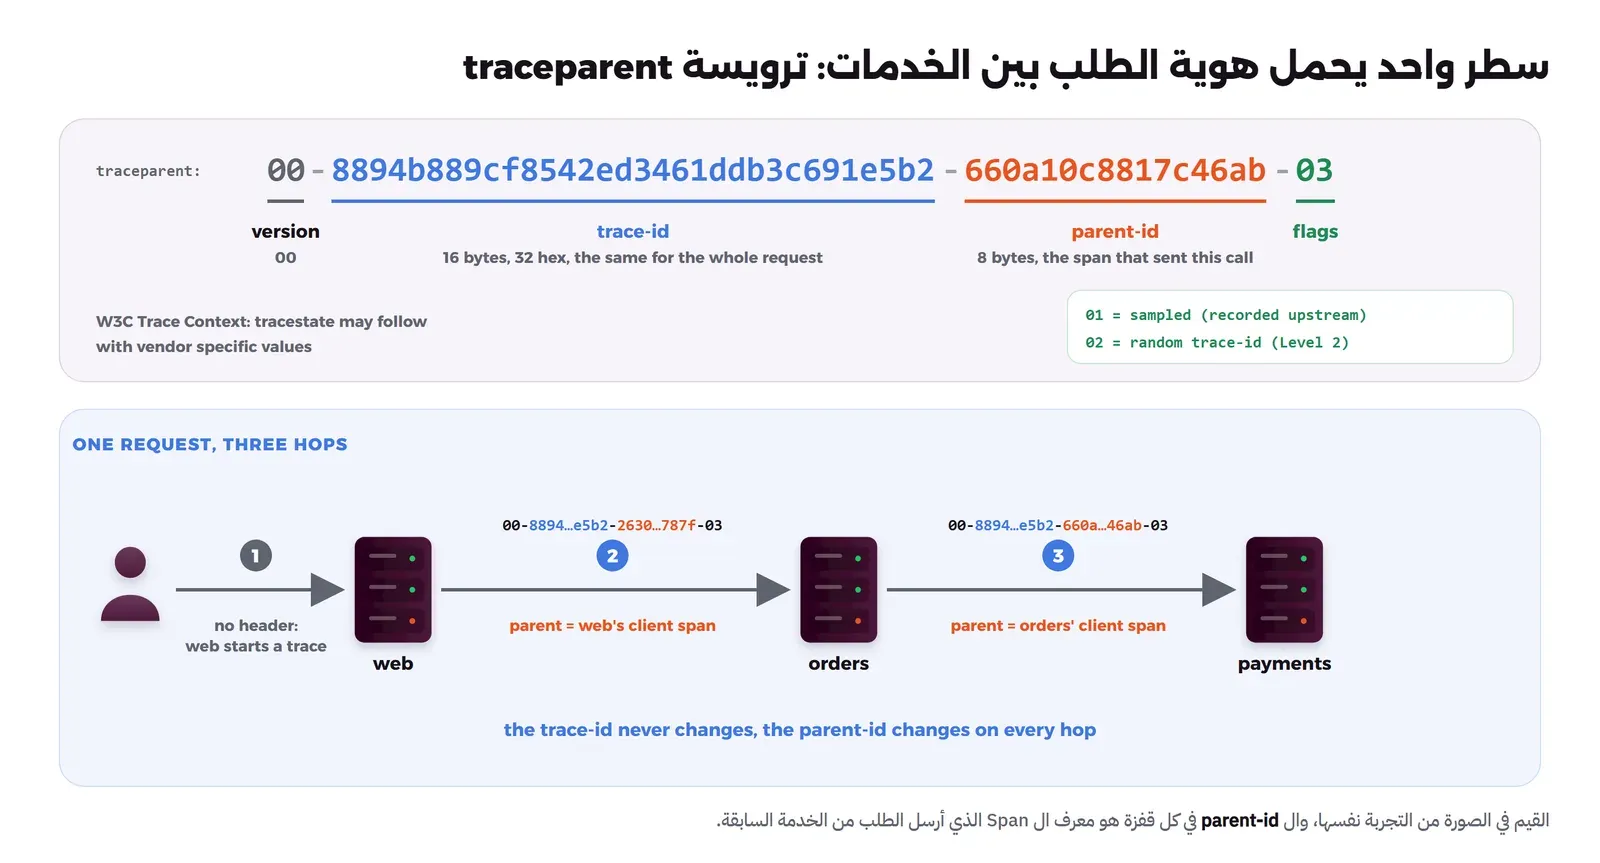
في الترويسة أعلاه لاحظ التالي:
- الحقل الأول
00هو الإصدار، والثانيtrace-idمن 16 بايت، والثالثparent-idمن 8 بايت، والمعيار يمنع أن يكون أي منهما أصفاراً كله، وإذا وصلت قيمة غير صالحة فعلى الخدمة أن تتجاهل الترويسة وتبدأ Trace جديداً. - الحقل الأخير هو الأعلام Flags، والبت الأيمن هو
sampled، أي أن المرسل سجل هذا الطلب، والخدمات بعده تحترم قراره عادة حتى لا يصل إليك Trace ناقص. والقيمة في التجربة03وليست01، والسبب أن البت الثاني في المستوى الثاني من المعيار يعني أن معرف ال Trace مولد عشوائياً، وهذا المستوى ما زال مسودة مرشحة Candidate Recommendation Draft وقت كتابة المقال. - ترويسة
tracestateاختيارية، وتحمل قيماً خاصة بكل أداة تتبع، ولا تحتاجها في أغلب الحالات.
أما داخل الخدمة نفسها فالسياق لا ينتقل في ترويسة وإنما في متغير يرتبط بالطلب الحالي، وفي Python تستخدم مكتبة OpenTelemetry الوحدة contextvars، ولذلك عندما ترسل عملاً إلى Thread آخر أو طابور داخلي فقد يضيع السياق، وهذا بالضبط ما سوف نكسره في التجربة.
ال Baggage: بيانات تسافر مع الطلب
يعرف W3C معياراً ثانياً اسمه Baggage، وهو ترويسة baggage تحمل أزواج مفتاح وقيمة من اختيارك، مثل معرف المستأجر Tenant ID أو اسم التجربة A/B، فتصل إلى كل خدمة في طريق الطلب حتى لو لم تمررها الخدمات بينها بنفسها. ولكن انتبه إلى أمرين: الأول أن ال Baggage لا يضاف إلى ال Spans تلقائياً، فإذا أردته في ال Trace فعليك أن تنسخه إلى خاصية، والثاني أنه يرسل في كل طلب صادر، ومنها الطلبات إلى خدمات خارجية لا تملكها، لذلك لا تضع فيه بريداً أو رقم هوية أو أي توكن.
traceparent القادمة من الإنترنت يكتبها الكلاينت كما يريد، فإذا قبلتها خدمتك الأمامية كما هي فقد يحدد أي شخص معرف ال Trace وعلم العينة لطلباته. والأسلم أن تبدأ الخدمة الأولى أو ال Reverse Proxy أمامها Trace جديداً للطلبات القادمة من الخارج، وأن تقبل الترويسة فقط من خدماتك الداخلية.ما هو OpenTelemetry؟
OpenTelemetry، واختصاراً OTel، مشروع مفتوح المصدر يعرف طريقة واحدة لإنتاج بيانات المراقبة الثلاث: ال Traces والمقاييس Metrics والسجلات Logs، وجمعها وإرسالها. ويذكر توثيقه أنه نتج عن دمج مشروعين سابقين هما OpenTracing وOpenCensus، وأنه ليس مكاناً لتخزين البيانات أو عرضها، فهو ينتج البيانات ويرسلها إلى الأداة التي تختارها. وبحسب صفحة المشروع في CNCF فقد قبل في المؤسسة في 7 مايو 2019، ووصل إلى مرحلة التخرج Graduated في 11 مايو 2026.
وفيما يلي القطع التي يجب أن تعرفها:
- ال API: الواجهة التي يستدعيها كودك ومكتباتك لإنشاء Span أو إضافة خاصية، وهي خفيفة ولا تفعل شيئاً إذا لم يوجد SDK، لذلك تستطيع المكتبات أن تعتمد عليها دون أن تفرض عليك شيئاً.
- ال SDK: التنفيذ الفعلي الذي يقرر ماذا يسجل (أخذ العينات)، ويجمع ال Spans في دفعات، ويرسلها عبر المصدر Exporter.
- القياس التلقائي Zero-code Instrumentation: في Python تثبت حزمة
opentelemetry-distroثم تشغل تطبيقك عبر الأمرopentelemetry-instrument، فيضيف Spans لإطارات ومكتبات معروفة مثل Flask وrequests دون تعديل الكود، كما يشرح دليل Python. - القياس اليدوي Manual Instrumentation: Spans تضيفها بنفسك حول كودك المهم مثل فحص الاحتيال أو حجز المخزون، لأن المكتبات لا تعرف أي جزء من منطقك يستحق القياس.
- بروتوكول OTLP: طريقة إرسال البيانات من ال SDK إلى ال Collector أو إلى أداة التخزين، عبر gRPC على المنفذ 4317 أو HTTP على المنفذ 4318.
- ال Collector: برنامج منفصل يستقبل البيانات ويعالجها ويرسلها، ومعماريته ثلاث مراحل: المستقبلات Receivers، والمعالجات Processors، والمصدرات Exporters، تربطها في خطوط Pipelines بحسب نوع البيانات.
والصورة التالية تبين المسار الذي سوف نبنيه في التجربة:
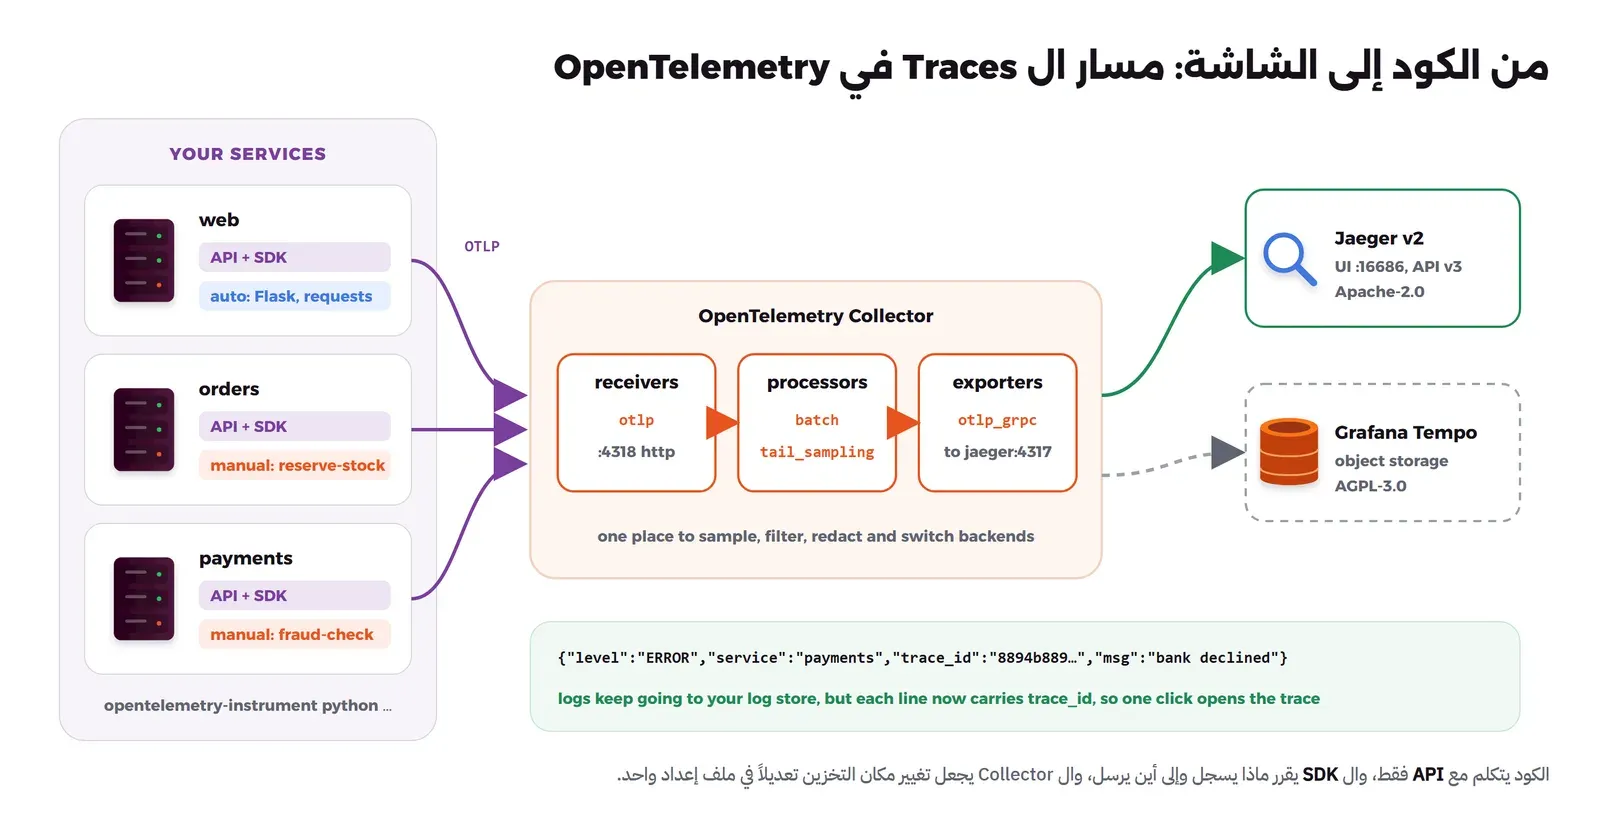
وقد يتساءل البعض: لماذا Collector في المنتصف، والتطبيق يستطيع أن يرسل إلى Jaeger مباشرة؟ والإجابة أن ال Collector يعطيك مكاناً واحداً تأخذ فيه العينات وتحذف فيه البيانات الحساسة من الخصائص وتغير فيه أداة التخزين أو ترسل إلى أداتين معاً، دون أن تعيد نشر كل خدمة، كما أن ال SDK يسلم البيانات بسرعة إلى Collector قريب منه بدل أن ينتظر أداة تخزين بعيدة. وفي فريق صغير بخدمتين أو ثلاث تستطيع أن تبدأ دونه، ولكنك سوف تحتاجه بمجرد أن تريد أخذ العينات في النهاية كما سيأتي.
أين تخزن ال Traces: Jaeger أم Grafana Tempo؟
OpenTelemetry ينتج البيانات فقط، فتحتاج أداة تخزنها وتعرضها، وأشهر خيارين مفتوحين للاستضافة على سيرفرك هما Jaeger وGrafana Tempo:
- Jaeger: بدأ في شركة Uber كما يذكر مستودعه، وقبل في CNCF سنة 2017 وتخرج في 31 أكتوبر 2019 بحسب صفحته في CNCF. والإصدار الثاني منه، كما يذكر توثيقه، مبني على إطار OpenTelemetry Collector نفسه، فيستقبل OTLP مباشرة، وفيه واجهة بحث وعرض خاصة به، ويخزن في الذاكرة للتجارب، أو في Cassandra أو Elasticsearch أو OpenSearch للإنتاج، وترخيصه Apache-2.0.
- Grafana Tempo: من Grafana Labs، ويقول توثيقه إنه لا يحتاج إلا تخزين كائنات Object Storage ليعمل، ولا توجد فيه واجهة خاصة، فتعرض ال Traces من Grafana، وتبحث فيها بلغة TraceQL. وترخيصه AGPL-3.0 كما في مستودعه، وهو ترخيص يلزمك بنشر تعديلاتك على Tempo نفسه إذا قدمته خدمة للآخرين عبر الشبكة، ولا يمس كود تطبيقك الذي يرسل إليه البيانات.
والقاعدة العملية: إذا كنت تستخدم Grafana للمقاييس وLoki للسجلات كما في تجربة السجلات فإن Tempo يكمل المجموعة نفسها بتخزين رخيص، وإذا أردت أداة مستقلة بواجهة جاهزة تبدأ بها في دقائق فابدأ بJaeger، وفي الحالتين يبقى كودك وال Collector كما هما ويتغير المصدر فقط.
أخذ العينات Sampling: لا تحفظ كل شيء
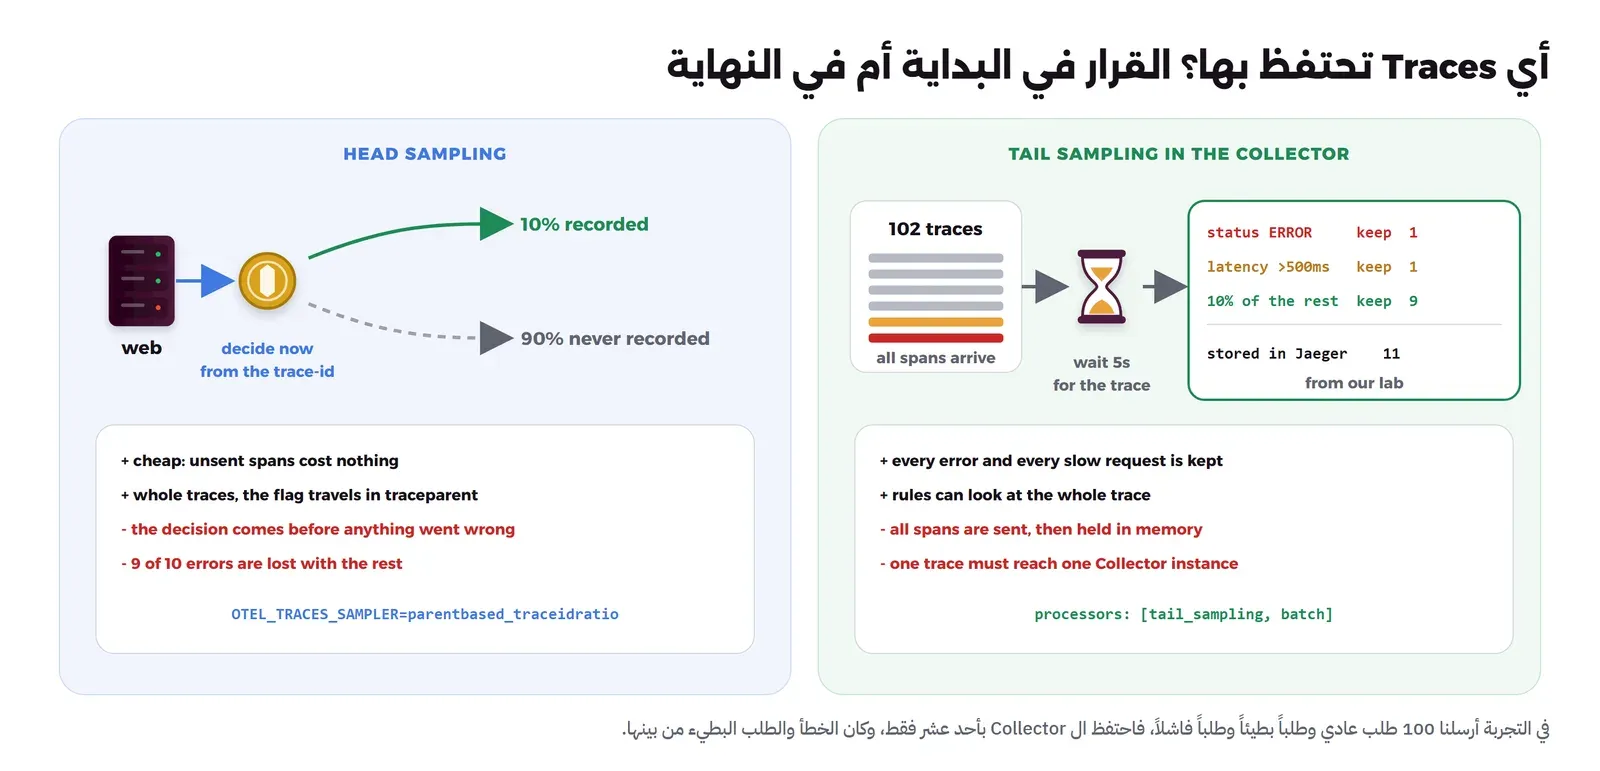
في التجربة كل طلب ينتج ثمانية Spans، فإذا كانت خدمتك تستقبل ألف طلب في الثانية فهذه ثمانية آلاف Span في الثانية تحتاج شبكة وتخزيناً ووقت فهرسة، وأغلبها طلبات ناجحة عادية لن ينظر إليها أحد. لذلك تحتفظ بجزء منها فقط، والسؤال هو متى تتخذ قرار الاحتفاظ. ويشرح توثيق أخذ العينات طريقتين:
- العينة في البداية Head Sampling: يقرر ال SDK في أول Span بناء على معرف ال Trace، مثلاً احتفظ بعشرة في المئة، ثم ينتقل القرار في علم
sampledإلى كل الخدمات بعده، فتحصل على Traces كاملة بتكلفة قليلة. والمتغيرOTEL_TRACES_SAMPLERقيمته الافتراضيةparentbased_always_on، أي سجل كل شيء واتبع قرار الأب، كما في متغيرات البيئة. ومشكلتها أن القرار يتخذ قبل أن يحدث أي شيء، فإذا احتفظت بعشرة في المئة ضاعت تسعة أخطاء من كل عشرة مع الطلبات العادية. - العينة في النهاية Tail Sampling: ترسل كل ال Spans إلى ال Collector، فينتظر حتى يكتمل ال Trace ثم يقرر: احتفظ بكل Trace فيه خطأ، وبكل Trace أبطأ من حد معين، وبنسبة صغيرة من الباقي. وثمنها أن ال Collector يحفظ ال Traces في الذاكرة أثناء الانتظار، وأن معالج tail_sampling يشترط أن تصل كل Spans ال Trace الواحد إلى نسخة Collector واحدة، فإذا كان عندك أكثر من نسخة احتجت طبقة توزيع بمعرف ال Trace أمامها.
والصورة التالية تقارن الطريقتين بنتيجة التجربة:
وفي الواقع يجمع كثير من الفرق بين الطريقتين، فتأخذ عينة في البداية بنسبة كبيرة لحماية خط البيانات من الحمل، ثم عينة في النهاية في ال Collector تحتفظ بالأخطاء والطلبات البطيئة، وهذا ما يقترحه توثيق OpenTelemetry نفسه للأنظمة ذات الحجم الكبير.
اربط السجلات بال Trace
ال Trace يخبرك أين ومتى، والسجل يخبرك لماذا بالتفصيل، فإذا وجدت Span فاشلاً تريد أن ترى سطور السجل التي كتبت داخله، وإذا وجدت سطر خطأ في السجل تريد أن تفتح ال Trace الذي يخصه. والطريقة أن يكتب كل سطر سجل trace_id وspan_id الحاليين، وهذا يغني عن معرف الطلب الذي تولده بنفسك، لأن trace_id يؤدي نفس الوظيفة وينتقل تلقائياً. وفي Python توفر أداة قياس الوحدة logging الحقول otelTraceID وotelSpanID وotelServiceName لكل سطر عند ضبط المتغير OTEL_PYTHON_LOG_CORRELATION=true، وسوف نستخدمها في التجربة مع صيغة JSON. أما أسماء الحقول ومكان تخزين السجلات وطريقة البحث فيها فقد شرحناها في أسماء الحقول الموحدة، فلا نعيدها هنا.
تجربة عملية: ثلاث خدمات وCollector وJaeger
سوف نبني متجراً صغيراً من ثلاث خدمات Flask: خدمة web التي يطلبها المتصفح، وتستدعي خدمة orders التي تحجز المخزون في قاعدة SQLite في الذاكرة ثم تستدعي خدمة payments التي تفحص الاحتيال ثم تطلب موافقة البنك. وفي خدمة الدفع خطآن مقصودان: فحص الاحتيال يبطؤ 1.2 ثانية إذا كان المبلغ 1000 أو أكثر، والبنك يرفض البطاقات التي تنتهي بـ 0000، والمطلوب أن نجد الاثنين من ال Trace وحده. والتجربة كلها تعمل على جهاز واحد بـ Docker Compose، والمنافذ مربوطة على 127.0.0.1 فقط، واستهلكت كل الخدمات معاً أقل من 200 ميجابايت من الذاكرة.
ملفات التجربة
أنشئ مجلداً فارغاً وضع فيه الملفات التالية، أولها Dockerfile واحد للخدمات الثلاث بإصدارات مثبتة:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir flask==3.1.3 requests==2.34.2 \
    opentelemetry-distro==0.66b1 opentelemetry-exporter-otlp-proto-http==1.45.1 \
    opentelemetry-instrumentation-flask==0.66b1 opentelemetry-instrumentation-requests==0.66b1 \
    opentelemetry-instrumentation-logging==0.66b1
WORKDIR /app
COPY web.py orders.py payments.py ./
ثم خدمة الواجهة web.py، ولاحظ أنها لا تحتوي أي سطر من OpenTelemetry، فكل ال Spans فيها تأتي من القياس التلقائي لFlask وrequests:
# web: the entry point the browser calls; it only forwards the checkout to orders
import logging, os
import requests
from flask import Flask, jsonify, request

app = Flask(__name__)
log = logging.getLogger("web")
ORDERS = os.environ["ORDERS_URL"]

@app.get("/checkout")
def checkout():
    order = {"item": request.args.get("item", "book"),
             "amount": int(request.args.get("amount", 100)),
             "card": request.args.get("card", "4242424242424242")}
    r = requests.post(f"{ORDERS}/orders", json=order, timeout=5)
    log.info("checkout finished status=%s", r.status_code)
    return jsonify(r.json()), r.status_code
ثم خدمة الطلبات orders.py، وفيها Span يدوي حول حجز المخزون، ومتغير PAY_MODE سوف نستخدمه في خطوة الكسر:
# orders: reserves stock in a small local database, then asks payments to charge the card
import contextvars, logging, os, sqlite3, threading
from concurrent.futures import ThreadPoolExecutor
import requests
from flask import Flask, jsonify, request
from opentelemetry import trace

app = Flask(__name__)
log = logging.getLogger("orders")
tracer = trace.get_tracer("orders")
PAYMENTS = os.environ["PAYMENTS_URL"]
MODE = os.environ.get("PAY_MODE", "inline")    # inline | thread | thread-fixed
pool = ThreadPoolExecutor(max_workers=4)

db = sqlite3.connect(":memory:", check_same_thread=False)
db.execute("CREATE TABLE stock (item TEXT PRIMARY KEY, qty INTEGER)")
db.execute("INSERT INTO stock VALUES ('book', 1000000)")
lock = threading.Lock()

def charge(order):
    return requests.post(f"{PAYMENTS}/pay", json=order, timeout=3)

@app.post("/orders")
def create_order():
    order = request.get_json()
    with tracer.start_as_current_span("reserve-stock") as span:     # a manual span around our own code
        span.set_attribute("app.item", order["item"])
        with lock:
            db.execute("UPDATE stock SET qty = qty - 1 WHERE item = ?", (order["item"],))
    if MODE == "thread":                       # the bug: the worker thread does not see the current span
        r = pool.submit(charge, order).result()
    elif MODE == "thread-fixed":               # the fix: run the call inside a copy of the current context
        r = pool.submit(contextvars.copy_context().run, charge, order).result()
    else:
        r = charge(order)
    if r.status_code != 200:
        log.error("payment failed status=%s", r.status_code)
        return jsonify({"order": "failed", "reason": r.json().get("error")}), 502
    log.info("order created item=%s", order["item"])
    return jsonify({"order": "created", **r.json()})
ثم خدمة الدفع payments.py، وفيها Spans يدوية لفحص الاحتيال وموافقة البنك، وحدث Event عند انطباق قاعدة المراجعة، وحالة خطأ عند رفض البنك:
# payments: a fraud check (slow for big amounts) and a bank call (fails for cards ending in 0000)
import logging, time
from flask import Flask, jsonify, request
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

app = Flask(__name__)
log = logging.getLogger("payments")
tracer = trace.get_tracer("payments")

@app.post("/pay")
def pay():
    o = request.get_json()
    log.info("incoming traceparent=%s", request.headers.get("traceparent"))
    trace.get_current_span().set_attribute("app.amount", o["amount"])
    with tracer.start_as_current_span("fraud-check") as span:
        span.set_attribute("app.rules_checked", 12)
        if o["amount"] >= 1000:
            span.add_event("manual review rule matched", {"app.rule": "amount>=1000"})
            time.sleep(1.2)                     # the slow part we will look for in the trace
        else:
            time.sleep(0.01)
    with tracer.start_as_current_span("bank-authorize") as span:
        time.sleep(0.03)
        if o["card"].endswith("0000"):
            err = RuntimeError("bank declined: card blocked")
            span.record_exception(err)
            span.set_status(Status(StatusCode.ERROR, str(err)))
            log.error("bank declined card=****%s", o["card"][-4:])
            return jsonify({"error": "card declined"}), 402
    return jsonify({"payment": "approved", "amount": o["amount"]})
ثم إعداد ال Collector collector.yaml، وهو أبسط خط ممكن: يستقبل OTLP عبر HTTP، ويجمع في دفعات، ويرسل إلى Jaeger عبر gRPC:
receivers:
  otlp:
    protocols:
      http:
        endpoint: 0.0.0.0:4318
processors:
  batch: {}
exporters:
  otlp_grpc/jaeger:
    endpoint: lab-trace-jaeger:4317
    tls:
      insecure: true
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [otlp_grpc/jaeger]
وإعداد ثان collector-tail.yaml سوف نستخدمه في خطوة أخذ العينات:
receivers:
  otlp:
    protocols:
      http:
        endpoint: 0.0.0.0:4318
processors:
  tail_sampling:
    decision_wait: 5s
    policies:
      - name: keep-errors
        type: status_code
        status_code: { status_codes: [ERROR] }
      - name: keep-slow
        type: latency
        latency: { threshold_ms: 500 }
      - name: ten-percent-of-the-rest
        type: probabilistic
        probabilistic: { sampling_percentage: 10 }
  batch: {}
exporters:
  otlp_grpc/jaeger:
    endpoint: lab-trace-jaeger:4317
    tls:
      insecure: true
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [tail_sampling, batch]
      exporters: [otlp_grpc/jaeger]
وأخيراً ملف compose.yaml:
# Distributed tracing lab: docker compose -p lab-trace up -d --build
name: lab-trace
x-app: &app
  image: lab-trace-app:1
  build: .
  networks: [lab-trace]
  mem_limit: 160m
x-otel: &otel
  OTEL_TRACES_EXPORTER: otlp
  OTEL_METRICS_EXPORTER: none
  OTEL_LOGS_EXPORTER: none
  OTEL_EXPORTER_OTLP_PROTOCOL: http/protobuf
  OTEL_EXPORTER_OTLP_ENDPOINT: http://lab-trace-collector:4318
  OTEL_PYTHON_LOG_CORRELATION: "true"
  OTEL_PYTHON_LOG_LEVEL: info
  OTEL_PYTHON_LOG_FORMAT: '{"level":"%(levelname)s","service":"%(otelServiceName)s","trace_id":"%(otelTraceID)s","span_id":"%(otelSpanID)s","msg":"%(message)s"}'
services:
  web:
    <<: *app
    container_name: lab-trace-web
    ports: ["127.0.0.1:26080:8000"]
    environment: { <<: *otel, OTEL_SERVICE_NAME: web, ORDERS_URL: "http://lab-trace-orders:8000" }
    command: opentelemetry-instrument flask --app web run --host 0.0.0.0 --port 8000
  orders:
    <<: *app
    container_name: lab-trace-orders
    environment: { <<: *otel, OTEL_SERVICE_NAME: orders, PAYMENTS_URL: "http://lab-trace-payments:8000", PAY_MODE: "${PAY_MODE:-inline}" }
    command: opentelemetry-instrument flask --app orders run --host 0.0.0.0 --port 8000
  payments:
    <<: *app
    container_name: lab-trace-payments
    environment: { <<: *otel, OTEL_SERVICE_NAME: payments }
    command: opentelemetry-instrument flask --app payments run --host 0.0.0.0 --port 8000
  collector:
    image: otel/opentelemetry-collector-contrib:0.162.0
    container_name: lab-trace-collector
    command: ["--config=/etc/otelcol/${COLLECTOR_CONFIG:-collector.yaml}"]
    volumes: ["./collector.yaml:/etc/otelcol/collector.yaml:ro", "./collector-tail.yaml:/etc/otelcol/collector-tail.yaml:ro"]
    networks: [lab-trace]
    mem_limit: 256m
  jaeger:
    image: cr.jaegertracing.io/jaegertracing/jaeger:2.22.0
    container_name: lab-trace-jaeger
    ports: ["127.0.0.1:26686:16686"]
    networks: [lab-trace]
    mem_limit: 512m
networks:
  lab-trace:
    name: lab-trace
في الإعداد أعلاه لاحظ التالي:
- الخدمات تعمل عبر
opentelemetry-instrument، وهو الذي يحمل ال SDK والقياس التلقائي قبل أن يبدأ Flask، ويقرأ إعداده من متغيرات البيئةOTEL_*. OTEL_SERVICE_NAMEيعطي كل خدمة اسمها في ال Traces، وبدونه سوف تظهر كلها باسمunknown_service.OTEL_PYTHON_LOG_FORMATيكتب كل سطر سجل بصيغة JSON معtrace_idوspan_id.- الخدمات ترسل إلى ال Collector فقط، وال Collector وحده يعرف عنوان Jaeger، فإذا قررت الانتقال إلى Tempo غيرت المصدر في ملف واحد.
- واجهة Jaeger على
127.0.0.1:26686وخدمة web على127.0.0.1:26080فقط، أما بقية المنافذ فداخل شبكة Docker.
وحتى نقرأ ال Traces من سطر الأوامر بدل الواجهة، نستخدم سكربت صغيراً tree.mjs يسأل واجهة Jaeger API v3 ويطبع ال Trace شجرة، ويحتاج Node.js 18 أو أحدث:
// Reads traces from Jaeger's API v3 (needs Node.js 18 or newer):
//   node tree.mjs <trace-id>   prints one trace as an indented tree
//   node tree.mjs --list       lists the traces of the web service in the last 10 minutes
const API = 'http://127.0.0.1:26686/api/v3';
const spansOf = (body) => body.result.resourceSpans.flatMap(rs => {
  const svc = rs.resource.attributes.find(a => a.key === 'service.name').value.stringValue;
  return rs.scopeSpans.flatMap(ss => ss.spans.map(s => ({ ...s, svc })));
});
const ms = s => (Number(BigInt(s.endTimeUnixNano) - BigInt(s.startTimeUnixNano)) / 1e6).toFixed(1);
const isError = s => s.status?.code === 2 || s.status?.code === 'STATUS_CODE_ERROR';

if (process.argv[2] === '--list') {
  const now = Date.now(), iso = t => new Date(t).toISOString();
  const q = `query.service_name=web&query.start_time_min=${iso(now - 600000)}&query.start_time_max=${iso(now + 60000)}&query.search_depth=1000`;
  const spans = spansOf(await (await fetch(`${API}/traces?${q}`)).json());
  const roots = spans.filter(s => !s.parentSpanId);
  for (const r of roots) {
    const url = r.attributes.find(a => a.key === 'http.target')?.value.stringValue ?? r.name;
    console.log(`${r.traceId}  ${ms(r).padStart(7)} ms  ${isError(r) ? 'ERROR' : 'ok   '}  ${url}`);
  }
  console.log(`${roots.length} traces`);
} else {
  const spans = spansOf(await (await fetch(`${API}/traces/${process.argv[2]}`)).json());
  const walk = (parent, depth) => spans.filter(s => (s.parentSpanId || '') === parent)
    .sort((a, b) => (BigInt(a.startTimeUnixNano) < BigInt(b.startTimeUnixNano) ? -1 : 1))
    .forEach(s => {
      const err = isError(s) ? `  ERROR: ${s.status.message || ''}` : '';
      const ev = (s.events || []).map(e => `  event: ${e.name}`).join('');
      console.log(`${'  '.repeat(depth)}${s.svc.padEnd(9)} ${s.name.padEnd(28 - depth * 2)} ${ms(s).padStart(7)} ms${err}${ev}`);
      walk(s.spanId, depth + 1);
    });
  const ids = new Set(spans.map(s => s.spanId));
  for (const root of new Set(spans.filter(s => !ids.has(s.parentSpanId || 'x')).map(s => s.parentSpanId || ''))) walk(root, 0);
  console.log(`${spans.length} spans`);
}
التشغيل وأول ثلاثة طلبات
شغل كل شيء، ثم أرسل ثلاثة طلبات: طلب عادي بمبلغ 100، وطلب بمبلغ 1500 يمر بالمراجعة البطيئة، وطلب ببطاقة تنتهي بـ 0000:
docker compose -p lab-trace up -d --build
for q in "amount=100" "amount=1500" "amount=100&card=4000000000000000"; do
  curl -s -w "  [%{http_code} %{time_total}s]\n" "http://127.0.0.1:26080/checkout?$q"
done
والمخرج سوف يكون كما يلي:
{"amount":100,"order":"created","payment":"approved"}
  [200 0.167796s]
{"amount":1500,"order":"created","payment":"approved"}
  [200 1.255763s]
{"order":"failed","reason":"card declined"}
  [502 0.063363s]
والمستخدم يرى هنا ما يراه في الواقع: طلب استغرق أكثر من ثانية دون سبب ظاهر، وطلب فشل بـ 502 مع رسالة عامة. والآن نبحث عن معرف ال Trace لكل منهما من سجل خدمة web، وال SDK يرسل ال Spans في دفعات كل خمس ثوان افتراضياً، لذلك انتظر لحظات قبل أن تبحث في Jaeger:
docker logs lab-trace-web 2>&1 | grep '"msg":"checkout' | tail -2{"level":"INFO","service":"web","trace_id":"24db913752b45fa3763a33731a31e68e","span_id":"167bdef4d21bddfb","msg":"checkout finished status=200"}
{"level":"INFO","service":"web","trace_id":"8894b889cf8542ed3461ddb3c691e5b2","span_id":"28c6536fffdbe098","msg":"checkout finished status=502"}الخطوة 1: أين ذهبت الثانية؟
نطبع ال Trace الأول، وهو طلب المبلغ 1500:
node tree.mjs 24db913752b45fa3763a33731a31e68eweb GET /checkout 1249.0 ms
web POST 1246.7 ms
orders POST /orders 1240.1 ms
orders reserve-stock 0.1 ms
orders POST 1236.7 ms
payments POST /pay 1232.5 ms
payments fraud-check 1200.3 ms event: manual review rule matched
payments bank-authorize 30.2 msفي المخرج أعلاه لاحظ التالي:
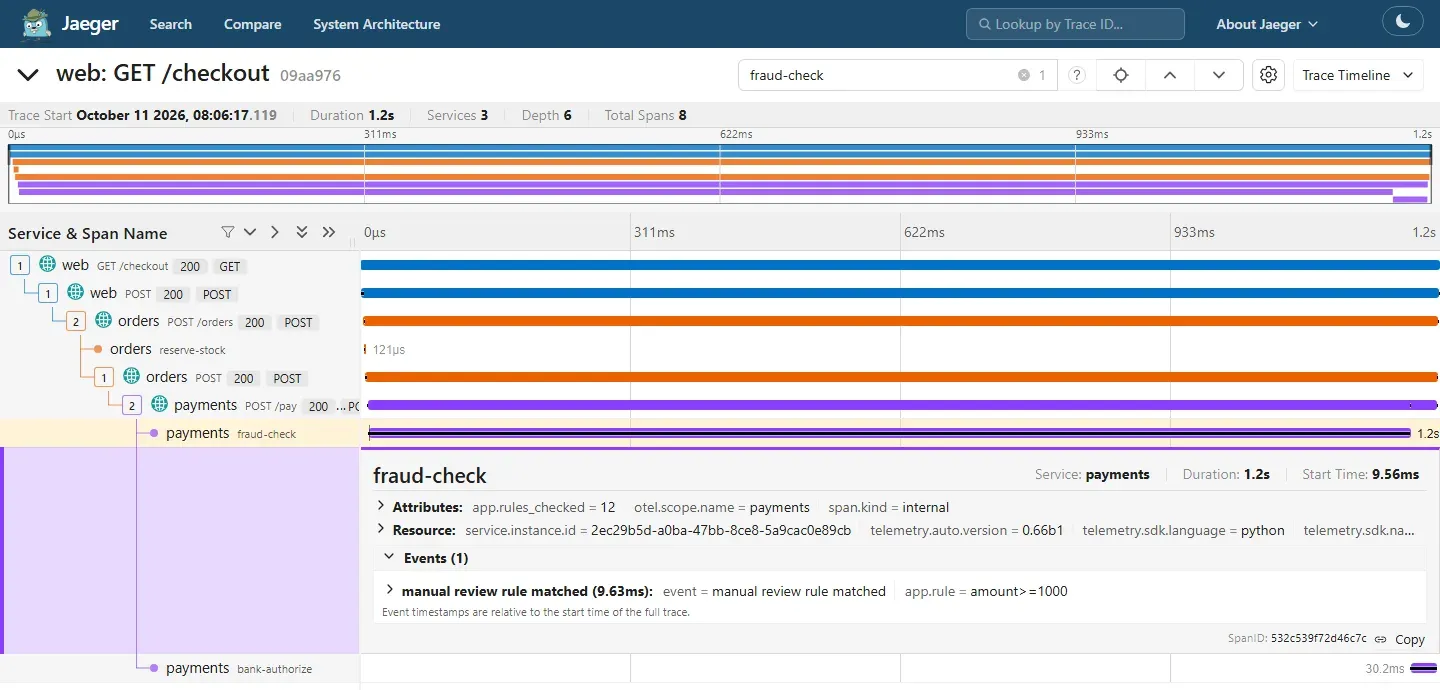
- من 1249 ملي ثانية ذهبت 1200.3 في
fraud-checkوحده، والحدث داخله يقول السبب: انطبقت قاعدة المراجعة اليدوية. ولم نحتج أن نفتح سجل أي خدمة. - الفرق بين
orders POSTبـ 1236.7 وpayments POST /payبـ 1232.5 هو أربع ملي ثانية تقريباً، وهو وقت الشبكة بين الخدمتين، فالمشكلة ليست في الشبكة. - حجز المخزون استغرق 0.1 ملي ثانية، فلو كنت ستبدأ بتحسين قاعدة البيانات لأنها المشتبه المعتاد فقد كنت ستضيع يومك.
والصورة التالية من واجهة Jaeger في تجربتنا لطلب آخر بنفس المبلغ، بعد البحث عن fraud-check وفتح تفاصيله:
الخطوة 2: من أين بدأ الخطأ؟
node tree.mjs 8894b889cf8542ed3461ddb3c691e5b2web GET /checkout 56.3 ms ERROR:
web POST 53.9 ms ERROR:
orders POST /orders 50.1 ms ERROR:
orders reserve-stock 0.1 ms
orders POST 47.0 ms ERROR:
payments POST /pay 42.8 ms
payments fraud-check 10.1 ms
payments bank-authorize 31.2 ms ERROR: bank declined: card blocked event: exceptionفي المخرج أعلاه لاحظ التالي:
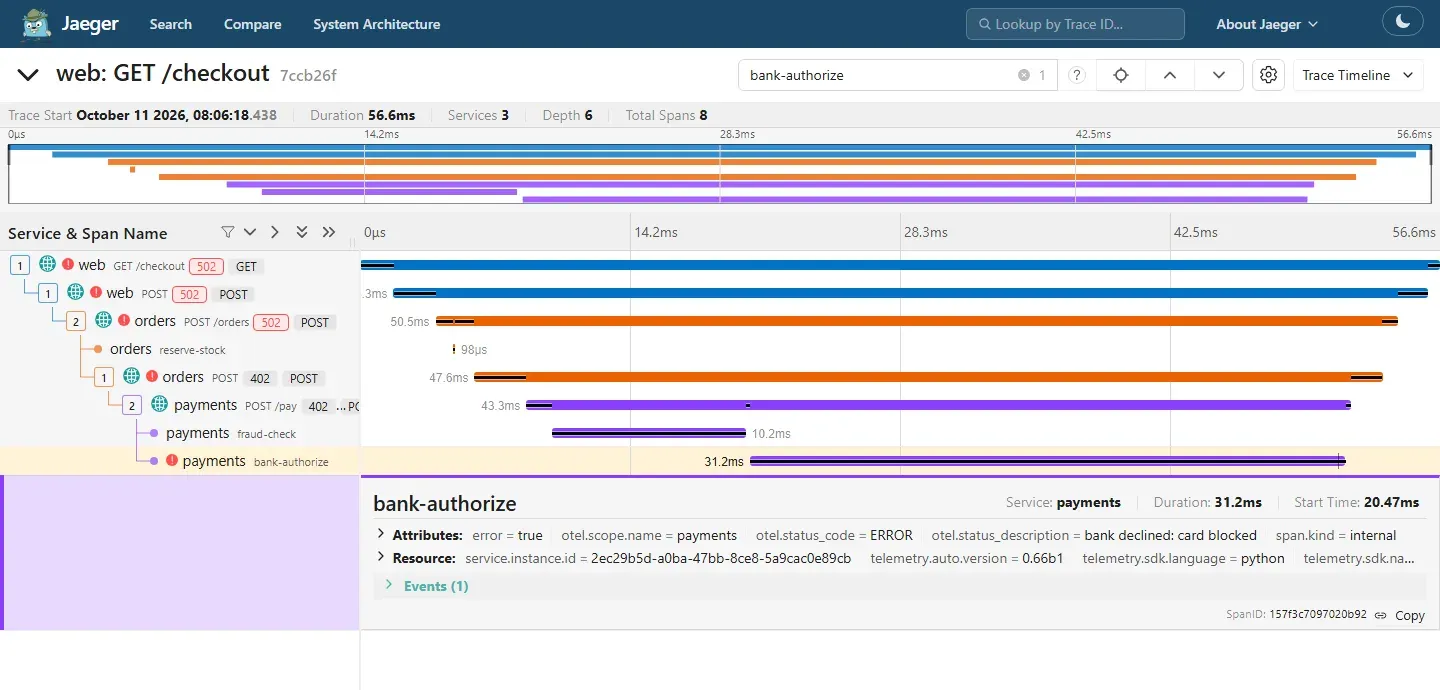
- الخطأ يظهر في خمسة Spans، ولكن أعمقها
bank-authorizeهو الوحيد الذي يحمل رسالة السبب وحدث الاستثناءexceptionالذي سجلهrecord_exception، أما الباقي فأخطاء نتجت عنه وهي تصعد إلى المستخدم. - Span السيرفر
payments POST /payليس خطأ رغم أنه رد بـ 402، بينما Span الكلاينتorders POSTالذي استقبل 402 خطأ، وهذا ما ذكرناه في الاتفاقيات الدلالية، ولو لم نعين الحالة يدوياً علىbank-authorizeلما كان في خدمة الدفع أي Span أحمر. - خدمة web حولت 402 إلى 502، فلو بحثت في السجل عن 502 لوجدت web وorders فقط ولظننت أن المشكلة بينهما.
الخطوة 3: من ال Trace إلى سطر السجل
الآن نبحث في سجلات الخدمتين بمعرف ال Trace الفاشل نفسه:
for s in orders payments; do
  docker logs lab-trace-$s 2>&1 | grep 8894b889cf8542ed3461ddb3c691e5b2
done
{"level":"ERROR","service":"orders","trace_id":"8894b889cf8542ed3461ddb3c691e5b2","span_id":"b33ed3156217b56f","msg":"payment failed status=402"}
{"level":"INFO","service":"payments","trace_id":"8894b889cf8542ed3461ddb3c691e5b2","span_id":"f0d8bc4397ae06ef","msg":"incoming traceparent=00-8894b889cf8542ed3461ddb3c691e5b2-660a10c8817c46ab-03"}
{"level":"ERROR","service":"payments","trace_id":"8894b889cf8542ed3461ddb3c691e5b2","span_id":"6d5de80777c7aa4a","msg":"bank declined card=****0000"}في المخرج أعلاه لاحظ التالي:
- كل سطر يحمل
trace_idنفسه في الخدمتين، فبحث واحد في السجل المركزي يجمع كل ما حدث في هذا الطلب، ومعهspan_idالذي يحدد في أي Span كتب السطر. - سطر
incoming traceparentيبين الترويسة كما وصلت إلى خدمة الدفع، ومعرف الأب فيها660a10c8817c46abهو Span الكلاينت في خدمة orders. - سطور سجل الوصول Access Log التي يكتبها خادم التطوير Werkzeug لا تظهر في البحث، لأنها تحمل
"trace_id":"0"، والسبب أنها تكتب بعد أن ينتهي Span الطلب، لذلك لا تعتمد على سجل الوصول لربط الطلبات، واكتب سطورك أنت داخل الطلب.
الخطوة 4: نكسر انتقال السياق عمداً
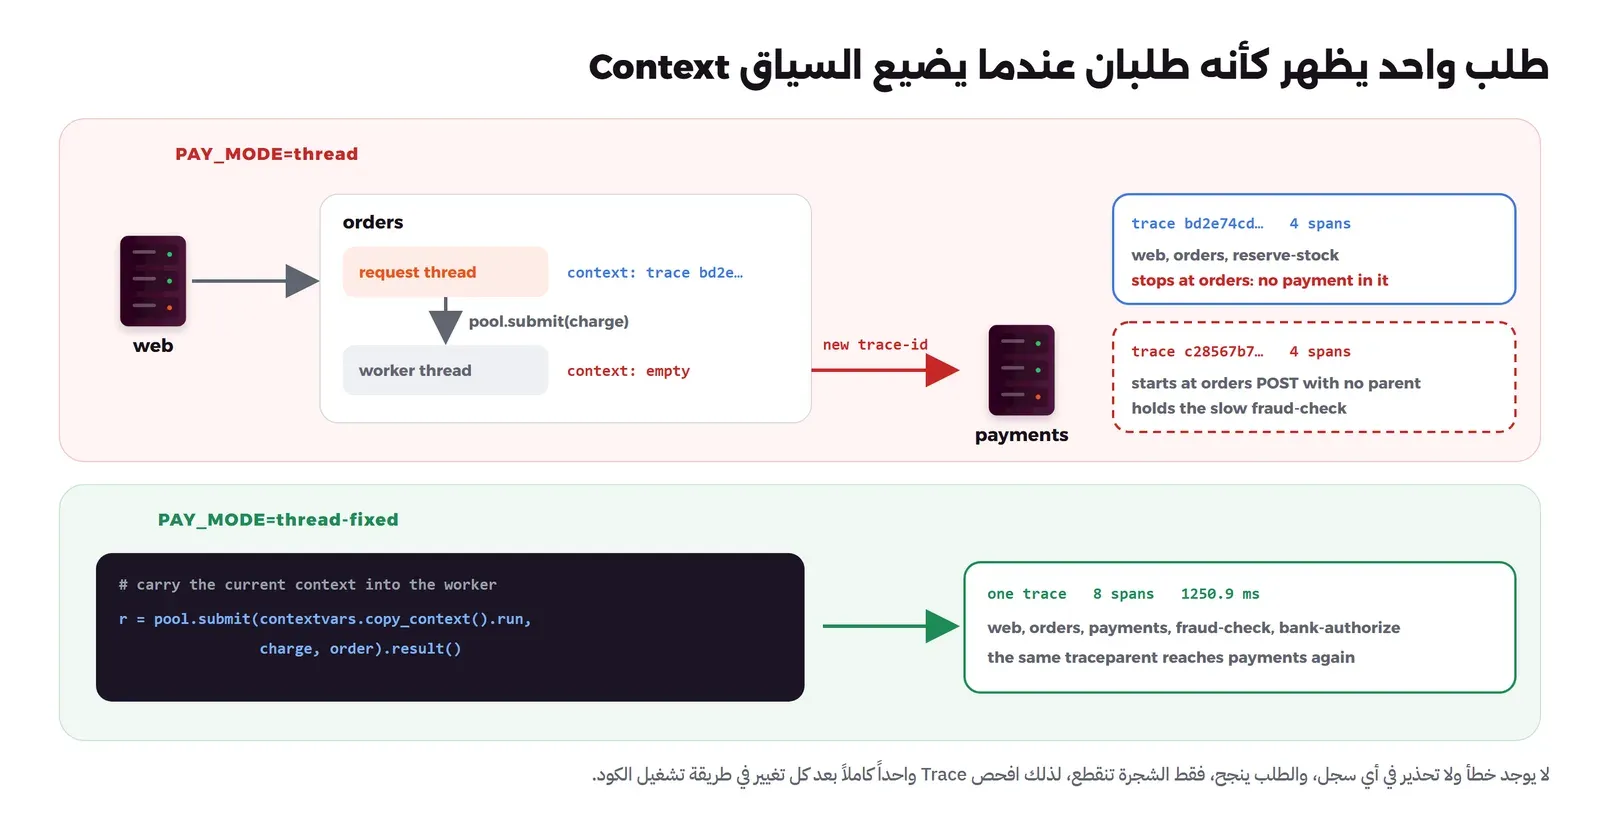
في كثير من الأنظمة يرسل الكود جزءاً من العمل إلى Thread Pool أو مهمة خلفية، وهنا يضيع السياق بهدوء. سوف نشغل خدمة orders بالوضع thread، فترسل استدعاء الدفع من Thread في ThreadPoolExecutor بدل Thread الطلب نفسه:
PAY_MODE=thread docker compose -p lab-trace up -d orders
curl -s "http://127.0.0.1:26080/checkout?amount=1500"
docker logs lab-trace-orders 2>&1 | grep '"msg":"order created' | tail -1
docker logs lab-trace-payments 2>&1 | grep incoming | tail -1
{"amount":1500,"order":"created","payment":"approved"}
{"level":"INFO","service":"orders","trace_id":"bd2e74cd17a1b20870aa54b30fc05e96","span_id":"442e12131221bb15","msg":"order created item=book"}
{"level":"INFO","service":"payments","trace_id":"c28567b79593b3101cd3d4fccc949d50","span_id":"ec72692da3b5e0a9","msg":"incoming traceparent=00-c28567b79593b3101cd3d4fccc949d50-61501da43f53207e-03"}الطلب نجح، ولا يوجد أي خطأ أو تحذير، ولكن لاحظ أن معرف ال Trace في orders يختلف عن الذي وصل إلى payments. والآن نطبع الاثنين:
node tree.mjs bd2e74cd17a1b20870aa54b30fc05e96
node tree.mjs c28567b79593b3101cd3d4fccc949d50
web GET /checkout 1280.2 ms
web POST 1267.7 ms
orders POST /orders 1260.8 ms
orders reserve-stock 0.2 ms
4 spans
orders POST 1254.9 ms
payments POST /pay 1244.9 ms
payments fraud-check 1200.3 ms event: manual review rule matched
payments bank-authorize 30.2 ms
4 spansال Trace الذي يبدأ من المستخدم يتوقف عند orders ولا يحتوي أي دفع، فإذا فتحته لتعرف لماذا استغرق 1280 ملي ثانية فلن تجد إلا reserve-stock بـ 0.2 ملي ثانية، والسبب الحقيقي موجود في Trace آخر يبدأ من orders POST بلا أب. وهذا يحدث لأن ال Thread الجديد لا يرى السياق الحالي، فتظن مكتبة requests أنه لا يوجد Trace وتبدأ واحداً جديداً. والحل أن تشغل الدالة داخل نسخة من السياق الحالي، وهذا هو الوضع thread-fixed في الملف:
r = pool.submit(contextvars.copy_context().run, charge, order).result()PAY_MODE=thread-fixed docker compose -p lab-trace up -d orders
curl -s "http://127.0.0.1:26080/checkout?amount=1500"
T=$(docker logs lab-trace-orders 2>&1 | grep '"msg":"order created' | tail -1 | sed 's/.*"trace_id":"\([0-9a-f]*\)".*/\1/')
node tree.mjs $Tweb GET /checkout 1250.9 ms
web POST 1248.7 ms
orders POST /orders 1243.6 ms
orders reserve-stock 0.2 ms
orders POST 1237.3 ms
payments POST /pay 1232.2 ms
payments fraud-check 1200.2 ms event: manual review rule matched
payments bank-authorize 30.2 ms
8 spansوالصورة التالية تلخص ما حدث في هذه الخطوة:
ونفس المشكلة تحدث مع الطوابير: إذا وضعت رسالة في طابور دون أن تضع معها traceparent في ترويسات الرسالة، فإن المستهلك يبدأ Trace جديداً، وبعض مكتبات القياس الخاصة بالطوابير تضيف الترويسة بنفسها، فتأكد من ذلك في Trace حقيقي، وإذا كتبت طابورك الخاص فعليك أن تضيفها بيدك.
الخطوة 5: أخذ العينات في النهاية
نرجع orders إلى الوضع العادي، ونعيد تشغيل Jaeger حتى نفرغ تخزينه في الذاكرة، ونشغل ال Collector بإعداد collector-tail.yaml، ثم نرسل مئة طلب عادي وطلباً بطيئاً وطلباً فاشلاً:
docker compose -p lab-trace up -d orders
docker restart lab-trace-jaeger
COLLECTOR_CONFIG=collector-tail.yaml docker compose -p lab-trace up -d collector
for i in $(seq 1 100); do curl -s -o /dev/null "http://127.0.0.1:26080/checkout?amount=100"; done
curl -s -o /dev/null "http://127.0.0.1:26080/checkout?amount=1500"
curl -s -o /dev/null "http://127.0.0.1:26080/checkout?amount=100&card=4000000000000000"
sleep 15
node tree.mjs --list
fe4fba511c2d5ad3a93fd40572324690 1241.5 ms ok /checkout?amount=1500
0b0c6ba0d31709eb5c10a06fa8cb225a 54.1 ms ERROR /checkout?amount=100&card=4000000000000000
63f9740ebd39ca24279043952820845a 55.0 ms ok /checkout?amount=100
c962c307c902726971e59a7f940e90b8 54.4 ms ok /checkout?amount=100
dba53f98e405729088a73944dee4bc99 53.9 ms ok /checkout?amount=100
fb46dacd25fab7ab2862511c3e5adb89 54.7 ms ok /checkout?amount=100
192a6b99f7f1c454e6f2e28be60abcda 64.2 ms ok /checkout?amount=100
1117aa656861ad155c26d1a46635a48b 68.3 ms ok /checkout?amount=100
004fc621d8e7fce8cc1875368f3e808e 63.9 ms ok /checkout?amount=100
977c11fd537542a35a3f1e92e1e1809e 54.6 ms ok /checkout?amount=100
fa2c497c9474e3f867d5b845e50b5b52 56.7 ms ok /checkout?amount=100
11 tracesفي المخرج أعلاه لاحظ التالي:
- من 102 طلب حفظ Jaeger أحد عشر فقط، ومنها الطلب البطيء والطلب الفاشل، وكلاهما حفظ بقاعدته الخاصة وليس بالحظ.
- من المئة طلب العادية بقيت تسعة، وهذه هي القاعدة الاحتمالية بعشرة في المئة، والرقم يتغير بين تشغيل وآخر، ففي تشغيل سابق للتجربة نفسها بقيت سبعة.
- لو استخدمنا العينة في البداية بعشرة في المئة لكان احتمال أن نحتفظ بالطلب الفاشل عشرة في المئة فقط.
- كل ال Spans وصلت إلى ال Collector وبقيت في ذاكرته خمس ثوان قبل القرار، وهذا ثمن القاعدة، فراقب ذاكرة ال Collector عندما تشغلها في الإنتاج.
إزالة التجربة
docker compose -p lab-trace down
docker image rm lab-trace-app:1
وJaeger في التجربة يخزن في الذاكرة، فكل ال Traces تختفي مع حذف ال Container، ولا يوجد Volume تحذفه.
أخطاء شائعة
- الاكتفاء بالقياس التلقائي، فترى Spans لطلبات HTTP وقاعدة البيانات فقط، وتبقى أهم أجزاء منطقك مثل فحص الاحتيال صندوقاً أسود داخل Span كبير.
- نسيان
OTEL_SERVICE_NAME، فتظهر كل الخدمات باسمunknown_serviceولا تعرف أي Span من أي خدمة. - تشغيل عمل في Thread أو مهمة خلفية أو طابور دون نقل السياق، فينقسم ال Trace بصمت كما رأينا في الخطوة 4.
- الاعتماد على الحالة التلقائية لرموز HTTP، فرفض البنك برمز 4xx لا يظهر خطأ في خدمة الدفع إلا إذا عينته بنفسك.
- وضع بيانات شخصية أو توكنات في الخصائص أو في ال Baggage، وهي تنتقل إلى أدوات التخزين وقد تخرج إلى خدمات خارجية.
- قبول ترويسة
traceparentمن الإنترنت كما هي في الخدمة الأولى. - حفظ كل ال Traces في الإنتاج دون عينات، ثم اكتشاف تكلفة التخزين بعد شهر، أو العكس: عينة في البداية بنسبة صغيرة تضيع معها أغلب الأخطاء.
- تشغيل أكثر من نسخة Collector بقاعدة tail_sampling دون أن تضمن وصول كل Spans ال Trace الواحد إلى نسخة واحدة.
- سجلات لا تحمل
trace_id، فتجد ال Span الفاشل ولا تستطيع أن تصل إلى تفاصيله في السجل.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- في النظام الموزع ينقطع مكدس الاستدعاءات عند كل استدعاء عبر الشبكة، ومعرف الطلب يجمع السطور ولكنه لا يرسم من استدعى من ولا كم استغرقت كل خطوة.
- ال Trace شجرة من ال Spans تجمعها
trace_idواحد، وكل Span يعرف أباه ويحمل خصائص وأحداثاً وحالة، والسبب في البطء هو أعمق Span طويل وليس أطولها. - السياق ينتقل بين الخدمات في ترويسة
traceparentالمعيارية، وداخل الخدمة في متغير مرتبط بالطلب، ويضيع بصمت عند ال Threads والمهام الخلفية والطوابير إذا لم تنقله. - OpenTelemetry يعطيك API وSDK وقياساً تلقائياً وبروتوكول OTLP وCollector، ولا يخزن شيئاً، فتختار Jaeger أو Tempo للتخزين والعرض.
- العينة في البداية رخيصة ولكنها لا ترى الخطأ، والعينة في النهاية تحفظ الأخطاء والطلبات البطيئة بثمن ذاكرة وتنظيم في ال Collector.
- اكتب
trace_idفي كل سطر سجل، فيصبح الانتقال بين السجل وال Trace بحثاً واحداً.
والتتبع يكشف أين يبطؤ الطلب، أما منع الخدمة البطيئة من إسقاط بقية النظام فموضوع المهلات وإعادة المحاولة وقاطع الدائرة، وهو في مقال مستقل ضمن نفس القسم:
 دليلكيف تمنع خدمة بطيئة من إسقاط نظامك كله؟لماذا تسقط خدمة بطيئة واحدة تطبيقك السليم، وكيف تحميه بالمهلة وإعادة المحاولة المحدودة وقاطع الدائرة ورفض الزائد.دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلMonolith أم Microservices؟ قرار صادق للفرق الصغيرة والكبيرةمتى يكفيك برنامج واحد مقسم إلى وحدات، ومتى تستحق الخدمات المصغرة ثمنها، مع حالات موثقة وتجربة تقيس الفرق.
 دليلاختبار الأحمال والضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع OpenTelemetry Collector Contrib 0.162.0 وJaeger 2.22.0 وPython 3.13.16 وOpenTelemetry Python 1.45.1.


