

لنفرض أنك أنهيت متجراً إلكترونياً صغيراً، واختبرته مع زملائك الخمسة فكانت كل صفحة تفتح في أقل من ثانية، ثم أطلقت حملة إعلانية قبل رمضان أو في موسم التخفيضات، فدخل خمسمئة شخص في نفس الدقائق، وبدأت الصفحات تتأخر عشر ثوان ثم تظهر رسالة 504 لنصف الزوار. والسبب أن الكود نفسه لم يتغير، ولكن أشياء كثيرة لا تظهر مع خمسة مستخدمين تظهر مع خمسمئة: طوابير الانتظار Queues أمام قاعدة البيانات، ومجمع الاتصالات Connection Pool الذي امتلأ، والاستعلام البطيء الذي كان يأخذ 20 مللي ثانية فصار ينتظر دوره خلف مئة استعلام مثله. والطريقة الوحيدة لتعرف ذلك قبل يوم الإطلاق، وليس فيه، هي اختبار الأحمال Load Testing، أي أن ترسل إلى تطبيقك حركة مرور مصنوعة تشبه حركة المستخدمين الحقيقيين، وتقيس ما يحدث له.
وقد ذكرنا في مقال أنواع الاختبارات أن اختبار الأداء يجيب عن أسئلة مختلفة تماماً عن اختبارات الوحدة والتكامل، ووعدنا بمقال خاص به، وهذا هو.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي أن يعمل التطبيق مع عدد قليل من المستخدمين، ولماذا تفشل الطرق السريعة مثل حلقة curl أو أداة تضرب رابطاً واحداً.
- أنواع اختبارات الأحمال: الحمل المتوقع Load والضغط Stress والقفزة Spike والتحمل الطويل Soak ونقطة الانكسار Breakpoint والتوسع Scalability، واختبار الدخان Smoke في خط CI، مع شكل الحمل في كل نوع وما تتعلمه منه.
- المقاييس وكيف تقرأها: المعدل Throughput والنسب المئوية للزمن Percentiles ونسبة الأخطاء Error Rate، والفرق بين النموذج المغلق Closed Model والنموذج المفتوح Open Model، ومشكلة الإغفال المنسق Coordinated Omission.
- كيف تبني اختباراً يشبه الواقع، وأين تشغله، ومتى يكون اختبار الأحمال على موقع غيرك هجوماً وليس اختباراً.
- الأدوات مفتوحة المصدر بتراخيصها: k6 وLocust وApache JMeter وGatling وArtillery، والأدوات السريعة مثل wrk وhey وVegeta وoha، مع تفصيل أكبر لأداتي Java المشهورتين JMeter وGatling.
- اختبار الأحمال داخل خط CI/CD، ثم تجربة عملية كاملة نجد فيها نقطة الانكسار وتسرب ذاكرة متعمداً، ونكتب نفس السيناريو في أربع أدوات، ثم نصلح عنق الزجاجة ونقيس الفرق.
لماذا يعمل التطبيق مع خمسة مستخدمين وينهار مع خمسمئة؟
التطبيق على السيرفر مجموعة من الموارد المحدودة: عدد أنوية المعالج CPU، وعدد العمال Workers أو الخيوط Threads التي تخدم الطلبات، وعدد الاتصالات في مجمع الاتصالات بقاعدة البيانات، وعدد الاتصالات التي تقبلها قاعدة البيانات نفسها، والذاكرة. ومع خمسة مستخدمين لا يمتلئ أي منها، فكل طلب يجد مورداً فارغاً ينتظره، أما عندما يصل عدد الطلبات المتزامنة إلى حد أحد هذه الموارد، فإن الطلب الجديد لا يفشل مباشرة وإنما يقف في طابور، ويزيد زمن الرد لكل من خلفه، وهذا ما يجعل الانهيار مفاجئاً: التطبيق يبدو ممتازاً حتى نقطة معينة، ثم يتدهور خلال دقائق. وقد شرحنا في مقال تجميع الاتصالات كيف يصبح المجمع Pool نفسه طابوراً، وفي مقال المعالج والخيوط والتزامن كيف يحدد عدد العمال ما يستطيع التطبيق خدمته في نفس اللحظة.
الطرق السريعة ولماذا لا تكفي
الحل الأول الذي يخطر على البال هو أن يفتح الفريق الموقع في نفس الوقت من عدة أجهزة، أو أن يكتب أحدهم حلقة for ترسل الطلب ب curl مئة مرة، وهذه الطريقة تفشل لأن عشرة أشخاص لا يصنعون حملاً حقيقياً، ولأن الحلقة ترسل الطلب التالي بعد انتهاء السابق، أي أنها ترسل طلباً واحداً في كل لحظة مهما كان عدد مرات تكرارها.
والحل الثاني أن تستخدم أداة سريعة مثل hey أو wrk وتعطيها رابط الصفحة الرئيسية مع مئتي اتصال متزامن، فتحصل على رقم كبير مثل «3000 طلب في الثانية»، وهذا أفضل من الحلقة لأنه يصنع تزامناً حقيقياً، لكنه ما زال بعيداً عن الواقع لأسباب واضحة: المستخدم الحقيقي لا يطلب نفس الرابط آلاف المرات، والصفحة الرئيسية غالباً هي أسرع صفحة في الموقع لأنها في ال Cache، والمستخدم يقرأ الصفحة ثوان قبل أن ينقر على التالية، ويسجل الدخول، ويبحث عن منتجات مختلفة تصل إلى أجزاء مختلفة من قاعدة البيانات. فالرقم الذي تحصل عليه صحيح، ولكنه يجيب عن سؤال لم يسأله أحد.
والطريقة الصحيحة هي أن تبدأ من سؤال واضح، مثل «هل يتحمل المتجر 300 زائر في نفس الوقت يتصفحون ويضيفون إلى السلة، مع بقاء 95% من الطلبات تحت نصف ثانية؟»، ثم تكتب سيناريو Scenario يمثل مسار المستخدم User Journey بخطواته وأوقات تفكيره، وتختار شكل الحمل المناسب للسؤال، وتحدد شروط النجاح قبل التشغيل، ثم تراقب السيرفر أثناء الاختبار لتعرف لماذا حدث ما حدث. وهذا ما يغطيه باقي المقال.
أنواع اختبارات الأحمال Load Testing
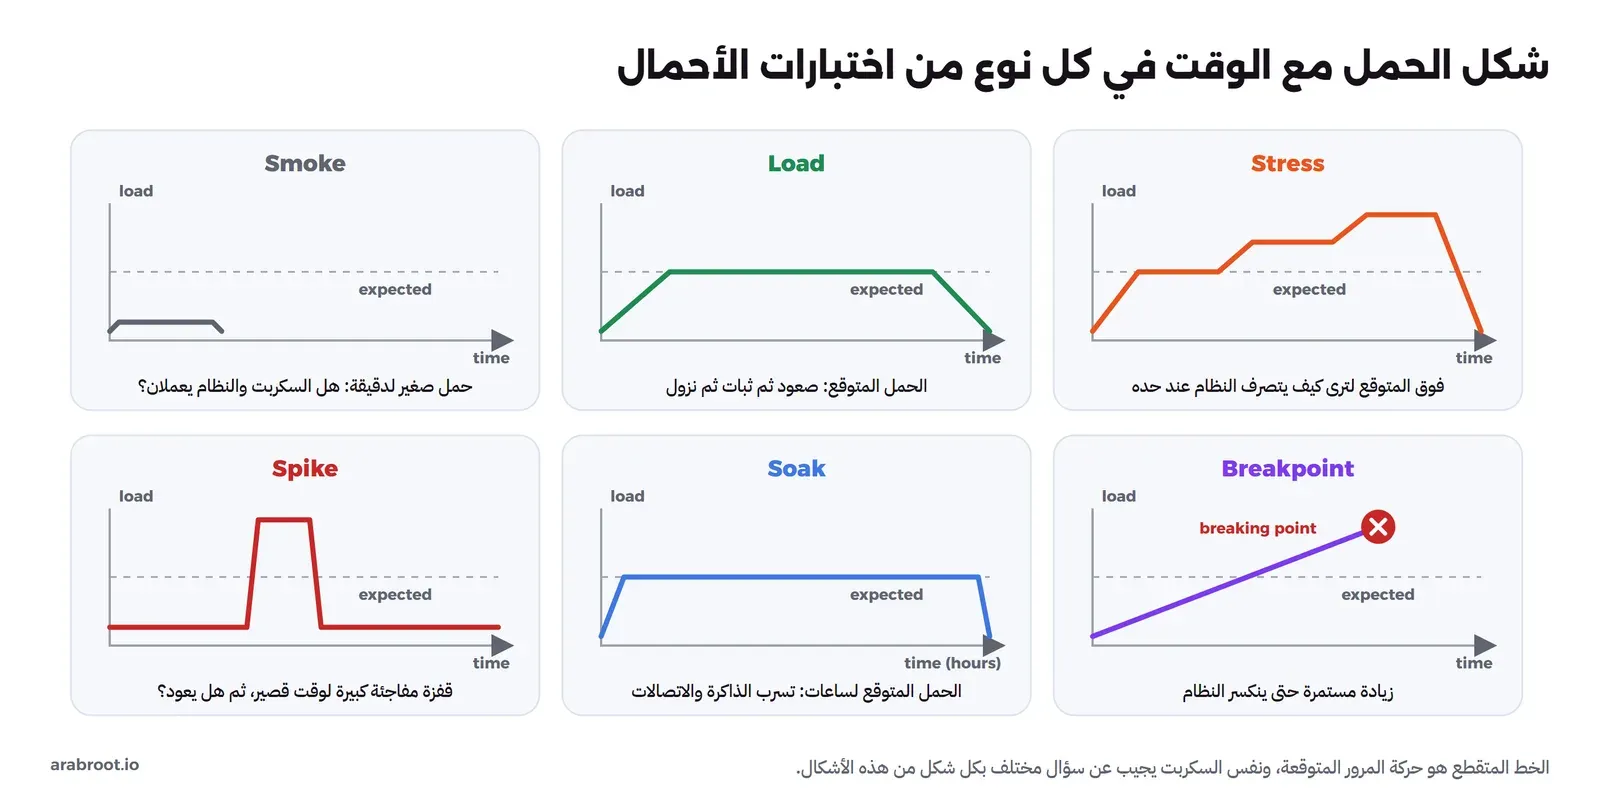
المصطلحات في هذا المجال ليست موحدة تماماً بين الفرق، لذلك سوف نعتمد التقسيم الذي تشرحه وثائق Grafana k6 عن أنواع الاختبارات، وهو تقسيم واضح يقوم على سؤال واحد: ما شكل الحمل مع الوقت، وماذا تريد أن تعرف؟ ولاحظ أن السكربت نفسه قد يبقى كما هو في كل الأنواع، والذي يتغير هو عدد المستخدمين ومدة الاختبار وشكل الصعود والنزول. والصورة التالية تبين شكل الحمل في كل نوع، والخط المتقطع هو حركة المرور المتوقعة:
اختبار الدخان Smoke Test
حمل صغير جداً، مستخدم أو اثنان لدقيقة أو أقل، وهدفه أن تتأكد أن السكربت نفسه يعمل وأن النظام يرد بشكل معقول قبل أن ترسل إليه حملاً كبيراً. وقد يبدو هذا النوع بلا فائدة، لكنه يوفر عليك ساعة كاملة من اختبار تحمل يفشل في الدقيقة الأولى بسبب رابط خطأ أو توكن منتهي، وهو أيضاً النوع المناسب لخط CI بعد كل نشر، كما سوف نرى.
اختبار الحمل المتوقع Load Test
هو ما تقصده الفرق عادة بكلمة «اختبار أحمال»، وتسميه وثائق k6 Average-load Test: صعود تدريجي Ramp-up إلى عدد المستخدمين الذي تتوقعه في يوم عادي أو في ساعة الذروة المعتادة، ثم ثبات لمدة تكفي لترى استقرار الأرقام، من خمس دقائق إلى ساعة، ثم نزول. والسؤال هنا: هل يحقق النظام أهدافك في الظروف التي تعرفها؟ فإذا فشل هذا الاختبار فلا معنى لأي اختبار أكبر منه، لأن المشكلة في الاستخدام العادي.
اختبار الضغط Stress Test
نفس الفكرة ولكن بحمل أعلى من المتوقع، مثل ضعف ذروة اليوم العادي، لأن يوم الحملة أو آخر أيام الشهر لا يشبه اليوم العادي. والسؤال هنا ليس «هل ينجح؟» فقط، وإنما «كيف يتصرف عند حده؟»: هل يبطئ تدريجياً مع بقاء الأخطاء قليلة، أم يبدأ في رد 502 و504 فجأة، أم تموت عملية التطبيق بسبب نفاد الذاكرة؟ والانهيار الهادئ الذي يبطئ ولا يفقد البيانات أفضل بكثير من انهيار يترك طلبات دفع معلقة في المنتصف.
اختبار القفزة Spike Test
قفزة مفاجئة وكبيرة وقصيرة، مثل إشعار يصل إلى كل مستخدمي التطبيق في نفس اللحظة، أو بداية بيع تذاكر في وقت معلن، أو رابط ينتشر في وسائل التواصل. والفرق بينه وبين اختبار الضغط أن الحمل لا يصعد تدريجياً، فلا يجد التوسع الآلي Autoscaling ولا ال Cache وقتاً ليستعد. وأهم سؤال هنا هو ما يحدث بعد انتهاء القفزة: هل يعود النظام إلى حالته الطبيعية خلال ثوان، أم يبقى بطيئاً لدقائق بسبب طابور طويل من الطلبات المتراكمة؟
اختبار التحمل الطويل Soak Test
ويسمى أيضاً Endurance Test، وهو الحمل المتوقع نفسه لساعات بدل دقائق. والسبب أن هناك مشكلات لا تظهر إلا مع الوقت: تسرب الذاكرة Memory Leak الذي يأكل بضعة ميجابايت كل دقيقة حتى يقتل النظام العملية بعد يومين، وتسرب الاتصالات Connection Leak عندما ينسى الكود إعادة اتصال إلى المجمع في حالة خطأ نادرة، وملفات السجلات التي تملأ القرص، والمهام المجدولة التي تعمل كل ساعة. وقد شرحنا في تحليل أداء سيرفر Linux كيف تقرأ أثر قاتل العمليات OOM Killer عندما يحدث ذلك في الإنتاج Production.
اختبار نقطة الانكسار Breakpoint Test
زيادة مستمرة دون سقف حتى ينكسر النظام، أي حتى تتجاوز الأخطاء أو زمن الرد الحد الذي حددته، فتوقف الاختبار وتسجل الحمل الذي حدث عنده ذلك. والنتيجة رقم مفيد للتخطيط: هذا السيرفر بهذه الإعدادات يتحمل حتى كذا طلباً في الثانية، ومن هذا الرقم يبدأ موضوع تخطيط السعة Capacity Planning المخطط له في مرحلة الأداء والموثوقية SRE من خارطة الطريق.
اختبار التوسع Scalability Test
هذا النوع لا تذكره وثائق k6 كنوع مستقل، ولكنه شائع بين الفرق، وفكرته أن تكرر نفس اختبار الضغط أو نقطة الانكسار مع موارد مختلفة، مثل نسخة واحدة من التطبيق ثم نسختين ثم أربع خلف موزع الحمل Load Balancer، وتقارن السعة في كل مرة. فإذا ضاعفت النسخ ولم تتضاعف السعة، فعنق الزجاجة Bottleneck في مكان مشترك بينها، وغالباً قاعدة البيانات أو مجمع الاتصالات. وقد شرحنا هذا الانتقال من سيرفر واحد إلى نسخ متعددة في مدخل إلى تصميم الأنظمة.
الأنواع في جدول واحد
| النوع | الحمل | المدة | السؤال | متى تشغله |
|---|---|---|---|---|
| Smoke | صغير جداً | أقل من دقيقتين | هل السكربت والنظام يعملان؟ | بعد كل نشر إلى بيئة الاختبار |
| Load | المتوقع | 5 إلى 60 دقيقة | هل نحقق أهدافنا في اليوم العادي؟ | قبل كل إصدار مهم، أو كل ليلة |
| Stress | فوق المتوقع | 5 إلى 60 دقيقة | كيف يتصرف النظام عند حده؟ | قبل المواسم والحملات |
| Spike | قفزة كبيرة | دقائق | هل يتحمل القفزة ويعود بعدها؟ | قبل الإطلاق أو الإشعارات الجماعية |
| Soak | المتوقع | ساعات | هل يتسرب شيء مع الوقت؟ | أسبوعياً أو قبل الإصدارات الكبيرة |
| Breakpoint | يزيد حتى الانكسار | حتى ينكسر | ما الحد الأقصى؟ | عند التخطيط للسعة |
| Scalability | نفس الاختبار بموارد مختلفة | عدة تشغيلات | هل تزيد السعة مع الموارد؟ | قبل أن تشتري سيرفرات إضافية |
المقاييس Metrics: ماذا تقيس، وكيف تقرأ النتيجة؟
تقرير أداة الأحمال يحتوي عشرات الأرقام، وأغلب الأخطاء في قراءته تأتي من النظر إلى الرقم الخطأ، لذلك سوف نبدأ بالأرقام الأربعة التي تحتاجها دائماً.
المعدل Throughput
عدد الطلبات التي ينجزها النظام في الثانية، واختصاراً RPS أي Requests Per Second، أو عدد العمليات الكاملة مثل «طلبات شراء في الدقيقة». ولاحظ أن الرقم المهم هو عدد الطلبات الناجحة في الثانية، لأن السيرفر الذي يرد ب 503 خلال مللي ثانية واحدة يستطيع أن يحقق معدلاً كبيراً جداً دون أن يخدم أحداً.
زمن الرد Latency والنسب المئوية Percentiles
قد شرحنا في لماذا p95 وp99 وليس المتوسط أن المتوسط Average يخفي الطلبات البطيئة التي يشعر بها المستخدمون، وأن p95 هو الزمن الذي تنتهي قبله 95% من الطلبات. وفي اختبارات الأحمال أضف إلى ذلك قاعدتين: الأولى أن تقيس كل نوع من الطلبات وحده، لأن صفحة البحث البطيئة تختفي داخل رقم إجمالي مليء بطلبات الصور السريعة، والثانية أن تنظر إلى الأرقام مع الوقت وليس في ملخص واحد آخر الاختبار، لأن ملخص اختبار ضغط مدته أربع دقائق يخلط الدقائق الهادئة بدقائق الانهيار في رقم واحد لا يمثل أياً منهما، كما سوف ترى في التجربة.
نسبة الأخطاء Error Rate
نسبة الطلبات التي فشلت، سواء برمز حالة 5xx أو بانتهاء المهلة Timeout أو برفض الاتصال. وانتبه هنا لنقطة يغفل عنها كثيرون: الطلب الفاشل يرجع غالباً بسرعة، فإذا كان 30% من الطلبات يرجع 503 فوراً فسوف يتحسن متوسط زمن الرد وp50 في التقرير، وقد يبدو الاختبار أسرع من اختبار ناجح. لذلك لا تقرأ زمن الرد أبداً دون نسبة الأخطاء بجانبه، وفي k6 تجد زمن الطلبات الناجحة وحدها في السطر expected_response:true.
التزامن Concurrency أم معدل الوصول Arrival Rate؟
هناك طريقتان لوصف الحمل، والفرق بينهما أهم مما يبدو. في النموذج المغلق Closed Model تحدد عدد المستخدمين الافتراضيين Virtual Users واختصاراً VUs، مثل 100 مستخدم، وكل مستخدم يرسل طلبه وينتظر الرد ثم يفكر ثم يرسل التالي. وفي النموذج المفتوح Open Model تحدد معدل وصول المستخدمين، مثل 20 مستخدماً جديداً كل ثانية، وتصل الطلبات بهذا المعدل مهما كان السيرفر سريعاً أو بطيئاً. وتشرح وثائق k6 عن النموذجين المشكلة في النموذج المغلق: عندما يبطئ النظام تحت الضغط ينتظر كل مستخدم افتراضي رده الطويل، فيطول زمن كل تكرار ويقل معدل الطلبات التي ترسلها الأداة، أي أن الأداة تخفف الحمل بنفسها في اللحظة التي تريد فيها أن ترى أثره. والصورة التالية تبين الفرق:
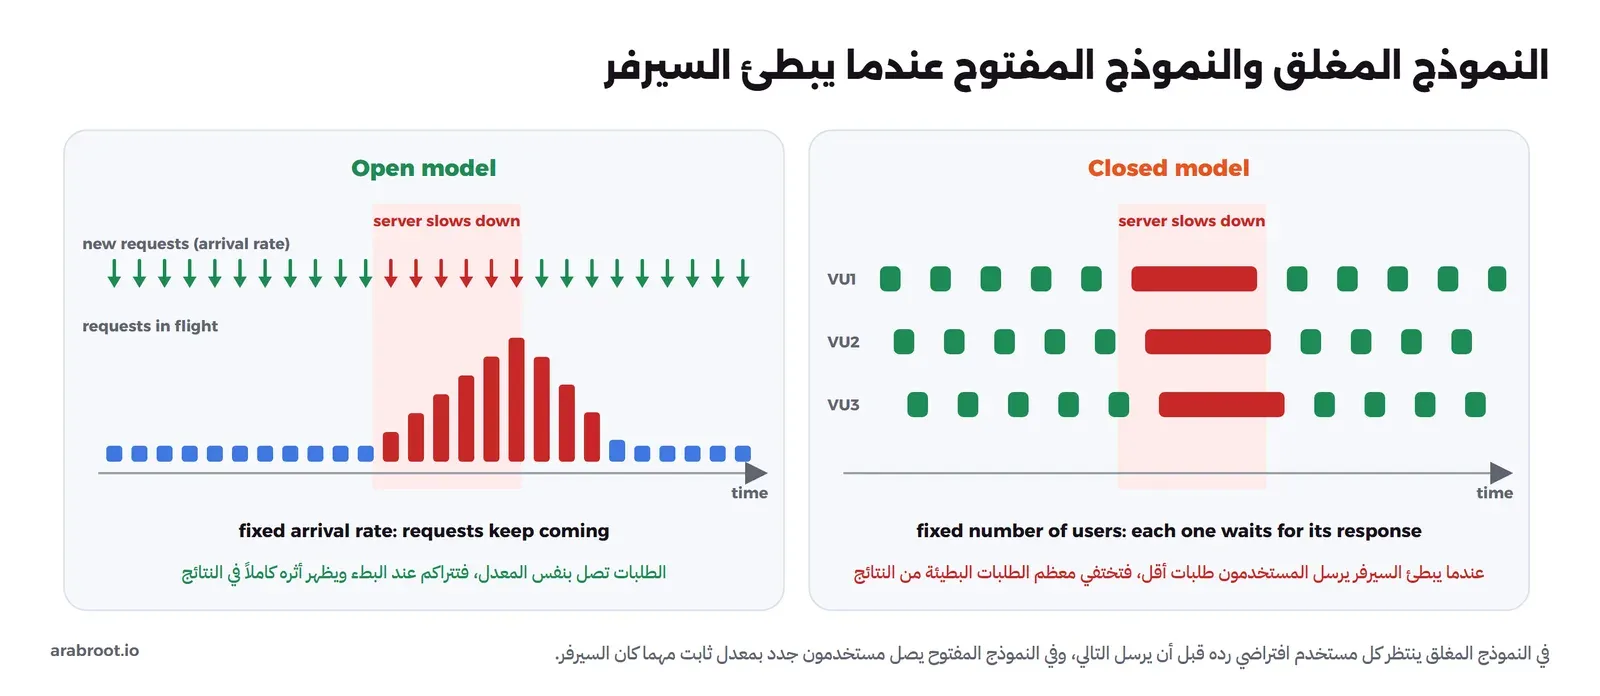
وهذه المشكلة لها اسم في القياس هو الإغفال المنسق Coordinated Omission، وقد شرحها Gil Tene في صفحة أداته wrk2: عندما ينتظر مولد الحمل الرد البطيء قبل أن يرسل الطلب التالي، فإنه «يتفق» مع السيرفر دون قصد على ألا يقيس أثناء فترات البطء، فالطلبات التي كان يجب أن ترسل في تلك الفترة لم ترسل أصلاً، ولم يسجل زمنها. والنتيجة أن p99 في التقرير يبدو أفضل بكثير مما سيشعر به المستخدمون الحقيقيون، لأن المستخدمين الحقيقيين لا ينتظرون بعضهم، وإنما يصل كل منهم في وقته. والحل أن تستخدم النموذج المفتوح عندما يكون سؤالك عن معدل محدد من الطلبات، وفي k6 يعني ذلك أحد المنفذين Executors اللذين يعملان بمعدل الوصول constant-arrival-rate وramping-arrival-rate، كما تذكر صفحة المنفذين Executors، وأن تقيس الزمن من اللحظة التي كان يجب أن يرسل فيها الطلب، كما تفعل wrk2 مع الخيار -R.
وقد يتساءل البعض: إذا كان النموذج المفتوح أدق، فلماذا يبقى النموذج المغلق؟ والإجابة أن بعض الأنظمة مغلقة فعلاً، مثل تطبيق داخلي لخمسين موظفاً لا يزيد عددهم مهما أبطأ النظام، أو عامل Worker يسحب المهام من طابور واحدة بعد الأخرى، فهنا النموذج المغلق هو الذي يشبه الواقع. أما موقع على الإنترنت فزواره لا يعرفون أن السيرفر مشغول، لذلك فالنموذج المفتوح أقرب إليه. ويربط بين النموذجين حساب بسيط: عدد المستخدمين المتزامنين يساوي معدل الوصول مضروباً في مدة بقاء كل مستخدم، فإذا وصل 10 مستخدمين في الثانية وبقي كل منهم 4 ثوان، فهناك حوالي 40 مستخدماً متزامناً في كل لحظة، وسوف ترى هذا الرقم نفسه في التجربة.
راقب تشبع موارد السيرفر Saturation أثناء الاختبار
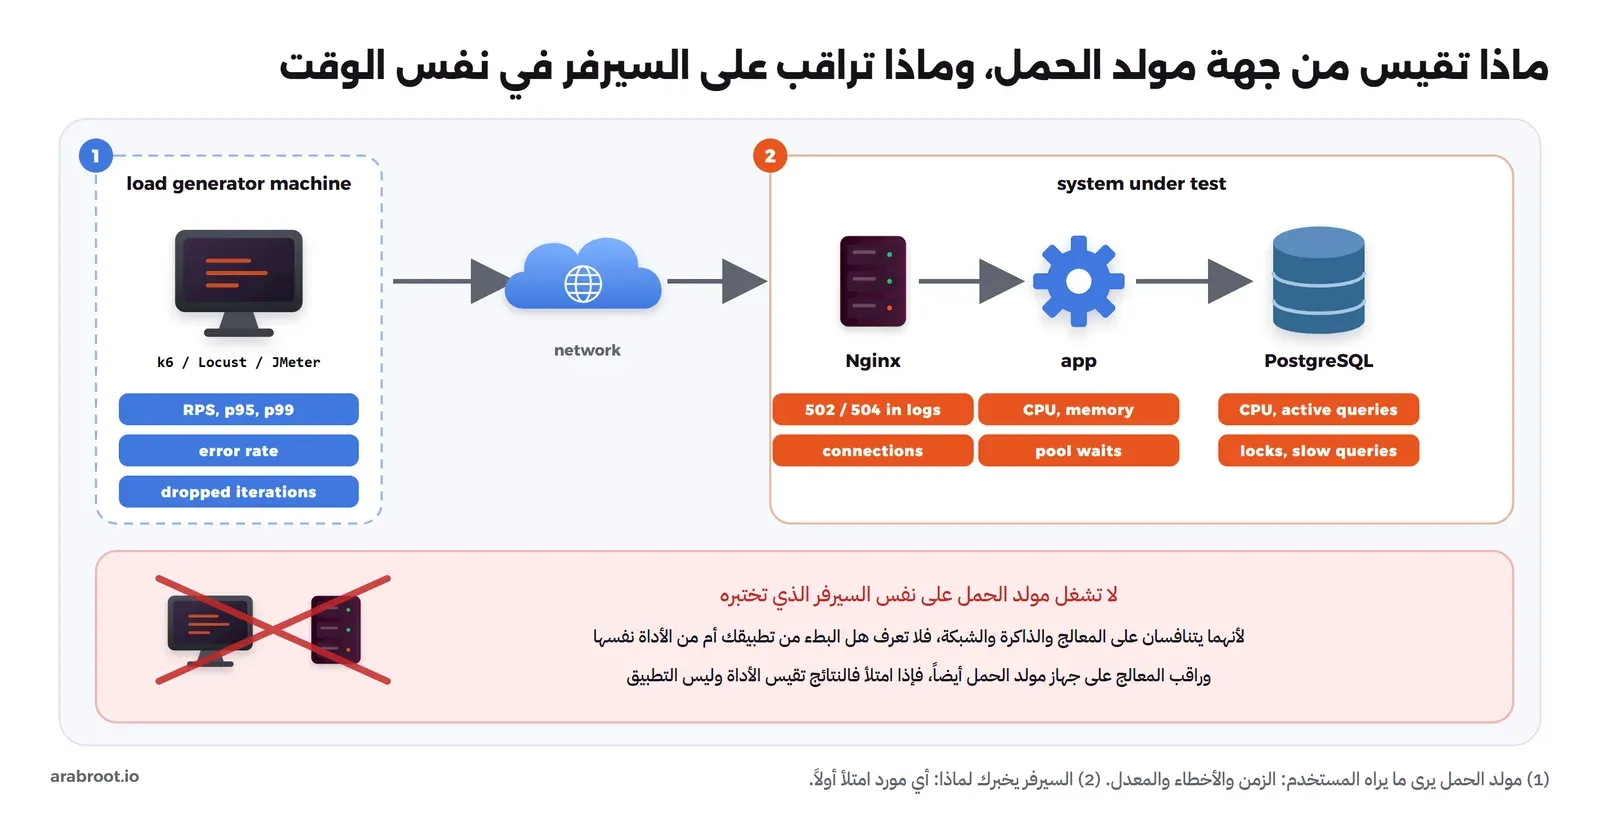
أداة الأحمال ترى النظام من الخارج كما يراه المستخدم، فتخبرك أن p95 صار ثانيتين، ولكنها لا تخبرك لماذا. ولذلك يجب أن تراقب الموارد على السيرفر في نفس الوقت: المعالج والذاكرة والقرص والشبكة على كل سيرفر، والاتصالات النشطة والاستعلامات البطيئة في قاعدة البيانات، وطابور المجمع Pool في التطبيق، وسجل ال Reverse Proxy. وطريقة USE التي شرحناها في استكشاف الأخطاء هي القائمة المناسبة هنا، والأوامر نفسها في تحليل أداء سيرفر Linux في 60 ثانية. والصورة التالية تبين ما تقيسه من كل جهة:
أين تنتهي السعة الحقيقية؟ نقطة الانعطاف Knee
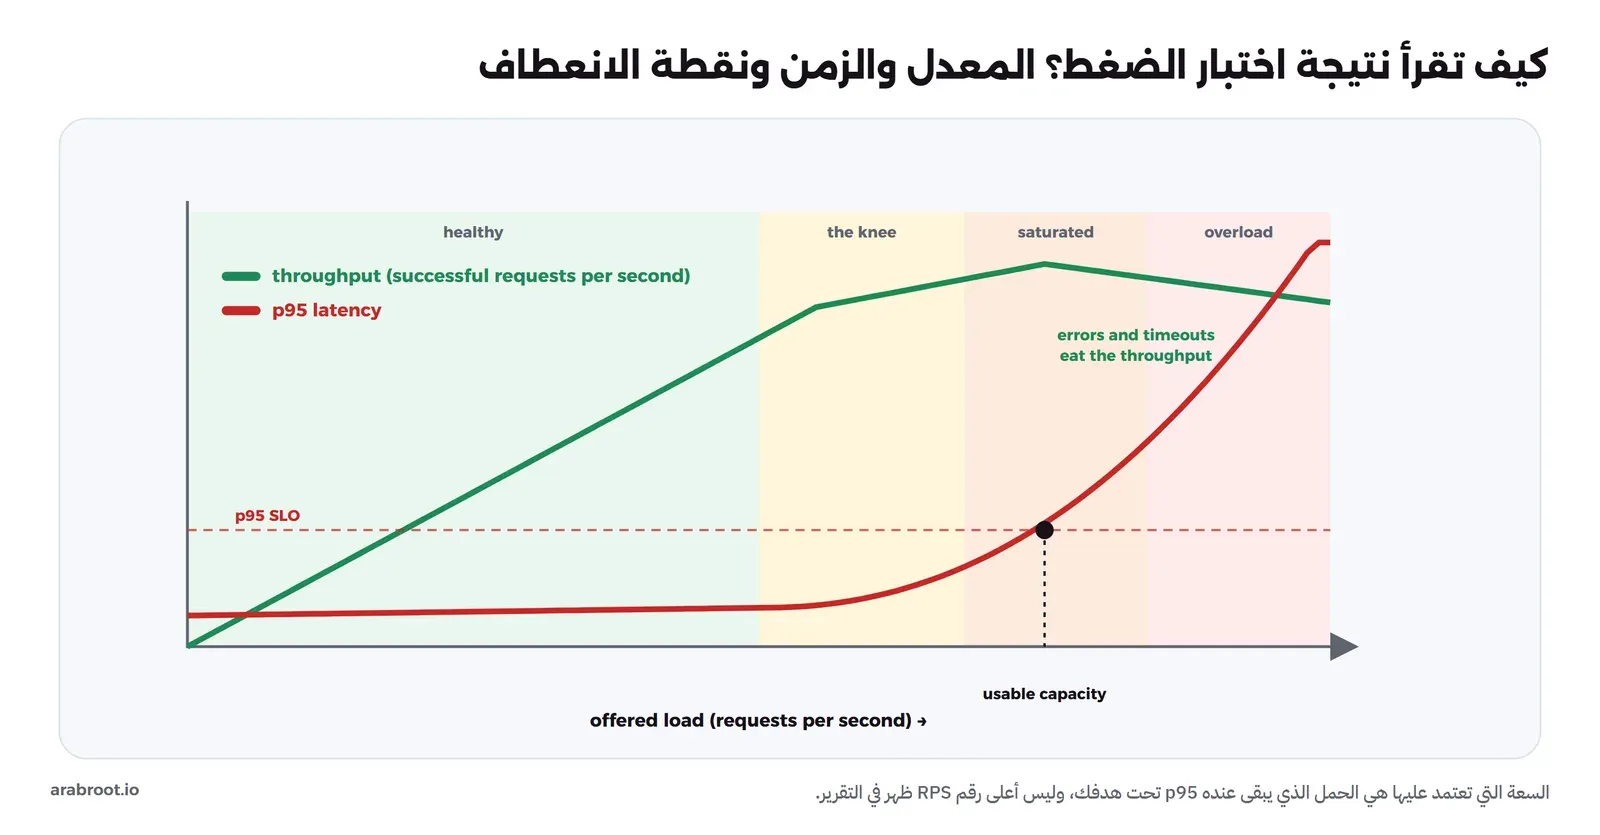
عندما تزيد الحمل تدريجياً في اختبار ضغط ثم ترسم المعدل وزمن الرد على نفس المحور، فسوف تجد غالباً نفس الشكل: في البداية يزيد المعدل مع الحمل ويبقى الزمن ثابتاً تقريباً، لأن كل طلب يجد مورداً فارغاً، ثم يصل أحد الموارد إلى حده فيتوقف المعدل عن الزيادة ويبدأ الزمن في الصعود بسرعة لأن الطلبات صارت تنتظر في طابور، وهذه هي نقطة الانعطاف Knee، ثم إذا زدت الحمل أكثر بدأت المهلات Timeouts والأخطاء، وقد ينخفض المعدل الناجح نفسه. والصورة التالية تبين ذلك:
شروط النجاح Thresholds وأهداف الخدمة SLO
الاختبار الذي لا يقول «نجح» أو «فشل» يتحول إلى تقرير يقرؤه شخص ويقول «تبدو الأرقام جيدة»، ثم ينسى الجميع أن p95 كان 300 مللي ثانية في الإصدار الماضي وصار 450. والحل أن تكتب شروط النجاح في السكربت نفسه قبل التشغيل، مثل «p95 لطلبات البحث أقل من 500 مللي ثانية، والأخطاء أقل من 1%»، وتسميها k6 Thresholds، وعندما يفشل أحدها تخرج الأداة برمز خروج Exit Code غير الصفر فيتوقف خط CI. ومن أين تأتي هذه الأرقام؟ الأفضل أن تأتي من أهداف الخدمة SLO التي اتفق عليها فريقك، وهي موضوع مخطط له في مرحلة الأداء والموثوقية SRE، وإذا لم تكن لديك أهداف بعد فابدأ من أرقام الإنتاج الحالية مع هامش، واجعل الاختبار يفشل عندما تسوء عنها.
كيف تبني اختبار أحمال Load Test يشبه الواقع؟
سيناريو Scenario يشبه المستخدم الحقيقي
- مسار المستخدم User Journey وليس رابطاً واحداً: ابدأ من سجلات الإنتاج أو من أداة التحليلات Analytics لتعرف أكثر الصفحات طلباً وبأي نسبة، ثم اكتب مساراً أو اثنين يمثلان أغلب الاستخدام، مثل تصفح المنتجات ثم فتح منتج ثم الإضافة إلى السلة.
- وقت التفكير Think Time: المستخدم الحقيقي يقرأ الصفحة ثوان قبل أن ينقر، فإذا حذفت هذا الانتظار فإن مئة مستخدم افتراضي يرسلون طلبات بمعدل آلاف المستخدمين الحقيقيين، فتظن أن السعة أقل مما هي، أو أكثر إذا كان الاختبار مغلقاً. اجعله عشوائياً في مدى، مثل ثانية إلى ثلاث ثوان، حتى لا يتحرك كل المستخدمين معاً.
- تنوع البيانات Data Variety: إذا طلب كل المستخدمين الافتراضيين نفس المنتج رقم 1، فإن قاعدة البيانات تجده في الذاكرة في كل مرة، وال Cache يرده دون أن يصل الطلب إلى التطبيق، فتقيس سرعة ال Cache وليس سرعة النظام. استخدم أرقاماً عشوائية أو ملف بيانات CSV بمئات المستخدمين والمنتجات.
- ال Cache بارد أم دافئ؟ بعد النشر أو إعادة التشغيل يكون ال Cache فارغاً Cold Cache، وبعد ساعة يكون ممتلئاً Warm Cache، والفرق بينهما قد يكون كبيراً، فاختبر الحالة التي تهمك واذكرها في النتيجة.
- ال CDN داخل الاختبار أم خارجه؟ إذا كانت الملفات الثابتة تأتي من ال CDN كما شرحنا في مقال CDN، فاختبر السيرفر الأصلي Origin مباشرة بطلبات ال API والصفحات الديناميكية، لأن إرسال حمل كبير عبر ال CDN يقيس شبكة مزود ال CDN، وقد يعتبره المزود هجوماً.
- إعادة استخدام الاتصال: المتصفح يعيد استخدام اتصال TCP وTLS لعدة طلبات كما شرحنا في HTTP وKeep-Alive، وأغلب الأدوات تفعل ذلك افتراضياً، فإذا كان زوارك يفتحون اتصالاً جديداً لكل زيارة قصيرة فاختبر ذلك أيضاً، لأن مصافحة TLS تستهلك معالج السيرفر.
بيئة اختبار Staging تشبه الإنتاج Production
نتيجة اختبار على لابتوب المطور لا تقول شيئاً عن سيرفر الإنتاج، والسبب أن الموارد مختلفة، وكذلك حجم البيانات، وهذه النقطة الأخيرة هي التي يغفل عنها أغلب الفرق: الاستعلام الذي لا يستخدم فهرساً Index يمر على كل الجدول، فإذا كان في بيئة الاختبار ألف صف فإنه يأخذ أقل من مللي ثانية ولن تراه أبداً، وإذا كان في الإنتاج مليون صف فهو عنق الزجاجة الأول. لذلك اجعل بيئة الاختبار Staging بنفس حجم الإنتاج قدر الإمكان، أو بنسبة معروفة منه، وبحجم بيانات قريب من الحقيقي، مع نفس الإصدارات ونفس الإعدادات. وقد شرحنا البيئات ومعاينة الميزات في البيئات وGitOps.
مولد الحمل Load Generator على جهاز آخر
لا تشغل أداة الأحمال على نفس السيرفر الذي تختبره، والسبب أنهما يتنافسان على نفس المعالج والذاكرة، فإذا ارتفع زمن الرد فلن تعرف هل السبب تطبيقك أم الأداة التي تأخذ نصف المعالج. وراقب جهاز مولد الحمل نفسه أيضاً، فتوصي وثائق k6 عن الاختبارات الكبيرة بأن يبقى استخدام المعالج على جهاز مولد الحمل تحت 80% والذاكرة تحت 90%، لأن الأداة المشغولة تتأخر في إرسال الطلبات وقياسها، فتقيس بطأها هي. وإذا احتجت حملاً أكبر من جهاز واحد فكل الأدوات الكاملة تدعم التشغيل الموزع على عدة أجهزة.
الصعود التدريجي Ramp-up ومدة الاختبار
ابدأ دائماً بصعود تدريجي Ramp-up بدلاً من إرسال كل المستخدمين في الثانية الأولى، إلا إذا كان سؤالك عن القفزة نفسها، والسبب أن البدء المفاجئ يقيس فتح الاتصالات وتسخين ال Cache أكثر مما يقيس الحالة المستقرة. واجعل مدة الثبات كافية لترى الأرقام تستقر، فاختبار مدته دقيقة واحدة لا يرى عمل جامع القمامة Garbage Collector الذي يعمل كل بضع دقائق، ولا المهمة المجدولة التي تعمل كل ربع ساعة.
هل تختبر على الإنتاج Production؟
بعض الفرق تختبر الأحمال على الإنتاج نفسه لأنه البيئة الوحيدة الحقيقية، وهذا ممكن ولكن بخطة: في وقت قليل الزيارات، مع إعلام الفريق ومن يتابع التنبيهات، ومع حد يوقف الاختبار آلياً عندما تزيد الأخطاء، مثل الخيار abortOnFail في Thresholds k6، ومع حسابات اختبار وبيانات لا تختلط ببيانات العملاء، ولا تقم بذلك على عملية فيها دفع حقيقي أو إرسال بريد إلى مستخدمين حقيقيين.
لا تختبر خدمات غيرك Third-party APIs عبر تطبيقك
إذا كان تطبيقك يستدعي بوابة دفع أو خدمة رسائل SMS أو API خارجية، فإن اختبار الأحمال يرسل إليها نفس الحمل، فتدفع ثمن آلاف الرسائل، أو تتجاوز حد الطلبات Rate Limit المسموح لحسابك، أو يحظر المزود حسابك. والحل أن تستبدلها في بيئة الاختبار ببديل Stub يرد بعد زمن قريب من زمنها الحقيقي، وقد شرحنا البدائل Test Doubles في أنواع الاختبارات.
أدوات اختبار الأحمال مفتوحة المصدر Open Source
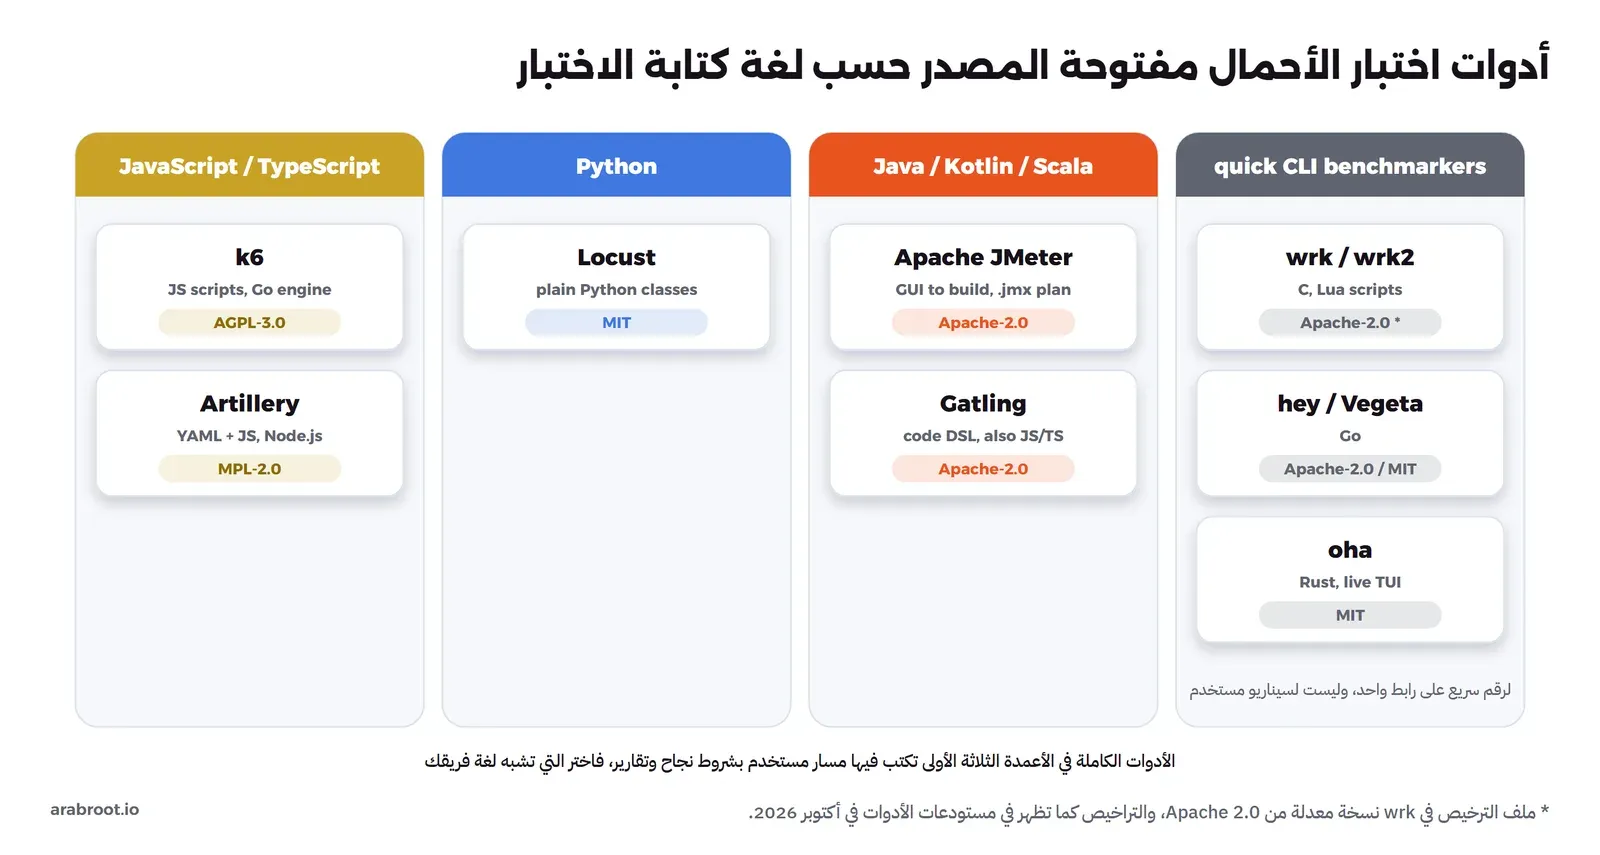
المشكلة التي تحلها هذه الأدوات واحدة: أن تكتب سيناريو المستخدم مرة واحدة، ثم تشغله بأي شكل من أشكال الحمل، وتحصل على أرقام موثوقة وشروط نجاح وتقرير. والفرق الأكبر بينها هو اللغة التي تكتب بها الاختبار، لأن الفريق الذي يكتب الاختبار بلغة يعرفها سوف يحافظ عليه، والفريق الذي يحتاج تعلم لغة جديدة سوف يتركه بعد الإصدار الأول. والصورة التالية تبين الأدوات حسب لغة الكتابة، والتراخيص كما تظهر في مستودعاتها:
أداة k6
k6 أداة من Grafana Labs مكتوبة بلغة Go، وتكتب فيها الاختبار بلغة JavaScript، وترخيصها AGPL-3.0. وتعمل كبرنامج واحد من سطر الأوامر دون واجهة رسومية، وتقرأ السيناريو ونموذج الحمل والشروط من ملف واحد، وتدعم النموذجين المفتوح والمغلق عبر المنفذين Executors، وتعطي ملخصاً في الطرفية، وتستطيع حفظ تقرير HTML من لوحتها المدمجة Web Dashboard، أو إرسال النتائج لحظياً إلى قواعد بيانات المقاييس مثل Prometheus وInfluxDB.
- نقاط القوة: ملف واحد بلغة يعرفها أغلب مطوري الويب، وشروط النجاح Thresholds جزء من السكربت ورمز الخروج جاهز لخط CI، واستهلاك قليل للموارد على مولد الحمل، ونماذج حمل واضحة بأسماء صريحة.
- نقاط الضعف: ال JavaScript فيها ليست Node.js، فلا تستطيع استخدام أي مكتبة من npm مباشرة، والترخيص AGPL يهمك إذا عدلت الأداة وقدمتها لغيرك كخدمة، وبعض الميزات مثل التشغيل الموزع المدار موجودة في خدمة Grafana Cloud k6 السحابية وليست في الأداة نفسها.
أداة Locust
Locust مكتوبة بلغة Python وترخيصها MIT، وتكتب فيها المستخدم ككلاس Python عادي فيه دوال المهام Tasks ووقت الانتظار بينها، كما في وثائق كتابة ملف locustfile. وتأتي بواجهة ويب تشغل منها الاختبار وترى الرسوم لحظياً، وتعمل أيضاً دون واجهة Headless لخط CI مع ملفات CSV وتقرير HTML، وتدعم التشغيل الموزع بجهاز رئيسي Master وعدة عمال Workers.
- نقاط القوة: كل قوة Python متاحة في السيناريو، من توليد البيانات إلى أي مكتبة بروتوكول، والكود مقروء لأي مطور Python، والترخيص MIT بلا قيود تذكر.
- نقاط الضعف: النموذج الأساسي مغلق، أي عدد مستخدمين وليس معدل وصول، وعملية Python الواحدة تستخدم نواة واحدة من المعالج، فتحتاج عدة عمال على مولد الحمل لحمل كبير، وشروط النجاح ليست جزءاً من الملف بنفس وضوح k6 وتحتاج كوداً بسيطاً أو أداة إضافية.
أداة Apache JMeter
Apache JMeter من أقدم أدوات الأحمال وأكثرها انتشاراً في الشركات، مكتوبة بلغة Java وترخيصها Apache-2.0، وتختبر HTTP وقواعد البيانات عبر JDBC وطوابير JMS وغيرها. والفكرة الأساسية فيها أن الاختبار ليس كوداً وإنما خطة اختبار Test Plan تبنيها في واجهة رسومية وتحفظها في ملف XML بامتداد .jmx، وتتكون الخطة من عناصر شجرية تشرحها صفحة بناء خطة الاختبار:
- مجموعة الخيوط Thread Group: تمثل المستخدمين، فتحدد عددهم ومدة الصعود Ramp-up ومدة الاختبار، وكل خيط Thread مستخدم افتراضي واحد، أي أنها نموذج مغلق. وللنموذج المفتوح أضافت الأداة Open Model Thread Group التي تحدد فيها معدل الوصول بدلاً من عدد الخيوط.
- العينات Samplers: الطلب نفسه، مثل HTTP Request، وكل عينة تسجل زمنها ونتيجتها.
- عناصر الإعداد Config Elements: إعدادات مشتركة مثل HTTP Request Defaults للسيرفر والمنفذ والمهلات، وCSV Data Set Config لقراءة بيانات المستخدمين من ملف.
- المؤقتات Timers: وقت التفكير، وتعمل قبل كل عينة Sampler داخل نطاقها وليس بعدها، وهذه نقطة تربك الكثيرين.
- التحققات Assertions: شروط على الرد مثل رمز الحالة أو نص في الصفحة، فإذا فشلت سجلت العينة كخطأ.
- المستمعات Listeners: تعرض النتائج وتحفظها، مثل View Results Tree وSummary Report، وهي مفيدة أثناء بناء الخطة ومكلفة أثناء الحمل.
وأهم قاعدة في JMeter تكتبها الوثائق بوضوح في صفحة البداية: الواجهة الرسومية لبناء الخطة وتجربتها فقط، أما الاختبار الحقيقي فيعمل من سطر الأوامر CLI Mode بالخيار -n، والسبب أن الواجهة والمستمعات تستهلك ذاكرة ومعالجاً كبيراً فتشوه الأرقام. والأمر المعتاد هو jmeter -n -t plan.jmx -l results.jtl -e -o report/، حيث يحفظ -l كل عينة في ملف JTL، وينشئ -e -o لوحة تقرير HTML بعد انتهاء الاختبار. وتذكر الوثائق أيضاً أن الذاكرة الافتراضية للأداة 1 جيجابايت، وقد تحتاج زيادتها عبر المتغير HEAP للاختبارات الكبيرة، وفي صفحة أفضل الممارسات نصائح أخرى مثل تعطيل المستمعات الثقيلة.
- نقاط القوة: تدعم بروتوكولات كثيرة غير HTTP، ومجتمع كبير وإضافات Plugins كثيرة، وواجهة رسومية يستطيع مختبر الجودة QA استخدامها دون برمجة، ولوحة تقرير HTML جاهزة، وترخيص Apache-2.0.
- نقاط الضعف: ملف XML طويل يصعب مراجعته في طلب الدمج Pull Request وحل التعارضات فيه، وكل مستخدم خيط Java كامل فيستهلك ذاكرة أكثر من الأدوات الحديثة، والمنطق المعقد يكتب في عناصر متفرقة ولغة Groovy داخل الواجهة.
أداة Gatling
Gatling مكتوبة بلغة Scala وتعمل على JVM، وترخيص النسخة مفتوحة المصدر Community Edition هو Apache-2.0، وهناك نسخة تجارية Gatling Enterprise للتشغيل الموزع المدار واللوحات والتعاون بين الفرق. وعلى عكس JMeter فالاختبار في Gatling كود، وتسميه محاكاة Simulation، وتكتبه بلغة Java أو Kotlin أو Scala، أو JavaScript وTypeScript في الإصدارات الحديثة، وتتكون المحاكاة من أربعة أجزاء:
- البروتوكول Protocol: إعدادات HTTP المشتركة مثل العنوان الرئيسي baseUrl والترويسات.
- السيناريو Scenario: خطوات المستخدم بالترتيب مع
execللطلب وpauseلوقت التفكير، والتحقق من الرد عبرcheck، والبيانات من مغذيات Feeders. - ملف الحقن Injection Profile: شكل الحمل، وتفصل فيه وثائق الحقن بين النموذج المفتوح بدوال مثل
rampUsersPerSecوconstantUsersPerSecوstressPeakUsers، والنموذج المغلق بدوال مثلconstantConcurrentUsers، وتنصح بألا تخلط بينهما في نفس السيناريو. - التحققات Assertions: شروط النجاح على الاختبار كله، مثل نسبة الفشل وp95 لطلب معين، كما في صفحة التحققات، وإذا فشلت فشل أمر البناء.
وتعمل المحاكاة عادة عبر أداة البناء التي يعرفها فريق Java، مثل Maven أو Gradle، وتنتج في النهاية تقرير HTML مفصلاً فيه توزيع الأزمنة ومعدل الطلبات وعدد المستخدمين مع الوقت.
- نقاط القوة: كود حقيقي يراجع في طلب الدمج ويعاد استخدامه، ونموذج حقن مفتوح واضح، واستهلاك موارد قليل لأنها لا تخصص خيطاً لكل مستخدم، وتقرير HTML غني، ومناسبة جداً لفريق يكتب Java أو Kotlin.
- نقاط الضعف: تحتاج بيئة JVM وأداة بناء، فالتشغيل الأول يحمل مكتبات كثيرة، وبعض الميزات مثل التشغيل الموزع المدار واللوحات المشتركة في النسخة التجارية، والبروتوكولات المدعومة أقل من JMeter.
أداة Artillery
Artillery مكتوبة على Node.js وترخيصها MPL-2.0، وتكتب فيها السيناريو بملف YAML مع إمكانية إضافة دوال JavaScript للمنطق المعقد، كما في وثائقها.
- نقاط القوة: ملف YAML قصير يسهل قراءته، ومكتبات npm متاحة في الدوال الإضافية، ودعم لبروتوكولات مثل WebSocket.
- نقاط الضعف: أقل انتشاراً من k6 وLocust فتجد أمثلة وإجابات أقل، والمنطق المعقد يتوزع بين YAML وملفات JavaScript، فيصعب تتبعه في السيناريوهات الطويلة.
الأدوات السريعة من سطر الأوامر CLI
هذه الأدوات لا تكتب فيها مسار مستخدم كاملاً، وإنما تضرب رابطاً واحداً بأقصى سرعة أو بمعدل ثابت، وهي مفيدة لسؤال واحد سريع، مثل «كم طلباً في الثانية يتحمل هذا ال Endpoint بعد التعديل؟» أو «هل إعداد Nginx الجديد أسرع؟»:
- wrk: مكتوبة بلغة C وسريعة جداً، وتقبل سكربت Lua لتعديل الطلبات، وملف ترخيصها نسخة معدلة من Apache 2.0، ولم يتغير مستودعها منذ 2021. ونسختها wrk2 بترخيص Apache-2.0 تضيف معدلاً ثابتاً بالخيار
-Rوتصحح الإغفال المنسق. - hey: مكتوبة بلغة Go بترخيص Apache-2.0، أمر واحد بسيط يعطي توزيع الأزمنة.
- Vegeta: مكتوبة بلغة Go بترخيص MIT، تعمل بمعدل ثابت من الطلبات، وتقرأ قائمة طلبات مختلفة من ملف، وتخرج النتائج بصيغ يمكن رسمها.
- oha: مكتوبة بلغة Rust بترخيص MIT، وتعرض الأرقام لحظياً في واجهة نصية داخل الطرفية.
وحدود هذه الأدوات واضحة: لا يوجد مسار مستخدم ولا وقت تفكير، ولا شروط نجاح بنفس الوضوح، وأغلبها يعمل بالنموذج المغلق بعدد اتصالات ثابت، فيقع في الإغفال المنسق إلا wrk2 وVegeta اللتين تعملان بمعدل ثابت. لذلك استخدمها للمقارنة السريعة بين إعدادين، وليس للإجابة عن سؤال «هل يتحمل الموقع يوم الحملة؟».
المقارنة في جدول واحد
| الأداة | لغة الاختبار | الترخيص | نموذج الحمل | نقاط القوة | نقاط الضعف |
|---|---|---|---|---|---|
| k6 | JavaScript | AGPL-3.0 | مفتوح ومغلق | ملف واحد، Thresholds ورمز خروج لخط CI، موارد قليلة | ليست Node.js، والترخيص AGPL |
| Locust | Python | MIT | مغلق أساساً | كل قوة Python، وواجهة ويب، وتشغيل موزع | نواة واحدة لكل عملية، وشروط النجاح تحتاج كوداً |
| Apache JMeter | واجهة رسومية وملف XML | Apache-2.0 | مغلق، ومفتوح عبر Open Model Thread Group | بروتوكولات كثيرة، وإضافات، ولوحة HTML، وتناسب من لا يبرمج | ملف XML صعب المراجعة، وخيط Java لكل مستخدم |
| Gatling | Java وKotlin وScala وJS وTS | Apache-2.0 للنسخة المفتوحة | مفتوح ومغلق | كود يراجع، وحقن مفتوح، وتقرير غني، وموارد قليلة | تحتاج JVM وأداة بناء، وبعض الميزات تجارية |
| Artillery | YAML وJavaScript | MPL-2.0 | مفتوح | ملف قصير، ومكتبات npm، وWebSocket | أقل انتشاراً، والمنطق موزع بين YAML وJavaScript |
| wrk وhey وVegeta وoha | سطر الأوامر | Apache-2.0 أو MIT | مغلق غالباً، وwrk2 وVegeta بمعدل ثابت | رقم سريع في ثوان | رابط واحد بلا سيناريو |
والخلاصة العملية: إذا كان فريقك يكتب JavaScript أو لا يفضل لغة معينة وتريد أداة لخط CI فابدأ ب k6، وإذا كان فريقك يكتب Python فاستخدم Locust، وإذا كان فريقك يكتب Java أو Kotlin فاستخدم Gatling، وإذا كان لديك مختبرو جودة لا يبرمجون أو تحتاج بروتوكولات غير HTTP أو لديك خطط JMeter قديمة فاستمر مع JMeter. وقد شرحنا الفرق بين التراخيص في البرمجيات مفتوحة المصدر وتراخيصها.
اختبار الأحمال داخل خط CI/CD
اختبار الأحمال الذي يعمل مرة في السنة قبل الحملة يكتشف المشكلة متأخراً، وبعد مئات التعديلات التي لا تعرف أيها السبب، والذي يعمل ساعة على كل طلب دمج يجعل خط CI بطيئاً فيتجاوزه الفريق. والحل الذي تتبعه الفرق هو التقسيم إلى مستويين، كما في الصورة التالية:
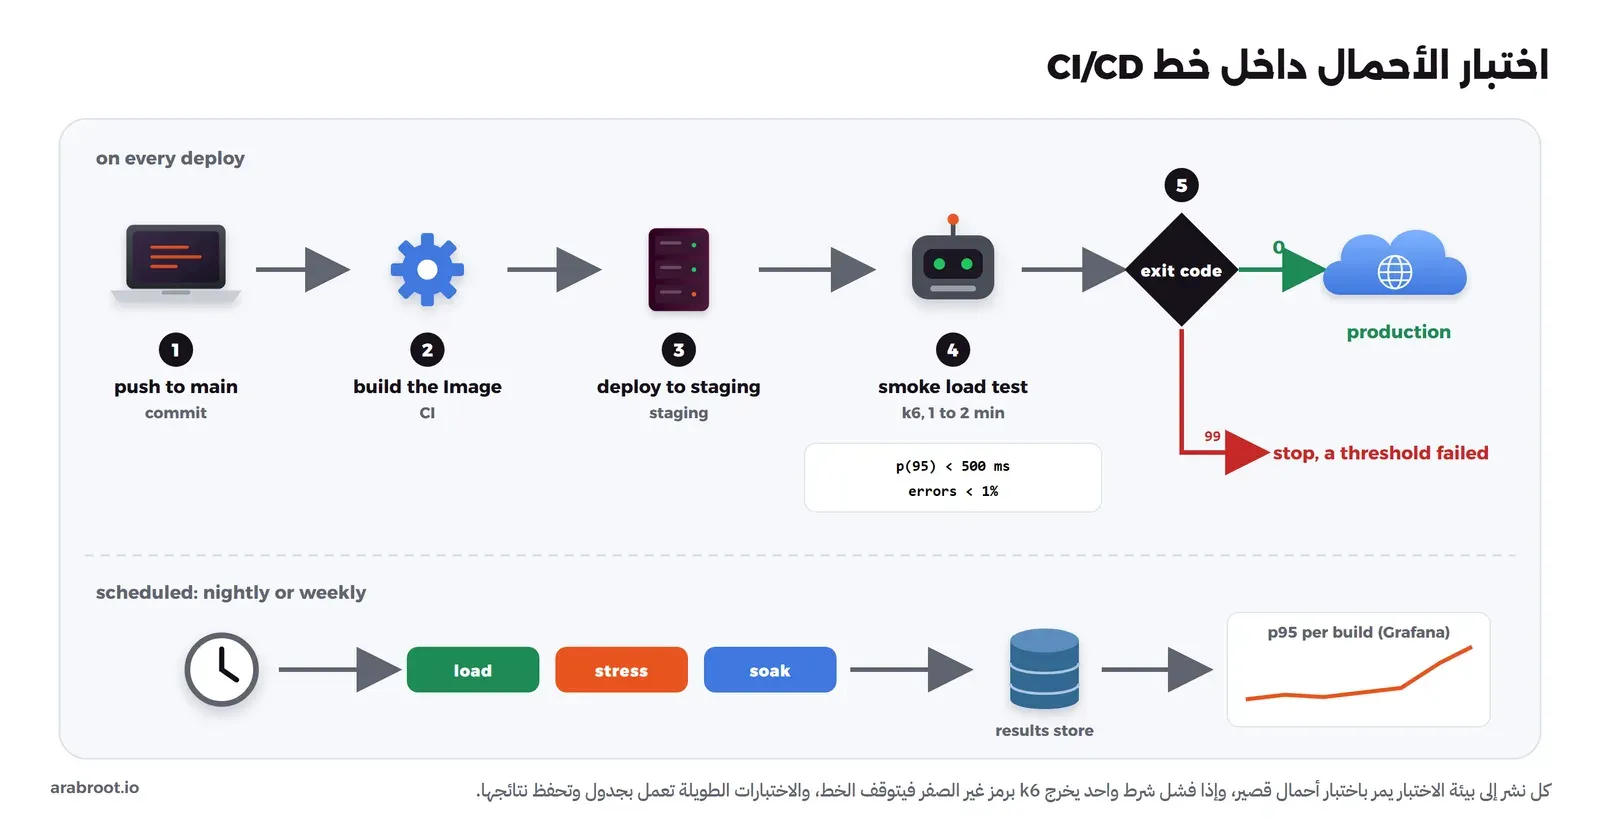
- بعد كل نشر إلى بيئة الاختبار: اختبار دخان أو حمل صغير لدقيقة أو دقيقتين بشروط نجاح، فإذا تراجع الأداء بشكل واضح، مثل استعلام جديد بلا فهرس، توقف الخط قبل الإنتاج. وفي k6 تخرج الأداة برمز 99 عندما يفشل أحد الشروط، كما سوف ترى في التجربة، وهذا كاف ليتوقف أي خط CI.
- بجدول ليلي أو أسبوعي: اختبار الحمل الكامل والضغط والتحمل الطويل على بيئة تشبه الإنتاج، لأنها تأخذ وقتاً طويلاً وتحتاج موارد.
- حفظ النتائج: رقم واحد لا يقول شيئاً، أما p95 لكل بناء على مدى شهرين فيكشف التراجع البطيء الذي لا يفشل أي اختبار بمفرده. لذلك أرسل النتائج إلى قاعدة بيانات مقاييس واعرضها في لوحة Grafana، وهي مواضيع مخطط لها في مرحلة المراقبة والسجلات Observability.
والمثال التالي يبين مهمة في Gitea Actions أو GitHub Actions تشغل اختبار الدخان من سكربت التجربة بعد النشر إلى بيئة الاختبار، وهو مثال للتوضيح لم نشغله في خط حقيقي، وقد شرحنا إعداد خطوط CI على سيرفرك في Gitea Actions:
  load-smoke:
    needs: deploy-staging
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Smoke load test on staging
        run: |
          docker run --rm -v "$PWD/k6:/scripts" \
            -e TEST_TYPE=smoke -e BASE_URL=https://staging.example.com \
            grafana/k6:latest run --quiet /scripts/load.js
في الإعداد أعلاه لاحظ التالي:
- المهمة تعتمد على مهمة النشر
needs: deploy-staging، فلا تعمل إلا بعد أن تصبح النسخة الجديدة على بيئة الاختبار. - لا توجد خطوة تقرأ النتيجة، لأن k6 تخرج برمز غير الصفر عند فشل أحد الشروط، فتفشل الخطوة ويتوقف الخط وحده.
- الرابط يأتي من المتغير
BASE_URL، فنفس السكربت يعمل على جهازك وعلى بيئة الاختبار.
تجربة عملية: نجد نقطة الانكسار Breaking Point ونصلحها
في هذه التجربة سوف نبني متجراً صغيراً من تطبيق FastAPI وقاعدة بيانات PostgreSQL خلف Nginx، فيه صفحة طلبات العميل بدون فهرس عن قصد ومجمع اتصالات صغير، ثم نشغل عليه اختبار حمل ينجح، واختبار ضغط يجد حده، واختبار قفزة، واختبار تحمل يكشف تسرب ذاكرة متعمداً، ثم نكتب نفس السيناريو في Locust وJMeter وGatling، ثم نصلح عنق الزجاجة ونعيد القياس. وكل مولدات الحمل تعمل في Containers على نفس شبكة Docker.
ملفات التجربة
أنشئ مجلداً للتجربة وضع فيه الملفات التالية، وأولها التطبيق في ملف app.py:
import os, time

from fastapi import FastAPI, HTTPException
from psycopg_pool import ConnectionPool, PoolTimeout

POOL_SIZE = int(os.environ.get("POOL_SIZE", "5"))
LEAK = os.environ.get("LEAK") == "1"

pool = ConnectionPool(os.environ["DATABASE_URL"], min_size=POOL_SIZE, max_size=POOL_SIZE, timeout=2)
app = FastAPI()
report_cache = {}  # LEAK=1: a "cache" that is never cleaned


@app.get("/api/health")
def health():
    return {"status": "ok"}


@app.get("/api/products")
def products():
    try:
        with pool.connection() as conn:
            rows = conn.execute("SELECT id, name, price FROM products ORDER BY id LIMIT 20").fetchall()
    except PoolTimeout:
        raise HTTPException(503, "database busy")
    return [{"id": r[0], "name": r[1], "price": float(r[2])} for r in rows]


@app.get("/api/customers/{customer_id}/orders")
def orders(customer_id: int):
    try:
        with pool.connection() as conn:
            rows = conn.execute(
                "SELECT id, total, created_at FROM orders WHERE customer_id = %s ORDER BY id DESC LIMIT 10",
                (customer_id,),
            ).fetchall()
    except PoolTimeout:
        raise HTTPException(503, "database busy")
    result = [{"id": r[0], "total": float(r[1]), "created_at": r[2].isoformat()} for r in rows]
    if LEAK:
        # the key is new on every request, so the dict only grows
        report_cache[(customer_id, time.time_ns())] = "x" * 20_000
    return result
في الكود أعلاه لاحظ التالي:
- المجمع Pool ثابت بخمسة اتصالات، وإذا لم يجد الطلب اتصالاً خلال ثانيتين يرد 503، وهي قيمة صغيرة عن قصد حتى يظهر الطابور بسرعة.
- الدالتان من النوع العادي
defوليسasync def، لذلك يشغلهما FastAPI في مجموعة خيوط Thread Pool، وكل طلب ينتظر اتصالاً من المجمع يحجز خيطاً. - المتغير
LEAK=1يشغل «Cache» لا يحذف منه شيء أبداً، ومفتاحه جديد في كل طلب، وهذا هو التسرب الذي سوف نكشفه في اختبار التحمل الطويل. وهذا النمط يحدث فعلاً عندما يضيف مطور قاموساً Dictionary عاماً ليحفظ نتيجة ما، وينسى أن المفتاح لا يتكرر.
ثم ملف Dockerfile:
FROM python:3.13-slim
RUN pip install --no-cache-dir fastapi==0.142.2 uvicorn==0.54.0 "psycopg[binary]==3.3.6" psycopg-pool==3.3.3
WORKDIR /app
COPY app.py .
CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000", "--no-access-log"]
ثم ملف init.sql الذي ينشئ 200 منتج و300 ألف طلب لعشرة آلاف عميل، دون فهرس على رقم العميل:
CREATE TABLE products (
    id    int PRIMARY KEY,
    name  text NOT NULL,
    price numeric(10,2) NOT NULL
);
INSERT INTO products SELECT g, 'Product ' || g, (random() * 500)::numeric(10,2) FROM generate_series(1, 200) g;

CREATE TABLE orders (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id int NOT NULL,
    total       numeric(10,2) NOT NULL,
    created_at  timestamptz NOT NULL DEFAULT now()
);
-- 300,000 orders for 10,000 customers, and no index on customer_id (on purpose)
INSERT INTO orders (customer_id, total, created_at)
SELECT (random() * 9999)::int + 1, (random() * 900 + 10)::numeric(10,2), now() - random() * interval '365 days'
FROM generate_series(1, 300000);
ANALYZE;
ثم إعداد Nginx في ملف nginx.conf، مع مهلة 10 ثوان للرد من التطبيق، وإعادة استخدام الاتصال بين Nginx والتطبيق كما شرحنا في إعدادات keepalive:
upstream app {
    server lab-load-app:8000;
    keepalive 32;
}
server {
    listen 80;
    location / {
        proxy_pass http://app;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_read_timeout 10s;
    }
}
وأخيراً ملف compose.yaml:
name: lab-load
services:
  db:
    image: postgres:18-alpine
    container_name: lab-load-db
    environment:
      POSTGRES_USER: app
      POSTGRES_PASSWORD: app-lab-password
      POSTGRES_DB: shop
    volumes:
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql:ro
      - lab-load-pgdata:/var/lib/postgresql
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U app -d shop"]
      interval: 2s
      retries: 150
  app:
    build: .
    image: lab-load-app
    container_name: lab-load-app
    environment:
      DATABASE_URL: postgresql://app:app-lab-password@lab-load-db:5432/shop
      POOL_SIZE: "5"
      LEAK: ${LEAK:-0}
    cpus: 1.0
    depends_on:
      db:
        condition: service_healthy
  nginx:
    image: nginx:1.31-alpine
    container_name: lab-load-nginx
    volumes:
      - ./nginx.conf:/etc/nginx/conf.d/default.conf:ro
    ports:
      - "127.0.0.1:19780:80"
    depends_on: [app]
volumes:
  lab-load-pgdata:
    name: lab-load-pgdata
networks:
  default:
    name: lab-load-net
في الإعداد أعلاه لاحظ التالي:
- التطبيق محدود بنواة واحدة
cpus: 1.0، كما يحدث في كثير من خطط الاستضافة الصغيرة، وقد شرحنا هذا الحد في الخيار --cpus. - فحص الصحة يستخدم
-h 127.0.0.1، والسبب أن صورة PostgreSQL الرسمية تشغل سيرفراً مؤقتاً أثناء تنفيذinit.sqlيستمع على ملف Socket فقط، فبدون هذا الخيار ينجح الفحص قبل أن ينتهي إدخال البيانات، وهذا ما حدث معنا في المحاولة الأولى فبدأ التطبيق وقاعدة البيانات ما زالت تجهز. - Nginx وحده ينشر منفذاً على الجهاز
127.0.0.1:19780لتجربة يدوية من المتصفح، أما مولدات الحمل فتصل إليه عبر الشبكةlab-load-netباسمlab-load-nginx.
التشغيل والتأكد من الأساسيات
الآن سوف نقوم بالتشغيل، وإدخال 300 ألف صف يأخذ دقيقة إلى ثلاث دقائق حسب الجهاز:
docker compose up -d --build
curl -s http://127.0.0.1:19780/api/health
والمخرج سوف يكون كما يلي:
{"status":"ok"}سكربت k6 بخمسة أشكال للحمل
نضع السكربت في مجلد k6 باسم load.js، وهو مسار مستخدم واحد مع خمسة أشكال للحمل نختار بينها بالمتغير TEST_TYPE:
import http from 'k6/http';
import { check, sleep } from 'k6';

const BASE = __ENV.BASE_URL || 'http://lab-load-nginx';

// One user journey, several load shapes: TEST_TYPE=smoke|load|stress|spike|soak
const SHAPES = {
  smoke: { executor: 'constant-vus', vus: 2, duration: '30s' },
  load: {
    executor: 'ramping-arrival-rate', startRate: 0, timeUnit: '1s',
    preAllocatedVUs: 60, maxVUs: 200,
    stages: [{ target: 10, duration: '30s' }, { target: 10, duration: '2m' }, { target: 0, duration: '15s' }],
  },
  stress: {
    executor: 'ramping-arrival-rate', startRate: 5, timeUnit: '1s',
    preAllocatedVUs: 800, maxVUs: 1500,
    stages: [{ target: 10, duration: '30s' }, { target: 50, duration: '1m' }, { target: 100, duration: '1m' },
             { target: 200, duration: '1m' }, { target: 0, duration: '15s' }],
  },
  spike: {
    executor: 'ramping-arrival-rate', startRate: 5, timeUnit: '1s',
    preAllocatedVUs: 800, maxVUs: 1500,
    stages: [{ target: 5, duration: '30s' }, { target: 200, duration: '10s' }, { target: 200, duration: '30s' },
             { target: 5, duration: '10s' }, { target: 5, duration: '40s' }],
  },
  soak: {
    executor: 'constant-arrival-rate', rate: 10, timeUnit: '1s', duration: __ENV.SOAK_DURATION || '10m',
    preAllocatedVUs: 60, maxVUs: 200,
  },
};

const TYPE = __ENV.TEST_TYPE || 'smoke';

export const options = {
  scenarios: { [TYPE]: SHAPES[TYPE] },
  thresholds: {
    http_req_failed: ['rate<0.01'],                       // less than 1% errors
    'http_req_duration{name:orders}': ['p(95)<500'],       // 95% of the orders requests under 500 ms
    'http_req_duration{name:products}': ['p(95)<300'],
  },
};

export default function () {
  const products = http.get(`${BASE}/api/products`, { tags: { name: 'products' } });
  check(products, { 'products 200': (r) => r.status === 200 });
  sleep(Math.random() * 2 + 1);                            // think time: 1 to 3 seconds

  const customer = Math.floor(Math.random() * 10000) + 1;  // a different customer each time
  const orders = http.get(`${BASE}/api/customers/${customer}/orders`, { tags: { name: 'orders' } });
  check(orders, { 'orders 200': (r) => r.status === 200 });
  sleep(Math.random() * 2 + 1);
}
في السكربت أعلاه لاحظ التالي:
- كل الأشكال ما عدا الدخان تستخدم منفذي معدل الوصول، أي النموذج المفتوح، والرقم
target: 10يعني عشرة مستخدمين جدد في الثانية، وكل مستخدم يطلب صفحتين. - الوسم
nameعلى كل طلب يجعل k6 يحسب زمن كل صفحة وحدها، والشروط Thresholds مكتوبة على كل صفحة بهدف مختلف. - رقم العميل عشوائي من عشرة آلاف، حتى لا تجد قاعدة البيانات نفس الصفوف في الذاكرة في كل طلب.
- الخيار
preAllocatedVUsيجهز المستخدمين الافتراضيين قبل البدء، والسبب أن k6 تحتاج مستخدماً افتراضياً فارغاً لتبدأ كل تكرار جديد، فإذا لم تجده تسجل التكرار كمفقود Dropped Iteration، كما في صفحة التكرارات المفقودة.
النتيجة خضراء في اختبار الحمل المتوقع Load Test
نبدأ باختبار الحمل المتوقع، عشرة مستخدمين في الثانية لدقيقتين بعد صعود نصف دقيقة، ونشغل k6 في Container على نفس الشبكة:
docker run --rm --name lab-load-k6 --network lab-load-net -v "$PWD/k6:/scripts" \
  -e TEST_TYPE=load grafana/k6:latest run --quiet /scripts/load.js
والمخرج سوف يكون كما يلي:
  █ THRESHOLDS

    http_req_duration{name:orders}
    ✓ 'p(95)<500' p(95)=46.3ms

    http_req_duration{name:products}
    ✓ 'p(95)<300' p(95)=6.6ms

    http_req_failed
    ✓ 'rate<0.01' rate=0.00%


  █ TOTAL RESULTS

    checks_total.......: 2848    16.89979/s
    checks_succeeded...: 100.00% 2848 out of 2848
    checks_failed......: 0.00%   0 out of 2848

    ✓ products 200
    ✓ orders 200

    HTTP
    http_req_duration..............: avg=12.07ms min=2.04ms med=8.74ms  max=97.05ms p(90)=26.84ms p(95)=37.37ms
      { expected_response:true }...: avg=12.07ms min=2.04ms med=8.74ms  max=97.05ms p(90)=26.84ms p(95)=37.37ms
      { name:orders }..............: avg=20.64ms min=5.55ms med=16.79ms max=97.05ms p(90)=37.37ms p(95)=46.3ms
      { name:products }............: avg=3.5ms   min=2.04ms med=2.89ms  max=29.03ms p(90)=4.86ms  p(95)=6.6ms
    http_req_failed................: 0.00%  0 out of 2848
    http_reqs......................: 2848   16.89979/s

    EXECUTION
    iteration_duration.............: avg=4.06s   min=2.02s  med=4.06s   max=5.94s   p(90)=5.16s   p(95)=5.42s
    iterations.....................: 1424   8.449895/s
    vus............................: 1      min=0         max=46
    vus_max........................: 60     min=60        max=60

    NETWORK
    data_received..................: 2.8 MB 17 kB/s
    data_sent......................: 252 kB 1.5 kB/s
في المخرج أعلاه لاحظ التالي:
- الشروط الثلاثة نجحت: p95 لصفحة الطلبات 46.3 مللي ثانية، ولصفحة المنتجات 6.6، ولا توجد أخطاء.
- صفحة الطلبات أبطأ من صفحة المنتجات بسبعة أضعاف تقريباً، وهذه أول إشارة إلى الاستعلام بدون فهرس، ولكنها ما زالت تحت الهدف بكثير، لذلك لا يظهر شيء في الاستخدام العادي.
- السطر
vusيقول إن أعلى عدد مستخدمين افتراضيين متزامنين كان 46، وهو الحساب الذي ذكرناه: عشرة في الثانية مضروبة في حوالي أربع ثوان لكل تكرار، كما يظهر فيiteration_duration.
أين ينكسر المتجر؟ اختبار الضغط Stress Test
الآن نرفع معدل الوصول درجة درجة إلى 200 مستخدم في الثانية، ونحفظ كل طلب في ملف CSV لنقرأ النتيجة مع الوقت، ونحفظ تقرير HTML من لوحة k6:
docker run --rm --name lab-load-k6 --network lab-load-net -v "$PWD/k6:/scripts" \
  -e TEST_TYPE=stress -e K6_WEB_DASHBOARD=true -e K6_WEB_DASHBOARD_EXPORT=/scripts/stress-report.html \
  grafana/k6:latest run --quiet --out csv=/scripts/stress.csv /scripts/load.js; echo "EXIT $?"
والمخرج سوف يكون كما يلي، وقد حذفنا بعض السطور التي لا تهمنا هنا:
time="2026-10-06T17:20:34Z" level=warning msg="Insufficient VUs, reached 1500 active VUs and cannot initialize more" executor=ramping-arrival-rate scenario=stress

  █ THRESHOLDS

    http_req_duration{name:orders}
    ✗ 'p(95)<500' p(95)=2.52s

    http_req_duration{name:products}
    ✗ 'p(95)<300' p(95)=2.53s

    http_req_failed
    ✓ 'rate<0.01' rate=0.00%


  █ TOTAL RESULTS

    checks_total.......: 32462   141.648981/s
    checks_succeeded...: 100.00% 32462 out of 32462
    checks_failed......: 0.00%   0 out of 32462

    ✓ products 200
    ✓ orders 200

    HTTP
    http_req_duration..............: avg=790.34ms min=1.7ms  med=150.77ms max=3.89s  p(90)=2.33s p(95)=2.52s
      { expected_response:true }...: avg=790.34ms min=1.7ms  med=150.77ms max=3.89s  p(90)=2.33s p(95)=2.52s
      { name:orders }..............: avg=793.74ms min=4.93ms med=164.01ms max=3.89s  p(90)=2.32s p(95)=2.52s
      { name:products }............: avg=786.93ms min=1.7ms  med=137.75ms max=3.87s  p(90)=2.34s p(95)=2.53s
    http_req_failed................: 0.00%  0 out of 32462
    http_reqs......................: 32462  141.648981/s

    dropped_iterations.............: 793    3.460281/s
    vus_max........................: 1500   min=800        max=1500

time="2026-10-06T17:20:54Z" level=error msg="thresholds on metrics 'http_req_duration{name:orders}, http_req_duration{name:products}' have been crossed"
EXIT 99
في المخرج أعلاه لاحظ التالي:
- الاختبار فشل كما نريد، وخرجت k6 بالرمز 99، وهذا هو الرمز الذي يوقف خط CI.
- لا توجد أخطاء إطلاقاً، ولكن p95 وصل إلى 2.5 ثانية، أي أن النظام لم ينهر وإنما صار المستخدمون ينتظرون في الطابور، وهذا انهيار هادئ أفضل من رد 502، ولكنه ما زال تجربة سيئة للمستخدم.
- التحذير في السطر الأول مهم جداً: وصلت k6 إلى حد 1500 مستخدم افتراضي، فلم تستطع أن تبدأ 793 تكراراً، أي أن الأداة نفسها لم ترسل الحمل الذي طلبناه في آخر الاختبار، لأن كل مستخدم افتراضي صار يبقى وقتاً أطول بسبب البطء. وهذا يحدث في النموذج المفتوح أيضاً عندما يصل إلى حد المستخدمين، فاقرأ هذا التحذير دائماً قبل أن تثق بالأرقام.
- الملخص النهائي يقول إن p50 كان 150 مللي ثانية، ولكنه رقم يخلط دقائق هادئة بدقائق انهيار، فلا يفيدنا في معرفة أين حدث الانعطاف.
لذلك نقرأ ملف CSV في نوافذ زمنية من 15 ثانية، والسكربت التالي windows.py يحسب لكل نافذة المعدل والنسب المئوية ونسبة الأخطاء ورموز الحالة:
# Summarise a k6 CSV output in time windows: requests per second, percentiles, errors and status codes
#   python windows.py stress.csv 15
import csv, sys
from collections import Counter, defaultdict

path, win = sys.argv[1], int(sys.argv[2]) if len(sys.argv) > 2 else 15
durations, codes = defaultdict(list), defaultdict(Counter)
for row in csv.DictReader(open(path)):
    if row["metric_name"] == "http_req_duration":
        w = int(row["timestamp"]) // win
        durations[w].append(float(row["metric_value"]))
        codes[w][row["status"]] += 1

def pct(values, p):
    values = sorted(values)
    return values[min(len(values) - 1, int(len(values) * p))]

first = min(durations)
print(f"{'from':>5} {'req/s':>6} {'p50ms':>7} {'p95ms':>7} {'p99ms':>7} {'errors':>7}  status")
for w in sorted(durations):
    d, c = durations[w], codes[w]
    errors = 100 * (len(d) - c["200"]) / len(d)
    print(f"{(w - first) * win:>4}s {len(d) / win:6.1f} {pct(d, .5):7.0f} {pct(d, .95):7.0f} {pct(d, .99):7.0f} {errors:6.1f}%  {dict(c)}")
ونشغله على ملف النتائج:
python windows.py k6/stress.csv 15والمخرج سوف يكون كما يلي:
 from  req/s   p50ms   p95ms   p99ms  errors  status
   0s    7.3       6      45      76    0.0%  {'200': 110}
  15s   16.1       9      41      55    0.0%  {'200': 241}
  30s   23.7       5      30      55    0.0%  {'200': 355}
  45s   43.2       5      26      33    0.0%  {'200': 648}
  60s   62.6       6      29      47    0.0%  {'200': 939}
  75s   82.7       6      26      36    0.0%  {'200': 1241}
  90s  103.5      15     339     448    0.0%  {'200': 1552}
 105s  129.8      10      34      59    0.0%  {'200': 1947}
 120s  153.0      19     100     176    0.0%  {'200': 2295}
 135s  174.5      72     574     643    0.0%  {'200': 2617}
 150s  213.8      64     883     956    0.0%  {'200': 3207}
 165s  250.3      24     601     725    0.0%  {'200': 3754}
 180s  234.3    1234    2326    2407    0.0%  {'200': 3515}
 195s  280.3    1560    3443    3805    0.0%  {'200': 4205}
 210s  331.8    2319    3745    3859    0.0%  {'200': 4977}
 225s   57.3     323    1355    1436    0.0%  {'200': 859}
والآن الصورة أوضح بكثير: حتى حوالي 130 طلباً في الثانية بقي p95 تحت 60 مللي ثانية تقريباً، ثم بدأ يصعد، وعند حوالي 175 طلباً في الثانية تجاوز هدف 500 مللي ثانية، وبعد 230 طلباً في الثانية صار بالثواني. فالسعة التي يمكن الاعتماد عليها لهذا المتجر بهذه الإعدادات في هذه التجربة حوالي 150 طلباً في الثانية، وليس 330 الذي يظهر في آخر سطر. ولاحظ أيضاً النافذة عند الثانية 90، حيث قفز p95 إلى 339 ثم عاد، وهذه قفزة من جهاز مشترك يعمل عليه غيرنا، أي من نوع الضجيج الذي تراه عندما يعمل مولد الحمل والتطبيق على نفس الجهاز.
وفي نفس الوقت، أثناء أعلى حمل، قمنا بقراءة الموارد من جهة السيرفر بالأوامر التالية:
docker stats --no-stream --format 'table {{.Name}}\t{{.CPUPerc}}\t{{.MemUsage}}' lab-load-app lab-load-db lab-load-nginx
docker exec lab-load-db psql -U app -d shop -c "SELECT state, count(*) FROM pg_stat_activity WHERE datname = 'shop' AND pid <> pg_backend_pid() GROUP BY 1"
docker exec lab-load-db psql -U app -d shop -c "SELECT round(extract(epoch FROM clock_timestamp() - query_start) * 1000) AS running_ms, left(query, 50) AS query FROM pg_stat_activity WHERE datname = 'shop' AND state = 'active' AND pid <> pg_backend_pid()"
والمخرج سوف يكون كما يلي:
NAME             CPU %     MEM USAGE / LIMIT
lab-load-app     51.80%    61.55MiB / 31.29GiB
lab-load-db      195.66%   67.16MiB / 31.29GiB
lab-load-nginx   11.29%    10.03MiB / 31.29GiB
 state  | count
--------+-------
 active |     4
 idle   |     1
(2 rows)

 running_ms |                       query
------------+----------------------------------------------------
          4 | SELECT id, total, created_at FROM orders WHERE cus
         21 | SELECT id, total, created_at FROM orders WHERE cus
         38 | SELECT id, total, created_at FROM orders WHERE cus
          2 | SELECT id, total, created_at FROM orders WHERE cus
         39 | SELECT id, total, created_at FROM orders WHERE cus
(5 rows)
في المخرج أعلاه لاحظ التالي:
- قاعدة البيانات تستخدم حوالي نواتين كاملتين 195%، والتطبيق نصف نواة فقط، فعنق الزجاجة ليس في كود Python وإنما في قاعدة البيانات.
- كل اتصالات المجمع الخمسة مشغولة تقريباً، وكلها تنفذ نفس الاستعلام على جدول الطلبات، والجدول pg_stat_activity هو المكان الذي تبدأ منه دائماً عندما تكون قاعدة البيانات مشغولة.
- كل استعلام يأخذ عشرات المللي ثواني، وخمسة اتصالات فقط تخدم كل الطلبات، فكل طلب زائد يقف في طابور المجمع ثم في طابور الخيوط في التطبيق، وهذا هو الزمن الذي رأيناه في k6.
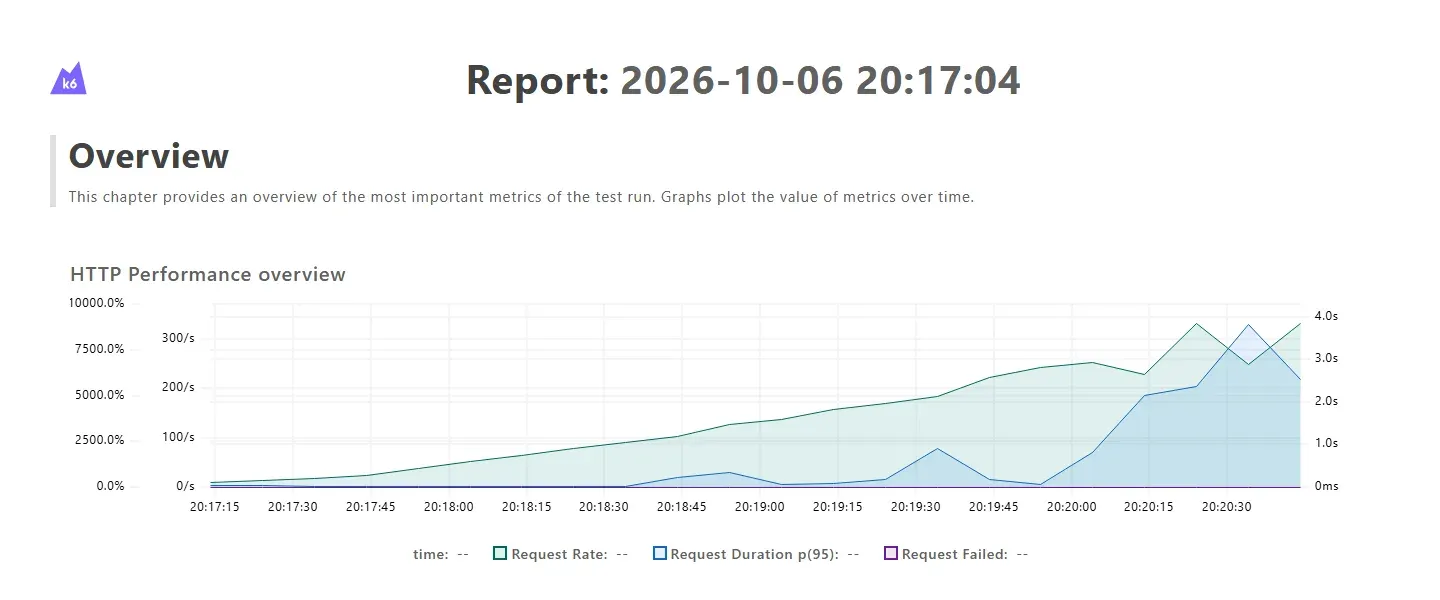
والصورة التالية من تقرير HTML الذي حفظته k6 لنفس الاختبار، ويظهر فيها المعدل باللون الأخضر وp95 باللون الأزرق وهو يرتفع في الدقيقة الأخيرة:
هل يعود المتجر بعد القفزة؟ اختبار Spike Test
الآن نقفز من 5 مستخدمين في الثانية إلى 200 خلال عشر ثوان، ونبقى نصف دقيقة، ثم نعود إلى 5:
docker run --rm --name lab-load-k6 --network lab-load-net -v "$PWD/k6:/scripts" \
  -e TEST_TYPE=spike grafana/k6:latest run --quiet --out csv=/scripts/spike.csv /scripts/load.js
python windows.py k6/spike.csv 10
والمخرج سوف يكون كما يلي، مع اختصار ملخص k6:
time="2026-10-06T17:22:23Z" level=warning msg="Insufficient VUs, reached 1500 active VUs and cannot initialize more" executor=ramping-arrival-rate scenario=spike

  █ THRESHOLDS

    http_req_duration{name:orders}
    ✗ 'p(95)<500' p(95)=3.86s

    http_req_duration{name:products}
    ✗ 'p(95)<300' p(95)=3.84s

    http_req_failed
    ✓ 'rate<0.01' rate=0.00%

    http_reqs......................: 14660  117.587507/s
    dropped_iterations.............: 1069   8.574423/s

 from  req/s   p50ms   p95ms   p99ms  errors  status
   0s    3.3       5      36      43    0.0%  {'200': 33}
  10s   10.0      10      42      58    0.0%  {'200': 100}
  20s   10.0       9      47      54    0.0%  {'200': 100}
  30s   35.0       3      22      33    0.0%  {'200': 350}
  40s  260.8     172    1162    1194    0.0%  {'200': 2608}
  50s  316.3    1180    1402    1434    0.0%  {'200': 3163}
  60s  304.3    1920    2303    2346    0.0%  {'200': 3043}
  70s  255.5    3622    3922    3973    0.0%  {'200': 2555}
  80s  219.9    3605    3858    3894    0.0%  {'200': 2199}
  90s   24.3     696    2157    2208    0.0%  {'200': 243}
 100s   10.1      11      29      39    0.0%  {'200': 101}
 110s   10.1       9      27      31    0.0%  {'200': 101}
 120s    6.4      13      25      45    0.0%  {'200': 64}
في المخرج أعلاه لاحظ التالي:
- خلال عشر ثوان من بداية القفزة قفز p95 من 22 مللي ثانية إلى أكثر من ثانية، ثم إلى حوالي أربع ثوان، لأن الطابور يكبر مع كل ثانية يستمر فيها الحمل فوق السعة.
- بعد انتهاء القفزة احتاج المتجر حوالي عشرين ثانية ليصرف الطابور المتراكم، ثم عاد p95 إلى أقل من 30 مللي ثانية، أي أنه تعافى تماماً، وهذه هي الإجابة التي يبحث عنها اختبار القفزة.
- مرة أخرى لم تستطع k6 أن تبدأ 1069 تكراراً، فالقفزة الحقيقية التي وصلت إلى المتجر كانت أصغر من 200 مستخدم في الثانية، وفي اختبار حقيقي يجب أن ترفع
maxVUsأو تستخدم جهاز مولد حمل أكبر حتى تعرف أن القفزة وصلت كاملة.
تسرب ذاكرة Memory Leak لا تراه k6 في اختبار التحمل الطويل Soak
الآن نعيد تشغيل التطبيق مع LEAK=1، ونشغل الحمل المتوقع، عشرة مستخدمين في الثانية، لمدة عشر دقائق، ونقرأ ذاكرة ال Container كل دقيقة من نافذة طرفية أخرى:
LEAK=1 docker compose up -d app
docker run --rm --name lab-load-k6 --network lab-load-net -v "$PWD/k6:/scripts" \
  -e TEST_TYPE=soak -e SOAK_DURATION=10m grafana/k6:latest run --quiet /scripts/load.js

# in another terminal, during the test
for i in $(seq 0 11); do
  echo "$(date +%T) $(docker stats --no-stream --format '{{.Name}} {{.CPUPerc}} {{.MemUsage}}' lab-load-app)"
  sleep 57
done
والمخرج من k6 سوف يكون كما يلي:
  █ THRESHOLDS

    http_req_duration{name:orders}
    ✓ 'p(95)<500' p(95)=44.24ms

    http_req_duration{name:products}
    ✓ 'p(95)<300' p(95)=7.21ms

    http_req_failed
    ✓ 'rate<0.01' rate=0.00%

    http_reqs......................: 12002  19.851174/s
    iterations.....................: 6001   9.925587/s
أما المخرج من حلقة docker stats فهو كما يلي:
20:23:40 lab-load-app 0.18% 44.43MiB / 31.29GiB
20:24:39 lab-load-app 5.38% 56.73MiB / 31.29GiB
20:25:37 lab-load-app 4.41% 68.13MiB / 31.29GiB
20:26:36 lab-load-app 5.12% 79.3MiB / 31.29GiB
20:27:34 lab-load-app 4.36% 90.64MiB / 31.29GiB
20:28:32 lab-load-app 5.72% 102MiB / 31.29GiB
20:29:31 lab-load-app 5.75% 113.4MiB / 31.29GiB
20:30:29 lab-load-app 6.02% 124.6MiB / 31.29GiB
20:31:27 lab-load-app 4.98% 135.9MiB / 31.29GiB
20:32:26 lab-load-app 6.81% 147.1MiB / 31.29GiB
20:33:24 lab-load-app 4.36% 158.6MiB / 31.29GiB
20:34:22 lab-load-app 0.18% 162.2MiB / 31.29GiB
وهنا الدرس الأهم في هذا القسم: كل شروط k6 نجحت، والأزمنة ثابتة طوال العشر دقائق، ولكن ذاكرة التطبيق زادت من 44 ميجابايت إلى 162 ميجابايت بخط مستقيم تقريباً، حوالي 11 ميجابايت في الدقيقة، وبعد انتهاء الاختبار في السطر الأخير بقيت الذاكرة كما هي ولم تنزل. وبهذا المعدل يستهلك التطبيق حوالي 650 ميجابايت في الساعة الواحدة، فيقتله OOM Killer أو حد ال Container بعد ساعات أو أيام حسب الذاكرة المتاحة، ولن ترى ذلك في أي اختبار مدته دقيقتان. لذلك اختبار التحمل الطويل لا يكتمل بنتيجة أداة الأحمال وحدها، وإنما بمراقبة الذاكرة وعدد الاتصالات وعدد الملفات المفتوحة على السيرفر طوال الاختبار، وفي الواقع يستمر هذا الاختبار ساعات وليس عشر دقائق. والإصلاح هنا أن يكون لأي Cache داخل التطبيق حد أقصى لعدد العناصر أو مدة صلاحية، أو أن يكون خارج عملية التطبيق في Redis أو Valkey مع مدة صلاحية TTL.
بعد ذلك نعيد التطبيق إلى وضعه الطبيعي:
docker compose up -d appنفس السيناريو في Locust
نضع الملف التالي في مجلد locust باسم locustfile.py:
import random

from locust import HttpUser, task, between


class Shopper(HttpUser):
    wait_time = between(1, 3)  # think time: 1 to 3 seconds

    @task(1)
    def browse(self):
        self.client.get("/api/products", name="products")
        self.wait()  # think time before the next request, like a real user
        customer = random.randint(1, 10000)
        self.client.get(f"/api/customers/{customer}/orders", name="orders")
ونشغله دون واجهة ويب بأربعين مستخدماً، يبدأ منهم اثنان كل ثانية، لمدة 150 ثانية، مع حفظ ملفات CSV وتقرير HTML:
docker run --rm --name lab-load-locust --network lab-load-net -v "$PWD/locust:/mnt/locust" -w /mnt/locust \
  locustio/locust:2.46.7 -f locustfile.py --headless -u 40 -r 2 -t 150s \
  -H http://lab-load-nginx --csv results --html report.html --only-summary
والمخرج سوف يكون كما يلي:
Type     Name                                                                          # reqs      # fails |    Avg     Min     Max    Med |   req/s  failures/s
--------|----------------------------------------------------------------------------|-------|-------------|-------|-------|-------|-------|--------|-----------
GET      orders                                                                          1404     0(0.00%) |     23       6      78     18 |    9.37        0.00
GET      products                                                                        1418     0(0.00%) |      5       2      23      4 |    9.47        0.00
--------|----------------------------------------------------------------------------|-------|-------------|-------|-------|-------|-------|--------|-----------
         Aggregated                                                                      2822     0(0.00%) |     14       2      78     11 |   18.84        0.00

Response time percentiles (approximated)
Type     Name                                                                                  50%    66%    75%    80%    90%    95%    98%    99%  99.9% 99.99%   100% # reqs
--------|--------------------------------------------------------------------------------|--------|------|------|------|------|------|------|------|------|------|------|------
GET      orders                                                                                 18     24     29     32     43     50     60     65     78     79     79   1404
GET      products                                                                                4      5      6      6     10     13     15     17     23     24     24   1418
--------|--------------------------------------------------------------------------------|--------|------|------|------|------|------|------|------|------|------|------|------
         Aggregated                                                                             11     15     18     21     32     43     53     60     76     79     79   2822
في الإعداد والمخرج أعلاه لاحظ التالي:
- Locust تعمل بالنموذج المغلق، فحددنا عدد المستخدمين 40 وليس معدل الوصول، ومع حوالي أربع ثوان لكل تكرار تعطي حوالي عشرة تكرارات في الثانية، أي نفس حمل k6، والنتيجة قريبة جداً: p95 لصفحة الطلبات 50 مللي ثانية.
- في المحاولة الأولى كتبنا
wait_timeفقط، وهو الانتظار بعد كل مهمة Task، فكان الطلبان في المهمة يرسلان خلف بعضهما دون انتظار، وتضاعف الحمل إلى حوالي 37 طلباً في الثانية بدلاً من 19. والسطرself.wait()يضيف وقت التفكير بين الطلبين، وهذا مثال على أن وقت التفكير يغير الحمل بالكامل. - الملفات
results_stats.csvوresults_stats_history.csvتحفظ الأرقام نفسها، والثاني يحفظها كل بضع ثوان، فتستطيع رسمها مع الوقت.
نفس السيناريو في JMeter من سطر الأوامر CLI
لا نحتاج تثبيت Java على الجهاز، وإنما نبني Docker Image صغيرة من ملف JMeter الرسمي، في مجلد jmeter:
FROM eclipse-temurin:21-jdk-alpine
ARG JMETER_VERSION=5.6.3
RUN wget -qO- https://dlcdn.apache.org/jmeter/binaries/apache-jmeter-${JMETER_VERSION}.tgz | tar -xz -C /opt \
 && ln -s /opt/apache-jmeter-${JMETER_VERSION}/bin/jmeter /usr/local/bin/jmeter
WORKDIR /tests
ENTRYPOINT ["jmeter"]
ثم خطة الاختبار في ملف plan.jmx، وفي العادة تبنيها من الواجهة الرسومية وتحفظها، ولكنها هنا مكتوبة باليد ومختصرة حتى تقرأها:
<?xml version="1.0" encoding="UTF-8"?>
<jmeterTestPlan version="1.2" properties="5.0" jmeter="5.6.3">
  <hashTree>
    <TestPlan guiclass="TestPlanGui" testclass="TestPlan" testname="Shop load test">
      <boolProp name="TestPlan.functional_mode">false</boolProp>
      <boolProp name="TestPlan.serialize_threadgroups">false</boolProp>
      <elementProp name="TestPlan.user_defined_variables" elementType="Arguments" guiclass="ArgumentsPanel" testclass="Arguments">
        <collectionProp name="Arguments.arguments"/>
      </elementProp>
    </TestPlan>
    <hashTree>
      <!-- Shared settings for every HTTP sampler -->
      <ConfigTestElement guiclass="HttpDefaultsGui" testclass="ConfigTestElement" testname="HTTP Request Defaults">
        <elementProp name="HTTPsampler.Arguments" elementType="Arguments" guiclass="HTTPArgumentsPanel" testclass="Arguments">
          <collectionProp name="Arguments.arguments"/>
        </elementProp>
        <stringProp name="HTTPSampler.protocol">http</stringProp>
        <stringProp name="HTTPSampler.domain">${__P(host,lab-load-nginx)}</stringProp>
        <stringProp name="HTTPSampler.port">80</stringProp>
        <stringProp name="HTTPSampler.connect_timeout">5000</stringProp>
        <stringProp name="HTTPSampler.response_timeout">15000</stringProp>
      </ConfigTestElement>
      <hashTree/>
      <!-- 40 virtual users, started over 30 seconds, for 150 seconds -->
      <ThreadGroup guiclass="ThreadGroupGui" testclass="ThreadGroup" testname="Shoppers">
        <stringProp name="ThreadGroup.on_sample_error">continue</stringProp>
        <elementProp name="ThreadGroup.main_controller" elementType="LoopController" guiclass="LoopControlPanel" testclass="LoopController">
          <boolProp name="LoopController.continue_forever">false</boolProp>
          <intProp name="LoopController.loops">-1</intProp>
        </elementProp>
        <stringProp name="ThreadGroup.num_threads">${__P(users,40)}</stringProp>
        <stringProp name="ThreadGroup.ramp_time">30</stringProp>
        <boolProp name="ThreadGroup.scheduler">true</boolProp>
        <stringProp name="ThreadGroup.duration">${__P(duration,150)}</stringProp>
        <stringProp name="ThreadGroup.delay">0</stringProp>
        <boolProp name="ThreadGroup.same_user_on_next_iteration">true</boolProp>
      </ThreadGroup>
      <hashTree>
        <HTTPSamplerProxy guiclass="HttpTestSampleGui" testclass="HTTPSamplerProxy" testname="products">
          <elementProp name="HTTPsampler.Arguments" elementType="Arguments" guiclass="HTTPArgumentsPanel" testclass="Arguments">
            <collectionProp name="Arguments.arguments"/>
          </elementProp>
          <stringProp name="HTTPSampler.path">/api/products</stringProp>
          <stringProp name="HTTPSampler.method">GET</stringProp>
          <boolProp name="HTTPSampler.use_keepalive">true</boolProp>
        </HTTPSamplerProxy>
        <hashTree>
          <!-- think time: JMeter runs a timer before the sampler it belongs to, 1 to 3 seconds -->
          <UniformRandomTimer guiclass="UniformRandomTimerGui" testclass="UniformRandomTimer" testname="Think time">
            <stringProp name="ConstantTimer.delay">1000</stringProp>
            <stringProp name="RandomTimer.range">2000</stringProp>
          </UniformRandomTimer>
          <hashTree/>
        </hashTree>
        <HTTPSamplerProxy guiclass="HttpTestSampleGui" testclass="HTTPSamplerProxy" testname="orders">
          <elementProp name="HTTPsampler.Arguments" elementType="Arguments" guiclass="HTTPArgumentsPanel" testclass="Arguments">
            <collectionProp name="Arguments.arguments"/>
          </elementProp>
          <stringProp name="HTTPSampler.path">/api/customers/${__Random(1,10000)}/orders</stringProp>
          <stringProp name="HTTPSampler.method">GET</stringProp>
          <boolProp name="HTTPSampler.use_keepalive">true</boolProp>
        </HTTPSamplerProxy>
        <hashTree>
          <UniformRandomTimer guiclass="UniformRandomTimerGui" testclass="UniformRandomTimer" testname="Think time">
            <stringProp name="ConstantTimer.delay">1000</stringProp>
            <stringProp name="RandomTimer.range">2000</stringProp>
          </UniformRandomTimer>
          <hashTree/>
        </hashTree>
      </hashTree>
    </hashTree>
  </hashTree>
</jmeterTestPlan>
في الخطة أعلاه لاحظ التالي:
- العنصر
HTTP Request Defaultsيحمل السيرفر والمنفذ والمهلات مرة واحدة، فلا تكررها في كل عينة. - مجموعة الخيوط
Shoppersفيها 40 خيطاً يبدأون خلال 30 ثانية لمدة 150 ثانية، والقيمة${__P(users,40)}تعني أن العدد يأتي من خيار سطر الأوامر-Jusers=إذا مررته، وإلا فهو 40، فنفس الخطة تعمل لاختبار الحمل والضغط. - كل عينة تحتها مؤقت
Uniform Random Timerمن ثانية إلى ثلاث، ويعمل قبل العينة وليس بعدها، والدالة${__Random(1,10000)}تختار عميلاً عشوائياً في كل طلب. - لا يوجد أي مستمع Listener في الخطة، لأن النتائج تحفظ من سطر الأوامر.
الآن نبني ال Image ونشغل الخطة من سطر الأوامر مع ملف النتائج ولوحة HTML:
docker build -t lab-load-jmeter jmeter
docker run --rm --name lab-load-jmeter --network lab-load-net -v "$PWD/jmeter:/tests" \
  lab-load-jmeter -n -t plan.jmx -l results.jtl -e -o report
والمخرج سوف يكون كما يلي، بعد حذف سطور التحذير من مكتبة السجلات:
Creating summariser <summary>
Created the tree successfully using plan.jmx
Starting standalone test @ 2026 Oct 6 17:35:40 GMT (1791308140844)
summary +    107 in 00:00:19 =    5.6/s Avg:    15 Min:     2 Max:    66 Err:     0 (0.00%) Active: 26 Started: 26 Finished: 0
summary +    543 in 00:00:30 =   18.1/s Avg:    12 Min:     2 Max:   108 Err:     0 (0.00%) Active: 40 Started: 40 Finished: 0
summary =    650 in 00:00:49 =   13.2/s Avg:    12 Min:     2 Max:   108 Err:     0 (0.00%)
summary +    594 in 00:00:30 =   19.8/s Avg:    13 Min:     2 Max:    69 Err:     0 (0.00%) Active: 40 Started: 40 Finished: 0
summary =   1244 in 00:01:19 =   15.7/s Avg:    13 Min:     2 Max:   108 Err:     0 (0.00%)
summary +    610 in 00:00:30 =   20.3/s Avg:    12 Min:     2 Max:    84 Err:     0 (0.00%) Active: 40 Started: 40 Finished: 0
summary =   1854 in 00:01:49 =   17.0/s Avg:    13 Min:     2 Max:   108 Err:     0 (0.00%)
summary +    608 in 00:00:30 =   20.3/s Avg:    13 Min:     2 Max:    74 Err:     0 (0.00%) Active: 40 Started: 40 Finished: 0
summary =   2462 in 00:02:19 =   17.7/s Avg:    13 Min:     2 Max:   108 Err:     0 (0.00%)
summary +    222 in 00:00:11 =   20.4/s Avg:    13 Min:     2 Max:    60 Err:     0 (0.00%) Active: 0 Started: 40 Finished: 40
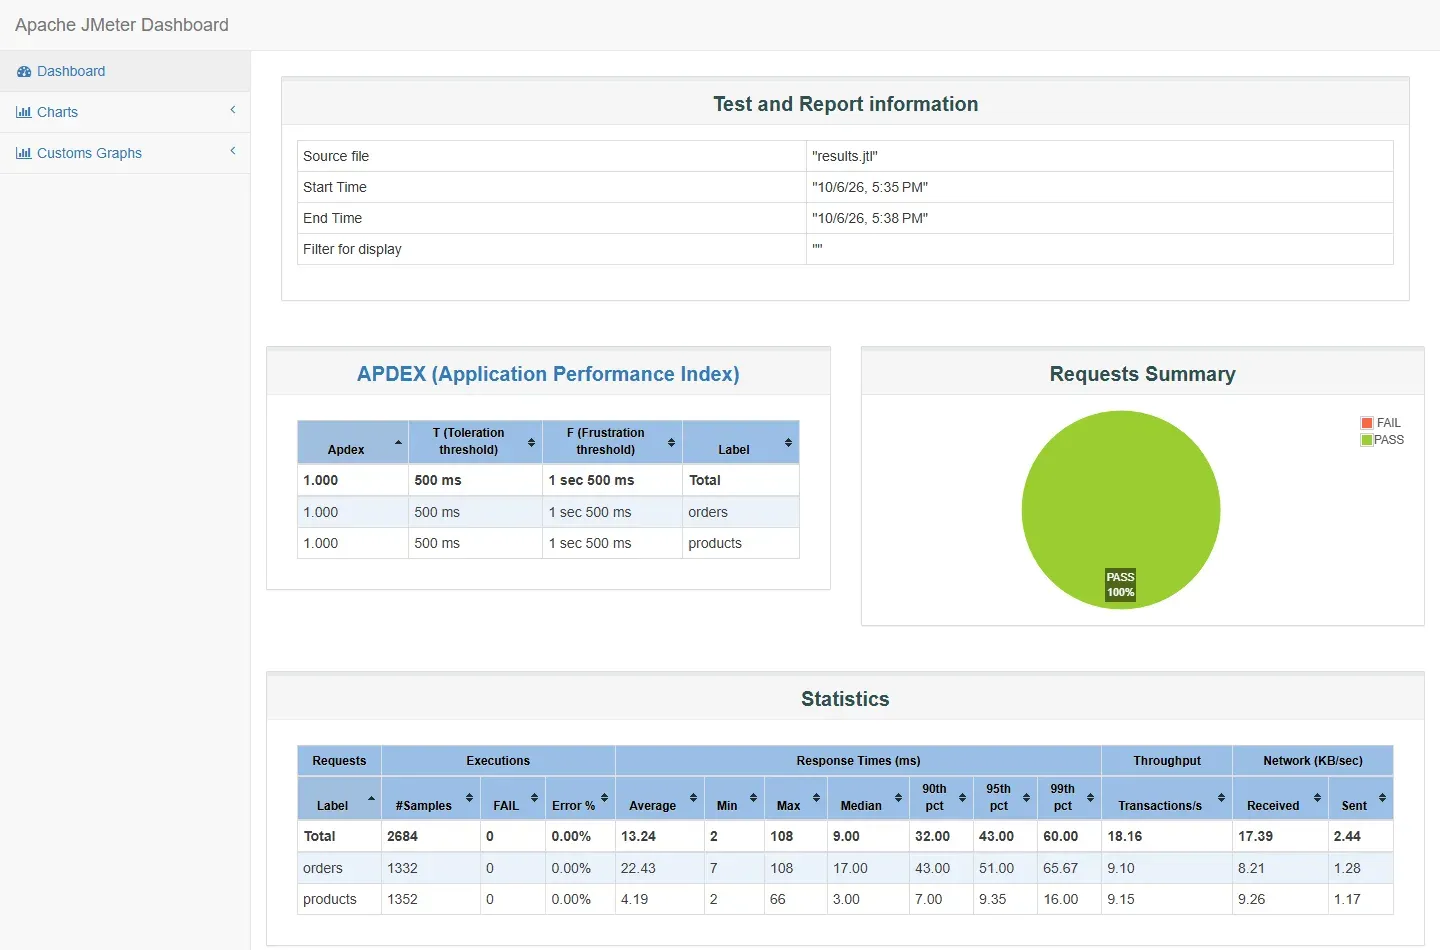
summary =   2684 in 00:02:30 =   17.9/s Avg:    13 Min:     2 Max:   108 Err:     0 (0.00%)
Tidying up ...    @ 2026 Oct 6 17:38:10 GMT (1791308290927)
... end of run
وسطور summary + هي أرقام آخر 30 ثانية، وسطور summary = هي المجموع منذ البداية، وهي مفيدة لتتابع الاختبار وهو يعمل. أما التفاصيل فتجدها في اللوحة التي أنشأها الخيار -e -o في المجلد report، وتظهر في الصورة التالية:
نفس السيناريو في Gatling بلغة Java
في مجلد gatling نضع ملف Maven باسم pom.xml:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
  <modelVersion>4.0.0</modelVersion>
  <groupId>lab</groupId>
  <artifactId>shop-load</artifactId>
  <version>1.0</version>

  <properties>
    <maven.compiler.release>21</maven.compiler.release>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
  </properties>

  <dependencies>
    <dependency>
      <groupId>io.gatling.highcharts</groupId>
      <artifactId>gatling-charts-highcharts</artifactId>
      <version>3.16.0</version>
      <scope>test</scope>
    </dependency>
  </dependencies>

  <build>
    <plugins>
      <plugin>
        <groupId>io.gatling</groupId>
        <artifactId>gatling-maven-plugin</artifactId>
        <version>4.21.12</version>
      </plugin>
    </plugins>
  </build>
</project>
ثم المحاكاة في الملف src/test/java/shop/ShopSimulation.java:
package shop;

import static io.gatling.javaapi.core.CoreDsl.*;
import static io.gatling.javaapi.http.HttpDsl.*;

import io.gatling.javaapi.core.*;
import io.gatling.javaapi.http.*;
import java.util.Iterator;
import java.util.Map;
import java.util.concurrent.ThreadLocalRandom;
import java.util.function.Supplier;
import java.util.stream.Stream;

public class ShopSimulation extends Simulation {

  HttpProtocolBuilder httpProtocol = http
      .baseUrl(System.getProperty("baseUrl", "http://lab-load-nginx"))
      .acceptHeader("application/json");

  // a different customer for every virtual user
  Iterator<Map<String, Object>> customers = Stream.generate(
      (Supplier<Map<String, Object>>) () -> Map.of("customer", ThreadLocalRandom.current().nextInt(1, 10001))
  ).iterator();

  ScenarioBuilder shopper = scenario("Shopper")
      .feed(customers)
      .exec(http("products").get("/api/products").check(status().is(200)))
      .pause(1, 3)                                   // think time: 1 to 3 seconds
      .exec(http("orders").get("/api/customers/#{customer}/orders").check(status().is(200)))
      .pause(1, 3);

  {
    setUp(
        shopper.injectOpen(                          // open model: new users arrive at a rate
            rampUsersPerSec(0).to(10).during(30),
            constantUsersPerSec(10).during(120)
        )
    ).protocols(httpProtocol)
     .assertions(
        global().failedRequests().percent().lt(1.0),
        details("orders").responseTime().percentile(95.0).lt(500),
        details("products").responseTime().percentile(95.0).lt(300)
     );
  }
}
في الكود أعلاه لاحظ التالي:
- الأجزاء الأربعة واضحة: البروتوكول
httpProtocol، والسيناريوshopperبخطواته وأوقات التفكير، والحقنinjectOpenبالنموذج المفتوح، والتحققاتassertionsبنفس شروط k6. - المغذي Feeder
customersيعطي كل مستخدم افتراضي رقم عميل عشوائياً، ويستخدمه الطلب عبر#{customer}. - الحقن يصعد من صفر إلى عشرة مستخدمين في الثانية خلال 30 ثانية، ثم يثبت دقيقتين، وهو نفس شكل اختبار الحمل في k6.
ونشغلها في Container من Docker Image الرسمية ل Maven، فلا نحتاج Java على الجهاز:
docker run --rm --name lab-load-gatling --network lab-load-net -v "$PWD/gatling:/project" -w /project \
  maven:3-eclipse-temurin-21 mvn -q -B gatling:test -Dgatling.simulationClass=shop.ShopSimulation
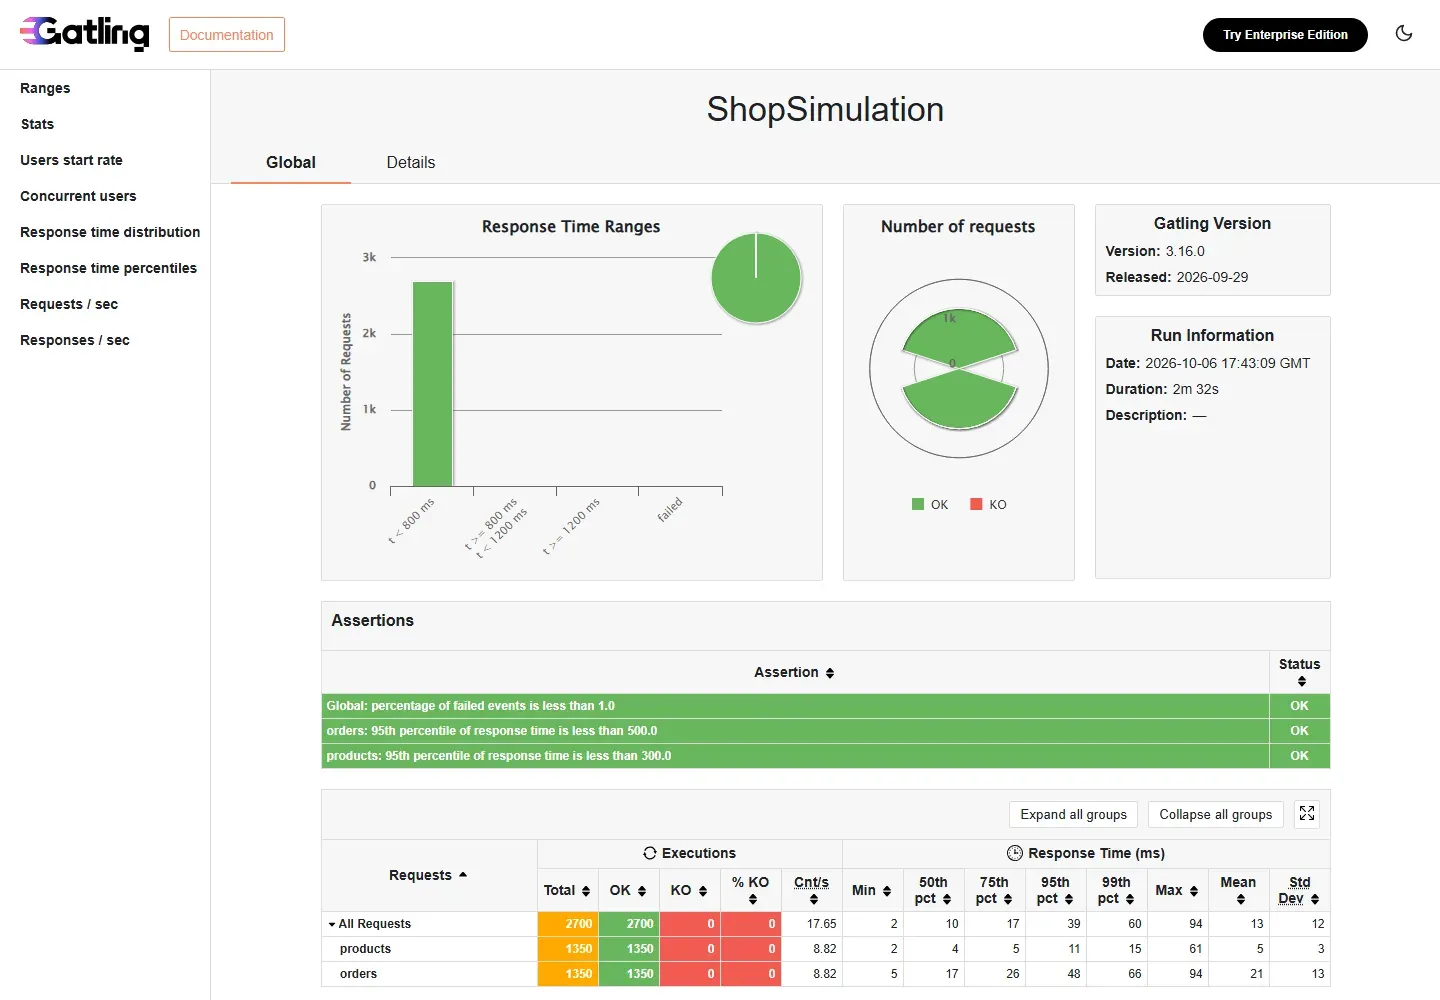
والمخرج في آخر التشغيل سوف يكون كما يلي:
========================================================================================================================
---- Global Information -------------------------------------------------------------|---Total---|-----OK----|----KO----
> request count                                                                      |     2,700 |     2,700 |         -
> min response time (ms)                                                             |         2 |         2 |         -
> max response time (ms)                                                             |        94 |        94 |         -
> mean response time (ms)                                                            |        13 |        13 |         -
> response time std deviation (ms)                                                   |        12 |        12 |         -
> response time 50th percentile (ms)                                                 |        10 |        10 |         -
> response time 75th percentile (ms)                                                 |        17 |        17 |         -
> response time 95th percentile (ms)                                                 |        39 |        39 |         -
> response time 99th percentile (ms)                                                 |        60 |        60 |         -
> mean throughput (rps)                                                              |     17.65 |     17.65 |         -
---- Response Time Distribution ----------------------------------------------------------------------------------------
> OK: t < 800 ms                                                                                          2,700   (100%)
> OK: 800 ms <= t < 1200 ms                                                                                   0     (0%)
> OK: t >= 1200 ms                                                                                            0     (0%)
> KO                                                                                                          0     (0%)
========================================================================================================================

Reports generated, please open the following file: file:///project/target/gatling/shopsimulation-20261006174305696/index.html
Global: percentage of failed events is less than 1.0 : true (actual : 0.0)
orders: 95th percentile of response time is less than 500.0 : true (actual : 48.0)
products: 95th percentile of response time is less than 300.0 : true (actual : 11.0)
والتحققات الثلاثة في آخر المخرج نجحت، ولو فشل أحدها لفشل أمر Maven نفسه وتوقف خط CI. والصورة التالية من تقرير HTML الذي أنشأته Gatling في المجلد target/gatling:
الأدوات الأربع على نفس الحمل
| الأداة | نموذج الحمل | عدد الطلبات | p95 للطلبات orders | p95 للمنتجات products | الأخطاء |
|---|---|---|---|---|---|
| k6 | مفتوح، 10 مستخدمين في الثانية | 2848 | 46.3 مللي ثانية | 6.6 مللي ثانية | 0% |
| Locust | مغلق، 40 مستخدماً | 2822 | 50 مللي ثانية | 13 مللي ثانية | 0% |
| JMeter | مغلق، 40 خيطاً | 2684 | 51 مللي ثانية | 9.35 مللي ثانية | 0% |
| Gatling | مفتوح، 10 مستخدمين في الثانية | 2700 | 48 مللي ثانية | 11 مللي ثانية | 0% |
والأرقام متقاربة لأن السيناريو واحد والحمل متقارب، والفروق الصغيرة من اختلاف التشغيلات على جهاز مشترك ومن طريقة كل أداة في حساب النسب المئوية. أي أن الأداة نفسها نادراً ما تكون سبب اختلاف النتائج، والسبب في أغلب الأحيان هو السيناريو ووقت التفكير ونموذج الحمل.
نصلح عنق الزجاجة Bottleneck ونعيد القياس
عرفنا من جهة السيرفر أن عنق الزجاجة هو استعلام صفحة الطلبات، فنضيف فهرساً على رقم العميل مع رقم الطلب بنفس ترتيب الاستعلام، ونتأكد من خطة التنفيذ:
docker exec lab-load-db psql -U app -d shop \
  -c "CREATE INDEX orders_customer_id_idx ON orders (customer_id, id DESC);" \
  -c "explain analyze SELECT id, total, created_at FROM orders WHERE customer_id = 42 ORDER BY id DESC LIMIT 10"
والمخرج سوف يكون كما يلي:
CREATE INDEX
                                                                 QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------------------------
 Limit  (cost=0.42..41.93 rows=10 width=22) (actual time=0.058..0.071 rows=10.00 loops=1)
   Buffers: shared hit=10 read=3
   ->  Index Scan using orders_customer_id_idx on orders  (cost=0.42..124.95 rows=30 width=22) (actual time=0.057..0.069 rows=10.00 loops=1)
         Index Cond: (customer_id = 42)
         Index Searches: 1
         Buffers: shared hit=10 read=3
 Planning:
   Buffers: shared hit=69 read=1
 Planning Time: 0.772 ms
 Execution Time: 0.184 ms
(10 rows)
الاستعلام صار يقرأ 13 صفحة من الفهرس في أقل من ربع مللي ثانية، بدلاً من المرور على 300 ألف صف. وقد شرحنا الفهارس وخطط التنفيذ في تصميم قواعد البيانات وتتبع الطلب البطيء. الآن نعيد اختبار الحمل المتوقع بنفس الأمر، والمخرج سوف يكون كما يلي:
  █ THRESHOLDS

    http_req_duration{name:orders}
    ✓ 'p(95)<500' p(95)=8.98ms

    http_req_duration{name:products}
    ✓ 'p(95)<300' p(95)=9.22ms

    http_req_failed
    ✓ 'rate<0.01' rate=0.00%
p95 لصفحة الطلبات نزل من 46.3 إلى 8.98 مللي ثانية. ثم نعيد اختبار الضغط بنفس الأمر ونقرأ ملف CSV الجديد بالسكربت نفسه، والمخرج سوف يكون كما يلي:
 from  req/s   p50ms   p95ms   p99ms  errors  status
   0s    1.0       4      12      12    0.0%  {'200': 15}
  15s   13.1       3      11      15    0.0%  {'200': 196}
  30s   18.3       3      10      16    0.0%  {'200': 275}
  45s   32.2       3      11      20    0.0%  {'200': 483}
  60s   52.2       3       7      12    0.0%  {'200': 783}
  75s   72.0       3       5       7    0.0%  {'200': 1080}
  90s   92.9       4      11      29    0.0%  {'200': 1394}
 105s  115.1       4       7      13    0.0%  {'200': 1727}
 120s  140.6       4       8      29    0.0%  {'200': 2109}
 135s  165.5       4      12      28    0.0%  {'200': 2483}
 150s  188.0       5     333     456    0.0%  {'200': 2820}
 165s  233.0       4      15      27    0.0%  {'200': 3495}
 180s  280.8       4      41      83    0.0%  {'200': 4212}
 195s  277.5     673    1308    1361    0.0%  {'200': 4163}
 210s  283.1    1834    2310    2475    0.0%  {'200': 4247}
 225s  228.7    2648    3146    3186    0.0%  {'200': 3430}
والصورة التالية تضع p95 في التشغيلين على نفس الرسم، بمقياس لوغاريتمي لأن الفرق بين المللي ثانية والثواني كبير:
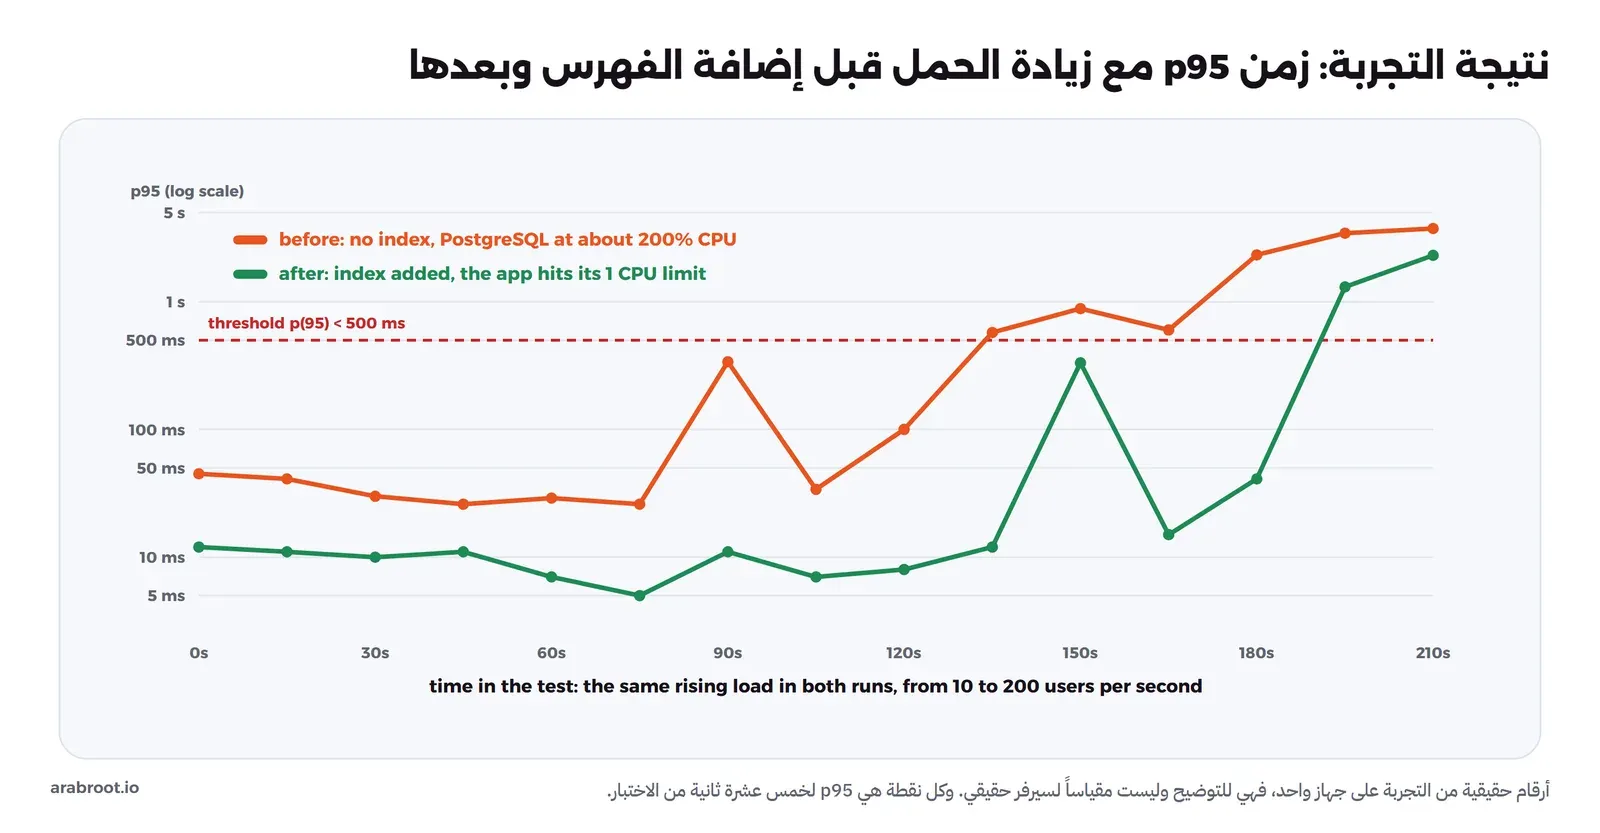
والاختبار ما زال يفشل في آخره، فقد بقي p95 حوالي 10 مللي ثانية حتى 165 طلباً في الثانية، ما عدا قفزة واحدة عند الثانية 150 من نفس ضجيج الجهاز المشترك، ووصل إلى 41 مللي ثانية عند 280، ثم صعد إلى الثواني. فما الذي امتلأ الآن؟ قمنا بقراءة الموارد أثناء أعلى حمل بنفس أمر docker stats مع إضافة مولد الحمل، ومع docker top للتطبيق:
NAME             CPU %     MEM USAGE / LIMIT
lab-load-app     85.42%    73.07MiB / 31.29GiB
lab-load-db      14.76%    80.2MiB / 31.29GiB
lab-load-nginx   13.02%    10.34MiB / 31.29GiB
lab-load-k6      26.25%    221.8MiB / 31.29GiB
PID                 NLWP                %CPU                COMMAND
12120               33                  14.8                /usr/local/bin/python3.13 /usr/local/bin/uvicorn app:app --host 0.0.0.0 --port 8000 --no-access-log
قاعدة البيانات نزلت من 195% إلى 15% تقريباً، أما التطبيق فوصل إلى 85% ثم 100% في القراءات التالية، أي إلى حده الكامل cpus: 1.0، فعنق الزجاجة انتقل من قاعدة البيانات إلى عملية uvicorn الواحدة. وهذا ما يحدث دائماً: إصلاح عنق الزجاجة لا يجعل النظام بلا حدود، وإنما ينقل الحد إلى المورد التالي، والخطوة التالية هنا هي عدة عمال Workers للتطبيق مع معالج أكثر، وقد شرحنا لماذا تحتاج عملية Python عمالاً متعددين في Python وقفل GIL. ولاحظ أيضاً أن k6 نفسها استخدمت ربع نواة فقط، فلم تكن هي سبب البطء هذه المرة، وهذه هي القراءة التي يجب أن تقوم بها قبل أن تثق بالنتيجة.
حذف التجربة
نحذف ال Containers وال Volume والشبكة التي أنشأتها التجربة، ثم ال Images التي بنيناها، بأسمائها فقط:
docker compose -p lab-load down -v
docker image rm lab-load-app lab-load-jmeter
ولا تستخدم docker system prune أو docker volume prune لتنظيف تجربة، لأنها تحذف أشياء لا علاقة لها بالتجربة إذا كان على الجهاز مشاريع أخرى.
أخطاء شائعة
- تشغيل مولد الحمل على نفس السيرفر: الأداة والتطبيق يتنافسان على المعالج، فلا تعرف ماذا تقيس، وقد رأيت في التجربة قفزات من الضجيج بسبب ذلك.
- النظر إلى المتوسط فقط: المتوسط يخفي الطلبات البطيئة، والملخص النهائي يخلط الدقائق الهادئة بدقائق الانهيار، فاقرأ p95 وp99 لكل نوع من الطلبات ومع الوقت.
- حذف وقت التفكير: مئة مستخدم افتراضي بلا انتظار ليسوا مئة مستخدم حقيقي، وقد رأيت في Locust كيف تضاعف الحمل بسبب سطر واحد.
- تجاهل الأخطاء: الطلبات الفاشلة سريعة فتحسن متوسط الزمن، فاقرأ الزمن دائماً مع نسبة الأخطاء، وزمن الطلبات الناجحة وحدها.
- الإغفال المنسق Coordinated Omission: النموذج المغلق يخفف الحمل عندما يبطئ السيرفر، فيبدو p99 أفضل من الحقيقة، فاستخدم معدل الوصول عندما يكون سؤالك عن معدل طلبات.
- تجاهل تحذيرات الأداة: رسالة «Insufficient VUs» أو التكرارات المفقودة Dropped Iterations تعني أن الحمل الذي طلبته لم يصل كاملاً.
- اختبار قصير جداً: دقيقتان لا تكشفان تسرب الذاكرة ولا المهام المجدولة، وقد رأيت أن اختبار التحمل نجح في k6 والذاكرة تتسرب.
- رابط واحد وبيانات واحدة: نفس المنتج في كل طلب يقيس ال Cache وليس النظام.
- بيئة اختبار ببيانات قليلة: الاستعلام بلا فهرس لا يظهر في جدول فيه ألف صف.
- مراقبة الأداة وحدها: بدون قراءة السيرفر أثناء الاختبار تعرف أن النظام أبطأ ولا تعرف لماذا.
قائمة تحقق
- السؤال مكتوب قبل التشغيل، مع عدد المستخدمين أو معدل الوصول وشروط النجاح.
- السيناريو مسار مستخدم حقيقي من سجلات الإنتاج، مع وقت تفكير عشوائي وبيانات متنوعة.
- نموذج الحمل مناسب للسؤال: معدل وصول لموقع عام، وعدد مستخدمين لنظام داخلي مغلق.
- بيئة الاختبار قريبة من الإنتاج في الموارد والإعدادات وحجم البيانات.
- الخدمات الخارجية مستبدلة ببدائل Stubs، ولا توجد رسائل أو مدفوعات حقيقية.
- مولد الحمل على جهاز آخر، ومعالجه تحت 80% أثناء الاختبار.
- الموارد على السيرفر مراقبة طوال الاختبار: المعالج والذاكرة والاتصالات وقاعدة البيانات.
- النتائج تقرأ مع الوقت، مع نسبة الأخطاء وتحذيرات الأداة.
- اختبار قصير بشروط نجاح بعد كل نشر إلى بيئة الاختبار، واختبارات أطول بجدول، والنتائج محفوظة كاتجاه.
- لا يوجد أي اختبار على موقع لا تملكه أو لم تحصل على إذن مكتوب لاختباره، والاختبار على الإنتاج بخطة وإعلام للفريق.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التطبيق ينهار تحت الحمل عندما يمتلئ أحد موارده المحدودة فتبدأ الطوابير، ولا يظهر ذلك مع عدد قليل من المستخدمين، لذلك تحتاج اختبار أحمال يبدأ من سؤال واضح وشروط نجاح.
- كل نوع يسأل سؤالاً مختلفاً بنفس السكربت: الدخان للتأكد، والحمل المتوقع لليوم العادي، والضغط للحد، والقفزة للتعافي، والتحمل الطويل للتسرب، ونقطة الانكسار للسعة.
- اقرأ المعدل الناجح وp95 وp99 لكل طلب مع الوقت، ومعها نسبة الأخطاء، وانتبه إلى أن النموذج المغلق يخفي البطء بالإغفال المنسق.
- أداة الأحمال تقول لك ماذا حدث، والسيرفر يقول لك لماذا، وقد رأيت في التجربة اختبار تحمل نجح في k6 بينما الذاكرة تتسرب.
- k6 وLocust وJMeter وGatling أعطت أرقاماً متقاربة لنفس السيناريو، فاختر الأداة التي تشبه لغة فريقك، واستخدم الأدوات السريعة لرقم سريع فقط.
- إصلاح عنق الزجاجة ينقل الحد إلى المورد التالي، فأعد القياس بعد كل إصلاح.
وفي مقالات قادمة بإذن الله ضمن مرحلة الأداء والموثوقية SRE سوف نتحدث عن أهداف الخدمة SLO، وعن قياس سرعة الصفحات من جهة المتصفح بأداتي Lighthouse وWebPageTest، وعن تخطيط السعة Capacity Planning، وعن هندسة الفوضى Chaos Engineering التي تختبر التعطل قبل أن يحدث.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلHTTP وHTTPS ببساطة: ماذا يحدث بين الرابط والصفحةماذا يحدث بين كتابة الرابط وظهور الصفحة، وكيف تقرأ الطلب والرد ورموز مثل 502 و504، ولماذا يكلف الاتصال الجديد أكثر.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة بتطبيق FastAPI 0.142 على Python 3.13 مع PostgreSQL 18 وNginx 1.31، واختبارات k6 2.3 وLocust 2.46 وApache JMeter 5.6.3 وGatling 3.16 في Docker، والتحقق من تراخيص الأدوات من مستودعاتها ومن تعريفات أنواع الاختبارات في وثائق Grafana k6.


