

في دليل تتبع الطلب البطيء رأينا طلباً واحداً ينتظر خدمة خارجية بلا مهلة حتى يقطعه Nginx برمز 504، وفي الأنظمة الموزعة للمبتدئين مررنا سريعاً على المهلة وإعادة المحاولة وقاطع الدائرة في فقرة لكل منها. ولكن المشكلة الحقيقية لا تظهر في طلب واحد، وإنما عندما يأتي عشرون طلباً في الثانية وكلها تنتظر الخدمة البطيئة نفسها، فتمتلئ موارد تطبيقك السليم واحداً بعد الآخر، ثم يتوقف عن الرد حتى على الصفحات التي لا علاقة لها بالخدمة البطيئة، ثم يرى موزع الحمل أنه لا يرد فيخرجه، فينتقل الحمل كله إلى النسخ الأخرى فتسقط هي أيضاً. وهذا هو الفشل المتتالي Cascading Failure، وهو من أكثر أسباب توقف الأنظمة الكبيرة شيوعاً.
وفي هذا المقال نأخذ كل نمط من أنماط الحماية ونقيس أثره بأرقام حقيقية من تجربة واحدة: خدمة أسعار نجعلها بطيئة عمداً، وتطبيق فيه عشرة خيوط Threads فقط، ومولد حمل يرسل الطلبات بمعدل ثابت كما يفعل المستخدمون.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تسقط خدمة بطيئة نظاماً سليماً، ولماذا البطء أسوأ من التوقف الكامل، مع قانون ليتل Little's Law الذي يحسب ذلك في سطر.
- المهلة Timeout: كيف تختار قيمتها، والفرق بين مهلة الاتصال ومهلة القراءة، والمهلة الواحدة التي تنتقل مع الطلب Deadline Propagation.
- إعادة المحاولة Retry مع التأخير المتزايد Exponential Backoff والعشوائية Jitter، وكيف تتحول إلى عاصفة إعادة المحاولة Retry Storm، وميزانية إعادة المحاولة Retry Budget.
- قاطع الدائرة Circuit Breaker وحالاته الثلاث، والحواجز Bulkheads، ورفض الزائد Load Shedding، والضغط العكسي Back-pressure في الطوابير.
- تجربة عملية بثماني خطوات: نسقط التطبيق، ثم نصلحه نمطاً بعد نمط، ونقرأ الأرقام في كل مرة.
كيف تسقط خدمة بطيئة نظاماً سليماً؟
أغلب تطبيقات الويب تخدم الطلبات من مجموعة محدودة من الخيوط أو العمليات أو الاتصالات: خيوط Tomcat في Java، و Workers في Gunicorn وPHP-FPM، والاتصالات في مجمع الاتصالات Connection Pool، وأمام هذه المجموعة طابور ينتظر فيه كل طلب لم يجد خيطاً فارغاً، ويصف كتاب Google SRE في فصل الفشل المتتالي هذا الشكل بأنه ما تعمل به أغلب السيرفرات التي تخصص خيطاً لكل طلب. وعدد الخيوط المشغولة في أي لحظة يحسبه قانون ليتل Little's Law في سطر واحد:
الخيوط المشغولة = عدد الطلبات في الثانية × مدة الطلب بالثواني
فإذا جاءك عشرون طلب دفع في الثانية، وكل طلب يسأل خدمة الأسعار التي ترد في 50 ملي ثانية، فأنت تحتاج خيطاً واحداً تقريباً (20 × 0.05)، وعندك عشرة، فالتطبيق مرتاح. والآن تتأخر خدمة الأسعار فتصبح ثلاث ثوان، والطلبات ما زالت عشرين في الثانية، فتحتاج 60 خيطاً (20 × 3) وعندك عشرة، والخمسون الباقية تنتظر في الطابور، والطابور يكبر كل ثانية بلا نهاية، وكل طلب جديد يقف خلفه، بما فيها طلب فحص الصحة /health الذي لا يسأل خدمة الأسعار أصلاً. والصورة التالية تبين ما حدث في الخطوة الأولى من المختبر:
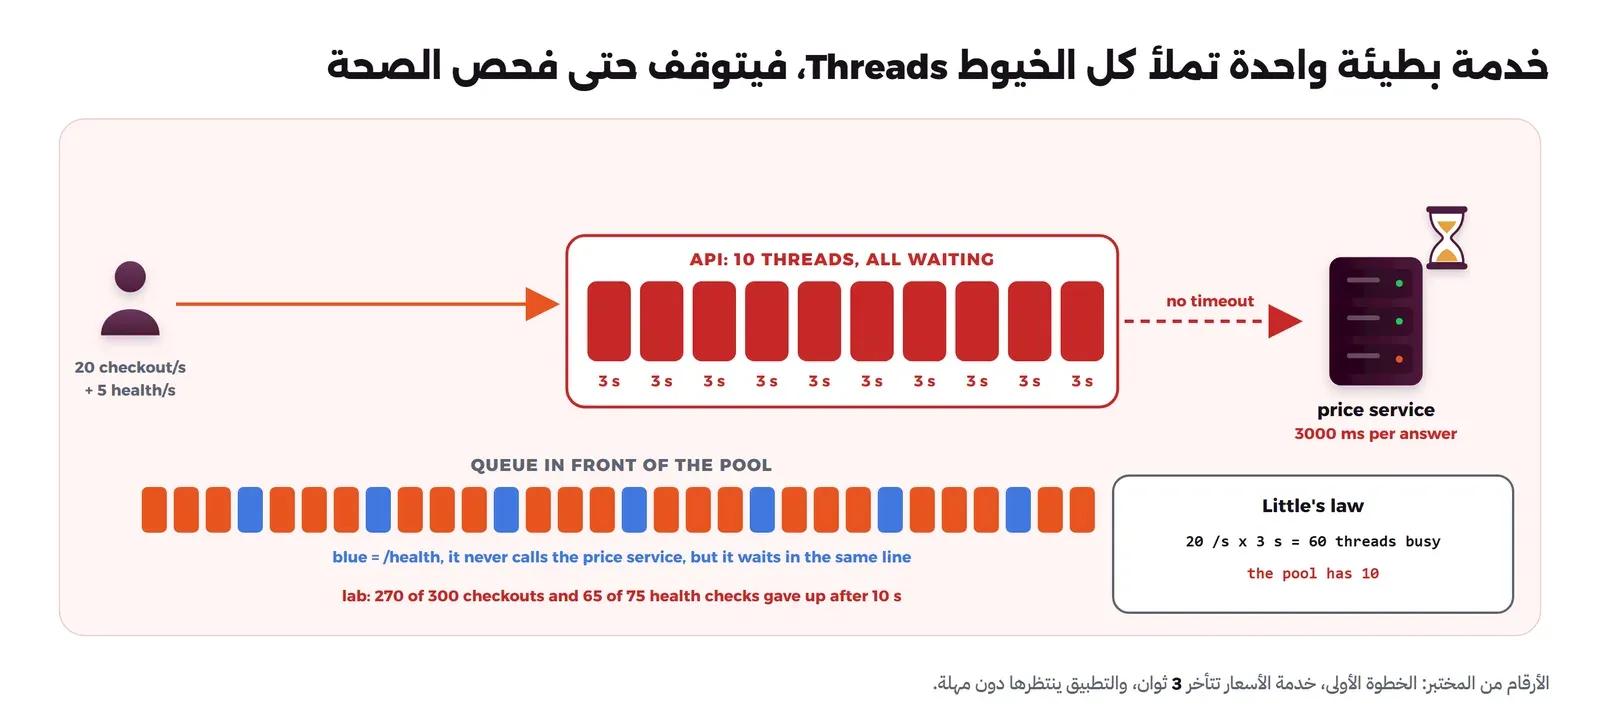
وقد يتساءل البعض: لماذا البطء أسوأ من التوقف الكامل؟ والإجابة أن الخدمة المتوقفة تماماً ترفض الاتصال في ملي ثوان، فيفشل الطلب بسرعة ويعود الخيط إلى المجموعة، أما الخدمة البطيئة فتقبل الاتصال ثم تمسك الخيط ثلاث ثوان، فتأكل مواردك وهي تبدو سليمة. ولاحظ في الصورة أن فحص الصحة نفسه فشل، وهذا يعني أن موزع الحمل أو Kubernetes سوف يقرر أن النسخة ميتة فيخرجها أو يعيد تشغيلها، فيذهب حملها إلى النسخ الباقية التي هي أصلاً في نفس الحالة، وهكذا يتحول بطء خدمة صغيرة إلى توقف النظام كله، ولهذا نصحنا في الأنظمة الموزعة بألا يفحص فحص الحياة Liveness الخدمات التي يعتمد عليها التطبيق.
وهناك أثر جانبي لا يراه أحد: المستخدم الذي ينتظر عشر ثوان ثم يغلق الصفحة لا يلغي شيئاً في السيرفر، فطلبه ما زال في الطابور، وعندما يصل دوره سوف يسأل التطبيق خدمة الأسعار ويحسب الرد ويرسله إلى اتصال مغلق. وفي المختبر استمر التطبيق بعد توقف الحمل أكثر من أربعين ثانية يرسل طلبات لم يعد أصحابها ينتظرونها، وظل فحص الصحة يفشل طوال هذه المدة.
المهلة Timeout: أول خط دفاع
كل اتصال عبر الشبكة يجب أن تكون له مهلة، والسبب أن مكتبات كثيرة تنتظر للأبد إذا لم تحدد لها مهلة، ومنها مكتبة Python القياسية: http.client تستخدم المهلة العامة إذا لم تعطها مهلة، وتوثيق socket يذكر أن هذه المهلة العامة تبدأ بقيمة None، أي بلا مهلة. وهذا ما فعله التطبيق في الخطوة الأولى من المختبر.
والمهلة نوعان، وتحتاج كليهما:
- مهلة الاتصال Connect Timeout: كم تنتظر حتى يقبل السيرفر الاتصال، وتكون قصيرة (مئات الملي ثواني داخل نفس الشبكة)، لأن السيرفر السليم يقبل الاتصال فوراً.
- مهلة القراءة Read Timeout أو مهلة الطلب كله: كم تنتظر الرد بعد أن أرسلت الطلب، وهي التي تحمي الخيوط من الخدمة البطيئة.
أما القيمة الصحيحة فتأتي من القياس وليس من التخمين، ويشرح مقال AWS Builders' Library عن المهلات وإعادة المحاولة الطريقة التي يستخدمونها: تختار نسبة مقبولة من المهلات الخاطئة، أي الطلبات التي كانت سوف تنجح لو انتظرت أكثر، مثل 0.1%، ثم تأخذ زمن الرد عند المئين المقابل للخدمة التي تتصل بها، وهو p99.9 في هذا المثال. فإذا كانت خدمة الأسعار ترد في 99.9% من الحالات خلال 250 ملي ثانية، فمهلة 300 ملي ثانية معقولة، ومهلة 30 ثانية (وهي القيمة الافتراضية في مكتبات كثيرة) لا تحميك من شيء.
وفي الخطوة الثانية من المختبر أضفنا مهلة 300 ملي ثانية فقط، والخدمة ما زالت بطيئة، فتغيرت الصورة كلها: طلبات الدفع فشلت كلها برمز 503 بعد 303 ملي ثانية بدل أن تعلق عشر ثوان، وفحص الصحة نجح 75 مرة من 75. والسبب قانون ليتل نفسه: 20 طلباً × 0.3 ثانية = 6 خيوط، وعندنا عشرة.
مهلة واحدة تنتقل مع الطلب
في نظام فيه أكثر من طبقة، المهلات الثابتة في كل طبقة لا تكفي، فإذا كان المستخدم ينتظر ثانيتين، والواجهة تعطي خدمة الطلبات ثانيتين، وخدمة الطلبات تعطي خدمة الأسعار ثانيتين، وخدمة الأسعار تعطي قاعدة البيانات ثانيتين، فقد تبقى قاعدة البيانات تعمل على استعلام بعد أن غادر المستخدم بثوان. والحل الذي يشرحه توثيق gRPC عن المهلات هو أن تحدد مهلة واحدة Deadline عند أول نقطة، وتنتقل مع الطلب إلى كل خدمة يستدعيها، فتأخذ كل خدمة ما بقي منها فقط، وتتوقف فوراً إذا انتهى:
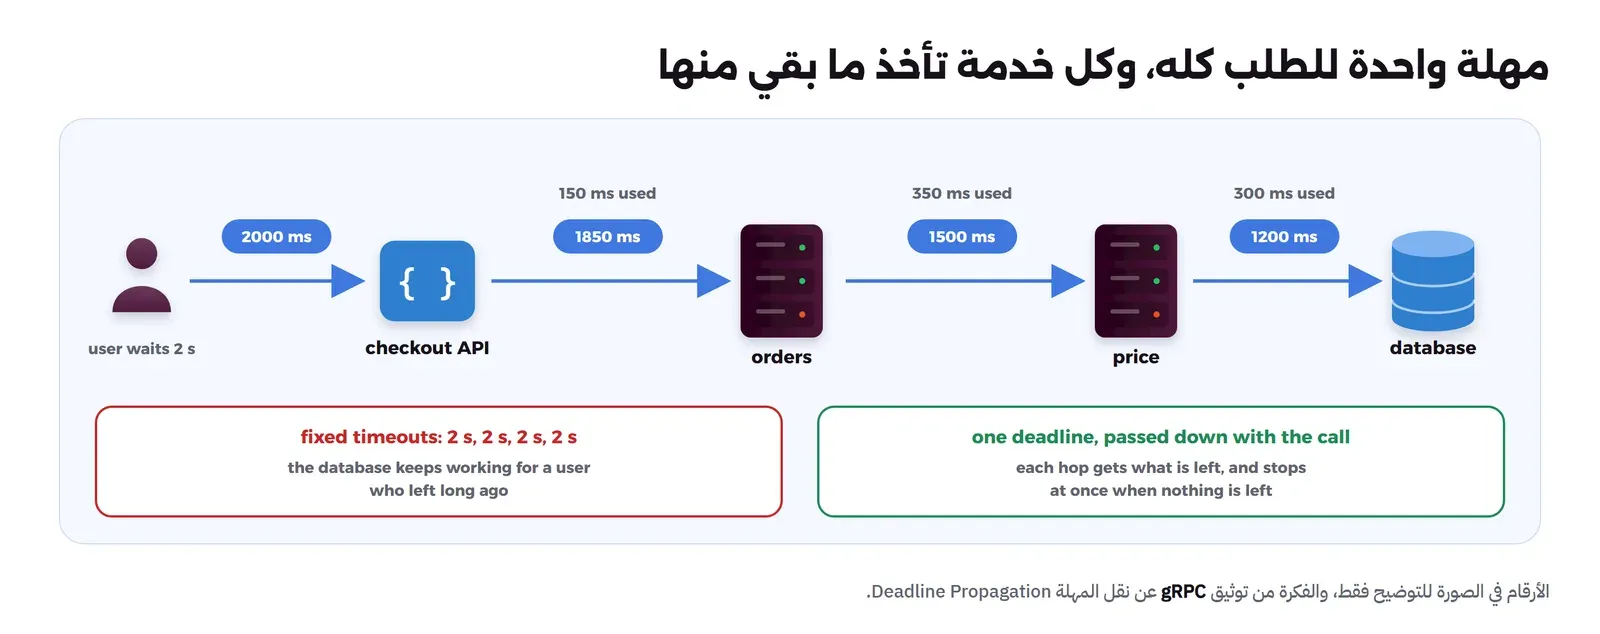
وفي gRPC تنتقل المهلة تلقائياً، أما في HTTP فلا توجد ترويسة معيارية لها، فإذا احتجتها فاتفق في فريقك على ترويسة داخلية تحمل الوقت الباقي، واحسب منها مهلة كل استدعاء، ولا تقبلها من الإنترنت كما هي.
إعادة المحاولة: علاج يتحول إلى مرض
إعادة المحاولة مفيدة عندما يكون الفشل عابراً، مثل اتصال انقطع أو سيرفر أعيد تشغيله، وهي آمنة فقط إذا كانت العملية آمنة عند التكرار Idempotent، أي أن تنفيذها مرتين يعطي نفس الأثر، وقد شرحنا ذلك بالتفصيل في مقال Idempotency. والحل البسيط أن تعيد المحاولة فوراً، وهو حل خطير، والسبب أن الخدمة التي فشلت غالباً فشلت لأنها مضغوطة، فإذا أعاد ألف كلاينت المحاولة في نفس اللحظة تضاعف الضغط عليها.
والحل المعروف هو التأخير المتزايد Exponential Backoff مع العشوائية Jitter، ويقارن Marc Brooker في مقال Exponential Backoff And Jitter المنشور في مدونة AWS في مارس 2015 بين عدة طرق للعشوائية منها Full Jitter وEqual Jitter وDecorrelated Jitter، والطريقة التي في المختبر هي Full Jitter: تنتظر وقتاً عشوائياً بين صفر وmin(cap, base × 2^attempt)، فتتوزع المحاولات بدل أن تضرب الخدمة معاً. وقد رأيت مثالاً كاملاً لها مع مفتاح منع التكرار في الأنظمة الموزعة، فلن نكرره.
ولكن التأخير وحده لا يمنع المشكلة الأكبر، وهي أن كل طبقة تعيد المحاولة. ويضرب مقال AWS Builders' Library مثالاً بطلب يمر بخمس طبقات من الخدمات وينتهي بقاعدة بيانات، وكل طبقة تحاول ثلاث مرات، فإذا بدأت قاعدة البيانات تفشل تحت الحمل زاد الحمل عليها 243 ضعفاً، لأن المحاولات تتضاعف في كل طبقة، وينصح لذلك بأن تعيد المحاولة في نقطة واحدة فقط من السلسلة. والصورة التالية تبين المثال، وتحته ما قسناه في المختبر:
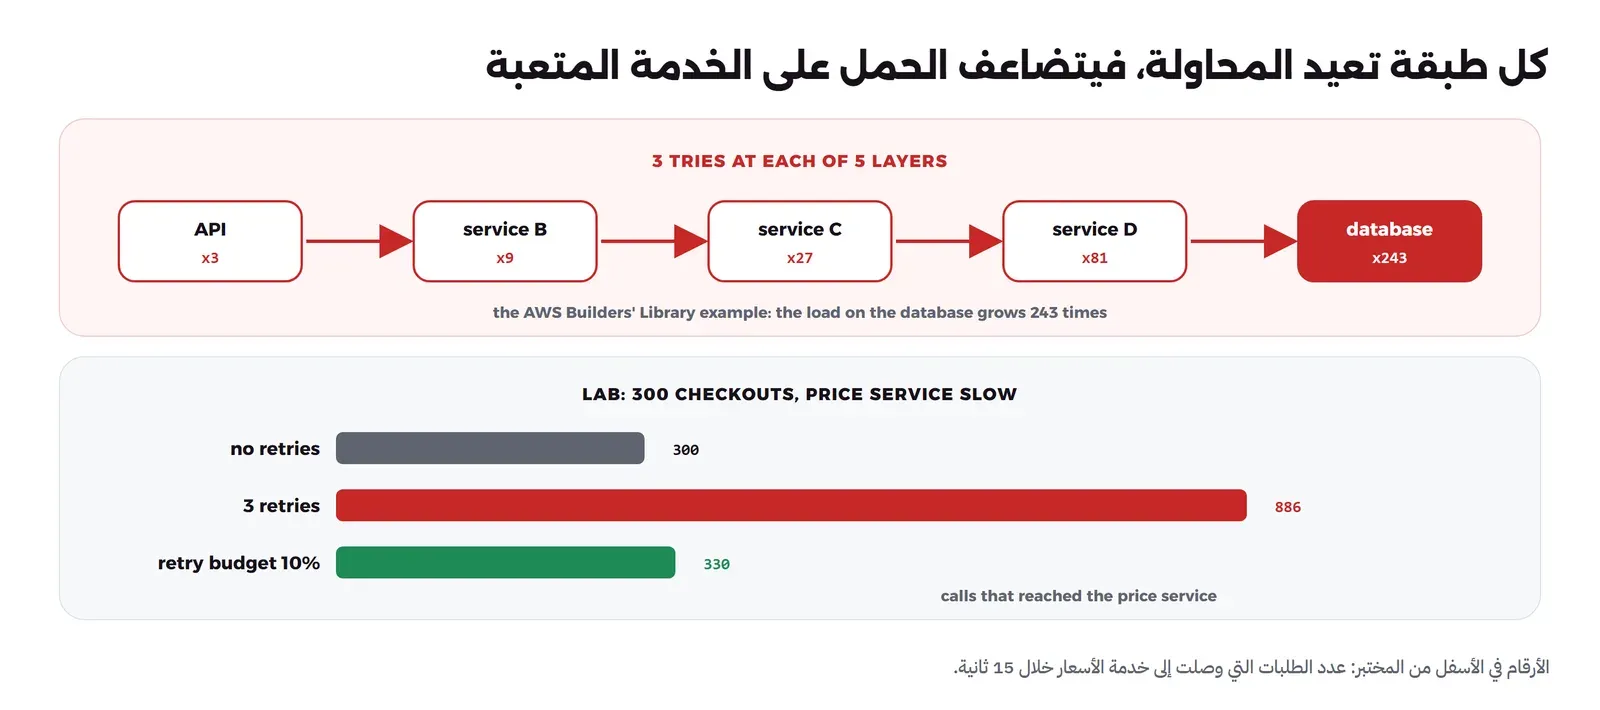
وفي الخطوة الثالثة من المختبر أضفنا ثلاث محاولات إضافية إلى المهلة نفسها، فوصل إلى خدمة الأسعار 886 طلباً بدل 300، وعاد التطبيق إلى السقوط، لأن كل طلب أصبح يمسك الخيط 1.2 ثانية (4 × 0.3)، والحساب 20 × 1.2 = 24 خيطاً، وعندنا عشرة، ففشل فحص الصحة مرة أخرى في 37 حالة من 75. أي أن إعادة المحاولة ألغت ما أصلحته المهلة.
والحل الذي يصفه كتاب Google SRE في فصل التعامل مع الحمل الزائد هو ميزانية إعادة المحاولة Retry Budget على مستويين: حد أقصى ثلاث محاولات للطلب الواحد، وحد لكل كلاينت لا تزيد فيه إعادة المحاولة عن 10% من طلباته، ويذكر الكتاب أن الحمل في حالة الفشل يقترب من ثلاثة أضعاف بالحد الأول وحده، وينزل إلى 1.1 ضعف تقريباً بإضافة الثاني. وفي الخطوة الرابعة من المختبر أضفنا ميزانية 10% فوصل إلى خدمة الأسعار 330 طلباً، ونجح فحص الصحة 75 مرة من 75.
ولاحظ شيئاً آخر في المختبر: التأخير بين المحاولات في طلب متزامن يمسك الخيط طوال فترة الانتظار، لذلك في المسار الذي ينتظر فيه مستخدم اجعل المحاولات قليلة (واحدة غالباً) وقصيرة، واترك المحاولات الطويلة للأعمال في الخلفية التي تمر عبر طابور يعيد المحاولة.
قاطع الدائرة Circuit Breaker
المهلة والميزانية تحددان كم تخسر في كل طلب، ولكن إذا كانت الخدمة متوقفة منذ دقائق فما فائدة أن يجربها كل طلب وينتظر 300 ملي ثانية ليفشل؟ وقاطع الدائرة، كما يشرحه Martin Fowler في مقاله عن Circuit Breaker، يعمل مثل القاطع الكهربائي في بيتك، وله ثلاث حالات:
- مغلق Closed: الطلبات تمر، والقاطع يعد النجاح والفشل في نافذة من آخر الطلبات.
- مفتوح Open: إذا تجاوزت نسبة الفشل الحد فتح القاطع، فيفشل كل طلب فوراً دون أن يخرج من التطبيق، فتأخذ الخدمة المتعبة وقتاً لتتعافى، وتعود خيوطك فوراً.
- نصف مفتوح Half-Open: بعد مدة محددة يسمح القاطع بعدد قليل من الطلبات التجريبية، فإذا نجحت أغلق، وإذا فشل أحدها فتح من جديد.
والقاطع في المختبر يفتح إذا فشل نصف آخر عشرة طلبات، ويبقى مفتوحاً خمس ثوان، ثم يسمح بثلاثة طلبات تجريبية، والصورة التالية تبين حالاته مع الأوقات الحقيقية من سجل التطبيق:
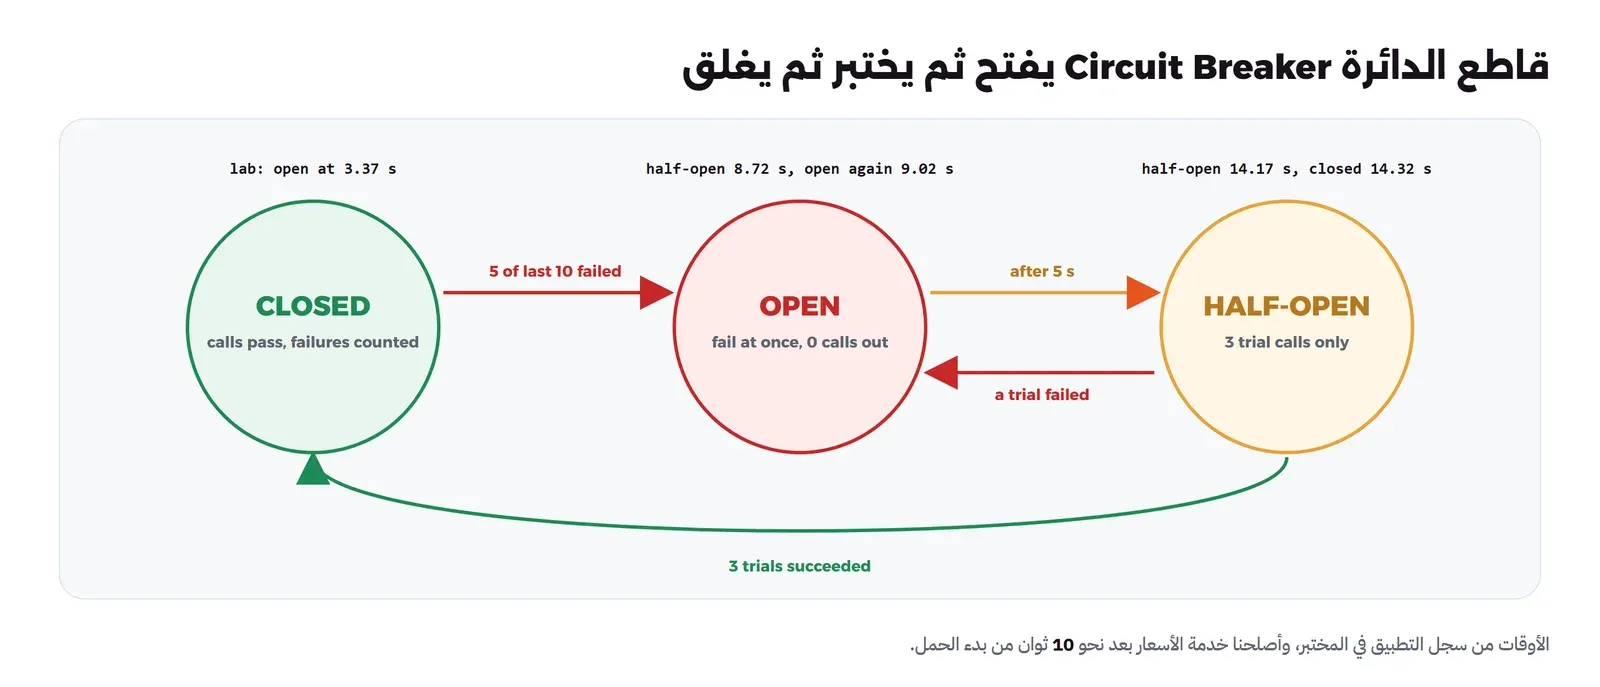
والأرقام الافتراضية في المكتبات أكبر بكثير من المختبر، فمثلاً توثيق Resilience4j في Java يذكر أن حد الفشل الافتراضي 50%، وأن القاطع لا يحسب النسبة قبل 100 طلب، وأنه يبقى مفتوحاً 60 ثانية قبل أن يجرب، ويمكنه أيضاً أن يفتح بسبب الطلبات البطيئة وليس الفاشلة فقط. لذلك اضبط هذه القيم على حجم حركتك الحقيقي، فقاطع يحتاج 100 طلب ليقرر لن يفتح أبداً على خدمة تستقبل طلباً كل ثانية.
والسؤال المهم هو ماذا تفعل عندما يكون القاطع مفتوحاً، ولا تقم بإظهار خطأ عام للمستخدم إذا كان هناك بديل معقول: آخر سعر محفوظ في ال Cache مع ملاحظة، أو إخفاء قسم «منتجات مقترحة» بدل إسقاط الصفحة، أو قبول الطلب ووضعه في طابور. وهذا ما يسمى التدهور المتدرج Graceful Degradation، وقراره قرار عمل وليس قراراً تقنياً، فاسأل صاحب المنتج: هل نبيع بسعر عمره خمس دقائق أم نرفض البيع؟
الحواجز Bulkheads: لا تجعل خدمة واحدة تأخذ كل شيء
اسم الحواجز من الجدران التي تقسم السفينة إلى غرف، فإذا دخل الماء غرفة لم تغرق السفينة كلها. وفي تطبيقك تعني أن تعطي كل خدمة خارجية حداً أقصى من الخيوط أو الاتصالات المتزامنة، فإذا علقت خدمة الأسعار أخذت حصتها فقط، وبقيت الخيوط الأخرى لفحص الصحة وبقية الصفحات. وفي الخطوة السادسة من المختبر لم نضع أي مهلة، ووضعنا حاجزاً يسمح بأربعة طلبات فقط إلى خدمة الأسعار في نفس الوقت، والطلب الخامس يفشل فوراً، فنجح فحص الصحة 75 مرة من 75 رغم أن الخدمة بطيئة ولا توجد مهلة، كما في الجزء الأيسر من الصورة التالية:
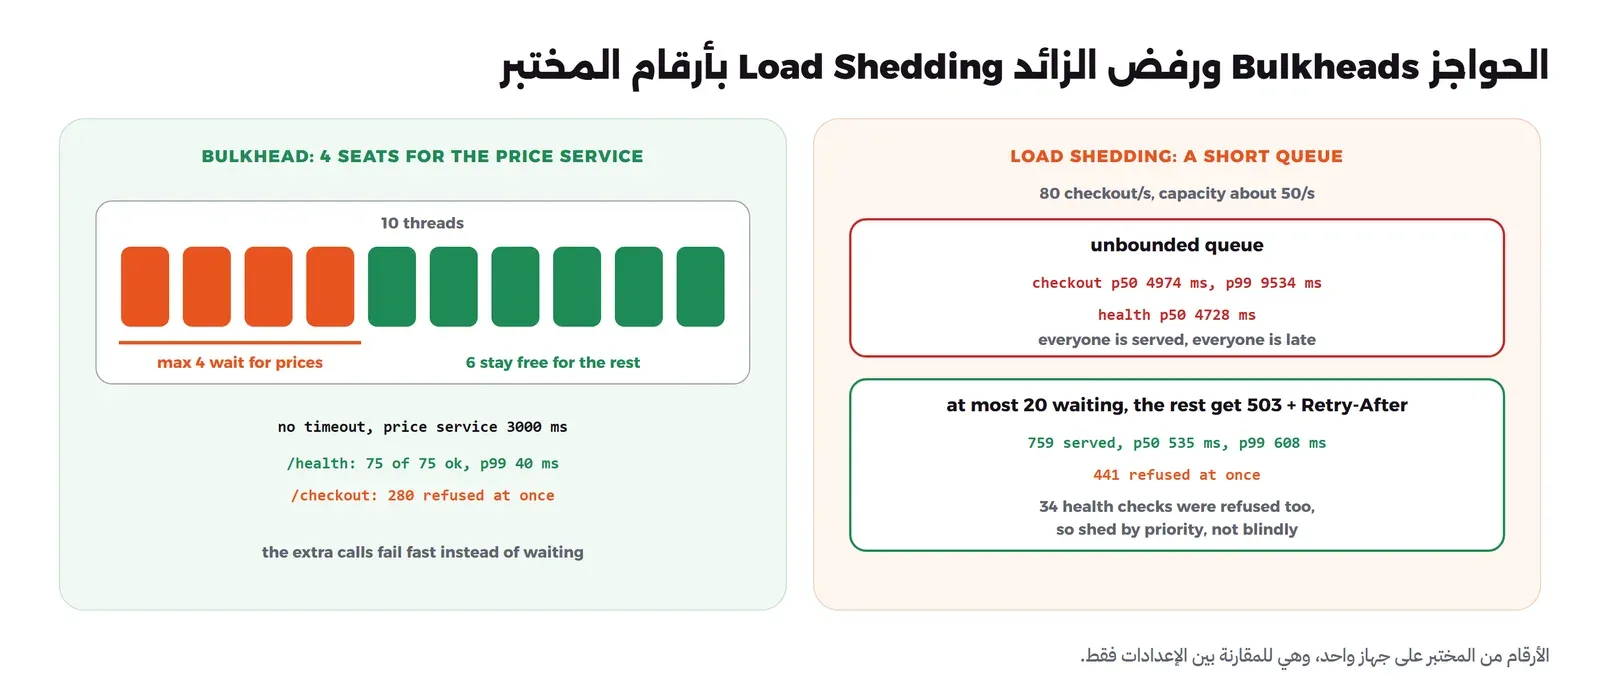
والحاجز والمهلة يكملان بعضهما ولا يغني أحدهما عن الآخر: المهلة تحدد كم يمسك الطلب الواحد الخيط، والحاجز يحدد كم خيطاً تأخذ الخدمة الواحدة مهما حدث. وأبسط صورة للحاجز تملكها اليوم دون كود هي مجمع اتصالات منفصل لكل قاعدة بيانات أو خدمة، بدل مجمع واحد مشترك.
رفض الزائد Load Shedding: الرفض السريع أرحم من الانتظار
حتى لو كانت كل الخدمات سليمة، فلكل تطبيق سعة، وفي المختبر جعلنا خدمة الأسعار ترد في 200 ملي ثانية، فسعة الخيوط العشرة نحو 50 طلباً في الثانية (10 ÷ 0.2)، ثم أرسلنا 80 طلباً في الثانية. وبطابور بلا حد خدم التطبيق الطلبات كلها، ولكن الوسيط وصل إلى خمس ثوان، وأبطأ الطلبات إلى تسع ثوان ونصف، أي أن الجميع خدموا والجميع تأخروا، وفي الواقع كان أغلبهم سيغادر قبل أن يصله الرد. ويقول كتاب Google SRE إن الأفضل للأنظمة ذات الحركة الثابتة أن يكون الطابور قصيراً مقارنة بعدد الخيوط.
وفي الخطوة السابعة جعلنا الطابور 20 طلباً كحد أقصى، والطلب الزائد يرد عليه فوراً برمز 503 مع الترويسة Retry-After، وهي الترويسة التي تخبر الكلاينت كم ينتظر قبل أن يعيد الطلب كما في المواصفة RFC 9110، فخدم التطبيق 759 طلباً بوسيط 535 ملي ثانية، ورفض 441 فوراً. ولاحظ أن 34 من فحوص الصحة رفضت أيضاً، لأن الرفض في المختبر لا يفرق بين الطلبات، وهذا خطأ في التصميم عن قصد لتراه: ارفض بحسب الأولوية، ففحص الصحة وطلبات الدفع تأخذ الأولوية على التقارير وصفحات البحث.
والفرق بين 503 و429 مهم: الرمز 503 يعني أن السيرفر نفسه مضغوط الآن، أما 429 فيعني أن هذا الكلاينت بالذات تجاوز حده، وهو موضوع تحديد معدل الطلبات Rate Limiting.
الضغط العكسي Back-pressure في الطوابير
رفض الزائد يرمي العمل، أما الضغط العكسي Back-pressure فيبطئ من يرسله. والفكرة أن المستهلك البطيء يجب أن يكون له طريق ليقول للمنتج «تمهل»، وإلا تراكمت الرسائل في الذاكرة حتى ينهار من يحملها. وأقدم مثال تعرفه هو TCP نفسه، فالمستقبل يعلن حجم النافذة التي يستطيع استقبالها، والمرسل لا يرسل أكثر منها. وفي الطوابير:
- الطابور المحدود Bounded Queue: كل طابور في الذاكرة داخل تطبيقك يجب أن يكون له حد، وعند امتلائه إما أن ينتظر المنتج، أو يرفض الرسالة ويخبر من أرسلها، أما الطابور بلا حد فهو تأجيل لانهيار الذاكرة.
- الوسيط Broker: يذكر توثيق RabbitMQ عن التحكم في التدفق أنه يطبق ضغطاً عكسياً على اتصالات النشر، فيبطئ الاتصالات التي تنشر أسرع مما تستطيع الطوابير استيعابه، حتى لا تنمو الذاكرة بلا حد، ولا يحتاج ذلك أي إعداد.
- جهة المستهلك: ال Prefetch في RabbitMQ هو حد الرسائل التي تكون مع ال Worker قبل أن يؤكدها، وقد شرحناه في الطابور للمبتدئين، وهو ضغط عكسي من المستهلك على الوسيط.
- بين الخدمات عبر HTTP: الرمز 503 أو 429 مع
Retry-Afterهو طريقة السيرفر ليقول «تمهل»، بشرط أن يحترمه الكلاينت ولا يعيد المحاولة فوراً.
والقاعدة العامة: كل مكان في النظام يمكن أن يتجمع فيه عمل يجب أن يكون له حد، وقرار واضح لما يحدث عند الوصول إليه، فإما أن تبطئ من يرسل، أو ترفض بسرعة وتخبره، أما أن تقبل كل شيء وتعده بالرد فهذا هو الخيار الوحيد الخاطئ.
التجربة العملية: نسقط التطبيق ثم نصلحه
التجربة فيها ثلاثة برامج Python صغيرة دون أي مكتبة خارجية، تعمل في Containers على شبكة واحدة: خدمة الأسعار dep.py التي نتحكم في بطئها وفشلها أثناء العمل، والتطبيق api.py الذي يخدم الطلبات من عشرة خيوط ونشغل فيه أنماط الحماية بمتغيرات البيئة، ومولد الحمل load.py الذي يرسل الطلبات بمعدل ثابت سواء انتهت الطلبات السابقة أم لا، وهذا مهم لأن المستخدمين الحقيقيين لا ينتظرون بعضهم، ويتخلى عن الطلب بعد عشر ثوان. والأرقام كلها من جهاز واحد، وهي للمقارنة بين الإعدادات فقط وليست قياساً لأداء أي شيء.
ملفات التجربة
الملف الأول dep.py، خدمة الأسعار:
# dep.py: the dependency (a "price service") that we can make slow or broken on purpose.
#   GET /price               answers after the current delay (or fails with 500)
#   GET /mode?delay=50&fail=0 changes the behaviour at runtime
#   GET /stats[?reset=1]     how many /price requests arrived
import json, threading, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from urllib.parse import urlparse, parse_qs

mode = {"delay_ms": 50, "fail": False}
received = 0
lock = threading.Lock()

class H(BaseHTTPRequestHandler):
    def reply(self, code, body):
        data = json.dumps(body).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def do_GET(self):
        global received
        u = urlparse(self.path); q = parse_qs(u.query)
        if u.path == "/price":
            with lock:
                received += 1
            time.sleep(mode["delay_ms"] / 1000)
            if mode["fail"]:
                return self.reply(500, {"error": "price db down"})
            return self.reply(200, {"sku": "A1", "price": 150})
        if u.path == "/mode":
            mode["delay_ms"] = int(q.get("delay", [mode["delay_ms"]])[0])
            mode["fail"] = q.get("fail", ["0"])[0] == "1"
            return self.reply(200, mode)
        if u.path == "/stats":
            with lock:
                n = received
                if "reset" in q:
                    received = 0
            return self.reply(200, {"received": n})
        self.reply(404, {"error": "not found"})

    def log_message(self, *a):
        pass

ThreadingHTTPServer.daemon_threads = True
ThreadingHTTPServer.request_queue_size = 1024
ThreadingHTTPServer(("0.0.0.0", 8080), H).serve_forever()
الملف الثاني api.py، وفيه كل الأنماط التي شرحناها، وكل نمط مطفأ حتى تشغله بمتغير بيئة:
# api.py: the service we protect. A fixed pool of WORKERS threads serves every request,
# like a thread-per-request app server with a maximum pool size.
#   GET /checkout  calls the dependency (dep:8080/price) with the protections switched on below
#   GET /health    answers at once, it never touches the dependency
# Settings (environment variables):
#   WORKERS=10       threads in the pool
#   TIMEOUT=0        seconds to wait for the dependency, 0 = wait forever (the library default)
#   RETRIES=0        extra attempts after a failure
#   BACKOFF=0        1 = exponential backoff with full jitter between attempts
#   RETRY_BUDGET=0   0 = no budget, 0.1 = retries may be at most 10% of the calls
#   BREAKER=0        1 = circuit breaker in front of the dependency
#   BULKHEAD=0       N = at most N calls to the dependency at the same time, the rest fail at once
#   MAX_QUEUE=0      N = at most N requests waiting for a thread, the rest get 503 + Retry-After
import http.client, json, os, random, socket, socketserver, threading, time
from collections import deque
from concurrent.futures import ThreadPoolExecutor
from http.server import BaseHTTPRequestHandler

WORKERS = int(os.getenv("WORKERS", "10"))
TIMEOUT = float(os.getenv("TIMEOUT", "0")) or None
RETRIES = int(os.getenv("RETRIES", "0"))
BACKOFF = os.getenv("BACKOFF", "0") == "1"
RETRY_BUDGET = float(os.getenv("RETRY_BUDGET", "0"))
BREAKER = os.getenv("BREAKER", "0") == "1"
BULKHEAD = int(os.getenv("BULKHEAD", "0"))
MAX_QUEUE = int(os.getenv("MAX_QUEUE", "0"))
T0 = time.monotonic()

def log(msg):
    print(f"[{time.monotonic() - T0:6.2f}s] {msg}", flush=True)

class Breaker:
    """closed -> open after 50% failures in the last 10 calls (at least 10 calls),
    open -> half-open after 5 s, half-open lets 3 trial calls through:
    3 successes -> closed, 1 failure -> open again."""
    def __init__(self, window=10, threshold=0.5, open_seconds=5, trials=3):
        self.window, self.threshold, self.open_seconds, self.trials = window, threshold, open_seconds, trials
        self.state, self.results, self.opened_at, self.in_trial, self.trial_ok = "closed", deque(maxlen=window), 0, 0, 0
        self.lock = threading.Lock()

    def allow(self):
        with self.lock:
            if self.state == "open" and time.monotonic() - self.opened_at >= self.open_seconds:
                self._go("half-open"); self.in_trial = self.trial_ok = 0
            if self.state == "open":
                return False
            if self.state == "half-open":
                if self.in_trial >= self.trials:
                    return False
                self.in_trial += 1
            return True

    def record(self, ok):
        with self.lock:
            if self.state == "half-open":
                if not ok:
                    self._open(); return
                self.trial_ok += 1
                if self.trial_ok >= self.trials:
                    self._go("closed"); self.results.clear()
                return
            self.results.append(ok)
            fails = self.results.count(False)
            if len(self.results) >= self.window and fails / len(self.results) >= self.threshold:
                self._open()

    def _open(self):
        self.opened_at = time.monotonic(); self._go("open")

    def _go(self, s):
        if s != self.state:
            log(f"breaker {self.state} -> {s}")
        self.state = s

breaker = Breaker() if BREAKER else None
bulkhead = threading.BoundedSemaphore(BULKHEAD) if BULKHEAD else None
calls = retries = 0
count_lock = threading.Lock()

class Fail(Exception):
    pass

def call_dep_once():
    conn = http.client.HTTPConnection("dep", 8080, timeout=TIMEOUT)
    try:
        conn.request("GET", "/price")
        r = conn.getresponse(); body = r.read()
        if r.status != 200:
            raise Fail(f"dep {r.status}")
        return json.loads(body)
    except (socket.timeout, TimeoutError):
        raise Fail("timeout")
    except OSError as e:
        raise Fail(type(e).__name__)
    finally:
        conn.close()

def retry_allowed():
    global retries
    with count_lock:
        if RETRY_BUDGET and retries >= RETRY_BUDGET * calls:
            return False
        retries += 1
        return True

def call_dep():
    global calls
    with count_lock:
        calls += 1
    for attempt in range(RETRIES + 1):
        if breaker and not breaker.allow():
            raise Fail("breaker open")
        if bulkhead and not bulkhead.acquire(blocking=False):
            raise Fail("bulkhead full")
        try:
            result = call_dep_once()
            if breaker: breaker.record(True)
            return result
        except Fail:
            if breaker: breaker.record(False)
            if attempt == RETRIES or not retry_allowed():
                raise
        finally:
            if bulkhead: bulkhead.release()
        if BACKOFF:
            time.sleep(random.uniform(0, min(2.0, 0.1 * 2 ** attempt)))   # full jitter

class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.0"
    def reply(self, code, body, extra=()):
        data = json.dumps(body).encode()
        self.send_response(code)
        for k, v in extra:
            self.send_header(k, v)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def do_GET(self):
        if self.path == "/health":
            return self.reply(200, {"status": "ok"})
        if self.path == "/checkout":
            try:
                return self.reply(200, {"order": "ok", "price": call_dep()["price"]})
            except Fail as e:
                return self.reply(503, {"error": str(e)})
        self.reply(404, {"error": "not found"})

    def log_message(self, *a):
        pass

waiting = 0
wait_lock = threading.Lock()

class PoolServer(socketserver.TCPServer):
    """Accepts connections on one thread and hands them to a fixed pool, like Tomcat or Gunicorn threads."""
    allow_reuse_address = True
    request_queue_size = 1024
    pool = ThreadPoolExecutor(max_workers=WORKERS)

    def process_request(self, request, client_address):
        global waiting
        with wait_lock:
            if MAX_QUEUE and waiting >= MAX_QUEUE:
                shed = True
            else:
                shed = False; waiting += 1
        if shed:   # load shedding: answer now, from the accept thread, instead of queueing
            request.sendall(b"HTTP/1.0 503 Service Unavailable\r\nRetry-After: 1\r\nContent-Length: 0\r\n\r\n")
            self.shutdown_request(request)
            return
        self.pool.submit(self.work, request, client_address)

    def work(self, request, client_address):
        global waiting
        with wait_lock:
            waiting -= 1
        try:
            self.finish_request(request, client_address)
        finally:
            self.shutdown_request(request)

log(f"api: WORKERS={WORKERS} TIMEOUT={TIMEOUT} RETRIES={RETRIES} BACKOFF={BACKOFF} "
    f"RETRY_BUDGET={RETRY_BUDGET} BREAKER={BREAKER} BULKHEAD={BULKHEAD} MAX_QUEUE={MAX_QUEUE}")
PoolServer(("0.0.0.0", 8000), H).serve_forever()
في الكود أعلاه لاحظ التالي:
- الكلاس
PoolServerيقلد سيرفرات التطبيقات المعتادة: خيط واحد يقبل الاتصالات ويضعها في طابور أمام عشرة خيوط، وMAX_QUEUEيحدد طول هذا الطابور، والرفض يحدث من خيط القبول نفسه دون أن ينتظر خيطاً فارغاً. - مع
TIMEOUT=0تنشئhttp.client.HTTPConnectionالاتصال بلا مهلة، وهذا هو السلوك الافتراضي للمكتبة. - القاطع والحاجز يفحصان قبل كل محاولة، فالمحاولة المكررة لا تتجاوزهما.
- الميزانية في
retry_allowedتقارن عدد إعادات المحاولة بعدد الطلبات منذ تشغيل التطبيق، وفي الإنتاج تكون نافذة زمنية متحركة.
الملف الثالث load.py، مولد الحمل:
# load.py: an open-loop load generator. New requests keep arriving at a fixed rate whether the
# old ones finished or not, which is how real users behave.
#   python load.py --checkout 20 --health 5 --seconds 15 [--at 8 --call http://dep:8080/mode?delay=50]
import argparse, http.client, statistics, threading, time, urllib.request
from collections import Counter, defaultdict

p = argparse.ArgumentParser()
p.add_argument("--checkout", type=float, default=20)   # requests per second to /checkout
p.add_argument("--health", type=float, default=5)      # requests per second to /health
p.add_argument("--seconds", type=float, default=15)
p.add_argument("--timeout", type=float, default=10)    # how long a user waits before giving up
p.add_argument("--at", type=float)                     # at this second ...
p.add_argument("--call")                               # ... call this URL (to fix or break the dependency)
a = p.parse_args()

results = defaultdict(list)    # path -> [(seconds, outcome)]
lock = threading.Lock()
threads = []

def one(path):
    t = time.monotonic()
    conn = http.client.HTTPConnection("api", 8000, timeout=a.timeout)
    try:
        conn.request("GET", path)
        r = conn.getresponse(); r.read()
        outcome = str(r.status)
    except TimeoutError:
        outcome = "client gave up"
    except OSError as e:
        outcome = type(e).__name__
    finally:
        conn.close()
    with lock:
        results[path].append((time.monotonic() - t, outcome))

def stream(path, rate):
    if rate <= 0:
        return
    start, i = time.monotonic(), 0
    while (due := start + i / rate) < start + a.seconds:
        time.sleep(max(0, due - time.monotonic()))
        th = threading.Thread(target=one, args=(path,)); th.start(); threads.append(th); i += 1

def trigger():
    time.sleep(a.at)
    urllib.request.urlopen(a.call).read()
    print(f"[{a.at:.0f}s] called {a.call}", flush=True)

ss = [threading.Thread(target=stream, args=("/checkout", a.checkout)), threading.Thread(target=stream, args=("/health", a.health))]
if a.at is not None:
    ss.append(threading.Thread(target=trigger))
for s in ss: s.start()
for s in ss: s.join()
for th in list(threads): th.join()

def pct(xs, q):
    xs = sorted(xs); return xs[min(len(xs) - 1, int(q * len(xs)))]

print(f"{'path':10} {'sent':>5} {'200':>5} {'503':>5} {'gave up':>8} {'p50 ms':>8} {'p99 ms':>8} {'max ms':>8}")
for path in ("/checkout", "/health"):
    rs = results[path]
    if not rs: continue
    c = Counter(o for _, o in rs); ms = [s * 1000 for s, _ in rs]
    other = sum(v for k, v in c.items() if k not in ("200", "503", "client gave up"))
    print(f"{path:10} {len(rs):5} {c['200']:5} {c['503']:5} {c['client gave up']:8} {pct(ms, .5):8.0f} {pct(ms, .99):8.0f} {max(ms):8.0f}"
          + (f"  other: {dict((k, v) for k, v in c.items() if k not in ('200', '503', 'client gave up'))}" if other else ""))
وأخيراً step.sh الذي يعيد تشغيل التطبيق بالإعدادات التي نريدها، ويضبط خدمة الأسعار، ويشغل الحمل، ثم يطبع ما وصل إلى خدمة الأسعار وسجل التطبيق:
#!/bin/sh
# step.sh "<api env vars>" "<dep mode>" <load.py args...>
#   restarts the api with the given settings, sets the dependency's mode, runs the load and prints the api log
# example: ./step.sh "TIMEOUT=0.3" "delay=3000" --checkout 20 --health 5 --seconds 15
set -e
ENV="$1"; MODE="$2"; shift 2
docker rm -f lab-resil-api >/dev/null 2>&1 || true
ARGS=""; for kv in $ENV; do ARGS="$ARGS -e $kv"; done
docker run -d --name lab-resil-api --network lab-resil-net --network-alias api -p 127.0.0.1:25080:8000 \
  $ARGS -v "$PWD/api.py:/api.py:ro" python:3.13.16-slim python -u /api.py >/dev/null
sleep 1
docker exec lab-resil-dep python -c "import urllib.request as u; u.urlopen('http://localhost:8080/mode?$MODE').read(); u.urlopen('http://localhost:8080/stats?reset=1').read()"
docker run --rm --name lab-resil-load --network lab-resil-net -v "$PWD/load.py:/load.py:ro" \
  python:3.13.16-slim python -u /load.py "$@"
echo "--- dependency received:"; docker exec lab-resil-dep python -c "import urllib.request as u; print(u.urlopen('http://localhost:8080/stats').read().decode())"
echo "--- api log:"; docker logs lab-resil-api 2>&1
والآن ننشئ الشبكة ونشغل خدمة الأسعار مرة واحدة لكل الخطوات:
docker network create lab-resil-net
docker run -d --name lab-resil-dep --network lab-resil-net --network-alias dep \
-v "$PWD/dep.py:/dep.py:ro" python:3.13.16-slim python -u /dep.pyexport MSYS_NO_PATHCONV=1 قبل الأوامر، لأنه يحول المسار /load.py في الأمر إلى مسار داخل مجلد Git فيفشل التشغيل، وهذا ما حدث معنا في أول تشغيل.الخطوة 0: كل شيء سليم
خدمة الأسعار ترد في 50 ملي ثانية، ولا توجد أي حماية، و20 طلب دفع و5 فحوص صحة في الثانية لمدة 15 ثانية:
./step.sh "" "delay=50&fail=0" --checkout 20 --health 5 --seconds 15path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 300 300 0 0 54 67 105
/health 75 75 0 0 2 34 34
--- dependency received:
{"received": 300}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=None RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=0كل الطلبات نجحت، والوسيط 54 ملي ثانية، وهو زمن خدمة الأسعار تقريباً، وهذا هو المرجع الذي نقارن به.
الخطوة 1: خدمة الأسعار بطيئة، ولا توجد مهلة
./step.sh "" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 15والمخرج سوف يكون كما يلي:
path        sent   200   503  gave up   p50 ms   p99 ms   max ms
/checkout    300    30     0      270    10010    10031    10073
/health       75    10     0       65    10010    10080    10080
--- dependency received:
{"received": 100}
--- api log:
[  0.00s] api: WORKERS=10 TIMEOUT=None RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=0
في المخرج أعلاه لاحظ التالي:
- من 300 طلب دفع نجح 30 فقط، وتخلى المستخدم عن 270 بعد عشر ثوان.
- فحص الصحة الذي لا يسأل خدمة الأسعار أصلاً فشل في 65 من 75، وهذا ما سوف يراه موزع الحمل فيخرج النسخة.
- العدد 30 ليس صدفة: عشرة خيوط تنهي طلباً كل ثلاث ثوان، أي نحو ثلاثة طلبات في الثانية، وخلال عشر ثوان تقريباً ينتهي 30 طلباً قبل أن يتخلى أصحابها.
والآن ننتظر بعد انتهاء الحمل ونسأل كل عشرين ثانية تقريباً: كم طلباً وصل إلى خدمة الأسعار، وهل يرد فحص الصحة خلال خمس ثوان؟
for i in 1 2 3 4; do
  docker exec lab-resil-dep python -c "import urllib.request as u; print(u.urlopen('http://localhost:8080/stats').read().decode())"
  docker run --rm --network lab-resil-net curlimages/curl:8.11.1 -s -o /dev/null -w "health %{http_code} %{time_total}s\n" -m 5 http://api:8000/health || echo "health timeout"
  sleep 15
done
{"received": 100}
health 000 5.001830s
health timeout
{"received": 204}
health 000 5.002775s
health timeout
{"received": 280}
health 200 0.001739s
{"received": 300}
health 200 0.001704sالحمل توقف، والمستخدمون غادروا كلهم، ولكن التطبيق استمر يرسل طلباتهم إلى خدمة الأسعار حتى أرسل الثلاثمئة كلها، وبقي فحص الصحة يفشل أكثر من أربعين ثانية بعد توقف الحمل، أي أن النسخة كانت ستبقى خارج موزع الحمل وقتاً أطول من العطل نفسه.
الخطوة 2: مهلة 300 ملي ثانية
./step.sh "TIMEOUT=0.3" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 15path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 300 0 300 0 303 311 339
/health 75 75 0 0 2 21 21
--- dependency received:
{"received": 300}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=0.3 RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=0طلبات الدفع ما زالت تفشل، لأن الخدمة بطيئة ولا يمكن إصلاح ذلك من هنا، ولكنها تفشل في 303 ملي ثوان برمز واضح، والتطبيق نفسه سليم: فحص الصحة نجح في كل المرات بوسيط 2 ملي ثانية.
الخطوة 3: ثلاث محاولات إضافية
./step.sh "TIMEOUT=0.3 RETRIES=3" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 15path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 300 0 130 170 10010 10039 10140
/health 75 38 0 37 9960 10043 10043
--- dependency received:
{"received": 886}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=0.3 RETRIES=3 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=0إعادة المحاولة أعادت السقوط: 886 طلباً إلى خدمة الأسعار المتعبة، وتخلى المستخدمون عن 170 طلب دفع و37 فحص صحة، ولم ينجح أي طلب دفع، فلم تكسب المحاولات شيئاً ودفعنا ثمنها كله.
الخطوة 4: ميزانية إعادة المحاولة 10%
./step.sh "TIMEOUT=0.3 RETRIES=3 RETRY_BUDGET=0.1" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 15path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 300 0 300 0 303 606 632
/health 75 75 0 0 2 16 16
--- dependency received:
{"received": 330}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=0.3 RETRIES=3 BACKOFF=False RETRY_BUDGET=0.1 BREAKER=False BULKHEAD=0 MAX_QUEUE=0نفس الإعداد مع ميزانية: 30 إعادة محاولة فقط (10% من 300)، والتطبيق سليم، وp99 أصبح 606 لأن بعض الطلبات أخذت محاولة ثانية. وعندما يكون الفشل عابراً فهذه المحاولات القليلة هي التي تنقذ الطلب، وعندما يكون الفشل دائماً فهي لا تكلف إلا 10%.
الخطوة 5: قاطع الدائرة، ثم إصلاح الخدمة
هذه المرة نشغل الحمل 20 ثانية، وبعد عشر ثوان يصلح مولد الحمل خدمة الأسعار فيعيد زمنها إلى 50 ملي ثانية:
./step.sh "TIMEOUT=0.3 BREAKER=1" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 20 \
  --at 10 --call "http://dep:8080/mode?delay=50"
[10s] called http://dep:8080/mode?delay=50
path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 400 168 232 0 2 305 369
/health 100 100 0 0 2 29 29
--- dependency received:
{"received": 187}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=0.3 RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=True BULKHEAD=0 MAX_QUEUE=0
[ 3.37s] breaker closed -> open
[ 8.72s] breaker open -> half-open
[ 9.02s] breaker half-open -> open
[ 14.17s] breaker open -> half-open
[ 14.32s] breaker half-open -> closedفي المخرج أعلاه لاحظ التالي:
- الأوقات في سجل التطبيق تبدأ من تشغيله، وهو يسبق الحمل بنحو ثانية، فالإصلاح حدث عند الثانية 11 تقريباً في هذا السجل.
- القاطع فتح بعد عشرة طلبات فاشلة، ثم جرب عند 8.72 والخدمة ما زالت بطيئة ففشلت التجربة وفتح مرة أخرى، ثم جرب عند 14.17 بعد الإصلاح فنجحت الطلبات الثلاثة وأغلق.
- وصل إلى خدمة الأسعار 187 طلباً من 400، فطوال فترة الفتح لم يصلها شيء، وهذا وقت تتعافى فيه، والوسيط 2 ملي ثانية لأن أغلب الطلبات الفاشلة فشلت فوراً دون انتظار المهلة.
- بعد إغلاق القاطع نجحت الطلبات كلها، وهي 168 طلب دفع ناجح.
الخطوة 6: حاجز بأربعة مقاعد دون مهلة
./step.sh "BULKHEAD=4" "delay=3000&fail=0" --checkout 20 --health 5 --seconds 15path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 300 20 280 0 2 3018 3057
/health 75 75 0 0 2 40 40
--- dependency received:
{"received": 20}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=None RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=4 MAX_QUEUE=0نفس الحالة التي أسقطت التطبيق في الخطوة الأولى، ولكن خدمة الأسعار لم تأخذ أكثر من أربعة خيوط، فبقي فحص الصحة سليماً، ونجح 20 طلب دفع (أربعة كل ثلاث ثوان)، ورفض الباقي فوراً.
الخطوة 7: حمل أكبر من السعة، مع رفض الزائد ودونه
خدمة الأسعار ترد في 200 ملي ثانية، فسعة التطبيق نحو 50 طلباً في الثانية، ونرسل 80. المرة الأولى بطابور بلا حد، والثانية بطابور أقصاه 20:
./step.sh "TIMEOUT=1" "delay=200&fail=0" --checkout 80 --health 5 --seconds 15
./step.sh "TIMEOUT=1 MAX_QUEUE=20" "delay=200&fail=0" --checkout 80 --health 5 --seconds 15
path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 1200 1200 0 0 4974 9534 9615
/health 75 75 0 0 4728 9344 9344
--- dependency received:
{"received": 1200}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=1.0 RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=0
path sent 200 503 gave up p50 ms p99 ms max ms
/checkout 1200 759 441 0 535 608 613
/health 75 41 34 0 313 406 406
--- dependency received:
{"received": 759}
--- api log:
[ 0.00s] api: WORKERS=10 TIMEOUT=1.0 RETRIES=0 BACKOFF=False RETRY_BUDGET=0.0 BREAKER=False BULKHEAD=0 MAX_QUEUE=20في المرة الأولى نجح كل شيء على الورق، ولكن وسيط الانتظار خمس ثوان، وفحص الصحة نفسه ينتظر أربع ثوان ونصف، وفي الإنتاج سوف يغادر أغلب هؤلاء قبل الرد. وفي المرة الثانية خدم التطبيق 759 طلباً في نحو نصف ثانية، ورفض 441 فوراً برمز 503 مع Retry-After: 1، ورفض معها 34 فحص صحة، وهذا ما ذكرناه عن الرفض بحسب الأولوية.
حذف التجربة
docker rm -f lab-resil-api lab-resil-dep
docker network rm lab-resil-net
المكتبات والأدوات
لا تكتب هذه الأنماط بنفسك في الإنتاج كما فعلنا في المختبر، فالمكتبات المعروفة مختبرة وتعطيك المقاييس Metrics لكل قاطع وحاجز:
- Java: Resilience4j، وفيها قاطع الدائرة والحواجز وإعادة المحاولة وتحديد المعدل.
- .NET: Polly، وفيها نفس الأنماط.
- Python: tenacity لإعادة المحاولة مع التأخير المتزايد والعشوائية، والمهلة تحددها في مكتبة HTTP نفسها في كل استدعاء.
- على مستوى البنية: Envoy وما يبنى عليه من Service Mesh يطبق حدود الاتصالات والطلبات المعلقة وإعادة المحاولة لكل خدمة دون تغيير الكود، وHAProxy يحدد المهلات والحد الأقصى للاتصالات لكل سيرفر.
وكل هذه الأنماط لا تختبر إلا تحت حمل، لذلك أضف خدمة بطيئة عمداً إلى اختبار الأحمال كما فعلنا هنا، وتابع كل طلب عبر الخدمات بـ التتبع الموزع حتى ترى أين ضاع الوقت.
أخطاء شائعة
- استدعاء خدمة عبر الشبكة دون مهلة، والاعتماد على القيمة الافتراضية للمكتبة التي قد تكون «للأبد».
- مهلة أطول من صبر المستخدم، مثل 30 ثانية لطلب ينتظره شخص أمام الشاشة.
- إعادة المحاولة في كل طبقة من السلسلة، فيتضاعف الحمل على الخدمة المتعبة.
- إعادة المحاولة فوراً ودون عشوائية، أو على عمليات غير آمنة عند التكرار مثل الخصم.
- قاطع دائرة بإعدادات افتراضية لا تناسب حجم الحركة، فلا يفتح أبداً أو يفتح بلا سبب.
- فحص صحة يسأل قاعدة البيانات والخدمات الخارجية، فتخرج كل النسخ معاً عند بطء خدمة واحدة.
- مجمع خيوط أو اتصالات واحد مشترك لكل الخدمات الخارجية.
- طوابير بلا حد في الذاكرة، ورفض لا يفرق بين طلب دفع وصفحة تقرير.
- كلاينت يتجاهل
Retry-Afterويعيد المحاولة فوراً.
قائمة تحقق
- لكل استدعاء عبر الشبكة مهلة اتصال ومهلة طلب، مبنية على p99 أو p99.9 المقاس.
- مهلة واحدة للطلب كله تنتقل إلى الخدمات التالية، ولا تبدأ خدمة عملاً لم يبق له وقت.
- إعادة المحاولة في طبقة واحدة، بتأخير متزايد مع عشوائية، وبميزانية، وعلى العمليات الآمنة عند التكرار فقط.
- قاطع دائرة أمام كل خدمة خارجية مهمة، مع بديل معقول عندما يفتح.
- حد أقصى للاتصالات المتزامنة لكل خدمة خارجية.
- طابور محدود أمام الخيوط، ورفض سريع بـ 503 و
Retry-After، بحسب الأولوية. - فحص الحياة لا يعتمد على الخدمات الأخرى.
- اختبار حمل فيه خدمة بطيئة عمداً قبل أن يحدث ذلك في الإنتاج.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الخدمة البطيئة أخطر من المتوقفة، لأنها تمسك الخيوط، وقانون ليتل يخبرك متى تنفد: الطلبات في الثانية × مدة الطلب.
- في المختبر أسقطت خدمة بطيئة واحدة التطبيق كله، حتى فحص الصحة، واستمر التطبيق يعمل لمستخدمين غادروا أكثر من أربعين ثانية.
- المهلة وحدها أعادت التطبيق سليماً، وإعادة المحاولة دون ميزانية أسقطته مرة أخرى بـ 886 طلباً بدل 300، والميزانية أعادته إلى 330.
- قاطع الدائرة يعطي الخدمة المتعبة وقتاً للتعافي ويعيد خيوطك فوراً، والحاجز يمنع خدمة واحدة من أخذ كل الخيوط حتى دون مهلة.
- رفض الزائد بطابور قصير و503 مع
Retry-Afterأرحم من خدمة الجميع متأخرين، والضغط العكسي يبطئ المرسل بدل أن يرمي عمله. - كل مكان يتجمع فيه عمل يحتاج حداً وقراراً لما يحدث عند الوصول إليه.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلتحديد معدل الطلبات Rate Limiting وخوارزمياتهكيف تعمل خوارزميات تحديد معدل الطلبات، وأيها يناسب واجهتك، وكيف تطبقها على عدة سيرفرات وترد بالرمز 429 الصحيح.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلاكتشاف الخدمات وإعداداتها مع Consul وetcdكيف تجد خدماتك بعضها رغم تغير عناوينها، وكيف توزع الإعدادات عليها، وماذا يحدث عندما يفقد العنقود الأغلبية.
 دليلاختبار الأحمال والضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 مع Python 3.13.16 (python:3.13.16-slim) وcurl 8.11.1.


